Niniejsze badanie przedstawia zautomatyzowany system prototypowania interfejsów użytkownika, integrujący zasady projektowania kognitywnego, percepcyjne modelowanie kolorów oraz głębokie uczenie. System ten poprawia dostępność, przejrzystość układu, harmonię kolorystyczną oraz spójność między różnymi ekranami, co prowadzi do tworzenia spójnych i zorientowanych na użytkownika projektów interfejsów.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Zautomatyzowany system prototypowania interfejsów użytkownika integrujący zasady projektowania poznawczego i wizualnego w celu poprawy użyteczności i przejrzystości układu
W tym artykule
Podsumowanie
Streszczenie
Efektywne projektowanie interfejsu użytkownika (UI) wymaga harmonijnej równowagi między atrakcyjnością wizualną, użytecznością poznawczą a spójnością układu. Jednak obecne podejścia do automatycznego generowania UI koncentrują się głównie na wyglądzie wizualnym lub detekcji komponentów i brakuje im zunifikowanych ram, które integrowałyby zasady poznawcze, inteligencję kolorystyczną i rozumowanie strukturalne. Ponadto istniejące metody obarczone są ograniczoną generalizacją układów, słabą interpretowalnością, statycznym doborem kolorów i niespójnym zachowaniem między ekranami. W tym kontekście niniejsza praca proponuje zautomatyzowane ramy prototypowania UI, które integrują detekcję komponentów opartą na szybkiej konwolucyjnej sieci neuronowej opartej na regionach (Faster R-CNN) oraz percepcyjne modelowanie kolorów sterowane przez jednolity obszar kolorów CIECAM02 (CAM02-UCS), wzbogacone o zasady projektowania wizualnego i poznawczego. Faster R-CNN jest wykorzystywany do identyfikacji komponentów UI i wnioskowania struktur hierarchicznych z wielkoskalowych zbiorów danych interfejsów. Ulepszony moduł generowania kolorów analizuje obrazy marki lub obrazy referencyjne, aby zapewnić percepcyjnie jednolite, harmonijne i zgodne z zasadami użyteczności motywy kolorystyczne przy użyciu CAM02-UCS. Wyniki te są następnie optymalizowane za pomocą zasad projektowania poznawczego, w tym grupowania Gestalt, praw Fittsa i Hicksa, odstępów opartych na uwadze oraz modelowania hierarchii wizualnej, aby automatycznie generować dopracowane, zorientowane na zadania układy UI. Eksperymenty przeprowadzone na zbiorach danych RICO, ENRICO i Guo’s UI Color wykazują, że proponowany system osiąga 92,4% dokładności detekcji komponentów, poprawia przejrzystość układu i dokładność kolejności czytania o 18,7% oraz tworzy palety kolorystyczne oceniane przez projektantów jako o 24,5% bardziej harmonijne w porównaniu z metodami bazowymi. Ewaluacje użytkowników wskazują również na 31% redukcję postrzeganego obciążenia poznawczego i 28% wzrost spójności projektowej między ekranami. Wyniki te dowodzą, że połączenie strukturalnego zrozumienia opartego na głębokim uczeniu z percepcyjnym modelowaniem kolorów i zasadami projektowania poznawczego pozwala na tworzenie prototypów UI, które są wysoce wydajne, estetycznie spójne i przyjazne dla użytkownika. Przedstawione ramy ustanawiają nowatorskie, kompleksowe podejście do inteligentnego i zorientowanego na człowieka automatycznego prototypowania UI.
Wprowadzenie
Graficzne interfejsy użytkownika (GUI) stanowią podstawowy środek komunikacji między ludźmi a systemami komputerowymi, znacząco wpływając na użyteczność, dostępność oraz ogólne doświadczenia użytkownika (UX)1,2. Nowoczesne systemy oprogramowania opierają się na intuicyjnych i atrakcyjnych wizualnie interfejsach, aby przyciągać i zatrzymywać użytkowników. Tradycyjnie projektowanie interfejsu użytkownika polega na tworzeniu układów graficznych, które są następnie tłumaczone na kod front-endowy przez inżynierów. Jednak różnice w protokołach specyficznych dla poszczególnych platform w zależności od systemu operacyjnego wymagają wielokrotnej adaptacji, co zwiększa złożoność i nakład pracy związany z rozwojem. Automatyczne generowanie kodu interfejsu użytkownika stało się zatem ważnym kierunkiem badań, pozwalającym na ograniczenie pracy ręcznej i zwiększenie wydajności procesu tworzenia oprogramowania.
Wczesne podejścia do zautomatyzowanego generowania interfejsów użytkownika (UI) łączą tradycyjne techniki przetwarzania obrazów z modelami głębokiego uczenia w celu detekcji i klasyfikacji obszarów3,4. Obecnie dominujące strategie generowania kodu GUI stosują techniki komputerowego rozpoznawania obrazu do analizy obrazów UI i ich konwersji na ustrukturyzowane reprezentacje front-endowe5,6,7. Podczas gdy metody przetwarzania obrazów opierają się na ręcznie definiowanych cechach, podejścia oparte na głębokim uczeniu wyodrębniają reprezentacje hierarchiczne z wielkoskalowych zbiorów danych. W konsekwencji badacze analizowali podejścia hybrydowe, które łączą głębokie uczenie ze specyficznymi dla danej dziedziny technikami przetwarzania obrazów w celu zwiększenia odporności i dokładności.
Kolor jest kolejnym kluczowym czynnikiem w projektowaniu interfejsu użytkownika (UI), wpływającym na postrzeganie przez użytkownika, użyteczność oraz estetykę1. Zachowanie spójności między treścią obrazu a schematami kolorystycznymi UI staje się wyzwaniem, gdy wejścia wizualne różnią się odcieniem i kontekstem8,9,10. W związku z tym znacząca część badań skupiła się na automatycznym generowaniu palet kolorów i percepcyjnym modelowaniu barw. Istniejące metody generowania kolorów obejmują techniki oparte na przestrzeni barw CIELAB11. Inne podejścia wykorzystują algorytmy klastrowania, takie jak k-średnich, do wyodrębniania dominujących kolorów z obrazów12. W rezultacie w nowszych pracach coraz częściej stosuje się podejścia oparte na danych i uczeniu maszynowym w celu modelowania kolorów.
Równolegle podejścia oparte na głębokim uczeniu znacząco poprawiły detekcję komponentów interfejsu użytkownika (UI) oraz rozumienie układu. Sieci neuronowe umożliwiły dokładniejszą analizę strukturalną interfejsów mobilnych13. Metody te koncentrują się jednak przede wszystkim na dokładności detekcji, często pomijając aspekty wyższego poziomu, takie jak użyteczność poznawcza, hierarchia układu i efektywność interakcji. Zaproponowano również generatywne modele syntezy układu UI14,15, lecz napotykają one trudności w utrzymaniu spójności między różnymi ekranami oraz w dostarczaniu interpretowalnych decyzji projektowych16. Inne podejścia skupiają się na podobieństwie wizualnym lub jakości renderowania, ale brakuje im ujednoliconego modelu łączącego semantykę komponentów, harmonię kolorystyczną i ograniczenia dotyczące użyteczności17. Rozpoznawanie tekstu jest również istotne dla zrozumienia treści UI. Techniki takie jak splotowe rekurencyjne sieci neuronowe (CRNNs) umożliwiają dokładne rozpoznawanie złożonych wzorców tekstowych na ekranach interfejsu18,19,20.
Zaproponowano kilka systemów służących do generowania kodu interfejsu użytkownika (UI) na podstawie szkiców lub obrazów. Sketch2Code wykorzystuje detekcję obiektów do konwersji szkiców na reprezentacje kodowe21,22, jednak jest on wrażliwy na jakość obrazu. REDRAW zapewnia zautomatyzowany proces zbierania danych i trenowania modeli, łącząc splotowe i rekurencyjne sieci neuronowe w celu generowania ustrukturyzowanych reprezentacji UI23,24. W późniejszych pracach wprowadzono ulepszone metryki oceny w celu analizy jakości wygenerowanego UI25. Nowsze podejścia obejmują modele oparte na dyfuzji i transformatorach do generowania układów, takie jak transformatory układu dyfuzyjnego bez metod autoenkodera, generowanie układu GUI z wykorzystaniem grafów rozmieszczenia GUI opartych na transformatorach oraz generowanie układu UI sterowane przez duże modele językowe26,27,28. Porównawczy przegląd tych podejść przedstawiono w Tabeli 1.
| Literatura i kluczowa metoda (metody) | Cel | Zalety | Wady |
| Zautomatyzowane generowanie motywów kolorystycznych interfejsu użytkownika na podstawie obrazów: ekstrakcja kolorów dominujących + percepcyjne modelowanie barw CAM02-UCS¹ | Automatyczne generowanie motywów kolorystycznych interfejsu użytkownika z obrazów referencyjnych przy jednoczesnej optymalizacji harmonii i użyteczności. | Silne ugruntowanie percepcyjne (CAM02-UCS); jawnie równoważy harmonię i użyteczność (kontrast i różnorodność); obejmuje implementację internetową oraz ocenę projektantów. | Skupienie wyłącznie na kolorystyce/motywie (nie na układzie ani strukturze komponentów); synteza interfejsu użytkownika oparta na regułach/heurystykach, a nie na uczeniu end-to-end. |
| Ujednolicenie generowania układu za pomocą rozdzielonego modelu dyfuzyjnego (LDGM)²⁵ | Ujednolicone, elastyczne generowanie układu dla scen graficznych i interfejsów użytkownika. | Najnowocześniejszy poziom różnorodności i sterowalności w generowaniu układów; obsługa generowania warunkowego oraz wielu typów atrybutów. | Wyniki oparte na dyfuzji mogą wykazywać problemy z wyrównaniem lub szczegółowym układem, jeśli nie zostaną odpowiednio ograniczone; wiążą się one z wyższą złożonością modelu i kosztem wnioskowania. |
| Transformery układu dyfuzyjnego bez metod autoenkodujących: transformer + dyfuzja do generowania układów (bez autoenkodera)²⁶ | Poprawa wierności i dopasowania dla benchmarków generowania układów (metryki FID, dopasowania i nakładania). | Lepsze uchwycenie korelacji semantycznych między sąsiadującymi obiektami; wysoka wydajność w zakresie wskaźnika FID oraz metryk wyrównania. | Koncentruje się przede wszystkim na geometrii układu (pozycjach, rozmiarach, kategoriach), a nie na semantyce interfejsu użytkownika. |
| Generowanie układu GUI za pomocą modeli opartych na Transformerach z grafów rozmieszczenia GUI (GUI-AGs)²⁷ | Tworzenie układów interfejsu graficznego użytkownika (GUI) na podstawie więzów pozycyjnych i grafowych w celu wsparcia projektantów. | Reprezentacje grafowe oddają więzy relacyjne; transformer umożliwia elastyczne generowanie warunkowane tymi więzami. | Może wymagać od projektantów jawnych grafów ograniczeń; ograniczony nacisk na kolorystykę i wskaźniki użyteczności. |
| Generowanie układów interfejsu użytkownika (UI) za pomocą modeli LLM kierowanych gramatyką UI: duże modele językowe (LLM) + hierarchiczna gramatyka UI²⁸ | Badanie dużych modeli językowych (LLM) w zakresie generowania układów oraz poprawa wyjaśnialności i kontroli poprzez reprezentacje gramatyczne. | Wysoki poziom sterowalności i wyjaśnialności; możliwość wykorzystania uczenia w kontekście (in-context learning) z dużych modeli językowych (typu GPT). | Prace na wczesnym etapie z ograniczoną walidacją empiryczną; projektowanie gramatyki i odporność w różnych interfejsach użytkownika (UI) |
Tabela 1: Porównanie istniejących metod modelowania kolorów i generowania układu interfejsu użytkownika (UI). Tabela podsumowuje reprezentatywne podejścia do projektowania interfejsu użytkownika, w tym generowanie motywów kolorystycznych, generowanie układu w oparciu o modele dyfuzyjne, metody oparte na transformatorach oraz generowanie układu kierowane przez duże modele językowe. Dla każdej metody przedstawiono zastosowaną technikę, cel, zalety i ograniczenia, podkreślając różnice w modelowaniu percepcyjnym, możliwościach generowania układu, sterowalności oraz kwestiach związanych z użytecznością.
Mimo tych postępów utrzymuje się kluczowe ograniczenie: żaden z istniejących systemów nie integruje wspólnie detekcji komponentów, percepcyjnego modelowania kolorów, zasad projektowania poznawczego oraz spójności układu wieloekranowego w ramach jednej, kompleksowej struktury end-to-end1. Obecne podejścia zazwyczaj optymalizują tylko jeden lub dwa aspekty — takie jak detekcja, układ lub kolor — bez uwzględnienia ich wzajemnych zależności. Ta fragmentacja podkreśla krytyczną lukę badawczą w opracowywaniu ujednoliconych, zorientowanych na człowieka zautomatyzowanych systemów prototypowania interfejsów użytkownika (UI). W szczególności zasady projektowania poznawczego, takie jak prawa Gestalt, prawo Fittsa i prawo Hicksa, są często traktowane koncepcyjnie, zamiast być formalnie zintegrowane z modelami obliczeniowymi.
Aby wyeliminować te ograniczenia, w niniejszym badaniu zaproponowano kompleksowy, zautomatyzowany system prototypowania interfejsów użytkownika (UI), który integruje detekcję komponentów, percepcyjne modelowanie kolorów oraz kognitywne zasady projektowania w ramach jednego systemu. System został opracowany w celu poprawy jakości układu, zmniejszenia obciążenia poznawczego, zwiększenia harmonii kolorystycznej oraz poprawy ogólnej użyteczności. Udoskonalenia te zostały zweryfikowane w drodze eksperymentów na zbiorach danych RICO, ENRICO oraz Guo’s UI Color, co wykazało skuteczność łączenia aspektów strukturalnych, percepcyjnych i kognitywnych w ramach jednego zautomatyzowanego procesu prototypowania UI. Postawiono hipotezę, że integracja detekcji komponentów opartej na głębokim uczeniu, percepcyjnego modelowania kolorów oraz kognitywnych zasad projektowania w ramach jednolitego systemu znacząco poprawi jakość prototypów UI w porównaniu z istniejącymi podejściami. W szczególności H1 zakłada, że system poprawia jakość układu, w tym wyrównanie, grupowanie i kolejność czytania. H2 zakłada, że system zmniejsza obciążenie poznawcze użytkownika. H3 sugeruje, że percepcyjne modelowanie kolorów poprawia koordynację barw i harmonię wizualną. H4 stwierdza, że poprawiona zostaje ogólna użyteczność oraz jakość estetyczna prototypów UI.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
W niniejszym badaniu wykorzystano publicznie dostępne zestawy danych; nie zaangażowano w nie ludzi ani zwierząt.
Proponowana zautomatyzowana platforma prototypowania interfejsów użytkownika (UI) integruje strukturalne rozumienie oparte na głębokim uczeniu, percepcyjnie jednorodne modelowanie kolorów oraz kognitywne zasady projektowania w celu generowania spójnych i zorientowanych na użytkownika prototypów interfejsu. Metodologia rozpoczyna się od architektury Faster R-CNN wytrenowanej na zbiorach danych RICO i ENRICO, służącej do wykrywania komponentów UI i wyodrębniania ich relacji hierarchicznych, co umożliwia dokładną interpretację zróżnicowanych układów ekranów. Wykryte komponenty są następnie przetwarzane przez moduł inteligencji kolorystycznej, który wyodrębnia wskazówki kolorystyczne na podstawie marki lub obrazu, modeluje podobieństwo percepcyjne przy użyciu CAM02-UCS i generuje harmonijne, świadome kontrastu oraz zgodne z zasadami dostępności palety kolorów. Następnie, poprzez silnik optymalizacji kognitywnej, stosowane są kognitywne zasady projektowania — w tym prawa grupowania Gestalt, prawo Fittsa, prawo Hicka, odstępy oparte na uwadze oraz ograniczenia hierarchii wizualnej — aby dopracować organizację przestrzenną i wyrównanie komponentów. Na koniec warstwa rozumowania układu integruje ograniczenia strukturalne, percepcyjne i kognitywne, aby wygenerować spójne wieloekranowe prototypy UI, które równoważą użyteczność, estetykę i przejrzystość funkcjonalną. Ten zintegrowany proces zapewnia spójność percepcyjną, redukuje obciążenie poznawcze i jest zgodny z zasadami projektowania zorientowanego na człowieka. Pełny schemat proponowanej metody przedstawiono na Rysunku 1.
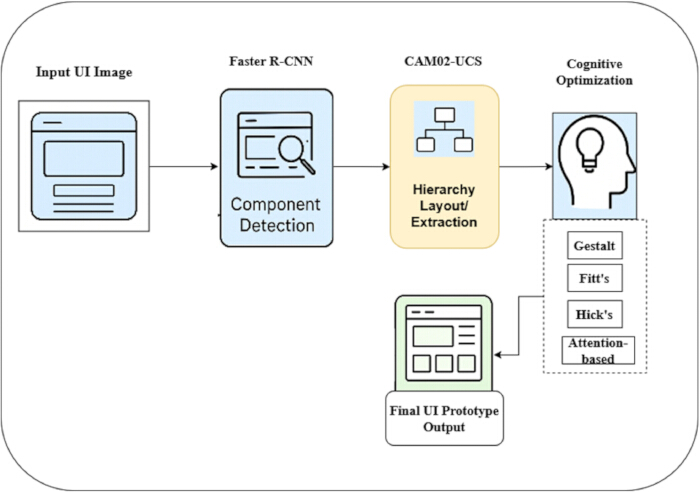
Rysunek 1. Ogólna architektura proponowanego zautomatyzowanego środowiska do prototypowania interfejsów użytkownika. Schemat przedstawia kompletny rurociąg przetwarzania, rozpoczynający się od wejściowego obrazu UI. Detekcja komponentów jest wykonywana przy użyciu Faster R-CNN w celu identyfikacji elementów interfejsu. Wykryte komponenty są następnie przetwarzane z wykorzystaniem modelowania percepcyjnego w oparciu o CAM02-UCS w celu ekstrakcji hierarchii i układu. Następnie stosowana jest optymalizacja poznawcza z wykorzystaniem zasad Gestalt, prawa Fittsa, prawa Hicka oraz korekt opartych na uwadze. Strzałki wskazują przepływ danych między modułami, co prowadzi do końcowego prototypu UI. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Przegląd schematu
Rysunek 1 przedstawia kompletny schemat przepływu pracy proponowanego zautomatyzowanego frameworka do prototypowania interfejsów użytkownika (UI), który przekształca surowy zrzut ekranu UI w poznawczo dopracowany prototyp. Proces rozpoczyna się od wejściowego obrazu UI, który jest przekazywany do modułu detekcji komponentów opartego na Faster R-CNN. Moduł ten identyfikuje elementy interfejsu, takie jak przyciski, ikony, pola tekstowe i kontenery, a następnie generuje odpowiadające im ramki ograniczające (bounding boxes) oraz etykiety klas. Wykryte komponenty są następnie przetwarzane na etapie ekstrakcji hierarchii i układu. W oparciu o relacje przestrzenne i wzorce strukturalne system konstruuje hierarchiczne drzewo układu, które odzwierciedla sposób, w jaki użytkownicy naturalnie postrzegają organizację ekranu. Reprezentacja ta oddaje grupowanie wizualne oraz zależności strukturalne między elementami UI. Wyekstrahowany układ jest następnie udoskonalany poprzez optymalizację poznawczą z zastosowaniem zasad projektowania zorientowanego na człowieka. Obejmują one grupowanie Gestalt dla klastrowania wizualnego, prawo Fittsa w celu optymalizacji rozmiaru i dostępności celów dotykowych, prawo Hicka w celu zmniejszenia złożoności podejmowania decyzji oraz odstępy oparte na uwadze w celu poprawy hierarchii wizualnej. W rezultacie układ staje się bardziej intuicyjny, czytelny i wydajny pod kątem interakcji z użytkownikiem. Na koniec zoptymalizowany układ jest łączony z percepcyjnym modelowaniem kolorów w celu wygenerowania spójnego prototypu UI. Powstały interfejs jest dokładny strukturalnie, harmonijny wizualnie i zgodny z ludzkimi oczekiwaniami dotyczącymi użyteczności.
Struktura została zaimplementowana przy użyciu PyTorch 2.0 na systemie Ubuntu 22.04. Eksperymenty przeprowadzono na systemie wyposażonym w układ GPU NVIDIA RTX 4090 (24 GB VRAM). Model Faster R-CNN wykorzystywał architekturę bazową ResNet-50 wstępnie wytrenowaną na zbiorze danych ImageNet. Trening przeprowadzono z wykorzystaniem optymalizatora stochastycznego spadku gradientu (SGD) przy współczynniku uczenia 0.001, wielkości partii (batch size) 16 i maksymalnie 60 epokach. Aby zapobiec przeuczeniu, zastosowano mechanizm wczesnego zatrzymania (early stopping) z wykorzystaniem zbioru walidacyjnego stanowiącego 20% danych. Choć trening zaplanowano na maksymalnie 60 epok, zbieżność była zazwyczaj osiągana wcześniej dzięki wczesnemu zatrzymaniu opartemu na stracie walidacyjnej. Moment pędu (momentum) oraz zanik wag (weight decay) ustawiono odpowiednio na 0.9 i 0.0005. Augmentacja danych obejmowała normalizację, losowe poziome odbicie lustrzane oraz losowe przycinanie i zmiana rozmiaru.
Przygotowanie zbioru danych
Aby wesprzeć proponowany zautomatyzowany system prototypowania interfejsu użytkownika (UI), wykorzystano trzy komplementarne zbiory danych: ENRICO29, RICO30 oraz zbiór kolorów UI autorstwa Guo1. Zbiór RICO zawiera 66 261 ekranów UI systemu Android pochodzących z 9 700 aplikacji, co zapewnia szeroką różnorodność niezbędną do detekcji komponentów i ekstrakcji hierarchicznego układu. Zbiór ENRICO obejmuje 1 464 wysokiej jakości zrzuty ekranu UI, ręcznie podzielone na 20 wzorców projektowych, co pozwala na lepszą generalizację w zakresie rozumowania strukturalnego i modelowania spójności układu. Zbiór kolorów UI autorstwa Guo składa się ze 128 wyselekcjonowanych obrazów UI z adnotacjami motywów kolorystycznych, które są wykorzystywane do modelowania percepcyjnego koloru i oceny palety. Jednak ze względu na stosunkowo niewielki rozmiar, zbiór ten może wprowadzać pewną zmienność w charakterystyce układu. Na potrzeby niniejszego badania przygotowano połączony zbiór 5 128 ekranów do trenowania i ewaluacji. Konkretnie, około 4 000 obrazów z RICO wykorzystano do trenowania modelu Faster R-CNN w celu detekcji komponentów, 1 000 obrazów z ENRICO posłużyło do uczenia wzorców układu i modelowania spójności strukturalnej, a 128 obrazów ze zbioru Guo wykorzystano do zadań związanych z oceną kolorów. Wszystkie obrazy znormalizowano do rozdzielczości 480 × 800 pikseli, przekonwertowano do jednolitej przestrzeni barw sRGB oraz ponownie opatrzono standardowymi ramkami ograniczającymi (bounding boxes) i metadanymi hierarchicznymi w celu zapewnienia kompatybilności między zbiorami danych. Przegląd zbiorów danych wykorzystanych w tym badaniu przedstawiono w Tabeli 2. Zbiór RICO wspiera wielkoskalową detekcję komponentów UI i analizę strukturalną, podczas gdy ENRICO zwiększa zdolność modelu do rozpoznawania wzorców układu i wymuszania spójności między ekranami. Zbiór kolorów UI autorstwa Guo, mimo mniejszej wielkości, odgrywa kluczową rolę w ocenie percepcyjnej harmonii kolorów i modelowania kontrastu. Razem zbiory te stanowią kompleksową i dobrze zbalansowaną podstawę do trenowania, walidacji i ewaluacji proponowanego zautomatyzowanego systemu prototypowania UI.
| Zbiór danych | Całkowita liczba dostępnych obrazów | Obrazy wykorzystane w badaniu | Cel w proponowanym schemacie |
| Zbiór danych RICO30 | 66,261 | 4,000 | wykrywanie komponentów interfejsu użytkownika, ekstrakcja układu strukturalnego |
| Zbiór danych ENRICO29 | 1,464 | 1,000 | uczenie wzorców projektowych, modelowanie spójności układu |
| Zbiór danych kolorów interfejsu użytkownika Guo1 | 128 | 128 | Ekstrakcja motywu kolorystycznego, percepcyjna ocena koloru |
| Suma całkowita | 67,853 | 5,128 | Kompleksowy zestaw danych do detekcji, analizy układu i modelowania kolorów |
Tabela 2: Podsumowanie zbiorów danych wykorzystanych w proponowanym modelu. Tabela przedstawia zbiory danych wykorzystane do uczenia i ewaluacji, w tym zbiory RICO, ENRICO oraz Guo’s UI Color. Podano w niej całkowitą liczbę dostępnych obrazów, podzbiór wykorzystany w niniejszym badaniu oraz konkretną rolę każdego zbioru danych w detekcji komponentów, modelowaniu układu i percepcyjnej analizie kolorów w ramach proponowanego modelu.
Zastosowano strategię próbkowania warstwowego, aby zachować różnorodność komponentów interfejsu użytkownika, struktur układu oraz rozkładów kolorów w zbiorach danych RICO, ENRICO i Guo. Zbiór danych został podzielony na podzbiory treningowy (70%), walidacyjny (15%) i testowy (15%) przy użyciu próbkowania warstwowego. Obrazy zostały znormalizowane przy użyciu średniej (0.485, 0.456 oraz 0.406) i odchylenia standardowego (0.229, 0.224 oraz 0.225). Augmentacja danych obejmowała losowe odwrócenie poziome (prawdopodobieństwo = 0.5) oraz losowe przycinanie (zakres skali: 0.8–1.0), a następnie zmianę rozmiaru do 224 × 224 pikseli, co było stosowane podczas trenowania.
Anotacja i wstępne przetwarzanie komponentów
Zbiory danych RICO, ENRICO oraz UI Color Dataset autorstwa Guo wspólnie obsługują trzy kluczowe komponenty funkcjonalne proponowanej ramowej architektury do automatycznego prototypowania interfejsów użytkownika (UI): detekcję komponentów, modelowanie układu oraz percepcyjną optymalizację kolorów. Zbiór RICO zawiera wielkoskalową kolekcję ponad 66 000 ekranów mobilnych UI i jest wykorzystywany głównie do trenowania modułu detekcji komponentów. Jego różnorodność umożliwia modelowi Faster R-CNN naukę odpornych reprezentacji typowych elementów UI, takich jak przyciski, obrazy i pola tekstowe, w szerokim zakresie aplikacji. Zapewnia to dokładną detekcję i lokalizację komponentów UI w zmiennych warunkach projektowych. Zbiór ENRICO dostarcza wysokiej jakości ekrany UI z etykietami wzorców, co służy do nauki relacji strukturalnych i schematów układu. Umożliwia to systemowi zrozumienie zależności między komponentami, organizacji hierarchicznej oraz powszechnych szablonów projektowych. Zbiór ten odgrywa krytyczną rolę w modelowaniu struktur układu i zapewnianiu spójności wieloekranowej, pozwalając architekturze na generowanie układów zgodnych z przyjętymi konwencjami projektowymi. Z kolei UI Color Dataset autorstwa Guo jest wykorzystywany specjalnie do percepcyjnego i kognitywnego modelowania kolorów. W przeciwieństwie do RICO i ENRICO, które koncentrują się na aspektach strukturalnych, zbiór ten zawiera wyselekcjonowane obrazy UI z adnotacjami motywów kolorystycznych. Adnotacje te są używane do trenowania modułów ekstrakcji kolorów i oceny harmonii. Poprzez mapowanie relacji kolorystycznych do percepcyjnych przestrzeni barwnych, takich jak CAM02-UCS, architektura uczy się generować palety kolorów, które równoważą kontrast, dostępność i spójność estetyczną. Razem zbiory te tworzą zintegrowany potok przetwarzania: RICO wspiera detekcję komponentów, ENRICO umożliwia zrozumienie wzorców układu i spójność strukturalną, a zbiór Guo ułatwia percepcyjną optymalizację kolorów. Ta integracja gwarantuje, że wygenerowane prototypy UI są dokładne pod względem strukturalnym, harmonijne wizualnie i zoptymalizowane kognitywnie.
Normalizację przeprowadzono, przyjmując średnią [0.485, 0.456, 0.406] oraz odchylenie standardowe [0.229, 0.224, 0.225]. W celu poprawy generalizacji modelu zastosowano techniki augmentacji danych, w tym losowe przycinanie, poziome odbicie lustrzane oraz obrót. Dodatkowo wartości pikseli przeskalowano do zakresu [0, 1], a wszystkie obrazy zmieniono na rozdzielczość 480 × 800 pixels, aby zapewnić spójność między zestawami danych. Obrazy przeskalowane do 224 × 224 pixels wykorzystano do augmentacji podczas trenowania, natomiast oryginalną rozdzielczość 480 × 800 pixels zachowano do analizy układu. Ramki ograniczające (bounding boxes) skorygowano, aby odfiltrować nieistotne adnotacje przy użyciu zdefiniowanych progów. Aby uzyskać jednolitość między zestawami danych, wszystkie elementy interfejsu użytkownika (UI) zostały ręcznie adnotowane przy użyciu narzędzia LabelImg. Przed przystąpieniem do adnotacji opracowano zdefiniowany schemat klasyfikacji elementów UI na takie kategorie jak przycisk, tekst, obraz, ikona i kontener. Do reprezentacji ramek ograniczających zastosowano jednolity układ współrzędnych, a informacje hierarchiczne zbudowano w oparciu o relacje przestrzenne między elementami oraz powiązania rodzic-dziecko w drzewie układu. Ponadto ustanowiono wytyczne w celu zapewnienia spójnej adnotacji elementów, właściwej obsługi nakładających się komponentów oraz egzekwowania minimalnych progów wielkości w zestawach danych RICO, ENRICO i Guo.
Szczegółowe sformułowania matematyczne dotyczące trenowania detekcji komponentów oraz ekstrakcji wzorca układu zostały przedstawione w Pliku uzupełniającym 1.
Model Faster R-CNN został przeszkolony przy użyciu algorytmu SGD z pędem (momentum) wynoszącym 0.9 oraz współczynnikiem zaniku wag (weight decay) na poziomie 0.0005. Początkowa szybkość uczenia została ustawiona na 0.001 i korygowana zgodnie z polityką schodkowego spadku (step decay) w oparciu o wyniki walidacji. Trening przeprowadzano przez maksymalnie 60 epok przy rozmiarze partii (batch size) równym 16. W celu zapobieżenia przeuczeniu zastosowano wczesne zatrzymanie (early stopping), wykorzystując zbiór walidacyjny stanowiący 20% danych treningowych.
Funkcja mapowania f(.) przyjmuje wykryte elementy interfejsu użytkownika (UI) jako dane wejściowe i generuje hierarchiczną reprezentację układu jako wynik. Oblicza ona relacje sąsiedztwa między elementami UI w oparciu o odległość przestrzenną oraz kryteria wyrównania, a następnie tworzy macierz sąsiedztwa w celu przedstawienia tych relacji. Następnie stosowany jest algorytm grupowania, taki jak DBSCAN, aby pogrupować powiązane komponenty. Na koniec pogrupowane elementy są organizowane w struktury hierarchiczne w oparciu o relacje rodzic-dziecko, tworząc ustrukturyzowaną reprezentację układu.
Szczegółowe sformułowania dla modelowania harmonii kolorów oraz ujednolicony cel optymalizacji zostały przedstawione w Pliku uzupełniającym 1.
Ta funkcja celu formalizuje matematycznie integrację detekcji strukturalnej, rozumowania dotyczącego układu oraz percepcyjnego modelowania kolorów, zapewniając, że wszystkie komponenty struktury wspólnie przyczyniają się do generowania spójnych i zorientowanych na użytkownika prototypów UI. Optymalizacja jest przeprowadzana w sposób modularny dla każdego komponentu struktury. Do trenowania modułu detekcji komponentów wykorzystuje się SGD, natomiast podczas wspólnej optymalizacji zunifikowanego celu stosowany jest optymalizator Adam. Połączony cel służy do sterowania ogólną wydajnością systemu. W etapach wspólnej optymalizacji funkcja celu jest minimalizowana przy użyciu optymalizatora Adam z szybkością uczenia 0,001 i rozmiarem partii 16. Trenowanie jest prowadzone przez maksymalnie 60 epok, z zastosowaniem wczesnego zatrzymania, gdy zmiana straty walidacyjnej jest mniejsza niż 10−4 przez pięć kolejnych epok.
Wykrywanie komponentów przy użyciu Faster R-CNN
Zaproponowane ramy wykorzystują model Faster R-CNN do automatycznego wykrywania komponentów interfejsu użytkownika (UI), w tym przycisków, ikon, pól tekstowych, obrazów i kontenerów. Faster R-CNN jest odpowiedni do tego zadania, ponieważ łączy wysoką dokładność detekcji obiektów z wydajnym generowaniem propozycji obszarów, co jest niezbędne w przypadku złożonych układów UI zawierających gęsto rozmieszczone elementy. Model wykorzystuje szkielet ResNet-50 wstępnie wytrenowany na zbiorze danych ImageNet do wyodrębniania splotowych map cech z każdego ekranu UI. Podczas trenowania wczesne warstwy zostały zamrożone, aby zachować ogólne cechy wizualne, natomiast wyższe warstwy (conv4_x i conv5_x) zostały dostrojone do wykrywania komponentów specyficznych dla UI. Mapy cech te rejestrują struktury wizualne, krawędzie, tekstury i granice komponentów. Podczas detekcji sieć propozycji obszarów (RPN) identyfikuje potencjalne regiony (kotwice), które prawdopodobnie zawierają komponenty UI. Kotwice są definiowane przy użyciu wielu skal (128, 256 i 512) oraz proporcji (1:1, 1:2 i 2:1), aby dostosować się do elementów UI o różnych rozmiarach. W trakcie trenowania kotwice z wskaźnikiem intersection-over-union (IoU) większym niż 0.7 w stosunku do ramek prawdy naziemnej (ground truth) są oznaczane jako pozytywne, natomiast te z IoU mniejszym niż 0.3 są oznaczane jako negatywne; kotwice o pośrednich wartościach IoU są pomijane. Każdej kotwicy przypisywane jest prawdopodobieństwo wskazujące na obecność komponentu. Następnie stosowana jest metoda non-maximum suppression (NMS), aby usunąć nadmiarowe i nakładające się propozycje, co zapewnia wydajną lokalizację istotnych elementów UI nawet w przeładowanych interfejsach. Po wygenerowaniu potencjalnych obszarów każda propozycja jest klasyfikowana do zdefiniowanych kategorii komponentów, a współrzędne jej ramki ograniczającej są doprecyzowane. Operacja ROI Align wyodrębnia reprezentacje cech o stałym rozmiarze dla każdej propozycji, które są następnie przetwarzane przez warstwy w pełni połączone w celu klasyfikacji i regresji. Gałąź klasyfikacji generuje prawdopodobieństwa klas, natomiast gałąź regresji przewiduje precyzyjne współrzędne ramki ograniczającej. Cały model Faster R-CNN jest trenowany end-to-end poprzez optymalizację wspólnej funkcji straty, która łączy stratę RPN ze stratą końcowej detekcji. Umożliwia to systemowi nie tylko dokładne rozpoznawanie komponentów UI, ale także ich precyzyjną lokalizację w zróżnicowanych strukturach interfejsu. Szczegółowy opis wykrywania komponentów za pomocą Faster R-CNN, obejmujący etap RPN, klasyfikację ROI, doprecyzowanie ramek ograniczających oraz końcowy cel optymalizacji, znajduje się w Supplementary File 1.
Algorytm S1 przedstawia szczegółowy schemat detekcji komponentów i ekstrakcji struktury (Plik uzupełniający 1). Opisuje on kompletny proces automatycznej detekcji komponentów interfejsu użytkownika (UI) oraz ekstrakcji struktury z surowego obrazu ekranu. Obraz wejściowy jest najpierw poddawany wstępnemu przetwarzaniu i przekazywany do szkieletu CNN w celu ekstrakcji głębokich cech wizualnych. Cechy te są wykorzystywane przez RPN do generowania kandydackich ramek ograniczających, które następnie są doprecyzowane poprzez klasyfikację i regresję. NMS usuwa nadmiarowe detekcje, aby zapewnić dokładną lokalizację. Po detekcji komponenty są grupowane na podstawie bliskości przestrzennej przy użyciu gęstościowego przestrzennego klastrowania aplikacji z szumem (DBSCAN). Ten etap klastrowania umożliwia budowę hierarchicznego drzewa UI, które odwzorowuje relacje rodzic-dziecko i logiczne grupowanie komponentów. Ta reprezentacja hierarchiczna stanowi podstawę dla późniejszej analizy układu i rozumienia UI. Rysunek 2 ilustruje proces detekcji komponentów Faster R-CNN na ekranie mobilnego UI. Interfejs wejściowy (po lewej) zawiera elementy UI, takie jak przyciski i bloki tekstu, które są automatycznie obramowane ramkami ograniczającymi. Wykryte regiony są następnie klasyfikowane do kategorii komponentów (np. Button i Text), co wskazują etykiety połączeń. Moduł detekcji Faster R-CNN (po prawej) doprecyzowuje współrzędne ramek ograniczających, przypisuje etykiety semantyczne i generuje ustrukturyzowane informacje na poziomie komponentów. Krok ten stanowi krytyczny fundament dla procesów downstream, w tym ekstrakcji układu, optymalizacji poznawczej i generowania prototypów UI, dostarczając dokładnych i semantycznie znaczących reprezentacji komponentów UI.
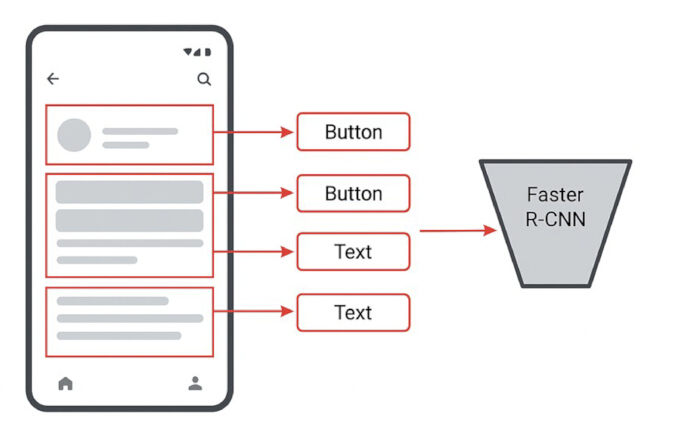
Rycina 2. Detekcja komponentów elementów interfejsu użytkownika przy użyciu Faster R-CNN. Rycina ilustruje detekcję komponentów UI z zrzutu ekranu interfejsu wejściowego. Obszary zainteresowania są identyfikowane za pomocą ramek ograniczających, a elementy takie jak przyciski i pola tekstowe są klasyfikowane przy użyciu Faster R-CNN. Strzałki wskazują mapowanie wykrytych komponentów na odpowiadające im etykiety semantyczne. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Ekstrakcja wzorców układu i modelowanie hierarchiczne
Po wykryciu komponentów za pomocą Faster R-CNN, każdy element interfejsu użytkownika (UI) jest reprezentowany przez ramkę ograniczającą (bounding box). Jednak same ramki te nie przekazują informacji o tym, jak elementy są zorganizowane strukturalnie w obrębie interfejsu, na przykład które z nich należą do nagłówków, pasków nawigacji lub zgrupowanych obszarów treści. Aby rozwiązać to ograniczenie, wykryte komponenty są przekształcane w logiczne drzewo UI, w którym każdy komponent jest traktowany jako węzeł, a komponenty powiązane funkcjonalnie lub wizualnie są grupowane pod wspólnymi węzłami nadrzędnymi. W celu identyfikacji znaczących grup układu stosuje się techniki klasteryzacji, takie jak DBSCAN lub hierarchiczna klasteryzacja aglomeracyjna. Metody te analizują bliskość przestrzenną i wzorce wyrównania między komponentami, aby wykryć relacje między elementami UI. W sposób analogiczny do praktyk projektowych stosowanych przez ludzi, system uczy się rozpoznawać typowe wzorce strukturalne, takie jak nagłówki, stopki, siatki i bloki treści. Po ustaleniu grupowania analizowane są dodatkowe właściwości strukturalne — w tym wyrównanie, organizacja siatki i kolejność odczytu — w celu stworzenia kompleksowej reprezentacji układu. Na przykład komponenty wyrównane w kolumnach o tej samej szerokości mogą wskazywać na układ oparty na kartach, podczas gdy elementy ułożone pionowo mogą wskazywać na interfejs oparty na formularzach lub kanale treści (feed). Poprzez integrację klasteryzacji, rozumowania przestrzennego i reguł wyrównania, framework buduje hierarchiczne drzewo UI, które oddaje zarówno grupowanie wizualne, jak i relacje funkcjonalne. Ta hierarchiczna reprezentacja służy jako podstawa do późniejszego dopracowania układu oraz modelowania spójności wieloekranowej, umożliwiając systemowi generowanie ustrukturyzowanych, spójnych i zorientowanych na użytkownika projektów interfejsu.
Szczegółowe sformułowania dotyczące odległości przestrzennej i podobieństwa wyrównania zostały przedstawione w Pliku uzupełniającym 1.
Klasteryzacja dla grupowania układu (DBSCAN)
W celu identyfikacji grup układu zastosowano algorytm DBSCAN. DBSCAN wykorzystuje dwa parametry: (1) ε = maksymalna odległość między sąsiednimi komponentami oraz (2) MinPts = minimalna liczba komponentów wymagana do utworzenia klastra. W tej analizie parametry DBSCAN zostały dobrane empirycznie na podstawie znormalizowanej rozdzielczości interfejsu użytkownika (480 × 800 pikseli). Parametr odległości sąsiedztwa ustawiono na ε = 50 pikseli, aby uchwycić bliskość przestrzenną między sąsiadującymi komponentami interfejsu. Minimalna liczba punktów wymagana do utworzenia klastra została ustawiona na MinPts = 3, aby uniknąć tworzenia nieistotnych lub pozornych grup komponentów interfejsu.
Szczegółowa formuła konstrukcji logicznego drzewa interfejsu użytkownika została przedstawiona w Pliku uzupełniającym 1.
Percepcyjne modelowanie barw z wykorzystaniem CAM02-UCS
Percepcyjne modelowanie barw zapewnia, że kolory użyte w generowanym interfejsie użytkownika (UI) są harmonijne, czytelne i efektywne poznawczo. Kolory dominujące są wyodrębniane ze źródeł wejściowych, takich jak obrazy UI, przy użyciu technik klastrowania. W szczególności zastosowano klastrowanie K-średnich z inicjalizacją K-means++ przez 300 iteracji w celu uzyskania reprezentatywnych palet barw. Jednak przestrzeń barw RGB nie odzwierciedla dokładnie ludzkiej percepcji wzrokowej, co oznacza, że numerycznie podobne kolory mogą wydawać się percepcyjnie różne. Aby wyeliminować to ograniczenie, wszystkie wyodrębnione kolory są przekształcane do przestrzeni CAM02-UCS, która jest percepcyjnie jednorodna. W tej przestrzeni równe odległości odpowiadają równym postrzeganym różnicom barw, co czyni ją odpowiednią do modelowania harmonii i kontrastu kolorów. Po zmapowaniu do CAM02-UCS percepcyjne różnice barw są obliczane za pomocą odległości euklidesowej, co pozwala systemowi na ilościowe określenie kontrastu, harmonii i zróżnicowania między kolorami. Kolory zbyt podobne są rozdzielane w celu poprawy czytelności, natomiast kolory o nadmiernym kontraście są łagodzone, aby uniknąć dyskomfortu wizualnego. Wygenerowana paleta jest zgodna ze standardami dostępności, takimi jak WCAG AA i AAA, co zapewnia wystarczający kontrast między elementami pierwszego planu a tłem. Ponadto harmonię barw wymusza ograniczenie relacji w palecie do schematów komplementarnych, analogicznych lub triadycznych, w zależności od zamierzonego motywu UI. Gwarantuje to, że wynikowa paleta barw jest nie tylko atrakcyjna wizualnie, ale także funkcjonalnie dostępna i zoptymalizowana poznawczo. Aby dalej dopracować paletę, stosowany jest proces optymalizacji przy zachowaniu ograniczeń dotyczących podobieństwa percepcyjnego, kontrastu, harmonii i spójności z marką. Wybierany jest kolor podstawowy (np. z identyfikacji wizualnej marki), a kolory wtórne są dostosowywane pod kątem luminancji i chromatyczności w celu zachowania hierarchii wizualnej. Mechanizm ewaluacji oparty na regułach ocenia potencjalne palety w oparciu o odległości percepcyjne i metryki dostępności, minimalizując obciążenie poznawcze przy jednoczesnym zachowaniu równowagi estetycznej. W rezultacie opracowany model generuje schematy kolorystyczne UI, które wykazują spójność, czytelność i jednorodność percepcyjną na poziomie profesjonalnym.
Szczegółowe wyrażenia matematyczne dla modelowania barw percepcyjnych w oparciu o CAM02-UCS zostały przedstawione w Pliku uzupełniającym 1.
Algorytm S2 (Plik uzupełniający 1) opisuje proces ekstrakcji i optymalizacji kolorów percepcyjnych w oparciu o model CAM02-UCS przy uwzględnieniu ograniczeń dotyczących harmonii i dostępności. Początkowo z obrazu wejściowego ekstrahowane są kolory dominujące, które następnie są przekształcane do przestrzeni CAM02-UCS, aby zapewnić zgodność różnic kolorystycznych z ludzką percepcją. Następnie oblicza się odległości percepcyjne między kolorami i ogranicza je do zdefiniowanych zakresów w celu zachowania przejrzystości i harmonii. Kolejno egzekwowana jest dostępność poprzez ocenę współczynników kontrastu luminancji zgodnie z wytycznymi WCAG. Końcowa paleta jest uzyskiwana poprzez optymalizację połączonej funkcji celu, która równoważy rozmieszczenie percepcyjne, wymagania dotyczące kontrastu oraz ograniczenia harmonii kolorystycznej. Zapewnia to, że wygenerowane schematy kolorów interfejsu użytkownika są nie tylko atrakcyjne wizualnie, ale także czytelne, dostępne i spójne percepcyjnie.
Optymalizacja projektu kognitywnego
Optymalizacja pod kątem projektowania poznawczego zapewnia, że automatycznie generowane prototypy interfejsu użytkownika (UI) są nie tylko spójne wizualnie, ale także łatwe do zrozumienia i obsługi. Moduł ten integruje kluczowe zasady projektowania poznawczego, w tym zasady Gestalt, prawo Fittsa oraz prawo Hicksa, aby ukierunkować rozmieszczenie, grupowanie i odstępy komponentów UI. Szczegółowe sformułowania matematyczne dotyczące optymalizacji projektowania poznawczego znajdują się w Pliku uzupełniającym 1.
Zintegrowany cel optymalizacji poznawczej
Wyrażenie matematyczne dla zintegrowanego celu optymalizacji poznawczej znajduje się w Pliku uzupełniającym 1. Współczynniki reprezentujące znaczenie grupowania wizualnego, wydajności interakcji oraz złożoności decyzji są oznaczone odpowiednio przez alfa, beta i gamma. W niniejszym badaniu wartości alfa, beta i gamma zostały określone empirycznie z wykorzystaniem zbioru danych walidacyjnych. Dla obecnego eksperymentu współczynniki ustawiono w następujący sposób: α = 0.5, β = 0.3 oraz γ = 0.2. Taka konfiguracja zapewnia skuteczną równowagę między grupowaniem wizualnym, wydajnością interakcji a prostotą podejmowania decyzji.
Spójność wieloekranowa i generowanie interfejsu użytkownika
Modelowanie spójności wieloekranowej zapewnia, że różne ekrany w ramach jednej aplikacji współdzielą spójną identyfikację wizualną, układ strukturalny i wzorzec interakcji. W miarę przechodzenia użytkowników między ekranami wykształcają oni oczekiwania dotyczące rozmieszczenia elementów, typografii, odstępów i hierarchii wizualnej. Aby sprostać tym oczekiwaniom, system analizuje wzorce międzyekranowe przy użyciu szablonów pochodnych z zestawów danych RICO i ENRICO. Szablony te obejmują powszechne struktury interfejsu użytkownika (UI), takie jak układy strona główna–szczegóły, wzorce lista–szczegóły, formularze wielokrokowe oraz przepływy pulpitów nawigacyjnych. Poprzez porównywanie rozmieszczenia komponentów i sposobu ich grupowania, system konstruuje międzyekranowy profil strukturalny, który określa, które elementy powinny pozostać spójne, a które mogą ulegać zmianom. Po zidentyfikowaniu wzorców strukturalnych, framework wymusza spójność skal typograficznych, proporcji odstępów, układów siatek i kotwic nawigacyjnych. Na przykład paski nagłówka zachowują stałą wysokość, przyciski główne utrzymują jednolity rozmiar i wyrównanie, a bloki treści następują po sobie w przewidywalnej kolejności wizualnej. Osiąga się to poprzez proces regularyzacji układu, który ocenia każdy ekran w odniesieniu do globalnych ograniczeń strukturalnych. Jeśli ekran odbiega od wyuczonych szablonów — na przykład poprzez niespójne dopełnienia (padding) lub niewyrównane tytuły — system automatycznie koryguje układ, aby przywrócić koherencję. Korekty te pomagają zapewnić płynne doświadczenie użytkownika (UX) i redukują koszty przełączania poznawczego między ekranami. Framework analizuje ponadto graf nawigacji między ekranami, aby zachować spójność przepływu interakcji. Identyfikowane są i egzekwowane powszechne wzorce nawigacji, w tym przejścia w przód/wstecz, nawigacja kartowa oraz wielokrokowe przepływy pracy. Każde przejście jest walidowane pod kątem zgodności z modelem mentalnym użytkownika, co poprawia użyteczność i zmniejsza dezorientację. W rezultacie model spójności wieloekranowej minimalizuje szum wizualny, zwiększa poczucie znajomości interfejsu i promuje ujednolicone doświadczenie interakcji.
Szczegółowe formuły matematyczne dotyczące spójności wieloekranowej oraz generowania interfejsu użytkownika znajdują się w Pliku uzupełniającym 1.
Na koniec silnik renderujący generuje wyniki wizualne w formatach takich jak makiety strukturalne SVG, prototypy HTML/CSS lub rastrowe makiety UI. Powstałe ekrany interfejsu użytkownika charakteryzują się poprawną kolejnością odczytu, harmonijnymi relacjami kolorystycznymi, precyzyjnym wyrównaniem do siatki oraz spójną hierarchią wizualną na wielu ekranach.
Algorytm S3 przedstawia proces optymalizacji poznawczo-wizualnego układu oraz przepływ pracy zapewniający spójność wieloekranową (Plik uzupełniający 1). Algorytm S3 opisuje zintegrowany proces optymalizacji poznawczej i strukturalnej wykorzystywany do generowania przyjaznych dla użytkownika układów interfejsu użytkownika (UI). Łączy on grupowanie percepcyjne (zasady Gestalt), efektywność interakcji (prawo Fittsa) oraz prostotę podejmowania decyzji (prawo Hicka) w ramach jednolitych ram optymalizacyjnych. W pierwszej kolejności oceniane są relacje przestrzenne między komponentami w celu ustalenia grup percepcyjnych. Następnie optymalizuje się efektywność interakcji poprzez dostosowanie rozmiaru i rozmieszczenia komponentów, podczas gdy złożoność decyzji jest kontrolowana poprzez ograniczenie liczby opcji przedstawianych użytkownikom. Dodatkowo algorytm wymusza spójność wieloekranową poprzez dopasowanie każdego ekranu do wyuczonych szablonów układu, zapewniając jednolitość typografii, odstępów i organizacji strukturalnej. Wielokryterialna funkcja optymalizacji doprecyzowuje następnie układ, równoważąc wyrównanie, odstępy i koszt poznawczy, co skutkuje interfejsem, który jest zarówno wizualnie spójny, jak i wydajny poznawczo. Ogólnie rzecz biorąc, algorytm ten zapewnia, że wygenerowane układy wieloekranowe zachowują wysoki poziom spójności wizualnej, użyteczności i klarowności percepcyjnej.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Zaproponowany zautomatyzowany framework prototypowania UI oceniono przy użyciu zintegrowanego zestawu danych obejmującego 5 128 ekranów UI z trzech źródeł: 4 000 obrazów RICO, 1 000 ekranów ENRICO oraz 128 próbek UI z adnotacjami kolorystycznymi z Guo’s UI Color Dataset. Ten zmieszany zestaw danych stanowi dobrze zrównoważony punkt odniesienia do oceny dokładności wykrywania komponentów, przejrzystości struktury układu, spójności wieloekranowej oraz percepcyjnej harmonii kolorystycznej.
Wyniki...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Wyniki wykazują statystycznie istotną poprawę w zakresie użyteczności, organizacji strukturalnej i jakości percepcyjnej (p < 0,05), co potwierdza skuteczność włączenia zasad projektowania poznawczego do zautomatyzowanego prototypowania interfejsów użytkownika (UI). W przeciwieństwie do tradycyjnych systemów generowania UI, które opierają się głównie na detekcji wizualnej lub heurystykach opartych na regułach, proponowany framework integruje grupowanie według zasad Gestalt, modelowanie hierarchii, ograniczenia dotyczą...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie deklarują żadnych konfliktów interesów.
Podziękowania
Autorzy wyrażają wdzięczność za wsparcie akademickie i instytucjonalne zapewnione przez Wuhan College of Foreign Languages & Foreign Affairs, Keimyung University oraz Shanghai Institute of Commerce and Foreign Languages podczas realizacji niniejszych badań.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| CPU (Procesor) | AMD Ryzen 9 7950X (16-rdzeniowy, 32-wątkowy, 4.5–5.7 GHz) | Advanced Micro Devices (AMD), USA | Ryzen 9 7950X |
| CUDA Toolkit | Wersja 11.8 | NVIDIA Corporation, USA | CUDA Toolkit 11.8 |
| cuDNN | Wersja 8.9 | NVIDIA Corporation, USA | cuDNN v8.9 |
| Faster R-CNN | Model detekcji obiektów (z siecią propozycji regionów) | Meta AI Research / Detectron2 | Framework Detectron2 |
| Matplotlib | Wersja 3.7 | Matplotlib Development Team | v3.7.0 |
| GPU NVIDIA RTX 4090 | Karta graficzna 24 GB GDDR6X | NVIDIA Corporation, Santa Clara, CA, USA | RTX 4090 |
| NumPy | Wersja 1.24 | NumPy Developers | v1.24.0 |
| OpenCV | Wersja 4.8 | OpenCV Foundation | v4.8.0 |
| PyTorch | Wersja 2.0 | PyTorch Foundation (Meta AI) | v2.0.0 |
| ResNet-50 z FPN | Szkieletowa sieć CNN z siecią piramidy cech | Microsoft Research / Detectron2 | ResNet-50-FPN |
| Scikit-learn | Wersja 1.3 | Scikit-learn Developers | v1.3.0 |
| SciPy | Wersja 1.10 | SciPy Community | v1.10.0 |
| Pamięć systemowa (RAM) | 64 GB DDR5 | Corsair / Kingston (lub odpowiednik) | Zestaw DDR5 64GB |
| System operacyjny Ubuntu | Wersja 22.04 LTS | Canonical Ltd., UK | Ubuntu 22.04 LTS |
Bibliografia
- Weingerl P. Automated image-based user interface color theme generation. Appl Sci. 2024;14:2850.
- Feng Z, Fang J, Cai B, Zhang Y. Guis2Code: Computer vision tool to generate code automatically from graphical user interface sketches. In: Proc Int Conf Artif Neural Netw; 2021; p. 53–65.
- Chen C, Zhang X, Yang Y, Li Y. GalleryDC: Design search knowledge discovery through auto-created GUI component gallery. Proc ACM Hum Comput Interact. 2019;3:1–22.
- Chen J, et al. Object detection for graphical user interface: Old-fashioned deep learning combination. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1202–1214.
- Xie M, et al. UIED: Hybrid tool for GUI element detection. In: Proc ACM Eur Softw Eng Conf Symp Found Softw Eng; 2020; p. 1655–1659.
- Gijsenij A, et al. Determining key colors from a design perspective using dE-means color clustering. Color Res Appl. 2023;48:69–87.
- Yuan LP, et al. InfoColorizer: Interactive recommendation of color palettes for infographics. IEEE Trans Vis Comput Graph. 2022;28:4252–4266.
- Cao Y, et al. Influences of color salience and location of website links on user performance and affective experience. Int J Hum Comput Interact. 2021;37:547–559.
- Liu W, Cao Y, Proctor RW. App icon color and border shape influence visual search efficiency and user experience. Int J Ind Ergon. 2021;84:103160.
- Yamin PAR, Park J, Kim HK, Hussain M. Effects of button colour and background on augmented reality interfaces. Behav Inf Technol. 2023;43:663–676.
- Deng L, Zhang ZR, Zhou FY, Liu RY. Effects of app icon border form and interface background color saturation. Adv Multimed. 2022;2022:1166656.
- Weingerl P, Hladnik A, Javoršek D. Machine learning model for extracting image prominent colors. Color Res Appl. 2020;45:409–426.
- Huang K, et al. WovenProbe: Probing possibilities for on-skin systems. In: Proc ACM Des Interact Syst Conf; 2021; p. 1193–1207.
- Dewez D, Guillemot C, Bailly G, Isenberg T. Dual body representations during an isomorphic 3D manipulation. IEEE Trans Vis Comput Graph. 2022;28:2047–2057.
- Kim J, Kim C, Nam KY. ThinkWrite: Design interventions for online petition deliberation. In: Proc CHI Conf Hum Factors Comput Syst Ext Abstr; 2022.
- Gao L, Wang Y, Müller S, Hudson SE. DataLev: Mid-air data physicalisation using acoustic levitation. In: Proc CHI Conf Hum Factors Comput Syst; 2023; p. 1–14.
- Khorsandi PM, Ogata M, Rekimoto J, Inami M. FabriCar: In-car media interactions using e-textile sensors. In: Proc ACM Des Interact Syst Conf; 2023; p. 764–776.
- Zhang Z, Ding Y, Huang C. Automatic front-end code generation via multi-head attention. In: Proc Int Conf Comput Eng Appl; 2023; p. 869–872.
- Jain V, et al. Sketch2code: Transformation of sketches to UI using deep neural network [preprint]. arXiv:1910.08930; 2019.
- Chai Y, et al. Dynamic prototype network for few-shot malware detection. IEEE Trans Knowl Data Eng. 2023;35:4754–4766.
- Qiu J, et al. AI security in 5G networks: Adversarial examples. IEEE Veh Technol Mag. 2020;15:95–100.
- Qiu J, et al. Automatic concept extraction from big data in smart city. IEEE Trans Comput Soc Syst. 2020;7:225–233.
- Xie M. UI2CODE: Computer vision-based reverse engineering of UI design [Internet]. GitHub; 2021. Available from: https://github.com
- Wang C, Bochkovskiy A, Liao HYM. CSPNet: Backbone enhancing learning capability of CNNs. In: Proc IEEE Conf Comput Vis Pattern Recognit Workshops; 2020; p. 1571–1580.
- Hui M, et al. Unifying layout generation with decoupled diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18434–18443.
- Wang Y, et al. Dolfin: Diffusion layout transformers without autoencoder. In: Proc Eur Conf Comput Vis; 2024; p. 513–530.
- Sobolevsky A, et al. GuiLGet: GUI layout generation with transformer [preprint]. arXiv:2304.09012; 2023.
- Lu Y, et al. UI layout generation with LLMs guided by UI grammar [preprint]. arXiv:2310.15455; 2023.
- Leiva LA, Hota A, Oulasvirta A. ENRICO: A dataset for mobile UI design modeling. In: Proc Int Conf Hum Comput Interact Mobile Devices Serv; 2020.
- Li G, et al. Learning to denoise mobile UI layouts. In: Proc CHI Conf Hum Factors Comput Syst; 2022; p. 1–15.
- Beltramelli T. pix2code: Generating code from a GUI screenshot. In: Proc ACM SIGCHI Symp Eng Interact Comput Syst; 2018.
- Zheng G, et al. LayoutDiffusion: Controllable diffusion model. In: Proc IEEE Conf Comput Vis Pattern Recognit; 2023; p. 18424–18433.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.