W niniejszym badaniu oceniono, czy interwencje w zakresie stylu życia oraz pielęgniarstwa onkologicznego w ginekologii poprawiają jakość życia kobiet z nowotworami ginekologicznymi. Istotną poprawę zaobserwowano jedynie w podgrupie pacjentek z rakiem jajnika po 6 miesiącach, podczas gdy ogólne dowody pozostały bardzo niepewne ze względu na znaczną heterogenność, niewielką liczebność podgrup oraz ograniczenia metodologiczne.
Artykuł badawczy
Metaanaliza wpływu interwencji pielęgniarskich w zakresie stylu życia i ginekologii onkologicznej na poprawę jakości życia
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
W niniejszej metaanalizie oceniono wpływ interwencji związanych ze stylem życia oraz pielęgniarstwem w onkologii ginekologicznej na jakość życia (QoL). Systematyczne przeszukiwanie baz danych przeprowadzone do czerwca 2026 roku pozwoliło zidentyfikować 1123 rekordy. Do analizy włączono trzynaście randomizowanych badań kontrolowanych z udziałem 915 kobiet z nowotworami ginekologicznymi. Wpływ interwencji w zakresie stylu życia i pielęgniarstwa onkologii ginekologicznej na QoL oceniono przy użyciu połączonych różnic średnich (MD) z 95% przedziałami ufności, stosując modele efektów losowych dla analiz ogólnych oraz modele efektów stałych dla analiz podgrup specyficznych dla danego nowotworu. W porównaniu z grupami kontrolnymi, interwencje znacząco poprawiły QoL u kobiet z rakiem jajnika (MD 4,28, 95% CI: 0,45–8,10, p = 0,03; I2 = 0%). Nie stwierdzono istotnych różnic w QoL po 6 miesiącach w grupie mieszanej nowotworów (MD 2,11, 95% CI: -0,90–5,12, p = 0,17; I2 = 71%), raka endometrium po 6 miesiącach (MD 2,00, 95% CI: –1,49–5,49, p = 0,26; I2 = 0%) ani w grupie mieszanej nowotworów po 3 miesiącach (MD 6,43, 95% CI: –0,16–13,01, p = 0,06; I2 = 74%). Jednakże wyraźna heterogeniczność, zróżnicowanie planów badań i interwencji, małe liczebności prób oraz zmienne ryzyko błędu ograniczają pewność wyników, co uzasadnia ostrożną interpretację i konieczność potwierdzenia w rzetelnych, zestandaryzowanych badaniach. Interwencje w zakresie stylu życia i pielęgniarstwa onkologii ginekologicznej znacząco poprawiły QoL wyłącznie u kobiet z rakiem jajnika po 6 miesiącach. Niemniej jednak znaczna heterogeniczność, ograniczenia metodologiczne oraz dowody o bardzo niskiej pewności nakazują ostrożną interpretację, a niezbędne jest przeprowadzenie większych, zestandaryzowanych badań.
Wprowadzenie
Nowotwory wywodzące się z żeńskich narządów rozrodczych określa się mianem nowotworów ginekologicznych. Nowotwory ginekologiczne, obejmujące złośliwe zmiany szyjki macicy, jajników, macicy, pochwy i sromu, pozostają istotnym problemem zdrowia publicznego, dotykając miliony kobiet na całym świecie1. Guzy te są nie tylko niszczące pod względem fizycznym, ale powodują również znaczny stres emocjonalny i psychiczny. Mimo postępów w leczeniu, globalna częstość występowania tych nowotworów rośnie, a ogólne rokowania w wielu regionach pozostają niekorzystne, szczególnie tam, gdzie dostęp do opieki zdrowotnej jest ograniczony. Badania nad pielęgniarską opieką w onkologii ginekologicznej podkreślają potrzebę stosowania kompleksowych, interdyscyplinarnych strategii w prowadzeniu pacjentek, biorąc pod uwagę znaczący wpływ tych nowotworów na jakość życia kobiet2. Z kolei skuteczne interwencje pielęgniarskie wykraczają poza opanowanie objawów fizycznych, takich jak ból i nudności; obejmują one również wsparcie emocjonalne, poradnictwo psychologiczne, edukację pacjentek oraz kompleksowe zarządzanie objawami. Interwencje te są kluczowe dla poprawy wyników leczenia, pomagają kobietom odnaleźć się w zawiłościach protokołów terapeutycznych i zapewniają opiekę holistyczną.
Rola interwencji pielęgniarskich w jakości życia wymaga dalszych badań, szczególnie w zakresie tego, jak różne aspekty opieki pielęgniarskiej wpływają na dobrostan fizyczny, emocjonalny i psychiczny w różnych grupach demograficznych pacjentów3. Skuteczna opieka pielęgniarska nad pacjentami z nowotworami może poprawić ich ogólny stan zdrowia. Pielęgniarstwo w onkologii ginekologicznej jest specjalistyczną dyscypliną pielęgniarską skoncentrowaną na zapewnieniu kompleksowego wsparcia kobietom zdiagnozowanym pod kątem nowotworów ginekologicznych. Nowotwory ginekologiczne obejmują guzy komórek granulozy, czerniaka dróg rodnych, raka szyjki macicy kwalifikującego się do operacji oszczędzającej płodność oraz raka endometrium4. Częstość występowania raka szyjki macicy w Europie spadła, jednak nadal stanowi on znaczne wyzwanie dla zdrowia publicznego. Potwierdzają to statystyki z 2018 roku, wskazujące na 61 000 nowych przypadków i 25 800 zgonów. Wyniki dotyczące przeżywalności wykazują nierówności regionalne, przy czym pięcioletnia względna przeżywalność w latach 2000–2007 wynosiła 62%, wahając się od 57% w Europie Wschodniej do 67% w Europie Północnej.
Rak szyjki macicy pozostaje poważnym problemem zdrowotnym na świecie, pomimo postępów w profilaktyce i leczeniu. Nierówności te podkreślają potrzebę ukierunkowanych interwencji pielęgniarskich w celu poprawy wyników leczenia pacjentek i przeciwdziałania nierównościom w opiece w różnych warunkach. Inne nowotwory ginekologiczne, takie jak guzy jajnika, macicy i sromu, stanowią znaczne wyzwania zdrowotne. Rak jajnika jest główną przyczyną zgonów z powodu nowotworów ginekologicznych na świecie, z ponad 300 000 nowych przypadków i 185 000 zgonów rocznie. Wskaźniki przeżywalności w przypadku nowotworów jajnika i macicy są zazwyczaj wyższe niż w przypadku raka szyjki macicy; niemniej jednak utrzymują się znaczące różnice między krajami i regionami. Podobnie jak w przypadku raka szyjki macicy, dysproporcje te wynikają z dostępności opieki zdrowotnej, metod wczesnego wykrywania oraz dostępnych opcji leczenia. Ukierunkowane interwencje pielęgniarskie w przypadku tych nowotworów są niezbędne do poprawy wyników leczenia i zwiększenia jakości życia kobiet na całym świecie5.
Pielęgniarki onkologiczne w ginekologii zapewniają holistyczną, skoncentrowaną na pacjencie opiekę, która wykracza poza wsparcie emocjonalne. Oprócz udzielania wsparcia emocjonalnego, ułatwiają one planowanie leczenia, reprezentują potrzeby pacjentek i prowadzą je przez proces terapii. Skuteczne terapie obejmują łagodzenie objawów, w tym uśmierzanie bólu, redukcję zmęczenia i kontrolę nudności, terapię psychologiczną oraz programy edukacyjne dla pacjentek, które poprawiają wyniki zarówno emocjonalne, jak i fizyczne6. Strategie leczenia wielodyscyplinarnego, łączące wsparcie psychologiczne z fizjoterapią, okazały się szczególnie korzystne w poprawie jakości życia. W konsekwencji pielęgniarki onkologiczne w ginekologii odgrywają kluczową rolę w zarządzaniu objawami, edukacji pacjentek i kompleksowym leczeniu, co przyczynia się do poprawy wyników terapeutycznych6. Ta specjalistyczna opieka pielęgniarska obejmuje podawanie chemioterapii, monitorowanie i interpretację parametrów życiowych, analizę odpowiedzi na leczenie oraz zapewnianie kompleksowego wsparcia, co wymaga szczególnego przeszkolenia i umiejętności w zakresie pielęgniarstwa onkologicznego7.
Opieka pielęgniarska znacząco poprawia dobrostan osób w różnych środowiskach opieki zdrowotnej. Szpitale zapewniają leczenie, monitorują stan pacjentów i współpracują z zespołem medycznym. Pielęgniarki w ośrodkach opieki domowej zapewniają ciągłe wsparcie, nadzorują przebieg chorób przewlekłych i pomagają pacjentom w zachowaniu niezależności8. Jakość życia obejmuje dobrostan fizyczny, psychiczny, emocjonalny i społeczny. Opieka pielęgniarska jest kluczowa w poprawie tych aspektów poprzez specyficzne interwencje. Ciągła opieka nad pacjentami z chorobami przewlekłymi obejmuje monitorowanie parametrów życiowych, podawanie leków oraz instruktaż w zakresie technik samokontroli8. Interwencje pielęgniarskie te skutecznie pomagają w zarządzaniu chorobami przewlekłymi, łagodząc objawy i poprawiając zdrowie fizyczne, co w konsekwencji zwiększa ogólną jakość życia.
Nowotwory ginekologiczne stanowią istotny problem zdrowia publicznego dla kobiet na całym świecie, z ponad 1 milionem diagnoz rocznie, co prowadzi do znacznych upośledzeń fizycznych i zaburzeń psychospołecznych, obniżając tym samym jakość życia9. Badania wskazują, że nawet 40% kobiet zdiagnozowanych z nowotworami ginekologicznymi doświadcza znacznego cierpienia psychicznego, podczas gdy 60% wskazuje na pogorszenie jakości życia związanej ze zdrowiem podczas leczenia (Global Cancer Statistics and Reports)10. Smits i wsp. nie stwierdzili istotnych efektów po podobnych terapiach, co podkreśla znaczenie zaangażowania uczestników i jakości wdrożenia w określaniu wyników11. Badanie to podkreśla krytyczną rolę pielęgniarek w zapobieganiu chorobom, promowaniu zdrowego stylu życia oraz zaspokajaniu fizycznych i emocjonalnych potrzeb pacjentek.
Niniejsze badanie ma na celu ocenę wpływu interwencji związanych ze stylem życia oraz opieki pielęgniarskiej w zakresie onkologii ginekologicznej na poprawę jakości życia kobiet z rozdiagnowanymi nowotworami ginekologicznymi, z wykorzystaniem przeglądu systematycznego i metaanalizy. Celem badania jest ocena wpływu konkretnych interwencji w zakresie stylu życia oraz opieki pielęgniarskiej onkologii ginekologicznej na kluczowe aspekty jakości życia, w tym dobrostan fizyczny, emocjonalny i społeczny. Skupienie się na znormalizowanych pomiarach jakości życia i ściśle określonych strategiach interwencyjnych zapewnia praktyczne dane na temat skuteczności tych metod. Badanie to analizuje w szczególności krótkoterminowe efekty (w ciągu sześciu miesięcy) intensywnej psychologicznej opieki pielęgniarskiej w zakresie dobrostanu emocjonalnego i społecznego. Ta ukierunkowana metodologia pozwala na kompleksową analizę wpływu konkretnych interwencji na wyniki jakości życia i dostarcza dowodów służących do opracowania spersonalizowanych strategii opieki.
Poprzednie przeglądy systematyczne, w tym opracowanie Smits i wsp.11, oceniały głównie interwencje związane ze stylem życia u kobiet z rakiem endometrium i jajnika i obejmowały stosunkowo niewielką liczbę badań. Od tego czasu pojawiły się dodatkowe dowody, a żaden przegląd systematyczny nie ocenił w sposób kompleksowy zarówno interwencji stylu życia, jak i opieki pielęgniarskiej w onkologii ginekologicznej w odniesieniu do szerszego zakresu nowotworów ginekologicznych. Dlatego celem niniejszego przeglądu systematycznego i metaanalizy była synteza aktualnych dowodów dotyczących wpływu tych interwencji na jakość życia.
Protokół
Kryteria kwalifikacji
Badania kwalifikowały się do analizy, jeśli spełniały wszystkie następujące kryteria: (1) obejmowały kobiety z dowolnym nowotworem ginekologicznym; (2) oceniały określoną interwencję w zakresie stylu życia lub interwencję prowadzoną przez pielęgniarki; (3) raportowały ilościowe dane dotyczące jakości życia; (4) były badaniami porównawczymi (interwencja vs. kontrola) lub obserwacyjnymi badaniami trajektorii, które dostarczały odpowiednich opisowych danych o jakości życia; (5) zostały opublikowane w języku angielskim. Do ilościowej metaanalizy interwencji w porównaniu z grupą kontrolną wymagana była jednoczesna grupa porównawcza12. Dwa badania bez grupy porównawczej zachowano wyłącznie do syntezy opisowej13. Nie zastosowano ograniczeń geograficznych.
Źródła informacji
Pełny proces wyboru badań przedstawiono na Rysunku 1 w formie diagramu przepływu PRISMA. Przeszukiwanie baz danych Cochrane Library, Embase, Google Scholar, OVID i PubMed przeprowadzono od momentu ich utworzenia do czerwca 2026 roku. Pobrane rekordy zaimportowano do programu EndNote 20, a następnie usunięto duplikaty. Dwóch recenzentów niezależnie oceniło tytuły i streszczenia, po czym przeprowadzono analizę pełnych tekstów potencjalnie kwalifikujących się badań. Rozbieżności rozstrzygano w drodze dyskusji. Zgodnie z wcześniej określonymi kryteriami kwalifikacji, do analizy uwzględniono wyłącznie publikacje w języku angielskim.
Strategia wyszukiwania
Strategię wyszukiwania opracowano w oparciu o schemat PICOS: Populacja — kobiety z nowotworami ginekologicznymi; Interwencja — interwencje związane ze stylem życia lub pielęgniarskie; Porównanie — standardowa opieka lub alternatywne interwencje; Wynik — jakość życia; Projekt badania — brak ograniczeń14. We wszystkich bazach danych zastosowano kompleksowy zestaw słów kluczowych i terminów ze słowników kontrolowanych; szczegółowe zapytania wyszukiwania dla każdej bazy danych przedstawiono w Tabeli 113.
Proces selekcji
Po pobraniu pełnych tekstów dwóch recenzentów niezależnie zweryfikowało, czy każdy raport spełnia wszystkie kryteria kwalifikacji. Dodatkowo sprawdzono listy autorów, nazwy badań (np. SUCCEED, WALC, BENITA, TOPCAT‑G), okresy rekrutacji oraz ośrodki badawcze w celu zidentyfikowania nakładających się kohort pacjentów. Potencjalnie nakładające się kohorty pacjentów zostały zidentyfikowane i udokumentowane. W przypadkach, gdy nakładające się raporty włączono do analizy głównej, ich wpływ oceniono w zaplanowanej analizie wrażliwości, w której wykluczono nakładający się zestaw danych.
Ekstrakcja danych i miary wyników
Dwoje recenzentów niezależnie wyekstrahowało dane ze wszystkich 15 włączonych raportów, korzystając ze zestandaryzowanego, przetestowanego formularza ekstrakcji danych. Rozbieżności rozstrzygano drogą konsensusu z autorem korespondencyjnym. Dla każdego badania zapisano następujące informacje: pierwszy autor, rok publikacji, kraj, projekt badania, typ nowotworu, opis interwencji, opis komparatora, wielkość próby w grupie, wiek uczestników i stopień zaawansowania choroby, narzędzie do oceny jakości życia (QoL), oceniane punkty czasowe oraz wszystkie numeryczne dane QoL (średnie, miary rozproszenia i wielkość próby w każdym ramieniu)15.
Kwantytatywne łączenie danych (13 badań porównawczych)
W celu przeprowadzenia metaanalizy porównującej grupę interwencyjną z kontrolną, końcowe wyniki po interwencji (średnie i odchylenia standardowe) zostały pobrane dla obu grup w określonych wcześniej punktach czasowych (3 i 6 miesięcy). W przypadku badań, w których raportowano zarówno wyniki końcowe, jak i zmiany wyników, pobrano jedynie wyniki końcowe16. Podejście metodologiczne do metaanalizy oraz ocena jakości badań opierały się na uznanych wytycznych Cochrane17. Przy wyborze modelu metaanalitycznego uwzględniono przewidywaną heterogeniczność kliniczną i metodologiczną między badaniami18, a heterogeniczność statystyczną określono za pomocą statystyki I2 zgodnie z opisem Higginsa i wsp.19. 13 badań porównawczych włączonych do syntezy ilościowej zostało zestawionych w Tabeli 220,21,22,23,24,25,26,27,28,29,30,31,32.
Mierniki wyników jakości życia, dopasowanie i metryka efektu
Odnotowano konkretne narzędzie do oceny jakości życia (QoL) wykorzystane w każdym badaniu. Zidentyfikowane skale obejmowały Functional Assessment of Cancer Therapy – General (FACT‑G), FACT‑Ovarian (FACT‑O), FACT‑Endometrial (FACT‑En), kwestionariusz Core 30 Europejskiej Organizacji ds. Badań i Leczenia Nowotworów (EORTC QLQ‑C30), Short Form‑36 (SF‑36) oraz skale specyficzne dla danej jednostki chorobowej. We wszystkich instrumentach wyższe wyniki wskazywały na lepszą jakość życia i nie uwzględniono narzędzi z odwróconą skalą punktową. Wszystkie wyekstrahowane dane dotyczące QoL zostały zatem sprowadzone do tej samej miary, przy czym dodatnia różnica średnich (MD) konsekwentnie przemawiała na korzyść grupy interwencyjnej.
W głównej metaanalizie wyodrębniono końcowe wyniki po interwencji, a nie wyniki zmiany względem poziomu bazowego. Decyzja ta była oparta na następujących przesłankach: (i) nie wszystkie badania raportowały wyniki zmiany lub ich odchylenia standardowe; (ii) wyniki końcowe odzwierciedlają bezwzględny stan jakości życia (QoL) po leczeniu, co jest istotne klinicznie; oraz (iii) zastosowanie wyników końcowych maksymalizowało liczbę badań, które można było połączyć. W przypadku, gdy badanie raportowało wiele podskal QoL, jako główny punkt końcowy priorytetowo traktowano globalny wynik QoL lub całkowity wynik FACT-G; w razie ich braku stosowano podskalę funkcjonowania fizycznego, co zostało wyraźnie zaznaczone w przypisach w Tabeli 2.
Jako miarę efektu zastosowano surową różnicę średnich (MD) zamiast standaryzowanej różnicy średnich (SMD), ponieważ wszystkie uwzględnione instrumenty są zwalidowane do pomiaru tego samego konstruktu podstawowego—jakości życia związanej ze zdrowiem—na koncepcyjnie podobnych skalach (całkowite wyniki mieszczą się w zakresie 0–100 lub 0–148). MD jest bezpośrednio interpretowalne w oryginalnych jednostkach tych skal i ma większe znaczenie kliniczne niż SMD wyrażone w jednostkach odchylenia standardowego. Nie zastosowano szacunków skorygowanych (np. średnich skorygowanych za pomocą ANCOVA), ponieważ kowarianty korekcyjne znacznie różniły się między badaniami, co naruszałoby porównywalność.
Konwersje odchylenia standardowego
W przypadku badań, w których raportowano błędy standardowe (SE) lub 95% przedziały ufności zamiast odchyleń standardowych, dokonano konwersji na SD przy użyciu standardowych wzorów: SD = SE × √n dla SE oraz SD = √n × (górna granica CI – dolna granica CI) / (2 × 1.96) dla 95% CI. W badaniach prezentujących mediany wraz z rozstępami międzykwartylnymi (IQR) nie imputowano średnich ani SD; takie dane wyodrębniono opisowo i nie uwzględniono ich w zbiorczych obliczeniach MD. W przypadku 13 badań, które weszły w skład syntezy ilościowej, taka imputacja nie była wymagana.
Obsługa brakujących danych
Preferencyjnie wyodrębniano szacunki w analizie intencji leczenia (ITT), gdy były one wyraźnie raportowane, ponieważ zapewniają one najbardziej konserwatywny i nieobciążony szacunek efektu terapeutycznego. W przypadku braku danych ITT, wyodrębniano dane zgodnie z protokołem (per-protocol) lub dane z pełnych przypadków, zgodnie z raportami oryginalnych autorów. Braki w średnich, SD lub wartościach wyników nie były uzupełniane metodą imputacji; braki odnotowano dla każdego badania i uwzględniono w analizie wrażliwości. Odnotowano badania, w których nie podano SD dla kluczowych punktów czasowych, a z autorami korespondencyjnymi skontaktowano się drogą elektroniczną w celu uzyskania brakujących statystyk. Jeśli w ciągu dwóch tygodni nie otrzymano odpowiedzi, wykorzystano najbardziej konserwatywne dostępne dane (np. połączone SD bazowe, jeśli brakowało SD po interwencji) lub wykluczono konkretny punkt czasowy z analizy zbiorczej.
Wieloramienne interwencje i wspólne grupy kontrolne
Żadne z włączonych badań nie przedstawiało więcej niż jednego ramienia interwencji w zakresie stylu życia lub opieki pielęgniarskiej w porównaniu z jedną wspólną grupą kontrolną, co wymagałoby podzielenia próby kontrolnej na potrzeby analizy. W jednym badaniu o modelu faktorialnym (McCloy et al.30) dane wyekstrahowano z połączonego ramienia ćwiczeń i uważności oraz z ramienia kontrolnego opieki standardowej, aby uprościć łączenie danych i uniknąć podwójnego liczenia. W przypadku nakładających się kohort badania SUCCEED (Von Gruenigen et al.21 oraz McCarroll et al.23) oba raporty zachowano w tabeli ekstrakcji. W głównej metaanalizie uwzględniono oba zestawy danych (ponieważ raportowano QoL w tym samym punkcie czasowym). W zaplanowanej analizie wrażliwości wykluczono ten drugi raport, aby ocenić wpływ duplikacji kohorty na oszacowanie zbiorcze; wyniki przedstawiono w tekście.
Nieporównawcze badania obserwacyjne
W przypadku dwóch raportów (Budisan et al.33 oraz Betea et al.34), w których brakowało równoległej grupy kontrolnej, nie wyodrębniono porównawczych danych dotyczących interwencji względem grupy kontrolnej (tj. nie można było obliczyć MD). Zamiast tego wyodrębniono opisowe dane dotyczące trajektorii QoL (zmiany wewnątrzgrupowo w czasie), które przedstawiono opisowo w tekście oraz w Tabeli 2. Nie zostały one uwzględnione w żadnym wykresie leśnym ani w zbiorczej syntezie ilościowej.
Ocena ryzyka błędu
Potencjalną błąd publikacji oraz inne efekty małych badań oceniano zarówno poprzez wizualną inspekcję wykresów lejkowych, jak i test regresji liniowej Eggera (który regresuje standaryzowany efekt interwencji względem jego precyzji). Ponieważ test Eggera ma ograniczoną moc statystyczną przy małej liczbie badań (zazwyczaj <10), wykresy lejkowe i testy Eggera zostały określone a priori i miały być przeprowadzane wyłącznie dla metaanaliz obejmujących 10 lub więcej badań. W przypadku wyników, w których uczestniczyło mniej niż 10 badań, nie podano wykresów lejkowych ani wartości p testu Eggera, ponieważ takie testy mają zbyt małą moc i mogą prowadzić do błędnych wniosków17.
Jakość metodologiczna 15 włączonych raportów została niezależnie oceniona przez dwóch recenzentów, a rozbieżności rozstrzygano w drodze dyskusji z autorami korespondencyjnymi. Ponieważ włączone badania obejmowały zarówno randomizowane badania kontrolowane (RCT; n = 13), jak i nierandomizowane obserwacyjne badania kohortowe (n = 2; Budisan et al.33; Betea et al.34), zastosowano narzędzia specyficzne dla danego projektu badania.
W przypadku RCT (13 badań) zastosowano narzędzie Cochrane RoB 2.0 (wersja zaktualizowana), oceniając każde badanie w pięciu domenach17: (1) proces randomizacji – generowanie sekwencji i maskowanie alokacji; (2) odchylenia od zamierzonych interwencji – maskowanie uczestników i personelu oraz określenie, czy analiza była przeprowadzona zgodnie z zasadą intencji leczenia (intention-to-treat); (3) brakujące dane dotyczące wyników – kompletność obserwacji i sposób postępowania z osobami, które wypadły z badania; (4) pomiar wyniku – maskowanie osób oceniających wyniki (szczególnie istotne w przypadku samoopisowej jakości życia, gdzie maskowanie jest trudniejsze do osiągnięcia, ale nadal brane pod uwagę); (5) wybór raportowanego wyniku – ryzyko selektywnego raportowania wyników (weryfikowane na podstawie rejestrów badań klinicznych lub opublikowanych protokołów, jeśli były dostępne).
Każda domena została oceniona jako niskie ryzyko, pewne zastrzeżenia lub wysokie ryzyko. Następnie dla każdego badania przypisano ogólną ocenę ryzyka błędu systematycznego: niskie (wszystkie domeny niskie), pewne zastrzeżenia (jedna lub więcej domen z pewnymi zastrzeżeniami) lub wysokie (jakakolwiek domena oceniona jako wysokie ryzyko lub wiele domen z pewnymi zastrzeżeniami). W przypadku wyników raportowanych przez pacjentów, takich jak jakość życia, zaślepienie uczestników jest często niewykonalne; w związku z tym brak zaślepienia uczestników nie skutkował automatycznym przypisaniem oceny wysokiego ryzyka. Zamiast tego brak zaślepienia został wyraźnie odnotowany jako potencjalne źródło błędu wykonania w ocenie domeny 2.
W przypadku nierandomizowanych obserwacyjnych badań kohortowych (2 badania), Budisan i wsp.33 oraz Betea i wsp.34 nie uwzględnili jednoczesnej grupy porównawczej, w związku z czym nie zostały one włączone do ilościowej metaanalizy. W badaniach tych, w celu oceny doboru próby, porównywalności (nie dotyczy ze względu na brak grupy porównawczej) oraz ustalenia wyników, zastosowano skalę Newcastle-Ottawa (NOS) dostosowaną do badań kohortowych. Jednakże z powodu braku ramienia kontrolnego uznano je za obarczone wysokim ryzykiem czynników zakłócających i błędu selekcji w przypadku jakichkolwiek wniosków przyczynowych. Zachowano je wyłącznie do celów opisowych; ich profile ryzyka błędu nie wpływają na zbiorcze szacunki efektu, lecz są udokumentowane w Tabeli 2.
Podsumowanie ryzyka błędu systematycznego
Stworzono zbiorczy schemat ryzyka błędu systematycznego (wykres sygnalizacji świetlnej), prezentujący oceny na poziomie poszczególnych domen dla każdego badania RCT. W skrócie, najczęstsze zastrzeżenia w badaniach RCT dotyczyły: (i) braku zaślepienia uczestników i personelu w odniesieniu do interwencji związanych ze stylem życia (domena 2 – niektóre obawy/wysokie ryzyko w 9 z 13 badań) oraz (ii) niepełne dane dotyczące wyników z powodu utraty uczestników (domena 3 – niektóre zastrzeżenia w 4 badaniach). Żadne badanie nie zostało ocenione jako niskie ryzyko we wszystkich domenach; większość (8/13) wykazała pewne wątpliwości, a 5/13 oceniono wysokie ryzyko ogólnie, głównie ze względu na brak ślepej próby oraz małe wielkości próby, co prowadzi do niskiej precyzji.
Pewność dowodów (GRADE)
Ogólną pewność zbioru dowodów dla każdego z połączonych wyników oceniono przy użyciu metodyka Grading of Recommendations Assessment, Development and Evaluation (GRADE), zgodnie z Podręcznikiem GRADE i przy użyciu oprogramowania GRADEpro GDT. Pewność oceniono jako wysoki, umiarkowany, niski, lub bardzo niski w pięciu obszarach: ryzyka błędu systematycznego, niespójności, pośredniości, nieprecyzyjności oraz błędu publikacji. Oceniare wyniki obejmują (1) jakość życia (QoL) po 6 miesiącach – ogólna onkologia ginekologiczna (połączone MD z 9 badań porównawczych); (2) QoL po 6 miesiącach – rak jajnika (połączona MD z 2 badań porównawczych); (3) jakość życia w 6. miesiącu – rak endometrium (połączona Różnica Średnich z 4 badań porównawczych, w tym nakładających się kohort SUCCEED); (4) jakość życia w 3. miesiącu – ogólna onkologia ginekologiczna (połączone MD z 6 badań porównawczych).
Miara efektu i model meta-analizy
Do ogólnych analiz za okres 6 miesięcy i 3 miesięcy zastosowano modele odwrotnej wariancji z efektami losowymi, ponieważ przewidywano znaczną heterogeniczność kliniczną i metodologiczną między badaniami, w tym różnice w typach nowotworów, komponentach interwencji, jej intensywności, czasie trwania oraz warunkach kontrolnych18. Modele odwrotnej wariancji z efektami stałymi zastosowano w analizach podgrup raka jajnika i endometrium, dla których nie zaobserwowano heterogeniczności statystycznej (I2 = 0%). Heterogeniczność oceniano przy użyciu statystyki I219.
Heterogeniczność została określona ilościowo przy użyciu statystyki I²2 statystyka, w której progi 25%, 50% i 75% reprezentują odpowiednio niską, umiarkowaną i wysoką heterogeniczność. Dodatkowo I2, τ2 zgłoszono dla analiz z efektami losowymi w celu określenia bezwzględnej wielkości wariancji międzybadaniowej. Wszystkie analizy przeprowadzono przy użyciu meta i metafor pakiety w programie R (wersja 4.3.1).
Uzasadnienie łączenia próbek pomimo znacznej heterogeniczności oraz sposób postępowania z heterogenicznością
W przypadku głównej analizy 6-miesięcznej wartość I2 = 71% wskazywała na znaczną heterogeniczność. Uznano, że pooling jest odpowiedni w ramach modelu efektów losowych z następujących powodów: (i) połączona estymacja reprezentuje średni efekt w różnych interwencjach i populacjach, co stanowi zasadne pytanie podsumowujące; (ii) model efektów losowych w sposób jawny włącza wariancję międzybadawczą (τ2) do błędu standardowego, co zmniejsza ryzyko błędnego uzyskania zbyt wąskich przedziałów ufności; (iii) przeprowadzono wcześniej określone analizy podgrup według typu nowotworu (jajnika, błony śluzowej trzonu macicy), aby wyjaśnić kliniczne źródła heterogeniczności; (iv) wykonano analizy wpływu i wrażliwości w celu oceny odporności połączonej estymacji.
Decyzja o łączeniu badań pomimo znacznej heterogeniczności statystycznej była podyktowana następującymi zasadami: interpretacja I2 — wartości I2 wynoszące 25%, 50% i 75% zostały uprzednio określone jako reprezentujące odpowiednio niską, umiarkowaną i wysoką heterogeniczność. Wartość I2 przekraczająca 75% wskazuje na znaczną heterogeniczność, co może sprawić, że łączenie danych będzie niewłaściwe, jeśli heterogeniczność ta nie może zostać w sposób znaczący wyjaśniona czynnikami klinicznymi lub metodologicznymi. Dla głównej ogólnej analizy 6-miesięcznej (I2 = 71%) zaplanowano analizy w podgrupach według rodzaju nowotworu (jajnika, endometrium), aby zbadać kliniczne źródła heterogeniczności. Podział na podgrupy znacznie zredukował I2 do 0% zarówno w podgrupie raka jajnika, jak i endometrium, co sugeruje, że główna część ogólnej heterogeniczności wynika z różnic w typie nowotworu i związanych z nimi celach interwencji. Jednak ze względu na to, że podgrupy te obejmują bardzo niewiele badań, nie można z całą pewnością stwierdzić, że heterogeniczność została w pełni wyjaśniona.
Przystąpienie do łączenia danych uznano za uzasadnione dla ogólnej analizy 6-miesięcznej, ponieważ: (i) pozwala to na uzyskanie średniego efektu podsumowującego dla szerokiego zakresu interwencji, co stanowi dopuszczalne pytanie w analizie metaanalitycznej; (ii) wartość τ2 została wyraźnie podana w celu ilościowego określenia wariancji między badaniami; (iii) przeprowadzono analizy wpływu, aby sprawdzić, czy wyniki nie są determinowane przez wartości odstające; oraz (iv) połączona ocena nie jest traktowana jako rozstrzygająca lub klinicznie wdrożeniowa — jest ona interpretowana jako generująca hipotezy i jest objęta licznymi zastrzeżeniami w dyskusji.
Zgodnie z podręcznikiem Cochrane, gdy I2 przekracza 75%, a analizy podgrup nie wyjaśniają w sposób przekonujący heterogeniczności, oszacowania zbiorcze należy interpretować z najwyższą ostrożnością. Ze względu na niewielką liczbę badań w podgrupach nie można z pewnością stwierdzić, że heterogeniczność została w pełni wyjaśniona. W związku z tym główny szacunek zbiorczy jest przedstawiony przede wszystkim w celach opisowych i eksploracyjnych i nie stanowi podstawy do zaleceń klinicznych. Wszystkie statystyki heterogeniczności (I2, τ2) oraz analizy wrażliwości są raportowane w sposób przejrzysty, co pozwala czytelnikom na ocenę stabilności samych oszacowań.
Analizy podgrup, analizy wrażliwości oraz analizy wpływu
W celu zbadania źródeł heterogeniczności przeprowadzono następujące z góry określone analizy, bez przeprowadzania metaregresji: 1) W ramach analizy podgrup ogólny wynik po 6 miesiącach został rozwarstwiony według typu nowotworu (jajnika, endometrium), aby zbadać, czy efekt różnił się w zależności od lokalizacji guza; 2) Analiza wrażliwości (nakładające się kohorty): Aby ocenić wpływ nakładających się kohort badania SUCCEED (Von Gruenigen i wsp.21 oraz McCarroll i wsp.23), powtórzono analizę podgrupy z nowotworem endometrium, wykluczając badanie McCarroll i wsp.23. 3) Analiza wpływu metodą leave-one-out: Każde badanie usuwano sekwencyjnie, a następnie ponownie obliczano łączną MD oraz I2 dla ogólnego wyniku po 6 miesiącach, aby zidentyfikować, czy pojedyncze badanie w nieproporcjonalny sposób wpływało na wyniki lub heterogeniczność; 4) Porównanie z modelem efektów stałych: Dla kompletności obliczono również szacunki łączone przy użyciu modelu efektów stałych (ważenie odwrotnością wariancji), aby porównać je z wynikami modelu efektów losowych; każda istotna rozbieżność wskazywałaby, że heterogeniczność międzybadaniowa w znaczący sposób wpływa na szacunki.
Nie przeprowadzono meta-regresji w celu zbadania ciągłych współzmiennych (np. wieku, wyjściowej jakości życia, czasu trwania interwencji), ponieważ liczba badań w każdej podgrupie (≤(9 dla ogólnego wyniku po 6 miesiącach) jest niewystarczająca, aby uzyskać wiarygodne współczynniki regresji. Z <przy 10 badaniach na jedną zmienną towarzyszącą meta-regresja ma bardzo niską moc statystyczną i jest podatna na błędy I rodzaju, a dostępne dane dotyczące zmiennych towarzyszących były raportowane niespójnie w różnych badaniach.
Błąd publikacji
Żaden z połączonych wyników nie obejmował 10 lub więcej badań. W związku z tym nie wykonano wykresów lejkowych ani testów regresji Eggera, ponieważ oceny te miałyby zbyt niską moc statystyczną i mogłyby być potencjalnie mylące, biorąc pod uwagę liczbę dostępnych badań.
Wyniki
Wybór badań
Systematyczny przegląd literatury w bazach PubMed, Embase, Cochrane Library, Ovid oraz Google Scholar przeprowadzony do czerwca 2026 roku pozwolił na zidentyfikowanie 1123 rekordów. Po usunięciu 897 duplikatów, 226 rekordów poddano analizie tytułów i streszczeń. Z tej liczby 124 rekordy zostały odrzucone na podstawie kryteriów kwalifikowalności. Pełną analizę tekstu przeprowadzono dla 102 raportów, z których 89 wykluczono z przyczyn udokumentowanych w schemacie PRISMA (Rycina 1; Plik uzupełniający 1). Ostatecznie 15 raportów spełniło kryteria włączenia i zostało uwzględnionych w przeglądzie systematycznym, w tym 13 porównawczych randomizowanych badań kontrolowanych oraz 2 nieporównawczych badań obserwacyjnych. Trzynaście randomizowanych badań kontrolowanych dostarczyło danych porównawczych między grupą interwencyjną a kontrolną, które można było wyekstrahować do ilościowej metaanalizy, natomiast dwa badania obserwacyjne zachowano wyłącznie do syntezy opisowej20,21,22,23,24,25,26,27,28,29,30,31,32.
Rysunek 1 przedstawia schemat blokowy PRISMA 2020 szczegółowo opisujący proces przesiewowy i selekcję. 13 randomizowanych badań kontrolowanych dostarczyło danych umożliwiających wyodrębnienie wyników dla grupy interwencyjnej w porównaniu z grupą kontrolną na potrzeby ilościowej metaanalizy20,21,22,23,24,25,26,27,28,29,30,31,32.
Charakterystyka badania
Charakterystyka 15 włączonych raportów została podsumowana w Tabeli 2. Trzynaście porównawczych badań RCT dostarczyło danych do syntezy ilościowej, natomiast dwa badania obserwacyjne zostały zachowane wyłącznie do syntezy narracyjnej. W 13 porównawczych badaniach RCT wzięło udział 915 kobiet, z czego zgodnie z pierwotnymi raportami 468 uczestniczek przydzielono do grup interwencji związanych ze stylem życia lub pielęgnacyjnej, a 447 do grup kontrolnych.
W przypadku ilościowych metaanaliz, 13 porównawczych badań RCT objęło 915 uczestników (468 w grupie interwencyjnej, 447 w grupie kontrolnej). Uwzględnione badania RCT zostały opublikowane w latach 2009–2025 i przeprowadzono je w wielu krajach, w tym w Stanach Zjednoczonych, Danii, Wielkiej Brytanii, Chinach, Egipcie i Rumunii. Typy nowotworów obejmowały raka jajnika (2 badania), raka endometrium (4 badania) oraz mieszane nowotwory ginekologiczne (7 badań). Interwencje były bardzo zróżnicowane i obejmowały: ustrukturyzowane programy ćwiczeń, modyfikację diety, poradnictwo w zakresie utraty masy ciała, sesje psychoedukacyjne, opiekę pooperacyjną prowadzoną przez pielęgniarki, opiekę inicjowaną przez pacjenta, uważność (mindfulness) za pomocą aplikacji oraz złożone interwencje związane ze stylem życia. Okres obserwacji trwał od 3 do 6 miesięcy.
Narzędzia do oceny jakości życia obejmowały: Functional Assessment of Cancer Therapy–General (FACT-G), FACT-Ovarian (FACT-O), FACT-Endometrial (FACT-En), European Organization for Research and Treatment of Cancer Quality of Life Questionnaire Core 30 (EORTC QLQ-C30), Short Form-36 (SF-36) oraz skale specyficzne dla danej jednostki chorobowej. Wszystkie narzędzia punktowano w taki sposób, aby wyższe wartości wskazywały na lepszą jakość życia.
Ocena ryzyka błędu systematycznego
Ryzyko błędu systematycznego (risk of bias) oceniono przy użyciu narzędzia Cochrane RoB 2.0 dla 13 badań RCT oraz skali Newcastle-Ottawa dla 2 obserwacyjnych badań kohortowych. Podsumowanie ocen na poziomie poszczególnych domen przedstawiono na wykresie sygnalizacyjnym (traffic-light plot) ryzyka błędu systematycznego. W przypadku badań RCT najczęstsze zastrzeżenia metodologiczne dotyczyły: (1) Domeny 2 (Odchylenia od zamierzonych interwencji): zaślepienie uczestników i personelu w odniesieniu do interwencji związanych ze stylem życia nie było możliwe w żadnym badaniu; 9 z 13 badań (69%) oceniono jako wykazujące "pewne zastrzeżenia" lub "wysokie ryzyko" w tej domenie; (2) Domeny 3 (Brakujące dane dotyczące wyników): w czterech badaniach (31%) dane dotyczące wyników były niepełne ze względu na wskaźnik ubytków przekraczający 20%, co oceniono jako "pewne zastrzeżenia"; (3) Domeny 1 (Proces randomizacji): w siedmiu badaniach (54%) odpowiednio opisano generowanie sekwencji i ukrywanie alokacji; w pozostałych raportowanie było niejasne lub niewystarczające; (4) Domeny 4 (Pomiar wyniku): we wszystkich badaniach zastosowano zwalidowane narzędzia do samooceny jakości życia (QoL); jednak zaślepienie osób oceniających wyniki nie było raportowane w sposób spójny; (5) Domeny 5 (Wybór raportowanego wyniku): sześć badań (46%) posiadało protokoły zarejestrowane prospektywnie; w pozostałych badaniach brakowało dostępnych protokołów, co budzi obawy dotyczące selektywnego raportowania wyników.
Ogólne oceny ryzyka obciążenia: Żadne badanie nie zostało ocenione jako niskie ryzyko we wszystkich domenach. Osiem badań (62%) oceniono jako budzące "pewne zastrzeżenia" ogólnie, a pięć badań (38%) oceniono jako "wysokie ryzyko" ogólnie, głównie ze względu na brak zaślepienia i małe wielkości próby, co doprowadziło do nieprecyzyjności.
W przypadku dwóch obserwacyjnych badań kohortowych (Budisan et al.33; Betea et al.34), brak jednoczesnej grupy porównawczej spowodował wysokie ryzyko wystąpienia czynników zakłócających oraz błędu selekcji w odniesieniu do wszelkich wniosków przyczynowych. Badania te zachowano wyłącznie do syntezy narracyjnej i nie włączono ich do zbiorczych szacunków efektu.
Główne punkty końcowe
Jakość życia po 6 miesiącach – ogólna onkologia ginekologiczna
Dziewięć porównawczych badań RCT dostarczyło danych w punkcie czasowym 6 miesięcy, obejmując 693 uczestników (358 w grupie interwencyjnej i 335 w grupie kontrolnej). Połączona średnia różnica (MD) obliczona z zastosowaniem modelu efektów losowych nie wykazała statystycznie istotnej poprawy jakości życia w 6. miesiącu w porównaniu z grupą kontrolną (MD = 2.11; 95% CI: –0.90 do 5.12; p = 0.17).
Rysunek 2 przedstawia wykres leśny (forest plot) dla tej analizy. Heterogeniczność była znaczna: I2 = 71%, τ2 = 10.60.
Jakość życia w 6. miesiącu – podgrupa z rakiem jajnika
Dwa badania (Zhou et al.25; Maurer et al.29) dostarczyły danych specyficznych dla raka jajnika, obejmując 124 uczestników (66 w grupie interwencyjnej, 58 w grupie kontrolnej). Połączona MD wskazała na statystycznie istotną poprawę jakości życia na korzyść grupy interwencyjnej (MD 4,28; 95% CI 0,45–8,10; p = 0,03). Rycina 3 przedstawia wykres leśny dla tej analizy. Heterogeniczność była niska: I2 = 0%, τ2 = 0.
Jakość życia po 6 miesiącach – podgrupa z rakiem endometrium
Cztery badania (Von Gruenigen et al.21; McCarroll et al.23; Rossi et al.24; Jeppesen et al.26) dostarczyły danych dotyczących raka endometrium, obejmujących 172 uczestników (92 w grupie interwencyjnej, 80 w grupie kontrolnej). Aby ocenić wpływ nakładających się kohort badania SUCCEED, powtórzono analizę podgrupy raka endometrium, wykluczając badanie McCarroll et al.23. Połączona MD zmieniła się nieznacznie z 2.00 (95% CI: –1.49–5.49) do 1.87 (95% CI: –1.62–5.36), a I2 pozostało na poziomie 0%. Wykluczenie McCarroll et al. nie zmieniło w sposób istotny połączonej oceny; efekt pozostał statystycznie nieistotny, a heterogeniczność nadal nie występowała (I2 = 0%). Rycina 4 przedstawia wykres leśny dla tej analizy. Heterogeniczność była niska: I2 = 0%, τ2 = 0.
Jakość życia po 3 miesiącach – ogólna onkologia ginekologiczna
Sześć badań porównawczych (Von Gruenigen et al.21; Donnelly et al.22; McCarroll et al.23; Maurer et al.29; Elzeblawy Hassan et al.32; McCloy et al.30) zgłosiło wyniki po 3 miesiącach, obejmując 275 uczestników (140 w grupie interwencyjnej i 135 w grupie kontrolnej). Połączona różnica średnich (MD) nie wykazała statystycznie istotnej różnicy między grupą interwencyjną a kontrolną (MD 6.43, 95% CI: −0.16 do 13.01, p = 0.06). Rysunek 5 przedstawia wykres leśny (forest plot) dla tej analizy. Heterogeniczność była znaczna (I2 = 74%, τ2 = 42.53).
Analizy w podgrupach
Przeprowadzono zaplanowane analizy podgrup według typu nowotworu, aby zbadać źródła heterogeniczności. W odniesieniu do ogólnego wyniku w onkologii ginekologicznej po 6 miesiącach: (1) podgrupa raka jajnika (2 badania): I2 = 0%, τ2 = 0; MD 4,28 (95% CI 0,45–8,10); (2) podgrupa raka endometrium (4 badania): I2 = 0%, τ2 = 0; MD 2,00 (95% CI: –1,49–5,49)
Podział na podgrupy według typu nowotworu znacząco zmniejszył heterogeniczność z I2 = 71% w analizie ogólnej do 0% w każdej podgrupie. Jednak mała liczba badań w każdej podgrupie (odpowiednio 2 i 4) ogranicza precyzję tych szacunków dla poszczególnych podgrup.
Nie przeprowadzono formalnych testów interakcji pomiędzy podgrupami, ponieważ liczba badań w każdej z nich (<10) była niewystarczająca do uzyskania wiarygodnych szacunków interakcji. Pozorne różnice w istotności statystycznej pomiędzy podgrupami raka jajnika i raka endometrium nie powinny być interpretowane jako dowód na zróżnicowane efekty leczenia w zależności od typu nowotworu.
Podobnie, nie przeprowadzono formalnego testu interakcji w czasie pomiędzy wynikami z 3. a 6. miesiąca.
Analizy wrażliwości
Wykluczenie nakładających się kohort
Aby ocenić wpływ nakładających się kohort badania SUCCEED (Von Gruenigen et al.21 oraz McCarroll et al.23), powtórzono analizę podgrupy błony śluzowej endometrium, wykluczając dane McCarroll et al.23.
Połączona różnica średnich (MD) zmieniła się nieznacznie z 2,00 (95% CI: –1,49–5,49) do 1,87 (95% CI: –1,62–5,36), a I2 pozostało na poziomie 0%. Wskazuje to, że powielona kohorta nie wpłynęła w istotny sposób na oszacowanie punktowe ani na wniosek o braku znaczącego efektu.
W przypadku ogólnego wyniku po 6 miesiącach, wykluczenie danych McCarroll et al. zmieniło skumulowaną MD z 2,11 (95% CI: −0,90–5,12) na 2,33 (95% CI: −1,16–5,82), przy czym I2 zmieniła się z 71% do około 72%. Efekt pozostał statystycznie nieistotny, co wskazuje, że wykluczenie nakładającej się kohorty nie zmieniło w sposób istotny ogólnego wniosku.
Analiza wpływu metodą leave-one-out
Sekwencyjne usuwanie poszczególnych badań pozwoliło uzyskać połączone wartości MD w zakresie od około 1,29 do 4,33. Heterogeniczność zazwyczaj pozostawała znacząca po wykluczeniu większości badań; jednak wykluczenie pracy McCorkle i wsp.20 zredukowało I2 do 0%, co wskazuje, że badanie to w znacznym stopniu przyczyniło się do obserwowanej heterogeniczności międzybadawczej. Ogólne wyniki należy zatem interpretować z ostrożnością.
Porównanie modeli efektów stałych
W modelu efektów stałych łączna MD dla ogólnego wyniku po 6 miesiącach wyniosła 3,80 (95% CI: 2,97–4,62), podczas gdy model efektów losowych wykazał MD na poziomie 2,11 (95% CI: −0,90–5,12). Różnica w istotności statystycznej między dwoma modelami wskazuje, że heterogeniczność międzybadaniowa istotnie wpływa na wnioskowanie z połączonych danych. Ze względu na znaczną heterogeniczność (I2 = 71%), szacunek z modelu efektów losowych uznano za bardziej odpowiedni do interpretacji.
Błąd publikacyjny
Żaden z połączonych wyników nie obejmował 10 lub więcej badań. W związku z tym nie wykonano wykresów lejkowych ani testów regresji Eggera, ponieważ oceny te miałyby zbyt niską moc statystyczną i mogłyby być potencjalnie mylące, biorąc pod uwagę liczbę dostępnych badań.
Chociaż ze względu na niewielką liczbę badań nie przeprowadzono formalnej oceny, nie można wykluczyć błędu publikacji oraz selektywnego raportowania. Podczas interpretacji dowodów należy zatem wziąć pod uwagę możliwość, że wyniki negatywne lub nieistotne nie zostały opublikowane.
Dostępność danych
Zbiór danych analizowany w niniejszym badaniu jest dostępny pod adresem 10.5281/zenodo.21777130 (https://doi.org/10.5281/zenodo.21777130).
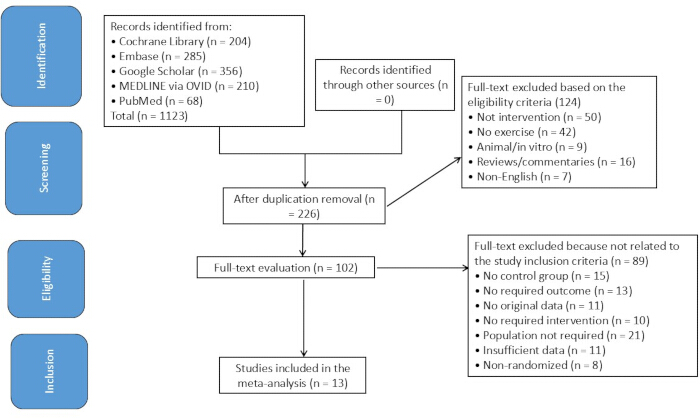
Rysunek 1: Diagram przepływu PRISMA 2020 dla wyboru badań. Schemat blokowy ilustrujący identyfikację, przesiewanie, ocenę kwalifikowalności i włączenie badań oceniających wpływ interwencji pielęgniarskich w zakresie stylu życia i onkologii ginekologicznej na jakość życia kobiet z nowotworami ginekologicznymi. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
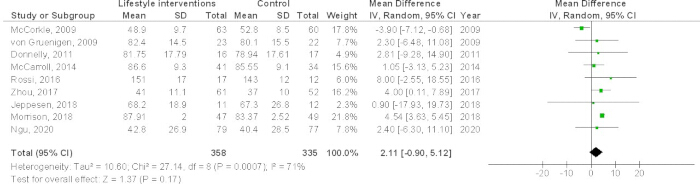
Rysunek 2: Wykres leśny jakości życia po 6 miesiącach u kobiet z nowotworami ginekologicznymi. Wykres leśny porównujący interwencje związane ze stylem życia oraz pielęgniarskie interwencje w onkologii ginekologicznej z grupami kontrolnymi w odniesieniu do jakości życia podczas wizyty kontrolnej po 6 miesiącach. Wyniki przedstawiono jako średnie różnice (MDs) z 95% przedziałami ufności (CIs) przy użyciu modelu efektów losowych. Dodatnie wartości MD sprzyjają grupie interwencyjnej. Heterogeniczność opisano za pomocą statystyki I2. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
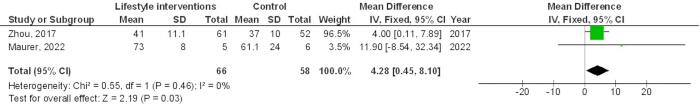
Rysunek 3: Wykres leśny jakości życia po 6 miesiącach u kobiet z rakiem jajnika. Wykres leśny przedstawiający wpływ interwencji w stylu życia oraz pielęgniarskich interwencji w zakresie onkologii ginekologicznej na jakość życia podczas 6-miesięcznej obserwacji u kobiet z rakiem jajnika. Wyniki przedstawiono jako średnie różnice (MD) z 95% przedziałami ufności (CI). Dodatnie wartości MD wskazują na korzyść grupy interwencyjnej, a heterogenność podsumowano za pomocą statystyki I2. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
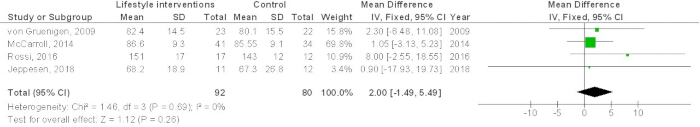
Rycina 4: Wykres leśny jakości życia po 6 miesiącach u kobiet z rakiem endometrium. Wykres leśny porównujący interwencje w stylu życia oraz pielęgniarskie interwencje w zakresie onkologii ginekologicznej z grupami kontrolnymi pod kątem jakości życia podczas 6-miesięcznej obserwacji u kobiet z rakiem endometrium. Wyniki przedstawiono jako różnice średnich (MDs) z 95% przedziałami ufności (CIs). Dodatnie wartości MD wskazują na korzyść grupy interwencyjnej, a heterogeniczność raportowano przy użyciu statystyki I2. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
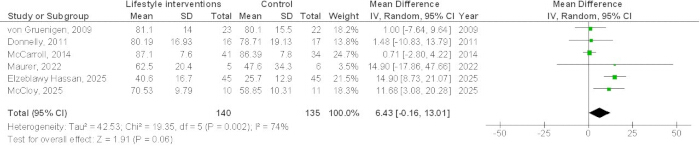
Rycina 5: Wykres leśny jakości życia po 3 miesiącach u kobiet z nowotworami ginekologicznymi. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
Wykres leśny porównujący interwencje związane ze stylem życia oraz pielęgniarstwem w onkologii ginekologicznej z grupami kontrolnymi pod kątem jakości życia w obserwacji po 3 miesiącach. Wyniki przedstawiono jako różnice średnich (MDs) z 95% przedziałami ufności (CIs) przy zastosowaniu modelu efektów losowych. Dodatnie wartości MD sprzyjają grupie interwencyjnej. Heterogeniczność określono za pomocą statystyki I2.
Tabela 1: Strategie przeszukiwania baz danych wykorzystane w przeglądzie literatury. W celu zidentyfikowania odpowiednich badań zastosowano kompleksowe strategie przeszukiwania w bazach PubMed, Embase, Cochrane Library, Ovid oraz Google Scholar. Terminy wyszukiwania łączyły kontrolowane słownictwo oraz słowa kluczowe w tekście swobodnym związane z nowotworami ginekologicznymi, interwencjami w stylu życia, pielęgniarstwem onkologicznym oraz jakością życia. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 2: Charakterystyka włączonych badań RCT. Podsumowanie charakterystyki włączonych badań, obejmujące projekt badania, typ nowotworu, interwencję i komparator, wielkość próby, narzędzie do oceny jakości życia, czas obserwacji oraz kwalifikację do ilościowej metaanalizy. Badania bez odpowiedniej grupy kontrolnej włączono wyłącznie do syntezy jakościowej. Kliknij tutaj, aby pobrać tę tabelę.
Plik uzupełniający 1: Lista kontrolna PRISMA 2020. Uzupełniona lista kontrolna PRISMA 2020 wskazująca numery stron rękopisu odpowiadające poszczególnym elementom sprawozdawczym, zgodnie z oświadczeniem PRISMA 2020 dotyczącym raportowania przeglądów systematycznych i metaanaliz.Aby pobrać ten plik, kliknij tutaj.
Dyskusja
Główna analiza przeprowadzona po 6 miesiącach nie wykazała statystycznie istotnej poprawy jakości życia (QoL) w przypadku mieszanych nowotworów ginekologicznych (MD 2,11, 95% CI: −0,90 do 5,12, p = 0,17), podczas gdy w podgrupie raka jajnika zaobserwowano istotną poprawę (MD 4,28, 95% CI: 0,45–8,10, p = 0,03). Nie zaobserwowano istotnego wpływu w przypadku raka endometrium po 6 miesiącach (MD 2,00, 95% CI: −1,49 do 5,49, p = 0,26) lub w przypadku nowotworów mieszanych w 3. miesiącu (MD 6,43, 95% CI: −0,16 do 13,01, p = 0,06).
Wyniki te nie wykazują istotnej ogólnej poprawy jakości życia (QoL) po 6 miesiącach, choć w podgrupie pacjentek z rakiem jajnika zaobserwowano znaczącą poprawę. Główna analiza po 6 miesiącach wykazała istotną heterogeniczność (I2 = 71%), a pewność dowodów GRADE dla wszystkich połączonych wyników oceniono jako bardzo niską. W związku z tym wyniki te należy uznać za generujące hipotezy, a nie za zmieniające praktykę kliniczną.
Kluczowe jest to, że pozornych różnic w istotności pomiędzy typami nowotworów a punktami czasowymi nie poddano formalnym testom interakcji i nie należy ich interpretować jako dowodu na zróżnicowaną skuteczność. Obserwowane wzorce mogą odzwierciedlać różnice w populacjach badanych, komponentach interwencji, wielkościach prób lub być wynikiem przypadku, a nie rzeczywistych różnic biologicznych lub czasowych. Wszelkie wnioski dotyczące czasu podania lub efektów specyficznych dla konkretnego guza mają charakter spekulatywny i wymagają potwierdzenia w przyszłych badaniach porównawczych typu head-to-head.
Porównanie z poprzednimi badaniami
Niniejsze wyniki są częściowo zgodne z wcześniejszym przeglądem systematycznym przeprowadzonym przez Smits i współpracowników10, w którym oceniano interwencje związane ze stylem życia u kobiet z rakiem endometrium oraz jajnika i stwierdzono ograniczoną liczbę dowodów na istotną poprawę jakości życia (QoL). Jednakże szersze uwzględnienie interwencji pielęgniarskich oraz dodatkowych badań opublikowanych po 2015 roku dostarcza bardziej aktualnego, choć wciąż niepewnego obrazu. Bardzo niska pewność GRADE w niniejszym przeglądzie jest znacznie bardziej ostrożna niż wnioski z niektórych badań pierwotnych, co odzwierciedla bardziej rygorystyczną ocenę metodologiczną zastosowaną w obecnym przeglądzie oraz wyraźne uznanie ograniczeń wynikających z bazy dowodowej11.
Zaobserwowana korzyść w podgrupie raka jajnika jest zgodna z wcześniejszymi badaniami przeprowadzonymi przez Zhou i współpracowników25 oraz Maurer i współpracowników29, którzy donieśli, że ustrukturyzowane interwencje w postaci ćwiczeń fizycznych poprawiły sprawność fizyczną i ogólne samopoczucie u osób po leczeniu raka jajnika. Może to wynikać ze znacznej kondycji fizycznej, neuropatii wywołanej chemioterapią oraz powikłań brzusznych, które ograniczają mobilność w tej populacji, czyniąc interwencje oparte na ćwiczeniach szczególnie korzystnymi. Jednakże mała liczba badań (n = 2) uniemożliwia wyciągnięcie wiarygodnych wniosków.
Z drugiej strony, brak istotnego wyniku w przypadku raka endometrium po 6 miesiącach przeczy niektórym wcześniejszym pozytywnym raportom z pojedynczych badań (np. Von Gruenigen et al.21; Rossi et al.24). Połączenie tych badań, w tym nakładających się kohort z badania SUCCEED, nie wykazało istotnego efektu, co sugeruje, że wcześniejsze pozytywne wyniki mogły zostać przeszacowane ze względu na małe liczebności próby lub błąd publikacyjny. Brak istotnego efektu może również odzwierciedlać heterogeniczność osób po przebytym raku endometrium, u których często występuje otyłość i zespół metaboliczny, co wymaga bardziej intensywnych lub spersonalizowanych interwencji w celu osiągnięcia mierzalnej poprawy jakości życia (QoL).
Niniejsze wyniki są zgodne z doniesieniami Mokhtari-Hessari i Montazeri35, którzy zgłosili znaczną poprawę jakości życia (QoL) dzięki interwencjom pielęgniarskim u pacjentek z rakiem piersi. Podobnie Aktas i Terzioglu36 stwierdzili, że pielęgnacja domowa znacząco poprawiła QoL u kobiet leczonych w ramach onkologii ginekologicznej, a Ma i wsp.37 wykazali, że intensywna pielęgnacyjna opieka psychologiczna złagodziła negatywne nastroje i poprawiła QoL u pacjentek z rakiem szyjki macicy. Te spójne sygnały w różnych typach nowotworów i środowiskach podkreślają potencjalną wartość kompleksowej opieki pielęgniarskiej, choć jakość metodologiczna dowodów wspierających te tezy pozostaje kwestią problematyczną.
Prawdopodobne mechanizmy
Choć połączone szacunki nie pozwalają na ustalenie związków przyczynowo-skutkowych, kilka ścieżek może wyjaśniać zaobserwowane sygnały dotyczące jakości życia (QoL). Ustrukturyzowana aktywność fizyczna i modyfikacja diety ograniczają pro‑cytokiny zapalne (np. IL‑6, TNF‑α) oraz C‑białka reaktywne, które są powiązane z nowotworami‑powiązanym zmęczeniem, bólem i depresją. U osób po raku endometrium oraz raku piersi utrata masy ciała i ćwiczenia fizyczne obniżają również poziom estrogenu i IGF‑1 poziomów, co potencjalnie wpływa na metabolizm guza i systemową równowagę energetyczną. Pod względem psychospołecznym, pielęgniarka‑prowadzono psychoedukację, poradnictwo oraz regularne wizyty kontrolne‑wzrost może nasilać autoregenerację‑skuteczność, zmniejszenie lęku przed nawrotem i poprawa przestrzegania zaleceń terapeutycznych. Bardziej spójne 6‑miesiąc (w porównaniu do 3‑efekty (choć nie zostały formalnie przetestowane) mogą odzwierciedlać czas niezbędny do utrwalenia się zmian behawioralnych oraz akumulacji adaptacji biologicznych. Żaden z tych mechanizmów nie został jednak bezpośrednio zmierzony w uwzględnionych badaniach; niniejsza dyskusja ma charakter spekulatywny i ma na celu ukierunkowanie przyszłych badań nad mechanizmami tych zjawisk.
Ograniczenia metodologiczne
Brak prospektywnej rejestracji protokołu: Głównym ograniczeniem jest brak rejestracji w prospektywnym rejestrze (np. PROSPERO, INPLASY lub OSF Registries). W przypadku braku publicznie dostępnego, prerejestrowanego protokołu istnieje ryzyko błędu raportowania lub selektywnego doboru wyników, ponieważ decyzje dotyczące wyboru badań, ekstrakcji danych i analizy nie mogą zostać niezależnie zweryfikowane w odniesieniu do uprzednio określonego planu. Czytelnicy powinni interpretować połączone szacunki, mając to na uwadze.
Wysoka heterogeniczność: Główna analiza 6-miesięczna wykazała I2 = 71%, co według wytycznych Cochrane jest uznawane za wartość "znaczną" i często stanowi kryterium przeciwko łączeniu danych. Chociaż podział na podgrupy według typu nowotworu zredukował I2 do 0% zarówno dla podgrupy raka jajnika, jak i raka endometrium, każda z podgrup obejmowała tylko kilka badań (odpowiednio 2 i 4), co sprawiło, że szacunki te są nieprecyzyjne. Heterogeniczności nie można z pewnością przypisać wyłącznie typowi nowotworu. Inne prawdopodobne źródła—różnice w intensywności interwencji, czasie trwania, sposobie podania, warunkach kontrolnych, wyjściowej charakterystyce uczestników oraz pomiarze wyników—nie zostały formalnie zbadane ze względu na niewystarczające dane dotyczące współzmiennych. Biorąc pod uwagę te okoliczności, połączone MD dla analizy głównej należy traktować jako matematycznie wygenerowane podsumowanie, a nie jako klinicznie istotną wartość szacunkową.
Ryzyko błędu systematycznego: Żadne badanie RCT nie zostało ocenione jako niskiego ryzyka we wszystkich domenach narzędzia Cochrane RoB 2.0. Większość została oceniona jako wykazująca "pewne wątpliwości" lub "wysokie ryzyko," przede wszystkim ze względu na brak zaślepienia uczestników (nieuniknione w przypadku interwencji dotyczących stylu życia) oraz niepełne dane dotyczące wyników. Włączenie nakładających się kohort z badania SUCCEED sztucznie zwiększa wagę tej konkretnej interwencji w podgrupie endometrium; analiza wrażliwości z wyłączeniem duplikatu nie zmieniła istotnie oceny punktowej, jednak pozostaje to ograniczeniem strukturalnym.
Uwzględnienie badań obserwacyjnych: Dwa z 15 włączonych raportów całkowicie pozbawione były grupy porównawczej (Budisan et al.33; Betea et al.34). Choć badania te zachowano na potrzeby syntezy opisowej, aby uniknąć błędu selekcji, nie mogły one zostać włączone do wspólnej analizy efektów interwencji i uznano, że obarczone są wysokim ryzykiem zakłóceń oraz błędem selekcji.
Różnorodność interwencji i wyników: Badania porównawcze obejmowały szeroki zakres interwencji—strukturalne programy ćwiczeń, modyfikację diety, poradnictwo w zakresie redukcji masy ciała, sesje psychoedukacyjne, monitorowanie prowadzone przez pielęgniarki, opiekę inicjowaną przez pacjenta oraz trening uważności oparty na aplikacji. Grupowanie tak zróżnicowanych interwencji pod ogólnym terminem "interwencja stylu życia/pielęgniarska" pozwala na oszacowanie średniego efektu, jednak średnia ta może nie odnosić się do żadnego konkretnego rodzaju interwencji. Podobnie, choć we wszystkich badaniach mierzono jakość życia związaną ze zdrowiem (QoL), zastosowano różne narzędzia (FACT-G, FACT-O, FACT-En, EORTC QLQ-C30, SF-36), co może wprowadzać heterogeniczność pośrednią.
Nie można było wiarygodnie ocenić błędu publikacji, ponieważ żadna z połączonych analiz wyników nie obejmowała 10 lub więcej badań. W związku z tym nie wykonano wykresów lejkowych ani testów regresji Eggera. Mała liczebność próby oraz przewaga badań z wynikami pozytywnymi w literaturze wskazują na możliwość, że wyniki negatywne lub neutralne nie zostały opublikowane.
Krótki okres obserwacji i brak analiz podgrup: Większość badań obejmowała krótkie okresy obserwacji (3–6 miesięcy), co ogranicza zrozumienie długoterminowej trwałości poprawy jakości życia (QoL). Brak kompleksowych analiz podgrup (np. ze względu na wiek, stadium choroby, status socjoekonomiczny) utrudnił zidentyfikowanie konkretnych kategorii pacjentów, którzy mogą odnieść największe korzyści.
pewność GRADE
Formalna ocena GRADE zaklasyfikowała ogólną pewność dowodów dla wszystkich czterech połączonych wyników jako BARDZO NISKĄ. Ocena ta odzwierciedla: (i) poważne lub bardzo poważne ryzyko błędu systematycznego w uwzględnionych badaniach RCT; (ii) bardzo poważną niespójność w odniesieniu do głównego punktu końcowego w 6. miesiącu (I2 = 71%); (iii) pośredniość w podgrupie endometrium, w której dominowali pacjenci z nadwagą/otyłością, co ogranicza możliwość generalizacji wyników; oraz (iv) poważną lub bardzo poważną nieprecyzyjność wynikającą z małej całkowitej liczby próbek w poszczególnych podgrupach oraz szerokich przedziałów ufności, które często obejmują wartość zerową. W konsekwencji zaufanie do szacunków efektu jest bardzo ograniczone; rzeczywiste efekty są prawdopodobnie znacznie inne niż raportowane wartości punktowe.
Implikacje kliniczne
Z uwagi na bardzo niską pewność dowodów oraz znaczną heterogeniczność, wyniki te mają charakter hipotezy‑generowanie zamiast utrwalania‑zmieniające się. Klinicyści nie powinni modyfikować rutynowej opieki wspomagającej w oparciu o te zagregowane szacunki. Niemniej jednak, kilka ostrożnych obserwacji może być pomocne podczas rozmów z pacjentami: (i) decyzje dotyczące opieki wspomagającej powinny być dostosowane do preferencji pacjenta i kontekstu klinicznego; (ii) podgrupa raka jajnika wykazała jedyny statystycznie spójny sygnał (MD 4,28, 95% CI: 0,45–8,10), co sugeruje, że populacja ta może w szczególności odnieść korzyści z interwencji w postaci ćwiczeń fizycznych, choć wniosek ten oparto jedynie na dwóch niewielkich badaniach. Spójne sygnały dodatnie we wszystkich badaniach podkreślają znaczenie kompleksowej opieki pielęgniarskiej, obejmującej leczenie bólu, wsparcie emocjonalne, edukację pacjenta oraz koordynację opieki, jako kluczowego elementu wielodyscyplinarnego leczenia nowotworów. Co istotne, widoczne różnice między typami nowotworów i punktami czasowymi nie zostały formalnie poddane testom interakcji i nie powinny być nadinterpretowane.
Przyszłe badania
Niniejszy przegląd ujawnia krytyczne luki w dowodach, które muszą zostać uzupełnione w przyszłych badaniach. Wysoki‑pilnie potrzebne są wysokiej jakości wieloośrodkowe badania z randomizacją i grupą kontrolną (RCT), z zastosowaniem zstandaryzowanych i sformalizowanych interwencji, opublikowane protokoły, zamierzenie‑do‑analizy lecznicze, dłuższa obserwacja‑do góry (≥12 miesięcy) oraz wcześniej określone analizy podgrup z formalnym testowaniem interakcji. Badania mechanistyczne powinny obejmować oceny biomarkerów (cytokin zapalnych, profili hormonalnych) oraz zwalidowane mediatory psychospołeczne (samo‑skuteczność, wsparcie społeczne), aby zidentyfikować, które komponenty interwencji są najskuteczniejsze i które podgrupy pacjentów odnoszą największe korzyści. Niezbędne są również oceny ekonomiczne w celu oszacowania kosztów‑skuteczność i pomóc w alokacji zasobów. Przyszłe przeglądy systematyczne z szerszą bazą dowodów powinny rozważyć, czy meta‑analiza pozostaje odpowiednia dla tak zróżnicowanych interwencji, czy też synteza narracyjna byłaby bardziej informatywna. Na koniec, pacjent‑wyniki zorientowane na pacjenta—łącznie z domeną‑specyficzne miary jakości życia (QoL) i pacjent‑miary raportowanych doświadczeń—Należy nadać im priorytet, włączając pacjentki i opinię publiczną w projektowanie badań, aby zapewnić, że nauka koncentruje się na kwestiach najistotniejszych dla kobiet z nowotworami ginekologicznymi.
W tej metaanalizie nie stwierdzono statystycznie istotnej poprawy ogólnej jakości życia (QoL) w 3. lub 6. miesiącu u kobiet z nowotworami ginekologicznymi. Istotna poprawa została zaobserwowana w podgrupie kobiet z rakiem jajnika w 6. miesiącu, natomiast w podgrupie z rakiem endometrium nie odnotowano istotnego efektu. Niemniej jednak znaczna heterogenność, ograniczenia metodologiczne, niewielka liczebność podgrup oraz dowody o bardzo niskiej pewności nakazują ostrożną interpretację wyników. Konieczne jest przeprowadzenie większych, dobrze zaprojektowanych badań z ustandaryzowanymi interwencjami i dłuższym okresem obserwacji, aby wyjaśnić wpływ interwencji w zakresie stylu życia i opieki pielęgniarskiej na jakość życia kobiet z nowotworami ginekologicznymi.
Oświadczenia
Autorzy nie deklarują żadnych konfliktów interesów.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| EndNote | Clarivate Analytics | https://endnote.com | Zarządzanie bibliografią, usuwanie duplikatów, formatowanie cytowań |
| GRADEpro GDT | Uniwersytet McMaster oraz Evidence Prime | Uniwersytet McMaster / Evidence Prime; https://gradepro.org | Ocena pewności dowodów GRADE (wersja online) |
| Lista kontrolna PRISMA 2020 | Oświadczenie PRISMA | Oświadczenie PRISMA; https://www.prisma-statement.org | Zgodność z raportowaniem |
| R | R Foundation for Statistical Computing | R Foundation; https://cran.r-project.org | Analiza statystyczna, analizy wrażliwości, analizy wpływu, rysunki (wersja 4.3.1 lub nowsza) |
| Pakiet R: meta | CRAN | CRAN; https://cran.r-project.org/package=meta | Funkcje metaanalizy (łączenie danych, heterogeniczność, wykresy leśne, wykresy lejkowe) w wersji 6.0.0 lub nowszej |
| Pakiet R: metafor | CRAN | CRAN; https://cran.r-project.org/package=metafor | estymacja REML, diagnostyka wpływu, dodatkowe funkcje meta-analityczne (4.0.0 lub nowsze) |
| Menedżer Przeglądów | RevMan | Cochrane Collaboration; https://training.cochrane.org/online-learning/core-software-cochrane-reviews/revman[reference:14] | Metaanaliza (łączenie danych, wykresy leśne, heterogeniczność, ocena ryzyka błędu systematycznego) Wersja 5.4 |
Bibliografia
- Ackroyd SA, Shih YCT, Kim B, Lee NK, Halpern MT. A look at the gynecologic oncologist workforce – are we meeting patient demand Gynecol Oncol. 2021;163(2):229-36.
- Williams N, et al. The supportive care needs of women experiencing gynaecological cancer: a Western Australian cross-sectional study. BMC Cancer. 2018;18(1):912.
- Bizzarri N, et al. Building a personalized medicine infrastructure for gynecological oncology patients in a high-volume hospital. J Pers Med. 2022;12(1):3.
- Buckley L, Robertson S, Wilson T, Sharpless J, Bolton S. The role of the specialist nurse in gynaecological cancer. Curr Oncol Rep. 2018;20(10):83.
- Parkinson N, Pratt H. Clinical nurse specialists and the psychosexual needs of patients with gynaecological cancer. Br Menopause Soc J. 2005;11(1):33-5.
- Kobleder A, Mayer H, Gehrig L, Senn B. “Promoting continuity of care”—specialist nurses’ role experiences in gynaecological oncology: a qualitative study. J Clin Nurs. 2017;26(23-24):4890-8.
- Cook O, McIntyre M, Recoche K, Lee S. “Our nurse is the glue for our team”—multidisciplinary team members' experiences and perceptions of the gynaecological oncology specialist nurse role. Eur J Oncol Nurs. 2019;41:7-15.
- Lavdaniti M, et al. Factors influencing quality of life in breast cancer patients six months after the completion of chemotherapy. Diseases. 2019;7(1):26.
- Perry S, Kowalski TL, Chang CH. Quality of life assessment in women with breast cancer: benefits, acceptability and utilization. Health Qual Life Outcomes. 2007;5(1):24.
- Chhikara BS, Parang K. Global cancer statistics 2022: the trends projection analysis. Chem Biol Lett. 2023;10(1):451.
- Smits A, et al. The effect of lifestyle interventions on the quality of life of gynaecological cancer survivors: a systematic review and meta-analysis. Gynecol Oncol. 2015;139(3):546-52.
- Stroup DF, et al. Meta-analysis of observational studies in epidemiology: a proposal for reporting. JAMA. 2000;283(15):2008-12.
- Page MJ, et al. The PRISMA 2020 statement: an updated guideline for reporting systematic reviews. BMJ. 2021;372:n71.
- Liberati A, et al. The PRISMA statement for reporting systematic reviews and meta-analyses of studies that evaluate health care interventions: explanation and elaboration. J Clin Epidemiol. 2009;62(10):e1-34.
- Gupta S, et al. Efficacy of generic oral directly acting agents in patients with hepatitis C virus infection. J Viral Hepat. 2018;25(7):771-8.
- Adeiza SS, Aminul I. Meta-meta-analysis of the mortality risk associated with MRSA compared to MSSA bacteraemia. Infez Med. 2024;32(2):131-7.
- Higgins J, et al., editors. Cochrane handbook for systematic reviews of interventions. 2nd ed. Wiley & Sons; Chichester, UK; 2019.
- Sheikhbahaei S, et al. FDG-PET/CT and MRI for evaluation of pathologic response to neoadjuvant chemotherapy in patients with breast cancer: a meta-analysis of diagnostic accuracy studies. Oncologist. 2016;21(8):931-9.
- Higgins JP, Thompson SG, Deeks JJ, Altman DG. Measuring inconsistency in meta-analyses. BMJ. 2003;327(7414):557-60.
- McCorkle R, et al. Effects of a nursing intervention on quality of life outcomes in post-surgical women with gynecological cancers. Psychooncology. 2009;18(1):62-70.
- Von Gruenigen VE, et al. A randomized trial of a lifestyle intervention in obese endometrial cancer survivors: quality of life outcomes and mediators of behavior change. Health Qual Life Outcomes. 2009;7(1):17.
- Donnelly CM, et al. A randomised controlled trial testing the feasibility and efficacy of a physical activity behavioural change intervention in managing fatigue with gynaecological cancer survivors. Gynecol Oncol. 2011;122(3):618-24.
- McCarroll ML, et al. Self-efficacy, quality of life, and weight loss in overweight/obese endometrial cancer survivors (SUCCEED): a randomized controlled trial. Gynecol Oncol. 2014;132(2):397-402.
- Rossi A, et al. Feasibility of a physical activity intervention for obese, socioculturally diverse endometrial cancer survivors. Gynecol Oncol. 2016;142(2):304-10.
- Zhou Y, et al. Randomized trial of exercise on quality of life in women with ovarian cancer: Women’s Activity and Lifestyle Study in Connecticut (WALC). J Natl Cancer Inst. 2017;109(12).
- Jeppesen M, Jensen P, Hansen D, Christensen R, Mogensen O. Patient-initiated follow up affects fear of recurrence and healthcare use: a randomised trial in early-stage endometrial cancer. BJOG. 2018;125(13):1705-14.
- Morrison V, et al. Trial of optimal personalised care after treatment—gynaecological cancer (TOPCAT-G): a randomized feasibility trial. Int J Gynecol Cancer. 2018;28(2):401-11.
- Ngu SF, et al. Nurse-led follow-up in survivorship care of gynaecological malignancies—a randomised controlled trial. Eur J Cancer Care (Engl). 2020;29(6):e13325.
- Maurer T, et al. Randomised controlled trial testing the feasibility of an exercise and nutrition intervention for patients with ovarian cancer during and after first-line chemotherapy (BENITA-study). BMJ Open. 2022;12(2):e054091.
- McCloy K, et al. Management of fatigue in gynaecological cancer: a feasibility study of an app-based exercise and mindfulness intervention. Gynecol Oncol Rep. 2025;60:101807.
- Darwish EAF, Tayel SEA, Meleis MEH, Abou Elwafa HE, Shaaban Marouf FSA. A randomized controlled trial of the effect of a psychoeducational intervention program on quality of life of patients with gynecological cancers. Alex J Med. 2025;61(1):6-14.
- Elzeblawy Hassan H, Khalaf Gooda W, Ragabahmed T, Shehta Said Farag D. Marital, sexual satisfaction and quality of life among post-hysterectomy women: impact of nursing counseling guided by BETTER model. Egypt J Health Care. 2025;16(1):99-116.
- Budisan C, et al. Physical, emotional, and stress-related dynamics over six months in newly diagnosed epithelial ovarian cancer survivors. J Clin Med. 2025;14(14):5087.
- Betea R, et al. Quality-of-life trajectories and perceived stress in women treated for uterine cancer: a six-month prospective study. Healthcare (Basel). 2025;13(15):1787.
- Mokhtari-Hessari P, Montazeri A. Health-related quality of life in breast cancer patients: review of reviews from 2008 to 2018. Health Qual Life Outcomes. 2020;18(1):338.
- Aktas D, Terzioglu F. Effect of home care service on the quality of life in patients with gynecological cancer. Asian Pac J Cancer Prev. 2015;16(9):4089-94.
- Ma Y, Kamalibaike M, Xin C, Li L. Effect of the intensive psychological nursing on adverse mood and quality of life in patients with cervical cancer. Am J Transl Res. 2021;13(8):9633-8.