Ten protokół opisuje rozwój i ocenę chatbota z generowaniem opartym na odzyskiwaniu, który odzyskuje i podsumowuje treści z internetowych wytycznych praktyki klinicznej dotyczących raka, aby generować odpowiedzi oparte na referencjach na zapytania użytkowników.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Opracowanie asystenta konwersacyjnego opartego na wytycznych, uzupełniającego informacje z sieci, odnoszącego się do internetowych wytycznych praktyki klinicznej dotyczących raka
W tym artykule
Podsumowanie
Streszczenie
Szeroka dostępność informacji medycznych w Internecie poprawiła dostęp pacjentów do wiedzy związanej ze zdrowiem; jednak zwiększyło to także narażenie na niedokładne informacje medyczne. Opieka nad chorymi na raka obejmuje złożone informacje, co utrudnia pacjentom identyfikację dokładnych i opartych na dowodach źródeł. Duże modele językowe umożliwiają interakcję w języku naturalnym, ale często generują halucynacje, co ogranicza ich zastosowanie w dostarczaniu informacji medycznych. Generowanie ulepszone o odwołania (RAG) ma potencjał do zmniejszenia tych ryzyk poprzez oparcie odpowiedzi na zewnętrznych źródłach referencyjnych. Niniejsze badanie opisuje opracowanie i ocenę przewodnika opartego na wytycznych, który korzysta z publicznie dostępnych, internetowych wytycznych praktyki klinicznej dotyczących raka. System wyodrębnia adresy URL ze stron zawierających spis treści wytycznych, przetwarza tekst stron za pomocą analizy morfologicznej i podobieństwa cosinusowego na podstawie częstości występowania terminów–odwrotnej częstości dokumentów, oraz konstruuje informacje referencyjne z wysoce istotnych stron. Duży model językowy wykorzystuje te odniesienia do generowania odpowiedzi ograniczanych do treści wytycznych. Jako wytyczna referencyjna została użyta Książeczka JLCS dla Pacjentów z Rakiem Płuc i Ich Rodzin. Zestawy pytań zawierały zarówno typy raka objęte wytycznymi, jak i typy raka nieobjęte wytycznymi, aby ocenić kontrolę odpowiedzi. Informacje medyczne zostały pomyślnie wyodrębnione ze stron zawierających spis treści, a 98% wyodrębnionych adresów URL zawierało referencyjną treść medyczną. W przypadku pytań objętych wytycznymi, chatbot generował odpowiedzi poprzez podsumowanie treści wytycznych i nie zidentyfikowano żadnych halucynacji podczas manualnej rewizji w zdefiniowanych warunkach testowych. W przypadku pytań nieobjętych wytycznymi, chatbot konsekwentnie odmawiał odpowiedzi i wskazywał, że dostępne informacje były niewystarczające. Struktura internetowa wytycznych ułatwiała efektywne skrobing i organizację treści referencyjnych na poziomie adresów URL. Ten protokół dostarcza praktycznych wskazówek dotyczących budowy systemów sztucznej inteligencji, które dostarczają informacji medycznych przy użyciu internetowych wytycznych praktyki klinicznej.
Wprowadzenie
Szerokie wykorzystanie internetu i mediów społecznościowych ułatwiło pacjentom dostęp do informacji medycznych1,2. Informacje dotyczące opieki nad chorobą nowotworową są często złożone i rozległe, co sprawia, że szczególnie trudno jest pacjentom zidentyfikować źródła, które są dokładne, odpowiednie i oparte na dowodach naukowych3. Podczas gdy zasoby internetowe mogą wspierać zrozumienie przez pacjenta, zawierają również znaczne ilości niepoprawnych informacji medycznych3, co może negatywnie wpływać na decyzje pacjentów dotyczące ich opieki4. Ponieważ dezinformacja dotycząca chorób nowotworowych może wpływać na wyniki pacjentów5, rośnie potrzeba systemów sztucznej inteligencji (AI), które mogą pomóc indywidualnym użytkownikom w wyszukiwaniu, podsumowaniu i interpretacji informacji medycznych6.
Duże modele językowe (LLM) umożliwiają użytkownikom dostęp do informacji poprzez naturalną konwersację językową7; jednakże, generacja dezinformacji (tj. halucynacje) pozostaje poważnym problemem w dziedzinie medycznej8,9,10,11. Jednym z kluczowych źródeł dezinformacji jest jakość i dokładność danych treningowych wykorzystanych do opracowania chatbota. Ponadto, statyczna natura szkolenia modelu oznacza, że wiedza może stać się przestarzała z czasem, ograniczając zdolność LLM do dostarczania aktualnych i odpowiednich kontekstowo informacji12,13. Te ograniczenia podkreślają znaczenie skutecznych strategii zarządzania wiedzą, aby zapewnić, że odpowiedzi chatbota pozostają dokładne, odpowiednie i aktualne. W szczególności, systemy, które mogą szybko uzyskać dostęp i odwołać się do aktualnych opartych na dowodach zasobów, takich jak wytyczne dotyczące praktyki klinicznej, są pożądane w środowiskach medycznych, gdzie zalecenia i standardy opieki nieustannie ewoluują. Aby sprostać temu wyzwaniu, generacja wzbogacona o odzyskiwanie (RAG), która generuje odpowiedzi poprzez uwzględnienie informacji z zewnętrznych źródeł wiedzy, przyciąga coraz większą uwagę10,13,14,15,16,17.
Mimo że RAG jest coraz częściej stosowany w chatbotach medycznych, ograniczona uwaga została poświęcona na to, jak wytyczne dotyczące praktyki klinicznej powinny być systematycznie włączane jako źródła informacji referencyjnych18. Wiele wytycznych dotyczących praktyki klinicznej jest dostępnych publicznie w sieci; jednakże, nadal nie jest jasne, czy ich istniejąca struktura internetowa może bezpośrednio służyć jako struktura odzyskiwania dla systemów RAG18. Ponadto, praktyczne metody konstruowania informacji referencyjnych bez manualnego rozwoju bazy wiedzy nie zostały dobrze ustalone.
W niniejszym badaniu, dążyliśmy do ustanowienia zasad projektowych dla systemów AI odwołujących się do wytycznych w dziedzinie medycznej poprzez opracowanie i ocenę chatbota RAG opartego na wytycznych, który wykorzystuje publicznie dostępne, internetowe wytyczne dotyczące praktyki klinicznej w dziedzinie chorób nowotworowych, umożliwiając w ten sposób prosty i terminowy dostęp do informacji opartych na wytycznych. Jako dowód koncepcji, oceniliśmy techniczną wykonalność pobierania wytycznych, generowania odpowiedzi i ograniczenia odpowiedzi przy użyciu istniejącej struktury internetowej publicznie dostępnych wytycznych dotyczących praktyki klinicznej, z celem zaproponowania powtarzalnego protokołu rozwoju dla systemów RAG odwołujących się do wytycznych.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Niniejsze badanie nie obejmuje osób, które wymagają ochrony przed ryzykiem związanym z badaniami. W związku z tym nie wymaga ono oceny przez instytucjonalną komisję etyczną zgodnie z japońskimi wytycznymi etycznymi dotyczącymi badań medycznych z udziałem ludzi19. Badanie to zostało opisane zgodnie z wytycznymi Transparent Reporting of a Multivariable Model for Individual Prognosis or Diagnosis (TRIPOD)-LLM20.
Schematyczny przegląd protokołu czatbota RAG opartego na wytycznych przedstawiono na Rysunku 1.
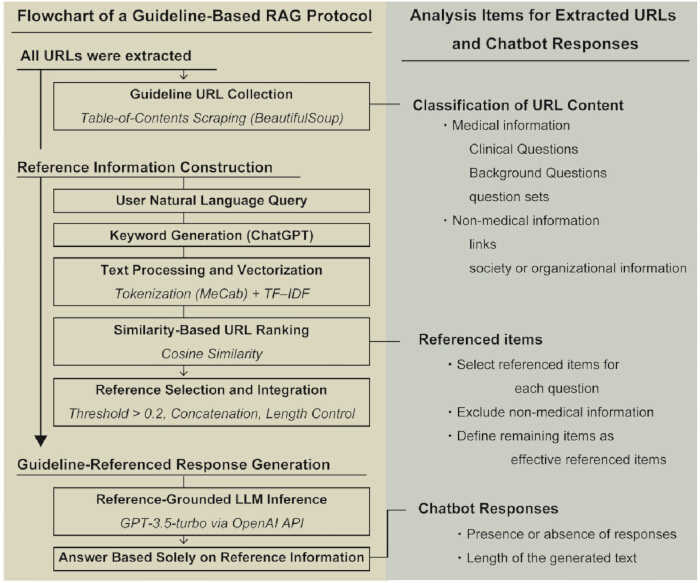
Rysunek 1. Przepływ pracy protokołu chatbota RAG (Retrieval-Augmented Generation) opartego na wytycznych. Schematyczny przegląd przepływu pracy chatbota RAG opartego na wytycznych. Adresy URL są wyodrębniane ze strony spisu treści internetowej wytycznej praktyki klinicznej i wykorzystywane do konstruowania informacji referencyjnych. Zapytania użytkowników są konwertowane na słowa kluczowe, a zawartość stron internetowych jest przetwarzana poprzez tokenizację, wektoryzację TF-IDF (term frequency–inverse document frequency) oraz analizę podobieństwa cosinusowego w celu zidentyfikowania odpowiednich stron wytycznych. Wybrane informacje referencyjne są integrowane i przekazywane do dużego modelu językowego w celu generowania odpowiedzi w oparciu wyłącznie o treść referencyjnych wytycznych. Prawy panel podsumowuje elementy oceny wykorzystywane dla wyodrębnionych adresów URL, informacji referencyjnych i odpowiedzi chatbota. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
1. Przygotowanie informacji referencyjnych na podstawie wytycznych dostępnych w sieci
- Wyodrębnić wszystkie adresy URL ze stron spisu treści docelowych internetowych wytycznych praktyki klinicznej, korzystając z biblioteki BeautifulSoup 4 (biblioteka do parsowania HTML) zaimplementowanej w języku programowania Python (wersja 3.12).
UWAGA: Skrypt do wyodrębniania adresów URL należy zaimplementować w języku programowania przy użyciu następujących pakietów: biblioteki do parsowania HTML (wersja 4.12.3) oraz requests (biblioteka do pobierania stron internetowych; wersja 2.32.3). Pakiety należy zainstalować za pomocą narzędzia pip. Pełny kod źródłowy do wyodrębniania adresów URL znajduje się w Pliku uzupełniającym 1. Szczegóły dotyczące oprogramowania podano w Tabeli materiałów. - Ręcznie sprawdzić wszystkie wyodrębnione adresy URL, aby potwierdzić poprawny dostęp oraz ich istotność dla docelowych wytycznych praktyki klinicznej.
- Zaklasyfikować każdy adres URL jako zawierający informacje medyczne lub niemedyczne. Klasyfikację adresów URL przeprowadził jeden autor (S.N.).
UWAGA: Informacje medyczne zdefiniowano jako treść wytycznych nadającą się do cytowania, w tym pytania kliniczne (CQs), pytania tła oraz zestawy pytań. Informacje niemedyczne obejmowały linki, strony stowarzyszeń lub organizacji oraz inne treści pomocnicze, które nie nadawały się do cytowania. - Skompilować zweryfikowane adresy URL w skoroszycie programu Microsoft Excel (format .xlsx), zapisując jeden adres URL w każdym wierszu. Uzyskaną listę adresów URL należy zapisać jako zbiór danych wejściowych do późniejszego pobierania tekstu, wstępnego przetwarzania i analizy podobieństwa.
2. Generowanie słów kluczowych z zapytań użytkowników
- Wprowadź zapytanie w języku naturalnym do ChatGPT (Generative Pre-trained Transformer, wersja 4o; model generowania słów kluczowych).
- Poproś model o wyodrębnienie dwóch słów kluczowych odpowiadających zapytaniu użytkownika.
- Do generowania słów kluczowych użyj następującego promptu napisanego w języku japońskim:
"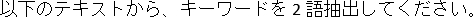 "
(Tłumaczenie na język angielski: „Extract two keywords from the following text.”) - Dołącz zapytanie użytkownika w języku naturalnym do tej instrukcji i prześlij je do modelu generowania słów kluczowych.
- Nie modyfikuj ręcznie żadnych parametrów modelu. Wykonaj generowanie słów kluczowych przy użyciu ustawień domyślnych modelu.
- Wygeneruj dwa słowa kluczowe dla każdego zapytania użytkownika. Zachowaj oba słowa kluczowe bez dalszych modyfikacji, filtrowania czy manualnej selekcji i wykorzystaj je do późniejszych obliczeń podobieństwa.
- Zapisz wygenerowane słowa kluczowe w skoroszycie Microsoft Excel (format .xlsx). Dla każdego rekordu zapisz oryginalne zapytanie użytkownika oraz odpowiadające mu wygenerowane słowa kluczowe w celu późniejszego wyszukiwania opartego na podobieństwie.
3. Przetwarzanie tekstu i obliczanie podobieństwa
- Pobierz pełną treść tekstową z każdego wyodrębnionego adresu URL, korzystając z biblioteki do pobierania stron internetowych oraz biblioteki do parsowania HTML. Wyodrębnij treść tekstową ze źródła HTML za pomocą funkcji get_text() biblioteki BeautifulSoup.
- Przeprowadź wstępne przetwarzanie wyodrębnionego tekstu stron internetowych oraz wygenerowanych słów kluczowych poprzez usunięcie tagów HTML i znaków innych niż japońskie.
- Wykonaj japońską analizę morfologiczną za pomocą MeCab (wersja 0.996; japoński analizator morfologiczny) z domyślnym słownikiem. Zachowaj wyłącznie rzeczowniki i połącz je w ciąg tekstowy rozdzielony spacjami.
- Połącz wygenerowane słowa kluczowe w jeden ciąg tekstowy i zastosuj te same procedury wstępnego przetwarzania i tokenizacji, które zostały użyte dla tekstu stron internetowych.
- Wygeneruj wektory TF–IDF (częstość występowania terminu – odwrotna częstość występowania w dokumentach) z przetworzonego tekstu stron internetowych i tekstu słów kluczowych, korzystając z implementacji TfidfVectorizer w bibliotece scikit-learn (wersja 1.6.1) z domyślnymi ustawieniami parametrów.
UWAGA: Wszystkie parametry TfidfVectorizer pozostawiono w wartościach domyślnych i nie zastosowano żadnych niestandardowych ustawień parametrów. - Oblicz podobieństwo cosinusowe między każdym wektorem strony internetowej a wektorem słów kluczowych za pomocą funkcji podobieństwa cosinusowego.
- Uporządkuj adresy URL w kolejności malejącej według wyników podobieństwa cosinusowego. Nie stosuj dodatkowych kryteriów rozstrzygania remisów.
- Wybierz strony z wynikiem podobieństwa cosinusowego ≥0,2 jako potencjalne informacje referencyjne.
UWAGA: Próg podobieństwa cosinusowego (0,2) został wybrany empirycznie podczas opracowywania systemu, aby nadać priorytet pełności wyszukiwania (recall) i uniknąć wykluczenia potencjalnie istotnych treści wytycznych. - Zachowaj wszystkie strony kandydackie spełniające próg podobieństwa.
4. Konstrukcja informacji referencyjnych
- Kolejno wyodrębnij treść tekstową z wybranych stron znajdujących się na górze listy rankingowej.
- Połącz wyodrębnione teksty w celu utworzenia jednego dokumentu referencyjnego.
- Przed przesłaniem do modelu LLM zastąp znaki nowej linii oraz kolejne znaki białych spacji w tekście referencyjnym pojedynczą spacją.
- Przytnij połączony tekst referencyjny do pierwszych 4 096 znaków przed przekazaniem go do modelu LLM.
UWAGA: Limit przycinania oparto na liczbie znaków, a nie tokenów. Limit 4 096 znaków wybrano empirycznie, aby upewnić się, że połączony prompt i informacje referencyjne mieszczą się w pojemności wejściowej modelu generowania odpowiedzi GPT-3.5-turbo-16k.
5. Generowanie odpowiedzi w oparciu o AI
- Przekaż przygotowane informacje referencyjne oraz oryginalne zapytanie użytkownika do modelu generującego odpowiedzi za pomocą interfejsu programistycznego aplikacji (API).
- Instruuj AI za pomocą następującego promptu (napisanego w całości w języku japońskim), aby zapewnić, że odpowiedzi będą generowane wyłącznie na podstawie dostarczonych informacji referencyjnych:
“You are a medical information assistant who provides guidance to cancer patients. Generate responses based solely on the following reference information, and do not use your own general knowledge or reasoning. Responses should be detailed and easy to understand, approximately 500 characters in length. If the reference information does not contain sufficient information to answer the question, respond with: ‘There is insufficient information in the text,’ without using any speculation or general knowledge.” - Przekaż informacje referencyjne i zapytanie użytkownika razem w jednej wiadomości użytkownika. Strukturuj dane wejściowe w następujący sposób: „Reference Information: [tekst referencyjny]”, a następnie „Question: [zapytanie użytkownika]”.
- Generuj odpowiedzi za pomocą modelu generującego odpowiedzi z następującymi ustawieniami: temperature = 0.1, maximum output length = 1,024 tokens, n = 1 oraz stop = None.
- Pobierz wygenerowaną przez AI odpowiedź do późniejszej ewaluacji.
UWAGA: Prześlij informacje referencyjne i zapytanie użytkownika jako jedną wiadomość użytkownika. Przekaż instrukcje generowania odpowiedzi oddzielnie jako wiadomość systemową.
6. Wytyczne referencyjne i formułowanie pytań
- Wybierz Przewodnik JLCS dla pacjentów z rakiem płuc i ich rodzin (Lung Guidebook)21, który jest dostępny bezpłatnie online, jako informacje referencyjne dla systemu chatbota RAG opartego na wytycznych.
- Utwórz dwie kategorie pytań ewaluacyjnych w zależności od rodzaju nowotworu: guzy grasicy, które mieszczą się w zakresie wytycznych, oraz glejak u dzieci, który wykracza poza zakres informacji referencyjnych.
- Sformułuj cztery pytania dotyczące diagnostyki i leczenia dla każdego rodzaju nowotworu:
„Jakie metody diagnostyczne są dostępne w przypadku guzów XX (np. grasicy lub glejaka u dzieci)?”
„Jakie są podejścia do diagnostyki patomorfologicznej w przypadku guzów XX?”
„Jakie opcje leczenia są dostępne w przypadku guzów XX?”
„Jakie są opcje leczenia chirurgicznego w przypadku guzów XX?” - Prześlij do chatbota pytania dotyczące rodzajów nowotworów objętych referencyjnymi wytycznymi dostępnymi w sieci. Na przykład prześlij pytanie dotyczące diagnostyki guzów grasicy, używając Lung Guidebook jako informacji referencyjnej.
- Prześlij do chatbota pytania wykraczające poza zakres referencyjnych wytycznych, aby ocenić jego zdolność do powstrzymania się od korzystania z zewnętrznych lub niezwiązanych informacji. Na przykład prześlij pytanie dotyczące glejaka u dzieci, używając Lung Guidebook jako informacji referencyjnej.
- Oceń każde pytanie w niezależnej sesji czatu. Nie przenoś historii konwersacji pomiędzy pytaniami.
- Zapisz odpowiedzi wygenerowane przez AI do późniejszej oceny.
7. Ocena odpowiedzi
- Przeprowadzić ręczną weryfikację wszystkich wygenerowanych odpowiedzi.
- Ocenić, czy każda odpowiedź zawiera halucynacje.
- Ocenić, czy każda odpowiedź jest poparta informacjami zawartymi w wytycznych referencyjnych.
UWAGA: Halucynacje zdefiniowano jako odpowiedzi zawierające nieistniejące zdarzenia, nazwy lub terminy, które mogłyby potencjalnie spowodować szkodę medyczną14. Wszystkie wygenerowane odpowiedzi zostały zweryfikowane pod kątem dokładności i braku halucynacji przez jednego autora z 8-letnim doświadczeniem w szpitalu uniwersyteckim, w tym w zakresie wsparcia pacjentów i komunikacji medycznej z pacjentami onkologicznymi. Wszelkie wątpliwości dotyczące klasyfikacji odpowiedzi rozstrzygano w drodze dyskusji z lekarzem współautorem z ponad 20-letnim doświadczeniem w usługach informacyjnych dla pacjentów onkologicznych w Narodowym Centrum Nowotworów w Japonii. - Odpowiedź uznaje się za popartą danymi tylko wtedy, gdy wszystkie istotne klinicznie stwierdzenia mogą zostać bezpośrednio potwierdzone w odnalezionych wytycznych referencyjnych, bez konieczności posługiwania się wiedzą dodatkową lub niepopartym wnioskowaniem.
- Zaklasyfikować każdą odpowiedź przy użyciu zdefiniowanych etykiet wyników. Odpowiedzi zawierające wyłącznie informacje poparte wytycznymi referencyjnymi zaklasyfikować jako „brak halucynacji”. Odpowiedzi zawierające informacje niepoparte danymi lub zmyślone zaklasyfikować jako „obecność halucynacji”.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Dostępność treści medycznych za pomocą stron z spisem treści
Architektura web-scraping zbierała adresy URL z strony ze spisem treści wytycznych. Z Książki Płuc wyodrębniono 106 adresów URL ze strony ze spisem treści, z których 104 (98%) zawierały informacje medyczne (Dodatek Tabela 1). Skuteczność odpowiedzi chatbota opartych na stronach treści wytycznych podsumowano w Tabeli 1. Chatbot generował odpowiedzi dla wszystkich czterech słów kluczow...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
W tej studii zbadaliśmy przydatność chatbota RAG opartego na wytycznych, który korzystał z internetowej wytycznej dotyczącej praktyki klinicznej—Przewodnika JLCS dla Pacjentów z Rakiem Płuca i Ich Rodzin—jako źródła informacji referencyjnych. Chatbot generował odpowiedzi oparte na treści wytycznych poprzez wykorzystanie struktury internetowej wytycznych i pobieranie stron na podstawie ich podobieństwa do pytań użytkowników. Takie podejście wykazało, że pobieranie na podstawie podobieństwa w połączeniu z generowaniu odpow...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie deklarują żadnych konfliktów interesów.
Podziękowania
Autorzy dziękują Kenichi Inoue, MD, PhD (Shonan Memorial Hospital Breast Center), za jego rozległe wsparcie techniczne w rozwoju chatbotu opartego na wytycznych i wzbogaconej reprezentacji. Autorzy dziękują również Chikako Yamaki, PhD, oraz wszystkim członkom zespołu badawczego w Instytucie Kontroli Raka, Narodowego Centrum Onkologii Japonii (Tokio, Japonia), za cenną poradę na temat zawartego w niniejszej pracy tematu. Dodatkowo autorzy dziękują Editage za edycję językową angielską. Ta praca została wsparta grantem naukowym z zakresu Zdrowia i Pracy (R6–Cancer Control–23EA1026).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Beautiful Soup 4 (wersja 4.12.3) | Beautiful Soup Project | N/A | Biblioteka Pythonu używana do wyciągania URL i parsowania HTML |
| ChatGPT wersja 4o | OpenAI | N/A | Używany do generowania słów kluczowych |
| GPT-3.5-turbo | OpenAI | N/A | Używany do generowania odpowiedzi |
| JLCS Guidebook for Lung Cancer Patients and Families | Japan Lung Cancer Society | N/A | Kliniczna wytyczna dostępna w sieci używana jako informacja referencyjna |
| MeCab (wersja 0.996) | MeCab Project | N/A | Japoński morfologiczny analizator |
| OpenAI API | OpenAI | N/A | Używany do generowania odpowiedzi opartych na AI |
| Python (wersja 3.12) | Python Software Foundation | N/A | Środowisko programistyczne |
| Requests (wersja 2.32.3) | Requests Project | N/A | Biblioteka Pythonu używana do pobierania stron internetowych |
| scikit-learn (wersja 1.6.1) | scikit-learn Developers | N/A | Używany do wektoryzacji TF–IDF i obliczania podobieństwa cosinusowego. |
| urllib.parse | Python Software Foundation | N/A | Biblioteka Pythonu używana do normalizacji URL i łączenia |
Bibliografia
- Helft PR, Hlubocky F, Daugherty CK. American oncologists' views of internet use by cancer patients: a mail survey of American Society of Clinical Oncology members. J Clin Oncol. 2003;21(5):942-947.
- Chen X, Siu LL. Impact of the media and the internet on oncology: survey of cancer patients and oncologists in Canada. J Clin Oncol. 2001;19(23):4291-4297.
- Goto Y, et al. Differences in the quality of information on the internet about lung cancer between the United States and Japan. J Thorac Oncol. 2009;4(7):829-833.
- Ogasawara R, et al. Reliability of cancer treatment information on the internet: observational study. JMIR Cancer. 2018;4(2):e10031.
- Johnson SB, Park HS, Gross CP, Yu JB. Complementary medicine, refusal of conventional cancer therapy, and survival among patients with curable cancers. JAMA Oncol. 2018;4(10):1375-1381.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28(1):31-38.
- The Lancet Digital Health. ChatGPT: friend or foe? Lancet Digit Health. 2023;5(3):e102.
- Huang L, et al. A survey on hallucination in large language models: principles, taxonomy, challenges, and open questions. arXiv. 2023;2311.05232.
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):248.
- Yang R, et al. Retrieval-augmented generation for generative artificial intelligence in health care. npj Health Syst. 2025;2(2).
- Zakka C, et al. Almanac—retrieval-augmented language models for clinical medicine. NEJM AI. 2024;1(2):AIoa2300068.
- Chow JCL, Li K. Developing effective frameworks for large language model-based medical chatbots: insights from radiotherapy education with ChatGPT. JMIR Cancer. 2025;11:e66633.
- Chow JCL, Li K. Large language models in medical chatbots: opportunities, challenges, and the need to address AI risks. Information. 2025;16(7):549.
- Nishisako S, Higashi T, Wakao F. Reducing hallucinations and trade-offs in responses in generative AI chatbots for cancer information: development and evaluation study. JMIR Cancer. 2025;11:e70176.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-9474.
- Gao Y, et al. Retrieval-augmented generation for large language models: a survey. arXiv. 2023;2312.10997.
- Jeong M, Sohn J, Sung M, Kang JJB. Improving medical reasoning through retrieval and self-reflection with retrieval-augmented large language models. Bioinformatics. 2024;40:i119-i129.
- Lewis M, et al. Grounding large language models in clinical evidence: a retrieval-augmented generation system for querying UK NICE clinical guidelines. arXiv. 2025;2510.02967.
- Ministry of Education, Culture, Sports, Science and Technology; Ministry of Health, Labour and Welfare; Ministry of Economy, Trade and Industry. Ethical guidelines for medical and biological research involving human subjects [Article in Japanese]. Ministry of Health, Labour and Welfare.
- Gallifant J, et al. The TRIPOD-LLM reporting guideline for studies using large language models. Nat Med. 2025;31:60-69.
- The Japanese Lung Cancer Society. JLCS Guidebook for Lung Cancer Patients and Families. Available at: https://www.haigan.gr.jp/public/guidebook/2024/. Accessed January 21, 2026.
- Liu M, et al. Evaluating the effectiveness of advanced large language models in medical knowledge: a comparative study using Japanese national medical examination. Int J Med Inform. 2025;193:105673.
- Kudo T, Yamamoto K, Matsumoto Y. Applying conditional random fields to Japanese morphological analysis. In: Proceedings of the 2004 Conference on Empirical Methods in Natural Language Processing. 2004:230-237.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.