W pracy zaproponowano kompleksowy, multimodalny system analizy emocji, który wykorzystuje koderach transformera, rozdzielone reprezentacje emocji oraz oparty na grafach mechanizm uwagi między-modalnej z mapowaniem wizualnym w celu zwiększenia dokładności rozpoznawania emocji w dwóch zbiorach danych.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Wizualne mapowanie multimodalnych cech emocji dla projektowania inteligentnych interakcji
W tym artykule
Podsumowanie
Streszczenie
Wizualne mapowanie multimodalnych cech emocjonalnych ma kluczowe znaczenie dla projektowania inteligentnych interfejsów, umożliwiając maszynom rozumienie, interpretowanie i reagowanie na afektywne stany człowieka. Niemniej jednak obecne algorytmy multimodalnego wykrywania emocji koncentrują się głównie na wydajności predykcyjnej, oferując niewielki wgląd w interpretowalność, świadomość interakcji czy międzymodalne interakcje na poziomie cech. W niniejszej pracy przedstawiono ramy wizualnego mapowania aspektów emocji multimodalnych, które łączą wizualizację zorientowaną na interakcję, interpretowalną naukę reprezentacji oraz predykcję emocji. Bez użycia ręcznie tworzonych cech, do ekstrakcji wysokopoziomowych osadzeń emocjonalnych z modalności tekstowej, dźwiękowej i wizualnej wykorzystano koderów opartych na transformerach. W celu zwiększenia odporności, informacje specyficzne dla emocji oraz specyficzne dla modalności zostały rozdzielone za pomocą techniki rozplątanej nauki reprezentacji. Dodatkowo stworzono opartą na grafach sieć uwagi międzymodalnej, wykorzystującą adaptacyjne ważenie uwagi do symulowania subtelnych relacji emocjonalnych między modalnościami. W celu zwiększenia przejrzystości opracowano moduł wielowidokowego mapowania wizualnego, który obrazuje czasowe trajektorie emocji, rozkłady uwagi międzymodalnej oraz ukryte osadzenia emocjonalne. Do oceny zaproponowanych ram wykorzystano zbiór danych Carnegie Mellon University Multimodal Opinion Sentiment and Emotion Intensity (CMU-MOSEI) oraz Chinese Multimodal Sentiment Analysis Dataset (CH-SIMS). Wyniki eksperymentalne wykazały, że zaproponowane ramy zapewniły lepszą interpretowalność na poziomie cech i wizualizację świadomą interakcji, konsekwentnie przewyższając reprezentatywne techniki bazowe pod względem dokładności, wskaźnika F1, korelacji oraz średniego błędu absolutnego. Ponadto moduł mapowania wizualnego umożliwił jakościową interpretację multimodalnych reprezentacji emocji, interakcji międzymodalnych i czasowej dynamiki emocji, wspierając analizę i wizualizację świadomą interakcji.
Wprowadzenie
Zdolność do prawidłowej identyfikacji i rozumienia ludzkich emocji stała się kluczowa dla usprawnienia interakcji między ludźmi a maszynami. Analiza emocji, poza tym że jest niezbędna do poprawy interakcji człowiek-komputer, ma potencjał zrewolucjonizować szereg dziedzin, w tym przeddiagnostykę medyczną1, analizę behawioralną w klasie2, monitorowanie psychologiczne pacjentów3, identyfikację zmęczenia w pojazdach4 oraz inteligentne zarządzanie w środowiskach inteligentnego domu5. Ostatnie osiągnięcia w dziedzinie informatyki afektywnej i uczenia głębokiego6 zwiększyły zainteresowanie tworzeniem systemów czasu rzeczywistego, które potrafią uchwycić złożoność ludzkich emocji.
Wiele obecnych metod opiera się głównie na danych unimodalnych, takich jak sygnały tekstowe, graficzne lub słuchowe7,8,9. Podejścia te wielokrotnie zawodzą w wykrywaniu subtelnych sygnałów, takich jak sarkazm czy niuanse zależne od kontekstu. Badania przesunęły się w stronę multimodalnej oceny emocji, która w celu przełamania tych ograniczeń łączy komplementarne dane z wielu źródeł10,11,12. Zalety łączenia wielu modalności zostały wykazane w modelach bazowych, takich jak wczesna fuzja z długo-krótkotrwałą pamięcią (EF-LSTM)13, lekkie głębokie sieci neuronowe FM (LF-DNN)14, sieci fuzji tensorowej (TFN) oraz podejścia oparte na fuzji multimodalnej o niskim rzędzie. Jednak większość tych metod opiera się na offline'owej generacji cech i nie nadaje się do dynamicznych sytuacji w świecie rzeczywistym.
W celu uwzględnienia stanów emocjonalnych, w ciągu ostatnich dziesięciu lat rozwinęły się badania i zastosowania w zakresie multimodalnej identyfikacji emocji15. Jednym z najbardziej wymagających i istotnych obszarów współczesnych badań jest ciągłe monitorowanie stanów emocjonalnych z wykorzystaniem różnorodnych źródeł danych16. Koncepcja multimodalności pojawiła się w sposób naturalny wraz z powstaniem tak zróżnicowanego systemu wiedzy, co doprowadziło do wielu postępów w wykorzystaniu emocji w dziedzinach takich jak obliczenia emocjonalne, interakcja człowiek-komputer (HCI), uczenie się, gry wideo, obsługa klienta, opieka medyczna, ocena doświadczeń użytkownika (UX) itp. Jednak zastosowanie technik rozpoznawania emocji w ewaluacji UX nie zawsze było tak proste.
Jednym z głównych powodów skupienia się na rozpoznawaniu multimodalnym, a nie na metodach unimodalnych, są immanentne wady polegania na pojedynczym źródle informacji. Systemy unimodalnego wykrywania emocji mogą cechować się niższą dokładnością z powodu brakujących lub niejasnych danych, podczas gdy schematy MER są bardziej niezawodne i oferują bardziej kompleksowe oraz wnikliwe zrozumienie stanów ekspresyjnych poprzez integrację wielu źródeł danych17. Na przykład sam język mimiki może być niewystarczający do precyzyjnej klasyfikacji uczuć, szczególnie gdy gesty są złożone lub niejasne. Jednak połączenie wyrazów twarzy z innymi formami komunikacji, takimi jak język lub sygnały fizyczne, może zwiększyć dokładność rozpoznawania uczuć.
Przeprowadzono szeroko zakrojone badania nad rozpoznawaniem emocji z wykorzystaniem kilku modalności. Wczesne studia koncentrowały się na identyfikacji cech wyróżniających w różnych modalnościach, takich jak dane graficzne, akustyczne lub tekstowe. Coraz bardziej oczywiste staje się jednak, że integracja różnych modalności może dostarczyć zrównoważonych informacji emocjonalnych, co prowadzi do bardziej wiarygodnego i precyzyjnego wykrywania sentymentu. Niniejszy segment omawia kluczowe postępy w jednowymiarowej i multimodalnej analizie emocji, koncentrując się na podejściach bazowych, ich niedociągnięciach oraz uzasadnieniu zastosowanej przez nas metody.
Wstępne badania nad rozpoznawaniem emocji koncentrowały się głównie na pojedynczej modalności. W obszarze wizualnym przełomowe badania doprowadziły do kategoryzacji prototypowych ruchów twarzy20. Kolejne postępy obejmowały techniki rejestrowania dynamiki czasowej, takie jak ruch wizualny21 oraz ukryte modele Markowa22, podczas gdy reakcje twarzy zostały podzielone na jednostki akcji przy użyciu Systemu Kodowania Ruchów Twarzy (FACS)23. Sieci LSTM oraz konwolucyjne sieci neuronowe (CNN) były z sukcesem wykorzystywane do ekstrakcji istotnych cech bezpośrednio z surowych sygnałów audio; metodologie identyfikacji emocji na podstawie dźwięku ewoluowały od konwencjonalnego przetwarzania sygnałów do głębokiego uczenia24. Ekstrakcja kontekstowych sygnałów sentymentu w tekstowej analizie emocji została znacznie usprawniona dzięki rekurencyjnym sieciom neuronowym (RNN) z wbudowanymi mechanizmami uwagi, a w ostatnim czasie przez modele oparte na transformerach. Pomimo tych osiągnięć, techniki unimodalne są z natury niezdolne do dokładnego odwzorowania złożoności doświadczeń ludzkich, ponieważ brakuje im informacji uzupełniających dostępnych w innych modalnościach.
W 2021 roku zaproponowano niektóre modele oparte na mechanizmach uwagi, takie jak model DialogXL25, w celu gromadzenia długoterminowych danych środowiskowych w obszarze identyfikacji sentymentu w konwersacjach. Kim i wsp.26 wprowadzili w 2021 roku model EmoBERTa, aby zwiększyć dokładność ERC. Model ten wykorzystuje dane o mówcach w celu ulepszenia cech uczestników rozmów oraz ich wzajemnych interakcji. W 2022 roku Li i wsp.27 zaprezentowali metodę CoG-BART. Organizacja ta wykorzystuje nadzorowane uczenie kontrastowe, aby poprawić zdolność modelu do interpretacji istotnych danych. Należy zauważyć, że uczenie nadzorowane wymaga znacznej ilości etykietowanych danych.
Typowym przykładem takich prac jest framework Multimodal Interaction-Aware Representation (MIAR)28, który wykorzystuje tokeny interakcji cech oraz wyrównanie kontrastowe w celu poprawy generalizacji między modalnościami. MIAR poprawia wyrównanie modalności i osiąga wysoką skuteczność w wielu zbiorach danych; jednak koncentruje się on przede wszystkim na dokładności predykcji, nie zajmując się odwzorowaniem wizualnym. Podobnie model Cross-Attentional Audio-Visual Fusion29 skutecznie rejestruje szczegółowe interakcje audiowizualne dla predykcji walencji i pobudzenia, ale jest ograniczony do dwóch modalności i nie posiada możliwości wizualizacji. Podejścia do modelowania czasowego oparte na sieciach LSTM i fuzji autoenkoderów pomyślnie oddają dynamikę czasową emocji, lecz zapewniają ograniczony wgląd w interakcje modalności i wyuczone reprezentacje emocjonalne. W ostatnim czasie metody oparte na transformerach, takie jak Transformer-based Multimodal Fusion Network (TMFN)30, wykazały wysoką skuteczność w zbiorach CMU-MOSI i CMU-MOSEI dzięki ulepszonej fuzji multimodalnej i uczeniu kontrastowemu. Niemniej jednak, podejścia te pozostają głównie zorientowane na wydajność i oferują ograniczone wsparcie dla wyjaśnialności, interpretacji na poziomie cech oraz wizualizacji zorientowanej na interakcje.
W celu usprawnienia integracji danych tekstowych, akustycznych i wizualnych zaproponowano szereg multimodalnych technik rozpoznawania emocji. Choć wczesne techniki fuzji, takie jak EF-LSTM i LF-DNN, nie były w stanie uchwycić złożonych interakcji międzymodalnych, wykazały one zalety wykorzystania informacji multimodalnych w analizie sentymentu i emocji. Mimo że model TFN poprawił wyniki na zbiorach referencyjnych, takich jak CMU-MOSI i CMU-MOSEI, oraz wprowadził jawne modelowanie interakcji międzymodalnych, jego użyteczność była ograniczona przez niską interpretowalność i wysoką złożoność obliczeniową. Aby poprawić dopasowanie modalności oraz dynamiczną fuzję cech, nowsze techniki, takie jak MIAR, modele fuzji z wzajemną uwagą (cross-attentional fusion), TMFN oraz adaptacyjne transformery multimodalne, wykorzystały topologie transformerów i mechanizmy uwagi. Metody te koncentrowały się przede wszystkim na wydajności predykcyjnej, oferując niewielki wgląd w reprezentacje emocjonalne na poziomie cech i zależności międzymodalne, mimo osiągnięcia konkurencyjnych wyników w powszechnych metrykach ewaluacyjnych, takich jak dokładność (accuracy), F1-score oraz średni błąd bezwzględny (mean absolute error). Ponadto niewiele badań opracowało techniki wizualizacji zdolne do ujawnienia ukrytych osadzeń emocji (latent emotion embeddings), rozkładów uwagi i czasowej dynamiki emocji, lub zintegrowało modelowanie interakcji międzymodalnych oparte na grafach. Zaproponowane podejście łączy wielowidokowe mapowanie wizualne, fuzję uwagi międzymodalnej opartą na grafach oraz uczenie reprezentacji rozplecionych (disentangled representation learning), aby wyeliminować te wady i zwiększyć wydajność multimodalnego rozpoznawania emocji.
Podobnie, Adaptive Multimodal Transformer32 proponuje fuzję opartą na wymianie, aby adaptacyjnie niwelować zakłócenia lub brakujące informacje modalne, zwiększając tym samym skuteczność klasyfikacji sentymentu. Chociaż podejście to może efektywnie rozwiązywać rozbieżności w rozkładzie informacji modalnych, jego konstrukcja jest specyficzna dla zadania analizy sentymentu i dostarcza ograniczonych informacji na temat wyuczonych reprezentacji emocjonalnych. Innym istotnym wkładem jest Multimodal Fusion Model33, który integruje sieci CNN, multiplikatywne sieci LSTM oraz mechanizm uwagi oparty na transformerach w celu rozpoznawania emocji multimodalnych w czasie rzeczywistym. Model ten przeprowadza pełną fuzję modalności wideo, audio i tekstu, wykazując wysoką skuteczność rozpoznawania. Niemniej jednak, podobnie jak inne istniejące modele, koncentruje się on głównie na dokładności predykcyjnej i brakuje mu jawnych cech umożliwiających wizualizację oraz interpretowalność zorientowaną na interakcję.
Podsumowując, choć obecne, najnowocześniejsze podejścia do multimodalnego rozpoznawania emocji odniosły znaczny sukces w przechwytywaniu interakcji międzymodalnych i zwiększaniu dokładności predykcji, większość z nich koncentruje się na zadaniach zorientowanych na samo rozpoznawanie. Mało uwagi poświęcono obszarom takim jak interpretowalność na poziomie cech, wizualizacja reprezentacji emocjonalnych w przestrzeni obrazu oraz włączanie proponowanego frameworka do projektowania inteligentnych interakcji. To właśnie z myślą o tych wyzwaniach wprowadzono proponowany framework.
Większość obecnych metod koncentruje się przede wszystkim na poprawie wydajności predykcyjnej, oferując niewielką interpretowalność wyuczonych reprezentacji emocjonalnych oraz interakcji między-modalnych, pomimo znaczących postępów w multimodalnym rozpoznawaniu emocji28,29. Złożone interakcje między modalnościami tekstową, akustyczną i wizualną są często trudne do wymodelowania dla obecnych strategii fuzji, szczególnie w przypadku wystąpienia rozbieżności między modalnościami oraz braków w informacjach 28,31. Chociaż architektury oparte na transformerach i mechanizmy uwagi usprawniły uczenie reprezentacji, ich przejrzystość i interpretowalność są często ograniczane przez brak wyraźnego oddzielenia informacji specyficznych dla emocji od informacji specyficznych dla modalności31,32,33. Ponadto tylko niewielka liczba badań analizowała modelowanie interakcji intermodalnych w oparciu o grafy lub tworzyła frameworki wizualizacyjne zdolne do ujawnienia temporalnej dynamiki emocji, rozkładów uwagi oraz embeddingów emocjonalnych. Wady te wskazują na konieczność opracowania interpretowalnego frameworka multimodalnego dla inteligentnej interakcji człowiek-maszyna, który łączyłby zorientowane na interakcję mapowanie wizualne z silnym uczeniem między-modalnym.
Niniejsza praca przedstawia interpretowalny model wizualnego mapowania multimodalnych aspektów emocji w projektowaniu inteligentnych interfejsów. Bez konieczności ręcznego tworzenia cech, system wykorzystuje głębokie uczenie end-to-end do ekstrakcji wysokopoziomowych reprezentacji emocjonalnych z modalności tekstowej, audio i wizualnej. Międzymodalne interakcje emocjonalne są modelowane za pomocą grafowego mechanizmu fuzji uwagi, który oddziela informacje specyficzne dla emocji od informacji specyficznych dla modalności, co umożliwia naukę rozplątanych reprezentacji oraz poprawia interpretowalność i odporność modelu. Dodatkowo stworzono moduł wizualizacji wielowidokowej, aby przedstawić czasową dynamikę emocji, międzymodalne wzorce uwagi oraz osadzenia emocji. Skuteczność i przydatność proponowanego modelu w inteligentnych systemach interakcji człowiek-maszyna zostały ocenione poprzez walidację na referencyjnych zbiorach danych do multimodalnego rozpoznawania emocji.
Niniejsza praca oferuje unikalne ramy dla wizualnego mapowania multimodalnych aspektów emocji, które wykraczają poza tradycyjne podejścia zorientowane na predykcję, aby przezwyciężyć słabe modelowanie interakcji międzymodalnych oraz ograniczoną interpretowalność w obecnych systemach identyfikacji emocji multimodalnych. W ramach jednej architektury zaproponowane podejście łączy multimodalne uczenie reprezentacji oparte na transformatorach, rozplecione (disentangled) modelowanie cech świadomych emocji, fuzję uwagi międzymodalnej opartą na grafach oraz wizualizację zorientowaną na interakcje. W przeciwieństwie do obecnych podejść, które koncentrują się głównie na wydajności klasyfikacji, opracowane ramy wyraźnie oddzielają reprezentacje specyficzne dla emocji od reprezentacji specyficznych dla modalności, co poprawia interpretowalność, odporność i spójność międzymodalną. Dodatkowo przedstawiono mechanizm uwagi oparty na grafach, aby umożliwić adaptacyjne modelowanie interakcji międzymodalnych poprzez przechwytywanie drobnoziarnistych współzależności emocjonalnych pomiędzy modalnościami tekstową, dźwiękową i wizualną. Stworzono moduł wizualnego mapowania wielowidokowego w celu zwiększenia przejrzystości poprzez ujawnienie czasowych trajektorii emocji, wzorców uwagi międzymodalnej i ukrytych osadzeń (embeddings) emocji, co zapewnia intuicyjny wgląd w proces podejmowania decyzji przez model. Oprócz zapewnienia lepszej wizualizacji i interpretowalności multimodalnej dynamiki emocjonalnej, ocena eksperymentalna na zbiorach danych referencyjnych CH-SIMS i CMU-MOSEI wykazała konkurencyjną wydajność pod względem dokładności, miary F1-score, średniego błędu bezwzględnego oraz korelacji.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Zaproponowana praca ma na celu poprawę projektowania inteligentnej interakcji poprzez zaproponowanie interpretowalnego ramowego podejścia do wizualnego mapowania wielomodalnych cech emocjonalnych. W pracy wykorzystano bazy danych CH-SIMS oraz CMU-MOSEI, które są publicznie dostępne. Oba zestawy danych pozyskano z oficjalnych źródeł i wykorzystano zgodnie z wytycznymi użytkowania, standardami badawczymi oraz warunkami licencyjnymi określonymi przez ich odpowiednich twórców. Wielomodalna zawartość zestawów danych, w tym dane tekstowe, audio oraz wideo, została najpierw zebrana i opisana przez dostawców danych zgodnie z uprawnieniami uczestników oraz protokołami gromadzenia danych. W badaniu nie miało miejsca bezpośredni kontakt z ludźmi, nie prowadzono rekrutacji nowych uczestników ani gromadzenia informacji umożliwiających identyfikację osób. Wszystkie analizy przeprowadzono przy użyciu publicznie dostępnych zestawów danych badawczych. W związku z tym nasza analiza danych wtórnych nie wymagała dodatkowej zgody etycznej ani przeglądu przez Komisję ds. Etyki Badań (IRB). Badanie przeprowadzono zgodnie z odpowiednimi wewnętrznymi zasadami instytucji regulującymi wykorzystywanie publicznie dostępnych zestawów danych, etyczne procedury badawcze oraz obowiązujące polityki wykorzystania danych.
Zastosowano opartą na grafach międzymodalną mechanikę uwagi, aby nauczyć się charakterystyki emocji w różnych modalnościach, wykorzystując cechy specyficzne dla emocji lub modalności w celu poprawy zrozumienia. Składnik wielowidokowego mapowania wizualnego jest używany do wzmocnienia interaktywnego projektowania z uwzględnieniem emocji w czasie rzeczywistym, a jego skuteczność szacowana jest w zakresie rozpoznawania emocji. Wyniki pokazują, że proponowana metoda poprawia zarówno interpretowalność, jak i efektywność inteligentnych interfejsów użytkownika zorientowanych na emocje w warunkach rzeczywistych. Rysunek 1 przedstawia schemat architektury proponowanego rozwiązania. Rysunek 1 pokazuje pełen schemat pracy proponowanego ramowego podejścia do wizualnego mapowania w kontekście uczenia się cech emocji w systemach interakcji wielomodalnej. Schemat rozpoczyna się od trzech zsynchronizowanych modalności wejściowych, a mianowicie tekstu, dźwięku i wideo, które pozyskują uzupełniające informacje emocjonalne odpowiednio z modalności językowej, prosodycznej i ekspresji twarzy. Każdy rodzaj modalności jest przetwarzany przez enkoder transformatora specyficzny dla danej modalności, w celu uzyskania reprezentacji wysokopoziomowych surowych danych wejściowych. Następnie reprezentacje są przekazywane do modułu uczenia się rozłączonych reprezentacji, w którym osadzenia specyficzne dla emocji są oddzielane od cech specyficznych dla modalności, aby zapewnić spójność nauczonych emocji w różnych źródłach danych. Osadzenia specyficzne dla emocji z każdej modalności są następnie agregowane przez opartą na grafach sieć uwagi międzymodalnej, która modeluje zależności emocjonalne między modalnościami i przypisuje dynamiczne wagi istotności każdej modalności na podstawie kontekstu interakcji. Ostatecznie ramy zapewniają zarówno wyniki klasyfikacji emocji, jak i wglądy w interakcję, co ułatwia przejrzyste podejmowanie decyzji zorientowanych na emocje oraz adaptacyjne projektowanie inteligentnej interakcji.
Uzyskiwanie danych multimodalnych
Zestawy danych CH-SIMS i CMU-MOSEI to dwa istniejące publiczne zestawy danych wielomodalnych, które zawierają informacje wielomodalne, takie jak zsynchronizowane wideo, dźwięk i tekst. Zestaw danych CH-SIMS obejmuje wielomodalne badania osób chińskich, w tym 2 281 segmentów wideo, pochodzących z wielu fragmentów filmów, seriali telewizyjnych oraz programów rozrywkowych. Dodanie odpowiadającego dźwięku i tekstu do tych segmentów wideo czyni badania nad analizą emocji z wykorzystaniem danych wielomodalnych bardziej interesującymi i wykonalnymi. Jednak największym zbiorem danych wielomodalnych służącym do analizy opinii, uczuć i emocji jest zestaw danych CMU-MOSEI, zebrany z ponad 23 000 klipów wideo zawierających wypowiedzi więcej niż 1000 mówców na różnorodne tematy. Zestaw danych został podzielony losowo na podzbiory treningowy (70%), walidacyjny (15%) i testowy (15%) z zachowaniem rozkładu klas.
Transkrypcje tekstowe, sygnały dźwiękowe i klatki wideo są uzyskiwane i synchronizowane za pomocą znaczników czasu, by odpowiadały sobie na drobnoziarnistym poziomie czasowym. Integracja na poziomie klatek zapewnia, że proponowane mechanizmy uczenia reprezentacji i fuzji opartej na grafach mogą łącznie modelować i wykorzystywać emocjonalną treść pochodzącą z ekspresji wizualnych, tonu głosu oraz treści językowych. Efektywne wydobywanie międzymodalnych dynamik emocjonalnych umożliwia ten typ techniki pozyskiwania danych wielomodalnych, który jest niezbędny dla projektowania inteligentnej interakcji i zrozumiałego mapowania wizualnego.
Tabela 1 przedstawia kluczowe struktury multimodalnych zbiorów danych emocjonalnych wykorzystanych w proponowanej metodzie. Aby uzyskać szerszy zakres powiązanych uczuć, takich jak wypowiadane słowa, intonacje głosu i wyrażenia twarzy, CH-SIMS oraz CMU-MOSEI integrują modalności wideo, audio i tekstowe pochodzące z tych zbiorów danych. Ponadto, w zbiorze CH-SIMS dostępna jest ograniczona liczba próbek danych, co umożliwia dogłębne zbadanie interakcji modalności oraz zmienności emocji w kontekście chińskim. Z drugiej strony, zbiór danych CMU-MOSEI ma większe znaczenie przy ocenie odporności algorytmów uczenia reprezentacji oraz powiązanych metod wizualizacji omawianych w tej pracy, ponieważ zawiera dużą ilość danych obejmujących różne języki, osoby oraz poziomy oznaczone emocji. Dodatkowo, w porównaniu do wcześniejszych badań, zmniejsza on trudności związane z wyborem informacji podczas testowania modeli.
Przetwarzanie wielomodalne i synchronizacja
Oznaczenia czasowe z zestawów danych CH-SIMS i CMU-MOSEI wykorzystano do synchronizacji modalności tekstowych, dźwiękowych i wizualnych, zapewniając spójne uczenie się reprezentacji wielomodalnych. Każda wypowiedź stanowiła podstawową jednostkę analizy i była powiązana z odpowiadającymi segmentami audio i wideo w tym samym przedziale czasowym. Wyrównanie przeprowadzono na poziomie wypowiedzi. Transkrypcję podzielono na segmenty na podstawie znaczników czasu początku i końca każdej wypowiedzi. Odpowiedniość między transkrypcją, dźwiękiem i obrazem ustanowiono poprzez wyodrębnienie odpowiadających klatek wideo i sygnałów dźwiękowych mieszczących się w tym samym przedziale czasowym. Podczas gdy segmenty dźwiękowe przetwarzano za pomocą Wav2Vec 2.0 w celu uzyskania reprezentacji akustycznych, ramki wizualne z segmentu wideo próbkowano z ustaloną częstotliwością i kodowano przy użyciu transformatora wizyjnego (ViT). Enkoder RoBERTa wykorzystano do tworzenia osadzeń tekstowych na podstawie transkrypcji wypowiedzi. Synchronizację czasową osiągnięto poprzez wyrównanie wszystkich cech modalności do jednej granicy wypowiedzi, ponieważ trzy modalności generowały sekwencje cech o różnej długości. Do normalizacji sekwencji o różnej długości zastosowano format o ustalonej długości. Dłuższe sekwencje skrócono do maksymalnej dozwolonej długości sekwencji, a krótsze uzupełniono zerami. Podczas uczenia maski uwagi stosowano w celu oddzielenia uzupełnionych elementów od prawidłowych pozycji cech. Osadzenia specyficzne dla modalności rzutowano do wspólnej przestrzeni ukrytej przed fuzją, aby pokonać różnice w długości sekwencji pomiędzy modalnościami. Zapewniło to spójność wymiarową i umożliwiło mechanizmowi uwagi opartemu na grafach skuteczne uczenie się interakcji międzymodalnych. Aby zachować jakość danych i integralność synchronizacji, próbki z uszkodzonymi plikami, brakującymi adnotacjami lub niepełnymi informacjami modalnymi wykluczono z badań.
Ekstrakcja cech oparta na transformatorach
Metoda uczenia głębokiego jest wykorzystywana do pozyskiwania reprezentacji cech wysokiego poziomu, uwzględniających emocje, z informacji pochodzących z wielu modalności, takich jak wizja, dźwięk i tekst, w sposób kompleksowy, po wyrównaniu danych wielomodalnych oraz po wykonaniu wszelkich wymaganych wstępnych przetwarzania. Dzięki zastosowaniu enkodera typu transformer w celu pozyskiwania wewnętrznie dyskryminacyjnych reprezentacji cech z surowych danych wielomodalnych, proponowana metoda eliminuje potrzebę inżynierii cech. Aby zapewnić spójność pomiędzy zestawami danych wykorzystywanymi w proponowanym podejściu, dla każdej modalności uczy się osadzenia o ustalonej wielkości. Na przykład, osadzenia cech o wymiarze 768 są uczone dla każdej z poszczególnych modalności, w tym obrazu, dźwięku i tekstu, tworząc wspólną przestrzeń cech stosowaną w całym podejściu, w szczególności podejście do ekstrakcji cech wykorzystywane w zestawie danych CH-SIMS oraz w zestawie danych CMU-MOSEI w celu pozyskiwania cech wysokiego poziomu z danych o różnych rozmiarach.
Modalność wizualna: transformator wizji do osadzania ramek z uwzględnieniem emocji
Model typu Vision Transformer (ViT-Base) został wykorzystany do wyodrębnienia informacji wizualnych z klatek wideo w celu uzyskania przestrzennych reprezentacji związanych z emocjami. Przed ekstrakcją cech ramki każdego segmentu wideo zostały przeskalowane do rozmiaru (224 × 224) pikseli i próbkowane w regularnych odstępach czasowych. Używając rozmiaru fragmentu 16 × 16 pikseli, architektura ViT-Base generuje serię tokenów wizualnych, które są przetwarzane przez 12 warstw enkodera typu transformer. Uzyskane reprezentacje na poziomie klatek zostały odwzorowane do przestrzeni osadzania o wymiarze 768 przy użyciu wstępnego modelu ViT jako szkieletu wizualnego. Osadzenia na poziomie klatek zostały zagregowane za pomocą uśredniania (mean pooling), tworząc końcową reprezentację wizualną dla każdego segmentu. Podczas treningu stosowano normalizację obrazów oraz typowe metody augmentacji, takie jak losowe przycinanie i odbijanie w poziomie, w celu poprawy zdolności uogólniania. Następnie zastosowano proponowany framework fuzji multimodalnej, aby połączyć te osadzenia wizualne z reprezentacjami tekstowymi i dźwiękowymi.
Aby zachować dynamikę czasową emocji, próbki wideo z zestawów danych CH-SIMS i CMU-MOSEI zostaną jednostajnie próbkowane dla modalności wizualnej. Klatki każdego wideo, 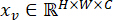 , mogą zostać podzielone na N sekcji o stałym rozmiarze, które następnie są spłaszczone i odwrotnie przekształcone do przestrzeni osadzania ukrytej o wymiarze
 . Seria jest tworzona poprzez dodanie osadzeń pozycyjnych oraz edytowalnego tokenu grupującego:
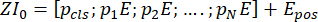 (1)
gdzie  oznacza kodowanie pozycyjne, a
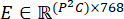 to macierz osadzania fragmentów obrazu (patch embedding matrix).
Używane są warstwy enkodera transformatora ułożone w stos, składające się z sieci typu feed-forward i wielogłowym samouwagą, które przetwarzają sekwencję osadzonych fragmentów. Przekształcenie w warstwie l opisane jest jako:
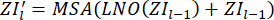 (2)
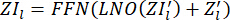 (3)
Aby uzyskać wektor cech wizualnych z uwzględnieniem emocji, wyodrębnia się dane wyjściowe odpowiadające tokenowi klasy jako wektor cech  . Aby zapewnić spójne reprezentacje wizualnych emocji pomimo różnic językowych i treści między zestawami danych, osadzenia na poziomie klatek z każdego segmentu wideo są łączone w celu uchwycenia ekspresji twarzy oraz ewolucji emocji.
Modalność dźwiękowa z wykorzystaniem Wav2Vec 2.0 do reprezentacji intonacji i semantycznych cech akustycznych Kontekstowe osadzenia mowy zostały wygenerowane przy użyciu wstępnego kodera Wav2Vec 2.0 jako podstawy akustycznej. Wektor cech akustycznych o ustalonej długości dla każdej frazy uzyskano poprzez agregację wyjściowych reprezentacji ukrytych za pomocą uśredniania. Model Wav2Vec 2.0 wykorzystano do ekstrakcji reprezentacji akustycznych z sygnałów dźwiękowych w celu uchwycenia kontekstowych i emocjonalnie istotnych cech mowy. Przed ekstrakcją cech nagrania dźwiękowe zostały znormalizowane i przeprobkowane do 16 kHz. Aby zapewnić synchronizację między modalnościami tekstową i wizualną, każdy segment dźwiękowy na poziomie wypowiedzi został wyizolowany przy użyciu granic czasowych podanych w adnotacjach zbioru danych. Wstępny kodera akustycznego został dostrojony podczas treningu modelu w celu poprawy adaptacji do konkretnego zadania, co umożliwiło uzyskanie reprezentacji dokładniej oddających emocjonalne aspekty sygnałów mowy. Następnie wykonano fuzję uwagi międzymodalnej opartej na grafach oraz rozłączne uczenie się reprezentacji, wykorzystując końcowe osadzenia dźwiękowe.
W modalności audio do modelowania sygnałów mowy pochodzących z pierwotnych informacji mowy w zestawach danych CH-SIMS i CMU-MOSEI wykorzystywany jest Wav2Vec-2.0, który bezpośrednio wyodrębnia cechy audio związane z emocjami. Dla każdego wejściowego sygnału mowy  istnieje konwolucyjne kodowanie cech:
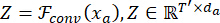 (4)
gdzie Z oznacza niskopoziomowe cechy prosodyczne, takie jak melodia, ton i energia. Sieć kontekstowa oparta na transformatorze jest przydatna dla powyższych struktur, reprezentując długozasięgowe zależności czasowe:
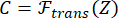 (5)
Dane akustyczne dotyczące cech rytmiczno-melodycznych i semantyki, które są niezbędne do wyrażania emocji, zawarte są w tych kontekstowych reprezentacjach akustycznych. Osadzenie dźwięku o określonej długości tworzy się poprzez wykonanie procedury agregacji czasowej:
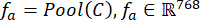 (6)
Projekt unika wykorzystywania cech akustycznych, takich jak MFCC, i osiąga trwałość poprzez proste wyodrębnianie reprezentacji z przebiegów czasowych, wykorzystując dane mowy angielskiej z CMU-MOSEI oraz dane mowy chińskiej z CH-SIMS.
Modalność tekstu przy użyciu RoBERTa do osadzania emocji w kontekście
W przypadku modalności tekstowej, do transkrypcji mowy z dwóch zestawów danych zastosowano głęboki dwukierunkowy transformator RoBERTa w celu wygenerowania kontekstowych znaczeń semantycznych i afektywnych. Do ekstrakcji reprezentacji tekstowych z danych transkrypcyjnych wykorzystano enkodery transformatorowe oparte na RoBERTa, aby uchwycić kontekstowe informacje semantyczne i emocjonalne. Dla zestawu danych CMU-MOSEI w języku angielskim użyto wstępnego modelu RoBERTa, podczas gdy dla chińskiego zestawu danych CH-SIMS zastosowano wariant RoBERTa dla języka chińskiego, aby lepiej uwzględnić językowe cechy specyficzne dla danego języka. Przetwarzanie wstępnego tekstu obejmowało tokenizację przy użyciu odpowiedniego tokenu RoBERTa dla każdego języka oraz normalizację tekstu. Aby zapewnić spójne przetwarzanie partii, sekwencje wejściowe zostały przekształcone w osadzenia tokenów i uzupełnione lub przycięte do ustalonej maksymalnej długości sekwencji. Zgodnie z formatem wejściowym RoBERTa, wprowadzono specjalne tokeny klasyfikacyjne i separatorowe. Uzyskano osadzenie tekstowe o ustalonej długości poprzez agregację kontekstowych reprezentacji tokenów generowanych przez enkoder transformatora przy użyciu końcowej reprezentacji zdania równoważnej [CLS]. Aby dostosować nauczone reprezentacje do zadania rozpoznawania emocji, wstępnie wytrenowane enkodery RoBERTa zostały udoskonalone poprzez wielomodalne uczenie. Następnie zastosowano proponowaną ramę fuzji wielomodalnej, aby połączyć osadzenia tekstowe z cechami audio i wizualnymi.
Osadzenia tokenów i kodowania pozycyjne mogą być połączone dla każdego tokenizowanego wejścia, 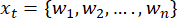 , aby utworzyć reprezentację wejściową w głębokiej dwukierunkowej technice transformacji znanej jako
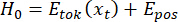 (7)
Ta forma jest reprezentowana przez warstwy transformera L, który wykorzystuje samouwagę do wykrywania zależności kontekstowych między słowami:
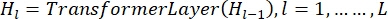 (8)
Osadzanie emocji w kontekście uzyskuje się przy użyciu końcowego stanu ukrytego tokenu klasyfikacji:
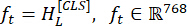 (9)
Polarność nastroju, emocje intensywne oraz powiązane implikacje to przykłady cech językowych związanych z emocjami, które zostaną odwzorowane w tym osadzeniu. RoBERTa ułatwia modelowanie niezależne od języka. Pozwala to systemowi na użycie tego samego rozmiaru osadzenia zarówno dla tekstów angielskich z zestawu danych CMU-MOSEI, jak i dla tekstów chińskich z zestawu danych CH-SIMS.
Trzy wektory cech specyficzne dla danej modalności o wymiarach 768, każdy z modalności wizualnej fv, dźwiękowej fa oraz tekstowej ft, są wyodrębniane w kroku uczenia reprezentacji cech głębokich. W inteligentnym projektowaniu interakcji, te wyuczone reprezentacje tworzą ujednoliconą przestrzeń cech wielomodalnych, która stanowi podstawę dla mapowania na poziomie cech, fuzji międzymodalnej opartej na grafach oraz uczenia się rozłącznych reprezentacji.
Uczenie reprezentacji rozłącznych
Po nauczeniu się głębokiej reprezentacji cech dodatkowe przetwarzanie wektorów cech wielomodalnych pochodzących z modalności wizualnej, dźwiękowej i tekstowej może dać rozłączny opis emocji. Jeśli osadzenia cech specyficznych dla modalności dźwiękowej, wizualnej i tekstowej użyte w poprzednim kroku są reprezentowane przez fv, fa i ft, odpowiednio, takie że  oraz
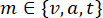 , celem tego kroku jest rozkład wszystkich cech modalności na dwa odrębne ukryte przedstawienia, w tym opisy emocji po uwzględnieniu poprzednich znaczeń każdej z różnych modalności.
Osiąga się to, podając cechę każdego rodzaju sygnału, fm, do dwóch równoległych sieci projekcyjnych: enkodera emocji  oraz enkodera modalności
 , w których generowane są dwa kodowania.
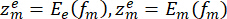 (10)
Gdzie  ukryta cecha związana z emocją jest reprezentowana przez
 , które reprezentuje ukrytą cechę charakterystyczną dla konkretnej modalności. Umożliwia to osadzaniu specyficznemu dla emocji komunikowanie się w przestrzeni poprzez wiele wejść, w tym dźwięk, obraz i tekst, zachowując jednocześnie unikalne dane strukturalne związane z każdą modalnością.
Efektywna separacja jest wymuszana poprzez rekonstrukcję z ograniczeniami niezależności. Rekonstrukcja cech oryginalnej modalności jest dana jako:
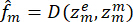 (11)
gdzie  jest siecią dekodującą. Strata rekonstrukcji zachowuje następujące dane:
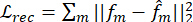 (12)
Dodatkowo ortogonalność, czyli dekorelacja, między emocjami a charakterystycznymi dla danej modalności przedstawieniami często ogranicza nakładanie się informacji:
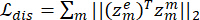 (13)
Osiągając te cele, model może nauczyć się reprezentacji emocji, które są wiarygodne, zrozumiałe i odporne na zmienność modalności. Późniejsza oparta na grafach fuzja wielomodalna oraz cechy mapowania wizualnego, szczególnie przy projektowaniu inteligentnej interakcji, w dużej mierze zależą od interpretowalnych, ustrukturyzowanych reprezentacji emocji.
Spójność emocji między modalnościami
Dodanie spójności emocjonalnej wyraźnie zwiększa skuteczność fuzji między modalnościami. Dzieje się tak, ponieważ strategie fuzji nie muszą uwzględniać dużych różnic między dwiema reprezentacjami, ponieważ osadzenia emocji specyficzne dla danej modalności współdzielą przestrzeń ukrytą. Łączna ilustracja dwóch emocji jest opisana następująco  . Fuzja ważona będzie bardziej stabilna, gdy reprezentacje specyficzne dla emocji będą spójne, ponieważ wariacje sygnałów z różnych modalności nie będą już wpływać na wynik.
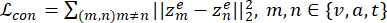 (14)
Wymuszając semantyczne dopasowanie informacji emocjonalnych, ten cel minimalizuje rozbieżności między różnymi modalnościami i zapewnia spójność percepcji emocji niezależnie od modalności użytej do ich wyrażenia. W konsekwencji spójna i emocjonalna przestrzeń reprezentacji jest tworzona poprzez rzutowanie sygnałów emocjonalnych uzyskanych z sygnałów mowy, ekspresji twarzy oraz treści językowej.
Wpływ na fuzję międzymodalną
Fuzja międzymodalna staje się bardziej efektywna, gdy wprowadza się spójność emocji pomiędzy modalnościami. Mechanizmy fuzji nie muszą już nadrobić znaczących różnic w reprezentacjach międzymodalnych, ponieważ osadzenia specyficzne dla emocji są wyrównane w wspólnej przestrzeni ukrytej. Połączona reprezentacja emocji jest zdefiniowana następująco:
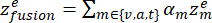 (15)
Gdzie αm reprezentuje wagę poświęconą modalności m. Wspólna agregacja staje się bardziej stabilna i zrozumiała, gdy reprezentacje specyficzne dla emocji są spójne, ponieważ wynik agregacji pokazuje uzupełniające się dowody emocjonalne, a nie sprzeczne sygnały modalności.
Matematycznie, obniżenie  wariancja między różnymi typami reprezentacji specyficznych dla emocji w odniesieniu do jest równoważne:
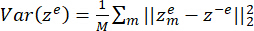 (16)
gdzie  oznacza średnią ekspresję emocji. Zmniejszona wariancja powoduje, że modalności wejściowe są ważone zgodnie z ich dokładnym znaczeniem emocjonalnym, a nie zakłóceniami modalności, co zapewnia lepszą zbieżność sieci oraz bardziej dokładną ocenę uwagi.
Ostatecznym celem naukowym wizualizacji rozłączonych emocji jest połączenie fragmentacji, rekonstrukcji oraz jednolitości emocjonalnej:
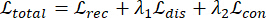 (17)
które dwa hiperparametry, λ1 i λ2, kontrolują związek między niezawodnością emocji w różnych modalnościach a ich rozłączeniem. Proponowany model pozyskuje niezależne od modalności, interpretowalne i możliwe do połączenia reprezentacje emocjonalne, aby osiągnąć ten cel, z naciskiem na zapewnienie solidnej podstawy do późniejszej fuzji opartej na grafach oraz reprezentacji na poziomie cech w projektowaniu inteligentnych interfejsów.
Fuzja uwagi międzymodalnej oparta na grafach
Wykorzystano sieć uwagi międzymodalnej opartą na grafach, aby zasymulować szczegółowe relacje emocjonalne pomiędzy modalnościami. Aby ułatwić przepływ informacji między modalnościami, zbudowano w pełni połączony graf wielomodalny, w którym każde modalityczne osadzenie (tekst, dźwięk i obraz) reprezentowane było jako węzeł grafu. Związki między modalnościami wykorzystano do ustalenia macierzy sąsiedztwa grafu, która następnie została ulepszona za pomocą uczonej metody uwagi. Przestrzeń ukrytą wspólną utworzono poprzez połączenie i rzutowanie wyników z kilku głowic uwagi. Jednolitą reprezentację emocji wielomodalnych wygenerowano następnie poprzez agregację reprezentacji węzłów przy użyciu agregacji ważonej uwagą. Ten połączony wektor został następnie przekazany do modułów predykcji i wizualizacji w celu analizy zorientowanej na interakcję oraz rozpoznawania emocji. Moduł fuzji grafowej miał wymiar reprezentacji ukrytej równy 256 oraz zawierał dwie warstwy uwagi grafowej, z których każda posiadała osiem głowic uwagi. Aby określić względną ważność sąsiednich modalności, obliczono i standaryzowano współczynniki uwagi pomiędzy połączonymi węzłami przy użyciu funkcji softmax. Po każdej warstwie uwagi grafowej zastosowano normalizację warstwy, połączenia residualne oraz współczynnik dropout równy 0,2, aby zwiększyć stabilność treningu i zmniejszyć przeuczenie. Po połączeniu i rzutowaniu wyników kilku głowic uwagi na wspólną przestrzeń ukrytą, reprezentacje węzłów zostały połączone w pojedynczy wektor emocji wielomodalnych przy użyciu agregacji ważonej uwagą. Następnie połączona reprezentacja została wykorzystana do mapowania wizualnego wielowidokowego i przewidywania emocji.
Za pomocą wielogłowowej uwagi grafowej przechwycono różnorodne interakcje międzymodalne. Funkcja softmax została wykorzystana do normalizacji współczynników uwagi pomiędzy połączonymi węzłami dla każdego węzła. Aby zwiększyć stabilność treningu i uniknąć przeuczenia, warstwy ułożonej jednostki fuzji grafowej zostały uzupełnione o połączenia resztkowe, normalizację warstwy oraz regularyzację typu dropout.
Wyrazy reprezentują oddzielnie reprezentacje odpowiadające emocjom uzyskanym za pomocą modalności wizualnej, dźwiękowej i tekstowej; każdy komponent znajduje się w przestrzeni ukrytej  . Modele węzłów modalności wykorzystują oznaczenie grafu
 , przy czym węzły zbioru
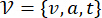 odpowiadają trzem węzłom modalności, aby wyraźnie wzmocnić wspólne zależności emocjonalne między różnymi reprezentacjami modalności.
Po przypisaniu wektora cech specyficznego dla emocji do każdego węzła w grafie, otrzymujemy:
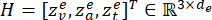 (18)
W przeciwieństwie do tradycyjnych metod fuzji, wykorzystujących wstępnie ustalone lub stałe wagi fuzji, proponowana metoda uczy się adaptacyjnych wag krawędzi na podstawie ich znaczenia oraz wzajemnych zależności, zarówno pomiędzy kanałami, jak i różnymi sytuacjami emocjonalnymi.
Sieć uwagi grafowej (GAT) jest wykorzystywana do fuzji międzymodalnej. Współczynnik uwagi jest obliczany dla każdego węzła i oraz jego sąsiednich węzłów, tj. węzła j:
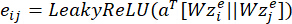 (19)
Efekt emocjonalny przełączania z trybu j na modalność i mierzony jest za pomocą znormalizowanych wag αij.
Następnie obliczany jest połączony wygląd każdego węzła modalności jako ważona grupa jego sąsiadów:
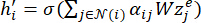 (20)
gdzie funkcja aktywacji  jest nieliniowa. Ostatecznie zaktualizowane cechy każdego węzła są łączone w celu uzyskania globalnej połączonej reprezentacji emocji:
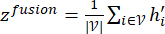 (21)
Jest to przydatna technika do interpretowalnego modelowania emocji i dalszego wizualnego mapowania, ponieważ rejestruje uzupełniające informacje z różnych modalności, zachowując przy tym skomplikowane relacje międzymodalnościowe.
Algorytm 1 (Supplementary File 1) przedstawia ogólny schemat przeprowadzenia grafowej fuzji wielomodalnej. Na początku tworzony jest graf z cechami specyficznymi dla emocji powiązanymi z każdą z modalności: wizualną, dźwiękową i tekstową. Następnie obliczane są wyniki uwagi dla każdej pary węzłów grafu, które reprezentują kombinację zależności emocjonalnych. Wyniki te są następnie normalizowane, aby wskazać względną wkład każdej modalności w określony kontekst emocjonalny, umożliwiając nauczenie się wag uwagi. Ogólny wektor osadzania emocji jest generowany w ostatnim etapie poprzez agregację cech powiązanych z węzłami grafu. W tym sensie ogólna fuzja cech wielomodalnych związanych z określonymi emocjami wykazuje potencjał pod względem adaptowalności, interpretowalności i inteligencji kontekstowej.
Rycina 2 przedstawia strukturę i zasadę działania proponowanej sieci uwagi krzyżowo-modalnej do fuzji sentymentu multimodalnego. Osadzenia specyficzne dla emocji, uzyskane niezależnie dla modalności tekstowej, dźwiękowej i wizyjnej, są najpierw przekazywane przez mechanizmy uwagi na poziomie modalności, które uczą się względnej ważności informacji językowych, głosowych i twarzowych w danym kontekście emocjonalnym. Ważone uwagą reprezentacje modalności są następnie łączone w celu utworzenia ujednoliconego osadzenia emocji, w którym macierz uwagi oddaje zależności międzymodalne oraz siłę interakcji. Macierz uwagi nauczona przez sieć dynamicznie moduluje wkłady poszczególnych modalności, umożliwiając skupienie się na modalności najbardziej informacyjnej, podczas ignorowania szumnych i mniej wartościowych. Zebrana reprezentacja emocji umożliwia dokładne rozpoznawanie emocji oraz szczegółową analizę stanów emocjonalnych, takich jak neutralność, przytulenie i niepokój.
Moduł mapowania wizualnego
Z wykorzystaniem sekcji mapowania wizualnego, stworzonej specjalnie w tym celu, inteligentny projektant interakcji może przekształcić ujednoliconą reprezentację stanu emocjonalnego w formę wizualną, która po procesie fuzji międzymodalnej, opartej na grafie, staje się zrozumiała i łatwa do odbioru.
Aby ułatwić zrozumienie ukrytych reprezentacji emocjonalnych, zastosowano techniki redukcji wymiarowości w celu wizualizacji nauczonych wielomodalnych osadzeń emocji. Po zredukowaniu wymiarowości cech przy zachowaniu większości wariancji za pomocą analizy głównych składowych (PCA), osadzenia zostały odwzorowane na przestrzeń dwuwymiarową przy użyciu rozproszonego osadzania stochastycznych sąsiadów t (t-SNE). Do t-SNE wykorzystano liczbę perplexity równą 30, współczynnik uczenia 200 oraz 1000 iteracji optymalizacji. Uzyskane rzuty posłużyły do wizualizacji klastrów specyficznych dla emocji oraz zależności między modalnościami. Znormalizowane wagi uwagi międzymodalnej, uzyskane za pomocą grafowej sieci uwagi, wykorzystano do tworzenia map cieplnych uwagi. Na tych mapach przedstawiono względne wkłady modalności tekstowej, dźwiękowej i wizualnej podczas przewidywania emocji. Nauczane współczynniki uwagi wykorzystano jako wagi krawędzi do tworzenia grafów interakcji międzymodalnych, co umożliwiło wizualną analizę relacji międzymodalnych oraz przepływu informacji w ramach struktury fuzji. Wykresy trajektorii emocji utworzono poprzez monitorowanie rozwoju ukrytych osadzeń emocji w kolejnych wypowiedziach, aby zbadać czasowe dynamiki emocjonalne. Te trajektorie rzutują światło na to, jak zmieniają się stany emocjonalne i wkłady poszczególnych modalności w czasie. Wszystkie wizualizacje stworzono przy użyciu pakietów Pythona Matplotlib i Scikit-learn. W celu oceny interpretowalności, formowania klastrów, wkładów modalności oraz czasowych dynamik emocji przeprowadzono analizy jakościowe wizualizacji osadzeń, grafów interakcji oraz map cieplnych uwagi.
Niech zmienna 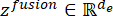 reprezentuje połączoną reprezentację stanu emocjonalnego uzyskaną za pomocą funkcji sieci grafowej z mechanizmem uwagi. W przeciwieństwie do wizualizacji na poziomie wyników wykresów stanu emocjonalnego, głównym celem modułu jest przekształcenie reprezentacji stanu emocjonalnego oraz odpowiadających im wag mechanizmu uwagi w zrozumiałą formę wizualną.
Korzystając z nauczonych wartości αji, tworzona jest mapa cieplna uwagi, umożliwiająca wizualną ocenę wkładu każdej modalności. Następnie sumowane są przychodzące wagi uwagi, aby określić złożony wskaźnik ważności dla każdej modalności:
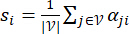 (22)
gdzie si reprezentuje względną emocjonalną przyczynę modalności I. Aby ułatwić tworzenie mapy cieplnej uwagi, uzyskane wartości są normalizowane i odwzorowywane na paletę kolorów, co ułatwia użytkownikowi identyfikację dominującej modalności w różnych krokach czasowych lub stanach interaktywnych. Dzięki różnorodnym modalnościom wejściowym – wizualnym, dźwiękowym lub tekstowym – taki interfejs pomaga użytkownikowi zrozumieć, jak działa mechanizm uwagi systemu.
Nauczony graf jest specyficznie modelowany jako „ważony graf interakcji”, aby reprezentować zależności między modalnościami emocji ludzkich. Samą modalność reprezentuje każdy węzeł w grafie, a siłę interakcji związanych z emocjami ludzkimi reprezentują wagi w postaci αji na krawędziach je łączących. Powyższy ważony graf obrazuje intensywność interakcji emocjonalnych człowieka. Definicja i oraz j jest następująca:
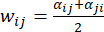 (23)
Grubość linii lub przezroczystość w wizualizacji grafu są odpowiednio wyświetlane dzięki tym wagom. Upraszcza to zrozumienie sposobu oddziaływania modalności. Projektant może lepiej zrozumieć, jak wskaźniki emocjonalne oddziałują na etapie procesu fuzji, dzięki grafom oddziaływania międzymodalnościowego.
Scalone osadzania emocji  w różnych krokach czasowych są redukowane do przestrzeni o niższej liczbie wymiarów za pomocą algorytmu redukcji wymiarowości, takiego jak PCA lub t-SNE, w celu przedstawienia ewolucji emocji w czasie:
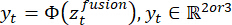 (24)
gdzie funkcja rzutowania jest reprezentowana przez  . Pojawienie się trajektorii emocji 2D/3D, które pokazują przejścia emocjonalne, intensywność oraz stabilność w interakcjach, można interpretować jako intuicyjny obraz ewolucji stanów emocjonalnych w czasie. Te aspekty mogą być wykorzystywane w inteligentnych interakcjach, podejmowaniu decyzji oraz monitorowaniu w czasie rzeczywistym.
W przeciwieństwie do konwencjonalnych systemów emocjonalnych, które jedynie zapewniają mapowania na określone klasy lub wyniki, ten system koncentruje się na pokazaniu, w jaki sposób emocje ludzkie kształtują się w jego wnętrzu. Ujawnia swój proces podejmowania decyzji, oferując wizualizacje cech pośrednich, w tym czynniki wagowe, interakcje między modelami oraz odpowiadające im ścieżki. Pozwala to użytkownikowi zrozumieć, w jaki sposób każdy czynnik — wizualny, głosowy lub językowy — wpływa na generowane przez niego odpowiedzi na emocje ludzkie.
Mapowanie emocji na zrozumiałe formy za pomocą reprezentacji wizualnych może zatem zniwelować lukę między analizą emocji przy użyciu metod uczenia głębokiego a ich integracją w projektowaniu inteligentnych interfejsów. Dane zebrane z obu podejść mogą następnie zostać wykorzystane do tworzenia bardziej precyzyjnych interfejsów użytkownika. W związku z tym proponowane podejście może dostarczyć projektantom interakcji kluczowych informacji umożliwiających tworzenie dokładniejszych interfejsów użytkownika. Innymi słowy, rozumienie emocji staje się bardzo aktywną częścią projektowania interakcji. Dokładność może wzrosnąć wyłącznie wtedy, gdy rozumienie emocji zostanie aktywnie włączone do projektowania interakcji.
Moduł mapowania wizualnego umożliwia wyjaśnialność na kilka powiązanych, ale różnych sposobów: wyjaśnialność na poziomie cech ujawnia podstawowe reprezentacje emocji tworzone przez sieć DNN, umożliwiając zrozumienie semantyki stosowanej do opisu każdej cechy związanej z emocjami; wyjaśnialność na poziomie modalności wykorzystuje dane z grafów interakcji oraz map cieplne uwagi wizualnej, aby opisać, w jaki sposób każda modalność – wizualna, dźwiękowa lub tekstowa – przyczynia się do decyzji dotyczących wyrażania emocji; wreszcie trajektorie wynikające z osadzania emocji pozwalają zrozumieć, jak każda modalność wizualna i tekstowa zmienia się w czasie z perspektywy dynamicznej interakcji. Zobacz algorytm 2 (Supplementary File 1).
Połączone wielomodalne cechy emocjonalne są odwzorowywane na wizualnie znaczące reprezentacje do projektowania inteligentnej interakcji przy użyciu proponowanego algorytmu wizualnego 2. Wagi uwagi wielomodalnej opartej na grafie są wykorzystywane do ilościowego określenia różnic między wejściowymi elementami wizualnymi, dźwiękowymi i tekstowymi w każdym kroku czasowym. Następnie różnice te są odwzorowywane na reprezentacje wizualne, aby podkreślić główne źródła wpływające na emocje, przy użyciu elementów wizualnych mapy cieplnej. Aby zapewnić pogłębiony wgląd w interakcję między elementami wejściowymi i przekazać ewolucję emocji generowaną przez elementy wejściowe wielomodalne, obliczane są siły wzajemnych interakcji w celu utworzenia wag interakcji wielomodalnych. Tymczasem widok ewolucji emocji jest tworzony poprzez odwzorowanie połączonych elementów emocjonalnych gromadzonych w czasie do przestrzeni o niskiej liczbie wymiarów, w celu wytworzenia ciągłej ewolucji elementu emocjonalnego.
Prognozowanie emocji i informacja zwrotna dotycząca interakcji
Wynik scalonej reprezentacji emocji, przedstawiony jako , jest następnie wykorzystywany jako funkcja zarówno do sprzężenia zwrotnego interakcji, jak i do przewidywania emocji. Ponadto przewidywanie emocji opisane jest jako model wielozadaniowy obejmujący zadanie regresji służące rozpoznawaniu ciągłej intensywności emocji oraz zadanie klasyfikacji służące rozpoznawaniu emocji dyskretnych. Do rozpoznawania emocji dyskretnych stosowany jest następujący model klasyfikacji oparty na funkcji softmax:
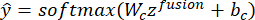 (25)
gdzie  oznacza oczekiwane prawdopodobieństwa klas emocji, a Wc i bc to parametry do nauczenia. Do poprawy celu klasyfikacji wykorzystano funkcję straty entropii krzyżowej:
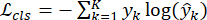 (26)
gdzie yk to rzeczywista etykieta, a K to liczba klas emocji. Gałąź regresyjna służy do równoległego szacowania intensywności emocji, generując przewidywania różnych ciągłych cech afektywnych, w tym walencji i pobudzenia. Nadaj jej następującą definicję:
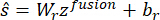 (27)
gdzie oczekiwana wartość intensywności emocji jest wskazywana przez  . Do poprawy zadania regresji wykorzystywana jest funkcja straty oparta na średnim błędzie kwadratowym:
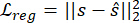 (28)
Ogólnie rzecz biorąc, dwa zadania są łączone w celu predykcyjnym:
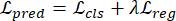 (29)
gdzie cele regresji i klasyfikacji są zrównoważone przez λ. Sugeruje to dynamiczną modyfikację modułu wizualizacji na podstawie zidentyfikowanego stanu emocjonalnego, aby umożliwić tego typu interaktywną pętlę zwrotną. Kontekst interakcji w danym czasie t jest reprezentowany przez ct. Odpowiedź modułu wizualizacji jest dana przez:
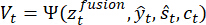 (30)
gdzie funkcja adaptacji wizualizacji jest reprezentowana przez  . Umożliwia to dostosowanie map cieplnych modalności, grafów interakcji oraz trajektorii emocji w czasie rzeczywistym na podstawie przewidywanych zmian i emocji. Oznacza to, że system zapewnia znaczące wsparcie dla sprzężenia zwrotnego, dodatkowo dobrze radząc sobie z przewidywaniem stanów emocjonalnych.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Niniejsza praca waliduje proponowany model mapowania wizualnego dla multimodalnych cech emocjonalnych pod kątem interpretowalności uwzględniającej interakcje oraz wydajności predykcyjnej, wykorzystując dwa zestawy danych referencyjnych: CH-SIMS oraz CMU-MOSEI. Wyniki eksperymentalne wskazują, że sugerowane podejście konsekwentnie osiąga lepsze rezultaty niż obecne techniki multimodalnego rozpoznawania emocji w różnych metrykach, w tym korelacji, dokładności, wyniku F1 oraz średniego błędu absolutnego (MAE). Rozplątana re...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Wyniki eksperymentalne wykazują, że w odniesieniu do zbiorów danych CH-SIMS i CMU-MOSEI proponowany framework mapowania wizualnego dla multimodalnych cech emocji przewyższa aktualne techniki multimodalnego rozpoznawania emocji. W porównaniu z modelami wczesnej i późnej fuzji, takimi jak EF-LSTM i TFN, proponowana technika osiąga wyższą dokładność oraz wartości F1 Score, co świadczy o jej odporności w przetwarzaniu zróżnicowanych informacji emocjonalnych. Poprawę działania tej metody można przypisać rozdzielonej reprezent...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie deklarują żadnych konfliktów interesów.
Podziękowania
Autorzy pragną podziękować za wsparcie udzielone przez School of Housing, Building and Planning, Universiti Sains Malaysia, Penang, Malezja, oraz School of Design Art, Changsha University of Science & Technology, Changsha, Chiny. Autorzy wyrażają również wdzięczność Xiamen Academy of Arts and Design, Fuzhou University, Xiamen, Chiny, za wsparcie akademickie i badawcze podczas realizacji niniejszej pracy.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Adam | Biblioteka optymalizatorów PyTorch | https://pytorch-optimizers.readthedocs.io/en/latest/ (Learning Rate = 1 × 10⁻⁴) | Optymalizacja parametrów podczas trenowania modelu |
| CH-SIMS | Oryginalne repozytorium zbioru danych | Najnowsza wersja publiczna | Zbiór danych referencyjnych do chińskiej multimodalnej analizy sentymentu/emocji |
| CMU-MOSEI | Repozytorium CMU Multimodal SDK | https://github.com/CMU-MultiComp-Lab/CMU-MultimodalSDK (Najnowsza wersja publiczna) | Zbiór danych referencyjnych do multimodalnego rozpoznawania sentymentu i emocji |
| Disentangled Emotion Encoder | Własna implementacja | https://pytorch-geometric.readthedocs.io/en/latest/(Architektura Dual Encoder) | Separacja reprezentacji ukrytych specyficznych dla emocji oraz specyficznych dla modalności |
| Graph Attention Network (GAT) | PyTorch Geometric | Multi-head GAT (https://pytorch-geometric.readthedocs.io/en/latest/) | Modelowanie między-modalnych relacji emocjonalnych i adaptacyjna fuzja cech |
| Graph-Based Cross-Modal Attention Layer | Własna implementacja | Multi-Head Attention Fusion | Uczenie szczegółowych zależności emocjonalnych pomiędzy modalnościami |
| Matplotlib | Projekt Matplotlib | 3.7+ | Generowanie wykresów i analityka wizualna |
| NetworkX | Projekt NetworkX | 3.0+ | Konstrukcja i wizualizacja grafów interakcji między-modalnych |
| NVIDIA GPU | NVIDIA Corporation | GPU z obsługą CUDA | Akceleracja trenowania transformatorów i grafowych sieci neuronowych |
| Principal Component Analysis (PCA) | Scikit-learn | sklearn.decomposition.PCA | Wstępna redukcja wymiarowości wysokowymiarowych osadzeń emocji |
| Python | Python Software Foundation | 3.8+ | Podstawowy język programowania do implementacji frameworka multimodalnej analizy emocji |
| PyTorch | PyTorch Foundation | 2.0+ | Opracowywanie, trenowanie i optymalizacja głębokich sieci neuronowych |
| RoBERTa | Hugging Face Transformers | https://huggingface.co/docs/transformers/index (roberta-base, osadzenia 768-dim) | Ekstrakcja kontekstowych lingwistycznych i semantycznych reprezentacji emocji |
| Seaborn | Projekt Seaborn | 0.12+ | Generowanie map ciepła atencji i wizualizacji statystycznych |
| t-distributed Stochastic Neighbor Embedding (t-SNE) | Scikit-learn | scikit-learn.org (Perplexity = 30, Iterations = 1000) | Wizualizacja klastrów i trajektorii ukrytych emocji |
| Ubuntu Linux | Canonical Ubuntu | 20.04 LTS lub nowsza | Środowisko wykonawcze eksperymentów |
| Vision Transformer (ViT-Base) | Google Research Vision Transformer | ViT-Base/16, osadzenia 768-dim | Ekstrakcja wizualnych reprezentacji uwzględniających emocje z klatek wideo |
| Wav2Vec 2.0 | Meta AI Research | Model bazowy, osadzenia 768-dim | Ekstrakcja kontekstowych akustycznych i mownych cech emocji |
Bibliografia
- Zhu X, et al. EMVAS: End-to-end multimodal emotion visualization analysis system. Complex Intell Syst. 2025;11:1-15.
- Zhu X, et al. A client-server based recognition system: Non-contact single/multiple emotional and behavioral state assessment methods. Comput Methods Programs Biomed. 2025;260:108564.
- Lasri I, Riadsolh A, Elbelkacemi M. Facial emotion recognition of deaf and hard-of-hearing students for engagement detection using deep learning. Educ Inf Technol. 2023;28:4069-4092.
- Saibene A, Assale M, Giltri M. Expert systems: Definitions, advantages and issues in medical field applications. Expert Syst Appl. 2021;177:114900.
- Poria S, Cambria E, Bajpai R, Hussain A. A review of affective computing: From unimodal analysis to multimodal fusion. Inf Fusion. 2017;37:98-125.
- Chatterjee R, et al. Real-time speech emotion analysis for smart home assistants. IEEE Trans Consum Electron. 2021;67(1):68-76.
- Zhu X, Huang Y, Wang X, Wang R. Emotion recognition based on brain-like multimodal hierarchical perception. Multimed Tools Appl. 2024;83:56039-56057.
- Khan M, El Saddik A, Alotaibi FS, Pham NT. AAD-Net: Advanced end-to-end signal processing system for human emotion detection and recognition using attention-based deep echo state network. Knowl Based Syst. 2023;270:110525.
- Chaturvedi I, Chen Q, Cambria E, McConnell D. Landmark calibration for facial expressions and fish classification. Signal Image Video Process. 2022;16:377-384.
- Li D, Liu J, Yang Z, Sun L, Wang Z. Speech emotion recognition using recurrent neural networks with directional self-attention. Expert Syst Appl. 2021;173:114683.
- Zhu X, et al. A review of key technologies for emotion analysis using multimodal information. Cogn Comput. 2024;16:1504-1530.
- Wang R, et al. Multimodal emotion recognition using tensor decomposition fusion and self-supervised multitasking. Int J Multimed Inf Retr. 2024;13:39.
- Fan C, Lin J, Mao R, Cambria E. Fusing pairwise modalities for emotion recognition in conversations. Inf Fusion. 2024;106:102306.
- Williams J, Kleinegesse S, Comanescu R, Radu O. Recognizing emotions in video using multimodal DNN feature fusion. Proceedings of Grand Challenge and Workshop on Human Multimodal Language. Melbourne, Australia. 2018;10.18653/v1/W18-3302.
- Zhao Z, Wang Y, Wang Y. Multi-level fusion of Wav2Vec 2.0 and BERT for multimodal emotion recognition. arXiv. 2022;arXiv:2207.04697.
- Middya AI, Nag B, Roy S. Deep learning based multimodal emotion recognition using model-level fusion of audio-visual modalities. Knowl Based Syst. 2022;244:108580.
- Maithri M, et al. Automated emotion recognition: Current trends and future perspectives. Comput Methods Programs Biomed. 2022;215:106646.
- Wu Y, Mi Q, Gao T. A comprehensive review of multimodal emotion recognition: Techniques, challenges, and future directions. Biomimetics. 2025;10(4):418.
- Zheng S, Zhang X, Liu Y, Li Z. CMFF: A cross-modal multi-layer feature fusion network for multimodal sentiment analysis. Appl Soft Comput. 2025;184(Pt B):113868.
- Yan L, Shi Y, Wei M, Wu Y. Multi-feature fusing local directional ternary pattern for facial expressions signal recognition based on video communication system. Alex Eng J. 2023;63:307-320.
- Guo X, Zhang Y, Lu S, Lu Z. Facial expression recognition: A review. Multimed Tools Appl. 2024;83(8):23689-23735.
- Liu ZT, Han MT, Wu BH, Rehman A. Audio emotion recognition based on convolutional neural network with attention-based bidirectional long short-term memory network and multitask learning. Appl Acoust. 2023;202:109178.
- Mirsamadi S, Barsoum E, Zhang C. Automatic audio emotion recognition using recurrent neural networks with local attention. 2017 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), New Orleans, LA, USA. 2017; 10.1109/ICASSP.2017.7952552.
- Gu T, He Z, Zhao H, Li M, Ying D. Aspect-based sentiment analysis with multi-granularity information mining and sentiment hint. Expert Syst Appl. 2024;252:124104.
- Shen W, Chen J, Quan X, Xie Z. DialogXL: All-in-one XLNet for multi-party conversation emotion recognition. Proc AAAI Conf Artif Intell. 2021;35(15):13789-13797.
- Kim T, Vossen P. EmoBERTa: Speaker-aware emotion recognition in conversation with RoBERTa. arXiv. 2021;arXiv:2108.12009.
- Li S, Yan H, Qiu X. Contrast and generation make BART a good dialogue emotion recognizer. Proc AAAI Conf Artif Intell. 2022;36(10):11002-11010.
- Zhu J, Yu J. MIAR: Modality interaction and alignment representation fusion for multimodal emotion. arXiv. 2026;arXiv:2601.02414.
- Praveen RG, Granger E, Cardinal P. Cross attentional audio-visual fusion for dimensional emotion recognition. 2021 16th IEEE International Conference on Automatic Face and Gesture Recognition (FG 2021), Jodhpur, India. 2021;10.1109/FG52635.2021.9667055.
- Salas-Cáceres J, López M, Martínez A, Rodríguez P. Multimodal emotion recognition based on a fusion of audio-visual information with temporal dynamics. Multimed Tools Appl. 2025;84:27327-27343.
- Fu J, Zhang Y, Wang L, Chen H. TMFN: A text-based multimodal fusion network with multi-scale feature extraction and unsupervised contrastive learning for multimodal sentiment analysis. Complex Intell Syst. 2025;11:133.
- Tuerhong G, Fu F, Wushouer M. Adaptive multimodal transformer based on exchanging for multimodal sentiment analysis. Sci Rep. 2025;15:27265.
- Gupta C, Sharma R, Patel S, Verma A. A multimodal fusion model for real-time environment emotion recognition using audio-visual-textual features. J Big Data. 2025;12:256.
- Yu W, Li X, Zhang H, Wang Z, Liu Z. CH-SIMS: A Chinese multimodal sentiment analysis dataset with fine-grained annotation of modality. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. 2020; 10.18653/v1/2020.acl-main.343.
- Zadeh A, et al. Multimodal language analysis in the wild: CMU-MOSEI dataset and interpretable dynamic fusion graph. Proceedings of the 56th Annual Meeting of the Association for Computational Linguistics, Melbourne, Australia. 2018; 10.18653/v1/P18-1208.
- Zadeh A, Chen M, Poria S, Cambria E, Morency LP. Tensor fusion network for multimodal sentiment analysis. arXiv. 2017;arXiv:1707.07250.
- Tsai YHH, Bai S, Yamada M, Morency LP, Salakhutdinov R. Multimodal transformer for unaligned multimodal language sequences. Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, Florence, Italy. 2019; 10.18653/v1/P19-1656.
- Moreno M, Rioseco P, Van Den Bosch H. Spectrum of the linearized Vlasov–Poisson equation around steady states from galactic dynamics. arXiv. 2023;arXiv:2305.05749.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.