Niniejszy protokół opisuje proces wielobiektowego śledzenia sterowanego poziomem pewności dla nagrań wideo ze zdarzeń sportowych, który integruje informacje o kolorze koszulki i numerze zawodnika w celu poprawy asocjacji trajektorii oraz spójności tożsamości w warunkach wahań pewności, okluzji oraz wizualnego podobieństwa zawodników.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Metoda śledzenia wielu obiektów sterowana stopniem pewności w materiałach wideo ze zdarzeń sportowych z wykorzystaniem semantycznej fuzji koszulek
W tym artykule
Podsumowanie
Streszczenie
Śledzenie wielu obiektów (Multi-Object Tracking, MOT) w nagraniach wideo ze zdarzeń sportowych dostarcza informacji o trajektoriach niezbędnych do analizy taktycznej, interpretacji zachowań zawodników oraz zautomatyzowanej analizy statystycznej. Jednak scenariusze sportowe często wiążą się z szybkimi zmianami kierunku, nagłymi zatrzymaniami, częstymi przesłonięciami obiektów oraz wizualnym podobieństwem członków tej samej drużyny, co prowadzi do wahań pewności detekcji i błędów w identyfikacji podczas asocjacji między klatkami. Aby rozwiązać te problemy, w niniejszym badaniu przedstawiono JerseyTrack – metodę MOT w sporcie sterowaną poziomem pewności, opartą na fuzji semantycznej koszulek. Przepływ pracy adaptacyjnie dzieli ramki detekcji na przedziały wysokiej, średniej i niskiej pewności, zgodnie z rozkładem pewności w każdej klatce. Detekcje o wysokiej pewności są asocjowane głównie w oparciu o podobieństwo ruchu, natomiast w przypadku detekcji o średniej i niskiej pewności dodatkowo wykorzystuje się cechy koloru koszulki oraz numeru zawodnika, wyodrębnione za pomocą klastrowania kolorów i lekkiego modelu optycznego rozpoznawania znaków (Optical Character Recognition, OCR). Cechy semantyczne te są łączone z informacjami o ruchu podczas dopasowania uzupełniającego, aby poprawić ciągłość trajektorii i spójność identyfikacji. Metodę oceniono na zbiorze danych SportsMOT. JerseyTrack osiągnął wynik 88,9% dla dokładności śledzenia wielu obiektów (Multiple Object Tracking Accuracy, MOTA), 74,3% dla wskaźnika IDF1 (IDentity F1 Score) oraz 69,9% dla dokładności śledzenia wyższego rzędu (Higher Order Tracking Accuracy, HOTA), co wykazuje poprawę wydajności śledzenia w analizowanych warunkach sportowych. Niniejszy protokół zapewnia odtwarzalny schemat integrowania asocjacji sterowanej pewnością z semantycznymi informacjami o koszulkach w celu usprawnienia śledzenia wielu obiektów w filmach sportowych.
Wprowadzenie
Śledzenie wielu obiektów (MOT) zapewnia ciągłą lokalizację obiektów i utrzymanie ich tożsamości w sekwencjach wideo, co umożliwia ekstrakcję trajektorii sportowców, analizę taktyczną oraz zautomatyzowaną analizę statystyczną w aplikacjach do analizy wideo w sporcie1,2,3. Niezawodne informacje wizualne są również powiązane z podejmowaniem decyzji specyficznych dla danej dyscypliny oraz oceną wyników w nauce o sporcie, co dodatkowo podkreśla wartość stabilnych danych o ruchu pochodzących z wideo dla dalszej analizy sportowej4. W scenariuszach sportowych niezawodność danych taktycznych zależy od ciągłości trajektorii śledzenia oraz spójności tożsamości celów.
W porównaniu do ogólnych scenariuszy MOT, filmy sportowe charakteryzują się gwałtownymi zmianami kierunku, nagłymi zatrzymaniami, skokami, gęstymi interakcjami oraz częstymi przesłonięciami. Czynniki te powodują znaczne wahania poziomu ufności ramek detekcyjnych i zwiększają częstotliwość detekcji o niskiej ufności, co może przerywać asocjację trajektorii5,6. Jednolite stroje drużynowe dodatkowo ograniczają zdolność dyskryminacyjną ogólnych cech wyglądu i zwiększają ryzyko pomyłek w identyfikacji wizualnie podobnych członków tej samej drużyny7,8. Gdy przesłonięcia i podobieństwo wyglądu występują w tej samej sekwencji, ufność detekcji spada, a informacje o wyglądzie celu stają się niepełne, co utrudnia asocjację trajektorii i utrzymanie tożsamości9,10. W MOT re-identyfikacja (Re-ID) odnosi się do procesu wiązania tej samej tożsamości celu w różnych klatkach, okresach przesłonięcia lub w przypadkach ponownego pojawienia się w kadrze, z wykorzystaniem wizualnych dowodów związanych z tożsamością. W filmach ze sportów drużynowych ogólne wskazówki Re-ID mogą być osłabione, ponieważ sportowcy z tej samej drużyny często noszą podobne stroje i mają zbliżoną budowę ciała. Przegląd literatury technicznej wskazuje, że fragmentacja trajektorii i pomyłki w identyfikacji w sportowym MOT są zazwyczaj rozwiązywane za pomocą dwóch komplementarnych podejść: wykorzystania poziomu ufności detekcji oraz wzmocnienia wskazówek tożsamości. JerseyTrack sytuuje się na przecięciu tych podejść, regulując wykorzystanie semantycznych wskazówek dotyczących strojów w zależności od jakości detekcji, zamiast jednolicie stosować informacje o kolorze i numerze zawodnika do wszystkich detekcji.
Niniejsze badanie przedstawia JerseyTrack, metodę śledzenia wielu obiektów (MOT) w sporcie, kierowaną poziomem ufności i opartą na semantycznej fuzji strojów sportowych. Metoda została opracowana dla nagrań wideo z dyscyplin zespołowych, w których sportowcy noszą widoczne stroje, a wyniki detekcji dostarczają ramki ograniczające wraz z wynikiem ufności. JerseyTrack łączy cztery główne komponenty: detekcję sportowców, partycjonowanie poziomów ufności, ekstrakcję semantycznych cech stroju oraz kaskadową asocjację międzyklatkową. Ufność detekcji jest wykorzystywana do adaptacyjnego podziału detekcji na grupy o wysokiej, średniej i niskiej ufności, które są przetwarzane przy użyciu różnych strategii asocjacji. Detekcje o wysokiej ufności są powiązane głównie na podstawie informacji o ruchu, podczas gdy w przypadku detekcji o średniej i niskiej ufności dodatkowo uwzględnia się kolor stroju oraz numer zawodnika, aby poprawić utrzymanie tożsamości w sytuacjach słabej widoczności dowodów wizualnych. Metoda jest przeznaczona do zadań analizy wideo sportowego wymagających stabilnych trajektorii sportowców, takich jak analiza taktyczna i interpretacja zachowań graczy.
Zaproponowane podejście posiada również ograniczenia operacyjne. Ekstrakcja semantyczna koszulek może być utrudniona przez silne przesłonięcia, rozmycie ruchu, niską rozdzielczość obrazu, nietypowe pozy zawodników lub niewidoczne numery na koszulkach. W takich przypadkach semantyczne wskazówki oparte na koszulkach mogą stać się niekompletne, a proces asocjacji w większym stopniu opiera się na spójności ruchu i weryfikacji wieloklatkowej. W związku z tym deklarowana wydajność w niniejszym badaniu jest ograniczona do ewaluowanych zbiorów danych i ustawień eksperymentalnych. Eksperymenty na zbiorze danych SportsMOT pokazują, że JerseyTrack poprawia ewaluowane metryki śledzenia i redukuje liczbę zdarzeń przełączania tożsamości w przetestowanych warunkach śledzenia sportowego. Główna trudność MOT w filmach sportowych polega na utrzymaniu ciągłości trajektorii i spójności tożsamości przy szybkim ruchu, przesłonięciach i podobieństwie wyglądu. Istniejące badania powiązane z JerseyTrack można szeroko podzielić na dwa kierunki badawcze: wykorzystanie pewności detekcji do asocjacji trajektorii oraz wzmacnianie wskazówek tożsamości poprzez specyficzne dla sportu cechy semantyczne.
Poziom ufności detekcji (detection confidence) jest szeroko stosowany do szacowania niezawodności ramek detekcji oraz do kierowania asocjacją trajektorii w MOT. Wczesne metody śledzenia zazwyczaj traktowały ufność jako binarny kryterium filtrowania, w którym detekcje poniżej ustalonego progu były usuwane w celu redukcji wyników fałszywie dodatnich11,12. Strategia ta redukuje liczbę zakłóconych detekcji, ale może również odrzucić rzeczywiste cele w przypadku okluzji, szybkiego ruchu lub niskiej jakości obrazu, co prowadzi do fragmentacji trajektorii13,14,15. Podobne strategie filtrowania wykazały również, że stałe progi ufności są wrażliwe na zmienność sceny i jakość detekcji16,17. Aby usprawnić wykorzystanie detekcji o niskim poziomie ufności, w ByteTrack wprowadzono strategię asocjacji, która zachowuje ramki o niskiej ufności jako potencjalne cele dla dopasowania wtórnego i łączy je z istniejącymi trajektoriami poprzez podobieństwo ruchu i historię trajektorii18. McByte rozszerza asocjację w sportowym MOT, wprowadzając czasowo propagowane maski segmentacji jako wskazówkę asocjacyjną, co poprawia odporność w warunkach szybkiego ruchu, okluzji i przesunięć kamery bez konieczności dodatkowego trenowania dla każdego wideo19. Powiązane badania zmodyfikowały również wykorzystanie detekcji o niskiej ufności, aby zachować słabe, ale potencjalnie poprawne cele podczas asocjacji20,21,22. Strategie asocjacji adaptacyjne względem ufności doprecyzowały następnie kryteria dopasowania zgodnie ze spójnością ruchu i niezawodnością detekcji23,24,25. Metody udoskonalania trajektorii oparte na regresji ramek detekcji i optymalizacji gładkości trajektorii były również stosowane w celu redukcji fragmentacji trajektorii26,27,28. Dodatkowe strategie udoskonalania zapewniają uzupełniające wsparcie dla zachowania ciągłości trajektorii w złożonych warunkach ruchu29. Czasowo spójny przepływ obiektów (temporal coherent object flow) dodatkowo modeluje czasową spójność na poziomie obiektu pomiędzy klatkami, stanowiąc kolejne podejście zorientowane na asocjację w celu redukcji przerw w trajektoriach w złożonych scenariuszach MOT30. Metody fuzji trackerów uczą się również z wyników wielu trackerów i wykorzystują oparte na uczeniu strategie selekcji lub fuzji, aby poprawić odporność śledzenia w różnych benchmarkach MOT31. Łącznie badania te wskazują, że asocjacja uwzględniająca ufność pomaga odzyskać przerwane trajektorie; jednak wskazówki dotyczące ufności i ruchu dostarczają ograniczone informacje o tożsamości, gdy zawodnicy z tej samej drużyny mają podobny wygląd wizualny. Chociaż metody te skutecznie łagodzą fragmentację trajektorii w scenariuszach ogólnych, napotykają one na inherentne ograniczenia w ustawieniach sportowych, ponieważ zawodnicy z tej samej drużyny często mają bardzo podobny wygląd, a poleganie wyłącznie na informacjach o ufności i ruchu nie może zapewnić wystarczającej podstawy do rozróżnienia tożsamości32,33,34. Nawet gdy ramki o niskiej ufności są skutecznie odzyskiwane, podobieństwo cech nadal może prowadzić do zamiany tożsamości (identity switching), co utrudnia spełnienie rygorystycznych wymagań dotyczących spójności tożsamości w analizie sportowej.
W celu poprawy dyskryminacji tożsamości w śledzeniu sportowców wykorzystywano również specyficzne dla sportu wskazówki tożsamościowe. Semantyczne informacje z koszulek, takie jak kolor drużyny i numer zawodnika, dostarczają wskazówek tożsamościowych, które są bardziej bezpośrednio związane z sytuacjami sportowymi niż ogólne osadzenia wyglądu35,36,37. Kolor koszulki był wykorzystywany do wspierania dyskryminacji na poziomie drużyny i redukcji pomyłek między drużynami, podczas gdy rozpoznawanie numeru zawodnika dostarcza bardziej precyzyjnej wskazówki tożsamościowej, gdy obszar numeru jest widoczny i czytelny38,39. Istniejące badania nad śledzeniem w sporcie włączyły specyficzne dla domeny cechy wizualne oraz rozpoznawanie kolorów koszulek, aby poprawić asocjację zawodników w zatłoczonych warunkach sportowych40,41. Powiązane prace nad rozpoznawaniem numerów na koszulkach i syntetycznymi danymi numerowymi dodatkowo wspierają modelowanie tożsamości w warunkach niskiej rozdzielczości lub częściowego przesłonięcia42,43. Badania te wskazują, że semantyka koszulek może wzmocnić reprezentację tożsamości w sports MOT. Jednak większość metod śledzenia wzbogaconych semantycznie nie modeluje w sposób wystarczający relacji między pewnością detekcji a jakością cech semantycznych. Detekcje o wysokiej pewności mogą już zawierać niezawodne informacje przestrzenne i dotyczące wyglądu, co sprawia, że powtarzająca się ekstrakcja semantyczna jest mniej efektywna. Detekcje o niskiej pewności często cierpią z powodu przesłonięcia, rozmycia, ucięcia lub niskiej rozdzielczości, co zmniejsza niezawodność wskazówek dotyczących koloru i numeru zawodnika. Ograniczenie to motywuje do zaprojektowania asocjacji sterowanej pewnością, w której semantyka koszulek jest wprowadzana w zależności od jakości detekcji, a nie stosowana jednolicie do wszystkich detekcji. Przejrzane badania pokazują, że asocjacja świadoma pewności i modelowanie semantyczne koszulek odnoszą się do różnych aspektów sports MOT. Strategie oparte na pewności określają głównie, czy detekcja powinna uczestniczyć w asocjacji i w jaki sposób powinna zostać dopasowana do istniejących trajektorii, podczas gdy strategie semantyczne koszulek przede wszystkim wzmacniają reprezentację tożsamości poprzez wskazówki specyficzne dla sportu. Jednak te dwa mechanizmy są często projektowane jako osobne komponenty. W rezultacie wskazówki semantyczne nie zawsze są dostosowywane do jakości detekcji, a poziomy pewności nie regulują bezpośrednio wykorzystania informacji o kolorze i numerze zawodnika podczas asocjacji. Rozdzielność ta ogranicza wspólne radzenie sobie z fragmentacją trajektorii i pomyłkami w tożsamości w materiałach wideo z gier zespołowych. Pozostała luka badawcza polega na powiązaniu oceny jakości pewności detekcji z semantyczną asocjacją koszulek w ramach tego samego procesu śledzenia.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Niniejsze badanie obejmowało wtórną analizę publicznie dostępnych wzorcowych zbiorów danych wideo, mianowicie SportsMOT, TeamTrack, SoccerNet Tracking, MOT17 oraz MOT20. Nie rekrutowano uczestników, nie przeprowadzono żadnej interwencji ani nie zebrano nowych danych dotyczących ludzi. Zgodnie z obowiązującymi wymogami instytucjonalnymi Uniwersytetu Bangkok Thonburi, badanie to nie wymagało zgody komisji etycznej.
Poniższy protokół opisuje przebieg prac wykorzystany do odtworzenia systemu JerseyTrack, od przygotowania danych po ewaluację śledzenia. Proces ten obejmuje przygotowanie zbioru danych, przygotowanie detektora, semantyczną ekstrakcję koszulek, partycjonowanie poziomów ufności, asocjację sterowaną poziomem ufności, inferencję śledzenia oraz ewaluację wydajności, co podsumowano na Rysunku 1. Wymagane oprogramowanie, zbiory danych oraz zasoby sprzętowe wymieniono w Tabeli materiałów.
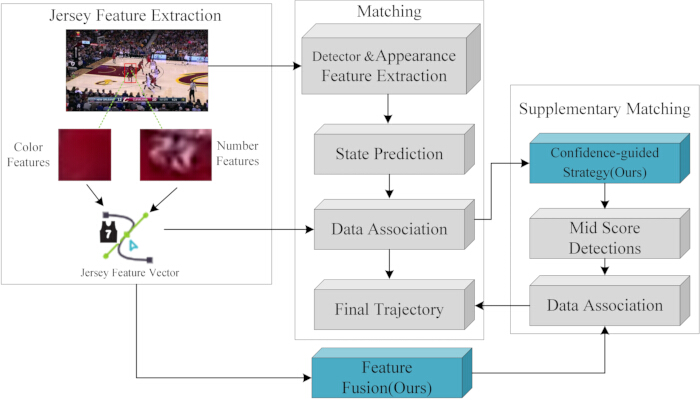
Rysunek 1. Ogólny schemat działania metody JerseyTrack. Schemat obejmuje ekstrakcję semantycznych cech koszulki, wstępne dopasowanie obiektów, uzupełniające dopasowanie sterowane poziomem ufności oraz fuzję cech. Cechy koloru drużyny i numeru zawodnika są ekstrahowane z wykrytych obszarów sportowców i włączane do procesu asocjacji w celu poprawy dopasowania trajektorii w warunkach niepewnej detekcji. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
1. Przygotowanie zbiorów danych i struktury katalogów
- Pobierz publiczne zestawy danych referencyjnych wymienione w Tabela materiałówDo przygotowania detektora i ewaluacji śledzenia należy wykorzystać zestaw danych SportsMOT jako główny zbiór. Zbiory TeamTrack, SoccerNet Tracking, MOT17 oraz MOT20 należy zachować do ewaluacji międzyzbiorowej.
- Przechowuj wszystkie zestawy danych w ujednoliconym katalogu projektu. Upewnij się, że detektor, moduł ekstrakcji semantycznej, moduł śledzenia oraz zestaw narzędzi ewaluacyjnych wykorzystują identyczne identyfikatory sekwencji.
- Konwertuj oficjalne adnotacje SportsMOT do formatu treningowego detektora, korzystając ze skryptu do przygotowania danych zastosowanego w niniejszym badaniu. Wykonaj następującą komendę:
..\venv\Scripts\python.exe scripts\prepare_data.py --config configs\datasets.local.json --dataset SportsMOT --out data\processed\SportsMOT_yolo --splits train val. - Skrypt do przygotowania danych (scripts/prepare_data.py) jest dostępny w repozytorium kodu źródłowego JerseyTrack (https://doi.org/10.5281/zenodo.21274352). Wymagane zależności oprogramowania są określone w pliku environment.yml i obejmują Python 3.12, PyTorch 2.11.0 oraz OpenCV 4.10 lub nowszy. Skonfiguruj środowisko oprogramowania za pomocą następującego polecenia: conda env create -f environment.yml. Uruchom skrypt do przygotowania danych, używając następującego polecenia: python scripts/prepare_data.py --config configs/datasets.local.json --dataset SportsMOT --out data/processed/SportsMOT_yolo --splits train val.
- Należy zweryfikować, czy proces konwersji wygenerował plik konfiguracyjny treningu detektora: data\processed\SportsMOT_yolo\data.yaml oraz manifest konwersji: data\processed\SportsMOT_yolo\conversion_manifest.csv.
UWAGA: W niniejszym badaniu przekonwertowany zbiór danych treningowych i walidacyjnych SportsMOT zawierał 90 sekwencji, 55 544 klatki oraz 608 152 adnotowane obiekty. - Należy sprawdzić reprezentatywne sekwencje, aby zweryfikować, czy kolejność klatek, współrzędne ramek ograniczających oraz etykiety tożsamości pozostają zgodne z oryginalnymi adnotacjami zestawu referencyjnego.
- Pliki adnotacji po konwersji należy zachować bez modyfikacji podczas przygotowania detektora, wnioskowania śledzenia oraz ewaluacji, aby wszystkie metody korzystały z tego samego podziału zbioru danych i protokołu ewaluacji.
UWAGA: Oczekiwanym rezultatem tej sekcji jest ustandaryzowany katalog treningowy detektora SportsMOT, zawierający przekonwertowane adnotacje, manifest konwersji oraz pliki z podziałem zbioru danych, które są niezbędne do przygotowania detektora i ewaluacji śledzenia.
2. Przygotowanie wyjść detektora
- Przeprowadź dostrojenie detektora obiektów, wykorzystując przygotowany zbiór treningowy SportsMOT. Zoptymalizuj detektor, stosując funkcję straty klasyfikacji oraz funkcję straty regresji ramek ograniczających zdefiniowane w Równaniu 1. Użyj rozdzielczości wejściowej detektora, wielkości partii (batch size), współczynnika uczenia (learning rate), liczby epok treningowych oraz pozostałych parametrów treningowych podanych w konfiguracji implementacji i w Tabeli materiałów
Ldet = Lcls + Lbox (1)
Gdzie Ldet oznacza całkowitą stratę detektora, Lcls oznacza stratę klasyfikacji, a Lbox oznacza stratę regresji ramek ograniczających.
UWAGA: Punkt kontrolny (checkpoint) detektora użyty w głównych eksperymentach (wewnętrzny identyfikator eksperymentu e3) został wytrenowany przy użyciu frameworka Ultralytics YOLO z konfiguracją zbioru danych SportsMOT w formacie YOLO (data/processed/SportsMOT_yolo/data.yaml). Uruchom trening detektora za pomocą następującego polecenia: yolo detect train data=data/processed/SportsMOT_yolo/data.yaml model=yolo11x.pt epochs=80 imgsz=960 batch=16 lr0=0.01 project=outputs/formal name=checkpoints/detector device=0. Po zakończeniu treningu użyj uzyskanego najlepiej działającego punktu kontrolnego do wygenerowania wyników detekcji dla sekwencji walidacyjnych za pomocą następującego polecenia: python scripts/formal_detect_yolo.py --dataset-root datasets/SportsMOT/dataset --split val --model outputs/formal/checkpoints/detector/weights/best.pt --out-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/detections --imgsz 960 --conf 0.05 --device 0 --batch 16. - Po zakończeniu treningu zapisz punkt kontrolny wytrenowanego detektora, odpowiadający mu plik metadanych oraz log treningowy.
UWAGA: W niniejszym badaniu punkt kontrolny detektora użyty do eksperymentów formalnych został zapisany jako:
outputs\formal\checkpoints\detector\sportsmot_yolo11x_i960_e3_best.pt. Odpowiadający mu plik metadanych został zapisany jako: outputs\formal\checkpoints\detector\sportsmot_yolo11x_i960_e3_best.json. Katalog wyjściowy detektora użyty do głównych eksperymentów walidacyjnych SportsMOT to: outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_threshold_sweep\t005\detections. - Uruchom wytrenowany detektor na każdej sekwencji walidacyjnej, aby wygenerować ramki ograniczające zawodników oraz wyniki pewności (confidence scores). Eksportuj jeden plik detekcji dla każdej sekwencji, zawierający indeks klatki, współrzędne ramki ograniczającej, pewność detekcji oraz etykietę klasy.
UWAGA: W przebiegu walidacji SportsMOT wykorzystanym w głównych eksperymentach, próg pewności wynoszący 0.05 wygenerował 343 990 detekcji zawodników. - Przejrzyj katalog wyjściowy detektora przed rozpoczęciem inferencji śledzenia. Potwierdź, że każda sekwencja posiada odpowiadający jej plik detekcji, że indeksy klatek są zgodne z przygotowaną sekwencją obrazów oraz że każdy rekord detekcji zawiera wynik pewności.
UWAGA: Oczekiwanym rezultatem tej sekcji jest kompletny katalog wyjściowy detektora, który służy jako dane wejściowe do semantycznej ekstrakcji numerów koszulek, partycjonowania poziomów pewności i asocjacji śledzenia.
3. Ekstrakcja cech semantycznych koszulek
- Wykorzystaj pliki wyjściowe z detektora do wycięcia obszarów z zawodnikami z każdej klatki wideo. Zapisz każdy wycięty obraz zawodnika wraz z identyfikatorem sekwencji, indeksem klatki i indeksem detekcji. Wyklucz nieprawidłowe wycinki z brakującą treścią obrazu lub ramkami ograniczającymi wykraczającymi poza granice obrazu. Zachowaj powiązanie między nazwą pliku wycinki a oryginalnym rekordem detekcji, aby wyekstrahowane cechy semantyczne mogły zostać dopasowane do odpowiadającej im detekcji podczas asocjacji śledzenia.
- Wyekstrahuj cechy koloru koszulki z wyciętych obrazów zawodników, korzystając ze skryptu ekstrakcji semantycznej zastosowanego w niniejszym badaniu.
UWAGA: Skrypty ekstrakcji cech semantycznych (scripts/extract_fast_color_semantics.py oraz scripts/formal_extract_semantics.py) są dostępne w repozytorium kodu źródłowego JerseyTrack (https://doi.org/10.5281/zenodo.21274352). Osobny plik konfiguracyjny nie jest wymagany; wszystkie parametry wykonania są przekazywane za pomocą argumentów wiersza poleceń.
Wygeneruj deskryptory koloru koszulki, używając następującego polecenia: python scripts/extract_fast_color_semantics.py --detections-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/detections --frames-root datasets/SportsMOT/dataset/val --out-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_t005_color. Wygeneruj cechy semantyczne numerów zawodników za pomocą modelu OCR, używając następującego polecenia: python scripts/formal_extract_semantics.py --detections-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/detections --frames-root datasets/SportsMOT/dataset/val --out-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_t005_ocr. Wygenerowane deskryptory koloru koszulki i wyniki prawdopodobieństwa numerów zawodników są powiązane identyfikatorem sekwencji i połączone w plikach cech semantycznych wykorzystywanych podczas asocjacji śledzenia. - Konwertuj każdy wycięty obraz zawodnika do przestrzeni barw Hue, Saturation, Value (HSV). Wyekstrahuj piksele pierwszego planu z obszaru koszulki i podsumuj dominujący kolor koszulki, stosując klasteryzację K-średnich z K = 3. Przed porównaniem cech znormalizuj wynikowy deskryptor koloru za pomocą normalizacji L2.
- Wytrenuj gałąź rozpoznawania numerów zawodników, używając wyciętych obrazów zawodników o rozmiarze wejściowym 128 × 64 pikseli. Wygeneruj pseudoetykiety numerów zawodników, stosując procedurę etykietowania z tzw. słabym nadzorem (weakly supervised labeling) zastosowaną w niniejszym badaniu. Wyklucz z obliczeń straty optycznego rozpoznawania znaków (OCR) wycinki z niewidocznymi, nieczytelnymi, silnie przesłoniętymi lub niską pewnością rozpoznania obszarami numerów zawodników.
- Zoptymalizuj gałąź OCR, korzystając ze straty entropii krzyżowej zdefiniowanej w Równaniu 2.
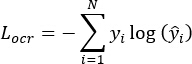 (2)
Tutaj Locr oznacza stratę OCR, yi oznacza nadzorowaną etykietę numeru zawodnika, a oznacza przewidzianą kategorię numeru zawodnika.
- Zoptymalizuj moduł ekstrakcji cech semantycznych, stosując adaptacyjny optymalizator, tempo uczenia, rozmiar partii, spadek wag (weight decay) oraz czas trenowania wymienione w Tabeli materiałów. Połącz stratę detektora i stratę OCR, stosując całkowity cel treningowy zdefiniowany w Równaniu 3.
Ltotal = Ldet + γLocr (3)
Tutaj Ltotal oznacza całkowitą stratę treningową, Ldet oznacza stratę detektora zdefiniowaną w Równaniu 1, Locr oznacza stratę OCR zdefiniowaną w Równaniu 2, a γ oznacza zdefiniowany przez użytkownika współczynnik wagowy dla straty OCR. - Zastosuj wytrenowaną gałąź OCR do każdego wyciętego obrazu zawodnika. Zapisz przewidzianą kategorię numeru zawodnika lub wektor prawdopodobieństwa dla każdej wycinki. Jeśli numer zawodnika nie jest widoczny lub pewność OCR jest poniżej progu zdefiniowanego w implementacji, zaznacz cechę numeru zawodnika jako niedostępną, zamiast wymuszać predykcję.
- Połącz deskryptor koloru koszulki i wynik numeru zawodnika w pliku cech semantycznych wykorzystywanym przez moduł śledzenia.
UWAGA: W głównym przebiegu walidacji SportsMOT skrypt ekstrakcji semantycznej przetworzył 343 990 detekcji bez brakujących klatek lub nieprawidłowych wycinków. W aktualnym pakiecie rewizyjnym podsumowanie ekstrakcji semantycznej wykazało ogólną dokładność ekstrakcji kolorów i OCR na poziomie 86,7% w ocenianych ustawieniach SportsMOT. Oczekiwanym wynikiem tej sekcji jest plik cech semantycznych, w którym każdy prawidłowy rekord detekcji jest powiązany z deskryptorem koloru koszulki, wynikiem numeru zawodnika (jeśli jest dostępny) oraz flagą wskazującą, czy informacje semantyczne są dostępne do asocjacji śledzenia.
4. Poziomy ufności wykrywania partycji
- Wczytaj plik z wynikami detektora dla każdej sekwencji wideo. Zbierz wyniki ufności wszystkich detekcji sportowców w każdej klatce.
- Podziel wyniki ufności na poziomie klatek na przedziały wysokiej, średniej i niskiej ufności, stosując klasteryzację K-średnich z K = 3, zgodnie z przepływem pracy asocjacji sterowanej ufnością przedstawionym na Rysunku 2. Wyznacz adaptacyjne progi ufności poprzez minimalizację wariancji wewnątrzklastrowej zgodnie z Równaniem 4.
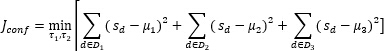 (4)
Tutaj sd oznacza wynik ufności detekcji d; D1, D2 i D3 oznaczają odpowiednio przedziały wysokiej, średniej i niskiej ufności; μ1, μ2 i μ3 oznaczają średnie wyniki ufności dla trzech przedziałów; a τ1 i τ2 oznaczają adaptacyjne progi ufności uzyskane z wyników klasteryzacji K-średnich.
UWAGA: Skrypt do partycjonowania ufności (scripts/formal_partition_confidence.py) jest dostępny w repozytorium kodu źródłowego JerseyTrack (https://doi.org/10.5281/zenodo.21274352). Moduł partycjonowania ufności wykorzystuje jednowymiarową procedurę klasteryzacji K-średnich opartą na NumPy z K = 3. Nie jest wymagany osobny plik konfiguracyjny; katalog wejściowy, katalog wyjściowy i parametr klasteryzacji są określane za pomocą argumentów wiersza poleceń. Wykonaj procedurę partycjonowania ufności za pomocą następującego polecenia: python scripts/formal_partition_confidence.py --detections-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/detections --out-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/confidence --k 3. Wymagane zależności programowe, w tym wersja NumPy, są określone w pliku environment.yml. - Uruchom procedurę partycjonowania ufności, używając katalogu z wynikami detektora jako wejścia.
UWAGA: W niniejszym badaniu katalog z wynikami detektora był: outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_threshold_sweep\t005\detections. Katalog wyjściowy partycjonowania ufności był: outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_threshold_sweep\t005\confidence. Wygenerowane pliki wyjściowe obejmowały pliki CSV z ufnością dla każdej sekwencji, _confidence_frame_summary.csv oraz _confidence_runtime.csv. - Przypisz etykietę poziomu ufności do każdej detekcji. Oznacz detekcje o wysokiej ufności dla asocjacji opartej na ruchu, detekcje o średniej ufności dla asocjacji semantyczno-ruchowej, a detekcje o niskiej ufności wyłącznie dla odzyskiwania trajektorii. Zachowaj oryginalny wynik ufności wraz z przypisaną etykietą poziomu ufności.
- Przeanalizuj rozkłady wyników ufności i reprezentatywne klatki, jak zilustrowano na Rysunku 3. Zweryfikuj, czy detekcje o wysokiej ufności odpowiadają głównie kompletnym i wiarygodnym ramkom ograniczającym sportowców, podczas gdy detekcje o średniej i niskiej ufności zawierają głównie detekcje częściowe, przesłonięte, rozmyte lub słabe.
UWAGA: Oczekiwanym wynikiem tej sekcji jest plik partycjonowania ufności zawierający indeks detekcji, oryginalny wynik ufności, przypisany poziom ufności oraz adaptacyjne progi ufności na poziomie klatki dla każdej detekcji.
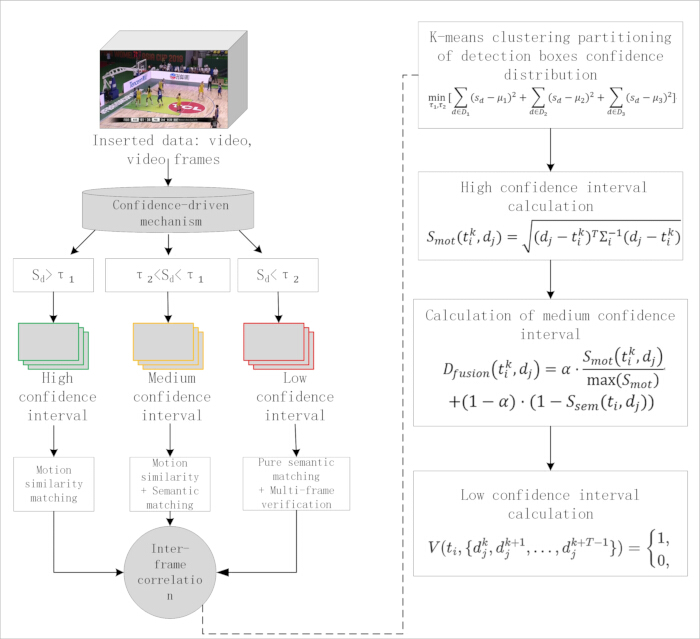
Rysunek 2. Strategia asocjacji sterowana poziomem ufności. Przepływ pracy dzieli ufność detekcji na przedziały wysokiej, średniej i niskiej ufności przy użyciu adaptacyjnego klastrowania ufności. Detekcje o wysokiej ufności są asocjowane na podstawie podobieństwa ruchu, detekcje o średniej ufności są asocjowane przy użyciu połączonego podobieństwa ruchu i semantyki koszulki, a detekcje o niskiej ufności są wykorzystywane do odzyskiwania trajektorii wspomaganego semantyką z weryfikacją wieloklatkową. Prawy panel podsumowuje sformułowania matematyczne wykorzystane do podziału ufności i asocjacji. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
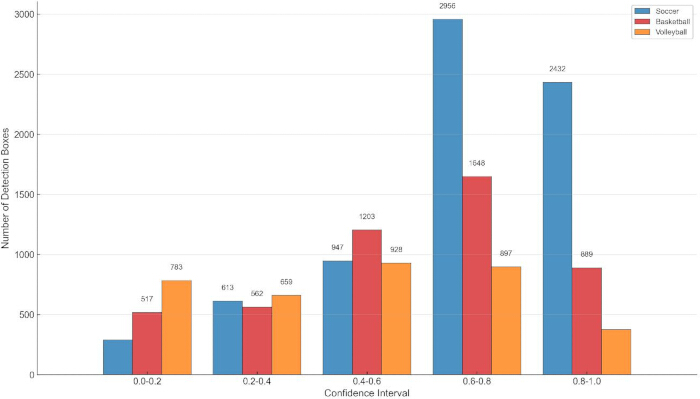
Rycina 3. Rozkład wyników ufności detekcji. Histogram przedstawia liczbę ramek detekcji sportowców w pięciu przedziałach ufności dla sekwencji piłki nożnej, koszykówki i siatkówki w zbiorze danych SportsMOT. Rozkład ten ilustruje różnice w ufności detektora w ocenianych kategoriach sportowych. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
5. Przeprowadzenie asocjacji kierowanej pewnością
- Wczytaj plik wyjściowy detektora, plik cech semantycznych oraz plik podziału ufności dla każdej sekwencji wideo. Zainicjuj tracker, korzystając z pierwszych poprawnych detekcji, i utrzymuj jeden stan trajektorii dla każdego śledzonego sportowca. Dla każdej kolejnej klatki przewiduj pozycję każdej istniejącej trajektorii, korzystając z modelu ruchu filtru Kalmana.
- Oblicz podobieństwo ruchu między każdą przewidywaną trajektorią a kandydującą detekcją, korzystając z odległości Mahalanobisa zdefiniowanej w Równaniu 5.
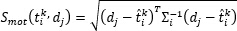 (5)
Tutaj oznacza I-tą trajektorię w klatce k,
 oznacza stan trajektorii przewidziany przez filtr Kalmana, dj oznacza kandydującą detekcję,
 oznacza odwróconą macierz kowariancji stanu przewidywanej trajektorii, a Smot oznacza odległość ruchu między przewidywaną trajektorią a detekcją.
UWAGA: Główny proces asocjacji jest zaimplementowany w jerseytrack/formal_tracker.py i wykonywany za pomocą scripts/formal_track.py; oba pliki są dostępne w repozytorium kodu źródłowego JerseyTrack (https://doi.org/10.5281/zenodo.21274352). Osobny plik konfiguracyjny nie jest wymagany. Wszystkie parametry czasu wykonania, w tym progi ufności, maksymalny wiek trajektorii, współczynniki wagi ruchu oraz waga odległości środka, są przekazywane jako argumenty wiersza poleceń. Pełna komenda wykonania i ustawienia parametrów są podane w Kroku 6.2. Implementacja wykorzystuje algorytm linear sum assignment z biblioteki SciPy do dopasowania węgierskiego oraz NumPy do asocjacji opartej na koszcie. - Uruchom proces śledzenia, używając pliku wyjściowego detektora, pliku cech semantycznych oraz pliku podziału ufności jako danych wejściowych.
UWAGA: W niniejszym badaniu główny tracker został zaimplementowany w jerseytrack\formal_tracker.py, a proces śledzenia wykonano za pomocą scripts\formal_track.py. - Powiąż detekcje o wysokim poziomie ufności z istniejącymi trajektoriami, korzystając ze spójności ruchu. Zaktualizuj dopasowane trajektorie i inicjuj nowe trajektorie tylko wtedy, gdy niedopasowane detekcje o wysokim poziomie ufności spełniają kryteria inicjalizacji trajektorii.
- Przejrzyj wyniki ekstrakcji semantycznej koszulek przedstawione na Rysunku 4 i skonstruuj wektor cech semantycznych koszulki dla każdej detekcji, łącząc deskryptor koloru drużyny i cechę numeru zawodnika zgodnie z Równaniem 6.
fsem = [fcol;fid] (6)
Tutaj fsem oznacza scalony wektor cech semantycznych, fcol oznacza deskryptor koloru drużyny, a fid oznacza cechę numeru zawodnika wygenerowaną przez gałąź OCR. - Powiąż detekcje o średnim poziomie ufności, łącząc podobieństwo ruchu z podobieństwem semantycznym koszulek. Oblicz scalony wynik dopasowania zgodnie z Równaniem 7.
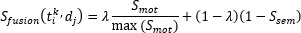 (7)
Tutaj Ssem oznacza podobieństwo cosinusowe między wektorami cech semantycznych trajektorii a kandydującej detekcji, Smot oznacza odległość ruchu zdefiniowaną w Równaniu 5, a λ oznacza adaptacyjny współczynnik fuzji równoważący człony podobieństwa ruchu i semantyki. - Oblicz adaptacyjny współczynnik fuzji zgodnie z Równaniem 8.
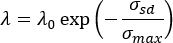 (8)
Tutaj λ0 oznacza początkowy współczynnik wagi ruchu, σsd oznacza odchylenie standardowe wyników ufności detekcji w bieżącej klatce, a σmax oznacza maksymalne odchylenie standardowe wyniku ufności używane do normalizacji. - Używaj detekcji o niskim poziomie ufności wyłącznie do odzyskiwania trajektorii. Dopasuj detekcje o niskim poziomie ufności do przerwanych trajektorii tylko wtedy, gdy dostępne są informacje semantyczne i spełnione są kryteria odzyskiwania. Zastosuj weryfikację wieloklatkową przed przywróceniem tożsamości trajektorii i odrzuć detekcje, które nie przejdą weryfikacji.
UWAGA: Gdy cecha numeru zawodnika jest niedostępna, wykonaj asocjację, korzystając z dostępnych informacji semantycznych i spójności ruchu, zamiast wymuszać dopasowanie numeru zawodnika. Oczekiwanym wynikiem tej sekcji jest klatka-po-klatce zapis śledzenia zawierający tożsamości trajektorii, ramki ograniczające, etykiety poziomu ufności, koszty ruchu, informacje semantyczne oraz ostateczne decyzje o asocjacji. W pakiecie dowodów rewizji wyniki śledzenia zostały zapisane w: outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_center_motion_sweep_round2\age45_h0p95_m0p94_l0p58_mw0p65_lw0p5_va0p25_hsp0p0_cdw0p1\tracking.
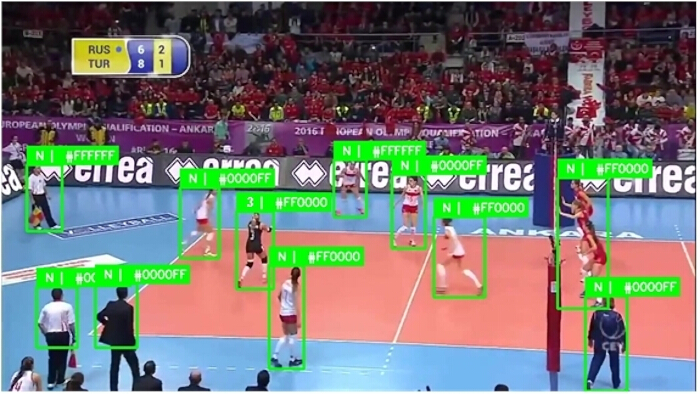
Rysunek 4. Ekstrakcja cech semantycznych koszulek. Reprezentatywne detekcje sportowców są opisane wyekstrahowanymi deskryptorami kolorów drużyn oraz informacjami o numerach zawodników, wygenerowanymi przez moduł ekstrakcji semantycznej koszulek. Wyekstrahowane cechy semantyczne są następnie włączane do asocjacji danych sterowanej poziomem ufności. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
6. Uruchomienie wnioskowania śledzenia i eksport wyników
- Przeprowadź inferencję śledzenia dla każdej sekwencji wideo, korzystając z przygotowanych plików wyjściowych detektora, plików cech semantycznych oraz plików partycji ufności. Przetwarzaj klatki wideo w kolejności chronologicznej, aby stany trajektorii, historia semantyczna i decyzje o odzyskaniu trajektorii były aktualizowane spójnie w całej sekwencji. Używaj tej samej konfiguracji inferencji dla wszystkich ocenianych sekwencji, chyba że wyraźnie wskazano ustawienia specyficzne dla danego zbioru danych.
UWAGA: Inferencja śledzenia została wykonana za pomocą skryptu scripts/formal_track.py, który jest dostępny w repozytorium kodu źródłowego JerseyTrack (https://doi.org/10.5281/zenodo.21274352). Osobny plik konfiguracyjny nie jest wymagany. Wykonaj inferencję śledzenia za pomocą następującego polecenia: python scripts/formal_track.py --detections-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/detections --semantic-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_t005_color --confidence-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_threshold_sweep/t005/confidence --out-dir outputs/formal_runs/sportsmot_val_yolo11x_i960_e3_center_motion_sweep_round2/age45_h0p95_m0p94_l0p58_mw0p65_lw0p5_va0p25_hsp0p0_cdw0p1/tracking --max-age 45 --high-threshold 0.95 --medium-threshold 0.94 --low-threshold 0.58 --medium-motion-weight 0.65 --low-motion-weight 0.5 --velocity-alpha 0.25 --center-distance-weight 0.1. Wszystkie niewskazane parametry zachowały wartości domyślne zapisane w zarchiwizowanym kodzie źródłowym. - Po inferencji zastosuj główną sekwencję postprocessingu za pomocą następujących poleceń: python scripts/merge_tracklets.py oraz python scripts/sweep_track_filter.py --min-len 95.
- Wyeksportuj wyniki śledzenia w formacie wymaganym przez zestaw narzędzi ewaluacyjnych. Uwzględnij indeks klatki, identyfikator trajektorii, współrzędne ramki ograniczającej (bounding box) oraz wszystkie pola wymagane przez format ewaluacji benchmarku. Zapisz jeden plik z wynikami śledzenia dla każdej sekwencji, stosując spójną konwencję nazewnictwa plików, aby każdy plik z wynikami mógł zostać dopasowany do odpowiadającego mu pliku z adnotacjami ground-truth.
- Zastosuj wyłącznie operacje postprocessingu użyte w niniejszym badaniu. Przeprowadź łączenie trackletów i filtrowanie ścieżek za pomocą skryptów postprocessingu opisanych w pakiecie rewizyjnym.
UWAGA: W niniejszym badaniu w przepływie pracy postprocessingu użyto następujących skryptów:
⋅ scripts\merge_tracklets.py
⋅ scripts\sweep_track_filter.py
⋅ scripts\correct_identity_swaps.py
⋅ scripts\sweep_identity_swap_correction.py
⋅ scripts\interpolate_tracks.py
⋅ scripts\sweep_track_interpolation.py - Przejrzyj wyeksportowane wyniki śledzenia przed ewaluacją ilościową. Potwierdź, że identyfikatory trajektorii pozostają numeryczne i spójne w obrębie każdej sekwencji, że nie brakuje indeksów klatek oraz że wszystkie ramki ograniczające mieszczą się w granicach obrazu.
UWAGA: Oczekiwanym wynikiem tej sekcji jest kompletny zestaw plików z wynikami śledzenia na poziomie sekwencji, gotowych do ewaluacji ilościowej.
7. Ocena wydajności śledzenia
- Oceń wyeksportowane pliki z wynikami śledzenia, korzystając z zestawu narzędzi ewaluacyjnych wymienionego w Tabeli materiałów. Dopasuj każdy plik z wynikiem śledzenia do odpowiadającego mu pliku z adnotacjami prawdy podstawowej (ground-truth) oraz podzbioru danych. Dla wszystkich porównywanych metod zastosuj tę samą konfigurację ewaluacji, aby upewnić się, że różnice w wydajności wynikają z rezultatów śledzenia, a nie z ustawień ewaluacji.
- Uruchom ewaluację za pomocą następującego polecenia
\.venv\Scripts\python.exe evaluation\trackeval\scripts\nun_mot_challenge.py --GT_FOLDER datasets\SportsMOT\dataset\val --RESULTS_DIR outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_center_motion_filter_fine
_round1\minlen95 --OUTPUT_FOLDER outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_center_motion_filter_fine_
round1\minlen95\trackeval --TRACKERS_TO_EVAL JerseyTrack_i960_e3_center_motion_minlen95 --BENCHMARK SportsMOT --SPLIT_TO_EVAL val
UWAGA: Ewaluacja została przeprowadzona przy użyciu standardowej implementacji metryk TrackEval (wersja 1.3.0) zarchiwizowanej w pakiecie reprodukowalności JerseyTrack. Nie wprowadzono żadnych modyfikacji w implementacjach metryk Higher Order Tracking Accuracy (HOTA), CLEAR ani Identity. Repozytorium zawiera wrapper wykonawczy w stylu MOTChallenge znajdujący się w evaluation/trackeval/scripts/run_mot_challenge.py, który konfiguruje ścieżki do zbioru danych i wyników oraz wywołuje standardowe metryki ewaluacyjne TrackEval. - Zapisz metryki ewaluacyjne raportowane w manuskrypcie, w tym Multiple Object Tracking Accuracy (MOTA), IDentity F1 Score (IDF1), Higher Order Tracking Accuracy (HOTA), Detection Accuracy (DetA), Association Accuracy (AssA), wyniki fałszywie dodatnie (FPs), fałszywie ujemne (FNs) oraz zdarzenia przełączenia tożsamości (identity-switching events). Wyeksportuj podsumowanie ewaluacji w formie tabeli i zachowaj pliki ewaluacyjne dla każdej sekwencji w celu weryfikacji.
- Podczas porównywania JerseyTrack z metodami bazowymi (baseline), dla wszystkich metod zastosuj ten sam podzbiór danych, wyniki detektora i konfigurację ewaluacji. Dla każdego porównania zapisz informacje o zbiorze danych, źródle wyników detektora, konfiguracji zestawu narzędzi ewaluacyjnych oraz wartościach metryk.
- Przejrzyj logi ewaluacji, aby zweryfikować, czy wszystkie sekwencje zostały pomyślnie ocenione i czy nie brakuje żadnych plików z wynikami śledzenia.
UWAGA: W niniejszym badaniu główny plik podsumowania TrackEval został zapisany w: outputs\formal_runs\sportsmot_val_yolo11x_i960_e3_center_motion_filter_fine_
round1\minlen95\trackeval\JerseyTrack_i960_
e3_center_motion_minlen95\pedestrian_summary.txt. Oczekiwanym rezultatem tej sekcji jest kompletna tabela podsumowująca ewaluację wraz z plikami metryk dla poszczególnych sekwencji, stanowiącymi podstawę raportowanych Wyników i późniejszej weryfikacji.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Niniejsza sekcja przedstawia ilościowe i jakościowe wyniki uzyskane w ramach ocenianych eksperymentów wielobiektowego śledzenia w sporcie. Wyniki koncentrują się na dokładności śledzenia, zachowaniu tożsamości obiektów, jakości asocjacji oraz odporności w testowanych konfiguracjach zbiorów danych. Roszczenia dotyczące wydajności są ograniczone do ocenianych metod, zbiorów danych, wyników detektora oraz konfiguracji zestawu narzędzi ewaluacyjnych opisanych w Protokołe i Konfiguracji Implementacji.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
W niniejszym badaniu oceniono workflow sportowego MOT sterowany pewnością, który łączy partycjonowanie na podstawie pewności detekcji z semantycznymi wskazówkami dotyczącymi koszulek. Asocjację sterowaną pewnością oraz fuzję cech semantycznych badano jako strategie komplementarne, mające na celu poprawę asocjacji danych w śledzeniu wielu obiektów12,20,23,24,46...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy oświadczają, że nie mają żadnych finansowych konfliktów interesów.
Podziękowania
Autorzy nie mają żadnych podziękowań do zadeklarowania.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| CUDA Runtime | NVIDIA | Wersja 12.8 | Środowisko uruchomieniowe obliczeń GPU wykorzystywane do trenowania detektora, ekstrakcji cech semantycznych i inferencji śledzenia. |
| EasyOCR | Jaided AI | Wersja 1.7.2 | Zestaw narzędzi do optycznego rozpoznawania znaków wykorzystywany do rozpoznawania numerów zawodników. |
| Kod źródłowy JerseyTrack | Autorzy | N/A | Własna implementacja zawierająca skrypty do przygotowania danych, ekstrakcji cech semantycznych, partycjonowania ufności, śledzenia, postprocesowania i ewaluacji. Dostępna pod adresem: https://doi.org/10.5281/zenodo.21274352 |
| Lekki model CRNN OCR | Autorzy | N/A | Własna konwolucyjna rekurencyjna sieć neuronowa (CRNN) wykorzystywana do rozpoznawania numerów zawodników. |
| Zbiór danych MOT17 | MOTChallenge | N/A | Publiczny zbiór danych referencyjnych wykorzystywany do ewaluacji międzyzbiorowej. Dostępny pod adresem: https://motchallenge.net/data/MOT17/ |
| Zbiór danych MOT20 | MOTChallenge | N/A | Publiczny zbiór danych referencyjnych wykorzystywany do ewaluacji międzyzbiorowej. Dostępny pod adresem: https://motchallenge.net/data/MOT20/ |
| motmetrics | Twórcy motmetrics | Wersja 1.4.0 | Biblioteka wykorzystywana do obliczania diagnostycznych metryk śledzenia wielu obiektów. |
| GPU NVIDIA | NVIDIA | GeForce RTX 5090 D V2 | Jednostka przetwarzania graficznego wykorzystywana do trenowania detektora i inferencji śledzenia. |
| Sterownik GPU NVIDIA | NVIDIA | Wersja 610.62 | Sterownik GPU wykorzystywany w środowisku eksperymentalnym. |
| NumPy | Twórcy NumPy | Wersja 2.4.4 | Biblioteka obliczeń numerycznych wykorzystywana do przetwarzania cech i obsługi danych. |
| OpenCV | OpenCV | Wersja 4.10.0 | Biblioteka wizji komputerowej wykorzystywana do ładowania, przycinania, wstępnego przetwarzania i wizualizacji obrazów. |
| Python | Python Software Foundation | Wersja 3.12.2 | Język programowania wykorzystywany w całym przepływie pracy. |
| PyTorch | PyTorch Foundation | Wersja 2.11.0+cu128 | Framework głębokiego uczenia wykorzystywany do implementacji detektora i modelu semantycznego. |
| scikit-learn | Twórcy scikit-learn | Wersja 1.9.0 | Biblioteka uczenia maszynowego wykorzystywana do klastrowania K-średnich podczas ekstrakcji kolorów koszulek i partycjonowania ufności. |
| Zbiór danych SoccerNet Tracking | SoccerNet | N/A | Publiczny benchmark śledzenia piłki nożnej wykorzystywany do ewaluacji międzyzbiorowej. Dostępny pod adresem: https://www.soccer-net.org/tasks/tracking |
| Zbiór danych SportsMOT | SportsMOT Benchmark | N/A | Główny zbiór danych referencyjnych wykorzystywany do przygotowania detektora i ewaluacji śledzenia. Dostępny pod adresem: https://deeperaction.github.io/datasets/sportsmot.html |
| Zbiór danych TeamTrack | TeamTrack Benchmark | N/A | Publiczny benchmark śledzenia sportowego wykorzystywany do ewaluacji międzyzbiorowej. Dostępny pod adresem: https://atomscott.github.io/TeamTrack/ |
| Torchvision | PyTorch Foundation | Wersja 0.26.0+cu128 | Biblioteka wizji komputerowej wykorzystywana z PyTorch do transformacji obrazów i wsparcia modeli. |
| TrackEval | Twórcy TrackEval | Wersja 1.3.0 | Zestaw narzędzi ewaluacyjnych wykorzystywany do obliczania dokładności śledzenia wielu obiektów (MOTA), wyniku F1 dla tożsamości (IDF1), dokładności śledzenia wyższego rzędu (HOTA), dokładności detekcji (DetA), dokładności asocjacji (AssA), wyników fałszywie dodatnich (FP), fałszywie ujemnych (FN) oraz zmian tożsamości (IDs). |
| Ultralytics | Ultralytics | Wersja 8.4.90 | Framework detekcji obiektów wykorzystywany do trenowania detektora i generowania detekcji sportowców. |
Bibliografia
- Naik BT, Hashmi MF, Bokde ND. A comprehensive review of computer vision in sports: open issues, future trends and research directions. Applied Sciences. 2022;12(9):4429-46.
- Cao W, Wang X, Liu X, Xu Y. A deep learning framework for multi-object tracking in team-sports videos. IET Computer Vision. 2024;18(5):574-90.
- Fu X, et al. A novel dataset for multi-view multi-player tracking in soccer scenarios. Applied Sciences. 2023;13(9):5361-77.
- Guo Y, et al. Does visual training enhance athletes' decision-making skills and sport-specific performance? A systematic review and meta-analysis. Scand J Med Sci Sports. 2025;35(10):e70140.
- Chen X, et al. Multi-object detection and tracking based on CRF network and spatio-temporal attention for sports videos. Scientific Reports. 2025;15(1):6808-21.
- Cheng X, Zhao H, Deng Y, Shen S. Multi-object tracking with predictive information fusion and adaptive measurement noise. Applied Sciences. 2025;15(2):736-48.
- Hu Q, Scott A, Yeung C, Fujii K. Basketball-SORT: an association method for complex multi-object occlusion problems in basketball multi-object tracking. Multimedia Tools Appl. 2024;83(38):86281-97.
- Meng W, Duan S, Ma S, Hu B. Motion-Perception Multi-Object Tracking (MPMOT): enhancing multi-object tracking performance via motion-aware data association and trajectory connection. Journal of Imaging. 2025;11(5):144.
- Nie G, Wang X, Zhang D, Wang H. SCT-Diff: seamless contextual tracking via diffusion trajectory. Journal of Imaging. 2026;12(1):38.
- Yue Y, et al. Improving multi-object tracking by full occlusion handle and adaptive feature fusion. IET Image Processing. 2023;17(12):3423-40.
- Li H, et al. Synergistic-aware cascaded association and trajectory refinement for multi-object tracking. Image Vis Comput. 2025;154:105695.
- Wang C, Xie H. FCD-Net: feature decorrelation and confidence-driven dynamic fusion for robust pedestrian recognition in autonomous driving. IEEE Trans Intell Transp Syst. 2025;26(1):1-13.
- Wan S, Chen W. Improved multi-target athlete tracking in sports videos using IYOLOv8-MTD and enhanced DeepSORT with hybrid attention and IMM. Informatica. 2025;49(35):101-16.
- Sun Z, et al. Multiple pedestrian tracking under occlusion: a survey and outlook. IEEE Trans Circuits Syst Video Technol. 2025;35(2):1009-27.
- Qian H, et al. Low-altitude multi-object tracking via graph neural networks with cross-attention and reliable neighbor guidance. Remote Sensing. 2025;17(20):3502.
- Liu C, Li H, Wang Z. FastTrack: a highly efficient and generic GPU-based multi-object tracking method with parallel Kalman filter. Int J Comput Vis. 2024;132(5):1463-83.
- Urdiales J, Martín D, Armingol JM. An improved deep learning architecture for multi-object tracking systems. Integr Comput Aided Eng. 2023;30(2):121-34.
- You L, et al. Multi-object vehicle detection and tracking algorithm based on improved YOLOv8 and ByteTrack. Electronics. 2024;13(15):3033.
- Stanczyk T, Yoon S, Bremond F. No train yet gain: towards generic multi-object tracking in sports and beyond [conference paper]. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops; 2025. p. 6085-94. https://doi.org/10.48550/arXiv.2506.01373
- Mandel T, et al. Detection confidence driven multi-object tracking to recover reliable tracks from unreliable detections. Pattern Recognit. 2023;135:109107.
- Hou M, Wu Y, Shi H, Mu X. A two-stage multi-object tracking algorithm with transformer and attention mechanism. Scientific Reports. 2025;15(1):31414.
- Wenkel S, et al. Confidence score: the forgotten dimension of object detection performance evaluation. Sensors. 2021;21(13):4350.
- Zhang F, Hu Y, Li Z, Luo D. Two-stage multi-object tracking via low confidence dynamic adaptive matching enhancement for autonomous driving. Applied Soft Computing. 2025;168:112101.
- Stanojevic VD, Todorovic BT. BoostTrack: boosting the similarity measure and detection confidence for improved multiple object tracking. Mach Vis Appl. 2024;35(3):53.
- Tan S, Kuang Z, Jin B. AppleYOLO: apple yield estimation method using improved YOLOv8 based on Deep OC-SORT. Expert Syst Appl. 2025;272:126764.
- Li YF, et al. Multi-object tracking with robust object regression and association. Comput Vis Image Underst. 2023;227:103586.
- Mao H, Chen Y, Li Z, Chen F, Chen P. SCTracker: multi-object tracking with shape and confidence constraints. IEEE Sensors Journal. 2023;24(3):3123-30.
- Ma J, Yang J, Zhang J, Fu F. Online multiple object tracker with enhanced features. Journal of Electronic Imaging. 2023;32(1):013030.
- Liu Y, et al. A full-detection association tracker with confidence optimization for real-time multi-object tracking. J Real-Time Image Process. 2024;21(4):1-15.
- Song Z, et al. Temporal coherent object flow for multi-object tracking [conference paper]. In: Proceedings of the AAAI Conference on Artificial Intelligence; 2025;39(7):6978-86. https://doi.org/10.1609/aaai.v39i7.32749.
- Scarrica VM, Staiano A. Learning from outputs: improving multi-object tracking performance by tracker fusion. Technologies. 2024;12(12):239.
- Miah M, Bilodeau GA, Saunier N. Learning data association for multi-object tracking using only coordinates. Pattern Recognit. 2025;160:111169.
- Yang C, Yang M, Li H. A survey on soccer player detection and tracking with videos. Visual Computer. 2025;41(2):815-29.
- Pham DT, Thuy NTT, Tran LQ. SportsORT: overcoming challenges of multi-object tracking in sports through domain-specific features and out-of-view re-association. Mach Vis Appl. 2025;36(6):1-17.
- Naik BT, Hashmi MF, Geem ZW, Bokde ND. DeepPlayer-Track: player and referee tracking with jersey color recognition in soccer. IEEE Access. 2022;10:32494-509.
- Scott A, et al. TeamTrack: a dataset for multi-sport multi-object tracking in full-pitch videos. Sports Engineering. 2024;27(2):24.
- Vats K, et al. Player tracking and identification in ice hockey. Expert Syst Appl. 2023;213:119250.
- Liu W, Yao J, Jiang F, Wang M. An improved multi-object tracking algorithm designed for complex environments. Sensors. 2025;25(17):5325.
- Kausalya K, Kanaga Suba Raja S. OTRN-DCN: an optimized transformer-based residual network with deep convolutional network for action recognition and multi-object tracking of adaptive segmentation using soccer sports video. Int J Wavelets Multiresolut Inf Process. 2024;22(1):2350034.
- Lopes JM, et al. Object and event detection pipeline for rink hockey games. Future Internet. 2024;16(6):179.
- Thulasya Naik B, Hashmi MF, Gupta A. EIoU-distance loss: an automated team-wise player detection and tracking with jersey colour recognition in soccer. Connection Science. 2024;36(1):2291991.
- Liu H, et al. Automated player identification and indexing using two-stage deep learning network. Scientific Reports. 2023;13(1):10036.
- Bhargavi D, Gholami S, Pelaez Coyotl E. Jersey number detection using synthetic data in a low-data regime. Front Artif Intell. 2022;5:988113.
- Dendorfer P, et al. MOTChallenge: a benchmark for single-camera multiple target tracking. Int J Comput Vis. 2021;129(4):845-81.
- Luiten J, et al. HOTA: a higher order metric for evaluating multi-object tracking. Int J Comput Vis. 2021;129(2):548-78.
- Pal SK, Pramanik A, Maiti J, Mitra P. Deep learning in multi-object video tracking: a review. Mach Vis Appl. 2021;51(9):6400-29.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.