Protokół Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC) integruje inspirowane kwantowo modelowanie poznawcze, wstępne przetwarzanie danych, selekcję cech oraz hybrydową naukę neuronową w celu identyfikacji zainteresowań studentów kierunków inżynieryjnych. Protokół ten przedstawia powtarzalny, hybrydowy przepływ pracy uczenia maszynowego inspirowanego kwantowo dla analityki edukacyjnej, zaprezentowany na przykładzie identyfikacji zainteresowań studentów inżynierii z wykorzystaniem wielowymiarowych danych edukacyjnych.
Artykuł badawczy
Identyfikacja zainteresowań studentów w oparciu o dane dla inteligentnych systemów zarządzania nauczaniem w uczelniach technicznych
W tym artykule
Podsumowanie
Streszczenie
Niniejszy protokół przedstawia inspirowany kwantowo model obliczeniowy służący do identyfikacji zainteresowań studentów kierunków inżynieryjnych z wykorzystaniem wielowymiarowych danych edukacyjnych i behawioralnych. Celem jest zapewnienie systematycznego i powtarzalnego schematu postępowania, który integruje wstępne przetwarzanie danych, analizę wzorców behawioralnych, selekcję cech oraz hybrydowe uczenie neuronowe w celu wsparcia podejmowania decyzji edukacyjnych i personalizacji nauczania. Proces rozpoczyna się od zastosowania skalowania Box-Cox Robust IQR (BCRIS), aby przetworzyć i znormalizować dane edukacyjne poprzez redukcję szumu semantycznego i poprawę jakości danych. Następnie zachowania uczniów podczas nauki są analizowane przy użyciu Kwantowego Modelu Stanu Poznawczego (QCSM), który reprezentuje przejścia behawioralne i ewoluujące preferencje uczenia się w warunkach niepewności. Następnie odpowiednie cechy są wybierane za pomocą algorytmu Kwantowo-Wspomaganej Optymalizacji Rojem Wielorybów do Selekcji Cech (QES-WOFS), aby zredukować nadmiarowość cech i zidentyfikować informacyjne charakterystyki behawioralne. Na koniec Meta-Uczący Hybrydowy Kwantowo-Klasyczny Klasyfikator Neuronowy (ML-HQNC) integruje uczenie inspirowane kwantowo z głębokimi sieciami neuronowymi w celu klasyfikacji zainteresowań studentów. Protokół został zwalidowany z wykorzystaniem publicznie dostępnego zbioru danych edukacyjnych. Wydajność modelu oceniono za pomocą konwencjonalnych metryk, w tym dokładności (accuracy), miary F1-score oraz pola powierzchni pod krzywą charakterystyki operacyjnej odbiornika (AUC), wraz z Precyzją Wykrywania Zainteresowań (IDP), Indeksem Stabilności Wzorców Kwantowych (QPSI) oraz Zyskiem Adaptacyjności Międzydomenowej (CDAG). Model osiągnął ogólną dokładność klasyfikacji na poziomie 96.17% w ocenianym zbiorze danych. Protokół ten dostarcza powtarzalnego schematu obliczeniowego do analizy wielowymiarowych danych edukacyjnych w celu wsparcia inteligentnego zarządzania edukacją i aplikacji do personalizowanego uczenia się.
Wprowadzenie
Systemy zarządzania edukacją są coraz częściej wykorzystywane w całym sektorze oświaty, co jest napędzane przez szybki postęp w dziedzinie technologii informacyjnych i sieci komputerowych. Ciągły rozwój szkolnictwa wyższego wiąże się ze zwiększoną liczbą studentów, szczególnie na kierunkach inżynieryjnych, co skutkuje znacznym przyrostem danych dotyczących zarządzania edukacją. Wzrost ten wspiera zrównoważony rozwój edukacyjny, przyspiesza informatyzację kształcenia oraz ułatwia tworzenie standaryzowanych systemów zarządzania edukacją, które poprawiają spójność i efektywność administracji dydaktycznej. Uczenie maszynowe (ML) dostarcza technik obliczeniowych, które umożliwiają systemom analizę danych, uczenie się na podstawie wzorców i ciągłe doskonalenie wydajności predykcyjnej bez konieczności jawnego programowania1,2.
Jakość edukacji jest fundamentalnym elementem szkolnictwa wyższego. W ostatnich latach egzaminy są powszechnie wykorzystywane do oceny stopnia zrozumienia treści kursu przez studentów kierunków inżynieryjnych oraz ich zdolności do przyswajania nowej wiedzy, co sprzyja ciągłemu doskonaleniu jakości kształcenia. Środowiska zorientowane na ucznia można tworzyć poprzez wykorzystanie różnorodnych zasobów edukacyjnych dostępnych na platformach online oraz stosowanie wielu teorii uczenia się w celu zaspokojenia potrzeb różnych uczniów. Efektywne nauczanie odgrywa kluczową rolę w poprawie wyników uczenia się studentów kierunków inżynieryjnych na uniwersytetach i uczelniach wyższych3,4. Ponadto skuteczne nauczanie sprzyja tworzeniu pozytywnego środowiska uczenia się, wspiera zrozumienie treści kursu i poprawia wyniki w nauce. Jakość edukacji jest oceniana za pomocą wielu wskaźników w całym procesie uczenia się, w tym struktury programu nauczania, środowiska w sali lekcyjnej oraz treści nauczania.
Kształcenie wyższe sprzyja rozwojowi intelektualnemu, osobistemu i społecznemu studentów. Jednocześnie zaangażowanie studentów – obejmujące wymiary behawioralne, emocjonalne i poznawcze – oraz wytrwałość akademicka stały się istotnymi czynnikami determinującymi wyniki uczenia się. Wysoki poziom zaangażowania studentów znacząco przyczynia się do długoterminowego sukcesu akademickiego5,6. Postępy w technologiach edukacyjnych stworzyły nowe możliwości dla analityki edukacyjnej opartej na danych poprzez modelowanie złożonych nieliniowych zależności między cechami poznawczymi, behawioralnymi i akademickimi studentów z wykorzystaniem technik uczenia maszynowego (Machine Learning, ML) oraz głębokiego uczenia (Deep Learning, DL).
Głównym wyzwaniem pozostaje skuteczna obserwacja i ocena dynamiki zajęć w klasie przy jednoczesnym uwzględnieniu ewoluujących zachowań uczniów. Tradycyjne podejścia do oceny jakości kształcenia i analizy zachowań studentów inżynierii są często czasochłonne i podatne na subiektywną ocenę ludzką. Brak uwagi uczniów podczas zajęć w klasie niekorzystnie wpływa na wyniki uczenia się i osiągnięcia akademickie7,8. Jednakże utrzymanie stałej uwagi studentów inżynierii pozostaje trudne ze względu na rozproszenia wewnętrzne i zewnętrzne oraz wahania motywacji.
Ocena i zwiększanie zaangażowania studentów stały się coraz ważniejsze w związku z powszechnym wprowadzeniem nauczania online, inteligentnych sal lekcyjnych oraz innych interaktywnych technologii edukacyjnych. Zapewnienie inkluzywności w zróżnicowanych grupach studentów kierunków inżynieryjnych dodatkowo podkreśla potrzebę stworzenia kompleksowych ram integrujących podejścia oparte na technologii z praktyką edukacyjną, przy jednoczesnym zachowaniu standardów prywatności i etyki. Ponadto ograniczona przejrzystość modeli oraz wyzwania związane z integracją technologii9,10, w tym błędy metodologiczne i kwestie sprawiedliwości edukacyjnej, nadal utrudniają rozwój systemów predykcyjnych zdolnych do wspierania uczących się poprzez ciągłe monitorowanie.
Metody uczenia maszynowego są szeroko stosowane w celu rozwiązania problemów edukacyjnych, takich jak przewidywanie ryzyka niepowodzeń uczniów oraz wskaźników rezygnacji ze studiów. Podejścia te wykazały zdolność do identyfikacji uczniów z grupy wysokiego ryzyka, wspierając tym samym interwencje poprawiające osiągnięcia akademickie11. Opracowano również systemy zarządzania edukacją oparte na sztucznej inteligencji (AI), aby usprawnić procesy administracyjne i akademickie w instytucjach szkolnictwa wyższego. Zbiory danych edukacyjnych zazwyczaj obejmują dokumentację akademicką, taką jak oceny z kursów, listy obecności i historię zapisów12.
Poprzednie badania analizowały zachowanie studentów z trzech perspektyw: danych ewaluacyjnych, metod oraz wyników13,14. W celu analizy cech behawioralnych studentów opracowano modele predykcyjne oparte na umiejętnościach informacyjnych. Badania te koncentrują się głównie na ocenie zachowań uczących się z wykorzystaniem metod głębokiego uczenia (Deep Learning, DL). Jednakże badania nad inteligentną oceną zachowań nauczycieli znajdują się wciąż we wczesnej fazie, co ogranicza postęp w tej dziedzinie. Szybkie konwolucyjne sieci neuronowe oparte na regionach (Fast R-CNNs) zostały zastosowane do zbiorów danych edukacyjnych w celu usprawnienia detekcji aktywności w klasie, wykazując znaczną poprawę wydajności w porównaniu z metodami tradycyjnymi15.
Modele dwukierunkowej długiej krótkotrwałej pamięci (Bi-LSTM) z wbudowanymi mechanizmami samomonitorowania poprawiły również dokładność przewidywania ocen studentów. Podobnie modele predykcyjne opracowane na podstawie zbiorów danych dotyczących zachowań w nauce online wykazały poprawę wydajności predykcyjnej16,17,18. Ponadto metoda k-średnich (KMC) była wykorzystywana do identyfikacji charakterystyki różnych grup studentów poprzez analizę skupień, dostarczając informacji o zachowaniach studentów, które wspierają usprawnienia w nauczaniu, zarządzaniu i uczeniu się. Zaproponowano również strategie oparte na głębokim uczeniu w celu poprawy wykrywania i oceny zachowań podczas nauczania w klasie. W tych podejściach cechy behawioralne w klasie są wykorzystywane do ustanowienia relacji między reprezentacjami cech a nadpłaszczyznami, stosując liniowo separowalne wartości startowe dla maszyny wektorów nośnych (SVM)19,20. Jednakże wyzwania takie jak przesłonięcia, drobnoziarniste szczegóły behawioralne oraz zakłócenia środowiskowe nadal ograniczają dokładność rozpoznawania zachowań studentów kierunków technicznych w środowisku klasowym.
Głębokie uczenie zostało zastosowane również do oceny efektów kształcenia w kursach uniwersyteckich, w tym do oceny edukacyjnej w ramach edukacji politycznej i ideologicznej21,22. Skuteczność tych modeli predykcyjnych została wykazana z wykorzystaniem publicznie dostępnych zbiorów danych edukacyjnych. Do przewidywania wyników w nauce studentów wykorzystano sieci neuronowe typu Spiking Neural Networks z przesuwanym sygnałem w przód (FSNNs), bazując na danych gromadzonych przez platformy e-learningowe i systemy zarządzania nauczaniem. Jak pokazano na Ryc. 1, proponowany schemat obliczeniowy wykorzystuje zbiór danych oceny edukacyjnej do identyfikacji zainteresowań studentów kierunków inżynierskich poprzez sekwencyjne etapy przetwarzania wstępnego danych, analizy wzorców behawioralnych, selekcji cech oraz klasyfikacji. Tabela 123,24,25,26,27,28,29,30,31,32 podsumowuje reprezentatywne metody opisane w poprzednich badaniach, wraz z zastosowanymi technikami i ich ograniczeniami w zakresie identyfikacji zainteresowań studentów w systemach zarządzania nauczaniem.
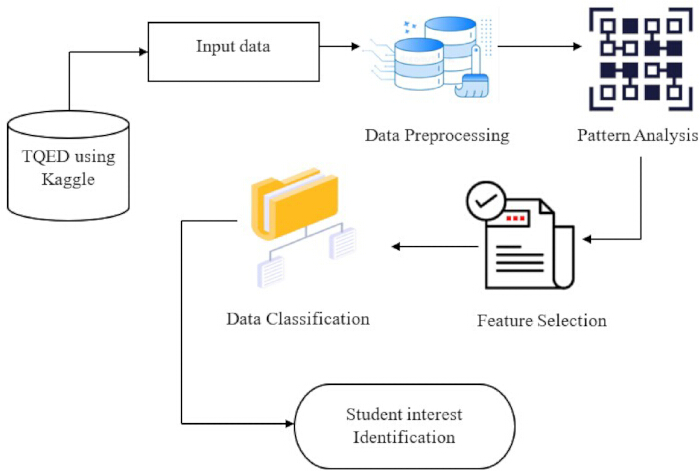
Rysunek 1: Schemat identyfikacji zainteresowań studentów. Ogólny przebieg proponowanego schematu identyfikacji zainteresowań studentów kierunków technicznych, obejmujący pozyskiwanie danych, wstępne przetwarzanie, analizę wzorców behawioralnych, wybór cech oraz klasyfikację. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Tabela 1: Analiza zachowań studentów w zarządzaniu nauczaniem.Podsumowanie reprezentatywnych metod, technik, zbiorów danych, metryk ewaluacji oraz zgłaszanych ograniczeń w analizie zachowań studentów w zarządzaniu nauczaniem. Kliknij tutaj, aby pobrać tę tabelę.
Swin Transformer oraz lekka sieć piramidy cech (Lightweight Feature Pyramid Network, FPN) zostały zastosowane do wykrywania zachowań uczniów w klasie poprzez wydajne przetwarzanie wieloskalowych map cech33. Ponadto, regulowana rekurencyjna sieć neuronowa optymalizowana algorytmem muszki owocowej (Fruit-Fly-Optimized Adjustable Recurrent Neural Network, PFFO-ARNN) była wykorzystywana do analizy zachowań uczniów podczas nauki online i przewidywania wyników z kursów34. Badania oparte na danych o zachowaniach studentów, zebranych z uniwersyteckich systemów zarządzania nauką, podkreśliły również nieefektywność i czasochłonność monitorowania zachowań w klasie przy użyciu konwencjonalnych metod głębokiego uczenia35. Tabela 236,37,38,39,40,41,42,43,44,45,46,47 podsumowuje reprezentatywne metody klasyfikacji, zbiory danych, metryki ewaluacji oraz zgłaszane ograniczenia dla inteligentnych systemów zarządzania nauczaniem w edukacji inżynieryjnej.
Tabela 2: Inteligentne systemy zarządzania nauczaniem oparte na głębokim uczeniu w edukacji inżynieryjnej.Porównanie reprezentatywnych systemów zarządzania nauczaniem opartych na głębokim uczeniu, zbiorów danych, metryk oceny oraz zgłaszanych ograniczeń. Kliknij tutaj, aby pobrać tę tabelę.
W poprzednim badaniu48 opracowano model oceny jakości nauczania mieszanego oparty na głębokich sieciach przekonań (DBN) i zaproponowano mieszaną strategię ewaluacji w celu oceny jakości nauczania na uniwersytetach. Zaproponowane podejście przewyższyło konwencjonalny algorytm genetyczny (GA) zarówno pod względem dokładności klasyfikacji, jak i czasu wykonania, osiągając dokładność powyżej 95% w czasie krótszym niż 5.4 ms. Model został przeszkolony przy użyciu etykietowanych zbiorów danych edukacyjnych i oceniony z zastosowaniem niezależnej strategii testowej49,50. Raportowane wyniki wykazały wysoką zdolność predykcyjną, przy średnim błędzie bezwzględnym (MAE) wynoszącym 0.593% i pierwiastku błędu średniokwadratowego (RMSE) na poziomie 0.785%.
Niedawne architektury z wzmocnioną uwagą, takie jak KANFormer51, integrują wielogłowicową samoatencję (multi-head self-attention) z sieciami Kołmogorowa-Arnolda, aby poprawić przewidywanie wyników uczniów poprzez wychwytywanie złożonych interakcji cech. Modele śledzenia wiedzy oparte na transformerach wykazały również poprawę dokładności przewidywań i interpretowalności, wykorzystując mechanizmy uwagi do modelowania trajektorii uczenia się studentów52. Chociaż architektury oparte na transformerach i mechanizmach uwagi poprawiły wydajność w zadaniach predykcji edukacyjnej poprzez modelowanie zależności kontekstowych i długozasięgowych interakcji cech, podejścia te koncentrują się przede wszystkim na przewidywaniu wyników uczniów lub śledzeniu wiedzy, a nie na identyfikacji zainteresowań uczniów z uwzględnieniem niepewności poprzez inspirowane kwantowo modelowanie poznawcze, zoptymalizowany wybór cech i hybrydowe meta-uczenie.
Pomimo ostatnich postępów w uczeniu maszynowym i głębokim uczeniu w obszarze analityki edukacyjnej, istniejące metody identyfikacji zainteresowań studentów kierunków inżynieryjnych wykazują szereg ograniczeń. Wiele konwencjonalnych podejść koncentruje się przede wszystkim na dokładności przewidywań, pomijając wieloaspektową naturę zachowań studentów, w tym ewoluujące preferencje w nauce, niepewność behawioralną, zależności kontekstowe oraz interakcje semantyczne. Co więcej, metody te często opierają się na tradycyjnym inżynierii cech i deterministycznych strategiach uczenia, które mogą nie uchwycić w sposób adekwatny nieliniowych wzorców behawioralnych ani nie dostosowywać się do dynamicznych środowisk uczenia się. W związku z tym konieczne jest opracowanie bardziej kompleksowych ram integrujących solidne przetwarzanie wstępne danych, inteligentne modelowanie behawioralne, adaptacyjny wybór cech oraz hybrydowe techniki uczenia, aby usprawnić analizę złożonych danych edukacyjnych.
Aby rozwiązać te ograniczenia, zaproponowane ramy integrują solidne przetwarzanie wstępne danych, inspirowane kwantowo modelowanie behawioralne, zoptymalizowany dobór cech oraz hybrydowe kwantowo-klasyczne uczenie neuronowe w ramach jednolitego przepływu obliczeniowego służącego do identyfikacji zainteresowań studentów kierunków inżynieryjnych. Poprzez połączenie tych komplementarnych komponentów, zaproponowany protokół zapewnia systematyczne i reprodukowalne podejście do analizy złożonych danych edukacyjnych w celu wsparcia spersonalizowanego uczenia się oraz podejmowania decyzji edukacyjnych.
Celem niniejszego badania jest opracowanie i walidacja struktury CQEI z wykorzystaniem wielowymiarowych danych edukacyjnych i behawioralnych w celu identyfikacji zainteresowań studentów inżynierii. Struktura ta łączy w sobie zaawansowane wstępne przetwarzanie danych, modelowanie stanów poznawczych inspirowane mechaniką kwantową, zoptymalizowany dobór cech oraz Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC) w celu analizy zachowań edukacyjnych studentów i ułatwienia dokładnej identyfikacji ich zainteresowań. Wydajność oceniono przy użyciu standardowych metryk, w tym dokładności, wyniku F1 oraz pola pod krzywą charakterystyki operacyjnej odbiornika (AUC), wraz z wskaźnikami Interest Detection Precision (IDP), Quantum Pattern Stability Index (QPSI) oraz Cross-Domain Adaptability Gain (CDAG). Poprzez zintegrowanie tych uzupełniających się komponentów w jeden przepływ obliczeniowy, proponowana struktura zapewnia systematyczne podejście do analityki edukacyjnej i inteligentnego podejmowania decyzji w obszarze edukacji.
Protokół
W niniejszym badaniu wykorzystano publicznie dostępny, zanonimizowany zestaw danych pobrany z repozytorium Kaggle. Bezpośrednio nie rekrutowano ani nie angażowano uczestników będących ludźmi, a żadne dane umożliwiające identyfikację osób nie były gromadzone. W związku z powyższym nie wymagano zgody instytucjonalnej komisji etycznej ani świadomej zgody uczestników. Narzędzia badawcze wykorzystane w tej pracy są wymienione w Tabeli materiałów.
1. Przegląd struktury CQEI
Zaproponowana struktura Quantum-Inspired Conceptual Education Intelligence (CQEI) zintegrowała wstępne przetwarzanie danych, analizę wzorców behawioralnych, selekcję cech oraz klasyfikację w celu zidentyfikowania zainteresowań studentów inżynierii przy użyciu zbioru danych Teaching Quality Evaluation pobranego z repozytorium Kaggle. Zbiór danych został najpierw poddany wstępnemu przetwarzaniu metodą Box–Cox Robust IQR Scaling (BCRIS) w celu redukcji szumów semantycznych i normalizacji cech wejściowych. Następnie przeanalizowano wzorce behawioralne studentów przy użyciu modelu Quantum Cognitive State Model (QCSM). W celu zidentyfikowania informatywnych cech przy jednoczesnej redukcji ich redundancji zastosowano algorytm Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS), modelujący kwantową optymalizację wyboru, istotność informacji zwrotnej oraz przejściowe zmienności behawioralne. Na koniec zintegrowano kwantowe uczenie z głębokimi rezdualnymi warstwami semantycznymi w ramach klasyfikatora Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC), aby zidentyfikować zainteresowania studentów.
Ogólny przebieg proponowanego frameworka ML-HQNC przedstawiono na rycinie 2. Protokół obejmował sześć kolejnych etapów, zaczynając od pozyskania zestawu danych edukacyjnych z repozytorium Kaggle, a następnie wstępnego przetwarzania danych przy użyciu metody Box–Cox Robust IQR Scaling (BCRIS), transformacji cech i reprezentacji behawioralnej z wykorzystaniem modelu Quantum Cognitive State Model (QCSM) oraz selekcji cech za pomocą algorytmu Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS). Wybrane cechy zostały następnie wykorzystane do trenowania i walidacji modelu za pomocą Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC), a cały framework został ostatecznie oceniony pod kątem dokładności (accuracy), miary F1-score, pola pod krzywą charakterystyki operacyjnej odbiornika (AUC), precyzji wykrywania zainteresowań (IDP), indeksu stabilności wzorców kwantowych (QPSI) oraz przyrostu adaptacyjności międzydomenowej (CDAG).
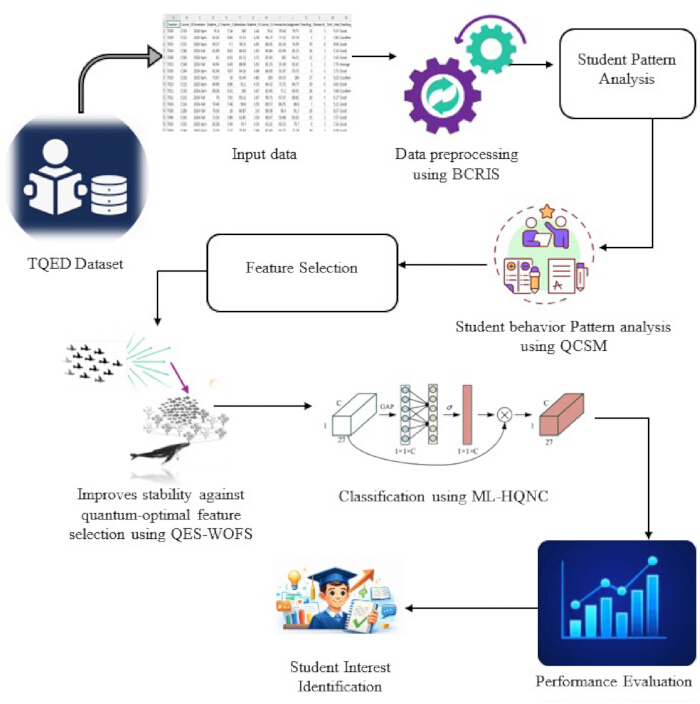
Rycina 2: Schemat hybrydowego kwantowo-klasycznego klasyfikatora neuronowego z meta-uczeniem (ML-HQNC). Ogólna architektura proponowanego frameworka ML-HQNC integrującego skalowanie Box–Cox Robust IQR (BCRIS) do wstępnego przetwarzania danych, kwantowy model stanu poznawczego (QCSM) do analizy wzorców behawioralnych, algorytm wyboru cech oparty na kwantowo-ulepszonej optymalizacji rojem wielorybów (QES-WOFS) oraz hybrydowe kwantowo-klasyczne uczenie neuronowe do klasyfikacji zainteresowań studentów. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
2. Zbiór danych do oceny jakości nauczania
Zaproponowany model opracowano z wykorzystaniem publicznie dostępnego zbioru danych Teaching Quality Evaluation Dataset pobranego z repozytorium Kaggle. Zbiór ten zawierał 1 014 rekordów edukacyjnych z 14 wielowymiarowymi cechami reprezentującymi wyniki w nauce, oceny z testów, frekwencję, charakterystykę dydaktyczną oraz wskaźniki behawioralne studentów, zgromadzone za pośrednictwem Comprehensive Education Management Platform (CEMP). Atrybuty te dostarczyły wielowymiarowych informacji edukacyjnych niezbędnych do modelowania nieliniowych zależności związanych z identyfikacją zainteresowań studentów kierunków inżynieryjnych.
Jak pokazano na rysunku 3, zbiór danych podzielono na podzbiory treningowy (80%) i testowy (20%). Do wytrenowania proponowanego modelu wykorzystano łącznie 800 rekordów, a 200 zarezerwowano do oceny wydajności. Zbiór danych jest publicznie dostępny pod adresem: https://www.kaggle.com/datasets/ziya07/teaching-quality-evaluation-dataset. Zbiory treningowe i testowe zostały następnie przetworzone przy użyciu proponowanego schematu w celu zbudowania modelu uczenia i poprawy jego zdolności predykcyjnych.
Pomimo że podstawowy zbiór danych nosi nazwę Teaching Quality Evaluation Dataset, celem niniejszego badania było określenie zainteresowań studentów inżynierii. Atrybuty edukacyjne, behawioralne i instruktażowe zawarte w zbiorze danych posłużyły jako zmienne wejściowe do trenowania i oceny proponowanej struktury. W związku z tym wszystkie raportowane wyniki predykcji i wskaźniki wydajności opisują skuteczność struktury w identyfikowaniu zainteresowań studentów inżynierii, a nie ocenę jakości nauczania. Przed wstępnym przetwarzaniem danych zweryfikowano zaimportowany zbiór, aby upewnić się, że wszystkie 1 014 rekordów zostało pomyślnie wczytanych, schemat zbioru danych jest zgodny z oczekiwanym formatem, a wszelkie brakujące lub zduplikowane rekordy zostały zidentyfikowane i usunięte.
3. Wstępne przetwarzanie danych z wykorzystaniem odpornego skalowania IQR Boxa-Coxa (BCRIS)
Do wstępnego przetwarzania i normalizacji zbioru danych edukacyjnych wykorzystano metodę odpornego skalowania IQR Boxa-Coxa (BCRIS), łącząc transformację Boxa-Coxa z odpornym skalowaniem opartym na rozstępie międzykwartylowym (IQR) w celu ograniczenia wpływu wartości ekstremalnych. Korekcja symetrii wraz z normalizacją wycentrowaną względem mediany pozwoliła na wygenerowanie statystycznie stabilnych i skalowalnych reprezentacji cech, odpowiednich do dalszej analizy. W ramach proponowanego modelu inteligencji edukacyjnej, BCRIS przekształcił wielowymiarowe wskaźniki edukacyjne, instruktażowe i behawioralne w reprezentacje cech o kontrolowanej wariancji. Cechy takie jak attendance_rate, interactive_sessions_percentage oraz powiązane zmienne edukacyjne zostały znormalizowane, aby poprawić spójność zbiorów danych treningowych i testowych. Szczegółowe wyjaśnienia matematyczne znajdują się w Pliku uzupełniającym 1 (Sekcja S1). Metoda BCRIS zapewniła kompatybilną z komputerami kwantowymi strategię wstępnego przetwarzania, która znormalizowała heterogeniczne dane edukacyjne przed późniejszą analizą statystyczną, zachowując jednocześnie kluczowe cechy behawioralne niezbędne do modelowania. Przed analizą behawioralną zweryfikowano potok przetwarzania, aby upewnić się, że znormalizowany zbiór danych nie zawiera błędnych ani brakujących wartości, szum semantyczny został zredukowany, a przetworzone cechy są odpowiednie do dalszego modelowania behawioralnego.
4. Transformacja cech i reprezentacja behawioralna przy użyciu kwantowego modelu stanu poznawczego (QCSM)
Kwantowy model stanu poznawczego (QCSM) został zaimplementowany w celu modelowania dynamiki zainteresowań studentów kierunków technicznych przy użyciu probabilistycznych reprezentacji inspirowanych mechaniką kwantową. Zainteresowanie studenta przedstawiono jako nakładanie się wielu stanów koncepcyjnych, które odzwierciedlały hierarchię pojęć poznawczych, niepewność, nakładanie się koncepcji, jednoczesne zaangażowanie w wiele tematów, wahania lub niezdecydowanie w zachowaniach uczenia się oraz prawdopodobieństwo zmian w preferencjach edukacyjnych. Wielowymiarowe wskaźniki z zestawu danych Engineering Teaching Quality Assessment, w tym Student_Avg_Score, Attendance_rate oraz Student_Feedback_Rating, zostały przedstawione jako przejścia poznawcze ważone amplitudą w znormalizowanej kwantowej przestrzeni stanów. Model QCSM połączył przejścia stanów kwantowych z wyrównaniem koncepcyjnym opartym na interferencji, aby wygenerować inspirowane kwantowo reprezentacje poznawcze odzwierciedlające stabilność i ewolucję zainteresowań studentów w czasie. Szczegółowe sformułowania matematyczne znajdują się w Pliku uzupełniającym 1 (Sekcja S2). Model QCSM modelował probabilistyczne stany poznawcze w celu reprezentacji przyswajania wiedzy, zmian koncepcyjnych, zaangażowania w naukę oraz zainteresowania przedmiotem poprzez znormalizowane reprezentacje stanu kwantowego. Reprezentacje behawioralne zostały zweryfikowane we wszystkich rekordach studentów, aby upewnić się, że wyekstrahowane cechy stanu poznawczego dokładnie oddają zachowania uczenia się i przejścia między tematami.
5. Selekcja cech z wykorzystaniem algorytmu Quantum-Enhanced Swarm–Whale Optimization Feature Selector (QES-WOFS)
Algorytm Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS) został zastosowany w celu zidentyfikowania optymalnego podzbioru cech oraz określenia wysokoinformacyjnych charakterystyk behawioralnych z wielowymiarowych danych edukacyjnych. Inspirowane mechaniką kwantową mechanizmy przeszukiwania usprawniły integrację globalnych i lokalnych strategii poszukiwania w celu optymalizacji cech. Zmienne edukacyjne, w tym interactive_sessions_percentage, assignments_time_percentage oraz course_completion_rate, zostały ocenione pod kątem ich korelacji z wynikiem docelowym. Potencjalne podzbiory cech modelowano przy użyciu kwantowych reprezentacji prawdopodobieństwa, podczas gdy mechanizm tunelowania kwantowego umożliwił probabilistyczne przejścia poza optima lokalne. Ważność cech oszacowano za pomocą wiarygodności brzegowej, aby ilościowo określić wkład każdej cechy w wydajność klasyfikacji oraz adaptacyjne stany roju. Algorytm QES-WOFS wyselekcjonował stabilne i istotne behawioralnie cechy, co poprawiło odporność na szum, zmienność międzysemestralną oraz okresowe wahania behawioralne.
Aby przezwyciężyć ograniczenia związane z niezależnym stosowaniem algorytmu optymalizacji wielorybów (WOA) lub optymalizacji rojem cząstek (PSO), algorytm QES-WOFS połączył globalną eksplorację opartą na PSO z lokalną eksploatacją opartą na WOA. Mechanizm tunelowania kwantowego dodatkowo umożliwił probabilistyczne przejścia poza optima lokalne, zwiększając tym samym różnorodność populacji, redukując nadmiarowość cech i poprawiając zbieżność do optymalnego podzbioru cech służącego do identyfikacji zainteresowań studentów kierunków technicznych.
Szczegółowe sformułowania matematyczne przedstawiono w Pliku uzupełniającym 1 (Sekcja S3). Algorytm QES-WOFS połączył kwantowe probabilistyczne kodowanie cech, strategię prędkości dostosowaną do PSO oraz mechanizm spiralnego wyszukiwania inspirowany wielorybami, aby zidentyfikować najbardziej informacyjne cechy edukacyjne. Hiperparametry zostały zoptymalizowane empirycznie przy użyciu zbioru treningowego. Wartości kandydackie oceniano poprzez systematyczne eksperymenty, a wybrano kombinację zapewniającą najwyższą wydajność walidacji. W szczególności parametr transformacji Boxa–Coxa (λ = 0.25), margines straty kontrastowej (m = 1.0) oraz współczynniki tunelowania kwantowego (α = 0.7 i β = 0.3) zostały wybrane na podstawie dokładności walidacji, wyniku F1 oraz zachowania zbieżności. Przed trenowaniem klasyfikatora zweryfikowano wyniki selekcji cech, aby upewnić się, że algorytm QES-WOFS wybrał optymalny podzbiór cech i usunął cechy redundantne lub o niskim znaczeniu.
6. Trenowanie i walidacja modelu z wykorzystaniem hybrydowego kwantowo-klasycznego klasyfikatora neuronowego opartego na meta-uczeniu (ML-HQNC)
Hybrydowy kwantowo-klasyczny klasyfikator neuronowy oparty na meta-uczeniu (ML-HQNC) został zaimplementowany poprzez połączenie głębokich sieci neuronowych z obliczeniami inspirowanymi kwantowo w celu zidentyfikowania zainteresowań studentów kierunków inżynieryjnych. Wielogłowicowe mechanizmy kwantowej uwagi oraz głębokie rezydualne warstwy semantyczne pozwoliły na uchwycenie złożonych nieliniowych zależności w wielowymiarowych danych edukacyjnych reprezentowanych za pomocą wariacyjnych obwodów kwantowych (VQCs). Cechy pochodzące z analizy behawioralnej, w tym student_average_grade, attendance_rate oraz student_feedback_rating, zostały rzutowane na kwantową przestrzeń stanów, w której znormalizowane dane wejściowe przekształcono w kwantowe reprezentacje oparte na amplitudach, aby zamodelować nakładające się i probabilistyczne wzorce zaangażowania. Znormalizowane wektory cech behawioralnych studentów obliczono zgodnie z równaniami podanymi w Supplementary File 1 (Section S4). Następnie ML-HQNC dokonał klasyfikacji i identyfikacji zainteresowań studentów kierunków inżynieryjnych.
Klasyfikator ML-HQNC wykorzystał strategię epizodycznego meta-uczenia podczas treningu. Do każdego epizodu przypisano jedno losowo wybrane zadanie meta-uczenia ze zbioru treningowego. Przy zachowaniu rozkładu klas, dane treningowe podzielono na zbiór wspierający (80%) oraz zbiór zapytań (20%). Zbiór wspierający służył do adaptacji parametrów specyficznych dla zadania poprzez wewnętrzną pętlę optymalizacji, natomiast zbiór zapytań służył do oceny zaadaptowanego modelu i obliczenia meta-straty wykorzystywanej do aktualizacji parametrów wspólnych. Podczas każdego cyklu treningowego wygenerowano łącznie 100 zadań meta-uczenia. Do adaptacji w pętli wewnętrznej wykorzystano pięć kroków aktualizacji gradientu z wewnętrzną prędkością uczenia 0,001, natomiast optymalizator Adam z zewnętrzną prędkością uczenia 0,0005 optymalizował meta-parametry. Losowe próbkowanie zadań powtarzano w każdej epoce treningowej, aby wystawić model na różnorodne wzorce zachowań i poprawić generalizację w odniesieniu do wcześniej nieznanych profili uczniów. Estymacja straty dla kwantowego wyrównania kontrastowego została opisana w Pliku uzupełniającym 1 (Równania 41–45). Trening modelu został zweryfikowany, aby zapewnić pomyślną zbieżność bez błędów obliczeniowych oraz potwierdzić, że krzywe straty treningowej i walidacyjnej ustabilizowały się w kolejnych epokach.
Wyniki
Zaproponowany framework ML-HQNC został oceniony w porównaniu z Fast R-CNN, Bi-LSTM, CNN oraz XGBoost przy użyciu konwencjonalnych metryk klasyfikacji, w tym dokładności (Accuracy), precyzji (Precision), czułości (Recall), miary F1-score oraz pola pod krzywą charakterystyki pracy odbiornika (AUC), wraz z zaproponowanymi metrykami oceny: precyzją detekcji zainteresowania (Interest Detection Precision – IDP), indeksem stabilności wzorca kwantowego (Quantum Pattern Stability Index – QPSI) oraz przyrostem adaptacyjności międzydomenowej (Cross-Domain Adaptability Gain – CDAG). Definicje matematyczne tych metryk znajdują się w pliku uzupełniającym 1 (sekcja S5).
Aby ocenić stabilność proponowanego schematu, wszystkie eksperymenty powtórzono pięciokrotnie, stosując różne randomizacje początkowe. Raportowane wartości wydajności przedstawiono jako średnią ± odchylenie standardowe z pięciu serii pomiarowych. Istotność statystyczną między proponowanym schematem a modelami bazowymi oceniono za pomocą sparowanego testu t, przyjmując, że p < 0,05 oznacza wynik istotny statystycznie.
Jak podsumowano w Tabeli uzupełniającej 1, eksperymenty symulacyjne przeprowadzono z wykorzystaniem zbioru danych Teaching Quality Evaluation Dataset zawierającego 1 014 rekordów. Łącznie 800 rekordów wykorzystano do trenowania modelu, natomiast 200 rekordów zarezerwowano do testów. Zaproponowany framework ML-HQNC oraz modele porównawcze zaimplementowano w środowisku Jupyter Notebook przy użyciu języka Python. Atrybut Teaching_Quality służył jako pierwotna zmienna celu w publicznie dostępnym zbiorze danych Teaching Quality Evaluation Dataset i składał się z dwóch klas: Good oraz Excellent. Etykiety te zostały wykorzystane jako cele predykcji do trenowania i ewaluacji frameworka ML-HQNC. Wynikowe kategorie predykcji podsumowano w Tabeli 3. Tabela uzupełniająca 2 przedstawia wyniki walidacji etapu preprocessingu Box–Cox Robust IQR Scaling (BCRIS). Potok preprocessingu usunął brakujące i zdublowane rekordy, ograniczył wpływ wartości odstających, znormalizował rozkłady cech oraz poprawił spójność semantyczną i behawioralną przed transformacją cech i trenowaniem modelu.
Tabela 3: Zmienna celu w zbiorze danych Teaching Quality Evaluation Dataset. Opis oryginalnej zmiennej celu Teaching_Quality oraz jej kategorii klasyfikacji (Good i Excellent) wykorzystanych do trenowania i ewaluacji modelu. Kliknij tutaj, aby pobrać tę tabelę.
Tabela uzupełniająca 3 przedstawia reprezentatywne cechy wygenerowane przez Kwantowy Model Stanu Poznawczego (QCSM). Wyekstrahowane cechy opisują zachowania uczenia się studentów, w tym stan poznawczy, zaangażowanie, niepewność, przejścia między tematami oraz spójność behawioralną, i służyły jako dane wejściowe do następnego etapu selekcji cech QES-WOFS. Tabela uzupełniająca S4 zawiera końcowe cechy wybrane przez algorytm QES-WOFS wraz z ich kategoriami, poziomami względwego wpływu oraz rolami funkcjonalnymi w proponowanym modelu. Charakterystyka wyekstrahowanych wielowymiarowych cech behawioralnych została podsumowana w Tabeli uzupełniającej 5. Tabela uzupełniająca 6 przedstawia reprezentatywne struktury krawędzi wygenerowane podczas reprezentacji behawioralnej dla dwóch klas predykcji (Dobry i Bardzo dobry).
Jak pokazano na Rysunku 4 i w Tabeli 4, zaproponowany model ML-HQNC osiągnął najwyższą wartość miary F1 (87,9%) spośród ocenianych metod. Odpowiednie wartości F1 dla modeli Fast R-CNN, Bi-LSTM, CNN oraz XGBoost wyniosły odpowiednio 77,9%, 80,2%, 82,8% i 85,8%. Istotność statystyczną oceniono za pomocą dwustronnego niezależnego testu t (p < 0,05).
Rysunek 5 oraz Tabela 5 podsumowują wyniki precyzji wykrywania zainteresowania (IDP). Zaproponowana struktura ML-HQNC osiągnęła IDP na poziomie 89,3%, w porównaniu do 79,11%, 82,12%, 84,6% i 87,10% dla odpowiednio Fast R-CNN, Bi-LSTM, CNN i XGBoost. Rysunek 6 oraz Tabela 6 przedstawiają wyniki indeksu stabilności wzorca kwantowego (QPSI). Zaproponowana struktura osiągnęła wartość QPSI wynoszącą 92,7%, podczas gdy Fast R-CNN, Bi-LSTM, CNN i XGBoost osiągnęły odpowiednio 81,1%, 84,11%, 87,4% i 90,9%. Rysunek 7 oraz Tabela 7 podsumowują wyniki przyrostu adaptacyjności międzydomenowej (CDAG). Zaproponowana struktura ML-HQNC osiągnęła najwyższą wartość CDAG (0,95) w porównaniu z Fast R-CNN (0,78), Bi-LSTM (0,83), CNN (0,80) i XGBoost (0,86). Jak pokazano na Rysunku 8 i w Tabeli 8, zaproponowana struktura ML-HQNC osiągnęła najwyższą dokładność klasyfikacji (96,17%). Odpowiednie dokładności dla Fast R-CNN, Bi-LSTM, CNN i XGBoost wyniosły odpowiednio 85,10%, 87,21%, 90,14% i 93,19%. Rysunek 9 oraz Tabela 9 przedstawiają czas obliczeniowy wymagany przez każdą z metod. Zaproponowana struktura ML-HQNC wymagała 9,02 ms, podczas gdy Fast R-CNN, Bi-LSTM, CNN i XGBoost wymagały odpowiednio 31,2 ms, 27,5 ms, 22,4 ms i 17,6 ms. Rysunek 10 przedstawia analizę charakterystyki pracy odbiornika (ROC). Zaproponowana struktura ML-HQNC osiągnęła AUC na poziomie 0,944, co wskazuje na wysoką częstość prawdziwie dodatnich i niską częstość fałszywie dodatnich w obrębie ocenianego progu klasyfikacji.
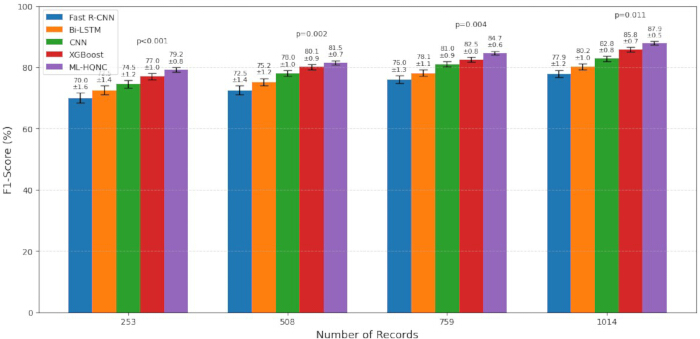
Rysunek 4: Porównanie wyniku F1 dla różnych rozmiarów zbioru danych. Porównanie wyniku F1 osiągniętego przez ML-HQNC oraz konkurencyjne modele dla różnych rozmiarów zbioru danych. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Słupki błędów reprezentują jedno odchylenie standardowe. Istotność statystyczną oceniono za pomocą dwustronnego niezależnego testu t (p < 0.05). Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Tabela 4: Porównanie wyniku F1-score dla różnych rozmiarów zbiorów danych.Porównanie wyniku F1-score uzyskanego przez ML-HQNC i konkurencyjne modele. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Kliknij tutaj, aby pobrać tę tabelę.
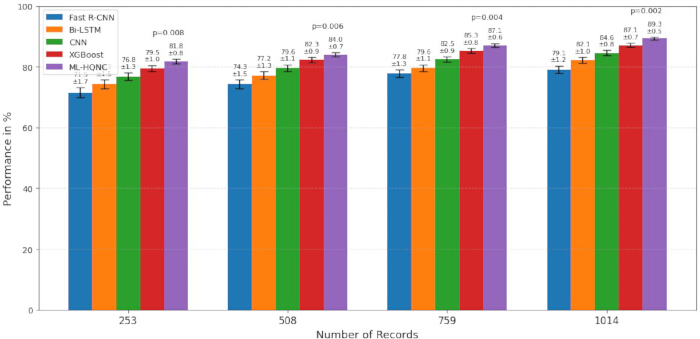
Rycina 5: Porównanie precyzji wykrywania obszarów zainteresowania (IDP) dla różnych rozmiarów zbiorów danych. Porównanie precyzji wykrywania obszarów zainteresowania (IDP) uzyskanej przez model ML-HQNC oraz modele konkurencyjne dla różnych rozmiarów zbiorów danych. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Słupki błędów reprezentują jedno odchylenie standardowe. Istotność statystyczną oceniono za pomocą dwustronnego niezależnego testu t (p < 0.05). Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
Tabela 5: Porównanie precyzji wykrywania zainteresowań (Interest Detection Precision, IDP) dla różnych rozmiarów zestawów danych. Porównanie precyzji wykrywania zainteresowań (IDP) osiągniętej przez model ML-HQNC oraz modele konkurencyjne. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Kliknij tutaj, aby pobrać tę tabelę.
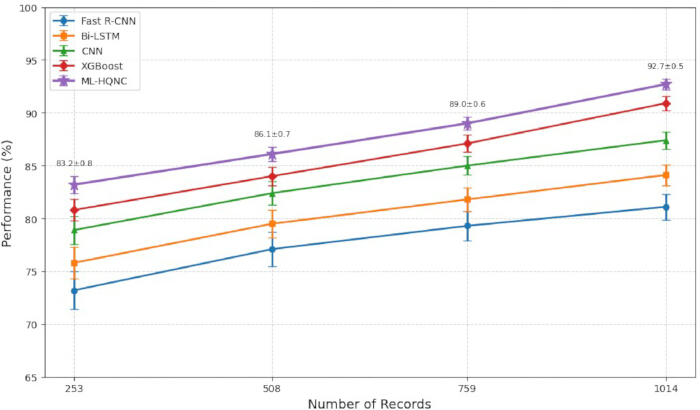
Rysunek 6: Porównanie indeksu stabilności wzorca kwantowego (QPSI) dla różnych rozmiarów zbiorów danych. Porównanie indeksu stabilności wzorca kwantowego (QPSI) osiągniętego przez model ML-HQNC oraz konkurencyjne modele przy różnych rozmiarach zbiorów danych. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Słupki błędu reprezentują jedno odchylenie standardowe. Istotność statystyczną oceniono za pomocą dwustronnego niezależnego testu t (p < 0.05). Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Tabela 6: Porównanie indeksu stabilności wzorca kwantowego (QPSI) dla różnych rozmiarów zbiorów danych. Porównanie indeksu stabilności wzorca kwantowego (QPSI) uzyskanego przez model ML-HQNC oraz modele konkurencyjne. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Kliknij tutaj, aby pobrać tę tabelę.
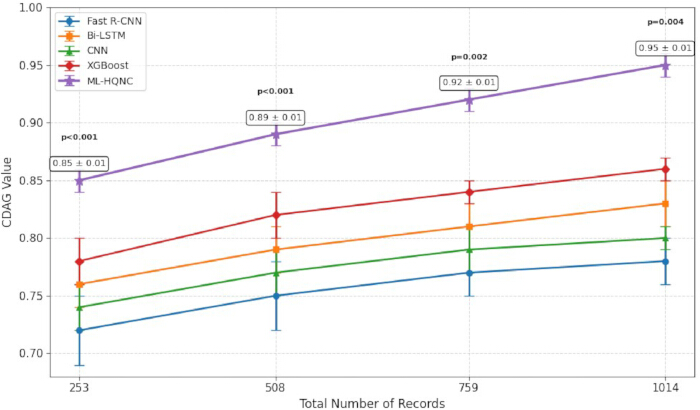
Rysunek 7: Porównanie zysku z adaptacyjności międzydomenowej (CDAG) dla różnych rozmiarów zestawów danych. Porównanie zysku z adaptacyjności międzydomenowej (CDAG) osiągniętego przez ML-HQNC oraz modele konkurencyjne dla różnych rozmiarów zestawów danych. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Słupki błędu reprezentują jedno odchylenie standardowe. Istotność statystyczną oceniono za pomocą dwustronnego niezależnego testu t (p < 0.05). Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
Tabela 7: Porównanie przyrostu adaptacyjności międzydomenowej (Cross-Domain Adaptability Gain, CDAG) dla różnych rozmiarów zbiorów danych. Porównanie przyrostu adaptacyjności międzydomenowej (CDAG) osiągniętego przez ML-HQNC i modele konkurencyjne. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Kliknij tutaj, aby pobrać tę tabelę.
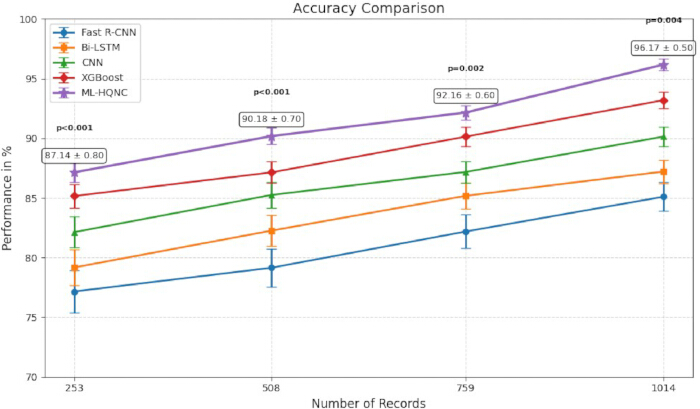
Rycina 8: Porównanie dokładności klasyfikacji dla różnych rozmiarów zbiorów danych. Porównanie dokładności klasyfikacji osiągniętej przez ML-HQNC oraz konkurencyjne modele dla różnych rozmiarów zbiorów danych. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Słupki błędów reprezentują jedno odchylenie standardowe. Istotność statystyczną oceniono za pomocą dwustronnego niezależnego testu t (p < 0,05). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Tabela 8: Porównanie dokładności klasyfikacji dla różnych rozmiarów zbiorów danych. Porównanie dokładności klasyfikacji uzyskanej przez model ML-HQNC oraz modele konkurencyjne. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Kliknij tutaj, aby pobrać tę tabelę.
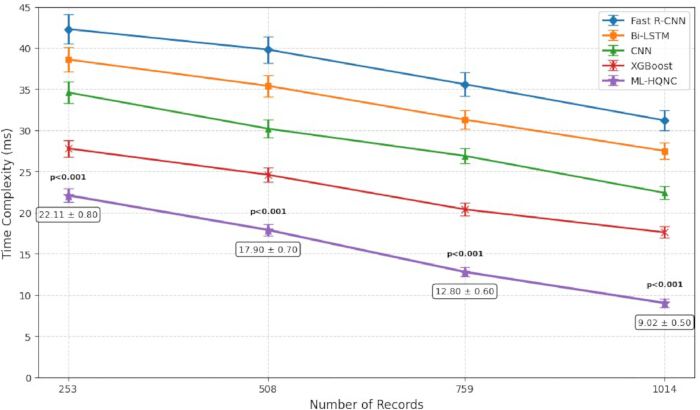
Rysunek 9: Porównanie czasu obliczeń dla różnych rozmiarów zbiorów danych. Porównanie czasu wykonania obliczeń modelu ML-HQNC oraz modeli konkurencyjnych dla różnych rozmiarów zbiorów danych. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Słupki błędu reprezentują jedno odchylenie standardowe. Niższe wartości wskazują na krótszy czas wykonania obliczeń. Istotność statystyczną oceniono za pomocą dwustronnego niezależnego testu t (p < 0,05). Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
Tabela 9: Porównanie czasu obliczeniowego dla różnych rozmiarów zbiorów danych. Porównanie czasu wykonania obliczeń modelu ML-HQNC oraz modeli konkurencyjnych. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Niższe wartości wskazują na krótszy czas wykonania obliczeń. Kliknij tutaj, aby pobrać tę tabelę.
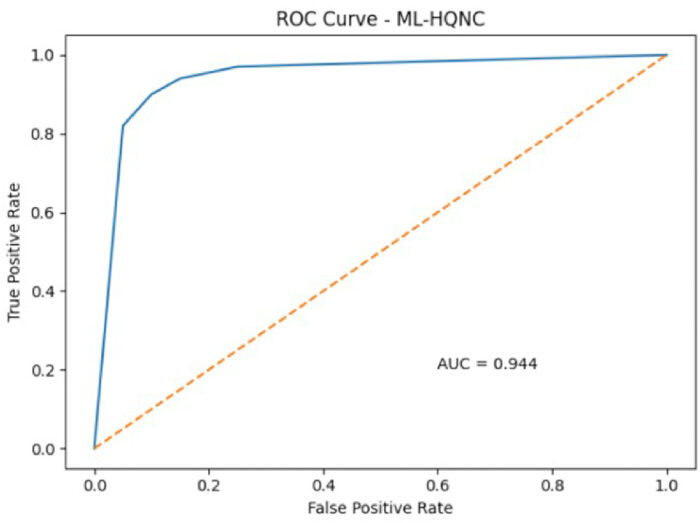
Rysunek 10: Porównanie powierzchni pod krzywą charakterystyki operacyjnej odbiornika (AUC).Porównanie AUC osiągniętego przez model ML-HQNC oraz modele konkurencyjne w identyfikacji zainteresowań studentów kierunków inżynieryjnych. Raportowane wartości AUC odpowiadają pojedynczemu przebiegowi eksperymentu, dlatego nie przedstawiono słupków błędów ani analiz istotności statystycznej. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Rycina uzupełniająca 1 przedstawia macierz korelacji reprezentatywnych zmiennych behawioralnych. Silne korelacje dodatnie zaobserwowano pomiędzy Avg_Score a Course_Completion_Rate (0,81) oraz pomiędzy Attendance_Rate a Course_Completion_Rate (0,75). Umiarkowane korelacje zaobserwowano pomiędzy Avg_Score a Course_Completion (0,72) oraz pomiędzy Attendance_Rate a Time_Assignment_Percentage (0,74). Ryciny uzupełniające 2 i 3, wraz z Tabelą 10, podsumowują mapy dokładności treningowej i testowej. Zaproponowana struktura ML-HQNC osiągnęła dokładność treningową na poziomie 96,1% oraz dokładność testową na poziomie 93,8%, przewyższając wyniki metod porównawczych. Ryciny uzupełniające 4 i 5, wraz z Tabelą 11, podsumowują analizę zbieżności. Zaproponowana struktura ML-HQNC osiągnęła najniższą stratę treningową (0,21) i stratę testową (0,26), wykazując stabilną zbieżność w całym procesie optymalizacji.
Tabela 12 podsumowuje ogólną wydajność proponowanego modelu ML-HQNC oraz metod porównawczych we wszystkich metrykach oceny. Proponowany model osiągnął najwyższą wydajność w zakresie Accuracy, F1-score, AUC, IDP, QPSI oraz CDAG, wymagając jednocześnie najkrótszego czasu obliczeń spośród ocenianych metod. Tabela 13 przedstawia analizę ablacyjną poszczególnych komponentów proponowanego modelu. Stopniowe wprowadzanie etapu wstępnego przetwarzania BCRIS, reprezentacji behawioralnej QCSM, algorytmu selekcji cech QES-WOFS oraz pełnego klasyfikatora ML-HQNC przynosiło stopniową poprawę wydajności klasyfikacji, co demonstruje wkład każdego komponentu w funkcjonowanie całego modelu.
Tabela 10: Porównanie dokładności treningowej i testowej. Porównanie dokładności treningowej i testowej uzyskanej przez model ML-HQNC oraz modele konkurencyjne. Raportowane wartości odpowiadają jednemu przebiegowi eksperymentalnemu. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 11: Porównanie strat podczas uczenia i testowania. Porównanie strat podczas uczenia i testowania uzyskanych przez model ML-HQNC oraz modele konkurencyjne. Raportowane wartości odpowiadają pojedynczemu przebiegowi eksperymentu. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 12: Ogólne porównanie wydajności.Porównanie modelu ML-HQNC z konkurencyjnymi modelami z wykorzystaniem wielu metryk oceny. Wyniki przedstawiono jako średnia ± odchylenie standardowe z pięciu niezależnych serii eksperymentalnych (n = 5). Kliknij tutaj, aby pobrać tę tabelę.
DOSTĘPNOŚĆ DANYCH:
Oryginalny zbiór danych Teaching Quality Evaluation Dataset wykorzystany w niniejszym badaniu jest publicznie dostępny w repozytorium Kaggle (https://www.kaggle.com/datasets/ziya07/teaching-quality-evaluation-dataset). Dostęp do zbioru danych może wymagać uwierzytelnienia użytkownika i podlega warunkom użytkowania serwisu Kaggle. W celu zapewnienia powtarzalności przy jednoczesnym przestrzeganiu warunków licencjonowania oryginalnego zbioru danych, zasoby wygenerowane w ramach badania — w tym syntetyczny zbiór danych, kod źródłowy, pliki implementacyjne i konfiguracyjne, opisy cech, schemat przetwarzania wstępnego oraz dokumentacja pomocnicza niezbędna do odtworzenia opisanych eksperymentów — zostały złożone w otwartym repozytorium Zenodo: https://doi.org/10.5281/zenodo.21393413.
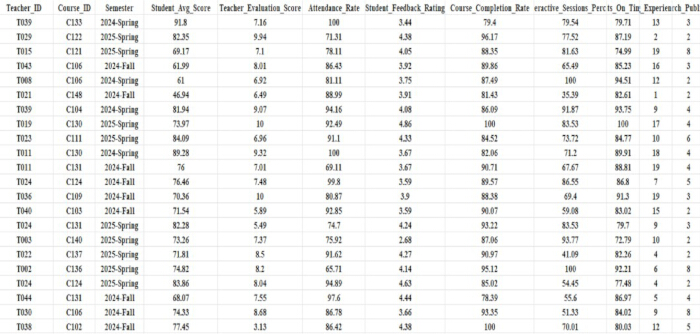
Rycina 3: Zbiór cech zestawu danych oceny jakości nauczania. Struktura i skład cech zestawu danych oceny jakości nauczania wykorzystanego do identyfikacji zainteresowań studentów kierunków technicznych. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Rysunek uzupełniający 1: Macierz korelacji cech. Macierz korelacji przedstawiająca relacje parowe między reprezentatywnymi zmiennymi edukacyjnymi i behawioralnymi wykorzystanymi w proponowanym frameworku ML-HQNC. Kliknij tutaj, aby pobrać ten plik.
Rysunek uzupełniający 2: Porównanie dokładności treningu. Porównanie dokładności treningu osiągniętej przez model ML-HQNC oraz modele konkurencyjne w trakcie procesu uczenia. Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 3: Porównanie dokładności testowania. Porównanie dokładności testowania osiągniętej przez ML-HQNC i konkurencyjne modele w trakcie procesu testowania. Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 4: Analiza straty treningowej. Porównanie straty treningowej osiągniętej przez ML-HQNC i modele konkurencyjne podczas optymalizacji modelu. Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 5: Analiza straty testowej. Porównanie straty testowej uzyskanej przez ML-HQNC oraz konkurencyjne modele podczas ewaluacji modelu. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 1: Parametry symulacji i ustawienia eksperymentalne. Podsumowanie parametrów symulacji, środowiska implementacji, podziału zbioru danych oraz ustawień eksperymentalnych wykorzystanych do oceny proponowanego frameworka ML-HQNC. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 2: Wyniki walidacji etapu preprocessingu Box–Cox Robust IQR Scaling (BCRIS). Porównanie reprezentatywnych charakterystyk zbioru danych przed i po preprocessingu, obejmujące brakujące wartości, duplikaty rekordów, obsługę wartości odstających, normalizację cech oraz spójność danych. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 3: Reprezentatywne cechy wygenerowane przez Kwantowy Model Stanu Poznawczego (QCSM). Reprezentatywne cechy behawioralne wygenerowane przez QCSM po wstępnym przetwarzaniu danych, w tym cechy stanu poznawczego, zaangażowania, niepewności, przejścia tematycznego oraz spójności behawioralnej. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 4: Cechy wybrane przez algorytm Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS). Końcowy podzbiór cech wybrany przez algorytm QES-WOFS wraz z odpowiadającymi im kategoriami cech, względnymi poziomami wpływu i rolami funkcjonalnymi w proponowanym modelu. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 5: Kategorie przewidywania jakości nauczania. Opis kategorii przewidywania oraz reprezentatywnych cech behawioralnych wykorzystanych przez proponowany framework ML-HQNC. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 6: Analiza czułości marginesu.Podsumowanie analizy czułości marginesu przeprowadzonej podczas oceny modelu. Prosimy kliknąć tutaj, aby pobrać ten plik.
Plik uzupełniający 1: Metody uzupełniające, sformułowania matematyczne, metryki oceny i tabele uzupełniające.Plik ten zawiera szczegółowe sformułowania matematyczne dla metod Box–Cox Robust IQR Scaling (BCRIS), Quantum Cognitive State Model (QCSM), Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS) oraz Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC), opisanych w głównym protokole. Zawiera on również definicje metryk oceny, parametry symulacji, ustawienia eksperymentalne oraz tabele uzupełniające S1–S6 wspierające wyniki przedstawione w głównym manuskrypcie. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Zaproponowany framework ML-HQNC wykazał poprawioną skuteczność w identyfikacji zainteresowań studentów kierunków inżynieryjnych poprzez zintegrowanie inspirowanego kwantowo modelowania behawioralnego, adaptacyjnego wyboru cech oraz meta-uczenia w jednolity przepływ obliczeniowy. W porównaniu z Fast R-CNN, Bi-LSTM, CNN oraz XGBoost, framework ten konsekwentnie osiągał wyższą wydajność zarówno w konwencjonalnych metrykach klasyfikacji, jak i w zaproponowanych metrykach oceny behawioralnej. Wyniki te sugerują, że połączenie reprezentacji stanu poznawczego inspirowanej kwantowo z adaptacyjną optymalizacją cech poprawiło zdolność frameworku do modelowania złożonych zachowań edukacyjnych przy jednoczesnym zachowaniu wysokiej skuteczności klasyfikacji. Niski czas obliczeń oraz niewielka różnica między wydajnością trenowania a testowania dodatkowo wskazują na stabilną optymalizację i dobrą generalizację.
Zaproponowane metryki ewaluacyjne uzupełniły konwencjonalne miary klasyfikacji, dostarczając dodatkowych informacji na temat modelowania behawioralnego. Precyzja wykrywania zainteresowań (Interest Detection Precision, IDP) określiła dokładność identyfikacji zainteresowań, wskaźnik stabilności wzorców kwantowych (Quantum Pattern Stability Index, QPSI) ocenił stabilność inspirowanych kwantowo reprezentacji behawioralnych, a zysk adaptacyjności międzydomenowej (Cross-Domain Adaptability Gain, CDAG) pozwolił ocenić zdolność frameworka do generalizacji w różnych partycjach danych. Wspólnie miary te zapewniły szerszą ocenę wydajności modelu niż same konwencjonalne metryki predykcyjne.
Analiza ablacji poszczególnych komponentów (Tabela 13) dodatkowo wykazała wkład każdego etapu proponowanego schematu postępowania. Włączenie etapu wstępnego przetwarzania Box–Cox Robust IQR Scaling (BCRIS) poprawiło spójność danych poprzez zmniejszenie wpływu wartości odstających i wygenerowanie znormalizowanych reprezentacji cech. Quantum Cognitive State Model (QCSM) przekształcił wielowymiarowe zmienne edukacyjne w reprezentacje behawioralne, które uchwyciły niepewność, zaangażowanie oraz ewoluujące preferencje uczenia się. Następująca po nim selekcja cech przy użyciu algorytmu Quantum-Enhanced Swarm–Whale Optimization Feature Selection (QES-WOFS) zredukowała nadmiarowość cech, zachowując jednocześnie informacyjne charakterystyki behawioralne. Ostatecznie integracja tych komponentów w ramach Meta-Learning Hybrid Quantum-Classical Neural Classifier (ML-HQNC) poprawiła wydajność klasyfikacji i zdolność do generalizacji w porównaniu z modelami bazowymi.
Proponowany protokół jest przeznaczony do identyfikacji zainteresowań studentów inżynierii przy użyciu wielowymiarowych danych edukacyjnych i behawioralnych zbieranych z cyfrowych środowisk uczenia się. Przepływ obliczeniowy może wspierać personalizację nauczania, doradztwo akademickie, planowanie programów nauczania oraz inteligentne zarządzanie edukacją, zapewniając systematyczne podejście do analizy zachowań edukacyjnych studentów i identyfikacji ewoluujących zainteresowań. Struktura ta jest szczególnie odpowiednia dla ustrukturyzowanych zbiorów danych edukacyjnych zawierających zmienne behawioralne, akademickie i kontekstowe.
Skuteczna implementacja zależy od dostępności wysokiej jakości danych edukacyjnych oraz odpowiednich zasobów obliczeniowych. Przed analizą zbiory danych edukacyjnych należy sprawdzić pod kątem brakujących wartości, zdublowanych rekordów i niespójności, ponieważ jakość danych bezpośrednio wpływa na wstępne przetwarzanie oraz późniejsze modelowanie behawioralne. Stabilne reprezentacje cech zależą również od właściwego przetwarzania wstępnego, transformacji cech oraz optymalizacji hiperparametrów. Podczas trenowania modelu należy monitorować zbieżność za pomocą krzywych straty dla zbioru treningowego i walidacyjnego, a parametry optymalizacji należy dostosować w razie potrzeby, aby utrzymać stabilny przebieg procesu uczenia.
Chociaż opracowane rozwiązanie wykazało skuteczne działanie z wykorzystaniem ocenianego zbioru danych, należy wziąć pod uwagę kilka ograniczeń. Protokół został zwalidowany przy użyciu jednego, publicznie dostępnego edukacyjnego zbioru danych; konieczna jest zatem dodatkowa ewaluacja z wykorzystaniem większych, wieloośrodkowych i bardziej zróżnicowanych zbiorów danych edukacyjnych, aby dalej ocenić możliwość generalizacji wyników. Ponadto hybrydowe środowisko uczenia inspirowanego kwantowo wymaga większych zasobów obliczeniowych niż konwencjonalne podejścia uczenia maszynowego ze względu na komponenty preprocessingu, optymalizacji i uczenia hybrydowego. Rozwiązanie to zależy również od dobrze adnotowanych danych edukacyjnych, a na jego wydajność mogą wpływać niekompletne, zaszumione lub silnie niezbalansowane zbiory danych.
Przyszłe prace skupią się na rozszerzeniu ram metodycznych o bardziej szczegółową identyfikację zainteresowań studentów w ramach wielu klas, włączeniu dodatkowych modalności danych edukacyjnych, takich jak informacje zwrotne w formie tekstowej, czasowe zachowania uczenia się oraz logi aktywności systemów zarządzania nauczaniem w czasie rzeczywistym, a także na ocenie protokołu w zróżnicowanych środowiskach kształcenia inżynierskiego. Dalsza optymalizacja przepływu obliczeniowego może również poprawić skalowalność i ułatwić wdrożenie w wielkoskalowych systemach zarządzania edukacją.
Podsumowując, proponowane środowisko ML-HQNC zapewnia odtwarzalny przepływ obliczeniowy do identyfikacji zainteresowań studentów kierunków inżynierskich z wykorzystaniem wielowymiarowych danych edukacyjnych. Dzięki integracji solidnego preprocessingu, behawioralnego modelowania inspirowanego kwantowo, adaptacyjnego wyboru cech oraz hybrydowego kwantowo-klasycznego uczenia neuronowego, środowisko to osiągnęło lepszą wydajność klasyfikacji przy zachowaniu stabilnej optymalizacji i wydajnych obliczeń. Cechy te potwierdzają potencjał jego zastosowania w inteligentnej analityce edukacyjnej oraz zarządzaniu kształceniem inżynierskim.
Oświadczenia
Autor oświadcza, że nie istnieją żadne konflikty interesów.
Podziękowania
Autor dziękuje Uniwersytetowi w Bengbu, Bengbu, Chiny, za zapewnienie wsparcia akademickiego i środowiska badawczego, które umożliwiły przeprowadzenie niniejszej pracy. Praca ta była finansowana w ramach Rocznego Projektu Inżynierii Jakości na poziomie szkoły z 2025 roku Uniwersytetu w Bengbu (nr 2025zhkc1).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Modele bazowe (Fast R-CNN, Bi-LSTM, CNN, XGBoost) | Implementacje open-source | Fast R-CNN (2015); implementacja TensorFlow/Keras v2.16; XGBoost v2.1.1 | Modele referencyjne wykorzystane do porównawczej oceny wydajności. |
| Moduł preprocessingu BCRIS | Opracowany w niniejszym badaniu | Wersja 1.0 | Niestandardowy moduł preprocessingu implementujący transformację Boxa-Coxa oraz odporną normalizację IQR. |
| Jupyter Notebook | Project Jupyter | Wersja 7.2.2 | Interaktywne środowisko programistyczne wykorzystane do implementacji, trenowania i testowania. |
| Klasyfikator ML-HQNC | Opracowany w niniejszym badaniu | Wersja 1.0 | Zaproponowany hybrydowy kwantowo-klasyczny klasyfikator sieci neuronowej z ramami meta-learningu. |
| Python | Python Software Foundation | Wersja 3.11.9 | Język programowania wykorzystany do rozwoju modelu i eksperymentów. |
| PyTorch | PyTorch Foundation | Wersja 2.5.1 | Framework deep learning wykorzystany do implementacji i trenowania modelu. |
| Model QCSM | Opracowany w niniejszym badaniu | Wersja 1.0 | Zaproponowany Kwantowy Model Stanu Poznawczego (Quantum Cognitive State Model) do reprezentacji wzorców behawioralnych. |
| Algorytm QES-WOFS | Opracowany w niniejszym badaniu | Wersja 1.0 | Zaproponowany algorytm selekcji cech Quantum-Enhanced Swarm–Whale Optimization. |
| Scikit-learn | Scikit-learn Developers | Wersja 1.6.1 | Biblioteka uczenia maszynowego wykorzystana do preprocessingu, selekcji cech i oceny. |
Bibliografia
- Xu Q, Deng H. Research on education management system based on machine learning and multidimensional data modeling. Applied Mathematics and Nonlinear Sciences. 2024;9(1). https://dialnet.unirioja.es/servlet/articulo?codigo=9386765
- Li D. An interactive teaching evaluation system for preschool education in universities based on machine learning algorithm. Comput Hum Behav. 2024;157:108211. https://doi.org/10.1016/j.chb.2024.108211
- Chunhua H, Kaabar MKA, Qiuju X, Zhang G. Fuzzy comprehensive evaluation of students' classroom experience in online teaching. International Journal of Emerging Technologies in Learning. 2023;18(21):79-88.
- He Z, et al. Assessment of influencing factors of college and universities' teaching effects using fuzzy and deep learning techniques. Scientific Reports. 2026;16:5168. https://doi.org/10.1038/s41598-026-35940-5
- Liu J. Innovation and practice of educational management system in colleges and universities based on the concept of data analysis education. Applied Mathematics and Nonlinear Sciences. 2023;9(1). https://www.researchgate.net/publication/377568313
- Li C, Cao Z. Deep learning-based AI model for predicting academic success and engagement among physical higher education students. Scientific Reports. 2025;15:45471. https://doi.org/10.1038/s41598-025-29000-7
- Kong Y, Dong R, Zhang H. Classroom behavior analysis and digital teaching quality evaluation based on spatiotemporal graph neural network. Discover Artificial Intelligence. 2025;5:404. https://doi.org/10.1007/s44163-025-00623-z
- Zedan F, Jabali RR, Raiyn J. Detecting student inattention using deep learning and behavioral analysis. Journal of International Education Practice. 2026;9(1):1-17.
- Feng F. Deep learning-based model for analyzing student engagement in activities. Scientific Reports. 2025;16:2552. https://doi.org/10.1038/s41598-025-32521-w
- Turkmenbayev A, et al. The application of machine learning in predicting student performance in university engineering programs: A rapid review. Frontiers in Education. 2025;10:1562586. https://doi.org/10.3389/feduc.2025.1562586
- Albreiki B, Zaki N, Alashwal H. A systematic literature review of student performance prediction using machine learning techniques. Education Sciences. 2021;11(9):552. https://doi.org/10.3390/educsci11090552
- Lai Q. Research on the refinement of college student education management based on artificial intelligence. Discover Artificial Intelligence. 2026;6:31. https://doi.org/10.1007/s44163-025-00651-9
- Yuanyuan L, et al. Research on the application framework of intelligent technologies to promote teachers' classroom teaching behavior evaluation. Frontiers of Education in China. 2023;18(1):12–35. https://doi.org/10.3868/s110-008-023-0012-8
- Shi Y, Sun F, Zuo H, Peng F. Analysis of learning behavior characteristics and prediction of learning effect for improving college students' information literacy based on machine learning. IEEE Access. 2023;11:50447-50461.
- Liu S, Zhang J, Su W. An improved method of identifying learner's behaviors based on deep learning. Journal of Supercomputing. 2022;78(10):12861-12872.
- Yang J. Accurate prediction and analysis of college students' performance from online learning behavior data. IEIE Transactions on Smart Processing and Computing. 2023;12(3):404-411.
- Xie Y, Zhang S, Liu Y. Abnormal behavior recognition in classroom pose estimation of college students based on spatiotemporal representation learning. Traitement du Signal. 2021;38(6):1769-1778.
- Shen X, Yuan C. A college student behavior analysis and management method based on machine learning technology. Wireless Communications and Mobile Computing. 2021;2021:6611630. https://doi.org/10.1155/2021/6611630
- Li G, et al. A convolutional neural network-based approach for the recognition and evaluation of classroom teaching behavior. Scientific Programming. 2021;2021:5513886. https://doi.org/10.1155/2021/5513886
- Feng C, et al. IMRMB-Net: A lightweight student behavior recognition model for complex classroom scenarios. PLoS ONE. 2025;20(2):e0318817. https://doi.org/10.1371/journal.pone.0318817
- Zhang Y, Liu T, Ru B. Effect evaluation and student behavior design method of moral education in colleges and universities under the environment of deep learning. Scientific Programming. 2022;2022:6056117. https://doi.org/10.1155/2022/6056117
- Liu C, Wang H, Yuan Z. A method for predicting the academic performances of college students based on education system data. Mathematics. 2022;10(19):3737. https://doi.org/10.3390/math10193737
- Vora DR, Iyer KR. Deep learning in engineering education: performance prediction using cuckoo-based hybrid classification. In: Machine Learning and Deep Learning in Real-Time Applications. Studies in Computational Intelligence, Vol. 841, pp. 187-218. Springer; Singapore; 2020.
- Li H, Liu Z. An intelligent educational system: analyzing student behavior and academic performance using multi-source data. Electronics. 2024;14(16):3328. https://doi.org/10.3390/electronics14163328
- Zhang Y, Li J. Deep learning-based model for predicting student learning behavior: a pathway to early intervention and enhanced outcomes. Journal of Computational Methods in Sciences and Engineering. 2025;25(2):1169-1184.
- Jia Q, He J. Student behavior recognition in classroom based on deep learning. Applied Sciences. 2024;14(18):7981. https://doi.org/10.3390/app14187981
- Luo H. Prediction of student decision-making behaviour based on machine learning algorithms. Pakistan Journal of Life and Social Sciences. 2024;22(2):11045-11058.
- Abdi A, Sedrakyan G, Veldkamp B. Students' feedback analysis model using deep learning-based method and linguistic knowledge for intelligent educational systems. Soft Computing. 2023;27(38):14073-14094.
- Ning X. Behavior recognition of college students based on improved deep learning algorithm. International Journal of Web-Based Learning and Teaching Technologies. 2023;18(1):1-16.
- Sravya MN, Prashanth D, Saifa S, Reddy LS. A comprehensive analysis of learning behaviour characteristics and predictive modeling of learning outcomes to enhance college-level academic performance. International Journal of Pharmacy and Medical Sciences. 2025;5(2):94-100.
- Kalita E, et al. Predicting student academic performance using Bi-LSTM: a deep learning framework with SHAP-based interpretability and statistical validation. Frontiers in Education. 2025;10:1581247. https://doi.org/10.3389/feduc.2025.1581247
- Alias MAH, Hambali N, Aziz MAA. Feature selection techniques and classification algorithms for student performance classification: a review. International Journal of Electrical and Computer Engineering. 2024;14(3):3230-3242.
- Wang Z, et al. Students' classroom behavior detection system incorporating deformable DETR with Swin Transformer and lightweight feature pyramid network. Systems. 2023;11(7):372. https://doi.org/10.3390/systems11070372
- Zou X. Design of student behavior analysis and management system based on deep learning. International Journal of High Speed Electronics and Systems. 2024;33(1):2450005. https://doi.org/10.1142/S012915642450005X
- Zhang Q. The impact of machine learning-based student behaviour detection on teaching in classroom scenarios. Journal of Information and Knowledge Management. 2025;24(1):2450101. https://doi.org/10.1142/S021964922450101X
- Yu C, Wang Y. College student management system based on K-means clustering algorithm. Int J New Dev Educ. 2022;4(2):28-33.
- Chen J, Lu H. Evaluation method of classroom teaching effect under intelligent teaching mode. Mobile Networks and Applications. 2022;27(3):1262-1270.
- Han X, Chen X. The evaluation model of engineering practice teaching with complex network analytic hierarchy process based on deep learning. Scientific Reports. 2025;15:14733. https://doi.org/10.1038/s41598-025-14733-x
- Guo S, et al. The analysis of teaching quality evaluation for college sports dance by convolutional neural network model and deep learning. Heliyon. 2024;10(8):e36067. https://doi.org/10.1016/j.heliyon.2024.e36067
- Gao Y. Deep learning-based strategies for evaluating and enhancing university teaching quality. Computers and Education: Artificial Intelligence. 2025;8:100362. https://doi.org/10.1016/j.caeai.2025.100362
- Li Y, Lu B. Intelligent educational systems based on adaptive learning algorithms and multimodal behavior modeling. PeerJ Computer Science. 2025;11:e3157. https://doi.org/10.7717/peerj-cs.3157
- Geng F, John AD, Chinnappan CV. Analysis of the teaching quality using novel deep learning-based intelligent classroom teaching framework. Progress in Artificial Intelligence. 2023;12(2):147-162.
- Veluri RK, et al. Learning analytics using deep learning techniques for efficiently managing educational institutes. Materials Today: Proceedings. 2022;51(Part 8):2317-2320.
- Chen W, Min L. The evaluation model of physical education teaching performance based on deep learning algorithm. Scalable Computing: Practice and Experience. 2025;26(3):458-466.
- Zhang Y. A comprehensive evaluation system for physical education teaching effectiveness supported by multimodal machine learning. Discover Artificial Intelligence. 2026;6:75. https://doi.org/10.1007/s44163-026-00075-x
- Pei Y, Lu G. Design of an intelligent educational evaluation system using deep learning. IEEE Access. 2023;11:29790-29799.
- Ding J, Su Y. A teaching management system for physical education in colleges and universities using the theory of multiple intelligences and SVM. Soft Computing. 2024;28(2):685-701.
- Li Y, Zhang L, Tian Y, Qi W. Research on teaching practice of blended higher education based on deep learning route. Computational Intelligence and Neuroscience. 2022;2022:5751843. https://doi.org/10.1155/2022/5751843
- Jiang X, Du Y, Zheng Y. Evaluation of physical education teaching effect using Random Forest model under artificial intelligence. Heliyon. 2024;10(1):e23576. https://doi.org/10.1016/j.heliyon.2024.e23576
- Li S, Liu T. Performance prediction for higher education students using deep learning. Complexity. 2021;2021:6620684. https://doi.org/10.1155/2021/6620684
- Alnasyan B, Basheri M, Alassafi MO, Alnasyan K. Kanformer: An Attention-Enhanced Deep Learning Model for Predicting Student Performance in Virtual Learning Environments. Social Network Analysis and Mining. 2025;15:25. https://doi.org/10.1007/s13278-025-01446-7
- Lu Y, Tong L, Cheng Y. Advanced Knowledge Tracing: Incorporating Process Data and Curricula Information via an Attention-Based Framework for Accuracy and Interpretability. Journal of Educational Data Mining. 2024;16(2):58-84.