Niniejszy protokół opisuje przepływ pracy oparty na głębokim uczeniu w celu segmentacji semantycznej, rekonstrukcji i syntezy artystycznego stylu wzorów niematerialnego dziedzictwa kulturowego, wykorzystując ekstrakcję cech opartą na transformatorach, rekonstrukcję przeciwstawną oraz przestrzennie adaptacyjne generowanie obrazów, aby wesprzeć cyfrową konserwację i kreatywne zastosowania w obszarze dziedzictwa.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Rekonstrukcja sterowana segmentacją semantyczną i synteza stylu artystycznego wzorów niematerialnego dziedzictwa kulturowego z wykorzystaniem frameworku głębokiego uczenia
W tym artykule
Podsumowanie
Streszczenie
Cyfrowa konserwacja i rekonstrukcja wzorów niematerialnego dziedzictwa kulturowego (ICH) zyskały na znaczeniu wraz z rozwojem technik syntezy obrazu opartych na głębokim uczeniu. Istniejące podejścia oparte na SegCycle-SPADE wykazały potencjał w zakresie segmentacji strukturalnej i artystycznej rekonstrukcji tradycyjnych wzorów rzemieślniczych; jednak nadal istnieją ograniczenia, w tym ograniczona różnorodność zbiorów danych, niewystarczające uwzględnienie semantyki kulturowej oraz nieodpowiednia konserwacja cech strukturalnych wzorów podczas rekonstrukcji. Aby sprostać tym wyzwaniom, w niniejszym badaniu zaproponowano ulepszony framework SegCycle-SPADE do segmentacji semantycznej i artystycznej rekonstrukcji typów wzorów ICH. Do dokładnej identyfikacji granic motywów i obszarów wzorów wykorzystano model segmentacji oparty na Transformerach, SegFormer. Ponadto wprowadzono moduł Cross-Attention Cultural Feature Fusion, aby wzmocnić motywy o znaczeniu kulturowym i poprawić reprezentację cech. Translacja i rekonstrukcja wzorów są realizowane za pomocą CycleGAN, natomiast do syntezy stylu artystycznego wykorzystano Spatial-Adaptive Denormalization (SPADE), aby zachować spójność semantyczną między mapami segmentacji a generowanymi obrazami. W celu poprawy generalizacji modelu i różnorodności artystycznej, framework został przeszkolony z wykorzystaniem zarówno zbioru danych motywów kulturowych Miao Batik, jak i zbioru danych WikiArt. Wyniki eksperymentalne wykazują, że zaproponowany framework SegCycle-SPADE z mechanizmem uwagi poprawia dokładność segmentacji oraz wydajność rekonstrukcji wzorów dziedzictwa w porównaniu z istniejącymi metodami rekonstrukcji opartymi na generatywnych sieciach przeciwstawnych (GAN). Zaproponowany framework stanowi skalowalne rozwiązanie dla dokumentacji dziedzictwa kulturowego wspomaganej sztuczną inteligencją, rekonstrukcji oraz artystycznej rewitalizacji tradycyjnych projektów wzorów.
Wprowadzenie
Dziedzictwo kulturowe, obejmujące zarówno elementy niematerialne, takie jak zwyczaje, języki i wierzenia, jak i elementy materialne, takie jak dzieła sztuki, budynki i zapisy pisemne, stanowi fundamentalny przejaw ludzkiej historii, kreatywności i tożsamości1. Konserwacja dziedzictwa dąży do umożliwienia społecznościom ponownego nawiązania więzi z ich korzeniami i pozwala przyszłym pokoleniom czerpać korzyści z ich zbiorowej pamięci kulturowej. Promuje ona również porozumienie międzykulturowe, uznanie różnorodnych tradycji i zwyczajów oraz akceptację odmiennych narracji historycznych. Te zasoby kulturowe pomagają nam zrozumieć wartości, perspektywy i doświadczenia poprzednich pokoleń oraz przyczyniają się do kształtowania współczesnych tożsamości społecznych i ciągłości kulturowej. Podstawowe zasady ochrony dziedzictwa kulturowego zostały przedstawione na Rysunku 1.
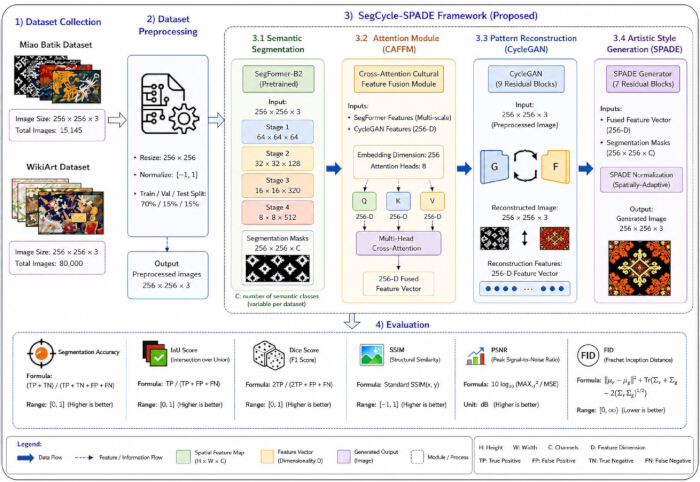
Rycina 1. Koncepcyjny przegląd rekonstrukcji wzorów dziedzictwa kulturowego z wykorzystaniem frameworka SegCycle-SPADE. Schematyczne przedstawienie proponowanego podejścia do rekonstrukcji i wzmacniania wzorów niematerialnego dziedzictwa kulturowego. Przepływ pracy obejmuje zbieranie zbiorów danych z zestawów Miao Batik i WikiArt, wstępne przetwarzanie obrazów, segmentację semantyczną przy użyciu SegFormer-B2, fuzję cech za pomocą modułu Cross-Attention Cultural Feature Fusion Module (CAFFM), rekonstrukcję wzorów za pomocą CycleGAN, syntezę stylu artystycznego za pomocą SPADE oraz końcową ocenę z wykorzystaniem metryk segmentacji i rekonstrukcji. Strzałki wskazują przepływ danych i reprezentacji cech w całym frameworku. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Zbiorowa pamięć i dziedzictwo kulturowe ludzkiego społeczeństwa są ucieleśnione w niematerialnym dziedzictwie kulturowym (ICH), które służy jako ważne medium ekspresji artystycznej i tożsamości kulturowej. Jednakże ICH stoi przed znacznymi wyzwaniami ze względu na skutki globalizacji i cyfryzacji2,3,4. Wiele zagrożonych praktyk ICH wymaga nowych podejść do ochrony i rozwoju ze względu na malejącą liczbę wykwalifikowanych rzemieślników oraz ograniczoną zdolność adaptacji do nowoczesnych rynków5,6. Jako ważny obszar badań nad ICH, projektowanie zrównoważone kładzie nacisk na zintegrowany rozwój kultury, społeczeństwa i środowiska, zapewniając praktyczną drogę do dalszej ochrony ICH. Dzięki podejściom opartym na projektowaniu zrównoważonym, ICH może zostać rewitalizowane przy jednoczesnym dostosowaniu do potrzeb współczesnego społeczeństwa7,8.
W niniejszym badaniu termin „wzory niematerialnego dziedzictwa kulturowego” odnosi się do wizualnych reprezentacji motywów, które komunikują i utrwalają immanentne niematerialne wartości kulturowe. W związku z tym proponowane ramy mają na celu zachowanie i udokumentowanie informacji kulturowych powiązanych z tymi motywami przy jednoczesnej rekonstrukcji ich form wizualnych.
Haft i batik ludu Miao są istotnymi formami niematerialnego dziedzictwa kulturowego (ICH) Chin, odzwierciedlającymi historię, wierzenia i tradycje społeczności Miao poprzez symboliczne motywy, takie jak ptaki, motyle i totemy przodków9. Motywy te są głęboko zakorzenione w strojach rytualnych i praktykach festiwalowych, a także przyczyniają się do lokalnego rozwoju kulturowego i gospodarczego10,11. Postępy w technologiach cyfrowych, w szczególności w dziedzinie sztucznej inteligencji (AI) i uczenia głębokiego (DL), stworzyły nowe możliwości dla konserwacji, analizy, rekonstrukcji i dokumentacji dziedzictwa kulturowego. Batik ludu Miao z prowincji Guizhou, będący jedną z najlepiej zachowanych tradycji batikowania w Chinach, służy jako ważne medium przekazywania wiedzy kulturowej, wierzeń, zwyczajów i rytuałów ludu Miao12,13,14,15,16.
Niedawne badania wykazały potencjał DL w zakresie ochrony dziedzictwa kulturowego i rekonstrukcji wzorów, osiągając lepszą dokładność segmentacji (dokładność pikseli = 88,6%, średni wskaźnik przecięcia nad sumą [IoU] = 78,1%) oraz wydajność rekonstrukcji w porównaniu z U-Net i DeepLabV3+1. Niemniej jednak nadal istnieją pewne wyzwania. Istniejące podejścia oparte na generatywnych sieciach przeciwstawnych (GAN) często mają trudności z zachowaniem drobnych szczegółów strukturalnych w złożonych wzorach17, podczas gdy ograniczona różnorodność zbiorów danych ogranicza generalizację modelu w różnych domenach kulturowych18. Ponadto modele translacji obraz-obraz, takie jak CycleGAN, mogą nie zachować spójności semantycznej między mapami segmentacji a wygenerowanymi obrazami19, a brak mechanizmów uwagi może prowadzić do utraty kulturowo istotnych detali motywów podczas rekonstrukcji20. W związku z tym, w celu skutecznej rekonstrukcji wzorów ICH niezbędne jest opracowanie ulepszonego frameworka integrującego segmentację opartą na transformerach, uczenie cech sterowane mechanizmem uwagi oraz trenowanie na wielu zbiorach danych.
Nowe możliwości ochrony dziedzictwa kulturowego pojawiły się dzięki digitalizacji haftów ludu Miao oraz szybkiemu rozwojowi generatywnej sztucznej inteligencji (AI). Modele dyfuzyjne, nowa klasa głębokich modeli generatywnych, wykazały wyjątkową skuteczność w zadaniach związanych z komputerowym rozpoznawaniem obrazu dzięki swoim potężnym możliwościom generowania treści21,22,23,24,25. Podczas procesu odwrotnej dyfuzji model stopniowo uczy się rekonstruować oryginalne dane wejściowe z reprezentacji zaszumionych26,27,28. Wcześniejsze badania analizowały również zastosowanie technologii rekonstrukcji trójwymiarowej oraz projektowania wspomaganego komputerowo (CAD) w celu ochrony i upowszechniania dziedzictwa kulturowego.
Mimo że konwolucyjne sieci neuronowe (CNN) i sieci GAN radzą sobie dobrze w generowaniu obrazów i zachowywaniu cech, wciąż borykają się z wyzwaniami związanymi z ograniczonymi polami recepcyjnymi, zapadaniem się trybów (mode collapse) oraz niestabilnością procesu trenowania29. Architektury oparte na transformatorach, takie jak SegFormer i Segmenter, doskonale radzą sobie z przechwytywaniem kontekstu globalnego i relacji semantycznych, jednak są one kosztowne obliczeniowo i mogą mieć trudności z odwzorowaniem drobnych detali. Chociaż modele dyfuzyjne, takie jak Stable Diffusion, wykazują silne możliwości generowania obrazów, często brakuje im precyzyjnej kontroli nad cechami strukturalnymi i artystycznymi generowanych projektów. Co więcej, większość istniejących podejść wykorzystuje niezależne strategie trenowania, co ogranicza efektywną wymianę informacji i wspólną optymalizację między komponentami segmentacji a generowania, prowadząc do kompromisu między dokładnością strukturalną a autentycznością artystyczną30.
Współczesne modele oparte na dyfuzji, takie jak latent diffusion i Stable Diffusion, pozwalają na wysokiej jakości syntezę obrazów, lecz wymagają iteracyjnego odszumiania, co prowadzi do zwiększenia kosztów obliczeniowych i czasu wnioskowania. Co więcej, zachowanie precyzyjnych motywów kulturowych i spójności strukturalnej pozostaje wyzwaniem bez zastosowania wyspecjalizowanych mechanizmów warunkowania. Generatywne modele oparte na transformatorach skutecznie przechwytują globalne zależności kontekstowe, jednak często wymagają one wielkoskalowych zbiorów danych i znacznych zasobów obliczeniowych. W przeciwieństwie do nich, proponowana architektura SegCycle-Spatially Adaptive Denormalization (SegCycle-SPADE) łączy segmentację opartą na SegFormer, fuzję cech z mechanizmem cross-attention, rekonstrukcję CycleGAN oraz syntezę sterowaną przez SPADE, aby zapewnić wyraźne prowadzenie strukturalne, poprawiając tym samym zachowanie motywów, spójność semantyczną i kontrolowaną rekonstrukcję wzorów dziedzictwa kulturowego.
Większość najnowocześniejszych technik segmentacji semantycznej opiera się na w pełni splotowych sieciach neuronowych (FCNN) o architekturze w kształcie litery U31. Podczas etapu kodowania, poprzez serię operacji splotu i undersamplingu, ekstrahowane są głębokie cechy o dużych polach recepcyjnych. Etap dekodowania stopniowo przywraca rozdzielczość przestrzenną poprzez upsampling, co ostatecznie umożliwia semantyczną predykcję na poziomie pikseli. Połączenia pomijające (skip connections) pozwalają na bezpośrednią integrację informacji o wysokiej rozdzielczości z różnych poziomów kodera w dekoderze, co kompensuje utratę informacji przestrzennych podczas undersamplingu i poprawia wydajność segmentacji w szerokim zakresie zastosowań32.
Choć niedawne metody oparte na sieciach GAN, CNN oraz modelach dyfuzyjnych wykazały obiecujące wyniki w generowaniu obrazów i rekonstrukcji dziedzictwa kulturowego, często mają one trudności z zachowaniem spójności semantycznej, utrzymaniem drobnych motywów strukturalnych oraz zapewnieniem powtarzalnej rekonstrukcji w obrębie zróżnicowanych wzorów kulturowych. Większość istniejących podejść traktuje segmentację, rekonstrukcję i syntezę stylu jako odrębne procesy, co może prowadzić do utraty istotnych elementów kulturowych i niespójnych wyników. Aby wypełnić tę lukę metodologiczną, w niniejszym badaniu zaproponowano jednolity framework SegCycle-SPADE, który integruje segmentację semantyczną opartą na SegFormer, nowatorski moduł fuzji cech kulturowych z mechanizmem Cross-Attention (CAFFM), rekonstrukcję opartą na CycleGAN oraz syntezę stylu sterowaną przez SPADE. Dzięki wyraźnej integracji informacji o segmentacji strukturalnej z generatywnym uczeniem cech, proponowany framework umożliwia bardziej niezawodną, semantycznie spójną i powtarzalną rekonstrukcję motywów niematerialnego dziedzictwa kulturowego (ICH), zachowując jednocześnie autentyczność kulturową i jakość artystyczną.
W niniejszym badaniu zidentyfikowano trzy główne ograniczenia obecnych podejść do rekonstrukcji dziedzictwa kulturowego: (i) niewystarczające zachowanie drobnych motywów strukturalnych w metodach rekonstrukcji opartych na sieciach GAN; (ii) ograniczoną generalizację wynikającą z trenowania na małych lub specyficznych dla danej dziedziny zbiorach danych; oraz (iii) nieodpowiednią spójność semantyczną między wynikami segmentacji a wygenerowanymi obrazami w ramach translacji obraz-obraz. Ponadto segmentacja, rekonstrukcja i synteza stylu są zazwyczaj traktowane jako osobne procesy, co prowadzi do utraty istotnych kulturowo elementów podczas rekonstrukcji. Poprzez połączenie semantycznej segmentacji opartej na transformerach, fuzji cech cross-attention, rekonstrukcji CycleGAN oraz syntezy artystycznej sterowanej przez SPADE w ramach ujednoliconej architektury, proponowany framework SegCycle-SPADE rozwiązuje te ograniczenia i poprawia zachowanie motywów, spójność semantyczną oraz autentyczność artystyczną w rekonstrukcji wzorów ICH.
Głównym celem niniejszego badania jest opracowanie ulepszonego frameworku SegCycle-SPADE do artystycznej rekonstrukcji wzorów niematerialnego dziedzictwa kulturowego (ICH) z wykorzystaniem segmentacji semantycznej. Framework integruje model SegFormer do dokładnej segmentacji motywów kulturowych, CycleGAN do rekonstrukcji wzorów oraz SPADE do artystycznej syntezy spójnej stylistycznie. W celu poprawy reprezentacji cech i zachowania drobnych szczegółów strukturalnych wprowadzono moduł CAFFM, który ułatwia efektywną interakcję między cechami segmentacji a cechami generatywnymi. Framework, trenowany na zbiorach danych Miao Batik oraz WikiArt, zwiększa autentyczność rekonstrukcji, spójność stylu oraz stopień zachowania motywów o znaczeniu kulturowym.
Poprzez połączenie segmentacji semantycznej, fuzji cech sterowanej uwagą, rekonstrukcji wzorów i syntezy stylu w ramach jednolitej architektury, niniejsza praca przedstawia nowatorski framework SegCycle-SPADE do artystycznej rekonstrukcji wzorów niematerialnego dziedzictwa kulturowego (ICH). Główne wkłady tej pracy są następujące. Po pierwsze, opracowano nowy framework rekonstrukcji sterowanej segmentacją semantyczną poprzez integrację SegFormer, co umożliwia precyzyjną ekstrakcję i zachowanie złożonych motywów kulturowych oraz elementów strukturalnych. Po drugie, wprowadzono nowy moduł CAFFM w celu skutecznego łączenia cech segmentacji z reprezentacjami generatywnymi, co pozwala modelowi uchwycić dalekosiężne zależności między motywami kulturowymi a wzorami stylów artystycznych. Po trzecie, zaproponowany CAFFM zwiększa stopień zachowania elementów istotnych kulturowo, jednocześnie poprawiając realizm wizualny i spójność strukturalną zrekonstruowanych wzorów dziedzictwa. Po czwarte, dzięki integracji CycleGAN do rekonstrukcji wzorów kulturowych oraz SPADE do sterowanej segmentacją syntezy artystycznej, framework zapewnia zarówno dokładność semantyczną, jak i autentyczność stylistyczną generowanych wyników. Po piąte, aby poprawić generalizację i różnorodność artystyczną, model został przeszkolony z wykorzystaniem zbioru danych motywów kulturowych Miao Batik do nauki wzorów kulturowych oraz zbioru danych WikiArt do reprezentacji stylu artystycznego. WikiArt służy jako pomocniczy zbiór danych do oceny zdolności generalizacji frameworku, odporności uczenia cech oraz skuteczności kontroli stylu w różnych kontekstach wizualnych, a nie jako styl docelowy do bezpośredniego zastosowania w produktach dziedzictwa kulturowego Miao. Wreszcie, w porównaniu z istniejącymi metodami rekonstrukcji dziedzictwa kulturowego opartymi na sieciach GAN, wyniki eksperymentalne wykazują, że proponowany framework SegCycle-SPADE osiąga lepszą dokładność segmentacji, wyższą jakość rekonstrukcji oraz większą spójność stylistyczną.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Zaproponowany model SegCycle-SPADE został opracowany w celu rekonstrukcji i ulepszenia tradycyjnych wzorów dziedzictwa kulturowego poprzez segmentację semantyczną, wzmacnianie cech z wykorzystaniem mechanizmu uwagi, rekonstrukcję generatywną oraz syntezę stylu artystycznego. W badaniu wykorzystano publicznie dostępne zbiory obrazów dziedzictwa kulturowego i artystycznego, w tym zbiór danych Miao Batik oraz zbiór danych WikiArt. W badaniach nie uczestniczyli ludzie, nie wykorzystano danych pacjentów, informacji osobowych, zwierząt ani dokumentacji klinicznej; w związku z tym nie wymagano zgody instytucjonalnej komisji etyki ani świadomej zgody. Na początek do ewaluacji wykorzystano zbiór motywów kulturowych Miao Batik oraz zbiór WikiArt. Zbiór danych Miao Batik został opisany w pracy Quan et al. (2024)32 i zawiera 15 148 adnotowanych obrazów tradycyjnych motywów batikowych ludu Miao. Istniejące adnotacje dostarczone przez twórców zbioru zostały wykorzystane bezpośrednio i w niniejszym badaniu nie generowano dodatkowych adnotacji manualnych. Następnie przeprowadzono wstępne przetwarzanie obrazów poprzez zmianę rozmiaru, normalizację, odszumianie oraz tworzenie maski segmentacji. Dokładne parametry wstępnego przetwarzania opisano w podrozdziale Data Preprocessing. Zaproponowany model wykorzystuje model oparty na transformerze o nazwie SegFormer-B2 do segmentacji semantycznej danych. Metoda ta została zaprojektowana w celu wykrywania kluczowych obszarów motywów kulturowych i uczenia się ich struktur. Segmentowane cechy są następnie wzmacniane za pomocą mechanizmu uwagi, w którym podkreślane są istotne informacje związane z motywami kulturowymi, a informacje nieistotne są odrzucane. Konfigurację mechanizmu uwagi opisano w podrozdziale CAFFM. Wzmocnione cechy są następnie przekazywane do CycleGAN, gdzie uszkodzone struktury są rekonstruowane poprzez uczenie cykliczne. Podczas uczenia sztucznie tworzono niekompletne próbki motywów, stosując operacje losowego maskowania i częściowego przesłaniania do oryginalnych obrazów Miao Batik. Procedury degradacji te symulowały brakujące regiony motywów i uszkodzenia strukturalne powszechnie obserwowane w zdegradowanych artefaktach dziedzictwa kulturowego. Powstałe niekompletne obrazy posłużyły jako wejścia do modułu rekonstrukcji CycleGAN, natomiast odpowiadające im obrazy oryginalne stanowiły cele rekonstrukcji. Zrekonstruowane wzory dziedzictwa kulturowego są następnie ulepszane za pomocą SPADE, gdzie wzmocnienie artystyczne jest realizowane na podstawie wygenerowanych map segmentacji. Wydajność zaproponowanego modelu oceniano przy użyciu ilościowych metryk segmentacji i jakości obrazu, natomiast autentyczność wizualną zrekonstruowanych motywów kulturowych oceniano jakościowo. Autentyczność wizualną oceniano poprzez inspekcję wizualną wygenerowanych wzorów kulturowych i nie była ona używana jako niezależna metryka ilościowa. Ocena koncentrowała się na zachowaniu motywu, spójności semantycznej, cechach kulturowych, koherencji strukturalnej i wyglądzie artystycznym w odniesieniu do odpowiadających im referencyjnych motywów kulturowych. Ilościowa ocena wydajności modelu została przeprowadzona z wykorzystaniem Segmentation Accuracy, IoU, Dice Coefficient, Structural Similarity Index Measure (SSIM), Peak Signal-to-Noise Ratio (PSNR) oraz Fréchet Inception Distance (FID). Rysunek 2 ilustruje ogólny przebieg pracy zaproponowanego modelu SegCycle-SPADE i podsumowuje metryki ewaluacyjne użyte w niniejszym badaniu.
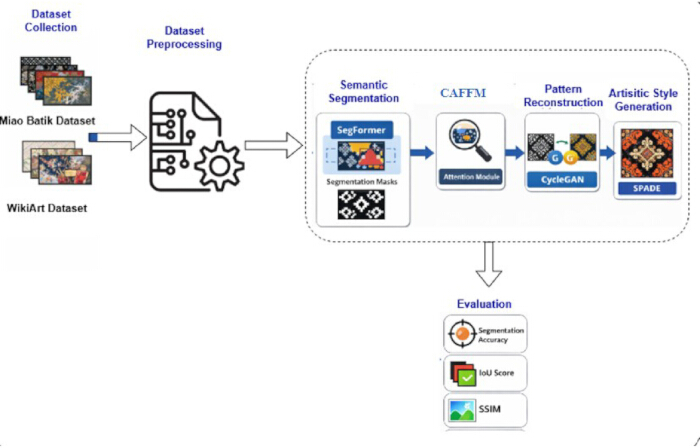
Rysunek 2. Ogólny schemat architektury proponowanego frameworka SegCycle-SPADE. Przegląd kompletnego przepływu pracy SegCycle-SPADE. Obrazy z zbiorów danych Miao Batik i WikiArt podlegają wstępnemu przetwarzaniu, a następnie są przetwarzane poprzez segmentację semantyczną z wykorzystaniem SegFormer-B2, wzmocnienie cech za pomocą CAFFM, rekonstrukcję wzorów za pomocą CycleGAN oraz generowanie stylu artystycznego z użyciem SPADE. Wydajność modelu jest oceniana za pomocą wskaźników takich jak Segmentation Accuracy, Intersection over Union (IoU), Dice Coefficient, Structural Similarity Index Measure (SSIM), PSNR, Fréchet Inception Distance (FID), natomiast autentyczność wizualna jest oceniana jakościowo. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Struktura SegCycle-SPADE do rekonstrukcji wzorów dziedzictwa kulturowego została zaprojektowana w celu integracji wielu komponentów DL dla dokładnej segmentacji motywów, ich rekonstrukcji oraz artystycznego ulepszenia, co zilustrowano na Rysunku 2. Obrazy z zestawu danych motywów kulturowych Miao Batik oraz zestawu danych WikiArt są wykorzystywane w celu zapewnienia różnorodnych wzorów kulturowych i stylów artystycznych. Początkowo obrazy są przetwarzane przy użyciu modułu segmentacji semantycznej opartego na SegFormer w celu identyfikacji i wyodrębnienia motywów kulturowych z tła. Ogólna architektura składa się z czterech głównych etapów. Po pierwsze, model SegFormer wyodrębnia mapy segmentacji semantycznej z obrazów wzorów kulturowych. Po drugie, CAFFM integruje cechy segmentacji z reprezentacjami generatywnymi, aby usprawnić uczenie cech. Po trzecie, moduł CycleGAN rekonstruuje wzory kulturowe przy użyciu scalonych reprezentacji cech. Na koniec moduł SPADE generuje ulepszone stylistycznie wyniki, zachowując spójność strukturalną poprzez syntezę kierowaną segmentacją. Udoskonalone mapy cech są następnie przetwarzane przez moduł rekonstrukcji CycleGAN, który uczy się przywracać niekompletne motywy kulturowe poprzez mapowanie zdegradowanych wzorów na ich odpowiadające im pełne formy. Próbki niekompletnych motywów zostały wygenerowane poprzez zastosowanie operacji losowego maskowania i częściowego przesłonięcia do oryginalnych obrazów Miao Batik, symulując tym samym brakujące obszary wzoru i degradację strukturalną powszechnie obserwowaną w uszkodzonych artefaktach kulturowych. Każdy zdegradowany obraz został sparowany z odpowiadającym mu obrazem oryginalnym, który służył jako cel rekonstrukcji podczas uczenia. Strategia ta umożliwiła modułowi CycleGAN naukę przywracania brakujących struktur motywów przy jednoczesnym zachowaniu spójności semantycznej i istotnych cech kulturowych. Ostatecznie generator SPADE tworzy wizualnie ulepszone wyniki artystyczne poprzez warunkowanie syntezy obrazu na wygenerowanych mapach segmentacji, utrzymując tym samym integralność strukturalną motywów kulturowych w całym procesie ulepszania artystycznego.
Proponowana struktura SegCycle-SPADE obejmuje następujące etapy.
Krok 1: Gromadzenie zbiorów danych
W celu realizacji celów związanych z nauką wzorców kulturowych i generowaniem stylu artystycznego wykorzystano dwa zbiory danych. Zbiór danych motywów kulturowych Miao Batik posłużył do dostarczenia informacji o tradycyjnych wzorach kulturowych. Zbiór ten jest publicznie dostępny poprzez Zenodo (https://doi.org/10.5281/zenodo.20807658) i zawiera 15 148 opisanych obrazów tradycyjnych motywów batikowych ludu Miao. Wykorzystano bezpośrednio istniejące adnotacje dostarczone przez twórców zbioru; w niniejszym badaniu nie tworzono dodatkowych adnotacji ręcznych. Zbiór danych WikiArt został wykorzystany w celu dostarczenia zróżnicowanych informacji o stylach artystycznych do generowania stylu artystycznego i został pobrany z publicznie dostępnego repozytorium WikiArt (https://www.wikiart.org/).
Krok 2: Przetwarzanie wstępne danych
Wszystkie obrazy zostały poddane przetwarzaniu wstępnemu poprzez zmianę rozmiaru, normalizację i redukcję szumu. Do wsparcia etapu segmentacji semantycznej wykorzystano istniejące adnotacje motywów kulturowych pochodzące z oryginalnych źródeł zbioru danych. W ramach niniejszego badania nie przeprowadzono żadnych dodatkowych procedur adnotacji ani ponownego etykietowania.
Krok 3: Segmentacja wzorców semantycznych przy użyciu SegFormer
Do segmentacji motywów kulturowych wykorzystano model SegFormer. Dokładny opis szkieletu (backbone) i strategii inicjalizacji modelu SegFormer znajduje się w podrozdziale Semantic Pattern Segmentation Using SegFormer. W szczególności do semantycznej segmentacji motywów zastosowano architekturę SegFormer-B2 ze szkieletem MIT-B2 wstępnie wytrenowanym na zbiorze ImageNet. Model ten skutecznie przechwytuje globalne informacje kontekstowe, zachowując jednocześnie złożone szczegóły strukturalne tradycyjnych wzorców kulturowych.
Krok 4: CAFFM
Moduł CAFFM łączy cechy segmentacji semantycznej z reprezentacjami generatywnymi, co pozwala frameworkowi na naukę zarówno charakterystyki motywów strukturalnych, jak i informacji o stylu artystycznym. Szczegóły dotyczące integracji CAFFM zostały przedstawione w podrozdziale CAFFM. Moduł ten znajduje się pomiędzy etapem segmentacji semantycznej opartej na SegFormer a etapem rekonstrukcji generatywnej, gdzie łączy cechy strukturalne pochodzące z segmentacji z cechami rekonstrukcji za pomocą wielogłowicowej uwagi krzyżowej (multi-head cross-attention). Proces ten poprawia zachowanie motywów kulturowych i zwiększa realizm zrekonstruowanych wyników.
Krok 5: Rekonstrukcja wzorca (CycleGAN)
Połączone cechy są następnie przetwarzane przez moduł CycleGAN w celu rekonstrukcji struktur wzorców kulturowych. Architektura i konfiguracja szkolenia CycleGAN zostały opisane w podrozdziale Rekonstrukcja wzorców przy użyciu CycleGAN. Moduł rekonstrukcyjny składa się z dwóch generatorów i dwóch dyskryminatorów, wykorzystuje architekturę generatora opartą na sieciach rezdualnych z dziewięcioma blokami rezdualnymi, stosuje dyskryminator PatchGAN i jest szkolony przy użyciu funkcji strat przeciwnych oraz spójności cyklicznej. Taka konfiguracja umożliwia dwukierunkowe mapowanie domen i ułatwia rekonstrukcję niepełnych struktur wzorców kulturowych.
Krok 6: Generowanie stylu artystycznego (SPADE)
Zrekonstruowane wzory są następnie przetwarzane przez moduł SPADE w celu przeprowadzenia syntezy stylu artystycznego sterowanej segmentacją. Konfiguracja generatora SPADE została opisana w podrozdziale Artistic Style Generation Using SPADE. Moduł wykorzystuje bloki rezydualne SPADE, warstwy normalizacji adaptacyjnej przestrzennie oraz warunkowanie semantyczne pochodzące z map segmentacji SegFormer i reprezentacji cech CAFFM. Dzięki warunkowaniu generowania obrazów na podstawie map segmentacji, syntetyczne wyniki zachowują zgodność strukturalną z oryginalnymi motywami kulturowymi, jednocześnie włączając cechy stylu artystycznego.
Krok 7: Szacowanie wydajności
Zaproponowany schemat został oceniony przy użyciu wielu metryk segmentacji i oceny jakości obrazu, w tym dokładności segmentacji, IoU, współczynnika podobieństwa Dice (Dice), SSIM, PSNR oraz FID. Aby ocenić spójność eksperymentalną, wszystkie doświadczenia powtórzono pięciokrotnie, stosując różne ziarna losowe, a wyniki przedstawiono jako średnia ± odchylenie standardowe. Istotność statystyczną oceniono za pomocą sparowanych testów t z progiem istotności p < 0,05.
Kolekcja zbiorów danych
W proponowanej strukturze SegCycle-SPADE wykorzystano dwa zbiory danych w celu zrozumienia wzorców kulturowych i uczenia stylów. Pierwszym zbiorem danych zastosowanym w proponowanej strukturze jest zbiór motywów kulturowych batików ludu Miao. Zbiór ten zawiera motywy kulturowe batików Miao, które zazwyczaj stanowią obrazy tradycyjnych batików Miao z motywami takimi jak zwierzęta, rośliny i kształty geometryczne, wykorzystywane w sztuce grupy etnicznej Miao. Zbiór ten zawiera obrazy z bogatymi informacjami o teksturze, co ma zazwyczaj kluczowe znaczenie dla zachowania dziedzictwa kulturowego. Drugim zbiorem danych wykorzystanym w proponowanej strukturze SegCycle-SPADE jest zbiór danych WikiArt. Zbiór ten zawiera ogromną liczbę dzieł sztuki, pochodzących zazwyczaj z różnych nurtów stylistycznych. Jest on wykorzystywany do złożonego uczenia stylów, co zazwyczaj służy ulepszaniu dzieł sztuki. Zbiór ten posiada 80 000 dzieł w wysokiej rozdzielczości (HD) z 27 różnymi wzorami, co czyni go bardziej użytecznym w zadaniach generowania lub transformacji stylów opartych na głębokim uczeniu (DL).
Zbiór danych Miao Batik:
Zbiór danych Miao Batik (https://doi.org/10.5281/zenodo.20807658) obejmuje 15 148 obrazów wzorów batikowych przedstawiających motywy o znaczeniu kulturowym. Obrazy zawierają różnorodne tradycyjne wzory, takie jak motywy zwierzęce (np. motyle i ryby), wzory roślinne oraz motywy geometryczne niosące symbolikę kulturową. Zbiór ten stanowi istotny element proponowanej architektury, ponieważ dostarcza autentycznych struktur kulturowych, które umożliwiają modułowi segmentacji dokładną identyfikację i zachowanie granic motywów podczas rekonstrukcji wzorca (Tabela 1). W niniejszym badaniu motywy o znaczeniu kulturowym odnoszą się do symbolicznych elementów wizualnych powszechnie dokumentowanych w literaturze dotyczącej dziedzictwa kulturowego ludu Miao i reprezentowanych w adnotacjach zbioru danych, w tym ptaków, motyli, wzorów kwiatowych oraz totemów przodków. Motywy te wybrano na podstawie ich udokumentowanego znaczenia kulturowego i powtarzającego się występowania w tradycyjnych projektach batików i haftów Miao, a nie wyłącznie na podstawie częstotliwości ich występowania lub kompozycji przestrzennej. Eksperckie adnotacje motywów oraz etykiety segmentacji pobrano z oryginalnego źródła zbioru danych Miao Batik i wykorzystano bezpośrednio w niniejszym badaniu. Autorzy nie przeprowadzali żadnych dodatkowych procedur ręcznego adnotowania, ponownego etykietowania ani adnotacji pod kierunkiem eksperta. Istniejące adnotacje dostarczone przez twórców zbioru danych wykorzystano do trenowania i ewaluacji segmentacji semantycznej.
| Parametr | Opis |
| Nazwa zbioru danych | Zbiór danych wzorów kulturowych batik ludu Miao |
| Źródło zbioru danych | Repozytorium Zenodo (DOI: 10.5281/zenodo.20807658) |
| Dziedzina | Niematerialne Dziedzictwo Kulturowe (NDK) / Analiza wzorów tekstylnych |
| Całkowita liczba obrazów | 15 148 obrazów |
| Typ obrazu | Cyfrowe obrazy tradycyjnych wzorów tkanin batikowych ludu Miao |
| Kategorie wzorców | Motywy zwierzęce, motywy roślinne i motywy geometryczne |
| Pochodzenie kulturowe | kultura etniczna Miao, prowincja Guizhou, Chiny |
| Oryginalna rozdzielczość obrazu | Obrazy o wysokiej rozdzielczości (zazwyczaj ≥ 1000 pikseli na krótszym boku) zarejestrowane jako skany surowe lub fotografie przed wstępnym przetwarzaniem |
| Rozdzielczość szkolenia | Obrazy przeskalowane do rozmiaru 256 × 256 pikseli podczas wstępnego przetwarzania |
| Dostępność adnotacji | W celu trenowania i ewaluacji wykorzystano bez zmian istniejące adnotacje segmentacyjne dostarczone przez twórców zbioru danych. W niniejszym badaniu nie przeprowadzono dodatkowej adnotacji manualnej, zmiany etykiet ani procedur potwierdzania przez ekspertów. |
| Zastosowanie w niniejszym badaniu | Segmentacja motywów kulturowych, ekstrakcja cech, zachowanie motywów i rekonstrukcja wzorców |
Tabela 1: Charakterystyka zbioru danych wzorów kulturowych batiku ludu Miao.Podsumowanie zbioru danych motywów kulturowych batiku ludu Miao wykorzystanego do segmentacji semantycznej, analizy wzorów kulturowych i rekonstrukcji motywów. Tabela opisuje źródło zbioru danych, charakterystykę obrazów, kategorie motywów, pochodzenie kulturowe, rozdzielczość obrazów oraz rolę zbioru w ramach proponowanego modelu SegCycle-SPADE.
Zbiór danych WikiArt:
Zbiór danych WikiArt [https://www.wikiart.org/] to popularne, wielkoskalowe cyfrowe repozytorium sztuki, które obejmuje ponad 80 000 obrazów reprezentujących 27 różnych stylów artystycznych, wymienionych w Tabeli 2. Style te obejmują m.in. renesans, impresjonizm, kubizm i surrealizm. Zbiór ten jest kluczowy w proponowanym modelu, ponieważ dostarcza wiedzy umożliwiającej modułowi SPADE tworzenie wzorów wzbogaconych kulturowo, przy jednoczesnym zachowaniu informacji strukturalnych uzyskanych w procesie segmentacji. Zbiór danych składa się z 56 000 obrazów do uczenia oraz 12 000 obrazów do walidacji i testowania. Obrazy zawarte w zbiorze pomagają w efektywnym trenowaniu modelu DL.
| Parametr | Opis |
| Nazwa zbioru danych | Zbiór danych WikiArt |
| Źródło zbioru danych | Repozytorium WikiArt (https://www.wikiart.org/) |
| Domena | Sztuka cyfrowa i malarstwo |
| Suma obrazów | Około 80 000 dzieł sztuki |
| Obrazy treningowe | 56,000 |
| Obrazy walidacyjne | 12,000 |
| Obrazy testowe | 12,000 |
| Style artystyczne | 27 stylów artystycznych, w tym renesansu, impresjonizmu, kubizmu, surrealizmu, ekspresjonizmu, realizmu i sztuki abstrakcyjnej |
| Oryginalna rozdzielczość obrazu | Oryginalne rozdzielczości obrazów różniły się w zależności od dzieł i źródeł. Podczas wstępnego przetwarzania obrazy zostały przeskalowane do jednolitej rozdzielczości 256 × 256 pikseli. |
| Rozdzielczość szkolenia | Obrazy zostały przeskalowane do rozmiaru 256 × 256 pikseli podczas przetwarzania wstępnego przed uczeniem stylu artystycznego oraz syntezą obrazu sterowaną segmentacją. |
| Partycjonowanie zbioru danych | Stratyfikowany podział losowy (70% zbiór treningowy, 15% zbiór walidacyjny i 15% zbiór testowy) przy użyciu stałego ziarna losowości 42 |
| Strategia próbkowania stylu | Zastosowano warstwowy dobór proporcjonalny, aby zachować rozkład 27 stylów artystycznych w podzbiorach treningowym, walidacyjnym i testowym. |
| Zastosowanie w niniejszym badaniu | Uczenie stylu artystycznego, reprezentacja stylu i synteza artystyczna sterowana segmentacją |
Tabela 2: Charakterystyka zbioru danych WikiArt. Podsumowanie zbioru danych WikiArt wykorzystanego do nauki stylu artystycznego i syntezy obrazów sterowanej stylem. Tabela opisuje źródło zbioru danych, rozkład obrazów, zakres stylów artystycznych, podział zbioru danych, rozdzielczość obrazów oraz jego zastosowanie w proponowanej strukturze SegCycle-SPADE.
Zbiór danych Miao Batik zawiera 15 148 obrazów przedstawiających tradycyjne motywy kulturowe ludu Miao.32 Zbiór danych jest publicznie dostępny za pośrednictwem Zenodo (https://doi.org/10.5281/zenodo.20807658). Przed trenowaniem modelu wszystkie obrazy zostały poddane inspekcji wizualnej, zmieniono ich rozmiar do 256 × 256 pikseli, znormalizowano oraz sprawdzono pod kątem uszkodzonych lub powielonych próbek. Przesiewowa kontrola jakości nie doprowadziła do wykluczenia żadnego z obrazów; w związku z tym wszystkie 15 148 obrazów zachowano do dalszych analiz. Zbiór danych został losowo podzielony na podzbiory treningowy (70%), walidacyjny (15%) i testowy (15%) przy użyciu stałego ziarna losowości (seed) wynoszącego 42, aby zapewnić powtarzalność podziału zbioru danych. Dostęp do zbioru danych WikiArt uzyskano poprzez oficjalne repozytorium WikiArt (https://www.wikiart.org/), które zawiera ponad 80 000 dzieł sztuki obejmujących 27 stylów artystycznych. W eksperymentach dotyczących uczenia stylu wykorzystano 56 000 obrazów do trenowania, 12 000 do walidacji i 12 000 do testowania.
Przetwarzanie wstępne danych
Przed trenowaniem proponowanego frameworka SegCycle-SPADE, zbiór motywów kulturowych Miao Batik oraz zbiór WikiArt poddano kilku etapom przetwarzania wstępnego w celu zapewnienia spójnej jakości obrazów i dokładnej reprezentacji cech. Do obu zbiorów zastosowano ten sam podstawowy proces przetwarzania wstępnego, obejmujący odszumianie gaussowskie, normalizację, zmianę rozmiaru do spójnej rozdzielczości wejściowej oraz weryfikację jakości obrazu. Zbiory danych pełniły jednak odmienne role w ramach frameworka. Zbiór WikiArt został wykorzystany do nauki i syntezy stylu artystycznego, natomiast zbiór Miao Batik służył głównie do segmentacji i rekonstrukcji motywów kulturowych. Poza tymi specyficznymi rolami nie wprowadzono żadnych zmian w przetwarzaniu wstępnym dla poszczególnych zbiorów. Aby zapewnić spójne przetwarzanie przez model DL, obrazy najpierw zmieniono do stałej rozdzielczości. Krok ten był niezbędny, ponieważ obrazy w obu zbiorach różniły się rozdzielczością w zależności od źródła. Zmiana rozmiaru poprawiła wydajność obliczeniową i zapobiegła wpływowi niespójności wymiarowych na proces trenowania. Drugim etapem przetwarzania wstępnego była normalizacja, w której wartości pikseli przeskalowano do ustandaryzowanego zakresu, aby ustabilizować aktualizacje gradientów podczas trenowania. Następnie obrazy przetworzono za pomocą filtrowania gaussowskiego w celu redukcji szumów, które mogłyby zakłócać struktury motywów kulturowych. W przypadku zbioru Miao Batik do trenowania i ewaluacji segmentacji semantycznej wykorzystano bez modyfikacji istniejące maski segmentacji motywów kulturowych, pozyskane bezpośrednio z oryginalnego źródła zbioru danych. Na potrzeby niniejszego badania nie generowano nowych masek segmentacji.
O ile nie wskazano inaczej, równania opisujące uznane metody zostały zaadaptowane z wcześniejszych badań i są odpowiednio cytowane. Równania opisujące proponowaną metodę CAFFM oraz kompozytowy system optymalizacji SegCycle-SPADE zostały opracowane przez autorów na potrzeby niniejszego badania.
Niech obraz wejściowy z zestawu danych będzie reprezentowany przez Równanie 1:
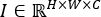 (1)
Tutaj H, W i C oznaczają odpowiednio wysokość obrazu, szerokość oraz liczbę kanałów kolorów. Wszystkie obrazy są zmieniane na stały wymiar H′ × W′, zgodnie z Równaniem 2:
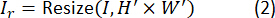
W tym przypadku Ir oznacza obraz po zmianie rozmiaru. Znormalizowane wartości pikseli oblicza się zgodnie z Równaniem 3:
 (3)
Pomaga to ustabilizować procedurę uczenia. Filtrowanie szumów jest wykonywane przy użyciu filtru Gaussa, zgodnie z Równaniem 4:
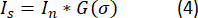
Tutaj G(σ) oznacza filtr Gaussa, a * symbolizuje splot. Zastosowano filtr Gaussa o jądrze 5 × 5 i odchyleniu standardowym σ = 1.0. W celu zredukowania artefaktów krawędziowych zastosowano dopełnienie lustrzane (reflective padding) dla pikseli brzegowych. Proces odszumiania przeprowadzono bezpośrednio po załadowaniu obrazu, przed skalowaniem i normalizacją. Aby zapewnić jednolity preprocessing w całym badaniu, tę samą konfigurację filtra zastosowano do każdego obrazu w zbiorach danych Miao Batik oraz WikiArt. Dla zbioru danych Miao Batik maski segmentacji są tworzone zgodnie z Równaniem 5:

Tutaj M jest maską segmentacji używaną do naprowadzania modelu SegFormer.
Potok przetwarzania wstępnego rozpoczyna się od pozyskania obrazów z zestawu danych Miao Batik oraz zestawu danych WikiArt, co przedstawiono na Rysunku 3. Podczas trenowania nie zastosowano technik augmentacji danych. Po przetwarzaniu wstępnym, które obejmowało zmianę rozmiaru, normalizację, odszumianie gaussowskie oraz przygotowanie masek segmentacyjnych, obrazy zostały bezpośrednio wykorzystane do trenowania, walidacji i testowania proponowanego frameworka SegCycle-SPADE. Pierwszy krok potoku przetwarzania wstępnego polega na zmianie rozmiaru obrazów do stałej wielkości, co pozwala modelowi DL na bardziej efektywne przetwarzanie danych. Drugi krok obejmuje normalizację, która konwertuje wartości pikseli do zestandaryzowanego zakresu numerycznego i ułatwia zbieżność modelu. Trzeci krok polega na usuwaniu szumu, w wyniku czego obrazy są oczyszczane z niepożądanych zakłóceń w celu poprawy rozpoznawania wzorców. Dodatkowo, w przypadku zestawu danych Miao Batik, adnotowane są obszary motywów kulturowych, co umożliwia generowanie masek wykorzystywanych w module segmentacji proponowanego modelu, zapewniając zachowanie motywów kulturowych podczas generowania. Końcowym wynikiem tego etapu jest czysty zestaw danych, gotowy do trenowania modułów segmentacji i generowania proponowanego modelu.
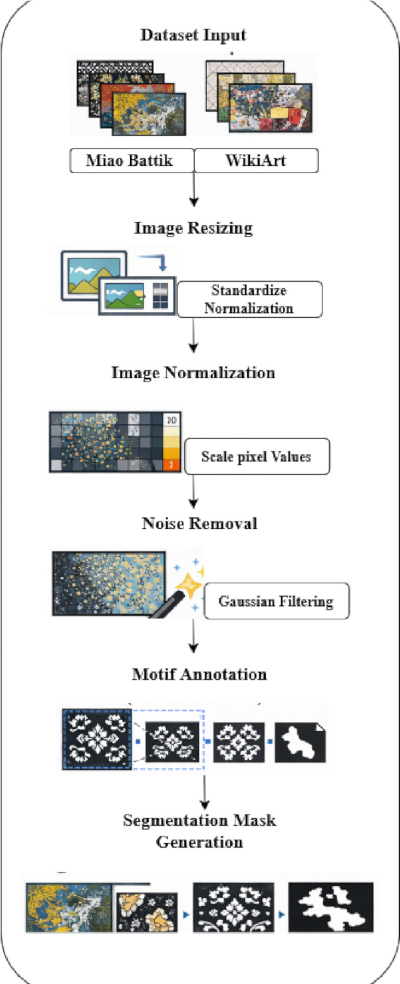
Rycina 3Potok wstępnego przetwarzania danych dla obrazów dziedzictwa kulturowego. Schemat przedstawiający procedury wstępnego przetwarzania obrazów zastosowane przed trenowaniem modelu. Potok obejmuje pozyskiwanie zbioru danych, zmianę rozmiaru obrazów, normalizację, odszumianie gaussowskie, istniejące adnotacje motywów kulturowych oraz przygotowanie masek segmentacyjnych. Powstałe przetworzone obrazy i maski służą jako dane wejściowe do segmentacji semantycznej i rekonstrukcji wzorców. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Każdy obraz został poddany procesowi kontroli jakości przed trenowaniem modelu. Zbiór danych Miao Batik zawierał 15 148 obrazów. Uszkodzone, powielone i niskiej jakości próbki zostały już usunięte przez pierwotnych twórców zbioru danych; w związku z tym podczas kontroli jakości w niniejszym badaniu nie wykluczono żadnych dodatkowych obrazów. CoConsequently, wszystkie 15 148 obrazy zostały zachowane do analizy. Podczas wstępnego przetwarzania obrazy ładowano w formacie RGB i zmieniano ich rozmiar do 256 × 256 pikseli przy użyciu interpolacji bilinearnej. Wartości pikseli przeskalowano z zakresu [0, 255] do [0, 1] poprzez podzielenie przez 255. Następnie zastosowano normalizację kanałową, używając wartości średnich [0.485, 0.456, 0.406] oraz wartości odchylenia standardowego [0.229, 0.224, 0.225] odpowiednio dla kanałów czerwonego, zielonego i niebieskiego. Potok wstępnego przetwarzania obejmował ładowanie obrazów, konwersję do RGB, zmianę rozmiaru, skalowanie wartości pikseli, normalizację oraz konwersję do tensorów. W razie potrzeby obrazy w skali szarości konwertowano do trójkanałowego formatu RGB, aby zachować kompatybilność z modelami DL. Po wstępnym przetwarzaniu obrazy podzielono na podzbiory treningowy, walidacyjny i testowy. Wszystkie etapy architektury SegCycle-SPADE — w tym segmentacja semantyczna, fuzja cech, rekonstrukcja motywów oraz synteza artystyczna oparta na SPADE — wykorzystywały spójną rozdzielczość wejściową 256 × 256 pikseli.
Segmentacja wzorców semantycznych przy użyciu SegFormer
Po tym etapie wstępnego przetwarzania, oczyszczone i znormalizowane obrazy z zestawu danych motywów kulturowych Miao Batik oraz zestawu danych WikiArt są przesyłane do modułu segmentacji semantycznej opartego na proponowanej strukturze SegFormer-B2. Celem tego kroku jest prawidłowa identyfikacja i oddzielenie motywów kulturowych obecnych w tradycyjnych wzorach. Proponowana struktura SegFormer opiera się na architekturze transformera, która zawiera hierarchiczny enkoder Transformer oraz lekki dekoder MLP, aby precyzyjnie przechwytywać zarówno globalne informacje kontekstowe, jak i szczegółowe informacje strukturalne ze złożonych wzorów dziedzictwa. Model najpierw ekstrahuje reprezentacje cech w wielu skalach z obrazu wejściowego, a następnie dokonuje fuzji tych reprezentacji za pomocą dekodera w celu wygenerowania dokładnych segmentowanych wzorów. Zapewnia to, że wzory na obrazach dziedzictwa są prawidłowo segmentowane na motywy takie jak wzory geometryczne, roślinne i symboliczne, oddzielając je tym samym od tła przy zachowaniu ich spójności strukturalnej. Informacje strukturalne te są następnie wykorzystywane na późniejszych etapach generowania wzorów w ramach struktury SegCycle-SPADE.
Przyjmijmy, że wstępnie przetworzony obraz wejściowy jest reprezentowany przez Równanie 6:
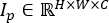 (6)
Koder SegFormer dzieli obraz na fragmenty (patche) i ekstrahuje cechy hierarchiczne przy użyciu warstw transformera, co przedstawiono w równaniu 71:
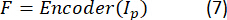
W tym przypadku F oznacza wieloskalowe mapy cech uzyskane z koderów transformera. Cechy te kodują zarówno lokalne wzorce tekstury, jak i globalne zależności kontekstowe między regionami motywów. Model SegFormer wyodrębnia mapy cech w różnych skalach, zgodnie z definicją w Równaniu 8:
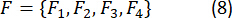
Zastosowanie reprezentacji wieloskalowych ułatwia wykrywanie wzorców o różnych rozmiarach w obrębie motywów kulturowych. Ostatecznie cechy są łączone przy użyciu dekodera MLP, zgodnie z Równaniem 91:
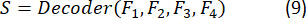
Tutaj S oznacza końcową przewidzianą mapę segmentacji.
Szkielet SegFormer-B2 został zainicjowany z wykorzystaniem wag wstępnie wytrenowanych na zbiorze ImageNet, a następnie dostrojony (fine-tuned) na zbiorze danych Miao Batik w celu segmentacji motywów kulturowych. Punkt kontrolny (checkpoint) modelu wstępnie wytrenowanego pobrano z oficjalnej implementacji SegFormer. Konkretnie, do inicjalizacji szkieletu SegFormer-B2 przed dostrojeniem wykorzystano punkt kontrolny MIT-B2 wstępnie wytrenowany na ImageNet-1K (mit_b2.pth), udostępniony w oficjalnym repozytorium SegFormer. Wagi wstępnie wytrenowane odpowiadają szkieletowi MIT-B2 opublikowanemu przez autorów SegFormer i posłużyły jako model inicjalny do treningu segmentacji semantycznej. Pozostałe warstwy specyficzne dla zadania zostały zainicjowane przy użyciu domyślnych procedur inicjalizacji wag PyTorch przed rozpoczęciem treningu.
W architekturze zastosowano czterostopniowy hierarchiczny koder Transformer z nakładającymi się osadzeniami łatek (patch embeddings). Na etapie początkowym rozmiar łatki ustawiono na 7 × 7 z krokiem 4. Dla każdego z czterech etapów kodera wymiary osadzeń wynosiły odpowiednio 64, 128, 320 i 512. W czterech etapach zastosowano kolejno 1, 2, 5 i 8 wielogłowicowych mechanizmów self-attention, a odpowiadające im głębokości kodera wynosiły 3, 4, 6 i 3 warstwy. Cechy wieloskalowe pobrane z kodera zostały zagregowane przy użyciu lekkiego dekodera opartego w całości na MLP. Przed utworzeniem końcowej mapy segmentacji dekoder rzutował cechy z każdego etapu kodera do jednej wspólnej przestrzeni osadzeń. Wszystkie bloki Transformera wykorzystywały funkcję aktywacji Gaussian Error Linear Unit (GELU). Podczas trenowania zastosowano współczynnik dropout wynoszący 0,1 w celu poprawy generalizacji i ograniczenia przeuczenia.
Podczas fazy uczenia framework SegFormer otrzymuje wstępnie przetworzone obrazy z obu zbiorów danych. Obrazy z zestawu danych Miao Batik zawierają obszary motywów, które służą jako etykiety do nadzorowanego uczenia modelu segmentacji. Koder Transformera przetwarza cały obraz i wychwytuje dalekosiężne zależności między komponentami obrazu, co jest szczególnie istotne w przypadku tradycyjnych wzorów batik zawierających motywy rozproszone przestrzennie. Hierarchiczny mechanizm ekstrakcji cech jednocześnie rejestruje struktury lokalne, takie jak powtarzalne tekstury geometryczne. Dekoder MLP przetwarza te wyekstrahowane cechy i generuje maskę segmentacji wyróżniającą obszary motywów. Mapy segmentacji wygenerowane na tym etapie są następnie wykorzystywane jako wejścia strukturalne dla modułu uwagi oraz etapu rekonstrukcji wzoru, co pomaga w zachowaniu autentyczności generowanych wzorów.
Motywy kulturowe podzielono na różne klasy w celu segmentacji semantycznej, zgodnie z ich cechami wizualnymi i kulturowymi. Taksonomia segmentacji obejmowała motywy zwierzęce (np. motyle, ryby, ptaki i inną symboliczną faunę), motywy roślinne (np. kwiaty, liście, pnącza i wzory botaniczne), motywy geometryczne (np. powtarzające się kształty, obramowania i abstrakcyjne struktury geometryczne) oraz obszary tła reprezentujące strefy bez motywów. Do przypisania każdego piksela do jednej z predefined klas wykorzystano maski segmentacji na poziomie piksela. Etykiety całkowitoliczbowe zakodowano w następujący sposób: Etykieta 0 = tło, Etykieta 1 = motywy zwierzęce, Etykieta 2 = motywy roślinne i Etykieta 3 = motywy geometryczne. Adnotacje segmentacyjne oraz etykiety motywów pobrano bezpośrednio z oryginalnego źródła zbioru danych Miao Batik. W niniejszym badaniu nie przeprowadzono dodatkowych procedur manualnej adnotacji, ponownego etykietowania, weryfikacji granic ani potwierdzania przez ekspertów. Istniejące adnotacje dostarczone przez twórców zbioru danych zostały wykorzystane bez modyfikacji do celów uczenia i ewaluacji.
Model SegFormer do segmentacji motywów kulturowych przetwarza wstępnie przetworzone obrazy z zestawu danych Miao Batik oraz zestawu danych WikiArt, wykorzystując mechanizm oparty na transformatorze do dokładnego wykrywania obszarów wzorów kulturowych, co przedstawiono na Rysunku 4. Najpierw obraz wejściowy zawierający tradycyjne motywy kulturowe jest dostarczany do modelu SegFormer. Koder transformatora wyodrębnia zarówno globalne informacje kontekstowe, jak i lokalne cechy strukturalne z fragmentów obrazu. Wynikowe cechy wieloskalowe są przekazywane do dekodera segmentacji, który wykorzystuje sieć Mix Feed-Forward Network w celu doprecyzowania reprezentacji cech i poprawy wykrywania motywów. Wynikiem modelu SegFormer jest maska segmentacji, która wyróżnia piksele odpowiadające wzorom kulturowym, jednocześnie tłumiąc nieistotne informacje w tle. Wyizolowane wzory kulturowe służą następnie jako wskazówki strukturalne dla kolejnych etapów frameworka SegCycle-SPADE.
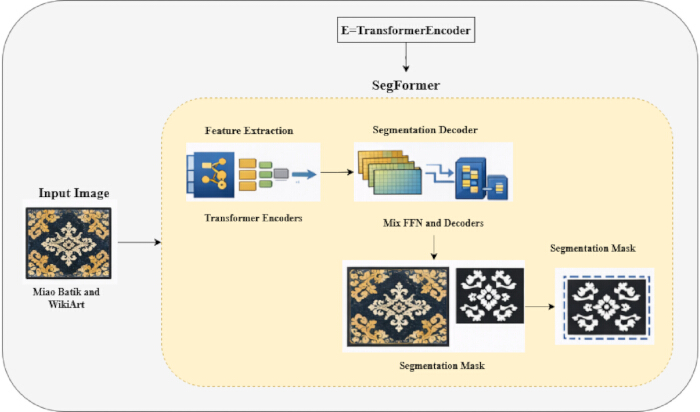
Rysunek 4Segmentacja semantyczna motywów kulturowych w oparciu o model SegFormer-B2. Architektura modułu segmentacji semantycznej SegFormer-B2 wykorzystywanego do ekstrakcji motywów kulturowych, wytrenowanego wyłącznie na zbiorze danych Miao Batik. Struktura składa się z enkodera opartego na transformatorze do wieloskalowej ekstrakcji cech oraz lekkiego dekodera segmentacyjnego służącego do generowania masek motywów. Model przewiduje cztery klasy semantyczne — zwierzęta, rośliny, geometryczne i tło — gdzie wynikowe maski segmentacyjne identyfikują regiony motywów o znaczeniu kulturowym, jednocześnie tłumiąc nieistotne informacje tła. Te wyniki segmentacji stanowią wytyczne strukturalne dla kolejnych etapów fuzji cech, rekonstrukcji i syntezy artystycznej w proponowanej strukturze SegCycle-SPADE. Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
W sugerowanym schemacie nie ma potrzeby tworzenia nowych adnotacji segmentacji. Zbiór danych Miao Batik został pobrany z istniejącego publicznego źródła, a model został wytrenowany przy użyciu powiązanych informacji o motywach dostarczonych przez twórców zbioru danych. Podczas procesu uczenia model SegFormer generował mapy segmentacji semantycznej. W rezultacie niniejsze badanie nie wymagało zastosowania dodatkowego oprogramowania do adnotacji manualnych, wytycznych dotyczących adnotacji ani procedur kontroli jakości adnotacji.
CAFFM
Aby poprawić interakcję między cechami segmentacji semantycznej a reprezentacjami rekonstrukcji generatywnej, w badaniu zaproponowano również moduł CAFFM. Koder SegFormer-B2 dostarcza mapy cech semantycznych do modułu CAFFM, natomiast etap rekonstrukcji CycleGAN dostarcza mapy cech generatywnych. W pierwszej kolejności warstwy projekcji liniowej są wykorzystywane do rzutowania obu strumieni cech do wspólnej przestrzeni osadzeń. Do obliczeń cross-attention tworzone są reprezentacje zapytania (Q), klucza (K) i wartości (V) przy użyciu wygenerowanych tensorów cech. Następnie relacje między informacjami o motywach strukturalnych a elementami stylu artystycznego są modelowane za pomocą wielogłowicowego mechanizmu cross-attention. Do połączonych reprezentacji cech stosuje się następnie normalizację warstwową, połączenia rezydualne oraz warstwy feed-forward z aktywacją GELU. Etap syntezy oparty na SPADE otrzymuje wyjście z modułu CAFFM, co pozwala na zachowanie istotnych kulturowo motywów bez utraty spójności artystycznej.
Aby zapewnić kompatybilność cech, cechy wejściowe są najpierw rzutowane za pomocą liniowych warstw projekcji na wspólną przestrzeń osadzeń o wymiarze osadzenia wynoszącym 256. Połączenia między semantycznymi informacjami strukturalnymi a reprezentacjami stylu generatywnego są następnie modelowane przy użyciu mechanizmu MultiHead Cross-Attention z ośmioma głowicami uwagi. Obliczenia uwagi krzyżowej wykorzystują wektory Zapytania (Q), Klucza (K) i Wartości (V), które są generowane przez specyficzne warstwy transformacji liniowej. W celu zwiększenia stabilności treningu i zachowania integralności cech, zastosowano połączenia rezydualne oraz normalizację warstwową (Layer Normalization), aby dodatkowo ulepszyć połączone reprezentacje cech. Nieliniowe uczenie cech jest następnie usprawniane poprzez zastosowanie sieci jednokierunkowej z funkcją aktywacji Gaussian Error Linear Unit (GELU). Moduł generuje reprezentację cech wyjściowych o wymiarze 256, która jest przekazywana do kolejnych etapów syntezy kreatywnej. CAFFM skutecznie łączy dane stylu artystycznego ze strukturami motywów kulturowych, wykorzystując technikę fuzji opartą na uwadze krzyżowej, co poprawia zachowanie motywów i spójność wizualną w zrekonstruowanych wzorach dziedzictwa kulturowego.
W proponowanym systemie cechy strukturalne są pochodne z zestawu danych Miao Batik, natomiast cechy stylistyczne są uczone na podstawie zestawu danych WikiArt. Niech mapa cech pochodna z sieci segmentacyjnej SegFormer z wykorzystaniem obrazów z zestawu danych Miao Batik będzie oznaczona jako Fs, natomiast mapa cech pochodna z gałęzi ekstrakcji cech stylistycznych z wykorzystaniem obrazów WikiArt będzie oznaczona jako Fa. Zaproponowany moduł CAFFM łączy obie domeny cech za pomocą mechanizmu uwagi krzyżowej (cross-attention), aby nauczyć się zależności strukturalnych i stylistycznych wzorów kulturowych. Tabela 3 przedstawia wszystkie charakterystyki architektury, w tym wymiary osadzeń (embedding dimensions), warstwy normalizacji, funkcje aktywacji oraz konfigurację głowic uwagi. Dla obrazu wejściowego o rozmiarze 256 × 256 pikseli, koder SegFormer-B2 wygenerował semantyczne mapy cech o rozmiarze 64 × 64 × 128, podczas gdy gałąź ekstrakcji cech stylistycznych wygenerowała mapy cech o rozmiarze 64 × 64 × 128. Obie mapy cech zostały rzutowane poprzez uczalne warstwy liniowe do wspólnej przestrzeni osadzeń o wymiarze 256 przed fuzją za pomocą uwagi krzyżowej.
| Parametr | Konfiguracja |
| Proponowany framework | SegCycle-SPADE |
| Model segmentacji semantycznej | SegFormer-B2 |
| Etapy enkodera SegFormer | 4 |
| Inicjalizacja wag | Wstępnie wytrenowany SegFormer-B2 na zbiorze ImageNet-1K (szkielet MIT-B2) |
| Źródło punktu kontrolnego | Oficjalne repozytorium NVIDIA SegFormer (https://github.com/NVlabs/SegFormer); punkt kontrolny: segformer.b2.512x512.ade.160k |
| Strategia dostrajania (fine-tuning) | Dostrajanie end-to-end na zbiorze danych Miao Batik |
| Rozmiar embeddingu patcha | 7 × 7 |
| Krok patcha | 4 |
| Wymiary embeddingów | 64, 128, 320 i 512 |
| Głębokości enkodera | 3, 4, 6 i 3 |
| Głowice uwagi (attention heads) | 1, 2, 5 i 8 |
| Typ dekodera | Dekoder All-MLP |
| Funkcja aktywacji | GELU |
| Współczynnik dropout | 0.1 |
| Moduł wzmacniania cech | Moduł fuzji cech kulturowych z krzyżową uwagą (CAFFM) |
| Wymiar embeddingu CAFFM | 256 |
| Głowice uwagi CAFFM | 8 |
| Skale fuzji CAFFM | 4 |
| Model rekonstrukcji | CycleGAN |
| Model generowania stylu | SPADE |
| Kulturowy zbiór danych | Zbiór danych Miao Batik |
| Zbiór danych stylów | Zbiór danych WikiArt |
| Obrazy Miao Batik | 15 148 |
| Obrazy WikiArt | Około 80 000 |
| Rozdzielczość obrazu wejściowego | 256 × 256 pikseli |
| Format koloru | RGB |
| Metoda interpolacji | Interpolacja liniowa |
| Metoda odszumiania | Filtrowanie gaussowskie |
| Rozmiar jądra Gaussa | 5 × 5 |
| Sigma Gaussa (σ) | 1 |
| Zakres normalizacji | [0, 1] |
| Wielkość partii (batch size) | 16 |
| Liczba epok | 100 |
| Optymalizator | Adam |
| Szybkość uczenia | 0.0002 |
| Parametry Adam | β₁ = 0.5, β₂ = 0.999, ε = 1 × 10⁻⁸, weight decay = 0 |
| Funkcje straty | Strata segmentacji, strata adwersarialna, strata spójności cyklu, strata rekonstrukcji, strata zachowania motywu oraz strata spójności stylu |
| Strategia podziału zbioru danych | Treningowy / Walidacyjny / Testowy |
| Zbiór treningowy | 70% |
| Zbiór walidacyjny | 15% |
| Zbiór testowy | 15% |
| Losowy seed | 42 |
| Metryki ewaluacji | Dokładność segmentacji, IoU, współczynnik Dice'a, SSIM, PSNR i FID |
| Język programowania | Python 3.8.10 |
| Framework głębokiego uczenia | PyTorch 1.10.0 |
| Platforma sprzętowa | NVIDIA RTX 3090 GPU (24 GB VRAM), Intel Core i7 (11. generacja), 32 GB RAM |
| Środowisko operacyjne | Ubuntu 20.04 LTS |
Tabela 3: Układ eksperymentalny i konfiguracja modelu. Podsumowanie komponentów architektonicznych, konfiguracji treningowej, ustawień przetwarzania wstępnego, zbiorów danych, parametrów optymalizacji, metryk ewaluacji oraz środowiska obliczeniowego wykorzystanego do implementacji i oceny proponowanego frameworka SegCycle-SPADE.
Moduł uwagi najpierw mapuje mapę cech na reprezentacje zapytania (query), klucza (key) i wartości (value) zgodnie z Równaniem 10:
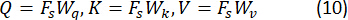
Tutaj Wq, Wk oraz Wv są wyuczalnymi macierzami wag. Wagi uwagi są obliczane na podstawie podobieństwa między wektorem zapytania a wektorem klucza zgodnie z Równaniem 1117:
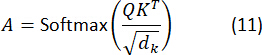
Tutaj dk to wymiar wektora klucza. Ulepszona reprezentacja cech jest obliczana poprzez pomnożenie wag uwagi przez macierz wartości zgodnie z Równaniem 12:
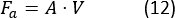
Tutaj Fa jest ulepszoną reprezentacją cech mapy cech. Ulepszona reprezentacja cech jest obliczana poprzez połączenie oryginalnych cech segmentacji z cechami ulepszonymi, uzyskanymi za pomocą mechanizmu uwagi zgodnie z Równaniem 13:
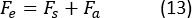
Tutaj Fe oznacza ulepszoną mapę cech wykorzystywaną do rekonstrukcji wzorca. Moduł CAFFM został rozszerzony o wieloskalowy mechanizm wzajemnej uwagi (cross-attention), aby wyodrębnić cechy motywów kulturowych w różnych skalach. Niech Fsi oznacza cechy segmentacji w skali i, natomiast Faj oznacza cechy stylu artystycznego w tej samej skali. Końcowa reprezentacja cech jest zdefiniowana zgodnie z Równaniem 14:
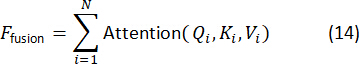
Tutaj Qi, Ki i Vi reprezentują odpowiednio macierze zapytań (query), kluczy (key) i wartości (value) w skali i, a N oznacza liczbę skal cech. W niniejszym badaniu N = 4, co odpowiada mapom cech wyekstrahowanym przy rozdzielczościach przestrzennych wynoszących odpowiednio 1/4, 1/8, 1/16 i 1/32 rozmiaru obrazu wejściowego. Te wieloskalowe reprezentacje cech zostały połączone przy użyciu nauczalnych wag uwagi przed rekonstrukcją i syntezą artystyczną. Powyższe rozszerzenie umożliwia metodzie ekstrakcję globalnych motywów i tekstur kulturowych w celu rekonstrukcji wzorów kulturowych. Moduł CAFFM znajduje się pomiędzy etapem segmentacji opartym na SegFormer a etapem kreatywnej syntezy opartym na SPADE w proponowanym systemie SegCycle-SPADE. Najpierw, podczas gdy CycleGAN jednocześnie tworzy cechy rekonstrukcyjne z informacjami stylistycznymi i wzorniczymi, SegFormer-B2 odzyskuje semantyczne mapy cech opisujące właściwości strukturalne motywów kulturowych. Moduł CAFFM przyjmuje te dwa strumienie cech i wykorzystuje fuzję opartą na mechanizmie cross-attention, aby zidentyfikować relacje między reprezentacjami strukturalnymi a artystycznymi. Aby stworzyć autentyczne kulturowo wzory przy zachowaniu spójności semantycznej i cech strukturalnych, powstałe połączone mapy cech są następnie przesyłane do modułu SPADE w celu kreatywnej syntezy sterowanej segmentacją.
Rekonstrukcja wzorów przy użyciu CycleGAN
Po zakończeniu etapu wzmacniania cech w oparciu o mechanizm uwagi, mapy cech będą zawierać wzmocnione struktury motywów kulturowych. Mapy cech mogą jednak nadal zawierać niekompletne lub uszkodzone obszary wzorów. Dlatego, aby rozwiązać problem rekonstrukcji wzorów, w proponowanym schemacie zostanie wykorzystany model CycleGAN. W proponowanym schemacie dwiema domenami będą oryginalne wzory motywów kulturowych oraz zrekonstruowane wzory motywów kulturowych. Wykorzystując wzmocnione cechy z poprzednich etapów, model CycleGAN zrekonstruuje wzory kulturowe, zachowując jednocześnie spójność strukturalną. Zapewni to, że wzory kulturowe, takie jak motywy geometryczne, roślinne i symboliczne, zachowają swoje rozmieszczenie przestrzenne. Oryginalne obrazy batiku ludu Miao zostały poddane operacjom losowego maskowania i częściowego przesłonięcia w celu wygenerowania niekompletnych lub uszkodzonych motywów kulturowych. Procedury degradacji te symulowały brakujące obszary wzorów oraz uszkodzenia strukturalne powszechnie obserwowane w zniszczonych artefaktach dziedzictwa kulturowego. Zdegradowane obrazy posłużyły jako dane wejściowe do modułu rekonstrukcji, natomiast odpowiadające im obrazy oryginalne służyły jako obrazy referencyjne do oceny wydajności i jakości rekonstrukcji. Strategia ta umożliwiła modelowi naukę przywracania brakujących struktur motywów przy jednoczesnym zachowaniu spójności semantycznej i cech kulturowych.
Przyjmijmy, że X jest domeną niekompletnych wzorców kulturowych, a Y domeną zrekonstruowanych wzorców kulturowych. Dwa generatory uczą się wykonywać odwzorowanie dwukierunkowe zgodnie z Równaniem 15:
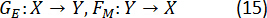
Tutaj GE jest wykorzystywane do rekonstrukcji struktur motywów, a FM służy do mapowania wzorców z powrotem na oryginalną domenę. Stratę adwersarialną stosuje się w celu zapewnienia, że zrekonstruowane wzorce są realistyczne (Równanie 16)30
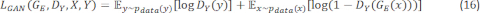
Tutaj DY jest dyskryminatorem służącym do rozróżniania wzorów rzeczywistych i zrekonstruowanych, a GE(x) oznacza wygenerowany wzór zrekonstruowany. CycleGAN wymusza również spójność cyklu, aby zachować układ strukturalny motywów kulturowych (Równanie 17)30.
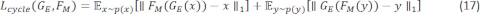
Końcowa funkcja straty została zdefiniowana za pomocą Równania 1830:
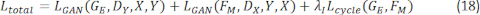
Tutaj λi oznacza współczynnik wagowy dla straty spójności cyklu (cycle-consistency loss), który podczas trenowania ustawiono na 10, zgodnie z oryginalną formulacją CycleGAN. Wartość ta została dobrana w celu zrównoważenia uczenia przeciwstawnego oraz spójności rekonstrukcji pomiędzy domeną źródłową a docelową.
Moduł rekonstrukcji CycleGAN składa się z dwóch generatorów i dwóch dyskryminatorów służących do dwukierunkowej translacji obrazów. Każdy generator opiera się na architekturze sieci rezdualnej (residual network), obejmującej początkową warstwę splotową 7 × 7, po której następują dwie warstwy splotowe downsamplingu, dziewięć bloków rezdualnych oraz dwie warstwy upsamplingu. Wszystkie operacje splotowe wykorzystują jądro o rozmiarze 3 × 3, z wyjątkiem warstwy wejściowej, w której zastosowano jądro 7 × 7 w celu poprawy ekstrakcji cech. Po każdej warstwie splotowej stosowana jest normalizacja instancji (Instance Normalization) w celu zwiększenia stabilności uczenia, natomiast w całej sieci generatora wykorzystywana jest funkcja aktywacji ReLU. Warstwa wyjściowa wykorzystuje funkcję aktywacji Tanh do generowania znormalizowanych obrazów wyjściowych. Dyskryminator opiera się na architekturze PatchGAN 70 × 70, składającej się z serii warstw splotowych z jądrami o rozmiarze 4 × 4 i progresywnie zwiększającą się liczbą kanałów cech. W dyskryminatorze zastosowano normalizację instancji oraz aktywację LeakyReLU (nachylenie ujemne = 0.2), aby poprawić dyskryminację cech i uczenie kontradyktoryjne. Moduł CycleGAN przyjmuje jako dane wejściowe wstępnie przetworzone obrazy motywów kulturowych i generuje zrekonstruowane reprezentacje wzorów, które są następnie przekazywane do CAFFM w celu integracji z cechami segmentacji. Trenowanie CycleGAN przeprowadzono przy użyciu optymalizatora Adam (β₁ = 0.5, β₂ = 0.999) z początkową prędkością uczenia 0.0002. Prędkość uczenia utrzymywano przez pierwsze 100 epok, a następnie liniowo zmniejszano do zera w pozostałym czasie trenowania. W celu stabilizacji uczenia dyskryminatora zastosowano bufor odtwarzania (replay buffer) zawierający 50 wcześniej wygenerowanych obrazów. Aktualizację generatorów i dyskryminatorów przeprowadzano w stosunku 1:1, gdzie jednej aktualizacji generatora towarzyszyła jedna aktualizacja dyskryminatora w każdej iteracji treningowej.
Proces rekonstrukcji w CycleGAN opiera się na ulepszonych mapach cech uzyskanych za pomocą mechanizmu CAFFM przedstawionego na Rysunku 5. Mapy cech zawierają ulepszone motywy kulturowe otrzymane w poprzednich etapach segmentacji i CAFFM. Mapy cech służą jako wejście do pierwszego generatora GE. Pierwszy generator GE uczy się odwzorowania niezbędnego do rekonstrukcji wzorów kulturowych. Wyniki są następnie przekazywane do dyskryminatora DY w celu odróżnienia rzeczywistych wzorów kulturowych od wzorów zrekonstruowanych. Dyskryminator DY pomaga generatorowi GE generować realistyczne wyniki. Aby zapewnić, że wzory kulturowe nie zostaną zniekształcone podczas rekonstrukcji, drugi generator FM wykonuje odwzorowanie spójności cyklu (cycle-consistency mapping). Drugi generator FM odwzorowuje wyniki z powrotem do oryginalnej domeny. Wyniki są następnie oceniane przez dyskryminator w celu zapewnienia realizmu. Ostateczne wyniki są następnie przekazywane do modułu SPADE w celu generowania stylu artystycznego w kolejnym etapie proponowanego frameworka SegCycle-SPADE.
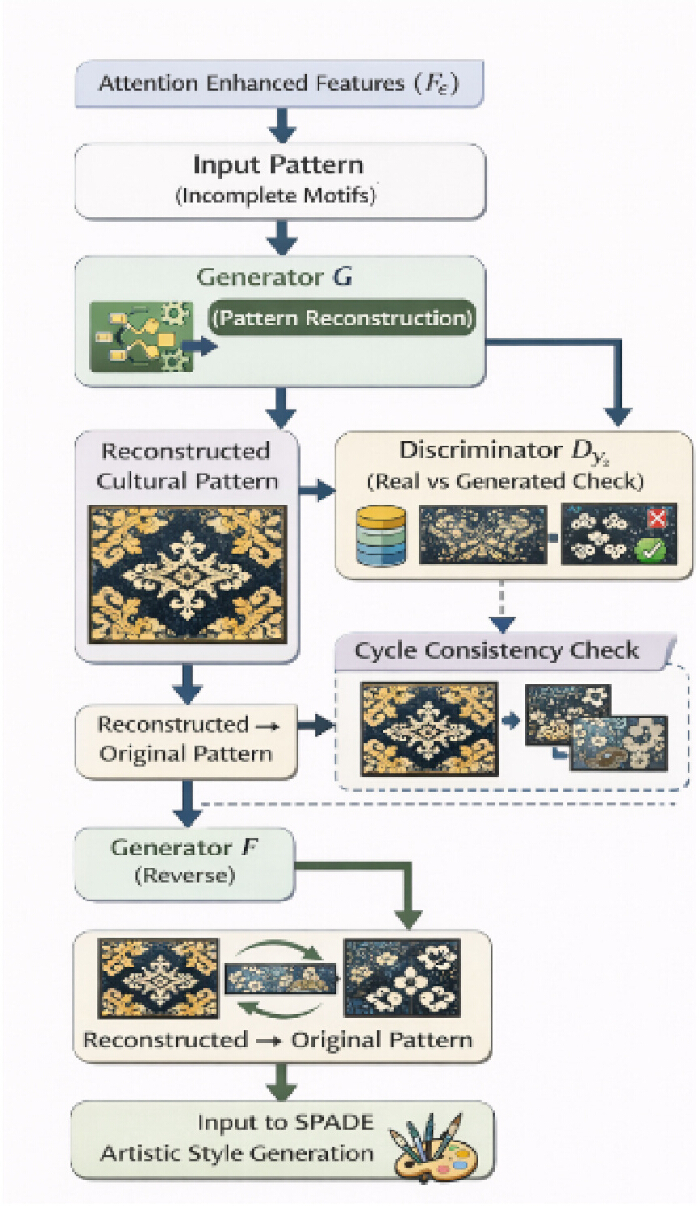
Rycina 5. Schemat rekonstrukcji wzorów oparty na CycleGAN. Przebieg pracy modułu rekonstrukcyjnego CycleGAN. Reprezentacje cech wzmocnione mechanizmem uwagi służą jako wejścia dla sieci generatora w celu rekonstrukcji niekompletnych motywów kulturowych. Dyskryminator ocenia zrekonstruowane wyniki w odniesieniu do wzorców referencyjnych, podczas gdy mapowanie spójności cyklu zachowuje integralność strukturalną podczas dwukierunkowej translacji obrazów. Zrekonstruowane motywy są następnie przekazywane do modułu SPADE w celu syntezy stylu artystycznego. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Generowanie stylu artystycznego za pomocą SPADE
Następnie zrekonstruowane motywy kulturowe są poddawane działaniu modułu SPADE w celu wygenerowania stylu artystycznego. Głównym celem modułu SPADE jest dodanie bogatszych wizualnie tekstur stylu artystycznego do zrekonstruowanych motywów kulturowych, bez naruszania ich układu strukturalnego. Moduł SPADE jest techniką warunkowego generowania obrazów, która wykorzystuje koncepcję segmentacji obrazu do tworzenia grafik. Wielokanałowe mapy semantyczne, odpowiadające wcześniej określonym klasom motywów, zostały zakodowane na podstawie masek segmentacji semantycznej wygenerowanych przez SegFormer-B2. Generator SPADE otrzymał te zakodowane mapy jako wejścia warunkujące. Parametry przestrzennie adaptacyjnego skalowania (γ) i przesunięcia (β) były generowane poprzez przetwarzanie map semantycznych w warstwach splotowych w obrębie każdej warstwy SPADE. Dzięki zastosowaniu tych parametrów do znormalizowanych aktywacji cech, generator był w stanie zachować granice motywów, układy strukturalne oraz informacje semantyczne podczas syntezy artystycznej. Kierowanie semantyczne mogło wpływać zarówno na wysokopoziomową rekonstrukcję strukturalną, jak i na niskopoziomową syntezę tekstury, ponieważ proces warunkowania był przeprowadzany na kilku warstwach generatora SPADE. W rezultacie stworzone wzory artystyczne włączyły cechy stylistyczne pozyskane z zestawu danych WikiArt, zachowując jednocześnie struktury motywów kulturowych zidentyfikowane na etapie segmentacji.
Zbiór danych WikiArt, obejmujący dzieła z 27 różnych kategorii artystycznych — takich jak renesans, impresjonizm, kubizm, ekspresjonizm, surrealizm, realizm i sztuka abstrakcyjna — został wykorzystany jako główny zasób do zrozumienia stylów artystycznych. Aby zapoznać model z różnorodnymi cechami twórczymi i poprawić generalizację stylu, podczas treningu losowo wybierano obrazy stylowe z różnych kategorii. Zbiór danych został podzielony na podzbiory treningowy, walidacyjny i testowy z zrównoważoną reprezentacją kategorii artystycznych, aby zminimalizować stronniczość stylu. W celu zapewnienia zrównoważonej reprezentacji wszystkich 27 kategorii artystycznych zastosowano próbkowanie warstwowe. Próbki z każdej kategorii zostały proporcjonalnie przypisane do podzbiorów treningowego, walidacyjnego i testowego, przy zachowaniu pierwotnego rozkładu klas. Moduł CAFFM został użyty do połączenia aspektów stylu pochodzących z obrazów WikiArt z cechami rekonstrukcji wygenerowanymi przez CycleGAN. Aby umożliwić sieci syntezującej przenoszenie cech artystycznych przy jednoczesnym zachowaniu struktury semantycznej i granic motywów kulturowych wywiedzionych z map segmentacji, otrzymane połączone reprezentacje dostarczono jako informacje warunkujące do generatora SPADE. Dzięki tej technice warunkowania stylu zaproponowana architektura była w stanie generować kulturowo autentyczne wzory artystyczne z spójnymi reprezentacjami strukturalnymi i stylowymi.
SPADE wprowadza również przestrzennie adaptacyjne parametry, które zależą od mapy segmentacji. Parametry te można zdefiniować zgodnie z Równaniem 191:
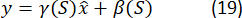
Tutaj γ(S) jest przestrzennie zmiennym parametrem skali, a β(S) jest przestrzennie zmiennym parametrem przesunięcia. Parametry te mogą pomóc generatorowi w tworzeniu różnych tekstur i stylów w zależności od regionu semantycznego na obrazach. Końcowe dzieło kultury można zdefiniować zgodnie z Równaniem 20:
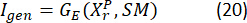
Tutaj GE to generator SPADE, XrP to zrekonstruowany wzór, a SM to mapa segmentacji. Końcowe dzieło zachowuje integralność strukturalną motywów kulturowych, jednocześnie poprawiając walory artystyczne. W celu optymalizacji sugerowanej architektury SegCycle-SPADE zastosowano złożoną funkcję straty, która równoważy dokładność segmentacji semantycznej, zachowanie motywów kulturowych, jakość rekonstrukcji wzoru oraz spójność stylu artystycznego. Ogólny cel szkolenia ustalono za pomocą ważonej mieszaniny straty segmentacji (Lseg), straty przeciwnika (Ladv), straty spójności cyklu (Lcycle), straty rekonstrukcji (Lrecon), straty zachowania motywu (Lmotif) oraz straty spójności stylu (Lstyle). Całkowita funkcja straty jest zdefiniowana w Równaniu 21:
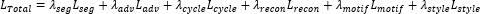 (21)
Aby zagwarantować spójność strukturalną pomiędzy wejściowymi a zrekonstruowanymi motywami kulturowymi, współczynnik straty spójności cyklicznej ustawiono na 10. W celu zachowania szczegółowych cech motywów i zwiększenia dokładności wizualnej, współczynnik straty rekonstrukcji ustawiono na 5. Aby podkreślić zachowanie kluczowych dla kultury wzorców strukturalnych podczas syntezy artystycznej, dla straty zachowania motywów zastosowano współczynnik 2. W celu promowania transferu stylu artystycznego bez nadmiernego zniekształcania semantycznych struktur motywów, współczynnik straty spójności stylu dostosowano do wartości 1. Aby utrzymać zrównoważony wkład pomiędzy generowaniem realistycznych obrazów a precyzyjną segmentacją motywów, przypisano równe wagi stracie segmentacji oraz stracie przeciwstawnej. Do obliczenia straty spójności stylu wykorzystano reprezentacje stylu oparte na cechach ze zbioru danych WikiArt. W szczególności cechy stylu artystycznego uchwycono za pomocą korelacji macierzy Grama, wyznaczonych z głębokich map cech. Różnicę normy Frobeniusa pomiędzy macierzami Grama obrazu stylu docelowego a obrazu wygenerowanego wykorzystano do obliczenia straty stylu, zgodnie z Równaniem 22:
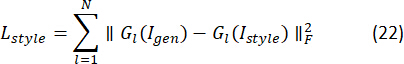
W tym zapisie Gl to macierz Grama obliczona z l-tej warstwy cech, Igen oznacza wygenerowany obraz artystyczny, Istyle oznacza docelowy obraz stylu z zestawu danych WikiArt, a F oznacza normę Frobeniusa. Taka formuła umożliwia zaproponowanemu modelowi zachowanie cech artystycznych przy jednoczesnym utrzymaniu integralności strukturalnej i semantycznej motywów kulturowych.
Połączone reprezentacje cech wygenerowane przez moduł CAFFM są wykorzystywane jako wejścia warunkujące dla modułu SPADE, który pełni funkcję komponentu syntezy artystycznej w proponowanym modelu. Generator SPADE składa się z siedmiu rezydualnych bloków SPADE o wymiarze cech ukrytych wynoszącym 256 kanałów i generuje obrazy wyjściowe w rozdzielczości 256 × 256 pikseli. Mapy segmentacji semantycznej otrzymane z modułu SegFormer–CAFFM służą jako wejścia warunkujące w wszystkich rezydualnych warstwach SPADE. Warstwy SPADE są stosowane przed funkcjami aktywacji w każdym bloku rezydualnym, co umożliwia semantyczne warunkowanie sterowane segmentacją. Poprzez kolejne operacje upsamplingu i splotu, reprezentacja cech ukrytych jest stopniowo doprecyzowana w celu wygenerowania artystycznych wzorów o wysokiej rozdzielczości przy jednoczesnym zachowaniu spójności semantycznej i struktury motywu. W całym generatorze stosowane są funkcje aktywacji LeakyReLU, a w warstwie wyjściowej zastosowano funkcję aktywacji Tanh w celu uzyskania znormalizowanych obrazów.
Algorytm i schemat pracy
Struktura SegCycle-SPADE integruje segmentację semantyczną, fuzję cech, rekonstrukcję wzorów oraz syntezę stylu artystycznego w ramach ujednoliconego potoku treningowego. Schemat pracy rozpoczyna się od pozyskania i wstępnego przetwarzania zbioru danych, obejmującego zmianę rozmiaru obrazów, normalizację, odszumianie oraz przygotowanie masek segmentacyjnych. Przetworzone obrazy są następnie analizowane przez sieć segmentacyjną SegFormer-B2 w celu wyodrębnienia semantycznych reprezentacji motywów. Uzyskane cechy segmentacji są łączone z cechami rekonstrukcji za pomocą modułu CAFFM, co umożliwia interakcję między informacjami o strukturze motywu a artystycznymi reprezentacjami cech. Połączone mapy cech są następnie przekazywane do modułu rekonstrukcji CycleGAN, który odtwarza niekompletne struktury motywów kulturowych przy zachowaniu spójności semantycznej. Zrekonstruowane wzory są następnie dostarczane do generatora SPADE w celu syntezy artystycznej sterowanej segmentacją, co pozwala na ulepszenie stylistyczne przy jednoczesnym zachowaniu granic motywów i autentyczności strukturalnej. Podczas trenowania parametry modelu są optymalizowane przy użyciu złożonej funkcji straty opisanej w Równaniach 21 i 22, która równoważy dokładność segmentacji, zachowanie motywów, jakość rekonstrukcji oraz spójność stylu artystycznego. Szczegółowy, krok po kroku opis implementacji, obejmujący ładowanie zbioru danych, wstępne przetwarzanie, inicjalizację modelu, iteracje treningowe, procedury walidacji, wybór punktów kontrolnych oraz końcową ewaluację, znajduje się w Pliku uzupełniającym 1 (Algorytm 1). Cały schemat algorytmiczny został zaimplementowany przy rozmiarze partii (batch size) wynoszącym 16, tempie uczenia (learning rate) 0.0002 oraz 100 epok treningowych. Do podziału zbioru danych, inicjalizacji modelu i wszystkich eksperymentów treningowych wykorzystano stały ziarno losowości (seed) o wartości 42. Ziarno to zastosowano spójnie w generatorach liczb pseudolosowych bibliotek Python, NumPy i PyTorch, aby zapewnić powtarzalność wyników. Optymalizator Adam skonfigurowano z parametrami β₁ = 0.5, β₂ = 0.999 oraz bez zaniku wag (weight decay = 0). Punkty kontrolne modelu wybierano na podstawie najwyższego wyniku IoU osiągniętego na zbiorze walidacyjnym.
Optymalizacja funkcji straty
Aby zachować struktury motywów kulturowych podczas rekonstrukcji i syntezy artystycznej, proponowany schemat wykorzystuje złożony cel optymalizacji, który łączy straty z segmentacji, adversarijalne, spójności cyklicznej, rekonstrukcji, zachowania motywu oraz spójności stylu. Pełny zapis matematyczny, współczynniki wagowe i definicja straty stylu zostały przedstawione w Równaniach 21 i 22 w podrozdziale Artistic Style Generation using SPADE. Komponent zachowania motywu penalizuje odchylenia strukturalne pomiędzy przewidywanymi obszarami motywu a odpowiadającymi im maskami segmentacji prawdy podstawowej (ground-truth), co sprzyja zachowaniu kulturowo istotnych struktur wzorów w całym procesie rekonstrukcji.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Zaproponowany framework SegCycle-SPADE został oceniony przy użyciu dwóch zbiorów danych: zbioru motywów kulturowych Miao Batik oraz zbioru WikiArt. Zbiór Miao Batik zawiera obrazy tradycyjnego dziedzictwa kulturowego i był wykorzystywany głównie do zadań segmentacji semantycznej i rekonstrukcji strukturalnej, natomiast zbiór WikiArt zawiera różnorodne style artystyczne i służył do uczenia i generowania stylów artystycznych. Obrazy z obu zbiorów danych zostały przetworzone przez pełny potok SegCycle-SPADE, obejmujący segm...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Ochrona i cyfrowa rekonstrukcja wzorów niematerialnego dziedzictwa kulturowego (ICH) zyskały w ostatnich latach coraz większą uwagę ze względu na stopniowe zanikanie tradycyjnego rzemiosła. Poprzednie badania próbowały przeciwdziałać utracie dziedzictwa kulturowego za pomocą technik przetwarzania obrazu opartych na głębokim uczeniu (DL). Na przykład Quan i wsp.32 zaproponowali strukturę ochrony dziedzictwa kulturowego opartą na grafach wiedzy i DL dla kultury batików ludu Miao z prowincji Guizhou....
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Konflikt interesów:
Autorzy nie deklarują żadnych konfliktów interesów.
Podziękowania
Autorzy pragną podziękować za wsparcie akademickie i instytucjonalne udzielone przez Guangdong Engineering Polytechnic oraz South China Normal University podczas realizacji niniejszych badań. Badania te zostały sfinansowane w ramach projektu ogólnego Narodowego Funduszu Nauk Społecznych z 2023 roku (nr 23BH161) pt. „Digital Regeneration Museum: Research on the Activation and Communication of Chinese Classic Calligraphy and Painting Cultural Relics”.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Optymalizator Adam | Biblioteka optymalizatorów PyTorch | Adam | Algorytm optymalizacji stosowany podczas trenowania modelu. |
| Zestaw narzędzi CUDA | NVIDIA Corporation | CUDA 11.3 | Akceleracja GPU dla obliczeń głębokiego uczenia. |
| cuDNN | NVIDIA Corporation | cuDNN 8.2 | Biblioteka akceleracji głębokich sieci neuronowych stosowana do przyspieszenia trenowania i wnioskowania. |
| CycleGAN | University of California, Berkeley / Open Source | Oficjalna implementacja PyTorch (https://github.com/junyanz/pytorch-CycleGAN-and-pix2pix) | Generatywna sieć przeciwstawna stosowana do rekonstrukcji motywów kulturowych. |
| Wagi wstępnie wytrenowane na ImageNet | ImageNet / Open Source | mit_b2.pth (Wstępnie wytrenowany punkt kontrolny ImageNet-1K) | Stosowane do inicjalizacji szkieletu SegFormer-B2 przed dostrajaniem na zbiorze danych Miao Batik. |
| Procesor Intel | Intel Corporation | Intel Core i7 (11. generacja) | CPU stosowany do wstępnego przetwarzania obrazów, wsparcia trenowania modelu i wnioskowania. |
| Matplotlib | Zespół programistów Matplotlib | Matplotlib 3.5.1 | Wizualizacja krzywych uczenia i wyników ewaluacji. |
| Zbiór danych Miao Batik | Repozytorium Zenodo | DOI: 10.5281/zenodo.20807658 | Zbiór danych motywów kulturowych zawierający 15 148 obrazów, stosowany do segmentacji semantycznej i rekonstrukcji wzorów. |
| NumPy | Programiści NumPy | NumPy 1.21.5 | Obliczenia numeryczne i przetwarzanie zbiorów danych. |
| GPU NVIDIA | NVIDIA Corporation | NVIDIA RTX 3090 (24 GB VRAM) | Platforma sprzętowa stosowana do trenowania modelu i wnioskowania. |
| OpenCV | OpenCV Foundation | OpenCV 4.5.5 | Wstępne przetwarzanie obrazów, zmiana rozmiaru, interpolacja i odszumianie gaussowskie. |
| System operacyjny | Canonical Ltd. | Ubuntu 20.04 LTS | Środowisko wykonawcze eksperymentów. |
| Pillow (PIL) | Python Imaging Library | Pillow 8.4.0 | Ładowanie i manipulacja obrazami. |
| Python | Python Software Foundation | Python 3.8.10 | Język programowania stosowany do implementacji i eksperymentów. |
| PyTorch | Meta AI | PyTorch 1.10.0 | Framework głębokiego uczenia stosowany do trenowania modelu i wnioskowania. |
| Ziarno losowości | Ustawienia eksperymentalne | 42 | Stałe ziarno stosowane do partycjonowania zbioru danych, inicjalizacji modelu i powtarzalności eksperymentów. |
| Scikit-learn | Programiści Scikit-learn | Scikit-learn 1.0.2 | Partycjonowanie zbioru danych, analiza statystyczna i metryki ewaluacji. |
| Seaborn | Społeczność Open Source | Seaborn 0.11.2 | Statystyczna wizualizacja danych. |
| SegFormer-B2 | NVIDIA Research / Open Source | SegFormer-B2 (Szkielet MIT-B2) | Model segmentacji semantycznej oparty na transformerach, stosowany do segmentacji motywów kulturowych. |
| Maski segmentacji / Adnotacje | Zbiór danych Miao Batik | Dołączone do zbioru danych | Etykiety segmentacji semantycznej na poziomie pikseli, stosowane do klasyfikacji motywów i trenowania. |
| SPADE | NVIDIA Research / Open Source | Oficjalna implementacja PyTorch (https://github.com/NVlabs/SPADE) | Model syntezy obrazu sterowany segmentacją, stosowany do generowania wzorów artystycznych. |
| TorchVision | Meta AI | TorchVision 0.11.1 | Narzędzia do przetwarzania obrazów i transformacje zbiorów danych stosowane z PyTorch. |
| Zbiór danych WikiArt | WikiArt | https://www.wikiart.org/ | Zbiór danych stylów artystycznych zawierający ponad 80 000 dzieł sztuki w 27 stylach artystycznych, stosowany do nauki i syntezy stylu. |
Bibliografia
- Huang B, Mo L. SegCycle-SPADE: An end-to-end framework for semantic segmentation-based automated extraction and artistic reconstruction of traditional craft patterns using conditional GAN. PLoS ONE. 2025;20:e0329100.
- Yan Z, et al. Digital sustainability of heritage: Exploring indicators affecting the effectiveness of digital dissemination of intangible cultural heritage through qualitative interviews. Sustainability. 2025;17:1593.
- Yan Z, et al. Construction of digital dissemination effects evaluation indicator system of traditional techniques of intangible cultural heritage. npj Heritage Science. 2025;13:224.
- Imon SS. Intangible cultural heritage as a tourism product in the historic city of Macao. In: Sustainable Management of Historic Settlements in Asia: Role of Intangible Cultural Heritage. Springer Nature Singapore; Singapore. 2025. p.233-240.
- Buragohain D, et al. Digitalizing cultural heritage through metaverse applications: Challenges, opportunities, and strategies. Heritage Science. 2024;12:295.
- Ma Y. The ghostly ethics of mediatized shaping: Cultural memory creative transformation of Anhui’s ICH in reviving the craftsmanship. Journal of Current Social Issues Studies. 2025;2:240-249.
- Wanju T, Wang Z, Tu Y. ICH and e-commerce: Bridging tradition and modernity in cultural creative products. Journal of Economics, Management and Trade. 2025;31:1-8.
- Sun L, et al. Research on the redesign of China’s intangible cultural heritage based on sustainable livelihood—The case of Luanzhou shadow play empowering rural development. Sustainability. 2024;16:4555.
- Pan S, et al. Constructing a sustainable evaluation framework for AIGC technology in Yixing Zisha pottery: Balancing heritage preservation and innovation. Sustainability. 2025;17:910.
- Na Z, Sharul Azim SR. Research on innovative development of Miao embroidery intangible cultural heritage in Guizhou, China based on digital design. Journal of Business and Economic Review. 2024;9:85-94.
- Guo S, Canessa A. Ethnic elder poverty: Miao household livelihoods and elderly self-sufficiency practices in Midwest China. Culture, Agriculture, Food and Environment. 2023;45:55-68.
- Han D, Cong L. Miao traditional patterns: The origins and design transformation. Visual Studies. 2023;38:425-432.
- Dong B, et al. Spatial distribution and tourism competition of intangible cultural heritage: Take Guizhou, China as an example. Heritage Science. 2023;11:64-80.
- Chen Z, Ren X, Zhang Z. Cultural heritage as rural economic development: Batik production amongst China’s Miao population. Journal of Rural Studies. 2021;81:182-193.
- Zhennan LY, Yahaya SR. An aesthetic study on traditional batik design of Miao ethnicity in China. Kupas Seni. 2021;9:12-25.
- Fu X, Razmjooy N. Preserving and enhancing cultural heritage through art design using feature pyramid network optimized by modified builder optimization algorithm. Scientific Reports. 2025;15:42603.
- Liu X, Wan J, Wang N. Ancient painting inpainting with regional attention-style transfer and global context perception. Applied Sciences. 2024;14:8777.
- Xu Q, Iwasaki M. Image restoration model of wood-structured raw lacquer cultural relics based on diffusion generation network. Journal of Asian Architecture and Building Engineering. 2025:1-19.
- Cherian A, Sullivan A. Sem-GAN: Semantically-consistent image-to-image translation [conference presentation]. Presented at: IEEE Winter Conference on Applications of Computer Vision (WACV); 2019. doi: 10.1109/WACV.2019.00196.
- Rombach R, et al. High-resolution image synthesis with latent diffusion models [conference presentation]. Presented at: IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR); 2022. p.10684-10695. Available from: http://openaccess.thecvf.com/content/CVPR2022/papers/Rombach_High-Resolution_Image_Synthesis_With_Latent_Diffusion_Models_CVPR_2022_paper.pdf.
- Gendy GGH, Nabil S. Diffusion models for image super-resolution: State-of-the-art and future directions. Neurocomputing. 2025;617:128911.
- Kazerouni A, et al. Diffusion models in medical imaging: A comprehensive survey. Medical Image Analysis. 2023;88:102846.
- Yang L, et al. Diffusion models: A comprehensive survey of methods and applications. ACM Computing Surveys. 2023;56:1-39.
- Croitoru FA, Hondru V, Ionescu RT, Shah M. Diffusion models in vision: A survey. IEEE Transactions on Pattern Analysis and Machine Intelligence. 2023;45:10850-10869.
- Cao H, et al. A survey on generative diffusion models. IEEE Transactions on Knowledge and Data Engineering. 2024;36:2814-2830.
- Po R, et al. State of the art on diffusion models for visual computing. Computer Graphics Forum. 2024;43:e15063.
- Thampanichwat C, et al. Mindful architecture from text-to-image AI perspectives: A case study of DALL-E, Midjourney, and Stable Diffusion. Buildings. 2025;15:972.
- Li W. Enhanced automated art curation using supervised modified CNN for art style classification. Scientific Reports. 2025;15:7319.
- Chen C. Algorithm and tool development for creative generation of graphic design of folk houses and ancient buildings integrating cultural and creative elements. Scalable Computing: Practice and Experience. 2024;25:4729-4736.
- Liu B, Ji J, Gu L, Jiang Z. An integrated CycleGAN-diffusion approach for realistic image generation [conference presentation]. Presented at: International Conference on Signal Processing and Machine Learning; 2024. p.92-101. doi: 10.1117/12.3027121.
- Bao Q, Zhao J, Liu Z, Liang N. AI-assisted inheritance of Qinghua porcelain cultural genes and sustainable design using low-rank adaptation and stable diffusion. Electronics. 2025;14:725.
- Quan H, et al. Protection of Guizhou Miao batik culture based on knowledge graph and deep learning. Heritage Science. 2024;12:1-22.
- Sun H, et al. HRPGAN: A GAN-based model to generate high-resolution remote sensing images. IOP Conference Series: Earth and Environmental Science. 2020;428:012060.
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. Available from: https://proceedings.neurips.cc/paper/2020/file/4c5bcfec8584af0d967f1ab10179ca4b-Paper.pdf.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.