Nefropatia cukrzycowa (DN) wiąże się z dysfunkcją mitochondriów. Wykorzystując transkryptomikę, farmakologię sieciową i uczenie maszynowe, zidentyfikowano CAT, FABP1, MAOA oraz MAOB jako potencjalne biomarkery związane z mitochondriami dla Ligustri Lucidi Fructus. W myszach db/db LLF zwiększył ekspresję CAT oraz MAOA, co stanowi podstawę do dalszych badań nad mechanizmami działania.
Artykuł badawczy
Identyfikacja potencjalnych biomarkerów związanych z mitochondriami dla Ligustri Lucidi Fructus w nefropatii cukrzycowej
W tym artykule
Podsumowanie
Streszczenie
Dysfunkcja mitochondriów oraz nadmierny stres oksydacyjny w obrębie mitochondriów są kluczowymi czynnikami patologicznymi napędzającymi uszkodzenie kanalików nerkowych w nefropatii cukrzycowej (DN). Chociaż Ligustri Lucidi Fructus (LLF) jest tradycyjnie stosowany w leczeniu DN, mechanizmy z tym związane, w szczególności te odnoszące się do genów i szlaków związanych z mitochondriami, pozostają słabo poznane. W niniejszym badaniu wykorzystano analizę różnicowej ekspresji zbioru danych GSE142025 w celu zidentyfikowania genów różnicowo wyrażonych (DEGs) związanych z DN. Geny cech wyselekcjonowano poprzez porównanie wyników czterech modeli uczenia maszynowego. Geny, które wykazały istotną różnicową ekspresję i spójne wzorce ekspresji w obu zbiorach danych, poddano dalszej ocenie za pomocą analizy krzywej charakterystyki operacyjnej odbiornika (ROC). Jako potencjalne biomarkery zdefiniowano te, których pole pod krzywą (AUC) było > 0,7 w obu zbiorach danych. Przeprowadzono analizy wzbogacenia funkcjonalnego, infiltracji immunologicznej, konstrukcji sieci oraz dokowania molekularnego. W celu oceny glikemii, mikroalbuminurii w moczu, histopatologii oraz ekspresji potencjalnych biomarkerów za pomocą RT-qPCR wykorzystano mysi model DN. CAT oraz MAOA były istotnie upregulowane in vivo. Potencjalne biomarkery były wzbogacone w szlaki związane z funkcją rybosomów, degradacją waliny, leucyny i izoleucyny, interakcjami cytokina-receptor cytokiny oraz peroksysomami. Wykazano ich negatywną korelację z komórkami T CD8+ i aktywowanymi komórkami tucznymi oraz pozytywną korelację z aktywowanymi komórkami NK i naiwnymi limfocytami B. Taksifolina, beta-sitosterol i eriodyktyol wykazały energie wiązania poniżej -5 kcal/mol z potencjalnymi biomarkerami. CAT i MAOA są obiecującymi kandydatami, które wymagają dalszych badań mechanistycznych.
Wprowadzenie
Nefropatia cukrzycowa (DN), będąca główną przyczyną schyłkowej niewydolności nerek na całym świecie, jest jedną z najczęstszych powikłań cukrzycy. Pod względem patologicznym charakteryzuje się nadmiernym gromadzeniem macierzy zewnątrzkomórkowej zarówno w kłębuszkach, jak i w kanalikach nerkowych, a także pogrubieniem i stwardnieniem wewnątrznerkowych naczyń krwionośnych2. DN jest powszechnie powiązana z białkomoczem i nadciśnieniem tętniczym3. Jej rozwój jest ściśle związany z uszkodzeniem komórek śródbłonka naczyniowego, nasiloną odpowiedzią zapalną oraz zwiększonym stresem oksydacyjnym wynikającym z przedłużonej hiperglikemii4. Częstość występowania DN rośnie na całym świecie, szczególnie wśród osób w średnim i starszym wieku cierpiących na cukrzycę. W miarę postępu choroby może ona prowadzić do schyłkowej niewydolności nerek, a nawet do powikłań sercowo-naczyniowych, co znacząco pogarsza jakość życia i rokowania pacjentów5. Pomimo postępów w podejściach diagnostycznych i terapeutycznych w przypadku DN, wczesne i dokładne biomarkery kandydackie do diagnozy pozostają nieuchwytne, a skuteczne strategie leczenia mające na celu odwrócenie procesów patologicznych są wciąż niedostępne. W związku z tym istnieje pilna potrzeba opracowania nowych, celowanych leków przeciwnefropatycznych.
Mitochondria są kluczowe dla bioenergetyki komórkowej, syntezy prekursorów metabolicznych, homeostazy wapniowej, produkcji reaktywnych form tlenu (ROS), sygnalizacji odpornościowej oraz apoptozy, z których wszystkie są niezbędne do utrzymania stabilności komórek i organizmu6. Jako centra energetyczne komórki, mitochondria odgrywają kluczową rolę w podstawowych procesach, takich jak glikoliza, cykl kwasu trójkarboksylowego i fosforylacja oksydacyjna7. Otyłość zaburza cykl Krebsa i mitochondrialny łańcuch oddechowy, co prowadzi do dysfunkcji mitochondriów i zwiększonej produkcji ROS. Podwyższone poziomy ROS w mitochondrialnym łańcuchu oddechowym mogą indukować stres oksydacyjny, który nasila odpowiedź zapalną związaną z otyłością i promuje apoptozę8. Niedawne badania podkreśliły istotną rolę dysfunkcji mitochondriów w patogenezie i progresji DN, w tym zaburzenia metabolizmu energetycznego, nadmierną generację ROS oraz nasiloną sygnalizację apoptozy9. Przewlekła dysfunkcja mitochondriów przyspiesza postęp choroby nerek10. Zatem poprawa funkcji mitochondriów mogłaby stanowić kluczową strategię ochronną przeciwko DN.
Ligustri Lucidi Fructus (LLF) to suszone, dojrzałe owoce z rodziny Luteaceae, znane ze swoich właściwości odżywczych dla wątroby i nerek, a także z możliwości przyciemniania włosów i poprawy widzenia. Zidentyfikowano naturalnie występujący heteropolisacharyd ekstrahowany z LLF, który wykazuje potencjał w ochronie nerek przed włóknieniem1. W ostatnich latach coraz większą uwagę poświęca się zastosowaniu LLF w leczeniu DN, wykazując znaczące efekty renoprotekcyjne1,12,13. Ponadto szeroko badano i potwierdzono złożoną relację między LLF a mitochondriami. W szczególności badanie wykazało, że LLF wywiera korzystne działanie poprzez modulowanie funkcji mitochondriów poprzez aktywację szlaku sygnalizacyjnego AMPK14. Mechanizm ten skutecznie chroni mitochondria przed uszkodzeniami spowodowanymi stresem oksydacyjnym. Wyniki te dodatkowo podkreślają kluczową rolę LLF w utrzymaniu komórkowego metabolizmu energetycznego i poprawie odporności komórek na stres oksydacyjny. Jednak dokładny mechanizm terapeutyczny, zwłaszcza w odniesieniu do przywracania funkcji mitochondriów, pozostaje słabo poznany.
Celem niniejszego badania było wyjaśnienie mechanizmów biologicznych leżących u podstaw terapeutycznego działania LLF na funkcje mitochondrialne w DN. Wykorzystując narzędzia bioinformatyczne, przeszukano publiczne bazy danych w celu zidentyfikowania potencjalnych biomarkerów związanych z efektami nefroprotekcyjnymi LLF, integrując dane transkryptomiczne z informacjami o składnikach aktywnych. Dalsze analizy, obejmujące infiltrację immunologiczną, powiązanie z cechami klinicznymi, modyfikację RNA m6A, wzbogacenie funkcjonalne, konstrukcję sieci regulacyjnych oraz dokowanie molekularne, wykazały, że biomarkery te odgrywają kluczową rolę w regulacji funkcji mitochondrialnych podczas leczenia DN. Walidacja in vivo dodatkowo potwierdziła ich znaczenie. Ta kompleksowa analiza pogłębia nasze zrozumienie mechanizmów, dzięki którym LLF leczy DN, i stanowi solidną podstawę do opracowania nowych celów terapeutycznych opartych na dysfunkcji mitochondriów.
Protokół
Gromadzenie danych
Macierze ekspresji genów oraz odpowiadające im dane kliniczne dla zestawów danych GSE142025 i GSE96804, dotyczących DN, pobrano z bazy danych Gene Expression Omnibus (GEO) (https://www.ncbi.nlm.nih.gov/geo/)15. Zbiór treningowy (GSE142025) obejmował próbki tkanki nerkowej od 27 pacjentów z DN oraz dziewięciu osób z grupy kontrolnej, które zostały zsekwencjonowane przy użyciu platformy GPL20301. Zbiór walidacyjny (GSE96804) składał się z danych sekwencyjnych od 41 pacjentów z DN i 20 osób z grupy kontrolnej, przetworzonych przy użyciu platformy GPL17586. Oba zestawy danych koncentrują się na tkance nerkowej; zestaw GSE96804 bada konkretnie kłębuszki nerkowe, będące główną jednostką filtracyjną nerki (Rysunek 1). Zestaw GSE142025 (zbiór treningowy) obejmuje próbki całej tkanki nerkowej i zapewnia szeroki przegląd krajobrazu transkryptomicznego DN. Z kolei zestaw GSE96804 (zbiór walidacyjny) skupia się specyficznie na tkance kłębuszkowej, która jest głównym miejscem uszkodzenia filtracji kłębuszkowej. Ponieważ te dwa zestawy danych nie zostały bezpośrednio połączone ze względu na różnice w platformach i tkankach, nie zastosowano korekcji efektu serii (batch effect). Zamiast tego przeprowadzono niezależną walidację między zestawami danych. Geny wykazujące spójne zmiany kierunkowe oraz powierzchnię pod krzywą (AUC) większą niż 0,7 w obu zestawach danych wybrano jako wiarygodne kandydaty, co potwierdza możliwość generalizacji wyników w różnych przedziałach tkanki nerkowej.
Łącznie 1 136 genów związanych z mitochondriami (MRGs) zostało pobranych z bazy danych MitoCarta3.0 (https://www.broadinstitute.org/mitocarta). Składniki aktywne LLF przewidziano przy użyciu bazy danych Traditional Chinese Medicine Systems Pharmacology (TCMSP) (http://sm.nwsuaf.edu.cn/lsp/tcmsp.php), w oparciu o próg biodostępności doustnej (OB) ≥30% oraz próg podobieństwa do leku (DL) ≥0,18. Następnie potencjalne geny docelowe dla składników aktywnych przewidziano przy użyciu bazy danych Swiss Target Prediction (http://www.swisstargetprediction.ch/).
Analiza ekspresji różnicowej
Analizę ekspresji różnicowej GSE142025 (DN vs. kontrola) przeprowadzono przy użyciu pakietu limma (v3.54.1), przyjmując kryteria istotności P.adj < 0,05 oraz |log2FoldChange| > 0,516. Wykresy wulkaniczne oraz mapy ciepła zwizualizowano odpowiednio przy użyciu pakietów ggplot2 (v 3.3.6) i ComplexHeatmap (v 2.14.0)17,18. Wykonano analizę części wspólnej dla genów DEGs, MRGs oraz potencjalnych genów docelowych składników aktywnych, a nakładające się geny zdefiniowano jako geny kandydackie. Sieć łączącą składniki aktywne z genami kandydackimi skonstruowano za pomocą oprogramowania Cytoscape (v 3.9.0)19.
Analiza wzbogacenia funkcjonalnego i konstrukcja sieci oddziaływań białko-białko (PPI)
Analizy wzbogacenia Gene Ontology (GO) oraz Kyoto Encyclopedia of Genes and Genomes (KEGG) dla genów kandydackich przeprowadzono przy użyciu pakietu clusterProfiler (v 4.6.2), aby zbadać ich funkcje biologiczne i powiązane szlaki sygnalizacyjne (P.adjust < 0.05). Następnie geny kandydackie wprowadzono do bazy danych STRING (https://cn.string-db.org/) w celu pobrania relacji PPI (poziom ufności ≥ 0.4), a następnie skonstruowano sieć PPI przy użyciu programu Cytoscape (v 3.9.0)20.
Uczenie maszynowe
Cztery algorytmy uczenia maszynowego, w tym las losowy (RF), k-najbliższych sąsiadów (KNN), częściowe najmniejsze kwadraty (PLS) oraz maszyna wektorów nośnych z radialną funkcją bazową (SVM), zostały zaimplementowane przy użyciu pakietu caret (v6.0-93) w oparciu o zbiór danych GSE142025. Geny kandydackie zidentyfikowane w poprzedniej analizie posłużyły jako zmienne predykcyjne, a status choroby (DN lub kontrola) jako wynik. Dla modelu KNN zastosowano 10-krotną walidację krzyżową przy użyciu funkcji trainControl z parametrem tuneLength = 10. Model RF dopasowano dla 20 drzew (ntree = 20); modele PLS i SVM dopasowano zgodnie z ustawieniami zaimplementowanymi w oryginalnym przepływie pracy pakietu caret.
Rozkłady residuów modelu oceniono przy użyciu pakietu DALEX (v2.4.3). Następnie przeprowadzono ocenę zmiennych opartą na permutacjach za pomocą funkcji variable_importance pakietu DALEX, określając pierwiastek błędu średniokwadratowego (RMSE) jako funkcję straty. Wynikowy dropout_loss reprezentuje RMSE uzyskany po permutacji odpowiadającej zmiennej21,2. W oryginalnym schemacie analitycznym zachowano zmienne z wartością dropout loss < 0,281 we wszystkich modelach, a geny wspólne dla wszystkich czterech modeli zdefiniowano jako konsensusowe geny cech do późniejszej walidacji.
Cztery modele uczenia maszynowego zostały wykorzystane przede wszystkim do ustalenia priorytetów cech, a nie do budowy końcowego klasyfikatora klinicznego. W związku z tym dyskryminacja diagnostyczna została następnie oceniona na poziomie pojedynczych genów przy użyciu analizy ROC w zbiorach danych odkrywczych i walidacyjnych.
Identyfikacja potencjalnych biomarkerów
W zbiorach danych GSE142025 i GSE96804 różnice w ekspresji genów cech między próbkami z DN a grupą kontrolną oceniano za pomocą testu Wilcoxona. Do analizy krzywej charakterystyki operacyjnej odbiornika (ROC) wybrano jedynie geny wykazujące istotną różnicową ekspresję (P < 0,05) oraz zgodne trendy ekspresji w obu zbiorach danych. Do generowania krzywych ROC i obliczania pola pod krzywą (AUC) wykorzystano pakiet pROC (v1.18.0), a geny z AUC > 0,7 w obu zbiorach danych sklasyfikowano jako potencjalne biomarkery23.
Analiza wzbogacenia zestawów genów (GSEA)
Funkcje biologiczne i szlaki sygnalizacyjne powiązane z potencjalnymi biomarkerami poddano dalszej analizie z wykorzystaniem GSEA na zbiorze danych GSE142025. W pierwszej kolejności, przy użyciu pakietu psych (v2.2.9), przeprowadzono analizę korelacji Spearmana potencjalnych biomarkerów ze wszystkimi pozostałymi genami.24Obliczono i uszeregowano współczynniki korelacji (od najwyższego do najniższego). Jako zestaw genów referencyjnych wykorzystano c2.cp.kegg.v2023.1.Hs.symbols.gmt z bazy Molecular Signatures Database (MSigDB, https://www.gsea-msigdb.org/gsea/msigdb/). Następnie, przy użyciu pakietu clusterProfiler (v4.6.2), przeprowadzono analizę GSEA w celu oceny wzbogacenia uszeregowanych genów w tle genetycznym. Zastosowano korektę dla wielokrotnych testów. poprzez metoda FDR oraz skorygowane P-wartości (oznaczone jako P.adjust) uznano za istotne, jeśli < 0.05.
Analiza modyfikacji m6A
W celu zbadania modyfikacji metylacyjnych RNA potencjalnych biomarkerów, wykorzystano bazę danych SRAMP (http://www.cuilab.cn/sramp/) do przewidywania miejsc modyfikacji m6A w biomarkerach, koncentrując się na pozycjach o wysokim stopniu pewności w obrębie ich struktur drugorzędowych. Następnie użyto bazy danych ENCORI (https://starbase.sysu.edu.cn/) do identyfikacji białek zmodyfikowanych przez m6A, które oddziałują z potencjalnymi biomarkerami, stosując parametr |HepG2 (shRNA)| > 1 w celu przesiewania kluczowych białek. W kolejnym kroku wykorzystano bazę danych RPISeq (http://pridb.gdcb.iastate.edu/RPISeq/) do przewidywania prawdopodobieństwa oddziaływań pomiędzy kluczowymi białkami a potencjalnymi biomarkerami. Sekwencje RNA obu cząsteczek przesłano w formacie tekstowym w celu wygenerowania wyników predykcji klasyfikatorów RF i SVM. Oddziaływanie uznano za istotne, gdy wynik przekroczył 0,525. Analizę SRAMP przeprowadzono z progiem „High” dla predykcji miejsc m6A, korzystając z trybu „Transcript” i parametrów domyślnych. W analizie ENCORI wykorzystano funkcję oddziaływań „miRNA-mRNA” z parametrem „HepG2 (shRNA)” > 1. Analiza RPISeq została wykonana przy użyciu klasyfikatora RF z parametrami domyślnymi; wyniki > 0,5 wskazywały na pozytywne oddziaływanie. Powyższe dane stanowią predykcje obliczeniowe, a nie dowody eksperymentalne na występowanie modyfikacji m6A lub oddziaływań RNA-białko w tkance nerek. Kryterium HepG2 shRNA zostało wyprowadzone z wstępnie obliczonych zbiorów danych ENCORI i może nie odzwierciedlać regulacji specyficznej dla nerek.
Analiza infiltracji immunologicznej
Algorytm CIBERSORT zastosowano w celu oszacowania proporcji 2 typów komórek odpornościowych w próbkach kontrolnych oraz próbkach DN z zestawu GSE142025, a wyniki zwizualizowano za pomocą mapy ciepła wygenerowanej przy użyciu pakietu ggplot2 (v3.3.6)26. Program CIBERSORT uruchomiono z wykorzystaniem macierzy sygnatur LM2, stosując 1 0 permutacji i wyłączając normalizację kwantylową (zgodnie z zaleceniami dla danych z mikromacierzy). Do dalszej analizy zakwalifikowano próbki z wartością p < 0,05 w CIBERSORT. CIBERSORT szacuje frakcje komórek odpornościowych na podstawie ekspresji z tkanki nerkowej w formie bulk, co nie pozwala na rozróżnienie infiltracji w konkretnych przedziałach (np. kłębuszkowej vs. cewkowo-śródmiąższowej) ani na odróżnienie leukocytów infiltrujących od rezydentnych komórek odpornościowych. Zatem zgłaszane korelacje dotyczą poziomu tkanki i powinny zostać zwalidowane za pomocą metod przestrzennych. Analizę korelacji Spearmana pomiędzy komórkami odpornościowymi o różnej liczebności a potencjalnymi biomarkerami przeprowadzono przy użyciu pakietu psych.
Konstrukcja sieci i dokowanie molekularne
MikroRNA (miRNA) oddziałujące z biomarkerami kandydackimi przewidziano z wykorzystaniem bazy danych miRNet (https://www.mirnet.ca). Następnie, za pomocą baz danych TarBase (http://www.diana.pcbi.upenn.edu/tarbase) oraz starbase (http://starbase.sysu.edu.cn/), przewidziano długie niekodujące RNA (lncRNA) celujące w zidentyfikowane miRNA. Do konstrukcji sieci wybrano lncRNA wspólne dla obu baz danych. Następnie, przy użyciu oprogramowania Cytoscape, zbudowano regulacyjną sieć lncRNA-miRNA-mRNA. W celu stworzenia sieci składnik aktywny-biomarker wybrano potencjalne składniki aktywne celujące w biomarkery kandydackie. Dodatkowo, składniki aktywne, biomarkery kandydackie oraz szlaki zidentyfikowane w GSEA wprowadzono do programu Cytoscape, aby stworzyć sieć składnik aktywny-biomarker-szlak.
Przeprowadzono analizę dokowania molekularnego w celu oceny powinowactwa wiązania między potencjalnymi składnikami aktywnymi a kandydującymi biomarkerami. Struktury 3D białek biomarkerowych pobrano z bazy danych Protein Data Bank Research Collaboratory for Structural Bioinformatics (RCSB PDB, https://www.rscb.org/pdb) w formacie plików PDB. Struktury 2D potencjalnych składników aktywnych pobrano w formacie SDF z bazy danych PubChem (http://pubchem.ncbi.nlm.nih.gov). Dokowanie molekularne wykonano przy użyciu platformy CB-Dock (http://clab.labshare.cn/cb-dock/php/blinddock.php). Energia wiązania mniejsza niż -5 kcal/mol wskazywała na silne powinowactwo wiązania27.
Przygotowanie i uwierzytelnienie Ligustri Lucidi Fructus
W niniejszym opracowaniu Ligustri Lucidi Fructus (LLF) odnosi się do suszonych dojrzałych owoców Ligustrum lucidum W. T. Aiton (Oleaceae). Materiał botaniczny został uwierzytelniony zgodnie z Farmakopeą Chińską, a próbki referencyjne nr 20240506, 2024091, 2024103 zostały zdeponowane w Shanxi University of Traditional Chinese Medicine.
W celu przygotowania odwaru 20 g odpowiednio przygotowanych plastrów LLF namaczano w 1,0 mL wody destylowanej przez 30 min w temperaturze pokojowej. Mieszaninę doprowadzono do gwałtownego wrzenia, a następnie gotowano na małym ogniu przez 60 min. Zebrano filtrat, a pozostałe materiały roślinne poddano ponownemu gotowaniu z kolejnymi 1,0 mL wody destylowanej przez 60 min. Oba filtraty połączono, przefiltrowano, odwirowano i zagęszczono pod zmniejszonym ciśnieniem, aby uzyskać końcowe stężenie zapasu wynoszące 1 g surowca/mL (całkowita objętość 10 mL). Przygotowany odwar przechowywano w temperaturze 4 °C do krótkotrwałego użycia lub w −20 °C do długotrwałego przechowywania. Jakość LLF oraz jego odwaru została rygorystycznie zidentyfikowana i zweryfikowana zgodnie ze standardami Farmakopei Chińskiej, aby zapewnić wiarygodność i powtarzalność eksperymentów.
Do identyfikacji jakościowej przeprowadzono chromatografię cienkowarstwową. W skrócie, odpowiednią objętość przygotowanego odwaru odwirowano, a nadosad ekstrahowano metanolem. Po filtracji roztwór próbki oraz roztwór wzorca specnuezhenide naniesiono na tę samą płytkę z żelem krzemianowym G. Po rozwinięciu, wysuszeniu i analizie w świetle ultrafioletowym plamka roztworu próbki wykazała zgodność koloru i położenia z związkiem referencyjnym, co potwierdziło obecność charakterystycznego składnika biologicznie czynnego w LLF.
W celu ilościowej kontroli jakości przeprowadzono detekcję za pomocą wysokosprawnej chromatografii cieczowej. Analizę wykonano przy użyciu kolumny C18 z mieszaniną metanol–woda jako fazą ruchomą. Długość fali detekcji ustawiono na 24 nm. Zawartość specnuezhenide w odwarze określono na podstawie krzywej wzorcowej. Wyniki wykazały stabilny i jednorodny skład chemiczny przygotowanego odwaru, co zapewniło spójną jakość leku podczas całego eksperymentu z interwencją na zwierzętach.
Doświadczenia na zwierzętach
Dwanaście samców myszy db/db klasy SPF (w wieku 8–9 tygodni) oraz sześć myszy db/m w tym samym wieku utrzymywano w zwierzęcej jednostce SPF Uniwersytetu Medycyny Tradycyjnej Chińskiej w Shanxi. Przed rozpoczęciem eksperymentów zwierzęta poddano 7-dniowej aklimatyzacji w cyklu 12 h światła / 12 h ciemności, z dostępem do pożywienia i wody ad libitum. Badanie zostało zatwierdzone przez Komisję Etyki Uniwersytetu Medycyny Tradycyjnej Chińskiej w Shanxi (numer zatwierdzenia 2022DW167). Zwierzęta wykazujące utratę masy ciała >20%, stan agonalny lub niezdolność do przyjmowania pokarmu i wody poddano humanitarnej eutanazji przed planowanym zakończeniem badania. Po zakończeniu badania wszystkie pozostałe myszy uśmiercono poprzez dostresycyjne wstrzyknięcie pentobarbitalu sodu do jamy otrzewnej, a następnie zwichnięcie kręgów szyjnych zgodnie z protokołami instytucjonalnymi.
Po okresie aklimatyzacji ustanowienie modelu DN u myszy db/db potwierdzono, stwierdzając poziom glukozy we krwi pobranej z żyły ogonowej ≥ 16 mmol/L oraz mikroalbuminurię, wskazaną przez dodatni wynik testu paskowego na mikroalbuminurię w moczu. Po pomyślnym ustanowieniu modelu DN myszy db/db podzielono losowo na dwie grupy (n = 6 na grupę): grupę modelu DN (DN) oraz grupę leczoną LLF (Treatment). Ponadto myszy db/m (n = 6) wykorzystano jako grupę kontrolną (Control). Dawkę wybrano na podstawie wcześniejszych badań farmakodynamicznych LLF u szczurów z cukrzycą i przeliczono na dawkę równoważną dla ludzi z zastosowaniem normalizacji powierzchni ciała28. Grupy Control i DN otrzymywały wodę destylowaną, natomiast grupa leczona otrzymywała 3,5 g/kg LLF przez 8 tygodni. Po 8 tygodniach podawania wszystkie myszy zostały uśmiercone w celu pobrania surowicy, moczu i tkanki nerek do dalszych badań.
Wskaźniki krwi i moczu
Poziomy glukozy w surowicy analizowano przy użyciu w pełni automatycznego analizatora biochemii krwi. Stężenie mikroalbuminurii w moczu zmierzono zgodnie z instrukcją dołączoną do zestawu (Plik uzupełniający 1).
Obserwacja patomorfologiczna tkanek nerek myszy
Tkanki nerek przygotowano do badania histopatologicznego. Po utrwaleniu w 4% paraformaldehydzie tkanki przemyto, odwodniono, zatopiono w parafinie i pocięto na skrawki. Następnie wykonano barwienie hematoksyliną i eozyną (HE), a zabarwione skrawki zbadano pod mikroskopem optycznym w celu oceny zmian patologicznych.
Ilościowa reakcja łańcuchowa polimerazy z odwrotną transkrypcją (RT-qPCR)
Do oznaczenia ekspresji potencjalnych biomarkerów w tkance nerek myszy wykorzystano metodę RT-qPCR. Całkowity RNA wyekstrahowano zgodnie z instrukcjami producenta, a następnie oceniono jego stężenie i jakość (Tabela 1). cDNA zsyntetyzowano z wyekstrahowanego RNA przy użyciu zestawu cDNA Synthesis Kit. Amplifikację przeprowadzono z użyciem par starterów wymienionych w Tabela 1z użyciem GAPDH jako gen referencyjny. Poziomy ekspresji względnej obliczono przy użyciu metody 2-−ΔΔCt metoda13,26.
Analiza statystyczna
Wszystkie analizy statystyczne przeprowadzono przy użyciu oprogramowania R (wersja 4.2.2) wraz z oprogramowaniem wymaganym dla odpowiednich procedur eksperymentalnych. O ile nie wskazano inaczej, wszystkie testy statystyczne były dwustronne, a różnice uznano za statystycznie istotne przy P < 0.05. Analizę różnicowej ekspresji transkryptomicznej przeprowadzono przy użyciu pakietu limma. Geny z dostosowanym P < 0.05 i wartością bezwzględną log2fold change większą niż 0.5 zdefiniowano jako różnicowo wyrażone.
Do porównania ekspresji genów kandydackich pomiędzy niezależnymi próbkami DN i kontrolnymi, tam gdzie wskazano w pierwotnym schemacie analizy, zastosowano nieparametryczne testy sum rang Wilcoxona. Korelacje między kandydackimi biomarkerami a frakcjami komórek odpornościowych oceniono za pomocą korelacji rang Spearmana.
Dane eksperymentalne przedstawiono jako średnia ± SD. Porównania pomiędzy trzema niezależnymi grupami zwierząt przeprowadzono za pomocą jednoczynnikowej analizy wariancji, gdy spełnione były założenia analizy parametrycznej. Do porównań post hoc zastosowano test najmniejszej istotnej różnicy w przypadku jednorodności wariancji, natomiast test T3 Dunnetta w przypadku wariancji niejednorodnych. Pomiary farmakodynamiczne z poziomu wyjściowego oraz z 8. tygodnia przeanalizowano i przedstawiono oddzielnie; nie wyciągnięto wniosków dotyczących interakcji grupa-czas. Skrypty R oraz dane źródłowe wykorzystane w analizach bioinformatycznych i uczeniu maszynowym znajdują się w Pliku uzupełniającym 1.
Wyniki
Aby systematycznie zbadać potencjalne biomarkery kandydackie związane z mitochondriami dla LLF w leczeniu DN, zaprojektowaliśmy czteroetapowy schemat analityczny (Rycina 1). W Etapie I zintegrowaliśmy dane transkryptomiczne z zestawu danych GSE142025 (zbiór treningowy, cała nerka, n=36) oraz GSE96804 (zbiór walidacyjny, kłębuszek, n = 61) z 1 136 genami związanymi z mitochondriami z bazy danych MitoCarta 3.0 oraz 517 przewidywanymi celami 9 aktywnych składników z bazy danych TCMSP. Nałożenie tych trzech zestawów genów pozwoliło wyłonić 9 genów kandydackich. W Etapie II zastosowano cztery modele uczenia maszynowego (RF, KNN, PLS i SVM), aby nadać priorytet genom cechom, przyjmując próg RMSE < 0,281. Walidacja międzyzbiorowa z wykorzystaniem analizy ROC (AUC > 0,7 w obu zbiorach danych) pozwoliła zidentyfikować cztery biomarkery kandydackie: CAT, FABP1, MAOB i MAOA. W Etapie III przeprowadziliśmy analizę GSEA w celu identyfikacji wzbogaconych szlaków KEGG, analizę infiltracji immunologicznej z użyciem CIBERSORT, przewidywanie modyfikacji m6A oraz skonstruowaliśmy sieci lncRNA-miRNA-mRNA, aktywny składnik–biomarker oraz aktywny składnik–biomarker–szlak, a następnie przeprowadziliśmy dokowanie molekularne. W Etapie IV oceniono efekty farmakodynamiczne LLF oraz zmiany w ekspresji mRNA czterech biomarkerów kandydackich w modelu mysim DN db/db.
Przesiewanie genów kandydackich dla leczenia DN za pomocą LLF
W zbiorze danych GSE142025 zidentyfikowano 3 810 DEG pomiędzy grupą DN a grupą kontrolną, w tym 1 904 DEG o zwiększonej i 1 906 DEG o zmniejszonej ekspresji (Ryc. 2A,B). Za pomocą bazy danych TCMSP przewidziano trzynaście składników aktywnych LLF, mianowicie: beta-sitosterol, kempferol, taksifolinę, Lucidumoside D, Lucidumoside D_qt, (20S)-24-ene-3,20-diol-3-acetate, eriodictyol, syringaresinol diglucoside_qt, Lucidusculine, Olitoriside, Olitoriside_qt, luteolinę i kwercetynę (Tabela 2). Cztery składniki aktywne — Lucidumoside D_qt, (20S)-24-ene-3,20-diol-3-acetate, syringaresinol diglucoside_qt oraz Olitoriside_qt — nie wykazały żadnych potencjalnych genów docelowych, natomiast pozostałe dziewięć składników pozwoliło przewidzieć 517 potencjalnych genów docelowych. Poprzez nałożenie 3 810 DEG, 1 136 MRG oraz 517 potencjalnych genów docelowych zidentyfikowano dziewięć genów kandydackich: GPX1, BAX, CASP8, MAOA, MAOB, CAT, AKR1B10, ALDH2 oraz FABP1 (Ryc. 2C). Następnie skonstruowano sieć powiązań między składnikami aktywnymi a genami kandydackimi (Ryc. 2D). Te dziewięć genów kandydackich wykazano w 341 terminach GO, w tym w odpowiedzi na substancje toksyczne, procesie katabolicznym organicznych związków hydroksylowych oraz detoksykacji komórkowej (Ryc. 2E). Ponadto powiązano je z 52 szlakami KEGG, takimi jak metabolizm tryptofanu, szlaki neurodegeneracyjne i metabolizm histydyny (Ryc. 2F).
Przesiewowe badanie potencjalnych biomarkerów leczenia DN w LLF
Sieć PPI ujawniła siedem węzłów i osiem krawędzi, z interakcjami pomiędzy MAOA, ALDH2, MAOB oraz AKR1B10 (Rycina 3A). Geny o wartościach RMSE mniejszych niż 0,281 w czterech modelach uczenia maszynowego zidentyfikowano jako geny cech: CAT, MAOB, MAOA, BAX oraz FABP1 (Rycina 3B-E). Analiza ekspresji wykazała, że poziomy CAT, FABP1, MAOB i MAOA różniły się istotnie pomiędzy grupą DN a grupą kontrolną i były spójne w obu zbiorach danych, GSE142025 oraz GSE96804 (Rycina 3F,G). Ponadto wartości AUC w analizie krzywej ROC dla tych genów przekroczyły 0,7 w obu zbiorach danych, co wskazuje, że mogą one skutecznie odróżniać próbki DN od próbek kontrolnych i służyć jako potencjalne biomarkery leczenia DN w LLF (Rycina 4A-H).
Znaczące wzbogacenie kandydatów na biomarkery w szlakach zapalnych i związanych z odpornością
Analiza GSEA zidentyfikowała cztery kandydatów na biomarkery, które były wyraźnie wzbogacone w szlaku sygnalizacji chemokin oraz w interakcjach cytokina-receptor cytokinowy (Rycina 5A-D). spośród nich szlak sygnalizacji peroksydazy wykazał istotny związek z CAT, MAOA oraz MAOB.
Korelacja potencjalnych biomarkerów z komórkami odpornościowymi
Zauważono istotne różnice w ekspresji dziewięciu typów komórek odpornościowych – naiwnych limfocytów B, makrofagów M0, makrofagów M1, makrofagów M2, aktywowanych komórek tucznych, aktywowanych komórek NK, spoczynkowych pamięciowych limfocytów T CD4+, naiwnych limfocytów T CD4+ oraz limfocytów T CD8+ – pomiędzy próbkami DN a kontrolnymi (P < 0.05) (Rycina 6A,B). Stwierdzono istotną korelację dodatnią (cor = 0.6) pomiędzy naiwnymi limfocytami B a aktywowanymi komórkami NK, natomiast istotną korelację ujemną (cor = -0.69) wykryto pomiędzy naiwnymi limfocytami B a aktywowanymi komórkami tucznymi (Rycina 6C). Wszystkie potencjalne biomarkery wykazały silne korelacje ujemne z limfocytami T CD8+ i aktywowanymi komórkami tucznymi oraz korelacje dodatnie z aktywowanymi komórkami NK i naiwnymi limfocytami B (Rycina 6D).
Interakcja kluczowych zmodyfikowanych białek m6A z potencjalnymi biomarkerami
Modyfikacja metylacji RNA m6A głęboko wpływa na syntezę i metabolizm RNA oraz jest zaangażowana w patogenezę różnych chorób29. Lokalizacje miejsc modyfikacji m6A w potencjalnych biomarkerach oraz ich wysokowiarygodne pozycje w strukturach drugorzędowych przedstawiono na Rysunku 7A-H. Dalsza analiza wykazała, że kluczowe białka zmodyfikowane przez m6A oddziałujące z CAT obejmowały AQR i RBM22, natomiast FABP1 oddziaływało zarówno z SF3A3, jak i AQR. Stwierdzono, że MAOA oddziałuje z IGF2BP3 i IGF2BP2, a MAOB z TIA1 (Tabela 3).
Korzystne predykcje wiązania in silico dla taksyfoliny, beta-sitosterolu i eriodiktyolu w LLF w leczeniu DN
W miRNet przewidywano, że CAT oddziałuje z 24 miRNA, podczas gdy FABP1 powiązany był z pięcioma miRNA. Dodatkowo MAOB i MAOA powiązano odpowiednio z 29 i 26 miRNA. spośród nich w bazach danych TarBase i Starbase zidentyfikowano 23 lncRNA. Następnie skonstruowano regulacyjną sieć lncRNA-miRNA-mRNA, obejmującą cztery potencjalne biomarkery, 74 miRNA i 23 lncRNA (Rysunek 8A). Potencjalne składniki aktywne celujące w potencjalne biomarkery obejmowały luteolinę, beta-sitosterol, eriodiktyol, kempferol, kwercetynę i taksyfolinę (Rysunek 8B). Ponadto, na podstawie składników aktywnych, potencjalnych biomarkerów i pięciu głównych szlaków zidentyfikowanych w GSEA, ustanowiono sieć składnik aktywny-biomarker-szlak (Rysunek 8C). Na przykład taksyfolina celowała w CAT w szlaku peroksysomowym. Energie wiązania pomiędzy CAT a taksyfoliną (-8.8 kcal/mol), FABP1 a beta-sitosterolem (-8.1 kcal/mol) oraz MAOB a eriodiktyolem (-9.8 kcal/mol) były wszystkie poniżej -5 kcal/mol, co sugeruje silne powinowactwo między tymi potencjalnymi biomarkerami a ich odpowiednimi składnikami aktywnymi27. Taksyfolinę, beta-sitosterol i eriodiktyol zidentyfikowano jako potencjalne składniki aktywne z korzystnymi predykcjami wiązania in silico w LLF w leczeniu DN (Rysunek 8D-F). Są one jednak przedstawione jako składniki przewidziane przez bazy danych, a nie potwierdzone bioaktywne produkty pośrednie obserwowanych efektów in vivo.
Walidacja potencjalnych biomarkerów w mysim modelu DN
Ocena farmakodynamiczna LLF w leczeniu myszy z DN
W okresie podawania preparatu monitorowano poziom glukozy we krwi oraz poziom mikroalbuminurii u myszy (Ryc. 9A-D). W porównaniu z grupą kontrolną, poziom glukozy we krwi i mikroalbuminurii w grupie modelu DN był istotnie podwyższony (P < 0,01); w porównaniu z grupą modelu DN, poziom glukozy we krwi myszy w grupie leczonej uległ istotnemu obniżeniu po 4 tygodniach podawania (P < 0,01), a poziom mikroalbuminurii u myszy w grupie leczonej uległ istotnemu obniżeniu po 8 tygodniach podawania (P < 0,05). Wyniki sugerują, że LLF może być korzystny w leczeniu DN.
Ocena patologiczna LLF w leczeniu myszy z DN
Po barwieniu HE w grupie kontrolnej zaobserwowano wyraźne struktury kłębuszkowe w tkance nerek. W przeciwieństwie do grupy normalnej, w grupie modelowej DN stwierdzono piknozę jąder komórkowych kłębuszków i hiperchromazję, a także naciek komórek zapalnych wokół kłębuszków. Leczenie LLF złagodziło uszkodzenia patologiczne w nerkach myszy db/db (Rycina 9E).
Analiza RT-PCR ekspresji potencjalnych biomarkerów u myszy z DN
Po pomyślnym opracowaniu modelu mysiego DN oraz zaobserwowaniu znaczącej poprawy objawów po leczeniu LLF, zastosowano metodę RT-qPCR w celu analizy zmian w potencjalnych biomarkerach. W porównaniu z grupą kontrolną, w grupie DN odnotowano znacząco obniżoną ekspresję CAT oraz MAOA (P < 0.05 lub P < 0.01). Z kolei grupa leczona wykazała znacząco wyższą ekspresję CAT i MAOA niż grupa DN (P < 0.05). Nie zaobserwowano jednak statystycznie istotnych różnic w ekspresji MAOB i FABP1 pomiędzy grupami (Rycyna 9F-I).
Dostępność danych
Zbiory danych dotyczących ekspresji genów przeanalizowane w niniejszym badaniu są publicznie dostępne w bazie Gene Expression Omnibus (GEO) pod numerami dostępu GSE142025 i GSE96804. Skrypty R wykorzystane do analiz bioinformatycznych wraz z eksperymentalnymi danymi źródłowymi (poziom glukozy we krwi, mikroalbuminuria oraz dane RT-qPCR) zostały udostępnione w Pliku uzupełniającym 1. Wszystkie pozostałe bazy danych, oprogramowanie i zasoby internetowe wykorzystane w tym badaniu są wymienione w Tabeli materiałów.
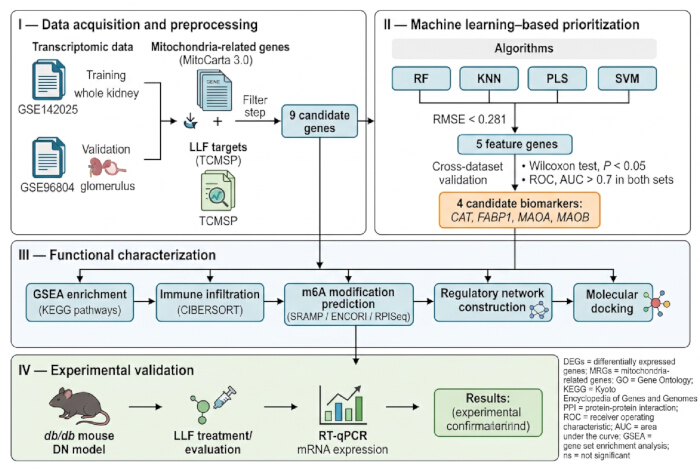
Rycina 1: Schemat badania. Zbiory danych transkryptomicznych, geny związane z mitochondriami oraz przewidywane cele Ligustri Lucidi Fructus zostały zintegrowane w celu zidentyfikowania genów kandydackich. Następnie zastosowano cztery algorytmy uczenia maszynowego do priorytetyzacji genów cech, a następnie przeprowadzono walidację międzyzbiorową, charakterystykę funkcjonalną oraz walidację eksperymentalną na myszach db/db. Skróty: DN = nefropatia cukrzycowa; DEGs = geny różnicowo wyrażone; MRGs = geny związane z mitochondriami; LLF = Ligustri Lucidi Fructus; RF = las losowy; KNN = k-najbliższych sąsiadów; PLS = częściowe najmniejsze kwadraty; SVM = maszyna wektorów nośnych; RMSE = pierwiastek błędu średniokwadratowego; GSEA = analiza wzbogacenia zbiorów genów; RT-qPCR = ilościowa reakcja łańcuchowa polimerazy z odwrotną transkrypcją. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
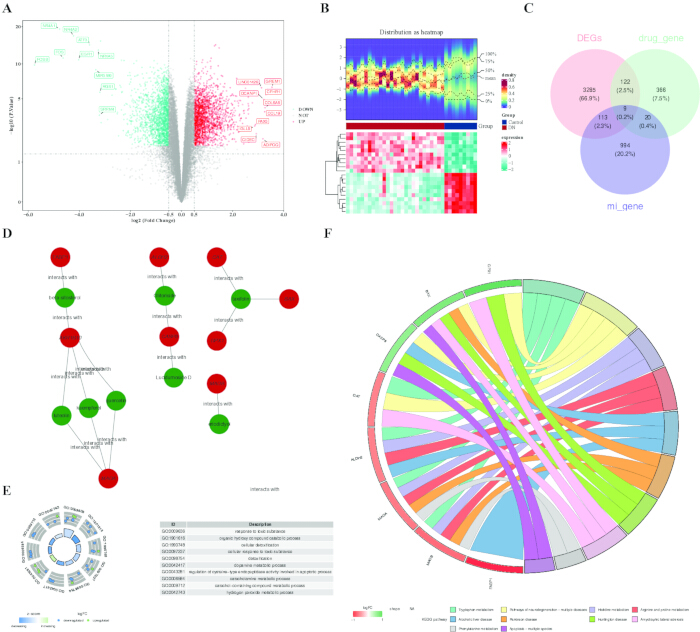
Rysunek 2: Przesiewanie i charakterystyka funkcjonalna genów kandydackich w leczeniu DN za pomocą LLF. (A) Wykres wulkaniczny przedstawiający geny różnicowo ekspresowane pomiędzy próbkami z DN a kontrolnymi w zbiorze GSE142025. (B) Mapa ciepła 10 najbardziej upregulowanych i 10 najbardziej downregulowanych genów w rankingu |log2FC|. (C) Diagram Venna przedstawiający część wspólną DEGs, MRGs oraz przewidywanych genów docelowych LLF. (D) Sieć zależności między aktywnym składnikiem a genami kandydackimi. (E) Analiza wzbogacenia Gene Ontology dla genów kandydackich. Wysokość słupka reprezentuje istotność wzbogacenia, a wynik z-score wskazuje przewidywany kierunek regulacji funkcjonalnej. (F) Analiza wzbogacenia szlaków Kyoto Encyclopedia of Genes and Genomes dla genów kandydackich. Skróty: DN = nefropatia cukrzycowa; LLF = Ligustri Lucidi Fructus; DEGs = geny różnicowo ekspresowane; MRGs = geny związane z mitochondriami; GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes. Aby wyświetlić większą wersję tego rysunku, kliknij tutaj.
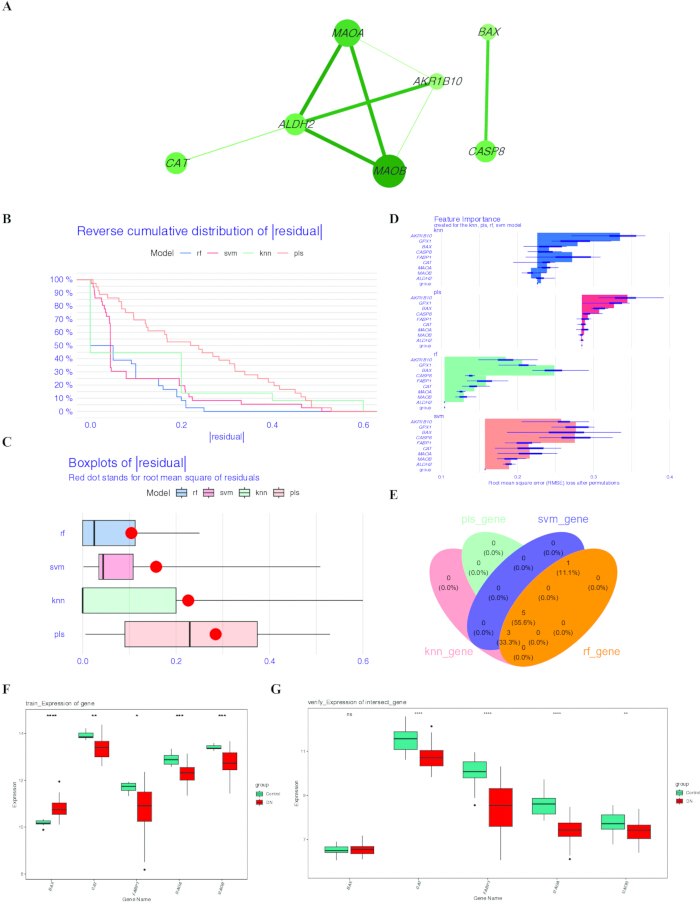
Rycina 3: Identyfikacja potencjalnych biomarkerów w oparciu o uczenie maszynowe. (A) Sieć oddziaływań białko-białko dla białek kodowanych przez potencjalne geny. (B) Odwrócony rozkład kumulatywny rezyduów dla modeli RF, KNN, PLS i SVM. (C) Wykresy pudełkowe przedstawiające rozkłady rezyduów dla czterech modeli; czerwony punkt oznacza pierwiastkowy błąd średni kwadratu. (D) Znaczenie potencjalnych genów w oparciu o RMSE w czterech modelach uczenia maszynowego. (E) Część wspólna genów cech spełniających kryterium RMSE < 0.281 we wszystkich czterech modelach. (F,G) Ekspresja wybranych genów cech odpowiednio w GSE142025 i GSE96804. Skróty: RF = random forest; KNN = k-nearest neighbor; PLS = partial least squares; SVM = support vector machine; RMSE = root mean square error. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
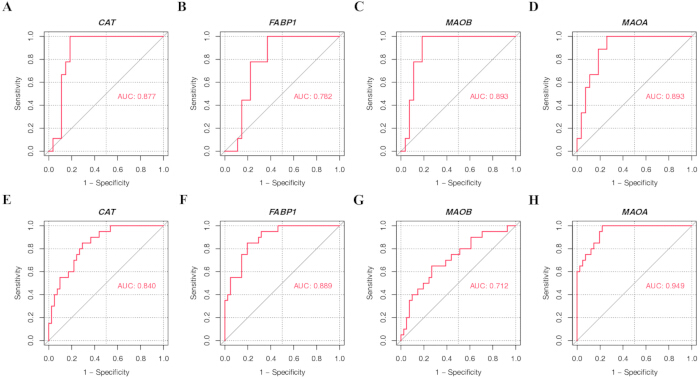
Rysunek 4: Krzywe charakterystyki operacyjnej odbiornika dla czterech kandydackich biomarkerów. Krzywe ROC dla CAT, FABP1, MAOB i MAOA w (A-D) zbiorze treningowym GSE142025 oraz (E-H) zbiorze walidacyjnym GSE96804. AUC oznacza pole powierzchni pod krzywą charakterystyki operacyjnej odbiornika. Skróty: ROC = charakterystyka operacyjna odbiornika; AUC = pole pod krzywą. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
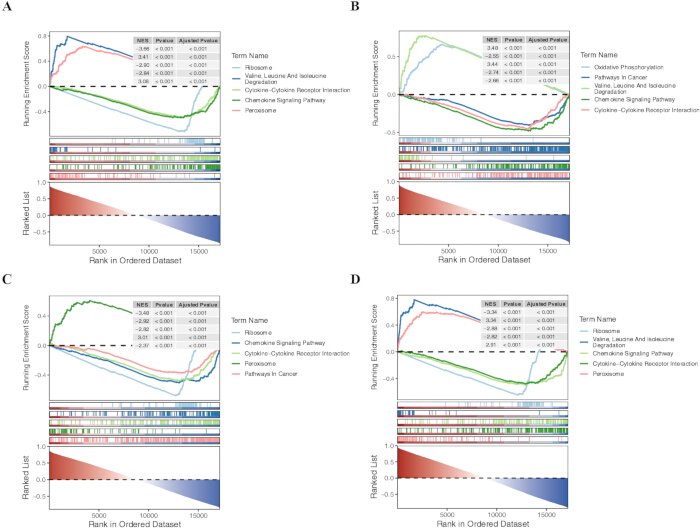
Rycina 5: Analiza wzbogacenia zbiorów genów dla potencjalnych biomarkerów. GSEA wykazująca istotnie wzbogacone szlaki KEGG związane z (A) CAT, (B) FABP1, (C) MAOA oraz (D) MAOB w zbiorze danych GSE142025. Skróty: GSEA = analiza wzbogacenia zbiorów genów; KEGG = Kyoto Encyclopedia of Genes and Genomes. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
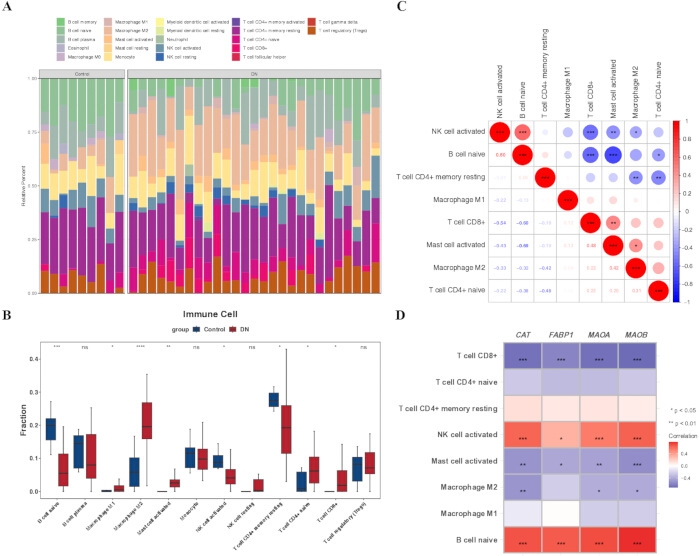
Rysunek 6: Infiltracja komórek odpornościowych i jej związek z kandydackimi biomarkerami w DN. (A) Relatywne proporcje 2 typów komórek odpornościowych oszacowane za pomocą CIBERSORT w próbkach z DN i kontrolnych. (B) Porównanie istotnie różniących się frakcji komórek odpornościowych pomiędzy grupami DN i kontrolną. (C) Macierz korelacji pomiędzy typami komórek odpornościowych o różnej liczebności. (D) Korelacje Spearmana pomiędzy ekspresją CAT, FABP1, MAOA i MAOB a typami komórek odpornościowych o różnej liczebności. Skróty: DN = nefropatia cukrzycowa. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
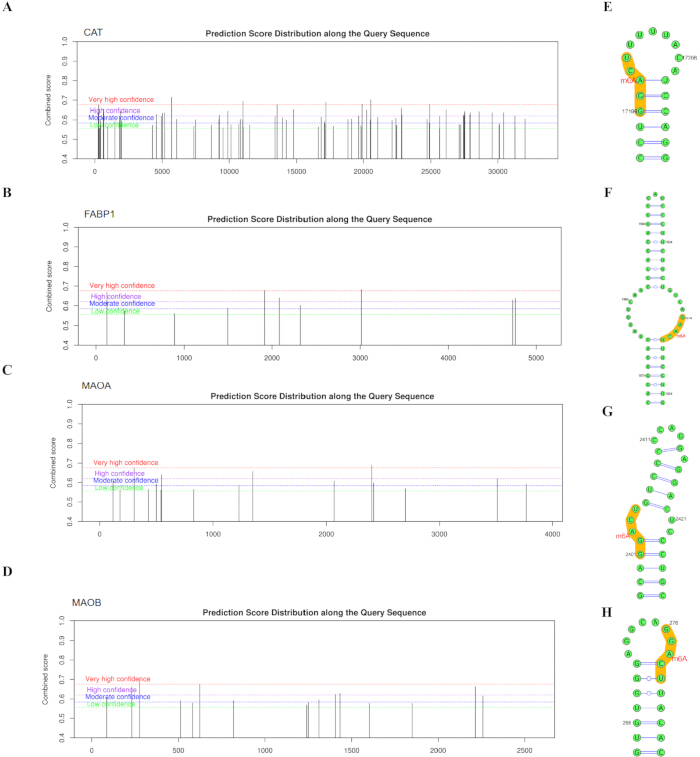
Rysunek 7: Przewidywane miejsca modyfikacji m6A oraz struktury drugorzędowe RNA transkryptów potencjalnych biomarkerów. Przewidywane miejsca modyfikacji m6A w (A) CAT, (B) FABP1, (C) MAOA i (D) MAOB. Przewidywane struktury drugorzędowe RNA wykazujące regiony o wysokim stopniu pewności powiązane z m6A dla (E) CAT, (F) FABP1, (G) MAOA i (H) MAOB. Regiony wyróżnione na żółto wskazują przewidywane fragmenty sekwencji zawierające miejsca modyfikacji m6A. Skrót: m6A = N6-metyloadenozyna. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
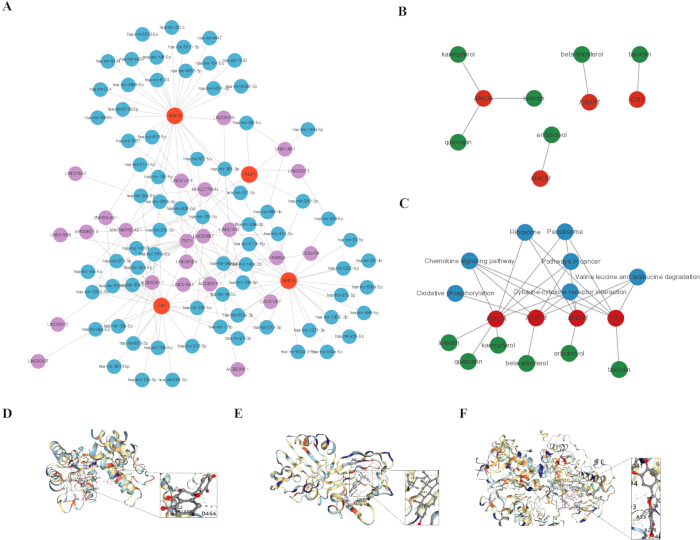
Rycina 8: Sieci regulacyjne i dokowanie molekularne potencjalnych składników aktywnych LLF. (A) Przewidywana sieć regulacyjna lncRNA–miRNA–mRNA obejmująca kandydatów na biomarkery. (B) Sieć potencjalnych składników aktywnych LLF i kandydatów na biomarkery. (C) Sieć składnik aktywny–biomarker–szlak na podstawie wyników GSEA. (D-F) Przewidywane konformacje dokowania molekularnego (D) CAT z taksifoliną, (E) FABP1 z beta-sitosterolem oraz (F) MAOB z eriodyktyolem. Skróty: LLF = Ligustri Lucidi Fructus; lncRNA = długie niekodujące RNA; miRNA = mikroRNA; GSEA = analiza wzbogacenia zbiorów genów. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
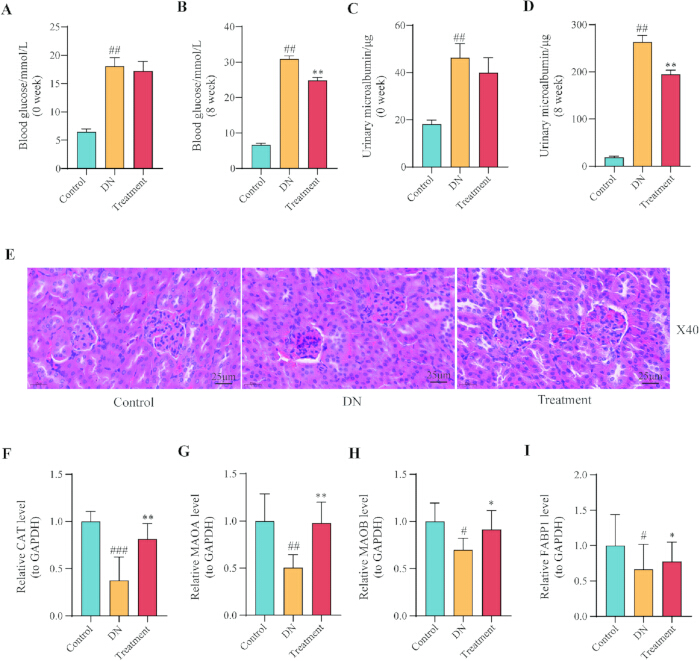
Rycina 9: Wpływ leczenia LLF na wskaźniki biochemiczne, histopatologię nerek i ekspresję potencjalnych biomarkerów u myszy db/db. (A,B) Poziomy glukozy we krwi odpowiednio w punkcie wyjściowym i w 8. tygodniu. (C,D) Poziomy mikroalbuminurii odpowiednio w punkcie wyjściowym i w 8. tygodniu. (E) Reprezentatywne przekroje nerek barwione hematoksyliną i eozyną z grup Control, DN i Treatment (powiększenie ×40; pasek skali = 25 µm). (F-I) Względne poziomy ekspresji mRNA w nerkach dla Cat, Maoa, Maob i Fabp1, odpowiednio, zmierzone za pomocą RT-qPCR. #P < 0,05, ##P < 0,01 oraz ###P < 0,01 względem grupy Control; *P < 0,05, **P < 0,01 oraz ***P < 0,01 względem grupy DN. Skróty: LLF = Ligustri Lucidi Fructus; DN = nefropatia cukrzycowa; RT-qPCR = ilościowa reakcja polimerazy w łańcuchu po odwrotnej transkrypcji. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
| starter | sekwencje |
| CAT F | TCACTGACGAGATGGCAC |
| CAT R | ATCGAACGGCAATAGGGGTC |
| FABP1 F | CAATAGGTCTGCCCGAGGAC |
| FABP1 R | GTCATGGTCTCCAGTTCGCA |
| MAOB F | GCACTGAAACAGCCTCAC |
| MAOB R | TCGTGCAGGGACATCCAAAG |
| MAOA F | ACTTACCCATTCCGTGGTGC |
| MAOA R | ACCACAGGGCAGATACCTCA |
| M-GAPDH F | CCTTCCGTGTTCCTACCCC |
| M-GAPDH R | GCCCAAGATGCCCTTCAGT |
Tabela 1: Sekwencje starterów użyte do analizy RT-qPCR tkanek nerek myszy. Skróty: F = starter forward; R = starter reverse; RT-qPCR = ilościowa reakcja polimerazy łańcuchowej z odwrotną transkrypcją.
| ID cząsteczki | Nazwa cząsteczki | OB (%) | DL | Liczba docelowa |
| MOL00358 | beta-sitosterol | 36.91 | 0.75 | 100 |
| MOL0042 | kaempferol | 41.88 | 0.24 | 103 |
| MOL04576 | taksyfolina | 57.84 | 0.27 | 92 |
| MOL05146 | Lucidumozyd D | 48.87 | 0.71 | 104 |
| MOL05147 | Lucidumoside D_qt | 54.41 | 0.47 | 0 |
| MOL05169 | (20S)-24-en-3,20-diol-3-acetan | 40.23 | 0.82 | 0 |
| MOL05190 | eriodictyol | 71.79 | 0.24 | 101 |
| MOL05195 | dyglukozyd syringaresinolu_qt | 83.12 | 0.8 | 0 |
| MOL05209 | Lucidusculina | 30.11 | 0.75 | 105 |
| MOL0521 | Olitoryzyd | 65.45 | 0.23 | 100 |
| MOL05212 | Olitorisid_qt | 103.23 | 0.78 | 0 |
| MOL006 | luteolina | 36.16 | 0.25 | 102 |
| MOL0098 | kwercetyna | 46.43 | 0.28 | 103 |
Tabela 2: Trzynaście składników aktywnych Ligustri Lucidi Fructus zidentyfikowanych przy użyciu bazy danych TCMSP. Skróty: OB = biodostępność doustna; DL = podobieństwo do leku.
| mRNA | Białko | RF | SVM |
| CAT | AQR | 0.7 | 0.98 |
| CAT | RBM2 | 0.8 | 0.97 |
| FABP1 | AQR | 0.65 | 0.94 |
| FABP1 | SF3A3 | 0.7 | 0.8 |
| MAOA | IGF2BP2 | 0.75 | 0.97 |
| MAOA | IGF2BP3 | 0.75 | 0.97 |
| MAOB | TIA1 | 0.85 | 0.89 |
Tabela 3: Przewidywane oddziaływania między czterema mRNA biomarkerów mitochondrialnych a białkami wiążącymi RNA związanymi z m6A. CAT, FABP1, MAOA i MAOB oznaczają ludzkie mRNA biomarkerów; AQR, RBM2, SF3A3, IGF2BP2, IGF2BP3 i TIA1 oznaczają białka wiążące RNA. Wyniki RF i SVM > 0.5 wskazują na przewidywane oddziaływania RNA–białko. Skróty: RF = random forest (las losowy); SVM = support vector machine (maszyna wektorów nośnych).
Plik uzupełniający 1. Skrypty bioinformatyczne i surowe dane eksperymentalne. Archiwum to zawiera skrypty R wykorzystane do przetwarzania danych, analizy ekspresji różnicowej, wzbogacenia funkcjonalnego, uczenia maszynowego, analizy charakterystyki operacyjnej odbiornika (ROC), analizy wzbogacenia zbiorów genów (GSEA), analizy korelacji Spearmana oraz analizy infiltracji komórek odpornościowych CIBERSORT, wraz z surowymi danymi dla poziomu glukozy we krwi, mikroalbuminurii w moczu oraz eksperymentów RT-qPCR. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
LLF jest powszechnie stosowanym tradycyjnym lekiem chińskim, wykorzystywanym przede wszystkim w celu odżywienia wątroby i nerek oraz w leczeniu cukrzycy i jej powikłań. Obecnie nie istnieją specyficzne leki ani terapie na DN, a jego leczenie opiera się głównie na terapiach hipoglikemicznych, hipolipemicznych i hipotensyjnych30,31,32. Jednakże terapie te mogą spowolnić postęp uszkodzeń nerek jedynie u niewielkiej grupy pacjentów3. Wykazano, że LLF wywiera działanie ochronne na nerki w modelach szczurzych DN poprzez korygowanie zaburzeń metabolizmu glukozy i lipidów oraz łagodzenie stresu oksydacyjnego34. Co istotne, jako organ o wyjątkowo wysokiej zawartości mitochondriów i wysokim zużyciu tlenu, nieprawidłowa dynamika mitochondriów w nerkach odgrywa kluczową rolę w patogenezie DN35. Niniejsze badanie ujawnia nowy mechanizm, dzięki któremu LLF może wpływać na funkcję mitochondriów poprzez specyficzne biomarkery kandydujące (CAT, FABP1, MAOB oraz MAOA) w leczeniu DN.
Poprzednie badania wykazały, że katalaza (CAT), białko wiążące kwasy tłuszczowe 1 (FABP1), monoaminooksydaza B (MAOB) oraz monoaminooksydaza A (MAOA) są w różnym stopniu zaangażowane w patogenezę DN. CAT uczestniczy w systemie obrony antyoksydacyjnej, chroniąc nerki przed uszkodzeniami wywołanymi stresem oksydacyjnym36. CAT, będący kluczowym enzymem antyoksydacyjnym w organizmie, bierze udział w regulacji występowania i progresji DN poprzez modulowanie fizjologicznych procesów związanych z mitochondriami37. CAT specyficznie katalizuje rozkład nadtlenku wodoru (H₂O₂) do wody i tlenu, skutecznie neutralizując ROS pochodzące z mitochondriów. Redukuje to uszkodzenia struktury i funkcji mitochondriów wywołane stresem oksydacyjnym, utrzymuje stabilność potencjału błony mitochondrialnej oraz wydajność fosforylacji oksydacyjnej, łagodząc tym samym uszkodzenia komórek nerkowych indukowane wysokim stężeniem glukozy i opóźniając progresję DN38. Co więcej, obniżenie ekspresji CAT prowadzi do niewystarczającej neutralizacji mitochondrialnych ROS, co nasila fragmentację mitochondriów i zaburzenia grzebieni mitochondrialnych. Hamuje to fuzję mitochondriów, jednocześnie promując ich podziały, co dodatkowo destabilizuje dynamikę mitochondrialną. W konsekwencji w komórkach wewnątrznerkowych, takich jak komórki kłębuszkowe i podocyty, rozwijają się zaburzenia metaboliczne, co przyspiesza włóknienie tkanki nerkowej39.
FABP1, jako członek rodziny białek wiążących kwasy tłuszczowe, uczestniczy przede wszystkim w transporcie, metabolizmie i wewnątrzkomórkowym przekazywaniu sygnałów długołańcuchowych kwasów tłuszczowych. Wykazano, że jego nieprawidłowa ekspresja jest ściśle powiązana z różnymi chorobami metabolicznymi i uszkodzeniami nerek, odgrywając kluczową rolę regulacyjną w rozwoju i progresji nefropatii cukrzycowej (DN)40. Badania wskazują, że FABP1 moduluje progresję DN poprzez zaburzanie metabolizmu lipidów. W cukrzycy nieprawidłowa ekspresja FABP1 zakłóca transport i metabolizm kwasów tłuszczowych. Nadmierne ilości wolnych kwasów tłuszczowych i ich metabolitów gromadzą się w tkance nerkowej, bezpośrednio uszkadzając komórki śródbłonka kłębuszków i komórki nabłonka cewek, co nasila stan zapalny i włóknienie nerek41. Jednocześnie FABP1 potęguje uszkodzenia tkanki nerkowej poprzez pośredniczenie w stresie oksydacyjnym i uszkodzeniach indukowanych hipoksją. Jego wydalanie z moczem może wzrosnąć przed wystąpieniem nieprawidłowych poziomów albuminurii, co stanowi nowy cel dla wczesnego przesiewu i diagnostyki DN41,42. Ponadto FABP1 odgrywa centralną rolę regulacyjną w mitochondrialnym metabolizmie kwasów tłuszczowych43. Badania wskazują, że zwiększona ekspresja FABP1 znacząco poprawia wydajność transportu kwasów tłuszczowych do mitochondriów, zwiększa aktywność mitochondrialnej β-oksydacji oraz aktywność enzymów cyklu kwasu trójkarboksylowego, poprawiając tym samym komórkowy metabolizm energetyczny4. Jednak mechanizm, za pomocą którego FABP1 wpływa na patogenezę DN poprzez udział w procesach związanych z mitochondriami, pozostaje niejasny. W innych stanach związanych z DN, MAOB i MAOA, jako enzymy zaangażowane w metabolizm neuroprzekaźników, były wiązane z progresją DN, przyczyniając się do zaburzenia stanu redoks w tkankach. Niniejsze badanie dodatkowo potwierdza kluczową rolę tych czterech potencjalnych biomarkerów w DN, przy czym ich poziomy ekspresji maleją w grupie z DN. Stawia się hipotezę, że modulowanie ekspresji tych potencjalnych biomarkerów może pomóc w redukcji stanu zapalnego i stresu oksydacyjnego w DN.
Na podstawie analizy wzbogacenia GSEA cztery potencjalne biomarkery — CAT, FABP1, MAOB oraz MAOA — zostały wzbogacone w wielu szlakach, w tym w szlaku sygnalizacji chemokin, interakcji cytokina-receptor cytokiny oraz szlakach peroksysomalnych. Chemokiny są kluczowymi elementami odpowiedzi immunologicznej, które promują stan zapalny. Szlak peroksydazy (POD) jest powiązany ze stresem oksydacyjnym45. Wykazano, że baikalina łagodzi przebieg DN poprzez redukcję stresu oksydacyjnego i stanu zapalnego, a jej mechanizm może obejmować aktywację szlaku sygnalizacji przeciwutleniającej zależnej od NrF2 oraz hamowanie zapalnego szlaku zależnego od MAPK45. Ponadto dysregulacja FABP1 w metabolizmie lipidów może przyczyniać się do stwardnienia kłębuszków i włóknienia śródmiąższowego w DN9. Wyniki te sugerują, że potencjalne biomarkery odgrywają krytyczną rolę w procesach zapalnych i stresie oksydacyjnym w DN. Celowanie w te potencjalne biomarkery w celu modulacji szlaków, na które wpływają, mogłoby złagodzić stan zapalny i stres oksydacyjny towarzyszący DN, hamując tym samym jego progresję.
Analiza bioinformatyczna wykazała, że poziomy infiltracji subpopulacji immunologicznych, takich jak limfocyty T CD8+, w tkance nerek w DN uległy znaczącej zmianie, a wzrost liczby limfocytów T CD8+ był istotnie i ujemnie skorelowany z ekspresją czterech kandydatów na biomarkery związane z mitochondriami (CAT, FABP1, MAOB, MAOA). Te przewidywania obliczeniowe są zgodne z wynikami obserwacji patomorfologicznych w doświadczeniach na zwierzętach: przekroje nerek myszy w grupie modelu DN barwione HE wykazały wyraźną infiltrację komórek zapalnych wokół kłębuszków; po interwencji z zastosowaniem LLF infiltracja nerkowych komórek zapalnych w grupie leczonej była znacznie zredukowana, a uszkodzenia patologiczne uległy poprawie. Sugeruje to, że zwiększona infiltracja komórek zapalnych jest kluczową cechą uszkodzenia nerek w DN, a LLF może pełnić rolę ochronną poprzez regulację infiltracji immunologicznej. Wynik ten jest zgodny z poprzednimi badaniami: infiltracja limfocytów T CD8+ wiąże się z rozwojem DN, a hamowanie ich odpowiedzi może łagodzić przebieg choroby46, co również nasila uszkodzenie nerek w nefropatii wywołanej adriamycyną47. Dodatkowo w patologii DN zmienia się liczba wielu rodzajów komórek odpornościowych, takich jak limfocyty B, makrofagi M1 / M2 oraz komórki NK48. Biomarker CAT może wpływać na funkcję komórek odpornościowych w DN49, a MAOA może również oddziaływać na mikrośrodowisko immunologiczne poprzez regulację polaryzacji makrofagów. Wyniki te wskazują, że ochronny efekt nerkowy LLF jest ściśle powiązany z regulacją nieprawidłowej infiltracji immunologicznej, w tym limfocytów T CD8+, co prowadzi do zmniejszenia uszkodzeń zapalnych. Ujemne korelacje między czterema kandydatami na biomarkery a limfocytami T CD8+ i aktywowanymi komórkami tucznymi sugerują, że geny te mogą modulować nerkowe mikrośrodowisko immunologiczne. Ekspresję CAT powiązano z polaryzacją makrofagów i aktywnością limfocytów T w tkankach metabolicznych. Jednakże nasze szacunki CIBERSORT pochodzą z transkryptomów całej tkanki nerkowej, co uniemożliwia rozróżnienie podtypów komórek odpornościowych infiltrujących przedziały kłębuszkowe i cewkowo-śródmiąższowe. Obserwowane korelacje należy interpretować jako powiązania służące do generowania hipotez, a nie jako dowód przyczynowej regulacji immunologicznej. Do zlokalizowania tych interakcji między układem immunologicznym a biomarkerami niezbędne będą przyszłe badania z wykorzystaniem multipleksowej immunohistochemii lub sekwencjonowania RNA pojedynczych komórek (single-cell RNA-seq).
W poprzednich badaniach zgłaszano biomarkery związane z mitochondriami w DN, w tym OPA1, MFN2, DRP1, PGC-1α oraz SOD2. Nasze wyniki dotyczące CAT i MAOA uzupełniają istniejącą literaturę, podkreślając znaczenie szlaków peroksysomalnych i oksydazy monoaminowej, które w kontekście mitochondrialnym w DN były słabiej opracowane. Co istotne, podczas gdy SOD2 i GPX1 są klasycznymi enzymami usuwającymi ROS, CAT celuje specyficznie w peroksysomalny H2O2, co sugeruje istnienie odrębnego przedziału subkomórkowego regulacji stresu oksydacyjnego.
Wykazano, że taksifolina (TA), będąca naturalnym flawonoidem, znacząco obniża poziom glukozy we krwi, kwasu moczowego, kreatyniny oraz insuliny w surowicy u szczurów z cukrzycą, łagodząc jednocześnie patologiczne zmiany nerkowe u tych zwierząt50. β-sitosterol może pośrednio poprawiać przebieg DN poprzez regulację równowagi lipidowej i wywieranie efektów przeciwzapalnych. Składniki β-sitosterolu w odwarze Huangqi Gegen (HGD) uczestniczą w szlakach związanych z DN, celując w cząsteczki takie jak czynnik wzrostu śródbłonka naczyniowego A (VEGFA) oraz interleukina-6 (IL-6). Efekty te obejmują działania przeciwzapalne, antyapoptotyczne, przeciwutleniające i autofagiczne, które redukują włóknienie nerek oraz uszkodzenia kory nerkowej i poprawiają funkcję nerek, co ostatecznie opóźnia progresję DN51. Wykazano również, że eriodiktyol, inny naturalny flawonoid, chroni przed udarem niedokrwiennym (IS) poprzez równoważenie stresu oksydacyjnego i stanu zapalnego52. Choć badania nad eriodiktyolem w kontekście DN są ograniczone, biorąc pod uwagę związek tej choroby ze stanem zapalnym i stresem oksydacyjnym, wysunięto hipotezę, że może on łagodzić DN poprzez podobne mechanizmy. Prognozy lekowe w niniejszym badaniu sugerują również, że taksifolina, β-sitosterol i eriodiktyol wykazują potencjalne działanie terapeutyczne w DN. Dokowanie molekularne pozwala przewidzieć możliwe konformacje i powinowactwa wiązania, ale nie potwierdza angażowania celu in vivo, biodostępności ani aktywności farmakologicznej. Wyniki te należy interpretować jako generujące hipotezy, a nie potwierdzające.
Poprzednie badania z zakresu farmakologii sieciowej nad nefropatią cukrzycową (DN) koncentrowały się głównie na pojedynczych szlakach sygnalizacyjnych (np. AGE-RAGE, PI3K-AKT i MAPK) i nie uwzględniały dysfunkcji mitochondriów ani nie wykorzystywały wielomodelowego uczenia maszynowego do priorytetyzacji biomarkerów. Nasze badanie wprowadza trzy postępy metodologiczne i biologiczne: (1) integrację genów różnicowo ekspresyjnych (DEGs) z całego transkryptomu ze zbiorami genów mitochondrialnych oraz przewidywaniami dotyczącymi celów leków; (2) zastosowanie czterech odrębnych modeli uczenia maszynowego z walidacją krzyżową między zbiorami danych w celu wyłonienia najbardziej wiarygodnych kandydatów; oraz (3) identyfikację szlaków peroksysomalnych (CAT) i monoaminooksydazy (MAOA/MAOB) — rzadziej badanych w kontekście mitochondrialnym w DN — jako potencjalnych osi terapeutycznych.
Brak statystycznie istotnych zmian w ekspresji MaoB i Fabp1 w nerkach myszy może wynikać z kilku czynników. Po pierwsze, dwa zbiory danych Gene Expression Omnibus (GEO) wykorzystane do priorytetyzacji kandydatów pochodziły z próbek nerek ludzkich (odpowiednio z całej nerki i kłębuszka), podczas gdy w naszym doświadczeniu na zwierzętach wykorzystano tkankę nerkową myszy. Różnice międzygatunkowe w regulacji genów mogą wpływać na bazowe poziomy ekspresji oraz odpowiedź na lek. Po drugie, stosunkowo mała liczebność próby (n = 6 na grupę) mogła ograniczyć moc statystyczną niezbędną do wykrycia umiarkowanej wielkości efektu. Po trzecie, tkankę pobrano 8 tygodni po leczeniu, co mogło nie uchwycić optymalnego okna czasowego dla wykrycia zmian transkrypcyjnych w MaoB i Fabp1, ponieważ geny te mogą być regulowane na poziomie białka lub aktywności, a nie na poziomie mRNA. Po czwarte, heterogeniczność tkanki — pomiędzy całą nerką a konkretnymi przedziałami — może przyczyniać się do rozbieżności. Wskazane jest dalsze badanie tych możliwości.
W niniejszym badaniu zastosowano zintegrowane podejście bioinformatyczne i uczenie maszynowe, aby zidentyfikować CAT, FABP1, MAOA i MAOB jako potencjalne mitochondrialne geny kandydackie dla LLF w przebiegu DN. Eksperymenty in vivo potwierdziły, że LLF istotnie zwiększa ekspresję CAT i MAOA w tkance nerkowej, co sugeruje, że geny te są obiecującymi celami dla dalszych badań mechanistycznych i terapeutycznych. W przeciwieństwie do nich, MAOB i FABP1 wykazały nieistotne trendy w tym samym kierunku, co podkreśla znaczenie walidacji eksperymentalnej przy priorytetyzacji przewidywań obliczeniowych. Wyniki te stanowią uzasadnienie dla przyszłych badań nad strategiami terapeutycznymi związanymi z mitochondriami w DN.
Oświadczenia
Autorzy nie deklarują żadnych konfliktów interesów.
Podziękowania
Pragniemy wyrazić naszą szczerą wdzięczność wszystkim osobom i organizacjom, które wspierały nas i pomagały nam w trakcie prowadzenia tych badań. Niniejsze badanie zostało sfinansowane przez National Natural Science Foundation of China (nr 81973486 i 82173974), projekty badawcze Shanxi Province Traditional Chinese Medicine Administration (nr 2024ZYYA021), projekt dyscypliny Shanxi University of Chinese Medicine (nr 2026XK24) oraz projekt z funduszu badań naukowych Shandong University of Chinese Medicine (nr KYZK2024Q13). Dziękujemy dr Qinqing Li, profesorowi nadzwyczajnemu na Shanxi University of Chinese Medicine, za autentykację materiału botanicznego.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 4% roztwór utrwalający tkanki z paraformaldehydu | Saiyin Biotechnology Co., Ltd. | 71033600 | |
| Etanol absolutny | Sinopharm Chemical Reagent Co., Ltd. | 10009218 | |
| Glukometr | Sinocare Inc. | GA-3 | |
| Zestaw do oznaczania azotu mocznika we krwi (BUN) | Nanjing Jianwei Bioengineering Institute | C03-2-1 | |
| myszy C57BLKS/J db/db | Changzhou Cavens Experimental Animal Co., Ltd. | SCXK (Su) 2021-013 | |
| myszy C57BLKS/J db/m | Changzhou Cavens Experimental Animal Co., Ltd. | SCXK (Su) 2021-0013 | |
| Wirówka | Hunan Xiangyi Laboratory Instrument Development Co., Ltd. | HI650 | |
| Hydrat chloralu | Shanghai Aladdin Biochemical Technology Co., Ltd. | 302-17-0 | |
| Cytoscape (v3.9.0) | https://cytoscape.org | ||
| Baza danych dla m6Predykcja modyfikacji | http://www.cuilab.cn/sramp/ | ||
| Baza danych składników aktywnych w tradycyjnej medycynie chińskiej | http://sm.nwsuaf.edu.cn/lsp/tcmsp.php | ||
| ENCORI / Starbase | https://starbase.sysu.edu.cn/ | ||
| Gene Expression Omnibus (GEO) | https://www.ncbi.nlm.nih.gov/geo/ | ||
| Zestaw do barwienia hematoksyliną i eozyną (HE) | Servicebio | C0105S | |
| Wirówka wysokoprędkościowa | Labnet, USA | C2500-R-230V | |
| Narzędzie do analizy infiltracji immunologicznej | https://cibersort.stanford.edu/ | ||
| Owoc Ligustru błyszczącego | Sichuan Quanyirun Biotechnology Co., Ltd. | 20240506 | |
| Mieszadło magnetyczne | Jintan Zhongtian Instrument Factory, Jiangsu | T8-1 | |
| Mikroskop | Olympus | BX53 | |
| Mikrotom | Leica, Niemcy | RM 2016 | |
| Spektrofotometr mikrokubetowy | Hangzhou Aosheng Instrument Co., Ltd. | Nano-300 | |
| miRNet | https://www.mirnet.ca | ||
| MitoCarta 3.0 | https://www.broadinstitute.org/mitocarta | ||
| Pakiet R do interpretacji modeli | https://cran.r-project.org/package=DALEX | ||
| Platforma dokowania molekularnego | http://clab.labshare.cn/cb-dock/ | ||
| Zestaw ELISA do oznaczania mikroalbuminurii u myszy | Test precyzyjny | EM0632 | |
| pasek testowy do oznaczania mikroalbuminurii u myszy | Guangzhou Huadu Gaoerbao Biotechnology Co., Ltd. | 20211203 | |
| Zestaw ELISA do oznaczania kreatyniny w surowicy mysiej | Abmart | AB590A | |
| MSigDB | https://www.gsea-msigdb.org/gsea/msigdb/ | ||
| Termocykler do PCR | Roche | Roche LightCycler 480 | |
| Oprogramowanie R (wersja 4.2.2) + pakiety R | https://www.r-project.org / CRAN/Bioconductor | ||
| RCSB PDB | https://www.rcsb.org | ||
| Zestaw do izolacji RNA | Beijing Jumei Biotech Co., Ltd. | MF-036-01 | |
| RPISeq | http://pridb.gdcb.iastate.edu/RPISeq/ | ||
| Zestaw do RT-qPCR | Beijing Jumei Biotech Co., Ltd. | MF949-T | |
| Salidrozyd | Sichuan Quanyirun Biotechnology Co., Ltd. | 20211009 | |
| Zestaw do oznaczania kreatyniny w surowicy | Nanjing Jianwei Bioengineering Institute | C01-2-1 | |
| wybieg dla zwierząt SPF | Uniwersytet Tradycyjnej Medycyny Chińskiej w Shanxi | ||
| SRAMP | http://www.cuilab.cn/sramp/ | ||
| Proszę podać tekst źródłowy do przetłumaczenia. | https://cn.string-db.org/ | ||
| SwissTargetPrediction | http://www.swisstargetprediction.ch/ | ||
| TCMSP | http://sm.nwsuaf.edu.cn/lsp/tcmsp.php | ||
| Tezhi Pigan | Sichuan Quanyirun Biotechnology Co., Ltd. | 20210602 | |
| Kąpiel flotacyjna do tkanek | Wuhan Junjie | JK-6 |
Bibliografia
- Thipsawat S. Early detection of diabetic nephropathy in patient with type 2 diabetes mellitus: a review of the literature. Diabetes Vasc Dis Res. 2021;18(6):14791641211058856.
- Kanwar YS, Sun L, Xie P, Liu FY, Chen S. A glimpse of various pathogenetic mechanisms of diabetic nephropathy. Annu Rev Pathol. 2011;6:395-423.
- Santulli G, et al. Prediabetes increases the risk of frailty in prefrail older adults with hypertension: beneficial effects of metformin. Hypertension. 2024;81(7):1637-43.
- Jin Q, et al. Oxidative stress and inflammation in diabetic nephropathy: role of polyphenols. Front Immunol. 2023;14:1185317.
- Alicic RZ, Rooney MT, Tuttle KR. Diabetic kidney disease: challenges, progress, and possibilities. Clin J Am Soc Nephrol. 2017;12(12):2032-45.
- Harrington JS, et al. Mitochondria in health, disease, and aging. Physiol Rev. 2023;103(4):2349-422.
- Peña FJ, et al. An integrated overview on the regulation of sperm metabolism (glycolysis-Krebs cycle-oxidative phosphorylation). Anim Reprod Sci. 2022;246:106805.
- de Mello AH, Costa AB, Engel JDG, Rezin GT. Mitochondrial dysfunction in obesity. Life Sci. 2018;192:26-32.
- Shen Y, et al. Notoginsenoside Fc, a novel renoprotective agent, ameliorates glomerular endothelial cells pyroptosis and mitochondrial dysfunction in diabetic nephropathy through regulating HMGCS2 pathway. Phytomedicine. 2024;126:155445.
- Zhang PN, et al. Mitochondrial dysfunction and diabetic nephropathy: nontraditional therapeutic opportunities. J Diabetes Res. 2021;2021:1010268.
- Zhang JL, et al. Structural characterization and protective effect against renal fibrosis of polysaccharide from Ligustrum lucidum Ait. J Ethnopharmacol. 2023;302(Pt A):115898.
- Luan R, et al. The protective effect of ethyl acetate and n-butanol fractions of wine-steamed Ligustri Lucidi Fructus on diabetic nephropathy in rats. Evid Based Complement Alternat Med. 2021;2021:6512242.
- Luan R, et al. Pharmacodynamics, pharmacokinetics, and kidney distribution of raw and wine-steamed Ligustri Lucidi Fructus extracts in diabetic nephropathy rats. Molecules. 2023;28(2):791.
- Seo HL, et al. Liqustri lucidi Fructus inhibits hepatic injury and functions as an antioxidant by activation of AMP-activated protein kinase in vivo and in vitro. Chem Biol Interact. 2017;262:57-68.
- Yan M, et al. Identification of pyroptosis-related genes and potential drugs in diabetic nephropathy. J Transl Med. 2023;21(1):490.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Gustavsson EK, et al. ggtranscript: an R package for the visualization and interpretation of transcript isoforms using ggplot2. Bioinformatics. 2022;38(15):3844-6.
- Gu Z, Eils R, Schlesner M. Complex heatmaps reveal patterns and correlations in multidimensional genomic data. Bioinformatics. 2016;32(18):2847-9.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-504.
- Wu T, et al. clusterProfiler 4.0: a universal enrichment tool for interpreting omics data. Innovation (Camb). 2021;2(3):100141.
- Dong H, et al. Identification through machine learning of potential immune-related gene biomarkers associated with immune cell infiltration in myocardial infarction. BMC Cardiovasc Disord. 2023;23(1):163.
- Pei B, et al. The development of prediction model for cuffed tracheal tube size from the middle finger in pediatrics: a concise and feasible approach. Transl Pediatr. 2023;12(12):2222-31.
- Robin X, et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77.
- Robles-Jimenez LE, et al. Worldwide traceability of antibiotic residues from livestock in wastewater and soil: a systematic review. Animals (Basel). 2021;12(1):60.
- Wang Y, et al. Bioinformatics analysis combined with clinical sample screening reveals that leptin may be a biomarker of preeclampsia. Front Physiol. 2022;13:1031950.
- Livak KJ, Schmittgen TD. Analysis of relative gene expression data using real-time quantitative PCR and the 2^−ΔΔCT method. Methods. 2001;25(4):402-8.
- Klejborowska G, et al. Synthesis, anticancer activity and molecular docking studies of N-deacetylthiocolchicine and 4-iodo-N-deacetylthiocolchicine derivatives. Bioorg Med Chem. 2021;32:116014.
- Reagan-Shaw S, Nihal M, Ahmad N. Dose translation from animal to human studies revisited. FASEB J. 2008;22(3):659-61.
- An Y, Duan H. The role of m6A RNA methylation in cancer metabolism. Mol Cancer. 2022;21(1):14.
- Mazzieri A, Porcellati F, Timio F, Reboldi G. Molecular targets of novel therapeutics for diabetic kidney disease: a new era of nephroprotection. Int J Mol Sci. 2024;25(7):3969.
- Breyer MD, Susztak K. The next generation of therapeutics for chronic kidney disease. Nat Rev Drug Discov. 2016;15(8):568-88.
- Leoncini G, et al. Blood pressure reduction and RAAS inhibition in diabetic kidney disease: therapeutic potentials and limitations. J Nephrol. 2020;33(5):949-63.
- Pofi R, et al. Diabetic nephropathy: focus on current and future therapeutic strategies. Curr Drug Metab. 2016;17(5):497-502.
- Arellano Buendía AS, et al. Immunomodulatory effects of the nutraceutical garlic derivative allicin in the progression of diabetic nephropathy. Int J Mol Sci. 2018;19(10):3107.
- Zhang X, Agborbesong E, Li X. The role of mitochondria in acute kidney injury and chronic kidney disease and its therapeutic potential. Int J Mol Sci. 2021;22(20):11253.
- Liu Y, et al. DsbA-L interacting with catalase in peroxisome improves tubular oxidative damage in diabetic nephropathy. Redox Biol. 2023;66:102855.
- Zhong Y, et al. Jujuboside A ameliorates high fat diet and streptozotocin induced diabetic nephropathy via suppressing oxidative stress, apoptosis, and enhancing autophagy. Food Chem Toxicol. 2022;159:112697.
- Zhong Y, et al. Dioscin relieves diabetic nephropathy via suppressing oxidative stress and apoptosis, and improving mitochondrial quality and quantity control. Food Funct. 2022;13(6):3660-73.
- Issac PK, et al. Protective effect of morin by targeting mitochondrial reactive oxygen species induced by hydrogen peroxide demonstrated at a molecular level in MDCK epithelial cells. Mol Biol Rep. 2022;49(6):4269-79.
- Abo El-Asrar M, Ismail EAR, Elnhrawy AM, Thabet RA. Fatty acid binding protein 1 (FABP1) and fatty acid binding protein 2 (FABP2) as a link between diabetic nephropathy and subclinical atherosclerosis in children and adolescents with type 1 diabetes. J Diabetes Complications. 2023;37(3):108414.
- Gholaminejad A, Fathalipour M, Roointan A. Comprehensive analysis of diabetic nephropathy expression profile based on weighted gene co-expression network analysis algorithm. BMC Nephrol. 2021;22(1):245.
- Tanaka M, et al. Urinary fatty acid-binding protein 4 is a promising biomarker for glomerular damage in patients with diabetes mellitus. J Diabetes Investig. 2025;16(4):670-9.
- Liu Y, et al. Gastric cancer adapts high lipid microenvironment via suppressing PPARG-FABP1 axis after arriving in the lymph node. Redox Biol. 2025;85:103759.
- Borús DL, et al. Fatty acid binding protein 1 (FABP1) depletion promotes an oxidative metabolic shift in Caco-2 colorectal cancer cells. Biochim Biophys Acta Mol Cell Biol Lipids. 2025;1870(7):159661.
- Chu Y, et al. Glutathione peroxidase-1 overexpression reduces oxidative stress, and improves pathology and proteome remodeling in the kidneys of old mice. Aging Cell. 2020;19(6):e13154.
- Zhang F, et al. Mesenchymal stem cells alleviate rat diabetic nephropathy by suppressing CD103+ DCs-mediated CD8+ T cell responses. J Cell Mol Med. 2020;24(10):5817-31.
- Cao Q, et al. Renal F4/80+ CD11c+ mononuclear phagocytes display phenotypic and functional characteristics of macrophages in health and in adriamycin nephropathy. J Am Soc Nephrol. 2015;26(2):349-63.
- Zhou W, et al. The landscape of immune cell infiltration in the glomerulus of diabetic nephropathy: evidence based on bioinformatics. BMC Nephrol. 2022;23(1):303.
- Bloch K, Shichman E, Vorobeychik M, Bloch D, Vardi P. Catalase expression in pancreatic alpha cells of diabetic and non-diabetic mice. Histochem Cell Biol. 2007;127(2):227-32.
- Zhao Y, et al. Taxifolin attenuates diabetic nephropathy in streptozotocin-induced diabetic rats. Am J Transl Res. 2018;10(4):1205-10.
- Ding S, Wang W, Song X, Ma H. Based on network pharmacology and molecular docking to explore the underlying mechanism of Huangqi Gegen Decoction for treating diabetic nephropathy. Evid Based Complement Alternat Med. 2021;2021:9928282.
- Guo S, et al. Correction: Eriodictyol: a review of its pharmacological activities and molecular mechanisms related to ischemic stroke. Food Funct. 2023;14(10):4949.