Niniejsze badanie analizuje procesy podejmowania decyzji oraz zachowania związane z poprawianiem tekstów u studentów filologii angielskiej tłumaczących narracje dotyczące Chin, integrując zapisy logowania uderzeń klawiszy z korpusem danmu, aby wykazać, w jaki sposób istotność tekstowa wpływa na wysiłek przetwarzania oraz jakość tłumaczenia.
Artykuł badawczy
Procesy podejmowania decyzji i zachowania korekcyjne w tłumaczeniu z języka chińskiego na angielski: dowody z analizy tłumaczeń narracji o Chinach wykonanych przez studentów filologii angielskiej
W tym artykule
Podsumowanie
Streszczenie
Wraz z rosnącą obecnością narracji skupionych na Chinach w obiegu międzynarodowym, przekład z języka chińskiego na angielski stał się obszarem negocjowania znaczeń, a nie jedynie prostym transferem lingwistycznym. Dla studentów przekładu główne wyzwanie wykracza poza dobór leksykalny; dotyczy ono decyzji o tym, jak oddać nasycone kulturowo odniesienia, postawy oceniające oraz pozycjonowanie narracyjne dla czytelników spoza kontekstu źródłowego. Niniejsze badanie analizuje procesy podejmowania decyzji w czasie rzeczywistym oraz zachowania związane z redagowaniem tekstu u 72 studentów filologii angielskiej tłumaczących narracje skupione na Chinach. Wykorzystując model procesu i produktu, badanie integruje dane z rejestracji uderzeń klawiszy zebrane za pomocą Translog-II, oceny produktów przekładu oraz pomocniczy korpus danmu (komentarzy zsynchronizowanych czasowo), traktowany jako warstwa istotności dla odbiorcy, a nie bezpośrednia miara trudności lingwistycznej na poziomie segmentu. Procesy tłumaczeniowe analizowano pod kątem czasu trwania pauz, częstotliwości poprawek, lokalizacji poprawek oraz rozkładu etapowego, natomiast jakość produktu oceniano za pomocą ocen eksperckich i celowanego kodowania segmentów związanych z kulturą. Korpus 18 642 komentarzy danmu z 24 filmów w serwisie Bilibili posłużył do zidentyfikowania publicznie istotnych motywów narracyjnych i ekspresji wrażliwych kulturowo. Wyniki pokazują, że segmenty nasycone kulturowo i gęste pod względem oceniającym wywoływały dłuższe pauzy, zwiększoną liczbę poprawek rekurencyjnych oraz gęstsze reformułowania w trakcie procesu. Tłumaczenia wyższej jakości wiązały się z selektywnymi, strategicznie zaplanowanymi poprawkami na poziomie dyskursu i adaptacji kulturowej, a nie z wyższą całkowitą liczbą poprawek. Nakładanie się narracyjnych wyzwalaczy istotnych w danmu z segmentami tłumaczenia wymagającymi dużego nakładu pracy interpretuje się jako zbieżny dowód na istotność dla odbiorcy i presję przetwarzania u tłumacza, a nie jako dowód przyczynowości. Badanie to rozwija wiedzę na temat procesu przekładu, łącząc zachowania redakcyjne z tłumaczeniem narracji osadzonych kulturowo i oferując wnioski dla szkolenia tłumaczy w zakresie komunikacji międzykulturowej.
Wprowadzenie
W ostatnich latach przekład dyskursu związanego z Chinami ewoluował z kwestii o charakterze stosunkowo specjalistycznym do centralnego problemu w komunikacji międzynarodowej1. Stawką w takim tłumaczeniu nie jest jedynie przekaz treści propozycjonalnych, lecz ponowna artykulacja publicznych narracji, które niosą ze sobą pozycjonowanie polityczne, ramy kulturowe oraz projektowanie odbiorcy. Prace nad przekładem chińskiego dyskursu politycznego coraz wyraźniej wskazują na ten aspekt: gdy teksty są tłumaczone dla czytelników spoza Chin, wybory dotyczące słownictwa, modalności i akcentów tekstowych stają się jednocześnie wyborami dotyczącymi tego, jak Chiny są opisywane i interpretowane za granicą2. Po sformułowaniu problemu w ten sposób, podejście skupione wyłącznie na produkcie końcowym staje się niewystarczające. Gotowy przekład może pokazać, co wybrano, ale nie może ukazać, w którym momencie pojawiła się niepewność, gdzie rozpoczęto reformułację ani w jaki sposób testowano i odrzucano konkurencyjne rozwiązania3.
Ograniczenia te pomagają wyjaśnić, dlaczego empiryczne badania nad procesem tłumaczenia stały się istotnym nurtem w ramach studiów nad przekładem, wykorzystując narzędzia do śledzenia procesu w celu rejestracji pauz, usunięć, wstawek oraz czasowego przebiegu podejmowania decyzji, zamiast wnioskować o nich pośrednio na podstawie tekstu końcowego4. Nie zastępuje to podejść skoncentrowanych na produkcie, socjologicznych, kulturowych czy korpusowych; raczej dostarcza ono dowodów na temat momentalnego formowania się decyzji tłumaczeniowych. Niedawne prace przeszły od opisywania izolowanych pauz do modelowania tłumaczenia jako aktywności ustrukturyzowanej czasowo. Na przykład taksonomia wahanie-orientacja-przepływ traktuje zachowanie tłumacza jako uporządkowaną alternację między niepewnością, poszukiwaniem a płynną produkcją, wyjaśniając, dlaczego określone fragmenty zadania stają się niestabilne i wymuszają sformułowanie tekstu na nowo5. Zmiana ta jest szczególnie istotna w przypadku tłumaczeń studenckich, w których biegłość językowa, wiedza merytoryczna i kontrola strategiczna rozwijają się jednocześnie6.
Dowody uzyskane dzięki połączeniu okulografii (eye-tracking) i rejestracji uderzeń w klawisze (keystroke logging) wskazują, że tłumacze początkujący nie rozdzielają uwagi równomiernie, a proces tworzenia tekstu docelowego często staje się głównym źródłem obciążenia poznawczego podczas tłumaczenia z języka chińskiego na angielski7. W konsekwencji to, co w gotowym produkcie jawi się jako lokalny problem z doborem słownictwa, może w rzeczywistości odzwierciedlać szerszą reorganizację uwagi i wysiłku w trakcie procesu tłumaczenia w czasie rzeczywistym8. Niedawne dowody sugerują ponadto, że studenci przekładu mogą tworzyć teksty o podobnej adekwatności powierzchniowej, mimo znaczących różnic w ilości wymaganego wysiłku, stopniu niepewności oraz zakresie samomonitorowania. Satysfakcjonujący efekt końcowy może opierać się na kruchym lub nieefektywnym ciągu decyzji, który można uchwycić jedynie za pomocą pomiarów wrażliwych na przebieg procesu9. Co więcej, badania porównawcze wskazują, że biegłość w tłumaczeniu wiąże się ze stabilną kontrolą metapoznawczą nad tym, kiedy należy zrobić pauzę, przeprowadzić kwerendę, kontynuować pisanie lub powrócić do tekstu w celu jego redakcji10.
Rewizja jest dokładnie tym momentem, w którym ten ukryty proces poznawczy staje się najbardziej widoczny. To wtedy tłumacze wracają do wcześniejszych sformułowań, testują alternatywy i rozstrzygają, czy problem ma charakter leksykalny, syntaktyczny, dyskursywny czy kulturowy. W związku z tym rewizję nie należy traktować jako końcowego etapu szlifowania tekstu, lecz jako kluczowy wskaźnik rozwoju tłumacza. Lepsze wyniki są powiązane ze sposobem konsolidacji alternatyw podczas procesu tworzenia, co dowodzi, że skuteczna rewizja jest selektywna, strategicznie zaplanowana w czasie i odpowiada na szersze wymagania tekstowe, a nie jest jedynie prostą kumulacją poprawek11,12,13.
Złożoność procesu podejmowania decyzji i wprowadzania poprawek staje się bardziej wyraźna, gdy tekst źródłowy jest narracją skoncentrowaną na Chinach, a nie neutralnym fragmentem informacyjnym. Takie teksty często opierają się na nasyconych kulturowo założeniach, osadzonych historycznie wyrażeniach oraz wskazówkach ewaluatywnych, których znaczenie zależy od wspólnego tła, a nie od wyraźnego wyłożenia treści14,15,16. Trudność tekstu zmienia samą ziarnistość przetwarzania; teksty narracyjne o dużym zagęszczeniu kulturowym lub ewaluatywnym zmuszają tłumaczy do pracy na mniejszych jednostkach, stosowania operacji nieliniowych oraz wielokrotnego lokalnego restrukturyzowania treści8. Dla tłumaczy-studentów głównym problemem jest decyzja, w jakim stopniu to utajone tło należy rozwinąć lub zreorganizować dla czytelników spoza pierwotnej wspólnoty dyskursywnej, aby nie doprowadzić do spłycenia specyfiki kulturowej.
Niniejsze badanie jest motywowane trzema konkretnymi lukami w wiedzy. Po pierwsze, wskaźniki procesu tłumaczenia, takie jak czas trwania pauzy, częstotliwość długich pauz, przerwy w ruchu kursora i konsultacje ze słownikiem, są często badane oddzielnie od typologii rewizji, co utrudnia dostrzeżenie, w jaki sposób presja decyzyjna przejawia się w późniejszej reformulacji. Po drugie, specyficzne kulturowo kategorie narracyjne otrzymują mniejszą uwagę w badaniach procesowych niż ogólne teksty akademickie lub ekspozycyjne, mimo że narracje skoncentrowane na Chinach często wymagają od tłumaczy jednoczesnego radzenia sobie z obciążeniem kulturowym, gęstością ewaluatywną i skondensowanymi implikacjami tła14,15,16. W niniejszym badaniu obciążenie kulturowe odnosi się do gęstości odniesień związanych z kulturą oraz wspólnych założeń; gęstość ewaluatywna odnosi się do jawnego lub ukrytego zajmowania stanowiska, intensywności afektywnej i ramowania nasyconego wartościami; natomiast kompresja narracyjna odnosi się do stopnia, w jakim informacje tła, relacje przyczynowe lub pozycjonowanie społeczne są skondensowane w krótkich fragmentach tekstu. Po trzecie, zadania translatorskie są zazwyczaj projektowane wyłącznie na podstawie analizy wewnątrztekstowej, przy niewielkim uwzględnieniu tego, czy segmenty zidentyfikowane jako trudne pokrywają się z punktami przyciągającymi uwagę opinii publicznej w obiegu cyfrowym. Danmu (komentarze wideo zsynchronizowane z czasem) mogą pełnić funkcję paratekstu i dyskursu partycypacyjnego, podkreślając to, co odbiorcy zauważają, kwestionują i reinterpretują17,18; jednakże istotność danmu należy traktować jako wskaźnik zaangażowania odbiorców na poziomie semantycznym, a nie jako bezpośredni zamiennik trudności lingwistycznej na poziomie segmentu.
W celu uzupełnienia tych luk, niniejsze badanie analizuje sposób, w jaki studenci filologii angielskiej podejmują decyzje i wprowadzają poprawki podczas tłumaczenia narracji dotyczących Chin z języka chińskiego na angielski. Poprzez wprowadzenie danych dotyczących procesu tłumaczenia oraz dyskursu cyfrowej publiczności w te same ramy analityczne, badanie ma na celu wyjaśnienie nie tylko tego, z czym zmagają się studenci-tłumacze, ale także dlaczego trudności te koncentrują się wokół określonych rodzajów znaczeń narracyjnych.
W szczególności niniejsze badanie podejmuje cztery pytania badawcze: (1) Jakie wzorce podejmowania decyzji charakteryzują przekład z języka chińskiego na angielski narracji o Chinach wykonywany przez studentów filologii angielskiej? (2) W jaki sposób zachowania redakcyjne różnią się w zależności od segmentów o różnym stopniu obciążenia kulturowego i gęstości narracyjnej? (3) Które wymiary zachowań redakcyjnych wiążą się z wyższą jakością tłumaczenia? oraz (4) Czy istotne kulturowo punkty zidentyfikowane w dyskursie danmu pokrywają się z segmentami, które generują największy wysiłek przetwarzania podczas tłumaczenia?
Odpowiednio, badanie testuje cztery powiązane hipotezy w jednej sekwencji analitycznej: H1 zakłada, że segmenty o wyższym obciążeniu kulturowym wywołają dłuższe pauzy, większą niepewność decyzyjną i częstsze rewizje niż segmenty o niższym obciążeniu kulturowym; H2 wyróżnia dwie ścieżki, przewidując, że gęstość oceniająca zwiększy liczbę opóźnionych rewizji, natomiast kompresja narracyjna zwiększy liczbę reformułowań na poziomie dyskursu; H3 zakłada, że jakość tłumaczenia będzie w większym stopniu wyjaśniana przez selektywność i czas wystąpienia rewizji niż przez samą całkowitą liczbę rewizji; a H4 przewiduje, że segmenty istotne dla danmu będą pokrywać się z segmentami tłumaczenia wymagającymi dużego wysiłku, co stanowi konwergencję asocjacyjną między istotnością dla odbiorcy a presją przetwarzania u tłumacza.
Protokół
Wszystkie metody z udziałem ludzi zostały przeprowadzone zgodnie z wytycznymi instytucjonalnymi i zostały zatwierdzone przez instytucjonalną komisję rewizyjną (IRB) lub komisję etyki badań z udziałem ludzi Uniwersytetu Normalnego w Hanshan. Przed rozpoczęciem eksperymentu od wszystkich uczestników uzyskano świadomą zgodę.
Ramy koncepcyjne i projekt badawczy
W niniejszym badaniu zastosowano projekt badawczy typu proces–produkt z pomocniczą warstwą dyskursywną, aby zbadać, w jaki sposób generowane przez widzów komentarze danmu wpływają na tłumaczenie napisów. Ramy analityczne zintegrowano z cechami tekstowymi, wskaźnikami procesu tłumaczenia oraz wynikami jakości tłumaczenia. W szczególności zbadano, czy uwaga widzów, odzwierciedlona w gęstości danmu, kierowała zasoby poznawcze tłumaczy na konkretne cechy tekstu oraz czy taki rozdział uwagi wpływał następnie na jakość tłumaczenia.
Aby zoperacjonalizować te ramy, w badaniu najpierw ustalono cechy tekstowe na poziomie segmentu w oparciu o cztery wymiary: ładunek kulturowy, gęstość ocenną, kompresję narracyjną oraz istotność danmu. Ładunek kulturowy odnosił się do obecności odniesień specyficznych kulturowo, które wymagały adaptacji lub wyjaśnienia. Gęstość ocenna mierzyła stężenie języka nacechowanego emocjonalnie lub postawowo w obrębie segmentu. Kompresja narracyjna oddawała stopień, w jakim treść semantyczna została skondensowana ze względu na ograniczenia napisów. Istotność danmu reprezentowała stopień uwagi widzów skierowanej na każdy segment napisów, kwantyfikowany przez liczbę zsynchronizowanych komentarzy danmu. W przeciwieństwie do konwencjonalnych miar trudności przekładu, istotność danmu odzwierciedlała społecznie rozproszoną uwagę, a nie wewnętrzną złożoność tekstu. Segment wywołujący duże zaangażowanie widzów niekoniecznie był trudniejszy do przetłumaczenia; zamiast tego reprezentował punkt o zwiększonym znaczeniu komunikacyjnym w ramach doświadczenia z oglądania.
Ramy analityczne składały się z trzech powiązanych ze sobą zbiorów danych. Zbiór danych na poziomie uczestnika obejmował indywidualne cechy demograficzne oraz doświadczenie w tłumaczeniu. Zbiór danych proces–produkt łączył każdy segment napisu z wskaźnikami behawioralnymi wyodrębnionymi z rejestracji naciśnięć klawiszy (keystroke logging) wraz z eksperckimi ocenami jakości tłumaczenia. Zbiór danych danmu zawierał zsynchronizowane komentarze widzów dopasowane do czasu wyświetlania napisów, na podstawie których obliczono wartości istotności (salience) danmu. Zbiory te zostały powiązane za pomocą identyfikatorów uczestników i segmentów, co umożliwiło jednoczesną analizę każdego przetłumaczonego segmentu napisu w relacji do cech tłumacza, behawioralnego przetwarzania poznawczego, uwagi widzów oraz wyników tłumaczenia. Końcowa zintegrowana baza danych obejmowała 216 pełnych sesji tłumaczenia i 3 168 obserwacji typu uczestnik–tekst–segment, stanowiąc podstawę empiryczną dla późniejszych analiz proces–produkt.
Przesiew uczestników i profilowanie tła
Próba składała się z 72 studentów filologii angielskiej zrekrutowanych z publicznego uniwersytetu w południowych Chinach, równomiernie rozdzielonych pomiędzy drugi, trzeci i czwarty rok studiów licencjackich (po 24 uczestników z każdego roku). Wszyscy uczestnicy byli rodzimymi użytkownikami języka chińskiego, przechodzącymi formalną naukę pisania i tłumaczenia w języku angielskim. Aby zapewnić porównywalność w populacji tłumaczy w trakcie szkolenia, wykluczono osoby, które mieszkały w kraju anglojęzycznym dłużej niż 6 miesięcy lub posiadały certyfikat tłumacza zawodowego. Uczestnicy nie zostali podzieleni na osobne grupy eksperymentalne ze względu na doświadczenie w tłumaczeniu, znajomość kultury lub poziom biegłości w drugim języku. Zamiast tego zarejestrowano rok studiów, wyniki z ostatnich testów biegłości języka angielskiego, ukończone kursy tłumaczenia, samoocenę znajomości zagadnień kulturowych związanych z Chinami oraz średni tygodniowy czas poświęcony na praktykę dwujęzyczną, a następnie uwzględniono je jako współzmienne na poziomie uczestnika w modelach statystycznych. Wyjaśnienie to rozwiązuje również kwestię niespójności w liczbie uczestników podniesioną podczas recenzji: zarówno rękopis, jak i zestaw danych do replikacji obejmują 72 uczestników, 216 sesji zadań oraz 3 168 obserwacji na poziomie segmentu.
Wybór tekstu źródłowego i konstruowanie zadań
Materiały do tłumaczenia składały się z trzech współczesnych tekstów narracyjnych dotyczących Chin, opracowanych specjalnie na potrzeby niniejszego badania, aby odzwierciedlały autentyczny dyskurs publiczny i uniknąć powielania materiałów chronionych prawem autorskim. Każdy tekst zawierał od 205 do 225 znaków chińskich, lecz różniły się one systematycznie pod względem charakterystyki wewnętrznej. Tekst A przedstawia narrację o powrocie do domu z okazji Święta Wiosny, charakteryzującą się umiarkowanym obciążeniem kulturowym i stosunkowo prostą składnią. Tekst B opisuje wspomnienia z Festiwalu Smoczych Łodzi i zawiera większe zagęszczenie wyrażeń specyficznych kulturowo oraz niejawnej wiedzy kontekstowej. Tekst C opisuje narrację dotyczącą wiejskiego livestreamingu i e-handlu, charakteryzującą się gęstym językiem wartościującym i skondensowaną pozycją narracyjną.
Teksty zostały systematycznie podzielone z wykorzystaniem granic zdań składowych, a następnie granic jednostek znaczeniowych, co pozwoliło na uzyskanie 44 jednostek analitycznych w trzech zadaniach przekładowych (Tabela 1). Przed formalnym kodowaniem opracowano instrukcję kodowania, w której zdefiniowano obciążenie kulturowe, gęstość ewaluatywną oraz kompresję narracyjną przy użyciu skal porządkowych od 1 do 5. Badanie pilotażowe z udziałem 12 studentów, którzy nie brali udziału w głównym eksperymencie, potwierdziło zamierzoną kalibrację trudności, jasność instrukcji zadań oraz stabilność granic segmentów pod kątem dopasowania uderzeń w klawisze.
Konstrukcja korpusu pomocniczego i mapowanie istotności
W celu zidentyfikowania publicznie istotnych wskazówek narracyjnych opracowano pomocniczy korpus danmu na podstawie 24 filmów z serwisu Bilibili, przesłanych między styczniem 2023 a grudniem 2025 roku. Do analizy włączono wyłącznie filmy, które odpowiadały jednej z trzech domen semantycznych reprezentowanych w tekstach źródłowych, zgromadziły ponad 50 000 wyświetleń, zawierały gęstą interakcję danmu oraz umożliwiały eksport i mapowanie tematyczne komentarzy zsynchronizowanych czasowo. Po usunięciu duplikatów oraz odfiltrowaniu emotikon, wypełniaczy onomatopeicznych i nieistotnych fragmentów, końcowy korpus objął 18 642 komentarze.
Słowa treściowe zostały ustandaryzowane i zgrupowane przy użyciu kotwic słów kluczowych powiązanych z tekstem źródłowym. Następnie każdemu segmentowi tekstu źródłowego przypisano ciągły wskaźnik istotności danmu, oparty na ważonej kompozycji znormalizowanej częstotliwości klastrów słów kluczowych, koncentracji komentarzy w odpowiadającym im klastrze tematycznym oraz średniej intensywności oceny. Procedura ta umożliwia porównanie wysiłku przetwarzania tłumacza z istotnością dla odbiorcy na poziomie klastrów semantycznych, a nie poprzez bezpośrednie dopasowanie leksykalne. Ponieważ danmu odzwierciedla reakcje odbiorców na filmy internetowe, a nie samo eksperymentalne zadanie tłumaczeniowe, istotność danmu jest interpretowana jako zewnętrzny wskaźnik zaangażowania widzów, a nie bezpośredni dowód na trudność językową segmentu źródłowego.
Procedura eksperymentalna i rejestracja danych
Sesje tłumaczeniowe przeprowadzono indywidualnie w kontrolowanym laboratorium komputerowym w zestandaryzowanych warunkach sprzętowych, programowych i w zakresie dostępu do Internetu (Rycina 2). Po pięciominutowym wprowadzeniu, w którym podkreślono konieczność tworzenia czytelnego tekstu w języku angielskim dla międzynarodowego odbiorcy, uczestnicy wykonali trzy minutowe ćwiczenie rozgrzewkowe z pisania po angielsku, aby zminimalizować wpływ aklimatyzacji do klawiatury. Trzy zadania tłumaczeniowe realizowano sekwencyjnie przy użyciu Translog-II, przy czym kolejność zadań zrównoważono zgodnie z modelem kwadratu łacińskiego, aby równomiernie rozłożyć potencjalne zmęczenie i efekty kolejności pomiędzy uczestnikami. Na każdy tekst przeznaczono uczestnikom maksymalnie 20 minut, z pięciominutowymi przerwami odpoczynkowymi pomiędzy nimi.
Choć dopuszczalne było korzystanie z wbudowanego słownika dwujęzycznego, zakazano używania systemów tłumaczenia maszynowego oraz zewnętrznych wyszukiwarek. Wszystkie naciśnięcia klawiszy, przerwy i ruchy kursora były rejestrowane automatycznie, a zapisy te uzupełniano synchronicznymi nagraniami ekranu w celu weryfikacji epizodów nielinearnej rewizji. Po zakończeniu każdego zadania uczestnicy wypełnili kwestionariusz samooceny trudności, który służył wyłącznie do pomocy w interpretacji przypadków granicznych podczas kodowania.
Pomiar procesu i kodowanie zmiennych
Zapisy uderzeń klawiszy zostały dopasowane do zdefiniowanej wcześniej struktury segmentów. Epizod dopasowania rozpoczynał się od pierwszego uderzenia klawisza w języku docelowym odpowiadającego danemu segmentowi i kończył się w momencie, gdy uczestnik definitywnie przeszedł do następnego segmentu. Nakładające się poprawki zostały ponownie przypisane przy użyciu zapisów śledzenia kursora z sygnaturą czasową.
Zachowania związane z podejmowaniem decyzji ilościowo określono za pomocą pięciu wskaźników: czasu trwania pierwszej pauzy przed rozpoczęciem tłumaczenia segmentu, średniego czasu trwania pauz wewnątrz segmentu, częstotliwości występowania pauz przekraczających dwie sekundy, liczby konsultacji ze słownikiem oraz liczby przerwań związanych z ruchem kursora, wskazujących na odejście od linearnego procesu redagowania (Table 2). Zachowania związane z rewizją zaklasyfikowano według dwóch wymiarów: czasu i funkcji. Wymiar czasu pozwolił odróżnić natychmiastowe rewizje lokalne od rewizji odroczonych, przeprowadzanych po przejściu do kolejnych segmentów. Kodowanie funkcjonalne zaklasyfikowało rewizje jako rewizje powierzchniowe (poprawki na poziomie formy bez zmiany semantycznej), rewizje znaczeniowe (modyfikacje leksykalne lub syntaktyczne), rewizje na poziomie dyskursu (korekty relacji między klauzulami lub spójności) oraz rewizje adaptacji kulturowej (reformulacje zorientowane na odbiorcę docelowego). Dwóch przeszkolonych koderów niezależnie analizowało każdy epizod rewizji przed rozstrzygnięciem i przypisywało pojedynczą główną kategorię funkcjonalną do każdego zdarzenia. Niezawodność między sędziami była wysoka dla wszystkich kodowanych miar. Kappa Cohena wskazała na istotną zgodność w przypadku kodowania kategorycznego funkcji rewizji (ĸ = 0.84, p < 0.001). Dla porządkowych zmiennych na poziomie tekstu, współczynniki korelacji wewnątrzklasowej (ICC, dwukierunkowy model mieszany, zgodność absolutna) wykazały wysoką niezawodność w odniesieniu do obciążenia kulturowego (ICC = 0.86), gęstości ewaluatywnej (ICC = 0.78) oraz kompresji narracyjnej (ICC = 0.82). Wszelkie wstępne rozbieżności w kodowaniu zostały następnie rozwiązane w drodze wspólnego rozstrzygnięcia.
Ocena jakości translokacji
Jakość tłumaczenia została oceniona niezależnie od danych procesowych przez dwóch recenzentów z wykształceniem doktoranckim i rozległym doświadczeniem w nauczaniu tłumaczeń. Nie znając tożsamości uczestników ani miar procesowych, recenzenci zastosowali 100-punktową rubrykę, rozdzieloną równomiernie na pięć wymiarów: dokładność semantyczną, biegłość językową, spójność narracyjną, oddanie kulturowe oraz odpowiedniość rejestru (Tabela 3). Rozbieżności w punktacji przekraczające osiem punktów inicjowały wspólną weryfikację i uzgodnienie oceny, a wypracowana średnia została przyjęta jako ostateczny wynik jakości tłumaczenia. Rejestry ocen sprzed weryfikacji zostały zachowane, aby umożliwić przejrzyste raportowanie niezawodności między sędziami w materiałach do replikacji.
Modelowanie statystyczne
Analizy przeprowadzono w trzech następujących po sobie etapach. W pierwszym etapie obliczono statystyki opisowe w celu podsumowania wszystkich zmiennych w podziale na grupy rocznikowe i typy tekstów. W drugim etapie przeanalizowano nakład pracy na poziomie segmentu, wykorzystując modele regresji z efektami mieszanymi, aby uwzględnić zagnieżdżoną strukturę segmentów w tekstach oraz powtarzane obserwacje od poszczególnych uczestników. Zmienne zależne, w tym czas trwania pierwszej pauzy i częstotliwość poprawek, modelowano jako funkcje obciążenia kulturowego, gęstości oceniającej, kompresji narracyjnej oraz istotności danmu, kontrolując jednocześnie poziom biegłości uczestników. W celu zwiększenia przejrzystości statystycznej uwzględniono korelacje predyktorów, diagnostykę wskaźnika inflacji wariancji (VIF), 95% przedziały ufności, szacunki wielkości efektu oraz wskaźniki dopasowania modelu.
W końcu wymodelowano jakość tłumaczenia, aby ocenić wkład predykcyjny momentu dokonania poprawki oraz funkcji poprawki w stosunku do ogólnej częstotliwości poprawek. Nakładanie się segmentów istotnych dla danmu i segmentów tłumaczenia wymagających dużego nakładu pracy oceniono z wykorzystaniem górnego kwintyla każdego rozkładu, ustandaryzowanego złożonego wskaźnika nakładu pracy oraz analizy prawdopodobieństwa nakładania się. Nie przeprowadzono eksploracyjnej analizy czynnikowej ani modelowania równań strukturalnych. W związku z tym towarzyszące im ryciny przedstawiono wyłącznie jako podsumowania koncepcyjne, opisowe lub oparte na regresji.
Wyniki
Ogólny profil sesji translacyjnych
Wszystkich 72 uczestników ukończyło trzy zadania translacyjne w ustandaryzowanych warunkach eksperymentalnych, co dało łącznie 216 pełnych sesji tłumaczenia. Po wyrównaniu segmentów końcowy zestaw danych analitycznych obejmował 3 168 obserwacji w układzie uczestnik-tekst-segment. Średni czas wykonania zadania w całej próbie wynosił 998,4 s na tekst, wykazując wyraźne różnice pomiędzy grupami rocznikowymi a tekstami źródłowymi (Tabela 4; Rysunek 3). W związku z tym zarówno rękopis, jak i towarzyszące dane konsekwentnie wskazują wielkość próby n = 72 uczestników; wszelkie rysunki podsumowujące podzbiory powinny w sposób jednoznaczny identyfikować te podzbiory.
Studenci czwartego roku wykonali zadania przekładu szybciej i z mniejszą liczbą przerw niż studenci drugiego roku. Różnica ta wykraczała poza samą prędkość przetwarzania. W grupie studentów czwartego roku odnotowano również krótszy średni czas trwania pierwszej pauzy, mniej długich pauz oraz niższą całkowitą liczbę poprawek, przy jednoczesnym osiągnięciu najwyższych wyników jakości tłumaczenia. W przeciwieństwie do nich, studenci drugiego roku wprowadzili najwięcej poprawek, z których większość stanowiły modyfikacje powierzchniowe i natychmiastowe korekty lokalne. Studenci na wyższym stopniu zaawansowania wykazali większy odsetek poprawek odroczonych oraz poprawek związanych z adaptacją kulturową, co wskazuje, że lepsze wyniki w tłumaczeniu wiązały się z selektywnymi strategiami rewizji, a nie z większą liczbą wprowadzonych poprawek.
Różnice między trzema tekstami źródłowymi były podobnie wyraźne. Tekst A charakteryzował się najkrótszym czasem ukończenia, najmniejszą liczbą długich pauz oraz najniższą gęstością rewizji. Teksty B i C nakładały większe wymagania przetwarzania, choć odbywało się to poprzez różne mechanizmy. Tekst B wywołał największą liczbę zdarzeń rewizyjnych związanych z kulturą, podczas gdy w Tekście C odnotowano najwyższą częstotliwość rewizji na poziomie dyskursu oraz najdłuższą średnią długość pauzy wewnątrz segmentu. Zatem źródło trudności w przetwarzaniu różniło się w zależności od tekstu. W Tekście B trudności koncentrowały się wokół odniesień kulturowych i ukrytych założeń kontekstowych, natomiast w Tekście C były one związane przede wszystkim z kompresją narracyjną i pozycjonowaniem ewaluatywnym.
Jednoczynnikowa analiza wariancji potwierdziła istotne różnice między grupami rocznikowymi w całkowitej jakości tłumaczenia, F (2, 69) = 31.84, p < 0.001, z dużym rozmiarem efektu (η2 ≈ 0.48 na podstawie średnich wyników uczestników). Porównania post hoc wykazały, że studenci czwartego roku uzyskali istotnie wyższe wyniki niż studenci trzeciego roku, którzy z kolei wypadli lepiej niż studenci drugiego roku. Ten sam wzorzec zaobserwowano w przypadku czasu trwania pierwszej pauzy, częstotliwości długich pauz oraz współczynnika opóźnionej rewizji. Zbiorczo te wstępne wyniki ustanawiają dwa ważne punkty dla kolejnych analiz. Po pierwsze, trzy teksty źródłowe różniły się trudnością przetwarzania, a nie tylko treścią tematyczną. Po drugie, wyższa jakość tłumaczenia wiązała się z reorganizacją procesów tłumaczeniowych, a nie z prostą redukcją wysiłku przetwarzania.
Wpływ istotności tekstowej na podejmowanie decyzji i zachowania związane z rewizją
Aby ustalić, czy właściwości tekstowe na poziomie segmentu pozwalały przewidzieć wysiłek przetwarzania, oszacowano modele efektów mieszanych dla czasu trwania pierwszej pauzy, częstotliwości długich pauz, całkowitej gęstości rewizji oraz gęstości rewizji opóźnionych. Obciążenie kulturowe, gęstość ewaluatywną, kompresję narracyjną oraz istotność danmu wprowadzono jako efekty stałe, natomiast uczestnika i segment uwzględniono jako losowe punkty przecięcia (Tabela 5; Rycina 4). Przesiewowe badanie predyktorów potwierdziło brak problematycznej współliniowości, gdyż wszystkie wartości współczynnika inflacji wariancji (VIF) znajdowały się znacznie poniżej konserwatywnego progu 2,5 (maksymalny VIF = 1,45). W celu oceny dopasowania modelu oraz proporcji wyjaśnionej wariancji, dla wszystkich modeli efektów mieszanych obliczono wartości R2 marginalne i kondycjonalne (marginalny R2 w zakresie od 0,08 do 0,19; kondycjonalny R2 w zakresie od 0,46 do 0,64). Pełne komponenty wariancji dla efektów losowych (punkty przecięcia dla uczestnika i segmentu) oraz odpowiadające im wskaźniki dopasowania modelu szczegółowo opisano w Tabeli 5. Oszacowania współczynników interpretowano łącznie z ich 95% przedziałami ufności, a nie wyłącznie na podstawie wartości p.
Obciążenie kulturowe wykazało najsilniejszy i najbardziej spójny efekt we wszystkich modelach. W modelu pierwszej pauzy każdy wzrost wyniku obciążenia kulturowego o jedną jednostkę wiązał się z wydłużeniem czasu trwania pierwszej pauzy o 0,91 s (b = 0,91, SE = 0,12, 95% CI [0,67, 1,15], p < 0,001). Obciążenie kulturowe znacząco zwiększało również częstotliwość długich pauz (b = 0,19, SE = 0,04, 95% CI [0,11, 0,27], p < ,001) oraz całkowitą gęstość rewizji (b = 0,27, SE = 0,06, 95% CI [0,15, 0,39], p < ,001). Zatem segmenty obciążone kulturowo nie tylko opóźniały wstępne przetwarzanie, ale także zwiększały prawdopodobieństwo późniejszej reformuły.
Kompresja narracyjna wykazała równie silny, lecz odrębny wzorzec efektów. Była ona silnym predyktorem rewizji na poziomie dyskursu (b = 0,31, SE = 0,07, 95% CI [0,17, 0,45], p < ,001) i znacząco zwiększała średni czas trwania pauz wewnątrz segmentu (b = 0,58, SE = 0,14, 95% CI [0,31, 0,85], p < ,001). W praktyce segmenty, które kondensowały obszerne informacje kontekstowe w krótkich fragmentach tekstu, rzadziej prowadziły do natychmiastowej substytucji leksykalnej, a częściej wymagały szerszego przemyślenia struktury.
Gęstość ewaluatywna również wniosła istotny wkład, choć jej główny wpływ odnotowano w przypadku opóźnionej rewizji, a nie latencji początkowej decyzji. W modelu opóźnionej rewizji gęstość ewaluatywna wykazała dodatni współczynnik (b = 0.23, SE = 0.05, 95% CI [0.13, 0.33], p < .001). Jej wpływ na czas trwania pierwszej pauzy był stosunkowo niewielki (b = 0.34, SE = 0.13, 95% CI [0.09, 0.59], p = 0.010). Wyniki te sugerują, że wskazówki ewaluatywne nie zawsze były rozpoznawane jako wąskie gardła w przetwarzaniu podczas wstępnego tłumaczenia. Zamiast tego często stawały się problematyczne dopiero po sporządzeniu pierwszej wersji tekstu, co skłaniało tłumaczy do ponownego rozważenia kwestii stanowiska, tonu lub odpowiedniości narracyjnej.
Wyróżnialność danmu pozostała istotnym predyktorem po skontrolowaniu zmiennych wewnętrznych tekstu. Istotnie przewidywała ona zarówno czas trwania pierwszej pauzy (b = 0.36, SE = 0.14, 95% CI [0.09, 0.63], p = 0.011), jak i całkowitą gęstość rewizji (b = 0.17, SE = 0.06, 95% CI [0.05, 0.29], p = 0.006). Chociaż wielkość tego efektu była mniejsza niż w przypadku obciążenia kulturowego i kompresji narracyjnej, jego stały wkład sugeruje, że segmenty przyciągające większą uwagę publiczną w korpusie danmu mają również tendencję do wymagania większego wysiłku przetwarzania podczas tłumaczenia. Wynik ten interpretuje się jako zbieżny dowód na istotność semantyczną, a nie jako dowód na to, że częstotliwość danmu bezpośrednio powoduje trudności w tłumaczeniu.
Zachowanie podczas rewizji i jakość tłumaczenia
Kolejne analizy miały na celu sprawdzenie, czy jakość tłumaczenia jest lepiej wyjaśniana przez całkowitą liczbę poprawek, czy przez ich charakterystykę czasową i funkcjonalną. Model jakości (Tabela 5) wykazał wyraźny wzorzec wyników. Całkowita liczba poprawek nie była istotnym predyktorem jakości tłumaczenia (b = 0,04, 95% CI [-0,06, 0,14], p = 0,412), podczas gdy zarówno czas wprowadzenia poprawek, jak i ich funkcja okazały się istotnymi predyktorami. Konkretnie, wskaźnik poprawek odroczonych (b = 1,12, 95% CI [0,39, 1,85], p = 0,003), poprawki na poziomie dyskursu (b = 1,76, 95% CI [0,96, 2,56], p < 0,001) oraz poprawki dotyczące adaptacji kulturowej (b = 2,04, 95% CI [1,14, 2,94], p < 0,001) były wszystkie pozytywnie powiązane z jakością tłumaczenia. W przeciwieństwie do nich, poprawki powierzchniowe wykazały niewielką, ale statystycznie istotną ujemną korelację (b = -0,63, 95% CI [-1,18, -0,08], p = 0,028).
Wyniki te wskazują, że sama liczba rewizji nie pozwala odróżnić produktywnego przekształcania tekstu od niestabilnego szkicowania (Rysunek 5). Jakościowa analiza skryptów translacyjnych potwierdziła tę interpretację. W tłumaczeniach z niższymi wynikami rewizje miały tendencję do grupowania się wokół lokalnych zamian leksykalnych i korekt gramatycznych, bez rozwiązywania głębszych niezgodności między chińskimi wskazówkami narracyjnymi a angielskim obramowaniem retorycznym. W tłumaczeniach z wyższymi wynikami odroczone rewizje często obejmowały reorganizację struktury informacji, wprowadzanie selektywnej eksplicytacji lub dostosowywanie języka oceniającego w celu poprawy przystępności dla międzynarodowego odbiorcy. Reprezentatywne przetłumaczone komentarze danmu — w tym „to sformułowanie jest bardzo chińskie”, „tło wymaga wyjaśnienia” oraz „zagraniczni widzowie mogą nie zrozumieć tego odniesienia” — ilustrują rodzaje istotnych kulturowo obaw dotyczących odbiorców, powiązanych z odpowiadającymi im grupami segmentów. Przykłady te zostały przedstawione wyłącznie w celu ułatwienia interpretacji i nie powinny być traktowane jako dowód intencji uczestników.
Nakładanie się istotności danmu i wąskich gardeł translacyjnych
W końcowej analizie zbadano, czy segmenty publicznie wyróżniające się w korpusie danmu pokrywały się z tymi, które wymagały największego wysiłku przetwarzania podczas tłumaczenia. Dla każdego segmentu obliczono złożony wskaźnik wysiłku poprzez standaryzację i zsumowanie czasu trwania pierwszej pauzy, częstotliwości długich pauz oraz gęstości poprawek. Następnie 20% segmentów o najwyższych wartościach tego złożonego wskaźnika wysiłku porównano z 20% segmentów o najwyższym rankingu istotności danmu.
Nakładka była znacząca: sześć z dziewięciu segmentów wymagających największego nakładu pracy pojawiło się również wśród dziewięciu segmentów o największej istotności danmu, co odpowiada stopniu pokrycia na poziomie 66,7%. Ponieważ porównanie górnego kwintyla obejmowało tylko dziewięć segmentów, przedział ufności Wilsona był stosunkowo szeroki (95% CI około 35,4%–87,9%). Niemniej jednak analiza dokładnego prawdopodobieństwa pokrycia wskazała, że nakładka sześciu lub więcej segmentów byłaby mało prawdopodobna przy losowym przydziale (p ≈ .001). Na poziomie segmentów istotność danmu była dodatnio skorelowana ze złożonym indeksem nakładu pracy (ρ Spearmana = 0,41, p = 0,006). Większość pokrywających się segmentów wystąpiła w tekstach B i C i koncentrowała się na odniesieniach zakorzenionych kulturowo, cyfrowej przedsiębiorczości oraz pozycjonowaniu ewaluacyjnym. Wyniki te sugerują, że dyskurs publiczny służy jako zewnętrzny wskaźnik miejsc, w których znaczenie narracyjne staje się szczególnie istotne, choć relacja ta pozostaje korelacyjna, a nie przyczynowa.
Wzięte razem, wyniki te wykazują, że wysiłek przetwarzania podczas tłumaczenia narracji skoncentrowanych na Chinach jest specyficzny dla poszczególnych segmentów i ukształtowany przede wszystkim przez obciążenie kulturowe, kompresję narracyjną oraz gęstość ewaluacyjną. Jakość tłumaczenia zależy nie od całkowitej objętości poprawek, lecz od opóźnionych, wrażliwych na dyskurs i zorientowanych kulturowo strategii rewizji. Wreszcie, zaobserwowana zbieżność między segmentami tłumaczenia wymagającymi dużego wysiłku a punktami narracyjnymi istotnymi w danmu potwierdza relację asocjacyjną między istotnością dla odbiorców a wysiłkiem przetwarzania tłumacza, nie sugerując przy tym, że sama istotność danmu powoduje trudności w tłumaczeniu.
Dostępność danych:
Wszystkie surowe dane, pliki logów uderzeń w klawisze, przetworzone obserwacje na poziomie segmentów i sesji, metadane wideo danmu oraz pierwsze 5 000 wyświetlonych komentarzy danmu znajdują się w arkuszu zestawu danych do replikacji. Pełny plik z komentarzami danmu zawiera 18 642 komentarze i został dołączony do pakietu danych. Dostęp do zestawu danych jest możliwy poprzez repozytorium Zenodo pod adresem https://doi.org/10.5281/zenodo.19289665.
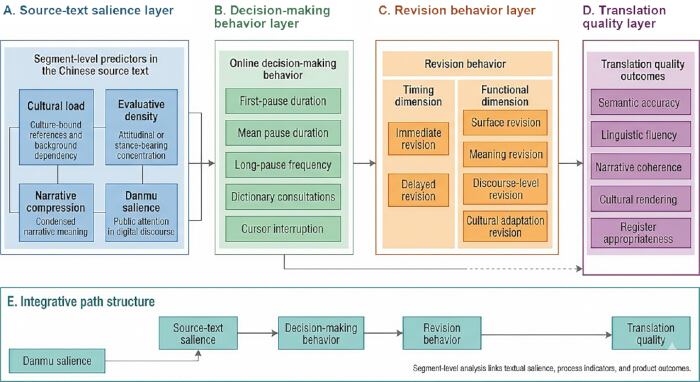
Rycina 1: Koncepcyjne ramy badania. (A) Tekstowe predyktory na poziomie segmentu, w tym obciążenie kulturowe, gęstość ewaluatywna, kompresja narracyjna oraz istotność danmu. (B) Wskaźniki procesu wykorzystane do operacjonalizacji zachowań decyzyjnych online, w tym czas pierwszej pauzy, średni czas pauzy, częstotliwość długich pauz, konsultacje ze słownikiem oraz przerwy kursora. (C) Dwuwymiarowa klasyfikacja zachowań rewizyjnych według czasu rewizji i funkcji rewizji. (D) Pięć wymiarów służących do oceny jakości tłumaczenia: dokładność semantyczna, płynność językowa, spójność narracyjna, oddanie kulturowe oraz odpowiedniość rejestru. (E) Ogólne ramy analityczne przedstawiające zależności między istotnością tekstu źródłowego, zachowaniami decyzyjnymi, zachowaniami rewizyjnymi a jakością tłumaczenia, gdzie istotność danmu służy jako zewnętrzny wskaźnik semantycznej wyrazistości dla odbiorcy. W niniejszym badaniu nie przeprowadzono ani nie przedstawiono analizy czynnikowej (EFA) ani modelowania równań strukturalnych (SEM). Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
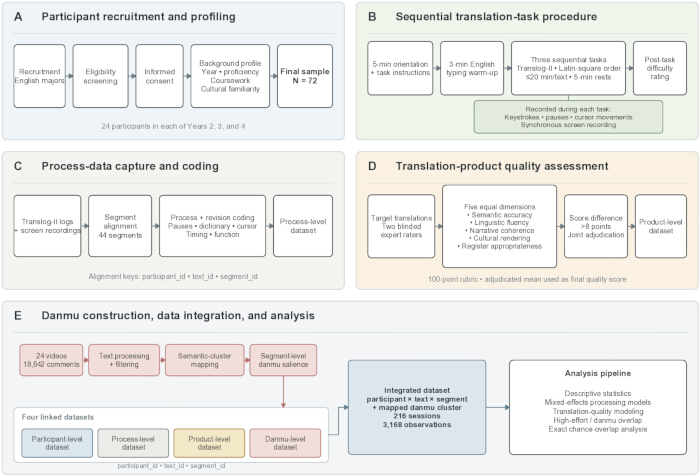
Rysunek 2: Przebieg gromadzenia i wyrównywania danych. (A) Rekrutacja uczestników, weryfikacja kryteriów kwalifikowalności, świadoma zgoda i zbieranie informacji wstępnych. (B) Realizacja trzech zadań translatorskich w systemie Translog-II w zestandaryzowanych warunkach eksperymentalnych. (C) Gromadzenie danych procesowych, w tym uderzeń w klawisze, pauz, ruchów kursora, epizodów rewizji oraz zsynchronizowanych nagrań ekranu. (D) Ślepa ocena produktów tłumaczeniowych przez ekspertów, a następnie rozstrzyganie rozbieżności w punktacji. (E) Budowa pomocniczego korpusu danmu i jego wyrównanie z zestawami danych na poziomie uczestnika, tekstu, segmentu, procesu i produktu w celu wygenerowania końcowego zintegrowanego zbioru danych wykorzystanego do analiz wnioskowania. Prosimy kliknąć tutaj, aby zobaczyć powiększoną wersję tego rysunku.
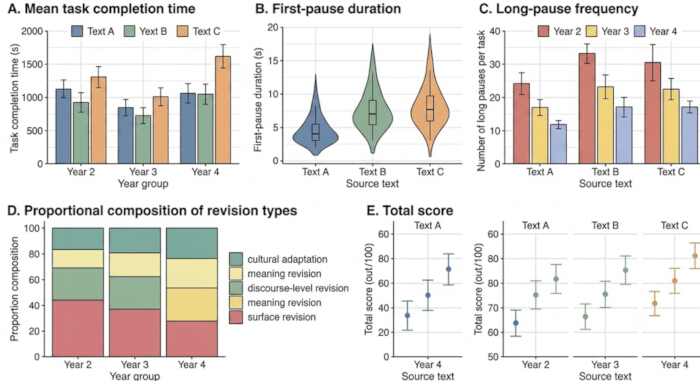
Rysunek 3: Rozkład miar procesu i produktu w zależności od grup rocznikowych i tekstów źródłowych. (A) Średni czas wykonania zadania w zależności od tekstu źródłowego i grupy wiekowej. (B) Rozkład czasu trwania pierwszej pauzy w trzech tekstach źródłowych. (C) Częstotliwość długich pauz w zależności od tekstu źródłowego i grupy wiekowej. (DProporcjonalny rozkład kategorii poprawek w poszczególnych grupach rocznikowych, w tym poprawek powierzchniowych, poprawek znaczeniowych, poprawek na poziomie dyskursu oraz poprawek związanych z adaptacją kulturową.E) Sumaryczne oceny jakości tłumaczenia w podziale na rok studiów dla każdego tekstu źródłowego. Wspólnie panele te pokazują, że wyższe lata studiów wiążą się z mniejszą liczbą przerw w procesie przetwarzania, bardziej selektywnymi strategiami rewizji oraz wyższą jakością tłumaczenia, podczas gdy teksty B i C nakładają większe wymagania przetwarzania niż tekst A. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej figury.
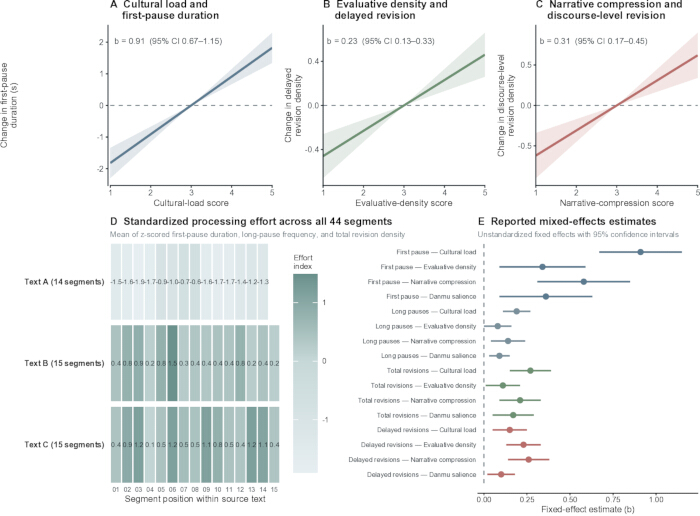
Rysunek 4: Wpływ istotności tekstu na poziomie segmentu na zachowanie w procesie tłumaczenia. (A) Dopasowany efekt marginalny obciążenia kulturowego na czas trwania pierwszej pauzy. (B) Dopasowany efekt marginalny gęstości ewaluatywnej na gęstość opóźnionych rewizji. (C) Dopasowany efekt marginalny kompresji narracyjnej na gęstość rewizji na poziomie dyskursu. (D) Mapa ciepła zestandaryzowanego wskaźnika wysiłku przetwarzania we wszystkich segmentach tekstu źródłowego, pogrupowana według tekstów źródłowych. (E) Zestandaryzowane współczynniki efektów stałych oszacowane na podstawie regresyjnych modeli efektów mieszanych. Rysunek pokazuje, że różne cechy tekstu aktywują odrębne ścieżki przetwarzania, przy czym obciążenie kulturowe, gęstość ewaluatywna i kompresja narracyjna przyczyniają się do wahań i rewizji poprzez częściowo różne mechanizmy. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
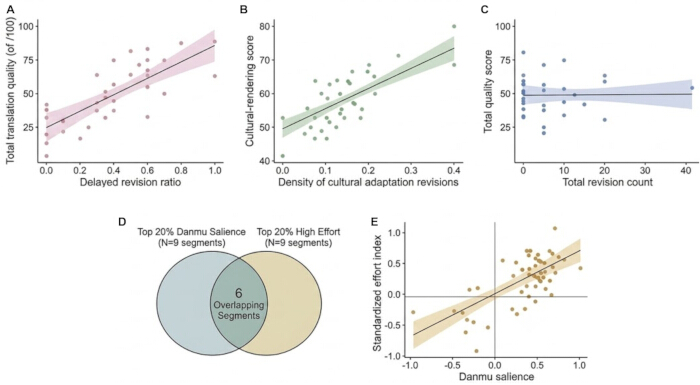
Rysunek 5: Związki między procesem tłumaczenia, jakością tłumaczenia a istotnością danmu. (A) Związek między współczynnikiem opóźnionej rewizji a całkowitą punktacją jakości tłumaczenia. (B) Związek między rewizjami w zakresie adaptacji kulturowej a punktacją oddania kontekstu kulturowego. (C) Związek między całkowitą liczbą rewizji a ogólną jakością tłumaczenia, wykazujący ograniczoną wartość prognostyczną samej ilości rewizji. (D) Część wspólna 20% segmentów o największej istotności danmu i 20% segmentów tłumaczenia wymagających największego nakładu pracy. (E) Związek na poziomie segmentu między istotnością danmu a zestandaryzowanym wskaźnikiem nakładu pracy nad przetwarzaniem. Wspólnie panele te pokazują, że wysoka jakość tłumaczenia wiąże się ze strategicznie zaplanowanymi w czasie i funkcjonalnie ukierunkowanymi rewizjami, a nie z samą ich liczbą, oraz że publicznie istotne segmenty narracyjne mają tendencję do pokrywania się z wąskimi gardłami procesu tłumaczenia. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
| Identyfikator tekstu | Temat narracyjny | znaki chińskie | Liczba segmentów | Wynik obciążenia kulturowego (1–5) | Wynik gęstości ewaluacyjnej (1–5) | Wynik kompresji narracyjnej (1–5) | Przewidywany stopień trudności | Uwaga dotycząca walidacji |
| Tekst A | Narracja o powrocie do domu podczas Festiwalu Wiosny | 212 | 14 | 3 | 2 | 3 | Umiarkowany | Przeprowadzono badanie pilotażowe z udziałem 12 studentów niebiorących udziału w głównym badaniu |
| Tekst B | Narracja wspomnieniowa z okazji Święta Smoczych Łodzi | 219 | 15 | 5 | 3 | 4 | Wysoki | Przetestowano pilotażowo z udziałem 12 studentów niebiorących udziału w badaniu |
| Tekst C | Narracja o transmitowaniu na żywo z terenów wiejskich i rozwoju rodzinnych miejscowości | 223 | 15 | 4 | 5 | 4 | Wysoki | Wstępnie przetestowano na grupie 12 studentów nieuczestniczących w badaniu |
Tabela 1: Profil tekstu źródłowego i struktura segmentów.
| Zmienna | Poziom | Definicja operacyjna | Jednostka miary |
| Czas trwania pierwszej pauzy | Segment | Czas od początku segmentu do pierwszego istotnego naciśnięcia klawisza w języku docelowym | Sekundy |
| Średnia czas trwania pauzy wewnątrzsegmentowej | Segment | Średni czas trwania wszystkich pauz w obrębie segmentu | Sekundy |
| Częstotliwość długich pauz | Segment | Liczba przerw dłuższych niż 2 sekundy | Liczba |
| Konsultacje słownikowe | Segment | Liczba aktywacji okna słownika podczas przetwarzania segmentu | Liczenie |
| Przerwy w ruchu kursora | Segment | Liczba odchyleń od liniowego kreślenia z użyciem kursora przed stabilnym ukończeniem | Liczba |
| Natychmiastowa rewizja | Segment | Poprawka wprowadzona przed sformułowaniem wykracza poza aktualny lokalny obszar tekstu | Liczba / gęstość |
| Opóźniona rewizja | Segment | Poprawka wprowadzona po przejściu procesu redagowania do późniejszego obszaru tekstu | Liczba / gęstość |
| Korekta powierzchniowa | Funkcja rewizji | Korekta na poziomie formy bez zmiany znaczenia semantycznego | Liczba / gęstość |
| Rewizja znaczenia | Funkcja rewizji | Zmiana leksykalna lub syntaktyczna wpływająca na wyrażanie znaczenia | Liczba / gęstość |
| Rewizja na poziomie dyskursu | Funkcja rewizji | Korekta relacji między zdaniami, spójności lub kolejności informacji | Liczba / gęstość |
| Rewizja adaptacji kulturowej | Funkcja rewizji | Przeformułowanie lub eksplikacja znaczeń uwarunkowanych kulturowo zorientowane na grupę docelową | Liczba / gęstość |
| Złożony wskaźnik wysiłku | Segment | Znormalizowany kompozyt czasu trwania pierwszej pauzy, częstotliwości długich pauz i gęstości rewizji | wynik z (z-score) |
| Istotność danmu | Segment / klaster semantyczny | Ważony wskaźnik zastępczy klastrów semantycznych oparty na znormalizowanej częstotliwości klastrów słów kluczowych, koncentracji komentarzy i intensywności ewaluacyjnej | Wynik ciągły |
Tabela 2: Definicje operacyjne zmiennych procesowych.
| Wymiar | Zakres wyników | Ocena ostrości |
| Dokładność semantyczna | 1-20 | Wierność znaczeniu źródłowemu, precyzja przekazanej treści oraz brak istotnych zniekształceń |
| Biegłość językowa | 1-20 | Poprawność gramatyczna, naturalność, idiomatyczność oraz czytelność na poziomie zdania |
| Spójność narracyjna | 1-20 | Przepływ informacji, powiązania między zdaniami, progresja oraz spójność tekstu |
| Adaptacja kulturowa | 1-20 | Obsługa odniesień kulturowych, eksplikacja, ramowanie i dostępność interpretacyjna |
| Stosowność rejestru | 1-20 | Dostosowanie do zamierzonego grona odbiorców, odpowiedniość stylistyczna i kontrola tonu |
Tabela 3: Rubryka oceny jakości tłumaczenia.
| Sekcja | Zmienna | Rok 2. (n = 24), średnia ± SD | Rok 3 (n = 24), średnia ± SD | Rok 4 (n = 24), średnia ± SD |
| Profil sesji na poziomie uczestnika | Czas wykonania zadania (s) | 1070.84 ± 18.22 | 996.59 ± 20.08 | 927.76 ± 19.91 |
| Profil sesji na poziomie uczestnika | Średni czas trwania pierwszej pauzy (s) | 7.09 ± 0.50 | 6.65 ± 0.40 | 6.38 ± 0.41 |
| Profil sesji na poziomie uczestnika | Częstotliwość długich pauz na zadanie | 21.04 ± 0.32 | 18.47 ± 0.30 | 16.31 ± 0.19 |
| Profil sesji na poziomie uczestnika | Całkowita liczba poprawek na zadanie | 28.65 ± 2.87 | 26.24 ± 2.63 | 24.59 ± 2.42 |
| Konfiguracja rewizji | Wskaźnik opóźnionych rewizji | 0.45 ± 0.01 | 0.54 ± 0.01 | 0.63 ± 0.01 |
| Konfiguracja rewizji | Współczynnik rewizji na poziomie dyskursu | 0.37 ± 0.01 | 0.40 ± 0.01 | 0.45 ± 0.01 |
| Konfiguracja rewizji | Współczynnik rewizji adaptacji kulturowej | 0.38 ± 0.01 | 0.42 ± 0.00 | 0.48 ± 0.01 |
| Konfiguracja rewizji | Wskaźnik rewizji powierzchni | 0.04 ± 0.00 | 0.02 ± 0.00 | 0.00 ± 0.00 |
| Jakość produktu | Całkowita ocena jakości | 77.82 ± 4.65 | 84.03 ± 4.44 | 88.27 ± 4.56 |
| Jakość produktu | Wskaźnik oddania kulturowego | 77.73 ± 4.49 | 83.95 ± 4.85 | 88.18 ± 4.86 |
Tabela 4: Statystyki opisowe dla zmiennych procesu i produktu.
| Zmienna wynikowa | Predyktor | b | SE | 95% CI | t/z | p |
| Czas trwania pierwszej pauzy | Obciążenie kulturowe | 0.91 | 0.12 | [0.67, 1.15] | 7.58 | < 0.001 |
| Czas trwania pierwszej pauzy | Gęstość ewaluacyjna | 0.34 | 0.13 | [0.09, 0.59] | 2.62 | 0.01 |
| Czas trwania pierwszej pauzy | Kompresja narracyjna | 0.58 | 0.14 | [0.31, 0.85] | 4.14 | < 0.001 |
| Czas trwania pierwszej pauzy | Istotność danmu | 0.36 | 0.14 | [0.09, 0.63] | 2.55 | 0.011 |
| Częstotliwość długich pauz | Obciążenie kulturowe | 0.19 | 0.04 | [0.11, 0.27] | 4.75 | < 0.001 |
| Częstotliwość długich pauz | Gęstość ewaluacyjna | 0.08 | 0.04 | [0.00, 0.16] | 2 | 0.046 |
| Częstotliwość długich pauz | Kompresja narracyjna | 0.14 | 0.05 | [0.04, 0.24] | 2.8 | 0.005 |
| Częstotliwość długich pauz | Istotność Danmu | 0.09 | 0.03 | [0.03, 0.15] | 3 | 0.003 |
| Całkowita gęstość rewizji | Obciążenie kulturowe | 0.27 | 0.06 | [0.15, 0.39] | 4.5 | < 0.001 |
| Całkowita gęstość rewizji | Gęstość ewaluacyjna | 0.11 | 0.05 | [0.01, 0.21] | 2.2 | 0.028 |
| Całkowita gęstość rewizji | Kompresja narracyjna | 0.21 | 0.06 | [0.09, 0.33] | 3.5 | < 0.001 |
| Całkowita gęstość rewizji | Istotność danmu | 0.17 | 0.06 | [0.05, 0.29] | 2.75 | 0.006 |
| Opóźniona gęstość rewizji | Obciążenie kulturowe | 0.15 | 0.05 | [0.05, 0.25] | 3 | 0.003 |
| Opóźniona gęstość rewizji | Gęstość ewaluacyjna | 0.23 | 0.05 | [0.13, 0.33] | 4.6 | < 0.001 |
| Opóźniona gęstość rewizji | Kompresja narracyjna | 0.26 | 0.06 | [0.14, 0.38] | 4.33 | < 0.001 |
| Opóźniona gęstość rewizji | Istotność Danmu | 0.1 | 0.04 | [0.02, 0.18] | 2.5 | 0.013 |
| Całkowity wynik jakości | Całkowite poprawki | 0.04 | 0.05 | [-0.06, 0.14] | 0.82 | 0.412 |
| Całkowita ocena jakości | Współczynnik opóźnionej rewizji | 1.12 | 0.37 | [0.39, 1.85] | 3.03 | 0.003 |
| Całkowity wynik jakości | Rewizje na poziomie dyskursu | 1.76 | 0.41 | [0.96, 2.56] | 4.29 | < 0.001 |
| Całkowita ocena jakości | Rewizje adaptacji kulturowej | 2.04 | 0.46 | [1.14, 2.94] | 4.43 | < 0.001 |
| Całkowita ocena jakości | Korekta powierzchniowa | -0.63 | 0.28 | [-1.18, -0.08] | -2.25 | 0.028 |
| Całkowita ocena jakości | Rocznik | 3.48 | 0.69 | [2.13, 4.83] | 5.04 | < 0.001 |
Tabela 5: Modele efektów mieszanych przewidujące zachowanie procesu na poziomie segmentu oraz jakość tłumaczenia.
Dyskusja
Niniejsze ustalenia wykazują, że trudność w tłumaczeniu z języka chińskiego na angielski narracji skoncentrowanych na Chinach nie jest rozłożona równomiernie w obrębie tekstu. Zamiast tego skupia się ona w segmentach, w których zbiegają się odniesienia kulturowe, stanowiska ocenne oraz skondensowane znaczenia narracyjne. Wspiera to ujęcie trudności tłumaczeniowej jako procesu, a nie jako deficytu słownictwa. Empiryczne badania nad procesem tłumaczenia podkreślają, że tłumaczenie jest aktywnością zorganizowaną czasowo, w której wahania, orientacja i produkcja są rozłożone nierównomiernie19. Obserwowana w niniejszym badaniu koncentracja wysiłku odzwierciedla sposób, w jaki konkretne segmenty wywierają większą presję interpretacyjną, zakłócając liniowy proces tworzenia szkicu w stopniu większym niż inne fragmenty. Weryfikację hipotez można podsumować w następujący sposób: H1 została potwierdzona, ponieważ obciążenie kulturowe zwiększyło częstotliwość wahań na wczesnym etapie oraz gęstość rewizji; H2 została doprecyzowana, ponieważ gęstość ocenna i kompresja narracyjna działały poprzez różne ścieżki rewizyjne; H3 została potwierdzona, ponieważ czas i funkcja rewizji silniej przewidywały jakość niż całkowita liczba poprawek; natomiast H4 została potwierdzona jako nakładanie się powiązań między istotnością danmu a segmentami wymagającymi dużego wysiłku, a nie jako związek przyczynowo-skutkowy.
W odniesieniu do zachowań podczas redakcji, dane wykazują, że całkowita liczba poprawek nie pozwala przewidzieć jakości tłumaczenia; natomiast głównymi czynnikami wpływającymi na lepsze wyniki są poprawki odroczone, na poziomie dyskursywnym oraz adaptacje kulturowe. To rozróżnienie sugeruje, że redakcja jest produktywna tylko wtedy, gdy jest przeprowadzana jako ustrukturyzowana ponowna ocena, a nie jako powtarzalne lokalne korekty. Zgodnie z badaniami nad śledzeniem ruchu gałek ocznych i rejestracją uderzeń klawiszy, które wskazują, że tłumacze początkujący inaczej rozkładają wysiłek, gdy zadania stają się trudne, zdolni studenci w niniejszym badaniu nie byli po prostu bardziej aktywni7. Selektywnie przerywali oni tymczasowe rozwiązania, dokonywali ich ponownej oceny na późniejszych etapach i kierowali poprawki na dopasowanie narracyjne lub kulturowe. W konsekwencji same oceny produktu końcowego są niewystarczające do wyjaśnienia wyników tłumacza, ponieważ porównywalne oceny końcowe często wynikają z zupełnie różnych trajektorii procesu9.
Zjawisko to można najlepiej zrozumieć przez pryzmat konwersji wysiłku. W tłumaczeniach ocenionych niżej wysiłek poznawczy pozostawał na poziomie lokalnym – studenci robili przerwy, zastępowali poszczególne leksemy lub korygowali przedimki, jednak nie potrafili rozwiązać głębszych rozbieżności między implikacjami tekstu źródłowego a ramami tekstu docelowego. Z kolei w pracach ocenionych wyżej wysiłek ten został przekształcony w decyzje strukturalne, które zoptymalizowały tekst pod kątem odbiorcy docelowego. Podobnie jak w badaniach nad efektami postedycji studenckiej, wyniki te potwierdzają, że wysiłek procesowy nie jest automatycznie korzystny; jego wartość zależy od tego, czy zostanie on przekonwertowany na interpretowalne ulepszenia tekstu20.
Ponadto różne właściwości tekstowe aktywują odmienne mechanizmy procesowe. Obciążenie kulturowe niezawodnie zwiększało wczesne wahania i gęstość rewizji, podczas gdy kompresja narracyjna silnie prognozowała rewizje na poziomie dyskursu. To rozróżnienie wyjaśnia, dlaczego trudne fragmenty przejawiają się inaczej w procesie tłumaczenia: niektóre zakłócają dostęp poznawczy na etapie wstępnego formułowania, podczas gdy inne stają się problematyczne dopiero podczas utrzymywania spójności w szerszych obszarach dyskursu. Zgodnie z badaniami wykazującymi, że trudne teksty generują mniejsze jednostki przetwarzania i gęstsze przerwy, wyniki te podkreślają, w jaki sposób skompresowane znaczenia kulturowe i oceniające zmuszają tłumaczy do oscylowania między lokalną ekspresją a globalnym ramowaniem narracyjnym8.
Istotnym wkładem metodologicznym niniejszego badania jest włączenie istotności danmu jako warstwy dyskursu odbiorców. Znaczna zbieżność między segmentami tłumaczeniowymi wymagającymi dużego nakładu pracy a segmentami istotnymi w danmu wskazuje, że wąskie gardła, z którymi mierzą się studenci, często pokrywają się z punktami przyciągającymi zwiększoną uwagę odbiorców w obiegu cyfrowym. Łączy to trudność tłumaczenia z dyskursem partycypacyjnym, nie utożsamiając przy tym obu tych konstruktów. Komentarze danmu ujawniają, co odbiorcy zauważają lub kwestionują w obiegu za pośrednictwem wideo, podczas gdy zapisy naciśnięć klawiszy i rewizji pokazują, w jaki sposób studenci-tłumacze przetwarzają semantycznie powiązane segmenty tekstu źródłowego. Najbardziej prawdopodobną interpretacją jest zatem koncepcja wspólnych wskazówek: odniesienia nasycone kulturowo, skondensowane założenia tła oraz pozycjonowanie ewaluatywne mogą jednocześnie przyciągać uwagę odbiorców i zwiększać presję przetwarzania u tłumacza21.
Z pedagogicznego punktu widzenia to pokrywanie się sugeruje, że narracje skoncentrowane na Chinach krążą w kontekstach, w których znaczenie jest negocjowane publicznie i szybko, pod wpływem konkurencyjnych priorytetów, takich jak natychmiastowość, zrozumiałość i dostosowanie do odbiorcy22. W związku z tym szkolenie tłumaczy musi ewoluować z postrzegania rewizji jako ogólnego etapu korekty w stronę kładzenia nacisku na interwencje funkcjonalne i strategicznie czasowe. Zaobserwowane wąskie gardła rzadko wynikały z samej terminologii; pojawiały się one tam, gdzie znaczenie narracji zależało od zakorzenionych kulturowo założeń, ram relacyjnych i selektywnego dostępu odbiorców. Podobnie jak w przypadku upowszechniania chińskiej literatury narracyjnej grup etnicznych, przenoszenie tych narracji wymaga wyjścia poza wierność leksykalną, aby ustalić, w jaki sposób lokalne znaczenie kulturowe powinno zostać zrestrukturyzowane w celu szerszej globalnej cyrkulacji23. Metodę tę można zastosować w szkoleniu tłumaczy, wykorzystując logi uderzeń klawiszy, nagrania ekranu oraz przykłady dyskursu odbiorców, aby pomóc studentom zidentyfikować, kiedy dany fragment wymaga eksplicytacji, zmiany kolejności, nadania ram kulturowych lub dostosowania rejestru, a nie zwykłego zastąpienia leksykalnego.
Interpretację tych wyników ograniczają kilka czynników. Po pierwsze, istotność danmu jest jedynie wskaźnikiem skupisk semantycznych odzwierciedlającym zaangażowanie odbiorców, a nie bezpośrednią miarą trudności lingwistycznej, a obecny model korelacyjny nie pozwala na ustalenie związku przyczynowo-skutkowego między istotnością publiczną a nakładem pracy translatorskiej. Przyszłe badania mogłyby eksperymentalnie manipulować obciążeniem kulturowym, gęstością ewaluatywną i kompresją narracyjną w celu przetestowania ścieżek przyczynowych. Po drugie, próba została ograniczona do tłumaczy w trakcie kształcenia z jednej uczelni, a doświadczenie uczestników, znajomość kultury i biegłość w drugim języku były kontrolowane statystycznie, a nie poprzez w pełni stratyfikowany dobór próby. Replikacja badań z udziałem tłumaczy zawodowych, studentów z wielu instytucji oraz osób o szerszym zakresie biegłości językowej wzmocniłaby możliwość generalizacji wyników. Po trzecie, teksty źródłowe zostały opracowane przez badaczy i przetestowane pilotażowo w celu skalibrowania zadania, jednak przyszłe badania powinny obejmować dodatkową walidację z wykorzystaniem autentycznych tekstów publicznych i niezależnych paneli opracowujących materiały. Po czwarte, kodowanie obciążenia kulturowego, gęstości ewaluatywnej, kompresji narracyjnej i funkcji rewizyjnych zależy od przejrzystych definicji operacyjnych, zapisów niezależnych koderów i weryfikowalnej niezawodności między sędziami wraz z rozstrzygniętym plikiem kodowania. Przyszłe badania mogą również łączyć rejestrację uderzeń klawiszy z okulografią, wywiadami retrospektywnymi, protokołami głośnego myślenia lub zadaniami z postedycji, aby przeprowadzić triangulację mechanizmów poznawczych leżących u podstaw decyzji o rewizji.
Ostatecznie badanie to wyjaśnia procesowe podstawy wyników studentów w tłumaczeniu narracji dotyczących Chin z języka chińskiego na angielski. Poprzez powiązanie danych z rejestracji naciśnięć klawiszy, oceny produktu końcowego oraz dyskursu cyfrowej publiczności, wyniki wykazują, że wąskie gardła w procesie tłumaczenia pojawiają się w punktach o silnym ładunku znaczeniowym w sferze publicznej. Decydującym czynnikiem w tłumaczeniu międzykulturowym nie jest sama liczba poprawek, lecz zdolność tłumacza do rozpoznania fragmentów wymagających interpretacyjnej restrukturyzacji oraz strategiczne odroczenie zamknięcia procesu tłumaczenia do momentu sformułowania stabilnego i odpowiedniego dla odbiorcy rozwiązania.
Oświadczenia
Autorzy nie mają żadnych konfliktów interesów do ujawnienia.
Wkład autorów
Weijia Chen: Konceptualizacja, metodologia, analiza formalna, badanie, przygotowanie pierwotnego projektu tekstu.
Chunming Wu: Projekt badania, wytyczne dotyczące analizy formalnej i procedur obsługi danych oraz recenzja i uwagi do poprawek w odpowiedzi na komentarze recenzentów.
Podziękowania
Badania te zostały sfinansowane z dwóch grantów przyznanych przez Hanshan Normal University. W szczególności stanowią one etapowy wynik badań w ramach programu 2023 First-Class Undergraduate Course (Offline First-Class Course) dla przedmiotu „Theory and Practice of Chinese–English Translation II” (nr zatwierdzenia YHS [2023] 172). Ponadto badanie zostało wsparte przez projekt 2025 Teaching Quality and Teaching Reform Project, wyznaczony jako Model Course for Curriculum-Based Ideological and Political Education dla przedmiotu „Chinese–English Translation” (nr zatwierdzenia YHSJ〔2025〕126). Autorzy wyrażają wdzięczność za wsparcie instytucjonalne udzielone w celu ukończenia niniejszych badań.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Korpus danmu z Bilibili | Bilibili | 24 videos; 18,642 comments;https://www.bilibili.com | Konstrukcja pomocniczego korpusu danmu i obliczanie istotności danmu na poziomie segmentu |
| Microsoft Excel | Microsoft Corporation | Excel 2021;https://www.microsoft.com/microsoft-365/excel | Czyszczenie danych, organizacja kodowania i wstępne zarządzanie danymi |
| R | R Foundation for Statistical Computing | R 4.3.1;https://www.r-project.org | Modelowanie efektów mieszanych, analiza korelacji i generowanie wykresów |
| Oprogramowanie do nagrywania ekranu | Stacja robocza laboratoryjna | Local workstation utility; no catalog number | Weryfikacja nieliniowych epizodów rewizji i backup danych procesowych |
| SPSS | IBM Corporation | SPSS Statistics 27.0;https://www.ibm.com/products/spss-statistics | Statystyka opisowa, ANOVA i podstawowe analizy statystyczne |
| Translog-II | Copenhagen Business School / CRITT | Translog-II;https://sites.google.com/site/centretranslationinnovation/translog-ii | Rejestracja uderzeń klawiszy oraz zapisywanie pauz, ruchów kursora i epizodów rewizji podczas zadań tłumaczeniowych |
Bibliografia
- Valdeón RA, Li S. Political discourse translation in contemporary Chinese and Western contexts. Translator. 2024;30(4):1-14.
- Du L, Afzaal M. Analyzing modality-mediated ideology in translated Chinese political discourses: An ideological square model approach. Humanit Soc Sci Commun. 2024;11:956.
- Carl M. Empirical translation process research: Past and possible future perspectives. Transl Cogn Behav. 2024;6(2):252-274.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589-1604.
- Carl M, et al. Hesitation, orientation, and flow: A taxonomy for deep temporal translation architectures. Ampersand. 2024;12:100164.
- Swar O, Mohsen M. Students' cognitive processes in L1 and L2 translation: Evidence from a keystroke logging program. Interact Learn Environ. 2023;31(10):6247-6263.
- Wang Y, Li S, Rasmussen YZ. Translators' allocation of cognitive resources in two translation directions: A study using eye-tracking and keystroke logging. Appl Sci. 2025;15(8):4401.
- Wang F, Xu Q. Processing of translation units by student and semi-professional translators in translating texts with different levels of translation difficulty. PLoS One. 2025;20(4):e0320809.
- Chen X, Yan JX. Examining student translators' writing and translation products: Quality, errors, and self-perceived mental workload. Interpret Transl Train. 2024;18(3):465-485.
- Dong D, Chen ML. Metacognitive strategies in translation: A comparative study of student and professional translators. Humanit Soc Sci Commun. 2025;12:890.
- Chen X, Yan JX. Investigating the processing effort in translation students' L2 writing and L2 translating: Evidence from keylogging. Humanit Soc Sci Commun. 2025;12:1810.
- Cao L, Doherty S, Lee JF. The process and product of translation revision: Empirical data from student translators using eye tracking and screen recording. Interpret Transl Train. 2023;17(4):548-565.
- Van Egdom GW, Schrijver I, Verplaetse H, Segers W. The impact of collaborative processes on target text quality in translator training. Interpret Transl Train. 2024;18(3):486-506.
- Riondel A. How to teach revision: Tips from an interview study. Interpret Transl Train. 2024;18(3):507-522.
- Lu S, Chen X. An experimental study on viewing perception and gratification of danmu subtitled online video streaming. J Spec Transl. 2024;42:217-238.
- Lei Y, Peng M, Han Y. Mistaken presuppositions and the translation of cultural texts: A study of two English translations of The Classic of Tea. Perspectives. 2025. doi:10.1080/0907676X.2025.2599854.
- Kim HR. Danmu as paratext: An exploratory study of paratextual functions in Chinese fan-subtitled videos. J Transl Stud. 2025;26(3):197-231.
- Wu X, Fitzgerald R. The danmu discourse of user engagement with cross-posted broadcast interviews in Chinese social media. Journalism. 2025;26(3):733-751.
- Yamada M, Carl M, Schaeffer MJ. Introduction to the special Ampersand issue on empirical translation process research. Ampersand. 2024;12:100179.
- Peng X, Wang X, Li X. When student translators meet with machine translation: The impacts of machine translation quality and perceived self-efficacy on post-editing performance. SAGE Open. 2024;14(4):21582440241291624.
- Yang Y. Making sense of the raw meat: A social semiotic interpretation of user translation on the danmu interface. Discourse Context Media. 2021;44:100550.
- Zeng D. Danmu subtitling as a self-regulative practice: A descriptive discourse analysis of Bilibili danmu subtitles from ethical perspectives. Front Psychol. 2025;16:1577260.
- Li Y, Cai X. The translation of ethnic literature: An analysis of the Chinese and English translations of the Yi folk narrative poem Ashima and their dissemination. Perspectives. 2025. doi:10.1080/0907676X.2025.2502935.