Niniejsza metoda przedstawia kompleksowy model oparty na wyjaśnialnej sztucznej inteligencji (XAI), który umożliwia bezpieczną migrację danych opieki zdrowotnej w chmurze, wykorzystując syntetyczny zbiór danych medycznych w kontrolowanym środowisku chmurowym. Wynikiem jest prototyp łączący bezpieczeństwo typu zero-trust, czasową kontrolę dostępu oraz wyjaśnialną detekcję anomalii w celu zapewnienia przejrzystości i bezpieczeństwa migracji.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Protokół eksperymentalny dla bezpiecznej migracji danych w chmurze sterowanej przez wyjaśnialną sztuczną inteligencję z wykorzystaniem syntetycznych danych medycznych
W tym artykule
Podsumowanie
Streszczenie
W systemach opieki zdrowotnej coraz częściej przeprowadza się migrację danych do chmury, co sprawia, że momenty transferu danych stają się obszarem prawdopodobnie największego ryzyka w zakresie bezpieczeństwa. Niniejsza praca opisuje odtwarzalny protokół bezpiecznej migracji danych w chmurze w oparciu o wyjaśnialną sztuczną inteligencję (XAI), wykorzystujący syntetyczny zbiór danych medycznych oraz kontrolowane środowisko chmurowe. Opracowana struktura łączy architekturę zerowego zaufania (zero-trust), czasowe nadawanie minimalnych uprawnień, szyfrowaną komunikację, centralny monitoring oraz wyjaśnialną detekcję anomalii, aby zapewnić bezpieczniejszą, przejrzystą i audytowalną migrację. W testach wykorzystano zbiór 10 GB syntetycznej elektronicznej dokumentacji medycznej, obejmujący około 20 milionów rekordów w 28 tabelach relacyjnych. Proces migracji przeprowadzono w usłudze Amazon Web Services (AWS) przy użyciu baz danych PostgreSQL i prywatnych sieci wirtualnych. Do detekcji anomalii wykorzystano algorytm Isolation Forest, a do bezpiecznej interpretacji zdarzeń posłużono się metodą Shapley Additive Explanations (SHAP). Strukturę oceniono na podstawie dziesięciu oddzielnych prób migracji, stosując takie mierniki jak czas ekspozycji poświadczeń, czas wykrycia incydentu, dokładność detekcji anomalii, opóźnienie migracji oraz integralność danych. W testowanej konfiguracji czas ekspozycji poświadczeń zredukowano z 24 h do 1 h (redukcja o 95,8%), dokładność detekcji anomalii wyniosła 97,4%, czas wykrycia incydentu skrócono do około 15 min, a pełna 100% integralność danych została zachowana dzięki walidacji sum kontrolnych. Jednakże silniejsze środki bezpieczeństwa spowodowały średni wzrost opóźnienia migracji o 11%. Wyniki te wykazują potencjał łączenia wyjaśnialnej AI z bezpiecznymi procesami migracji do chmury w zarządzaniu danymi medycznymi.
Wprowadzenie
Przetwarzanie w chmurze stanowi obecnie integralną część systemów opieki zdrowotnej na całym świecie, oferując skalowalną przestrzeń dyskową, zasoby obliczeniowe oraz możliwość wymiany dokumentacji medycznej, wspieranie systemów wspomagania decyzji i umożliwianie analityki zdrowotnej za pośrednictwem chmury1,2,3. W związku z tym, że wiele instytucji ochrony zdrowia modernizuje swoje systemy informatyczne, przejście do chmury stało się dla nich kluczowym krokiem w celu przeniesienia wrażliwych danych medycznych przechowywanych w starszych systemach lokalnych do chmury4. Prawidłowa migracja prowadzi do łatwiejszego odzyskiwania danych, prowadzenia operacji w bardziej efektywny sposób oraz wspierania analityki na wyższym poziomie inteligencji, jednak jednocześnie nie można ignorować poważnych ryzyk związanych z bezpieczeństwem i prywatnością, które wiążą się z przenoszeniem danych z jednego miejsca w drugie5.
Faza migracji jest powszechnie uważana za szczególnie ryzykowny moment w cyklu życia danych, ponieważ ze względu na naturę tego procesu dane medyczne są aktywnie przenoszone między systemami i sieciami6. Ponadto organizacje mogą być narażone na zagrożenia takie jak kradzież poświadczeń, nieautoryzowany dostęp, przechwytywanie danych, manipulacje schematami, a nawet utratę danych podczas fazy migracji6,7. Środowiska opieki zdrowotnej są mniej odporne na takie ryzyka, ponieważ informacje o pacjentach są niezwykle wrażliwe i w związku z tym wymagają najwyższego poziomu zgodności z przepisami oraz środkami bezpieczeństwa8,9. Bez tego nie jest możliwe zapewnienie poufności, integralności i rozliczalności danych, jeśli przepływ pracy migracji nie jest zabezpieczony i monitorowalny10,11.
Opracowano szereg ram bezpieczeństwa i standardów mających na celu poprawę bezpieczeństwa chmury. Na przykład Architektura Zero Trust opracowana przez National Institute of Standards and Technology (NIST) opiera się na ciągłej weryfikacji użytkowników, urządzeń i usług12, podczas gdy ramy wdrażania chmury (cloud adoption frameworks) dostarczają wytycznych w zakresie zarządzania, zarządzania tożsamością, szyfrowania i monitorowania13. W rzeczywistości współczesne metody bezpieczeństwa chmury koncentrują się na automatyzacji, infrastrukturze jako kodzie (infrastructure-as-code) oraz ciągłym monitorowaniu14,15. Choć podejścia te opierają się na cennych zasadach bezpieczeństwa, w dużej mierze dotyczą one ogólnego wdrażania chmury i środowisk operacyjnych, a nie samego procesu migracji16. W istocie rzadko przedstawiają one szczegółowe, krok po kroku i reprodukowalne procedury wykonywania bezpiecznych przepływów pracy migracji danych medycznych do chmury, które łączyłyby zarządzanie tożsamością, bezpieczny transfer danych, walidację, monitorowanie oraz utwardzanie systemu po migracji17.
Wykrywanie anomalii za pomocą uczenia maszynowego zostało uznane za pomocną technologię w monitorowaniu bezpieczeństwa środowisk chmurowych. Pozwala ono na wykrywanie nieprawidłowej aktywności systemu, a także potencjalnych incydentów bezpieczeństwa18. Niemniej jednak wiele metod wykrywania anomalii to systemy zamknięte, które nie dostarczają wyjaśnień dotyczących uzasadnienia oznaczenia zdarzenia bezpieczeństwa jako podejrzane19. Brak możliwości wyjaśnienia decyzji podejmowanych przez system obniża zaufanie administratorów, utrudnia audytowanie i zmniejsza wartość zautomatyzowanych decyzji dotyczących bezpieczeństwa w ściśle regulowanych środowiskach opieki zdrowotnej20. Metody wyjaśnialnej sztucznej inteligencji (XAI), takie jak SHapley Additive exPlanations (SHAP) oraz Local Interpretable Model-agnostic Explanations (LIME), nie tylko dostarczają jasnych wyjaśnień dla predykcji uczenia maszynowego, ale także zwiększają zrozumienie, rozliczalność i zaufanie do systemów monitorowania bezpieczeństwa21,22.
Mimo że bezpieczeństwo chmury i wyjaśnialna sztuczna inteligencja poczyniły ogromne postępy, wciąż brakuje odtwarzalnych protokołów eksperymentalnych łączących zabezpieczenia migracji z wyjaśnialnym monitorowaniem bezpieczeństwa w celu ich integracji23. Istniejące badania koncentrują się głównie na pojedynczych komponentach, takich jak szyfrowanie, kontrola dostępu, wykrywanie anomalii lub zarządzanie chmurą, i nigdzie nie oferują zintegrowanej metodologii, którą można by systematycznie wdrożyć, ocenić i odtworzyć24. Co więcej, niemal żadne badania nie podjęły próby połączenia zasad bezpieczeństwa zero-trust, czasowego najmniejszego uprawnienia, scentralizowanej obserwowalności oraz wyjaśnialnego wykrywania anomalii w ramach jednego przepływu pracy migracji chmury w sektorze ochrony zdrowia25,26.
Niniejsza praca wprowadza oparty na wyjaśnialnej sztucznej inteligencji (Explainable AI) framework do bezpiecznej migracji danych w chmurze w systemach opieki zdrowotnej, aby wypełnić tę lukę. Proponowana architektura wykorzystuje model zerowego zaufania (zero-trust), dostęp ograniczony czasowo, bezpieczną komunikację, centralne logowanie i monitorowanie oraz opartą na SHAP interpretowalną detekcję anomalii w uporządkowanym procesie migracji27,28. Protokół stanowi instrukcję krok po kroku dotyczącą wdrażania, monitorowania i oceny bezpiecznej migracji danych medycznych w warunkach eksperymentalnych. Poprzez połączenie mechanizmów kontroli bezpieczeństwa z interpretowalnym monitorowaniem AI, proponowany framework ma na celu zwiększenie poziomu przejrzystości, audytowalności i bezpieczeństwa w całym cyklu życia migracji29,30.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
W niniejszym badaniu wykorzystano w pełni syntetyczny zestaw danych medycznych, wygenerowany w celu eksperymentalnej oceny bezpiejnej migracji danych w chmurze. Nie użyto rzeczywistych danych pacjentów, chronionych informacji zdrowotnych (PHI) ani możliwych do zidentyfikowania rekordów medycznych. W związku z powyższym nie wymagano zgody Komisji Bioetycznej ani świadomej zgody uczestników. Wszystkie materiały wykorzystane w tym badaniu zostały ujęte w Tabeli materiałów.
1. Przegląd
- Skonfiguruj bezpieczne środowisko migracji chmurowej składające się z warstwy źródłowej, warstwy centrum migracji, warstwy docelowej, warstwy sieciowej, warstwy zarządzania tożsamością i dostępem, warstwy obserwowalności oraz warstwy wyjaśnialnej sztucznej inteligencji (Explainable AI).
- Wdróż wszystkie komponenty w izolowanych środowiskach chmurowych, aby zapewnić bezpieczną migrację danych medycznych. Ustanów szyfrowane kanały komunikacyjne pomiędzy wszystkimi komponentami systemu.
- Wykonaj protokół poprzez przygotowanie zbiorów danych, konfigurację środowiska, wdrożenie architektury, bezpieczną migrację, monitorowanie anomalii oraz walidację po migracji. Ogólna architektura proponowanych ram bezpiecznej migracji danych w chmurze sterowanej przez wyjaśnialną sztuczną inteligencję została przedstawiona na Rysunku 1.
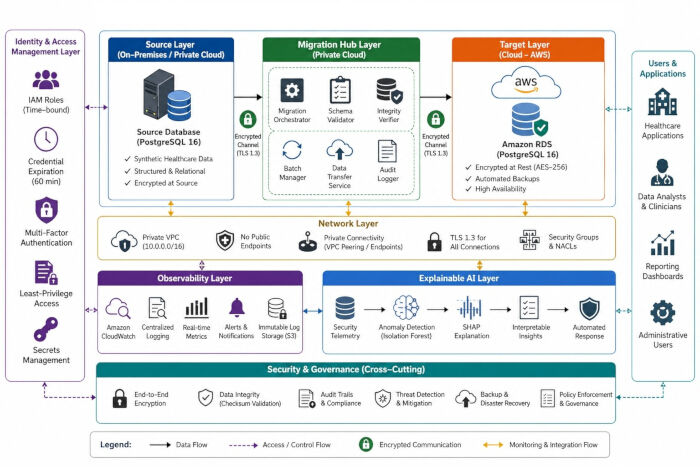
Rycina 1: Ogólna architektura bezpiecznego frameworku migracji danych w chmurze dla systemów opieki zdrowotnej, opartego na wyjaśnialnej sztucznej inteligencji (XAI). Struktura składa się z warstwy zarządzania tożsamością i dostępem, warstwy bazy danych źródłowych, warstwy centrum migracji, warstwy docelowej chmurowej bazy danych, warstwy bezpieczeństwa sieciowego, warstwy obserwowalności, warstwy monitorowania opartego na wyjaśnialnej sztucznej inteligencji oraz horyzontalnych usług bezpieczeństwa i ładu danych. Architektura integruje czasową kontrolę dostępu opartą na zasadzie najmniejszych uprawnień, komunikację szyfrowaną protokołem TLS 1.3, weryfikację integralności opartą na sumach kontrolnych, ciągłe monitorowanie bezpieczeństwa oraz wyjaśnialność opartą na wartościach SHAP, aby zapewnić bezpieczną, przejrzystą i powtarzalną migrację baz danych w ochronie zdrowia. Rysunek został przygotowany przez autorów przy użyciu programu Microsoft PowerPoint (Microsoft 365). Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
2. Konfiguracja środowiska obliczeniowego
- Konfiguracja środowiska obliczeniowego
- Przygotuj zasoby obliczeniowe niezbędne do bezpiejnej migracji danych w chmurze oraz monitorowania opartego na wyjaśnialnej sztucznej inteligencji (explainable AI).
- Zainstaluj i skonfiguruj cały sprzęt, oprogramowanie, usługi chmurowe, bazy danych, narzędzia bezpieczeństwa oraz biblioteki uczenia maszynowego wymienione w Tabeli materiałów. Przed rozpoczęciem eksperymentu migracyjnego upewnij się, że wszystkie wymagane komponenty są sprawne.
- Konfiguracja środowiska chmurowego
- Skonfiguruj środowisko chmurowe bezpieczne dla migracji danych medycznych. Utwórz prywatną sieć VPC w celu zapewnienia płynnej komunikacji pomiędzy systemem źródłowym, centrum migracyjnym a systemem docelowym. Zastosuj silne szyfrowanie nie tylko podczas przechowywania danych, ale również w trakcie ich przesyłania.
- Przygotuj docelową bazę danych oraz usługi migracyjne zgodnie ze szczegółami podanymi w Tabeli materiałów.
- Skonfiguruj zarządzanie tożsamością i dostępem oraz skonfiguruj usługi monitorowania i logowania.
3. Przygotowanie i opis zbioru danych
- Wygeneruj syntetyczny zestaw danych medycznych przy użyciu biblioteki Faker w języku Python, wymienionej w Tabeli Materiałów. Skonfiguruj atrybuty demograficzne, w tym wiek pacjenta, płeć, pochodzenie etniczne i lokalizację geograficzną, korzystając z predefined probability distributions.
- Wygeneruj informacje kliniczne, w tym diagnozy, wyniki badań laboratoryjnych, leki, alergie, procedury i przyjęcia do szpitala, zachowując realistyczne zależności kliniczne.
- Wygeneruj podłużne dane o wizytach pacjentów poprzez przypisanie wielu wizyt do poszczególnych pacjentów zgodnie z predefined visit-frequency distributions.
- Wygeneruj znaczniki czasu dla przyjęć, badań laboratoryjnych, podania leków, wypisów oraz logów audytowych, stosując chronologiczne szeregowanie zdarzeń.
- Wprowadź klinicznie realistyczne brakujące wartości, zdublowane rekordy oraz obserwacje odstające zgodnie z predefined data-quality distributions.
- Zastąp wszystkie dane osobowe wartościami syntetycznymi wygenerowanymi za pomocą biblioteki Faker. Przed eksportem zestawu danych zweryfikuj integralność referencyjną i spójność logiczną. Eksportuj zwalidowany zestaw danych w formacie SQL kompatybilnym z PostgreSQL. Skonfiguruj zestaw danych tak, aby wspierał realistyczne scenariusze migracji danych medycznych. Charakterystyka wygenerowanego zestawu danych została podsumowana w Tabeli 1.
- Zdefiniuj relacje bazodanowe. Przypisz Patient_ID jako klucz główny dla tabeli pacjentów. Ustanów relacje klucza obcego między tabelami pacjentów, wizyt, badań laboratoryjnych, leków i logów audytowych. Przed rozpoczęciem migracji zweryfikuj integralność referencyjną we wszystkich tabelach.
- Symuluj realistyczne cechy danych medycznych. Wygeneruj wiek pacjentów przy użyciu rozkładu normalnego. Wygeneruj częstotliwość wizyt przy użyciu rozkładu Poissona. Wprowadź brakujące wartości na poziomie 5%, aby zasymulować niekompletność rzeczywistych EHR. Przed migracją zastąp wszystkie identyfikatory pacjentów wartościami zahaszowanymi. Zweryfikuj, czy wszystkie wygenerowane rekordy są zgodne z predefined schema constraints.
- Zwaliduj wygenerowany zestaw danych, sprawdzając spójność schematu, integralność referencyjną, brakujące wartości, zdublowane rekordy oraz predefined quality constraints przed migracją.
| Parametr | Wartość |
| Typ zbioru danych | Syntetyczny zbiór danych EHR z ochrony zdrowia |
| Rozmiar zbioru danych | 10 GB |
| Całkowita liczba rekordów | 20 milionów |
| Liczba tabel | 5 tabel głównych – 28 tabel relacyjnych |
| Rekordy pacjentów | 5 00 0 |
| Rekordy wizyt | 10 0 0 |
| Wyniki laboratoryjne | 4 0 0 |
| Rekordy leków | 3 0 0 |
| Logi audytu | 5 00 00 |
| Klucz główny | Patient_ID |
| Odsetek brakujących wartości | 5% |
| Rozkład wieku | Rozkład normalny |
| Częstotliwość wizyt | Rozkład Poissona |
| Próg spójności | <0.1% naruszeń |
Tabela 1: Charakterystyka syntetycznego zbioru danych opieki zdrowotnej wykorzystanego do walidacji protokołu. Tabela przedstawia opis zbioru danych, taki jak rozmiar bazy danych, liczba tabel relacyjnych, całkowita liczba rekordów, atrybuty pacjentów, zmienne kliniczne oraz charakterystyki walidacyjne niezbędne do odtworzenia eksperymentów z bezpiejnej migracji.
4. Wdrożenie architektury systemu
- Wdrożyć bezpieczną architekturę migracji do chmury, składającą się z warstwy źródłowej, warstwy centrum migracyjnego, warstwy docelowej, warstwy bezpieczeństwa sieciowego, warstwy obserwowalności oraz warstwy wyjaśnialnej sztucznej inteligencji. Architektura systemu wdrożona w niniejszym badaniu została przedstawiona na Rysunku 2.
- Struktura składa się z sześciu warstw roboczych, które w procesie migracji realizują swoje funkcje sekwencyjnie. Pierwsza warstwa, warstwa źródłowa, zawiera syntetyczną bazę danych opieki zdrowotnej.
- Centrum migracyjne odpowiada za ekstrakcję schematu, zaszyfrowany transfer danych, walidację integralności oraz orchestrację migracji. Warstwa docelowa to miejsce, w którym migrowana baza danych jest przechowywana w Amazon RDS PostgreSQL.
- Warstwa bezpieczeństwa sieciowego zabezpiecza całą komunikację poprzez wykorzystanie prywatnych punktów końcowych VPC, szyfrowania TLS 1.3, grup bezpieczeństwa oraz list kontroli dostępu do sieci.
- Warstwa obserwowalności stale gromadzi logi uwierzytelniania, logi migracji, logi aktywności bazy danych oraz zdarzenia bezpieczeństwa przy pomocy Amazon CloudWatch.
- Warstwa wyjaśnialnej sztucznej inteligencji pobiera zgromadzoną telemetrię bezpieczeństwa, przetwarza ją za pomocą algorytmu Isolation Forest i generuje wyjaśnienia w oparciu o SHAP dla wykrytych anomalii. Wszystkie warstwy architektoniczne komunikują się ze sobą poprzez prywatne kanały sieciowe, które są uwierzytelniane podczas całego przepływu pracy migracyjnej.
- Wdrożyć i zweryfikować środowisko bazy danych źródłowych, aby zapewnić bezpieczny dostęp i dostępność danych przed migracją.
- Skonfigurować bazę danych PostgreSQL 16 z syntetycznym zbiorem danych opieki zdrowotnej. W bazie źródłowej przechowywać informacje o pacjentach, szczegóły wizyt, wyniki badań laboratoryjnych, rekordy leków oraz logi audytowe.
- Ograniczyć dostęp do bazy danych wyłącznie dla uprawnionych usług migracyjnych i użytkowników administracyjnych. Zweryfikować dostępność i łączność bazy danych przed rozpoczęciem operacji migracyjnych.
- Skonfigurować centrum migracyjne w celu koordynacji ekstrakcji schematu, zaszyfrowanego transferu danych i orchestracji migracji.
- Wdrożyć dedykowany serwer migracyjny w prywatnej chmurze wirtualnej (VPC). Skonfigurować usługi orchestracji migracji do koordynacji ekstrakcji schematu, transferu danych i działań walidacyjnych.
- Uruchomić usługi walidacji schematu, aby zweryfikować kompatybilność między środowiskiem źródłowym a docelowym. Uruchomić usługi weryfikacji integralności w celu walidacji migrowanych danych w trakcie i po transferze. Zweryfikować komunikację między centrum migracyjnym a systemami baz danych przed wykonaniem zadań migracyjnych.
- Wdrożyć warstwę docelową. Wdrożyć Amazon RDS PostgreSQL 16 jako docelowe środowisko bazy danych. Uruchomić usługi automatycznego tworzenia kopii zapasowych i odzyskiwania. Włączyć szyfrowanie AES-256 dla danych przechowywanych w docelowej bazie danych.
- Skonfigurować bezpieczeństwo sieciowe. Wyłączyć wszystkie publiczne adresy IP powiązane z zasobami migracyjnymi. Zezwolić na komunikację wyłącznie poprzez prywatne punkty końcowe w obrębie VPC. Skonfigurować listy kontroli dostępu do sieci (NACL) i grupy bezpieczeństwa. Włączyć szyfrowanie TLS 1.3 dla całej komunikacji między komponentami systemu. Zweryfikować, czy żadne publicznie dostępne punkty końcowe nie pozostały aktywne.
- Skonfigurować scentralizowany monitoring do ciągłego gromadzenia zdarzeń bezpieczeństwa, logów migracji i metryk wydajności systemu.
- Uruchomić usługi logowania i monitorowania Amazon CloudWatch. Gromadzić logi uwierzytelniania, logi migracji, logi aktywności bazy danych oraz logi zdarzeń bezpieczeństwa. Skonfigurować okres retencji logów na 365 dni. Włączyć niezmienny magazyn logów w celu wsparcia wymagań audytowych i zgodności. Zweryfikować zbieranie metryk w czasie rzeczywistym i generowanie alertów.
- Skonfigurować środowisko wyjaśnialnej sztucznej inteligencji do wykrywania anomalii w czasie rzeczywistym i generowania interpretowalnych wyjaśnień w zakresie bezpieczeństwa.
- Wdrożyć usługi wykrywania anomalii w środowisku monitorowania. Skonfigurować strukturę wyjaśnialnej sztucznej inteligencji do przetwarzania telemetrii bezpieczeństwa generowanej podczas migracji. Połączyć strumienie telemetrii bezpieczeństwa z poziomu źródła, centrum migracyjnego, docelowej bazy danych oraz usług monitorowania.
- Włączyć wykrywanie anomalii w czasie rzeczywistym i generowanie wyjaśnień w oparciu o SHAP. Zweryfikować poprawność pobierania danych telemetrycznych przed rozpoczęciem eksperymentów migracyjnych.
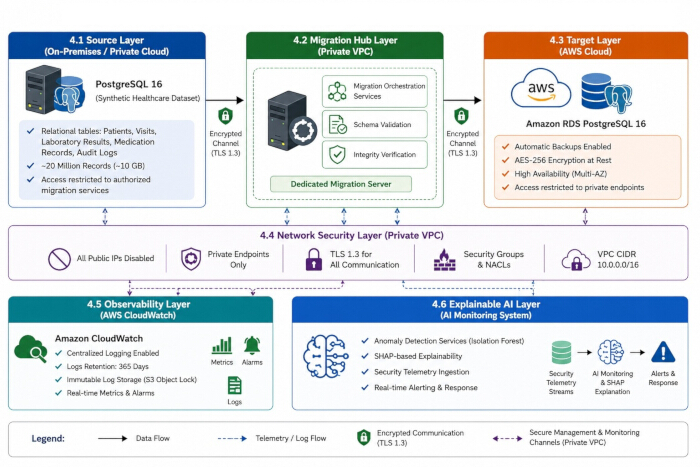
Rysunek 2: Architektura wdrożeniowa bezpiecznego modelu migracji chmury w ochronie zdrowia. Środowisko wdrożeniowe przedstawia źródłową bazę danych PostgreSQL zawierającą syntetyczny zbiór danych z obszaru opieki zdrowotnej, dedykowany węzeł migracyjny w ramach prywatnej chmury wirtualnej (VPC), docelową bazę danych Amazon RDS PostgreSQL, warstwę bezpieczeństwa sieciowego, scentralizowany monitoring za pomocą Amazon CloudWatch oraz warstwę monitorowania Wyjaśnialnej Sztucznej Inteligencji (XAI). Cała komunikacja odbywa się poprzez prywatne punkty końcowe chronione szyfrowaniem TLS 1.3. Rysunek został przygotowany przez autorów przy użyciu programu Microsoft PowerPoint (Microsoft 365). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
5. Bezpieczny przepływ pracy migracji
UWAGA: Wykonaj bezpieczny proces migracji, przeprowadzając modelowanie zagrożeń, transfer schematu, bezpieczną migrację danych, walidację migracji oraz utwardzanie systemu po migracji.
- Zidentyfikuj potencjalne zagrożenia dla bezpieczeństwa i przypisz odpowiednie środki ograniczające przed rozpoczęciem procesu migracji.
- Zidentyfikuj zasoby migracyjne, potencjalne wektory ataków oraz realistyczne scenariusze cyberataków.
- Oceń ryzyko kradzieży poświadczeń wynikające z przejęcia tokenów uwierzytelniających, ataki wewnętrzne obejmujące nieautoryzowany dostęp administracyjny, ataki typu replay celujące w uprzednio przechwycone żądania uwierzytelniania, ataki man-in-the-middle (MITM) polegające na próbach przechwycenia zaszyfrowanych kanałów komunikacyjnych, manipulacje schematem mające na celu modyfikację struktur bazy danych podczas migracji oraz ataki polegające na eskalacji uprawnień w celu uzyskania nieautoryzowanych uprawnień administracyjnych.
- Sprawdź, czy stosowanie czasowego zarządzania poświadczeniami zgodnie z zasadą najmniejszych uprawnień jest wystarczające do zapobiegania kradzieży poświadczeń i atakom eskalacji uprawnień. Zweryfikuj, czy komunikacja szyfrowana protokołem TLS 1.3 chroni przed atakami typu replay oraz atakami man-in-the-middle.
- Zweryfikuj, czy polityki zarządzania tożsamością i dostępem (IAM) zapobiegają nieautoryzowanemu dostępowi administracyjnemu. Potwierdź, że ciągłe logowanie audytowe rejestruje wszystkie działania migracyjne związane z bezpieczeństwem. Upewnij się, że weryfikacja za pomocą sum kontrolnych SHA-256 pozwala wykryć nieautoryzowane zmiany w schemacie lub danych.
- Zweryfikuj, czy framework wyjaśnialnego wykrywania anomalii potrafi zlokalizować nietypowe działania migracyjne i dostarczyć interpretowalne wyjaśnienia w zakresie bezpieczeństwa. Stwórz mapę środków kontroli bezpieczeństwa dla każdego zidentyfikowanego zagrożenia. Potwierdź, że wszystkie zidentyfikowane zagrożenia zostały odpowiednio zneutralizowane przed rozpoczęciem migracji bazy danych. Autorzy podsumowali model zagrożeń i środki kontroli bezpieczeństwa w Tabeli 2.
- Przenieś schemat bazy danych. Wyeksportuj definicje schematu z oryginalnej bazy danych PostgreSQL. Zwaliduj kompatybilność schematu ze środowiskiem docelowej bazy danych. Zweryfikuj struktury tabel, klucze główne, klucze obce, indeksy i więzy. Wdróż zwalidowane definicje schematu do docelowej bazy danych. Potwierdź pomyślne wdrożenie schematu przed przekazaniem danych.
- Przenieś dane medyczne w sposób bezpieczny za pomocą zaszyfrowanych kanałów komunikacyjnych, stale monitorując działania migracyjne.
- Skonfiguruj rozmiar partii migracyjnej na 10 0 rekordów na transakcję. Ustanów zaszyfrowane kanały komunikacyjne przy użyciu TLS 1.3. Przesyłaj dane poprzez prywatne punkty końcowe sieci w obrębie wirtualnej chmury prywatnej (VPC).
- Włącz automatyczne ponownienia z maksymalną liczbą trzech prób dla nieudanych transakcji.
Utrzymaj przepustowość transferu danych w zakresie od 10 MB/s do 150 MB/s. Nieprzerwanie monitoruj działania migracyjne podczas całego procesu transferu. Rejestruj wszystkie zdarzenia migracyjne w scentralizowanych logach audytowych.
- Zweryfikuj kompletność i integralność migracji poprzez porównanie sum kontrolnych, liczby rekordów i struktur bazy danych.
- Wygeneruj wartości skrótów SHA-256 dla wszystkich tabel źródłowych przed migracją oraz wartości skrótów SHA-256 dla wszystkich tabel docelowych po migracji. Porównaj wartości sum kontrolnych źródła i celu. Zweryfikuj liczbę wierszy w bazie źródłowej i docelowej. Sprawdź spójność schematów, relacji między tabelami i więzów bazy danych. Uznać migrację za udaną tylko wtedy, gdy wartości sum kontrolnych, liczba rekordów i struktury schematów są identyczne.
- Usuń tymczasowe uprawnienia i sfinalizuj środki kontroli bezpieczeństwa po pomyślnym zakończeniu migracji danych.
- Natychmiast po zakończeniu migracji odwołaj wszystkie tymczasowe poświadczenia migracyjne. Usuń podwyższone uprawnienia migracyjne z kont usługowych. Zarchiwizuj logi audytowe i zapisy monitorowania bezpieczeństwa.
- Zweryfikuj pomyślne zakończenie procedur kopii zapasowych. Wycofaj z eksploatacji tymczasowe serwery migracyjne i zasoby pomocnicze. Przeprowadź końcowy przegląd bezpieczeństwa zmigrowanego środowiska. Udokumentuj wyniki migracji i rezultaty walidacji. Pełny bezpieczny przepływ pracy migracyjnej zastosowany w tej badaniu został przedstawiony na Rysunku 3.
| Scenariusz zagrożenia | Kontrola bezpieczeństwa | Metoda detekcji | Łagodzenie |
| Kradzież poświadczeń | Tymczasowe minimalne uprawnienia (TLP) | logi IAM | Automatyczne odwoływanie poświadczeń |
| Atak wewnętrzny | Kontrola dostępu oparta na rolach (RBAC) | Logi audytowe + SHAP | Zakończenie sesji |
| Atak powtórzeniowy | TLS 1.3 + walidacja wartości nonce | Monitorowanie sieci | Odrzuć zdublowane zapytania |
| Atak typu Man-in-the-Middle (MITM) | Szyfrowanie TLS 1.3 | Walidacja certyfikatu | Szyfrowana komunikacja |
| Manipulacja schematem | Suma kontrolna SHA-256 + walidacja schematu | Weryfikacja integralności | Przywróć zweryfikowany schemat |
| Eskalacja uprawnień | Wdrażanie polityk IAM | Logi bezpieczeństwa | Cofnięcie uprawnień |
Tabela 2: Model zagrożeń i odpowiednie środki bezpieczeństwa podjęte w proponowanym schemacie migracji.Tabela przedstawia główne reprezentatywne zagrożenia dla bezpieczeństwa oraz odpowiadające im mechanizmy łagodzenia skutków, oparte na zasadach bezpieczeństwa zerowego zaufania, szyfrowaniu, zarządzaniu tożsamością, weryfikacji integralności, monitorowaniu i wyjaśnialnej detekcji anomalii.
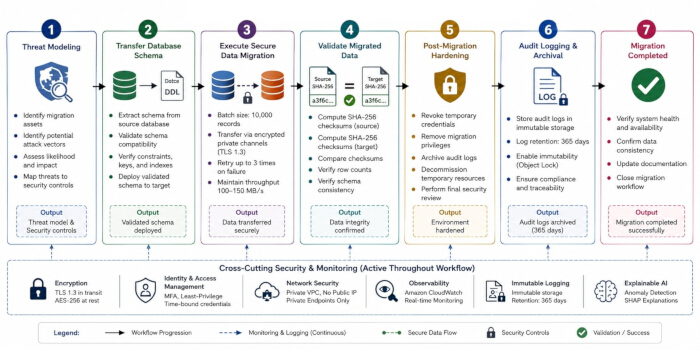
Rysunek 3: Schemat proponowanego bezpiecznego protokołu migracji chmurowej bazy danych. Protokół składa się z siedmiu kolejnych etapów: modelowania zagrożeń, transferu schematu, bezpiecznej migracji bazy danych, walidacji migrowanych danych, utwardzania po migracji, logowania audytowego i archiwizacji oraz zakończenia migracji. W całym procesie migracji utrzymywane są monitorowanie bezpieczeństwa, szyfrowana komunikacja, zarządzanie tożsamością, niezmienne logowanie oraz wyjaśnialne wykrywanie anomalii. Rysunek został przygotowany przez autorów przy użyciu programu Microsoft PowerPoint (Microsoft 365). Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej figury.
6. Konfiguracja monitorowania wyjaśnialnej sztucznej inteligencji (explainable AI)
UWAGA: Schemat procesu obejmuje: identyfikację cech bezpieczeństwa migracji, budowę modelu wykrywającego nieprawidłowości, rozpoznawanie momentów, w których działania migracyjne są podejrzane, oraz generowanie wyjaśnialnych wyników za pomocą metod interpretacji SHAP.
- Wyodrębnij i przygotuj cechy telemetrii bezpieczeństwa niezbędne do detekcji anomalii oraz analizy wyjaśnialności.
- Zbierz logi zabezpieczeń z serwerów baz danych, serwerów uwierzytelniających, serwerów aplikacji oraz systemów monitorowania sieci. Agreguj wszystkie zdarzenia związane z migracją w scentralizowanym repozytorium logów. Usuń zdublowane rekordy oraz niekompletne wpisy. Zsynchronizuj znaczniki czasu we wszystkich źródłach logów, korzystając z uniwersalnego czasu koordynowanego (UTC).
- Oblicz częstotliwość dostępu dla każdego użytkownika podczas operacji migracji. Zapisz liczbę nieudanych prób logowania powiązanych z każdym kontem. Monitoruj zmiany adresów IP źródłowych w trakcie sesji migracyjnych.
- Zmierz czas trwania sesji użytkownika od momentu zainicjowania logowania do jego zakończenia. Oblicz wolumeny transferu danych przychodzących i wychodzących podczas działań migracyjnych. Znormalizuj wszystkie wyekstrahowane cechy, stosując normalizację Min-Max.
- Tabela 3 podsumowuje funkcje bezpieczeństwa wykorzystywane do detekcji anomalii i analizy wyjaśnialności.
- Wytrenuj i zwaliduj model Isolation Forest, wykorzystując przygotowany zestaw cech bezpieczeństwa.
- Podziel zbiór danych. Losowo podziel zbiór danych na zbiór treningowy (70%), zbiór walidacyjny (15%) oraz zbiór testowy (15%). Zachowaj spójny rozkład zdarzeń prawidłowych i anomalnych we wszystkich podzbiorach.
- Wybór modelu wyjaśnialnej sztucznej inteligencji (Explainable AI). Wybierz algorytm Isolation Forest, ponieważ efektywnie wykrywa on anomalie w aktywnościach migracyjnych bez konieczności stosowania etykietowanych danych treningowych. Wykorzystaj ten algorytm do izolowania nietypowych obserwacji poprzez rekurencyjne, losowe partycjonowanie przestrzeni cech.
- Zastosuj TreeExplainer z biblioteki SHAP w celu ilościowego określenia wpływu każdej cechy bezpieczeństwa na przewidywanie anomalii oraz zwiększenia przejrzystości procesu monitorowania bezpieczeństwa.
- Skonfiguruj model detekcji anomalii. Zainicjuj model Isolation Forest. Skonfiguruj model, korzystając z parametrów wymienionych w Tabela 4.
- Zdefiniuj sformułowanie matematyczne wykorzystywane do obliczania wyników anomalii i wyjaśnij wkład poszczególnych cech.
- Zdefiniuj wektor cech bezpieczeństwa dla każdego zdarzenia migracji zgodnie z Równaniem 1.
xi = [x1 , x2, x3, Proszę podać tekst źródłowy do tłumaczenia.4, x5 ] (1)
gdzie x1 oznacza częstotliwość dostępu, x2 oznacza liczbę nieudanych prób logowania, x3 oznacza częstotliwość zmiany adresu IP, x4 oznacza czas trwania sesji, a x5 oznacza objętość transferu danych. - Wyodrębnij funkcje bezpieczeństwa z logów migracji. Znormalizuj wszystkie wartości funkcji przed trenowaniem modelu. Oblicz wynik anomalii Isolation Forest dla każdego zdarzenia migracji, korzystając z równania 2.
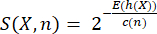 (2)
gdzie S(X,n)) oznacza wynik anomalii obserwacji X, X oznacza wektor cech bezpieczeństwa, E(h(X)) to oczekiwana długość ścieżki obserwacji X, c(n) to średnia długość ścieżki dla nieudanych wyszukiwań w binarnym drzewie poszukiwań, a n to całkowita liczba próbek treningowych. Współczynnik normalizacji oblicza się zgodnie z Równaniem 3.
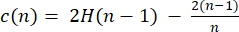 (3)
gdzie H(n-1) oznacza (n-1)-tą liczbę harmoniczną. - Zdarzenia migracyjne z wynikiem anomalii przekraczającym zdefiniowany próg decyzyjny należy zaklasyfikować jako anomalne.
- Zastosuj metodę SHAP (SHapley Additive exPlanations), aby wyjaśnić wkład każdej cechy bezpieczeństwa w prognozowanie anomalii. Oblicz wartość SHAP dla cechy i, korzystając z równania 4.
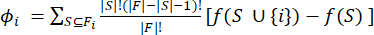 (4)
gdzie (F) oznacza pełny zestaw cech, (S) oznacza podzbiór cech, a (f(.)) oznacza funkcję predykcyjną lasu izolacyjnego (Isolation Forest). - Oblicz globalną istotność cech, wyznaczając średnią bezwzględną wartość SHAP zgodnie z równaniem 5.
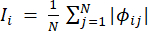 (5)
gdzie (N) oznacza całkowitą liczbę zdarzeń migracji. - Uszereguj funkcje bezpieczeństwa według ich średnich bezwzględnych wartości SHAP. Wygeneruj wykresy podsumowujące SHAP (summary plots), wykresy zależności (dependence plots) oraz wykresy sił (force plots), aby zwizualizować globalną i lokalną istotność funkcji.
- Zdefiniuj wektor cech bezpieczeństwa dla każdego zdarzenia migracji zgodnie z Równaniem 1.
- Wytrenuj model Isolation Forest, wykorzystując zbiór treningowy. Oceń wydajność modelu za pomocą zbioru walidacyjnego. W razie potrzeby zmień progi kontaminacji (contamination thresholds). Zapisz konfigurację modelu, która wykazuje najlepsze wyniki. Zwaliduj wydajność modelu. Wyznacz takie miary jak dokładność (accuracy), precyzja (precision), czułość (recall), wynik F1 (F1-score) oraz ROC-AUC. Zanotuj wskaźniki wydajności modelu do późniejszego porównania.
- Zastosuj wytrenowany model w celu zidentyfikowania nieprawidłowych zdarzeń migracyjnych i sklasyfikowania podejrzanych aktywności.
- Wykonaj predykcję anomalii. Zastosuj wytrenowany model Isolation Forest do zbioru testowego. Wygeneruj wyniki anomalii (anomaly scores) dla wszystkich zdarzeń migracyjnych.
- Zidentyfikuj podejrzane działania. Ustal, czy zdarzenia migracyjne są typowe, czy anomalne. Oznacz jako podejrzane te zdarzenia, które przekraczają określone poziomy anomalii. Przygotuj dokumentację anomalii do kontroli bezpieczeństwa.
- Zakończenie procesu detekcji anomalii pozwala na uzyskanie wyników oceny anomalii (anomaly scores), zaklasyfikowanie zdarzeń migracyjnych jako normalne lub anomalne, pomiar skuteczności detekcji za pomocą analizy ROC oraz zidentyfikowanie kluczowych anomalii bezpieczeństwa. Przykłady wyników uzyskanych w ramach zaprojektowanego procesu przedstawiono w Rycina 4.
- Kategoryzuj wykryte anomalie. Klasyfikuj anomalie na anomalie uwierzytelniania, anomalie sieciowe, anomalie sesji oraz anomalie przesyłu danych. Zachowaj etykiety anomalii dla analizy wyjaśniającej.
- Oceń skuteczność detekcji. Przeanalizuj zarejestrowane do chwili obecnej incydenty bezpieczeństwa. Następnie, przyjmując je jako punkt odniesienia, oceń wykryte anomalie i ustal, które z nich były anomaliami rzeczywistymi. Wyznacz wskaźnik wykrywalności anomalii oraz odsetek wyników fałszywie dodatnich. Sporządź oficjalny zapis dokumentacji dokładności detekcji, aby umożliwić jej reprodukcję.
- Wygeneruj wyjaśnienia oparte na metodzie SHAP, aby zinterpretować wkład poszczególnych cech bezpieczeństwa w prognozy anomalii.
- Skonfiguruj środowisko SHAP. Wczytaj wytrenowany model Isolation Forest. Zainicjuj narzędzie SHAP TreeExplainer. Zweryfikuj poprawność integracji modelu detekcji anomalii z frameworkiem wyjaśnialności.
- Wybierz próbki tła. Losowo wybierz 10 reprezentatywnych próbek z zestawu danych treningowych. Wybrane próbki wykorzystaj jako zestaw danych tła SHAP. Oblicz wartości SHAP. Oblicz wartości SHAP dla wszystkich wykrytych anomalii. Zmierz wkład poszczególnych cech w predykcje anomalii. Zapisz wyniki SHAP do dalszej analizy.
- Generuj wyjaśnienia globalne. Twórz wykresy podsumowujące SHAP, obrazujące ogólną istotność cech. Generuj wykresy słupkowe SHAP na podstawie średnich bezwzględnych wartości SHAP. Twórz wykresy zależności SHAP dla cech o wysokim stopniu wpływu.
- Generuj lokalne wyjaśnienia. Wybierz reprezentatywne anomalne zdarzenia migracyjne. Utwórz wykresy sił oraz wykresy kaskadowe SHAP. Zwizualizuj wkład cech odpowiedzialnych za każdą anomalię.
- Reprezentatywne wyniki wyjaśnialności wygenerowane podczas procesu interpretacji przedstawiono w Rysunek 5Wizualizacje te obrazują globalne znaczenie cech, rankingi wkładu cech, zależności między wpływowymi cechami bezpieczeństwa oraz lokalne wyjaśnienia dla poszczególnych anomalii migracyjnych.
- Uporządkuj funkcje bezpieczeństwa. Oblicz średnie bezwzględne wartości SHAP dla wszystkich funkcji. Uporządkuj funkcje zgodnie z ich wkładem w detekcję anomalii. Zidentyfikuj najbardziej wpływowe wskaźniki bezpieczeństwa oddziałujące na bezpieczeństwo migracji. Tabela 5 podsumowuje rankingi istotności cech w oparciu o metodę SHAP.
- Zweryfikuj spójność wyjaśnień. Powtórz analizę SHAP w pięciu niezależnych seriach eksperymentalnych. Zmierz stabilność i spójność wyjaśnień. Potwierdź, że rankingi cech pozostają stabilne w powtórnych analizach.
UWAGA: Tabela 6 zawiera zestawienie typowych problemów występujących podczas wyjaśnialnego wykrywania anomalii oraz zalecane działania korygujące.
| Cecha | Opis | Cel |
| Częstotliwość dostępu | Liczba żądań dostępu użytkowników podczas migracji | Wykrywanie nieprawidłowych zachowań w dostępie |
| Liczba nieudanych prób logowania | Liczba nieudanych prób uwierzytelnienia | Identyfikacja prób nieautoryzowanego dostępu lub ataków typu brute-force |
| Zmiany adresu IP | Częstotliwość zmian adresu IP źródłowego | Wykrywanie podejrzanych zachowań w sieci |
| Czas trwania sesji | Długość sesji użytkowników podczas migracji | Identyfikacja nieprawidłowych aktywności sesji |
| Wolumen przesyłu danych | Ilość danych przeniesionych podczas migracji | Wykrywanie nietypowego przesyłania lub eksfiltracji danych |
Tabela 3: Cechy telemetrii bezpieczeństwa wykorzystane do wyjaśnialnego wykrywania anomalii. Tabela przedstawia cechy bezpieczeństwa monitorowane podczas migracji bazy danych, ich znaczenie, sposoby pomiaru oraz sposób, w jaki pomogły one w wykrywaniu anomalii i analizie wyjaśnialności.
| Parametr | Wartość | Opis |
| Algorytm | Las izolacyjny | Model detekcji anomalii |
| liczba estymatorów | 100 | Liczba drzew izolacyjnych |
| zanieczyszczenie | 0.02 | Oczekiwana proporcja anomalii |
| maksymalna liczba próbek | Auto | Liczba próbek pobranych z jednego drzewa |
| parametr random_state | 42 | Ziarno odtwarzalności |
| bootstrapping | Fałszywy | Losowanie bez zwracania |
| Zbiór treningowy | 70% | Dane treningowe modelu |
| Zbiór walidacyjny | 15% | Walidacja hiperparametrów |
| Zbiór testowy | 15% | Końcowa ocena modelu |
Tabela 4: Konfiguracja Isolation Forest wykorzystanego do wykrywania anomalii podczas bezpiejnej migracji bazy danych. Tabela ta szczegółowo przedstawia ustawienia hiperparametrów modelu Isolation Forest dla procesu trenowania, takie jak sposób podziału zbioru danych, poziom kontaminacji, liczba estymatorów, ziarno losowości oraz konfigurację ewaluacji.
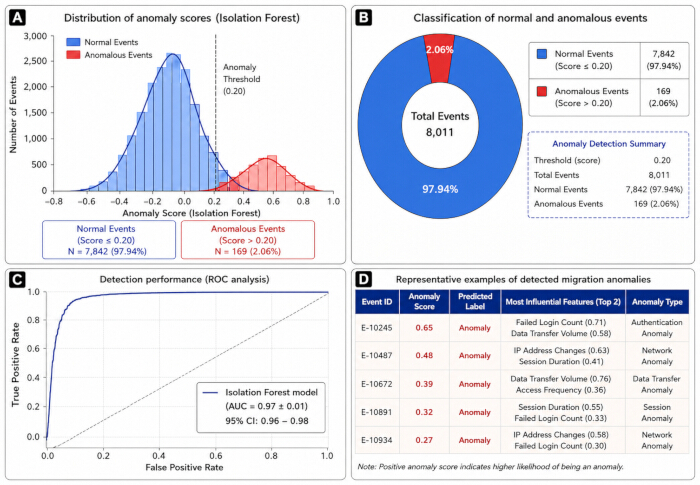
Rysunek 4: Reprezentatywne wyniki frameworka detekcji anomalii podczas bezpiecznej migracji danych w chmurze. (A) Rozkład wyników anomalii Isolation Forest z zaznaczonym progiem anomalii. (B) Klasyfikacja zdarzeń migracyjnych na kategorie prawidłowe i anomalne. (C) Krzywa charakterystyki operacyjnej odbiornika (ROC) wykazująca skuteczność modelu Isolation Forest (AUC = 0,97 ± 0,01). (D) Reprezentatywne zdarzenia anomalnych migracji przedstawiające wyniki anomalii, przewidziane etykiety, wpływowe cechy bezpieczeństwa oraz kategorie anomalii. Rysunek ten został wygenerowany przez autorów przy użyciu języka Python 3.1 (Matplotlib 3.9) i sformatowany w programie Microsoft PowerPoint (Microsoft 365). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
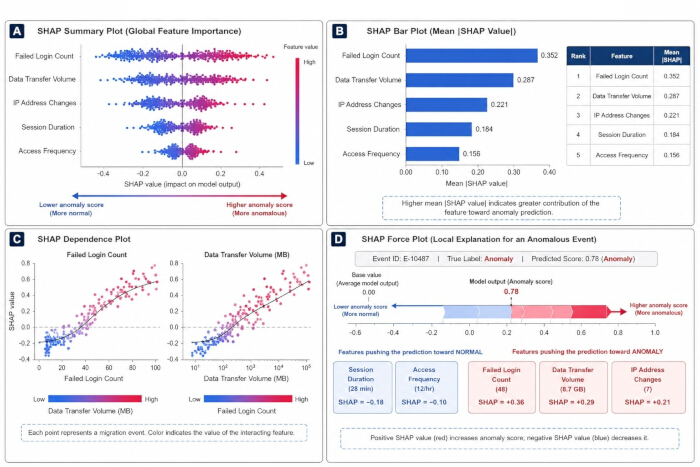
Rysunek 5: Przykłady wyników wyjaśnialności w oparciu o metodę SHAP, wygenerowane podczas interpretacji anomalii. (A) Wykres podsumowujący SHAP, wyróżniający najważniejsze cechy w skali globalnej. (B) Ranking funkcji bezpieczeństwa na podstawie ich średnich bezwzględnych wartości SHAP. (C) Wykresy zależności SHAP obrazujące, w jaki sposób liczba nieudanych logowań oraz wolumen przesyłu danych wpływają na prognozowanie anomalii. (D) wykres sił SHAP zapewniający lokalne wyjaśnienie typowego zdarzenia nieprawidłowej migracji. Wykresy te prezentują globalną i lokalną interpretowalność proponowanego modelu detekcji anomalii. Rycina ta została wygenerowana przez autorów przy użyciu języka Python 3.1 (Matplotlib 3.9) i sformatowana w programie Microsoft PowerPoint (Microsoft 365). Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
| Ranga | Cecha | Średnia bezwzględna wartość SHAP | Interpretacja |
| 1 | Liczba nieudanych prób logowania | 0.352 | Najbardziej wpływowy wskaźnik anomalnej aktywności |
| 2 | Wolumen przesyłu danych | 0.287 | Kluczowy wkład w detekcję anomalii |
| 3 | Zmiany adresu IP | 0.221 | Wskazuje na podejrzane zachowanie sieci |
| 4 | Czas trwania sesji | 0.184 | Związane z nieprawidłowymi sesjami użytkownika |
| 5 | Częstotliwość dostępu | 0.156 | Odzwierciedla nietypowe wzorce dostępu |
Tabela 5: Wyniki istotności cech SHAP dla danych telemetrycznych z zakresu bezpieczeństwa. Tabela przedstawia ranking cech bezpieczeństwa według ich średnich bezwzględnych wartości SHAP i określa ich poszczególny wkład w przewidywanie anomalii.
| Wydanie | Możliwa przyczyna | Rekomendowane rozwiązanie |
| Wykryto niewiele anomalii | Parametr zanieczyszczenia zbyt niski | Zwiększ próg kontaminacji i ponownie wytrenuj model. |
| Wysoki odsetek wyników fałszywie dodatnich | Zaszumione lub niespójne logi migracji | Oczyść dane z logów i znormalizuj cechy bezpieczeństwa przed trenowaniem modelu. |
| Niestabilne wyjaśnienia SHAP | Niewystarczająca liczba próbek tła | Zwiększ liczbę reprezentatywnych próbek tła wykorzystywanych przez SHAP. |
| Niska dokładność detekcji anomalii | Niezbalansowanie cech lub niewystarczający preprocessing | Zastosuj procedury normalizacji cech, balansowania oraz kontroli jakości. |
| Powolna zbieżność modelu | Duży zbiór danych lub ograniczone zasoby obliczeniowe | Zoptymalizuj hiperparametry lub wykorzystaj procesor GPU/przetwarzanie równoległe. |
| Błędy komunikacyjne | Niestabilność sieci podczas monitorowania | Zweryfikuj bezpieczne kanały komunikacji i powtórz synchronizację. |
| Brakujące funkcje bezpieczeństwa | Niepełny zbiór logów | Zweryfikuj źródła logów przed ekstrakcją cech i wygeneruj ponownie zestaw danych cech. |
Tabela 6: Przewodnik po rozwiązywaniu problemów w bezpiecznej migracji bazy danych w oparciu o wyjaśnialną sztuczną inteligencję (Explainable Artificial Intelligence). Tabela ta zawiera podsumowanie typowych problemów wdrożeniowych, możliwych przyczyn, objawów diagnostycznych, zalecanych działań oraz wyników oczekiwanych w wyniku wykonania protokołu i jego powtarzalności.
7. Ocena wydajności
UWAGA: Ta sekcja opisuje procedurę eksperymentalną wykorzystaną do porównania podstawowego modelu migracji z proponowanym modelem migracji opartym na wyjaśnialnej sztucznej inteligencji o zerowym zaufaniu (zero-trust explainable AI). Ocena wydajności obejmuje bezpieczeństwo, zdolność wykrywania anomalii, efektywność migracji oraz walidację statystyczną w identycznych warunkach eksperymentalnych.
- Skonfiguruj zarówno środowisko bazowe, jak i proponowane w identycznych warunkach, aby umożliwić rzetelne porównanie wydajności.
- Skonfiguruj konwencjonalne środowisko migracji. Skonfiguruj długoterminowe statyczne poświadczenia z okresem ważności przekraczającym 24 h. Włącz publiczne punkty końcowe sieci dla dostępu do bazy danych. Wyłącz mechanizmy wykrywania anomalii i wyjaśnialności oparte na AI. Monitoruj czynności migracyjne ręcznie, korzystając z konwencjonalnych logów bezpieczeństwa. Zapisz zdarzenia migracyjne do późniejszego porównania wydajności.
- Skonfiguruj strukturę migracji Zero-Trust. Włącz tymczasowe poświadczenia o minimalnych uprawnieniach z automatycznym wygasaniem po zakończeniu migracji. Wyłącz wszystkie publiczne punkty końcowe sieci. Włącz komunikację w sieci prywatnej przy użyciu bezpiecznych kanałów.
- Wdróż wytrenowany model wykrywania anomalii Isolation Forest. Włącz SHAP TreeExplainer w celu interpretacji modelu. Skonfiguruj zautomatyzowany monitoring bezpieczeństwa w całym procesie migracji. Zweryfikuj bezpieczną komunikację między wszystkimi komponentami migracji przed wykonaniem.
- Przeprowadź powtarzalne eksperymenty migracyjne w kontrolowanych warunkach, aby ocenić odtwarzalność struktury.
- Wykonaj eksperyment migracyjny. Przeprowadź dziesięć niezależnych eksperymentów migracyjnych zarówno dla środowiska bazowego, jak i proponowanego. Zachowaj identyczną konfigurację sprzętową, programową i sieciową podczas wszystkich eksperymentów.
- Zmigruj 10 GB danych medycznych podczas każdego uruchomienia eksperymentalnego. Powtórz wszystkie eksperymenty w identycznych warunkach obciążenia. Zapisuj zdarzenia bezpieczeństwa, logi migracji, wyniki wykrywania anomalii oraz czasy wykonania podczas każdego eksperymentu.
- Zwaliduj spójność migracji. Oblicz sumy kontrolne SHA-256 przed i po migracji. Zweryfikuj pełną spójność danych po każdym eksperymencie migracyjnym. Udokumentuj wyniki walidacji sum kontrolnych.
- Oblicz ilościowe metryki bezpieczeństwa, migracji i wykrywania anomalii w celu oceny porównawczej.
- Zmierz wydajność bezpieczeństwa. Zmierz czas ekspozycji poświadczeń. Oblicz liczbę odsłoniętych poświadczeń podczas migracji. Zmierz czas wykrycia incydentów. Zapisz czas ekspozycji na publiczną sieć.
- Oceń wydajność wykrywania anomalii. Oblicz dokładność wykrywania anomalii, precyzję, pełność (recall), wynik F1 oraz pole pod krzywą charakterystyki operacyjnej odbiornika (AUC). Oceń wydajność migracji. Zmierz całkowity opóźnienie migracji i oblicz przepustowość migracji. Zapisz narzut komunikacyjny wprowadzony przez mechanizmy bezpieczeństwa.
- Przeprowadź walidację statystyczną. Oblicz średnią i odchylenie standardowe dla wszystkich metryk wydajności. Oblicz 95% przedziały ufności. Przeprowadź sparowane testy t-Studenta, aby porównać strukturę bazową i proponowaną. Przyjmij istotność statystyczną przy p < 0,05. Reprezentatywne wyniki oceny wydajności wygenerowane podczas porównania eksperymentalnego przedstawiono na Rysunku 6.
- Tabela 7 podsumowuje ilościowe porównanie wydajności między strukturą bazową a proponowaną strukturą migracji.
Tabela 8 podsumowuje typowe problemy wdrożeniowe napotkane podczas bezpiecznej migracji bazy danych, ich możliwe przyczyny oraz zalecane działania korygujące.
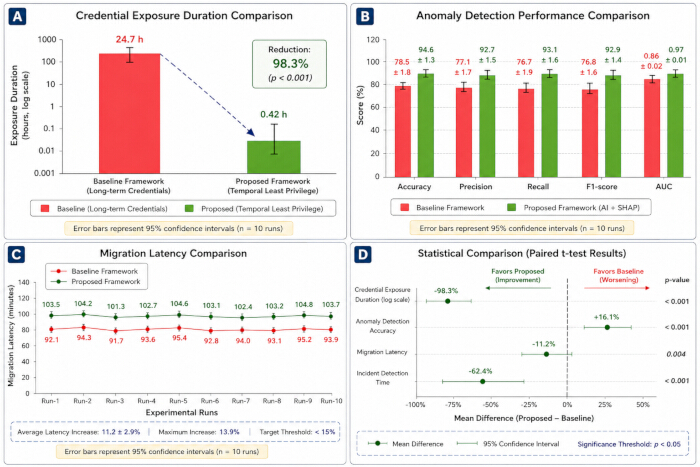
Rycina 6: Porównanie wydajności podstawowego modelu migracji oraz proponowanego bezpiecznego modelu migracji do chmury, opartego na koncepcji zerowego zaufania (zero-trust) i wyjaśnialnej sztucznej inteligencji (explainable AI). (A) Porównanie czasu ekspozycji poświadczeń przy użyciu długoterminowych oraz czasowych poświadczeń o minimalnych uprawnieniach. (B) Porównanie metryk wydajności detekcji anomalii, w tym dokładności, precyzji, pełności (recall), wyniku F1 oraz AUC. (C) Porównanie opóźnienia migracji w dziesięciu niezależnych próbach eksperymentalnych, wykazujące, że wzrost opóźnienia pozostał poniżej zdefiniowanego progu akceptacji. (D) Porównanie statystyczne kluczowych wskaźników wydajności z użyciem sparowanych testów t Studenta, przedstawiające różnice średnich i 95% przedziały ufności. Słupki błędów reprezentują 95% przedziały ufności z dziesięciu niezależnych serii eksperymentalnych. Rysunek został przygotowany przez autorów przy użyciu programu Python 3.1 (Matplotlib 3.9) i sformatowany w programie Microsoft PowerPoint (Microsoft 365). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
| Metryka wydajności | Model bazowy (średnia ± SD) | Proponowany model (średnia ± SD) | Poprawa | 95% przedział ufności | p-value |
| Czas ekspozycji poświadczeń (h) | 24.70 ± 1.32 | 0.42 ± 0.18 | redukcja o 98.3% | 23.6–24.9 | <0.01 |
| Dokładność wykrywania anomalii (%) | 72.4 ± 2.1 | 94.6 ± 1.3 | +2.2% | 20.8–23.5 | <0.001 |
| Precyzja (%) | 68.1 ± 2.5 | 92.7 ± 1.5 | +24.6% | 23.1–26.0 | <0.001 |
| Czułość (%) | 70.3 ± 2.4 | 93.1 ± 1.6 | +2.8% | 21.4–24.2 | <0.01 |
| Wskaźnik F1 (%) | 69.2 ± 2.2 | 92.9 ± 1.4 | +23.7% | 22.3–25.0 | <0.01 |
| AUC | 0.78 ± 0.03 | 0.97 ± 0.01 | +0.19 | 0.17–0.21 | <0.01 |
| Opóźnienie migracji (min) | 87.6 ± 3.2 | 97.4 ± 2.9 | narzut 1.2% | 8.9–10.7 | 0.02 |
| Integralność danych (%) | 9.8 | 10.0 | poprawa o 0.2% | 0.1–0.3 | 0.031 |
| Ekspozycja na sieć publiczną | Włączona | Eliminowana | wyeliminowana w 100% | N/D | <0.01 |
Tabela 7: Bazowe i proponowane bezpieczne frameworki migracji baz danych: porównanie wydajności. Tabela przedstawia czas ekspozycji poświadczeń, skuteczność wykrywania anomalii, opóźnienie migracji, integralność danych oraz ulepszenia zabezpieczeń ocenione ilościowo podczas walidacji protokołu.
| Wydanie | Możliwa przyczyna | Rekomendowane rozwiązanie |
| Błąd uwierzytelniania migracji | Wygasłe lub nieprawidłowe dane uwierzytelniające tymczasowe | Odśwież tymczasowe dane uwierzytelniające i zweryfikuj zasady IAM przed ponownym uruchomieniem migracji. |
| Wysokie opóźnienie migracji | Przeciążenie sieci lub niewystarczająca przepustowość | Zoptymalizuj rutowanie sieci, zaplanuj migrację w okresach niskiego natężenia ruchu i zweryfikuj łączność punktów końcowych. |
| Fałszywie dodatnie alerty o anomaliach | Niewłaściwy próg zanieczyszczenia w Isolation Forest | Dostrój parametr zanieczyszczenia, korzystając ze zbioru walidacyjnego, a następnie przeprowadź ponowny trening modelu. |
| Niestabilne wyjaśnienia SHAP | Niewystarczająca lub niereprezentatywna liczba próbek tła | Zwiększ rozmiar próby tła SHAP i zapewnij reprezentatywność próbkowania. |
| Niezgodność integralności danych | Przerwana migracja lub uszkodzony transfer danych | Ponowić migrację po zweryfikowaniu wartości sum kontrolnych SHA-256 oraz spójności źródła i celu. |
| Błąd bezpiecznego połączenia z punktem końcowym | Błędy konfiguracji zapory sieciowej lub TLS | Zweryfikuj certyfikaty SSL/TLS, reguły zapory sieciowej oraz konfigurację prywatnego punktu końcowego. |
| Niska dokładność detekcji anomalii | Niepełna ekstrakcja cech lub niewłaściwe przetwarzanie wstępne | Przejrzyj proces inżynierii cech, znormalizuj cechy bezpieczeństwa i przeprowadź ponowne trenowanie modelu. |
| Problemy z zbieżnością modelu | Niewłaściwe hiperparametry | Dostrój parametry uczenia i zweryfikuj wydajność modelu przed wdrożeniem. |
Tabela 8: Przewodnik po rozwiązywaniu problemów podczas bezpiejnej migracji bazy danych opieki zdrowotnej. Tabela wymienia częste błędy migracji, ich możliwe przyczyny, zalecane środki naprawcze oraz oczekiwane wyniki, aby zapewnić niezawodną realizację protokołu bezpiecznej migracji.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Przegląd eksperymentu
Zaproponowany protokół bezpiecznej migracji danych w chmurze z wykorzystaniem wyjaśnialnej sztucznej inteligencji (XAI) został oceniony przy użyciu syntetycznego zbioru danych medycznych obejmującego około 20 milionów rekordów elektronicznej dokumentacji medycznej (EHR), rozdzielonych pomiędzy 28 relacyjnych tabel bazy danych, o łącznej wielkości 10 GB. Eksperymenty przeprowadzono w środowisku chmurowym Amazon Web Services (AWS), wykorzystując Amazon RDS ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
W niniejszej pracy opracowano powtarzalny i bezpieczny protokół migracji bazy danych w chmurze, który integruje zasady bezpieczeństwa zero-trust, czasowy dostęp z minimalnymi uprawnieniami (least-privilege), wyjaśnialną sztuczną inteligencję (XAI) oraz ciągłe monitorowanie bezpieczeństwa, wszystko to w ramach ograniczonego środowiska eksperymentalnego. Celem niniejszego artykułu nie było opracowanie nowego algorytmu migracji; dlatego autorzy przedstawiają przede wszystkim zestandaryzowany proces, który umożliwia badaczom...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy oświadczają, że nie mają żadnych konkurencyjnych interesów finansowych, relacji handlowych ani osobistych, które mogłyby wpłynąć na pracę przedstawioną w niniejszym badaniu. Autorzy nie mają żadnych konfliktów interesów do ujawnienia. Wszystkie materiały niezbędne do odtworzenia metodologii przedstawionej w tym badaniu są publicznie dostępne w repozytorium GitHub. Repozytorium jest dostępne pod adresem: https://github.com/priyankanalawade896-tech/XAI-Secure-Cloud-Data-Migration. Repozytorium zawiera wyłącznie syntetycznie wygenerowane dane referencyjne i nie zawiera żadnych rzeczywistych informacji o pacjentach, chronionych informacji zdrowotnych ani identyfikowalnych dokumentacji medycznych.
Podziękowania
Autorzy dziękują za wsparcie instytucjonalne zapewnione przez ich respective jednostki macierzyste podczas opracowywania i oceny niniejszego protokołu. Autorzy dziękują również za możliwość korzystania z instytucjonalnych zaplecz obliczeniowych oraz zasobów chmury obliczeniowej, które wsparły eksperymentalną walidację proponowanego bezpiecznego frameworka migracji danych w chmurze.
Badania te nie otrzymały zewnętrznego finansowania. Badanie zostało przeprowadzone z wykorzystaniem instytucjonalnych zaplecz badawczych i zasobów obliczeniowych udostępnionych przez jednostki macierzyste autorów. Nie otrzymano żadnych grantów ani wsparcia finansowego z żadnej publicznej, komercyjnej lub non-profit agencji finansującej.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Szyfrowanie AES | NIST | AES-256 | Szyfrowanie danych w spoczynku |
| Amazon RDS PostgreSQL | Amazon Web Services | PostgreSQL 16 | Baza danych docelowa |
| Platforma chmurowa | Amazon Web Services | AWS | Infrastruktura chmurowa |
| CloudWatch | Amazon Web Services | Najnowsza stabilna wersja | Monitorowanie i logowanie |
| Docker | Docker Inc. | 27.0 | Konteneryzacja |
| Faker | Faker Developers | 30.0 | Generowanie danych syntetycznych |
| GPU | NVIDIA | RTX 4090 | 24 GB VRAM |
| Matplotlib | Matplotlib Developers | 3.9 | Wizualizacja |
| NumPy | NumPy Developers | 1.26 | Przetwarzanie numeryczne |
| System operacyjny | Canonical | Ubuntu 22.04 LTS | Środowisko systemowe |
| Pandas | PyData | 2.2 | Przetwarzanie danych |
| PostgreSQL | PostgreSQL Global Development Group | 16 | Baza danych źródłowa |
| Python | Python Software Foundation | 3.11 | Język programowania |
| Scikit-learn | Scikit-learn Developers | 1.5 | Uczenie maszynowe |
| SHAP | SHAP Developers | 0.46 | Wyjaśnialna AI |
| Terraform | HashiCorp | 1.8 | Zarządzanie infrastrukturą |
| TLS | IETF | TLS 1.3 | Szyfrowanie danych w transmisji |
| Wirtualna chmura prywatna | Amazon Web Services | VPC | Prywatne środowisko sieciowe |
| Stacja robocza | Dell/HP | NA | Intel Xeon Gold 6226R, 64 GB RAM, 1 TB SSD |
Bibliografia
- Kindervag J. Build security into your network's DNA: The Zero Trust Network Architecture. Cambridge (MA): Forrester Research; 2010.
- Rose S, Borchert O, Mitchell S, Connelly S. Zero Trust Architecture. NIST Special Publication 800-207. Gaithersburg (MD): National Institute of Standards and Technology; 2020. doi:10.6028/NIST.SP.800-207.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119. doi:10.1038/s41746-020-00323-1.
- Kairouz P, McMahan HB, Avent B, Bellet A, Bennis M, Bhagoji AN, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210. doi:10.1561/2200000083.
- Nguyen DC, Ding M, Pathirana PN, Seneviratne A, Li J, Niyato D, et al. Privacy-preserving federated learning: A comprehensive survey. IEEE Commun Surv Tutor. 2021;23(3):1622-1651. doi:10.1109/COMST.2021.3075434.
- Sarker IH. AI-driven cybersecurity: An overview, security intelligence modeling, and research directions. SN Comput Sci. 2021;2:173. doi:10.1007/s42979-021-00557-0.
- Kuo AM. Opportunities and challenges of cloud computing to improve health care services. J Med Internet Res. 2011;13(3):e67. doi:10.2196/jmir.1867.
- Kota TK. Cloud migration for healthcare data: Challenges and solutions. Nanotechnol Percept. 2024;20:3048-3062.
- Rancea A, Anghel I, Cioara T. Edge computing in healthcare: Innovations, opportunities, and challenges. Future Internet. 2024;16(9):329.
- Mersha M, et al. Explainable artificial intelligence: A survey of needs, techniques, applications, and future direction. Neurocomputing. 2024;599:128111. doi:10.1016/j.neucom.2024.128111.
- Mennella C, Maniscalco U, De Pietro G, Esposito M. Ethical and regulatory challenges of AI technologies in healthcare: A narrative review. Heliyon. 2024;10(4):e26297. doi:10.1016/j.heliyon.2024.e26297.
- Roppelt JS, Kanbach DK, Kraus S. Artificial intelligence in healthcare institutions: A systematic literature review on influencing factors. Technol Soc. 2024;76:102443. doi:10.1016/j.techsoc.2023.102443.
- Lekkala S, Avula R, Gurijala P. Next-Gen firewalls: Enhancing cloud security with generative AI. J Artif Intell Cloud Comput. 2024;3(4):1-9. doi:10.47363/JAICC/2024(3)404.
- Al-Hammuri K, Gebali F, Kanan A. ZTCloudGuard: Zero Trust context-aware access management framework to avoid medical errors in the era of generative AI and cloud-based health information ecosystems. AI. 2024;5(3):1111-1131. doi:10.3390/ai5030055.
- Pfeifer B, Sirocchi C, Bloice MD, Kreuzthaler M, Urschler M. Federated unsupervised random forest for privacy-preserving patient stratification. Bioinformatics. 2024;40(Suppl 2):ii198-ii207. doi:10.1093/bioinformatics/btae382.
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: Challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60. doi:10.1109/MSP.2020.2975749.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions. In: Proceedings of the 31st International Conference on Neural Information Processing Systems (NeurIPS); 2017. p. 4768-4777.
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 1135-1144. doi:10.1145/2939672.2939778.
- Ortigossa ES, Gonçalves T, Nonato LG. Explainable artificial intelligence (XAI)—From theory to methods and applications. IEEE Access. 2024;12:80799-80846. doi:10.1109/ACCESS.2024.3409843.
- Chaddad A, et al. Explainable, domain-adaptive, and federated artificial intelligence in medicine. IEEE/CAA J Autom Sin. 2023;10(4):859-876. doi:10.1109/JAS.2023.123123.
- Albshaier L, Almarri S, Albuali A. Federated learning for cloud and edge security: A systematic review of challenges and AI opportunities. Electronics. 2025;14(5):1019. doi:10.3390/electronics14051019.
- Vani MS, Sudhakar RV, Mahendar A, et al. Personalized health monitoring using explainable AI: Bridging trust in predictive healthcare. Sci Rep. 2025;15:31892. doi:10.1038/s41598-025-15867-z.
- Zakhmi K, et al. Evolving Zero Trust architectures for AI-driven cyber threats in healthcare and other high-risk data environments: A systematic review. Cureus. 2025;17(6):e85446. doi:10.7759/cureus.85446.
- Selvaperumal D, et al. Artificial intelligence-enabled zero-trust cyber security framework for smart healthcare infrastructure. Int J Artif Intell Mach Learn. 2026;6(2 Suppl):204-217. doi:10.51483/IJAIML.6.2s.2026.204-217.
- Abbas SR, Seol H, Abbas Z, Lee SW. Exploring the role of artificial intelligence in smart healthcare: A capability and function-oriented review. Healthcare (Basel). 2025;13(14):1642. doi:10.3390/healthcare13141642.
- Al-Nafjan A, et al. Artificial intelligence in predictive healthcare: A systematic review. J Clin Med. 2025;14(19):6752. doi:10.3390/jcm14196752.
- Qureshi SS, et al. Advanced AI-driven intrusion detection for securing cloud-based industrial IoT. Egypt Inform J. 2025;30:100644. doi:10.1016/j.eij.2025.100644.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 785-794. doi:10.1145/2939672.2939785.
- Liu FT, Ting KM, Zhou ZH. Isolation Forest. In: Proceedings of the 8th IEEE International Conference on Data Mining; 2008. p. 413-422. doi:10.1109/ICDM.2008.17.
- Abadi M, Agarwal A, Barham P, Brevdo E, Chen Z, Citro C, et al. TensorFlow: A system for large-scale machine learning. In: Proceedings of the 12th USENIX Symposium on Operating Systems Design and Implementation (OSDI); 2016. p. 265-283.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.