Niniejsze badanie opracowuje warstwową strukturę optymalizacji promptów opartą na modelu DeepSeek, mającą na celu zwiększenie kompetencji transferu pisania w języku angielskim w kontekstach międzykulturowych. Dzięki zastosowaniu trzystopniowego łańcucha promptów oraz quasi-eksperymentu z udziałem 60 studentów filologii angielskiej, wyniki wykazały istotną poprawę w grupie eksperymentalnej w porównaniu z grupą kontrolną.
Artykuł badawczy
Optymalizacja promptów DeepSeek w nauczaniu pisania w języku angielskim w kontekście międzykulturowym: praktyczne badanie kompetencji transferowych
W tym artykule
Podsumowanie
Streszczenie
Aby rozwiązać problem polegający na tym, że tradycyjne nauczanie pisania w języku angielskim zaniedbuje systematyczne rozwijanie transferu językowego, a istniejące ramy promptów nie sprawdzają się w nauczaniu klasowym, w niniejszym badaniu skonstruowano hierarchiczny system treningu transferu oparty na modelu DeepSeek, obejmujący cztery progresywne poziomy zadań: zdanie, akapit, dyskurs i kulturę, przy czym wszystkie zadania zdefiniowano w formie potrójnej. Utworzono pięciowymiarową bibliotekę zadań obejmującą składnię, strukturę, kulturę, rejestr i logikę, a ukierunkowane prompty są automatycznie generowane na podstawie autentycznych szkiców prac pisemnych studentów. Zintegrowany z architekturą Mixture of Experts (MoE) modelu, opracowano zagnieżdżony łańcuch promptów, aby podzielić skomplikowane polecenia na trzy sekwencyjne fazy: reorganizację semantyczną, rewizję językową i adaptację kulturową. Przyjmując quasi-eksperymentalny plan badań, do projektu zrekrutowano 60 studentów drugiego roku filologii angielskiej z jednego uniwersytetu, dzieląc ich na grupę eksperymentalną i kontrolną po 30 osób każda, w celu przeprowadzenia trzytygodniowej etapowej interwencji w trzech rundach treningowych. Wyniki po eksperymencie wykazują, że wynik transferu kulturowego w grupie eksperymentalnej wzrósł z 2,8 do 4,5, w porównaniu z zaledwie 0,3 wzrostu w grupie kontrolnej; średnia ocena wystawiona przez nauczyciela poprawiła się z 59,1 do 74,4, podczas gdy w grupie kontrolnej wzrost wyniósł z 60,1 do 64,9. Większość współczynników korelacji między oceną AI a oceną nauczyciela przekracza 0,8, a ponad 90% uczestników zatwierdziło funkcje przeredagowania przez AI oraz optymalizacji strukturalnej. Ze względu na niewielką liczebność próby w tym badaniu, opisane podejście optymalizacyjne jest wykonalne do wdrożenia na zajęciach z pisania w języku angielskim na poziomie uniwersyteckim.
Wprowadzenie
W nauczaniu pisania w języku angielskim w kontekście międzykulturowym osoby uczące się języka angielca jako obcego często mierzą się z problemem niewystarczającej zdolności transferu podczas przechodzenia od wiedzy językowej do praktycznego zastosowania1,2. Mimo że studenci posiadają pewne podstawy gramatyczne i leksykalne, mają trudności z efektywnym przekształcaniem wzorców zdań, struktur i wyrażeń kulturowych w rzeczywiste teksty, co skutkuje sformalizowaną wypowiedzią i ograniczonym sposobem myślenia, wpływając tym samym na ogólną jakość pisania3. Dodatkowo międzykulturowe różnice w strukturze języka, organizacji logicznej i normach pragmatycznych jeszcze bardziej zwiększają złożoność transferu pisemnego4. W ostatnich latach duże modele językowe (LLM) zapewniły nowe wsparcie techniczne dla nauczania pisania5. Inteligentne narzędzia do pisania, takie jak DeepSeek, wykazały silne możliwości w zakresie generowania i rekonstrukcji języka. Jednak w praktyce dydaktycznej ograniczają się one głównie do powierzchniowej korekty językowej i nie zostały jeszcze głęboko zintegrowane z procesem nauczania skoncentrowanym na kształtowaniu zdolności transferu. Brakuje im orientacji na cele dydaktyczne oraz sterowalności zachowań generatywnych6,7. Dominujące aplikacje do pisania wspomaganego przez AI ograniczają swoje funkcje głównie do powierzchniowej korekty błędów gramatycznych, zamiast celować w kształtowanie systematycznych kompetencji transferowych, co skutkuje słabą kontrolą nad wynikami modelu z perspektywy dydaktycznej.
Istniejące badania nad wsparciem pisania dla osób uczących się angielskiego jako drugiego języka (ESL) dzielą się na trzy główne kategorie: konwencjonalne informacje zwrotne oparte na promptach, ogólne interwencje polegające na korekcie tekstu przez AI oraz trening transferu koncentrujący się na działaniach manualnych. Po pierwsze, ogólne badania nad inżynierią promptów priorytetyzują techniczną optymalizację odpowiadania na pytania i przeredagowywania tekstu, bez dopasowania do hierarchicznych celów nauczania transferu8,9. Po drugie, typowe korepetycje ESL oparte na ChatGPT skupiają się na ogólnej poprawie poprawności pisania, a nie na warstwowym rozwijaniu transferu syntaktycznego, strukturalnego i międzykulturowego10. Po trzecie, tradycyjna pedagogika transferu oparta na imitacji i pisaniu kontrastowym nie posiada zamkniętej pętli informacji zwrotnej wspieranej przez inteligentne narzędzia11. W odróżnieniu od wcześniejszych badań, niniejsza praca dostosowuje hierarchiczne prompty zorientowane na transfer, zgodne z wielopoziomowymi celami nauczania, oraz buduje workflow automatycznego generowania promptów na podstawie przykładów, tworząc unikalny mechanizm treningu w zamkniętej pętli, łączący generowanie modelu, informację zwrotną nauczyciela i korektę ucznia.
Wcześniejsza literatura zakłada potencjalny związek obejmujący lingwistyczną dywergencję kulturową, immanentne ograniczenia strukturalne modelu oraz niespójną praktykę klasową, jednak taki łańcuch przyczynowy pozostaje niewystarczająco zweryfikowany empirycznie w istniejących badaniach i staje się główną hipotezą badawczą analizowaną w niniejszej pracy12,13. W odniesieniu do cech charakterystycznych modelu DeepSeek przytoczonych w niniejszym artykule, jego otwarty interfejs instrukcyjny oraz projekt routingu ekspertów oparty na architekturze MoE zostały opisane w istniejących raportach technicznych modelu oraz w badaniach nad zastosowaniem języka. Opierając się na tych udokumentowanych cechach modelu, niniejsze badanie dostosowuje zagnieżdżone łańcuchy promptów w celu rozbicia złożonych zadań transferu międzykulturowego i opracowuje dynamiczne reguły harmonogramowania podmodeli dla zróżnicowanych zadań transferowych. Skupiając się na rozwoju ustrukturyzowanej zdolności transferu, obecna praca bada ukierunkowaną optymalizację promptów w DeepSeek, dążąc do przekształcenia dużych modeli językowych z uniwersalnych narzędzi edycji tekstu w specjalistyczne systemy treningu transferowego dla nauczania pisania w języku angielskim na poziomie akademickim.
W obszarze badań nad pisaniem w drugim języku zjawisko transferu od dawna stanowi główny temat14,15. Tradycyjna teoria transferu językowego koncentruje się przede wszystkim na pozytywnych i negatywnych efektach transferu języka ojczystego na proces przyswajania języka docelowego, ze szczególnym uwzględnieniem fonetyki, słownictwa i składni16. Mirzayev E wskazał, że w nauczaniu pisania w języku angielskim jako drugim (ESL) negatywny transfer z pierwszego języka pozostaje kluczowym czynnikiem ograniczającym rozwój umiejętności pisania uczniów17. Wraz z rozszerzaniem zakresu badań środowisko naukowe stopniowo przeniosło swoją uwagę na transfer struktury tekstu18. Pisanie w języku pośrednim (interjęzyku) często charakteryzuje się błędami językowymi i fosylizacją wynikającymi z wielu czynników19. Jednocześnie coraz większą uwagę poświęca się teorii transferu poznawczego20. Teoria ta podkreśla różnice w organizacji poznawczej i wzorcach ekspresji w procesie pisania. Na przykład pisanie w kręgu zachodnim kładzie nacisk na rozumowanie liniowe i eksplicytną logikę, podczas gdy tradycja chińska preferuje podejście spiralne i wieloznaczność semantyczną. Między tymi dwoma podejściami istnieje znaczące napięcie. W związku z tym transfer językowy obejmuje nie tylko konwersję jednostek językowych, ale także adaptację i przekształcanie struktur myślowych oraz kulturowych norm ekspresji na głębszym poziomie, co stanowi istotne wyzwanie w obecnym nauczaniu pisania w języku angielskim21.
W praktyce rozwijania zdolności transferu, istniejące badania często wykorzystują strategie takie jak pisanie imitacyjne22, pisanie kontrastywne23 oraz trening tłumaczenia24, aby usprawnić zrozumienie i zastosowanie mechanizmów transferu języka docelowego przez uczących się. Pisanie imitacyjne pomaga w budowaniu podstawowych umiejętności dyskursywnych, lecz może łatwo prowadzić do sztywności strukturalnej; pisanie kontrastywne może poprawić styl językowy i świadomość kulturową, ale brakuje w nim systematycznego warstwowania zadań i spersonalizowanej informacji zwrotnej; trening tłumaczenia może promować rozpoznawanie metafor kulturowych, jednak bez odpowiedniego prowadzenia może łatwo doprowadzić do odchyleń semantycznych lub nieodpowiedniości pragmatycznej. Powyższe strategie opierają się głównie na manualnych demonstracjach i wskazówkach empirycznych25, brakuje im wyraźnej konstrukcji strategii transferu i systematycznych mechanizmów informacji zwrotnej, a ich dostosowanie do indywidualnych różnic w biegłości językowej i stylach poznawczych jest utrudnione. Chociaż w niektórych badaniach próbowano rozszerzyć trening transferu poprzez zdywersyfikowane zadania pisemne26,27, proces nauczania nie stworzył jeszcze zamkniętej pętli „cel transferu–generowanie języka–informacja zwrotna o strategii”; efekt internalizacji strategii transferu jest ograniczony, a rozwój zdolności transferu uczniów w rzeczywistych zadaniach pisemnych pozostaje niewystarczający28.
Wraz z rozwojem technologii dużych modeli językowych, ich potencjał wspomagający nauczanie języków budzi coraz większe zainteresowanie29. Generatywne narzędzia AI, reprezentowane przez ChatGPT (Chat Generative Pre-trained Transformer)30 oraz DeepSeek31, są powszechnie wykorzystywane w takich scenariuszach jak korekta tekstów, przeredagowywanie oraz dostosowywanie języka. Diasamidze i wspólnicy wykazali, że studenci ESL korzystający z ChatGPT osiągnęli lepsze wyniki niż grupa ucząca się metodą tradycyjną pod względem poprawności gramatycznej, bogactwa słownictwa oraz umiejętności organizacji tekstu32. Jednakże istniejące zastosowania ograniczają się głównie do powierzchownego przetwarzania języka i brakuje w nich systematycznego kierownictwa w zakresie celów transferu. Ranade wskazał, że projekty oparte na promptach w obecnych scenariuszach edukacyjnych opierają się w większości na ogólnych szablonach, a generowana treść wykazuje brak adaptacyjności kontekstowej i specyfiki zadań33. Ponadto trenowanie głównych modeli opiera się na otwartym korpusie i brakuje w nim głębokiego modelowania różnic w kulturowych ekspresjach języka chińskiego i angielskiego. W generowanych tekstach często pojawia się nieodpowiedniość kulturowa oraz nienaturalna pragmatyka34,35, co ogranicza ich pogłębione zastosowanie w nauczaniu transferu pisania międzykulturowego.
Protokół
Zgoda komisji etycznej
Przed rozpoczęciem eksperymentu autorzy uzyskali zgodę (Numer zgody: NBCC-ETH-2026-037) z uczelni i przekazali dokumenty świadomej zgody wszystkim uczestniczącym studentom. Wszyscy studenci zostali jasno poinformowani o celach badań, procedurach eksperymentalnych oraz zasadach wykorzystania danych. Udział w badaniu był dobrowolny, a uczestnicy mogli wycofać się z niego w dowolnym momencie. Wszystkie dane osobowe oraz prace pisemne zostały zanonimizowane w celu ochrony prywatności i wykorzystane wyłącznie do analizy akademickiej. Wszystkich 60 uczestników podpisało formularz zgody przed wzięciem udziału w badaniu. Uczestników wybrano z dwóch równoległych klas pisania w języku angielskim dla studentów drugiego roku w tej samej wyższej szkole zawodowej, stosując metodę doboru wygodnego. Kryteria włączenia obejmowały: zdanie egzaminu CET-6 z wynikiem > 425, brak nieobecności w bieżącym semestrze oraz średnie oceny z dwóch ostatnich testów pisania w ramach jednostek lekcyjnych. Kryteria wykluczenia obejmowały: długotrwałe korzystanie z komercyjnego oprogramowania AI do pisania w języku angielskim poza zajęciami oraz ciężką dysleksję.
Zmienność dla wszystkich ciągłych zmiennych wynikowych przedstawiono jako średnia ± odchylenie standardowe (SD). Wszystkie analizy przeprowadzono przy wielkości próby n = 30 uczestników na grupę (grupa eksperymentalna vs grupa kontrolna), łącznie N = 60. Dla podłużnych danych z powtarzanymi pomiarami zastosowano analizę wariancji z powtarzanymi pomiarami (RM-ANOVA), aby zbadać główne efekty grupy i czasu oraz interakcję grupa-czas. Testy t dla prób niezależnych wykorzystano do post-hoc porównań parami w poszczególnych punktach czasowych. Grupa kontrolna otrzymała tradycyjną instrukcję pisania oraz generyczne, bezpłatne, niedostosowane narzędzie AI do pisania (bez warstwowych promptów, bez szablonów zorientowanych na transfer). Liczba godzin nauczania, zadania pisemne, częstotliwość informacji zwrotnych i teksty szkoleniowe były identyczne jak w grupie eksperymentalnej, z wyjątkiem braku interwencji w postaci dostosowanego, zagnieżdżonego łańcucha promptów oraz biblioteki zadań pięcio poziomowej wykorzystanej w niniejszym badaniu. Grupa eksperymentalna korzystała z instrukcji opartych na modelu DeepSeek w celu optymalizacji nauki pisania, obejmujących wskazówki w formie zagnieżdżonego łańcucha promptów, wyniki adaptacji międzykulturowej oraz mechanizm „generowanie-refleksja-regenerowanie”. Grupa kontrolna natomiast stosowała tradycyjne metody nauczania lub niezoptymalizowane narzędzia wspomagane przez AI. Poprzez porównanie efektów nauczania w obu grupach zweryfikowano skuteczność metody treningu transferowego opartej na dużym modelu językowym w poprawie zdolności transferu pisania u studentów.
Ogólna koncepcja badawcza
Celem niniejszego badania była poprawa umiejętności transferu pisania w języku angielskim u uczniów oraz opracowanie skutecznych metod projektowania dydaktycznego, ze szczególnym uwzględnieniem adaptacji DeepSeek do celów edukacyjnych. Po pierwsze, zaproponowano strategię optymalizacji instrukcji w celu przeprojektowania promptów modelu. Poprawiło to zgodność generowanych wyników z wieloma celami transferu w nauczaniu pisania, w tym w zakresie struktury składniowej, logiki akapitów oraz ekspresji kulturowej. Po drugie, zadania pisemne przygotowane przez nauczycieli przekształcono w ustrukturyzowane i zorientowane na cel szablony promptów. Następnie ustanowiono relację mapowania między zadaniami dydaktycznymi a zachowaniami modelu. Zwiększyło to sterowalność modelu i zapewniło, że generowana treść była istotna z pedagogicznego punktu widzenia. Na koniec w ramach badania opracowano zamknięty proces treningowy transferu: „generowanie–refleksja–przepisywanie–regenerowanie”. Proces ten zachęcał uczniów do identyfikowania strategii transferu i aktywnego doskonalenia ekspresji językowej przy wsparciu modelu. Poprzez powtarzalne iteracje sukcesywnie wzmacniano międzyjęzykowe i międzykulturowe umiejętności transferu pisania u uczniów. Kroki transformacji struktury zdania przedstawiono na Rysunku 1A–D.
Aby wyjaśnić pełną logikę działania systemu szkolenia z pisania wspomaganego przez AI oraz poprawić powtarzalność, cały przebieg implementacji został podsumowany w Tabeli 1, obejmującej kluczowe etapy, takie jak dane wejściowe, interwencje nauczyciela, zastosowanie promptów, aktywności studentów, wyniki końcowe oraz odpowiadające im kryteria oceny.
Strategia konstruowania zadań zorientowanych na transfer
Niniejsze badanie skupiło się na rozwijaniu umiejętności transferu w pisaniu w języku angielskim. Opracowano ścieżkę zadań transferowych prowadzącą od poziomu powierzchownego do głębokiego, systematycznie prowadząc studentów przez proces opanowywania i praktykowania wielopoziomowych strategii transferu językowego. Aby opisać strukturę tej ścieżki jako całości, zdefiniowano ją jako czteroetapowy zestaw zadań:
T = {T1,T2,T3,T4} (1)
T1 reprezentuje zadanie transferu na poziomie zdania, które koncentruje się na podstawowych operacjach struktury gramatycznej, takich jak rozszerzanie krótkich zdań, zmiana strony oraz zastępowanie klauzul, aby pomóc studentom w opanowaniu różnorodnych metod budowy zdań. T2 to zadanie transferu na poziomie akapitu, które nakierowuje studentów na organizację i powiązania informacji w obrębie akapitu oraz uczy ich poprawy przejrzystości strukturalnej i spójności wypowiedzi poprzez wydobywanie zdań głównych i dostosowywanie logiki między zdaniami. T3 reprezentuje zadanie na poziomie dyskursu, które rozciąga się na ogólny układ logiczny i rytm argumentacji rozdziału, prowadząc studentów do konstruowania angielskiego artykułu z kompletnym systemem argumentacji poprzez dostosowanie kolejności akapitów i optymalizację relacji zestawienia strukturalnego. T4 to zadanie transferu na poziomie kulturowym, które wymaga od studentów zidentyfikowania ukrytych cech ekspresji kulturowej w pisaniu w języku ojczystym, takich jak niedosłowne sformułowania i sugestie semantyczne, oraz przekształcenia ich w formy bezpośrednie lub logicznie jawne, zgodne z kulturą języka docelowego. Proces ewolucji przedstawiono na Rysunku 2. Aby zwiększyć operacyjność i możliwość ewaluacji projektu zadań, w niniejszym badaniu zdefiniowano każdy poziom zadania jako formę trójki:
Ti = (Si,Gi,Ei) (2)
Sj oznacza próbkę wejściową zadania, Gi oznacza docelową operację transferu, a Ei oznacza wspierające kryteria oceny. Dzięki tej ustrukturyzowanej formie zapewniono, że każdy poziom zadania opierał się na opanowaniu strategii z poprzedniego poziomu i był wyposażony w odpowiednie próbki, opisy celów oraz kryteria wydajności, co zapewniło mechanizm stabilnego postępu ścieżki transferu. W procesie konstruowania systemu treningu transferowego, aby osiągnąć systematyczne pokrycie typów zadań i efektywne zarządzanie wezwaniami dydaktycznymi, w badaniu tym zbudowano ustrukturyzowaną bibliotekę zadań obejmującą pięć typów celów transferu, opartą na powszechnych wymiarach konwersji językowej w transferze pisemnym. Bibliotekę zadań sformalizowano jako:
M = {(Dj,TDj)∣j = 1,2,3,4,5} (3)
Dj odpowiada pięciu wymiarom transferu: transferowi składniowemu, strukturalnemu, kulturowemu, rejestrowemu oraz logicznemu; zbiór zadań TDj powiązany z każdym z tych wymiarów reprezentuje jego podzbiór operacji. W procesie tworzenia biblioteki zadań autorzy w pierwszej kolejności podsumowali i sklasyfikowali typowe trudności w transferze oraz rodzaje błędów językowych na podstawie licznych autentycznych próbek prac pisemnych studentów, a następnie, w połączeniu z rzeczywistymi potrzebami dydaktycznymi i standardami oceny, podzielili poszczególne typy transferu na obszary funkcjonalne oraz ustalili kluczowe cele szkoleniowe i tryby operacyjne dla każdego zadania. Każde zadanie zostało przedstawione w formie abstrakcyjnej struktury trójkowej:
Ti,j = (Si,j,Gi,j,Ci,j) (4)
Si,j reprezentuje próbkę wejściową zadania, Gi,j jest opisem celu transferu zadania, a Ci,j to wymiar oceny i kontroli zadania. W zadaniu transferu syntaktycznego w niniejszym badaniu zaprojektowano sekwencję reorganizacji zdań postępującą od prostych do trudnych, obejmującą łączenie zdań, zagnieżdżanie zdań składowych, konwersję na stronę bierną oraz pojęcia pokrewne, z целью poprawy umiejętności uczniów w zakresie rozbudowy zdań i przekształceń gramatycznych. Zadanie transferu strukturalnego koncentrowało się na optymalizacji logiki akapitów, wzmacnianiu organizacji informacji i zwiększaniu zdolności do konstrukcji logicznej poprzez przeredagowanie zdań głównych, sortowanie zdań uzupełniających oraz rekonstrukcję relacji przyczynowo-skutkowych i przykładów. Zadanie transferu kulturowego oparto na korpusie międzykulturowym i ukierunkowano na odchylenia pragmatyczne, takie jak wyrażenia niejawne i eufemizmy. Zaprojektowano konwersje wypowiedzi zbliżone do rzeczywistego kontekstu, aby promować rozwój adaptacyjności kulturowej. Zadanie transferu rejestru prowadziło uczniów przez proces przekształcania wypowiedzi mówionych w język akademicki oraz opanowanie strategii przełączania rejestrów. Zadanie transferu logicznego skupiało się na konstruowaniu łańcuchów rozumowania i zapewnianiu jasności wypowiedzi, przeprowadzając trening z zakresu stosowania spójników, eksplicytacji relacji logicznych oraz przejść między akapitami.
W oparciu o rzeczywiste próbki prac pisemnych uczniów, w niniejszym badaniu opracowano proces generowania promptów ściśle powiązany z zadaniami dydaktycznymi, mający na celu zwiększenie trafności instrukcji oraz praktyczności generowanych treści. Proces ten był prowadzony przez nauczycieli, którzy w trakcie nauczania wybierali reprezentatywne fragmenty tekstów uczniów, koncentrując się na typowych problemach z transferem, takich jak zdania redundantne, chaotyczna struktura oraz niewłaściwe wyrażenia kulturowe. Następnie, za pomocą interfejsu systemu, naniesiono adnotacje określające typy transferu w celu doprecyzowania celów szkoleniowych. Po otrzymaniu informacji z adnotacji system automatycznie aktywował moduł identyfikacji zadań transferowych. Następnie dopasował dane wejściowe do zdefiniowanej biblioteki zadań i biblioteki szablonów promptów. Proces dopasowania uwzględniał takie czynniki jak typ transferu, cechy lingwistyczne oraz struktura tekstu. Na podstawie tych czynników system wybrał najodpowiedniejszy szablon i wygenerował wstępny prompt. System wspierał również strukturalne przetwarzanie wzmacniające. Adnotacje nauczycieli zostały przekształcone w znormalizowany format, który może być łatwo interpretowany przez model. Do promptu wbudowano odpowiednie wskazówki instruktażowe, aby pomóc modelowi dokładnie zrozumieć zarówno intencje nauczyciela, jak i pytania ucznia. Aby zwiększyć elastyczność i sterowalność instrukcji, system zawierał moduł wsparcia nauczyciela. Moduł ten pozwalał nauczycielom na dopracowywanie promptów poprzez modyfikację wytycznych instruktażowych, dostosowywanie ustawień kontekstowych oraz personalizację tonu i stylu. W rezultacie nauczyciele uzyskali większą kontrolę nad procesem generowania i mogli lepiej dostosować go do różnych scenariuszy dydaktycznych.
Mechanizm optymalizacji poleceń Deepseek
W oparciu o praktyczne potrzeby treningu transferu pisania w języku angielskim, w niniejszym badaniu opracowano pięć rodzajów szablonów promptów zorientowanych na transfer. Szablony te zostały zaprojektowane w celu naprowadzania i regulowania zachowania generatywnego modelu językowego. Szablon transferu strukturalnego skupiał się na organizacji akapitów i strukturze dyskursu. Pomagał on studentom reorganizować teksty poprzez stosowanie struktur takich jak wstęp–rozwinięcie–zakończenie oraz poprawę logicznego przepływu myśli. Szablon transferu składniowego kładł nacisk na złożoność na poziomie zdań. Zachęcał do stosowania zróżnicowanych struktur gramatycznych, w tym strony biernej, konstrukcji równoległych i zdań złożonych, aby zwiększyć wyrafinowanie formy pisemnej. Szablon transferu kulturowego odnosił się do stosowności kulturowej w pisaniu. Pomagał studentom w adaptacji sformułowań pod wpływem języka ojczystego i kultury do form bardziej naturalnych i akceptowalnych w kontekstach anglojęzycznych. Szablon transferu rejestru koncentrował się na adaptacji stylu i kontroli rejestru. Pomagał studentom dostosować język do różnych celów pisania, odbiorców i gatunków. Szablon transferu logicznego miał na celu wzmocnienie organizacji logicznej. Promował efektywne wykorzystanie relacji takich jak przyczyna i skutek, porównanie i kontrast oraz rozwój równoległy, poprawiając tym samym spójność i rygor argumentacji. Razem pięć tych szablonów objęło główne wymiary transferu pisania, zapewniając ustrukturyzowane wsparcie dydaktyczne zarówno dla projektowania zadań nauczania, jak i dla generowania tekstów w oparciu o model.
Każdy typ szablonu opierał się na ujednoliconym formacie, aby zapewnić jego uniwersalność i możliwość adaptacji w różnych sytuacjach dydaktycznych. Szablon zawierał cztery kluczowe elementy: pierwszym był cel instrukcji, który jasno określał wymagane zadanie transferu; drugim był przykładowy wprowadzany tekst (sample input), który dostarczał studentom autentycznych fragmentów językowych jako korpus stanowiący podstawę dla efektywności instrukcji; trzecim był oczekiwany wynik (target output), prezentujący standardowy styl idealnego produktu językowego po transferze, służący studentom do porównania i dostrajania modelu; czwartym była sugestia użycia, wyjaśniająca poziom językowy, typ tekstu oraz strategię stosowania właściwą dla danego szablonu, a także zawierająca regulowane podpowiedzi parametrów w celu zwiększenia kontroli nad generowaniem i poprawy efektu prowadzenia dydaktycznego.
Aby dalej zilustrować logikę projektowania i praktyczne zastosowanie szablonów promptów, poniżej przedstawiono reprezentatywne przykłady pięciu promptów zorientowanych na transfer. Wszystkie szablony były zgodne z jednolitym schematem, który składał się z celu instrukcji, przykładowego wejścia, docelowego wyjścia oraz sugestii dotyczących zastosowania. Studenci byli instruowani, aby rozbudowywać proste zdania, zmieniać strony czynną i bierną oraz wplatać zdania podrzędne w celu wzbogacenia różnorodności syntaktycznej. Na przykład, dla szkicu studenckiego „I study English writing. It is very important for cross-cultural communication”, zoptymalizowany wynik brzmi „Learning English writing plays a vital role in improving learners’ ability of cross-cultural communication”. Prompt ten był odpowiedni do treningu na poziomie zdań dla studentów drugiego roku filologii angielskiej na umiarkowanym poziomie trudności, koncentrując się na podstawowej rekonstrukcji syntaktycznej i transformacji strony. Inny typ promptu był skierowany na transfer kulturowy, mający na celu identyfikację sformułowań typu „Chinglish”, będących wynikiem wpływu rodzimego myślenia kulturowego, oraz przeredagowanie zdań na naturalne angielskie wyrażenia pragmatyczne, zgodne z zachodnimi normami kulturowymi. Przyjmując jako przykład zdanie studenckie „Many people think you must work hard if you want to succeed”, wersja poprawiona brzmiała „People generally believe that diligence is the key to success”. Prompt ten zastosowano w treningu transferu na poziomie kulturowym, skupiając się na eliminowaniu ukrytych chińskich schematów myślowych i promowaniu jawnej ekspresji w kontekście języka angielskiego.
W ramach niniejszego badania opracowano również trzystopniowy zagnieżdżony łańcuch promptów, który przyjmował szkice akapitów studentów jako jednolity wsad i działał w kolejnych fazach. Pierwsza faza polegała na reorganizacji semantycznej, w której prompt wymagał od uczestnika przeorganizowania zdań w danym akapicie, optymalizacji logicznego uporządkowania myśli oraz sformułowania pełnego akapitu z wyraźnymi zdaniami wprowadzającymi. Druga faza obejmowała rewizję językową, polegającą na przeredagowaniu poprawionego akapitu na formalny angielski akademicki, zastąpieniu słownictwa potocznego oraz odpowiednim zastosowaniu zdań złożonych i struktur biernych. Trzecia faza stanowiła adaptację kulturową, w której prompt kierował użytkowników do weryfikacji ekspresji kulturowo-pragmatycznych w tekście, usunięcia interferencji kulturowej języka ojczystego oraz dopracowania treści tak, aby odpowiadała angielskim konwencjom pisania międzykulturowego. Powyższe przykłady w pełni zademonstrowały tryby działania pojedynczych szablonów promptów oraz zagnieżdżonych łańcuchów promptów. Na tej podstawie w badaniu zaprojektowano kompletny etapowy łańcuch promptów połączony z architekturą MoE modelu DeepSeek.
Aby przezwyciężyć ograniczenia jednorazowych promptów w zakresie kontroli generowania i głębokości odpowiedzi na zadania, w niniejszym badaniu zaprojektowano strukturę zagnieżdżonego łańcucha promptów o charakterystyce fazowej i ciągłej, umożliwiającą hierarchiczne prowadzenie i stopniowe generowanie złożonych zadań translacyjnych. Mechanizm ten podzielił kompletne zadanie translacyjne na kilka podcelów, dla których zaprojektowano odpowiadające im szablony promptów; zostały one połączone szeregowo w logicznej kolejności: rekonstrukcja semantyczna, dostosowanie stylu językowego oraz adaptacja pragmatyki kulturowej, tworząc łańcuch generowania z zależnością kontekstową. W badaniu zaimplementowano optymalizację zagnieżdżonego łańcucha promptów dla DeepSeek poprzez jego standardowy otwarty interfejs API. Model DeepSeek natywnie wykorzystuje architekturę Mixture of Experts (MoE) wyposażoną w automatyczny backendowy system routingu ekspertów, który działa jako wewnętrzny moduł wnioskowania niezależny od zewnętrznych promptów. Dostosowane wieloetapowe prompty modyfikowały jedynie cechy treści danych wejściowych modelu. W odpowiedzi na wymogi semantyczne, stylistyczne i kulturowe zawarte w zoptymalizowanych danych wejściowych, natywny mechanizm routingu MoE modelu autonomicznie aktywował najodpowiedniejsze moduły eksperckie podczas generowania tekstu. Trzystopniowy projekt promptów, koncentrujący się na reorganizacji semantycznej, dostosowaniu stylu i adaptacji kulturowej, służył jedynie doprecyzowaniu tekstów wejściowych i nie ingerował w wewnętrzną logikę wyboru i alokacji ekspertów modelu.
Pod względem procesu operacyjnego system otrzymywał teksty uczniów przesłane przez nauczycieli, przekazywał adnotacje docelowe i automatycznie określał, czy włączyć zagnieżdżoną strukturę łańcuchową. W przypadku jej włączenia system realizował kolejno trzy etapy: pierwszym etapem była reorganizacja semantyczna, polegająca na wywołaniu szablonu transferu struktury w celu optymalizacji organizacji akapitów i wskazówek logicznych; drugim etapem była korekta stylu językowego, wykorzystująca szablon językowy do przekształcenia wyrażeń potocznych w akademicki język pisany; trzecim etapem była adaptacja kulturowa, polegająca na wywołaniu szablonu transferu kulturowego w celu identyfikacji i zastąpienia wyrażeń niezgodnych z kulturą języka docelowego, co pozwalało na wygenerowanie bardziej autentycznego tekstu.
Każda runda generowania wykorzystywała wynik z poprzedniej rundy jako dane wejściowe oraz zachowywała pamięć podręczną wektora kontekstu, aby zapewnić spójność semantyczną. Nauczyciele dostosowywali strukturę łańcucha promptów w interfejsie systemu, w tym wybór szablonu, modyfikację instrukcji oraz korektę sekwencji. System obsługiwał również funkcję „pakietu kombinacji szablonów”, która umożliwiała nauczycielom wygodne ponowne wykorzystanie lub przypisywanie zadań w partiach. Dodatkowo system posiadał wbudowany dynamiczny mechanizm przerywania i sprzężenia zwrotnego, który dostarczał wyniki pośrednie po każdym generowaniu. Nauczyciele naniesiali adnotacje lub korygowali kolejne instrukcje w czasie rzeczywistym, tworząc zamkniętą pętlę dydaktyczną „generowanie-korekta-regenerowanie”.
Generowanie i ewaluacja modelu
W procesie generowania i oceny tekstów w oparciu o model DeepSeek, w niniejszym badaniu skonstruowano wielowymiarowy mechanizm automatycznego punktowania w celu systematycznej analizy i ilościowej oceny wygenerowanego tekstu w trzech aspektach: złożoności składniowej, standaryzacji strukturalnej oraz spójności dyskursu. W badaniu wykorzystano parser zależności spaCy oraz moduł rozszerzający do rozwiązywania koreferencji Coreferee w celu ekstrakcji cech tekstu i automatycznej oceny. Parser zależności spaCy analizował strukturę składniową angielskiego tekstu, wyodrębniając kluczowe wskaźniki, takie jak średnia długość zdania i liczba zdań wtrąconych, co umożliwiło ilościową analizę złożoności składniowej. Moduł rozszerzający Coreferee do rozwiązywania koreferencji, działający w ramach frameworka spaCy, służył przede wszystkim do identyfikacji wewnętrznych relacji referencyjnych w tekście i oceny referencyjnej spójności dyskursu, zapewniając wsparcie techniczne dla automatycznego punktowania jakości pisania. Ze względu na ograniczenia sieciowe, wspomniane zagraniczne strony z otwartym kodem źródłowym były niedostępne.
W pierwszej kolejności system ocenił złożoność składniową. Wyekstrahowano cechy takie jak średnia długość zdania, głębokość osadzania zdań podrzędnych oraz zróżnicowanie zdań. Cechy te uzyskano za pomocą analizy zależności oraz modelowania głębokich drzew składniowych. Na podstawie wyników system ocenił, czy studenci pomyślnie przeszli od prostych wzorców zdań do struktur bardziej złożonych. Po drugie, system ocenił organizację akapitów. Połączono reprezentacje tekstowe oparte na modelu BERT z modelami klasyfikacyjnymi w celu zidentyfikowania kluczowych elementów akapitu, w tym zdań wprowadzających temat, zdań pomocniczych i zdań podsumowujących. Następnie sporządzono mapę struktury akapitu, aby ustalić, czy organizacja tekstu jest zgodna z konwencjami angielskiego pisarstwa akademickiego. Po trzecie, system ocenił spójność tekstu. Zbadano użycie spójników logicznych, spójność semantyczną między zdaniami oraz jakość powiązań referencyjnych w całym tekście. Wskaźniki te posłużyły do oceny przejrzystości rozwoju logicznego i płynności wywodu. Aby zmierzyć spójność tematyczną, system obliczył podobieństwo semantyczne przy użyciu reprezentacji wektorowych. Spójność referencyjną oceniono za pomocą technik rozstrzygania koreferencji, co pomogło zredukować luki semantyczne i wieloznaczne odniesienia. Na koniec wyniki ze wszystkich wymiarów zostały zintegrowane w jednolity wektor punktowy. Wyniki zostały zestandaryzowane w celu stworzenia kompleksowego systemu oceny, umożliwiającego wiarygodne porównywanie różnych próbek tekstowych.
W fazie oceny manualnej w niniejszym badaniu opracowano trójwymiarowy system punktacji dla treningu transferu pisania, obejmujący oczywistość zachowań transferowych, naturalność wypowiedzi oraz adaptację kulturową, aby zwiększyć trafność oceny nauczycielskiej i skuteczność informacji zwrotnych w procesie nauczania. System ten łączył funkcje pomocnicze w celu organicznego powiązania punktacji ilościowej z komentarzami jakościowymi. W wymiarze zachowań transferowych nauczyciele oceniali wykorzystanie przez uczniów strategii transferu podczas przeredagowania tekstów w oparciu o określone cele zadań. System zapewniał widok porównawczy tekstu oryginalnego i wersji wygenerowanej, co pomogło nauczycielom zidentyfikować, czy operacje takie jak korekta zdań i rekonstrukcja strukturalna skutecznie odzwierciedlały wymagany typ transferu.
Ocena naturalności wypowiedzi koncentrowała się na płynności i autentyczności generowanego języka. Nauczyciele wykorzystywali wskaźniki językowe generowane przez system, aby ocenić, czy zdania były zgodne z nawykami językowymi rodzimych użytkowników języka angielskiego oraz by ocenić, czy struktura gramatyczna, kolokacje wyrazowe i rytm zdania były naturalne i odpowiednie. Wskazywali oni również problemy i sugerowali alternatywne sformułowania za pomocą adnotacji. Wymiar adaptacji kulturowej skupiał się na stosowności pragmatyki międzykulturowej. Nauczyciele musieli zidentyfikować, czy tekst zawiera niewłaściwe sformułowania wynikające z interferencji kultury języka źródłowego, takie jak wieloznaczność semantyczna, konflikty retoryczne lub niejasne oceny wartości. System dostarczał przykłady częstych błędów wynikających z odchyleń kulturowych oraz umożliwiał nauczycielom wyjaśnienie podstaw wprowadzenia poprawek i wymogów kontekstu kulturowego w komentarzach, prowadząc uczniów do zwiększenia świadomości transferu kulturowego i dokładności wypowiedzi. Każdy wymiar był oceniany w skali 5-stopniowej i obejmował wolne adnotacje oraz moduły z sugerowanymi odpowiedziami. Końcowe wyniki oceny przedstawiono w formie wykresu radarowego.
Aby zwiększyć efektywność oceny i wesprzeć praktyczne zastosowanie w klasie, w niniejszym badaniu opracowano mechanizm wspólnej oceny, łączący punktację opartą na AI z oceną nauczyciela. System przeprowadzał w pierwszej kolejności wielowymiarową ocenę tekstu wygenerowanego przez DeepSeek. Za pomocą modułu automatycznego punktowania oceniano kluczowe aspekty, takie jak złożoność składniowa, organizacja akapitów oraz spójność tekstu. Wyniki punktacji były następnie wyświetlane w czasie rzeczywistym w interfejsie nauczyciela. Nauczyciele analizowali szczegółowe oceny dla każdego wymiaru i dostosowywali je w razie potrzeby, opierając się na swojej wiedzy merytorycznej oraz rozumieniu wyników transferu uczniów. Dodawali oni również ukierunkowane komentarze bezpośrednio w tekście, aby przekazać informacje zwrotne i sugestie dydaktyczne, których automatyczna punktacja mogła nie uchwycić. W każdym wymiarze oceny zastosowano pięciostopniową skalę ocen. Interfejs zawierał również moduły adnotacji tekstowych i rekomendacji, aby ułatwić personalizację informacji zwrotnych. Wyniki oceny wizualizowano za pomocą wykresu radarowego, co pozwalało nauczycielom na szybką identyfikację mocnych i słabych stron uczniów w różnych wymiarach transferu.
Dodatkowo system umożliwiał nauczycielom dostosowanie wag poszczególnych wymiarów lub wyników ogólnych w celu ich dopasowania do celów dydaktycznych. Funkcja ta zapewniła, że końcowa ocena dokładniej odzwierciedlała rzeczywiste osiągnięcia i potrzeby edukacyjne uczniów. Po zakończeniu ręcznego przeglądu system automatycznie zintegrował dane oceniające wygenerowane przez maszynę oraz przez nauczyciela. Następnie wygenerowano wizualny raport z informacją zwrotną. Raport zawierał wykres radarowy wydajności transferu oraz wykres śledzenia wersji. Wizualizacje te w przejrzysty sposób ilustrowały zmiany w zdolnościach transferowych uczniów na przestrzeni wielu rund generowania i poprawiania tekstów, umożliwiając ciągłe monitorowanie postępów w nauce.
Proces uczenia transferowego
W niniejszym badaniu zaprojektowano kompletny proces treningu transferu. W pierwszej kolejności nauczyciel wyznaczał konkretne zadania z pisania w języku angielskim w oparciu o cele dydaktyczne oraz rzeczywisty poziom uczniów, określając typ transferu i główny punkt treningu. Następnie system automatycznie generował odpowiednie instrukcje promptów na podstawie zadań wyznaczonych przez nauczyciela i wywoływał model DeepSeek w celu przygotowania pierwszej wersji tekstu, która służyła jako materiał bazowy do przeredagowania i treningu transferu przez uczniów. Po otrzymaniu pierwszej wersji tekstu uczniowie musieli aktywnie zidentyfikować cechy transferu odzwierciedlone w tekście i w ukierunkowany sposób przeredagować treść, wykorzystując poznane strategie transferu w celu poprawy poprawności struktury składniowej, organizacji akapitów oraz ekspresji kulturowej. Po zakończeniu przeredagowania nauczyciel przeprowadził szczegółowy przegląd przesłanego tekstu, podkreślając skuteczność strategii transferu i oferując konkretne sugestie dotyczące poprawy oraz wskazówki pisarskie. Na podstawie informacji zwrotnych od nauczyciela ponownie wywołano model DeepSeek w celu wygenerowania wersji zoptymalizowanej, co dodatkowo wsparło uczniów w dopracowaniu tekstów i pogłębieniu praktyki stosowania strategii transferu. Na koniec uczeń przesyłał ostateczną wersję tekstu, wypełniał tabelę poznawczą transferu, dokonywał samooceny oraz podsumowywał metody transferu i ich efekty, co sprzyjało poprawie zdolności metapoznawczych i internalizacji umiejętności transferu pisania. Zaprojektowana na potrzeby tego badania tabela poznawcza transferu przedstawiona jest w Tabeli 2.
Wszystkie elementy oceniano w skali od 1 do 5, gdzie 1 oznacza brak biegłości, a 5 pełną biegłość. Dane z samooceny zebrano po trzech rundach sekwencyjnego szkolenia; punkty odniesienia oceny odnoszą się do zdefiniowanych wcześniej standardów operacji transferu w pięciowymiarowej bibliotece zadań.
Wyniki
Nauczanie projektowania eksperymentów
W niniejszym badaniu wykorzystano podstawową wersję open-source DeepSeek, opierając się na otwartym interfejsie API platformy do wywołań programistycznych. Pełny zestaw pięciu tekstów szablonów promptów, cztery poziomy wpisów przykładów zadań, tagi kategorii adnotacji transferowych oraz reguły mapowania dopasowań błędów pisarskich do szablonów zostały zestawione w dodatkowym aneksie. System posiadał stałe parametry wywołań: współczynnik temperatury wynoszący 0.7, natomiast generowana długość była ograniczana dynamicznie w zależności od typu pytania pisemnego. Proces ściśle przestrzegał stałej sekwencji: rekonstrukcja semantyczna > korekta stylistyczna > adaptacja kulturowa, wykonując zagnieżdżone wywołania łańcuchów promptów. Wyniki generowane przez model były ręcznie wybierane przez instruktora w celu uzyskania skutecznych tekstów do nauczania w klasie.
Do przeprowadzenia oceny manualnej zaproszono troje pełnoetatowych wykładowców pisania w języku angielskim na poziomie uniwersyteckim z ponad 5-letnim doświadczeniem. Przed oficjalnym ocenianiem wszyscy sędziowie przeszli ustandaryzowany trening, zapoznając się z wymiarami oceny, 5-punktową skalą punktową, transferem kulturowym, składnią, dyskursem oraz innymi szczegółami punktacji, a następnie przeszli kalibrację wstępną. Wszystkie eseje studentów zostały ocenione niezależnie przez dwóch nauczycieli w trybie ślepego, podwójnie ślepego oceniania. Jeśli różnica między ocenami dwóch sędziów przekraczała 1 punkt (w skali do 5), trzeci doświadczony nauczyciel rozstrzygał spór, a średnia z dwóch poprawnych ocen była przyjmowana jako ostateczny wynik manualny dla danej próbki. W fazie ewaluacji, w zależności od celów badawczych, uczestniczyły dwie grupy oceniających. Troje pełnoetatowych nauczycieli pisania w języku angielskim na uniwersytecie z ponad 5-letnim stażem prowadziło ślepe, podwójne ocenianie wszystkich próbek tekstów studenckich w eksperymencie właściwym, a trzeci doświadczony nauczyciel pełnił rolę arbitra w przypadku rozbieżności w ocenach przekraczających 1 punkt w skali 5-punktowej. Z kolei pięciu oceniających wzięło udział w teście niezawodności między sędziami z wykorzystaniem współczynnika korelacji wewnątrzklasowej (ICC), który przeprowadzono oddzielnie w celu weryfikacji spójności standardów oceny między sędziami. Różnica w liczbie oceniających wynika z odmiennych wymagań funkcjonalnych: trzech głównych nauczycieli zapewniło praktyczną punktację danych eksperymentalnych, podczas gdy rozszerzony panel pięciu oceniających dostarczył bardziej solidnych dowodów na niezawodność całego systemu ewaluacji.
Złożoność składniowa, ocena struktury tekstu BERT oraz podobieństwo semantyczne są oceniane w zakresie od 0 do 5 punktów. Wagi dla każdego wymiaru zostały ustalone zgodnie ze standardami nauczania i badań nad pisaniem w języku obcym: składnia 0,35, struktura tekstu 0,35 oraz logika i kultura 0,3. Wartości wag oparto na dojrzałych systemach ilościowej oceny pisania w tej samej dziedzinie. Moduł automatycznego oceniania AI został skalibrowany przy użyciu progów opartych na 15 wcześniej sklasyfikowanych wypracowań modelowych. Ocena ludzka odbywała się zgodnie z ujednoliconą pięciostopniową skalą ocen. Ocenianie maszynowe i kalibracja ludzka zostały połączone w celu przeprowadzenia weryfikacji przedeksperymentalnej przed formalną ewaluacją.
Zadanie dydaktyczne zostało zrealizowane w oparciu o trzy poziomy celów transferu: „składnia-struktura-kultura”, obejmując trzy rundy szkoleniowe, z których każda trwała jeden tydzień. Pierwsza runda polegała na przeredagowaniu zdań w celu zwiększenia różnorodności syntaktycznej i precyzji wypowiedzi; druga runda obejmowała rekonstrukcję struktury na poziomie akapitów w celu poprawy organizacji treści i spójności logicznej; trzecia runda koncentrowała się na transferze na poziomie kulturowym, aby wzmocnić międzykulturową świadomość pragmatyczną oraz zdolność adaptacji wypowiedzi. Ze względu na powtarzane pomiary zebrane od tych samych uczestników w teście wstępnym, podczas trzech kolejnych rund szkoleniowych oraz w teście końcowym, jako główną metodę statystyczną przyjęto analizę wariancji z powtarzanymi pomiarami (RM-ANOVA), aby zbadać główne efekty grupy (eksperymentalna vs kontrolna), główne efekty czasu pomiaru oraz efekt interakcji grupa × czas, który odzwierciedlał, czy zmiany wyników w trakcie szkolenia różniły się między obiema kohortami. Założenie sferyczności zweryfikowano testem Mauchly'ego; w przypadku naruszenia sferyczności zastosowano poprawkę Greenhouse'a-Geissera. Testy t dla próbek niezależnych zostały zarezerwowane wyłącznie do post-hoc parowych porównań międzygrupowych w poszczególnych punktach czasowych, natomiast korelacja Pearsona i d Cohena posłużyły odpowiednio do oceny spójności punktacji oraz kwantyfikacji wielkości efektu.
Wszystkie analizy statystyczne zostały określone przed rozpoczęciem gromadzenia danych. Do porównania wskaźników pisania przed i po interwencji pomiędzy dwiema grupami zastosowano testy t dla prób niezależnych, przyjmując pierwotną hipotezę zerową o braku różnic międzygrupowych w zakresie efektywności transferu umiejętności pisania. Analizę korelacji Pearsona wykorzystano do ilościowego określenia liniowej zależności między automatycznym ocenianiem przez AI a ocenami wystawionymi manualnie przez nauczycieli, natomiast wskaźnik d Cohena obliczono jako standaryzowaną wielkość efektu dla porównań międzygrupowych. Próg istotności dla wszystkich testów hipotez ustalono na poziomie α = 0.05, a dla wszystkich statystyk testowych obliczono 95% przedziały ufności. Do wykonania wszystkich obliczeń statystycznych wykorzystano program SPSS 26.0. W zbiorach danych dotyczących wyników testów uczniów oraz kwestionariuszy nie wystąpiły braki danych, ponieważ wszyscy uczestnicy ukończyli pełny trzyetapowy trening oraz powiązane z nim oceny; w związku z tym nie było konieczności stosowania imputacji ani usuwania przypadków z brakującymi wartościami.
Budowa systemu wskaźników oceny
Aby kompleksowo ocenić wyniki studentów w treningu transferu pisania w języku angielskim, w niniejszym badaniu skonstruowano wielowymiarowy system oceny obejmujący trzy poziomy celów transferu: „składnia-struktura-kultura”, integrujący biegłość językową, reakcję na model, informację zwrotną od nauczyciela oraz autopercepcję, i określono sześć kluczowych wskaźników. Po pierwsze, „wskaźnik transferu pisania” był kompleksowym wskaźnikiem oceny obejmującym różnorodność syntaktyczną, przejrzystość strukturalną oraz adaptacyjność kulturową, łączącym automatyczne punktowanie systemu z ręczną oceną nauczyciela w celu przeprowadzenia analizy ilościowej. „Wynik złożoności syntaktycznej” wykorzystywał technologię przetwarzania języka naturalnego do wyodrębniania cech takich jak średnia długość zdania, liczba poziomów zagnieżdżenia zdań podrzędnych oraz częstotliwość stosowania fraz czasownikowych, aby ocenić bogactwo i złożoność zdań konstruowanych przez studentów. Analiza „dopasowania stylu akademickiego” badała proporcję stosowania strony biernej oraz udział formalnego słownictwa, w oparciu o model NLP (Natural Language Processing), aby określić, czy tekst jest zgodny z normami stylistycznymi angielskiego pisania akademickiego. Ponadto w badaniu wprowadzono wymiar oceny subiektywnej, zbierając za pomocą kwestionariuszy dla nauczycieli opinie na temat akceptacji i praktyczności sugestii generowanych przez model, aby ocenić rzeczywisty wpływ nauczania wspomaganego przez AI. „Zmiany w ocenach nauczycielskich” odzwierciedlały wpływ nauczania wspomaganego przez AI na poprawę jakości pisania poprzez porównanie ocen wystawionych przez nauczycieli pracom studentów przed i po eksperymencie. Wreszcie, „Autoewaluacja zdolności transferu przez studenta” wykorzystywała tabelę poznania transferu, aby pomóc studentom w samodzielnej ocenie opanowania struktury, składni, kultury i innych wymiarów, zwiększając tym samym ich świadomość metapoznawczą i zdolność refleksji. Szczegółowe opisy i źródła danych dla każdego wskaźnika przedstawiono w Tabeli 3.
Wskaźniki składniowe i stylistyczne zostały obliczone automatycznie za pomocą analizy zależności oraz klasyfikacji opartej na modelu BERT, z znormalizowanymi wynikami w zakresie od 0 do 5; ocena manualna odbywała się w skali 5-stopniowej. Formuły obliczeniowe dla złożoności składniowej wykorzystywały całkowitą liczbę słów podzieloną przez liczbę klauzul jako główny mianownik. Źródło surowych danych: wypracowania z testów wstępnych i końcowych wszystkich 60 zakwalifikowanych studentów.
Wyniki eksperymentalne i analiza
Aby w sposób intuicyjny przedstawić kompleksowe różnice w wynikach uczniów w trzech wymiarach: transferu syntaktycznego, transferu strukturalnego i transferu kulturowego, na Rysunku 3 porównano średni wskaźnik transferu pisania uczniów z grupy eksperymentalnej i grupy kontrolnej przed i po przeprowadzeniu eksperymentu: Rysunek 3 wykazał różnicę w średnich wynikach między grupą eksperymentalną a grupą kontrolną w trzech wymiarach transferu syntaktycznego, strukturalnego i kulturowego. Grupa eksperymentalna wykazała znaczną poprawę zdolności transferu w każdym z wymiarów po zakończeniu eksperymentu, a zewnętrzny okrąg wykresu radarowego jest znacznie większy od okręgu wewnętrznego, co wskazuje, że metoda optymalizacji instrukcji oparta na modelu DeepSeek ma pozytywny wpływ na promowanie rozwoju zdolności transferu pisania w języku angielskim u uczniów. W przeciwieństwie do niej, w grupie kontrolnej poszczególne wskaźniki zdolności transferu pozostały stosunkowo niezmienione przed i po eksperymencie. Ogólna poprawa była ograniczona, co wskazuje, że tradycyjne metody nauczania lub narzędzia wspomagane przez AI, w których nie zoptymalizowano instrukcji systemowych, pełnią ograniczoną rolę w treningu transferu. Skuteczne pobudzenie potencjału uczenia się uczniów w wielowymiarowym transferze językowym okazało się być wyzwaniem.
Średnie indeksy transferu pisemnego w grupie eksperymentalnej w wymiarach transferu składniowego, transferu strukturalnego i transferu kulturowego przed eksperymentem wynosiły odpowiednio 3,0, 2,9 oraz 2,8, a po eksperymencie wzrosły do 4,3, 4,1 i 4,5, co oznacza wzrosty o odpowiednio 1,3, 1,2 i 1,7, wskazując na korzystny efekt interwencji zastosowanej metody nauczania na różnych poziomach transferu. Wyniki grupy kontrolnej przed eksperymentem wynosiły 3,0, 3,0 i 2,9. Po eksperymencie wartości te wzrosły odpowiednio do 3,4, 3,3 i 3,2, co jest wynikiem znacząco niższym niż w grupie eksperymentalnej. Szczególną uwagę zwraca wymiar transferu kulturowego, w którym grupa eksperymentalna wykazała najistotniejszą poprawę – wzrost z 2,8 do 4,5, czyli o 1,7 punktu, co jest wartością znacznie wyższą niż wzrost o 0,3 punktu w grupie kontrolnej. Wynik ten sugeruje, że proponowana metoda nauczania odgrywa istotną rolę w pomaganiu studentom w identyfikacji i adaptacji do norm ekspresji kulturowej języka angielskiego. Odzwierciedliło się to nie tylko w korektach formy językowej, ale także w zwiększeniu międzykulturowej świadomości pragmatycznej studentów oraz pogłębieniu ich rozumienia nawyków ekspresji kulturowej języka docelowego. Transfer językowy przejawiał się przede wszystkim w złożoności składniowej, adaptacji stylu językowego oraz w innych aspektach. W badaniu wykorzystano zautomatyzowaną technologię NLP do przeprowadzenia dogłębnej analizy tekstów pisemnych studentów, wyekstrahowano kluczowe cechy językowe i połączono je z ocenami nauczycieli, aby systematycznie ocenić zmiany w zdolnościach transferu językowego studentów w trzech rundach zadań.
Złożoność syntaktyczna i styl lingwistyczny
Pod względem złożoności syntaktycznej w badaniu odnotowano średnią długość zdania oraz liczbę poziomów zagnieżdżenia zdań w tekście wygenerowanym przez studentów po wykonaniu wyznaczonego zadania pisemnego w każdej rundzie zadań. Te dwa wskaźniki były powszechnie stosowane do pomiaru złożoności ekspresji językowej. Efektywnie odzwierciedlały one poziom rozwoju studentów w zakresie różnorodności zdań i zdolności do organizacji strukturalnej, co przedstawiono na Rysunku 4.
W ramach podłużnej analizy ewolucji złożoności składniowej, w grupie eksperymentalnej odnotowano wyraźną tendencję wzrostową w trzech rundach zadań, co odzwierciedla skuteczny wpływ treningu transferowego na zdolność studentów do kształtowania struktur językowych. Pod kątem średniej długości zdania, w grupie eksperymentalnej wzrosła ona z 12,5 słowa w zadaniu 1 do 16,1 słowa w zadaniu 3, co stanowi wzrost o 3,6 słowa i jest wynikiem znacząco wyższym niż wzrost w grupie kontrolnej, który w tym samym okresie wyniósł zaledwie 0,9 słowa (z 12,4 do 13,3). Podobnie, w wymiarze złożoności strukturalnej, mierzonej liczbą warstw zagnieżdżenia zdań składowych, grupa eksperymentalna odnotowała wzrost z 1,8 do 2,7 warstwy, podczas gdy w grupie kontrolnej wzrost ten był stosunkowo powolny, od 1,7 do 1,9 warstwy. Aby dodatkowo zweryfikować, czy różnica w złożoności składniowej między dwiema grupami studentów jest istotna statystycznie, w badaniu zastosowano testy t dla prób niezależnych do analizy średniej długości zdania oraz liczby poziomów zagnieżdżenia zdań składowych na trzech etapach zadań. Wyniki wykazały istotną różnicę między grupą eksperymentalną a kontrolną pod względem średniej długości zdania, t(58) = 4.23, p < 0.001, Cohen’s d = 0.98; stwierdzono również istotną różnicę w liczbie poziomów zagnieżdżenia zdań składowych, t(58) = 3.15, p = 0.002, Cohen’s d = 0.78. Porównanie to wykazało, że systematyczny trening transferowy nie tylko poprawił umiejętność konstruowania złożonych zdań przez studentów, ale także wzmocnił ich biegłość w strategiach organizacji gramatycznej. W szczególności podczas trzeciego etapu zadania studenci z grupy eksperymentalnej wykazali większą elastyczność w stosowaniu wielowarstwowych zdań składowych i złożonych struktur zdaniowych. Odzwierciedlało to zauważalne przejście w transferze językowym z poziomu „funkcjonalnego” na poziom bardziej „strategiczny”. Ścieżka treningowa zorientowana na transfer stale podnosiła umiejętności transferu składniowego studentów, skutecznie przełamując ograniczenia pisania pojedynczymi zdaniami oraz stałe wzorce ekspresji często spotykane w tradycyjnym nauczaniu. W zakresie adaptacji stylu językowego w badaniu przeanalizowano teksty pisane przez studentów przed i po eksperymencie. Wykorzystano model NLP do określenia proporcji słownictwa formalnego oraz częstotliwości użycia strony biernej jako kluczowych wskaźników oceny dopasowania stylu języka naukowego. Wskaźniki te odzwierciedlały, czy studenci posiadają świadomość językową i zdolność ekspresji pozwalającą na adaptację do stylu docelowego w pisaniu po angielsku. Odpowiednie wyniki przedstawiono na Rysunku 5.
Rysunek 5 przedstawia zmiany w dopasowaniu stylu akademickiego w grupie eksperymentalnej i grupie kontrolnej przed i po wykonaniu zadania, koncentrując się głównie na dwóch kluczowych wskaźnikach: udziale formalnego słownictwa oraz częstotliwości stosowania strony biernej. Ogólnie rzecz biorąc, po ukończeniu treningu transferowego opartego na modelu DeepSeek, zdolność adaptacji do stylu akademickiego w grupie eksperymentalnej uległa znaczącej poprawie, co dowodzi skuteczności tej metody nauczania w kształtowaniu świadomości norm językowych u studentów oraz ich umiejętności dostosowania się do stylu akademickiego. W odniesieniu do udziału formalnego słownictwa, w grupie eksperymentalnej wzrósł on z 0,42 przed zadaniem do 0,56 po zadaniu, co stanowi stosunkowo znaczący wzrost. W przeciwieństwie do tego, w grupie kontrolnej odnotowano jedynie niewielki wzrost, z 0,43 do 0,48, co sugeruje ograniczoną poprawę. Wynik ten wykazał, że po otrzymaniu systematycznych wskazówek dotyczących promptowania oraz informacji zwrotnej z modelu, studenci z grupy eksperymentalnej byli bardziej skłonni do używania w procesie pisania formalnego słownictwa spełniającego wymogi stylu akademickiego, a ich styl językowy stopniowo zbliżał się do standardów angielskiego pisania akademickiego. Jeśli chodzi o częstotliwość stosowania strony biernej, w grupie eksperymentalnej wzrosła ona znacząco z 0,18 przed zadaniem do 0,27 po zadaniu, co stanowi wzrost o 0,09; natomiast w grupie kontrolnej wzrost ten wyniósł zaledwie 0,02.
Aby dodatkowo zweryfikować, czy powyższe zmiany są istotne statystycznie, w badaniu przeprowadzono test t dla prób niezależnych na danych przed i po wykonaniu zadania. Wyniki wykazały, że w grupie eksperymentalnej nastąpiła istotna poprawa w proporcji słownictwa formalnego, t(58) = 3.89, p < 0.001, d Cohena = 0.92; wzrost częstotliwości użycia strony biernej był również istotny, t(58) = 4.56, p < 0.001, d Cohena = 1.05. Wskazuje to, że studenci w grupie eksperymentalnej poczynili znaczne postępy w adaptacji stylu językowego, a postępy te nie były przypadkowe, lecz stanowiły wynik połączonego efektu systematycznego kierowania za pomocą promptów oraz informacji zwrotnej z modelu.
Weryfikacja statystyczna
Ponadto, aby dodatkowo zweryfikować wiarygodność treści generowanych przez AI w praktyce nauczania, w badaniu porównano średnie wyniki treści generowanych przez AI oraz treści opracowanych przez nauczycieli w zależności od różnych typów promptów. Spójność między nimi oceniono poprzez obliczenie współczynnika korelacji Pearsona. Odpowiednie wyniki porównania przedstawiono w Tabeli 4. Tabela 4 pokazuje spójność treści generowanych przez AI oraz ocen nauczycieli w pięciu typach promptów zorientowanych na transfer. Z perspektywy średniego wyniku, ocena AI była ogólnie nieco niższa od oceny nauczyciela. Niemniej jednak, różnica ta mieściła się w rozsądnym zakresie w większości typów zadań, co wskazuje, że model DeepSeek wykazuje wysoką stabilność i wartość referencyjną w ocenie zadań z transferu pisania. W przypadku promptu dotyczącego transferu syntaktycznego średnia ocena nauczyciela wyniosła 4,1, a ocena AI 4,0, co oznacza różnicę zaledwie 0,1 między nimi. W promptach dotyczących transferu strukturalnego i logicznego ocena AI była o jedynie 0,1 punktu niższa od oceny nauczyciela, co wskazuje, że model potrafi lepiej symulować kryteria oceny nauczyciela w tych zadaniach, które wiążą się z wysokim stopniem struktury języka i jasnymi regułami. W przeciwieństwie do tego, odchylenia w punktacji w przypadku promptów dotyczących transferu kulturowego i transferu rejestru są stosunkowo wyraźne, z ocenami AI wynoszącymi odpowiednio 3,6 i 3,7, co jest wynikiem o 0,2 niższym od ocen nauczycieli, odzwierciedlając fakt, że AI nadal wykazuje pewne ograniczenia przy zadaniach o wysokim stopniu subiektywizmu, takich jak implikacje semantyczne i pragmatyka kulturowa. Niezawodność międzyoceniaczy oceniono za pomocą ICC (n = 5 oceniających). Ogólny wskaźnik ICC dla oceny manualnej wyniósł 0,86, a wskaźniki ICC dla każdego wymiaru mieściły się w zakresie od 0,82 do 0,89, co wskazuje na satysfakcjonującą zgodność między oceniającymi.
Dalsza analiza współczynnika korelacji Pearsona wykazała, że spójność wyników dla różnych promptów znajdowała się na wysokim poziomie, co wskazuje, że ocena AI była nie tylko zbliżona do oceny nauczyciela pod względem wartości, ale wykazywała również dobrą relację liniową w trendzie oceniania. Wśród nich współczynnik spójności dla promptu transferu syntaktycznego był najwyższy i wynosił 0.87, natomiast dla promptów transferu strukturalnego i logicznego wyniósł odpowiednio 0.83 i 0.85, co wskazuje, że wyniki ewaluacji AI w zakresie złożoności syntaktycznej, organizacji akapitów i spójności logicznej są wysoce zgodne z oceną nauczyciela. Może to wynikać z faktu, że zadania te mają jasne cele i mierzalne cechy językowe, co ułatwiło rozpoznawanie przez model i stabilną ocenę. Współczynnik korelacji dla promptu transferu domenowego wyniósł 0.81. Mimo niewielkiego spadku, nadal wykazał on silną zdolność ewaluacyjną, co wskazuje, że AI posiada pewien stopień zdolności oceny na poziomie adaptacji stylistycznej. Jednakże współczynnik spójności dla promptu transferu kulturowego wyniósł zaledwie 0.79, co było wynikiem niższym niż w przypadku innych typów, choć wciąż mieściło się w dopuszczalnym zakresie.
Aby zbadać przydatność różnych typów promptów w praktyce nauczania oraz stopień ich akceptacji przez nauczycieli, opracowano kwestionariusz satysfakcji z odpowiedzi na prompty. Pięciu nauczycieli języka angielskiego (oznaczonych jako T1–T5) poproszono o ocenę sugestii generowanych przez pięć typów promptów w pięciostopniowej skali (od bardzo niezadowolony do bardzo zadowolony), co przedstawiono na Rysunku 6: oceny pięciu nauczycieli dla pięciu typów promptów nieco się różnią, jednak ogólne uznanie było wysokie. Wśród nich najwyższe noty uzyskały prompty dotyczące „transferu składniowego” (syntactic transfer) oraz „transferu kulturowego” (cultural transfer), z średnią wynoszącą 4.0, co odzwierciedla ich wysoką praktyczność i adaptacyjność w nauczaniu. W przeciwieństwie do nich, prompt dotyczący „transferu rejestru” (register transfer) uzyskał stosunkowo niską ocenę, średnio zaledwie 2.4, a niektórzy nauczyciele, tacy jak T4 i T5, wystawili najniższe noty, co wskazuje, że jego wytyczne i adaptacyjność w zastosowaniach dydaktycznych wciąż wymagają poprawy.
Na poziomie indywidualnym wystąpiły wyraźne różnice w tendencjach oceniania nauczycieli. Ogólna ocena T1 była pozytywna, co wskazuje na wysoki stopień akceptacji pisania wspomaganego przez AI, podczas gdy oceny T5 były niskie w wielu wymiarach Promptów, szczególnie w zakresie „transferu rejestru” oraz „transferu logicznego”. Różnica ta może wynikać z doświadczenia dydaktycznego nauczycieli, preferencji językowych lub stopnia zaznajomienia się z narzędziami AI, co sugeruje, że przyszłe projektowanie Promptów powinno uwzględniać mechanizmy spersonalizowanego dostosowania, aby zwiększyć akceptację wśród różnych grup nauczycieli. Aby dodatkowo zweryfikować rzeczywisty wpływ nauczania wspomaganego przez AI na poprawę jakości pisania uczniów, w badaniu porównano zmiany w ocenach ogólnych grupy eksperymentalnej i grupy kontrolnej, wystawionych przez nauczycieli przed i po eksperymencie. Wyniki porównania przedstawiono na Rysunku 7.
Jak pokazano na Rysunku 7, ogólne wyniki grupy eksperymentalnej i grupy kontrolnej, ocenione przez nauczycieli przed i po eksperymencie, wykazały istotne różnice. Ogólnie, po zastosowaniu interwencji dydaktycznej w postaci optymalizacji instrukcji w oparciu o model DeepSeek, ogólny wynik grupy eksperymentalnej wykazał znaczną tendencję wzrostową. W przeciwieństwie do niej, zmiana wyników w grupie kontrolnej była stosunkowo niewielka. Średnia ocena nauczycielska grupy eksperymentalnej przed eksperymentem wynosiła 59,1 punktu, a średnia ocena po eksperymencie wzrosła znacząco do 74,4 punktu, co stanowi wzrost o 15,3 punktu. Wskazuje to, że nauczanie wspomagane przez AI miało pozytywny wpływ na jakość pisania uczniów. Z wykresu pudełkowego zaobserwowano, że zakres rozkładu wyników grupy eksperymentalnej również uległ rozszerzeniu. W szczególności pudełko wyników po eksperymencie znajduje się znacznie wyżej niż przed nim, a wartości maksymalne i minimalne wzrosły, co świadczy o znaczącej poprawie ogólnego poziomu uczniów. Z kolei zmiany wyników w grupie kontrolnej były stosunkowo ograniczone. Przed eksperymentem średni wynik grupy kontrolnej wynosił 60,1 punktu, a po eksperymencie 64,9 punktu, co stanowi wzrost o 4,8 punktu. Wzrost ten był znacznie niższy niż w grupie eksperymentalnej, a pudełko wyników grupy kontrolnej nie zmieniło się znacząco przed i po eksperymencie, co wskazuje, że tradycyjne metody nauczania lub nieoptymalizowane narzędzia wspomagane przez AI mają ograniczony wpływ na poprawę jakości pisania.
Ponadto w badaniu tym wykorzystano tabelę poznania transferowego, aby przeprowadzić studentów przez trzy rundy samooceny rozwoju ich umiejętności w zakresie dostosowania strukturalnego, transformacji zdań oraz ekspresji kulturowej, między innymi, w celu odzwierciedlenia trendu zmian w świadomości metapoznawczej studentów i ich opanowaniu strategii transferowych. Wyniki przedstawiono na Rysunku 8. Zgodnie z danymi z wykresu radarowego samooceny zdolności transferowych studentów przedstawionymi na Rysunku 8, samoocena studentów w pięciu wymiarach: transferu strukturalnego, transferu syntaktycznego, transferu kulturowego, transferu rejestru i transferu logicznego w trzech rundach zadań wykazała tendencję wzrostową, co wskazuje, że dzięki interwencji dydaktycznej w postaci optymalizacji instrukcji opartej na modelu DeepSeek, zdolność studentów do stosowania strategii transferowych uległa znacznej poprawie. W pierwszej rundzie zadań oceny w samoocenie studentów były ogólnie niskie. Wśród pięciu wymiarów „transfer strukturalny” i „transfer logiczny” uzyskały oceny odpowiednio 3,2 i 3,0, podczas gdy „transfer kulturowy” i „transfer rejestru” uzyskały 2,5 i 2,7, co wskazuje, że studenci wciąż nie byli biegli w identyfikowaniu i stosowaniu strategii transferowych. Do drugiej rundy zadań oceny każdego z elementów uległy poprawie, przy czym „transfer strukturalny” wzrósł do 3,8, „transfer syntaktyczny” do 3,5, a „transfer logiczny” do 3,7. Wykazało to, że dzięki wskazówkom nauczycieli i wsparciu w postaci informacji zwrotnych z modelu, studenci stopniowo opanowali kluczowe aspekty podstawowych operacji transferowych i zaczęli je stosować w praktycznym pisaniu. W trzeciej rundzie zadań oceny w samoocenie studentów znacząco wzrosły, przy czym „transfer strukturalny” i „transfer logiczny” osiągnęły odpowiednio 4,5 i 4,3, a pozostałe wymiary ustabilizowały się powyżej 4,0 punktów, co wykazuje trwały efekt wielokrotnych rund treningu transferowego w poprawie kontroli nad formą językową i zdolnością konstruowania tekstu. Na tym etapie studenci uformowali podstawową pętlę poznawczą między rozumieniem, wykonaniem a refleksją nad strategiami transferowymi. Oprócz informacji zwrotnych od nauczyciela, w badaniu przeprowadzono również ankietę satysfakcji dotyczącą funkcji pisania wspomaganego przez AI wśród wszystkich studentów z grupy eksperymentalnej, w wyniku czego zebrano łącznie 30 prawidłowo wypełnionych kwestionariuszy. Kwestionariusz oceniał działanie AI w trzech modułach funkcjonalnych: sugestie przeredagowania, optymalizacja strukturalna oraz wskazówki kulturowe i wymagał od studentów wyboru opcji zgodnie z pięciostopniową skalą standardów. Wyniki przedstawiono w Tabeli 5.
Zgodnie z wynikami ankiety satysfakcji studentów dotyczącej funkcji pisania wspomaganego przez AI przedstawionymi w Tabeli 5, studenci z grupy eksperymentalnej ogólnie pozytywnie ocenili działanie AI w trzech modułach funkcjonalnych: sugestii przeredagowania, optymalizacji struktury oraz podpowiedzi kulturowych, co wskazuje na dobre perspektywy zastosowania systemów pisania wspomaganego przez AI w celu zwiększenia wydajności treningu pisania i jakości wsparcia dydaktycznego. Ogólnie ponad 90% studentów zadeklarowało, że są „bardzo zadowoleni” lub „zadowoleni” z dwóch funkcji: „sugestii przeredagowania” oraz „optymalizacji struktury”, przy czym „sugestie przeredagowania” uzyskały najwyższy poziom satysfakcji, wynoszący 91%, co wskazuje na wysoki stopień uznania zdolności AI w zakresie rekonstrukcji syntaktycznej i szlifowania języka. W porównaniu z nimi satysfakcja z funkcji „podpowiedzi kulturowych” była stosunkowo niższa. Mimo to osiągnęła ona 83%, co wskazuje, że choć AI wykazuje pewną złożoność i subiektywizm w kierowaniu ekspresją międzykulturową, jej rola w pomaganiu studentom w identyfikowaniu i korygowaniu interferencji kulturowych języka ojczystego została uznana przez większość badanych. W odniesieniu do niezadowolenia, odsetek studentów, którzy wybrali odpowiedź „niezadowolony” lub „bardzo niezadowolony” we wszystkich trzech funkcjach, wyniósł mniej niż 5%, co świadczy o dobrej użyteczności i akceptacji funkcji wspomaganych przez AI w większości scenariuszy zastosowań. Warto zauważyć, że proporcja studentów, którzy ocenili funkcję „podpowiedzi kulturowych” jako „przeciętną”, była stosunkowo wysoka, co sugeruje, że obecna AI może nie w pełni spełniać oczekiwania studentów w kwestiach związanych z adaptacją kulturową i wciąż istnieje przestrzeń do ulepszeń. Kompleksowa analiza wykazuje, że metoda optymalizacji instrukcji oparta na DeepSeek została szeroko uznana przez studentów, szczególnie w zakresie wsparcia formy językowej.
RM-ANOVA
Przeprowadzono dwuczynnikową analizę wariancji z powtarzanymi pomiarami (RM-ANOVA), aby zbadać wpływ grupy (czynnik międzygrupowy: grupa eksperymentalna vs grupa kontrolna) oraz czasu (czynnik wewnątrzgrupowy: pretest, Zadanie 1, Zadanie 2, Zadanie 3, posttest), a także ich interakcję na wyniki transferu pisania w języku angielskim u studentów. Test Mauchly’ego wykazał naruszenie założenia sferyczności (p < 0.05), dlatego zastosowano korektę Greenhouse’a-Geissera w celu dostosowania stopni swobody dla efektów wewnątrzgrupowych. Wszystkie analizy oparto na n = 30 uczestnikach w każdej grupie. Wyniki przedstawiono w Tabeli 6:
Wyniki analizy ANOVA z powtarzanymi pomiarami z korekcją Greenhouse’a–Geissera wykazały istotne efekty główne dla Grupy, Czasu oraz interakcji Grupa × Czas we wszystkich mierzonych wymiarach (p < 0.001). W przypadku Ogólnego Indeksu Transferu zaobserwowano istotny efekt Grupy (F(1,58) = 76,32), a także istotny efekt Czasu (F(2,14,124,12) = 92,75) oraz istotną interakcję Grupa × Czas (F(2,14,124,12) = 68,49), co sugeruje, że zmiany w ogólnej wydajności transferu w czasie różniły się istotnie pomiędzy grupami.
Podobnie, transfer syntaktyczny wykazał istotne efekty dla Grupy (F(1,58) = 52,18), Czasu (F(2,11,122,38) = 71,26) oraz interakcji Grupa × Czas (F(2,11,122,38) = 45,73), co wskazuje na odmienne wzorce rozwoju zdolności transferu syntaktycznego w zależności od grup i punktów pomiarowych. W przypadku transferu strukturalnego również zidentyfikowano istotne efekty dla Grupy (F(1,58)=48,65), Czasu (F(2,09,121,22) = 67,81) oraz interakcji (F(2,09,121,22) = 41,36), co odzwierciedla spójną poprawę z trajektoriami zależnymi od grupy. Co istotne, transfer kulturowy wykazał najsilniejsze efekty: istotny efekt Grupy (F(1,58) = 81,44), wyraźny efekt Czasu (F(2,07,119,96) = 98,52) oraz silną interakcję Grupa × Czas (F(2,07,119,96) = 79,27), co sugeruje najbardziej znaczący i zróżnicowany wzorzec wzrostu w tym wymiarze. Ogólnie wszystkie wskaźniki wykazują statystycznie istotne efekty, potwierdzając, że interwencja wywarła stabilny i zróżnicowany wpływ na rozwój transferu w czasie.
DOSTĘPNOŚĆ DANYCH:
Wszystkie dane wygenerowane lub przeanalizowane w ramach niniejszego badania zostały zawarte w tym artykule. Surowe dane z oceny zostały przedstawione w Tabela uzupełniająca 1.
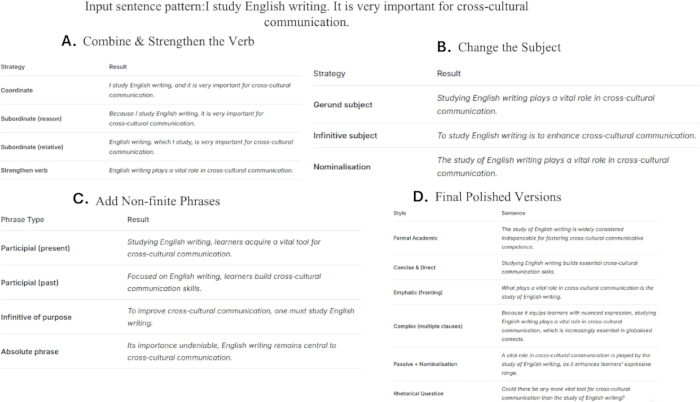
Rysunek 1: Kroki transformacji struktury zdania. (A) Strategie łączenia i wzmacniania czasowników w celu poprawy struktury zdania. (B) Alternatywne transformacje podmiotu, w tym podmioty w formie gerundium, bezokolicznika i rzeczowników. (C) Wykorzystanie fraz nieosobowych w celu zwiększenia różnorodności i zwięzłości zdań. (D) Przykłady dopracowanych wersji końcowych wykazujących poprawę stylu akademickiego i międzykulturowej ekspresji w języku angielskim. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
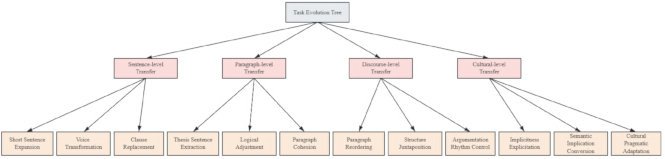
Rysunek 2: Schemat drzewa ewolucji zadań. Przedstawia on progresywną strukturę czteropoziomowych zadań transferowych, obejmujących poziom zdania, akapitu, dyskursu oraz poziom kulturowy. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
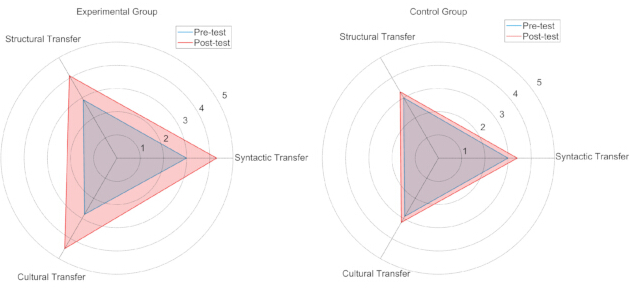
Rycina 3: Porównanie zdolności transferu pisania przed i po eksperymencie. Wykres radarowy przedstawia wyniki przed i po teście dla grupy eksperymentalnej oraz grupy kontrolnej w wymiarach transferu składniowego, strukturalnego i kulturowego. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
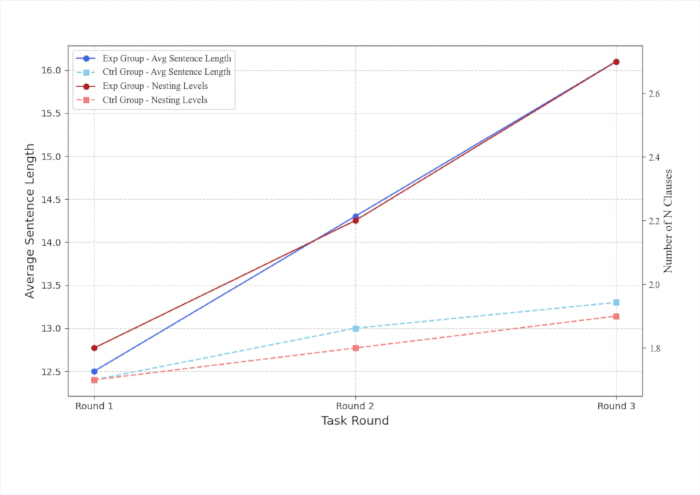
Rycina 4: Wykres liniowy trendu złożoności syntaktycznej. Przedstawiono zmiany w średniej długości zdań i poziomach zagnieżdżenia zdań składowych w trzech zadaniach treningowych. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
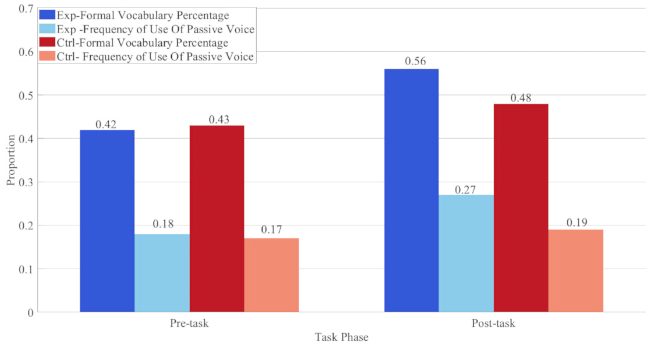
Rysunek 5: Dopasowanie terminologii akademickiej. Na rysunku przedstawiono zmiany w proporcji słownictwa formalnego i częstotliwości występowania strony biernej przed i po interwencji. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
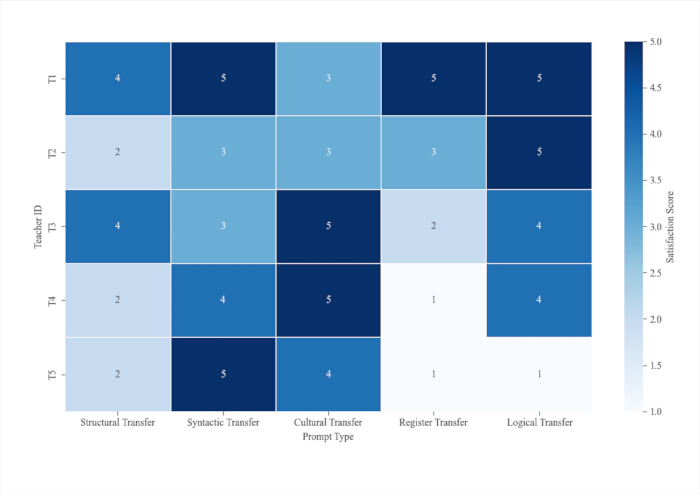
Rysunek 6: Mapa ciepła satysfakcji z odpowiedzi na prompty. Podsumowano tutaj oceny pięciu typów szablonów promptów udzielone przez uczestniczących nauczycieli. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
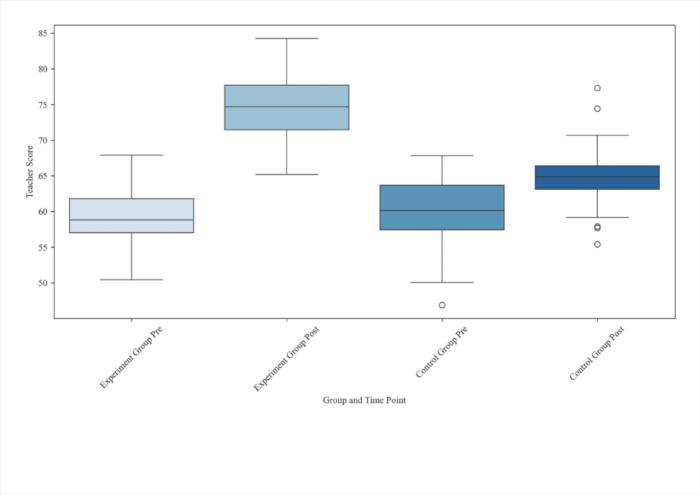
Rycina 7: Wykres pudełkowy zmian w ocenach nauczycielskich. Wykres pudełkowy przedstawia rozkład i ogólne zmiany ocen pisania wystawionych przez nauczycieli dla dwóch grup przed i po eksperymencie. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
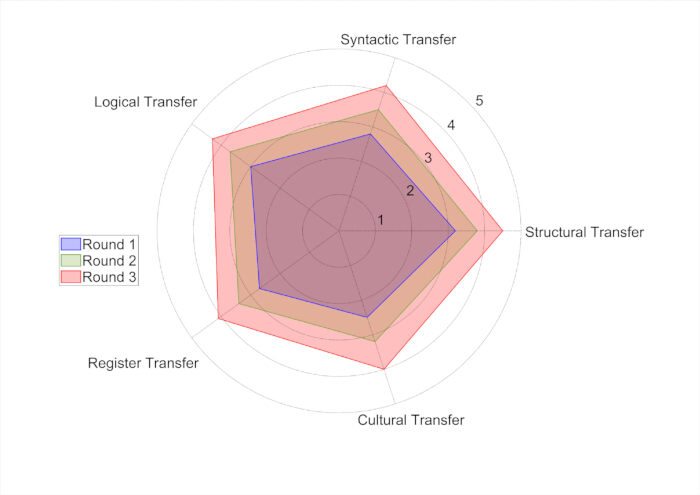
Rysunek 8: Wykres radarowy samooceny umiejętności transferu u studentów. Przedstawia on wyniki samooceny studentów w pięciu wymiarach transferu w trzech rundach szkoleniowych. Aby wyświetlić powiększoną wersję tego rysunku, kliknij tutaj.
| Proszę podać tekst źródłowy do przetłumaczenia. | Obsługa dla nauczyciela | Typ promptu | Operacja studenta | Wynik | Kryteria oceny |
| Oryginalne szkice tekstów napisanych przez studentów (zdania/akapity/eseje) | 1. Oznacz rodzaje transferu i poziomy zadań 2. Dostosuj parametry promptu, jeśli jest to konieczne | Pojedynczy prompt transferowy / Trzystopniowy zagnieżdżony łańcuch promptów | 1. Zapoznaj się ze strategiami przenoszenia wiedzy 2. Popraw wersje robocze na podstawie informacji zwrotnych od AI 3. Przeprowadź samoocenę | Tekst poprawiony przez AI + końcowy projekt poprawiony przez studenta | Złożoność syntaktyczna, racjonalność strukturalna, adekwatność kulturowa, spójność logiczna, standaryzacja rejestru (skala 0–5) |
Tabela 1: Podsumowanie schematu postępowania. Tabela ta podsumowuje pełny schemat operacyjny szkolenia z zakresu transferu pisania w języku angielskim wspomaganego przez AI, obejmując materiały wejściowe, działania nauczyciela i ucznia, rodzaje promptów, końcowe wyniki oraz odpowiadające im kryteria oceny.
| Kategoria projektu | Spis treści |
| Zrozumienie celów misji | Proszę o zwięzłe opisanie celów migracyjnych tej serii zadań redakcyjnych, takich jak dostosowanie strukturalne, adaptacja kulturowa oraz konwersja językowa. |
| Zastosowana strategia migracji | Prosimy o wymienienie przyjętych strategii migracji (można wybrać kilka odpowiedzi): |
| Dostosowanie strukturalne | |
| Przekształcanie zdań | |
| Zmiana języka | |
| Manifestacje kulturowe | |
| Wzmocnienie powiązań logicznych | |
| Inne: _______ | |
| Przepisuj przykłady i instrukcje | Wybierz 1–2 przeredagowane zdania, przedstaw wersje przed i po zmianach oraz wyjaśnij przyczyny wprowadzonych poprawek i zamierzone cele przekładu. |
| Napotkane trudności i wątpliwości | Opisz wszelkie problemy, jakie napotkałeś podczas migracji, lub pytania, jakie pojawiły się w związku z konkretnym sformułowaniem. |
| Wynik samooceny (w skali od 1 do 5 punktów) | Prosimy o ocenę przeredagowanego tekstu w oparciu o następujące trzy aspekty: |
| • Dokładność zastosowania strategii (/5) | |
| • Naturalność i płynność wypowiedzi (/5) | |
| • Dopasowanie kulturowe (/5) | |
| Cele dotyczące przyszłej poprawy stylu pisania | Krótko opisz zdolność do transferu, którą chciałbyś wzmocnić lub zoptymalizować w kolejnej rundzie treningu |
Tabela 2: Tabela transferu poznawczego. Do samooceny strategii transferu pisania przez studentów przyjęto skalę ocen od 1 do 5 (1 = brak biegłości, 5 = pełna biegłość).
| Nazwa wskaźnika | Opis | Źródło danych |
| Indeks transferu pisma (0–5) | Ilościowy wskaźnik kompleksowo mierzący zdolność transferu językowego, obejmujący trzy poziomy: składnię, strukturę i kulturę. | Automatyczne ocenianie przez system + ocenianie ręczne przez nauczycieli |
| Wskaźnik złożoności syntaktycznej | W tym m.in. średnia długość zdania, liczba zdań podrzędnych, bogactwo fraz czasownikowych itd. | Automatyczna analiza NLP |
| Dostosowanie stylu akademickiego | Czy jest to zgodne z angielskimi standardami pisania akademickiego? | Ocena modelu przetwarzania języka naturalnego |
| Satysfakcja z odpowiedzi na prompt | Akceptacja i praktyczna ocena sugestii generowanych przez model w opinii nauczycieli | Kwestionariusz dla nauczyciela |
| Zmiany w ocenianiu podczas recenzji nauczyciela | Porównanie ocen nauczycieli przed i po eksperymencie w celu odzwierciedlenia poprawy jakości pisania | Arkusze ocen nauczycieli |
| Samoocena zdolności do transferu wiedzy u studentów | Studenci dokonują samooceny swojego stopnia opanowania poszczególnych wymiarów transferu | Wypełnij formularz świadomości migracyjnej |
Tabela 3: Podsumowanie wskaźników oceny, opisów i źródeł danych. Tabela ta wyjaśnia definicje, metody pomiaru oraz oryginalne źródła danych dla każdego z głównych wskaźników oceny w niniejszym badaniu.
| Typ promptu | Średnia ocena nauczycieli | Średnia punktacja AI | Współczynnik korelacji Pearsona |
| Transfer strukturalny | 4 | 3.9 | 0.83 |
| Transfer syntaktyczny | 4.1 | 4 | 0.87 |
| Transfer kulturowy | 3.8 | 3.6 | 0.79 |
| Transfer rejestrów | 3.9 | 3.7 | 0.81 |
| Transfer logiczny | 4.2 | 4.1 | 0.85 |
Tabela 4: Porównanie spójności między treściami wygenerowanymi przez AI a ocenami nauczycieli. Wyniki wykazują spójność między treściami wygenerowanymi przez AI a ocenami nauczycieli dla różnych typów promptów.
| Elementy funkcyjne | Bardzo zadowolony | Zadowolony | Ogólnie | Niezadowolony | Bardzo niezadowolony |
| Sugestia przeredagowania | 66% | 25% | 7% | 1.50% | 0.50% |
| Optymalizacja strukturalna | 60% | 30% | 7% | 2% | 1% |
| Wskazówki dotyczące hodowli | 55% | 28% | 12% | 3.50% | 1.50% |
Tabela 5: Statystyki badania satysfakcji studentów z funkcji wspomaganych przez AI.Statystyki przedstawiają rozkład satysfakcji studentów w zakresie funkcji przeredagowania tekstu, optymalizacji struktury oraz promptów kulturowych przez AI.
| Pomiar | Grupa F(df) | Czas F(df)GG | Grupa × Czas F(df)GG | p |
| Ogólny wskaźnik transferu | 76.32 (1, 58) | 92.75 (2.14, 124.12) | 68.49 (2.14, 124.12) | <0.001 |
| Transfer syntaktyczny | 52.18 (1, 58) | 71.26 (2.11, 122.38) | 45.73 (2.11, 122.38) | <0.001 |
| Transfer strukturalny | 48.65 (1, 58) | 67.81 (2.09, 121.22) | 41.36 (2.09, 121.22) | <0.001 |
| Transfer kulturowy | 81.44 (1, 58) | 98.52 (2.07, 119.96) | 79.27 (2.07, 119.96) | <0.001 |
Tabela 6: Podsumowanie wyników ANOVA z powtarzanymi pomiarami. Przedstawia ona wyniki dwuczynnikowej analizy ANOVA z powtarzanymi pomiarami dla ogólnych wyników transferu pisania oraz trzech jego podwymiarów, w tym efekty główne grupy, czasu oraz interakcję grupa-czas. Skróty: GG = korekta Greenhouse'a–Geissera.
Tabela uzupełniająca 1: Ocena surowych danych. Zawiera surowe dane wykorzystane we wszystkich analizach w niniejszym badaniu.Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Niniejsza praca konstruuje wielopoziomowe ramy optymalizacji instrukcji, oparte na architekturze MoE modelu DeepSeek, przeznaczone do nauczania transferu pisania w języku angielskim w kontekście międzykulturowym. Koncentrując się na czteropoziomowych zadaniach progresywnych – od poziomu zdania po wymiar kulturowy – oraz pięciokategorycznej zestandaryzowanej bibliotece zadań, badanie realizuje automatyczne generowanie promptów w oparciu o rzeczywiste próbki prac pisemnych uczniów i ustanawia trzystopniowe zagnieżdżone łańcuchy promptów w celu dekompozycji złożonych adaptacyjnych zadań międzykulturowych. W przeciwieństwie do konwencjonalnego, ogólnego projektowania promptów ograniczonego do korekty tekstu, proponowane rozwiązanie ściśle wiąże kompilację promptów z celami nauczania transferu językowego i buduje zamknięty cykl dydaktyczny obejmujący generowanie przez model, adnotację nauczyciela oraz iteracyjną rewizję ucznia. Z perspektywy rozwoju dyscypliny, niniejsza praca rozszerza praktyczne granice inżynierii promptów w akwizycji drugiego języka, dostarczając mierzalnej ścieżki konstrukcji szablonów łączących charakterystykę parametrów dużych modeli językowych z ukierunkowanym treningiem w klasach EFL. Wzbogaca ona również dowody empiryczne dla badań nad międzykulturowym transferem pragmatycznym w środowisku wspomaganym przez AI, uzupełniając istniejące wyniki badań skupiające się wyłącznie na błędach negatywnego transferu składniowego36,37.
Dane z empirycznego quasi-eksperymentu potwierdzają, że grupa eksperymentalna uzyskała wyraźną poprawę we wskaźnikach transferu składniowego, strukturalnego i kulturowego, jednak kilka immanentnych ograniczeń zawęża możliwość generalizacji wyników badań. Ze względu na warunki badawcze w studium zastosowano nielosowy podział na grupy klasowe bez wprowadzenia ślepej próby dla oceniających, a wszystkie próbki pobrano od studentów filologii angielskiej jednej uczelni, co utrudnia wykluczenie wpływu autonomicznej motywacji do nauki studentów oraz długotrwałych nawyków dydaktycznych nauczycieli na zmienność wyników. Ponadto interwencja ta trwała tylko trzy tygodnie, co stanowi krótkoterminowy program szkoleniowy. W połączeniu z jednocentrowym projektem próbkowania, w którym wszyscy uczestnicy zostali zrekrutowani z jednej szkoły zawodowej, zaobserwowane pozytywne efekty mogą nie być w pełni stabilne w długoterminowej praktyce nauczania. W związku z tym wyniki badań należy interpretować z ostrożnością, a bezpośrednia generalizacja wniosków na różne typy uczelni, dłuższe cykle nauczania lub grupy studentów o różnym poziomie biegłości językowej jest niezasadna.
W praktycznym zastosowaniu dydaktycznym obecny system optymalizacji promptów w połączeniu z modelem DeepSeek wykazuje wyraźne ograniczenia i typowe przypadki błędów. W zadaniach dotyczących transferu kulturowego i rejestru model sporadycznie generuje pragmatycznie nieodpowiednie wyrażenia lub sztywne wyniki konwersji stylu podczas przetwarzania tekstów o subtelnych konotacjach kulturowych i zależnych od kontekstu wymaganiach stylistycznych38,39; nie potrafi on również precyzyjnie zidentyfikować utajonego, rodzimego sposobu myślenia w długich i złożonych akapitach, co prowadzi do niepełnej korekty sformułowań typu „Chinglish”. W automatycznym ocenianiu spójność ewaluacji AI znacznie spada w przypadku wysoce subiektywnych elementów pragmatyki kulturowej, a model nie jest w stanie efektywnie rozróżnić niuansów w ekspresji retorycznej i implikacjach międzykulturowych. Ponadto trzystopniowy zagnieżdżony łańcuch promptów jest podatny na odchylenia semantyczne w wielorundowym generowaniu iteracyjnym, gdzie błędy z pierwszego etapu reorganizacji semantycznej są dziedziczone i potęgowane w kolejnych krokach rewizji językowej i adaptacji kulturowej40,41.
W kontekście trendów dalszego rozwoju, można wprowadzić ulepszenia w trzech praktycznych wymiarach. Po pierwsze, należy rozszerzyć skalę biblioteki zadań poprzez zgromadzenie korpusu tekstów pisanych przez osoby niebędące specjalistami w zakresie języka angielskiego oraz studentów o różnym poziomie biegłości językowej, aby wzmocnić kompatybilność szablonów dla zróżnicowanych grup uczniów. Po drugie, warto połączyć ciągłe dostrajanie lekkich podmodułów DeepSeek w celu zmniejszenia odchyleń występujących w ocenie transferu kulturowego przez AI, która w obecnych statystykach wykazała słabszą spójność w porównaniu z oceną nauczycielską. Po trzecie, należy zintegrować cały system optymalizacji promptów z konwencjonalnymi platformami do internetowej nauki języków obcych, aby umożliwić automatyczną, długoterminową akumulację danych dla ciągłej, iteracyjnej optymalizacji reguł promptowania. Dzięki stałemu wzbogacaniu zasobów międzyjęzykowych korpusów kulturowych, oczekuje się, że proponowany framework techniczny rozszerzy zakres swojego zastosowania o nauczanie tłumaczenia dwujęzycznego oraz kursy komunikacji międzykulturowej w kolejnych badaniach.
Oświadczenia
Autorzy oświadczają, że nie mają żadnych finansowych konfliktów interesów.
Podziękowania
Niniejsza praca była wspierana przez Projekt Planowania Edukacji Prowincji Zhejiang 2026: Badania nad rekonstrukcją ram kompetencji dydaktycznych i strategiami promocji nauczycieli szkół wyższych w warunkach cyfrowego i inteligentnego upodmiotowienia (nr projektu: ZWT26024; nr zatwierdzenia: 2026SCG360).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Wstępnie wytrenowany model językowy BERT | https://github.com/google-research/bert | Reprezentacja tekstu, rozpoznawanie struktury akapitów, obliczanie podobieństwa semantycznego oraz klasyfikacja tekstu wspierają automatyczną ocenę treści pisemnych. | |
| Coreferee | Explosion AI | https://github.com/explosion/coreferee | Identyfikowane są relacje referencyjne w tekście oraz oceniana jest spójność referencyjna dyskursu, aby wspomóc automatyczną ocenę jakości pisania. |
| Duży model językowy DeepSeek | DeepSeek AI | https://chat.deepseek.com/ | W oparciu o architekturę modelu MoE przeprowadzono optymalizację instrukcji i projektowanie łańcucha słów promptu. Model wykorzystuje stałe parametry: współczynnik temperatury 0,7, a generowana długość jest dynamicznie ograniczana w zależności od typu pytania. |
| spaCy | Explosion AI | https://github.com/explosion/spaCy | Analizowana jest zależna struktura składniowa tekstu angielskiego, a wskaźniki takie jak średnia długość zdania i liczba zdań podrzędnych są ekstrahowane w celu ilościowej oceny złożoności składniowej. |
| SPSS 26.0 | IBM | https://www.ibm.com/products/spss-statistics | Przeprowadzono analizy statystyczne, takie jak ANOVA dla pomiarów powtarzanych (RM-ANOVA), test t dla próbek niezależnych, analiza korelacji Pearsona, obliczenie wielkości efektu (d Cohena’) oraz test niezawodności (ICC). |
Bibliografia
- Maqsood M, Zahid A, Asghar T, et al. Issues in teaching English in a cultural context. Migr Lett. 2024; 21(4): 1020–1027.
- Tran NT, Nguyen TT, Pham HH. Exploring the challenges of L1 negative transfer among Vietnamese English language learners: a qualitative study. rEFLections. 2024; 31(2): 837–857.
- Zhu P. Cultural dimensions as guidelines in handling language problems for effective written communication across cultures. Int J Linguist Lit Transl. 2023; 6(12): 85–95.
- Zeng Z, Nair SM, Wider W. A comparative study of Chinese EFL undergraduates' pragmatic competence in English letter writing between urban and suburban universities. World J Engl Lang. 2022; 12(6): 377–388.
- Litvinova TA, Mikros GK, Dekhnich OV. Writing in the era of large language models: a bibliometric analysis of the research field. Nauchnyi Rezultat Voprosy Teoreticheskoi i Prikladnoi Lingvistiki. 2024; 10(4): 5–16.
- Long M. Cultivating interdisciplinary foreign language talents through interdisciplinary synergy of on-campus teaching and off-campus practices under the new liberal arts. Educ Rev USA. 2025; 9(5): 520–526.
- Voss E, Cushing ST, Ockey GJ, et al. The use of assistive technologies including generative AI by test takers in language assessment: a debate of theory and practice. Lang Assess Q. 2023; 20(4-5): 520-532.
- Manyasa J. When language transfer is negative: analysis of morpho-syntactic interference errors by learners of French in Tanzanian higher learning institutions. J Foreign Lang. 2021; 13(1): 165-190.
- Fikri N. The study of language transfer in EFL students' translation work. J Pendidik Nonformal. 2023; 1(1): 9.
- Ahmat A, Yang Y, Ma B, et al. Cross-lingual prompting method with semantic-based answer space clustering. Appl Intell. 2025; 55(2): 1-17.
- Maity S, Deroy A, Sarkar S. Investigating large language models for prompt-based open-ended question generation in the technical domain. SN Comput Sci. 2024; 5(8): 1-32.
- Wu W, Cao Y, Yi N, et al. Detecting and reducing the factual hallucinations of large language models with metamorphic testing. Proc ACM Softw Eng. 2025; 2(FSE): 1432-1453.
- Kaganovich P, Münz-Manor O, Ezra-Tsur E. Style transfer of modern Hebrew literature using text simplification and generative language modeling. CEUR Workshop Proc. 2023; 1613: 73-95.
- Yuan Y. Influence of native language transfer on senior high school English writing. Theory Pract Lang Stud. 2021; 11(2): 170-176.
- Jiamin M. The influence of cultural factors on language transfer in second language acquisition. Res J Engl Lang Lit. 2024; 12(1): 186-195.
- Zhang L. Native language transfer in vocabulary acquisition: an empirical study from connectionist perspective. J Lang Teach Res. 2023; 14(2): 446-458.
- Mirzayev E. The influence of first language interference on ESL writing skills. EuroGlob J Linguist Lang Educ. 2024; 1(1): 33-39.
- Fujiwara Y, Iwao T, Ito H, et al. Exploring the transfer of topic-comment structures called unagi-sentences in Asian L2 Englishes: cross-proficiency-level and cross-varietal studies. Asian Englishes. 2025; 27(1): 25-40.
- Guo Q. Interlanguage and its implications to second language teaching and learning. Pac Int J. 2022; 5(4): 8-14.
- Vereeck A, Janse M, De Herdt K, et al. Why Plato needs psychology: proposal for a theoretical framework underpinning research on the cognitive transfer effects of studying classical languages. Psiholoska Obzorja. 2023; 32: 121-130.
- Zhang W. Study on the negative transfer of mother tongue on college students. Int J Front Sociol. 2023; 5(16): 164-171.
- Li C. A review of theories, pedagogies and vocabulary learning tasks of English vocabulary learning apps for Chinese EFL learners. J China Comput Assist Lang Learn. 2024; 4(2): 346-375.
- Nsengimana I, Niyibizi E, Ngabonziza JDA. The impact of language transfers on learners' writing skills in English learning among students in Mahama Refugee Camp, Rwanda. Afr J Empir Res. 2024; 5(3): 605-613.
- Jovein S K, Sharifabad E D, Yazdani M. On the relationship between university translator training programs and the translation market requirements: The case of English translation graduates and postgraduates of Imam Reza International University. Journal of Critical Studies in Language and Literature. 2024; 5(6): 1-13.
- Qin X. Collaborative inquiry in action: a case study of lesson study for intercultural education. Asian Pac J Second Foreign Lang Educ. 2024; 9(1): 66-91.
- Sun L, Asmawi A. The effect of WeChat-based instruction on Chinese EFL undergraduates’ business English writing performance. International Journal of Instruction. 2023; 16(1): 43-60.
- Moro G, Piscaglia N, Ragazzi L, et al. Multi-language transfer learning for low-resource legal case summarization. Artificial Intelligence and Law. 2024; 32(4): 1111-1139.
- Sun Y. A study of college English writing teaching based on dynamic assessment. Pac Int J. 2023; 6(1): 83-88.
- Jeon J, Lee S. Large language models in education: a focus on the complementary relationship between human teachers and ChatGPT. Educ Inf Technol. 2023; 28(12): 15873-15892.
- Kostka I, Toncelli R. Exploring applications of ChatGPT to English language teaching: opportunities, challenges, and recommendations. TESL-EJ. 2023; 27(3): n3-n22.
- Antara IMAR, Anggreni NPY. Analyzing grammatical errors in EFL students' opinion essays using DeepSeek AI: patterns and pedagogical implications. Stilistika. 2025; 13(2): 210-218.
- Diasamidze L, Tedoradze T. Enhancing ESL students' writing skills through natural language processing model ChatGPT. Eurasia Proc Educ Soc Sci. 2024; 35: 230-238.
- Ranade N, Saravia M, Johri A. Using rhetorical strategies to design prompts: a human-in-the-loop approach to make AI useful. AI Soc. 2025; 40(2): 711-732.
- Zhou W, Gao B. Construction and application of English-Chinese multimodal emotional corpus based on artificial intelligence. Int J Hum Comput Interact. 2025; 41(3): 1782-1793.
- Chen B, Bao L, Zhang R, et al. A multi-strategy computer-assisted EFL writing learning system with deep learning incorporated and its effects on learning: a writing feedback perspective. J Educ Comput Res. 2024; 61(8): 60-102.
- Jeon H. Designing teaching for transfer in English for academic purposes. RELC Journal. 2024; 55(2): 567-577.
- Pei Y J. Construction of a" Feedback-Revision" Teaching Model for Senior High School English Continuation Writing Based on Generative AI. International Journal of Educational Development. 2026; 3(1): 16-25.
- Holubnycha L, Kuznetsova O, Shchokina T, et al. AI-Powered Teaching: Literature Review of ChatGPT's Impact on University Educators. International Journal of Interactive Mobile Technologies. 2025; 19(15): 41.
- Almuhanna M A. Teachers' perspectives of integrating AI-powered technologies in K-12 education for creating customized learning materials and resources. Education and Information Technologies. 2025; 30(8): 10343-10371.
- Hastomo T, Mandasari B, Widiati U. Scrutinizing Indonesian pre-service teachers’ technological knowledge in utilizing AI-powered tools. Journal of education and learning (EduLearn). 2024; 18(4): 1572-1581.
- Cai H, Lu L, Han B, et al. Exploring pre-service teachers’ reflection mediated by an AI-powered teacher dashboard in video-based professional learning: a pilot study. Educational technology research and development. 2025; 73(2): 1129-1154.