W niniejszym badaniu zintegrowano farmakologię sieciową, dokowanie molekularne, dynamikę molekularną oraz metodę MM-PBSA, aby określić priorytetowe potencjalne oddziaływania białkowe leków prolekowych pułapkujących miejsca abazyczne, reagujących na glutation w NSCLC. Związek 5 został wytypowany do dalszych badań w odniesieniu do MMP9 i SRC; pozostają one jednak kandydatami obliczeniowymi. Wyniki mają charakter generujący hipotezy i wymagają walidacji biochemicznej oraz komórkowej.
Artykuł badawczy
Priorytetyzacja in silico potencjalnych oddziaływań białkowych dla proleków pułapkujących miejsca abazyczne, reagujących na glutation, w niedrobnokomórkowym raku płuca
W tym artykule
Podsumowanie
Streszczenie
Niedrobnokomórkowy rak płuca (NSCLC) pozostaje główną przyczyną śmiertelności związanej z nowotworami, a skuteczność leczenia jest często ograniczona przez nabytą oporność oraz toksyczność systemową. Proleki pułapkujące miejsca abazyczne, reagujące na glutation, wykazały selektywną aktywność przeciwnowotworową w poprzednich badaniach eksperymentalnych, jednak nie ustalono jeszcze, czy ich uwolnione metabolity wykazują istotne oddziaływania z białkami istotnymi w przebiegu nowotworu. W niniejszej pracy zintegrowany schemat in silico, łączący farmakologię sieciową, dokowanie molekularne, dynamikę molekularną (MD) oraz analizę powierzchni powierzchniowej Poisson-Boltzmanna z mechaniką molekularną (MM-PBSA), został wykorzystany do priorytetyzacji testowalnych hipotez dotyczących oddziaływań białkowych dla dwóch proleków reagujących na glutation (Związek 1 i Związek 2), ich produktów zawierających grupę aminooksylową (Związek 4 i Związek 5) oraz dopasowanej pary kontrolnej niepułapkującej (Związek 3 i Związek 6). Zidentyfikowano dwadzieścia jeden wspólnych celów związanych ze związkami i chorobą, a na podstawie topologii oddziaływań białko-białko priorytetyzowano kinazę serynowo-treoninową 1 AKT (AKT1), receptor naskórkowego czynnika wzrostu (EGFR), czynnik martwicy nowotworów (TNF), metaloproteinazę macierzy 9 (MMP9) oraz nie receptorową kinazę tyrozynową protoonkogenu SRC (SRC). Związek 5 uzyskał najkorzystniejszą pojedynczą wartość AutoDock Vina dla MMP9 (-8.418 kcal·mol⁻1) i wykazał porównawczo trwałe pozy pochodzące z dokowania w trajektoriach MD dla MMP9 i SRC. Jednak najwyżej oceniona poza MMP9 nie wykazała bezpośredniej koordynacji katalitycznego jonu Zn2⁺ ani bezpośredniego zaangażowania His401, Glu402, His405 lub His411, zatem nie można jej przypisać kanonicznego trybu wiązania inhibicyjnego dla MMP9. Analizy MD i MM-PBSA charakteryzują jedynie zachowanie trajektorii i względny ranking energetyczny tych kompleksów; nie dowodzą one zaangażowania celu wewnątrzkomórkowego, inhibicji enzymatycznej ani regulacji szlaków. Ustanowiona aktywność pułapkująca miejsca abazyczne oraz nowo przewidziane oddziaływania białkowe są zatem traktowane jako oddzielne, potencjalnie równoległe hipotezy, a nie jako udowodowany łańcuch mechanistyczny. Podsumowując, wyniki priorytetyzują konkretne pary związek-cel do przyszłych testów, ale nie ustanawiają wielocelowego mechanizmu przeciwnowotworowego w NSCLC.
Wprowadzenie
Niedrobnokomórkowy rak płuca (NSCLC) jest najczęstszym podtypem histologicznym raka płuca i pozostaje główną przyczyną śmiertelności związanej z nowotworami na całym świecie1. Mimo znacznych postępów w terapii celowanej i onkologii precyzyjnej, długoterminowa skuteczność leczenia jest nadal często ograniczana przez nabytą oporność, ograniczoną trwałość odpowiedzi oraz toksyczność związaną z leczeniem2. Leki celowane w receptor naskórkowego czynnika wzrostu (EGFR) poprawiły wyniki u pacjentów wyselekcjonowanych molekularnie, jednak w trakcie leczenia niemal nieuchronnie rozwija się oporność, co stwarza pilną potrzebę opracowania strategii terapeutycznych działających poprzez alternatywne lub uzupełniające mechanizmy3,4. Konwencjonalna chemioterapia oparta na platynie pozostaje istotnym elementem leczenia, ale jej korzyść kliniczna jest ograniczona przez toksyczność kumulatywną i oporność podczas długotrwałego stosowania5,6. Wspólnie ograniczenia te podkreślają potrzebę zidentyfikowania środków przeciwnowotworowych, które są odmienne pod względem mechanistycznym i selektywnie aktywowane w środowisku guza.
Wśród endogennych uszkodzeń DNA miejsca abasyczne lub apyrimidinowe są niezwykle liczne i mają istotne znaczenie biologiczne, gdyż każdego dnia w każdej komórce powstają tysiące takich uszkodzeń7. Gdy te uszkodzenia nie są skutecznie naprawiane, mogą zostać przekształcone w pęknięcia nici, co może sprzyjać niestabilności genomicznej i śmierci komórki8,9. Endonukleaza apurynowa/apyrymidynowa 1 jest kluczowym enzymem w szlaku naprawy przez wycinanie zasad, ponieważ rozcina ona miejsca abasyczne i umożliwia dalsze etapy procesu naprawczego10,11. Ta zależność od procesu naprawy sprawiła, że uszkodzenia związane z miejscami abasycznymi stały się atrakcyjnym celem w opracowywaniu leków przeciwnowotworowych12. W oparciu o tę koncepcję opracowano wcześniej proleki pułapkujące miejsca abasyczne, reagujące na glutation, aby wykorzystać podwyższone stężenie glutationu w komórkach nowotworowych. Produkty aktywowane glutationem zawierają funkcjonalność aminooksy zdolną do pułapkowania aldehydowych miejsc abasycznych, a wcześniejsze prace eksperymentalne wykazały selektywną cytotoksyczność, zatrzymanie cyklu komórkowego oraz apoptozę w komórkach H129913. Dane te potwierdzają komponent pułapkowania uszkodzeń DNA w projekcie związku. Nie wykazują one jednak, że MMP9, SRC, EGFR, AKT1 lub TNF są regulowane w odpowiedzi na pułapkowanie miejsc abasycznych. W związku z tym każda interakcja z białkiem docelowym zidentyfikowana w niniejszej analizie obliczeniowej musi być traktowana jako osobna hipoteza, chyba że oba procesy zostaną wykazane w tym samym systemie biologicznym.
Niniejsze badanie zostało zaprojektowane w oparciu o to rozróżnienie. Pierwszym poziomem uzasadnienia biologicznego jest wcześniej opracowana chemia uwalniania zależna od glutationu oraz pułapkowanie miejsc abasycznych14. Drugim poziomem, badanym w niniejszej pracy, jest pytanie badawcze: czy macierzyste proleki lub ich uwolnione produkty są obliczeniowo kompatybilne z wybranymi białkami związanymi z nowotworami. W celu priorytetyzacji białek kandydackich wykorzystano farmakologię sieciową, a następnie przeprowadzono dokowanie, symulacje MD oraz analizy MM-PBSA w celu zbadania wybranych kompleksów białko-ligand15,16. Obliczenia te nie miały na celu wykazania, że przewidywane białka pośredniczą w znanym fenotypie uszkodzenia DNA, ani ustanowienia związku przyczynowego między pułapkowaniem miejsc abasycznych a sygnalizacją onkogenną. Zamiast tego, zastosowany schemat postępowania posłużył do wygenerowania uporządkowanego zbioru hipotez możliwych do zweryfikowania eksperymentalnie, które mogą zostać później ocenione za pomocą testów wiązania bezpośredniego, aktywności enzymatycznej, szlaków sygnałowych, uszkodzeń DNA oraz analiz fenotypowych.
Protokół
Zatwierdzenie przez instytucjonalną komisję bioetyczną nie było wymagane, ponieważ badanie miało charakter w pełni obliczeniowy i nie obejmowało udziału ludzi, kręgowców, biospekimenów pochodzących od pacjentów ani możliwych do zidentyfikowania danych osobowych. W związku z tym świadoma zgoda nie była wymagana. Wszystkie bazy danych, pakiety oprogramowania, pola siłowe i zasoby obliczeniowe wykorzystane w tym protokole są wymienione w Tabeli materiałów.
Badane związki i schemat analityczny
Jako cząsteczki badawcze wykorzystano wcześniej opisane związki pułapkujące miejsca abazowe, reagujące na glutation17. Związek 1 oraz Związek 2 wybrano jako macierzyste proleki, ponieważ rozszczepienie indukowane glutationem generuje odpowiednio produkty zawierające grupę aminooksy: Związek 4 i Związek 5. Związki 4 i 5 wybrano do analizy strukturalnej, ponieważ reprezentują one uwolnione gatunki, które zachowują reaktywną wobec miejsc abazowych grupę aminooksy. Związek 3 włączono jako dopasowaną strukturalną kontrolę reagującą na glutation; jego produkt rozszczepienia, Związek 6, nie posiada funkcjonalności aminooksy niezbędnej do kowalencyjnego pułapkowania aldehydów w miejscach abazowych. W związku z tym Związki 1–3 uwzględniono w odwróconej predykcji celu w celu porównania szkieletów macierzystych, Związki 4 i 5 oceniono pod kątem priorytetowych białek, a Związek 6 wykorzystano jako ligand kontrolny negatywny w porównaniu MD dla SRC. Trajektorię SRC–Związek 6 włączono, aby zapewnić dopasowany komparator strukturalny dla układu Związku 5 zawierającego grupę aminooksy, a nie jako dowód na to, że sama grupa aminooksy determinuje wiązanie z SRC. Struktury chemiczne i zależności aktywacyjne Związków 1–6 przedstawiono na Ryc. 1. Taki projekt celowo oddziela ugruntowaną chemię pułapkowania uszkodzeń DNA od obecnej analizy generującej hipotezy dotyczące możliwych oddziaływań z białkami.
Przewidywanie celów związanych ze związkiem
Struktury dwuwymiarowe Związku 1, Związku 2 i Związku 3 zostały zapisane w formacie MDL MOL, a następnie przekonwertowane na kanoniczne ciągi SMILES (simplified molecular-input line-entry system) przy użyciu programu Open Babel w wersji 3.1.1 z formatem wyjściowym kanonicznego SMILES18. Każdy wyeksportowany ciąg został ponownie zaimportowany, a zregenerowana struktura została wizualnie zweryfikowana z odpowiadającą jej strukturą dwuwymiarową przed przesłaniem do narzędzia SwissTargetPrediction, z ograniczeniem gatunkowym do Homo sapiens19. Zachowano przewidywane cele o niezerowych wartościach prawdopodobieństwa. Listy celów uzyskane dla trzech związków zostały połączone, usunięto duplikaty, a pozostałe cele zestandaryzowano zgodnie z oficjalnymi symbolami genów człowieka przed dalszą analizą. Zestandaryzowane pary związek-cel zostały zaimportowane do oprogramowania do wizualizacji i analizy sieci w formie tabeli sieciowej, w której związki i przewidywane cele reprezentowano jako węzły, a relacje związek-cel jako krawędzie, w celu wizualizacji przewidywanych zależności między celami20.
Wyszukiwanie celów związanych z chorobą i identyfikacja celów wspólnych
Cele związane z chorobą pobrano z bazy danych GeneCards, stosując termin wyszukiwania „lung cancer H1299”21. Zastosowano próg oceny istotności powyżej 0,27, aby zachować geny o silniejszym powiązaniu z tym zapytaniem. Symbole genów zostały ustandaryzowane, a powtarzające się wpisy usunięto ręcznie. Nakładanie się przewidzianych celów związku z celami związanymi z chorobą zidentyfikowano za pomocą internetowego narzędzia do analizy diagramów Venna/części wspólnych22. Do późniejszych analiz oddziaływań białko-białko (PPI), analizy wzbogacenia oraz priorytetyzacji celów zachowano wyłącznie cele wspólne.
Analiza oddziaływań białko-białko i przesiewanie kluczowych celów
Częściowo pokrywające się cele wprowadzono do narzędzia Search Tool for the Retrieval of Interacting Genes/Proteins (STRING) w wersji 11.5, ograniczając gatunki do Homo sapiens a minimalny wymagany wynik interakcji ustawiony na 0,40023Otrzymane dane dotyczące PPI zaimportowano do programu Cytoscape w wersji 3.10.0 w celu wizualizacji i analizy topologii. W ramach analizy topologii sieci dla każdego węzła w oryginalnej 21-węzłowej sieci PPI obliczono stopień (degree), centralność pośrednictwa (betweenness centrality) oraz centralność bliskości (closeness centrality); otrzymane wartości wykorzystano następnie do sekwencyjnego filtrowania w oparciu o medianę, opisanego poniżej24Miary centralności obliczono dla oryginalnej sieci PPI składającej się z 21 węzłów, a następnie wykorzystano je do sekwencyjnego filtrowania. Mediana stopnia oryginalnej sieci wynosiła 12 i zachowano węzły o stopniu ≥ 12, co pozwoliło wyłonić 13 kandydatów. Wśród tych 13 kandydatów mediana centralności pośrednictwa wyniosła 0,031293, a mediana centralności bliskości 0,769231. Drugi filtr zachował węzły o centralności pośrednictwa ≥ 0,031293 oraz centralności bliskości > 0,769231, co pozwoliło na wyłonienie pięciu kandydatów na węzły centralne (huby): AKT1, EGFR, TNF, MMP9 oraz SRC. Raportowane wartości centralności przeniesiono z oryginalnej sieci składającej się z 21 węzłów, zamiast obliczać je ponownie po wydzieleniu podzbioru. Wyłonione pięć kandydatów na węzły centralne wykorzystano do dalszej analizy strukturalnej. Oryginalne metryki topologiczne odnoszą się do nieskierowanej sieci PPI zawierającej 21 węzłów i 116 krawędzi.
Analiza wzbogacenia w oparciu o Gene Ontology oraz Kyoto Encyclopedia of Genes and Genomes
Wspólne cele poddano analizie wzbogacenia Gene Ontology (GO) oraz Kyoto Encyclopedia of Genes and Genomes (KEGG) przy użyciu bazy Database for Annotation, Visualization and Integrated Discovery (DAVID), ograniczając gatunek do Homo sapiens25. Wzbogacenie GO oceniano pod kątem procesów biologicznych (BP), składników komórkowych (CC) i funkcji molekularnych (MF), a także pod kątem szlaków sygnalizacyjnych KEGG. W tej analizie eksploracyjnej progiem włączenia służącym do zachowania wpisów o wzbogaceniu była nominalna wartość p < 0.10; skorygowane wartości p według metody Benjamini, wartości Bonferroniego, wskaźniki fałszywych odkryć (FDR) oraz wartości testu dokładnego Fishera zostały przedstawione w tabelach uzupełniających, ale nie były używane do zdefiniowania zbioru zachowanych elementów. Zachowane wpisy uszeregowano według nominalnej wartości p. Do późniejszej wizualizacji i interpretacji wybrano 20 najważniejszych szlaków KEGG oraz 10 najważniejszych terminów z każdej kategorii GO. Wykresy słupkowe i pęcherzykowe wygenerowano przy użyciu internetowego narzędzia do wizualizacji bioinformatycznej.
Przygotowanie receptorów i ligandów do dokowania molekularnego
Struktury krystaliczne wybranych białek pobrano z RCSB Protein Data Bank (PDB): AKT1, PDB ID 3O96; EGFR, PDB ID 5UWD; TNF, PDB ID 2AZ5; MMP9, PDB ID 1GKC oraz SRC, PDB ID 2H8H. Struktury białek wykorzystane do dokowania przygotowano w oprogramowaniu do wizualizacji molekularnej poprzez usunięcie współkrystalizowanych ligandów i cząsteczek wody, a następnie przetworzono w oprogramowaniu do przygotowania dokowania. W przypadku MMP9 osobno zachowano niemodyfikowaną kopię PDB 1GKC jako referencję krystalograficzną dla otoczenia katalitycznego Zn2⁺ oraz trybu wiązania N2-[(2R)-2-{[formyl(hydroxy)amino]methyl}-4-methylpentanoyl]-N,3-dimethyl-L-valinamide (NFH). W łańcuchu A 1GKC katalityczny Zn2⁺ jest koordynowany przez His401, His405 i His411 w odległościach odpowiednio 2,21, 2,23 i 2,22 Å, podczas gdy dwa atomy tlenu NFH koordynują Zn2⁺ w odległościach 2,07 i 2,38 Å; Glu402 jest katalitycznym resztą kwasowo-zasadową. Kontakty krystalograficzne te posłużyły jako pozytywna referencja strukturalna do oceny mapy oddziaływań dokowania Związku 5. Dla SRC do obliczeń MD dla SRC wykorzystano PDB 2H8H. Porównania strukturalne te służyły wyłącznie do interpretacji i nie były traktowane jako dowód inhibicji enzymu lub wiązania z celem wewnątrzkomórkowym.
Struktury trójwymiarowe Związku 4 i Związku 5 zostały pobrane z bazy PubChem i zoptymalizowane poprzez minimalizację energii w oprogramowaniu do modelowania molekularnego26. Ligandy zostały protonowane w warunkach fizjologicznych i zminimalizowane przy użyciu pola siłowego Merck molecular force field 94 (MMFF94) do momentu, aż gradient energii spadł poniżej 0,01 kcal·mol⁻1·Å⁻1. W oprogramowaniu do przygotowania dokowania dodano atomy wodoru, przypisano ładunki Gasteigera oraz zdefiniowano wiązania rotowalne. Związek 6, produkt rozszczepienia glutationowego kontrolnego Związku 3 (niepułapkującego), został przygotowany według tego samego schematu i zadokowany do SRC wyłącznie w celu wygenerowania pozy startowej dla trajektorii MD dopasowanej kontroli. Zatem Związek 6 nie został wprowadzony jako dodatkowy przewidywany ligand terapeutyczny ani nie był wykorzystywany do potwierdzenia mechanizmu wielocelowego.
Procedura dokowania molekularnego
Dokowanie molekularne przeprowadzono przy użyciu oprogramowania do dokowania molekularnego zgodnie z protokołem dokowania półelastycznego, w którym receptory pozostawały sztywne, a ligandy były elastyczne27,28. Dla każdego receptora środek pola dokowania (docking box) został ustawiony w pozycji ko-krystalizowanego ligandu, tak aby obszar przeszukiwania odpowiadał eksperymentalnie zdefiniowanej kieszeni wiążącej. Wymiary pola dokowania ustawiono na 24 Å × 24 Å × 24 Å dla AKT1, EGFR i SRC, 26 Å × 26 Å × 26 Å dla MMP9 oraz 28 Å × 28 Å × 28 Å dla TNF. Parametr exhaustiveness ustawiono na 32, liczbę generowanych póz na 20, a zakres energii na 4 kcal·mol⁻1. Do analizy oddziaływań wybrano najlepiej ocenioną konformację z każdego przebiegu dokowania.
Aby ocenić wewnętrzną wiarygodność konfiguracji dokowania, każdy ligand kokrystalizowany został ponownie zadokowany do odpowiadającej mu kieszeni receptora przy użyciu tych samych parametrów, przyjmując jako kryterium akceptacji średniokwadratowy odchylenie (RMSD) dla ciężkich atomów poniżej 2,0 Å. Końcowe pozy przeanalizowano w oprogramowaniu do wizualizacji molekularnej. W przypadku kompleksu MMP9–Związek 5, zachowana mapa oddziaływań została sprawdzona pod kątem bezpośredniej koordynacji liganda z katalitycznym jonem Zn2⁺ oraz kontaktów z His401, Glu402, His405 i His411, a pozycję liganda porównano z krystalograficzną pozą NFH w PDB 1GKC. Ilościowy dystans koordynacji metalu podawano tylko wtedy, gdy w zachowanej pozie widoczna była bezpośrednia koordynacja liganda z Zn2⁺; w przeciwnym razie oznaczano go jako nie dotyczy, zamiast go wnioskować. Zatem poza koordynacyjną pozą dokowania MMP9, której brakowało tych kanonicznych cech centrum katalitycznego, zaklasyfikowano jako niekanoniczną i nie interpretowano jej jako dowodu na inhibicję enzymatyczną MMP9. Bardziej ogólnie, wyniki AutoDock Vina oraz pozy dokowania wykorzystano do względnej priorytetyzacji i stawiania hipotez, a nie jako dowód powinowactwa wiązania lub oddziaływania z celem wewnątrzkomórkowym.
Protokół dynamiki molekularnej
Kompleksy białko-ligand wybrane do analizy MD skonstruowano na podstawie póz wiązania uzyskanych z dokowania. Obliczenia MD przeprowadzono przy użyciu oprogramowania GROMACS29. Białka sparametryzowano z wykorzystaniem pola siłowego CHARMM36, natomiast typy atomów i parametry ligandów przypisano za pomocą ogólnego pola siłowego Amber drugiej generacji (GAFF2)30,31. Częściowe ładunki metodą korekcji ładunku wiązania Austin Model 1 (AM1-BCC) wygenerowano za pomocą narzędzi do parametryzacji małych cząsteczek i generowania topologii ligandów; następnie oprogramowanie do generowania topologii ligandów stworzyło pliki topologii ligandów kompatybilne z GROMACS32,33,34. Każdy kompleks umieszczono w pudełku z wodą TIP3P z okresowymi warunkami brzegowymi, przy minimalnej odległości od substancji rozpuszczonej do krawędzi pudełka wynoszącej 1,0 nm. Aby zneutralizować ładunek netto w każdym układzie dodano jony sodu i chlorku, a następnie dodano dodatkowy NaCl w celu uzyskania końcowej siły jonowej 0,15 M.
Minimalizację energii przeprowadzono przy użyciu algorytmu najszybszego spadku do momentu, aż maksymalna siła spadła poniżej 1000 kJ·mol⁻1·nm⁻1. Zminimalizowane układy poddano następnie ekwilibracji w warunkach stałej liczby cząstek, ciśnienia i temperatury (NPT) w 310 K i 1 bar, stosując więzy pozycyjne dla szkieletu białka. Temperaturę kontrolowano za pomocą termostatu V-rescale, a ciśnienie za pomocą barostatu Parrinello-Rahman. Dalekosiężne oddziaływania elektrostatyczne obliczano metodą Particle Mesh Ewald. Odcięcie oddziaływań elektrostatycznych krótkiego zasięgu oraz odcięcie van der Waalsa ustawiono na 1,0 nm, a wszystkie wiązania obejmujące atomy wodoru ograniczono przy użyciu algorytmu LINCS (linear constraint solver). Trajektorie produkcyjne generowano przez 150 ns z krokiem czasowym integracji wynoszącym 2 fs, a współrzędne zapisywano co 10 ps do późniejszej analizy.
Analiza trajektorii
Analizy trajektorii przeprowadzono na zrównoważonych fragmentach trajektorii produkcyjnych. Wartości RMSD szkieletu białka oraz RMSD ligandu obliczono po dopasowaniu metodą najmniejszych kwadratów do początkowej konformacji referencyjnej. Wartości średniokwadratowych fluktuacji (RMSF) obliczono dla każdego aminokwasu z osobna, wykorzystując atomy Cα. Analizę wiązań wodorowych między każdym ligandem a jego receptorem przeprowadzono, stosując limit odległości donor-akceptor wynoszący 3.5 Å oraz limit kąta donor-wodór-akceptor wynoszący 30°. Obsadzalność wiązania wodorowego zdefiniowano jako proporcję analizowanych klatek, w których dane wiązanie wodorowe występowało. Metryki te wykorzystano do oceny stabilności strukturalnej, elastyczności na poziomie poszczególnych aminokwasów oraz trwałości kontaktów międzycząsteczkowych w trzech trajektoriach MD.
Obliczanie wolnej energii wiązania metodą powierzchniową Poisson-Boltzmanna w mechanice molekularnej (MM-PBSA)
Wolną energię wiązania obliczono metodą MM-PBSA z wykorzystaniem oprogramowania do analizy MM-PBSA na zrównoważonych fragmentach trajektorii MD35. Dla każdego kompleksu białko-ligand do analizy wolnej energii wykorzystano ostatnie 50 ns z 150 ns trajektorii produkcyjnej. Próbkowano łącznie 500 równomiernie rozmieszczonych klatek w odstępach 100 ps od 100,0 ns do 149,9 ns; punkt końcowy 150,0 ns został wyłączony z zestawu próbek. Całkowitą wolną energię wiązania obliczono jako sumę energii van der Waalsa, energii elektrostatycznej, energii solwatacji polarnej oraz energii solwatacji niepolarnej:
ΔG_bind = ΔE_vdW + ΔE_ele + ΔG_polar + ΔG_nonpolar (1)
Nie zastosowano korekty entropii. Średnie energie swobodne wiązania oraz odchylenia standardowe obliczono dla wszystkich próbkowanych klatek.
Kontrole powtarzalności i walidacji obliczeniowej
Wszystkie nazwy genów użyte w etapach przewidywania celu, wyszukiwania celów związanych z chorobą oraz analizy przecięcia zostały ustandaryzowane do oficjalnych symboli genów ludzkich przed przeprowadzeniem dalszych analiz. W odniesieniu do wszystkich par receptor-ligand utrzymano identyczne parametry dokowania. Poprawność konfiguracji dokowania sprawdzono technicznie poprzez ponowne dokowanie odpowiedniego liganda kokrystalizowanego do każdej kieszeni receptora, stosując te same ustawienia wyszukiwania oraz z góry określony próg akceptacji RMSD ciężkich atomów wynoszący <2.0 Å. Krystalograficzny kompleks MMP9–NFH zachowano jako pozytywną referencję strukturalną dla środowiska katalitycznego Zn2⁺, natomiast kompleks SRC–Compound 6 służył jako dopasowany komparator nietrapiący do analizy trajektorii SRC. Trajektorie MD sprawdzono pod kątem stabilności temperatury i ciśnienia oraz braku anormalnego dryfu objętości boxu przed włączeniem ich do kolejnych analiz. Wszystkie pliki wejściowe, struktury receptorów, pliki topologii ligandów, pliki konfiguracyjne dokowania, pliki parametrów MD oraz rekordy wyboru ramek MM-PBSA zostały zarchiwizowane w celu zapewnienia powtarzalności obliczeń.
Wyniki
Przewidywanie celów związanych z związkiem oraz identyfikacja celów wspólnych
Odwrócona predykcja celów dla związków 1–3 doprowadziła do wyłonienia 212 potencjalnych ludzkich celów. Równolegle, wyszukiwanie celów chorobowych w bazie GeneCards przy użyciu słowa kluczowego „lung cancer H1299” i progu wyniku istotności powyżej 0,27 zidentyfikowało 188 celów związanych z NSCLC. Analiza przecięcia między celami przewidzianymi dla związków a pulą celów związanych z chorobą wykazała 21 wspólnych celów, które zachowano do wszystkich dalszych analiz. Nakładanie się tych dwóch zestawów celów przedstawiono na Rysunku 2. Wyniki te wskazują, że badane związki skupiły się na ograniczonym podzbiorze celów istotnych dla choroby, a nie na rozproszonej, nieswoistej przestrzeni celów.
Analiza oddziaływań białko-białko i przesiewanie kluczowych celów
21 wspólnych celów zaimportowano do bazy STRING w celu skonstruowania sieci PPI. Powstała sieć składała się z 21 węzłów i 116 krawędzi. Wartości stopnia węzłów w Tabeli uzupełniającej 1 sumują się do 232, co jest zgodne z liczbą 116 krawędzi nieskierowanych. Dla tej pierwotnej sieci obliczono wartości centralności. Mediana stopnia wyniosła 12; zastosowanie kryterium stopnia ≥ 12 pozwoliło zachować 13 kandydatów. Wśród tych 13 kandydatów mediana centralności pośrednictwa wyniosła 0,031293, a mediana centralności bliskości wyniosła 0,769231. Zastosowanie centralności pośrednictwa ≥ 0,031293 wraz z centralnością bliskości > 0,769231 pozwoliło wytypować pięciu głównych kandydatów (hubów): AKT1, EGFR, TNF, MMP9 oraz SRC. Wartości przedstawione dla zachowanych podzbiorów są metrykami centralności z oryginalnej sieci 21 węzłów przeniesionymi podczas filtrowania; nie były one przeliczane dla podsieci 13-węzłowych lub 5-węzłowych. Ich centralność sieciowa została wykorzystana wyłącznie do uszeregowania kandydatów do późniejszej oceny opartej na strukturze i nie powinna być interpretowana jako dowód na to, że są one biologicznymi celami badanych związków. Tabela uzupełniająca 1, Tabela uzupełniająca 2 oraz Tabela uzupełniająca 3 przedstawiają odpowiednio metryki dla początkowej sieci 21 węzłów, 13 kandydatów zachowanych po pierwszym etapie przesiewowym oraz końcowych pięciu kandydatów-hubów. Sekwencyjne przesiewanie sieci PPI oraz końcowych pięciu kandydatów-hubów przedstawiono na Rysunku 3A, Rysunku 3B, Rysunku 3C, oraz Rysunku 3D.
Analiza wzbogacenia według Gene Ontology oraz Kyoto Encyclopedia of Genes and Genomes
Analiza wzbogacenia funkcjonalnego 21 wspólnych celów zidentyfikowała 121 ścieżek KEGG spełniających nominalne kryterium włączenia p < 0,10. 20 najwyżej ocenionych ścieżek przedstawiono na Rysunku 4A. Wśród nich szczególnie wyróżniały się oporność endokrynna, ścieżki nowotworowe, proteoglikany w nowotworach, oporność na inhibitory kinazy tyrozynowej EGFR oraz ścieżka sygnałowa ErbB. Ścieżki te są ściśle powiązane z proliferacją, przeżyciem, inwazją oraz opornością na leczenie w przypadku NSCLC. Pełne statystyki wzbogacenia dla wszystkich 121 zachowanych ścieżek KEGG spełniających nominalne p < 0,10 znajdują się w Tabeli uzupełniającej 4.
Analiza wzbogacenia GO zidentyfikowała ponadto 177 terminów BP, 29 terminów CC oraz 61 terminów MF spełniających to samo nominalne kryterium włączenia p < 0.10. 10 najwyżej ocenionych terminów z każdej kategorii przedstawiono na Rysunku 4B, Rysunku 4C, oraz Rysunku 4D. Dominujące procesy biologiczne obejmowały pozytywną regulację proliferacji komórek mięśni gładkich związanych z naczyniami, przejście G2/M cyklu komórkowego mitotycznego, sygnalizację receptora insulinopodobnego czynnika wzrostu, fosforylację białek, negatywną regulację apoptozy oraz transdukcję sygnału. Głównymi terminami komponentów komórkowych były jądro komórkowe, tratwa błonowa, adhezja ogniskowa, błona plazmatyczna oraz region telomerowy chromosomu. Z kolei najwyżej ocenione terminy funkcji molekularnych przedstawione na Rysunku 4D obejmowały aktywność kinazy białkowej, aktywność serynowej kinazy białkowej, wiązanie ATP, aktywność seryno-treoninowej kinazy białkowej, aktywność tyrozynowej kinazy białkowej, aktywność kinazy heptapeptydowych powtórzeń CTD polimerazy RNA II, aktywność kinazy, aktywność kinazy histonu H2AXY142, aktywność kinazy histonu H3Y41 oraz wiązanie białek identycznych. Pełne statystyki wzbogacenia dla BP, CC i MF podano w Tabeli uzupełniającej 5, Tabeli uzupełniającej 6 oraz Tabeli uzupełniającej 7. Łącznie wyniki wzbogacenia te wskazują, że przecięty zestaw celów jest skoncentrowany w procesach sygnalizacji, regulacji przeżycia i odpowiedzi onkogennej istotnych dla progresji NSCLC.
Priorytetyzacja kompleksów metabolit-cel w oparciu o dokowanie molekularne
Przeprowadzono dokowanie molekularne Związku 4 oraz Związku 5 z pięcioma białkami wybranymi na podstawie topologii sieci. Wartości przedstawione w Tabeli 1 to wyniki dokowania uzyskane w programie AutoDock Vina, a nie eksperymentalnie zmierzone wolne energie wiązania. Związek 5 uzyskał najkorzystniejszy pojedynczy wynik dla MMP9 (-8,418 kcal·mol⁻1), a następnie Związek 4 dla MMP9 (-7,840 kcal·mol⁻1). Związek 5 uzyskał również korzystniejsze wyniki niż Związek 4 dla AKT1 oraz EGFR, podczas gdy Związek 4 wypadł nieco lepiej dla SRC (-6,549 wobec -6,204 kcal·mol⁻1) i TNF (-5,436 wobec -5,299 kcal·mol⁻1). Zatem Związek 5 nie wykazał jednolitej przewagi w wynikach dla wszystkich pięciu białek. Wyniki dokowania wykorzystano wyłącznie do wytypowania reprezentatywnych kompleksów do dalszej analizy strukturalnej.
Reprezentatywne konformacje dokowania przedstawiono na Rysunku 5. Na mapie oddziaływań MMP9–Związek 5 o najwyższym rankingu wyświetlone kontakty znajdowały się w pobliżu Ala417 i Pro421, w odległościach wynoszących odpowiednio około 3,0 Å i 2,4 Å. Na zachowanej mapie oddziaływań dla najlepszej pozy nie odnotowano bezpośredniej koordynacji Związek 5-ZN2⁺, a także nie wykazano bezpośrednich kontaktów z His401, Glu402, His405 lub His411. Kontrastuje to z krystalograficzną referencją 1GKC, w której His401, His405 i His411 koordynują katalityczny ZN2⁺ w odległościach 2,21, 2,23 i 2,22 Å, a inhibitor z grupy odwrotnych hydroksamianów NFH koordynuje ten sam ZN2⁺ poprzez dwa atomy tlenu w odległościach 2,07 i 2,38 Å. Ponieważ na zachowanej mapie oddziaływań nie odnotowano bezpośredniej koordynacji Związek 5-ZN2⁺, nie przypisano żadnej odległości koordynacyjnej Związek 5-ZN2⁺; interpretuje się to jako brak wykazanej bezpośredniej koordynacji na zachowanej mapie, a nie jako zmierzoną wartość separacji metalu. Porównanie trójwymiarowe z krystalograficzną referencją MMP9–NFH przedstawiono na Rysunku uzupełniającym 1. Zatem geometria ta różni się od kanonicznego, zależnego od cynku trybu wiązania inhibicyjnego, a obecny wynik dokowania nie pozwala na zaklasyfikowanie Związku 5 jako inhibitora MMP9. MMP9 zachowano do analizy MD jedynie w celu ustalenia, czy ta specyficzna niekanoniczna geometria dokowania utrzymywała się podczas trajektorii. W przypadku pozostałych kompleksów Związek 5 wykazał przewidywane kontakty z AKT1 i SRC, natomiast Związek 4 utworzył również określone oddziaływania dokowania z MMP9 i SRC. Zgodnie z Rysunkiem 5F, obserwacje te opisują przewidywane oddziaływania i względne wyniki dokowania, a nie eksperymentalnie zweryfikowane powinowactwa.
Do analizy MD wybrano trzy kompleksy w celu porównawczym, a nie potwierdzającym. Kompleks MMP9–Compound 5 wybrano ze względu na najkorzystniejszy pojedynczy wynik dokowania, ale nienaturalną pozę MMP9, która wymagała ostrożnej analizy strukturalnej. Jako drugi kandydat na kompleks wybrano SRC–Compound 5, natomiast SRC–Compound 6 włączono jako dopasowaną trajektorię kontrolną bez pułapkowania. Odpowiadające im konformacje początkowe przedstawiono na Rysunku 6A, Rysunku 6B, oraz Rysunku 6C. Taki projekt umożliwił porównanie trwałości wybranych geometrii dokowania bez traktowania stabilności MD jako dowodu na zaangażowanie celu lub regulację funkcjonalną.
Analiza dynamiki molekularnej
Aby porównać trwałość wybranych geometrii pochodzących z dokowania w dynamicznych warunkach wodnych, wygenerowano trajektorie MD o długości 150 ns dla kompleksów MMP9–Związek 5 oraz SRC (PDB 2H8H)–Związek 5, przyjmując trajektorię SRC (PDB 2H8H)–Związek 6 jako dopasowaną kontrolę negatywną. Konformacje początkowe przedstawiono na Rysunku 6A, Rysunku 6B, oraz Rysunku 6C. W analizowanych trajektoriach Związek 5 wykazał niższe RMSD liganda (Rysunek 6D) w systemach MMP9 i SRC niż Związek 6 w SRC. Trajektoria MMP9–Związek 5 osiągnęła reżim o stosunkowo niskich fluktuacjach, trajektoria SRC–Związek 5 ustabilizowała się po początkowym okresie dostosowania, a trajektoria SRC–Związek 6 wykazała większe fluktuacje. Różnice te wskazują na większą trwałość wybranych póz dokowania Związku 5 podczas symulacji MD. Nie dowodzą one jednak, że Związek 5 wiąże MMP9 lub SRC w komórkach, a trajektoria MMP9 nie niweluje braku kanonicznej oddziaływania z katalitycznym ZN2⁺ w pozie początkowej.
Wartości RMSD szkieletu białkowego wykazały podobny wzorzec porównawczy. Trajektoria MMP9–Compound 5 weszła w relatywnie stabilny reżim szkieletu po około 30 ns, podczas gdy trajektoria SRC–Compound 5 wykazała późniejsze plateau, a trajektoria SRC–Compound 6 charakteryzowała się większymi fluktuacjami. Obserwacje te opisują wyłącznie zachowanie trajektorii. Stabilna trajektoria szkieletu białkowego lub ligandu nie może potwierdzić wewnątrzkomórkowego zajęcia celu, inhibicji enzymu ani modulacji sygnalizacji. Profile RMSD szkieletu białkowego dla wszystkich trzech układów przedstawiono na Rysunku uzupełniającym 2.
Analiza trajektorii
Do opisania trwałości kontaktów w trajektoriach MD wykorzystano analizy zajmowania wiązań wodorowych oraz fluktuacji reszt aminokwasowych (Rysunek 7A). Związek 5 wykazał wysoką zajętość wiązania wodorowego z Arg95 w trajektorii MMP9 (>85%) oraz powtarzającą się interakcję z Leu325 w trajektorii SRC (>70%), podczas gdy reprezentatywne kontakty w kontroli SRC–Związek 6 charakteryzowały się niższą zajętością. Reszty te nie są przedstawione jako dowód na funkcjonalną modulację celu; wartości zajętości wskazują jedynie, jak często określone kontakty występowały podczas analizowanych trajektorii.
Analiza RMSF reszt w kieszeni wiążącej wykazała różnice w lokalnej elastyczności specyficzne dla danego układu (Rysunek 7B). Trajektoria SRC–Związek 6 wykazała kilka większych fluktuacji lokalnych niż trajektoria SRC–Związek 5, podczas gdy trajektoria MMP9–Związek 5 wykazała porównawczo ograniczony profil fluktuacji w obrębie własnego zestawu reszt kieszeni wiążącej. Ponieważ MMP9 i SRC są różnymi białkami, ich wartości RMSF na poziomie reszt nie były interpretowane jako bezpośrednie porównanie reszta po reszcie. Wraz z zajętością wiązań wodorowych, wyniki te charakteryzują trwałość kontaktu i lokalną elastyczność, pomagając w priorytetyzacji kompleksów do testów eksperymentalnych. Nie ustalają one MMP9 ani SRC jako celów wewnątrzkomórkowych ani nie dowodzą, że którekolwiek z tych białek pośredniczy w fenotypie przeciwnowotworowym związków.
Obliczanie wolnej energii wiązania metodą powierzchniowej powierzchni Poisson-Boltzmanna w mechanice molekularnej
Szacunki MM-PBSA obliczone z segmentów trajektorii po osiągnięciu stanu równowagi przedstawiono na Rysunku 8. Kompleks MMP9–Związek 5 dał szacunkową wartość ΔG_bind wynoszącą -19,65 ± 6,43 kcal·mol⁻1, kompleks SRC–Związek 5 dał -17,72 ± 6,84 kcal·mol⁻1, a kontrolny kompleks SRC–Związek 6 dał -10,37 ± 5,61 kcal·mol⁻1. W ramach niniejszego protokołu obliczeniowego względna hierarchia energetyczna wynosiła zatem: MMP9–Związek 5, następnie SRC–Związek 5 i SRC–Związek 6. Wartości te są szacunkami zależnymi od metody, wyprowadzonymi z ograniczonego segmentu trajektorii, i nie zastosowano w nich korekty entropii. Zostały one zatem wykorzystane wyłącznie do porównań wewnątrz badania i nie powinny być interpretowane jako eksperymentalnie zmierzone powinowactwa wiązania ani jako dowód na funkcjonalną modulację białka.
W analizach dokowania, MD, zajętości kontaktów (contact-occupancy), fluktuacji reszt oraz MM-PBSA, Związek 5 został priorytetyzowany obliczeniowo do dalszych badań w kompleksach MMP9 i SRC. Zgodność tych obliczeń wzmacnia uzasadnienie wyboru tych par do kolejnych eksperymentów, jednak nie potwierdza ona, że MMP9 lub SRC są bezpośrednimi celami wewnątrzkomórkowymi. W szczególności niekanoniczna poza MMP9 oraz brak wykazanej koordynacji katalitycznego ZN2⁺ uniemożliwiają wnioskowanie o kanonicznym mechanizmie hamowania MMP9 na podstawie obecnych danych strukturalnych.
Wnioski wynikające z otrzymanych rezultatów
Przepływ obliczeniowy pozwolił na wyselekcjonowanie 21 nakładających się celów związanych z chorobą oraz zidentyfikowanie AKT1, EGFR, TNF, MMP9 i SRC jako potencjalnych węzłów topologicznych (hubs). Analizy oparte na strukturach pozwoliły dodatkowo wyróżnić Związek 5 do dalszych badań eksperymentalnych w kompleksach MMP9 i SRC. Wyniki te nie wykazują bezpośredniego oddziaływania na cele, hamowania MMP9 lub SRC, regulacji szlaków sygnałowych ani przyczynowego związku mechanistycznego między oddziaływaniami białek a wcześniej ustalonym efektem pułapkowania miejsc abasycznych. Badanie to wspiera zatem zestaw sprawdzalnych hipotez obliczeniowych, a nie eksperymentalnie potwierdzony wielocelowy mechanizm przeciwrodzajowy w NSCLC.
DOSTĘPNOŚĆ DANYCH:
Zbiór danych wspierający wyniki niniejszego badania jest publicznie dostępny w: Wang X, Peng Z, Xing Y, Xue L. In silico prioritization of potential protein interactions for glutathione-responsive abasic site-trapping prodrugs in non-small cell lung cancer [dataset]. Figshare; 2026. doi:10.6084/m9.figshare.33313620.v1.
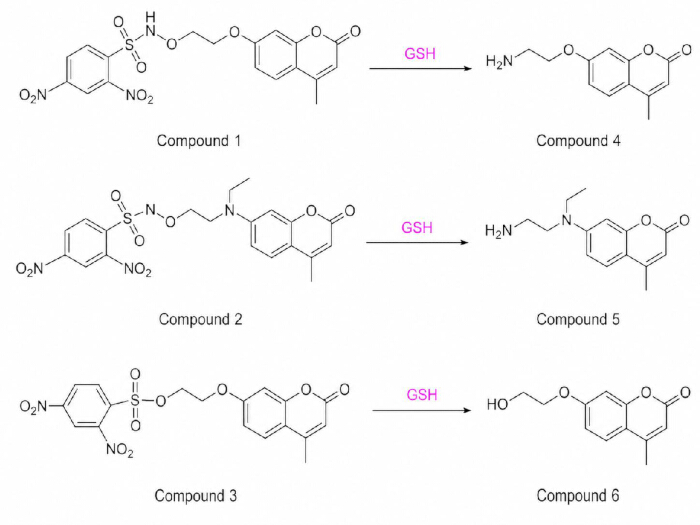
Rysunek 1: Struktury chemiczne i zależności konwersji indukowanej przez glutation badanych związków. Związek 1 i związek 2 to proleki reagujące na glutation, które uwalniają odpowiednio zawierające grupę aminooksy metabolity: związek 4 i związek 5. Związek 3 jest dopasowaną kontrolą strukturalną reagującą na glutation, która generuje związek 6, pozbawiony funkcjonalności pułapkowania miejsc abazycznych za pomocą grupy aminooksy. Związki 1–3 zostały wykorzystane do odwrotnej predykcji celu, związki 4 i 5 do dokowania do celu centralnego (hub-target), a związek 6 jako ligand kontrolny w porównaniu dynamiki molekularnej SRC. Skróty: SRC, protoonkogen SRC, nie receptorowa kinaza tyrozynowa. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
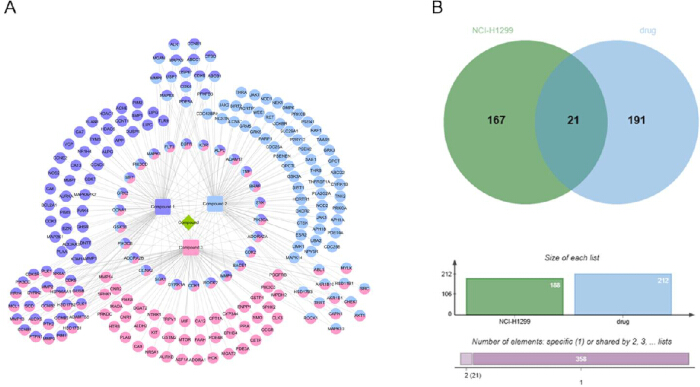
Rycina 2: Przecięcie między celami przewidzianymi dla związków a celami związanymi z niedrobnokomórkowym rakiem płuca. (A) Sieć związków i celów wygenerowana na podstawie wyników odwrotnego przewidywania celów dla związków 1–3. (B) Diagram Venna pokazujący nakładanie się celów przewidzianych dla związków i celów związanych z chorobą, pobranych za pomocą zapytania dotyczącego raka płuca H1299. 21 wspólnych celów zachowano do analizy oddziaływań białko-białko, analizy wzbogacenia oraz późniejszej priorytetyzacji opartej na strukturze. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
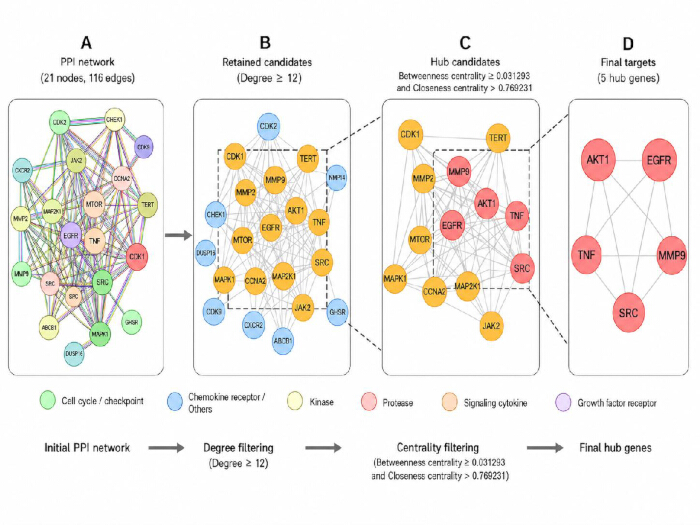
Rysunek 3: Sieć oddziaływań białko-białko i przesiewanie kluczowych celów. (A) Sieć oddziaływań białko-białko dla 21 wspólnych celów (116 krawędzi). (B) Pierwszy etap przesiewania z zastosowaniem parametru Degree ≥ 12, który pozwolił na wyłonienie 13 kandydatów. (C) Drugi etap przesiewania 13 wybranych kandydatów z zastosowaniem centralności pośrednictwa (betweenness centrality) ≥ 0,031293 i centralności bliskości (closeness centrality) > 0,769231, co pozwoliło uzyskać pięciu kandydatów na węzły centralne (huby). (D) Ostatecznych pięciu kandydatów na węzły centralne: AKT1, EGFR, TNF, MMP9 oraz SRC. Wartości centralności wykorzystane w sekwencyjnych filtrach obliczono dla pierwotnej sieci składającej się z 21 węzłów i 116 krawędzi i przeniesiono bezpośrednio, zamiast przeliczać je po utworzeniu każdego podzbioru. Skróty: AKT1, kinaza seryno-treoninowa 1; EGFR, receptor epidermalnego czynnika wzrostu; TNF, czynnik martwicy nowotworu; MMP9, metaloproteinaza macierzy 9; SRC, protoonkogen SRC, niereceptorowa kinaza tyrozynowa. Prosimy kliknąć tutaj, aby wyświetlić większą wersję tego rysunku.
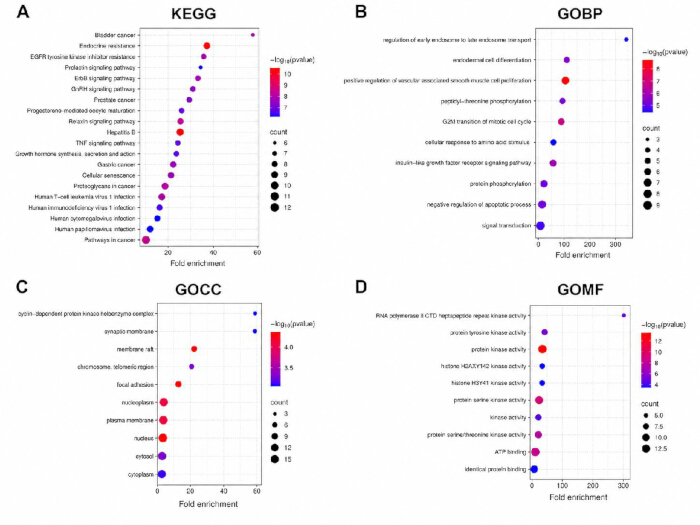
Rysunek 4: Analiza wzbogacenia funkcjonalnego dla wspólnych celów. (A) Wykres bąbelkowy 20 najlepiej wzbogaconych ścieżek Kyoto Encyclopedia of Genes and Genomes. (B) Wykres słupkowy 10 najlepiej wzbogaconych terminów procesu biologicznego Gene Ontology. (C) Wykres słupkowy 10 najlepiej wzbogaconych terminów składnika komórkowego Gene Ontology. (D) Wykres słupkowy 10 najlepiej wzbogaconych terminów funkcji molekularnej Gene Ontology. Wartość wzbogacenia (fold enrichment) jest przedstawiona na osi x w końcowej wizualizacji; rozmiar bąbelka w panelu A odzwierciedla liczbę genów. Wszystkie wpisy KEGG i GO zawarte w Tabelach Uzupełniających 4–7 spełniły nominalne kryterium włączenia p < 0,10; na wykresach przedstawiono ścieżki/terminy o najwyższym rankingu według nominalnej wartości p. W tabelach uzupełniających podano wartości skorygowane pod kątem wielokrotnego testowania, jednak nie były one używane do włączenia danych. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
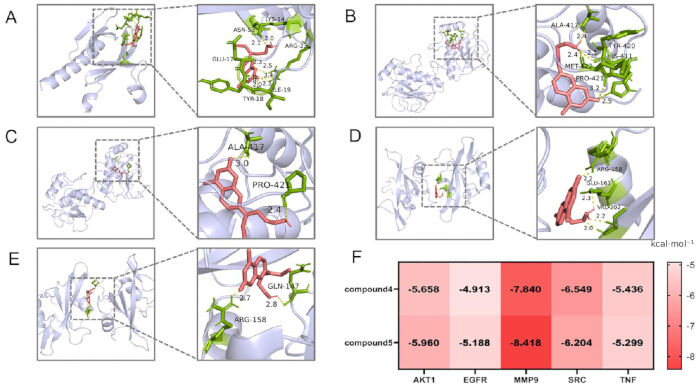
Rysunek 5: Pozycje dokowania molekularnego i wyniki AutoDock Vina dla Związku 4 i Związku 5 z uprzednimi białkami. (A) Przewidywana pozycja dokowania Związku 5 z AKT1. (B) Przewidywana pozycja dokowania Związku 4 z MMP9. (C) Najwyżej oceniana przewidywana pozycja Związku 5 z MMP9; wyświetlone kontakty znajdują się w pobliżu Ala417 i Pro421, natomiast nie zaznaczono bezpośredniej koordynacji katalitycznego ZN2⁺ ani bezpośredniego kontaktu z His401, Glu402, His405 lub His411. Pozycja ta nie jest zatem prezentowana jako kanoniczny tryb wiązania hamującego MMP9. Porównanie z referencyjną mapą oddziaływań ze strukturą krystaliczną MMP9 związanego z NFH (PDB 1GKC), zawierające krystalograficzne odległości koordynacji ZN2⁺, znajduje się na Rysunku uzupełniającym 3. (D) Przewidywana pozycja dokowania Związku 4 z SRC. (E) Przewidywana pozycja dokowania Związku 5 z SRC. (F) Mapa ciepła wyników dokowania AutoDock Vina (kcal·mol⁻1) dla Związku 4 i Związku 5 w odniesieniu do pięciu uprzednich białek. Bardziej ujemne wartości wskazują na korzystniejsze wyniki Vina w ramach tego protokołu dokowania; nie są one eksperymentalnie zmierzonymi powinowactwami wiązania. Skróty: AKT1, kinaza serynowo-treoninowa 1; MMP9, metaloproteinaza macierzy 9; NFH, N2-[(2R)-2-{[formylo(hydroksy)amino]metylo}-4-metylo-pentanoylo]-N,3-dimetylo-L-walinamid; SRC, protoonkogen SRC, niereceptoryna kinaza tyrozynowa; PDB, Protein Data Bank; Ala, alanina; Pro, prolina; His, histydyna; oraz Glu, glutaminian. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
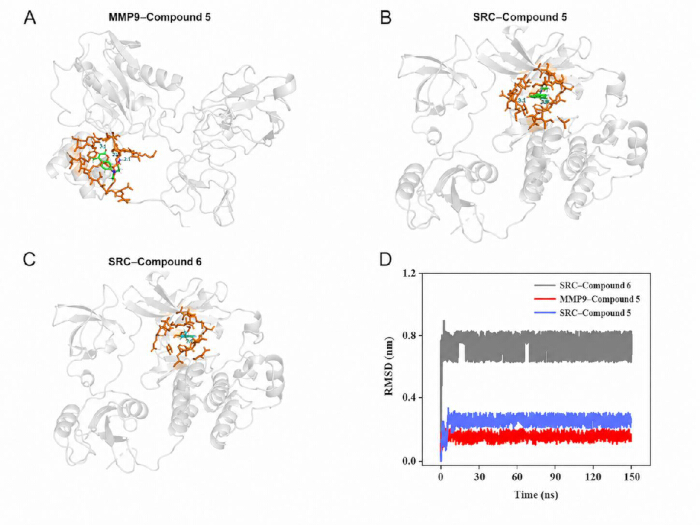
Rysunek 6: Przegląd strukturalny i analiza stabilności ligandów w kompleksach MD. (A) Początkowa konformacja dokowania Związku 5 z MMP9, wykorzystana jako struktura wyjściowa do symulacji MD. (B) Początkowa konformacja dokowania Związku 5 z SRC (PDB 2H8H). (C) Początkowa konformacja dokowania Związku 6 z SRC (PDB 2H8H); Związek 6 jest produktem rozszczepienia glutationowego kontrolnego Związku 3 i nie posiada funkcjonalności pułapkowania miejsca abazycznego za pomocą grupy aminooksylowej. (D) Średnia kwadratowa odchyłka (RMSD) ligandu względem początkowej pozy dokowania w trajektoriach 150 ns dla MMP9–Związek 5, SRC–Związek 5 oraz SRC–Związek 6. Panel porównuje trwałość pozy podczas MD i nie wykazuje wiązania z celem wewnątrzkomórkowym. Skróty: MD, dynamika molekularna; MMP9, metaloproteinaza macierzy 9; SRC, protoonkogen SRC, nie receptorowa tyrozynowa kinaza; PDB, Protein Data Bank; RMSD, średnia kwadratowa odchyłka. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
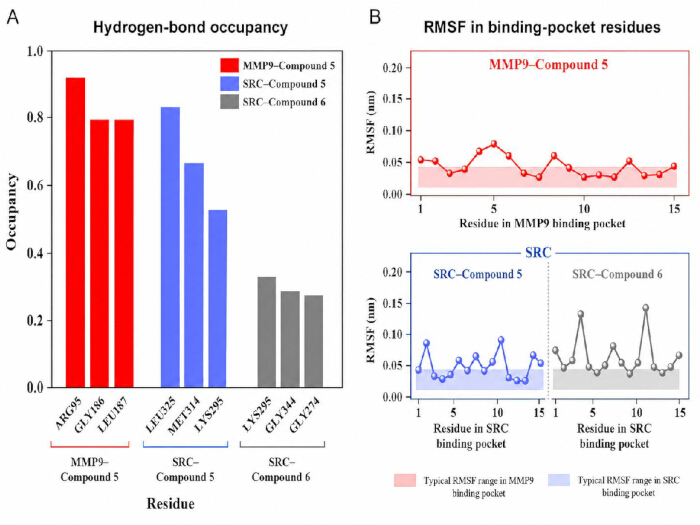
Rysunek 7: Cechy dynamicznych oddziaływań podczas analizy dynamiki molekularnej. (A) Częstość występowania reprezentatywnych wiązań wodorowych ligand-białko podczas trajektorii 150 ns dla MMP9–Związek 5, SRC–Związek 5 oraz SRC–Związek 6. (B) Średniokwadratowe odchylenie fluktuacji (RMSF) reszt w kieszeni wiążącej. Profil MMP9 jest interpretowany w obrębie układu MMP9, podczas gdy profile SRC–Związek 5 i SRC–Związek 6 stanowią bezpośrednie porównanie w obrębie SRC. Analizy te opisują trwałość kontaktów i lokalną elastyczność podczas MD i nie wykazują wewnątrzkomórkowego wiązania z celem ani funkcjonalnej modulacji MMP9 lub SRC. Skróty: MD, dynamika molekularna; MMP9, metaloproteinaza macierzy 9; SRC, protoonkogen SRC, niereceptorowa kinaza tyrozynowa; RMSF, średniokwadratowe odchylenie fluktuacji. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
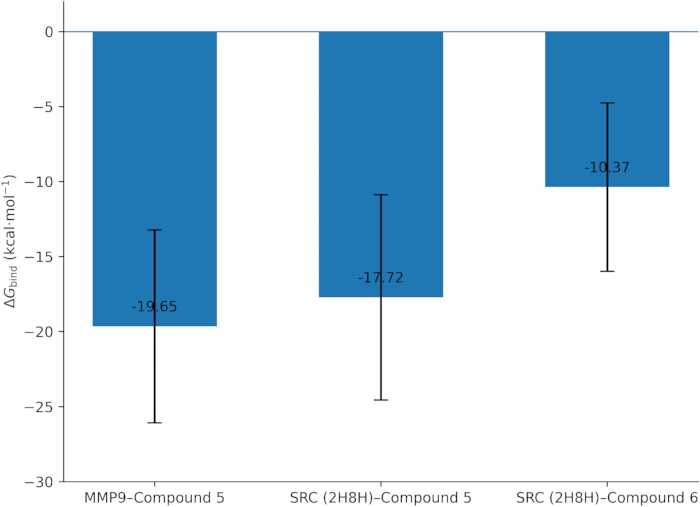
Rysunek 8: Szacunki energetyczne metodą powierzchni obszaru Poisson-Boltzmanna w mechanice molekularnej dla analizowanych kompleksów. Szacunkowe wartości ΔG_bind uzyskane metodą powierzchni obszaru Poisson-Boltzmanna w mechanice molekularnej z wyrównanych segmentów trajektorii kompleksów MMP9–Związek 5, SRC (PDB 2H8H)–Związek 5 oraz SRC (PDB 2H8H)–Związek 6. Wartości przedstawiono jako średnia ± odchylenie standardowe; służą one do względnego porównania w ramach badania, a nie jako eksperymentalnie zmierzone powinowactwa wiązania. Rysunek 8 wykorzystuje etykietę osi y ΔG_bind (kcal·mol⁻1), zgodnie z równaniem i terminologią użytą w sekcjach Metody i Wyniki. Skróty: MMP9, metaloproteinaza macierzy 9; SRC, protoonkogen SRC, niereceptorowa kinaza tyrozynowa; PDB, Protein Data Bank; ΔG_bind, swobodna energia wiązania; MM-PBSA, powierzchnia obszaru Poisson-Boltzmanna w mechanice molekularnej. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
| Związek | AKT1 (kcal·mol⁻¹) | EGFR (kcal·mol⁻¹) | MMP9 (kcal·mol⁻¹) | SRC (kcal·mol⁻¹) | TNF (kcal·mol⁻¹) |
| Związek 4 | -5.658 | -4.913 | -7.840 | -6.549 | -5.436 |
| Związek 5 | -5.960 | -5.188 | -8.418 | -6.204 | -5.299 |
Tabela 1: Wyniki dokowania AutoDock Vina dla Związku 4 i Związku 5 względem pięciu priorytetowych białek. Wyniki dokowania AutoDock Vina (kcal·mol⁻1) dla Związku 4 i Związku 5 z AKT1, EGFR, MMP9, SRC i TNF. Bardziej ujemne wartości wskazują na korzystniejsze wyniki w ramach określonego protokołu dokowania. Wartości te są wynikami obliczeniowymi i nie powinny być opisywane jako eksperymentalnie zmierzone wolne energie wiązania lub powinowactwa. Skróty: AKT1, kinaza serynowo-treoninowa 1; EGFR, receptory czynnika wzrostu naskórka; MMP9, metaloproteinaza macierzy 9; SRC, protoonkogen SRC, nie receptorowa kinaza tyrozynowa; TNF, czynnik martwicy nowotworu.
Rycina uzupełniająca 1: Porównanie strukturalne krystalograficznego wzorca MMP9–NFH oraz najlepiej ocenionej pozy dockingowej MMP9–Związek 5. (A) Otoczenie katalitycznego jonu Zn2⁺ w kompleksie referencyjnym MMP9–NFH (PDB 1GKC), przedstawiające His401, His405, His411, Glu402 oraz zaznaczone odległości koordynacyjne NFH. (B) Najlepiej oceniona pozy dockingowa Związku 5, przedstawiająca zaznaczone kontakty z Ala417 i Pro421. (C) Alternatywny widok trójwymiarowy tej samej pozy dockingowej Związku 5. Porównanie służy jako odniesienie strukturalne i nie dowodzi inhibicji MMP9. Skróty: MMP9, metaloproteinaza macierzy 9; NFH, N2-[(2R)-2-{[formylo(hydroksy)amino]metylo}-4-metylopentanoylo]-N,3-dimetylo-L-walinamid; PDB, Protein Data Bank; Ala, alanina; Pro, prolina; His, histydyna; Glu, glutaminian.Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 2: Średnio kwadratyczne odchylenie (RMSD) szkieletu białkowego podczas analizy dynamiki molekularnej. Profile średnio kwadratycznego odchylenia szkieletu białkowego dla układów MMP9–Związek 5, SRC (PDB 2H8H)–Związek 5 oraz SRC (PDB 2H8H)–Związek 6 w pełnym zakresie trajektorii dynamiki molekularnej. Na ostatnim wykresie zastosowano ustandaryzowane etykiety MMP9–Związek 5, SRC–Związek 5 oraz SRC–Związek 6, a osie opisano jako RMSD (nm) i Time (ns). Profile opisują zależne od czasu zachowanie konformacyjne podczas MD i nie powinny być interpretowane jako dowód wiązania komórkowego lub regulacji białek. Skróty: MMP9, metaloproteinaza macierzy 9; SRC, protoonkogen SRC, nie receptorowa kinaza tyrozynowa; PDB, Protein Data Bank; RMSD, średnio kwadratyczne odchylenie; MD, dynamika molekularna.Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 3: Porównanie otoczenia katalitycznego ZN2⁺ w kompleksie referencyjnym 1GKC-NFH oraz najlepiej ocenionej pozie dokowania Związku 5. W krystalograficznym kompleksie referencyjnym MMP9–NFH (PDB 1GKC) pozostałości His401, His405 i His411 koordynują katalityczny ZN2⁺ w odległościach odpowiednio 2,21, 2,23 i 2,22 Å, a dwa atomy tlenu NFH koordynują ZN2⁺ w odległościach 2,07 i 2,38 Å; Glu402 jest katalityczną pozostałością kwasowo-zasadową. W przeciwieństwie do tego, zachowana mapa oddziaływań dla najlepiej ocenionego Związku 5 wykazuje kontakty z Ala417 (3,0 Å) i Pro421 (2,4 Å), ale nie wykazuje adnotowanej bezpośredniej koordynacji ZN2⁺ ani bezpośrednich kontaktów z His401, Glu402, His405 lub His411. W związku z tym nie przypisano odległości koordynacji Związek 5-ZN2⁺. Porównanie to wspiera klasyfikację pozy Związku 5 jako niekanonicznego przewidywanego powiązania, a nie kanonicznego, cynkozależnego trybu wiązania hamującego. Skróty: MMP9, metaloproteinaza macierzy 9; PDB, Protein Data Bank; Ala, alanina; Pro, prolina; His, histydyna; Glu, glutaminian.Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 1: Metryki topologiczne dla początkowej sieci oddziaływań białko-białko składającej się z 21 węzłów i 116 krawędzi. Parametry topologiczne dla wszystkich 21 węzłów celów przecinających przed przesiewaniem opartym na centralności, w tym średnia długość najkrótszej ścieżki, centralność pośrednictwa, centralność bliskości, współczynnik grupowania, stopień, ekscentryczność, łączność sąsiedztwa, radialność, stres oraz współczynnik topologiczny. Suma stopni węzłów wynosi 232, co odpowiada 116 krawędziom nieskierowanym.Prosimy kliknąć tutaj, aby pobrać ten plik.
Tabela uzupełniająca 2: Metryki topologiczne sieci pierwotnej dla 13 kandydatów pozostawionych po screeningu opartym na stopniu węzła. Parametry topologiczne dla 13 węzłów pozostawionych po zastosowaniu kryterium stopnia do początkowej sieci składającej się z 21 węzłów i 116 krawędzi. Wartości te są metrykami z pierwotnej sieci (21 węzłów, 116 krawędzi), przeniesionymi do kolejnego etapu filtrowania według centralności pośrednictwa (betweenness) i centralności bliskości (closeness); nie zostały one ponownie obliczone dla podsieci składającej się z 13 węzłów.Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 3: Topologiczne metryki oryginalnej sieci dla pięciu końcowych kandydatów na huby zachowanych po sekwencyjnym filtrowaniu. Topologiczne parametry oryginalnej sieci składającej się z 21 węzłów i 116 krawędzi dla pięciu końcowych kandydatów na huby: AKT1, EGFR, TNF, MMP9 i SRC, zachowanych po sekwencyjnym filtrowaniu. Przeniesione wartości te służą wyłącznie priorytetyzacji opartej na sieci i nie stanowią metryk obliczonych ponownie dla podsieci pięciu węzłów ani nie potwierdzają tych białek jako eksperymentalnie zwalidowanych celów terapeutycznych. Skróty: AKT1, kinaza serynowo-treoninowa 1; EGFR, receptor epidermalnego czynnika wzrostu; TNF, czynnik martwicy nowotworu; MMP9, metaloproteinaza macierzy 9; SRC, protoonkogen SRC, niereceptorowa kinaza tyrozynowa.Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 4: Pełne wyniki wzbogacenia w bazie Kyoto Encyclopedia of Genes and Genomes dla 121 szlaków spełniających nominalne kryterium włączenia p < 0,10. Pełne statystyki wzbogacenia Kyoto Encyclopedia of Genes and Genomes dla wszystkich 121 zachowanych szlaków spośród 21 przecinających się celów (nominalne p < 0,10), w tym stosunek genów, liczba genów, sumy list, trafienia w populacji, sumy populacji, wartości p, wartości Benjamini, stopień wzbogacenia, wartości Bonferroni, wskaźniki fałszywych odkryć oraz wartości dokładnego testu Fishera. 20 najwyżej sklasyfikowanych szlaków przedstawiono na rysunku 4A. Kryterium nominalnej wartości p definiowało włączenie; wartości Benjamini, Bonferroni i wskaźniki fałszywych odkryć podano dla przejrzystości i nie były one używane do zdefiniowania zestawu zachowanych szlaków.Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 5: Pełne wyniki wzbogacania procesów biologicznych Gene Ontology (177 terminów spełniających kryterium nominalne p < 0,10). Pełne statystyki wzbogacania dla wszystkich 177 zachowanych terminów procesów biologicznych Gene Ontology (nominalne p < 0,10), obejmujące stosunek genów, liczbę genów, sumę listy, trafienia w populacji, sumę populacji, wartość p, wartość Benjamini, krotność wzbogacenia, wartość Bonferroni, wskaźnik fałszywych odkryć oraz wartość dokładnego testu Fishera. 10 najwyżej sklasyfikowanych terminów przedstawiono na Rysunku 4B. Kryterium nominalnej wartości p określało włączenie do analizy; wartości skorygowane podano w celu zapewnienia przejrzystości i nie były one wykorzystywane do zdefiniowania zestawu zachowanych terminów.Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 6: Pełne wyniki wzbogacenia komponentów komórkowych Gene Ontology (29 terminów spełniających nominalne p < 0,10). Pełne statystyki wzbogacenia dla wszystkich 29 zachowanych terminów komponentów komórkowych Gene Ontology (nominalne p < 0,10), w tym stosunek genów, liczba genów, suma listy, trafienia w populacji, suma populacji, wartość p, wartość Benjamini, stopień wzbogacenia (fold enrichment), wartość Bonferroniego, wskaźnik fałszywych odkryć (FDR) oraz wartość dokładnego testu Fishera. 10 najwyżej sklasyfikowanych terminów przedstawiono na Ryc. 4C. Kryterium nominalnej wartości p definiowało włączenie do analizy; wartości skorygowane podano w celu zapewnienia przejrzystości i nie były one używane do zdefiniowania zbioru zachowanych terminów.Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 7: Pełne wyniki wzbogacenia funkcji molekularnych Gene Ontology (61 terminów spełniających nominalne p < 0,10). Pełne statystyki wzbogacenia dla wszystkich 61 zachowanych terminów funkcji molekularnych Gene Ontology (nominalne p < 0,10), w tym stosunek genów, liczba genów, suma listy, trafienia w populacji, suma populacji, wartość p, wartość Benjamini, krotność wzbogacenia, wartość Bonferroni, wskaźnik fałszywych odkryć oraz wartość dokładnego testu Fishera. 10 najwyżej sklasyfikowanych terminów przedstawiono na Ryc. 4D. Kryterium nominalnej wartości p określało włączenie do analizy; wartości skorygowane podano w celu zapewnienia przejrzystości i nie były one używane do zdefiniowania zestawu zachowanych terminów.Prosimy kliknąć tutaj, aby pobrać ten plik.
Dyskusja
Niniejsze badanie należy interpretować w ramach dwupoziomowego mechanizmu. Pierwszy poziom jest poparty wcześniejszymi pracami eksperymentalnymi: aktywacja zależna od glutationu uwalnia gatunek zawierający grupę aminooksy, która może wychwytywać aldehydowe miejsca abazyczne, a ta klasa związków wykazała selektywną cytotoksyczność, wpływ na cykl komórkowy oraz indukcję apoptozy w komórkach H1299. Drugi poziom ma charakter eksploracyjny i stanowi główny cel obecnej pracy: obliczeniowe przewidywanie celów oraz analizy strukturalne sugerują, że ta sama seria chemiczna może być również kompatybilna z wybranymi białkami powiązanymi z nowotworami. Żaden eksperyment w niniejszym badaniu nie dowodzi, że przewidywane interakcje białkowe zachodzą w komórkach ani że są one następstwem wychwytywania miejsc abazycznych. W związku z tym dwa te poziomy zostały celowo rozdzielone, zamiast łączyć je w udowodniony mechanizm wielocelowy.
Na poziomie sieciowym, 21 przecinających się celów było wzbogaconych w szlaki związane z rakiem i opornością, a AKT1, EGFR, TNF, MMP9 oraz SRC zajmowały centralne pozycje w sieci PPI. Wyniki te są przydatne do priorytetyzacji kandydatów, jednak centralność sieci i wzbogacenie nie mogą wykazać, że związek fizycznie oddziałuje na białko lub zmienia dany szlak. Białka węzłowe powinny zatem być rozważane jako kandydaci do walidacji celowanej. Ustalenie roli funkcjonalnej wymagałoby bezpośredniej perturbacji lub eksperymentów z angażowaniem celu w tej samej linii komórkowej NSCLC, która była używana do pomiaru fenotypu komórkowego.
MMP9 obrazuje, dlaczego to rozróżnienie jest istotne. Związek 5 uzyskał najkorzystniejszy pojedynczy wynik dokowania z MMP9, jednak zachowana mapa oddziaływań dla najlepszej pozy nie wykazała bezpośredniej koordynacji katalitycznego jonu Zn2+ ani bezpośredniego zaangażowania His401, Glu402, His405 lub His411. W krystalograficznym wzorcu 1GKC reszty His401, His405 i His411 koordynują Zn2+ w odległościach odpowiednio 2,21, 2,23 i 2,22 Å, podczas gdy dwa atomy tlenu NFH koordynują Zn2+ w odległościach 2,07 i 2,38 Å; Glu402 jest katalityczną resztą kwasowo-zasadową. Mapa Związku 5 wykazała natomiast kontakty w pobliżu Ala417 i Pro421. Rycina uzupełniająca 3 przedstawia porównanie z referencyjną mapą oddziaływań. Ponieważ nie odnotowano bezpośredniej koordynacji Związku 5 z Zn2+, nie przypisano żadnej odległości koordynacyjnej Związek 5-Zn2+. W związku z tym obecny wynik strukturalny najlepiej opisać jako niekanoniczną przewidywaną asocjację z MMP9, a nie jako dowód na inhibicję centrum katalitycznego. Następująca trajektoria MD sprawdza jedynie, czy ta konkretna poza dokowania pozostaje stabilna w czasie; nie może ona przekształcić niekanonicznej geometrii dokowania w dowód inhibicji enzymatycznej36,37. MMP9 powinno zatem pozostać kandydatem do testów biochemicznych, a nie głównym lub zwalidowanym celem. MMP9 jest szeroko omawiane w kontekście inwazji nowotworowej, przebudowy mikrośrodowiska guza oraz strategii terapeutycznych skierowanych przeciwko MMP938,39.
Taka sama granica dowodowa dotyczy SRC. Trajektoria SRC–Compound 5 wykazała bardziej trwałe kontakty niż kontrola SRC–Compound 6, jednak stabilność MD nie jest równoznaczna z wewnątrzkomórkowym stopniem zajętości celu40,41. Zastosowanie Compound 6 zapewnia dopasowane porównanie dla niepułapkującego produktu rozszczepienia i wzmacnia wewnętrzne porównanie strukturalne, jednak nie dowodzi, że funkcjonalność aminooksy odpowiada za wiązanie SRC lub że sygnalizacja SRC w komórkach uległa zmianie. Bezpośrednia ocena całkowitego poziomu SRC, stosunku p-SRC/SRC, markerów sygnalizacji downstream oraz ortogonalne pomiary zaangażowania celu byłyby niezbędne do potwierdzenia takiej tezy.
Metoda MM-PBSA dostarcza analogicznie względnej oceny energetycznej dla próbkowanych trajektorii, a nie eksperymentalnego pomiaru powinowactwa. Bardziej korzystne wartości dla kompleksów MMP9–Związek 5 oraz SRC–Związek 5 w porównaniu do SRC–Związek 6 są spójne z porównawczymi obserwacjami trajektorii, jednak obliczenia te są wrażliwe na próbkowane konformacje i przybliżenia metodologiczne, a niniejsza analiza nie uwzględniała korekty entropowej. Zgodność wyników dokowania, symulacji MD oraz MM-PBSA zwiększa zatem jedynie wewnętrzną spójność obliczeniową; nie potwierdza ona funkcjonalnej modulacji MMP9 lub SRC.
Zależność między pułapkowaniem miejsc abazycznych a przewidywanymi oddziaływaniami białkowymi pozostaje nierozstrzygnięta. Jedną z możliwości jest to, że uwolniony przez glutation szkielet aminooksy zachowuje swoją uznaną aktywność w pułapkowaniu uszkodzeń DNA, wykazując jednocześnie niezależne, równoległe oddziaływania z wybranymi białkami. Inna możliwość zakłada, że niektóre z przewidywanych oddziaływań białkowych nie zachodzą w biologicznie istotnych stężeniach lub nie przyczyniają się do fenotypu. Obecne dane nie pozwalają rozróżnić tych możliwości. Wykazanie mechanistycznego powiązania wymagałoby jednoczesnego pomiaru odpowiedzi na uszkodzenia DNA oraz zmian w szlakach białkowych po zastosowaniu związku, a następnie przeprowadzenia eksperymentów perturbacyjnych wykazujących, że modyfikacja potencjalnego celu zmienia fenotyp przeciwnowotworowy.
Przyszła walidacja eksperymentalna powinna zostać przeprowadzona na komórkach H1299, czyli tym samym modelu komórkowym, który został wykorzystany w poprzedniej charakterystyce eksperymentalnej tej serii związków chemicznych. Etapowa strategia powinna w pierwszej kolejności polegać na porównaniu związku Compound 5 z nośnikiem oraz odpowiadającym mu, niepułapkującym związkiem Compound 6, przy użyciu testów przeżywalności w zależności od stężenia, apoptozy, cyklu komórkowego, migracji/inwazji oraz testów γH2AX, aby ustalić kontekst fenotypowy i poziom uszkodzeń DNA42. Następnie należy zbadać MMP9 za pomocą zymografii żelatynowej i analizy ekspresji białek, natomiast sygnalizację SRC należy ocenić poprzez pomiar całkowitego poziomu SRC oraz SRC fosforylowanego w pozycji Tyr416, przyjmując stosunek p-SRC/SRC jako główny odczyt sygnalizacyjny. Bezpośrednie powiązanie związku z białkiem powinno zostać ocenione niezależnie przy użyciu ortogonalnej metody badania wiązania z celem, takiej jak powierzchniowy rezonans plazmonowy43. Interakcję kandydacką należy uznać za potwierdzoną eksperymentalnie tylko wtedy, gdy dowody na bezpośrednie wiązanie będą zgodne z odpowiadającym im funkcjonalnym odczytem komórkowym. Perturbacje genetyczne lub farmakologiczne MMP9 lub SRC stanowiłyby dodatkowy test sprawdzający, czy którykolwiek z kandydatów przyczynia się przyczynowo do fenotypu H1299. Taka etapowa struktura zachowuje rozróżnienie między wcześniej ustanowioną aktywnością pułapkującą miejsca abazyczne a hipotezami dotyczącymi interakcji MMP9/SRC wyłonionymi drogą obliczeniową, definiując jednocześnie bezpośrednią ścieżkę dla późniejszych testów eksperymentalnych.
Oświadczenia
Autorzy oświadczają, że nie mają żadnych konkurencyjnych interesów finansowych ani innych konfliktów interesów związanych z niniejszą pracą. Podmioty finansujące nie brały udziału w projektowaniu badania, w gromadzeniu, analizie lub interpretacji danych, w pisaniu rękopisu ani w decyzji o opublikowaniu wyników.
Podziękowania
Praca ta była wspierana przez Projekt Młodzieżowy Departamentu Edukacji Prowincji Liaoning (JYTQN2023441), Projekt Inicjacyjny Badań Doktoranckich Wspólnego Funduszu Prowincji Liaoning Departamentu Nauki i Technologii (2023-BSBA-151) oraz Projekt Wsparcia Młodych Talentów Naukowo-Technologicznych Uniwersytetu Medycznego w Jinzhou (JYQT202305). Podczas redakcji manuskryptu wykorzystano ChatGPT (OpenAI) w celu korekty językowej, organizacji tekstu oraz wsparcia w rewizji. Autorzy sprawdzili i zweryfikowali zawartość naukową, interpretację danych oraz ostateczne sformułowania i biorą pełną odpowiedzialność za treść manuskryptu.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| ACPYPE | twórcy ACPYPE / Bio2Byte | Wersja 2023.11.14 | Generowanie i konwersja plików topologii ligandów małocząsteczkowych do formatu kompatybilnego z GROMACS. |
| AmberTools (Antechamber) | Zespół programistyczny AMBER | AmberTools 23.3 | Przypisanie ładunków częściowych metodą AM1-BCC i generowanie parametrów liganda w GAFF2. |
| AutoDock Vina | Laboratorium Forliego, Scripps Research | Wersja 1.2.5 | Dokowanie molekularne i generowanie uszeregowanych póz białko-ligand. |
| AutoDockTools (MGLTools) | Center for Computational Structural Biology, Scripps Research | Wersja 1.5.7 | Przygotowanie receptora i liganda, przypisanie ładunków Gasteigera, zdefiniowanie wiązań rotowalnych oraz konwersja do formatu PDBQT. |
| BIOVIA Discovery Studio Visualizer | Dassault SystèmesèBIOVIA | Wersja 2025 | Wizualizacja poz dockingowych i analiza oddziaływań białko-ligand. |
| pole siłowe CHARMM36 | Laboratorium MacKerella / twórcy pola sił CHARMM | CHARMM36 | Parametryzacja białek do obliczeń dynamiki molekularnej; w całym badaniu konsekwentnie stosowano pole CHARMM36 (nie CHARMM36m). |
| Chem3D Ultra (ChemOffice Professional) | Oprogramowanie Revvity Signals | Wersja 22.2 | Minimalizacja energii ligandu z wykorzystaniem pola siłowego MMFF94. |
| Związki 1–6 | Wcześniej zsyntetyzowano zgodnie z opisem w Li et al., ACS Chemical Biology (2022) | Nie dotyczy | Glutation-responsywne proleki macierzyste, produkty uwalniania oraz dopasowana para kontrolna bez pułapkowania wykorzystane w przepływie obliczeniowym. |
| cytoHubba | twórcy cytoHubba / Cytoscape App Store | Wersja 0.1 | Analiza stopnia, centralności pośrednictwa i centralności bliskości w celu priorytetyzacji węzłów hub-target. |
| Cytoscape | Konsorcjum Cytoscape | Wersja 3.10.0 | Wizualizacja sieci interakcji związek-cel oraz PPI i analiza topologiczna. |
| Zasoby bioinformatyczne DAVID | Laboratorium Retrowirologii Ludzkiej i Immunoinformatyki, Frederick National Laboratory for Cancer Research | Zasób internetowy | Analiza wzbogacenia Gene Ontology oraz KEGG; nominalne p &Wartość < 0,10 została przyjęta jako eksploracyjne kryterium włączenia; raportowano wartości skorygowane, jednak nie służyły one do zdefiniowania zbioru zachowanych cech. |
| GAFF2 | Zespół programistyczny AMBER | GAFF2 | Parametryzacja pola siłowego ligandu. |
| Baza danych genów ludzkich GeneCards | Pakiet GeneCards / LifeMap Sciences, Inc. / Instytut Nauki Weizmanna | Zasób internetowy | Wyszukiwanie celów związanych z chorobą przy użyciu zapytania „lung cancer H1299”. |
| gmx_MMPBSA | Zespół programistyczny gmx_MMPBSA | Wersja 1.6.3 | Obliczenia wolnej energii wiązania MM-PBSA na podstawie trajektorii dynamiki molekularnej z programu GROMACS; pobrano 500 klatek z 100,0–149,9 ns w odstępach 100 ps, z wyłączeniem punktu końcowego 150,0 ns; nie zastosowano korekty entropii. |
| GROMACS | Zespół Programistyczny GROMACS | Wersja 2024.4 | Generowanie trajektorii dynamiki molekularnej oraz analiza trajektorii. |
| Platforma do wizualizacji online Microbioinfo | Shanghai Newcore Biotechnology Co., Ltd. / Microbioinfo | Zasób internetowy | Generowanie słupkowych wykresów wzbogaceń i wykresów bąbelkowych. |
| Open Babel | Zespół programistyczny Open Babel | Wersja 3.1.1 | Konwersja plików strukturalnych do kanonicznych kodów SMILES dla danych wejściowych do SwissTargetPrediction. |
| PubChem | Krajowe Centrum Biotechnologii Informacyjnej (National Center for Biotechnology Information), Narodowa Biblioteka Medyczna USA (U.S. National Library of Medicine), NIH | Zasób internetowy | Pozyskiwanie trójwymiarowych struktur ligandów. |
| System Grafiki Molekularnej PyMOL | Schrödinger, LLC | Wersja 2.5.4 | Przygotowanie białka, wizualizacja struktury i analiza pozy dokowania. |
| RCSB Protein Data Bank | Research Collaboratory for Structural Bioinformatics (RCSB) | ID PDB: 3O96; 5UWD; 2AZ5; 1GKC; 2H8H | Pobieranie struktur białek odpowiednio dla AKT1, EGFR, TNF, MMP9 i SRC. |
| Proszę podać tekst źródłowy (STRING), który należy przetłumaczyć. | Konsorcjum STRING | Wersja 11.5 | Konstrukcja sieci oddziaływań białko-białko; Homo sapiens; minimalny wymagany wynik oddziaływania 0,400; oryginalne parametry topologiczne odpowiadają nieskierowanej sieci PPI składającej się z 21 węzłów i 116 krawędzi. |
| SwissTargetPrediction | Grupa Modelowania Molekularnego, Uniwersytet w Lozannie / SIB Swiss Institute of Bioinformatics | Zasób internetowy | Odwrócona predykcja celu dla związków 1–3; gatunki ograniczone do Homo sapiens. |
| model wody TIP3P | Zaimplementowano w GROMACS | TIP3P | Trzymiejscowy model wody z jawnie uwzględnionym rozpuszczalnikiem wykorzystywany do solwatacji kompleksów białko-ligand. |
| Diagramy Venna | BioinfoGP, Centro Nacional de Biotecnología (CNB-CSIC) | Wersja 2.1 | Część wspólna list celów przewidywanych dla związku i związanych z chorobą. |
Bibliografia
- Sung H, et al. Global cancer statistics 2020: GLOBOCAN estimates of incidence and mortality worldwide for 36 cancers in 185 countries. CA Cancer J Clin. 2021;71:209-49.
- Herbst RS, Morgensztern D, Boshoff C. The biology and management of non-small cell lung cancer. Nature. 2018;553:446-54.
- Kim J, et al. Updates on the treatment of epidermal growth factor receptor-mutant non-small cell lung cancer. Cancer. 2025;131:e35778.
- Lin Y, Wang X, Jin H. EGFR-TKI resistance in NSCLC patients: mechanisms and strategies. Am J Cancer Res. 2014;4:411-35.
- Dasari S, et al. Pharmacological effects of cisplatin combination with natural products in cancer chemotherapy. Int J Mol Sci. 2022;23:1532.
- Ellie S, et al. Chemotherapy drugs cyclophosphamide, cisplatin and doxorubicin induce germ cell loss in an in vitro model of the prepubertal testis. Sci Rep. 2018;8:1773.
- De Bont R, van Larebeke N. Endogenous DNA damage in humans: a review of quantitative data. Mutagenesis. 2004;19:169-85.
- Ciccia A, Elledge SJ. The DNA damage response: making it safe to play with knives. Mol Cell. 2010;40:179-204.
- David SS, Williams SD. Chemistry of glycosylases and endonucleases involved in base-excision repair. Chem Rev. 1998;98:1221-62.
- Robson CN, Hickson ID. Isolation of cDNA clones encoding a human apurinic/apyrimidinic endonuclease that corrects DNA repair and mutagenesis defects in E. coli xth (exonuclease III) mutants. Nucleic Acids Res. 1991;19:5519-23.
- Sczepanski JT, et al. Rapid DNA-protein cross-linking and strand scission by an abasic site in a nucleosome core particle. Proc Natl Acad Sci U S A. 2010;107:22475-80.
- Krokan HE, Bjørås M. Base excision repair. Cold Spring Harb Perspect Biol. 2013;5:a012583.
- Li X, et al. Selective antitumor activity and photocytotoxicity of glutathione-activated abasic site trapping agents. ACS Chem Biol. 2022;17:797-803.
- Hopkins AL. Network pharmacology: the next paradigm in drug discovery. Nat Chem Biol. 2008;4:682-90.
- Meng XY, et al. Molecular docking: a powerful approach for structure-based drug discovery. Curr Comput Aided Drug Des. 2011;7:146-57.
- Hollingsworth SA, Dror RO. Molecular dynamics simulation for all. Neuron. 2018;99:1129-43.
- Genheden S, Ryde U. The MM/PBSA and MM/GBSA methods to estimate ligand-binding affinities. Expert Opin Drug Discov. 2015;10:449-61.
- O'Boyle NM, et al. Open Babel: an open chemical toolbox. J Cheminform. 2011;3:33.
- Daina A, Michielin O, Zoete V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 2019;47:W357-64.
- Shannon P, et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13:2498-504.
- Stelzer G, et al. The GeneCards Suite: from gene data mining to disease genome sequence analyses. Curr Protoc Bioinformatics. 2016;54:1.30.1-1.30.33.
- Oliveros JC. Venny: an interactive tool for comparing lists with Venn's diagrams [Internet]. BioinfoGP, CNB-CSIC; 2007-2015.
- Szklarczyk D, et al. The STRING database in 2021: customizable protein-protein networks and functional characterization of user-uploaded gene/measurement sets. Nucleic Acids Res. 2021;49:D605-12.
- Chin CH, et al. cytoHubba: identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8:S11.
- Sherman BT, et al. DAVID: a web server for functional enrichment analysis and functional annotation of gene lists (2021 update). Nucleic Acids Res. 2022;50:W216-21.
- Kim S, et al. PubChem 2023 update. Nucleic Acids Res. 2023;51:D1373-80.
- Eberhardt J, et al. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61:3891-8.
- Gerek ZN, Ozkan SB. A flexible docking scheme to explore the binding selectivity of PDZ domains. Protein Sci. 2010;19:914-28.
- Abraham MJ, et al. GROMACS: high-performance molecular simulations through multi-level parallelism from laptops to supercomputers. SoftwareX. 2015;1-2:19-25.
- Best RB, et al. Optimization of the additive CHARMM all-atom protein force field targeting improved sampling of backbone and side-chain dihedral angles. J Chem Theory Comput. 2012;8:3257-73.
- Vassetti D, Pagliai M, Procacci P. Assessment of GAFF2 and OPLS-AA general force fields in combination with the water models TIP3P, SPCE, and OPC3 for the solvation free energy of druglike organic molecules. J Chem Theory Comput. 2019;15:1983-95.
- Jakalian A, Jack DB, Bayly CI. Fast, efficient generation of high-quality atomic charges. AM1-BCC model: II. Parameterization and validation. J Comput Chem. 2002;23:1623-41.
- Sousa da Silva AW, Vranken WF. ACPYPE—AnteChamber PYthon Parser interfacE. BMC Res Notes. 2012;5:367.
- Case DA, et al. AmberTools. J Chem Inf Model. 2023;63:6183-91.
- Valdés-Tresanco MS, et al. gmx_MMPBSA: a new tool to perform end-state free-energy calculations with GROMACS. J Chem Theory Comput. 2021;17:6281-91.
- Islam MT, Jang NH, Lee HJ. Natural products as regulators against matrix metalloproteinases for the treatment of cancer. Biomedicines. 2024;12:794.
- Mondal S, et al. Matrix metalloproteinase-9 (MMP-9) and its inhibitors in cancer: a minireview. Eur J Med Chem. 2020;194:112260.
- Rashid ZA, Bardaweel SK. Novel matrix metalloproteinase-9 (MMP-9) inhibitors in cancer treatment. Int J Mol Sci. 2023;24:12133.
- Kessenbrock K, Plaks V, Werb Z. Matrix metalloproteinases: regulators of the tumor microenvironment. Cell. 2010;141:52-67.
- Vandooren J, Van den Steen PE, Opdenakker G. Biochemistry and molecular biology of gelatinase B or matrix metalloproteinase-9 (MMP-9): the next decade. Crit Rev Biochem Mol Biol. 2013;48:222-72.
- Merchant N, et al. Matrix metalloproteinases: their functional role in lung cancer. Carcinogenesis. 2017;38:766-80.
- Chabanon RM, et al. Targeting the DNA damage response in immuno-oncology: developments and opportunities. Nat Rev Cancer. 2021;21:701-17.
- Das S, et al. Surface plasmon resonance as a fascinating approach in target-based drug discovery and development. TrAC Trends Anal Chem. 2024;171:117501.