Niniejszy protokół przedstawia powtarzalny proces głębokiego uczenia, wykorzystujący wielokanałowe dane z cykli oraz opracowane cechy w celu przewidywania stanu zdrowia akumulatorów litowo-jonowych, pozostałego okresu użytkowania oraz wydajności magazynowania energii.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
odtwarzalny przepływ pracy głębokiego uczenia do przewidywania wydajności baterii litowo-jonowych przy użyciu wielokanałowych danych z cykli ładowania i rozładowania
W tym artykule
Podsumowanie
Streszczenie
Niniejszy protokół przedstawia powtarzalny schemat głębokiego uczenia do przewidywania wydajności baterii litowo-jonowych z wykorzystaniem wielokanałowych danych z cykli ładowania i rozładowania. Aby rozwiązać ograniczenia istniejących modeli opartych na danych, związane z integracją informacji z wielu źródeł oraz reprezentacją cech, zastosowano metodę wykorzystującą pięć publicznie dostępnych zbiorów danych o bateriach. Dane wejściowe obejmują surowe sygnały operacyjne, w tym napięcie, natężenie prądu, pojemność, temperaturę, rezystancję wewnętrzną oraz wydajność kulombiczną i energetyczną, wraz z cechami wypracowanymi, takimi jak pojemność przyrostowa, napięcie różnicowe i przepływ energii. Protokół szczegółowo opisuje znormalizowane procedury preprocessingu służące do konstruowania tensorów czasowych na poziomie baterii w wielu oknach obserwacyjnych. W celu zwiększenia powtarzalności, w ramach schematu oceniono kandydujące architektury sieci neuronowych, w tym głębokie sieci neuronowe, konwolucyjne sieci neuronowe (CNN), sieci z długiej krótkotrwałej pamięcią (LSTM), modele CNN–LSTM oraz modele oparte na transformerach, stosując stałe ziarna losowe, powtórzone przebiegi ewaluacyjne oraz monitorowanie środowiska. Reprezentatywne wyniki wykazały, że architektura CNN–LSTM z zintegrowanymi danymi wielokanałowymi i wypracowanymi cechami osiągnęła korzystną wydajność predykcyjną spośród ocenianych modeli. Wybrana konfiguracja pozwoliła uzyskać średni błąd bezwzględny na poziomie 0,024 oraz wartość R2 wynoszącą 0,955 dla szacowania stanu zdrowia (state-of-health), zachowując jednocześnie wysoką wydajność predykcyjną dla szacowania pozostałego okresu użytkowania (remaining useful life) oraz energii możliwej do rozładowania. Analizy ablacyjne i badania odporności dodatkowo wykazały wkład integracji cech wielokanałowych oraz stabilność skoncentrowanego na powtarzalności schematu podczas wielokrotnych ewaluacji. Ta znormalizowana metodologia dostarcza powtarzalnych ram dla zarządzania cyklem życia baterii i modelowania predykcyjnego w zróżnicowanych warunkach eksploatacyjnych.
Wprowadzenie
Baterie litowo-jonowe odgrywają kluczową rolę w globalnym przejściu na odnawialne źródła energii ze względu na ich wysoką gęstość energii, długą żywotność cykliczną i niski stopień samorozładowania w zastosowaniach obejmujących zarówno elektronikę przenośną, jak i systemy magazynowania energii w skali sieciowej. Jednakże długotrwała eksploatacja nieuchronnie prowadzi do stopniowej degradacji pojemności i wzrostu rezystancji wewnętrznej1. Spadek wydajności ten nie tylko obniża rentowność ekonomiczną, ale także stwarza poważne zagrożenia dla bezpieczeństwa, w tym ryzyko niekontrolowanego wzrostu temperatury (thermal runaway). Wraz z przyspieszającym wdrażaniem wielkoskalowych systemów magazynowania energii, zarządzanie cyklem życia baterii staje się coraz bardziej złożone2. Tradycyjne monitorowanie oparte na progach oraz protokoły manualnych inspekcji są niewystarczające w dynamicznych środowiskach operacyjnych3. Co więcej, poleganie na pojedynczym parametrze jest nieadekwatne do dokładnego przewidywania stanu zdrowia baterii (SOH) lub pozostałego okresu użytkowania (RUL) w warunkach zmiennych prędkości ładowania i rozładowywania, temperatur otoczenia oraz wahań napięcia rozładowania4. Choć obecny schemat postępowania został zwalidowany głównie przy użyciu zestawów danych z cykli kontrolowanych laboratoryjnie, architektura wielokanałowa i ramy modelowania czasowego mogą wspierać przyszłą adaptację do dynamicznych warunków operacyjnych występujących w zastosowaniach w pojazdach elektrycznych oraz w zmiennych środowiskach zewnętrznych.
Degradacja baterii jest wysoce złożonym, nieliniowym procesem elektrochemicznym napędzanym przez wzrost warstwy pasywnej elektrolitu stałego (SEI), utratę aktywnego litu oraz pogorszenie struktury materiałów elektrodowych. Historycznie szacowanie stanu opierało się na modelach obwodów zastępczych lub elektrochemicznych równaniach różniczkowych cząstkowych (PDE)5. Chociaż te modele fizyczne dostarczają cennych informacji mechanistycznych, obarczone są one znacznym narzutem obliczeniowym i trudnościami w identyfikacji parametrów podczas przetwarzania sprzężonych sygnałów wielokanałowych. W konsekwencji ich implementacja w czasie rzeczywistym w systemach zarządzania bateriami (BMS) jest poważnie ograniczona przez złożoną kinetykę dyfuzji oraz zmienność środowiskową w warunkach rozładowania z wysokim natężeniem prądu6. W przeciwieństwie do nich, proponowany schemat głębokiego uczenia (DL) koncentruje większość zapotrzebowania obliczeniowego w fazie uczenia offline, podczas gdy wytrenowany model wykonuje porównawczo szybką inferencję podczas wdrożenia. Taka architektura może zatem wspierać przyszłą implementację w systemach BMS o ograniczonych zasobach oraz w środowiskach obliczeń krawędziowych (edge computing).
W ostatnim czasie podejścia oparte na głębokim uczeniu (DL) sterowanym danymi wyłoniły się jako potężne narzędzia dzięki ich wyjątkowym możliwościom dopasowania nieliniowego. Niemniej jednak istniejące metodologie DL wykazują dwa główne ograniczenia. Po pierwsze, wiele podejść opiera się głównie na pojedynczych krzywych degradacji pojemności lub specyficznych progach napięcia rozładowania, pomijając przy tym immanentne korelacje czasoprzestrzenne między wielokanałowymi odpowiedziami podczas cyklowania, takimi jak napięcie, prąd i temperatura. Ograniczenie to zmniejsza odporność modelu w scenariuszach operacyjnych w wielu warunkach7. Poprzednie badania wykazały, że pomijanie stanów termicznych podczas złożonych operacji może przyspieszyć kumulację błędów predykcyjnych8,9. Po drugie, w zastosowanym uczeniu maszynowym (ML) istnieje trwały problem z powtarzalnością. Zróżnicowanie warunków eksperymentalnych, niewystarczająco opisane potoki przetwarzania wstępnego oraz arbitralnie dobrane hiperparametry sieci neuronowych często sprawiają, że modele, które w innym przypadku byłyby odporne, zawodzą podczas walidacji międzyzbiorowej10. Aby zmniejszyć ryzyko wycieku informacji podczas przetwarzania wstępnego i prognozowania wczesnych cykli, proponowany przepływ pracy wyznacza czynniki skalowania normalizacji i bazowe wartości cech inżynieryjnych wyłącznie z zestawów treningowych przed zewnętrzną walidacją i ewaluacją międzyzbiorową.
Aby wypełnić te krytyczne luki, ogólnym celem niniejszego protokołu jest przedstawienie zautomatyzowanego, wysoce powtarzalnego przepływu pracy (workflow) opartego na głębokim uczeniu (DL) do przewidywania wydajności magazynowania energii w akumulatorach litowo-jonowych z wykorzystaniem wielokanałowych danych z cykli ładowania i rozładowania. Teoretyczną podstawą tej metody jest jawne uchwycenie złożonych, długoterminowych zależności związanych z degradacją akumulatorów poprzez integrację wielomodalnych danych szeregów czasowych w wysokowymiarowej architekturze sieci neuronowej. Kluczową zaletą tego protokołu w porównaniu do istniejących podejść opartych na fizyce i DL jest jego całościowa standaryzacja, która ustanawia kompletny potok obejmujący wstępne przetwarzanie surowych sygnałów, inżynierię cech, trenowanie modelu oraz ocenę niepewności. Choć hybrydowe architektury sieci neuronowych były badane wcześniej, obecny przepływ pracy kładzie nacisk na standaryzowaną integrację wielokanałową poprzez dopasowanie elektrochemicznych zmiennych cyklicznych do zaprojektowanych cech degradacji w ramach struktury treningowej skoncentrowanej na powtarzalności. W przeciwieństwie do wielu wcześniej raportowanych przepływów pracy, niniejszy protokół zawiera standaryzowane konfiguracje parametrów, stałe ziarna losowe (random seeds), powtarzane uruchomienia ewaluacyjne oraz kompleksowe śledzenie środowiska, aby poprawić powtarzalność w heterogenicznych zbiorach danych o akumulatorach i różnych warunkach laboratoryjnych. Dodatkowo, przepływ pracy systematycznie porównuje wiele architektur sieci neuronowych, aby ocenić stabilność predykcyjną i wydajność dla różnych konfiguracji wejściowych. W obrębie ewaluowanych zbiorów danych i ustawień eksperymentalnych, architektura łącząca konwolucyjną sieć neuronową z długo- i krótkotrwałą pamięcią (CNN–LSTM) wykazała korzystniejszą wydajność predykcyjną w stosunku do badanych samodzielnych modeli CNN oraz modeli opartych na transformatorach, łącząc lokalną ekstrakcję cech z modelowaniem długodystansowych sekwencji czasowych przy zachowaniu umiarkowanej złożoności obliczeniowej. Protokół ten jest odpowiedni dla badaczy i inżynierów dążących do opracowania powtarzalnych i adaptacyjnych do środowiska modeli predykcyjnych dla zarządzania cyklem życia akumulatorów.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Zatwierdzenie instytucjonalnej komisji etycznej nie było wymagane dla niniejszego badania, ponieważ badanie wykorzystywało wyłącznie publicznie dostępne zestawy danych dotyczących cyklowania baterii litowo-jonowych i nie obejmowało uczestników będących ludźmi, zwierząt ani próbek biologicznych.
1. Pozyskiwanie i organizacja danych
- Pozyskanie wielokanałowych zbiorów danych z cykli
- Pobierz zbiory danych z cykli baterii litowo-jonowych z publicznie dostępnych repozytoriów bateryjnych zawierających rekordy cykli ładowania i rozładowania. Pozyskaj zbiory danych CALCE, SANYO, PANASONIC, KOKAM i GOTION bezpośrednio z ich odpowiednich instytucjonalnych repozytoriów otwartego dostępu lub poprzez łącza cyfrowych identyfikatorów obiektów (DOI), aby zachować spójność wersji zbiorów danych.
- Wybierz próbki baterii zawierające pełną liczbę cykli, pomiary pojemności oraz co najmniej jedną ciągłą krzywą ładowania-rozładowania. Zweryfikuj ciągłość, potwierdzając, że w obrębie pojedynczego cyklu nie występuje przerwa przekraczająca dwie godziny oraz że obie fazy – prądu stałego i napięcia stałego – zostały w pełni zarejestrowane.
- Filtrowanie surowych rekordów cykli
- Przefiltruj surowe rekordy cykli, aby zachować próbki zawierające pomiary temperatury, rezystancji wewnętrznej, wydajności kulombowskiej i wydajności energetycznej. Wyklucz z procesu analizy ogniwa baterii, którym brakuje tych obowiązkowych kanałów stanu, ponieważ późniejsza wielokanałowa fuzja cech wymaga pełnego zestawu fizycznych zmiennych wejściowych.
- Usuń cykle zawierające niekompletne rekordy, niespójne znaczniki czasu, niezdefiniowane procedury testowe lub niejasne warunki zakończenia ładowania-rozładowania. Zdefiniuj cykle anomalne jako takie, które wykazują nagłe spadki pojemności przekraczające 5% między sąsiednimi cyklami, pomiary napięcia poza zakresem roboczym specyficznym dla danej chemii lub niemonotoniczne odstępy znaczników czasu.
- Budowa czasowej bazy danych baterii
- Zorganizuj zachowane rekordy cykli chronologicznie, aby zbudować bazę danych szeregów czasowych na poziomie baterii.
- Przechowuj przetworzone zbiory danych w formacie Hierarchical Data Format wersja 5 (HDF5). Utrzymuj ustandaryzowaną strukturę katalogów zorganizowaną według źródła zbioru danych, systemu chemicznego i indywidualnego identyfikatora ogniwa baterii.
- Przypisz unikalne identyfikatory do poszczególnych ogniw baterii przed partycjonowaniem zbioru danych. Wprowadź grupowanie na podstawie identyfikatora ogniwa baterii podczas podziału na zbiór treningowy i testowy, aby zapewnić, że wszystkie sekwencyjne cykle z jednej fizycznej baterii pozostaną wyłącznie w jednym podzbiorze danych.
UWAGA: Przechowuj oryginalne surowe zbiory danych oddzielnie przed wstępnym przetwarzaniem, normalizacją, ponownym próbkowaniem lub inżynierią cech.
- Definiowanie okien obserwacyjnych
- Skonstruuj wielokanałowe okna obserwacyjne, wykorzystując pierwsze 50 cykli, pierwsze 10 cykli oraz pierwsze 20% całkowitego cyklu życia baterii. Oblicz próg 20% cyklu życia, mnożąc całkowitą żywotność cykliczną przed degradacją pojemności do końca okresu eksploatacji przez 0,2.
- Wyrównaj pomiary napięcia, prądu, pojemności, temperatury, rezystancji wewnętrznej i wydajności w każdym oknie obserwacyjnym przed konstrukcją tensora.
- Sformatuj końcową strukturę wejściową jako tensor trójwymiarowy składający się z długości okna obserwacyjnego, 128 ustandaryzowanych punktów próbkowania wewnątrzcyklicznych oraz uporządkowanego wielokanałowego zestawu cech.
2. Wstępne przetwarzanie danych i inżynieria cech
- Wstępne przetwarzanie surowych danych z cykli
- Przeprowadź jednolite wstępne przetwarzanie surowych zestawów danych z cykli, aby ustandaryzować jakość danych ze wszystkich źródeł baterii. Wykonaj wszystkie procedury wstępnego przetwarzania, synchronizacji i standaryzacji przy użyciu języka Python 3.10 z biblioteką Pandas do manipulacji szeregami czasowymi i SciPy do interpolacji numerycznej.
- Usuń wartości odstające, wykryj brakujące wartości, skalibruj znaczniki czasu, zidentyfikuj fazy ładowania i rozładowania oraz znormalizuj częstotliwości próbkowania przed dalszą analizą. Zastosuj zmodyfikowaną metodę progowania Z-score z kryterium odrzucenia większym niż 3,0 w celu wykrywania anomalii.
- Wykrywaj brakujące wartości automatycznie, identyfikując flagi NaN we wszystkich tablicach numerycznych. Rozróżnij fazy ładowania i rozładowania na podstawie polaryzacji prądu, przypisując dodatnie wartości prądu do cykli ładowania, a ujemne wartości prądu do cykli rozładowania.
- Zrekonstruuj brakujące segmenty sygnału, stosując kawałkowe sześcienne wielomiany interpolacyjne Hermite'a, aby zachować elektrochemiczną dynamikę czasową podczas dopasowania przejść fazowych.
- Próbkowanie krzywych cyklicznych
- Wykonaj ponowne próbkowanie krzywych cyklicznych w przypadku wykrycia różnic w gęstości próbkowania lub dryftu sygnału w zestawach danych. Uruchamiaj automatyczne próbkowanie za każdym razem, gdy odstęp między kolejnymi pomiarami odbiega o więcej niż 10% w stosunku do mediany częstotliwości próbkowania odpowiadającej fazy cyklu.
- Ustandaryzuj liczbę punktów próbkowania w każdym cyklu, aby zredukować zmienność zapisów specyficzną dla danej platformy. Zmapuj wszystkie sekwencje czasowe na stałą siatkę przestrzenną, stosując jednowymiarową interpolację liniową.
- Skompresuj lub rozszerz każdy profil ładowania i rozładowania do dokładnie 128 równoodległych punktów próbkowania przed konstrukcją tensora.
- Normalizacja zmiennych ciągłych
- Znormalizuj wszystkie zmienne ciągłe przed trenowaniem modelu, aby ustabilizować zbieżność sieci i zredukować błąd systematyczny związany ze skalą. Zastosuj skalowanie Min-Max, aby przekształcić wszystkie zmienne ciągłe w zakres numeryczny od 0 do 1.
- Oblicz wszystkie parametry normalizacji wyłącznie na podstawie zbioru treningowego. Zastosuj zamrożone parametry skalowania do zbiorów walidacyjnych i testowych, aby zredukować ryzyko wycieku danych czasowych w przód podczas przewidywania wczesnych cykli.
- Konstrukcja wielokanałowych tensorów wejściowych
- Podziel ciągłe zapisy cykli dla każdej baterii na segmenty czasowe o stałej długości. Ustrukturyzuj segmenty czasowe zgodnie z predefiniowanymi oknami obserwacyjnymi odpowiadającymi pierwszym 50 cyklom, pierwszym 100 cyklom lub pierwszym 20% cyklu życia baterii.
- Wyrównaj pomiary napięcia, prądu, pojemności, temperatury, rezystancji wewnętrznej i wydajności w każdym segmencie czasowym przed konstrukcją tensora.
- Złącz wyrównane macierze cech w trójwymiarowy tensor o formacie (N × 128 × C), gdzie N reprezentuje długość okna obserwacyjnego, 128 oznacza znormalizowane punkty próbkowania wewnątrz cyklu, a C reprezentuje całkowitą liczbę fizycznych i wypracowanych kanałów cech.
- Ekstrakcja cech inżynieryjnych
- Wyekstrahuj inżynieryjne cechy elektrochemiczne z surowych sygnałów cyklicznych, aby usprawnić identyfikację wzorców degradacji. Oblicz cechy pojemności przyrostowej i napięcia różnicowego poprzez wyznaczenie dQ/dV i dV/dQ w znormalizowanej siatce próbkowania.
- Zastosuj filtrowanie Savitzky’ego–Golaya w celu wygenerowania wygładzonych krzywych pojemności przyrostowej i napięcia różnicowego.
- Wyekstrahuj wskaźniki degradacji, w tym przesunięcia szczytowego napięcia, różnice napięć przejść fazowych oraz zmienność przepływu energii z cyklu na cykl z przefiltrowanych cech elektrochemicznych.
3. Budowa i trenowanie modelu DL
- Budowa kandydujących modeli predykcyjnych
- Opracuj ustandaryzowany system treningu i ewaluacji dla wszystkich modeli predykcyjnych przedstawionych na Rysunku 1A. Zaimplementuj przepływ pracy DL przy użyciu PyTorch w wersji 2.0 lub nowszej.
- Przeprowadź proces treningowy, korzystając z modułowych skryptów Python do ładowania danych, inicjalizacji modelu, optymalizacji i ewaluacji.
- Przygotuj bazowe modele tradycyjnego ML, w tym regresję liniową, lasy losowe oraz modele drzew decyzyjnych wzmocnionych gradientem. Skonfiguruj model lasów losowych z 10 drzewami i maksymalną głębokością wynoszącą 10.
- Skonfiguruj system drzew decyzyjnych wzmocnionych gradientem, stosując szybkość uczenia 0.1 i maksymalną głębokość drzewa 5 za pomocą biblioteki Scikit-learn.
- Przygotuj kandydujące architektury DL, w tym wielowarstwowy perceptron, jednowymiarową sieć CNN, sieć LSTM, model CNN–LSTM oraz modele oparte na transformerach.
- Ustandaryzuj kluczowe hiperparametry dla wszystkich architektur DL, stosując optymalizator AdamW, funkcje aktywacji GELU (Gaussian error linear unit), wymiar ukryty 128 oraz współczynnik dropout 0.2.
- Konfiguracja architektury CNN–LSTM
- Skonfiguruj architekturę CNN–LSTM w celu fuzji wielokanałowych informacji o cyklach z tensorów wejściowych (Rysunek 1B). Buduj hybrydową architekturę, kaskadując ekstraktor cech splotowych do dwóch stosowanych warstw rekurencyjnych, z których każda zawiera 128 jednostek ukrytych.
- Zakończ architekturę za pomocą trzech równoległych, w pełni połączonych głowic regresyjnych do jednoczesnej predykcji SOH, RUL i energii rozładowalnej.
- Przetwórz wielokanałowe tensory wejściowe przez trzy kolejne jednowymiarowe warstwy splotowe o rozmiarach jądra odpowiednio 3, 5 i 7, aby wyekstrahować lokalne cechy wieloskalowe.
- Zastosuj normalizację wsadową (batch normalization) po każdej warstwie splotowej, aby poprawić stabilność gradientu podczas optymalizacji.
- Przekształć mapy cech splotowych w ciągłe sekwencje czasowe przed modelowaniem sekwencyjnym.
- Wprowadź zakodowane sekwencje czasowe do stosowanych warstw rekurencyjnych, aby uchwycić długodystansowe zależności degradacji w obrębie zdefiniowanych okien obserwacyjnych.
- Podział zbiorów danych do treningu modeli
- Podziel przetworzone zbiory danych ogniw bateryjnych na podzbiory treningowy, walidacyjny i testowy w stosunku 70:15:15. Wykonaj podział zbioru danych przy użyciu stałej wartości ziarna losowego 42.
- Zastosuj próbkowanie warstwowe w oparciu o chemię baterii, aby zachować zrównoważone rozkłady degradacji we wszystkich podzbiorach danych.
- Wykonaj podział zbioru danych ściśle na poziomie ogniwa bateryjnego, zamiast randomizować poszczególne cykle, aby zachować sekwencyjne trajektorie degradacji.
- Traktuj każde ogniwo baterii jako niepodzielną jednostkę podczas podziału, aby zapobiec wyciekowi informacji między zbiorami danych.
- Zweryfikuj programowo izolację zbiorów danych, obliczając część wspólną identyfikatorów ogniw bateryjnych w podzbiorach treningowym, walidacyjnym i testowym oraz potwierdzając brak nakładania się.
- Skompletuj zewnętrzny zbiór testowy, wykorzystując pełny zbiór danych GOTION dla litowo-żelazowo-fosforanowych (LFP) ogniw, do ewaluacji poza rozkładem (out-of-distribution) i oceny generalizacji międzyzbiorowej.
- Udostępnij kod źródłowy, pliki konfiguracji środowiska i przetworzone partycje zbioru danych w publicznym repozytorium GitHub, aby zapewnić przejrzystość metodyczną i powtarzalność.
- Inicjalizacja treningu modelu
- Ustaw funkcję straty regresji na średni błąd kwadratowy przed treningiem. Oblicz globalny cel treningowy poprzez agregację wartości straty z każdego celu predykcyjnego przy zastosowaniu równych wag.
- Ustaw początkową szybkość uczenia na 1 × 10⁻³ i wybierz rozmiar wsadu 32 lub 64 w zależności od wielkości zbioru danych.
- Użyj rozmiaru wsadu 64 dla zbiorów danych zawierających więcej niż 5 0 cykli, aby poprawić wykorzystanie sprzętu. Użyj rozmiaru wsadu 32 dla mniejszych zbiorów danych, aby poprawić stabilność optymalizacji.
UWAGA: Wybierz te hiperparametry poprzez wstępną ewaluację metodą grid-search, aby zrównoważyć szybkość zbieżności i stabilność gradientu dla różnych okien obserwacyjnych.
- Zastosowanie kontroli treningu
- Zastosuj dynamiczny harmonogram szybkości uczenia oparty na zmianach straty walidacyjnej. Zmniejsz szybkość uczenia o współczynnik 0.5, jeśli strata walidacyjna nie ulegnie poprawie przez 5 kolejnych epok.
- Utrzymaj minimalny próg szybkości uczenia 1 × 10⁻⁵ podczas optymalizacji.
- Zatrzymaj trening modelu po maksymalnie 10 epokach, aby ograniczyć przeuczenie.
- Zastosuj wczesne zatrzymanie (early stopping), jeśli strata walidacyjna nie spadnie przez 15 kolejnych epok. Przywróć wagi modelu odpowiadające iteracji walidacyjnej o najlepszych wynikach.
- Prowadzenie dokumentacji powtarzalności
- Ustaw stałą wartość ziarna losowego 42 przed inicjalizacją i treningiem modelu.
- Zastosuj stałe ziarno losowe konsekwentnie w module random języka Python, NumPy oraz w backendzie PyTorch, wyłączając niedeterministyczne operacje CUDA.
- Zapisz środowisko programistyczne, wersje zależności, ustawienia parametrów, partycje danych i wyniki treningu dla każdego przebiegu eksperymentalnego.
- Wszystkie przepływy pracy DL wykonaj w systemie Ubuntu 2.04 z akceleracją CUDA 1.8 na stacji roboczej wyposażonej w jednostkę przetwarzania graficznego NVIDIA RTX 3090 lub równoważny sprzęt.
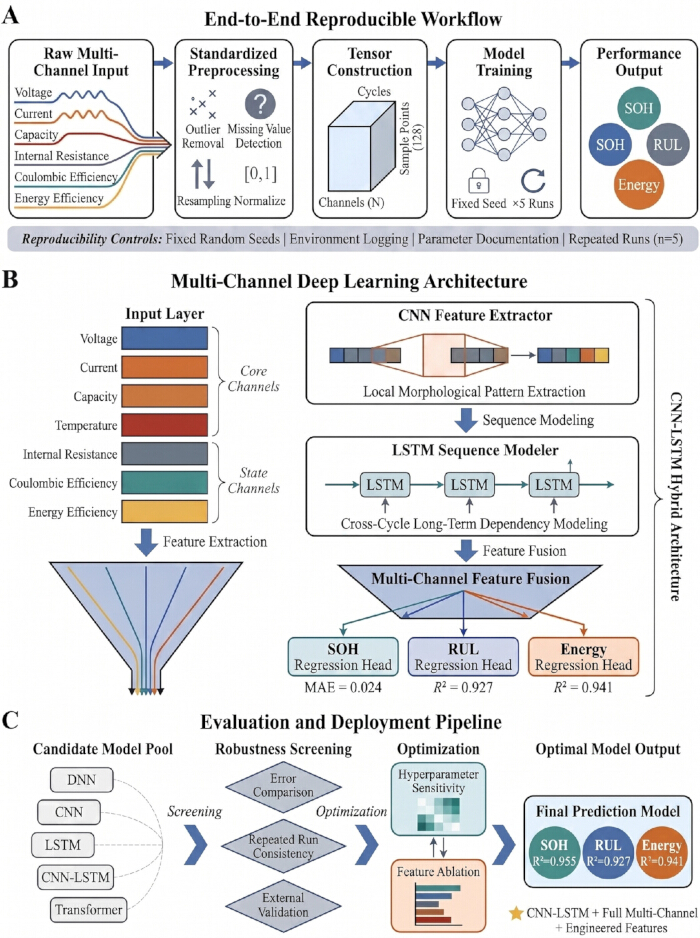
Rycina 1Powtarzalny schemat pracy (workflow) oparty na głębokim uczeniu (DL) dla wielokanałowej predykcji wydajności akumulatorów litowo-jonowych. (A) Kompletny, odtwarzalny schemat postępowania ilustrujący wielokanałową akwizycję danych, zestandaryzowane przetwarzanie wstępne, konstrukcję tensorów, trenowanie modelu oraz przewidywanie wskaźników wydajności baterii. Kontrole odtwarzalności obejmują stałe ziarna liczb pseudolosowych, powtarzalne cykle trenowania, śledzenie parametrów oraz logowanie środowiska. (BHybrydowa architektura CNN–LSTM wykorzystywana do wielokanałowej ekstrakcji cech, modelowania sekwencji czasowych, fuzji cech oraz przewidywania stanu zdrowia (SOH), pozostałego okresu użytkowania (RUL) i energii możliwej do rozładowania.C) Potok ewaluacji i wdrażania przedstawiający przesiewowe badanie modeli kandydujących, ocenę odporności, optymalizację hiperparametrów oraz końcowy wybór modelu. Aby wyświetlić powiększoną wersję tej ryciny, kliknij tutaj.
4. Ewaluacja modelu i przewidywanie celu
- Generowanie predykcji modelu
- Przetworzenie docelowych zbiorów danych testowych (battery-datasets) przez każdy wytrenowany model. Przed inferencją należy załadować wstępnie przetworzone zbiory testowe jako zserializowane tensory PyTorch.
- Wykonanie kroku inferencji w przód (forward pass) przy użyciu menedżera kontekstu wyłączającego obliczanie gradientów, aby zapobiec niezamierzonej aktualizacji parametrów podczas ewaluacji.
- Generowanie równoległych predykcji dla każdego wskaźnika wydajności przy użyciu wytrenowanych głowic regresyjnych.
- Wyodrębnienie jednoczesnych wyników z trzech równoległych głowic regresyjnych skonfigurowanych do predykcji SOH, RUL oraz energii możliwej do rozładowania.
- Obliczanie wartości docelowych dla predykcji
- Obliczanie SOH poprzez porównanie aktualnej dostępnej pojemności z początkową pojemnością akumulatora.
- Zdefiniowanie początkowej pojemności akumulatora jako maksymalnej pojemności rozładowania zarejestrowanej podczas pierwszych trzech cykli stabilizacyjnych.
- Obliczenie SOH jako stosunku pojemności w aktualnym cyklu do ustalonej bazowej pojemności początkowej.
- Szacowanie RUL poprzez określenie progu operacyjnego, przy którym kończy się stabilna pojemność akumulatora.
- Zdefiniowanie końca okresu eksploatacji (end of life) jako numeru cyklu, w którym pojemność akumulatora nieodwracalnie spada poniżej 80% nominalnej pojemności znamionowej.
- Obliczenie RUL jako liczby pozostałych cykli od aktualnego punktu obserwacji do zdefiniowanego progu końca okresu eksploatacji.
- Prognozowanie energii możliwej do rozładowania na podstawie zarejestrowanych warunków rozładowania.
- Obliczenie rzeczywistej (ground-truth) energii możliwej do rozładowania poprzez numeryczne całkowanie iloczynu napięcia rozładowania i prądu rozładowania w całym przedziale rozładowania przy użyciu metody całkowania trapezowego.
- Ocena wydajności predykcyjnej
- Obliczenie średniego błędu bezwzględnego (MAE), pierwiastka średniokwadratowego błędu (RMSE), średniego bezwzględnego błędu procentowego (MAPE) oraz współczynnika determinacji (R2) dla każdego celu predykcji.
- Obliczenie wszystkich metryk ewaluacyjnych przy użyciu modułu metrics biblioteki Scikit-learn ze zstandaryzowanymi formułami statystycznymi.
- Zastosowanie identycznych obliczeń metryk dla wszystkich modeli, zbiorów danych i konfiguracji wejściowych w celu zachowania spójności oceny.
- Agregacja wszystkich metryk wydajności dla połączonych próbek akumulatorów w niezależnym zbiorze testowym w celu oceny ogólnej generalizacji modelu.
- Raportowanie wydajności warstwowej
- Obliczenie średniej i odchylenia standardowego dla każdej metryki ewaluacyjnej w powtórzonych seriach eksperymentalnych.
- Wyprowadzenie raportowanych miar statystycznych z pięciu niezależnych inicjalizacji modelu.
- Podanie 95% przedziałów ufności wraz ze średnimi metrykami wydajności w celu określenia niepewności predykcyjnej.
- Porównanie wydajności modelu dla różnych długości okien obserwacyjnych i konfiguracji kanałów wejściowych.
- Stratyfikacja analizy porównawczej przy użyciu okien obserwacyjnych odpowiadających 50 cyklom, 100 cyklom i 200 cyklom.
- Ocena wydajności predykcyjnej dla wielu konfiguracji wejściowych, od wejść obejmujących tylko pojemność po pełną integrację wielokanałowych tensorów. Workflow ewaluacji, weryfikacji odporności i wyboru wdrożenia przedstawiono na Ryc. 1C.
5. Analiza powtarzalności, odporności i czułości
- Weryfikacja powtarzalności i odporności
- Utrzymaj identyczne partycje danych, przepływy pracy wstępnego przetwarzania oraz procedury eksperymentalne we wszystkich ocenach powtarzalności przedstawionych na Rysunku 2A.
- Oblicz współczynnik zmienności dla głównych metryk oceny w powtórzonych próbach, aby ocenić spójność powtarzalności.
- Powtórz wszystkie procedury oceny, korzystając z tego samego zestandaryzowanego przepływu pracy treningowej i testowej.
- Inicjuj każdą powtórną ocenę przy użyciu zrandomizowanych wag sieci, zachowując te same deterministyczne procedury ładowania i przetasowywania danych.
- Przeprowadzenie powtórznych eksperymentów treningowych
- Trenuj modele predykcyjne wielokrotnie w identycznych warunkach eksperymentalnych, korzystając z predefined fixed random-seed values, aby zapewnić powtarzalną inicjalizację wag.
- Przeprowadź pięć niezależnych cykli treningowych przy użyciu identycznych partycji zbioru danych, aby zredukować zmienność wynikającą z danych.
- Oblicz końcowe metryki wydajności, wyciągając średnią z metryk oceny uzyskanych z pięciu powtórzonych cykli treningowych.
- Agreguj końcowe metryki odporności, używając uśrednionych wyników oceny, zamiast łączyć surowe tensory predykcji.
- Ocena wrażliwości hiperparametrów
- Modyfikuj indywidualnie szybkość uczenia, rozmiar partii (batch size), wymiar warstwy ukrytej oraz współczynnik dropout podczas analizy wrażliwości.
- Oceń szybkości uczenia w zakresie od 1 × 10⁻⁴ do 1 × 10⁻², rozmiary partii od 32 do 128, wymiary ukryte od 32 do 256 oraz współczynniki dropout od 0.1 do 0.5.
- Zapisuj odpowiadające im zmiany w dokładności predykcyjnej po każdej korekcie hiperparametru.
- Kwantyfikuj zmienność wydajności predykcyjnej za pomocą RMSE i R2.
- Przeprowadzenie analizy ablacji cech
- Usuwaj wybrane kanały wejściowe, w tym temperaturę, rezystancję wewnętrzną oraz wektory cech inżynieryjnych, z wielokanałowego strumienia wejściowego.
- Przeprowadź ablację cech, stosując strategię leave-one-out poprzez usuwanie jednej grupy cech na raz, przy zachowaniu pozostałej wielokanałowej struktury wejściowej.
- Porównaj wynikową wydajność predykcyjną po każdym eksperymencie usuwania cech, aby ocenić wkład poszczególnych grup cech w stabilność i dokładność modelu.
- Kwantyfikuj względny wkład każdej grupy cech, obliczając procentowy wzrost średniego błędu absolutnego w stosunku do w pełni zintegrowanego wielokanałowego modelu bazowego. Patrz Rysunek 2B w celu zapoznania się z przepływem pracy oceny odporności i analizy wrażliwości
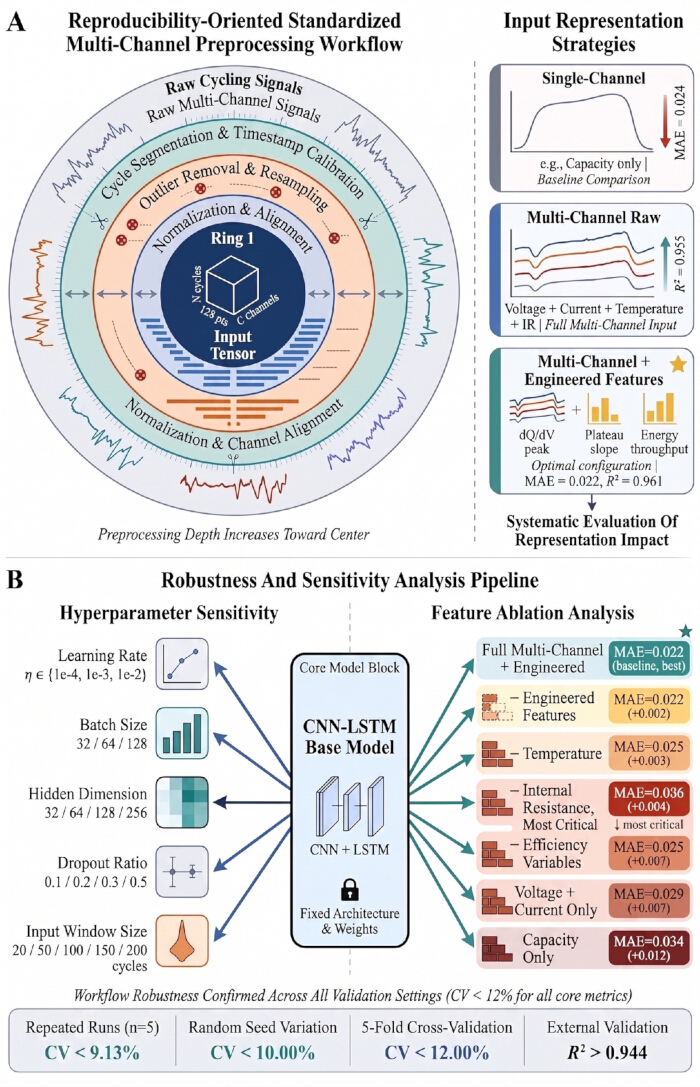
Rycina 2Zestandaryzowany schemat przetwarzania wstępnego, oceny odporności oraz analizy wrażliwości. (A) Standaryzowany schemat przetwarzania wstępnego sygnałów wielokanałowych, ilustrujący przetwarzanie surowych sygnałów cyklicznych, kalibrację znaczników czasu, usuwanie wartości odstających, ponowne próbkowanie, normalizację, wyrównywanie kanałów oraz konstrukcję tensora. Strategie reprezentacji danych wejściowych porównują wejścia jednokanałowe, surowe wejścia wielokanałowe oraz wejścia wielokanałowe połączone z cechami syntetycznymi. (B) Potok analizy odporności i czułości przedstawiający systematyczną perturbację hiperparametrów, ewaluację wielokrotnych uruchomień, analizę ablacji cech, walidację krzyżową oraz zewnętrzną walidację przepływu pracy CNN–LSTM. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Wielokanałowe sygnały cykliczne i dystrybucja danych
Przeanalizowano reprezentatywne wielokanałowe sygnały cyklizacji i rozkłady wydajności, aby scharakteryzować zachowanie baterii litowo-jonowych w odpowiedzi na cyklizację. W badaniu wykorzystano pięć zbiorów danych baterii litowo-jonowych reprezentujących wiele układów chemicznych, w tym tlenek litu i kobaltu (LCO), tlenek niklu, kobaltu i glinu (NCA), tlenek niklu, manganu i kobaltu (NMC) oraz LFP (Tabela 1...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Opisany w niniejszym protokole powtarzalny przepływ pracy DL wykazał dokładną możliwość przewidywania wydajności akumulatorów litowo-jonowych przy użyciu wielokanałowych danych z cykli ładowania i rozładowania. W oceniających warunkach eksperymentalnych przepływ pracy osiągnął wartość MAE w zbiorze testowym na poziomie 0,024 oraz wartość R2 równą 0,955 dla szacowania SOH, co potwierdza jego potencjalną użyteczność w zarządzaniu cyklem życia baterii oraz w zastosowaniach monitorowania magazynowania energii
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy oświadczają, że nie stwierdzono żadnych konkurencyjnych interesów finansowych ani konfliktów interesów.
Podziękowania
Autorzy wyrażają wdzięczność za wsparcie instytucjonalne zapewnione przez Wydział Fizyki Southern University of Science and Technology oraz Homerton College na Uniwersytecie w Cambridge, które udostępniły środowisko akademickie i zasoby obliczeniowe niezbędne do przeprowadzenia tych badań. Autorzy dziękują również instytucjom badawczym i współpracownikom, którzy udostępnili publicznie otwarte zbiory danych dotyczące baterii litowo-jonowych, w tym CALCE, SANYO, PANASONIC, KOKAM oraz GOTION, co umożliwiło przeprowadzenie tej kompleksowej analizy wielokanałowej.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| zbiór danych baterii CALCE | Center for Advanced Life Cycle Engineering (CALCE), University of Maryland | https://calce.umd.edu/battery-data | Źródło wielokanałowych danych z cykli pracy baterii litowo-jonowych do trenowania i walidacji modelu |
| CUDA Toolkit | NVIDIA | Wersja 11.8 | Akceleracja GPU dla trenowania modeli DL |
| zbiór danych GOTION IFP20100140A | Mendeley Data | https://doi.org/10.17632/vpw4t7ytbx.2 | Zewnętrzna walidacja i wielokanałowa analiza degradacji baterii |
| zbiór danych KOKAM SLPB533459H4 | Mendeley Data | https://doi.org/10.17632/7w4y4fzzbb.1 | Wielokanałowe modelowanie i walidacja degradacji baterii |
| Matplotlib | Matplotlib Development Team | Wersja 3.7.1 | Wizualizacja wydajności modelu, analiza wrażliwości i wyniki reprodukowalności |
| NumPy | NumPy Developers | Wersja 1.24.3 | Obliczenia numeryczne i konstrukcja tensorów |
| zbiór danych PANASONIC NCR18650BD | Mendeley Data | https://doi.org/10.17632/wykht8y7tg.1 | Źródło wielokanałowych danych z cykli pracy i ekstrakcja cech inżynieryjnych |
| Pandas | Pandas Developers | Wersja 2.0.3 | Organizacja danych, przetwarzanie wstępne i zarządzanie danymi tabelarycznymi |
| PyTorch | PyTorch Foundation | Wersja 2.0.1 | Konstrukcja i trenowanie architektur głębokiego uczenia, w tym modelu CNN–LSTM |
| Python | Python Software Foundation | Wersja 3.10.12 | Przetwarzanie wstępne danych, inżynieria cech, trenowanie i ewaluacja modelu |
| zbiór danych SANYO UR18650E | NASA Prognostics Data Repository | https://ti.arc.nasa.gov/tech/dash/groups/pcoe/prognostic-data-repository/ | Źródło wielokanałowych danych z cykli pracy do oceny reprodukowalności i walidacji modelu |
| Scikit-learn | Scikit-learn Developers | Wersja 1.2.2 | Implementacja modelu bazowego, partycjonowanie zbioru danych i obliczanie metryk wydajności |
Bibliografia
- Lu J, Xiong R, Tian J. Deep learning to estimate lithium-ion battery state of health without additional degradation experiments. Nat Commun. 2023;14:2760.
- Zhang H, Li Y, Zheng S. Battery lifetime prediction across diverse ageing conditions with inter-cell deep learning. Nat Mach Intell. 2025;7:270–7.
- Zhang Y, et al. State-of-health estimation for lithium-ion batteries via incremental energy analysis and hybrid deep learning model. Batteries. 2025;11(6):217.
- Liu C, et al. Deep learning for state of health estimation of lithium-ion batteries in electric vehicles: A systematic review. Energies. 2025;18(6):1463.
- Chen C, Wei J, Li Z. Remaining useful life prediction for lithium-ion batteries based on a hybrid deep learning model. Processes. 2023;11(8):2333.
- Chen B, et al. Lithium-ion battery state of health estimation based on feature reconstruction and Transformer-GRU parallel architecture. Energies. 2025;18(5):1236.
- Zhao W, Ding W, Zhang S, Zhang Z. Enhancing lithium-ion battery lifespan early prediction using a multi-branch vision transformer model. Energy. 2024;302:131816.
- Hu J, et al. Early prediction of lithium-ion battery degradation with a generative pre-trained transformer. Nat Commun. 2026;17:126.
- Li Y, et al. Accurate and adaptive state of health estimation for lithium-ion battery based on patch learning framework. Measurement. 2025;250:117083.
- Geng M, et al. Interpretable deep learning with uncertainty quantification for lithium-ion battery SOH estimation. Energy. 2025;335:138027.
- Li Y, et al. State-of-health prediction of lithium-ion batteries using feature fusion and a hybrid neural network model. Energy. 2025;319:135163.
- Zhou J, et al. Deep learning estimation of state of health for lithium-ion batteries using multi-level fusion features of discharge curves. J Power Sources. 2025;653:237781.
- Wang Y, et al. A comprehensive review of machine learning-based state of health estimation for lithium-ion batteries: Data, features, algorithms, and future challenges. Renew Sustain Energy Rev. 2025;224:116125.
- Severson KA, et al. Data-driven prediction of battery cycle life before capacity degradation. Nat Energy. 2019;4(5):383–91.
- Wu R, et al. Confidence-aware quantile Transformer for reliable degradation prediction of battery energy storage systems. Reliab Eng Syst Saf. 2025;260:111019.
- Yang H, et al. Privacy-preserving collaborative battery fault warning for massive electric vehicles by heterogeneous data from charging stations. Nat Commun. 2026;17:974.
- Liu Y, et al. A hybrid deep learning approach for remaining useful life prediction of lithium-ion batteries based on discharging fragments. Appl Energy. 2024;358:122555.
- Bockrath S, Lorentz V, Pruckner M. State of health estimation of lithium-ion batteries with a temporal convolutional neural network using partial load profiles. Appl Energy. 2023;329:120307.
- Zhang Z, et al. Multi-cycle charging information guided state of health estimation for lithium-ion batteries based on pre-trained large language model. Energy. 2024;313:133993.
- Li Z, Zhang X, Gao W. State of health estimation of lithium-ion battery during fast charging process based on BiLSTM-Transformer. Energy. 2024;311:133418.
- Bao X, et al. Hybrid deep neural network with dimension attention for state-of-health estimation of lithium-ion batteries. Energy. 2023;278:127734.
- He N, et al. Early prediction of battery lifetime based on graphical features and convolutional neural networks. Appl Energy. 2024;353:122048.
- Rieger LH, et al. Uncertainty-aware and explainable machine learning for early prediction of battery degradation trajectory. Digit Discov. 2023;2(1):112–22.
- Li H, et al. A cross-material lithium-ion battery state of health estimation method based on three-stage domain adaptation. Energy. 2025;139376.
- Han T, et al. Source-free dynamic weighted federated transfer learning for state-of-health estimation of lithium-ion batteries with data privacy. IEEE Trans Power Electron. 2024;39(11):15085–100.
- Rhyu J, et al. Systematic feature design for cycle life prediction of lithium-ion batteries during formation. Joule. 2025;9(5):101884.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.