Przedstawiamy tutaj odtwarzalny protokół do opracowywania i oceny modeli wyjaśnialnej sztucznej inteligencji dla analityki opieki zdrowotnej. Przepływ pracy integruje przetwarzanie danych, modelowanie predykcyjne, wyjaśnialność opartą na SHAP-, LIME- i Grad-CAM, ocenę ilościową oraz walidację zorientowaną na człowieka, aby wspierać przejrzyste i godne zaufania podejmowanie decyzji klinicznych.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Reprodukowalny protokół rozwijania i oceniania wyjaśnialnych sztucznych ram inteligencji w analityce opieki zdrowotnej
W tym artykule
Podsumowanie
Streszczenie
Wyjaśnialna Sztuczna Inteligencja (XAI) jest coraz bardziej rozpoznawana jako niezbędne narzędzie do budowy zaufanych systemów AI w opiece zdrowotnej, gdzie przejrzystość i zdolność wyjaśniania decyzji są istotnymi składnikami podejmowania klinicznych decyzji. Niniejsza publikacja przedstawia powtarzalne podejście eksperymentalne do opracowywania i ewaluacji wyjaśnialnych systemów AI dla analityki opieki zdrowotnej. Opracowany potok integruje kroki przetwarzania danych, modelowania predykcyjnego, generowania interpretacji i ewaluacji w jeden bezproblemowy przepływ pracy, który można zastosować zarówno do strukturalnych danych klinicznych, jak i zestawów danych z obrazowania medycznego. Modele uczenia maszynowego zespołowego wykazały wysoką wydajność predykcyjną w strukturalnych zbiorach danych tabelarycznych, podczas gdy modele głębokiego uczenia są skuteczne w uczeniu się złożonych wzorców w danych z obrazowania medycznego. Techniki takie jak SHAP, LIME i Grad-CAM to globalne i lokalne wyjaśnienia, które ułatwiają interpretację modelu. Bardzo pomocne. Ilościowa ocena ramówki obejmuje wiele różnych metryk, takich jak dokładność, precyzja, odzyskanie, wynik F1, ROC-AUC, metryki wyjaśnień, wierność i stabilność. Wyniki wskazują, że gdy warunki eksperymentalne są kontrolowane, ramówka wykazała poprawę wydajności predykcyjnej i jakości wyjaśnień w warunkach ewaluacji eksperymentalnej. Jako dokument przewodni, niniejsza praca wspiera powtarzalność i skalowalność, trwałe wdrażanie przez inne żywe istoty. Ta przejrzysta, zrozumiała dla ludzi inteligencja sztucznna jest fundamentem, na którym wsparcie podejmowania decyzji klinicznych i systemy analityki opieki zdrowotnej zdobywają zaufanie i szerokie zastosowanie.
Wprowadzenie
Inteligencja sztucznna (AI) stała się ważnym elementem współczesnej opieki zdrowotnej poprzez wsparcie diagnozy chorób, prognozowania, stratyfikacji ryzyka, analizy obrazów medycznych oraz podejmowania decyzji klinicznych1. Postępy w uczeniu maszynowym i głębokim nauce umożliwiły systemom opieki zdrowotnej przetwarzanie dużych objętości strukturalizowanych i niestrukturalizowanych danych, często osiągając wydajność predykcyjną zbliżoną lub przewyższającą konwencjonalne podejścia statystyczne2. Mimo tych osiągnięć, wiele modeli AI działa jako złożone systemy typu czarna skrzynka, co utrudnia klinikom i interesariuszom sektora opieki zdrowotnej zrozumienie, jak generowane są prognozy3. Ta niedostateczna przejrzystość może ograniczać zaufanie, przyjęcie i odpowiedzialność w wymagających środowiskach opieki zdrowotnej4,5.
Wyjaśnialna inteligencja sztucznna (XAI) pojawiła się jako obiecujące podejście do poprawy przejrzystości i interpretowalności modeli uczenia maszynowego6. Powszechnie stosowane techniki wyjaśniania, w tym SHAP (Shapley additive explanations), LIME (Local interpretable model-agnostic explanations) i Gradient-weighted class activation mapping (Grad-CAM), zapewniają wgląd w zachowanie modelu poprzez mechanizmy przypisywania cech i wizualnych wyjaśnień7,8,9. Metody te są coraz częściej stosowane w zastosowaniach medycznych w celu wsparcia interpretacji klinicznych, audytów modeli i wsparcia decyzyjnego10,11. Jednak samo wyjaśnianie nie gwarantuje niezawodności, powtarzalności ani przydatności klinicznej. Ostatnie badania wskazują na wyzwania związane z niestabilnością wyjaśnień, wrażliwością na zmiany, ograniczonym weryfikowaniem przez kliników oraz niespójnościami między wynikami wyjaśnień a prawdziwym rozumowaniem modelu12,13,14,15.
Oprócz wyzwań związanych z wyjaśnialnością, powtarzalność pozostaje istotnym problemem w badaniach nad uczeniami maszynowym w opiece zdrowotnej16,17,18. Wiele opublikowanych badań dostarcza ograniczonych informacji dotyczących procedur przetwarzania wstępnego, środowisk oprogramowania, konfiguracji hiperparametrów, strategii walidacji i przepływów pracy implementacyjnych, co utrudnia niezależne powtórzenie19,20,21. Ponadto, badania nad AI w opiece zdrowotnej często koncentrują się na wydajności predykcyjnej, zapewniając jednocześnie ograniczone wytyczne dotyczące oceny jakości wyjaśnień, ewaluacji zorientowanej na klienta i praktycznych kwestii implementacyjnych22. Ograniczenia te mogą utrudniać translację systemów AI z wyjaśniania z środowisk badawczych do rzeczywistych ustawień opieki zdrowotnej23,24,25,26,27.
Obecne XAI w opiece zdrowotnej często oceniają pojedyncze techniki wyjaśniania lub modele predykcyjne w izolacji i rzadko dostarczają zstandardyzowanych protokołów, które integrują przygotowanie danych, modelowanie predykcyjne, ocenę wyjaśnialności, ewaluację zorientowaną na człowieka i zasoby dotyczące powtarzalności28,29,30,31. W konsekwencji, badacze i praktycy mogą napotkać trudności przy odtwarzaniu przepływów pracy, porównywaniu metod wyjaśniania lub ocenie praktycznej przydatności systemów AI z wyjaśnianiem w różnych zbiorach danych i dziedzinach zastosowań w opiece zdrowotnej. Dlatego potrzebny jest kompleksowy i powtarzalny protokół, aby ułatwić spójną implementację, ewaluację i raportowanie przepływów pracy z wyjaśnialną sztuczną inteligencją w opiece zdrowotnej32,33,34,35.
Przedstawiamy protokół powtarzalny do rozwijania, ewaluacji i interpretacji systemów sztucznej inteligencji z wyjaśnianiem w analityce zdrowotnej. Protokół integruje przetwarzanie wstępne danych, modelowanie predykcyjne, ocenę wyjaśnialności przy użyciu SHAP, LIME i Grad-CAM, ewaluację zorientowaną na klienta, procedury walidacji i zasoby dotyczące powtarzalności w jednolitym przepływie pracy. Celem jest zapewnienie zstandardyzowanego ramowania, które wspiera przejrzysty rozwój modeli, ocenę jakości wyjaśnień i powtarzalną implementację w różnorodnych zbiorach danych opieki zdrowotnej36,37,38,39. Metodologiczny wkład tej pracy polega na integracji analityki predykcyjnej, ewaluacji wyjaśnial
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Wszystkie zestawy danych wykorzystane w niniejszym badaniu pobrano z publicznie dostępnych i w pełni zanonimizowanych repozytoriów, w tym z UCI Machine Learning Repository, bazy danych PhysioNet MIMIC-III oraz zbiorów danych NIH Chest X-ray. Nie uzyskano dostępu do żadnych możliwych do zidentyfikowania informacji o pacjentach. Badanie było zgodne z instytucjonalnymi wytycznymi etycznymi dotyczącymi wtórnej analizy publicznie dostępnych, zanonimizowanych danych. Formalna zgoda Instytucjonalnej Komisji Przeglądowej (Institutional Review Board) nie była wymagana, ponieważ nie rekrutowano bezpośrednio uczestników będących ludźmi i nie korzystano z chronionych informacji zdrowotnych.
1. Przegląd schematów doświadczalnych
- Opracowanie powtarzalnego i wyjaśnialnego potoku sztucznej inteligencji (XAI) dla przejrzystej analityki opieki zdrowotnej. Organizacja przepływu pracy z podziałem na warstwę danych, warstwę przetwarzania wstępnego, warstwę modelowania, warstwę wyjaśnialności, warstwę ewaluacji oraz warstwę wizualizacji.
- Integracja tych modułów w ujednolicony przepływ pracy zdolny do przetwarzania ustrukturyzowanych danych klinicznych, elektronicznej dokumentacji medycznej oraz zbiorów danych z obrazowania medycznego.
- Zapewnienie, aby każdy moduł przyczyniał się do powtarzalności, interpretowalności, skalowalności oraz standaryzacji wykonania eksperymentów.
- Zaprojektowanie modularnej architektury wspierającej ciągły strumieniowanie danych oraz zapewnienie, aby każdy etap potoku przyczyniał się do powtarzalności, interpretowalności i skalowalności w całym przebiegu eksperymentu.
2. Środowisko obliczeniowe i konfiguracja systemu
- Przed uruchomieniem schematu pracy zainstaluj wymagane zależności programistyczne, otwierając terminal wiersza poleceń i wykonując następującą komendę:
pip install numpy pandas scikit-learn tensorflow shap lime opencv-python matplotlib seaborn - Przed przystąpieniem do wstępnego przetwarzania danych i opracowywania modelu zweryfikuj pomyślną instalację wszystkich pakietów oprogramowania i potwierdź ich kompatybilność z wersjami wymienionymi w Tabeli materiałów.
- Jako główne środowisko programistyczne wykorzystaj Python 3.11. Zainstaluj i skonfiguruj NumPy 1.26 oraz Pandas 2.1 do manipulacji danymi i zadań inżynierii cech. Zainstaluj Scikit-learn 1.5 do opracowywania i ewaluacji modeli uczenia maszynowego.
- Zainstaluj TensorFlow 2.15 do trenowania i wnioskowania modeli głębokiego uczenia. Zainstaluj SHAP 0.46 oraz LIME 0.2.0 do analizy wyjaśnialności. Zainstaluj OpenCV 4.10 do zadań przetwarzania obrazów. Zainstaluj Matplotlib 3.9 oraz Seaborn 0.13 do wizualizacji danych i raportowania wyników. Pełne specyfikacje oprogramowania oraz szczegóły implementacji niezbędne do zapewnienia powtarzalności znajdują się w Tabeli materiałów.
- Skonfiguruj środowisko obliczeniowe, korzystając ze stacji roboczej wyposażonej w procesor wielordzeniowy, akcelerację jednostki przetwarzania graficznego (GPU) oraz zasoby pamięci wystarczające do obsłużenia dużych zbiorów danych medycznych i obciążeń związanych z głębokim uczeniem.
- Ustaw stałe ziarna liczb losowych (random seeds) dla partycjonowania danych, inicjalizacji modelu i procedur trenowania, aby zapewnić powtarzalność między poszczególnymi uruchomieniami eksperymentów. Włącz mechanizmy logowania w celu rejestrowania operacji wstępnego przetwarzania danych, konfiguracji modelu, ustawień hiperparametrów, procedur trenowania oraz wyników ewaluacji w całym schemacie pracy.
- Skonfiguruj architektury modeli, parametry optymalizacji, tempo uczenia, wielkość partii (batch size), ustawienia trenowania oraz wartości hiperparametrów zgodnie ze specyfikacjami podsumowanymi w Tabeli 1. Przestrzegaj tych ustawień podczas eksperymentów replikacyjnych, aby zapewnić spójność z raportowanymi wynikami.
- Oczekiwany wynik – w pełni skonfigurowane i powtarzalne środowisko obliczeniowe z wszystkimi wymaganymi pakietami oprogramowania, zasobami sprzętowymi, mechanizmami logowania i ustawieniami konfiguracji modelu, gotowe do późniejszego wstępnego przetwarzania danych, opracowywania modelu, analizy wyjaśnialności oraz procedur ewaluacji.
| Komponent | Parametr | Wartość | Opis |
| Random Forest | n_estimators | 100 | Liczba drzew |
| Random Forest | max_depth | None | Głębokość drzewa |
| XGBoost | learning_rate | 0.01 | Współczynnik uczenia |
| XGBoost | n_estimators | 100 | Liczba rund boostingu |
| CNN | epochs | 25 | Epoki uczenia |
| CNN | batch_size | 32 | Wielkość partii |
| CNN | optimizer | Adam | Algorytm optymalizacji |
| MLP | hidden_layers | 2 | Liczba warstw ukrytych |
| MLP | activation | ReLU | Funkcja aktywacji |
| Ogólne | train_split | 70% | Udział danych treningowych |
| Ogólne | validation_split | 15% | Udział danych walidacyjnych |
| Ogólne | test_split | 15% | Udział danych testowych |
Tabela 1: Szczegóły implementacji i konfiguracja hiperparametrów.
Tabela ta podsumowuje środowisko obliczeniowe, biblioteki oprogramowania, konfiguracje modeli uczenia maszynowego i głębokiego uczenia, ustawienia optymalizacji, tempo uczenia, rozmiary partii, parametry treningowe oraz wartości hiperparametrów wykorzystane podczas oceny eksperymentalnej proponowanego wyjaśnialnego frameworka AI.
3. Przygotowanie i wstępne przetwarzanie zbioru danych
- Wybierz publicznie dostępne zestawy danych z zakresu opieki zdrowotnej, aby zapewnić przejrzystość i powtarzalność przebiegu eksperymentu.;
- Wykorzystaj cztery reprezentatywne scenariusze opieki zdrowotnej do walidacji proponowanego modelu: (i) diagnostyka raka piersi z wykorzystaniem zbioru Wisconsin Breast Cancer Dataset, (ii) przewidywanie ryzyka cukrzycy z wykorzystaniem zbioru Pima Indians Diabetes Dataset, (iii) przewidywanie wyników klinicznych z wykorzystaniem elektronicznej dokumentacji medycznej MIMIC-III oraz (iv) klasyfikacja chorób klatki piersiowej z wykorzystaniem zbioru NIH Chest X-ray Dataset. Wybierz te zestawy danych, aby ocenić model w odniesieniu do ustrukturyzowanych rekordów klinicznych, podłużnej dokumentacji medycznej oraz modalności obrazowania medycznego powszechnie stosowanych w systemach wspomagania decyzji w ochronie zdrowia.
- Zaimportuj każdy zestaw danych do środowiska Python i podziel rekordy na cechy wejściowe oraz zmienne docelowe. Zorganizuj ustrukturyzowane dane kliniczne dla zadań przewidywania chorób, elektroniczną dokumentację medyczną dla podłużnej analizy wyników oraz zestawy obrazowania medycznego dla zadań klasyfikacji diagnostycznej. Zweryfikuj integralność każdego zestawu danych przed przystąpieniem do operacji preprocessingu.
- Zidentyfikuj i uzupełnij brakujące wartości, stosując odpowiednie techniki imputacji. Zestandaryzuj cechy numeryczne poprzez procedury skalowania i normalizacji cech, aby zapewnić porównywalność między zmiennymi.
- Zakoduj zmienne kategoryczne, stosując odpowiednie metody kodowania w zależności od charakterystyki zestawu danych. Przeprowadź selekcję cech za pomocą analizy korelacji i miar istotności cech opartych na modelach, aby zidentyfikować najistotniejsze zmienne i zredukować wymiarowość danych.
- Przed trenowaniem modelu zmień rozmiar wszystkich obrazów medycznych na 224, 224 pikseli. Znormalizuj wartości intensywności pikseli zgodnie z wymaganiami wybranej architektury głębokiego uczenia. Zastosuj techniki augmentacji danych, w tym rotację obrazów i poziome odbicie lustrzane, aby poprawić generalizację modelu i ograniczyć overfitting. Zweryfikuj jakość obrazów i zapewnij spójność wymiarów obrazów w całym zestawie danych.
- Oceń integralność danych, analizując kompletność zestawu danych, spójność oraz dopasowanie cech do etykiet. Upewnij się, że wszystkie rekordy są prawidłowo przypisane do odpowiadających im klas docelowych. Przejrzyj charakterystykę zestawów danych, w tym wielkość próby, liczbę cech i modalność danych, zgodnie z podsumowaniem w Tabeli 2.
- Wdróż procedury walidacji specyficzne dla danego zestawu danych, aby zapewnić rygor metodologiczny i powtarzalność. Zapisz wielkość próby, rozkład klas, strategię podziału na zbiory treningowy, walidacyjny i testowy, środki zapobiegające wyciekowi danych, procedury optymalizacji hiperparametrów, projekt walidacji krzyżowej oraz protokół testów zewnętrznych dla każdego zestawu danych. Podsumuj te procedury walidacyjne w Tabeli 3.
- Przeprowadź kontrole jakości preprocessingu, oceniając sposób obsługi brakujących wartości, usuwanie wartości odstających, skalowanie cech, kodowanie kategoryczne, zachowanie rozkładu klas oraz procedury partycjonowania zestawu danych. Upewnij się, że operacje preprocessingu są stosowane spójnie we wszystkich zestawach danych.
- Potwierdź brak istotnego wycieku danych podczas partycjonowania zestawów danych. Przejrzyj wyniki walidacji preprocessingu przedstawione na Rysunku 1, aby upewnić się, że wygenerowano zestandaryzowane zestawy danych do późniejszych analiz uczenia maszynowego i wyjaśnialności.
- Oczekiwany wynik – wygenerowanie oczyszczonych i zestandaryzowanych zestawów danych z odpowiednio uzupełnionymi brakującymi wartościami, zakodowanymi zmiennymi kategorycznymi, znormalizowanymi cechami numerycznymi oraz rekordami podzielonymi na podzbiory treningowe, walidacyjne i testowe. Upewnij się, że charakterystyka zestawów danych, rozkłady klas i procedury walidacji odpowiadają tym raportowanym w Tabeli 2 i Tabeli 3 oraz potwierdź pomyślną walidację preprocessingu, zgodnie z przedstawionym na Rysunku 1.
| Zbiór danych | Typ | Próbki | Cechy | Cel |
| Rak piersi | Tabularny | 569 | 30 | Łagodne/Złośliwe |
| Cukrzyca | Tabularny | 768 | 8 | Wynik leczenia cukrzycy |
| MIMIC-III | elektroniczna dokumentacja medyczna (EDM) | ~60,000 | Zmienne kliniczne | Śmiertelność |
| RTG klatki piersiowej | Obrazowanie | ~112,000 | Obrazy | Etykiety chorób |
Tabela 2: Charakterystyka zbiorów danych i przypadki użycia w opiece zdrowotnej.
Tabela ta zawiera podsumowanie zestawów danych medycznych wykorzystanych w badaniu, w tym typ zestawu danych, liczbę próbek, liczbę cech, zmienne objaśniane, domenę zastosowań w ochronie zdrowia oraz powiązane przypadki użycia klinicznego. Zestawy danych obejmują ustrukturyzowane rekordy kliniczne, elektroniczną dokumentację medyczną oraz dane obrazowania medycznego, aby wykazać możliwość zastosowania opracowanego modelu w różnorodnych scenariuszach analityki medycznej.
| Zbiór danych | Wielkość próby | Rozkład klas | Strategia podziału | Zapobieganie wyciekom | Wyszukiwanie hiperparametrów | Walidacja krzyżowa | Test zewnętrzny |
| Rak piersi (UCI Wisconsin) | 569 | 357 łagodne / 212 złośliwe | 70/15/15 | Preprocessing wyłącznie dla zbioru treningowego | Przeszukiwanie siatki | 5-krotna stratyfikowana walidacja krzyżowa | Niezależny zbiór walidacyjny |
| Cukrzyca u Indian Pima | 768 | 500 osób bez cukrzycy / 268 osób z cukrzycą | 70/15/15 | Preprocessing wyłącznie dla zbioru treningowego | Przeszukiwanie siatki (Grid Search) | 5-krotna stratyfikowana walidacja krzyżowa (CV) | Niezależny zbiór walidacyjny |
| MIMIC-III EHR | 5274 | Kohorty stratyfikowane według wyników | 70/15/15 na poziomie pacjenta | Separacja na poziomie pacjenta | Losowe przeszukiwanie | 5-krotna walidacja krzyżowa na poziomie pacjenta | Niezależny zbiór walidacyjny |
| RTG klatki piersiowej NIH | 112120 | Zapalenie płuc/Normalny nabłonek wielowarstwowy | 70/15/15 | Separacja na poziomie obrazu | Przeszukiwanie losowe | 5-krotna stratyfikowana walidacja krzyżowa (CV) | Niezależny zbiór walidacyjny |
Tabela 3: Walidacja na poziomie zbioru danych i projekt eksperymentalny.
W poniższej tabeli podsumowano metodologię walidacji zastosowaną dla każdego zbioru danych, w tym wielkość próby, rozkład klas, strategię podziału na zbiory treningowy, walidacyjny i testowy, procedury zapobiegania wyciekowi danych, metody optymalizacji hiperparametrów, strukturę walidacji krzyżowej oraz protokoły testów zewnętrznych. Środki te zostały wprowadzone w celu zapewnienia rygoru metodologicznego, powtarzalności oraz bezstronnej oceny modelu.
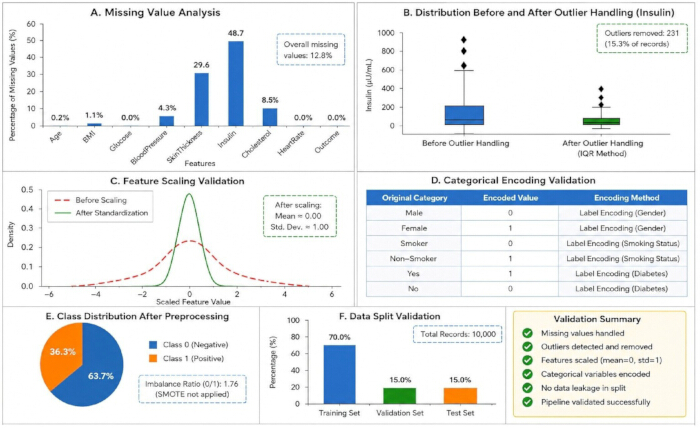
Rysunek 1: Walidacja potoku wstępnego przetwarzania danych.
Wyniki walidacji kluczowych operacji wstępnego przetwarzania przeprowadzonych przed opracowaniem modelu. (A) Analiza brakujących wartości dla reprezentatywnych cech opieki zdrowotnej. (B) Rozkład zmiennej numerycznej przed i po obsłudze wartości odstających. (C) Walidacja skalowania cech z wykorzystaniem standaryzacji. (D) Walidacja kodowania kategorycznego. (E) Rozkład klas po wstępnym przetwarzaniu. (F) Walidacja podziału danych na zbiory treningowy, walidacyjny i testowy. Wyniki te potwierdzają pomyślne wstępne przetwarzanie i przygotowanie zbiorów danych do modelowania predykcyjnego oraz analizy wyjaśnialności. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
4. Architektura systemu ramowego wyjaśnialnej sztucznej inteligencji
- Zorganizuj strukturę w ramach architektury warstwowej, aby ułatwić przetwarzanie modułowe, zwiększyć przejrzystość przepływu pracy i wesprzeć powtarzalną implementację. Skonfiguruj warstwę danych (Data Layer) do odbierania i zarządzania surowymi zbiorami danych opieki zdrowotnej. Kieruj wszystkie przychodzące zbiory danych przez warstwę danych przed rozpoczęciem operacji preprocessingu.
- Przeprowadź procedury czyszczenia, transformacji, normalizacji, inżynierii cech oraz kodowania danych w warstwie preprocessingu (Preprocessing Layer). Upewnij się, że wszystkie operacje preprocessingu zostały zakończone przed przystąpieniem do opracowania modelu.
- Opracuj modele predykcyjne w warstwie modelowania (Modeling Layer), wykorzystując algorytmy uczenia maszynowego i uczenia głębokiego. Wytrenuj modele Gradient Boosting, Random Forest, wielowarstwowy perceptron (MLP) oraz splotowe sieci neuronowe (CNN), wykorzystując przetworzone zbiory danych i zoptymalizowane konfiguracje hiperparametrów.
- Zastosuj techniki wyjaśnialności w warstwie wyjaśnialności (Explainability Layer), aby zinterpretować predykcje modeli. Wygeneruj wyjaśnienia atrybucji cech za pomocą SHAP i LIME dla ustrukturyzowanych zbiorów danych. Wygeneruj mapy ciepła Grad-CAM dla modeli opartych na obrazach, aby zwizualizować obszary wpływające na predykcje modelu.
- Oceń wydajność predykcyjną i wyjaśnialność w warstwie ewaluacji (Evaluation Layer). Oblicz dokładność (accuracy), precyzję (precision), pełność (recall), wynik F1 (F1-score), ROC-AUC, wierność (fidelity), stabilność oraz metryki oceny zorientowane na klinicystę. Zapisz wszystkie wyniki ewaluacji do późniejszej analizy i raportowania.
- Wygeneruj klinicznie interpretowalne wyniki wizualne w warstwie wizualizacji (Visualization Layer). Stwórz wykresy porównawcze wydajności, wizualizacje istotności cech, wykresy podsumowujące SHAP, wyjaśnienia LIME, mapy ciepła Grad-CAM oraz pulpity raportowe przeznaczone dla klinicystów. Zapisz wszystkie wyniki wizualne do dołączenia do końcowego raportu eksperymentalnego.
- Przejrzyj pełną architekturę struktury przedstawioną na Rysunku 2 przed przystąpieniem do realizacji przepływu pracy.
- Oczekiwany wynik – Wygenerowanie w pełni wytrenowanych modeli uczenia maszynowego i uczenia głębokiego, w tym architektur Gradient Boosting, Random Forest, CNN i MLP. Zapisz konfiguracje modeli, zoptymalizowane hiperparametry, logi z trenowania, pliki punktów kontrolnych (checkpoint), wyniki wyjaśnialności oraz artefakty wizualizacji do późniejszej ewaluacji i analizy interpretowalności.
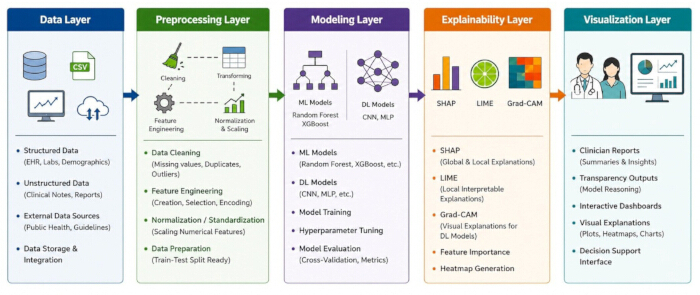
Rysunek 2: Architektura systemu ramowego wyjaśnialnej sztucznej inteligencji (Explainable AI) w analityce opieki zdrowotnej. Kliknij tutaj, aby zobaczyć powiększoną wersję tego rysunku.
5. Wykonanie przepływu pracy
- Pobierz zbiory danych medycznych z publicznie dostępnych repozytoriów i zapisz je w ustrukturyzowanych formatach odpowiednich do analizy z wykorzystaniem uczenia maszynowego i głębokiego uczenia. Przed rozpoczęciem procedury eksperymentalnej zapoznaj się z pełnym schematem przepływu pracy przedstawionym na Rysunku 3.
- Przeprowadź czyszczenie i wstępne przetwarzanie danych zgodnie z procedurami opisanymi w Sekcji 3. Znormalizuj zmienne numeryczne, stosując odpowiednie metody skalowania. Zakoduj zmienne kategoryczne, używając właściwych technik kodowania. Zidentyfikuj i uzupełnij brakujące wartości, stosując strategie imputacji specyficzne dla danego zbioru danych. Przed przystąpieniem do opracowywania modelu zweryfikuj jakość danych, dopasowanie cech do etykiet oraz kompletność zbioru danych.
- Podziel każdy zbiór danych na podzbiory treningowy, walidacyjny i testowy, aby zapewnić bezstronną ewaluację modelu. Zachowaj rozkłady klas podczas podziału zbiorów danych i wdróż środki zapobiegające wyciekowi danych (leakage), jeśli jest to właściwe. Podzbiór testowy zastrzeż wyłącznie do końcowej ewaluacji modelu.
- Wytrenuj modele uczenia maszynowego na ustrukturyzowanych zbiorach danych, korzystając z algorytmów opartych na zespołach (ensemble), w tym Gradient Boosting i Random Forest. Wytrenuj modele głębokiego uczenia na zbiorach danych obrazowych, wykorzystując architektury splotowych sieci neuronowych (CNN) zdolnych do uczenia się przestrzennych cech obrazu. Iteracyjnie aktualizuj parametry modelu podczas treningu i monitoruj wyniki walidacji po każdej epoce uczenia. Zastosuj wczesne zatrzymanie (early stopping), gdy wyniki walidacji ulegną pogorszeniu lub przestaną się poprawiać zgodnie z predefiniowanymi kryteriami zatrzymania.
- Zoptymalizuj hiperparametry modelu, stosując systematyczne strategie przeszukiwania, takie jak grid search i randomized search. Dostosuj szybkość uczenia (learning rate), liczbę estymatorów, głębokość drzew, wielkość partii (batch size), liczbę epok oraz inne parametry specyficzne dla modelu w zależności od wyników walidacji. Wybierz model końcowy na podstawie jego zdolności predykcyjnych i możliwości generalizacji na zbiorach walidacyjnych.
- Po zakończeniu trenowania modelu zastosuj metody wyjaśnialności. Wygeneruj wyjaśnienia globalne, korzystając z technik atrybucji cech, aby zidentyfikować zmienne najsilniej wpływające na predykcje modelu. Wygeneruj wyjaśnienia lokalne, aby przeanalizować poszczególne przypadki predykcji i ocenić zachowanie modelu na poziomie pojedynczych próbek. Stwórz mapy ciepła Grad-CAM dla modeli klasyfikacji obrazów, aby wyróżnić obszary obrazu przyczyniające się do przewidzianego wyniku. Zapisz wszystkie wyniki wyjaśnień do późniejszej analizy i raportowania.
- Oceń wydajność predykcyjną, korzystając z dokładności (accuracy), precyzji (precision), czułości (recall), wyniku F1 (F1-score) oraz pola pod krzywą charakterystyki pracy odbiornika (ROC-AUC). Oceń jakość wyjaśnień za pomocą metryk wierności (fidelity) i stabilności, aby zweryfikować niezawodność i spójność wyjaśnień. Porównaj wydajność modelu w różnych zbiorach danych i metodach wyjaśnialności, aby ocenić odporność i generalizowalność opracowanego frameworku.
- Wygeneruj wizualizacje i raporty analityczne, aby przedstawić wyniki w sposób interpretowalny klinicznie. Stwórz wykresy porównawcze wydajności, wykresy istotności cech, wizualizacje podsumowujące SHAP, wyniki wyjaśnień LIME, mapy ciepła Grad-CAM oraz inne klinicznie istotne wizualizacje. Przed raportowaniem przejrzyj wszystkie wyniki wizualne, aby zapewnić ich przejrzystość i spójność.
- Udokumentuj wszystkie operacje wstępnego przetwarzania, konfiguracje modeli, ustawienia hiperparametrów, procedury wyjaśnialności, strategie walidacji i wyniki ewaluacji. Prowadź szczegółową dokumentację eksperymentalną, aby ułatwić reprodukowalność i niezależną replikację schematu pracy. Zweryfikuj spójność wyników w powtórzonych uruchomieniach eksperymentalnych i zarchiwizuj wszystkie artefakty procesu dla przyszłych odniesień.
- Oczekiwany wynik – wygenerowanie w pełni wytrenowanego modelu predykcyjnego z zoptymalizowanymi hiperparametrami, zapisanych wag modelu, logów treningowych, metryk wydajności oraz wyników wyjaśnialności, w tym wyjaśnień SHAP, wyjaśnień LIME i map ciepła Grad-CAM. Zapisz wszystkie artefakty modelu, raporty ewaluacyjne i wizualizacje do późniejszej analizy oraz oceny reprodukowalności.
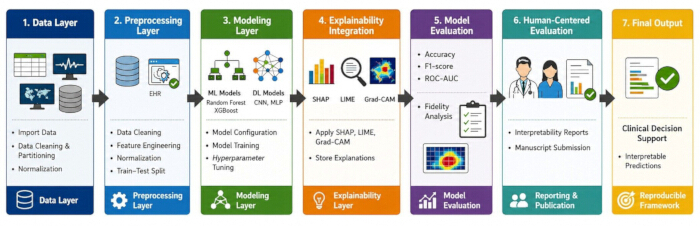
Rysunek 3: Kompletny schemat przepływu pracy w potoku wyjaśnialnej sztucznej inteligencji (XAI). Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
6. Ocena modelu i analiza wyjaśnialności
- Oceń wydajność modelu predykcyjnego przy użyciu standardowych metryk klasyfikacji, w tym dokładności (accuracy), precyzji (precision), czułości (recall), wyniku F1 (F1-score) oraz pola pod krzywą charakterystyki pracy odbiornika (ROC-AUC). Oblicz dokładność, aby zmierzyć ogólną poprawność klasyfikacji.
- Oblicz precyzję, aby ocenić proporcję poprawnie zidentyfikowanych pozytywnych predykcji. Oblicz czułość, aby ocenić zdolność modelu do identyfikacji przypadków pozytywnych. Oblicz wynik F1, aby zrównoważyć precyzję i czułość. Oblicz ROC-AUC, aby ocenić zdolność dyskryminacyjną dla różnych progów klasyfikacji.
- Zastosuj te metryki oceny konsekwentnie we wszystkich zbiorach danych i architekturach modeli, aby umożliwić obiektywne porównanie wydajności. Zapisz wszystkie wartości metryk i przechowuj wyniki oceny do późniejszej analizy statystycznej i raportowania.
- Oceń wydajność wyjaśnialności przy użyciu metryk wierności (fidelity) i stabilności (stability). Oblicz wierność, aby określić stopień, w jakim wygenerowane wyjaśnienia dokładnie odzwierciedlają predykcje modelu i sposób podejmowania decyzji.
- Oblicz stabilność, porównując wyjaśnienia wygenerowane z podobnych próbek wejściowych i kwantyfikując spójność wyników wyjaśnień. Zweryfikuj, czy wartości wierności i stabilności spełniają predefiniowane kryteria jakości przed interpretacją wyjaśnień modelu.
- Porównaj wydajność wyjaśnialności dla wyników uzyskanych metodami SHAP, LIME i Grad-CAM.
- Oczekiwany wynik – wygenerowanie ilościowych wyników oceny, w tym metryk dokładności, precyzji, czułości, wyniku F1, ROC-AUC, wierności i stabilności. Przygotowanie wyników wyjaśnialności i wizualizacji odpowiednich do raportowania naukowego, oceny powtarzalności oraz interpretacji klinicznej.
7. Ocena zorientowana na człowieka
- Zrekrutuj 12 pracowników służby zdrowia, w tym 6 lekarzy, 3 radiologów i 3 analityków danych klinicznych. Wybierz uczestników z wcześniejszym doświadczeniem w podejmowaniu decyzji klinicznych, interpretacji obrazów medycznych, analityce zdrowotnej lub przeglądzie elektronicznej dokumentacji medycznej. Uzyskaj świadomą zgodę od wszystkich uczestników przed rozpoczęciem procedury oceny.
- Po zakończeniu trenowania modelu i analizy wyjaśnialności, losowo wybierz 100 przypadków ze zbiorów testowych. Wygeneruj dwa warunki oceny dla każdego przypadku:
- wynik zawierający tylko predykcję oraz
- predykcję wraz z informacjami dotyczącymi wyjaśnialności. Zrandomizuj kolejność prezentacji przypadków i warunków oceny, aby zminimalizować błąd prezentacji oraz efekty uczenia się.
- Przygotuj ustandaryzowane formularze oceny zawierające wyniki predykcji, wygenerowane wyjaśnienia oraz kwestionariusze oceny. Prezentuj przypadki uczestnikom indywidualnie, korzystając z komputerowego interfejsu oceny.
- Poinstruuj uczestników, aby analizowali każdy przypadek niezależnie, bez omawiania odpowiedzi z innymi oceniającymi. Zapewnij uczestnikom możliwość przeprowadzenia wszystkich ocen w identycznych warunkach eksperymentalnych.
- Przeprowadź ankietę z wykorzystaniem pięciostopniowej skali Likerta, dostosowanej na podstawie opublikowanych badań nad oceną wyjaśnialnej sztucznej inteligencji. Poinstruuj uczestników, aby ocenili poziom zaufania, interpretowalność i użyteczność dla każdego analizowanego przypadku. Zapisz odpowiedzi z kwestionariusza elektronicznie i zweryfikuj wypełnienie wszystkich elementów ankiety przed przejściem do analizy statystycznej.
- W trakcie procesu oceny mierz obiektywne wskaźniki użyteczności klinicznej. Zapisz zgodność decyzji, porównując decyzje uczestników z odpowiadającymi im etykietami referencyjnymi lub wynikami rzeczywistymi (ground-truth). Oblicz zgodność decyzji jako procent decyzji uczestników zgodnych z wynikiem referencyjnym.
- Zapisz czas analizy dla każdego przypadku, mierząc odstęp między prezentacją przypadku a końcowym przesłaniem odpowiedzi. Oblicz średni czas analizy oddzielnie dla warunków predykcji-tylko oraz predykcji-z-wyjaśnieniem.
- Oblicz średnie wyniki zaufania, interpretowalności i użyteczności dla wszystkich uczestników i przypadków oceny. Porównaj wyniki uzyskane w warunkach predykcji-tylko i predykcji-z-wyjaśnieniem.
- Po zakończeniu wszystkich ocen uczestników przeprowadź testy t-studenta dla prób zależnych, aby ustalić, czy różnice w zaufaniu, interpretowalności, użyteczności, zgodności decyzji i czasie analizy są istotne statystycznie. Dla wszystkich porównań statystycznych przyjmij próg istotności p < 0.05.
- Po zebraniu odpowiedzi od wszystkich uczestników oblicz współczynnik Fleissa Kappa, aby ocenić zgodność między oceniającymi. Wykorzystaj zagregowane oceny uczestników do określenia spójności ocen pomiędzy recenzentami. Interpretuj wartości Fleissa Kappa zgodnie z ustalonymi wytycznymi dotyczącymi zgodności i zapisz wynikowe statystyki zgodności.
- Podsumuj demografię uczestników, metodologię oceny, projekt kwestionariusza, procedury analizy statystycznej, obiektywne miary wydajności oraz wyniki zgodności między oceniającymi w Tabeli 4.
- Przeanalizuj wyniki modelu w obu warunkach oceny i porównaj odpowiedzi uczestników pomiędzy tymi warunkami. Zweryfikuj, czy wyjaśnienia poprawiają zaufanie, interpretowalność i użyteczność, nie wpływając negatywnie na jakość decyzji.
- Potwierdź spójność ocen uczestników za pomocą obliczonej statystyki Fleissa Kappa. Zapisz wszystkie wyniki oceny do późniejszego raportowania i oceny reprodukowalności.
- Oczekiwany wynik – wygenerowanie wyników zaufania klinicystów, ocen interpretowalności, ocen użyteczności, miar zgodności decyzji, statystyk czasu analizy, wyników testów t-studenta dla prób zależnych oraz statystyk zgodności między oceniającymi. Dostarczenie dowodów ilościowych opisujących użyteczność kliniczną, interpretowalność i wiarygodność frameworku wyjaśnialnej sztucznej inteligencji.
| Parametr | Wartość |
| Eksperci | 12 |
| Lekarze | 6 |
| Radiolodzy | 3 |
| Analitycy danych klinicznych | 3 |
| Omówione przypadki | 100 |
| Projekt oceny | Randomizacja (tylko predykcja vs predykcja + wyjaśnienie) |
| Narzędzie badawcze | 5-stopniowa skala Likerta |
| Ocena zaufania | Interpretowalność, zaufanie, użyteczność |
| Test statystyczny | Test t-studenta dla prób zależnych (p < 0,05) |
| Niezawodność międzyoceniająca | Kappa Fleissa |
| Mierniki obiektywne | Zgodność decyzji, czas recenzji |
Tabela 4: Protokół oceny zorientowanej na człowieka i projekt oceny klinicznej.
Tabela ta przedstawia ramy oceny klinicznej wykorzystane do analizy interpretowalności, wiarygodności i użyteczności systemu wyjaśnialnej sztucznej inteligencji. Podsumowano w niej informacje dotyczące demografii uczestników, metodologii przeglądu przypadków, projektu ankiety, procedur analizy statystycznej, oceny niezawodności między sędziami oraz obiektywnych miar oceny.
8. Walidacja i ocena powtarzalności
- Przeprowadź badania walidacyjne i studia ablacyjne w celu oceny odporności i niezawodności proponowanego modelu. Zidentyfikuj cechy o wysokich wynikach istotności, wykorzystując wybrane metody wyjaśnialności. Usuwaj istotne cechy stopniowo i ponawiaj trenowanie modeli predykcyjnych po każdym etapie usunięcia cechy.
- Oceń wydajność modelu po każdym eksperymencie ablacyjnym, korzystając z metryk takich jak dokładność (accuracy), precyzja (precision), czułość (recall), wynik F1 oraz ROC-AUC. Porównaj uzyskane wartości wydajności z wynikami modelu bazowego, aby określić wkład poszczególnych cech w wyniki predykcji.
- Oceń stabilność wyjaśnień, generując wyjaśnienia dla podobnych próbek wejściowych przy użyciu metod SHAP, LIME oraz Grad-CAM. Porównaj wyniki wyjaśnień w ramach powtórzonych ewaluacji i określ stopień spójności za pomocą zdefiniowanych metryk stabilności. Zweryfikuj, czy wyjaśnienia pozostają stabilne przy niewielkich zmianach danych wejściowych oraz w powtórzonych seriach eksperymentalnych.
- Zapisuj wszystkie procedury eksperymentalne w całym przebiegu procesu. Dokumentuj operacje wstępnego przetwarzania danych, procedury podziału zbioru danych, architektury modeli, ustawienia hiperparametrów, konfiguracje trenowania, metody wyjaśnialności, strategie walidacji oraz metryki oceny. Przechowuj wszystkie parametry konfiguracji i wyniki eksperymentalne w formacie strukturalnym, aby umożliwić reprodukowalność i niezależną weryfikację.
- Przejrzyj wszystkie zapisy eksperymentalne, aby zapewnić ich kompletność i spójność. Zweryfikuj, czy przebieg procesu można powtórzyć, korzystając z udokumentowanych procedur, plików konfiguracyjnych i specyfikacji oprogramowania. Utrzymuj modułową strukturę procesu, aby ułatwić adaptację protokołu w przyszłych badaniach oraz umożliwić przekształcenie go w wideo-protokół eksperymentalny zgodny z wymaganiami metodologicznymi JoVE.
9. Materiały dotyczące powtarzalności
- Wszystkie eksperymenty należy przeprowadzać z wykorzystaniem stałych ziarn randomizacji (random seeds), aby zapewnić powtarzalność wyników w kolejnych uruchomieniach. Kod źródłowy, skrypty do wstępnego przetwarzania danych, pliki konfiguracyjne, specyfikacje środowiska, parametry modeli oraz skrypty do wizualizacji należy przechowywać w publicznie dostępnym repozytorium.
- Należy przedstawić szczegółowe instrukcje dotyczące pozyskiwania zbiorów danych, ich wstępnego przetwarzania, przeprowadzania eksperymentów, trenowania modelu, generowania wyjaśnień (explainability), procedur walidacji oraz odtwarzania wszystkich raportowanych tabel i rycin. Należy zarchiwizować wszystkie komponenty przepływu pracy niezbędne do niezależnej replikacji, w tym specyfikacje oprogramowania, schematy wstępnego przetwarzania, pliki konfiguracyjne, instrukcje dostępu do zbiorów danych, punkty kontrolne modelu (checkpoints) oraz zasoby wizualizacyjne.
- Podsumuj zasoby programistyczne, przepływy przetwarzania wstępnego, pliki konfiguracyjne, instrukcje dostępu do zbiorów danych oraz zasoby służące do odtwarzalności wykorzystane w ramach całego systemu w Tabela 5.
- Oczekiwany rezultat Wygeneruj kompletny, powtarzalny pakiet eksperymentalny zawierający skrypty preprocessingu, pliki konfiguracyjne, wytrenowane modele, punkty kontrolne modeli (checkpoints), wyniki analizy wyjaśnialności, raporty walidacyjne, artefakty wizualizacji, specyfikacje oprogramowania oraz dokumentację niezbędną do niezależnej replikacji i weryfikacji proponowanego frameworku.
| Zasób | Opis |
| Kod źródłowy | Skrypty implementacyjne w języku Python do wstępnego przetwarzania danych, trenowania modelu, wyjaśnialności i ewaluacji |
| Plik środowiskowy | plik requirements.txt zawierający zależności i wersje pakietów |
| Pliki konfiguracyjne | Ustawienia architektury modelu, hiperparametry i konfiguracje eksperymentów |
| Stałe ziarna losowe | Użyto ziarna (seed) o wartości 42 w celu zapewnienia powtarzalności eksperymentów |
| Instrukcje dostępu do zbioru danych | Linki i procedury pozyskiwania publicznych zbiorów danych z zakresu opieki zdrowotnej |
| Skrypty do wstępnego przetwarzania | Skrypty do czyszczenia, normalizacji, kodowania i selekcji cech danych |
| Skrypty do generowania rycin | Skrypty do regeneracji wszystkich rycin w manuskrypcie |
| Skrypty do generowania tabel | Skrypty do reprodukcji raportowanych tabel i metryk |
| Przykładowe dane wejściowe | Przykładowe zestawy danych i pliki wejściowe |
| Przykładowe wyniki | Wyniki predykcji, wyjaśnienia i raporty z ewaluacji |
Tabela 5: Zasoby dotyczące powtarzalności i materiały eksperymentalne.
Tabela ta podsumowuje zasoby udostępnione w celu zapewnienia powtarzalności eksperymentów, w tym kod źródłowy, skrypty do wstępnego przetwarzania danych, pliki konfiguracyjne, specyfikacje środowiska, instrukcje dostępu do zbiorów danych, ustawienia stałych ziarn losowości (random seed), skrypty do generowania wykresów oraz przykładowe pliki wejściowe i wyjściowe niezbędne do odtworzenia raportowanych wyników.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Dokonaliśmy szczegółowej oceny komponentu wyjaśniającej sztucznej inteligencji w całym naszym procesie, analizując skuteczność przewidywań dla różnych typów danych medycznych, w tym zarówno ustrukturyzowanych danych klinicznych, jak i obrazów medycznych. Wyniki wykazały spójną wydajność predykcyjną we wszystkich ocenianych zbiorach danych. Wśród przetestowanych modeli model gradient boosting osiągnął najwyższą dokładność na poziomie 97,4%, a następnie model random forest z wynikiem 94,2%. Metody głębokiego uczenia zastos...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
To badanie opracowało i oceniło spostrzegalny przepływ pracy sztucznej inteligencji z możliwością wyjaśnienia (XAI) dla analityki opieki zdrowotnej, który integruje modelowanie predykcyjne, ocenę możliwości wyjaśnienia, ocenę ukierunkowaną na klinicyna i zasoby dotyczące powtarzalności w jednym protokole. Wyniki wykazały, że modele uczenia maszynowego oparte na ensemblu, szczególnie Gradient Boosting i Random Forest, osiągnęły najwyższą wydajność predykcyjną na ocenionych strukturalnych zbiorach danych dotyczących opieki...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy deklarują, że nie mają żadnych konkurencyjnych interesów finansowych ani konfliktów interesów związanych z tą pracą. Badania przeprowadzono niezależnie bez żadnych komercyjnych lub finansowych relacji, które mogłyby być uznane za potencjalny konflikt interesów.
Deklaracja użycia sztucznej inteligencji
Narzędzia sztucznej inteligencji zostały wykorzystane do doskonalenia języka, sprawdzania gramatyki i pomocy edytorskiej podczas przygotowywania rękopisu. Cały naukowy treść, projekt eksperymentu, analiza danych, interpretacja i ostateczna weryfikacja rękopisu zostały wykonane przez autorów. Autorzy przejrzeli i zweryfikowali wszystkie wyniki wspomaganej sztuczną inteligencją, aby zapewnić dokładność, integralność i zgodność z wytycznymi czasopisma.
Podziękowania
Autorzy dziękują swoim odpowiednim instytucjom za zapewnienie niezbędnej infrastruktury i wsparcia badawczego w celu przeprowadzenia tego badania. Autorzy z okazji wykorzystania publicznie dostępnych zestawów danych i narzędzi open-source, które ułatwiły opracowanie i ocenę proponowanego wyjaśnialnego frameworku AI. Szczególne podziękowania kierujemy do ekspertów z dziedziny, którzy dostarczyli cenny wgląd podczas fazy oceny zorientowanej na człowieka.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| GPU Workstation | Producent | N/D | Trening modeli uczenia się głębokiego |
| Jupyter Notebook | Project Jupyter | Najnowsza stabilna wersja | Interaktywne wykonywanie eksperymentów |
| LIME | LIME | Wersja 0.2.0 | Lokalne interpretowalne wyjaśnienia |
| Matplotlib | Matplotlib Project | Wersja 3.9 | Wizualizacja danych |
| MIMIC-III Database | PhysioNet | Wersja 1.4 | Analiza elektronicznych dokumentów zdrowotnych |
| NIH Chest X-ray Dataset | NIH Clinical Center | Publiczny zestaw danych | Klasyfikacja chorób klatki piersiowej |
| NumPy | NumPy Developers | Wersja 1.26 | Obliczenia numeryczne i operacje na tablicach |
| OpenCV | OpenCV Foundation | Wersja 4.10 | Przetwarzanie obrazów |
| Pandas | Pandas Development Team | Wersja 2.1 | Manipulacja danymi i przetwarzanie wstępne |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | Publiczny zestaw danych | Przewidywanie ryzyka cukrzycy |
| Python 3.11 | Python Software Foundation | Wersja 3.11 | Główne środowisko programistyczne |
| Scikit-learn | scikit-learn | Wersja 1.5 | Algorytmy uczenia maszynowego i ewaluacja |
| Seaborn | Seaborn | Wersja 0.13 | Wizualizacja statystyczna |
| SHAP | SHAP | Wersja 0.46 | Atrybucja funkcji i wyjaśnialność |
| TensorFlow | TensorFlow | Wersja 2.15 | Rozwój modeli uczenia się głębokiego |
| Windows / Ubuntu Linux | Microsoft / Canonical | N/D | System operacyjny |
| Wisconsin Breast Cancer Dataset | UCI Machine Learning Repository | Publiczny zestaw danych | Diagnoza raka piersi |
Bibliografia
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you. Explaining the predictions of any classifier. Presented at: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2016. p. 1135-44. doi:10.1145/2939672.2939778.
- Selvaraju RR, et al. Grad-CAM: Visual explanations from deep networks via gradient-based localization. Int J Comput Vis. 2020;128(2):336-59.
- Tjoa E, Guan C. A survey on explainable artificial intelligence: Toward medical XAI. IEEE Trans Neural Netw Learn Syst. 2021;32(11):4793-813.
- Samek W, et al. Explainable AI: Interpreting, Explaining and Visualizing Deep Learning. Springer; Cham; 2019.
- Arrieta AB, et al. Explainable artificial intelligence: Concepts, taxonomies, opportunities and challenges toward responsible AI. Inf Fusion. 2020;58:82-115.
- Holzinger A, et al. Causability and explainability of artificial intelligence in medicine. Wiley Interdiscip Rev Data Min Knowl Discov. 2020;10(5):e1312.
- Topol E. Deep medicine: How artificial intelligence can make healthcare human again. Nat Med. 2020;25:44-56.
- Esteva A, et al. A guide to deep learning in healthcare. Nat Med. 2019;25(1):24-9.
- Rajpurkar P, Chen E, Banerjee O, Topol EJ. AI in health and medicine. Nat Med. 2022;28:31-38.
- Doshi-Velez F, Kim B. Towards a rigorous science of interpretable machine learning. arXiv. 2021. doi:10.48550/arXiv.1702.08608.
- Molnar C. Interpretable Machine Learning. Lulu Press; 2022.
- Rudin C. Stop explaining black box machine learning models for high-stakes decisions and use interpretable models instead. Nat Mach Intell. 2019;1(5):206-15.
- Zhang Q, Zhu S. Visual interpretability for deep learning: A survey. Front Inf Technol Electron Eng. 2020;21:27-39.
- Holzinger A, Biemann C, Pattichis CS, Kell DB. What do we need to build explainable AI systems for the medical domain. arXiv. 2020. Available at: https://arxiv.org/abs/1712.09923.
- McDermott MB, et al. Reproducibility in machine learning for health. Nat Med. 2021;27:1016-23.
- Kelly CJ, et al. Key challenges for delivering clinical impact with AI. BMC Med. 2019;17:195.
- Ahmad MA, Teredesai A, Eckert C. Interpretable machine learning in healthcare. Proc ACM Conf Health Inference Learn. 2021;4:1-7.
- Ghassemi M, Oakden-Rayner L, Beam AL. The false hope of current approaches to explainable AI in healthcare. Lancet Digit Health. 2021;3(11):e745-50.
- Carvalho DV, Pereira EM, Cardoso JS. Machine learning interpretability: A survey on methods and metrics. Inf Fusion. 2020;58:82-115.
- Chen RJ, et al. Synthetic data in healthcare: A narrative review. Nat Biomed Eng. 2021;5:493-97.
- Zhou B, et al. Learning deep features for discriminative localization. Presented at: Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition; 2016. p. 2921-29.
- Vellido A. The importance of interpretability and visualization in machine learning for applications in medicine and health care. Expert Syst Appl. 2020;146:113222.
- Lipton ZC. The mythos of model interpretability. Commun ACM. 2018;61(10):36-43.
- Guidotti R, et al. A survey of methods for explaining black box models. ACM Comput Surv. 2018;51(5):93.
- Suresh H, Guttag J. A framework for understanding unintended consequences of machine learning. Commun ACM. 2021;64(12):42-50.
- Wiens J, et al. Do no harm: A roadmap for responsible machine learning for health care. Nat Med. 2019;25(9):1337-40.
- Rajkomar A, Dean J, Kohane I. Machine learning in medicine. N Engl J Med. 2019;380(14):1347-58.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions. Presented at: Advances in Neural Information Processing Systems. 2017;30:4765-74.
- Agarwal R, et al. Neural additive models: Interpretable machine learning with neural nets. Presented at: Advances in Neural Information Processing Systems. 2021;34:4699-711.
- Singh C, Murdoch WJ, Yu B. Hierarchical interpretations for neural network predictions. Proc Natl Acad Sci U S A. 2020;117(32):19950-57.
- Tonekaboni S, Joshi S, McCradden MD, Goldenberg A. What clinicians want: Contextualizing explainable machine learning for clinical end use. Nat Mach Intell. 2019;1(5):176-85.
- Wang F, Preininger A. AI in health care: Applications, challenges, and future directions. Annu Rev Biomed Data Sci. 2019;2:221-52.
- Azizi S, et al. Big self-supervised models advance medical AI. Nat Med. 2021;27(8):1431-42.
- Zhang Y, et al. Explainable deep learning for healthcare: Methods, applications and challenges. IEEE Access. 2020;8:120455-475.
- Holzinger A, et al. Explainable AI methods: A brief overview. Mach Learn Knowl Extr. 2021;3(2):606-27.
- Rudin C, Radin J. Why are we using black box models in AI when we do not need to A lesson from an explainable AI competition. Nat Mach Intell. 2019;1(5):206-15.
- Doshi-Velez F, et al. Accountability of AI Under the Law: The Role of Explanation. Harvard University; Cambridge; 2020.
- Kaur H, et al. Interpreting interpretability: Understanding data scientists' use of interpretability tools for machine learning. Presented at: Proceedings of the CHI Conference on Human Factors in Computing Systems; 2020. p. 1-14.
- Caruana R, et al. Intelligible models for healthcare: Predicting pneumonia risk and hospital 30-day readmission. Presented at: Proceedings of the ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; 2015. p. 1721-30.
- Mangalote IAC, et al. Development and validation of a class imbalance-resilient cardiac arrest prediction framework incorporating multiscale aggregation, ICA and explainability. IEEE Trans Biomed Eng. 2025;72(5):1674-84.
- Ansari MY, Mangalote IAC, Masri D, Dakua SP. Neural network-based fast liver ultrasound image segmentation. Presented at: 2023 International Joint Conference on Neural Networks; 2023. p. 1-8.
- Dakua SP, et al. Artificial intelligence enabled biomineralization for eco-friendly nanomaterial synthesis: Charting future trends. Nano Select. 2025;6(5):e202400118.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.