Zaproponowany framework MSCNN-LSTM integruje wielkoskalową ekstrakcję cech przestrzennych z modelowaniem sekwencji czasowych w celu rozpoznawania akcji w nagraniach wideo ze sportu, przechwytując precyzyjne cechy przestrzenne oraz czasowe wzorce ruchu, przy jednoczesnym osiągnięciu konkurencyjnej wydajności klasyfikacji na benchmarkowych zbiorach danych dotyczących akcji sportowych.
Artykuł badawczy
Rozpoznawanie czynności w materiałach wideo z dyscyplin sportowych przy użyciu wieloskalowych sieci konwolucyjnych z modelowaniem czasowym opartym na długiej krótkotrwałej pamięci (LSTM)
W tym artykule
Podsumowanie
Streszczenie
Rozpoznawanie czynności w filmach sportowych pozostaje wyzwaniem ze względu na złożoną dynamikę ruchu, przesłonięcia oraz wysoką zmienność wewnątrzklasową. Choć istniejące podejścia oparte na głębokim uczeniu, w tym modele CNN-BiLSTM oraz modele bazujące na uczeniu transferowym, wykazały skuteczność w rozpoznawaniu ludzkiej aktywności, ich wydajność może być ograniczona w scenariuszach sportowych charakteryzujących się szybkimi i zróżnicowanymi ruchami. Wiele istniejących metod opiera się na jednoskalowych filtrach splotowych, które mogą nie uchwycić efektywnie jednoczesnych szczegółowych i ogólnych cech ruchu. Aby rozwiązać to ograniczenie, w niniejszym badaniu zaproponowano wieloskalową konwolucyjną sieć neuronową (MSCNN) zintegrowaną z siecią Long Short-Term Memory (LSTM) do rozpoznawania czynności w filmach sportowych. Sieć MSCNN wyodrębnia reprezentacje przestrzenne w wielu polach recepcyjnych za pomocą równoległych jąder splotowych, co umożliwia naukę zarówno szczegółowych, jak i kontekstowych cech ruchu. Cechy te są następnie przetwarzane przez sieć LSTM w celu uchwycenia zależności czasowych i ciągłości ruchu w kolejnych klatkach. Ocena eksperymentalna została przeprowadzona na zestawach danych referencyjnych UCF11, UCF Sports oraz JHMDB. Zaproponowany model MSCNN-LSTM osiągnął dokładność klasyfikacji wynoszącą odpowiednio 98,3%, 95,4% i 81,7%, przewyższając podejścia porównawcze ocenione w tym badaniu. Analiza ablacyjna dodatkowo wykazała wkład wieloskalowego wyodrębniania cech oraz modelowania czasowego w ogólną wydajność. Wyniki te potwierdzają potencjał zaproponowanego rozwiązania w zakresie łączenia informacji przestrzennych i czasowych do rozpoznawania czynności w filmach sportowych.
Wprowadzenie
Rozpoznawanie aktywności człowieka ma szerokie zastosowanie w różnych dziedzinach świata rzeczywistego, w tym w inteligentnym nadzorze, wykrywaniu anomalii, audiowizualnym wyszukiwaniu opartym na akcjach oraz monitorowaniu pacjentów w opiece zdrowotnej1,2. Rozpoznawanie akcji, szczególnie w strumieniach wideo z systemów nadzoru i platform mediów społecznościowych, posiada znaczący potencjał w zakresie wykrywania anomalii i rozumienia zdarzeń3. Akcje ludzkie są identyfikowane w analizie wideo poprzez obserwację różnych części ciała, takich jak dłonie i nogi. W przeciwieństwie do obrazów statycznych, pojedyncza klatka jest często niewystarczająca do reprezentacji akcji4. Na przykład początkowa poza podczas gry w piłkę nożną i skakania przez skakankę może wydawać się podobna na pojedynczej klatce. Różnice między tymi akcjami stają się widoczne, gdy są one obserwowane w sekwencji klatek, które rejestrują wzorce ruchu i interakcje ludzkiego ciała z otoczeniem5,6,7. Skróty użyte w całym tekście zostały zestawione w Tabeli 1 w celu poprawy czytelności i zapewnienia spójności terminologicznej.
| Skrót | Pełna forma |
| Sztuczna inteligencja | Sztuczna inteligencja |
| AUC | Pole pod krzywą |
| BiLSTM (dwukierunkowa długa krótkoterminowa pamięć) | Dwukierunkowa pamięć długo- i krótkotrwała |
| CNN (konwolucyjna sieć neuronowa) | Splotowa sieć neuronowa |
| CUDA | Compute Unified Device Architecture |
| miara F1 | Średnia harmoniczna precyzji i pełności |
| GPU (procesor graficzny) | Karta graficzna (GPU) |
| HAR | Rozpoznawanie aktywności ludzkiej |
| JHMDB | Wspólna baza danych ruchu człowieka |
| LSTM (długo-krótkoterminowa pamięć) | Długa krótkotrwała pamięć |
| mAP-T | Średnia precyzja czasowa (Temporal Mean Average Precision) |
| MCC | Współczynnik korelacji Matthewsa |
| MSCNN | Wieloskalowa splotowa sieć neuronowa |
| Krzywa ROC | Charakterystyka Operacyjna Odbiornika |
| TSI | Wskaźnik stabilności czasowej |
| UCF | University of Central Florida |
| VRAM | Pamięć VRAM (Video Random Access Memory) |
Tabela 1: Lista skrótów użytych w manuskrypcie. Powszechne skróty i akronimy używane w całym badaniu wraz z ich pełnymi formami.
Szybka i dokładna klasyfikacja filmów sportowych jest istotna dla szerokiego zakresu zastosowań8,9,10, w tym dla analityki sportowej, detekcji zdarzeń, wyszukiwania treści oraz systemów rekomendacji11,12,13. Wraz z szybkim wzrostem ilości treści wideo związanych ze sportem, ograniczenia wcześniejszych ram analitycznych stały się coraz bardziej widoczne14. W związku z tym rośnie zapotrzebowanie na solidne podejścia zdolne do radzenia sobie ze złożonością i dynamicznym charakterem aktywności sportowych. Tradycyjne metody klasyfikacji filmów sportowych w dużej mierze opierały się na deskryptorach tworzonych ręcznie, takich jak przepływ optyczny i histogramy orientacji gradientów (HOG), aby charakteryzować wzorce ruchu i aktywności w filmach sportowych15.
Sieci ConvNet, które odniosły spektakularne sukcesy w klasyfikacji statycznych obrazów, zostały również zastosowane w analizie wideo. Jednak rozpoznawanie czynności pozostaje większym wyzwaniem, ponieważ filmy zawierają dynamiczne informacje czasoprzestrzenne. Obecne podejścia oparte na głębokim uczeniu można ogólnie podzielić na trzy grupy: sieci dwustrumieniowe16, sieci splotowe 3D oraz architektury wydajne obliczeniowo. Aby nauczyć się informacji temporalnych z przepływu optycznego, sieci dwustrumieniowe wykorzystują dodatkową sieć ConvNet17,18, choć podejście to jest kosztowne obliczeniowo. Podczas gdy architektury splotowe 3D, takie jak C3D, I3D i R3D, potrafią bezpośrednio modelować informacje czasowe, znacznie zwiększają one liczbę parametrów, co utrudnia optymalizację. Metody wydajne obliczeniowo próbują zmniejszyć złożoność modelu poprzez badanie dekomponowanych operacji 3D.
Ponadto, ponieważ sieci CNN potrafią ekstrahować lokalne cechy przestrzenne, a sieci LSTM mogą przechwytywać informacje o kontekście czasowym, modele hybrydowe mogą skutecznie uczyć się czasoprzestrzennych wzorców ruchu z danych wejściowych czujników. Niedawne badania łączące architektury CNN i rekurencyjnych sieci neuronowych przyniosły obiecujące wyniki18,19,20. Jednak ze względu na to, że sieci LSTM kompresują informacje podczas przetwarzania sekwencji, szum wprowadzony podczas ekstrakcji cech może wpływać na wydajność rozpoznawania. Aby rozwiązać ten problem, w kilku badaniach zastosowano mechanizmy uwagi21,22. Mechanizmy uwagi umożliwiają modelowi skupienie się na cechach najistotniejszych dla zadania rozpoznawania, co tym samym poprawia wydajność klasyfikacji.
Chociaż głębokie dwukierunkowe modele LSTM połączone z ekstrakcją cech opartą na CNN przyniosły obiecujące wyniki w rozpoznawaniu aktywności ludzkiej, wciąż istnieje kilka wyzwań przy rozszerzaniu tych ram na rozpoznawanie akcji w nagraniach wideo ze sportu. Po pierwsze, istniejące architektury CNN-LSTM często wykorzystują jednoskalową ekstrakcję cech splotowych, co może ograniczać ich zdolność do przechwytywania akcji występujących w wielu rozdzielczościach przestrzennych i czasowych, takich jak jednoczesny ruch zawodnika i obiektu w scenach sportowych. Wieloskalowe sieci splotowe, w tym 3D CNN23 oraz dwustrumieniowe sieci CNN, wykazały znaczenie przechwytywania wskazówek przestrzennych i ruchowych w różnych skalach, choć koncepcja ta pozostaje słabiej zbadana w hybrydowych systemach opartych na LSTM. Po drugie, większość wcześniejszych modeli CNN-BiLSTM24 skupia się przede wszystkim na krótkoterminowych zależnościach czasowych, podczas gdy długodystansowa ciągłość ruchu i interakcje między obiektami, powszechne w sportach drużynowych, mogą nie być odpowiednio reprezentowane. Wiele podejść opartych na uczeniu transferowym, takich jak MobileNetV2 i ResNet, opiera się na statycznych cechach klatek i nie w pełni wykorzystuje mechanizmy uwagi czasowej lub adaptacyjną wieloskalową fuzję cech25. Ponadto większość istniejących modeli była oceniana głównie na zbiorach referencyjnych, takich jak UCF11 i JHMDB. Nowsze zbiory danych specyficzne dla sportu, które rejestrują złożony ruch kamery i wzorce aktywności, takie jak SoccerNet i FineGym, pozostają niedostatecznie zbadane. Ograniczenia te podkreślają potrzebę opracowania wieloskalowego frameworku ekstrakcji cech splotowych zintegrowanego z modułami pamięci czasowej, takimi jak sieci LSTM lub BiLSTM, aby lepiej przechwytywać zarówno szczegółowe reprezentacje przestrzenne, jak i długodystansowe zależności czasowe w rozpoznawaniu akcji w wideo sportowym.
Dodatkowo sieci CNN potrafią wyodrębniać lokalne cechy przestrzenne, podczas gdy sieci LSTM mogą modelować kontekst czasowy. Hybrydowe architektury CNN-RNN wykazały zatem obiecującą skuteczność w rozpoznawaniu aktywności ludzkiej26,27. Niedawne badania rozszerzyły konwencjonalne struktury CNN–LSTM poprzez włączenie komplementarnych strategii uczenia w celu poprawy rozpoznawania aktywności ludzkiej. Na przykład wprowadzono mechanizmy uwagi, aby uwypuklić cechy istotne dla zadania i stłumić reprezentacje mniej informacyjne, co poprawia wydajność rozpoznawania28. Inne podejścia zastosowały uczenie wielozadaniowe w celu wspólnej optymalizacji zadań rozpoznawania akcji i segmentacji czasowej, zwiększając efektywność uczenia i reprezentację cech29. Mimo tych postępów istniejące metody mogą nadal mieć ograniczoną zdolność do rozróżniania wizualnie podobnych akcji, ponieważ precyzyjne cechy przestrzenne i czasowe nie zawsze są skutecznie przechwytywane. Tabela 2 podsumowuje zalety i ograniczenia istniejących podejść30.
| Referencja / Rok | Zastosowana metoda | Zbiór(y) danych | Metryki wydajności | Kluczowe zalety | Ograniczenia |
| Hassan et al. (2024)1 | KFDI (Key Frame Dynamic Image) | UCF11 | Dokładność: 85.3% | Efektywny wybór klatek kluczowych i ulepszona reprezentacja obrazu dynamicznego. | Wrażliwość na błędy wyboru klatek; ograniczone modelowanie czasowe. |
| Zhou et al. (2023)24 | Dilated CNN + BiLSTM + Residual Block | UCF11, UCF Sports | Dokładność: UCF11: 89 i UCF Sports: 92.2% | Integruje uczenie przestrzenne i czasowe; przechwytuje informacje wieloskalowe. | Wysokie wymagania obliczeniowe; ryzyko przeuczenia na małych zbiorach danych. |
| Ullah et al. (2025)34 | Local–Global Feature + QSVM | UCF11 | Dokładność: 82.6% | Łączy cechy ręcznie projektowane i głębokie w celu zapewnienia niezawodnego rozpoznawania. | Wymaga ręcznego dostrajania; ograniczona skalowalność. |
| Shin et al. (2025)25 | ViT-ReT (Vision Transformer + Recurrent Transformer) | UCF11, UCF50, UCF101 i JHMDB | Dokładność: UCF11: 97.73%; UCF50: 98.81%; UCF101: 98.46%; JHMDB: 83.38% | Przechwytuje dalekosiężne zależności przestrzenne i czasowe. | Wysoki koszt obliczeniowy i duże wymagania dotyczące danych. |
| Su et al. (2024)23 | 3D-CNN | UCF11 | Dokładność: 85.1% | Uczenie cech czasoprzestrzennych w modelu end-to-end. | Wysokie wymagania dotyczące pamięci i jednostek GPU. |
| Karuppannan et al. (2024)35 | Deep Autoencoder + CNN | UCF11 | Dokładność: 96.2% | Uczy zwarte reprezentacje cech. | Ograniczone długoterminowe modelowanie czasowe. |
| Sahoo et al. (2020)36 | HAR-Depth | KTH, UCF sports, JHMDB, UCF101 i HMDB51 | Dokładność: KTH: 97.67%; UCF Sports: 95.00%; JHMDB: 73.13%; UCF101: 92.97%; HMDB51: 69.74% | Efektywne uczenie czasowe oparte na głębi. | Wymaga dokładnej estymacji głębi i rozległego wstępnego przetwarzania. |
Tabela 2: Porównanie istniejących metod głębokiego uczenia w rozpoznawaniu akcji w nagraniach wideo ze sportu.Podsumowanie reprezentatywnych podejść opartych na głębokim uczeniu, w tym zestawów danych, charakterystyki metodologicznej, zalet i ograniczeń, z uwzględnieniem luk badawczych, które wypełnia proponowany model MSCNN-LSTM.
Zaproponowano strukturę animacji twarzy sterowanej synchronizacją audio, łączącą model odszumiania twarzy (Facial Denoiser Model, FDM) z lokalno-globalnym modelem dyfuzyjnym w przestrzeni ukrytej (Local-to-global Latent Diffusion Model, LG-LDM) w celu generowania emocjonalnie ekspresyjnych animacji twarzy. Do rekonstrukcji szczegółowej trójwymiarowej geometrii twarzy oraz subtelnych wariacji ekspresji wykorzystano zorientowany na emocje wektorowy kwantyzowany wariacyjny autoenkoder (Emotion-centric Vector Quantized Variational Autoencoder, EVQ-VAE)31. Opracowano również strukturę robotycznego chwytania z uwzględnieniem przesłonięć, wykorzystującą binokularny wzrok stereoskopowy do segmentacji celu, lokalizacji, wnioskowania o przesłonięciach oraz szacowania pozy chwytu dla wielu celów w warunkach przesłonięcia32. Dodatkowo wprowadzono dwuetapową strukturę ekstrakcji terenu z chmur punktów z wykorzystaniem projekcji siatki i adaptacyjnego podziału na koszyki, w której prawdopodobieństwa wysokości i krzywizny służyły do doprecyzowania granic między terenem a przeszkodami po wstępnej ekstrakcji opartej na analizie cech w siatce33.
Pomimo znaczących postępów w rozpoznawaniu czynności w oparciu o głębokie uczenie, istniejące metody wciąż mają trudności z radzeniem sobie z wysoką zmiennością i złożonością filmów sportowych, w tym z gwałtownym ruchem, ruchami kamery oraz interakcjami między wieloma zawodnikami. Wiele tradycyjnych modeli opartych na sieciach CNN lub LSTM działa w jednej skali przestrzennej, przez co mogą one mieć trudności z efektywnym uchwyceniem zarówno lokalnych, jak i globalnych wzorców ruchu. Ponadto wyzwaniem pozostaje utrzymanie spójności czasowej w sekwencjach o długim czasie trwania lub w przypadku nakładających się czynności. Chociaż metody uczenia transferowego poprawiły ekstrakcję cech, ich adaptacja do specyficznych dla sportu zbiorów danych pozostaje stosunkowo słabo zbadana.
Celem niniejszego badania jest opracowanie i ocena struktury wieloskalowej splotowej sieci neuronowej z długą krótkotrwałą pamięcią (MSCNN-LSTM) do rozpoznawania akcji w nagraniach wideo ze sportu, poprzez integrację wieloskalowej ekstrakcji cech przestrzennych z modelowaniem czasowym opartym na LSTM w celu uchwycenia zarówno szczegółowych cech przestrzennych, jak i długoterminowych zależności czasowych. Proponowana struktura wykorzystuje komplementarne jądra splotowe oraz wielopoziomową fuzję cech, aby poprawić reprezentację złożonych akcji sportowych w trudnych warunkach. Jej wydajność została oceniona na zestawach danych referencyjnych UCF11, UCF Sports i JHMDB przy użyciu wskaźników takich jak dokładność, precyzja, czułość, wynik F1-score, średnia precyzja w czasie (mAP-T), wskaźnik stabilności czasowej (TSI), współczynnik kappa Cohen’a (κ), współczynnik korelacji Matthewsa (MCC) oraz powierzchnia pod krzywą ROC (AUC). Wyniki eksperymentalne wykazały konkurencyjną wydajność w porównaniu z metodami ocenianymi w tym badaniu, co podkreśla potencjał tej struktury w analityce sportowej, monitorowaniu wyników sportowców, automatycznym wykrywaniu zdarzeń oraz analizie wideo z dziedziny sportu.
Protokół
W niniejszym badaniu zastosowano dwuetapowy model głębokiego uczenia do rozpoznawania akcji w filmach sportowych, integrujący wieloskalową konwolucyjną sieć neuronową (MSCNN) z siecią Long Short-Term Memory (LSTM). Do opracowania i oceny modelu wykorzystano publicznie dostępne zestawy danych referencyjnych, a mianowicie UCF11, UCF Sports oraz JHMDB. Nie gromadzono nowych danych od uczestników i nie uzyskano dostępu ani nie przetwarzano danych osobowych. Ze względu na to, że badanie opierało się na wtórnej analizie publicznie dostępnych, zanonimizowanych zestawów danych i nie wiązało się z bezpośrednim udziałem ludzi, nie było wymagane uzyskanie zgody instytucjonalnej komisji etycznej ani świadomej zgody uczestników.
Przepływ pracy składał się z próbkowania klatek i normalizacji czasowej, po których nastąpiła ekstrakcja cech przy użyciu modułu MSCNN. Wyekstrahowane cechy zostały następnie przetworzone przez sieć LSTM w celu modelowania czasowego, a następnie przekazane do warstwy klasyfikacji wieloklasowej. Na koniec model został wytrenowany i oceniony przy użyciu wybranych zestawów danych referencyjnych. Rycina 1 ilustruje ogólną architekturę proponowanego schematu.
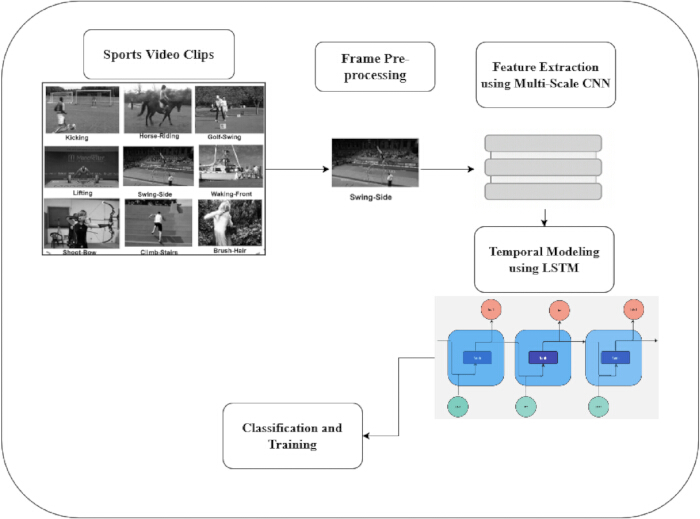
Rycina 1: Proponowana struktura MSCNN-LSTM do rozpoznawania akcji w wideo sportowym. Ogólny schemat przepływu ilustrujący wstępne przetwarzanie wideo, wieloskalową ekstrakcję cech przestrzennych, uczenie sekwencji czasowych oraz klasyfikację akcji. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Rysunek 1 przedstawia schemat proponowanego systemu rozpoznawania akcji w filmach sportowych, opartego na hybrydowej architekturze MSCNN-LSTM. Proces rozpoczyna się od klipów wideo z dyscyplin sportowych zawierających różne czynności atletyczne, w tym kopanie piłki, jazdę konną i zamach w golfie. W fazie wstępnego przetwarzania surowe nagrania wideo zostały rozbite na poszczególne klatki, które następnie przycięto, zestandaryzowano i przygotowano do wprowadzenia do modelu. Przetworzone klatki zostały następnie przekazane do modułu MSCNN w celu ekstrakcji cech. Wieloskalowa architektura konwolucyjna przechwytuje cechy przestrzenne w różnych polach recepcyjnych, co umożliwia wydobycie zarówno informacji lokalnych, jak i kontekstowych z klatek wideo. Wyekstrahowane wektory cech zostały następnie przetworzone przez sieć LSTM w celu zamodelowania zależności czasowych oraz ewolucji ruchu w kolejnych klatkach. Na koniec moduł klasyfikacji i uczenia wykorzystał wyuczone reprezentacje czasoprzestrzenne do przewidzenia kategorii akcji dla każdego klipu wideo. Proponowany system składa się z czterech następujących po sobie kroków, rozpoczynając od gromadzenia i wstępnego przetwarzania danych z zestawów danych referencyjnych UCF11 (YouTube Actions), UCF Sports oraz JHMDB. Każdy film sportowy został przekształcony w sekwencję klatek, które zostały przeskalowane, znormalizowane i rozszerzone poprzez rotację, odbicie lustrzane oraz przycinanie, aby zwiększyć odporność na zmienność środowiskową. Wstępnie przetworzone klatki zostały następnie poddane obróbce przez proponowaną wieloskalową konwolucyjną sieć neuronową (MSCNN), w której równoległe gałęzie konwolucyjne z jądrami 3 × 3, 5 × 5 i 7 × 7 ekstrahowały komplementarne lokalne i kontekstowe cechy przestrzenne. Cechy wieloskalowe te zostały skonkatenowane i dopracowane przy użyciu normalizacji wsadowej (batch normalization) oraz maksymalnego pulingu (max pooling) w celu wygenerowania kompaktowych reprezentacji cech. Wynikowe cechy na poziomie klatek zostały następnie przekazane do sieci Long Short-Term Memory (LSTM) w celu zamodelowania zależności czasowych między kolejnymi klatkami. Końcowe wyjścia z sieci LSTM zostały spłaszczone i przekazane przez warstwy w pełni połączone z aktywacją ReLU, a następnie do klasyfikatora Softmax w celu przewidzenia kategorii akcji. Sieć była trenowana przy użyciu optymalizatora Adam z funkcją straty entropii krzyżowej i regularyzacją dropout w celu redukcji przeuczenia. Wydajność modelu została ostatecznie oceniona na zestawach danych referencyjnych UCF11, UCF Sports i JHMDB przy użyciu wskaźników dokładności (accuracy), precyzji (precision), czułości (recall) oraz miary F1-score.
1. Gromadzenie i wstępne przetwarzanie danych
W niniejszym badaniu wykorzystano trzy publicznie dostępne zestawy danych referencyjnych dla sportu i ludzkich działań. Zbiory te zawierają rzeczywiste nagrania sportowe z różnorodnym ruchem kamery, różnymi punktami widzenia oraz różną złożonością tła. W szczególności w badaniu wykorzystano zbiór UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php), który zawiera 11 kategorii działań zgromadzonych z 1 168 filmów z serwisu YouTube, nagranych z udziałem około 25 osób, z wieloma próbkami dla każdego działania. Baza danych Joint-Annotated Human Motion Database (JHMDB)34,35 zawiera 21 klas działań i 928 adnotowanych filmów. Zbiór UCF Sports składa się z 10 klas działań i 150 sekwencji wideo pochodzących ze źródeł nadawczych o rozdzielczości 720 × 480 pikseli (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php).
Wspólnie zbiory danych te obejmują zarówno sporty indywidualne, jak i drużynowe, zapewniając zróżnicowanie pod względem czasu trwania i skali wizualnej w celu oceny proponowanego frameworka rozpoznawania akcji MSCNN-LSTM. W ramach procesu weryfikacji jakości danych zbiory UCF11, UCF Sports oraz JHMDB zostały sprawdzone pod kątem uszkodzonych filmów, zduplikowanych plików oraz klipów z niepełnymi adnotacjami. Nie zidentyfikowano próbek spełniających te kryteria wykluczenia; w związku z tym wszystkie dostępne filmy zachowano do dalszej analizy. Następnie zbiory danych podzielono na podzbiory treningowy (70%), walidacyjny (15%) i testowy (15%) przy użyciu spójnej strategii losowego podziału. Rysunek 2 przedstawia reprezentatywne obrazy wykorzystane do treningu i ewaluacji.
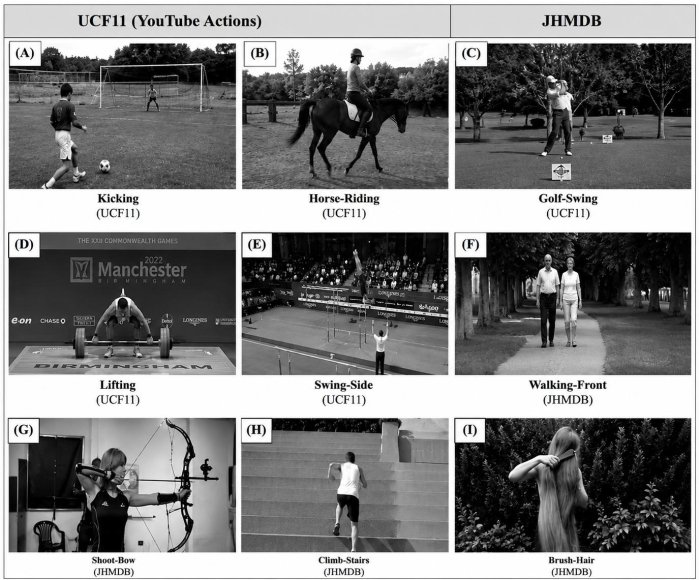
Rycina 2: Reprezentatywne klatki z benchmarkowych zbiorów danych do rozpoznawania działań sportowych. Panele (A–D) przedstawiają przykłady ze zbioru danych UCF11 (YouTube Actions), panele (E–H) ze zbioru danych UCF Sports, a panele (I–L) ze zbioru danych JHMDB. Klatki ilustrują wariacje w klasach działań, punktach widzenia, tłach, warunkach oświetlenia oraz złożoności ruchu. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
Zaproponowany model rozpoznawania akcji został oceniony na zbiorach danych benchmarkowych UCF11, UCF Sports i JHMDB, co podsumowano w Tabeli 3. Zbiory te reprezentują różnorodne wzorce ruchu oraz trudne warunki środowiskowe. Zbiór danych UCF11 (YouTube Actions) zawiera akcje sportowe z 11 klas, zarejestrowane w zmiennych warunkach oświetlenia, punktów widzenia i tła. Zbiór UCF Sports składa się ze 150 filmów z dyscyplin sportów polowych pochodzących z profesjonalnych transmisji, zawierających realistyczne sekwencje ruchu. Zbiór JHMDB dostarcza szczegółowych adnotacji ruchu ludzkiego dla 21 drobnoziarnistych kategorii akcji i służy jako zbiór benchmarkowy dla czasoprzestrzennego rozpoznawania akcji. Razem zbiory te posłużyły do oceny wydajności modelu w scenariuszach sportowych i dotyczących ludzkich działań. Sieć była trenowana przy użyciu optymalizatora Adam przez 100 epok z rozmiarem partii 32, początkową stopą uczenia 0,001 i funkcją straty entropii krzyżowej. Do końcowej ewaluacji wybrano model z najniższą stratą walidacyjną. We wszystkich eksperymentach zastosowano stałe ziarno losowości 42. W celu poprawy zbieżności zastosowano wczesne zatrzymanie (early stopping) oraz redukcję stopy uczenia w przypadku plateau, a podczas trenowania LSTM wykorzystano przycinanie gradientów z progiem 5,0, aby zapobiec eksplozji gradientów. Zaproponowany model MSCNN-LSTM zawierał około 15 milionów trenowalnych parametrów. Konfiguracja sprzętowa i programowa wykorzystana do implementacji została podsumowana w Tabeli 4. Ponieważ rozkłady klas były wystarczająco zrównoważone, nie zastosowano dodatkowych procedur ważenia klas ani ponownego próbkowania. Modele porównawcze zaimplementowano przy użyciu hiperparametrów opisanych w ich oryginalnych badaniach, harmonizując ustawienia trenowania tam, gdzie było to możliwe. Wartości wydajności raportowano jako średnią ± odchylenie standardowe z pięciu niezależnych uruchomień z różnymi inicjalizacjami losowymi. Różnice między zaproponowanym modelem a modelami porównawczymi oceniano za pomocą sparowanych testów t przy progu istotności p < 0,05.
| Zbiór danych | Liczba klas | Liczba filmów | Rozdzielczość (px) | Proszę podać tekst źródłowy do tłumaczenia. | Opis |
| UCF11 (Działania w serwisie YouTube) | 11 | 1168 | Zmienna (≈ 320×240) | University of Central Florida | Obejmuje 11 ludzkich czynności sportowych (np. rzut do kosza, nurkowanie, zamach w golfie, żonglowanie piłką nożną). Filmy zostały pobrane z serwisu YouTube i charakteryzują się dużą zmiennością oświetlenia, punktu widzenia oraz tła. |
| Sport UCF | 10 | 150 | 720×480 | Zbiór danych UCF Sports Action Dataset | Zawiera aktywności sportowe, takie jak nurkowanie, jazda konna, zamach w golfie, bieganie i podnoszenie ciężarów, zarejestrowane z rzeczywistych materiałów z transmisji telewizyjnych (BBC, ESPN). |
| JHMDB | 21 | 928 | 320×240 | Instytut Maks Plancka ds. Inteligentnych Systemów | Obejmuje codzienne aktywności oraz sporty, takie jak chwytanie, skakanie, czesanie włosów, strzelanie i bieganie, wraz z adnotacjami stawów do analizy ruchu i pozy. |
Tabela 3: Charakterystyka zbiorów danych referencyjnych użytych do trenowania i ewaluacji. Przegląd zbiorów danych UCF11, UCF Sports oraz JHMDB, obejmujący liczbę klas czynności, próbek wideo, charakterystykę zbiorów danych oraz ich rolę w trenowaniu, walidacji i testowaniu modelu.
| Wykorzystane parametry | Opis |
| Język programowania | Python 3.8.18 [4] |
| Środowisko głębokiego uczenia | TensorFlow 2.15.0 [1] |
| Akcelerator GPU | NVIDIA GeForce RTX 3090 (24 GB VRAM) [1] |
| procesor (CPU) | Intel Core i9 @ 3,5 GHz × 16 rdzeni |
| System operacyjny | Windows 11 |
| Pamięć operacyjna (RAM) | 64 GB DDR4 |
| Optymalizator | Adam (learning rate = 0,001) |
| Wielkość partii | 32 |
| Liczba epok | 100 |
| Funkcje aktywacji | ReLU (warstwy CNN), Softmax (warstwa wyjściowa) |
| Wskaźnik rezygnacji | 0.5 |
Tabela 4: Środowisko symulacyjne i konfiguracja hiperparametrów proponowanego modelu MSCNN-LSTM. Specyfikacje sprzętowe, środowisko programistyczne, ustawienia optymalizatora, szybkość uczenia, rozmiar partii, liczba epok, wymiary wejściowe oraz inne hiperparametry użyte podczas trenowania i ewaluacji modelu.
2. Wstępne przetwarzanie
Przed treningiem każdy surowy film został przekonwertowany na uporządkowany czasowo ciąg klatek, a następnie znormalizowany, poddany próbkowaniu czasowemu i augmentacji. Każdy film wejściowy V został najpierw przekonwertowany na ciąg klatek i przedstawiony jako tensor 4D V ∈ RT×H×W×C, gdzie T to liczba klatek, H × W i oznacza indeks klatki, a C oznacza liczbę kanałów kolorów (3 dla RGB). Potok przetwarzania wstępnego składał się z ekstrakcji klatek, zmiany rozmiaru przestrzennego, a następnie przycinania środkowego lub losowego do stałej rozdzielczości (H′, W′), normalizacji intensywności każdego piksela oraz opcjonalnej augmentacji danych, w tym losowego odwracania, skalowania i jitteringu kolorów, przed ekstrakcją cech. Konkretnie, normalizacja intensywności została zaimplementowana jako standardowa normalizacja wyników (z-score), zgodnie z równaniem (1).
 (1)
gdzie μ, σ to średnie i odchylenia standardowe kanałów obliczone dla zbioru treningowego, lub jako skalowanie min-max zgodnie z równaniem (2).
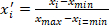 (2)
Po normalizacji każda klatka była reprezentowana jako F̃t ∈ RH′×W′×C′, a wynikający z tego tensor wideo był reprezentowany jako V′ ∈ RT×H′×W′×C. W wieloskalowym frontendzie splotowym uzyskano wiele przestrzennych map cech o różnych polach recepcyjnych poprzez zastosowanie kilku splotów 2-D (lub 3-D w przypadku wczesnych splotów czasoprzestrzennych) o różnych rozmiarach jądra; następnie dla każdej klatki lub krótkiego klipu wideo wygenerowano reprezentację cech czasowych i przekazano ją do modułu LSTM. W oryginalnej pracy zastosowano MobileNetV2, a następnie Deep BiLSTM do modelowania czasowego; powyższy potok wstępnego przetwarzania jest w pełni kompatybilny z zastąpieniem go kombinacją wieloskalowego splotu i LSTM.
3. Pobieranie próbek i normalizacja czasowa
Ponieważ długości filmów T różnią się pomiędzy zbiorami danych oraz w ich obrębie, stosujemy jednolity próbkowanie lub ponowne próbkowanie czasowe klatek, aby zapewnić wieloskalowej splotowej sieci neuronowej + LSTM stałą długość wejściową N w postaci klatek lub krótkich fragmentów. Jednolite indeksy klatek można obliczyć zgodnie z Równaniem (3),
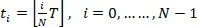 (3)
zatem sekwencja pobranych klatek to Vs = {F̃t0, …, F̃tN−1}. Gdy wymagana jest większa wierność czasowa, wykonujemy liniową interpolację czasową: dla dowolnego resamplowanego ułamkowego czasu τ ∈ [0, T−1] obliczonego zgodnie z równaniem (4).
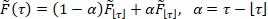 (4)
tak aby próbkowana ponownie sekwencja Vs posiadała dokładnie N klatek i zachowywała płynność ruchu. Alternatywnie, próbkowanie za pomocą krótkich, ciągłych klipów (długość okna czasowego w z krokiem s) daje zestaw tensorów klipów, gdzie każdy klip Cj ∈ RT×H′×W′×C oraz j = 0, …, ⌊(T − w)/s⌋. W celu normalizacji czasowej wewnątrz sieci skuteczne jest proste pooling czasowy w wielu skalach: dla sekwencji cech czasowych X = {x1, …, xN} generowanej przez sploty wieloskalowe, należy zastosować cechy po poolingu zgodnie z równaniem (5).
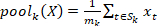 (5)
gdzie Sk jest wsparciem czasowym dla skali k (np. Sk mogą być niepokrywającymi się blokami lub rozszerzonymi indeksami), a mk = |Sk|.
Przed ekstrakcją cech wszystkie filmy zostały przeskalowane do wymiarów 224 × 224 pikseli i próbkowane z częstotliwością 25 klatek na sekundę. W każdym eksperymencie zastosowano stałą długość sekwencji wynoszącą 32 klatki. Techniki augmentacji danych obejmowały m.in. losowe przycinanie (skala = 0,8–1,0), losową rotację (±15°), losowe odwrócenie poziome (prawdopodobieństwo = 0,5) oraz modyfikację jasności (±20%). Do standaryzacji wartości pikseli wykorzystano średnie wartości ImageNet [0,485, 0,456, 0,406] oraz odchylenia standardowe [0,229, 0,224, 0,225]. W przypadku każdej sekwencji wideo do próbkowania czasowego zastosowano jednostajny wybór klatek. Dłuższe nagrania były jednostajnie przycinane lub próbkowane w celu zachowania spójnej długości sekwencji, natomiast filmy zawierające mniej niż 32 klatki zostały uzupełnione zerami. Parametry te stosowano konsekwentnie przez cały proces uczenia i oceny.
4. Ekstrakcja cech przy użyciu MSCNN
W celu usprawnienia reprezentacji przestrzennej czynności w nagraniach wideo ze sportami zastosowano wieloskalową splotową sieć neuronową (MSCNN). Konwencjonalne splotowe sieci neuronowe opierające się na pojedynczym rozmiarze jądra mogą mieć ograniczone możliwości przechwytywania cech w wielu skalach przestrzennych. Ze względu na to, że niektóre czynności sportowe wykazują podobne cechy wizualne, architektura splotowa jednoskalowa może mieć trudności z jednoczesnym przechwytywaniem cech lokalnych i globalnych. Aby wyeliminować to ograniczenie, proponowany schemat wykorzystuje jądra splotowe o różnych rozmiarach do przeprowadzania wieloskalowej ekstrakcji i fuzji cech.
W proponowanej architekturze sieci zastosowano jądra splotu 1 × 1 w celu organizacji informacji pomiędzy kanałami oraz redukcji wymiarowości map cech wejściowych. Ponadto warstwy te zwiększają zdolność ekspresyjną sieci poprzez wprowadzenie dodatkowych transformacji cech i reprezentacji nieliniowych. Jądra splotu o różnych rozmiarach umożliwiają ekstrakcję informacji przestrzennych w wielu skalach. Po ważonej fuzji cech wieloskalowych przeprowadzana jest sekwencyjna normalizacja, aby poprawić stabilność uczenia. W celu złagodzenia problemów zanikania i eksplozji gradientu podczas trenowania głębokiej sieci, sugerowana architektura wykorzystuje połączenia rezydualne oraz modelowanie czasowe oparte na LSTM.
Projekt wieloskalowy zwiększa zdolność sieci do przechwytywania cech w różnych rozdzielczościach przestrzennych i poprawia możliwości reprezentacji cech. Ponadto konwencjonalny jądro splotu N × N zostaje rozłożone na operacje splotu N × 1 oraz 1 × N. Sploty N × 1 i 1 × N zastosowane w module MSCNN zostały zaprojektowane w celu przechwytywania komplementarnych cech kierunkowych i wieloskalowych cech przestrzennych z poszczególnych klatek wideo. Operacje splotowe te wzmacniają reprezentację cech przestrzennych poprzez wyodrębnianie wzorców w różnych skalach pola recepcyjnego. Relacje czasowe między kolejnymi klatkami są następnie modelowane przez moduł LSTM, który przetwarza sekwencję cech wyodrębnionych przez MSCNN w celu nauczenia się długoterminowych zależności czasowych niezbędnych do rozpoznawania czynności.
Każdy film sportowy V = {F1, F2, …, FT} jest rozkładany na T klatek. Aby zakodować zmienność przestrzenną, na przykład pozę zawodnika, rozmycie ruchu czy trajektorię piłki, zastosowano gałęzie splotowe w trzech różnych skalach s ∈ {1, 2, 3}, odpowiadających rozmiarom jądra 3 × 3, 5 × 5 oraz 7 × 7. Każda gałąź ekstrahuje mapy cech zgodnie z równaniem (6):
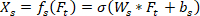 (6)
Gdzie Ws oraz bs to wagi i przesunięcia splotowe w skali s, a σ to funkcja aktywacji ReLU. Warstwa fuzji wieloskalowej agreguje cechy zgodnie z równaniem (7):
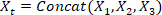 (7)
Ten połączony tensor cech osadza zarówno precyzyjne wskazówki dotyczące ruchu, jak i kontekstowe informacje z dużych obszarów, takie jak aktywności grupowe. Rysunek 3 przedstawia wyłącznie moduł ekstrakcji cech MSCNN. Warstwa LSTM (256 jednostek ukrytych), warstwa gęsta (128 neuronów) oraz warstwa dropout (0,5) wykorzystywane do modelowania czasowego i klasyfikacji są przedstawione oddzielnie na Rysunku 4.
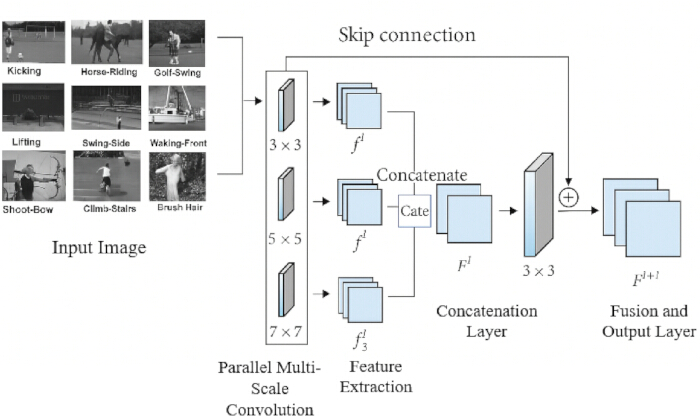
Rysunek 3: Proponowany moduł ekstrakcji cech wieloskalowej splotowej sieci neuronowej (MSCNN). Trzy równoległe gałęzie splotowe z jądrami o rozmiarach 3 × 3, 5 × 5 i 7 × 7 ekstrahują dopełniające się wieloskalowe cechy przestrzenne, które są łączone przed modelowaniem czasowym przez sieć LSTM. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
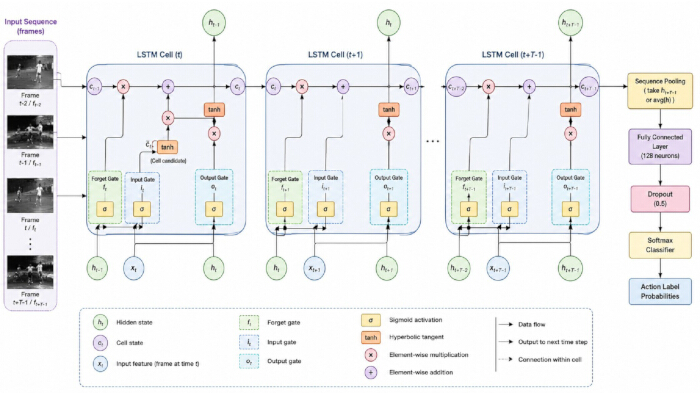
Rycina 4: Proponowana architektura LSTM do rozpoznawania akcji w filmach sportowych. Moduł LSTM modeluje zależności czasowe poprzez operacje bramki wejściowej, bramki zapominania i bramki wyjściowej w kolejnych klatkach wideo. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Rycina 3 przedstawia proponowany moduł ekstrakcji cech w ramach wielkoskalowej konwolucyjnej sieci neuronowej (MSCNN) do rozpoznawania akcji w nagraniach wideo z wydarzeń sportowych. Klatki wejściowe z wideo były przetwarzane równolegle przez trzy gałęzie konwolucyjne o rozmiarach jąder 3 × 3, 5 × 5 i 7 × 7, z których każda zawierała 64 filtry w celu uchwycenia komplementarnych, drobno- i gruboziarnistych cech przestrzennych. Wyniki zostały przetworzone za pomocą normalizacji wsadowej (Batch Normalization), funkcji aktywacji ReLU oraz maksymalnego próbkowania (max pooling) 2 × 2, a następnie skonkatenowane i połączone za pomocą konwolucji 1 × 1 ze 128 filtrami. Rezydualne połączenie pomijające (residual skip connection) pozwoliło na zachowanie niskopoziomowych informacji przestrzennych i poprawę przepływu gradientu. Połączone mapy cech zostały spłaszczone i przekazane do warstwy LSTM z 256 jednostkami ukrytymi w celu modelowania temporalnego, a następnie do warstwy w pełni połączonej ze 128 neuronami, funkcją aktywacji ReLU i współczynnikiem dropout wynoszącym 0,5 przed końcową klasyfikacją za pomocą warstwy Softmax. Wielkoskalowe mapy cech (f1l, f2l i f3l) zostały skonkatenowane w celu utworzenia reprezentacji scalonej (Fl), która została następnie poddana dalszej obróbce przez konwolucję 3 × 3 w celu wygenerowania mapy cech wyjściowych dla kolejnej warstwy. Ta hierarchiczna architektura umożliwiła naukę komplementarnych cech przestrzennych w wielu polach recepcyjnych, co poprawiło wydajność rozpoznawania akcji sportowych.
5. Modelowanie czasowe z użyciem sieci LSTM
Aby zamodelować ewolucję czasową krawędzi wideo, zagregowana sekwencja cech została przekazana do systemu LSTM w celu uchwycenia dynamicznych zależności i ciągłości ruchu. Dla każdego filmu wejściowego najpierw wyodrębniono wieloskalowe cechy CNN dla każdej klatki. Przyjmijmy, że klatki wideo to I1, …, IT. Dla każdej klatki t i każdej skali s wieloskalowy enkoder splotowy generuje wektor cech ft(s) ∈ Rd. Następnie skale łączono w jeden deskryptor klatki za pomocą projekcji + konkatenacji lub sumy ważonej, zgodnie z równaniem (8):
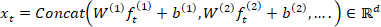 (8)
Następnie wprowadź sekwencję {xt}tT=1 do sieci LSTM w celu zamodelowania dynamiki czasowej. W standardowej notacji LSTM, w czasie t bramki i stany są opisane w równaniach (9) do (13):
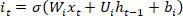 (9)
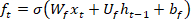 (10)
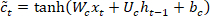 (11)
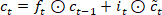 (12)
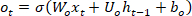 (13)
Tutaj σ oznacza aktywację sigmoidalną, a ⊙ mnożenie elementowe.) Chociaż architektury dwukierunkowych LSTM mogą być wykorzystywane do przechwytywania kontekstu czasowego zarówno z przeszłości, jak i przyszłości, zaproponowana struktura wykorzystuje standardowy LSTM do modelowania zależności czasowych pomiędzy sekwencyjnymi klatkami wideo. Wybór ten jest zgodny z architekturą MSCNN-LSTM przedstawioną w niniejszym badaniu. Po przetworzeniu klipu uzyskano reprezentację klipu (np. ostatni stan ukryty lub pooling czasowy): z = Poolt(vt).
Rysunek 4 przedstawia schemat działania proponowanej architektury LSTM do rozpoznawania czynności sportowych. Sieć otrzymywała sekwencję klatek wideo lub cech wyekstrahowanych przez CNN i przetwarzała je w kolejnych krokach czasowych (t−2, t−1 oraz t). Każda komórka LSTM składała się z bramki wejściowej, bramki zapominania i bramki wyjściowej, które regulowały przepływ informacji w sieci. Bramka wejściowa wprowadzała nowe informacje do stanu komórki, bramka zapominania odrzucała nieistotne informacje czasowe, a bramka wyjściowa generowała stan ukryty przekazywany do następnego kroku czasowego. Stan komórki zachowywał długoterminowe zależności czasowe, podczas gdy stan ukryty rejestrował krótkoterminowe informacje czasowe. Po sekwencyjnym przetwarzaniu wyniki LSTM zostały poddane operacji pooling w celu wygenerowania czasowej reprezentacji cech, która została przekazana do warstwy w pełni połączonej oraz klasyfikatora Softmax w celu przewidzenia odpowiadającej czynności sportowej. Sieć była trenowana przy użyciu optymalizatora Adam przez 100 epok z wielkością partii 32, początkową prędkością uczenia 0,001 oraz funkcją straty cross-entropy. Do końcowej ewaluacji wybrano model o najniższej stracie walidacyjnej. Aby zapewnić odtwarzalność, wszystkie eksperymenty przeprowadzono przy użyciu stałego ziarna losowości 42. W celu poprawy zbieżności zastosowano mechanizm wczesnego zatrzymania (early stopping) oraz redukcję prędkości uczenia w przypadku plateau, a podczas trenowania LSTM zastosowano przycinanie gradientów (gradient clipping) z progiem 5,0, aby zapobiec problemowi eksplodujących gradientów. Proponowany model MSCNN-LSTM zawierał około 15 milionów parametrów trenowalnych.
Końcowe wyniki klas i prawdopodobieństwo są obliczane przy użyciu warstwy liniowej + funkcji softmax, zgodnie z równaniem (14):
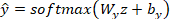 (14)
Przeprowadź trenowanie poprzez minimalizację straty entropii krzyżowej dla etykietowanych klipów, zgodnie z równaniem (15):
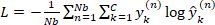 (15)
gdzie Nb to rozmiar partii, C liczba klas, a y(n) to one-hot ground truth. Regularyzacja (dropout na xt/wyjściach LSTM, weight decay) oraz przycinanie gradientów (gradient clipping) są stosowane w celu zwiększenia stabilności dla długich sekwencji sportowych.
Wyniki
Zaproponowany model MSCNN-LSTM został przeszkolony i oceniony na zbiorach danych UCF11 (YouTube Actions), UCF Sports oraz JHMDB, które obejmowały różnorodne akcje sportowe, punkty widzenia i wzorce ruchu. Ze względu na wystarczająco zrównoważony rozkład klas nie zastosowano dodatkowych procedur ważenia klas ani ponownego próbkowania. Modele porównawcze zaimplementowano z wykorzystaniem hiperparametrów opisanych w oryginalnych badaniach, harmonizując ustawienia treningowe tam, gdzie było to możliwe. Wyniki przedstawiono jako średnią ± odchylenie standardowe z pięciu niezależnych uruchomień z różnymi losowymi inicjalizacjami. Różnice między zaproponowanym modelem a modelami porównawczymi oceniono za pomocą sparowanych testów t przy progu istotności p < 0,05.
Rysunek 5 przedstawia porównanie dokładności klasyfikacji dla trzech zbiorów danych. Model MSCNN-LSTM osiągnął najwyższą dokładność, wynoszącą 98,3% dla zbioru UCF11, 95,4% dla UCF Sports oraz 81,7% dla JHMDB. Wartości te przewyższyły wyniki uzyskane przez modele Dilated CNN–BiLSTM, Two-Stream LSTM oraz ViT-ReT. Niższa dokładność w przypadku zbioru JHMDB odzwierciedlała większą trudność w rozpoznawaniu szczegółowych działań w materiałach wideo o niższej rozdzielczości.
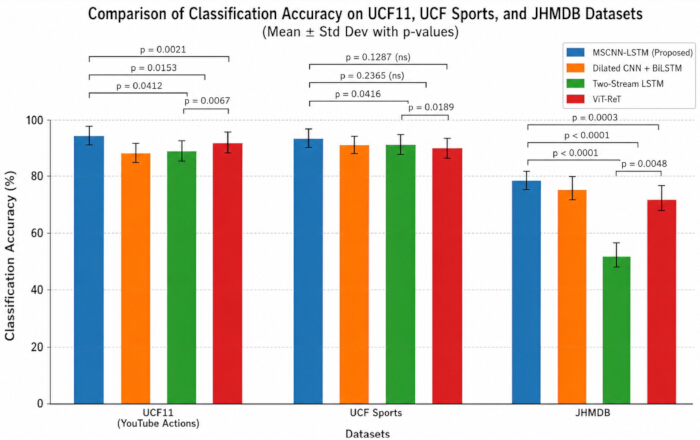
Rycina 5: Porównanie dokładności klasyfikacji (%) różnych modeli głębokiego uczenia na zbiorach danych wideo ze sportem. Dokładność klasyfikacji modeli MSCNN-LSTM, ViT-ReT, Two-Stream LSTM oraz Dilated CNN + BiLSTM w zbiorach danych UCF11, UCF Sports i JHMDB. Wyniki przedstawiono jako średnia ± SD z pięciu niezależnych uruchomień (n = 5). Słupki błędów reprezentują jedno odchylenie standardowe. Istotność statystyczną oceniono za pomocą dwustronnych sparowanych testów t (p < 0,05). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Zaproponowany model osiągnął również najwyższą precyzję we wszystkich zbiorach danych, z wartościami wynoszącymi około 96% dla UCF11, 93% dla UCF Sports i 78% dla JHMDB (Rysunek 6). Wartości pełności (recall) wynosiły odpowiednio około 95%, 94% i 77% (Rysunek 7), natomiast odpowiadające im miary F1-score wynosiły około 95,5%, 93,5% i 77,5% (Rysunek 8). Wyniki te wskazały, że model zachował korzystną równowagę między prawidłową identyfikacją klas czynności a ograniczaniem wyników fałszywie dodatnich.
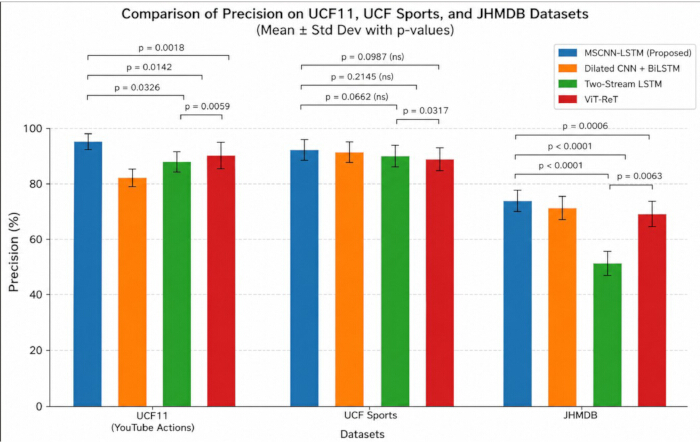
Rycina 6: Porównanie precyzji (%) różnych modeli głębokiego uczenia na zbiorach danych z nagraniami wideo z dyscyplin sportowych. Wartości precyzji przedstawiono jako średnia ± SD z pięciu niezależnych uruchomień (n = 5). Słupki błędów reprezentują jedno odchylenie standardowe. Istotność statystyczną oceniono za pomocą dwustronnych sparowanych testów t (p < 0.05). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
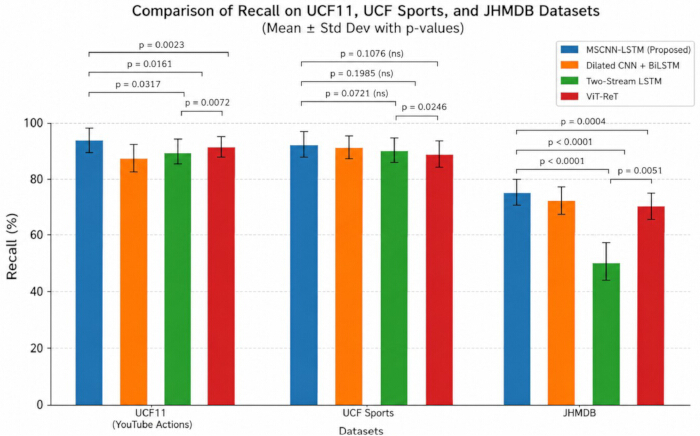
Rycina 7: Porównanie pełności (%) różnych modeli głębokiego uczenia na zbiorach danych wideo ze sportem. Wartości pełności przedstawiono jako średnia ± SD z pięciu niezależnych uruchomień (n = 5). Słupki błędu reprezentują jedno odchylenie standardowe. Istotność statystyczną oceniono za pomocą dwustronnych sparowanych testów t (p < 0.05). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
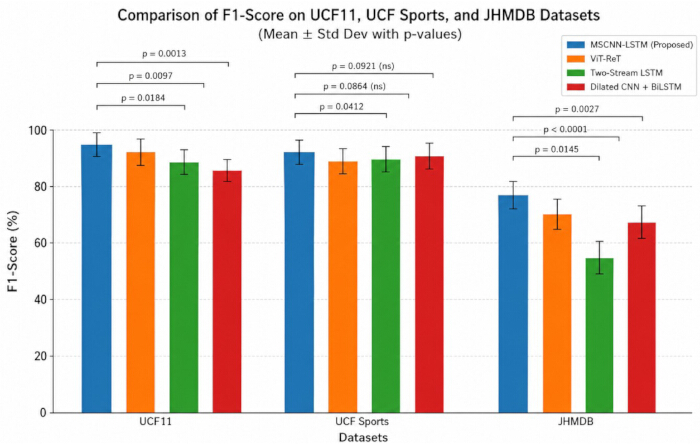
Rysunek 8: Porównanie wskaźnika F1-score (%) dla różnych modeli głębokiego uczenia na zbiorach danych z filmami sportowymi. Wartości F1-score przedstawiono jako średnią ± SD z pięciu niezależnych uruchomień (n = 5). Słupki błędów reprezentują jedno odchylenie standardowe. Istotność statystyczną oceniono za pomocą dwustronnych sparowanych testów t (p < 0,05). Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Tabela 5 przedstawia wyniki dla kappa Cohena oraz współczynnika korelacji Matthewsa. W zbiorze UCF11 proponowany model osiągnął κ = 0.96 i MCC = 0.96, w porównaniu do wartości κ/MCC wynoszących odpowiednio 0.92/0.92 dla ViT-ReT, 0.90/0.90 dla Two-Stream LSTM oraz 0.87/0.87 dla Dilated CNN–BiLSTM. W zbiorze UCF Sports model MSCNN-LSTM osiągnął κ = 0.95 i MCC = 0.94, przewyższając odpowiadające im wartości uzyskane przez ViT-ReT (0.90/0.90), Two-Stream LSTM (0.88/0.89) oraz Dilated CNN–BiLSTM (0.84/0.85). W zbiorze JHMDB proponowany model osiągnął κ = 0.83 i MCC = 0.84, w porównaniu do 0.74/0.75 dla ViT-ReT, 0.70/0.71 dla Two-Stream LSTM oraz 0.71/0.72 dla Dilated CNN–BiLSTM. Wyniki te wykazały silniejszą zgodność między etykietami przewidywanymi a rzeczywistymi dla proponowanego modelu.
| Model | Zbiór danych | Kappa Cohena (κ) | Współczynnik korelacji Matthewsa (MCC) |
| Dilated CNN + BiLSTM [4] | UCF11 (YouTube Actions) | 0.87 ± 0.01 | 0.88 ± 0.01 |
| UCF Sports | 0.84 ± 0.02 | 0.85 ± 0.02 | |
| JHMDB | 0.71 ± 0.03 | 0.72 ± 0.03 | |
| Two-Stream LSTM [38] | UCF11 (YouTube Actions) | 0.90 ± 0.01 | 0.91 ± 0.01 |
| UCF Sports | 0.88 ± 0.02 | 0.89 ± 0.02 | |
| JHMDB | 0.70 ± 0.03 | 0.71 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer) [6] | UCF11 (YouTube Actions) | 0.92 ± 0.01 | 0.92 ± 0.01 |
| UCF Sports | 0.90 ± 0.01 | 0.90 ± 0.01 | |
| JHMDB | 0.74 ± 0.02 | 0.75 ± 0.02 | |
| Proponowany MSCNN–LSTM | UCF11 (YouTube Actions) | 0.96 ± 0.01 | 0.96 ± 0.01 |
| UCF Sports | 0.95 ± 0.01 | 0.94 ± 0.01 | |
| JHMDB | 0.83 ± 0.02 | 0.84 ± 0.02 |
Tabela 5: Porównanie współczynnika kappa Cohena (κ) i współczynnika korelacji Matthewsa (MCC) dla różnych modeli głębokiego uczenia. Porównanie wydajności modeli MSCNN-LSTM, ViT-ReT, Two-Stream LSTM oraz Dilated CNN + BiLSTM na zbiorach danych UCF11, UCF Sports i JHMDB. Wyższe wartości wskazują na silniejszą zgodność między etykietami przewidywanymi a rzeczywistymi oraz większą niezawodność klasyfikacji. Wartości podano jako średnia ± SD z pięciu niezależnych uruchomień (n = 5).
Rysunek 9 przedstawia krzywe charakterystyki pracy odbiornika (ROC). Zaproponowany model MSCNN-LSTM osiągnął wartości AUC wynoszące 0,975 dla zbioru UCF11, 0,961 dla UCF Sports oraz 0,937 dla JHMDB. Spójnie wysokie wartości AUC wskazują na silną dyskryminację między klasami czynności w zbiorach danych o różnym stopniu złożoności.
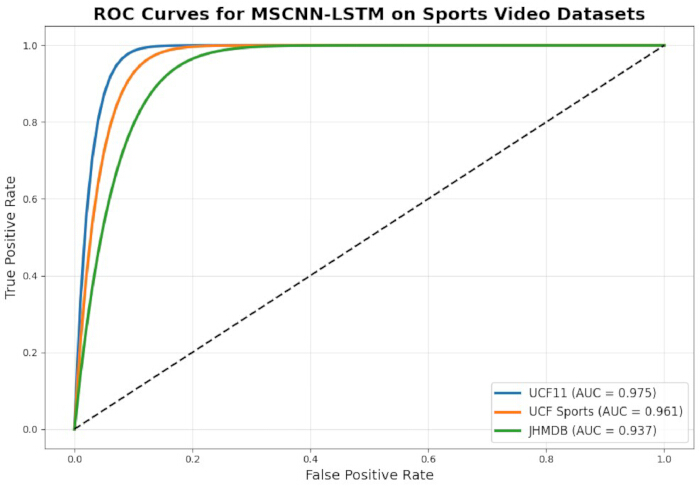
Rycina 9: Krzywe charakterystyki operacyjnej odbiornika (ROC) dla zaproponowanego modelu MSCNN-LSTM.Krzywe ROC dla zbiorów danych UCF11, UCF Sports oraz JHMDB, ilustrujące kompromis między odsetkiem prawdziwie dodatnich a odsetkiem fałszywie dodatnich wyników. Powierzchnia pod krzywą (AUC) podsumowuje zdolność dyskryminacyjną modelu dla różnych progów klasyfikacji. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Wyniki wydajności temporalnej podsumowano w Tabeli 6. W przypadku zbioru UCF11 proponowany model osiągnął mAP-T na poziomie 98,3%, dokładność na poziomie klatek wynoszącą 96,5% oraz TSI wynoszący 0,95. Dla zbioru UCF Sports odpowiadające im wartości wyniosły odpowiednio 95,4%, 94,0% i 0,93. W przypadku JHMDB model osiągnął mAP-T wynoszący 81,7%, dokładność na poziomie klatek 78,9% oraz TSI wynoszący 0,88 (Tabela 7). Wartości te były wyższe niż uzyskane przez modele porównawcze i wskazały na poprawę spójności temporalnej oraz stabilności predykcji zarówno w przypadku krótkich, jak i długich sekwencji działań.
| Metoda | Zbiór danych | mAP-T (%) | Dokładność na poziomie klatek (%) | Wskaźnik Stabilności Czasowej (TSI) |
| Rozszerzona sieć CNN + BiLSTM4 | UCF11 (Działania w serwisie YouTube) | 93.6 ± 0.8 | 91.8 ± 0.9 | 0.87 ± 0.01 |
| Sporty UCF | 90.2 ± 1.0 | 89.1 ± 1.1 | 0.83 ± 0.02 | |
| JHMDB | 72.4 ± 1.5 | 70.3 ± 1.7 | 0.78 ± 0.03 | |
| Dwustrumieniowa sieć LSTM38 | UCF11 (Działania w serwisie YouTube) | 94.8 ± 0.7 | 92.6 ± 0.8 | 0.89 ± 0.01 |
| Sport w UCF | 91.3 ± 0.9 | 90.0 ± 1.0 | 0.85 ± 0.02 | |
| JHMDB | 73.8 ± 1.4 | 71.5 ± 1.6 | 0.79 ± 0.03 | |
| ViT-ReT (Vision Transformer + Recurrent Transformer)6 | UCF11 (Działania w serwisie YouTube) | 95.5 ± 0.6 | 93.4 ± 0.7 | 0.90 ± 0.01 |
| Sporty UCF | 92.4 ± 0.8 | 91.2 ± 0.9 | 0.87 ± 0.01 | |
| JHMDB | 74.6 ± 1.3 | 72.8 ± 1.4 | 0.81 ± 0.02 | |
| . | UCF11 (Działania w serwisie YouTube) | 98.3 ± 0.5 | 96.5 ± 0.6 | 0.95 ± 0.01 |
| Sport UCF | 95.4 ± 0.7 | 94.0 ± 0.8 | 0.93 ± 0.01 | |
| JHMDB | 81.7 ± 1.1 | 78.9 ± 1.3 | 0.88 ± 0.02 |
Tabela 6: Porównanie czasowych metryk wydajności dla rozpoznawania akcji w filmach sportowych. Wyniki eksperymentalne średniej precyzji dla segmentów czasowych (mAP-T), dokładności na poziomie klatek oraz indeksu stabilności czasowej (TSI) dla różnych modeli głębokiego uczenia w zestawach danych referencyjnych. Wartości przedstawiono jako średnia ± SD z pięciu niezależnych uruchomień (n = 5).
| Konfiguracja | Wieloskalowa sieć neuronowa splotowa (MSCNN) | LSTM (długo-krótkoterminowa pamięć) | Dokładność (%) | Wskaźnik F1 (%) | mAP-T (%) |
| Baseline oparty wyłącznie na CNN | ✗ | ✗ | 90.4 ± 1.2 | 89.8 ± 1.3 | 88.9 ± 1.4 |
| CNN + LSTM | ✗ | ✓ | 93.1 ± 0.9 | 92.4 ± 1.0 | 91.7 ± 1.1 |
| Wyłącznie MSCNN | ✓ | ✗ | 94.2 ± 0.8 | 93.6 ± 0.9 | 92.8 ± 1.0 |
| Proponowany model MSCNN-LSTM | ✓ | ✓ | 98.3 ± 0.5 | 97.8 ± 0.6 | 97.1 ± 0.6 |
Tabela 7: Badanie ablacyjne zaproponowanego frameworka MSCNN-LSTM. Wkład w wydajność komponentów MSCNN i LSTM przy identycznych ustawieniach uczenia i ewaluacji. Wartości przedstawiono jako średnia ± SD z pięciu niezależnych uruchomień (n = 5).
Rysunek 10, Rysunek 11, Rysunek 12 przedstawiają odpowiednio znormalizowane wierszowo macierze pomyłek dla zbiorów UCF11, UCF Sports oraz JHMDB. Wszystkie trzy macierze wykazały wyraźną dominację przekątnej, co wskazuje na poprawną identyfikację większości klas czynności. Ograniczone błędy poza przekątną występowały głównie pomiędzy czynnościami o podobnych charakterystykach wizualnych lub ruchowych. Macierz JHMDB wykazała stosunkowo większą pomyłkę klas, co jest zgodne z niższymi wynikami ilościowymi zaobserwowanymi w przypadku tego bardziej wymagającego zbioru danych.
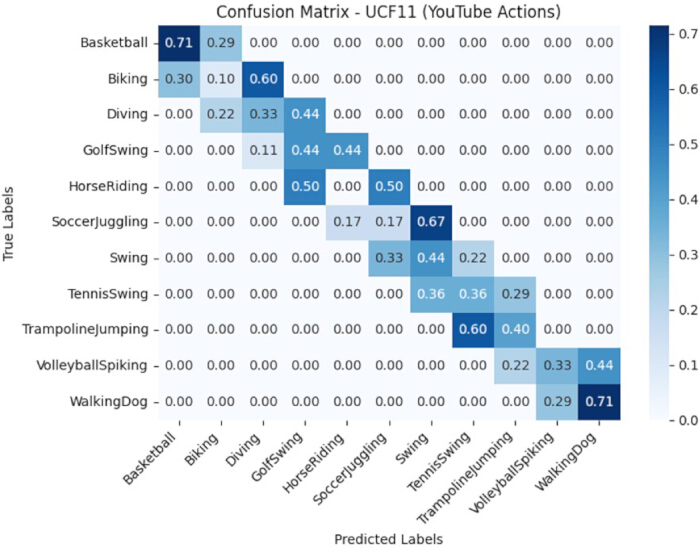
Rycina 10: Znormalizowana w wierszach macierz pomyłek proponowanego modelu MSCNN-LSTM na zbiorze danych UCF11. Każdy wiersz został znormalizowany do jedności, a wartości na przekątnej reprezentują czułość (recall) dla poszczególnych klas, a nie ogólną dokładność klasyfikacji, która jest raportowana osobno. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
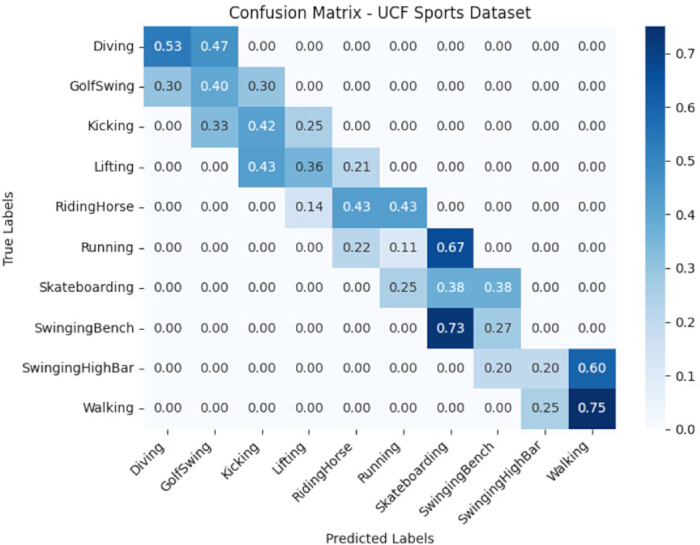
Rycina 11: Znormalizowana w wierszach macierz pomyłek proponowanego modelu MSCNN-LSTM na zbiorze danych UCF Sports. Każdy wiersz został znormalizowany do jedności, a wpisy na przekątnej reprezentują czułość (recall) dla poszczególnych klas, a nie ogólną dokładność klasyfikacji, która jest raportowana osobno. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
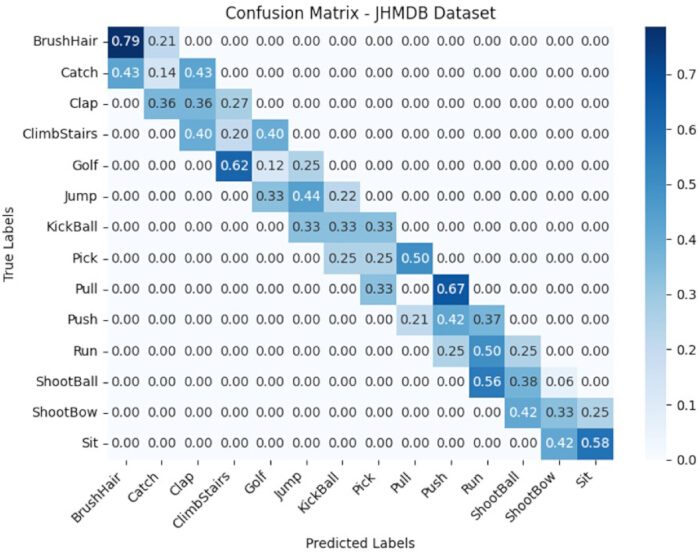
Rysunek 12: Znormalizowana wierszowo macierz pomyłek proponowanego modelu MSCNN-LSTM dla zbioru danych JHMDB. Każdy wiersz jest znormalizowany do jedności, a wpisy na przekątnej reprezentują czułość (recall) dla poszczególnych klas, a nie ogólną dokładność klasyfikacji, która jest raportowana osobno. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Ogólnie rzecz biorąc, zaproponowany model MSCNN-LSTM konsekwentnie przewyższał analizowane modele porównawcze pod względem klasyfikacji, zgodności, dyskryminacji oraz miar stabilności czasowej. Wyniki potwierdziły hipotezę, że połączenie wieloskalowej ekstrakcji cech przestrzennych z modelowaniem czasowym opartym na sieci LSTM poprawia rozpoznawanie akcji sportowych w zbiorach danych o różnej złożoności ruchu, jakości obrazu oraz warunkach kąta widzenia.
DOSTĘPNOŚĆ DANYCH:
Zbiory danych analizowane w niniejszym badaniu są publicznie dostępne z następujących źródeł: zbiór danych UCF11 (YouTube Actions) (https://www.crcv.ucf.edu/data/UCF_YouTube_Action.php) oraz zbiór danych UCF Sports (https://www.crcv.ucf.edu/data/UCF_Sports_Action.php). Aby wesprzeć odtwarzalność tego badania, potok przetwarzania wstępnego, partycjonowanie zbiorów danych (generowanie podziału na zbiór treningowy/walidacyjny/testowy), pliki implementacyjne, pliki konfiguracyjne oraz dokumentacja pomocnicza wykorzystana w eksperymentach zostały zdeponowane w repozytorium Zenodo i są publicznie dostępne pod adresem https://doi.org/10.5281/zenodo.21020947.
Dyskusja
Zaproponowana struktura MSCNN-LSTM konsekwentnie przewyższała oceniane podejścia we wszystkich analizowanych zestawach danych referencyjnych: UCF11, UCF Sports oraz JHMDB. Poprzednie metody oparte na Dilated CNN–BiLSTM, architekturach Vision Transformer oraz 3D CNN wykazały się skutecznością w uczeniu cech czasoprzestrzennych, lecz mogą być ograniczone przez wysoką złożoność obliczeniową, znaczne wymagania treningowe lub niewystarczającą reprezentację drobnoziarnistych wzorców ruchu23,24,25. W przeciwieństwie do nich, zaproponowana struktura zintegrowała wieloskalową ekstrakcję cech przestrzennych z modelowaniem czasowym opartym na LSTM, co umożliwiło uchwycenie zarówno lokalnych szczegółów ruchu, jak i długodystansowych zależności czasowych. Integracja ta poprawiła rozpoznawanie złożonych czynności sportowych, zmniejszyła pomyłki międzyklasowe i zwiększyła spójność czasową, szczególnie w przypadku bardziej wymagającego zbioru danych JHMDB. Wyniki te wskazują, że zaproponowana struktura zapewniła zrównoważoną reprezentację informacji przestrzennych i czasowych w porównaniu z ocenianymi podejściami opartymi na sieciach CNN, sieciach rekurencyjnych i transformerach.
Z perspektywy teoretycznej framework MSCNN-LSTM zapewnił ujednolicone podejście do fuzji cech wieloskalowych oraz sekwencyjnego uczenia temporalnego36,37. Zastosowanie hierarchicznych pól recepcyjnych umożliwiło ekstrakcję informacji przestrzennych w różnych skalach, podczas gdy LSTM modelowała zależności pomiędzy następującymi po sobie klatkami wideo. Konstrukcja ta rozszerzyła konwencjonalny rurociąg CNN-LSTM poprzez zachowanie lokalnych i kontekstowych informacji przestrzennych przed modelowaniem temporalnym. Stabilna wydajność w obrębie zbiorów danych zawierających zróżnicowane klasy działań, wzorce ruchu i punkty widzenia kamery dodatkowo potwierdziła odporność proponowanej architektury.
Z praktycznego punktu widzenia opracowany model wykazał potencjał w zakresie zautomatyzowanej analityki sportowej, oceny wyników sportowców, detekcji zdarzeń oraz analizy wideo z dyscyplin sportowych. Przed wdrożeniem konieczna jest jednak dalsza walidacja w rzeczywistych warunkach operacyjnych. Mimo że architektura ta osiągnęła wysoką skuteczność rozpoznawania, jej przydatność dla urządzeń o ograniczonych zasobach lub chmurowych platform analitycznych powinna zostać potwierdzona poprzez dodatkową ocenę kosztów obliczeniowych, czasu wnioskowania, zapotrzebowania na pamięć oraz zużycia energii.
Analiza ablacyjna wykazała komplementarny wkład komponentów MSCNN i LSTM. MSCNN poprawiła ekstrakcję cech przestrzennych poprzez naukę reprezentacji w wielu skalach pola recepcyjnego, podczas gdy LSTM usprawniło modelowanie czasowe poprzez przechwytywanie zależności ruchu pomiędzy następującymi po sobie klatkami. Pełna konfiguracja MSCNN-LSTM osiągnęła najlepsze wyniki, co wskazuje na to, że wieloskalowa ekstrakcja cech przestrzennych i modelowanie sekwencji czasowych wspólnie przyczyniły się do zaobserwowanej poprawy w rozpoznawaniu czynności.
Podsumowując, zaproponowany model MSCNN-LSTM skutecznie połączył naukę reprezentacji przestrzennych i czasowych w celu rozpoznawania akcji w filmach sportowych. Ewaluacja na zbiorach danych UCF11, UCF Sports oraz JHMDB wykazała poprawę wydajności w porównaniu z analizowanymi podejściami opartymi na głębokim uczeniu. Wyniki te potwierdziły hipotezę, że integracja wieloskalowych cech splotowych z modelowaniem czasowym opartym na LSTM poprawia rozpoznawanie złożonych czynności sportowych. Niemniej jednak, wymagana jest walidacja na większych, bardziej zróżnicowanych i międzydomenowych zbiorach danych, aby ustalić możliwość generalizacji oraz zastosowanie w rzeczywistych warunkach.
Należy wziąć pod uwagę kilka ograniczeń. Po pierwsze, ewaluacja została ograniczona do publicznie dostępnych zestawów danych referencyjnych i może nie w pełni odzwierciedlać różnorodność oraz złożoność rzeczywistych środowisk sportowych. Po drugie, mimo zastosowania stałych podziałów na zbiory treningowe, walidacyjne i testowe, nie można całkowicie wykluczyć błędu systematycznego zestawu danych oraz niezamierzonego wycieku danych. Po trzecie, raportowana wydajność może się różnić w zależności od składu zestawu danych, inicjalizacji modelu, procedur preprocessingu oraz ustawień treningowych. Ponadto komponenty splotowe wieloskalowe i modelowania czasowego zwiększyły wymagania obliczeniowe, co może wpływać na wdrożenie na urządzeniach o ograniczonych zasobach. Struktura nie została również oceniona z wykorzystaniem zewnętrznych zestawów danych ani w rzeczywistych scenariuszach produkcyjnych w czasie rzeczywistym.
Modele wideo oparte na transformatorach wykazują wysoką skuteczność w dużych zbiorach danych do rozpoznawania czynności, lecz często wymagają znacznych zasobów obliczeniowych oraz obszernych danych treningowych. Zaproponowany schemat MSCNN-LSTM oferuje alternatywne podejście, łącząc wieloskalową ekstrakcję cech przestrzennych z rekurencyjnym modelowaniem czasowym. Przyszłe badania powinny dotyczyć walidacji międzyzbiorowej, wnioskowania w czasie rzeczywistym, optymalizacji obliczeń, szacowania niepewności oraz architektur hybrydowych integrujących mechanizmy uwagi oparte na transformatorach z proponowanym schematem wieloskalowym CNN-LSTM38.
Oświadczenia
Autorzy deklarują brak konfliktów interesów.
Podziękowania
Badania te zostały przeprowadzone w Center of Artificial Intelligence Technology (CAIT), Wydziale Informatyki i Technologii (Faculty of Information Science and Technology) na Universiti Kebangsaan Malaysia. Autorzy z wdzięcznością dziękują za wsparcie instytucjonalne oraz udostępnione zaplecze badawcze. Praca ta nie otrzymała żadnego konkretnego finansowania z żadnej publicznej, komercyjnej lub non-profit agencji finansującej.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Karta graficzna GeForce RTX 3090 GPU | NVIDIA Corporation | RTX 3090, 24 GB VRAM | Wykorzystywane do trenowania i wnioskowania w modelach głębokiego uczenia |
| Procesor Intel Core i9 | Intel Corporation | 16-rdzeniowy, 3,5 GHz | Wykorzystywany do przetwarzania wstępnego danych i obliczeń |
| Pamięć systemowa | Ogólny | 64 GB pamięci RAM DDR4 | Obsługuje przetwarzanie wideo na wielką skalę |
| Język programowania Python | Python Software Foundation | Wersja 3.8.18 | Podstawowy język programowania użyty do implementacji |
| TensorFlow | Wersja 2.15 | Framework głębokiego uczenia wykorzystany do opracowania modelu | |
| System operacyjny | Microsoft Corporation | Windows 11 | Opracowanie i eksperymentacja nad modelem |
| Zestaw narzędzi CUDA (CUDA Toolkit) | NVIDIA Corporation | CUDA 11.8 | Akceleracja GPU w trenowaniu modeli |
| cuDNN | NVIDIA Corporation | cuDNN 8.9.7 | Biblioteka akceleracji głębokich sieci neuronowych |
| OpenCV | Otwarte oprogramowanie | Wersja 4.8.1 | Ekstrakcja i przetwarzanie wstępne klatek wideo |
| NumPy | Otwarty kod źródłowy | Wersja 1.24.4 | Obliczenia numeryczne i przetwarzanie tablic |
| Scikit-learn | Otwarte oprogramowanie | Wersja 1.3.2 | Ocena wydajności i analiza statystyczna |
| Matplotlib | Otwarte oprogramowanie | Wersja 3.7.5 | Wizualizacja wyników eksperymentalnych |
| Zbiór danych UCF11 | University of Central Florida | Publiczny zbiór danych | Benchmarkowy zbiór danych do rozpoznawania akcji sportowych |
| Zbiór danych sportowych UCF | University of Central Florida | Publiczny zestaw danych | Benchmarkowy zestaw danych do rozpoznawania aktywności sportowych |
| Zbiór danych JHMDB | Instytut Informatyki Maxa Plancka | Publiczny zbiór danych | Zestaw danych referencyjnych do rozpoznawania ruchu i czynności człowieka |
Bibliografia
- Hassan N, Miah ASM, Shin J. A deep bidirectional LSTM model enhanced by transfer-learning-based feature extraction for dynamic human activity recognition. Appl Sci. 2024;14:603. https://doi.org/10.3390/app14020603
- Egawa R, et al. Dynamic fall detection using graph-based spatial temporal convolution and attention network. Electronics. 2023;12:3234. https://doi.org/10.3390/electronics12153234
- Riahi M, Eslami M, Safavi SH, Torkamani Azar F. Human activity recognition using improved dynamic image. IET Image Process. 2020;14:3223–3231. https://doi.org/10.1049/iet-ipr.2020.0372
- Muhammad K, et al. Human action recognition using attention-based LSTM network with dilated CNN features. Future Gener Comput Syst. 2021;125:820–830. https://doi.org/10.1016/j.future.2021.06.017
- Al-Obaidi S, Al-Khafaji H, Abhayaratne C. Making sense of neuromorphic event data for human action recognition. IEEE Access. 2021;9:82686–82700. https://doi.org/10.1109/ACCESS.2021.3085769
- Wensel J, Ullah H, Munir A. ViT-ReT: Vision and recurrent transformer neural networks for human activity recognition in videos. IEEE Access. 2023;11:72227–72249. https://doi.org/10.1109/ACCESS.2023.3293445
- Vrskova R, Hudec R, Kamencay P, Sykora P. Human activity classification using the 3DCNN architecture. Appl Sci. 2022;12:931. https://doi.org/10.3390/app12020931
- Ullah A, et al. Action recognition using optimized deep autoencoder and CNN for surveillance data streams of non-stationary environments. Future Gener Comput Syst. 2019;96:386–397. https://doi.org/10.1016/j.future.2019.01.041
- Jaouedi N, Boujnah N, Bouhlel MS. A new hybrid deep learning model for human action recognition. J King Saud Univ Comput Inf Sci. 2020;32:447–453. https://doi.org/10.1016/j.jksuci.2018.08.001
- Zebhi S, Al-Modarresi SMT, Abootalebi V. Converting video classification problem to image classification with global descriptors and pre-trained network. IET Comput Vis. 2020;14:614–624. https://doi.org/10.1049/iet-cvi.2020.0023
- Cust E, Sweeting AJ, Ball K, Robertson S. Machine and deep learning for sport-specific movement recognition: A systematic review. J Sports Sci. 2019;37:568–600. https://doi.org/10.1080/02640414.2018.1504613
- Cao S, Wang B, Zhang W, Ma L. Visual consensus modeling for video-text retrieval. In Proc AAAI Conf Artif Intell. 2022:167–175. https://doi.org/10.1609/aaai.v36i1.19890
- Yu H, et al. Fine-grained video captioning for sports narrative. In Proc IEEE Conf Comput Vis Pattern Recognit (CVPR). 2018:6006–6015. https://doi.org/10.1109/CVPR.2018.00628
- Browne P, Sweeting AJ, Woods CT, Robertson S. Methodological considerations for furthering the understanding of constraints in applied sports. Sports Med Open. 2021;7:22. https://doi.org/10.1186/s40798-021-00307-9
- Gao T, et al. Sports video classification method based on improved deep learning. Appl Sci. 2024;14:948. https://doi.org/10.3390/app14020948
- Dong Z, Xie M, Li X. Multi-scale receptive fields convolutional network for action recognition. Appl Sci. 2023;13:3403. https://doi.org/10.3390/app13063403
- Liu S, et al. Human memory update strategy: A multi-layer template update mechanism for remote visual monitoring. IEEE Trans Multimed. 2021;23:2188–2198. https://doi.org/10.1109/TMM.2020.3009234
- Liu S, Liu D, Muhammad K, Ding W. Effective template update mechanism in visual tracking with background clutter. Neurocomputing. 2021;458:615–625. https://doi.org/10.1016/j.neucom.2021.05.032
- Haque MN, et al. GRU-based attention mechanism for human activity recognition. In Proc ICASERT. 2019:1–6. https://doi.org/10.1109/ICASERT.2019.8934521
- Al-qaness MA, Dahou A, AbdElaziz M, Helmi A. Multi-ResAtt: Multilevel residual network with attention for human activity recognition using wearable sensors. IEEE Trans Ind Inform. 2022;19:144–152. https://doi.org/10.1109/TII.2022.3147850
- Duan F, et al. A multi-task deep learning approach for sensor-based human activity recognition and segmentation. IEEE Trans Instrum Meas. 2023;72:2514012. https://doi.org/10.1109/TIM.2023.3264512
- Gomes E, et al. Machine learning algorithms for activity-intensity recognition using accelerometer data. Sensors. 2021;21:1214. https://doi.org/10.3390/s21041214
- Su C, et al. A novel model for fall detection and action recognition combining lightweight 3D-CNN and ConvLSTM networks. Pattern Anal Appl. 2024;27:3. https://doi.org/10.1007/s10044-023-01234-5
- Zhou T, et al. Behavior recognition based on improved density clustering and context-guided Bi-LSTM model. Multimed Tools Appl. 2023;82:45471–45488. https://doi.org/10.1007/s11042-023-14678-9
- Shin J, et al. Video-based human activity recognition using hybrid deep learning model. Comput Model Eng Sci. 2025;143:3615. https://doi.org/10.32604/cmes.2025.058341
- Vrskova R, Hudec R, Kamencay P, Sykora P. A new approach for abnormal human activities recognition based on ConvLSTM architecture. Sensors. 2022;22:2946. https://doi.org/10.3390/s22082946
- Vijeikis R, Raudonis V, Dervinis G. Efficient violence detection in surveillance. Sensors. 2022;22:2216. https://doi.org/10.3390/s22062216
- Rendón-Segador F, et al. ViolenceNet: Dense multi-head self-attention with bidirectional ConvLSTM for detecting violence. Electronics. 2021;10:1601. https://doi.org/10.3390/electronics10131601
- Kalfaoglu E, Kalkan S, Alatan A. Late temporal modeling in 3D CNN architectures with BERT for action recognition. In Proc ECCV Workshops. 2020. https://doi.org/10.1007/978-3-030-66823-5_43
- Moaaz M, Mohamed E. Violence detection in surveillance videos using deep learning. Inf Bull Fac Comput Artif Intell. 2020;2:6.
- Song W, et al. Expressive 3D facial animation generation based on local-to-global latent diffusion. IEEE Trans Vis Comput Graph. 2024;30:7397–7407. https://doi.org/10.1109/TVCG.2024.3456213
- Li L, Cherouat A, Snoussi H, Wang T. Grasping with occlusion-aware ally method in complex scenes. IEEE Trans Autom Sci Eng. 2025;22:5944–5954. https://doi.org/10.1109/TASE.2024.3434610
- Li R, et al. UE-Extractor: A grid-to-point ground extraction framework for unstructured environments. IEEE Robot Autom Lett. 2025;10:5991–5998. https://doi.org/10.1109/LRA.2025.3563127
- Jhuang, H., Gall, J., Zuffi, S., Schmid, C., Black, M. J. Towards understanding action recognition. Proceedings of the IEEE International Conference on Computer Vision. 3192–3199, doi:10.1109/ICCV.2013.396 (2013).
- OpenMMLab. MMAction2: JHMDB dataset preparation. GitHub. https://github.com/open-mmlab/mmaction2/tree/main/tools/data/jhmdb (2026).
- Ullah W, Khalid YN, Khan SH. A novel deep hybrid framework with ensemble-based feature optimization for HAR. arXiv preprint arXiv:2508.18695. 2025. https://arxiv.org/abs/2508.18695
- Karuppannan K, Darmanayagam SE, Cyril SR. Human action recognition using fusion-based discriminative features and LSTM classification. Concurr Comput Pract Exp. 2022;34:e7250. https://doi.org/10.1002/cpe.7250
- Sahoo SP, et al. HAR-depth: A novel framework for human action recognition using sequential learning and depth estimated history images. IEEE Trans Emerg Top Comput Intell. 2020;5:813–825. https://doi.org/10.1109/TETCI.2020.3006543