This study proposes an algorithm that tightly couples the hierarchical visual features captured by a shifted-window hierarchical transformer encoder with the prior depth of the Manhattan 3D bounding box generated by line-segment detection, thereby achieving high-precision semantic reconstruction of complex indoor scenes.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
A Semantic Parsing Method for Indoor Scene Images Based on Prior Knowledge of Building Structure
W tym artykule
Podsumowanie
Streszczenie
To address semantic prediction discontinuities and physical boundary distortions caused by furniture occlusion in complex indoor scenes, this paper proposes a semantic parsing method that leverages building-structure priors. The scheme uses a shifted-window hierarchical transformer encoder to extract multi-scale visual features and combines a gradient-direction-consistency line segment detection algorithm to construct a Manhattan 3D bounding box. This bounding box is transformed into a signed distance field (SDF) prior to encoding discrete geometric contours into a continuous physical potential field. A structure-guided cross-attention mechanism forces the visual signals to align with real 3D orthogonal geometric boundaries, restoring feature continuity in occluded areas. A spatial adjacency graph constructed from superpixel nodes drives a Graph Convolutional Network (GCN) to aggregate features, ensuring macroscopic semantic consistency within the physical load-bearing plane. A combination of pixel-level cross-entropy loss and a custom-designed structural consistency loss strengthens the constraints, penalizing out-of-bounds predictions. Experiments across multiple independent runs show that the mean intersection over union (mIoU) reaches 68.7% with a standard deviation of 0.2%, and the structural boundary F1 score reaches 76.4% with a standard deviation of 0.3%, confirming the robust performance of the proposed modules. With a single image node size of 256, the average inference time remained at 61 ms.
Wprowadzenie
Indoor scene image semantic analysis occupies a core position in three-dimensional spatial cognition and intelligent spatial reasoning tasks1,2. Visual feature extraction in real physical environments is often severely hindered by complex spatial layouts3. Solving the semantic discontinuity and physical boundary distortion of the building foundation structure building foundation structure caused by large-scale furniture occlusion is important for spatial cognition research4,5. Accurately removing interference from cluttered objects and restoring the physical continuity of the same wall and floor will directly determine the accuracy of three-dimensional scene reconstruction and global spatial logic analysis6. The semantic discontinuity caused by large-scale furniture occlusion and the structural repair effect of the proposed building-prior guidance are illustrated in Figure 1, where the occluded red green blue (RGB) input in Table 1A, baseline mask distortion in Figure 1B, and structure-prior repair result in Figure 1C are compared under the same indoor scene condition.
To meet the accuracy requirements of spatial logical reasoning, current mainstream pixel-driven visual networks face multiple obstacles when dealing with complex indoor environments7,8. Indoor spaces are often filled with dense furniture and cluttered furnishings, resulting in a significant loss of low-level visual boundary signals in the images9. Conventional feature extraction mechanisms rely excessively on local two-dimensional color and texture responses, lacking a macroscopic understanding of the rigid orthogonal laws of three-dimensional man-made structures10. This limitation of the local receptive field makes feature propagation easily interrupted, making it difficult to extend the global topology across occlusions11. Currently, there is an urgent need to solve the core problem of semantic prediction discontinuities and severe distortions of physical boundaries caused by occlusion and interference12.
To address structural faults in building foundations caused by occlusion and interference, the academic community has developed a variety of targeted intervention measures13. Cross-modal feature aggregation networks effectively compensate for the inherent deficiencies of a single visual modality in spatial perception by introducing depth maps or text priors to assist with red-green-blue (RGB) images14,15. Boundary perception and adaptive context selection frameworks inject physical contour enhancement strategies into the feature decoding stage, which greatly improves the edge fit of prediction results in complex scenes16,17. Inference models based on GCNs and feature interaction mechanisms significantly improve feature smoothness and macro-semantic consistency in homogeneous regions by constructing node-level connections18,19. Integrating explicit Manhattan structural priors into the visual feature extraction pipeline enforces geometric consistency boundaries, which addresses the feature discontinuity challenges caused by extensive foreground object occlusion20.
To address the core challenge of semantic prediction faults and severe distortions of physical boundaries associated with building infrastructure, a semantic parsing framework is proposed based on a closed-loop coupling mechanism incorporating architectural priors. This framework transcends naive engineering pipelines by establishing a bidirectional mapping alignment between continuous geometric potential fields and discrete visual feature manifolds, forming a non-trivial synergy that rectifies occlusion errors through structural laws. This scheme relies on a multi-scale visual backbone network and a line-segment detection algorithm based on vanishing-point estimation to acquire local appearance features and orthogonal edge priors that represent the Manhattan 3D bounding box in parallel, and then transform them into an SDF. The algorithm employs a structure-guided cross-attention mechanism, using visual features as query vectors and treating SDF features as keys and values for dot-product calculations, thereby forcing the visual signal to align with the real 3D geometric boundary in the feature space. A spatial adjacency graph constructed from superpixel nodes and spatial coplanarity edge features is fed into a GCN to perform cross-node feature aggregation and message passing. The end-to-end parameter optimization process jointly employs pixel-level cross-entropy and a custom structural consistency loss function, which strictly constrains and penalizes predicted pixels that cross the building-prior boundary. The complete semantic parsing pipeline is summarized in Figure 2, which links RGB image input, geometric prior extraction, cross-attention alignment, superpixel graph reasoning, and semantic mask decoding within a unified architecture.
Early scene parsing networks relied on convolutional operations to capture local appearance textures, but due to limitations in local receptive fields, they exhibited insufficient semantic coherence of large-scale targets21,22. Previous studies have applied the self-attention module of the visual Transformer architecture to extract global contextual information and construct long-distance pixel association features23,24. Cross-modal multi-view feature aggregation strategies extract the three-dimensional geometric spatial features of the scene by fusing depth-map point clouds and text command inputs25,26. Hybrid attention mechanisms for feature fusion targeting specific domains have gradually matured. By constructing feature interaction bridges, they have significantly reduced energy loss and feature sparsity in multi-scale transmission of visual signals and improved the robustness of complex-structure parsing. Cutting-edge encoder designs jointly integrate and infer high-frequency domain spatial details alongside global and local features, strengthening the network's ability to distinguish fine-grained semantic categories with high similarity and improving indoor parsing accuracy27,28. Recent advancements in semantic segmentation architectures provide valuable references for optimizing computational efficiency and spatial perception. Models designed for dense prediction and multi-scale contextual aggregation extract fine-grained geometric features from complex backgrounds. Feature decoupling and synergistic fusion strategies address the semantic ambiguity in boundary regions. Lightweight attention mechanisms and gated aggregation modules optimize the parameter distribution, thereby accelerating inference while preserving local structural details. Implementing these efficient architectural designs offers theoretical guidance for reducing the computational overhead of non-Euclidean topological inference operations in indoor scene parsing.
Building structure priors and 3D layout estimation are used to correct local visual parsing errors29. Previous studies have extracted orthogonal and parallel geometric features of indoor buildings as inference constraints to reduce network prediction bias caused by cluttered indoor backgrounds30,31. Existing schemes use line segment detection algorithms and image ablation point analysis techniques to generate Manhattan 3D bounding boxes to map the physical boundaries of rooms and assist in the localization of underlying visual features32. The joint architecture of the boundary awareness module and the multi-scale context implicitly embeds prior structural information into the high-dimensional feature decoding process, forcing the network to output semantic masks that closely match the real physical contours, effectively improving the jaggedness and blurring of object edges33. Semi-supervised or weakly supervised loss function designs with boundary enhancement properties have been widely explored. Relying on rigorous mathematical formulas to punish independent pixel classification behavior that violates spatial topological rules, the geometric smoothness and structural integrity of the final segmentation result are guaranteed from the source of gradient optimization34.
Some studies have used graph neural networks to perform cross-domain aggregation of visual features and reasoning about topological relationships in high-dimensional space35. The superpixel segmentation algorithm pre-aggregates adjacent pixel blocks with similar color response and texture features into independent connected nodes. The superpixel segmentation algorithm compresses the computational redundancy of the graph structure at the image level and preserves the basic geometric topology of the image36. The GCN built on the high-dimensional node feature vector, and the adjacency matrix representing spatial proximity drives the efficient directional transmission and interactive fusion of multi-scale visual information along the physical connected graph in the spatial domain37,38. The application of the temporal information enhancement module and the hybrid multi-scale skip connection mechanism suppresses the excessive smoothing and homogenization of node features generated in the process of multi-layer deep message passing39. The multi-scale graph wavelet transform technology, and the pseudo-label element learning optimization strategy optimize the anti-background noise mechanism of the node feature update formula, so that features with the same semantic attributes maintain a cooperative response mode in complex network topology40. The graph-based reasoning mechanism maps regular pixel grids to non-Euclidean topological spaces to perform feature aggregation calculations of irregular building structures and interior components41.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Przed trenowaniem sieci przygotowano zestawy danych scen RGB wewnątrz pomieszczeń oraz ich adnotacje semantyczne. Wielkoskalowy zestaw danych 3D wnętrz oraz zestaw danych scen RGB-D wewnątrz pomieszczeń (patrz Tabela materiałów) pobrano z ich oficjalnych repozytoriów. Zachowano sceny wnętrz zawierające przesłonięcia przez meble, zmienność oświetlenia, przerwy w granicach ścian oraz złożone układy przestrzenne, aby dopasować je do docelowego scenariusza segmentacji. Etykiety semantyczne przekształcono w indeksowane jednokanałowe maski adnotacji w formacie PNG, a wszystkie obrazy RGB i maski semantyczne zmieniono rozmiarem do 512 × 512 pikseli. Podczas trenowania zastosowano augmentację danych online, obejmującą losowe poziome odbicie lustrzane z prawdopodobieństwem 0,5, losowe skalowanie jasności w zakresie od 0,8 do 1,2 oraz losowy obrót od −10° do +10°, aby rozszerzyć rozkład układów strukturalnych. Kanały RGB znormalizowano, przyjmując wartości średnie 0,485, 0,456 i 0,406 oraz wartości odchylenia standardowego 0,229, 0,224 i 0,225. W przypadku wielkoskalowego benchmarku 3D wnętrz zastosowano oficjalny podział danych wykorzystany w tej badaniu, obejmujący 1201 scen treningowych i 312 scen walidacyjnych do opracowania i walidacji modelu. Benchmark scen RGB-D wewnątrz pomieszczeń realizowano zgodnie z oficjalnym protokołem ewaluacyjnym, wykorzystując 795 obrazów treningowych i 654 obrazy testowe. W przypadku tych dwóch publicznych benchmarków nie stosowano dodatkowego podziału procentowego.
Jako szkielet kodera transformera z przesuwnym oknem zainicjowano hierarchiczną sieć transformatora wizualnego o przesuniętym oknie (patrz Tabela Materiałów). Rozmiar osadzania patchy (patch embedding) skonfigurowano na 4 x 4 piksele. Wymiary osadzania dla czterech etapów hierarchicznych ustawiono odpowiednio na 128, 256, 512 i 1024, a liczbę bloków transformera w tych czterech etapach na 2, 2, 18 i 2. Rozmiar lokalnego okna uwagi ustawiono na 7 x 7, natomiast liczbę głowic uwagi dla czterech etapów hierarchicznych na 4, 8, 16 i 32. Wewnątrz wszystkich warstw wielowarstwowego perceptrona zastosowano nieliniowe ciągłe funkcje aktywacji. Downsampling przestrzenny przeprowadzano poprzez operacje łączenia patchy (patch-merging) z krokiem 2 po każdym etapie hierarchicznym. Podstawowa architektura sieci oraz hiperparametry modułu wnioskowania splotowego zostały podsumowane w Tabeli 1.
Następnie przeprowadzono ekstrakcję cech z map cech wejściowych przy użyciu mechanizmu przesuniętego okna samo-uwagi (shifted-window self-attention). Każda mapa cech została podzielona na niezachodzące na siebie lokalne okna o wymiarach przestrzennych 7 × 7. Mechanizm uwagi w regularnych oknach oraz uwaga w przesuniętych oknach były stosowane naprzemiennie w sąsiadujących blokach transformera z przesuniętymi oknami. Odległość przesunięcia cyklicznego ustawiono na 3 piksele, a w obrębie każdego lokalnego okna uwagi zastosowano kodowanie względnego obciążenia pozycyjnego. Lokalne cechy wizualne zostały zagregowane za pomocą wielogłowicowej samo-uwagi w celu wygenerowania hierarchicznych, wieloskalowych reprezentacji cech.
Strukturalne priory Techniki Manhattan zostały wyekstrahowane z wewnętrznych obrazów RGB. Segmenty krawędzi strukturalnych wykryto za pomocą algorytmu detekcji segmentów linii opartego na spójności kierunku gradientu. Dominujące kierunki strukturalne zgrupowano przy użyciu algorytmu RANSAC (random sample consensus) (patrz w Tabela materiałów) na podstawie estymacji punktu zbiegu. Zrekonstruowano trzy wzajemnie prostopadłe kierunki Manhattan, aby wygenerować reprezentację 3D w formie ograniczającego prostokąta Manhattan (Manhattan 3D bounding box). Zrekonstruowaną granicę strukturalną przekształcono w mapę SDF poprzez obliczenie minimalnej odległości euklidesowej z każdego piksela do najbliższego odcinka linii granicznej.
Cechy wzajemnej uwagi sterowanej strukturą zostały wygenerowane po uzyskaniu cech wizualnych i priorytetów SDF. Rozmaitość cech wizualnych została odwzorowana na tensor zapytania Q za pomocą liniowej macierzy transformacji W sub Q element of double-struck cap R to the formation matrix W sub Q element of double-struck cap R to the formation matrix 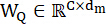 . Priorytet ciągłego pola dystansu został odwzorowany na tensor klucza K oraz tensor wartości V za pomocą macierzy transformacji
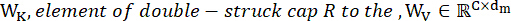 , a wymiar modelu ustawiono na 512. Modulacja wielogłowicowa podzieliła przestrzeń projekcji na 8 niezależnych podprzestrzeni, z których każda głowica miała wymiar 64. Priorytet układu przestrzennego rzutował dyskretne współrzędne pikseli na ciągłe pole potencjału i generował macierz powinowactwa strukturalnego S jako jawne addytywne obciążenie przestrzenne do modulacji macierzy podobieństwa iloczynu skalarnego. Tensor cech wizualnych posłużył jako źródło zapytania, ponieważ analiza semantyczna wymaga, aby każda lokalizacja wizualna aktywnie pobierała strukturalnie spójne dowody z przestrzeni priorytetów geometrycznych. Priorytet SDF został użyty jako źródło klucza i wartości, ponieważ przechowuje on ciągły dystans brzegowy oraz strukturalne wskazówki wewnątrz-zewnątrz pochodzące z układu Manhattan. Człon iloczynu skalarnego mierzył kompatybilność między wyglądem semantycznym a priorytetem geometrycznym, podczas gdy addytywny człon strukturalny λS przesuwał wagi uwagi w stronę pikseli znajdujących się na tej samej płaszczyźnie fizycznej lub w pobliżu tego samego konturu architektonicznego. Współczynnik λ reprezentował stopień pewności w zakresie wyekstrahowanego priorytetu strukturalnego i kontrolował zakres, w jakim sztywne ograniczenia ortogonalne zostały włączone do rozkładu uwagi. Sformułowanie to zredukowało dyfuzję cech międzygranicznych spowodowaną przesłonięciem przez meble i zachowało adaptacyjne rozluźnienie w układach nie-Manhattan. Rozkład uwagi sterowanej strukturą został obliczony zgodnie z Równaniem 1.
Równanie 1: 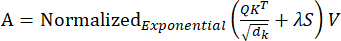
gdzie A oznacza macierz agregacji uwagi sterowanej strukturą, Q oznacza tensor zapytania (query) wygenerowany z cech wizualnych, K oznacza tensor klucza (key) wygenerowany z cech a priori SDF, V oznacza tensor wartości (value) wygenerowany z reprezentacji strukturalnych a priori, dk oznacza wymiar cech tensora klucza, λ oznacza adaptacyjny współczynnik wag strukturalnych używany do określenia pewności geometrycznej obszarów lokalnych i rozluźnienia sztywnych ograniczeń ortogonalnych w przestrzennych układach niemanhattańskich, a S oznacza macierz powinowactwa SDF. Dzielenie przez dk ustabilizowało skalę logitów uwagi i zapobiegło powstawaniu nadmiernie skoncentrowanych wag uwagi przy dużych wymiarach cech. Znormalizowana funkcja wykładnicza (patrz: Tabela materiałów) przekształciła zmodyfikowane wyniki podobieństwa w znormalizowany rozkład przestrzenny, co pozwoliło każdemu pikselowi agregować informacje strukturalne a priori w oparciu o spójność semantyczną i geometryczną. Taka konstrukcja wyjaśnia, dlaczego wygląd wizualny i priory teoretyczne granic architektonicznych są łączone na poziomie uwagi, a nie poprzez bezpośrednią konkatenację cech.
Graf topologii superpikseli został zbudowany na podstawie mapy cech wyrównanej strukturalnie. Mapę cech podzielono przy użyciu algorytmu generowania regionów przestrzennych. Liczbę superpikseli ustawiono na 256, współczynnik zwartości na 10, współczynnik wygładzania Gaussa na 1,0, a liczbę iteracji na 10. Ograniczenia bliskości przestrzennej wymuszono poprzez ustawienie wagi metryki odległości na stały stosunek 1,0 do odległości w przestrzeni kolorów cech podczas klastrowania, co pozwoliło na utrzymanie jednorodnego generowania węzłów na gęstych granicach szumu. Piksele o jednolitych odpowiedziach semantycznych zostały zagregowane w węzły superpikseli. Krawędzie grafu zbudowano zgodnie z relacjami sąsiedztwa przestrzennego, siłą powinowactwa SDF oraz ograniczeniami spójności geometrycznej współpłaszczyznowości. Proces budowy macierzy powinowactwa strukturalnego i łączności topologicznej przedstawiono na Rysunku 3, który obrazuje, w jaki sposób prowadzenie SDF zostało przekształcone w relacje przestrzenne na poziomie grafu.
Sformułowanie grafu wprowadzono w celu przekształcenia gęstego rozumowania na poziomie pikseli w rozumowanie przestrzenne na poziomie węzłów w obrębie jednorodnych regionów strukturalnych. Każdy węzeł superpiksela reprezentował lokalny obszar o podobnej odpowiedzi semantycznej i ciągłości przestrzennej, podczas gdy każda krawędź reprezentowała niezawodną ścieżkę transmisji cech, podlegającą ograniczeniom sąsiedztwa, powinowactwa pola odległości oraz spójności koplanarnej. Taka konstrukcja ograniczyła wpływ izolowanych szumów pikselowych i umożliwiła przysłoniętym regionom ścian, podłóg i sufitów odbieranie komunikatów z fizycznie sąsiednich węzłów. Konstrukcja krawędzi służyła zatem jako matematyczny pomost pomiędzy ciągłym prowadzeniem SDF a dyskretnym, nieeuklidesowym rozumowaniem grafowym.
Skonfigurowano trójwarstwową grafową splotową sieć rozumowania z wymiarami cech ukrytych wynoszącymi 512, 256 i 128. Grafowa warstwa splotowa przeprowadzała wygładzanie cech w strukturze grafu w oparciu o relacje przestrzenne węzłów. Autopętla macierzy sąsiedztwa pozwalała zachować pierwotny stan każdego węzła podczas przekazywania komunikatów, zapobiegając usunięciu cech niewielkiego regionu strukturalnego przez otaczające go duże regiony. Symetryczna normalizacja skalowała elementy macierzy sąsiedztwa przez iloczyn odwrotności pierwiastków kwadratowych stopni węzłów, aby węzły o wysokim i niskim stopniu wnosiły wkład o zbliżonej wartości liczbowej podczas propagacji. Propagacja w przód realizowała lokalną agregację przestrzenną, w której stan każdego węzła absorbował wysokowymiarowe cechy z sąsiednich klastrów współpłaszczyznowych przed zastosowaniem elementowej nieliniowej funkcji prostowania. Taka konstrukcja sprawiła, że grafowa warstwa splotowa przybliżała dyfuzję semantyczną wzdłuż fizycznie znaczących płaszczyzn wewnętrznych, zamiast nieograniczonego wygładzania ponad granicami niepowiązanych obiektów. Cechy węzłów grafu oceniano zgodnie z Równaniem 2.
Równanie 2: 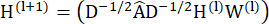
Projekcja z gęstych cech pikseli na węzły superpikseli, przekazywanie wiadomości za pomocą splotu grafowego oraz odwrotna projekcja współrzędnych zostały przedstawione na Rysunku 4, co wyjaśnia ścieżkę agregacji cech od regularnych siatek obrazu do topologii nieeuklidesowej i z powrotem do gęstej reprezentacji semantycznej. Projekcja z gęstych cech pikseli na Rysunku 4A na węzły superpikseli na Rysunku 4B, przekazywanie wiadomości za pomocą splotu grafowego na Rysunku 4C oraz odwrotna projekcja współrzędnych na Rysunku 4D wyjaśniają ścieżkę agregacji cech od regularnych siatek obrazu do topologii nieeuklidesowej i z powrotem do gęstej reprezentacji semantycznej.
gdzie H(l) oznacza tensor cech węzłów l-tej warstwy splotu grafowego, Â oznacza macierz sąsiedztwa z połączeniami samopętlowymi, D oznacza macierz stopni odpowiadającą macierzy sąsiedztwa, W(l) oznacza uczną macierz wag l-tej warstwy splotu grafowego, a σ oznacza funkcję aktywacji ReLU (Rectified Linear Unit). Termin ÂH(l) agreguje cechy z sąsiednich węzłów superpikseli, natomiast D−1/2 i D−1/2 balansują wkład węzłów o różnej gęstości połączeń. Uczna macierz W(l) rzutuje zagregowane cechy węzłów do nowej przestrzeni semantycznej, co pozwala warstwie grafowej odróżnić spójność strukturalną od zwykłego sąsiedztwa przestrzennego. Nieliniowa aktywacja zachowuje różnice w odpowiedziach między obszarami koplanarnymi a niekoplanarnymi po agregacji cech.
Cechy segmentacji semantycznej zostały zdekodowane po wnioskowaniu grafowym. Dekoder skonstruowano z trzech etapów upsamplingu z interpolacją biliniową oraz operacji fuzji z połączeniami pomijającymi (skip-connections) między warstwami. Płytkie cechy przestrzenne kodera zostały połączone z wysokopoziomowymi semantycznymi cechami dekodera poprzez fuzję kanałową. Rozdzielczość cech przywrócono do pierwotnego rozmiaru obrazu, a końcowa mapa przewidywania prawdopodobieństwa semantycznego została wygenerowana za pomocą warstwy splotu 1 × 1.
Pełna sieć analizy semantycznej została wytrenowana przy użyciu optymalizatora z rozdzielonymy zanikiem wag (weight-decay) (patrz Tabela Materiałów). Początkowa szybkość uczenia została ustawiona na 0,0001, współczynnik zaniku wag na 0,01, a rozmiar serii (batch size) na 8 dla obu publicznych zestawów referencyjnych. Współczynnik zaniku pierwszego momentu ustawiono na 0,9, współczynnik zaniku drugiego momentu na 0,999, a współczynnik epsilon dla stabilności numerycznej na 1 × 10⁻8. Stratę walidacyjną monitorowano po każdej epoce, a punkty kontrolne (checkpoints) zapisywano w momencie wzrostu mIoU na zbiorze walidacyjnym. Sieć była trenowana przez 300 epok przy użyciu wielomianowej strategii zaniku szybkości uczenia z potęgą zaniku równą 0,9. Przeprowadzono pięć niezależnych procesów trenowania z różnymi losowymi inicjacjami ziarna (random-seed), aby stworzyć statystycznie rygorystyczną bazę oceny. Sieć optymalizowano wspólnie, wykorzystując stratę entropii krzyżowej na poziomie pikseli oraz stratę spójności strukturalnej. Wszystkie eksperymenty wykonano na platformie obliczeniowej wyposażonej w sprzęt do obliczeń równoległych o dużej pojemności pamięci; szczegółowe informacje o sprzęcie podano w Tabeli Materiałów.
Wspólna optymalizacja wymusiła geometryczne wyrównanie granic poprzez obliczenie wielkości gradientu przestrzennego tensora prawdopodobieństwa klasy. Strata spójności strukturalnej została wykorzystana jako regulator, mnożąc normę gradientów przestrzennych predykcji przez ciągłe wartości SDF. Uzasadnienie matematyczne polegało na tym, że zmiany kategorii semantycznej powinny koncentrować się w pobliżu rzeczywistych konturów architektonicznych, gdzie SDF dąży do zera, podczas gdy wnętrza płaskich ścian, podłóg i sufitów powinny zachowywać gładkie odpowiedzi semantyczne. Gdy pojawiał się duży gradient predykcji daleko od granicy strukturalnej, człon pola dystansu zwiększał karę i zniechęcał do fałszywych przejść semantycznych wewnątrz jednorodnej płaszczyzny fizycznej. Gdy gradient predykcji pojawił się w pobliżu konturu o zerowym dystansie, kara pozostawała ograniczona i zachowywała uzasadnione przejścia klas wzdłuż granic architektonicznych. Regiony przejścia semantycznego zostały ograniczone tak, aby pokrywały się z konturami zerowego dystansu SDF, zgodnie z równaniem 3.
Równanie 3: 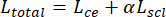
gdzie Ltotal oznacza końcową funkcję celu optymalizacji, Lce oznacza stratę entropii krzyżowej na poziomie pikseli, Lscl oznacza stratę kary za spójność strukturalną, a α oznacza współczynnik wagowy straty strukturalnej. Termin entropii krzyżowej zapewniał semantyczny nadzór na poziomie pikseli za pomocą masek adnotacji, podczas gdy termin spójności strukturalnej narzucał regularyzację geometryczną z wykorzystaniem priorytetów architektonicznych. Współczynnik wagowy α równoważył rozpoznawanie kategorii i dopasowanie granic, zapobiegając przeuczeniu optymalizacji pod kątem dokładności lokalnych etykiet lub sztywnych konturów strukturalnych. Ten wspólny cel powiązał semantykę wizualną, spójność granic fizycznych oraz trenowalne parametry sieci w ramach jednolitego celu optymalizacji.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Układ eksperymentalny
W niniejszym badaniu wykorzystano dwa standardowe zestawy danych do analizy scen wewnętrznych – wielkoskalowy trójwymiarowy zestaw danych wnętrz oraz zestaw danych scen wewnętrznych RGB-D – w celu oceny wydajności i dostrojenia modelu. Wielkoskalowy trójwymiarowy zestaw danych wnętrz zawiera realistycznie zeskanowane, złożone sceny przestrzeni fizycznej oraz widoki RGB o wysokiej rozdzielczości, zapewniając wysokoprecyzyjne, pikselowe etykiety semantyczne...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
This paper's algorithm tightly couples the hierarchical visual features captured by a shifted-window hierarchical transformer encoder with the prior depth of the Manhattan 3D bounding box generated by line-segment detection, thereby achieving high-precision semantic reconstruction of complex indoor scenes. A structure-guided cross-attention mechanism forces the visual signal to align with the true geometric boundary calibrated by the SDF, thereby restoring the continuity of low-level features in locally occluded area...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
The authors declare that they have no financial conflicts of interest.
Podziękowania
Funding: Key Research and Development Program of Shaanxi (Program No. 2024CY2-GJHX-76).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| AdamW optimizer | PyTorch Contributors | https://pytorch.org/ | |
| CCANet | Zihao Z. et al. | https://doi.org/10.1109/TCDS.2024.3455356 | |
| CMPFFNet | Zhou W. et al. | https://doi.org/10.1109/TASE.2023.3332021 | |
| ConvNeXt | Meta AI Research | https://github.com/facebookresearch/ConvNeXt | |
| InternImage | OpenGVLab | https://github.com/OpenGVLab/InternImage | |
| Mask2Former | Meta AI Research | https://github.com/facebookresearch/Mask2Former | |
| MaskDINO | IDEA-Research | https://github.com/IDEA-Research/MaskDINO | |
| NYUv2 | http://cs.nyu.edu/~silberman/datasets/nyu_depth_v2.html | ||
| OneFormer | SHI Labs | https://github.com/SHI-Labs/OneFormer | |
| RANSAC algorithm | scikit-learn developers | https://scikit-learn.org/ | |
| ScanNet V2 | http://www.scan-net.org/ | ||
| SegFormer | NVIDIA | https://github.com/NVlabs/SegFormer | |
| SGCA_GCN | Authors of this study | Proposed method (N/A) | |
| Softmax function | PyTorch Contributors | https://pytorch.org/ | |
| Swin Transformer | Microsoft Research | https://github.com/microsoft/Swin-Transformer |
Bibliografia
- Zhang Z et al. CCANet: cross-modality comprehensive feature aggregation network for indoor scene semantic segmentation. IEEE Trans Cogn Dev Syst. 2024;17:366–378.
- Cui Y et al. Improving the segmentation of confusable indoor structures using point convolution and sparse vector attention. Geospat Inf Sci. 2025:1–22.
- Yang L, Cai H. Cost-efficient image semantic segmentation for indoor scene understanding using weakly supervised learning and BIM. J Comput Civ Eng. 2023;37:04022062–04022082.
- Uckan T, Aslan C, Hark C. A comprehensive hybrid approach for indoor scene recognition combining CNNs and text-based features. Sensors. 2025;25(17):5350. doi:10.3390/s25175350.
- Sun R et al. Training indoor and scene-specific semantic segmentation models to assist blind and low-vision users in activities of daily living. IEEE Open J Eng Med Biol. 2025;6:533–539.
- Ye S, Hu Y, Lin M. Indoor scene reconstruction with fine-grained details using hybrid representation and normal prior enhancement. IEEE Trans Vis Comput Graph. 2024;31:5275–5287.
- Naseer A et al. Multimodal scene recognition using semantic segmentation and deep learning integration. PeerJ Comput Sci. 2025;11. doi:10.7717/peerj-cs.2858.
- Bae JH, Yu GH, Lee JH. Superpixel image classification with graph convolutional neural networks based on learnable positional embedding. Appl Sci. 2022;12:9176–9190.
- Zhang H, Zou J, Zhang L. EMS-GCN: an end-to-end mixhop superpixel-based graph convolutional network for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2022;60:1–16.
- Mu Y, Ou L, Chen W. Superpixel-based graph convolutional network for UAV forest fire image segmentation. Drones. 2024;8:142–158.
- Khatun Z, Jonsson H Jr, Tsirilaki M. Beyond pixel: superpixel-based MRI segmentation through traditional machine learning and graph convolutional network. Comput Methods Programs Biomed. 2024;256:108398–108412.
- Yongyin L, Caixia Y. Cross-attention swin transformer for detailed segmentation of ancient architectural color patterns. Front Neurorobot. 2024;18:1513488–1513508.
- Zhou X, Zhou L, Gong S. Swin transformer embedding dual stream for semantic segmentation of remote sensing imagery. IEEE J Sel Top Appl Earth Obs Remote Sens. 2023;17:175–189.
- Ning X, Jiang L, Li W. Swin-MGNet: swin transformer-based multiview grouping network for 3D object recognition. IEEE Trans Artif Intell. 2024;6:747–758.
- Ke A, Luo J, Cai B. UNet-like network fused swin transformer and CNN for semantic image synthesis. Sci Rep. 2024;14:16761–16779.
- Li Y et al. IED-GCN: an internal and external decoupled graph convolutional network for landslide susceptibility assessment. IEEE Trans Geosci Remote Sens. 2025;63:1–17.
- He T, Chen J. DC-GCN: a lightweight graph convolutional network integrating local and global context for semantic segmentation. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:28283–28299. doi:10.1109/JSTARS.2025.3626006.
- Imani M. Superpixel-based graph convolutional neural network for polarimetric synthetic aperture radar image classification. Sci Rep. 2026;16:4736. doi:10.1038/s41598-025-34965-6.
- Wang S, Feng S, Wang Z. Structural prior-guided and feature-enhanced transformer with masked image modeling pretraining for retinal layers and fluid segmentation in macular edema OCT images. Biomed Opt Express. 2025;16:5096–5117.
- Yuan Z et al. Structure-aware progressive multimodal fusion network for RGB-T crack segmentation. J Imaging. 2025;11(11):384. doi:10.3390/jimaging11110384.
- Xu S, Shen R, Liu E. A structure-prior-guided adaptive context selection network for remote sensing semantic segmentation. Electron Lett. 2025;61. doi:10.1049/ell2.70161.
- Minaee S, Boykov Y, Porikli F. Image segmentation using deep learning: a survey. IEEE Trans Pattern Anal Mach Intell. 2021;44:3523–3542.
- Zhou E, Murray AT, Baik J. Mapping 3D classroom seats based on partial object point cloud completion. Cartogr Geogr Inf Sci. 2024;51:404–420.
- Nishi T, Kawasaki S, Iewaki K. M3R-CNN: on effective multimodal fusion of RGB and depth cues for instance segmentation in bin picking. Adv Robot. 2023;37:1143–1157.
- Zhou W, Xiao Y, Yan W. CMPFFNet: cross-modal and progressive feature fusion network for RGB-D indoor scene semantic segmentation. IEEE Trans Autom Sci Eng. 2023;21:5523–5533.
- Zhou W, Xiao Y, Liu Y. FIMKD: feature implicit mapping knowledge distillation for RGB-D indoor scene semantic segmentation. IEEE Trans Artif Intell. 2024;5:6488–6499.
- Liu J, Jiang Z, Xu X. Multi-robot collaborative complex indoor scene segmentation via multiplex interactive learning. CAAI Trans Intell Technol. 2025;10:1646–1660.
- Zhang S, Xie M. MIPANet: optimizing RGB-D semantic segmentation through multimodal interaction and pooling attention. Front Phys. 2024;12:1411559–1411572.
- Li JW et al. Construction of a multiscale feature fusion model for indoor scene recognition and semantic segmentation. Sci Rep. 2025;15:14701. doi:10.1038/s41598-025-95465-1.
- Liang X et al. Indoor building structure segmentation in unorganized point clouds based on corner feature. Eng Constr Archit Manag. 2025. doi:10.1108/ECAM-10-2024-1433.
- Wu LF, Wei D, Xu CA. CFANet: the cross-modal fusion attention network for indoor RGB-D semantic segmentation. J Imaging. 2025;11(6):177. doi:10.3390/jimaging11060177.
- Fan L, Zhou Y, Liu H. Combining swin transformer with UNet for remote sensing image semantic segmentation. IEEE Trans Geosci Remote Sens. 2023;61:1–11.
- Wang Z, Liao Z, Zhou B. SwinURNet: hybrid transformer-CNN architecture for real-time unstructured road segmentation. IEEE Trans Instrum Meas. 2024;73:1–16.
- Zhang H et al. Frequency-domain-guided swin transformer and global-local feature integration for remote sensing images semantic segmentation. IEEE Trans Geosci Remote Sens. 2025;63:5612611. doi:10.1109/TGRS.2025.3535724.
- Li GY, Chen J, Jang SI. SwinCross: cross-modal swin transformer for head and neck tumor segmentation in PET-CT images. Med Phys. 2024;51:2096–2107.
- Tang Y, Hu X, Ke T. Semantic segmentation of high-resolution remote sensing imagery via an end-to-end graph attention network with superpixel embedding. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:7236–7252.
- Wang R, Nie Y, Geng J. Multiscale superpixel-guided weighted graph convolutional network for polarimetric SAR image classification. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:3727–3741.
- Li S, Wu K, Liu H. Hyperspectral image classification based on multiscale feature search graph convolutional network with meta pseudo-labels. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:23485–23504.
- Yang B, Cheng X, Guo J. Temporal information-enhanced graph convolutional network with superpixel-pixel gated knowledge dynamic selection for change detection in satellite time series. IEEE J Sel Top Appl Earth Obs Remote Sens. 2024;17:18399–18412.
- Zhang H, Ku J, Zhao J. Multi-scale graph wavelet convolutional network for hyperspectral image classification. Front Remote Sens. 2025;6:1637820. doi:10.3389/frsen.2025.1637820.
- Zhou Q, Wang L, Gao G. Boundary-guided lightweight semantic segmentation with multiscale semantic context. IEEE Trans Multimedia. 2024;26:7887–7900.
- Xu X, Yen GG, Zhao C. Boundary-based active domain adaptation for semantic segmentation under adverse conditions. IEEE Trans Neural Netw Learn Syst. 2025;36:14721–14734.
- Tang Y, Feng S, Zhao C. A semantic change detection network based on boundary detection and task interaction for high-resolution remote sensing images. IEEE Trans Neural Netw Learn Syst. 2025;36:17184–17198.
- Guan L, Yuan X. Dynamic weighting and boundary-aware active domain adaptation for semantic segmentation in autonomous driving environment. IEEE Trans Intell Transp Syst. 2024;25:18461–18471.
- Fenglei W, Xin G, Zongze Z. A boundary-enhanced semantic segmentation model for buildings. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:5733–5748.
- Shan K, Tan L, Li Y, Jia T. Multi-scale boundary-aware network for remote sensing image semantic segmentation. Sci Rep. 2026;16:3797. doi:10.1038/s41598-025-33943-2.
- Wu D, Guo Z, Li A. Conditional boundary loss for semantic segmentation. IEEE Trans Image Process. 2023;32:3717–3731.
- Li Y, Zhang C, Wang H. Boundaries matter: a novel multibranch semisupervised semantic segmentation method. IEEE Intell Syst. 2024;40:35–44.
- Wang JQ, Chen T, Zheng L. A multiscale remote sensing semantic segmentation model with boundary enhancement based on UNetFormer. Sci Rep. 2025;15:14737. doi:10.1038/s41598-025-99663-9.
- Jung H, Choi HS, Kang M. Boundary enhancement semantic segmentation for building extraction from remote sensed image. IEEE Trans Geosci Remote Sens. 2021;60:1–12.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.