Niniejszy protokół opisuje implementację interoperacyjnej platformy internetowej, która integruje dane kliniczne oparte na standardzie FHIR z generowaniem wspomaganym wyszukiwaniem (Retrieval-Augmented Generation) oraz wieloagentowymi dużymi modelami językowymi w celu wsparcia decyzji klinicznych. Przepływ pracy umożliwia odtwarzalne wdrożenie, standaryzowaną integrację danych oraz ewaluację analizy danych medycznych wspomaganej przez sztuczną inteligencję (AI).
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Interoperacyjna platforma internetowa oparta na dużych modelach językowych do analizy danych medycznych: protokół wsparcia decyzji klinicznych
W tym artykule
Podsumowanie
Streszczenie
Procesy podejmowania decyzji klinicznych są często utrudnione przez fragmentaryczną dokumentację medyczną w formie elektronicznej oraz ograniczoną interoperacyjność między heterogenicznymi systemami informacji zdrowotnej. Niniejszy artykuł przedstawia szczegółowy protokół wdrażania interoperacyjnej platformy internetowej, która integruje dane kliniczne za pomocą standardu Fast Healthcare Interoperability Resources (FHIR), wraz z wykorzystaniem generowania wspomaganego wyszukiwaniem (RAG), dużych modeli językowych (LLM) oraz wieloagentowego frameworku rozumowania klinicznego w celu wsparcia analizy danych medycznych i decyzji klinicznych. Protokół opisuje kompletny przepływ pracy, w tym konfigurację środowiska obliczeniowego, przetwarzanie wstępne zestawów danych klinicznych, integrację danych w oparciu o FHIR, budowę bazy wektorowej, konfigurację wyszukiwania, inżynierię promptów, orkiestrację wieloagentową oraz ewaluację systemu. Reprezentatywne wyniki wykazują zdolność platformy do generowania klinicznie istotnych i spójnych kontekstowo odpowiedzi przy jednoczesnej poprawie interoperacyjności semantycznej między heterogenicznymi źródłami danych. Wydajność systemu oceniono za pomocą uzupełniających miar ilościowych i semantycznych, w tym BLEU, ROUGE, BERTScore oraz podobieństwa cosinusowego. Przeprowadzono ocenę jakościową z wykorzystaniem publicznie dostępnych, w pełni anonimizowanych referencyjnych zestawów danych medycznych w celu zweryfikowania powtarzalności proponowanego przepływu metodologicznego. Zaproponowana architektura łączy standaryzowaną interoperacyjność opieki zdrowotnej z modelami językowymi wspomaganymi wyszukiwaniem, aby poprawić rozumowanie kontekstowe, ograniczyć halucynacje i wspierać powtarzalne, wspomagane przez AI procesy kliniczne. Protokół ten dostarcza skalowalny i powtarzalny model dla badaczy i programistów dążących do wdrożenia interoperacyjnych, dbających o prywatność i inteligentnych systemów opieki zdrowotnej do wsparcia decyzji klinicznych, analizy danych medycznych oraz przyszłych badań translacyjnych.
Wprowadzenie
Informacje zdrowotne są rutynowo generowane w szpitalach, centrach diagnostycznych, laboratoriach i przychodniach, często pozostając rozproszone pomiędzy heterogenicznymi systemami informacyjnymi. Ta fragmentacja ogranicza interoperacyjność i utrudnia terminowy dostęp do kompleksowej dokumentacji pacjentów, co stwarza trwałe wyzwania dla opieki klinicznej, integracji danych oraz zarządzania opieką zdrowotną1,2,3,4.
Konsekwencje tej fragmentacji stają się szczególnie widoczne w procesach klinicznych, które zależą od terminowego dostępu do informacji o pacjencie. Gdy pracownicy służby zdrowia nie mogą uzyskać pełnej i zintegrowanej dokumentacji medycznej, ocena kliniczna staje się trudniejsza, co zwiększa ryzyko podejmowania niepełnych decyzji i obniża efektywność udzielania opieki, szczególnie w sytuacjach nagłych5,6.
Ostatnie osiągnięcia w dziedzinie sztucznej inteligencji (AI), w szczególności duże modele językowe (LLMs), rozszerzyły zakres podejść obliczeniowych dostępnych w zastosowaniach opieki zdrowotnej. Modele te były badane w zadaniach takich jak pomoc diagnostyczna, triaż kliniczny i wsparcie decyzji. Na przykład Jahan i wsp.5 ocenili zastosowanie LLMs w zadaniach biomedycznych, natomiast Taylor i wsp.7 zbadali dostrojone modele w zakresie cyfrowego przesiewowego badania zdrowia psychicznego, raportując obiecujące wyniki w specjalistycznych warunkach klinicznych.
Zastosowanie modeli LLM rozszerzyło się również na bardziej wyspecjalizowane dziedziny kliniczne. Song i wsp. 49 badali ich wykorzystanie w diagnostyce pylicy płuc, natomiast Chien i wsp.8 zastosowali te modele do analizy wzorców obciążenia pracą opiekunów nieformalnych. W okulistyce Xue i wsp.9 zaproponowali system odpowiadania na pytania w diagnostyce jaskry, a Tan i wsp.3 oraz Wu i wsp.10 opisali zastosowanie LLM w hybrydowych systemach diagnostycznych i konsultacjach w ramach tradycyjnej medycyny chińskiej.
Zastosowanie LLM nie ogranicza się wyłącznie do bezpośrednich aplikacji klinicznych. Zhang i wsp.11 zbadali ich wykorzystanie w rozpoznawaniu emocji w scenariuszach dotyczących zdrowia psychicznego, natomiast Sarzaeim i wsp.12 przeanalizowali inteligentne systemy policyjne, które mogą również przyczynić się do analiz związanych ze zdrowiem publicznym. Badania te ilustrują szeroką stosowalność podejść opartych na LLM w różnych domenach związanych z opieką zdrowotną.
Choć duże modele językowe (LLMs) rozszerzyły możliwości zastosowań w opiece zdrowotnej, ich integracja ze środowiskami klinicznymi wciąż wiąże się z istotnymi wyzwaniami technicznymi, organizacyjnymi i regulacyjnymi. Praktyczne wdrożenie wymaga odpowiedniej infrastruktury obliczeniowej, skutecznego zarządzania danymi oraz zgodności z ramami regulacyjnymi, takimi jak Ogólne rozporządzenie o ochronie danych (GDPR) oraz brazylijska Ogólna ustawa o ochronie danych (LGPD). Ramy te określają wymogi dotyczące bezpiecznego i etycznego przetwarzania wrażliwych informacji zdrowotnych, rozwiązując jednocześnie kwestie związane z prywatnością, niezawodnością i stronniczością algorytmiczną w systemach opieki zdrowotnej wspomaganych przez AI13,14.
Interoperacyjność pomiędzy heterogenicznymi źródłami danych opieki zdrowotnej, w tym elektroniczną dokumentacją medyczną (EHR), systemami obrazowania medycznego oraz urządzeniami Internetu Rzeczy (IoT), nadal stanowi główne wyzwanie techniczne dla wdrażania rozwiązań opieki zdrowotnej wspomaganych przez AI. W tym kontekście ustandaryzowane ramy interoperacyjności, takie jak HL7 FHIR, zapewniają ustrukturyzowany mechanizm wymiany informacji klinicznych pomiędzy różnymi systemami, zachowując jednocześnie spójność semantyczną i wspierając skalowalną integrację.
Niniejsza praca przedstawia interoperacyjną platformę internetową, która integruje duże modele językowe (LLM) ze standardami interoperacyjności opieki zdrowotnej w celu wsparcia analizy danych medycznych w heterogenicznych środowiskach klinicznych. Zaproponowana architektura łączy integrację danych w oparciu o standard HL7 FHIR z generowaniem wspomaganym wyszukiwaniem (RAG) oraz wieloagentowym środowiskiem przetwarzania, aby zapewnić kontekstową analizę wspomaganą przez AI, przy jednoczesnym zachowaniu zgodności z obowiązującymi wymogami dotyczącymi ochrony danych, w tym z brazylijską ogólną ustawą o ochronie danych (LGPD).
Niniejszy protokół opisuje interoperacyjną architekturę służącą do integracji heterogenicznych danych klinicznych z wykorzystaniem uznanych standardów interoperacyjności w ochronie zdrowia. Szczegółowo opisano w nim również implementację wieloagentowego potoku przetwarzania opartego na dużych i małych modelach językowych (LLM oraz SLM), wraz z ramami ewaluacyjnymi łączącymi metryki ilościowe i analizy jakościowe w celu oceny funkcjonowania proponowanej platformy.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Niniejsza analiza nie wiązała się z rekrutacją uczestników będących ludźmi, dostępem do identyfikowalnych dokumentacji pacjentów ani eksperymentami na zwierzętach. Protokół został opracowany i oceniony wyłącznie z wykorzystaniem publicznie dostępnych i w pełni anonimowych zbiorów danych w celu walidacji metodologicznej. Nie uzyskano dostępu ani nie przetwarzano żadnych danych osobowych dotyczących stanu zdrowia. W związku z tym nie było wymagane zatwierdzenie przez Instytucjonalną Komisję Rewizyjną (IRB) lub Komisję Etyki Badań. Protokół opracowano zgodnie z obowiązującymi zasadami ochrony danych, w tym brazylijską Ogólną Ustawą o Ochronie Danych (LGPD), aby wspierać przyszłe zastosowania obejmujące dane kliniczne.
Wybór i wstępne przetwarzanie zbioru danych
Zaproponowany protokół został oceniony przy użyciu publicznie dostępnych i w pełni zanonimizowanych zbiorów danych klinicznych, obejmujących ustrukturyzowaną elektroniczną dokumentację medyczną (EHR), dane z systemów odpowiadania na pytania kliniczne oraz zbiory obrazowania medycznego w celu walidacji metodologicznej. Przed integracją z platformą zbiory danych poddano standaryzowanym procedurom wstępnego przetwarzania, w tym normalizacji danych, usuwaniu niespójnych lub niepełnych rekordów, mapowaniu na zasoby HL7 FHIR, oczyszczaniu tekstu, segmentacji na fragmenty do wyszukiwania oraz generowaniu osadzeń (embeddingów) dla indeksowania wektorowego. Kroki wstępnego przetwarzania zapewniły spójność semantyczną w heterogenicznych źródłach danych, co ułatwiło interoperacyjność i umożliwiło reprodukowalność zaproponowanego przepływu pracy, przy jednoczesnym zachowaniu zgodności z obowiązującymi zasadami prywatności danych.
Zbiory danych pozyskano z publicznie dostępnych repozytoriów referencyjnych, powszechnie wykorzystywanych w badaniach nad sztuczną inteligencją i zdrowiem cyfrowym. Wybrano je tak, aby reprezentowały heterogeniczne informacje kliniczne, w tym ustrukturyzowaną elektroniczną dokumentację medyczną (EHR), nieustrukturyzowane opisy kliniczne, zadania z zakresu odpowiadania na pytania kliniczne oraz metadane obrazowania medycznego. Zamiast oceniać konkretną kohortę kliniczną, protokół koncentruje się na zademonstrowaniu odtwarzalnego przepływu pracy wdrożeniowej, który może zostać dostosowany do różnych zbiorów danych opieki zdrowotnej. Różnorodność tych referencyjnych zbiorów danych umożliwia walidację potoku interoperacyjności, generowania wspomaganego wyszukiwaniem (RAG) oraz wieloagentowego systemu rozumowania w wielu modalnościach danych klinicznych.
Konfiguracja środowiska eksperymentalnego
Środowisko eksperymentalne skonfigurowano w celu oceny interoperacyjnej platformy w kontrolowanych i powtarzalnych warunkach. Architektura obejmuje moduły ingestii danych, warstwy interoperacyjności, duże modele językowe (LLMs) oraz komponenty ewaluacyjne zorganizowane w pojedynczy potok przetwarzania do analizy danych medycznych. Rysunek 1 przedstawia kompletny przepływ pracy, od ingestii danych klinicznych po generowanie wyników diagnostycznych.
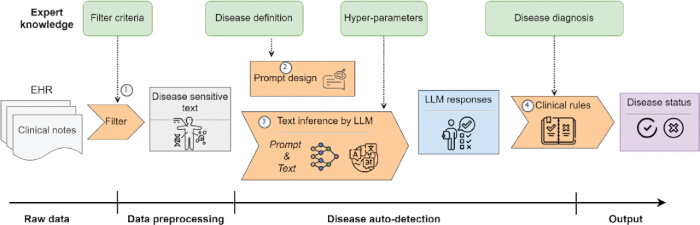
Rysunek 1: Ogólny schemat działania systemu ilustrujący potok przetwarzania od surowych danych klinicznych do wyniku statusu choroby. Proces rozpoczyna się od pobierania elektronicznej dokumentacji medycznej (EHR), po czym następuje filtrowanie i wstępne przetwarzanie danych w celu wyodrębnienia informacji istotnych dla danej choroby. Etap projektowania ustrukturyzowanego promptu integruje wiedzę ekspercką, definicje chorób oraz hiperparametry, co umożliwia efektywną interakcję z dużym modelem językowym (LLM). LLM przeprowadza wnioskowanie tekstowe w celu wygenerowania odpowiedzi uwzględniających kontekst, które są następnie oceniane na podstawie reguł klinicznych w celu ustalenia ostatecznego statusu choroby. Schemat podkreśla integrację wstępnego przetwarzania danych, promptowania opartego na wiedzy oraz wnioskowania opartego na AI w celu wsparcia podejmowania decyzji klinicznych. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Architektura interoperacyjności w ochronie zdrowia
Infrastruktura backendowa przyjmuje architekturę modułową opartą na interfejsach RESTful API w celu wsparcia komunikacji między komponentami platformy (Rycina 2). Architektura ta obejmuje heterogeniczne informacje kliniczne, w tym ustrukturyzowaną elektroniczną dokumentację medyczną (EHR), notatki lekarzy oraz metadane pochodzące z systemów obrazowania medycznego. Ponieważ dane te pochodzą z wielu źródeł i formatów, interoperacyjność osiągnięto dzięki ustandaryzowanym modelom danych, w szczególności w ramach standardu Fast Healthcare Interoperability Resources (FHIR)15,16,17..Zastosowanie FHIR wspiera ustrukturyzowaną wymianę informacji przy jednoczesnym zachowaniu skalowalności i elastyczności w rozproszonych środowiskach opieki zdrowotnej. Wprowadzono również mechanizmy komunikacyjne oparte na standardzie HL7, aby ułatwić integrację z przestarzałymi systemami klinicznymi, które są nadal szeroko stosowane w placówkach ochrony zdrowia16,17.
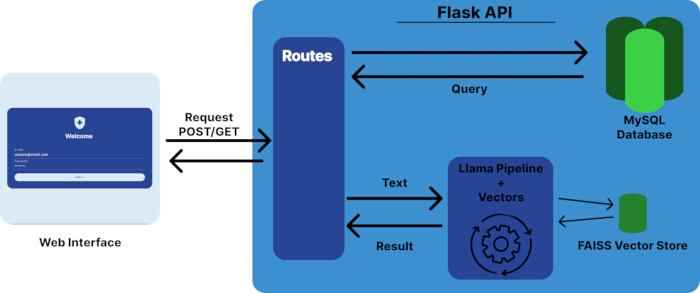
Rysunek 2: Architektura systemu proponowanej interoperacyjnej platformy. Interfejs sieciowy komunikuje się z zapleczem (backendem) poprzez API Flask przy użyciu żądań HTTP POST/GET. API zarządza routingiem, przetwarzaniem zapytań oraz interakcją z ustrukturyzowanymi i nieustrukturyzowanymi źródłami danych. Baza danych MySQL przechowuje ustrukturyzowane dane kliniczne, natomiast wektorowy magazyn danych oparty na FAISS wspiera wyszukiwanie podobieństw w operacjach odzyskiwania informacji. Potok oparty na LLaMA przetwarza dane wejściowe w formie tekstowej i generuje odpowiedzi przy użyciu reprezentacji wektorowych, umożliwiając generowanie wspomagane wyszukiwaniem (Retrieval-Augmented Generation, RAG). Architektura podkreśla integrację usług sieciowych, zarządzania bazami danych, wyszukiwania wektorowego oraz wnioskowania dużego modelu językowego w ramach jednego, zunifikowanego systemu. Prosimy kliknąć tutaj, aby zobaczyć powiększoną wersję tego rysunku.
Konfiguracja przepływu pracy dla wielu agentów
Architektura wieloagentowa jest zorganizowana w wyspecjalizowane agenty funkcjonalne odpowiedzialne za odrębne etapy przepływu pracy. Agent wstępnego przetwarzania wykonuje normalizację danych i mapowanie FHIR, po którym następuje agent wyszukiwania odpowiedzialny za przeszukiwanie semantyczne w bazie wektorowej. Agent wnioskowania integruje pobrany kontekst z LLM w celu generowania odpowiedzi, podczas gdy agent walidacji weryfikuje spójność i formatowanie wyników przed zwróceniem końcowej odpowiedzi. Koordynacja agentów opiera się na sekwencyjnej strategii orchestracji, w której wynik każdego agenta służy jako dane wejściowe dla następnego etapu, co zapewnia powtarzalną i modularną implementację.
Integracja danych klinicznych
Warstwa integracji danych agreguje informacje z wielu źródeł klinicznych i przygotowuje je do dalszego przetwarzania. Wstępne przetwarzanie obejmuje normalizację danych, tokenizację oraz wyrównywanie encji w celu poprawy spójności semantycznej w heterogenicznych zbiorach danych. Ponieważ informacje kliniczne różnią się strukturą i jakością, operacje te pomagają zredukować szum i ułatwiają interakcję z modelami AI. Zastosowano również strategie mapowania strukturalnego w celu zharmonizowania różnych formatów danych i zachowania kompatybilności z potokiem przetwarzania, co zilustrowano na Rysunku 315,16,17.
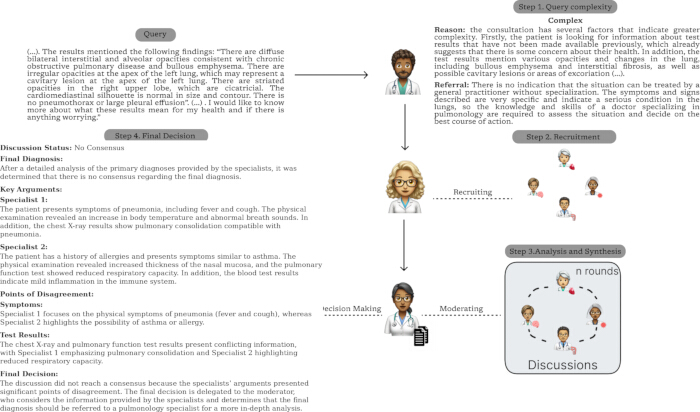
Rysunek 3: Szczegółowy przykład procesu wieloagentowego rozumowania klinicznego. Rysunek ilustruje, w jaki sposób zapytanie kliniczne jest analizowane w wielu etapach, obejmujących ocenę złożoności, rekrutację specjalistów, wspólną dyskusję oraz ostateczne podejmowanie decyzji. Proces ten demonstruje zdolność systemu do dynamicznego dostosowywania strategii rozumowania w zależności od złożoności zapytania, co zwiększa zarówno efektywność, jak i dokładność diagnostyczną w scenariuszach wspierania decyzji klinicznych. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Konfiguracja potoku generowania rozszerzonego o pobieranie (Retrieval-Augmented Generation)
Generowanie wspomagane wyszukiwaniem (Retrieval-Augmented Generation, RAG) jest wykorzystywane w celu zapewnienia analizy uwzględniającej kontekst poprzez połączenie wyszukiwania informacji z możliwościami generatywnymi dużych modeli językowych. Zapytania użytkownika są przekształcane w reprezentacje wektorowe przy użyciu modeli embeddingowych, a następnie dopasowywane do bazy wektorowej za pomocą semantycznego wyszukiwania podobieństwa w celu pobrania najistotniejszych fragmentów kontekstowych. Pobrane dokumenty są następnie łączone z oryginalnym zapytaniem przed etapem wnioskowania przez LLM. Strategia ta pomaga dostarczyć informacji kontekstowych podczas generowania odpowiedzi i jest powiązana z poprawą spójności faktograficznej oraz redukcją halucynacji w aplikacjach wymagających szerokiej wiedzy, w tym w ochronie zdrowia18,19. Rycina 1 oraz Rycina 3 przedstawiają ogólny schemat przepływu wyszukiwania oraz odpowiadający mu proces wnioskowania.
Dla każdego żądania użytkownika ostateczny prompt jest konstruowany dynamicznie poprzez połączenie oryginalnego zapytania z najbardziej odpowiednimi fragmentami kontekstowymi pobranymi z bazy wektorowej. Pobrane informacje są włączane jako dowody kontekstowe przed wnioskowaniem, co pozwala modelowi językowemu generować odpowiedzi oparte na pobranej wiedzy z zakresu opieki zdrowotnej, przy jednoczesnym zachowaniu spójności semantycznej i ograniczeniu generowania treści niepopartych danymi.
Inżynieria promptów i rozumowanie wieloagentowe
Protokół wykorzystuje ustrukturyzowane strategie promptowania w celu poprawy interpretacji kontekstowej podczas generowania odpowiedzi. Techniki te, wraz z zaawansowanymi mechanizmami wnioskowania, pomagają kierować procesem rozumowania w złożonych scenariuszach klinicznych i są zgodne z ostatnimi doniesieniami w literaturze20.
Architektura obejmuje wieloagentowy system złożony ze wyspecjalizowanych modułów pełniących odrębne funkcje w potoku przetwarzania, w tym walidację danych, filtrowanie kontekstu, wsparcie wnioskowania klinicznego oraz weryfikację wyników. Modularna organizacja umożliwia wykonywanie zadań sekwencyjnie lub równolegle, zapewniając elastyczność w zależności od różnych wymagań przetwarzania (Rysunek 4). Rozdzielenie tych działań pomiędzy wielu agentów zmniejsza zależność od pojedynczego modelu językowego i wspiera bardziej odporny przepływ pracy. Strategia architektoniczna ta jest zgodna z ostatnimi osiągnięciami w dziedzinie rozproszonej sztucznej inteligencji i projektowania inteligentnych systemów21,22.
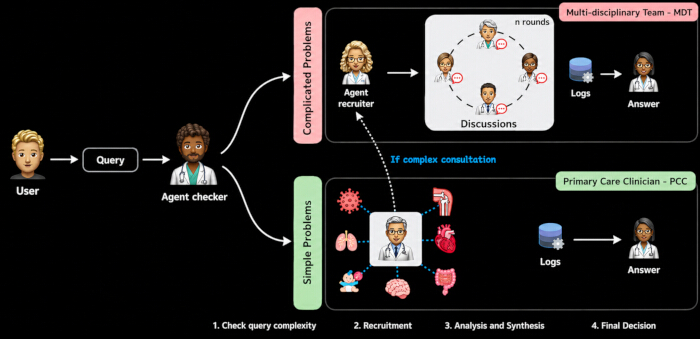
Rysunek 4: Wieloagentowy schemat decyzyjny dla rozumowania klinicznego. Proces rozpoczyna się od zapytania użytkownika, które jest oceniane przez agenta weryfikującego odpowiedzialnego za ocenę złożoności zapytania. W przypadku złożonych kwestii system dynamicznie rekrutuje wielodyscyplinarny zespół (MDT) wyspecjalizowanych agentów, którzy uczestniczą w iteracyjnych rundach dyskusji, aby przeanalizować problem i dokonać syntezy wiedzy przed podjęciem ostatecznej decyzji. W przypadku prostszych spraw zapytanie jest obsługiwane przez agenta lekarza podstawowej opieki zdrowotnej (PCC), co umożliwia szybsze generowanie odpowiedzi. Ta adaptacyjna architektura równoważy wydajność i głębię analityczną, poprawiając jakość decyzji oraz skalowalność systemu w zastosowaniach opieki zdrowotnej. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Ocena wydajności
Wydajność systemu oceniono za pomocą komplementarnych metryk, które oddają zarówno jakość językową, jak i spójność semantyczną wygenerowanych wyników. Do pomiaru podobieństwa syntaktycznego na podstawie nakładania się n-gramów zastosowano BLEU23, natomiast ROUGE posłużyło do oceny pełności (recall) i zakresu treści, szczególnie w zadaniach streszczania i ekstrakcji informacji24. Podobieństwo semantyczne oceniono za pomocą BERTScore, który wykorzystuje osadzenia kontekstowe pochodzące z modeli opartych na transformatorach do porównywania tekstów wygenerowanych i referencyjnych25. Dodatkowe analizy obejmowały perpleksję oraz podobieństwo cosinusowe w celu zbadania odpowiednio pewności modelu i spójności semantycznej26,27.
Wybrane metryki oceny zapewniają komplementarne perspektywy na wydajność systemu poprzez połączenie analiz leksykalnych i semantycznych. Kombinacja ta jest szczególnie istotna w zastosowaniach opieki zdrowotnej, gdzie interpretacja kontekstowa jest tak samo ważna jak podobieństwo leksykalne. Platformę oceniano w kontrolowanym środowisku obliczeniowym, które wspiera zarówno wdrożenie w chmurze, jak i lokalne. Lokalna implementacja modeli LLM została uwzględniona jako opcja w celu spełnienia wymogów dotyczących prywatności danych i zmniejszenia zależności od zewnętrznych usług podczas przetwarzania poufnych informacji klinicznych. Ta strategia wdrożenia jest zgodna z ramami ochrony danych i może zostać dostosowana do różnych środowisk operacyjnych4.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Wydajność systemu oceniono przy użyciu komplementarnych wskaźników ilościowych wraz z analizą jakościową, aby zbadać zarówno poprawność językową, jak i spójność semantyczną wygenerowanych wyników. Strategia oceny ta łączy miary leksykalne i semantyczne, aby zapewnić szerszą charakterystykę zachowania modelu w zadaniach generowania języka związanego z opieką zdrowotną.
Tabela 1 przedstawia wyniki ilościowe uzyskane za pomocą miar BLEU, ROUGE oraz BERTScore. Metryki te wybrano, ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Ocena przedstawiona w niniejszym badaniu stanowi walidację metodologiczną przeprowadzoną z wykorzystaniem publicznie dostępnych i w pełni zanonimizowanych referencyjnych zbiorów danych medycznych. Nie przeprowadzono prospektywnej walidacji klinicznej z udziałem personelu medycznego ani rekrutacją pacjentów, ponieważ celem niniejszej pracy jest zaprezentowanie odtwarzalnego protokołu implementacji, a nie skuteczności klinicznej.
Wyniki niniejszego badania sugerują, że połączenie standardów inte...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy oświadczają, że nie istnieją żadne konkurencyjne interesy finansowe ani relacje osobiste, które mogłyby wpłynąć na pracę przedstawioną w niniejszym manuskrypcie. Narzędzia generatywnej sztucznej inteligencji (AI) zostały wykorzystane wyłącznie w celu pomocy w redakcji językowej, korekcie gramatycznej i poprawie czytelności tekstu. Cała treść naukowa, projekt badania, metodologia, analiza danych, interpretacja wyników oraz decyzje redakcyjne zostały opracowane, zweryfikowane i zatwierdzone przez autorów, którzy biorą pełną odpowiedzialność za treść niniejszego manuskryptu.
Podziękowania
Autorzy pragną podziękować Laboratoriom Systemów Wbudowanych i Rozproszonych (LESC) na Federalnym Uniwersytecie Ceara (UFC) za zapewnienie środowiska badawczego oraz dyskusje techniczne, które wsparły opracowanie niniejszej pracy. Autorzy wyrażają również wdzięczność twórcom i opiekunom oprogramowania o otwartym kodzie źródłowym, standardów interoperacyjności oraz publicznie dostępnych zbiorów danych wykorzystanych w ramach niniejszego badania.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| FAISS | Meta Platforms Inc. | Version 1.8.0 | Baza danych wektorowych wykorzystywana do wyszukiwania podobieństwa w potoku Retrieval-Augmented Generation (RAG). |
| FHIR Standard | HL7 International | Release 4 (R4) | Standard interoperacyjności w opiece zdrowotnej przyjęty do strukturalnej wymiany danych klinicznych. |
| Flask | Pallets Projects | Version 3.0.3 | Framework webowy Python wykorzystywany do implementacji backendowego API RESTful. |
| HL7 Standard | HL7 International | Version 2.x | Starszy protokół przesyłania komunikatów wykorzystywany do interoperacyjności z systemami informacji szpitalnej. |
| HTTP REST API | Custom Implementation | N/A | Warstwa komunikacji RESTful pomiędzy frontendem, backendem, bazą danych a usługami AI. |
| LangChain | LangChain Inc. | Version 0.3.x | Framework wykorzystywany do integracji LLM, prompt engineeringu oraz przepływów Retrieval-Augmented Generation. |
| LangGraph | LangChain Inc. | Version 0.2.x | Framework wykorzystywany do orkiestracji wieloagentowego przepływu rozumowania klinicznego. |
| LLaMA 3.1 8B Instruct | Meta Platforms Inc. | Version 3.1 | Duży model językowy (LLM) zastosowany do rozumowania klinicznego i generowania języka naturalnego. |
| MySQL Community Server | Oracle Corporation | Version 8.0 | Relacyjna baza danych wykorzystywana do przechowywania strukturalnych danych klinicznych. |
| Ollama | Ollama Inc. | Version 0.9.x | Lokalny silnik inferencji wykorzystywany do uruchamiania dużych modeli językowych przy zachowaniu prywatności pacjentów. |
| Python | Python Software Foundation | Version 3.11 | Język programowania wykorzystywany do implementacji całej platformy. |
| PyTorch | Linux Foundation | Version 2.4 | Framework głębokiego uczenia wykorzystywany do inferencji dużych modeli językowych. |
| Retrieval-Augmented Generation (RAG) Pipeline | Custom Implementation | N/A | Framework AI łączący wyszukiwanie semantyczne z inferencją LLM w celu generowania odpowiedzi świadomych kontekstu. |
| Sentence Transformers | Hugging Face Inc. | all-MiniLM-L6-v2 | Model embeddingowy wykorzystywany do generowania gęstych reprezentacji wektorowych dla semantycznego wyszukiwania dokumentów. |
| Ubuntu Linux | Canonical Ltd. | Version 24.04 LTS | System operacyjny wykorzystywany do rozwoju i ewaluacji eksperymentalnej. |
| Visual Studio Code | Microsoft Corporation | Version 1.100 | Zintegrowane środowisko programistyczne wykorzystywane do implementacji i debugowania oprogramowania. |
Bibliografia
- Chukwu E, Garg L. A systematic review of blockchain in healthcare: frameworks, prototypes, and implementations. IEEE Access. 2020;8:21196-21214. doi:10.1109/ACCESS.2020.2969881.
- Al-Nbhany WANA, Zahary AT, Al-Shargabi AA. Blockchain-IoT healthcare applications and trends: a review. IEEE Access. 2024;12:4178-4212. doi:10.1109/ACCESS.2023.3349187.
- Tan Y, et al. MedChatZH: a Chinese medical large language model. Comput Biol Med. 2024;172:108290.
- OLLAMA TEAM. Ollama: Run Large Language Models locally. Version 0.x. San Francisco: Ollama, 2024.
- Jahan I, Laskar MTR, Peng C, Huang JX. A comprehensive evaluation of large language models on benchmark biomedical text processing tasks. Comput Biol Med. 2024;171:108189. doi:10.1016/j.compbiomed.2024.108189.
- Liu X, Zhou Y, Wang Z, et al. Disease topic modeling of users' inquiry texts: a text mining-based PQDR-LDA model for analyzing the online medical records. IEEE Trans Eng Manag. 2023.
- Taylor N, Kormilitzin A, Lorge I, Nevado-Holgado A, Cipriani A, Joyce DW. Model development for bespoke large language models for digital triage assistance in mental health care. Artif Intell Med. 2024;157:102988.
- Song M, et al. PneumoLLM: a large language vision model for pneumonia diagnosis. Med Image Anal. 2024;97:103248.
- Chien SC, Yen CM, Chang YH, Chen YE, Liu CC, Hsiao YP, et al. Using large language model (LLM) to identify high-burden informal caregivers in long-term care. Comput Methods Programs Biomed. 2024;255:108329. doi:10.1016/j.cmpb.2024.108329.
- Xue X, Zhang D, Sun C, et al. Xiaoqing: a Q&A model for glaucoma based on LLMs. Comput Biol Med. 2024;174:108399.
- Wu D, Nie L, Mumtaz RA, Agarwal K. A LLM-based hybrid-transformer diagnosis system in healthcare. IEEE J Biomed Health Inform. 2024.
- Zhang Y, et al. LLM-enhanced multi-teacher knowledge distillation for modality-incomplete emotion recognition in daily healthcare. IEEE J Biomed Health Inform. 2024.
- Sarzaeim P, Mahmoud QH, Azim A. A framework for LLM-assisted smart policing system. IEEE Access. 2024;12:74915-74929. doi:10.1109/ACCESS.2024.3404862.
- Leme RS, Blank M. Lei Geral de Proteção de Dados e segurança da informação na área da saúde. Cad Ibero-Am Direito Sanit. 2020;9(3):210-224. doi:10.17566/ciads.v9i3.690.
- Zaganelli MV, Binda Filho DL. O sigilo médico e os dados sensíveis na telemedicina à luz da Lei Geral de Proteção de Dados. RECIIS. 2023;17(3):729-740. doi:10.29397/reciis.v17i3.3689.
- Tabari P, Costagliola G, De Rosa M, Boeker M. State-of-the-art Fast Healthcare Interoperability Resources (FHIR)-based data model and structure implementations: systematic scoping review. JMIR Med Inform. 2024.
- Martinez T, et al. HL7 systems and interoperability ecosystems in modern healthcare. IEEE Rev Biomed Eng. 2024.
- Chen L, et al. HL7 integration and semantic interoperability in distributed healthcare networks. IEEE J Biomed Health Inform. 2024.
- Liu W, Li W, Huang W, Gao Y. Security framework for medical data sharing. Telemed E-Health. 2024.
- Basile LJ, Carbonara N, Panniello U, Pellegrino R. How can technological resources improve the quality of healthcare service? IEEE Trans Eng Manag. 2024;71:5771-5781. doi:10.1109/TEM.2022.3192405.
- Singh A, et al. Prompt engineering in large language models: a survey using SWOT analysis [preprint]. arXiv. 2024
- Chen L, Chen Y, Liang W, Li X, Li KC, Wang J, Xiong N. MASS: a multiattribute sketch secure data sharing scheme for IoT wearable medical devices based on blockchain. IEEE Internet Things J. 2025;12(2):1990-2001. doi:10.1109/JIOT.2024.3468733.
- Autoridade Nacional de Proteção de Dados (BR). Diretrizes para agentes de tratamento de pequeno porte. Brasília (DF): ANPD; 2021.
- Patel R, Kim H. Interoperability in EHR. IEEE Transactions on Biomedical Engineering, v. 70, n. 8, p. 2341-2354, ago. 2023. DOI: 10.1109/TBME.2023.3241567.
- Zhang T, Kishore V, Wu F, Weinberger KQ, Artzi Y. BERTScore: evaluating text generation with BERT. In: International Conference on Learning Representations (ICLR); 2020.
- Chen X, Lu X, Li Q, Li D, Zhu F. Integration of LLM and Human-AI Coordination for Power Dispatching With Connected Electric Vehicles Under SAGVNs. IEEE Trans Veh Technol. 2025;74(2):1992-2002. doi:10.1109/TVT.2024.3434969
- Zhou S, Chen C, Gu HH. Testing and evaluating SNOMED CT web browsers' textual search feature. In: Proceedings of the IEEE International Conference on Bioinformatics and Biomedicine (BIBM); 2019.
- McPeak G, Sautmann A, George O, Hallal A, Simal EA, Schwartz AL, Abaluck J, Ravi N, Pless R. An LLM's medical testing recommendations in a Nigerian clinic: potential and limits of prompt engineering for clinical decision support. In: Proceedings of the 2024 IEEE 12th International Conference on Healthcare Informatics (ICHI); 2024.
- LLAMA TEAM, AI @ META. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783, 2024. Disponível em: https://arxiv.org/abs/2407.21783.
- Conselho Nacional de Saúde (BR). Resolução nº 466, de 12 de dezembro de 2012. Aprova as diretrizes e normas regulamentadoras de pesquisas envolvendo seres humanos. Brasília (DF): Ministério da Saúde; 2012.
- Singhal K, Azizi S, Tu T, et al. Large language models encode clinical knowledge. Nature. 2023;620:172-180. doi:10.1038/s41586-023-06291-2.
- Sahoo P, et al. A systematic survey of prompt engineering in large language models [preprint]. arXiv. 2024. Available from: https://arxiv.org/abs/2402.07927
- Yan Y, Hou Y, Xiao Y, Zhang R, Wang Q. KNOWNET: guided health information seeking from LLMs via knowledge graph integration. IEEE Trans Vis Comput Graph. 2024.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.