Niniejszy protokół generuje reprezentacje odzieży uwzględniające strukturę poprzez integrację semantycznego parsowania komponentów, modelowania topologii, kodowania cech w dwustrumieniowym modelu oraz fuzji sterowanej strukturą. Umożliwia on badaczom z zakresu komputerowego rozpoznawania obrazów i projektowania odzieży wyszukiwanie ubrań oraz porównywanie ich z referencjami projektowymi w oparciu o organizację komponentów i układ sylwetki, a nie kolor czy teksturę.
Artykuł metodologiczny
Protokół uczenia cech obrazu w oparciu o topologię elementów garderoby na poziomie obrazu dla wyszukiwania referencji projektowych
W tym artykule
Podsumowanie
Streszczenie
Metody wyszukiwania obrazów odzieży często kładą nacisk na kolor i teksturę, co może prowadzić do pomyłek między ubraniami o podobnym wyglądzie, ale różnym układzie elementów. Niniejsze badanie przedstawia protokół uczenia cech uwzględniający elementy dla wyszukiwania obrazów odzieży i porównywania referencji projektowych. Protokół analizuje semantyczne regiony odzieży, konstruuje graf komponentów ubrania na poziomie obrazu, równolegle koduje wygląd oraz relacje między komponentami, a następnie łączy obie reprezentacje za pomocą funkcji strat spójności strukturalnej, relacji strukturalnej i dyskryminacji strukturalnej. Obrazy z zbioru DeepFashion2 zostały zestandaryzowane do wymiarów 512 x 512 pikseli, przeanalizowane za pomocą HRNet-W48, zakodowane przy użyciu ResNet-50 oraz splotu grafowego i ocenione poprzez strukturalne wyszukiwanie oraz klasteryzację. Kompletny model osiągnął indeks spójności strukturalnej 0,81, indeks dyskryminacji strukturalnej 0,71, wskaźnik Recall@5 na poziomie 89,2%, średnią precyzję (mAP) 86,4% oraz współczynnik sylwetki 0,74. Protokół ten umożliwia wyszukiwanie struktury odzieży, porównywanie strukturalne oraz lokalizację różnic w przypadkach, gdy wygląd powierzchni nie reprezentuje wiarygodnie konstrukcji ubrania.
Wprowadzenie
Wraz z postępującą integracją komputerowego rozpoznawania obrazu i sztucznej inteligencji w przemyśle odzieżowym, analiza obrazów odzieży stopniowo rozszerzyła się z podstawowych zadań rozpoznawania na analizę zorientowaną na projektowanie oraz wsparcie decyzji1,2. W procesie projektowania odzieży rozróżnienie między schematami projektowymi zależy bardziej od kompozycji strukturalnej i relacji między komponentami niż od prostych różnic w wyglądzie, co sprawia, że ekspresyjność strukturalna cech obrazu odzieży w systemach wspomagania projektowania jest kluczowym czynnikiem wpływającym na skuteczność analizy3,4. Jednak większość istniejących metod wizualnych wciąż opiera się na teksturze, kolorze i konturach globalnych jako głównych cechach, co utrudnia systematyczną analizę hierarchii ubrań i różnic konstrukcyjnych w procesie projektowania5,6. Dlatego opracowanie metody uczenia cech obrazu świadomej struktury w celu wspomagania projektowania odzieży jest istotne dla poprawy obiektywizmu i spójności analizy projektowej7. Niniejszy protokół jest odpowiedni w sytuacjach, gdy odzież posiada podobne kolory, tekstury lub kontury globalne, ale różni się organizacją komponentów, wzorami połączeń lub układem przestrzennym. W takich warunkach reprezentacje skoncentrowane na wyglądzie mają tendencję do grupowania strukturalnie różnych projektów blisko siebie w przestrzeni cech, co osłabia niezawodność wyszukiwania i porównywania projektów. Protokół ten odnosi się do zadań, w których relacje między komponentami odzieży stanowią główną podstawę dla wyszukiwania strukturalnego, oceny projektu oraz analizy zlokalizowanych różnic.
Pod względem skali danych, złożoności modeli oraz różnorodności zadań, obecne badania nad automatyczną analizą i rozumieniem obrazów odzieży poczyniły znaczne postępy8,9. Jednak w praktycznych zastosowaniach informacje o strukturze odzieży są często zawarte w wynikach segmentacji lub detekcji w sposób niejawny i nie są uwzględniane w jednolitym modelowaniu na etapie uczenia cech, co skutkuje brakiem stabilnego rozróżnienia między różnymi projektami strukturalnymi w przestrzeni cech10,11. Relacje przestrzenne, ograniczenia hierarchiczne i struktury topologiczne między elementami odzieży nie są jawnie kodowane, co utrudnia reprezentacjom cech odzwierciedlenie różnic strukturalnych na poziomie projektu12,13. Brak jawnego modelowania strukturalnego ogranicza ziarnistość analizy i niezawodność decyzji w oparciu o cechy obrazów odzieży w scenariuszach wspomagania projektowania, co stanowi główną barierę w rozwoju inteligentnych systemów projektowania z głębszym rozumieniem semantycznym14.
W celu wsparcia uczenia cech i analizy obrazów odzieży, w ramach powiązanych badań zbadano kilka kierunków technicznych15. Metody segmentacji semantycznej i parsowania ubrań umożliwiły szczegółowe wyodrębnienie obszarów i komponentów odzieży poprzez adnotacje na poziomie pikseli, stanowiąc podstawę dla ekstrakcji informacji strukturalnych16,17. Metody wyszukiwania ubrań na podstawie zapytania obrazowego wprowadziły fuzję topologii i kolorów oraz tekstur, wyrównanie uwagi globalnej i lokalnej, parsowanie ubrań, reprezentację wieloskalową i wielok granularityczną oraz resztkową uwagę z selekcją cech. Metody te znajdują zastosowanie w wyszukiwaniu katalogowym, dopasowywaniu konsumenta do sklepu, międzydomenowym wyszukiwaniu produktów oraz wizualnym wyszukiwaniu w e-commerce. Ich ustawienia aplikacyjne są ściśle powiązane z wyszukiwaniem referencji projektowych, ponieważ każda z tych metod szereguje obrazy odzieży na podstawie zapytania wizualnego, choć ich reprezentacje nie zachowują typowej sąsiedniości komponentów ani relacji porządku pionowego podczas fuzji cech18,19,20. Jednocześnie badania nad scenariuszami projektowania i rekomendacji stopniowo wprowadziły fuzję multimodalną, modelowanie relacji i analizę stylu, rozszerzając granice zastosowań wizualnych cech odzieży21,22. Chociaż metody te poczyniły postępy w swoich odpowiednich zadaniach, ich kluczowe cechy wciąż w dużej mierze opierają się na opisach wyglądu, a informacje strukturalne nie zostały jednolicie zamodelowane jako immanentne ograniczenie dla uczenia cech, co utrudnia zaspokojenie potrzeb wsparcia projektowania odzieży w zakresie wyrównywania i porównywania strukturalnego23.
Aby rozwiązać problem niewystarczającej zdolności do różnicowania strukturalnego w systemach wspomagania projektowania odzieży, w niniejszej pracy zaproponowano metodę uczenia cech obrazu opartą na percepcji struktury ubioru. Metoda ta włącza wyniki analizy odzieży oraz kluczowe informacje strukturalne do etapu wprowadzania obrazu, wspólnie modelując obszary komponentów ubrania, relacje przestrzenne i połączenia hierarchiczne. Kodowanie relacji strukturalnych oraz wyrównywanie cech wizualnych jawnie integrują ograniczenia dotyczące odzieży z procesem uczenia cech, tworząc reprezentację, która zachowuje zarówno wygląd wizualny, jak i spójność strukturalną. Cecha ta charakteryzuje różnice strukturalne odzieży w ujednoliconej przestrzeni, stanowiąc stabilną podstawę dla późniejszej analizy podobieństwa strukturalnego, klastrowania strukturalnego oraz podejmowania decyzji w procesie wspomaganego projektowania, co łagodzi problem błędnej interpretacji cech wynikający z braku modelowania struktury w istniejących metodach. W przeciwieństwie do ogólnych strategii wyszukiwania wizualnego, które traktują informacje strukturalne jako luźno powiązane atrybuty pomocnicze, niniejszy framework buduje mechanizm modulacji cech skoncentrowany na relacjach topologicznych. Mechanizm ten skłania wyuczoną reprezentację do odzwierciedlania widocznej organizacji regionów odzieży przy jednoczesnym ograniczeniu odpowiedzi zdominowanych przez teksturę. Każdy węzeł grafu oznacza obszar semantyczny na poziomie obrazu, a każda relacja w grafie opisuje widoczne sąsiedztwo lub znormalizowaną pozycję względną w płaszczyźnie obrazu. Powstałe osadzenie umożliwia porównanie układu komponentów i organizacji sylwetki pomiędzy obrazami odzieży. Regiony i relacje te nie są elementami wykrojów, połączeniami szwów, punktami orientacyjnymi konstrukcji ani parametrami stopniowania. W porównaniu z metodami wyszukiwania opartymi na wyglądzie, protokół ten zachowuje jawna topologię komponentów przez cały proces uczenia cech, zamiast traktować informacje strukturalne jako wynik analizy końcowej. W porównaniu z podejściami wprowadzającymi wskazówki strukturalne jedynie jako dane wejściowe pomocnicze, kodowanie dwustrumieniowe i fuzja spójna z topologią zachowują relacje geometryczne, redukując odpowiedzi zdominowane przez teksturę. Wynikowa reprezentacja wspiera wyszukiwanie struktury odzieży, klastrowanie strukturalne, selekcję referencyjną dla projektów oraz lokalną analizę różnic projektowych, dostarczając dowodów na poziomie komponentów, które pozostają interpretowalne w procesie projektowania odzieży. Badania powiązane z tym protokołem obejmują uczenie cech obrazów odzieży, modelowanie struktury ubioru, reprezentację świadomą struktury oraz analizę wizualną w celu wspomagania projektowania odzieży.
Na poziomie reprezentacji cech badania nad obrazami odzieży od dawna koncentrują się na modelowaniu wyglądu, głębokiej ekstrakcji cech oraz reprezentacji wieloskalowej24,25. Wczesne prace wykorzystywały konwolucyjne sieci neuronowe do przeprowadzania modelowania end-to-end obrazów odzieży w zadaniach klasyfikacji, wyszukiwania i dopasowania podobieństwa26,27. Następnie wprowadzono fuzję cech wieloskalowych oraz uczenie międzydomenowe, aby złagodzić różnice w obrazach odzieży przy różnych kątach widzenia, pozach i warunkach fotografowania28,29. W zadaniach wyszukiwania stosowano mechanizmy uwagi oraz strategie kompresji cech w celu poprawy dyskryminatywności cech i wydajności obliczeniowej30,31. Metody te zapewniają niezawodne rozróżnianie wyglądu, jednak procesy uczenia cech nadal skupiają się na globalnych informacjach wizualnych i brakuje im systematycznych reprezentacji wewnętrznych struktur odzieży32. Metody złożonego wyszukiwania mody dodatkowo łączą obraz referencyjny z tekstowymi instrukcjami modyfikacji, jednak ich modalność zapytania różni się od analizowanego tutaj protokołu opartego wyłącznie na obrazach. Są one omawiane jako powiązany komercyjny kierunek wyszukiwania i nie zostały włączone do porównania ilościowego, ponieważ dodatkowy wpis tekstowy uniemożliwiłby kontrolowaną ewaluację zapytań obrazowych.
Wraz z przesunięciem ciężaru analizy obrazów odzieży z rozróżniania wyglądu na zrozumienie struktury, badania coraz częściej koncentrują się na modelowaniu komponentów garderoby, relacji geometrycznych i połączeń topologicznych33. Sieci segmentacji semantycznej umożliwiły analizę na poziomie poszczególnych elementów odzieży dzięki projekcji cech i mechanizmom wielokrotnej uwagi, zapewniając wiarygodną podstawę do ekstrakcji informacji strukturalnych34,35. Metody detekcji punktów kluczowych i modelowania topologii strukturalnej dodatkowo scharakteryzowały relację między konturami odzieży a strukturami lokalnymi, wzmacniając zdolność modelu do reprezentowania cech geometrycznych ubrań36,37. W kilku badaniach wprowadzono struktury grafowe i sieci wnioskowania relacyjnego w celu modelowania zależności między komponentami odzieży, co poprawiło precyzję rozpoznawania szczegółów oraz wydajność wyszukiwania międzydomenowego38,39. Prace te potwierdziły istotną rolę informacji strukturalnych w analizie wizualnej, jednak struktura jest najczęściej wykorzystywana jako cecha pomocnicza lub wynik pośredni, a system uczenia cech, w którego centrum znajdują się ograniczenia strukturalne, nie został jeszcze opracowany40.
W zakresie wspomagania projektowania odzieży, opracowania te wspierały rekomendacje projektowe, analizę stylu, konstrukcję systemów interaktywnych oraz ewaluację projektów zorientowaną na strukturę41. Badania nad systemami rekomendacyjnymi pozwoliły na dopasowanie odzieży i personalizację rekomendacji poprzez integrację cech wizualnych z preferencjami użytkowników42. Prace związane ze wspomaganiem projektowania badały nowe ścieżki inteligentnego wsparcia projektowego, łącząc modele generatywne, modelowanie stylu oraz mechanizmy współpracy człowieka z komputerem43. Badania nad wirtualnym przymierzaniem, pomiarem rozmiaru i transferem stylu rozszerzyły zastosowanie wizualnej analizy odzieży w całym procesie projektowania i produkcji. Chociaż badania te wzbogaciły techniczne formy wspomagania projektowania odzieży, ich kluczowe cechy wizualne są nadal napędzane głównie przez wygląd i brakuje im ujednoliconej reprezentacji struktury projektu do celów analizy. W przeciwieństwie do nich, niniejsza praca traktuje strukturę ubrania jako główny parametr ograniczający reprezentację cech i dostarcza metody reprezentacji wizualnej do analizy strukturalnej w ramach wspomagania projektowania odzieży.
Mimo tych postępów, współczesne metody projektowania generatywnego często traktują warunki strukturalne jako luźne macierze kierowania przestrzennego w ramach procesów dyfuzyjnych. Obecne frameworki analizy strukturalnej reprezentują topologie jako pomocnicze etykiety semantyczne, oddzielone od głównej przestrzeni osadzania wizualnego. Proponowany framework zmienia ten mechanizm poprzez zdefiniowanie ograniczenia topologicznego opartego na priorytecie grafu, które w sposób jawny moduluje uczenie cech wizualnych na poziomie komponentów. Cel spójności wielopoziomowej sprawia, że odzież o podobnym układzie komponentów na poziomie obrazu pozostaje blisko siebie w przestrzeni cech, jednocześnie oddzielając elementy garderoby o różnej organizacji widocznych obszarów. Cel ten zmniejsza zależność od tekstury w oceniającym ustawieniu wyszukiwania, ale nie ustanawia niezmienności względem zmian materiału, pozy lub tła. Protokół ten należy wybrać, gdy obraz wejściowy zawiera wystarczająco widoczny pojedynczy element garderoby, komponenty semantyczne zachowują identyfikowalne granice, a cel analityczny wymaga porównania strukturalnego na poziomie komponentów, a nie ogólnego rozpoznawania kategorii. Jest on przeznaczony dla badaczy wizji komputerowej, projektantów odzieży oraz zespołów zajmujących się cyfrowym rozwojem ubrań, zaangażowanych w analizę wizualną wrażliwą na strukturę. Nie jest on przeznaczony do zadań skupiających się wyłącznie na rozpoznawaniu kolorów lub materiałów, ani do obrazów, na których topologia odzieży jest w dużej mierze przesłonięta. Poniższy protokół przedstawia przebieg pracy od przygotowania zbioru danych i mapowania prawdopodobieństwa semantycznego, przez konstrukcję relacji geometrycznych, kodowanie cech dwustrumieniowych, fuzję sterowaną strukturą, aż po optymalizację opartą na spójności. Cały proces przedstawiono w Rysunku 1.
Protokół
W niniejszym badaniu wykorzystano publicznie dostępne zestawy danych obrazów odzieży; nie rekrutowano uczestników będących ludźmi, nie gromadzono danych osobowych, nie przeprowadzano eksperymentów na zwierzętach ani nie używano materiałów biologicznych. Zatwierdzenie przez komisję etyki instytucjonalnej oraz świadoma zgoda nie mają zastosowania.
1. Środowisko programistyczne i konfiguracja projektu
- Umieść udostępnione pliki projektu w katalogu z wystarczającą ilością miejsca na dane i otwórz terminal w głównym katalogu projektu.
- Uruchom polecenie conda env create -f environment.yml, aby utworzyć środowisko oprogramowania. Uruchom conda activate garment_structure, aby aktywować środowisko.
- Uruchom polecenia python --version, conda --version, pip show numpy, pip show torch, pip show torchvision oraz nvidia-smi. Zapisz pełny wynik poleceń w pliku software_versions.txt.
- Używaj tego samego zarejestrowanego środowiska do przetwarzania wstępnego, trenowania, inferencji, pomiaru wydajności i ewaluacji. Zapisz w tym samym pliku nazwę pliku punktu kontrolnego (checkpoint) HRNet-W48 i wartość SHA-256, identyfikator wag ResNet-50 wstępnie wytrenowanych na zbiorze ImageNet i wartość SHA-256, źródło udostępnienia DeepFashion2 oraz identyfikator repozytorium kodu źródłowego.
- Utwórz katalogi data_raw, data_processed, parser_outputs, structural_priors, feature_outputs, checkpoints, logs oraz evaluation_results w głównym katalogu projektu.
- Otwórz plik configs/protocol.yaml. W polu dataset_root wpisz ścieżkę do katalogu DeepFashion2, w parser_checkpoint ścieżkę do punktu kontrolnego wstępnie wytrenowanego modelu HRNet-W48, a w output_root katalog wyjściowy projektu.
- Ustaw input_height na 512, input_width na 512, batch_size na 32, structural_categories_per_batch na 8, samples_per_category na 4, random_seed na 42, feature_dimension na 512, structural_constraint_weight na 1.0, structural_relationship_weight na 0.5, structural_discrimination_weight na 1.0 oraz separation_threshold na 0.3.
- Ustaw optymalizator na mini-batch stochastic gradient descent. Ustaw initial_learning_rate na 0.0001, momentum na 0.9, weight_decay na 0.0005, max_epochs na 120, learning_rate_schedule na multi-step decay oraz learning_rate_decay_factor na 0.1. W polu learning_rate_milestones wpisz zweryfikowane epoki spadku stosowane w udostępnionej konfiguracji.
- Uruchom polecenie python tools/export_experiment_tables.py --config configs/protocol.yaml --output evaluation_results. Eksportuj pełną konfigurację modelu do pliku model_setting_statistics.csv. Upewnij się, że wyeksportowany plik rejestruje rozmiar obrazu wejściowego, format wejściowy, skład partii (batch composition), optymalizator, szybkość uczenia, harmonogram szybkości uczenia, liczbę epok, spadek wag (weight decay), pęd (momentum), prawdopodobieństwa augmentacji, wymiar cech, wagi strat strukturalnych, próg separacji, ziarna losowe (random seeds), regułę wyboru punktu kontrolnego oraz liczbę niezależnych uruchomień.
- Oczekiwany wynik: Potwierdź, że środowisko oprogramowania uruchamia się bez błędów zależności, plik software_versions.txt zawiera zapis środowiska, wszystkie katalogi wyjściowe istnieją, a plik configs/protocol.yaml zawiera poprawne ścieżki bezwzględne i ustawienia numeryczne.
UWAGA: Podczas przetwarzania danych, trenowania modelu, inferencji i ewaluacji używaj tego samego środowiska i pliku konfiguracji. Przechowuj kopię pliku configs/protocol.yaml z każdym wytrenowanym punktem kontrolnym.
ROZWIĄZYWANIE PROBLEMÓW: Jeśli tworzenie środowiska zostanie przerwane z powodu niedostępności pakietu, usuń niekompletne środowisko, zweryfikuj kanały pakietów w pliku environment.yml i utwórz środowisko ponownie. Jeśli nvidia-smi nie raportuje procesora graficznego, przerwij trenowanie modelu i przywróć sterownik graficzny oraz środowisko CUDA. Jeśli podczas wykonywania pojawi się błąd katalogu, zastąp ścieżki względne ścieżkami bezwzględnymi i zweryfikuj uprawnienia do zapisu dla output_root.
2. Akceptacja obrazów wejściowych, konstrukcja zbioru danych i przetwarzanie wstępne
- Używaj wyłącznie plików z rozszerzeniami JPG, JPEG lub PNG. Stosuj obrazy RGB 8-bitowe zawierające pojedyncze główne ubiory.
- Zachowaj obrazy RGB 8-bitowe o szerokości i wysokości co najmniej 512 pikseli z jednym możliwym do zidentyfikowania głównym uborem. Odrzuć obraz, gdy pierwszy plan z uborem zajmuje mniej niż 15% całkowitej powierzchni obrazu, gdy więcej niż 5% granicy maski ubioru pokrywa się z krawędzią obrazu, gdy obszar ubioru pomocniczego przekracza 10% obszaru głównego ubioru, gdy szacowany obszar przesłonięty przekracza 20% maski głównego ubioru lub gdy wariancja odpowiedzi Laplasjanu jest niższa niż 100.
- Zapisz identyfikator obrazu, zmierzoną wartość, wyzwoloną regułę wykluczenia oraz ścieżkę adnotacji w pliku excluded_samples.csv.
- Zastosuj reguły akceptacji danych wejściowych do obrazów źródłowych DeepFashion2 przed etykietowaniem strukturalnym i partycjonowaniem danych. Zapisz każdy zaakceptowany i odrzucony identyfikator obrazu, oryginalny podział zbioru danych, identyfikator adnotacji ubioru, identyfikator pary źródłowej, stosunek powierzchni pierwszego planu, stosunek kontaktu z granicą, stosunek przesłonięcia, wynik rozmycia oraz końcowy status zachowania w pliku data_filtering_manifest.csv.
- Uruchom python tools/prepare_data.py --config configs/protocol.yaml.
- Odczytaj ramkę ograniczającą (bounding box) ubioru z adnotacji zbioru danych. Rozszerz ramkę ograniczającą o 5% jej szerokości i wysokości, nie przekraczając granic obrazu.
- Wytnij obszar ubioru, zachowując jego oryginalny stosunek proporcji, dodaj wypełnienie zerami (zero padding) w celu utworzenia obrazu kwadratowego i zmień rozmiar wypełnionego obrazu do 512 x 512 pikseli.
- Konwertuj zmieniony rozmiar obrazu na tensor RGB z wartościami zmiennoprzecinkowymi. Podziel każdą wartość piksela przez 255.
- Znormalizuj kanały czerwony, zielony i niebieski, stosując średnie odpowiednio 0,485, 0,456 i 0,406 oraz odchylenia standardowe 0,229, 0,224 i 0,225.
- Zastosuj poziome odbicie lustrzane z prawdopodobieństwem 0,5 oraz losowe wymazywanie z prawdopodobieństwem 0,2 dla obrazów treningowych. W przypadku obrazów walidacyjnych i testowych zastosuj wyłącznie deterministyczne wycinanie, wypełnianie, zmianę rozmiaru i normalizację.
- Uruchom python tools/assign_structural_levels.py --config configs/protocol.yaml po wygenerowaniu siedmiokanałowych map komponentów oraz macierzy wspólnych granic i kolejności pionowej. Dla każdego zachowanego obrazu oblicz liczbę węzłów aktywnych, liczbę spójnych komponentów, liczbę węzłów rozgałęzień, liczbę niezależnych cykli oraz najdłuższą skierowaną ścieżkę kolejności pionowej. Zdefiniuj węzeł rozgałęzienia jako węzeł aktywny połączony z co najmniej trzema innymi węzłami aktywnymi w grafie wspólnych granic.
- Przypisz poziom S1, gdy graf jest spójny, nie zawiera niezależnego cyklu, nie zawiera węzła rozgałęzienia i ma najdłuższą ścieżkę kolejności pionowej nie dłuższą niż dwie krawędzie. Przypisz S2, gdy graf jest spójny, nie zawiera niezależnego cyklu, zawiera dokładnie jeden węzeł rozgałęzienia i ma najdłuższą ścieżkę kolejności pionowej nie dłuższą niż dwie krawędzie. Przypisz S3, gdy graf jest spójny, nie zawiera niezależnego cyklu i zawiera co najmniej dwa węzły rozgałęzień lub ścieżkę kolejności pionowej o długości co najmniej trzech krawędzi. Przypisz S4, gdy graf jest spójny, zawiera dokładnie jeden niezależny cykl i ma ścieżkę kolejności pionowej nie dłuższą niż dwie krawędzie. Przypisz S5, gdy graf zawiera co najmniej dwa niezależne cykle lub zawiera jeden niezależny cykl wraz ze ścieżką kolejności pionowej o długości co najmniej trzech krawędzi.
- Zastosuj reguły w kolejności S5, S4, S3, S2 i S1, a obliczone statystyki grafu, przypisany poziom oraz identyfikator reguły zapisz w pliku structural_level_manifest.csv.
- Wygeneruj wstępne etykiety S1–S5 automatycznie z zapisanych masek komponentów i macierzy relacji. Oznacz próbkę jako strukturalnie niejednoznaczną, gdy jej graf komponentów zawiera więcej niż jeden spójny komponent, gdy średnia maksymalna prawdopodobieństwo komponentu w obrębie pierwszego planu ubioru jest niższe niż 0,60, gdy aktywny komponent zajmuje mniej niż 1% pierwszego planu ubioru lub gdy przypisany poziom strukturalny zmienia się po zmianie szerokości kontaktu z granicą z jednego piksela na dwa piksele.
- Przekaż każdą niejednoznaczną próbkę dwóm autorom do niezależnej inspekcji obrazu źródłowego, mapy komponentów, macierzy wspólnych granic, macierzy kolejności pionowej i wstępnego grafu. Zachowaj etykietę, gdy wyniki obu inspekcji są zgodne. W przypadku rozbieżności przekaż próbkę trzeciemu autorowi i przyjmij decyzję większościową jako ostateczną etykietę. Wyklucz próbkę, gdy po przeglądzie nie uda się odzyskać stabilnej relacji komponentów. Zapisz etykietę automatyczną, etykiety z przeglądu, powód rozbieżności, etykietę końcową oraz status wykluczenia w pliku structural_label_audit.csv.
- Oblicz wartość SHA-256 dla każdego zachowanego pliku źródłowego oraz oblicz 64-bitowy hash percepcyjny z znormalizowanego wycinka ubioru. Umieść obrazy o identycznych wartościach SHA-256 w tej samej grupie dokładnych duplikatów. Umieść obrazy, których hashe percepcyjne mają odległość Hamminga nie większą niż cztery, w tej samej grupie bliskich duplikatów po zweryfikowaniu, że pochodzą one z tej samej instancji ubioru.
- Połącz wszystkie obrazy współdzielące ten sam identyfikator pary źródłowej DeepFashion2 lub tożsamość ubioru w jedną grupę źródłową. Zapisz hashe plików, hashe percepcyjne, identyfikatory źródłowe i identyfikatory grup duplikatów w pliku duplicate_group_manifest.csv.
- Przeprowadź partycjonowanie danych na poziomie grupy źródłowej, a nie na poziomie pojedynczego obrazu. Przypisz każdą grupę dokładnych duplikatów, grupę bliskich duplikatów i grupę tożsamości źródłowej w całości do jednego podzbioru. Sprawdź wszystkie pary między podzbiorami po partycjonowaniu i zapisz każdy wykryty konflikt tożsamości, konflikt hasha i konflikt hasha percepcyjnego w pliku leakage_audit.csv. Odtwórz manifesty, aż plik leakage_audit.csv nie będzie zawierał nierozwiązanych rekordów między podzbiorami.
- Uwarstwi grupy źródłowe według końcowych etykiet S1-S5 i przypisz pełne grupy do podzbiorów treningowego, walidacyjnego i testowego zgodnie z zweryfikowaną alokacją przedstawioną w Tabeli 1. Podaj dokładną liczbę obrazów i liczbę grup źródłowych dla każdego poziomu strukturalnego i podzbioru.
- Oblicz faktyczne wartości procentowe zbioru treningowego, walidacyjnego i testowego z końcowej zachowanej kohorty, a nie z niefiltrowanego zbioru danych. Nie używaj obrazów walidacyjnych, testowych, wykluczonych obrazów niejednoznacznych ani obrazów należących do ich grup duplikatów podczas uczenia parametrów, określania progów, dostosowywania reguł poziomu strukturalnego lub wyboru punktów kontrolnych (checkpoints).
- Zapisz przetworzone obrazy w katalogu data_processed/images. Zapisz pliki train_manifest.csv, validation_manifest.csv, test_manifest.csv, pair_manifest.csv oraz structural_level_manifest.csv w katalogu data_processed/manifests.
- Odczytaj końcowe etykiety strukturalne, status przeglądu, identyfikatory grup duplikatów, identyfikatory grup źródłowych i etykiety podzbiorów z przetworzonych manifestów. Policz automatycznie zaakceptowane próbki, próbki sprawdzone ręcznie, wykluczenia z powodu niejednoznaczności, wykluczenia duplikatów, grupy źródłowe, obrazy treningowe, obrazy walidacyjne i obrazy testowe dla poziomów od S1 do S5.
- Oblicz rzeczywiste proporcje podzbiorów, średnią liczbę węzłów aktywnych, średnią liczbę węzłów rozgałęzień, średnią liczbę niezależnych cykli, średnią głębokość kolejności pionowej oraz średnią liczbę krawędzi typowanych. Zapisz kompletne statystyki w pliku evaluation_results/dataset_statistics.csv.
- Oczekiwany wynik: Potwierdź, że każdy zaakceptowany obraz jest 8-bitowym obrazem RGB o rozmiarze 512 x 512 pikseli i posiada jeden rekord filtrowania, jedną końcową etykietę poziomu strukturalnego, jeden identyfikator grupy źródłowej, jeden identyfikator grupy duplikatów, jedną etykietę podzbioru i jedną prawidłową ścieżkę adnotacji. Potwierdź, że każda niejednoznaczna próbka posiada kompletny rekord przeglądu. Potwierdź, że żaden identyfikator źródłowy, grupa dokładnych duplikatów, grupa bliskich duplikatów ani tożsamość ubioru nie występuje w więcej niż jednym podzbiorze. Potwierdź, że liczby obrazów w plikach train_manifest.csv, validation_manifest.csv, test_manifest.csv i dataset_statistics.csv są identyczne.
UWAGA: Zachowaj oryginalne nieprzetworzone obrazy w katalogu data_raw. Nie stosuj losowej augmentacji do obrazów walidacyjnych ani testowych.
ROZWIĄZYWANIE PROBLEMÓW: Jeśli wycinanie usuwa kołnierz, rękaw, rąbek lub nogawkę spodni, przywróć oryginalną adnotację i zwiększ zachowany margines granicy. Jeśli ubiór wydaje się rozciągnięty, sprawdź, czy przed zmianą rozmiaru zastosowano kwadratowe wypełnienie. Jeśli przetworzony obraz zawiera jeden lub cztery kanały, przekonwertuj plik źródłowy na RGB 8-bitowy i ponownie uruchom wstępne przetwarzanie. Jeśli identyfikatory duplikatów występują w różnych podzbiorach, odbuduj wszystkie manifesty podzbiorów przed treningiem.
3. Parsowanie komponentów wizualnych z ograniczeniem do pierwszego planu i mapowanie prawdopodobieństwa
- Uruchom python tools/parse_components.py --config configs/protocol.yaml.
- Załaduj pretrenowany punkt kontrolny (checkpoint) semantycznego parsowania odzieży HRNet-W48 z parser_checkpoint. Zweryfikuj, czy punkt kontrolny generuje kategorie komponentów odzieży zdefiniowane w mapowaniu adnotacji zbioru danych. Przełącz sieć parsowania semantycznego w tryb ewaluacji i wyłącz obliczanie gradientów.
- Odczytaj przetworzone obrazy z plików train_manifest.csv, validation_manifest.csv i test_manifest.csv w odpowiedniej kolejności.
- Wyodrębnij z każdego obrazu wejściowego jeden siedmiokanałowy tensor odpowiedzi semantycznej i przyjmij wartość K równą siedmiu w całym przebiegu procesu. Użyj stałej kolejności kategorii: Upper Trim Region, Neckline Region, Bodice Region, Left Lower-Garment Region, Right Lower-Garment Region, Middle Lower-Garment Region oraz Hem Region. Zachowaj tę kolejność w mapach prawdopodobieństwa, macierzach komponentów, macierzach grafów, macierzach cech, manifestach i plikach wizualizacji.
- Zastosuj funkcję softmax wzdłuż wymiaru kanałów, aby wygenerować mapę prawdopodobieństwa komponentów semantycznych P. Zweryfikuj, czy sumy prawdopodobieństw we wszystkich K kanałach dla każdego piksela wynoszą jeden z tolerancją 0,0001.
- Załaduj maskę przedplanu odzieży z adnotacji zbioru danych i wyrównaj ją z przetworzonym obrazem o wymiarach 512 x 512. Ustaw prawdopodobieństwo każdego komponentu poza przedplanem odzieży na zero. Ponownie znormalizuj prawdopodobieństwa komponentów wewnątrz maski przedplanu wzdłuż wymiaru kanałów.
- Zweryfikuj, czy każdy aktywny region komponentu pozostaje w obrębie przedplanu odzieży. Odrzuć sparsowany przykład, jeśli kolorowy region komponentu rozciąga się na otaczającą ścianę, podłogę, zasłonę lub inny obszar tła. Zapisz identyfikator odrzuconego obrazu i błąd parsowania w pliku parsing_quality_log.csv.
- Oblicz współczynnik pokrycia przedplanu dla każdego komponentu i oznacz komponenty z fragmentarycznymi regionami lub niepopartymi obszarami izolowanymi do ręcznej inspekcji.
- Zapisz tensor odpowiedzi semantycznej w parser_outputs/logits. Zapisz mapę prawdopodobieństwa w parser_outputs/probability_maps. Zapisz podgląd komponentów z kodowaniem kolorami w parser_outputs/previews.
- Oczekiwany wynik: Potwierdź, że każdy zaakceptowany obraz generuje jedną siedmiokanałową mapę prawdopodobieństwa ograniczoną do przedplanu o rozmiarze przestrzennym 512 x 512 pikseli, jeden siedmiokanałowy tensor odpowiedzi semantycznej i jeden obraz podglądu. Potwierdź, że indeksy kanałów od jednego do siedmiu odpowiadają stałej kolejności komponentów zdefiniowanej w kroku 3.4. Potwierdź, że wszystkie kolorowe regiony komponentów pozostają w obrębie przedplanu odzieży i że piksele tła mają zerowe prawdopodobieństwo komponentu. Potwierdź, że identyfikator pliku odpowiada odpowiedniemu wpisowi w manifestach źródłowych.
UWAGA: Zachowaj ciągłe prawdopodobieństwa komponentów wewnątrz przedplanu odzieży podczas modelowania strukturalnego. Traktuj wynikowe regiony jako obszary analizy wizualnej. Nie interpretuj ich granic jako linii szwów, linii cięcia, konturów elementów wykroju, zaszewek, nacięć lub referencji stopniowania.
ROZWIĄZYWANIE PROBLEMÓW: Jeśli wszystkie kanały wykazują niemal jednolite prawdopodobieństwa, sprawdź parser_checkpoint, kolejność kanałów RGB oraz normalizację obrazu. Jeśli komponent pozostaje nieobecny w całym podzbiorze, porównaj indeks adnotacji z indeksem kanału wyjściowego parsera. Jeśli kolory komponentów rozciągają się na tło, zweryfikuj wyrównanie maski przedplanu, ustawienia interpolacji i współrzędne adnotacji przed konstrukcją grafu. Jeśli region wizualny obejmuje wiele niezwiązanych ze sobą obszarów odzieży, oznacz próbkę jako błąd parsowania i wyklucz ją z generowania a priori struktury. Jeśli prawdopodobieństwa kanałów nie sumują się do jedności, zastosuj softmax wzdłuż wymiaru kanałów, a nie wzdłuż któregokolwiek z wymiarów przestrzennych. Jeśli brakuje pliku wyjściowego, znajdź ostatni przetworzony identyfikator w logach parsera i wznowij parsowanie od następnego identyfikatora.
4. Modelowanie geometrii komponentów na poziomie obrazu i relacji przestrzennych
- Wczytaj tensor płytkich cech wizualnych oraz odpowiadającą mu mapę prawdopodobieństwa P dla każdego obrazu.
- Pomnóż każdy przestrzenny wektor cech przez prawdopodobieństwo przypisane do odpowiadającego komponentu semantycznego.
- Zsumuj ważone wektory cech w wymiarach przestrzennych i podziel sumę przez całkowitą masę prawdopodobieństwa komponentu.
- Przypisz wektor zerowy i wskaźnik nieaktywnego węzła do każdego komponentu o zerowej masie prawdopodobieństwa.
- Zastosuj normalizację L2 do każdego zanurzenia (embeddingu) aktywnego komponentu i ułóż zanurzenia zgodnie z ustalonym porządkiem komponentów semantycznych.
- Oblicz poziome i pionowe współrzędne środka płaszczyzny obrazu dla każdego komponentu wizualnego na podstawie jego rozkładu prawdopodobieństwa ograniczonego do pierwszego planu. Znormalizuj współrzędne względem szerokości i wysokości obrazu.
- Oblicz poziome i pionowe rozprzestrzenienie każdego komponentu wizualnego na płaszczyźnie obrazu w tym samym systemie współrzędnych znormalizowanych. Używaj tych wartości wyłącznie do opisania zakresu obszaru widocznego na przetworzonym obrazie.
- Utwórz siedem węzłów grafu zgodnie z ustalonym porządkiem komponentów, zachowując nieaktywne komponenty jako węzły zerowe. Skonstruuj macierz wspólnych granic 7 x 7, wykorzystując kontakt ośmiu sąsiadów między maskami komponentów pierwszego planu. Skonstruuj macierz kolejności pionowej 7 x 7, stosując stałe relacje od obszaru górnego wycięcia (Upper Trim Region) do obszaru linii szyi (Neckline Region), od obszaru linii szyi do obszaru stanu (Bodice Region), od obszaru stanu do każdego obszaru dolnej części garderoby oraz od każdego obszaru dolnej części garderoby do obszaru rąbka (Hem Region). Zapisz każdą poprawną relację w obu kierunkach.
- Dodaj pętlę własną dla każdego aktywnego węzła przed splotem grafowym, a relacje połączone z nieaktywnymi węzłami pozostaw jako zerowe.
- Oblicz względne przesunięcie środka oraz względną dyspersję przestrzenną między każdą uporządkowaną parą komponentów semantycznych. Ułóż parami wartości geometryczne, aby utworzyć tensor relacji geometrycznych.
- Oblicz iloczyn skalarny dla każdej pary znormalizowanych zanurzeń komponentów. Zastosuj funkcję softmax wzdłuż wierszy do otrzymanej macierzy podobieństwa i użyj wartości jako wag relacji.
- Pomnóż tensor relacji geometrycznych przez odpowiadające wagi relacji i zagreguj ważone relacje dla każdego komponentu.
- Zapisz macierz zanurzeń komponentów, macierz środków komponentów, macierz dyspersji przestrzennej, macierz wspólnych granic, macierz kolejności pionowej, macierz pętli własnych, macierz wag relacji, maskę nieaktywnych węzłów, mapowanie etykiet komponentów oraz reprezentację strukturalnych założeń wstępnych (structural priors) w pliku structural_priors. Zapisz każdą macierz z siedmioma wierszami i siedmioma kolumnami, gdzie jest to możliwe. Cały proces konstrukcji od mapy komponentów ograniczonej do pierwszego planu do strukturalnych założeń topologii komponentów odzieży na poziomie obrazu przedstawiono na Rysunku 2.
- Wygeneruj nakładkę grafu komponentów dla każdej próbki wizualizacji na podstawie mapy prawdopodobieństwa ograniczonej do pierwszego planu, macierzy środków komponentów, typowanej macierzy sąsiedztwa, maski nieaktywnych węzłów i mapowania etykiet komponentów.
- Umieść każdy aktywny węzeł w odpowiadającym mu środku komponentu. Narysuj krawędzie ciągłe dla wspólnych granic pierwszego planu oraz krawędzie przerywane dla zdefiniowanych relacji kolejności pionowej.
- Zapisz każdą nakładkę grafu w katalogu structural_priors/visualizations, używając identyfikatora obrazu źródłowego. Zarejestruj ścieżkę obrazu źródłowego, ścieżkę mapy prawdopodobieństwa, ścieżkę środków komponentów, ścieżkę typowanego sąsiedztwa, ścieżkę maski nieaktywnych węzłów, identyfikator punktu kontrolnego analizy semantycznej oraz ścieżkę nakładki grafu w pliku component_graph_visualization_manifest.csv.
- Oczekiwany wynik: Potwierdź, że każdy obraz generuje macierz zanurzeń komponentów z K wierszami, typowaną macierz sąsiedztwa z K wierszami i K kolumnami, macierz wag relacji z K wierszami i K kolumnami, maskę nieaktywnych węzłów z K wartościami oraz jedną reprezentację strukturalnych założeń wstępnych na poziomie obrazu. Potwierdź, że każda wybrana próbka wizualizacji generuje nakładkę grafu komponentów, w której aktywne węzły pozostają w obrębie odpowiadających im obszarów odzieży.
UWAGA: Zachowaj ten sam porządek komponentów wizualnych we wszystkich macierzach, manifestach, grafach, plikach cech i nakładkach grafów. Traktuj środki komponentów, wartości rozprzestrzenienia przestrzennego i relacje grafowe jako deskryptory obszarów odzieży w płaszczyźnie obrazu. Nie interpretuj grafu komponentów jako szkieletu pozy człowieka ani nie wyprowadzaj jego węzłów z anatomicznych współrzędnych stawów. Nie przeliczaj tych deskryptorów na długości szwów, promienie krzywizn, szerokości zaszewek, pozycje nacięć, kierunki nitki osnowy, przyrosty stopniowania ani wymiary elementów wykroju.
ROZWIĄZYWANIE PROBLEMÓW: Jeśli macierz zawiera wartość nienumeryczną, sprawdź mianownik masy prawdopodobieństwa i normalizację współrzędnych. Jeśli wagi relacji koncentrują się na jednym komponencie, odejmij maksimum wiersza od macierzy podobieństwa przed zastosowaniem funkcji softmax. Jeśli liczba węzłów grafu różni się między obrazami, upewnij się, że nieaktywne komponenty pozostają obecne jako wektory zerowe, zamiast być usuwane.
5. Dwustrumieniowe kodowanie cech z uwzględnieniem struktury
- Wczytaj wagi ResNet-50 pretrenowane na zbiorze ImageNet, a następnie usuń końcowe warstwy poolingu i klasyfikacji.
- Przepuść każdy znormalizowany obraz odzieży przez sieć ResNet-50 i wyodrębnij tensor wyglądu z etapu szkieletowego (backbone) określonego przez parametr appearance_stage w pliku configs/protocol.yaml. Zweryfikuj nazwę etapu, liczbę kanałów wyjściowych oraz przestrzenne wymiary wyjścia generowane przez wybrany etap szkieletowy dla obrazu wejściowego o rozmiarze 512 x 512 pikseli. Używaj tego samego etapu w każdym przebiegu trenowania, wnioskowania, ablacji i porównania.
- Zmień rozmiar semantycznej mapy prawdopodobieństwa do wymiarów przestrzennych tensora cech wyglądu poprzez interpolację biliniową. Pomnóż tensor cech wyglądu przez każdą zmienioną mapę prawdopodobieństwa komponentów, a następnie zagreguj ważone odpowiedzi w wymiarach przestrzennych.
- Przepuść każde osadzenie (embedding) wyglądu komponentu przez warstwę rekalibracji kanałów zdefiniowaną w configs/protocol.yaml. Zanotuj typ warstwy, wymiar wejściowy, wymiar wyjściowy, współczynnik redukcji, funkcję aktywacji oraz regułę współdzielenia parametrów. Ustaw resulting siedem wektorów komponentów w stałej kolejności semantycznej, aby utworzyć macierz cech wyglądu.
- Przepuść każdy wektor relacji geometrycznych przez warstwę projekcji strukturalnej i ustaw wymiar wyjściowy na 512. Skonstruuj graf komponentów z macierzą wag relacji i maską węzłów nieaktywnych.
- Zastosuj dwie grafowe warstwy konwolucyjne o wymiarze wejściowym 512 i wymiarze wyjściowym 512. Zastosuj normalizację wsadową (batch normalization) po każdej grafowej warstwie konwolucyjnej, a następnie zastosuj LeakyReLU. Zanotuj wartość ujemnego nachylenia (negative-slope) używaną przez LeakyReLU. Zastosuj maskę węzłów nieaktywnych po każdej warstwie, aby zachować zerowe cechy dla nieaktywnych komponentów.
- Zastosuj wyrównanie semantyczne z znormalizowanymi osadzeniami komponentów i ułóż wynikowe wektory w stos, aby utworzyć macierz cech strukturalnych.
- Oczekiwany wynik: Potwierdź, że każdy obraz generuje jedną macierz cech wyglądu i jedną macierz cech strukturalnych. Potwierdź, że obie macierze zawierają K wierszy i 512 kolumn.
UWAGA: Pozostaw nieaktywne komponenty jako wektory zerowe i zachowaj kolejność komponentów ustaloną podczas konstrukcji priorytetu strukturalnego.
ROZWIĄZYWANIE PROBLEMÓW: Jeśli dwie macierze cech zawierają różną liczbę wierszy, sprawdź mapowanie kategorii semantycznych i obsługę węzłów nieaktywnych. Jeśli mnożenie macierzy zgłasza błąd wymiaru, zweryfikuj, czy wyjście projekcji strukturalnej i wymiary kanałów wyglądu wynoszą 512. Jeśli cechy strukturalne pozostają zerowe dla wszystkich aktywnych komponentów, sprawdź, czy krawędzie grafu i wagi relacji zostały dodane do aktualnej partii (batch).
6. Fuzja cech sterowana strukturą
- Zastosuj sekwencję fuzji cech sterowaną strukturą przedstawioną na Rysunku 3. Przepuść macierz cech strukturalnych przez warstwę wag fuzji i zastosuj funkcję aktywacji zdefiniowaną przez fusion_activation w pliku configs/protocol.yaml. Zapisz nazwę aktywacji, wymiar wejściowy, wymiar wyjściowy oraz informację, czy parametry są współdzielone pomiędzy siedmioma węzłami komponentów.
- Zweryfikuj, czy wygenerowana macierz wag strukturalnych zawiera K wierszy i 512 kolumn.
- Pomnóż macierz cech wyglądu przez macierz wag strukturalnych element po elemencie.
- Złącz modulowaną macierz wyglądu oraz macierz cech strukturalnych wzdłuż wymiaru kanałów.
- Złącz 512-wymiarowy modulowany wektor wyglądu oraz 512-wymiarowy wektor strukturalny dla każdego komponentu, aby utworzyć wektor 1024-wymiarowy. Przepuść złączony wektor przez warstwę projekcji fuzji i zredukuj jego wymiar z 1024 do 512.
- Dodaj oryginalną macierz cech strukturalnych do macierzy projektowanej za pomocą połączenia rezydualnego.
- Ustaw wektory komponentów po fuzji w stałej kolejności semantycznej i zastosuj normalizację L2 do spłaszczonej reprezentacji uwzględniającej strukturę.
- Zapisz macierz wag strukturalnych, modulowaną macierz wyglądu, macierz komponentów po fuzji oraz końcową reprezentację uwzględniającą strukturę w folderze feature_outputs.
- Oczekiwany wynik: Potwierdź, że każdy obraz generuje jedną macierz komponentów po fuzji z K wierszami i 512 kolumnami oraz jeden znormalizowany wektor cech uwzględniający strukturę, powiązany z identyfikatorem obrazu źródłowego.
UWAGA: Zachowaj macierz wag strukturalnych oraz macierz komponentów po fuzji do wizualizacji odpowiedzi i lokalnej analizy różnic.
ROZWIĄZYWANIE PROBLEMÓW: Jeśli wartości po fuzji nadal rosną, sprawdź wyjście aktywacji i warstwę normalizacji. Jeśli wszystkie wagi strukturalne dążą do tej samej wartości, upewnij się, że cechy strukturalne różnią się między obrazami i że warstwa fuzji otrzymuje gradienty. Jeśli pliki cech i identyfikatory obrazów nie pasują do siebie, przebuduj manifest wyjściowy przed treningiem lub ewaluacją wyszukiwania.
7. Trenowanie modelu i optymalizacja spójności
- Wczytaj pięć losowych wartości ziarna (seed) zapisanych w pliku configs/seeds.yaml. Dla każdego uruchomienia ustaw to samo ziarno losowe dla Pythona, NumPy, operacji PyTorch CPU oraz wszystkich urządzeń CUDA. Włącz algorytmy deterministyczne, wyłącz tryb benchmarku cuDNN i zapisz dokładne pięć wartości ziarna w odpowiadającym im katalogu uruchomienia.
- Wczytaj przetworzony manifest treningowy, manifest par, mapy prawdopodobieństwa oraz priory priory strukturalne.
- Sformuj każdą partię treningową (batch) tak, aby zawierała osiem kategorii strukturalnych i cztery próbki o różnym wyglądzie z każdej kategorii.
- Oblicz stratę spójności strukturalnej (structural consistency loss) z dodatnich par próbek, które współdzielą ten sam priory strukturalny.
- Oblicz stratę spójności relacji strukturalnych (structural relationship consistency loss) na podstawie odległości parzystych między cechami komponentów.
- Oblicz stratę dyskryminacji strukturalnej (structural discrimination loss) z negatywnych par próbek o heterogenicznych strukturach i zastosuj próg separacji wynoszący 0.3.
- Połącz cel wyglądu, cel spójności strukturalnej, cel relacji strukturalnych oraz cel dyskryminacji strukturalnej przy użyciu wag zapisanych w pliku configs/protocol.yaml. Proces optymalizacji przestrzeni cech sterowany przez trzy cele strukturalne przedstawiono na Rysunku 4.
- Uruchom polecenie python train.py --config configs/protocol.yaml. Zaktualizuj wszystkie trenowalne parametry za pomocą stochastycznego spadku gradientu dla mini-batchy (mini-batch stochastic gradient descent), stosując początkową stopę uczenia, momentum, spadek wag (weight decay), liczbę epok, czynnik spadku oraz epoki spadku zdefiniowane w kroku 1.8. Zapisuj stopę uczenia po każdej epoce w logu treningowym.
- Zapisuj po każdej epoce całkowitą stratę, stratę wyglądu, stratę spójności strukturalnej, stratę relacji strukturalnych, stratę dyskryminacji strukturalnej, stopę uczenia, wskaźnik spójności strukturalnej (SCI), wskaźnik dyskryminacji strukturalnej (SDI) oraz Recall@5.
- Oceniaj model na pliku validation_manifest.csv po każdej epoce. Zapisz punkt kontrolny (checkpoint) powiązany z najwyższym wskaźnikiem SCI dla walidacji w pliku checkpoints/selected_model.pth.
- Powtórz trening pięć razy z pięcioma zapisanymi ziarnami losowymi. Zapisz każdy plik konfiguracyjny, log treningowy i wybrany punkt kontrolny w osobnym katalogu uruchomienia.
- Oczekiwany wynik: Potwierdź, że każde uruchomienie generuje log treningowy, log walidacyjny, plik metryk na poziomie epok oraz jeden wybrany punkt kontrolny. Potwierdź, że wybrany punkt kontrolny opiera się na wydajności walidacyjnej, a nie testowej.
UWAGA: Używaj tych samych manifestów treningowych, walidacyjnych i testowych w każdym porównaniu modeli i eksperymencie ablacyjnym.
ROZWIĄZYWANIE PROBLEMÓW: Jeśli strata stanie się niewartościowa (non-numeric), przerwij trening, sprawdź masy prawdopodobieństwa komponentów, zmniejsz stopę uczenia dziesięciokrotnie i zrestartuj proces od ostatniego poprawnego punktu kontrolnego. Jeśli wskaźnik SCI dla walidacji pozostaje niezmienny mimo spadku straty treningowej, sprawdź, czy parametry propagacji i fuzji grafu otrzymują gradienty. Jeśli pamięć graficzna zostanie wyczerpana, zmniejsz rozmiar partii i zachowaj efektywny rozmiar partii wynoszący 32 poprzez akumulację gradientów. Jeśli wydajność walidacyjna gwałtownie zmienia się między uruchomieniami, zweryfikuj zapisane ziarno losowe oraz kolejność w manifeście danych.
8. Wnioskowanie, wyszukiwanie, klastrowanie i weryfikacja wyników
- Uruchom python infer.py --config configs/protocol.yaml --checkpoint checkpoints/selected_model.pth. Wygeneruj mapy prawdopodobieństwa, priorytety strukturalne, macierze cech wyglądu, macierze cech strukturalnych, macierze komponentów połączonych oraz końcowe wektory cech dla każdego obrazu testowego.
- Zapisz wszystkie wyniki wnioskowania w folderze feature_outputs/test i zarejestruj ich ścieżki w pliku test_feature_manifest.csv. Oblicz podobieństwo cosinusowe między każdą cechą zapytania a wszystkimi cechami w galerii. Posortuj identyfikatory galerii w kolejności malejącej podobieństwa. Zapisz pięć najwyżej ocenionych wyników dla każdego zapytania w pliku evaluation_results/retrieval_results.csv.
- Dla każdej próbki wyszukiwania wybranej do wizualizacji załaduj typowaną macierz sąsiedztwa, macierz wag relacji, macierz środków komponentów, maskę węzłów nieaktywnych, mapowanie etykiet komponentów oraz macierz komponentów połączonych obrazu zapytania. Załaduj te same pliki dla najwyżej ocenionego wyniku wygenerowanego przez model uwzględniający strukturę.
- Wyrenderuj graf komponentów zapytania oraz graf komponentów obrazu wyszukanego na podstawie ich zapisanych środków komponentów i typowanych macierzy sąsiedztwa. Zachowaj stałą kolejność komponentów i typy relacji użyte podczas wnioskowania modelu.
- Wyrenderuj typowaną macierz sąsiedztwa zapytania jako macierz kategoryczną. Użyj oddzielnych wartości macierzy dla relacji nieaktywnych, wspólnych granic i kolejności pionowej. Oznacz osie poziomą i pionową identyfikatorami komponentów przechowywanymi w mapowaniu etykiet komponentów.
- Zastosuj normalizację L2 do macierzy komponentów połączonych zapytania oraz macierzy komponentów połączonych obrazu wyszukanego. Oblicz podobieństwo cosinusowe między każdym komponentem zapytania a każdym komponentem obrazu wyszukanego. Zapisz wynikową macierz odpowiedniości komponentów K × K w pliku evaluation_results/structural_retrieval_evidence.
- Dla każdej pary referencyjno-docelowej wybranej do analizy różnic lokalnych załaduj typowaną macierz sąsiedztwa, macierz środków komponentów, macierz dyspersji przestrzennej, macierz wag relacji i macierz komponentów połączonych dla obu obrazów.
- Oblicz różnicę bezwzględną między dwiema typowanymi macierzami sąsiedztwa. Oblicz różnice bezwzględne w przesunięciu środków komponentów, dyspersji przestrzennej i wagach relacji, korzystając ze stałej kolejności komponentów. Zapisz wynikową macierz różnic topologicznych oraz macierz różnic relacji geometrycznych w pliku evaluation_results/structural_difference_evidence.
- Oblicz odległość L2 między odpowiadającymi sobie wierszami dwóch macierzy komponentów połączonych. Znormalizuj odległości na poziomie komponentów i przypisz je do węzłów docelowego grafu komponentów. Zwiększ szerokość krawędzi zgodnie z znormalizowaną różnicą wag relacji. Zapisz wynikowy graf różnic komponentów po połączeniu.
- Zarejestruj identyfikatory obrazów, ścieżki do macierzy, ścieżki do grafów, kolejność komponentów, identyfikator punktu kontrolnego oraz ścieżki wyjściowe wizualizacji w pliku structural_visualization_manifest.csv. Wygeneruj wszystkie wizualizacje strukturalne programowo z zapisanych plików; nie dodawaj węzłów grafu, krawędzi grafu ani wartości macierzy ręcznie.
- Zastosuj metodę K-średnich z pięcioma klastrami do końcowych wektorów cech i zapisz przypisania do klastrów w pliku evaluation_results/cluster_assignments.csv. Uruchom python evaluate.py --config configs/protocol.yaml --feature_dir feature_outputs/test.
- Oblicz SCI, SDI, Recall@5, średnią precyzję (mAP) oraz współczynnik sylwetki dla każdego uruchomienia. Użyj SCI do oceny zwartości znormalizowanych cech współdzielących tę samą etykietę strukturalną, a SDI do oceny separacji między różnymi etykietami strukturalnymi. Użyj Recall@5 do oceny, czy odpowiednie dopasowanie strukturalne pojawia się na krótkiej liście wyników, a mAP do oceny jakości rankingowania w całej galerii. Współczynnika sylwetki używaj wyłącznie do analizy klastrowania.
- Oblicz średnią arytmetyczną i odchylenie standardowe próby dla pięciu niezależnych uruchomień. Zachowaj pięć wartości na poziomie każdego uruchomienia dla każdej metody i metryki. Nie stosuj normalizacji min-max, normalizacji rang ani skalowania w oparciu o porównywane metody. Przeprowadź test t-studenta dla prób zależnych, używając wyników uzyskanych przy tym samym ziarnie losowym, i zapisz statystykę testową oraz dokładną dwustronną wartość istotności.
- Porównaj liczbę przetworzonych identyfikatorów testowych, plików cech, rekordów wyszukiwania i przypisań do klastrów. Rozwiąż każdą niezgodność przed raportowaniem lub interpretacją wyników ewaluacji.
- Oczekiwany wynik: Potwierdź, że każdy obraz testowy posiada jeden kompletny rekord wnioskowania, jedną listę wyszukiwania, jedno przypisanie do klastra i jeden zestaw danych wejściowych do ewaluacji. Potwierdź, że każdy przypadek wyszukiwania wybrany do wizualizacji posiada graf komponentów zapytania, graf komponentów obrazu wyszukanego, typowaną macierz sąsiedztwa i macierz odpowiedniości komponentów połączonych.
- Potwierdź, że każdy przypadek różnicy strukturalnej posiada macierz różnic topologicznych, macierz różnic relacji geometrycznych, graf różnic komponentów po połączeniu, mapę ciepła różnic przestrzennych i nałożenie odpowiedzi. Potwierdź, że wszystkie pliki wizualizacyjne są powiązane z ich macierzami źródłowymi poprzez plik structural_visualization_manifest.csv. Zapisz czystą mapę ciepła, nałożenie na obraz docelowy, maskę pierwszego planu i współrzędne regionu o najwyższej odpowiedzi dla każdego wizualizowanego przypadku.
- Zaakceptuj obliczoną odpowiedź różnicową tylko wtedy, gdy dominujący region o wysokiej odpowiedzi pokrywa się z pierwszym planem odzieży i pozostaje wspierany przez odpowiednią zmianę w typowanej macierzy sąsiedztwa, zmianę relacji geometrycznej i dowody odległości komponentów po połączeniu. Jeśli najsilniejsza odpowiedź znajduje się głównie poza pierwszym planem odzieży, sprawdź wynik parsowania, graf komponentów i rekord połączenia.
UWAGA: Do wnioskowania na zbiorze testowym użyj punktu kontrolnego wybranego ze zbioru walidacyjnego. Nie wybieraj ani nie wymieniaj punktu kontrolnego na podstawie metryk zbioru testowego. Używaj tej samej kolejności komponentów, reguły węzłów nieaktywnych, kodowania typów relacji i procesu normalizacji podczas generowania grafów i macierzy w trakcie wnioskowania i wizualizacji.
ROZWIĄZYWANIE PROBLEMÓW: Jeśli wnioskowanie zostanie przerwane przed przetworzeniem wszystkich obrazów testowych, znajdź ostatni identyfikator w logu wnioskowania i wznowij proces od następnego identyfikatora. Jeśli wyniki wyszukiwania są zdominowane przez podobieństwo kolorystyczne, sprawdź wyniki priorytetów strukturalnych i połączenia oraz zweryfikuj, czy ładowanie punktu kontrolnego przebiegło pomyślnie. Jeśli ewaluacja zgłasza duplikaty identyfikatorów, przebuduj plik test_feature_manifest.csv i usuń powtarzające się rekordy przed ponownym obliczeniem. Jeśli metoda K-średnich wygeneruje pusty klaster, zweryfikuj normalizację cech i uruchom klastrowanie ponownie z zapisanym ziarnem losowym.
9. Porównawcza ocena modelu
- Uruchom polecenie python compare_models.py --config configs/protocol.yaml.
- Wytrenuj i oceń modele ResNet-50, Part-based Convolutional Baseline (PCB), GCN, FashionGraph, Swin Transformer, CLIP, Topology Feature Histogram with Color and Texture Fusion, Attention-Guided Cascade Network, MMFL-Net, FARE-RNET oraz proponowaną metodę, korzystając z tych samych manifestów treningowych, walidacyjnych i testowych.
- Zastosuj ten sam rozmiar obrazu, operacje preprocessingu, liczbę epok treningowych, efektywną wielkość batcha, zapytania ewaluacyjne oraz implementację metryk dla każdej metody.
- Zachowaj global average pooling dla ResNet-50. Zastosuj dopasowanie w pasach poziomych (horizontal-strip alignment) w PCB. Zastosuj stały graf odzieży na poziomie obrazu w GCN. Zastosuj dynamiczną inferencję grafu sterowaną atrybutami w FashionGraph. Użyj standardowych koderów obrazu dla Swin Transformer i CLIP. Zaimplementuj Topology Feature Histogram with Color and Texture Fusion z wykorzystaniem deskryptorów topologii, koloru i tekstury. Zaimplementuj Attention-Guided Cascade Network z wykorzystaniem globalnych i lokalnych gałęzi cech wraz z parsingiem odzieży. Zaimplementuj MMFL-Net z wykorzystaniem wieloskalowych i wielkoziarenkowych gałęzi cech. Zaimplementuj FARE-RNET z wykorzystaniem uwagi rezdualnej (residual attention), selekcji cech i rozszerzonego kodowania kontekstowego (dilated contextual encoding).
- Używaj wyłącznie gałęzi obraz-zapytanie każdej metody porównawczej. Przetrenuj każdą trenowalną metodę na wspólnym manifeście treningowym i wybierz jej punkt kontrolny (checkpoint) na podstawie wspólnego manifestu walidacyjnego. Wygeneruj rankingową listę galerii dla każdego zapytania testowego.
- Rzutuj każde wyuczone osadzenie (embedding) do 512 wymiarów poprzez zarejestrowaną trenowalną warstwę liniową, jeśli jego oryginalny wymiar jest inny. Zastosuj normalizację L2 przed rankingiem podobieństwa cosinusowego. Użyj tego samego przypisania zapytanie-galeria i implementacji metryk dla wszystkich metod.
- Powtórz każdą metodę porównawczą z tymi samymi pięcioma losowymi ziarnami (seeds). Raportuj średnią i odchylenie standardowe próby dla SCI, SDI, Recall@5, mAP i współczynnika sylwetki (silhouette coefficient). Dla każdej metryki przeprowadź dwustronny sparowany test t między proponowaną metodą a każdą metodą porównawczą, używając wyników uzyskanych przy tym samym losowym ziarnie. Zapisz pięć wartości na poziomie każdego uruchomienia, statystykę testową, stopnie swobody i dokładną wartość p w pliku evaluation_results/comparison_metrics.csv.
- Oblicz SCI, SDI, Recall@5, mAP oraz współczynnik sylwetki dla każdej metody. Zapisz wszystkie wartości na poziomie poszczególnych uruchomień oraz wartości zagregowane w pliku evaluation_results/comparison_metrics.csv.
- Oczekiwany wynik: Potwierdź, że plik comparison_metrics.csv zawiera te same pola metryk i tę samą liczbę niezależnych uruchomień dla każdej metody porównawczej.
UWAGA: Nie zmieniaj partycji danych, kodu metryk ani przypisań zapytanie-galeria pomiędzy metodami porównawczymi.
ROZWIĄZYWANIE PROBLEMÓW: Jeśli model porównawczy generuje wymiar cech inny niż 512, dodaj pojedynczą zarejestrowaną liniową warstwę projekcji przed obliczeniem metryk i wytrenuj tę warstwę wraz z odpowiadającym jej modelem. Jeśli model nie zbiega przy wspólnej prędkości uczenia (learning rate), użyj prędkości uczenia określonej w jego opublikowanej implementacji i zachowaj wszystkie pozostałe warunki eksperymentalne. Zapisz każde ustawienie specyficzne dla danej metody w dzienniku porównawczym.
Wyniki
Wszystkie opisane eksperymenty zostały przeprowadzone z wykorzystaniem środowiska sprzętowego i programowego udokumentowanego w Tabeli 2 oraz w Tabeli Materiałów. Przez cały proces wstępnego przetwarzania, uczenia, wnioskowania i ewaluacji stosowano te same wersje sterownika graficznego, CUDA, cuDNN, Python, NumPy, PyTorch oraz torchvision. Kompletne środowisko sprzętowe i programowe zostało zestawione w Tabeli 2 oraz w Tabeli Materiałów. Tabela 1 zawiera podsumowanie przetworzonych zbiorów treningowych, walidacyjnych i testowych wraz ze statystykami topologii na poziomie obrazu. Tabela 2 przedstawia wspólną konfigurację zastosowaną we wszystkich metodach porównawczych.
Wyniki oceny porównawczej
Ocena porównawcza została przeprowadzona zgodnie z powszechnie stosowanymi podziałami danych, operacjami preprocessingu, kontrolami treningu oraz definicjami metryk określonymi w sekcjach 7–9 protokołu. Tabela 3 porównuje ogólne koder wizualne, modele wyrównane do części obiektu, grafowe reprezentacje odzieży, sieci wyszukiwania mody międzydomenowej, metody fuzji topologii i wyglądu oraz metody wizualnego wyszukiwania w e-commerce, przy czym wszystkie zostały ocenione przy użyciu tego samego protokołu zapytań obrazowych. Metody specyficzne dla danej domeny obejmują Topology Feature Histogram with Color and Texture Fusion (TFH-CT), Attention-Guided Cascade Network (AGC-Net), Multi-scale and Multi-granularity Feature Learning Network (MMFL-Net) oraz Fashion Retrieval using Residual Network with Egret Swarm Optimization (FARE-RNET). Wszystkie metryki oceny w Tabeli 3 są przedstawione jako średnia i odchylenie standardowe próby z pięciu niezależnych uruchomień przy użyciu tych samych ziarn losowości (random seeds), manifestu treningowego, manifestu walidacyjnego, manifestu testowego, przypisania zapytanie-galeria oraz implementacji metryk. Sparowane wartości p- zostały obliczone oddzielnie dla SCI, SDI, Recall@5, mAP i współczynnika sylwetki poprzez porównanie każdej metody z metodą proponowaną w dopasowanych warunkach ziarn losowości. Wyniki te stanowią podstawę ilościową dla późniejszych analiz w zakresie wizualizacji strukturalnej, wyszukiwania, klastrowania i projektowania.
Reprezentatywne wyniki protokołu i ich interpretacja
O pomyślnym wykonaniu protokołu świadczy fakt, że graf komponentów na poziomie obrazu, zrekonstruowany z zapisanych plików analizy i grafu, umieszcza każdy aktywny węzeł w odpowiadającym mu regionie odzieży i zachowuje typy relacji zapisane w typowanej macierzy sąsiedztwa, co przedstawiono na Rysunku 5C. Odpowiedź uwzględniająca strukturę powinna pozostać skoncentrowana na pierwszym planie odzieży, jak pokazano na Rysunku 5D. Rysunek 6E przedstawia oczekiwany wynik wyszukiwania, w którym proponowana metoda redukuje wpływ czerwonego tła i wyszukuje odzież górną zamiast niepowiązanych czerwonych obiektów. Rysunek 6B–G wykazuje również, że ranking wyszukiwania jest wspierany przez relacje komponentów na poziomie obrazu oraz korespondencję komponentów po fuzji. Wynik ten odzwierciedla odtworzenie ogólnej kategorii odzieży, mimo że długość rękawów i lokalna topologia nadal różnią się w wyszukanych próbkach.
Typowe przypadki błędów obejmują aktywację zdominowaną przez teksturę na Rysunku 5B, wyszukiwanie sterowane kolorem tła w górnym rzędzie Rysunku 6 oraz resztkową aktywację tła na Rysunku 7. Rysunek 7 należy interpretować jako lokalizację częściową, ponieważ dominująca odpowiedź podąża za powiększoną sylwetką dolnej części ciała i prawą krawędzią ubrania, podczas gdy resztkowa aktywacja pozostaje w sąsiednich obszarach tła. Lokalizację uznaje się za wspartą strukturalnie tylko wtedy, gdy macierz różnic topologicznych, macierz różnic relacji geometrycznych, graf różnic komponentów po fuzji oraz odpowiedź przestrzenna identyfikują spójne obszary ubrania. Przestrzenny punkt zapalny (hotspot) bez odpowiadających mu zmian w macierzy lub komponentach wskazuje na zakłócenia wizualne, a nie na dowody strukturalne.
Uruchomienie protokołu uznaje się za prawidłowe, gdy każdy zaakceptowany obraz generuje znormalizowaną semantyczną mapę prawdopodobieństwa, macierz relacji o wymiarach K wierszy i K kolumn, macierze cech wyglądu i struktury o wymiarach K wierszy i 512 kolumn oraz skończony zunifikowany wektor cech powiązany z prawidłowym identyfikatorem obrazu. Inspekcja wizualna powinna potwierdzić, że topologia odpowiada komponentom odzieży, że odpowiedź tła jest niższa niż odpowiedź pierwszego planu, a wyniki wyszukiwania są determinowane przez kategorię i strukturę odzieży, a nie przez kolor tła. Fragmentaryczne mapy prawdopodobieństwa, brakujące węzły komponentów, macierze nienumeryczne, rozproszone odpowiedzi tła lub wyszukiwanie zdominowane przez kolor wskazują na niepowodzenie wykonania i wymagają weryfikacji parsowania, konstrukcji grafu, fuzji cech lub ładowania punktów kontrolnych.
Analiza wizualna odpowiedzi komponentów odzieży na poziomie obrazu
Rycina 5 porównuje bazowy model ResNet-50 z modelem uwzględniającym komponenty przy użyciu tego samego obrazu odzieży. Rycina 5B przedstawia mapę aktywacji klas dla bazowego modelu wyglądu. Rycina 5C prezentuje graf komponentów odzieży na poziomie obrazu, zrekonstruowany z mapy prawdopodobieństwa ograniczonej do pierwszego planu, macierzy centrów komponentów, typowanej macierzy sąsiedztwa, maski węzłów nieaktywnych oraz mapowania etykiet komponentów wygenerowanych w sekcjach 3 i 4 protokołu. Rycina 5D prezentuje odpowiedź aktywacyjną reprezentacji połączonej. Do wygenerowania Ryciny 5C nie użyto żadnego estymatora pozy człowieka ani adnotacji stawów ludzkich.
Odpowiedź bazowa koncentrowała się na lokalnych obszarach tekstury w dolnej części odzieży i nie podążała konsekwentnie za pełną granicą ubrania, co przedstawiono na ryc. 5B. Na ryc. 5C każdy węzeł odpowiada środkowi aktywnego obszaru komponentu odzieży, natomiast każda krawędź reprezentuje wspólną granicę pierwszego planu lub zdefiniowaną relację porządku pionowego. Graf odzwierciedla organizację obszarów odzieży i nie reprezentuje ludzkich stawów anatomicznych. Odpowiedź uwzględniająca strukturę obejmowała główny pierwszy plan odzieży, zachowując jednocześnie niższą aktywację w większości obszarów tła, co pokazano na ryc. 5D. Wyniki te wskazują, że graf komponentów oraz moduł fuzji cech zredukowały aktywację zdominowaną przez teksturę w analizowanym obrazie.
Analiza podobieństwa strukturalnego odzieży i wyniki referencyjne projektu
Rysunek 6 przedstawia ranking wyników wyszukiwania wraz z dowodami strukturalnymi wykorzystanymi do jego interpretacji. Graf komponentów zapytania na Rysunku 6B rejestruje aktywne regiony odzieży oraz ich typowane relacje, natomiast macierz na Rysunku 6C obnaża wzorzec relacji dostarczony do propagacji grafu. Wyniki bazowe na Rysunku 6D są nadal zdominowane przez czerwone wskazówki dotyczące wyglądu. Wyniki uwzględniające strukturę na Rysunku 6E zachowują kategorię odzieży górnej dla różnych kolorów i tła. Graf komponentów najwyżej ocenionego wyniku na Rysunku 6F umożliwia bezpośrednie porównanie z grafem zapytania, a macierz odpowiedniości na Rysunku 6G ujawnia, czy komponenty współdzielące te same identyfikatory pozostają wyrównane po fuzji sterowanej strukturą. Odpowiedniość diagonalną należy interpretować łącznie z brakującymi węzłami i zmienionymi relacjami grafu. Silne podobieństwo wyglądu bez zgodności grafów nie stanowi sukcesu w zakresie wyszukiwania strukturalnego.
Odzyskane elementy garderoby zachowują kategorię ogólną, jednak różnice w konfiguracji rękawów i lokalnych relacjach między komponentami wskazują na niepełną odpowiedniość w skali szczegółowej. Zaproponowana metoda osiągnęła wskaźnik Recall@5 na poziomie 89,2% oraz mAP wynoszący 86,4%, co przedstawiono w Tabeli 3. Wartości ilościowe te opisują wydajność rankingu, natomiast Rysunek 6B–G dostarcza pośrednich dowodów strukturalnych wspierających tę interpretację. Wniosek dotyczący wyszukiwania ogranicza się zatem do poprawy odporności na zakłócenia wywołane kolorem tła oraz silniejszej organizacji komponentów na poziomie obrazu w ramach przetestowanego zapytania.
Odpowiedź na różnice strukturalne i wsparcie analizy projektowej
Mapa ciepła czystej odpowiedzi różnicowej na Rysunku 7H pokazuje, że dominująca odpowiedź jest skoncentrowana na powiększonej sylwetce dolnej części ciała oraz prawej krawędzi odzieży na obrazie docelowym. Nałożenie obrazów na Rysunku 7I wykazuje, że najsilniejsza odpowiedź pozostaje zgodna z głównym planem pierwszego planu odzieży, podczas gdy słabsza aktywacja w przyległych obszarach zasłon i ścian pozostaje jako resztkowa interferencja tła. Odpowiedź przestrzenną należy interpretować wspólnie z wykresem komponentów i dowodami macierzowymi przedstawionymi na Rysunkach 7C–G. Odpowiedź jest traktowana jako prawidłowa różnica strukturalna tylko wtedy, gdy obszar odzieży o wysokiej odpowiedzi jest zgodny ze zmianą sąsiedztwa, zmianą relacji geometrycznej oraz wzorcem odległości komponentów po fuzji.
Różnicę strukturalną uznaje się tylko wtedy, gdy zmiana typowej sąsiedniości na Rysunku 7E lub zmiana relacji geometrycznej na Rysunku 7F współwystępuje ze zwiększoną odległością komponentów na Rysunku 7G oraz odpowiedzią przestrzenną wyrównaną do pierwszego planu na Rysunku 7H,I. Powiększony obszar dolnej części ciała oraz prawa granica odzieży spełniają to kryterium międzyetapowe. Aktywacja nad zasłoną i ścianą nie odpowiada zmianom w węzłach komponentów, wzorcach relacji ani zintegrowanym odległościom komponentów, w związku z czym zostaje odrzucona jako niestrukturalna interferencja szczątkowa. Wynik ten wspiera lokalizację różnic na poziomie obrazu, lecz nie stwierdza wariacji w wzorach krawieckich ani parametrach konstrukcyjnych.
Analiza rozkładu przestrzennego i klastrów strukturalnych cech
Analiza rozkładu utajonej przestrzeni cech ujawnia zdolność modelu do rozróżniania semantyki strukturalnej odzieży. Analiza ta sprawdza, czy rozkład a priori struktur organizuje ubrania o różnych konfiguracjach topologicznych w odrębne rozmaitości cech. Wybrano pięć reprezentatywnych kategorii strukturalnych ze zbioru testowego: bluzki z krótkim rękawem, spodnie, spódnice, długie płaszcze oraz sukienki. Wielowymiarowe wektory cech zostały rzutowane na płaszczyznę dwuwymiarową przy użyciu stochastycznego osadzania sąsiadów z rozkładem t (t-SNE). Oceniono spójność podobnych próbek oraz separację próbek niepodobnych, aby scharakteryzować organizację semantyki strukturalnej w przestrzeni cech. Rozkład t-SNE przestrzeni cech uwzględniającej strukturę przedstawiono na Rysunku 8.
Projekcja t-SNE utworzyła pięć głównych regionów cech z ograniczonym nakładaniem się sąsiednich kategorii, co przedstawiono na Rysunku 8A. Reprezentatywne próbki odpowiadające pięciu regionom kategorii pokazano na Rysunku 8B. Wartość SCI wynosząca 0,81 odzwierciedla zwartość próbek współdzielących tę samą etykietę strukturalną, a wartość SDI wynosząca 0,71 odzwierciedla separację między próbkami o różnych etykietach strukturalnych, zgodnie z danymi w Tabeli 3 i wizualizacją na Rysunku 8. Wskaźniki te należy interpretować jako miary rozkładu w przestrzeni cech i nie określają one bezpośrednio współczynnika fałszywych alarmów. Topy z krótkim rękawem i spódnice zajmowały różne główne regiony w rzutowanej przestrzeni cech, podczas gdy niewielka liczba próbek pozostała w pobliżu granic sąsiednich kategorii, jak pokazano na Rysunku 8A. Spodnie i sukienki również wykazały wyraźną separację od kategorii sąsiednich. Taki rozkład wskazuje, że a priori grafu przyczyniło się do organizacji strukturalnej na poziomie kategorii bez powodowania całkowitej separacji klastrów. Ewaluacja oddziela jakość reprezentacji od skuteczności wyszukiwania. SCI ocenia, czy odzież o tej samej etykiecie strukturalnej pozostaje zwarta w wyuczonej przestrzeni cech, natomiast SDI ocenia, czy odzież o różnych etykietach strukturalnych pozostaje odseparowana. Metryki te odpowiadają celowi reprezentacji strukturalnej protokołu. Recall@5 mierzy, czy strukturalnie istotny element garderoby pojawia się w pierwszych pięciu wynikach wyszukiwania, podczas gdy mAP mierzy jakość rankingu we wszystkich istotnych próbkach z galerii. Metryki te odpowiadają celowi wyszukiwania referencji projektowych. Współczynnik sylwetkowy został użyty wyłącznie do oceny wydajności klastrowania, ponieważ SCI i SDI charakteryzują już organizację przestrzeni cech.
Rycina 9 przedstawia surowe wyniki z pięciu uruchomień dla czterech reprezentatywnych metod bez normalizacji między metodami. Rycina 9A prezentuje SCI i SDI w ich oryginalnej skali, natomiast Rycina 9B przedstawia Recall@5 i mAP jako wartości procentowe. Markery poszczególnych uruchomień oraz linie błędu odchylenia standardowego pokazują zmienność związaną z trenowaniem modelu, a nie tylko zagregowany ranking. Baseline oparty na wyglądzie osiągnął SCI na poziomie 0,62, podczas gdy proponowana metoda osiągnęła SCI wynoszące 0,81 oraz SDI wynoszące 0,71 (Tabela 3 i Rycina 9A). Wyniki SCI i SDI wskazują na silniejszą zwartość wewnątrz etykiet oraz lepszą separację między etykietami w ocenianych warunkach. Proponowana metoda osiągnęła Recall@5 na poziomie 89,2% oraz mAP na poziomie 86,4% (Tabela 3 i Rycina 9B). Te metryki wyszukiwania oceniają różne właściwości rankingu i są interpretowane oddzielnie od SCI i SDI. Spójna kolejność metod w czterech metrykach wskazuje na zgodność między jakością reprezentacji a wydajnością wyszukiwania, ale nie oznacza to, że względna poprawa jest identyczna we wszystkich czterech wymiarach oceny.
Eksperymenty ablacyjne i analiza skuteczności modułów strukturalnych
Eksperyment ablacyjny porównuje pełny model z wariantami, w których usunięto a priori strukturę lub moduł fuzji. Wszystkie trzy konfiguracje wykorzystują te same obrazy referencyjne i docelowe, co umożliwia bezpośrednie porównanie odpowiedzi tła oraz koncentracji lokalizacji. Wariant bez a priori struktury usuwa graf komponentów odzieży na poziomie obrazu oraz powiązane z nim ograniczenia relacji, polegając wyłącznie na konwolucyjnym szkielecie w celu ekstrakcji cech wyglądu; wariant bez fuzji zachowuje inferencję grafu, ale usuwa piramidę cech, wykorzystując jedynie semantyczne cechy wysokiego poziomu. Wizualizowane mapy ciepła różnic ujawniają specyficzne role każdego modułu w tłumieniu szumów i definiowaniu granic; jakościowe porównanie odpowiedzi różnic strukturalnych w różnych konfiguracjach modułów przedstawiono na Ryc. 10.
Mapy odpowiedzi na Rysunku 10C–E zostały wygenerowane przy użyciu wspólnej skali odpowiedzi i identycznych ustawień nałożenia. Wariant bez struktury a priori (structure prior) wykazał silną aktywację w lewym tle oraz wokół niezwiązanych obszarów otoczenia, co przedstawiono na Rysunku 10C. Wariant bez modułu fuzji zredukował część tej odpowiedzi poza obszarem odzieży, lecz nadal wykazywał szersze rozproszenie na dolnej części odzieży i w otaczającym obszarze po prawej stronie, jak pokazano na Rysunku 10D. Pełny model dodatkowo skoncentrował dominującą odpowiedź w stronę głównego pierwszego planu odzieży, co przedstawiono na Rysunku 10E. Rysunek 10F bezpośrednio wizualizuje różnicę w odpowiedziach ograniczonych do pierwszego planu pomiędzy wariantem bez fuzji a pełnym modelem, wykazując, że pełny model tłumi resztkowe rozproszenie boczne, zachowując jednocześnie główną odpowiedź zgodną z kształtem odzieży. Wyniki te wskazują, że struktura a priori głównie zredukowała szum otoczenia, a moduł fuzji dodatkowo poprawił koncentrację odpowiedzi i dopasowanie strukturalne. Rysunek 10E reprezentuje relatywną poprawę, a nie całkowite usunięcie aktywacji tła.
Tabela 4 przedstawia wartości SCI, SDI oraz Recall@5 dla wariantów bez priorytetu strukturalnego, bez modułu fuzji oraz dla pełnego modelu. Usunięcie priorytetu strukturalnego obniżyło SCI z 0,81 do 0,65 oraz Recall@5 z 89,2% do 74,5%. Usunięcie modułu fuzji obniżyło SDI z 0,71 do 0,64 oraz Recall@5 z 89,2% do 85,1%, co stanowi spadek o 4,1 punktu procentowego. Wyniki te wskazują, że priorytet strukturalny miał większy wpływ na spójność strukturalną i wyszukiwanie, podczas gdy fuzja cech poprawiła dopasowanie między informacjami o wyglądzie a informacjami strukturalnymi.
Analiza wydajności porównuje koszt obliczeniowy pełnego modelu z bazowym modelem ResNet-50. Bazowy model ResNet-50 wymagał 25,6 miliona parametrów i 4,1 miliarda operacji zmiennoprzecinkowych. Pełny model uwzględniający strukturę wymagał 29,3 miliona parametrów i 5,4 miliarda operacji zmiennoprzecinkowych. Średni czas inferencji wynosił 15 milisekund na obraz dla modelu bazowego i 22 milisekundy na obraz dla pełnego modelu, co stanowi wzrost o 7 milisekund. Wynik ten wskazuje na mierzalny koszt obliczeniowy, który należy wziąć pod uwagę podczas wdrażania protokołu w procesach pracy wrażliwych na czas (Tabela 5)). Waga ograniczenia strukturalnego została określona na podstawie zbioru walidacyjnego przed końcową ewaluacją testową. Wskaźnik Validation Recall@5 badano dla wag ograniczenia strukturalnego wynoszących 0,1, 0,3, 0,5, 0,8, 1,0, 1,2, 1,5 oraz 2,0. Wagę 1,0 ustalono na stałe dla każdego kolejnego procesu trenowania i testowania. Rysunek 11 dokumentuje wybór wagi ograniczenia strukturalnego 1,0 na podstawie walidacji.
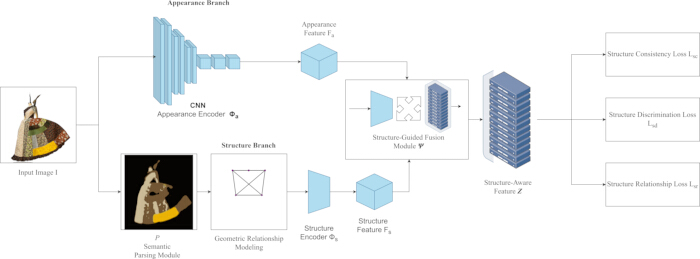
Rycina 1: Ogólny schemat protokołu uczenia cech obrazów odzieży z uwzględnieniem struktury. Wejściowy obraz odzieży jest przetwarzany przez gałąź cech wyglądu oraz gałąź cech strukturalnych, która wykorzystuje analizę semantyczną i modelowanie grafów przestrzennych. Obie reprezentacje są przetwarzane przez moduł fuzji sterowany strukturą w celu wygenerowania końcowej cechy uwzględniającej strukturę. Strata spójności strukturalnej, strata dyskryminacji strukturalnej oraz strata relacji strukturalnych wspólnie ograniczają przestrzeń cech. Rycina pokazuje, w jaki sposób wygląd odzieży i topologia komponentów są integrowane podczas uczenia cech. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
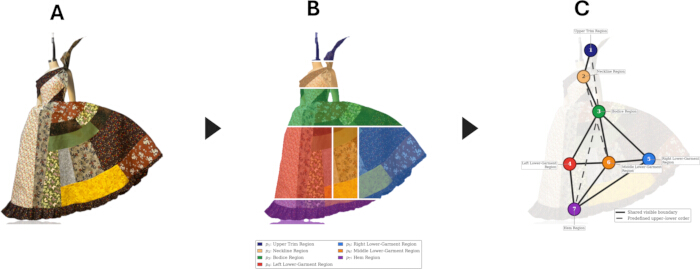
Rycina 2: Konstrukcja topologii komponentów odzieży na poziomie obrazu. (A) Wejściowy obraz odzieży I. (B) Mapa komponentów wizualnych ograniczona do pierwszego planu P, w której siedem kolorów oznacza regiony odzieży na poziomie obrazu. Wszystkie piksele tła są wykluczone z kanałów komponentów. (C) Graf relacji komponentów na poziomie obrazu G. Węzły reprezentują widoczne regiony odzieży, krawędzie ciągłe reprezentują wspólne granice pierwszego planu, a relacje przerywane reprezentują zdefiniowaną kolejność pionową. Mapa i graf wspierają wyszukiwanie obrazów i porównywanie struktur wizualnych. Nie reprezentują one elementów wykrojów, geometrii szwów, struktur zaszewek, parametrów stopniowania ani instrukcji krojenia. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
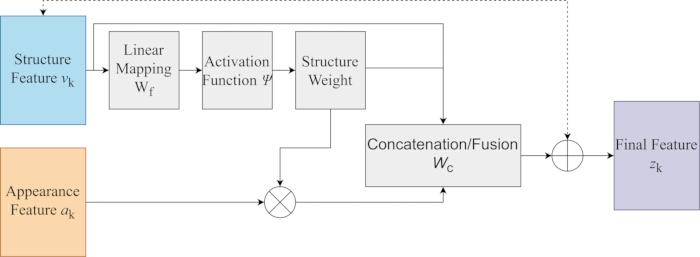
Rysunek 3: Moduł fuzji cech kierowanej strukturą. Cecha strukturalna jest przekształcana przez mapowanie liniowe i funkcję aktywacji Ψ w celu wygenerowania wagi struktury. Waga struktury moduluje cechę wyglądu poprzez mnożenie element po elemencie. Zmodulowana cecha wyglądu oraz cecha strukturalna są łączone (konkatenowane) i rzutowane przez Wc, po czym dodawana jest rezydualna cecha strukturalna w celu wygenerowania końcowej cechy komponentu. Rysunek pokazuje, że informacje strukturalne regulują ważenie cech wyglądu przed końcową fuzją. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
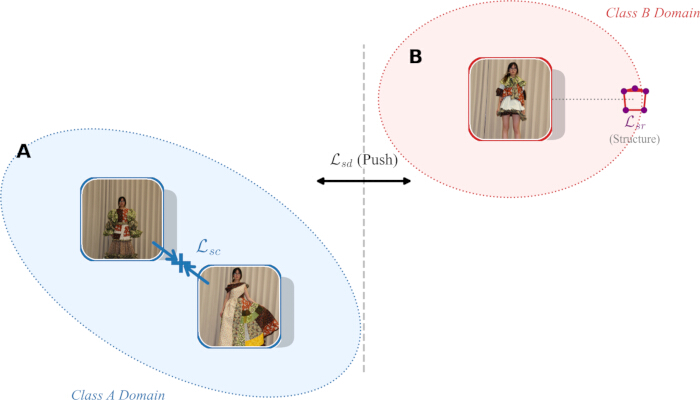
Rycina 4: Optymalizacja przestrzeni cech pod kątem ograniczeń spójności strukturalnej. (A) Próbki należące do tej samej klasy strukturalnej są przybliżane do siebie poprzez stratę spójności struktury (structure consistency loss), podczas gdy relacje między ich wewnętrznymi komponentami są zachowane dzięki stracie relacji strukturalnej (structure relationship loss). (B) Próbki z różnych klas strukturalnych są od siebie oddalane za pomocą straty dyskryminacji struktury (structure discrimination loss). Rycina pokazuje, w jaki sposób trzy cele strukturalne wspólnie zwiększają zwartość wewnątrzklasową oraz separację międzyklasową. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
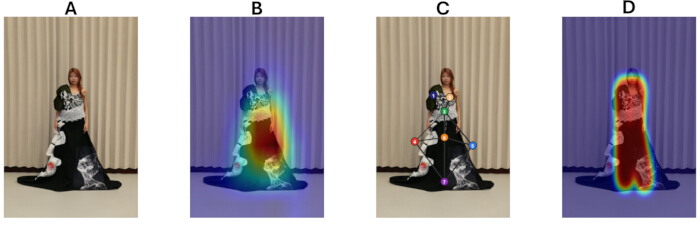
Rycina 5: Reprezentatywne odpowiedzi cech odzieży i wizualizacja grafu komponentów. (A) Wejściowy obraz odzieży. (B) Odpowiedź aktywacji klas dla bazowego modelu wyglądu ResNet-50. (C) Graf komponentów odzieży na poziomie obrazu został zrekonstruowany z mapy komponentów ograniczonej do pierwszego planu, macierzy centrów komponentów, typowanej macierzy sąsiedztwa, maski węzłów nieaktywnych oraz mapowania etykiet komponentów, które zostały zapisane podczas sekcji 3 i 4 protokołu. Węzły oznaczają aktywne obszary odzieży, krawędzie ciągłe oznaczają wspólne granice pierwszego planu, a krawędzie przerywane oznaczają zdefiniowane relacje porządku pionowego. (D) Odpowiedź aktywacji zintegrowanej reprezentacji uwzględniającej komponenty. Porównanie pokazuje różnicę między aktywacją zdominowaną przez teksturę a aktywacją kierowaną przez obszary odzieży. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
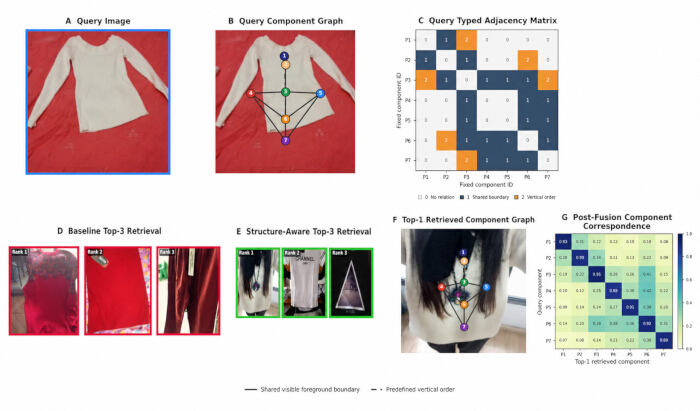
Rysunek 6: Wyniki wyszukiwania i pośrednie dowody strukturalne przy zakłóceniach w postaci czerwonego tła. (A) Obraz zapytania. (B) Graf komponentów zapytania wygenerowany z zapisanych środków komponentów i typowanej macierzy sąsiedztwa. (C) Typowana macierz sąsiedztwa zapytania, w której wartości macierzy rozróżniają relacje nieaktywne, wspólne granice pierwszego planu oraz predefiniowane relacje porządku pionowego. (D) Trzy najlepsze wyniki wyszukiwania uzyskane za pomocą bazowej metody wyglądu. (E) Trzy najlepsze wyniki uzyskane za pomocą reprezentacji uwzględniającej strukturę. (F) Graf komponentów najwyżej ocenionego wyniku uwzględniającego strukturę. (G) Macierz korespondencji komponentów po fuzji między zapytaniem a najwyżej ocenionym wynikiem. Wysoka korespondencja na przekątnej wskazuje na zgodność między komponentami o tych samych identyfikatorach, natomiast słabe lub przesunięte odpowiedzi wskazują na brak lub niezgodność organizacji komponentów. Wyniki wyszukiwania zachowują ogólną kategorię górnej części ciała, ale nie wykazują pełnej zgodności w konfiguracji rękawów i topologii lokalnej. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
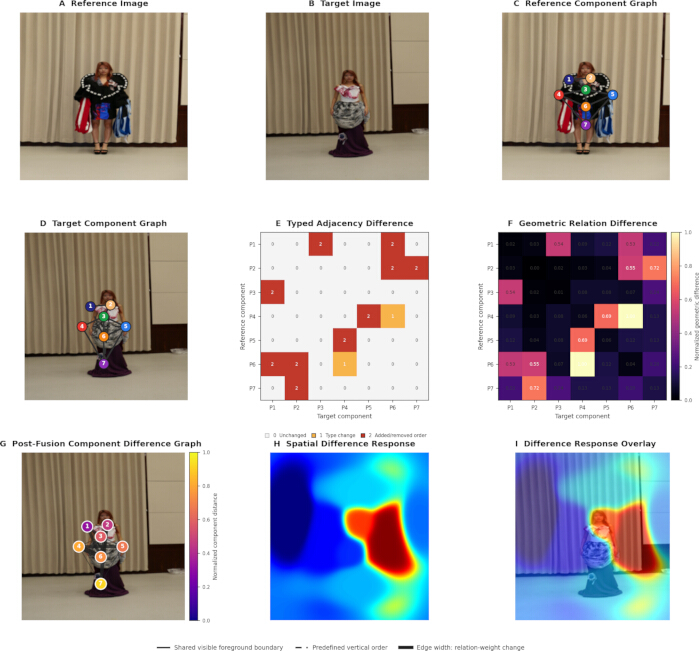
Rycina 7: Śledzenie różnic strukturalnych od topologii odzieży na poziomie obrazu do odpowiedzi przestrzennej. (A) Obraz referencyjny. (B) Obraz docelowy. (C) Graf komponentów referencyjny. (D) Graf komponentów docelowy. Oba grafy zostały zrekonstruowane z zapisanych środków komponentów i typowanych macierzy sąsiedztwa. (E) Typowana macierz różnic sąsiedztwa. (F) Różnica relacji geometrycznych jest wyprowadzona z przesunięcia środków komponentów, dyspersji przestrzennej i zmian wag relacji. (G) Graf różnic komponentów po fuzji, gdzie intensywność węzła reprezentuje znormalizowaną odległość między odpowiadającymi sobie zfuzjowanymi wektorami komponentów, a szerokość krawędzi reprezentuje zmianę wagi relacji. (H) Mapa ciepła czystej odpowiedzi na różnice przestrzenne została wyrenderowana przy użyciu tej samej stałej skali odpowiedzi co nakładka. (I) Odpowiedź nałożona na obraz docelowy. Różnica strukturalna jest akceptowana tylko wtedy, gdy zmiana sąsiedztwa, zmiana relacji geometrycznych, zmiana odległości komponentów i odpowiedź cieplna wyrównana do pierwszego planu pozostają spójne. Aktywacja tła bez odpowiadających jej dowodów na istnienie komponentów lub relacji jest traktowana jako interferencja szczątkowa, a nie jako rzeczywista różnica w strukturze odzieży. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
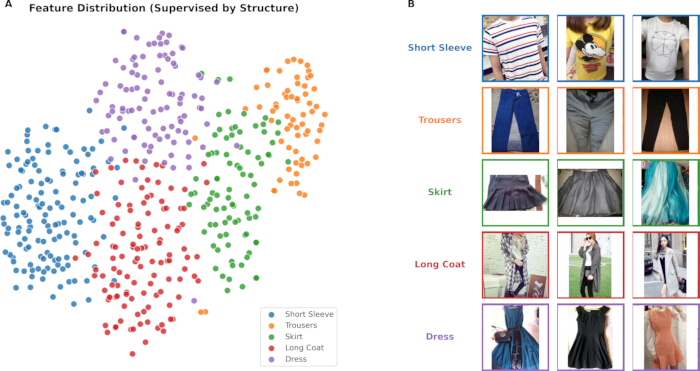
Rysunek 8: Klastrowanie w przestrzeni cech z uwzględnieniem struktury. (A) Projekcja t-SNE dla bluzek z krótkim rękawem, spodni, spódnic, długich płaszczy i sukienek. Pięć kategorii tworzy główne obszary cech z ograniczonym nakładaniem się w pobliżu granic między nimi. (B) Reprezentatywne obrazy testowe przypisane do pięciu kategorii odzieży, gdzie kolor obramowania odpowiada kolorowi kategorii w części (A). Rysunek przedstawia organizację strukturalną na poziomie kategorii, zachowując niewielką liczbę próbek w pobliżu sąsiadujących obszarów kategorii. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
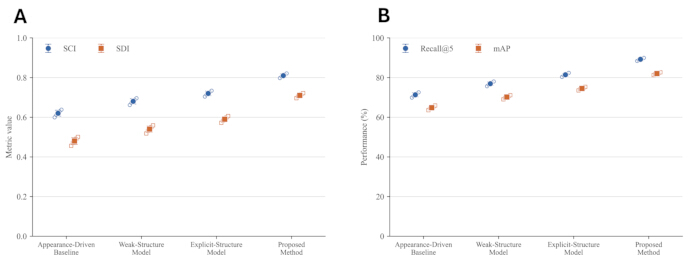
Rysunek 9: Porównanie surowej wydajności w odniesieniu do struktury przestrzeni cech i celów rankingu wyszukiwania. (A) SCI i SDI dla modelu bazowego opartego na wyglądzie, modelu o słabej strukturze, modelu o jawnej strukturze oraz proponowanej metody. (B) Recall@5 i mAP dla tych samych czterech metod. Duże znaczniki oznaczają średnią arytmetyczną z pięciu niezależnych uruchomień, linie błędów oznaczają odchylenie standardowe próbki, a małe znaczniki oznaczają wyniki poszczególnych uruchomień. SCI i SDI są przedstawione w stałej skali od zera do jednego, natomiast Recall@5 i mAP są przedstawione w stałej skali procentowej od zera do stu. Nie zastosowano normalizacji min-max ani przeskalowania między metodami. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
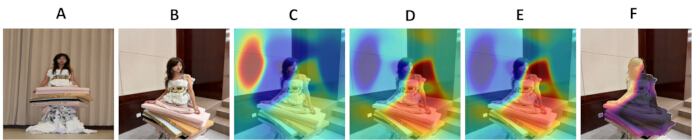
Rysunek 10: Odpowiedzi dotyczące różnic strukturalnych przy różnych konfiguracjach modułów. (A) Obraz referencyjny. (B) Obraz docelowy. (C) Odpowiedź wariantu bez priorytetu strukturalnego. (D) Odpowiedź wariantu bez modułu fuzji. (E) Odpowiedź pełnego modelu. (C–E) zostały wyrenderowane przy użyciu tej samej znormalizowanej skali odpowiedzi, mapy kolorów i ustawień nakładki. (F) Absolutna różnica odpowiedzi ograniczona do pierwszego planu pomiędzy wariantem bez fuzji a pełnym modelem. Pełny model zachowuje główną odpowiedź wyrównaną do garderoby, redukując jednocześnie rozproszenie resztkowe poza głównym obszarem strukturalnym. Porównanie pokazuje, że priorytet strukturalny redukuje zakłócenia poza obszarem garderoby, a moduł fuzji dodatkowo wyostrza odpowiedź strukturalną. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
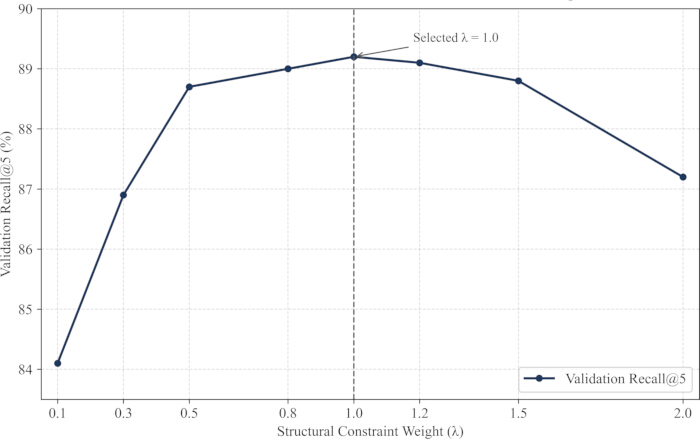
Rycina 11: Wybór wagi ograniczenia strukturalnego w oparciu o walidację. Wartość Validation Recall@5 przedstawiono dla wag ograniczenia strukturalnego wynoszących 0.1, 0.3, 0.5, 0.8, 1.0, 1.2, 1.5 oraz 2.0. Każdy punkt oznacza średnią arytmetyczną z pięciu cykli walidacji, a każda linia błędu oznacza odchylenie standardowe próbki. Przed końcową ewaluacją testową wagę ustalono na poziomie 1.0. Rycina ta dokumentuje procedurę wyboru parametrów i nie stanowi niezależnego wkładu architektonicznego. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
Tabela 1: Alokacja zbioru danych i statystyki topologii na poziomie obrazu dla podzbiorów odzieży od S1 do S5. Tabela przedstawia liczbę obrazów treningowych, walidacyjnych, testowych oraz całkowitą, wraz ze średnią liczbą komponentów semantycznych, liczbą aktywnych węzłów, liczbą krawędzi typowanych oraz liczbą adnotowanych punktów charakterystycznych w płaszczyźnie obrazu dla każdego poziomu strukturalnego. Wszystkie wartości zostały wygenerowane z przetworzonych manifestów danych. Liczba obrazów treningowych, walidacyjnych i testowych została uzyskana z końcowych manifestów podzbiorów po przeglądzie strukturalnym, kontroli grup duplikatów i inspekcji wycieku danych, natomiast statystyki topologii obliczono z końcowych rekordów grafów, stosując ten sam porządek komponentów i definicje relacji, co podczas oceny modelu. Kliknij tutaj, aby pobrać ten plik.
Tabela 2: Środowisko obliczeniowe, konfiguracja wejściowa, augmentacja, reprezentacja, optymalizacja, strata oraz ustawienia odtwarzalności stosowane w całym protokole. Tabela zawiera dokładne wersje systemu operacyjnego, procesora, zainstalowanej pamięci, jednostki przetwarzania graficznego, pamięci graficznej, sterownika graficznego, CUDA, cuDNN, Pythona, NumPy, PyTorch i torchvision wraz z rozmiarem obrazu, konstrukcją partii (batch), optymalizatorem, harmonogramem tempa uczenia, liczbą epok, ziarnami liczb losowych, wymiarami reprezentacji oraz wagami celów strukturalnych. Każda wartość jest powiązana z plikiem software_versions.txt, configs/protocol.yaml lub odpowiednim zapisem treningowym. Prosimy kliknąć tutaj, aby pobrać ten plik.
Tabela 3: Ilościowe porównanie ogólnych modeli reprezentacji wizualnej, modeli odzieży opartych na grafach oraz specyficznych dla domeny metod wyszukiwania mody. Tabela przedstawia koncentrację wyszukiwania, modalność zapytania, SCI, SDI, Recall@5, mAP oraz współczynnik sylwetki dla jedenastu metod przy tych samych partycjach danych i protokole ewaluacji. Każda metryka jest raportowana jako średnia i odchylenie standardowe próbki z pięciu niezależnych uruchomień. Raportowane wartości p uzyskano z dwustronnych sparowanych testów t-Studenta, porównując każdą metodę porównawczą z metodą proponowaną przy użyciu wyników uzyskanych dla tych samych pięciu losowych ziarn (seeds). Metoda proponowana traktowana jest jako wiersz referencyjny. Kliknij tutaj, aby pobrać ten plik.
Tabela 4: Wyniki ablacji dla modułu struktury a priori i fuzji cech.W tabeli przedstawiono wskaźniki SCI, SDI oraz Recall@5 dla wariantu bez struktury a priori, wariantu bez modułu fuzji oraz pełnego modelu. Usunięcie struktury a priori powoduje większy spadek SCI i Recall@5, natomiast usunięcie modułu fuzji obniża SDI i dopasowanie odpowiedzi. Pełny model osiąga najwyższe wartości dla wszystkich trzech metryk. Kliknij tutaj, aby pobrać ten plik.
Tabela 5: Wydajność obliczeniowa modelu bazowego ResNet-50 oraz kompletnego modelu uwzględniającego strukturę. Tabela przedstawia liczbę trenowalnych parametrów, liczbę operacji zmiennoprzecinkowych na obraz oraz średni czas wnioskowania na obraz w identycznym środowisku sprzętowym i programowym, opisanym w Tabeli 2 oraz w Tabeli Materiałów. Oba modele wykorzystują tę samą rozdzielczość obrazu, ustawienia partii wnioskowania, operacje preprocessingu oraz procedurę pomiaru czasu. Model kompletny dodaje 3,7 miliona parametrów, 1,3 miliarda operacji zmiennoprzecinkowych oraz 7 milisekund czasu wnioskowania na obraz w stosunku do modelu bazowego. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Najbardziej krytycznymi etapami protokołu są wstępne przetwarzanie chroniące odzież oraz parsowanie komponentów semantycznych ograniczone do pierwszego planu. Centra komponentów, wartości dyspersji przestrzennej, relacje wspólnych granic, relacje porządku pionowego, wagi relacji oraz reprezentacje scalone są pochodne z wyników parsowania. Przecieki granic, scalone obszary komponentów, brakujące obszary komponentów oraz błędne przypisania kanałów propagują się podczas konstrukcji grafu i fuzji cech. Błędy te mogą prowadzić do powstania plików grafów o poprawnych wymiarach, podczas gdy reprezentowane relacje komponentów pozostają niespójne z odzieżą źródłową. W związku z tym mapa prawdopodobieństwa, ograniczenie pierwszego planu, podgląd komponentów oraz zapis jakości parsowania muszą zostać zweryfikowane przed zaakceptowaniem priorytetu strukturalnego.
Konstrukcja grafu i fuzja cech wymagają ustalonej kolejności komponentów semantycznych. Graf jest wyprowadzony z komponentów odzieży znajdujących się na pierwszym planie oraz ich relacji w płaszczyźnie obrazu. Rysunki dotyczące wyszukiwania i lokalizacji różnic ujawniają ścieżkę przetwarzania strukturalnego, zamiast wyświetlać jedynie końcowe obrazy w rankingu lub mapy ciepła odpowiedzi. Typowane macierze sąsiedztwa dokumentują dyskretne relacje między komponentami, macierze relacji geometrycznych dokumentują znormalizowaną organizację przestrzenną, a macierze komponentów po fuzji dokumentują reprezentację używaną do wyszukiwania i lokalizacji. Wnioski strukturalne należy przyjąć tylko wtedy, gdy te reprezentacje pośrednie są zgodne z końcowym wynikiem wizualnym. Graf komponentów nie wykorzystuje punktów anatomicznych, współrzędnych stawów ludzkich ani sieci do estymacji pozy. Nakładkę grafu należy zaakceptować tylko wtedy, gdy jej węzły i typy relacji zostały odtworzone z zapisanych plików komponentów i sąsiedztwa. Nieaktywne komponenty powinny pozostać wektorami zerowymi z wskaźnikami nieaktywnych węzłów, a macierze cech wyglądu i cech strukturalnych muszą każda zawierać K wierszy i 512 kolumn przed fuzją. Kontrole te zapobiegają interpretowaniu błędów dopasowania węzłów i błędów wymiarowości jako zachowania modelu.
Rozwiązywanie problemów należy rozpocząć od pierwszego niewłaściwego wyniku pośredniego. Jednolite mapy prawdopodobieństwa wskazują na błędy punktów kontrolnych, normalizacji lub indeksowania kategorii; nienumeryczne macierze strukturalne wskazują na nieprawidłowe mianowniki prawdopodobieństwa lub skalowanie współrzędnych; rozproszone odpowiedzi i odzyskiwanie zdominowane przez kolory wskazują na słabe priory struktur, nieudany proces fuzji lub nieprawidłowe ładowanie punktu kontrolnego. Logi treningowe powinny potwierdzać obecność gradientów w grafie i warstwach fuzji, a także wybór punktu kontrolnego w oparciu o walidację. Wizualna odpowiedź cieplna nie powinna być stosowana jako samodzielny wniosek strukturalny. Musi ona zostać zweryfikowana z zapisaną maską pierwszego planu, wpisaną zmianą sąsiedztwa, macierzą relacji geometrycznych oraz grafem różnic komponentów po fuzji. Pozostała aktywacja poza obszarem ubrania na pierwszym planie wskazuje na ograniczoną specyficzność odpowiedzi, a nie na potwierdzoną różnicę strukturalną.
W porównaniu do wyszukiwania opartego na wyglądzie, niniejszy protokół wprowadza topologię komponentów przed uczeniem metrycznym. W przeciwieństwie do modeli grafowych o słabych więzach strukturalnych i stałej topologii, wagi relacji semantycznych dostosowują propagację grafu do aktualnej odzieży. Kompletny model osiągnął wskaźnik SCI na poziomie 0.81, SDI wynoszący 0.71, Recall@5 na poziomie 89.2%, mAP wynoszący 86.4% oraz współczynnik sylwetki wynoszący 0.74, zgodnie z danymi przedstawionymi w Tabeli 3. Dodatkowe moduły strukturalne zwiększyły liczbę parametrów z 25.6 miliona do 29.3 miliona oraz czas wnioskowania z 15 do 22 milisekund na obraz, co odnotowano w Tabeli 4. Wkład techniczny protokołu polega na konstrukcji grafu komponentów odzieży na poziomie obrazu, równoległym kodowaniu wyglądu i relacji komponentów, mechanizmie fuzji cech sterowanym strukturą oraz celach spójności strukturalnej, relacyjnej i dyskryminacyjnej. Analiza walidacyjna przedstawiona na Rysunku 11 służy jedynie określeniu stałego współczynnika uczenia i nie jest prezentowana jako wkład w architekturę sieci lub projekt funkcji celu.
Protokół pozostaje podatny na silną okluzję, nachodzące na siebie elementy garderoby, małe obrazy źródłowe, zmienność pozy, złożone tła oraz ubrania, których widoczna organizacja nie jest zgodna ze stałym schematem siedmiu regionów. Asymetryczne projekty, odpinane warstwy, gęste drapowania, wielowarstwowe dolne części garderoby oraz nachodzące na siebie regiony dekoracyjne mogą łączyć kilka regionów semantycznych lub wprowadzać relacje komponentów, które nie występują w obecnej definicji grafu. Okluzja może tłumić aktywny komponent, przesuwać jego centroid prawdopodobieństwa i usuwać poprawną relację wspólnej granicy. Rysunek 6 przedstawia odzyskanie ogólnej kategorii górnej części ciała, ale niepełne dopasowanie topologii rękawów, natomiast Rysunki 7 i 10 wykazują odpowiedzi w przyległych obszarach tła. Wyniki te pokazują, że poprawne wymiary tensorów i łączność grafu nie gwarantują semantycznie poprawnej interpretacji strukturalnej. Niniejsze badanie wspiera zatem wyszukiwanie oparte na obrazach, grupowanie i lokalizację różnic, a nie efektywność procesu projektowego lub bezpośrednią estymację parametrów wzorów. Wszystkie eksperymenty ilościowe w niniejszym badaniu zostały przeprowadzone na zachowanej i strukturalnie ponownie oznakowanej kohorcie DeepFashion2. Obecne wyniki nie potwierdzają odporności w odniesieniu do niezależnych zbiorów danych z różnymi taksonomiami odzieży, standardami adnotacji, kulturowymi kategoriami ubioru, źródłami obrazów lub środowiskami akwizycji. Przeniesienie do innego zbioru danych może wymagać ponownego mapowania siedmiu kanałów komponentów i rekonstrukcji schematu relacji typowanych. Przedstawione wnioski są zatem ograniczone do oceniającego rozkładu danych i definicji komponentów na poziomie obrazu.
W ramach tych ograniczeń protokół zapewnia powtarzalną sekwencję przejścia od obrazów odzieży do reprezentacji uwzględniających poszczególne komponenty poprzez parsing semantyczny, modelowanie relacji geometrycznych, kodowanie dwustrumieniowe oraz fuzję sterowaną strukturą. Przyszła walidacja zostanie przeprowadzona z wykorzystaniem niezależnych zbiorów danych odzieżowych o różnych systemach adnotacji, kategoriach ubrań, pozach i warunkach tła. Zostanie również zbadane, czy obecne mapowanie siedmiu regionów wymaga rozszerzenia w przypadku asymetrycznych, warstwowych, odpinanych i specyficznych kulturowo struktur odzieży. Ręcznie rysowane szkice projektowe, wariacje między różnymi tkaninami oraz parametryczna regulacja wykrojów pozostają odrębnymi kierunkami zastosowań, które wymagają specyficznych dla danego zadania danych i procedur oceny. Profesjonalna użyteczność i efektywność przeglądu projektów wymagają oddzielnie udokumentowanego badania z udziałem ludzi, z określonymi uczestnikami, kryteriami oceny i procedurami statystycznymi.
Oświadczenia
Autorzy nie deklarują żadnych konfliktów interesów.
Podziękowania
Niniejsza praca została sfinansowana w ramach drugiej partii kluczowych projektów reformy nauczania na poziomie studiów licencjackich na szczeblu prowincjonalnym w okresie 14. Planu Pięcioletniego, w ramach projektu pt. Reforma i eksploracja nauczania „Projektowania odzieży i ubioru” w oparciu o model wspólnej budowy „trzech integracji i trzech fuzji” (numer projektu JGZD2024096).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Centralna jednostka przetwarzająca | Intel Corporation | Intel Core i9-13900K, 24 rdzenie, 32 wątki, do 5,80 GHz | |
| Conda | Anaconda, Inc., anaconda.com | Miniconda3 23.11.0 | |
| Zestaw narzędzi CUDA | NVIDIA Corporation, developer.nvidia.com | CUDA 11.8 | |
| cuDNN | NVIDIA Corporation, developer.nvidia.com | cuDNN 8.9.7 | |
| Zbiór danych DeepFashion2 | Chiński Uniwersytet w Hongkongu, github.com/switchablenorms/DeepFashion2 | Oficjalne wydanie DeepFashion2, wersja 1.0 | |
| Jednostka przetwarzania graficznego | NVIDIA Corporation | NVIDIA GeForce RTX 4090, 24 GB GDDR6X | |
| Punkt kontrolny analizy semantycznej HRNet-W48 | Projekt HRNet, github.com/HRNet/HRNet-Semantic-Segmentation | hrnet_w48_garment_parser_7class.pth, punkt kontrolny projektu wersja 1.0 | |
| Wagi ResNet-50 pretrenowane na zbiorze ImageNet | PyTorch Foundation, pytorch.org | ResNet50_Weights.IMAGENET1K_V2 | |
| Matplotlib | Zespół Programistyczny Matplotlib, matplotlib.org | Wersja 3.8.2 | |
| NumPy | Programiści NumPy, numpy.org | Wersja 1.26.4 | |
| Sterownik karty graficznej NVIDIA | NVIDIA Corporation | Wersja 546.33 | |
| OpenCV-Python | Zespół OpenCV, opencv.org | Wersja 4.8.1.78 | |
| System operacyjny | Microsoft Corporation | Windows 11 Pro 23H2, 64-bit, wersja systemu 22631.3155 | |
| Pandas | Zespół programistów Pandas, pandas.pydata.org | Wersja 2.1.4 | |
| Python | Python Software Foundation, python.org | Wersja 3.10.13 | |
| PyTorch | PyTorch Foundation, pytorch.org | Wersja 2.1.2 z CUDA 11.8 | |
| PyYAML | Projekt PyYAML, pyyaml.org | Wersja 6.0.1 | |
| scikit-learn | Deweloperzy scikit-learn, scikit-learn.org | Wersja 1.3.2 | |
| SciPy | Deweloperzy SciPy, scipy.org | Wersja 1.11.4 | |
| Repozytorium kodu źródłowego | Uzupełniające archiwum kodu źródłowego przedłożone wraz z rękopisem | Protokół topologii odzieży, wersja 1.0 | |
| Urządzenie do przechowywania | Samsung Electronics | Samsung 990 PRO NVMe SSD, 2 TB | |
| Pamięć systemowa | Kingston Technology | Kingston FURY Beast DDR5, 64 GB, 2 × 32 GB, 5600 MHz | |
| torchvision | PyTorch Foundation, pytorch.org | Wersja 0.16.2 z CUDA 11.8 | |
| Stanowisko robocze | Kastomizowana stacja robocza do głębokiego uczenia | Intel Core i9-13900K, NVIDIA GeForce RTX 4090, 64 GB pamięci RAM, dysk SSD NVMe 2 TB |
Bibliografia
- Xiang Z, Zhu C, Qian M, Shen Y, Shao Y. FashionSegNet: a model for high-precision semantic segmentation of clothing images. Vis Comput. 2024;40:1711-1727. doi:10.1007/s00371-023-02881-3.
- Sun K, Zhang J, Zhang P, Yuan K, Li G. TsrNet: a two-stage unsupervised approach for clothing region-specific textures style transfer. J Vis Commun Image Represent. 2023;91:103778. doi:10.1016/j.jvcir.2023.103778.
- Yang N, Ma X. Enhanced composed fashion image retrieval with a multi-hop reasoning framework. Sci Rep. 2025;15:32217. doi:10.1038/s41598-025-17402-6.
- Karthika Priya D, Sathyabama B. FARE-RNET: fashion cloth retrieval via Egret Swarm Optimization-based Convolutional Attention Module integrated ResNet. Int J Comput Intell Syst. 2026;19:29. doi:10.1007/s44196-025-00979-1.
- Köktürk Güzel BE. Efficient image retrieval in fashion: leveraging clustering and principal component analysis for search space reduction. Erzincan Univ J Sci Technol. 2024;17:638-649. doi:10.18185/erzifbed.1500279.
- Zhang X, Sun H, Ma J. Research on clothing image retrieval combining topology features with color texture features. Mathematics. 2024;12:2363. doi:10.3390/math12152363.
- Abbas W, Zhang Z, Asim M, Chen J, Ahmad S. AI-driven precision clothing classification: revolutionizing online fashion retailing with hybrid two-objective learning. Information. 2024;15:196. doi:10.3390/info15040196.
- Shirkhani S, Mokayed H, Saini R, Hum YC. Study of AI-driven fashion recommender systems. SN Comput Sci. 2023;4:514. doi:10.1007/s42979-023-01932-9.
- Balloni E, Pietrini R, Frontoni E, Mancini A, Paolanti M. OutfitAI: shop the outfit with a deep learning-based intelligent expert system. Multimed Tools Appl. 2025;84:40195-40214. doi:10.1007/s11042-025-20753-x.
- Kachbal I, El Abdellaoui S. Computer vision for fashion: a systematic review of design generation, simulation, and personalized recommendations. Information. 2026;17:11. doi:10.3390/info17010011.
- Saranya MS, Geetha P. Cross-domain fashion cloth retrieval via novel attention-guided cascade neural network and clothing parsing. Comput Vis Image Underst. 2023;235:103777. doi:10.1016/j.cviu.2023.103777.
- Ning T, Gao Y, Han Y. Segmentation of ethnic clothing patterns with fusion of multiple attention mechanisms. Complex Intell Syst. 2024;10:5759-5770. doi:10.1007/s40747-024-01457-5.
- Jiang A, Liu L, Fu X, Liu L, Peng W. Clothing hierarchical feature representation and association learning for cross-modal fashion retrieval. J Comput Aided Des Comput Graph. 2025;37:654-667. doi:10.3724/SP.J.1089.2023-00263.
- An H, Lee KY, Choi Y, Park M. Conceptual framework of hybrid style in fashion image datasets for machine learning. Fash Text. 2023;10:18. doi:10.1186/s40691-023-00338-8.
- Adel M, Mohammed AM, Elsaid AH, Abdelatey A. Deep learning for new fashion product demand prediction: integrating visual similarity and demand correction in cold-start scenarios. Int J Data Sci Anal. 2026;22:9. doi:10.1007/s41060-025-00888-8.
- Tang Y, Ye D, Tao F, Du G. Enhanced group relation learning via aligned attention masking for fashion product captioning. J King Saud Univ Comput Inf Sci. 2025;37:170. doi:10.1007/s44443-025-00195-z.
- Lyu X, Li X, Zhang Y, Lu W. Two-stage method for clothing feature detection. Big Data Cogn Comput. 2024;8:35. doi:10.3390/bdcc8040035.
- Tang G, Yu F, Li H, Shi Y, Liu L, Peng T, et al. ClothSeg: semantic segmentation network with feature projection for clothing parsing. J Vis Commun Image Represent. 2023;97:103980. doi:10.1016/j.jvcir.2023.103980.
- Cao S, Chai W, Hao S, Zhang Y, Chen H, Wang G. DiffFashion: reference-based fashion design with structure-aware transfer by diffusion models. IEEE Trans Multimedia. 2024;26:3962-3975. doi:10.1109/TMM.2023.3318297.
- Hou J, Lu Y, Yang Y, Liu Z. PDN: a priori dictionary network for fashion parsing. Appl Sci. 2024;14:3509. doi:10.3390/app14083509.
- Moratelli N, Barraco M, Morelli D, Cornia M, Baraldi L, Cucchiara R. Fashion-oriented image captioning with external knowledge retrieval and fully attentive gates. Sensors. 2023;23:1286. doi:10.3390/s23031286.
- Islam T, Miron A, Liu X, Li Y. Deep learning in virtual try-on: a comprehensive survey. IEEE Access. 2024;12:29475-29502. doi:10.1109/ACCESS.2024.3368612.
- Yan H, Zhang H, Liu L, Zhou D, Xu X, Zhang Z, et al. Toward intelligent design: an AI-based fashion designer using generative adversarial networks aided by sketch and rendering generators. IEEE Trans Multimedia. 2023;25:2323-2338. doi:10.1109/TMM.2022.3146010.
- Xie Z, Zhou Z, Wang Z, Ding H, Ma L. Multi-scale spatial feature-guided cloth landmark estimation. J Comput Aided Des Comput Graph. 2022;34:1763-1771. doi:10.3724/SP.J.1089.2022.19189.
- Jiang J, Wu D, Deng H, Long Y, Tang W, Li X, et al. HAIGEN: towards human-AI collaboration for facilitating creativity and style generation in fashion design. Proc ACM Interact Mob Wearable Ubiquitous Technol. 2024;8:107. doi:10.1145/3678518.
- Danner M, Brake E, Kosel G, Kyosev Y, Rose K, Rätsch M, et al. AI-assisted pattern generator for garment design. Commun Dev Assem Text Prod. 2024;5:195-206. doi:10.25367/cdatp.2024.5.p195-206.
- Bao C, Zhang X, Chen J, Miao Y. MMFL-net: multi-scale and multi-granularity feature learning for cross-domain fashion retrieval. Multimed Tools Appl. 2023;82:37905-37937. doi:10.1007/s11042-022-13648-8.
- Yang G. Clothing design style recommendation using optimized semantic-preserved generative adversarial network. J Electr Syst. 2024;20 Suppl 3:2396-2409. doi:10.52783/jes.3064.
- Wang Z, Tao X, Zeng X, Xing Y, Xu Z, Bruniaux P. Design of customized garments towards sustainable fashion using 3D digital simulation and machine learning-supported human-product interactions. Int J Comput Intell Syst. 2023;16:16. doi:10.1007/s44196-023-00189-7.
- Wu J, Huang Y, Gao M, Gao Z, Zhao J, Zhang H, et al. A two-stream hybrid convolution-transformer network architecture for clothing-change person re-identification. IEEE Trans Multimedia. 2024;26:5326-5339. doi:10.1109/TMM.2023.3331569.
- Khalid M, Keming M, Hussain T. Design and implementation of clothing fashion style recommendation system using deep learning. Rom J Inf Technol Autom Control. 2021;31:123-136. doi:10.33436/v31i4y202110.
- Wang Y, Liu L, Fu X, Liu L. MCCP: multi-modal fashion compatibility and conditional preference model for personalized clothing recommendation. Multimed Tools Appl. 2024;83:9621-9645. doi:10.1007/s11042-023-15659-5.
- Ma J, Sun H, Yang D, Zhang H. Personalized fashion recommendations for diverse body shapes and local preferences with contrastive multimodal cross-attention network. ACM Trans Intell Syst Technol. 2024;15:82. doi:10.1145/3637217.
- Yu Z, Zhao Y, Hong B, Jin Z, Huang J, Cai D, et al. Apparel-invariant feature learning for person re-identification. IEEE Trans Multimedia. 2022;24:4482-4492. doi:10.1109/TMM.2021.3119133.
- Peng D, Liu R, Lu J, Zhang S. Unsupervised multi-modal modeling of fashion styles with visual attributes. Appl Soft Comput. 2022;115:108214. doi:10.1016/j.asoc.2021.108214.
- Mathews A, Sejal N, Venugopal KR. Analysis of content based image retrieval using deep feature extraction and similarity matching. Int J Adv Comput Sci Appl. 2022;13:646-655. doi:10.14569/IJACSA.2022.0131277.
- Zhang C, Ji X, Cai L. Clothing recommendation with multimodal feature fusion: price sensitivity and personalization optimization. Appl Sci. 2025;15:4591. doi:10.3390/app15084591.
- Zhao M, Gao S, Ma J, Zhang Z. Joint clothes image detection and search via anchor-free framework. Neural Netw. 2022;155:84-94. doi:10.1016/j.neunet.2022.08.011.
- Fontanini T, Ferrari C. Would your clothes look good on me? Towards transferring clothing styles with adaptive instance normalization. Sensors. 2022;22:5002. doi:10.3390/s22135002.
- Kim S, Moon H, Oh J, Lee Y, Kwon H, Kim S. Automatic measurements of garment sizes using computer vision deep learning models and point cloud data. Appl Sci. 2022;12:5286. doi:10.3390/app12105286.
- Chang YH, Zhang YY. Deep learning for clothing style recognition using YOLOv5. Micromachines. 2022;13:1678. doi:10.3390/mi13101678.
- de Medeiros Dantas IJ, Curth M, Freire AG. Exploring databases for training models in machine learning in the fashion industry. DAT J. 2024;9:157-174. doi:10.29147/datjournal.v9i2.877.
- Zhu S, Zou X, Qian J, Wong WK. Learning structured relation embeddings for fine-grained fashion attribute recognition. IEEE Trans Multimedia. 2024;26:1652-1664. doi:10.1109/TMM.2023.3284593.