Niniejsze badanie przedstawia dwuetapowy model klasyfikacji pokrycia terenu z wykorzystaniem danych hiperspektralnych i LiDAR, wykorzystujący ekstrakcję cech MetaFormer oraz dwukierunkowe dopasowanie przepływu (bidirectional flow matching) w celu wyrównania międzymodalnego przed fuzją. Ewaluacja przeprowadzona na trzech publicznych zbiorach danych referencyjnych wykazuje konkurencyjną skuteczność klasyfikacji w ramach ustalonych protokołów testowych.
Artykuł badawczy
Ciągłe uczenie krzyżomodalnych pól wektorowych w klasyfikacji pokrycia terenu na podstawie danych hiperspektralnych i LiDAR
W tym artykule
Podsumowanie
Streszczenie
Klasyfikacja w ramach multimodalnego teledetekcji odgrywa istotną rolę w takich zastosowaniach, jak mapowanie obszarów miejskich i monitorowanie środowiska. Jednak heterogeniczne rozkłady cech w różnych modalnościach pomiarowych mogą prowadzić do niedopasowania cech i niespójności semantycznej, co ogranicza skuteczność fuzji multimodalnej. Istniejące podejścia do fuzji multimodalnej, w tym metody splotowe, oparte na grafach, mechanizmach uwagi, metodach kontrastowych, transportowych oraz sekwencyjnych, potrafią wykorzystać informacje komplementarne, lecz mogą nie dopasować w sposób wystarczający rozkładów cech specyficznych dla danej modalności. Niniejsze badanie proponuje FlowErs, dwuetapowy framework klasyfikacji multimodalnej, który rozwiązuje ten problem poprzez dopasowanie przepływu multimodalnego (multimodal flow matching). Hipoteza robocza zakłada, że redukcja rozbieżności w sparowanych rozkładach cech przed fuzją cech poprawia klasyfikację pokrycia terenu w ramach ustalonych protokołów referencyjnych. W pierwszym etapie specyficzne dla modalności koder MetaFormer ekstrahują reprezentacje hierarchiczne z obrazowania hiperspektralnego (HSI) oraz danych LiDAR (light detection and ranging). Następnie moduł dopasowania przepływu multimodalnego uczy się uwarunkowanych czasowo pól prędkości w celu transportu sparowanych rozkładów cech w stronę wspólnej reprezentacji latentnej, wykorzystując dwukierunkowy cel błędu średniokwadratowego. W drugim etapie przetrenowany moduł dopasowania jest ponownie wykorzystywany do wyrównania reprezentacji multimodalnych przed przeprowadzeniem klasyfikacji na poziomie pikseli przez lekki moduł fuzji. Ewaluacja na trzech publicznych zbiorach danych referencyjnych wykazała maksymalną ogólną dokładność (OA) na poziomie 97,56% przy stałym podziale zbiorów. Wyniki różniły się w zależności od poszczególnych klas pokrycia terenu; w badaniu omówiono ograniczenia specyficzne dla klas oraz wpływ niezrównoważenia klas na metryki zagregowane. Obecna ewaluacja ogranicza się do eksperymentów ze stałym podziałem, bez statystycznej analizy powtórzeń lub profilowania obliczeniowego. Przyszłe prace będą dotyczyć odporności statystycznej, wydajności obliczeniowej oraz generalizacji międzyregionalnej.
Wprowadzenie
Precyzyjna klasyfikacja użytkowania i pokrycia terenu (LULC) z wykorzystaniem obrazowania teledetekcyjnego jest niezbędna w szerokim zakresie praktycznych zastosowań, w tym w rozwoju urbanistycznym, monitorowaniu środowiska, zarządzaniu kryzysowym oraz zrównoważonym rozwoju1. W ostatnich latach coraz większą dostępność zyskały multimodalne dane teledetekcyjne, w tym obrazowanie hiperspektralne (HSI), detekcja i pomiar odległości światłem (LiDAR) oraz radar z syntetyczną aperturą (SAR). Zwiększona dostępność tych danych znacząco rozszerzyła możliwości teledetekcji w zakresie szczegółowej klasyfikacji pokrycia terenu2. Te tryby detekcji rejestrują odmienne, lecz uzupełniające się charakterystyki powierzchni Ziemi. HSI dostarcza bogatych informacji spektralnych służących do charakterystyki składu materiałowego, podczas gdy LiDAR zapewnia dokładne informacje strukturalne i wysokościowe3. Integracja tych heterogenicznych źródeł danych może pozwolić na stworzenie bardziej dyskryminujących, odpornych na szumy i semantycznie kompleksowych reprezentacji cech niż w przypadku stosowania pojedynczego trybu detekcji4.
Niemniej jednak, efektywne wykorzystanie danych multimodalnych pozostaje długotrwałym wyzwaniem5. Główna trudność wynika z przyrodzonej heterogeniczności modalności sensorycznych, które różnią się rozdzielczością przestrzenną, charakterystyką szumów, rozkładami statystycznymi i semantyką cech6. Na przykład ten sam obiekt pokrycia terenu może być reprezentowany jako wysokowymiarowa sygnatura widmowa w HSI oraz jako rzadkie struktury geometryczne w LiDAR7. W konsekwencji cechy specyficzne dla danej modalności często znajdują się na różnych rozmaitościach cech, co sprawia, że bezpośrednia fuzja cech jest nieefektywna lub potencjalnie błędna. Co więcej, wiele istniejących podejść do fuzji multimodalnej, w tym metody oparte na konwolucjach, mechanizmach uwagi i Transformerach,B przyjmuje implicitnie założenie, że cechy wyekstrahowane z różnych czujników są już wyrównane przestrzennie i semantycznie8. Jednak w praktycznych zastosowaniach założenie to często okazuje się nieprawdziwe. Prosta konkatenacja cech lub fuzja na poziomie pikseli nie pozwala na odpowiednie uchwycenie rozbieżności międzymodalnych, co może prowadzić do niestabilnej optymalizacji i obniżenia zdolności do generalizacji. Ponadto, choć metody fuzji oparte na mechanizmach uwagi poprawiają interakcję cech, mogą one oferować ograniczone modelowanie dalekosiężnych zależności międzymodalnych, które są niezbędne dla wielkoskalowej lub wysokorozdzielczej klasyfikacji pokrycia terenu9. W rezultacie skuteczne wyrównanie heterogenicznych reprezentacji cech pozostaje głównym wyzwaniem w multimodalnym teledetekcji, ponieważ niekompatybilne osadzenia mogą ograniczać integrację informacji komplementarnych.
Aby stawić czoła temu wyzwaniu, dopasowanie między modalnościami zostało sformułowane jako problem warunkowego transportu cech. Dopasowanie przepływu (flow matching) zapewnia matematycznie uzasadnione ramy dla uczenia się ciągłych i odwracalnych odwzorowań pomiędzy heterogenicznymi rozkładami cech10. Transportuje ono jeden rozkład w kierunku innego poprzez zależne od czasu pole prędkości sparametryzowane za pomocą zwykłego równania różniczkowego (ODE), co sprzyja ciągłym transformacjom pomiędzy rozmaitościami cech11. W przeciwieństwie do modeli opartych na dyfuzji, które polegają na stochastycznych perturbacjach szumem lub ukrytym dopasowaniu rozkładów poprzez trening przeciwstawny, dopasowanie przepływu uczy się deterministycznych, bijektywnych transformacji pomiędzy ustrukturyzowanymi przestrzeniami cech12. Te właściwości sprawiają, że dopasowanie przepływu jest dobrze dostosowane do multimodalnego teledetekcji, gdzie HSI, LiDAR i SAR reprezentują odpowiednio wysokowymiarowe rozmaitości cech, które przechwytują komplementarne właściwości powierzchni Ziemi13. W związku z tym, dopasowanie przepływu zapewnia systematyczne podejście do ustanawiania korespondencji między modalnościami poprzez ciągły transport cech, promując jednocześnie spójność geometryczną podczas dopasowania cech. Przy odpowiednich założeniach regularności, przepływ ODE może zapewnić odwzorowanie odwracalne; jednak dokładna odwracalność i interpretowalność fizyczna nie zostały empirycznie ocenione w niniejszym badaniu. Hipoteza robocza zakłada, że zmniejszenie rozbieżności w sparowanych rozkładach cech przed fuzją cech poprawia zagregowaną klasyfikację pokrycia terenu przy stałych podziałach benchmarkowych.
Kierując się tymi rozważaniami, proponowana struktura, FlowErs, wprowadza etap dopasowania oparty na przepływie (flow-based alignment) w ramach architektury dwuetapowej. W pierwszym etapie trenowana jest dwukierunkowa sieć przepływu, aby dopasować rozmaitości cech każdej modalności. Konkretnie, specyficzne dla danej modalności szkielety MetaFormer ekstrahują hierarchiczne osadzenia cech, a cel dopasowania przepływu (flow-matching objective) jest optymalizowany w celu transportu próbek między specyficznymi dla modalności rozkładami cech. Proces ten zapewnia gładką i odwracalną transformację między przestrzeniami cech, co sprzyja ściślejszemu dopasowaniu reprezentacji należących do tej samej klasy semantycznej w obrębie wspólnej domeny latentnej. W drugim etapie wstępnie wytrenowany moduł dopasowania przepływu zostaje zamrożony, a nowe wejścia multimodalne są transformowane przed połączeniem przez lekki klasyfikator. Ta rozdzielona strategia trenowania oddziela dopasowanie geometryczne od klasyfikacji semantycznej, co pozwala obu etapom na optymalizację komplementarnych celów. Moduł dopasowania ma na celu zmniejszenie rozbieżności w rozkładach cech przed fuzją cech i nie pretenduje do udowodnionej gwarancji zachowania objętości. Ponadto FlowErs zapewnia jawne sformułowanie transportu cech dla fuzji multimodalnej, choć odporność na błędy rejestracji nie została w niniejszym badaniu oceniana oddzielnie.
Główne wkłady niniejszego badania podsumowano w następujący sposób. Przedstawiono FlowErs jako dwuetapowy schemat dla multimodalnej klasyfikacji pokrycia terenu. W proponowanym schemacie cechy specyficzne dla danej modalności są najpierw ekstrahowane przy użyciu enkoderów MetaFormer, a następnie wyrównywane poprzez moduł oparty na przepływie przed lekką fuzją cech. Ta rozdzielona architektura umożliwia efektywną optymalizację przy jednoczesnym zachowaniu elastyczności w różnych modalnościach teledetekcyjnych. Ponadto w badaniu tym zbadano warunkowe dopasowanie przepływu jako mechanizm transportu cech dla sparowanego, międzymodalnego wyrównywania cech w multimodalnej teledetekcji. Dwukierunkowy moduł przepływu przewiduje przeciwstawne cele prędkości dla sparowanych reprezentacji cech przed fuzją cech, zapewniając tym samym jawną strategię wyrównywania przed integracją multimodalną. Co więcej, proponowany schemat został oceniony na trzech publicznych zbiorach danych referencyjnych, osiągając maksymalną ogólną dokładność (OA) na poziomie 97,56% przy zastosowaniu dostarczonych stałych podziałów zestawów danych. W pracy wyraźnie udokumentowano również ograniczenia na poziomie klas oraz zakres obecnej oceny.
Ostatnie postępy w dziedzinie dopasowania przepływu (flow matching) ugruntowały jego pozycję jako potężnego frameworka modelowania generatywnego, który jednoczy modele oparte na dyfuzji, energii i transporcie. Zamiast symulować trajektorie stochastyczne, jak w modelach dyfuzyjnych, flow matching uczy deterministycznego równania różniczkowego zwyczajnego (ODE), które transportuje prosty rozkład a priori, taki jak szum gaussowski, do docelowego rozkładu danych za pomocą uczenia się pola prędkości15. Taka sformułowanie bezpośrednio wiąże estymację wyniku (score estimation) z ewolucją gęstości, co skutkuje gładszymi trajektoriami prawdopodobieństwa i bardziej stabilną dynamiką uczenia. Kluczową zaletą flow matching jest jego deterministyczny i wydajny obliczeniowo charakter. Modele przepływu prostowanego (rectified flow models)16 dodatkowo upraszczają trajektorie transportu do niemal linii prostych, co poprawia stabilność numeryczną i umożliwia generowanie wysokiej jakości próbek przy stosunkowo niewielkiej liczbie kroków całkowania. Kolejne badania, w tym modele spójności (consistency models)17, włączyły cele inspirowane dyfuzją do kompaktowych frameworków opartych na przepływie, aby osiągnąć porównywalną lub lepszą jakość próbek przy wydajnej inferencji. Ponadto uczenie oparte na przepływie może wykorzystywać wstępnie wytrenowane szkielety dyfuzyjne (diffusion backbones), co ułatwia stosowanie wielkoskalowych generatywnych rozkładów a priori przy jednoczesnym obniżeniu kosztów próbkowania. Ostatnie studia rozszerzyły zastosowanie flow matching na szeroki zakres aplikacji. Na przykład Hu i wsp.18 zbadali szkielety transformerowe oraz manipulacje w przestrzeni utajonej w celu kontrolowanej i kompozycyjnej edycji obrazów przy użyciu flow matching. Inne zastosowania obejmują syntezę obrazów19, diagnostykę uszkodzeń łożysk20 oraz wielocelowe, wielkoszewowe spawanie robotyczne21. Wspólnie badania te wykazują, że flow matching znajduje zastosowanie poza wysokorozdzielczą i warunkową syntezą obrazów, zapewniając jednocześnie ugruntowane podstawy teoretyczne z potencjałem do generalizacji domenowej. Poprzez uczenie się ciągłych, deterministycznych map transportu, flow matching zapewnia równowagę między wydajnością, sterowalnością a wiernością generatywną. Jego sformułowanie oparte na ODE oferuje ujednoliconą perspektywę na nowoczesne modelowanie generatywne i stanowi teoretyczną podstawę dla aplikacji obejmujących multimodalną reprezentację danych oraz dopasowanie cech.
Klasyfikacja w multimodalnym teledetekcyjnym badaniu zdalnym ma na celu przepokonanie ograniczeń poszczególnych modalności pomiarowych poprzez integrację komplementarnych informacji z HSI, obrazowania multispektralnego, LiDAR oraz SAR. Wczesne podejścia do fuzji opierały się na cechach definiowanych ręcznie lub algorytmach opartych na jądrach, takich jak maszyny wektorów nośnych (SVM), jednak były one ograniczone przez wysoką wymiarowość i niewystarczającą interakcję między modalnościami22. Postępy w głębokim uczeniu umożliwiły zastosowanie ustrukturyzowanych strategii fuzji, w tym fuzji wczesnej, pośredniej i późnej, przy czym fuzja na poziomie cech zapewnia praktyczną równowagę między integracją informacji a złożonością obliczeniową23. Konwolucyjne sieci neuronowe (CNN) skutecznie przechwytują lokalne informacje przestrzenno-spektralne, podczas gdy architektury oparte na Transformerach modelują zależności długodystansowe przy wyższym koszcie obliczeniowym24. W konsekwencji, hybrydowe architektury CNN–Transformer stały się coraz popularniejsze, ponieważ łączą one komplementarne zalety obu podejść. Reprezentatywne przykłady obejmują metody fuzji skal sąsiednich, które wzmacniają informacje kontekstowe poprzez interakcje między skalami25, oraz frameworki wielopoziomowe, które łączą płytkie cechy CNN z głębokimi reprezentacjami Transformera za pomocą adaptacyjnych mechanizmów uwagi26. Wspólnie badania te podkreślają znaczenie efektywnej interakcji między skalami i modalnościami w celu redukcji redundancji cech i poprawy reprezentacji semantycznej.
Niedawne osiągnięcia pozwoliły również na zbadanie strategii komplementarnych dla uczenia multimodalnego. Na przykład metody reprezentacji o niskim rzędzie, takie jak struktura oparta na krzywej Ebbinghausa, ograniczają przeuczenie poprzez zachowanie struktury rozmaitości przy jednoczesnym tłumieniu nadmiarowych informacji27. Równolegle badano rozproszone uczenie multimodalne w celu rozwiązania problemów związanych z prywatnością i ograniczeniami komunikacyjnymi w zastosowaniach praktycznych. Przykładowo, FedFusion rzutuje cechy płytkie na podprzestrzenie o niskim rzędzie, aby umożliwić federacyjne uczenie multimodalne28. Wspólnie badania te ilustrują trzy komplementarne kierunki badawcze: hybrydowe architektury CNN–Transformer dla zrównoważenia modelowania cech lokalnych i globalnych, uczenie o niskim rzędzie w celu redukcji nadmiarowości i szumu oraz uczenie rozproszone dla skalowalnego i zapewniającego prywatność wdrożenia. Niemniej jednak wciąż pozostają istotne wyzwania, w tym brak równowagi między modalnościami, ograniczona dostępność etykietowanych danych oraz kompromis między kompresją modelu a dokładnością klasyfikacji. Wyzwania te stały się motywacją do dalszych badań nad lekkimi, generalizowalnymi strukturami fuzji multimodalnej. Niedawne podejścia do wyrównania multimodalnego włączyły również mechanizmy uwagi międzymodalnej, uczenie kontrastowe, fuzję opartą na grafach, adaptację domenową oraz strategie dopasowania rozkładów. W przeciwieństwie do nich, FlowErs formułuje wyrównanie multimodalne jako sparowany, uwarunkowany czasowo transport cech i jest prezentowany jako komplementarna strategia wyrównania, a nie uniwersalny zamiennik dla istniejących podejść.
Protokół
W niniejszym badaniu wykorzystano wyłącznie publicznie dostępne zestawy danych referencyjnych (Houston2013, Augsburg oraz MUUFL) do klasyfikacji pokrycia terenu w teledetekcji. Nie zaangażowano żadnych uczestników będących ludźmi, nie przeprowadzono eksperymentów na zwierzętach ani nie pobrano nowych próbek biologicznych. W związku z powyższym zgoda instytucjonalnej komisji etycznej nie była wymagana.
Przegląd badania
Zaproponowany framework FlowErs przeprowadza multimodalną klasyfikację pokrycia terenu za pomocą dwuetapowej strategii uczenia. Jego ogólny schemat działania przedstawiono na rysunku 1A–C. Framework składa się z trzech głównych komponentów: (i) enkoderów opartych na MetaFormer, które wyodrębniają hierarchiczne reprezentacje cech z heterogenicznych modalności sensorycznych, (ii) modułu multimodalnego dopasowania przepływu (MFM), który w sposób jawny wyrównuje rozkłady cech międzymodalnych oraz (iii) lekkiej głowicy klasyfikacyjnej, która przewiduje kategorie pokrycia terenu na podstawie połączonych reprezentacji cech. Ogólny proces polega najpierw na wyodrębnieniu cech specyficznych dla danej modalności, następnie na wyrównaniu tych cech w wspólnej przestrzeni latentnej poprzez warunkowe dopasowanie przepływu, a na koniec na przeprowadzeniu klasyfikacji pokrycia terenu na poziomie pikseli z wykorzystaniem wyrównanych reprezentacji multimodalnych.
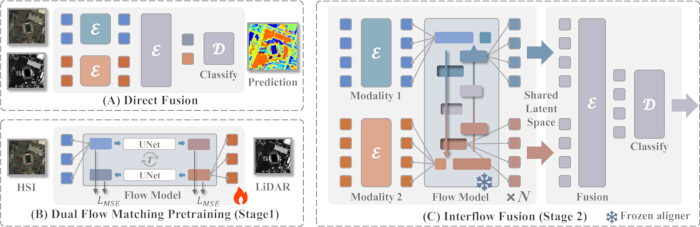
Rysunek 1: Przegląd proponowanej architektury FlowErs do multimodalnej klasyfikacji pokrycia terenu. (A) Konwencjonalna bezpośrednia fuzja cech, w której cechy specyficzne dla danej modalności, wyekstrahowane z obrazowania hiperspektralnego (HSI) i danych LiDAR (light detection and ranging), są łączone bezpośrednio przed klasyfikacją. (B) Etap 1: Bidirectional multimodal flow-matching pretraining. Warunkowana czasem sieć U-Net uczy się ciągłego, dwukierunkowego transportu cech między reprezentacjami cech specyficznymi dla modalności, wykorzystując funkcję straty średnio-kwadratowego błędu (mean-squared-error loss) w celu wyrównania heterogenicznych rozkładów cech. (C) Etap 2: Interflow fusion. Wstępnie wytrenowany moduł dopasowania przepływu (flow-matching) zostaje zamrożony i ponownie wykorzystany do wyrównania reprezentacji cech specyficznych dla modalności przed lekką fuzją cech i pikselową klasyfikacją pokrycia terenu. E, koder; D, dekoder; T, osadzenie czasu (time embedding); , strata średnio-kwadratowego błędu (mean-squared-error loss); S, wspólna reprezentacja latentna. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Zaproponowane ramy oddzielają wyrównywanie cech od klasyfikacji semantycznej poprzez dwuetapową strategię uczenia. W pierwszym etapie moduł MFM jest uczony rozpoznawania dwukierunkowego transportu cech pomiędzy rozmaitościami cech specyficznymi dla danej modalności. W drugim etapie wstępnie wytrenowany moduł wyrównywania przepływu zostaje zamrożony i ponownie wykorzystany do wyrównania multimodalnych reprezentacji cech przed lekką fuzją cech i klasyfikacją. Ta rozdzielna konstrukcja pozwala modułowi wyrównywania i sieci klasyfikacyjnej optymalizować komplementarne cele, jednocześnie redukując rozbieżności w rozkładzie cech przed fuzją multimodalną.
Przegląd teoretyczny
Flow matching (dopasowanie przepływu) to niedawno zaproponowany paradygmat modelowania generatywnego, który uczy się ciągłego deterministycznego przekształcenia między dwoma rozkładami prawdopodobieństwa. W przeciwieństwie do modeli opartych na dyfuzji, które wprowadzają stochastyczność poprzez perturbacje szumem, flow matching bezpośrednio parametryzuje uczalne pole prędkości, które w sposób ciągły transportuje jeden rozkład prawdopodobieństwa w stronę drugiego. Ta sformułowana jako ciągły transport metoda umożliwia wyrównanie cech za pomocą równania różniczkowego zwykłego (ODE), co pozwala na ewolucję sparowanych reprezentacji cech z różnych modalności sensorycznych wzdłuż wspólnej trajektorii przed fuzją cech. W niniejszym badaniu zastosowano warunkowy flow matching (conditional flow matching) w celu nauczenia dwukierunkowego transportu cech między osadzeniami specyficznymi dla danej modalności, wyekstrahowanymi przez koderzy MetaFormer. Model jest trenowany przy użyciu warunkowego celu dopasowania przepływu, który minimalizuje rozbieżność między przewidywanym a docelowym polem prędkości w odniesieniu do interpolowanych reprezentacji cech. Pełne sformułowanie matematyczne, wyprowadzenie teoretyczne, równania sterujące oraz cel treningowy znajdują się w Supplementary File 1.
Sformułowanie problemu
Klasyfikacja pokrycia terenu na podstawie multimodalnych danych z teledetekcji polega na uczeniu reprezentacji semantycznych z heterogenicznych modalności pomiarowych, takich jak HSI i LiDAR. Modalności te wykazują odmienne charakterystyki pomiarowe. HSI pozyskuje bogate informacje spektralne z setek kanałów ( ), podczas gdy LiDAR dostarcza szczegółowych informacji strukturalnych z relatywnie niewielką liczbą kanałów (
 ). Ta dysproporcja między bogactwem spektralnym a rzadkością strukturalną tworzy znaczną lukę domenową w rozkładach cech, co sprawia, że bezpośrednia fuzja cech jest suboptimalna i potencjalnie niestabilna.
Formalnie, dla pary wejść multimodalnych, 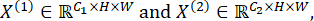 celem jest przewidzenie semantycznej mapy na poziomie pikseli zgodnie z Równaniem 1:
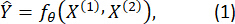
Tutaj 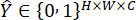 jest tensorem etykiet zakodowanych w formacie one-hot, C oznacza całkowitą liczbę kategorii pokrycia terenu, a θ reprezentuje wszystkie możliwe do wyuczenia parametry modelu. Zbiór danych Houston2013 zawiera obraz o rozmiarze 349 × 1905 pikseli z 144 pasmami hiperspektralnymi (HSI) i jednym pasmem LiDAR. Zbiór danych Augsburg zawiera obraz o rozmiarze 1152 × 480 pikseli z 224 pasmami HSI i jednym pasmem LiDAR. Zbiór danych MUUFL zawiera obraz o rozmiarze 325 × 220 pikseli z 64 pasmami HSI i dwoma pasmami LiDAR. Dla wszystkich zbiorów danych wejściowe fragmenty obrazów zostały zmienione na rozmiar 32 × 32 pikseli przed rozpoczęciem treningu.
Konwencjonalne podejścia multimodalne łączą cechy specyficzne dla danej modalności poprzez konkatenację lub mechanizmy uwagi, przyjmując implicite, że różne modalności znajdują się w kompatybilnej przestrzeni cech. Jednakże założenie to rzadko znajduje zastosowanie w przypadku danych z teledetekcji, ponieważ statystyczne rozkłady specyficzne dla modalności oraz charakterystyki przestrzenno-spektralne różnią się od siebie w znacznym stopniu.
Aby wyraźnie zniwelować tę rozbieżność, wprowadzono moduł dopasowania przepływu (flow matching),  . Moduł ten jest parametryzowany przez
 i uczy się ciągłych dwukierunkowych transformacji między rozmaitościami cech specyficznymi dla danej modalności. W szczególności (Równanie 2),
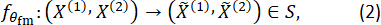
Tutaj S oznacza wspólną przestrzeń latentną, w której geometrycznie wyrównano reprezentacje cech specyficzne dla danej modalności. Następnie wyrównane reprezentacje cech są łączone i klasyfikowane zgodnie z Równaniem 3 w następujący sposób:
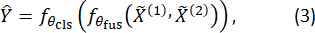
Tutaj  oraz
 oznaczają odpowiednio moduły fuzji cech i klasyfikacji. Sformułowanie to definiuje ogólną strukturę frameworku FlowErs. Zamiast polegać wyłącznie na niejawnej statystycznej fuzji cech, proponowany framework wprowadza jawny mechanizm wyrównania oparty na przepływie, który w sposób ciągły przenosi specyficzne dla danej modalności reprezentacje cech do wspólnej przestrzeni latentnej przed fuzją cech multimodalnych i predykcją semantyczną.
Koder MetaFormer
FlowErs wykonuje między-modalne wyrównanie cech przy użyciu lekkich koderów specyficznych dla danej modalności, które uczą się informatywnych i geometrycznie spójnych reprezentacji cech z każdej modalności sensorycznej. Jak zilustrowano na Rysunku 2, każda modalność jest przetwarzana przez niezależny koder oparty na architekturze MetaFormer. MetaFormer generalizuje podstawowy projekt Transformera poprzez rozdzielenie mieszania tokenów od transformacji kanałów bez jawnego obliczania samo-uwagi (self-attention). Taka konstrukcja umożliwia wydajne przetwarzanie wysokowymiarowych danych HSI, pozostając jednocześnie dostosowalną do modalności o niskiej liczbie kanałów, takich jak LiDAR.
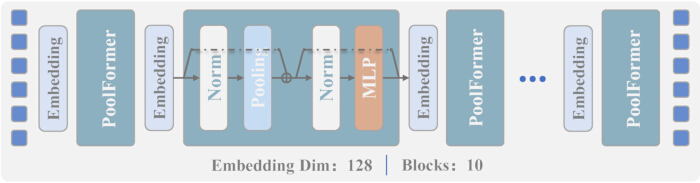
Rysunek 2: Architektura specyficznego dla danej modalności koder MetaFormer wykorzystanego w proponowanym frameworku FlowErs. Koder przekształca wejścia specyficzne dla modalności w hierarchiczne reprezentacje cech poprzez powtarzające się bloki embeddingu i PoolFormer. Każdy blok PoolFormer składa się z normalizacji, mieszania tokenów opartego na poolingu, dodawania rezydualnego, normalizacji oraz wielowarstwowego perceptrona (MLP). Wynikowe hierarchiczne reprezentacje cech są przekazywane do multimodalnego modułu flow-matching w celu wyrównania cech międzymodalnych. Norm, normalizacja; MLP, wielowarstwowy perceptron. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Dla każdej modalności  , koder MetaFormer
 , przekształca wejście
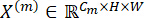 w hierarchię reprezentacji ukrytych cech (Równanie 4):
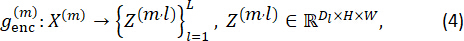
W tym przypadku L oznacza całkowitą liczbę etapów kodera, a Dl oznacza wymiar zanurzenia (embedding) na etapie l. Koder MetaFormer składa się z trzech etapów (N = 3) o wymiarach zanurzenia wynoszących odpowiednio 64, 128 i 256. Odpowiadające im liczby bloków PoolFormer na każdym etapie to 2, 6 i 2, zgodnie z progresywną architekturą hierarchiczną opisaną w manuskrypcie.
Każdy enkoder rozpoczyna się od splotu 1 × 1, który rzutuje kanały wejściowe na wspólną przestrzeń osadzeń (Równanie 5):
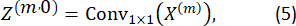
Za tą warstwą projekcji następują L ułożonych warstwowo bloków MetaFormer. Każdy blok składa się z dwóch operacji rezydualnych: (i) mieszania tokenów poprzez pooling przestrzenny w celu agregacji informacji kontekstowych oraz (ii) transformacji kanałów za pomocą wielowarstwowego perceptrona (MLP) w celu doprecyzowania reprezentacji cech widmowo-przestrzennych. Operacje te są opisane w Równaniach 6 i 7 w następujący sposób:
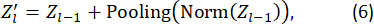

W tym przypadku Pooling(·) oznacza agregację kontekstu przestrzennego opartą na średnim pulingu (average-pooling), a MLP(·) oznacza dwuwarstwową splotową sieć sprzężenia bezpośredniego z funkcją aktywacji GELU i regularyzacją typu dropout.
Koder posiada architekturę hierarchiczną, w której wymiar zanurzenia (embedding dimension) zwiększa się stopniowo w kolejnych etapach (na przykład 64  128 256). Taka progresywna konstrukcja pozwala głębszym warstwom kodować coraz bogatsze informacje przestrzenno-spektralne, zwiększając jednocześnie zdolność reprezentacyjną wyuczonych cech. Implementacja wykorzystuje jądro pulingu o rozmiarze 3 × 3, wymiar ukryty MLP wynoszący 128 oraz współczynnik dropout na poziomie 0,1. Wszystkie warstwy splotowe w koderze MetaFormer wykorzystują jądra 1 × 1 z krokiem (stride) równym 1 i bez wypełnienia (padding). Operator pulingu wykorzystuje średni puling (average pooling) 3 × 3 z krokiem 1 i wypełnieniem 1. W całym koderze zastosowano normalizację wsadową (BatchNorm2d). MLP ma wymiar ukryty 128, wykorzystuje funkcję aktywacji GELU oraz współczynnik dropout 0,1. Trzy etapy kodera zawierają odpowiednio 2, 6 i 2 bloki PoolFormer, a te ustawienia architektoniczne są stosowane konsekwentnie we wszystkich etapach.
W porównaniu z enkoderami opartymi na architekturze Transformer, enkoder MetaFormer eliminuje kwadratowy koszt obliczeniowy związany z mechanizmem self-attention, jednocześnie redukując błąd systematyczny specyficzny dla danej modalności podczas ekstrakcji cech. Jego mikser tokenów oparty na poolingu efektywnie agreguje lokalny kontekst przestrzenny, natomiast dopasowanie międzymodalne jest następnie realizowane przez moduł flow matching. W rezultacie reprezentacje cech najwyższego poziomu generowane przez enkoder stanowią semantycznie informatywne i geometrycznie spójne dane wejściowe dla wyrównania cech multimodalnych.
Multimodalne dopasowanie przepływu
Głównym wyzwaniem po ekstrakcji cech jest dopasowanie heterogenicznych reprezentacji cech pochodzących z różnych modalności sensorycznych, które znajdują się na odmiennych rozmaitościach cech. Bezpośrednia konkatenacja  oraz
 często daje słabe wyniki ze względu na niespójne rozkłady cech i obciążenia specyficzne dla danej modalności. FlowErs w sposób jawny rozwiązuje ten problem poprzez wprowadzenie modułu MFM, który uczy się ciągłych, dwukierunkowych przekształceń między dwiema przestrzeniami cech, co przedstawiono koncepcyjnie na Rysunku 1B.
Niech 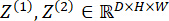 oznacza reprezentacje cech wyekstrahowane przez kodery MetaFormer. Ciągłe pole przepływu sparametryzowane przez czas interpolacji
 definiuje się za pomocą Równania 8 w następujący sposób:
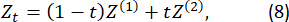
W tym przypadku t = 0 odpowiada modalności źródłowej, a t = 1 odpowiada modalności docelowej.
Model dopasowania przepływu (flow matching), , zaimplementowano jako warunkowaną czasem sieć U-Net, która przewiduje chwilowe pole prędkości sterujące transformacją wzdłuż tej trajektorii interpolacji. Każdy predyktor przepływu składa się z trzech bloków downsamplingu (64 128 256 512) i trzech odpowiadających im bloków upsamplingu (512 256 128 64), wykorzystując sploty 3 × 3, normalizację wsadową (batch normalization) oraz funkcję aktywacji ReLU (rectified linear unit). Pośrednie osadzenia czasu (time embeddings) mają odpowiednio wymiary 128, 256, 512, 256 i 128. Osadzenie czasu wykorzystuje stałe sinusoidalne kodowanie pozycyjne. Całkowanie równania różniczkowego zwykłego (ODE) wykonuje się za pomocą metody Eulera w przód z ustalonym rozmiarem kroku. Podczas trenowania liczbę kroków całkowania ustawiono na 6, natomiast podczas inferencji domyślnie zastosowano 5 kroków całkowania. Rzeczywista liczba iteracji pętli całkowania jest obliczana jako 
Przewidywane pole prędkości jest określone przez Równanie 9 w następujący sposób:
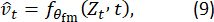
Tutaj  oznacza przewidywaną prędkość chwilową. Model uczy się przybliżać przemieszczenie
 co sprzyja ciągłym transformacjom między przestrzeniami cech specyficznymi dla danej modalności. Cel treningowy jest sformułowany jako uwarunkowana czasem dwukierunkowa strata średniokwadratowa (MSE) w następujący sposób (Równanie 10):
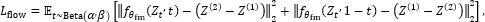 (10)
Próbkowanie t z określonego rozkładu Beta wystawia model na pośrednie stany interpolacji, ale nie zapewnia dokładnej spójności cyklicznej. W przeciwieństwie do metod wyrównywania opartych na dyfuzji, zaproponowana formulacja dopasowania przepływu (flow matching) jest deterministyczna, nie wymaga próbkowania stochastycznego podczas wnioskowania i może być trenowana z wykorzystaniem danych zarówno etykietowanych, jak i nieetykietowanych.
Wytrenowany model przepływu służy następnie jako deterministyczny operator wyrównywania, który rzutuje specyficzne dla danej modalności reprezentacje cech do wspólnej przestrzeni utajonej S. Wyrównane reprezentacje uzyskuje się w następujący sposób (Równanie 11):
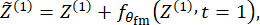
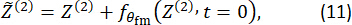
Tutaj  oraz
 oznaczają wyrównane reprezentacje cech. Wyrównanie oparte na przepływach (flow-based alignment) jest stosowane do pośrednich reprezentacji cech z dwóch pierwszych etapów koderów (Etap 1 i 2), o wymiarach osadzenia odpowiednio 64 i 128. Cechy kodera najwyższego poziomu (Etap 3, wymiar osadzenia 256) nie są przetwarzane przez moduł dopasowania przepływu (flow-matching). Zamiast tego cechy te są bezpośrednio łączone (konkatenowane) i przekazywane do klasyfikatora w celu dokonania predykcji multimodalnej.
Ten mechanizm wyrównania dwukierunkowego stopniowo przemieszcza reprezentacje cech specyficznych dla danej modalności w stronę wspólnej przestrzeni latentnej poprzez ciągłe pole przepływu. W konsekwencji, stają się one bardziej ściśle wyrównane przed fuzją cech multimodalnych, zapewniając semantycznie spójne i geometrycznie kompatybilne reprezentacje cech dla późniejszej klasyfikacji.
Procedura szkoleniowa
FlowErs wykorzystuje zarówno dane etykietowane, jak i nieetykietowane, utrzymując stabilne wyrównanie międzymodalne dzięki dwuetapowej strategii uczenia, co zilustrowano na Rysunku 1(B,C). W pierwszym etapie, za pomocą nienadzorowanego dopasowania przepływu (flow matching), uczeniu poddawany jest moduł wyrównania niezmienniczego względem modalności. W drugim etapie przeprowadzana jest nadzorowana klasyfikacja z wykorzystaniem wyrównanych reprezentacji latentnych przy jednoczesnym ponownym użyciu wstępnie wytrenowanego modułu wyrównania przepływu.
Etap 1: Nienadzorowany wstępny trening przepływu
Dla danych multimodalnych par obrazów,  specyficzne dla modalności reprezentacje cech,
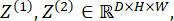 są ekstrahowane przy użyciu koderów MetaFormer. Pośrednie reprezentacje cech są generowane za pomocą interpolacji zdefiniowanej w równaniu 8, gdzie
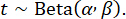 Moduł dopasowania przepływu (flow matching),
 , jest optymalizowany poprzez minimalizację dwukierunkowej funkcji celu warunkowanej czasem, zdefiniowanej w równaniu 10, bez użycia etykiet klas. Na tym etapie aktualizowane są jedynie parametry dopasowania przepływu,
 , co pozwala modelowi nauczyć się odpowiedniości uwzględniających geometrię zarówno z próbek etykietowanych, jak i nieetykietowanych przed klasyfikacją nadzorowaną. Etap 1 (pretrening dopasowania przepływu) został przeprowadzony przy użyciu optymalizatora AdamW z szybkością uczenia 1 × 10⁻4, współczynnikiem decay wag 1 × 10⁻2 oraz harmonogramem szybkości uczenia z wyżarzaniem cosinusoidalnym (cosine annealing). Dla zbiorów danych Houston2013 i Trento zastosowano wielkość partii (batch size) wynoszącą 16, natomiast dla zbiorów Augsburg i MUUFL wielkość partii wynosiła 32. Moduł dopasowania przepływu był trenowany wstępnie przez 2 000 epok z wykorzystaniem próbek etykietowanych i nieetykietowanych. Ziarno losowości (random seed) zostało ustalone na 3407. Wszystkie eksperymenty przeprowadzono przy użyciu biblioteki PyTorch na pojedynczym procesorze GPU NVIDIA A100 (80 GB pamięci).
Etap 2: Klasyfikacja nadzorowana z wykorzystaniem wspólnego dopasowywacza (Shared Aligner)
Wstępnie wytrenowany moduł dopasowania przepływu (flow matching) jest wykorzystywany ponownie podczas uczenia nadzorowanego i jest stosowany do dwóch pierwszych etapów kodera, a nie do wszystkich poziomów cech. Wyrównane reprezentacje cech są następnie łączone za pomocą głowicy klasyfikacyjnej w celu wygenerowania predykcji na poziomie pikseli. Optymalizacja nadzorowana minimalizuje maskowaną stratę entropii krzyżowej (Równanie 12):
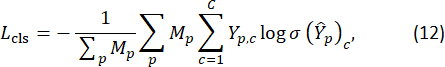
W tym przypadku M oznacza maskę etykiet, Y oznacza etykiety prawdy podstawowej (ground-truth) zakodowane w formie one-hot, a σ(·) oznacza funkcję softmax. Podczas Etapu 2 (uczenie nadzorowane) wstępnie wytrenowany moduł dopasowania przepływu (flow-matching) pozostawał całkowicie zamrożony i służył jako stały operator wyrównania międzymodalnego. Jego wstępnie wytrenowane wagi zostały wczytane na początku Etapu 2 i nie były aktualizowane podczas uczenia nadzorowanego. Optymalizowane były jedynie parametry kodera MetaFormer oraz klasyfikatora. Uczenie nadzorowane przeprowadzono przy użyciu optymalizatora AdamW z szybkościami uczenia specyficznymi dla zbiorów danych: 1 × 10⁻4 (Houston2013), 1 × 10⁻3 (Augsburg), 1 × 10⁻2 (MUUFL) oraz 1 × 10⁻5 (Trento). Współczynnik zaniku wag (weight decay) ustawiono na 1 × 10⁻2 dla wszystkich zbiorów danych z wyjątkiem MUUFL, dla którego zastosowano wartość 5 × 10⁻2. W zależności od zbioru danych zastosowano wielkość partii (batch size) wynoszącą 16 lub 32. Modele trenowano przez 100 epok (Houston2013 i MUUFL), 200 epok (Augsburg) oraz 20 epok (Trento), stosując harmonogram szybkości uczenia z wyżarzaniem cosinusowym (cosine annealing). Jako funkcję straty zastosowano CrossEntropyLoss z redukcją średnią. Nie zastosowano wczesnego zatrzymania (early stopping); zamiast tego, jako model końcowy wybrano punkt kontrolny modelu, który osiągnął najwyższą całkowitą dokładność (OA) na zbiorze testowym. Kompletny schemat implementacji dwuetapowej procedury uczenia został podsumowany w Pliku uzupełniającym S1 (Algorytm S1).
Ta rozdzielona strategia trenowania oddziela dopasowanie geometryczne od dyskryminacji semantycznej. Podczas Etapu 1 model uczy się ciągłych dwukierunkowych mapowań cech, wykorzystując cel dopasowania przepływu (flow-matching). Podczas Etapu 2 wstępnie wytrenowany moduł dopasowania zapewnia wspólną operację transportu cech przed multimodalną fuzją cech, podczas gdy sieć klasyfikacyjna uczy się reprezentacji dyskryminujących klasy z dopasowanej przestrzeni latentnej. Ponowne wykorzystanie wstępnie wytrenowanego modułu dopasowania sprzyja spójnemu wyrównaniu cech przed fuzją, jednak nie jest ono przedstawiane jako niezależna gwarancja poprawy generalizacji.
Zbiory danych eksperymentalnych
Zaproponowany model został oceniony przy użyciu trzech reprezentatywnych multimodalnych zbiorów danych referencyjnych do teledetekcji: Houston201329, Augsburg30 oraz MUUFL31.
Zbiór danych Houston2013 został udostępniony w ramach konkursu IEEE GRSS Data Fusion Contest. Przedstawia on zróżnicowany krajobraz miejski w Houston w USA i zawiera 15 klas pokrycia terenu, w tym obszary mieszkalne, drogi, roślinność oraz zbiorniki wodne. Zbiór danych obejmuje obrazy HSI z 144 pasmami spektralnymi obejmującymi zakres od widzialnego do bliskiej podczerwieni, wraz z jednopasmowym cyfrowym modelem powierzchni (DSM) pochodzącym z danych LiDAR o rozdzielczości przestrzennej 2,5 m. Złożone tekstury miejskie oraz znaczna wewnątrzklasowa zmienność spektralna sprawiają, że zbiór ten jest wymagający pod kątem dokładnej klasyfikacji pokrycia terenu.
Zbiór danych Augsburg został pozyskany nad gęsto zabudowanym obszarem miejskim w Niemczech. Składa się on z obrazowania hiperspektralnego z 224 pasmami spektralnymi obejmującymi zakres długości fal 400–1000 nm wraz ze wspólnymi zarejestrowanymi danymi wysokościowymi LiDAR. Zbiór danych zawiera 17 adnotowanych klas pokrycia terenu, w tym konstrukcje budowlane, gołą glebę, asfalt, roślinność i cień, przy rozdzielczości przestrzennej 2 m. W porównaniu z Houston2013, Augsburg wykazuje silniejsze korelacje spektralne oraz większą różnorodność klas, stanowiąc wymagający punkt odniesienia do oceny wyrównania cech między modalnościami oraz generalizacji.
Zbiór danych MUUFL Gulfport został zebrany na terenie kampusu uniwersyteckiego i reprezentuje środowisko półmiejskie z obfitą roślinnością oraz niewielkimi strukturami stworzonymi przez człowieka. Zbiór danych obejmuje odszumione obrazy hiperspektralne 64-pasmowe wraz z pomiarami LiDAR dwupasmowymi, składającymi się z informacji o wysokości i intensywności. Zawiera on 11 klas pokrycia terenu i wykazuje wysoką szczegółowość przestrzenną, obecność pikseli mieszanych oraz zmienne warunki oświetlenia, co czyni go odpowiednim do oceny multimodalnej fuzji cech w klasyfikacji małych obiektów.
Łącznie te trzy zestawy danych referencyjnych obejmują znaczną zmienność w zakresie rozdzielczości przestrzennej (1–2,5 m), wymiarowości spektralnej (64–224 pasma), złożoności scen oraz składu pokrycia terenu. W konsekwencji stanowią one zróżnicowany benchmark do oceny skuteczności i zdolności do generalizacji multimodalnych metod klasyfikacji pokrycia terenu. Główne charakterystyki zestawów danych podsumowano w Tabeli 1. Podziały na zbiory treningowe i testowe dla wszystkich trzech zestawów odpowiadają oficjalnym podziałom referencyjnym dostarczonym przez pierwotnych dostawców danych. W szczególności zestaw danych Houston2013 wykorzystuje oficjalny podział z konkursu IEEE GRSS Data Fusion Contest z 2013 roku, obejmujący 2832 próbki treningowe i 12 197 próbki testowe. Zestaw danych Augsburg wykorzystuje oficjalnie dostarczone adnotacje mask_train oraz mask_test, co daje 4538 próbek treningowych i 47 896 próbek testowych. Zestaw danych MUUFL wykorzystuje oficjalny podział train_test_gt.mat, zawierający 28 645 próbek treningowych i 24 283 próbki testowe. Dla każdego zestawu danych, jako pojedyncza próbka treningowa lub testowa, wyekstrahowano fragment obrazu o rozmiarze 32 × 32 pikseli wycentrowany na każdym etykietowanym pikselu. Nie przeprowadzono żadnego dodatkowego podziału ani ponownego próbkowania danych.
| Właściwość | Houston2013 | Augsburg | MUUFL |
| Rozmiar obrazu HSI (piksele) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| Rozmiar obrazu LiDAR (piksele) | 349 × 1905 | 1152 × 480 | 325 × 220 |
| pasma spektralne HSI | 144 | 224 | 64 |
| pasma LiDAR | 1 | 1 | 2 |
| Zakres długości fal HSI | 0.38–1.05 µm | 0.40–1.00 µm | 375–1050 nm |
| Zakres długości fali LiDAR | Nie dotyczy | Nie dotyczy | Nie dotyczy |
| Rozdzielczość przestrzenna (HSI) | 2,5 m | 2,0 m | 0,54 m × 1,00 m |
| Rozdzielczość przestrzenna (LiDAR) | 2,5 m | 2,0 m | 0,60 m × 0,78 m |
| Liczba klas pokrycia terenu | 15 | 17 | 11 |
Tabela 1: Charakterystyka trzech multimodalnych zestawów danych referencyjnych do teledetekcji wykorzystanych w ocenie. Tabela podsumowuje wymiary obrazów, charakterystykę spektralną, rozdzielczości przestrzenne oraz liczbę klas pokrycia terenu dla zestawów danych referencyjnych Houston2013, Augsburg i MUUFL, które zostały użyte do oceny proponowanego frameworku FlowErs.
Szczegóły implementacji
Struktura FlowErs została zaimplementowana w środowisku PyTorch, a jej trenowanie i ewaluacja odbyły się przy użyciu jednostki przetwarzania graficznego (GPU) z 80 GB pamięci. Proces trenowania przeprowadzono przez 100 epok, stosując wielkość partii (batch size) równą 16. Wykorzystano optymalizator AdamW z początkową prędkością uczenia 1 × 10⁻⁴ oraz współczynnikiem zaniku wag (weight decay) 1 × 10⁻². Do aktualizacji prędkości uczenia w trakcie trenowania zastosowano harmonogram typu cosine annealing. Aby poprawić generalizację modelu i ograniczyć przeuczenie, zastosowano współczynnik dropout na poziomie 0,1. Do optymalizacji nadzorowanej wykorzystano funkcję straty cross-entropy. W celu zapewnienia powtarzalności wszystkie eksperymenty zainicjowano przy użyciu stałego ziarna losowego (random seed) 3407. Dostarczone partycje treningowe/testowe wykorzystano bez tworzenia dodatkowego podziału walidacyjnego. Każdy fragment wejściowy (patch) został przeskalowany do rozmiaru 32 × 32 pikseli przed rozpoczęciem trenowania. Nie zastosowano augmentacji danych, jawnej korekcji rejestracji obrazów ani dodatkowej normalizacji w loaderze danych. Piksele powiązane z etykietami negatywnymi zostały wykluczone z obliczeń nadzorowanej funkcji straty. Obsługa brakujących lub zaszumionych pikseli nie była oceniana oddzielnie.
Metryki oceny
Do oceny wydajności klasyfikacji wykorzystano trzy powszechnie stosowane wskaźniki ewaluacyjne: OA, średnią dokładność (AA) oraz współczynnik Kappa (k). OA mierzy proporcję poprawnie sklasyfikowanych próbek spośród wszystkich próbek, AA reprezentuje średnią dokładność klasyfikacji dla wszystkich klas pokrycia terenu, a współczynnik Kappa określa stopień zgodności między klasyfikacją przewidywaną a referencyjną po uwzględnieniu zgodności przypadkowej. Wyższe wartości wszystkich trzech wskaźników wskazują na lepszą wydajność klasyfikacji. Wszystkie wartości przedstawione w tabelach 2–6 są punktowymi oszacowaniami z podziału stałego, uzyskanymi przy użyciu ziarna losowego 3407. Nie podano przedziałów ufności, testów istotności statystycznej ani wartości p.
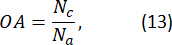
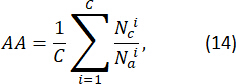
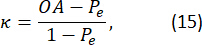
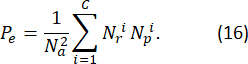
W tym przypadku Nc oraz Na oznaczają odpowiednio całkowitą liczbę poprawnie sklasyfikowanych próbek oraz liczbę ocenianych próbek.  oraz
 oznaczają odpowiednio liczbę poprawnie sklasyfikowanych próbek oraz całkowitą liczbę próbek dla i-tej klasy. W obliczeniach współczynnika Kappa, Pe oznacza prawdopodobieństwo wystąpienia zgodności przypadkowej, a
 oraz
 oznaczają odpowiednio referencyjną i przewidywaną liczbę próbek dla i-tej klasy.
Wyniki
Ogólny schemat procesu ewaluacji proponowanego frameworka FlowErs przedstawiono na Rycina 1, w którym podsumowano dwuetapową strategię klasyfikacji multimodalnej. Proces ekstrakcji cech specyficznych dla danej modalności, oparty na koderze MetaFormer, przedstawiono w Rycina 2, a główne charakterystyki trzech zestawów danych referencyjnych wykorzystanych do ewaluacji zostały podsumowane w Tabela 1Wydajność klasyfikacji została następnie oceniona na zbiorach danych referencyjnych MUUFL, Houston2013 i Augsburg z wykorzystaniem wskaźników OA, AA oraz współczynnika Kappa (κ) zdefiniowane w sekcji Protokół.
Porównanie z innymi metodami
W celu przeprowadzenia kompleksowego porównania proponowanego modelu uwzględniono kilka referencyjnych sieci klasyfikacji multimodalnej. DFINet32 integruje informacje hiperspektralne i multispektralne za pomocą modułu głębokiej uwagi krzyżowej (depth-wise cross-attention), aby poprawić interakcję cech poprzez wiele funkcji straty. DSHFNet33 wprowadza dynamiczną strategię fuzji hierarchicznej, która progresywnie łączy reprezentacje w skali drobnej i grubej. MDL-Middle34 wykorzystuje strategię fuzji cech warstw pośrednich, aby zrównoważyć informacje z wielu modalności sensorycznych. CMCL35 traktuje dane HSI i LiDAR jako komplementarne widoki tej samej sceny i stosuje uczenie kontrastowe wraz z podwójnym dostrajaniem w celu poprawy wyrównania cech. Two-Branch36 wykorzystuje dwuścieżkową architekturę splotową, która niezależnie przetwarza każdą modalność przed fuzją cech. ExViT37 wykonuje multimodalne przetwarzanie patchy przy użyciu równoległych gałęzi Transformera z modułami uwagi międzymodalnej. DSymFuse38 rozszerza dwu-gałęziową architekturę Transformera poprzez hierarchiczną fuzję cech lokalno-globalnych. CTPMSN39 łączy architektury splotowe i Transformer z wyrównaniem promptów tekstowo-wizualnych, aby poprawić spójność semantyczną i dyskryminację klas. Wartości porównawcze zostały pobrane z cytowanych publikacji lub opisanych w nich protokołów ewaluacyjnych i nie były generowane przy użyciu ujednoliconej implementacji ani wspólnego środowiska eksperymentalnego. W związku z tym porównania te należy interpretować jako opisowe zestawienia referencyjne, a nie kontrolowane oceny bezpośrednie.
Zbiór danych MUUFL
Wyniki klasyfikacji uzyskane dla zbioru danych MUUFL Gulfport zostały podsumowane w Tabeli 2, a reprezentatywne mapy klasyfikacji przedstawiono na Rysunku 3A–J. W raportowanym stałym podziale benchmarkowym zaproponowany framework osiągnął OA na poziomie 95,24% oraz współczynnik Kappa wynoszący 93,69%, w porównaniu do odpowiednio 93,99% i 92,03% dla CTPMSN. Efektywność na poziomie klas różniła się w zależności od kategorii pokrycia terenu. W porównaniu z CTPMSN, zaproponowany framework osiągnął wyższą dokładność klasyfikacji dla klas Trees, Mostly Grass oraz Mixed Surface, odpowiednio o 2,73%, 3,16% i 1,86%. Z kolei klasa Yellow Curb pozostała problematyczna ze względu na ograniczoną liczbę dostępnych próbek, a jej raportowana dokładność była niższa niż w przypadku kilku metod porównawczych. W związku z tym zaobserwowana poprawa ogólnej wydajności nie powinna być interpretowana jako wskazanie na lepsze wyniki dla każdej poszczególnej klasy pokrycia terenu. Porównanie jakościowe na Rysunku 3A–I przedstawia mapy klasyfikacji wygenerowane przez oceniane metody, natomiast Rysunek 3J prezentuje odpowiadającą im referencyjną mapę prawdy terenowej (ground-truth), ilustrującą rozkład przestrzenny klas pokrycia terenu w zbiorze danych MUUFL Gulfport.
| Klasa | DFINet | DSHFNet | MDL-Środkowy | CMCL | Dwugwiazdowy | ExVit | DSymFuse | CTPMSN | FlowErs |
| Drzewa | 89.2 | 74.91 | 87.31 | 84.86 | 91.32 | 92.64 | 91.24 | 95.55 | 98.28 |
| Głównie trawy | 72.98 | 84.63 | 76.38 | 86.54 | 80.65 | 77.48 | 79.57 | 88.92 | 92.08 |
| Powierzchnia mieszana | 69.22 | 34.77 | 68.33 | 54.75 | 67.92 | 82.07 | 82.23 | 87.92 | 89.78 |
| Ziemia/piasek | 76.68 | 87.06 | 78.74 | 84.45 | 78.32 | 93.74 | 89.17 | 97.27 | 93.55 |
| Droga | 86.68 | 81.09 | 83.76 | 86.25 | 84.34 | 90.35 | 85.6 | 94.52 | 95.94 |
| Woda | 100 | 99.25 | 88.52 | 98.53 | 100 | 99.38 | 100 | 100 | 97.56 |
| Cień | 83.29 | 90.65 | 92.12 | 97.72 | 84.89 | 91.47 | 91 | 95.98 | 90.54 |
| Budowa | 93.26 | 90.22 | 89.69 | 97.54 | 93.76 | 89.27 | 96.29 | 96.29 | 98.26 |
| Chodnik | 57.34 | 53.09 | 77.06 | 77.98 | 71.32 | 73.54 | 79.62 | 88.07 | 79.61 |
| Żółty krawężnik | 84.28 | 1.03 | 96.75 | 80.62 | 81.41 | 93.72 | 91.57 | 97.37 | 48.91 |
| Panele z tkaniny | 97.92 | 92.79 | 99.41 | 98.41 | 99.21 | 99.41 | 100 | 99.41 | 93.13 |
| Ogólna dokładność (OA) | 83.87 | 74.29 | 83.54 | 82.45 | 85.61 | 89.94 | 88.78 | 93.99 | 95.24 |
| Średnia dokładność (AA) | 82.76 | 73.23 | 84.37 | 85.9 | 85.1 | 90.12 | 89.54 | 94.68 | 88.88 |
| Współczynnik kappa (κ × 100) | 79.82 | 67.92 | 78.84 | 78.37 | 81.22 | 85.37 | 85.37 | 92.03 | 93.69 |
Tabela 2: Wydajność klasyfikacji (%) różnych metod na zbiorze danych referencyjnych MUUFL. Wydajność klasyfikacji dla poszczególnych klas wraz z całkowitą dokładnością (OA), średnią dokładnością (AA) i współczynnikiem Kappa (κ) uzyskanymi przez proponowany framework FlowErs oraz metody konkurencyjne na zbiorze danych referencyjnych MUUFL.
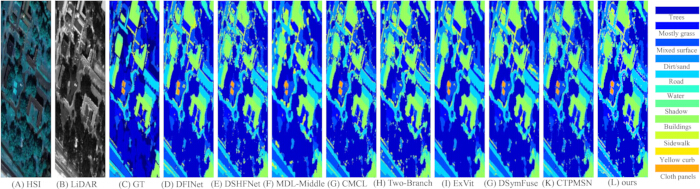
Rycina 3: Reprezentatywne wyniki klasyfikacji pokrycia terenu dla zbioru danych referencyjnych MUUFL. (A) Obrazowanie hiperspektralne (HSI). (B) Obraz z detekcji i pomiaru odległości (LiDAR). (C) Referencyjna mapa prawdy terenowej (GT). (D–L) Mapy klasyfikacji wygenerowane odpowiednio przez DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN oraz proponowany framework FlowErs. Legenda kolorów określa klasy pokrycia terenu przedstawione na każdej mapie klasyfikacji.Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Zbiór danych Houston2013
Wyniki klasyfikacji uzyskane dla zbioru danych Houston2013 przedstawiono w Tabela 3or reprezentatywne mapy klasyfikacji przedstawiono w Rycina 4A–JW raportowanym, stałym podziale zestawu referencyjnego, proponowany model osiągnął dokładność całkowitą (OA) na poziomie 97,56% oraz współczynnik Kappa wynoszący 97,39%. W porównaniu z raportowanymi wynikami CTPMSN, proponowany model wykazał OA wyższą o około 3,8 punktu procentowego. Poprawę odnotowano również w klasach obszarów zabudowy mieszkaniowej (Residential) oraz dróg szybkiego ruchu (Highway), gdzie wzrosty wyniosły odpowiednio około 2,4 i 0,5 punktu procentowego. Jednakże klasa obszarów handlowych (Commercial) pozostała stosunkowo trudna i wykazała niższą dokładność klasyfikacji niż kilka konkurujących metod, co może odzwierciedlać podobieństwo spektralne i przestrzenne z innymi miejskimi kategoriami pokrycia terenu. Ogólnie rzecz biorąc, zagregowane wyniki wskazują na poprawę wydajności klasyfikacji w tym zestawie referencyjnym, wykazując jednocześnie, że wyniki różniły się w zależności od poszczególnych klas. Porównanie jakościowe w Rycina 4A–I przedstawia mapy klasyfikacji wygenerowane przez oceniane metody, podczas gdy Rysunek 4J przedstawia odpowiadającą mu referencyjną mapę prawdy naziemnej, ilustrującą przestrzenny rozkład klas pokrycia terenu w zbiorze danych Houston2013.
| Klasa | DFINet | DSHFNet | MDL-Środkowy | CMCL | Dw Gałęziowy | ExVit | DSymFuse | CTPMSN | FlowErs |
| Zdrowa trawa | 82.39 | 85.58 | 83.1 | 82.91 | 80.31 | 81.67 | 80.06 | 96.96 | 100 |
| Trawa poddana stresowi | 100 | 94.65 | 85.06 | 95.68 | 92.44 | 100 | 78.67 | 94.27 | 96.94 |
| Sztuczna trawa | 100 | 98.12 | 99.6 | 94.93 | 99.23 | 99.01 | 99.41 | 99.41 | 99.84 |
| Drzewo | 100 | 93.09 | 91.57 | 93.37 | 98.75 | 98.96 | 95.55 | 96.21 | 99.6 |
| Gleba | 98.76 | 99.91 | 98.86 | 99.43 | 99.2 | 99.91 | 98.67 | 99.43 | 100 |
| Woda | 94.5 | 93.1 | 100 | 97.3 | 95.32 | 100 | 95.8 | 100 | 97.6 |
| Mieszkalny | 87.5 | 66.65 | 97.64 | 92.58 | 90.87 | 93.28 | 87.22 | 86.86 | 99.29 |
| Komercyjny | 91.53 | 76.29 | 88.13 | 87.96 | 95.31 | 89.27 | 85.85 | 94.61 | 84.07 |
| Droga | 84.19 | 36.29 | 85.93 | 80.76 | 82.63 | 89.42 | 93.29 | 88.07 | 92.73 |
| Autostrada | 69.32 | 89 | 74.42 | 57.41 | 66.69 | 71.33 | 67.95 | 81.66 | 99.74 |
| Kolejnictwo | 96.76 | 94.78 | 84.54 | 79.57 | 93.44 | 92.88 | 79.13 | 97.7 | 99.72 |
| Parking 1 | 83.27 | 88.39 | 95.39 | 52.83 | 85.67 | 89.63 | 91.07 | 93.28 | 95.42 |
| Parking nr 2 | 85.36 | 96.46 | 87.37 | 92.42 | 86.17 | 89.47 | 84.21 | 95.09 | 99.18 |
| Kort tenisowy | 100 | 97.3 | 95.14 | 83.04 | 98.72 | 97.89 | 100 | 100 | 99.72 |
| Bieżnia lekkoatletyczna | 99.21 | 100 | 100 | 97.02 | 100 | 97.97 | 100 | 100 | 99.83 |
| Ogólna dokładność (OA) | 91.21 | 85.02 | 89.55 | 83.87 | 90.01 | 91.57 | 87.57 | 93.74 | 97.56 |
| Średnia dokładność (AA) | 92.42 | 87.55 | 91.05 | 85.76 | 90.98 | 92.32 | 89.09 | 94.9 | 97.58 |
| Współczynnik kappa (κ × 100) | 91.09 | 83.59 | 87.59 | 82.76 | 89.1 | 90.85 | 85.29 | 93.21 | 97.39 |
Tabela 3: Wydajność klasyfikacji (%) różnych metod na zbiorze danych referencyjnych Houston2013. Wydajność klasyfikacji dla poszczególnych klas wraz z ogólną dokładnością (OA), średnią dokładnością (AA) oraz współczynnikiem Kappa (κ) uzyskanymi przez proponowany framework FlowErs oraz metody konkurencyjne na zbiorze danych referencyjnych Houston2013.
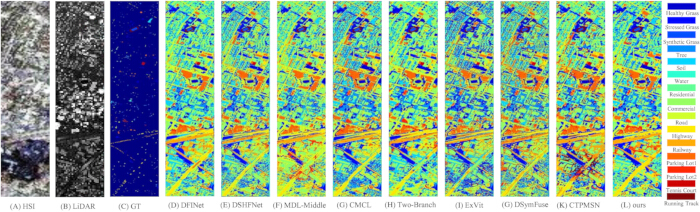
Rysunek 4: Reprezentatywne wyniki klasyfikacji pokrycia terenu dla zbioru danych referencyjnych Houston2013. (A) Obrazowanie hiperspektralne (HSI). (B) Obraz z detekcji i pomiaru odległości światłem (LiDAR). (C) Referencyjna mapa prawdy terenowej (GT). (D–L) Mapy klasyfikacji wygenerowane odpowiednio przez DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN oraz proponowany framework FlowErs. Legenda kolorów określa klasy pokrycia terenu przedstawione na każdej mapie klasyfikacji. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Zbiór danych z Augsburgen
Wyniki klasyfikacji uzyskane dla zbioru danych Augsburg podsumowano w Tabeli 4, a reprezentatywne mapy klasyfikacji przedstawiono na Rysunku 5A–J. Zbiór danych ten charakteryzuje się znaczną zmiennością wewnątrzklasową oraz złożoną strukturą tła. W raportowanym stałym podziale benchmarkowym zaproponowany model osiągnął OA na poziomie 97,56% oraz AA na poziomie 89,21%. W porównaniu z wymienionymi metodami benchmarkowymi zaproponowany model wykazał wyższą dokładność klasyfikacji dla klas przemysłowych (Industrial) i handlowych (Commercial) o odpowiednio około 14 i 45 punktów procentowych. Różnica między OA a AA wskazuje, że na ogólną wydajność wpłynęła częstotliwość występowania klas, podczas gdy AA odzwierciedla średnią wydajność we wszystkich klasach. W związku z tym raportowane OA należy interpretować wraz z wynikami dla poszczególnych klas, ponieważ wydajność klasyfikacji różniła się w zależności od kategorii pokrycia terenu. Porównanie jakościowe na Rysunku 5A–I przedstawia mapy klasyfikacji wygenerowane przez oceniane metody, natomiast Rysunek 5J prezentuje odpowiadającą im referencyjną mapę prawdy terenowej (ground-truth), ilustrującą przestrzenny rozkład klas pokrycia terenu w zbiorze danych Augsburg.
| Klasa | DFINet | DSHFNet | MDL-Middle | CMCL | Two-Branch | ExVit | DSymFuse | CTPMSN | FlowErs |
| Drzewa | 96.41 | 98.21 | 91.72 | 94.27 | 95.85 | 93.64 | 90.58 | 93.36 | 99.57 |
| Zabudowa mieszkaniowa | 96.88 | 42.08 | 95.19 | 69.84 | 92.75 | 97.71 | 96.32 | 97.37 | 98.97 |
| Zabudowa przemysłowa | 58.2 | 47.29 | 62.61 | 35.22 | 72.66 | 65.82 | 72.45 | 64.6 | 86.41 |
| Niskie rośliny | 92.22 | 51.75 | 87.76 | 80.27 | 88.9 | 84.88 | 89.65 | 96.72 | 99.58 |
| Ogród działkowy | 55.87 | 95.94 | 50.86 | 89.33 | 72.86 | 46.85 | 62.91 | 58.69 | 91.22 |
| Zabudowa handlowa | 10.98 | 50.91 | 24.24 | 45.59 | 20.32 | 24.49 | 17.22 | 29.73 | 74.3 |
| Woda | 22.87 | 67.78 | 29.04 | 54.87 | 36.82 | 24.49 | 13.27 | 15.53 | 74.39 |
| Dokładność całkowita (OA) | 88.78 | 56.59 | 87.74 | 75.94 | 87.29 | 87.72 | 88.35 | 91.56 | 97.56 |
| Średnia dokładność (AA) | 62.29 | 65.47 | 63.06 | 67.61 | 67.78 | 62.56 | 63.2 | 65.14 | 89.21 |
| Współczynnik Kappa (κ × 100) | 84.32 | 46.78 | 82.69 | 67.83 | 82.58 | 82.49 | 83.36 | 87.88 | 96.48 |
Tabela 4: Wydajność klasyfikacji (%) różnych metod na zbiorze danych referencyjnych Augsburg. Wydajność klasyfikacji dla poszczególnych klas wraz z ogólną dokładnością (OA), średnią dokładnością (AA) oraz współczynnikiem Kappa (κ) uzyskanymi przez proponowany system FlowErs i metody konkurencyjne na zbiorze danych referencyjnych Augsburg.
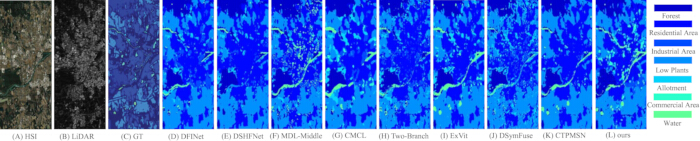
Rycina 5: Reprezentatywne wyniki klasyfikacji pokrycia terenu dla zbioru danych referencyjnych Augsburg. (A) Obrazowanie hiperspektralne (HSI). (B) Obraz z detekcji i pomiaru odległości za pomocą światła (LiDAR). (C) Referencyjna mapa prawdy terenowej (GT). (D–L) Mapy klasyfikacji wygenerowane odpowiednio przez DFINet, DSHFNet, MDL-Middle, CMCL, Two-Branch, ExVit, DSymFuse, CTPMSN oraz proponowany framework FlowErs. Legenda kolorów identyfikuje klasy pokrycia terenu reprezentowane na każdej mapie klasyfikacji. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
Aby ułatwić dokładniejsze porównanie wizualne problematycznych obszarów, w Rysunku 6 przedstawiono powiększone widoki reprezentatywnych ROI z zestawów danych MUUFL, Houston2013 oraz Augsburg. Te powiększenia uwypuklają granice obiektów oraz drobnoziarniste struktury przestrzenne, które są mniej widoczne na mapach klasyfikacji pełnych scen pokazanych na Rysunkach 3–5, dostarczając dodatkowych dowodów jakościowych na skuteczność klasyfikacji w trzech benchmarkowych zestawach danych.
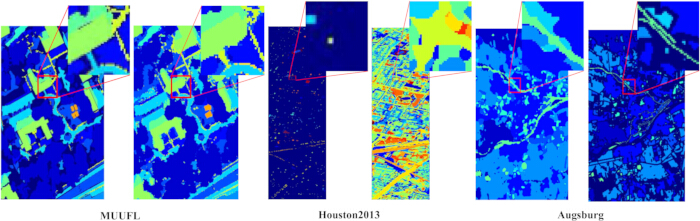
Rycina 6: Powiększone widoki reprezentatywnych obszarów zainteresowania (ROI) z zestawów danych MUUFL, Houston2013 oraz Augsburg. Reprezentatywne ROI z zestawów danych MUUFL, Houston2013 oraz Augsburg zostały powiększone, aby ułatwić wizualne porównanie szczegółów klasyfikacji w małej skali. Czerwone ramki wskazują wybrane obszary, a odpowiadające im powiększone widoki podkreślają granice obiektów, małe struktury oraz inne trudne obszary, które są słabo widoczne na pełnych mapach klasyfikacji scen przedstawionych na Rycynach 3–5. Powiększone widoki te stanowią dodatkową jakościową ocenę wyników klasyfikacji. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
Badanie ablacyjne
Wpływ modułu multimodalnego dopasowania przepływu:
Aby ocenić wkład modułu MFM, przeprowadzono eksperymenty ablacyjne z wykorzystaniem trzech konfiguracji modelu: pełnego frameworka FlowErs (Baseline), modelu bez modułu MFM (w/o MFM) oraz uproszczonego modelu wykorzystującego jednokierunkowe wyrównanie przepływu (Single Flow). Odpowiednie wyniki ilościowe podsumowano w Tabeli 5.
| Metoda | MUUFL | Houston2013 | Augsburg | ||||||
| OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | |
| Wartość bazowa | 95.24 | 88.88 | 93.69 | 97.56 | 97.58 | 97.39 | 97.56 | 89.21 | 96.48 |
| bez MFM | 92.87 | 86.02 | 91.05 | 95.31 | 95.28 | 94.97 | 95.12 | 87.06 | 93.98 |
| Pojedynczy przepływ | 94.38 | 87.43 | 92.72 | 96.58 | 96.47 | 96.22 | 96.47 | 88.36 | 95.47 |
Tabela 5: Analiza ablacyjna proponowanego frameworka FlowErs na zestawach danych referencyjnych MUUFL, Houston2013 i Augsburg. Przedstawiono wyniki klasyfikacji dla pełnego modelu (Baseline) oraz dwóch wariantów ablacyjnych, wykorzystując ogólną dokładność (OA), średnią dokładność (AA) oraz współczynnik Kappa (κ).
W porównaniu z modelem bazowym, usunięcie modułu MFM doprowadziło do niższych wartości OA, AA i Kappa we wszystkich trzech zestawach danych referencyjnych. Konfiguracja Single Flow wykazała wydajność pośrednią między pełnym modelem a modelem bez MFM, co wskazuje, że jednokierunkowe dopasowanie cech zachowało część obserwowanego wzrostu wydajności, nie osiągając jednak całkowitej wydajności implementacji dwukierunkowej. Obserwacje te sugerują, że dwukierunkowy moduł dopasowania przepływu przyczynił się do raportowanej wydajności w ocenianych ustawieniach referencyjnych. Raportowane różnice stanowią punktowe oszacowania dla stałego podziału danych, uzyskane przy użyciu jednego ziarna losowego, i powinny zatem być interpretowane opisowo, a nie jako dowód istotności statystycznej.
W trzech zestawach danych referencyjnych największe zagregowane różnice w wydajności między modelem bazowym (Baseline) a modelami ablacyjnymi zaobserwowano w zestawie danych MUUFL, natomiast stosunkowo mniejsze różnice odnotowano w zestawie Houston2013. W przypadku pełnego modelu zaobserwowano poprawę zarówno OA, jak i AA w stosunku do konfiguracji ablacyjnych, co wskazuje na wyższą zagregowaną wydajność klasyfikacji wraz z lepszą średnią wydajnością klas w ocenianych podziałach referencyjnych. Wyniki te są zgodne z hipotezą badawczą, według której wyrównanie cech przed fuzją multimodalną może poprawić wydajność klasyfikacji; jednak w niniejszym badaniu nie przeprowadzono powtórzonych eksperymentów ani analiz statystycznych.
Wpływ liczby kroków integracji przepływu:
Aby dalej ocenić wpływ liczby kroków całkowania przepływu w module MFM, liczbę kroków całkowania zmieniano w zakresie od 2 do 10. Odpowiadające im wyniki klasyfikacji podsumowano w Tabeli 6. Parametr kroku całkowania kontroluje dyskretyzację ciągłego procesu transportu cech podczas wyrównania multimodalnego, gdzie mniejsze wartości reprezentują grubszą dyskretyzację, a większe wartości reprezentują dyskretyzację drobniejszą. Jak pokazano w Tabeli 6, najwyższe oszacowania punktowe dla stałego podziału w ramach ocenianych metryk uzyskano przy liczbie kroków całkowania równej 6. Wydajność zazwyczaj rosła wraz ze zwiększeniem liczby kroków całkowania z 2 do 6, po czym raportowana wydajność pozostała względnie stabilna lub nieznacznie spadła w trzech zestawach danych referencyjnych. Obserwacje te wskazują, że nominalne ustawienie sześciu kroków całkowania zapewniło najwyższą zagregowaną wydajność w ocenianych warunkach referencyjnych. Ponieważ raportowane wyniki opierają się na pojedynczym ziarnie losowym i stałych podziałach zestawów referencyjnych, różnice te należy interpretować opisowo, a nie jako dowód na statystycznie istotne różnice w wydajności.
| Kroki integracji przepływu | MUUFL | Houston2013 | Augsburg | ||||||
| OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | OA (%) | AA (%) | κ × 100 | |
| 2 | 92.37 | 84.63 | 90.12 | 95.73 | 96.12 | 95.64 | 94.86 | 85.73 | 92.76 |
| 3 | 93.58 | 85.47 | 90.98 | 96.32 | 96.48 | 96.01 | 95.61 | 86.48 | 93.51 |
| 4 | 94.31 | 86.51 | 91.76 | 96.88 | 96.92 | 96.57 | 96.18 | 87.34 | 94.12 |
| 5 | 94.92 | 87.62 | 92.54 | 97.18 | 97.22 | 97.05 | 96.89 | 88.02 | 95.07 |
| 6 | 95.24 | 88.88 | 93.69 | 97.56 | 97.58 | 97.39 | 97.56 | 89.21 | 96.48 |
| 7 | 95.12 | 88.56 | 93.5 | 97.49 | 97.44 | 97.31 | 97.34 | 88.84 | 96.21 |
| 8 | 94.95 | 88.22 | 93.2 | 97.31 | 97.29 | 97.17 | 96.98 | 88.46 | 95.82 |
| 9 | 94.63 | 87.75 | 92.85 | 97.09 | 97.03 | 96.88 | 96.45 | 87.92 | 95.28 |
| 10 | 94.21 | 86.97 | 92.18 | 96.77 | 96.81 | 96.61 | 95.87 | 87.03 | 94.61 |
Tabela 6: Wpływ liczby kroków integracji przepływu na wydajność klasyfikacji dla zestawów danych benchmarkowych MUUFL, Houston2013 i Augsburg. Wydajność klasyfikacji przedstawiono jako ogólną dokładność (OA), średnią dokładność (AA) oraz współczynnik Kappa (κ) dla różnych liczb kroków integracji przepływu. Sześć kroków integracji odpowiada konfiguracji zastosowanej w końcowym frameworku FlowErs.
Wśród ocenianych zbiorów danych, zbiór MUUFL wykazał największą zmienność wyników wraz ze zmianą liczby kroków integracji, podczas gdy zbiór Houston2013 wykazał stosunkowo mniejsze zmiany, osiągając jednocześnie najwyższą raportowaną wydajność przy sześciu krokach integracji. Zbiór Augsburg wykazał podobną tendencję z relatywnie niewielką zmiennością wydajności przy różnych ustawieniach liczby kroków. Wspólnie obserwacje te sugerują, że umiarkowana liczba kroków integracji przepływu zapewniła najwyższą raportowaną wydajność klasyfikacji dla ocenianych zbiorów danych. Niniejsza analiza nie obejmuje powtórzonych eksperymentów, szacowania niepewności, profilowania obliczeniowego, odporności na brakujące modalności lub zaszumione dane wejściowe ani generalizacji międzyregionalnej, w związku z czym nie wyciągnięto wniosków w tych aspektach.
Ocena przeprowadzona na trzech zbiorach danych referencyjnych wykazała konkurencyjną zagregowaną wydajność klasyfikacji przy raportowanych stałych podziałach zbiorów, z maksymalną wartością OA wynoszącą 97,56%. Eksperymenty ablacyjne wykazały, że pełna konfiguracja dwukierunkowego dopasowania przepływu (bidirectional flow-matching) konsekwentnie osiągała wyższą zagregowaną wydajność niż odpowiadające jej modele ablacyjne we wszystkich ocenianych zbiorach danych. Analizy dla poszczególnych klas wskazały, że wydajność klasyfikacji różniła się w zależności od kategorii pokrycia terenu, przy czym klasy mniejszościowe oraz kategorie o podobnym widmie pozostawały stosunkowo trudne i przyczyniały się do zaobserwowanej różnicy między OA a AA w niezbalansowanych zbiorach danych. Niniejsza ocena opiera się na punktowych oszacowaniach dla stałych podziałów uzyskanych przy użyciu pojedynczego ziarna losowego i nie obejmuje oszacowań niepewności z wielokrotnych uruchomień, testów istotności statystycznej, profilowania obliczeniowego, wrażliwości na błędy rejestracji przestrzennej, odporności na brakujące lub zaszumione modalności ani generalizacji międzyregionalnej. Kwestie te wymagają dalszych badań w przyszłych studiach.
Dostępność danych:
Publiczne zestawy danych referencyjnych wykorzystane w niniejszym badaniu są dostępne u ich pierwotnych dostawców. Materiały implementacyjne, mapy predykcji oraz wyniki ewaluacji są publicznie dostępne w repozytorium Zenodo pod adresem https://doi.org/10.5281/zenodo.21395701.
Plik uzupełniający 1: Sformułowanie matematyczne i algorytm uczenia frameworka FlowErs. Niniejszy plik uzupełniający zawiera pełne sformułowanie matematyczne leżące u podstaw proponowanego frameworka FlowErs, w tym sformułowanie przepływu ciągłego (Równania S1–S2), równanie przepływu prawdopodobieństwa (Równanie S3), optymalną ścieżkę przepływu (Równania S4–S5), cel uczenia warunkowego dopasowania przepływu (Równanie S6) oraz powiązane właściwości teoretyczne. Plik zawiera również Algorytm S1, który podsumowuje kompletny dwuetapowy proces uczenia, obejmujący nienadzorowane wstępne uczenie dopasowania przepływu, a następnie nadzorowaną klasyfikację multimodalną.
Dyskusja
Niniejsza praca przedstawia FlowErs, multimodalny system teledetekcyjny, który oddziela dopasowanie cech między modalnościami od klasyfikacji semantycznej za pomocą dwuetapowej strategii uczenia. Zamiast bezpośrednio łączyć heterogeniczne cechy specyficzne dla danej modalności, proponowany system najpierw dopasowuje reprezentacje cech przy użyciu warunkowego dopasowania przepływu (conditional flow matching) przed fuzją multimodalną i klasyfikacją. Konstrukcja ta rozwiązuje długotrwały problem heterogeniczności rozkładów cech między HSI a LiDAR, gdzie różnice w mechanizmach pomiarowych często ograniczają skuteczność konwencjonalnych strategii fuzji opartych na konkatenacji lub mechanizmach uwagi23,26,35,36,37,38,39. Poprzez sformułowanie dopasowania multimodalnego jako ciągłego transportu cech, FlowErs rozszerza niedawne osiągnięcia w dziedzinie dopasowania przepływu z modelowania generatywnego na uczenie reprezentacji w multimodalnej teledetekcji15,16,17,18,19,20,21. W ocenianych warunkach benchmarkowych proponowany system osiągnął konkurencyjną zagregowaną wydajność klasyfikacji na zbiorach danych Houston2013, Augsburg i MUUFL, a towarzysząca mu analiza ablacyjna dodatkowo potwierdziła wkład modułu dwukierunkowego dopasowania przepływu w raportowaną wydajność dla stałego podziału danych.
Przedstawione wyniki sugerują, że jawne dopasowanie cech przed fuzją multimodalną może poprawić kompatybilność heterogenicznych reprezentacji cech wyekstrahowanych z różnych modalności detekcyjnych. Poprzednie metody multimodalnego teledetekcji opierały się głównie na sieciach splotowych, architekturach opartych na Transformerach, mechanizmach uwagi, uczeniu kontrastowym lub fuzji sterowanej promptami w celu wzmocnienia interakcji cech23,26,35,36,37,38,39. Chociaż podejścia te wykazały wysoką wydajność klasyfikacji, większość z nich zakłada, że osadzenia specyficzne dla danej modalności mogą być bezpośrednio łączone po ekstrakcji cech. W przeciwieństwie do nich, FlowErs wprowadza pośredni etap dopasowania geometrycznego, który w sposób ciągły przenosi cechy specyficzne dla danej modalności do wspólnej przestrzeni latentnej przed klasyfikacją. Ewaluacja w podziale na klasy wykazuje, że ogólne poprawy wydajności nie rozłożyły się równomiernie we wszystkich kategoriach pokrycia terenu. Na przykład kilka klas mniejszościowych i spektralnie podobnych kategorii miejskich pozostało stosunkowo trudnymi do sklasyfikowania, a zaobserwowana różnica między OA a AA, szczególnie w przypadku zbioru danych Augsburg, odzwierciedla wpływ niezbilansowania klas wraz ze zmienną wydajnością na poziomie klas. W związku z tym zgłoszone zagregowane metryki należy interpretować wspólnie z wynikami dla poszczególnych klas, a nie jako dowód jednolitych usprawnień w każdej kategorii.
Eksperymenty ablacyjne dodatkowo potwierdzają proponowaną konstrukcję. Usunięcie modułu multimodalnego dopasowania przepływu (multimodal flow matching) obniżyło zagregowaną wydajność klasyfikacji we wszystkich trzech zbiorach danych referencyjnych, podczas gdy wariant przepływu jednokierunkowego konsekwentnie wykazywał wyniki pośrednie między pełnym modelem a modelem bez wyrównania przepływu. Obserwacje te są zgodne z hipotezą roboczą, według której dwukierunkowy transport cech może poprawić odpowiedniość międzymodalną przed fuzją cech w ocenianych warunkach referencyjnych. Podobnie analiza integracji przepływu wykazała, że pośrednia dyskretyzacja wyuczonej trajektorii transportu zapewniła najwyższą zagregowaną wydajność, przy czym sześć kroków integracji stanowi nominalny punkt pracy w obecnej implementacji. Wzrost wydajności stał się marginalny lub nieznacznie spadł przy dodatkowych krokach integracji, co sugeruje, że coraz bardziej szczegółowa dyskretyzacja może przynosić malejące korzyści w ocenianych warunkach eksperymentalnych. Kwestia tego, czy ten punkt pracy jest generalizowalny na inne zbiory danych, modalności sensoryczne lub architektury sieci, pozostaje do zbadania.
Przy interpretacji niniejszych wyników należy wziąć pod uwagę kilka ograniczeń. Po pierwsze, ewaluacja była ograniczona do trzech publicznie dostępnych zbiorów danych referencyjnych z wykorzystaniem stałych podziałów treningowych/testowych oraz jednego ziarna losowego. W konsekwencji nie oceniono niepewności wynikającej z wielokrotnych uruchomień, przedziałów ufności, istotności statystycznej ani zmienności między uruchomieniami. Po drugie, metody porównawcze zostały zaczerpnięte z ich odpowiednich publikacji, a nie zaimplementowane ponownie w ramach wspólnego schematu eksperymentalnego; dlatego zgłoszone porównania należy interpretować opisowo, a nie jako kontrolowane, bezpośrednie reprodukcje. Po trzecie, nie zbadano odporności na brakujące modalności, zaszumione obserwacje, błędną rejestrację przestrzenną oraz generalizację międzyregionalną. Ponadto, choć dopasowanie przepływów (flow matching) dostarcza teoretycznych podstaw dla ciągłego i potencjalnie odwracalnego transportu cech15,16,17, dokładna odwracalność, zachowanie topologii oraz interpretowalność fizyczna wyuczonych transformacji nie zostały empirycznie zweryfikowane w niniejszym badaniu. Podobnie nie przeprowadzono oddzielnej analizy charakterystyki obliczeniowej, w tym czasu wnioskowania, zużycia pamięci oraz złożoności operacji zmiennoprzecinkowych.
Alternatywne podejścia do badania dopasowania multimodalnego wciąż ewoluują. W niedawnych badaniach analizowano uczenie kontrastowe, fuzję opartą na grafach, uczenie reprezentacji niskiego rzędu, multimodalne uczenie sterowane promptami, uczenie federacyjne oraz hybrydowe architektury konwolucyjno-transformerowe w celu usprawnienia integracji cech multimodalnych23,26,27,28,35,36,37,38,39. Strategie te pozostają komplementarne, a nie wzajemnie wykluczające się, a przyszłe prace mogą badać kombinacje jawnego transportu cech opartego na przepływach z istniejącymi paradygmatami dopasowania. Poza klasyfikacją pokrycia terenu, ciągłe dopasowanie cech może mieć zastosowanie również w pokrewnych zadaniach multimodalnego teledetekcji, w tym w segmentacji semantycznej, detekcji zmian, rozpoznawaniu obiektów, monitoringu środowiska, ocenie skutków katastrof, rolnictwie precyzyjnym oraz mapowaniu miejskim, gdzie coraz bardziej dostępne są komplementarne tryby teledetekcji2,3,4,5,6,7,8,9,23.
Przyszłe badania powinny ocenić proponowany model w bardziej zróżnicowanych warunkach eksperymentalnych, uwzględniając analizy statystyczne z powtórzeniami, profilowanie obliczeniowe, odporność na brakujące lub zaszumione modalności, czułość na błędy rejestracji przestrzennej oraz ocenę transferu między regionami. Dodatkowe badania analizujące alternatywne parametryzacje przepływu, różne architektury enkoderów oraz większe multimodalne zbiory danych benchmarkowych pozwoliłyby lepiej określić generalizowalność i praktyczną przydatność proponowanej metodologii. Podsumowując, obecne wyniki wskazują, że jawne dopasowanie cech poprzez warunkowe dopasowanie przepływu stanowi obiecującą strategię uzupełniającą dla multimodalnej klasyfikacji teledetekcyjnej, wskazując jednocześnie na szereg możliwości dalszego rozwoju metodologicznego i kompleksowej oceny.
Oświadczenia
Konflikt interesów:
Autorzy deklarują, że nie występuje konflikt interesów.
Podziękowania
This work was financially supported by the Scientific Research Fund Project of Shaanxi A&F University (Grant No. ZK25-38) and the Education Department of Shaanxi Province (Grant No. 24JK0734).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Optymalizator AdamW | PyTorch Foundation | Zawarty w PyTorch | Wykorzystany do optymalizacji modelu. Użyto wersji PyTorch 2.5.0. |
| Zbiór danych referencyjnych Augsburg | Hu J et al. (Earth System Science Data, 2022); Remote Sensing Technology, LMU Munich | https://doi.org/10.5281/zenodo.7185498 | Publiczny multimodalny zbiór danych referencyjnych do teledetekcji, wykorzystany do ewaluacji modelu. |
| CUDA Toolkit | NVIDIA | CUDA Toolkit 12.4; https://developer.nvidia.com/cuda-12-4-0-download-archive | Wykorzystany do trenowania i inferencji modelu z akceleracją GPU. |
| Jednostka przetwarzania graficznego (GPU) | NVIDIA Corporation | NVIDIA A100 80 GB PCIe | Wykorzystana do trenowania i ewaluacji modelu. |
| Zbiór danych referencyjnych Houston2013 | IEEE Geoscience and Remote Sensing Society Data Fusion Contest | http://www.grss-ieee.org/community/technical-resources/data-fusion/2013-grss-data-fusion-contest/ | Publiczny zbiór danych referencyjnych obrazowania hiperspektralnego i LiDAR, wykorzystany do ewaluacji modelu. |
| Zbiór danych referencyjnych MUUFL Gulfport | University of Florida (Gader P et al., Technical Report REP-2013-570) | https://github.com/GatorSense/MUUFLGulfport | Publiczny zbiór danych referencyjnych obrazowania hiperspektralnego i LiDAR, wykorzystany do ewaluacji modelu. |
| System operacyjny | Canonical Ltd. | Ubuntu 22.04 LTS; https://ubuntu.com | Środowisko obliczeniowe wykorzystane do opracowania, trenowania i ewaluacji modelu. |
| PyTorch | PyTorch Foundation | PyTorch 2.5.0; https://pytorch.org/get-started/previous-versions/#v250 | Framework deep learning wykorzystany do implementacji, trenowania i ewaluacji modelu FlowErs. |
| Python | Python Software Foundation | Python 3.11; https://www.python.org/downloads/release/python-3110/ | Język programowania wykorzystany do implementacji i wykonania przepływu obliczeń. |
Bibliografia
- Geng X, et al. Fast and effective: Progressive hierarchical fusion classification for remote sensing images. IEEE Trans Multimed. 2024;26:9776–89.
- Tian F, et al. HireNet: Hierarchical-relation network for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–10.
- Ye Z, et al. A multiscale incremental learning network for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Li Q, Chen Y, He X, Huang L. Co-training transformer for remote sensing image classification, segmentation, and detection. IEEE Trans Geosci Remote Sens. 2024;62:1–18.
- Qin A, et al. Deep updated subspace networks for few-shot remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Wang S, et al. Personalized multiparty few-shot learning for remote sensing scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Yang JY, et al. Multifrequency graph convolutional network with cross-modality mutual enhancement for multisource remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Zhou G, Qian L, Gamba P. A novel iterative self-organizing pixel matrix entanglement classifier for remote sensing imagery. IEEE Trans Geosci Remote Sens. 2024;62:1–21.
- Zhu J, et al. MVP: Meta visual prompt tuning for few-shot remote sensing image scene classification. IEEE Trans Geosci Remote Sens. 2024;62:1–13.
- Gat I, et al. Discrete flow matching. Adv Neural Inf Process Syst. 2024;37:133345–85.
- Miller BK, Chen RT, Sriram A, Wood BM. FlowMM: Generating materials with Riemannian flow matching [Internet]. 2024 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2406.04713
- Xin Y, et al. Confidence-weighted dual-teacher networks with biased contrastive learning for semi-supervised semantic segmentation in remote sensing images. IEEE Trans Geosci Remote Sens. 2024;62:1–16.
- He Y, et al. IGroupSS-Mamba: Interval group spatial-spectral Mamba for hyperspectral image classification. IEEE Trans Geosci Remote Sens. 2024;62:1–14.
- Liao D, Wang Q, Lai T, Huang H. Joint classification of hyperspectral and LiDAR data based on Mamba. IEEE Trans Geosci Remote Sens. 2026;19:11445–61.
- Lipman Y, et al. Flow matching for generative modeling [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=PqvMRDCJT9t
- Liu X, et al. Flow straight and fast: Learning to generate and transfer data with rectified flow [conference paper]. Presented at: 11th International Conference on Learning Representations (ICLR); 2023. Available from: https://openreview.net/forum id=XVjTT1nw5z
- Geng Z, et al. Consistency models made easy [conference paper]. Presented at: 13th International Conference on Learning Representations (ICLR); 2025. Available from: https://openreview.net/forum id=1x7sJYh37d
- Hu VT, et al. Latent space editing in transformer-based flow matching [conference paper]. Presented at: AAAI Conference on Artificial Intelligence; 2024;38:2247–55. Available from: https://doi.org/10.1609/aaai.v38i3.28014
- Jeong J, Kim K, Kim W, Kim NJ. Real-time person image synthesis using a flow matching model [Internet]. 2025 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/2505.03562
- Kakesh MH, et al. An efficient data generation method based on flow matching for bearing fault diagnosis under imbalanced data conditions. IEEE Trans Energy Convers. 2026;1–11.
- Chu Z, et al. End-to-end seam tracking with flow matching-based diffusion policy [conference paper]. Presented at: International Conference on Machine Intelligence and Nature-Inspired Computing (MIND); Xiamen, China; 2025. p. 304–9. Available from: https://doi.org/10.1109/MIND67540.2025.11351867
- Melgani F, Bruzzone L. Classification of hyperspectral remote sensing images with support vector machines. IEEE Trans Geosci Remote Sens. 2004;42:1778–90.
- Li J, et al. Deep learning in multimodal remote sensing data fusion: A comprehensive review. Int J Appl Earth Obs Geoinf. 2022;112:102926.
- Vaswani A, et al. Attention is all you need [Internet]. 2017 [cited 2026 Jul 6]. Available from: https://arxiv.org/abs/1706.03762
- Zhuang Y, Chen M, Zhu D. UWASR-GAN: An attention-guided multi-scale residual framework for underwater image enhancement in underwater Internet of Things applications. IEEE Internet Things J. 2026;12:29452–71.
- Ma X, Zhang X, Pun MO, Liu M. A multilevel multimodal fusion transformer for remote sensing semantic segmentation. IEEE Trans Geosci Remote Sens. 2024;62:1–15.
- Xie W, Lu Y, Li D, Li Y. Ebbinghaus-curve guided low-rank component-induced attention for multisource remote sensing classification. IEEE Trans Geosci Remote Sens. 2024;62:1–12.
- Li D, Xie W, Li Y, Fang L. FedFusion: Manifold-driven federated learning for multi-satellite and multi-modality fusion. IEEE Trans Geosci Remote Sens. 2023;62:1–13.
- Debes C, et al. Hyperspectral and LiDAR data fusion: Outcome of the 2013 GRSS data fusion contest. IEEE J Sel Top Appl Earth Obs Remote Sens. 2014;7:2405–18.
- Hu J, et al. MDAS: A new multimodal benchmark dataset for remote sensing. Earth Syst Sci Data Discuss. 2022:1–26.
- Gader P, et al. MUUFL Gulfport hyperspectral and LiDAR airborne data set. University of Florida; Gainesville (FL); Technical Report REP-2013-570; 2013.
- Gao Y, et al. Hyperspectral and multispectral classification for coastal wetland using depthwise feature interaction network. IEEE Trans Geosci Remote Sens. 2021;60:1–15.
- Feng Y, Song L, Wang L, Wang X. DSHFNet: Dynamic scale hierarchical fusion network based on multiattention for hyperspectral image and LiDAR data classification. IEEE Trans Geosci Remote Sens. 2023;61:1–14.
- Hong D, et al. More diverse means better: Multimodal deep learning meets remote-sensing imagery classification. IEEE Trans Geosci Remote Sens. 2020;59:4340–54.
- Feng Z, et al. Cross-modal contrastive learning for remote sensing image classification. IEEE Trans Geosci Remote Sens. 2023;61:1–13.
- Xu X, et al. Multisource remote sensing data classification based on convolutional neural network. IEEE Trans Geosci Remote Sens. 2017;56:937–49.
- Yao J, et al. Extended vision transformer (ExViT) for land use and land cover classification: A multimodal deep learning framework. IEEE Trans Geosci Remote Sens. 2023;61:1–15.
- Chang H, et al. Deep symmetric fusion transformer for multimodal remote sensing data classification. IEEE Trans Geosci Remote Sens. 2024;63:1–15.
- Wang A, et al. CTPMSN: Enhancing multimodal remote sensing classification with composite text prompts. IEEE J Sel Top Appl Earth Obs Remote Sens. 2025;18:27960–27978.