Niniejszy protokół opisuje ustrukturyzowaną metodologię projektowania usług służącą do diagnozowania złożonych problemów w niskoryzykownych procesach konsultacyjnych oraz aplikacyjnych w ramach usług publicznych. Podejście to integruje mapowanie interesariuszy, mapowanie podróży użytkownika, współprojektowanie oraz prototypowanie niskiej wierności, wraz z symulowaną, opartą na zadaniach oceną zachowań użytkowników, procesów podejmowania decyzji oraz użyteczności materiałów serwisowych przed ich wdrożeniem.
Artykuł metodologiczny
Systemowy protokół wizualizacji projektowania usług dla złożonych problemów w procesach konsultacji i stosowania niskoryzykownych usług publicznych
21 wyświetleń
⸱
11 września 2026
W tym artykule
Podsumowanie
Streszczenie
Złożone problemy w usługach publicznych o charakterze „złośliwych” (wicked problems), obejmujące wielu interesariuszy, rozproszone informacje, niejasne granice odpowiedzialności oraz brak jednego, bezspornego rozwiązania, są trudne do ustrukturyzowania w rutynowych warunkach administracyjnych. Niniejszy artykuł przedstawia systematyczny protokół wizualizacji projektowania usług dla niskoryzykownych zastosowań w usługach publicznych oraz procesów konsultacyjnych, definiowanych jako usługi administracyjne, które nie rozstrzygają o leczeniu medycznym, statusie prawnym, kwalifikowalności finansowej, ochronie dzieci, wynikach postępowań dyscyplinarnych ani innych decyzjach o wysokim stopniu ryzyka wpływających na prawa obywatelskie. Protokół integruje mapowanie interesariuszy, mapowanie ścieżki klienta w usługach publicznych, współprojektowanie metodą Double Diamond oraz testowanie prototypów niskiej wierności, aby przekształcić rozproszone wyzwania administracyjne w możliwe do wdrożenia, współprojektowane koncepcje usług i ocenić je za pomocą symulowanych zadań. W reprezentatywnej ścieżce niskoryzykownej aplikacji administracyjnej, testowanie symulowanych zadań z udziałem 28 uczestników (12 zapisów zadań bazowych i 12 zapisów zadań po prototypowaniu) wykazało krótszy czas realizacji zadań (178.4 ± 49.6 s–121.7 ± 38.2 s), mniej błędów (1.86 ± 0.91–0.79 ± 0.63 błędu na zadanie) oraz wyższy wskaźnik sukcesu w zadaniach (62.5%–82.1%) po zapoznaniu się z materiałami wygenerowanymi zgodnie z protokołem. Wyniki te stanowią dowody użyteczności oparte na zadaniach, ponieważ stała sekwencja przed i po może obejmować efekty uczenia się. Ten reprodukowalny protokół zapewnia ustrukturyzowane, oparte na wizualizacji podejście do diagnozowania złożonych problemów w usługach publicznych i prototypowania rozwiązań w niskoryzykownych środowiskach administracyjnych.
Wprowadzenie
Organizacje usług publicznych coraz częściej mierzą się ze złożonymi wyzwaniami, których nie da się rozwiązać za pomocą prostych korekt administracyjnych. Problemy te charakteryzują się udziałem wielu podmiotów, rozproszoną odpowiedzialnością, nierównym dostępem do informacji oraz napięciami między ustandaryzowanymi procedurami administracyjnymi a zróżnicowanymi potrzebami użytkowników. Zamiast twierdzić, że takie problemy można rozwiązać za pomocą w pełni powtarzalnego wzoru, niniejszy protokół traktuje je jako ograniczone, niskoryzykowne problemy usługowe o cechach problemów „złośliwych” (wicked problems), które mogą zostać ustrukturyzowane, zwizualizowane i zbadane poprzez powtarzalne kroki facylitacji1,2. W rutynowym świadczeniu usług publicznych problemy te objawiają się jako awarie operacyjne: obywatele mają trudności z zidentyfikowaniem wymaganych materiałów, pracownicy pierwszej linii styku mierzą się z powtarzającymi się zapytaniami, a administratorzy egzekwują zasady, które nie są bezpośrednio widoczne dla użytkowników końcowych.
Aby rozwiązać te złożone problemy, innowacje w usługach publicznych przesunęły się z reformy wewnętrznej wydajności w stronę podejść partycypacyjnych i zorientowanych na użytkownika. Aktualne badania wskazują, że współtworzenie (co-creation) i współprodukcja (co-production) umożliwiają obywatelom, specjalistom oraz organizacjom wspólny wkład w innowacje usługowe3,4,5. Jednak ta zmiana w kierunku partycypacji wprowadza wyzwanie metodologiczne. Choć różnorodni interesariusze mogą zgadzać się, że dana usługa jest niewydajna, rzadko osiągają konsensus co do tego, gdzie następuje załamanie strukturalne, kto jest najbardziej dotknięty problemem lub jakie konkretne interwencje są wymagane.
Niniejszy protokół jest przeznaczony dla badaczy w dziedzinie projektowania usług, badaczy administracji publicznej, zespołów ds. usprawniania usług miejskich lub uniwersyteckich oraz przeszkolonych facylitatorów, którzy potrzebują powtarzalnego podejścia do przekształcania skarg wielu interesariuszy w wizualne materiały diagnostyczne przed wdrożeniem. Jest on najbardziej odpowiedni dla zastosowań o niskim stopniu ryzyka, takich jak usługi konsultacyjne, rejestracyjne, sprawdzanie statusu oraz usługi obserwacyjne, w których użytkownicy muszą interpretować wymagania, przygotowywać materiały, przechodzić przez wiele etapów usługi i koordynować działania z wieloma podmiotami. Nie należy go stosować jako głównej metody w sytuacjach podejmowania decyzji w stanach nagłych, w przypadku wysoce wystandaryzowanych transakcji z ustalonymi procedurami jednoetapowymi, w orzecznictwie prawnym, leczeniu medycznym, ochronie dzieci, decyzjach dotyczących statusu imigracyjnego, ustalaniu pomocy finansowej, procesach dyscyplinarnych ani w żadnym środowisku wymagającym dostępu do zidentyfikowanych akt spraw.
W porównaniu do samodzielnej analizy interesariuszy, mapowania podróży użytkownika czy warsztatów partycypacyjnych, proponowany schemat pracy łączy mapowanie aktorów, szczegółową analizę usług na poszczególnych etapach, wspólne formułowanie wyzwań oraz symulowane testowanie prototypów w ramach jednej, weryfikowalnej sekwencji. Taka integracja zapobiega przechodzeniu zespołów bezpośrednio od ogólnego niezadowolenia do pomysłów na rozwiązania, z pominięciem wcześniejszej identyfikacji osób dotkniętych problemem, miejsca występowania błędów oraz materiałów, które można bezpiecznie przetestować. Niedawne przeglądy projektowania partycypacyjnego w sektorze publicznym i zdrowiu publicznym również podkreślają potrzebę przejrzystych procesów, jawnej facylitacji oraz uważnej oceny dynamiki uczestnictwa i władzy4,6,7,8,9.
Projektowanie usług (service design) oferuje praktyczne ramy do rozwiązania tego problemu poprzez metody wizualne, partycypacyjne i zorientowane na prototypowanie6,8,10. Zamiast traktować błędy w usługach jako abstrakcyjne deficyty w polityce, projektowanie usług analizuje interakcje między użytkownikami, personelem, punktami styku a procesami zapleczowymi. W związku z tym, w administracji publicznej coraz częściej proponuje się współprojektowanie (co-design) jako sposób angażowania obywateli w definiowanie złożonych problemów4,7,1. Jednak inicjatywy współprojektowania często okazują się niewystarczające, gdy brakuje im strukturalnego mechanizmu przekładania subiektywnych doświadczeń interesariuszy na testowalne materiały usług publicznych lub gdy nie zarządzają one w sposób jawny różnicami w zakresie władzy i wpływów wśród uczestników.
Rygorystyczne przejście metodologiczne wymaga sekwencyjnej integracji specyficznych narzędzi analitycznych. Mapowanie interesariuszy służy jako baza diagnostyczna poprzez wyjaśnienie zaangażowania aktorów, ich wpływów, zależności oraz asymetrii informacji12. Następnie wykorzystuje się mapowanie ścieżki klienta (journey mapping), aby zidentyfikować konkretne punkty krytyczne (pain points) oraz niejasności w zakresie odpowiedzialności na poszczególnych etapach świadczenia usług13. W dalszej kolejności model Double Diamond zapewnia ustrukturyzowaną ścieżkę przekształcania tych zmapowanych dysfunkcji w możliwe do realizacji wyzwania projektowe, oddzielając dywergentną eksplorację problemu od konwergentnego opracowywania rozwiązań7,8,14. Na koniec testowanie prototypów niskiej wierności (low-fidelity) umożliwia bezpieczną ocenę współprojektowanych koncepcji przed ich wdrożeniem — jest to krok niezbędny w usługach publicznych, gdzie przedwczesne zmiany mogą zakłócić dostęp obywateli lub zwiększyć obciążenie administracyjne15,16.
Pomimo rosnącej liczby wytycznych metodologicznych dotyczących tych narzędzi, odtwarzalność pozostaje krytycznym ograniczeniem w literaturze przedmiotu dotyczącej współprojektowania usług publicznych6,7,8,17. Wiele badań opisuje warsztaty projektowe w sposób ogólny, co zaciera precyzyjne kroki analityczne niezbędne do niezależnej replikacji. Rygorystyczna metoda powinna ustanowić stałe etapy, określony przydział czasu, zestandaryzowane zasady punktacji, spójne wyniki wizualne oraz przejrzyste kryteria podejmowania decyzji. Co więcej, powinna ona wyraźnie odróżniać ocenę użyteczności opartej na zadaniach na wczesnym etapie od szerszych twierdzeń dotyczących wydajności agentów w rzeczywistych warunkach.
Niniejszy artykuł przedstawia systematyczny protokół wizualizacji projektowania usług, opracowany w celu ustrukturyzowania złożonych problemów z udziałem wielu interesariuszy w obszarze niskoryzykowych innowacji w usługach publicznych4,6,16,17. Protokół, zaprojektowany specjalnie dla procesów konsultacyjnych i aplikacyjnych w usługach publicznych, sekwencyjnie integruje mapowanie interesariuszy, mapowanie podróży użytkownika, warsztat Double Diamond oraz testowanie prototypów. Nadrzędnym celem jest dostarczenie badaczom i praktykom wysoce powtarzalnego, krok po kroku opisanego podejścia, pozwalającego przejść od rozproszonych skarg na usługi do wizualnej diagnozy, obiektywnego zdefiniowania problemu oraz empirycznego testowania współprojektowanych koncepcji usług.
Protokół
Reprezentatywne zastosowanie opisane w niniejszym artykule zostało zatwierdzone przez Komitet Etyki ds. Ochrony Badań na Ludziach w City University of Macau, Macau, Chiny (numer zatwierdzenia 2600AL2401; ważne od 10 stycznia 2026 r. do 10 stycznia 2028 r.). Przed przystąpieniem do badania od wszystkich uczestników uzyskano pisemną lub elektroniczną świadomą zgodę. Protokół nie obejmował interwencji medycznych, populacji wrażliwych, wprowadzania w błąd, próbek biologicznych, prywatnych danych finansowych, indywidualnej oceny wyników ani dostępu do oficjalnych rejestrów administracyjnych. Narzędzia badawcze wykorzystane w protokole wymieniono w Tabeli materiałów.
1. Rekrutacja uczestników i definicja kontekstu
- Wybierz aplikację usługi publicznej o niskim poziomie ryzyka oraz proces konsultacji do oceny, np. gminną, uniwersytecką lub lokalną ścieżkę administracyjną, która wymaga wyszukiwania informacji, wyjaśnienia kwalifikowalności, przygotowania materiałów, złożenia wniosku, przetwarzania, powiadomienia i wsparcia po realizacji.
- Wyklucz konteksty obejmujące leczenie medyczne, prowadzenie spraw prawnych, status imigracyjny, ochronę dzieci, ustalanie pomocy finansowej, procedury dyscyplinarne, decyzje w sytuacjach awaryjnych lub oficjalne akta administracyjne.
- Uznaj problem usługi publicznej za odpowiedni do niniejszego protokołu, jeśli wykazuje on co najmniej trzy złożone cechy typu „wicked problem” (problemy odporne na rozwiązanie): zaangażowanie wielu grup interesariuszy, niejasne granice odpowiedzialności, powtarzające się błędy w koordynacji między podmiotami, niepełne lub niespójne informacje o usługach oraz brak jednego uzgodnionego rozwiązania.
UWAGA: Nie przedstawiaj protokołu jako rozwiązania w pełni „złośliwego” problemu (wicked problem). Przedstaw go jako sposób strukturyzacji ograniczonego, niskoryzykownego problemu usługi publicznej w celu diagnozy, współprojektowania i testowania symulacyjnego. - Zrekrutuj 80–120 uczestników do etapu kwestionariuszowego na podstawie ich znajomości korzystania, świadczenia, koordynacji lub zarządzania usługami publicznymi.
- Przyjmij tę wielkość próby jako pragmatyczny cel planowania, aby zapewnić stabilne opisowe profile interesariuszy w kilku grupach ról, zachowując jednocześnie wykonalność nieinterwencyjnego badania projektowania usług.
- Wybierz uczestników reprezentujących wszystkie główne role interesariuszy zaangażowanych w proces usługi publicznej.
- Stwórz podgrupę 20–30 uczestników, którzy wezmą udział w warsztatach współprojektowania oraz w etapach testowania prototypów.
- Sformuj 4–6 grup warsztatowych o mieszanych rolach, dbając o to, aby każda grupa była wystarczająco mała, by umożliwić aktywny udział.
- Upewnij się, że każda grupa o mieszanych rolach obejmuje co najmniej trzy kategorie interesariuszy, np. obywateli, pracowników pierwszej linii obsługi, pracowników społecznych lub administratorów.
- Rozdziel obywateli i dostawców usług podczas wstępnych dyskusji nad mapowaniem interesariuszy, jeśli spodziewane są nierówności w relacjach władzy.
- Przeprowadź syntezę w grupach o mieszanych rolach po wstępnych dyskusjach. Podczas syntezy stosuj ustrukturyzowaną kolejność wypowiedzi, pisemne formułowanie pomysłów w ciszy, anonimowe przesyłanie kart oraz anonimowe głosowanie kropkowe, aby zapobiec dominowaniu wkładu obywateli przez administratorów lub kadrę profesjonalną.
- Zwróć szczególną uwagę na rekrutację uczestników, przygotowanie ról oraz warunki, które pozwalają użytkownikom wnosić własne pomysły, a nie tylko odpowiadać na problemy zdefiniowane przez ekspertów7,9,18.
- Poinstruuj wszystkich uczestników, aby nie ujawniali imion i nazwisk, numerów identyfikacyjnych, adresów domowych, numerów telefonów, identyfikatorów spraw, dokumentacji medycznej, akt prawnych, danych o dochodach ani plików z wynikami pracy agencji.
- Przypisz nieidentyfikowalne kody uczestników (np. P001 i P002).
- Przeszkol wszystkich facylitatorów przed rozpoczęciem zbierania danych, korzystając z tego samego scenariusza facylitacji, przykładowych kart punktów zapalnych (pain-points), rubryki wyzwań projektowych oraz przykładów oceny prototypów.
- KROK KRYTYCZNY: Skalibruj facylitatorów, prosząc ich o niezależną klasyfikację co najmniej pięciu przykładowych punktów zapalnych i pięciu roboczych stwierdzeń typu „Jak moglibyśmy” (How might we).
UWAGA: Facylitatorzy muszą osiągnąć co najmniej 80% zgodności w decyzjach dotyczących włączenia, grupowania i rewizji przed przejściem dalej. - Omów rozbieżności, dopóki facylitatorzy nie osiągną co najmniej 80% zgodności w decyzjach dotyczących włączenia, grupowania i rewizji.
- W miarę możliwości korzystaj z co najmniej dwóch facylitatorów: jednego głównego facylitatora prowadzącego dyskusję oraz jednego obserwatora rejestrującego czas, równowagę w udziale uczestników i odchylenia od protokołu.
- Jeśli wielu facylitatorów prowadzi równoległe grupy, przeprowadź 15–20 min podsumowanie (debriefing) po każdym głównym etapie i odnotuj wszelkie różnice w podpowiedziach lub zasadach interpretacji w arkuszu audytu.
OSTRZEŻENIE: Po zakończeniu rekrutacji uczestników, uzyskaniu zgód, przeszkoleniu facylitatorów i przygotowaniu materiałów badacze mogą zrobić przerwę przed rozpoczęciem Etapu 1. Wznów prace dopiero po potwierdzeniu, że wszyscy uczestnicy mają przypisane kody, a wszystkie arkusze robocze nie zawierają żadnych danych identyfikacyjnych.
2. Przygotowanie materiałów do protokołu
- Przygotuj materiały do protokołu przed jego wdrożeniem.
- Przygotuj arkusz informacji dla uczestnika, anonimowy kwestionariusz oparty na rolach, arkusz mapowania interesariuszy, arkusz pięciostopniowej oceny interesariuszy, szablon mapowania ścieżki usług publicznych, karty punktów zapalnych (pain-points), szablon wyzwania projektowego, karty rozwiązań, arkusz wyboru prototypu, rubrykę kalibracji facylitatora, arkusze zadań symulowanych, listę kontrolną ekwiwalentności zestawów zadań, rubrykę oceny prototypu, arkusz kodowania, składnię analizy lub notatki dotyczące przepływu pracy oraz listę kontrolną deidentyfikacji.
- Przypisz każdemu materiałowi specyficznemu dla badania trwały wewnętrzny identyfikator oraz numer wersji.
- Zorganizuj szablon mapowania ścieżki w siedmiu domyślnych etapach: wyszukiwanie informacji, wyjaśnianie kwalifikowalności lub wymagań, przygotowanie materiałów, złożenie wniosku, przetwarzanie międzywydziałowe, powiadomienie o wyniku oraz wsparcie po realizacji.
- Modyfikuj nazwy etapów dopiero po udokumentowaniu różnic między wybraną usługą a domyślną, niskoryzykowną ścieżką wnioskowania administracyjnego.
- Zachowaj tę samą sekwencję punktów styku, odpowiedzialnych podmiotów, danych wejściowych, wyników, punktów zapalnych oraz konsekwencji dalszych.
- Zaprojektuj symulowane scenariusze usług publicznych do arkuszy zadań prototypowych, nie uwzględniając żadnych rzeczywistych danych osobowych, administracyjnych ani agencyjnych.
- Zapoznaj się z Tabelą 1 w celu sprawdzenia etapów, przydziału czasu, materiałów i predefiniowanych wyników wymaganych dla protokołu.
- Zapoznaj się z Tabelą 2 w celu sprawdzenia elementów zbierania danych, reguł punktacji, progów ważności oraz mechanizmów ochrony danych.
- Wykorzystaj metody projektowania usług (service design), aby uczynić złożone problemy w obszarze usług publicznych widocznymi, możliwymi do omówienia i przetestowania19.
Tabela 1: Etapy protokołu, czas trwania, wymagane materiały i zdefiniowane wyniki.Przebieg protokołu obejmuje główne czynności, uczestników, szacowany czas realizacji, wymagane materiały oraz oczekiwane wyniki dla każdego etapu.Proszę kliknąć tutaj, aby pobrać tę tabelę.
Tabela 2: Metryki gromadzenia danych, metody, kryteria wykluczenia i mechanizmy ochrony danych. Metryki gromadzone na każdym etapie protokołu, odpowiadające im metody gromadzenia danych, zdefiniowane kryteria wykluczenia oraz środki podjęte w celu ochrony poufności uczestników i integralności danych.Kliknij tutaj, aby pobrać tę tabelę.
3. Etap 1: Mapowanie interesariuszy
- Poleć uczestnikom skorzystanie z arkusza mapowania interesariuszy w celu indywidualnego wypisania od pięciu do ośmiu aktorów zaangażowanych w wybrany proces usługi publicznej.
- Przeznacz 25–35 min na etap mapowania interesariuszy.
- W celu zapoznania się z ogólnym schematem protokołu wizualizacji odwołaj się do Rysunku 1.
- Poproś uczestników o ocenę każdego wymienionego aktora w czterech wymiarach, używając zakotwiczonej skali pięciostopniowej (1 = bardzo niski; 5 = bardzo wysoki): wpływ na wynik usługi, zależność od innych aktorów, dostęp do informacji o usłudze oraz presja koordynacyjna.
- Przedstaw pisemne przykłady, zanim uczestnicy dokonają ocen.
- Zdefiniuj wysoki wpływ jako aktora, którego decyzja, opóźnienie lub interpretacja w istotny sposób wpływają na wynik usługi.
- Zdefiniuj wysoką zależność jako aktora, który nie może ukończyć procesu usługi bez informacji, potwierdzenia lub działania innych aktorów.
- Oblicz średnią ocenę dla każdej grupy interesariuszy w każdym wymiarze.
- Oznacz rozbieżność wynoszącą dwa punkty lub więcej między grupami interesariuszy w tym samym wymiarze jako lukę w percepcji, ponieważ reprezentuje ona przesunięcie o co najmniej 40% skali pięciostopniowej i jest wystarczająco duża, aby stanowić podstawę do dyskusji podczas warsztatów, a nie być jedynie niewielkim szumem w ocenach.
- Każdą oznaczoną lukę w percepcji przenieś do dyskusji warsztatowej.
- Wykorzystaj wyniki mapowania interesariuszy, aby uwidocznić role aktorów, zależności, wpływ i asymetrie informacyjne przed rozpoczęciem prac nad nowym projektem20.
- Wygeneruj profil relacji aktorów zawierający kategorie interesariuszy, średnie oceny wymiarów oraz oznaczone luki w percepcji.
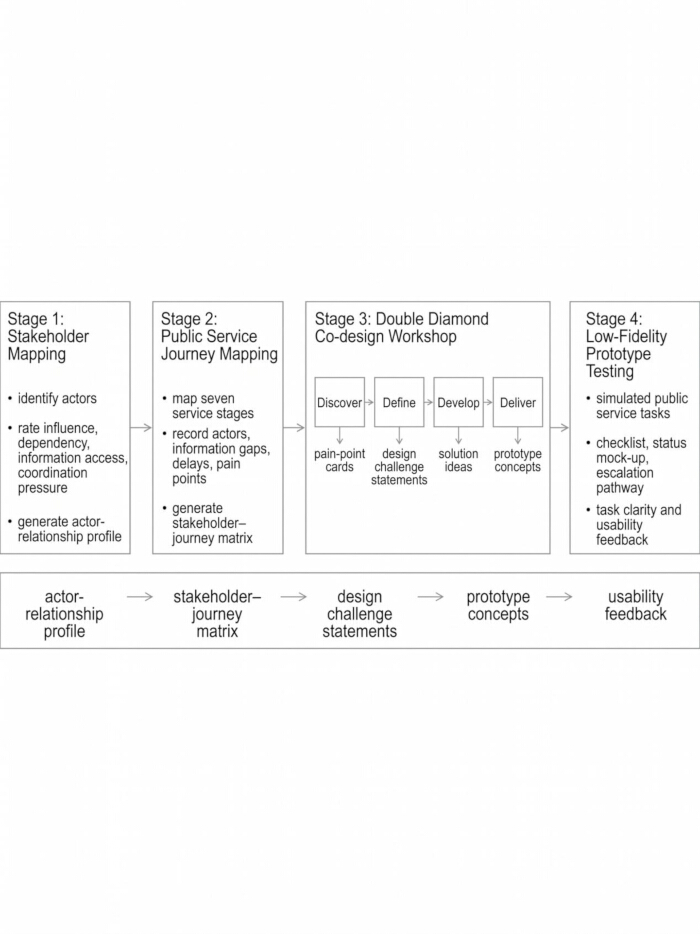
Rysunek 1: Ogólny schemat postępowania protokołu wizualizacji projektowania usług publicznych.Przepływ pracy składa się z czterech powiązanych etapów: mapowania interesariuszy, mapowania ścieżki użytkownika usług publicznych, współprojektowania w modelu Double Diamond oraz testowania prototypu. Wyniki obejmują profile relacji aktorów, macierze ścieżek interesariuszy, sformułowania wyzwań projektowych, koncepcje prototypów oraz wczesne informacje zwrotne dotyczące użyteczności. Fazy Discover, Define, Develop i Deliver w ramach modelu Double Diamond zostały wyróżnione, aby zilustrować przejście od dywergentnej eksploracji do konwergentnego opracowywania rozwiązań. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
4. Etap 2: Mapowanie ścieżki użytkownika w usługach publicznych
- Poprowadź podgrupę warsztatową przez proces mapowania siedmiostopniowego procesu usługowego.
- Przeznacz na ten etap od 45 do 60 min.
- Poleć uczestnikom zapisanie głównego aktora, informacji wejściowych, informacji wyjściowych, kanału komunikacji, typowego opóźnienia, punktu zapalnego (pain point), stopnia dotkliwości oraz konsekwencji dla każdego etapu.
- Poproś uczestników o ocenę dotkliwości każdego punktu zapalnego w skali pięciostopniowej (1 = niewielka niedogodność; 5 = poważna awaria mogąca wpłynąć na dostęp do usługi, wywołać formalną skargę lub spowodować znaczną eskalację).
- KROK KRYTYCZNY: Łącz punkty zapalne tylko wtedy, gdy odnoszą się one do tego samego etapu ścieżki, dotyczą tego samego rodzaju luki informacyjnej lub niejednoznaczności odpowiedzialności i prowadzą do podobnych konsekwencji w dalszych etapach.
- Zachowaj w surowym pliku kodowania punkty zapalne zgłoszone przez tylko jednego uczestnika. Nie nadawaj im priorytetu, chyba że otrzymały ocenę dotkliwości 4 lub 5.
- Utwórz zintegrowaną macierz ścieżki interesariuszy (Rysunek 2), aby zwizualizować występowanie punktów zapalnych (P), luk informacyjnych (I), niejednoznaczności odpowiedzialności (R) oraz możliwości przeprojektowania (O) w komórkach macierzy.
- Wykorzystaj mapowanie ścieżki do lokalizacji awarii usług w kolejnych punktach styku, zamiast traktować niezadowolenie lub opóźnienie jako pojedynczy, zagregowany wynik21.
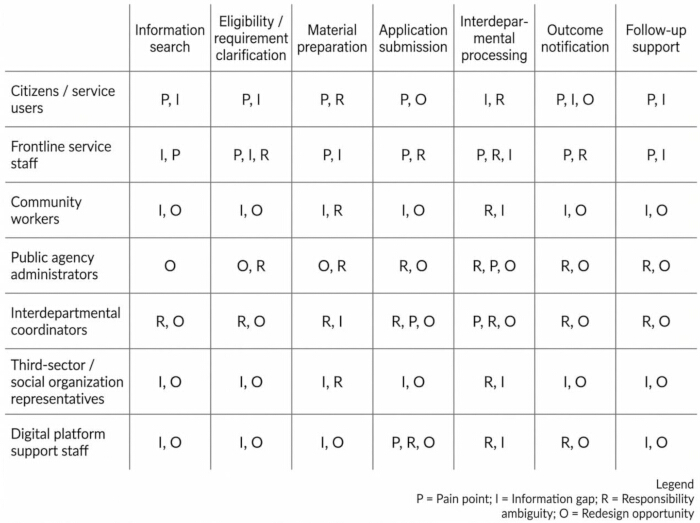
Rysunek 2: Zintegrowana macierz ścieżki interesariuszy do wizualizacji problemów w usługach publicznych. Macierz organizuje siedem etapów usługi publicznej na osi poziomej oraz główne grupy interesariuszy na osi pionowej. Każda komórka wskazuje obecność konkretnych problemów z usługą, oznaczonych następującymi skrótami: P = punkt zapalny (pain point); I = luka informacyjna; R = niejednoznaczna odpowiedzialność; O = szansa na przeprojektowanie. Macierz służy jako wizualny pomost między mapowaniem interesariuszy a współprojektowaniem, łącząc role interesariuszy z problemami specyficznymi dla poszczególnych etapów usługi. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
5. Etap 3: Warsztaty współprojektowania w modelu Double Diamond
- Przeprowadź warsztat współprojektowania (co-design) oparty na modelu Double Diamond podczas sesji trwającej od 2,5 do 3 h.
- Zastosuj ramowy model Double Diamond, aby oddzielić fazę dywergencyjnej eksploracji od fazy konwergencyjnego podejmowania decyzji7,8,14.
- Zapewnij udział obywateli, pracowników pierwszej linii, administratorów i organizacji partnerskich we współtworzeniu lub współprojektowaniu, zamiast polegać wyłącznie na wewnętrznej reformie prowadzonej przez ekspertów4,22.
- Zrealizuj fazę Discover (30–40 min).
- Poproś uczestników o przeanalizowanie macierzy podróży interesariuszy i dodanie brakujących kart z punktami zapalnymi (pain-points).
- Upewnij się, że każda poprawna karta punktu zapalnego zawiera zapis etapu podróży, dotkniętego aktora, awarię usługi, lukę informacyjną lub niejasność w odpowiedzialności oraz skutki pochodne.
- Zrealizuj fazę Define (40–50 min).
- Poproś każdego uczestnika o ciche wybranie trzech kart punktów zapalnych, które najlepiej reprezentują poważne awarie usług obejmujące wielu aktorów.
- Zastosuj anonimowe głosowanie kropkami lub ranking pisemny przed dyskusją otwartą, aby zredukować efekt statusu i dysproporcje władzy.
- Pogrupuj wybrane karty zgodnie z etapem podróży, dotkniętym aktorem, luką informacyjną lub niejasnością w odpowiedzialności oraz skutkami pochodnymi.
- Poproś facylitatora o odczytanie każdej grupy na głos i potwierdzenie przez uczestników, że karty opisują tę samą awarię usługi.
- Przekształć każdą grupę w pojedyncze sformułowanie wyzwania projektowego typu „Jak moglibyśmy” (How might we).
- Upewnij się, że każde sformułowanie wyzwania projektowego określa dotkniętego aktora, problematyczny etap podróży, awarię usługi oraz pożądany kierunek ulepszenia.
- Zweryfikuj każde wyzwanie projektowe za pomocą czteropunktowego rubryku oceniającego szczegółowość, jasność określenia aktora, powiązanie z mapowanymi dowodami oraz wykonalność testowania za pomocą prototypu niskiej wierności.
- Zrewiduj każde sformułowanie, które pomija aktora, łączy wiele niezwiązanych ze sobą awarii, przedwcześnie proponuje rozwiązanie lub nie może zostać przetestowane przy użyciu symulowanych materiałów usługowych.
- Zapisz pierwotny projekt, powód rewizji oraz ostateczne zatwierdzone sformułowanie w arkuszu audytowym.
OSTRZEŻENIE: Badacze mogą przerwać prace po zatwierdzeniu ostatecznych sformułowań wyzwań projektowych i wznowić je po przygotowaniu kart rozwiązań oraz arkuszy wyboru prototypów. - Zrealizuj fazę Develop (50–60 min).
- Poproś uczestników o wygenerowanie pomysłów ulepszenia usług dla każdego wyzwania projektowego i zapisanie ich na kartach rozwiązań.
- Wyklucz pomysły wymagające rzeczywistych danych przypadków, indywidualnych rejestrów kwalifikowalności, istotnych zmian prawnych lub politycznych bądź identyfikowalnych aktów administracyjnych.
- Zrealizuj fazę Deliver (30–40 min).
- Poproś uczestników o ocenę każdego pomysłu rozwiązania w pięciostopniowej skali pod kątem oczekiwanego wpływu na usługę, wykonalności wdrożenia, zgody interesariuszy oraz przydatności do testowania zadań symulowanych.
UWAGA: Wybierz koncepcje prototypów z wynikiem średnim co najmniej 4,0 zarówno dla wykonalności, jak i testowalności. Próg ten jest wymagany, aby zapewnić, że prototypy nadają się do testowania zadań symulowanych bez występowania wąskich gardeł wdrożeniowych.
6. Etap 4: Testowanie prototypu o niskiej wierności
- Opracuj prototypy o niskiej wierności (low-fidelity) dla priorytetowych koncepcji.
- Przygotuj trzy formaty prototypów: jednostronicową listę kontrolną wymagań usługi, makietę śledzenia statusu usługi oraz ścieżkę kontaktu zwrotnego lub eskalacji.
- KROK KRYTYCZNY: Przed testowaniem utwórz dwa dopasowane zestawy zadań. Upewnij się, że zestawy zadań są zrównoważone pod względem kroków decyzyjnych, długości tekstu do przeczytania, wymaganych pól, złożoności scenariusza i przewidywanego czasu wykonania.
- Dopasuj zestawy zadań pod kątem liczby kroków decyzyjnych, długości tekstu do przeczytania, wymaganych pól, złożoności scenariusza i przewidywanego czasu wykonania.
- Przeprowadź pilotaż dopasowanych zestawów zadań z trzema do pięciu użytkownikami spoza badania.
- Zrewiduj zestawy zadań, jeśli średni czas wykonania różni się o więcej niż 10%.
- Przeprowadź symulowane zadania z zakresu usług publicznych w celu oceny prototypów.
- W miarę możliwości zastosuj projekt zrównoważony (counterbalanced) lub z grupą kontrolną, aby odróżnić znajomość zadania od ekspozycji na prototyp.
- Jeśli wszyscy uczestnicy wykonają zadania bazowe przed zadaniami poekspozycyjnymi, odnotuj to jako potencjalne ryzyko wystąpienia efektu uczenia się w sekcjach Protokół, Wyniki i Dyskusja.
- Przed ekspozycją na prototyp przedstaw każdemu uczestnikowi cztery scenariusze zadań bazowych.
- Po ekspozycji na prototyp przedstaw cztery porównywalne, ale nie identyczne scenariusze zadań.
- Ustal maksymalny limit czasu wynoszący 5 min dla każdego zadania.
- Przeczytaj identyczne instrukcje do zadań każdemu uczestnikowi.
- Nie udzielaj wskazówek podczas wykonywania zadań. Ogranicz wyjaśnienia wyłącznie do pytań proceduralnych.
- Mierz czas wykonania zadania w sekundach, od momentu przedstawienia zadania do udzielenia ostatecznej odpowiedzi.
- Oznacz zadanie jako nieukończone, przypisz czas wykonania 300 s i zakoduj sukces zadania jako 0, jeśli uczestnik nie ukończy zadania w ciągu 5 min.
- Zakoduj zadanie jako wykonane pomyślnie tylko wtedy, gdy uczestnik wybierze poprawną odpowiedź lub przejdzie przez wszystkie wymagane kroki decyzyjne w wyznaczonym czasie.
- Oblicz liczbę błędów, sumując pominięte, błędne lub niepotrzebne kroki decyzyjne.
- Mierz ocenianą przez uczestnika przejrzystość bezpośrednio po każdym zadaniu, korzystając z pięciostopniowej skali (1 = bardzo niejasne; 5 = bardzo jasne).
- Po zakończeniu wszystkich zadań poproś uczestników o ocenę użyteczności prototypu oraz zamiaru jego wdrożenia.
UWAGA: Testowanie prototypu ocenia opartą na zadaniach przejrzystość i użyteczność materiałów wygenerowanych zgodnie z protokołem, a nie poprawę efektywności usług publicznych23.
7. Analiza danych i kontrola jakości
- Wyklucz odpowiedzi w kwestionariuszu ukończone w czasie krótszym niż 3 min, odpowiedzi z więcej niż 20% brakujących wartości, odpowiedzi identyczne we wszystkich pozycjach skali Likerta lub odpowiedzi zawierające niespójne informacje o roli.
- Podsumuj dane z kwestionariusza, stosując średnie i odchylenia standardowe dla zmiennych ciągłych oraz częstości i procenty dla zmiennych kategorycznych.
- Zakoduj dane dotyczące interesariuszy i mapowania podróży użytkownika, korzystając z ustrukturyzowanego arkusza kodowania. Dwóch badaczy powinno niezależnie zakodować co najmniej 20% materiału przed dyskusją w celu osiągnięcia konsensusu, a następnie należy zaraportować procent zgodności oraz współczynnik kappa Cohena lub równoważną statystykę niezawodności.
- Przeanalizuj wyniki warsztatów, zliczając ważne karty punktów zapalnych (pain-points), klastry problemów, sformułowania wyzwań projektowych, pomysły na rozwiązania, oceny wykonalności oraz wybrane koncepcje prototypów.
- Oblicz wynik użyteczności prototypu specyficzny dla protokołu na podstawie pięciu pozycji w skali pięciostopniowej: jasność wymagań, widoczność statusu, jasność kolejnego kroku, łatwość wykonania zadania oraz pewność w korzystaniu z materiału. Przekształć surowy wynik (z zakresu od 5 do 25) na skalę 0-100, stosując wzór:
wynik użyteczności = (wynik surowy - 5) / 20 x 10017 - Przeanalizuj dane z testów prototypu, aby wyodrębnić wskaźniki jasności i użyteczności oparte na zadaniach. Użyj programu IBM SPSS Statistics (Analyze > Compare Means > Paired-Samples T Test; Analyze > Nonparametric Tests > Related Samples; Analyze > Descriptive Statistics > Crosstabs > Statistics > McNemar) lub równoważnych poleceń w R (t.test(..., paired = TRUE), wilcox.test(..., paired = TRUE), oraz mcnemar.test()), aby wyeksportować statystykę testową, dokładną wartość P, 95% przedział ufności (jeśli dostępny) oraz wielkość efektu.
- Interpretuj wartości P opisowo przy przyjętym poziomie alfa 0,05 i podkreśl kierunek, wielkość oraz spójność efektu we wszystkich wskaźnikach24.
- Zagreguj wielokrotne rekordy zadań na poziomie uczestnika lub zastosuj odpowiedni model pomiarów powtarzanych, jeśli analizowane są jednocześnie cztery zadania na warunek.
UWAGA: Nie traktuj wszystkich rekordów zadań jako statystycznie niezależnych, chyba że założenie to jest wyraźnie uzasadnione. - KROK KRYTYCZNY: Dokumentuj wszystkie decyzje dotyczące czyszczenia danych, kodowania, dopasowywania zestawów zadań i analizy statystycznej w arkuszu audytowym, aby zapewnić odtwarzalność. Upewnij się, że wszystkie zanonimizowane dane są przechowywane w plikach chronionych hasłem, dostępnych wyłącznie dla zespołu badawczego.
Wyniki
Kwalifikowalność uczestników i wykonalność protokołu
Protokół został pomyślnie wdrożony, uzyskując 100 poprawnych odpowiedzi w kwestionariuszach (wskaźnik ukończenia 89,3%) oraz wyodrębnioną podgrupę 28 uczestników, którzy przeszli etapy warsztatów i testowania prototypu. Zachowani uczestnicy reprezentowali siedem kategorii interesariuszy zaangażowanych w proces usług publicznych: obywateli lub użytkowników usług (n = 32), pracowników pierwszej linii obsługi (n = 18), pracowników społecznych (n = 14), administratorów agencji publicznych (n = 12), koordynatorów międzywydziałowych (n = 8), przedstawicieli trzeciego sektora (n = 10) oraz personel wsparcia platform cyfrowych (n = 6).
28 uczestników warsztatów podzielono na pięć grup o mieszanym składzie ról, tak aby każda grupa obejmowała co najmniej trzy kategorie interesariuszy. Wszystkie grupy przeprowadziły mapowanie interesariuszy, mapowanie podróży użytkownika, współprojektowanie w modelu Double Diamond oraz testowanie prototypów, tworząc profile relacji aktorów, macierze podróży interesariuszy, zweryfikowane sformułowania wyzwań projektowych, koncepcje prototypów oraz zapisy symulowanych testów zadań (Tabela 3). Ustrukturyzowane etapy mapowania wymagały mniejszej liczby interwencji moderatora niż fazy definiowania problemu.
Tabela 3: Kryteria włączenia uczestników, skład grup interesariuszy i etapy wdrażania protokołu. Rekrutacja i włączenie uczestników, skład grup interesariuszy, udział w warsztatach, ukończenie protokołu oraz wyniki wdrażania w czterech etapach protokołu. Kliknij tutaj, aby pobrać tę tabelę.
Wyniki wizualizacji: mapowanie interesariuszy i mapowanie ścieżki użytkownika
Etap mapowania interesariuszy pozwolił na zidentyfikowanie dziewięciu kategorii aktorów, z których siedem pojawiało się konsekwentnie we wszystkich grupach i utworzyło oś pionową macierzy interesariusz-ścieżka. Administratorzy agencji publicznych uzyskali najwyższe średnie wyniki w zakresie wpływu, natomiast obywatele uzyskali najwyższe wyniki w zakresie zależności i najniższe wyniki w zakresie dostępu do informacji. Zidentyfikowano dziewięć luk w percepcji, zdefiniowanych jako rozbieżności w ocenach wynoszące dwie punkty lub więcej. Największa luka wystąpiła w postrzeganym dostępie do informacji pomiędzy obywatelami a administratorami.
Etap mapowania podróży użytkownika pozwolił na sformułowanie 126 surowych stwierdzeń dotyczących punktów krytycznych (tzw. pain-points). Po ustrukturyzowanym scaleniu według etapu podróży i następstw dalszych, zachowano 38 unikalnych błędów w obsłudze, z których 12 spełniło zdefiniowane kryteria priorytetyzacji (częstotliwość ≥10% lub dotkliwość ≥4,0). Większość priorytetowych błędów wystąpiła podczas przygotowania materiałów, wyjaśniania uprawnień oraz procesów międzywydziałowych. Wyniki te zostały zsyntetyzowane w zintegrowanej macierzy podróży interesariuszy (Rysunek 2).
Transformacja współprojektowania i generowanie prototypów
Podczas warsztatu współprojektowania w modelu Double Diamond uczestnicy stworzyli 94 poprawne karty punktów zapalnych (pain-points), które zgrupowano w 14 obszarach problemowych. Z 17 pierwotnych sformułowań wyzwań projektowych sześć wymagało poprawy, ponieważ brakowało w nich kierunku ulepszenia, zbyt szeroko zdefiniowano dotkniętego nimi aktora lub zaproponowano rozwiązanie przed jasnym zdefiniowaniem problemu. Po rewizji opartej na rubryce zachowano 11 sformułowań wyzwań projektowych.
W fazie opracowywania (Develop) uczestnicy wygenerowali 32 pomysły na usprawnienie usług. Zastosowanie zdefiniowanych progów wykonalności i testowalności (wyniki ≥4,0) pozwoliło zawęzić tę liczbę do sześciu wybranych koncepcji. Do testów opartych na zadaniach wybrano trzy koncepcje prototypów niskiej wierności: jednostronicową listę kontrolną wymagań usługowych, makietę śledzenia stanu usługi oraz zdefiniowaną ścieżkę eskalacji (Rycina 3). Wyniki liczbowe ze wszystkich etapów wizualizacji i wspólnego projektowania (co-design) podsumowano w Tabeli 4.
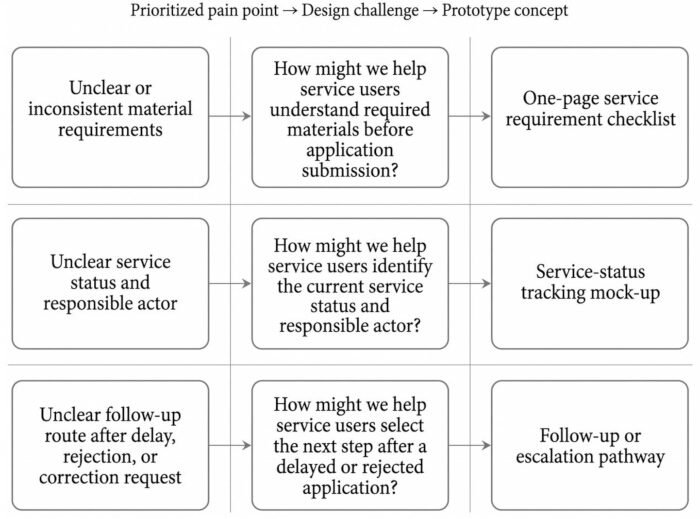
Rysunek 3: Ścieżka transformacji od punktów krytycznych do prototypu. Rysunek przedstawia trzy ścieżki transformacji od priorytetowych punktów krytycznych do sformułowań wyzwań projektowych i koncepcji prototypów o niskiej wierności. Wyzwania projektowe zaprezentowano w formacie „Jak moglibyśmy”, będącym kolaboracyjną techniką projektową służącą do definiowania problemów jako otwartych możliwości wypracowania rozwiązań. Przedstawione przykłady obejmują: (1) niejasne lub niespójne wymagania materiałowe przekształcone w jednostronicową listę kontrolną wymagań usługowych; (2) niejasny status usługi i osobę odpowiedzialną przekształcone w makietę śledzenia statusu usługi; oraz (3) niejasne ścieżki postępowania po opóźnieniach, odrzuceniu lub prośbach o korektę przekształcone w ścieżkę dalszego postępowania lub eskalacji. Prosimy kliknąć tutaj, aby zobaczyć powiększoną wersję tego rysunku.
Tabela 4: Wyniki generowane przez protokół oraz wyniki ilościowych testów opartych na zadaniach. Wyniki generowane na każdym etapie protokołu, wraz z ilościowymi rezultatami symulowanej oceny prototypu opartej na zadaniach, obejmują wskaźniki użyteczności i wydajności. Kliknij tutaj, aby pobrać tę tabelę.
Wyniki testowania prototypu w oparciu o zadania
Protokół pozwolił na wygenerowanie 224 zapisów symulowanych zadań od 28 uczestników, obejmujących 112 zapisów zadań wyjściowych (baseline) i 112 zapisów zadań po wprowadzeniu prototypu. Materiały wygenerowane zgodnie z protokołem wiązały się z poprawą wydajności podczas symulowanych zadań. Przeprowadzono analizę prób parowanych na poziomie uczestnika (n = 28), aby uwzględnić korelacje wewnątrzindywidulane w powtarzanych zadaniach. Średni czas wykonania zadania istotnie zmniejszył się z 178.4 ± 35.8 s w punkcie wyjściowym do 121.7 ± 28.4 s po wprowadzeniu prototypu (średnia różnica = −56.7 s; 95% CI, −68.3 – −45.1 s; Cohen’s dz = −1.92; t-test dla prób parowanych, P < 0.001). Podobnie, średnia liczba błędów na uczestnika spadła z 1.86 ± 0.61 do 0.79 ± 0.44 (średnia różnica = −1.07 błędów; 95% CI, −1.27 – −0.87; Cohen’s dz = −2.05; t-test dla prób parowanych, P < 0.001). Wskaźniki sukcesu zadań przeanalizowano za pomocą testu znaków Wilcoxona na proporcjach sukcesów na poziomie uczestnika, co wykazało istotną poprawę (Z = −4.12, P < 0.001). Średnie oceny przejrzystości również istotnie wzrosły na poziomie uczestnika, zwiększając się z 3.1 ± 0.5 do 4.2 ± 0.4 (średnia różnica = 1.10 punktów; 95% CI, 0.94 do 1.26; Cohen’s dz = 2.71; t-test dla prób parowanych, P < 0.001).
Ogólny wskaźnik sukcesu w wykonywaniu zadań wzrósł z 62,5% (70/112 rekordów zadań) w punkcie wyjścia do 82,1% (92/112 rekordów zadań) po ekspozycji na prototyp, co stanowi wzrost o 19,6 punktu procentowego (95% CI, od 8,2 do 31,1 punktu procentowego; porównanie dwóch proporcji, P = 0,001). Ponieważ zagregowane liczby wskazują na 22 dodatkowe pomyślnie wykonane rekordy zadań po ekspozycji na prototyp, wszystkie możliwe tabele niezgodności parzystych dały dokładny wynik czułości testu McNemara poniżej P < 0,01, co potwierdza ten sam kierunek wnioskowania, unikając jednocześnie konieczności rekonstrukcji niedostępnych rozbieżnych par na poziomie indywidualnym.
Wyniki zgłaszane przez uczestników były zgodne z tymi ustaleniami operacyjnymi. Średnie oceny przejrzystości wzrosły z 3,1 ± 0,7 do 4,2 ± 0,5 w pięciostopniowej skali (n = 112 zapisów zadań na warunek; średnia różnica = 1,10 pkt; 95% CI, 0,94 do 1,26; standaryzowana średnia różnica na poziomie podsumowania = 1,81; P na poziomie podsumowania < 0,001). Końcowe materiały osiągnęły wynik użyteczności specyficzny dla protokołu na poziomie 78,4 ± 9,6 oraz ocenę intencji wdrożenia 4,1 ± 0,6 (Rysunek 4). Wskaźniki użyteczności zostały obliczone na podstawie pięciu elementów badania specyficznych dla protokołu, a nie na podstawie standaryzowanej Skali Użyteczności Systemu (SUS). Otwarte odpowiedzi potwierdziły te wyniki: 21 z 28 uczestników zgłosiło poprawę przejrzystości wizualnej macierzy podróży interesariusza, 17 z 28 zgłosiło jaśniejszy podział ról aktorów, 19 z 28 zgłosiło jaśniejszy przebieg etapów usługi, a 20 z 28 potwierdziło praktyczną użyteczność materiałów prototypowych.
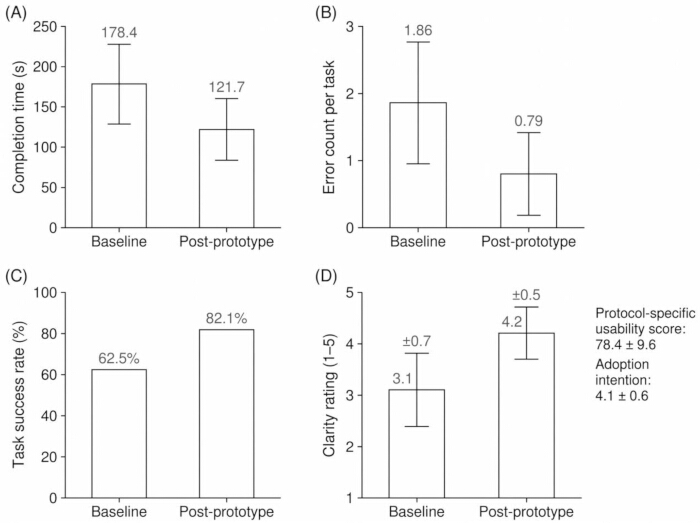
Rysunek 4: Wyniki przejrzystości i użyteczności w oparciu o zadania po zapoznaniu się z prototypem. (A) Średni czas ukończenia zadania (s). (B) Średnia liczba błędów na zadanie. (C) Odsetek sukcesów w realizacji zadań (%). (D) Przejrzystość oceniana przez uczestników (skala 1–5). Dodatkowe wskaźniki w panelu (D) obejmują wynik użyteczności specyficzny dla protokołu oraz zamiar przyjęcia rozwiązania. Słupki reprezentują średnie na poziomie uczestników, a słupki błędów wskazują odchylenie standardowe (SD). Porównania między warunkami wyjściowymi a warunkami po zastosowaniu prototypu przeprowadzono na poziomie uczestników i były one istotne statystycznie (P < 0.001) dla czasu ukończenia, liczby błędów, przejrzystości i odsetka sukcesów w realizacji zadań. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Dyskusja
Niniejszy protokół przedstawia systematyczną i powtarzalną metodę strukturyzowania złożonych problemów w niskoryzykownych środowiskach usług publicznych. Poprzez sekwencyjną integrację mapowania interesariuszy, mapowania podróży użytkownika, współprojektowania w modelu Double Diamond oraz testowania prototypów o niskiej wierności, metoda ta przekłada rozproszone skargi wielu aktorów na testowalne interwencje serwisowe, zachowując jednocześnie wyraźne rozróżnienie między dowodami z symulowanej użyteczności a rzeczywistą wydajnością administracyjną. Reprezentatywne wyniki wykazują, że wyzwania w usługach publicznych rzadko ograniczają się do pojedynczego kroku proceduralnego; są one zamiast tego rozproszone pomiędzy użytkowników, pracowników pierwszej linii oraz administratorów zaplecza (back-office). Kluczowym wkładem tego protokołu jest możliwość uwidocznienia tych wielostronnych zależności i asymetrii informacji jeszcze przed rozpoczęciem opracowywania rozwiązań.
Kluczowym elementem niniejszego protokołu jest macierz ścieżki interesariusza. W usługach publicznych z udziałem wielu podmiotów interesariusze często różnie interpretują źródła błędów w świadczeniu usług. Macierz ta pełni funkcję obiektu granicznego – namacalnego artefaktu, który jest dostosowywalny do różnych granic koncepcyjnych przy zachowaniu wspólnej tożsamości wśród grup uczestników, co ułatwia wypracowanie konsensusu między różnymi rolami oraz wspólne projektowanie25,26. Poprzez przełożenie rozproszonego niezadowolenia użytkowników na obserwowalne zdarzenia przypisane do konkretnych etapów, macierz zmniejsza ryzyko nieprecyzyjnego definiowania problemów i zapobiega tendencji uczestników warsztatów do wprowadzania znanych, lecz nieskutecznych korekt administracyjnych.
Ustrukturyzowane zastosowanie modelu Double Diamond wspiera kontrolowane przejście od eksploracji problemu do praktycznego przeprojektowania usługi. Wyniki wskazują, że przejście od ogólnych skarg do precyzyjnych wyzwań projektowych typu „Jak moglibyśmy” (How might we) jest często najbardziej wymagającą fazą procesu, wymagającą aktywnej facylitacji, wyraźnych kryteriów selekcji oraz udokumentowanych rewizji. Bez tych ograniczeń strukturalnych (określenia dotkniętego aktora, etapu podróży, usterki usługi i zamierzonej poprawy), sesje współprojektowania mogą generować generyczne rozwiązania, które nie rozwiązują zmapowanych usterki usługi. Bezpośredni związek między priorytetowym punktem zapalnym (np. niejasne wymagania materiałowe) a odpowiadającym mu prototypem (np. jednostronicowa lista kontrolna) ilustruje walidację generatywną protokołu.
Należy odróżnić wyniki testowania prototypu opartego na zadaniach, uzyskane za pomocą niniejszego protokołu, od twierdzeń o rzeczywistej poprawie funkcjonowania organizacji. Obserwowany spadek czasu wykonania zadań oraz liczby błędów wskazuje, że wspólnie zaprojektowane materiały są jasne i użyteczne w warunkach symulowanych. Jednak prototypowanie na wczesnym etapie w sektorze publicznym służy przede wszystkim wspieraniu procesu uczenia się i ograniczaniu ryzyka przed wdrożeniem16,27. Stała sekwencja testów przed i po zastosowaniu, wykorzystana w reprezentacyjnej aplikacji, może również wprowadzać efekty zaznajomienia się z zadaniem lub efekty uczenia się, ponieważ uczestnicy wykonywali zadania bazowe przed zadaniami z prototypem. W przyszłych wdrożeniach należy zastosować zrównoważoną kolejność zadań, dopasowane grupy kontrolne lub modele z powtarzanymi pomiarami, aby odróżnić efekty prototypu od efektów uczenia się.
Rozwiązywanie typowych problemów z protokołem jest niezbędne dla zapewnienia powtarzalności. Jeśli mapowanie interesariuszy prowadzi jedynie do powstania ogólnych etykiet aktorów, facylitatorzy powinni poprosić uczestników o określenie zależności decyzyjnej, informacyjnej lub koordynacyjnej związanej z każdym aktorem. Jeśli mapy podróży zmieniają się w listy skarg, facylitatorzy powinni przypisać każdą kartę do konkretnego etapu podróży, dotkniętego aktora, luki informacyjnej oraz wynikającej z niej konsekwencji.
Modyfikacja protokołu jest oczekiwana w przypadku przeniesienia przepływu pracy do różnych środowisk usług publicznych. W przypadku administracyjnych usług uniwersyteckich etykiety etapów mogą kłaść większy nacisk na procesy rejestracji, odwołań i wsparcia. W procesie przeprojektowania ścieżek opieki ambulatoryjnej w ochronie zdrowia należy rozszerzyć zabezpieczenia etyczne oraz zatwierdzenia w ramach nadzoru klinicznego. W przypadku koordynacji opieki społecznej wymogi dotyczące ochrony danych międzyagencyjnych mogą wymagać silniejszej deidentyfikacji i kontroli skierowań. Różnice kulturowe, administracyjne i rządowe mogą również wpływać na to, jak swobodnie uczestnicy krytykują procedury, w jaki sposób rozdzielana jest władza w grupach mieszanych oraz czy wymagane jest anonimowe głosowanie lub oddzielne mapowanie użytkowników i dostawców.
Przy stosowaniu tej metody należy wziąć pod uwagę kilka ograniczeń. Po pierwsze, protokół został opracowany specjalnie dla usług konsultacyjnych i administracyjnych o niskim stopniu ryzyka. Zastosowanie go w środowiskach o wysokiej stawce, takich jak interwencje medyczne czy rozstrzygnięcia prawne, wymagałoby znacznie silniejszych zabezpieczeń etycznych, wiedzy specjalistycznej w danej dziedzinie oraz rygorystycznych protokołów ochrony danych. Po drugie, choć rozdzielenie grup użytkowników i dostawców podczas początkowego etapu mapowania może ograniczyć tłumienie negatywnych opinii, wrodzone nierównowagi w hierarchii mogą nadal wpływać na dynamikę współpracy podczas syntezy z udziałem osób o różnych rolach. Po trzecie, sukces fazy Definiowania (Define) pozostaje zależny od doświadczenia facylitatora. Niezależne grupy badawcze powinny zatem stosować ustandaryzowane szkolenia dla facylitatorów, ćwiczenia kalibracyjne, listy kontrolne obserwacji oraz omówienia po sesjach przed porównywaniem wyników uzyskanych w różnych warunkach.
Podsumowując, ten systematyczny protokół wizualizacji zapewnia ustrukturyzowane, ograniczone etycznie podejście do diagnozowania i prototypowania rozwiązań dla złożonych problemów w usługach publicznych. Przesuwa on innowacje w usługach publicznych poza sferę abstrakcyjnych dyskusji nad polityką, dostarczając powtarzalny zestaw narzędzi, który łączy reformy kierowane przez ekspertów z projektowaniem zorientowanym na użytkownika. Przyszłe badania powinny zastosować ten protokół w dodatkowych obszarach usług publicznych, w tym w miejskich usługach cyfrowych, administracji uniwersyteckiej, wsparciu edukacyjnym, przeprojektowaniu ścieżek ambulatoryjnych w opiece zdrowotnej oraz koordynacji opieki społecznej. W przyszłych badaniach należy również ocenić, jak prototypy opracowane podczas kontrolowanych warsztatów sprawdzają się po wdrożeniu w rutynowych procesach administracyjnych.
Oświadczenia
Autorzy oświadczają, że nie stwierdzono konfliktu interesów.
Podziękowania
Autorzy dziękują wszystkim uczestnikom, w tym obywatelom, pracownikom służb pierwszego kontaktu oraz administratorom agencji publicznych, za udział w kwestionariuszach, warsztatach współprojektowania oraz sesjach testowania prototypów. Ich wkład i spostrzeżenia dotyczące doświadczeń z usługami publicznymi z udziałem wielu interesariuszy wsparły opracowanie tego systematycznego protokołu wizualizacji projektowania usług.
Autorzy pragną również podziękować za wsparcie instytucjonalne i akademickie udzielone przez Faculty of Innovation and Design w City University of Macau, College of Art and Design w Shenzhen University oraz College of Art and Design w Guangdong Baiyun University. Badanie to nie otrzymało żadnego konkretnego grantu od żadnej agencji finansującej z sektora publicznego, komercyjnego ani non-profit.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Notatki dotyczące składni analizy lub przepływu pracy | Zespół badawczy | PSD-VP-S17 v1.1 | W celu udokumentowania przepływu pracy w programie SPSS lub równoważnym środowisku R dla porównań parzystych, testów Wilcoxona, kontroli czułości McNemara, wielkości efektu, przedziałów ufności oraz raportowania wyników. |
| Anonimowy kwestionariusz oparty na rolach | Zespół badawczy | PSD-VP-S02 v1.1 | W celu zebrania informacji o rolach interesariuszy oraz wstępnych spostrzeżeń na temat wybranego procesu usług publicznych. |
| Lista kontrolna deidentyfikacji | Zespół badawczy | PSD-VP-S14 v1.1 | W celu zapewnienia, że nazwiska uczestników, numery identyfikacyjne, adresy, identyfikatory spraw i dokumentacja administracyjna nie są gromadzone ani ujawniane. |
| Szablon wyzwania projektowego | Zespół badawczy | PSD-VP-S07 v1.1 | W celu przekształcenia zgrupowanych punktów zapalnych w ustrukturyzowane, testowalne pytania typu „Jak moglibyśmy”. |
| Rubryka kalibracji moderatora | Zespół badawczy | PSD-VP-S15 v1.1 | W celu standaryzacji przygotowania moderatorów, kodowania przykładów, rewizji treści wyzwań oraz zapewnienia spójności między moderatorami. |
| Pięciopunktowa karta oceny interesariuszy | Zespół badawczy | PSD-VP-S04 v1.1 | W celu oceny wpływu, zależności, dostępu do informacji oraz presji koordynacyjnej każdego interesariusza. |
| IBM SPSS Statistics | IBM Corporation | Version 26.0 or later | W celu przeprowadzenia analiz opisowych, testów t dla prób zależnych, testów znakowych Wilcoxona oraz testów McNemara dla wyników testowania prototypów. |
| Materiały do prototypowania niskiej wierności | Zespół badawczy | PSD-VP-S10 v1.1 | W celu opracowania i przetestowania wczesnych materiałów usługowych, w tym listy kontrolnej wymagań, makiety statusu usługi oraz ścieżki dalszych działań. |
| Microsoft Excel | Microsoft Corporation | Microsoft 365 or equivalent | W celu organizacji danych z kwestionariuszy, obliczania statystyk opisowych, zarządzania arkuszami kodowania i przygotowywania tabel podsumowujących. |
| Karty punktów zapalnych | Zespół badawczy | PSD-VP-S06 v1.1 | W celu rejestrowania awarii usług, luk informacyjnych, niejednoznaczności odpowiedzialności, dotkniętych podmiotów oraz konsekwencji wtórnych. |
| Karta informacyjna dla uczestnika | Zespół badawczy | PSD-VP-S01 v1.1 | W celu wyjaśnienia celu badania, procedur, praw uczestnika oraz wymogów dotyczących zgody przed przystąpieniem do udziału. |
| Zabezpieczony hasłem magazyn danych | Instytucyjny lub zespołowy system komputerowy | Access restricted to research team | W celu bezpiecznego przechowywania deidentyfikowanych danych z kwestionariuszy, wyników warsztatów, plików kodowania i zapisów z testowania zadań. |
| Rubryka oceny prototypu | Zespół badawczy | PSD-VP-S12 v1.1 | W celu oceny przejrzystości prototypu, użyteczności, sukcesu w realizacji zadań, liczby błędów oraz intencji wdrożenia. |
| Karta wyboru prototypu | Zespół badawczy | PSD-VP-S09 v1.1 | W celu wyboru koncepcji prototypów spełniających zdefiniowane progi wykonalności i testowalności. |
| Szablon mapowania ścieżki usługi publicznej | Zespół badawczy | PSD-VP-S05 v1.1 | W celu zmapowania procesu usługi publicznej w zakresie wyszukiwania informacji, wyjaśniania wymagań, przygotowania materiałów, składania wniosków, przetwarzania, powiadomień i wsparcia po realizacji. |
| Arkusze zadań symulowanych | Zespół badawczy | PSD-VP-S1 v1.1 | W celu oceny realizacji zadań, dokładności decyzji oraz przejrzystości przed i po ekspozycji na prototyp. |
| Karty rozwiązań | Zespół badawczy | PSD-VP-S08 v1.1 | W celu udokumentowania pomysłów na usprawnienie usług wypracowanych podczas warsztatów współprojektowania Double Diamond. |
| Arkusz mapowania interesariuszy | Zespół badawczy | PSD-VP-S03 v1.1 | W celu zidentyfikowania 5–8 podmiotów zaangażowanych w proces usługi publicznej oraz wizualizacji ról i zależności między nimi. |
| Ustrukturyzowany arkusz kodowania | Zespół badawczy | PSD-VP-S13 v1.1 | W celu kodowania danych z mapowania interesariuszy, wyników mapowania ścieżki, klastrów punktów zapalnych i rezultatów warsztatów. |
| Lista kontrolna równoważności zestawów zadań | Zespół badawczy | PSD-VP-S16 v1.1 | W celu udokumentowania dopasowania zadań wyjściowych i po-prototypowych pod kątem kroków decyzyjnych, długości tekstu do przeczytania, wymaganych pól, złożoności i czasu wykonania w pilotażu. |
Bibliografia
- Rittel HWJ, Webber MM. Dilemmas in a general theory of planning. Policy Sci. 1973;4(2):155-69.
- Suoheimo M, Vasques R, Rytilahti P. Deep diving into service design problems: Visualizing the iceberg model of design problems through a literature review on the relation and role of service design with wicked problems. Des J. 2021;24(2):231-51.
- Voorberg WH, Bekkers V, Tummers LG. A systematic review of co-creation and co-production: Embarking on the social innovation journey. Public Manag Rev. 2015;17(9):1333-57.
- Schwoerer K, Keppeler F, Mussagulova A, Puello S. CO-DESIGN-ing a more context-based, pluralistic, and participatory future for public administration. Public Adm. 2022;100(1):72-97.
- Edelmann N, Mergel I. Co-production of digital public services in Austrian public administrations. Adm Sci. 2021;11(1):https://doi.org/10.3390/admsci11010022
- Blomkamp E. Systemic design practice for participatory policymaking. Policy Des Pract. 2022;5(1):12-31.
- Vargas C, et al. Exploring co-design: A systematic review of concepts, processes, models, and frameworks used in public health research. J Public Health. 2025;47(4):https://doi.org/10.1093/pubmed/fdaf084
- Wacnik P, Daly SR, Verma A. Participatory design: A systematic review and insights for future practice. Des Sci. 2025;11:https://doi.org/10.1017/dsj.2025.10009
- Udoewa V. An introduction to radical participatory design: Decolonising participatory design processes. Des Sci. 2022;8:https://doi.org/10.1017/dsj.2022.24
- Stickdorn M, Schneider J. This is service design thinking: Basics, tools, cases. BIS Publishers; Amsterdam; 2011. https://www.wiley.com/en-us/This+is+Service+Design+Thinking%3A+Basics%2C+Tools%2C+Cases-p-9781118156308
- Blomkamp E. The promise of co-design for public policy. Aust J Public Adm. 2018;77(4):729-43.
- Bryson JM. What to do when stakeholders matter: Stakeholder identification and analysis techniques. Public Manag Rev. 2004;6(1):21-53.
- Folstad A, Kvale K. Customer journeys: A systematic literature review. J Serv Theory Pract. 2018;28(2):196-227.
- Design C. Eleven lessons: Managing design in eleven global brands. Design Council; London; 2007. https://www.idi-design.ie/content/files/ElevenLessons_Design_Council_2.pdf
- Steen M, Manschot M, De Koning N. Benefits of co-design in service design projects. Int J Des. 2011;5(2):53-60.
- Not E, et al. Designing a digital environment to support the co-production of public services: Balancing multiple requirements and governance concepts. Digit Gov: Res Pract. 2024;5(3):https://doi.org/10.1145/3603632
- Excellence UGCfPS. Design thinking for public service excellence. UNDP Global Centre for Public Service Excellence; Singapore; 2014. https://www.undp.org/publications/designthinking-public-service-excellence
- Osborne SP. The new public governance? Public Manag Rev. 2006;8(3):377-87.
- Hartley J. Innovation in governance and public services: Past and present. Public Money Manage. 2005;25(1):27-34.
- Freeman RE. Strategic management: A stakeholder approach. Pitman; Boston; 1984.
- Stickdorn M, Hormess ME, Lawrence A, Schneider J. This is service design doing: Applying service design thinking in the real world. O'Reilly Media; Sebastopol; 2018. https://www.thisisservicedesigndoing.com/
- Bovaird T. Beyond engagement and participation: User and community coproduction of public services. Public Adm Rev. 2007;67(5):846-60.
- Donetto S, Pierri P, Tsianakas V, Robert G. Experience-based co-design and healthcare improvement: Realizing participatory design in the public sector. Des J. 2015;18(2):227-48.
- Tomczak M, Tomczak E. The need to report effect size estimates revisited: An overview of some recommended measures of effect size. Trends Sport Sci. 2014;21(1):19-25.
- Sanders EBN, Stappers PJ. Co-creation and the new landscapes of design. CoDesign. 2008;4(1):5-18.
- Star SL, Griesemer JR. Institutional ecology, 'translations' and boundary objects: Amateurs and professionals in Berkeley's Museum of Vertebrate Zoology, 1907-39. Soc Stud Sci. 1989;19(3):387-420.
- Liedtka J. Why design thinking works. Harv Bus Rev. 2018;96(5):72-9.