Niniejszy protokół z zakresu nauk behawioralnych i oceny psychologicznej standaryzuje przeprowadzanie ankiet online, punktację, weryfikację jakości danych oraz powtarzalną analizę w celu oceny uzależnienia od internetu i trudności w regulacji emocji wśród studentów uniwersytetów.
Artykuł metodologiczny
Znormalizowany protokół kwestionariuszowy do oceny uzależnienia od internetu i regulacji emocji u studentów uczelni wyższych
W tym artykule
Podsumowanie
Streszczenie
Korzystanie z Internetu jest głęboko zakorzenione w życiu akademickim, jednak problematycznego użytkowania sieci nie można ocenić w sposób adekwatny wyłącznie na podstawie czasu ekspozycji. Dowody wskazują, że maladaptywne lub kompulsywne wzorce korzystania z Internetu wiążą się z trudnościami w regulacji emocji, jednak niespójności w kolejności kwestionariuszy, kryteriach kwalifikacji, progach przesiewowych, procedurach punktacji oraz raportowaniu analitycznym nadal ograniczają porównywalność między badaniami. Niniejszy artykuł metodologiczny przedstawia zestandaryzowany protokół kwestionariuszowy dla badań z zakresu nauk behawioralnych i oceny psychologicznej, badających uzależnienie od Internetu oraz trudności w regulacji emocji wśród studentów. Przepływ pracy obejmuje stałą sekwencję kwestionariuszy, uprzednio określone kryteria kwalifikacji, ustawienia obowiązkowych odpowiedzi, progi czasu wypełniania oparte na badaniu pilotażowym, sekwencyjne przesiewowe sprawdzanie jakości danych, zestandaryzowaną punktację testu uzależnienia od Internetu oraz 16-elementowej skali trudności w regulacji emocji, a także reprodukowalne analizy opisowe, korelacyjne i wielowymiarowe analizy regresji. Protokół określa również archiwizację surowych odpowiedzi, logów przesiewowych, plików README/codebook oraz finalnego zbioru danych gotowego do analizy. Przedstawiono reprezentatywną implementację w celu zademonstrowania wykonania protokołu, a nie w celu walidacji narzędzi czy ustalenia rozpowszechnienia zjawiska. W tej implementacji zaproszono 520 studentów, z czego zwrócono 480 kwestionariuszy. Po sekwencyjnym wykluczeniu duplikatów, zbyt szybkich odpowiedzi, nieprawidłowych wyników testów uwagi, schematycznego odpowiadania, niespójności logicznej oraz brakujących danych kluczowych, zachowano 452 ważne kwestionariusze. Predefiniowana demonstracja analityczna badała związek między całkowitym wynikiem testu uzależnienia od Internetu a całkowitym wynikiem skali trudności w regulacji emocji. W zachowanej próbie średni całkowity wynik testu uzależnienia od Internetu wyniósł 51,94, a średni całkowity wynik skali trudności w regulacji emocji wyniósł 35,95. Trudności w regulacji emocji rosły wraz ze wzrostem nasilenia uzależnienia od Internetu, a związek ten pozostał wyraźny po skorygowaniu o demograficzne i behawioralne zmienne towarzyszące. Protokół ten zapewnia przejrzysty przepływ pracy, który może być powtarzany, audytowany i adaptowany w przyszłych badaniach przekrojowych, z powtarzanymi pomiarami lub badaniach podłużnych w populacjach akademickich.
Wprowadzenie
Korzystanie z Internetu stało się powszechnym elementem życia studenckiego, obejmującym pracę akademicką, komunikację społeczną, rozrywkę, poszukiwanie informacji oraz radzenie sobie z emocjami. Z tego powodu zachowania studentów w sieci nie powinny być interpretowane jedynie jako ekspozycja na ekran lub czas spędzony online. Wcześniejsze dowody wykazały, że problematyczne korzystanie z Internetu było widoczne wśród młodzieży i populacji studenckiej jeszcze przed okresem wysokiego nasycenia obecnym środowiskiem platform mobilnych1. Nowsze badania prowadzone na uczelniach dodatkowo wskazują, że problematyczne korzystanie z Internetu występuje na tyle często, że wymaga systematycznej oceny, a nie jedynie nieformalnego opisu2.
Studenci są populacją szczególnie istotną dla standaryzowanej oceny, ponieważ presja akademicka, przejście do nowego środowiska społecznego, niezależne życie oraz zwiększona autonomia często występują na tym samym etapie rozwoju. Wymagania te są często zarządzane za pomocą tych samych urządzeń i platform cyfrowych, których regulacja może stać się trudna. Przegląd meta-analityczny wykazał, że problematyczne korzystanie z internetu wśród studentów wiąże się z wieloma skutkami w zakresie zdrowia psychicznego, co wspiera interpretację tego zjawiska jako szerszego problemu behawioralnego i psychologicznego, a nie jedynie wąskiego problemu związanego z użytkowaniem technologii3. Odczuwany stres został również powiązany z wzorcami uzależnienia od internetu wśród studentów, co sugeruje, że podczas projektowania badań opartych na kwestionariuszach w tej dziedzinie należy uwzględnić presję emocjonalną i kontekstową4.
Niniejszy protokół posługuje się terminem „uzależnienie od internetu” w odniesieniu konkretnie do konstruktu mierzonego za pomocą testu uzależnienia od internetu oraz jego ustalonych kategorii punktowych. Szerszy termin „problematyczne korzystanie z internetu” jest stosowany podczas omawiania szerszej literatury dotyczącej dezadaptacyjnych, nadmiernych lub funkcjonalnie upośledzających zachowań związanych z internetem. Termin „kompulsywne korzystanie z internetu” jest używany wyłącznie wtedy, gdy cytowana literatura kładzie nacisk na utratę kontroli, przymus lub powtarzalne użytkowanie mimo negatywnych konsekwencji. Terminy te są zatem powiązane, ale nie są traktowane jako w pełni zamienne. W przypadku implementacji protokołu z wykorzystaniem Testu Uzależnienia od Internetu, termin „uzależnienie od internetu” zostaje zachowany jako terminologia specyficzna dla narzędzia; w przypadku stosowania alternatywnych lub zrewidowanych instrumentów, terminologia powinna być dostosowana do etykiet konstruktów i założeń diagnostycznych wybranego miernika.
Regulacja emocji stanowi prawdopodobny psychologiczny punkt wyjścia do zrozumienia, dlaczego niektórzy studenci przechodzą z częstego korzystania z internetu do nieadaptacyjnego korzystania z internetu. Jednoroczne badanie prospektywne wykazało, że trudności w regulacji emocji były istotne zarówno dla późniejszego wystąpienia, jak i remisji uzależnienia od internetu wśród studentów5. Wynik ten jest istotny dla projektowania protokołu, ponieważ regulacja emocji nie jest jedynie dodatkowym korelatem; może ona wpływać na to, w jaki sposób studenci korzystają z internetu, aby unikać, redukować lub zarządzać dystresem. Jednocześnie istotne pozostaje funkcjonowanie społeczne. Problematyczne korzystanie z internetu wiązało się z umiejętnościami społecznymi studentów, co wskazuje, że czynniki interpersonalne i emocjonalne powinny być oceniane wraz ze zmiennymi dotyczącymi korzystania z narzędzi cyfrowych6. W okresie COVID-19 problematyczne korzystanie z internetu współwystępowało również z szerszymi trudnościami psychologicznymi u chińskich studentów, co dodatkowo potwierdza potrzebę ustrukturyzowanej oceny w środowisku akademickim7.
Kolejnym wyzwaniem jest heterogeniczność zachowań cyfrowych. Studenci mogą korzystać z platform cyfrowych w celu nauki, kontaktów społecznych, rozrywki, pozyskiwania informacji o zdrowiu lub tymczasowego ukojenia emocjonalnego, a nie każde częste użytkowanie jest szkodliwe. Przegląd systematyczny dotyczący cyfrowego użytkowania związanego ze zdrowiem psychicznym wśród studentów uniwersytetów wykazał, że zaangażowanie cyfrowe może służyć wielu celom psychologicznym8. W związku z tym w tej dziedzinie niezbędne są procedury odróżniające zwykłe, częste użytkowanie od użytkowania problematycznego lub rozregulowanego. Niedawne dowody dotyczące problematycznego korzystania ze smartfonów wśród studentów uniwersytetów podobnie sugerują, że ryzyko zależy od wzorca zachowań, funkcji i kontekstu, a nie tylko od czasu trwania9. Z tego powodu niniejszy protokół łączy czas trwania korzystania z internetem, użytkowanie w późnych godzinach nocnych, główną aktywność online oraz ustandaryzowaną punktację objawów, zamiast polegać na pojedynczym wskaźniku ekspozycji.
Kolejnym głównym źródłem niespójności są kwestie pomiarowe. Test uzależnienia od Internetu pozostaje jednym z najpowszechniej stosowanych narzędzi do oceny objawów uzależnienia od Internetu, jednak jego wymiarowość i interpretacja różniły się w zależności od warunków badania. Systematyczne dowody psychometryczne wskazują, że narzędzie to było szeroko wykorzystywane, mimo że wciąż budzi wątpliwości w zakresie struktury czynnikowej i interpretacji punktacji10. Podobne zastrzeżenia zgłoszono w badaniach próbek studentów, w których powszechne stosowanie skali nie rozstrzygnęło w pełni niepewności dotyczącej mierzonego konstruktu11. Badania walidacyjne przeprowadzone w populacjach studentów hiszpańskich i peruwiańskich wykazują również, że narzędzie to może funkcjonować w sposób odpowiedni, jednak jego właściwości psychometryczne powinny być rozpatrywane w odniesieniu do konkretnej populacji docelowej, w której jest ono stosowane12,13.
Protokół został zatem zaprojektowany tak, aby zapewnić stabilność przebiegu prac, przy jednoczesnej elastyczności w doborze instrumentów. Test uzależnienia od Internetu został tutaj zastosowany ze względu na jego dotychczasowe wykorzystanie, dostępne wartości progowe oraz porównywalność z wcześniejszymi badaniami prowadzonymi wśród studentów. Protokół nie wymaga jednak, aby test uzależnienia od Internetu pozostawał preferowanym narzędziem w nieskończoność. Jeśli ramy diagnostyczne ewoluują lub jeśli nowsze instrumenty okażą się bardziej odpowiednie dla konkretnej populacji, można zachować ten sam przebieg prac, zastępując jedynie moduł specyficzny dla danej skali, zakres wyników, progi nasilenia, wpisy w książce kodowej oraz dokumentację README. Wszelkie takie zamiany powinny zostać dokonane przed rozpoczęciem formalnego zbierania danych i zgłoszone jako modyfikacja protokołu, a nie doraźna zmiana analityczna.
Problem metodologiczny poruszony w niniejszym artykule nie sprowadza się jedynie do tego, że badania nad uzależnieniem od internetu i regulacją emocji prowadzą do różnych wniosków. W rzeczywistości wiele badań różni się pod względem kolejności kwestionariuszy, kryteriów kwalifikowalności, ustawień platformy ankietowej, sposobu obsługi powielonych odpowiedzi, procedur kontroli uwagi, progów czasu wypełniania, zasad postępowania z brakującymi danymi, weryfikacji punktacji oraz raportowania plików gotowych do analizy. Różnice te utrudniają porównywanie wyników, ich reprodukcję oraz włączenie do późniejszych syntez dowodów. Niniejszy protokół odpowiada na tę lukę poprzez ustalenie sekwencji administracji, logiki przesiewowej, struktury punktacji i ścieżki analitycznej w sposób, który można powtarzać, audytować i przejrzyście modyfikować. Jego wkład ma zatem charakter protokołowy: dostarcza on reprodukowalnego schematu postępowania dla obserwacyjnych badań z zakresu nauk behawioralnych i oceny psychologicznej w populacjach akademickich, zamiast proponować nowy konstrukt psychologiczny lub prezentować badanie rozpowszechnienia jako główny wynik.
Protokół
Badanie zatytułowane „A Standardized Questionnaire Protocol for Internet Addiction and Emotion Regulation Assessment in University Students” zostało przeanalizowane i zatwierdzone przez Komitet Etyki i Akademicki Uniwersytetu Ekonomicznego i Biznesowego w Zhengzhou (numer zatwierdzenia 20260113004) przed rozpoczęciem rekrutacji uczestników14. W badaniu zastosowano przekrojowy, anonimowy projekt kwestionariusza online z udziałem studentów studiów stacjonarnych w wieku 18–24 lat; badanie przeprowadzono zgodnie z instytucjonalnymi wymogami etycznymi oraz Deklaracją Helsińską. Przed uzyskaniem dostępu do kwestionariusza pobrano elektroniczną zgodę na udział. Uczestnicy otrzymali elektroniczną kartę informacyjną opisującą cel badania, procedury, dobrowolny charakter uczestnictwa oraz środki ochrony danych; mieli oni również możliwość wycofania się w dowolnym momencie bez żadnych konsekwencji. W głównym pliku ankiety nie gromadzono bezpośrednio identyfikowalnych danych osobowych, takich jak imię i nazwisko, numer legitymacji studenckiej, dokładny adres, numer telefonu, osobisty adres e-mail czy konto w mediach społecznościowych. Identyfikatory generowane przez platformę służyły wyłącznie do wykrywania powielonych odpowiedzi i zostały usunięte przed analizą zbioru danych. Wszystkie dane przechowywano w sposób bezpieczny i analizowano w formie zanonimizowanej. Ten schemat postępowania z kwestionariuszem nie został zarejestrowany prospektywnie przed rekrutacją uczestników. Niemniej jednak wszystkie kluczowe elementy protokołu, w tym zablokowana wersja kwestionariusza, plik README/codebook, log przesiewowy, zasady punktacji, składnia analizy oraz pliki schematu gotowe do analizy, zostały zarchiwizowane i udostępnione jako uzupełniające materiały z przebiegu prac w celu zapewnienia powtarzalności i możliwości audytu.
Identyfikatory odpowiedzi generowane przez platformę oraz techniczne identyfikatory ograniczone do urządzenia lub konta były wykorzystywane wyłącznie do weryfikacji duplikatów odpowiedzi i zostały usunięte z końcowego zanonimizowanego zbioru danych analitycznych. Główne zmienne i reguły punktacji podsumowano w Tabeli 1, a pełny słownik zmiennych znajduje się w Tabeli uzupełniającej 1. Pliki kwestionariusza, książka kodowa, dziennik weryfikacji, plan wyników oraz materiały z przepływem pracy gotowe do analizy zostały udostępnione w Pliku uzupełniającym 1.
| Dziedzina | Zmienna | Kodowanie/Punktowanie | Rola w protokole |
| Kryteria kwalifikacji | Wiek | Lata; dopuszczalny zakres 18–24 | Zmienna kwalifikacyjna i kowariancja |
| Dane demograficzne | Płeć | 1 = mężczyzna; 2 = kobieta; 3 = nie chcę podać | Zmienna opisowa i kowariant regresji |
| Dane demograficzne | Rok akademicki | 1 = pierwszy rok; 2 = drugi rok; 3 = trzeci rok; 4 = czwarty rok lub wyższy; 5 = studia podyplomowe | Zmienna opisowa |
| Dane demograficzne | Kategoria dyscypliny | 1 = nauki humanistyczne i społeczne; 2 = nauki ścisłe i inżynieria; 3 = biznes i zarządzanie; 4 = sztuka i design; 5 = pozostałe | Zmienna opisowa |
| Dane demograficzne | Typ miejsca zamieszkania | 1 = akademik; 2 = wynajmowane mieszkanie poza kampusem; 3 = dom rodzinny; 4 = inne | Zmienna opisowa |
| Dane demograficzne | Miesięczne koszty utrzymania | 1 = <1 000 CNY; 2 = 1 000–1 999 CNY; 3 = 2 000–2 999 CNY; 4 = ≥3 000 CNY | Zmienna opisowa |
| Zachowania w zakresie korzystania z Internetu | Korzystanie z internetu w dni powszednie | 1 = <2 h; 2 = 2–3,9 h; 3 = 4–5,9 h; 4 = ≥6 h | Kowariancja behawioralna |
| Zachowania w zakresie korzystania z Internetu | Korzystanie z internetu w weekendy | 1 = <2 h; 2 = 2–3,9 h; 3 = 4–5,9 h; 4 = ≥6 h | Kowariant behawioralny |
| Zachowania związane z korzystaniem z Internetu | Główna aktywność online | 1 = nauka; 2 = media społecznościowe; 3 = gry; 4 = rozrywka/wideo; 5 = zakupy; 6 = zastosowanie mieszane; 7 = inne | Zmienna opisowa |
| Zachowania w zakresie korzystania z Internetu | Główne urządzenie dostępu | 1 = smartfon; 2 = tablet; 3 = laptop/komputer stacjonarny; 4 = urządzenia mieszane | Zmienna opisowa |
| Zachowania w zakresie korzystania z Internetu | Użytkowanie w godzinach nocnych po 23:00 | 1 = nigdy; 2 = rzadziej niż raz w tygodniu; 3 = 1–2 noce w tygodniu; 4 = 3–5 nocy w tygodniu; 5 = prawie każdej nocy | Behawioralna współzmienna i zmienna przesiewowa spójności logicznej |
| Skala rdzenia | całkowity wynik IAT | Suma 20 pozycji; każda pozycja oceniana w skali 1–5; zakres całkowity 20–100 | Główna zmienna niezależna |
| Skala rdzenia | grupa ciężkości IAT | 20–39 = używanie prawidłowe; 40–69 = używanie problematyczne; 70–100 = ciężkie używanie problematyczne | Zmienna grupująca |
| Skala rdzenia | całkowity wynik w skali DERS-16 | Suma 16 pozycji po wymaganym odkodowaniu odwrotnym; całkowity zakres 16–80 | Główna zmienna zależna |
| Skala rdzenia | podskale DERS-16 | Obliczone zgodnie z ustalonym kluczem punktacji DERS-16 | Opisowe wyniki regulacji emocji |
| Kowariant | Czas trwania snu | 1 = <6 h; 2 = 6–6,9 h; 3 = 7–7,9 h; 4 = ≥8 h | Zmienna korygująca |
| Zmienna towarzysząca | Tygodniowa aktywność fizyczna | 0 = brak; 1 = 1–2 sesje; 2 = 3–4 sesje; 3 = ≥5 sesje | Zmienna korygująca |
| Kowariancja | Stres akademicki | 1 = niski; 2 = umiarkowany; 3 = wysoki | Zmienna korygująca |
| Kontrola jakości | Kontrola uwagi | 1 = zaliczony; 0 = niezaliczony | Kryterium wykluczenia |
| Kontrola jakości | Czas wykonania | Czas trwania ukończenia w sekundach | Zmienna przesiewowa oparta na czasie |
| Kontrola jakości | Liczba odpowiedzi z długimi ciągami | Maksymalna długość serii identycznych odpowiedzi w 36 punktowanych elementach skali | Zmienna przesiewowa o wzorcowej odpowiedzi |
| Kontrola jakości | Odchylenie standardowe wewnątrz osobnicze | Odchylenie standardowe wewnątrz osobowe dla 36 punktowanych pozycji skali | Zmienna przesiewowa o niezmiennym zakresie odpowiedzi |
| Kontrola jakości | Flaga spójności logicznej | 0 = brak niespójności; 1 = wykryto niespójność | Zmienna badania spójności logicznej |
Tabela 1: Zmienne kluczowe, struktura kodowania i zasady punktacji stosowane w ustandaryzowanym protokole kwestionariusza.Tabela ta podsumowuje kluczowe zmienne dotyczące kwalifikowalności, demografii, korzystania z internetu, skal, kowariantów oraz kontroli jakości użyte w głównym schemacie postępowania. Zawiera wartości kodowania, zakresy wyników, zasady punktacji oraz role głównych zmiennych wykorzystywanych do przeprowadzania ankiet, przesiewu, punktacji i analizy. Skróty: IAT = test uzależnienia od internetu; DERS-16 = 16-elementowa skala trudności w regulacji emocji. Kliknij tutaj, aby pobrać tę tabelę.
1. Ustalenie populacji badawczej, struktury kwestionariusza i przebiegu badania
- Zdefiniowanie populacji docelowej i poprawnej próby
- Zrekrutuj studentów studiów licencjackich i magisterskich w trybie stacjonarnym w wieku 18–24 lat, którzy są w stanie samodzielnie wypełnić kwestionariusz za pomocą telefonu komórkowego lub komputera. Odnotuj wersję językową kwestionariusza i zastosuj wersje skal, które zostały zwalidowane lub odpowiednio dostosowane do docelowej populacji studentów.
- W przypadku włączenia studentów zagranicznych, studentów z niepełnosprawnościami lub wielojęzycznych grup studentów, udokumentuj wszelkie modyfikacje dotyczące dostępności lub języka przed rozpoczęciem zbierania danych.
- Ogranicz udział do jednej wypełnionej odpowiedzi na uczestnika. Jeśli jest to możliwe, skorzystaj z funkcji ograniczania urządzeń, kont, plików cookie lub uwierzytelnionych linków dostępnych na platformie ankietowej.
UWAGA: W przypadku, gdy to samo konto uczestnika generuje odpowiedzi z wielu urządzeń, zidentyfikuj i uzgodnij te rekordy podczas usuwania duplikatów, korzystając z identyfikatora ograniczonego do konta, znacznika czasu, statusu kwestionariusza oraz podobieństwa wzorców odpowiedzi. - Ustal minimalną końcową poprawną próbę na poziomie 450 kwestionariuszy i kontynuuj rekrutację do momentu, aż oczyszczony zbiór danych pozostanie powyżej tego progu po przeprowadzeniu selekcji.
UWAGA: Jeśli głównym celem analizy jest ciężka problematyka korzystania z internetu lub inna mała podgrupa, ustal większy cel rekrutacyjny przed rozpoczęciem zbierania danych. - Zapisz liczbę osób zaproszonych, liczbę otrzymanych odpowiedzi, liczbę osób wykluczonych na każdym z wcześniej określonych etapów selekcji oraz końcową liczbę zachowanych rekordów, aby przepływ uczestników mógł zostać później podsumowany na Rysunku 1.
- Konstrukcja kwestionariusza w stałej kolejności
- Uporządkuj kwestionariusz w następującej sekwencji: świadoma zgoda, informacje demograficzne, zachowania związane z korzystaniem z internetu, Internet Addiction Test, krótka forma skali trudności w regulacji emocji (Difficulties in emotion regulation scale short form), czas trwania snu, tygodniowa aktywność fizyczna i postrzegany stres akademicki. Zachowaj tę kolejność bez zmian dla wszystkich uczestników. Nie randomizuj kolejności głównych skal.
- Zapisz wiek, płeć, rok studiów, kategorię dyscypliny, rodzaj miejsca zamieszkania oraz miesięczne wydatki na utrzymanie, korzystając z zamkniętych kategorii odpowiedzi. Oznacz wszystkie elementy demograficzne jako obowiązkowe.
UWAGA: W przypadku płci uwzględnij opcje: mężczyzna, kobieta oraz „wolę nie podawać”. Zachowaj opcję „wolę nie podawać” w analizach opisowych. W analizach regresji zakoduj płeć za pomocą zmiennych wskaźnikowych, przyjmując płeć męską jako kategorię referencyjną i uwzględniając oddzielne wskaźniki dla płci żeńskiej oraz opcji „wolę nie podawać”. Nie usuwaj uczestników wyłącznie z powodu wybrania opcji „wolę nie podawać”. - Zapisz czas korzystania z internetu w dni powszednie, czas korzystania z internetu w weekendy, główną aktywność online, główne urządzenie dostępu oraz korzystanie z internetu późno w nocy po godzinie 23:00. Zakoduj korzystanie późno w nocy jako: 1 = nigdy, 2 = rzadziej niż raz w tygodniu, 3 = 1–2 noce w tygodniu, 4 = 3–5 nocy w tygodniu oraz 5 = prawie każdej nocy.
- Zapisz okres akademicki, w którym przeprowadzono badanie. W reprezentacyjnej implementacji ankieta została przeprowadzona podczas regularnego semestru dydaktycznego, poza tygodniami egzaminów końcowych, konkretnie w 6. i 7. tygodniu semestru.
- Przeprowadzenie i punktowanie głównych narzędzi
- Przeprowadź 20-punktowy test uzależnienia od internetu (Internet addiction test) jako skalę obowiązkową i punktuj każdy element w skali od 1 do 5. Zsumuj wszystkie 20 elementów, aby uzyskać wynik całkowity w zakresie od 20 do 100, a następnie zaklasyfikuj wyniki 20–39 jako użytkowanie normalne, 40–69 jako użytkowanie problematyczne oraz 70–100 jako ciężkie użytkowanie problematyczne15.
- Używaj terminu „uzależnienie od internetu” przy raportowaniu wyników i grup nasilenia opartych na IAT. Używaj terminu „problematyczne korzystanie z internetu” wyłącznie w odniesieniu do szerszej literatury lub konstruktów niezwiązanych z IAT.
- Przeprowadź 16-punktową krótką formę skali trudności w regulacji emocji bezpośrednio po teście uzależnienia od internetu i punktuj każdy element w skali od 1 do 5. Przed sumowaniem odwróć kodowanie elementów 1, 6 i 8, a następnie oblicz wynik całkowity w zakresie od 16 do 80, gdzie wyższe wyniki wskazują na większe trudności w regulacji emocji16.
- Wygeneruj pięć wyników podskal dla nieakceptacji, celów, impulsywności, strategii i jasności po zweryfikowaniu odwróconego kodowania.
- Ponownie sprawdź kierunek kodowania wszystkich elementów odwróconych przed obliczeniem wyników całkowitych i podskal. Stosuj ten sam klucz punktowania DERS-16 dla każdego uczestnika i udokumentuj klucz punktowania w pliku README/codebook.
- W przypadku zastosowania zrewidowanego lub alternatywnego narzędzia do badania uzależnienia od internetu, wymień moduł specyficzny dla skali przed rozpoczęciem zbierania danych i zaktualizuj nazwy elementów, zakres wyników, progi nasilenia, składnię punktowania, plik README/codebook, zrzuty ekranu kwestionariusza oraz Tabelę materiałów.
- Dodanie kowariantów i jednego elementu kontroli uwagi
- Zapisz czas trwania snu jako <6 h, 6–6,9 h, 7–7,9 h oraz ≥8 h. Zapisz częstotliwość tygodniowej aktywności fizycznej jako 0, 1–2, 3–4 oraz ≥5 sesji. Zapisz postrzegany stres akademicki jako niski, umiarkowany lub wysoki. Zdefiniuj jedną sesję aktywności fizycznej jako ≥20 min aktywności o umiarkowanej lub dużej intensywności.
- Wstaw jeden element kontroli uwagi z wymuszoną odpowiedzią w sekcji behawioralnej i wymagaj od uczestnika wybrania jednej określonej opcji odpowiedzi. Element kontroli uwagi użyty w reprezentacyjnej implementacji brzmiał: „Aby potwierdzić, że uważnie czytasz, wybierz dla tego pytania odpowiedź '3 = czasami'”. Oznacz każdy kwestionariusz, który nie przejdzie tego testu, do wykluczenia podczas oczyszczania danych17.
KROK KRYTYCZNY: Nie zmieniaj sformułowań pytań, kotwic odpowiedzi, kolejności skal, progów wykluczenia, ustawień platformy ankietowej, zasad kodowania ani zasad analizy statystycznej po formalnym rozpoczęciu zbierania danych.
UWAGA: Podsumuj główne zmienne, wartości kodowania, zakresy wyników i zasady punktowania w Tabeli 1. Przekaż pełny słownik zmiennych, pola statusu plików, flagi selekcji, pola identyfikatorów technicznych, zmienne śledzenia zbioru danych, nazwy plików i wersje oprogramowania w Uzupełniającej Tabeli 1 oraz w pliku README/codebook.
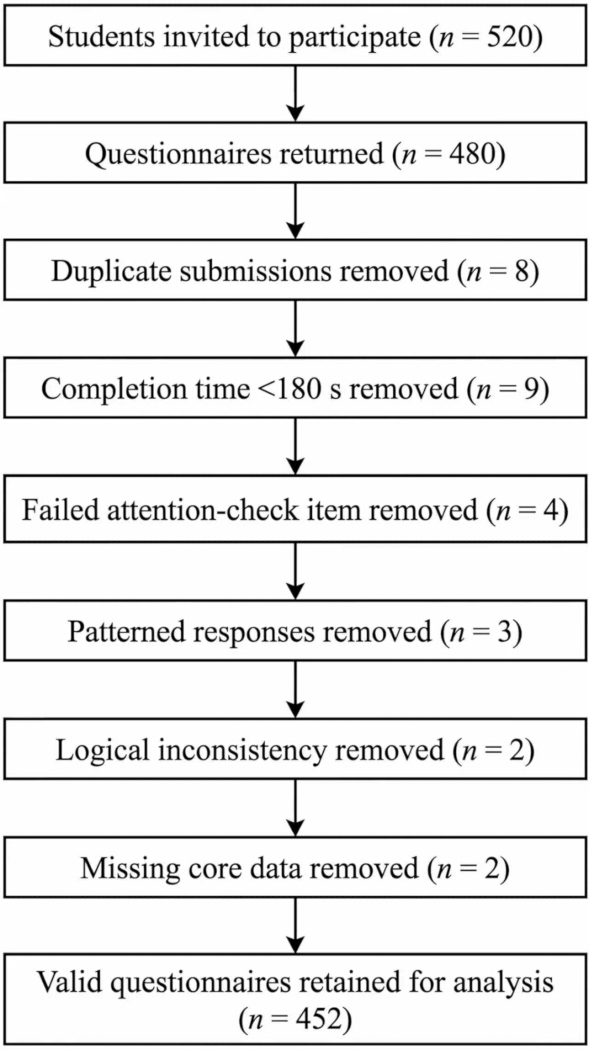
Rysunek 1: Schemat przepływu kwestionariuszy w procesie rekrutacji, przesiewu, wykluczania i końcowej retencji do analizy. Ten diagram przepływu przedstawia proces od zaproszonych studentów i otrzymanych kwestionariuszy, poprzez sekwencyjny przesiew jakości danych i wykluczanie według określonych kryteriów, aż po końcową retencję prawidłowych kwestionariuszy do analizy. Rysunek przedstawia liczbę zaproszonych studentów, zwróconych kwestionariuszy, rekordów wykluczonych na każdym etapie przesiewu oraz końcową próbę analityczną. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
2. Przetestowanie kwestionariusza w badaniu pilotażowym i ustalenie ostatecznej wersji terenowej
- Przeprowadzenie testu pilotażowego pełnego kwestionariusza
- Przeprowadzenie pełnego kwestionariusza wśród 20–30 studentów, którzy spełniają formalne kryteria włączenia, ale nie zostaną uwzględnieni w końcowym zbiorze danych.
- Odnotowanie czasu wypełnienia oraz pisemnych opinii na temat przejrzystości, obciążenia respondentów, dostępu technicznego, kolejności pytań, zrozumienia pytań kontrolnych oraz wszelkich niejednoznaczności w opcjach odpowiedzi demograficznych lub behawioralnych.
- Zapisanie wielkości próby pilotażowej, mediany czasu wypełnienia, rozstępu międzykwartylowego, minimalnego i maksymalnego czasu wypełnienia oraz wszystkich zmian w treści wprowadzonych po testach pilotażowych.
- W reprezentacyjnej implementacji pilotaż objął 25 studentów, mediana czasu wypełnienia wyniosła 540 s, a oczekiwany czas wypełnienia ustalono na 6–8 min.
- Korekta niejednoznacznych sformułowań, powielonych znaczeń, niejasnych opcji odpowiedzi lub problemów z wyświetlaniem oprogramowania zidentyfikowanych podczas testów pilotażowych, a następnie zamrożenie ostatecznej wersji kwestionariusza przed formalnym udostępnieniem.
UWAGA: Jeśli badanie obejmuje studentów wielojęzycznych, osoby starsze, młodzież lub studentów z niepełnosprawnościami, należy przeprowadzić dodatkowe testy poznawcze lub pilotaż w podgrupach przed formalnym udostępnieniem.
- Ustalenie ustawień operacyjnych i reguł eksportu
- Utworzenie nowego projektu ankiety na wybranej platformie ankiet online. Wprowadzenie strony zgody jako pierwszej strony i ustawienie pozycji dotyczącej zgody jako wymaganego elementu rozgałęziającego.
- Skonfigurowanie ankiety w taki sposób, aby uczestnicy, którzy nie wyrażą zgody, automatycznie opuszczali ankietę bez wglądu w treść kwestionariusza.
- Wprowadzenie wszystkich pytań demograficznych, dotyczących korzystania z internetu, IAT, DERS-16, zmiennych towarzyszących oraz pytań kontrolnych, stosując zatwierdzone sformułowania i kotwice odpowiedzi. Ustawienie wszystkich kluczowych pozycji jako obowiązkowych.
- Aktywacja automatycznej rejestracji czasu rozpoczęcia, czasu zakończenia, czasu trwania wypełniania, statusu odpowiedzi oraz identyfikatora odpowiedzi generowanego przez platformę.
- Włączenie kontroli jednej odpowiedzi na uczestnika, jeśli są dostępne, w tym uwierzytelnionych linków do ankiety, ograniczeń urządzeń, zapobiegania powtórzeniom na podstawie plików cookie, zapobiegania powtórzeniom na podstawie konta lub ustawień weryfikacji duplikatów odpowiedzi. Zapisanie włączonych kontroli w pliku README/codebook.
- Wyłączenie zbierania niepotrzebnych bezpośrednich identyfikatorów. Jeśli platforma domyślnie rejestruje adres IP, należy wyłączyć przechowywanie adresu IP lub zastąpić go nieidentyfikującym polem przesiewowym pod kątem duplikatów, o ile pozwalają na to zasady instytucjonalne.
UWAGA: Jeśli adresy IP lub metadane urządzeń są tymczasowo przechowywane w celu wykrywania duplikatów, należy je przechowywać wyłącznie w zaszyfrowanym pliku surowym, ograniczyć dostęp do analityka badania i usunąć je przed utworzeniem końcowego zbioru danych analitycznych. - Określenie, czy dopuszczalne jest wstrzymanie i wznowienie ankiety. W niniejszym protokole funkcja formalnego zapisywania i powrotu w różnych sesjach nie jest włączona. Uczestnicy mogą wstrzymać wypełnianie tylko w obrębie tej samej otwartej sesji przeglądarki, a zarejestrowany czas wypełnienia obejmuje cały upływ czasu.
- Eksport surowego pliku wyników zarówno w formacie arkusza kalkulacyjnego, jak i w formacie wartości rozdzielonych przecinkami (CSV) po zamknięciu ankiety18. Eksport również pliku z mapowaniem ankiety na dokument lub kopii PDF/A zawierającej ostateczną treść kwestionariusza, kolejność pytań, ustawienia rozgałęzień, ustawienia pozycji obowiązkowych oraz strukturę kodowania. Zapisanie tych plików z nazwami uwzględniającymi wersjonowanie.
- Obliczenie mediany czasu wypełnienia z pilotażu i ustawienie minimalnego progu ważnego czasu wypełnienia na około jedną trzecią tej wartości. Ustalenie ostatecznego dolnego progu na 180 s i stosowanie go jednolicie podczas formalnej selekcji.
- Ponieważ wartość odcięcia ta pochodzi z próby pilotażowej, należy ponownie ustalić próg w przypadku wdrożenia protokołu w istotnie innej populacji, na innej platformie, w innej wersji językowej lub w innych warunkach instytucjonalnych.
UWAGA: Archiwizacja zrzutów ekranu końcowego kwestionariusza, eksportu końcowego kwestionariusza, pliku README/codebook, dziennika pilotażu, treści pytań kontrolnych, szablonu dziennika selekcji, ustawień eksportu oraz składni statystycznej jako plików uzupełniających lub audytowych.
3. Udostępnienie kwestionariusza i archiwizacja surowego zbioru danych
- Rekrutacja uczestników za pomocą stałych kanałów
- Rozesłać jedno ustandaryzowane zaproszenie poprzez studenckie grupy komunikacyjne, kanały klasowe lub instytucjonalne listy mailingowe w ustalonym 14-dniowym oknie zbierania danych.
- Podać cel badania, przewidywany czas wypełnienia wynoszący 6–8 min, informację o anonimowym przetwarzaniu danych, dobrowolności udziału oraz braku kar akademickich lub nagród za nieuczestnictwo zarówno w zaproszeniu, jak i na stronie zgody.
- Wyświetlić stronę zgody przed pojawieniem się jakiegokolwiek elementu kwestionariusza i wymagać aktywnego wyrażenia zgody przed wejściem. Nie zezwalać na dostęp do treści kwestionariusza bez potwierdzenia zgody.
- Zaznaczyć na stronie zgody, że uczestnicy mogą przerwać wypełnianie przed ostatecznym przesłaniem, a niekompletne odpowiedzi nie zostaną wykorzystane w końcowej analizie.
- Stosować tę samą zablokowaną wersję kwestionariusza we wszystkich kanałach rekrutacyjnych. W przypadku korzystania z kilku kanałów rekrutacyjnych, odnotowywać kanał tylko wtedy, gdy został on wcześniej określony jako zmienna badania.
- Zachowanie surowego pliku z odpowiedziami
- Zachować wszystkie otrzymane rekordy, w tym zgłoszenia niekompletne i później wykluczone, w surowym pliku eksportu. Wyeksportować pełny zestaw danych natychmiast po zamknięciu ankiety i zapisać go jako raw_returns_YYYYMMDD.csv oraz raw_returns_YYYYMMDD.xlsx.
- Zachować w surowym pliku oryginalny czas przesłania, czas wypełniania, status odpowiedzi, wygenerowany przez platformę identyfikator odpowiedzi oraz techniczny identyfikator urządzenia lub konta. Nie nadpisywać tych pól podczas późniejszego czyszczenia danych.
- Zapisać jedną kopię surowych danych w trybie tylko do odczytu przed rozpoczęciem screeningu. Przechowywać surowy plik, dziennik screeningu i końcowy zestaw danych analitycznych w oddzielnych folderach. Ograniczyć dostęp do surowego pliku zawierającego identyfikatory techniczne wyłącznie do upoważnionego personelu badawczego.
OSTRZEŻENIE: Nie zbierać w głównym pliku ankiety informacji bezpośrednio identyfikujących, takich jak pełne imię i nazwisko, numer legitymacji studenckiej, dokładny adres w akademiku, osobisty numer telefonu, osobisty adres e-mail lub konto w mediach społecznościowych.
UWAGA: Wstrzymać proces po eksporcie surowych danych, zapisać jedną kopię zestawu danych w trybie tylko do odczytu i wznowić czyszczenie danych wyłącznie z tej zachowanej kopii.
4. Przesiewowe sprawdzenie zwróconych kwestionariuszy i utworzenie końcowego zbioru danych do analizy
- Zastosuj sekwencję przesiewową w ustalonej kolejności
- Posortuj wszystkie zwrócone rekordy według identyfikatora ograniczonego do urządzenia, identyfikatora ograniczonego do konta (jeśli jest dostępny), znacznika czasu, statusu kwestionariusza i podobieństwa odpowiedzi. W pierwszej kolejności zidentyfikuj duplikaty zgłoszeń. Zachowaj najwcześniejszy kompletny rekord, gdy dwa lub więcej zgłoszeń pochodzi od tego samego uczestnika w obrębie tego samego cyklu zbierania danych.
- Jeśli wykryto wiele zgłoszeń z tego samego uwierzytelnionego konta, ale z różnych urządzeń, potraktuj je jako duplikaty zgłoszeń od tego samego uczestnika. Zachowaj najwcześniejszy kompletny rekord i odrzuć późniejsze kompletne rekordy. Jeśli najwcześniejszy rekord jest niekompletny, a późniejszy jest kompletny, zachowaj najwcześniejszy kompletny rekord.
- Usuń rekordy z czasem wypełniania <180 s, przejrzyj rekordy wypełnione w czasie 180–240 s i w czwartym kroku usuń rekordy, które nie przeszły testu uwagi opartego na odpowiedziach kierowanych. Odnotuj liczbę usuniętych rekordów na każdym etapie w pliku screening_log_v1.xlsx19.
- W przypadku rekordów wypełnionych w czasie 180–240 s przeprowadź manualną weryfikację, wykorzystując wynik testu uwagi, flagę odpowiedzi w długich ciągach, odchylenie standardowe wewnątrz osobnicze oraz flagę spójności logicznej.
- Zachowaj rekord o prędkości granicznej tylko wtedy, gdy nie występuje żadna dodatkowa flaga jakości danych. Każdą decyzję dotyczącą prędkości granicznej odnotuj w dzienniku przesiewowym.
- Usuń rekordy schematyczne, niespójne lub niekompletne
- Usuń wszystkie kwestionariusze wykazujące odpowiedzi w długich ciągach, definiowane jako 18 lub więcej kolejnych identycznych odpowiedzi w 36 punktowanych elementach skali, lub odchylenie standardowe wewnątrz osobnicze ≤0.25 w tych elementach.
- Usuń każdy kwestionariusz wykazujący niemożliwe kombinacje behawioralne. Zdefiniuj „najwyższą kategorię odpowiedzi w niemal wszystkich elementach testu uzależnienia od Internetu” jako wynik 5 w co najmniej 18 z 20 elementów IAT.
UWAGA: Reguła niespójności logicznej jest aktywowana, gdy respondent raportuje korzystanie z Internetu w dni powszednie i weekendy w najniższej kategorii czasu trwania (<2 h na dobę), korzystanie z Internetu późno w nocy zakodowane jako „prawie każdej nocy” oraz wynik 5 w co najmniej 18 z 20 elementów IAT. Zastosuj tę regułę dopiero po zakończeniu przesiewania pod kątem duplikatów, czasu wypełniania, testu uwagi i odpowiedzi schematycznych. - Usuń wszystkie kwestionariusze z brakującymi wartościami w dowolnym elemencie IAT, dowolnym elemencie DERS-16 lub dowolnej wcześniej określonej współzmiennej.
UWAGA: Ta reguła kompletnych przypadków jest stosowana, ponieważ ankieta online wykorzystuje obowiązkowe elementy rdzeniowe, a reprezentatywny model regresji wymaga stałego zestawu współzmiennych. Gdy brakujące dane współzmiennych przekraczają 5%, zastosuj wcześniej określoną alternatywną metodę uzupełniania brakujących danych, taką jak imputacja wielokrotna. - Przypisz jeden anonimowy identyfikator badania do każdego zachowanego rekordu i zapisz pozostały plik jako analytic_dataset_v1.csv oraz analytic_dataset_v1.xlsx.
- Usuń z końcowego zestawu danych analitycznych identyfikatory odpowiedzi wygenerowane przez platformę, identyfikatory ograniczone do urządzenia, identyfikatory ograniczone do konta, adresy IP (jeśli zostały zachowane podczas przesiewania), znaczniki czasu oraz notatki z weryfikacji w tekście wolnym. Zachowaj tylko anonimowy identyfikator badania i zmienne analityczne.
KROK KRYTYCZNY: Zastosuj sekwencję przesiewową w tej samej kolejności dla każdego rekordu i nie przywracaj przypadków wykluczonych na wcześniejszych etapach. Przypisz pierwsze aktywowane kryterium wykluczenia jako główny powód wykluczenia, a flagi wtórne odnotuj wyłącznie jako uwagi w dzienniku przesiewowym.
UWAGA: Podsumuj końcową liczbę wykluczeń z podziałem na powody w Tabeli 2 i dopilnuj, aby liczby te były identyczne z przepływem uczestników przedstawionym później na Rysunku 1.
| Kolejność przesiewania | Element przesiewowy | Zasada operacyjna | Badanie przesiewowe aktywności | Zasada dokumentowania |
| Krok 1 | Konserwacja surowego eksportu | Wyeksportuj wszystkie otrzymane rekordy niezwłocznie po zamknięciu ankiety i zapisz je jako raw_returns_RRRRMMDD.csv oraz raw_returns_RRRRMMDD.xlsx | Zachowaj jedną kopię tylko do odczytu przed rozpoczęciem jakiegokolwiek oczyszczania | Archiwizuj w folderze raw-data |
| Krok 2 | Weryfikacja zgody i dostępu | Identyfikacja rekordów bez aktywnej elektronicznej świadomej zgody przed uzyskaniem dostępu do kwestionariusza | Wyklucz z procesu analitycznego rekordy bez zgody | Zarejestruj wykluczone lub niedostępne rekordy w pliku screening_log_v1.xlsx, jeśli zostały one zachowane w eksporcie z platformy |
| Krok 3 | Przesiewowe usuwanie duplikatów | Zidentyfikuj rekordy posiadające ten sam identyfikator ograniczony do urządzenia lub identyfikator ograniczony do konta w obrębie tego samego cyklu zbierania danych, które są zgodne pod względem płci, wieku, roku akademickiego oraz wykazują co najmniej 80% identycznych odpowiedzi w kwestionariuszu | Zachowaj najwcześniejszy kompletny rekord i wyklucz wszystkie późniejsze duplikaty | Zarejestruj liczbę wykluczeń oraz wartości affected raw_record_id w pliku screening_log_v1.xlsx; przypisz główny powód wykluczenia (exclusion_reason) = 1 |
| Krok 4 | Uzgadnianie duplikatów z wielu urządzeń | Identyfikacja wielu kompletnych zgłoszeń z tego samego uwierzytelnionego konta uczestnika przesłanych z różnych urządzeń | Traktuj te rekordy jako duplikaty zgłoszeń; zachowaj najwcześniejszy kompletny rekord | Zapisz identyfikator ograniczony do konta oraz zachowany raw_record_id w pliku screening_log_v1.xlsx; dla późniejszych rekordów przypisz główny exclusion_reason = 1 |
| Krok 5 | Przesiewowe badanie czasu zakończenia | Zidentyfikuj wszystkie kwestionariusze z czasem wypełnienia <180 s | Automatycznie wyklucz wszystkie takie rekordy | Zarejestruj liczbę osób wykluczonych w pliku screening_log_v1.xlsx; przypisz główny powód wykluczenia (exclusion_reason) = 2 |
| Krok 6 | Przegląd prędkości granicznej | Zidentyfikuj wszystkie kwestionariusze z czasem wypełniania wynoszącym 180–240 s | Ręcznie przejrzyj każdy rekord, korzystając z flag kontrolnych uwagi (attention-check), długich ciągów znaków (long-string), odchylenia standardowego wewnątrz osób (within-person SD) oraz flag logicznych; zachowaj rekord tylko wtedy, gdy nie występuje żadna dodatkowa flaga. | Każdy przypadek należy odnotować jako retained_after_manual_review = 1 lub excluded_after_manual_review = 1 w pliku screening_log_v1.xlsx |
| Krok 7 | Przesiewowa weryfikacja uwagi | Zidentyfikuj wszystkie rekordy, które nie przeszły testu uwagi w formie pytania z wymuszoną odpowiedzią. | Wyklucz wszystkie nieudane rekordy, które nie zostały wykluczone na wcześniejszym etapie | Zarejestruj liczbę wykluczonych osób w pliku screening_log_v1.xlsx; przypisz główny powód wykluczenia (exclusion_reason) = 3 |
| Krok 8 | Przesiewowe badanie odpowiedzi wzorcowych | Zidentyfikuj rekordy z 18 lub więcej kolejnymi identycznymi odpowiedziami w obrębie 36 punktowanych pozycji skali lub z wewnątrzosobowym odchyleniem standardowym (SD) ≤0,25 w obrębie tych pozycji | Wykluczyć wszystkie takie rekordy, które nie zostały wykluczone na wcześniejszym etapie | Zarejestruj liczbę osób wykluczonych w pliku screening_log_v1.xlsx; przypisz główny powód wykluczenia (exclusion_reason) = 4 |
| Krok 9 | Przesiewowa ocena spójności logicznej | Zidentyfikuj rekordy wykazujące uprzednio określoną niemożliwą kombinację behawioralną: weekday_internet_use oraz weekend_internet_use zakodowane jednocześnie jako <2 h, późnowieczorne użytkowanie (late_night_use) zakodowane jako prawie każdej nocy oraz wynik 5 punktów w co najmniej 18 z 20 pozycji testu IAT | Wyklucz wszystkie takie rekordy, które nie zostały wykluczone na wcześniejszym etapie | Zarejestruj liczbę wykluczonych osób oraz notatkę z przeglądu w pliku screening_log_v1.xlsx; przypisz główny powód wykluczenia (exclusion_reason) = 5 |
| Krok 10 | Przesiewowe badanie braku rdzenia | Zidentyfikuj rekordy z jakąkolwiek brakującą wartością w zmiennych IAT_1–IAT_20, DERS_1–DERS_16, age, sex, weekday_internet_use, weekend_internet_use, sleep_duration, physical_activity lub academic_stress; odpowiedź „prefer not to say” w przypadku zmiennej sex jest traktowana jako prawidłowa odpowiedź, a nie jako wartość brakująca | Wyklucz wszystkie takie rekordy, które nie zostały wykluczone na wcześniejszym etapie | Zarejestruj liczbę osób wykluczonych w pliku screening_log_v1.xlsx; przypisz główny powód wykluczenia (exclusion_reason) = 6 |
| Krok 11 | Podstawowe przypisanie wykluczeń | Identyfikacja rekordów spełniających więcej niż jedno kryterium wykluczenia | Przyjmij pierwsze spełnione kryterium w uprzednio określonej sekwencji przesiewowej jako główny powód wykluczenia | Rejestruj flagi wtórne wyłącznie w notatkach do recenzji; nie przypisuj wielu głównych powodów |
| Krok 12 | Usuwanie identyfikatorów technicznych | Zidentyfikuj identyfikatory odpowiedzi generowane przez platformę, identyfikatory ograniczone do urządzenia, identyfikatory ograniczone do konta, znaczniki czasu oraz wszelkie tymczasowo przechowywane metadane techniczne w wyczyszczonym pliku | Usuń te pola z końcowego zbioru danych analitycznych po zakończeniu przesiewania | Usuwanie dokumentów w pliku screening_log_v1.xlsx |
| Krok 13 | Końcowa retencja | Zachowaj wszystkie rekordy, które przeszły wszystkie poprzednie etapy przesiewowe | Przypisz jeden anonimowy identyfikator badania do każdego zachowanego rekordu | Zapisz jako analytic_dataset_v1.csv i analytic_dataset_v1.xlsx |
| Krok 14 | Podsumowanie przesiewowe | Należy policzyć liczbę usuniętych obiektów na każdym etapie oraz końcową liczbę zachowanych obiektów | Podsumuj końcowe zliczenia do raportu w manuskrypcie | Zachowaj wartości liczbowe w Tabeli 2 identyczne z tymi w Ryc. 1 |
| Krok 15 | Zachowanie ścieżki audytu | Należy zachować plik surowy, dziennik przesiewowy oraz końcowy zestaw danych analitycznych jako oddzielne pliki | Nie nadpisywać, nie łączyć ani nie edytować ręcznie zarchiwizowanych plików źródłowych | Przechowywać osobno w folderach z danymi surowymi, screeningowymi i analitycznymi |
Tabela 2: Predefiniowana sekwencja przesiewowa, progi wykluczenia, działania przesiewowe i zasady dokumentowania czyszczenia kwestionariuszy.Tabela ta podsumowuje ustaloną kolejność przesiewową stosowaną do czyszczenia zwróconych kwestionariuszy, obejmującą weryfikację zgody i dostępu, wykrywanie duplikatów, uzgadnianie wielokrotnych urządzeń, przesiewanie czasu wypełniania, przegląd prędkości granicznej, błędy kontroli uwagi, schematyczne odpowiedzi, niespójności logiczne, kluczowe brakujące dane, usuwanie identyfikatorów technicznych, ostateczne zachowanie danych oraz zachowanie ścieżki audytu. Skróty: IAT = test uzależnienia od internetu; DERS-16 = 16-elementowa skala trudności w regulacji emocji. Kliknij tutaj, aby pobrać tę tabelę.
5. Punktowanie zmiennych, weryfikacja rzetelności i przygotowanie pliku do analizy
- Wygenerowanie wyników całkowitych, wyników podskal i pochodnych zmiennych kategorycznych
- Zsumuj wyniki 20 pozycji IAT, aby uzyskać całkowity wynik uzależnienia od internetu, a następnie zapisz zarówno wynik ciągły, jak i trzystopniową klasę nasilenia w pliku przygotowanym do analizy.
- Odwróć kodowanie pozycji 1, 6 i 8 w DERS-16, oblicz wynik całkowity oraz wyniki pięciu podskal, a następnie dołącz wszystkie zmienne pochodne do tego samego zbioru danych na poziomie uczestnika.
- Przeprowadź kontrolę zakresu przed obliczeniem wyników. Potwierdź, że wszystkie wartości pozycji IAT i DERS-16 mieszczą się w przedziale 1–5, wszystkie wartości zakodowane odwrotnie mieszczą się w przedziale 1–5, całkowite wyniki IAT mieszczą się w przedziale 20–100, a całkowite wyniki DERS-16 mieszczą się w przedziale 16–80. Zapisz wynik kontroli zakresu w dzienniku punktacji.
- Rekodowanie kowariancji na stałe kategorie analityczne
- Rekoduj czas korzystania z internetu w dni powszednie i w weekendy na kategorie: <2 h, 2–3.9 h, 4–5.9 h oraz ≥6 h. Rekoduj nocne korzystanie z internetu na kategorie: nigdy, <1 noc/tydzień, 1–2 noce/tydzień, 3–5 nocy/tydzień oraz prawie każdej nocy.
- Rekoduj czas trwania snu, częstotliwość aktywności fizycznej i postrzegany stres akademicki zgodnie z uprzednio określonymi zasadami kategoryzacji zdefiniowanymi w sekcji 1.4 i zapisz rekodowane wartości pod stałymi nazwami zmiennych w tym samym zbiorze danych.
- Rekoduj płeć na potrzeby regresji, używając dwóch zmiennych wskaźnikowych: kobieta versus mężczyzna oraz preferuję nie podawać versus mężczyzna. Opisz kodowanie w przypisie do tabeli oraz w pliku README/codebook.
- Weryfikacja rzetelności punktacji i spójności wewnętrznej
- Oblicz alfę Cronbacha dla całkowitego wyniku IAT i całkowitego wyniku DERS-16 przed przeprowadzeniem analizy inferencyjnej. Ponownie sprawdź kodowanie pozycji, kodowanie odwrotne i niemożliwe zakresy pozycji, jeśli którakolwiek z wartości alfa jest <0.7020. Przedstaw wartości alfy Cronbacha w sekcji Reprezentatywne wyniki.
- Oblicz korelacje pozycji z sumą lub wartościy alfy po usunięciu pozycji, jeśli którakolwiek ze skal wykazuje nieoczekiwanie niską spójność wewnętrzną. Nie usuwaj pozycji skali z analizy głównej, chyba że usunięcie pozycji zostało uprzednio określone lub badanie zostało wyraźnie zaprojektowane jako badanie walidacji psychometrycznej.
- Zapisz finalny zbiór danych przygotowany do analizy wraz z plikiem README zawierającym nazwy zmiennych, zasady kodowania, progi wykluczenia, nazwy plików, wersje oprogramowania, wersję kwestionariusza, składnię punktacji, specyfikację modelu regresji oraz procedury niezbędne do ponownego wygenerowania tego samego zbioru danych.
6. Analiza danych i zapewnienie reprodukowalności wyników
- Wygenerowanie statystyk opisowych i porównań grupowych
- Zmienne ciągłe przedstawić jako średnią ± odchylenie standardowe, a zmienne kategoryczne jako częstość i procent. Podsumować charakterystykę demograficzną, zachowania w zakresie korzystania z internetu oraz wyniki w skalach, korzystając z predefined output structure.
- Podać wielkość próby wykorzystaną w każdej analizie. Jako mianownik przyjąć zachowaną próbę analityczną, chyba że w tabeli wyraźnie zaznaczono inaczej.
- Porównać całkowite wyniki DERS-16 oraz wyniki podskal w trzech grupach nasilenia IAT, stosując testy dwustronne z α = 0.05 dla analiz głównych. Podać standaryzowane wielkości efektu tam, gdzie jest to odpowiednie.
UWAGA: W przypadku porównań grupowych podać η2 lub częściowe η2 dla analizy wariancji lub równoważną nieparametryczną wielkość efektu, jeśli zastosowano test nieparametryczny. Interpretować ostrożnie porównania w podgrupie z ciężkim problematycznym użytkowaniem, gdy podgrupa ta jest mała. - Obliczyć korelację Pearsona między całkowitym wynikiem IAT a całkowitym wynikiem DERS-16, jeżeli obie zmienne wykazują akceptowalny rozkład; w przeciwnym razie zastosować korelację Spearmana jako analizę wrażliwości. Podać n, r lub ρ, 95% przedział ufności (jeśli został wygenerowany przez oprogramowanie statystyczne), wartość p oraz interpretację wielkości efektu.
- Dopasowanie skorygowanego modelu regresji i archiwizacja wyników
- Jako zmienną zależną przyjąć całkowity wynik DERS-16, a jako główną zmienną niezależną całkowity wynik IAT. Jako współzmienne wprowadzić wiek, płeć, korzystanie z internetu w dni powszednie, korzystanie z internetu w weekendy, czas trwania snu, aktywność fizyczną oraz postrzegany stres akademicki. Model ten stanowi zdefiniowaną demonstrację analityczną ustandaryzowanego przepływu pracy.
- Przed interpretacją skorygowanego modelu regresji ocenić założenia regresji oraz stabilność modelu. Sprawdzić wykresy rezyduów względem wartości dopasowanych pod kątem liniowości i homoskedastyczności, przeanalizować wykres Q-Q lub przeprowadzić test normalności dla rozkładu rezyduów oraz obliczyć współczynniki inflacji wariancji (VIF) w celu oceny współliniowości.
- Opisać wyniki tych diagnostyk w sekcji Representative Results lub w uzupełniających wynikach analiz.
- W przypadku wykrycia heteroskedastyczności rezyduów, podać błędy standardowe odporne na heteroskedastyczność w ramach analizy wrażliwości.
- W przypadku wystąpienia obserwacji wpływowych podać, czy główny współczynnik dla całkowitego wyniku IAT pozostaje istotnie niezmieniony po przeprowadzeniu diagnostyki wpływów. Nie usuwać obserwacji wpływowych, chyba że spełniona zostanie wcześniej określona reguła jakości danych.
- Podać nieskorygowane współczynniki, błędy standardowe, współczynniki standaryzowane, wartości p , R2 modelu, skorygowane R2, statystykę F modelu oraz zakres VIF dla modelu skorygowanego. Uwzględnić wielkość próby w tytule tabeli lub w przypisie do tabeli.
- W przypadku testowania interakcji, efektów podgrup lub ścieżek mediacji, należy określić te analizy przed zebraniem danych lub oznaczyć je jako eksploracyjne. Podstawowy protokół nie wymaga testowania interakcji, chyba że różnice między podgrupami są zdefiniowanym celem badania.
- Zapisać całą składnię statystyczną, tabele wyników, wykresy rezyduów, wyniki VIF, wyniki niezawodności oraz wygenerowane ryciny pod nazwami plików z kontrolą wersji. Generować wszystkie raportowane wyniki bezpośrednio z pliku analytic_dataset_v1, a nie z plików edytowanych ręcznie.
UWAGA: Tekst protokołu powinien skupiać się na replikacji przepływu pracy. Szczegółowe statystyki reprezentatywne, wykresy podgrup, diagnostykę regresji, ocenę współliniowości oraz wyniki modelu przedstawić w sekcji Representative Results.
Wyniki
Przebieg badania i końcowa retencja analityczna
Wyniki demonstrują wykonanie zestandaryzowanego procesu ankietowego, a nie niezależną walidację testu uzależnienia od Internetu lub kwestionariusza DERS-16. W ciągu 14-dniowego okresu ankietowania zaproszono do udziału 520 studentów, z czego zwrócono 480 kwestionariuszy. Przesiewanie przeprowadzono w ściśle określonej kolejności. Najpierw usunięto 8 powtarzających się zgłoszeń, następnie 9 kwestionariuszy, których czas wypełnienia był krótszy niż 180 s, 4 kwestionariusze, w których nie zaliczono kontrolnego pytania o uwagę (directed-response attention-check), 3 kwestionariusze wykazujące schematyczne odpowiedzi, 2 kwestionariusze z niespójnością logiczną oraz 2 kwestionariusze z brakującymi danymi kluczowymi. Po zakończeniu pełnej sekwencji przesiewania w końcowym zbiorze danych analitycznych zachowano 452 ważne kwestionariusze. Końcowy wskaźnik retencji wyniósł 94,2% spośród zwróconych kwestionariuszy i 86,9% spośród zaproszonych studentów. Schemat przepływu kwestionariuszy od zaproszenia do końcowej retencji analitycznej przedstawiono na Rysunku 1.
Charakterystyka uczestników
Ostateczna próba analityczna obejmowała 452 studentów, ze średnią wieku 20,41 ± 1,58 lat. Większość respondentów stanowiły kobiety (279 studentek), natomiast mężczyzn było 167, a 6 osób wybrało opcję „wolę nie odpowiedzieć”. Uczestnicy reprezentowali wszystkie lata studiów oraz wiele różnych kierunków, przy czym największy odsetek stanowili studenci drugiego i trzeciego roku. Większość respondentów mieszkała w akademikach, a miesięczne wydatki na utrzymanie koncentrowały się w kategoriach 1 000–1 999 i 2 000–2 999. W zachowanej próbie odnotowano również znaczną rutynową ekspozycję na internet. W dni powszednie rozkład czasu korzystania z sieci skupiał się głównie w kategoriach 2–3,9 h oraz 4–5,9 h, natomiast w weekendy czas ten wzrósł – 322 z 452 studentów deklarowało co najmniej 4 h dziennie. Dominującym sposobem dostępu był smartfon. Najczęściej zgłaszanymi głównymi aktywnościami online były media społecznościowe, rozrywka/wideo oraz cele edukacyjne. Powszechne było korzystanie z sieci późno w nocy (po godzinie 23:00) – 228 z 452 studentów deklarowało taką aktywność co najmniej 3 noce w tygodniu. Czas trwania snu koncentrował się w przedziale od 6 do 7,9 h, aktywność fizyczną najczęściej określano jako 1–2 sesje w tygodniu, a najczęstszą odpowiedzią w kwestii stresu akademickiego był stres umiarkowany. Profil demograficzny i behawioralny zachowanej próby przedstawiono w Tabeli 3.
| Cecha | Kategoria | n | % |
| Płeć | Mężczyzna | 167 | 36.9 |
| Kobieta | 279 | 61.7 | |
| Woli nie podawać | 6 | 1.3 | |
| Rok akademicki | Pierwszy rok | 88 | 19.5 |
| Drugi rok | 124 | 27.4 | |
| Trzeci rok | 131 | 29 | |
| Czwarty rok i powyżej | 79 | 17.5 | |
| Studia podyplomowe | 30 | 6.6 | |
| Kategoria dyscypliny | Humanistyka i nauki społeczne | 118 | 26.1 |
| Nauki ścisłe i inżynieryjne | 96 | 21.2 | |
| Biznes i zarządzanie | 104 | 23 | |
| Sztuka i projektowanie | 82 | 18.1 | |
| Inne | 52 | 11.5 | |
| Typ zakwaterowania | Akademik na kampusie | 301 | 66.6 |
| Wynajem poza kampusem | 79 | 17.5 | |
| Dom rodzinny | 58 | 12.8 | |
| Inne | 14 | 3.1 | |
| Miesięczne koszty utrzymania, CNY | <1,000 | 61 | 13.5 |
| 1,000–1,999 | 176 | 38.9 | |
| 2,000–2,999 | 149 | 33 | |
| ≥3,000 | 66 | 14.6 | |
| Korzystanie z internetu w dni powszednie | <2 h | 52 | 11.5 |
| 2–3.9 h | 157 | 34.7 | |
| 4–5.9 h | 166 | 36.7 | |
| ≥6 h | 77 | 17 | |
| <2 h | 29 | 6.4 | |
| 2–3.9 h | 101 | 22.3 | |
| 4–5.9 h | 178 | 39.4 | |
| ≥6 h | 144 | 31.9 | |
| Główna aktywność online | Nauka | 74 | 16.4 |
| Media społecznościowe | 126 | 27.9 | |
| Gry | 61 | 13.5 | |
| Rozrywka/wideo | 102 | 22.6 | |
| Zakupy | 28 | 6.2 | |
| Użytek mieszany | 47 | 10.4 | |
| Inne | 14 | 3.1 | |
| Główne urządzenie dostępu | Smartfon | 323 | 71.5 |
| Tablet | 18 | 4 | |
| Laptop/komputer stacjonarny | 67 | 14.8 | |
| Urządzenia mieszane | 44 | 9.7 | |
| Użytek późnonocny po 23:00 | Nigdy | 48 | 10.6 |
| Rzadziej niż raz w tygodniu | 57 | 12.6 | |
| 1–2 noce/tydzień | 119 | 26.3 | |
| 3–5 nocy/tydzień | 141 | 31.2 | |
| Prawie każdej nocy | 87 | 19.2 | |
| Czas trwania snu | <6 h | 83 | 18.4 |
| 6–6.9 h | 146 | 32.3 | |
| 7–7.9 h | 157 | 34.7 | |
| ≥8 h | 66 | 14.6 | |
| Tygodniowa aktywność fizyczna | Brak | 91 | 20.1 |
| 1–2 sesje | 176 | 38.9 | |
| 3–4 sesje | 128 | 28.3 | |
| ≥5 sesji | 57 | 12.6 | |
| Stres akademicki | Niski | 73 | 16.2 |
| Umiarkowany | 241 | 53.3 | |
| Wysoki | 138 | 30.5 | |
| Wiek, lata | Średnia ± SD | 20.41 ± 1.58 | — |
Tabela 3: Podstawowe cechy demograficzne i behawioralne zachowanej próby.Tabela ta przedstawia profil demograficzny i charakterystykę korzystania z internetu w końcowej zachowanej próbie po wstępnym, określonym przesiewie. Zmienne obejmują płeć, rok studiów, kategorię dyscypliny, rodzaj miejsca zamieszkania, miesięczne wydatki na utrzymanie, korzystanie z internetu w dni powszednie i w weekendy, główną aktywność online, główne urządzenie dostępu, korzystanie z sieci w późnych godzinach nocnych po 23:00, czas trwania snu, tygodniową aktywność fizyczną, stres akademicki oraz wiek. Skróty: CNY = juan chiński; SD = odchylenie standardowe. Kliknij tutaj, aby pobrać tę tabelę.
Stopień nasilenia uzależnienia od Internetu, wyniki regulacji emocji i niezawodność
W pełnej zachowanej próbce (n = 452) średni całkowity wynik testu uzależnienia od Internetu wyniósł 51,94 ± 16,58. Zgodnie z wcześniej określonymi progami nasilenia, 200 respondentów zaklasyfikowano jako użytkowników normalnych, 239 jako użytkowników problematycznych i 13 jako użytkowników z ciężkimi zaburzeniami, co czyni grupę użytkowników problematycznych największą podgrupą. Średni całkowity wynik DERS-16 w zachowanej próbce wyniósł 35,95 ± 8,89. Test uzależnienia od Internetu wykazał akceptowalną spójność wewnętrzną z alfą Cronbacha na poziomie 0,91, a DERS-16 również wykazał akceptowalną spójność wewnętrzną z alfą Cronbacha na poziomie 0,88. Po zbadaniu całkowitych wyników DERS-16 w trzech grupach nasilenia IAT, grupa normalnego użytkowania miała najniższą średnią, grupa problematycznego użytkowania miała wyższą średnią, a grupa ciężkich zaburzeń użytkowania miała najwyższą średnią. Porównanie grup pod kątem całkowitego wyniku DERS-16 było statystycznie istotne w zachowanej próbce (n = 452; F = 72,80, p < 0,001; η2 = 0,245). Ten sam wzorzec kierunkowy był widoczny w podsumowaniach podskal DERS-16. Ze względu na małą liczebność podgrupy z ciężkimi zaburzeniami użytkowania (n = 13), wartości dla tej podgrupy przedstawiono jako część ogólnego wzorca rozkładu, a nie jako podstawę do szczegółowych wniosków dotyczących tej podgrupy. Nasilenie uzależnienia od Internetu oraz wyniki regulacji emocji podsumowano w Tabeli 4.
| Pomiar | Normalne zastosowanie | Problematyczne używanie | Ciężkie problematyczne stosowanie | Suma |
| n = 200 | n = 239 | n = 13 | n = 452 | |
| całkowity wynik IAT | 34.20 ± 3.90 | 65.33 ± 6.90 | 78.70 ± 6.20 | 51.94 ± 16.58 |
| całkowity wynik w skali DERS-16 | 31.20 ± 7.10 | 39.24 ± 8.30 | 48.50 ± 9.60 | 35.95 ± 8.89 |
| brak akceptacji DERS-16 | 5.90 ± 1.90 | 7.29 ± 2.10 | 8.90 ± 2.40 | 6.72 ± 2.16 |
| Cele DERS-16 | 6.20 ± 1.80 | 7.82 ± 2.00 | 9.10 ± 2.30 | 7.14 ± 2.09 |
| impuls DERS-16 | 5.80 ± 1.70 | 7.72 ± 2.10 | 9.40 ± 2.50 | 6.92 ± 2.19 |
| Strategie DERS-16 | 9.60 ± 2.90 | 12.29 ± 3.30 | 15.10 ± 3.80 | 11.18 ± 3.44 |
| Przejrzystość DERS-16 | 3.70 ± 1.30 | 4.18 ± 1.40 | 5.00 ± 1.60 | 3.99 ± 1.41 |
| alfa Cronbacha dla IAT | — | — | — | 0.91 |
| Alfa Cronbacha dla DERS-16 | — | — | — | 0.88 |
| Porównanie grup całkowitych DERS-16 | — | — | — | F = 72,80; p < 0.001; η² = 0.245 |
| Korelacja Pearsona między wynikiem całkowitym IAT a wynikiem całkowitym DERS-16 | — | — | — | n = 452; r = 0,524; 95% CI: 0,45–0,59; p < 0.001 |
Tabela 4: Grupy stopnia nasilenia uzależnienia od Internetu, wyniki regulacji emocji, niezawodność i korelacja w końcowej próbie analitycznej.Tabela ta przedstawia całkowite wyniki IAT, całkowite wyniki DERS-16 oraz wartości podskal DERS-16 w grupach: normalnego użytkowania, problematycznego użytkowania oraz ciężkiego problematycznego użytkowania. Przedstawia również średnie dla całej próby, wartości alfa Cronbacha dla IAT i DERS-16, porównanie grup pod kątem całkowitego wyniku DERS-16 oraz korelację Pearsona między całkowitym wynikiem IAT a całkowitym wynikiem DERS-16. Skróty: IAT = test uzależnienia od Internetu; DERS-16 = 16-punktowa skala trudności w regulacji emocji; CI = przedział ufności; SD = odchylenie standardowe. Kliknij tutaj, aby pobrać tę tabelę.
Związek między uzależnieniem od internetu a regulacją emocji
W zachowanej próbie analitycznej (n = 452) oceniono zdefiniowane wcześniej powiązanie między ciągłymi wynikami całkowitymi IAT a wynikami całkowitymi DERS-16. Korelacja Pearsona między całkowitym wynikiem IAT a całkowitym wynikiem DERS-16 była dodatnia i miała umiarkowaną wartość (r = 0.524, 95% CI: 0.45–0.59, p < 0.001). Studenci z wyższymi całkowitymi wynikami IAT mieli zatem tendencję do zgłaszania większych ogólnych trudności w regulacji emocji. Wynik ten był zgodny z rozkładem grup według stopnia nasilenia i nie zależał wyłącznie od kategorycznej klasyfikacji IAT, co przedstawiono w Tabeli 4.
Wielowymiarowa analiza regresji
Skorygowany model regresji obejmował zachowaną próbę analityczną (n = 452). Całkowity wynik DERS-16 wprowadzono jako zmienną zależną, a całkowity wynik IAT jako główną zmienną niezależną. W tym samym modelu uwzględniono jako kowarianty wiek, płeć, korzystanie z internetu w dni powszednie, korzystanie z internetu w weekendy, czas trwania snu, tygodniową aktywność fizyczną oraz stres akademicki. Płeć wprowadzono przy użyciu z góry określonego kodowania zmiennych wskaźnikowych, przyjmując płeć męską jako kategorię odniesienia i osobne wskaźniki dla płci żeńskiej oraz opcji „wolę nie podawać”. Po skorygowaniu całkowity wynik IAT pozostał dodatnio skorelowany z całkowitym wynikiem DERS-16 (B = 0.21, SE = 0.02, β = 0.39, p < 0.001). Wśród kowariantów stres akademicki wykazał dodatnią korelację z całkowitym wynikiem DERS-16 (B = 2.36, β = 0.23, p < 0.001), podczas gdy czas trwania snu (B = -1.12, β = -0.13, p < 0.001) i tygodniowa aktywność fizyczna (B = -0.84, β = -0.10, p = 0.003) były ujemnie skorelowane z całkowitym wynikiem DERS-16. Korzystanie z internetu w dni powszednie zachowało mniejszy współczynnik dodatni po skorygowaniu (B = 0.71, β = 0.09, p = 0.015), natomiast korzystanie z internetu w weekendy nie pozostało statystycznie istotne w modelu skorygowanym (B = 0.49, β = 0.07, p = 0.071). Wiek oraz oba wskaźniki płci nie były istotnymi niezależnymi predyktorami przy tej samej specyfikacji. Model wyjaśnił 39,8% wariancji całkowitego wyniku DERS-16, przy skorygowanym R2 wynoszącym 0.386, a cały model był statystycznie istotny, F(9, 442) = 32.47, p < 0.001. Nie stwierdzono współliniowości, a czynniki inflacji wariancji mieściły się w przedziale od 1.03 do 1.42. Diagnostyka rezyduów nie wykazała poważnych naruszeń liniowości ani homoskedastyczności w analizie rezyduów względem wartości dopasowanych. Wykres Q-Q rezyduów nie wykazał istotnych odchyleń od przybliżonego rozkładu normalnego. Test Breusch-Pagana nie był statystycznie istotny, p = 0.214. Maksymalna odległość Cooka wyniosła 0.18 i żadna obserwacja nie przekroczyła odległości Cooka równej 0.50. Skorygowany model regresji przedstawiono w Tabeli 5.
| Predictor | B | SE | β | t | p | VIF |
| Stała | 18.42 | 2.11 | — | 8.73 | <0.001 | — |
| Całkowity wynik IAT | 0.21 | 0.02 | 0.39 | 9.84 | <0.001 | 1.42 |
| Wiek | 0.18 | 0.11 | 0.03 | 1.64 | 0.102 | 1.08 |
| Płeć, kobieta vs mężczyzna | 0.62 | 0.54 | 0.04 | 1.15 | 0.252 | 1.05 |
| Płeć, woli nie podawać vs mężczyzna | 0.28 | 1.89 | 0.01 | 0.15 | 0.882 | 1.03 |
| Korzystanie z Internetu w dni powszednie | 0.71 | 0.29 | 0.09 | 2.45 | 0.015 | 1.36 |
| Korzystanie z Internetu w weekendy | 0.49 | 0.27 | 0.07 | 1.81 | 0.071 | 1.31 |
| Czas trwania snu | -1.12 | 0.31 | -0.13 | -3.61 | <0.001 | 1.18 |
| Tygodniowa aktywność fizyczna | -0.84 | 0.28 | -0.1 | -3 | 0.003 | 1.12 |
| Stres akademicki | 2.36 | 0.39 | 0.23 | 6.05 | <0.001 | 1.27 |
Tabela 5: Wielowymiarowa regresja liniowa całkowitego wyniku DERS-16 w zależności od całkowitego wyniku IAT i współzmiennych w końcowej próbie analitycznej.Tabela ta przedstawia skorygowany model regresji, w którym zmienną zależną jest całkowity wynik DERS-16, a główną zmienną niezależną całkowity wynik IAT. Jako współzmienne uwzględniono wiek, płeć, korzystanie z internetu w dni powszednie, korzystanie z internetu w weekendy, czas trwania snu, tygodniową aktywność fizyczną oraz stres akademicki. W tabeli podano również współczynniki standaryzowane, wskaźniki inflacji wariancji oraz diagnostykę modelu. Skróty: IAT = test uzależnienia od internetu; DERS-16 = 16-punktowa skala trudności w regulacji emocji; VIF = wskaźnik inflacji wariancji. Prosimy kliknąć tutaj, aby pobrać tę tabelę.
Tabela uzupełniająca 1: Pełny słownik zmiennych, obecność plików, struktura kodowania i pola zarządzania danymi wykorzystywane w ustandaryzowanym procesie kwestionariuszowym.Niniejsza tabela uzupełniająca zawiera kompletny słownik zmiennych dla protokołu, w tym zmienne dotyczące etyki i zgody, zmienne dotyczące ustawień ankiety, zmienne demograficzne, zmienne dotyczące korzystania z internetu, flagi kontroli jakości, elementy skali, wyniki pochodne, kowarianty, pola identyfikatorów technicznych, zmienne śledzenia zbioru danych, informacje o statusie plików oraz reguły kodowania. Skróty: IAT = internet addiction test; DERS-16 = 16-item difficulties in emotion regulation scale .Kliknij tutaj, aby pobrać ten plik.
Plik uzupełniający 1: Materiały dotyczące schematu postępowania z kwestionariuszem uzupełniającym.Ten plik uzupełniający zawiera pliki kwestionariuszy, książkę kodową, dziennik przesiewowy, plan wyników oraz materiały do schematu postępowania gotowe do analizy, wykorzystane w celu odtworzenia ustandaryzowanego schematu przeprowadzania kwestionariusza, przesiewu, punktacji i analizy.Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Głównym wkładem niniejszego artykułu jest ustandaryzowany proces przeprowadzania ankiety, a nie zaobserwowany reprezentatywny związek między uzależnieniem od Internetu a trudnościami w regulacji emocji. Implementacja wykazała, że ustalona sekwencja obejmująca elektroniczną zgodę, pytania demograficzne, zachowania związane z korzystaniem z Internetu, punktację IAT, punktację DERS-16, zbieranie współzmiennych, sekwencyjny screening jakości danych oraz reprodukowalną analizę regresji może zostać zrealizowana na próbie studentów uniwersytetu. Ten nacisk na procedury jest istotny, ponieważ w literaturze problematyczne korzystanie z Internetu jest często łączone z dysregulacją emocjonalną, jednak niespójne procedury administracyjne i oczyszczania danych mogą utrudniać porównywanie wyników między badaniami21. Przedstawiony proces wspiera zatem porównywalność, czyniąc kolejność pomiarów, zasady wykluczania, etapy punktacji oraz wyniki analityczne jawnymi przed rozpoczęciem interpretacji.
Kilka kroków procedury jest szczególnie istotnych dla zapewnienia powtarzalności. Po pierwsze, zgoda elektroniczna musi zostać udzielona przed uzyskaniem dostępu do kwestionariusza, a identyfikatory techniczne wykorzystywane do wykrywania duplikatów muszą zostać oddzielone od końcowego, zanonimizowanego zbioru danych analitycznych. Po drugie, wykrywanie duplikatów powinno poprzedzać weryfikację czasu wypełniania, kontrolę pytań sprawdzających uważność, wykrywanie powtarzalnych schematów odpowiedzi, weryfikację spójności logicznej oraz kontrolę brakujących danych, ponieważ zmiana tej kolejności może wpłynąć na ostateczną wielkość zachowanej próby. Po trzecie, procedury punktowania IAT oraz DERS-16, w tym kodowanie odwrotne i klasyfikacja nasilenia, muszą zostać ustalone przed rozpoczęciem gromadzenia danych. Kroki te ograniczają możliwą do uniknięcia zmienność w internetowych badaniach ankietowych i są zgodne z szerszymi zastrzeżeniami, według których wyniki dotyczące uzależnienia od internetu mogą być wpływane przez stres, samokontrolę i lęk, a także przez różnice w procedurach pomiarowych22.
Protokół wymaga również przeprowadzenia kilku kontroli w celu rozwiązywania problemów podczas jego wdrażania. Jeśli platforma ankietowa nie może ograniczyć wielokrotnego przesyłania zgłoszeń, wykrywanie duplikatów powinno opierać się na kombinacji identyfikatorów ograniczonych do konta, identyfikatorów ograniczonych do urządzenia, znaczników czasu, statusu kwestionariusza oraz podobieństwa wzorców odpowiedzi. Jeśli wiele rekordów mieści się w zakresie prędkości granicznej, należy wspólnie przeanalizować wynik kontroli uwagi, liczbę odpowiedzi w formie długich ciągów znaków, odchylenie standardowe w obrębie osoby oraz flagę spójności logicznej, zamiast polegać wyłącznie na czasie wypełniania. Jeśli współczynnik alfa Cronbacha jest nieoczekiwanie niski, przed podjęciem jakichkolwiek decyzji na poziomie poszczególnych pozycji należy sprawdzić kodowanie pozycji, kodowanie odwrócone oraz zakresy wyników. Procedury te są szczególnie istotne, ponieważ zachowania związane z internetem i smartfonami są powiązane z procesami snu i regulacji emocji, co sprawia, że niedbała selekcja lub błędne kodowanie mogą stać się potencjalnym źródłem zniekształconych wniosków23.
Progi wykluczania zastosowane w reprezentatywnej implementacji należy traktować jako zestandaryzowane w ramach tego przepływu pracy, lecz nie jako uniwersalnie stałe dla wszystkich przyszłych populacji. Dolny próg czasu ukończenia wynoszący 180 s został wyznaczony na podstawie testów pilotażowych i powinien zostać ponownie skalibrowany, gdy protokół będzie stosowany u osób starszych, młodzieży, respondentów wielojęzycznych, w przypadku kwestionariuszy dostosowanych do potrzeb osób z niepełnosprawnościami lub na platformach o innym formacie wyświetlania. Reguła niespójności logicznej oraz kryteria odpowiedzi wzorcowych mogą również wymagać dostosowania, jeśli długość skali, kolejność pozycji lub kotwice odpowiedzi będą się różnić. Podobnie, mała, poważna podgrupa problematycznego użytkowania w reprezentatywnej implementacji wskazuje, że badania zaprojektowane pod kątem porównań podgrup powinny zwiększyć cele rekrutacyjne lub zastosować próbkowanie warstwowe przed rozpoczęciem zbierania danych. Taka elastyczność jest istotna, ponieważ zmienne behawioralne i związane ze stylem życia, w tym aktywność fizyczna, mogą oddziaływać na uwagę, ruminacje i samoregulację w sposób zróżnicowany w zależności od grupy studentów24.
Przy stosowaniu tego protokołu należy wziąć pod uwagę kilka ograniczeń. Przepływ pracy opiera się na narzędziach samoopisowych, w związku z czym błąd przypominania, efekt desirability (tendencja do udzielania społecznie pożądanych odpowiedzi) oraz wariancja wynikająca ze wspólnej metody mogą wpływać zarówno na pomiary ekspozycji, jak i wyniki. Ryzyka te można zmniejszyć, choć nie wyeliminować, stosując neutralne sformułowania, stałą kolejność pytań w kwestionariuszu, testy uwagi, uprzednio określone współzmienne oraz przejrzyste raportowanie brakujących danych i wykluczeń. Przyszłe badania mogą również wprowadzić obiektywne pomiary zachowań cyfrowych, takie jak logi czasu ekranu smartfona, rejestry korzystania z aplikacji lub podsumowania aktywności na platformach, aby wzmocnić trafność teoretyczną. Dodatki te wymagają jednak osobnych zapisów w zgodzie na udział w badaniu, zabezpieczeń prywatności, procedur minimalizacji danych oraz zasad łączenia danych. Powinny one zatem być wprowadzane jako zaplanowane rozszerzenia protokołu, a nie nieformalne dodatki do procesu wypełniania kwestionariusza25.
Protokół jest adaptowalny, jednak nie należy go przenosić mechanicznie do każdego środowiska. W populacjach pozauniwersyteckimi może być konieczna rewizja kryteriów kwalifikacji, kanałów rekrutacji, elementów stresu akademickiego oraz kategorii korzystania z internetu. W międzynarodowych badaniach wieloośrodkowych przed agregacją danych należy udokumentować tłumaczenie, adaptację kulturową, równoważność platformy, obsługę stref czasowych, zasady ochrony danych oraz monitorowanie na poziomie ośrodka. Jeśli IAT zostanie zastąpiony nowszym miernikiem lub narzędziem specyficznym dla danej populacji, można zachować dotychczasowy schemat pracy, jednak przed rozpoczęciem gromadzenia danych należy zaktualizować zakres wyników, progi nasilenia, książkę kodową, składnię, Tabelę materiałów oraz słownik zmiennych uzupełniających. Rozróżnienie między czasem korzystania z internetu a jego dysregulowanym użytkowaniem jest istotne, ponieważ sam czas spędzony w sieci może nie oddawać tego samego konstruktu, co użytkowanie problematyczne lub kompulsywne26.
Wreszcie, przedstawiona implementacja miała charakter przekrojowy i nie powinna być interpretowana jako dowód na kierunek czasowy zależności. Zaobserwowany związek między całkowitym wynikiem IAT a całkowitym wynikiem DERS-16 demonstruje sposób działania ścieżki analitycznej, a nie to, czy trudności w regulacji emocji powodują problematyczne korzystanie z internetu, czy też problematyczne korzystanie z internetu pogarsza regulację emocji w czasie. Podobne wzorce przekrojowe zgłaszano w innych środowiskach akademickich, jednak do zbadania kierunkowości i zmian niezbędne są badania podłużne lub z powtarzanymi pomiarami27. Wartość niniejszego protokołu polega na tym, że zapewnia on stabilny podstawowy schemat pracy dla takich przyszłych badań. Poprzez standaryzację procesu wyrażania zgody, przeprowadzania ankiet, screeningu, punktowania, kontroli rzetelności, diagnostyki modeli, archiwizacji plików oraz dokumentacji uzupełniającej, protokół ten może wspierać bardziej odtwarzalne badania przekrojowe i może zostać rozszerzony na projekty podłużne lub interwencyjne, gdy pytania o aspekt czasowy staną się głównym celem28. Uwzględnienie książki kodowej, dziennika screeningu, planu wyników oraz materiałów z workflow przygotowanego do analizy jest również zgodne z zasadami dokumentowania oprogramowania badawczego i workflow zorientowanego na standardy FAIR29 oraz z szerszymi zaleceniami otwartej nauki w zakresie przejrzystego i odtwarzalnego raportowania30.
Oświadczenia
Autor nie zgłasza żadnych konfliktów interesów.
Podziękowania
Praca ta została sfinansowana w ramach Projektu Nauk Miękkich Prowincji Henan 2025, „Badanie wpływu i ścieżki optymalizacji zmian w populacji w wieku szkolnym na wysokojakościowy rozwój prywatnego szkolnictwa wyższego w prowincji Henan” (numer projektu 252400410490) oraz w ramach Projektu Doktoralnego Funduszu Badawczego Uniwersytetu Ekonomii i Biznesu w Zhengzhou 2025, „Badanie mechanizmu formowania i mechanizmu kierowania opinią publiczną w zakresie zachowań sieciowych grup studentów”. Autor dziękuje Uniwersytetowi Ekonomii i Biznesu w Zhengzhou za wsparcie instytucjonalne.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Zbiór danych gotowy do analizy | Wewnętrzny dokument specyficzny dla badania | analytic_dataset_v1.csv i analytic_dataset_v1.xlsx | Końcowy zanonimizowany zbiór danych wykorzystany do wszystkich raportowanych analiz opisowych, rzetelności, korelacji i regresji |
| Składnia analizy | Wewnętrzny dokument specyficzny dla badania | analysis_syntax_v1.R lub równoważny plik skryptu | Wykorzystywana do reprodukcji weryfikacji punktowania, kontroli rzetelności, statystyk opisowych, analizy korelacji, modelowania regresji, obliczeń VIF oraz wyników diagnostycznych |
| Sformułowanie pytania kontrolnego uwagi | Wewnętrzny dokument specyficzny dla badania | attention_check_v1.txt | Ustalona treść pytania kontrolnego uwagi z wymuszoną odpowiedzią, stosowana podczas przeprowadzania ankiety |
| Kwestionariusz DERS-16 | Oryginalne źródło skali lub autoryzowana/zaadaptowana wersja kwestionariusza | Krótka forma skali trudności w regulacji emocji (Difficulties in Emotion Regulation Scale) składająca się z 16 pozycji | Wykorzystywana do oceny trudności w regulacji emocji; punktowanie odbywa się zgodnie z ustalonym kluczem punktowania DERS-16 opisanym w książce kodowej |
| Elektroniczna karta informacyjna i strona zgody | Wewnętrzny dokument specyficzny dla badania | consent_form_v1.pdf lub strona zgody na platformie | Wykorzystywana do przekazania informacji o badaniu i uzyskania elektronicznej świadomej zgody przed udostępnieniem kwestionariusza |
| Arkusz konwencji nazewnictwa plików | Wewnętrzny dokument specyficzny dla badania | file_naming_convention_v1.xlsx | Wykorzystywany do standaryzacji nazw plików surowych, oczyszczonych, analitycznych, logów przesiewowych, książki kodowej oraz plików wynikowych |
| Zrzuty ekranu końcowego kwestionariusza | Wewnętrzny dokument specyficzny dla badania | questionnaire_screenshots_v1.pdf | Wykorzystywane do udokumentowania ostatecznego wyglądu ankiety, kolejności pozycji, kotwic odpowiedzi oraz ustawień pozycji obowiązkowych |
| Zintegrowane środowisko programistyczne | Posit | RStudio Desktop | Wykorzystywane do zarządzania skryptami, logami i reprodukowalnymi przepływami pracy analitycznej |
| Kwestionariusz testu uzależnienia od internetu | Oryginalne źródło skali lub autoryzowana/zaadaptowana wersja kwestionariusza | Internet Addiction Test składający się z 20 pozycji | Wykorzystywany do oceny objawów uzależnienia od internetu i klasyfikacji użytkowania jako normalne, problematyczne lub poważnie problematyczne |
| Platforma ankiet online | Qualtrics | XM Platform; konto instytucjonalne lub licencjonowane | Wykorzystywana do budowy kwestionariusza, wymuszania pozycji obowiązkowych, zarządzania dostępem na podstawie zgody, ograniczania wielokrotnych zgłoszeń (jeśli włączono) oraz eksportu danych odpowiedzi |
| Opcjonalny pakiet statystyczny sterowany menu | IBM | SPSS Statistics | Wykorzystywany, gdy wymagany jest przepływ analizy oparty na GUI dla statystyk opisowych, kontroli rzetelności lub analizy regresji |
| Plik README/książka kodowa | Wewnętrzny dokument specyficzny dla badania | README_v1.txt lub codebook_v1.xlsx | Wykorzystywana do udokumentowania nazw zmiennych, reguł kodowania, zakresów punktowych, reguł odwróconego kodowania, progów wykluczeń, nazw plików i wersji oprogramowania |
| Kopia archiwalna tylko do odczytu | Portable document format | PDF/A lub zatwierdzony przez instytucję archiwalny plik PDF | Wykorzystywana do zachowania ostatecznego narzędzia ankietowego, strony zgody oraz dokumentów wspierających protokół |
| Arkusz logów przesiewowych | Wewnętrzny dokument specyficzny dla badania | screening_log_v1.xlsx | Wykorzystywany do dokumentowania przesiewania duplikatów, czasu wypełniania, błędów w pytaniach kontrolnych uwagi, schematycznego odpowiadania, niespójności logicznej, braków danych, decyzji z przeglądu ręcznego oraz końcowej liczby zachowanych rekordów |
| Oprogramowanie arkusza kalkulacyjnego | Microsoft | Format arkusza Microsoft Excel (.xlsx) | Wykorzystywane do logów przesiewowych, słownika zmiennych, zapisów przeglądu ręcznego oraz przygotowania uzupełniających arkuszy roboczych |
| Środowisko obliczeń statystycznych | R Foundation / CRAN | R 4.5.3 | Wykorzystywane do weryfikacji punktowania, statystyk opisowych, kontroli rzetelności, analizy korelacji, analizy regresji, obliczeń VIF oraz wyników diagnostycznych |
| Plik uzupełniający 1 | Uzupełniający plik specyficzny dla badania | Supplementary File 1.xlsx | Zawiera materiały dotyczące przepływu pracy kwestionariusza, książkę kodową, logi przesiewowe, plan wyników oraz materiały przepływu pracy gotowe do analizy |
| Tabela uzupełniająca S1 | Uzupełniająca tabela specyficzna dla badania | Supplementary Table S1 | Zawiera kompletny słownik zmiennych, informacje o obecności plików, strukturę kodowania, pola identyfikatorów technicznych, zmienne przesiewowe oraz pola śledzenia zbioru danych |
| Dokument eksportu ankiety | Qualtrics | Eksport ankiety do Worda lub eksport do PDF | Wykorzystywany do archiwizacji ostatecznego sformułowania kwestionariusza, kolejności pozycji, ustawień rozgałęzień, ustawień pozycji obowiązkowych oraz kodowania odpowiedzi |
| Format eksportu ankiety | Qualtrics | Eksport CSV | Wykorzystywany do zachowania surowych odpowiedzi oraz eksportu danych gotowych do analizy |
Bibliografia
- Moreno MA, et al. Problematic internet use among US youth: a systematic review. Arch Pediatr Adolesc Med. 2011;165:797-805.
- Ramón-Arbués E, et al. Prevalence and factors associated with problematic internet use in a population of Spanish university students. Int J Environ Res Public Health. 2021;18:7620.
- Cai Z, et al. Associations between problematic internet use and mental health outcomes of students: a meta-analytic review. Adolesc Res Rev. 2023;8:45-62.
- Gong Z, Wang L, Wang H. Perceived stress and internet addiction among Chinese college students: mediating effect of procrastination and moderating effect of flow. Front Psychol. 2021;12:632461.
- Tsai JK, et al. Relationship between difficulty in emotion regulation and internet addiction in college students: a one-year prospective study. Int J Environ Res Public Health. 2020;17:4766.
- Romero-López M, Pichardo C, De Hoces I, García-Berbén T. Problematic internet use among university students and its relationship with social skills. Brain Sci. 2021;11:1301.
- Xie X, et al. Problematic internet use was associated with psychological problems among university students during COVID-19 outbreak in China. Front Public Health. 2021;9:675380.
- Montagni I, et al. Mental health-related digital use by university students: a systematic review. Telemed J E Health. 2020;26:131-146.
- Candussi CJ, Kabir R, Sivasubramanian M. Problematic smartphone usage, prevalence and patterns among university students: a systematic review. J Affect Disord Rep. 2023;14:100643.
- Moon SJ, Hwang JS, Kim JY, Shin AL, Bae SM, Kim JW. Psychometric properties of the Internet Addiction Test: a systematic review and meta-analysis. Cyberpsychol Behav Soc Netw. 2018;21:473-484.
- Jelenchick LA, Becker T, Moreno MA. Assessing the psychometric properties of the Internet addiction test in US college students. Psychiatry Res. 2012;196:296-301.
- Tafur-Mendoza AA, Acosta-Prado JC, Zárate-Torres RA, Ramírez-Ospina DE. Assessing the psychometric properties of the Internet addiction test in Peruvian university students. Int J Environ Res Public Health. 2020;17:5782.
- Fernández-Villa T, Molina AJ, García-Martín M, Llorca J, Delgado-Rodríguez M, Martín V. Validation and psychometric analysis of the Internet addiction test in Spanish among college students. BMC Public Health. 2015;15:953.
- World Medical Association. World Medical Association Declaration of Helsinki: ethical principles for medical research involving human subjects. JAMA. 2013;310:2191-2194.
- Wei Z, Hassan NC, Hassan SA, Ismail N, Gu X, Dong J. Psychometric validation of Young’s Internet addiction test among Chinese undergraduate students. PLoS One. 2025;20:e0320641.
- Bjureberg J, et al. Development and validation of a brief version of the Difficulties in emotion regulation scale : the DERS-16. J Psychopathol Behav Assess. 2016;38:284-296.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK: Research and Methods. 2023;32:3-38.
- Broman KW, Woo KH. Data organization in spreadsheets. Am Stat. 2018;72:2-10.
- Leiner DJ. Too fast, too straight, too weird: non-reactive indicators for meaningless data in internet surveys. Surv Res Methods. 2019;13:229-248.
- Taber KS. The use of Cronbach’s alpha when developing and reporting research instruments in science education. Res Sci Educ. 2018;48:1273-1296.
- Gioia F, Rega V, Boursier V. Problematic Internet use and emotional dysregulation among young people: a literature review. Clin Neuropsychiatry. 2021;18:41-54.
- Chen M, Zhang X. Factors influencing internet addiction among university students: the mediating roles of self-control and anxiety. Acta Psychol (Amst). 2024;250:104535.
- Akbari M, Seydavi M, Sheikhi S, Spada MM. Problematic smartphone use and sleep disturbance: the roles of metacognitions, desire thinking, and emotion regulation. Front Psychiatry. 2023;14:1137533.
- Wang S, Cheng Y, Yang Y, Lu B. The impact of physical activity on internet addiction among college students: the chain mediation role of rumination and mindfulness. BMC Public Health. 2025;25:3643.
- Struminskaya B, Sakshaug JW. Ethical considerations for augmenting surveys with auxiliary data sources. Public Opin Q. 2023;87:619-633.
- Yin J, et al. Associations between both smartphone addiction and objectively measured smartphone use and sleep quality and duration among university students: a cross-sectional study. JMIR Ment Health. 2025;12:e77796.
- Hainagiu SM, Neagu SN. Caught in the Web—emotional regulation difficulties and internet addiction among Romanian medical and technical university students: a pilot cross-sectional study. Healthcare (Basel). 2025;13:2528.
- Guo C, Chen M, Ji X, Li J, Ma Y, Zang S. Association between internet addiction and sleep quality in medical students: a longitudinal study. Front Psychol. 2025;16:1517590.
- Barker M, Chue Hong NP, Katz DS, Lamprecht AL, Martinez-Ortiz C, Psomopoulos F, et al. Introducing the FAIR Principles for research software. Sci Data. 2022;9:622.
- Nosek BA, Alter G, Banks GC, Borsboom D, Bowman SD, Breckler SJ, et al. Promoting an open research culture. Science. 2015;348:1422-1425.