Niniejsze badanie przedstawia retrospektywny schemat postępowania klinicznego służący do szacowania ryzyka nadciśnienia płucnego u starszych pacjentów hospitalizowanych z powodu ostrego zaostrzenia przewlekłej obturacyjnej choroby płuc, z wykorzystaniem rutynowo dostępnych zmiennych klinicznych oraz modelu predykcyjnego opartego na nomogramie.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Nomogram danych rutynowych do oceny ryzyka nadciśnienia płucnego u pacjentów w wieku podeszłym z ostrym zaostrzeniem przewlekłej obturacyjnej choroby płuc
W tym artykule
Podsumowanie
Streszczenie
Nadciśnienie płucne jest klinicznie istotnym powikłaniem u starszych pacjentów hospitalizowanych z powodu ostrego zaostrzenia przewlekłej obturacyjnej choroby płuc, jednak wczesna ocena ryzyka pozostaje trudna w podstawowej opiece zdrowotnej oraz w warunkach szpitalnych z ograniczonymi zasobami. W niniejszym retrospektywnym badaniu kohortowym opracowano i wewnętrznie oceniono nomogram oparty na danych rutynowych do szacowania ryzyka nadciśnienia płucnego. Analizie poddano łącznie 230 starszych pacjentów hospitalizowanych z powodu ostrego zaostrzenia przewlekłej obturacyjnej choroby płuc między majem 2023 r. a majem 2025 r. Pacjentów podzielono na grupę z nadciśnieniem płucnym i grupę bez nadciśnienia płucnego na podstawie wyników echokardiografii przezklatkowej. Porównano charakterystykę demograficzną, choroby współistniejące, wskaźniki morfologii krwi, markery krzepnięcia, markery stanu zapalnego oraz markery stresu sercowego między grupami. Potencjalne predyktory wybrano za pomocą analizy jednowymiarowej, oceny istotności klinicznej, oceny redundancji oraz wielowymiarowej regresji logistycznej. Cztery zmienne — stosunek neutrofili do limfocytów, peptyd natriuretyczny typu B, D-dimery oraz wywiad w kierunku astmy — były niezależnie powiązane z nadciśnieniem płucnym i zostały włączone do głównego nomogramu. Model wykazał dobrą dyskryminację, z polem pod krzywą ROC wynoszącym 0,82. Analiza krzywej decyzji wskazała na potencjalną korzyść netto w zakresie prawdopodobieństw progowych od około 1% do 70%. Wyniki kalibracji wymagały ostrożnej interpretacji ze względu na resztkowe odchylenie kalibracji. Przedstawiony schemat postępowania zapewnia praktyczne podejście do wczesnej stratyfikacji ryzyka nadciśnienia płucnego u starszych pacjentów hospitalizowanych z powodu ostrego zaostrzenia przewlekłej obturacyjnej choroby płuc. Niemniej jednak, przed szerszym wdrożeniem klinicznym wymagana jest walidacja zewnętrzna i rekalibracja modelu.
Wprowadzenie
Przewlekła obturacyjna choroba płuc jest powszechnym przewlekłym zaburzeniem układu oddechowego, charakteryzującym się uporczywym ograniczeniem przepływu powietrza, objawami oddechowymi oraz nawracającymi epizodami pogorszenia stanu klinicznego. Pozostaje ona główną przyczyną zachorowalności, śmiertelności oraz obciążenia systemów opieki zdrowotnej na całym świecie1. Zażalenie ostre przewlekłej obturacyjnej choroby płuc odnosi się do gwałtownego nasilenia objawów oddechowych, w tym duszności, kaszlu i produkcji plwociny, a często jest wywoływane przez infekcję, ekspozycję środowiskową lub inne ostre czynniki uszkadzające2. U pacjentów w wieku podeszłym zaostrzenia ostre często występują w obecności wielochorobowości, upośledzonej rezerwy sercowo-płucnej, stanu zapalnego w całym organizmie oraz zmniejszonej tolerancji fizjologicznej, co utrudnia wczesną ocenę ryzyka.
Nadciśnienie płucne jest istotnym powikłaniem przewlekłej obturacyjnej choroby płuc, szczególnie podczas zaostrzeń ostrych. Jego rozwój wiąże się z przewlekłą hipoksją, przebudową naczyń płucnych, dysfunkcją śródbłonka, aktywacją stanu zapalnego oraz zwiększonym obciążeniem następczym prawej komory3. Podwyższone ciśnienie w tętnicy płucnej obserwowano u pacjentów z ostrym zaostrzeniem przewlekłej obturacyjnej choroby płuc, co może pogarszać niewydolność oddechową, obciążenie prawej strony serca, czas hospitalizacji oraz przeżywalność4. Wpływ prognostyczny ten jest szczególnie istotny u pacjentów starszych oraz osób z zaawansowaną chorobą serca i płuc5,6. Wczesna identyfikacja pacjentów z podwyższonym ryzykiem nadciśnienia płucnego może zatem wspomóc ściślejszy monitoring, terminową ocenę echokardiograficzną oraz skierowanie na dalszą diagnostykę kardiologiczną i pulmonologiczną.
Cewnikowanie prawej części serca pozostaje złotym standardem w potwierdzaniu nadciśnienia płucnego; jednak jego inwazyjność, koszt, wymagania techniczne oraz ograniczona dostępność ograniczają jego zastosowanie jako wstępnego badania przesiewowego w wielu szpitalach podstawowych i powiatowych7. Echokardiografia przezklatkowa jest powszechnie stosowaną nieinwazyjną metodą oceny, lecz jej wiarygodność może być ograniczona przez nadmierne napowietrzenie płuc, słabe okna akustyczne oraz zmiany rozedmowe u pacjentów z przewlekłą obturacyjną chorobą płuc8. Choć ograniczenia te nie zmniejszają wartości klinicznej echokardiografii, podkreślają one potrzebę wprowadzenia prostego schematu szacowania ryzyka, który można by zastosować przed badaniem obrazowym lub równolegle z nim.
Rutynowe zmienne kliniczne i laboratoryjne mogą pomóc w zaspokojeniu tej potrzeby. Stosunek neutrofili do limfocytów jest obliczany na podstawie wyników morfologii krwi i odzwierciedla równowagę między zapaleniem indukowanym przez neutrofile a regulacją odpornościową zależną od limfocytów9. Powiązano go z aktywnością choroby i niekorzystnymi następstwami w schorzeniach płuc oraz układu sercowo-naczyniowego10. BNP (natriuretyczny peptyd mózgowy typu B) jest łatwo dostępnym markerem naprężeń ściany mięśnia sercowego, przeciążenia ciśnieniowego prawej komory oraz obciążenia krążenia płucnego11. D-dimer odzwierciedla aktywację krzepnięcia i wtórną fibrynolizę i może wzrastać podczas ostrych zaostrzeń z powodu hipoksemii, infekcji, uszkodzenia śródbłonka oraz ograniczonej mobilności12. Jednakże mało prawdopodobne jest, aby pojedynczy biomarker w pełni oddawał profil ryzyka nadciśnienia płucnego u starszych pacjentów z ostrym zaostrzeniem przewlekłej obturacyjnej choroby płuc.
Nomogram stanowi praktyczny sposób przekształcenia wielowymiarowego modelu predykcyjnego w indywidualną ocenę ryzyka. W porównaniu z samym raportowaniem współczynników regresji, umożliwia on integrację wielu predyktorów na poziomie pacjenta w narzędzie interpretowalne klinicznie13. W poprzednich badaniach nad predykcją kliniczną stosowano modele oparte na nomogramach w celu wsparcia oceny ryzyka przy łóżku pacjenta, jednak ich użyteczność zależy od przejrzystego wyboru predyktorów, odpowiedniej kalibracji, walidacji oraz ostrożnej interpretacji14. Nowatorstwo niniejszego badania polega na opracowaniu przepływu pracy opartego na danych rutynowych dla pacjentów w wieku podeszłym, hospitalizowanych z powodu ostrego zaostrzenia przewlekłej obturacyjnej choroby płuc, poprzez integrację informacji dotyczących stanu zapalnego, stresu sercowego, krzepnięcia oraz fenotypu dróg oddechowych w praktycznym nomogramie. Celem badania była identyfikacja predyktorów klinicznych powiązanych z nadciśnieniem płucnym zdefiniowanym w echokardiografii oraz konstrukcja wewnętrznie zwalidowanego modelu do wczesnej stratyfikacji ryzyka, a nie do stawiania ostatecznej diagnozy.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Protokół badania został przejrzany i zatwierdzony przez Komisję Etyczną Szpitala Medycyny Tradycyjnej Chińskiej w hrabstwie Santai w Mianyang, prowincja Sichuan (nr zatwierdzenia 2025003). Badanie przeprowadzono zgodnie z zasadami Deklaracji Helsińskiej. Przed włączeniem do badania od każdego pacjenta lub krewnego pierwszego stopnia uzyskano pisemną świadomą zgodę. W tym retrospektywnym badaniu kohortowym przeanalizowano dokumentację kliniczną osób starszych hospitalizowanych z powodu ostrego zaostrzenia przewlekłej obturacyjnej choroby płuc (AECOPD) w Oddziale Chorób Płuc i Intensywnej Terapii Szpitala Medycyny Tradycyjnej Chińskiej w hrabstwie Santai w okresie od maja 2023 do maja 2025 roku. Badanie zostało zaprojektowane w celu zidentyfikowania rutynowo dostępnych klinicznych predyktorów nadciśnienia płucnego (PH) oraz opracowania nomogramu do indywidualnej oceny ryzyka PH. Instrumenty laboratoryjne, system echokardiograficzny, materiały do pobierania krwi, narzędzia do ekstrakcji danych oraz oprogramowanie statystyczne wykorzystane w tym procesie wymieniono w Tabeli Materiałów.
1. Przesiew pacjentów i ocena kwalifikowalności
Pacjenci hospitalizowani z rozpoznaniem wypisowym AECOPD w okresie badania zostali wyłonieni poprzez system elektronicznej dokumentacji medycznej pacjentów stacjonarnych. Każda dokumentacja została przejrzana w celu potwierdzenia, że pacjent ma co najmniej 60 lat oraz że rozpoznanie przewlekłej obturacyjnej choroby płuc jest zgodne z kryteriami diagnostycznymi Global Initiative for Chronic Obstructive Lung Disease z 2021 roku15. AECOPD zdefiniowano jako ostre pogorszenie objawów oddechowych, które wymagało hospitalizacji i dodatkowego leczenia. W przypadku pacjentów z więcej niż jedną hospitalizacją z powodu AECOPD w okresie badania, do analizy włączono jedynie pierwszą kwalifikującą się hospitalizację.
Pacjentów włączono do badania, gdy spełnione zostały wszystkie poniższe kryteria: wiek co najmniej 60 lat; hospitalizacja z powodu AECOPD między majem 2023 a majem 2025; wykonane badanie echokardiograficzne przezklatkowe podczas indeksowej hospitalizacji; dostępna pierwsza na czczo próbka krwi żylnej po przyjęciu do szpitala; oraz kompletne informacje kliniczne, laboratoryjne i echokardiograficzne niezbędne do budowy modelu. Wykluczono pacjentów z ciężką niewydolnością wątroby, schyłkową niewydolnością nerek, aktywnym procesem nowotworowym, nadciśnieniem płucnym wynikającym z innych znanych przyczyn, pierwotną chorobą lewej komory serca, chorobą tkanki łącznej, taką jak twardzina układowa, aktywną gruźlicą płuc lub w przypadku braku kluczowych zmiennych niezbędnych do klasyfikacji wyników lub budowy modelu.
Przed usunięciem rekordów ze względu na niepełne informacje, sprawdzono wiek, płeć, historię palenia, historię spożywania alkoholu, historię alergii na leki, nadciśnienie tętnicze, cukrzycę, chorobę wieńcową, astmę, rozstrzenie oskrzelowe, infekcję płuc, rozedmę, niewydolność oddechową, niewydolność serca, status nadciśnienia płucnego w echokardiografii, wskaźniki pełnej krwi, albuminy, kreatyninę, wysokoczułe białko C-reaktywne, D-dimer, fibrynogen, peptyd natriuretyczny typu B oraz stosunek neutrofili do limfocytów. Liczbę przesiewowych i wykluczonych rekordów, przyczyny wykluczenia oraz ostateczną liczbę włączonych przypadków odnotowano w celu sporządzenia schematu wyboru pacjentów (Rycina 1).
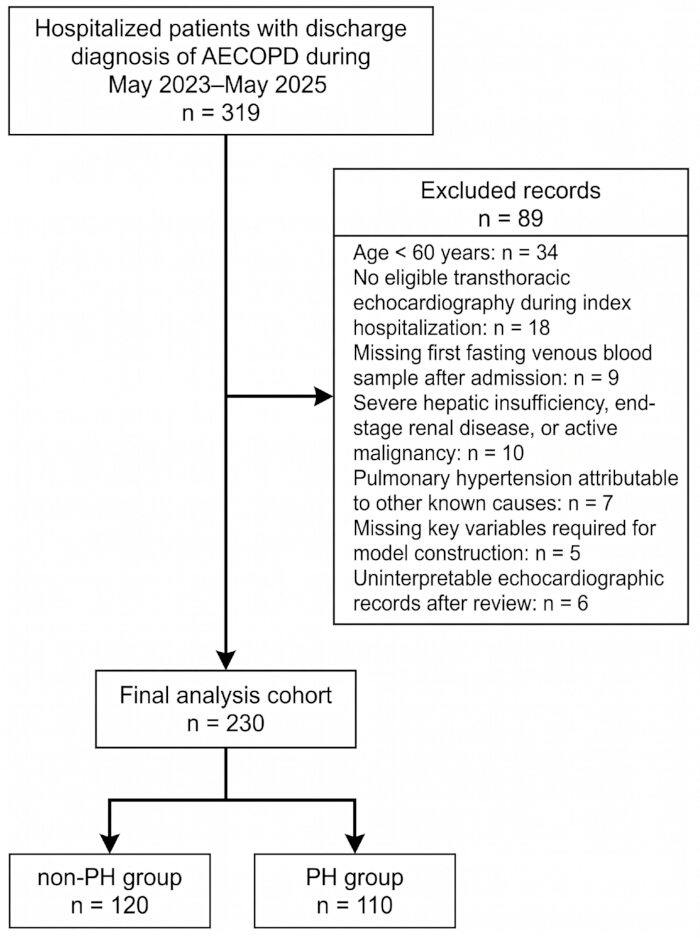
Rycina 1: Przesiew pacjentów i tworzenie kohorty. Diagram przepływu przedstawia identyfikację rekordów, ocenę kwalifikowalności, wykluczenia oraz ostateczny podział starszych pacjentów hospitalizowanych z powodu AECOPD. Pacjentów zaklasyfikowano do grupy bez PH lub z PH na podstawie wyników echokardiografii przezklatkowej. Skróty: AECOPD, ostre zaostrzenie przewlekłej obturacyjnej choroby płuc; PH, nadciśnienie płucne. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
2. Grupowanie kliniczne i definicja diagnostyczna nadciśnienia płucnego
Włączeni pacjenci zostali podzieleni na grupę bez nadciśnienia płucnego (non-PH) oraz grupę z nadciśnieniem płucnym (PH) na podstawie wyników echokardiografii przezklatkowej wykonanej podczas hospitalizacji. Schemat diagnostyczny oparto na wytycznych Europejskiego Towarzystwa Kardiologicznego oraz Europejskiego Towarzystwa Oddechowego z 2015 roku dotyczących nadciśnienia płucnego16. W tym retrospektywnym zbiorze danych za podstawę diagnostyczną przyjęto spoczynkową echokardiografię przezklatkową. Badania przeprowadzili przeszkoleni lekarze echokardiografii, stosując standardowe przekroje przyścianowe, wierzchołkowe i podżebrowe. Przed przydzieleniem do grup zweryfikowano interpretowalność obrazów echokardiograficznych, ponieważ słabe okna akustyczne są częste u pacjentów z przewlekłą obturacyjną chorobą płuc. Rekord uznano za odpowiedni do klasyfikacji PH, gdy sygnał Dopplera z niedomykalności zastawki trójdzielnej był mierzalny lub gdy na podstawie interpretowalnych przekrojów serca można było ocenić rozmiar prawej komory, grubość jej ścian oraz funkcję skurczową.
Skurczowe ciśnienie w tętnicy płucnej oszacowano na podstawie maksymalnej prędkości cofania przepływu przez zastawkę trójdzielną oraz szacowanego ciśnienia w prawym przedsionku. Ciśnienie w prawym przedsionku oceniano na podstawie średnicy dolnej żyły głównej i stopnia jej zapadania się podczas wdechu, gdy oba pomiary były dostępne. Nadciśnienie płucne (PH) zdefiniowano jako szacowane skurczowe ciśnienie w tętnicy płucnej wynoszące co najmniej 40 mmHg. W przypadkach, gdy nie można było wiarygodnie oszacować skurczowego ciśnienia w tętnicy płucnej, klasyfikacja PH wymagała pośrednich dowodów echokardiograficznych na zajęcie prawej komory, w tym powiększenia prawej komory, przerostu prawej komory, dysfunkcji skurczowej prawej komory, spłaszczenia przegrody międzykomorowej lub poszerzenia tętnicy płucnej. Dokumentacja echokardiograficzna z nieczytelnymi obrazami, niemożliwymi do prześledzenia sygnałami Dopplera z zastawki trójdzielnej lub niespójnymi znaleziskami w obrębie prawej strony serca została zweryfikowana przez drugiego lekarza echokardiografistę przed ostatecznym przydziałem do grupy. Dokumentacja, która pozostała nieinterpretowalna po weryfikacji, została wykluczona z końcowej analizy. W końcowej kohorcie kryteria kwalifikacji spełniło 230 pacjentów w wieku podeszłym; 120 pacjentów przydzielono do grupy bez PH, a 110 pacjentów do grupy z PH.
3. Ekstrakcja zmiennych demograficznych i klinicznych
Wszystkie dane kliniczne pobrano z elektronicznego systemu dokumentacji medycznej pacjentów stacjonarnych, korzystając ze standaryzowanego formularza gromadzenia danych. Odnotowano płeć, wiek, historię palenia tytoniu, historię spożywania alkoholu, historię alergii na leki, nadciśnienie tętnicze, cukrzycę, chorobę wieńcową, astmę, rozstrzenie oskrzeli, infekcje płuc, rozedmę, niewydolność oddechową oraz niewydolność serca. Historię palenia tytoniu zdefiniowano jako zużycie co najmniej 100 papierosów w ciągu całego życia, a historię spożywania alkoholu jako regularne spożywanie alkoholu co najmniej dwa razy w tygodniu.
Zakażenie płuc diagnozowano na podstawie objawów ze strony układu oddechowego, oznak fizykalnych, wyników obrazowania klatki piersiowej oraz, gdy były dostępne, dowodów mikrobiologicznych. Niewydolność serca diagnozowano w oparciu o objawy kliniczne, oznaki fizykalne, poziom peptydu natriuretycznego typu B oraz wyniki badania echokardiograficznego. Informacje o chorobach współistniejących weryfikowano z rozpoznaniami przy wypisie, wpisami w kartach przebiegu choroby, raportami z badań obrazowych, wynikami badań laboratoryjnych oraz dokumentacją konsultacyjną, w zależności od dostępności.
4. Gromadzenie i przetwarzanie zmiennych laboratoryjnych
Jako źródło danych laboratoryjnych wykorzystano pierwszą próbkę krwi żylnej pobraną na czczo rano, w dniu następującym po przyjęciu do szpitala. Punkt czasowy ten odpowiadał pierwszemu porannemu pobraniu krwi po przyjęciu i przed rutynową dzienną korektą leczenia, o ile informacje te były dostępne w dokumentacji medycznej. Z szpitalnego systemu informacyjnego laboratorium wyekstrahowano wskaźniki morfologii krwi, wskaźniki biochemiczne, markery krzepnięcia, markery stanu zapalnego oraz markery stresu sercowego.
Z raportu z morfologii krwi zapisano liczbę neutrofili, liczbę limfocytów, liczbę płytek krwi, średnią objętość płytki krwi oraz współczynnik zmienności rozkładu szerokości erytrocytów. Stosunek neutrofili do limfocytów obliczono w następujący sposób:
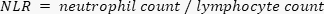
Z odpowiednich raportów laboratoryjnych odnotowano poziomy albumin, kreatyniny, D-dimerów, fibrynogenu, białka C-reaktywnego wysokiej czułości oraz peptydy natriuretyczne typu B. W całym zbiorze danych zastosowano spójne jednostki pomiarowe: albuminy w g/L, kreatyninę w µmol/L, białko C-reaktywne wysokiej czułości w mg/L, D-dimery w µg/mL, fibrynogen w g/L, liczbę neutrofili, liczbę limfocytów oraz liczbę płytek krwi w ×109/L, średnią objętość płytek krwi w fL oraz peptydy natriuretyczne typu B w pg/mL.
5. Czyszczenie i przygotowanie danych
Zbiór danych został sprawdzony przed przeprowadzeniem analizy statystycznej. Każdy włączony rekord zweryfikowano pod kątem kwalifikowalności, przypisania do grupy, kompletności wyników laboratoryjnych, interpretowalności echokardiograficznej oraz dostępności potencjalnych predyktorów. Usunięto bezpośrednie identyfikatory osobowe, a każdemu pacjentowi przypisano numer identyfikacyjny badania. Rekordy powielone, powtarzające się hospitalizacje, niespójne etykiety grup, błędne daty oraz nieprawdopodobne wartości laboratoryjne sprawdzono w odniesieniu do oryginalnej elektronicznej dokumentacji medycznej i raportu laboratoryjnego. Nie przeprowadzano imputacji dla kluczowych zmiennych wynikowych ani predyktorów, ponieważ ostateczny model oparto na analizie przypadków kompletnych.
Zmienne ciągłe przeanalizowano pod kątem charakterystyki rozkładu. Zmienne o rozkładzie normalnym przedstawiono jako średnią ± odchylenie standardowe, zmienne o rozkładzie nienormalnym jako medianę z rozstępem międzykwartylowym, a zmienne kategoryczne jako liczebność i wartości procentowe. Przed modelowaniem wielowymiarowym zbadano zmienne klinicznie powiązane pod kątem redundancji. Liczbę neutrofili oraz liczbę limfocytów przeanalizowano wraz ze stosunkiem neutrofili do limfocytów; infekcję płuc przeanalizowano wraz z liczbą neutrofili, wysokoczułym białkiem C-reaktywnym oraz stosunkiem neutrofili do limfocytów; niewydolność serca przeanalizowano wraz z peptydem natriuretycznym typu B i echokardiograficznymi obrazami serca; D-dimer i fibrynogen przeanalizowano jako zmienne związane z krzepliwością, a liczbę płytek krwi, średnią objętość płytek krwi oraz współczynnik zmienności rozkładu szerokości erytrocytów jako zmienne hematologiczne.
6. Jednowymiarowe porównanie między grupami
Porównano charakterystykę demograficzną, choroby współistniejące, wskaźniki laboratoryjne oraz zmienne dotyczące grupowania echokardiograficznego pomiędzy grupą bez PH a grupą z PH. W przypadku zmiennych ciągłych o rozkładzie normalnym zastosowano test t dla próby niezależnej. Dla zmiennych ciągłych o rozkładzie innym niż normalny wykorzystano test U Manna-Whitneya. W zależności od oczekiwanej liczby obserwacji w komórkach, dla zmiennych kategorycznych zastosowano test χ2 lub dokładny test Fishera. Za istotną statystycznie uznano dwustronną wartość P mniejszą niż 0,05. Zmienne wykazujące istotne różnice między grupami zostały zakwalifikowane do oceny wielowymiarowej wraz z klinicznie istotnymi predyktorami.
7. Wieloczynnikowa analiza regresji logistycznej
Do identyfikacji niezależnych predyktorów związanych z PH u starszych pacjentów z AECOPD zastosowano binarną regresję logistyczną. Jako zmienna zależna posłużył status PH. Predyktory ciągłe wprowadzono w ich oryginalnych jednostkach pomiaru, a predyktory kategoryczne zakodowano jako zmienne binarne. Zmienne kandydackie wybrano na podstawie wyników analizy jednowymiarowej oraz istotności klinicznej. W pierwszej kolejności zidentyfikowano zmienne z P < 0,05 w porównaniu jednowymiarowym, a następnie poddano je analizie pod kątem redundancji, interpretowalności i nakładania się klinicznego.
Pierwotne zmienne kandydackie obejmowały białko C reaktywne wysokiej czułości, D-dimery, współczynnik zmienności szerokości rozkładu erytrocytów, liczbę płytek krwi, średnią objętość płytek krwi, stosunek neutrofilów do limfocytów, peptyd natriuretyczny typu B, chorobę wieńcową oraz astmę w wywiadzie. Liczba neutrofilów i liczba limfocytów nie były wprowadzane jednocześnie ze stosunkiem neutrofilów do limfocytów, ponieważ stanowiły one składowe tego stosunku. Zakażenia płuc i niewydolność serca zostały ocenione podczas analizy redundancji. Aby sprawdzić, czy ich wykluczenie wpłynęło na interpretację modelu, przeprowadzono analizę wrażliwości poprzez dodanie zakażeń płuc i niewydolności serca do głównego zestawu predyktorów. Porównano oszacowania regresji, dyskryminację, kalibrację oraz kliniczną korzyść netto pomiędzy modelem głównym a modelem wrażliwości.
Multikoliniowość wśród potencjalnych predyktorów oceniono za pomocą czynników inflacji wariancji. Zmienne kategoryczne zakodowano przed obliczeniami, a zmienne ciągłe wprowadzono w tych samych jednostkach, których użyto do modelowania regresji. Przyjęto, że czynnik inflacji wariancji poniżej 5 wskazuje na brak silnej multikoliniowości. Dla zmiennych włączonych do modelu wielowymiarowego podano współczynniki regresji, błędy standardowe, wartości χ2 Walda, ilorazy szans, 95% przedziały ufności, wartości P oraz czynniki inflacji wariancji.
8. Konstrukcja nomogramu
Nomogram został opracowany na podstawie niezależnych predyktorów uwzględnionych w wieloczynnikowym modelu regresji logistycznej. Ostatecznymi predyktorami były: D-dimer, stosunek neutrofili do limfocytów, peptyd natriuretyczny typu B oraz historia astmy. Model regresji logistycznej przekształcono w nomogram punktowy przy użyciu oprogramowania R i pakietu rms. Dla zbioru danych modelowych wygenerowano obiekt rozkładu danych, dopasowano model regresji logistycznej, a współczynniki regresji wykorzystano do przypisania punktów każdemu predyktorowi. W przypadku każdego pacjenta zsumowano punkty za D-dimer, stosunek neutrofili do limfocytów, peptyd natriuretyczny typu B oraz historię astmy, aby uzyskać wynik całkowity, który następnie przyporządkowano do szacowanego prawdopodobieństwa wystąpienia PH.
Nomogram zinterpretowano zgodnie ze standardowymi procedurami opartymi na punktacji opisanymi w poprzednich badaniach nad modelami predykcji klinicznej17,18. Wartość D-dimerów pacjenta, stosunek neutrofili do limfocytów, wartość peptydu natriuretycznego typu B oraz status astmatyczny naniesiono na odpowiadające im osie. Od wartości każdego predyktora poprowadzono linię pionową do skali punktowej. Punkty zsumowano w celu uzyskania wyniku całkowitego, a następnie z osi wyniku całkowitego poprowadzono linię pionową do osi przewidywanego prawdopodobieństwa, aby uzyskać zindywidualizowaną szacowaną szansę wystąpienia PH. Ilustracyjny przypadek pacjenta wykorzystany w manuskrypcie został wybrany na podstawie wartości mieszczących się w granicach lub bliskich obserwowanemu rozkładowi klinicznemu w kohorcie.
9. Ocena wydajności modelu
Dyskryminację modelu oceniono za pomocą analizy krzywej charakterystyki operacyjnej odbiornika (ROC) oraz pola pod krzywą (AUC). Pole pod krzywą przedstawiono wraz z 95% przedziałem ufności. Nomogram porównano z poszczególnymi predyktorami oraz z modelem łączącym ilościowe markery laboratoryjne. Kalibrację oceniono poprzez porównanie prawdopodobieństw przewidywanych z zaobserwowanymi wynikami nadciśnienia płucnego (PH). Krzywą kalibracji wygenerowano z wykorzystaniem metody bootstrapowej. Przedstawiono punkt przecięcia kalibracji, nachylenie kalibracji, średni błąd bezwzględny, wynik Briera oraz test Hosmera-Lemeshow. Obliczono również skorygowany metodą bootstrap punkt przecięcia kalibracji oraz skorygowane metodą bootstrap nachylenie kalibracji. Test Hosmera-Lemeshow zinterpretowano łącznie z krzywą kalibracji i ilościowymi wskaźnikami kalibracji.
Użyteczność kliniczną oceniono za pomocą analizy krzywej decyzyjnej. Korzyść netto wykreślono w zależności od prawdopodobieństw progowych i porównano z referencyjnymi strategiami „lecz wszystkich” oraz „nie lecz nikogo”. Zidentyfikowano zakres prawdopodobieństwa progowego, w którym model zapewniał wyższą korzyść netto niż strategie referencyjne.
10. Walidacja wewnętrzna i powtarzalność
Walidację wewnętrzną przeprowadzono za pomocą metody bootstrapowania z 1 000 powtórzeniami. W każdym powtórzeniu bootstrapowym model był ponownie dopasowywany i testowany w celu oszacowania optymizmu w wydajności modelu. Obliczono i przedstawiono wskaźniki dyskryminacji oraz kalibracji skorygowane o optymizm wraz z pozorną wydajnością modelu.
Analizy statystyczne przeprowadzono przy użyciu standardowego oprogramowania statystycznego oraz programu R w wersji 4.5.2. Pakiety R zostały wykorzystane do modelowania regresji logistycznej, konstrukcji nomogramu, analizy krzywych charakterystyki operacyjnej odbiornika (ROC), oceny kalibracji, walidacji wewnętrznej oraz analizy krzywych decyzji. Nomogram został skonstruowany przy użyciu pakietu rms w programie R.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Przesiew pacjentów i charakterystyka kohorty
Łącznie 230 starszych pacjentów hospitalizowanych z powodu ostrego zaostrzenia przewlekłej obturacyjnej choroby płuc (AECOPD) spełniło kryteria kwalifikacji i zostało uwzględnionych w analizie końcowej. Na podstawie oceny echokardiograficznej przezklatkowej 120 pacjentów przypisano do grupy bez nadciśnienia płucnego (non-PH), a 110 pacjentów do grupy z nadciśnieniem płucnym (PH) (Rysunek 1). Ogólne char...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
W niniejszym badaniu opracowano nomogram oparty na danych rutynowych do szacowania ryzyka nadciśnienia płucnego (PH) u starszych pacjentów hospitalizowanych z powodu ostrego zaostrzenia przewlekłej obturacyjnej choroby płuc (AECOPD). W modelu podstawowym zachowano cztery łatwo dostępne zmienne: stosunek neutrofili do limfocytów (NLR), poziom peptydu natriuretycznego typu B (BNP), poziom D-dimerów oraz wywiad w kierunku astmy. Nomogram wykazał lepszą dyskryminację niż pojedyncze markery ilościowe oraz potencjalną korzyść ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy deklarują brak konkurencyjnych interesów finansowych lub innych konfliktów interesów związanych z niniejszą pracą.
Wkład autorów
Mingfeng Wu: projekt badania, nadzór i realizacja, przygotowanie i korekta manuskryptu oraz koordynacja obowiązków zespołu; Li Zhang: zbieranie i organizacja danych, analiza statystyczna oraz przygotowanie manuskryptu; Xiong Wang: zbieranie danych i przygotowanie manuskryptu; Shaohua Xu: analiza statystyczna i korekta manuskryptu; Li Xie: korekta manuskryptu.
Podziękowania
Badanie to było wspierane przez Naukowe Projekty Badawcze Administracji Medycyny Tradycyjnej w Prowincji Sichuan, w tym Practical Exploration of Constructing a Pulmonary Hypertension Prediction Model for Elderly Patients with Chronic Obstructive Pulmonary Disease Based on the NLR Ratio (Grant No. 25MSZX321) and Construction of a County Medical Community Laboratory Service Model and Policy Response Research Driven by “Drone Delivery + AI-Assisted Diagnosis” (Grant No. 25MSZX322). Autorzy dziękują Szpitalowi Medycyny Tradycyjnej w Hrabstwie Santai za wsparcie tego badania.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Automatyczny analizator biochemii klinicznej | Mindray Bio-Medical Electronics Co., Ltd. | BS-480 | Stosowany do pomiaru albuminy w surowicy, kreatyniny oraz wysokoczułej białka C-reaktywnego w rutynowych badaniach laboratoryjnych klinicznych. |
| Automatyczny analizator koagulometrii | Mindray Bio-Medical Electronics Co., Ltd. | C3510 | Stosowany do pomiaru D-dimerów i fibrynogenu w rutynowych badaniach krzepliwości. |
| Automatyczny analizator hematologiczny | Mindray Bio-Medical Electronics Co., Ltd. | BC-5380 | Stosowany do pomiaru liczby neutrofili, liczby limfocytów, liczby płytek krwi, średniej objętości płytki krwi oraz współczynnika zmienności rozkładu objętości erytrocytów. |
| Analizator do immunochemicznych testów chemiluminescencyjnych | Mindray Bio-Medical Electronics Co., Ltd. | CL-1200i | Stosowany do pomiaru natriuretycznego peptydu typu B w rutynowych badaniach laboratoryjnych klinicznych. |
| Odczynniki, kalibratory i kontrole do immunochemicznych testów chemiluminescencyjnych | Mindray Bio-Medical Electronics Co., Ltd. | CL-series reagent system | Stosowane do testów immunochemicznych z chemiluminescencją i kontroli jakości. |
| Odczynniki, kalibratory i kontrole do biochemii klinicznej | Mindray Bio-Medical Electronics Co., Ltd. | BS-series reagent system | Stosowane do rutynowych oznaczeń biochemii klinicznej wykonywanych na analizatorze z serii BS. |
| Kalibratory i kontrole koagulacyjne | Mindray Bio-Medical Electronics Co., Ltd. | Product-specific* | Stosowane do kontroli jakości i kalibracji oznaczeń koagulacyjnych. |
| Pakiet dcurves | CRAN | dcurves | Stosowany do przeprowadzania analizy krzywych decyzyjnych i obliczania klinicznej korzyści netto dla różnych prawdopodobieństw progowych. |
| Probówka do pobierania krwi żylnej z EDTA | BD | Vacutainer K2EDTA tube (REF 367856) | Stosowana do oznaczania morfologii krwi pełnej. |
| System elektronicznej dokumentacji medycznej | Santai County Traditional Chinese Medicine Hospital | Not applicable | Stosowany do pobierania danych demograficznych pacjentów wewnątrzszpitalnych, zapisów o przyjęciu, rozpoznań przy wypisie, chorób współistniejących, notatek z przebiegu leczenia, raportów obrazowych, zapisów konsultacji oraz wyników klinicznych. |
| Odczynniki, kalibratory i kontrole hematologiczne | Mindray Bio-Medical Electronics Co., Ltd. | BC-series reagent system | Stosowane do rutynowych badań morfologii krwi pełnej oraz kontroli jakości analizatora. |
| IBM SPSS Statistics | IBM Corp. | Version 26.0 | Stosowany do statystyki opisowej, porównań grupowych i wstępnej analizy regresji logistycznej. |
| Laboratoryjny system informatyczny | Santai County Traditional Chinese Medicine Hospital | Not applicable | Stosowany do pobierania parametrów morfologii krwi pełnej, wskaźników biochemicznych, markerów koagulacyjnych, markerów zapalnych oraz markerów stresu kardiologicznego. |
| Pakiet pROC | CRAN | pROC | Stosowany do analizy krzywej charakterystyki operacyjnej odbiornika i szacowania pola pod krzywą (AUC). |
| Oprogramowanie statystyczne R | R Foundation for Statistical Computing | Version 4.5.2 | Stosowane do modelowania regresji logistycznej, konstrukcji nomogramów, analizy krzywej charakterystyki operacyjnej odbiornika, oceny kalibracji, wewnętrznej walidacji metodą bootstrap oraz analizy krzywych decyzyjnych. |
| Pakiet ResourceSelection | CRAN | ResourceSelection | Stosowany do przeprowadzania testu dopasowania Hosmera-Lemeshow. |
| Pakiet rms | CRAN (Frank E. Harrell Jr.) | rms | Stosowany do modelowania regresji, konstrukcji nomogramów, oceny kalibracji i walidacji wewnętrznej. |
| Probówka do pobierania krwi żylnej z separatorem surowicy | BD | Vacutainer SST tube (REF 367820) | Stosowana do oznaczeń biochemicznych w surowicy i markerów zapalnych. |
| Probówka do pobierania krwi żylnej z cytrynianem sodu | BD | Vacutainer citrate tube (REF 363080) | Stosowana do badań krzepliwości, w tym oznaczenia D-dimerów i fibrynogenu. |
| Ustandaryzowany formularz ekstrakcji danych klinicznych | Created by the study team | Not applicable | Stosowany do ekstrakcji z retrospektywnej dokumentacji zdefiniowanych wcześniej zmiennych demograficznych, klinicznych, laboratoryjnych i echokardiograficznych. |
| System echokardiografii przezklatkowej | GE HealthCare | Vivid E95 | Stosowany do szacowania skurczowego ciśnienia w tętnicy płucnej oraz oceny wielkości prawej komory, grubości ścian i funkcji skurczowej. |
Bibliografia
- Adeloye D, et al. Global, regional, and national prevalence of, and risk factors for, chronic obstructive pulmonary disease (COPD) in 2019: a systematic review and modelling analysis. Lancet Respir Med. 2022;10:447-58.
- Chronic Obstructive Pulmonary Disease Group of Chinese Thoracic Society, Chronic Obstructive Pulmonary Disease Committee of Chinese Association of Chest Physician. Guidelines for the diagnosis and management of chronic obstructive pulmonary disease, revised version 2021. Chin J Tuberc Respir Dis. 2021;44:170-205.
- Johnson S, et al. Pulmonary hypertension: a contemporary review. Am J Respir Crit Care Med. 2023;208:528-48.
- Munshi RF, Pellegrini JR Jr, Patel P, Anjum F. Impact of pulmonary hypertension in patients with acute exacerbation of chronic obstructive pulmonary disease and its effect on healthcare utilization. Pulm Circ. 2021;11(3):20458940211046838.
- Prins KW, et al. Disproportionate right ventricular dysfunction and poor survival in group 3 pulmonary hypertension. Am J Respir Crit Care Med. 2018;197:1496-9.
- Andersen KH, et al. Prevalence, predictors, and survival in pulmonary hypertension related to end-stage chronic obstructive pulmonary disease. J Heart Lung Transplant. 2012;31:373-80.
- Chen Y, et al. Right heart catheterization-related complications: a review of the literature and best practices. Cardiol Rev. 2020;28:36-41.
- Younis M, et al. Echocardiography and pulmonary hypertension in patients with chronic obstructive pulmonary disease undergoing lung transplantation evaluation. Am J Med Sci. 2024;367:95-104.
- Pascual-González Y, López-Sánchez M, Dorca J, Santos S. Defining the role of neutrophil-to-lymphocyte ratio in COPD: a systematic literature review. Int J Chron Obstruct Pulmon Dis. 2018;13:3651-62.
- Lee SJ, et al. Usefulness of neutrophil to lymphocyte ratio in patients with chronic obstructive pulmonary disease: a prospective observational study. Korean J Intern Med. 2016;31:891-8.
- Leuchte HH, et al. Brain natriuretic peptide is a prognostic parameter in chronic lung disease. Am J Respir Crit Care Med. 2006;173:744-50.
- Husebø GR, et al. Coagulation markers as predictors for clinical events in COPD. Respirology. 2021;26:342-51.
- Iasonos A, Schrag D, Raj GV, Panageas KS. How to build and interpret a nomogram for cancer prognosis. J Clin Oncol. 2008;26:1364-70.
- Balachandran VP, Gonen M, Smith JJ, DeMatteo RP. Nomograms in oncology: more than meets the eye. Lancet Oncol. 2015;16(4):e173-e180.
- Global Initiative for Chronic Obstructive Lung Disease. Global Strategy for the Diagnosis, Management, and Prevention of Chronic Obstructive Pulmonary Disease: 2021 Report. Global Initiative for Chronic Obstructive Lung Disease; Fontana; 2021.
- Galiè N, et al. 2015 ESC/ERS Guidelines for the diagnosis and treatment of pulmonary hypertension. Eur Heart J. 2016;37:67-119.
- Wu Z, Zhan S, Wang D, Tang C. A novel nomogram for predicting the risk of acute heart failure in intensive care unit patients with COPD. Chronic Obstr Pulm Dis. 2025;12(2):117-126.
- Cheng H, et al. A risk nomogram for predicting prolonged intensive care unit stays in patients with chronic obstructive pulmonary disease. Front Med. 2023;10:1177786.
- Zinellu A, et al. Clinical significance of the neutrophil-to-lymphocyte ratio and platelet-to-lymphocyte ratio in acute exacerbations of COPD: present evidence and future perspectives. Eur Respir Rev. 2022;31(166):220095.
- Jiang T, et al. Value of the neutrophil-to-lymphocyte ratio in chronic obstructive pulmonary disease complicated with pulmonary hypertension. J Int Med Res. 2023;51(1):3000605231200266.
- Hawkins NM, et al. B-type natriuretic peptides in chronic obstructive pulmonary disease: a systematic review. BMC Pulm Med. 2017;17:11.
- Hu G, et al. Prognostic role of D-dimer for in-hospital and 1-year mortality in exacerbations of COPD. Int J Chron Obstruct Pulmon Dis. 2016;11:2729-36.
- Zuo H, et al. Predictive value of novel inflammation-based biomarkers for pulmonary hypertension in the acute exacerbation of chronic obstructive pulmonary disease. Anal Cell Pathol (Amst). 2019;2019:5189165.
- Hayiroglu MI, Cicek V, Kilic S, Cinar T. Mean serum D-dimer level to predict in-hospital mortality in COVID-19 patients. Rev Assoc Med Bras (1992). 2021;67:1108-13.
- Guney BC, et al. Evaluation of N/LP ratio as a predictor of disease progression and mortality in COVID-19 patients admitted to the intensive care unit. Medeni Med J. 2021;36:241-8.
- Hayiroglu MI, Cinar T, Tekkesin AI. Fibrinogen and D-dimer variances and anticoagulation recommendations in COVID-19: current literature review. Rev Assoc Med Bras (1992). 2020;66:842-8.
- Collins GS, Reitsma JB, Altman DG, Moons KGM. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: the TRIPOD statement. Ann Intern Med. 2015;162:55-63.
- Moons KGM, et al. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis: explanation and elaboration. Ann Intern Med. 2015;162(1):W1-W73.
- Kalenderoglu K, et al. Heart rate variability nomogram predicts atrial fibrillation in patients with moderate to high burden of premature ventricular complexes. Medicina (Kaunas). 2026;62:243.
- Cicek V, et al. A new risk prediction model for the assessment of myocardial injury in elderly patients undergoing non-elective surgery. J Cardiovasc Dev Dis. 2025;12(1):6.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.