Niniejsze badanie przedstawia odtwarzalny rurociąg bioinformatyczny integrujący transkryptomikę, uczenie maszynowe oraz analizę nacieku immunologicznego w celu zidentyfikowania potencjalnych biomarkerów diagnostycznych i sieci regulacyjnych w przewlekłej obturacyjnej chorobie płuc (POChP).
Artykuł badawczy
UPP1 jako biomarker diagnostyczny: wnioski z integracyjnej bioinformatyki i analiz infiltracji immunologicznej w POChP
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
POChP jest postępującym zaburzeniem oddechowym charakteryzującym się utrwalonym ograniczeniem przepływu powietrza i przewlekłym stanem zapalnym, jednak rola modyfikacji RNA N4-acetylcytydyny (ac4C) w jego patogenezie pozostaje w dużej mierze nieznana. Celem niniejszego badania było systematyczne przeszukanie opublikowanej bazy danych w poszukiwaniu genów powiązanych z ac4C (ac4C-RGs) oraz zbadanie ich sieci regulacyjnych w POChP, aby zidentyfikować potencjalne biomarkery do dalszych badań mechanistycznych, bez zakładania bezpośredniej zależności regulacyjnej między jakimkolwiek konkretnym genem a modyfikacją ac4C. Geny różnicowo wyrażone (DEG) zidentyfikowano na podstawie profili transkrypcyjnych, a analizę sieci współwyrażania genów z wagami (WGCNA) zastosowano w celu wykrycia kluczowych modułów współwyrażania. Przeprowadzono analizę krzyżową między DEG, istotnymi modułami a ac4C-RGs. Kluczowe geny wyłoniono za pomocą regresji LASSO oraz algorytmów XGBoost i lasów losowych, a następnie skonstruowano model diagnostyczny oparty na regresji logistycznej. Wydajność modelu oceniono za pomocą analizy krzywej charakterystyki operacyjnej odbiornika (ROC), pola pod krzywą (AUC) z 95% przedziałami ufności, oceny krzywej kalibracyjnej oraz analizy krzywej decyzyjnej (DCA). Zidentyfikowano łącznie 160 wspólnych genów, a sześć genów centralnych (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B i B4GALT2) zostało spójnie wybranych przez wszystkie trzy algorytmy uczenia maszynowego. Model diagnostyczny wykazał dobrą zdolność dyskryminacyjną, z wartościami AUC wynoszącymi odpowiednio 0,766, 0,759 i 0,723 w zbiorze treningowym, wewnętrznym zbiorze testowym i zewnętrznym zbiorze walidacyjnym. Analiza sieci regulacyjnych zasugerowała potencjalne osie ceRNA i interakcje czynników transkrypcyjnych, natomiast profilowanie infiltracji immunologicznej ujawniło istotne korelacje między kluczowymi genami a wieloma podzbiorami komórek odpornościowych. Analiza interakcji lek-gen oraz dokowanie molekularne wskazały, że fluorouracyl, kapecytabina i 5-benzyloacyloorydyna mogą wykazywać korzystne przewidywane powinowactwa wiązania z UPP1. Podsumowując, geny PTRF, PRKCDBP, UPP1, TOR3A, FAM168B i B4GALT2 zostały zidentyfikowane jako potencjalne biomarkery związane z ac4C w POChP, potencjalnie zaangażowane w regulację immunologiczną i metaboliczną, co stanowi podstawę dla przyszłych badań funkcjonalnych i poszukiwań terapeutycznych.
Wprowadzenie
POChP jest przewlekłym i heterogennym schorzeniem układu oddechowego, charakteryzującym się postępującym ograniczeniem przepływu powietrza wynikającym z nieprawidłowości w strukturach pęcherzyków płucnych i dróg oddechowych1,2. Nierównowaga między proteazami a antyproteazami, stres oksydacyjny, przewlekły stan zapalny oraz starzenie komórkowe stanowią podstawowe mechanizmy patofizjologiczne POChP, prowadząc do destrukcji strukturalnej i upośledzenia czynności tkanki płucnej3,4. Co więcej, na POChP wpływa wiele czynników ryzyka, w tym wieloletnie palenie tytoniu, zanieczyszczenie środowiska, narażenie zawodowe, infekcje dróg oddechowych oraz podatność genetyczna5,6. POChP stanowi znaczne obciążenie dla globalnej gospodarki. Przewiduje się, że w latach 2020–2050 będzie ono odpowiadać za 0,111% globalnego PKB rocznie7. Chociaż obecne strategie terapeutyczne, takie jak leki rozszerzające oskrzela, glikokortykosteroidy wziewne, rehabilitacja płucna i długoterminowa tlenoterapia, mogą łagodzić objawy, zatrzymanie progresji choroby pozostaje wyzwaniem. Ze względu na wyraźną heterogenność kliniczną wyniki leczenia pacjentów są bardzo zróżnicowane8. Dlatego pilnie potrzebne są nowe biomarkery diagnostyczne i wskaźniki prognostyczne, aby usprawnić zarządzanie POChP i zwiększyć przeżywalność pacjentów.
Modyfikacja RNA odnosi się do chemicznych zmian w cząsteczkach RNA, które mogą zmieniać strukturę i funkcję RNA w celu regulacji ekspresji genów9,10. Do powszechnych modyfikacji RNA należą N6-metyloadenozyna (m6A), pseudourydyna (Ψ), 5-metylocytozyna (m5C) oraz ac4C11. Modyfikacja ac4C odgrywa kluczową rolę w zachowaniu stabilności mRNA i promowaniu translacji mRNA12,13. NAT10 jest jedynym znanym enzymem eukariotycznym katalizującym modyfikację ac4C, a jego aktywność jest niezbędna do powstania tej modyfikacji14. Badania wykazały silną korelację między stresem oksydacyjnym, starzeniem się komórek, stanem zapalnym a modyfikacją ac4C. Na przykład limfocyty T CD4+ w tkankach jelita grubego osób z nieswoistymi zapaleniami jelit (IBD) wykazują wyraźnie podwyższone poziomy NAT1015. NAT10 zwiększa acetylację ac4C chemokin CCL2 i CXCL1, promując tym samym naciekanie makrofagów i neutrofili oraz zaostrzając uszkodzenia zapalne16. Odpowiedź komórkowa na stres oksydacyjny może obejmować modyfikację ac4C, o czym świadczy znaczny wzrost poziomów ac4C w warunkach stresu oksydacyjnego. Ponadto NAT10 promuje włóknienie płuc indukowane przez PM2.5 poprzez stabilizację mRNA TGFB1 za pomocą modyfikacji ac4C, wywołując tym samym przejście nabłonkowo-mezenchymalne17. Jednak rola modyfikacji ac4C w POChP pozostaje w dużej mierze niezbadana, co podkreśla potrzebę dalszych badań w tym obszarze.
W badaniu tym wykorzystano bazę danych GEO w celu zidentyfikowania DEGs pomiędzy pacjentami z COPD a grupą kontrolną. Opublikowaną listę ac4C-RGs, opracowaną na podstawie danych multiomicznych18, zintegrowano następnie z DEGs w celu zidentyfikowania wspólnych kandydatów. Biorąc pod uwagę, że modyfikacja ac4C wpływa na stan zapalny i stres oksydacyjny – kluczowe procesy w COPD – wysunięto hipotezę, że geny związane z siecią regulacyjną ac4C mogą być rozregulowane w COPD. Jednak geny wspólne nie były traktowane jako bezpośrednie substraty NAT10 ani geny bezpośrednio regulowane przez ac4C; uznano je raczej za kandydatów powiązanych z siecią związaną z ac4C. Kluczowe geny wyselekcjonowano za pomocą wielu algorytmów uczenia maszynowego, a następnie zbudowano i zwalidowano model diagnostyczny. Następnie określono istotne szlaki zaangażowane w patogenezę COPD i przewidziano potencjalne leki celowane. Na koniec przeprowadzono analizy RT-qPCR w celu potwierdzenia poziomów ekspresji kluczowych genów, co dostarczyło wstępnych informacji na temat patofizjologii COPD i potencjalnych kierunków poszukiwań terapeutycznych.
Protokół
Oświadczenie komisji etyki
Badanie to zostało przeprowadzone zgodnie z Deklaracją Helsińską. Protokół został zatwierdzony przez Komisję Etyczną Szpitala Tradycyjnej Medycyny Chińskiej Shenzhen Luohu (numer zatwierdzenia 2024-LHQZYYYXLL-KY-039), a od wszystkich uczestników przed włączeniem do badania uzyskano pisemną świadomą zgodę. Szczegółowe informacje na temat narzędzi badawczych i materiałów wykorzystanych w tym protokole znajdują się w Tabeli materiałów.
Źródło i przetwarzanie danych
Zbiory danych dotyczących ekspresji genów powiązanych z POChP pobrano z bazy Gene Expression Omnibus (GEO). Zbiór GSE54837 wykorzystano jako zbiór transkryptomiczny, a zbiór GSE112811 posłużył jako zestaw walidacyjny (Tabela 1). Geny ac4C-RG zgromadzono na podstawie literatury18. Geny różnicowo ulegające ekspresji (DEG) pomiędzy grupą z POChP a grupą kontrolną zidentyfikowano przy użyciu pakietu R limma. Geny DEG uznano za statystycznie istotne, jeśli |log2FC| > 0 oraz p < 0,05. W celu wizualizacji ogólnego rozkładu zmian ekspresji genów wygenerowano wykresy wulkaniczne.
Konstrukcja WGCNA
Analizę WGCNA przeprowadzono na zbiorze danych GSE54837 przy użyciu języka R w celu zidentyfikowania modułów związanych z POChS. Przed konstrukcją sieci zidentyfikowano i usunięto próbki odstające za pomocą hierarchicznej analizy skupień, wykorzystując funkcję hclust z metodą średniego wiązania (average linkage) oraz miarą odległości euklidesowej. Optymalna wartość parametru miękkiego progowania (soft-thresholding power) (β = 10) wybrano, aby uzyskać wskaźnik dopasowania topologii bezskalowej R2 ≥ 0,85, zapewniając równowagę między topologią wolną od skali a średnią łącznością. Skonstruowano macierz sąsiedztwa, którą następnie przekształcono w macierz nakładania topologicznego (TOM). Moduły genów zidentyfikowano przy użyciu algorytmu dynamicznego cięcia drzewa (deepSplit = 2, minClusterSize = 50). Moduły o korelacjach eigen-genów > Następnie, przy użyciu funkcji mergeCloseModules, scalono moduły o wartości 0,75. W celu zidentyfikowania modułów związanych z POChP do dalszej analizy, eigengeny modułów skorelowano z cechami klinicznymi (status POChP, wiek, płeć i status palenia) przy użyciu współczynników korelacji Pearsona.
Przesiewanie, analiza wzbogacenia i analiza sieci PPI dla genów nakładających się
W celu zidentyfikowania genów wspólnych dla DEG, genów modułu MEsalmon oraz ac4C-RG wygenerowano wykres Venna przy użyciu pakietu R ggvenn. Analizę wzbogacenia funkcjonalnego genów wspólnych przeprowadzono z wykorzystaniem baz danych Gene Ontology (GO) oraz Kyoto Encyclopedia of Genes and Genomes (KEGG) przy użyciu pakietu R clusterProfiler. Informacje o oddziaływaniach białko-białko (PPI) pobrano z bazy danych STRING (https://string-db.org/), aby przeanalizować interakcje na poziomie białek pomiędzy genami wspólnymi. Do wizualizacji wynikowej sieci PPI wykorzystano oprogramowanie Cytoscape.
Identyfikacja kluczowych genów za pomocą uczenia maszynowego
Zastosowano trzy techniki uczenia maszynowego: regresję LASSO (least absolute shrinkage and selection operator), XGBoost (extreme gradient boosting) oraz las losowy (RF). Regresję LASSO zaimplementowano przy użyciu pakietu glmnet z 10-krotną walidacją krzyżową w celu wyznaczenia optymalnego parametru kary λ. Parametr type.measure ustawiono na "deviance", a parametr family na "binomial". Optymalne λ wybrano na podstawie kryterium λmin, które minimalizuje dewiancję z walidacji krzyżowej, co pozwoliło wyłonić 17 genów. XGBoost wykonano przy użyciu pakietu xgboost z następującymi hiperparametrami: nrounds = 100, max_depth = 6, eta = 0.3, subsample = 0.8, colsample_bytree = 0.8 oraz eval_metric = "logloss". Istotność cech uszeregowano według metryki gain, a następnie wybrano 30 najważniejszych genów. Las losowy zaimplementowano przy użyciu pakietu randomForest z ntree = 200. Istotność cech uszeregowano według średniego spadku współczynnika Gini i wybrano 30 najważniejszych genów. Geny wybrane przez trzy metody uczenia maszynowego poddano analizie części wspólnej, aby zidentyfikować kluczowe geny do dalszych analiz.
Budowa i ocena modelu regresji logistycznej do przewidywania ryzyka
Zbiór danych GSE54837 został losowo podzielony na zestaw treningowy (70%) i zestaw testowy (30%). Na podstawie zestawu treningowego zbudowano model regresji logistycznej przy użyciu funkcji glm z pakietu MASS, przyjmując poziomy ekspresji kluczowych genów jako cechy wejściowe. Wydajność modelu oceniono za pomocą krzywych ROC wygenerowanych przy użyciu pakietu pROC. Przedziały ufności 95% dla AUC obliczono za pomocą 2000 replik bootstrapowych. Kalibrację modelu oceniono za pomocą krzywych kalibracyjnych wygenerowanych z 1000 prób bootstrapowych (pakiet rms). Analizę DCA przeprowadzono przy użyciu pakietu dca w celu oceny wypadkowej korzyści klinicznej dla zakresu prawdopodobieństw progowych. W celu ułatwienia indywidualnej oceny ryzyka skonstruowano nomogram przy użyciu funkcji nomogram z pakietu rms.
Równanie regresji miało postać:
logit(P) = 0.5823 + 0.6010 × UPP1 - 0.6563 × PTRF + 0.3853 × B4GALT2 - 0.3972 × FAM168B + 0.1848 × PRKCDBP - 0.4787 × TOR3A. (1)
W tym przypadku P oznacza przewidywane prawdopodobieństwo wystąpienia COPD, a każdy współczynnik reprezentuje wkład odpowiadającej mu wartości ekspresji genu w logarytm szans wystąpienia COPD.
Analiza ekspresji, sieć GeneMANIA oraz molekularna sieć regulacyjna
Poziomy ekspresji genów pomiędzy grupą z POChP a grupą kontrolną w zbiorze danych GSE54837 porównano za pomocą testu sum rang Wilcoxona. W celu wizualizacji rozkładu poziomów ekspresji wygenerowano wykresy pudełkowe z wykorzystaniem pakietu ggplot2, z naniesioną medianą, rozstępem międzykwartylowym (IQR) oraz poszczególnymi punktami danych. Do konstrukcji sieci genowych i przewidywania interakcji funkcjonalnych wykorzystano narzędzie GeneMANIA. Wyszukiwanie przeprowadzono z parametrami domyślnymi: gatunek = Homo sapiens, maksymalna liczba powiązanych genów = 20. Powstałą sieć pobrano i zwizualizowano, przy czym kolory krawędzi wskazywały typy interakcji. W celu zbadania mechanizmów regulacji potranskrypcyjnej skonstruowano sieć konkurencyjnych endogennych RNA (ceRNA). miRNA celujące w sześć kluczowych genów przewidziano z wykorzystaniem dwóch niezależnych baz danych: DIANA-microT (wynik ≥ 0,8) oraz miRanda (wynik ≥ 140, energia ≤ −20 kcal/mol). Do konstrukcji par miRNA-mRNA wykorzystano część wspólną miRNA zidentyfikowanych przez obie bazy danych. Następnie, z wykorzystaniem bazy danych StarBase, przewidziano lncRNA celujące w te miRNA. Sieć regulacyjną lncRNA-miRNA-mRNA skonstruowano i zwizualizowano przy użyciu programu Cytoscape. Relacje regulacji transkrypcyjnej przewidziano za pomocą ChIP-X Enrichment Analysis Version 3 (ChEA3). Dla każdego kluczowego genu z przewidzianymi TF wybrano 10 czynników transkrypcyjnych o najwyższych wynikach wzbogacenia. Sieć regulacyjną TF-cel skonstruowano w programie Cytoscape.
Analiza wzbogacenia zestawów genów oraz ocena infiltracji komórek odpornościowych
Analizę wzbogacenia zestawów genów (GSEA) przeprowadzono przy użyciu pakietu clusterProfiler w celu zbadania funkcji biologicznych każdego kluczowego genu. Dla każdego kluczowego genu próbki podzielono na grupy o wysokiej i niskiej ekspresji w oparciu o wartość mediany. Analizę ekspresji różnicowej pomiędzy dwiema grupami wykonano za pomocą pakietu limma, a otrzymaną listę genów uszeregowano według wartości signed log₂ fold-change. Analizę GSEA przeprowadzono przy użyciu funkcji gseGO dla terminów procesów biologicznych GO oraz funkcji gseKEGG dla szlaków KEGG, stosując następujące parametry: minGSSize = 10, maxGSSize = 500, pvalueCutoff = 0.05 oraz nPerm = 1 000. Względną obfitość 28 typów komórek odpornościowych oszacowano za pomocą analizy wzbogacenia zestawów genów dla pojedynczych próbek (ssGSEA) zaimplementowanej w pakiecie GSVA. Kuratowana macierz sygnatur zestawów genów zawierająca geny markerowe dla 28 typów komórek odpornościowych została pozyskana z literatury przedmiotowej19. Dla każdej próbki zastosowano funkcję gsva z parametrami method = "ssgsea", ssgsea.norm = TRUE oraz kcdf = "Gaussian". Współczynniki korelacji Spearmana pomiędzy wynikami wzbogacenia ssGSEA a poziomami ekspresji sześciu kluczowych genów obliczono za pomocą funkcji cor.test. Wartości p skorygowano pod kątem wielokrotnych testów metodą Benjamini-Hochberga. Macierz korelacji zwizualizowano w formie mapy ciepła (heatmap) przy użyciu pakietu pheatmap.
Przewidywanie leków, dokowanie molekularne i analiza powiązań z chorobami
Potencjalne związki terapeutyczne ukierunkowane na kluczowe geny zidentyfikowano przy użyciu bazy danych DrugBank. W programie Cytoscape skonstruowano sieć interakcji „lek ukierunkowany na kluczowy gen”, aby zwizualizować przewidywane oddziaływania lek-gen. Przeprowadzono dokowanie molekularne przy użyciu platformy CB-Dock2 w celu oceny powinowactwa wiązania. Trójwymiarową strukturę białka ludzkiego UPP1 pobrano z Protein Data Bank (PDB ID: 7B8T). Struktury molekularne leków (w formacie SMILES) pozyskano z bazy PubChem. Dokowanie wykonano przy użyciu silnika AutoDock Vina, a wyniki uszeregowano według wolnej energii wiązania (ΔG, w kcal/mol). Kompleksy dokowania zwizualizowano za pomocą programu PyMOL. Powiązania między kluczowymi genami a chorobami ludzi związanymi z ekspozycją na czynniki środowiskowe zbadano przy użyciu Comparative Toxicogenomics Database (CTD). Każdy gen analizowano oddzielnie, a następnie wyekstrahowano dziesięć najsilniej powiązanych chorób i przedstawiono je za pomocą wykresów radarowych.
Protokół RT-qPCR
Próbki krwi żylnej obwodowej pobrano od ośmiu pacjentów z POChP oraz ośmiu zdrowych osób z grupy kontrolnej w szpitalu Shenzhen Luohu Hospital of Traditional Chinese Medicine. POChP zdiagnozowano zgodnie z kryteriami Global Initiative for Chronic Obstructive Lung Disease (GOLD), definiującymi chorobę jako stosunek FEV1/FVC < 0,70 po podaniu leku rozszerzającego oskrzela. Grupa kontrolna składała się z dopasowanych pod względem wieku i płci zdrowych ochotników, bez historii chorób dróg oddechowych i z prawidłowymi wynikami prób czynnościowych płuc (przewidywane FEV1% ≥ 80% oraz FEV1/FVC ≥ 0,70). Informacje wyjściowe dotyczące pacjentów przedstawiono w Tabeli 2. Całkowite RNA wyekstrahowano z próbek krwi pacjentów z POChP przy użyciu zestawu do ekstrakcji RNA z krwi. W celu syntezy cDNA, 500 ng całkowitego RNA poddano odwrotnej transkrypcji z wykorzystaniem zestawu do syntezy cDNA z usuwaniem genomowego DNA, zgodnie z dostarczonym protokołem. Otrzymane cDNA rozcieńczono do stężenia 150 ng/μL.
Analizę RT-qPCR przeprowadzono z wykorzystaniem qPCR master mix opartego na SYBR Green w systemie PCR w czasie rzeczywistym. Każda reakcja o objętości 10 μL zawierała 5 μL 2x SYBR Green master mix, po 0,5 μL starterów bezpośrednich i odwrotnych (10 μM), 1 μL rozcieńczonego cDNA (15 ng/μL) oraz 3 μL wody wolnej od nukleaz. Warunki cykliczności obejmowały wstępną denaturację w 95 °C przez 5 min, a następnie 40 cykli: 95 °C przez 10 s i 60 °C przez 30 s, z końcową analizą krzywej topnienia od 60 °C do 95 °C w celu weryfikacji swoistości amplifikacji. Wszystkie reakcje przeprowadzono w trzech powtórzeniach technicznych. Jako wewnętrzny gen referencyjny wykorzystano β-actin. Efektywność starterów dla każdego genu docelowego została zwalidowana za pomocą serii rozcieńczeń krzywej standardowej i mieściła się w zakresie od 90% do 110%. Poziomy ekspresji genów znormalizowano do β-actin, a względną ekspresję obliczono metodą 2-ΔΔCt. Porównania statystyczne między grupą z COPD a grupą kontrolną przeprowadzono za pomocą testu U Manna-Whitneya.
Analiza statystyczna
Wizualizacje sieci zostały utworzone przy użyciu programu Cytoscape, a analizy statystyczne przeprowadzono w oprogramowaniu R. O ile nie wskazano inaczej, w przypadku danych o rozkładzie nienormalnym zastosowano test U Manna-Whitneya, a w przypadku danych o rozkładzie normalnym test t Studenta w celu porównania dwóch grup. Wartość p < 0,05 uznano za statystycznie istotną.
Wyniki
Identyfikacja genów wspólnych, analiza wzbogacenia i konstrukcja sieci PPI
Z zestawu danych GSE54837 zidentyfikowano 3 371 DEG, w tym 1 675 DEG o zwiększonej ekspresji i 1 696 DEG o zmniejszonej ekspresji. 10 genów o najistotniejszej regulacji w górę i w dół przedstawiono na Rysunku 1A. Przeprowadzono hierarchiczną analizę skupień danych GSE54837 (Rysunek dodatkowy 1A), a w celu zapewnienia bezskalowej topologii sieci zastosowano miękki parametr progowy równy 10 (Rysunek 1B). Moduły koekspresji genów skonstruowano metodą dynamicznego cięcia drzewa (dynamic tree cut) przy minimalnej wielkości modułu wynoszącej 50 genów, a każdemu modułowi przypisano odrębny kolor (Rysunek dodatkowy 1B). Moduły o korelacji eigengenów > 0,75 zostały następnie połączone (Rysunek dodatkowy 1C, Rysunek 1C), co doprowadziło do uzyskania 14 odrębnych modułów. Na podstawie analizy korelacji Pearsona między eigengenami modułów a cechami klinicznymi, moduł MEsalmon (obejmujący 5 226 genów) wykazał najistotniejszą dodatnią korelację z COPD (r = 0,35, p = 7 x 10⁻8, Rysunek 1D). Analiza Venna wykazała 160 wspólnych genów spośród 3 371 DEG, 5 226 genów modułu MEsalmon i 2 118 ac4C-RG (Rysunek 1E). Analiza wzbogacenia funkcjonalnego tych 160 genów wykazała, że istotne terminy GO obejmowały wiązanie jednoniciowego RNA, regulację procesu metabolicznego mRNA oraz szlak sygnałowy RIG-I (Rysunek 1F). Ponadto analiza KEGG wykazała, że geny te były przede wszystkim wzbogacone w fagocytozę zależną od receptora Fc gamma R, szlak nadzoru mRNA oraz adhezję ogniskową (Rysunek 1G). Sieć PPI wspólnych genów zawierała 118 węzłów i 196 krawędzi (Rysunek 1H).
Identyfikacja sześciu kluczowych genów w POChP
Aby dalej zidentyfikować potencjalne kluczowe geny spośród 160 wspólnych kandydatów, zastosowano trzy algorytmy uczenia maszynowego. W pierwszej kolejności przeprowadzono regresję LASSO, wykorzystując walidację krzyżową do wyznaczenia optymalnego parametru kary (λ) ≈ 0,091 (Rysunek 2A). Wykres profilu współczynników wskazał, że przy optymalnej wartości λ zachowano 17 genów (Rysunek 2B). Analiza XGBoost pozwoliła zidentyfikować 30 genów z najwyższym wzmocnieniem (gain), wśród których PTRF, WBP11 i LDOC1L wykazały wysoką wartość prognostyczną (Rysunek 2C). Algorytm RF w podobny sposób uszeregował 30 najważniejszych genów według ich wskaźników istotności Gini, gdzie wśród najbardziej prognostycznych znalazły się PTRF, RFX5 i PRKCDBP (Rysunek 2D). Analiza części wspólnej genów wybranych trzema metodami pozwoliła zidentyfikować sześć kluczowych genów wspólnych: PTRF, PRKCDBP, UPP1, TOR3A, FAM168B i B4GALT2 (Rysunek 2E).
Konstrukcja modelu diagnostycznego i analiza ekspresji kluczowych genów
Wykorzystując 70% zbioru danych GSE54837 jako zestaw treningowy, opracowano model regresji logistycznej obejmujący sześć kluczowych genów. Analiza krzywej ROC wykazała umiarkowaną wydajność diagnostyczną, z wartościami AUC wynoszącymi odpowiednio 0,766 (95% CI: 0,691–0,8417), 0,759 (95% CI: 0,6368–0,8817) oraz 0,723 (95% CI: 0,6085–0,8596) dla zestawu treningowego, wewnętrznego zestawu testowego i zewnętrznego zestawu walidacyjnego (Rycina 3A–C). Analiza kalibracji potwierdziła wysoką niezawodność, a DCA wskazała na wyraźną netto korzyść kliniczną dla szerokiego zakresu prawdopodobieństw progowych zarówno w zestawach treningowych (Rycina 3D–E), jak i walidacyjnych (Rycina 3F–G). Skonstruowano nomogram w celu wizualizacji wkładu każdego genu i ułatwienia indywidualnej oceny ryzyka (Rycina 3H). Analiza ekspresji wykazała, że B4GALT2, PRKCDBP i UPP1 były znacząco upregulowane w próbkach z COPD, podczas gdy FAM168B, PTRF i TOR3A były downregulowane (Rycina 3I).
Sieć regulacyjna i analiza funkcjonalna kluczowych genów w POChS
Za pomocą analizy GeneMANIA skonstruowano funkcjonalną sieć interakcji obejmującą 20 genów najsilniej powiązanych z zidentyfikowanymi genami hub (Rycyna 4A). Większość połączeń stanowiły interakcje fizyczne, a następnie korelacje koekspresji oraz wspólne domeny białkowe. Adnotacja funkcjonalna wykazała istotne wzbogacenie w procesach takich jak kataboliczny proces małych cząsteczek zawierających nukleobazy, proces kataboliczny nukleozydów oraz tratwy błony plazmatycznej. Regulację potranskrypcyjną zbadano poprzez przecięcie predykcji miRNA z baz danych DIANA-microT oraz miRanda, co pozwoliło na zidentyfikowanie ośmiu nakładających się miRNA (Rycyna 4B). Następnie skonstruowano oś regulacyjną lncRNA-miRNA-mRNA. Zgodnie z diagramem Sankeya dwa zidentyfikowane miRNA, oba związane z regulacją FAM168B, miały być celem siedmiu lncRNA; w przypadku pozostałych pięciu genów hub nie zidentyfikowano takich interakcji regulacyjnych (Rycyna 4C). Regulację transkrypcyjną zgłębiono dalej przy użyciu platformy ChEA3, która przewidziała nadrzędne czynniki transkrypcyjne (TFs) dla B4GALT2, UPP1, FAM168B oraz TOR3A. Wybrano dziesięć najważniejszych TFs dla każdego genu w celu konstrukcji sieci regulacyjnej TF-cel (Rycyna 4D). Przeprowadzono analizę GSEA, aby zbadać funkcje biologiczne sześciu kluczowych genów. UPP1 był istotnie wzbogacony w procesach biologicznych, takich jak proces metaboliczny diacyloglicerolu i biosyntetyczny proces trifosforanów nukleozydów purynowych, a także w szlakach obejmujących proteasom i metabolizm ksenobiotyków przez cytochrom P450 (Rycyna 4E–F). Wyniki wzbogacenia dla pozostałych pięciu kluczowych genów przedstawiono w Rycynie uzupełniającej 2A–J.
Infiltracja immunologiczna UPP1 i przewidywanie celów terapeutycznych w POChP
Poziomy infiltracji 28 typów komórek odpornościowych w grupach kontrolnej i z POChP oceniono za pomocą algorytmu ssGSEA. U pacjentów z POChP komórki B pamięci, mieloidalne komórki supresorowe oraz aktywowane komórki dendrytyczne wykazały istotnie wyższe wyniki wzbogacenia. W przeciwieństwie do nich, komórki T pomocnicze typu 1, aktywowane komórki B oraz niedojrzałe komórki B wykazały istotnie niższe wyniki wzbogacenia (Rysunek 5A). Należy zauważyć, że ssGSEA dostarcza względnych szacunków wzbogacenia komórek odpornościowych na podstawie danych transkryptomicznych, a nie bezpośrednich pomiarów proporcji komórek odpornościowych. Analiza korelacji wykazała, że sześć kluczowych genów wykazywało zróżnicowane wzorce powiązań z podzbiorami komórek odpornościowych. Konkretnie, UPP1, PRKCDBP i B4GALT2 korelowały dodatnio z poziomami infiltracji komórek B pamięci, aktywowanych komórek dendrytycznych i mieloidalnych komórek supresorowych (Spearman ρ > 0,4, p < 0,05), podczas gdy PTRF, TOR3A i FAM168B wykazały korelacje ujemne z komórkami T pomocniczymi typu 1 i aktywowanymi komórkami B (Spearman ρ < −0,3, p < 0,05). Pełna macierz korelacji została przedstawiona na mapie ciepła (Rysunek 5B). Analiza predykcji leków zidentyfikowała UPP1 jako jedyny gen spośród sześciu kandydatów z przewidywanymi interakcjami z małymi cząsteczkami. W bazie danych zidentyfikowano trzy związki, w tym fluorouracyl, kapecytabinę i 5-benzyloacylo-urydynę, jako potencjalne związki oddziałujące z UPP1 (Rysunek 5C). Związki te są stosowane głównie w onkologii lub w warunkach eksperymentalnych, a ich znaczenie w POChP wymaga dalszych badań. Obliczenia wolnej energii wiązania wykazały, że 5-benzyloacylo-urydyna wykazywała najsilniejsze powinowactwo wiązania, co sugeruje stosunkowo wyższe przewidywane powinowactwo wiązania (Tabela 3). Wizualizacje dokowania molekularnego dla wszystkich trzech związków wskazały na korzystne przewidywane konformacje wiązania z UPP1, co jest zgodne z obliczeniowymi predykcjami dokowania, a nie z walidacją eksperymentalną (Rysunek 5D–F). Ponadto analiza CTD wykazała, że wszystkie sześć kluczowych genów było silnie powiązanych z różnymi fenotypami chorób, w tym z odroczonymi skutkami ekspozycji prenatalnej, utratą masy ciała, hepatomegalią i stanami zapalnymi (Rysunek 5G–L).
Walidacja RT-qPCR kluczowych genów diagnostycznych w próbkach klinicznych
W celu walidacji poziomów ekspresji kluczowych genów pobrano próbki krwi od ośmiu pacjentów z POChP oraz ośmiu osób z grupy kontrolnej; analiza ta została uznana za wstępną walidację ze względu na ograniczoną wielkość próby. Jak pokazano na Ryc. 6A–F, ekspresja genów PTRF, TOR3A i FAM168B była istotnie obniżona, natomiast ekspresja PRKCDBP i UPP1 była istotnie podwyższona w próbkach od pacjentów z POChP, co jest zgodne z trendami zaobserwowanymi w analizie bioinformatycznej. W przeciwieństwie do nich, w przypadku ekspresji B4GALT2 nie zaobserwowano istotnych różnic między obiema grupami. Rozbieżność ta może wynikać z ograniczonej liczby próbek lub różnic w typach próbek pomiędzy zbiorami danych a preparatami klinicznymi.
OŚWIADCZENIE DOTYCZĄCE DOSTĘPNOŚCI DANYCH:
Wszystkie dane z sekwencjonowania RNA pobrano z bazy danych Gene Expression Omnibus (GEO, https://www.ncbi.nlm.nih.gov), przy czym zestaw GSE54837 wybrano jako zbiór treningowy, a GSE112811 jako zbiór walidacyjny. Kod wykorzystany w tej analizie jest dostępny pod adresem https://doi.org/10.5281/zenodo.21771476.
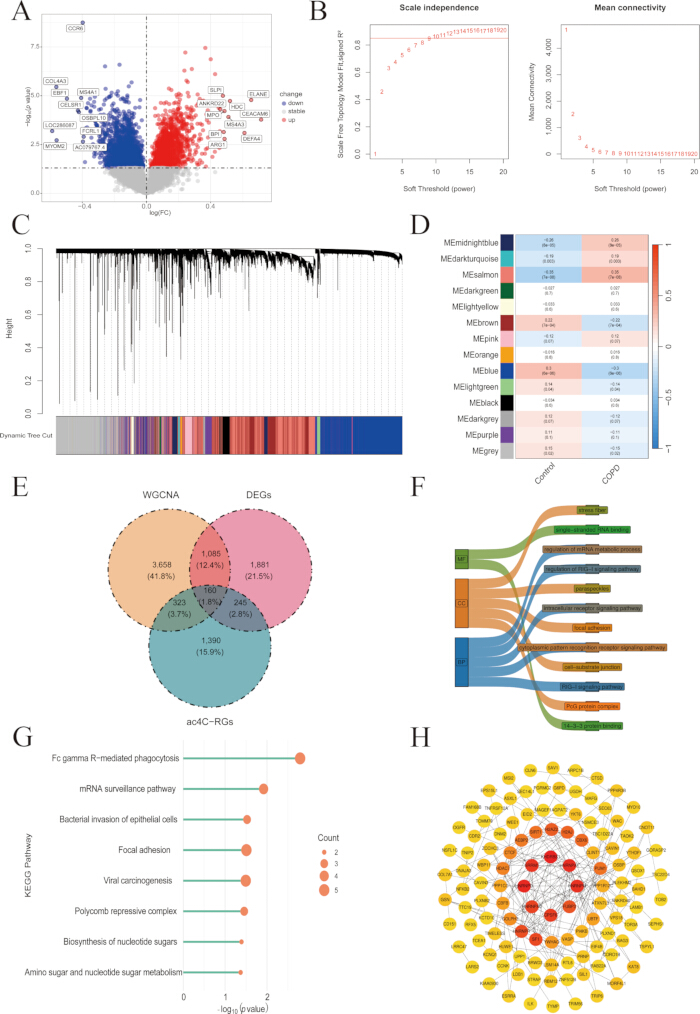
Rysunek 1: Identyfikacja wspólnych genów, analiza wzbogacenia i konstrukcja sieci PPI. (A) Wykres wulkaniczny genów DEG w zbiorze danych GSE54837. (B) Przesiewanie miękkiego progu. (C) Dendrogram klastrowania modułów (po scaleniu). (D) Mapa ciepła korelacji między modułami a cechami. (E) Diagram Venna służący do identyfikacji wspólnych genów. (F) Diagram Mulberry analizy wzbogacenia GO, przedstawiający główne wyniki wzbogacenia genów wspólnych w kategoriach MF, CC i BP. (G) Diagram lollipop analizy wzbogacenia szlaków sygnalizacyjnych KEGG, gdzie rozmiar bąbelka reprezentuje liczbę wzbogaconych genów. (H) Sieć PPI genów wspólnych; węzły reprezentują białka, a krawędzie reprezentują oddziaływania białko-białko. Skróty: DEGs = geny o różnej ekspresji; PPI = oddziaływanie białko-białko; GO = Gene Ontology; MF = funkcja molekularna; CC = komponent komórkowy; BP = proces biologiczny; KEGG = Kyoto Encyclopedia of Genes and Genomes; ac4C-RGs = geny związane z N4-acetylcytydyną. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
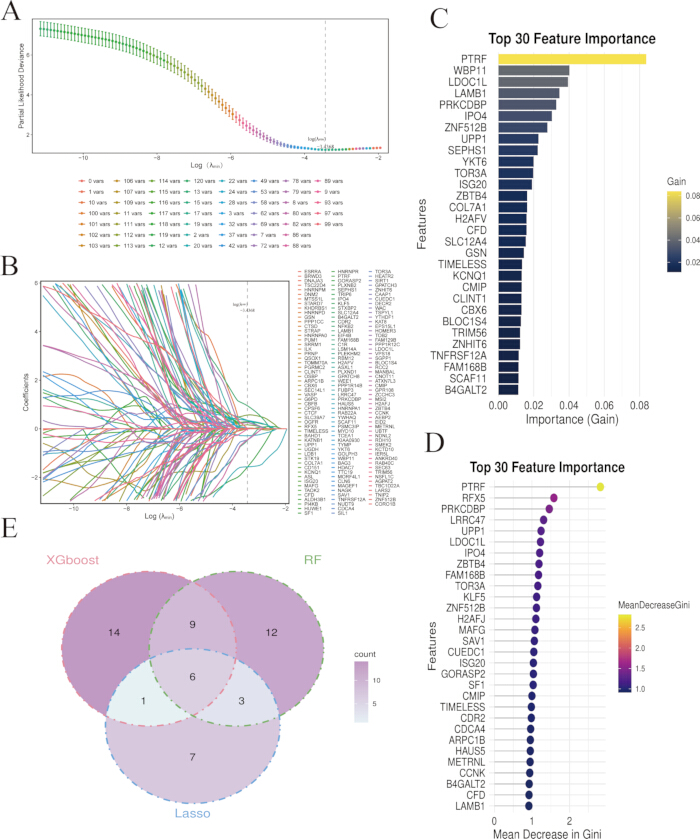
Rysunek 2: Identyfikacja sześciu kluczowych genów w COPD. (A) Krzywa walidacji krzyżowej LASSO. (B) Diagram ścieżki współczynników regresji LASSO. Wraz ze wzrostem λ współczynniki nieistotnych genów zbiegają do 0. (C) Ranking istotności cech XGBoost. Oś x reprezentuje wartość zysku (gain), oś y reprezentuje nazwę genu, a głębokość koloru reprezentuje istotność. (D) Ranking istotności cech RF. Oś x reprezentuje średni spadek współczynnika Giniego. (E) Diagram Venna nakładających się genów uzyskanych poprzez analizę krzyżową trzech algorytmów. Skróty: LASSO = least absolute shrinkage and selection operator; XGBoost = extreme gradient boosting; RF = random forest. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
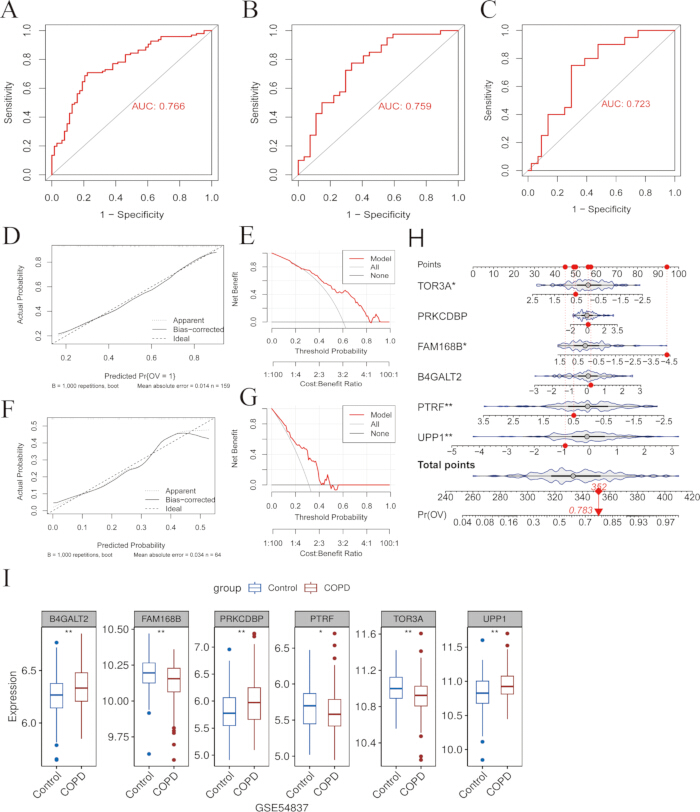
Rycina 3: Konstrukcja modelu diagnostycznego i analiza ekspresji kluczowych genów. (A) Krzywa ROC zestawu treningowego. (B) Krzywa ROC wewnętrznego zestawu testowego. (C) Krzywa ROC zewnętrznego zestawu walidacyjnego. (D) Krzywa kalibracyjna zestawu treningowego. (E) DCA zestawu treningowego. (F) Krzywa kalibracyjna zewnętrznego zestawu walidacyjnego. (G) DCA zewnętrznego zestawu walidacyjnego. (H) Nomogram sześciu kluczowych genów. W celu przewidzenia indywidualnego ryzyka COPD, każdemu genowi przypisana jest odpowiednia punktacja. (I) Analiza ekspresji sześciu kluczowych genów w próbkach z COPD i próbkach kontrolnych z zestawu danych GSE54837. Skróty: ROC = charakterystyka operacyjna odbiornika; AUC = pole pod krzywą; DCA = analiza krzywych decyzyjnych; COPD = przewlekła obturacyjna choroba płuc. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
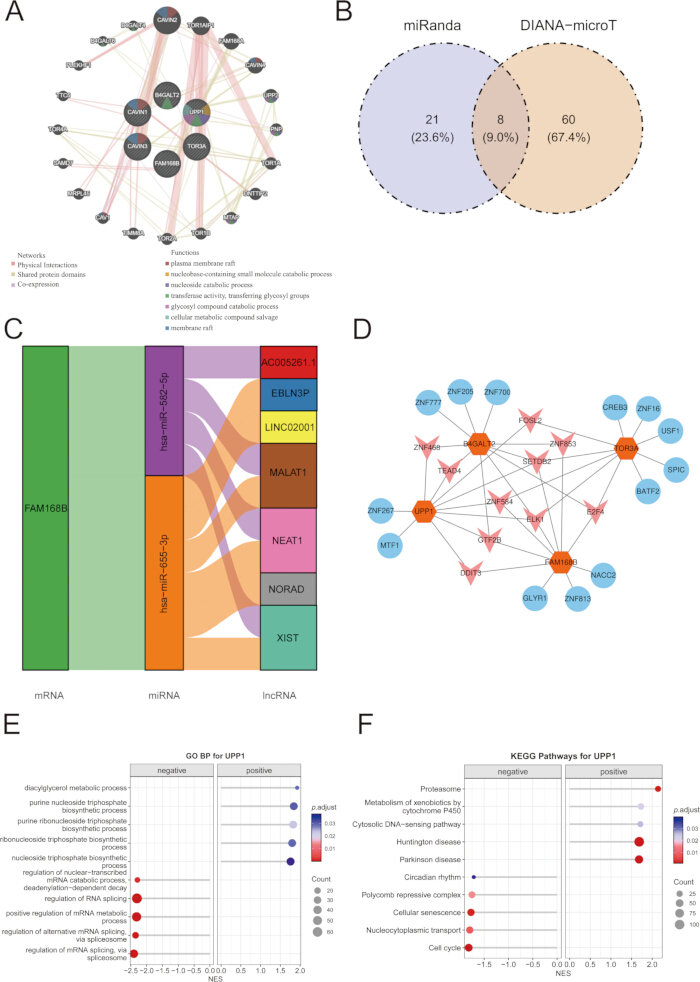
Rysunek 4: Sieć regulacyjna i znaczenie funkcjonalne kluczowych genów w POChP. (A) Wyniki analizy GeneMANIA dla 6 kluczowych genów. Kolor linii wskazuje korelację między genami, a kolor węzłów oznacza różne kategorie funkcjonalne. (B) Diagram Venna z analizy krzyżowej baz danych DIANA-microT i miRanda. (C) Diagram Sankeya dla sieci regulacyjnej ceRNA. (D) Potencjalna sieć regulacyjna czynników transkrypcyjnych. Niebieskie węzły reprezentują czynniki transkrypcyjne, a pomarańczowe węzły reprezentują geny docelowe. (E) Analiza wzbogacenia GSEA pojedynczego genu UPP1, w tym GO. (F) Analiza wzbogacenia GSEA pojedynczego genu UPP1, w tym KEGG. Skróty: GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes. Kliknij tutaj, aby zobaczyć powiększoną wersję tego rysunku.
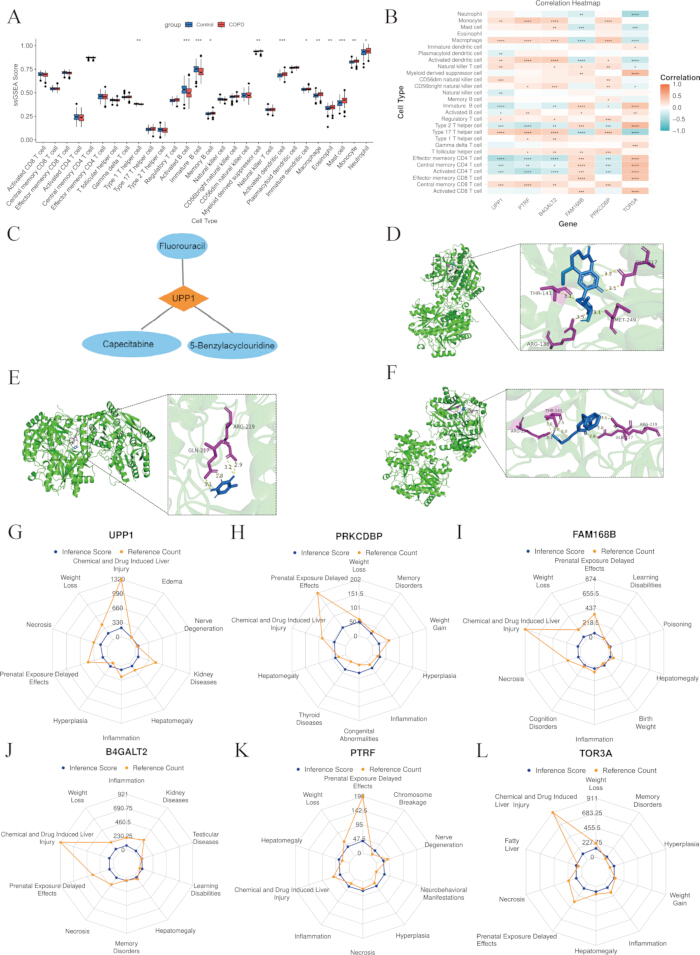
Rysunek 5: Infiltracja immunologiczna kluczowych genów i przewidywanie celów terapeutycznych w POChS. (A) Różnice w liczebności komórek odpornościowych pomiędzy grupami. (B) Mapa ciepła korelacji między komórkami odpornościowymi a kluczowymi genami. (C) Sieć interakcji między kluczowymi genami a przewidywanymi lekami. (D) Dokowanie molekularne 5-fluorouracylu z UPP1. (E) Dokowanie molekularne kapecytabiny z UPP1. (F) Dokowanie molekularne 5-benzylacylo-urydyny z UPP1. Dla każdego związku obraz po lewej stronie przedstawia ogólną konformację dokowania, a obraz po prawej stronie pokazuje lokalne interakcje wiązania. (G) Analiza CTD dla B4GALT2. (H) Analiza CTD dla FAM168B. (I) Analiza CTD dla PRKCDBP. (J) Analiza CTD dla PTRF. (K) Analiza CTD dla TOR3A. (L) Analiza CTD dla UPP1. Prosimy kliknąć tutaj, aby wyświetlić większą wersję tego rysunku.
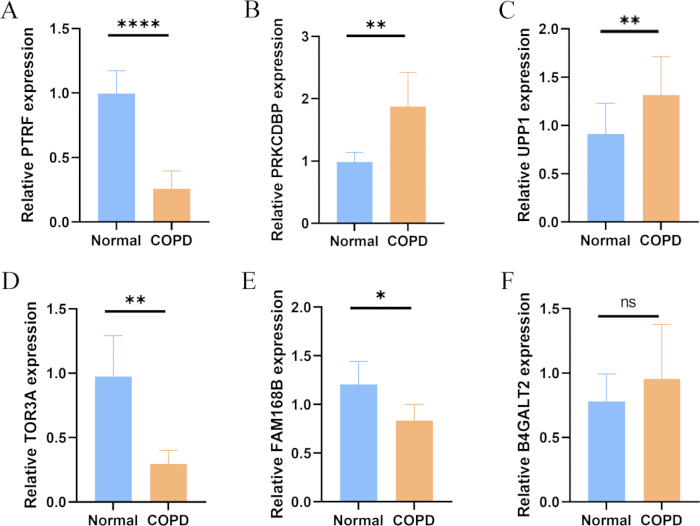
Rycina 6: Walidacja RT-qPCR ekspresji kluczowych genów w próbkach z POChP i kontrolnych. (A) Względna ekspresja PTRF. (B) Względna ekspresja PRKCDBP. (C) Względna ekspresja UPP1. (D) Względna ekspresja TOR3A. (E) Względna ekspresja FAM168B. (F) Względna ekspresja B4GALT2. ns = brak istotności, p > 0.05; * p < 0.05; ** p < 0.01; *** p < 0.001; **** p < 0.0001. Skrót: RT-qPCR = ilościowa reakcja polimerazy w łańcuchu z odwrotną transkrypcją. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Rycina uzupełniająca 1: Próbki zbioru danych GSE54837 oraz klastrowanie modułów genowych. (A) Diagram klastrowania próbek ze zbioru danych GSE54837. (B) Dendrogram klastrowania modułów przed scaleniem. Geny zostały pogrupowane przy użyciu metody dynamic tree cut w celu zidentyfikowania odrębnych modułów. (C) Dendrogram klastrowania hierarchicznego eigengenów modułów. Moduły o podobnych wzorcach ekspresji zostały zgrupowane na podstawie podobieństwa ich eigengenów.Kliknij tutaj, aby pobrać ten plik.
Rycina dodatkowa 2: Analiza wzbogacenia GSEA. (A) Analiza GO dla PRKCDBP. (B) Analiza KEGG dla PRKCDBP. (C) Analiza GO dla PTRF. (D) Analiza KEGG dla PTRF. (E) Analiza GO dla TOR3A. (F) Analiza KEGG dla TOR3A. (G) Analiza GO dla FAM168B. (H) Analiza KEGG dla FAM168B. (I) Analiza GO dla B4GALT2. (J) Analiza KEGG dla B4GALT2. Skróty: GO = Gene Ontology; KEGG = Kyoto Encyclopedia of Genes and Genomes.Kliknij tutaj, aby pobrać ten plik.
| Zbiór danych | Kontrole | Pacjenci | Platforma sekwencjonowania |
| GSE54837 | 90 | 136 | GPL570 |
| GSE112811 | 44 | 20 | GPL570 |
Tabela 1: Zbiory danych ekspresji genów wykorzystane w badaniu. Charakterystyka zbiorów danych GSE54837 i GSE112811 wykorzystanych odpowiednio do opracowania modelu/testów wewnętrznych oraz walidacji zewnętrznej.
| Pacjent | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 |
| Płeć (K/M) | M | M | M | F | M | M | M | M |
| Wiek (lata) | 69 | 72 | 75 | 73 | 68 | 70 | 69 | 71 |
| Status palenia | Tak | Tak | Rzucenie palenia (2 lata) | Nie | Tak | Tak | Tak | Rzucenie palenia (5 lat) |
| Palenie w paczkopeach | 20 dziennie / 30 lat | 15 na dzień / 35 lat | 20 dziennie / 50 lat | 20 dziennie / 40 lat | 30 dziennie / 40 lat | 15 na dzień / 40 lat | 20 dziennie / 30 lat | |
| grupa z POChP | 2 | 3 | 3 | 2 | 2 | 3 | 2 | 3 |
Tabela 2: Charakterystyka wyjściowa uczestników badania.Demograficzna i kliniczna charakterystyka wyjściowa pacjentów z COPD oraz zdrowych osób kontrolnych włączonych do walidacji metodą RT-qPCR.
| Nazwa cząsteczkowa | Gen | Wynik (kcal/mol) |
| 5-benzylacylo-urydyna | UPP1 | -9.6 |
| Kapecytabina | UPP1 | -6.1 |
| Fluoruracyl | UPP1 | -5.5 |
Tabela 3: Wyniki dokowania molekularnego dla UPP1 i związków kandydackich.
Przewidywane wyniki dokowania molekularnego dla oddziaływań UPP1 z fluorouracylem, kapecytabiną i 5-benzyloacylo-urydyną, wraz z ich powinowactwami wiązania.
Dyskusja
Konserwacyjna modyfikacja RNA ac4C, która występuje głównie w matrycowym RNA (mRNA) i transferowym RNA (tRNA), zwiększa stabilność mRNA oraz wydajność translacji20. NAT10 jest jedyną znaną acetylotransferazą RNA pośredniczącą w modyfikacji ac4C21. Badania wykazały, że NAT10 jest nadmiernie ekspresyjny w komórkach nabłonkowych płuc pacjentów z POChP. Wyciszenie NAT10 zaburza funkcję mitochondriów oraz odpowiedzi transkrypcyjne22. W oparciu o zintegrowaną analizę multiomiczną, w niniejszej pracy zidentyfikowano sześć kluczowych genów ściśle powiązanych z POChP i opracowano model diagnostyczny, który wykazał umiarkowaną skuteczność diagnostyczną i potencjalną wartość dla dalszych badań. Dalsza analiza ujawniła kluczowe role tych genów w regulacji transkrypcyjnej, sieciach ceRNA oraz w mikrośrodowisku immunologicznym. Ponadto przewidziano potencjalne leki celowane, co dostarcza wiedzy na temat patogenezy POChP i ułatwia opracowanie spersonalizowanych strategii precyzyjnego leczenia. Wykorzystując WGCNA oraz analizę różnicowej ekspresji, zidentyfikowano geny, które były zarówno różnicowo ekspresyjne w POChP, jak i obecne w wcześniej opublikowanej liście genów powiązanych z ac4C. Należy zauważyć, że geny te wybrano na podstawie ich powiązania z regulacyjną siecią ac4C, a nie na podstawie udowodnionych powiązań mechanistycznych z NAT10 lub acetylacją ac4C, co pozwoliło uzyskać łącznie 160 genów kandydackich. Za pomocą algorytmów uczenia maszynowego zidentyfikowano sześć kluczowych genów (PTRF, PRKCDBP, UPP1, TOR3A, FAM168B oraz B4GALT2). Wśród nich PTRF odgrywa krytyczną rolę w indukowanym przez roztocza kurzu domowego (HDM) zapaleniu dróg oddechowych poprzez regulację nekroptozy makrofagów zapośredniczonej przez oś IL-33-ZBP1, co sugeruje, że może on być zaangażowany w przewlekłe stany zapalne płuc, takie jak POChP23. Lai i wsp.24 wykazali, że egzogenne podawanie urydyny hamuje ferroptozę w makrofagach poprzez szlak Nrf2/SLC7A11/GPX4, łagodząc tym samym ostry uszkodzenie płuc spowodowane sepsą. Chociaż w tkance płucnej w modelach ostrego uszkodzenia płuc zaobserwowano nadekspresję UPP1, kluczowego enzymu w metabolizmie urydyny, jego dokładna rola — oraz to, czy ta nadekspresja stanowi reakcję ochronną, czy jest następstwem uszkodzenia tkanki — wymaga dalszego wyjaśnienia. Wynik ten sugeruje jednak, że UPP1 może mieć potencjalny związek z procesami patofizjologicznymi zapalnych chorób płuc, takich jak POChP, co uzasadnia dalsze badania. Pozostałe cztery kluczowe geny były rzadziej badane w zaburzeniach związanych z płucami, ale na podstawie ich funkcji w innych chorobach oraz naszych obecnych ustaleń, wysunęliśmy hipotezę dotyczącą potencjalnych szlaków, poprzez które mogą one przyczyniać się do patogenezy POChP.
W oparciu o sześć kluczowych genów skonstruowaliśmy model diagnostyczny POChP i potwierdziliśmy jego wysoką wydajność prognostyczną. Analiza ekspresji wykazała, że UPP1, B4GALT2 oraz PRKCDBP były istotnie upregulowane, podczas gdy FAM168B, PTRF oraz TOR3A były wyraźnie downregulowane w POChP. Choć w analizie zbioru danych B4GALT2 zidentyfikowano jako upregulowany, w walidacji metodą RT-qPCR nie zaobserwowano istotnej różnicy. Rozbieżność ta może wynikać z ograniczonej wielkości próby, heterogeniczności kohorty oraz różnic w źródłach próbek pomiędzy publicznymi zbiorami danych a klinicznymi próbkami krwi. Analiza wzbogacenia zestawów genów (GSEA) wykazała, że kluczowe geny te były istotnie wzbogacone w procesach splicing RNA i procesowania mRNA, a także w takich szlakach jak cykl komórkowy i uzależnienie od nikotyny. Nieodwracalne zatrzymanie cyklu komórkowego uznaje się za główny mechanizm leżący u podstaw starzenia się komórek, co może w znacznym stopniu przyczyniać się do patofizjologii POChP25,26. Dalsza analiza wskazała, że fenotyp wydzielniczy związany ze starzeniem (SASP), indukowany przez uszkodzenia DNA, może promować trwałą progresję POChP poprzez podtrzymywanie przewlekłego stanu zapalnego i zaostrzanie uszkodzeń tkanki płucnej27. Wcześniejsza praca przeglądowa analizowała również powiązania genetyczne leżące u podstaw uzależnienia od nikotyny i POChP28. Choć palenie tytoniu jest głównym czynnikiem ryzyka POChP, tylko niewielka część palaczy zapada na tę chorobę, co sugeruje, że czynniki genetyczne odgrywają istotną rolę zarówno w POChP, jak i w uzależnieniu od nikotyny. Liu i wsp.29 podsumowali role białek wiążących RNA (RBP) w POChP i nadciśnieniu płucnym (PH), podkreślając ich udział w przebudowie naczyniowej płuc i odpowiedziach zapalnych poprzez regulację splicingu mRNA i potranskrypcyjnej ekspresji genów, co wskazuje na ich potencjał jako biomarkerów i celów terapeutycznych. Podsumowując, kluczowe geny i powiązane z nimi szlaki zidentyfikowane w niniejszym badaniu nie tylko pogłębiają nasze zrozumienie patogenezy POChP, ale także stanowią solidną podstawę do opracowania przyszłych biomarkerów diagnostycznych i celowanych strategii terapeutycznych.
Sieć ceRNA obejmuje różne rodzaje RNA, w tym lncRNA, circRNA oraz mRNA, które konkurencyjnie wiążą się ze wspólnymi miRNA, tworząc tym samym wzajemne relacje regulacyjne i wpływając na ekspresję genów30. Ta złożona sieć uczestniczy w licznych procesach fizjologicznych i patologicznych oraz przyczynia się do wyjaśnienia mechanizmów regulacji genów i patogenezy takich chorób jak nowotwory i przewlekłe schorzenia zapalne. Na przykład Wang i wsp. skonstruowali sieć koekspresji ceRNA obejmującą 11 lncRNA, pięć miRNA i 16 mRNA, w której rdzenna podsieć była powiązana ze zmianami w proporcjach komórek odpornościowych i funkcji płuc w POChP31. Podobnie Zhang i wsp.32 opracowali sieć ceRNA typu circRNA-miRNA-mRNA w oparciu o monocyty krwi obwodowej od palących mężczyzn, identyfikując dysregulowane circRNA oraz kluczowe szlaki związane z POChP. Nasza analiza sieci koekspresji wykazała, że kluczowe geny tworzyły przede wszystkim połączenia funkcjonalne poprzez interakcje fizyczne, koekspresję oraz wspólne domeny białkowe i były znacznie wzbogacone w wielu szlakach związanych z metabolizmem. Na podstawie tych wyników skonstruowaliśmy dalej regulacyjną sieć czynnik transkrypcyjny (TF)-cel oraz oś regulacyjną miRNA-lncRNA-mRNA. Wyniki te sugerują, że kluczowe geny mogą być regulowane wspólnie poprzez wielopoziomowe mechanizmy z udziałem lncRNA, czynników transkrypcyjnych i miRNA w POChP.
Infiltracja immunologiczna odzwierciedla stan odpornościowy, wskazując na rozkład i aktywność komórek odpornościowych w tkankach lub krwi. Na tej podstawie, za pomocą skriningu komputerowego, przewidziano potencjalne leki kandydackie, a następnie przeprowadzono symulacje dokowania molekularnego w celu oceny powinowactwa wiązania i stabilności z białkami docelowymi. Wspólnie analizy te ułatwiają identyfikację nowych czynników terapeutycznych i dostarczają głębszego wglądu w mechanizmy chorobowe. W niniejszym badaniu sześć kluczowych genów wykazało pozytywną korelację z większością infiltracji komórek odpornościowych. Przewidywanie leków pozwoliło zidentyfikować potencjalne interakcje między UPP1 a fluorouracylem, capecytabiną i 5-benzyloacykloorydyną, przy czym ta ostatnia wykazała najsilniejsze powinowactwo wiązania, co zostało dodatkowo potwierdzone w dokowaniu molekularnym. Należy zauważyć, że fluorouracyl i capecytabina są stosowane głównie jako środki przeciwnowotworowe i zostały zidentyfikowane w niniejszym badaniu jako związki oddziałujące z UPP1 na podstawie przewidywań bazodanowych, a nie jako zwalidowane opcje terapeutyczne w POChP. Wcześniejsze badania wykazały, że miejscowe podawanie fluorouracylu może poprawić drożność dróg oddechowych w przypadkach ciężkiej niedrożności dróg oddechowych33. Jednakże inne dowody wskazują, że fluorouracyl i capecytabina mogą indukować toksyczność płucną, szczególnie u pacjentów z istniejącymi wcześniej schorzeniami płuc34. Dlatego ich potencjalna przydatność w POChP wymaga dalszej weryfikacji eksperymentalnej i bezpieczeństwa. Ponadto analiza CTD wykazała, że wszystkie sześć kluczowych genów było powiązanych z wieloma procesami patologicznymi. Łącznie zintegrowana analiza infiltracji immunologicznej, przewidywania leków i dokowania molekularnego dostarcza nowych celów molekularnych oraz podstaw teoretycznych dla precyzyjnego leczenia POChP, co sprzyja opracowywaniu i translacji klinicznej powiązanych leków.
Należy jednak uznać kilka ograniczeń. Badanie oparto na publicznych zbiorach danych o stosunkowo ograniczonym źródle próbek, co może wprowadzać efekty seryjne (batch effects) oraz potencjalne przeuczenie modelu. Walidacja za pomocą RT-qPCR została przeprowadzona w małej kohorcie, a zaobserwowana niespójność w ekspresji B4GALT2 sugeruje możliwą heterogeniczność grupy. Dodatkowo analizy nacieku immunologicznego oraz przewidywania leków miały charakter obliczeniowy i wymagają dalszej walidacji eksperymentalnej. Ponadto, jako bioinformatyczne badanie w fazie odkrycia, nasz model diagnostyczny został oceniony przede wszystkim za pomocą wartości AUC z 95% przedziałami ufności. Kompleksowe wskaźniki wydajności, takie jak czułość, swoistość, wartości predykcyjne oraz szczegółowe statystyki kalibracji, nie zostały w pełni ocenione ze względu na retrospektywny charakter publicznych zbiorów danych i ograniczoną liczbę próbek. W związku z tym nasz model należy traktować jako narzędzie typu proof-of-concept, a jego użyteczność kliniczna wymaga dalszej walidacji w większych kohortach prospektywnych.
Dzięki zintegrowanym analizom bioinformatycznym i uczeniu maszynowemu, w niniejszym badaniu zidentyfikowano sześć kluczowych genów istotnie powiązanych z COPD. Opracowano solidny model diagnostyczny, który wykazał niezawodną wydajność prognostyczną w wielu kohortach. Analizy funkcjonalne ujawniły, że geny te uczestniczą w krytycznych sieciach regulacyjnych obejmujących regulację transkrypcyjną i potranskrypcyjną, naciekanie komórek odpornościowych oraz szlaki związane z uzależnieniem od nikotyny i cyklem komórkowym. Analizy predykcji leków i dokowania molekularnego wskazały UPP1 jako obiecujący cel terapeutyczny, przy czym kilka związków kandydackich wykazało silne powinowactwo wiązania. Podsumowując, wyniki te poszerzają naszą wiedzę na temat patofizjologii COPD i dostarczają cennych celów molekularnych dla przyszłego rozwoju terapii oraz strategii medycyny precyzyjnej.
Oświadczenia
Autorzy oświadczają, że nie występuje konflikt interesów. Od wszystkich osób uczestniczących w badaniu uzyskano świadomą zgodę.
Podziękowania
Wyrażamy wdzięczność szpitalowi Shenzhen Luohu Hospital of Traditional Chinese Medicine za udostępnienie zaplecza klinicznego oraz wsparcie administracyjne niezbędne do przeprowadzenia niniejszego badania. Wreszcie dziękujemy wszystkim pacjentom i zdrowym ochotnikom, którzy wzięli udział w tym badaniu; ich wkład był nieodzowny dla realizacji tej pracy. Praca ta została sfinansowana przez Sanming Project of Medicine in Shenzhen (No. SZZYSM202401018), Luohu District Priority Specialty Funds (No. LX202402021) oraz Luohu District Priority Specialty Funds (No. LX202302064).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| βstartery do $\beta$-aktyny | Tsingke | Proszę podać tekst źródłowy do tłumaczenia. | Do przodu: 5’-CATGTACGTTGCTATCCAGGC-3’ Odwrócenie: 5’-CTCCTTAATGTCACGCACGAT-3’ |
| startery do genu B4GALT2 | Tsingke | Ponieważ nie dostarczono tekstu źródłowego do przetłumaczenia, proszę o przesłanie treści, którą mam przełożyć na język polski zgodnie z wytycznymi. | Przesuń w przód: 5’-GGGCAGACTGCTGATCGAG-3’ Odwrócenie: 5’-CCGGTGTCTAAAGGGGATGAT-3’ |
| CB-Dock2 | LabShare | Online | Dokowanie molekularne |
| clusterProfiler | Bioconductor | v4.14.6 | Analiza wzbogacenia |
| Cytoscape | Konsorcjum Cytoscape | v3.8.3 | Wizualizacja sieci |
| DrugBank | Uniwersytet Alberta | Online | Przewidywanie leków |
| startery FAM168B | Tsingke | Proszę podać tekst źródłowy do tłumaczenia. | Przesunięcie: 5’-TCTGGGGTTCCCTATGCAAAT-3’ Odwrócenie: 5’-GTAGGATTCGCTCCAGGATACA-3’ |
| glmnet | CRAN | v4.1 | Regresja LASSO |
| GSVA (analiza wzbogacenia zestawów genów) | Bioconductor | v1.52.3 | analiza ssGSEA |
| Supermix do syntezy pierwszej nici cDNA Hifair III | YEASEN | 11141ES | synteza cDNA |
| Hieff RTPCR SYBR Green Master Mix | YEASEN | 11201ES | amplifikacja qPCR |
| limma | Bioconductor | v3.54.0 | Ekspresja różnicowa |
| System LightCycler 480 II | Roche | LightCycler 480 II | PCR w czasie rzeczywistym |
| startery PTRF | Tsingke | Ponieważ nie dostarczono tekstu źródłowego do przetłumaczenia, proszę o przesłanie treści, którą należy przełożyć na język polski zgodnie z wytycznymi. | Prawe: 5’-GGGCCGTAGACCAGATCCA-3’ Odwrotność: 5’-CTTGCTCACCGTATTGCTCGT-3’ |
| startery PRKCDBP | Tsingke | Ponieważ nie dostarczono tekstu źródłowego do przetłumaczenia, proszę o przesłanie treści, którą należy przełożyć na język polski zgodnie z wytycznymi. | Do przodu: 5’-CACGTTCTGCTCTTCAAGGAG-3’ Odwrócenie: 5’-TGTACCTTCTGCAATCCGGTG-3’ |
| oprogramowanie R | R Foundation | v4.4.2 | Obliczenia statystyczne |
| las losowy | CRAN | v4.7 | Las Losowy |
| Zestaw do izolacji RNA z krwi MolPure Blood RNA Kit | YEASEN | 19241ES50 | Ekstrakcja RNA |
| baza danych STRING | EMBL | Online | sieć PPI |
| startery TOR3A | Tsingke | Ponieważ nie dostarczono tekstu źródłowego do przetłumaczenia, proszę o przesłanie treści, którą należy przełożyć na język polski. Jestem gotowy do przygotowania profesjonalnego przekładu naukowego zgodnie z wytycznymi dla treści JoVE. | Forward: 5’-CCCTTGCTCTGTCGTTCCAC-3’ Odwrócenie: 5’-CCCGTCCCGATACAGGTTC-3’ |
| startery UPP1 | Tsingke | Nie dotyczy | Do przodu: 5’-CTGTCAGTCATGGTATGGGCA-3’ Odwrócenie: 5’-GAGCACCGGGCATAGTACA-3’ |
| WGCNA (analiza sieci współwyrażenia genów ważona) | CRAN | v1.72 | Sieć koekspresji |
| XGBoost | CRAN | v1.7 | Algorytm XGBoost |
Bibliografia
- Hogg JC. Pathophysiology of airflow limitation in chronic obstructive pulmonary disease. Lancet. 2004;364(9435):709-21.
- Baraldo S, Turato G, Saetta M. Pathophysiology of the small airways in chronic obstructive pulmonary disease. Respiration. 2012;84(2):89-97.
- Fischer BM, Pavlisko E, Voynow JA. Pathogenic triad in COPD: oxidative stress, protease-antiprotease imbalance, and inflammation. Int J Chron Obstruct Pulmon Dis. 2011;6:413-21.
- Pandey KC, De S, Mishra PK. Role of proteases in chronic obstructive pulmonary disease. Front Pharmacol. 2017;8:512.
- Wang L, Xie J, Hu Y, Tian Y. Air pollution and risk of chronic obstructed pulmonary disease: the modifying effect of genetic susceptibility and lifestyle. EBioMedicine. 2022;79:103994.
- Elonheimo HM, et al. Environmental substances associated with chronic obstructive pulmonary disease-a scoping review. Int J Environ Res Public Health. 2022;19(7):3945.
- Chen S, et al. The global economic burden of chronic obstructive pulmonary disease for 204 countries and territories in 2020-50: a health-augmented macroeconomic modelling study. Lancet Glob Health. 2023;11(8):e1183-e93.
- Rutten-van Mölken MP, et al. Costs and effects of inhaled corticosteroids and bronchodilators in asthma and chronic obstructive pulmonary disease. Am J Respir Crit Care Med. 1995;151(4):975-82.
- Ontiveros RJ, Stoute J, Liu KF. The chemical diversity of RNA modifications. Biochem J. 2019;476(8):1227-45.
- Roundtree IA, Evans ME, Pan T, He C. Dynamic RNA modifications in gene expression regulation. Cell. 2017;169(7):1187-200.
- Wang C, et al. RNA modification in cardiovascular disease: implications for therapeutic interventions. Signal Transduct Target Ther. 2023;8(1):412.
- Zhang W, et al. ac4C acetylation regulates mRNA stability and translation efficiency in osteosarcoma. Heliyon. 2023;9(6):e17103.
- Qiu L, Jing Q, Li Y, Han J. RNA modification: mechanisms and therapeutic targets. Mol Biomed. 2023;4(1):25.
- Luo J, Cao J, Chen C, Xie H. Emerging role of RNA acetylation modification ac4C in diseases: current advances and future challenges. Biochem Pharmacol. 2023;213:115628.
- Li H, et al. RNA cytidine acetyltransferase NAT10 maintains T cell pathogenicity in inflammatory bowel disease. Cell Discov. 2025;11(1):19.
- Wang JN, et al. NAT10 exacerbates acute renal inflammation by enhancing N4-acetylcytidine modification of the CCL2/CXCL1 axis. Proc Natl Acad Sci U S A. 2025;122(17):e2418409122.
- Shenshen W, et al. NAT10 accelerates pulmonary fibrosis through N4-acetylated TGFB1-initiated epithelial-to-mesenchymal transition upon ambient fine particulate matter exposure. Environ Pollut. 2023;322:121149.
- Liu J, et al. Unveiling ac4C modification pattern: a prospective target for improving the response to immunotherapeutic strategies in melanoma. J Transl Med. 2025;23(1):287.
- Su F, et al. Multimodal single-cell analyses outline the immune microenvironment and therapeutic effectors of interstitial cystitis/bladder pain syndrome. Adv Sci (Weinh). 2022;9(18):e2106063.
- Schiffers S, Oberdoerffer S. ac4C: a fragile modification with stabilizing functions in RNA metabolism. RNA. 2024;30(5):583-94.
- Jiao L, et al. Emerging role of N-acetyltransferase 10 in diseases: RNA ac4C modification and beyond. Mol Biomed. 2025;6(1):46.
- Zheng N, et al. Regulatory roles of NAT10 in airway epithelial cell function and metabolism in pathological conditions. Cell Biol Toxicol. 2023;39(4):1237-56.
- Du J, et al. PTRF-IL33-ZBP1 signaling mediating macrophage necroptosis contributes to HDM-induced airway inflammation. Cell Death Dis. 2023;14(7):432.
- Lai K, et al. Uridine alleviates sepsis-induced acute lung injury by inhibiting ferroptosis of macrophage. Int J Mol Sci. 2023;24(6):5093.
- Kumari R, Jat P. Mechanisms of cellular senescence: cell cycle arrest and senescence associated secretory phenotype. Front Cell Dev Biol. 2021;9:645593.
- Ogrodnik M, Salmonowicz H, Jurk D, Passos JF. Expansion and cell-cycle arrest: common denominators of cellular senescence. Trends Biochem Sci. 2019;44(12):996-1008.
- Kumar M, Seeger W, Voswinckel R. Senescence-associated secretory phenotype and its possible role in chronic obstructive pulmonary disease. Am J Respir Cell Mol Biol. 2014;51(3):323-33.
- Pérez-Rubio G, et al. Role of genetic susceptibility in nicotine addiction and chronic obstructive pulmonary disease. Rev Invest Clin. 2019;71(1):36-54.
- Liu Y, Wang R, Jiang T. RNA-binding proteins as a molecular link between COPD and pulmonary hypertension. Int J Med Sci. 2025;22(8):1979-91.
- Marques TM, Gama-Carvalho M. Network approaches to study endogenous RNA competition and its impact on tissue-specific microRNA functions. Biomolecules. 2022;12(2):332.
- Wang J, Xia B, Ma R, Ye Q. Comprehensive analysis of a competing endogenous RNA co-expression network in chronic obstructive pulmonary disease. Int J Chron Obstruct Pulmon Dis. 2023;18:2417-29.
- Zhang J, et al. Construction of a ceRNA network and screening of potential biomarkers and molecular targets in male smokers with chronic obstructive pulmonary disease. Front Genet. 2024;15:1376721.
- Celikoğlu F, Celikoğlu SI. Intratumoural chemotherapy with 5-fluorouracil for palliation of bronchial cancer in patients with severe airway obstruction. J Pharm Pharmacol. 2003;55(10):1441-8.
- Chan AK, Choo BA, Glaholm J. Pulmonary toxicity with oxaliplatin and capecitabine/5-fluorouracil chemotherapy: a case report and review of the literature. Onkologie. 2011;34(8-9):443-6.