Niniejszy protokół integruje wielowymiarowe dane transkryptomiczne z uczeniem maszynowym w celu identyfikacji genów związanych ze starzeniem i mitochondriami w kardiomiopatii rozstrzeniowej, co służy odkrywaniu biomarkerów i subtypowniu molekularnemu.
Artykuł badawczy
Identyfikacja genów węzłowych związanych ze starzeniem i mitochondriami w kardiomiopatii rozstrzeniowej
W tym artykule
Podsumowanie
Streszczenie
Kardiomiopatia rozstrzeniowa (DCM) charakteryzuje się rozszerzeniem lewej komory oraz dysfunkcją skurczową i jest powiązana z dysfunkcją mitochondriów oraz aktywacją immunologiczno-zapalną. Jednakże molekularne sygnatury związane ze starzeniem oraz mitochondrialne szlaki regulacyjne w DCM pozostają nie do końca poznane. W niniejszym badaniu przeanalizowano sześć zbiorów danych z transkryptomiki bulk oraz jeden zbiór danych z sekwencjonowania RNA pojedynczych komórek (scRNA-seq) z bazy danych Gene Expression Omnibus. Po normalizacji danych, korekcji efektu serii (batch correction) oraz adnotacji typów komórek, zidentyfikowano geny kandydujące związane ze starzeniem i mitochondriami, wykorzystując analizę różnicowej ekspresji, analizę ważonej sieci koekspresji genów (WGCNA) oraz konstrukcję sieci oddziaływań białko-białko. Geny kluczowe wyłoniono w dalszej kolejności za pomocą regresji LASSO (least absolute shrinkage and selection operator), lasów losowych (random forest) oraz rekurencyjnej eliminacji cech za pomocą maszyn wektorów nośnych (SVM-RFE). W celu charakterystyki immunologicznego mikrośrodowiska serca w DCM przeprowadzono analizy infiltracji komórek odpornościowych, komunikacji międzykomórkowej oraz podtypowania molekularnego. Łącznie z DCM powiązano 66 genów związanych ze starzeniem i 16 genów związanych z mitochondriami, które były głównie wzbogacone w szlak sygnałowy czynnika indukowanego hipoksją 1 (HIF-1), fosforylację oksydacyjną oraz szlaki związane z syntazą tlenku azotu. Analizy uczenia maszynowego i sekwencjonowania RNA pojedynczych komórek zidentyfikowały SERPINE1, TGFB2, CYBB i TLR2 jako geny kluczowe. CYBB i TLR2 wykazywały wysoką ekspresję w monocytach i makrofagach, podczas gdy SERPINE1 i TGFB2 były wyrażane głównie w komórkach zrębu. Analiza krajobrazu immunologicznego wykazała zwiększoną aktywację prozapalnych makrofagów oraz zmienioną komunikację międzykomórkową w próbkach DCM. Na podstawie ekspresji genów kluczowych próbki DCM podzielono na dwa podtypy molekularne, powiązane odpowiednio z szlakiem sygnałowym czynnika wzrostu śródbłonka naczyniowego (VEGF) oraz biosyntezą pierwotnych kwasów żółciowych. Niniejszy protokół zapewnia zintegrowane ramy dla identyfikacji potencjalnych biomarkerów i podtypów molekularnych w DCM.
Wprowadzenie
Kardiomiopatia rozstrzeniowa (DCM) jest zaburzeniem mięśnia sercowego charakteryzującym się rozszerzeniem lewej komory oraz upośledzeniem funkcji skurczowej. Jest to trzecia najczęstsza przyczyna niewydolności serca i główny powód wskazywany do transplantacji serca na całym świecie1. Badania populacyjne szacują rozpowszechnienie tej choroby na około 1 na 250 dorosłych, przy czym częściej występuje ona u mężczyzn, a znaczna część przypadków wynika z wariantów monogenicznych2. Wyniki te wskazują, że zarówno podatność genetyczna, jak i czynniki środowiskowe przyczyniają się do wystąpienia i progresji DCM.
Patogeneza DCM obejmuje wzajemnie powiązane procesy, w tym aktywację zapalną, stres oksydacyjny, apoptozę kardiomiocytów oraz rozregulowane sygnałowanie profibrotyczne. Polimorfizmy genetyczne związane ze stanem zapalnym, w tym warianty promotora czynnika martwicy nowotworu-α, powiązano z podatnością na wirusową postać DCM3. Zwiększony stres oksydacyjny skorelowano również ze śmiercią kardiomiocytów i dysfunkcją lewej komory w podtypach DCM u ludzi4. Ponadto aberracyjna aktywacja szlaków sygnałowych Wnt/β-catenin oraz kalcyneuryny/jądrowego czynnika aktywowanych limfocytów T promuje przerost mięśnia sercowego i włóknienie śródmiąższowe, przyczyniając się tym samym do progresji choroby5,6. Dysfunkcja mitochondriów jest kolejnym istotnym elementem DCM, ponieważ kardiomiocyty charakteryzują się wysokim zapotrzebowaniem energetycznym. Zaburzenia biogenezy mitochondriów, homeostazy wapnia, mitofagii oraz integralności mitochondrialnego DNA mogą upośledzać fosforylację oksydacyjną i przyczyniać się do postępującej dysfunkcji serca7,8,9,10.
Mimo tych odkryć mechanistycznych, nadal istnieją istotne luki w wiedzy. W szczególności nie zdefiniowano w pełni zależności czasowych i przyczynowych między strukturalnym przebudowaniem mitochondriów a dysfunkcją bioenergetyczną podczas inicjacji i progresji DCM11. Zbadano kilka strategii terapeutycznych. Terapia komórkami macierzystymi wykazała potencjał regeneracyjny poprzez efekty parakrynne, cytoprotekcyjne i immunomodulacyjne, jednak konieczna pozostaje optymalizacja źródeł komórek, dróg podania oraz przeżywalności po transplantacji12. Podejścia z zakresu terapii genowej, w tym dostarczanie oparte na wirusach adeno-zależnych oraz edycja genomu oparta na systemie CRISPR, oferują również potencjalne strategie precyzyjnego leczenia. Niemniej jednak ograniczenia związane z tropizmem kardiologicznym, immunogennością wektorów i długoterminowym bezpieczeństwem pozostają nierozwiązane13.
Publiczne zbiory danych transkryptomicznych z repozytoriów takich jak Gene Expression Omnibus (GEO) są powszechnie wykorzystywane do odkrywania biomarkerów w DCM. Zasoby te zapewniają dostęp do wieloośrodkowych kohort klinicznych, wspierają kosztowo efektywne i powtarzalne badania oraz mogą zwiększyć moc statystyczną poprzez integrację wielu zbiorów danych14. Profilowanie transkryptomiczne umożliwia również przesiewowe poszukiwanie genów kandydatów w całym genomie, subtypownie molekularne oraz analizę na poziomie szlaków sygnałowych15. Jednak publiczne zbiory danych mają swoje ograniczenia, w tym techniczne efekty serii (batch effects), heterogeniczność kliniczną i etiologiczną, ograniczoną możliwość wnioskowania przyczynowo-skutkowego oraz niepełne informacje podłużne lub prognostyczne16. W związku z tym wyniki uzyskane z publicznych zbiorów danych transkryptomicznych są najbardziej odpowiednie do generowania hipotez i priorytetyzacji potencjalnych biomarkerów i wymagają walidacji w niezależnych kohortach oraz modelach eksperymentalnych.
Wiele badań bioinformatycznych nad DCM opiera się głównie na analizie ekspresji różnicowej, która może generować wyniki fałszywie dodatnie i nie charakteryzuje w pełni sieci koekspresji genów ani heterogeniczności komórkowej w obrębie tkanki serca. Aby wyeliminować te ograniczenia, w niniejszym badaniu zastosowano zintegrowaną strategię analityczną łączącą metody komplementarne. Analiza transkryptomiczna bulk dostarcza profili ekspresji na poziomie tkanki, odpowiednich do porównań w układzie przypadek-kontrola. Analiza ważonej sieci koekspresji genów (WGCNA) identyfikuje moduły genowe związane z cechami fenotypowymi i umożliwia priorytetyzację funkcjonalnie powiązanych zestawów genów, a nie pojedynczych genów o różnej ekspresji. Analiza sieci interakcji białko-białko (PPI) identyfikuje geny o wysokim stopniu połączeń na podstawie topologii sieci. Trzy algorytmy uczenia maszynowego — regresja LASSO (least absolute shrinkage and selection operator), lasy losowe (random forest) oraz rekurencyjna eliminacja cech z wykorzystaniem maszyn wektorów wspierających (SVM-RFE) — zostały użyte do identyfikacji potencjalnych biomarkerów w zintegrowanych zbiorach danych¹⁷. Następnie wykorzystano sekwencjonowanie RNA pojedynczych komórek (scRNA-seq) do zbadania wzorców ekspresji specyficznych dla typów komórek oraz sieci komunikacji międzykomórkowej18.
Choć dysfunkcja mitochondriów oraz związane ze starzeniem zmiany molekularne były badane osobno w kontekście DCM, ich wspólne powiązania ze zmianami transkrypcyjnymi związanymi z chorobą pozostają niedostatecznie poznane. W niniejszym badaniu zintegrowano wiele zbiorów danych z sekwencjonowania transkryptomu bulk oraz scRNA-seq, aby zidentyfikować geny hub związane ze starzeniem i mitochondriami w DCM, scharakteryzować immunologiczne mikrośrodowisko serca oraz zbadać podtypy molekularne w oparciu o zidentyfikowane geny. To zintegrowane podejście zostało wykorzystane do wyłonienia priorytetowych potencjalnych biomarkerów i zapewnienia podstawy dla późniejszych badań mechanistycznych i walidacyjnych.
Protokół
Wszystkie procedury dotyczące zwierząt zostały przeanalizowane i zatwierdzone przez Komitet Etyki Doświadczeń na Zwierzętach Drugiego Szpitala Afiliacyjnego Uniwersytetu Medycyny Chińskiej w Henan (numer zatwierdzenia HNSZYYYJS2023011150). Wszystkie procedury przeprowadzono zgodnie z Wytycznymi dotyczącymi etycznej oceny dobrostanu zwierząt laboratoryjnych (GB/T 35892-2018) oraz zasadami 3R: zastępowania (Replacement), ograniczania (Reduction) i udoskonalania (Refinement). Odczynniki, bazy danych, oprogramowanie i sprzęt użyte w niniejszym badaniu są wymienione w Tabeli materiałów.
1. Zasoby danych i materiały eksperymentalne
Jako grupę modelową wykorzystano samce transgenicznych myszy CTNTR141W klasy SPF o fenotypie spontanicznej kardiomiopatii rozstrzeniowej (DCM) i masie ciała 25 ± 2 g. Jako grupę kontrolną wykorzystano samce myszy C57BL/6J klasy SPF w tym samym wieku i o masie ciała 25 ± 2 g. Każda grupa składała się z 12 myszy. Wszystkie zwierzęta pozyskano z instytucji posiadających aktualne licencje na produkcję zwierząt laboratoryjnych i przetrzymywano w środowisku barierowym klasy SPF w temperaturze 22 ± 2 °C i wilgotności względnej 40%–60% przy 12-godzinnym cyklu światło/ciemność, z wolnym dostępem do sterylizowanej karmy i wody. Po 1 tygodniu aklimatyzacji wszystkie myszy utrzymywano w tych samych warunkach przez kolejne 4 tygodnie przed oceną funkcji serca i pobraniem próbek. Na początku eksperymentu wszystkie myszy miały od 6 do 8 tygodni. Myszy poddano głębokiej anestezji, a następnie uśmiercono poprzez zwichnięcie stawów szyjnych.
Z bazy danych Gene Expression Omnibus (GEO)19 pobrano siedem publicznych zbiorów danych transkryptomicznych z tkanki mięśnia lewej komory pacjentów z DCM. Zbiory te obejmowały sześć zbiorów transkryptomicznych typu bulk oraz jeden zbiór sekwencjonowania RNA pojedynczych komórek (scRNA-seq), GSE145154. W analizie uwzględniono frakcje CD45-dodatnie oraz CD45-ujemne. Obie frakcje komórek, CD45-dodatnie i CD45-ujemne, połączono przed klastrowaniem. Tożsamość próbki wykorzystano jako główną zmienną wsadową (batch variable) dla integracji metodą Harmony. Do analizy włączono próbki lewej komory zdrowej oraz lewej komory z DCM z zestawu GSE145154, a konkretnie: GSM4307515, GSM4307516, GSM4307520 i GSM4307521. Zbiory danych wykorzystane w niniejszym badaniu to GSE145154, GSE5406, GSE42955, GSE57338, GSE79962, GSE116250 oraz GSE141910. Wykluczono wszystkie próbki inne niż DCM, pozostawiając jedynie próbki kontrolne (grupa Control) i próbki DCM (grupa DCM). Po kontroli jakości żadne próbki nie zostały usunięte. Informacje o próbkach z włączonych zbiorów GEO przedstawiają się następująco: GSE5406 zawierał 102 próbki (16 kontrolnych i 86 próbek DCM); GSE42955 zawierał 17 próbek (5 kontrolnych i 12 próbek DCM); GSE57338 zawierał 231 próbek (136 kontrolnych i 95 próbek DCM); GSE79962 zawierał 20 próbek (11 kontrolnych i 9 próbek DCM); GSE116250 zawierał 51 próbek (14 kontrolnych i 37 próbek DCM); a GSE141910 zawierał 322 próbki (161 kontrolnych i 161 próbek DCM).
2. Wstępne przetwarzanie danych transkryptomicznych z próbek zbiorczych
Surowe macierze ekspresji oraz pliki z adnotacjami klinicznymi dla sześciu zbiorów danych zbiorczych pobrano przy użyciu pakietu GEOquery20. Dla zbiorów danych z mikromacierzy Affymetrix pobrano surowe pliki CEL, a dla zbiorów danych RNA-seq pobrano surowe macierze zliczeń. Korekcję tła, normalizację kwantylową oraz obliczenia ekspresji dla danych z mikromacierzy przeprowadzono przy użyciu algorytmu robust multi-array average zaimplementowanego w pakiecie affy21.
Dane zliczeń RNA-seq zostały znormalizowane metodą przyciętej średniej wartości M (trimmed mean of M-values) w pakiecie edgeR22 i przekształcone w wartości log₂-transformowanych zliczeń na milion (counts per million). Identyfikatory sond zostały zamienione na oficjalne symbole genów przy użyciu plików adnotacji specyficznych dla danej platformy. W przypadku przypisania wielu sond do tego samego genu obliczano średnią wartość ekspresji.
Techniczne efekty serii między zbiorami danych usunięto za pomocą algorytmu ComBat w pakiecie sva23. Źródło zbioru danych oraz platformę detekcji określono jako czynniki serii. Przed i po korekcie efektów serii przeprowadzono analizę głównych składowych, aby ocenić skuteczność usuwania tych efektów.
3. Wstępne przetwarzanie danych transkryptomicznych pojedynczych komórek i adnotacja komórek
Macierz ekspresji genów z GSE145154 została zaimportowana do oprogramowania Seurat w celu utworzenia obiektu Seurat przy użyciu wersji Seurat 524. Komórki niskiej jakości wykluczono, stosując następujące progi: od 200 do 6 000 wykrytych genów na komórkę, całkowita liczba unikalnych identyfikatorów molekularnych (UMI) powyżej 500 oraz odsetek genów mitochondrialnych poniżej 25%. Komórki wykraczające poza te progi kontroli jakości zostały odrzucone jako komórki niskiej jakości lub uszkodzone. Wykluczanie komórek niskiej jakości przeprowadzono wyłącznie w oparciu o opisane powyżej progi kontroli jakości.
Normalizację logarytmiczną przeprowadzono przy użyciu funkcji NormalizeData z czynnikiem skalowania wynoszącym 10 000. Wybrano 3 000 najbardziej zmiennych genów za pomocą funkcji FindVariableFeatures z zastosowaniem metody vst. Dane zostały przeskalowane za pomocą ScaleData, a następnie przeprowadzono analizę głównych składowych w celu liniowej redukcji wymiarowości.
Efekty serii korygowano za pomocą algorytmu Harmony25 przy użyciu funkcji RunHarmony, określając tożsamość próbek jako zmienną grupującą. Do klastrowania komórek za pomocą funkcji FindNeighbors i FindClusters wykorzystano pierwsze 15 głównych składowych. Klastrowanie przeprowadzono przy użyciu algorytmu Leiden przy rozdzielczości 0,15. Nieliniowa redukcja wymiarowości oraz wizualizacja zostały wykonane za pomocą metody przybliżonej i rzutowanej jednorodnej rozmaitości (UMAP).
Typy komórek zostały opisane przy użyciu kanonicznych genów markerowych oraz zautomatyzowanej adnotacji z wykorzystaniem pakietu SingleR26. Geny markerowe były następujące: limfocyty B, IGKC, MS4A1 oraz CD79A; kardiomiocyty, TNNI3, MYL2 oraz ACTC1; komórki śródbłonka, VWF, PECAM1 oraz EGFL7; makrofagi, C1QC, C1QB oraz C1QA; monocyty, S100A8, S100A9 oraz G0S2; komórki NK, NKG7, GNLY oraz CCL5; komórki mięśni gładkich, MYL9, TAGLN oraz ACTA2; komórki stromalne, FBLN1, LUM oraz DCN; i limfocyty T, CD3E, CD3G oraz CD3D.
4. Analiza ekspresji różnicowej i punktacja wzbogacenia zestawów genów
Przy użyciu pakietu limma27 skonstruowano model liniowy w celu porównania ekspresji genów między grupą DCM a grupą kontrolną zdrowych osobników. Za istotnie różnicujące się uznano geny o wartości P < 0,05 i bezwzględnej zmianie krotności (fold change) większej niż 1,5, co odpowiada bezwzględnej wartości log₂ fold change większej niż 0,58.
Przeprowadzono analizę wzbogacenia zestawów genów dla pojedynczych próbek (single-sample gene set enrichment analysis), aby obliczyć wyniki wzbogacenia dla zestawów genów związanych ze starzeniem oraz mitochondriami w każdej próbce28. Różnice w wynikach wzbogacenia pomiędzy grupą DCM a grupą zdrowej kontroli oceniono za pomocą testu sum rang Wilcoxona, przyjmując wartość P < 0,05 za statystycznie istotną.
Na poziomie pojedynczych komórek wartości punktowe modułów związanych ze starzeniem oraz mitochondrialnych obliczono za pomocą funkcji AddModuleScore w pakiecie Seurat. Różnice w wartościach punktowych modułów między grupami oceniono przy użyciu testu suma rang Wilcoxona.
Sygnatury genowe związane ze starzeniem pobrano z bazy danych CellAge (https://genomics.senescence.info/cells/), a zestawy genów związanych z mitochondriami uzyskano z GeneCards (https://www.genecards.org/). Pełne listy genów wykorzystane do punktacji znajdują się w Pliku uzupełniającym 1.
5. Konstrukcja ważonej sieci koekspresji genów
Do konstrukcji sieci wybrano 5000 genów kodujących białka o najwyższej wariancji ekspresji w danych transkrypomicznych z całej tkanki. Funkcję pickSoftThreshold zastosowano do obliczenia indeksu dopasowania topologii bezskalowej dla wielu potęg progu miękkiego. Optymalny próg określono jako minimalną potęgę, która pozwala uzyskać sieć bezskalową z wartością R2 powyżej 0,9. W związku z tym do dalszych analiz sieciowych przyjęto potęgę progu miękkiego β = 5.
Podpisana ważona sieć koekspresji została skonstruowana przy użyciu funkcji blockwiseModules z minimalną wielkością modułu wynoszącą 30. Współczynniki korelacji Pearsona obliczono pomiędzy eigengenem każdego modułu a wynikiem wzbogacenia związanym ze starzeniem lub mitochondriami. Moduły o bezwzględnym współczynniku korelacji większym niż 0,4 i P < 0,001 uznano za moduły istotnie powiązane.
Geny w ramach modułów wykazujących istotne powiązania poddano analizie przecięcia z genami o różnym poziomie ekspresji, aby zidentyfikować geny kandydackie związane ze starzeniem w przebiegu DCM oraz geny kandydackie związane z mitochondriami w przebiegu DCM.
6. Analiza wzbogacenia funkcjonalnego
Analizy wzbogacenia funkcjonalnego, w tym analizy ontologii genów (GO) oraz ścieżek z bazy Kyoto Encyclopedia of Genes and Genomes (KEGG), przeprowadzono dla genów kandydackich przy użyciu pakietu clusterProfiler29. Wzbogacenie GO obejmowało trzy standardowe kategorie: proces biologiczny, komponent komórkowy oraz funkcję molekularną.
Wszystkie analizy przeprowadzono z wykorzystaniem adnotacji dla gatunku ludzkiego, stosując stopień fałszywych odkryć (FDR) do korekty wartości P oraz próg wartości q wynoszący 0,05. Zbiory genów ograniczono do zakresu wielkości od 10 do 500 genów, a terminy z FDR < 0,05 zdefiniowano jako istotne statystycznie. Na koniec wyniki wzbogacenia GO zwizualizowano za pomocą zgrupowanych wykresów słupkowych, natomiast wyniki wzbogacenia KEGG przedstawiono na wykresach bąbelkowych.
7. Konstrukcja sieci PPI i przesiewanie genów hubowych
Kandydackie geny wprowadzono do bazy danych STRING w wersji 11.530, ustawiając organizm na Homo sapiens oraz próg ufności interakcji na łączny wynik większy niż 0,7. Odłączone węzły zostały ukryte, a dane dotyczące interakcji wyeksportowano w formacie wartości rozdzielanych tabulatorem.
Dane dotyczące oddziaływań zostały zaimportowane do programu Cytoscape w wersji 3.9.1 w celu wizualizacji31. Wyniki topologiczne węzłów obliczono za pomocą wtyczki CytoHubba32, stosując trzy algorytmy: stopień (Degree), maksymalny komponent sąsiedztwa (maximum neighborhood component) oraz centralność maksymalnej kliki (maximal clique centrality).
Podstawowe moduły funkcjonalne w obrębie sieci zidentyfikowano za pomocą wtyczki MCODE33, stosując następujące parametry domyślne: próg stopnia (degree cutoff), 2; k-core, 2; próg oceny węzła (node score cutoff), 0,2 oraz maksymalna głębokość, 100. Geny sklasyfikowane w pierwszej dziesiątce przez wszystkie trzy algorytmy topologiczne zestawiono z genami w rdzeniowej podsieci MCODE, aby wyłonić końcowe geny stanowiące centra (huby) oddziaływań białko-białko.
8. Wybór genów kluczowych w oparciu o uczenie maszynowe i budowa modelu diagnostycznego
Aby zapewnić powtarzalność i zrównoważoną reprezentację, zintegrowany zbiór danych transkryptomicznych bulk podzielono losowo na zbiory treningowy i walidacyjny w stosunku 7:3, stosując stały ziarno losowości (seed = 123456). Podział ten był stratyfikowany według grupy chorobowej (DCM vs. kontrolna), aby zachować spójne proporcje klas w obu zbiorach. Przed podziałem skorygowano efekty serii z różnych źródeł danych za pomocą pakietu sva, a zintegrowane próbki traktowano jako jednolita kohorta podczas losowej alokacji.
Zastosowano trzy algorytmy uczenia maszynowego w celu przesiewowego wyboru genów kandydackich. W pierwszej kolejności przeprowadzono regresję logistyczną LASSO poprzez funkcja cv.glmnet w pakiecie glmnet34Zbudowano model klasyfikacji binarnej z 5-krotną walidacją krzyżową, przyjmując AUC jako metrykę oceny. Geny z niezerowymi współczynnikami przy wartości lambda.min zostały wyselekcjonowane jako geny kandydackie.
Po drugie, z wykorzystaniem pakietu randomForest35 zbudowano model klasyfikacji lasów losowych składający się z 500 drzew decyzyjnych. Liczbę zmiennych próbkowanych dla każdego podziału ustawiono jako pierwiastek kwadratowy całkowitej liczby cech. Istotność genów określono na podstawie współczynnika Giniego, a do dalszej analizy wybrano 10 genów o najwyższych wskaźnikach istotności.
Po trzecie, analizę SVM-RFE przeprowadzono przy użyciu funkcji rfe z pakietu caret36. Liczbę cech ustawiono w zakresie od 1 do 10, a do trenowania modelu zastosowano 5-krotną walidację krzyżową. Ostatecznie wybrano podzbiór genów z optymalną dokładnością walidacji krzyżowej.
Geny zidentyfikowane przez wszystkie trzy algorytmy zdefiniowano jako ostateczne rdzeniowe geny związane ze starzeniem i mitochondriami w DCM. Następnie skonstruowano modele diagnostyczne z wykorzystaniem 10 algorytmów klasyfikacji: drzewa decyzyjnego, maszyny gradient boosting, wzmocnionego uogólnionego modelu liniowego, k-najbliższych sąsiadów, regresji logistycznej, sieci neuronowej, cząstkowych najmniejszych kwadratów, lasu losowego, maszyny wektorów nośnych oraz ekstremalnego gradient boostingu.
Krzywe charakterystyki operacyjnej odbiornika (ROC) zostały wygenerowane przy użyciu pakietu pROC37. Aby ocenić wydajność diagnostyczną w zestawach treningowym i walidacyjnym, obliczono pole pod krzywą (AUC), dokładność, czułość oraz swoistość.
Przeprowadzono analizę SHapley Additive exPlanations w celu obliczenia wkładu każdego z głównych genów w przewidywania modelu38. Wygenerowano wykresy podsumowujące oraz wykresy wodospadowe dla każdej próbki. Przyjęto, że ostateczny model diagnostyczny z polem pod krzywą większym niż 0,8 w zbiorze walidacyjnym wykazuje dobrą wydajność diagnostyczną.
9. Wnioskowanie o komunikacji międzykomórkowej
Sieci komunikacji międzykomórkowej w mikrośrodowisku serca wywnioskowano przy użyciu pakietu CellChat39. Obiekt CellChat skonstruowano w oparciu o bazę danych CellChatDB.human. Ligandy i receptory wykazujące różnicową ekspresję zidentyfikowano za pomocą funkcji identifyOverExpressedGenes, a istotne pary interakcji odfiltrowano przy użyciu funkcji identifyOverExpressedInteractions.
Prawdopodobieństwa komunikacji między typami komórek obliczono przy użyciu funkcji computeCommunProb. Globalna sieć komunikacji na poziomie typów komórek została zagregowana za pomocą aggregateNet. Liczbę interakcji oraz siłę komunikacji między każdą parą typów komórek określono ilościowo i zwizualizowano za pomocą map ciepła oraz wykresów słupkowych.
10. Kwantyfikacja infiltracji komórek odpornościowych
Wskaźniki wzbogacenia dla 28 typów komórek odpornościowych obliczono dla każdej próbki zbiorczej (bulk), wykorzystując analizę wzbogacenia zestawów genów w pojedynczej próbce (single-sample gene set enrichment analysis)28 oraz zestaw genów sygnatury komórek odpornościowych40. Do porównania wskaźników wzbogacenia komórek odpornościowych pomiędzy grupą DCM a grupą zdrowej kontroli zastosowano test suma rang Wilcoxona. Za statystycznie istotne uznano wyniki P < 0,05.
Przeprowadzono analizę korelacji Pearsona w celu oceny związku między poziomami ekspresji genów kluczowych a wynikami wzbogacenia komórek odpornościowych. Wszystkie korelacje z P < 0,05 uznano za istotne statystycznie.
11. Grupowanie konsensusowe w celu podtypowania molekularnego
Nadzorowane grupowanie konsensusowe próbek DCM zostało przeprowadzone na podstawie profili ekspresji genów kluczowych za pomocą pakietu ConsensusClusterPlus41. Parametry grupowania ustawiono na maksymalną liczbę 6 klastrów, 1000 iteracji ponownego próbkowania oraz proporcję ponownego próbkowania wynoszącą 0.8. Do grupowania zastosowano metodę PAM (Partitioning Around Medoids) z wykorzystaniem odległości euklidesowej, a w celu zapewnienia powtarzalności wyników użyto stałego ziarna generatora liczb losowych.
Optymalną liczbę podtypów określono na podstawie wykresu delta area oraz wyników stabilności klastrów konsensusowych, ostatecznie identyfikując K = 2. Następnie przeprowadzono analizę głównych składowych, aby potwierdzić wyraźne rozdzielenie dwóch podtypów molekularnych.
W celu obliczenia wyników wzbogacenia ścieżek KEGG dla poszczególnych próbek zastosowano analizę wariancji zestawów genów (gene set variation analysis)42. Do wykrywania różnic w aktywacji ścieżek między podtypami wykorzystano pakiet limma27, a za statystycznie istotne uznano wartości P mniejsze niż 0,05.
12. Echokardiograficzna ocena funkcji serca
Myszy znieczulono poprzez wykonano dostryk peritonealny 1% pentobarbitalu sodowego (30 mg/kg), a zwierzę unieruchomiono w pozycji grzbietnej na termostatycznym stole operacyjnym. Po usunięciu owłosienia klatki piersiowej w obszarze przedsercowym równomiernie nanesiono żel do badań ultrasonograficznych.
Echokardiografię w trybie M sterowaną obrazowaniem dwuwymiarowym przeprowadzono na poziomie mięśni brodawkowatych lewej komory przy użyciu systemu ultrasonograficznego dla małych zwierząt. Przechwycono trzy kolejne stabilne cykle serca w celu pomiaru końcowego rozkurczowego średnicy lewej komory, końcowej skurczowej średnicy, frakcji wyrzutowej oraz skracania frakcyjnego. Wszystkie oceny echokardiograficzne zostały przeprowadzone w sposób zaślepiony przez profesjonalnego ultrasonografistę.
Z każdej grupy losowo wybrano trzy myszy do badania echokardiograficznego, a następnie te 6 zwierząt łącznie uśmiercono w celu pobrania tkanki mięśnia sercowego i przeprowadzenia pomiarów metodą ELISA. Pozostałe zwierzęta doświadczalne poddano dodatkowym równoległym analizom laboratoryjnym, a ich dane nie zostały uwzględnione w niniejszym badaniu.
13. Pobieranie tkanki mięśnia sercowego, ekstrakcja białek i test immunoenzymatyczny (ELISA)
Po ocenie echokardiograficznej myszy uśmiercono w głębokiej narkozie. Następnie szybko pobrano tkanki serca. poprzez wykonano medianową torakotomię, a następnie wypreparowano mięsień lewej komory serca w warunkach chłodzenia na lodzie. Wyizolowane tkanki dokładnie przemyto lodowatym roztworem soli fizjologicznej w buforze fosforanowym, aby usunąć pozostałości krwi wewnątrzsercowej. Po odsączeniu nadmiaru płynu jałowym papierem filtracyjnym próbki natychmiast zamrożono w ciekłym azocie i przechowywano w temperaturze −80 °C do późniejszej ekstrakcji białek, przy ścisłym unikaniu wielokrotnych cykli zamrażania i rozmrażania.
Zamrożone tkanki mięśnia sercowego zważono i pocięto na lodzie na fragmenty o wielkości około 1 mm3. Tkanki poddano lizie w lodowatym buforze lizującym RIPA zawierającym inhibitory proteaz i fosfataz w zestandaryzowanym stosunku 100 µL buforu na 10 mg tkanki. Próbki w pełni zhomogenizowano mechanicznie na lodzie i inkubowano przez 30 min, aby uzyskać całkowitą lizę komórek.
Lizaty wirowano przy 12,000 × g przez 15 min w temperaturze 4 °C. Powstałe nadsączki zebrano do probówek wolnych od enzymów, a całkowite stężenie białka określono za pomocą zestawu do oznaczania białek kwasem bicinchononowym zgodnie z protokołami producenta. Wszystkie próbki znormalizowano do identycznego stężenia białka przy użyciu buforu do lizy.
Poziomy ekspresji białek czterech genów hub w lizatach mięśnia sercowego zmierzono przy użyciu odpowiednich zestawów do testu immunoenzymatycznego (ELISA). Seryjnie rozcieńczone wzorce oraz znormalizowane lizaty tkankowe naniesiono w duplikacie (100 µL na dołek) na wcześniej powlekone mikropłytki. Płytki inkubowano przez 2 h w temperaturze pokojowej, a następnie dokładnie przemyto buforem do mycia dołączonym do zestawu.
Do każdego dołka dodano przeciwciało sprzężone z enzymem i inkubowano przez 1 h w temperaturze pokojowej, a następnie przeprowadzono dokładne przemycie. Następnie dodano roztwór chromogenu substratu, a płytki inkubowano przez 20 min w temperaturze pokojowej w ciemności. Reakcję barwną przerwano za pomocą roztworu stopującego, a wartości absorbancji zmierzono przy 450 nm (długość fali referencyjnej: 570 nm) przy użyciu pełnofalowego czytnika mikropłytek.
14. Analiza statystyczna
Wszystkie analizy statystyczne oraz wizualizacje danych wykonano przy użyciu programu R w wersji 4.2.3. W przypadku pomiarów stężeń metodą ELISA dla każdego genu docelowego (TGFB2, SERPINE1, CYBB, TLR2), w pierwszej kolejności zastosowano test Shapiro-Wilka w celu oceny normalności rozkładu danych osobno w grupie kontrolnej (Control) i grupie z DCM. Następnie użyto testu F do oceny jednorodności wariancji pomiędzy obiema grupami. Metodę porównania międzygrupowego określono na podstawie wyników testu jednorodności wariancji: jeśli wariancje były jednorodne (P ≥ 0.05), do porównania wartości średnich między grupami zastosowano nieparzysty test t Studenta; jeśli wariancje były niejednorodne (P < 0.05), do analizy wykorzystano poprawiony test t Welcha. Wszystkie testy były dwustronne, a próg istotności statystycznej ustalono na poziomie P < 0.05. Dane przedstawiono w formie wykresów pudełkowych z nałożonymi rozproszonymi punktami danych indywidualnych. Wartości P dla wszystkich testów oraz rodzaj zastosowanego testu t zostały szczegółowo opisane na każdym wykresie.
Wyniki
Preprocessing danych i analiza różnicowej ekspresji
Wszystkie sześć zbiorów danych transkryptomicznych poddano standaryzowanemu preprocessingowi oraz korekcie efektu seryjnego przed analizą końcową. Dane z mikromacierzy znormalizowano przy użyciu algorytmu robust multi-array average, natomiast dane liczbowe z RNA-seq znormalizowano metodą trimmed mean of M-values. Zastosowano algorytm ComBat w celu usunięcia technicznych efektów seryjnych związanych z pochodzeniem zbioru danych i platformą detekcji. Analiza głównych składowych wykazała, że przed korektą próbki grupowały się według źródła zbioru danych, natomiast po korekcie były rozłożone bardziej równomiernie, bez widocznego podziału na serie.
Analizę różnicowej ekspresji między grupą z rozstrzeniową kardiomiopatią (DCM) a grupą kontrolną (HC) przeprowadzono przy użyciu pakietu limma. Mapa ciepła 20 genów o najbardziej znaczącej różnicy w ekspresji wykazała rozdzielenie profili ekspresji pomiędzy dwiema grupami (Rysunek 1A). Łącznie zidentyfikowano 1 473 geny różnicowo eksponowane, stosując progi wartości P < 0,05 oraz |log₂ fold change| > 0,58. Wśród nich 819 genów wykazywało nadekspresję, a 654 obniżoną ekspresję w próbkach mięśnia sercowego z DCM (Rysunek 1B).
Następnie przeprowadzono analizę wzbogacenia zestawów genów dla pojedynczych próbek (GSEA), aby obliczyć wyniki wzbogacenia dla zestawów genów związanych ze starzeniem oraz z mitochondriami w każdej próbce. Oba wyniki różniły się istotnie pomiędzy grupą DCM a grupą HC (Rysunek 1C).
Ważona analiza sieci współekspresji genów
Ważoną analizę sieci współekspresji genów przeprowadzono w celu zidentyfikowania modułów genowych powiązanych z wynikami wzbogacenia dla starzenia oraz dla mitochondriów. Do konstrukcji sieci wykorzystano 5 0 genów kodujących białka o najwyższej wariancji ekspresji w zbiorze danych bulk. Przy mocy miękkiego progowania β = 5 wskaźnik dopasowania topologii bezskalowej przekroczył R2 = 0,9, spełniając kryterium sieci bezskalowej (Rycina 1D).
Grupowanie hierarchiczne i łączenie modułów pozwoliły zidentyfikować trzy moduły genów. Wszystkie trzy moduły były istotnie skorelowane z wynikiem związanym ze starzeniem. Moduł turkusowy wykazał najsilniejszą korelację z wynikiem związanym ze starzeniem (r = 0.69, P < 0.001). W przypadku wyniku mitochondrialnego istotnie skorelowane były moduły niebieski i szary, przy czym moduł niebieski wykazał najsilniejszy związek (r = 0.56, P < 0.01; Rycina 1E). W związku z tym do przesiewu genów związanych ze starzeniem wybrano moduł turkusowy, a do przesiewu genów związanych z mitochondriami wybrano moduł niebieski.
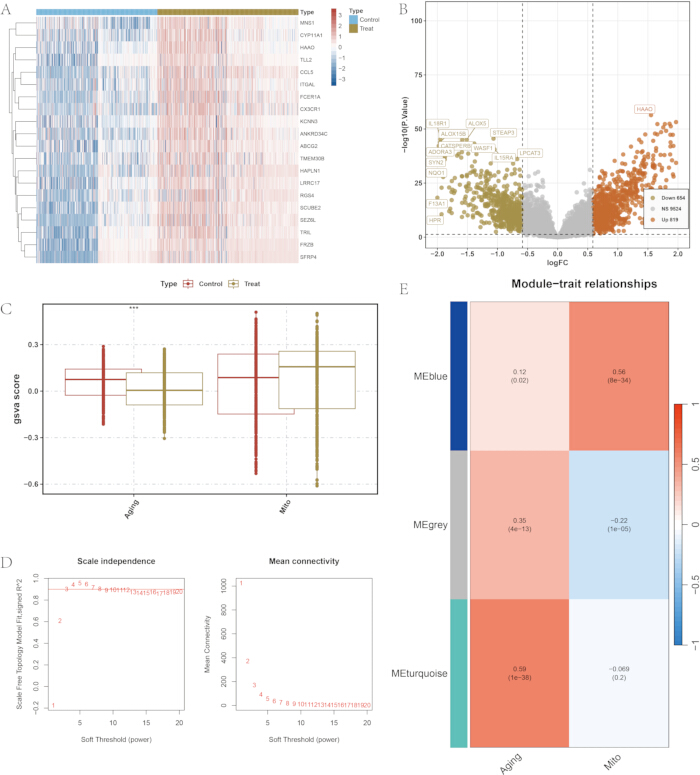
Rycina 1Analiza różnicowej ekspresji oraz konstrukcja ważonej sieci współekspresji genów. (A) Mapa ciepła 20 genów o najistotniejszej różnicy w ekspresji pomiędzy grupą z rozszerzoną kardiomiopatią (DCM) a grupą kontrolną (HC). (B) Wykres wulkaniczny (volcano plot) wszystkich genów różnicowo wyrażonych. Kolor czerwony oznacza geny o zwiększonej ekspresji, zielony geny o zmniejszonej ekspresji, a szary geny nieistotne statystycznie. Progi wartości P wyniosły < 0,05 oraz |log₂ fold change| > 0.58. (C) Wykresy pudełkowe wyników analizy wzbogacenia zbiorów genów dla pojedynczych próbek dla zbiorów genów związanych ze starzeniem oraz związanych z mitochondriami. (D) Wybór miękkiego progu dla ważonej analizy sieci koekspresji genów, przedstawiający indeks dopasowania topologii bezskalowej oraz średnią łączność dla różnych potęg miękkiego progowania. (E) Mapa ciepła korelacji między eigengenami modułów a wskaźnikami związanymi ze starzeniem i mitochondrialnymi. Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
Identyfikacja genów kandydackich powiązanych ze starzeniem i mitochondriami
Geny kandydackie zidentyfikowano poprzez wyznaczenie części wspólnej dla genów o różnej ekspresji, genów w wybranych modułach analizy sieci współekspresji genów z przypisanymi wagami oraz odpowiadających im referencyjnych zestawów genów. Analiza ta pozwoliła na zidentyfikowanie 6 genów kandydackich związanych ze starzeniem w przebiegu DCM (Rysunek 2A) oraz 16 genów kandydackich związanych z mitochondriami w przebiegu DCM (Rysunek 2B).
Analiza wzbogacenia Gene Ontology wykazała, że geny kandydackie związane ze starzeniem były wzbogacone w procesy biologiczne, w tym biosyntezętlenku azotu oraz organizację macierzy pozakomórkowej zawierającej kolagen (Rysunek 2C). Geny kandydackie związane z mitochondriami były wzbogacone w terminy powiązane z mitochondrialnym metabolizmem energetycznym, w tym z wewnętrzną błoną mitochondrialną i kompleksami łańcucha oddechowego (Rysunek 2D).
Analiza w Kyoto Encyclopedia of Genes and Genomes wykazała, że geny kandydackie związane ze starzeniem były wzbogacone w szlaki sygnałowe czynnika indukowanego hipoksją-1, kinazy 3-fosfoinosytydowej-kinazy białkowej B oraz końcowych produktów zaawansowanej glikacji-receptora dla końcowych produktów zaawansowanej glikacji (Rysunek 2E). Geny kandydackie związane z mitochondriami były wzbogacone w szlaki obejmujące fosforylację oksydacyjną (Rysunek 2F).
Wzorce różnicowej ekspresji 6 genów kandydatów związanych ze starzeniem pomiędzy grupą DCM a grupą HC zwizualizowano za pomocą mapy ciepła ekspresji (Rycina 2G). Wzorce ekspresji 16 genów kandydatów związanych z mitochondriami zwizualizowano za pomocą wykresów pudełkowych (Rycina 2H).
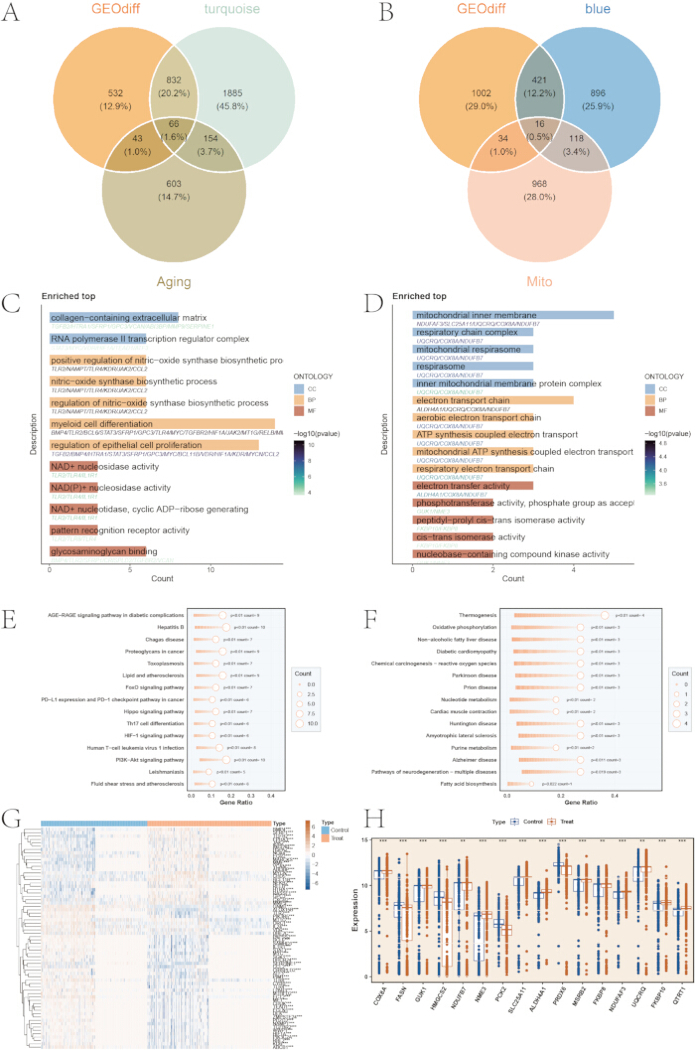
Rycina 2Przesiewowe wyselekcjonowanie i wzbogacenie funkcjonalne genów kandydackich. (A) Diagram Venna przedstawiający część wspólną genów o różnej ekspresji, genów z modułów analizy ważonej sieci koekspresji genów oraz referencyjnego zestawu genów związanych ze starzeniem. (B) Diagram Venna przedstawiający część wspólną dla genów o różnej ekspresji, genów z modułu analizy sieci współekspresji genów z wagami oraz zestawu referencyjnego genów związanych z mitochondriami. (C) Analiza wzbogacenia Ontologii Genów dla genów kandydackich związanych ze starzeniem. (D) Analiza wzbogacenia Gene Ontology dla genów kandydackich związanych z mitochondriami. (E) analiza wzbogacenia ścieżek Kyoto Encyclopedia of Genes and Genomes dla genów kandydackich związanych ze starzeniem. (F) analiza wzbogacenia szlaków Kyoto Encyclopedia of Genes and Genomes dla genów kandydackich związanych z mitochondriami. (G) Mapa ciepła ekspresji 6 kandydackich genów związanych ze starzeniem w grupach DCM i HC. (H) Wykresy pudełkowe ekspresji 16 genów kandydackich związanych z mitochondriami w grupach DCM i HC. Aby wyświetlić powiększoną wersję tej figury, kliknij tutaj.
Adnotacja typów komórek w zbiorze danych sekwencjonowania RNA pojedynczych komórek
Zbiór danych sekwencjonowania RNA pojedynczych komórek GSE145154 został wykorzystany do walidacji w rozdzielczości pojedynczych komórek. Po filtrowaniu kontroli jakości, normalizacji logarytmicznej i korekcie efektu serii metodą Harmony, komórki z różnych próbek zostały rozłożone w przestrzeni aproksymacji i projekcji rozmaitości jednostkowej (UMAP) bez widocznego rozdzielenia specyficznego dla próbek. Wykorzystując 15 pierwszych głównych składowych oraz rozdzielczość klastrowania wynoszącą 0,15, komórki podzielono na 9 klastrów (Rycina 3A).
Kanoniczne geny markerowe i automatyczna adnotacja z wykorzystaniem SingleR pozwoliły zidentyfikować 9 głównych typów komórek: makrofagi, komórki NK, limfocyty T, limfocyty B, komórki śródbłonka, komórki mięśni gładkich, monocyty, komórki zrębowe oraz kardiomiocyty (Rycina 3B). Wzorce ekspresji specyficznych dla typów komórek genów markerowych potwierdziły te adnotacje (Rycina 3C).
Wyniki modułu mitochondrialnego obliczono dla każdej komórki przy użyciu funkcji AddModuleScore, a różnice między grupą z kardiomiopatią rozszerzeniową a grupą kontrolną osób zdrowych były istotne statystycznie (P < 2.2 × 10⁻16; Rysunek 3D). Wyniki modułu związanego ze starzeniem również różniły się istotnie między obiema grupami (P < 2.2 × 10⁻16; Rysunek 3E). Projekcja wyników mitochondrialnych na przestrzeń aproksymacji i projekcji rozmaitości jednorodnej (UMAP) wykazała, że wysokie wyniki obserwowano głównie w kardiomiocytach (Rysunek 3F). W przeciwieństwie do tego, wysokie wyniki związane ze starzeniem obserwowano przede wszystkim w makrofagach (Rysunek 3G).
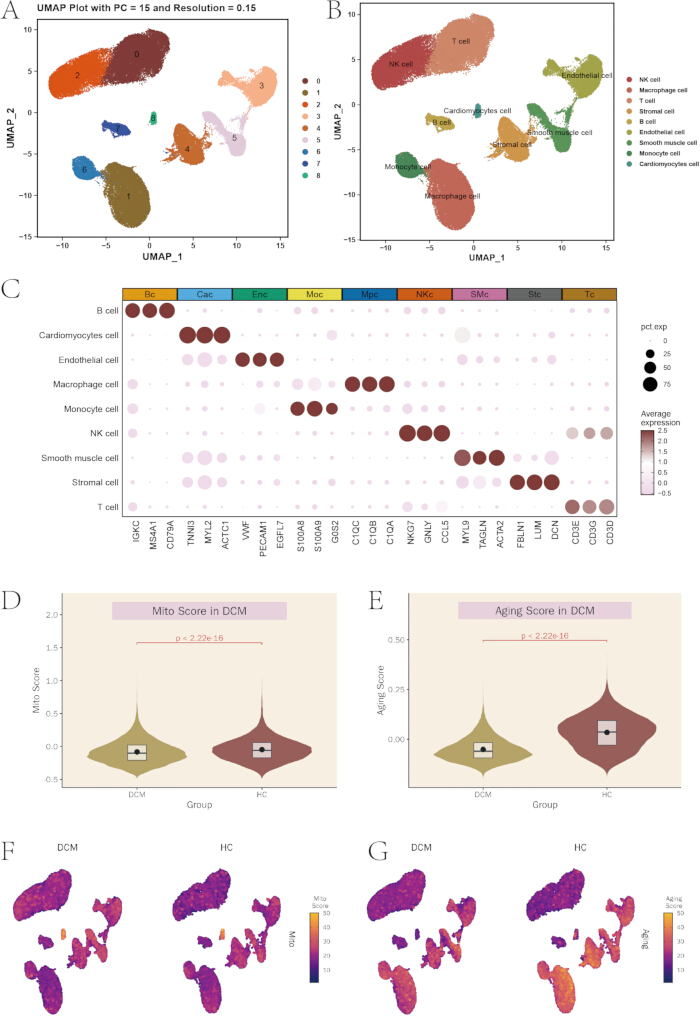
Rycina 3Adnotacja transkryptomu pojedynczych komórek i analiza wyników modułowych. (A) Wykres UMAP (Uniform Manifold Approximation and Projection) klastrów komórek wygenerowany przy użyciu pierwszych 15 głównych składowych i rozdzielczości klastrowania wynoszącej 0,15. (B) Wykres UMAP (Uniform Manifold Approximation and Projection) z adnotacjami typów komórek. (C) Wykres pęcherzykowy przedstawiający ekspresję kanonicznych genów markerowych w różnych typach komórek. (D) Wykres skrzypcowy wyników modułów mitochondrialnych w grupach DCM i HC. (E) Wykres skrzypcowy wyników modułów związanych ze starzeniem się w grupach DCM i HC. (FWykres Uniform Manifold Approximation and Projection (UMAP) przedstawiający rozkład wyników modułów mitochondrialnych w poszczególnych komórkach.G) Wykres aproksymacji i projekcji równomiernej rozmaitości (UMAP) przedstawiający rozkład wyników modułów związanych ze starzeniem się w poszczególnych komórkach. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
Konstrukcja sieci oddziaływań białko-białko
Łączny zestaw 6 genów kandydackich związanych ze starzeniem oraz 16 genów związanych z mitochondriami wprowadzono do bazy danych STRING wersja 1.5 w celu skonstruowania sieci oddziaływań białko-białko, stosując próg wysokiego poziomu wiarygodności dla łącznego wyniku (combined score) > 0,7. Sieć zaimportowano do programu Cytoscape w celu wizualizacji i analizy topologicznej (Rysunek 4A).
Do identyfikacji silnie powiązanych węzłów i głównych podsieci wykorzystano analizy stopnia, centralności maksymalnej kliki, maksymalnego komponentu sąsiedztwa oraz MCODE. Podsieci zidentyfikowane tymi metodami przedstawiono na Ryc. 4B–E.
Dziesięć genów o najwyższym rankingu według stopnia, centralności maksymalnej kliki oraz maksymalnego komponentu sąsiedztwa zestawiono z genami w rdzennej podsieci MCODE. Analiza ta pozwoliła zidentyfikować 10 genów kandydackich: TGFB2, TLR2, SERPINE1, CYBB, KDR, TLR4, HIF1A, CCL2, MMP9 oraz CXCR2.
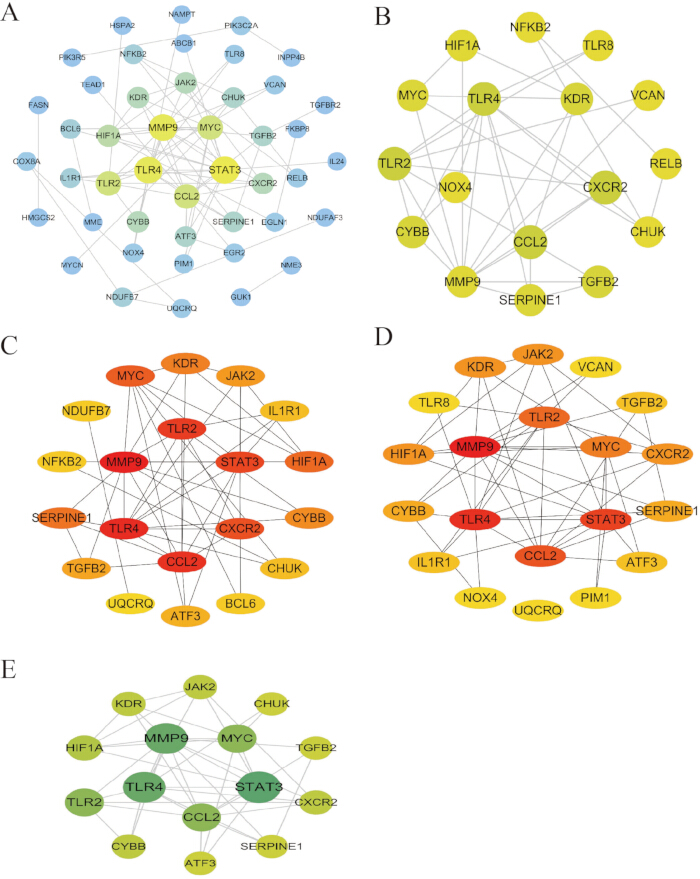
Rysunek 4Konstrukcja sieci oddziaływań białko-białko i analiza w celu wyłonienia genów węzłowych.
(A) Ogólna sieć oddziaływań białko-białko genów kandydackich. (B) Podsieć rdzeniowa zidentyfikowana za pomocą MCODE. (C) Podsieć rdzeniowa zidentyfikowana za pomocą centralności maksymalnej kliki. (D) Podsieć rdzeniowa zidentyfikowana za pomocą maksymalnego komponentu sąsiedztwa. (E) Podsieć rdzeniowa zidentyfikowana na podstawie stopnia węzła. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Przesiewanie genów hubowych w oparciu o uczenie maszynowe
Do przesiewania genów hubowych spośród 10 kandydatów do oddziaływań białko-białko zastosowano trzy algorytmy uczenia maszynowego: regresję logistyczną z zastosowaniem operatora najmniejszego absolutnego skurczenia i selekcji (LASSO), lasy losowe (random forest) oraz rekurencyjną eliminację cech opartą na maszynie wektorów wspierających (SVM-RFE). Wszystkie analizy przeprowadzono z użyciem stałego ziarna losowego (set.seed(12345)) i 5-krotnej walidacji krzyżowej. W modelu LASSO za kandydatów uznano geny o niezerowych współczynnikach dla optymalnej wartości lambda (lambda.min) (Rysunek 5A).
W modelu maszyny wektorów wspierających z rekurencyjną eliminacją cech (SVM-RFE) najwyższą dokładność walidacji krzyżowej na poziomie 0,859 osiągnięto przy uwzględnieniu 10 cech (Rycina 5B), przy odpowiadającym temu minimalnym poziomie błędu wynoszącym 0,141 (Rycina 5C). Model lasów losowych z 500 drzewami decyzyjnymi wykazał stabilną zbieżność poziomu błędu out-of-bag (Rycina 5D). Ranking istotności genów oparty na współczynniku Gini uplasował TGFB2, TLR2, SERPINE1 i CYBB wśród genów o najwyższej randze (Rycina 5E). Część wspólna genów wybranych przez wszystkie trzy algorytmy pozwoliła wyłonić cztery końcowe geny hubowe: CYBB, SERPINE1, TGFB2 i TLR2 (Rycina 5F).
Przeprowadzono analizę SHapley Additive exPlanations, aby ocenić wkład każdego genu hubowego w prognozy modelu. TGFB2 uzyskał najwyższą średnią bezwzględną wartość SHapley Additive exPlanations wynoszącą 0,249, a następnie SERPINE1 na poziomie 0,103, CYBB na poziomie 0,083 oraz TLR2 na poziomie 0,078 (Rycina 6A). Wykres podsumowujący (summary plot) przedstawił rozkład i kierunek wkładu genów w badanych próbkach (Rycina 6B). Wykresy zależności (dependence plots) zilustrowały relację między wartościami poszczególnych genów a ich wkładem w model (Rycina 6C), natomiast wykresy kaskadowe dla poszczególnych próbek (per-sample waterfall plots) ukazały wkład każdego genu w indywidualne prognozy (Rycina 6D).
Następnie, przy użyciu 10 algorytmów klasyfikacji, skonstruowano diagnostyczne modele klasyfikacyjne oparte na czterech genach hubowych. W zbiorze treningowym większość algorytmów osiągnęła wartości powierzchni pod krzywą powyżej 0,85 (Rysunek 6E). W wewnętrznym zbiorze walidacyjnym większość algorytmów osiągnęła wartości powierzchni pod krzywą powyżej 0,78 (Rysunek 6F).
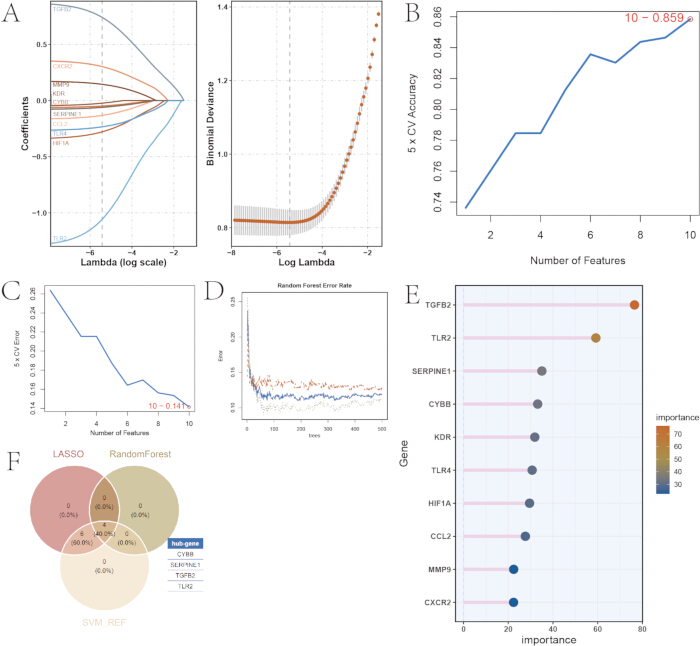
Rysunek 5Przesiewowe badanie genów centralnych w oparciu o uczenie maszynowe. (ATrajektoria współczynników regresji metodą LASSO (least absolute shrinkage and selection operator) oraz wybór optymalnej wartości lambda.B) Krzywa dokładności walidacji krzyżowej dla modelu maszyny wektorowychnośników z rekurencyjną eliminacją cech. (C) Krzywa błędu walidacji krzyżowej dla modelu maszyny wektorów wspierających z rekurencyjną eliminacją cech. (D) Krzywa błędu out-of-bag dla modelu lasu losowego. (E) Ranking istotności genów na podstawie współczynnika Gini w modelu lasów losowych. (F) Diagram Venna przedstawiający geny węzłowe (hub genes) zidentyfikowane przez trzy algorytmy uczenia maszynowego. Aby wyświetlić powiększoną wersję tej ryciny, należy kliknąć tutaj.
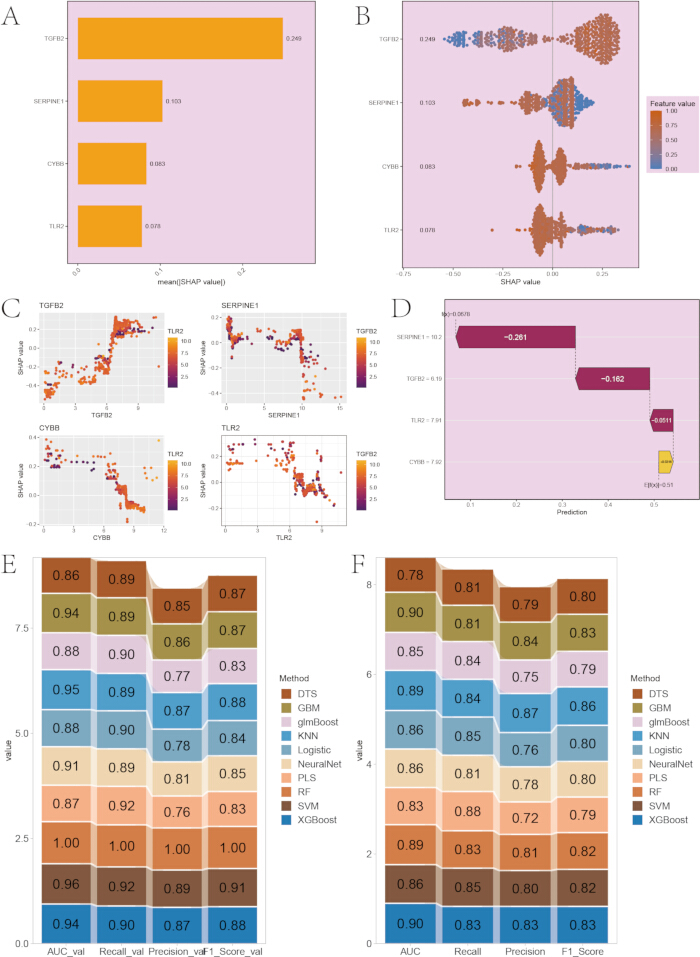
Rysunek 6Ocena modelu diagnostycznego oraz analiza SHapley Additive exPlanations. (A) Średnie bezwzględne wartości SHapley Additive exPlanations dla czterech genów hubowych. (B) Wykres podsumowujący SHapley Additive exPlanations przedstawiający rozkład i kierunek wkładu genów. (C) wykresy zależności SHapley Additive exPlanations dla każdego genu hubowego. (D) Wykres kaskadowy (waterfall plot) SHapley Additive exPlanations dla reprezentatywnej próbki. (E) Mapa ciepła wydajności diagnostycznej 10 algorytmów klasyfikacji w zbiorze treningowym. (F) Mapa ciepła wydajności diagnostycznej 10 algorytmów klasyfikacji w zbiorze walidacyjnym. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej figury.
Walidacja na poziomie pojedynczych komórek i analiza komunikacji międzykomórkowej
Wzorce ekspresji czterech genów węzłowych oceniono na poziomie pojedynczych komórek. Analiza rozkładu typów komórek wykazała, że CYBB i TLR2 wykazywały wysoką ekspresję w monocytach i makrofagach, podczas gdy SERPINE1 i TGFB2 były wyrażane głównie w komórkach zrębu (Rycina 7A).
Wykresy skrzypcowe wykazały, że ekspresja CYBB różniła się znacząco pomiędzy grupą z kardiomiopatią rozszerzeniową a grupą kontrolną osób zdrowych (Rysunek 7B). SERPINE1 (Rysunek 7C), TGFB2 (Rysunek 7D) oraz TLR2 (Rysunek 7E) również wykazały istotne różnice między grupami. Wszystkie cztery geny były znacząco nadmiernie eksprimowane w grupie z kardiomiopatią rozszerzeniową w stosunku do zdrowych kontroli, przy P < 0,01 dla każdego porównania.
Sieci komunikacji międzykomórkowej w mikrośrodowisku serca wywnioskowano z wykorzystaniem narzędzia CellChat oraz bazy danych ligand-receptor. Liczba i ogólna siła oddziaływań międzykomórkowych różniły się pomiędzy grupą z rozszerzoną kardiomiopatią a grupą kontrolną (Rysunek 7F). Zaobserwowano również różnice w sile komunikacji pomiędzy poszczególnymi typami komórek (Rysunek 7G). Monocyty, makrofagi, kardiomiocyty oraz komórki zrębu były głównymi uczestnikami sieci komunikacyjnej.
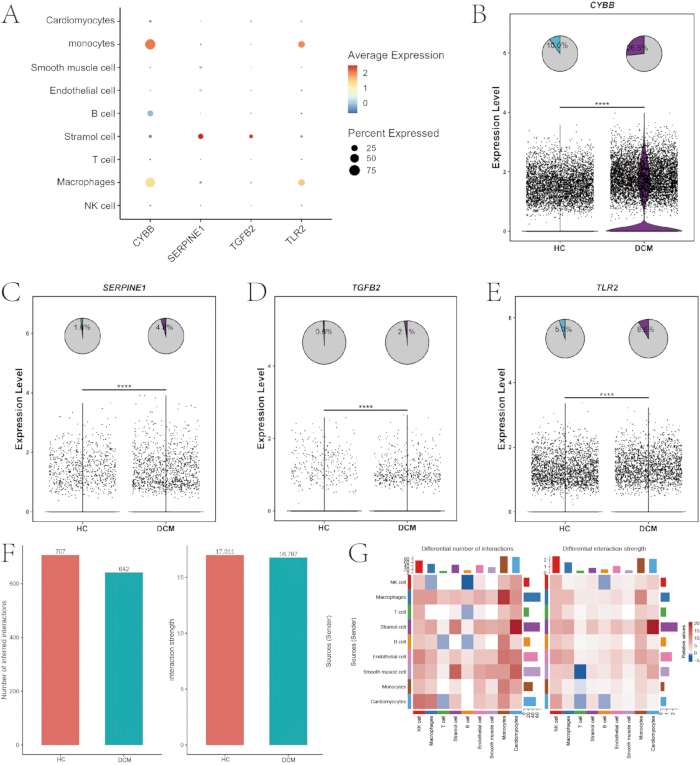
Rycina 7Walidacja genów hub w pojedynczych komórkach oraz analiza komunikacji międzykomórkowej. (A) Wykres pęcherzykowy przedstawiający ekspresję czterech genów węzłowych w różnych typach komórek. (B) Wykres skrzypcowy ekspresji CYBB w grupach DCM i HC. (C) Wykres skrzypcowy ekspresji SERPINE1 w grupach DCM i HC. (D) Wykres skrzypcowy ekspresji TGFB2 w grupach DCM i HC. (E) Wykres skrzypcowy ekspresji TLR2 w grupach DCM i HC. (F) Wykres słupkowy przedstawiający liczbę i całkowitą siłę oddziaływań międzykomórkowych. (G) Mapa ciepła przedstawiająca różnice w sile komunikacji międzykomórkowej pomiędzy grupami. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Analiza infiltracji komórek odpornościowych
Wskaźniki wzbogacenia dla 28 podgrup komórek odpornościowych obliczono dla każdej próbki zbiorczej (bulk), stosując analizę wzbogacenia zestawów genów dla pojedynczych próbek (ssGSEA). Obfitość większości typów komórek odpornościowych różniła się znacząco pomiędzy grupą z rozszerzeniową kardiomiopatią a grupą kontrolną zdrową (Rysunek 8A).
Następnie przeprowadzono analizę korelacji Pearsona w celu oceny związku między ekspresją genów węzłowych (hub genes) a wynikami wzbogacenia komórek odpornościowych. Ekspresja CYBB była istotnie skorelowana z liczebnością wielu typów komórek odpornościowych (Rysunek 8B). Podobne korelacje zaobserwowano dla SERPINE1 (Rysunek 8C), TGFB2 (Rysunek 8D) oraz TLR2 (Rysunek 8E). CYBB, SERPINE1 i TLR2 wykazały pozytywne korelacje z kilkoma populacjami wrodzonych komórek odpornościowych, w tym z monocytami i makrofagami.
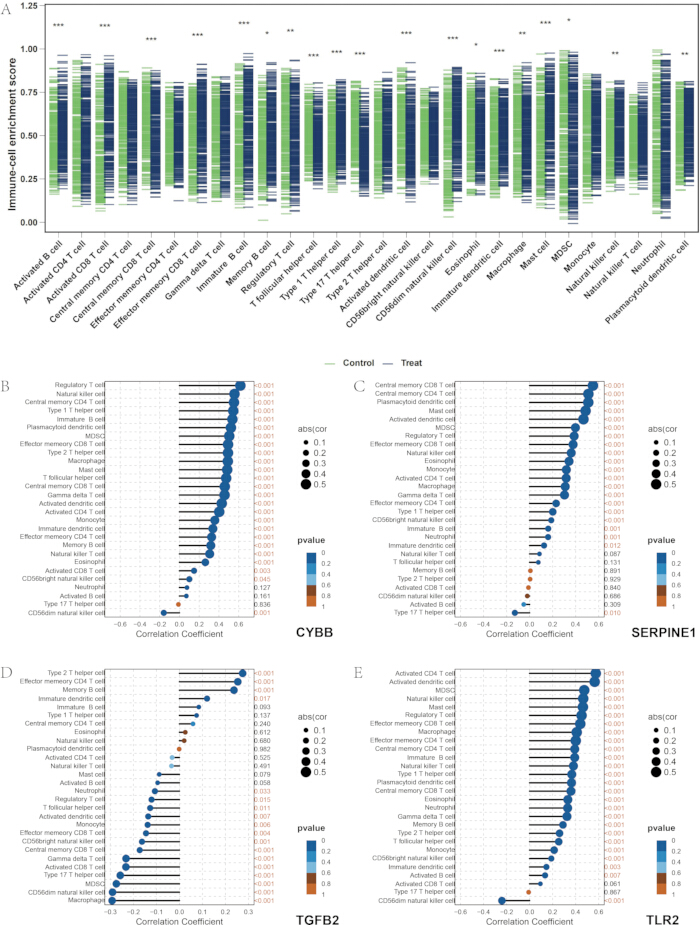
Rycina 8Infiltracja komórek odpornościowych i analiza korelacyjna. (A) Wykresy pudełkowe wyników wzbogacenia dla 28 typów komórek odpornościowych w grupach DCM i HC. (B) Wykres typu lollipop przedstawiający korelacje między ekspresją CYBB a licznością komórek odpornościowych. (C) Wykres typu lollipop przedstawiający korelacje między ekspresją SERPINE1 a liczebnością komórek odpornościowych. (D) Wykres typu lollipop przedstawiający korelacje między ekspresją TGFB2 a obfitością komórek odpornościowych. (E) Wykres typu lollipop przedstawiający korelacje między ekspresją TLR2 a liczebnością komórek odpornościowych. Proszę kliknąć tutaj, aby wyświetlić powiększoną wersję tej figury.
Podtypowanie molekularne kardiomiopatii rozszerzeniowej
Przeprowadzono nienadzorowane grupowanie konsensualne (unsupervised consensus clustering) próbek z kardiomiopatią rozszerzeniową na podstawie profili ekspresji czterech genów węzłowych (hub genes). Macierz grupowania konsensualnego potwierdziła podział przy K = 2 (Rysunek 9A). Wykres delta area dodatkowo potwierdził, że optymalną liczbą klastrów jest K = 2, co pozwoliło na podział próbek na dwa podtypy molekularne: C1 i C2 (Rysunek 9B).
Poziomy ekspresji CYBB, SERPINE1 i TLR2 różniły się znacząco pomiędzy dwoma podtypami (Rycina 9C). Obfitość wielu podzbiorów komórek odpornościowych również różniła się pomiędzy podtypami (Rycina 9D). Analiza wariacji zestawów genów (GSVA) wykazała względną aktywację szlaku sygnalizacyjnego czynnika wzrostu śródbłonka naczyniowego w podtypie C1, podczas gdy biosynteza pierwotnych kwasów żółciowych oraz biosynteza glikosfingolipidów były wzbogacone w podtypie C2 (Rycina 9E). Analiza głównych składowych (PCA) wykazała rozdzielenie próbek przypisanych do dwóch podtypów (Rycina 9F).
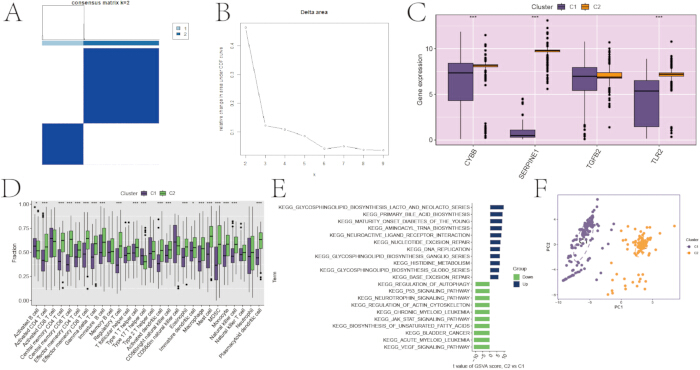
Rycina 9Grupowanie konsensualne w celu subtypizacji molekularnej kardiomiopatii rozszerzony. (A) Macierz klastrowania konsensusowego dla K = 2. (B) Wykres powierzchni Delta użyty do wyznaczenia optymalnej liczby klastrów. (C) Wykresy pudełkowe ekspresji genów węzłowych w dwóch podtypach molekularnych. (D) Wykresy pudełkowe liczebności komórek odpornościowych w dwóch podtypach molekularnych. (EMapa ciepła szlaków Kyoto Encyclopedia of Genes and Genomes wykazujących różnice w stopniu wzbogacenia pomiędzy dwoma podtypami molekularnymi.F) Wykres analizy głównych składowych pokazujący rozdzielenie dwóch podtypów molekularnych. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
In vivo walidacja w mysim modelu rozstrzeniowego kardiomiopatii
Do walidacji in vivo wykorzystano myszy transgeniczne CTNTR141W z samoistnym fenotypem rozstrzeniowej kardiomiopatii. W porównaniu z dopasowanymi wiekowo myszami kontrolnymi typu dzikiego C57BL/6J, myszy transgeniczne wykazały znacznie zwiększony końcoworozkurczowy wymiar lewej komory oraz zmniejszoną frakcję wyrzutową lewej komory, co jest zgodne z rozszerzeniem komory i dysfunkcją skurczową (Rysunek 10A).
Całkowite białko wyekstrahowano z tkanki mięśnia komory lewej, a stężenia białek kodowanych przez cztery geny węzłowe (hub genes) zmierzono za pomocą enzymatycznego testu immunoabsorpcyjnego (ELISA) po normalizacji całkowitego białka metodą kwasu bicinchoniminowego. Wszystkie analizy przeprowadzono w dubletach. Krzywe wzorcowe posiadały współczynniki korelacji (R2) ≥ 0,9, a współczynniki zmienności między dubletami wynosiły poniżej 10%. Istotność statystyczną między grupą kontrolną a grupą DCM oceniano za pomocą testu t Studenta lub testu t Welcha, w zależności od równości wariancji określonej testem F (normalność rozkładu potwierdzono testem Shapiro-Wilka). Poziomy białek mięśnia sercowego odpowiadające wszystkim czterem genom węzłowym były znacząco podwyższone u myszy z kardiomiopatią rozstrzeniową (DCM) w porównaniu z grupą kontrolną (Rycina 10B). Do walidacji metodą ELISA w każdej grupie włączono 3 powtórzenia biologiczne (poszczególne myszy). Do walidacji metodą ELISA w każdej grupie włączono trzy niezależne powtórzenia biologiczne. Wyniki te należy uznać za wstępne i wymagają potwierdzenia w większej kohorcie.
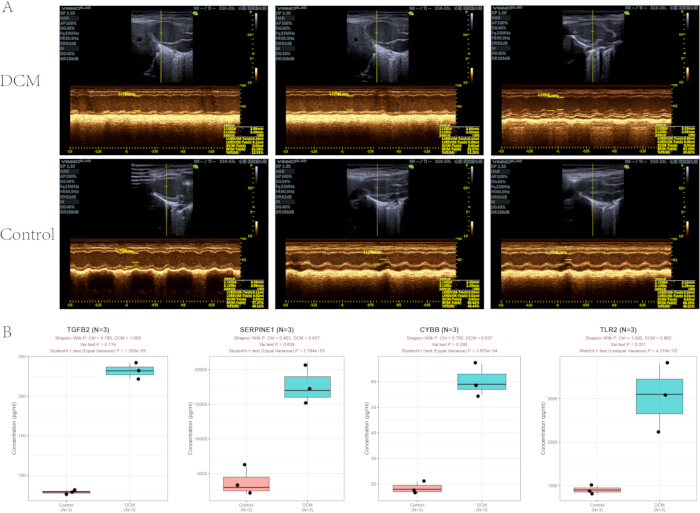
Rycina 10: In vivo walidacja w transgenicznym modelu mysim rozszerzeniowej kardiomiopatii CTNTR141W. (A) Reprezentatywne obrazy echokardiograficzne w trybie M myszy z kardiomiopatią rozstrzeniową (DCM) transgenicznych CTNTR141W oraz myszy kontrolnych typu dzikiego. (B) Ilościowe oznaczenie metodą ELISA czterech białek pochodzących z genów centralnych (hub genes) w tkankach mięśnia lewej komory myszy. Wykresy pudełkowe przedstawiają stężenia białek dla grup kontrolnej (Control) i DCM (n = 3 powtórzenia biologiczne na grupę). Na każdym wykresie pudełkowym: ciągła pozioma linia wewnątrz pudełka oznacza wartość mediany; górna i dolna granice pudełka reprezentują 75. i 25. percentyl (rozstęp międzykwartylny, IQR); górne i dolne wąsy sięgają maksymalnego i minimalnego punktu danych niebędącego wartością odstającą w zakresie 1,5 × IQR; pojedyncze czarne kropki odpowiadają niezależnym powtórzeniom biologicznym od pojedynczych zwierząt. Oś Y wskazuje bezwzględne stężenie białka: pg/mL dla TGFB2 i CYBB, ng/mL dla TLR2 i SERPINE1. Porównania statystyczne między dwiema grupami przeprowadzono za pomocą testu t-Studenta (przy równości wariancji) lub testu t-Welcha (przy nierówności wariancji), przy czym normalność rozkładu zweryfikowano testem Shapiro-Wilka, a jednorodność wariancji oceniono testem F. Oświadczenie o ograniczeniach: wyniki ELISA uzyskane z n = 3 powtórzeń są wstępnymi wynikami eksploracyjnymi i wymagają przyszłej walidacji na większej liczbie próbek. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Dostępność danych:
Sześć zbiorów danych transkrypcyjnych z populacji komórek oraz jeden zbiór danych sekwencjonowania RNA pojedynczych komórek przeanalizowanych w niniejszym badaniu są publicznie dostępne w bazie danych Gene Expression Omnibus pod numerami dostępu GSE5406, GSE4295, GSE5738, GSE7962, GSE16250, GSE141910 oraz GSE145154. Analiza pojedynczych komórek obejmowała próbki GSM4307515, GSM4307516, GSM4307520 i GSM4307521 z zestawu GSE145154. Wszystkie pozostałe dane wygenerowane lub przeanalizowane podczas tego badania, wraz z kodem obliczeniowym, zawarto w opublikowanym artykule oraz w jego plikach z informacjami uzupełniającymi. W szczególności Plik uzupełniający 1 zawiera pełne listy genów związanych ze starzeniem i mitochondriami, sygnaturę immunologiczną dla 28 komórek, niestandardowe skrypty analityczne, znormalizowane macierze danych transkrypcyjnych, dane źródłowe dla testów ELISA oraz surowe dane źródłowe stanowiące podstawę wszystkich rycin w manuskrypcie.
Plik uzupełniający 1: Zbiory genów związanych ze starzeniem i mitochondriami, sygnatury immunologiczne, skrypty analityczne, znormalizowane dane transkryptomiczne oraz dane źródłowe do rycin. Prosimy kliknąć tutaj, aby pobrać ten plik.
Dyskusja
Zintegrowany wielowarstwowy schemat postępowania połączył bulkową metaanalizę transkryptomiczną, konstrukcję ważonej sieci koekspresji genów, zespołowe uczenie maszynowe, walidację transkryptomiczną pojedynczych komórek oraz weryfikację na modelu zwierzęcym in vivo. Cztery powiązane ze starzeniem i mitochondriami geny hubowe CYBB, SERPINE1, TGFB2 oraz TLR2 zostały zidentyfikowane jako potencjalne biomarkery diagnostyczne kardiomiopatii rozstrzeniowej (DCM). Integracja sześciu niezależnych zbiorów danych transkryptomicznych lewej komory z repozytorium Gene Expression Omnibus, obejmujących platformy mikromacierzy oraz sekwencjonowania RNA, pozwoliła ograniczyć błąd wynikający z analizy pojedynczego zbioru danych i zwiększyła podstawę statystyczną analizy43,44,45. Analiza ważonej sieci koekspresji genów w połączeniu z predefiniowanymi zestawami genów mitochondrialnych i związanych ze starzeniem umożliwiła identyfikację powiązanych z cechą modułów funkcjonalnych, zamiast polegania wyłącznie na analizie ekspresji różnicowej46. Zespołowe uczenie maszynowe zredukowało błąd specyficzny dla algorytmów związany z poszczególnymi metodami wyboru cech47,48, podczas gdy analiza SHapley Additive exPlanations pozwoliła na ilościowe określenie wkładu każdego genu hubowego w predykcje modelu49. Walidacja w bulkowych transkryptomach mięśnia sercowego, transkryptomach pojedynczych komórek oraz w transgenicznym modelu mysim pozwoliła na dalszą charakterystykę dystrybucji komórkowej i poziomów białek w mięśniu sercowym dla wybranych genów50.
Korekcja efektu serii była krytycznym etapem zintegrowanej analizy, ponieważ pozostała zmienność specyficzna dla zestawu danych mogła wpłynąć na analizę ekspresji różnicowej oraz powiązania moduł-cecha. Dlatego źródło zestawu danych oraz platforma detekcji zostały uwzględnione jako czynniki serii w modelu ComBat. Pozostałe, zależne od zestawu danych grupowanie na wykresach analizy głównych składowych wskazywałoby na niepełną korekcję i potencjalne obciążenie systematyczne44. Potęga miękkiego progowania była również istotna dla konstrukcji ważonej sieci koekspresji genów. Wybrano minimalną wartość, która zapewniła wskaźnik dopasowania topologii bezskalowej R2 > 0,9, co dało β = 5. Niższa wartość może prowadzić do powstania modułów fragmentarycznych lub funkcjonalnie nieinformatywnych, natomiast wyższa wartość może osłabić łączność genów i zmniejszyć moc statystyczną analizy korelacji moduł-cecha46. Progi kontroli jakości pojedynczych komórek zostały dostosowane do tkanki serca, ponieważ kardiomiocyty charakteryzują się wysoką aktywnością metaboliczną. W celu usunięcia komórek przerwanych i niskiej jakości przy jednoczesnym zachowaniu kardiomiocytów wdrożono rygorystyczną strategię filtrowania z odcięciem procentowym genów mitochondrialnych poniżej 25% oraz zakresem wykrytych genów od 200–6 00050. Stałe ziarno losowości, ustawione jako set.seed(12345), zostało zastosowane do podziału zestawu danych, trenowania modelu i walidacji krzyżowej, aby zmniejszyć zmienność w powtórzonych analizach uczenia maszynowego47.
Potwierdzenie genotypu, ustandaryzowane warunki utrzymania oraz spójne pomiary echokardiograficzne były kluczowe dla zachowania stabilności fenotypowej w eksperymentach na zwierzętach. Transgeniczne myszy CTNTR141W wykazują rozszerzenie lewej komory oraz dysfunkcję skurczową po określonym okresie aklimatyzacji i karmienia51. Weryfikacja genotypu przed podziałem na grupy jest niezbędna w celu wykluczenia zwierząt nietransgenicznych i zapobieżenia błędnej klasyfikacji fenotypu. Pomiary echokardiograficzne należy przeprowadzać w sposób spójny na poziomie mięśni brodawkowatych lewej komory, wyciągając średnią z trzech kolejnych stabilnych cykli serca. Zmienność pozycji obrazowania lub głębokości znieczulenia może zwiększyć rozrzut pomiarów frakcji wyrzutowej lewej komory51. Jakość testu ELISA oceniano za pomocą współczynników korelacji krzywej wzorcowej, R2 ≥ 0,99, oraz współczynników zmienności < 10% pomiędzy dubletami. Słaba liniowość krzywej wzorcowej lub niespójne pomiary dubletów mogą wprowadzić błąd systematyczny do szacunków stężenia białka.
Podczas wdrażania schematu pracy mogą pojawić się różne problemy analityczne. Utrzymujące się rozdzielenie partii po korekcie ComBat może odzwierciedlać współliniowość między zmiennymi partii a czynnikami klinicznymi, niewystarczające filtrowanie genów o niskiej ekspresji lub niemodelowaną zmienność techniczną. Jeśli są dostępne, współzmienne kliniczne, takie jak wiek i płeć, mogą zostać włączone jako zmienne chronione, a geny o zerowej ekspresji w więcej niż 70% próbek mogą zostać usunięte w celu redukcji szumu44. W przypadku pozostania resztkowego rozdzielenia można rozważyć uzupełniającą korektę za pomocą removeBatchEffect. Nieoczekiwanie wysoka lub niska liczba genów różnicowo wyrażonych może wymagać oceny heterogeniczności próbek, normalizacji, wartości odstających oraz doboru progów27. Niskie korelacje moduł-cecha można rozwiązać poprzez ponowną ocenę progu wariancji, potęgi miękkiego progowania (soft-thresholding power) oraz ekstremalnych wartości cech. Rozszerzenie zbioru z 5 000 do 7 500 najbardziej zmiennych genów lub zastąpienie analizy wzbogacenia zbiorów genów dla pojedynczej próbki analizą wariancji zbiorów genów (gene set variation analysis) może poprawić wykrywanie modułów46. Nadmierna liczba izolowanych węzłów w sieci oddziaływań białko-białko może wymagać dostosowania progu ufności STRING lub rozszerzenia zbioru genów kandydackich30. Słaba wydajność uczenia maszynowego może odzwierciedlać różnice w rozkładzie między zestawami treningowym a walidacyjnym, redundancję cech lub brak równowagi grup. Próbkowanie warstwowe, redukcja redundantnych cech lub nadpróbkowanie klasy mniejszościowej mogą zmniejszyć te efekty47. Niejednoznaczne klastrowanie pojedynczych komórek może wymagać ponownej oceny korekty Harmony, wyboru głównych składowych oraz adnotacji genów markerowych50.
Należy wziąć pod uwagę kilka ograniczeń. Zbiory danych transkryptomicznych pozyskano retrospektywnie z publicznych repozytoriów, co uniemożliwiło kontrolę nad pierwotnym projektem badań oraz klinicznymi czynnikami zakłócającymi. Adnotacje kliniczne w zbiorach danych były niepełne, a w większości z nich brakowało szczegółowych informacji na temat etiologii, historii przyjmowanych leków, wieku pacjentów oraz długoterminowych wyników. Ograniczenia te uniemożliwiły ocenę powiązań między wybranymi genami a rokowaniem, odpowiedzią na leczenie lub starzeniem chronologicznym52. Mimo korekty efektu serii mogą nadal występować pozostałe wariacje techniczne. Analiza opierała się głównie na ekspresji mRNA i nie obejmowała zintegrowanych danych epigenomicznych, proteomicznych ani metabolomicznych. W związku z tym nie można było określić aktywności białek, regulacji potranslacyjnej ani mechanizmów nadrzędnych. Uwzględniono tylko jeden zbiór danych z poziomu pojedynczych komórek, co ograniczyło ocenę heterogeniczności komórkowej w różnych etiologiach DCM50. Transgeniczny model CTNTR141W reprezentuje głównie dziedziczną postać DCM związaną z mutacją troponiny T serca i może nie odzwierciedlać idiopatycznych, wirusowych lub niedokrwiennych postaci tej choroby51. Różnice gatunkowe między myszami a ludźmi również ograniczają bezpośrednią translację kliniczną. Walidacja na poziomie białka została ograniczona do tkanki mięśnia sercowego myszy; nie przeprowadzono badań na dużych kohortach klinicznych ani porównań z uznanymi biomarkerami. Cztery geny hub nie są specyficzne dla DCM i mogą być również zmienione w innych schorzeniach sercowo-naczyniowych lub stanach zapalnych. Ponadto wybór kandydatów oparto na zdefiniowanych wcześniej zestawach genów związanych ze starzeniem i mitochondriami. Ta strategia oparta na hipotezach może wykluczać geny spoza wybranych zestawów referencyjnych, natomiast wyznaczenie części wspólnej dla trzech algorytmów uczenia maszynowego może pomijać geny zidentyfikowane tylko przez jedną metodę48.
Ramy analityczne mogą wspierać przyszłe badania nad subtypami molekularnymi, walidację biomarkerów oraz badania multiomiczne w DCM. Panel czterech genów może zostać oceniony w niezależnych kohortach krwi obwodowej lub mięśnia sercowego przed uznaniem go za narzędzie diagnostyczne lub służące do określania subtypów. Subtypy C1 i C2 wykazały odmienne profile ścieżek immunologicznych i metabolicznych, co stanowi podstawę do późniejszej walidacji specyficznych dla subtypów cech biologicznych15. Wybrane geny mogą być również badane w badaniach dokowania molekularnego, badaniach komórkowych i funkcjonalnych. TLR2 i CYBB są powiązane z sygnalizacją zapalną i produkcją reaktywnych form tlenu, podczas gdy TGFB2 i SERPINE1 są powiązane z włóknieniem i przebudową serca53. Integracja z danymi proteomicznymi, metabolomicznymi, epigenomicznymi, badaniami asocjacyjnymi całego genomu oraz randomizacją mendlowską może pomóc w ocenie zależności regulacyjnych i potencjalnych związków przyczynowych54. Przepływ pracy można również dostosować do badań transkryptomicznych kardiomiopatii przerostowej, kardiomiopatii niedokrwiennej i niewydolności serca poprzez zastąpienie specyficznych dla danej choroby zbiorów danych i zestawów genów referencyjnych45. Przyszłe włączenie testów jednokomórkowych dla sekwencjonowania chromatyny dostępnej dla transpozazy oraz transkryptomiki przestrzennej może dostarczyć dodatkowych informacji na temat regulacji komórkowej i ekspresji przestrzennej. Zaobserwowane wzbogacenie sygnatur związanych ze starzeniem w makrofagach oraz sygnatur mitochondrialnych w kardiomiocytach było zgodne z wcześniejszymi doniesieniami na temat procesów zapalnych i mitochondrialnych w chorobach serca55,56,57.
Niniejsze badanie posiada kilka ograniczeń, które należy odnotować. W szczególności komercyjne zestawy ELISA wykorzystane do oznaczania ilości białek zostały oficjalnie zwalidowane pod kątem wykrywania docelowych białek w próbkach surowicy. W niniejszym badaniu jako macierz detekcyjną zamiast surowicy przyjęto lizaty tkanek mięśnia sercowego. Chociaż w całym przebiegu analizy ściśle przestrzegano spójnych procedur przygotowania próbek i operacji eksperymentalnych, aby zapewnić niezawodność i porównywalność danych doświadczalnych, brak oficjalnej walidacji tych zestawów ELISA przez producenta dla próbek lizatów tkanek mięśnia sercowego może prowadzić do potencjalnych niewielkich odchyleń w wynikach ilościowych białek. W związku z tym zastosowanie zestawów ELISA specyficznych dla surowicy do lizatów tkanek mięśnia sercowego stanowi ograniczenie metodologiczne niniejszego badania.
Oświadczenia
Autor oświadcza, że nie ma żadnych konfliktów interesów.
Podziękowania
Wyrażamy wdzięczność za udostępnienie publicznych danych za pośrednictwem bazy danych Gene Expression Omnibus. Dziękujemy również recenzentom oraz redaktorom za konstruktywne uwagi do manuskryptu. Praca ta była wspierana przez Projekt Badawczy na Poziomie Departamentu Prowincjonalnego (Grant nr 2021JDZX2026), pt. „Mechanizm formuły Yiqi Huoxue w łagodzeniu aterosklerotycznego przebudowywania naczyń poprzez regulację zapalną zależną od KLF2-Nrf2”.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Żel do ultradźwięków Aquasonic Clear | Parker Laboratories, Inc. | Mar-34 | Stosowany do obrazowania echokardiograficznego małych zwierząt. |
| Zestaw do oznaczania białka BCA | Thermo Fisher Scientific | 23227 | Detekcja przy 562 nm; zakres 20–2 000 µg/mL; stosowany do ilościowego oznaczania całkowitej zawartości białka w lizatach serca myszy. |
| Baza danych CellAge | Human Ageing Genomic Resources | https://genomics.senescence.info/cells/ | Źródło sygnatur genów związanych ze starzeniem. |
| CytoHubba, wtyczka do Cytoscape | Cytoscape App Store | Version 0.1 | Stosowana do oceny topologii węzłów w sieciach oddziaływań białko-białko. |
| Cytoscape | Cytoscape Consortium | Version 3.9.1 | Stosowany do wizualizacji sieci oddziaływań białko-białko. |
| Pełnozakresowy czytnik mikropłytek | Thermo Fisher Scientific | Multiskan FC | Stosowany do pomiaru absorbancji w testach ELISA. |
| Gene Expression Omnibus | National Center for Biotechnology Information | https://www.ncbi.nlm.nih.gov/geo/ | Publiczne repozytorium wykorzystywane do pozyskiwania zbiorów danych transkryptomicznych. |
| GeneCards | Weizmann Institute of Science | https://www.genecards.org/ | Źródło zestawów genów związanych z mitochondriami. |
| Koktajl inhibitorów proteaz i fosfataz Halt, 100×, bez EDTA | Thermo Fisher Scientific | 78441 | Przechowywany w 4 °C; dodawany do buforu RIPA w stężeniu 10 µL/mL bezpośrednio przed użyciem. |
| Ciekły azot | Lokalny dostawca gazów laboratoryjnych | Not applicable | Stosowany do błyskawicznego zamrażania tkanki mięśnia sercowego. |
| Samce myszy C57BL/6J klasy SPF, wiek 6–8 tygodni, masa 25 ± 2 g | Beijing Vital River Laboratory Animal Technology Co., Ltd. | Not applicable | Licencja na produkcję zwierząt nr SCXK (Jing) 2021-0006; stosowane jako kontrole prawidłowe. |
| Samce transgenicznych myszy DCM CTNTR141W klasy SPF, wiek 6–8 tygodni, masa 25 ± 2 g | Institute of Laboratory Animal Science, Chinese Academy of Medical Sciences | Not applicable | Licencja na produkcję zwierząt nr SCXK (Jing) 2021-0065; stosowane jako spontaniczny model DCM. |
| MCODE, wtyczka do Cytoscape | Cytoscape App Store | Version 2.0.2 | Stosowana do identyfikacji kluczowych funkcjonalnych podsieci w sieciach oddziaływań białko-białko. |
| Zestaw ELISA dla mysiego CYBB | Biogradetech | A-QEK09250-96wells | Stosowany w niniejszym badaniu do pomiaru CYBB w lizatach tkanki mięśnia sercowego myszy. |
| Zestaw ELISA dla mysiego PAI-1 | EK-BIO | ML30970 | Stosowany w niniejszym badaniu do pomiaru PAI-1 (białka kodowanego przez SERPINE1) w lizatach tkanki mięśnia sercowego myszy. |
| Zestaw ELISA dla mysiego TGF-β2 | ElaBoX | SEKM-0036 | Stosowany w niniejszym badaniu do pomiaru TGF-β2 w lizatach tkanki mięśnia sercowego myszy. |
| Zestaw ELISA dla mysiego TLR-2 | Solarbio | SEKM-0163 | Stosowany w niniejszym badaniu do pomiaru TLR-2 w lizatach tkanki mięśnia sercowego myszy. |
| Fosforanowy bufor solny, pH 7.4, bez wapnia i magnezu | Biological Industries | 02-024-1ACS | Sterylny roztwór 1×; przechowywany w 4 °C; stosowany do płukania tkanek i rozcieńczeń. |
| Pakiet R: caret | CRAN | Version 6.0-94 | Stosowany do rekurencyjnej eliminacji cech w maszynach wektorów nośnych (SVM-RFE). |
| Pakiet R: CellChat | CellChat developers | Version 1.6.1 | Stosowany do wnioskowania o komunikacji międzykomórkowej na podstawie danych z sekwencjonowania RNA pojedynczych komórek. |
| Pakiet R: clusterProfiler | Bioconductor | Version 4.8.3 | Stosowany do analizy wzbogacenia funkcjonalnego. |
| Pakiet R: ConsensusClusterPlus | Bioconductor | Version 1.64.0 | Stosowany do nienadzorowanego klastrowania konsensusowego. |
| Pakiet R: edgeR | Bioconductor | Version 3.42.4 | Stosowany do normalizacji danych z sekwencjonowania RNA metodą uśrednionej wartości M (TMM). |
| Pakiet R: GEOquery | Bioconductor | Version 2.68.0 | Stosowany do pobierania danych z Gene Expression Omnibus. |
| Pakiet R: glmnet | CRAN | Version 4.1-8 | Stosowany do regresji logistycznej metodą LASSO. |
| Pakiet R: limma | Bioconductor | Version 3.56.2 | Stosowany do analizy różnicowej ekspresji i modelowania statystycznego. |
| Pakiet R: pROC | CRAN | Version 1.18.5 | Stosowany do analizy krzywej charakterystyki operacyjnej odbiornika (ROC). |
| Pakiet R: randomForest | CRAN | Version 4.7-1.2 | Stosowany do uczenia maszynowego metodą lasów losowych. |
| Pakiet R: Seurat | CRAN | Version 5.0.1 | Stosowany do analizy danych z sekwencjonowania RNA pojedynczych komórek. |
| Pakiet R: SingleR | Bioconductor | Version 2.2.0 | Stosowany do zautomatyzowanej adnotacji typów komórek. |
| Pakiet R: sva | Bioconductor | Version 3.48.0 | Stosowany do korekcji efektu serii za pomocą metody ComBat. |
| Wirówka chłodząca | Sigma-Aldrich | SIGMA 3-K | Stosowana do wirowania lizatów tkanki mięśnia sercowego. |
| Bufor do lizy i ekstrakcji RIPA | Thermo Fisher Scientific | 89900 | Gotowy do użycia roztwór 1×; przechowywany w 4 °C; przed użyciem uzupełniany inhibitorami proteaz i fosfataz. |
| System obrazowania ultradźwiękowego dla małych zwierząt | VINNO Technology Co., Ltd. | VINN06LAB | Stosowany do echokardiograficznej oceny funkcji serca. |
| Pentobarbital sodu | Sinopharm Chemical Reagent Co. | 20040428 | Przygotowany jako roztwór 1%, 10 mg/mL, w sterylnej soli fizjologicznej; stosowany do znieczulenia domięśniowego w dawce 30 mg/kg. |
| Baza danych STRING | STRING Consortium | Version 11.5 | Stosowana do konstrukcji sieci oddziaływań białko-białko. |
| Homogenizator tkanek TGrinder H24 | TIANGEN | OSE-TH-01 | Stosowany do homogenizacji tkanki mięśnia sercowego myszy w buforze RIPA z prędkością 6,0 m/s przez 30–60 s w ciągu 2–3 cykli. |
| Termostatyczna platforma dla zwierząt/podgrzewany stół operacyjny dla małych zwierząt | Shanghai Yuyan Scientific Instrument Co., Ltd. | T-30350 | Stosowany do utrzymania myszy w temperaturze 37 °C podczas echokardiografii; zakres pracy od temperatury pokojowej do 50 °C. |
Bibliografia
- Pinto YM et al. Proposal for a revised definition of dilated cardiomyopathy, hypokinetic non-dilated cardiomyopathy, and its implications for clinical practice: a position statement of the ESC working group on myocardial and pericardial diseases. Eur Heart J. 2016;37(23):1850-1858. https://doi.org/10.1093/eurheartj/ehv727
- Newman NA, Burke MA. Dilated Cardiomyopathy: A Genetic Journey from Past to Future. Int J Mol Sci. 2024;25(21):11460. https://doi.org/10.3390/ijms252111460
- Mishra B et al. Tumour necrosis factor-alpha promoter polymorphism and its association with viral dilated cardiomyopathy in Indian population: a pilot study. Indian J Med Microbiol. 2015;33(1):16–20. https://doi.org/10.4103/0255-0857.148368
- Frustaci A et al. Oxidative myocardial damage in human cocaine-related cardiomyopathy. Eur J Heart Fail. 2015;17(3):283-290. https://doi.org/10.1002/ejhf.219
- Ni B et al. The role of β-catenin in cardiac diseases. Front Pharmacol. 2023;14:1157043. https://doi.org/10.3389/fphar.2023.1157043
- Kuwahara K et al. TRPC6 fulfills a calcineurin signaling circuit during pathologic cardiac remodeling. J Clin Invest. 2006;116(12):3114-3126. https://doi.org/10.1172/JCI27702
- He SL et al. Mitochondrial-related gene expression profiles suggest an important role of PGC-1alpha in the compensatory mechanism of endemic dilated cardiomyopathy. Exp Cell Res. 2013;319(17):2604–2616. https://doi.org/10.1016/j.yexcr.2013.07.017
- Luczak ED et al. Mitochondrial CaMKII causes adverse metabolic reprogramming and dilated cardiomyopathy. Nat Commun. 2020;11(1):4416. https://doi.org/10.1038/s41467-020-18165-6
- Li E et al. BMAL1 regulates mitochondrial fission and mitophagy through mitochondrial protein BNIP3 and is critical in the development of dilated cardiomyopathy. Protein Cell. 2020;11(9):661–679. https://doi.org/10.1007/s13238-020-00713-1
- Alila-Fersi O et al. First description of a novel mitochondrial mutation in the MT-TI gene associated with multiple mitochondrial DNA deletion and depletion in family with severe dilated mitochondrial cardiomyopathy. Biochem Biophys Res Commun. 2018;497(4):1049-1054. https://doi.org/10.1016/j.bbrc.2018.02.162
- Ramaccini D et al. Mitochondrial Function and Dysfunction in Dilated Cardiomyopathy. Front Cell Dev Biol. 2020;8:624216. https://doi.org/10.3389/fcell.2020.624216
- Yang J et al. Stem cells in the treatment of myocardial injury-induced cardiomyopathy: mechanisms and efficient utilization strategies. Front Pharmacol. 2025;16:1600604. https://doi.org/10.3389/fphar.2025.1600604
- Van Linthout S et al. State of the art and perspectives of gene therapy in heart failure. A scientific statement of the Heart Failure Association of the ESC, the ESC Council on Cardiovascular Genomics and the ESC Working Group on Myocardial & Pericardial Diseases. Eur J Heart Fail. 2025;27(1):5–25. https://doi.org/10.1002/ejhf.3516
- Alimadadi A, Munroe PB, Joe B, Cheng X. Meta-Analysis of Dilated Cardiomyopathy Using Cardiac RNA-Seq Transcriptomic Datasets. Genes (Basel). 2020;11(1):60. https://doi.org/10.3390/genes11010060
- Verdonschot J et al. Clustering of Cardiac Transcriptome Profiles Reveals Unique Subgroups of Dilated Cardiomyopathy Patients. JACC Basic Transl Sci. 2023;8(4):406–418. https://doi.org/10.1016/j.jacbts.2022.10.007
- Zhu T et al. Identification and Verification of Feature Biomarkers Associated With Immune Cells in Dilated Cardiomyopathy by Bioinformatics Analysis. Front Genet. 2022;13:874544. https://doi.org/10.3389/fgene.2022.874544
- Li H et al. Identification of Centrosome Duplication-Related Biomarkers in Hypertrophic Cardiomyopathy Through Integrative Multi-Omics, Single-Cell Transcriptomics, and Experimental Validation. J Am Heart Assoc. 2026;15(12):e047416. https://doi.org/10.1161/JAHA.125.047416
- Ni L et al. Dissecting and validation the biomarker of heart failure progression in patients with atherosclerosis by single-cell sequencing, bioinformatics, and machine learning. Front Genet. 2025;16:1587274. https://doi.org/10.3389/fgene.2025.1587274
- Barrett T et al. NCBI GEO: archive for functional genomics data sets--update. Nucleic Acids Res. 2013;41(Database issue):D991–D995. https://doi.org/10.1093/nar/gks1193
- Davis S, Meltzer PS. GEOquery: a bridge between the Gene Expression Omnibus (GEO) and BioConductor. Bioinformatics. 2007;23(14):1846-1847. https://doi.org/10.1093/bioinformatics/btm254
- Irizarry RA et al. Exploration, normalization, and summaries of high density oligonucleotide array probe level data. Biostatistics. 2003;4(2):249-264. https://doi.org/10.1093/biostatistics/4.2.249
- Robinson MD, McCarthy DJ, Smyth GK. edgeR: a Bioconductor package for differential expression analysis of digital gene expression data. Bioinformatics. 2010;26(1):139–140. https://doi.org/10.1093/bioinformatics/btp616
- Leek JT et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882–883. https://doi.org/10.1093/bioinformatics/bts034
- Butler A et al. Integrating single-cell transcriptomic data across different conditions, technologies, and species. Nat Biotechnol. 2018;36(5):411-420. https://doi.org/10.1038/nbt.4096
- Korsunsky I et al. Fast, sensitive and accurate integration of single-cell data with Harmony. Nat Methods. 2019;16(12):1289-1296. https://doi.org/10.1038/s51592-019-0619-0
- Aran D et al. Reference-based analysis of lung single-cell sequencing reveals a transitional profibrotic macrophage. Nat Immunol. 2019;20(2):163-172. https://doi.org/10.1038/s41590-018-0276-y
- Ritchie ME et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. https://doi.org/10.1093/nar/gkv007
- Barbie DA et al. Systematic RNA interference reveals that oncogenic KRAS-driven cancers require TBK1. Nature. 2009;462(7269):108-112. https://doi.org/10.1038/nature08460
- Yu G et al. clusterProfiler: an R package for comparing biological themes among gene clusters. OMICS. 2012;16(5):284-287. https://doi.org/10.1089/omi.2011.0118
- Szklarczyk D et al. STRING v11: protein-protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607–D613. https://doi.org/10.1093/nar/gky1131
- Shannon P et al. Cytoscape: a software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504. https://doi.org/10.1101/gr.1239303
- Chin CH et al. cytoHubba: identifying hub objects and sub-networks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11. https://doi.org/10.1186/1752-0509-8-S4-S11
- Bader GD, Hogue CW. An automated method for finding molecular complexes in large protein interaction networks. BMC Bioinformatics. 2003;4:2. https://doi.org/10.1186/1471-2105-4-2
- Friedman J, Hastie T, Tibshirani R. Regularization Paths for Generalized Linear Models via Coordinate Descent. J Stat Softw. 2010;33(1):1-22. https://doi.org/10.18637/jss.v033.i01
- Touw WG et al. Data mining in the Life Sciences with Random Forest: a walk in the park or lost in the jungle. Brief Bioinform. 2013;14(3):315-326. https://doi.org/10.1093/bib/bbs034
- Chicco D. Ten quick tips for machine learning in computational biology. BioData Min. 2017;10:35. https://doi.org/10.1186/s13040-017-0155-3
- Robin X et al. pROC: an open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics. 2011;12:77. https://doi.org/10.1186/1471-2105-12-77
- Lundberg SM et al. From Local Explanations to Global Understanding with Explainable AI for Trees. Nat Mach Intell. 2020;2(1):56-67. https://doi.org/10.1038/s42256-019-0138-9
- Jin S et al. Inference and analysis of cell-cell communication using CellChat. Nat Commun. 2021;12(1):1088. https://doi.org/10.1038/s41467-021-21246-9
- Charoentong P et al. Pan-cancer Immunogenomic Analyses Reveal Genotype-Immunophenotype Relationships and Predictors of Response to Checkpoint Blockade. Cell Rep. 2017;18(1):248–262. https://doi.org/10.1016/j.celrep.2016.12.019
- Wilkerson MD, Hayes DN. ConsensusClusterPlus: a class discovery tool with confidence assessments and item tracking. Bioinformatics. 2010;26(12):1572–1573. https://doi.org/10.1093/bioinformatics/btq170
- Hänzelmann S, Castelo R, Guinney J. GSVA: gene set variation analysis for microarray and RNA-seq data. BMC Bioinformatics. 2013;14:7. https://doi.org/10.1186/1471-2105-14-7
- Zheng Y et al. Exploring Key Genes to Construct a Diagnosis Model of Dilated Cardiomyopathy. Front Cardiovasc Med. 2022;9:865096. https://doi.org/10.3389/fcvm.2022.865096
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-127. https://doi.org/10.1093/biostatistics/kxj037
- Koslow M, Mondaca-Ruff D, Xu X. Transcriptome studies of inherited dilated cardiomyopathies. Mamm Genome. 2023;34(2):312-322. https://doi.org/10.1007/s00335-023-09978-z
- Zhang B, Horvath S. A general framework for weighted gene co-expression network analysis. Stat Appl Genet Mol Biol. 2005;4:Article17. https://doi.org/10.2202/1544-6115.1128
- Lin M et al. Machine learning and multi-omics integration: advancing cardiovascular translational research and clinical practice. J Transl Med. 2025;23(1):388. https://doi.org/10.1186/s12967-025-06425-2
- Climente-González H et al. Interpretable machine learning leverages proteomics to improve cardiovascular disease risk prediction and biomarker identification. Commun Med (Lond). 2025;5(1):170. https://doi.org/10.1038/s43856-025-00872-0
- Shah P et al. Predicting cardiovascular risk with hybrid ensemble learning and explainable AI. Sci Rep. 2025;15(1):17927. https://doi.org/10.1038/s41598-025-01650-7
- Chaffin M et al. Single-nucleus profiling of human dilated and hypertrophic cardiomyopathy. Nature. 2022;608(7921):174-180. https://doi.org/10.1038/s41586-022-04817-8
- Juan F et al. The changes of the cardiac structure and function in cTnTR141W transgenic mice. Int J Cardiol. 2008;128(1):83-90. https://doi.org/10.1016/j.ijcard.2008.03.006
- Russell-Hallinan A et al. Single-Cell RNA Sequencing Reveals Cardiac Fibroblast-Specific Transcriptomic Changes in Dilated Cardiomyopathy. Cells. 2024;13(9):752. https://doi.org/10.3390/cells13090752
- Knowlton KU. Dilated Cardiomyopathy. Circulation. 2019;139(20):2339-2341. https://doi.org/10.1161/CIRCULATIONAHA.119.040037
- Smith GD, Ebrahim S. Mendelian randomization: prospects, potentials, and limitations. Int J Epidemiol. 2004;33(1):30-42. https://doi.org/10.1093/ije/dyh132
- Chen R et al. Macrophages in cardiovascular diseases: molecular mechanisms and therapeutic targets. Signal Transduct Target Ther. 2024;9(1):130. https://doi.org/10.1038/s41392-024-01840-1
- Liu R et al. Tead1 is essential for mitochondrial function in cardiomyocytes. Am J Physiol Heart Circ Physiol. 2020;319(1):H89-H99. https://doi.org/10.1152/ajpheart.00732.2019
- Sharma S et al. SOD2 deficiency in cardiomyocytes defines defective mitochondrial bioenergetics as a cause of lethal dilated cardiomyopathy. Redox Biol. 2020;37:101740. https://doi.org/10.1016/j.redox.2020.101740