Niniejsze badanie przedstawia RareCode – nienadzorowany model głębokiego uczenia, który wykrywa anomalie w obrazach histopatologicznych raka jelita grubego poprzez analizę rzadkości aktywacji książki kodowej (Codebook Activation Rarity – CAR), co stwarza potencjał do wspomagania wstępnej przesiewowej diagnostyki bez konieczności użycia etykietowanych danych treningowych.
Artykuł badawczy
RareCode: Nienadzorowany system głębokiego uczenia do detekcji anomalii w obrazach histopatologicznych raka jelita grubego
W tym artykule
Podsumowanie
Streszczenie
Nienadzorowane wykrywanie anomalii w obrazach histopatologicznych było szeroko badane z wykorzystaniem podejść opartych na rekonstrukcji, które mierzą błędy rekonstrukcji, jednak metody te często nie potrafią uchwycić subtelnych patologicznych zmian na poziomie semantycznym ze względu na naturalną heterogeniczność tekstur tkanek. Aby rozwiązać ten problem, niniejsze badanie przedstawia RareCode – framework oparty na kwantyzacji wektorowej, który rozszerza paradygmat detekcji poza rekonstrukcję na poziomie pikseli, aby włączyć analizę aktywacji książki kodowej (codebook) na poziomie semantycznym. Główną innowacją jest scoring Rzadkości Aktywacji Książki Kodowej (Codebook Activation Rarity, CAR), który profiluje częstotliwość aktywacji każdego wpisu w książce kodowej podczas uczenia wyłącznie na próbkach prawidłowych i oznacza rzadkie aktywacje jako wskaźniki anomalii w czasie wnioskowania, uzupełniając w ten sposób błędy rekonstrukcji o dyskryminację na poziomie semantycznym. W oparciu o ten jednoskalowy mechanizm CAR wprowadzono dodatkowo moduł Wieloskalowej Hierarchicznej Książki Kodowej (Multi-scale Hierarchical Codebook, MHC), wykorzystujący książki kodowe o różnych rozmiarach z wyuczalnymi wagami fuzji, aby uchwycić wzorce patologiczne obejmujące zarówno grube struktury na poziomie tkanki, jak i drobne szczegóły na poziomie komórkowym. Wykorzystując projekt wieloskalowy, generowane są hierarchiczne mapy ciepła anomalii dla każdego poziomu ziarnistości książki kodowej, co dostarcza patologom interpretowalnych, wielowymiarowych wizualnych wskazówek lokalizacji, wskazujących zarówno miejsce, jak i poziom strukturalny występowania anomalii. Pięciokrotna walidacja krzyżowa na klinicznie adnotowanym zbiorze obrazów histopatologicznych raka jelita grubego, pozyskanym ze szpitala Shenzhen People's Hospital, wykazuje, że RareCode osiąga pole pod krzywą (AUC) na poziomie 96,82%, przewyższając metody bazowe. Analiza per-klasa wykazała wyższą skuteczność w wykrywaniu nowotworów (AUC = 99,44%, swoistość = 94,21%) niż w wykrywaniu stanów zapalnych (AUC = 94,30%, swoistość = 60,44%). Wyniki te sugerują, że analiza CAR może stanowić obiecujące nienadzorowane podejście do wykrywania anomalii histopatologicznych, potencjalnie wspierając kliniczny przesiew w diagnostyce raka jelita grubego.
Wprowadzenie
Niezawodne badanie histopatologiczne w kierunku raka jelita grubego pozostaje ograniczone przez konieczność adnotacji eksperckich i manualnej weryfikacji, szczególnie w sytuacjach, gdy zmiany zapalne i nowotworowe wykazują nakładającą się morfologię1,2. Ograniczenia te stanowią motywację do stosowania nienadzorowanych podejść obliczeniowych, które uczą się na podstawie prawidłowej tkanki bez konieczności przeprowadzania wyczerpujących adnotacji zmian patologicznych3,4.
Kliniczna pilność automatycznego screeningu histopatologicznego wynika z rosnącej dysproporcji między zapotrzebowaniem diagnostycznym a dostępną wiedzą specjalistyczną w dziedzinie patomorfologii; obciążenie diagnostyczne przypadające na jednego patologa w USA wzrosło o ponad 40% w ciągu jednej dekady, podczas gdy liczba pracowników tego sektora nadal malała5. W przypadku raka jelita grubego (CRC) zorganizowane programy przesiewowe wiązały się z redukcją śmiertelności o 29-68%6, jednak możliwości manualnej oceny patomorfologicznej pozostają ograniczone ze względu na dostępność personelu. Zautomatyzowany system wstępnej oceny, który niezawodnie identyfikuje podejrzane przypadki do priorytetowej analizy, mógłby pomóc w zmniejszeniu tego obciążenia i skrócić czas oczekiwania na wynik diagnostyczny. Wdrożenie takich systemów wymaga jednak zarówno wysokiej czułości, aby uniknąć pominięcia wyników prawdziwie dodatnich, jak i odpowiedniej swoistości, aby zapobiec nadmiernej liczbie fałszywych alarmów7.
Nienadzorowana detekcja anomalii (UAD) zyskuje na znaczeniu w analizie obrazów medycznych8, ponieważ pozwala na modelowanie rozkładów tkanek prawidłowych bez konieczności posiadania etykiet treningowych dla zmian patologicznych3,9,10. Modele oparte na rekonstrukcji, w tym autoenkodery, wariacyjne autoenkodery, generatywne sieci przeciwstawne oraz warianty z pamięcią wspomaganą, identyfikują anomalie poprzez błędy rekonstrukcji, jednak dekodery o wysokiej pojemności mogą wciąż rekonstruować obszary patologiczne z wysoką wiernością11,12,13,14,15,16,17. Metody oparte na cechach, takie jak PatchCore i PaDiM, wykorzystują wstępnie wytrenowane reprezentacje, choć cechy wyuczone na obrazach naturalnych mogą nie w pełni oddawać atypię mikroskopową w histopatologii18,19,20,21. Specjalistyczne modele bazowe dla patomorfologii oraz detektory anomalii oparte na modelach dyfuzyjnych stanowią potężne alternatywy, lecz ich zapotrzebowanie na dane lub koszty obliczeniowe mogą ograniczać ich bezpośrednie zastosowanie w badaniach wysokoprzepustowych22,23. Niedawne metody zautomatyzowane i ewolucyjne, takie jak EvoAAE24 i MoARNN-AM25, dodatkowo ilustrują wartość adaptacyjnej optymalizacji modeli w detekcji anomalii, choć konteksty ich zastosowania różnią się od analizy obrazów histopatologicznych. Z kolei metody oparte na kwantyzacji wektorowej (VQ) wprowadzają dyskretne ograniczenia książki kodowej (codebook), co może ograniczyć mapowanie identyczności; jednak istniejące podejścia oparte na VQ wciąż opierają się głównie na przestrzennych błędach rekonstrukcji i nie w pełni wykorzystują informacje semantyczne zawarte w wzorcach aktywacji książki kodowej26,27.
Chociaż wspomniane metody wykazują obiecującą skuteczność w domenach ogólnych, ich zastosowanie w złożonych scenariuszach histopatologicznych wiąże się z konkretnymi wyzwaniami. Obrazy histopatologiczne charakteryzują się złożoną heterogennością tkanek na wielu poziomach strukturalnych28. W praktyce analiza obrazów odbywa się zazwyczaj na lokalnych fragmentach obrazu wyodrębnionych z przekrojów tkanek, a diagnoza patologiczna ma z natury charakter wielkoskalowy: patolodzy oceniają morfologię gruczołów i tkanek przy małym powiększeniu, badając jednocześnie pleomorfizm jądrowy i figury mitotyczne przy dużym powiększeniu29. Zidentyfikowaliśmy trzy kluczowe ograniczenia obecnych podejść: Po pierwsze, anomalie patologiczne i tkanki prawidłowe wykazują duże podobieństwo w niskopoziomowych cechach wizualnych, takich jak style barwienia i lokalne tekstury, co sprawia, że metody oparte na rekonstrukcji zawodzą w wykrywaniu subtelnych anomalii, ponieważ zarówno próbki prawidłowe, jak i anomalne mogą dawać podobną jakość rekonstrukcji na poziomie semantycznym. Po drugie, większość istniejących metod wykorzystuje jednoskalową ekstrakcję cech, co utrudnia jednoczesne uchwycenie cech anomalnych zarówno na poziomie tkankowym, jak i komórkowym30,31. Po trzecie, mimo że główne metody potrafią generować mapy ciepła na poziomie pikseli, często nie udaje im się w sposób intuicyjny uchwycić hierarchicznych atrybutów anomalii, co ogranicza przydatność takich modeli jako narzędzi wspomagających diagnostykę kliniczną.
Aby sprostać powyższym wyzwaniom, proponujemy RareCode – framework UAD, który bada wzorce aktywacji książki kodowej (codebook) oraz hierarchiczną reprezentację cech na wielu poziomach abstrakcji. Framework wprowadza trzy główne komponenty: (1) mechanizm oceny rzadkości aktywacji książki kodowej (Codebook Activation Rarity, CAR), który oblicza wyniki rzadkości na podstawie częstotliwości aktywacji wpisów trenowanych wyłącznie na próbkach prawidłowych, co pozwala odróżnić próbki prawidłowe od anomalnych na poziomie semantycznym i dostarcza sygnały dyskryminacyjne uzupełniające tradycyjne błędy rekonstrukcji przestrzennej; (2) architekturę fuzji wieloskalowej hierarchicznej książki kodowej (Multi-scale Hierarchical Codebook, MHC), która wychwytuje cechy patologiczne na wielu poziomach ziarnistości – od grubych wzorców strukturalnych po drobnoziarniste szczegóły komórkowe – poprzez zastosowanie książek kodowych o różnej pojemności, przy czym adaptacyjna fuzja jest realizowana za pomocą wag uczących się; (3) hierarchiczny moduł lokalizacji interpretowalnej, który wykorzystuje architekturę wieloskalową do generowania map ciepła anomalii o różnej ziarnistości, dostarczając patologom wieloskalowych, semantycznie interpretowalnych referencji diagnostycznych.
Główną hipotezą niniejszego badania było to, że profile częstotliwości aktywacji książek kodów, wyprowadzone z książek kodów trenowanych wyłącznie na obrazach histopatologicznych prawidłowego jelita grubego, będą kodować istotne semantycznie informacje o anomaliach wykraczające poza błąd rekonstrukcji na poziomie pikseli, a wieloskalowa integracja tych komplementarnych sygnałów poprawi rozróżnianie obrazów zawierających tkankę nowotworową lub zapalną od obrazów prawidłowych w porównaniu z reprezentatywnymi metodami UAD, oceniane przede wszystkim za pomocą AUC. Aby zweryfikować tę hipotezę, oceniliśmy RareCode, stosując 5-krotną walidację krzyżową na klinicznie adnotowanym zbiorze danych CRC, oraz przeprowadziliśmy analizy ablacyjne i lokalizacyjne w celu zbadania wkładu i interpretowalności jego kluczowych komponentów.
Protokół
Niniejsze badanie zostało zatwierdzone przez Komitet Etyczny ds. Badań Klinicznych Szpitala Ludowego w Shenzhen'szpitala (nr zgody: LL-KY-2025300-01). Wymóg uzyskania świadomej zgody został odwołany przez komitet etyczny, ponieważ niniejsze badanie retrospektywne wykorzystywało istniejące obrazy histopatologiczne i materiały kliniczne bez bezpośredniego kontaktu z pacjentami ani interwencji. Wszystkie dane kliniczne i obrazy histopatologiczne zostały zanonimizowane przed analizą, a w badaniu nie wykorzystano żadnych informacji umożliwiających identyfikację osób. Wszystkie dane wykorzystane w badaniach zostały przetworzone zgodnie ze standardami etycznymi instytucjonalnych i krajowych komitetów ds. badań naukowych.
Omówienie ramowe
Ogólna architektura proponowanego ramowego rozwiązania UAD, RareCode, została przedstawiona na Rycina 1. Ramy pracy wykorzystują równoległą architekturę dwuramieniową. Dla każdego obrazu wejściowego o rozmiarze 512 x 512 niepokrywające się fragmenty o rozmiarach 32 x 32 i 64 x 64 są wyodrębniane jako wejścia o skali odpowiednio drobnej i grubej. Fragmenty 64 x 64 są zmieniane do rozmiaru 32 x 32 przed przekazaniem do sieci, aby oba ramiona współdzieliły ten sam rozmiar wejściowy enkodera-dekodera, zachowując jednocześnie różne pola odbiorcze. Enkodery w każdym ramieniu odwzorowują wyodrębnione cechy w przestrzeń ukrytą, gdzie moduł MHC nakłada ograniczenia dyskretyzacji. Następnie dekodery rekonstruują obraz z kwantyzowanych cech w celu obliczenia błędów rekonstrukcji w dziedzinie przestrzennej. Mechanizm CAR mierzy następnie stopień anomalii na poziomie semantycznym poprzez analizę częstości aktywacji w zbiorze kodowym. Wreszcie model łączy wyniki rekonstrukcji i wyniki CAR za pomocą ważonej kombinacji, aby uzyskać wyniki anomalii na poziomie obrazu. Framework RareCode jest uczony kompleksowo (end-to-end) wyłącznie na podstawie próbek normalnych, bez konieczności adnotowania anomalii. Dwuramieniowa architektura została wykorzystana w celu przechwycenia zarówno lokalnych cech komórkowych, jak i szerszych struktur gruczołowych. Moduł MHC został wykorzystany do modelowania tych cech za pomocą zbiorów kodowych o różnej pojemności.
Architektura enkoder-dekoder
RareCode konstruuje strukturalnie niezależne enkodery i dekodery dla gałęzi szczegółowej i ogólnej. Każda gałąź wykorzystuje ten sam projekt enkoder-dekoder, ale nie współdzieli parametrów. Enkoder składa się z czterech bloków konwolucyjnych, z których każdy zawiera konwolucję 3 × 3, normalizację wsadową, aktywację ReLU oraz dropout. Liczba kanałów rośnie od 64 do 128, następnie do 256, a końcową mapę cech spłaszcza się i rzutuje na 64-wymiarowy ukryty wektor cech. Dekoder jest lustrzanym odbiciem enkodera i zawiera warstwę rzutowania w pełni połączoną oraz cztery warstwy konwolucji transponowanej, odtwarzając każdy fragment do oryginalnego rozmiaru wejściowego sieci. Błąd rekonstrukcji obliczany jest jako średniokwadratowy błąd pomiędzy wejściem a odtworzonymi fragmentami. Łącząc tę strukturę enkoder-dekoder z dyskretnymi ograniczeniami słownika kodowego, RareCode uczy się kompaktowych reprezentacji tkanki prawidłowej i mierzy odchylenia podczas wnioskowania.
Wieloskalowy hierarchiczny kodeks
Aby uchwycić cechy patologiczne na wielu poziomach abstrakcji—od szerokich wzorców tkankowych po zlokalizowane zmiany komórkowe—moduł MHC wykorzystuje K dyskretnych kodeków  o różnej pojemności n1, n2, ..., nKW końcowej konfiguracji FourScales każda gałąź zawiera cztery kodeksy o 64, 128, 256 oraz 512 wpisach odpowiednio, a każdy wpis w kodeksie ma 64-wymiarowe osadzenie. Dla każdej zakodowanej cechy fragmentu najbliższy wpis w kodeksie jest wybierany na podstawie odległości euklidesowej. Skwantyzowane wyjścia z różnych kodeksów są następnie łączone za pomocą nauczanych wag, znormalizowanych pomiędzy kodeksami. Oczekuje się, że mniejsze kodeksy, ze względu na silniejsze ograniczenia kompresji, kodują ogólne, typowe wzorce, abstrahujące od lokalnych różnic, podczas gdy większe kodeksy zachowują cechy bardziej szczegółowe, oddające konkretniejsze cechy strukturalne. Dla każdego kodeksu
 , gdzie ek(i)
 Rd oznacza i-ty wektor osadzania w k-tym kodeksie, cechy ciągłe są odwzorowywane na dyskretną przestrzeń kodeksu poprzez wyszukiwanie najbliższego sąsiada (równ. 1 i 2):
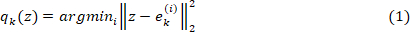

Aby osiągnąć adaptacyjne fuzję cech wieloskalowych, wprowadzamy nauczalne wagi. Po normalizacji softmax wykonywane jest ważone sumowanie nad zakwantyzowanymi wyjściami z każdej księgi kodów (równ. 3):
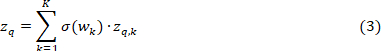
gdzie σ(·) oznacza funkcję softmax, zapewniającą, że wagi spełniają Σk σ(wk) = 1. Ten rodzaj konstrukcji pozwala modelowi na automatyczne dostosowywanie współczynników udziału kartotek na różnych poziomach szczegółowości w oparciu o semantyczną zawartość cech wejściowych.
W celu zoptymalizowania uczenia się kodbooka przyjmujemy standardową funkcję straty VQ (równ. 4):
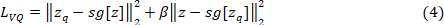
gdzie sg[·] oznacza operację zatrzymania gradientu, a β = 0,25 to współczynnik wagi straty zobowiązania. Pierwszy składnik zachęca wektory słownika kodowego do przemieszczania się w kierunku wyjść enkodera, podczas gdy drugi składnik zachęca wyjścia enkodera do zachowania spójności z odpowiadającymi im wektorami słownika kodowego. Kompletny mechanizm wieloskalowego VQ przedstawiono na Rycina 2.
Ocenianie rzadkości aktywacji kodów
CAR mierzy anomalie na poziomie semantycznym na podstawie statystyk aktywacji słownika, oszacowanych na podstawie normalnych próbek uczących. Po zakończeniu uczenia modelu wszystkie normalne obrazy uczące zostały przepuszczone przez enkoder i moduł MHC bez augmentacji danych. Dla każdej gałęzi i każdego słownika zarejestrowano indeks przypisania każdej cechy fragmentu oraz zliczono liczbę przypisań do każdego wpisu w słowniku. Następnie liczby te zostały unormowane w celu uzyskania rozkładu częstości aktywacji dla danego słownika (równanie 5):

Podczas wnioskowania każdy obraz testowy był przetwarzany za pomocą tej samej procedury ekstrakcji fragmentów, kodowania i przypisywania najbliższego sąsiada z katalogu kodów. Dla każdego przypisanego wpisu w katalogu kodów, wartość rzadkości obliczana jest jako ujemny logarytm częstości jego aktywacji w zbiorze treningowym normalnych przypadków (Równ. 6):

gdzie ε jest małą stałą wykorzystywaną w celu zapewnienia stabilności numerycznej. W związku z tym wpis w słowniku kodów o niskiej częstotliwości otrzymuje wyższy wynik rzadkości, co sugeruje, iż odpowiadający mu cechę fragmentu mniej zgodna jest z nauczoną dystrybucją tkanki prawidłowej. Wyniki rzadkości na poziomie fragmentów były uśredniane w obrębie każdego obrazu oraz pomiędzy ramionami o wysokiej i niskiej rozdzielczości, w celu uzyskania odpowiedzi rzadkości na poziomie obrazu.
Aby uzupełnić rzadkość opartą na częstości aktywacji, obliczamy również wynik odległości kwantyzacji oparty na percentylach (równ. 7):
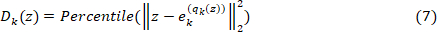
Wynik ten pochodzi od odległości euklidesowej między każdym zakodowanym wektorem cech a jego najbliższym wpisem w słowniku kodowym. Rozkład odległości szacuje się na podstawie normalnych próbek treningowych, a odległości próbek testowych przelicza się na wyniki percentylowe. Wyższe wyniki percentylowe wskazują, że zakodowana cecha jest trudniejsza do reprezentacji przy użyciu nauczonych prototypów normalnego słownika kodowego.
Ostateczna ocena CAR łączy rzadkość aktywacji i odległość kwantyzacji we wszystkich kodeksach za pomocą nauczalnych wag kodeksów (równ. 8):
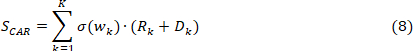
Te same znormalizowane wagi kodowego słownika, które są stosowane do fuzji cech wieloskalowych, wykorzystywane są również w fuzji na poziomie ocen, zapewniając spójność między uczeniem reprezentacji a ocenianiem anomalii. Otrzymany wynik CAR obliczany jest na poziomie obrazu, a następnie łączy się go z wynikiem rekonstrukcji, aby uzyskać końcową ocenę anomalii. Całkowity mechanizm oceniania CAR przedstawiono na Rycina 3.
Ostateczne obliczenie wyniku anomalii
Łączymy błędy rekonstrukcji w dziedzinie przestrzennej ze wskaźnikami CAR na poziomie semantycznym. Przed połączeniem oba wskaźniki są oddzielnie normalizowane za pomocą min-max opartego na percentylach, aby zmniejszyć wpływ skrajnych wartości odstających. Ostateczny, obrazowy wskaźnik niezwykłości definiuje się następnie jako (równ. 9):
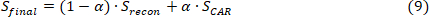
gdzie Srekon oznacza znormalizowany średni błąd rekonstrukcji w przestrzeni pikseli, odzwierciedlający jakość rekonstrukcji próbek; SCAR to wynik CAR opisany powyżej, oddający stopnie anomalii na poziomie semantycznym. Hiperparametr α [0,1] kontroluje względną wagę między dwoma składowymi, przy czym optymalne wartości są wyznaczane na zbiorach walidacyjnych.
Cel szkolenia
Framework RareCode jest szkolony end-to-end wyłącznie przy użyciu próbek normalnych. Całkowity błąd treningowy składa się z następujących składowych (Równanie 10):

Każdy termin jest definiowany następująco: Strata rekonstrukcji: 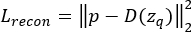 , mierząc średni błąd kwadratowy między fragmentami wejściowymi p i odtworzone plamy D(zq) po kwantyzacji. Strata ta jest stosowana oddzielnie do 32 × 32 patch branch (
 ) i 64 × 64 patch branch (
 ) aby zapewnić skuteczne naukę cech na obu skalach przestrzennych.
Opis zestawu danych
Aby ocenić działanie RareCode, przeprowadzono eksperymenty na klinicznie opisanym zbiorze danych obrazów histopatologicznych raka jelita grubego (CRC), obejmującym obrazy przekrojów tkanek jelita grubego barwionych hematoksyliną i eozyną (H&E)&E), uzyskany z Shenzhen People's Hospital. Wszystkie obrazy w tym zbiorze pochodzą z rzeczywistych przypadków klinicznych. Obrazy zostały zdigitalizowane w powiększeniu 40x z oryginalną rozdzielczością 1024 × 1024 piksele. W celu zapewnienia rzetelności i jakości adnotacji wszystkie etykiety kategorii próbek zostały wspólnie przeanalizowane i potwierdzone przez dwóch lub więcej wybitnych specjalistów-patologów zgodnie z protokołem podwójnie ślepego badania.
Na podstawie cech histopatologicznych zbiór danych został podzielony na trzy klasy: tkankę normalną (1226 obrazów), nowotwór (1215 obrazów) oraz stan zapalny (1214 obrazów). W ustawieniu binarnym UAD próbki z nowotworem i stanem zapalnym traktowane były jako anomalie, natomiast próbki normalne stanowiły rozkład odniesienia. Takie sformułowanie odzwierciedla zamierzone zadanie triażu polegające na oddzieleniu przypadków wymagających dalszej oceny patologicznej od tych, które są morfologicznie normalne.
Wszystkie H&Obrazy postrzegane w świetle odbitym zostały przeskalowane do rozmiaru 512 × 512 pikseli przed użyciem jako wejście sieci. Do oceny zastosowano warstwową pięciokrotną walidację krzyżową. W każdej części normalne próbki najpierw podzielono na podzbiory uczący, walidacyjny i testowy (przytrzymywany). RareCode trenowano wyłącznie na normalnych próbkach z podzbioru uczącego. Podzbiór walidacyjny, zawierający również wyłącznie normalne próbki, użyto do selekcji modelu, dostrajania hiperparametrów oraz wyboru wagi fuzji. αZestaw testowy typu „held-out”, składający się z niezobaczonych próbek normalnych oraz próbek nietypowych, w tym nowotworowych i zapalnych, został użyty wyłącznie do końcowej oceny wydajności modelu i nie był wykorzystywany do uczenia modelu, doboru hiperparametrów ani α selekcji. Przedstawiono reprezentatywne kategorie, strukturę zbioru danych oraz protokół walidacji w Rycina 4.
Szczegóły implementacji
Zaproponowany system RareCode oraz porównawcze metody referencyjne zaimplementowano przy użyciu PyTorch. Wszystkie eksperymenty przeprowadzono na stacji roboczej wyposażonej w pojedynczą kartę graficzną NVIDIA GeForce RTX 4060 Ti (16 GB). W celu konfiguracji architektury sieci, aby uchwycić cechy na różnych skalach przestrzennych, architektura dwurzędowa przetwarza niepokrywające się fragmenty w dwóch skalach: 32 × 32 piksele (mniejsze pole odbiorcze, przechwytujące lokalne wzory tekstury) i 64 × 64 piksele (większe pole odbiorcze, obejmujące szerszy kontekst przestrzenny), odpowiednio. Wymiar ciągłego osadzania cech generowanego przez oba enkodery gałęzi jest jednolicie ustawiony na 64. W module MHC konfigurujemy cztery kodeksy o różnych pojemnościach dla każdej gałęzi, z odpowiednio 64, 128, 256 i 512 dyskretnymi prototypami.
W trakcie optymalizacji sieć była trenowana kompleksowo przez 50 epok z rozmiarem partii równym 8. Do aktualizacji wag zastosowano optymalizator AdamW z początkowym współczynnikiem uczenia równym 5 × i współczynnik regularyzacji wag (weight decay) w celu zapobiegania przeuczeniu. Dodatkowo, aby zapewnić gładką zbieżność procesu uczenia, zastosowano harmonogram zmian szybkości uczenia typu kosinusoidalnego (cosine annealing), co umożliwia dokładniejszą optymalizację w późniejszych etapach treningu. Rozmiary fragmentów (patch sizes) oraz rozmiary słownika kodowego (codebook sizes) dobrano tak, aby zrównoważyć reprezentację wieloskalową i koszt obliczeniowy. Ostateczną konfigurację FourScales poparto analizą ablacyjną, i α został wybrany na zbiorze walidacyjnym przed oceną na zbiorze testowym.
W celu analizy wpływu złożoności dekodera zaimplementowano wariant złożonego dekodera oparty na konfiguracji FourScales. Wariant ten wykorzystywał ten sam podział danych, rozmiary codebooków, liczbę epok treningowych, optymalizator, współczynnik uczenia oraz walidację opartą na α selekcji i metryk oceny jako model FourScales. Podstawowy dekoder został zastąpiony dekoderem w stylu EMCAD, zawierającym bloki splotu głębokościowego wieloskalowego oraz moduły uwagi bloku splotowego (CBAM). Po każdym z pierwszych trzech etapów podwyższania próbkowania za pomocą transponowanego splotu, równolegle 3 × 3, 5 × 5 i 7 × Zastosowano 7 splotów wgłąb, po których nastąpił 1 × 1 fuzja punktowa, normalizacja wsadowa, aktywacja ReLU, połączenie resztkowe oraz uwaga CBAM. CBAM zawierała uwagę kanałową opartą na deskryptorach uśredniania i maksymalnego uśredniania oraz uwagę przestrzenną wykorzystującą 7 × 7 splotów. Ostatni etap wykorzystywał splot transponowany i aktywację sigmoidalną do rekonstrukcji 32 × 32 plastry.
Wyniki
Porównanie z metodami bazowymi
Aby ocenić framework RareCode, jako metody bazowe wybrano kilka reprezentatywnych metod UAD, obejmujących metody oparte na rekonstrukcji (CAE32, VAE12, SAE33, MAE34, PatchSAE35), rekonstrukcję wspomaganą pamięcią (MemAE36), destylację wiedzy (STFPM37), syntetyczne generowanie anomalii (DRAEM38) oraz ekstrakcję cech z modeli wstępnie wytrenowanych (PatchCore18). Dobór metod bazowych skupił się na rozwiązaniach, które mogą być trenowane lub stosowane przy porównywalnych budżetach obliczeniowych i założeniach dotyczących danych (dostęp wyłącznie do nieoznakowanych próbek treningowych stanu normalnego), co zapewniło, że różnice w wydajności odzwierciedlają wkład metodologiczny, a nie różnice w skali danych do wstępnego trenowania. W celu zapewnienia sprawiedliwego porównania wszystkie metody oceniono przy użyciu tych samych 5-krotnych podziałów danych, tego samego potoku przetwarzania wstępnego, tych samych metryk oceny i tego samego środowiska obliczeniowego. Modele trenowano zgodnie z tym samym protokołem UAD, wykorzystując wyłącznie normalne próbki treningowe, przy czym hiperparametry i progi wybrano na zbiorze walidacyjnym, a ostateczną wydajność oceniono wyłącznie na wydzielonym zbiorze testowym. Tabela 1 podsumowuje wyniki 5-krotnej walidacji krzyżowej, a Rycina 5 przedstawia porównania na wielokryterialnych wykresach radarowych.
Jak pokazano w Tabela 1 i Rycina 5RareCode osiąga korzystną wydajność detekcji oraz stabilność statystyczną w zbiorze danych CRC. Pod względem AUC, RareCode (96,82 ± 0,23%) przewyższa wiele bazowych modeli opartych na rekonstrukcji, w tym MemAE (94,97 ± 0,81%). Analiza statystyczna potwierdza, że RareCode przewyższa wszystkie modele bazowe oparte na rekonstrukcji (testy t dla prób zależnych, p < 0,05), przy czym poprawa w stosunku do MemAE osiągnęła istotność statystyczną (p < 0,01). RareCode wykazuje niską wariancję wyników (odchylenie standardowe wynoszące 0,23%), co wskazuje na spójną stabilność między fałdami. Ograniczona skuteczność DRAEM, opartego na syntetycznych anomaliach, prawdopodobnie wynika z faktu, że proste strategie nakładania tekstur nie są w stanie w sposób odpowiedni symulować złożonej atypii patologicznej.
Jeśli chodzi o specyficzność, RareCode osiąga 58,24 ± 5,99%, przewyższając wszystkie porównywane metody w zakresie redukcji wskaźników wyników fałszywie dodatnich. Reprezentuje to poprawę o około 25 punktów procentowych w stosunku do linii bazowej opartej wyłącznie na rekonstrukcji (NoCAR, 33,76%), co wykazuje wkład mechanizmu CAR w redukcję wyników fałszywie dodatnich. Niższa specyficzność metod STFPM i PatchCore, które opierają się na cechach wstępnie wytrenowanych na obrazach naturalnych, może częściowo odzwierciedlać lukę domenową między obrazami naturalnymi a histopatologicznymi. Warto zauważyć, że STFPM i DRAEM wykazują wysoką wariancję specyficzności (±33,53% i ±7,09%), przy czym specyficzność dla poszczególnych fałdów waha się od wartości bliskich zeru do poziomów umiarkowanych, co budzi obawy co do niezawodności ich wdrożenia.
Wydajność detekcji w poszczególnych klasach>
Analizę w poszczególnych klasach przeprowadzono poprzez oddzielne porównanie próbek z nowotworem i stanem zapalnym z próbkami prawidłowymi (Tabela 2). RareCode osiągnął wyższą wydajność w detekcji nowotworów (AUC = 99,44 ± 0,12%, recall = 98,13 ± 0,29%, specyficzność = 94,21 ± 2,22%) niż w detekcji stanów zapalnych (AUC = 94,30 ± 0,44%, recall = 96,55 ± 0,78%, specyficzność = 60,44 ± 4,34%). Wyniki te sugerują, że RareCode może wykazywać silniejszą dyskryminację w przypadku zmian złośliwych niż zmian zapalnych, podczas gdy granica między stanem zapalnym a stanem prawidłowym wydaje się w znacznym stopniu przyczyniać do obniżenia ogólnej specyficzności.
Badanie ablacyjne
Aby zbadać wkład kluczowych komponentów w ramach struktury RareCode, przeprowadzono eksperymenty ablacyjne w celu oceny wpływu mechanizmu CAR oraz modułu MHC na wydajność detekcji. Wyniki szczegółowo przedstawiono w Tabeli 3. Jak pokazano na Rysunku 6A, dodanie CAR do bazowego modelu opartego wyłącznie na rekonstrukcji poprawiło AUC z 92,81% do 95,92%, a fuzja wieloskalowych książek kodowych (codebooks) dodatkowo zwiększyła AUC do 96,82%. Rysunek 6B pokazuje, że CAR poprawił również swoistość, zwiększając ją z 33,76% w modelu bazowym NoCAR do 58,24% w pełnym modelu FourScales. Wyniki te potwierdzają komplementarną wartość rzadkości aktywacji książki kodowej oraz fuzji wieloskalowej.
Dodatkowo, przy użyciu konfiguracji FourScales przeprowadzono analizę ablacyjną złożoności dekodera. Jak pokazano w Tabeli 3, wariant z rozbudowanym dekoderem, wykorzystujący wieloskalowe bloki splotów głębinowych (depthwise convolution) oraz moduły uwagi bloków splotowych (CBAM), wykazał niższą wartość AUC niż podstawowy model FourScales (95,17 ± 0,44% vs. 96,82 ± 0,23%). Wynik ten sugeruje, że w ramach obecnej konfiguracji RareCode opartej na VQ-AE, zwiększenie pojemności dekodera nie poprawiło wydajności detekcji anomalii i może obniżać skuteczność reprezentacji ograniczonej przez książkę kodową (codebook).
Hierarchiczna analiza odpowiedzi przestrzennej
Aby zbadać odpowiedzi przestrzenne generowane przez RareCode, błąd rekonstrukcji na poziomie fragmentów oraz mapy rzadkości książki kodów zostały zagregowane na poziomie obrazu i porównane pomiędzy próbkami normalnymi a anomalnymi. Do ilościowego określenia separacji odpowiedzi na poziomie obrazu wykorzystano stosunek energii, d Cohena oraz AUC. Szczegółowe wyniki przedstawiono w Tabeli 4, Rysunku 7 oraz Rysunku 8.
Wyniki pokazują, że wskaźniki rzadkości książki kodowej (codebook rarity scores) na wszystkich skalach wykazują podwyższoną odpowiedź w przypadku próbek anomalnych (stosunki energii > 1). Książki kodowe o mniejszej pojemności (Codebook 64) osiągają silniejszą dyskryminację na poziomie lokalizacji (78,79% AUC), co jest zgodne z oczekiwaniem, że wyższe stopnie kompresji sprzyjają uczeniu się bardziej abstrakcyjnych wzorców prototypowych, które są bardziej czułe na odchylenia od archetypów prawidłowej tkanki. Sam błąd rekonstrukcji zapewnia znaczną zdolność wykrywania anomalii (93,31% AUC), podczas gdy wyniki CAR dostarczają uzupełniających sygnałów z wymiaru częstotliwości semantycznej.
Analiza jakościowa Rysunku 7 wykazała, że podwyższone odpowiedzi w próbkach nowotworowych pokrywały się z obecnością gruczołów nieregularnych i zagęszczonych, powiększeniem jąder komórkowych, hiperchromazją, pseudostratyfikacją oraz utratą polaryzacji nabłonka. W próbkach zapalnych silniejsze odpowiedzi obserwowano wokół zniekształconych krypt oraz gęstych nacieków komórek zapalnych. Książki kodowe o mniejszej pojemności miały tendencję do wychwytywania szerszych odchyleń architektonicznych, natomiast książki kodowe o większej pojemności generowały bardziej zlokalizowane odpowiedzi na poziomie komórkowym. Wyniki te stanowią jakościową interpretację morfologiczną, a nie walidację na poziomie pikseli.
Analiza parametrów fuzji
Waga fuzji α równoważy wkłady błędu rekonstrukcji przestrzennej oraz wyniku CAR do końcowego wyniku anomalii. Optymalne wartości α dla każdego folderu określono za pomocą przeszukiwania siatki (krok 0,05) na zestawach walidacyjnych, a wyniki przedstawiono w Tabeli 5 oraz Rysunku 9. Optymalne wartości α koncentrują się głównie w zakresie 0,85-0,95, przy średniej 0,90 ± 0,05. W optymalnych konfiguracjach model osiąga średnią wartość AUC na poziomie 96,82 ± 0,23% na zestawach testowych. Wyższe optymalne wagi (około 0,90) sugerują, że wyniki CAR w większym stopniu przyczyniają się do końcowej detekcji niż błąd rekonstrukcji, podczas gdy błąd rekonstrukcji zapewnia pomocnicze ograniczenia lokalne. W porównaniu z ustawieniem α = 0 w analizie czułości (AUC = 93,29%), wybrane w procesie walidacji ustawienie fuzji poprawiło AUC o około 3,53 punktu procentowego.
Podsumowując, niniejsza praca przedstawia framework RareCode do nienadzorowanego wykrywania anomalii w obrazach histopatologicznych, którego celem jest złagodzenie problemu mapowania tożsamościowego (identity-mapping) występującego w tradycyjnych modelach generatywnych. Mechanizm CAR ogranicza nadmierne poleganie na błędach rekonstrukcji na poziomie pikseli, natomiast moduł MHC zapewnia hierarchiczne reprezentacje cech o wielu poziomach granulacji, co umożliwia komplementarną dyskryminację anomalii na różnych poziomach abstrakcji. Eksperymenty na zbiorze danych CRC wykazują, że RareCode osiąga AUC na poziomie 96,82%, przy czym analiza per-klasa wskazuje na skuteczne wykrywanie nowotworów (AUC = 99,44%) oraz silniejszą dyskryminację nowotworów w stosunku do stanów zapalnych, co sugeruje, że nakładanie się obrazów stanów zapalnych i tkanek prawidłowych pozostaje głównym wyzwaniem. Badania ablacyjne potwierdzają, że integracja dyskretnych cech semantycznych z VQ z wieloskalowymi reprezentacjami morfologicznymi tkanki poprawia wydajność detekcji. Wysoka czułość (98,40%) i umiarkowana swoistość (58,24%) modelu RareCode wskazują na jego potencjał jako narzędzia do wstępnej przesiewowej selekcji w celu priorytetyzacji podejrzanych obrazów histopatologicznych; jednak jego rzeczywisty wpływ na obciążenie pracą patologów będzie wymagał prospektywnej oceny przepływu pracy.
Dostępność danych:
Zbiór obrazów histopatologicznych CRC wykorzystany w niniejszym badaniu pozyskano ze szpitala Shenzhen People's Hospital na podstawie instytucjonalnej zgody komisji etycznej (nr zatwierdzenia LL-KY-2025300-01). Ze względu na prywatność pacjentów oraz instytucjonalną politykę udostępniania danych, zbiór ten nie jest publicznie dostępny. Dostęp może zostać przyznany na uzasadnioną prośbę skierowaną do autora korespondencyjnego, pod warunkiem uzyskania zgody instytucjonalnej i podpisania umów o wykorzystaniu danych. Kod źródłowy frameworku RareCode jest publicznie dostępny pod adresem https://github.com/XL-alg/RareCode.
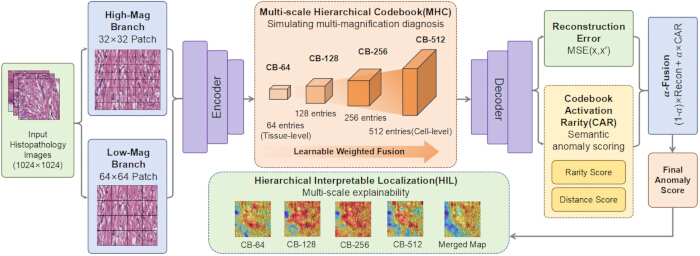
Rycina 1Ogólna architektura i przepływ danych w ramach frameworka RareCode. A 512 × 512 H&Obraz histopatologiczny barwiony hematoksyliną i eozyną (H&E) zostaje podzielony na niezachodzące na siebie fragmenty o wymiarach 32 × 32 i 64 × 64 fragmenty obrazu jako wejścia w skali drobnej i grubej. Dwie gałęzie kodują fragmenty do osadzeń latentnych, stosują dyskretyzację za pomocą wieloskalowego hierarchicznego słownika kodowego (Multi-scale Hierarchical Codebook, MHC) i rekonstruują fragmenty w celu obliczenia wyników błędu rekonstrukcji. Równolegle mechanizm rzadkości aktywacji słownika (Codebook Activation Rarity, CAR) szacuje rzadkość semantyczną na podstawie profili częstotliwości aktywacji słownika wyuczonych z normalnych próbek treningowych. Znormalizowane wyniki rekonstrukcji i CAR są następnie łączone w celu wygenerowania końcowego wyniku anomalii na poziomie obrazu, natomiast odpowiedzi na poziomie fragmentów są rzutowane z powrotem na płaszczyznę obrazu w celu lokalizacji hierarchicznej. Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
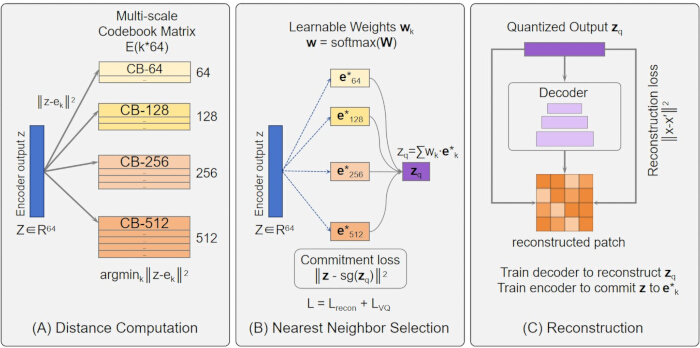
Rycina 2: Mechanizm wieloskalowej kwantyzacji wektorowej. (A) Obliczanie odległości między cechami wyjściowymi kodera a wektorami osadzeń książki kodowej. (B) Wybór najbliższego sąsiada i ważona fuzja w obrębie książek kodowych o pojemnościach 64, 128, 256 i 512. (C) Rekonstrukcja z kwantyzowanych cech za pomocą transponowanego dekodera konwolucyjnego. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
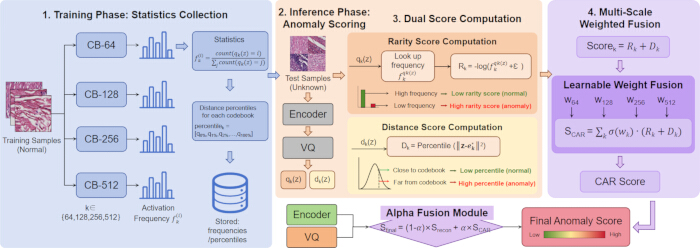
Rysunek 3: Mechanizm oceny CAR. Na tym schemacie przedstawiono cztery etapy: Etap 1: statystyki częstotliwości aktywacji są obliczane wyłącznie na podstawie normalnych próbek treningowych. Etap 2: próbki testowe otrzymują indeksy aktywacji i odległości za pomocą kodera i kwantyzacji wektorowej. Etap 3: wyniki rzadkości i wyniki odległości są obliczane na podstawie profili częstotliwości zbioru treningowego. Etap 4: wyniki z każdej skali książki kodowej są łączone za pomocą wag adaptacyjnych w celu uzyskania końcowego wyniku CAR. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
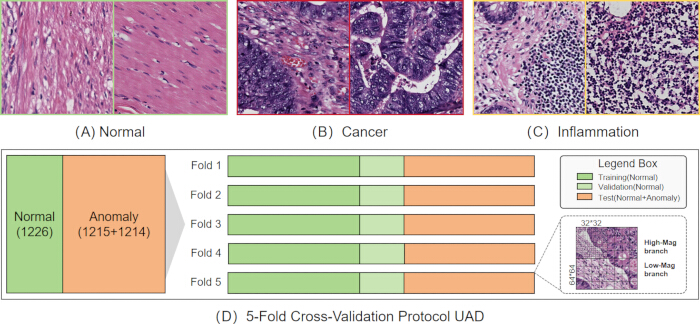
Rysunek 4Skład zbioru danych CRC oraz protokół eksperymentalny. (A–C) Reprezentatywne H&Obrazy histopatologiczne tkanek normalnego jelita grubego, raka jelita grubego oraz stanu zapalnego jelita grubego, barwione H&E. (D) protokół 5-krotnej walidacji krzyżowej dla UAD, w którym próbki prawidłowe wykorzystano do uczenia i walidacji, natomiast wydzielone próbki prawidłowe i anomalne posłużyły do testowania. Obrazy zostały zdigitalizowane przy powiększeniu 40x i podzielone na fragmenty o rozmiarach 32 x 32 oraz 64 x 64. Kolor zielony, jasnozielony i pomarańczowy oznaczają odpowiednio zbiory treningowy, walidacyjny i testowy. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
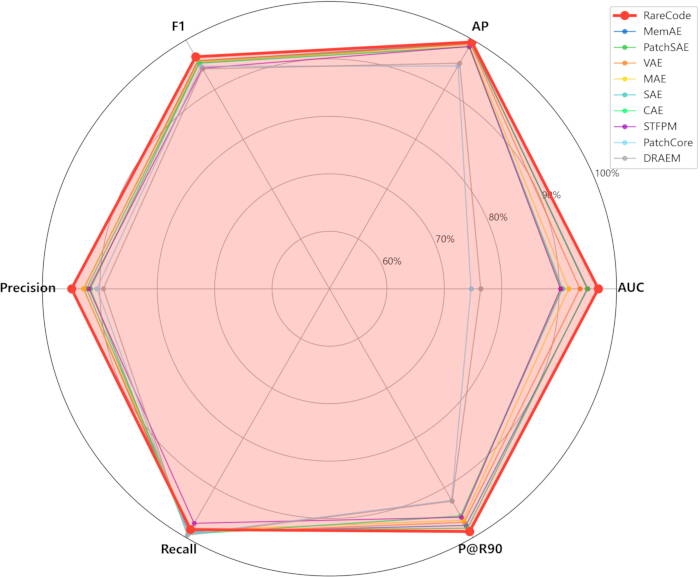
Rysunek 5: Wykres radarowy wielometrycznego porównania metod detekcji anomalii. Wykres radarowy porównujący RareCode z metodami bazowymi pod kątem AUC, średniej precyzji (AP), wyniku F1, precyzji, czułości oraz precyzji przy 90% czułości (P@R90). Wszystkie wartości reprezentują średnią wydajność w 5-krotnej walidacji krzyżowej. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
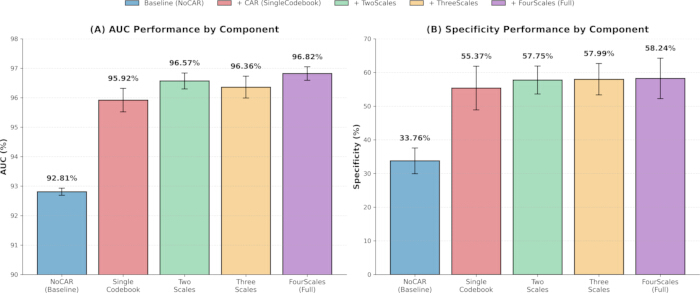
Rysunek 6: Analiza przyrostowego wkładu komponentów badania ablacyjnego. (A) Porównanie wyników AUC wykazujące stopniową poprawę od linii bazowej opartej wyłącznie na rekonstrukcji (NoCAR), poprzez konfiguracje z pojedynczą książką kodową, aż po konfiguracje wieloskalowe. (B) Porównanie specyficzności wykazujące wpływ mechanizmu CAR na redukcję wyników fałszywie dodatnich. Wszystkie słupki błędów reprezentują odchylenie standardowe (SD) dla 5-krotnej walidacji krzyżowej. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
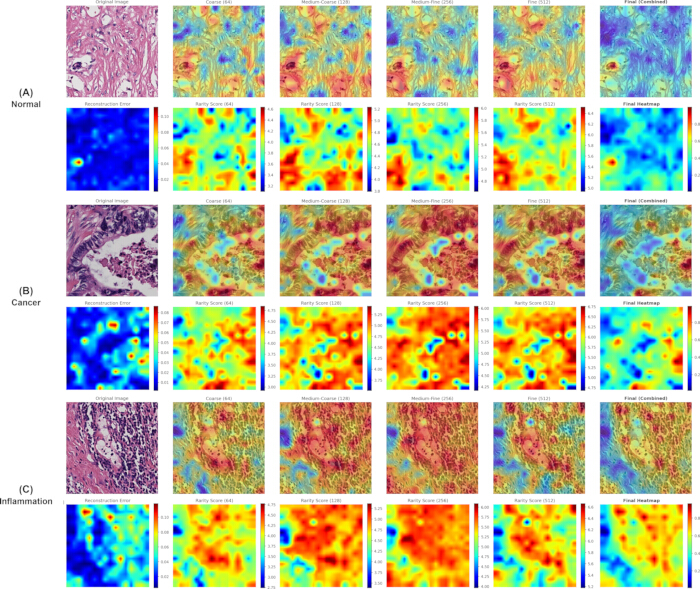
Rycina 7: Hierarchiczne mapy ciepła lokalizacji dla wielkoskalowych książek kodowych. Przedstawiono reprezentatywne przykłady dla próbek (A) prawidłowych, (B) nowotworowych i (C) zapalnych. Każdy wiersz zawiera obraz oryginalny, nałożoną warstwę (overlay), mapę błędów rekonstrukcji, mapy wyników rzadkości z książek kodowych o różnych pojemnościach (64, 128, 256 i 512) oraz końcową scaloną mapę lokalizacji. Książki kodowe o mniejszej pojemności podkreślają wzorce o grubszym ziarnie poprzez silniejszą abstrakcję kompresji, podczas gdy książki kodowe o większej pojemności zachowują drobniejsze szczegóły strukturalne. Regiony o wysokiej odpowiedzi jakościowo odpowiadają histopatologicznym cechom związanym z nowotworem lub zapaleniem, ale nie zostały one zwalidowane za pomocą adnotacji eksperckich na poziomie pikseli. Aby wyświetlić powiększoną wersję tej ryciny, kliknij tutaj.
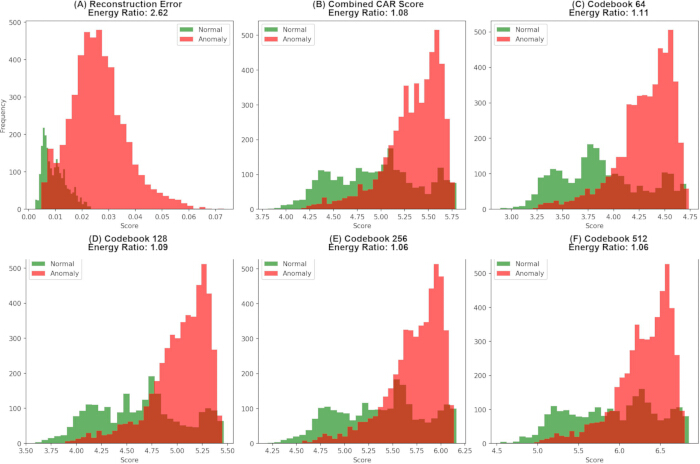
Rysunek 8: Histogramy rozkładu różnych typów wyników. Histogramy porównują rozkłady wyników między próbkami normalnymi a anomalnymi dla (A) błędu rekonstrukcji, (B) połączonego wyniku CAR, (C) Codebook 64, (D) Codebook 128, (E) Codebook 256 oraz (F) Codebook 512. Zielone i czerwone histogramy oznaczają odpowiednio próbki normalne i anomalne. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
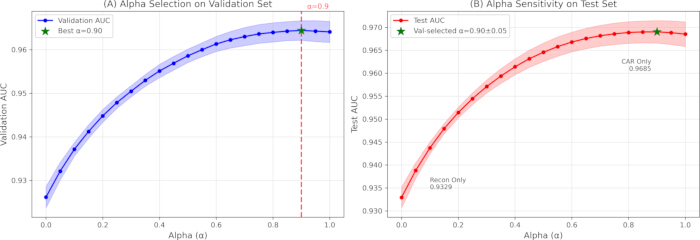
Rysunek 9: Analiza czułości parametru Alpha. (A) AUC zestawu walidacyjnego wykorzystane do wyboru α. (B) AUC zestawu testowego dla różnych wartości α. Wybrane w walidacji wartości α mieściły się w zakresie od 0,85 do 0,95, ze średnią 0,90 ± 0,05, co jest zgodne z Tabelą 5. Zmienność AUC pozostała poniżej 0,5% przy zmianie α w zakresie [0,70, 1,00], co wskazuje na stabilną wydajność w szerokim zakresie parametrów. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
| Metoda | AUC (%) | AP (%) | F1 (%) | Precyzja (%) | Czułość (%) | Swoistość (%) | P@R90 (%) |
| CAE | 90.37 ± 0.94 | 98.62 ± 0.18 | 95.34 ± 0.15 | 91.64 ± 0.40 | 99.35 ± 0.22 | 28.14 ± 3.88 | 95.66 ± 0.32 |
| SAE | 90.58 ± 0.94 | 98.66 ± 0.18 | 95.34 ± 0.15 | 91.67 ± 0.40 | 99.32 ± 0.24 | 28.46 ± 3.97 | 95.71 ± 0.30 |
| VAE | 93.60 ± 0.82 | 99.13 ± 0.12 | 95.86 ± 0.19 | 92.81 ± 0.49 | 99.12 ± 0.29 | 39.07 ± 4.70 | 96.94 ± 0.43 |
| MAE | 91.65 ± 2.75 | 98.76 ± 0.50 | 95.61 ± 0.60 | 92.87 ± 1.56 | 98.55 ± 0.55 | 39.74 ± 14.32 | 96.55 ± 0.97 |
| MemAE | 94.97 ± 0.81 | 99.35 ± 0.11 | 95.78 ± 0.33 | 92.82 ± 1.07 | 98.95 ± 0.60 | 39.15 ± 9.99 | 97.57 ± 0.33 |
| PatchSAE | 94.86 ± 0.36 | 99.34 ± 0.05 | 95.39 ± 0.13 | 92.32 ± 0.27 | 98.67 ± 0.12 | 34.91 ± 2.57 | 98.13 ± 0.24 |
| STFPM | 90.23 ± 3.05 | 98.70 ± 0.44 | 94.32 ± 0.21 | 91.90 ± 3.51 | 97.14 ± 3.38 | 29.82 ± 33.53 | 95.93 ± 1.96 |
| DRAEM | 76.34 ± 2.82 | 95.34 ± 0.90 | 94.19 ± 0.07 | 89.39 ± 0.65 | 99.56 ± 0.65 | 6.19 ± 7.09 | 92.69 ± 0.57 |
| PatchCore | 74.64 ± 1.82 | 94.76 ± 0.55 | 94.73 ± 0.05 | 90.52 ± 0.15 | 99.36 ± 0.12 | 17.49 ± 1.54 | 92.54 ± 0.15 |
| RareCode | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 94.93 ± 0.67 | 98.40 ± 0.48 | 58.24 ± 5.99 | 98.80 ± 0.10 |
Tabela 1: Wyniki porównania z metodami bazowymi (5-krotna walidacja krzyżowa). Wydajność detekcji algorytmu RareCode oraz dziewięciu bazowych metod UAD na zbiorze danych CRC. Metryki obejmują AUC, średnią precyzję (AP), czułość (recall), swoistość (specificity), wynik F1, precyzję przy 90% czułości (P@R90) oraz precyzję. Wszystkie wartości przedstawiają średnią ± SD z 5-krotnej walidacji krzyżowej. Pogrubione wartości wskazują najlepszą wydajność dla danej metryki.
| Kategoria | AUC (%) | AP (%) | F1 (%) | Czułość (%) | Swoistość (%) |
| Nowotwór | 99.44 ± 0.12 | 99.86 ± 0.03 | 98.34 ± 0.17 | 98.13 ± 0.29 | 94.21 ± 2.22 |
| Zapalenie | 94.30 ± 0.44 | 98.48 ± 0.12 | 93.44 ± 0.29 | 96.55 ± 0.78 | 60.44 ± 4.34 |
Tabela 2: Wyniki detekcji dla poszczególnych klas w zależności od podtypów anomalii. Oddzielna ocena wydajności detekcji RareCode dla próbek nowotworowych i zapalnych w zestawieniu z próbkami prawidłowymi. Metryki dla poszczególnych klas, w tym AUC, AP, F1-score, recall oraz swoistość, obliczono przy użyciu optymalnych progów specyficznych dla danej klasy.
| Wariant | Konfiguracja książki kodowej | CAR | AUC (%) | AP (%) | F1 (%) | Swoistość (%) | P@R90 (%) |
| NoCAR |  | | 92.81 ± 0.12 | 99.05 ± 0.02 | 95.30 ± 0.08 | 33.76 ± 3.82 | 96.72 ± 0.12 |
| Pojedyncza Księga Kodów | [256] |  | 95.92 ± 0.40 | 99.47 ± 0.05 | 96.25 ± 0.14 | 55.37 ± 6.51 | 98.31 ± 0.43 |
| DwieSkale | [128, 512] | | 96.57 ± 0.27 | 99.56 ± 0.04 | 96.45 ± 0.12 | 57.75 ± 4.14 | 98.75 ± 0.12 |
| ThreeScales | [128, 256, 512] | | 96.36 ± 0.37 | 99.53 ± 0.05 | 96.52 ± 0.17 | 57.99 ± 4.65 | 98.60 ± 0.23 |
| CzterySkale | [64, 128, 256, 512] | | 96.82 ± 0.23 | 99.59 ± 0.03 | 96.63 ± 0.15 | 58.24 ± 5.99 | 98.80 ± 0.10 |
| FourScales + złożony dekoder | [64, 128, 256, 512] | | 95.17 ± 0.44 | 99.39 ± 0.06 | 95.32 ± 0.20 | 53.83 ± 21.45 | 98.40 ± 0.37 |
Tabela 3: Wyniki badania ablacyjnego. Porównanie wydajności konfiguracji RareCode wraz z progresywnym dodawaniem komponentów: bazowy model z samą rekonstrukcją (NoCAR), CAR z pojedynczą książką kodową (SingleCodebook) oraz konfiguracje wieloskalowe (TwoScales, ThreeScales, FourScales). Uwzględniono również dodatkową ablację złożoności dekodera z wykorzystaniem konfiguracji FourScales. Metryki obejmują AUC, średnią precyzję (AP), wynik F1, swoistość oraz precyzję przy 90% czułości (P@R90).
| Typ wyniku | Stosunek energii | d Cohena | AUC (%) |
| Błąd rekonstrukcji | 2.623 | 2.006 | 93.31 |
| Połączony CAR | 1.078 | 1.002 | 74.85 |
| Książka kodów 64 | 1.109 | 1.207 | 78.79 |
| Codebook 128 | 1.085 | 1.067 | 76.19 |
| Książka kodów 256 | 1.065 | 0.916 | 72.80 |
| Książka kodów 512 | 1.064 | 0.833 | 70.38 |
Tabela 4: Analiza na poziomie obrazów odpowiedzi wynikających z lokalizacji. Średni błąd rekonstrukcji obrazu oraz odpowiedzi rzadkości książki kodowej porównano pomiędzy próbkami prawidłowymi a anomalnymi, wykorzystując stosunek energii, d Cohena oraz AUC.
| Złożyć | Optymalny α | Val AUC (%) | AUC testu (%) |
| 1 | 0.95 | 96.22 | 96.91 |
| 2 | 0.9 | 96.38 | 96.39 |
| 3 | 0.85 | 96.71 | 96.82 |
| 4 | 0.85 | 96.22 | 96.93 |
| 5 | 0.95 | 96.72 | 97.05 |
| Średnia | 0.90 ± 0.05 | 96.45 ± 0.23 | 96.82 ± 0.23 |
Tabela 5: Optymalne wartości alfa w poszczególnych fałdach. Optymalna waga fuzji alfa wyznaczona za pomocą przeszukiwania siatki (krok 0,05) na zestawach walidacyjnych dla każdego fałdu walidacji krzyżowej, wraz ze statystykami średniej i SD.
Dyskusja
Wyniki sugerują, że wzorce aktywacji książki kodowej mogą dostarczać informacji uzupełniających względem błędów rekonstrukcji przestrzennej. Poprawa wyników przy przejściu z modelu NoCAR na pełny model FourScales potwierdza potencjalny wkład punktacji CAR, natomiast dobrane wagi fuzji wskazują, że rzadkość semantyczna może odgrywać istotną rolę w końcowym wyniku anomalii. Jednym z możliwych wyjaśnień jest fakt, że nieprawidłowości związane z CRC mogą obejmować różne skale morfologiczne, od atypii jądrowej po zaburzenia architektury gruczołowej, i dlatego mogą korzystać z reprezentacji cech o wielu poziomach ziarnistości14. Obecny model obejmuje różne zakresy przestrzenne, wykorzystując płaty 32 × 32 oraz 64 × 64 przy tym samym poziomie powiększenia; przyszła integracja z frameworkami do przetwarzania obrazów całych preparatów (WSI) może dodatkowo wesprzeć hierarchiczną analizę na poziomie całego slajdu39.
W ujęciu klinicznym RareCode można uznać przede wszystkim za narzędzie do wstępnej segregacji (triage), a nie za autonomiczny system diagnostyczny. Wysoka czułość (98,40%) sugeruje stosunkowo niskie ryzyko pominięcia przypadków anomalnych40, natomiast umiarkowana swoistość (58,24%) prawdopodobnie odzwierciedla trudność w odróżnieniu zmian zapalnych od prawidłowej tkanki w warunkach braku nadzoru. Wyższa swoistość specyficzna dla raka (94,21%) dodatkowo wskazuje, że fałszywe alarmy mogą występować rzadziej w przypadku najbardziej krytycznego klinicznie podtypu. Te charakterystyki wydajności wspierają potencjalne zastosowanie RareCode jako narzędzia do wstępnego przesiewu w celu priorytetyzacji przypadków wymagających oceny eksperckiej oraz usprawnienia przeglądu patomorfologicznego5,6.
Wyniki dla poszczególnych klas mogą dodatkowo potwierdzać potencjalną rolę RareCode w triażu. Stosunkowo lepsza wydajność w przypadku nowotworów niż w przypadku stanów zapalnych może odzwierciedlać bardziej wyraźne odchylenia architektoniczne i cytologiczne często obserwowane w tkankach złośliwych, w tym utratę polarności, pleomorfizm jądrowy oraz desmoplazję zrębu14,39. W przeciwieństwie do tego, zmiany zapalne mogą w większym stopniu pokrywać się z wariancją tkanki łagodnej, co może częściowo wyjaśniać niższą swoistość specyficzną dla stanów zapalnych. W związku z tym ogólną swoistość należy interpretować z ostrożnością, przyjmując wykrywanie nowotworów jako klinicznie istotny przypadek użycia, a nie jako ostateczną, autonomiczną diagnozę.
Potencjalne tryby błędów modelu RareCode należy interpretować w kontekście jego celu uczenia jednoklasowego. Ponieważ model uczy się wzorców tkanki prawidłowej, a nie kategorii specyficznych dla danej choroby, zmiany nienowotworowe, takie jak nabłonek regeneracyjny, włóknienie, martwica lub wyraźny stan zapalny, mogą również otrzymać wysokie wyniki anomalii. I odwrotnie, subtelna dysplazja lub rak dobrze zróżnicowany z niemal prawidłową architekturą gruczołową mogą wywołać słabszą odpowiedź. Czynniki techniczne, w tym zmienność barwienia, fałdy tkanki, artefakty cięcia, brak ostrości i kompresja obrazu, mogą również wpływać na błędy rekonstrukcji i częstotliwość aktywacji księgi kodów. Rozważania te sugerują, że wdrożenie kliniczne wymagałoby kontroli jakości obrazu, harmonizacji barwień, kalibracji uwzględniającej specyfikę skanera oraz walidacji wieloośrodkowej39,41.
Zakres porównań z metodami bazowymi. Ocena eksperymentalna w niniejszej pracy koncentruje się na metodach działających w ramach porównywalnych założeń dotyczących danych i obliczeń — w szczególności na metodach, które mogą być trenowane w modelu end-to-end przy użyciu wyłącznie niewielkiej liczby nieoznaczonych próbek normalnych, bez konieczności korzystania z zewnętrznych korpusów do wstępnego trenowania. Zakres ten obejmuje główne paradygmaty w nienadzorowanym wykrywaniu anomalii: metody oparte na rekonstrukcji (CAE, VAE, SAE, MAE, PatchSAE), metody z rozszerzeniem o pamięć (MemAE), destylację wiedzy (STFPM), augmentację syntetyczną (DRAEM) oraz dopasowanie cech wstępnie wytrenowanych (PatchCore). Przyznajemy, że dwie kategorie metod nie zostały włączone jako bezpośrednie bazy porównawcze. Po pierwsze, modele bazowe specyficzne dla patomorfologii (UNI, CONCH, CTransPath) wykorzystują wstępne trenowanie na milionach wyselekcjonowanych obrazów patologicznych, a ich przewaga w wydajności wynika przede wszystkim ze skali i różnorodności danych treningowych, a nie z samego mechanizmu wykrywania anomalii; bezpośrednie porównanie doprowadziłoby zatem do pomieszania wpływu danych treningowych z wpływem metodologii detekcji. Suboptymalna wydajność STFPM i PatchCore — oba wykorzystujące szkielety wstępnie wytrenowane na zbiorze ImageNet — empirycznie ilustruje wpływ luki domenowej w przypadku zastosowania ogólnych cech wstępnie wytrenowanych w scenariuszach histopatologicznych i sugeruje, że specyficzne dla patomorfologii wstępne trenowanie może zniwelować tę lukę. Po drugie, metody wykrywania anomalii oparte na dyfuzji, choć obiecujące, nakładają znacznie większe obciążenie obliczeniowe podczas inferencji (zazwyczaj wymagając setek iteracyjnych kroków odszumiania), co ogranicza ich przydatność w wysokoprzepustowych procesach przesiewowych w klinice, gdzie wydajność przetwarzania jest wymogiem praktycznym. Przyszłe prace zbadają, czy włączenie do architektury RareCode koderów wstępnie wytrenowanych dla patomorfologii — w miejsce obecnego kodera trenowanego w modelu end-to-end — może dalej poprawić wydajność detekcji, zachowując jednocześnie zalety interpretowalności mechanizmu CAR.
Należy zwrócić uwagę na kilka ograniczeń. Po pierwsze, walidacja ograniczyła się do zbioru danych CRC z jednego ośrodka, a dalsza ocena wieloośrodkowa obejmująca różne instytucje, skanery i protokoły barwienia jest konieczna. Po drugie, choć swoistość specyficzna dla nowotworu była obiecująca, ogólna swoistość nadal była uwarunkowana granicą między stanem zapalnym a tkanką prawidłową. Po trzecie, nie dysponowano adnotacjami ekspertów na poziomie pikseli; w związku z tym nie można było obliczyć wskaźników Dice oraz IoU, a ocena lokalizacji ograniczyła się do wizualizacji jakościowej i analizy na poziomie obrazu zagregowanych odpowiedzi przestrzennych. Po czwarte, wciąż konieczne są formalne badania z udziałem diagnostów, aby ustalić, czy hierarchiczne mapy ciepła mogą poprawić dokładność diagnostyczną lub efektywność przeglądu. Wreszcie, RareCode obecnie wykonuje analizę na poziomie fragmentów i obrazów, a wdrożenie na poziomie WSI wymagałoby integracji z dodatkowymi ramami przetwarzania39,41,42.
Przyszłe prace powinny ocenić RareCode na publicznych zbiorach referencyjnych oraz w kohortach wieloośrodkowych po integracji z ramami przetwarzania WSI. Prospektywne badania z udziałem lekarzy mogą pomóc w ocenie potencjalnego wpływu narzędzia na dokładność diagnostyczną, czas przeglądu oraz zgodność między obserwatorami42. Dodatkowe kierunki rozwoju obejmują poprawę wydajności obliczeniowej, rozszerzenie modelu w stronę subtypizacji anomalii wieloklasowych oraz integrację uczenia wieloinstancyjnego (multiple-instance learning) w celu diagnozowania na poziomie całego preparatu28,39.
Oświadczenia
Autorzy oświadczają, że nie mają żadnych znanych konfliktów interesów finansowych ani relacji osobistych, które mogłyby wpłynąć na pracę opisaną w niniejszym artykule. Podczas przygotowywania tej pracy korzystaliśmy z ChatGPT w celu poprawy języka i przejrzystości manuskryptu oraz w celu pomocy w generowaniu kodu do wizualizacji danych. Po skorzystaniu z tego narzędzia sprawdziliśmy i zredagowaliśmy treść w razie potrzeby i bierzemy pełną odpowiedzialność za opublikowany artykuł.
Podziękowania
Badania te były wspierane przez Yong Dai Academician's Workstation (Diagnostic Technology for Autoimmune Diseases) (Wan Ke Science and Technology [2023] nr 317), projekt Graduate Innovation Fund z Hefei National Research Center for Health Science and Technology Joint Research Center for Occupational Medicine and Health Open Fund (nr OMH-2023-04) oraz projekt badań klinicznych i translacyjnych prowincji Anhui (nr 202427610020132).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Karta graficzna GeForce RTX 4060 Ti GPU | NVIDIA | N/D | 16 GB VRAM; w wszystkich eksperymentach wykorzystano jedną jednostkę GPU (RRID:SCR_022858) |
| Matplotlib | Zespół programistyczny Matplotlib | Wersja 3.8.4 | Wizualizacja danych i generowanie rycin (RRID:SCR_008624) |
| NumPy | Programiści NumPy | Wersja 1.26.4 | Obliczenia numeryczne i operacje na tablicach (RRID:SCR_008633) |
| pandas | Zespół programistyczny pandas | Wersja 2.2.3 | Organizacja danych i przetwarzanie wyników w formie tabelarycznej (RRID:SCR_018214) |
| Poduszka | Współtwórcy Python Imaging Library / Pillow | Wersja 10.3.0 | Ładowanie i wstępne przetwarzanie obrazów |
| Python | Python Software Foundation | Wersja 3.12.3 | Język programowania wykorzystany do opracowania modelu i analizy danych (RRID:SCR_008394) |
| PyTorch | Meta Platforms, Inc. | Wersja 2.7.0+cu118 | Środowisko uczenia głębokiego wykorzystane do implementacji i trenowania modelu (RRID:SCR_018536) |
| scikit-learn | Deweloperzy scikit-learn | Wersja 1.4.2 | Walidacja krzyżowa, podział na zbiór treningowy i testowy oraz metryki ewaluacji (RRID:SCR_002577) |
| SciPy | Deweloperzy SciPy | Wersja 1.13.1 | Analiza statystyczna (RRID:SCR_008058) |
| torchvision | Projekt PyTorch | Wersja 0.22.0+cu118 | Przetwarzanie wstępne obrazów i transformacja danych |
| tqdm | Deweloperzy tqdm | Wersja 4.66.4 | Monitorowanie postępów szkolenia i ewaluacji |
Bibliografia
- Fan J, Sun Q, Di Y, et al. DIPathMamba: A domain-incremental weakly supervised state space model for pathology image segmentation. Med Image Anal. 2025;103:103563.
- Nan T, Zheng S, Qiao S, et al. Deep learning quantifies pathologists' visual patterns for whole slide image diagnosis. Nat Commun. 2025;16(1):5493.
- Lagogiannis I, Meissen F, Kaissis G, et al. Unsupervised pathology detection: a deep dive into the state of the art. IEEE Trans Med Imaging. 2024;43(1):241-252.
- Tian Y, Liu F, Pang G, et al. Self-supervised pseudo multiclass pre-training for unsupervised anomaly detection and segmentation in medical images. Med Image Anal. 2023;90:102930.
- Metter DM, Colgan TJ, Leung ST, et al. Trends in the US and Canadian pathologist workforces from 2007 to 2017. JAMA Netw Open. 2019;2(5):e194337.
- Shaukat A, Levin TR. Current and future colorectal cancer screening strategies. Nat Rev Gastroenterol Hepatol. 2022;19(8):521-531.
- Ancker JS, Edwards A, Nosal S, et al. Effects of workload, work complexity, and repeated alerts on alert fatigue in a clinical decision support system. BMC Med Inform Decis Mak. 2017;17(1):36.
- Litjens G, Kooi T, Ehteshami Bejnordi B, et al. A survey on deep learning in medical image analysis. Med Image Anal. 2017;42:60-88.
- Stepec D, Skocaj D. Unsupervised detection of cancerous regions in histology imagery using image-to-image translation. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops. 2021:3785-3792.
- Li Y, Lao Q, Kang Q, et al. Self-supervised anomaly detection, staging and segmentation for retinal images. Med Image Anal. 2023;87:102805.
- Hinton GE, Salakhutdinov RR. Reducing the dimensionality of data with neural networks. Science. 2006;313(5786):504-507.
- Kingma DP, Welling M. Auto-encoding variational Bayes. In: Proceedings of the 2nd International Conference on Learning Representations (ICLR). 2014.
- Goodfellow IJ, Pouget-Abadie J, Mirza M, et al. Generative adversarial nets. In: Advances in Neural Information Processing Systems. 2014;27:2672-2680.
- Lu S, Zhang W, Zhao H, et al. Anomaly detection for medical images using heterogeneous auto-encoder. IEEE Trans Image Process. 2024;33:2770-2782.
- Yang Z, Zhang T, Soltani Bozchalooi I, et al. Memory-augmented generative adversarial networks for anomaly detection. IEEE Trans Neural Netw Learn Syst. 2022;33(6):2324-2334.
- Huyan N, Quan D, Zhang X, et al. Unsupervised outlier detection using memory and contrastive learning. IEEE Trans Image Process. 2022;31:6440-6454.
- Jézéquel L, Beaudet J, Histace A, et al. Unified anomaly detection via multi-scale contrasted memory. IEEE Trans Image Process. 2026;35:2802-2815.
- Roth K, Pemula L, Zepeda J, et al. Towards total recall in industrial anomaly detection. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:14298-14308.
- Defard T, Setkov A, Loesch A, et al. PaDiM: a patch distribution modeling framework for anomaly detection and localization. In: International Conference on Pattern Recognition. Cham: Springer; 2021:475-489.
- Zingman I, Stierstorfer B, Lempp C, et al. Learning image representations for anomaly detection: application to discovery of histological alterations in drug development. Med Image Anal. 2024;92:103067.
- Jiang Y, Cao Y, Shen W. Prototypical learning guided context-aware segmentation network for few-shot anomaly detection. IEEE Trans Neural Netw Learn Syst. 2025;36(7):12016-12026.
- Wang X, Zhao J, Marostica E, et al. A pathology foundation model for cancer diagnosis and prognosis prediction. Nature. 2024;634(8035):970-978.
- Frotscher A, Kapoor J, Wolfers T, et al. Unsupervised anomaly detection in medical imaging using aggregated normative diffusion. Med Image Anal. 2026;109:103895.
- Zeng GQ, Yang YW, Lu KD, et al. Evolutionary adversarial autoencoder for unsupervised anomaly detection of industrial Internet of Things. IEEE Trans Reliab. 2025;74(3):3454-3468.
- Lu KD, Zhang BX, Xu Y, et al. MoARNN-AM: multi-objective automated recurrent neural network with attention mechanism for cyber-attack detection of UAV. IEEE Trans Consum Electron. 2026;72(1):1738-1749.
- van den Oord A, Vinyals O, Kavukcuoglu K. Neural discrete representation learning. In: Advances in Neural Information Processing Systems. 2017;30:6306-6315.
- Ghafourian A, Shui H, Upadhyay D, et al. Targeted collapse regularized autoencoder for anomaly detection: black hole at the center. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10348-10358.
- Gao Z, Mao A, Dong Y, et al. SMMILe enables accurate spatial quantification in digital pathology using multiple-instance learning. Nat Cancer. 2025;6(12):2025-2041.
- Wang X, Liu H, Zhang Y, et al. Joint modeling histology and molecular markers for cancer classification. Med Image Anal. 2025;102:103505.
- Jin H, Shen J, Cui L, et al. Dynamic graph based weakly supervised deep hashing for whole slide image classification and retrieval. Med Image Anal. 2025;101:103468.
- Schmitz R, Madesta F, Nielsen M, et al. Multi-scale fully convolutional neural networks for histopathology image segmentation: from nuclear aberrations to the global tissue architecture. Med Image Anal. 2021;70:101996.
- Masci J, Meier U, Ciresan D, et al. Stacked convolutional auto-encoders for hierarchical feature extraction. In: International Conference on Artificial Neural Networks. Berlin: Springer; 2011:52-59.
- Ng A. Sparse autoencoder. CS294A Lecture Notes. 2011;72:1-19.
- He K, Chen X, Xie S, et al. Masked autoencoders are scalable vision learners. In: Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition. 2022:16000-16009.
- Lim H, Choi J, Choo J, et al. Sparse autoencoders reveal selective remapping of visual concepts during adaptation. In: Proceedings of the 13th International Conference on Learning Representations (ICLR). 2025.
- Gong D, Liu L, Le V, et al. Memorizing normality to detect anomaly: memory-augmented deep autoencoder for unsupervised anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2019:1705-1714.
- Wang G, Han S, Ding E, et al. Student-teacher feature pyramid matching for anomaly detection. In: Proceedings of the 32nd British Machine Vision Conference (BMVC). 2021.
- Zavrtanik V, Kristan M, Skocaj D. DRAEM: a discriminatively trained reconstruction embedding for surface anomaly detection. In: Proceedings of the IEEE/CVF International Conference on Computer Vision. 2021:8330-8339.
- Niazi MKK, Parwani AV, Gurcan MN. Digital pathology and artificial intelligence. Lancet Oncol. 2019;20(5):e253-e261.
- Raab SS, Grzybicki DM, Janosky JE, et al. Clinical impact and frequency of anatomic pathology errors in cancer diagnoses. Cancer. 2005;104(10):2205-2213.
- Schömig-Markiefka B, Pryalukhin A, Hulla W, et al. Quality control stress test for deep learning-based diagnostic model in digital pathology. Mod Pathol. 2021;34(12):2098-2108.
- Steiner DF, MacDonald R, Liu Y, et al. Impact of deep learning assistance on the histopathologic review of lymph nodes for metastatic breast cancer. Am J Surg Pathol. 2018;42(12):1636-1646.