Niniejszy protokół przedstawia ustrukturyzowany i podlegający audytowi proces przetwarzania zanonimizowanych danych z kwestionariusza dobrostanu studentów studiów licencjackich, obejmujący etapy od surowego eksportu i weryfikacji odpowiedzi, przez punktację skal, sprawdzanie niezawodności, diagnostykę regresji i weryfikację źródeł danych dla rycin, aż po przygotowanie wyników analitycznych do wizualizacji.
Artykuł metodologiczny
Ustrukturyzowany schemat pracy w zakresie przesiewania, punktowania i wizualizacji danych z kwestionariusza dobrostanu studentów studiów licencjackich
W tym artykule
Podsumowanie
Streszczenie
Badania oparte na kwestionariuszach są powszechnie stosowane do badania dobrostanu studentów, jednak ścieżka proceduralna od surowych odpowiedzi do analizowalnych zmiennych, tabel statystycznych i wyników wizualnych jest często niewystarczająco udokumentowana. Niniejszy protokół prezentuje ustrukturyzowany i podlegający audytowi przepływ pracy w zakresie przetwarzania zanonimizowanych danych z kwestionariuszy dobrostanu studentów studiów licencjackich, zbieranych za pomocą wielu sekcji opartych na skalach typu Likerta. Przepływ pracy rozpoczyna się od uzyskania zgody komisji etycznej, dokumentacji zgód, konfiguracji kwestionariusza i eksportu surowych danych, a następnie przechodzi przez przesiewowe badanie odpowiedzi, weryfikację duplikatów odpowiedzi, obsługę brakujących danych, kodowanie pozycji, odwracanie punktacji, ocenę niezawodności, analizę opisową, analizę korelacji, kontrastowe porównanie grup, modelowanie regresyjne, sprawdzanie diagnostyczne i przygotowanie źródeł do wizualizacji. Przykładowy kwestionariusz wykorzystuje udokumentowane źródłowo i dostosowane do badania sekcje skal opracowane na podstawie Depression Anxiety Stress Scales-21, Tuckman Procrastination Scale, Psychological Sense of School Membership Scale, literatury dotyczącej pomiaru myślenia wyższego rzędu oraz dokumentacji skal subiektywnego dobrostanu. Emocje negatywne, prokrastynacja akademicka, poczucie przynależności do szkoły, myślenie wyższego rzędu i subiektywny dobrostan służą jako przykładowe zmienne na poziomie skali, aby pokazać, w jaki sposób odpowiedzi na poziomie pozycji mogą zostać przekształcone w możliwe do prześledzenia wyniki analityczne. Reprezentatywne wyniki obejmują tabelę przepływu przesiewowego, podsumowanie demograficzne, statystyki opisowe i weryfikację zakresów, szacunki spójności wewnętrznej, macierz korelacji, wyniki porównań kontrastowych, współczynniki regresji, diagnostykę reszt i wpływów oraz pliki źródłowe rycin. Protokół kładzie nacisk na uprzednio określone reguły decyzyjne, powiązaną mapę skal, dziennik przesiewowy przed analizą, weryfikację odwróconej punktacji oraz weryfikację źródeł numerycznych dla rycin. Zamiast proponować nową skalę psychometryczną, walidować model pomiarowy lub ustanawiać związki przyczynowo-skutkowe, metoda ta dostarcza praktycznej i podlegającej audytowi procedury dla badaczy, którzy muszą przesiewać, punktować, analizować i wizualizować dane z kwestionariuszy dotyczące dobrostanu studentów. Przepływ pracy można zaadaptować do pokrewnych badań opartych na kwestionariuszach, pod warunkiem zdefiniowania mapy skal, zgody etycznej, reguł punktacji, progów przesiewowych odpowiedzi i plików źródłowych wizualizacji przed rozpoczęciem analizy.
Wprowadzenie
Subiektywny dobrostan jest istotnym wynikiem w badaniach nad studentami, ponieważ odzwierciedla sposób, w jaki oceniają oni swoje życie, doświadczenia emocjonalne, relacje społeczne oraz codzienne funkcjonowanie w środowisku uczenia się. W szkolnictwie wyższym dobrostan studentów jest wielowymiarowy i nie ogranicza się jedynie do satysfakcji z życia lub samego stresu psychologicznego1. Dane z kwestionariuszy pozostają zatem użyteczne, gdy badacze muszą przeanalizować doświadczenia emocjonalne, behawioralne, społeczne, poznawcze oraz związane z dobrostanem w ramach tej samej struktury analitycznej.
Wartość danych z kwestionariusza zależy nie tylko od wybranych konstruktów, ale także od sposobu przekształcenia surowych odpowiedzi w zmienne analityczne. Wiele badań raportuje wyniki skal, macierze korelacji, porównania grup lub modele regresji bez przedstawienia pośrednich decyzji łączących surowe rekordy z końcowymi tabelami i rysunkami. Brakujące odpowiedzi mogą być traktowane niespójnie, pytania z odwróconą punktacją mogą zostać błędnie zakodowane, zdublowane zgłoszenia mogą pozostać w zbiorze danych, a odpowiedzi udzielone bez należytej uwagi mogą być uznane za poprawne obserwacje. Decyzje dotyczące brakujących danych powinny być zatem zaplanowane, udokumentowane i zaraportowane, a nie traktowane jako niewidoczny krok post hoc2. Dane z kwestionariuszy online wymagają również wyraźnych reguł oceny jakości odpowiedzi, ponieważ zbyt szybkie wypełnianie, zaznaczanie tych samych odpowiedzi (straight-lining), niespójne odpowiedzi i inne wzorce niskiego zaangażowania mogą zniekształcić statystyki opisowe, szacunki niezawodności oraz zaobserwowane powiązania3.
Nowatorstwo tego protokołu polega na powiązanym ścieżce audytu, prowadzącej od surowego eksportu kwestionariusza do końcowych wyników statystycznych i wizualnych. W szczególności przepływ pracy uzupełnia zmapowana skala, dziennik przesiewowy przed analizą, punkt kontrolny odwróconego punktowania, dziennik weryfikacji punktacji, weryfikację źródeł numerycznych dla wykresów oraz ślad audytowy łączący każdą tabelę lub rysunek z plikiem źródłowym. Odróżnia to tę metodę od standardowych praktyk oczyszczania danych ankietowych, punktowania skal, testowania rzetelności lub wizualizacji. Zamiast jedynie stwierdzać, że dane z kwestionariusza zostały oczyszczone i przeanalizowane, protokół precyzuje, który plik jest zablokowany, który plik jest poddawany przesiewowi, jakie reguły są stosowane, jakie wyniki skal są generowane oraz która zweryfikowana tabela numeryczna służy do stworzenia każdego wyniku wizualnego.
Przebieg pracy zaprezentowano na przykładzie zanonimizowanych danych z kwestionariusza wypełnionego przez studentów, zawierających pięć zmiennych na poziomie skali: negatywne emocje, prokrastynację akademicką, poczucie przynależności do szkoły, myślenie wysokiego rzędu oraz subiektywny dobrostan. Konstrukty te wybrano, aby dostarczyć przykładów z zakresu emocjonalnego, behawioralnego, kontekstu szkolnego, poznawczego oraz zorientowanych na efekt w ramach jednego ustrukturyzowanego i możliwego do audytu procesu. Prokrastynacja akademicka została powiązana z późniejszymi problemami ze zdrowiem psychicznym u studentów uczelni wyższych, w tym z depresją, lękiem i skutkami związanymi ze stresem4. Poczucie przynależności do szkoły i subiektywny dobrostan są również ściśle powiązane w populacjach studenckich, co uzasadnia uwzględnienie miar przynależności i dobrostanu w ramach tego samego systemu przetwarzania kwestionariuszy5. W niniejszym protokole konstrukty te służą jednak do zademonstrowania przebiegu pracy, a nie do ustanowienia przyczynowego modelu psychologicznego.
Kluczowym elementem protokołu jest oddzielenie decyzji dotyczących przetwarzania danych od interpretacji merytorycznej. Mapa skali jest przygotowywana przed analizą, kryteria jakości odpowiedzi są ustalane przed punktowaniem skali, weryfikacja odwróconego punktowania jest kończona przed testowaniem statystycznym, a wykresy są generowane dopiero po sprawdzeniu ich numerycznych tabel źródłowych. Ta sekwencja jest istotna, ponieważ skale odpowiedzi typu Likerta wymagają starannego dopasowania sformułowań pozycji, kotwic odpowiedzi, kierunku punktowania oraz obróbki statystycznej6. Protokół priorytetyzuje również przejrzyste wstępne przetwarzanie i weryfikację punktowania nad złożonością modelu. Modele predykcyjne lub wielozmienne mogą być użyteczne w badaniach studenckich7, a podsumowania graficzne mogą usprawnić interpretację, o ile pozostają powiązane z zweryfikowanymi macierzami numerycznymi8, lecz oba te elementy zależą od przejrzystego przygotowania zmiennych wejściowych. Z tego powodu w przepływie pracy analizę korelacji, kontrastowe porównania grup, modelowanie regresyjne, weryfikację diagnostyczną oraz wizualizację wykorzystano jako moduły przykładowe, a nie jako obowiązkowe twierdzenia merytoryczne.
Niniejszy protokół jest przeznaczony dla badaczy potrzebujących praktycznego schematu przetwarzania kwestionariuszy dla zanonimizowanych danych dotyczących dobrostanu studentów. Jest on odpowiedni w sytuacjach, gdy odpowiedzi na poszczególne pytania kwestionariusza są eksportowane z platformy online, zmienne na poziomie skal muszą zostać obliczone z pozycji typu Likerta, a celem jest uzyskanie przejrzystych wyników opisowych, korelacyjnych, porównań grupowych, regresji, diagnostyki oraz danych gotowych do wizualizacji. Protokół nie służy do ustanawiania związków przyczynowo-skutkowych, walidacji nowych skal, zastępowania konfirmacyjnej analizy czynnikowej, testowania niezmienności pomiarowej ani zastępowania modelowania odpowiedzi na pozycje (IRT) lub modelowania zmiennych latentnych. Jego wkład ma charakter proceduralny: czyni on ścieżkę od rekordów kwestionariuszowych do raportowanych tabel i rycin widoczną, powtarzalną i możliwą do zweryfikowania. Podejście to jest zgodne z aktualnymi zagadnieniami dotyczącymi jakości danych z ankiet online9, sprawdzania regresji i wartości wpływu10 oraz weryfikowalnych schematów analizy opartej na kwestionariuszach11.
Protokół
Niniejsze badanie z udziałem ludzi zostało przeanalizowane i zatwierdzone przez Komisję Etyki College of Aeronautics w Guizhou Open University (nr zatwierdzenia GZOU-EDU-2024-015). Komisja stwierdziła, że badanie kwalifikuje się do zwolnienia z wymogów etycznych, ponieważ wykorzystano w nim anonimowe, dobrowolne procedury ankietowe, a ryzyko dla uczestników nie przekraczało poziomu minimalnego. Wszyscy uczestnicy wyrazili elektroniczną świadomą zgodę przed wypełnieniem kwestionariusza i mogli zaprzestać udzielania odpowiedzi w dowolnym momencie bez żadnych konsekwencji. Ponieważ kilka pytań dotyczyło negatywnych emocji, stresu, samotności, bezradności, niezadowolenia lub powiązanych z nimi doświadczeń związanych z dobrostanem, na stronie zgody oraz na końcowej stronie kwestionariusza podano dane kontaktowe do badacza i instytucji dla uczestników, którzy odczuli dyskomfort. Zestaw danych wykorzystany w niniejszym protokole został zanonimizowany przed screeningiem, punktacją, analizą i wizualizacją. Pełny kwestionariusz został udostępniony jako Supplementary File 1.
1. Przygotowanie kwestionariusza, materiałów etycznych i artefaktów przepływu pracy
- Przed zaprogramowaniem kwestionariusza należy zdefiniować populację kwalifikującą się do badania, środowisko badania, konstrukty kwestionariusza oraz planowane wyniki analizy.
- Należy przygotować wniosek o zgodę komisji etyki, obejmujący populację docelową, kanał rekrutacji, treść kwestionariusza, szacowany czas wypełnienia, ochronę anonimowości, przechowywanie danych, procedurę wycofania się, informacje o wsparciu dla uczestników oraz planowane analizy.
- Przed rozpoczęciem gromadzenia danych w folderze projektu należy zapisać dokument potwierdzający zgodę lub zwolnienie z oceny etycznej, treść formularza zgody, tekst rekrutacyjny, wersję kwestionariusza, informacje o wsparciu dla uczestników oraz planowany schemat postępowania.
- Populację docelową należy zdefiniować jako studentów studiów licencjackich/magisterskich w trybie stacjonarnym, którzy ukończyli co najmniej 18 lat, są obecnie zapisani do uczelni wyższej, rozumieją treść kwestionariusza i są w stanie wyrazić świadomą zgodę.
- Przed rekrutacją należy zdefiniować kryteria wykluczenia. Wyklucza się respondentów, którzy odmówili wyrażenia zgody, nie spełniają definicji populacji docelowej, przesyłają duplikaty odpowiedzi, przekraczają próg brakujących danych lub spełniają łączone kryteria odpowiedzi nieprawidłowych opisane w kroku 1.4.
- Oświadczenie o świadomej zgodzie należy umieścić na początku kwestionariusza. Należy w nim określić cel badania, dobrowolny charakter uczestnictwa, przybliżony czas wypełnienia (12 min), ochronę anonimowości, prawo do wycofania się, plan wykorzystania danych, dane kontaktowe badacza oraz informacje o kontakcie w celu uzyskania wsparcia.
- Nie wolno gromadzić danych bezpośrednio identyfikujących, takich jak numery legitymacji studenckiej, numery PESEL lub inne krajowe numery identyfikacyjne, numery telefonów komórkowych, osobiste adresy e-mail, adresy akademików ani innych identyfikatorów osobowych.
- Kwestionariusz należy ułożyć w następującej kolejności: świadoma zgoda, informacje demograficzne, pytania dotyczące negatywnych emocji, pytania dotyczące prokrastynacji akademickiej, pytania dotyczące poczucia przynależności do szkoły, pytania dotyczące myślenia wysokiego rzędu oraz pytania dotyczące subiektywnego dobrostanu.
- Przed zaprogramowaniem kwestionariusza należy wybrać narzędzia badawcze. W niniejszym protokole negatywne emocje oceniano za pomocą 21-elementowej skali Depression Anxiety Stress Scales-21, prokrastynację akademicką za pomocą 16-elementowej skali Tuckman Procrastination Scale, poczucie przynależności do szkoły za pomocą 18-elementowej skali Psychological Sense of School Membership Scale, myślenie wysokiego rzędu za pomocą 20-elementowego zestawu pytań opracowanego na podstawie literatury dotyczącej pomiaru myślenia wysokiego rzędu, a subiektywny dobrostan za pomocą 20-elementowej skali subiektywnego dobrostanu przeznaczonej do badań studentów12,13,14,15,16.
- Przed zaprogramowaniem kwestionariusza należy przygotować zablokowaną mapę skal. Powinna ona zawierać nazwę konstruktu, oryginalną nazwę skali, oryginalne przypisanie bibliograficzne, wersję językową, status zgody lub autoryzacji, procedurę tłumaczenia lub adaptacji, kod pytania, treść pytania, zakres odpowiedzi, kotwice odpowiedzi, kierunek punktacji, status pytania z odwróconą punktacją, końcową zmienną na poziomie skali oraz regułę punktowania.
- Zestaw pytań można opisać jako skalę zwalidowaną tylko wtedy, gdy udokumentowano narzędzie źródłowe, przypisanie bibliograficzne, dowody walidacji oraz status adaptacji lub tłumaczenia. Jakiekolwiek zestawy pytań opracowane przez autorów lub specyficzne dla badania należy zidentyfikować w Tabeli 1 oraz w Pliku uzupełniającym 1.
- Struktura pomiarowa musi zostać zablokowana przed rozpoczęciem gromadzenia danych. W przypadku narzędzi tłumaczonych lub adaptowanych należy zakończyć proces tłumaczenia, recenzji, uzgodnień i testów pilotażowych przed rozpoczęciem rekrutacji.
- Należy przygotować pakiet audytowy schematu postępowania, który obejmuje zablokowany plik kwestionariusza, mapę skal, listę kontrolną eksportu surowych danych, dziennik przesiewowy, dziennik weryfikacji punktacji, dziennik analizy, szablon tabeli źródeł rycin oraz plik z syntaktyką lub skryptem analizy.
- Wszystkie elementy schematu postępowania powinny posiadać wersjonowane nazwy plików.
- Należy zdefiniować wymagane kolumny dla każdego pliku audytowego.
- Dziennik przesiewowy zawiera ID rekordu, kryterium przesiewowe, status flagi, status wykluczenia, powód wykluczenia, datę decyzji oraz inicjały recenzenta.
- Mapa skal zawiera nazwę konstruktu, źródło skali, kod pytania, treść pytania, zakres odpowiedzi, kotwice odpowiedzi, status odwróconej punktacji, nazwę końcowej zmiennej, regułę punktowania oraz status zgody lub adaptacji.
- Dziennik weryfikacji punktacji zawiera kod pytania, oryginalny zakres wartości, przekodowany zakres wartości, formułę odwróconej punktacji, wynik kontroli zakresu, status rozbieżności, wprowadzoną korektę oraz datę korekty.
- Tabela źródeł rycin zawiera numer ryciny, numer panelu, tabelę źródłową, naniesione zmienne, wyświetloną statystykę, wielkość próby oraz status weryfikacji.
- Przed zaprogramowaniem kwestionariusza należy zdefiniować analityczny schemat postępowania: przeprowadzenie badania, eksport surowych danych, przesiewanie odpowiedzi, punktowanie skal, ocena niezawodności, analiza opisowa, analiza korelacji, porównanie grup o wysokich i niskich wynikach, modelowanie regresji, kontrole diagnostyczne oraz przygotowanie wizualizacji17.
- Protokół należy strukturyzować w oparciu o decyzje, operacje i wyniki weryfikacji, a nie o ścieżki w menu oprogramowania.
- Jeżeli pozwalają na to zasady instytucji i czasopisma, należy udostępnić zasoby schematu postępowania, w tym plik kwestionariusza, mapę skal, szablon dziennika przesiewowego, szablon dziennika punktowania, plik z syntaktyką lub skryptem analizy oraz tabele źródeł rycin.
UWAGA: Rycina 1 przedstawia drogę od przygotowania kwestionariusza do eksportu surowych danych, przesiewania odpowiedzi, punktowania skal, analizy statystycznej, kontroli diagnostycznych i wyników wizualizacji. Tabela 1 zawiera informacje o narzędziu źródłowym, liczbie pytań, zakresie odpowiedzi, schemacie punktowania, regule odwróconej punktacji, statusie zgody lub adaptacji oraz końcowej zmiennej na poziomie skali dla każdego konstruktu.
2. Konfiguracja i dystrybucja kwestionariusza
- Należy potwierdzić, że platforma kwestionariuszowa obsługuje bramkę zgody, wymagane pola, weryfikację duplikatów zgłoszeń, rejestrację znaczników czasu oraz zapisywanie czasu trwania odpowiedzi.
- Stworzyć kwestionariusz za pomocą platformy do ankiet online wymienionej w Tabeli materiałów. Zaprogramować kwestionariusz zgodnie z zatwierdzoną mapą skal.
- Przed udostępnieniem linku do ankiety porównać zaprogramowany kwestionariusz z zatwierdzoną mapą skal punkt po punkcie. Wszelkie poprawki odnotować w dzienniku badania.
- Ustawić punkt dotyczący świadomej zgody jako pierwsze wymagane pole. Zaprogramować automatyczne przerwanie kwestionariusza w momencie, gdy uczestnik wybierze opcję „Nie zgadzam się na udział”.
- Zaprogramować sekcje skali demograficznej i psychologicznej zgodnie z kolejnością ustaloną w kroku 1.8. Użyć kodów pytań zgodnych z mapą skal.
- Ustawić pytania skali psychologicznej jako wymagane tylko wtedy, gdy jest to dozwolone przez zgodę komisji etycznej lub zwolnienie z niej oraz gdy uczestnicy mogą wycofać się bez żadnych konsekwencji. Jeśli wymuszanie odpowiedzi nie jest dozwolone, należy zapisać regułę postępowania z brakującymi danymi przed rozpoczęciem ich gromadzenia.
- Wyświetlać kotwice odpowiedzi przed każdą sekcją skali i zachować spójność kotwic w obrębie każdej skali18.
- Wyłączyć możliwość wielokrotnego przesyłania zgłoszeń, jeśli platforma ankietowa oferuje taką funkcję. Zachować wszelkie anonimowe identyfikatory urządzenia, przeglądarki, platformy lub zgłoszenia niezbędne do weryfikacji duplikatów odpowiedzi.
- Włączyć automatyczną rejestrację czasu przesłania oraz czasu trwania wypełniania ankiety.
- Ustawić okres otwarcia kwestionariusza na 7 dni kalendarzowych lub zastosować okno zbierania danych zatwierdzone przez komisję etyczną.
- Wysłać link do kwestionariusza za pośrednictwem zatwierdzonego instytucjonalnego kanału rekrutacji. Przekazać wszystkim uczestnikom takie same instrukcje pisemne.
- Zamknąć kwestionariusz po zakończeniu określonego okna zbierania danych.
UWAGA: W dzienniku badania należy zachować treść zaproszenia do rekrutacji, link do kwestionariusza, daty otwarcia i zamknięcia, ustawienia platformy, treść zgody, końcową wersję kwestionariusza oraz ustawienia eksportu danych z platformy.
3. Eksport i zabezpieczenie surowych danych
- Niezwłocznie po zamknięciu okna zbierania danych wyeksportuj odpowiedzi z wypełnionych kwestionariuszy do pliku arkusza kalkulacyjnego.
- Zapisz pierwszy wyeksportowany plik jako zablokowany surowy zbiór danych. Nie edytuj tego pliku.
- Utwórz jedną kopię roboczą do celów przesiewowych, punktacji i analizy. Nazwij plik, podając datę, numer wersji oraz identyfikator projektu.
- Potwierdź, że wyeksportowany plik zawiera jeden wiersz na każdego respondenta oraz jedną kolumnę na każdą zmienną demograficzną, pytanie z kwestionariusza, zmienną znacznika czasu, zmienną platformy lub pochodną pole platformy.
- Przechowuj zablokowany surowy zbiór danych, kopię roboczą, mapę skali, plik kwestionariusza, dziennik badania, dziennik przesiewowy, dziennik weryfikacji punktacji, dziennik analizy, tabele źródłowe rycin oraz plik składni lub skryptu w folderze projektu chronionym hasłem.
- Sprawdź, czy zbiór danych nie zawiera bezpośrednio identyfikowalnych informacji. Usuń z kopii roboczej przed analizą wszelkie nieoczekiwane pola identyfikacyjne i odnotuj w dzienniku badania nazwę pola, przyczynę usunięcia, datę usunięcia oraz osobę odpowiedzialną za weryfikację.
- Przed udostępnieniem lub opublikowaniem danych na poziomie uczestnika sprawdź możliwość pośredniej identyfikacji. Przeanalizuj małe komórki demograficzne utworzone przez kombinacje płci, wieku, roku studiów, kategorii instytucji i kategorii kierunku studiów. Jeśli komórka zawiera mniej niż pięciu respondentów, połącz kategorie, zanonimizuj komórkę lub udostępnij wyłącznie dane zagregowane.
- Zapisz status dostępności danych w dzienniku badania, w tym informację o tym, czy dane na poziomie uczestnika są dostępne, ograniczone ze względu na wymogi etyczne lub prywatność, czy zostały zastąpione zagregowanym zbiorem danych z przepływu pracy.
- Przed oczyszczaniem danych utwórz dziennik przesiewowy. Zapisz surową wielkość próby, kryterium przesiewowe, liczbę rekordów oznaczonych, liczbę rekordów usuniętych, liczbę rekordów zachowanych, przyczynę wykluczenia, datę decyzji oraz inicjały weryfikującego.
- Przed analizą statystyczną utwórz plik śledzenia analizy. Zapisz nazwę oprogramowania, wersję oprogramowania, system operacyjny, nazwy plików, wersję danych, wersję skryptu lub składni oraz datę każdego uruchomienia analizy.
UWAGA: Zablokowanego surowego zbioru danych używaj wyłącznie do weryfikacji. Wszystkie działania przesiewowe, punktację i analizę przeprowadzaj na kopii roboczej.
4. Przesiewanie odpowiedzi i tworzenie zbioru danych analitycznych
- Zastosuj określone wcześniej reguły wykluczania i kontroli jakości przed obliczeniem jakiegokolwiek wyniku na poziomie skali.
- Zastosuj reguły przesiewowe do kopii roboczej w następującej kolejności: status zgody, kwalifikowalność, powtórne zgłoszenia, brakujące dane, czas trwania odpowiedzi, odpowiedzi liniowe, wartości poza zakresem oraz połączone wskaźniki jakości odpowiedzi.
- Po każdej operacji przesiewowej zapisz w dzienniku przesiewowym liczbę rekordów oznaczonych, usuniętych i zachowanych. Nie nadpisuj wcześniejszych wersji pliku roboczego.
- Usuń wszystkie rekordy, w których element świadomej zgody został oznaczony jako „Nie” lub pozostał nieodpowiedziany.
- Usuń wszystkie rekordy, które nie spełniają kryteriów włączenia określonych w kroku 1.4.
- Przeprowadź przesiew pod kątem powtórnych zgłoszeń, wykorzystując anonimowe identyfikatory odpowiedzi, czas przesłania, flagi powtórnych zgłoszeń platformy oraz powtarzające się wzorce odpowiedzi.
- W przypadku wykrycia zdublowanych wpisów zachowaj pierwsze kompletne zgłoszenie, chyba że udokumentowany powód uzasadnia zachowanie późniejszej kompletnej odpowiedzi.
- Popraw wszystkie reguły jakości odpowiedzi przed obliczeniem wyników skal. Tabela 2 podsumowuje progi wykluczania, progi oznaczania, uzasadnienie, wsparcie literaturowe oraz plan analizy wrażliwości zastosowane w procesie.
- Przeprowadź przesiew pod kątem brakujących danych. Usuń respondenta, gdy brakuje więcej niż 20% wszystkich elementów skali. Zastąp pojedynczy brakujący element średnim wynikiem respondenta dla tej samej skali tylko wtedy, gdy ukończono co najmniej 80% tej skali. Nie imputuj zmiennych demograficznych, chyba że zmienna ta nie jest używana w żadnej analizie.
- Zapisz liczbę respondentów wykluczonych z powodu braku więcej niż 20% elementów skali oraz liczbę osób, u których zastosowano imputację średnią wewnątrz skali. W obecnym zbiorze danych 4 respondentów zostało wykluczonych z powodu braku więcej niż 20% elementów skali, a 21 respondentów otrzymało imputację średnią wewnątrz skali dla 37 pojedynczych brakujących elementów.
- Przeprowadź przesiew pod kątem czasu trwania odpowiedzi. Oznacz odpowiedzi udzielone w czasie krótszym niż 180 s. Traktuj tę wartość jako flagę zbyt szybkiego udzielenia odpowiedzi, a nie jako automatyczną regułę wykluczania.
- Przeprowadź przesiew pod kątem odpowiedzi liniowych. Oznacz odpowiedź, gdy ta sama opcja została wybrana dla więcej niż 90% wszystkich elementów skali Likerta. Traktuj tę wartość jako flagę wzorca odpowiedzi, a nie jako automatyczną regułę wykluczania.
- Przeprowadź przesiew pod kątem dodatkowych wskaźników niskiego zaangażowania, w tym dowodów na powtórne zgłoszenia, niemożliwych znaczników czasu, powtarzających się ciągów odpowiedzi w oddzielnych zgłoszeniach lub konfliktów między metadanymi platformy a treścią kwestionariusza.
- Usuń oznaczoną odpowiedź tylko wtedy, gdy co najmniej dwa wskaźniki kontroli jakości sugerują nieprawidłowe udzielenie odpowiedzi, takie jak ekstremalnie krótki czas ukończenia w połączeniu z odpowiedziami liniowymi, dowody na powtórne zgłoszenia lub niemożliwe metadane platformy19.
- Zapisz wszystkie oznaczone rekordy, nawet jeśli zostały zachowane. W obecnym zbiorze danych 19 odpowiedzi zostało oznaczonych ze względu na czas ukończenia < 180 s, 8 odpowiedzi zostało oznaczonych ze względu na >90% odpowiedzi liniowych, a 13 rekordów zostało wykluczonych, ponieważ spełniły dwa lub więcej wskaźników jakości odpowiedzi.
- Przeprowadź przesiew pod kątem wartości poza zakresem. Potwierdź, że elementy dotyczące negatywnych emocji mieszczą się w zakresie 1–4, elementy dotyczące prokrastynacji akademickiej, przynależności szkolnej i myślenia wyższego rzędu mieszczą się w zakresie 1–5, a elementy dotyczące subiektywnego dobrostanu mieszczą się w zakresie 1–6.
- Koryguj wartość tylko wtedy, gdy oryginalny eksport wyraźnie wskazuje na błąd formatowania. Nie zmieniaj poprawnych wyników psychologicznych tylko dlatego, że wydają się niezwykle wysokie lub niskie.
- Wygeneruj tabelę przepływu przesiewowego raportującą przesłane kwestionariusze, wykluczenia ze względu na zgodę i kwalifikowalność, wykluczenia duplikatów, wykluczenia z powodu brakujących danych, flagi jakości odpowiedzi, połączone wykluczenia kontroli jakości, imputacje pojedynczych elementów, zachowane przypadki analityczne oraz końcową wielkość próby analitycznej.
- Uzupełnij tabelę przepływu przesiewowego, korzystając z zablokowanego dziennika przesiewowego, i zachowaj wyeksportowany zapis audytowy decyzji przesiewowych. W obecnym zbiorze danych przepływ przesiewowy był następujący: przesłane kwestionariusze, n = 448; wykluczenia ze względu na zgodę lub kwalifikowalność, n = 6; usunięte powtórne zgłoszenia, n = 5; rekordy wykluczone z powodu >20% brakujących elementów skali, n = 4; rekordy wykluczone z powodu dwóch lub więcej wskaźników jakości odpowiedzi, n = 13; końcowy zbiór danych analitycznych, n = 420.
- Zapisz zachowane rekordy jako zbiór danych analitycznych. Użyj nowej, wersjonowanej nazwy pliku i zachowaj dziennik przesiewowy wraz ze zbiorem danych analitycznych.
UWAGA: Zachowaj poprawne wyniki ekstremalne, chyba że występuje udokumentowany problem z jakością odpowiedzi.
5. Punktacja skal psychologicznych
- Przekształć odpowiedzi na poziomie pozycji w zmienne na poziomie skal dopiero po zakończeniu weryfikacji odpowiedzi i zapisaniu zbioru danych analitycznych.
- Zakoduj wszystkie pozycje typu Likerta zgodnie z kotwicami odpowiedzi w zablokowanym kwestionariuszu oraz regułami punktowania w mapie skali.
- Pozostaw oryginalne zmienne pozycji bez zmian. Utwórz oddzielne zmienne pochodne dla pozycji przekodowanych lub punktowanych odwrotnie.
- Oblicz wynik każdej skali zgodnie z zablokowaną mapą skali oraz odpowiadającym jej instrumentem źródłowym lub instrukcją punktowania.
- Zastosuj odwrócone punktowanie dla wyznaczonych pozycji dotyczących subiektywnego dobrostanu przed obliczeniem wyniku subiektywnego dobrostanu. Dla skali odpowiedzi 1–6 oblicz każdą odwróconą pozycję jako 7 minus wynik oryginalny i dodaj _R do nazwy zmiennej pochodnej.
- Do obliczania subiektywnego dobrostanu używaj zmiennych z odwróconym punktowaniem, a nie zmiennych oryginalnych.
- Oblicz wynik na poziomie każdej skali jako średnią z jej zachowanych pozycji: emocji negatywnych, prokrastynacji akademickiej, poczucia przynależności do szkoły, myślenia wyższego rzędu oraz subiektywnego dobrostanu.
- Nazwij końcowe zmienne na poziomie skal jako: Negative emotion, Academic procrastination, School belongingness, Higher-order thinking oraz Subjective well-being.
- Zweryfikuj minimalną i maksymalną wartość każdej zmiennej na poziomie skali w odniesieniu do jej teoretycznego zakresu odpowiedzi. Ponownie sprawdź kodowanie, odwrócone punktowanie i obsługę brakujących wartości, jeśli jakikolwiek wynik wykracza poza oczekiwany zakres.
- Przed analizą inferencyjną zweryfikuj kierunek każdej skali w odniesieniu do mapy skali. Wyższe wyniki powinny odzwierciedlać zamierzony kierunek konstruktu.
- Przed analizą przeprowadź audyt odwróconego punktowania. Przelicz ponownie pozycje z odwróconym punktowaniem dla losowej podgrupy rekordów lub dla wszystkich pozycji z odwróconym punktowaniem, jeśli jest to możliwe, i zapisz wynik audytu w dzienniku weryfikacji punktowania.
- W przypadku wykrycia błędu w punktowaniu popraw zmienną pochodną, ponownie wygeneruj wynik dotkniętej skali, zaktualizuj dziennik weryfikacji punktowania i ponownie uruchom wszystkie dalsze analizy oraz tabele źródłowe rycin w oparciu o poprawiony zbiór danych analitycznych.
UWAGA: Traktuj odwrócone punktowanie i weryfikację zakresu jako wymagane punkty kontrolne przed analizą korelacji, porównaniem grup, modelowaniem regresji lub wizualizacją.
6. Ocena spójności wewnętrznej i właściwości opisowych
- Oblicz spójność wewnętrzną, skorygowane korelacje element-suma oraz statystyki opisowe dla każdej skali, wykorzystując zmienne elementów zdefiniowane w zablokowanej mapie skal.
- Zapisz wartość alfa Cronbacha, numer elementu, wielkość próby prawidłowej, skorygowane korelacje element-suma oraz wartości alfa po usunięciu elementu dla każdej skali.
- Przyjmij wartość alfa Cronbacha wynoszącą 0.70 jako minimalny akceptowalny próg niezawodności dla tego schematu postępowania. Przed usunięciem jakiegokolwiek elementu sprawdź sformułowanie pytania, kierunek punktacji, odwróconą punktację, zgodność z konstruktem oraz dokumentację narzędzia źródłowego20.
- Oblicz omegę McDonalda jako uzupełniającą estymację niezawodności, jeśli środowisko analityczne na to pozwala. Raportuj wartość omegi wraz z alfą Cronbacha, gdy obie estymacje prowadzą do różnych interpretacji niezawodności.
- Przeanalizuj każdy element o ujemnej lub bardzo niskiej skorygowanej korelacji element-suma przed rozważeniem jego usunięcia. Traktuj to w pierwszej kolejności jako możliwy problem z kodowaniem, odwróconą punktacją lub zgodnością z konstruktem.
- Nie usuwaj elementu wyłącznie w celu zwiększenia wartości alfa Cronbacha. Usunięcie elementu musi być uzasadnione instrukcją punktowania, sformułowaniem pytania, skorygowaną korelacją element-suma, dopasowaniem koncepcyjnym oraz udokumentowaną weryfikacją punktacji.
- Oblicz statystyki opisowe dla wszystkich pięciu zmiennych na poziomie skali, w tym średnią, odchylenie standardowe, minimum, maksimum, skośność i kurtozę.
- Sprawdź występowanie efektu podłogi lub sufitu, zapisując proporcję respondentów z minimalnymi i maksymalnymi możliwymi wynikami dla każdej skali.
- Zapisz estymacje niezawodności, diagnostykę element-suma, statystyki opisowe oraz wszelkie decyzje dotyczące punktacji w dzienniku analizy.
UWAGA: Alfa Cronbacha jest stosowana jako punkt kontrolny niezawodności, a nie jako pełna procedura walidacji psychometrycznej. Gdy wymagana jest formalna ewaluacja pomiaru, uzupełnij ten schemat postępowania o omegę McDonalda, potwierdzającą analizę czynnikową, testowanie niezmienniczości pomiaru, modelowanie odpowiedzi na elementy lub inne metody zmiennych ukrytych.
7. Przeprowadzenie analizy korelacji
- Należy wykorzystać pięć zweryfikowanych zmiennych na poziomie skali: negatywne emocje, prokrastynację akademicką, poczucie przynależności do szkoły, myślenie wyższego rzędu oraz subiektywny dobrostan.
- Przed obliczeniem korelacji Pearsona należy sprawdzić rozkłady oraz dwuwymiarowe wykresy rozrzutu dla każdej pary zmiennych na poziomie skali.
- Należy ocenić, czy zmienne wykazują w przybliżeniu ciągłą zmienność wyników, silną skośność, zależności nieliniowe lub wpływowe wzorce wartości odstających.
- Oblicz współczynniki korelacji Pearsona oraz dwustronne wartości p dla wszystkich par zmiennych na poziomie skali, jeżeli założenia są dopuszczalne dla analizy powiązań opisowych.
- Zapisz współczynnik korelacji, pwartość p, wielkość próby oraz kierunek związku dla każdej pary zmiennych.
- Współczynniki korelacji należy podawać z dokładnością do trzech miejsc po przecinku.
- Porównaj kierunek każdego współczynnika z mapą skali. Ponownie sprawdź punktację pozycji, jeśli współczynnik jest sprzeczny z zamierzonym kierunkiem konstruktu.
- Zapisz zweryfikowaną macierz korelacji jako numeryczną tabelę źródłową dla mapy ciepła korelacji w sekcji Reprezentatywne wyniki.
- W przypadku wyraźnej asymetrii rozkładów, konieczności zastosowania czułości na poziomie skali porządkowej lub gdy wykresy rozrzutu sugerują monotoniczne, lecz nieliniowe powiązania, należy powtórzyć analizę z wykorzystaniem korelacji Spearmana i porównać kierunek oraz względną wielkość tych powiązań.
- Należy odnotować, czy wyniki testów Pearsona i Spearmana doprowadziły do tej samej interpretacji merytorycznej.
UWAGA: Należy wykorzystać analizę korelacji zarówno do opisowej weryfikacji powiązań, jak i do audytu kierunku punktowania.
8. Utworzenie grup o wysokim i niskim subiektywnym poczuciu dobrostanu
- Należy użyć oczyszczonego i ocenionego zbioru danych analitycznych. Nie należy wracać do surowego eksportu w celu konstruowania grup.
- Jako główny wynik w modelowaniu regresji należy wykorzystać ciągły wskaźnik subiektywnego dobrostanu. Grupowanie wysoki-niski należy stosować wyłącznie do kontrastowego porównania profili.
- Należy posortować respondentów według wskaźnika subiektywnego dobrostanu od najwyższego do najniższego.
- Należy zastosować uprzednio określoną zasadę 27% grup ekstremalnych w celu zdefiniowania grup o wysokim i niskim subiektywnym dobrostanie. Uzasadnienie dla tego progu należy udokumentować w Tabeli 2 oraz w dzienniku analizy.
- Respondentów z górnych 27% należy przypisać do grupy wysokiego subiektywnego dobrostanu, a respondentów z dolnych 27% do grupy niskiego subiektywnego dobrostanu.
- Środkowe 46% należy zachować w pełnym zbiorze danych analitycznych na potrzeby statystyk opisowych, analizy korelacji, porównania płci i modelowania regresji, ale należy wykluczyć te przypadki z kontrastu wysoki-niski.
- Należy utworzyć zmienną grupującą o nazwie Grupa subiektywnego dobrostanu. Grupę górną należy zakodować jako Wysoka, grupę dolną jako Niska, a pozostałych respondentów jako Średnia.
- Należy potwierdzić, że grupy wysoka i niska zawierają zamierzoną liczbę przypadków. W przypadku wystąpienia identycznych wyników na granicy 27%, należy zastosować uprzednio określoną zasadę postępowania z remisami i odnotować tę decyzję w dzienniku analizy.
- Należy przeprowadzić analizę wrażliwości, gdy granica 27% powoduje niestabilność przynależności do grup z powodu identycznych wyników lub małej wielkości próby. Należy zastosować alternatywną, uprzednio określoną zasadę, taką jak grupowanie tercylowe, i zgłosić, czy interpretacja pozostała niezmieniona.
UWAGA: Grupowanie wysoki-niski jest procedurą kontrastu opisowego. Nie powinno ono zastępować ciągłego wskaźnika subiektywnego dobrostanu w głównym modelu regresji.
9. Porównanie grup o wysokim i niskim subiektywnym poczuciu dobrostanu
- Przefiltruj analityczny zbiór danych, aby zachować tylko respondentów zakodowanych jako „Wysoki” (High) lub „Niski” (Low) w zmiennej grupującej dobrostan subiektywny.
- Porównaj grupy o wysokim i niskim poziomie pod kątem emocji negatywnych, prokrastynacji akademickiej, poczucia przynależności do szkoły oraz myślenia wyższego rzędu.
- Przed porównaniem grup sprawdź rozkłady specyficzne dla grup, wielkości próby oraz równość wariancji dla każdej zmiennej.
- Zastosuj test t dla prób niezależnych, gdy założenia dotyczące rozkładu i wariancji są spełnione. Zastosuj test t Welcha, gdy założenie o równości wariancji nie jest spełnione.
- Zapisz średnie grupowe, odchylenia standardowe, różnice średnich, wartości t, stopnie swobody, wartości p oraz 95% przedziały ufności.
- Oblicz d Cohena dla każdej różnicy między grupami i zinterpretuj wielkość efektu wraz z wartością p.
- Sprawdź, czy kierunek każdej różnicy między grupami jest zgodny z definicjami konstruktów i macierzą korelacji.
- Zapisz zweryfikowaną tabelę porównań grupowych jako źródło numeryczne dla wszelkich wizualizacji porównań grupowych.
- Przedstaw tę analizę jako kontrast między ekstremalnymi profilami dobrostanu subiektywnego.
UWAGA: Nie interpretuj porównania wysokiego i niskiego poziomu jako dowodu przyczynowo-skutkowego.
10. Badanie różnic między płciami
- Usuń filtr grup wysokich i niskich i powróć do pełnego zbioru danych analitycznych.
- Użyj płci jako opisowej zmiennej grupującej, a nie jako zmiennej przyczynowej.
- Porównaj respondentki i respondentów pod kątem negatywnych emocji, prokrastynacji akademickiej, poczucia przynależności do szkoły, myślenia wyższego rzędu oraz subiektywnego dobrostanu.
- Przed porównaniem sprawdź wielkość prób dla poszczególnych grup, brakujące dane, rozkłady oraz równość wariancji.
- Zastosuj test t dla prób niezależnych, gdy założenia są spełnione. Zastosuj test t Welcha, gdy założenie o równości wariancji nie jest spełnione.
- Zapisz średnie grupowe, odchylenia standardowe, różnice średnich, wartości t, stopnie swobody, wartości p, 95% przedziały ufności oraz wartości d Cohena.
- Zinterpretuj różnice ze względu na płeć w sposób opisowy i zaraportuj wielkości efektu wraz z wartościami p.
- Nie używaj wyników porównania płci do uzasadnienia wykluczeń post hoc, modyfikacji skali ani interpretacji przyczynowych.
UWAGA: Porównania ze względu na płeć są uwzględnione jako opisowe kontrole podgrup w ramach tego przepływu pracy dla kwestionariusza przekrojowego.
11. Oszacowanie modelu regresji
- Przyjmij subiektywny dobrostan jako zmienną zależną.
- Przyjmij negatywne emocje, prokrastynację akademicką, poczucie przynależności do szkoły oraz myślenie wyższego rzędu jako jednoczesne predyktory na poziomie skali21.
- Użyj ciągłych zmiennych na poziomie skali utworzonych podczas punktowania skal. Nie zastępuj ciągłego wyniku subiektywnego dobrostanu zmienną grupową (wysoki-niski).
- Dopasuj model główny, stosując wielokrotną regresję liniową z jednoczesnym wprowadzaniem zmiennych.
- Zapisz nieustandaryzowane współczynniki, współczynniki ustandaryzowane, błędy standardowe, wartości t, wartości p, 95% przedziały ufności, R2, skorygowane R2, tolerancję oraz współczynnik inflacji wariancji.
- Przyjmij wartości współczynnika inflacji wariancji poniżej 5,00 jako próg braku silnej współliniowości.
- Przeanalizuj dwuzmienne wykresy rozrzutu, wykresy regresji cząstkowej lub wykresy komponentów i reszt, aby ocenić, czy zależności między predyktorami a subiektywnym dobrostanem są w przybliżeniu liniowe.
- Oceń niezależność reszt za pomocą statystyki Durbina-Watsona.
- Oceń normalność reszt za pomocą wykresu Q-Q reszt oraz formalnego testu normalności, jeśli jest on odpowiedni dla wielkości próby.
- Oceń homoskedastyczność za pomocą wykresu ustandaryzowanych reszt w funkcji ustandaryzowanych wartości przewidywanych.
- Zapisz ustandaryzowane reszty, ustandaryzowane wartości przewidywane, wartości dźwigni oraz dystans Cooka do celów diagnostycznych.
- Oszacuj uzupełniający model skorygowany, uwzględniający cztery predyktory psychologiczne oraz zmienne demograficzne opisane w charakterystyce próby, w tym płeć, wiek, rok studiów, kategorię instytucji i kategorię kierunku studiów, o ile zmienne te są dostępne i mają odpowiedni rozkład.
- Porównaj model główny z uzupełniającym modelem skorygowanym. Odnotuj, czy kierunek, wielkość i interpretacja statystyczna czterech predyktorów psychologicznych pozostają stabilne po korekcie demograficznej.
- Zapisz zweryfikowane współczynniki ustandaryzowane i 95% przedziały ufności z modelu głównego jako numeryczną tabelę źródłową dla wykresu współczynników w sekcji Reprezentatywne Wyniki22.
UWAGA: Interpretuj współczynniki regresji jako powiązania warunkowe, a nie efekty przyczynowe. Model skorygowany demograficznie jest wykorzystywany w analizie wrażliwości, aby ocenić, czy wnioski z przepływu pracy pozostają stabilne po uwzględnieniu dostępnych zmiennych tła.
12. Diagnostyka modelu regresji
- Przeanalizuj standaryzowane reszty z dopasowanego modelu regresji. Oznacz przypadki, w których bezwzględna wartość standaryzowanej reszty jest większa niż 3,00.
- Przeanalizuj wartości dźwigni (leverage) oraz dystans Cooka w celu zidentyfikowania obserwacji wpływowych.
- Oznacz obserwacje z dystansem Cooka większym niż 4/n jako potencjalnie wpływowe, gdzie n to wielkość próby analitycznej. Przyjmij dystans Cooka większy niż 1,00 jako próg referencyjny dla silnego wpływu, a nie jako jedyną granicę przesiewową.
- Przeanalizuj wykres reszt względem wartości przewidywanych pod kątem nieliniowości, nierówności wariancji oraz nietypowych skupisk.
- Przeanalizuj wykres Q-Q reszt oraz wynik testu normalności reszt. Odnotuj, czy ocena normalności wspiera zastosowanie modelu liniowego do opisowej analizy powiązań.
- Odnotuj statystykę Durbina-Watsona i określ, czy niezależność reszt jest akceptowalna.
- Zweryfikuj wszystkie oznaczone przypadki z dziennikiem przesiewowym, dziennikiem weryfikacji punktacji oraz kryteriami kwalifikowalności.
- Zatrzymaj oznaczone przypadki, jeżeli stanowią one poprawne obserwacje i nie wynikają z błędów wprowadzania danych, błędów w punktacji, powielonych zgłoszeń, naruszeń kryteriów kwalifikowalności lub udokumentowanych problemów z jakością odpowiedzi.
- Popraw lub usuń oznaczony przypadek tylko wtedy, gdy ścieżka audytu zidentyfikuje udokumentowany błąd proceduralny, błąd kwalifikowalności, kodowania, punktacji lub wprowadzania danych.
- Ponownie uruchom model regresji po każdej udokumentowanej korekcie i porównaj współczynniki, przedziały ufności, R2, skorygowany R2 oraz wyniki diagnostyczne z modelem pierwotnym.
- Przeprowadź kontrolę wrażliwości na wpływ poprzez ponowne dopasowanie modelu po wykluczeniu przypadków z dystansem Cooka większym niż 4/n. Zaraportuj, czy interpretacja merytoryczna uległa zmianie.
- Odnotuj ostateczną decyzję diagnostyczną w dzienniku analizy, w tym liczbę przypadków oznaczonych na podstawie standaryzowanych reszt, liczbę przypadków oznaczonych dystansem Cooka większym niż 4/n, maksymalną wartość dystansu Cooka, statystykę Durbina-Watsona oraz wnioski z kontroli normalności i liniowości reszt.
UWAGA: Nie usuwaj przypadków wpływowych wyłącznie w celu poprawy dopasowania modelu. Usunięcie lub korekta muszą opierać się na udokumentowanej przyczynie wynikającej ze ścieżki audytu.
Wyniki
Zbiór danych analitycznych wygenerowany po weryfikacji odpowiedzi
Przepływ pracy weryfikacji odpowiedzi pozwolił na wygenerowanie analitycznego zbioru danych obejmującego 420 zanonimizowanych rekordów studentów z 448 przesłanych kwestionariuszy. W dzienniku weryfikacji odnotowano każdy punkt decyzyjny. Sześć rekordów usunięto z powodu niespełnienia wymogów dotyczących zgody lub kwalifikowalności, usunięto pięć powielonych zgłoszeń, cztery rekordy wykluczono z powodu braku ponad 20% wszystkich pozycji skali, a 13 rekordów wykluczono, ponieważ spełniały dwa lub więcej wskaźników jakości odpowiedzi. Dziewiętnaście odpowiedzi oznaczono z powodu czasu wypełniania <180 s, osiem odpowiedzi oznaczono z powodu >90% odpowiedzi jednowymiarowych, a u 21 respondentów zastosowano imputację średnią wewnątrzskalową dla 37 odizolowanych brakujących pozycji. Końcowy analityczny zbiór danych nie zawierał bezpośrednio identyfikujących informacji o uczestnikach, żaden zachowany przypadek nie przekroczył progu wykluczenia z powodu brakujących danych, a wszystkie zachowane odpowiedzi na pozycje mieściły się w predefined zakresach odpowiedzi. Przepływ weryfikacji podsumowano w Tabeli 3.
Przeanalizowana próba obejmowała 275 kobiet i 145 mężczyzn, co stanowiło odpowiednio 65,5% i 34,5% zbioru danych analitycznych. Średni wiek wynosił 20,1 ± 1,2 lat. Respondenci byli rozdzieleni na cztery lata studiów licencjackich, przy czym rok 1. do roku 4. stanowiły odpowiednio 27,1%, 27,4%, 25,5% i 20,0% próby. Zbiór danych obejmował również trzy kategorie instytucjonalne i pięć kategorii kierunków studiów. Po weryfikacji kategorii żadna opublikowana komórka demograficzna nie zawierała mniej niż pięciu respondentów. Charakterystyka demograficzna zbioru danych analitycznych została podsumowana w Tabeli 4.
Konstrukcja skal, weryfikacja zakresów i przykłady nieoptymalnego przepływu pracy
Po zakodowaniu pozycji i odwróceniu punktacji obliczono pięć zmiennych na poziomie skal: negatywne emocje, prokrastynację akademicką, poczucie przynależności do szkoły, myślenie wysokiego rzędu oraz subiektywny dobrostan. Każdy wynik pozostał w teoretycznym zakresie odpowiedzi. Wyniki dla negatywnych emocji mieściły się w przedziale od 1.048 do 3.143 w skali 1-4. Prokrastynacja akademicka, poczucie przynależności do szkoły oraz myślenie wysokiego rzędu mieściły się w zakresach odpowiednio od 1.312 do 4.250, od 2.333 do 4.444 oraz od 2.350 do 4.850 w ich odpowiednich skalach 1–5. Subiektywny dobrostan mieścił się w przedziale od 2.000 do 5.300 w skali 1–6. Weryfikacja odwróconej punktacji nie wykazała rozbieżności między wyprowadzonymi zmiennymi z odwróconą punktacją a zablokowaną regułą punktowania w końcowym zbiorze danych analitycznych. Kontrole te potwierdziły, że kodowanie pozycji, odwracanie punktacji, obsługa brakujących pozycji oraz agregacja wyników zostały wykonane bez wykrywalnych błędów zakresu.
Przepływ pracy wygenerował również suboptymalne przykłady audytu, które ilustrują sposób wykrywania błędów lub wątpliwych wyników przed końcową analizą. Podczas uruchomienia audytu wykryto błędnie obliczoną wartość odwróconej punktacji dobrostanu subiektywnego, ponieważ dziennik weryfikacji punktacji porównał wartość oryginalną, oczekiwany wzór „reversed score = 7-original score”, wartość pochodną oraz końcowy zakres skali. Zmienna pochodna została skorygowana, wynik dobrostanu subiektywnego został wygenerowany ponownie, a wszystkie pochodne wyniki opisowe, korelacyjne, porównawcze, regresyjne, diagnostyczne oraz źródła figur zostały przeliczone ponownie. W innym roboczym pliku pośrednim podczas weryfikacji zakresu zidentyfikowano wartość pozycji wykraczającą poza zakres, co powiązano z obsługą arkusza kalkulacyjnego, a nie z zablokowanym eksportem surowych danych. Kopia robocza została skorygowana i udokumentowana bez zmiany jakiejkolwiek poprawnej odpowiedzi ekstremalnej. Przeanalizowano również ostrzeżenie dotyczące niezawodności, gdy jedna pozycja wykazała niższą skorygowaną korelację pozycja-suma niż pozostałe pozycje w tej samej skali; ponieważ sformułowanie pozycji, kierunek punktacji i dopasowanie do konstruktu były poprawne, pozycja została zachowana. Zidentyfikowano niezgodność w roboczej wizualizacji, gdy rycina nie zgadzała się z jej zweryfikowaną numeryczną tabelą źródłową; rycina została wygenerowana ponownie na podstawie zweryfikowanej tabeli, a rekord źródła ryciny został zaktualizowany. Przykłady te pokazują, że przepływ pracy nie tylko generuje poprawne wyniki, ale także wykrywa błędy kodowania, problemy z zakresem, ostrzeżenia dotyczące niezawodności, niezgodności między ryciną a źródłem oraz zastrzeżenia co do jakości odpowiedzi za pomocą ścieżki audytu.
Właściwości opisowe i spójność wewnętrzna
Pięć zmiennych na poziomie skali wykazało użyteczną zmienność. Średni wynik emocji negatywnych wyniósł 2,099 ± 0,391, a średni wynik prokrastynacji akademickiej 2,639 ± 0,484. Poczucie przynależności do szkoły oraz myślenie wysokiego rzędu wykazały umiarkowanie wysokie wartości średnie, wynoszące odpowiednio 3,343 ± 0,390 oraz 3,627 ± 0,418. Średni wynik subiektywnego dobrostanu wyniósł 3,784 ± 0,543. W żadnej skali nie zaobserwowano wyraźnego efektu podłogi ani sufitu, a odsetek respondentów osiągających teoretyczne minimum lub maksimum był niższy niż 2,0% dla każdej skali.
Spójność wewnętrzna była akceptowalna dla wszystkich pięciu skal. Wartości alfa Cronbacha mieściły się w przedziale od 0,834 do 0,899, przekraczając wcześniej określony próg 0,70. Najwyższą spójność wewnętrzną wykazano dla emocji negatywnych, przy współczynniku alfa Cronbacha wynoszącym 0,899, a następnie dla subiektywnego dobrostanu na poziomie 0,895. Wartości omega McDonalda mieściły się w zakresie od 0,842 do 0,906, a szacunki omega nie zmieniły interpretacji niezawodności. Analiza skorygowanych korelacji element-suma nie wykazała żadnych elementów wymagających usunięcia. Statystyki opisowe oraz szacunki niezawodności przedstawiono w Tabeli 5.
Struktura korelacji między zmiennymi na poziomie skal
Macierz korelacji została wykorzystana jako opisowa miara powiązań oraz do weryfikacji kierunku punktacji. Przed obliczeniem korelacji Pearsona przeanalizowano rozkłady skal oraz dwuwymiarowe wykresy rozrzutu. Żadna ze zmiennych nie wykazała znacznej skośności ani kurtozy, a na żadnym wykresie nie zaobserwowano silnego wzorca nieliniowego, który unieważniłby opisową analizę korelacji Pearsona. Dobrostan subiektywny korelował ujemnie z emocjami negatywnymi (r = -0,496) oraz prokrastynacją akademicką (r = -0,294), a dodatnio z poczuciem przynależności do szkoły (r = 0,481) oraz myśleniem wysokiego rzędu (r = 0,386). Pozostałe powiązania były zgodne z tą samą logiką punktacji: emocje negatywne wiązały się dodatnio z prokrastynacją akademicką (r = 0,270) i ujemnie z poczuciem przynależności do szkoły (r = -0,346) oraz myśleniem wysokiego rzędu (r =-0,205); prokrastynacja akademicka wiązała się ujemnie z poczuciem przynależności do szkoły (r = -0,222) oraz myśleniem wysokiego rzędu (r = -0,134); natomiast poczucie przynależności do szkoły wiązało się dodatnio z myśleniem wysokiego rzędu (r = 0,310). Pełna macierz korelacji Pearsona została przedstawiona w Tabeli 6.
Analiza wrażliwości Spearmana przyniosła taką samą interpretację kierunkową dla wszystkich par zmiennych. Korelacje Spearmana między subiektywnym poczuciem dobrostanu a czterema predyktorami wyniosły ρ = -0,502 dla emocji negatywnych, ρ = -0,301 dla prokrastynacji akademickiej, ρ = 0,477 dla poczucia przynależności do szkoły oraz ρ = 0,392 dla myślenia wyższego rzędu. Zweryfikowana macierz Pearsona posłużyła jako numeryczna tabela źródłowa do wizualizacji. Rysunek 2A przedstawia pełną mapę ciepła korelacji dla pięciu zmiennych na poziomie skali. Rysunek 2B pokazuje cztery korelacje z subiektywnym poczuciem dobrostanu.
Demonstracja kontrastowa z wykorzystaniem grup o wysokim i niskim poziomie subiektywnego dobrostanu
Reguła grupowania 27% została zastosowana jako demonstracja kontrastowego przepływu pracy, a nie jako merytoryczna klasyfikacja rzeczywistych profili dobrostanu. Reguła ta pozwoliła na utworzenie dwóch grup o równej liczebności: 113 respondentów w grupie o wysokim subiektywnym dobrostanie i 113 w grupie o niskim subiektywnym dobrostanie. Środkowa grupa 194 respondentów została zachowana w pełnym zbiorze danych analitycznych, lecz wykluczona z tego porównania kontrastowego. Żaden przypadek wartości granicznej nie zmienił przypisania do grup.
Niniejszy moduł wykazał, że opisany schemat pracy pozwala na wygenerowanie zdefiniowanej wcześniej zmiennej grupującej, przefiltrowanie zbioru danych analitycznych, obliczenie statystyk opisowych specyficznych dla grup, przeprowadzenie porównań grupowych zgodnie z przyjętymi założeniami oraz eksport zweryfikowanej tabeli źródłowej do wizualizacji. Grupa o wysokim poziomie subiektywnego dobrostanu wykazała niższy poziom emocji negatywnych niż grupa o niskim poziomie subiektywnego dobrostanu (1.864 ± 0.358 vs. 2.335 ± 0.343; różnica średnich = -0.472) oraz mniejszą prokrastynację akademicką (2.455 ± 0.476 vs. 2.801 ± 0.483; różnica średnich = -0.346). Poczucie przynależności do szkoły oraz myślenie wyższego rzędu były wyższe w grupie o wysokim poziomie subiektywnego dobrostanu, z różnicami średnich wynoszącymi odpowiednio 0.454 i 0.351. Wszystkie cztery porównania były istotne (p < 0.001), przy wartościach d Cohena wynoszących -1.346 dla emocji negatywnych, -0.722 dla prokrastynacji akademickiej, 1.279 dla poczucia przynależności do szkoły oraz 0.860 dla myślenia wyższego rzędu. W przypadkach, gdy założenie o równości wariancji nie zostało spełnione, zastosowano test t Welcha; w pozostałych przypadkach utrzymano standardowy test t dla prób niezależnych. Wyniki te nie powinny być interpretowane jako dowód na to, że wybrane predyktory definiują rzeczywiste profile dobrostanu uczniów, ponieważ grupy zostały utworzone na podstawie zmiennej wynikowej, a następnie porównane pod kątem zmiennych skorelowanych. Porównanie grupy wysokiej i niskiej zostało podsumowane w Tabeli 7.
Porównanie opisowe ze względu na płeć
Płeć analizowano jako opisową zmienną grupującą. Respondentki wykazały nieco wyższą średnią wartość w skali emocji negatywnych niż respondenci (2,129 ± 0,380 vs 2,042 ± 0,407). Różnica ta była istotna statystycznie, ale niewielka pod względem wielkości (p = 0,033; Cohen’s d = 0,224). Prokrastynacja akademicka, poczucie przynależności do szkoły, myślenie wyższego rzędu oraz subiektywny dobrostan nie wykazały znaczących różnic ze względu na płeć. Średnie wartości subiektywnego dobrostanu były niemal identyczne u kobiet i mężczyzn (3,781 ± 0,521 vs 3,789 ± 0,583; p = 0,887; Cohen’s d = -0,015). Analizy wrażliwości przeprowadzone za pomocą testu t Welcha nie zmieniły interpretacji wyników porównania płci. Wyniki różnic ze względu na płeć przedstawiono w Tabeli 8.
Model regresji jako przykład generowania modelu i weryfikacji diagnostycznej
Model wielorakiej regresji liniowej został wykorzystany jako przykład generowania, diagnozowania i weryfikowania modelu na podstawie punktowych danych z kwestionariusza. Subiektywny dobrostan wprowadzono jako zmienną zależną, natomiast negatywne emocje, prokrastynację akademicką, poczucie przynależności do szkoły oraz myślenie wyższego rzędu wprowadzono jednocześnie jako predyktory na poziomie skali. Celem tego modułu było zademonstrowanie ekstrakcji współczynników, kontroli współliniowości, diagnostyki rezyduów, oceny wpływu, analizy wrażliwości skorygowanej o dane demograficzne oraz przygotowania rycin i źródeł.
Model wyjaśnił umiarkowaną część wariancji subiektywnego dobrostanu, przy R2 = 0.411 i skorygowanym R2 = 0.406. Emocje negatywne wykazały najwyższy ujemny współczynnik standaryzowany (B = -0.450, standaryzowane β = -0.324). Prokrastynacja akademicka również wykazała ujemny współczynnik (B = -0.130, standaryzowane β = -0.116). Poczucie przynależności do szkoły oraz myślenie wysokiego rzędu wykazały odpowiednio dodatnie współczynniki standaryzowane β = 0.275 i β = 0.218. Wszystkie cztery predyktory były istotne statystycznie w dopasowanym modelu: emocje negatywne, poczucie przynależności do szkoły oraz myślenie wysokiego rzędu przy p < 0.001, a prokrastynacja akademicka przy p = 0.004. Nie stwierdzono współliniowości, ponieważ wszystkie wartości współczynnika inflacji wariancji znajdowały się poniżej 1.24. Przedstawione wyniki regresji są reprezentatywnymi wynikami weryfikacji modelu, a nie ostatecznym wyjaśnieniem psychologicznym dobrostanu uczniów. Tabela 9 zawiera pełne wyniki regresji.
Uzupełniający model skorygowany o dane demograficzne oszacowano poprzez dodanie płci, wieku, roku studiów, kategorii instytucji oraz kategorii kierunku studiów do czterech predyktorów psychologicznych. Model skorygowany wyjaśnił podobną proporcję wariancji, przy R2 = 0.427 i skorygowanym R2 = 0.414. Kierunek i interpretacja statystyczna czterech predyktorów psychologicznych pozostały bez zmian po korekcie demograficznej. Model wrażliwości skorygowany o dane demograficzne przedstawiono w Tabeli 10. Rysunek 3A przedstawia współczynniki standaryzowane oraz 95% przedziały ufności dla czterech predyktorów. Rysunek 3B prezentuje analizę diagnostyczną opartą na standaryzowanych wartościach przewidywanych, standaryzowanych resztach oraz dystansie Cooka.
Diagnostyka regresji i utrzymanie modelu
Diagnostyka regresji nie wykazała, aby dopasowany model był determinowany przez pojedynczy wpływowy rekord. Wykresy bivariantne i regresji cząstkowej nie wykazały silnej nieliniowości. Wykres reszt w funkcji wartości przewidywanych nie wykazał poważnej heteroskedastyczności ani nietypowego grupowania. Statystyka Durbina-Watsona wyniosła 1,93, co potwierdza akceptowalną niezależność reszt. Wykres Q-Q reszt nie wykazał poważnych odchyleń od rozkładu normalnego. Formalny test normalności reszt był istotny statystycznie, W = 0,992, p = 0,031, jednak wykres Q-Q oraz wielkość próby uzasadniły utrzymanie modelu liniowego do opisowej analizy powiązań.
Dwa rekordy miały wartości bezwzględne standaryzowanych reszt przekraczające 3,00. Żaden rekord nie miał odległości Cooka większej niż 1,00. Stosując bardziej czuły próg odległości Cooka >4/n, gdzie n = 420 i 4/n = 0,0095, 17 rekordów oznaczono jako potencjalnie wpływowe. Największa dystans Cooka wyniosła 0,037. Przypadki oznaczonych reszt oraz przypadki wpływowe zweryfikowano z dziennikiem przesiewowym, dziennikiem weryfikacji punktacji oraz kryteriami kwalifikowalności. W żadnym z nich nie stwierdzono błędów w wprowadzaniu danych, nieprawidłowej punktacji, powtórzonych odpowiedzi, braku kwalifikowalności ani udokumentowanych problemów z jakością odpowiedzi; w związku z tym przypadki te pozostawiono w końcowym modelu. Analizę wrażliwości na wpływ, wykluczając przypadki z dystansem Cooka >4/n, co dało taką samą interpretację schematu postępowania jak w modelu głównym. Maksymalna bezwzględna zmiana współczynników standaryzowanych wyniosła 0,026, a skorygowany R2 zmieniły się z 0,406 na 0,405. Wyniki diagnostyczne i czułości podsumowano w Tabela 11.
Wewnętrzna weryfikacja potoku analitycznego
Przepływ pracy powtórzono na oczyszczonym i punktowanym zbiorze danych analitycznych, stosując te same reguły punktacji, progi decyzyjne oraz plik śledzenia analizy. Powtórzono analizę spójności wewnętrznej, statystykę opisową, analizę korelacji, porównania grup o wysokich i niskich wartościach, porównania ze względu na płeć, modelowanie regresji, kontrolę diagnostyczną oraz przygotowanie źródeł do wizualizacji. Powtórzone wyniki były zgodne z pierwotną statystyką opisową, macierzą korelacji, wartościami porównań grupowych, współczynnikami regresji, wynikami diagnostycznymi oraz plikami źródłowymi wizualizacji. Potwierdziło to stabilność obliczeniową potoku analitycznego podczas jego zastosowania do tego samego, zablokowanego zbioru danych analitycznych. Kontrola ta nie stanowi niezależnej powtarzalności proceduralnej, która wymagałaby od niezależnego analityka zastosowania pełnego przepływu pracy na zablokowanym eksporcie danych surowych i uzyskania tych samych udokumentowanych wyników.
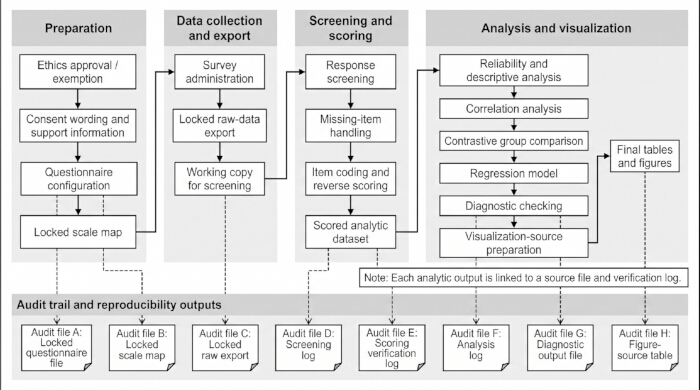
Rycina 1: Schemat przetwarzania danych dotyczących subiektywnego dobrostanu na podstawie kwestionariuszy. Schemat przedstawia sekwencję protokołu i kluczowe wyniki audytu, w tym przygotowanie etyczne, konfigurację kwestionariusza, przeprowadzenie ankiety, eksport surowych danych, mapę skal, dziennik przesiewowy, punktowany zbiór danych analitycznych, zweryfikowane tabele analizy, diagnostykę regresji, pliki źródłowe rycin oraz wyniki wizualizacji. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
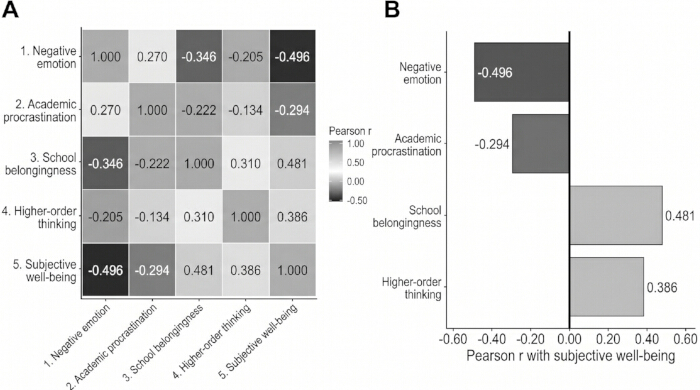
Rysunek 2: Struktura korelacji między zmiennymi na poziomie skal. (A) Mapa ciepła korelacji Pearsona wygenerowana na podstawie zweryfikowanej macierzy korelacji w Tabeli 6. (B) Profil korelacji skoncentrowany na subiektywnym dobrostanie, wygenerowany z tej samej zweryfikowanej tabeli źródłowej. Przedstawiono wszystkie pięć zmiennych na poziomie skal: emocje negatywne, prokrastynację akademicką, poczucie przynależności do szkoły, myślenie wyższego rzędu oraz subiektywny dobrostan. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
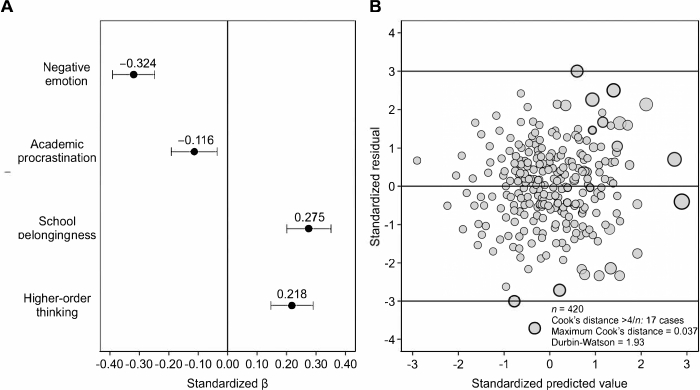
Rysunek 3: Wizualizacja współczynników regresji i diagnostyki. (A) Ustandaryzowane współczynniki regresji i 95% przedziały ufności wygenerowane na podstawie głównych wyników regresji przedstawionych w Tabeli 9. (B) Wyświetlanie diagnostyki regresji wygenerowane na podstawie ustandaryzowanych wartości przewidywanych, ustandaryzowanych reszt oraz wartości dystansu Cooka podsumowanych w Tabeli 11. Większe wartości dystansu Cooka wskazują na obserwacje o większym potencjalnym wpływie na dopasowany model. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Tabela 1: Struktura kwestionariusza i schemat punktacji skali. Tabela ta podsumowuje strukturę pomiarową, w tym nazwę konstruktu, instrument źródłowy, cytowanie źródła, status adaptacji lub dokumentacji, numer pozycji, zakres odpowiedzi, kierunek punktacji, wymóg odwrócenia punktacji, metodę punktacji, końcową zmienną na poziomie skali oraz rolę w protokole. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 2: Kryteria przesiewowe odpowiedzi i kryteria decyzji analitycznych.W tabeli tej wymieniono uprzednio określone kryteria dotyczące weryfikacji zgody, badania kwalifikowalności, przeglądu zdublowanych odpowiedzi, obsługi brakujących danych, oznaczania czasu trwania odpowiedzi, wykrywania odpowiedzi liniowych (straight-line response), zakresów poprawnych odpowiedzi, oceny niezawodności, klasyfikacji grup wysokich i niskich, diagnostyki regresji oraz analizy wrażliwości. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 3: Schemat selekcji od przesłanych kwestionariuszy do końcowego zbioru danych analitycznych. Tabela ta przedstawia liczbę przesłanych kwestionariuszy, rekordów oznaczonych flagami, usuniętych rekordów, zachowanych rekordów oraz źródła weryfikacji na każdym etapie selekcji. Czas wypełniania oraz odpowiedzi liniowe potraktowano jako flagi jakości odpowiedzi, a nie jako automatyczne kryteria wykluczenia. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 4: Charakterystyka demograficzna zbioru danych analitycznych. Tabela ta podsumowuje zachowane zanonimizowane rekordy studentów po weryfikacji odpowiedzi, w tym płeć, wiek, rok studiów licencjackich, kategorię instytucji oraz kategorię kierunku studiów. Przed raportowaniem sprawdzono komórki demograficzne pod kątem ryzyka pośredniej identyfikowalności. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 5: Statystyki opisowe, weryfikacja zakresu i spójność wewnętrzna pięciu zmiennych na poziomie skali.Tabela ta przedstawia numer pozycji, zakres teoretyczny, zakres obserwowany, średnią, odchylenie standardowe, alfę Cronbacha, omegę McDonald’a oraz stężenie efektu podłogi/sufitu dla negatywnych emocji, prokrastynacji akademickiej, poczucia przynależności do szkoły, myślenia wyższego rzędu i subiektywnego dobrostanu. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 6: Macierz korelacji Pearsona dla zmiennych na poziomie skali. Tabela ta przedstawia współczynniki korelacji Pearsona pomiędzy negatywnymi emocjami, prokrastynacją akademicką, poczuciem przynależności do szkoły, myśleniem wysokiego rzędu a subiektywnym dobrostanem. Macierz została wykorzystana jako wynik opisowej analizy powiązań oraz jako etap weryfikacji kierunku punktacji. Aby pobrać tę tabelę, kliknij tutaj.
Tabela 7: Porównanie kontrastowe między grupami o wysokim i niskim poziomie subiektywnego dobrostanu. W tabeli tej porównano negatywne emocje, prokrastynację akademicką, poczucie przynależności do szkoły oraz myślenie wyższego rzędu u respondentów z górnych 27% i dolnych 27% wyników subiektywnego dobrostanu. Porównanie to demonstruje proces grupowania i porównywania, a nie merytoryczną klasyfikację profili dobrostanu. Aby pobrać tę tabelę, kliknij tutaj.
Tabela 8: Porównanie opisowe ze względu na płeć. Tabela ta przedstawia porównania opisowe negatywnych emocji, prokrastynacji akademickiej, poczucia przynależności do szkoły, myślenia wysokiego rzędu oraz subiektywnego dobrostanu ze względu na płeć. Płeć została potraktowana jako opisowa zmienna grupująca. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 9: Główny model wielokrotnej regresji liniowej przewidujący subiektywny dobrostan. W tabeli przedstawiono główny model regresji, w którym subiektywny dobrostan był zmienną zależną, a negatywne emocje, prokrastynacja akademicka, poczucie przynależności do szkoły oraz myślenie wyższego rzędu zostały wprowadzone jednocześnie jako predyktory na poziomie skali. Uwzględniono wartości błędu standardowego, przedziału ufności oraz współczynnika inflacji wariancji. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 10: Model wrażliwości regresji skorygowanej o dane demograficzne, przewidujący subiektywny dobrostan. W tabeli przedstawiono cztery predyktory psychologiczne po skorygowaniu o płeć, wiek, rok studiów licencjackich, kategorię instytucji oraz kategorię kierunku studiów. Kategoryczne zmienne demograficzne wprowadzono z wykorzystaniem kodowania pozornego (dummy coding). Uwzględniono wartości błędu standardowego, przedziału ufności oraz współczynnika inflacji wariancji. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 11: Diagnostyka regresji i kontrole wrażliwości na punkty wpływowe. Tabela ta podsumowuje wyniki analizy rezyduów, punktów wpływowych oraz diagnostykę modelu, w tym standaryzowane rezydua, dystans Cooka > 1,00, dystans Cooka > 4/n, maksymalny dystans Cooka, statystykę Durbina-Watsona, wykres Q-Q rezyduów, test normalności rezyduów, wykres rezyduów w funkcji wartości przewidywanych, kontrolę liniowości oraz analizę wrażliwości na punkty wpływowe. Kliknij tutaj, aby pobrać tę tabelę.
Plik uzupełniający 1: Struktura kwestionariusza, pochodzenie skal oraz dokumentacja punktacji.Ten plik uzupełniający zawiera kolejność przeprowadzania kwestionariusza, treść świadomej zgody, zmienne demograficzne, dokumentację instrumentów źródłowych, kody pozycji, punkty zakotwiczenia odpowiedzi, informacje o adaptacji i statusie dokumentacji, kierunek punktacji, zasady punktacji odwróconej, konstrukcję końcowych zmiennych na poziomie skal, zasady postępowania z brakującymi pozycjami, pola powiązań z jakością odpowiedzi, zasady weryfikacji zakresów oraz powiązania z literaturą dla pięciu konstruktów kwestionariusza. Służy on jako uzupełnienie kwestionariusza/książka kodowa w celu dokumentowania programowania skal, punktacji i weryfikacji w procesie analizy. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Niniejszy protokół standaryzuje powszechny, lecz często niedostatecznie opisywany proces w badaniach nad dobrostanem opartych na kwestionariuszach: przejście od surowych zapisów odpowiedzi do danych po przesiewie, punktowanych zmiennych skalowych, wyników statystycznych i plików przygotowanych do wizualizacji. Wkładem tej pracy nie jest opracowanie nowej teorii subiektywnego dobrostanu ani zaproponowanie modelu przyczynowego. Zamiast tego, przedstawiony schemat postępowania zapewnia możliwą do audytu ścieżkę konfiguracji kwestionariusza, przesiewu odpowiedzi, punktowania skal, sprawdzania rzetelności, analizy opisowej, analizy powiązań, diagnostyki regresji oraz weryfikacji źródeł rycin. Rozróżnienie to jest istotne, ponieważ audytowalność w badaniach opartych na ankietach zależy od decyzji proceduralnych podejmowanych często przed rozpoczęciem interpretacji statystycznej, w tym od tego, które rekordy zostaną zachowane, w jaki sposób potraktowane zostaną brakujące odpowiedzi, jak przetworzone zostaną pytania z odwróconą punktacją oraz w jaki sposób numeryczne tabele źródłowe zostaną powiązane z wynikami wizualnymi. Wyraźne określenie tych decyzji ogranicza wątpliwe praktyki pomiarowe w badaniach opartych na skalach23 i wspiera bardziej przejrzystą kulturę badawczą24.
Kluczowym elementem protokołu jest wykorzystanie konkretnych artefaktów audytowych zamiast samego opisu słownego. Zrewidowany schemat pracy łączy każdy konstrukt z instrumentem źródłowym, zakresem elementów, kotwicami odpowiedzi, kierunkiem punktacji, regułą odwróconej punktacji, końcową zmienną na poziomie skali oraz informacjami o adaptacji lub statusie dokumentacji. Ścieżka audytu obejmuje zablokowany plik kwestionariusza, zablokowaną mapę skali, zablokowany eksport surowych danych, log przesiewowy, log weryfikacji punktacji, log analizy, plik wyników diagnostycznych oraz tabelę źródeł rycin. Pliki te wyjaśniają, która wersja kwestionariusza została zastosowana, które rekordy wykluczono lub zachowano, w jaki sposób wygenerowano wyniki i która zweryfikowana tabela została użyta do stworzenia każdej ryciny. W sytuacjach, gdy dane na poziomie uczestnika nie mogą być udostępnione publicznie, syntetyczny zbiór danych o tej samej strukturze zmiennych wraz z uzupełnionymi logami przesiewowymi i punktacyjnymi może umożliwić czytelnikom przetestowanie obliczeniowego schematu pracy bez dostępu do rekordów identyfikowalnych lub pośrednio identyfikowalnych. Taka struktura oparta na artefaktach jest zgodna z zasadą FAIR, zgodnie z którą reużywalne wyniki badań wymagają jasnego pochodzenia, struktury i warunków dostępu25.
Reprezentatywne wyniki należy interpretować jako rezultaty przepływu pracy, a nie jako merytoryczne dowody dotyczące psychologicznych determinant dobrostanu studentów. Porównanie wysokiego i niskiego poziomu subiektywnego dobrostanu zostało wprowadzone w celu zademonstrowania, w jaki sposób można zaimplementować, zweryfikować i zaraportować z góry określoną regułę grupowania; nie należy go interpretować jako rzeczywistej klasyfikacji profili dobrostanu. Podobnie model regresji pokazuje, w jaki sposób dane z punktowanych kwestionariuszy mogą być modelowane, sprawdzane pod kątem współliniowości, oceniane za pomocą diagnostyki residuów i wartości wpływowych oraz powiązane z zweryfikowaną tabelą źródeł rycin. Nie dowodzi on, że negatywne emocje, prokrastynacja akademicka, poczucie przynależności do szkoły lub myślenie wysokiego rzędu w sposób przyczynowy determinują subiektywny dobrostan. Ponieważ wszystkie główne zmienne zostały zebrane za pomocą tego samego kwestionariusza samoopisowego w jednym punkcie czasowym, nie można wykluczyć błędu wspólnej metody, efektów stylu odpowiedzi oraz wspólnego kontekstu pomiarowego26.
Niniejszy schemat postępowania nie zastępuje również pełnej walidacji psychometrycznej. Alfa Cronbacha, omega McDonald’a, sprawdzanie zakresu obserwowanego, analiza korelacji pozycji z sumą oraz weryfikacja odwróconego kodowania są przydatnymi krokami kontroli jakości w audytowalnym procesie punktowania, jednak nie ustanawiają one trafności czynnikowej, niezmienniczości pomiarowej, właściwości odpowiedzi na pozycje ani porównywalności międzygrupowej. Badania wykorzystujące kwestionariusz do merytorycznego testowania teorii powinny obejmować potwierdzającą analizę czynnikową, testowanie niezmienniczości pomiarowej w odpowiednich grupach demograficznych lub instytucjonalnych oraz dodatkowe kontrole trafności, gdy jest to właściwe27. Z tego względu niniejszy protokół należy rozumieć jako audytowalną strukturę przetwarzania i raportowania danych, a nie jako kompletne badanie walidacyjne dla zawartych w nim konstruktów.
Przebieg pracy zaprezentowano na przykładzie jednego studenta studiów licencjackich, wykorzystując dane z ankiet wypełnianych przez respondentów, zebrane w jednym punkcie czasowym, bez zewnętrznej walidacji. Nie należy zakładać możliwości bezpośredniego przeniesienia tej metody na inne populacje, dyscypliny, instytucje, języki i uwarunkowania kulturowe. W przypadku ponownego zastosowania tego schematu pracy w innym kontekście, mapa skal powinna zostać opracowana na nowo, a nie skopiowana mechanicznie. Badacze powinni zweryfikować pochodzenie pozycji, status tłumaczenia lub adaptacji, zależność pozycji dotyczących dobrostanu od czynników kulturowych i kontekstowych, kotwice odpowiedzi, zasady odwróconego punktowania, interpretację wyników oraz lokalne wymogi etyczne. Procedury tłumaczenia i adaptacji wymagają wyraźnej dokumentacji, a nie nieformalnych zmian sformułowań28, a interpretacja wyników testów edukacyjnych i psychologicznych powinna pozostać powiązana z dowodami dotyczącymi zamierzonego zastosowania i populacji29.
W praktyce protokół ten jest najbardziej użyteczny jako audytowalna struktura przetwarzania i raportowania danych w badaniach nad dobrostanem opartych na kwestionariuszach. Pomaga on badaczom uczynić decyzje dotyczące oczyszczania, punktowania, diagnostyki i wizualizacji widocznymi przed rozpoczęciem interpretacji. Przyszłe zastosowania powinny przetestować ten schemat pracy na niezależnych próbach, w różnych środowiskach instytucjonalnych, w projektach podłużnych oraz w niezależnie replikowanych zespołach analitycznych. Zewnętrzna walidacja, prerejestrowane reguły decyzyjne, udostępnione syntetyczne zbiory danych, wypełnione przykładowe dzienniki przesiewowe/punktowe oraz niezależna replikacja analityczna dodatkowo wzmocniłyby przenaszalność i wiarygodność tego schematu pracy.
Oświadczenia
Autorzy nie deklarują żadnych konfliktów interesów.
Podziękowania
Autorzy dziękują studentom, którzy wzięli udział w badaniu ankietowym, za wsparcie podczas gromadzenia danych. Autorzy dziękują również odpowiednim instruktorom i asystentom badawczym za pomoc w dystrybucji ankiet, organizacji danych, weryfikacji wyników oraz przygotowaniu tabel i rysunków. Praca ta nie otrzymała żadnego konkretnego finansowania.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| pakiet R broom | CRAN | pakiet R | Służy do konwertowania wyników regresji na ustrukturyzowane tabele współczynników i podsumowań modeli. |
| pakiet car dla języka R | CRAN | pakiet R | Stosowane do weryfikacji czynnika inflacji wariancji oraz wsparcia diagnostyki regresji. |
| Dokumentacja źródłowa Kwestionariusza Depresji, Lęku i Stresu-21 (DASS-21) | Psychology Foundation of Australia | Lovibond i Lovibond, 1995 | Dokumentacja źródłowa dla sekcji dotyczącej emocji negatywnych. W przepływie pracy zastosowano sformułowania dostosowane do badania, zgodne z aktualną oceną stanów emocjonalnych negatywnych. |
| pakiet R dplyr | CRAN | pakiet R | Stosowane do filtrowania danych, rekodowania, grupowania, podsumowań przepływu przesiewowego oraz przygotowywania tabel analitycznych. |
| pakiet R ggplot2 | CRAN | pakiet R | Wykorzystano do wygenerowania mapy ciepła korelacji, wykresu korelacji subiektywnego dobrostanu, wykresu współczynników regresji oraz wyświetlacza diagnostycznego. |
| Dokumentacja źródłowa pomiaru myślenia wysokiego rzędu | Springer Nature | DOI: 10.1038/s41598-024-70908-3 | Dokumentacja źródłowa dla sekcji dotyczącej myślenia wysokiego rzędu. W przepływie pracy wykorzystano zestaw zadań dostosowany do badania, zgodny z myśleniem analitycznym, oceniającym, refleksyjnym, integrującym oraz opartym na dowodach. |
| IBM SPSS Statistics | IBM Corp. | Wersja 29.0.2.0 | Stosowane do statystyki opisowej, Cronbach’alfa Cronbacha, korelacja Pearsona, próby niezależne i test Welcha’testy t, wielokrotna regresja liniowa, statystyka Durbina-Watsona, standaryzowane reszty, wartości dźwigni, odległość Cooka’odległość D i współczynniki inflacji wariancji. |
| pakiet psych do języka R | CRAN | pakiet R | Stosowane w podsumowaniach psychometrycznych, Cronbach’weryfikacja współczynnika alfa Cronbacha oraz metoda McDonalda’s omega. |
| Dokumentacja źródłowa skali psychologicznego poczucia przynależności do szkoły | Wiley | Psychol Sch. 1993;30(1):79-90 | Dokumentacja źródłowa dla sekcji dotyczącej poczucia przynależności do szkoły. W przepływie pracy zastosowano sformułowania dostosowane do badania, zgodne z postrzeganą akceptacją, więzią, wsparciem i poczuciem przynależności w środowisku szkolnym. |
| środowisko statystyczne R | R Foundation for Statistical Computing | Wersja 4.4.2 | Wykorzystywane do wtórnej weryfikacji analitycznej, McDonald’$\omega$ (omega), testy czułości Spearmana, przygotowanie wyników regresji, przygotowanie wyników diagnostycznych oraz przygotowanie źródeł wizualizacji. |
| pakiet R readxl | CRAN | pakiet R | Służy do importowania eksportów kwestionariuszy z arkuszy kalkulacyjnych do procesu weryfikacji w programie R. |
| Dokumentacja źródłowa Skali Subiektywnego Dobrostanu dla obywateli Chin | Naukowy & Wydawnictwa akademickie | DOI: 10.5923/j.ijap.20190905.01 | Dokumentacja źródłowa dla sekcji dotyczącej subiektywnego dobrostanu. W przepływie pracy wykorzystano sformułowania dostosowane do badania oraz pytania z odwróconą punktacją, powiązane z satysfakcją z życia, poczuciem sensu, wsparciem, postępem, niezadowoleniem, poczuciem bezradności oraz doświadczeniami z zakresu dobrostanu związanymi ze stresem. |
| Plik uzupełniający 1: Struktura kwestionariusza i dokumentacja skali | Autorzy | Plik uzupełniający 1 | Zawiera strukturę przeprowadzonego kwestionariusza, kolejność konstruktów, pochodzenie skal, kody pozycji, kotwice odpowiedzi, kierunek punktacji, zasady odwróconego kodowania, sposób konstruowania wyników na poziomie skali oraz informacje o statusie dokumentacji. |
| Dokumentacja źródłowa Skali Prokrastynacji Tuckmana | SAGE Publications | Educ Psychol Meas. 1991;51(2):473-480 | Dokumentacja źródłowa dla sekcji dotyczącej prokrastynacji akademickiej. W przepływie pracy zastosowano sformułowania dostosowane do badania, zgodne z zachowaniami dotyczącymi zwłoki akademickiej i odkładania zadań na później. |
| platforma do ankiet online Wenjuanxing | Changsha Ranxing Information Technology Co., Ltd. | Platforma internetowa | Wykorzystywane do elektronicznej zgody, programowania kwestionariuszy, gromadzenia odpowiedzi na pytania, rejestracji znaczników czasu, zapisywania czasu trwania wypełniania, weryfikacji zdublowanych zgłoszeń oraz eksportu surowych odpowiedzi. |
Bibliografia
- 1. Khatri P et al. Student well-being in higher education: scale development and validation with implications for management education. Int J Manag Educ. 2024;22(1):100933.
- Mirzaei A, Carter SR, Patanwala AE, Schneider CR. Missing data in surveys: key concepts, approaches, and applications. Res Social Adm Pharm. 2022;18(2):2308-16.
- Gummer T, Roßmann J, Silber H. Using instructed response items as attention checks in web surveys: properties and implementation. Sociol Methods Res. 2021;50(1):238-64.
- Johansson F et al. Associations between procrastination and subsequent health outcomes among university students in Sweden. JAMA Netw Open. 2023;6(1):e2249346.
- Li X, Kuo YL, Huggins TJ. Perceived feedback and school belonging: the mediating role of subjective well-being. Front Psychol. 2024;15:1450788.
- Sönning L. Ordinal response scales: psychometric grounding for design and analysis. Res Methods Appl Linguist. 2024;3(3):100156.
- Song P et al. Predictive analysis of college students’ academic procrastination behavior based on a decision tree model. Humanit Soc Sci Commun. 2024;11:869.
- Dudáš A. Graphical representation of data prediction potential: correlation graphs and correlation chains. Vis Comput. 2024;40(10):6969-82.
- Niessen ASM, Meijer RR, Tendeiro JN. Detecting careless respondents in web-based questionnaires: which method to use? J Res Pers. 2016;63:1-11.
- Parsons J, Bao L. A unified approach for outliers and influential data detection: the value of information in retrospect. Stat. 2022;11(1):e442.
- Donche V et al. Careless responding in online student learning surveys: profiles and impact on data quality. Frontline Learn Res. 2026;13(3):1-14.
- Lovibond SH, Lovibond PF. Manual for the Depression Anxiety Stress Scales. 2nd ed. Psychology Foundation; Sydney; 1995.
- Tuckman BW. The development and concurrent validity of the Procrastination Scale. Educ Psychol Meas. 1991;51(2):473-80.
- Goodenow C. The psychological sense of school membership among adolescents: scale development and educational correlates. Psychol Sch. 1993;30(1):79-90.
- Li D, Fan X, Meng L. Development and validation of a higher-order thinking skills (HOTS) scale for major students in the interior design discipline for blended learning. Sci Rep. 2024;14:20287.
- Huang L, Xing Z. A nationwide study on Subjective Well-being Scale for Chinese Citizens (SWBS-cc). Int J Appl Psychol. 2019;9(5):117-27.
- DeSimone JA, Harms PD, DeSimone AJ. Best practice recommendations for data screening. J Organ Behav. 2015;36(2):171-81.
- Revilla MA, Saris WE, Krosnick JA. Choosing the number of categories in agree-disagree scales. Sociol Methods Res. 2014;43(1):73-97.
- Muszyński M. Attention checks and how to use them: review and practical recommendations. ASK Res Methods. 2023;32(1):3-38.
- McNeish D. Thanks coefficient alpha, we’ll take it from here. Psychol Methods. 2018;23(3):412-33.
- Romeo I, Stanislaw H, McCreary J, Hawley M. The importance of belonging for well-being in college students. PLOS Ment Health. 2024;1(1):e0000057.
- Kastellec JP, Leoni EL. Using graphs instead of tables in political science. Perspect Polit. 2007;5(4):755-71.
- Flake JK, Fried EI. Measurement schmeasurement: questionable measurement practices and how to avoid them. Adv Methods Pract Psychol Sci. 2020;3(4):456-65.
- Nosek BA et al. Promoting an open research culture. Science. 2015;348(6242):1422-5.
- Wilkinson MD et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.
- Podsakoff PM, MacKenzie SB, Lee JY, Podsakoff NP. Common method biases in behavioral research: a critical review of the literature and recommended remedies. J Appl Psychol. 2003;88(5):879-903.
- Vandenberg RJ, Lance CE. A review and synthesis of the measurement invariance literature: suggestions, practices, and recommendations for organizational research. Organ Res Methods. 2000;3(1):4-70.
- van de Vijver FJR, Hambleton RK. Translating tests: some practical guidelines. Eur Psychol. 1996;1(2):89-99.
- American Educational Research Association, American Psychological Association, National Council on Measurement in Education. Standards for educational and psychological testing. American Educational Research Association; Washington, DC; 2014.