Oceniono eksploracyjne ramy uczenia maszynowego (ML) wykorzystujące dane okołooperacyjne w celu przewidywania encefalopatii wywołanej środkiem kontrastowym (CIE) po zabiegach neurointerwencyjnych. Model Naiwnych Bayesa wykazał najbardziej zrównoważoną wydajność opisową, a stosunek dawki kontrastu do wskaźnika eGFR (CGR) został zidentyfikowany jako istotny potencjalny predyktor dla indywidualnej oceny ryzyka.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Przewidywanie encefalopatii indukowanej środkiem kontrastowym po zabiegach neurointerwencyjnych z wykorzystaniem uczenia maszynowego
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
CIE jest rzadkim, lecz ciężkim powikłaniem po procedurach neurointerwencyjnych, dla którego wciąż brakuje niezawodnych, nieinwazyjnych narzędzi prognostycznych. Celem niniejszego badania było opracowanie i walidacja modelu ML do przewidywania CIE z wykorzystaniem okołoperacyjnych danych klinicznych i proceduralnych oraz ocena wartości prognostycznej CGR w odniesieniu do CIE. Było to jednoośrodkowe badanie retrospektywne, do którego włączono w sposób następczy 161 pacjentów poddanych procedurom neurointerwencyjnym w Oddziale Neurochirurgii Szpitala Generalnego Northern Theater w okresie od stycznia 2024 do grudnia 2025 roku. Potencjalne okołoperacyjne predyktory CIE zidentyfikowano za pomocą analizy jednowymiarowej w połączeniu z regresją LASSO. Na podstawie wybranych zmiennych wytrenowano i zoptymalizowano pięć modeli ML: Naive Bayes, maszynę wektorów nośnych (SVM), k-najbliższych sąsiadów (KNN), LightGBM oraz wielowarstwowy perceptron (MLP). Wydajność modeli oceniono kompleksowo, wykorzystując pole pod krzywą charakterystyki operacyjnej odbiornika (AUC) oraz analizę krzywej decyzyjnej (DCA). Wśród ocenianych modeli model Naive Bayes wykazał najkorzystniejszą wydajność opisową w wewnętrznym zbiorze testowym, z AUC wynoszącym 0.952 (95% CI: 0.843–1.000), czułością 100% i swoistością 90,3%; parametry te należy jednak interpretować ostrożnie, ponieważ zbiór danych był wyraźnie niezrównoważony, a wewnętrzna kohorta testowa była mała i zawierała jedynie bardzo ograniczoną liczbę zdarzeń CIE. Wyniki DCA zasugerowały potencjalną kliniczną korzyść netto dla wybranych prawdopodobieństw progowych. Analiza istotności cech wskazała, że CGR znajdował się wśród najwyżej ocenianych potencjalnych predyktorów powiązanych z ryzykiem CIE w tym zbiorze danych. Model Naive Bayes oceniony w tym badaniu może dostarczyć wstępnych ram stratyfikacji ryzyka do okołoperacyjnej oceny CIE po procedurach neurointerwencyjnych. CGR okazał się istotną cechą prognostyczną i może pomóc w indywidualnej stratyfikacji ryzyka. Przed zastosowaniem klinicznym konieczna jest dalsza walidacja zewnętrzna.
Wprowadzenie
W ciągu ostatnich dwóch dekad małoinwazyjne techniki interwencyjne fundamentalnie zmieniły paradygmat leczenia chorób naczyniowo-mózgowych1. Procedury neurointerwencyjne — dzięki zaletom w postaci wysokiej skuteczności i minimalnej inwazyjności — stały się istotnymi opcjami terapeutycznymi w wybranych zaburzeniach naczyniowo-mózgowych2. Jednakże wraz ze wzrostem złożoności procedur interwencyjnych zwiększają się również dawki stosowanych środków kontrastowych, ciśnienia wtrysku oraz czas ekspozycji na kontrast. W konsekwencji powikłania związane ze stosowaniem środków kontrastowych stały się przedmiotem coraz większej uwagi3,4,5,6,7. CIE, czyli ostre, przejściowe zaburzenie neurologiczne wywołane przez jodowe środki kontrastowe (ICM), jest coraz częściej uznawane za istotne klinicznie powikłanie, szczególnie w przypadku złożonych procedur neurointerwencyjnych. Typowe objawy kliniczne CIE pojawiają się zazwyczaj od kilku minut do 24 h po podaniu środka kontrastowego i obejmują zmiany stanu świadomości (takie jak senność, majaczenie lub śpiączka), ślepotę korową, ogniskowe deficyty neurologiczne (takie jak hemipareza lub afazja) oraz drgawki4,5,6. Chociaż większość przypadków CIE ma charakter samoograniczający się, a objawy zazwyczaj ustępują w ciągu 48 do 72 h, u niektórych pacjentów mogą wystąpić trwałe uszkodzenia neurologiczne. Ciężkie przypadki mogą nawet doprowadzić do śmierci z powodu masywnego obrzęku mózgu4,7. Ta nieprzewidywalność wyników podkreśla pilną potrzebę opracowania wiarygodnego narzędzia do wczesnego przewidywania ryzyka w okresie okołooperacyjnym.
Wraz ze wzrostem objętości danych klinicznych tradycyjne metody statystyczne stają się coraz mniej wystarczające w przypadku wysokowymiarowych danych medycznych wykazujących współliniowość. Co więcej, analizy jednowymiarowe lub proste modele regresji logistycznej często nie oddają złożonych, nieliniowych interakcji między zmiennymi. ML oferuje nowy wymiar w rozwiązywaniu tych problemów8. Algorytmy ML — takie jak SVM, maszyny gradientowego wzmocnienia (LightGBM) i MLP — potrafią automatycznie identyfikować ukryte wzorce w wysokowymiarowych przestrzeniach cech i konstruować modele nieliniowe o silnych możliwościach predykcyjnych8,9,10,11. Jednakże, dążąc do wysokiej dokładności prognozowania, „czarnoskrzynkowy” charakter tych algorytmów, charakteryzujący się brakiem interpretowalności, często budzi obawy w kwestii zaufania do podejmowanych decyzji medycznych12,13. W przeciwieństwie do nich, algorytm Naive Bayes, dzięki prostej logice probabilistycznej i wrodzonej interpretowalności, wykazuje unikalne zalety w klinicznych badaniach na małych próbach14,15. Poprzez ocenę wkładu prawdopodobieństwa a posteriori każdej zmiennej predykcyjnej w zdarzenie końcowe, model Naive Bayes nie tylko zapewnia wydajność predykcyjną, ale także dostarcza klinicystom intuicyjnych informacji wspierających podejmowanie decyzji. Ponadto, w celu ilościowej oceny niezrównowagi między dawką środka kontrastowego a indywidualną zdolnością do jego usuwania, w niniejszym badaniu innowacyjnie wprowadzono stosunek ilości środka kontrastowego do eGFR (CGR) jako cechę kluczową. U pacjentów z niższą rezerwą czynnościową nerek nawet umiarkowane dawki środków kontrastowych mogą prowadzić do niezwykle wysokich wartości CGR, co może zwiększyć podatność na CIE. CGR może stanowić klinicznie intuicyjną złożoną miarę integrującą obciążenie środkiem kontrastowym i zdolność nerek do jego usuwania, choć jego dodatkowa wartość predykcyjna wymaga dalszej walidacji. Poprzez włączenie tego zintegrowanego biomarkera, celem niniejszego badania było opracowanie ramy predykcyjnej, która dokładniej odzwierciedla rzeczywistość patofizjologiczną.
Podsumowując, celem niniejszego badania było opracowanie i walidacja modelu predykcyjnego CIE opartego na uczeniu maszynowym (ML), wykorzystującego okołooperacyjne zmienne kliniczne i proceduralne16. Konkretne cele obejmowały: (1) wprowadzenie i ocenę wskaźnika CGR jako eksploracyjnego indeksu złożonego; (2) zbudowanie i porównanie wydajności pięciu modeli ML — Naive Bayes, SVM, KNN, LightGBM oraz MLP; oraz (3) identyfikację optymalnego modelu. Ze względu na ograniczoną liczbę zdarzeń CIE, porównanie modeli miało charakter eksploracyjny i służyło generowaniu hipotez. W ostateczności badanie to może dostarczyć wstępnych ram stratyfikacji ryzyka CIE w praktyce neurointerwencyjnej, jednak nie powinno być ono stosowane jako samodzielne narzędzie do podejmowania decyzji klinicznych bez zewnętrznej walidacji. Podstawy koncepcyjne CGR oraz jego zależność od ekspozycji na kontrast i klirensu nerkowego zilustrowano na Ryc. 1A. Ogólny przebieg badania, obejmujący wstępne przetwarzanie danych, podział na zbiór treningowy i testowy, wybór cech oraz opracowanie modelu, przedstawiono na Ryc. 1B. Ramy porównawczej oceny pięciu modeli ML przedstawiono na Ryc. 1C.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Protokół badania został przeanalizowany i zatwierdzony przez Komisję Etyczną Szpitala Generalnego Północnego Dowództwa Teatralnego (Numer zgody: Ethics Y (2026) 75). Choć dane kliniczne pochodziły od pacjentów leczonych między styczniem 2024 roku a grudniem 2025 roku, niniejsze badanie zostało przeprowadzone jako analiza retrospektywna istniejących dokumentów klinicznych. Zgoda etyczna uzyskana w 2026 roku obejmowała retrospektywną ekstrakcję danych, deidentyfikację, analizę oraz publikację tych wcześniej zgromadzonych danych klinicznych. Przed uzyskaniem zgody etycznej nie przeprowadzono żadnej prospektywnej interwencji ani rekrutacji pacjentów. Wymóg pisemnej świadomej zgody został zniesiony ze względu na retrospekcyjny, obserwacyjny charakter badania. Wszystkie procedury zostały przeprowadzone zgodnie z Deklaracją Helsińską, a wszystkie dane kliniczne zostały poddane deidentyfikacji przed analizą. Niniejsza analiza została przeprowadzona w ramach zatwierdzonego retrospektywnego projektu badawczego dotyczącego danych klinicznych w zakresie neurointerwencji. Materiały i sprzęt wymagane do opisanych poniżej procedur zostały zestawione w Tabeli Materiałów.
Rekrutacja pacjentów i określenie CIE
Potencjalnie kwalifikujących się pacjentów zidentyfikowano poprzez przeszukanie systemu elektronicznej dokumentacji medycznej w celu znalezienia osób leczonych w Oddziale Neurochirurgii w General Hospital of Northern Theater Command między styczniem 2024 a grudniem 2025 roku. Wstępne wyszukiwanie ograniczono do daty przyjęcia, oddziału, diagnozy choroby naczyniowo-mózgowej oraz zapisów o zabiegach neurointerwencyjnych. Szczegółowy przebieg przesiewu pacjentów i przydziału do kohort przedstawiono na Rysunku 2. Pacjenci kwalifikowali się do włączenia do badania, jeśli spełniali wszystkie poniższe kryteria: (1) wiek od 30 do 80 lat; (2) diagnoza choroby naczyniowo-mózgowej wymagająca oceny neurointerwencyjnej lub leczenia; (3) dostępność pełnej dokumentacji klinicznej i wyników badań laboratoryjnych; oraz (4) wykonanie pooperacyjnego badania CT głowy w ciągu 3 dni po zabiegu.
Pacjentów wykluczono, jeżeli dysponowano niepełnymi danymi klinicznymi lub obrazowymi, nie zostali poddani interwencji endowaskularnej, wykazywali ciężkie przedoperacyjne deficyty neurologiczne (wynik w zmodyfikowanej skali Rankin $\ge$4), stwierdzono u nich ostry zawał mózgu w przedoperacyjnym obrazowaniu dyfuzyjnym (DWI), cierpieli na przewlekłą chorobę nerek w stadium G4 lub wyższym zgodnie z kryteriami Kidney Disease: Improving Global Outcomes (KDIGO) lub mieli ciężką chorobę sercowo-naczyniową. Kryteria włączenia i wykluczenia stosowano sekwencyjnie. Po wstępnym przeszukaniu elektronicznym każdy rekord kandydata został sprawdzony ręcznie w celu potwierdzenia kwalifikowalności oraz udokumentowania przyczyny wykluczenia, jeśli była ona dotyczyć. Po przesiewie kwalifikowalnych pacjentów losowo przydzielono do kohorty treningowej i testowej w stosunku 8:2, w tym kohorty treningowej (n = 128) oraz kohorty testowej (n = 33). W celu zachowania spójnego rozkładu przypadków CIE i non-CIE pomiędzy obiema kohortami zastosowano stratyfikowany dobór losowy.
Rozpoznanie CIE opierano przede wszystkim na związku czasowym między wystąpieniem objawów a zabiegami interwencji naczyniowo-mózgowych, w połączeniu z wykluczającą oceną obrazową. Dwóch niezależnych specjalistów interwencji naczyniowo-mózgowych przeanalizowało pooperacyjną dokumentację kliniczną, czas wystąpienia objawów, manifestacje neurologiczne oraz wyniki badań obrazowych po operacji we wszystkich podejrzewanych przypadkach. Rozbieżności rozstrzygano w drodze dyskusji aż do osiągnięcia konsensusu. Pacjentów uznawano za osoby z CIE, jeśli w ciągu 24 h po zakończeniu procedury neurointerwencyjnej wystąpiła nowo powstała ślepota korowa, zaburzenia świadomości (w tym somnolencja, delirium lub śpiączka), napad drgawkowy lub ogniskowe deficyty neurologiczne, takie jak hemipareza lub afazja.
Po wystąpieniu objawów wykluczono alternatywne przyczyny mogące wywołać podobne manifestacje neurologiczne, analizując pooperacyjne obrazy CT lub MRI wraz z przebiegiem klinicznym. Pooperacyjna tomografia komputerowa (CT) głowy została wykonana zgodnie z instytucjonalnym standardowym protokołem niekontrastowej tomografii czaszki. Podstawowe parametry akwizycji obejmowały napięcie lampy 80 kVp, prąd lampy 260 mA, grubość warstwy 0,5 mm oraz standardową rekonstrukcję osiową. Obrazy zostały przeanalizowane w oknach mózgowym i kostnym przez doświadczonych klinicystów. W diagnostyce różnicowej uwzględniono ostry krwotok wewnątrzczaszkowy, krwotok podpajęczynówkowy, krwotok wewnątrzmozgowy, nowo powstały rozległy zawał mózgu, zmiany związane z napadami drgawkowymi, infekcje oraz zaburzenia metaboliczne. Badania CT przeprowadzone po wystąpieniu objawów zazwyczaj wykazywały ogniskowy lub rozlany obrzęk mózgu oraz cienie o wysokiej gęstości obejmujące korę, obszary podkorowe lub przestrzeń podpajęczynówkową, co imitowało zmiany krwotoczne. Wyniki MRI zazwyczaj wykazują obrzęk kory, szczególnie w obrębie kory skroniowo-ciemieniowo-potylicznej. U niektórych pacjentów badania CT lub MRI nie wykazały jednak żadnych wyraźnych nieprawidłowości, mimo zgodnych manifestacji klinicznych.
Pozyskiwanie zmiennych okołooperacyjnych i konstrukcja CGR
Ogólne dane demograficzne, w tym wiek, płeć i masa ciała, zostały pobrane ze ustrukturyzowanych pól w systemie elektronicznej dokumentacji medycznej. Zmienne dotyczące historii klinicznej, w tym historia palenia tytoniu, spożycie alkoholu, nadciśnienie tętnicze, cukrzyca oraz choroba wieńcowa, zostały pobrane z notatek przyjęcia, dokumentacji historii chorób oraz rozpoznań przy wypisie, a następnie zweryfikowane pod kątem spójności. Dane laboratoryjne pobrano z systemu informacji laboratoryjnej. W przypadku każdego pacjenta wykorzystano pierwszą próbkę krwi żylnej pobraną po przyjęciu do szpitala, a przed zabiegiem neurointerwencyjnym. Pobrane zmienne laboratoryjne obejmowały poziom kreatyniny w surowicy, szacowany współczynnik filtracji kłębuszkowej (eGFR), cholesterol całkowity oraz poziom trójglicerydów. eGFR obliczono przy użyciu równania opartego na poziomie kreatyniny opracowanego przez Chronic Kidney Disease Epidemiology Collaboration (CKD-EPI) i pobrano z szpitalnego systemu informacji laboratoryjnej.
Ponieważ złożoność procedury, ekspozycja na środek kontrastowy oraz lokalizacja zmiany mogą wpływać na przerwanie bariery krew-mózg i retencję środka kontrastowego podczas zabiegów neurointerwencyjnych, do modelu predykcyjnego włączono również okołozabiegowe zmienne proceduralne. Zmienne związane z procedurą obejmowały lokalizację zmiany, rodzaj zabiegu, czas trwania procedury, rodzaj środka kontrastowego oraz całkowitą objętość kontrastu. Lokalizację zmiany i rodzaj zabiegu określono na podstawie raportów operacyjnych i zapisów angiograficznych. Czas trwania procedury zdefiniowano jako czas od nakłucia tętnicy do zakończenia zabiegu neurointerwencyjnego. Całkowitą objętość kontrastu zdefiniowano jako skumulowaną objętość podanego jodowego środka kontrastowego od początku do końca zabiegu. Środkami kontrastowymi zastosowanymi w niniejszym badaniu były niejonowe ICA, w tym jodiksanol (320 mg jodu/mL), podawane zgodnie z instytucjonalną praktyką kliniczną. Wszystkie zabiegi neurointerwencyjne objęte badaniem zostały wykonane pod kontrolą cyfrowej angiografii subtrakcyjnej przez doświadczony zespół neurointerwencyjny w ośrodku badawczym. Wszystkie procedury wykonano z wykorzystaniem dostępu przez tętnicę udową. Podczas interwencji pacjenci otrzymywali śródoperacyjne przeciwkrzepliwe podanie heparyny, a czas krzepnięcia (ACT) utrzymywano w zakresie docelowym 250–300 s. Parametry życiowe były monitorowane w sposób ciągły przez cały czas trwania zabiegu.
Interwencje terapeutyczne, w tym embolizacja tętniaka, angioplastyka i implantacja stentów, były wykonywane zgodnie z charakterystyką zmiany i decyzją operatora. Odpowiednie mikrocewniki, spirale, stenty lub balony wybrano zgodnie z wymaganiami procedury. Podczas obrazowania angiograficznego i interwencji środki kontrastowe podawano albo za pomocą wtryskiwarki wysokociśnieniowej, albo poprzez ręczny wlew o stałej prędkości. Rodzaj środka kontrastowego oraz całkowita objętość kontrastu zostały pobrane z dokumentacji proceduralnej i zweryfikowane z zapisami anestezjologicznymi lub pielęgniarskimi, jeśli były one dostępne. Dokumentacja z niespójnymi lub niepełnymi informacjami dotyczącymi objętości kontrastu była przeglądana ręcznie przed włączeniem do końcowego zbioru danych analitycznych.
Wszystkie zmienne związane z procedurą, w tym czas trwania procedury, rodzaj interwencji terapeutycznej, użycie urządzeń oraz zapisy o podaniu środka kontrastowego, zostały systematycznie przejrzane i zweryfikowane pod kątem kompletności i spójności przed analizą. Aby ilościowo ocenić brak równowagi między obciążeniem środkiem kontrastowym a wydolnością klirensu nerkowego, CGR ustanowiono jako kluczową zmienną prognostyczną i obliczono zgodnie z następującym równaniem:
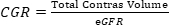 (1)
Całkowitą objętość kontrastu zapisano w mL, a eGFR w mL/min/1,73 m2. Wartość eGFR wykorzystana do obliczenia CGR była przedoperacyjną wartością eGFR uzyskaną z pierwszej próbki krwi żylnej pobranej po przyjęciu do szpitala, a przed zabiegiem neurointerwencyjnym. Dla każdego pacjenta CGR obliczono po zweryfikowaniu zarówno całkowitej objętości kontrastu, jak i eGFR. Licznikiem była całkowita objętość kontrastu w mL, a mianownikiem eGFR w mL/min/1,73 m2. Tę samą zasadę obliczeń zastosowano u wszystkich pacjentów przed opracowaniem modelu.
Wybór cech i schemat pracy ML
Aby zapewnić solidność analityczną, wszystkie zmienne kliniczne i laboratoryjne poddano systematycznym procedurom kontroli jakości przed analizą. Przed opracowaniem modelu obliczono proporcję brakujących danych dla każdej potencjalnej zmiennej. W końcowym zbiorze danych analitycznych nie odnotowano brakujących wartości wśród uwzględnionych predyktorów lub etykiet wyników; w związku z tym żadna zmienna nie została wykluczona ze względu na braki, a wielokrotna imputacja nie była wymagana. Szczegółowe podsumowanie brakujących danych znajduje się w Tabeli uzupełniającej 1.
Wszystkie potencjalne zmienne predykcyjne zostały wstępnie ocenione za pomocą analiz jednowymiarowych w celu zbadania ich związku z występowaniem CIE. Metody statystyczne wybrano w zależności od charakterystyki rozkładu danych. Zmienne o rozkładzie normalnym przedstawiono jako średnia ± odchylenie standardowe i porównano za pomocą testu t dla prób niezależnych. Zmienne o rozkładzie nienormalnym przedstawiono jako mediana (rozstęp międzykwartylny, IQR) i analizowano za pomocą testu U Manna-Whitneya. Zmienne kategoryczne przedstawiono w postaci liczebności i procentów, a następnie analizowano za pomocą testu chi-kwadrat lub dokładnego testu Fishera. Istotność statystyczną określono jako p < 0.05.
Przed opracowaniem modelu cały zbiór danych został losowo podzielony na kohorty treningową i testową w stosunku 8:2. W celu zminimalizowania przeuczenia i redukcji współliniowości do selekcji cech zastosowano regresję LASSO (least absolute shrinkage and selection operator) w połączeniu z 10-krotną walidacją krzyżową. Selekcję cech, dostrajanie hiperparametrów oraz opracowanie modelu przeprowadzono wyłącznie na kohorcie treningowej, aby uniknąć wycieku danych. Wewnętrzna kohorta testowa nie była wykorzystywana podczas szacowania parametrów imputacji, selekcji cech, dostrajania hiperparametrów ani trenowania modelu; została ona użyta tylko raz do końcowej oceny wydajności. Optymalizację hiperparametrów przeprowadzono za pomocą strategii przeszukiwania siatki (grid search) z 10-krotną walidacją krzyżową w obrębie kohorty treningowej. W szczególności kohorta treningowa została losowo podzielona na 10 wzajemnie wykluczających się podzbiorów. W każdej iteracji dziewięć podzbiorów służyło do trenowania modelu, a pozostały podzbiór do walidacji. Proces ten powtórzono 10 razy, aby upewnić się, że każdy podzbiór pełnił rolę kohorty walidacyjnej dokładnie raz.
Wszystkie analizy obliczeniowe przeprowadzono w środowisku Python. Opracowanie i ewaluacja modeli ML zostały wykonane przy użyciu biblioteki scikit-learn. Skrypty analityczne wykorzystane do wstępnego przetwarzania danych, selekcji cech, trenowania modeli, oceny wydajności oraz DCA zostały udostępnione jako uzupełniające pliki z kodem. W implementacji modeli cechy wyselekcjonowane za pomocą regresji LASSO posłużyły jako zmienne wejściowe dla wszystkich kandydujących klasyfikatorów. Zmienne ciągłe zostały wystandaryzowane przy użyciu normalizacji z-score w obrębie kohorty treningowej, a te same parametry skalowania zastosowano do wewnętrznej kohorty testowej. Zmienne kategoryczne zakodowano zgodnie z predefined coding scheme, a definicje zmiennych i schemat kodowania zamieszczono w Supplementary Table 2. Zaimplementowano pięć klasyfikatorów: naiwny klasyfikator bayesowski z rozkładem Gaussa (Gaussian Naive Bayes), SVM, KNN, LightGBM oraz MLP. W przypadku SVM dostrojono typ jądra, parametr regularyzacji C oraz współczynnik jądra gamma. Dla KNN dostrojono liczbę sąsiadów oraz strategię ważenia odległości. W przypadku LightGBM dostrojono liczbę estymatorów, tempo uczenia (learning rate), maksymalną głębokość drzewa oraz liczbę liści. Dla MLP dostrojono strukturę warstw ukrytych, funkcję aktywacji, parametr regularyzacji oraz tempo uczenia. Naiwny klasyfikator bayesowski z rozkładem Gaussa zaimplementowano przy określonym ustawieniu wygładzania wariancji (variance smoothing). Optymalna kombinacja hiperparametrów dla każdego modelu została wybrana na podstawie wyników walidacji krzyżowej w obrębie kohorty treningowej. Końcowe zoptymalizowane kombinacje hiperparametrów wybrane dla każdego modelu podsumowano w Supplementary Table 3. Po wyborze hiperparametrów każdy końcowy model został ponownie dopasowany do pełnej kohorty treningowej i raz oceniony w wewnętrznej kohorcie testowej.
Porównania wydajności modeli
Na podstawie wybranych predyktorów opracowano i porównano pięć modeli ML. Wydajność modeli oceniono w kohortach treningowej i testowej, wykorzystując pole powierzchni pod krzywą charakterystyki operacyjnej odbiornika (AUC), 95% przedział ufności (95% CI), czułość, swoistość oraz dokładność. W celu porównania zdolności dyskryminacyjnych poszczególnych modeli wygenerowano krzywe charakterystyki operacyjnej odbiornika. Optymalny próg klasyfikacji dla każdego modelu wyznaczono wyłącznie w kohorcie treningowej z wykorzystaniem indeksu Youdena. Wyznaczony próg został następnie ustalony i zastosowany bez zmian w wewnętrznej kohorcie testowej do obliczenia metryk wydajności zależnych od progu.
Analiza krzywej decyzyjnej
Analizę krzywej decyzyjnej (DCA) przeprowadzono poprzez obliczenie korzyści netto dla każdego modelu w zakresie prawdopodobieństw progowych, a następnie porównano strategię opartą na modelu z dwiema strategiami domyślnymi: leczeniem wszystkich pacjentów oraz nieleczeniem żadnego z pacjentów. Wybrano metodę DCA, ponieważ pozwala ona na jednoczesną ocenę zdolności dyskryminacyjnej oraz potencjalnej użyteczności klinicznej w kontekście podejmowania decyzji okołoperacyjnych. W celu zapewnienia powtarzalności, pełny proces badawczy zrealizowano w następującej kolejności: identyfikacja pacjentów w systemie elektronicznej dokumentacji medycznej, zastosowanie kryteriów włączenia i wyłączenia, rozstrzyganie CIE przez dwóch niezależnych specjalistów, ekstrakcja i wzajemna weryfikacja zmiennych demograficznych, historii klinicznej, wyników laboratoryjnych oraz zmiennych związanych z procedurą, obliczenie CGR, ocena brakujących danych i podział na kohorty treningową i testową, selekcja cech metodą LASSO w kohorcie treningowej, optymalizacja hiperparametrów za pomocą 10-krotnej walidacji krzyżowej, końcowe dopasowanie modelu w pełnej kohorcie treningowej, ocena w wewnętrznej kohorcie testowej, ocena wydajności w oparciu o ROC, wyznaczenie progu za pomocą indeksu Youdena oraz DCA.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Rekrutacja pacjentów i wyznaczenie CIE
W badaniu ujęto łącznie 161 pacjentów, u których przeprowadzono zabiegi neurointerwencyjne, z czego u 12 (7,5%) wystąpiło CIE, a u 149 (92,5%) nie. Szczegółowy proces przesiewowy i grupowania pacjentów przedstawiono na Rysunku 2. Rozpoznanie CIE postawiono na podstawie związku czasowego między wystąpieniem objawów a zabiegami neurointerwencyjnymi, w połączeniu z wykluczającymi wynikami badań obrazowych. Repre...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
CIE jest rzadkim, lecz potencjalnie poważnym powikłaniem po zabiegach neurointerwencyjnych, charakteryzującym się ostrą dysfunkcją neurologiczną, która występuje krótko po podaniu środków kontrastowych. Chociaż stan ten jest zazwyczaj odwracalny, w niektórych przypadkach może prowadzić do trwałych deficytów neurologicznych, a nawet do wyników zagrażających życiu, co podkreśla znaczenie wczesnej identyfikacji ryzyka17,18,19,...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy oświadczają, że nie występuje konflikt interesów. Platforma OnekeyAI została wykorzystana w niniejszym badaniu wyłącznie jako narzędzie badawcze do ustrukturyzowanej analizy danych i opracowywania modeli.
Podziękowania
Praca ta była wspierana przez Wspólny Program Planu Nauki i Technologii Prowincji Liaoning (Kluczowy Program Badań i Rozwoju; grant nr 2025JH2/101800053) oraz Program Talentów Xingliao Prowincji Liaoning (grant nr XLYC2403134). Autorzy dziękują również Oddziałowi Neurochirurgii Generalnego Szpitala Teatru Północnego za wsparcie w gromadzeniu danych pacjentów i analizie obrazowania neurologicznego.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Elektroniczny system dokumentacji medycznej | Northern Theater General Hospital | Instytucjonalny system kliniczny | Wykorzystany do retrospekcyjnej ekstrakcji danych Gromadzenie zmiennych demograficznych i danych z historii klinicznej |
| Laboratoryjny system informatyczny | Northern Theater General Hospital | Instytucjonalny system laboratoryjny | Wykorzystany do retrospekcyjnej ekstrakcji danych laboratoryjnych Gromadzenie danych dotyczących kreatyniny w surowicy, eGFR, profilu lipidowego oraz innych danych laboratoryjnych |
| System cyfrowej angiografii subtrakcyjnej | Philips | Allura Xper FD 20 (z Interventional Workstation R1.3.2) | Wykorzystany podczas rutynowych procedur klinicznych Procedura neurointerwencyjna i rejestracja zużycia kontrastu |
| Skaner CT | Philips | Ingenuity CT | Wykorzystany do pooperacyjnej oceny obrazowej Pooperacyjna ocena tomografii komputerowej czaszki |
| Platforma analizy danych strukturalnych OnekeyAI | OnekeyAI | 20240916 | Wykorzystana jako narzędzie badawcze; brak roli w podejmowaniu decyzji klinicznych Przetwarzanie wstępne danych strukturalnych, budowa modelu, ewaluacja modelu i generowanie rycin |
| Python | Python Software Foundation | 3.7.12 | Otwartoźródłowy język programowania Przetwarzanie wstępne danych, analiza statystyczna, opracowanie modelu i wizualizacja |
| scikit-learn | scikit-learn developers | 1.0.2 | Otwartoźródłowa biblioteka uczenia maszynowego dla języka Python LASSO, Naive Bayes, SVM, KNN, MLP, analiza ROC i metryki wydajności |
Bibliografia
- Nunna R, et al. Advances in the endovascular management of cerebrovascular disease. Mo Med. 2024;121:127-135.
- Jiang B, et al. Cerebral aneurysm treatment: modern neurovascular techniques. Stroke Vasc Neurol. 2016;1:93-100.
- Allison C, et al. Contrast-induced encephalopathy after cerebral angiogram: a case series and review of literature. Case Rep Neurol. 2021;13:405-413.
- Vazquez S, et al. Incidence and risk factors for acute transient contrast-induced neurologic deficit: a systematic review with meta-analysis. Stroke Vasc Interv Neurol. 2022;2:e000142.
- Meijer FJA, et al. Contrast-induced encephalopathy: neuroimaging findings and clinical relevance. Neuroradiology. 2022;64:1265-1268.
- Quintas-Neves M, et al. Contrast-induced neurotoxicity related to neurological endovascular procedures: a systematic review. Acta Neurol Belg. 2020;120:1419-1424.
- Mariajoseph FP, et al. Clinical management of contrast-induced neurotoxicity: a systematic review. Acta Neurol Belg. 2024;124:1141-1149.
- Deo RC. Machine learning in medicine. Circulation. 2015;132:1920-1930.
- Rajkomar A, Dean J, Kohane IS. Machine learning in medicine. N Engl J Med. 2019;380:1347-1358.
- Kline A, et al. Multimodal machine learning in precision health: a scoping review. NPJ Digit Med. 2022;5:171.
- Esteva A, et al. A guide to deep learning in healthcare. Nat Med. 2019;25(1):24-29.
- Topol EJ. High-performance medicine: the convergence of human and artificial intelligence. Nat Med. 2019;25(1):44-56.
- Agrawal R, et al. Fostering trust and interpretability: integrating explainable AI (XAI) with machine learning for enhanced disease prediction and decision transparency. Diagn Pathol. 2025;20:105.
- Domingos P, Pazzani M. On the optimality of the simple Bayesian classifier under zero-one loss. Mach Learn. 1997;29:103-130.
- Sarker IH. Machine learning: algorithms, real-world applications and research directions. SN Comput Sci. 2021;2:160.
- Collins GS, et al. Transparent reporting of a multivariable prediction model for individual prognosis or diagnosis (TRIPOD): the TRIPOD statement. Br J Cancer. 2015;112(2):251-259.
- Wu B, et al. Radiological findings of contrast-induced encephalopathy following cerebral angiography: a case report. Medicine (Baltimore). 2023;102:e33855.
- Wang K, et al. Contrast-induced encephalopathy after neurointerventional procedures: a series of three cases. Case Rep Neurol Med. 2025;2025:4384841.
- Chu YT, et al. Contrast-induced encephalopathy after endovascular thrombectomy for acute ischemic stroke. Stroke. 2020;51:3756-3759.
- Leong S, Fanning NF. Persistent neurological deficit from iodinated contrast encephalopathy following intracranial aneurysm coiling: a case report and review of the literature. Interv Neuroradiol. 2012;18(1):33-41.
- Hepburn M, et al. Fatal brain injury following carbon dioxide angiography. J Stroke Cerebrovasc Dis. 2020;29:105350.
- Matsubara N, et al. Contrast-induced encephalopathy following embolization of intracranial aneurysms in hemodialysis patients. Neurol Med Chir (Tokyo). 2017;57:641-648.
- Maclean MA, et al. Contrast-induced encephalopathy and the blood-brain barrier. Can J Neurol Sci. 2025;52:85-94.
- Cristaldi PMF, et al. Contrast-induced encephalopathy and permanent neurological deficit: a case report and literature review. Surg Neurol Int. 2021;12:273.
- Babyak MA. What you see may not be what you get: a brief, nontechnical introduction to overfitting in regression-type models. Psychosom Med. 2004;66(3):411-421.
- Zevallos CB, et al. Greater intraprocedural systolic blood pressure and blood pressure variability are associated with contrast-induced neurotoxicity after neurointerventional procedures. J Neurol Sci. 2021;420:117209.
- Zevallos CB, et al. Clinical and imaging features of contrast-induced neurotoxicity after neurointerventional surgery. World Neurosurg. 2020;142:e316-e324.
- Barbieri L, et al. Contrast volume to creatinine clearance ratio for the prediction of contrast-induced nephropathy in patients undergoing coronary angiography or percutaneous intervention. Eur J Prev Cardiol. 2016;23:931-937.
- Bhat T, et al. Neutrophil to lymphocyte ratio and cardiovascular diseases: a review. Expert Rev Cardiovasc Ther. 2013;11:55-59.
- Abbott NJ, Rönnbäck L, Hansson E. Astrocyte-endothelial interactions at the blood-brain barrier. Nat Rev Neurosci. 2006;7(1):41-53.
- Simental-Mendía LE, Rodríguez-Morán M, Guerrero-Romero F. The product of fasting glucose and triglycerides as surrogate for identifying insulin resistance in apparently healthy subjects. Metab Syndr Relat Disord. 2008;6:299-304.
- Spina R, et al. Contrast-induced encephalopathy following cardiac catheterization. Catheter Cardiovasc Interv. 2017;90:257-268.
- Steyerberg EW, et al. Internal validation of predictive models: efficiency of some procedures for logistic regression analysis. J Clin Epidemiol. 2001;54(8):774-781.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.