Niniejsze badanie przedstawia ramy współpracy cyber-fizycznej w kontekście Przemysłu 5.0, oparte na wyjaśnialnej sztucznej inteligencji (XAI), które wykorzystują model CNN-transformer oraz metodę SHAP do wykrywania anomalii akustycznych w przemyśle przy użyciu zbioru danych MIMII. Integracja z obliczeniami krawędziowymi (edge computing) wspiera interpretowalne, zorientowane na człowieka utrzymanie predykcyjne.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Współpraca cyber-fizyczna wspierana przez wyjaśnialną sztuczną inteligencję na potrzeby zrównoważonej produkcji w Przemysle 5.0
W tym artykule
Podsumowanie
Streszczenie
W niniejszym badaniu przedstawiamy innowacyjne podejście do zrównoważonej produkcji części przemysłowych z wykorzystaniem systemu współpracy cyberfizycznej opartego na wyjaśnialnej sztucznej inteligencji (XAI) dla Przemysłu 5.0. Stwierdzono, że obecne cyberfizyczne systemy ludzkie (CPHS) integrują AI w ograniczonym stopniu i często brakuje im wyjaśnialności. W związku z tym istnieje potrzeba poprawy ich skalowalności i elastyczności, zgodnie z zasadami Przemysłu 5.0: odpornością, długoterminową żywotnością i orientacją na człowieka. Aby wyeliminować te niedociągnięcia, wprowadzamy architekturę integrującą głębokie uczenie i wyjaśnialną AI w ekosystemie systemu cyberfizycznego (CPS), aby umożliwić inteligentne i wyjaśnialne podejmowanie decyzji. W szczególności wykorzystujemy zbiór danych Malfunctioning Industrial Machine Investigation and Inspection (MIMII) do wykrywania usterek maszyn na podstawie sygnałów akustycznych. Sygnały audio poddawane są transformacji spektralnej w celu wygenerowania obrazów spektrogramów, które są następnie przetwarzane przez konwolucyjną sieć neuronową (CNN) w celu ekstrakcji cech przestrzennych oraz przez koder transformera dla cech czasowych. Aby zwiększyć przejrzystość i ułatwić współpracę z człowiekiem w pętli (human-in-the-loop), podejście oparte na Shapley additive explanations (SHAP) pomaga operatorom zrozumieć proces podejmowania decyzji przez system, wyróżniając cechy wejściowe wpływające na przewidywania modelu. Ponadto framework ten został zastosowany w systemie cyberfizycznym opartym na przetwarzaniu brzegowym (edge computing), aby osiągnąć niskie opóźnienia i niskie zużycie energii przy jednoczesnym zapewnieniu szybkich odpowiedzi, co przyczynia się do zapewnienia zrównoważonego środowiska produkcyjnego. Wyniki eksperymentalne pokazują, że proponowana architektura CNN-Transformer osiąga dokładność na poziomie 98,5% i przewyższa istniejące systemy CPHS, zachowując niskie opóźnienia. Wykorzystanie wyjaśnialnej AI w takim systemie współpracy cyberfizycznej znacznie zwiększa zaufanie operatora i umożliwia płynną współpracę człowieka z maszyną.
Wprowadzenie
Przejście od Przemysłu 4.0, który kładł nacisk na technologię, mechanizację i komunikację, do nowego modelu Przemysłu 5.0, łączącego postęp technologiczny z adaptacyjnością, zrównoważonym rozwojem i orientacją na człowieka, wpłynęło na dynamiczną ewolucję systemów przemysłowych1,2. Komisja Europejska definiuje Przemysł 5.0 jako paradygmat skoncentrowany nie tylko na wydajności i efektywności, ale także na trzech filarach: antropocentryzmie, zrównoważonym rozwoju i odporności. Warto zauważyć, że ostatnie badania wskazały na rolę systemów AI, współpracy człowieka z maszyną oraz zrównoważonej produkcji jako głównych motorów napędowych środowisk Przemysłu 5.03,4. Tradycyjne metody utrzymania ruchu nie są już wystarczające w tym ewoluującym środowisku przemysłowym. Aby zapewnić odporność w złożonych, niestabilnych kontekstach, utrzymanie ruchu musi ewoluować w stronę formy bardziej adaptacyjnej i systemowej5. Od 2011 roku Przemysł 4.0 był dominującym modelem transformacji przemysłowej w Europie, zachęcając firmy do cyfrowej transformacji w celu usprawnienia operacji i maksymalizacji dostępnych zasobów4. Zwiększanie wydajności bez eliminacji pracy ludzkiej w produkcji, przy jednoczesnej ochronie zdrowia i bezpieczeństwa pracowników, jest zatem niezbędne. Z tego powodu przedsiębiorstwa i naukowcy zaczęli definiować zasady paradygmatu Przemysłu 5.05,6,7, częściowo motywowani japońską koncepcją Społeczeństwa 5.08,9,10,11. Mimo zwiększonego nacisku na zrównoważone utrzymanie ruchu w najnowszej literaturze, większość istniejących ocen systematycznych pozostaje fragmentaryczna lub specyficzna dla danej dziedziny, brakuje kompleksowych ram integrujących odporność, zrównoważony rozwój i AI. Na przykład autorzy badają praktyki zrównoważonego utrzymania ruchu dla konkretnych systemów lub strategii, w tym zrównoważone całkowite utrzymanie produkcyjne (STPM), podczas gdy badacze rozważają włączenie tematów zrównoważonego rozwoju do technik utrzymania ruchu12,13,14. Autor przeprowadził kompleksową ocenę kryteriów przyjęcia zrównoważonego rozwoju i wyróżnił czynniki technologiczne, które pozwalają produkcji wywierać pozytywny, zrównoważony wpływ15. Niemniej jednak w ramach paradygmatu Przemysłu 5.0 zrównoważony rozwój, odporność i podejmowanie decyzji w oparciu o AI nie są w pełni zintegrowane w żadnej z tych prac. W rezultacie kwestie zrównoważonego rozwoju są często traktowane w oddzielnych metodach utrzymania ruchu. Metoda SHAP wyróżnia się na tle innych technik wyjaśnialnej sztucznej inteligencji (XAI) dzięki teoretycznie uzasadnionej metodzie przypisywania cech16,17,18.
Podejmowanie decyzji w oparciu o dane jest możliwe dzięki AI, jednak dokładne modele często wymagają dużych zbiorów danych. Konwencjonalne techniki uczenia maszynowego (ML), takie jak drzewa decyzyjne, regresja logistyczna i regresja liniowa, często wykazują niską skuteczność w sytuacjach wysoce nieliniowych, ponieważ zakładają stosunkowo proste rozkłady danych19. Głębokie sieci neuronowe (DNN) omijają te ograniczenia, ucząc się złożonych reprezentacji cech z masowych zbiorów danych20. Według badań21, głębsze sieci często radzą sobie lepiej niż struktury płytkie w złożonych zadaniach decyzyjnych, jednak ich rosnąca głębokość i złożoność parametrów sprawiają, że model staje się mniej interpretowalny22.
Cyberfizyczny system (CPS) jest kluczową technologią umożliwiającą produkcję w ramach Przemysłu 5.0, ponieważ łączy w sobie rozproszoną inteligencję, komputery wbudowane, procesy fizyczne i komunikację. Aby umożliwić elastyczne, inteligentne i działające w czasie rzeczywistym operacje przemysłowe, nowoczesne systemy CPS szybko integrują obliczenia krawędziowe (edge computing), sztuczną inteligencję krawędziową (edge AI) oraz ekologiczny Internet Rzeczy (G-IoT)23,24. Zrównoważony rozwój i odporność zostały podkreślone w niedawnych badaniach nad Utrzymaniem 4.0 i inteligentnym utrzymaniem ruchu. Podczas gdy wcześniejsze prace badały znaczenie technologii Utrzymania 4.0 w zrównoważonej produkcji i proponowały modele ramowe dla zrównoważonego utrzymania, studia bibliometryczne i systematyczne oceniały technologie inteligentnego utrzymania ruchu25,26,27,28. Dalsze badania analizowały integrację zrównoważonego utrzymania ruchu w środowiskach Przemysłu 4.0 oraz systemach produkcji zorientowanych na zrównoważony rozwój29,30,31,32. Koncepcja Operatora 4.033, zorientowane na człowieka ramy Przemysłu 5.034 oraz perspektywy społeczno-ekonomiczne35 przyciągnęły znaczną uwagę do utrzymania ruchu zorientowanego na człowieka. Dodatkowo, w ostatnich badaniach podkreślono postępy w zakresie cyfrowego utrzymania ruchu36, utrzymania predykcyjnego i preskryptywnego37,38 oraz strategii zrównoważonego utrzymania ruchu39,40. Pomimo tych postępów, badania pozostają rozproszone i niewiele z nich oferuje spójny paradygmat integrujący wyjaśnialną sztuczną inteligencję, zrównoważony rozwój, odporność i zorientowaną na człowieka współpracę cyberfizyczną. Systemy cyberfizyczne (CPS) nie osiągnęły pełnej autonomii mimo ich rosnącego wdrożenia, a paradygmat Przemysłu 5.0 nie promuje takiego rozwiązania. Przemysł 5.0 kładzie natomiast większy nacisk na nadzór człowieka, współpracę i podejmowanie decyzji. Poprzez włączenie ludzkiego myślenia i współpracy do procesów cyberfizycznych, systemy cyber-ludzkie, takie jak CPS z człowiekiem w pętli (HiLCPSs)41, CPS zorientowane na człowieka (HCPSs)42,43 oraz cyberfizyczne systemy ludzkie (CPHSs)44, rozszerzają tradycyjne systemy CPS. Integracja ta poprawia adaptacyjność, przejrzystość, bezpieczeństwo i odporność, umożliwiając współpracę w czasie rzeczywistym między inteligentnymi systemami a ludzkimi operatorami45,46.
Wykrywanie anomalii dźwiękowych w przemyśle zostało znacznie usprawnione dzięki nowym architekturom, w tym Vision Transformer (ViT), Audio Spectrogram Transformer (AST), Conformer oraz uczeniu samosuperwizowanemu; jednak ich integracja z wyjaśnialnymi systemami cyberfizycznymi dla Przemysłu 5.0 pozostaje ograniczona. Bez połączenia wyjaśnialności, wdrożenia krawędziowego oraz wsparcia decyzji z udziałem człowieka (human-in-the-loop) w ramach jednego systemu, obecne badania koncentrują się głównie na dokładności klasyfikacji lub na interpretowalności opartej na metodach XAI post hoc. Niniejsze badanie proponuje nowatorską architekturę współpracy cyberfizycznej CNN-Transformer z obsługą wyjaśnialnej sztucznej inteligencji (Explainable AI), która łączy obliczenia krawędziowe, modelowanie zależności czasowych, wyjaśnialność opartą na SHAP, uczenie cech przestrzennych oraz wsparcie decyzji skoncentrowane na człowieku, aby umożliwić zrównoważoną produkcję w ramach Przemysłu 5.0 i przezwyciężyć te ograniczenia.
W związku z tym nadal istnieje znaczący deficyt badawczy. Obecne techniki wykrywania anomalii akustycznych oparte na sieciach CNN/Transformer stawiają na wydajność klasyfikacji, lecz brakuje im współpracy cyber-fizycznej oraz wyjaśnialności. Chociaż ramy Przemysłu 5.0 oferują koncepcyjne modele skoncentrowane na człowieku, nie integrują one wyjaśnialnego głębokiego uczenia, inteligencji krawędziowej oraz wspomagania decyzji przez operatora w jednym systemie, natomiast techniki konserwacji predykcyjnej oparte na XAI zwiększają przejrzystość, lecz działają niezależnie od architektur CPHS. Dlatego wciąż brakuje jednolitego systemu cyber-fizycznego z udziałem człowieka w ramach Przemysłu 5.0, który integrowałby precyzyjne wykrywanie anomalii słuchowych, wyjaśnialność opartą na SHAP, wdrożenie z wykorzystaniem urządzeń krawędziowych oraz współpracę z człowiekiem w pętli sterowania.
W niniejszej pracy zaproponowano nowy paradygmat współpracy cyberfizycznej oparty na modelu CNN-Transformer z wykorzystaniem wyjaśnialnej sztucznej inteligencji (Explainable AI) dla Przemysłu 5.0, mający na celu pokonanie tych ograniczeń. Sugerowana architektura łączy w ramach jednego systemu CPHS wdrożenie obliczeń krawędziowych (edge computing), ekstrakcję cech przestrzennych opartą na CNN, uczenie zależności czasowych w oparciu o Transformer, wyjaśnialność opartą na metodzie SHAP oraz wsparcie decyzji z udziałem człowieka (human-in-the-loop). W przeciwieństwie do obecnych metod, które traktują te elementy niezależnie, proponowane rozwiązanie oferuje zintegrowane podejście, które jednocześnie zwiększa wydajność wykrywania anomalii, przejrzystość modelu, efektywność operacyjną oraz współpracę zorientowaną na człowieka w celu zapewnienia zrównoważonej produkcji.
Głównym celem niniejszego badania jest stworzenie cyber-fizycznego systemu ludzkiego (CPHS) opartego na wyjaśnialnej sztucznej inteligencji (XAI) dla zrównoważonej produkcji w ramach Przemysłu 5.0, poprzez połączenie wyjaśnialności opartej na metodzie SHAP, przetwarzania krawędziowego (edge computing) oraz wspierania decyzji z udziałem człowieka (human-in-the-loop) z hybrydowym podejściem do detekcji anomalii akustycznych opartym na architekturze CNN-Transformer. W szczególności proponowany schemat ma na celu zwiększenie dokładności wykrywania anomalii przy jednoczesnym zapewnieniu jasnych i zrozumiałych prognoz, ułatwienie efektywnego wdrożenia na krawędzi sieci oraz zachęcanie do wspólnego podejmowania decyzji przez systemy inteligentne i operatorów ludzkich. Poprzez jednoczesne osiągnięcie wysokiej wydajności detekcji, wyjaśnialności, niskich opóźnień operacyjnych oraz zorientowanej na człowieka współpracy cyber-fizycznej, ta zintegrowana architektura rozwiązuje niedoskonałości obecnych systemów detekcji anomalii akustycznych, konserwacji predykcyjnej opartej na XAI oraz struktur CPHS.
Zaproponowana architektura przedstawia zintegrowany system cyberfizyczny z udziałem człowieka (CPHS) oparty na wyjaśnialnej sztucznej inteligencji (Explainable AI) dla Przemysłu 5.0, w przeciwieństwie do obecnych technik wykrywania anomalii akustycznych, które koncentrują się głównie na dokładności klasyfikacji. W ramach jednej architektury łączy ona ekstrakcję cech przestrzennych opartą na sieciach CNN, modelowanie czasowe oparte na Transformerach, wyjaśnialność opartą na SHAP, przetwarzanie krawędziowe (edge computing) oraz wsparcie decyzji z udziałem człowieka (human-in-the-loop). Zaproponowana architektura rozwiązuje kluczowe problemy przejrzystości, wsparcia operatora i współpracy cyberfizycznej poprzez połączenie precyzyjnego wykrywania anomalii z zrozumiałym procesem podejmowania decyzji i wdrożeniem krawędziowym w czasie rzeczywistym. Głównym wkładem naukowym niniejszej pracy jest integracja na poziomie systemowym, która odróżnia proponowane podejście od wcześniejszych badań skupiających się wyłącznie na wykrywaniu anomalii, wyjaśnialnej sztucznej inteligencji lub samych ramach Przemysłu 5.0.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Sugerowana metodologia wykorzystuje systemowe podejście do cyberfizycznych systemów ludzkich (CPHS) w ramach Przemysłu 5.0, które łączy wyjaśnialne głębokie uczenie z ramami współpracy cyberfizycznej opartymi na przetwarzaniu brzegowym (edge computing) w celu wspierania zrównoważonych procesów produkcyjnych. W pierwszej kolejności problem zostaje zdefiniowany poprzez wskazanie pewnych ograniczeń obecnych rozwiązań CPHS, takich jak brak inteligencji opartej na AI, brak wyjaśnialności oraz brak współpracy skoncentrowanej na człowieku. Aby sprostać tym wyzwaniom, proponowane rozwiązanie wykorzystuje zbiór danych MIMII do monitorowania stanu maszyn przemysłowych przy użyciu przetwarzania sygnałów akustycznych.
Zaproponowany schemat rozpoczyna się od wprowadzenia wygenerowanych spektrogramów do modelu CNN, który wyodrębnia cechy przestrzenne poprzez rozpoznawanie istotnych wzorców częstotliwości powiązanych z różnymi stanami maszyn. Wyekstrahowane cechy przestrzenne zostaną przekształcone w sekwencje i wprowadzone do modułu kodującego transformera w celu uchwycenia zależności czasowych za pomocą mechanizmu self-attention. Przekształcona reprezentacja cech jest następnie przekazywana do w pełni połączonego modułu klasyfikatora w celu zaklasyfikowania stanów maszyn jako normalne lub nieprawidłowe. Ponadto, aby zapewnić przejrzystość i ułatwić podejmowanie decyzji zorientowanych na człowieka, zastosowano podejście do wyjaśnialności SHAP, aby wyjaśnić przewidywania poprzez wybór istotnych obszarów czasowo-częstotliwościowych w wyjściu modelu. Zaprojektowany model zostanie zaimplementowany w środowisku CPS z obsługą brzegu sieci (edge-enabled), co umożliwi wnioskowanie w czasie rzeczywistym przy niskim opóźnieniu obliczeniowym i niskim zużyciu energii. Dodatkowo zintegrowany zostanie schemat human-in-the-loop, aby umożliwić operatorom weryfikację wyników przy użyciu rezultatów wyjaśnialności. Wydajność jest walidowana za pomocą dokładności (accuracy), precyzji (precision), pełności (recall) i miary F1-score, a także innych metryk na poziomie systemu, takich jak opóźnienie i efektywność energetyczna.
Zaproponowany schemat stanowi mechanizm CPHS oparty na XAI dla zrównoważonej produkcji w kontekście Przemysłu 5.0, a jego przebieg przedstawiono jako potok procesowy – od pozyskiwania danych po inteligentne podejmowanie decyzji i ich realizację, co pokazano na Rysunku 1. W początkowej fazie procedury pozyskiwania danych sygnały dźwiękowe są zbierane z maszyn przemysłowych, takich jak silniki, pompy i łożyska, z wykorzystaniem zbiorów danych, w tym MIMII. Uzyskane w ten sposób sygnały danych są przekazywane do kolejnego etapu, zwanego wstępnym przetwarzaniem danych, gdzie podlegają filtrowaniu, normalizacji i segmentacji. Na warstwie reprezentacji cech posegmentowane sygnały danych są ostatecznie konwertowane na spektrogram przy użyciu krótkoczasowej transformaty Fouriera (STFT).
Następnie warstwa modelu AI wykorzystuje obrazy spektrogramów do ekstrakcji cech za pomocą modułu CNN, identyfikując wzorce przestrzenne i anomalie. Następnie wyekstrahowane cechy są przekształcane i wprowadzane do koderu transformera, który uczy się zależności czasowych i relacji długodystansowych poprzez mechanizmy self-attention. Wynikowe wektory cech są klasyfikowane jako normalne lub abnormalne przy użyciu warstwy klasyfikacji. Aby zapewnić przejrzystość procesu predykcji, warstwa wyjaśnialności wykorzystuje SHAP do wyróżnienia istotnych obszarów czasowo-częstotliwościowych na spektrogramie.
Dodatkowo istnieje proces z udziałem człowieka (human-in-the-loop), w którym operatorzy interpretują wyniki modelu i dostarczają na ich podstawie informacji zwrotnych. W warstwie wdrożeniowej model działa na infrastrukturze CPHS opartej na krawędzi (edge-based), co zapewnia szybką inferencję i niski pobór mocy, z opcjonalnym interfejsem łączącym z systemami chmurowymi w celu realizacji wymagań dotyczących przechowywania danych lub zaawansowanej analityki. W całości struktura ta zapewnia dokładne wykrywanie usterek, wyjaśnialność oraz efektywne działanie w czasie rzeczywistym, zgodnie z wymogami Przemysłu 5.0.
Definicja problemu i analiza wymagań
Cyberfizyczne systemy ludzkie (CPHS) w środowiskach Przemysłu 5.0 obiecują inteligencję, zrównoważony rozwój i koncentrację na człowieku. Niemniej jednak, współczesne ramy budowy CPHS są ograniczane przez brak zaawansowanych możliwości opartych na AI, wyjaśnialności oraz odpowiedniego wsparcia dla współpracy człowieka z maszyną. W rzeczywistości konwencjonalne CPHS opierają się na modelach regułowych lub nieinterpretowalnych, co utrudnia adaptację do zmieniających się warunków przemysłowych i ogranicza zaufanie operatorów do automatyzacji. Co więcej, konwencjonalne CPHS nie potrafią efektywnie analizować wysoce złożonych danych, takich jak przemysłowe sygnały akustyczne zawierające komponenty zarówno przestrzenne (tj. częstotliwościowe), jak i zależne od czasu, które są istotne dla konserwacji predykcyjnej. W związku z tym konieczne jest stworzenie ram, które umożliwią wykrywanie anomalii maszyn z wysoką precyzją, dostarczanie wyjaśnień oraz działanie na krawędzi sieci (edge computing), co w ten sposób umożliwi funkcjonowanie CPS.
Tutaj x(t) jest sygnałem wejściowym akustycznym, S(f,t) jest reprezentacją spektrogramową sygnału,  jest etykietą a θ jest zestawem parametrów architektury CNN-Transformer. Symbole użyte w kolejnych równaniach są wprowadzane bezpośrednio po ich pierwszym wystąpieniu, aby zachować poprawność matematyczną.
Z matematycznego punktu widzenia zadanie to można sformalizować jako problem uczenia nadzorowanego. Niech sygnał akustyczny przemysłowy będzie oznaczony jako x(t). STFT sygnału x(t) oblicza się zgodnie z wzorem:
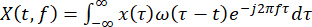 (1)
gdzie ω(.) jest funkcją okna, a f jest częstotliwością. Wygenerowany spektrogram 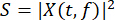 służy jako dane wejściowe dla algorytmu głębokiego uczenia. Celem jest wytrenowanie funkcji odwzorowania
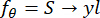 (2)
gdzie to etykieta klasy (normalna lub nieprawidłowa), S to wejściowy spektrogram, y to przewidywana etykieta wyjściowa, a θ to zbiór parametrów możliwych do wyuczenia w architekturze CNN-Transformer. Problem optymalizacji sformułowano jako minimalizację straty klasyfikacji:
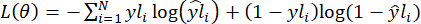 (3)
z zastrzeżeniem ograniczeń dotyczących minimalnej latencji  , efektywności energetycznej
 oraz interpretowalności, gdzie wyjaśnienie ∅(SHAP) oddaje znaczenie cech w procesie predykcji,
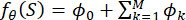 (4)
gdzie  to wkład każdej poszczególnej cechy. Zgodnie z powyższym, wymagania projektowe obejmują następujące elementy: (i) niezawodną detekcję anomalii opartą na hybrydowym głębokim uczeniu, (ii) interpretowalne wyniki umożliwiające interwencję człowieka oraz (iii) implementację w ramach CPS wzmocnionego krawędziowo.
Pozyskiwanie i wstępne przetwarzanie zbioru danych
W związku z tym, aby ocenić proponowaną strukturę CPHS opartą na wyjaśnialnej sztucznej inteligencji (Explainable AI), wybrano zbiór danych MIMII13. Zbiór ten jest powszechnie stosowanym wzorcem do wykrywania anomalii w maszynach przemysłowych przy użyciu sygnałów akustycznych. Baza ta zawiera nagrania dźwiękowe różnych maszyn, takich jak prowadnice przesuwne, wentylatory, pompy i zawory, w normalnych oraz awaryjnych warunkach pracy. Dla każdej maszyny nagrania różnią się w zależności od ustawień i środowiska akustycznego. Dzięki temu zbiór ten nadaje się do trenowania i oceny modeli w rzeczywistych warunkach przemysłowych.
Podczas gdy zbiór danych MIMII jest powszechnie wykorzystywany w badaniach nad nienadzorowanym wykrywaniem anomalii, które podczas treningu opierają się wyłącznie na próbkach normalnych, zawiera on jawne adnotacje zarówno dla normalnych, jak i anomalnych stanów maszyn. Problem sformułowano jako nadzorowane zadanie klasyfikacji binarnej, aby przetestować zdolność zaproponowanej architektury CNN-Transformer opartej na wyjaśnialnej sztucznej inteligencji (Explainable AI) do rozróżniania zdrowych stanów maszyn od uszkodzonych. W szczególności zastosowano oficjalne etykiety MIMII, przypisując etykietę klasy 0 do próbek normalnych oraz etykietę klasy 1 do próbek anomalnych.
Tabela 1 przedstawia szczegółowy opis zbioru danych. W niniejszych badaniach rozważono około 12 000 nagrań sygnałów akustycznych, obejmujących zarówno prawidłową, jak i wadliwą pracę maszyn. Zgodnie z wymogami, wszystkie nagrania w tej studyjnej analizie zostały zarejestrowane z częstotliwością 16 kHz i trwają 10 s. Chociaż zbiór danych zawiera około 12 000 nagrań, wybrano zrównoważony pod względem klas podzbiór 2 000 nagrań testowych wyłącznie w celu wizualizacji macierzy pomyłek. Wszystkie raportowane metryki wydajności obliczono przy użyciu pełnego zestawu testowego (około 2 400 nagrań). Ponadto próbki treningowe i testowe zostały rozdzielone w stosunku 80:20 na potrzeby trenowania modelu. Baza ta jest dobrze dostosowana do zastosowań w Przemysle 5.0, ponieważ uwzględnia warunki hałasu w czasie rzeczywistym. Rozkład nagrań wykorzystanych w tej pracy przedstawiono w Tabeli 2. Z tego zbioru danych wybrano około 12 000 nagrań obejmujących wszystkie typy maszyn i warunki stosunku sygnału do szumu (SNR) dla eksperymentów nad nadzorowaną klasyfikacją binarną z podziałem na zbiór treningowy i testowy w stosunku 80:20; tabela ta przedstawia typy maszyn przemysłowych, odpowiadające im identyfikatory maszyn, całkowitą liczbę prawidłowych i anomalnych nagrań akustycznych, warunki SNR oraz eksperymentalny podział na zbiór treningowy/testowy zastosowany w nadzorowanej klasyfikacji binarnej.
Eksperyment przeprowadzono z wykorzystaniem zbioru danych MIMII (Malfunctioning Industrial Machine Investigation and Inspection) w wersji 1.0, który obejmuje cztery typy maszyn przemysłowych: wentylatory, pompy, zawory i szyny prowadzące. Dane zostały zebrane z różnych identyfikatorów maszyn (ID00–ID06, w zależności od typu maszyny) oraz w różnych warunkach. Baza danych MIMII zawiera dane pozyskane przy stosunkach sygnału do szumu (SNR) wynoszących −6 dB, 0 dB oraz +6 dB. Dane normalne odpowiadają sprawnemu stanowi maszyny przemysłowej, natomiast dane anomalne odpowiadają stanowi wadliwemu. Klasy zostały oznaczone na podstawie adnotacji w bazie danych, gdzie dane normalne oznaczono jako klasa 0, a dane anomalne jako klasa 1.
Rzetelna procedura oceny wymagała, aby podział na zbiory treningowy i testowy nastąpił na poziomie oryginalnych nagrań audio przed jakimikolwiek etapami dzielenia, augmentacji lub tworzenia spektrogramów. W rezultacie segmenty audio z tego samego nagrania nie mogły pojawić się jednocześnie w zbiorze treningowym i testowym. W eksperymencie oceniającym wykorzystano nagrania o różnych stosunkach sygnału do szumu (−6 dB, 0 dB i +6 dB), co umożliwiło ocenę proponowanego modelu w różnych warunkach przemysłowych.
Aby zapobiec wyciekowi danych, podział na zbiór treningowy i testowy przeprowadzono w oparciu o oryginalne pliki audio, przed jakimkolwiek segmentowaniem lub generowaniem spektrogramów. Segmenty z tego samego 10 s nagrania audio przypisano wyłącznie do zbioru treningowego lub testowego, tak aby żadne segmenty nie występowały w obu zbiorach jednocześnie. Następnie spektrogramy zostały wygenerowane i rozszerzone oddzielnie dla każdego zbioru danych. W ten sposób uniknięto problemu wycieku danych, co zapobiegło zbyt optymistycznej ocenie wydajności.
Przetwarzanie wstępne zbioru danych
Surowe sygnały akustyczne z zestawu danych MIMII są następnie przetwarzane w celu poprawy jakości sygnału i umożliwienia skutecznej ekstrakcji cech. Sygnał wejściowy jest oznaczony jako x(t), gdzie t oznacza czas. Pierwszym etapem jest filtrowanie szumów, podczas którego szumy tła są usuwane za pomocą funkcji filtrującej w następujący sposób:
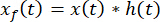 (5)
gdzie ∗ reprezentuje proces splotu, a h(t) jest odpowiedzią impulsową filtra. Proces ten zwiększa klarowność sygnału akustycznego i minimalizuje skutki szumów, które często występują w środowiskach przemysłowych. Normalizacja sygnału jest stosowana w celu zapewnienia, aby amplitudy wszystkich sygnałów audio były porównywalne przed wprowadzeniem ich do modelu głębokiego uczenia. Sygnał znormalizowany, oznaczony jako xn(t), jest obliczany jako:
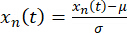 (6)
gdzie μ oraz σ to odpowiednio wartość średnia i odchylenie standardowe sygnału wejściowego. Dzięki tej procedurze wszystkie sygnały wejściowe mają zagwarantowaną wartość średnią równą zero oraz jednostkową wariancję. Na koniec, w celu przetwarzania, znormalizowany sygnał wejściowy zostaje podzielony na wiele małych fragmentów. Przyjmując, że długość całego sygnału wynosi T, zostaje on rozbity na N nakładających się ramek o długości L przy użyciu funkcji przesuwnego okna:
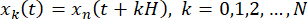 (7)
gdzie H to wielkość skoku (hop size). Spektrogram można zdefiniować za pomocą poniższego wzoru:
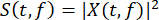 (8)
Spektrogramy uzyskane w ten sposób są wprowadzane do frameworka opartego na sieci CNN-transformer w celu wyodrębnienia cech przestrzennych i czasowych, co umożliwia skuteczną detekcję anomalii. Rysunek 2 przedstawia potok przetwarzania wstępnego.
Rysunek 2 przedstawia pionowy potok przetwarzania wstępnego, który można zastosować do danych akustycznych pozyskanych w przemyśle. W pierwszej kolejności surowe sygnały audio są wyodrębniane z zestawu danych MIMII i przekazywane do etapu usuwania szumów w celu redukcji zakłóceń. Następnie sygnał jest normalizowany, aby wyeliminować niespójności amplitudy i zapewnić jego jednolitość. Sygnał jest później dzielony na mniejsze, nakładające się sekcje. Po segmentacji do danych stosowane są transformacje STFT, aby przekształcić sygnały z dziedziny czasu w sygnały czasowo-częstotliwościowe. Następnie, w ramach generowania spektrogramu sygnału, obliczane jest widmo mocy. W ten sposób produktem końcowym procesu będą przetworzone wstępnie spektrogramy, które zostaną wykorzystane w proponowanym modelu CNN-transformer.
Generowanie spektrogramu
Po normalizacji i segmentacji danych sygnały akustyczne są przekształcane w reprezentację czasowo-częstotliwościową przy użyciu krótkoterminowej transformaty Fouriera (STFT). Powstający spektrogram stanowi graficzną reprezentację zmian w składzie częstotliwości w okresie analizy. W warunkach przemysłowych usterki maszyn zazwyczaj objawiają się jako wzorce częstotliwości, co sprawia, że spektrogramy są bardziej użyteczne w wykrywaniu anomalii maszynowych.
W rezultacie przetworzone dane są konwertowane na obrazy spektrogramów, aby odróżnić przypadki prawidłowego i nieprawidłowego działania maszyn. Dane audio zostaną przekształcone w wiele spektrogramów, co umożliwi modelowi uczenia się analizę lokalnych komponentów częstotliwości oraz zmian czasowych w procesie pracy maszyny. Obrazy te służą jako dane wejściowe dla modelu CNN-transformer, w którym sieć CNN obsługuje wzorce przestrzenne (częstotliwościowe), natomiast transformery odpowiadają za relacje czasowe.
Algorytm 1: Generowanie spektrogramu z sygnałów akustycznych
Wejście: Surowy sygnał audio x(t)
Wynik: Spektrogram S(t, f)
Krok 1: Załadowanie sygnału audio x(t)
Krok 2: Zastosuj filtrowanie szumów
Krok 3: Normalizacja sygnału xn(t)
Krok 4: Segmentacja sygnału na klatki:
dla k = 1 do N
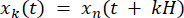
koniec pętli
Krok 5: Zastosuj funkcję okna w(t) do każdego segmentu
Krok 6: Obliczenie STFT:
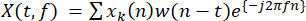 (9)
Krok 7: Oblicz wartość amplitudy:
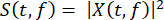 (10)
Krok 8: Zapisz spektrogram S(t, f)
Krok 9: Zwrócenie zbioru danych spektrogramu
Proces generowania spektrogramów rozpoczyna się od pozyskania oryginalnego sygnału audio, po czym następują etapy przetwarzania wstępnego, takie jak redukcja szumów i normalizacja sygnału, aby zapewnić jego integralność i jakość. Następnie znormalizowany sygnał audio jest dzielony na wiele nachodzących na siebie okien, aby uchwycić charakterystykę czasową zarówno okresów długoterminowych, jak i krótkoterminowych. Aby zapobiec wyciekowi widma, każdy z fragmentów jest mnożony przez funkcję okna przed przekazaniem do krótkoczasowej transformaty Fouriera (STFT). Następnie przetworzony sygnał jest reprezentowany jako funkcja o wartościach zespolonych w dziedzinie częstotliwości, a następnie podnosi się do kwadratu wartości ich amplitud. W ten sposób energia częstotliwości w danym czasie jest reprezentowana przez spektrogramy. Na koniec są one zapisywane jako dane w formie obrazów i przekazywane do sieci neuronowej w celu przeprowadzenia treningu.
Ekstrakcja cech przestrzennych przy użyciu CNN
Po procesie tworzenia spektrogramów uzyskane obrazy czasowo-częstotliwościowe są przyjmowane jako dane wejściowe i przekazywane do konwolucyjnej sieci neuronowej (CNN). Przyjmując spektrogram wejściowy jako  , gdzie H oznacza domenę częstotliwości, a W domenę czasu. Celem zastosowania sieci CNN w tym przypadku jest nauczenie się dyskryminatywnych cech przestrzennych ze spektrogramu wejściowego. Cechy te pomogą odróżnić normalne od nieprawidłowego zachowania maszyn w środowisku przemysłowym.
Podstawową operacją wykonywaną przez splotową sieć neuronową (CNN) jest splot. Splot z określonym filtrem  definiuje się jako:
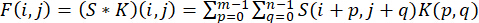 (11)
Opisana powyżej operacja umożliwia sieci neuronowej identyfikację lokalnych cech przestrzennych, takich jak krawędzie, częstotliwości i zawartość harmoniczna, w spektrogramie. Odbywa się to poprzez wielokrotne operacje filtrowania, które generują różne reprezentacje cech, tworząc kilka map cech. Po splotach następuje nieliniowa funkcja aktywacji, jak pokazano poniżej:
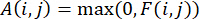 (12)
Ta nieliniowość umożliwia sieci wychwytywanie i reprezentowanie złożonych zależności między zmiennymi. Kolejnym etapem w konwolucyjnej sieci neuronowej jest zastosowanie operacji poolingu. Powszechnie stosowana technika max poolingu jest wyrażona matematycznie w następujący sposób:
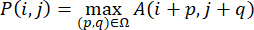 (13)
gdzie Ω oznacza okno poolingu. Pooling pomaga w osiągnięciu niezmienniczości translacyjnej i zachowaniu jedynie istotnych informacji przy jednoczesnym odrzuceniu redundancji. Wykorzystując splotową sieć neuronową, można hierarchicznie wyodrębnić cechy wyższego poziomu – od zmiennych niskopoziomowych, takich jak częstotliwości, aż po złożone zachowania maszyn. W konsekwencji mapy cech mogą być wykorzystane do przedstawienia końcowego wyniku sieci:
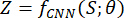 (14)
gdzie reprezentuje wyuczalne parametry sieci CNN. Mapy cech zawierają bogate informacje przestrzenne i są przekształcane w sekwencje, aby służyć jako wejścia dla koderach transformera w kolejnej fazie. Opisany powyżej proces ekstrakcji cech przestrzennych jest kluczowy dla umożliwienia modelowi wykrywania drobnych anomalii w przemysłowych sygnałach akustycznych.
Rycina 3 przedstawia sposób horyzontalnej ekstrakcji cech przestrzennych z wejściowego spektrogramu przy użyciu modelu CNN. Proces rozpoczyna się od spektrogramu wejściowego, który koduje właściwości czasowo-częstotliwościowe sygnału audio w formie obrazowej. Spektrogram wejściowy jest następnie przekazywany do warstwy splotowej, w której różne rodzaje filtrów ekstrahują cechy przestrzenne, takie jak pasma częstotliwości, krawędzie i tekstury, generując w ten sposób mapy cech. Następnie wyekstrahowane mapy cech przechodzą przez nieliniową funkcję aktywacji — jednostkę liniową z prostowaniem (ReLU) — co pozwala sieci neuronowej wykrywać zależności w danych wejściowych. Mapy cech są następnie przekazywane do warstwy poolingu, w której rozmiar mapy zostaje zredukowany przy zachowaniu jej najważniejszych charakterystyk. Ten proces warstw splotowych, aktywacji i poolingu powtarza się wielokrotnie, tworząc hierarchię reprezentacji cech, która zaczyna się od prostych elementów i ewoluuje w stronę bardziej złożonych cech związanych z pracą maszyn.
Modelowanie czasowe z wykorzystaniem koder transformer
Po wyekstrahowaniu cech przestrzennych za pomocą CNN, kolejnym krokiem jest wyprowadzenie map cech wysokiego poziomu, które przechwytują wzorce oparte na częstotliwościach wyuczone ze spektrogramu. Powstałe mapy cech są następnie spłaszczane i przekształcane w sekwencje w celu uchwycenia informacji czasowych w sygnale akustycznym. Przy założeniu, że mapy cech są reprezentowane przez 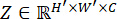 , gdzie H', W', i C to odpowiednio wysokość, szerokość i liczba kanałów, wyprowadzana jest następująca sekwencja:
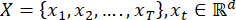 (15)
gdzie T oznacza długość sekwencji, a d jest wymiarem cechy. Następnie Transformer wykorzystuje powyższą sekwencję do modelowania długoterminowych zależności przy użyciu mechanizmu self-attention. Model transformer, w przeciwieństwie do konwencjonalnych modeli rekurencyjnych, przetwarza każdy element sekwencji równolegle i wykorzystuje wagi uwagi do określenia względnej istotności każdego fragmentu. Mechanizm uwagi działa poprzez wykorzystanie wektorów Zapytania Q (Query), Klucza K (Key) i Wartości V (Value) generowanych dla każdego wejścia xt zgodnie z:
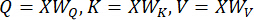 (16)
podczas gdy WQ, WK, WV są wagami trenowalnymi. Podobieństwa między elementami są wyznaczane za pomocą:
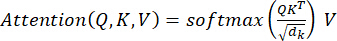 (17)
dk to istotny wymiar wektorów. Ta procedura ułatwia modelowi naukę zależności z odległych kroków czasowych w sygnale i pozwala skupić się wyłącznie na istotnych segmentach czasowych. Aby zwiększyć zdolność sieci do uczenia się, zastosowano mechanizm uwagi wielogłowicowej (multihead attention), który polega na równoległym uczeniu się z wejścia przez kilka głowic uwagi:
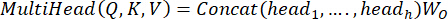 (18)
Każda głowica odpowiada za odmienne cechy sekwencji wejściowej w dziedzinie czasu. Następnie zastosowano sieci neuronowe z przesuwniem w przód oraz połączenia rezydualne:
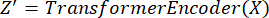 (19)
Wynikowa zakodowana sekwencja rejestruje zarówno cechy przestrzenne, jak i czasowe danych wejściowych. Sekwencja ta jest przesyłana do warstwy klasyfikatora w celu wykrycia anomalii.
Rysunek 4 przedstawia ogólny proces modelowania czasowego z wykorzystaniem koderen transformer na cechach wyekstrahowanych z CNN. Najpierw wykorzystuje się mapy cech wyekstrahowane z CNN, które zawierają informacje przestrzenne ze spektrogramu. Mapy cech są spłaszczane do postaci sekwencji, w której każdy element odpowiada określonej znacznikowi czasu. Następnie sekwencja przechodzi przez transformację liniową, która odwzorowuje dane na wektory o określonym wymiarze. Ponieważ modele transformer nie posiadają wrodzonej zdolności do przechwytywania zależności czasowych, do wektorów zanurzeń dodawane jest kodowanie pozycyjne w celu zachowania struktury czasowej sekwencji. Na koniec sekwencja przechodzi przez koder transformer, składający się ze stosu wielu warstw, w których zastosowano mechanizm wielogłowicowej samouwag (multi-head self-attention), aby umożliwić modelowi naukę powiązań między znacznikami czasu w sekwencji. Sieć neuronowa typu feed-forward dodatkowo udoskonala te zanurzenia, podczas gdy połączenia rezydualne zapewniają efektywną propagację gradientów. Proces ten jest powtarzany w kolejnych warstwach stosu kodera transformer, które przechwytują progresywnie bardziej złożone interakcje czasowe. Ostatecznie zanurzenia sekwencji są łączone w reprezentację o stałej długości poprzez pooling (np. average pooling lub token klasyfikacji (CLS)), co daje globalną reprezentację cech czasowych.
Warstwa klasyfikacji
Po kodowaniu czasowym za pomocą koder-transformera (transformer encoder), wyjściem będzie sekwencja zakodowanych wektorów, z których każdy zawiera cechy związane zarówno z przestrzennym, jak i czasowym aspektem sygnału wejściowego. Pierwszym krokiem w kierunku klasyfikacji na podstawie zakodowanych danych wyjściowych jest zagregowanie wszystkich tych cech w jeden wektor. Osiąga się toy poprzez zastosowanie uśredniania (mean pooling) sekwencji wektorów cech lub poprzez wykorzystanie tzw. „tokenu klasyfikacyjnego” (classification token). Przyjmijmy, że wyjściem Transformera jest 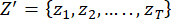 , gdzie każdy
 . Zagregowana cecha h jest obliczana jako:
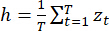 (20)
Następnie zagregowany wektor cech h reprezentuje dane wejściowe w formie skondensowanej i służy jako wejście klasyfikatora. Część klasyfikacyjna składa się z jednej lub więcej warstw gęstych, które przekształcają wyuczoną reprezentację w przestrzeń wyjściową. Warstwa gęsta realizuje przekształcenie zdefiniowane w następujący sposób:
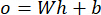 (21)
gdzie o to wyjście (logity), b to wektor obciążenia, a W to macierz wag. Te ostatnie stanowią nieznormowane wyniki klas. Aby wprowadzić nieliniowość do modelu, często stosuje się funkcje aktywacji, takie jak ReLU. Na koniec do logitów stosowana jest funkcja aktywacji softmax w celu uzyskania prawdopodobieństwa dla każdej klasy:
 (22)
gdzie C oznacza liczbę klas (C = 2; normalna i nieprawidłowa). Predykcja klasy będzie oparta na maksymalnej wartości prawdopodobieństwa. Podczas trenowania optymalne wartości parametrów modelu są uzyskiwane poprzez minimalizację funkcji straty entropii krzyżowej między etykietami rzeczywistymi a przewidywanymi, co pozwala na dokładną klasyfikację stanów maszyn. Podsumowując, warstwa klasyfikacji pełni kluczową funkcję w przekształcaniu wyekstrahowanych cech czasowych, uzyskanych przy użyciu architektury Transformer, w praktyczne decyzje. Dzięki odpowiedniemu rozróżnianiu między zdrowymi a uszkodzonymi stanami maszyn, w paradygmacie Industry 5.0 możliwe staje się wykrywanie anomalii i inteligentne podejmowanie decyzji.
Rycina 5 przedstawia zasadę działania warstwy klasyfikacji, która następuje po enkoderze transformera. Proces rozpoczyna się od wyjściowej zakodowanej sekwencji, w której każdy wektor zawiera informacje czasowe wyuczone z danych wejściowych. Wektory te są łączone w jeden wektor, znany jako globalny wektor cech. Następnie globalny wektor cech jest przekazywany przez kilka gęstych warstw sieci neuronowej. W każdej gęstej warstwie wykonywane są operacje mnożenia macierzy w celu stworzenia kombinacji liniowych danych wejściowych. Po tym etapie można zastosować nieliniową funkcję aktywacji, taką jak ReLU, aby zwiększyć elastyczność w uczeniu granic decyzyjnych. Na końcu ostatniej gęstej warstwy znajdują się wyniki logitów dla każdej klasy. Wyniki logitów te mogą zostać wykorzystane w funkcji Softmax do obliczenia wyników prawdopodobieństwa dla każdej klasy. Wyniki prawdopodobieństwa te służą do określenia, czy dane wejściowe należą do Klasy 0 (Normalna) czy Klasy 1 (Nieprawidłowa).
Wyjaśnialność z wykorzystaniem SHAP
Po zaklasyfikowaniu sygnałów wejściowych przez model, generowane są predykcje określające, czy maszyna pracuje prawidłowo, czy w sposób nieprawidłowy. Niemniej jednak w środowisku Przemysłu 5.0 samo tworzenie predykcji jest niewystarczające; system musi również zapewnić przejrzystość i wyjaśnialność, aby wspierać proces podejmowania decyzji przez człowieka. Poniższy schemat wykorzystuje SHAP – model oparty na teorii gier, który kwantyfikuje znaczenie każdej cechy w określaniu predykcji. W ten sposób SHAP przypisuje wagi cechom, co pozwala ocenić względną istotność różnych sekcji spektrogramu wejściowego dla końcowej predykcji.
Matematyczna formulacja SHAP opiera się na dekompozycji modelu f(x):
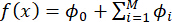 (23)
gdzie ∅0 jest wartością bazową (średnim wynikiem modelu), ∅i jest efektem i-tej cechy, a M to liczba cech wejściowych. Na potrzeby niniejszego badania cechami są przedziały czasowo-częstotliwościowe ze spektrogramu. Wartości SHAP są dodatnie, jeśli przyczyniają się do prawdopodobieństwa wystąpienia stanu nieprawidłowego, a ujemne w przeciwnym razie. Ta formulacja gwarantuje unikalne, lokalnie spójne wyjaśnienie dla każdej predykcji. Metodę SHAP można zastosować do wytrenowanego modelu CNN-transformer, aby uzyskać wyjaśnienie oparte na istotności cech. Reprezentacja wizualna wskaże najważniejsze przedziały czasowo-częstotliwościowe w spektrogramie, które wpływają na proces podejmowania decyzji. Na przykład nieprawidłowa praca urządzenia może skutkować wystąpieniem określonych pasm częstotliwości o wysokiej energii, które framework SHAP zidentyfikuje jako istotne czynniki wpływające na proces decyzyjny.
Dodatkowo, SHAP może sprzyjać współpracy między ludźmi a maszynami w środowisku cyber-fizycznym. Wynika to z faktu, że przewidywania mogą być wyjaśnione za pomocą intuicyjnych wizualizacji, co pozwala operatorom i systemom decyzyjnym weryfikować prognozy, analizować problem i podejmować odpowiednie kroki. Nie tylko zwiększa to zaufanie, ale także sprawia, że procesy produkcyjne oparte na AI są niezawodne i rozliczalne. Dzięki integracji algorytmów głębokiego uczenia, spełniających aktualne standardy wydajności, z SHAP, który zapewnia wyjaśnialność, proponowana architektura spełnia wymagania Przemysłu 5.0.
Algorytm 2: Wyjaśnialność predykcji modelu w oparciu o SHAP
Dane wejściowe: Wytrenowany model f(x), wejściowy spektrogram S
Wynik: wartości SHAP  oraz mapa objaśnień
Krok 1: Wprowadzenie spektrogramu S do wytrenowanego modelu
Krok 2: Obliczenie prognozy: y = f(S)
Krok 3: Inicjalizacja wyjaśniacza SHAP zorientowanego na głębokie uczenie
Krok 4: Oblicz wartości SHAP:
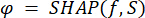
Krok 5: Dla każdej cechy i w S:
Obliczenie wkładu 
Krok 6: Wygeneruj mapę wyjaśnień:
Wyróżnij obszary o wysokim 
Krok 7: Wizualizacja istotności cech (mapa ciepła)
Krok 8: Zwrócenie wartości SHAP i mapy wyjaśnień
Algorytm wyjaśnialności oparty na metodzie SHAP rozpoczyna pracę od pobrania przetworzonego obrazu spektrogramu jako danych wejściowych i wprowadzenia go do przeszkolonej architektury CNN-transformer w celu dokonania predykcji (np. normalny lub nieprawidłowy stan maszyny). Po uzyskaniu predykcji za pomocą przeszkolonej architektury, metoda SHAP jest wykorzystywana do interpretacji modelu. W szczególności obliczane są wartości SHAP (ϕ) dla każdej cechy wejściowej, aby ustalić, które komponenty czasowo-częstotliwościowe sygnału wejściowego mają największy wpływ na predykcję. Aby obliczyć te wartości, należy porównać wyniki modelu dla danych wejściowych z określonymi cechami oraz bez nich.
Po obliczeniu wartości SHAP dla każdej cechy, jej wpływ na prognozę można ocenić na podstawie znaku i wielkości wartości SHAP. Na przykład cechy o wyższych wartościach SHAP z większym prawdopodobieństwem wpływają na wynik, a znak dodatni lub ujemny wskazuje, że dana cecha przesuwa prognozę odpowiednio w stronę klasy prawidłowej lub nieprawidłowej. Na podstawie uzyskanych wyników można stworzyć mapę wyjaśnień w formie mapy ciepła.
Na koniec algorytm generuje zarówno wartości SHAP, jak i wizualizacje, co pozwala zrozumieć, w jaki sposób ludzie mogą analizować decyzje modelu. Technika ta zwiększa przejrzystość procesu i umożliwia zaangażowanie człowieka w podejmowanie decyzji, zapewniając tym samym zarówno dokładność przewidywań algorytmu, jak i jego niezawodność w przemyśle opartym na AI. W celu zwiększenia wiarygodności analizy wyjaśnialności wybrano reprezentatywne próbki testowe z dokładnie zdiagnozowanych anomalnych przypadków dla różnych typów maszyn. Podczas gdy globalna analiza istotności cech SHAP została przeprowadzona poprzez agregację wartości SHAP w całym zestawie danych testowych w celu zidentyfikowania spójnie wpływowych lokalizacji czasowo-częstotliwościowych, dla tych reprezentatywnych przypadków wygenerowano lokalne wyjaśnienia SHAP. Bez konieczności wprowadzania adnotacji eksperckich, ta zintegrowana analiza lokalna i globalna oferuje wiarygodną interpretację przewidywań modelu.
Integracja CPS z obsługą krawędziową
Proponowane rozwiązanie jest wykorzystywane w ramach CPS z obsługą krawędziową, którego celem jest osiągnięcie wydajności, zrównoważenia oraz operacji przemysłowych w czasie rzeczywistym. Po przeszkoleniu modelu, transformator CNN zostanie wdrożony za pomocą podejścia obliczeń krawędziowych. Wspomniana warstwa obliczeń krawędziowych znajduje się w pobliżu urządzeń przemysłowego Internetu Rzeczy (IIoT), w tym czujników i maszyn. Zamiast przesyłać wszystkie zebrane dane do chmury, urządzenie krawędziowe wykonuje wnioskowanie na przychodzącym sygnale akustycznym bez konieczności jego wcześniejszego transferu. Dzięki temu system może niemal natychmiast wykryć nieprawidłowości w działaniu maszyn i podjąć niezbędne kroki, zanim sytuacja ulegnie dalszemu pogorszeniu. Inną zaletą tego podejścia z obsługą krawędziową jest poprawiona latencja i wydajność, ponieważ dane są analizowane w pobliżu miejsca ich generowania. Innymi słowy, w przeciwieństwie do podejścia chmurowego, gdzie czas wnioskowania Tinf
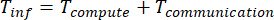 (24)
Opóźnienie, w ujęciu ogólnym, zostanie znacznie zredukowane dzięki zmniejszeniu Tcommunication. Inną korzyścią jest zmniejszone zużycie przepustowości oraz energii wydatkowanej podczas ciągłej transmisji danych. System ten jest zatem skalowalny i zrównoważony w przypadku dużych zakładów przemysłowych z licznymi podłączonymi urządzeniami. Ponadto CPS umożliwia interakcję z warstwą fizyczną (maszynami), AI (warstwą obliczeniową) oraz warstwą ludzką.
Współpraca z człowiekiem w pętli (human-in-the-loop)
Kluczowym elementem sugerowanego systemu CPS w ramach Przemysłu 5.0, który obejmuje aktywny udział operatorów ludzkich w procesie podejmowania decyzji obok modeli AI, jest współpraca typu human-in-the-loop. Mianowicie, zgodnie z zaprojektowaną strukturą, system nie staje się autonomiczną „czarną skrzynką”, lecz umożliwia operatorom interakcję z nim oraz obserwację wyjaśnialnych wyników predykcji w formie objaśnień SHAP. Przedmiotowe predykcje odnoszą się do wyników (normalny/nienormalny), którym towarzyszą wizualizacje fragmentów spektrogramów wykorzystanych do ich sporządzenia.
Taka interakcja pomaga operatorom lepiej zrozumieć, w jaki sposób dokładnie tworzona jest prognoza oraz które czynniki mają na nią wpływ. Udział człowieka polega na weryfikacji wyników systemu i umożliwieniu operatorom ich zmiany w razie potrzeby, w oparciu o ich profesjonalny osąd. Współpraca z operatorami sprawia, że system jest bardziej godny zaufania, wydajny, bezpieczny i niezawodny, co pomaga zapobiegać błędom.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Przedstawiony system współpracy cyber-fizycznej zintegrowany z wyjaśnialną sztuczną inteligencją (Explainable AI) został przetestowany eksperymentalnie na około 12 000 nagrań audio z zestawu danych MIMII Dataset, który zawiera zarówno normalne, jak i anormalne stany pracy maszyn. Zbiór treningowy składał się z około 9 600 rekordów danych, natomiast zbiór testowy obejmował około 2 400 próbek audio. Na podstawie uzyskanych wyników zaproponowany model CNN-transformer osiągnął dokładność klasyfikacji na poziomie 98,5% dla zb...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Wyniki eksperymentalne wykazują, że proponowana architektura CNN-transformer przewyższa poszczególne algorytmy dzięki efektywnej integracji uczenia cech przestrzennych i czasowych. Zgodnie z badaniem ablacyjnym, choć sieć CNN wyodrębnia dyskryminacyjne cechy oparte na częstotliwości ze spektrogramów, enkoder transformera poprawia wydajność modelu poprzez przechwytywanie długodystansowych zależności czasowych w sygnałach akustycznych. Co więcej, macierz pomyłek wykazuje bardzo niewielką liczbę wyników fałszywie negatywnyc...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Narzędzie AI (ChatGPT) zostało wykorzystane wyłącznie w celu pomocy w redakcji językowej oraz poprawy gramatyki, jasności i czytelności tekstu. Narzędzia AI nie były wykorzystywane do generowania danych naukowych, przeprowadzania eksperymentów, analizy wyników, interpretacji ustaleń ani wyciągania wniosków naukowych. Cała treść naukowa, analiza danych, interpretacja oraz ostateczna wersja manuskryptu zostały niezależnie sprawdzone, zweryfikowane i zatwierdzone przez autorów, którzy biorą pełną odpowiedzialność za dokładność i rzetelność pracy. Autorzy nie wykazują żadnych konfliktów interesów.
Podziękowania
FINANSOWANIE: Niniejsza praca była wspierana przez Key Project on Higher Education Teaching Reform in Shaanxi Province (projekt nr 23BG053); Scientific Research Foundation for High-Level Talents of Shaanxi Polytechnic University (projekt nr BSJ-2023-08) oraz Scientific Research Project of Shaanxi Polytechnic University (projekt nr 2024YKYB-006). Autorzy serdecznie dziękują Shaanxi Polytechnic University w Xianyang, Chiny, oraz Xi’an Traffic Engineering University w Xi’an, Chiny, za udostępnienie zaplecza oraz wsparcie instytucjonalne, które umożliwiły przeprowadzenie tych badań.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Skala wsparcia społecznego | Opublikowana skala akademicka; opracowana pierwotnie przez Parka, a następnie zrewidowana i uzupełniona przez Kima | wersja 25-elementowa; 5-stopniowa skala Likerta; brak komercyjnego numeru katalogowego | Pomiar postrzeganego wsparcia społecznego wśród przyszłych nauczycieli edukacji wczesnoszkolnej w zakresie wsparcia emocjonalnego, informacyjnego, materialnego oraz oceniającego. Ogólny współczynnik Cronbacha’s alpha = 0,96. |
| Skala poczucia własnej skuteczności nauczycieli | Opublikowana skala akademicka; opracowana pierwotnie przez Enochsa i Riggsa; wersja badania zaadaptowana dla języka chińskiego | wersja 25-elementowa; 5-stopniowa skala odpowiedzi Likerta; brak komercyjnego numeru katalogowego | Ocenia skuteczność nauczycieli w chińskim kontekście kształcenia przyszłych nauczycieli edukacji przedszkolnej w zakresie ogólnego poczucia własnej skuteczności nauczyciela oraz osobistego poczucia własnej skuteczności nauczyciela. Ogólny współczynnik Cronbacha’s alpha = 0,96. |
| Skala Interakcji Nauczyciel-Dziecko | Opublikowana skala akademicka; opracowana przez Lee i zweryfikowana przez panel ekspertów badania pod kątem zastosowania w Chinach | wersja 30-elementowa; 5-stopniowa skala Likerta; brak numeru katalogowego producenta | Ocenia samo-sprawozdawane kompetencje w interakcjach nauczyciel-dziecko, a nie obserwowaną jakość interakcji w klasie. Obejmuje interakcję emocjonalną, interakcję werbalną oraz interakcję behawioralną; ogólny współczynnik Cronbacha’s alpha = 0,94. |
| Kwestionariusz informacji demograficznych | Zespół badawczy, współpraca Sichuan University of Arts and Science / Daegu University | Sekcja niestandardowego kwestionariusza badania; brak komercyjnego numeru katalogowego | Zebrano charakterystykę uczestników, obejmującą płeć, wykształcenie, kategorię zawodową, miejsce stażu, czas trwania stażu, rodzaj stażu oraz typ przedszkola. |
| Informacje dla uczestnika i skrypt świadomej zgody | Zespół badawczy; zatwierdzony przez Komitet Etyki Badań Uniwersytetu w Daegu | Numer zgody komisji etycznej: XXX; lokalny rejestr zatwierdzeń do weryfikacji | Stosowane przed rozprowadzeniem kwestionariusza w celu wyjaśnienia celu badania oraz treści ankiety i uzyskania świadomej zgody od uczestników będących studentami kierunków przygotowujących do zawodu nauczyciela edukacji wczesnoszkolnej. |
| Pakiet kwestionariusza badania pilotażowego | Zespół badawczy i panel ekspertów | Wersja pilotażowa użyta 1 czerwca–5, 2024; brak komercyjnego numeru katalogowego | Przeprowadzono badanie pilotażowe w celu oceny jasności i odpowiedniości Skali Postrzegania Zawodu (Professional Perceptions Scale), Skali Wsparcia Społecznego (Social Support Scale), Skali Poczucia Własnej Skuteczności Nauczyciela (Teacher Self-Efficacy Scale), Skali Interakcji Nauczyciel-Dziecko (Teacher-Child Interaction Scale) oraz pozycji demograficznych na grupie 50 studentów kierunku pedagogika wczesnoszkolna i przedszkolna. |
| Procedura przeglądu przez panel ekspertów | Zespół badawczy; panel ekspertów składający się z dwóch profesorów edukacji wczesnodziecięcej, jednego dyrektora przedszkola, trzech opiekunów staży oraz zespołu badawczego | Przegląd treści oparty na konsensusie; brak komercyjnego numeru modelu | Służy do weryfikacji pozycji skali pod kątem wieloznaczności, stopnia dopasowania, klarowności semantycznej, odpowiedniości rozwojowej oraz relewantności kulturowej przed przeprowadzeniem formalnego badania. |
| Drukowane formularze kwestionariuszy do wypełniania na miejscu | Zespół badawczy; lokalne instytucjonalne materiały ankietowe | Papierowe kwestionariusze ankiet; brak komercyjnego numeru katalogowego | Wykorzystano do przeprowadzania ankiet w miejscu badań. W końcowej próbie uzyskano 336 prawidłowo wypełnionych ankiet stacjonarnych przed ich połączeniem z ankietami online. |
| Tencent | aplikacja mobilna WeChat; wersję należy zweryfikować w zapisach urządzenia/aplikacji z czerwca–Lipiec 2024 | Wykorzystano jako kanał dystrybucji online do przeprowadzenia ankiety; za pośrednictwem drogi online/WeChat zebrano 27 wypełnionych kwestionariuszy online. | |
| Procedura rekrutacji telefonicznej i osobistej | Zespół badawczy | Znormalizowana procedura rekrutacji; brak komercyjnego numeru katalogowego | Służy do kontaktowania się z instytucjami/uczestnikami, wyjaśnienia celu badania oraz treści ankiety, a także do uzyskania świadomej zgody przed przeprowadzeniem kwestionariusza. |
| SPSS Statistics | IBM | Wersja 27.0 | Stosowane do statystyki opisowej, współczynników korelacji Pearsona, alfy Cronbacha’analiza rzetelności alfa Cronbacha, sprawdzanie normalności rozkładu za pomocą skośności i kurtozy oraz test Harmana’jednoczynnikowy test obciążenia metodą wspólną. |
| SPSS Amos | IBM | Wersja 26.0 | Stosowane do analizy czynnikowej potwierdzającej, modelowania równań strukturalnych, testowania niezmienniczości pomiarowej w wielu grupach, testowania efektów pośrednich metodą bootstrap oraz porównywania alternatywnych modeli. |
| Microsoft Excel | Microsoft | Microsoft 365 Excel lub lokalnie zainstalowana wersja programu Excel; przed przesłaniem należy zweryfikować dokładną wersję lokalną (build) | Zalecane/stosowane jako środowisko robocze do organizacji zakodowanych danych z ankiet, słownika danych, tabel uzupełniających oraz tabeli materiałów JoVE. Dokładna wersja lokalna powinna zostać zweryfikowana przez autorów. |
| Kryteria indeksów dopasowania w modelowaniu równań strukturalnych | Opublikowane wytyczne metodologiczne; w manuskrypcie przywołano referencje do Schreiber i wsp. oraz Kline | Brak komercyjnego numeru katalogowego; kryteria zastosowane w planie analizy statystycznej | Definiuje i raportuje wskaźniki dopasowania modelu, w tym statystykę chi-kwadrat, chi-kwadrat podzielony przez stopnie swobody, indeks Tuckera-Lewisa, wskaźnik porównawczego dopasowania (CFI), skorygowany wskaźnik dobroci dopasowania (AGFI), przyrostowy wskaźnik dopasowania (IFI), pierwiastkowy średni błąd kwadratowy przybliżenia (RMSEA) oraz standaryzowany pierwiastkowy średni błąd kwadratowy residuum (SRMR). |
| Procedura testowania mediacji metodą bootstrapową | SPSS Amos / plan analizy statystycznej zespołu badawczego | 5 000 próbek bootstrapowych; 95% przedziały ufności skorygowane o obciążenie | Wykorzystano do badania powiązań pośrednich poprzez poczucie skuteczności nauczycieli. Efekty pośrednie uznano za istotne, gdy 95-procentowy przedział ufności skorygowany o obciążenie nie obejmował zera. |
| Procedura badania niezmienniczości pomiaru | SPSS Amos / plan analizy statystycznej zespołu badawczego | Wielogrupowa analiza czynnikowa potwierdzająca; ΔCFI &< 0,010 oraz ΔRMSEA (pierwiastkowy średni błąd kwadratowy przybliżenia) &kryteria < 0,015 | Wykorzystano do oceny niezmienności konfiguracyjnej, metrycznej i skalarniej w zależności od płci, rodzaju programu, czasu trwania stażu oraz instytucji przed interpretacją połączonych szacunków SEM. |
Bibliografia
- Fraga-Lamas P, Barros D, Lopes SI, Fernández-Caramés TM. Mist and edge computing cyber-physical human-centered systems for Industry 5.0: A cost-effective IoT thermal imaging safety system. Sensors (Basel). 2022;22(21):8500.
- Breque M, De Nul L, Petridis A. Industry 5.0: Towards a sustainable, human-centric and resilient European industry. Brussels: European Commission; 2021:https://research-and-innovation.ec.europa.eu/knowledge-publications-tools-and-data/publications/all-publications/industry-50-towards-sustainable-human-centric-and-resilient-european-industry_en.
- Sariişik G, Demir S. Industry 5.0: A human-centric paradigm for sustainable and resilient industrial transformation. Journal of Social Perspective Studies. 2025;2(2):50–66.
- Liu X et al. Evaluating the interactions of multi-dimensional value for sustainable product-service systems with a grey DEMATEL-ANP approach. J Manuf Syst. 2021;60:449–458.
- Di Nardo M et al. The maintenance in Industry 4.0: Assistance and implementation [conference paper]. Presented at: 32nd European Safety and Reliability Conference; Dublin, Ireland; 2022. p. 2286–2292. https://hdl.handle.net/20.500.12607/48222.
- Kagermann H, Lukas WD, Wahlster W. Industrie 4.0: Mit dem Internet der Dinge auf dem Weg zur 4. industriellen Revolution. VDI Nachrichten. 2011;(13):2–3. https://www.dfki.de/fileadmin/user_upload/DFKI/Medien/News_Media/Presse/Presse-Highlights/vdinach2011a13-ind4.0-Internet-Dinge.pdf.
- Council for Science, Technology and Innovation. Report on the Fifth Science and Technology Basic Plan. Tokyo: Cabinet Office, Government of Japan; 2015:https://www8.cao.go.jp/cstp/kihonkeikaku/5basicplan_en.pdf.
- Nahavandi S. Industry 5.0—A human-centric solution. Sustainability (Basel). 2019;11(16):4371.
- Paschek D, Mocan A, Draghici A. Industry 5.0—The expected impact of the next industrial revolution [conference paper]. Presented at: MakeLearn and TIIM International Conference; Piran, Slovenia; 2019. p. 125–132. https://toknowpress.net/ISBN/978-961-6914-25-3/papers/ML19-017.pdf.
- Maddikunta PKR et al. Industry 5.0: A survey on enabling technologies and potential applications. J Ind Inf Integr. 2022;26:100257.
- Longo F, Padovano A, Umbrello S. Value-oriented and ethical technology engineering in Industry 5.0: A human-centric perspective for the design of the factory of the future. Appl Sci (Basel). 2020;10(12):4182.
- Gong Y, Chung YA, Glass J. AST: Audio Spectrogram Transformer [conference paper]. Presented at: Interspeech 2021; Brno, Czech Republic; 2021. p. 571–575. https://www.isca-archive.org/interspeech_2021/gong21b_interspeech.html.
- Purohit H et al. MIMII dataset: Sound dataset for malfunctioning industrial machine investigation and inspection [conference paper]. Presented at: 4th Workshop on Detection and Classification of Acoustic Scenes and Events; New York, NY; 2019. p. 209–213. https://dcase.community/documents/workshop2019/proceedings/DCASE2019Workshop_Purohit_21.pdf.
- Hallioui A et al. A review of sustainable total productive maintenance. Sustainability (Basel). 2023;15(16):12362.
- Vasić S et al. Identification of criteria for enabling the adoption of sustainable maintenance practice: An umbrella review. Sustainability (Basel). 2024;16(2):767.
- Barredo Arrieta A et al. Explainable artificial intelligence: Concepts, taxonomies, opportunities, and challenges toward responsible AI. Inf Fusion. 2020;58:82–115.
- Lundberg SM, Lee SI. A unified approach to interpreting model predictions [conference paper]. Presented at: 31st International Conference on Neural Information Processing Systems; Long Beach, CA; 2017. p. 4765–4774. https://papers.nips.cc/paper/7062-a-unified-approach-to-interpreting-model-predictions.
- Du M, Liu N, Hu X. Techniques for interpretable machine learning. Commun ACM. 2020;63(1):68–77.
- Sarker IH. Machine learning: Algorithms, real-world applications and research directions. SN Comput Sci. 2021;2(3):160.
- Saxe A, Nelli S, Summerfield C. If deep learning is the answer, what is the question? Nat Rev Neurosci. 2021;22(1):55–67.
- Piccialli F et al. A survey on deep learning in medicine: Why, how and when? Inf Fusion. 2021;66:111–137.
- Li Z et al. A survey of convolutional neural networks: Analysis, applications, and prospects. IEEE Trans Neural Netw Learn Syst. 2022;33(12):6999–7019.
- Gil M, Albert M, Fons J, Pelechano V. Engineering human-in-the-loop interactions in cyber-physical systems. Inf Softw Technol. 2020;126:106349.
- Krugh M, Mears L. A complementary cyber-human systems framework for Industry 4.0 cyber-physical systems. Manuf Lett. 2018;15:89–92.
- Jasiulewicz-Kaczmarek M et al. Recent advances in smart and sustainable maintenance [invited-session proposal]. Presented at: 10th IFAC Conference on Manufacturing Modelling, Management and Control; Nantes, France; 2022. https://hub.imt-atlantique.fr/mim2022/wp-content/uploads/2021/12/7a519.pdf.
- Jasiulewicz-Kaczmarek M, Gola A. Maintenance 4.0 technologies for sustainable manufacturing—An overview. IFAC-PapersOnLine. 2019;52(10):91–96.
- Saihi A, Ben-Daya M, As’ad RA. Maintenance and sustainability: A systematic review of modeling-based literature. J Qual Maint Eng. 2023;29(1):155–187.
- Bastas A. Sustainable manufacturing technologies: A systematic review of the latest trends and themes. Sustainability (Basel). 2021;13(8):4271.
- Franciosi C, Iung B, Miranda S, Riemma S. Maintenance for sustainability in the Industry 4.0 context: A scoping literature review. IFAC-PapersOnLine. 2018;51(11):903–908.
- Franciosi C et al. Measuring maintenance impacts on the sustainability of manufacturing industries: From a systematic literature review to a framework proposal. J Clean Prod. 2020;260:121065.
- Vrignat P, Kratz F, Avila M. Sustainable manufacturing, maintenance policies, prognostics and health management: A literature review. Reliab Eng Syst Saf. 2022;218:108140.
- Durán O, Aguilar J, Capaldo A, Arata A. Fleet resilience: Evaluating maintenance strategies in critical equipment. Appl Sci (Basel). 2021;11(1):38.
- Ciccarelli M, Papetti A, Germani M. Exploring how new industrial paradigms affect the workforce: A literature review of Operator 4.0. J Manuf Syst. 2023;70:464–483.
- Madzik P et al. Human-centricity in Industry 5.0—Revealing hidden research topics by unsupervised topic modeling using latent Dirichlet allocation. Eur J Innov Manag. 2025;28(1):113–138.
- Farivar F, Klarin A, Kanani-Moghadam V. Industry 5.0: A socio-technical system perspective on human agency and institutional legitimacy. J Manag Organ. 2026;32(4):1168–1189.
- Karki BR, Porras J. Digitalization for sustainable maintenance services: A systematic literature review. Digit Bus. 2021;1(2):100011.
- Santiago RAdF et al. Data-driven models applied to predictive and prescriptive maintenance of wind turbines: A systematic review of approaches based on failure detection, diagnosis, and prognosis. Energies (Basel). 2024;17(5):1010.
- Carvalho JN, Silva FR, Nascimento EGS. Challenges of the biopharmaceutical industry in the application of prescriptive maintenance in the Industry 4.0 context: A comprehensive literature review. Sensors (Basel). 2024;24(22):7163.
- Santos ACdJ, Cavalcante CAV, Wu S. Maintenance policies and models: A bibliometric and literature review of strategies for reuse and remanufacturing. Reliab Eng Syst Saf. 2023;231:108983.
- Orošnjak M, Brkljač N, Ristić K. Fostering cleaner production through the adoption of sustainable maintenance: An umbrella review with a questionnaire-based survey analysis. Clean Prod Lett. 2025;8:100095.
- Ji Z, Zhou Y, Wang B, Zang J. Human–cyber–physical systems in the context of new-generation intelligent manufacturing. Engineering (Beijing). 2019;5(4):624–636.
- Wang B et al. Toward human-centric smart manufacturing: A human–cyber–physical systems perspective. J Manuf Syst. 2022;63:471–490.
- Jiao J, Zhou F, Gebraeel NZ, Duffy V. Towards augmenting cyber-physical-human collaborative cognition for human–automation interaction in complex manufacturing and operational environments. Int J Prod Res. 2020;58(16):5089–5111.
- Yilma BA, Panetto H, Naudet Y. Systemic formalisation of cyber-physical-social systems: A systematic literature review. Comput Ind. 2021;129:103458.
- Zhou Y, Yu FR, Chen J, Kuo YH. Cyber-physical-social systems: A state-of-the-art survey, challenges and opportunities. IEEE Commun Surv Tutor. 2020;22(1):3
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.