Niniejsze badanie proponuje hybrydowy model prognozowania kosztów dla sieci elektroenergetycznych, który łączy fizyczne kwoty kosztów z dynamicznymi korektami makroekonomicznymi i technologicznymi oraz kompensacją rezydualną opartą na algorytmie XGBoost. Osiągając wartość MAPE na poziomie 2,34%, model ten równoważy dokładność i interpretowalność, odpowiadając na potrzeby przejrzystości regulacyjnej w procesie ustalania taryf.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Prognozowanie retrospektywne z wykorzystaniem danych z sieci prowincjonalnych oraz hybrydowego modelu fizyczno-AI opartego na kwotach
W tym artykule
Podsumowanie
Streszczenie
Globalna transformacja energetyczna oraz trwające reformy rynku energii elektrycznej wymagają od przedsiębiorstw sieci elektroenergetycznych zrównoważenia niezawodnych dostaw energii z coraz bardziej rygorystycznymi regulacjami dotyczącymi taryf przesyłowych i dystrybucyjnych. Tradycyjne metody budżetowania oparte na ekstrapolacji historycznej często nie oddają fizycznych podstaw eksploatacji aktywów, natomiast modele uczenia maszynowego oparte na danych osiągają wysoką dokładność prognostyczną, ale brakuje im przejrzystości wymaganej do regulacyjnej weryfikacji kosztów. Aby rozwiązać problem kompromisu między dokładnością prognozowania a interpretowalnością, w niniejszym badaniu zaproponowano hybrydowy model prognozowania kosztów oparty na kwotach kosztowych. Struktura ta wykorzystuje zestandaryzowane kwoty operacyjne jako fizyczną podstawę budżetowania i zawiera dynamiczny mechanizm ewolucji kwot sterowany warunkami makroekonomicznymi oraz postępem technologicznym. Do uchwycenia nieliniowych residuów wykraczających poza szacunki oparte na kwotach zastosowano algorytm Extreme Gradient Boosting (XGBoost), natomiast do interpretacji wpływu kluczowych czynników kosztowych wykorzystano metodę SHAP (Shapley Additive exPlanations). Model oceniono na podstawie zanonimizowanych danych operacyjnych z 16 lat z prowincjonalnej sieci energetycznej w Chinach. Osiągnął on średni procentowy błąd bezwzględny (MAPE) na poziomie 2,34%, redukując błędy prognozowania odpowiednio o 61,8%, 46,6% i 34,1% w porównaniu z modelami SARIMAX, samodzielnym XGBoost oraz Attention-LSTM. Zaproponowana struktura integruje inżynieryjne zasady kwot kosztowych z wyjaśnialną sztuczną inteligencją, zapewniając zarówno dokładne długoterminowe prognozy kosztów, jak i przejrzyste narzędzie wspomagania decyzji w zakresie weryfikacji regulacyjnych kosztów dopuszczalnych.
Wprowadzenie
Globalna transformacja energetyczna przekształca zarządzanie aktywami sieci elektroenergetycznych oraz praktyki operacyjne poprzez integrację rozproszonej generacji z odnawialnych źródeł energii, rosnącą liczbę ekstremalnych zjawisk pogodowych oraz powszechne wdrażanie technologii IoT, co wymaga większej elastyczności operacyjnej i zasobów konserwacyjnych w celu zapewnienia niezawodności systemu1,2. Jednocześnie organy regulacyjne w sektorze energetycznym wzmocniły nadzór nad taryfami za przesył i dystrybucję za pomocą takich ram, jak brytyjski system RIIO oraz przeglądy stóp zwrotu przeprowadzane przez Federalną Komisję Regulacyjną Energii (FERC) w USA, kładąc nacisk na przejrzystość uzasadnienia kosztów3. Chiny w podobny sposób przyjęły mechanizm regulacyjny „koszt dopuszczalny plus rozsądny zwrot”, wymagający od przedsiębiorstw energetycznych wykazania wyraźnych powiązań między działaniami inżynieryjnymi a wydatkami finansowymi4. Jednakże przedsiębiorstwa energetyczne często nie dysponują przejrzystymi narzędziami ilościowymi, które łączyłyby eksploatację fizycznych aktywów z prognozami kosztów, co ogranicza skuteczność regulacyjnej weryfikacji kosztów5.
Istniejące podejścia do prognozowania wykazują istotne ograniczenia w tym środowisku6. Tradycyjne metody, w tym budżetowanie przyrostowe i modele oparte na ARIMA, zakładają stosunkowo stabilne wzorce historyczne i często wykazują niską skuteczność w przypadku zmian strukturalnych spowodowanych wahaniami gospodarczymi lub ekstremalnymi zjawiskami pogodowymi7. Z kolei nowoczesne modele uczenia maszynowego, takie jak architektury LSTM i Transformer, zapewniają wysoką dokładność predykcyjną w prognozach krótkoterminowych, lecz brakuje im interpretowalności inżynieryjnej wymaganej do podejmowania decyzji regulacyjnych8,9. Chociaż niedawne hybrydowe podejścia do prognozowania łączą techniki statystyczne i uczenie maszynowe, zazwyczaj pomijają one znormalizowane inżynieryjne kwoty kosztowe, które stanowią podstawę systemów rachunkowości sieci elektroenergetycznych10. Aby rozwiązać te ograniczenia, niniejsze badanie proponuje hybrydowe ramy prognozowania sterowane kwotami, które łączą dynamiczną ewolucję kwot z korektą residuów opartą na uczeniu maszynowym, zachowując interpretowalność inżynieryjną przy jednoczesnej poprawie dokładności prognoz.
Jeden z głównych kierunków badawczych wynika z regulacji bodźcowych w branżach monopolu naturalnego, w tym z brytyjskiego mechanizmu RPI-X oraz chińskiego systemu weryfikacji kosztów dopuszczalnych11. Badania te koncentrują się przede wszystkim na ocenie efektywności operacyjnej przy użyciu analizy obwiedni danych (DEA) oraz stochastycznej analizy frontyry (SFA)12. W poprzednich pracach badano długoterminowe zależności między wydatkami kapitałowymi (CAPEX), wydatkami operacyjnymi (OPEX) a efektywnością kosztową w celu wsparcia regulacji taryfowych13,14. Choć podejścia te dostarczają cennych informacji makroekonomicznych, ich wyniki są zazwyczaj wyrażone jako relatywne wskaźniki efektywności, a nie prognozy pieniężne odpowiednie do rocznego budżetowania15,16. Co więcej, modele frontyry zazwyczaj zakładają względną stabilność struktury aktywów fizycznych i warunków operacyjnych, co ogranicza ich zdolność do uchwycenia gwałtownych zmian kosztów wynikających ze starzenia się aktywów, wymiany infrastruktury lub szybkiego wzrostu popytu17,18.
Drugi kierunek badawczy koncentruje się na modelach prognozowania opartych na statystyce i sztucznej inteligencji. Wczesne badania wykorzystywały wieloraką regresję liniową oraz modele autoregresyjnej zintegrowanej średniej ruchomej z zewnętrznymi zmiennymi (ARIMAX) do przewidywania kosztów19. W ostatnim czasie modele regresji wektorów wsparcia, lasy losowe, XGBoost, LSTM oraz modele Transformer znacząco poprawiły wydajność prognozowania dzięki wykorzystaniu nieliniowych zależności i wielowymiarowych przestrzeni cech20,21,22. Podejścia te często uwzględniają wskaźniki makroekonomiczne, takie jak zapotrzebowanie na energię elektryczną, indeksy cen producentów (PPI) oraz zmienne klimatyczne23. Jednak koszty eksploatacji sieci energetycznej wynikają z działań inżynieryjnych, degradacji aktywów, harmonogramowania konserwacji i decyzji zarządczych, a nie tylko ze zmiennych makroekonomicznych24. W konsekwencji modele oparte wyłącznie na danych często funkcjonują jako tzw. „czarne skrzynki”, co utrudnia wyjaśnienie prognozowanych kosztów podczas przeglądów regulacyjnych lub weryfikacji kosztów dopuszczalnych25,26.
Zarządzanie kwotami kosztów inżynieryjnych stanowi potencjalne rozwiązanie tego problemu27. Rachunkowość oparta na działaniach (ABC) od dawna opiera się na ustandaryzowanych kwotach operacyjnych w celu szacowania zapotrzebowania na pracę, materiały, sprzęt i konserwację w ramach rutynowych operacji sieciowych28. Główne chińskie przedsiębiorstwa energetyczne opracowały kompleksowe bazy danych kwot obejmujące czynności kontrolne, konserwacyjne, testowe, naprawcze oraz wymianę sprzętu. Niemniej jednak standardy inżynieryjne te są wykorzystywane głównie do rozliczeń projektowych i audytów, a nie do dynamicznego prognozowania długoterminowego29,30. Co więcej, standardy kwotowe są zazwyczaj aktualizowane jedynie co kilka lat, co sprawia, że są one niewystarczająco responsywne w obliczu zmieniających się cen surowców, postępu technologicznego i praktyk operacyjnych31. Stosowanie systemów kwotowych w odniesieniu do milionów rozproszonych aktywów stwarza również znaczne wyzwania obliczeniowe dla prognozowania na dużą skalę32.
Mimo znaczących postępów w prognozowaniu statystycznym, uczeniu maszynowym i zarządzaniu kosztami inżynieryjnymi, żaden istniejący system nie integruje w sposób efektywny ustandaryzowanych kwot kosztów inżynieryjnych, dynamicznych korekt makroekonomicznych oraz wyjaśnialnego uczenia maszynowego w ramach jednolitego modelu prognozowania służącego do regulacyjnej weryfikacji kosztów. Postawiono hipotezę, że połączenie dynamicznie ewoluujących kwot kosztowych z uczeniem resztkowym opartym na XGBoost może poprawić dokładność prognoz długoterminowych, zachowując jednocześnie przejrzystość inżynieryjną wymaganą do podejmowania decyzji regulacyjnych. Aby przetestować tę hipotezę, opracowano hybrydowy system prognozowania oparty na kwotach, który integruje fizyczne modelowanie kosztów, mechanizmy korekty makroekonomicznej i technologicznej, kompensację resztkową XGBoost oraz interpretację modelu w oparciu o SHAP. Zaproponowane podejście ma na celu zapewnienie zarówno dokładnych długoterminowych prognoz kosztów, jak i przejrzystych dowodów wspierających weryfikację kosztów dopuszczalnych w ramach nowoczesnych regulacji rynku energii elektrycznej.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
W niniejszym badaniu wykorzystano zanonimizowane dane operacyjne i finansowe zebrane z prowincjonalnej sieci elektroenergetycznej we wschodnich Chinach. Wszystkie dane zostały zagregowane i pozbawione cech identyfikacyjnych przed analizą; nie uwzględniono żadnych danych osobowych ani wrażliwych informacji na poziomie indywidualnym. W związku z tym zgoda komisji etycznej nie była wymagana. Dostęp do danych oraz ich analiza odbywały się zgodnie z obowiązującymi przepisami o ochronie danych oraz umowami instytucjonalnymi regulującymi informacje w sektorze energetycznym.
Przegląd struktury prognozowania
Aby zintegrować podejścia do prognozowania oparte na fizyce i na danych, opracowano hybrydowy model prognozowania, który łączy inżynieryjne normy kosztowe z uczeniem maszynowym. Zamiast prostego łączenia wielu algorytmów, model ten opiera się na zasadzie, zgodnie z którą modele fizyczne ustanawiają prognozę bazową, natomiast uczenie maszynowe kompensuje błędy rezydualne. Taka konstrukcja gwarantuje, że proces prognozowania jest ugruntowany w mechanizmach fizycznych leżących u podstaw produkcji i eksploatacji sieci elektroenergetycznej, zamiast polegać wyłącznie na ekstrapolacji historycznych kosztów.
W ramach opracowanej struktury w pierwszej kolejności ustanowiono hierarchiczne mapowanie pomiędzy aktywami sieci elektroenergetycznej, zestandaryzowanymi czynnościami operacyjnymi a finansowymi kontami kosztów. Koszty produkcji i eksploatacji są traktowane jako pieniężne reprezentacje zasobów zużywanych przez aktywa fizyczne — w tym stacje transformatorowe, linie przesyłowe, linie rozdzielcze, urządzenia pomiarowe i sprzęt do inspekcji cyfrowych — podczas rutynowych działań, takich jak inspekcja, konserwacja, testowanie, naprawa i wymiana. Kwoty kosztowe służą jako łącznik pomiędzy mierzalnym obciążeniem inżynieryjnym a odpowiadającymi mu wydatkami finansowymi.
Jak zilustrowano na Rysunku 1, kwoty kosztowe funkcjonują jako zestandaryzowane jednostki rozliczeniowe wbudowane w cały proces eksploatacji i konserwacji aktywów, a nie jako abstrakcyjne reguły alokacji finansowej. Obciążenia operacyjne aktywów na najniższym poziomie są przekształcane w zestandaryzowane kwoty operacyjne, a następnie przypisywane do kategorii kosztów, obejmujących robociznę, materiały, sprzęt budowlany, usługi zewnętrzne oraz zaopatrzenie awaryjne. Takie hierarchiczne mapowanie zachowuje interpretowalność inżynieryjną i identyfikowalność regulacyjną w całym procesie prognozowania oraz stanowi fizyczną podstawę do konstrukcji statycznego bazowego modelu kwot.
Przegląd schematu metodologicznego
Proponowana struktura prognozowania składa się z trzech sekwencyjnych etapów: (1) konstrukcji fizycznej bazy odniesienia z wykorzystaniem kwot obciążenia na poziomie zasobów, (2) dynamicznej ewolucji kwot kosztów poprzez korekty makroekonomiczne i technologiczne oraz (3) kompensacji pozostałości opartej na uczeniu maszynowym w celu uchwycenia systematycznych efektów nieliniowych. Jak pokazano na Rysunku 1, struktura ta ustanawia hierarchiczne mapowanie od zasobów najniższego poziomu i standaryzowanych czynności operacyjnych do prognoz kosztów produkcji i eksploatacji. Szczegóły implementacji każdego etapu opisano w poniższych podrozdziałach.
Fizyczny model kosztów bazowych oparty na obciążeniach na poziomie zasobów
Koszt produkcji i eksploatacji sieci elektroenergetycznej, Ctotal, obejmuje wydatki związane z wieloma działaniami operacyjnymi, w tym z eksploatacją podstacji, konserwacją linii przesyłowych, zarządzaniem siecią dystrybucyjną, obsługą klienta oraz systemami wspomagającymi. W niniejszym badaniu przyjęto, że bazowy koszt eksploatacji jest określany przez obciążenie generowane przez każdą zestandaryzowaną czynność operacyjną oraz odpowiadającą jej kwotę kosztową.
Statyczny koszt bazowy oblicza się następująco:
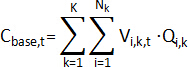 (1)
gdzie Vi,k,t oznacza obciążenie związane z i-tym zasobem lub zadaniem operacyjnym w kategorii biznesowej k w okresie t, a Qi,k reprezentuje odpowiadający mu ustandaryzowany koszt jednostkowy określony przez system kwot kosztów inżynieryjnych. Kategoria biznesowa obejmuje główne funkcje operacyjne, takie jak konserwacja podstacji, inspekcja linii przesyłowych, eksploatacja sieci dystrybucyjnej oraz obsługa klienta. Podwójna suma agreguje koszty wszystkich ustandaryzowanych działań operacyjnych w celu oszacowania teoretycznych wydatków bazowych niezbędnych do utrzymania normalnego funkcjonowania sieci.
Równanie (1) ustanawia fizyczną zależność między obciążeniem prac inżynieryjnych a wydatkami finansowymi poprzez bezpośrednie przypisanie ustandaryzowanych czynności operacyjnych do kont kosztowych. W przeciwieństwie do czysto statystycznych modeli prognozowania, sformułowanie to zapewnia interpretowalną bazę inżynieryjną, która stanowi podstawę dla późniejszej dynamicznej regulacji kwot oraz korekty pozostałości opartej na uczeniu maszynowym. Równanie opracowano na podstawie praktyk operacyjnych i systemu kwot kosztowych stosowanego przez prowincjonalne przedsiębiorstwa sieci elektroenergetycznych w Chinach. Tabela 1 podsumowuje oznaczenia użyte w Równaniu (1), w tym obciążenie prac (Vi,k,t), ustandaryzowany koszt jednostkowy (Qi,k), liczbę zadań operacyjnych (Nk) oraz indeks kategorii biznesowej (k).
Mechanizm dynamicznej ewolucji kwot w warunkach zewnętrznych zaburzeń środowiskowych
Znormalizowane kwoty kosztów (Qi,k) zapewniają fizycznie interpretowalną wartość bazową, lecz nie uwzględniają zmian w warunkach makroekonomicznych ani postępu technologicznego. Aby poprawić ich długoterminową stosowalność, wprowadzono mechanizm dynamicznej ewolucji w celu dostosowania kwot bazowych w odpowiedzi na inflację cen oraz wzrosty wydajności wynikające z rozwoju technologii.
Pierwsza korekta uwzględnia zmiany w kosztach pozyskiwania wynikające z inflacji makroekonomicznej. Eksploatacja i konserwacja sieci elektroenergetycznych w dużej mierze zależą od materiałów masowych, w tym miedzi, aluminium i stali krzemowej, których ceny są ściśle powiązane z wahaniami Indeksu Cen Producentów (PPI). Ponieważ  jest indeksem o wartości bazowej 100, zostaje on najpierw przekształcony w ustandaryzowaną stopę inflacji:
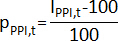 (2)
Na tej podstawie funkcję korekty cen  definiuje się następująco:
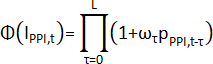 (3)
gdzie  jest wektorem obciążenia o długości L spełniającym
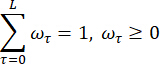
Struktura opóźnienia reprezentuje odroczony przekaz inflacji makroekonomicznej na koszty zamówień w łańcuchu dostaw sieci elektroenergetycznej. Przekształcenie wskaźnika PPI w zestandaryzowaną stopę inflacji pozwala zachować skumulowany efekt zmian cen, unikając jednocześnie błędu skalowania związanego z bezpośrednim wykorzystaniem wartości wskaźnika. Równania (2) i (3) zostały dostosowane z uznanych modeli korekty inflacji makroekonomicznej, a struktura opóźnienia została skalibrowana pod kątem cykli zamówień w sektorze energetycznym33,34.
Postęp technologiczny został uwzględniony poprzez współczynnik redukcji kosztów, który odzwierciedlał poprawę wydajności operacyjnej wynikającą z takich udoskonaleń jak inspekcje za pomocą bezzałogowych statków powietrznych, inteligentna robotyka oraz technologie cyfrowego utrzymania ruchu. Współczynnik korekty technologicznej definiuje się jako:
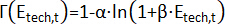 (4)
W tej części α i β są empirycznymi współczynnikami elastyczności oszacowanymi na podstawie historycznych danych panelowych przy użyciu nieliniowej metody najmniejszych kwadratów. Aby zapewnić, że czynnik postępu technologicznego zawsze reprezentuje rozsądną redukcję kosztów jednostkowej kwoty, proces estymacji parametrów nakłada ograniczenie 0 < Γ(Etech,t) ≤ 1. Należy zauważyć, że czynnik ten odzwierciedla przede wszystkim długoterminową poprawę wydajności wynikającą z zastąpienia dojrzałej technologii. Równanie (4) jest oryginalne dla niniejszej pracy i adaptuje koncepcję krzywej uczenia się z literatury dotyczącej kosztów technologii energetycznych35,36 do operacji konserwacji sieci. Dodatkowe koszty, które mogą wystąpić na wczesnym etapie wdrażania sprzętu cyfrowego, takie jak równoległe działanie starych i nowych systemów, integracja platform, testy komunikacyjne oraz dodatkowa konserwacja, nie są wymuszone odliczane od kwoty bazowej; zamiast tego są one identyfikowane przez następujący po nich moduł kompensacji reszt oparty na uczeniu maszynowym:
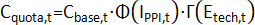 (5)
gdzie Cbase,t oznacza statyczny koszt bazowy obliczony na podstawie obciążeń zasobów najniższego poziomu oraz zestandaryzowanych kwot kosztów operacyjnych; oddaje efekt przenoszenia makroekonomicznych wahań cen na ceny materiałów, sprzętu i usług zewnętrznych; a Γ(Etech,t) odzwierciedla redukcję jednostkowych kosztów eksploatacji i konserwacji opartą na wydajności po osiągnięciu dojrzałości technologicznej. Dzięki powyższemu mechanizmowi dynamicznej ewolucji, baza kwotowa nie pozostaje już na statycznej podstawie księgowej, lecz może adaptacyjnie dostosowywać się do zmian w środowisku ekonomicznym i warunkach technologicznych. Równanie (5) jest oryginalnym elementem niniejszej pracy i reprezentuje nowatorską integrację korekt cenowych i technologicznych w ramach struktury bazy kwotowej.
Systematyczne przechwytywanie nieliniowych rezyduów pod ograniczeniami kwotowymi
Pomimo złożonych korekt ewolucyjnych, model kwotowy nieuchronnie generuje systematyczne odchylenia w przypadku nieprzewidywalnych zakłóceń pogodowych związanych z katastrofami oraz nagłych dyrektyw politycznych, takich jak wzrost kosztów obsługi reklamacji klientów w okresach tymczasowej redukcji taryf. Odchylenie to tworzy wyraz resztowy po obu stronach równania:
Rt=Cactual,t-Cquota,t (6)
Ponieważ konwencjonalne reguły fizyczne nie są w stanie wyjaśnić tego aspektu, rozwiązaniem tych ograniczeń może być uczenie maszynowe. Aby uniknąć przekleństwa wymiarowości spowodowanego cechami wysokowymiarowymi, w niniejszym badaniu wykorzystano algorytm XGBoost oparty na zespołach drzew decyzyjnych do modelowania nieliniowej zależności Rt37,38. Zdefiniowano macierz cech silnych zaburzeń Xt, obejmującą cechy meteorologiczne, takie jak roczna liczba ekstremalnych dni mroźnych Dice , oraz intensywność polityki makroekonomicznej.
W przypadku kompensatora nieliniowego składającego się z drzew regresyjnych, logika generowania przewidywanego residuum  może zostać wyrażona jako39:
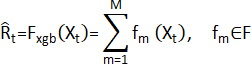 (7)
gdzie F oznacza przestrzeń wszystkich możliwych struktur drzew klasyfikacyjnych i regresyjnych. Aby zrównoważyć dokładność dopasowania i zapobiec przeuczeniu, w m-tej iteracji konstruowana jest i minimalizowana zregularizowana funkcja celu zawierająca człon kary za złożoność strukturalną:
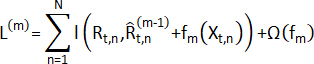 (8)
gdzie  jest wypukłą funkcją straty mierzącą różnicę między rzeczywistym a przewidywanym residuum. W niniejszej pracy zastosowano stratę Hubera (Huber Loss) w celu zwiększenia odporności modelu na anomalne szczyty wydatków. Człon regularyzacji
 jest wykorzystywany do ograniczenia złożoności struktury drzewa i jest definiowany jako:
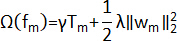 (9)
gdzie Tm oznacza liczbę liści w m-tym drzewie, wm oznacza odpowiadający im wektor wag liści, a γ i λ oznaczają odpowiednio współczynnik kary za liczbę węzłów liści oraz współczynnik regularyzacji wag.
Końcowe równanie prognozy to:
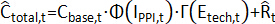 (10)
Dalsze rozwinięcie:
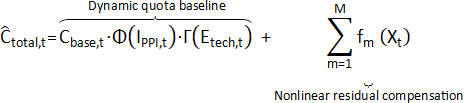 (11)
Powyższy wzór matematycznie przedstawia strukturę pętli zamkniętej proponowanego modelu prognozowania. Końcowy popyt na koszty produkcji i eksploatacji nie jest generowany bezpośrednio przez model uczenia maszynowego; zamiast tego uzyskuje się go poprzez nałożenie nieliniowej kompensacji rezydualnej zidentyfikowanej przez moduł uczenia maszynowego na dynamiczną linię bazową kwot. Wśród tych komponentów czynniki cenowe i technologiczne odzwierciedlają przede wszystkim dynamiczną ewolucję linii bazowej kwot, podczas gdy czynniki trudne do jednoznacznego scharakteryzowania za pomocą reguł, takie jak szoki klimatyczne, zakłócenia polityczne i gwałtowny wzrost liczby zdarzeń naprawczych, są wychwytywane przez moduł kompensacji rezydualnej oparty na uczeniu maszynowym. Równania (10) i (11) są oryginalnym wkładem niniejszej pracy i syntetyzują fizyczną linię bazową z rezydualną detekcją opartą na ML w ujednolicony system prognozowania.
Rysunek 2 pokazuje, że wyniki prognozowania proponowanego modelu wykazują wyraźną hierarchiczną logikę generowania. Z jednej strony kwota bazowa zapewnia stabilną, przejrzystą i możliwą do zweryfikowania podstawę fizyczną dla zapotrzebowania na koszty; z drugiej strony korekty cen, efekty technologiczne i pozostałości wstrząsów zewnętrznych umożliwiają modelowi adaptację do dynamicznych zmian w złożonych środowiskach. W porównaniu z modelami typu „czarna skrzynka”, które bezpośrednio generują wartości przewidywane, taka struktura dekompozycji pozwala wyraźnie wskazać, „dlaczego koszty rosną lub spadają”, co zwiększa interpretowalność wyników modelu podczas przeglądu budżetu oraz regulacji taryf przesyłowych i dystrybucyjnych.
Źródła danych i procedury ich gromadzenia
Modele teoretyczne muszą zostać rygorystycznie zwalidowane za pomocą danych empirycznych, aby wykazać ich praktyczną użyteczność. Ponieważ podstawowe dane finansowe sektora energetycznego zawierają wrażliwe informacje związane z funkcjonowaniem infrastruktury krajowej, w niniejszym badaniu wyodrębniono wysokoprecyzyjne, zanonimizowane miesięczne dane księgowe z typowej prowincjonalnej sieci elektroenergetycznej wschodnich Chin, nazwanej dla przejrzystości E-Grid, obejmujące 16 kolejnych lat kalendarzowych od 2010 do 2025 roku. Prowincja ta przeszła przez typowy cykl ekonomiczny, przechodząc od wzrostu napędzanego przez tradycyjny przemysł ciężki do zaawansowanej produkcji, przy czym skumulowany roczny wskaźnik wzrostu skali aktywów sieci osiągnął 7,4%. Złożona ewolucja jej struktury kosztów ma zatem potencjalne znaczenie dla innych szybko rozwijających się systemów sieciowych. Dane pochodzą z trzech głównych źródeł: (1) wewnętrznych dzienników eksploatacji i konserwacji rejestrujących obciążenia robocze na poziomie aktywów, częstotliwość inspekcji i zdarzenia naprawcze; (2) systemów księgowości finansowej dostarczających miesięczne zestawienia kosztów pracy, materiałów, sprzętu oraz usług zewnętrznych; oraz (3) zewnętrznych baz danych środowiskowych, w tym zapisów meteorologicznych z China Meteorological Administration oraz wskaźników makroekonomicznych z National Bureau of Statistics.
Kontrola jakości i postępowanie z brakującymi danymi
W odniesieniu do ponad 130 początkowych wskaźników zintegrowanych z systemów wieloźródłowych wdrożono rygorystyczną procedurę kontroli jakości. Brakujące punkty danych, stanowiące mniej niż 3% całkowitej liczby obserwacji, uzupełniono za pomocą interpolacji liniowej dla zmiennych ciągłych z trendami czasowymi oraz imputacji mody dla wskaźników kategorycznych. Wartości odstające zidentyfikowano metodą rozstępu międzykwartylowego (IQR), a wartości przekraczające 3,0-krotność IQR powyżej trzeciego kwartyla poddano winsoryzacji do 99. percentyla, aby zachować integralność danych i zminimalizować zniekształcenia spowodowane wartościami ekstremalnymi.
Rozważania dotyczące wielkości próby
Zbiór danych obejmuje 192 obserwacje miesięczne (styczeń 2010–grudzień 2025), z czego 156 obserwacji (2010–2022) przeznaczono do uczenia i walidacji, a 36 obserwacji (2023–2025) zarezerwowano do testowania poza próbką. Choć wielkość tej próby jest stosunkowo niewielka jak na zastosowania głębokiego uczenia, jest ona odpowiednia dla algorytmu XGBoost, który dzięki mechanizmom regularyzacji i przycinania drzew został zaprojektowany tak, aby efektywnie działać na małych i średnich tabularnych zbiorach danych. Aby zminimalizować ryzyko potencjalnego przeuczenia, zastosowano następujące środki: (1) rygorystyczne kary za regularyzację (γ = 0.1, λ = 1.0), (2) wczesne zatrzymanie z parametrem patience wynoszącym 50 rund oraz (3) konserwatywne ograniczenia głębokości drzew (max depth = 5). Środki te wspólnie zapewniają stabilność i zdolność modelu do generalizacji pomimo ograniczonej wielkości próby.
Segmentacja danych i heterogeniczna integracja wieloźródłowa
W celu rygorystycznego testowania dane z okresu od stycznia 2010 do grudnia 2022 roku przypisano do przedziału treningowo-walidacyjnego, zawierającego 156 obserwacji, który służy do trenowania czynników ewolucji kwot oraz sieci rezydualnej kompensacji kwot. Okres od stycznia 2023 do grudnia 2025 roku zarezerwowano jako wydzielony, poza-próbkowy zbiór testowy, zawierający 36 obserwacji. Dlaczego ten okres został wybrany jako końcowe pole testowe? Powodem jest fakt, że te trzy lata zbiegły się z przyspieszeniem budowy nowoczesnych systemów energetycznych, co zostało potęgowane przez wielkoskalowe ekstremalne zjawiska wysokich temperatur związane z El Niño oraz szybki i nierównomierny wzrost rozproszonej generacji energii odnawialnej. Sieć elektroenergetyczna stanęła przed bezprecedensową presją w łańcuchach dostaw materiałów i alokacji siły roboczej do napraw.
Naukowe zestawienie i ilościowe zdefiniowanie czynników generujących koszty stanowią podstawę zapewnienia, że rezydualna sieć uczenia maszynowego może skutecznie wychwytywać systematyczne fluktuacje. Opierając się na logice zarządzania standardowymi kosztami operacyjnymi w systemach energetycznych, niniejsze badanie przełamuje jednowymiarowość tradycyjnego prognozowania finansowego, które opiera się wyłącznie na historycznych przepływach pieniężnych, i zamiast tego rekonstruuje inżynierię cech w oparciu o cztery kluczowe granice: skalę aktywów fizycznych, warunki eksploatacji i konserwacji, ewolucję makroekonomiczną oraz zewnętrzne środowisko klimatyczne, wykorzystując oryginalne dzienniki operacyjne i zewnętrzne księgi systemowe. W rzeczywistym procesie modelowania, dla ponad 130 pierwotnych wskaźników wynikających z integracji systemów wieloźródłowych, w badaniu zastosowano testy korelacji Pearsona w celu wyeliminowania wysoce kolinearnych zmiennych redundantnych, przyjmując próg |r| > 0,85. W oparciu o wiedzę ekspercką doświadczonych specjalistów ds. sieci elektroenergetycznych, ostatecznie wybrano 42 kluczowe cechy wejściowe do utworzenia macierzy cech Xt. Aby przejrzyście przedstawić strukturę danych i rozkład tensora wejściowego, w Tabeli 2 wybrano 12 reprezentatywnych cech kluczowych z czterech powyższych wymiarów oceny i podsumowano ich statystyki opisowe z okresu obserwacji.
Aby dalej zilustrować przestrzenno-topologiczną podstawę wieloźródłowego systemu cech, Rysunek 3 przedstawia zanonimizowany schemat topologii badanej prowincjonalnej sieci elektroenergetycznej. Na rysunku naniesiono stacje transformatorowe o różnych poziomach napięcia, korytarze transmisyjne, rozproszone klastry odnawialnych źródeł energii, centra obciążeń oraz reprezentatywne strefy zakłóceń środowiskowych. Topologia ta pomaga wyjaśnić, dlaczego koszty produkcji i eksploatacji są wspólnie determinowane przez skalę aktywów, strukturę sieci, intensywność napraw awaryjnych oraz zewnętrzne wstrząsy klimatyczne. Stanowi ona również podstawę interpretacji przestrzennej dla zmiennych sterujących resztami wykorzystywanych w module kompensacyjnym XGBoost.
Tabela 2 pokazuje, że zmienne objaśniające w różnych wymiarach biznesowych wykazują wyraźnie odmienne formy statystyczne. Zmienne dotyczące aktywów fizycznych, reprezentujące endogenną dynamikę rozwoju przedsiębiorstwa, takie jak moc podstacji i długość linii, mają stosunkowo stabilne odchylenia standardowe oraz wartości skośności skoncentrowane między 0,1 a 0,8. Ich ogólna struktura danych jest w przybliżeniu rozkładem normalnym, co obiektywnie odzwierciedla cechę stabilnego rozwoju sieci elektroenergetycznej w cyklu budowy infrastruktury. Jaskrawym kontrastem są zmienne meteorologiczne i zmienne zakłóceń środowiska zewnętrznego znajdujące się na dole tabeli. Na przykład skumulowana liczba dni z wysoką temperaturą na poziomie ostrzegawczym w ciągu ostatnich 90 dni oraz indeks wpływu wyłączeń linii wykazują niezwykle silną prawostronną skośność, z wartościami skośności odpowiednio 2,15 i 2,45. Ten typowy rozkład ciężkoogonowy potwierdza obiektywny punkt krytyczny, którego nie można ignorować w rzeczywistej eksploatacji i konserwacji sieci elektroenergetycznej: choć ekstremalne klęski pogodowe występują stosunkowo rzadko w skali roku, to po ich wystąpieniu często powodują wykładniczy wzrost nakładów pracy naprawczej i zużycia części zamiennych. Z innej perspektywy, wysoka niejednorodność i skośność wartości ekstremalnych w rozkładzie tych cech wieloźródłowych ujawniają teoretyczne ograniczenia tradycyjnych liniowych modeli szeregów czasowych, takich jak ARIMAX, które opierają się na założeniach normalności i homoskedastyczności podczas śledzenia złożonych kosztów sieci elektroenergetycznej. Nie tylko dodatkowo uzasadnia to racjonalność wprowadzenia modułu uczenia maszynowego poza bazową linią księgowości fizycznej, ale także zapewnia solidne wsparcie statystyczne dla wyboru modelu drzew XGBoost w niniejszej pracy, który potrafi efektywnie obsługiwać rzadkie rozkłady cech i nieliniowe odwzorowania w celu przybliżenia reszt kosztów.
Konfiguracja systemu optymalizacji hiperparametrów i ewaluacji
Po określeniu przestrzeni wejściowej cech, ustawienie hiperparametrów modelu bezpośrednio wpływa na wydajność dopasowania sieci przybliżającej reszty. Ponieważ sieć kompensacyjna XGBoost obejmuje wiele parametrów, w tym głębokość drzewa (max depth), tempo uczenia oraz wyrazy kary regularyzacyjnej, a parametry te wchodzą w nieliniowe interakcje, konwencjonalne przeszukiwanie siatki (grid search) charakteryzuje się nie tylko wysoką złożonością obliczeniową, ale także tendencją do utykania w minimach lokalnych w przestrzeniach wielowymiarowych. Dlatego w procesie strojenia parametrów w niniejszym badaniu zastosowano Tree-structured Parzen Estimator (TPE), metodę optymalizacji bayesowskiej. Algorytm TPE potrafi dynamicznie kierować kolejnymi kierunkami próbkowania, wykorzystując sprzężenie zwrotne z funkcji straty z poprzednich ewaluacji. Poprzez konstruowanie a posteriori szacunku gęstości jądra (KDE) zmiennej celu, adaptacyjnie zawęża on przestrzeń poszukiwania parametrów, umożliwiając modelowi przybliżenie globalnej optymalnej konfiguracji hiperparametrów bez ponoszenia wysokich kosztów obliczeniowych. Celem optymalizacji TPE była minimalizacja RMSE na zbiorze walidacyjnym w ciągu 100 iteracji, z zastosowaniem wczesnego zatrzymania po 50 rundach bez poprawy wyniku.
Po zakończeniu optymalizacji parametrów na wewnętrznym zbiorze walidacyjnym, w celu obiektywnej oceny końcowej wydajności każdego modelu na zewnętrznym zbiorze testowym oraz w celu spełnienia ilościowych wymogów oceny organów regulacyjnych w zakresie weryfikacji kosztów, w niniejszym badaniu wykorzystano średni bezwzględny błąd procentowy (MAPE) do ilościowego określenia względnego odchylenia w przewidzianej sekwencji. Jednocześnie, aby odpowiedzieć na praktyczną potrzebę kontrolowania ekstremalnych błędów w przewidywaniu kosztów w procesach operacyjnych, wprowadzono pierwiastkowy błąd średni kwadratu (RMSE), aby nałożyć surowsze kary za większe błędy. Na koniec, współczynnik determinacji, R2, określa całkowitą moc wyjaśniającą regresji w stosunku do rzeczywistej wariancji celu.
Definicje matematyczne wskaźników są następujące:
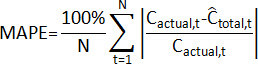 (12)
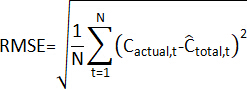 (13)
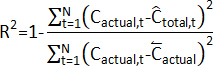 (14)
gdzie  oznacza rzeczywisty koszt produkcji i eksploatacji w okresie t,
 oznacza koszt przewidziany przez model,
 oznacza średni rzeczywisty koszt w próbie testowej, a N to liczba próbek w zbiorze testowym.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Panoramic porównanie dokładności prognozowania z redukcją wymiarowości
Kiedy wszystkie modele zoptymalizowane za pomocą Tree-structured Parzen Estimator (TPE) zostały ocenione na zbiorze testowym spoza próby z lat 2023–2025, obejmującym wahania związane z odbudową popandemiczną oraz ekstremalne zjawiska wysokich temperatur, możliwe stało się obiektywne porównanie wydajności głównych algorytmów prognozowania. Aby zapewnić rygorystyczną i kompleksową ocenę, uwzględniono cztery m...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Niniejsze badanie wykazuje, że integracja przemysłowych kwot kosztowych z uczeniem maszynowym zapewnia interpretowalne i dokładne ramy dla długoterminowego prognozowania kosztów sieci elektroenergetycznych. Wyniki wskazują, że zmienne związane z klimatem, w szczególności dni z ekstremalnie wysokimi temperaturami oraz wskaźniki wpływu wyłączeń linii, są dominującymi czynnikami wpływającymi na reszty kosztowe, co podkreśla rosnący wpływ zakłóceń zewnętrznych na wydatki przedsiębiorstw użyteczności publicznej. Wnioski te su...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Wszyscy autorzy deklarują brak konfliktów interesów.
WKŁAD AUTORÓW:
Xiaohui Wang opracował i zaprojektował badanie, opracował metodologię, przeprowadził formalną analizę i przygotował projekt rękopisu. Tong Li przyczynił się do kurateli danych, implementacji oprogramowania i walidacji. Yanchao Lu przyczynił się do opracowania metodologii, przeprowadzenia badań i interpretacji danych. Quanfeng Lv zapewnił zasoby, nadzorował pozyskiwanie danych i krytycznie ocenił rękopis. Fan Liu nadzorował projekt, przyczynił się do konceptualizacji i interpretacji wyników, zapewnił finansowanie i krytycznie zredagował rękopis. Wszyscy autorzy zapoznali się z końcową wersją rękopisu i ją zatwierdzili
Podziękowania
Praca ta była wspierana przez Projekt Technologiczny State Grid Corporation of China o nazwie „Research on Production and Operation Cost Allocation Analysis and Asynchronous Optimization Technology” (numer projektu: 520600250029-183-ZN).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Zanonimizowany miesięczny zestaw danych księgowych E-Grid | Prowincjonalna sieć energetyczna we wschodnich Chinach | N/A | Zanonimizowany miesięczny zestaw danych dotyczących kosztów produkcji i eksploatacji (2010–2025) obejmujący 192 obserwacje, w tym dane o aktywach fizycznych, eksploatacji i konserwacji, dane makroekonomiczne oraz środowiskowe. Wykorzystany do opracowania modelu (156 obserwacji) oraz testowania poza próbką (36 obserwacji). |
| Biblioteka do wykresów Matplotlib | Matplotlib development team | 3.5.2 | Wykorzystana do generowania rycin do manuskryptu i wyników graficznych, w tym wykresów wydajności modelu, wizualizacji topologii, diagnostyki reszt, wykresów radarowych oraz wizualnych podsumowań związanych z SHAP. |
| Biblioteka obliczeń numerycznych NumPy | NumPy developers | 1.22.3 | Wykorzystana do operacji na tablicach numerycznych, obliczeń macierzowych i kontroli powtarzalności. W odpowiednich miejscach zastosowano stałe ziarno losowe (random seed) o wartości 42. |
| Biblioteka manipulacji danymi Pandas | pandas development team | 1.4.2 | Wykorzystana do importu, integracji, restrukturyzacji, filtrowania i preprocessingu danych, w tym imputacji brakujących wartości, wyrównania szeregów czasowych i przygotowania zmiennych wejściowych modelu. |
| Środowisko programistyczne Python | Python Software Foundation | 3.9.13 | Środowisko programistyczne wykorzystane do implementacji pełnego przepływu pracy prognozowania, w tym preprocessingu danych, inżynierii cech, trenowania modelu, optymalizacji hiperparametrów, predykcji, testowania statystycznego i oceny wydajności. |
| Biblioteka uczenia maszynowego Scikit-learn | scikit-learn contributors | 1.0.2 | Wykorzystana do preprocessingu danych, podziału na zbiór treningowy i walidacyjny, pomocniczej oceny modelu oraz procedur statystycznych, w tym analizy korelacji Pearsona i obliczania wybranych metryk wydajności. |
| Biblioteka obliczeń naukowych SciPy | SciPy contributors | 1.9.0 | Wykorzystana do obliczeń statystycznych, w tym analizy korelacji Pearsona oraz procedur pomocniczych do obsługi wartości odstających i winsoryzacji. |
| Implementacja Tree-structured Parzen Estimator | Optuna contributors | 3.1.0 | Implementacja optymalizacji bayesowskiej wykorzystana do dostrajania hiperparametrów XGBoost, w tym maksymalnej głębokości drzewa, tempa uczenia i parametrów regularyzacji. Tree-structured Parzen Estimator został zaimplementowany za pomocą otwartoźródłowego pakietu Optuna. |
| Biblioteka oprogramowania XGBoost | DMLC / XGBoost contributors | 1.7.1 | Biblioteka uczenia zespołowego opartego na drzewach decyzyjnych, wykorzystana do nieliniowej kompensacji reszt. Model zaimplementował zregulowaną funkcję celu z funkcją straty Hubera i karami za złożoność drzewa, zgodnie z opisem w równaniach 7–9. |
Bibliografia
- Rao H, Li J, Sun X. Demand forecasting and allocation optimization of green power grid supply chain based on machine learning algorithm: A study based on the whole-process data of power grid materials. Sustainability. 2025;17(3):1247.
- Huang C, et al. Demand response for industrial micro-grid considering photovoltaic power uncertainty and battery operational cost. IEEE Trans Smart Grid. 2021;12(4):3043-3055.
- Phuangpornpitak N, Prommee W. A study of load demand forecasting models in electric power system operation and planning. GMSARN Int J. 2016;10:19-24.
- Nasir J, et al. A hybrid LMD–ARIMA–machine learning framework for enhanced forecasting of financial time series: Evidence from the NASDAQ Composite Index. Mathematics. 2025;13(15):2389.
- Matos C, et al. Model for integrating the electricity cost consumption and power demand into aggregate production planning. Appl Sci. 2022;12(15):7577.
- Valenzuela J, Mazumdar M, Kapoor A. Influence of temperature and load forecast uncertainty on estimates of power generation production costs. IEEE Trans Power Syst. 2000;15(2):668-674.
- Khan F, et al. A hybrid vector autoregressive model for accurate macroeconomic forecasting: An application to the US economy. Mathematics. 2025;13(11):1706.
- Fatema I, Kong X, Fang G. Electricity demand and price forecasting model for sustainable smart grid using comprehensive long short-term memory. Int J Sustain Eng. 2021;14(6):1714-1732.
- Singh AK, Ibraheem SK, Muazzam M, Chaturvedi DK. An overview of electricity demand forecasting techniques. Netw Complex Syst. 2013;3(3):38-48.
- Iftikhar H, et al. A novel hybrid framework for forecasting stock indices based on nonlinear time series models. Comput Stat. 2025;40(8):4163-4186.
- Jiang P, Li R, Lu H, Zhang X. Modeling of electricity demand forecast for power system. Neural Comput Appl. 2020;32(11):6857-6875.
- Chan SC, et al. Load/price forecasting and managing demand response for smart grids: Methodologies and challenges. IEEE Signal Process Mag. 2012;29(5):68-85.
- Hernandez L, et al. A survey on electric power demand forecasting: Future trends in smart grids, microgrids and smart buildings. IEEE Commun Surv Tutor. 2014;16(3):1460-1495.
- Zareipour H, Canizares CA, Bhattacharya K. Economic impact of electricity market price forecasting errors: A demand-side analysis. IEEE Trans Power Syst. 2009;25(1):254-262.
- Botterud A. Forecasting renewable energy for grid operations. In: Renewable Energy Integration. Academic Press; 2017:133-143.
- Mirowski P, Chen S, Ho TK, Yu CN. Demand forecasting in smart grids. Bell Labs Tech J. 2014;18(4):135-158.
- Sobu A, Wu G. Optimal operation planning method for isolated micro grid considering uncertainties of renewable power generations and load demand. In: IEEE PES Innovative Smart Grid Technologies [conference proceedings]. IEEE; 2012. Available at: https://ieeexplore.ieee.org/
- Han B, et al. Optimal design of an on-grid microgrid considering long-term load demand forecasting: A case study. Distrib Gener Altern Energy J. 2020;35:345-362.
- Tripathy SC. Demand forecasting in a power system. Energy Convers Manag. 1997;38(14):1475-1481.
- Adshead NS, Price DH. Demand forecasting and cost performance in a model of a real manufacturing unit. Int J Prod Res. 1987;25(9):1251-1265.
- Gellert A, et al. A study on forecasting electricity production and consumption in smart cities and factories. Int J Inf Manage. 2019;49:546-556.
- Hernández L, et al. A multi-agent system architecture for smart grid management and forecasting of energy demand in virtual power plants. IEEE Commun Mag. 2013;51(1):106-113.
- Klingler AL, Teichtmann L. Impacts of a forecast-based operation strategy for grid-connected PV storage systems on profitability and the energy system. Sol Energy. 2017;158:861-868.
- Ghalehkhondabi I, Ardjmand E, Weckman GR, Young WA. An overview of energy demand forecasting methods published in 2005–2015. Energy Syst. 2017;8(2):411-447.
- Aderibigbe AO, et al. Enhancing energy efficiency with AI: A review of machine learning models in electricity demand forecasting. Eng Sci Technol J. 2023;4(6):341-356.
- Arumugham V, et al. An artificial-intelligence-based renewable energy prediction program for demand-side management in smart grids. Sustainability. 2023;15(6):5453.
- Dudek G, Piotrowski P, Baczyński D. Intelligent forecasting and optimization in electrical power systems: Advances in models and applications. Energies. 2023;16(7):3024.
- Liu N, et al. A hybrid forecasting model with parameter optimization for short-term load forecasting of micro-grids. Appl Energy. 2014;129:336-345.
- Mohammad AA, et al. Mathematical and statistical modelling of electricity demand forecasting using artificial neural networks and SARIMA: Implications for energy supply chain planning. Alex Eng J. 2026;139:98-108.
- Singh AR, et al. A blockchain-enabled multi-agent deep reinforcement learning framework for real-time demand response in renewable energy grids. Energy Strateg Rev. 2025;62:101905.
- Lu R, et al. Data-driven real-time price-based demand response for industrial facilities energy management. Appl Energy. 2021;283:116291.
- Kondaiah VY, Saravanan B, Sanjeevikumar P, Khan B. A review on short-term load forecasting models for micro-grid application. J Eng. 2022;2022(7):665-689.
- Lee BL, Wilson C, Simshauser P, Majiwa E. Deregulation, efficiency and policy determination: An analysis of Australia's electricity distribution sector. Energy Econ. 2021;98:105210.
- Wang Y, et al. Transmission network expansion planning considering wind power and load uncertainties based on multi-agent DDQN. Energies. 2021;14(19):6073.
- Ding Q, Zhao H. Study on e-commerce logistics cost control methods in the context of COVID-19 prevention and control. Soft Comput. 2021;25(18):11955-11963.
- Duan Y, Xu Z, Chen H, Wang Y. Novel machine learning approach for enhanced smart grid power use and price prediction using advanced Shark Smell-tuned flexible support vector machine. Sci Rep. 2025;15(1):20909.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining [conference proceedings]. San Francisco, CA, USA; 2016. Available at: https://doi.org/10.1145/2939672.2939785
- Lin KY, et al. Predictive maintenance in industrial systems: An XGBoost-based approach for failure time estimation and resource optimization. J Ind Prod Eng. 2025;42(8):876-899.
- Ajayi OO, Kurien AM, Djouani K, Dieng L. A proactive predictive model for machine failure forecasting. Machines. 2025;13(8):663.
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Chen H, Gao T, Wang L, Guo P. Explainable machine learning methods for predicting electricity consumption in a long-distance crude oil pipeline. Sci Rep. 2025;15(1):43305.
- Neubauer A, Brandt S, Kriegel M. Explainable multi-step heating load forecasting: Using SHAP values and temporal attention mechanisms for enhanced interpretability. Energy AI. 2025;20:100480.
- Ahmad T, Chen H. Potential of three variant machine-learning models for forecasting district-level medium-term and long-term energy demand in smart grid environment. Energy. 2018;160:1008-1020.
- Masa-Bote D, et al. Improving photovoltaics grid integration through short-time forecasting and self-consumption. Appl Energy. 2014;125:103-113.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.