Niniejszy protokół integruje przewidywanie celów dla metabolitów mikrobiologicznych, transkryptomikę błony śluzowej odbytnicy, analizę oddziaływań białko-białko i wzbogacenia szlaków, dokowanie molekularne, symulacje dynamiki molekularnej oraz szacowanie wolnej energii wiązania metodą mechaniki molekularnej/powierzchniowej powierzchni Poisson–Boltzmann (MM-PBSA) w celu stworzenia uszeregowionej, służącej do generowania hipotez krótkiej listy kandydackich genów gospodarza związanych z metabolitami oraz strukturalnie priorytetyzowanych kompleksów białko-ligand do dalszych badań eksperymentalnych.
Artykuł metodologiczny
Obliczeniowy schemat postępowania w celu priorytetyzacji genów gospodarza powiązanych z metabolitami mikrobiologicznymi w zespole jelita drażliwego z przewagą zaparć
W tym artykule
Podsumowanie
Streszczenie
Nie istnieje ustandaryzowany potok obliczeniowy do systematycznego priorytetyzowania genów gospodarza powiązanych z metabolitami mikrobiologicznymi oraz kompleksów białko-ligand z publicznie dostępnych baz danych chemicznych, genomicznych i strukturalnych. Niniejszy artykuł opisuje ośmioetapowy schemat postępowania, który przyjmuje zdefiniowany przez użytkownika zestaw metabolitów pochodzących z mikrobioty jelitowej i generuje rankingową listę kandydatów na powiązane z metabolitami geny gospodarza, wzbogaconych szlaków biologicznych oraz strukturalnie priorytetyzowanych kompleksów białko-ligand do dalszych badań eksperymentalnych. Potok integruje (i) chemoinformatyczne profilowanie metabolitów; (ii) przewidywanie potencjalnych celów z wielu baz danych przy użyciu narzędzia do przewidywania celów w oparciu o oddziaływania białko-chemikalia i ligandy oraz programu do dokowania molekularnego; (iii) analizę różnicowej ekspresji genów na podstawie publicznie dostępnych danych transkrypcyjnych; (iv) nakładanie celów na geny o różnicowej ekspresji; (v) konstrukcję sieci oddziaływań białko-białko i wzbogacanie szlaków; (vi) dokowanie molekularne z wykorzystaniem programu do dokowania molekularnego; (vii) symulację dynamiki molekularnej przez 200 ns przy użyciu silnika dynamiki molekularnej z polem siłowym białek stosowanym w symulacjach dynamiki molekularnej; oraz (viii) szacowanie wolnej energii wiązania metodą MM-PBSA. Jako przykład praktyczny, dziewięć metabolitów pochodzących z mikrobioty jelitowej lub modyfikowanych przez mikrobiotę, reprezentujących krótkołańcuchowe kwasy tłuszczowe, kwasy żółciowe, metabolity pochodne tryptofanu oraz urolitynę A, zostało przetworzonych z wykorzystaniem publicznego zestawu danych transkrypcyjnych błony śluzowej odbytnicy IBS-C GSE36701. Schemat postępowania wyłonił ranking 17 unikalnych przewidywanych genów powiązanych z metabolitami, które wykazywały różnicową ekspresję w tym zbiorze danych. Dokowanie, symulacja dynamiki molekularnej oraz analizy MM-PBSA pozwoliły na strukturalną priorytetyzację pięciu kompleksów metabolit-białko: kwas litocholowy-VDR, kwas litocholowy-NR1H4/FXR, kwas ursodeoksycholowy-NR1H4/FXR, tryptamina-HTR2A (symulowana w jawnej dwuwarstwie lipidowej 1-Palmitoyl-2-oleoyl-sn-glycero-3-phosphocholine (POPC)) oraz urolityna A-CASP3. Protokół został zaprojektowany tak, aby można go było dostosować do innych zestawów metabolitów, zbiorów danych transkrypcyjnych chorób oraz klas celów; wszystkie wyniki są generującymi hipotezy przewidywaniami obliczeniowymi, które wymagają niezależnej replikacji transkrypcyjnej, walidacji na poziomie białka oraz funkcjonalnych testów odpowiedzi na ligandy przed wyciągnięciem wniosków przyczynowych lub terapeutycznych.
Wprowadzenie
Zespół jelita drażliwego z zaparciami (IBS-C) jest powszechnym funkcjonalnym zaburzeniem przewodu pokarmowego charakteryzującym się nawracającym bólem brzucha, zmianą rytmu wypróżnień, wzdęciami i zaparciami, a jego globalna rozpowszechnienie szacuje się na około 10–15% ogólnej populacji1,2. Obecne terapie farmakologiczne, w tym sekregogi, prokinetyki i leki rozkurczowe, mogą poprawić poszczególne objawy u części pacjentów; jednak odpowiedź na leczenie pozostaje niejednorodna, a trwałe remisje osiąga się rzadko, co odzwierciedla złożoną, wieloczynnikową patobiologię tego schorzenia1,3,4. W związku z tym niezbędne jest pełniejsze mechanistyczne zrozumienie tego, w jaki sposób sygnały mikrobioty jelitowej są przekazywane na poziomie błony śluzowej, aby sformułować sprawdzalne hipotezy dotyczące nowych celów terapeutycznych.
Mikrobiota jelitowa przyczynia się do homeostazy dolnego odcinka przewodu pokarmowego poprzez produkcję i biotransformację chemicznie zróżnicowanych metabolitów, w tym krótkołańcuchowych kwasów tłuszczowych (SCFA), wtórnych kwasów żółciowych, związków pochodnych tryptofanu oraz metabolitów pochodnych polifenoli, takich jak urolityny5,6,7,8. Cząsteczki te komunikują się z komórkami gospodarza poprzez szeroki i nie w pełni scharakteryzowany repertuar celów molekularnych, który wykracza daleko poza kanoniczne błonowe receptory wykrywające metabolity, obejmując receptory jądrowe, enzymy cytozolowe, białka modyfikujące histony, prekursory hormonów peptydowych oraz wewnątrzkomórkowe białka sygnałowe9. U pacjentów z zespołem jelita drażliwego (IBS) udokumentowano zmiany w składzie społeczności mikroorganizmów jelitowych oraz w profilach metabolitów, co stanowi biologiczne uzasadnienie dla zbadania, czy geny gospodarza związane z reaktywnością na metabolity mikrobiologiczne ulegają zaburzeniom transkrypcyjnym w błonie śluzowej odbytnicy w przebiegu IBS-C10.
Panel dziewięciu metabolitów zdefiniowano a priori, aby zapewnić zwarty, zróżnicowany chemicznie i biologicznie interpretowalny zestaw małych cząsteczek pochodzących z mikrobioty jelitowej lub modyfikowanych przez nią. Wybór oparto na pięciu kryteriach: reprezentacji głównych klas metabolitów mikrobiologicznych zaangażowanych w sygnalizację gospodarz-mikrobiota; znanej lub prawdopodobnej ekspozycji błony śluzowej dalszych odcinków jelit; dostępności jednoznacznych identyfikatorów PubChem i struktur kanonicznych; wielkości cząsteczki i łatwości analizy strukturalnej dla przewidywania celu na podstawie ligandów oraz dokowania; oraz wcześniejszego prawdopodobieństwa sygnalizacji nabłonkowej, neuroimmunologicznej, enteroendokrynnej, receptorów jądrowych lub związanej z motoryką w przebiegu IBS-C. Wybrany panel obejmował maślan i propionian jako SCFA; kwas chenodeoksycholowy, kwas litocholowy i kwas ursodeoksycholowy jako kwasy żółciowe; tryptaminę, kwas indolo-3-propionowy i kwas indolo-3-mlekowy jako metabolity pochodne tryptofanu oraz urolitynę A jako polifenolowy metabolit pochodzący z mikrobioty jelitowej5,6,7,8,9,10.
Większość wcześniejszych badań obliczeniowych i eksperymentalnych analizowała poszczególne pary metabolit–receptor lub metabolit–enzym w izolacji, co jest podejściem, które nie oddaje rozproszonego i zbieżnego charakteru sygnalizacji metabolitów mikrobiologicznych w obrębie ścieżek gospodarza9,11. Integracja wielu etapów analitycznych zapewnia wzajemnie wzmacniającą się moc filtrowania, której żaden pojedynczy etap nie może zapewnić samodzielnie. Obliczeniowa predykcja celu w oparciu o wyselekcjonowane bazy danych pozwala uzyskać szeroki zestaw kandydackich białek gospodarza dla każdego metabolitu. Przecięcie tych danych z transkrypomicznymi danymi istotnymi dla danej choroby znacznie filtruje ten zestaw, pozostawiając jedynie kandydatów, których transkrypty uległy zmianie w kontekście choroby. Następnie analiza wzbogacenia ścieżek oraz analiza sieci oddziaływań białko-białko przypisuje zredukowaną listę kandydatów do znanych modułów biologicznych. Dokowanie molekularne zapewnia wstępną obliczeniową ocenę komplementarności kieszeni wiążącej dla każdego kompleksu kandydackiego, a dodatkowa 200 ns symulacja dynamiki molekularnej (MD) z dekompozycją wolnej energii wiązania MM-PBSA wprowadza wymiar termodynamiczny i rozdzielczość czasową do priorytetyzacji strukturalnej, co nie jest możliwe na podstawie samych wyników dokowania. Wykonywanie każdego kroku niezależnie, bez systematycznej integracji i sekwencyjnego filtrowania, doprowadziłoby do powstania list kandydatów zbyt obszernych, aby były one możliwe do zweryfikowania eksperymentalnie, a także uniemożliwiłoby wykrycie zbieżnej architektury ścieżek.
W ramach niniejszego protokołu przez termin „gen związany z metabolitem” (MAG) rozumiemy gen ludzki, którego produkt białkowy został wskazany jako potencjalny cel molekularny jednego lub więcej metabolitów pochodzących z mikrobioty jelitowej przez co najmniej jedną kuratowaną bazę danych przewidywań obliczeniowych, a którego transkrypty wykazują różnicową ekspresję w zbiorze danych transkrypomicznych związanych z chorobą, wykorzystanym do zademonstrowania schematu postępowania. Ta definicja operacyjna celowo obejmuje receptory błonowe oraz receptory jądrowe, enzymy cytozolowe, białka sygnałowe, prekursory hormonów peptydowych i inne białka wewnątrzkomórkowe. Oznaczenie jako MAG nie stanowi dowodu eksperymentalnego na to, że metabolit wiąże się, tworzy kompleks białko–ligand, aktywuje receptor, zmienia ilość białka lub wywołuje chorobę, lecz jest nominacją opracowaną obliczeniowo w celu sformułowania hipotezy, która wymaga walidacji eksperymentalnej.
Niniejszy protokół opisuje pełny, ośmioetapowy schemat obliczeniowy (Rysunek 1) z wystarczającym poziomem szczegółów operacyjnych, aby umożliwić niezależne powtórzenie badania, adaptację do innych paneli metabolitów lub zbiorów danych o chorobach oraz rozszerzenie na inne konteksty interakcji między gospodarzem a mikrobiotą. Schemat ten jest wyraźnie zdefiniowany jako ramy generowania hipotez i priorytetyzacji strukturalnej, które operują wyłącznie na publicznie dostępnych zasobach omicznych i strukturalnych i nie służą do wnioskowania o zmienionych stężeniach metabolitów, stanach aktywacji receptorów, zmianach w ekspresji białek, aktywności sygnalizacji w dół lub znaczeniu klinicznym wyłącznie na podstawie wyników obliczeniowych. W niniejszej pracy demonstrujemy protokół na przykładzie dziewięciu metabolitów pochodzących z mikrobioty jelitowej lub modyfikowanych przez mikrobiotę oraz publicznego zbioru danych transkrypomicznych błony śluzowej odbytnicy w IBS-C (GSE36701), w celu identyfikacji MAG-ów i priorytetyzacji kompleksów metabolit-białko do późniejszych badań eksperymentalnych.
Protokół
W analizie wykorzystano wyłącznie ogólnodostępne, zanonimizowane dane transkrypcyjne z zestawu GSE36701 oraz ogólnodostępne bazy danych chemicznych, białkowych i strukturalnych. Dostęp do baz danych uzyskano między styczniem a majem 2026 roku. Każda późniejsza data dostępu została odnotowana w osobnej Tabeli Materiałów.
1. Projekt badania, wymagania sprzętowe i programistyczne
- Zdefiniuj schemat pracy przed rozpoczęciem analizy. Wykorzystaj osiem etapów: wybór metabolitów, przewidywanie celów, analiza różnicowej ekspresji, nakładanie się genów różnicowo eksponowanych (DEG) z celami, analiza interakcji białko-białko (PPI) / wzbogacenia szlaków, dokowanie molekularne, symulacja MD oraz szacowanie MM-PBSA.
- Odnotuj, że dokowanie, MD i MM-PBSA są wyłącznie narzędziami do priorytetyzacji strukturalnej. Nie interpretuj tych wyników jako dowodów eksperymentalnych na wiązanie, aktywację receptora, zmianę zawartości białka, skuteczność terapeutyczną lub przyczynowość choroby.
- Potwierdź sprzęt obliczeniowy przed uruchomieniem symulacji MD. Użyj 64-bitowego systemu operacyjnego Linux, procesora 6-rdzeniowego lub lepszego, platformy akceleracji GPU z ≥8 GB VRAM lub równoważnej platformy akceleracji GPU z co najmniej 8 GB VRAM, minimum 32 GB RAM oraz co najmniej 200 GB wolnej przestrzeni dyskowej na każdy system MD.
- Zapisz podstawowe oprogramowanie: silnik dynamiki molekularnej, program do dokowania molekularnego ligandów z metabolitów do białek docelowych, narzędzie do konwersji formatów plików chemicznych12, program do generowania trójwymiarowych ligandów, narzędzie do przygotowania ligandów, zestaw narzędzi do przygotowania danych wejściowych do dokowania, program do dokowania molekularnego ligandów z metabolitów do białek docelowych, ogólne środowisko programistyczne, środowisko obliczeń statystycznych z frameworkiem oprogramowania bioinformatycznego oraz pakiet do analizy różnicowej ekspresji genów.
- Zapisz narzędzia do analizy strukturalnej: internetowe narzędzie do konstruowania systemów błonowych, usługę parametryzacji ligandów zgodną z CHARMM, narzędzie do obliczania energii wiązania w mechanice molekularnej/ciągłym rozpuszczalniku, bibliotekę konwersji topologii i parametrów molekularnych, program do trójwymiarowej wizualizacji molekularnej oraz narzędzie do wizualizacji molekularnej i tworzenia dwuwymiarowych diagramów oddziaływań 2021 (patrz Tabela Materiałów w celu uzyskania linków do pobierania i informacji o wersjach).
- Zapisz w Tabeli Materiałów/pliku środowiskowym dokładne identyfikatory wersji użytego pola siłowego białek do symulacji dynamiki molekularnej, CGenFF, CHARMM-GUI, frameworka R/bioinformatycznego oraz narzędzia do obliczania energii wiązania w mechanice molekularnej/ciągłym rozpuszczalniku. Brakujące identyfikatory oznacz jako „not recoverable”; nie wnioskuj ich samodzielnie.
2. Wybór metabolitów i charakterystyka chemoinformatyczna
- Zdefiniuj panel metabolitów przed przystąpieniem do przewidywania celów. Uwzględnij maślan (PubChem CID: 264), propionian (CID: 1032), kwas chenodeoksycholowy (CID: 10133), kwas litocholowy (CID: 9903), kwas ursodeoksycholowy (CID: 31401), tryptaminę (CID: 1150), kwas indole-3-propionowy (CID: 3744), kwas indole-3-mlekowy (CID: 92904) oraz urolitynę A (CID: 5488186).
- Pobierz kanoniczne ciągi SMILES (Simplified Molecular Input Line Entry System) oraz numery PubChem CID dla każdego metabolitu. Przed przewidywaniem celów zweryfikuj synonimy i zduplikowane struktury. Zapisz końcowe identyfikatory w głównym arkuszu metabolitów.
- Wprowadź kanoniczne ciągi SMILES do narzędzia internetowego do przewidywania właściwości fizykochemicznych i ADME13 (patrz Tabela materiałów). Odnotuj masę cząsteczkową, topologiczną polarną powierzchnię cząsteczki (TPSA), konsensus logP, liczbę donatorów wiązań wodorowych, liczbę akceptorów wiązań wodorowych, liczbę wiązań rotowalnych, przewidywany stopień wchłaniania w przewodzie pokarmowym, przewidywania dotyczące glikoproteiny P oraz alerty Lipinskiego, Vebera, Ghose'a, Egana, Muegge'a i PAINS.
- Zachowaj metabolity z pomyślnie rozpoznaną strukturą, masą cząsteczkową ≤500 Da i brakiem alertów PAINS. Odnotuj każde niespełnione kryterium oraz decyzję o zachowaniu lub wykluczeniu metabolitu.
- Przypisz stany jonizacji przed dalszym przewidywaniem celów i dokowaniem. Dla maślanu i propionianu zastosuj zdeprotonowane karboksylany, dla kwasów żółciowych neutralne formy kwasów karboksylowych, dla tryptaminy protonowany amon, a dla pozostałych metabolitów formy neutralne.
3. Przewidywanie potencjalnych ludzkich celów
- Otwórz narzędzie do przewidywania celów interakcji chemiczno-białkowych14 (patrz Tabela materiałów). Wprowadź nazwę każdego metabolitu lub numer PubChem CID, wybierz Homo sapiens (ID taksonomiczne: 9606) i ustaw minimalną łączną punktację interakcji na poziomie ≥0,700.
- Nadaj priorytet kanałom dowodów z eksperymentów i kuratorowanych baz danych w przewidywaniu celów interakcji chemiczno-białkowych. Pobierz pełną tabelę asocjacji białkowych dla każdego metabolitu.
- Otwórz program do dokowania molekularnego15 (patrz Tabela materiałów). Prześlij każdy kanoniczny ciąg SMILES z wybranym gatunkiem Homo sapiens i zachowaj cele o prawdopodobieństwie ≥0,70.
- Połącz wyniki przewidywania celów interakcji chemiczno-białkowych oraz programu do dokowania molekularnego jako zbiór sumy dla każdego metabolitu. Zachowaj każdy cel spełniający próg którejkolwiek z baz danych i usuń dokładnie powtarzające się wpisy symboli genów.
- Znormalizuj wpisy białek do symboli genów zatwierdzonych przez Komitet Nazewnictwa Genów HUGO (HGNC), korzystając z mapowania identyfikatorów białek na ustandaryzowane symbole genów zatwierdzone przez HGNC lub zintegrowanej bazy informacji o genach ludzkich (patrz Tabela materiałów). Rozwiąż aliasy, przestarzałe symbole i adnotacje izoform, aby przypisać jeden symbol genu do jednego białka.
- Sklasyfikuj każdy cel jako receptor błonowy, receptor jądrowy, enzym, wewnątrzkomórkowe białko sygnałowe, hormon peptydowy, białko powiązane z hormonami lub inne białko wewnątrzkomórkowe. Zapisz klasę w tabeli celów.
4. Zbiór danych transkryptomicznych i analiza różnicowej ekspresji genów
- Uzyskaj dostęp do zestawu danych GSE36701 poprzez internetowe narzędzie NCBI do analizy różnicowej ekspresji genów16,17 (patrz Tabela materiałów). Odnotuj, że zestaw danych zawiera dane o ekspresji z biopsji błony śluzowej odbytnicy grup z IBS-C, zespołem jelita drażliwego z przewagą biegunek (IBS-D), IBS poinfekcyjnym oraz grupą zdrowych ochotników18.
- Przeszukaj bazy GEO oraz ArrayExpress w celu znalezienia niezależnej kohorty walidacyjnej. Użyj kombinacji haseł: IBS-C, constipation-predominant irritable bowel syndrome, rectal mucosa, colonic mucosa, biopsy, transcriptome, microarray oraz RNA-seq. Zapisz nazwy repozytoriów, terminy wyszukiwania, datę wyszukiwania oraz informację, czy zidentyfikowano porównywalny zestaw danych walidacyjnych.
- Uruchom internetowe narzędzie do analizy różnicowej ekspresji genów z rekordu GSE36701 (patrz Tabela materiałów). Przypisz 18 próbek IBS-C do grupy IBS-C, 40 zdrowych ochotników do grupy kontrolnej, a próbki IBS-D oraz IBS poinfekcyjnego pozostaw bez przypisania.
- Przeprowadź analizę różnicowej ekspresji, korzystając z frameworka pakietu do analizy różnicowej ekspresji genów z korekcją wskaźnika fałszywych odkryć (FDR) metodą Benjamini-Hochberga19. Pobierz pełną tabelę wyników zawierającą ID sondy, symbol genu, pełną nazwę genu, logFC, AveExpr, umiarkowaną statystykę t, surową wartość P oraz skorygowaną wartość P.
- Zredukuj sondy do wpisów na poziomie genów. Usuń sondy pozbawione symboli genów; w przypadku powielonych symboli zachowaj sondę z najniższą wartością FDR; w przypadku remisów wybierz większą bezwzględną wartość logFC.
5. Analiza nakładania się celów i genów różnicowo wyrażanych oraz ocena statystyczna
- Wykonaj część wspólną każdej przewidywanej listy celów specyficznych dla danego metabolitu z listą DEG na poziomie genów przy FDR < 0,05. Zapisz nakładające się geny, metabolit pochodzenia, logFC, skorygowaną wartość P oraz kierunek ekspresji.
- Połącz listy nakładania specyficzne dla metabolitów w nieredundantną listę MAG. Oblicz całkowitą liczbę przewidywanych celów, liczbę nakładania specyficznych dla metabolitów oraz całkowitą liczbę unikalnych MAG.
- Ocenia spójność kierunkową na poziomie sond dla genów z wieloma sondami. Oznacz każdy gen, dla którego sondy wykazują rozbieżność w kierunku ekspresji.
- Sporządź tabelę kontyngencyjną do dokładnego testu Fishera, wykorzystując całkowitą liczbę wpisów po agregacji genów, całkowitą liczbę DEG, całkowitą liczbę unikalnych przewidywanych celów oraz zaobserwowane MAG. Oblicz jednostronną wartość P, iloraz szans oraz 95% przedział ufności przy użyciu implementacji dokładnego testu Fishera.
- Jeśli tło DEG przekracza 50%, przedstaw nakładanie jako opisowe, a nie jako niezależnie zwalidowane wzbogacenie. Jednolitną regulację w dół traktuj jako opisowy wzorzec kierunkowy, chyba że przeprowadzono oddzielny test kierunkowości.
6. Analiza sieci oddziaływań białko-białko i wzbogacenie szlaków
- Prześlij pełną, unikalną listę MAG do narzędzia do budowy sieci oddziaływań białko-białko i wzbogacania szlaków20 (patrz Tabela materiałów). Wybierz gatunek Homo sapiens i ustaw minimalną wartość wyniku oddziaływania na 0.700.
- Wyeksportuj połączoną sieć budowy oddziaływań białko-białko i wzbogacania szlaków oraz pełną tabelę oddziaływań. Jeśli analiza tekstowa (text-mining) generuje nienaturalnie gęstą topologię, odznacz tę opcję i zachowaj kanały eksperymentalne, koekspresyjne oraz bazodanowe.
- Wygeneruj podsieci klas metabolitów dla MAG powiązanych z SCFA, kwasami żółciowymi oraz tryptaminą/serotoniną. Użyj tych samych ustawień organizmu i poziomu ufności, co w narzędziu do budowy sieci oddziaływań białko-białko i wzbogacania szlaków.
- Przeprowadź analizę budowy sieci oddziaływań białko-białko i wzbogacania szlaków w oparciu o Kyoto Encyclopedia of Genes and Genomes (KEGG)21, Reactome22 oraz Procesy Biologiczne Gene Ontology (GO)23,24. Zastosuj korektę Benjamini–Hochberg BH FDR <0.05 i wyeksportuj wszystkie tabele wzbogacenia.
7. Dokowanie molekularne
- Pobierz eksperymentalnie określone struktury receptorów z Protein Data Bank RCSB PDB (Research Collaboratory for Structural Bioinformatics)25 (patrz Tabela materiałów). Dla pięciu priorytetowych kompleksów białko-ligand wykorzystaj VDR/1DB1, NR1H4/FXR/3DCT, CASP3/2DKO oraz HTR2A/6A93.
- Przygotuj każdy receptor, zachowując łańcuch A i usuwając cząsteczki wody, ligandy kokrystalizowane, kofaktory, jony oraz rekordy HETATM niebędące białkami. W przypadku struktury 6A93 przed przygotowaniem receptora usuń segment fuzji z lysozymem T4.
- Dodaj wodory polarne, przypisz ładunki Gasteigera i zapisz każdy receptor w formacie PDBQT za pomocą zestawu narzędzi do struktur molekularnych. Przed konwersją do PDBQT sprawdź stany protonacji histydyny w miejscu wiązania i udokumentuj wybrane stany.
- Wygeneruj trójwymiarową strukturę każdego liganda w narzędziu do konwersji plików struktur chemicznych. Przeprowadź minimalizację energii przy użyciu Universal Force Field (UFF) przez 500 kroków, przypisz stan jonizacji dla pH 7,4, przypisz ładunki Gasteigera i zapisz plik w formacie PDBQT.
- Zdefiniuj przestrzeń dokowania (docking box) o wymiarach 25 Å x 25 Å x 25 Å, wyśrodkowaną na centroidzie liganda kokrystalizowanego. Użyj centrów o współrzędnych (10, 19, 33) dla VDR, (137, 31, 78) dla FXR, (37, 34, 32) dla CASP3 oraz (12, −1, 61) dla HTR2A.
- Przeprowadź dokowanie molekularne ligandów będących metabolitami do białek docelowych26,27, przyjmując parametry: exhaustiveness = 8, seed = 42, num_modes = 9 oraz energy_range = 3 kcal/mol. Zapisz najwyżej oceniony wynik Vina (Vina score) oraz wartości średniokwadratowego odchylenia (RMSD) dla wszystkich póz.
- Wybierz tryb 1 (mode 1) dla każdego priorytetowego kompleksu. Wygeneruj dwuwymiarowe schematy oddziaływań ligand-pozostałość w narzędziu do wizualizacji molekularnej i dwuwymiarowych diagramów oddziaływań oraz trójwymiarowe widoki receptor-ligand w programie do trójwymiarowej wizualizacji molekularnej.
- Wykonaj kontrole redokowania dla VDR/1DB1 i FXR/3DCT. Zaakceptuj konfigurację dokowania receptora, gdy RMSD dla ciężkich atomów wynosi <2,0 Å w stosunku do pozy krystalograficznej.
- Przeprowadź kontrole dokowania krzyżowego (cross-docking), dokując kwas litocholowy (LCA) do CASP3 oraz tryptaminę do VDR. Porównaj wyniki dla ligandów cognate i non-cognate oraz odnotuj przypadki, w których różnica wyników wynosi <1,0 kcal/mol.
8. Symulacja dynamiki molekularnej
- Wygeneruj parametry ligandu za pomocą usługi parametryzacji ligandów kompatybilnej z CHARMM28 (patrz Tabela Materiałów). Sprawdź wszystkie wyniki kar (penalty scores) i zaznacz każdy parametr z karą >50.
- Konwertuj pliki strumieniowe ligandów na pliki .itp i .prm kompatybilne z silnikiem dynamiki molekularnej za pomocą skryptu do konwersji topologii pola siłowego. Połącz pliki topologii ligandu i białka dla każdego kompleksu.
- Zastosuj ponowne rozdzielenie masy wodoru (hydrogen mass repartitioning) przy użyciu biblioteki konwersji topologii molekularnej i parametrów. Wygeneruj topologie wodne, wykorzystując pole siłowe białek stosowane w symulacjach dynamiki molekularnej29 oraz jawny trójpunktowy model wody30.
- Solwatuj kompleksy wodne w pudełku dodekaedralnym z odstępem od krawędzi substancji rozpuszczonej wynoszącym co najmniej 1.2 nm. Zneutralizuj systemy i dodaj NaCl do stężenia 0.15 M.
- Zbuduj system błonowy tryptamina-HTR2A za pomocą internetowego narzędzia do konstrukcji systemów błonowych31,32,33 (patrz Tabela Materiałów). Użyj współrzędnych receptora wyrównanych z bazą danych orientacji białek błonowych34 (patrz Tabela Materiałów), czystej dwuwarstwy POPC, warstw wody o grubości 22.5 Å oraz 0.15 M NaCl.
- Zminimalizuj energię wszystkich systemów metodą najstromniejszego zejścia przez maksymalnie 50 000 kroków. Przed ekwilibracją potwierdź zbieżność przy Fmax <1000 kJmol-1nm-1.
- Przeprowadź ekwilibrację systemów wodnych w fazach zespołu o stałej liczbie cząsteczek, objętości i temperaturze (NVT) oraz zespołu o stałej liczbie cząsteczek, ciśnieniu i temperaturze (NPT). Ekwilibruj system błonowy, korzystając z sześciostopniowego internetowego przepływu pracy przygotowania i ekwilibracji systemów molekularnych z stopniowo zwalnianymi więzami.
- Przeprowadź 200 ns produkcyjnej dynamiki molekularnej (MD) dla wszystkich pięciu kompleksów. Zastosuj krok czasowy 4 fs z ponownym rozdzieleniem masy wodoru (HMR), termostat V-rescale w 310 K, barostat Parrinello-Rahman przy 1 bar, elektrostatykę Particle mesh Ewald (PME)35 oraz więzy LINCS36.
- Przeanalizuj końcowe trajektorie za pomocą narzędzi do analizy trajektorii dynamiki molekularnej. Oblicz RMSD szkieletu, fluktuację średniokwadratową (RMSF) atomów Cα, promień żyroskopowy, powierzchnię dostępną dla rozpuszczalnika (SASA) oraz wiązania wodorowe białko-ligand, wykorzystując ostatnie 150 ns jako główny okno analizy.
9. Szacowanie wolnej energii wiązania metodą MM-PBSA
- Wyodrębnij migawki trajektorii do analizy MM-PBSA. Wykorzystaj 2001 klatek dla każdego kompleksu w środowisku wodnym oraz 201 przetworzonych klatek dla podsystemu HTR2A osadzonego w błonie.
- Uruchom narzędzie do obliczeń energii wiązania metodą mechaniki molekularnej i rozpuszczalnika kontinuum37 z solwatacją Poissona-Boltzmanna, stałą dielektryczną wewnętrzną = 1, stałą dielektryczną zewnętrzną = 80, solwatacją niepolarną opartą na SASA oraz bez korekty entropowej. Podaj średnią swobodną energię wiązania oraz odchylenie standardowe.
- Przeprowadź dekompozycję na poszczególne reszty dla wszystkich pięciu kompleksów. Wskaż reszty stabilizujące i destabilizujące o wartościach bezwzględnych wkładów ≥0,5 kcalmol−1.
Wyniki
Potencjalne cele powiązane z metabolitami
Dziewięć metabolitów wygenerowało zróżnicowane, przewidywane zestawy celów w programie do przewidywania interakcji chemicznych z białkami oraz w programie do dokowania molekularnego. Propionian, tryptamina, kwasy żółciowe i urolityna A przyniosły kilka celów o znanej istotności dla sygnalizacji żołądkowo-jelitowej. Przewidywany krajobraz celów obejmował kanoniczne receptory błonowe, receptory jądrowe, enzymy wewnątrzkomórkowe, białka sygnalizacyjne oraz białka związane z hormonami peptydowymi. W związku z tym wyniki końcowe opisano jako geny związane z metabolitami (MAGs), a nie tylko jako znaleziska dotyczące receptorów (Tabela 1).
Weryfikacja w odniesieniu do zgłoszonych oddziaływań metabolit-białko
Aby zestawić wyniki przewidywania celów z istniejącą wiedzą eksperymentalną, przewidywane relacje między celami a metabolitami sklasyfikowano w trzech poziomach dowodów: (i) bezpośrednie lub bliskie interakcje metabolit-białko na poziomie klasy, potwierdzone eksperymentalnie, w których wykazano, że metabolit lub blisko spokrewniony metabolit endogenny wiąże, aktywuje, hamuje lub funkcjonalnie reguluje kodowane białko; (ii) interakcje wsparte przez szlaki metaboliczne lub klasę celów, w których przewidywany cel należy do uznanego szlaku reagującego na metabolity lub rodziny receptorów, ale bezpośrednie dowody dla konkretnej pary metabolit-białko są ograniczone; oraz (iii) powiązania wyłącznie obliczeniowe, dla których w analizowanej literaturze nie zidentyfikowano bezpośredniej interakcji eksperymentalnej. Niniejszy benchmarking służył do kontekstualizacji, a nie walidacji, przewidywanych MAGs.
Kilka przewidywań powtórzyło wcześniej opisane mechanizmy biologiczne. Interakcję Propionian-FFAR2 uznano za potwierdzoną eksperymentalnie, ponieważ FFAR2/GPR43 jest kanonicznym receptorem krótkołańcuchowych kwasów tłuszczowych. Interakcję Maślan-HDAC3 zaklasyfikowano jako potwierdzoną eksperymentalnie lub na podstawie klasy, ponieważ maślan jest uznanym inhibitorem deacetylazy histonowej, a przewidywane nakładanie się dotyczyło członka rodziny HDAC. Przewidywania związane z kwasami żółciowymi obejmujące NR1H4/FXR i VDR uznano za poparte ugruntowaną biologią jądrowych receptorów kwasów żółciowych, szczególnie w przypadku hydrofobowych kwasów żółciowych, takich jak LCA; przewidywania dotyczące FXR związane z kwasem ursodeoksycholowym (UDCA) interpretowano z ostrożnością, ponieważ UDCA jest zazwyczaj słabszym lub zależnym od kontekstu ligandem FXR. Przewidywania dotyczące HTR1B, HTR2A, HTR2B i HTR6 związane z tryptaminą zaklasyfikowano jako poparte szlakiem serotonergicznym, a nie jako potwierdzone bezpośrednie interakcje specyficzne dla receptora, ponieważ tryptamina jest pochodną monoaminy tryptofanu produkowaną przez mikroby, a receptory serotoninowe są uznanymi regulatorami motoryki i wydzielania w przewodzie pokarmowym. Interakcję Urolityna A-CASP3 uznano za popartą szlakiem na podstawie opublikowanych powiązań między urolityną A a odpowiedziami apoptotycznymi/zależnymi od kaspaz, a nie na podstawie bezpośrednich dowodów wiązania CASP3. Przewidywania dla kwasu indolo-3-mlekowego-KYAT1 oraz kwasu indolo-3-propionowego-KYAT1 pozostawiono jako hipotezy wyłącznie obliczeniowe, ponieważ szersza literatura potwierdza sygnałowanie gospodarza za pomocą mikrobiologicznych pochodnych indolu, ale nie bezpośrednie wiązanie KYAT1 przez te konkretne metabolity7,8,38,39,40.
W związku z tym Tabela 1 odróżnia komputerowe typowanie celów od poziomu wcześniejszego wsparcia eksperymentalnego lub analizy szlaków. Zawiera ona również dla każdego celu źródło predykcji (predykcję celu interakcji chemicznej z białkiem, program dokowania molekularnego lub oba), połączony wynik interakcji dla predykcji celu interakcji chemicznej z białkiem oraz prawdopodobieństwo z programu dokowania molekularnego, gdy cel został zidentyfikowany za pomocą programu dokowania molekularnego. Przewidywane cele bez bezpośrednich wcześniejszych dowodów eksperymentalnych opisano jako kandydackie geny związane z metabolitami, które wymagają niezależnej walidacji na poziomie białka oraz odpowiedzi na ligand.
Nakładanie się przewidywanych celów i genów różnicowo wyrażanych w IBS-C
Przecięcie zunifikowanych przewidywanych list celów oraz wyników różnicowej ekspresji na poziomie genów pozwoliło na zidentyfikowanie 17 unikalnych przewidywanych genów związanych z metabolitami, których ekspresja była istotnie różnicowa w porównaniu IBS-C z grupą zdrowych ochotników. Wszystkie 17 genów wykazało obniżoną ekspresję. Zbiór ten obejmował receptory błonowe i jądrowe (CASR, FFAR2, GPR68, HTR1B, HTR2A, HTR2B, HTR6, NR1H4, TBXA2R, VDR) oraz białka niereceptorowe (CASP3, GCG, GNAQ, GPHN, HDAC3, KYAT1, MLN) (Tabela 1, Rysunek 2A,B).
Wszystkie 17 MAGs spełniło próg fałszywego odkrycia (FDR) poniżej 0,05; 16 z 17 spełniło bardziej rygorystyczny warunek FDR < 0,001, natomiast pozostały gen (HTR1B) był istotny przy FDR < 0,05. Siedem z 17 celów (CASP3, GCG, GNAQ, GPHN, GPR68, HDAC3, TBXA2R) spełniło zarówno warunek FDR < 0,001, jak i bezwzględną wartość log2 fold change przekraczającą 1,0 (zakres logFC od −1,34 do −1,10), co wskazuje na silną i spójną downregulację dla tego podzbioru. Pozostałe cele wykazały umiarkowaną, ale statystycznie istotną downregulację (|logFC| w zakresie od 0,45 do 0,97). Ten jednolity wzorzec opisowy interpretowano z ostrożnością, biorąc pod uwagę charakterystykę ekspresji w całym genomie dla tego zbioru danych (patrz ocena statystyczna poniżej).
Ocena statystyczna pokrywania się DEG z genami docelowymi
Aby formalnie ocenić istotność statystyczną nakładania się 17 genów, zastosowano jednostronny dokładny test Fishera, przyjmując 17 przewidzianych genów docelowych jako zbiór zapytań oraz wszystkie 18 296 unikalnych wpisów zredukowanych do poziomu genów wykrytych w GSE36701 jako tło genomiczne. W tym tle 17 296 genów (94,5%) wykazało różnicową ekspresję przy FDR < 0.05, co odzwierciedla niemal powszechną supresję transkrypcyjną w porównaniu błony śluzowej odbytnicy w IBS-C. Wszystkie 17 przewidzianych genów docelowych znajdowało się wśród genów o różnicowej ekspresji (obserwowany stopień nakładania się 17/17, 100%). Biorąc pod uwagę 94,5-procentowy wskaźnik różnicowej ekspresji w tle, oczekiwany stopień nakładania się dla dowolnego losowo wybranego zbioru 17 genów wynosi 16,1 genu. Dokładny test Fishera dał wynik p = 0.384 przy skorygowanym o ciągłość ilorazie szans wynoszącym 2,03 (95% przedział ufności 0,12–33,73), co nie było istotne statystycznie przy α = 0.05 (Rycina 3A–C).
Wynik ten wskazuje, że zaobserwowana pokrywność 17/17 nie przekracza pokrywności oczekiwanej przypadkowo przy profilu ekspresji w całym genomie dla tego zbioru danych. W związku z tym wnioski te są interpretowane jako opisowy wzorzec kierunkowy, w którym wszystkie 17 przewidywanych celów było spójnie i znacząco obniżonych (downregulated) w tkance błony śluzowej odbytnicy w IBS-C, a nie jako dowód na statystyczne wzbogacenie lub niezależną walidację względem tła genomicznego. Formalne testowanie wzbogacenia wymagałoby replikacji w zbiorach danych transkrypcyjnych o bardziej selektywnych profilach ekspresji różnicowej, w których znaczenie statystyczne osiąga znacznie mniej niż połowa wszystkich genów. Należy podkreślić, że jednolity spadek ekspresji wszystkich 17 pokrywających się genów jest obserwacją opisową, a nie oddzielnie zwalidowanym wynikiem statystycznym, ponieważ tło ekspresji różnicowej w tym zbiorze danych jest samo w sobie przeważnie obniżone; wspólny kierunek spadkowy wśród pokrywających się genów był zatem oczekiwany i nie został poddany formalnemu testowi kierunkowości. Jednolity kierunek ten nie powinien być zatem interpretowany jako niezależny dowód statystyczny na skoordynowaną regulację specyficzną dla metabolitów.
Wzorce specyficzne dla metabolitów
Propionian wykazał największą liczbę wspólnych genów, w tym CASR, FFAR2, GCG, GNAQ, GPHN, GPR68, MLN oraz TBXA2R, co sugeruje możliwy udział szlaków sygnałowych reagujących na krótkołańcuchowe kwasy tłuszczowe oraz powiązanych z białkiem Gq. Masłonian wykazał wspólną ekspresję z HDAC3, co jest zgodne z biologią deacetylazy histonowej powiązanej z masłonianem, choć sama obniżona ekspresja mRNA nie potwierdza zmiany reaktywności na masłonian. Wspólne geny powiązane z kwasami żółciowymi obejmowały receptory jądrowe VDR oraz NR1H4, które są uznanymi efektorami sygnalizacji kwasów żółciowych w jelitach38,39. Tryptamina wykazała wspólną ekspresję z HTR1B, HTR2A, HTR2B oraz HTR6, co wskazuje na sygnalizację serotoninergiczną jako potencjalny moduł, będący układem o dobrze udokumentowanej roli w motoryce i sekrecji przewodu pokarmowego40. Kwas indole-3-mlekowy i kwas indole-3-propionowy wykazały wspólną ekspresję z KYAT1, a urolityna A z CASP3.
Wzbogacenie szlaków
Analiza wzbogacenia funkcjonalnego 17 wspólnych genów zidentyfikowała szlaki związane z sygnalizacją downstream receptora sprzężonego z białkiem G (GPCR), sygnalizacją Gαq, wiązaniem ligandów GPCR, synapsą serotoninergiczną, interakcjami ligand-receptor neuroaktywny, transdukcją sygnału wapniowego, sygnalizacją cAMP oraz sekrecją hormonów peptydowych. Wyniki te są zgodne ze składem zestawu genów i potwierdzają jego spójność biologiczną, jednak odzwierciedlają one adnotacje funkcjonalne przesłanych genów, a nie stanowią niezależnego dowodu na aktywność na poziomie całych szlaków.
Struktura sieci oddziaływań białko-białko
Konstrukcja sieci oddziaływań białko-białko oraz analiza wzbogacenia ścieżek sygnałowych zostały zinterpretowane w obrębie trzech komplementarnych sieci. W połączonej metasieci obejmującej 17 genów (Sieć 1) najbardziej wyraźną strukturą wspieraną przez adnotacje był komponent sygnalizacji GPCR/Gαq z centrum w GNAQ, łączący GNAQ z genami związanymi z receptorami, w tym TBXA2R, CASR, HTR2A i HTR2B. Zachowano również ograniczoną łączność receptorów serotoninowych, najsilniej między HTR2A i HTR2B, podczas gdy kilka innych genów pozostało izolowanych lub słabo połączonych przy wybranym progu ufności. Sieć specyficzna dla propionianu (Sieć 2) wykazała bardziej ograniczoną topologię, w której GNAQ zachowało wspierane przez adnotacje połączenia z CASR i TBXA2R, natomiast FFAR2, GPR68, GCG, GPHN i MLN były izolowane lub słabo połączone. Sieć tryptaminy/serotoniny (Sieć 3) obejmowała HTR1B, HTR2A, HTR2B i HTR6; w obrębie tego podzbioru HTR2A i HTR2B wykazały główne połączenie wspierane przez adnotacje, podczas gdy HTR1B i HTR6 nie były bezpośrednio połączone przy przyjętym progu (Rysunek 4A–C).
Dokowanie molekularne
Przeprowadzono dokowanie molekularne dla pięciu wybranych kompleksów metabolit-białko. Pary kwas żółciowy-receptor jądrowy wykazały korzystniejsze wyniki Vina niż urolityna A-CASP3 oraz tryptamina-HTR2A. Kompleks LCA-VDR uzyskał najlepszy wynik −10.0 kcal/mol, a następnie LCA-NR1H4/FXR (−9.9 kcal/mol) oraz UDCA-NR1H4/FXR (−9.4 kcal/mol). Urolityna A-CASP3 oraz tryptamina-HTR2A uzyskały niższe, lecz wciąż dopuszczalne wyniki wynoszące −7.1 kcal/mol (Tabela 2).
W przypadku kompleksu LCA-VDR (PDB ID: 1DB1) przewidziana poza była stabilizowana przez konwencjonalne wiązanie wodorowe pomiędzy tlenem grupy karboksylowej LCA a Ser278 (4,29 Å), wraz z rozległymi kontaktami hydrofobowymi z udziałem Leu230, Val234, Trp286, Val300, His305, Tyr295, Leu233 i His397, oraz dodatkowymi kontaktami van der Waalsa z Met272, Leu313, Ile271, Ile268, Leu309, Phe422, Val418, Ala231, Ala303, Cys288, Ser275 i Phe150. Najwyżej oceniona poza uzyskała wynik Vina wynoszący −10,0 kcal/mol, rozmiar kawerny 2055 Å3 oraz środek siatki w punkcie (10, 19, 33) (Tabela 3, Rysunek 5A,B).
W przypadku kompleksu LCA-NR1H4/FXR (PDB ID: 3DCT), wynik dokowania wynoszący −9.9 kcal/mol współwystępował z przewidywanymi wiązaniami wodorowymi z udziałem His294 i Ile335, oddziaływaniem π-Sigma z His294 oraz hydrofobowymi kontaktami typu Alkyl lub π-Alkyl z udziałem Met290, Met328, Ala291, Leu287, Ile352 i His447, przy czym dodatkowe kontakty van der Waalsa wspierały zakotwiczenie szkieletu steroidowego w kieszeni FXR (Tabela 4, Rysunek 6A,B).
Przewidziana poza kompleksu UDCA-NR1H4/FXR (PDB ID: 3DCT) wykazała konwencjonalne wiązanie wodorowe z His447 (3,66 Å), kolejne wiązanie wodorowe z Gly322 (3,46 Å), oddziaływanie π-anionowe z Val325 (4,96 Å) oraz wiązanie węgiel-wodór z Trp469 (4,51 Å). Mapa oddziaływań zidentyfikowała również niekorzystne kontakty donor-donor z Arg395 (3,89 Å) i Gln396 (3,40 Å), co sugeruje, że niższy wynik Vina dla UDCA w porównaniu z LCA w tej samej kieszeni receptora może wynikać z mniej korzystnej lokalnej geometrii lub elektrostatyki (Tabela 5, Rycina 7A,B).
W kompleksie urolityny A-CASP3 (PDB ID: 2DKO) przewidywany tryb wiązania charakteryzował się konwencjonalnymi wiązaniami wodorowymi z Gln161 (3,78 i 4,19 Å), Ser120 (3,95 Å) oraz Arg207 (3,05 i 3,77 Å), a dodatkowo był stabilizowany przez oddziaływania π-kationowe z Arg207, wiązanie wodorowe typu π-donora z Cys163 oraz dodatkowe kontakty π-alkilowe i siły van der Waalsa z udziałem Arg64, Ala162, His121, Ser205 i Trp206 (Tabela 6, Rysunek 8A,B).
W przypadku kompleksu tryptamina-HTR2A (PDB ID: 6A93), przewidywana poza została ustabilizowana przez elektrostatyczny mostek solny pomiędzy protonowaną aminą tryptaminy a Asp155, konserwowanym asparaginianem helisy transbłonowej 3 (D3.32 w numeracji Ballesteros-Weinsteina), który kotwiczy protonowaną aminę ligandów aminergicznych w receptorach serotoninowych i pokrewnych41,42,43, wraz z wiązaniami wodorowymi z Thr160 i Ser159, kontaktami aromatycznymi z Phe340 i Trp336 oraz oddziaływaniami π-Alkyl z Val156 i Ile163. Dodatkowe kontakty van der Waalsa z Tyr370, Phe339, Ser242, Phe243, Phe332 i Leu123 potwierdziły wzorzec wiązania w kieszeni ortosterycznej (Tabela 7, Rysunek 9A,B).
Walidacja protokołu dokowania
Aby ocenić wiarygodność protokołu dokowania, przeprowadzono dwa uzupełniające się eksperymenty kontrolne. W przypadku kontroli redokowania (pozytywnych) ligandy kokrystalizowane zostały wyekstrahowane z ich referencyjnych struktur rentgenowskich i ponownie zadokowane do ich natywnych miejsc wiązania. Najwyżej oceniona przewidywana poza dla analogu witaminy D VDX w VDR/1DB1 odbiegała o 0,87 Å od pozycji krystalograficznej, a ligand kokrystaliczny WAY-362450 w FXR/3DCT odbiegał o 1,79 Å; obie wartości znajdowały się poniżej konwencjonalnego progu akceptacji 2,0 Å, co potwierdza geometryczną poprawność protokołu dokowania dla tych systemów receptorowych (Rysunek 10A,B). W przypadku kontroli cross-dokowania (negatywnych) kwas litocholowy zadokowano do kaspazy-3 (2DKO), proteazy cysteinowej, dla której nie jest on znanym ligandem, co dało przewidywany wynik (−8,3 kcal/mol) słabszy o 1,7 kcal/mol niż w przypadku jego cognate target VDR (−10,0 kcal/mol), co jest zgodne z przewidywaną selektywnością miejsca wiązania. Dokowanie tryptaminy do VDR dało przewidywany wynik −6,4 kcal/mol w porównaniu z −7,1 kcal/mol dla jej cognate target HTR2A; różnica 0,7 kcal/mol mieści się w raportowanej niepewności wyników dokowania molekularnego ligandów będących metabolitami do białek docelowych i wskazuje zatem jedynie na umiarkowaną przewidywaną selektywność dla tego mniejszego ligandu (Rysunek 10C). Wspólnie kontrole te wskazują, że protokół dokowania odwzorowuje znane geometrie wiązania i rozróżnia pary cognate od non-cognate w przetestowanych warunkach, pozostając jednocześnie przewidywaniami obliczeniowymi, które nie zastępują eksperymentalnych pomiarów powinowactwa (Tabela 8).
Symulacja dynamiki molekularnej
Symulacje dynamiki molekularnej przeprowadzono dla pięciu priorytetowych kompleksów w trajektoriach produkcyjnych o czasie trwania 200 ns. Cztery kompleksy rozpuszczalne i receptorów jądrowych symulowano w jawny rozpuszczalniku wodnym, natomiast kompleks tryptaminy z HTR2A symulowano w jawnej dwuwarstwie lipidowej POPC, aby zapewnić fizjologicznie odpowiednie środowisko błonowe dla tego receptora sprzężonego z białkiem G. Analizy pozwoliły ocenić stabilność dynamiczną zakotwiczonych póz w warunkach zależnych od czasu oraz porównać względne zachowanie strukturalne różnych kompleksów (Tabela 9).
Profil RMSD kompleksu LCA-VDR/1DB1 wykazał krótki okres równoważenia podczas pierwszych 10 ns, po którym nastąpił stabilny plateau, z fluktuacjami głównie w zakresie 0,20–0,28 nm (Rysunek 11A). Wartości RMSF były niskie, a fluktuacje szkieletu białkowego wynosiły < 0,15 nm dla większości reszt (Rysunek 11B). Analiza wiązań wodorowych wykazała trwałą sieć 2–5 wiązań wodorowych, z okazjonalnymi wzrostami do 7 (Rysunek 11C). Promień gyracji (Rg) utrzymywał się w zakresie 1,25–1,75 nm, a powierzchnia dostępna dla rozpuszczalnika (SASA) utrzymywała się na poziomie około 130 nm2 (Rysunek 11D,E).
Kompleks urolithina A-CASP3/2DKO wykazał większą aktywność dynamiczną. Wartość RMSD początkowo wzrosła, a następnie oscylowała między 0,4 a 0,7 nm, z krótkotrwałym zdarzeniem o wysokim odchyleniu około 165 ns (Rysunek 12A). Analiza RMSF wykazała wysoką mobilność na poziomie reszt, przy czym największe fluktuacje zaobserwowano w obszarze elastycznej pętli wokół reszty 175 (Rysunek 12B). Analiza wiązań wodorowych ujawniła początkową rozległą sieć około 2–5 wiązań w ciągu pierwszych 30–40 ns, po której następowały głównie od 0 do 2 przerywanych wiązań (Rysunek 12C). Odpowiednie profile promienia gyracji i SASA przedstawiono na Rysunku 12D,E.
W przypadku systemów kwasów żółciowych NR1H4/FXR (3DCT), profil RMSD szkieletu białkowego utrzymywał się w stosunkowo wąskim zakresie przez większość trajektorii (Ryc. 13A), podczas gdy profil RMSF wykazał mniejszą mobilność w regionach rdzeniowych i większe fluktuacje w regionach elastycznych (Ryc. 13B). Kompleks LCA-3DCT utrzymywał około trzech do czterech trwałych wiązań wodorowych przez całą trajektorię, natomiast kompleks UDCA-3DCT wykazywał większe fluktuacje wiązań wodorowych oraz zmniejszenie ich liczby po około 125 ns. Profile promienia żyroskopowego dla systemów związanych z LCA i UDCA przedstawiono odpowiednio na Ryc. 13C,D, a odpowiadające im profile SASA przedstawiono na Ryc. 13E,F.
Dynamika molekularna błony kompleksu tryptaminy-HTR2A
Kompleks tryptamina-HTR2A/6A93 symulowano przez 200 ns w jawnej dwuwarstwie lipidowej POPC składającej się z 258 cząsteczek lipidów, jawnego trójmiejscowego modelu wody oraz 0,15 M NaCl, co dało całkowitą wielkość systemu wynoszącą około 100 925 atomów33,44,45. Receptor pozostał stabilnie osadzony w dwuwarstwie przez cały czas trwania trajektorii (Rysunek 14). Wartość RMSD szkieletu wzrosła z około 0,10 nm do stabilnego plateau w okolicach 0,15–0,20 nm w ciągu pierwszych 100 ns i pozostała stabilna później, przy czym wszystkie wartości były poniżej 0,25 nm, co wskazuje, że receptor zachował stabilną konformację w środowisku błony bez globalnego rozfałdowania (Rysunek 15A). Wartości RMSF dla poszczególnych reszt wykazały niskie fluktuacje w rdzeniu helis błonowych z oczekiwaną wyższą mobilnością w obszarach pętli i regionach terminalnych, co jest zgodne z typową elastycznością GPCR (Rysunek 15B). Promień bezwładności był ściśle ograniczony do wartości między około 2,06 a 2,12 nm, a SASA fluktuowała w wąskim zakresie bez postępującego dryfu; oba parametry potwierdziły zachowanie zwartego pęczka transmembrane (Rysunek 15C,D).
Wiązania wodorowe między białkiem a ligandem były utrzymywane przez cały czas trwania trajektorii (Rysunek 15E), przy czym odnotowano znaczne wahania w liczbie wiązań wodorowych, która mieściła się w przedziale od 1 do 3. Aby szczegółowo ocenić trwałość kluczowej interakcji jonowej, monitorowano przez całą trajektorię minimalną odległość między protonowanym azotem amoniowym tryptaminy a atomami tlenu grupy karboksylowej Asp155 (D3.32). Odległość ta pozostawała ściśle rozłożona wokół średniej wartości 0,270 nm (minimum 0,247 nm, maksimum 0,424 nm), a kontakt mostka solnego (< 0,4 nm) był utrzymywany przez 99,9% czasu symulacji, z jedynie dwoma krótkotrwałymi odchyleniami i bez żadnego trwałego zdarzenia dysocjacji (Rysunek 16). Wyniki te sugerują, że konserwatywna interakcja jonowa Asp155 była wystarczająca do stabilizacji tryptaminy w kieszeni ortosterycznej HTR2A podczas symulacji w błonie.
Wolna energia wiązania MM-PBSA i dekompozycja na poszczególne reszty
Przeprowadzono analizę MM-PBSA, aby wprowadzić dodatkową warstwę priorytetyzacji energetycznej dla pięciu kompleksów (Tabela 10). W przypadku czterech kompleksów w środowisku wodnym dekompozycja na poszczególne reszty pozwoliła zidentyfikować głównych kontrybutorów energetycznych dla każdego przewidzianego modelu wiązania. W kompleksie LCA-VDR/1DB1 ligand oraz Gln317 wykazały korzystny wkład, podczas gdy Trp286 wykazał wkład niekorzystny. W kompleksie urolityna A-CASP3/2DKO reszty Arg64 i Arg207 wykazały silnie ujemne wkłady na poziomie poszczególnych reszt, co wskazuje na znaczną stabilizację polarną lub elektrostatyczną; niemniej jednak odpowiadająca im trajektoria pozostała wysoce dynamiczna, co dowodzi, że korzystna energetyka na poziomie reszt sama w sobie nie gwarantuje trwałej stabilności kompleksu. W systemach 3DCT wiązanie LCA było napędzane przede wszystkim przez Arg331, natomiast wiązanie UDCA angażowało bardziej rozproszoną sieć energetyczną obejmującą Glu326, Asp394, Arg395, Arg441 oraz Asp470. W czterech systemach wodnych dekompozycja MM-PBSA potwierdziła względną priorytetyzację kompleksów opartych na LCA.
W przypadku kompleksu tryptaminy-HTR2A/6A93 osadzonego w błonie, analiza MM-PBSA została przeprowadzona na podsystemie białko-ligand wyodrębnionym z trajektorii dwuwarstwy46,47. Odnotowano korzystne wkłady dla liganda oraz Asp155 (D3.32), który był zdecydowanie dominującym stabilizującym wkładem na poziomie poszczególnych reszt, co jest zgodne z interakcją mostka solnego zidentyfikowaną zarówno w dokowaniu, jak i w analizach odległości trajektorii. Trp137 wykazał największy niekorzystny wkład na resztę spośród otaczających reszt kieszeni ortosterycznej (Ser86, Phe87, Phe133, Phe140, Phe141, Val156, Ser159, Thr160, Ile163, Val167, Tyr171), które wspólnie tworzą aromatyczną i polarną sieć kontaktów wyścielającą kieszeń wiążącą. Wartości te stanowią względne szacunki obliczeniowe służące do priorytetyzacji strukturalnej i nie są eksperymentalnymi powinowactwami wiązania.
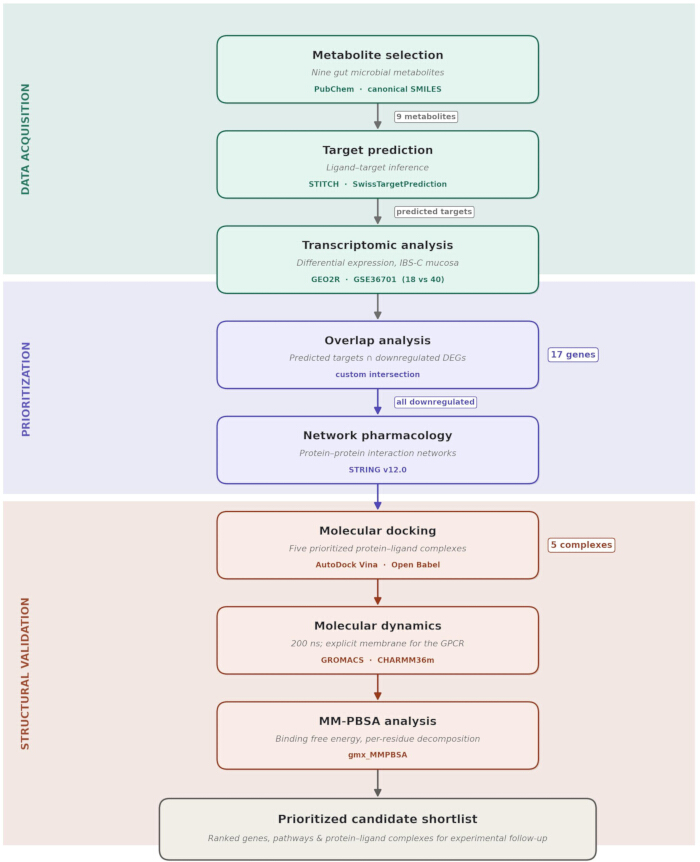
Rycina 1: Obliczeniowy schemat priorytetyzacji genów gospodarza powiązanych z metabolitami w IBS-C. Schematyczne przedstawienie ośmioetapowego procesu integrującego wybór metabolitów, predykcję celów, analizę różnicowej ekspresji transkrypcyjnej, analizę nakładania się, analizę wzbogacenia sieci i szlaków, dokowanie molekularne, symulację dynamiki molekularnej oraz analizę wolnej energii wiązania MM-PBSA. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
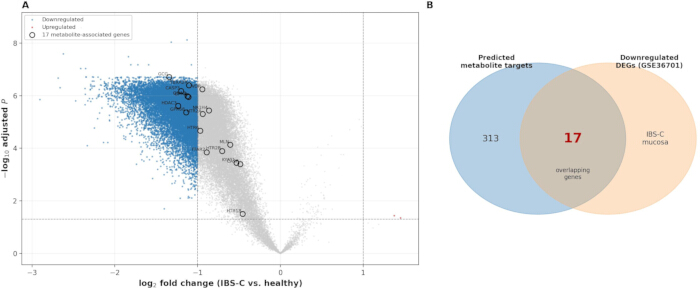
Rycina 2: Analiza różnicowej ekspresji i nakładania się metabolitów z celami w błonie śluzowej IBS-C. (A) Wykres wulkaniczny różnicowej ekspresji na poziomie genów w GSE36701. Niebieskie punkty: geny o istotnie obniżonej ekspresji; czerwone punkty: geny o istotnie podwyższonej ekspresji; szare punkty: geny nieistotne. Wybrane nakładające się geny powiązane z metabolitami zostały oznaczone. (B) Diagram Venna pokazujący nakładanie się 330 unikalnych przewidywanych celów metabolicznych i genów o obniżonej ekspresji w GSE36701; wspólnych było 17 genów. Aby wyświetlić większą wersję tej ryciny, kliknij tutaj.
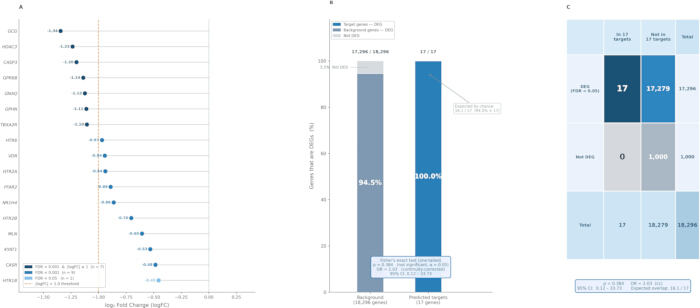
Rysunek 3: Ocena statystyczna 17 przewidywanych genów celów metabolicznych w odniesieniu do GSE36701. (A) Log2 krotności zmiany (fold change) dla każdego z 17 genów, zakolorowane według stopnia istotności. (B) Szybkość różnicowej ekspresji genów tła w porównaniu do przewidywanych celów, z zastosowaniem dokładnego testu Fishera. (C) Do dokładnego testu Fishera wykorzystano tabelę kontyngencji 2x2. Wszystkie 17 celów było istotnie obniżonych (downregulated); nakładanie się tych danych interpretowane jest jako opisowy wzorzec kierunkowy, a nie wzbogacenie statystyczne. Kliknij tutaj, aby wyświetlić większą wersję tego rysunku.
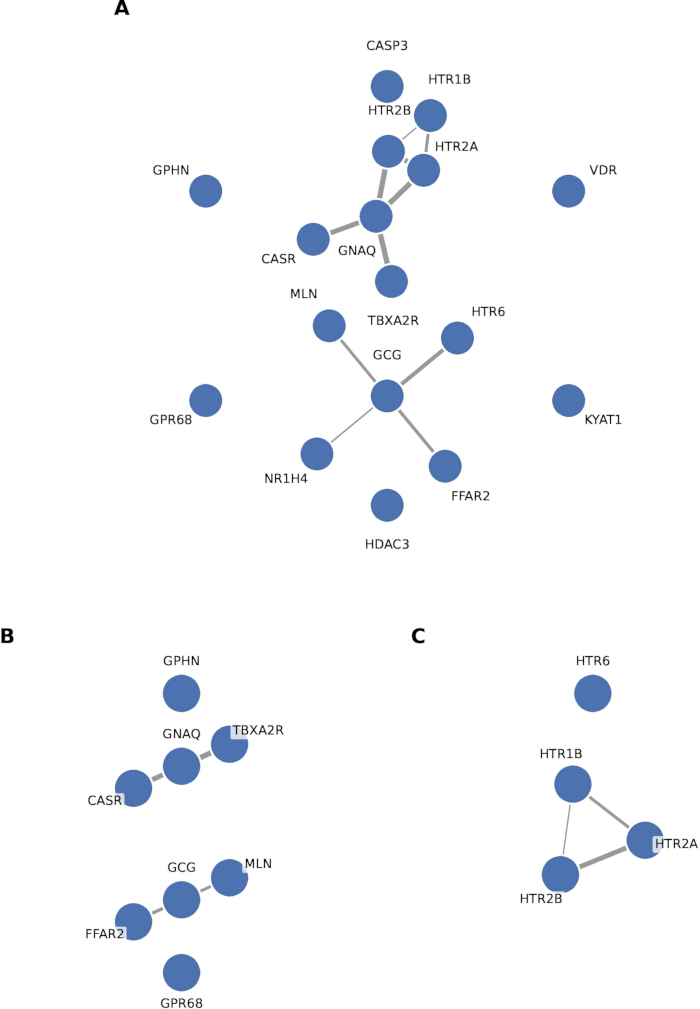
Rycina 4: Konstrukcja złożonej sieci interakcji białko-białko oraz wzbogacenie ścieżek w sieciach interakcji białko-białko dla nakładających się genów związanych z metabolitami. (A) Sieć 1: połączona meta-sieć wszystkich 17 genów. (B) Sieć 2: specyficzna dla propionianu sieć ośmiu genów (CASR, FFAR2, GCG, GNAQ, GPHN, GPR68, MLN, TBXA2R). (C) Sieć 3: sieć tryptaminy/serotoniny czterech genów (HTR1B, HTR2A, HTR2B, HTR6). Sieci zostały wygenerowane dla Homo sapiens, stosując konstrukcję sieci interakcji białko-białko i wzbogacenie ścieżek przy poziomie ufności ≥ 0,700. Krawędzie reprezentują funkcjonalne powiązania potwierdzone adnotacjami Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
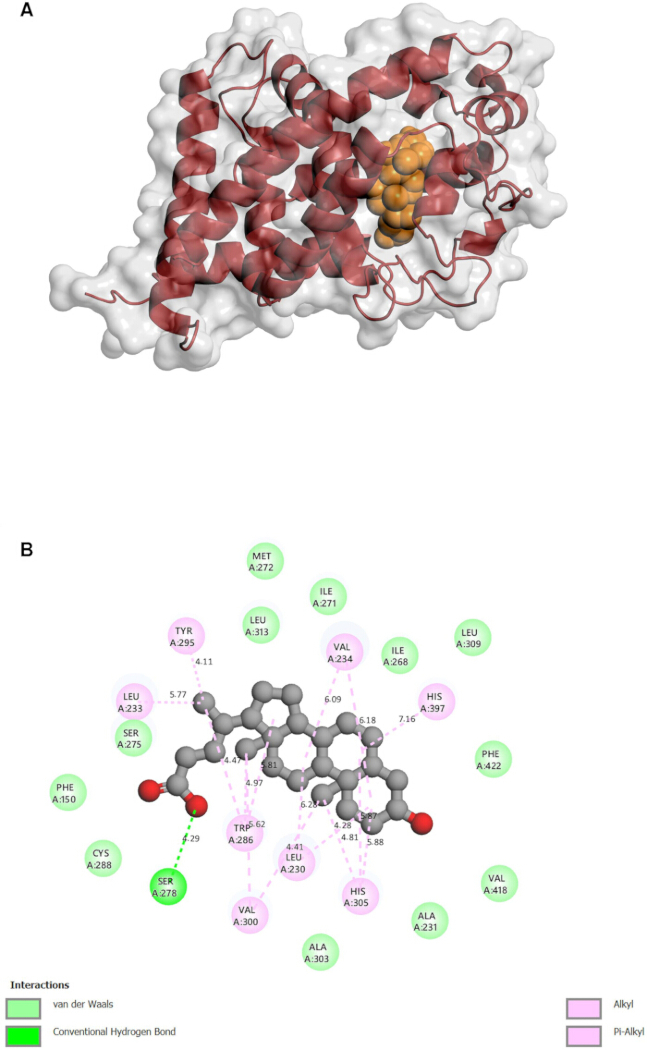
Rycina 5: Trójwymiarowa i dwuwymiarowa reprezentacja strukturalna kwasu litocholowego w kompleksie z VDR (PDB ID: 1DB1). (A) Trójwymiarowy model powierzchniowy i schematyczny (cartoon), w którym kwas litocholowy przedstawiono w formie sfer. (B) Dwuwymiarowa mapa oddziaływań pokazująca wiązanie wodorowe z Ser278 oraz otaczające kontakty hydrofobowe i siły van der Waalsa. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
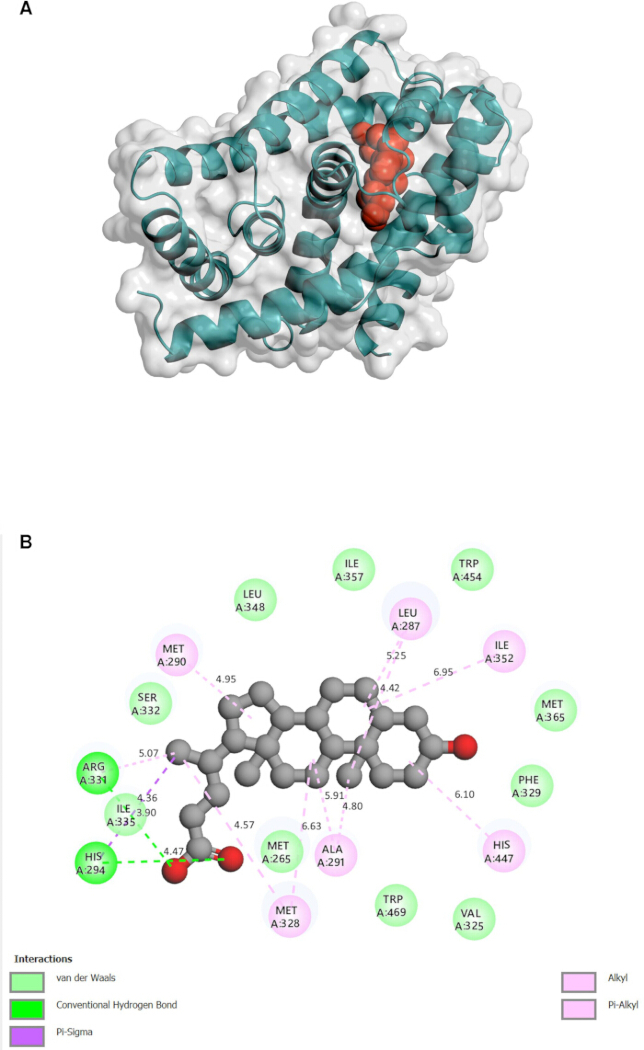
Rycina 6. Trójwymiarowa i dwuwymiarowa reprezentacja strukturalna kwasu litocholowego w kompleksie z NR1H4/FXR (PDB ID: 3DCT). (A) Reprezentacja powierzchniowa i schematyczna (cartoon) w trzech wymiarach. (B) Dwuwymiarowa mapa oddziaływań pokazująca wiązania wodorowe z His294 i Ile335, oddziaływanie π-Sigma oraz kontakty otaczające. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
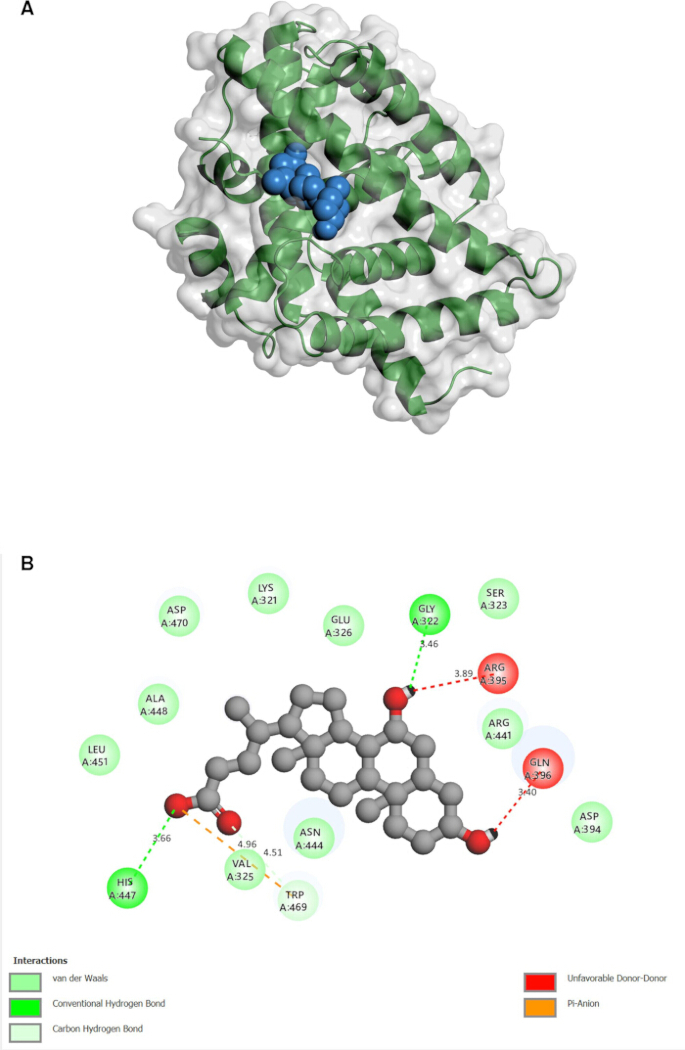
Rycina 7: Trójwymiarowa i dwuwymiarowa reprezentacja strukturalna kwasu ursodeoksycholowego w kompleksie z NR1H4/FXR (PDB ID: 3DCT). (A) Trójwymiarowa reprezentacja powierzchniowa i schematyczna (cartoon). (B) Dwuwymiarowa mapa oddziaływań wykazująca wiązania wodorowe z His447 i Gly322, oddziaływanie π-anionowe z Val325, wiązanie węgiel-wodór z Trp469 oraz niekorzystne kontakty donor-donor z Arg395 i Gln396. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
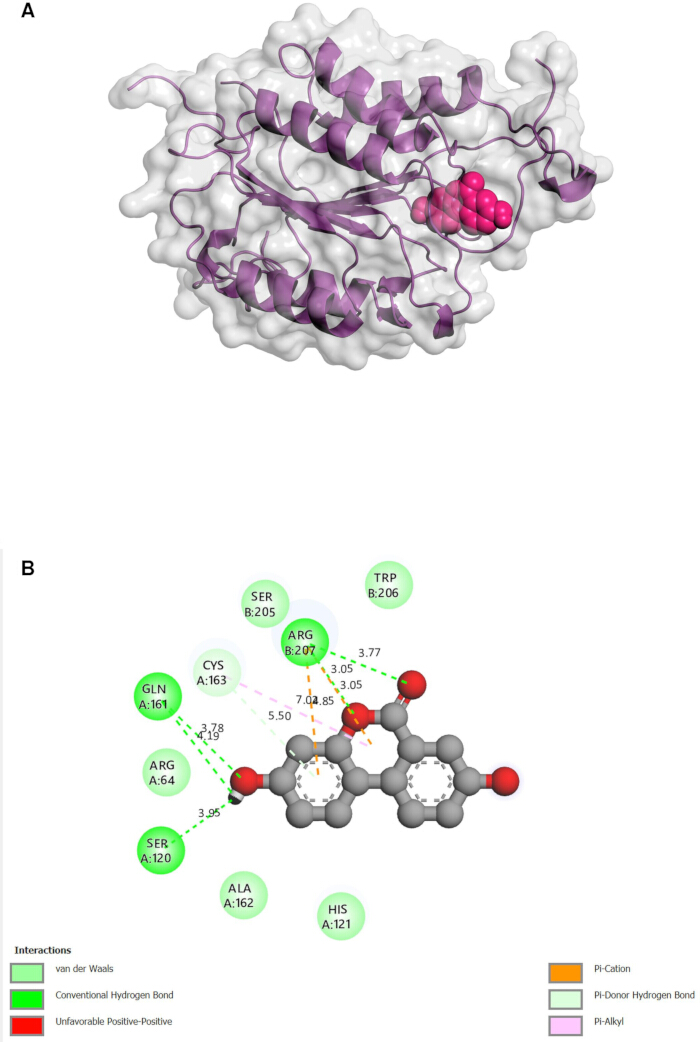
Rysunek 8: Trójwymiarowa i dwuwymiarowa reprezentacja strukturalna urolityny A w kompleksie z CASP3 (PDB ID: 2DKO). (A) Trójwymiarowa reprezentacja powierzchniowa i schematyczna (cartoon). (B) Dwuwymiarowa mapa oddziaływań przedstawiająca wiązania wodorowe z Gln161, Ser120 i Arg207, oddziaływania π-kation z Arg207, wiązanie wodorowe π-donor z Cys163 oraz kontakty otaczające. Aby zobaczyć powiększoną wersję tego rysunku, kliknij tutaj.
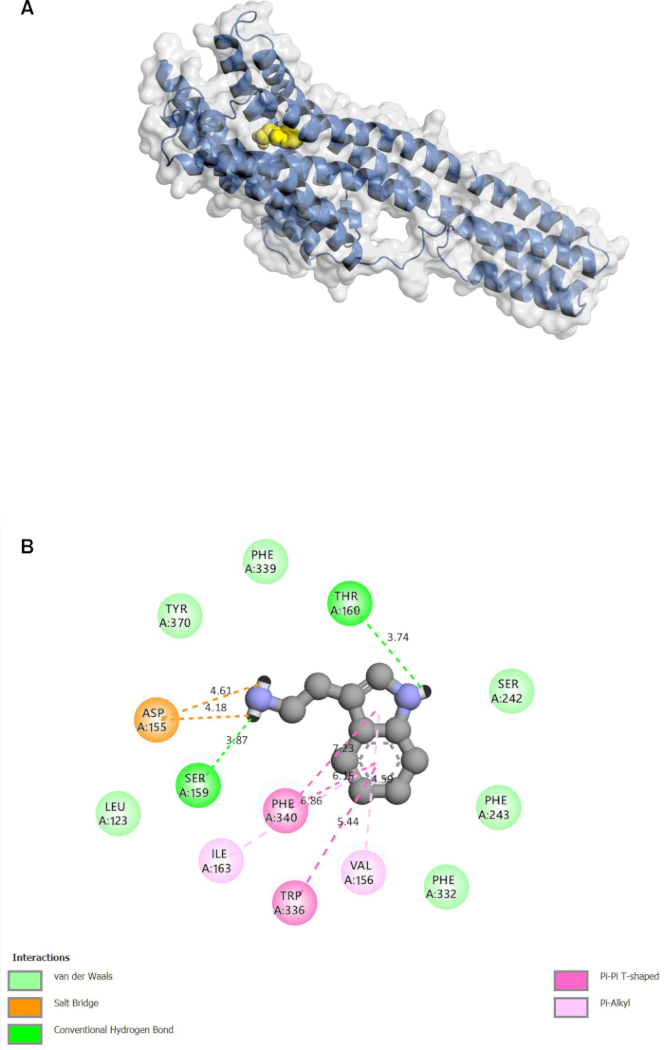
Rycina 9: Trójwymiarowa i dwuwymiarowa reprezentacja strukturalna tryptaminy w kompleksie z HTR2A (PDB ID: 6A93). (A) Trójwymiarowa reprezentacja powierzchniowa i schematyczna wygenerowana w programie do trójwymiarowej wizualizacji molekularnej. (B) Dwuwymiarowa mapa oddziaływań wygenerowana w narzędziu do wizualizacji molekularnej i tworzenia dwuwymiarowych schematów oddziaływań, ilustrująca mostek solny Asp155 oraz dodatkowe oddziaływania w miejscu wiązania. Proszę kliknąć tutaj, aby zobaczyć powiększoną wersję tej ryciny.
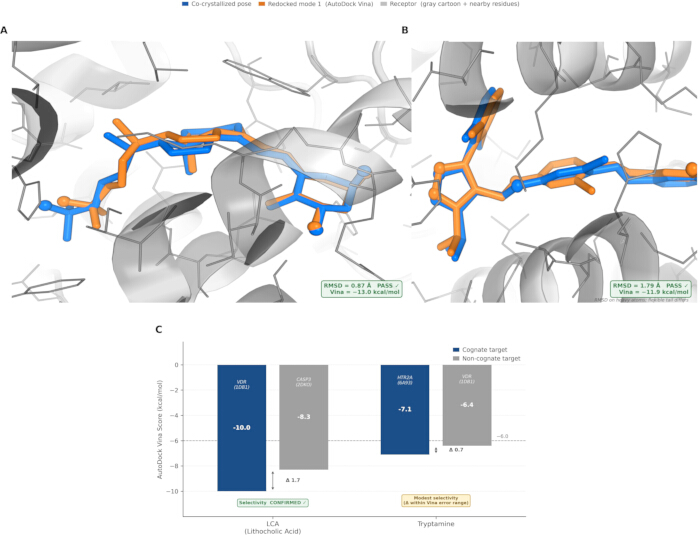
Rysunek 10: Walidacja protokołu dokowania. (A,B) Redokowanie ligandów kokrystalizowanych do struktur VDR/1DB1 (RMSD 0.87 Å) i FXR/3DCT (RMSD 1.79 Å); nałożone pozy krystalograficzne i redokowane, obie poniżej progu akceptacji 2.0 Å. (C) Selektywność dokowania krzyżowego: wyniki Vina dla ligandów kognatywnych i niekognatywnych dla kwasu litocholowego i tryptaminy. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
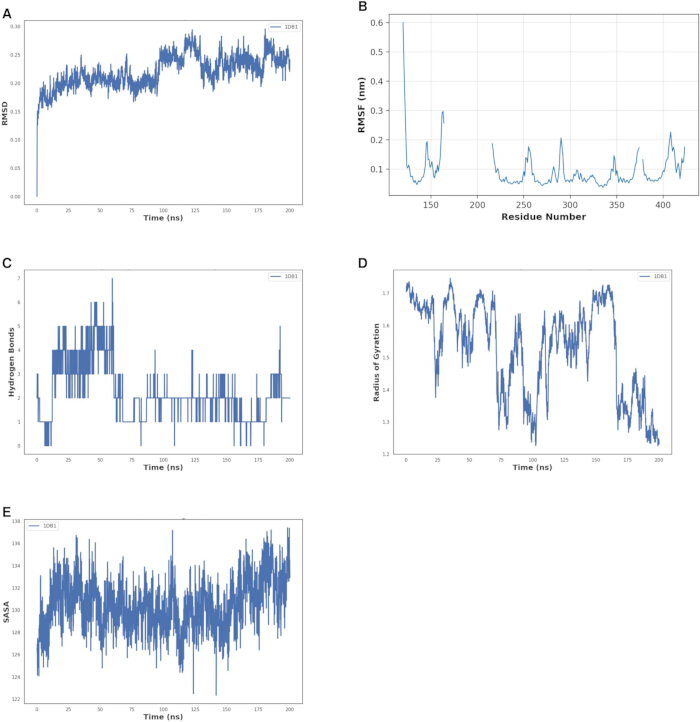
Rycina 11. Analiza trajektorii dynamiki molekularnej kompleksu LCA-VDR/1DB1 w czasie 200 ns. (A) Profil RMSD. (B) Profil RMSF. (C) Liczba wiązań wodorowych. (D) Profil promienia gyracji. (E) Profil SASA. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
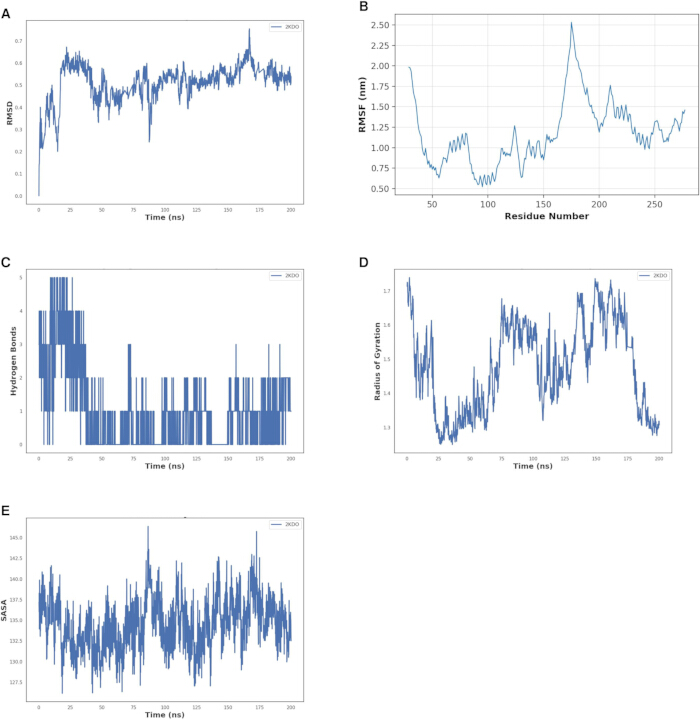
Rycina 12: Analiza trajektorii dynamiki molekularnej kompleksu urolityny A-CASP3/2DKO w czasie 200 ns. (A) Profil RMSD wykazujący szerokie fluktuacje konformacyjne i przejściowe zdarzenie o wysokim odchyleniu w okolicach 165 ns. (B) Profil RMSF wykazujący wyraźną elastyczność na poziomie reszt w pobliżu reszty 175. (C) Liczba wiązań wodorowych. (D) Profil promienia żyroskopowego. (E) Profil SASA. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
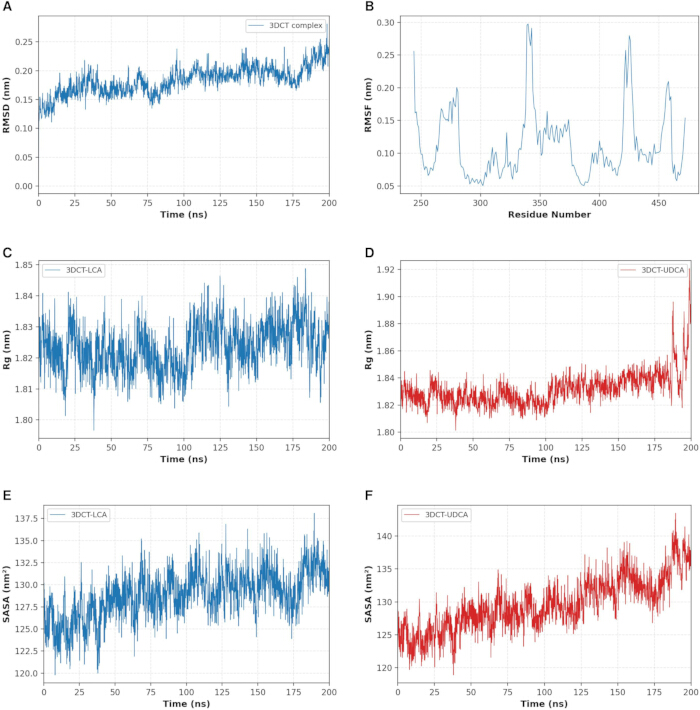
Rycina 13: Analiza trajektorii dynamiki molekularnej systemów kwasów żółciowych NR1H4/FXR (3DCT) w czasie 200 ns. (A) Profil RMSD szkieletu dla kompleksu 3DCT. (B) Profil RMSF szkieletu. (C) Profil promienia żyracji dla 3DCT-LCA. (D) Profil promienia żyracji dla 3DCT-UDCA. (E) Profil SASA dla 3DCT-LCA. (F) Profil SASA dla 3DCT-UDCA. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
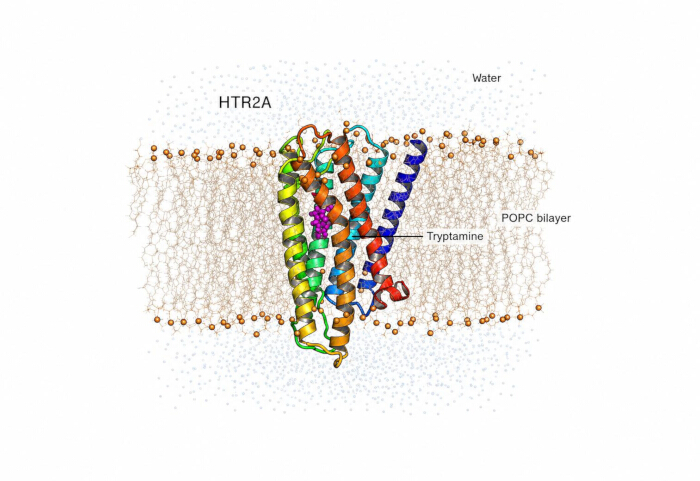
Rysunek 14: Kompleks tryptamina-HTR2A osadzony w jawnej lipidowej dwuwarstwie POPC. Receptor przedstawiono w formie schematycznej (cartoon) przecinającej dwuwarstwę, lipidy POPC jako linie z zaznaczonymi grupami fosforanowymi w głowach, a tryptaminę wewnątrz kieszeni ortosterycznej. Woda jest pokazana powyżej i poniżej błony. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
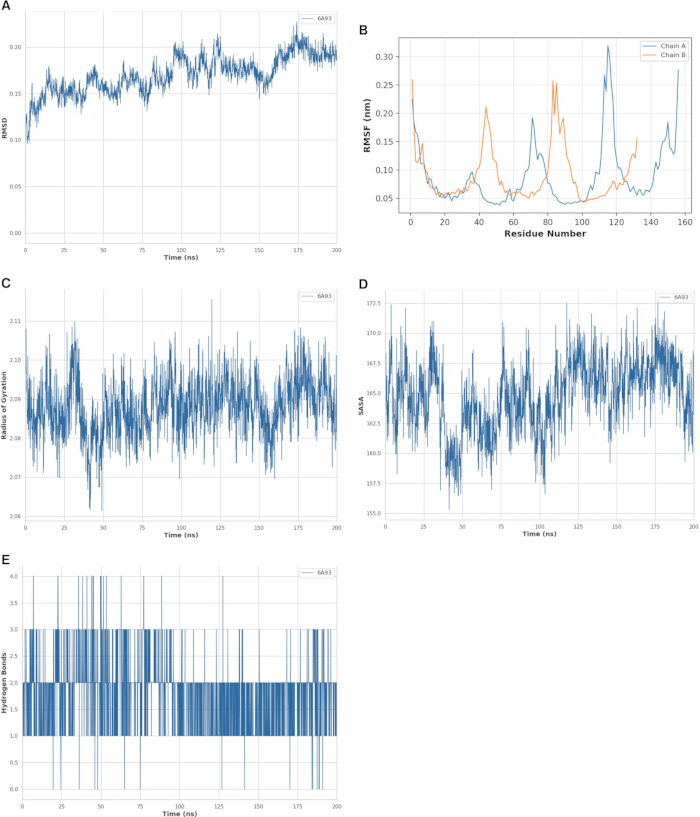
Rycina 15: Analiza trajektorii dynamiki molekularnej kompleksu tryptamina-HTR2A/6A93 w czasie 200 ns w jawnej dwuwarstwie lipidowej POPC. (A) Profil RMSD szkieletu białkowego. (B) Profil RMSF dla poszczególnych reszt. (C) Profil promienia gyracji. (D) Profil SASA. (E) Liczba wiązań wodorowych białko-ligand. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
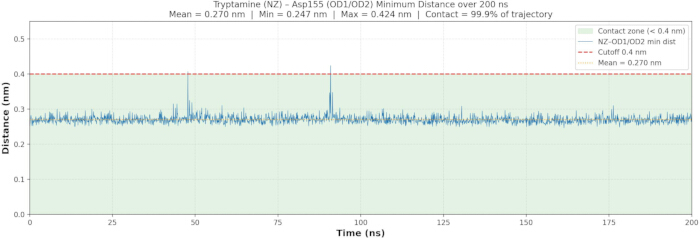
Rysunek 16: Trwałość oddziaływania jonowego tryptamina–Asp155 (D3.32) w trajektorii błonowej trwającej 200 ns. Minimalna odległość między azotem amonowym tryptaminy a atomami tlenu grupy karboksylowej Asp155 jest przedstawiona w funkcji czasu; linia przerywana oznacza próg kontaktu mostka solnego wynoszący 0.4 nm. Kontakt był utrzymywany przez 99.9% czasu symulacji. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
| Symbol genu | Metabolit(y) wyjściowy(e) | Kategoria funkcjonalna | log2FC | FDR (skorygowana wartość P) | Poziom istotności |
| GCG | Propionian | Białko powiązane z hormonami peptydowymi | −1.342 | 1,97e−7 | FDR (częstość fałszywych odkryć) <0.001 & |logFC > 1 |
| HDAC3 | Maślan | Enzym | −1.234 | 2,44e−6 | FDR (częstość fałszywych odkryć) <0.001 & |logFC| > 1 |
| Kaspaza 3 | Urolityna A | Enzym | −1.198 | 6,66e−7 | FDR (korekta na wielu testach) <0.001 & |logFC| > 1 |
| GPR68 | Propionian | Receptor błonowy | −1.137 | 4,35e−6 | FDR (skorygowana wartość p dla wielu porównań) <0.001 & |logFC| > 1 |
| GNAQ | Propionian | Wewnątrzkomórkowe białko sygnałowe | −1.122 | 1,05e−6 | FDR (kontrola błędów pierwszego rodzaju w testach wielokrotnych) <0.001 & |logFC| > 1 |
| GPHN | Propionian | Inne białko wewnątrzkomórkowe | −1.109 | 1,13e−6 | FDR (częstość fałszywych odkryć) <0.001 & |logFC| > 1 |
| TBXA2R | Propionian | Receptor błonowy | −1.104 | 4,04e−7 | FDR (korekta na fałszywe odkrycia) <0.001 & |logFC| > 1 |
| HTR6 | Tryptamina | Receptor błonowy | −0.967 | 2,17e−5 | FDR (korekta na całkowity wskaźnik fałszywych odkryć) <0.001 |
| VDR | Kwas litocholowy | Receptor jądrowy | −0.942 | 5,73e−7 | FDR (korekta błędów wielokrotnych) <0.001 |
| HTR2A | Tryptamina | Receptor błonowy | −0.937 | 4,99e−6 | FDR (korekta na wielokrotne testowanie) <0.001 |
| FFAR2 | Propionian | Receptor błonowy | −0.889 | 1,44e−4 | FDR (kontrola tempa odkryć fałszywych) <0.001 |
| NR1H4 | Kwas litocholowy / Kwas ursodeoksycholowy | Receptor jądrowy | −0.861 | 3,68e−6 | FDR (kontrola błędów pierwszego rodzaju) <0.001 |
| HTR2B | Tryptamina | Receptor błonowy | −0.702 | 1,29e−4 | FDR (stopień fałszywego odkrycia) <0.001 |
| MLN | Propionian | Białko powiązane z hormonem peptydowym | −0.605 | 7,39e−5 | FDR (kontrola fałszywych odkryć) <0.001 |
| KYAT1 | Kwas indolo-3-mlekowy / Kwas indolo-3-propionowy | Enzym | −0.530 | 3,61e−4 | FDR (korekta na fałszywe odkrycia) <0.001 |
| CASR | Propionian | Receptor błonowy | −0.483 | 4,05e−4 | FDR (częstość fałszywych odkryć) <0.001 |
| HTR1B | Tryptamina | Receptor błonowy | −0.455 | 3,18e−2 | FDR (korygowanie stopy fałszywych odkryć) <0.05 |
Tabela 1: Przewidywane geny docelowe powiązane z metabolitami, nakładające się z genami o różnej ekspresji w zbiorze danych błony śluzowej odbytnicy w IBS-C. Wszystkie wymienione nakładające się geny były wyciszone. Tabela 1 została przesłana oddzielnie jako arkusz kalkulacyjny i zawiera dla każdego celu: metabolit(y) pochodzenia, kategorię funkcjonalną, źródło przewidywania celu (przewidywanie celu interakcji chemiczno-białkowej, program dokowania molekularnego lub oba), łączny wynik interakcji z przewidywania celu interakcji chemiczno-białkowej oraz prawdopodobieństwo z programu dokowania molekularnego, a w razie dostępności: poziom przewidywania, log2 fold change oraz FDR z poziomem istotności ekspresji. Źródło: Wartości ekspresji genów pobrano z tabeli różnicowej ekspresji GSE36701 ze zgrupowanymi genami (sonda o najniższym FDR na gen). Źródło przewidywania celu oraz wartości ufności skompilowano z wyników przewidywania celu interakcji chemiczno-białkowej i programu dokowania molekularnego, stosując progi: łączny wynik interakcji z przewidywania celu interakcji chemiczno-białkowej ≥ 0,700 oraz prawdopodobieństwo z programu dokowania molekularnego ≥ 0,70. Wyniki przewidywania celu interakcji chemiczno-białkowej to wyniki łączone w skali 0–1; STP oznacza prawdopodobieństwo z programu dokowania molekularnego. Poziom 1 = ścisłe wsparcie przewidywania celu interakcji chemiczno-białkowej; Poziom 1+ = ścisłe wsparcie przewidywania celu interakcji chemiczno-białkowej potwierdzone przez program dokowania molekularnego.
| Kompleks | Białko (PDB ID) | Ligand | Wynik Vina (kcal/mol) | Wielkość otworu (A^3) | Centrum siatki X,Y,Z (A) | Pole wyszukiwania (A) |
| LCA-VDR | VDR (1DB1) | Kwas litocholowy | −10.0 | 2055 | 10, 19, 33 | 25 x 25 x 25 |
| LCA-NR1H4/FXR | NR1H4/FXR (3DCT) | Kwas litocholowy | −9.9 | 3395 | 137, 31, 78 | 25 x 25 x 25 |
| UDCA-NR1H4/FXR | NR1H4/FXR (3DCT) | Kwas ursodeoksycholowy | −9.4 | 3395 | 137, 31, 78 | 25 x 25 x 25 |
| Urolityna A-CASP3 | CASP3 (2DKO) | Urolityna A | −7.1 | 233 | 37, 34, 32 | 25 x 25 x 25 |
| Tryptamina-HTR2A | HTR2A (6A93) | Tryptamina | −7.1 | 3238 | 12, −1, 61 | 25 x 25 x 25 |
Tabela 2: Wyniki dokowania molekularnego: najwyżej ocenione wyniki dokowania molekularnego ligandów metabolitów do białek docelowych oraz parametry kawerny dla pięciu priorytetowych kompleksów białko-ligand. Rozmiar kawerny podano w Å3. Źródło: Docking_Validation/Results/Docking_Validation_Results.xlsx, arkusz 'Original_Docking_Scores'. Dokowanie molekularne ligandów metabolitów do białek docelowych; exhaustiveness = 8, seed = 42 (stały), num_modes = 9 dla wszystkich kompleksów; przedstawiono najwyżej ocenioną (tryb 1) pozę.
| Typ oddziaływania | Pozostałość/pozostałości | Odległość (A) | Uwagi |
| Konwencjonalne wiązanie wodorowe | Ser278 | 4.29 | tlen grupy karboksylowej LCA |
| Kontakt hydrofobowy / Pi-Alkyl | Leu230, Val234, Trp286, Val300, His305, Tyr295, Leu233, His397 | - | |
| Kontakt van der Waalsa | Met272, Leu313, Ile271, Ile268, Leu309, Phe422, Val418, Ala231, Ala303, Cys288, Ser275, Phe150 | - |
Tabela 3: Tryby wiązania wygenerowane dla dokowania kwasu litocholowego do VDR (PDB ID: 1DB1).Źródło: narzędzie do wizualizacji molekularnej i dwuwymiarowych diagramów interakcji, dwuwymiarowe diagramy interakcji ligand-pozostałość, zgodnie z opisem w sekcji Wyniki (Dokowanie molekularne) manuskryptu. „-” oznacza, że wartość odległości nie została indywidualnie podana dla tego kontaktu.
| Typ oddziaływania | Pozostałość/pozostałości | Odległość (A) | Notatki |
| Wiązanie wodorowe | His294 | - | |
| Wiązanie wodorowe | Ile335 | - | |
| oddziaływanie pi-sigma | His294 | - | |
| Alkilowe / Pi-alkilowe (hydrofobowe) | Met290, Met328, Ala291, Leu287, Ile352, His447 | - | |
| Kontakt van der Waalsa | Dodatkowe reszty kieszeni (nieokreślone pojedynczo w źródle) | - | Wspiera dopasowanie szkieletu steroidowego |
Tabela 4: Tryby wiązania wygenerowane dla dokowania kwasu litocholowego z NR1H4/FXR (PDB ID: 3DCT).
Źródło: narzędzie do wizualizacji molekularnej i tworzenia dwuwymiarowych schematów oddziaływań; dwuwymiarowe schematy oddziaływań ligand-pozostałość, przedstawione w sekcji Wyniki (Dokowanie molekularne) manuskryptu. Znak „-” oznacza, że dla danego kontaktu nie podano indywidualnej wartości odległości.
| Typ oddziaływania | Pozostałość/-ości | Odległość (A) | Notatki |
| Konwencjonalne wiązanie wodorowe | His447 | 3.66 | |
| Wiązanie wodorowe | Gly322 | 3.46 | |
| Oddziaływanie pi-anionowe | Val325 | 4.96 | |
| Wiązanie węgiel-wodór | Trp469 | 4.51 | |
| Niekorzystny kontakt donor-donor | Arg395 | 3.89 | |
| Niekorzystny kontakt donora z donorem | Gln396 | 3.40 |
Tabela 5: Sposoby wiązania wygenerowane dla dokowania kwasu ursodeoksycholowego z NR1H4/FXR (PDB ID: 3DCT). Źródło: narzędzia do wizualizacji molekularnej i dwuwymiarowych diagramów oddziaływań 2D ligand-residue, zgodnie z opisem w sekcji Wyniki (Dokowanie molekularne) artykułu. Znak „-“ oznacza, że wartość odległości dla danego kontaktu nie została raportowana indywidualnie.
| Typ oddziaływania | Pozostałość(y) | Odległość (A) | Uwagi |
| Konwencjonalne wiązanie wodorowe | Gln161 | 3.78 | |
| Konwencjonalne wiązanie wodorowe | Gln161 | 4.19 | drugi kontakt |
| Konwencjonalne wiązanie wodorowe | Ser120 | 3.95 | |
| Konwencjonalne wiązanie wodorowe | Arg207 | 3.05 | |
| Konwencjonalne wiązanie wodorowe | Arg207 | 3.77 | drugi kontakt |
| Oddziaływanie pi-kationowe | Arg207 | - | |
| Wiązanie wodorowe z donorem pi | Cys163 | - | |
| kontakt pi-alkilowy / van der Waalsa | Arg64, Ala162, His121, Ser205, Trp206 | - |
Tabela 6: Tryby wiązania wygenerowane podczas dokowania urolityny A do CASP3 (PDB ID: 2DKO).Źródło: narzędzie do wizualizacji molekularnej i dwuwymiarowych schematów oddziaływań – dwuwymiarowe schematy oddziaływań ligand-pozostałość, opisane w sekcji Wyniki (Dokowanie molekularne) manuskryptu. „-” oznacza, że wartość odległości dla danego kontaktu nie została podana indywidualnie.
| Typ oddziaływania | Pozostałość(y) | Odległość (A) | Uwagi |
| Elektrostatyczny mostek solny | Asp155 (D3.32) | - | protonowana amina tryptaminy |
| Wiązanie wodorowe | Thr160 | - | |
| Wiązanie wodorowe | Ser159 | - | |
| Kontakt aromatyczny | Phe340, Trp336 | - | |
| Oddziaływanie pi-alkilowe | Val156, Ile163 | - | |
| Kontakt van der Waalsa | Tyr370, Phe339, Ser242, Phe243, Phe332, Leu123 | - |
Tabela 7: Tryby wiązania wygenerowane dla dokowania tryptaminy do HTR2A (PDB ID: 6A93). Źródło: narzędzie do wizualizacji molekularnej i dwuwymiarowych schematów oddziaływań — dwuwymiarowe schematy oddziaływań ligand-pozostałość, zgodnie z opisem w sekcji Wyniki (Dokowanie molekularne) manuskryptu. Symbol „-” oznacza, że wartość odległości dla danego kontaktu nie została podana indywidualnie.
| (A) Walidacja redockingu (kontrole pozytywne) | ||||||
| Id PDB | Białko | Ligand kokryształu | Wynik Viny (kcal/mol) | RMSD (Å) | Próg (A) | Wynik |
| 1DB1 | VDR | VDX (analog witaminy D) | −13.0 | 0.87 | 2.0 | PASS |
| 3DCT (trójwymiarowa tomografia komputerowa) | FXR | WAY-362450 (064) | −11.9 | 1.79 | 2.0 | PASS |
| (B) Walidacja cross-dockingu (kontrole negatywne) | ||||||
| Ligand | Cel pokrewny (PDB) | Wynik pokrewieństwa (kcal/mol) | Cel niehomologiczny (PDB) | Wynik dla nienaturalnych par zasad (kcal/mol) | Delta (kcal/mol) | Selektywność |
| Kwas litocholowy | VDR (1DB1) | −10.0 | CASP3 (2DKO) | −8.3 | 1.7 | Potwierdzono |
| Tryptamina | HTR2A (6A93) | −7.1 | VDR (1DB1) | −6.4 | 0.7 | Umiarkowana (w granicach niepewności Viny +/−0,5–1,0) |
Tabela 8: Wyniki walidacji protokołu dokowania: wartości RMSD dla redokowania (kontrole pozytywne) oraz wyniki cross-dokowania (kontrole negatywne). Źródło: Docking_Validation/Results/Docking_Validation_Results.xlsx oraz Docking_Validation/Logs/*.log (dokowanie molekularne ligandów metabolicznych do białek docelowych, exhaustiveness = 8, seed = 42, pole 25 Å × 25 Å × 25 Å). RMSD obliczono poprzez dopasowanie nazw atomów ciężkich (bez superpozycji).
| Kompleks | RMSD (nm), średnia + / – SD (zakres) | Rg (nm), średnia + / – SD (zakres) | SASA (nm^2), średnia + / – SD (zakres) | Więzi H, średnia + / – SD (zakres) | RMSF (nm), średnia (max) |
| LCA-VDR/1DB1 | 0.230 + / – 0.025 (0.167–0.296) | 1.889 + / − 0.009 (1.863–1.919) | 130.4 + / − 2.3 (122.3–137.4) | 1.9 + / − 0.9 (0–7) | 0.093 (max 0.600 w reszucie 120) |
| LCA-NR1H4/FXR/3DCT | 0.190 + / – 0.020 (0.135–0.281) | 1.824 + / − 0.008 (1.804–1.849) | 129.7 + / − 2.3 (121.9–138.1) | 3.8 + / − 0.7 (1–6) | 0.113 (max 0.298) |
| UDCA-NR1H4/FXR/3DCT | 0.190 + / – 0.020 (0.135–0.281) | 1.834 + / − 0.013 (1.809–1.921) | 131.0 + / −3.4 (121.6–143.5) | 1.1 + / − 1.1 (0–5) | 0.113 (max 0.298) |
| Urolithin A-CASP3/2DKO | 0.521 + / – 0.058 (0.244–0.755) | 1.892 + / − 0.024 (1.839–1.984) | 134.9 + / − 3.0 (126.4–146.4) | 0.6 + / − 0.7 (0–3) | 1.172 (max 2.532 w reszucie 175) |
| Tryptamine-HTR2A/6A93 (błona) | 0.177 + / –0.017 (0.131–0.227) | 2.089 + / − 0.007 (2.070–2.116) | 165.1 + / − 2.7 (156.–172.7) | 1.7 + / − 0.7 (0–4) | 0.090 (max 0.319) |
Tabela 9: Podsumowanie zachowania w symulacji dynamiki molekularnej przez 200 ns dla pięciu priorytetowych kompleksów białko-ligand, w tym systemu tryptaminy-HTR2A osadzonego w błonie.Źródło: pliki narzędzi do analizy trajektorii dynamiki molekularnej (.xvg) — gmx rms, gmx gyrate, gmx sasa, gmx hbond, gmx rmsf — obliczone dla końcowych 150 ns (50–200 ns) każdego 200 ns przebiegu produkcyjnego, zgodnie z krokiem 8.8 protokołu. RMSD/Rg dopasowane do szkieletu białkowego; promień sondy SASA 0.14 nm; odcięcie donor-akceptor wiązania wodorowego 0.35 nm / 30 °. LCA-3DCT i UDCA-3DCT dzielą jedną trajektorię szkieletu białkowego (RMSD, RMSF) z parametrami Rg/SASA/wiązaniami wodorowymi specyficznymi dla ligandu.
| Tryptamina-HTR2A/6A93 (błona) — ilościowy rozkład na poszczególne reszty | ||
| Reszta | Całkowity wkład ddG (kcal/mol), średnia + / − SD | Kierunek |
| Asp155 (D3.32) | −89.94 + / − 6.81 | Stabilizujący (dominujący) |
| Tryptamina (ligand) | −13.01 + / − 6.22 | Stabilizujący |
| Tyr171 | 13.62 + / − 4.54 | Destabilizujący |
| Val167 | 23.32 + / − 3.96 | Destabilizujący |
| Val156 | 20.03 + / − 3.81 | Destabilizujący |
| Thr160 | 4.86 + / − 3.64 | Destabilizujący |
| Ser159 | 24.16 + / − 3.48 | Destabilizujący |
| Ser86 | 24.48 + / − 3.65 | Destabilizujący |
| Phe87 | 35.18 + / − 4.04 | Destabilizujący |
| Phe133 | 32.80 + / −3.70 | Destabilizujący |
| Phe140 | 30.63 + / − 3.84 | Destabilizujący |
| Phe141 | 35.25 + / − 3.55 | Destabilizujący |
| Ile163 | 27.64 + / − 3.71 | Destabilizujący |
| Trp137 | 53.77 + / − 4.32 | Destabilizujący (największy niekorzystny) |
| Pozostałe cztery kompleksy — reszty zidentyfikowane w rozkładzie na poszczególne reszty (jakościowo) | ||
| Kompleks | Reszta | Kierunek |
| LCA-VDR/1DB1 | Ligand (LCA) | Korzystny |
| LCA-VDR/1DB1 | Gln317 | Korzystny |
| LCA-VDR/1DB1 | Trp286 | Niekorzystny |
| LCA-NR1H4/FXR/3DCT | Arg331 | Korzystny (dominujący) |
| UDCA-NR1H4/FXR/3DCT | Glu326 | Mieszana/rozproszona sieć |
| UDCA-NR1H4/FXR/3DCT | Asp394 | Mieszana/rozproszona sieć |
| UDCA-NR1H4/FXR/3DCT | Arg395 | Mieszana/rozproszona sieć |
| UDCA-NR1H4/FXR/3DCT | Arg441 | Mieszana/rozproszona sieć |
| UDCA-NR1H4/FXR/3DCT | Asp470 | Mieszana/rozproszona sieć |
| Urolityna A-CASP3/2DKO | Arg64 | Silnie korzystny (polarny/elektrostatyczny) |
| Urolityna A-CASP3/2DKO | Arg207 | Silnie korzystny (polarny/elektrostatyczny) |
Tabela 10: Dekompozycja MM-PBSA na poszczególne reszty KRÓTKI STRESZCZENIE: reszty stabilizujące i destabilizujące (bezwzględny wkład ≥ 0,5 kcal mol⁻1) dla każdego z pięciu priorytetowych kompleksów białko-ligand, w tym systemu tryptaminy-HTR2A osadzonego w błonie. Źródło: Membrane Simulation/03_MMPBSA/results/FINAL_DECOMP_MMPBSA.dat (narzędzie do obliczeń energii wiązania w modelu mechaniki molekularnej/ciągłego rozpuszczalnika – dekompozycja na poszczególne reszty metodą Generalized Born (GB), 'Complex: Total Energy Decomposition'). Numery reszt przekształcono z wewnętrznego numerowania systemu zbudowanego w CHARMM-GUI (przesunięcie +68) na oryginalne numerowanie PDB 6A93 stosowane w pozostałych częściach niniejszej pracy.
Źródło: Dane z poprzednich symulacji MD/1DB1,2KD0, LCA & UDCA_3DCT}/mmpbsa_*/Decomposition_NORMAL_GB_Complex_TDC*.svg oraz wyniki z manuskryptu (wolna energia wiązania MM-PBSA i dekompozycja na poszczególne reszty). Dla tych czterech kompleksów w katalogu projektu nie ma numerycznych plików wyjściowych .dat/.csv dla poszczególnych reszt (dostępne są jedynie wyrenderowane wykresy SVG z tekstem w formie ścieżek wektorowych, którego nie można wyekstrahować maszynowo); zgodnie z treścią manuskryptu zgłoszono jedynie tożsamość reszt oraz kierunek korzystny/niekorzystny. Dokładne wkłady w kcal/mol dla tych czterech kompleksów nie są dostępne w repozytorium źródłowym.
Dyskusja
Niniejsze eksploracyjne badanie obliczeniowe demonstruje zintegrowany, powtarzalny schemat postępowania służący do priorytetyzacji genów gospodarza związanych z metabolitami drobnoustrojów oraz kompleksów białko-ligand, zastosowany w tym przypadku do publicznego zbioru danych transkrypomicznych błony śluzowej odbytnicy w IBS-C. Przy użyciu tego schematu podzbiór przewidywanych genów związanych z metabolitami drobnoustrojów pokrywał się z genami konsekwentnie obniżonymi w zbiorze danych, grupując się w obrębie szlaków związanych z GPCR, układem serotoninergicznym, sygnalizacją wapniową, neuroaktywnymi receptorami ligandów oraz receptorami jądrowymi – systemami coraz częściej wiązanymi z komunikacją między mikrobiotą a gospodarzem48,49. Wyniki te należy interpretować ściśle jako generujące hipotezy: analiza nie mierzy stężeń metabolitów drobnoustrojów, ilości białek receptorowych, wiązania ligandów, aktywacji receptorów, sygnalizacji w dół, motoryki, sekrecji, reakcji bólowych ani wyników klinicznych. Najsilniejszym uzasadnionym wnioskiem jest stwierdzenie, że zidentyfikowane geny i szlaki są kandydatami do walidacji eksperymentalnej, a nie potwierdzonymi mechanizmami choroby.
Kluczowe znaczenie niniejszego protokołu, w odniesieniu do wcześniejszych prac badających pojedyncze pary metabolit-receptor w izolacji, polega na integracji przewidywania celu, publicznych danych transkrypcyjnych, analizy sieci, dokowania z kontrolami walidacyjnymi, dynamiki molekularnej oraz MM-PBSA w jeden sekwencyjny potok priorytetyzacji. Każdy etap zawęża i kontekstualizuje zestaw kandydatów wygenerowany na poprzednim etapie, a właśnie to sekwencyjne filtrowanie sprawia, że końcowa lista kandydatów jest możliwa do zweryfikowania eksperymentalnie. Moduł GPCR skoncentrowany na GNAQ oraz moduł związany z receptorem serotoninowym zidentyfikowane w tej pracy są biologicznie prawdopodobne, biorąc pod uwagę rolę sygnalizacji Gq w aktywacji fosfolipazy C, produkcji inozytolo-1,4,5-trisfosforanu, mobilizacji wapnia, sekrecji i funkcji enteroendokrynnych, a także uznaną rolę sygnalizacji krótkołańcuchowych kwasów tłuszczowych i pochodnych tryptofanu w homeostazie śluzówki oraz sygnalizacji serotonergicznej w motoryce przewodu pokarmowego, sekrecji, wrażliwości trzewnej i komunikacji oś gut-brain10,18,50,51.
Kluczową cechą metodologiczną niniejszego badania jest traktowanie receptora HTR2A wbudowanego w błonę. Ponieważ symulacja w fazie rozpuszczalnej nie może odtworzyć środowiska lipidowego, które determinuje zachowanie konformacyjne receptora sprzężonego z białkiem G, kompleks tryptaminy z HTR2A symulowano w jawnej dwuwarstwie POPC. W tym środowisku błonowym receptor pozostał stabilny strukturalnie przez całą 200 ns trajektorię, a mostek solny między grupą amoniową tryptaminy a Asp155 (D3.32) był utrzymywany przez niemal cały czas symulacji. Fakt, że trzy niezależne linie dowodowe – poza dokowania, trwały dystans kontaktu w trakcie trajektorii oraz dominujący wkład MM-PBSA na poszczególne reszty – wskazują na tę samą konserwowaną oddziaływanie z D3.32, zapewnia spójność wewnętrzną przewidzianego sposobu wiązania tryptaminy, który odzwierciedla kanoniczną geometrię wiązania ligandów aminergicznych w receptorach serotoninowych.
Podczas odtwarzania tego schematu pracy należy wziąć pod uwagę pewne kwestie metodologiczne. Błędy w strukturze kanonicznej lub związki oznaczone jako PAINS (Pan-assay interference compounds) przenoszą się na etap przewidywania celów i dokowania, co wymaga dokładnego wyboru metabolitów i kurateli chemoinformatycznej. Należy zminimalizować zestawy celów wynikające z szumu, konsekwentnie stosując kryteria ufności (przewidywanie celów oddziaływania chemiczno-białkowego: ≥0.700; program dokowania molekularnego: ≥0.70; konstrukcja sieci oddziaływań białko-białko i wzbogacenie szlaków: ≥0.700). Przewidziane cele powinny być grupowane według kategorii funkcjonalnych, aby uniknąć błędnego zakwalifikowania wszystkich genów powiązanych z metabolitami jako receptorów. Precyzyjne przetwarzanie wstępne struktur PDB, minimalizacja energii ligandów oraz rozmieszczenie siatki wokół znanych reszt wiążących są kluczowymi aspektami dokowania, a wprowadzone tutaj kontrole redokowania i dokowania krzyżowego zapewniają obiektywną miarę poprawności metodologii dokowania. Zakres powtarzalności w dynamice molekularnej jest definiowany przez kombinację parametryzacji pola siłowego, odpowiedniej solwatacji lub budowy błony, etapowej ekwilibracji oraz właściwego próbkowania produkcyjnego.
Typowe adaptacje i kroki rozwiązywania problemów obejmują poluzowanie progów, jeśli przewidywanie celu nie zwraca żadnych trafień, sprawdzanie spójności kierunkowej na poziomie sond dla genów z wieloma sondami oraz interpretowanie odizolowanych węzłów w konstrukcji sieci oddziaływań białko-białko i wzbogacaniu szlaków jako zależnych od progu, a nie jako biologicznie nieistotnych. W przypadku receptorów błonowych należy stosować jawne symulacje dwuwarstwy lipidowej zamiast symulacji w środowisku wodnym, co zilustrowano w opisanym tutaj метоdzie HTR2A. W sytuacjach, gdy konieczna jest dekompozycja energii na poszczególne reszty, obliczenia muszą być wykonane przy użyciu silnika umożliwiającego dekompozycję, a raportowana numeracja reszt powinna zostać uzgodniona z natywną numeracją receptora, aby uniknąć niejednoznaczności. Sugerujemy, aby wyniki wzbogacania szlaków traktować przede wszystkim jako kontekst organizacyjny dla listy kandydatów, a nie jako walidację na poziomie szlaków. Mechanicznie wzbogacenie terminów dotyczących GPCR, układu serotonergicznego lub sygnalizacji wapniowej będzie występować zawsze, gdy lista genów zawiera wiele genów receptorów serotoninowych, niezależnie od koregulacji na poziomie białek. Wartości RMSD, Rg i RMSF dla systemu HTR2A osadzonego w błonie powinny być interpretowane z uwzględnieniem dwuwarstwy lipidowej: spadek Rg w późniejszej trajektorii może odzwierciedlać indukowaną przez dwuwarstwę adaptację konformacyjną wiązki transbłonowej, a nie globalne rozfałdowanie, natomiast trwałe wiązania wodorowe ligand-białko należy interpretować łącznie z ogólną stabilnością RMSD.
Ograniczenia niniejszego badania są znaczące i ograniczają interpretację wyników. Badanie oparto na jednym, stosunkowo niewielkim publicznym zbiorze danych, a przeszukiwanie głównych publicznych repozytoriów transkrypcyjnych (internetowe narzędzie do analizy różnicowej ekspresji genów oraz ArrayExpress) nie pozwoliło w momencie analizy na zidentyfikowanie niezależnego zbioru danych transkrypcyjnych błony śluzowej odbytnicy w przebiegu IBS-C o porównywalnym projekcie i platformie, który mógłby służyć jako kohorta replikacyjna. Brak niezależnej replikacji transkrypcyjnej jest istotnym ograniczeniem i żadne stwierdzenie w niniejszym manuskrypcie nie powinno być interpretowane jako zewnętrzna walidacja wyników uzyskanych z pojedynczego zbioru danych. Zbiór danych wykazuje niemal powszechną różnicową ekspresję (około 94,5% genów jest istotnych, z czego ogromna większość jest wyciszona), co sprawia, że konwencjonalne statystyki wzbogacenia są nieinformacyjne i uniemożliwia wyciągnięcie wniosków na temat specyfiki wyciszenia genów docelowych w stosunku do tła genomicznego; w związku z tym nakładka jest raportowana jako opisowy wzorzec kierunkowy, a nie statystyczne wzbogacenie. Masowa transkryptomika błony śluzowej nie pozwala odróżnić rzeczywistej regulacji genów od zmian w składzie komórkowym. Ekspresja mRNA nie determinuje zawartości białka ani odpowiedzi funkcjonalnej. Bazy danych do przewidywania celów obciążone są błędem adnotacji, a wyniki dokowania, MD oraz MM-PBSA zależą od wyboru pola siłowego, parametryzacji ligandu, pozycji startowej, czasu symulacji oraz adekwatności próbkowania. Dokładne identyfikatory wersji/budowy dla niektórych komponentów serwerów WWW i pakietów, w tym usługi parametryzacji ligandów kompatybilnej z CHARMM, CHARMM-GUI oraz środowiska obliczeń statystycznych
Wersje kompilacji pakietów oraz podwersje narzędzia do obliczeń energii wiązania metodą mechaniki molekularnej/ciągłego rozpuszczalnika nie zostały w pełni odzyskanymi z archiwalnego zapisu projektu i powinny być raportowane jako dostępne w oddzielnej Tabeli materiałów. Wartości MM-PBSA są szacunkami względnymi, nie zawierają jawnego składnika entropii konfiguracyjnej i nie powinny być interpretowane jako powinowactwa eksperymentalne. Badaniu brakuje danych metabolomicznych, w związku z czym nie można określić, czy dostępność ligandów jest zmieniona w IBS-C, ani czy zaobserwowane zmiany w ekspresji są przyczynami, konsekwencjami, odpowiedziami kompensacyjnymi czy nieistotnymi korelacjami.
Przyszłe zastosowania tej metody powinny obejmować niezależną replikację transkrypcyjną, ilościową reakcję łańcuchową polimerazy (qPCR) i walidację na poziomie białka, lokalizację typów komórek za pomocą transkryptomiki jednokomórkowej lub przestrzennej, profilowanie metabolomiczne odpowiednich klas metabolitów oraz funkcjonalne testy odpowiedzi na ligand w kolonoidach pochodzących od pacjentów, eksplantach błony śluzowej lub porównywalnych modelach. Porównania z kohortami pacjentów z IBS z przewagą biegunek, IBS mieszanym, nieswoistymi zapaleniami jelit oraz zaparciami niepowiązanymi z IBS1,2 pomogłyby ustalić specyficzność choroby. W odniesieniu do komponentu strukturalnego, replikacja trajektorii MD, przeprowadzenie analiz wrażliwości z alternatywnymi pozami startowymi oraz pełna dokumentacja depozycji topologii, trajektorii oraz plików wejściowych i wyjściowych MM-PBSA dodatkowo wzmocniłyby powtarzalność. Eksperymentalne testy odpowiedzi na ligand pozostają niezbędne do ustalenia, czy priorytetowe kompleksy są funkcjonalnie istotne; obecne wyniki nie stanowią podstawy do twierdzeń klinicznych lub terapeutycznych.
Oświadczenia
Autor deklaruje brak konfliktów interesów.
Podziękowania
W ramach niniejszego badania nie otrzymano zewnętrznego finansowania. Wyrażamy wdzięczność za publiczną dostępność zbioru danych GSE36701 oraz zasobów STITCH, SwissTargetPrediction, SwissADME, STRING, RCSB Protein Data Bank, Gene Expression Omnibus, CHARMM-GUI i Orientations of Proteins in Membranes (OPM), a także oprogramowania AutoDock Vina, GROMACS, CHARMM36m, CGenFF, gmx_MMPBSA, Open Babel, PyMOL i Discovery Studio Visualizer.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| AutoDock Vina | Scripps Research / open source | v1.2.7; https://vina.scripps.edu/ | Dokowanie molekularne ligandów metabolitów do białek docelowych. |
| CGenFF/ParamChem | SilcsBio / University of Maryland | v4.6; https://cgenff.com/ | Parametryzacja pola siłowego ligandów dla dynamiki molekularnej. |
| Pole siłowe CHARMM36m | Twórcy CHARMM / open source | CHARMM36m; https://www.charmm.org/charmm/resources/charmm-force-fields/ | Pole siłowe białek stosowane w symulacjach dynamiki molekularnej. |
| CHARMM-GUI Membrane Builder | CHARMM-GUI / Lehigh University | Serwer WWW; dokładna wersja nieodzyskiwalna; https://www.charmm-gui.org/?doc=input/membrane | Konstrukcja i konfiguracja ekwilibracji jawnego systemu błony POPC. |
| Discovery Studio Visualizer | BIOVIA (Dassault Systèmes) | 2021; https://discover.3ds.com/discovery-studio-visualizer-download | Dwuwymiarowa analiza oddziaływań ligand-pozostałość. |
| GEO2R | NCBI Gene Expression Omnibus | Narzędzie WWW; dostęp w okresie styczeń-maj 2026; https://www.ncbi.nlm.nih.gov/geo/geo2r/ | Analiza różnicowej ekspresji GSE36701. |
| GeneCards | Instytut Nauki Weizmanna | Baza danych WWW; dostęp w okresie styczeń-maj 2026; https://www.genecards.org/ | Weryfikacja symboli i informacji o genach podczas standaryzacji celów. |
| gmx_MMPBSA | Open source (Valdés-Tresanco i in.) | 1.5.x; https://valdes-tresanco-ms.github.io/gmx_MMPBSA/ | Szacowanie wolnej energii wiązania MM-PBSA i dekompozycja na poszczególne pozostałości. |
| GROMACS | Zespół programistów GROMACS / open source | 2024.2; https://www.gromacs.org/ | Silnik symulacji dynamiki molekularnej. |
| Zbiór danych transkrypcyjnych GSE36701 | NCBI Gene Expression Omnibus | GSE36701; https://www.ncbi.nlm.nih.gov/geo/query/acc.cgi?acc=GSE36701 | Publiczny zbiór danych ekspresji śluzówki odbytnicy IBS-C. |
| Open Babel | Open source | 3.2.0; https://openbabel.org/ | Konwersja formatów plików chemicznych, generowanie trójwymiarowych ligandów i przygotowanie ligandów. |
| Baza danych OPM | University of Michigan | Baza danych WWW; dostęp w okresie styczeń-maj 2026; https://opm.phar.umich.edu/ | Współrzędne orientacji białek w błonach (Orientation of Proteins in Membranes) użyte do wyrównania HTR2A. |
| ParmEd | Twórcy ParmEd / open source | 4.x; https://parmed.github.io/ParmEd/html/index.html | Repartycja masy wodoru i przetwarzanie topologii symulacji molekularnych. |
| PyMOL | Schrödinger / open source | 2.x; https://www.pymol.org/ | Trójwymiarowa wizualizacja strukturalna i ryciny receptor-ligand. |
| RCSB Protein Data Bank | RCSB PDB | Baza danych WWW; dostęp w okresie styczeń-maj 2026; https://www.rcsb.org/ | Źródło eksperymentalnych struktur białek i współrzędnych PDB. |
| STITCH | Konsorcjum STITCH (EMBL) | v5.0; https://stitch.embl.de/ | Przewidywanie celów oddziaływań chemicznych z białkami. |
| STRING | Konsorcjum STRING / ELIXIR | v12.0; https://version-12-0.string-db.org/ | Konstrukcja sieci oddziaływań białko-białko i wzbogacenie szlaków. |
| SwissADME | SIB Swiss Institute of Bioinformatics / University of Lausanne | Narzędzie WWW; dostęp w okresie styczeń-maj 2026; https://www.swissadme.ch/ | Deskryptory chemoinformatyczne, przewidywania farmakokinetyczne i ocena PAINS. |
| SwissTargetPrediction | SIB Swiss Institute of Bioinformatics / University of Lausanne | Narzędzie WWW; dostęp w okresie styczeń-maj 2026; https://www.swisstargetprediction.ch/ | Przewidywanie ludzkich białek docelowych na podstawie ligandów. |
| UniProt ID Mapping | Konsorcjum UniProt | Usługa WWW; dostęp w okresie styczeń-maj 2026; https://www.uniprot.org/id-mapping | Mapowanie identyfikatorów białek na standaryzowane symbole genów zatwierdzone przez HGNC. |
| NVIDIA RTX 3080 | NVIDIA Corporation | RTX 3080; ≥8 GB VRAM; wersja CUDA/sterownika nie określona w manuskrypcie | Jednostka przetwarzania graficznego obsługująca CUDA, użyta do symulacji dynamiki molekularnej. |
| GPU kompatybilne z CUDA | NVIDIA Corporation | Wersja zestawu narzędzi CUDA nie określona w manuskrypcie; ≥8 GB VRAM | GPU obsługujące CUDA z ≥8 GB VRAM; stacja robocza wymagała również ≥32 GB RAM i 6-rdzeniowego procesora CPU. |
| Ubuntu Linux | Canonical Ltd. / open source | 22.04 LTS | 64-bitowy system operacyjny Linux. |
| Python 3.9 | Python Software Foundation | 3.9 | Ogólne środowisko programistyczne użyte do skryptowania i analizy przepływu pracy. |
| Gene Expression Omnibus (GEO) | NCBI / U.S. National Library of Medicine | Publiczne repozytorium WWW; wersja oprogramowania nie określona w manuskrypcie | Publiczne repozytorium danych genomiki funkcjonalnej. |
| AutoDockTools/MGLTools | Molecular Graphics Laboratory, Scripps Research | 1.5.7 | Zestaw narzędzi do przygotowania struktur molekularnych i danych wejściowych do dokowania. |
| Narzędzia analityczne GROMACS | Zespół programistów GROMACS / open source | 2024.2 | Narzędzia do analizy trajektorii dynamiki molekularnej. |
| Sześciostopniowy protokół CHARMM-GUI | CHARMM-GUI / Lehigh University | Protokół WWW; dokładna wersja nieodzyskiwalna | Wieloetapowy, internetowy przepływ pracy przygotowania i ekwilibracji systemu molekularnego. |
| cgenff_charmm2gmx_py3.py | Skrypt konwersyjny open-source; źródło nie określone w manuskrypcie | Wersja nie określona w manuskrypcie | Skrypt konwersyjny topologii pola siłowego. |
| Python | Python Software Foundation | 3.9 | Ogólne środowisko programistyczne. |
| SciPy | Społeczność SciPy / open source | Wersja nie określona w manuskrypcie | Biblioteka obliczeń naukowych. |
| scipy.stats.fisher_exact | Społeczność SciPy / open source | Wersja SciPy nie określona w manuskrypcie | Implementacja dokładnego testu Fishera’a. |
| R | R Foundation for Statistical Computing | 4.3.x | Środowisko obliczeń statystycznych. |
| Bioconductor | Projekt Bioconductor / open source | 3.18 | Framework oprogramowania bioinformatycznego. |
| limma | Projekt Bioconductor / open source | Wersja nie określona w manuskrypcie | Pakiet do analizy różnicowej ekspresji genów. |
| Procedura Benjamini–Hochberg | Metoda statystyczna | Nie dotyczy (procedura statystyczna) | Metoda korekty współczynnika fałszywych odkryć (FDR). |
| NVIDIA RTX 3080 | NVIDIA Corporation | RTX 3080; ≥8 GB VRAM; wersja CUDA/sterownika nie określona w manuskrypcie | Jednostka przetwarzania graficznego z co najmniej 8 GB pamięci wideo. |
| GPU kompatybilne z CUDA | NVIDIA Corporation | Wersja zestawu narzędzi CUDA nie określona w manuskrypcie; ≥8 GB VRAM | Jednostka przetwarzania graficznego wspierająca ogólne obliczenia równoległe. |
| Ubuntu Linux 22.04 LTS | Canonical Ltd. / open source | 22.04 LTS | 64-bitowy system operacyjny Linux. |
| TIP3P | Twórcy pola siłowego CHARMM / open source | TIP3P; brak wersji oprogramowania | Jawny trójpunktowy model wody. |
| MM/PBSA | Twórcy gmx_MMPBSA / open source | gmx_MMPBSA 1.5.x | Metoda obliczania energii wiązania mechanika molekularnego/powierzchni Poisson–Boltzmana. |
Bibliografia
- Ford AC, Lacy BE, Talley NJ. Irritable bowel syndrome. N Engl J Med. 2017;376(26):2566–2578.
- Sperber AD, et al. Worldwide prevalence and burden of functional gastrointestinal disorders: results of the Rome Foundation Global Study. Gastroenterology. 2021;160(1):99–114.e3.
- Chang L, et al. AGA clinical practice guideline on the pharmacological management of irritable bowel syndrome with constipation. Gastroenterology. 2022;163(1):118–136.
- Lacy BE, et al. ACG clinical guideline: management of irritable bowel syndrome. Am J Gastroenterol. 2021;116(1):17–44.
- Lavelle A, Sokol H. Gut microbiota-derived metabolites as key actors in inflammatory bowel disease. Nat Rev Gastroenterol Hepatol. 2020;17(4):223–237.
- Morrison DJ, Preston T. Formation of short-chain fatty acids by the gut microbiota and their impact on human metabolism. Gut Microbes. 2016;7(3):189–200.
- Ridlon JM, et al. Consequences of bile salt biotransformations by intestinal bacteria. Gut Microbes. 2016;7(1):22–39.
- Roager HM, Licht TR. Microbial tryptophan catabolites in health and disease. Nat Commun. 2018;9(1):3294. doi:10.1038/s41467-018-05470-4.
- Krautkramer KA, Fan J, Bäckhed F. Gut microbial metabolites as multi-kingdom intermediates. Nat Rev Microbiol. 2021;19(2):77–94.
- Pittayanon R, et al. Gut microbiota in patients with irritable bowel syndrome: a systematic review. Gastroenterology. 2019;157(1):97–108.
- Hopkins AL. Network pharmacology: the next paradigm in drug discovery. Nat Chem Biol. 2008;4(11):682–690.
- O’Boyle NM, et al. Open Babel: an open chemical toolbox. J Cheminform. 2011;3:33. doi:10.1186/1758-2946-3-33.
- Daina A, Michielin O, Zoete V. SwissADME: a free web tool to evaluate pharmacokinetics, drug-likeness, and medicinal chemistry friendliness of small molecules. Sci Rep. 2017;7:42717. doi:10.1038/srep42717.
- Szklarczyk D, et al. STITCH 5: augmenting protein–chemical interaction networks with tissue and affinity data. Nucleic Acids Res. 2016;44(D1):D380–D384.
- Daina A, Michielin O, Zoete V. SwissTargetPrediction: updated data and new features for efficient prediction of protein targets of small molecules. Nucleic Acids Res. 2019;47(W1):W357–W364.
- Barrett T, et al. NCBI GEO: archive for functional genomics data sets—update. Nucleic Acids Res. 2013;41(D1):D991–D995.
- Edgar R, Domrachev M, Lash AE. Gene Expression Omnibus: NCBI gene expression and hybridization array data repository. Nucleic Acids Res. 2002;30(1):207–210.
- Swan C, et al. Identifying and testing candidate genetic polymorphisms in irritable bowel syndrome: association with TNFSF15 and TNFα. Gut. 2013;62(7):985–994.
- Ritchie ME, et al. Limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47. doi:10.1093/nar/gkv007.
- Szklarczyk D, et al. The STRING database in 2023: protein–protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638–D646.
- Kanehisa M, Goto S. KEGG: Kyoto Encyclopedia of Genes and Genomes. Nucleic Acids Res. 2000;28(1):27–30.
- Gillespie M, et al. The Reactome pathway knowledgebase 2022. Nucleic Acids Res. 2022;50(D1):D687–D692.
- Ashburner M, et al. Gene Ontology: tool for the unification of biology. Nat Genet. 2000;25(1):25–29.
- Gene Ontology Consortium, et al. The Gene Ontology knowledgebase in 2023. Genetics. 2023;224(1):iyad031. doi:10.1093/genetics/iyad031.
- Berman HM, et al. The Protein Data Bank. Nucleic Acids Res. 2000;28(1):235–242.
- Eberhardt J, Santos-Martins D, Tillack AF, Forli S. AutoDock Vina 1.2.0: new docking methods, expanded force field, and Python bindings. J Chem Inf Model. 2021;61(8):3891–3898.
- Trott O, Olson AJ. AutoDock Vina: improving the speed and accuracy of docking. J Comput Chem. 2010;31(2):455–461.
- Vanommeslaeghe K, et al. CHARMM general force field: a force field for drug-like molecules compatible with the CHARMM all-atom additive biological force fields. J Comput Chem. 2010;31(4):671–690.
- Huang J, MacKerell AD Jr. CHARMM36 all-atom additive protein force field: validation based on comparison to NMR data. J Comput Chem. 2013;34(25):2135–2145.
- Jorgensen WL, et al. Comparison of simple potential functions for simulating liquid water. J Chem Phys. 1983;79(2):926–935.
- Abraham MJ, et al. GROMACS: high-performance molecular simulations through multi-level parallelism from laptops to supercomputers. SoftwareX. 2015;1–2:19–25.
- Jo S, Kim T, Iyer VG, Im W. CHARMM-GUI: a web-based graphical user interface for CHARMM. J Comput Chem. 2008;29(11):1859–1865.
- Wu EL, et al. CHARMM-GUI Membrane Builder toward realistic biological membrane simulations. J Comput Chem. 2014;35(27):1997–2004.
- Lomize MA, et al. OPM database and PPM web server: resources for positioning proteins in membranes. Nucleic Acids Res. 2012;40(D1):D370–D376.
- Darden T, York D, Pedersen L. Particle mesh Ewald: an N log(N) method for Ewald sums in large systems. J Chem Phys. 1993;98(12):10089–10092.
- Hess B, Bekker H, Berendsen HJC, Fraaije JGEM. LINCS: a linear constraint solver for molecular simulations. J Comput Chem. 1997;18(12):1463–1472.
- Valdés-Tresanco MS, Valdés-Tresanco ME, Valiente PA, Moreno E. gmx_MMPBSA: a new tool to perform end-state free-energy calculations with GROMACS. J Chem Theory Comput. 2021;17(10):6281–6291.
- Fiorucci S, Distrutti E. Bile acid-activated receptors, intestinal microbiota, and the treatment of metabolic disorders. Trends Mol Med. 2015;21(11):702–714.
- Wahlström A, Sayin SI, Marschall HU, Bäckhed F. Intestinal crosstalk between bile acids and microbiota and its impact on host metabolism. Cell Metab. 2016;24(1):41–50.
- Gershon MD, Tack J. The serotonin signaling system: from basic understanding to drug development for functional gastrointestinal disorders. Gastroenterology. 2007;132(1):397–414.
- Kim K, et al. Structure of a hallucinogen-activated Gq-coupled 5-HT2A serotonin receptor. Cell. 2020;182(6):1574–1588.e19.
- Ballesteros JA, Weinstein H. Integrated methods for the construction of three-dimensional models and computational probing of structure–function relations in G protein-coupled receptors. In: Sealfon SC, editor. Receptor Molecular Biology. Methods in Neurosciences. Vol. 25. San Diego: Academic Press; 1995. p. 366–428.
- McCorvy JD, Roth BL. Structure and function of serotonin G protein-coupled receptors. Pharmacol Ther. 2015;150:129–142.
- Klauda JB, et al. Update of the CHARMM all-atom additive force field for lipids: validation on six lipid types. J Phys Chem B. 2010;114(23):7830–7843.
- Lee J, et al. CHARMM-GUI input generator for NAMD, GROMACS, AMBER, OpenMM, and CHARMM/OpenMM simulations using the CHARMM36 additive force field. J Chem Theory Comput. 2016;12(1):405–413.
- Genheden S, Ryde U. The MM/PBSA and MM/GBSA methods to estimate ligand-binding affinities. Expert Opin Drug Discov. 2015;10(5):449–461.
- Kollman PA, et al. Calculating structures and free energies of complex molecules: combining molecular mechanics and continuum models. Acc Chem Res. 2000;33(12):889–897.
- Cryan JF, et al. The microbiota–gut–brain axis. Physiol Rev. 2019;99(4):1877–2013.
- Koh A, De Vadder F, Kovatcheva-Datchary P, Bäckhed F. From dietary fiber to host physiology: short-chain fatty acids as key bacterial metabolites. Cell. 2016;165(6):1332–1345.
- Tan J, et al. The role of short-chain fatty acids in health and disease. Adv Immunol. 2014;121:91–119.
- Agus A, Planchais J, Sokol H. Gut microbiota regulation of tryptophan metabolism in health and disease. Cell Host Microbe. 2018;23(6):716–724.