Ten protokół opisuje reprodukowalny hybrydowy przepływ pracy kwantowo-klasyczny do klasyfikacji choroby Parkinsona na podstawie nagrań głosu ludzkiego, w tym przetwarzanie danych, implementację obwodu kwantowego, trening modelu i walidację krzyżową do niezależnej replikacji.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Możliwe do powtórzenia kwantowo-klasyczne protokoły hybrydowe do klasyfikacji choroby Parkinsona na podstawie nagrań głosu ludzkiego
W tym artykule
Podsumowanie
Streszczenie
Choroba Parkinsona jest postępującym zaburzeniem neurodegeneracyjnym, dla którego dostępne, niskokosztowe metody przesiewowych badań nadal są ograniczone. Nagrania głosu z utrzymywanym samogłoskowym dźwiękiem zawierają mierzalne akustyczne biomarkery związane z dysfonią związaną z chorobą, które mogą być uzyskiwane bez specjalistycznego sprzętu. Protokół ten opisuje cztero-qubitową hybrydową sieć konwolucyjną kwantowo-klasyczną (QI-HCNN), która łączy parametryzowane obwody kwantowe z płytką klasyczną warstwą klasyfikacji w celu sklasyfikowania choroby Parkinsona za pomocą wymiarowo zredukowanych akustycznych cech głosu. Protokół ten również porównuje proponowany podejście z wymiarowo dopasowaną klasyczną siecią neuronową i klasyfikatorami drzew gradientowo wzmacnianych, trenowanymi zarówno na zredukowanych, jak i pełnych zestawach cech. Korzystając z publicznie dostępnego, anonimowego zestawu danych zawierającego 195 nagrań głosów od 31 osób, QI-HCNN osiągnęła pole pod krzywą charakterystyki odbiornika (AUC) wynoszące 0,78 przy użyciu trzykroć warstwowej walidacji krzyżowej, w porównaniu z 0,87 dla dopasowanej klasycznej sieci neuronowej i 0,94-0,95 dla klasyfikatorów bazowych gradientowo wzmacnianych, trenowanych odpowiednio na zredukowanych i pełnych zestawach cech. Kontrolowany analityczny proces eliminacji wykazał, że jedna z dwóch operacji splątania w obwodzie nie mogła wpływać na zmierzony wynik z powodu zaprojektowania, podczas gdy pozostała operacja splątania raczej zmniejszała niż poprawiała wydajność klasyfikacji w porównaniu z wariantem nie-splątanym. Dodatkowo walidacja krzyżowa zgrupowana według pacjentów wykazała, że oszacowania wydajności znacznie się różniły w zależności od osób przypisanych do zestawu testowego, co odzwierciedla ograniczony rozmiar grupy. Protokół ten zapewnia zatem w pełni określoną i niezależnie powtarzalną kwantowo-klasyczną bazę odniesienia wraz z opartą na danych oceną sił i ograniczeń obecnej konstrukcji obwodu, zapewniając metodologiczną podstawę dla przyszłych badań zamiast wspierania twierdzeń o gotowości diagnostycznej.
Wprowadzenie
Choroba Parkinsona jest przewlekłym zaburzeniem neurodegeneracyjnym spowodowane stopniowym ubytkiem neuronów dopaminergicznych w substancji czarnej, które dotyka ponad 10 milionów ludzi na całym świecie i stanowi znaczne i rosnące obciążenie zdrowia publicznego1. Choroba powoduje zarówno objawy motoryczne, w tym drżenie, sztywność i bradykinezję, jak i objawy nie-motoryczne, takie jak zaburzenia snu i ageuzja. Kliniczna diagnoza opiera się głównie na badaniu neurologicznym przy użyciu standaryzowanych skal oceny motoryki, uzupełnionym, jeśli jest dostępny, obrazowaniem transportera dopaminy; jednak, oba podejścia wymagają specjalistycznej wiedzy i infrastruktury, które nie są wszędzie dostępne, a wczesna ocena kliniczno-oceniana pozostaje subiektywna2. Ponieważ obecnie nie ma terapii modyfikującej przebieg choroby, wczesne wykrycie jest warte przede wszystkim dlatego, że umożliwia wcześniejszą terapię objawową i monitorowanie w czasie. To zapotrzebowanie motywowało rozwój nisko-kosmetycznych, skalowalnych i nieinwazyjnych podejść do przesiewowego badania, które mogą uzupełniać, a nie zastępować, ocenę kliniczną.
Upośledzenie głosu należy do najwcześniejszych mierzalnych zmian związanych z chorobą Parkinsona i często poprzedza jawne objawy motoryczne3. Utrzymane fonowanie trwale utrzymanej samogłoski zapewnia kontrolowany sygnał, z którego można wyodrębnić cechy akustyczne, w tym drżenie, miganie, stosunek harmoniczny do szumów, entropię gęstości okresów nawrotów i analizę fluktuacji zdetrendowanych. Te cechy wielokrotnie wykazano, że zawierają informacje diagnostycznie istotne i mogą być uzyskiwane za pomocą sprzętu rejestrującego klasy konsumenckiej4,5. Publicznie dostępny zestaw danych referencyjnych pochodzący z takich nagrań stał się standardowym polem testowym dla tego zadania, a klasyczne metody uczenia maszynowego zastosowane do pełnego zestawu cech, w tym maszyny wektorowe wsparcia, lasy losowe i drzewa gradientowo wzmocnione, zgłaszały wartości area-under-the-receiver-operating-characteristic-curve zbliżające się do 0,996,7,8, co sugeruje, że zadanie klasyfikacji jest blisko rozwiązane, gdy używany jest pełny zestaw cech i odpowiednie strategie radzenia sobie z brakiem równowagi klas. Uczenie maszynowe kwantowe pojawiło się jako alternatywny paradygmat obliczeniowy dla zadań klasyfikacji biomedycznych, w którym parametryzowane obwody kwantowe wykorzystują superpozycję i splątanie do reprezentacji interakcji cech przy stosunkowo niewielu parametrach do trenowania, a gradienty obwodów mogą być obliczane analitycznie za pomocą reguły przesunięcia parametrów, a nie aproksymacji różnicowymi skończonymi9. Jednak wiele opublikowanych badań opisujących “kwantowe” lub “kwantowo inspirowane” sieci neuronowe do zastosowań biomedycznych implementuje całkowicie klasyczne architektury, które przyjmują kwantowo inspirowane formalizmy matematyczne bez wykonywania faktycznego parametryzowanego obwodu kwantowego ani na symulatorze, ani na sprzęcie kwantowym10. Ostatnie osiągnięcia w wykrywaniu choroby Parkinsona obejmowały również hybrydowe architektury sieci neuronowych konwolucyjno-transformatorowych11, metody głębokiego uczenia oparte na uważności dla rezonansu magnetycznego (MRI)12 oraz lekkie sieci neuronowe konwolucyjne zaprojektowane dla wydajnego obliczeniowo diagnozowania13, co ilustruje szybki rozwój podejść sztucznej inteligencji w wielu modalnościach danych. Bardziej ogólnie, nieinwazyjne wspomaganie diagnozy komputerowej zostało z powodzeniem rozszerzone na inne zastosowania biomedyczne, w tym hybrydowe potoki uczenia maszynowego i głębokiego uczenia dla obrazowania medycznego14. Porównawcze oceny architektur głębokiego uczenia na tej samej publicznej bazie danych głosów pokazują dalszą mocną wydajność osiągalną przy użyciu konwencjonalnych modeli klasycznych o pełnym zestawie cech15.
Te osiągnięcia podkreślają szczególną potrzebę metodologiczną reprodukowalnego hybrydowego modelu konwolucyjnej sieci neuronowej kwantowo-klasycznej (QI-HCNN), który (i) wykonuje prawdziwy, w pełni określony parametryzowany obwód kwantowy; (ii) jest oceniany za pomocą identycznych cech wejściowych zarówno w stosunku do pasującej architektonicznie sieci neuronowej klasycznej, jak i mocnej klasycznej bazy porównawczej; oraz (iii) jest ewaluowany za pomocą protokołu, który wyraźnie bada główne źródła błędu w małych zbiorach danych biomedycznych, w tym brak równowagi klas, zakłócenia demograficzne i wycieki danych na poziomie pacjenta podczas walidacji krzyżowej.
Ogólnym celem tego protokołu jest zapewnienie w pełni reprodukowalnego przepływu pracy QI-HCNN do klasyfikacji choroby Parkinsona za pomocą nagrań głosów ludzkich. Protokół opisuje cztero-qubitowy parametryzowany obwód kwantowy za pomocą kodowania kątowego, dwóch warstw splątania opartych
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Niniejszy protokół wykorzystuje publicznie dostępny, zanonimizowany zbiór danych z nagraniami głosów pochodzący od zewnętrznego dostawcy. Autorzy nie gromadzili nowych danych od uczestników, a do przeprowadzenia niniejszego badania nie była wymagana dodatkowa zgoda komisji bioetycznej (IRB). Zbiór danych opisany w podrozdziale Pozyskiwanie zbioru danych i przetwarzanie danych na poziomie uczestnika został pierwotnie zgromadzony przez Little i współpracowników3 na podstawie instytucjonalnej zgody etycznej, nie zawiera bezpośrednich informacji identyfikujących uczestników (wyłącznie zanonimizowane identyfikatory nagrań) i jest publicznie dostępny do celów badawczych. Należy sprawdzić, zgodnie z polityką danej instytucji, czy wtórna analiza tego publicznie dostępnego zbioru danych wymaga oceny etycznej. W instytucji autorów ustalono, że retrospektywna analiza wtórna tego w pełni zanonimizowanego, publicznie zarchiwizowanego zbioru danych jest zwolniona z pełnej oceny IRB.
Pozyskiwanie zbioru danych i przetwarzanie danych na poziomie uczestnika
Pobrano zbiór danych Parkinson’s Disease Classification (UCI Machine Learning Repository, Dataset ID 174), pierwotnie opisany przez Little i wsp.3. Zbiór danych zawierał 195 nagrań długotrwałej fonacji samogłoski /a/ od 31 osób (23 z diagnozą choroby Parkinsona i 8 zdrowych osób kontrolnych; zakres wieku: 46–85 lat). Ponieważ repozytorium nie udostępnia wersjonowanego identyfikatora DOI, dokładna data pobrania została odnotowana i wprowadzona do Tabeli materiałów. Zbiór danych został dostarczony w formie pliku wartości rozdzielanych przecinkami (CSV) (parkinsons.csv). Nie było wymaganej dekompresji ani konwersji plików, a plik zaimportowano bezpośrednio przy użyciu funkcji read_csv z biblioteki Pandas (patrz Tabela materiałów).
Zweryfikowano, że pobrany zestaw danych zawiera 195 wierszy i 24 kolumny, w tym jedną kolumnę identyfikatora nagrania (format: phon_R01_S  podmiot
 _ nagranie), 22 kolumny ciągłych cech akustycznych (Tabela 1) oraz jedną kolumnę binarnych etykiet klas (status: 1 = choroba Parkinsona; 0 = zdrowa kontrola). Tabela 1 służyła jako punkt odniesienia dla wszystkich cech akustycznych i kategorii cech w całym protokole.
| Kategoria | Reprezentatywne cechy | Znaczenie kliniczne |
| Częstotliwość podstawowa | MDVP:Fo(Hz), MDVP:Fhi(Hz), MDVP:Flo(Hz) | Średnia, maksymalna i minimalna częstotliwość podstawowa fonacji; odzwierciedla stabilność drgań fałdów głosowych. |
| Jitter (perturbacja częstotliwości) | MDVP:Jitter(%), MDVP:Jitter(Abs), MDVP:RAP, MDVP:PPQ, Jitter:DDP | Zmienność okresu podstawowego z cyklu na cykl, odzwierciedlająca zaburzenia kontroli motorycznej krtani. |
| Shimmer (perturbacja amplitudy) | MDVP:Shimmer, MDVP:Shimmer(dB), Shimmer:APQ3, Shimmer:APQ5, MDVP:APQ, Shimmer:DDA | Zmienność amplitudy sygnału z cyklu na cykl, odzwierciedlająca zachrypniętą lub niestabilną fonację. |
| Miary szumu | NHR, HNR | Stosunek szumu do składowych harmonicznych (tonalnych) sygnału głosowego. |
| Dynamika nieliniowa / skalowanie fraktalne | RPDE, D2, DFA, spread1, spread2, PPE | Miary nieliniowej dynamiki głosu, periodyczności oraz długozasięgowych korelacji czasowych związanych z drganiami fałdów głosowych. |
Tabela 1: Kategorie cech akustycznych wykorzystane do klasyfikacji choroby Parkinsona. 22 akustyczne cechy głosu wyodrębnione z zestawu danych klasyfikacji choroby Parkinsona zostały podzielone na pięć kategorii cech: częstotliwość podstawowa, jitter, shimmer, miary szumu oraz dynamika nieliniowa. Dla każdej kategorii wymieniono reprezentatywne cechy wraz z ich odpowiadającym znaczeniem klinicznym. MDVP, Multidimensional Voice Program; RAP, relative average perturbation; PPQ, pitch period perturbation quotient; APQ, amplitude perturbation quotient; DDP, difference of differences of periods; DDA, average absolute difference of amplitudes; NHR, noise-to-harmonics ratio; HNR, harmonics-to-noise ratio; RPDE, recurrence period density entropy; D2, correlation dimension; DFA, detrended fluctuation analysis; PPE, pitch period entropy.
Identyfikator uczestnika dla każdego nagrania został wyodrębniony poprzez analizę podciągu znaków poprzedzającego ostatni podkreślnik w nazwie nagrania. Na przykład: phon_R01_S01_1 i phon_R01_S01_2 zostały przypisane do uczestnika S01. W przypadku wszystkich opisanych procedur walidacji grupowanej lub z pominięciem jednego uczestnika (leave-one-participant-out) wykorzystano identyfikatory uczestników zamiast identyfikatorów nagrań w Protokół ewaluacyjny podrozdział, ponieważ nagrania uzyskane od tego samego uczestnika są skorelowane akustycznie. Po ekstrakcji wygenerowano i przeanalizowano tabelę częstotliwości identyfikatorów, aby potwierdzić, że wszystkie 195 nagrań przypisano dokładnie do 31 unikalnych uczestników, że żadne nagranie nie pozostało nieprzypisane oraz że liczba nagrań na jednego uczestnika była zgodna z dokumentacją źródłowego zbioru danych.
Rozkład klas zestawiono zarówno na poziomie nagrań (147 nagrań z chorobą Parkinsona, 75,4%; 48 nagrań z grupy kontrolnej osób zdrowych, 24,6%), jak i na poziomie uczestników (23 z 31 uczestników, 74,2%, zdiagnozowanych z chorobą Parkinsona). Oba rozkłady zostały raportowane, ponieważ niezrównoważenie klas na poziomie nagrań i na poziomie uczestników nie jest identyczne i wpływa na późniejszą ewaluację.
Brak grup kontrolnych osób zdrowych oraz pacjentów z chorobą Parkinsona, dobranych pod względem wieku lub płci w zbiorze danych źródłowych, został odnotowany jako ograniczenie badania i przeniesiony do sekcji Dyskusja, ponieważ cecha ta wynika z pierwotnego procesu gromadzenia danych i nie może zostać skorygowana podczas późniejszego przetwarzania wstępnego.
Procedura wstępnego przetwarzania
Wszystkie procedury wstępnego przetwarzania były wykonywane niezależnie w obrębie każdego folderu treningowego procedury walidacji krzyżowej opisanej w podrozdziale Protokół oceny. Zarówno etapy normalizacji Min–Max, jak i analiza głównych składowych (PCA) były dopasowywane z wykorzystaniem wyłącznie partycji treningowej każdego folderu. Dopasowane transformacje zostały następnie zastosowane do odpowiadającej im wydzielonej partycji testowej bez ponownego dopasowania, aby zapobiec wyciekowi informacji z partycji testowej do parametrów wstępnego przetwarzania.
22 surowe cechy akustyczne w każdym podziale treningowym zostały znormalizowane przy użyciu skalera Min–Max z zakresem wyjściowym [0, π]. Dopasowany skaler został następnie zastosowany zarówno do podziałów treningowych, jak i testowych w odpowiadającej im partii (Równanie 1). Równanie 1 opiera się na standardowej formule normalizacji Min–Max i zostało zdefiniowane dla niniejszego protokołu. Normalizacja Min–Max została przeprowadzona przy użyciu klasy MinMaxScaler z biblioteki scikit-learn (wersja 1.8.0) z parametrami feature_range=(0, π), copy=True oraz clip=False.
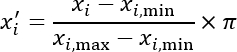 (1)
Model PCA z n_components = 4 dopasowano, wykorzystując wyłącznie znormalizowane dane treningowe. Następnie dopasowaną transformację PCA zastosowano zarówno do partycji treningowej, jak i testowej. Dla każdego przejścia (fold) odnotowano proporcję całkowitej wariancji wyjaśnianej przez cztery zachowane główne składowe. W analizach opisanych w niniejszym opracowaniu cztery zachowane główne składowe wyjaśniły 81,5% całkowitej wariancji (odpowiednio 50,3%, 16,3%, 9,4% i 5,5%). Analizę PCA przeprowadzono przy użyciu klasy PCA z parametrami n_components=4, svd_solver="full", whiten=False oraz random_state=42.
Ponieważ PCA może generować ujemne wartości wyników składowych, zastosowano drugi skaler Min–Max z zakresem wyjściowym [0, π], dopasowany na podstawie przekształconego przez PCA zbioru treningowego. Dopasowany skaler zastosowano następnie zarówno do zbioru treningowego, jak i testowego. Każda przekształcona wartość z zestawu testowego, która wykraczała poza przedział [0, π], została przycięta do najbliższej granicy, ponieważ skaler został dopasowany wyłącznie na podstawie zbioru treningowego. W zbiorze danych nie wystąpiły cechy o zerowej wariancji. Zakres każdej cechy we wszystkich 195 nagraniach był ściśle dodatni, w związku z czym nie wystąpił problem dzielenia przez zero. Potwierdzono to, weryfikując, że przeskalowany wynik nie zawierał wartości NaN ani nieskończonych.
Cztery ponownie znormalizowane komponenty główne przypisano sekwencyjnie jako kąty rotacji dla qubitów 0, 1, 2 i 3 podczas procedury kodowania kątowego opisanej w podrozdziale Konstrukcja obwodu kwantowego. Pierwszy komponent główny przypisano do qubitu 0, drugi do qubitu 1, trzeci do qubitu 2, a czwarty do qubitu 3. Tym samym zakończono proces preprocessingu i przekazano przetworzone cechy klasyczne do obwodu kwantowego. Po drugim etapie skalowania Min–Max potwierdzono, że wszystkie wartości wyjściowe mieszczą się w przedziale [0, π]. Wartości w partycji testowej, które z powodu zaokrągleń zmiennoprzecinkowych znalazły się minimalnie poza tym zakresem, zostały przycięte do najbliższej granicy za pomocą funkcji clip z biblioteki NumPy (wersja 2.4.4). Procedura ta zapewniła, że wszystkie cztery wejścia do warstwy kodowania kątowego były poprawnymi kątami rotacji w przedziale [0, π].
Konstrukcja obwodu kwantowego
Obwód czterokubitowy został skonstruowany przy użyciu symulatora wektora stanu (statevector simulator) wymienionego w Tabeli materiałów oraz sekwencji bramek opisanej poniżej. Uzupełniający plik kodu 1 posłużył jako kompletna, wykonywalna implementacja obwodu, zawierająca wszystkie funkcje pomocnicze do konstrukcji bramek oraz obliczania gradientu metodą przesunięcia parametrów (parameter-shift gradient computation). Rysunek 1 przedstawia pełny przepływ pracy, od wstępnego przetwarzania nagrania głosowego, poprzez cztery warstwy obwodu, klasyczną głowicę post-processingu, aż po końcową klasyfikację.
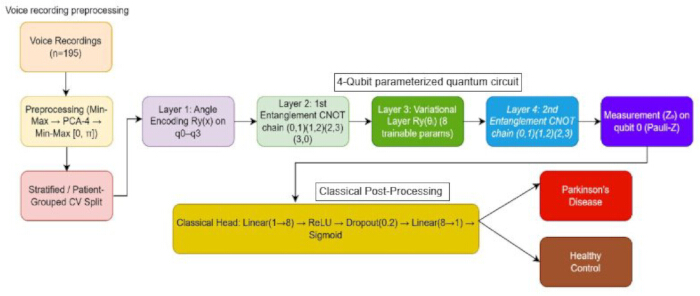
Rysunek 1. Architektura systemu i przepływ pracy obwodu kwantowego. Przepływ pracy dla klasyfikacji choroby Parkinsona na podstawie nagrań głosu ludzkiego. Schemat przedstawia wstępne przetwarzanie nagrań głosowych, warstwową lub zgrupowaną według pacjentów walidację krzyżową, wykonanie parametrycznego kwantowego obwodu czterokubitowego, pomiar Pauli-Z pojedynczego kubitu na kubicie 0, klasyczne postprzetwarzanie oraz końcową klasyfikację binarną jako choroba Parkinsona lub zdrowa grupa kontrolna. CNOT, bramka kontrolowanego NOT; PCA, analiza głównych składowych; ReLU, jednostka liniowa z prostowaniem. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Czterobitowy rejestr został zainicjowany w stanie bazy obliczeniowej ∣0000.
W warstwie kodowania kątowego zastosowano bramkę rotacji Ry (xi) dla kubitu i, gdzie i = 0,1,2,3, wykorzystując cztery kąty wygenerowane przez potok wstępnego przetwarzania (Równanie 2). Równanie 2 opisuje standardową procedurę kodowania kątowego stosowaną w parametryzowanych obwodach kwantowych, zgodną z ramami uczenia parametryzowanych obwodów kwantowych opracowanymi przez Mitarai i wsp.9, i została ona tutaj zastosowana w specyficznej konfiguracji czterech kubitów zdefiniowanej dla niniejszego protokołu.
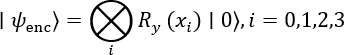 (2)
W przypadku pierwszej warstwy splątania zastosowano kolisty łańcuch bramek NOT kontrolowanych w następującej kolejności sterowanie-cel: (0,1), (1,2), (2,3) oraz (3,0).
W przypadku warstwy wariacyjnej osiem trenowalnych parametrów od w0 do w7 zainicjowano poprzez niezależne próbkowanie z rozkładu normalnego ze średnią 0 i odchyleniem standardowym 0,3. Użyte ziarno losowe odnotowano w Tabeli materiałów. Osiem wariacyjnych parametrów kwantowych zainicjowano za pomocą numpy.random.default_rng(42 + fold_index).normal(0, 0.3, size = 8), gdzie fold_index jest numerem folda zaczynającym się od zera, co zapewniło specyficzne dla każdego folda, ale powtarzalne inicjalizacje. Dla każdego kubitu i = 0, 1, 2 i 3 zastosowano bramkę Rz(wi), a następnie bramkę Ry(wi+4) (Równanie 3). Równanie 3 opisuje wariacyjną (trenowalną) warstwę kwantową zgodną z ogólnym schematem uczenia parametryzowanych obwodów kwantowych wprowadzonym przez Mitarai i wsp. 9, która została tutaj zaimplementowana przy użyciu specyficznej sekwencji bramek i parametryzacji zdefiniowanej dla niniejszego protokołu.
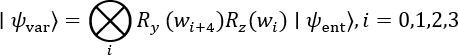 (3)
W przypadku drugiej warstwy splątania zastosowano otwarty łańcuch bramek controlled-NOT w następującej kolejności sterowanie-cel: (0,1), (1,2) oraz (2,3). Łańcuch ten nie został zamknięty powrotem do kubitu 0.
Wartość oczekiwana operatora Pauliego-Z dla samego kubitu 0,  , została obliczona przy użyciu iloczynu wewnętrznego wektora stanu. Wykonanie obwodu przeprowadzono za pomocą niestandardowego symulatora wektorów stanu zaimplementowanego przy użyciu standardowych operacji na tablicach numerycznych (Supplementary Coding File 1; qhcnn.py). W całym procesie zastosowano precyzję Complex128 (numpy.complex128). Wartości oczekiwane obliczono analitycznie z iloczynu wewnętrznego wektora stanu, w związku z czym nie przeprowadzono próbkowania opartego na liczbie pomiarów (shots). Nie było wymagane użycie zewnętrznego frameworka do obliczeń kwantowych. Gdyby zamiast symulatora wektorów stanu użyto symulatora opartego na próbkowaniu lub urządzenia kwantowego, wykonano by powtórne pomiary kubitu 0 w bazie obliczeniowej, a otrzymane częstotliwości bitów przeliczono by na wartość oczekiwaną (Equation 4). Equation 4 jest standardowym kwantowomechanicznym wzorem na wartość oczekiwaną i została ona tutaj zastosowana do obserwabla Pauliego dla pojedynczego kubitu zdefiniowanego dla obecnego protokołu. Ponieważ nie przeprowadzono próbkowania opartego na liczbie pomiarów, nie było wymagane łagodzenie błędów pomiarowych. Symulator wykorzystywał indeksowanie kubitów w systemie big-endian, gdzie kubit 0 odpowiadał najbardziej znaczącemu bitowi indeksu wektora stanu. Konwencja ta została wprost uwzględniona podczas konstruowania obserwabla Pauliego, aby zapewnić pomiar poprawnej wartości oczekiwanej.
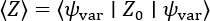 (4)
Gradient względem każdego z ośmiu parametrów wariacyjnych obliczono przy użyciu reguły przesunięcia parametru (parameter-shift rule). Podczas każdego obliczania gradientu obwód oceniano dwukrotnie dla każdego parametru, raz dla θ + π/2 i raz dla θ - π/2 (Równanie 5). Równanie 5 to standardowa reguła przesunięcia parametru wprowadzona przez Mitarai i współpracowników9, która została tutaj zastosowana bez modyfikacji.
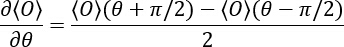 (5)
Druga warstwa splątania, zgodnie z powyższym opisem, nigdy nie zastosowała bramki CNOT z kubitem 0 jako celem. Ponieważ bramka CNOT nie zmienia zredukowanego stanu swojego kubitu sterującego, druga warstwa splątania nie mogła zmienić , niezależnie od wartości parametrów podlegających uczeniu. Aby umożliwić drugiej warstwie splątania wpływ na mierzony wynik w zmodyfikowanym protokole, kubit 0 musiałby zostać uwzględniony jako cel, na przykład poprzez zamknięcie łańcucha dodatkową bramką CNOT (3,0), lub zamiast wartości oczekiwanej dla pojedynczego kubitu należałoby zmierzyć obserwabel wielokubitowy. W niniejszym protokole zachowano pierwotnie określoną drugą warstwę splątania, a jej zmierzony wkład przedstawiono wprost w sekcji Wyniki, zamiast wprowadzać cichą korektę, ponieważ takie zachowanie obwodu stanowi część obecnych ustaleń.
Klasyczna warstwa postprocesowania
Klasyczny etap postprocesowania składał się z sieci neuronowej z jednokierunkowym przepływem informacji (feed-forward), zaimplementowanej przy użyciu standardowych operacji numerycznych opartych na tablicach, wymienionych w Tabela materiałówPojedynczy skalarny sygnał wyjściowy obwodu,  zostało zmapowane na osiem jednostek ukrytych za pomocą w pełni połączonej warstwy, po której zastosowano funkcję aktywacji ReLU (rectified linear unit). Podczas trenowania zastosowano warstwę dropout z prawdopodobieństwem zachowania 0,8 (wskaźnik dropout = 0,2). Następnie osiem jednostek ukrytych zmapowano na pojedynczą jednostkę wyjściową przy użyciu drugiej w pełni połączonej warstwy, a w celu wygenerowania końcowego prawdopodobieństwa klasy, ŷ (Równanie 6). Równanie 6 definiuje konkretną klasyczną architekturę postprocessingu zastosowaną w niniejszym protokole, która obejmuje standardowe operacje liniowe, jednostki liniowe z prostowaniem (ReLU) oraz operacje sigmoidalne.
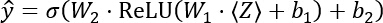 (6)
Macierze wag pierwszej i drugiej warstwy zostały zainicjalizowane poprzez niezależne próbkowanie z rozkładu normalnego ze średnią 0 i odchyleniem standardowym 0,5, natomiast wszystkie wyrazy biasu zainicjalizowano wartością 0. Ta sama instancja generatora liczb pseudolosowych i ziarno, które zostały użyte do inicjalizacji kwantowych parametrów wariacyjnych, zostały zastosowane również w warstwie klasycznej, aby zapewnić powtarzalność między poszczególnymi uruchomieniami. Konkretnie, klasyczne macierze wag zainicjalizowano za pomocą numpy.random.default_rng(42 + fold_index).normal(0, 0.5, size=...), podczas gdy wszystkie wyrazy biasu zainicjalizowano zerem. Na początku każdego etapu walidacji krzyżowej tworzono jedną instancję generatora liczb pseudolosowych z ziarnem 42 + fold_index, która była wykorzystywana sekwencyjnie do inicjalizacji parametrów kwantowych, inicjalizacji wag klasycznych, tasowania mini-wsadów oraz generowania masek dropout, zamiast stosowania oddzielnych, niezależnych strumieni ziarna dla każdego procesu.
Podczas trenowania zastosowano dropout poprzez generowanie nowo próbkowanej maski binarnej przy każdym przejściu w przód, korzystając z konwencji inverted-dropout, w której jednostki pozostające w sieci były skalowane przez 1/0.8. Podczas walidacji i testowania dropout został całkowicie wyłączony, a do wnioskowania wykorzystano pełną, nieskalowaną sieć.
Połączony model QI-HCNN zawierał 33 parametry trenowalne: osiem kwantowych parametrów wariacyjnych z obwodu kwantowego oraz 25 parametrów klasycznych. Komponent klasyczny składał się z ośmiu wag i ośmiu biasów w pierwszej warstwie w pełni połączonej, wraz z ośmioma wagami i jednym biasem w drugiej warstwie w pełni połączonej. Wymiary tensorów wag i biasów wynosiły 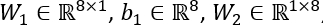 oraz
 . Klasyczna warstwa postprocesingu została zaimplementowana w całości przy użyciu standardowych operacji na tablicach numerycznych, bez dodatkowego frameworka do uczenia maszynowego. Wszystkie obliczenia klasyczne zostały wykonane z użyciem arytmetyki float64 (podwójnej precyzji).
Trenowanie modelu
Obwód kwantowy opisany w podrozdziale Budowa obwodu kwantowego oraz klasyczna warstwa postprocessingu opisana w podrozdziale Klasyczna warstwa postprocessingu zostały połączone w jeden kompleksowy model możliwy do trenowania. Wszystkie 33 trenowalne parametry zostały zoptymalizowane wspólnie przy użyciu optymalizatora Adam z początkową szybkością uczenia 0.01 oraz mechanizmem weight decay, zaimplementowanym jako kara L2, zastosowana wyłącznie do klasycznych macierzy wag. Optymalizator Adam został zaimplementowany ręcznie przy użyciu standardowych operacji na tablicach numerycznych z następującymi ustawieniami: learning rate = 0.01, β1 = 0.9, β2 = 0.999, ∈ = 1 × 10⁻⁸ oraz weight decay = 1 × 10⁻⁴, zastosowany tylko do klasycznych macierzy wag, a nie do wyrazów biasu czy kwantowych parametrów wariacyjnych.
Jako funkcję straty zastosowano binarną entropię krzyżową. W celu przeprowadzenia procedury balansowania klas po podziale, opisanej w Protokół oceny w podsekcji wkład do funkcji straty każdej próbki treningowej był ważony odwrotnością częstotliwości występowania jej klasy wewnątrz partycji treningowej bieżącego folderu. W przypadku protokołu niezrównoważonego przypisano jednolite wagi próbek. Binarną entropię krzyżową obliczono jako średnią stratę dla wszystkich próbek w każdym mini-batchu, stosując standardowy wzór dla binarnej entropii krzyżowej.
Model był trenowany przez 30 epok z wykorzystaniem mini-wsadów po 16 próbek. Próbki treningowe były losowo przemieszane na początku każdej epoki przy użyciu numpy.random.default_rng(42 + fold_index).permutation(n) w celu wygenerowania losowej kolejności próbek. W przypadku, gdy liczba próbek treningowych nie była podzielna przez 16, ostatni mniejszy mini-wsad był zachowywany i przetwarzany w jego rzeczywistej wielkości, zamiast być odrzucony.
Podczas treningu zastosowano schodkowy harmonogram tempa uczenia. Tempo uczenia było mnożone przez 0,7 po każdych 10 ukończonych epokach, a konkretnie na początku 11. i 21. epoki.
Gradienty dla ośmiu kwantowych parametrów wariacyjnych obliczono przy użyciu reguły przesunięcia parametru opisanej w podrozdziale Konstrukcja obwodu kwantowego. Gradienty dla 25 parametrów klasycznych obliczono za pomocą standardowego różniczkowania w trybie wstecznym wyłącznie przez warstwę klasyczną. Wyjście obwodu kwantowego, , oraz jego gradienty z reguły przesunięcia parametru służyły jako interfejs pomiędzy obwodem kwantowym a warstwą klasyczną. Wszystkie 33 parametry zostały zaktualizowane przy użyciu tej samej instancji optymalizatora Adam.
Nie zastosowano wczesnego zatrzymywania w oparciu o walidację. Każdy model był trenowany zgodnie ze stałym harmonogramem 30 epok, a wyniki uzyskane na wydzielonej partii testowej raportowano po zakończeniu ostatniej epoki. Wszystkie parametry modelu (kwantowe parametry wariacyjne, klasyczne macierze wag oraz wyrazy bias) były reinicjalizowane niezależnie na początku każdego etapu walidacji krzyżowej przy użyciu ziarna losowości specyficznego dla danego etapu (42 + fold_index). Parametry nie były współdzielone pomiędzy etapami ani uruchomieniami bazowymi.
Środowisko obliczeniowe, w tym procesor, pamięć, wersje oprogramowania oraz przybliżony czas rzeczywisty trenowania na jedną partycję (fold), odnotowano w Tabeli Materiałów.
Protokół oceny
Wydajność modelu oceniono za pomocą procedur walidacji krzyżowej na poziomie nagrań i na poziomie uczestników, wraz z porównaniami z modelami bazowymi, analizami balansowania klas, eksperymentami z ablacją obwodów, testami istotności statystycznej oraz analizami ważności cech.
W ramach ewaluacji podstawowej 195 nagrań głosowych podzielono na trzy stratyfikowane foldy przy użyciu stałego ziarna losowego, zachowując w każdym foldzie stosunek nagrań osób z chorobą Parkinsona do grupy kontrolnej na poziomie 75,4%/24,6%. Model opisany w poprzednich sekcjach był trenowany przy użyciu dwóch foldów i ewaluowany na pozostałym foldzie testowym; procedurę tę powtarzano do momentu, aż każdy fold posłużył raz jako partycja testowa. Dla każdego foldu obliczono dokładność (accuracy), precyzję (precision), czułość (recall), wynik F1 (F1-score) oraz pole pod krzywą charakterystyki ROC (AUC–ROC), a następnie przedstawiono je jako średnią ± odchylenie standardowe z trzech foldów. Podstawową trzykrotną stratyfikowaną walidację krzyżową zaimplementowano przy użyciu klasy StratifiedKFold z parametrami n_splits=3, shuffle=True oraz random_state=42.
Przewidywania klas binarnej generowano poprzez zastosowanie stałego progu prawdopodobieństwa 0,50 do przewidywanego prawdopodobieństwa klasy, ŷ, otrzymanego z klasycznej warstwy post-processingu. Dokładność, precyzję, pełność oraz wynik F1 obliczono na podstawie tych przewidywań po zastosowaniu progu, podczas gdy AUC–ROC obliczono bezpośrednio z ciągłych wartości prawdopodobieństwa bez ich progowania. Precyzję, pełność oraz wynik F1 obliczono przy użyciu funkcji metrycznych z parametrem zero_division=0, przypisując wartość 0,0 każdej niezdefiniowanej metryce. Podczas opisanych eksperymentów nie wystąpiły żadne takie niezdefiniowane warunki.
Modele bazowe oceniono przy użyciu identycznych podziałów na foldy oraz tej samej czterowymiarowej reprezentacji cech wstępnie przetworzonych, wygenerowanej przez potok przetwarzania wstępnego. Klasyczny wielowarstwowy perceptron zawierający jedną warstwę ukrytą z ośmioma jednostkami z funkcją aktywacji ReLU, dopasowany architektonicznie do komponentu klasycznego modelu hybrydowego, ale bez obwodu kwantowego, został przeszkolony przy użyciu optymalizatora Adam z karą L2 wynoszącą 1 × 10⁻⁴. Przeszkolono również klasyfikator drzew z wzmocnieniem gradientowym (gradient-boosted tree), wykorzystując tę samą czterowymiarową reprezentację, z parametrami: 200 drzew, maksymalna głębokość drzewa równa 3, współczynnik uczenia 0,1 oraz ważenie klas równe odwrotności częstotliwości występowania klas w każdym foldzie treningowym. Dodatkowo przeszkolono drugi klasyfikator drzew z wzmocnieniem gradientowym, wykorzystując pełną reprezentację 22 cech wygenerowaną po wstępnej normalizacji Min–Max, bez zastosowania PCA lub kwantowego kodowania cech. Model ten wykorzystał 300 drzew, maksymalną głębokość drzewa równą 4, współczynnik uczenia 0,05 oraz tę samą strategię ważenia klas na podstawie odwrotności częstotliwości w foldach treningowych. Bazowy klasyczny wielowarstwowy perceptron zaimplementowano przy użyciu MLPClassifier z parametrami: hidden_layer_sizes=(8,), activation="relu", solver="adam", alpha=1 × 10⁻4, batch_size="auto", learning_rate_init=0.001, max_iter=500, early_stopping=False, shuffle=True oraz random_state=42. Zastosowano domyślną jednolitą inicjalizację wag Glorota (Xaviera) zapewnioną przez implementację. Bazowe modele drzew z wzmocnieniem gradientowym zaimplementowano przy użyciu XGBoost 3.3.0 z parametrami: objective = "binary:logistic", eval_metric = "logloss", tree_method = "auto", subsample = 1.0, colsample_bytree = 1.0, reg_alpha = 0, reg_lambda = 1 oraz random_state = 42.
Aby ocenić wpływ balansowania klas po podziale, główną procedurę walidacji krzyżowej powtórzono dla modelu QI-HCNN z włączonym ważeniem próbek. Wagi balansujące obliczano wyłącznie na podstawie części treningowej każdego folderu po podziale na zbiór treningowy i testowy; nie obliczano ich z odpowiadającej im wydzielonej części testowej.
Eksperymenty z ablacją komponentów obwodu przeprowadzono poprzez czterokrotne powtórzenie pełnego procesu preprocessingu, trenowania i ewaluacji, modyfikując jedynie dwie warstwy splątania obwodu kwantowego. Cztery warianty obwodu obejmowały: (i) kompletny obwód zawierający obie warstwy splątania; (ii) obwód z usuniętą pierwszą warstwą splątania i zachowaną drugą; (iii) obwód z zachowaną pierwszą warstwą splątania i usuniętą drugą; oraz (iv) obwód z usunięciem obu warstw splątania. We wszystkich czterech eksperymentach zastosowano identyczne partycje fałdów, ziarna liczb pseudolosowych oraz konfiguracje trenowania, aby wszelkie zaobserwowane różnice w wydajności można było przypisać wyłącznie konfiguracji warstw splątania.
W ramach oceny odporności przeprowadzono walidację krzyżową z grupowaniem według uczestników, dzieląc 31 uczestników (zamiast 195 nagrań) na pięć grup, z których każda zawierała od sześciu do siedmiu osób. W każdej iteracji model był trenowany przy użyciu nagrań od uczestników z czterech grup i oceniany przy użyciu nagrań od uczestników z pozostałej grupy, co gwarantowało, że żaden uczestnik nie dostarczył nagrań jednocześnie do zbioru treningowego i testowego w obrębie tego samego podziału (fold). Dokładność, precyzja, czułość, wynik F1 oraz AUC–ROC zostały przedstawione jako średnia ± odchylenie standardowe z pięciu podziałów grupowań uczestników dla modelu QI-HCNN, klasycznego wielowarstwowego perceptrona oraz modelu bazowego gradient-boosted opartego na czterech cechach. Walidację krzyżową z grupowaniem według uczestników zaimplementowano przy użyciu klasy GroupKFold z parametrem n_splits=5, gdzie identyfikatory uczestników służyły jako zmienna grupująca. Ponieważ GroupKFold nie przetasowuje grup, uczestnicy zostali przypisani zgodnie z domyślną deterministyczną kolejnością implementacji, co zaowocowało podziałami zawierającymi sześciu lub siedmiu uczestników w każdej grupie.
Istotność statystyczną oceniono, stosując testy znaków Wilcoxona dla par do wartości AUC–ROC uzyskanych dla każdego folda w przypadku modeli podstawowych i modelu głównej ewaluacji. Podano dokładne wartości p oraz odpowiadającą im liczbę par obserwacji, ponieważ moc statystyczna tego testu jest ograniczona przy dostępności niewielkiej liczby foldów. A priori zdefiniowano cztery porównania parzyste AUC–ROC: (1) QI-HCNN względem klasycznego wielowarstwowego perceptrona; (2) QI-HCNN względem modelu bazowego gradient-boosted tree dopasowanego za pomocą PCA; (3) klasycznego wielowarstwowego perceptrona względem modelu bazowego gradient-boosted tree dopasowanego za pomocą PCA; oraz (4) niezbalansowanego modelu QI-HCNN względem modelu QI-HCNN zbalansowanego po podziale danych. Nie zastosowano korekty na wielokrotne porównania, ponieważ analizy miały charakter eksploracyjny, a ograniczona liczba foldów znacząco obniżyła moc statystyczną.
Analizę istotności cech przeprowadzono z wykorzystaniem klasyfikatora drzew gradientowych wytrenowanego na pełnej reprezentacji składającej się z 22 cech. Wyekstrahowano i uszeregowano wyniki istotności cech oparte na zysku (gain) dla wszystkich oryginalnych cech akustycznych. Oddzielnie, wyłącznie w celach raportowania, dopasowano analizę PCA do pełnego zbioru danych; nie była ona wykorzystywana podczas ewaluacji modelu. Dla każdej oryginalnej cechy akustycznej zsumowano wartości bezwzględne ładunków dla czterech zachowanych głównych komponentów, a następnie uszeregowano cechy według tych wartości. Zaraportowano obie metody rankingowe oraz zakres ich pokrywania się. W przypadku analizy istotności cech opartej na zysku, implementacja drzew gradientowych wygenerowała unikalne zmiennoprzecinkowe wartości zysku i nie wystąpiły żadne remisy. W przypadku rankingów ładunków głównych komponentów, remisy w zsumowanych wartościach bezwzględnych ładunków rozstrzygano zgodnie z oryginalną kolejnością kolumn cech w zbiorze danych.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Wszystkie wartości liczbowe podane w tekście są zgodne i identyczne z tymi przedstawionymi na Rysunkach 2–8 oraz w Tabelach 2–4. Każdy rysunek został wygenerowany bezpośrednio z kodu dostarczonego w Uzupełniającym Pliku Kodowania 1, a nie przygotowany ręcznie, co zapewnia spójność między raportowanymi wartościami liczbowymi a naniesionymi danymi.
Wstępna skuteczność walidacji krzyżowej
W ramach protokołu treningu niezbalan...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Ten protokół określa w pełni odtwarzalną architekturę QI-HCNN do klasyfikacji choroby Parkinsona na podstawie nagrań głosowych, w której każda brama, wybór inicjalizacji parametrów, krok przetwarzania wstępnego i procedura oceny są opisane na poziomie wystarczającym do niezależnej implementacji. Proponowany obwód jest oceniany za pomocą identycznych cech wejściowych i identycznych podziałów walidacji krzyżowej w porównaniu z dopasowanym architektonicznie klasycznym wielowarstwowym perceptronem i liniowymi bazami gradient...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Konflikt interesów:
Autorzy deklarują, że nie mają żadnych konkurencyjnych interesów finansowych ani niefinansowych związanych z niniejszą pracą.
Podziękowania
Ta praca nie była finansowana przez żadną agencję ani organizację, ani technicznie, ani finansowo. Autorzy dziękują osobom zarządzającym repozytorium uczenia maszynowego UCI za zapewnienie publicznego dostępu do zestawu danych z nagraniami głosów użytych w niniejszym badaniu.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Adam optimizer | Standardowa implementacja optymalizacji numerycznej | Niestandardowa implementacja; NumPy 2.4.4 | Optymalizacja łączna parametrów kwantowych i klasycznych; Trenowanie modelu |
| Implementacja binarnej funkcji straty entropii krzyżowej | Niestandardowa implementacja przy użyciu NumPy | NumPy 2.4.4; średnia strata (średnia redukcja) dla każdego mini-batchu | Funkcja straty w trakcie trenowania; Trenowanie modelu |
| Klasyfikator drzewa z wzmocnieniem gradientowym | Open-source biblioteka gradientowego wzmacniania XGBoost | XGBoost 3.3.0; objective="binary:logistic"; eval_metric="logloss"; tree_method="auto"; random_state=42 | Klasyczne linie bazowe dopasowane do PCA i pełne cechy; Protokół ewaluacji |
| Biblioteka do uczenia maszynowego | Open-source biblioteka do uczenia maszynowego scikit-learn | scikit-learn 1.8.0 | Skalowanie Min–Max, analiza głównych składowych, stratyfikowana walidacja krzyżowa, walidacja krzyżowa zgrupowana po uczestnikach, linia bazowa wielowarstwowe perceptron i metryki ewaluacji |
| Biblioteka do numerycznych obliczeń | Open-source biblioteka do numerycznych obliczeń NumPy | NumPy 2.4.4 | Podstawowe operacje na tablicach, symulacja stanu wektorowego, inicjalizacja parametrów i ręczne obliczanie gradientów |
| Zbiór danych do klasyfikacji choroby Parkinsona | Little, McSharry, Roberts, Costello i Moroz; udostępniony przez UCI Machine Learning Repository | Identyfikator zbioru danych UCI 174; 195 nagrań od 31 uczestników; dane dostępne 19 czerwca 2025 | Źródłowy zbiór danych nagrań głosu z utrzymanym samogłoskami; https://archive.ics.uci.edu/dataset/174 |
| Biblioteka do naukowego obliczania | Open-source biblioteka do naukowego obliczania SciPy | SciPy 1.17.1 | Testowanie statystycznej istotności Wilcoxona; Protokół ewaluacji |
| Symulator stanu wektorowego | Niestandardowy symulator stanu wektorowego (Dodatkowy plik kodu 1; qhcnn.py) | Czysta implementacja NumPy; precyzja complex128 (podwójna); nie wymagany zewnętrzny backend | Wykonanie cztero-qubitowego obwodu kwantowego; Budowa obwodu kwantowego |
| Biblioteka do analizy danych tabelarycznych | Open-source biblioteka do analizy danych Pandas | Pandas 3.0.2 | Ładowanie zbioru danych, inspekcja i manipulacja tabelaryczna |
| Środowisko obliczeniowe stacji roboczej | Lokalna stacja robocza CPU (kontener Linux hostowany w chmurze) | CPU x86_64; Ubuntu Linux; Python 3; nie użyto GPU ani sprzętu kwantowego; czas trenowania około 30–60 sekund na jeden przebieg | Środowisko obliczeniowe używane dla wszystkich treningów i ewaluacji; Symulacja stanu wektorowego na CPU; nie wymagany GPU ani sprzęt kwantowy |
Bibliografia
- Rabie H, Akhloufi MA. A review of machine learning and deep learning for Parkinson's disease detection. Discov Artif Intell. 2025;5:24.
- Devi SVA, et al. Hybrid deep learning methods for enhancing Parkinson's disease early detection [conference presentation]. Presented at: 4th International Conference on Smart Applications, Data and Living (ICSADL); 2025; Bhimdatta, Nepal. IEEE. p. 1462-1469. Available from: https://doi.org/10.1109/ICSADL65848.2025.10933259.
- Little MA, et al. Exploiting nonlinear recurrence and fractal scaling properties for voice disorder detection. Biomed Eng Online. 2007;6:23.
- Costantini G, et al. Artificial intelligence-based voice assessment of patients with Parkinson's disease off and on treatment. Sensors (Basel). 2023;23(4):2293.
- Gunduz H. Deep learning-based Parkinson's disease classification using vocal feature sets. IEEE Access. 2019;7:115540-115551.
- Naeem I, et al. Voice biomarkers as prognostic indicators for Parkinson's disease using machine learning techniques. Sci Rep. 2025;15:12129.
- Ebrahimzadeh E, et al. Explainable machine learning for early detection of Parkinson's disease in aging populations using vocal biomarkers. Front Aging Neurosci. 2025;17:1672971.
- Alishah S. An explainable ensemble and deep learning framework for accurate and interpretable Parkinson's disease detection from voice biomarkers. Diagnostics (Basel). 2025;15(22):2892.
- Mitarai K, Negoro M, Kitagawa M, Fujii K. Quantum circuit learning. Phys Rev A. 2018;98(3):032309.
- Alissa M, et al. Parkinson's disease diagnosis using convolutional neural networks and figure-copying tasks. Neural Comput Appl. 2022;34(2):1433-1453.
- Kumari GRP, Ravi Kanth M, Kamal MV. Parkinson's disease early detection using hybrid attentive CNN-transformer model. Neural Comput Appl. 2025;37(32):26523-26543.
- Palakayala R, Kuppusamy P. AttentionLUNet: a hybrid model for Parkinson's disease detection using MRI brain. IEEE Access. 2024;12:91752-91769.
- Wang X, et al. A light-weight CNN model for efficient Parkinson's disease diagnostics [conference presentation]. Presented at: IEEE International Symposium on Computer-Based Medical Systems (CBMS); 2023; L'Aquila, Italy. IEEE. p. 616-621. Available from: https://doi.org/10.1109/CBMS58004.2023.00289.
- Haq I, et al. Lung nodules localization and report analysis from computerized tomography (CT) scan using a novel machine learning approach. Appl Sci. 2022;12(24):12614.
- Alzaidi A, et al. Comparative study of deep learning models for Parkinson's disease detection using the UCI vocal dataset. TBench. 2025;5(2):10021
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.