Niniejsze badanie analizuje związek pomiędzy toczniem rumieniowatym układowym a nawracającymi poronieniami oraz wskazuje IFI27 jako potencjalny biomarker do dalszych badań.
Artykuł badawczy
Randomizacja mendlowska i bioinformatyka identyfikują IFI27 jako potencjalny biomarker nawracających poronień w toczniu układowym
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
Systemyczny toczeń rumieniowaty (SLE) wiąże się z niekorzystnymi wynikami ciąży, jednak związek przyczynowy między SLE a nawracającymi stratami ciąży (RPL) oraz ich wspólne cechy molekularne pozostają niejasne. W niniejszym badaniu zintegrowano dwukierunkową dwupróbkową randomizację mendlowską (MR) oraz bioinformatyczne analizy transkrypcyjne w celu zbadania tej zależności i zidentyfikowania potencjalnych wspólnych biomarkerów. Wybrano bazy FinnGen i UK Biobank, ponieważ dostarczają one dużych, niepokrywających się statystyk podsumowujących badania asocjacyjne całego genomu (GWAS) dla osób pochodzenia europejskiego. Geny różnicowo wyrażone (DEGs) zidentyfikowano w zbiorach GSE61635 (krew; |log₂ fold change| > 1) oraz GSE165004 (błona śluzowa endometrium; |log₂ fold change| > 0.5) przy zastosowaniu skorygowanego P < 0.05, a następnie przeprowadzono analizę wzbogacenia funkcjonalnego, analizę oddziaływań białko-białko (PPI), przesiewanie genów kluczowych (hub-genes), regresję metodą najmniejszego całkowitego skurczu i selekcji (LASSO), walidację zewnętrzną z użyciem GSE50772 i GSE198700, analizę charakterystyki operacyjnej odbiornika (ROC) oraz analizę wzbogacenia zbiorów genów w pojedynczej próbce (ssGSEA). Genetycznie przewidywany SLE był powiązany ze statystycznie istotnym, lecz ilościowo niewielkim wzrostem liczby spontanicznych poronień (iloraz szans [OR] dla metody ważenia odwrotnością wariancji [IVW] = 1.01, 95% przedział ufności [CI] = 1.00–1.02; P < 0.001). Siła instrumentów była odpowiednia, a analizy wrażliwości nie wykazały istotnej heterogeniczności, plejotropii kierunkowej ani wpływowego pojedynczego wariantu. Pięćdziesiąt dziewięć wspólnych DEGs było wzbogaconych w odpowiedzi immunologiczne przeciwwirusowe, adhezję komórkową oraz procesy związane z apoptozą. Gen IFI27 był konsekwentnie nadwyrażony w krwi w przypadku SLE, ale niedowyrażony w endometrium i kosmkach błonowych w przypadku RPL, podczas gdy CXCL11 nie uzyskał spójnej walidacji zewnętrznej. Retrospektywne analizy ROC wykazały powierzchnie pod krzywą (AUC) wynoszące 0,822 dla SLE i 0,872 dla RPL. Obliczone wyniki ssGSEA wykazały korelacje między ekspresją IFI27 a sygnaturami kilku typów komórek odpornościowych, w tym komórek pomocniczych T2 (Th2). Wyniki te wskazują IFI27 jako potencjalny biomarker wspólny dla SLE i RPL; konieczne są jednak prospektywne badania kliniczne i eksperymentalne w celu potwierdzenia jego znaczenia biologicznego i klinicznego.
Wprowadzenie
Toczeń rumieniowaty układowy (SLE) jest złożoną chorobą autoimmunologiczną charakteryzującą się zajęciem wielu układów i przewlekłą dysregulacją immunologiczną1. Nieprawidłowości patologiczne w SLE przypisuje się przede wszystkim upośledzonym odpowiedziom odpornościowym adaptacyjnym oraz odkładaniu się kompleksów antygen-przeciwciało, co prowadzi do autoimmunologicznie zapośredniczonego uszkodzenia tkanek i narządów2,3. Globalna zapadalność na SLE wynosi około 5,14 (1,4–15,13) przypadków na 100 000 osobolat, przy szacowanej zapadalności wynoszącej 8,82 (2,4–25,99) przypadków na 100 000 osobolat wśród kobiet4. SLE dotyka osób w każdym wieku, ale występuje głównie u kobiet w wieku rozrodczym5,6. Pacjentki w ciąży z SLE są narażone na zwiększone ryzyko niekorzystnych wyników ciąży, w tym nawracających poronień, martwego urodzenia, przedwczesnego porodu oraz ograniczenia wzrostu płodu wewnątrzmacicznie7,8. Nawracające straty ciąży (RPL) definiuje się jako dwa lub więcej poronień przed 20–24 tygodniem gestacji9. Zgłaszana rozpowszechnienie tego zjawiska wynosi około 2,6%10, co czyni je klinicznie istotnym powikłaniem rozrodczym. Około 20% ciężarnych pacjentek z SLE doświadcza poronienia11, a SLE jest uznawane za ważny czynnik ryzyka RPL12. Proponowane mechanizmy obejmują zmiany hormonalne i dysregulację immunologiczną. Biomarkery, takie jak przeciwciała przeciwkardiolipinowe i przeciwciała przeciwko fosfolipidom (lupus anticoagulant), były badane jako potencjalne predyktory niekorzystnych wyników ciąży u pacjentek z SLE11. Autoprzeciwciała te mogą wiązać się z komórkami trofoblastycznymi łożyska, zmieniać sygnalizację, proliferację i inwazję trofoblastów, modulować wydzielanie hormonów i cytokin oraz zwiększać apoptozę, przyczyniając się tym samym do upośledzenia przebiegu ciąży13. Ponadto beta-2 glikoproteina I (β2-GPI), główny antygen w zespole antyfosfolipidowym, jest ekspresjonowana w tkance łożyskowej. Wiązanie przeciwciał anty-β2-GPI z β2-GPI hamuje wzrost i różnicowanie trofoblastów, co prowadzi do wad łożyska. Interakcja ta sprzyja również tworzeniu środowiska prozapalnego, charakteryzującego się produkcją niszczących cytokin i aktywacją dopełniacza, co przyczynia się do zakrzepicy łożyska i nawracających poronień14,15. Jednakże wcześniejsze badania często nie zawierały kompleksowych analiz lokalnych tkanek rozrodczych, takich jak błona desidualna, co ograniczało możliwość powiązania systemowych biomarkerów z lokalnymi zmianami patologicznymi. Ponadto prowadzenie ciąży powikłanej SLE oraz zapobieganie niekorzystnym wynikom ciąży pozostają wyzwaniem. Podatność genetyczna przyczynia się do rozwoju SLE, a warianty genetyczne są również powiązane z patogenezą RPL16,17. Niemniej jednak nie jest jasne, czy istnieje związek przyczynowo-skutkowy między SLE a RPL, a także jakie mechanizmy molekularne i wspólne geny leżą u podstaw ich współwystępowania.
Randomizacja mendlowska (MR) jest uznaną metodą wnioskowania przyczynowego, która wykorzystuje warianty genetyczne jako zmienne instrumentalne do szacowania efektów przyczynowych ekspozycji na wyniki choroby18. Dzięki wykorzystaniu związku między genotypem a fenotypem, MR ogranicza błąd wynikający z czynników zakłócających i przyczynowości odwrotnej w porównaniu z konwencjonalnymi badaniami obserwacyjnymi. Równolegle postępy w platformach mikromacierzy genomicznych i sekwencjonowaniu wysokoprzepustowym umożliwiły analizy bioinformatyczne w celu identyfikacji kandydatów na biomarkery diagnostyczne i cele terapeutyczne poprzez profilowanie transkrypcyjne. Integracja tych uzupełniających się podejść może zapewnić bardziej kompleksowe zrozumienie związku między SLE a RPL, łącząc przyczynowe dowody genetyczne z wzorcami ekspresji genów powiązanymi z chorobą. Dlatego celem niniejszego badania było zbadanie potencjalnego związku przyczynowego między SLE a RPL, identyfikacja wspólnych kandydatów na biomarkery i szlaków biologicznych oraz priorytetyzacja celów do przyszłej walidacji. Aby osiągnąć te cele, przepływ analityczny został zdefiniowany następująco: dwukierunkowe MR w celu oceny kierunku przyczynowości; niezależne analizy różnicowej ekspresji genów, a następnie integracja transkrypcyjna; analiza sieci oddziaływań białko-białko (PPI) oraz regresja metodą LASSO (least absolute shrinkage and selection operator) w celu priorytetyzacji biomarkerów; zewnętrzna walidacja ekspresji i analiza charakterystyki operacyjnej odbiornika (ROC) oraz analiza wzbogacenia zestawów genów w pojedynczej próbce (ssGSEA) w celu oceny powiązań z sygnaturami komórek odpornościowych. Ten etapowy przepływ pracy został podsumowany na Rysunku 1.
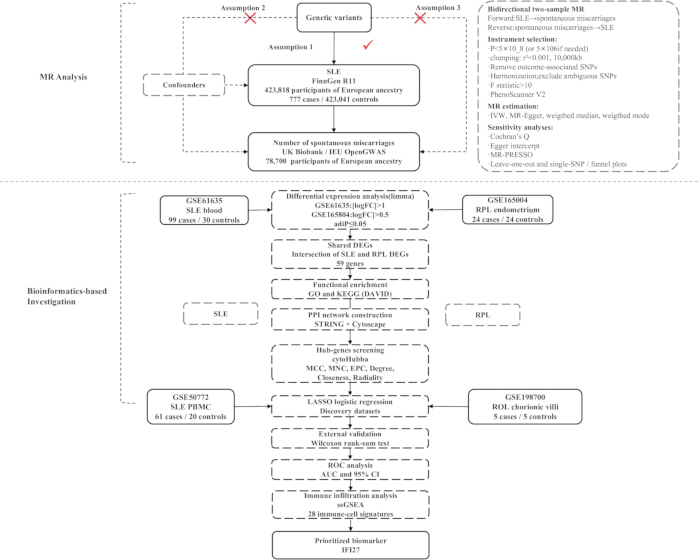
Rysunek 1. Projekt badania i schemat analityczny.
Górny panel przedstawia dwukierunkową analizę randomizacji mendlowskiej (MR) dwóch próbek oceniającą związek między toczniem rumieniowatym układowym (SLE) a liczbą samoistnych poronień z wykorzystaniem statystyk podsumowujących badania asocjacyjnych całego genomu (GWAS). Przedstawiono wybór instrumentów, grupowanie w nierównowadze sprzężeń (clumping), analizy randomizacji mendlowskiej (MR) oraz analizy wrażliwości. Dolny panel opisuje schemat bioinformatyczny, obejmujący analizę ekspresji różnicowej, identyfikację wspólnych genów o różnicowej ekspresji (DEGs), analizę wzbogacenia funkcjonalnego, konstrukcję sieci oddziaływań białko-białko (PPI), przesiewanie genów kluczowych (hub-gene), regresję metodą LASSO (least absolute shrinkage and selection operator), walidację zewnętrzną, analizę charakterystyki operacyjnej odbiornika (ROC), analizę wzbogacenia zestawów genów w pojedynczej próbce (ssGSEA) oraz priorytetyzację kandydującego biomarkera IFI27. IVW, ważona odwrotnością wariancji; KEGG, Kyoto Encyclopedia of Genes and Genomes; GO, Gene Ontology. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Protokół
Zatwierdzenie etyczne nie było wymagane dla niniejszego badania, ponieważ obejmowało ono wyłącznie wtórne analizy publicznie dostępnych, zanonimizowanych statystyk podsumowujących badania asocjacyjne całego genomu (GWAS) oraz zbiorów danych transkrypcyjnych. Nie rekrutowano nowych uczestników, nie pobierano próbek biologicznych i nie uzyskano dostępu do informacji umożliwiających identyfikację poszczególnych osób. W oryginalnych badaniach FinnGen, UK Biobank oraz Gene Expression Omnibus wskazano, że zatwierdzenie etyczne i świadoma zgoda zostały uzyskane zgodnie z odpowiednimi wymogami instytucjonalnymi, krajowymi i specyficznymi dla danej bazy danych. Wszystkie zbiory danych wykorzystane w niniejszym badaniu były pobierane i analizowane zgodnie z obowiązującymi zasadami korzystania z baz danych, warunkami dostępu do danych oraz wytycznymi etycznymi. Autorzy nie podejmowali prób ponownej identyfikacji żadnego z uczestników. W związku z tym do tej wtórnej analizy nie była wymagana dodatkowa pisemna świadoma zgoda. Treść niniejszego badania składa się z dwóch części: analizy MR oraz analizy bioinformatycznej (Rysunek 1). Badanie miało charakter całkowicie obliczeniowy i wykorzystano w nim publicznie dostępne zbiory danych transkrypcyjnych oraz statystyki podsumowujące GWAS. Nie wykorzystano żadnych odczynników ani materiałów eksploatacyjnych do prac laboratoryjnych.
Analiza MR
Źródła danych, pozyskiwanie i wstępne przetwarzanie statystyk podsumowujących GWAS:
Statystyki podsumowujące GWAS dla tocznia rumieniowatego pobrano z FinnGen Release 11 (finngen_R11_L12_LUPUS; RRID:SCR_022254), będącego kohortą populacyjną z Finlandii. Fenotyp zdefiniowano przy użyciu kodu ICD-10 L93; badanie objęło 423 818 uczestników, w tym 777 przypadków i 423 041 kontroli. Plik ze statystykami podsumowującymi FinnGen pobrano z publicznego portalu danych FinnGen w skompresowanym formacie z separatorami tabulatorami, a następnie zaimportowano do środowiska R za pomocą funkcji read_exposure_data() lub read_outcome_data() w pakiecie TwoSampleMR, w zależności od tego, czy zbiór danych służył jako ekspozycja, czy wynik. Zachowano rsID, chromosom, pozycję genomiczną, allel efektu, drugi allel, częstość występowania allelu efektu, współczynnik beta, błąd standardowy oraz wartość P asocjacji.
Statystyki podsumowujące liczbę samoistnych poronień uzyskano z UK Biobank za pośrednictwem zasobu IEU OpenGWAS (ukb-b-419; RRID:SCR_012815), obejmującego 78 700 uczestników. W analizie w kierunku w przód powiązania wybranych polimorfizmów pojedynczego nukleotydu (SNP) z FinnGen z wynikiem uzyskano za pomocą funkcji extract_outcome_data(outcomes = "ukb-b-419", proxies = FALSE). W analizie w kierunku wstecznym SNP powiązane z toczniem rumieniowatym pobrano za pomocą funkcji extract_instruments(outcomes = "finngen_R11_L12_LUPUS", clump = FALSE), po czym z pliku statystyk podsumowujących UK Biobank wyodrębniono odpowiadające im powiązania SNP. Charakterystyka zbiorów danych GWAS wykorzystanych w dwukierunkowych analizach MR została podsumowana w Tabeli 1.
| Cecha | Wielkość próby | Pochodzenie | Konsorcjum | Rok | Identyfikator zbioru danych GWAS |
| Toczeń rumieniowaty | 4,23,818 | europejski | FinnGen (RRID: SCR_022254) | 2024 | finngen_R11_L12_TOCZEŃ |
| Liczba samoistnych poronień | 78,700 | Europejski | UK Biobank (RRID: SCR_012815) | 2018 | ukb-b-419 |
Tabela 1: Statystyki podsumowujące badania asocjacji całego genomu (GWAS) wykorzystane w dwukierunkowej analizie randomizacji mendlowskiej.
Tabela zawiera zestawienie publicznie dostępnych zbiorów danych z badań asocjacji całego genomu, wykorzystanych jako źródła ekspozycji i wyników w analizach randomizacji mendlowskiej w kierunku prostym i odwrotnym, w tym wielkość próby, pochodzenie etniczne, źródło danych, rok publikacji danych oraz identyfikator zbioru danych.
Wybrano bazy danych FinnGen oraz UK Biobank, ponieważ dostarczają one dużych, publicznie dostępnych zbiorów danych pochodzących głównie od osób z populacji europejskich, wywodzących się z niepokrywających się populacji źródłowych, i zawierają wystarczający zakres wariantów dla MR dwupróbkowego. Nie zgłoszono żadnych nakładek między próbkami ekspozycji i wyników. Ponieważ wykorzystano wyłącznie dane na poziomie podsumowującym, nie uzyskano dostępu do danych genotypowych na poziomie indywidualnym, nie przeprowadzono dodatkowej normalizacji na poziomie uczestników i żaden z uczestników nie został wykluczony przez obecnych badaczy. Opierano się na procedurach kontroli jakości na poziomie próbek i wariantów wdrożonych przez pierwotne konsorcja GWAS. Podczas obecnej analizy przeprowadzono dodatkową kontrolę jakości na poziomie wariantów poprzez filtrowanie istotności, grupowanie w nierównowadze sprzężeń (clumping), harmonizację alleli, ocenę siły instrumentu oraz przesiew plejotropii, zgodnie z opisem poniżej.
W wersji 11 danych FinnGen pozycje genomowe są raportowane zgodnie z GRCh38/hg38, podczas gdy zharmonizowane zbiory danych IEU OpenGWAS oraz zasób referencyjny nierównowagi sprzężeń wykorzystują adnotacje wariantów zgodne z GRCh37. W związku z tym warianty ekspozycji i wyników dopasowywano przede wszystkim za pomocą stabilnych rsID, a nie współrzędnych chromosomowo-pozycyjnych. Nie przeprowadzano bezpośredniego dopasowywania pozycji między różnymi wersjami genomu (cross-build). Warianty bez jednoznacznego rsID lub z niespójnymi informacjami o allelach w różnych zbiorach danych zostały wykluczone przed analizą MR. Statystyki podsumowujące FinnGen Release 11 wykorzystują GRCh38, natomiast dane OpenGWAS są zharmonizowane zgodnie z konwencją sekwencji referencyjnej stosowaną dla Build 37. Dopasowanie według rsID jest zatem istotne przy łączeniu tych dwóch zasobów.
Projekt badania MR:
Ściśle przestrzegaliśmy wytycznych STROBE-MR (Plik uzupełniający 1)19. Zastosowano dwukierunkowy projekt MR z dwiema próbkami w celu oceny związku między genetycznie przewidzianym toczniem rumieniowatym a liczbą samoistnych aborcji. W analizie w przód toczeń rumieniowaty traktowano jako ekspozycję, a liczbę samoistnych aborcji jako wynik. W analizie odwrotnej zamieniono ekspozycję i wynik, a następnie powtórzono cały proces wyboru instrumentów, grupowania nierównowagi sprzężeń (clumping), harmonizacji danych, szacowania przyczynowości oraz analizy wrażliwości. Jako zmienne instrumentalne (IVs) wykorzystano polimorfizmy pojedynczego nukleotydu (SNPs). Cały proces przeprowadzono w następującej kolejności: pozyskanie i formatowanie statystyk podsumowujących GWAS; wybór SNP powiązanych z ekspozycją; usunięcie wariantów zduplikowanych lub niepełnie adnotowanych; grupowanie nierównowagi sprzężeń; wyodrębnienie odpowiadających im powiązań z wynikiem; wykluczenie SNP bezpośrednio powiązanych z wynikiem; harmonizacja alleli ekspozycji i wyniku; obliczenie siły instrumentu; przesiewanie potencjalnych fenotypów zakłócających; szacowanie efektów przyczynowych; ocena heterogeniczności i plejotropii horyzontalnej; wykrywanie wartości odstających za pomocą metody Mendelian Randomization Pleiotropy RESidual Sum and Outlier (MR-PRESSO); oraz analizy wrażliwości typu „leave-one-out” i dla pojedynczych SNP. Wszystkie analizy MR wykonano przy użyciu R wersja 4.4.2 (RRID:SCR_001905), TwoSampleMR wersja 0.6.6 (RRID:SCR_019010), MRPRESSO wersja 1.0 (RRID:SCR_023697) oraz forestploter wersja 1.1.2. Analiza MR opierała się na trzech podstawowych założeniach. Po pierwsze, zgodnie z założeniem istotności, wybrane SNP muszą być silnie powiązane z ekspozycją. Po drugie, zgodnie z założeniem niezależności, wybrane SNP muszą być niezależne od czynników zakłócających związek między ekspozycją a wynikiem. Po trzecie, zgodnie z założeniem ograniczenia wykluczającego, wybrane SNP muszą wpływać na wynik wyłącznie poprzez ekspozycję20 (Rysunek 1).
Metody wyboru SNP:
Wybór instrumentów przeprowadzono w następującej kolejności: (1) wybrano SNP powiązane z ekspozycją przy P < 5 × 10⁻⁸; w przypadku niewystarczającej liczby instrumentów zastosowano P < 5 × 10⁻⁶; (2) użyto funkcji clump_data() do przeprowadzenia grupowania w nierównowadze sprzężeń (clumping) przy R2 < 0.001 i odległości genetycznej 10 000 kb, poluzowując kryteria do R2 < 0.01 w obrębie 5 000 kb tylko wtedy, gdy było to konieczne do zachowania analizowalnego zestawu instrumentów; (3) odfiltrowano SNP istotnie powiązane z wynikiem, stosując próg P = 5 × 10⁻⁵; (4) użyto funkcji harmonise_data() do harmonizacji alleli ekspozycji i wyniku oraz wykluczono warianty palindromiczne lub w inny sposób niejednoznaczne; (5) obliczono siłę instrumentu jako F = β2/SE2 i wykluczono SNP z F < 10; oraz (6) przeanalizowano zachowane SNP w PhenoScanner V2 pod kątem fenotypów, które mogłyby zakłócać zależność między SLE a utratą ciąży21. Przeciwciała przeciwfosfolipidowe (aPL) mogą być wspólnym czynnikiem ryzyka dla SLE i liczby samoistnych poronień. Poszczególne SNP przeszukiwano w PhenoScanner V2. Wszystkie kandydujące SNP przeszukano w PhenoScanner V2 przy użyciu domyślnego katalogu GWAS w celu odzyskania wszystkich zgłoszonych powiązań w badaniach asocjacyjnych całego genomu (GWAS). Próg istotności ustalono na P < 1 × 10⁻5, a użyto domyślnej wersji genomu referencyjnego (GRCh37). Ponieważ populacja badana była pochodzenia europejskiego, włączono wyszukiwanie wariantów zastępczych (proxy) z wykorzystaniem europejskiego panelu referencyjnego (proxies = "EUR"), z progiem LD R2 > 0.8 w oknie 1 000 kb. Wszystkie pozostałe parametry wyszukiwania pozostawiono na ustawieniach domyślnych. SNP wykazujące istotne powiązania z wcześniej określonym czynnikiem zakłócającym, przeciwciałami przeciwfosfolipidowymi (aPL), uznano za potencjalnie plejotropowe i wykluczono z końcowego zestawu zmiennych instrumentalnych, aby zminimalizować naruszenie założenia ograniczenia wykluczenia w randomizacji mendlowskiej. Instrumentalne SNP zachowane dla analiz MR w kierunku prostym i odwrotnym wymieniono odpowiednio w Tabelach uzupełniających 1 i 2.
Analiza statystyczna:
Po wyborze instrumentów i harmonizacji alleli, oszacowania przyczynowe obliczono przy użyciu funkcji mr() w pakiecie TwoSampleMR. Procedura analityczna była realizowana w następującej kolejności. Po pierwsze, całkowity efekt przyczynowy oszacowano za pomocą czterech metod MR: ważenia odwrotnością wariancji (IVW), regresji MR-Egger, ważonej mediany oraz ważonej mody. Oszacowania efektu dla liczby samoistnych poronień oraz SLE przedstawiono jako ilorazy szans wraz z odpowiadającymi im 95% przedziałami ufności i wartościami P. Metoda IVW została wyznaczona jako główna analiza, ponieważ zapewnia wysoką moc statystyczną, gdy wszystkie uwzględnione SNP są poprawnymi zmiennymi instrumentalnymi i nie występuje plejotropia horyzontalna. Jednak oszacowanie IVW może być obarczone błędem w przypadku wystąpienia plejotropii horyzontalnej22. Regresja MR-Egger była wykorzystywana przede wszystkim do oceny wnioskowania przyczynowego w obecności potencjalnej plejotropii horyzontalnej23. Podejście oparte na ważonej medianie wymaga, aby co najmniej 50% wagi analitycznej pochodziło z poprawnych IV. Metoda ta jest optymalna, gdy występuje heterogeniczność, ale nie występuje plejotropia horyzontalna24. Ważona moda identyfikuje klastry zmiennych instrumentalnych o podobnych efektach przyczynowych i szacuje efekt na podstawie największego klastra25. Oszacowania efektów uzyskane za pomocą czterech metod MR przedstawiono na Rysunku 2. Po drugie, heterogeniczność między oszacowaniami przyczynowymi dla poszczególnych SNP oceniono za pomocą testu Q Cochrana zaimplementowanego w funkcji mr_heterogeneity(). Statystyka Q reprezentuje ważoną sumę kwadratów odchyleń poszczególnych oszacowań SNP od całkowitego oszacowania przyczynowego. Wartość P testu Q < 0.05 uznano za dowód heterogeniczności, w takim przypadku zastosowano model IVW z efektami losowymi. W przypadku braku istotnej heterogeniczności zastosowano model IVW z efektami stałymi26. Po trzecie, kierunkową plejotropię horyzontalną oceniono za pomocą testu punktu przecięcia MR-Egger zaimplementowanego w funkcji mr_pleiotropy_test(). Punkt przecięcia istotnie różniący się od zera przy P < 0.05 uznano za dowód kierunkowej plejotropii horyzontalnej. Po czwarte, wykonano procedurę MR-PRESSO przy użyciu funkcji mr_presso() w pakiecie MRPRESSO (RRID:SCR_023697) w celu wykrycia SNP o odstających efektach plejotropowych27. Po wykryciu wartości odstających zostały one usunięte, a analizę przyczynową powtórzono przy użyciu pozostałych instrumentów. Globalny test MR-PRESSO wykorzystano do oceny ogólnej plejotropii horyzontalnej, a test zniekształcenia rozważono przy ocenie, czy usunięcie wartości odstających istotnie zmieniło oszacowanie przyczynowe. Po piąte, przeprowadzono analizę wrażliwości leave-one-out przy użyciu funkcji mr_leaveoneout(). W tej analizie każdy SNP był kolejno wykluczany, a połączone oszacowanie przyczynowe było przeliczane z wykorzystaniem pozostałych SNP. Wyniki zwizualizowano za pomocą mr_leaveoneout_plot(), aby określić, czy ogólna asocjacja była nieproporcjonalnie napędzana przez pojedynczy instrument. Po szóste, wygenerowano indywidualne oszacowania dla poszczególnych SNP przy użyciu funkcji mr_singlesnp(). Oszacowania te posłużyły do skonstruowania wykresów lejkowych za pomocą mr_funnel_plot(), aby wizualnie ocenić asymetrię, która mogła wynikać z kierunkowej plejotropii horyzontalnej. Podsumowujące wykresy leśne wygenerowano przy użyciu forestploter (wersja 1.1.2), aby przedstawić oszacowania efektów i przedziały ufności uzyskane z różnych metod MR. Wykres rozrzutu forward MR, wykres leśny dla poszczególnych SNP, analiza leave-one-out oraz wykres lejkowy przedstawiono odpowiednio na Rysunkach Uzupełniających 1–4.
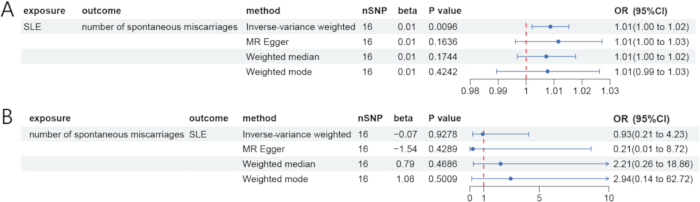
Rycina 2Wyniki dwukierunkowej analizy randomizacji mendlowskiej.
(A) Wykres leśny (forest plot) analizy randomizacji mendlowskiej (MR) w kierunku prostym, gdzie ekspozycją był toczeń rumieniowaty układowy (SLE), a wynikiem liczba samoistnych poronień. (B) Wykres leśny analizy MR w kierunku odwrotnym, gdzie ekspozycją była liczba samoistnych poronień, a wynikiem SLE. Szacunki efektu przedstawiono jako ilorazy szans (OR) z 95% przedziałami ufności (CI) dla metod: ważenia odwrotnością wariancji (inverse-variance weighted), MR-Egger, ważonej mediany oraz ważonej mody. SNP, polimorfizm pojedynczego nukleotydu. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Przyjęto, że związek przyczynowy jest potwierdzony, gdy szacunek IVW był statystycznie istotny przy P < 0,05, szacunki MR-Egger, ważona mediana oraz ważona moda wskazywały kierunki zgodne z szacunkiem IVW, a wyniki nie uległy istotnym zmianom w wyniku analizy heterogeniczności, plejotropii, MR-PRESSO lub analizy wrażliwości leave-one-out. Wszystkie testy statystyczne były dwustronne.
Analiza bioinformatyczna
Dane z mikromacierzy:
Transkrypcyjne zestawy danych pobrano z bazy danych Gene Expression Omnibus (GEO; RRID:SCR_005012)28. Przetworzone pliki Series Matrix, metadane próbek oraz pliki adnotacji platform pobrano dla zestawów GSE61635, GSE165004, GSE50772 i GSE198700. Platformę, źródło tkanki, wielkość próby oraz kategorię analizy dla każdego zestawu danych podsumowano w Tabeli 2. Ponieważ zestawy danych pochodziły z różnych tkanek i platform mikromacierzy, każdy z nich został poddany wstępnemu przetwarzaniu i analizowany niezależnie. Macierze ekspresji z różnych zestawów danych nie były bezpośrednio łączone i nie zastosowano korekty efektu seryjnego (batch correction) między platformami. Integracja między zestawami danych została przeprowadzona na poziomie symboli genów dopiero po niezależnym zakończeniu analizy ekspresji różnicowej w każdym z zestawów danych odkrywczych.
| Zbiór danych GEO | Choroba | Platforma | Tkanka (Homo sapiens) | Przypadki | Kontrole | Typ eksperymentu | Współtwórca | Kategoria zbioru danych |
| GSE61635 | Toczeń rumieniowaty układowy (SLE) | GPL570 | Krew pełna | 99 | 30 | Mikromacierz ekspresyjna | Greidinger EL | Zbiór danych odkrywczych |
| GSE165004 | Nawracające poronienia (RPL) | GPL16699 | Błona śluzowa endometrium | 24 | 24 | Mikromacierz ekspresyjna | Keleş ID29 | Zbiór danych odkrywczych |
| GSE50772 | Toczeń rumieniowaty układowy (SLE) | GPL570 | Monocyty krwi obwodowej (PBMCs) | 61 | 20 | Mikromacierz ekspresyjna | Kennedy WP30 | Zbiór danych walidacyjnych |
| GSE198700 | Nawracające poronienia (RPL) | GPL13534 | Kosmki błonowe | 5 | 5 | Mikromacierz ekspresyjna | Li Y31 | Zbiór danych walidacyjnych |
Tabela 2: Zbiory danych transkryptomicznych wykorzystane w analizach bioinformatycznych.
W tabeli podsumowano zbiory danych transkryptomicznych z bazy Gene Expression Omnibus (GEO) uwzględnione w analizach odkrywczych i walidacyjnych, w tym jednostkę chorobową, platformę mikromacierzy, źródło tkanki, wielkość próby, rodzaj eksperymentu, autora pierwotnego badania oraz kategorię zbioru danych.
Zestaw danych GSE61635 został wygenerowany przy użyciu platformy Affymetrix Human Genome U133 Plus 2.0 Array (GPL570) i obejmował 99 tablic z krwi pełnej pobranej od pacjentów z SLE, w tym powtórne wizyty niektórych pacjentów, oraz 30 tablic od niezależnych zdrowych kontroli. Zdeponowana macierz ekspresji została poddana przez pierwotnych badaczy procedurom odpornej korekcji tła dla wielu tablic (robust multiarray average background correction), normalizacji kwantylowej, podsumowaniu zestawów sond oraz transformacji log2. W związku z tym nie przeprowadzono ponownej korekcji tła ani normalizacji kwantylowej. Identyfikatory pacjentów zostały wyodrębnione z metadanych GEO i zachowane na potrzeby modelowania pomiarów powtarzanych.
Zbiór GSE165004 został wygenerowany przy użyciu platformy Agilent SurePrint G3 Human Gene Expression v2 8×60K Microarray (GPL16699). Pełny zestaw danych obejmował 24 płodne kontrole, 24 pacjentki z RPL oraz 24 pacjentki z niejasną przyczyną niepłodności. Uwzględniono jedynie 24 próbki z RPL i 24 próbki kontrolne od płodnych kobiet, pobrane w 19–21 dniach cyklu menstruacyjnego; 24 próbki od pacjentek z niejasną przyczyną niepłodności zostały wykluczone, ponieważ znajdowały się poza zdefiniowanym zakresem porównania29. Wykorzystano macierz ekspresji znormalizowaną przez depozytariusza i nie stosowano dodatkowej normalizacji między macierzami po potwierdzeniu porównywalności rozkładów próbek za pomocą wykresów pudełkowych i wykresów gęstości.
Zbiór GSE50772 posłużył jako niezależny zestaw danych walidacyjnych dla SLE i obejmował próbki mononuklearnych komórek krwi obwodowej od 61 pacjentów z SLE oraz 20 zdrowych kontroli, uzyskane przy użyciu GPL57030. Zbiór GSE198700 został wygenerowany przy użyciu GPL13534 i zawiera próbki kosmków błoniastych od pięciu pacjentek z RPL oraz pięciu kontroli z aborcji na życzenie31. Złożona macierz ekspresji została zaimportowana w całości i poddana jednokrotnej transformacji log2(x + 1), ponieważ złożone wartości ekspresji podano w skali nielogarytmicznej. Transformację tę zastosowano do pełnej macierzy ekspresji przed kontrolą jakości na poziomie próbek, adnotacją sond, podsumowaniem na poziomie genów, walidacją genów kandydackich, analizą ekspresji różnicowej, testowaniem porównawczym grup oraz analizą ROC. Geny kandydackie nie były transformowane oddzielnie, a podczas późniejszych analiz walidacyjnych nie przeprowadzono żadnej dodatkowej transformacji logarytmicznej. Dla wszystkich zbiorów danych tożsamości próbek, status choroby, pochodzenie tkanki i etykiety grup zostały zweryfikowane z odpowiednimi metadanymi GEO przed analizą. Kontrola jakości obejmowała ocenę wielkości bibliotek lub rozkładów ekspresji, wykresy pudełkowe dla poszczególnych próbek, analizę głównych składowych, klasteryzację hierarchiczną oraz mapy ciepła odległości między próbkami. Po ocenie kontroli jakości nie wykluczono żadnych dodatkowych próbek.
Analiza ekspresji różnicowej:
Analizy ekspresji różnicowej przeprowadzono niezależnie dla zbiorów GSE61635 i GSE165004 przy użyciu pakietu limma w wersji 3.60.6 (RRID:SCR_010943). Wszystkie macierze ekspresji zorganizowano tak, aby geny znajdowały się w wierszach, a próbki w kolumnach. Próg ekspresji różnicowej ustalono na |log₂ fold change| > 1 dla GSE61635 oraz |log₂ fold change| > 0.5 dla GSE165004, przy wartości P skorygowanej metodą Benjamini-Hochberga (BH) < 0.05. Wykresy wulkaniczne (volcano plots) wygenerowano za pomocą ggplot2 w wersji 3.5.1 (RRID:SCR_014601). Mapy ciepła (heatmaps) dla 50 najistotniejszych genów o różnicowej ekspresji (DEG), uszeregowanych według skorygowanej wartości P, wygenerowano przy użyciu pheatmap w wersji 1.0.12 (RRID:SCR_016418). Wspólne geny DEG zidentyfikowano poprzez przecięcie oficjalnych symboli genów z list istotnych DEG dla SLE i RPL przy użyciu podstawowej funkcji R intersect(), a następnie zwizualizowano za pomocą ggvenn w wersji 0.1.16 (RRID:SCR_025300). Mapy ciepła ekspresji różnicowej, wykresy wulkaniczne oraz część wspólna list DEG dla SLE i RPL są przedstawione na Rysunku 3.
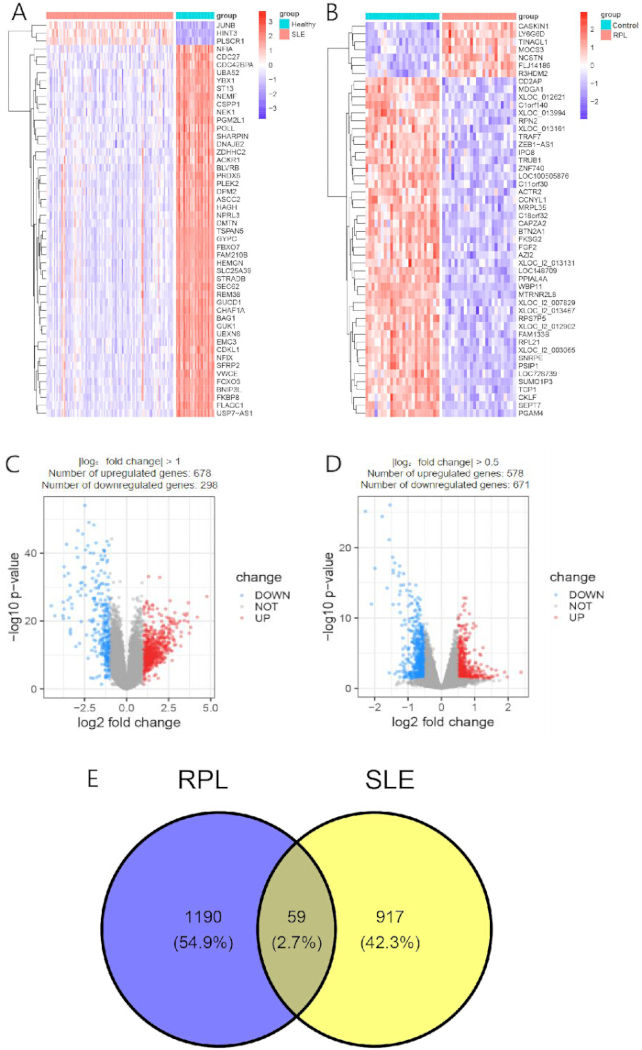
Rysunek 3. Geny o różnej ekspresji w toczniu układowym i nawracających stratach ciąży.
(A) Mapa ciepła 50 najistotniejszych genów o różnej ekspresji (DEG) pomiędzy pacjentami z toczniem układowym (SLE) a zdrową grupą kontrolną w zbiorze GSE61635. (B) Mapa ciepła 50 najistotniejszych DEG pomiędzy pacjentkami z nawracającymi stratami ciąży (RPL) a płodną grupą kontrolną w zbiorze GSE165004. (C) Wykres wulkaniczny różnicowej ekspresji genów w GSE61635. (D) Wykres wulkaniczny różnicowej ekspresji genów w GSE165004. (E) Diagram Venna pokazujący nakładanie się list istotnych DEG z zestawów danych odkrywczych dla SLE i RPL. DEG, geny o różnej ekspresji. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Analiza wzbogacenia funkcjonalnego wspólnych DEG:
W celu przeprowadzenia analizy funkcji DEG na poziomie molekularnym wykorzystano narzędzie online DAVID (wersja 2021; RRID:SCR_001881)32 do wykonania analiz wzbogacenia funkcjonalnego Gene Ontology (GO) oraz szlaków Kyoto Encyclopedia of Genes and Genomes (KEGG). Jako typ identyfikatora przesłano oficjalne symbole genów ludzkich, a jako gatunek wybrano Homo sapiens. Niestandardowa populacja tła obejmowała część wspólną wszystkich genów, które przeszły adnotację sond oraz kontrolę jakości i były mierzalne zarówno w GSE61635, jak i GSE165004. Minimalny próg liczby genów ustalono na 2, a maksymalny wynik EASE, reprezentujący zmodyfikowaną jednostronną wartość P testu dokładnego Fishera w programie DAVID, ustalono na 0,05. Wielokrotne porównania kontrolowano za pomocą procedury Benjamini–Hochberga, przedstawionej w kolumnie „Benjamini” narzędzia DAVID. Terminy funkcjonalne uznano za istotne statystycznie, gdy wynik EASE był < 0,05, a wartość P skorygowana metodą Benjamini wynosiła < 0,05. Pełne wyniki z programu DAVID, obejmujące nazwy terminów, liczebność genów, wyniki EASE, wartości P skorygowane metodą Benjamini, mapowania genów wejściowych oraz mapowania genów tła, wyeksportowano do pliku z rozdzielaczem tabulatorowym. Do wizualizacji przefiltrowanych wyników z programu DAVID wykorzystano stronę internetową CNSknowall. Wyniki wzbogacenia GO i KEGG przedstawiono na Rysunku 4A.
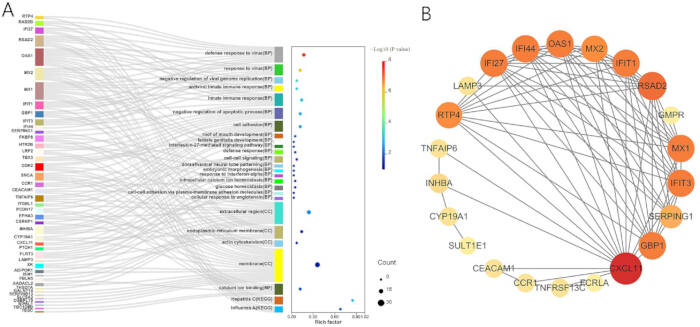
Rysunek 4. Analiza wzbogacenia funkcjonalnego i sieć oddziaływań białko-białko dla wspólnych genów o różnej ekspresji.
(A) Analizy wzbogacenia Gene Ontology (GO) oraz Kyoto Encyclopedia of Genes and Genomes (KEGG) dla 59 wspólnych genów o różnej ekspresji (DEGs). Diagram Sankeya ilustruje relacje między genami a wzbogaconymi terminami GO, a towarzyszący wykres pęcherzykowy podsumowuje wzbogacone terminy GO i KEGG w zależności od czynnika wzbogacenia (rich factor), liczby genów oraz istotności statystycznej. (B) Sieć oddziaływań białko-białko (PPI) skonstruowana z 59 wspólnych DEGs przy użyciu bazy STRING i zwizualizowana w programie Cytoscape. Wielkość i kolor węzła odzwierciedlają łączność w sieci, a krawędzie wskazują przewidywane asocjacje białko-białko. BP, proces biologiczny; CC, komponent komórkowy; MF, funkcja molekularna. Proszę kliknąć tutaj, aby wyświetlić większą wersję tego rysunku.
Sieć PPI i identyfikacja genów kluczowych:
Wspólne DEG przesłano do programu STRING wersja 11.0 (RRID:SCR_005223)33, wybierając Homo sapiens jako organizm (identyfikator taksonomiczny: 9606). Wykorzystano pełną sieć STRING, uwzględniając zarówno funkcjonalne, jak i fizyczne interakcje białkowe. Aktywowano wszystkie dostępne kanały dowodowe, w tym dowody eksperymentalne, bazy danych kuratorowanych, koekspresję, text mining, sąsiedztwo genów, fuzję genów oraz koocurencję genów.
Minimalny wymagany wynik interakcji ustalono na 0,400, co odpowiada średniemu poziomowi ufności. Nie dodawano dodatkowych interaktorów pierwszej ani drugiej sfery; w związku z tym sieć zawierała wyłącznie białka kodowane przez zgłoszone wspólne DEGs. Krawędzie sieci wyświetlono w trybie ufności i wyeksportowano jako plik wartości rozdzielanych tabulatorami, zawierający oddziałujące białka i połączone wyniki STRING. Wyniki ufności STRING reprezentują pewność co do istnienia powiązania, a nie wielkość lub siłę wiązania interakcji.
Plik sieci STRING został zaimportowany do programu Cytoscape w wersji 3.10.0 (RRID:SCR_003032)34. Przed analizą topologii sieci usunięto węzły nie wykazujące żadnych interakcji z innym zgłoszonym białkiem35. Pozostałą sieć potraktowano jako sieć nieskierowaną. Połączone wyniki STRING zachowano jako atrybuty krawędzi w celu wizualizacji, natomiast rankingi cytoHubba wygenerowano przy użyciu domyślnych nieważonych definicji topologicznych. Wynikowa sieć PPI została przedstawiona na Rysunku 4B.
Geny hub zostały uszeregowane przy użyciu oprogramowania cytoHubba wersja 0.1 (RRID:SCR_017677) z zastosowaniem sześciu algorytmów: Maximal Clique Centrality (MCC), Maximum Neighborhood Component (MNC), Edge Percolated Component (EPC), Degree, Closeness oraz Radiality36. Dla każdego algorytmu geny uszeregowano w kolejności malejącej i wyłoniono 10 najwyżej sklasyfikowanych genów. Kandydatów na huby sieciowe zdefiniowano jako ścisły zbiór wspólny (część wspólną) sześciu list top 10. W związku z tym gen uznano za hub sieciowy tylko wtedy, gdy znalazł się on wśród 10 najwyżej sklasyfikowanych genów wygenerowanych przez wszystkie sześć algorytmów. Rankingi oraz procedura wyznaczania części wspólnej zostały wyeksportowane i zarchiwizowane. 10 najwyżej sklasyfikowanych genów zidentyfikowanych przez każdy algorytm cytoHubba przedstawiono w Tabeli 3.
| Ranga | Centralność maksymalnej kliki (MCC) | Maksymalny komponent sąsiedztwa (MNC) | Perkolacyjny komponent krawędzi (EPC) | Stopień | Bliskość | Radialność |
| 1 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 | RSAD2 |
| 2 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 | RTP4 |
| 3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 | IFIT3 |
| 4 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 | IFI27 |
| 5 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 | IFI44 |
| 6 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 | GBP1 |
| 7 | MX1 | MX1 | MX1 | MX1 | MX1 | MX1 |
| 8 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 | OAS1 |
| 9 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 | IFIT1 |
| 10 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 | CXCL11 |
Tabela 3: 10 najważniejszych genów hubowych zidentyfikowanych przez sześć algorytmów rankingowych cytoHubba.
Wspólne geny o różnej ekspresji zostały uszeregowane przy użyciu sześciu algorytmów topologii sieci zaimplementowanych w dodatku cytoHubba do programu Cytoscape. Dla porównania przedstawiono 10 najwyżej ocenionych genów wygenerowanych przez każdy z algorytmów: Maximal Clique Centrality (MCC), Maximum Neighborhood Component (MNC), Edge Percolated Component (EPC), Degree, Closeness oraz Radiality.
Regresja LASSO w celu identyfikacji genów kluczowych:
Logistyczna regresja LASSO została przeprowadzona niezależnie w zbiorach danych odkrywczych dla SLE i RPL przy użyciu pakietu glmnet w wersji 4.1-8 (RRID:SCR_015505). Macierz predyktorów składała się z znormalizowanych wartości ekspresji potencjalnych węzłów sieci (hubów), w której wiersze stanowiły próbki, a kolumny geny. Stan choroby zakodowano jako 1, a stan kontrolny jako 0. Dostosowano dwumianowy uogólniony model liniowy z czystą karą LASSO, stosując family = "binomial" oraz alpha = 1. Zmienne predyktora zostały znormalizowane wewnętrznie przy użyciu standardize = TRUE i uwzględniono wyraz wolny (intercept). Przydziały do 10-krotnej walidacji krzyżowej z rozwarstwieniem klas generowano oddzielnie dla zbiorów danych SLE i RPL za pomocą własnego kodu w języku R. W obrębie każdej warstwy stanu choroby indeksy próbek zostały losowo przemieszane i rozdzielone tak równomiernie, jak to możliwe, pomiędzy 10 grup (folds) przy użyciu funkcji sample(rep(seq_len(10), length.out = n)). Przed wygenerowaniem przydziałów do grup dla każdego zbioru danych ustawiono ziarno generatora liczb losowych (random seed) na 123 w celu zapewnienia powtarzalności. Ponieważ każda grupa stanu choroby zawierała więcej niż 10 próbek, każda grupa walidacji krzyżowej obejmowała zarówno przypadki, jak i kontrolę. Powstałe wektory całkowite (foldid_sle oraz foldid_rpl) przekazano do argumentu foldid funkcji cv.glmnet(), a te same przydziały do grup zastosowano dla wszystkich ocenianych wartości λ w ramach odpowiedniego zbioru danych.
Modele dopasowano przy użyciu parametrów family = "binomial", alpha = 1, nfolds = 10, type.measure = "deviance", standardize = TRUE, intercept = TRUE, nlambda = 100, thresh = 1 × 10⁻7 oraz maxit = 100000. Parametr kary wybrano na podstawie lambda.min, zdefiniowanego jako wartość lambda generująca minimalną średnią krzyżową dewiancję dwumianową. Bardziej konserwatywny parametr lambda.1se, zdefiniowany jako największa wartość lambda mieszcząca się w granicach jednego błędu standardowego od minimalnego błędu walidacji krzyżowej, zapisano jako wynik analizy czułości. Procedurę LASSO zastosowano oddzielnie do zbiorów GSE61635 i GSE165004. Geny z niezerowymi współczynnikami w obu modelach specyficznych dla danej choroby zdefiniowano jako wspólne geny kandydackie wybrane metodą LASSO. Poprzez wprowadzenie składnika regularyzacji L1 metoda ta skutecznie redukuje współczynniki mniej informatywnych genów do zera, wykonując tym samym selekcję cech37. Profile współczynników oraz krzywe 10-krotnej walidacji krzyżowej dla zbiorów odkrywczych SLE i RPL przedstawiono na Rysunku 5.
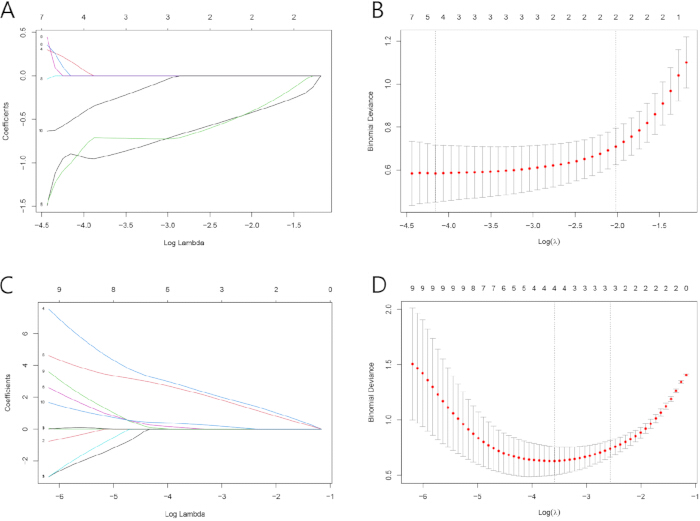
Rysunek 5. Analiza regresji LASSO (least absolute shrinkage and selection operator) genów węzłowych sieci.
(A) Profilem współczynników wygenerowane przez logistyczną regresję LASSO dla zestawu danych odkrywczych tocznia rumieniowatego układowego (SLE) (GSE61635). (B) Krzywa dziesięciokrotnej walidacji krzyżowej użyta do wyznaczenia optymalnego parametru kary (λ) dla modelu SLE. (C) Profile współczynników wygenerowane przez logistyczną regresję LASSO dla zestawu danych odkrywczych nawracających poronień (RPL) (GSE165004). (D) Krzywa dziesięciokrotnej walidacji krzyżowej użyta do wyznaczenia optymalnego parametru kary (λ) dla modelu RPL. Liczby na górnej osi x wskazują liczbę niezerowych współczynników regresji dla każdej wartości λ. Pionowe linie przerywane wskazują λ_min oraz λ_1se. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Walidacja wartości diagnostycznej genów kluczowych:
Wzorce ekspresji genów kandydackich wybranych metodą LASSO oceniono w niezależnym zbiorze danych SLE GSE50772 oraz w niezależnym zbiorze danych RPL GSE198700. Zewnętrzne zbiory danych wykorzystano dopiero po zakończeniu selekcji genów kandydackich w zbiorach GSE61635 i GSE165004. W zbiorach walidacyjnych nie przeprowadzono dodatkowej selekcji cech ani dopasowania modelu. Ekspresję genów kandydackich porównywano pomiędzy przypadkami a grupą kontrolną za pomocą dwustronnego testu sum rang Wilcoxona. W przypadku badania więcej niż jednego genu kandydackiego w obrębie zbioru danych, uzyskane wartości P korygowano za pomocą procedury Benjamini–Hochberga. Gen kandydacki uznano za zreplikowany zewnętrznie, gdy jego ekspresja różniła się istotnie pomiędzy przypadkami a grupą kontrolną po korekcie dla wielokrotnych porównań, a kierunek tej różnicy był zgodny z odpowiadającym mu zbiorem danych odkrywczych. Wzorce ekspresji genów kandydackich w zbiorach odkrywczych i walidacyjnych przedstawiono na Rysunku 6.
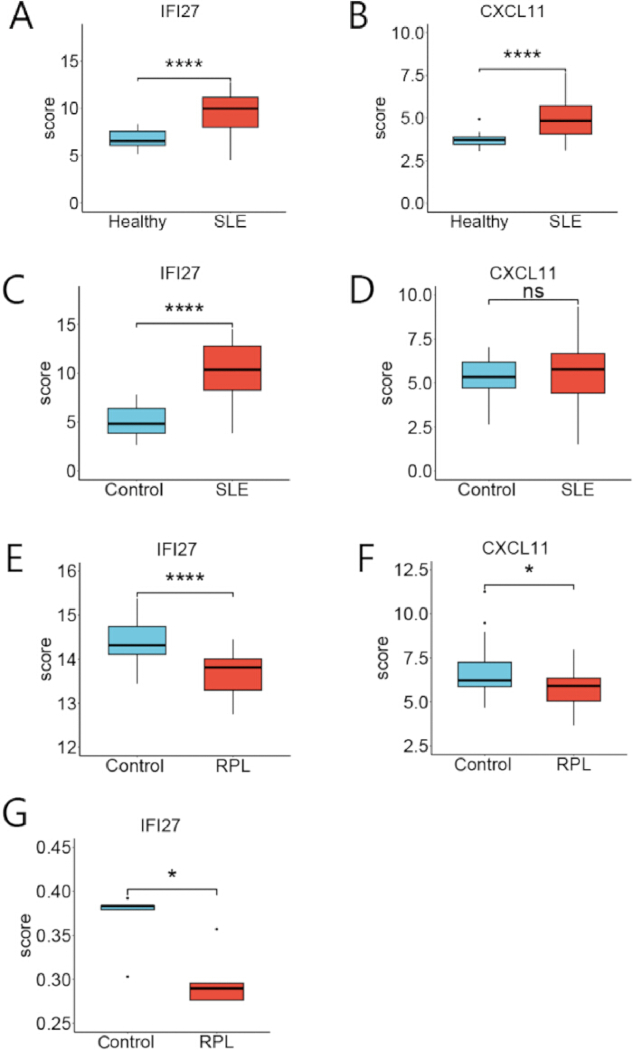
Rycina 6Ekspresja IFI27 i CXCL11 w zbiorach danych odkrywczych i walidacyjnych.
(A,B) Ekspresja odpowiednio IFI27 i CXCL11 w zbiorze danych odkrywczych dla tocznia rumieniowatego układowego (SLE) (GSE61635). (C,D) Ekspresja odpowiednio IFI27 i CXCL11 w niezależnym zbiorze danych walidacyjnych dla SLE (GSE50772). (E,F) Ekspresja odpowiednio IFI27 i CXCL11 w zbiorze danych odkrywczych dla nawracających poronień samych (RPL) (GSE165004). (G) Ekspresja IFI27 w niezależnym zbiorze danych walidacyjnych dla RPL (GSE198700). Ekspresję genów porównywano między grupami za pomocą dwustronnego testu suma rang Wilcoxona. P wartości skorygowano metodą Benjamini-Hochberga w przypadku testowania wielu genów kandydackich w obrębie tego samego zbioru danych. P < 0.05; **** P < 0,0001; ns, nieistotne. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Analizy charakterystyki operacyjnej odbiornika (ROC) przeprowadzono przy użyciu pROC w wersji 1.18.5 (RRID:SCR_024286)38. Dla każdego kandydującego genu w każdym zbiorze danych odkrywczych wygenerowano osobne krzywe ROC. Pole pod krzywą ROC (AUC) oraz jego dwustronny 95% przedział ufności obliczono metodą DeLonga. Eksploracyjny punkt odcięcia diagnostycznego wyznaczono za pomocą maksymalnego indeksu Youdena. Przedziały ufności dla punktu odcięcia, czułości i swoistości obliczono przy użyciu 2 000 stratyfikowanych powtórzeń bootstrapowych z ziarnem liczb pseudolosowych ustawionym na 123. AUC wykorzystano jako niezależną od progu miarę dyskryminacji39. Ponieważ zbiory danych miały charakter retrospektywny i zostały wygenerowane przy użyciu różnych tkanek, platform oraz procedur normalizacji, punkty odcięcia wyznaczone na podstawie indeksu Youdena obliczano oddzielnie dla każdego zbioru danych i traktowano je jako eksploracyjne progi specyficzne dla danego zbioru. Nie uznano ich za standaryzowane punkty odcięcia klinicznego i nie przenoszono ich bezpośrednio między platformami. Zewnętrzne wyniki ROC stanowią walidację transkryptomiczną, a nie prospektywną walidację kliniczną. pROC obsługuje przedziały ufności DeLonga dla AUC oraz optymalizację indeksu Youdena za pomocą funkcji coords(), natomiast przedziały ufności dla współrzędnych ROC można oszacować za pomocą stratyfikowanego resamplingu bootstrapowego. Krzywe ROC oraz zestawienia dyskryminacji genów kandydujących w zbiorach danych odkrywczych dla SLE i RPL przedstawiono na Rysunku 7.
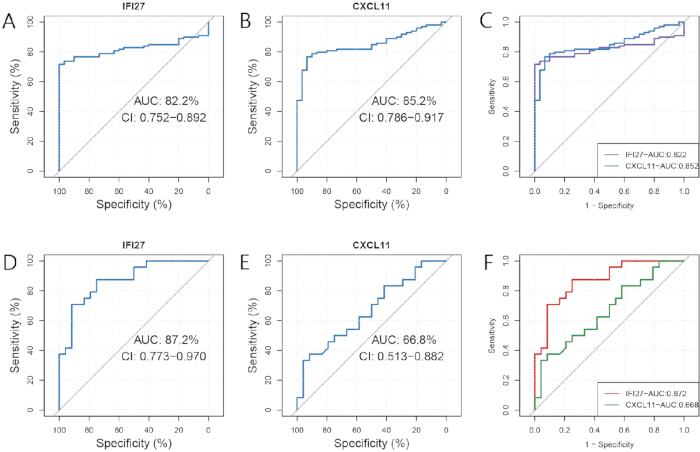
Rysunek 7. Analiza charakterystyki operacyjnej odbiornika dla genów kandydackich.
(A) Krzywa charakterystyki operacyjnej odbiornika (ROC) dla IFI27 w zbiorze danych odkrywczych dla tocznia rumieniowatego układowego (SLE). (B) Krzywa ROC dla CXCL11 w zbiorze danych odkrywczych SLE. (C) Podsumowanie wydajności diagnostycznej IFI27 i CXCL11 w zbiorze danych odkrywczych SLE. (D) Krzywa ROC dla IFI27 w zbiorze danych odkrywczych dla nawracających stratnych ciąż (RPL). (E) Krzywa ROC dla CXCL11 w zbiorze danych odkrywczych RPL. (F) Podsumowanie wydajności diagnostycznej IFI27 i CXCL11 w zbiorze danych odkrywczych RPL. Wartości pola pod krzywą (AUC) przedstawiono wraz z 95% przedziałami ufności (CIs). Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
Infiltracja immunologiczna ssGSEA:
Biorąc pod uwagę rolę dysregulacji komórek odpornościowych w patogenezie SLE i RPL40,41, wzbogacenie komórek odpornościowych wywnioskowano obliczeniowo w zestawach danych odkrywczych GSE61635 i GSE165004. Analizę przeprowadzono oddzielnie dla każdego zestawu danych, nie łącząc ich ze sobą. Zbiór sygnatur genowych komórek odpornościowych składał się z zestawów genów markerowych dla 28 populacji komórek odpornościowych opisanych przez Charoentonga et al.42. Oryginalna uzupełniająca tabela sygnatur genowych została przekształcona w nazwaną listę zestawów genów przy użyciu oficjalnych symboli genów ludzkich. Powtórzone symbole w obrębie każdego zestawu genów zostały usunięte. Geny nieobecne w odpowiadającej im macierzy ekspresji zostały odrzucone, a zestawy genów zawierające mniej niż pięć dopasowanych genów po mapowaniu identyfikatorów zostały wykluczone z danego zestawu danych. Analizę wzbogacenia zestawów genów dla pojedynczych próbek (ssGSEA) przeprowadzono za pomocą GSVA wersja 1.52.3 (RRID:SCR_021058) oraz GSEABase wersja 1.66.0. W wersji GSVA 1.52.3 wymagany jest obiekt parametrów specyficzny dla metody. Użyto następujących parametrów: minSize = 5, maxSize = 500, alpha = 0.25, normalize = TRUE oraz checkNA = "yes.”
Parametr alpha ustawiono na 0.25 i włączono końcową normalizację wyników ssGSEA. Zbiory genów ograniczono do 5–500 genów po dopasowaniu do macierzy ekspresji. W celu zapewnienia spójności obliczeń między systemami zastosowano wykonanie jednowątkowe. Parametr kcdf nie został użyty, ponieważ nie jest on parametrem procedury ssgseaParam() w wersji GSVA 1.52.3. Metoda ssGSEA generuje relatywne wyniki wzbogacenia zbiorów genów na poziomie próbek, a nie eksperymentalnie zmierzone liczby komórek odpornościowych lub absolutne frakcje komórkowe43. Przepływ pracy w GSVA 1.52.3 wymaga obiektu parametrów specyficznych dla danej metody, a parametry ssGSEA obejmują wartość alpha, normalizację wyników oraz limity wielkości zbiorów genów.
Dla każdej sygnatury komórek odpornościowych wartości ssGSEA porównano pomiędzy grupą chorobową a kontrolną za pomocą dwustronnego testu sum rang Wilcoxona. Wartości P dla 28 porównań typów komórek skorygowano oddzielnie w każdym zbiorze danych, stosując metodę Benjamini–Hochberga. Sygnatury komórek odpornościowych z wartością P po korekcie < 0,05 uznano za różnicowo wzbogacone.
Korelacje rang Spearmana obliczono pomiędzy ekspresją genów kandydackich a wynikiem ssGSEA dla każdej sygnatury komórek odpornościowych w każdym zbiorze danych. Wartości P korelacji skorygowano metodą Benjamini-Hochberga dla wszystkich kombinacji genów kandydackich i komórek odpornościowych w danym zbiorze danych. Korelacje uznano za statystycznie istotne przy skorygowanej wartości P < 0,05. Macierze korelacji zwizualizowano przy użyciu ggcorrplot w wersji 0.1.4.1, a wykresy porównawcze grup wygenerowano za pomocą ggplot2 w wersji 3.5.1.
Do wszystkich testów statystycznych wykorzystano surowe znormalizowane wyniki ssGSEA. Mapy ciepła i wizualizacje skumulowane posłużyły wyłącznie do prezentacji opisowej. Wyników nie interpretowano jako bezpośrednich proporcji komórek odpornościowych, a zaobserwowane powiązania traktowano jako korelacje obliczeniowe, a nie eksperymentalnie wykazane oddziaływania komórka–gen. Profile wzbogacenia sygnatur komórek odpornościowych, porównania grup oraz korelacje z ekspresją genów kandydackich przedstawiono na Rycynie 8.
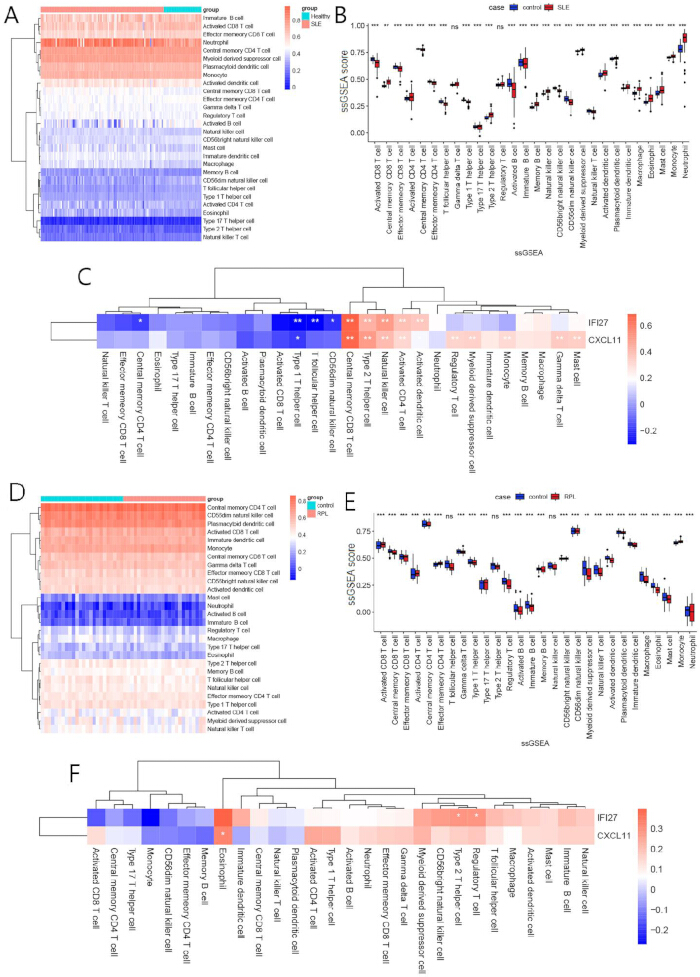
Rycina 8Wzbogacenie sygnatur komórek odpornościowych i korelacje z wspólnymi genami kandydackimi w toczniu układowym oraz nawracających porażeniach ciąży.
(A) Mapa ciepła z klastrowaniem hierarchicznym wyników analizy wzbogacenia zbiorów genów dla pojedynczych próbek (ssGSEA) dla 28 sygnatur komórek odpornościowych w zbiorze danych odkrywczych dla tocznia rumieniowatego układowego (SLE). (B) Porównanie wyników ssGSEA dla sygnatur komórek odpornościowych pomiędzy pacjentami z SLE a zdrowymi kontrolami. (C) Mapa ciepła korelacji Spearmana przedstawiająca powiązania między ekspresją IFI27 i CXCL11 a wynikami ssGSEA dla 28 sygnatur komórek odpornościowych w zbiorze danych odkrywczych dla SLE. (D) Mapa ciepła z klastrowaniem hierarchicznym wyników ssGSEA dla 28 sygnatur komórek odpornościowych w zbiorze danych odkrywczych dla nawracających poronień (RPL). (E) Porównanie wyników ssGSEA dla sygnatur komórek odpornościowych pomiędzy pacjentami z RPL a kontrolami płodnymi. (F) Mapa ciepła korelacji Spearmana przedstawiająca powiązania między ekspresją IFI27 i CXCL11 a wynikami ssGSEA dla 28 sygnatur komórek odpornościowych w zbiorze danych odkrywczych dla RPL. Korelacje obliczono przy użyciu korelacji rang Spearmana, a P Wartości skorygowano metodą Benjamini’ego-Hochberga. P < 0.05; ** P < 0.01; *** P < 0,001; ns, nieistotne statystycznie. Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
Wyniki
Analiza MR
Po wyborze instrumentów i harmonizacji danych do analizy MR w kierunku prostym wybrano 16 SNP, w której SLE traktowano jako ekspozycję, a liczbę samoistnych poronień jako wynik. Szczegółowe informacje na temat zmiennych instrumentalnych znajdują się w Tabeli uzupełniającej 1. Wszystkie wybrane SNP miały statystykę F większą niż 10, co wskazuje na niskie prawdopodobieństwo wystąpienia błędu słabego instrumentu. Każde wybrane SNP zostało również przeskanowane za pomocą PhenoScanner V2; nie zidentyfikowano żadnego SNP powiązanego z aPL. Analiza MR-PRESSO nie wykazała wartości odstających. Test Q Cochrana nie wykazał istotnej heterogeniczności między szacunkami dla poszczególnych SNP (Q = 16,12, P = 0,31); w związku z tym zastosowano model IVW z efektami stałymi. Test przechwycenia MR-Egger nie wykazał kierunkowej plejotropii poziomej (P = 0,69). Analiza IVW wykazała statystycznie istotny, choć ilościowo niewielki, dodatni związek między genetycznie przewidywanym SLE a liczbą samoistnych poronień (iloraz szans [OR] = 1,01, 95% przedział ufności [CI] = 1,00–1,02, P < 0,01; Rysunek 2A). Szacunki efektu uzyskane za pomocą regresji MR-Egger (OR = 1,01, 95% CI = 1,00–1,03, P = 0,16), metody ważonej mediany (OR = 1,01, 95% CI = 1,00–1,02, P = 0,17) oraz metody ważonej mody (OR = 1,01, 95% CI = 0,99–1,03, P = 0,42) były spójne kierunkowo z szacunkiem IVW, choć pojedynczo nie osiągnęły istotności statystycznej. Analiza leave-one-out wykazała, że wykluczenie pojedynczego SNP nie zmieniło w istotny sposób szacunku połączonego, a w przybliżeniu symetryczny wykres lejkowy nie dostarczył wizualnych dowodów na to, aby wynik był determinowany przez wyraźną plejotropię kierunkową. Odpowiedni wykres rozrzutu, leśny wykres specyficzny dla SNP, analiza leave-one-out oraz wykres lejkowy przedstawiono na Rysunkach uzupełniających 1–4.
W analizie odwrotnej MR, po wyborze instrumentów zachowano 16 SNP, a wszystkie miały statystykę F większą niż 10 (Tabela uzupełniająca 2). Analiza MR-PRESSO nie zidentyfikowała żadnych wartości odstających. Test Q Cochrana nie wykazał istotnej heterogeniczności (Q = 13.41, P = 0.50), a test przecięcia MR-Egger nie dostarczył dowodów na kierunkową plejotropię horyzontalną (P = 0.41). Estymacja IVW nie potwierdziła związku między genetycznie przewidzianą liczbą samoistnych poronień a ryzykiem SLE (OR = 0.93, 95% CI = 0.21–4.23, P = 0.93; Rycina 2B). Łącznie wyniki MR wspierają umiarkowany związek w kierunku wprost, od genetycznie przewidzianego SLE do liczby samoistnych poronień, podczas gdy analiza odwrotna nie potwierdziła związku między genetycznie przewidzianą liczbą samoistnych poronień a ryzykiem SLE.
Analiza bioinformatyczna
Analiza ekspresji różnicowej:
Analiza ekspresji różnicowej zbioru GSE61635 pozwoliła zidentyfikować 976 DEG pomiędzy grupą z SLE a grupą zdrowej kontroli, w tym 678 genów o nadekspresji i 298 genów o obniżonej ekspresji (Ryc. 3C). Analiza GSE165004 wykazała 1 249 DEG pomiędzy grupami RPL a kontrolną, w tym 578 genów o nadekspresji i 671 genów o obniżonej ekspresji (Ryc. 3D). Mapy ciepła przedstawiające 50 najistotniejszych DEG w dwóch zestawach danych odkrywczych zaprezentowano na Ryc. 3A i Ryc. 3B. Ponadto w obu zestawach danych zidentyfikowano 59 wspólnych DEG (Ryc. 3E). Wspólne DEG stworzyły zestaw genów wykorzystany w późniejszych analizach wzbogacenia funkcjonalnego i analizach sieciowych.
Analiza wzbogacenia funkcjonalnego wspólnych DEG:
59 wspólnych DEG poddano analizom wzbogacenia GO i szlaków KEGG z wykorzystaniem narzędzia DAVID. W kategorii procesów biologicznych wspólne DEG były wzbogacone w odpowiedzi obronne na wirusy, odpowiedź na wirusy, negatywną regulację replikacji genomu wirusa, wrodzoną odpowiedź immunologiczną przeciwwirusową, negatywną regulację procesu apoptozy oraz adhezję komórkową. Wzbogacone terminy składników komórkowych obejmowały region zewnątrzkomórkowy, błonę retikulum endoplazmatycznego, cytoszkielet aktynowy oraz błonę. Wśród wzbogaconych terminów funkcji molekularnych zidentyfikowano wiązanie jonów wapnia. Analiza KEGG wykazała wzbogacenie w szlakach związanych z zapaleniem wątroby typu C oraz grypą A (Rycina 4A). Wyniki te wskazują, że wspólne DEG były przede wszystkim związane z przeciwwirusowymi i immunologicznymi procesami biologicznymi, co zapewnia kontekst funkcjonalny dla genów wspólnych dla zbiorów danych odkrywczych SLE i RPL.
Sieć PPI i identyfikacja genów centralnych (hub genes)
59 wspólnych DEG przesłano do bazy STRING w celu zbudowania sieci PPI, stosując minimalny wskaźnik ufności interakcji wynoszący 0,400. Powstała sieć zawierała 59 węzłów i 80 krawędzi. Sieć zaimportowano do programu Cytoscape w wersji 3.10.0 w celu wizualizacji, a przed analizą topologiczną usunięto izolowane węzły (Rysunek 4B). Ranking genów centralnych przeprowadzono za pomocą wtyczki cytoHubba. Zastosowano sześć algorytmów: Maximal Clique Centrality (MCC), Maximum Neighborhood Component (MNC), Edge Percolated Component (EPC), Degree, Closeness oraz Radiality. Wśród najwyżej ocenianych genów wygenerowanych przez wszystkie sześć algorytmów zidentyfikowano te same 10 genów: RSAD2, RTP4, IFIT3, IFI27, IFI44, GBP1, MX1, OAS1, IFIT1 oraz CXCL11 (Tabela 3). Geny te zostały zatem zatrzymane jako potencjalne węzły sieci do późniejszej regresji LASSO.
Regresja LASSO zidentyfikowała IFI27 i CXCL11 jako wspólne geny kandydackie
10 kandydackich genów węzłowych poddano analizie regresji LASSO w zestawach danych odkrywczych dla SLE i RPL. W zestawie danych SLE cztery geny zachowały niezerowe współczynniki przy wybranej wartości lambda: IFIT3, IFI27, IFI44 i CXCL11, z współczynnikami odpowiednio 2,575, 0,057, 2,359 i 0,307 (Rycina 5A,B). W zestawie danych RPL cztery geny zachowały niezerowe współczynniki: IFI27, GBP1, OAS1 i CXCL11, z współczynnikami odpowiednio −0,897, 0,167, −1,007 i −0,519 (Rycina 5C,D). Porównanie genów wybranych przez dwa modele specyficzne dla danej choroby pozwoliło zidentyfikować IFI27 i CXCL11 jako wspólne geny kandydackie wyselekcjonowane metodą LASSO. Te dwa geny zostały następnie ocenione w zestawach danych odkrywczych i zewnętrznych zestawach walidacyjnych.
Zewnętrzna walidacja ekspresji IFI27 i CXCL11
Wzorce ekspresji dwóch genów kandydackich oceniono z wykorzystaniem niezależnych zbiorów danych walidacyjnych GSE50772 i GSE198700 pobranych z bazy danych GEO. W zbiorze GSE61635 zarówno IFI27, jak i CXCL11 były istotnie zwiększone w grupie SLE w porównaniu z grupą kontrolną zdrowych osób (Rycyna 6A,B). W niezależnym zbiorze walidacyjnym SLE (GSE50772) IFI27 nadal wykazywało istotnie zwiększoną ekspresję (Rycina 6C), natomiast ekspresja CXCL11 nie różniła się istotnie między grupami (Rycina 6D). W zbiorze odkrywczym RPL (GSE165004) ekspresja zarówno IFI27, jak i CXCL11 była istotnie obniżona w grupie RPL w porównaniu z grupą kontrolną (Rycina 6E,F). W niezależnym zbiorze walidacyjnym RPL (GSE198700) ekspresja IFI27 pozostała istotnie obniżona w grupie RPL (Rycina 6G), natomiast CXCL11 nie wykryto. Ogólnie IFI27 wykazało spójną różnicową ekspresję zarówno w zbiorach odkrywczych, jak i walidacyjnych dla SLE oraz RPL. W przeciwieństwie do niego, wyniki dla CXCL11 nie zostały spójnie powtórzone w zewnętrznych zbiorach walidacyjnych. W związku z tym IFI27 został uznany za priorytetowy wspólny biomarker kandydacki do dalszych analiz.
Wstępna ocena dyskryminacji diagnostycznej
Przeprowadzono analizę charakterystyki operacyjnej odbiornika (ROC), aby ocenić zdolność ekspresji IFI27 i CXCL11 do rozróżnienia próbek chorobowych od kontrolnych w analizowanych retrospektywnych zbiorach danych transkrypcyjnych. W przypadku SLE, IFI27 wykazało pole pod krzywą ROC (AUC) wynoszące 0,822 (95% CI = 0,752–0,892; Rysunek 7A), natomiast CXCL11 wykazało AUC wynoszące 0,852 (95% CI = 0,786–0,917; Rysunek 7B). Porównanie krzywych ROC dla dwóch genów kandydackich w zbiorze danych SLE przedstawiono na Rysunku 7C. W przypadku RPL, IFI27 wykazało AUC wynoszące 0,872 (95% CI = 0,773–0,970; Rysunek 7D), natomiast CXCL11 wykazało AUC wynoszące 0,668 (95% CI = 0,513–0,882; Rysunek 7E). Porównanie krzywych ROC dla dwóch genów kandydackich w zbiorze danych RPL przedstawiono na Rysunku 7F. IFI27 wykazało wartości AUC powyżej 0,80 w obu zbiorach danych chorobowych i wykazało bardziej spójną walidację zewnętrzną niż CXCL11 w analizowanych zbiorach danych ekspresyjnych. Wyniki te wskazują na IFI27 jako biomarker kandydacki do dalszej oceny. Jednakże, ponieważ analizy ROC zostały przeprowadzone z wykorzystaniem retrospektywnych publicznych zbiorów danych transkrypcyjnych, wyniki należy interpretować jako wstępny dowód dyskryminacji transkrypcyjnej, a nie jako prospektywną walidację diagnostyki klinicznej.
Obliczeniowa ocena infiltracji immunologicznej
W celu oceny wzbogacenia 28 sygnatur komórek odpornościowych w zbiorach danych odkrywczych GSE61635 i GSE165004 przeprowadzono analizę ssGSEA. Mapy ciepła wzbogacenia komórek odpornościowych dla zbiorów danych SLE i RPL przedstawiono odpowiednio na Ryc. 8A,D, natomiast odpowiadające im porównania grupowe wyników ssGSEA zaprezentowano na Ryc. 8B,E. W zbiorze danych SLE wiele sygnatur komórek odpornościowych różniło się istotnie między pacjentami z SLE a zdrową grupą kontrolną, w tym sygnatury reprezentujące limfocyty T CD8+, limfocyty T CD4+, limfocyty B, komórki dendrytyczne, limfocyty T pomocnicze typu 1 (Th1), limfocyty T pomocnicze typu 2 (Th2), limfocyty T pomocnicze typu 17 (Th17), komórki NK, makrofagi, eozynofile, komórki tuczne, monocyty i neutrofile (Ryc. 8B). W zbiorze danych RPL wyniki ssGSEA dla aktywowanych limfocytów T CD8+, aktywowanych limfocytów T CD4+, efektorowych komórek pamięci CD4+ T, komórek Th17 i monocytów były wyższe w grupie RPL niż w grupie kontrolnej. Z kolei wyniki ssGSEA dla limfocytów T regulatorowych (Treg) i makrofagów były niższe w grupie RPL niż w grupie kontrolnej (Ryc. 8E). Analiza korelacji wykazała, że w zbiorze danych SLE ekspresja IFI27 i CXCL11 korelowała dodatnio z wynikami ssGSEA dla aktywowanych limfocytów T CD4+, komórek NK, komórek Th2 oraz centralnych komórek pamięci CD8+ T, a ujemnie z wynikiem ssGSEA dla komórek Th1 (Ryc. 8C). W zbiorze danych RPL ekspresja IFI27 korelowała dodatnio z wynikami ssGSEA dla komórek Treg i Th2, natomiast ekspresja CXCL11 korelowała dodatnio z wynikiem ssGSEA dla eozynofili (Ryc. 8F).
Dostępność danych:
W ramach niniejszego badania nie wygenerowano nowych pierwotnych danych dotyczących uczestników będących ludźmi. Wszystkie analizy oparto wyłącznie na publicznie dostępnych statystykach podsumowujących badania asocjacyjnych całego genomu (GWAS) oraz zbiorach danych transkrypcyjnych. Statystyki podsumowujące GWAS dla SLE pobrano z FinnGen Release 11 (numer dostępu: finngen_R11_L12_LUPUS). Statystyki podsumowujące dla liczby samorzutnych aborcji pobrano z zasobu IEU OpenGWAS (numer dostępu: ukb-b-419), który opiera się na danych UK Biobank. Zbiory danych transkrypcyjnych pobrano z National Center for Biotechnology Information Gene Expression Omnibus (GEO) pod numerami dostępu GSE61635, GSE165004, GSE50772 oraz GSE198700. Publicznie dostępne zbiory danych można znaleźć w następujących repozytoriach:
-- FinnGen Wydanie 11: https://r11.finngen.fi/
-- IEU OpenGWAS: https://gwas.mrcieu.ac.uk/
-- Gene Expression Omnibus (GEO): https://www.ncbi.nlm.nih.gov/geo/
Przetworzone dane stanowiące podstawę wyników niniejszego badania zostały zamieszczone w artykule oraz w jego materiałach uzupełniających. Nie uzyskano dostępu ani nie przechowywano danych na poziomie indywidualnym lub danych umożliwiających identyfikację uczestników. Przepływ analityczny wykonano przy użyciu ogólnodostępnego oprogramowania i pakietów, zgodnie z opisem w protokole.
Plik uzupełniający 1. Uzupełniona lista kontrolna raportowania STROBE-MR.
Uzupełniona lista kontrolna Strengthening the Reporting of Observational Studies in Epidemiology Using Mendelian Randomization (STROBE-MR) wskazująca, w których miejscach rękopisu omówiono poszczególne zalecane elementy raportowania. Kliknij tutaj, aby pobrać ten plik.
Rysunek uzupełniający 1. Wykres rozrzutu analizy randomizacji mendlowskiej w kierunku przednim.
Wykres rozrzutu przedstawiający powiązania między efektami genetycznymi instrumentalnych polimorfizmów pojedynczego nukleotydu (SNP) w stosunku do tocznia układowego (SLE) a liczbą samoistnych poronień. Każdy punkt reprezentuje jeden SNP, a poziome i pionowe słupki błędów wskazują błędy standardowe szacunków efektu SNP. Linie regresji odpowiadają metodom randomizacji mendlowskiej: ważonej odwrotnością wariancji, MR-Egger, ważonej medianie oraz ważonej modzie. Kliknij tutaj, aby pobrać ten plik.
Rysunek uzupełniający 2. Specyficzne dla polimorfizmu pojedynczego nukleotydu szacunki przyczynowe z analizy w przód metodą randomizacji mendlowskiej.
Wykres leśny przedstawiający szacunek efektu przyczynowego dla każdego instrumentalnego polimorfizmu pojedynczego nukleotydu (SNP) w związku między toczniem układowym (SLE) a liczbą samoistnych poronień. Czarne punkty reprezentują specyficzne dla SNP szacunki efektów z 95% przedziałami ufności. Czerwone punkty reprezentują ogólne szacunki efektu przyczynowego uzyskane przy użyciu metody ważonej odwrotnością wariancji oraz metody MR-Egger. Pionowa przerywana linia wskazuje efekt zerowy. Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 3. Analiza wrażliwości typu „leave-one-out” dla analizy mendlowskiej randomizacji w kierunku pozytywnym.
Wykres leśny przedstawiający wyniki analizy wrażliwości typu „leave-one-out”, oceniającej związek między toczniem rumieniowatym układowym (SLE) a liczbą samoistnych poronień. Każdy czarny punkt reprezentuje ogólną szacunkową wartość efektu przyczynowego ważonego odwrotnością wariancji po sekwencyjnym wykluczeniu jednego instrumentalnego polimorfizmu pojedynczego nukleotydu (SNP), a linie poziome wskazują odpowiadające im 95% przedziały ufności. Czerwony punkt reprezentuje ogólną szacunkową wartość ważoną odwrotnością wariancji, uzyskaną przy użyciu wszystkich instrumentalnych SNP. Pionowa przerywana linia oznacza brak efektu. Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 4. Wykres lejkowy dla analizy randomizacji mendlowskiej w kierunku w przód.
Wykres lejkowy przedstawiający rozkład szacunków efektu przyczynowego dla konkretnych SNP w badaniu związku między toczniem rumieniowatym układowym (SLE) a liczbą samoistnych poronień. Każdy punkt reprezentuje jeden instrumentalny polimorfizm pojedynczego nukleotydu (SNP). Linie pionowe wskazują całkowite szacunki efektu przyczynowego uzyskane przy użyciu metody ważonej odwrotnością wariancji oraz metody MR-Egger. Oś y reprezentuje odwrotność błędu standardowego (1/SE). Prosimy kliknąć tutaj, aby pobrać ten plik.
Tabela uzupełniająca 1. Instrumentalny polimorfizm pojedynczego nukleotydu wybrany do analizy forward Mendelian randomization.
Tabela zawiera listę instrumentalnych polimorfizmów pojedynczego nukleotydu (SNP) wykorzystanych w analizie forward Mendelian randomization w odniesieniu do tocznia układowego i liczby samoistnych poronień, w tym najbliższy adnotowany gen, chromosom, pozycję genomiczną, allel efektowy, częstość występowania allelu efektowego, wielkość efektu (Beta), błąd standardowy (SE), wartość P oraz statystykę F. Pozycje chromosomowe oparto na wersji asemblacji genomu źródłowego użytej w badaniu GWAS (genome-wide association study). Statystykę F obliczono jako Beta2/SE2. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 2. Polimorfizmy pojedynczego nukleotydu wykorzystane jako instrumenty w analizie odwrotnej randomizacji mendlowskiej.
Tabela zawiera zestawienie instrumentalnych polimorfizmów pojedynczego nukleotydu (SNP) wykorzystanych w analizie odwrotnej randomizacji mendlowskiej, w której ekspozycją była liczba samoistnych poronień, a wynikiem toczeń układowy, wraz z informacjami o najbliższym adnotowanym genie, chromosomie, pozycji genomowej, allelu efektowym, częstości występowania allelu efektowego, wielkości efektu (Beta), błędzie standardowym (SE), wartości P oraz statystyce F. Pozycje chromosomowe opierają się na wersji montażu genomu użytej w badaniu asocjacyjnym całego genomu. Statystykę F obliczono jako Beta2/SE2. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Poprzez dwukierunkową analizę MR połączoną z wielowymiarowymi analizami bioinformatycznymi, badanie to zidentyfikowało pozytywną zależność przyczynową między SLE a RPL, jednocześnie systematycznie przesiewając wspólne biomarkery transkrypcyjne. Z naszej wiedzy jest to pierwsze badanie integrujące dwukierunkową analizę MR, analizy transkrypcyjne oraz analizy infiltracji immunologicznej w celu zbadania tej relacji. Chociaż obserwowana wielkość efektu MR była niewielka (IVW OR = 1,01), zależność ta była konsekwentnie wspierana przez wiele komplementarnych metod MR i analizy wrażliwości, bez dowodów na istotną heterogeniczność, plejotropię horyzontalną czy wpływ znaczących wartości odstających, co sugeruje, że obserwowana relacja jest statystycznie stabilna, lecz ilościowo niewielka. W związku z tym obecne wyniki należy interpretować jako dowód wspierający niewielki wkład genetyczny SLE w podatność na RPL, a nie jako duży efekt kliniczny. Poprzez integrację wnioskowania przyczynowego z walidacją transkrypcyjną i analizami infiltracji immunologicznej, badanie to dostarcza odtwarzalnych ram dla priorytetyzacji kandydackich biomarkerów dla złożonych zaburzeń rozrodu o podłożu immunologicznym. Badanie przeprowadzone w Egipcie między 2007 a 2021 rokiem, obejmujące 123 kobiety z SLE i łącznie 201 ciąż, wykazało, że 20,4% ciąż u kobiet z SLE zakończyło się utratą płodu44. Wcześniejsze badania sugerowały analogicznie, że SLE jest istotnym czynnikiem ryzyka RPL, ponieważ dysregulacja immunologiczna może zwiększać prawdopodobieństwo utraty ciąży12.
Analizy bioinformatyczne wykazały, że 59 wspólnych genów o różnej ekspresji (DEGs) było przede wszystkim wzbogaconych w szlaki związane z przeciwwirusową odpowiedzią immunologiczną, adhezją komórkową oraz regulacją apoptozy. Infekcje wirusowe mogą przyczyniać się do patogenezy SLE. Pacjenci z SLE często wykazują dysfunkcję zarówno wrodzonej, jak i nabytej odpowiedzi immunologicznej45,46, co czyni ich bardziej podatnymi na infekcje wirusowe. Ta zwiększona podatność może przyczyniać się do utraty ciąży poprzez mechanizmy takie jak zapalenie łożyska i uszkodzenie komórek łożyska47. Jako kluczowy element łożyska, zmiany w autofagii i zachowaniu biologicznym trofoblastów były również powiązane z występowaniem RPL48,49. Wspólnie obserwacje te sugerują, że dysregulacja immunologiczna związana z SLE może wpływać na wyniki ciąży poprzez oddziaływanie na funkcję komórek trofoblastycznych. Dalsze analizy zidentyfikowały IFI27 i CXCL11 jako potencjalne geny węzłowe wspólne dla SLE i RPL. Jednakże IFI27 został wybrany do dalszych analiz, ponieważ wykazał większą spójność biologiczną w niezależnych zestawach danych. Chociaż oba geny zostały wybrane przez model LASSO, tylko IFI27 wykazał spójną różnicową ekspresję zarówno w zbiorze odkrywczym, jak i w zewnętrznych zbiorach walidacyjnych, podczas gdy CXCL11 nie został spójnie zreplikowany w zbiorach walidacyjnych. Ponadto IFI27 wykazał silniejszą dyskryminację diagnostyczną dla RPL i pozostawał znacząco dysregulowany w zbiorach danych dotyczących krwi i tkanek rozrodczych. Zbiorczo wyniki te wskazują na IFI27 jako bardziej solidny kandydat na biomarker niż CXCL11, choć wymagana jest dodatkowa walidacja eksperymentalna. Walidacja z wykorzystaniem zbioru danych SLE GSE50772 i zbioru danych RPL GSE198700 wykazała, że ekspresja IFI27 pozostawała spójnie dysregulowana w zbiorach walidacyjnych. Co istotne, IFI27 był nadmiernie eksponowany w próbkach krwi pacjentek z SLE, co jest zgodne z wcześniejszymi badaniami50, ale był niedoeksponowany w próbkach błony śluzowej endometrium i kosmków błonowych u pacjentek z RPL. Ten kontrastujący wzorzec może odzwierciedlać różnice między systemową dysregulacją immunologiczną a lokalnym środowiskiem immunologicznym na granicy matka-płód w przypadku SLE powikłanego RPL.
IFI27 jest genem indukowanym przez interferon, który bierze udział w odporności przeciwwirusowej, sygnalizacji interferonowej oraz odpowiedziach odpornościowych gospodarza po infekcji wirusowej51,52. W prawidłowej ciąży ekspresja IFI27 jest wyraźnie zwiększona w komórkach trofoblastu53, co sugeruje istotną rolę fizjologiczną w utrzymaniu funkcji trofoblastu. W przeciwieństwie do tego, nasze analizy wykazały obniżoną ekspresję IFI27 w błonie śluzowej macicy i kosmkach błony płodowej u pacjentek z RPL. Choć wynik ten różni się od niektórych wcześniejszych doniesień54, należy go interpretować ostrożnie, ponieważ w niniejszym badaniu zintegrowano zestawy danych transkrypcyjnych pochodzących z różnych tkanek, a nie z dopasowanych próbek matczyno-płodowych. Jednym z możliwych wyjaśnień jest to, że przewlekła systemowa aktywacja interferonu typu I w SLE indukuje trwałą sygnalizację interferonową w krążących komórkach odpornościowych, jednocześnie promując desensytyzację receptorów, wyczerpanie immunologiczne lub kompensacyjne mechanizmy ujemnego sprzężenia zwrotnego na styku matczyno-płodowym. Alternatywnie, tkankowo swoista regulacja epigenetyczna lub różnice w składzie komórkowym między krwią obwodową a tkankami rozrodczymi mogą tłumić lokalną ekspresję IFI27 mimo systemowej aktywacji interferonu. Hipotezy te pozostają w sferze domniemań i wymagają walidacji mechanistycznej z wykorzystaniem dopasowanych próbek krwi matki, tkanki błony śluzowej macicy i trofoblastu, idealnie na poziomie pojedynczych komórek, aby rozróżnić tkankowo swoiste i komórkowo swoiste mechanizmy regulacyjne55.
Analiza nacieku immunologicznego wskazała na istotne różnice w sygnaturach komórek odpornościowych zarówno w przypadku SLE, jak i RPL, charakteryzujące się przede wszystkim zmianami w populacjach związanych z limfocytami T CD4+. Ekspresja IFI27 była dodatnio skorelowana z wzbogaceniem komórek Th2 w obu jednostkach chorobowych; jednak wyniki te stanowią korelacje obliczeniowe pochodzące z analizy ssGSEA, a nie eksperymentalnie zweryfikowane interakcje biologiczne. Poprzednie badania wykazały, że krew obwodowa pacjentów z SLE zawiera zmniejszone proporcje komórek Th1 i Treg, ale zwiększone proporcje komórek Th256,57, co jest zgodne z naszymi ustaleniami. Podczas prawidłowej ciąży równowaga immunologiczna Th1/Th2 na granicy matka-płód przesuwa się w stronę stanu z dominacją Th258. Zatem obniżona ekspresja IFI27 w tkankach rozrodczych może odzwierciedlać zmiany w lokalnej homeostazie immunologicznej związanej z upośledzoną tolerancją matczyno-płodową, choć to, czy IFI27 bezpośrednio reguluje ten proces, pozostaje do potwierdzenia eksperymentalnego.
Należy przyznać, że istnieją pewne ograniczenia. Po pierwsze, choć analizy MR wsparły tezę o związku przyczynowym, szacowany efekt genetyczny był stosunkowo niewielki, co sugeruje, że SLE stanowi tylko jeden z elementów wieloczynnikowej patogenezy RPL. Po drugie, integracja transkryptomiczna obejmowała zestawy danych wygenerowane z różnych tkanek (krew obwodowa, błona śluzowa macicy i kosmki pozapłodowe), platform mikromacierzy oraz niezależnych kohort, co mimo spójnej walidacji IFI27 mogło wprowadzić heterogeniczność biologiczną i techniczną. Po trzecie, zewnętrzna kohorta walidacyjna dla kosmków pozapłodowych obejmowała ograniczoną liczbę próbek, co mogło obniżyć moc statystyczną i uogólnialność wyników. Po czwarte, ponieważ publicznie dostępne zestawy danych zawierały ograniczone informacje kliniczne, nie można było w pełni ocenić istotnych czynników, takich jak aktywność choroby, status przeciwciał przeciwfosfolipidowych, stosowanie leków, stadium ciąży oraz inne kliniczne zmienne towarzyszące. Wreszcie, choć przesiew PhenoScanner zminimalizował potencjalne zakłócenia plejotropowe w analizach MR, nie można całkowicie wykluczyć pozostałych czynników zakłócających.
Z perspektywy translacyjnej IFI27 należy obecnie traktować jako potencjalny biomarker, a nie klinicznie zwalidowany marker diagnostyczny. Przed wdrożeniem klinicznym niezbędne są prospektywne badania wieloośrodkowe w celu potwierdzenia jego skuteczności diagnostycznej w zróżnicowanych populacjach, ustanowienia standaryzowanych platform analitycznych i progów diagnostycznych oraz określenia, w jaki sposób etap ciąży, aktywność choroby i leczenie immunosupresyjne wpływają na ekspresję IFI27. Eksperymenty funkcjonalne, wraz z transkryptomiką przestrzenną i analizami transkryptomicznymi pojedynczych komórek, będą również niezbędne do wyjaśnienia, czy IFI27 aktywnie przyczynia się do regulacji odporności matczyno-płodowej, czy jedynie odzwierciedla indukowaną przez interferon aktywację immunologiczną.
Oświadczenia
Konflikt interesów:
Autorzy oświadczają, że nie mają żadnych konkurencyjnych interesów finansowych ani niefinansowych.
Podziękowania
Praca ta była wspierana przez Beijing Municipal Administration of Traditional Chinese Medicine Major Difficult Diseases Integration of Traditional Chinese and Western Medicine Key Project (2023BJSZDYNJBXTGG-003), National-Level Public Welfare Scientific Research Fund for Basic Research Business of Institutes (ZZ16-XRZ-038) oraz High-Level Chinese Medical Hospital Promotion Project (HLCMHPP2023087). Źródła finansowania nie brały udziału w projektowaniu badania, gromadzeniu danych, analizie danych, interpretacji danych, przygotowaniu rękopisu ani w decyzji o przedłożeniu rękopisu do publikacji. Autorzy dziękują badaczom i uczestnikom badania FinnGen, UK Biobank oraz National Center for Biotechnology Information Gene Expression Omnibus (GEO) za udostępnienie ich zbiorów danych. Autorzy pragną również podziękować konsorcjum FinnGen, które integruje próbki z fińskich biobanków z ogólnokrajowymi danymi z rejestrów zdrowia dzięki współpracy fińskich organizacji badawczych, biobanków i partnerów międzynarodowych.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| zbiór sygnatur genowych 28 typów komórek odpornościowych | Opublikowany uzupełniający zasób sygnatur genowych | Uzupełniająca lista genów markerowych komórek odpornościowych opisana przez Charoentong i wsp. (Referencja 42) | Nie dotyczy RRID: Niedostępne Cel / uwagi: Sygnatury komórek odpornościowych wykorzystywane do analizy ssGSEA. |
| CNSknowall | platforma internetowa CNSknowall | pliki wyjściowe DAVID | Nie dotyczy RRID: Niedostępne Cel / uwagi: Wizualizacja przefiltrowanych wyników analizy wzbogacenia funkcjonalnego. |
| Stanowisko komputerowe | Instytucjonalne środowisko informatyczne | Nie dotyczy | Nie dotyczy RRID: Nie dotyczy Cel / uwagi: Analizy obliczeniowe. |
| Materiały eksploatacyjne | Nie dotyczy | Nie dotyczy | Nie dotyczy RRID: Nie dotyczy Cel / uwagi: Nie wykorzystano żadnych materiałów eksploatacyjnych do prac laboratoryjnych. |
| Cytoscape | Konsorcjum Cytoscape | Nie dotyczy | 3.10.0 RRID: SCR_003032 Cel / uwagi: Białko–wizualizacja sieci oddziaływań białkowych i analiza topologii |
| cytoHubba | Sklep z aplikacjami Cytoscape | Nie dotyczy | 0.1 RRID: SCR_017677 Cel / uwagi: Ranking genów węzłowych (hub-genes) z wykorzystaniem wskaźników MCC, MNC, EPC, stopnia (Degree), bliskości (Closeness) oraz radialności (Radiality). |
| Narzędzie do adnotacji funkcjonalnej DAVID | National Institutes of Health / National Cancer Institute | Przesłane wspólne listy genów różnicowo wyrażonych (DEG) oraz genów tła | 2021 RRID: SCR_001881 Cel / uwagi: Analiza wzbogacenia ontologii genów (Gene Ontology) oraz szlaków KEGG. |
| Europejski panel referencyjny LD | Projekt 1000 Genomów / IEU OpenGWAS | Panel europejski Fazy 3 (warianty kompatybilne z GRCh37) | Faza 3 RRID: Nie zgłoszono Cel / uwagi: Klastrowanie nierównowagi sprzężeń za pomocą przepływu pracy OpenGWAS/TwoSampleMR. |
| FinnGen | Konsorcjum FinnGen | finngen_R11_L12_TOCZEŃ | Wydanie 11 RRID: SCR_022254 Cel / uwagi: Statystyki podsumowujące GWAS dla tocznia rumieniowatego. |
| forestploter | CRAN | Nie dotyczy | 1.1.2 RRID: Niedostępne Cel / uwagi: Wizualizacja wykresu leśnego (forest plot) dla estymacji randomizacji mendlowskiej. |
| Gene Expression Omnibus (GEO) | Krajowe Centrum Informacji Biotechnologicznych | GSE61635; GSE165004; GSE50772; GSE198700 | Nie dotyczy RRID: SCR_005012 Cel / uwagi: Źródła zestawów danych transkrypcyjnych do odkryć i walidacji. |
| Ontologia Genów | Konsorcjum Gene Ontology | termy GO uzyskane za pomocą narzędzia DAVID | adnotacje DAVID 2021 RRID: SCR_002811 Cel / uwagi: Adnotacja procesów biologicznych, komponentów komórkowych i funkcji molekularnych. |
| ggcorrplot | CRAN | Nie dotyczy | 0.1.4.1 RRID: Niedostępne Cel / uwagi: Wizualizacja genu kandydującego–macierze korelacji komórek odpornościowych. |
| ggplot2 | CRAN | Nie dotyczy | 3.5.1 RRID: SCR_014601 Cel / uwagi: Wykresy wulkaniczne, wykresy pudełkowe i inne grafiki statystyczne. |
| ggvenn | CRAN | Nie dotyczy | 0.1.16 RRID: SCR_025300 Cel / uwagi: Wizualizacja wspólnych genów o zróżnicowanej ekspresji. |
| glmnet | CRAN | Nie dotyczy | 4.1-8 RRID: SCR_015505 Cel / uwagi: Regresja logistyczna LASSO i walidacja krzyżowa. |
| GSE165004 | NCBI GEO | GSE165004 / GPL16699 | Przetworzona macierz serii RRID: SCR_005012 Cel / uwagi: Zbiór danych odkrywczych dla błony śluzowej endometrium w przypadku RPL. |
| GSE198700 | NCBI GEO | GSE198700 / GPL13534 | Przetworzona macierz serii RRID: SCR_005012 Cel / uwagi: Niezależny zestaw danych walidacyjnych dla kosmków błonowych w przypadku RPL. |
| GSE50772 | NCBI GEO | GSE50772 / GPL570 | Przetworzona macierz serii RRID: SCR_005012 Cel / uwagi: Niezależny zbiór danych walidacyjnych dla mononuklearnych komórek krwi obwodowej w toczniu rumieniowatym układowym (SLE). |
| GSE61635 | NCBI GEO | GSE61635 / GPL570 | Przetworzona macierz serii RRID: SCR_005012 Cel / uwagi: Zbiór danych odkrywczych z krwi pełnej w SLE. |
| GSEABase | Bioconductor | Nie dotyczy | 1.66.0 RRID: Niedostępne Cel / uwagi: Zarządzanie zestawami genów komórek odpornościowych dla metody ssGSEA. |
| GSVA (analiza wzbogacenia zestawów genów) | Bioconductor | Nie dotyczy | 1.52.3 RRID: SCR_021058 Cel / uwagi: Analiza wzbogacenia zestawów genów dla pojedynczej próbki (ssGSEA). |
| IEU OpenGWAS | Jednostka Epidemiologii Integracyjnej MRC | ukb-b-419; finngen_R11_L12_LUPUS | Nie dotyczy RRID: Nie zgłoszono Cel / uwagi: Pobieranie statystyk podsumowujących GWAS oraz zharmonizowanych danych dotyczących asocjacji genetycznych. |
| Kiotońska Encyklopedia Genów i Genomów (KEGG) | Kanehisa Laboratories | ścieżki KEGG analizowane za pomocą DAVID | adnotacje DAVID 2021 RRID: SCR_012773 Cel / uwagi: Adnotacja wzbogacenia szlaków. |
| limma | Bioconductor | Nie dotyczy | 3.60.6 RRID: SCR_010943 Cel / uwagi: Analiza ekspresji różnicowej. |
| MRPRESSO | Verbanck i wsp. | Nie dotyczy | 1 RRID: SCR_023697 Cel / uwagi: Wykrywanie plejotropii horyzontalnej i odstających zmiennych instrumentalnych. |
| pheatmap | CRAN | Nie dotyczy | 1.0.12 RRID: SCR_016418 Cel / uwagi: Mapy ciepła ekspresji. |
| PhenoScanner V2 | Konsorcjum PhenoScanner | Zapytania o fenotyp na poziomie SNP | Wersja 2 RRID: Niedostępne Cel / uwagi: Przesiewowe badanie zachowanych polimorfizmów pojedynczego nukleotydu (SNP) pod kątem potencjalnych korelacji z fenotypami zakłócającymi. |
| pROC | CRAN | Nie dotyczy | 1.18.5 RRID: SCR_024286 Cel / uwagi: Krzywe ROC, wartości AUC, przedziały ufności DeLonga, punkty odcięcia indeksu Youdena oraz przedziały ufności bootstrapowe. |
| R | R Foundation for Statistical Computing | Nie dotyczy | 4.4.2 RRID: SCR_001905 Cel / uwagi: Środowisko obliczeń statystycznych. |
| Odczynniki | Nie dotyczy | Nie dotyczy | Nie dotyczy RRID: Nie dotyczy Cel / uwagi: Nie użyto żadnych odczynników laboratoryjnych. |
| Proszę podać tekst do przetłumaczenia. | Konsorcjum STRING | Homo sapiens (takson 9606); minimalny wynik interakcji 0,400 | 11 RRID: SCR_005223 Cel / uwagi: Białko–konstrukcja sieci oddziaływań białkowych |
| TwoSampleMR | Jednostka Epidemiologii Integracyjnej MRC | Nie dotyczy | 0.6.6 RRID: SCR_019010 Cel / uwagi: Dwukierunkowa dwupróbkowa randomizacja mendlowska, ekstrakcja danych, harmonizacja, szacowanie przyczynowości oraz analizy wrażliwości. |
| UK Biobank | UK Biobank | ukb-b-419 | zestaw danych podsumowujących za rok 2018 RRID: SCR_012815 Cel / uwagi: Statystyki podsumowujące GWAS dla liczby samoistnych poronień. |
Bibliografia
- Petri M. Pregnancy and systemic lupus erythematosus. Best Pract Res Clin Obstet Gynaecol. 2020;64:24-30.
- Zhao X, et al. Advances in drug therapy for systemic lupus erythematosus. Curr Med Chem. 2021;28(7):1251-1268.
- Stanescu II, et al. Salivary biomarkers of inflammation in systemic lupus erythematosus. Ann Anat. 2018;219:89-93.
- Tian J, Zhang D, Yao X, Huang Y, Lu Q. Global epidemiology of systemic lupus erythematosus: A comprehensive systematic analysis and modelling study. Ann Rheum Dis. 2023;82(3):351-356.
- Palma Dos Reis CR, et al. Prediction of adverse pregnancy outcomes in women with systemic lupus erythematosus. Clin Rev Allergy Immunol. 2020;59(2):287-294.
- Venne K, Scott S, Bernatsky S, Vinet E. Induced abortions in women with systemic lupus erythematosus. Lupus. 2021;30(4):484-488.
- Kim JW, et al. Lupus low disease activity state achievement is important for reducing adverse outcomes in pregnant patients with systemic lupus erythematosus. J Rheumatol. 2021;48(5):707-716.
- Braga A, et al. Systemic lupus erythematosus and pregnancy: A Portuguese case-control study. Clin Rev Allergy Immunol. 2022;62(2):324-332.
- Dimitriadis E, Menkhorst E, Saito S, Kutteh WH, Brosens JJ. Recurrent pregnancy loss. Nat Rev Dis Primers. 2020;6(1):98.
- Quenby S, et al. Miscarriage matters: The epidemiological, physical, psychological, and economic costs of early pregnancy loss. Lancet. 2021;397(10285):1658-1667.
- Valeff NJ, Ventimiglia MS, Diao L, Jensen F. Lupus and recurrent pregnancy loss: The role of female sex hormones and B cells. Front Endocrinol (Lausanne). 2023;14:1233883.
- Gao R, Zeng X, Qin L. Systemic autoimmune diseases and recurrent pregnancy loss: Research progress in diagnosis and treatment. Chin Med J (Engl). 2021;134(17):2140-2142.
- Pantham P, Abrahams VM, Chamley LW. The role of anti-phospholipid antibodies in autoimmune reproductive failure. Reproduction. 2016;151(5):R79-R90.
- Meroni PL, et al. Updating on the pathogenic mechanisms of antiphospholipid antibody-associated pregnancy loss. Clin Rev Allergy Immunol. 2008;34(3):332-337.
- Blank M, Shoenfeld Y. Antiphospholipid antibody-mediated reproductive failure in antiphospholipid syndrome. Clin Rev Allergy Immunol. 2010;38(2–3):141-147.
- Babker A, et al. Frequency of ACE I/D and PAI-1 4G/5G polymorphisms in women with recurrent pregnancy loss in Sudan. Biomed Pharmacol J. 2025;18(3):1953-1961.
- Babker AM, et al. Detection of human platelet antigen polymorphisms (HPA-1 and HPA-3) and factor XIII mutation in Sudanese women with recurrent pregnancy loss. BMC Res Notes. 2024;17(1):66.
- Grover S, Del Greco MF, Stein CM, Ziegler A. Mendelian randomization. Methods Mol Biol. 2017;1666:581-628.
- Skrivankova VM, et al. Strengthening the reporting of observational studies in epidemiology using Mendelian randomization: The STROBE-MR statement. JAMA. 2021;326(16):1614-1621.
- Emdin CA, Khera AV, Kathiresan S. Mendelian randomization. JAMA. 2017;318(19):1925-1926.
- Burgess S, Thompson SG, CRP CHD Genetics Collaboration. Avoiding bias from weak instruments in Mendelian randomization studies. Int J Epidemiol. 2011;40(3):755-764.
- Hemani G, et al. The MR-Base platform supports systematic causal inference across the human phenome. eLife. 2018;7:e34408.
- Bowden J, Davey Smith G, Burgess S. Mendelian randomization with invalid instruments: Effect estimation and bias detection through Egger regression. Int J Epidemiol. 2015;44(2):512-525.
- Bowden J, Davey Smith G, Haycock PC, Burgess S. Consistent estimation in Mendelian randomization with some invalid instruments using a weighted median estimator. Genet Epidemiol. 2016;40(4):304-314.
- Hartwig FP, Davey Smith G, Bowden J. Robust inference in summary data Mendelian randomization via the zero modal pleiotropy assumption. Int J Epidemiol. 2017;46(6):1985-1998.
- Burgess S, Butterworth A, Thompson SG. Mendelian randomization analysis with multiple genetic variants using summarized data. Genet Epidemiol. 2013;37(7):658-665.
- Verbanck M, Chen CY, Neale B, Do R. Detection of widespread horizontal pleiotropy in causal relationships inferred from Mendelian randomization between complex traits and diseases. Nat Genet. 2018;50(5):693-698.
- Barrett T, et al. NCBI GEO: Archive for functional genomics data sets—update. Nucleic Acids Res. 2013;41(Database issue):D991-D995.
- Keleş İD, et al. Gene pathway analysis of the endometrium at the start of the window of implantation in women with unexplained infertility and unexplained recurrent pregnancy loss: Is unexplained recurrent pregnancy loss a subset of unexplained infertility? Hum Fertil (Camb). 2023;26(5):1129-1141.
- Kennedy WP, et al. Association of the interferon signature metric with serological disease manifestations but not global activity scores in multiple cohorts of patients with SLE. Lupus Sci Med. 2015;2(1):e000080.
- Matsumoto Y, et al. Characteristic DNA methylation profiles of chorionic villi in recurrent miscarriage. Sci Rep. 2022;12(1):11673.
- Sherman BT, Lempicki RA. Systematic and integrative analysis of large gene lists using DAVID bioinformatics resources. Nat Protoc. 2009;4(1):44-57.
- Szklarczyk D, et al. STRING v11: Protein–protein association networks with increased coverage, supporting functional discovery in genome-wide experimental datasets. Nucleic Acids Res. 2019;47(D1):D607-D613.
- Shannon P, et al. Cytoscape: A software environment for integrated models of biomolecular interaction networks. Genome Res. 2003;13(11):2498-2504.
- Jia P, Zheng S, Long J, Zheng W, Zhao Z. dmGWAS: Dense module searching for genome-wide association studies in protein–protein interaction networks. Bioinformatics. 2011;27(1):95-102.
- Chin CH, et al. cytoHubba: Identifying hub objects and subnetworks from complex interactome. BMC Syst Biol. 2014;8(Suppl 4):S11.
- Mohammadi M. A projection neural network for the generalized Lasso. IEEE Trans Neural Netw Learn Syst. 2020;31(6):2217-2221.
- Kumar R, Indrayan A. Receiver operating characteristic (ROC) curve for medical researchers. Indian Pediatr. 2011;48(4):277-287.
- de Hond AAH, Steyerberg EW, van Calster B. Interpreting area under the receiver operating characteristic curve. Lancet Digit Health. 2022;4(12):e853-e855.
- Xu H, et al. Single-cell transcriptomics reveals CCL3+ classical monocyte subset linked to autoimmune pathogenesis. J Inflamm Res. 2025;18:16273-16291.
- Zych M, et al. Surface immune checkpoints as potential biomarkers in physiological pregnancy and recurrent pregnancy loss. Int J Mol Sci. 2024;25(17):9378.
- Charoentong P, et al. Pan-cancer immunogenomic analyses reveal genotype-immunophenotype relationships and predictors of response to checkpoint blockade. Cell Rep. 2017;18(1):248-262.
- Liu J, Lu J, Wang G, Gu L, Li W. Prognostic characteristics of a six-gene signature based on ssGSEA in sarcoma. Aging (Albany NY). 2024;16(2):1536-1554.
- Mokbel A, et al. Pregnancy outcomes among Egyptian women with systemic lupus erythematosus: A prospective cohort study. Lupus. 2023;32(4):521-530.
- Illescas-Montes R, Corona-Castro CC, Melguizo-Rodríguez L, Ruiz C, Costela-Ruiz VJ. Infectious processes and systemic lupus erythematosus. Immunology. 2019;158(3):153-160.
- Banko A, et al. Epstein-Barr virus infection as a potential indicator of the occurrence and clinical presentation of systemic lupus erythematosus. Front Immunol. 2023;14:1307589.
- Nigro G, et al. Role of infections in recurrent spontaneous abortion. J Matern Fetal Neonatal Med. 2011;24(8):983-989.
- Yang D, et al. YY1-PVT1 affects trophoblast invasion and adhesion by regulating mTOR pathway-mediated autophagy. J Cell Physiol. 2020;235(10):6637-6646.
- Guan D, et al. Immunologic insights in recurrent spontaneous abortion: Molecular mechanisms and therapeutic interventions. Biomed Pharmacother. 2024;177:117082.
- Zhao X, et al. Identification of key biomarkers and immune infiltration in systemic lupus erythematosus by integrated bioinformatics analysis. J Transl Med. 2021;19(1):35.
- Villamayor L, et al. The IFN-stimulated gene IFI27 counteracts innate immune responses after viral infections by interfering with RIG-I signaling. Front Microbiol. 2023;14:1176177.
- Lim FY, et al. High-frequency home self-collection of capillary blood correlates IFI27 expression kinetics with SARS-CoV-2 viral clearance. J Clin Invest. 2023;133(23):e173715.
- Apps R, et al. Genome-wide expression profile of first-trimester villous and extravillous human trophoblast cells. Placenta. 2011;32(1):33-43.
- Li Y, et al. RNA sequencing of decidua reveals differentially expressed genes in recurrent pregnancy loss. Reprod Sci. 2021;28(8):2261-2269.
- Dankers W, et al. Failing maternal-fetal tolerance in SLE (FaMaLE): A prospective cohort study for finding the molecular mechanisms behind pregnancy complications. Lupus Sci Med. 2025;12(1):e001668.
- Xiang S, et al. Imbalance of helper T cell type 1, helper T cell type 2, and associated cytokines in patients with systemic lupus erythematosus: A meta-analysis. Front Pharmacol. 2022;13:988512.
- Tu J, et al. UC-BSC exosomes regulate Th17/Treg balance in patients with systemic lupus erythematosus via miR-19b/KLF13. Cells. 2022;11(24):4123.
- Wang W, et al. T helper (Th) cell profiles in pregnancy and recurrent pregnancy loss: Th1/Th2/Th9/Th17/Th22/Tfh cells. Front Immunol. 2020;11:2025.