Niniejsza praca bada algorytm optymalizacji dynamicznego harmonogramowania, który integruje model Transformer oraz uczenie przez wzmacnianie PPO, koncentrując się na częstych konfliktach zasobów i opóźnieniach w odpowiedziach podczas planowania działań związkowych.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Algorytm dynamicznego harmonogramowania i optymalizacji zasobów dla działań związkowych poprzez integrację transformera i uczenia ze wzmocnieniem
W tym artykule
Podsumowanie
Streszczenie
W celu rozwiązania problemu obniżonej efektywności organizacyjnej spowodowanej częstymi konfliktami w alokacji zasobów oraz opóźnieniami w odpowiedziach harmonogramowania przy zarządzaniu działaniami związków zawodowych, w niniejszej pracy zaproponowano dynamiczny algorytm harmonogramowania integrujący model Transformer oraz PPO (Proximal Policy Optimization). W konkretnej implementacji najpierw zaprojektowano ujednoliconą strukturę modelowania scenariuszy harmonogramowania, aby przekształcić stany działań, personelu i zasobów w wejścia tensorowe, osiągając tym samym wielowymiarową integrację ograniczeń. Następnie wykorzystano mechanizm wielogłowicowej uwagi (multi-head attention) Transformera do kodowania szeregów czasowych historycznych żądań dotyczących działań oraz stanu zasobów, co pozwoliło na wyodrębnienie wielowymiarowych cech czasoprzestrzennych i zwiększenie percepcji ryzyk związanych z konfliktami. Następnie, w oparciu o wyniki kodowania i sieć strategiczną PPO, generowane są działania harmonogramowania z aktualnego stanu, aby zwiększyć adaptacyjność strategii do złożonych środowisk. Na koniec, dzięki aktualizacji przycinania oraz mechanizmowi korekcji funkcji przewagi, zapewniono stabilność strategii podczas iteracji oraz poprawę wydajności harmonogramowania. Eksperymenty wykazały, że przy gęstości zadań wynoszącej 1000, średni czas decyzji algorytmu harmonogramowania wynosi 0,72s, a średnie opóźnienie odpowiedzi to 1,59s, co wskazuje na wysoką szybkość reakcji i efektywność podejmowania decyzji. W obrębie siedmiu typów i poziomów złożoności działań współczynnik konfliktów zasobów wynosi 0,05–0,12, średni stopień wykorzystania zasobów wynosi 0,75–0,86, a wskaźnik stabilności harmonogramowania wynosi 0,8–0,91, co skutecznie redukuje częste konflikty w alokacji zasobów i zapewnia wysoką stabilność harmonogramowania. W warunkach wysokiej współbieżności wskaźnik równowagi zasobów oraz wskaźnik odporności transferu strategii wynoszą odpowiednio 0,88 i 0,85, co świadczy o dobrej adaptacyjności do obciążeń wynikających z współbieżności zadań.
Wprowadzenie
Działalność związków zawodowych wiąże się ze złożonym harmonogramowaniem wielu zadań i zasobów, co wymaga od systemu efektywnych możliwości dynamicznego reagowania1,2. Wymagania dotyczące działań często ulegają zmianom, a dystrybucja personelu i zasobów lokalowych jest złożona, co może łatwo prowadzić do konfliktów w harmonogramie i marnotrawstwa zasobów3,4. Dokładne rejestrowanie historii działań i statusu zasobów w czasie rzeczywistym, a także poprawa zdolności identyfikowania i reagowania na potencjalne konflikty, są kluczowe dla zwiększenia efektywności operacyjnej organizacji5,6. Integracja zaawansowanej technologii modelowania szeregów czasowych i algorytmów uczenia ze wzmocnieniem pozwala na głębokie zrozumienie i inteligentną optymalizację w złożonych środowiskach harmonogramowania, pomagając zmaksymalizować wykorzystanie zasobów, przyspieszyć reakcję w planowaniu oraz promować inteligentną modernizację zarządzania działalnością związków zawodowych.
Jednakże stosowane w praktyce podejścia do planowania opierają się w dużej mierze na statycznych regułach, co uniemożliwia adaptację do częstych zmian zadań i wahań w dostępności zasobów, prowadząc często do wydłużonego czasu odpowiedzi i poważnych konfliktów zasobowych. W planowaniu działalności związkowej typy zadań są bardzo zróżnicowane, wykorzystanie zasobów jest silnie ograniczone i często ulega zmianom, a zależności między działaniami oraz konkurencja o zasoby tworzą złożoną mapę planowania7,8. W praktyce harmonogram działań nie może być efektywnie dopasowany do dostępnych okien czasowych zasobów, takich jak personel i lokale9,10, co często prowadzi do konfliktów osłabiających ogólną spójność operacji organizacyjnych11,12. System planowania nie zmierza do osiągnięcia pojedynczego celu optymalizacji, lecz do wypracowania równowagi między wielowymiarowymi wskaźnikami, takimi jak minimalizacja konfliktów zasobowych, maksymalizacja szybkości odpowiedzi, stabilność strategii planowania oraz wskaźnik realizacji zadań13,14, co wykazuje typowe cechy optymalizacji wielokryterialnej. Ponadto działania związków zawodowych charakteryzują się wyraźnymi fazami i cyklami, a strategie planowania muszą dynamicznie dostosowywać się do zmiennych struktur zapotrzebowania na zasoby w różnych etapach zadań. Statyczne plany generowane jednorazowo nie są w stanie wspierać środowiska wykonawczego o wysokiej częstotliwości zmian15,16. Istniejąca logika planowania nie uwzględnia pogłębionej analizy historycznych zachowań zadań ani wzorców zmian statusu zasobów, przez co nie jest w stanie dostarczać dokładnych prognoz i wnioskować o przyszłych strategiach17,18. Strategia planowania systemu reaguje powoli na nagłe zadania i tymczasowe zmiany w zasobach, co wpływa na ogólną trwałość operacji19,20. Budowa systemu planowania o cechach predykcyjności, elastyczności i stabilności stała się kluczowym wymogiem technicznym w zastosowaniach praktycznych. Wymaga to od modelu wysokiej zdolności percepcji informacji wielowymiarowych, pamięci sekwencyjnej oraz możliwości migracji strategii, a także utrzymania odporności w podejmowaniu decyzji i równowagi zasobów w środowisku wielozadaniowym, co umożliwia inteligentną i optymalną koordynację planowania działalności związkowej.
Liczne badania zaproponowały różnorodne rozwiązania problemu dynamicznego harmonogramowania. Wśród nich kombinacja głębokiego uczenia i uczenia ze wzmocnieniem wykazała silną zdolność adaptacji i optymalizacji. Niektórzy badacze wykorzystują LSTM (Long Short-Term Memory)21,22 do modelowania danych szeregów czasowych i łączą je ze strategiami uczenia ze wzmocnieniem w celu optymalizacji zachowania harmonogramowania, osiągając określone rezultaty. Inny typ badań wykorzystuje metodę heurystyczną opartą na algorytmie zachłannym, kładąc nacisk na prostotę i efektywność decyzji o harmonogramowaniu, co jest odpowiednie dla scenariuszy z jasno określonymi regułami23,24. Inne prace badały zastosowanie głębokiej sieci Q (DQN) w harmonogramowaniu, osiągając ulepszone strategie dzięki aproksymacji funkcji wartości25,26. Jednakże metody te wykazują takie problemy jak niewystarczające wychwytywanie długoterminowych zależności, niestabilne aktualizacje strategii oraz duże opóźnienia w odpowiedzi w przypadku złożonych i zmiennych scenariuszy aktywności połączonej, co utrudnia zaspokojenie potrzeb harmonogramowania w przypadku zadań o wysokiej gęstości i zróżnicowanym charakterze. W związku z tym zbudowanie algorytmu harmonogramowania z efektywną ekstrakcją cech i stabilnymi możliwościami aktualizacji strategii stało się wąskim gardłem, które wymaga przełamania w obecnych badaniach.
W badaniach nad harmonogramowaniem wielodomenowym architekturę Transformer zastosowano w różnych zadaniach predykcji szeregów czasowych i optymalizacji harmonogramowania ze względu na mechanizm wielogłowicowej autouwagi (multi-head self-attention), który skutecznie wychwytuje długoterminowe zależności czasowe27,28. W połączeniu z algorytmem PPO w uczeniu ze wzmocnieniem strategia jest aktualizowana w sposób stabilny i wydajny poprzez przycinanie funkcji celu; podejście to wykazało dobrą skuteczność w takich obszarach jak sterowanie robotami i inteligentna produkcja29,30,31. Niektóre badania podjęły próbę zintegrowania Transformera z uczeniem ze wzmocnieniem w celu złożonego harmonogramowania zasobów32. Jednak w dynamicznym harmonogramowaniu działań związkowych niewiele opracowań odnosi się do połączenia różnorodnych typów działań i złożonych ograniczeń zasobowych. W niektórych badaniach wykorzystano grafowe sieci neuronowe do modelowania zależności między zasobami a zadaniami, co pozwoliło poprawić dokładność identyfikacji konfliktów33,34. Część naukowców optymalizowała harmonogramowanie zasobów w oparciu o obliczenia krawędziowe (edge computing), aby zwiększyć wydajność i sprawność modelu35,36. Metody te wykazują jednak ograniczone możliwości modelowania kontekstu czasowego. W związku z tym w niniejszej pracy zaproponowano wykorzystanie Transformera do kodowania sekwencji historycznych działań i stanów zasobów w połączeniu z siecią polityki PPO, aby uzyskać wysoką percepcję ryzyk konfliktowych oraz stabilną aktualizację strategii harmonogramowania w celu sprostania zmiennym i złożonym potrzebom planowania działań związkowych.
W nowszych badaniach optymalizacja szeregowania zasobów była analizowana z różnych perspektyw, takich jak konsolidacja maszyn wirtualnych (VM) w celu zwiększenia efektywności energetycznej w obliczeniach chmurowych37, algorytmy uwierzytelniania w sieciach komórkowych38, ulepszona konsolidacja VM z migracją na żywo dla zrównoważonych obliczeń chmurowych39, optymalizacja ruchu przy użyciu przewidywania czasu oczekiwania i algorytmów ewolucyjnych40 oraz oparta na blockchain przechowalnia chmurowa z ulepszoną optymalizacją i zachowaniem integralności41. Choć prace te dostarczają cennych informacji na temat alokacji zasobów i algorytmów optymalizacji, koncentrują się one głównie na infrastrukturze chmurowej, telekomunikacji lub systemach przechowywania danych i nie odnoszą się bezpośrednio do ograniczeń dotyczących wielu typów aktywności, dynamicznych konfliktów zasobów personelu i miejsc oraz wymagań dotyczących szeregowania w czasie rzeczywistym, które są nieodłącznym elementem zarządzania działalnością związkową. Rozbieżność ta dodatkowo podkreśla potrzebę stworzenia dedykowanego systemu szeregowania, dostosowanego do kontekstu organizacyjnego działań związkowych.
Istniejące metody planowania działań związkowych często nie oddają długoterminowych zależności czasoprzestrzennych i nie zapewniają stabilności polityki w obliczu dynamicznych zmian, co prowadzi do powolnego czasu reakcji i częstych konfliktów zasobów. Aby wypełnić te luki badawcze, w niniejszym badaniu zaproponowano model optymalizacji harmonogramowania oparty na zasadzie, że wielogłowicowy mechanizm uwagi (multi-head attention) Transformera może skutecznie kodować sekwencje historyczne w celu przewidywania konfliktów, a Optymalizacja Bliskiej Polityki (PPO) z przyciętą funkcją celu zapewnia stabilne i adaptacyjne aktualizacje polityki. W szczególności Transformer został zastosowany do kodowania sekwencji stanu aktywności i zasobów, wyodrębniając kluczowe cechy czasoprzestrzenne w celu zwiększenia przewidywania konfliktów, natomiast PPO połączono z tym procesem dla wydajnego generowania działań harmonogramowania i stabilnych aktualizacji. Zaprojektowano zunifikowaną macierz ograniczeń do mapowania aktywności, personelu i obiektów, co poprawia rozpoznawanie złożonych zależności. Główne innowacje niniejszej pracy obejmują: (1) integrację kodowania czasowego i uczenia przez wzmacnianie specyficznie dla planowania działań związkowych; (2) mechanizm uwagi uwzględniający konflikty, który priorytetyzuje postrzeganie ryzyka; oraz (3) aktualizację z pruningiem z korekcją funkcji przewagi (advantage function), aby zapewnić odporność strategii przy wysokiej współbieżności. Obszerne eksperymenty przy różnych gęstościach i stopniu złożoności zadań potwierdzają przewagę modelu nad istniejącymi metodami w zakresie szybkości reakcji, wykorzystania zasobów i stabilności, dostarczając praktyczne i skalowalne inteligentne rozwiązanie do zarządzania harmonogramowaniem działań związkowych.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Rysunek 1 przedstawia strukturę systemu harmonogramowania działań związkowych, który integruje modelowanie szeregów czasowych i uczenie ze wzmocnieniem. Warstwa wejściowa integruje harmonogramy działań, dostępność zasobów oraz informacje o oknach czasowych personelu, a następnie konstruuje wielowymiarową macierz relacji konfliktów zadań i zasobów za pomocą modułu grafu ograniczeń. Transformer wykonuje kodowanie z wielogłowicową uwagą (multi-head attention) nad historyczną sekwencją stanów działań i zasobów, generując stany ukryte z zależnościami czasowymi. Moduł strategii wykorzystuje wyniki kodowania do generowania rozkładów działań i estymacji stanu, a następnie podejmuje decyzje o harmonogramowaniu po próbkowaniu działań. Wyniki wykonania są przekazywane z powrotem do środowiska, co aktualizuje status zasobów i generuje natychmiastowe nagrody. Na tej podstawie moduł optymalizacji konstruuje funkcję celu z przycinaniem (clipping objective function), ocenia funkcję przewagi i koryguje estymację sieci wartości, aby ograniczyć dryf strategii i zapewnić stabilne aktualizacje zachowań harmonogramowania. Pomiędzy modułami tworzona jest zamknięta pętla danych, aby osiągnąć wysoką czułość postrzegania konfliktów zasobów i adaptacyjne aktualizacje strategii w dynamicznych środowiskach, co poprawia zdolność inteligentnego reagowania i efektywność alokacji zasobów systemu harmonogramowania działań związkowych w scenariuszach wielozadaniowych i silnie ograniczonych.
Modelowanie scenariuszy harmonogramowania aktywności związkowych
Wszystkie zapytania o aktywności w systemie harmonogramowania są zorganizowane w dyskretne sekwencje harmonogramowania oparte na krokach czasowych. Każda aktywność jest zdefiniowana za pomocą określonych czasów rozpoczęcia i zakończenia, kategorii zasobów, etapów oraz poziomów priorytetu. Status wykorzystania obiektu jest modelowany jako dwuwymiarowa macierz slotów czasowych, w której oś pozioma reprezentuje ustandaryzowaną jednostkę czasu, a oś pionowa reprezentuje numer zasobu przestrzennego. Status zasobów jest oznaczany jako dostępny lub zajęty, tworząc początkową mapę rozkładu zasobów o strukturze statycznej. Informacje dotyczące harmonogramowania personelu są rozszerzone w wymiarze czasowo-tożsamościowym w celu zbudowania ciągłego wektora okien czasowych, z których każdy rejestruje status zadania-bezczynności personelu oraz numer działu. Wszystkie informacje wejściowe są zintegrowane w trójwymiarową strukturę tensora, gdzie denotes dyskretny krok czasowy, denotes liczbę jednostek zasobów, a denotes odpowiadający kod atrybutu wykorzystania zasobów (np. czy zasób jest zajęty, numer aktywności, priorytet wykorzystania itp.). Struktura ta pozwala systemowi harmonogramowania na odczyt konfiguracji zasobów w dowolnym momencie, zapewniając ujednoliconą reprezentację różnych typów statusów zasobów.
Po powiązaniu informacji o zadaniu z modelem, wektor intensywności zadania jest ustawiany na podstawie priorytetu aktywności i okresu wykorzystania zasobów. Kombinacje zadań, które mogą powodować konflikt, są oznaczane za pomocą metody wykrywania nakładania się okien czasowych. Kombinacje konfliktowe są konwertowane na zbiory węzłów, a zbiory krawędzi są konstruowane na podstawie wspólnych typów i okresów zasobów, aby jawnie przedstawić ukryte zależności. Ostatecznie skonstruowany graf zadań zawiera informacje graniczne dotyczące sekwencji czasowej, nakładania się zasobów lub konfliktów ograniczeń, stanowiąc strukturalną podstawę dla późniejszego wykrywania konfliktów i generowania strategii harmonogramowania. Struktura ta zachowuje dynamiczny charakter harmonogramowania zadań oraz ciągłe zmiany stanu zasobów, umożliwiając w czasie rzeczywistym percepcję zmian w ograniczeniach harmonogramowania.
Wykrywanie konfliktów wykorzystuje rzadkie regiony pokrywania się wymiarów czasu i zasobów w strukturze tensora jako warunki początkowe do oceny. Implementuje ono statyczne kodowanie relacji dla par zadań z pokrywającymi się celami harmonogramowania. Konstruuje ono strukturę grafu G=(V,E,C), gdzie V reprezentuje zbiór węzłów aktywnych, E reprezentuje krawędzie wygenerowane na podstawie konfliktów zasobów, a C jest macierzą kodowania wag konfliktów dla krawędzi. Funkcja wagi konfliktu jest zdefiniowana w następującej formie:
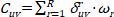 (1)
Wśród nich Cuv jest wagą konfliktu między czynnościami u i v; u, v to indeksy czynności; R to całkowita liczba typów zasobów; δuvr ∈ {0,1} wskazuje, czy okna czasowe czynności u i v nakładają się na zasobie r; ωr to waga czułości konfliktu zasobu r. Funkcja ta wykonuje ważoną sumę intensywności konfliktów, uwzględniając różnice w znaczeniu konfliktów zasobów dla wyników harmonogramowania, zachowując jednocześnie mierzalny sposób wyrażenia rozkładu siły konfliktu.
Powyższa struktura grafu konfliktów zostaje przekształcona w macierz granic ograniczeń za pomocą reprezentacji macierzy rzadkiej. Każdy element macierzy zawiera stopień konfliktu zasobów. Macierz ta jest osadzona w procesie podejmowania decyzji o harmonogramowaniu, aby określić, czy zadania mogą być wykonywane równolegle, podczas gdy logika ekranowania działań znajduje się w sieci polityk. Aby poradzić sobie z okresową agregacją aktywności i dużym zagęszczeniem gwałtownych wzrostów liczby zadań, zaimplementowano mechanizm dynamicznej aktualizacji w celu monitorowania zmian w statusie zadań i modyfikowania zawartości macierzy w czasie rzeczywistym w miarę zwalniania lub dodawania zasobów, co zapewnia ciągłość i spójność granic harmonogramowania w całym procesie ewolucji zadań.
Zastosowanie tej struktury grafu konfliktów umożliwia systemowi harmonogramowania wizualne modelowanie potencjalnych wąskich gardeł w zasobach oraz wzorców nakładania się zadań, co poprawia efektywność analizy rozsprzęgającej sieci decyzyjnej w przypadku złożonych scenariuszy ograniczeń. Zachowanie systemu harmonogramowania nie opiera się już na logice dopasowania opartej na regułach. Zamiast tego poszukuje on optymalnej ścieżki w przestrzeni ograniczeń, co zwiększa zdolność do dynamicznego równoważenia lokalnych konfliktów zasobów z globalnym planem zadań. System może zachować stabilność harmonogramowania i spójność zadań w środowisku, w którym zasoby ulegają wahaniom, a zadania są często dodawane lub usuwane.
Rysunek 2 przedstawia schemat struktury sieci oparty na relacjach wag konfliktu zadań. Każdy węzeł na rysunku reprezentuje zadanie do zaplanowania, a linie między węzłami wskazują konflikty w wykorzystaniu zasobów. Grubość krawędzi odzwierciedla wagę konfliktu. Im poważniejszy konflikt, tym grubsza linia. Obliczenie wagi integruje nakładanie się zasobów i łączy czułość konfliktową różnych zasobów, aby utworzyć złożoną intensywność konfliktu między zadaniami. Struktura grafu ujawnia, że niektóre zadania tworzą obszary gęsto połączone, co wskazuje na znaczną konkurencję o wykorzystanie zasobów. Ten rodzaj lokalnego zjawiska agregacji konfliktów jest głównym źródłem wąskich gardeł w zasobach i opóźnień zadań w procesie harmonogramowania, a algorytm szeregowania może odpowiednio wyznaczyć cele mediacji priorytetów. Układ węzłów wykorzystuje strategię rozmieszczenia sterowanego siłami (force-directed layout), aby automatycznie agregować zadania o wysokim stopniu konfliktu, co pozwala systemowi szeregowania zidentyfikować kluczowe grupy zadań i zoptymalizować rozkład strategii, zwiększając tym samym ogólną spójność szeregowania i koordynację zasobów.
Kodowanie historycznej sekwencji stanów
W oparciu o skonstruowany graf konfliktów i macierz ograniczeń, kolejnym krokiem jest zakodowanie historycznych sekwencji działań i stanów zasobów, aby można było wyodrębnić wzorce czasowe leżące u podstaw tych ograniczeń do późniejszego podejmowania decyzji. Kluczowe informacje w scenariuszu harmonogramowania obejmują zapytania o działania, zmiany stanu zasobów oraz zapisy informacji zwrotnych o zadaniach. Informacje te stanowią wiele heterogenicznych szeregów czasowych, odpowiadających takim atrybutom jak punkty czasowe zdarzeń, identyfikatory wykorzystania zasobów oraz status wykonania działań. Aby ujednolicić strukturę przetwarzania, każdy typ danych wejściowych jest kodowany jako sekwencja wektorów o tej samej długości, a w celu zapewnienia wyrównania stanów podczas synchronizacji czasu ustanawia się ujednolicony indeks czasowy. Jednostka wejściowa w każdym momencie jest reprezentowana przez konkatenację trzech zestawów wektorów cech: wektor cech działań reprezentuje typ zadania, priorytet i numer etapu; wektor cech zasobów rejestruje bieżące zajętość zasobów, pozostałą pojemność i pozycję dostępnego okna; wektor cech informacji zwrotnej opisuje, czy zadanie zostało pomyślnie wykonane w poprzednim momencie oraz czy wystąpił konflikt zasobów lub zdarzenie opóźnienia.
Wszystkie cechy są transformowane liniowo i odwzorowane na tę samą przestrzeń wymiarową w celu uzyskania zestandaryzowanej macierzy zanurzeń X ∈ ℝT×d, gdzie T oznacza liczbę kroków czasowych, a d jest ujednoliconym wymiarem zanurzenia. Aby zachować strukturę czasową, macierz wejściowa jest dodawana element po elemencie do macierzy kodowania pozycji P, tworząc wejście uwzględniające pozycję:
Z = X + P (2)
Z jest końcową sekwencją wejściową, która służy jako wejście do następnego mechanizmu uwagi. Projekt kodowania pozycji wykorzystuje stały szablon funkcji sinus i cosinus, aby zapobiec wyciekowi informacji z przyszłości i zapewnić ścisłe przestrzeganie więzów przyczynowości podczas kodowania. Powyższa struktura umożliwia modelowi jednoczesne postrzeganie charakterystyki zadań, stanu zasobów oraz pozycji czasowej. Posiada ona pełną podstawę pamięci stanu, zapewniając wysoką rozdzielczość i ujednoliconą strukturę dla późniejszego mechanizmu uwagi.
Moduł uwagi przetwarza sekwencję wejściową w celu uchwycenia potencjalnych relacji pomiędzy wieloma krokami czasowymi. Wykorzystuje się wiele grup głów uwagi do oddzielnego przetwarzania sekwencji, co zwiększa czułość modelu na różne typy ścieżek ewolucji stanów. Każda głowa uwagi generuje z sekwencji wejściowej macierz zapytań Q, macierz kluczy K oraz macierz wartości V, oblicza macierz rozkładu wag i generuje reprezentację ważoną. Wyjście z pojedynczej głowy uwagi definiuje się jako:
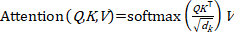 (3)
dk jest liczbą wymiarów cech na głowicę. W tym wzorze, QK⊤ reprezentuje podobieństwo między momentami, √dk stosuje się w celu zapewnienia stabilności numerycznej, a funkcja softmax zapewnia normalizację wag. Różne głowice uwagi skupiają się na różnych kombinacjach kroków czasowych, a przechwytywane przez nie dynamiczne zależności są zróżnicowane, co pomaga w ujawnieniu niejawnych reguł, takich jak prekursory konfliktów zadań, wzorce zużycia zasobów oraz nietypowe trendy sprzężeń zwrotnych.
Wszystkie wyjścia głowic uwagi są łączone i przekazywane przez warstwę transformacji liniowej w celu wygenerowania zunifikowanej sekwencji kodującej, która służy jako wejście stanu dla sieci generującej strategię harmonogramowania. Sekwencja ta osadza trajektorię zachowania zadań, charakterystykę zmian zasobów oraz wpływ poprzednich odchyleń wykonania w bieżącym oknie harmonogramowania, skutecznie rozwiązując problem wysokiej zależności historycznej w zachowaniach harmonogramowania i rzadkiej ekspresji cech. W warstwie wyjściowej kodowania włączono moduły połączeń rezydualnych oraz normalizacji warstwowej, aby zwiększyć stabilność treningu i zdolność głębokiej sieci do zachowania ekspresji.
Sekwencja wyjściowych stanów ukrytych nie tylko zachowuje informacje o ewolucji czasowej, ale także reaguje na zmiany wynikające z nagłych zadań lub tymczasowych niedopasowań zasobów, wykazując silną zdolność adaptacyjną. Taka konstrukcja strukturalna pozwala uniknąć jawnego definiowania reguł, umożliwia ustrukturyzowane modelowanie dynamicznych środowisk harmonogramowania oraz wspiera kolejne moduły polityki w generowaniu rozwiązań harmonogramowania o globalnej spójności i lokalnej adaptacyjności w warunkach wielokryterialnych.
Generowanie dynamicznej strategii harmonogramowania
Zakodowane sekwencje stanów ukrytych, zawierające zarówno zależności czasowe, jak i informacje o konfliktach zasobów, są następnie wprowadzane do sieci polityki w celu wygenerowania działań harmonogramowania dostosowanych do aktualnego środowiska. Sekwencja stanów ukrytych wyjściowa z modułu kodującego służy jako wejście dla sieci strategii harmonogramowania. Zbiór wektorów stanu w każdym momencie stanowi wyraz obserwacji aktualnego środowiska, obejmując ewolucję charakterystyki zadań, trendy wykorzystania zasobów oraz historyczne trajektorie sprzężeń zwrotnych. Wymiar reprezentacji stanu oraz długość okna czasowego są stałe, a ciągłość zmian stanu jest rejestrowana za pomocą mechanizmu przesuwnej aktualizacji. Przed przesłaniem wektora stanu do sieci polityki jest on normalizowany i reorganizowany pod kątem cech, aby zapewnić, że wejście utrzymuje stabilny rozkład numeryczny w przestrzeni wysokowymiarowej, co redukuje eksplozję gradientu i fluktuacje zbieżności.
Struktura sieci polityki wykorzystuje dwuodnogowy moduł wyjściowy, w którym jedna odnoga generuje rozkład działań, a druga wyjściem jest estymata funkcji wartości stanu. Przestrzeń działań obejmuje wszystkie zadania możliwe do zaplanowania oraz zasoby możliwe do przydzielenia. Mechanizm selekcji kandydatów odfiltrowuje nielegalne lub redundantne kombinacje operacji, tworząc ograniczony, dopuszczalny zbiór działań. Odnoga polityki generuje rozkład prawdopodobieństwa π(at|st), gdzie at reprezentuje działanie planistyczne w danym kroku czasowym, a st jest aktualnym wejściem stanu. Do wyboru działań z rozkładu w celu faktycznego planowania stosowana jest ustandaryzowana strategia próbkowania Gaussa lub próbkowania softmax. Drugim wyjściem jest estymata funkcji wartości stanu, która reprezentuje oczekiwaną długoterminową nagrodę w danym stanie i służy do ewaluacji oraz aktualizacji polityki.
W sieci polityki warstwa ukryta stosuje funkcje aktywacji oraz normalizację wsadową, aby poprawić nieliniową ekspresyjność i przyspieszyć zbieżność sieci. W procesie podejmowania decyzji priorytet wykonania, koszt harmonogramowania zasobów oraz historyczna wydajność różnych zadań są traktowane jako czynniki uwagi i stosowane w mechanizmie wyboru akcji za pomocą specyficznej macierzy wag, tworząc adaptacyjnie regulowaną strukturę wyjściową polityki. Taka konstrukcja pozwala uniknąć polegania na sztywnych regułach, zwiększając tym samym elastyczność strategii w radzeniu sobie z nagłymi konfliktami i wąskimi gardłami strukturalnymi.
Strategia harmonogramowania wykorzystuje mechanizm losowego próbkowania do generowania rzeczywistej sekwencji działań. W każdym cyklu harmonogramowania z aktualnego rozkładu działań próbkowane jest działanie do wykonania, a następnie aktualizowany jest status zasobów oraz znacznik węzła zadania. Po wykonaniu działania system oblicza bezpośrednią nagrodę zwrotną na podstawie zmian w zasobach i wyników postępu zadań, aby zmierzyć wpływ tej rundy harmonogramowania na cel ogólny. Projekt nagrody uwzględnia wiele wymiarów, w tym wskaźnik ukończenia zadań, efektywność wykorzystania zasobów oraz stopień tłumienia konfliktów. Moduł ten przekazuje informację zwrotną do modułu aktualizacji strategii za pomocą kompleksowych wskaźników.
Cały proces harmonogramowania konstruuje łańcuch decyzyjny Markowa i wykorzystuje metodę empirycznego próbkowania trajektorii do zapisu sekwencji stan-działanie-nagroda, oznaczonej jako (st, at, rt, st+1). Optymalizacja strategii opiera się na konstrukcji funkcji przewagi, w której szacunek przewagi jest zdefiniowany w następującej formie:
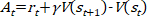 (4)
At oznacza wartość przewagi, rt to aktualna natychmiastowa nagroda, γ to czynnik dyskontujący nagrodę, a V(st) i V(st+1) to wyjściowe wartości funkcji wartości stanu odpowiednio w stanie aktualnym i następnym. Funkcja przewagi odzwierciedla stopień przewagi aktualnego działania w stosunku do średniego wyniku strategii. Jest ona wykorzystywana do kierowania późniejszą optymalizacją strategii. Jeśli At > 0, oznacza to, że aktualne działanie jest lepsze od średnich oczekiwań i jego prawdopodobieństwo powinno zostać zwiększone; w przeciwnym razie tendencja do jego wyboru powinna zostać zmniejszona.
Podczas procesu aktualizacji strategii, aby uniknąć oscylacji strategii spowodowanych nadmiernymi amplitudami aktualizacji, stosuje się mechanizm ucinania rozkładu docelowego w celu ograniczenia zakresu zmian między nową a starą strategią, co pozwala na zachowanie ciągłości i stabilności wyjścia sieci. Ustanowiono ścisłe powiązanie między rozkładem działań a nagrodą zwrotną, co umożliwia strategii natychmiastową reakcję na zmiany w złożonych ograniczeniach. Mechanizm ten zapewnia stabilność podejmowania decyzji i racjonalne harmonogramowanie zasobów w sytuacjach, gdy zadania często ulegają zmianie lub dochodzi do nagłego niedopasowania zasobów, skutecznie zapobiegając takim problemom jak dublowanie alokacji, przeciążenie zasobów czy zatory w kolejkach zadań. System harmonogramowania może utrzymywać lepszy stan operacyjny przy różnej gęstości zadań i niedoborach zasobów, wykazując silne zdolności adaptacyjne.
Iteracja strategii i mechanizm stabilnej aktualizacji
Aby zapewnić, że generowane strategie harmonogramowania pozostają stabilne i nie ulegają degradacji w kolejnych rundach treningowych, w tej podsekcji wprowadzono iteracyjny mechanizm aktualizacji z przycinaniem (clipping) i korektą przewagi (advantage correction). Ustalono interwał aktualizacji ucięcia między strategią starą a nową oraz zastosowano funkcję celu z przycinaniem, aby ograniczyć dryf strategii i zapobiec wstrząsom w harmonogramowaniu podczas procesu aktualizacji strategii. Sieć wyceny jest korygowana w połączeniu z funkcją przewagi w celu poprawy dokładności długoterminowego harmonogramowania.
Rozkład prawdopodobieństwa wyjścia akcji sieci polityki jest podatny na gwałtowne wahania podczas ciągłych iteracji harmonogramowania, co może prowadzić do niestabilnego zachowania lub nieuporządkowanej alokacji zasobów. Aby złagodzić szok harmonogramowania spowodowany dryfem polityki, zaprojektowano skrócony interwał aktualizacji w celu kontrolowania zakresu zmian między nową a starą polityką oraz skonstruowano człon ograniczający, aby doprecyzować funkcję celu. Historyczne prawdopodobieństwo polityki jest zapisywane w rundzie próbkowania, a następnie tworzony jest człon proporcji z aktualnym prawdopodobieństwem polityki. Cel aktualizacji polityki został określony jako:
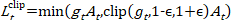 (5)
Tutaj gt = πθ(at|st)/πθold(at|st) oznacza stosunek prawdopodobieństwa między nową a starą polityką; ε to próg przycinania, który ogranicza zakres aktualizacji polityki. Gdy stosunek przekroczy tę granicę, zamiast niego stosowana jest wartość przycinania, aby zapobiec generowaniu przez strategię nadmiernych gradientów z ekstremalnych próbek, co zapewnia, że korekta parametrów sieci pozostaje w zadanym zakresie. Taka struktura dynamicznie ogranicza zakres zmian w strategii wyjściowej dla każdej rundy planowania, utrzymując gładkość i spójność wyjścia strategii przy gęstych rozkładach zadań oraz znacząco redukując stopień niestabilności zachowania planowania.
Funkcja celu strategii jest rozszerzona o wyrazy regularyzacji oraz nagrody za entropię podczas procesu aktualizacji, aby zwiększyć różnorodność rozkładu działań i zapobiec przedwczesnej zbieżności. Każda runda aktualizacji strategii wykorzystuje wiele partii próbek trajektorii doświadczeń do treningu kroczącego, co pozwala na utrzymanie szerokiego zakresu pokrycia przestrzeni stanów. Po porównaniu rozkładu prawdopodobieństwa sekwencji działań wyjściowych przed i po aktualizacji obliczana jest stopa odchylenia rozkładu, a sztywny próg odfiltrowuje dopuszczalny zakres zaburzeń strategii. Mechanizm ten zapewnia kontrolę granic dla migracji strategii harmonogramowania między cyklami, co zapobiega przeuczeniu wynikającemu z gwałtownych zmian w stanie zasobów.
Aktualizacje strategii opierają się na ocenie stanu dostarczonej przez funkcję wartości. Odchylenia w szacowaniu wartości stanu mogą bezpośrednio wpływać na poprawność funkcji przewagi, zmieniając tym samym kierunek iteracji strategii. Aby poprawić dokładność wyceny, skonstruowano mechanizm powrotny dla wielu szeregów czasowych, a zdyskontowana skumulowana wartość przyszłych nagród jest wykorzystywana do korekty aktualnej wartości stanu. Nagroda powrotna przyjmuje strukturę Uogólnionej Estymacji Przewagi (GAE), która jest zdefiniowana jako:
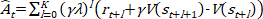 (6)
Ât to skorygowana wartość przewagi; λ to współczynnik równowagi backtrackingu; rt+l reprezentuje natychmiastową nagrodę w kroku (t+l); V(st+l) to wartość stanu wyjściowa z sieci wyceny. Struktura ta integruje krótkoterminową, natychmiastową informację zwrotną oraz długoterminowe oczekiwania dotyczące stanu, aby korygować odchylenia w przewidywaniach odpowiedzi strategii na przyszłe konflikty zasobów, szczytowe obciążenia i akumulację zadań. λ kontroluje głębokość backtrackingu i automatycznie dostosowuje się podczas okresów gwałtownych wahań dynamiki zasobów, aby zwiększyć odporność reakcji sieci wyceny na zdarzenia nagłe.
Wieloskalowa struktura zależna od czasu, osadzona w funkcji przewagi, umożliwia sieci oceniającej modelowanie długoterminowych trendów zasobów. W celu wykrycia odchyleń w wyjściu polityki stosowany jest indeks spójności zachowania polityki, który pozwala ocenić, czy sieć wykazuje nadmierną reakcję na błąd oceny. Reszty różnicowe sprzężenia zwrotnego monitorują zachowanie aktualizacji polityki, a cel treningowy oraz amplituda aktualizacji wag funkcji wartości są dynamicznie korygowane. Sieć wartości i sieć polityki są optymalizowane wspólnie, aby zapewnić, że szacowanie wartości nie odbiega od celu ukończenia zadania, zapobiegając jednocześnie błędnej ocenie stanu konfliktów zasobów przez wysokoczęstotliwościowe harmonogramowanie.
Ten stabilny mechanizm aktualizacji polityki pozwala skutecznie utrzymać sterowalność i spójność aktualizacji zachowań polityki w wysokowymiarowym dynamicznym środowisku zadań, zwiększając efektywność pokrycia zadań oraz elastyczność wykorzystania zasobów, co tworzy strukturę inteligentnego harmonogramowania o charakterze ciągle iteracyjnym. Zachowanie harmonogramowania zapobiega wpadaniu w optima lokalne w długoterminowej ewolucji i zwiększa ogólną zdolność adaptacji do zmian w schematach zadań oraz fluktuacji w cyklach zasobów.
Rysunek 3A przedstawia trend wartości funkcji celu w zależności od liczby iteracji treningowych przy różnych warunkach progu ucinania. Oś pozioma reprezentuje liczbę iteracji treningowych, a oś pionowa numeryczną wartość przyciętej funkcji celu. Wartość ε została ustawiona na 0,1, 0,2 i 0,3, co reprezentuje różne stopnie siły kontroli dryfu strategii. Krzywa odpowiadająca mniejszej wartości ε wykazuje mniejsze wahania, a funkcja celu pozostaje stabilna. Przy ε = 0,1 całkowita wartość funkcji celu mieści się w przedziale od 0,8 do 1, co wskazuje na stopniowy i stabilny charakter aktualizacji strategii. Jednak większa wartość ε prowadzi do wyraźnych fluktuacji. Przy ε = 0,3 całkowita wartość funkcji celu mieści się w przedziale od 0,65 do 0,95, a krzywa funkcji celu wykazuje większą amplitudę oscylacji, co odzwierciedla ryzyko poważnego odchylenia w procesie aktualizacji strategii. Im mniejszy próg, tym bardziej stabilna jest strategia, co jest odpowiednie dla środowisk harmonogramowania o wysokich ograniczeniach. Rysunek 3B pokazuje zmiany w uogólnionej ocenie przewagi (generalized advantage estimate) przy różnych współczynnikach równowagi cofania. Wartość λ została ustawiona odpowiednio na 0,8, 0,9 i 1,0 w celu kontrolowania głębokości cofania przyszłych nagród. Krzywa pokazuje, że im wyższa wartość λ, tym mniejsze fluktuacje GAE, gładszy trend długoterminowy i dokładniejsze uchwycenie potencjalnego wpływu zachowań harmonogramowania po wielu krokach. Krzywa dla λ = 0,8 wykazuje wyraźne fluktuacje okresowe, co wskazuje na większą wrażliwość na natychmiastowe nagrody i lepsze dopasowanie do krótkoterminowych, nagłych zadań. W przeciwieństwie do tego, λ = 1,0 koncentruje się bardziej na modelowaniu trendów długoterminowych i jest odpowiednie dla scenariuszy zadań okresowych.
Analiza złożoności obliczeniowej i skalowalności
Złożoność obliczeniowa proponowanego frameworka Transformer-PPO jest określona przez dwa główne komponenty: enkoder Transformer oraz optymalizację polityki PPO.
Dla koderem Transformera z L warstwami, H głowicami uwagi, wymiarem osadzenia d i długością sekwencji wejściowej T (historycznym oknem czasowym), złożoność czasowa jednego przejścia w przód wynosi O(L·T2·d + L·T·d2), gdzie człon T2 wynika z mechanizmu samo-uwagi (self-attention). W implementacji przyjęto L = 3, H = 4, d = 128, a T zostało ustalone na 100 kroków czasowych, co skutkuje możliwym do opanowania obciążeniem obliczeniowym. W przypadku dłuższych okien historycznych człon kwadratowy T2 staje się czynnikiem dominującym; jednak w praktyce planowanie aktywności związkowej zazwyczaj obejmuje skończone horyzonty historyczne (np. kwartalne lub roczne okna przesuwne), a rozdzielczość kroków czasowych można dostosować, aby zrównoważyć dokładność i wydajność.
W przypadku komponentu PPO sieć polityki oraz sieć wartości to lekkie sieci MLP (po 256 i 128 neuronów w warstwie ukrytej), których złożoność wnioskowania wynosi O(d·m), gdzie m to liczba jednostek ukrytych, co jest wartością pomijalną w porównaniu z koderem Transformera. Aktualizacja polityki podczas uczenia obejmuje wiele epok aktualizacji gradientu dla mini-batchy, o złożoności O(B·E·d2), gdzie B to rozmiar partii (batch size), a E to liczba epok aktualizacji.
Pod względem skalowalności struktura ta wykazuje trzy korzystne właściwości. Po pierwsze, mechanizm uwagi może być zrównoleglony w krokach czasowych, co umożliwia wydajną akcelerację GPU. Po drugie, rozmiar modelu jest niezależny od liczby aktywności lub zasobów, ponieważ macierz ograniczeń jest konstruowana dynamicznie dla każdego kroku harmonogramowania, a nie osadzona jako stałe parametry. Pozwala to na wdrożenie tego samego wytrenowanego modelu w związkach o różnych skalach bez konieczności ponownego trenowania. Po trzecie, w scenariuszach o ekstremalnie dużej skali, długość okna historycznego T oraz wymiar osadzenia d mogą zostać zmniejszone jako kompromis, lub można zastosować wariant rzadkiej uwagi (sparse attention), aby zredukować złożoność z O(T2) do O(T log T) lub O(T).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Dane eksperymentalne
Aby kompleksowo ocenić wydajność przedstawionego w niniejszej pracy algorytmu dynamicznego harmonogramowania Transformer-PPO, w eksperymencie wykorzystano jako zbiór danych referencyjnych dane dotyczące zarządzania aktywnościami z dużego związku przedsiębiorstwa z ostatnich trzech lat. Zbiór ten zawiera ponad 5 000 rekordów aktywności obejmujących różne typy, w tym spotkania, szkolenia i rozrywkę, wraz z informacjami o harmonogramowaniu wielu zasobów, takich jak sale, sprzęt i pe...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Wyniki eksperymentalne wykazują, że proponowany algorytm Transformer-PPO konsekwentnie przewyższa metody bazowe (LSTM-PPO, greedy search oraz DQN) we wszystkich metrykach oceny. Wyższa wydajność wynika z dwóch kluczowych czynników. Po pierwsze, mechanizm wielogłowicowej uwagi (multi-head self-attention) modelu Transformer skutecznie wychwytuje długoterminowe zależności czasowe w sekwencjach aktywności i stanów zasobów, co umożliwia proaktywną identyfikację potencjalnych konfliktów. Wyjaśnia to, dlaczego wskaźnik konflikt...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy oświadczają, że nie występuje u nich konflikt interesów finansowych.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Python 3.9 | Python Software Foundation | https://www.python.org/downloads/release/python-390/ | Podstawowy język programowania |
| PyTorch 1.12 | Meta AI | https://pytorch.org/get-started/previous-versions/ | Framework głębokiego uczenia (implementacja Transformer/PPO) |
| NumPy 1.23 | NumPy Developers | https://numpy.org/doc/stable/release/1.23.0-notes.html | Biblioteka obliczeń numerycznych |
| Matplotlib 3.5 | Matplotlib Development Team | https://matplotlib.org/stable/users/installing.html | Wizualizacja wyników |
| Zbiór danych harmonogramowania działań związkowych | Wewnętrzna baza danych współpracującego przedsiębiorstwa (zanonimizowana) | Niedostępny publicznie ze względu na umowę poufności; badacze mogą kontaktować się z autorem korespondencyjnym w celu uzyskania dostępu | Ponad 5 000 zapisów aktywności (spotkania, szkolenia, rozrywka) z dużego związku zawodowego w przedsiębiorstwie z okresu trzech lat |
| NVIDIA A100 GPU | |||
| PyTorch |
Bibliografia
- Bosire RK, Muya J, Matula D. Employee recognition programs and employee output as moderated by workers’ union activities: evidence from Kenyatta National Hospital (KNH), Kenya. Saudi J Bus Manag Stud. 2021;6(3):61-70.
- Carneiro B, Costa HA. Digital unionism as a renewal strategy? Social media use by trade union confederations. J Ind Relat. 2022;64(1):26-51.
- Geelan T. Introduction to the special issue: the internet, social media and trade union revitalization—still behind the digital curve or catching up? New Technol Work Employ. 2021;36(2):123-39.
- Hennebert MA, Pasquier V, Lévesque C. What do unions do…with digital technologies? An affordance approach. New Technol Work Employ. 2021;36(2):177-200.
- Panagiotopoulos P. Digital audiences of union organising: a social media analysis. New Technol Work Employ. 2021;36(2):201-18.
- Wang W, Seifert R. Trade-union-engendered employee trust in senior management: a case study of digitalisation. Ind Relat J. 2024;55(6):472-91.
- Katsabian T. Collective action in the digital reality: the case of platform-based workers. Mod Law Rev. 2021;84(5):1005-40.
- Holgate J. Trade unions in the community: building broad spaces of solidarity. Econ Ind Democr. 2021;42(2):226-47.
- Ovi RP, Rana MS, Jodder PK, Sarkar B. Performance evaluation of e-service delivery of union digital centers at the local level using composite indexing method: a study of Batiaghata upazilla in Khulna district. Inf Dev. 2024;40(4):620-34.
- Crossan J, et al. Colours of democracy: trade union banners and the contested articulations of democratic spatial practices. Trans Inst Br Geogr. 2023;48(1):23-38.
- Victor C, Kavishe AM. The challenges faced by trade unions in improving employee welfare and strategies to address them: a case of the Tanzania Union of Government and Health Employees (TUGHE) at the National Health Insurance Fund (NHIF). Afr J Empir Res. 2025;6(1):189-200.
- Rogalewski A. Trade unions challenges in organising Polish workers: a comparative case study of British and Swiss trade union strategies. Eur J Ind Relat. 2022;28(4):385-404.
- Pacetti V, Rossi P, Romens AI. Remotizzare, o non remotizzare: questo è il dilemma. Imprese e sindacati di fronte alla remotizzazione ibrida del lavoro. Stato Merc. 2023;43(3):421-49.
- Hunt T, Connolly H. COVID-19 and the work of trade unions: adaptation, transition and renewal. Ind Relat J. 2023;54(2):150-66.
- Joyce S, Stuart M, Forde C. Theorising labour unrest and trade unionism in the platform economy. New Technol Work Employ. 2023;38(1):21-40.
- Dupuis M. Algorithmic management and control at work in a manufacturing sector: workplace regime, union power and shopfloor conflict over digitalisation. New Technol Work Employ. 2025;40(1):81-101.
- Suryadevara S. Real-time task scheduling optimization in WirelessHART networks: challenges and solutions. Int J Adv Eng Technol Innov. 2022;1(3):29-55.
- Roşu D, Cojanu F, Ştefănică V, et al. Experimental management of work collectives through social and socialization activities. J Phys Educ Sport. 2022;22(7):1742-47.
- Ahmed AAA, et al. Multi-project scheduling and material planning using Lagrangian relaxation algorithm. Ind Eng Manag Syst. 2021;20(4):580-87.
- Gao H, et al. TBDB: token bucket-based dynamic batching for resource scheduling supporting neural network inference in intelligent consumer electronics. IEEE Trans Consum Electron. 2024;70(1):1134-44.
- Ouhame S, Hadi Y, Ullah A. An efficient forecasting approach for resource utilization in cloud data centers using a CNN-LSTM model. Neural Comput Appl. 2021;33(16):10043-55.
- Valarmathi K, Kanaga Suba Raja S. Resource utilization prediction technique in the cloud using a knowledge-based ensemble random forest with an LSTM model. Concurr Eng. 2021;29(4):396-404.
- Yang Y, Shen H. Deep reinforcement learning enhanced greedy optimization for online scheduling of batched tasks in cloud HPC systems. IEEE Trans Parallel Distrib Syst. 2022;33(11):3003-14.
- Tang B, Luo J, Obaidat MS, Vijayakumar P. Container-based task scheduling in a cloud-edge collaborative environment using a priority-aware greedy strategy. Cluster Comput. 2023;26(6):3689-705.
- Zhang Y, Zou YH, Zhang XD. Manufacturing resource scheduling based on a deep Q-network. Wuhan Univ J Nat Sci. 2022;27(6):531-38.
- Mangalampalli S, et al. DRLBTSA: deep reinforcement learning-based task-scheduling algorithm in cloud computing. Multimed Tools Appl. 2024;83(3):8359-87.
- Wang Y, Wang Q, Chu X. Energy-efficient online scheduling of transformer inference services on GPU servers. IEEE Trans Green Commun Netw. 2022;6(3):1649-59.
- Liu L, et al. Dynamic sparse attention for scalable transformer acceleration. IEEE Trans Comput. 2022;71(12):3165-78.
- He X, et al. Channel assignment and power allocation for throughput improvement with PPO in B5G heterogeneous edge networks. Digit Commun Netw. 2024;10(1):109-16.
- Liu H, et al. A new multi-domain cooperative resource scheduling method using proximal policy optimization. Neural Comput Appl. 2024;36(9):4931-45.
- Jin J, Xu Y. Optimal policy characterization enhanced proximal policy optimization for multitask scheduling in cloud computing. IEEE Internet Things J. 2022;9(9):6418-33.
- Chavva M, Veera S. Dynamic cost-aware language models: a real-time framework for optimizing cloud resource recommendations. Int J Mach Learn Sustain Dev. 2023;5(2):1-15.
- Zhao Z, et al. Link scheduling using graph neural networks. IEEE Trans Wirel Commun. 2023;22(6):3997-4012.
- Zhang Z, et al. A resource optimization scheduling model and algorithm for heterogeneous computing clusters based on GNN and RL. J Supercomput. 2024;80(16):24138-72.
- Chai F, et al. Joint multi-task offloading and resource allocation for mobile edge computing systems in satellite IoT. IEEE Trans Veh Technol. 2023;72(6):7783-95.
- Luo Q, et al. Resource scheduling in edge computing: a survey. IEEE Commun Surv Tutor. 2021;23(4):2131-65.
- Gupta A, Namasudra S, Kumar P. An enhanced strategy for energy-efficient cloud computing environment through VM consolidation. In: Dagur A, Singh K, Mehra PS, Shukla DK, editors. Intelligent Computing and Communication Techniques. Boca Raton (FL): CRC Press; 2025. p. 330–34. https://doi.org/10.1201/9781003530176-46
- Sombo B, Apeh ST, Edeoghon IA. Review on authentication algorithms in cellular communication networks. Cloud Comput Data Sci. 2025;6(1):54-66.
- Gupta A, Kumar P, Namasudra S. Sustainable cloud computing: an enhanced energy-efficient VM consolidation approach using live migration. Iran J Comput Sci. 2026;9:27. doi:10.1007/s42044-025-00385-y.
- García F, et al. Traffic optimization through waiting prediction and evolutive algorithms. Int J Interact Multimed Artif Intell. 2025;9(3):96-103.
- Sharma P, Namasudra S, Lorenz P. Blockchain-based cloud storage system with enhanced optimization and integrity preservation. Presented at: IEEE International Conference on Communications (ICC); Rome, Italy; 2023. p. 3744-49.
- Ding F, et al. Transformer-enhanced DQN approach for energy- and cost-efficient large-scale dynamic workflow scheduling in a heterogeneous environment. IEEE Internet Things J. 2024;11(22):37351-67.
- Yu H, Tang N, Zhu Z, Guo Z. Flexible job-shop scheduling via gated recurrent unit and deep reinforcement learning. Knowl Based Syst. 2025;330:114734. doi:10.1016/j.knosys.2025.114734.
- Do KH, et al. Graph Neural PPO for joint user association and resource allocation in Open RAN [conference paper]. Presented at: 40th International Conference on Information Networking (ICOIN); Hanoi, Vietnam; 2026. p. 37-42.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.