Niniejsze badanie analizuje biomarkery elektroencefalograficzne służące do rozróżniania choroby Alzheimera, otępienia czołowo-skroniowego oraz zdrowej grupy kontrolnej. Modele Random Forest wykorzystujące cechy takie jak wartość średnia kwadratowa (RMS), gęstość widmowa mocy oraz entropia zostały zinterpretowane przy użyciu wyjaśnialnej sztucznej inteligencji (XAI) i analizy wielkości efektu. Usunięcie cech entropii o niskim wpływie poprawiło wydajność klasyfikacji, pozwalając na osiągnięcie 94% dokładności testowej.
Artykuł badawczy
Fuzja biomarkerów wielodomenowej elektroencefalografii w klasyfikacji otępienia opartej na uczeniu maszynowym
W tym artykule
Podsumowanie
Streszczenie
Elektroencefalografia (EEG) była badana jako nieinwazyjna metoda charakteryzacji aktywności mózgu w stanach neurodegeneracyjnych. W niniejszym badaniu oceniono, czy wielodomenowe biomarkery EEG mogą odróżnić chorobę Alzheimera (AD), otępienie czołowo-skroniowe (FTD) oraz zdrową grupę kontrolną (HC). Publicznie dostępny zbiór danych zawierał zapisy EEG w stanie spoczynku z zamkniętymi oczami od 88 uczestników, w tym 36 osób z AD, 23 z FTD i 29 zdrowych osób z grupy kontrolnej. Do klasyfikacji za pomocą uczenia maszynowego wyodrębniono wielodomenowe biomarkery EEG oraz cechy demograficzne. Cechy pochodzące z EEG obejmowały pierwiastkową średnią kwadratową (RMS), gęstość widmową mocy (PSD) oraz miary entropii. Klasyfikator Random Forest został przeszkolony z wykorzystaniem połączonego zestawu cech i zinterpretowany za pomocą wyjaśnialnej sztucznej inteligencji. W celu oceny wkładu poszczególnych cech przeprowadzono analizy stabilności cech i wielkości efektu d Cohena, a następnie analizę ablacyjną. Cechy oparte na entropii wykazały najniższy wkład w klasyfikację. Pełny model wielodomenowy osiągnął 96% dokładności treningowej i 92% dokładności testowej. Po usunięciu cech entropijnych dokładność testowa wzrosła do 94%. Wyniki te opisują wydajność klasyfikacji wybranych wielodomenowych cech EEG i demograficznych w ramach modelu Random Forest.
Wprowadzenie
Choroba Alzheimera (AD) jest postępującym schorzeniem neurologicznym związanym z pogorszeniem funkcji poznawczych i motorycznych. Jej rozpowszechnienie znacznie wzrasta wraz z wiekiem, a otępienie stanowi główną przyczynę zachorowalności i śmiertelności wśród osób starszych1,2,3,4,5. Ze względu na to, że diagnoza i klasyfikacja choroby pozostają wyzwaniem, analizę sygnałów mózgowych badano jako metodę charakteryzacji zmian neurofizjologicznych związanych z otępieniem.
Elektroencefalografia (EEG) jest nieinwazyjną metodą rejestracji aktywności elektrycznej mózgu, która była badana w chorobie Alzheimera oraz innych zaburzeniach neurologicznych6,7,8,9,10,11. Sygnały EEG odzwierciedlają potencjały elektryczne generowane przez aktywność neuronalną i są rejestrowane nieinwazyjnie z wielu miejsc na skórze głowy12,13,14. Aktywność mózgu jest zazwyczaj charakteryzowana za pomocą pasm częstotliwości delta, theta, alfa, beta i gamma15. Choroba Alzheimera była wiązana z spowolnieniem EEG, zmniejszoną złożonością sygnału oraz zaburzoną synchronizacją16. Analizy spektralne wykazały zwiększoną aktywność w pasmach delta i theta wraz ze zmniejszoną aktywnością w pasmach alfa i beta u osób z AD w porównaniu z grupami kontrolnymi (HC)17,18,19. Wcześniejsze badania nad klasyfikacją EEG wykazały wysoką skuteczność w rozróżnianiu AD od zdrowych kontroli (HC) oraz otępienia czołowo-skroniowego (FTD) od HC. Z kolei różnicowanie między AD a FTD było zazwyczaj bardziej wymagające10,11.
Metody uczenia maszynowego były wykorzystywane do identyfikacji wzorców w sygnałach EEG związanych z chorobami neurologicznymi20,21. Ekstrakcja cech jest zatem istotnym elementem klasyfikacji opartej na EEG. Wcześniejsze badania analizowały cechy spektralne, czasowe, stopień złożoności oraz łączność funkcjonalną w połączeniu z modelami uczenia maszynowego3,15,22,23. Cechy spektralne są szczególnie istotne, ponieważ kwantyfikują zależne od częstotliwości zmiany w aktywności mózgu, w tym zmniejszoną aktywność alfa i zwiększoną aktywność theta zgłaszane w przebiegu AD23,24,25,26.
W kilku badaniach opartych na EEG oceniono różne kombinacje cech, klasyfikatorów i strategii walidacji. Analiza oparta na łączności była wykorzystywana do rozróżnienia AD, FTD i HC, przy czym zgłaszana skuteczność klasyfikacji różniła się w zależności od porównania i procedury wyboru cech27. Oceńiano również cechy oparte na analizie Fouriera w celu rozróżnienia AD, łagodnych zaburzeń poznawczych (MCI) i zdrowych kontroli, choć ograniczeniami były niewystarczający preprocessing oraz możliwe przeuczenie związane ze strategią walidacji28. Nieliniowe miary złożoności EEG wykazały potencjał dyskryminacyjny w klasyfikacji AD, przy czym niektóre z nich osiągnęły wysoką dokładność, czułość i swoistość, choć ich przydatność w odniesieniu do MCI i rozróżniania stadiów choroby pozostaje ograniczona21.
Metody głębokiego uczenia oparte na czasowo-częstotliwościowych reprezentacjach EEG były również badane pod kątem wieloklasowej klasyfikacji AD, MCI i HC29. Mimo raportowania wysokiej wydajności klasyfikacji, ograniczenia obejmują małe lub wyselekcjonowane kohorty, brak równowagi klas, heterogeniczną ciężkość choroby, brak zewnętrznej walidacji oraz ograniczoną interpretowalność modeli29. Strategia walidacji stanowi również istotny aspekt metodologiczny. Podejścia niezależne od uczestnika wykazały, że konwencjonalna walidacja krzyżowa na poziomie epoki może zawyżać wydajność, gdy epoki pochodzące od tego samego uczestnika znajdują się zarówno w zbiorze treningowym, jak i testowym30. Ograniczenie to jest szczególnie istotne podczas porównywania wyników klasyfikacji w badaniach wykorzystujących różne schematy walidacji.
Mierniki złożoności i łączności oceniano również za pomocą klasyfikatorów maszyn wektorów nośnych, przy czym łączność oparta na fazie oraz entropia wieloskalowa wykazały różny poziom zdolności dyskryminacyjnych31,32. Inne prace wykorzystujące cechy wyprowadzone z transformacji Fouriera i falkowej donosiły o zmiennej wydajności w porównaniach między grupami AD, MCI i HC, przy czym klasyfikacja wieloklasowa pozostaje zazwyczaj trudniejsza niż klasyfikacja binarna14. Podejścia oparte na entropii i synchronizacji wykazały ponadto zdolność do rozróżniania grup AD i kontrolnych, choć charakterystyka populacji kontrolnej może wpływać na zaobserwowaną wielkość efektu2.
Niniejsze badanie ocenia wielodomenowy zestaw cech obejmujący wartość efektywną (RMS), gęstość widmową mocy (PSD) oraz miary entropii wyodrębnione z pasm częstotliwości EEG, wraz z wiekiem jako zmienną demograficzną. RMS reprezentuje amplitudę sygnału w każdym pasmie częstotliwości, podczas gdy PSD reprezentuje moc w dziedzinie częstotliwości. Entropia została uwzględniona jako miara złożoności sygnału. Cechy te dostarczają komplementarnych opisów aktywności EEG i są oceniane za pomocą klasyfikatora Random Forest. W badaniu przeanalizowano ponadto istotność cech, ich stabilność, wyjaśnialną sztuczną inteligencję oraz analizę wielkości efektu, aby ocenić względny wkład wyodrębnionych cech. Niniejsze badanie bada skuteczność wielodomenowych cech EEG, w tym miar spektralnych, czasowych i opartych na złożoności, w odróżnianiu choroby Alzheimera (AD), otępienia czołowo-skroniowego (FTD) oraz zdrowych osób kontrolnych (HC) przy użyciu uczenia maszynowego. Badane jest również, które cechy pasm częstotliwości EEG w największym stopniu przyczyniają się do klasyfikacji przy zastosowaniu gęstości widmowej mocy (PSD), wartości efektywnej (RMS) oraz miar entropii. Ponadto badanie porównuje wkład cech opartych na mocy, w tym PSD i RMS, z wkładem cech opartych na entropii oraz ocenia wpływ wieku na model klasyfikacji.
Protokół
Schematyczny przegląd procesu przetwarzania wstępnego EEG, ekstrakcji cech i klasyfikacji przedstawiono na Rysunku 1. Materiały i oprogramowanie wykorzystane w badaniu wymieniono w Tabeli materiałów.
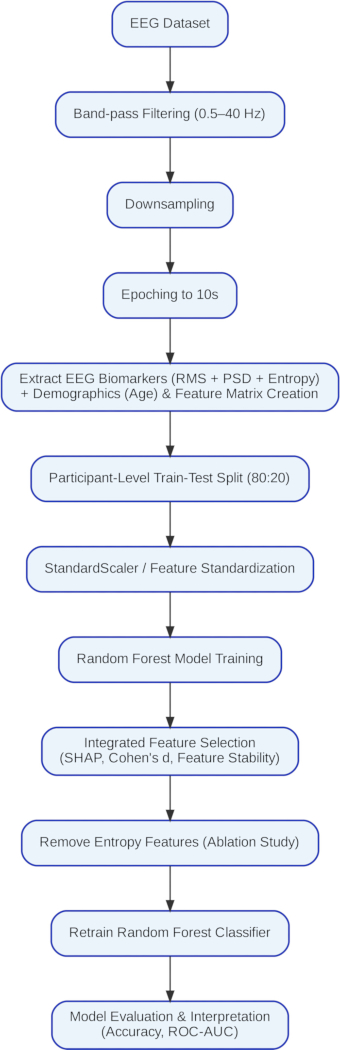
Rycina 1: Schemat procesu wstępnego przetwarzania EEG, ekstrakcji cech i klasyfikacji. Schematyczny przegląd przebiegu badania, obejmujący weryfikację danych EEG, filtrowanie pasmowo-przepustowe i ponowną referencję, ekstrakcję cech takich jak pierwiastka z średniej kwadratów (RMS), gęstość widmowa mocy (PSD) oraz entropia, dodanie wieku, podział na zbiór treningowy i testowy, opracowanie modelu Random Forest, analizę stabilności cech, analizę SHAP, analizę wielkości efektu d Cohena, zintegrowaną selekcję cech, ablację cech entropii, ponowne trenowanie modelu oraz ewaluację wydajności. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
1. Pozyskiwanie danych
Publicznie dostępny zestaw danych EEG w stanie spoczynku pobrano z repozytorium OpenNeuro (zbiór danych ds004504, wersja 1.0.9)33. Zweryfikowano etykiety uczestników oraz informacje demograficzne. Zbiór danych obejmował 88 uczestników, w tym 36 osób z chorobą Alzheimera (AD), 23 z otępieniem czołowo-skroniowym (FTD) oraz 29 zdrowych kontroli (HC).
2. Import nagrań EEG
Dla każdego uczestnika nagranie EEG zostało załadowane przy użyciu biblioteki MNE-Python. Sprawdzono każdy plik EEG, aby potwierdzić, że jest on dostępny, może zostać pomyślnie zaimportowany i zawiera poprawny identyfikator uczestnika. Nagrania z brakującymi lub uszkodzonymi plikami zostały wykluczone. Na tym etapie zachowano oryginalną częstotliwość próbkowania EEG wynoszącą 500 Hz. Sygnały poddano downsamplingowi w celu zmniejszenia obciążenia obliczeniowego, przy jednoczesnym zachowaniu wszystkich istotnych klinicznie informacji EEG dla niniejszego badania.
3. Filtrowanie pasmowo-przepustowe
Ciągłe zapisy EEG zostały przefiltrowane przy użyciu czwartorzędowego filtra pasmowo-przepustowego z dolną częstotliwością odcięcia 0.5 Hz i górną częstotliwością odcięcia 40 Hz.
4. Referencja do wspólnej średniej i epokowanie
Do przefiltrowanych zapisów EEG zastosowano referencję do wspólnej średniej (CAR). Dla każdej próbki czasu obliczano średni sygnał ze wszystkich dostępnych kanałów EEG, a następnie odejmowano go od każdego kanału. Zreferencjonowane sygnały EEG zachowano do dalszej analizy. Każdy zreferencjonowany zapis EEG podzielono na epoki o stałej długości przy użyciu funkcji make_fixed_length_epochs() w bibliotece MNE-Python. Zastosowano czas trwania epoki wynoszący 10 s z nakładaniem 0 s.
5. Walidacja epok
W przypadku każdego uczestnika zachowano jedynie pełne 10s epoki. Wszelkie pozostałe segmenty EEG krótsze niż 10 s na końcu nagrania zostały odrzucone. Każda zachowana epoka została następnie wykorzystana jako oddzielna próbka do ekstrakcji cech.
6. Przygotowanie cech
Mimo że w zbiorze źródłowym dostępne były dane z Mini-Mental State Examination (MMSE), wykluczono je z niniejszej analizy. Wyekstrahowane cechy EEG połączono z danymi demograficznymi uczestników, w tym wiekiem i etykietami diagnostycznymi, pobranymi z pliku metadanych participants.csv. Jako wspólny klucz wykorzystano identyfikator uczestnika, a zachowano jedynie tych uczestników, dla których dostępne były zarówno rekordy cech EEG, jak i odpowiadające im informacje demograficzne.
Wielodomenowa macierz cech obejmowała pięć cech pierwiastka średniokwadratowego (RMS) (delta_rms, theta_rms, alpha_rms, beta_rms i gamma_rms), pięć cech gęstości widmowej mocy (PSD) (delta_psd, theta_psd, alpha_psd, beta_psd i gamma_psd) oraz pięć cech entropii (delta_entropy, theta_entropy, alpha_entropy, beta_entropy i gamma_entropy). Wiek włączono jako uzupełniającą zmienną demograficzną. Ponieważ rozkłady wieku mogą różnić się pomiędzy grupami diagnostycznymi, nie można było całkowicie wykluczyć zakłóceń demograficznych. Grupa diagnostyczna, zdefiniowana jako AD, HC lub FTD, została przypisana jako etykieta docelowa.
7. Przetwarzanie wstępne danych i podział na zbiór treningowy i testowy
Podczas przetwarzania wstępnego częstotliwość próbkowania zapisów została zmniejszona z 500 Hz do 250 Hz w celu ograniczenia wymagań obliczeniowych przy jednoczesnym zachowaniu istotnych informacji o częstotliwościach EEG.
Zbiór danych został podzielony na podzbiory treningowy (80%) i testowy (20%) na poziomie pacjenta, stosując strategię podziału grupowanego. Przewidywania na poziomie pacjenta uzyskano następnie poprzez głosowanie większościowe spośród przewidzianych epok należących do każdego uczestnika. W głównej ewaluacji zastosowano grupowany podział na zbiór treningowy i testowy na poziomie pacjenta, aby zapobiec obecności epok tego samego uczestnika w obu podzbiorach. Przewidywania na poziomie pacjenta uzyskano poprzez głosowanie większościowe spośród przewidzianych epok należących do każdego uczestnika. Zbiór danych sprawdzono pod kątem brakujących wartości, a brakujące obserwacje usunięto lub uzupełniono (imputowano) w zależności od potrzeb. Etykiety diagnostyczne zostały zakodowane. Do danych treningowych dopasowano StandardScaler, a następnie zastosowano go zarówno do zbioru treningowego, jak i testowego.
8. Opracowanie modelu lasów losowych
Klasyfikator Random Forest zainicjowano przy użyciu 80 drzew, maksymalnej głębokości drzewa równej 10, maksymalnie czterech cech, minimum pięciu próbek na liść oraz stanu losowego 42. Klasyfikator wytrenowano z wykorzystaniem zestandaryzowanego zbioru treningowego.
9. Ocena modelu
Przewidziano etykiety klas dla zbiorów treningowego i testowego. Stworzono macierz pomyłek, a następnie obliczono dokładność, precyzję, czułość oraz wskaźnik F1 wraz z raportem klasyfikacji. Odnotowano dokładność treningową i testową.
W przypadku ewaluacji w odniesieniu do poszczególnych uczestników należy upewnić się, że wszystkie epoki danego uczestnika zostały przypisane wyłącznie do podzbioru treningowego lub testowego. Klasyfikator Random Forest został wytrenowany przy użyciu tych samych hiperparametrów, co w analizie głównej.
10. Walidacja krzyżowa
Jako dodatkowa procedura oceny modelu przeprowadzono pięciokrotną stratyfikowaną walidację krzyżową z parametrami shuffle = True oraz random_state = 30. Obliczono średnią dokładność oraz odchylenie standardowe dla pięciu podzbiorów. Analizę tę przeprowadzono oddzielnie od głównej oceny z wykorzystaniem zbioru testowego na poziomie podmiotu.
11. Analiza stabilności cech
Stabilność cech oceniono poprzez 10-krotne powtórzenie trenowania modelu Random Forest z wykorzystaniem losowych ziarn (seeds) od 0 do 9. Dla każdego uruchomienia odnotowano dokładność testową oraz wyniki istotności cech. Obliczono średnią i odchylenie standardowe wyniku istotności cech dla każdego predyktora na podstawie 10 uruchomień, a następnie uszeregowano predyktory zgodnie z ich stabilnością. Analizę tę wykorzystano do oceny spójności rankingów cech, a nie do zastąpienia podstawowej oceny na poziomie podmiotów.
12. Analiza wyjaśnialnej sztucznej inteligencji
Do wytrenowanego modelu Random Forest zastosowano SHAP TreeExplainer. Obliczono wartości SHAP w celu oszacowania wkładu każdej cechy w prognozy modelu. Dla każdej cechy obliczono średnią bezwzględną wartość SHAP, a następnie uszeregowano cechy zgodnie z ich wkładem SHAP. Zidentyfikowano cechy o konsekwentnie niskich wartościach SHAP i porównano je z wynikami analiz stabilności cech oraz analizy współczynnika d Cohena. Cechy wykazujące konsekwentnie niski wkład wybrano do późniejszej ablacji i ponownego trenowania modelu.
13. Analiza wielkości efektu statystycznego
Wartość d Cohena została obliczona dla każdego biomarkera EEG dla porównań AD versus HC, AD versus FTD oraz FTD versus HC. Wielkość efektu interpretowano, przyjmując progi 0,20 dla efektu małego, 0,50 dla efektu średniego i 0,80 dla efektu dużego.
14. Zintegrowana selekcja cech
Porównano wyniki analizy istotności cech metodą Random Forest, analizy SHAP oraz analizy współczynnika d Cohena. Predyktory, które konsekwentnie wykazywały niską istotność cechy, niski wkład SHAP oraz niewielką wielkość efektu, zostały zidentyfikowane jako kandydaci do usunięcia.
15. Ablacja cech
Cechy entropii zostały ocenione w eksploracyjnej analizie ablacji, a następnie skonstruowano zredukowaną macierz cech zawierającą RMS, PSD oraz wiek. Klasyfikator Random Forest został ponownie wytrenowany przy użyciu tych samych hiperparametrów. Proces trenowania modelu, testowania, walidacji krzyżowej oraz analiza charakterystyki operacyjnej odbiornika (ROC) zostały powtórzone z wykorzystaniem zredukowanego zestawu cech.
16. Analiza ROC
Prawdopodobieństwa klas uzyskano z zoptymalizowanego klasyfikatora Random Forest. Wieloklasowe krzywe ROC wygenerowano przy użyciu strategii one-versus-rest. Obliczono wartości pola pod krzywą (AUC) dla poszczególnych klas oraz średnią wartość AUC.
17. Porównanie wydajności
Wydajność pełnego modelu cech porównano z wydajnością zredukowanego modelu cech otrzymanego po ablacji cech entropijnych.
Wyniki
Model Random Forest osiągnął 96% dokładności treningowej i 92% dokładności testowej. Makrośrednia wartość F1-score wyniosła 92%, natomiast średnia ważona F1-score również wyniosła 92%, co wskazuje na porównywalną wydajność w trzech klasach. Wydajność klasyfikacji była najwyższa dla klasy choroby Alzheimera (AD), podczas gdy klasa otępienia czołowo-skroniowego (FTD) wykazała porównawczo niższą wydajność, jak przedstawiono w Tabeli 1.
Do oceny separacji klas w zależności od progów klasyfikacji zastosowano analizę charakterystyki operacyjnej odbiornika (ROC). Jak pokazano na Rysunku 2, pole powierzchni pod krzywą ROC (AUC) przekroczyło 0,98 dla wszystkich trzech klas, co wskazuje na wysoką rozdzielność między grupami z AD, FTD oraz grupą zdrowej kontroli (HC).
Przeprowadzono analizę SHAP z wykorzystaniem TreeExplainer w celu oceny wpływu poszczególnych cech na model klasyfikacji Random Forest. Wykres słupkowy podsumowania na Rysunku 3 przedstawił względny wkład gęstości widmowej mocy (PSD), wartości średniej kwadratowej (RMS), entropii oraz cech demograficznych. Cechy o wyższych bezwzględnych wartościach SHAP miały silniejszy wpływ na przewidywania modelu, podczas gdy cechy związane z entropią wykazywały stosunkowo niski wkład.
Analizę stabilności cech przeprowadzono poprzez powtórzenie trenowania modelu Random Forest dla określonych ziarn losowości. Dla każdego uruchomienia zapisano dokładność testową oraz wyniki istotności cech, a następnie obliczono średnią i odchylenie standardowe istotności cech. Model osiągnął w tej analizie średnią dokładność klasyfikacji na poziomie 95%, przy odchyleniu standardowym wynoszącym 0,17%. Te powtórzone uruchomienia służyły przede wszystkim do oceny spójności rankingów cech i były rozpatrywane oddzielnie od głównej oceny z wykorzystaniem zbioru walidacyjnego na poziomie pacjentów. Wiek zajął wysoką pozycję w analizie stabilności cech, co przedstawiono w Tabeli 2. Cechy theta_psd i theta_rms również uzyskały wysokie rankingi, podczas gdy alpha_psd, alpha_rms, beta_psd i beta_rms wykazały umiarkowaną istotność.
Obliczono współczynnik d Cohena, aby ocenić wielkość różnic między grupami, zgodnie z przedstawionymi danymi w Tabeli 3. Największe zgłoszone różnice między uczestnikami z AD a zdrową grupą kontrolną wykazano w przypadku tłumienia pasma alfa (alpha_rms, d = 0,97; alpha_psd, d = 0,87) oraz zwiększonej aktywności theta (theta_rms, d = 0,72). Wyniki te były zgodne ze spowolnieniem korowym zgłaszanym w badaniach EEG nad otępieniem34. Cechy oparte na entropii wykazały porównawczo mniejsze wielkości efektu. Porównania między AD a FTD przyniosły głównie małe do umiarkowanych wielkości efektu.
Cechy pasma alfa wykazały duże wielkości efektu dla porównań AD kontra HC oraz FTD kontra HC. Dla AD kontra HC zgłoszone wielkości efektu wyniosły −0,87 dla alpha_psd oraz −0,97 dla alpha_rms. W przypadku FTD kontra HC tłumienie pasma alfa wyniosło −0,73. Cecha theta_psd wykazała wielkość efektu 0,61 dla AD kontra HC, podczas gdy theta_rms wykazała wielkość efektu 0,72. Mniejsze różnice zaobserwowano dla AD kontra FTD.
Cechy pasma beta wykazały przeważnie małe do umiarkowanych wielkości efektu grupy. Wielkości efektu dla beta_psd wynosiły −0.35 dla AD kontra HC oraz −0.41 dla AD kontra FTD, natomiast beta_rms wykazała głównie niewielkie efekty. Cechy pasma gamma wykazały umiarkowane efekty dla niektórych porównań. Wielkość efektu gamma_psd wynosiła 0.47 dla FTD kontra HC i 0.20 dla AD kontra HC, podczas gdy gamma_rms wykazała wielkość efektu 0.50 dla FTD kontra HC.
Wartości Delta PSD oraz RMS wykazały niewielkie dodatnie wielkości efektu dla AD versus HC (odpowiednio 0,29 i 0,34) oraz FTD versus HC (odpowiednio 0,25 i 0,25). Wielkości efektu dla AD versus FTD były bliskie zeru. Delta entropii wykazała niewielkie wielkości efektu we wszystkich trzech porównaniach (0,08, 0,20 i −0,11).
Analizy stabilności cech, SHAP oraz wielkości efektu wskazały na stosunkowo niski wkład cech entropii. W związku z tym przeprowadzono analizę ablacyjną poprzez wykluczenie cech entropii i zachowanie RMS, PSD oraz wieku. Po ablacji cech model Random Forest osiągnął 96% dokładności treningowej i 94% dokładności testowej. Wynik ten zinterpretowano jako porównanie eksploracyjne w ramach ocenianego systemu selekcji cech. Precyzja, czułość, wynik F1 oraz liczba próbek dla klas AD, HC i FTD przedstawione są w Tabeli 4.
Wyniki przed i po ablacji cechy entropii porównano w Tabeli 5. Dokładność testowa wzrosła z 92% do 94% po usunięciu entropii. Zmiany w poszczególnych klasach przedstawiono w Tabeli 6. Dla FTD precyzja wzrosła o 4%, a wynik F1 o 2%. Czułość dla grupy HC wzrosła o 4%, podczas gdy precyzja spadła o 2%. Miary wydajności dla średniej makro (macro-average) i średniej ważonej (weighted-average) wzrosły o około 1%–2% po ablacji cech.
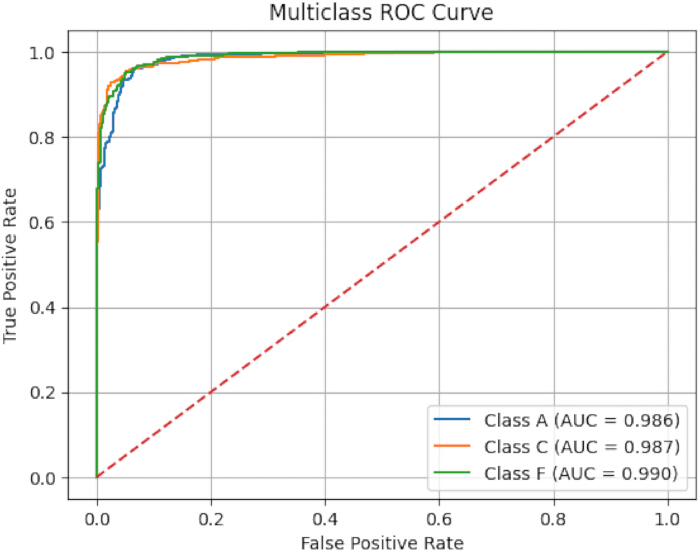
Rysunek 2Krzywe charakterystyki operacyjnej odbiornika dla choroby Alzheimera, otępienia czołowo-skroniowego oraz zdrowych osób kontrolnych. Wieloklasowe krzywe charakterystyki pracy odbiornika (ROC) wygenerowane przy użyciu metody one-kontrastrategia spoczynkowa dla choroby Alzheimera (klasa A), otępienia czołowo-skroniowego (klasa F) oraz zdrowych kontroli (klasa C). Dla każdej klasy obliczono pole pod krzywą (AUC). Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej figury.
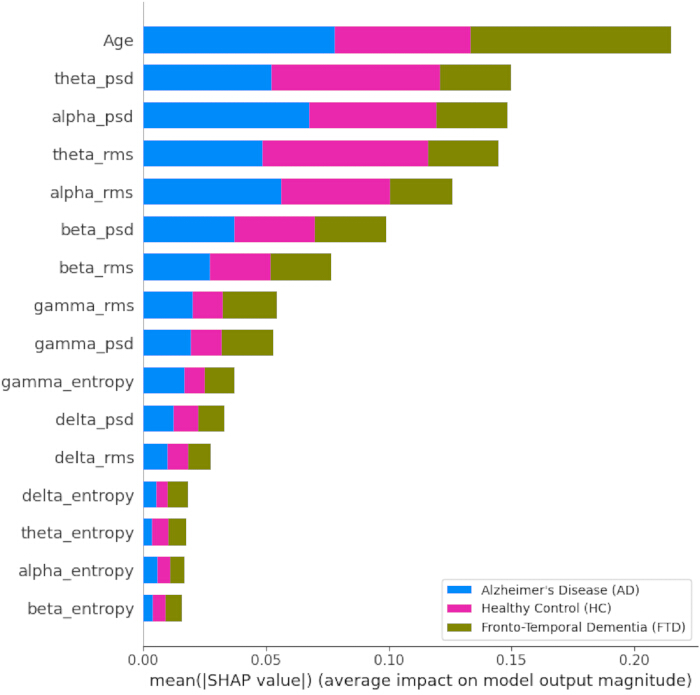
Rysunek 3: Analiza podsumowująca SHAP wytrenowanego modelu Random Forest. Podsumowujący wykres słupkowy przedstawiający względny wkład cech demograficznych oraz cech pochodnych z EEG w model klasyfikacji Random Forest. Do uszeregowania wkładu cech takich jak średnia kwadratowa (RMS), gęstość widmowa mocy (PSD), entropia oraz wiek wykorzystano średnie bezwzględne wartości SHAP. Kliknij tutaj, aby zobaczyć powiększoną wersję tego rysunku.
| Precyzja | Czułość | Wskaźnik F1 (F1-Score) | Wsparcie | |
| choroba Alzheimera | 0.92 | 0.95 | 0.94 | 579 |
| Kontrola | 0.93 | 0.92 | 0.93 | 480 |
| Otępienie czołowo-skroniowe | 0.93 | 0.87 | 0.9 | 314 |
| Średnia makro | 0.93 | 0.92 | 0.92 | 1373 |
| Średnia ważona | 0.93 | 0.92 | 0.92 | 1373 |
Tabela 1: Raport klasyfikacji danych testowych. Precyzja, pełność, wynik F1 oraz liczba próbek (support) dla klas: choroba Alzheimera, zdrowa grupa kontrolna i otępienie czołowo-skroniowe w zbiorze testowym, wraz z miarami wydajności średniej makro i średniej ważonej.
| Cecha | Średnia | Odchylenie standardowe |
| Wiek | 0.1966 | 0.0017 |
| gęstość widmowa mocy theta | 0.0936 | 0.0027 |
| theta_rms | 0.0911 | 0.0023 |
| alpha_psd | 0.0824 | 0.0022 |
| alpha_rms | 0.0824 | 0.0024 |
| beta_psd | 0.0638 | 0.0013 |
| beta_rms | 0.0629 | 0.0012 |
| gamma_psd | 0.0534 | 0.001 |
| gamma_rms | 0.0527 | 0.0014 |
| delta_psd | 0.0403 | 0.0007 |
| delta_rms | 0.0359 | 0.001 |
| entropia_gamma | 0.0326 | 0.0008 |
| entropia alfa | 0.0325 | 0.0006 |
| beta_entropia | 0.0283 | 0.0009 |
| entropia_theta | 0.0258 | 0.0004 |
| delta_entropii | 0.0255 | 0.0005 |
Tabela 2: Ranking stabilności cech modelu Random Forest. Średnie wartości istotności cech i odpowiadająca im zmienność uzyskana z powtarzanego trenowania modelu Random Forest z użyciem losowych ziarn (random seeds) od 0 do 9. Cechy zostały uszeregowane zgodnie z ich stabilnością w poszczególnych uruchomieniach.
| Cecha | AD vs. HC | AD vs. FTD | FTD vs. HC |
| PSD delta | 0.293 | -0.069 | 0.253 |
| PSD theta | 0.612 | 0.23 | 0.355 |
| PSD alpha | -0.869 | -0.219 | -0.64 |
| PSD beta | -0.352 | -0.408 | 0.201 |
| PSD gamma | 0.201 | -0.326 | 0.468 |
| Entropia delta | 0.081 | 0.199 | -0.111 |
| Entropia theta | 0.208 | 0.033 | 0.163 |
| Entropia alpha | -0.061 | 0.071 | -0.137 |
| Entropia beta | -0.37 | -0.042 | -0.332 |
| Entropia gamma | -0.338 | 0.047 | -0.391 |
| RMS delta | 0.342 | 0.041 | 0.251 |
| RMS theta | 0.718 | 0.354 | 0.318 |
| RMS alpha | -0.977 | -0.205 | -0.73 |
| RMS beta | -0.494 | -0.365 | 0.015 |
| RMS gamma | 0.187 | -0.33 | 0.5 |
Tabela 3: Porównanie wielkości efektu d Cohena pomiędzy grupami diagnostycznymi. Wartości d Cohena dla biomarkerów EEG w porównaniach: choroba Alzheimera kontra zdrowa grupa kontrolna, choroba Alzheimera kontra otępienie czołowo-skroniowe oraz otępienie czołowo-skroniowe kontra zdrowa grupa kontrolna.
| Precyzja | Czułość | Wskaźnik F1 | Wsparcie | |
| choroba Alzheimera | 0.94 | 0.95 | 0.94 | 579 |
| Kontrola | 0.91 | 0.96 | 0.94 | 480 |
| Otępienie czołowo-skroniowe | 0.97 | 0.89 | 0.92 | 314 |
| Średnia makro | 0.94 | 0.93 | 0.93 | 1373 |
| Średnia ważona | 0.94 | 0.94 | 0.94 | 1373 |
Tabela 4: Raport klasyfikacji po ablacji cech. Precyzja, pełność, wynik F1 oraz liczba próbek (support) dla klas choroby Alzheimera, grupy kontrolnej osób zdrowych oraz otępienia czołowo-skroniowego po usunięciu cech entropii i ponownym przeszkoleniu modelu Random Forest.
| Metryka | Przed ablacją | Po ablacji | Zmiana |
| Dokładność treningowa | 0.96 | 0.96 | 0% zmiany |
| Dokładność testowa | 0.92 | 0.94 | +2% poprawy |
| Precyzja Macro | 0.93 | 0.94 | +1% poprawy |
| Czułość Macro | 0.92 | 0.93 | +1% poprawy |
| Wskaźnik F1 Macro | 0.92 | 0.93 | +1% poprawy |
| Precyzja ważona | 0.93 | 0.94 | +1% poprawy |
| Czułość ważona | 0.92 | 0.94 | +2% poprawy |
| Wskaźnik F1 ważony | 0.92 | 0.94 | +2% poprawy |
Tabela 5: Porównanie wydajności przed i po ablacji cech. Porównanie metryk wydajności modelu dla pełnego wielodomenowego zestawu cech oraz zredukowanego zestawu cech uzyskanego po usunięciu cech entropii.
DOSTĘPNOŚĆ DANYCH:
Przetworzony zestaw danych CSV wykorzystany do opracowania i analizy modelu został udostępniony jako Plik uzupełniający 1. Kod wstępnego przetwarzania danych jest dostępny w notatniku Python pod adresem https://colab.research.google.com/drive/1PwidMZCbbIHdthDhat5OEZa7ya6f0-aC?usp=sharing, a kod budowy modelu i analizy jest dostępny pod adresem https://colab.research.google.com/drive/1q8wYJjQpofAqZGYxz9xHKB0emGF4YGwM?usp=sharing. Przetworzony zestaw danych CSV można również odtworzyć, korzystając z udostępnionego kodu wstępnego przetwarzania
| Klasa | Metryka | Przed | Po | Zmiana |
| Choroba Alzheimera | Precyzja | 0.92 | 0.94 | 0.02 |
| Czułość | 0.95 | 0.95 | Brak zmian | |
| Miara F1 | 0.94 | 0.94 | Brak zmian | |
| Kontrola | Precyzja | 0.93 | 0.91 | −2% |
| Czułość | 0.92 | 0.96 | 0.04 | |
| Miara F1 | 0.93 | 0.94 | 0.01 | |
| FTD | Precyzja | 0.93 | 0.97 | 0.04 |
| Czułość | 0.87 | 0.89 | 0.02 | |
| Miara F1 | 0.9 | 0.92 | 0.02 |
Tabela 6: Zmiany wydajności w podziale na klasy przed i po ablacji cech. Zmiany precyzji (precision), pełności (recall) i miary F1 (F1-score) dla klas choroby Alzheimera, zdrowej grupy kontrolnej oraz otępienia czołowo-skroniowego po usunięciu cech entropii.
Plik uzupełniający 1: Przetworzony zestaw danych cech EEG na poziomie epoki wykorzystany do opracowania modelu i analizy. Prosimy kliknąć tutaj, aby pobrać ten plik.
Dyskusja
Do klasyfikacji próbek elektroencefalograficznych (EEG) na grupy z chorobą Alzheimera (AD), otępieniem czołowo-skroniowym (FTD) oraz zdrową grupę kontrolną (HC) wykorzystano klasyfikator Random Forest, stosując cechy wielodomenowe, w tym gęstość widmową mocy (PSD), wartość średnia kwadratowa (RMS) oraz miary entropii. Wiek włączono jako uzupełniającą zmienną demograficzną. Ponieważ rozkłady wieku mogły różnić się pomiędzy grupami diagnostycznymi, nie można było całkowicie wykluczyć zakłóceń demograficznych, a zatem zgłoszona skuteczność odzwierciedlała połączony wkład informacji demograficznych i elektrofizjologicznych. Analiza zbadała zdolność wielodomenowych cech EEG do rozróżniania grup AD, FTD i HC oraz oceniła wkład cech z pasm delta, theta, alpha, beta i gamma w proces klasyfikacji35. Analizy stabilności cech i wielkości efektu wykazały, że cechy oparte na mocy, w tym PSD i RMS, miały silniejszy wkład niż cechy oparte na entropii. Wyekstrahowane biomarkery EEG odzwierciedlały również wzorce związane ze spowolnieniem rytmów i zmniejszoną aktywnością alpha.
Wcześniejsze badania oceniały cechy EEG oparte na entropii, PSD oraz RMS, stosując różne podejścia uczenia maszynowego2,14,27,28,36,37. Entropii używano do charakteryzacji złożoności i nieregularności EEG, podczas gdy PSD służyło do ilościowego określania charakterystyki spektralnej2,14,27,28,36. RMS oceniano również jako cechę pasma częstotliwości37. W poprzedniej pracy, wykorzystując ten sam zbiór danych, zastosowano binarną klasyfikację opartą na PSD z walidacją metodą leave-one-subject-out33. Niniejsza analiza połączyła natomiast RMS, entropię i PSD w pasmach alfa, beta, gamma, theta i delta w ramach wieloklasowego modelu klasyfikacji. Na tym samym zbiorze danych oceniono lekki transformer EEG, stosując binarną strategię klasyfikacji leave-one-subject-out. Lekki transformer EEG oceniony na tym samym zbiorze danych z wykorzystaniem binarnej strategii klasyfikacji leave-one-subject-out wykazał dokładność na poziomie 83,28%. Bezpośrednie porównanie numeryczne z niniejszymi wynikami należy interpretować ostrożnie, ponieważ zadanie klasyfikacji oraz procedury walidacji były odmienne38.
Cechy pasma alfa wykazały największe wielkości efektu w rozróżnianiu AD od HC oraz FTD od HC, a zwiększona aktywność theta również przyczyniła się do różnicowania AD od HC. Cechy pasma beta wykazały mniejsze efekty między grupami, natomiast cechy oparte na entropii wykazały porównawczo ograniczoną użyteczność dyskryminacyjną. Cechy pasma gamma wykazały umiarkowane efekty w niektórych porównaniach, w tym FTD versus HC. Wcześniejsze badania zgłaszały niższą moc alfa i zmienioną aktywność theta w AD oraz powiązanych porównaniach diagnostycznych23,25,39. Entropia była również opisywana jako potencjalnie informatywny biomarker w chorobach neurodegeneracyjnych36, co wskazuje, że jej wkład może się różnić w zależności od zbioru danych, definicji cech i podejścia analitycznego.
Maszyny wektorów nośnych były często wykorzystywane w poprzednich badaniach nad klasyfikacją EEG3,21,24,37. Klasyfikator Random Forest zastosowany w niniejszej analizie dostarczył szacunki istotności cech i był odpowiedni dla ustrukturyzowanego zestawu cech wykorzystanego w tym badaniu40,41. Po ablacji cech entropii uzyskano dokładność trenowania i testowania wynoszącą odpowiednio 96% i 94%. Usunięcie cech entropii wiązało się z poprawą wydajności modelu, co potwierdza niższy względny wkład zaobserwowany dla tych cech w analizach stabilności, SHAP i wielkości efektu. Podejścia oparte na głębokim uczeniu i transformatorach były również stosowane w klasyfikacji EEG, choć metody te zazwyczaj wymagają większych zbiorów danych i są zaprojektowane dla reprezentacji wielowymiarowych lub sekwencyjnych27,39,42,43,44,45.
Sygnały EEG są zaszumione i niestacjonarne, a modele zespołowe oparte na drzewach decyzyjnych mogą zapewnić odporność podczas analizy ustrukturyzowanych reprezentacji cech. W niniejszym badaniu wartość RMS, PSD, entropię oraz wiek oceniono jako komplementarne dane wejściowe dla modelu Random Forest. RMS reprezentowało amplitudę sygnału w obrębie pasm częstotliwości, PSD reprezentowało moc widmową, a entropia reprezentowała złożoność sygnału. Wyniki wykazały, że w ocenianym modelu PSD i RMS miały silniejszy wpływ na klasyfikację niż entropia. Wiek również przyczynił się do działania modelu, choć jego uwzględnienie wprowadziło możliwość wystąpienia zakłóceń demograficznych. Przyszłe badania mogłyby ocenić dodatkowe zmienne demograficzne oraz alternatywne podejścia z zakresu uczenia maszynowego lub głębokiego uczenia na większych zbiorach danych, aby dalej ocenić generalizowalność i wydajność klasyfikacji.
Oświadczenia
Nie zgłoszono żadnych znanych konfliktów interesów finansowych, relacji osobistych, powiązań finansowych ani innych działań, które mogłyby wpłynąć na wyniki opisane w niniejszym badaniu.
Podziękowania
Wyrażamy uznanie dla publicznie dostępnego zbioru danych EEG wykorzystanego w niniejszym badaniu oraz dla wkładu badaczy, którzy udostępnili ten zbiór danych do celów badawczych. Nie otrzymano żadnego konkretnego finansowania z publicznych, komercyjnych ani non-profit agencji finansujących.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Google Colab | [potwierdź środowisko]środowisko wykonawcze colab | Środowisko obliczeniowe oparte na chmurze wykorzystywane do uruchamiania notatników analitycznych | |
| MNE-Python | Projekt MNE-Python | 1.12.1 | Stosowane do preprocessingu EEG, referencjonowania, filtrowania i segmentacji na epoki |
| NumPy | Projekt NumPy | (2.0.2) | Wykorzystywane do obliczeń numerycznych i operacji na tablicach |
| zbiór danych EEG z OpenNeuro | OpenNeuro | ds004504, (1.0.9) | Publicznie dostępny zbiór danych EEG w stanie spoczynku zawierający zapisy osób z AD, FTD oraz HC |
| Python | Python Software Foundation | [3.12.13 (main, Mar 4 2026, 09:23:07) [GCC 11.4.0]] | Środowisko programistyczne wykorzystane do przetwarzania danych i opracowania modelu |
| scikit-learn | projekt scikit-learn | 1.6.1 | Stosowane do wstępnego przetwarzania, grupowego podziału danych, klasyfikacji metodą Random Forest oraz oceny wydajności |
| SciPy | projekt SciPy | (1.16.3) | Wykorzystywane do przetwarzania sygnałów i obliczeń statystycznych |
| SHAP | Projekt SHAP | 0.52.0 | Wykorzystywane do analizy w ramach wyjaśnialnej sztucznej inteligencji z użyciem TreeExplainer |
Bibliografia
- Rodrigues PM, et al. Early prediction of Alzheimer's with the electroencephalogram. Procedia Comput Sci. 2016;100:865–71. https://doi.org/10.1016/j.procs.2016.09.236
- Houmani N, et al. Diagnosis of Alzheimer's disease with electroencephalography in a differential framework. PLoS One. 2018;13(3):e0193607. https://doi.org/10.1371/journal.pone.0193607
- Tripanpitak K, et al. Biomarkers for Alzheimer's disease and mild cognitive impairment: recent advances in task-based EEG. J Alzheimers Dis. 2025 [Epub ahead of print].
- Kung HC, Hoyert DL, Xu J, Murphy SL. Deaths: final data for 2005. Natl Vital Stat Rep. 2008;56(10):1-120.
- Falk TH, Fraga FJ, Trambaiolli L, Anghinah R. EEG amplitude modulation analysis for semi-automated diagnosis of Alzheimer's disease. EURASIP J Adv Signal Process. 2012;2012(1):192. https://doi.org/10.1186/1687-6180-2012-192
- Lehmann C, et al. Application and comparison of classification algorithms for recognition of Alzheimer's disease in electrical brain activity (EEG). J Neurosci Methods. 2007;161(2):342–50. https://doi.org/10.1016/j.jneumeth.2006.10.023
- Campanharo AS, Doescher E, Ramos FM. Automated EEG signals analysis using quantile graphs. In: Ferrández Vicente JM, Álvarez-Sánchez JR, de la Paz López F, Adeli H, editors. International Work-Conference on Artificial Neural Networks (IWANN 2017). Cham: Springer; 2017. p. 95–103. https://doi.org/10.1007/978-3-319-59147-6_9
- Adeli H, Ghosh-Dastidar S, Dadmehr N. Alzheimer's disease: models of computation and analysis of EEGs. Clin EEG Neurosci. 2005;36(3):131–40. https://doi.org/10.1177/155005940503600303
- Zheng H, Xiong X, Zhang X. Multi-threshold recurrence rate plot: a novel methodology for EEG analysis in Alzheimer's disease and frontotemporal dementia. Brain Sci. 2024;14(6):565. https://doi.org/10.3390/brainsci14060565
- Zheng X, et al. Diagnosis of Alzheimer's disease via resting-state EEG: integration of spectrum, complexity, and synchronisation signal features. Front Ageing Neurosci. 2023;15:1288295. https://doi.org/10.3389/fnagi.2023.1288295
- Abd Rahman F, Othman MF, Shaharuddin NA. Analysis methods of EEG signals: a review in EEG applications for brain disorders. J Teknol. 2015;72(2):41-6.
- Jackson AF, Bolger DJ. The neurophysiological bases of EEG and EEG measurement: a review for the rest of us. Psychophysiology. 2014;51(11):1061–71. https://doi.org/10.1111/psyp.12283
- Fouad IA, Labib FEZM. Identification of Alzheimer's disease from central lobe EEG signals utilising machine learning and a residual neural network. Biomed Signal Process Control. 2023;86:105266. https://doi.org/10.1016/j.bspc.2023.105266
- Fiscon G, et al. Combining EEG signal processing with supervised methods for Alzheimer's patients' classification. BMC Med Inform Decis Mak. 2018;18(1):35. https//doi.org/10.1186/s12911-018-0613-7
- Dauwels J, Vialatte F, Cichocki A. Diagnosis of Alzheimer's disease from EEG signals: where are we standing? Curr Alzheimer Res. 2010;7(6):487–505. https://doi.org/10.2174/156720510792231720
- Jelic V, Kowalski J. Evidence-based evaluation of diagnostic accuracy of resting EEG in dementia and mild cognitive impairment. Clin EEG Neurosci. 2009;40(2):129-42.
- Coben LA, Danziger WL, Berg L. Frequency analysis of the resting awake EEG in mild senile dementia of Alzheimer type. Electroencephalogr Clin Neurophysiol. 1983;55(4):372–80. https://doi.org/10.1016/0013-4694(83)90124-4
- Cibils D. Dementia and qEEG (Alzheimer's disease). Suppl Clin Neurophysiol. 2002;54:289-94.
- Ramírez-Arias FJ, et al. Evaluation of machine learning algorithms for the classification of EEG signals. Technologies. 2022;10(4):79. https://doi.org/10.3390/technologies10040079
- Hosseini MP, Hosseini A, Ahi K. A review on machine learning for EEG signal processing in bioengineering. IEEE Rev Biomed Eng. 2021;14:204–18. https://doi.org/10.1109/RBME.2020.2969915
- Vicchietti ML, Ramos FM, Betting LE, Campanharo AS. Computational methods of EEG signals analysis for Alzheimer's disease classification. Sci Rep. 2023;13(1):8184.
- Rahimi P, Noroozian M, Hatami J, Sadeghi M. Differential role of electroencephalography between mild cognitive impairment and Alzheimer disease during spatial working memory task. Iran J Neurodevelop Disord. 2025;4(1):101-10.
- Wang J, et al. Alzheimer's disease diagnosis using rhythmic power changes and phase differences: a low-density EEG study. Front Aging Neurosci. 2025;16:1485132. https://doi.org/10.3389/fnagi.2024.1485132
- Senkaya Y, Kurnaz C, Ozbilgin F. Enhancing Alzheimer's diagnosis with machine learning on EEG: a spectral feature-based comparative analysis. Diagnostics (Basel). 2025;15(17):2190. https://doi.org/10.3390/diagnostics15172190
- McBride JC, et al. Spectral and complexity analysis of scalp EEG characteristics for mild cognitive impairment and early Alzheimer's disease. Comput Methods Programs Biomed. 2014;114(2):153–63. https://doi.org/10.1016/j.cmpb.2014.01.019
- Al-Nuaimi AH, Jammeh E, Sun L, Ifeachor E. Changes in the EEG amplitude as a biomarker for early detection of Alzheimer's disease. In: 2016 38th Annual International Conference of the IEEE Engineering in Medicine and Biology Society (EMBC); 2016; Orlando, FL, USA. Piscataway: IEEE; 2016. p. 993–6. https://doi.org/10.1109/EMBC.2016.7590869
- Ma Y, Bland JKS, Fujinami T. Classification of Alzheimer's disease and frontotemporal dementia using electroencephalography to quantify communication between electrode pairs. Diagnostics (Basel). 2024;14(19):2189. https://doi.org/10.3390/diagnostics14192189
- Fiscon G, et al. Alzheimer's disease patients classification through EEG signals processing. In: 2014 IEEE Symposium on Computational Intelligence and Data Mining (CIDM); 2014; Orlando, FL, USA. IEEE; 2014. p. 105–12. https://doi.org/10.1109/CIDM.2014.7008655
- Fouladi S, et al. Efficient deep neural networks for classification of Alzheimer’s disease and mild cognitive impairment from scalp EEG recordings. Cogn Comput. 2022;14(4):1247–68. https://doi.org/10.1007/s12559-022-10022-y
- Miltiadous A, et al. Alzheimer’s disease and frontotemporal dementia: A robust classification method of EEG signals and a comparison of validation methods. Diagnostics. 2021;11(8):1437. https://doi.org/10.3390/diagnostics11081437
- Nobukawa S, et al. Classification methods based on complexity and synchronization of electroencephalography signals in Alzheimer’s disease. Front Psychiatry. 2020;11:255. https://doi.org/10.3389/fpsyt.2020.00255
- Huggins CJ, et al. Deep learning of resting-state electroencephalogram signals for three-class classification of Alzheimer’s disease, mild cognitive impairment and healthy ageing. J Neural Eng. 2021;18(4):046087. https://doi.org/10.1088/1741-2552/ac1a80
- Miltiadous A, et al. DICE-net: a novel convolution–transformer architecture for Alzheimer detection in EEG signals. IEEE Access. 2023;11:71840–58. https://doi.org/10.1109/ACCESS.2023a.3294618
- Miller R. Theory of the normal waking EEG: from single neurones to waveforms in the alpha, beta and gamma frequency ranges. Int J Psychophysiol. 2007;64(1):18–23. https://doi.org/10.1016/j.ijpsycho.2006.07.009
- Thomas JS, Thivakaran TK. Data mining algorithms and statistical techniques for identification of schizophrenia: A survey. In: 2020 International Conference on Smart Technologies in Computing, Electrical and Electronics (ICSTCEE); 2020; Bengaluru, India. IEEE; 2020. p. 246–51. https://doi.org/10.1109/ICSTCEE49637.2020.9276856
- Cacciotti A, et al. EEG entropy insights in the context of physiological aging and Alzheimer's and Parkinson's diseases: a comprehensive review. Geroscience. 2024;46(6):5537–57. https://doi.org/10.1007/s11357-024-01200-5
- Subhashree S, Eric PV. A unique EEG-Hyfusion fully automated stacked model for classification of Alzheimer's disease and frontotemporal dementia. J Vis Exp. 2026;(228):e69762.
- Miltiadous A, et al. A dataset of scalp EEG recordings of Alzheimer's disease, frontotemporal dementia and healthy subjects from routine EEG. Data (Basel). 2023;8(6):95. https://doi.org/10.3390/data8060095
- Malakouti SM, Menhaj MB, Suratgar AA. Enhanced epilepsy detection using discrete wavelet transform and bandpass filtering on EEG data: integration of ART-based and LVQ models. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.02.001
- Durga P, et al. An ensemble model for detection of Parkinson's disease by comparing numerous machine learning models and XGBoost based on vocal features. Clin eHealth. 2025. https://doi.org/10.1016/j.ceh.2025.01.001
- Behnamian A, et al. A systematic approach for variable selection with random forests: achieving stable variable importance values. IEEE Geosci Remote Sens Lett. 2017;14(11):1988–92. https://doi.org/10.1109/LGRS.2017.2745049
- Macia G, Liddell A, Doyle V. Conversational AI with large language models to increase the uptake of clinical guidance. Clin eHealth. 2024;7:147–52. https://doi.org/10.1016/j.ceh.2024.07.001
- Zhao W. Research on the deep learning of small sample data based on transfer learning. AIP Conf Proc. 2017;1864(1):020018. https://doi.org/10.1063/1.4992835
- Hassan U, Singhal A. Convolutional neural network framework for EEG-based ADHD diagnosis in children. Health Inf Sci Syst. 2024;12(1):44. https://doi.org/10.1007/s13755-024-00303-x
- Jeong T, Park U, Kang SW. Novel quantitative electroencephalogram feature image adapted for deep learning: verification through classification of Alzheimer’s disease dementia. Front Neurosci. 2022;16:1033379. https://doi.org/10.3389/fnins.2022.1033379