Niniejsze badanie identyfikuje osiem genów prognostycznych związanych z katastrofą mitotyczną (PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2, S100B) w gruczolakoraku płuca, tworzy model ryzyka o akceptowalnej wydajności predykcyjnej oraz ujawnia odmienne cechy mikrośrodowiska immunologicznego pomiędzy grupami ryzyka.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Identyfikacja genów prognostycznych związanych z katastrofą mitotyczną w gruczolakoraku płuca za pomocą analizy transkryptomu
W tym artykule
Podsumowanie
Streszczenie
Gruczolakorak płuca (LUAD), najczęstszy podtyp raka płuca, charakteryzuje się złym rokowaniem. Choć w LUAD można wywołać katastrofę mitotyczną, prowadzącą do śmierci komórek, prognostyczne i biologiczne znaczenie genów związanych z katastrofą mitotyczną (MCRGs) w tej chorobie pozostaje niejasne. Z kohorty TCGA-LUAD wyselekcjonowano geny różnicowo ekspresjonowane (DEGs) związane z LUAD, a geny wspólne zdefiniowano poprzez przecięcie DEGs z MCRGs. Potencjalne geny prognostyczne wybrano za pomocą uczenia maszynowego, po czym skonstruowano wielogenowy model prognostyczny. Ustanowiono ośmioelementową sygnaturę prognostyczną obejmującą PDGFB, LDHA, ZEB2, H2AX, FKBP4, DMD, ANXA2 oraz S100B, która wykazała akceptowalną niezawodność predykcyjną w zbiorze treningowym, z wartościami pola pod krzywą (AUCs) dla 2, 3 i 5 lat wynoszącymi odpowiednio 0,723, 0,715 i 0,625 (poprawiony metodą bootstrap wskaźnik C: 0,699, 95% CI: 0,657-0,742) oraz spójną walidację w zbiorze GSE31210 (AUCs: 0,812, 0,766 i 0,814). Pacjenci z grupy niskiego ryzyka wykazywali znacznie lepsze wyniki przeżycia, zwiększoną infiltrację immunologiczną, wyższe wyniki immunologiczne i stromalne, wyższe immunophenoscores oraz bardziej aktywne cykle odporności przeciwnowotworowej. Pomiędzy grupami wysokiego i niskiego ryzyka zaobserwowano istotne różnice w obciążeniu mutacyjnym guza oraz wrażliwości na leki. Ilościwa reakcja polimerazy w łańcuchu (qPCR) potwierdziła profile transkrypcyjne sześciu potencjalnych genów związanych z rokowaniem w próbkach klinicznych. Nomogram uwzględniający wynik ryzyka i stadium kliniczne wykazał dobrą wydajność predykcyjną. Wyniki te dowodzą, że osiem potencjalnych genów związanych z MCRG ma duży potencjał do przewidywania wyników leczenia pacjentów i stratyfikacji ryzyka w LUAD, przy czym grupy ryzyka różnią się wyraźnymi charakterystykami mikrośrodowiska immunologicznego.
Wprowadzenie
Rak płuca pozostaje jednym z najczęstszych i najgroźniejszych nowotworów na świecie1,2. Wśród niedrobnokomórkowych raków płuca (NSCLC) dominuje gruczolakorak płuca (LUAD), który odpowiada za około 40% wszystkich przypadków raka płuca3,4. Pomimo znaczących postępów w procedurach operacyjnych, terapiach celowanych molekularnie, inhibitorach punktów kontrolnych układu odpornościowego oraz schematach terapii skojarzonej, rokowania kliniczne pacjentów z LUAD pozostają niekorzystne5,6. Chociaż w diagnostyce LUAD powszechnie stosuje się podejścia patomorfologiczne i obrazowe, posiadają one wrodzone ograniczenia w zakresie oddania heterogeniczności guza oraz jego charakterystyki molekularnej. Z kolei analiza tkanki nowotworowej oparta na molekularnych biomarkerach może dostarczyć bardziej kompleksowych informacji o biologii nowotworu i przyczynić się do oceny prognostycznej oraz opracowania zindywidualizowanych strategii leczenia7. Dlatego identyfikacja wiarygodnych biomarkerów molekularnych pozostaje istotna dla poprawy przewidywań prognostycznych i zrozumienia biologii LUAD.
Mitoza, będąca kluczowym mechanizmem replikacji komórkowej, gwarantuje wierny podział powielonych chromosomów pomiędzy dwie komórki potomne8. Rozregulowanie procesów mitotycznych może sprzyjać niekontrolowanej proliferacji komórek, niestabilności genomowej oraz progresji nowotworu. Katastrofa mitotyczna (MC) definiuje szlak śmierci komórkowej wyzwalany w przypadku niepowodzenia zakończenia mitozy, wynikający zazwyczaj z uszkodzenia aparatu wrzecionowego lub wadliwego działania punktów kontrolnych cyklu komórkowego9. Na poziomie morfologicznym MC objawia się nieprawidłowościami komórkowymi, w tym wielojądrowością, obecnością mikron jąder, konfiguracjami wrzecion wielobiegunowych oraz poliploidyzacją10. Jako mechanizm eliminowania komórek z ciężkimi defektami mitotycznymi, MC może przyczyniać się do hamowania progresji nowotworu9. Delecja p53 w komórkach LUAD A549 może indukować katastrofę mitotyczną, a w konsekwencji śmierć komórki11, co sugeruje potencjalny związek między MC a procesami komórkowymi związanymi z LUAD. Niemniej jednak znaczenie prognostyczne i funkcje biologiczne genów związanych z katastrofą mitotyczną (MCRGs) w LUAD pozostają słabo poznane.
W niniejszym badaniu systematycznie przeanalizowano znaczenie prognostyczne i domniemaną istotność biologiczną MCRGs w LUAD, wykorzystując dane z TCGA oraz GEO. Kandydackie MCRGs zidentyfikowano w pierwszej kolejności poprzez analizy różnicowej ekspresji oraz analizy przecięcia zbiorów. Zastosowano kilka podejść uczenia maszynowego w celu przesiewowej analizy genów kandydackich i opracowania prognostycznej sygnatury ryzyka, która została następnie poddana walidacji zewnętrznej. W celu poprawy przewidywania przeżywalności opracowano nomogram łączący wynik ryzyka z charakterystyką kliniczną. Dodatkowo, w celu zbadania implikacji biologicznych i użyteczności klinicznej zidentyfikowanych genów, przeprowadzono charakterystykę mikrośrodowiska immunologicznego, ocenę mutacji somatycznych oraz ocenę chemiowrażliwości. Wspólnie wyniki te wykazują potencjał prognostyczny MCRGs w LUAD i mogą pomóc w opracowaniu biomarkerów oraz zindywidualizowanym podejściu terapeutycznym.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Badanie zostało przeprowadzone zgodnie z Deklaracją Helsińską, a protokół został zatwierdzony przez Komisję Etyczną Anhui Chest Hospital (K2025-07) w dniu 22 kwietnia 2025 roku. Od wszystkich osób biorących udział w badaniu uzyskano świadomą zgodę.
Ekstrakcja i normalizacja danych
Profile transkrypcyjne oraz odpowiadające im zestawy danych klinicznych dla LUAD pozyskano z kohort TCGA i GEO. Zbiór danych TCGA-LUAD wyznaczono jako zestaw treningowy, natomiast GSE72094, GSE31210 oraz GSE26939 posłużyły jako kohorty do walidacji zewnętrznej (Tabela 1). Ponadto, z poprzedniego badania zebrano 90 MCRG12(Tabela uzupełniająca 1). Dane transkryptomiczne zaadnotowano przy użyciu GENCODE v36 lub odpowiadających im plików adnotacji platformy GPL. Identyfikatory sond przekształcono w symbole genów, zduplikowane geny scalono za pomocą funkcji avereps, a w celu wygenerowania macierzy ekspresji na poziomie genów zachowano wyłącznie geny kodujące białka. W przypadku zbioru treningowego TCGA-LUAD geny z wartością FPKM (fragmentów na kilobaza modelu eksonu na milion zmapowanych fragmentów) < odrzucano próbki, w których więcej niż 50% wartości było filtrowanych, a pozostałe wartości ekspresji poddano transformacji log2 (log2[FPKM+1]). W przypadku kohort walidacyjnych z bazy GEO pobrano surowe dane o ekspresji, zmapowano identyfikatory sond na symbole genów przy użyciu odpowiednich plików adnotacji platformy, a następnie wiele sond odpowiadających temu samemu genowi scalono poprzez uśrednienie ich wartości ekspresji. Zbiory danych te poddano transformacji log2, gdy było to konieczne. Nie zastosowano korekcji efektu seryjnego (batch effect) między platformami TCGA i GEO, ponieważ przyjęto strategię standaryzacji dla każdej kohorty z osobna, aby zapewnić względną porównywalność. Konkretnie, zarówno dla kohorty treningowej, jak i walidacyjnych, wartości ekspresji genów wycentrowano i przeskalowano (transformacja z-score), wykorzystując średnią i odchylenie standardowe dla każdego zbioru danych indywidualnie. Następnie te same współczynniki regresji Coxa, wyznaczone na podstawie zbioru treningowego, wykorzystano do obliczenia wyników ryzyka (risk scores) dla wszystkich kohort. Aby zachować przydatność kliniczną i uniknąć przeuczenia (overfitting) do jakiegokolwiek zbioru walidacyjnego, medianowy wynik ryzyka kohorty treningowej zastosowano jako stały punkt odcięcia do stratyfikacji pacjentów na grupy wysokiego i niskiego ryzyka we wszystkich zewnętrznych kohortach walidacyjnych. Wyekstrahowano dostępne informacje kliniczne, w tym wiek, płeć, stopień zaawansowania patologicznego, stopień zaawansowania według klasyfikacji TNM (Tumor-Node-Metastasis), typ histologiczny, czas przeżycia, status przeżycia oraz typ tkanki. Punktem końcowym było przeżycie całkowite (OS). Próbki z niepełnymi informacjami o przeżyciu lub czasie przeżycia < Wykluczono 30 dni. Czas przeżycia przeliczono na lata, a status przeżycia zakodowano jako 0 dla osób żyjących i 1 dla osób zmarłych.
Identyfikacja i analizy funkcjonalne genów kandydackich
Pakiet Limma posłużył do zidentyfikowania genów różnicowo wyrażonych (DEG) pomiędzy próbkami guza LUAD a próbkami prawidłowymi w zestawie treningowym13. DEG zdefiniowano według następujących kryteriów: |log2FC| > 0,5 oraz skorygowana wartość p < 0,05. Następnie wykorzystano algorytm klastrowania rozmytego mfuzz z pakietu R ClusterGVis w celu podzielenia DEG na odrębne klastry ekspresji. Analizę Gene Ontology – Procesy Biologiczne (GO-BP) przeprowadzono dla pięciu najbardziej reprezentatywnych genów w każdym klastrze, wybranych na podstawie ich wyników przynależności. Zbiór wspólnych genów uzyskano poprzez wyznaczenie części wspólnej DEG i MCRG. Analiza wzbogacenia funkcjonalnego z wykorzystaniem Gene Ontology/Kyoto Encyclopedia of Genes and Genomes (GO/KEGG) pozwoliła ocenić znaczenie biologiczne nakładających się genów. Sieci oddziaływań białko-białko (PPI) wygenerowano na podstawie bazy danych STRING14. W celu zwiększenia wiarygodności sieci zachowano jedynie oddziaływania o wskaźniku pewności > 0,7.
Przesiewowe badanie genów prognostycznych
Do przeprowadzenia jednowymiarowej analizy regresji Coxa w celu zidentyfikowania genów prawdopodobnie powiązanych z przeżyciem całkowitym w przypadku LUAD wykorzystano pakiet Survival15. Geny z wartością p < 0,05 uznano za potencjalne wskaźniki prognostyczne. Kohorta treningowa TCGA-LUAD obejmowała 50 pacjentów z kompletnymi danymi dotyczącymi przeżycia, z których u 216 (43,2%) wystąpiły zgony podczas obserwacji. Stosunek liczby genów kandydackich (n = 108) do liczby zdarzeń (n = 216) wynosił w przybliżeniu 1:2, co jest dopuszczalne w analizie regresji Coxa. Następnie do dalszej selekcji cech wykorzystano analizę regresji LASSO (Least Absolute Shrinkage and Selection Operator) oraz model XGBoost (Extreme Gradient Boosting). Modele proporcjonalnych hazardów Coxa zbudowano z parametrem family = "cox" za pomocą funkcji cv.glmnet z pakietu glmnet. Optymalny parametr regularyzacji określono za pomocą 10-krotnej walidacji krzyżowej, przyjmując wartość λ.min reprezentującą minimalny błąd walidacji krzyżowej jako optymalną wartość λ. Geny z niezerowymi współczynnikami regresji wyodrębniono jako cechy kandydackie. W modelu XGBoost czas przeżycia i status przeżycia połączono w jedną zmienną wynikową, przypisując wartości dodatnie do zdarzeń zgonu, a wartości ujemne do przypadków ocenzurowanych. Parametry ustawiono jako objective = "survival: cox" oraz eval_metric = "cox-nloglik", przy 100 iteracjach i współczynniku uczenia 0,1. Po wytrenowaniu modelu obliczono wskaźniki istotności genów na podstawie wartości przyrostu cech (feature gain). Po posortowaniu wyników istotności w kolejności malejącej wybrano 20 najważniejszych genów, aby zredukować wymiarowość cech i złożoność modelu. Geny wspólne dla wyników LASSO i XGBoost zidentyfikowano jako kandydackie geny prognostyczne.
Konstrukcja i ocena modelu prognostycznego
Model prognostyczny opracowano przy użyciu wieloczynnikowej analizy regresji Coxa dla zidentyfikowanych genów kandydatów. Wyniki oceny ryzyka obliczano indywidualnie w następujący sposób:
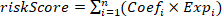 .
gdzie Coefi oznacza współczynnik dla genu i, a Expi wskazuje odpowiednią wartość ekspresji genu. Następnie pacjentów podzielono na dwie grupy: wysokiego i niskiego ryzyka, przyjmując medianę wyniku ryzyka jako punkt odcięcia. Następnie stworzono zależne od czasu krzywe charakterystyki operacyjnej odbiornika (ROC). Aby ocenić potencjał do przeuczenia modelu, przeprowadzono wewnętrzną walidację metodą bootstrap z 1 0 iteracjami ponownego próbkowania w celu obliczenia skorygowanego o obciążenie wskaźnika C (C-index) oraz zależnych od czasu wartości AUC z 95% przedziałami ufności. Wygenerowano krzywe kalibracyjne, aby ocenić zgodność między przewidywanym a obserwowanym prawdopodobieństwem przeżycia w 2., 3. i 5. roku. Ponadto, przy użyciu pakietu ggDCA w środowisku R, przeprowadzono analizę krzywych decyzyjnych (DCA), aby ocenić kliniczną korzyść netto modelu w punktach czasowych 2, 3 i 5 lat, kwantyfikując potencjalną wartość wyniku ryzyka w podejmowaniu decyzji klinicznych przy różnych prawdopodobieństwach progowych. Różnice w przeżywalności między grupami zróżnicowanymi pod kątem ryzyka oraz w innych kategoriach klinicznych porównano za pomocą krzywych przeżycia Kaplana-Meiera (KM) z testem log-rank. Ponadto, w celu wyjaśnienia wkładu poszczególnych genów w wydajność modelu, zastosowano analizę Shapley Additive exPlanations (SHAP) dla post-hoc interpretacji wyjaśniającej.
Opracowanie nomogramu i walidacja zewnętrzna
Zależności między obliczonymi wskaźnikami ryzyka a różnymi cechami klinicznymi (w tym płcią, wiekiem i stopniem zaawansowania TNM) badano za pomocą testu suma rang Wilcoxona lub testu Kruskala-Wallisa, aby ocenić przydatność kliniczną modelu. W celu sprawdzenia, czy wskaźnik ryzyka funkcjonuje jako niezależny czynnik prognostyczny, zmienne kliniczne wraz ze wskaźnikiem ryzyka włączono do wieloczynnikowego modelowania regresji Coxa. Następnie, przy użyciu pakietu R regplot, stworzono nomogram prognostyczny łączący niezależne kliniczne czynniki ryzyka (np. stopień zaawansowania) i genetyczny wskaźnik ryzyka, aby spersonalizować przewidywania prawdopodobieństwa przeżycia. Krzywe kalibracyjne wykorzystano do oceny zgodności prawdopodobieństwa przeżycia przewidywanego przez nomogram z rzeczywistymi wynikami przeżycia. Na koniec ostateczną zdolność prognostyczną i uogólnialność zintegrowanego systemu nomogramowego rygorystycznie zweryfikowano za pomocą zależnych od czasu krzywych ROC oraz kompleksowych analiz podgrup klinicznych KM w obrębie kohort.
Analiza nacieku immunologicznego i analiza podtypów immunologicznych
Do oszacowania względnych proporcji 2 typów komórek odpornościowych w celu oceny infiltracji komórek immunologicznych u pacjentów z LUAD wykorzystano narzędzie CIBERSORT z macierzą sygnatur genów leukocytów (LM2). Zależności między prognostycznymi poziomami ekspresji genów a infiltracją immunologiczną oceniono za pomocą analizy korelacji Spearmana. Wyniki Immune, stromal, tumor purity oraz ESTIMATE uzyskano za pomocą algorytmu ESTIMATE, a różnice między grupami ryzyka oceniono testem Wilcoxona. Pacjenci z LUAD zostali przypisani do sześciu immunologicznych podtypów przy użyciu pakietu ImmuneSubtypeClassifier16. Test Wilcoxona wykorzystano dodatkowo do porównania rozkładu podtypów immunologicznych w poszczególnych grupach ryzyka.
Analiza punktów kontrolnych odporności, immunofenoscore i cyklu odporności nowotworowej
W niniejszym badaniu test sum rang Wilcoxona posłużył do oceny 21 genów punktów kontrolnych odpowiedzi immunologicznej17 w grupach stratyfikowanych według ryzyka, w celu charakterystyki krajobrazu immunologicznego LUAD. Korelacja Spearmana powiązała potencjalne geny prognostyczne z genami punktów kontrolnych. Aby ocenić różnice w odpowiedzi na inhibitory punktów kontrolnych układu odpornościowego (ICIs) u pacjentów z LUAD o różnych poziomach ryzyka, dane immunophenoscore (IPS) dla terapii anty-PD-1 i anty-CTLA-4 pobrano z The Cancer Immunome Atlas (TCIA)18, a bazy danych Tracking Tumor Immunophenotype (TIP)19 użyto do oceny aktywności cyklu odporności nowotworowej poprzez porównanie odpowiadających im wyników pomiędzy grupami ryzyka.
Analiza mutacji somatycznych i wrażliwości na leki
Narzędzie do analizy mutacji TCGA posłużyło do pobrania profili mutacji somatycznych dla przypadków TCGA-LUAD w celu zbadania różnic w wzorcach mutacji pomiędzy grupami ryzyka. Dane dotyczące mutacji zostały przetworzone i zwizualizowane za pomocą pakietu maftools. Dla każdego preparatu określono poziom obciążenia mutacyjnego guza (TMB), a następnie zestawiono go pomiędzy dwiema kategoriami ryzyka. Analizę wrażliwości farmakogenomicznej przeprowadzono z wykorzystaniem pakietu pRRophetic zgodnie z bazą danych Genomics of Drug Sensitivity in Cancer (GDSC)20. Dla każdego pacjenta z LUAD przewidziano wartości połowicznej maksymalnej stężenia hamującego (IC50) dla leków przeciwnowotworowych, a różnice między grupami ryzyka ilościowo określono za pomocą testu sum rang Wilcoxona.
Ocena poziomów ekspresji genów prognostycznych
Każdy zestaw danych posłużył do oceny poziomów transkrypcji wybranych genów kandydackich związanych z rokowaniem. Aby powiązać ekspresję genów z rokowaniem pacjentów, optymalne punkty odcięcia wyznaczono za pomocą funkcji surv_cutpoint w pakiecie R survminer. Na podstawie tych progów przypadki LUAD podzielono na podgrupy o wysokiej i niskiej ekspresji do późniejszej analizy przeżywalności.
Ponadto, z Anhui Chest Hospital pobrano pięć par dopasowanych guzów LUAD i sąsiadującej tkanki prawidłowej, a następnie przeprowadzono walidację za pomocą qPCR. Każdy uczestnik wyraził pisemną zgodę na udział w badaniu. Do walidacji qPCR wybrano sześć potencjalnych genów prognostycznych (PDGFB, LDHA, ZEB2, FKBP4, DMD i S10B). RNA wyekstrahowano z homogenizowanych próbek tkanki przy użyciu odczynnika do ekstrakcji RNA, a następnie przeprowadzono ekstrakcję chloroformem i precypitację izopropanolem. Za pomocą spektrofotometru zmierzono stężenie i czystość RNA. Walidację qPCR sześciu potencjalnych genów prognostycznych przeprowadzono z wykorzystaniem mieszaniny PCR opartej na SYBR Green w systemie PCR w czasie rzeczywistym: wstępna denaturacja w 95 °C przez 30 s, a następnie 40 cykli: 95 °C przez 20 s, 5 °C przez 20 s i 72 °C przez 20 s. Ekspresję względną obliczono i znormalizowano względem dehydrogenazy gliceraldehydu-3-fosforanu (GAPDH) metodą 2-ΔCt. Szczegółowe informacje na temat wszystkich odczynników i instrumentów znajdują się w tabeli materiałów.
Analiza statystyczna
Analizy statystyczne przeprowadzono przy użyciu oprogramowania do obliczeń statystycznych i tworzenia wykresów. Sieć oddziaływań białko-białko z wizualizowano za pomocą oprogramowania do analizy sieci. Po ocenie normalności rozkładu, w przypadku zmiennych ciągłych o rozkładzie normalnym zastosowano test t Studenta, a w przypadku zmiennych o rozkładzie nienormalnym – test U Manna-Whitneya.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Identyfikacja genu kandydującego i analiza funkcjonalna
Wykryto łącznie 4 915 DEG, w tym 2 485 DEG o obniżonej ekspresji oraz 2 430 DEG o podwyższonej ekspresji (Rysunek 1A). Analiza klastrowania modułów funkcjonalnych podzieliła te DEG na sześć modułów ekspresyjnych (C1-C6), z których moduły C1, C2, C3 i C5 wykazały względnie wyższą ekspresję w próbkach nowotworowych (Rysunek 1B). Adnotacja funkcjonalna wskazała, że ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
LUAD jest jedną z głównych postaci raka płuc i nadal stanowi znaczne obciążenie dla zdrowia publicznego21. MC jest procesem związanym z śmiercią komórek, który może przyczyniać się do eliminowania komórek z ciężkimi nieprawidłowościami mitotycznymi oraz do hamowania progresji nowotworu22. Dlatego zbadanie potencjalnej roli MCRGs w LUAD może pomóc w zidentyfikowaniu biomarkerów prognostycznych i poprawić zrozumienie biologii LUAD. W badaniu przeanalizowano znaczenie prognost...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy oświadczają, że nie występuje konflikt interesów.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| ClusterGVis | CRAN | wersja 0.1.2 | Klastrowanie i wizualizacja ekspresji genów |
| Cytoscape | Cytoscape Consortium | wersja 3.9.1 | Wizualizacja sieci interakcji białkowych RRID:SCR_003032 |
| System qPCR CFX384 Real-Time Quantitative Fluorescent PCR System | Bio-Rad | CFX384 Touch | odczynnik do qPCR |
| starter DMD | Tsingke | N/D | Forward: 5’-GCTCAACCATCGATTTGCAGCC-3’ Reverse: 5’-TTCAGCCTCCAGTGGTTCAAGC-3’ |
| starter FKBP4 | Tsingke | N/D | Forward: 5’-TGACTCCAGTCTGGATCGCAAG-3’ Reverse: 5’-CTGGTTTGCAGGTGATGTGGCA-3’ |
| GEO | NCBI | Narzędzie online | Pozyskiwanie zewnętrznego zbioru danych walidacyjnych LUAD RRID:SCR_005012 |
| starter GAPDH | Tsingke | N/D | Forward: 5’-GTCTCCTCTGACTTCAACAGCG-3’ Reverse: 5’-ACCACCCTGTTGCTGTAGCCAA-3’ |
| glmnet | CRAN | wersja 4.1-8 | Wybór cech w regresji LASSO RRID:SCR_015505 |
| starter LDHA | Tsingke | N/D | Forward: 5’-GGATCTCCAACATGGCAGCCTT-3’ Reverse: 5’-AGACGGCTTTCTCCCTCTTGCT-3’ |
| limma | Bioconductor | wersja 3.60.6 | Przesiewowe wyznaczanie DEG RRID:SCR_010943 |
| maftools | Bioconductor | wersja 2.20.0 | Wizualizacja danych o mutacjach somatycznych RRID:SCR_024519 |
| pRRophetic | CRAN | 0.5 | Przewidywanie wartości IC50 leków RRID:SCR_024417 |
| starter PDGFB | Tsingke | N/D | Forward: 5’-GAGATGCTGAGTGACCACTCGA-3’ Reverse: 5’-GTCATGTTCAGGTCCAACTCGG-3’ |
| qPCR SYBR Green Master Mix | Vazyme | Q111-02 | odczynnik do qPCR |
| Oprogramowanie R | R Foundation | wersja 4.2.2 | Analiza bioinformatyczna |
| regplot | CRAN | wersja 1.1 | Tworzenie wykresów liniowych |
| survival | CRAN | wersja 3.8-3 | Analiza przeżywalności i regresja Coxa RRID:SCR_021137 |
| STRING | STRING Consortium | Narzędzie online | Analiza sieci interakcji białkowych RRID:SCR_005223 |
| starter S100B | Tsingke | N/D | Forward: 5’-GAAGAAATCCGAACTGAAGGAGC-3’ Reverse: 5’-TCCTGGAAGTCACATTCGCCGT-3’ |
| survminer | CRAN | wersja 0.5.0 | Wykresy i optymalizacja krzywych przeżywalności RRID:SCR_021094 |
| TRIzol | Tiangen | DP424 | odczynnik do qPCR |
| TCGA | NCI | Narzędzie online | Pozyskiwanie danych klinicznych i transkryptomicznych LUAD RRID:SCR_003193 |
| starter ZEB2 | Tsingke | N/D | Forward: 5’-AATGCACAGAGTGTGGCAAGGC-3’ Reverse: 5’-CTGCTGATGTGCGAACTGTAGG-3’ |
Bibliografia
- Asada K, et al. Multi-omics and clustering analyses reveal the mechanisms underlying unmet needs for patients with lung adenocarcinoma and identify potential therapeutic targets. Mol Cancer. 2024;23(1):182.
- Sun Q, et al. Prediction of lung adenocarcinoma prognosis and diagnosis with a novel model anchored in circadian clock-related genes. Sci Rep. 2024;14(1):18202.
- Ho KH, et al. Cancer Essential Genes Stratified Lung Adenocarcinoma Patients with Distinct Survival Outcomes and Identified a Subgroup from the Terminal Respiratory Unit Type with Different Proliferative Signatures in Multiple Cohorts. Cancers (Basel). 2021;13(9):2128.
- Zhang J, et al. Unraveling the Expression Patterns of Immune Checkpoints Identifies New Subtypes and Emerging Therapeutic Indicators in Lung Adenocarcinoma. Oxid Med Cell Longev. 2022;2022:3583985.
- Zheng T, et al. The pathological significance and potential mechanism of ARHGEF6 in lung adenocarcinoma. Comput Biol Med. 2023;158:106894.
- Yu Y, et al. Predicting potential therapeutic targets and small molecule drugs for early-stage lung adenocarcinoma. Biomed Pharmacother. 2024;174:116528.
- Guo Q, et al. Heterogeneous mutation pattern in tumor tissue and circulating tumor DNA warrants parallel NGS panel testing. Mol Cancer. 2018;17(1):131.
- Wang S, et al. Development and validation of a mitotic catastrophe-related genes prognostic model for breast cancer. PeerJ. 2024;12:e18075.
- Mao Z, et al. Mitotic catastrophe heterogeneity: implications for prognosis and immunotherapy in hepatocellular carcinoma. Front Immunol. 2024;15:1409448.
- Zhang QY, et al. Multiple Regulatory Mechanisms of Post-Translational Modifications and Therapeutic Potential of Mitotic Catastrophe. Int J Mol Sci. 2026;27(8):3370..
- Minemoto Y, et al. Loss of p53 induces M-phase retardation following G2 DNA damage checkpoint abrogation. Arch Biochem Biophys. 2003;412(1):13-9.
- Liu Y, et al. Developing a prognosis and chemotherapy evaluating model for colon adenocarcinoma based on mitotic catastrophe-related genes. Sci Rep. 2024;14(1):1655.
- Ritchie ME, et al. limma powers differential expression analyses for RNA-sequencing and microarray studies. Nucleic Acids Res. 2015;43(7):e47.
- Szklarczyk D, et al. The STRING database in 2023: protein-protein association networks and functional enrichment analyses for any sequenced genome of interest. Nucleic Acids Res. 2023;51(D1):D638-d46.
- Lei J, et al. Clinicopathological characteristics of pheochromocytoma/paraganglioma and screening of prognostic markers. J Surg Oncol. 2023;128(4):510-8.
- Thorsson V, et al. The Immune Landscape of Cancer. Immunity. 2018;48(4):812-30.e14.
- Guo Y, et al. Novel immune checkpoint-related gene model to predict prognosis and treatment responsiveness in low-grade gliomas. Heliyon. 2023;9(9):e20178.
- Sun X, et al. A transcriptomic-based model associated with PARP inhibitor sensitivity and immunogenic signatures in ovarian cancer. Discover Oncology. 2026;843.
- Wang L, et al. Identification of an ac4C modification related gene signature for predicting prognosis in laryngeal squamous cell carcinoma patients based on single-cell analysis and machine learning. 2026.
- Lin W, et al. Screening of Molecular Markers of Cisplatin Resistance in Lung Adenocarcinoma and Functional Verification Based on TCGA Database. Cancer Research on Prevention and Treatment. 2024;49(6):569-74.
- Gao W, et al. Promising therapeutic efficacy and safety of a novel integrin α6-targeting peptide-drug conjugate in lung adenocarcinoma. Molecular Cancer 2025;24(1):190.
- Vitale I, et al. Mitotic catastrophe: a mechanism for avoiding genomic instability. Nat Rev Mol Cell Biol. 2011;12(6):385-92.
- Liu M, et al. CDK1-mediated phosphorylation of LDHA fuels mitosis through LDHB-dependent lactate oxidation. EMBO Reports 2025;26(20):4923-4949.
- Zhang W, et al. Inhibition of LDHA suppresses cell proliferation and increases mitochondrial apoptosis via the JNK signaling pathway in cervical cancer cells. Oncology reports 2022;47(4).
- Mangé A, et al. FKBP4 connects mTORC2 and PI3K to activate the PDK1/Akt-dependent cell proliferation signaling in breast cancer. Theranostics. 2019;9(23):7003-7015.
- Meng W, et al. FKBP4 Accelerates Malignant Progression of Non-Small-Cell Lung Cancer by Activating the Akt/mTOR Signaling Pathway. Analytical cellular pathology (Amsterdam) 2020;2020:6021602.
- Xiu-Ying H, et al. PDGFBB facilitates tumorigenesis and malignancy of lung adenocarcinoma associated with PI3K-AKT/MAPK signaling. Sci Rep. 2024;14(1):4191.
- Sharma D, Singh M, Rani R. Role of LDH in tumor glycolysis: Regulation of LDHA by small molecules for cancer therapeutics. Semin Cancer Biol. 2022;87:184-95.
- Zhang P, et al. An Epithelial-Mesenchymal Transition-Based Prognostic Model for Survival Prediction in Lung Adenocarcinoma: COL5A2 and ZEB2. Current gene therapy 2026.
- Xu X, et al. Proteomic landscape of lung adenocarcinoma precancerous lesions reveals mitochondrial dsRNA-associated immune and stress responses. American journal of cancer research 2025;15(9):3888-3903.
- Li P, et al. Peripheral blood mononuclear cell DNA methylation biomarkers for prognostic stratification in Chinese lung adenocarcinoma: a genome-wide epigenetic profiling study. Clinical Epigenetics 2025;17(1):177.
- Chaudhary S, et al. Dissecting the MUC5AC/ANXA2 signaling axis: implications for brain metastasis in lung adenocarcinoma. Exp Mol Med. 2024;56(6):1450-60.
- Kondrup M, Nygaard AD, Madsen JS, Bechmann T. S100B as a biomarker for brain metastases in patients with non-small cell lung cancer. Biomed Rep. 2020;12(4):204-8.
- Jones L, Naidoo M, Machado LR, Anthony K. The Duchenne muscular dystrophy gene and cancer. Cell Oncol (Dordr). 2021;44(1):19-32.
- Peng G, Yan J, Shi P, Li H. LINC01140 Hinders the Development of Breast Cancer Through Targeting miR-200b-3p to Downregulate DMD. Cell Transplant. 2023;32:9636897231211202.
- Alnassar N, et al. Downregulation of Dystrophin Expression Occurs across Diverse Tumors, Correlates with the Age of Onset, Staging and Reduced Survival of Patients. Cancers (Basel). 2023;15(5):1378.
- Luce LN, Abbate M, Cotignola J, Giliberto F. Non-myogenic tumors display altered expression of dystrophin (DMD) and a high frequency of genetic alterations. Oncotarget. 2017;8(1):145-55.
- Hu Z, et al. IL6-STAT3-C/EBPβ-IL6 positive feedback loop in tumor-associated macrophages promotes the EMT and metastasis of lung adenocarcinoma. J Exp Clin Cancer Res. 2024;43(1):63.
- Ugel S, Canè S, De Sanctis F, Bronte V. Monocytes in the Tumor Microenvironment. Annu Rev Pathol. 2021;16:93-122.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
Ten artykuł został opublikowany
Film wkrótce dostępny