Ten protokół opisuje, jak skonstruować, wytrenować i wycenić wieloperspektywiczną ramę sieci Vision Mamba w kształcie litery U dla segmentacji obrazów medycznych, umożliwiającą powtarzalną segmentację zmian skórnych i narządów jamy brzusznej poprzez standaryzowane przygotowanie zestawu danych, implementację modelu i ocenę wydajności.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
Wielowidokowa struktura sieci Vision Mamba w kształcie litery U do segmentacji obrazów medycznych
W tym artykule
Podsumowanie
Streszczenie
Segmentacja obrazów medycznych wymaga metod obliczeniowych, które dokładnie uchwytują globalny kontekst, lokalne granice oraz struktury anatomiczne wieloskalowe, zachowując jednocześnie możliwość reprodukcji w różnych zastosowaniach. W tym artykule przedstawiono protokół budowy, trenowania i oceny Multi-view Vision Mamba U-Shaped Network framework dla dwuwymiarowej segmentacji obrazów medycznych. Protokół zapewnia możliwość reprodukcji procesu, który obejmuje pozyskiwanie publicznego zbioru danych, przetwarzanie obrazu i maski, budowę sieci, trenowanie modelu, wybór punktów zapisu i ilościową oraz jakościową ocenę wydajności. Framework włącza skanowanie cech wielowidokowych, aby uchwycić uzupełniające informacje przestrzenne, konturowe, skalowe i graniczne, oraz stosuje wieloetapowe łączenie cech w architekturze kodera-dekodera w kształcie U w celu poprawy integracji cech podczas segmentacji. Protokół jest demonstrowany przy użyciu publicznie dostępnych zbiorów danych dotyczących segmentacji zmian skórnych i narządów jamy brzusznej. Zgodnie z opisanym przepływem implementacji, framework osiąga konkurencyjną wydajność segmentacji przy użyciu standardowych metryk ewaluacji. Dzięki przestrzeganiu procedur przedstawionych w tym protokole, naukowcy mogą odtworzyć implementację modelu, wytrenować sieć przy użyciu określonych ustawień eksperymentalnych, ocenić wydajność segmentacji oraz dostosować przepływ pracy do pokrewnych zadań segmentacji obrazów medycznych wymagających rozbudowanej analizy opartej na nauce głębokiej.
Wprowadzenie
Segmentacja obrazów medycznych jest fundamentalnym zadaniem w dziedzinach wizji komputerowej oraz analizy obrazów medycznych1,2,3. Polega ona na podziale obrazu na wiele obszarów lub obiektów w celu ich dalszej analizy i przetwarzania. Technologia ta jest szczególnie istotna w obrazowaniu medycznym, ponieważ pomaga klinicystom w identyfikacji i lokalizacji obszarów patologicznych, co przekłada się na poprawę dokładności diagnostycznej i planowania leczenia. Wraz z rozwojem technologii obrazowania medycznego, takich jak obrazowanie rezonansem magnetycznym (MRI), tomografia komputerowa (CT) oraz pozytonowa tomografia emisyjna (PET), zapotrzebowanie na dokładne techniki segmentacji obrazów medycznych stale rośnie. Obecne metody segmentacji obrazów medycznych można szeroko podzielić na trzy główne podejścia: metody oparte na konwolucyjnych sieciach neuronowych (CNN)4, metody oparte na Transformerach5 oraz metody oparte na modelach przestrzeni stanów (SSM)6,7. Metody oparte na CNN zazwyczaj wykorzystują architektury sieci w kształcie litery U do segmentacji obrazów medycznych. Najpowszechniej stosowaną architekturą w tej kategorii jest U-Net8, która wykazała skuteczność architektury koder-dekoder w kształcie litery U w segmentacji obrazów biomedycznych. U-Net3+ łączy gęste połączenia pomijające (skip connections) z UNet++9 z pełnoskalowymi połączeniami pomijającymi w celu wzmocnienia agregacji cech wieloskalowych. Jednakże metody oparte na CNN mają ograniczoną zdolność do przechwytywania zależności długozasięgowych, a zatem mogą nie modelować efektywnie kontekstowych informacji dalekiego zasięgu.
Metody oparte na transformerach skutecznie przechwytują zależności dalekosiężne dzięki mechanizmowi self-attention, który umożliwia obliczenia równoległe i przypisywanie różnych wag uwagi do różnych obszarów zainteresowania. UNETR++10 wprowadza moduł Efficient Paired Attention (EPA), aby zredukować liczbę parametrów i koszt obliczeniowy. nnFormer11 łączy przeplatane operacje splotowe i self-attention oraz wprowadza lokalno-globalny mechanizm self-attention oparty na wolumenach w celu uczenia reprezentacji wolumetrycznych w trójwymiarowej (3D) segmentacji obrazów medycznych. H2Former12 proponuje wydajny, hierarchiczny, hybrydowy Vision Transformer, który łączy mechanizmy uwagi z ekstrakcją cech opartą na CNN w koderze. Jednakże metody oparte na transformerach wykazują kwadratową złożoność obliczeniową wraz ze wzrostem długości sekwencji, co skutkuje znacznie wyższym kosztem obliczeniowym. Rysunek 1 ilustruje motywację dla MVM-UNet i porównuje proponowaną strategię skanowania wielowidokowego z istniejącymi frameworkami segmentacji opartymi na SSM.
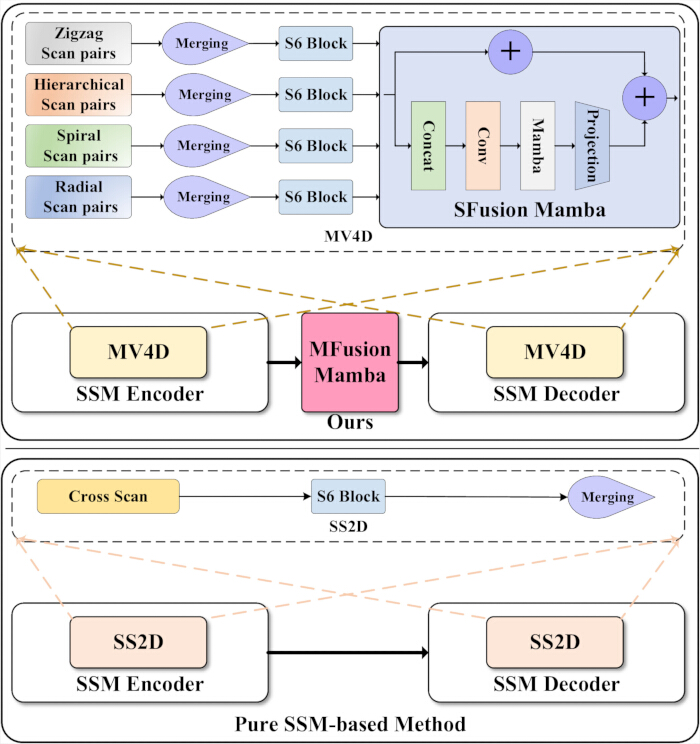
Rycina 1. Porównanie MVM-UNet z istniejącymi architekturami segmentacji opartymi wyłącznie na modelach przestrzeni stanów (SSM). Porównanie konwencjonalnego frameworka segmentacji opartego wyłącznie na modelu przestrzeni stanów (SSM) z proponowaną architekturą Multi-View Mamba U-Net (MVM-UNet). Górny panel przedstawia MVM-UNet, w którym moduł Multi-View 4-Directional (MV4D) ekstrahuje komplementarne cechy za pomocą par skanowania zygzakowatego, hierarchicznego, spiralnego i radialnego, które są integrowane przez Spatial Fusion Mamba (SFusion Mamba), podczas gdy Multistage Fusion Mamba (MFusion Mamba) agreguje wieloskalowe cechy koderów przed dekodowaniem. Dolny panel pokazuje reprezentatywną architekturę opartą wyłącznie na SSM, wykorzystującą moduły Selective Scan 2-Dimensional (SS2D) ze skanowaniem krzyżowym. Rycina podkreśla różnice architektoniczne między konwencjonalnymi sieciami segmentacji opartymi na SSM a proponowanym modelem MVM-UNet. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Metody oparte na SSM łączą globalne możliwości modelowania Transformerów z liniową złożonością obliczeniową. Architektura Mamba selektywnie przetwarza informacje wejściowe przy użyciu selektywnego modelu przestrzeni stanów (Selective-SSM), co pozwala modelowi na dynamiczną regulację parametrów w zależności od wejścia, przy jednoczesnym filtrowaniu nieistotnych informacji i podkreślaniu cech informacyjnych. Vim13 oraz VMamba14 adaptują architekturę Mamba do zadań związanych z komputerowym rozpoznawaniem obrazu. U-Mamba15 wykorzystuje hybrydową architekturę CNN–SSM, aby zbadać zastosowanie SSM w segmentacji obrazów medycznych, natomiast Mamba-UNet16 przyjmuje w pełni opartą na SSM architekturę enkoder–dekoder do segmentacji obrazów medycznych. Metody te osiągają konkurencyjne wyniki, wykorzystując przy tym znacznie mniejszą liczbę parametrów. Jednak obecne metody oparte na SSM/Mamba ekstrahują cechy obrazu głównie za pomocą prostych fragmentów obrazu (patchy) i strategii skanowania SS2D, co niesie ze sobą szereg ograniczeń w przypadku segmentacji obrazów medycznych. Po pierwsze, techniki SS2D i oparte na patchach zostały zaprojektowane głównie dla ogólnych zadań komputerowego rozpoznawania obrazu. Local Mamba17 oraz Motion Mamba18 zasugerowały, że strategia skanowania SS2D jest niewystarczająca dla wszystkich zadań wizualnych, ponieważ różne strategie skanowania przechwytują różne rodzaje informacji wizualnych. Po drugie, strategia skanowania SS2D jest stosunkowo prosta i opiera się wyłącznie na poziomych i pionowych kierunkach skanowania. W rezultacie może ona nie wystarczająco oddawać złożone relacje przestrzenne i drobne szczegóły strukturalne. Segmentacja obrazów medycznych wymaga jednoczesnego modelowania globalnego kontekstu przestrzennego oraz precyzyjnych lokalnych cech anatomicznych. Co więcej, obecne metody oparte na SSM/Mamba zapewniają ograniczoną fuzję cech między enkoderem a dekoderem. Architektury takie jak UNet++ i FATNet poprawiają dokładność segmentacji poprzez ulepszoną fuzję cech, co podkreśla znaczenie efektywnej integracji cech w segmentacji obrazów medycznych.
Aby rozwiązać te ograniczenia, w niniejszej pracy zaproponowano nowy framework do segmentacji obrazów medycznych oparty na Mamba, nazwany MVM-UNet. Jak pokazano na Rysunku 1, zaproponowany moduł wielowidokowy czterokierunkowy (Multi-View Four-Directional, MV4D) pełni funkcję głównego komponentu ekstrakcji cech w MVM-UNet i został zaprojektowany specjalnie do segmentacji obrazów medycznych poprzez integrację informacji z czterech różnych strategii skanowania. Każda strategia skanowania ekstrahuje komplementarne cechy obrazu i reprezentuje inny widok obrazu wejściowego. Skanowanie zygzakowate19 zmienia kierunek przejścia na końcu każdego wiersza lub kolumny, co pozwala na zrównoważenie lokalnych i globalnych informacji przestrzennych. W przeciwieństwie do niego, schematy skanowania spiralnego i radialnego20 zapewniają kompleksowe pokrycie poprzez rozszerzanie się od środka na zewnątrz lub od peryferii do wewnątrz. Skanowanie hierarchiczne18 przechwytuje cechy lokalne i globalne w wielu skalach. Aby poprawić odporność każdej strategii skanowania, pary skanów są łączone przed wprowadzeniem do bloku S6. Moduł Scan-view Fusion Mamba (SFusion Mamba) integruje następnie cechy wyekstrahowane z czterech modalności skanowania. W celu efektywnego wykorzystania wieloskalowych cech kodera, w pracy zaproponowano ponadto wieloskalowy moduł fuzji Mamba (MFusion Mamba), który akumuluje i łączy wyjścia z każdego etapu kodera przed przekazaniem połączonych cech do dekodera. MVM-UNet został oceniony na zbiorach danych ISIC 2017, ISIC 2018 oraz Synapse. Wyniki eksperymentalne wykazują, że MVM-UNet osiąga konkurencyjną wydajność segmentacji na zbiorach danych ISIC 2017, ISIC 2018 i Synapse.
Reprezentatywne architektury segmentacji przyczyniły się do dalszego rozwoju segmentacji obrazów medycznych. U-Net został z sukcesem zastosowany w zadaniach analizy obrazów biomedycznych, takich jak liczenie komórek, detekcja oraz morfometria21. Architektury CNN wzbogacone o mechanizmy uwagi, takie jak CA-Net22, poprawiają reprezentację cech dzięki kompleksowym mechanizmom uwagi. Reprezentatywne frameworki segmentacji oparte na Transformerach, w tym TransUNet23, Pyramid Medical Transformer24, Swin U-Net25, TransAttUNet26 oraz TransCUNet27, dodatkowo demonstrują skuteczność globalnego modelowania cech opartego na uwadze w segmentacji obrazów medycznych.
Konstrukcja MVM-UNet wynika z dwóch ograniczeń istniejących metod segmentacji opartych na SSM/Mamba. Po pierwsze, wiele obecnych modeli Vision Mamba opiera się na prostych dwuwymiarowych strategiach skanowania, które mogą być niewystarczające w przypadku obrazów medycznych zawierających nieregularne granice zmian chorobowych, małe obszary docelowe i wielkoskalowe struktury anatomiczne. Po drugie, konwencjonalne architektury koder-dekoder w kształcie litery U przekazują cechy głównie poprzez odpowiadające im połączenia pomijające (skip connections), co ogranicza bezpośrednie wykorzystanie informacji z wieloetapowego kodera podczas dekodowania. W związku z tym MVM-UNet wprowadza MV4D w celu usprawnienia wielowidokowego modelowania przestrzennego oraz MFusion Mamba, aby jawnie agregować cechy wieloetapowego kodera. Konstrukcja ta ma na celu dostosowanie modelowania dalekiego zasięgu opartego na Mamba do specyficznych wymagań segmentacji obrazów medycznych.
Chociaż MVM-UNet opiera się na ogólnym paradygmacie koder-dekoder oraz modelowaniu sekwencji w oparciu o Mamba, jego nowatorstwo polega na sposobie adaptacji i integracji tych komponentów w celu segmentacji obrazów medycznych. Zamiast prostego włączenia standardowego bloku Mamba do szkieletu sieci w kształcie litery U, proponowana struktura przeprojektowuje proces modelowania przestrzennego poprzez wiele zorientowanych na zadanie gałęzi par skanowania, wprowadza SFusion Mamba do integracji reprezentacji specyficznych dla skanowania, ulepsza blok MVV o ścieżki rezydualne i projekcyjne oraz wprowadza MFusion Mamba pomiędzy koderem a dekoderem w celu agregacji wieloetapowych cech kodera przed dekodowaniem. To rozwiązanie na poziomie architektury ma na celu rozwiązanie problemów z nieregularnymi granicami, małymi obszarami docelowymi oraz wieloskalowymi strukturami anatomicznymi, które są powszechnie obserwowane w obrazach medycznych.
Niniejszy protokół jest najbardziej odpowiedni dla zadań segmentacji wymagających jednoczesnego modelowania dalekosiężnych informacji kontekstowych, nieregularnych granic obiektów oraz wielkoskalowych struktur anatomicznych w dwuwymiarowych obrazach medycznych. W porównaniu z metodami segmentacji opartymi na sieciach CNN, konstrukcja enkoder-dekoder oparta na modelu Mamba zapewnia skuteczny mechanizm modelowania kontekstu, zachowując jednocześnie znany badaczom segmentacji obrazów medycznych schemat pracy w kształcie litery U. W porównaniu z metodami opartymi na Transformerach, proponowany framework unika bezpośredniego zastosowania kwadratowej samoatencji i jest przeznaczony dla badaczy dążących do globalnego modelowania kontekstowego przy użyciu stosunkowo wydajnego mechanizmu modelowania sekwencji. W związku z tym protokół ten jest odpowiedni do segmentacji zmian skórnych, segmentacji narządów brzusznych oraz podobnych zadań segmentacji dwuwymiarowych obrazów medycznych, w których istotne są zarówno globalne informacje strukturalne, jak i lokalne szczegóły granic.
Niniejszy protokół posiada również ograniczenia, które należy wziąć pod uwagę przed jego zastosowaniem. Może on być zbędny w przypadku stosunkowo prostych zadań segmentacji, w których lekka sieć CNN zapewnia już wystarczającą wydajność. Ponadto nie został on zaprojektowany bezpośrednio do pełnej trójwymiarowej segmentacji wolumetrycznej bez odpowiedniej adaptacji architektury. Badacze dysponujący bardzo ograniczoną liczbą adnotowanych danych, ograniczonymi zasobami jednostki przetwarzania graficznego (GPU) lub wymagający wysokiej interpretowalności modeli klasycznych powinni również uwzględnić te ograniczenia przed zastosowaniem protokołu. Ogólnie rzecz biorąc, metoda ta jest przeznaczona dla badaczy dążących do odtworzenia i oceny opartego na Mamba frameworka segmentacji o kształcie litery U, który równoważy modelowanie kontekstu dalekiego zasięgu, lokalną reprezentację granic oraz wieloetapową fuzję cech.
Kluczowe wkład naukowy są następujące:
1. Niniejsza praca przedstawia nowatorski framework do segmentacji obrazów medycznych oparty na modelu Mamba, nazwany MVM-UNet. W przeciwieństwie do podejść bezpośrednio wykorzystujących istniejące bloki oparte na SS2D lub standardowe bloki Mamba, MVM-UNet wprowadza MV4D w celu modelowania cech obrazów medycznych z czterech komplementarnych widoków par skanowania, obejmujących skanowanie zygzakowate, hierarchiczne, spiralne oraz radialne.
2. W niniejszej pracy zaprojektowano SFusion Mamba oraz blok MVV w celu zintegrowania reprezentacji specyficznych dla skanu i usprawnienia transformacji cech. SFusion Mamba łączy cechy wyodrębnione z różnych gałęzi par skanów, podczas gdy gałęzie resztkowe oraz projekcji w górę i w dół (Up-Down Projection) wewnątrz bloku MVV zapewniają komplementarne ścieżki cech, które stabilizują i wzbogacają reprezentacje cech.
3. Niniejsza praca wprowadza MFusion Mamba jako pośredni, wieloetapowy moduł fuzji pomiędzy koderem a dekoderem. W przeciwieństwie do konwencjonalnych połączeń pomijających (skip connections), które przekazują głównie cechy z odpowiadających sobie etapów, MFusion Mamba w sposób jawny agreguje wieloetapowe cechy kodera poprzez fuzję od ogółu do szczegółu (coarse-to-fine fusion), dostarczając wzbogaconych informacji do procesu dekodowania.
4. Szeroko zakrojone wyniki eksperymentalne wykazują, że proponowany model MVM-UNet osiąga konkurencyjną skuteczność segmentacji w zbiorach danych ISIC 2017 i ISIC 2018 oraz wysoką skuteczność w zbiorze danych do segmentacji wielu organów Synapse. Ponadto kompleksowe badania ablacyjne potwierdzają wkład każdego komponentu w strukturze MVM-UNet.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
W niniejszym badaniu wykorzystano wyłącznie publicznie dostępne i zanonimizowane zbiory danych obrazowania medycznego, w tym ISIC 2017, ISIC 2018 oraz Synapse. W ramach badania nie pozyskano nowych uczestników będących ludźmi, obiektów zwierzęcych ani możliwych do zidentyfikowania prywatnych dokumentacji medycznych. Zbiór danych ISIC 2017 użyty w tej pracy stanowił zbiór danych do segmentacji zmian skórnych z wyzwania ISIC 2017 Challenge, pozyskany z oficjalnego repozytorium danych International Skin Imaging Collaboration (https://challenge.isic-archive.com/data/#2017). Wersja zbioru danych wykorzystana w badaniu odpowiada zadaniu segmentacji zmian ISIC 2017, obejmując oficjalne podziały na zbiory treningowe, walidacyjne i testowe. Zbiór danych został pobrany 15 marca 2024 r. Zbiór danych ISIC 2018 użyty w tej pracy stanowił zbiór danych do segmentacji granic zmian z Zadania 1 wyzwania ISIC 2018 Challenge, pozyskany z oficjalnego repozytorium danych International Skin Imaging Collaboration (https://challenge.isic-archive.com/data/#2018). Wersja zbioru danych wykorzystana w badaniu odpowiada ISIC 2018 Task 1: Lesion Boundary Segmentation. Zbiór danych został pobrany 8 lipca 2024 r.
Zbiór danych Synapse wykorzystany w niniejszym badaniu to zbiór danych CT jamy brzusznej Multi-Atlas Labeling Beyond the Cranial Vault, pobrany z repozytorium Synapse pod identyfikatorem dostępu syn3193805 (https://www.synapse.org/Synapse:syn3193805). Zbiór danych użyty w tym badaniu odpowiada powszechnie stosowanemu zbiorowi danych do segmentacji wielu organów w obrazowaniu CT jamy brzusznej obejmującemu 30 przypadków. Pobranym archiwum było Abdomen/RawData.zip, dostępne pod identyfikatorem syn3193805. W momencie pobierania repozytorium nie udostępniło osobnego numeru wersji, etykiety wydania ani datowanej wersji wydania. Zgodnie ze standardowym podziałem przyjętym w poprzednich badaniach, 18 przypadków wykorzystano do uczenia, a 12 przypadków do testowania. Podział danych był zgodny z listą przypadków użytą w TransUNet23. W szczególności przypadki treningowe to case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 oraz case0037, natomiast przypadki testowe to case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 oraz case0035. Zbiór danych pobrano 9 lipca 2024 r. Ponieważ w badaniu wykorzystano wyłącznie publicznie dostępne, zanonimizowane zbiory danych i nie prowadzono gromadzenia nowych danych od ludzi ani identyfikowalnych informacji prywatnych, eksperymenty obliczeniowe opisane w niniejszym protokole nie wymagały zgody instytucjonalnej komisji bioetycznej. Nie uzyskano formalnej pisemnej decyzji o zwolnieniu z wymogu zgody instytucjonalnej. Jeśli wymagają tego lokalne zasady instytucjonalne, badacze powinni uzyskać decyzję o zwolnieniu instytucjonalnym przed przeprowadzeniem wtórnych analiz publicznie dostępnych zbiorów danych. Dla niniejszego badania nie było dostępnego numeru referencyjnego zwolnienia z oceny etycznej ani formalnej dokumentacji zwolnienia.
1. Przygotowanie zbiorów danych
- Pobierz zbiór danych do segmentacji zmian skórnych ISIC 2017 z oficjalnego repozytorium International Skin Imaging Collaboration. Użyj oficjalnych partycji treningowej, walidacyjnej i testowej. Zweryfikuj, czy zbiór danych zawiera 2 000 obrazów treningowych, 150 obrazów walidacyjnych i 600 obrazów testowych.
- Pobierz zbiór danych do segmentacji zmian skórnych ISIC 2018 z oficjalnego repozytorium International Skin Imaging Collaboration. Użyj oficjalnych partycji treningowej, walidacyjnej i testowej. Zweryfikuj, czy zbiór danych do segmentacji zawiera 2 594 obrazy treningowe, 100 obrazów walidacyjnych i 1 000 obrazów testowych.
- Pobierz zbiór danych do segmentacji wielu organów Synapse. Użyj standardnego podziału składającego się z 18 przypadków (2 212 przekrojów osiowych) do treningu i 12 przypadków (1 567 przekrojów osiowych) do testów. Nie wprowadzaj oddzielnego zbioru walidacyjnego.
- Zarezerwuj 12 przypadków testowych wyłącznie do końcowej ewaluacji. Nie używaj przypadków testowych do trenowania modelu, strojenia hiperparametrów ani wyboru modelu. Zadanie segmentacji obejmuje osiem organów jamy brzusznej: aortę, pęcherzyk żółciowy, śledzionę, lewą nerkę, prawą nerkę, wątrobę, trzustkę i żołądek.
- Użyj następującego podziału zbioru danych Synapse. 18 przypadków treningowych to: case0031, case0007, case0009, case0005, case0026, case0039, case0024, case0034, case0033, case0030, case0023, case0040, case0010, case0021, case0006, case0027, case0028 oraz case0037. 12 przypadków testowych to: case0008, case0022, case0038, case0036, case0032, case0002, case0029, case0003, case0001, case0004, case0025 oraz case0035.
- Zorganizuj każdy zbiór danych w oddzielne foldery z obrazami i maskami. Upewnij się, że każdy obraz posiada odpowiadającą mu maskę segmentacyjną z tym samym identyfikatorem przypadku.
- Konwertuj każdą maskę zmiany skórnej na binarną mapę segmentacji pierwszego planu i tła. Zachowaj oryginalne wieloklasowe etykiety organów dla zbioru danych Synapse.
- Dla zbiorów danych ISIC 2017 i ISIC 2018, po konwersji na maskę binarną, przypisz wartość etykiety 0 do pikseli tła i 1 do pikseli zmiany (pierwszego planu). Piksele z oryginalnymi wartościami masek większymi od 0 są traktowane jako pierwszy plan i konwertowane na 1, natomiast piksele z oryginalnymi wartościami masek równymi 0 są traktowane jako tło i pozostają jako 0. Dla zbioru danych Synapse zachowaj oryginalne całkowitoliczbowe wartości etykiet, gdzie 0 reprezentuje klasę tła, a 1–8 reprezentuje osiem klas organów pierwszego planu.
- Zmień rozmiar obrazów i masek ISIC 2017 oraz ISIC 2018 do 256 × 256 pikseli bez zachowania oryginalnych proporcji. Nie stosuj przycinania ani dopełniania.
- Zmień rozmiar każdego przekroju CT Synapse i odpowiadającej mu mapy etykiet do 224 × 224 pikseli. Użyj interpolacji bilinearnej dla obrazów RGB, interpolacji splajnami trzeciego rzędu dla przekrojów CT oraz interpolacji najbliższego sąsiada dla masek segmentacyjnych.
- Zmień rozmiar obrazów w języku Python.
- Dla zbiorów danych ISIC 2017 i ISIC 2018 użyj niestandardowej transformacji myResize zaimplementowanej w utils.py, która wywołuje torchvision.transforms.functional.resize, aby zmienić rozmiar tensorów obrazu i maski do 256 × 256 pikseli. Nie określaj w tej transformacji jawnego trybu interpolacji ani argumentu antyaliasingu.
- Dla zbioru danych Synapse użyj scipy.ndimage.zoom w datasets/dataset.py. Zmień rozmiar przekrojów obrazów CT do 224 × 224 pikseli, stosując interpolację splajnami trzeciego rzędu (order = 3), a mapy etykiet zmień rozmiar, stosując interpolację najbliższego sąsiada (order = 0). Nie stosuj oddzielnej operacji antyaliasingu ani ustawienia anti_aliasing=True podczas zmiany rozmiaru.
- Znormalizuj każdy obraz RGB ISIC przed konwersją na tensor, używając średniej i odchylenia standardowego (SD) specyficznych dla danego zbioru danych zgodnie z Równaniem 1:
 (1)
Następnie przeskaluj znormalizowany obraz do zakresu 0–255 za pomocą normalizacji min-max.- Użyj µ = 159.922 i σ = 28.871 dla zbioru treningowego ISIC 2017 oraz µ = 148.429 i σ = 25.748 dla zbiorów walidacyjnego i testowego ISIC 2017. Użyj µ = 157.561 i σ = 26.706 dla zbioru treningowego ISIC 2018 oraz µ = 149.034 i σ = 32.022 dla zbiorów walidacyjnego i testowego ISIC 2018.
- Konwertuj każdy znormalizowany obraz na tensor o kształcie 3 × 256 × 256. Konwertuj każdą maskę binarną na tensor o kształcie 1 × 256 × 256.
- Wykonaj normalizację min-max niezależnie dla każdego obrazu po normalizacji średnią i odchyleniem standardowym specyficznym dla zbioru danych. Konkretnie, odejmij średnią specyficzną dla zbioru danych od każdego obrazu i podziel przez odpowiadające odchylenie standardowe.
- Oblicz minimalne i maksymalne wartości intensywności ze znormalizowanego obrazu i przeskaluj obraz do zakresu 0–255, używając tych wartości minimalnych i maksymalnych dla każdego obrazu. Nie używaj wartości minimalnych i maksymalnych dla całego zbioru danych w tym kroku przeskalowania min-max.
- Przygotuj każdy przekrój CT Synapse jako dwuwymiarowy obraz w skali szarości. Konwertuj każdy przekrój CT na typ float32 i dodaj pojedynczy wymiar kanału, aby uzyskać tensor wejściowy o kształcie 1 × 224 × 224.
- Zachowaj każdą mapę etykiet Synapse jako jednokanałową maskę całkowitoliczbową o kształcie 224 × 224. Nie stosuj dodatkowej normalizacji średnia-SD na poziomie zbioru danych w ładowarce danych.
- Użyj wstępnie przetworzonych plików Synapse dostarczonych w formacie .npz dla przekrojów treningowych i w formacie .npy.h5 dla wolumenów testowych. Ładuj tablice obrazów i etykiet bezpośrednio z każdego pliku .npz podczas treningu i bezpośrednio z każdego pliku .npy.h5 podczas testów. Nie stosuj dodatkowego przycinania intensywności, okienkowania CT, normalizacji na poziomie zbioru danych ani ponownego próbkowania surowego wolumenu w udostępnionej ładowarce danych.
- Podczas trenowania modelu konwertuj każdy załadowany dwuwymiarowy przekrój na float32, zmień jego rozmiar do docelowego rozmiaru przestrzennego za pomocą scipy.ndimage.zoom z order = 3 dla przekrojów obrazów i order = 0 dla map etykiet, a następnie konwertuj zmienione tablice na tensory z pojedynczym wymiarem kanału.
- Zastosuj augmentację danych wyłącznie do zbioru treningowego. Dla ISIC 2017 i ISIC 2018 zastosuj losowe odbicie poziome (p = 0.5), losowe odbicie pionowe (p = 0.5) i losową rotację (p = 0.5) z kątem losowanym z zakresu 0° do 360°.
- Zastosuj tę samą transformację geometryczną do każdej pary obraz-maska. Podczas walidacji i testowania stosuj wyłącznie zmianę rozmiaru, normalizację i konwersję na tensor.
- Dla zbioru danych Synapse zastosuj losową rotację i losowe odbicie podczas treningu. Losowo obracaj każdą parę obraz-etykieta o k × 90°, gdzie k ∈ {0,1,2,3}, losowo odbijaj parę obraz-etykieta wzdłuż jednej osi przestrzennej lub losowo obracaj parę obraz-etykieta o kąt losowany z zakresu od −20° do 20°.
- Nie stosuj stochastycznej augmentacji podczas testowania.
- Zastosuj augmentację danych do zbioru danych Synapse, korzystając z wzajemnie wykluczających się gałęzi zaimplementowanych w transformacji RandomGenerator.
- Dla każdej próbki treningowej najpierw sprawdź warunek random.random() > 0.5. Jeśli warunek zostanie spełniony, zastosuj random_rot_flip, składający się z losowego obrotu o 90° (k = 0, 1, 2 lub 3), a następnie losowego odbicia wzdłuż jednej osi przestrzennej.
- Jeśli pierwsza gałąź nie zostanie wybrana, sprawdź drugi warunek, random.random() > 0.5. Jeśli ten warunek zostanie spełniony, zastosuj random_rotate, używając losowo wybranego kąta obrotu między −20° a 20°. Jeśli żaden z warunków nie zostanie spełniony, nie stosuj stochastycznej augmentacji do próbki.
- Zastosuj tę samą transformację zarówno do obrazu wejściowego, jak i do odpowiadającej mu mapy etykiet.
- Ustaw ziarno losowości (random seed) przed ładowaniem zbioru danych, wstępnym przetwarzaniem i treningiem. Użyj ziarna 1, 52 i 100 dla głównych eksperymentów porównawczych oraz ziarna 100 dla badań ablacyjnych, chyba że określono inaczej.
- Zainicjuj generatory liczb losowych Python, NumPy, PyTorch CPU, PyTorch CUDA i cuDNN przed skonstruowaniem ładowarki danych. Pozostaw partycje zbioru danych, procedury wstępnego przetwarzania, ustawienia augmentacji, parametry normalizacji, strategię zmiany rozmiaru i wstępne przetwarzanie ewaluacji niezmienione we wszystkich uruchomieniach z różnymi ziarnami.
- Ustaw num_workers = 0 dla eksperymentów ISIC i Synapse, aby przeprowadzić ładowanie danych w procesie głównym. Przed skonstruowaniem zbioru danych i utworzeniem DataLoadera, zainicjuj globalne ziarno losowości za pomocą funkcji set_seed, aby zainicjować generatory liczb losowych Python, NumPy, PyTorch CPU, PyTorch CUDA i cuDNN. Nie definiuj oddzielnej funkcji worker_init_fn ani generatora losowości specyficznego dla DataLoadera, ponieważ nie są one używane w udostępnionej implementacji.
2. Konstrukcja architektury MVM-UNet
- Zbuduj proponowaną sieć Multi-view Vision Mamba UNet (MVM-UNet), wykorzystując architekturę koder-dekoder w kształcie litery U.
- Ustaw wymiar obrazu wejściowego na H × W × 3. Prześlij obraz wejściowy przez warstwę embeddingu patchy.
- Zaimplementuj warstwę embeddingu patchy, używając splotu 2D o rozmiarze jądra 4 × 4, kroku (stride) 4, trzech kanałach wejściowych i 96 kanałach wyjściowych.
- Przekształć mapę cech wejściowych do rozdzielczości przestrzennej H/4 × W/4 z C = 96 kanałami wyjściowymi.
- Zbuduj cztery etapy kodera i cztery etapy dekodera. Po każdym etapie kodera zmniejsz rozdzielczość przestrzenną o połowę i podwoj wymiar kanałów.
- Zastosuj symetryczną konfigurację koder-dekoder. Ustaw liczbę bloków MVV w koderze i dekoderze na {2, 2, 2, 2}.
- Umieść dwa bloki MVV w każdym etapie kodera oraz dwa bloki MVV w każdym etapie dekodera.
- Wstaw blok MVV do każdego etapu kodera i dekodera. Wykorzystaj moduł MV4D jako główny moduł ekstrakcji cech wewnątrz każdego bloku MVV.
- Wstaw moduł MFusion Mamba pomiędzy koderem a dekoderem. Użyj tego modułu do fuzji wieloetapowych cech kodera przed dekodowaniem.
- Skonfiguruj ogólny przepływ pracy MVM-UNet. Wykorzystaj MV4D do ekstrakcji cech w całym koderze.
- Zachowaj wyjścia kodera jako połączenia pomijające (skip connections). Prześlij wyjścia kodera do odpowiadających im etapów dekodera.
- Prześlij cechy kodera do MFusion Mamba przed dekodowaniem. Stopniowo zwiększaj rozdzielczość (upsampling) zfuzowanej reprezentacji poprzez dekoder i wygeneruj końcową mapę segmentacji za pomocą głowicy segmentacji.
- Prześlij obraz wejściowy I ∈ ℝB×H×W×3 przez warstwę embeddingu patchy, aby otrzymać
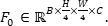 Gdzie C = 96.
- Wygeneruj mapy cech kodera: E1 ∈ ℝB×H/4×W/4×C, E2 ∈ ℝB×H/8×W/8×2C, E3 ∈ ℝB×H/16×W/16×4C oraz E4 ∈ ℝB×H/32×W/32×8C. Użyj bloków MVV zawierających MV4D w każdym etapie kodera.
- Zachowaj każdą cechę kodera dla odpowiadającego połączenia pomijającego. Prześlij wszystkie cechy kodera do MFusion Mamba w celu wieloetapowej fuzji cech.
- Dostosuj cechy kodera do wspólnej przestrzeni cech przed fuzją gruboziarnistą (coarse) i drobnoziarnistą (fine) wewnątrz MFusion Mamba. Prześlij zfuzowaną reprezentację do dekodera.
- Stopniowo zwiększaj rozdzielczość reprezentacji dekodera. Zfuzuj cechy dekodera z E3 przy H/16 × W/16, E2 przy H/8 × W/8 oraz E1 przy H/4 × W/4.
- Zwiększ rozdzielczość końcowej cechy dekodera do oryginalnej rozdzielczości obrazu. Wygeneruj mapę predykcji
 ∈ ℝB×H×W×K. Gdzie K = 1 dla binarnej segmentacji zmian chorobowych oraz K = 8 dla segmentacji wieloorganowej Synapse.
- Informacje o ogólnej architekturze sieci znajdują się na Rysunku 2, a pełna specyfikacja architektury warstwa po warstwie, w tym operacje, główne parametry i wymiary cech wyjściowych dla każdego etapu, w Tabeli uzupełniającej 1
- Warstwy przejścia koder–dekoder
- Zmniejsz rozdzielczość cech kodera, używając warstw przejścia patch-merging. Dla każdego przejścia pobierz cztery przestrzennie przeplatane grupy cech z sąsiedztwa 2 × 2, skonkatenuj je wzdłuż wymiaru kanałów, zastosuj normalizację warstwową (LayerNorm) i rzutuj wynikową cechę o wymiarze 4C na 2C kanałów za pomocą liniowej warstwy bez przesunięcia (bias-free). Operacja ta zmniejsza rozdzielczość przestrzenną dwukrotnie, jednocześnie podwajając wymiar kanałów.
- Zwiększ rozdzielczość cech dekodera, używając warstw przejścia patch-expanding. Zastosuj liniową projekcję bez przesunięcia, przestrzennie zreorganizuj rozszerzone cechy, aby zwiększyć rozdzielczość dwukrotnie, a następnie zastosuj LayerNorm po rozszerzeniu przestrzennym. Powtórz tę operację, aby stopniowo zrekonstruować mapy cech od H/32 × W/32 do H/16 × W/16, H/8 × W/8 oraz H/4 × W/4.
- Dostosuj cechy kodera w module MFusion Mamba, zmieniając ich rozmiar do docelowej rozdzielczości przestrzennej za pomocą interpolacji dwuliniowej (align_corners = False), a następnie stosując wyuczalną liniową projekcję kanałów przed fuzją cech.
- Głowica segmentacji
- Zwiększ rozdzielczość końcowej mapy cech dekodera z H/4 × W/4 do oryginalnej rozdzielczości obrazu (H × W) za pomocą końcowej warstwy patch-expanding. Zastosuj projekcję liniową, wykonaj reorganizację przestrzenną z czynnikiem rozszerzenia 4 i zastosuj LayerNorm.
- Rzutuj zrekonstruowaną mapę cech na K kanałów wyjściowych za pomocą splotu 1 × 1 po konwersji tensora do formatu channel-first.
- Wygeneruj końcową predykcję podczas ewaluacji, stosując funkcję aktywacji sigmoid dla binarnej segmentacji zmian chorobowych lub funkcję aktywacji softmax, a następnie argmax dla segmentacji wieloorganowej Synapse. Nie stosuj funkcji aktywacji wewnątrz samej głowicy segmentacji.
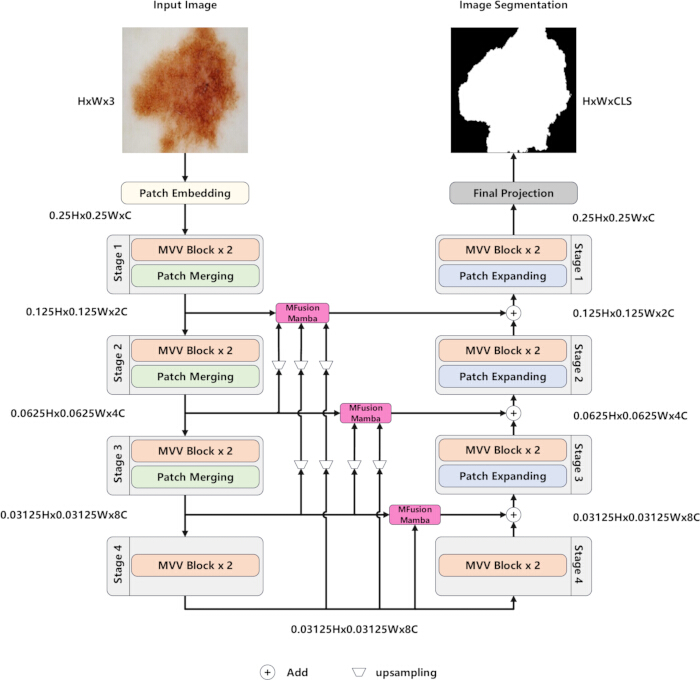
Rycina 2. Ogólna architektura Multi-View Mamba U-Net (MVM-UNet). Przegląd proponowanej architektury Multi-View Mamba U-Net (MVM-UNet). Obraz wejściowy jest konwertowany na osadzenia patchy (patch embeddings) i przetwarzany przez cztery etapy kodera, składające się z bloków Multi-View Vision (MVV) rozdzielonych operacjami łączenia patchy (patch-merging). Cechy kodera są agregowane przez Multi-stage Fusion Mamba (MFusion Mamba) i przekazywane do dekodera poprzez połączenia pomijające (skip connections). Dekoder stopniowo przywraca rozdzielczość przestrzenną, korzystając z operacji rozszerzania patchy (patch-expanding), a następnie generuje końcową mapę segmentacji za pomocą warstwy projekcji. Aby zobaczyć powiększoną wersję tej ryciny, kliknij tutaj.
3. Konstrukcja modułu MV4D
- Użyj modułu MV4D jako podstawowej jednostki ekstrakcji cech w bloku MVV. Wprowadź wejściowe fragmenty cech (feature patches) do czterech gałęzi par skanowania. Pełny pseudokod spłaszczania przestrzennego, konstrukcji indeksów par skanowania, gromadzenia sekwencji, przetwarzania S6/Mamba, odwróconego uporządkowania przestrzennego, fuzji par skanowania, fuzji SFusion Mamba, projekcji oraz zmiany kształtu wyjścia znajduje się w Algorytmie 1, Pliku uzupełniającym 1.
- Zastosuj dokładnie te same procedury generowania indeksów skanowania zygzakowatego, hierarchicznego, spiralnego i radialnego, które zostały zaimplementowane w models/mvmunet/core.py. Dla każdej strategii skanowania przyjmij kolejność skanowania w przód oraz kolejność odwrotną jako jedną dwukierunkową parę skanowania.
- Skonstruuj parę skanowania zygzakowatego. Przesuwaj się po cechach obrazu w naprzemiennych kierunkach na końcu każdego wiersza lub kolumny. Wykorzystaj ten wzór skanowania do zrównoważenia lokalnych i globalnych informacji przestrzennych.
- Skonstruuj parę skanowania hierarchicznego. Uchwyć cechy w wielu skalach przestrzennych. Wykorzystaj ten wzór skanowania do wzmocnienia ekstrakcji reprezentacji lokalnych i globalnych.
- Skonstruuj parę skanowania spiralnego. Skanuj cechy obrazu od środka w stronę krawędzi lub od krawędzi w stronę środka. Wykorzystaj ten wzór skanowania do poprawy ekstrakcji globalnych informacji o konturach.
- Skonstruuj parę skanowania radialnego. Skanuj cechy obrazu wzdłuż wielu kierunków promieniowych. Wykorzystaj ten wzór skanowania do poprawy ekstrakcji lokalnych szczegółów granic i krawędzi.
- Połącz każdą parę skanowania przed wprowadzeniem połączonej sekwencji do bloku S6. Zastosuj projekt parzysty, aby zwiększyć odporność każdej strategii skanowania przy zachowaniu wydajności obliczeniowej.
- Wprowadź sekwencję wyjściową z każdej gałęzi pary skanowania do bloku S6. Uzyskaj cztery reprezentacje cech odpowiadające widokom skanowania zygzakowatego, hierarchicznego, spiralnego i radialnego.
- Połącz cztery wyekstrahowane reprezentacje cech za pomocą modułu SFusion Mamba. Użyj dwóch równoległych ścieżek fuzji. W pierwszej ścieżce zintegruj cztery cechy poprzez dodawanie element po elemencie.
- W drugiej ścieżce SFusion Mamba dokonaj konkatenacji czterech cech. Przetwórz skonkatenowaną reprezentację za pomocą Conv1d i Mamba. Zredukuj wymiar kanału za pomocą warstwy projekcji, aby dopasować go do wymiaru wyjścia bloku S6.
- Skonfiguruj blok S6/Mamba, przyjmując wymiar cech C jako wymiar modelu. Użyj warstwy projekcji, aby zmapować każdą połączoną cechę pary skanowania z powrotem do wymiaru kanału C przed fuzją.
- W module SFusion Mamba wykonaj dodawanie element po elemencie w pierwszej ścieżce. W drugiej ścieżce dokonaj konkatenacji cech czterech widoków skanowania przed operacjami Conv1d, Mamba i projekcją liniową. Zastosuj operacje normalizacji, projekcji liniowej, splotu separowalnego w głębi (depth-wise separable convolution) oraz aktywacji otaczające MV4D, zgodnie z opisem w kroku 4.
- Zsumuj wyniki dwóch ścieżek fuzji, aby uzyskać końcowe wyjście modułu MV4D.
- Skonstruuj cztery komplementarne gałęzie par skanowania zamiast stosowania wyłącznie kierunków skanowania poziomego i pionowego. Użyj skanowania zygzakowatego, aby podkreślić ciągłe przemieszczanie się w przestrzeni, skanowania hierarchicznego do wzmocnienia reprezentacji wieloskalowej, skanowania spiralnego do uchwycenia informacji o konturach od środka do krawędzi oraz skanowania radialnego do poprawy ekstrakcji lokalnych szczegółów zorientowanych na granice.
- Przetwórz każdą gałąź pary skanowania niezależnie. Połącz wynikowe cechy za pomocą SFusion Mamba. Zmapuj każdą przetworzoną sekwencję z powrotem do jej pierwotnego porządku przestrzennego przed fuzją.
- Dla mapy cech wejściowych X ∈ ℝB×H×W×C, spłaszcz ją do postaci Xseq ∈ ℝB×L×C, gdzie L = H × W.
- Zmień kolejność spłaszczonej sekwencji zgodnie z indeksami skanowania dla każdej gałęzi pary skanowania. Przetwórz każdą uporządkowaną sekwencję za pomocą bloku S6. Przywróć przetworzoną sekwencję do pierwotnego porządku przestrzennego.
- Połącz cechy czterech widoków skanowania poprzez ścieżkę addytywną oraz ścieżkę SFusion Mamba, aby uzyskać końcowe wyjście MV4D. Architekturę MV4D przedstawiono na Rysunku 3, a pełny przebieg implementacji na poziomie tensorów znajduje się w Algorytmie 1, Pliku uzupełniającym 1.
- Użyj kompletnej implementacji programowej w models/mvmunet/core.py. Plik ten zawiera generatory indeksów skanowania, PairwiseScanMamba, SequenceS6, SFusion Mamba oraz moduł opakowujący MV4D.
- Generowanie wielowidokowych indeksów skanowania
- Wygeneruj indeksy skanowania zgodnie z udostępnioną implementacją w models/mvmunet/core.py. Dla mapy cech wejściowych o rozmiarze przestrzennym H × W, spłaszcz każdą lokalizację piksela do jednowymiarowego indeksu za pomocą wzoru: index = r × W + c, gdzie r i c oznaczają odpowiednio współrzędne wiersza i kolumny.
- Wygeneruj skan zygzakowaty, przechodząc przez przekątne obrazu o stałej wartości r + c. Zbierz prawidłowe indeksy pikseli dla każdej przekątnej i zmieniaj kierunek przejścia poprzez odwrócenie kolejności każdej parzystej przekątnej.
- Wygeneruj skan hierarchiczny poprzez rekurencyjny podział obrazu na cztery kwadranty. Odwiedzaj kolejno kwadranty: lewy górny, prawy górny, lewy dolny i prawy dolny, dopóki wysokość lub szerokość podregionu nie będzie mniejsza lub równa 2 pikselom, a następnie przejdź przez pozostałe piksele w kolejności wierszowej.
- Wygeneruj skan spiralny, przechodząc po zewnętrznej granicy obrazu od lewej do prawej wzdłuż górnego wiersza, w dół wzdłuż prawej kolumny, od prawej do lewej wzdłuż dolnego wiersza i w górę wzdłuż lewej kolumny, stopniowo zwężając granicę w stronę środka obrazu.
- Wygeneruj skan radialny, sortując każdy piksel zgodnie z kwadratem jego odległości od środka obrazu, a następnie zgodnie z kątem polarnym obliczonym za pomocą funkcji atan2.
- Wygeneruj skan odwrotny dla każdej strategii skanowania poprzez odwrócenie odpowiadającej mu kolejności skanowania w przód. Połącz sekwencje skanowania w przód i w tył, aby utworzyć jedną parę skanowania dla każdej strategii przed przekazaniem par skanowania do modułu MV4D.
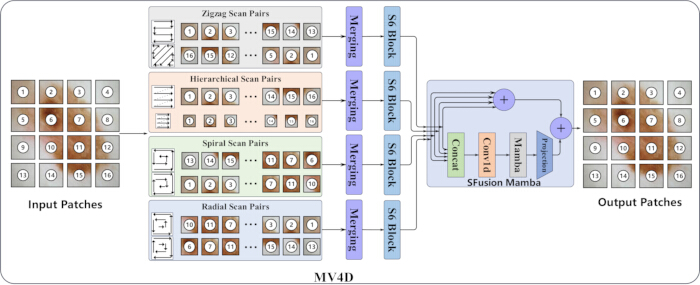
Rysunek 3. Architektura modułu Multi-View 4-Directional (MV4D). Struktura modułu ekstrakcji cech Multi-View 4-Directional (MV4D). Fragmenty wejściowe są przetwarzane przez cztery komplementarne gałęzie par skanowania, obejmujące skanowanie zygzakowate, hierarchiczne, spiralne i radialne. Cechy wyekstrahowane z czterech gałęzi są łączone, przetwarzane za pomocą bloków przestrzeni stanów i integrowane przez Spatial Fusion Mamba (SFusion Mamba) w celu wygenerowania wyjściowej reprezentacji cech. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
4. Konstrukcja bloku MVV
- Zbuduj blok MVV, wykorzystując jedną gałąź główną i dwie gałęzie pomocnicze. Zastosuj ogólną strukturę przedstawioną na Rysunku 4.
- Zastosuj normalizację warstwową (layer normalization) do cechy wejściowej w gałęzi głównej. Przekaż znormalizowaną cechę do warstwy liniowej. Następnie przekaż przekształconą cechę do splotu separowalnego głębokościowo (depth-wise separable convolution).
- Przetwórz przekształconą cechę za pomocą splotu separowalnego głębokościowo. Zastosuj funkcję aktywacji GELU. Przekaż aktywowaną cechę do modułu MV4D.
- Skonstruuj pierwszą gałąź pomocniczą jako tożsamościowe połączenie rezydualne (identity residual connection). Połącz cechę wejściową bezpośrednio z końcowym wyjściem. Wykorzystaj tę gałąź do zachowania oryginalnej reprezentacji i stabilizacji procesu uczenia.
- Skonstruuj drugą gałąź pomocniczą jako gałąź projekcji w dół-w górę (projection down-up branch). Skompresuj cechę wejściową za pomocą warstwy projekcji w dół. Przywróć wymiar cechy za pomocą warstwy projekcji w górę.
- Połącz wyjścia gałęzi głównej oraz obu gałęzi pomocniczych. Uzyskaj końcowe wyjście bloku MVV. Pełną architekturę przedstawiono na Rysunku 4.
- Ustaw wymiar ukryty gałęzi głównej równy wymiarowi kanału wejściowego Cs. Zastosuj LayerNorm(Cs) przed główną projekcją liniową i użyj warstwy liniowej o wymiarach Cs→Cs. Zastosuj splot separowalny głębokościowo składający się ze splotu głębokościowego 3×3 z dopełnieniem (padding) 1, groups = Cs i bez przesunięcia (bias), a następnie splotu punktowego (point-wise convolution) 1×1 bez przesunięcia.
- Zastosuj funkcję aktywacji GELU po splotcie separowalnym głębokościowo. Przekaż aktywowaną cechę do MV4D i zastosuj wyjściową projekcję liniową o wymiarach Cs→Cs. Skonfiguruj gałąź projekcji w dół-w górę, używając LayerNorm(Cs), współczynnika projekcji 4, projekcji w dół Cs→Cs/4, aktywacji GELU oraz projekcji w górę Cs/4→Cs.
- Połącz gałąź tożsamościową, gałąź projekcji w dół-w górę oraz przetworzoną przez drop-path gałąź główną za pomocą dodawania element po elemencie, aby uzyskać końcowe wyjście bloku MVV.
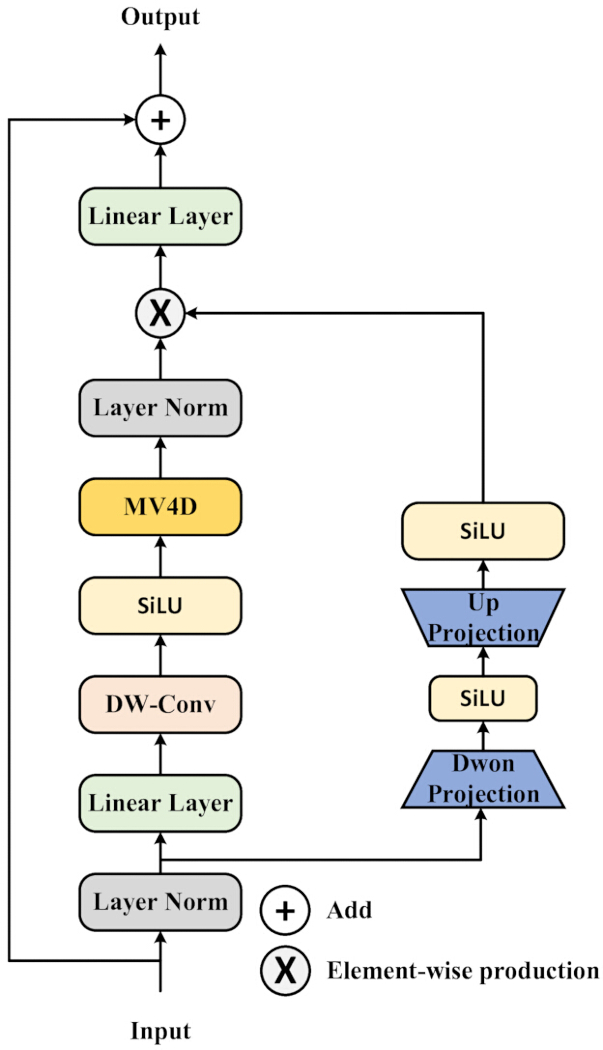
Rycina 4. Architektura bloku Multi-View Vision (MVV). Struktura bloku Multi-View Vision (MVV). Blok składa się z głównej gałęzi ekstrakcji cech zawierającej moduł Multi-View 4-Directional (MV4D) wraz z splotem głębokościowym (depthwise convolution), normalizacją i warstwami projekcji liniowej. Pomocnicza gałąź projekcji góra-dół zapewnia bramkowaną modulację cech poprzez mnożenie element po elemencie przed dodaniem rezydualnym w celu wygenerowania wyjściowej reprezentacji cech. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
5. Konstrukcja MFusion Mamba
- Zbierz mapy cech ze wszystkich etapów kodera. Dopasuj cechy kodera do ujednoliconej przestrzeni reprezentacji poprzez zmianę rozmiaru lub rzutowanie, jeśli jest to konieczne. Pełny przebieg implementacji na poziomie tensorów znajduje się w Algorytmie 2, Plik uzupełniający 1.
- W razie potrzeby zmień rozmiar cech kodera do docelowej rozdzielczości przestrzennej. Rzutuj cechy o różnych wymiarach kanałów do tego samego wymiaru kanału. Dopasuj wszystkie cechy kodera przed wieloetapową fuzją.
- Przekaż dopasowane cechy kodera do komponentu fuzji grubej (Coarse Fusion). Wykonaj fuzję grubą przy użyciu produktu Hadamarda. Wygeneruj reprezentację fuzji grubej.
- Przekaż reprezentację fuzji grubej do komponentu fuzji precyzyjnej (Fine Fusion). Skonstruuj dwie równoległe ścieżki fuzji precyzyjnej. Przetwórz obie ścieżki niezależnie.
- Przetwórz pierwszą ścieżkę fuzji precyzyjnej za pomocą warstwy liniowej. Przetwórz drugą ścieżkę fuzji precyzyjnej za pomocą up-projection, Conv1d, Mamba i down-projection. Przywróć wymiar cech po operacji down-projection.
- Połącz wyjścia dwóch ścieżek fuzji precyzyjnej przy użyciu produktu Hadamarda. Zastosuj końcową warstwę liniową. Uzyskaj wyjście MFusion Mamba.
- Przekaż wyjście MFusion Mamba do dekodera. Zdekoduj fuzjonowaną reprezentację wieloetapową wraz z cechami pomostowymi (skip features) kodera-dekodera. Wygeneruj końcową mapę segmentacji.
- Dopasuj cechy kodera z różnych etapów do ujednoliconej przestrzeni cech przed fuzją grubą. Przetwórz dopasowane reprezentacje cech w etapach fuzji grubej i precyzyjnej. Architekturę MFusion Mamba przedstawiono na Rysunku 5, a pełny przebieg implementacji na poziomie tensorów znajduje się w uzupełniającym Algorytmie 2.
- Parametry implementacji MFusion Mamba należy ustawić w następujący sposób: dla każdej cechy kodera Ei rzutuj wymiar kanału z Ci do Ct. W razie potrzeby zmień rozmiar rzutowanych cech do docelowego rozmiaru przestrzennego, stosując interpolację biliniową z parametrem align_corners=False.
- Zastosuj produkt Hadamarda, aby przeprowadzić fuzję grubą (Coarse Fusion) dopasowanych cech kodera. Skonfiguruj pierwszą ścieżkę fuzji precyzyjnej za pomocą warstwy liniowej o wymiarach Ct → Ct. Skonfiguruj drugą ścieżkę fuzji precyzyjnej za pomocą up-projection Ct → 2Ct, Conv1d, bloku Mamba/S6 o wymiarze modelu 2Ct, jednym kierunku skanowania, wymiarze stanu 16 oraz down-projection 2Ct → Ct.
- Zfuzuj wyjścia ścieżek fuzji precyzyjnej przy użyciu produktu Hadamarda. Zastosuj końcowe rzutowanie liniowe o wymiarach od Ct do Ct. Przekaż fuzjonowaną reprezentację wieloetapową do dekodera.
- Fuzja wieloetapowych cech kodera przy użyciu MFusion Mamba:
- Zbierz cechy kodera ze wszystkich czterech etapów kodera (E1, E2, E3 i E4) i użyj ich jako wejścia do modułu MFusion Mamba. Do fuzji w dekoderze nie wybieraj tylko cech kodera z odpowiadającego etapu.
- Dopasuj wszystkie cechy kodera do rozdzielczości przestrzennej wymaganej dla bieżącego etapu dekodera. Przed fuzją cech zmień rozmiar cech kodera do docelowej rozdzielczości i rzutuj je na wymagany wymiar kanału.
- Powtórz procedurę dopasowania cech dla każdego etapu dekodera. Gdy dekoder pracuje w rozdzielczościach H/16 × W/16, H/8 × W/8 i H/4 × W/4, zmień rozmiar i rzutuj E1, E2, E3 oraz E4 do odpowiedniej docelowej przestrzeni cech.
- Zfuzuj dopasowane wieloetapowe cechy kodera za pomocą operacji fuzji grubej (Coarse Fusion) i precyzyjnej (Fine Fusion) modułu MFusion Mamba, a następnie połącz fuzjonowaną reprezentację z cechami dekodera w odpowiadającej skali.
- Wykonaj operacje rzutowania cech, zmiany rozmiaru i fuzji zgodnie z udostępnioną implementacją w pliku models/mvmunet/core.py.
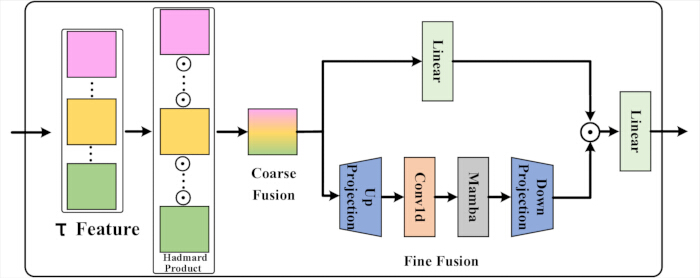
Rycina 5. Architektura modułu Multi-stage Fusion Mamba (MFusion Mamba). Struktura modułu Multi-stage Fusion Mamba (MFusion Mamba). Cechy z kodera wieloskalowego są najpierw łączone za pomocą fuzji grubej (coarse fusion), a następnie dopracowywane w module fuzji precyzyjnej (Fine Fusion), składającym się z projekcji liniowej, splotu jednowymiarowego (Conv1d), bloku Mamba oraz warstw projekcji cech, przed wygenerowaniem scalonej reprezentacji cech wykorzystywanej przez dekoder. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
6. Trenowanie modelu
- Wytrenuj model MVM-UNet w systemie Ubuntu 22.04.1 z jądrem Linux w wersji 6.8.0. Wykorzystaj stację roboczą wyposażoną w procesor Intel Core i9-13900K 13. generacji oraz układ GPU NVIDIA A800. Przez cały proces trenowania i ewaluacji stosuj tę samą konfigurację sprzętową.
- Zaimplementuj i wytrenuj model przy użyciu PyTorch 2.0.1 z CUDA 11.8. Przed rozpoczęciem trenowania zainstaluj wszystkie wymagane zależności programowe.
- Użyj optymalizatora AdamW z początkową prędkością uczenia 3 × 10⁻⁵, β1 = 0.9, β2 = 0.999, ε = 1 × 10⁻⁸ oraz współczynnikiem zaniku wag (weight decay) wynoszącym 0.01. Ustaw wielkość partii (batch size) na 32, chyba że określono inaczej.
- Trenuj każdy model przez 300 epok. Zastosuj harmonogram prędkości uczenia oparty na wyżarzaniu cosinusoidalnym (cosine annealing) z ηmin = 1 × 10⁻⁵. Ustaw rozmiar obrazu wejściowego na 256 × 256 dla zestawów ISIC 2017 i ISIC 2018 oraz na 224 × 224 dla Synapse.
- W głównych eksperymentach porównawczych wykorzystaj trzy niezależne ziarna losowości (1, 52 i 100). Powtórz pełną procedurę trenowania i ewaluacji dla każdego ziarna. Końcowe wyniki ilościowe przedstaw jako średnią ± SD z trzech uruchomień.
- We wszystkich badaniach ablacyjnych stosuj stałe ziarno losowości 100, chyba że określono inaczej. Pozostaw bez zmian podział zbiorów danych, strategię preprocessingu, architekturę sieci, optymalizator, prędkość uczenia, wielkość partii oraz liczbę epok treningowych we wszystkich eksperymentach ablacyjnych.
- W przypadku binarnej segmentacji zmian w zestawach ISIC 2017 i ISIC 2018 użyj funkcji straty BCE-Dice. Ustaw wagi dla strat BCE i Dice na 1.0. Dla Synapse użyj funkcji straty CE-Dice i ustaw wagi zarówno dla entropii krzyżowej, jak i straty Dice na 1.0.
- Zmień rozmiar, znormalizuj i rozszerz (augmentuj) obrazy treningowe ISIC 2017 oraz ISIC 2018, stosując procedurę preprocessingu opisaną w kroku 1. W przypadku obrazów treningowych Synapse zastosuj zmianę rozmiaru, losową rotację i losowe odbicie lustrzane zgodnie z opisem w kroku 1. Przez wszystkie cykle trenowania stosuj identyczne ustawienia preprocessingu.
- Wybieraj punkty kontrolne (checkpoints) modelu zgodnie z protokołem walidacji specyficznym dla danego zbioru danych. Dla ISIC 2017 i ISIC 2018 zapisuj punkt kontrolny z najlepszymi wynikami walidacji, przeprowadzając walidację co 30 epok. Trenuj Synapse przez 300 epok bez zbioru walidacyjnego i do testowania wykorzystaj końcowy punkt kontrolny trenowania.
- Oficjalny zbiór walidacyjny wykorzystuj wyłącznie do wyboru modelu w przypadku ISIC 2017 i ISIC 2018. Nie używaj zbioru testowego Synapse do trenowania, dostrajania hiperparametrów ani wyboru punktów kontrolnych. Wszystkie dane testowe zastrzeż wyłącznie do końcowej ewaluacji.
- W celu zapewnienia powtarzalności zastosuj następujące parametry trenowania. Ustaw wielkość partii na 32 dla wszystkich zbiorów danych. Użyj optymalizatora AdamW z początkową prędkością uczenia 3 × 10⁻⁵, β1 = 0.9, β2 = 0.999, ε = 1 × 10⁻⁸ oraz współczynnikiem zaniku wag 1 × 10⁻².
- Skonfiguruj harmonogram prędkości uczenia z wyżarzaniem cosinusoidalnym z Tmax = 50 i ηmin = 1×10⁻⁵ dla ISIC 2017 i ISIC 2018. Dla Synapse skonfiguruj harmonogram z Tmax = 100 i ηmin = 1×10⁻⁵. Pozostaw konfigurację harmonogramu bez zmian we wszystkich powtórzeniach eksperymentów.
- Trenuj wszystkie modele z wykorzystaniem arytmetyki pełnej precyzji FP32. Wyłącz automatyczny trening z mieszaną precyzją (automatic mixed-precision). Nie stosuj przycinania gradientów (gradient clipping) podczas optymalizacji.
- Utrzymuj niezmienione ustawienia precyzji, strategię aktualizacji gradientów, konfigurację optymalizatora, harmonogram prędkości uczenia oraz protokół ziarna losowości we wszystkich eksperymentach porównawczych, badaniach ablacyjnych i uruchomieniach w celu weryfikacji powtarzalności.
- Wybierz najlepszy punkt kontrolny modelu:
- Ewaluuj model na zbiorze walidacyjnym po każdej epoce treningowej dla zbiorów danych ISIC 2017 i ISIC 2018.
- Oblicz stratę Binary Cross-Entropy (BCE)-Dice dla każdej partii walidacyjnej i wyznacz średnią stratę walidacyjną dla całego zbioru walidacyjnego.
- Zapisz aktualny model jako najlepszy punkt kontrolny, gdy średnia strata walidacyjna będzie niższa od wcześniej odnotowanego minimum straty walidacyjnej.
- Podczas walidacji rejestruj średni współczynnik Intersection over Union (mIoU), współczynnik podobieństwa Dice (DSC), dokładność (Acc), swoistość (Spe) oraz czułość (Sen) wyłącznie w celu monitorowania wydajności. Nie stosuj tych metryk jako kryterium wyboru punktu kontrolnego.
7. Ocena modelu
- Oceń wytrenowany model, wykorzystując oficjalny zestaw testowy dla każdego zbioru danych. Zestaw testowy należy wykorzystać wyłącznie do końcowej oceny wydajności.
- Dla zbiorów ISIC 2017 i ISIC 2018 oblicz wartości mIoU, DSC, Acc, Sen i Spe. We wszystkich obliczeniach należy wykorzystać liczbę prawdziwie dodatnich (TP), fałszywie dodatnich (FP), prawdziwie ujemnych (TN) i fałszywie ujemnych (FN) wyników na poziomie piksela.
- Zastosuj sigmoidlaną funkcję aktywacji do wyjścia modelu dla zbiorów ISIC 2017 oraz ISIC 2018. Przekształć mapę prawdopodobieństwa w binarną maskę segmentacji, stosując próg 0,5. Oblicz miary ewaluacyjne przy użyciu Równania 2–6:
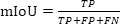 (2)
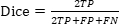 (3)
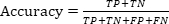 (4)
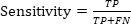 (5)
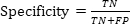 (6)
- W przypadku zbioru Synapse zastosuj funkcję aktywacji softmax do wyjścia modelu. Przypisz każdy piksel lub woksel do klasy o najwyższym prawdopodobieństwie, wykorzystując operację argmax. Oblicz współczynnik DSC oraz odległość Hausdorffa z 95. percentylem (HD95) dla każdego organu w obszarze pierwszego planu i podaj wartości średnie dla wszystkich przypadków testowych.
- Porównaj model MVM-UNet z reprezentatywnymi metodami segmentacji opartymi na sieciach CNN, Transformerach oraz modelach przestrzeni stanów (SSM). Dla wszystkich metod zastosuj identyczne podziały zbioru danych, procedury przetwarzania wstępnego, rozdzielczości wejściowe oraz metryki oceny.
- Należy wykorzystać oficjalne partycje treningowe, walidacyjne i testowe dla zbiorów ISIC 2017 oraz ISIC 2018. W przypadku zbioru Synapse należy zastosować standardowy podział na 18 przypadków treningowych i 12 przypadków testowych. Rozdzielczość wejściową należy ustawić na [wartość] dla zbiorów ISIC oraz na [wartość] dla zbioru Synapse.
- Metody bazowe należy odtworzyć z wykorzystaniem ich oficjalnych implementacji, o ile są one dostępne. Wyniki odtworzone należy raportować jako średnią ± SD z powtórzonych serii pomiarowych. Wartości zgłoszone w literaturze należy zachować w formie oryginalnej publikacji i wyraźnie odróżnić je w odpowiednich uwagach do tabel.
- Przeprowadź badania ablacyjne, korzystając ze stałego ziarna losowości (random seed) wynoszącego 100, chyba że określono inaczej. Pozostaw podziały zbioru danych, procedurę wstępnego przetwarzania, rozdzielczość wejściową, optymalizator, harmonogram tempa uczenia, wielkość partii (batch size), liczbę epok, funkcję straty oraz metryki ewaluacji bez zmian we wszystkich eksperymentach ablacyjnych.
- Oceń wkład MV4D, SFusion Mamba, odgałęzienia projekcji w górę i w dół (Up-Down Projection branch) w bloku MVV, MFusion Mamba, rozmiaru obrazu wejściowego, wartości dropout oraz konfiguracji warstw kodera-dekodera. W każdym eksperymencie ablacyjnym modyfikuj wyłącznie docelowy komponent lub parametr.
- Przeprowadź test znaków rang Wilcoxona, wykorzystując sparowane wyniki dla każdego obrazu w przypadku zbiorów ISIC 2017 i ISIC 2018 oraz sparowane wyniki dla każdego przypadku w przypadku zbioru Synapse. Przyjmij, że wartość p mniejsza niż 0,05 wskazuje na istotność statystyczną.
- Oceń wydajność obliczeniową, wykorzystując to samo środowisko sprzętowe i rozdzielczość danych wejściowych dla wszystkich metod. Zmierz czas trenowania na jedną epokę, czas inferencji na obraz, szczytowe zużycie pamięci GPU podczas trenowania, liczbę parametrów modelu oraz liczbę operacji zmiennoprzecinkowych (FLOPs). Oblicz FLOPs na podstawie pojedynczego przejścia w przód (forward pass).
- Wybierz reprezentatywne przykłady jakościowe wyłącznie ze zbioru testowego po zakończeniu ewaluacji modelu. Porównaj oryginalny obraz, maskę referencyjną (ground-truth) oraz maskę przewidzianą, stosując identyczne przypadki testowe we wszystkich metodach. Wybierz reprezentatywne przykłady obejmujące małe cele, nieregularne krawędzie, niejednoznaczne krawędzie oraz reprezentatywne struktury wieloorganowe.
- Oblicz wskaźniki oceny i przeprowadź analizę statystyczną
- Oblicz wskaźniki segmentacji dla zbiorów danych ISIC 2017 i ISIC 2018 w języku Python, wykorzystując biblioteki NumPy oraz sklearn.metrics.confusion_matrix. Zastosuj próg 0,5 dla mapy prawdopodobieństwa predykcji, wyznacz wartości TP, FP, TN i FN na poziomie piksela, a następnie na podstawie tych wartości oblicz mIoU, DSC, Acc, Sen i Spe.
- Oblicz współczynnik DSC oraz HD95 dla zbioru danych Synapse, korzystając odpowiednio z funkcji medpy.metric.binary.dc oraz medpy.metric.binary.hd95. Przed obliczeniem metryk ewaluacyjnych zastosuj funkcję softmax, a następnie argmax do wyników modelu.
- Oblicz liczbę operacji FLOPs oraz trenowalnych parametrów, korzystając z funkcji thop.profile podczas jednego przejścia w przód.
- Wykonaj test znakowy Wilcoxona w języku Python, korzystając z funkcji scipy.stats.wilcoxon. Użyj sparowanych wartości metryk dla każdego obrazu w przypadku zbiorów danych ISIC 2017 i ISIC 2018 oraz sparowanych wartości metryk dla każdego przypadku w przypadku zbioru danych Synapse.
8. Definicja funkcji straty
- W przypadku segmentacji wieloklasowej należy zastosować standardową funkcję straty entropii krzyżowej (CE), a w przypadku segmentacji binarnej standardową funkcję straty BCE. Do segmentacji należy użyć standardowej formuły straty Dice. Równania 7–11 definiują funkcje straty wykorzystane w niniejszym protokole.
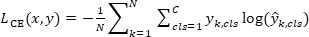 (7)
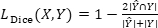 (8)
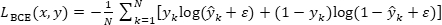 (9)
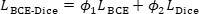 (10)
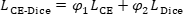 (11)
- Dla zbiorów ISIC 2017 i ISIC 2018 ustaw wagi straty BCE i Dice na 1.0, tak aby
 1 = 1.0 oraz 2 = 1.0. Dla zbioru Synapse ustaw wagi straty CE i Dice na 1.0, tak aby φ1 = 1.0 oraz φ2 = 1.0.
- Zaimplementuj funkcje straty w pliku utils.py. Do członu BCE użyj nn.BCELoss, a do członu CE nn.CrossEntropyLoss. Binarną stratę Dice oblicz poprzez spłaszczenie każdej przewidzianej maski oraz maski rzeczywistej (ground-truth), obliczenie straty Dice dla każdej próbki i wyciągnięcie średniej straty z całej partii (batch). Wieloklasową stratę Dice oblicz poprzez konwersję mapy etykiet docelowych do formatu one-hot, zastosowanie funkcji softmax do wyjścia modelu, obliczenie straty Dice dla każdej klasy i wyciągnięcie średniej straty ze wszystkich klas.
- Ustaw stałą wygładzania (smoothing constant) na 1 dla binarnej straty Dice oraz na 1×10⁻⁵ dla wieloklasowej straty Dice. Zaimplementuj stratę BCE-Dice za pomocą klasy BceDiceLoss z parametrami wb = 1 i wd = 1. Zaimplementuj stratę CE-Dice za pomocą klasy CeDiceLoss z parametrem loss_weight = [1, 1]. Pozostaw stałe wygładzania, strategię redukcji oraz implementację programową bez zmian dla wszystkich zbiorów danych, ziarn (random seeds) i eksperymentów.
- Skonfiguruj redukcję straty:
- Utwórz instancje nn.BCELoss() i nn.CrossEntropyLoss() bez jawnego określania argumentu reduction.
- Dla obu funkcji straty zastosuj domyślne ustawienie redukcji PyTorch (reduction = "mean"). Nie używaj reduction = "sum" ani wyjścia straty bez redukcji.
9. Ustawienia i wykonanie powtarzalności
- Pobrać udostępnioną implementację ze strony https://github.com/LIXUEGUANG002/MVM-UNet. Korzystać z repozytorium wraz z pakietami oprogramowania, zestawami danych, specyfikacjami sprzętowymi i zasobami obliczeniowymi wymienionymi w Tabeli Materiałów.
- Sklonować repozytorium i wejść do katalogu projektu, wykonując polecenie git clone https://github.com/LIXUEGUANG002/MVM-UNet.git, a następnie cd MVM-Unet.
- Skonfigurować eksperyment ISIC 2017 lub ISIC 2018, ustawiając nazwę zestawu danych, ścieżkę do zestawu danych, rozmiar wejścia, wielkość partii (batch size), liczbę epok, funkcję straty, optymalizator, harmonogram tempa uczenia (learning-rate scheduler) oraz ziarno losowe (random seed) w pliku configs/config_setting.py. Uruchomić skrypt treningowy z głównego katalogu repozytorium za pomocą polecenia python train.py.
- Skonfigurować eksperyment Synapse, ustawiając nazwę zestawu danych, ścieżkę do danych treningowych, ścieżkę do wolumenów testowych, katalog list, rozmiar wejścia, liczbę klas, wielkość partii (batch size), liczbę epok, funkcję straty, optymalizator, harmonogram tempa uczenia (learning-rate scheduler) oraz ziarno losowe (random seed) w pliku configs/config_setting_synapse.py. Uruchomić skrypt treningowy z głównego katalogu repozytorium za pomocą polecenia python train_synapse.py.
- Przeprowadzić ewaluację opartą wyłącznie na inferencji, ustawiając only_test_and_save_figs = True, best_ckpt_path na ścieżkę do wytrenowanego punktu kontrolnego (checkpoint) oraz img_save_path na katalog wyjściowy w odpowiednim pliku konfiguracyjnym. Uruchomić python train.py dla ISIC 2017 lub ISIC 2018, lub python train_synapse.py dla Synapse, aby wygenerować wyniki predykcji i ryciny jakościowe.
- Użyć udostępnionej wersji kodu źródłowego:
- Sklonować udostępnione repozytorium GitHub i wybrać commit ee891b42c2f083c4990eed72f1d4463adc5e103e w gałęzi master przed konfiguracją zestawów danych, skryptów treningowych i ustawień ewaluacji.
- Użyć tego commita w celu odtworzenia eksperymentów opisanych w niniejszym badaniu. W momencie rewizji manuskryptu w repozytorium nie była dostępna oznaczona wersja wydawnicza (tagged release version).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Oczekiwane wyniki i interpretacja
Przy prawidłowej implementacji niniejszego protokołu oczekuje się, że wytrenowany model MVM-UNet zapewni stabilną wydajność segmentacji w powtórzonych uruchomieniach, z jedynie niewielkimi różnicami pomiędzy różnymi ziarnami losowości (random seeds) dla większości metryk ewaluacyjnych. W przypadku zbiorów ISIC 2017 i ISIC 2018 pomyślne wyniki objawiają się wysokimi wartościami DSC, mIoU, Acc, Sen i Spe, wraz z przewidzianymi maskami zmian, które ściśle odpowiadają gr...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Ten protokół opisuje MVM-UNet, strukturę segmentacji obrazów medycznych opartą na Mamba. Metoda została zaprojektowana, aby rozwiązać dwie ograniczenia istniejących modeli segmentacji. Po pierwsze, konwencjonalne metody oparte na CNN mają ograniczoną zdolność do modelowania zależności dalekiego zasięgu i hierarchicznych informacji kontekstowych w złożonych obrazach medycznych43. Po drugie, metody oparte na Transformerach mogą modelować globalny kontekst, ale zwykle wymagają wyższych kosztów oblicz...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy deklarują, że nie mają żadnych konkurencyjnych interesów finansowych.
Podziękowania
To badanie nie otrzymało żadnego zewnętrznego finansowania.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Hardware - GPU workstation or GPU server | Institutional computing platform / local workstation | Custom-built local GPU workstation; Ubuntu 22.04.1 with Linux kernel 6.8.0; Intel Core i9-13900K CPU; NVIDIA A800 GPU; 128 GB RAM; 512 GB local storage. | Computational platform for training, validation, testing, ablation, and inference-only experiments. |
| Hardware - Graphics processing unit (GPU) | NVIDIA Corporation | NVIDIA A800 GPU (80 GB memory). | GPU-accelerated model training and inference. |
| Hardware - Central processing unit (CPU) | Intel Corporation / AMD | 13th Gen Intel Core i9-13900K CPU. | Host processor for data loading, preprocessing, and experiment execution. |
| Hardware - System memory (RAM) | Institutional computing platform / local workstation | 128 GB system RAM | Memory for dataset loading, preprocessing, and training. |
| Hardware - Storage | Institutional computing platform / local workstation | 2 TB NVMe solid-state drive. | Storage for datasets, checkpoints, logs, and generated prediction figures. |
| Software environment - Operating system | Canonical Ltd. | Recommended: Ubuntu 22.04.1 LTS | Operating system for the computational environment. |
| Software environment - Conda environment | Anaconda, Inc. / Miniconda | Environment name: mvmunet | Python environment used to install and isolate dependencies. |
| Software environment - Python | Python Software Foundation | Python 3.8 | Programming language used for implementation and experiment execution. |
| Software environment - CUDA toolkit | NVIDIA Corporation | CUDA Toolkit 11.8 | GPU computing backend required by PyTorch and Mamba-related packages. |
| Software environment - cuDNN | NVIDIA Corporation | cuDNN 8.7.0. | GPU-accelerated deep-learning primitives used through PyTorch. |
| Python package - PyTorch | PyTorch | torch == 2.0.1 | Deep-learning framework for model training, loss calculation, optimization, and inference. |
| Python package - Torchvision | PyTorch | torchvision == 0.14.0 | Image transform utilities used in preprocessing and augmentation. |
| Python package - Torchaudio | PyTorch | torchaudio == 0.13.0 | Installed with the recommended PyTorch environment. |
| Python package - timm | timm developers | timm == 0.4.12 | Model-component or utility dependency listed in the repository environment instructions. |
| Python package - triton | OpenAI / Triton developers | triton == 2.0.0 | Dependency used by GPU-accelerated sequence modeling components. |
| Python package - causal-conv1d | causal-conv1d developers | causal_conv1d == 1.0.0 | Efficient causal convolution dependency required by the Mamba implementation. |
| Python package - mamba-ssm | Mamba SSM developers | mamba_ssm == 1.0.1 | State-space sequence modeling package used for Mamba/S6-related components. |
| Python package - NumPy | NumPy developers | NumPy version 1.24.3. | Numerical computation and array operations. |
| Python package - SciPy | SciPy developers | SciPy version 1.10.1. | Scientific computation; scipy.ndimage.zoom is imported in utils.py. |
| Python package - SimpleITK | Insight Software Consortium | SimpleITK version 2.2.1. | Medical image input/output and preprocessing utility imported in utils.py. |
| Python package - MedPy | MedPy developers | MedPy version 0.4.0. | Medical image metric calculation package imported in utils.py. |
| Python package - scikit-image | scikit-image developers | scikit-image version 0.21.0. | Image-processing dependency listed in README. |
| Python package - scikit-learn | scikit-learn developers | scikit-learn version 1.3.2. | Machine-learning utility package listed in README. |
| Python package - matplotlib | Matplotlib developers | Matplotlib version 3.7.2. | Used for saving qualitative visualization figures. |
| Python package - h5py | h5py developers | h5py version 3.9.0. | HDF5 file support for Synapse test volumes. |
| Python package - thop | THOP developers | THOP version 0.1.1.post2209072238. | Used when calculating FLOPs and parameter-related computational cost. |
| Python package - packaging | Python Packaging Authority | packaging version 23.1. | Dependency listed in README. |
| Python package - pytest | pytest developers | pytest version 7.4.0. | Dependency listed in README. |
| Python package - chardet | chardet developers | chardet version 5.2.0. | Dependency listed in README. |
| Python package - yacs | YACS developers | yacs version 0.1.8. | Configuration utility dependency listed in README. |
| Python package - termcolor | termcolor developers | termcolor version 2.3.0. | Logging/terminal utility dependency listed in README. |
| Python package - submitit | submitit developers | submitit version 1.4.5. | Experiment/job utility dependency listed in README. |
| Python package - tensorboardX | tensorboardX developers | tensorboardX version 2.6.2.2. | Training log visualization utility listed in README. |
| Python package - ml-collections | ml_collections developers | ml-collections version 0.1.1. | Imported by configs/config_setting_synapse.py. |
| Dataset - ISIC 2017 Challenge dataset | International Skin Imaging Collaboration | ISIC 2017 skin lesion segmentation dataset | Public de-identified dermoscopic skin lesion images and masks used for binary segmentation. |
| Dataset - ISIC 2018 Challenge Task 1 dataset | International Skin Imaging Collaboration | ISIC 2018 Task 1: Lesion Boundary Segmentation | Public de-identified dermoscopic skin lesion images and masks used for binary segmentation. |
| Dataset - Synapse Multi-Atlas Labeling Beyond the Cranial Vault dataset | Synapse / Sage Bionetworks | Accession identifier: syn3193805 | Public abdominal CT multi-organ segmentation dataset. |
| Data organization - ISIC 2017 data folder | Authors / repository layout | data/isic2017/ | Expected local folder containing train and validation images/masks. |
| Data organization - ISIC 2018 data folder | Authors / repository layout | data/isic2018/ | Expected local folder containing train and validation images/masks. |
| Data organization - Synapse data folder | Authors / repository layout | data/Synapse/ | Expected local folder for Synapse lists, train_npz, and test_vol_h5. |
| Source code - MVM-UNet source-code repository | Authors / GitHub | Branch: master;Git commit hash: ee891b42c2f083c4990eed72f1d4463adc5e103e. | Complete source-code implementation of the protocol. |
| Source code - ISIC configuration file | Authors | configs/config_setting.py | Configuration file for ISIC-style binary segmentation. |
| Source code - Synapse configuration file | Authors | configs/config_setting_synapse.py | Configuration file for Synapse multi-organ segmentation. |
| Source code - ISIC training script | Authors | train.py | Training and validation entry point for ISIC-style binary segmentation. |
| Source code - Synapse training script | Authors | train_synapse.py | Training and validation entry point for Synapse multi-class segmentation. |
| Source code - |
Bibliografia
- Zhang F, et al. Cross co-teaching for semi-supervised medical image segmentation. Pattern Recognit. 2024;152:110485.
- Gu Y, et al. Dual-scale enhanced and cross-generative consistency learning for semi-supervised medical image segmentation. Pattern Recognit. 2025;158:111140.
- Zhu X, Wang W, Zhang C, Wang H. Polyp-Mamba: A hybrid multi-frequency perception gated selection network for polyp segmentation. Inf Fusion. 2025;115:103161.
- Iqbal S, et al. TBConvL-Net: A hybrid deep learning architecture for robust medical image segmentation. Pattern Recognit. 2025;158:111147.
- Zhao Z, et al. Balanced feature fusion collaborative training for semi-supervised medical image segmentation. Pattern Recognit. 2025;157:110986.
- Zhou T, et al. MambaYOLACT: You only look at Mamba prediction head for head-neck lymph nodes. Artif Intell Rev. 2025;58(6).
- Zhao Y, et al. MGF-GCN: Multimodal interaction Mamba-aided graph convolutional fusion network for semantic segmentation of remote sensing images. Inf Fusion. 2025;122:103268.
- Ronneberger O, Fischer P, Brox T. U-Net: Convolutional networks for biomedical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2015.
- Zhou Z, Siddiquee MMR, Tajbakhsh N, Liang J. UNet++: Redesigning skip connections to exploit multiscale features in image segmentation. IEEE Trans Med Imaging. 2019;39(6):1856-1867.
- Shaker A, et al. UNETR++: Delving into efficient and accurate 3D medical image segmentation. IEEE Trans Med Imaging. 2024;43(9):3377-3390.
- Zhou HY, et al. nnFormer: Volumetric medical image segmentation via a 3D Transformer. IEEE Trans Image Process. 2023;32:4036-4045.
- He A, et al. H2Former: An efficient hierarchical hybrid Transformer for medical image segmentation. IEEE Trans Med Imaging. 2023;42(9):2763-2775.
- Zhu L, et al. Vision Mamba: Efficient visual representation learning with bidirectional state space model. In: Proceedings of the 41st International Conference on Machine Learning (ICML). 2024.
- Liu Y, et al. VMamba: Visual state space model. Adv Neural Inf Process Syst. 2024;37:103031-103063.
- Ma J, Li F, Wang B. U-Mamba: Enhancing long-range dependency for biomedical image segmentation. arXiv. 2024;arXiv:2401.04722.
- Wang Z, et al. Mamba-UNet: UNet-like pure visual Mamba for medical image segmentation. arXiv. 2024;arXiv:2402.05079.
- Huang T, et al. LocalMamba: Visual state space model with windowed selective scan. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Zhang Z, et al. Motion Mamba: Efficient and long sequence motion generation. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Hu VT, et al. Zigma: A DiT-style zigzag Mamba diffusion model. In: European Conference on Computer Vision (ECCV). Springer; 2024.
- Rahman MM, et al. Mamba in vision: A comprehensive survey of techniques and applications. arXiv. 2024;arXiv:2410.03105.
- Falk T, et al. U-Net: Deep learning for cell counting, detection, and morphometry. Nat Methods. 2019;16(1):67-70.
- Gu R, et al. CA-Net: Comprehensive attention convolutional neural networks for explainable medical image segmentation. IEEE Trans Med Imaging. 2020;40(2):699-711.
- Chen J, et al. TransUNet: Rethinking the U-Net architecture design for medical image segmentation through the lens of Transformers. Med Image Anal. 2024;97:103280.
- Zhang Z, Zhang W. Pyramid medical Transformer for medical image segmentation. arXiv. 2021;arXiv:2104.14702.
- Cao H, et al. Swin-Unet: UNet-like pure Transformer for medical image segmentation. In: European Conference on Computer Vision (ECCV). Springer; 2022.
- Chen B, et al. TransAttUNet: Multi-level attention-guided U-Net with Transformer for medical image segmentation. IEEE Trans Emerg Top Comput Intell. 2023.
- Jiang S, Li J. TransCUNet: UNet cross-fused Transformer for medical image segmentation. Comput Biol Med. 2022;150:106207.
- Wu R, Liu Y, Liang P, Chang Q. H-vmunet: High-order Vision Mamba UNet for medical image segmentation. Neurocomputing. 2025;624:129447.
- Liu J, et al. Swin-UMamba: Adapting Mamba-based vision foundation models for medical image segmentation. IEEE Trans Med Imaging. 2024.
- Huang X, et al. MISSFormer: An effective Transformer for 2D medical image segmentation. IEEE Trans Med Imaging. 2023;42(5):1484-1494.
- Ruan J, et al. MALUNet: A multi-attention and lightweight U-Net for skin lesion segmentation. In: 2022 IEEE International Conference on Bioinformatics and Biomedicine (BIBM). IEEE; 2022.
- Ruan J, Xiang S. VM-UNet: Vision Mamba UNet for medical image segmentation. arXiv. 2024;arXiv:2402.02491.
- Valanarasu JMJ, Patel VM. UNeXt: MLP-based rapid medical image segmentation network. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2022.
- Ren S, Li X. HResFormer: Hybrid residual Transformer for volumetric medical image segmentation. IEEE Trans Neural Netw Learn Syst. 2025;36(6):10558-10566.
- Karimijafarbigloo S, Azad R, Kazerouni A, Merhof D. MedScale-Former: Self-guided multiscale Transformer for medical image segmentation. Med Image Anal. 2025;103.
- Yan S, et al. Multi-scale convolutional attention frequency-enhanced Transformer network for medical image segmentation. Inf Fusion. 2025;119.
- Gao Y, Zhou M, Metaxas DN. UTNet: A hybrid Transformer architecture for medical image segmentation. In: Medical Image Computing and Computer-Assisted Intervention (MICCAI). Springer; 2021.
- Mei J, et al. SANet: A slice-aware network for pulmonary nodule detection. IEEE Trans Pattern Anal Mach Intell. 2021;44(8):4374-4387.
- Hu XZ, Jeon WS, Rhee SY. ATT-UNet: Pixel-wise staircase attention for weed and crop detection. In: 2023 International Conference on Fuzzy Theory and Its Applications (iFUZZY). IEEE; 2023.
- Wang X, et al. Transferable normalization: Towards improving transferability of deep neural networks. Adv Neural Inf Process Syst. 2019;32.
- Azad R, et al. TransDeepLab: Convolution-free Transformer-based DeepLabV3+ for medical image segmentation. In: International Workshop on Predictive Intelligence in Medicine (PRIME). Springer; 2022.
- Ruan J, Gao J, Xie M, Xiang S. Learning multi-axis representation in frequency domain for medical image segmentation. Mach Learn. 2025;114(1):10.
- Goodfellow I, Bengio Y, Courville A. Deep Learning. MIT Press; Cambridge, MA; 2016.
- Milletari F, Navab N, Ahmadi SA. V-Net: Fully convolutional neural networks for volumetric medical image segmentation. In: 2016 Fourth International Conference on 3D Vision (3DV). IEEE; 2016.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.