Niniejsze badanie przekrojowe analizowało powiązania między wykorzystaniem generatywnej sztucznej inteligencji, stylem nauczania, biegłością cyfrową, motywacją, lękiem a kreatywnością u studentów kierunków języka angielskiego jako obcego w Arabii Saudyjskiej, wskazując motywację jako istotny mediator obserwowanych zależności.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Generatywna sztuczna inteligencja, motywacja, lęk i kreatywność w saudyjskich klasach języka angielskiego jako obcego: badanie przekrojowe
W tym artykule
Podsumowanie
Streszczenie
Narzędzia sztucznej inteligencji (AI), takie jak ChatGPT, są coraz częściej włączane do nauczania języka angielskiego jako obcego (EFL); brakuje jednak wystarczających dowodów na to, w jaki sposób ich wykorzystanie wiąże się ze stylem nauczania, kompetencjami cyfrowymi, motywacją, lękiem przed mówieniem w obcym języku (FLCA) oraz kreatywnością w kontekście Arabii Saudyjskiej. Niniejsze badanie miało na celu zbadanie powiązań między tymi konstruktami oraz analizę mediacyjnej roli motywacji w ramach jednolitego modelu koncepcyjnego. Przeprowadzono ilościowe badanie przekrojowe wśród 280 studentów studiów licencjackich EFL na publicznym uniwersytecie w Arabii Saudyjskiej, wykorzystując zwalidowane kwestionariusze. Proponowane zależności przeanalizowano za pomocą modelowania równań strukturalnych metodą najmniejszych kwadratów częściowych (PLS-SEM). Wyniki wykazały, że korzystanie z ChatGPT, styl nauczania oraz kompetencje cyfrowe były dodatnio skorelowane z motywacją studentów. Wyższa motywacja wiązała się z niższym poziomem FLCA i wyższym poziomem kreatywności. Motywacja pełniła również rolę mediatora w relacjach między korzystaniem z ChatGPT, stylem nauczania, kompetencjami cyfrowymi a FLCA. Wyniki te sugerują, że doświadczenia motywacyjne studentów są ściśle powiązane z zależnościami między praktykami dydaktycznymi, wykorzystaniem technologii a efektami nauki języka. Badanie dostarcza dowodów wspierających integrację odpowiednich strategii nauczania, generatywnych narzędzi AI oraz kompetencji cyfrowych w edukacji językowej, podkreślając jednocześnie znaczenie uwzględnienia motywacyjnych i emocjonalnych doświadczeń studentów podczas wdrażania środowisk uczenia się wspieranych technologicznie.
Wprowadzenie
Królestwo Arabii Saudyjskiej przechodzi transformacyjną reformę edukacyjną w ramach programu Vision 2030, który priorytetowo traktuje rozwój umiejętności XXI wieku, kompetencji cyfrowych oraz innowacyjnych podejść pedagogicznych na wszystkich poziomach edukacji1. W tym kontekście krajowym nauczanie języka angielskiego jako obcego (EFL) wciąż boryka się z uporczywymi wyzwaniami, w tym z kulturą zorientowaną na egzaminy, która kładzie większy nacisk na naukę pamięciową i wyniki testów niż na kompetencje komunikacyjne2,3. Ograniczone możliwości autentycznej interakcji w języku angielskim poza klasą, wraz z wysokim poziomem lęku przed wystąpieniami w języku obcym (FLCA), dodatkowo ograniczają chęć uczniów do komunikowania się i znaczącego angażowania się w język docelowy4. Wyzwania te skłoniły pedagogów i decydentów do poszukiwania innowacyjnych podejść, które rozwiązują deficyty motywacyjne, bariery emocjonalne oraz kwestie kreatywnego wykorzystania języka. Sztuczna inteligencja (AI) wyłoniła się jako obiecująca droga wspierania nauki języka i przekształcania praktyk dydaktycznych5. Wśród zastosowań AI w nauczaniu języka angielskiego (ELT), ChatGPT, konwersacyjny generatywny model AI, przyciągnął znaczną uwagę ze względu na zapewnianie interaktywnego ćwiczenia języka oraz natychmiastowej, indywidualnej informacji zwrotnej w kontekstach konwersacyjnych w czasie rzeczywistym6. Funkcje te są szczególnie istotne w saudyjskich klasach EFL, gdzie nauczanie skoncentrowane na nauczycielu i ograniczona interakcja uczniów wciąż ograniczają kreatywną produkcję językową7. ChatGPT może pomóc w przezwyciężeniu tych ograniczeń, zapewniając możliwości autentycznego, niskostresowego ćwiczenia języka z rozmówcą AI8.
Ostatnie reformy edukacyjne w Arabii Saudyjskiej zachęciły do przejścia w stronę pedagogiki skoncentrowanej na uczniu, tworząc możliwości integracji technologii AI, które promują aktywne uczestnictwo, krytyczne myślenie i uczenie się kierowane samodzielnie9,10. Przy odpowiednim wdrożeniu ChatGPT może wspierać tę transformację, rozszerzając praktykę językową poza tradycyjne zajęcia lekcyjne11. Jednakże skuteczność integracji AI zależy częściowo od kompetencji cyfrowych studentów, definiowanych jako ich zdolność do efektywnej oceny, wykorzystywania i angażowania się w technologie cyfrowe w celu nauki12. Kompetencje cyfrowe umożliwiają uczącym się produktywne wykorzystanie narzędzi AI przy jednoczesnym minimalizowaniu potencjalnych ryzyk, w tym nadmiernego polegania na nich oraz dezinformacji13. Kompetencja ta jest szczególnie ważna w saudyjskiej edukacji wyższej, gdzie transformacja cyfrowa przyspieszyła w ramach programu Vision 203014.
Choć wcześniejsze badania analizowały narzędzia AI, styl nauczania, biegłość cyfrową, motywację, lęk oraz kreatywność w sposób oddzielny, ograniczono dowody na to, jak te konstrukty współoddziałują w ramach zunifikowanego modelu w niezachodnich kontekstach EFL, takich jak Arabia Saudyjska. Motywację konsekwentnie identyfikuje się jako istotny mechanizm łączący praktyki dydaktyczne z efektami uczenia się, w tym z niższym poziomem lęku, większą kreatywnością i trwałym zaangażowaniem15. Jednak zależności między użytkowaniem ChatGPT, stylem nauczania, biegłością cyfrową, motywacją, FLCA a kreatywnością nie zostały kompleksowo zbadane w saudyjskim kontekście EFL16. Wypełnienie tej luki może dostarczyć teoretycznych i praktycznych spostrzeżeń niezbędnych do projektowania wspomaganych technologicznie środowisk nauki języka, które wspierają rozwój motywacyjny, emocjonalny i twórczy studentów. W związku z tym niniejsze badanie analizuje relacje między użytkowaniem ChatGPT, stylem nauczania, biegłością cyfrową, motywacją, FLCA a kreatywnością wśród saudyjskich studentów studiów licencjackich EFL. W szczególności badane są: (1) zależności między użytkowaniem ChatGPT, stylem nauczania a biegłością cyfrową a motywacją studentów; (2) zależności motywacji z FLCA i kreatywnością; oraz (3) mediacyjna rola motywacji w relacjach między użytkowaniem ChatGPT, stylem nauczania, biegłością cyfrową a zmiennymi wynikowymi, takimi jak lęk i kreatywność.
Niniejsze badanie wnosi wkład w edukację EFL oraz naukę wspomaganą technologicznie poprzez włączenie wykorzystania narzędzi AI do istniejących modeli motywacji i nauki języków, rozszerzając tym samym rozumienie nauki języków wspieranej technologicznie we współczesnych środowiskach edukacyjnych. Dostarcza ono również dowodów, które mogą być pomocne dla pedagogów, projektantów programów nauczania i decydentów dążących do zintegrowania narzędzi AI z nauczaniem EFL w Arabii Saudyjskiej. Poprzez zbadanie motywacji jako mediatora łączącego wykorzystanie technologii i praktyki dydaktyczne z FLCA oraz kreatywnością, badanie oferuje specyficzne dla danego kontekstu dowody wspierające rozwój zorientowanej na ucznia edukacji językowej, zgodnej z celami reformy edukacyjnej Arabii Saudyjskiej.
Teoria Autodeterminacji (SDT) dostarcza ram teoretycznych do zrozumienia związku między praktykami nauczania a motywacją uczniów w kontekstach edukacyjnych17. Zgodnie z SDT, motywacja wewnętrzna oraz autonomiczne formy motywacji zewnętrznej są wspierane, gdy trzy podstawowe potrzeby psychologiczne uczniów – autonomia, kompetencja i relacyjność – zostaną zaspokojone w środowisku uczenia się18. Styl nauczania jest zatem kluczowym czynnikiem kontekstowym wpływającym na motywację i zaangażowanie uczniów19. Praktyki nauczania wspierające autonomię, które zapewniają znaczące możliwości wyboru, uznają perspektywę uczniów i wyjaśniają cele działań edukacyjnych, promują motywację wewnętrzną oraz samodzielne zaangażowanie20. W kontekstach nauczania języka angielskiego jako obcego (EFL), podejścia zorientowane na ucznia, w tym style nauczania oparte na roli facylitatora i delegatora, były wiązane z większym zaangażowaniem, uczestnictwem i zainteresowaniem uczniów nauką języka21,22. Przeciwnie, nauczanie zorientowane na nauczyciela może obniżać motywację poprzez ograniczanie uczestnictwa i autonomii uczniów przy jednoczesnym kładzeniu większego nacisku na nagrody zewnętrzne niż na zainteresowanie wewnętrzne23,24. W saudyjskim kontekście EFL, gdzie nauczanie tradycyjne historycznie kładło nacisk na zapamiętywanie i przekaz zorientowany na nauczyciela25, przyjęcie bardziej zorientowanych na ucznia podejść do nauczania może wspierać motywację uczniów26. W oparciu o te podstawy teoretyczne i empiryczne sformułowano następującą hipotezę: H1: Styl nauczania pozytywnie wpływa na motywację uczniów EFL.
Zależność między technologią edukacyjną a motywacją uczących się była szeroko badana27,28. Model Akceptacji Technologii (TAM) sugeruje, że motywacja uczniów do korzystania z technologii edukacyjnych jest kształtowana przez postrzeganą użyteczność oraz postrzeganą łatwość obsługi, które wpływają na intencje behawioralne i wykorzystanie technologii29. W odniesieniu do ChatGPT model ten sugeruje, że studenci, którzy postrzegają to narzędzie jako użyteczne i łatwe w obsłudze, chętniej wykorzystują je do nauki języka30. Badania empiryczne wykazały pozytywne korelacje między nauką języka wspomaganą przez AI a motywacją studentów, przy czym funkcje interaktywne, natychmiastowa informacja zwrotna oraz spersonalizowane ćwiczenia przyczyniają się do utrzymania zaangażowania31,32. ChatGPT może również redukować bariery związane z lękiem językowym, oferując możliwość ćwiczenia języka w warunkach niskiej presji, co może zachęcać do dalszego posługiwania się językiem33. Potencjał ten jest szczególnie istotny w kontekście saudyjskim, gdzie FLCA został zidentyfikowany jako ważna bariera dla motywacji i osiągnięć językowych34. Na podstawie tych wniosków teoretycznych i empirycznych sformułowano następującą hipotezę: H2: Stosowanie ChatGPT pozytywnie wpływa na motywację studentów EFL.
Alfabetyzacja cyfrowa stała się ważnym determinantem motywacji uczniów we współczesnych środowiskach nauczania języka angielskiego jako obcego (EFL)35. Odnosi się ona do zdolności skutecznego wyszukiwania, oceniania i wykorzystywania technologii cyfrowych oraz mediów w procesie uczenia się36. W kontekście EFL alfabetyzacja cyfrowa umożliwia uczącym się efektywne korzystanie z zasobów cyfrowych, w tym z ChatGPT, systemów zarządzania uczeniem się oraz narzędzi multimedialnych, w celu wspierania nauki języka i motywacji37. Uczniowie o wyższym poziomie alfabetyzacji cyfrowej chętniej i pewniej korzystają z technologii edukacyjnych, co sprzyja budowaniu kompetencji i autonomii, które są powiązane z motywacją wewnętrzną38. Są oni również lepiej przygotowani do wykorzystywania narzędzi cyfrowych do samodzielnej praktyki językowej, otrzymywania informacji zwrotnych i utrzymywania zaangażowania w naukę39. Na podstawie tej literatury sformułowano następującą hipotezę: H3: Alfabetyzacja cyfrowa uczniów EFL pozytywnie wpływa na ich motywację do nauki EFL.
FLCA i kreatywność są ściśle powiązanymi konstruktami w edukacji EFL, choć ich relacja pozostaje złożona40. Lęk może ograniczać wyniki uczniów w zadaniach wymagających kreatywności, elastyczności poznawczej, myślenia dywergencyjnego i ekspresji własnej41. FLCA odzwierciedla lęk uczniów przed popełnianiem błędów, negatywną oceną oraz niską pewność siebie, co może utrudniać kreatywną produkcję językową42. Kreatywność jest jednak istotną kompetencją w nauce EFL, ponieważ wspiera innowacyjne i odpowiednie kontekstowo posługiwanie się językiem31. Wcześniejsze badania wykazały, że uczniowie z wyższym poziomem lęku rzadziej uczestniczą w zajęciach z kreatywnego pisania i komunikacji ustnej43,44. Na podstawie tej literatury sformułowano następujące hipotezy: 1) H4: motywacja studentów EFL jest ujemnie skorelowana z ich lękiem oraz 2) H5: lęk studentów EFL negatywnie wpływa na ich kreatywność.
Motywacja dostarcza teoretycznego mechanizmu, poprzez który styl nauczania, korzystanie z ChatGPT oraz kompetencje cyfrowe mogą wiązać się z FLCA45. Uczniowie zmotywowani z większym prawdopodobieństwem wykazują aktywny udział, wytrwałość w obliczu trudności oraz niższy poziom lęku komunikacyjnego46. Wspierające praktyki nauczania, nauka języka wspomagana przez AI oraz wyższe kompetencje cyfrowe były wiązane z wyższą motywacją i niższym poziomem lęku w środowiskach EFL47,48,49. Poprzednie badania sugerują również, że większa motywacja wiąże się z niższym lękiem w klasie i zwiększoną kreatywnością, co wspiera uznanie motywacji za potencjalny mediator łączący praktyki dydaktyczne i wykorzystanie technologii z efektami uczenia się50,51,52. Na podstawie tej literatury zaproponowano następujące hipotezy: 1) H6: Motywacja mediuje związek między stylem nauczania a lękiem studentów EFL; 2) H7: Motywacja mediuje związek między korzystaniem z ChatGPT a lękiem studentów EFL; oraz 3) H8: Motywacja mediuje związek między kompetencjami cyfrowymi studentów EFL a ich lękiem. Rysunek 1 ilustruje hipotetyczny model, w którym styl nauczania, korzystanie z ChatGPT i kompetencje cyfrowe wiążą się z motywacją studentów EFL, która z kolei mediuje ich relacje z FLCA i kreatywnością.
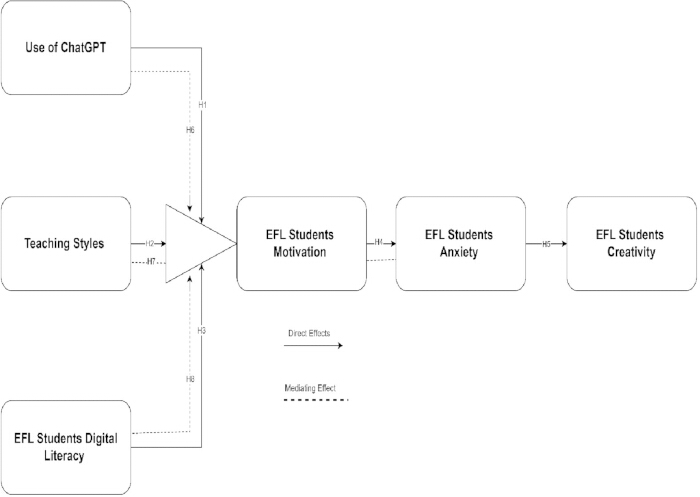
Rycina 1. Hipotetyczny model badawczy. Model przedstawia hipotetyczne zależności między korzystaniem z ChatGPT, stylem nauczania, biegłością cyfrową, motywacją, lękiem w klasie języka obcego a kreatywnością studentów uczących się języka angielskiego jako obcego (EFL). Linie ciągłe reprezentują bezpośrednie hipotetyczne zależności, a linie przerywane reprezentują zależności pośrednie, zgodnie z oznaczeniami na rycinie. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Chociaż badanie nie wymagało formalnej zgody komisji etycznej ze względu na nieeksperymentalny projekt anonimowej ankiety, która nie obejmowała interwencji fizycznych, manipulacji ani wprowadzania uczestników w błąd, wszystkie procedury zostały przeprowadzone zgodnie z zasadami etycznymi Deklaracji Helsińskiej oraz wytycznymi Amerykańskiego Towarzystwa Psychologicznego dotyczącymi badań z udziałem ludzi. Przed rozpoczęciem gromadzenia danych uzyskano świadomą zgodę od wszystkich uczestników. Instytucja nie wymagała ani nie wystawiła formalnej zgody etycznej lub zwolnienia z niej dla tego typu badania. Wszyscy respondenci zostali wyraźnie poinformowani o celu badania, dobrowolności ich udziału, prawie do wycofania się w dowolnym momencie bez żadnych konsekwencji oraz o rygorystycznych środkach poufności zastosowanych w odniesieniu do ich danych. Nie gromadzono ani nie raportowano żadnych danych umożliwiających identyfikację osób, a wszystkie dane zostały wykorzystane wyłącznie do zagregowanej analizy akademickiej. Szczególną uwagę zwrócono na nienarzucające się, pełne szacunku sformułowania, aby upewnić się, że ankieta nie koliduje z działalnością akademicką ani dobrostanem psychologicznym uczestników. Formularz świadomej zgody znajduje się w Supplementary File 1. Ponadto materiały wykorzystane w tym badaniu są wymienione w Table of Materials.
Projekt badawczy
W tej sekcji opisano plan badania, procedury gromadzenia danych oraz szczegóły dotyczące próby wykorzystanej w badaniu mającym na celu analizę zależności między stylem nauczania, korzystaniem z ChatGPT, kompetencjami cyfrowymi, motywacją, lękiem a kreatywnością uczniów uczących się angielskiego jako języka obcego (EFL). W badaniu zastosowano ilościowy, przekrojowy plan badawczy, aby zbadać mediacyjną rolę motywacji w relacjach między stylem nauczania, korzystaniem z ChatGPT, kompetencjami cyfrowymi i lękiem wśród uczniów EFL oraz sprawdzić, w jaki sposób zmienne te wspólnie wiążą się z kreatywnością. W celu zgromadzenia danych pierwotnych przyjęto ustrukturyzowaną metodologię ankietową, co zapewniło standaryzację i niezawodność pomiaru konstruktów. Do oceny wszystkich zmiennych, w tym stylu nauczania, korzystania z ChatGPT, kompetencji cyfrowych, motywacji, FLCA i kreatywności, wykorzystano zwalidowane skale.
Dane i próbka
Dane do niniejszego badania zostały zebrane od studentów EFL (angielskiego jako języka obcego) zapisanych na Uniwersytecie w Dżudzie, uczelni publicznej w Arabii Saudyjskiej, znanej z nacisku na edukację językową oraz integrację technologii w nauczaniu. Uczestników wybrano przy użyciu techniki celowego doboru próby, która uznana została za odpowiednią dla tego badania ze względu na specyficzne kryteria włączenia, wymagające od uczestników posiadania aktywnego doświadczenia w korzystaniu z narzędzi AI, takich jak ChatGPT, w ich środowisku uczenia się. To nieprobabilistyczne podejście do doboru próby było konieczne, ponieważ pytania badawcze koncentrowały się na konkretnej populacji — studentach EFL, którzy mieli styczność zarówno z tradycyjnymi, jak i wspomaganymi technologicznie metodami nauczania, a dobór losowy nie gwarantowałby włączenia uczestników spełniających te kryteria. Chociaż dobór celowy ogranicza możliwość generalizacji wyników na szerszą populację, był on uzasadniony w tym badaniu eksploracyjnym, aby zapewnić, że uczestnicy posiadają odpowiednie doświadczenia i perspektywy niezbędne do realizacji celów badawczych. Aby zminimalizować ograniczenia wynikające z celowego doboru próby, podjęto wysiłki w celu włączenia uczestników o zróżnicowanym wykształceniu akademickim i różnym stopniu biegłości technologicznej, co zwiększyło reprezentatywność próby w ramach populacji docelowej. Ostateczna próba składała się z 280 studentów EFL studiujących na poziomie licencjackim, co uznano za liczebność wystarczającą dla zastosowanych technik statystycznych.
Określenie adekwatności wielkości próby oparto na uznanych wytycznych dla modelowania równań strukturalnych (SEM). Badacze zalecają minimalny stosunek 10 przypadków na każdy szacowany parametr dla SEM, przy czym bardziej konserwatywne wytyczne sugerują 20 przypadków na parametr dla SEM metodą najmniejszych kwadratów częściowych (PLS-SEM). Model pomiarowy obejmował 29 pozycji dla biegłości cyfrowej, 25 pozycji dla stylu nauczania i 32 pozycji dla FLCA, a także dodatkowe pozycje dotyczące użytkowania ChatGPT, motywacji i kreatywności. Wytyczne PLS-SEM zalecają również, aby minimalna wielkość próby była równa 10-krotności największej liczby wskaźników formatywnych lub największej liczby ścieżek strukturalnych skierowanych do konkretnego konstruktu; w związku z tym próba 280 uczestników przekroczyła te minimalne wymagania. Ponadto analiza mocy post hoc z wykorzystaniem programu G*Power53 wykazała, że próba 280 uczestników zapewniła moc statystyczną przekraczającą 0,95 dla wykrywania średnich wielkości efektu (f2 = 0,15) przy α = 0,05, co przekracza powszechnie zalecany próg 0,80. Taka wielkość próby zapewnia wiarygodne szacunki parametrów i wystarczającą moc statystyczną do wykrycia istotnych zależności między zmiennymi badania, uwzględniając jednocześnie złożoność proponowanych modeli pomiarowych i strukturalnych.
Uczestnicy i procedura
Uczestnikami byli studenci EFL w wieku od 18 do 25 lat, z czego większość stanowili studenci pierwszego i drugiego roku studiów licencjackich zapisani na kursy języka angielskiego. Badanie przeprowadzono między wrześniem a październikiem 2025 roku, podczas którego zaproszono studentów do dobrowolnego udziału. Proces rekrutacji obejmował działania informacyjne za pośrednictwem oficjalnych kanałów uniwersyteckich, w tym wiadomości e-mail i ogłoszenia na zajęciach. Uczestnikami byli studenci EFL w wieku 18–25 lat, zapisani na pierwszy lub drugi rok studiów licencjackich na kursach języka angielskiego. Kwalifikowalność określono na podstawie zdefiniowanych kryteriów włączenia i wyłączenia. Kwalifikowali się uczestnicy, którzy (a) byli oficjalnie zapisani na studia licencjackie z języka angielskiego na Uniwersytecie w Dżudzie, (b) byli w wieku 18–25 lat oraz (c) byli zarejestrowani jako studenci pierwszego lub drugiego roku. Wykluczono studentów, którzy (a) byli studentami studiów magisterskich lub studentami wyższych lat poza podstawowym cyklem kursów, (b) znajdowali się poza określonym zakresem wiekowym lub (c) brali udział w fazie wstępnego testowania kwestionariusza. Aby zapewnić świadomą zgodę, uczestnicy zostali poinformowani o celu badania, dobrowolności ich udziału oraz poufności udzielonych odpowiedzi. Narzędziem gromadzenia danych był ustrukturyzowany kwestionariusz samoopisowy, rozprowadzony fizycznie oraz elektronicznie za pomocą bezpiecznej platformy internetowej. Zaadaptowano zwalidowane skale do pomiaru stylu nauczania, użytkowania ChatGPT, umiejętności cyfrowych, motywacji studentów, FLCA oraz kreatywności. Uczestników poproszono o ocenę odpowiedzi w 5-stopniowej skali Likerta, gdzie 1 oznaczało „Zdecydowanie się nie zgadzam”, a 5 „Zdecydowanie się zgadzam”. Wstępne testowanie kwestionariusza przeprowadzono na małej grupie 30 studentów w celu zapewnienia przejrzystości i rzetelności. Na podstawie wyników wstępnych testów wprowadzono niewielkie korekty sformułowań w celu poprawy zrozumiałości pozycji, a nie zidentyfikowano istotnych problemów z rzetelnością lub trafnością skali. Aby zachować integralność danych i zachęcić do szczerych odpowiedzi, zagwarantowano anonimowość i zapewniono uczestników, że ich dane zostaną wykorzystane wyłącznie do celów badawczych. Z początkowych 300 zebranych odpowiedzi, 280 uznano za poprawne po przesiewowym badaniu danych niekompletnych lub niespójnych, co przełożyło się na wskaźnik retencji wynoszący 93%. Procedury przesiewowe danych obejmowały analizę wzorców odpowiedzi pod kątem tzw. straight-liningu, nadmiernej liczby brakujących danych (powyżej 10%) oraz wielowymiarowych wartości odstających z wykorzystaniem odległości Mahalanobisa. Podejście metodologiczne to stanowi solidną podstawę do analizy relacji między zmiennymi badania i dostarcza cennych informacji na temat roli stylu nauczania, narzędzi AI i umiejętności cyfrowych w kształtowaniu motywacji, lęku i kreatywności studentów EFL.
Po zebraniu danych 20 odpowiedzi z początkowej puli 300 wykluczono na podstawie zdefiniowanych wcześniej kryteriów: 12 odpowiedzi usunięto z powodu nadmiernej liczby brakujących danych przekraczającej 10% pozycji kwestionariusza, 5 wyeliminowano ze względu na występowanie schematu odpowiedzi liniowej (jednakowe odpowiedzi we wszystkich pozycjach świadczące o braku zaangażowania), a 3 zidentyfikowano jako wielowymiarowe wartości odstające przy użyciu odległości Mahalanobisa (p < 0,001) i następnie usunięto, aby zapobiec zniekształceniu wyników SEM. Braki w danych dla zachowanych przypadków uzupełniono za pomocą imputacji średnią w sytuacjach, gdy brakujące dane były minimalne (mniej niż 5% na przypadek), ponieważ podejście to jest dopuszczalne przy niewielkim udziale braków w wielkoskalowych badaniach ankietowych. Końcowy wskaźnik retencji wynoszący 93% (280 poprawnych odpowiedzi z 300 zebranych kwestionariuszy) reprezentuje proporcję użytecznych odpowiedzi zachowanych z całkowitej liczby zebranych kwestionariuszy; nie należy jednak interpretować tego jako rzeczywistego wskaźnika odpowiedzi, ponieważ nie można było obliczyć dokładnej liczby zaproszonych uczestników, gdyż łączone metody dystrybucji fizycznej i elektronicznej poprzez oficjalne kanały uniwersyteckie uniemożliwiły precyzyjne śledzenie całkowitej liczby zaproszeń. Ograniczenie to zostało uwzględnione, w związku z czym wartość 93% raportowana jest jako proporcja poprawnych odpowiedzi zachowanych z zebranych kwestionariuszy, a nie jako wskaźnik odpowiedzi w stosunku do całej zaproszonej populacji.
Narzędzia i miary
W badaniu tym wykorzystano ugruntowane i zwalidowane skale, starannie dostosowane do kontekstu nauczania języka angielskiego jako obcego (EFL), aby zmierzyć kluczowe konstrukty: styl nauczania, kompetencje cyfrowe, wykorzystanie ChatGPT, FLCA, motywację oraz kreatywność. Każda skala została wybrana ze względu na jej trafność i kompleksowość w uchwyceniu odpowiednich wymiarów badanych zmiennych. Kompetencje cyfrowe mierzono za pomocą dostosowanej skali opracowanej na podstawie pracy Rodríguez-de-Dios et al.54, obejmującej sześć wymiarów i 29 pozycji. Wymiary te obejmowały: umiejętności technologiczne, umiejętności bezpieczeństwa osobistego, umiejętności krytyczne, umiejętności bezpieczeństwa urządzeń, umiejętności informacyjne oraz umiejętności komunikacyjne, co pozwoliło na kompleksową ocenę biegłości studentów w zakresie kompetencji cyfrowych niezbędnych w nowoczesnym kontekście edukacyjnym. Wykorzystanie ChatGPT oceniano za pomocą 8-pozycyjnej skali dostosowanej z pracy Abbas et al.55, koncentrującej się na interakcji studentów z narzędziem AI w zadaniach nauki języka. Styl nauczania oceniano za pomocą dostosowanej wersji Kwestionariusza Stylu Nauczania Grashy (Grasha’s Teaching Style Inventory)56. Instrument ten mierzy pięć wymiarów stylów nauczania: autorytarny, ekspercki, osobisty model, facylitatora oraz delegatora. Wymiary te odzwierciedlają różne podejścia dydaktyczne wpływające na doświadczenia edukacyjne studentów EFL. FLCA mierzono za pomocą dostosowanej skali opracowanej na podstawie pracy Briesmaster i Briesmaster57. Instrument ten badał lęk w trzech wymiarach: lęk komunikacyjny (10 pozycji), lęk przed testami (10 pozycji) oraz lęk przed negatywną oceną (7 pozycji). Motywację studentów oceniano za pomocą skali dostosowanej z pracy Kanoksilapatham et al.58, mierzącej trzy wymiary: promocję i zapobieganie instrumentalne, etnocentryzm i integratywność oraz nastawienie do nauki języka angielskiego. Skala obejmowała łącznie 20 pozycji. Kreatywność studentów EFL mierzono za pomocą skali dostosowanej z pracy Govindasamy et al.59, która oceniała cztery wymiary: oryginalność, elastyczność, biegłość i szczegółowość. Każdy wymiar mierzono za pomocą trzech pozycji. Aby zapewnić kulturowe i kontekstowe dopasowanie instrumentów do środowiska EFL, zastosowano systemową procedurę adaptacji. Ponieważ oryginalne skale zostały opracowane w języku angielskim, dwóch dwujęzycznych ekspertów EFL przeanalizowało i uprościło język, aby zwiększyć klarowność dla studentów studiów licencjackich na poziomie średniozaawansowanym, zachowując jednocześnie oryginalne znaczenie każdego konstruktu. Dostosowane wersje zostały następnie przetłumaczone zwrotnie na język ojczysty uczestników przez niezależnego tłumacza w celu weryfikacji równoważności lingwistycznej i pojęciowej, a wszelkie rozbieżności rozstrzygnięto w drodze dyskusji w zespole badawczym. Następnie trzech doświadczonych wykładowców EFL oceniło dostosowane instrumenty pod kątem merytorycznej istotności, adekwatności kulturowej oraz przejrzystości pozycji, co zaowocowało niewielkimi korektami sformułowań i zastąpieniem kulturowo nieznanych przykładów tam, gdzie było to stosowne. Na koniec zrewidowane instrumenty poddano testom pilotażowym z udziałem 30 studentów (patrz sekcja Procedura), a opinie uczestników wykorzystano do wprowadzenia dodatkowych drobnych poprawek w sformułowaniach w celu poprawy zrozumiałości. Ten wieloetapowy proces zapewnił, że dostosowane instrumenty zachowały swoje oryginalne właściwości psychometryczne, będąc jednocześnie odpowiednimi dla docelowej populacji studentów EFL. Pełny kwestionariusz po adaptacji znajduje się w Pliku uzupełniającym 2 (Supplementary File 2).
Metody analizy danych
Dane zebrane na potrzeby niniejszego badania zostały poddane analizie przy użyciu pakietu Statistical Package for the Social Sciences (SPSS 26) oraz programu SmartPLS 4 z zastosowaniem metody PLS-SEM. To dualne podejście metodologiczne zapewniło kompleksową analizę danych, obejmującą zarówno aspekty opisowe, jak i weryfikacyjne, przy jednoczesnym testowaniu hipotetycznych zależności oraz efektów mediacji w modelu badawczym. Początkowo program SPSS został wykorzystany do przeprowadzenia wstępnej analizy danych, w tym oczyszczania danych, obliczenia statystyk opisowych oraz testów rzetelności. Przesiew danych obejmował sprawdzenie brakujących wartości, wartości odstających oraz normalności rozkładu w celu zapewnienia jakości i spójności zbioru danych. Obliczono statystyki opisowe, w tym średnią, odchylenie standardowe i rozkłady częstotliwości, aby podsumować charakterystykę próby. Główna analiza została przeprowadzona w programie SmartPLS 4. Wybrano metodę PLS-SEM ze względu na jej przydatność w analizie złożonych modeli z wieloma konstruktami oraz wysoką odporność przy małych i średnich licznościach próby. Analiza została przeprowadzona w dwóch etapach: ocenie modelu pomiarowego oraz ocenie modelu strukturalnego. W ramach oceny modelu pomiarowego zweryfikowano rzetelność wskaźników, rzetelność spójności wewnętrznej (przy użyciu rzetelności złożonej [CR]), trafność zbieżną (przy użyciu średniej wariancji wyekstrahowanej [AVE]) oraz trafność różnicową (przy użyciu wskaźnika heterotrait–monotrait [HTMT]).
Po walidacji modelu pomiarowego oceniono model strukturalny w celu zweryfikowania hipotetycznych zależności między stylem nauczania, korzystaniem z ChatGPT, kompetencjami cyfrowymi, motywacją, lękiem a kreatywnością. Przeanalizowano współczynniki ścieżek, aby określić siłę i istotność efektów bezpośrednich i pośrednich, a istotność oceniono za pomocą metody bootstrappingu z 5 000 prób wielokrotnych. Aby ocenić istotność efektów bezpośrednich, pośrednich i mediacyjnych, skonstruowano skorygowane pod kątem obciążenia (BC) przedziały ufności bootstrap dla 5 000 prób z poziomem ufności 95%. Za pomocą bootstrapowych przedziałów ufności oceniono również efekty mediacyjne motywacji w relacjach między stylem nauczania, korzystaniem z ChatGPT, kompetencjami cyfrowymi a lękiem. Dopasowanie modelu i jego moc predykcyjną oceniono za pomocą współczynnika determinacji (R2), istotności predykcyjnej (Q2) oraz zestandaryzowanego pierwiastka średniokwadratowego reszt (SRMR).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Statystyka opisowa
Statystyka opisowa zapewnia przegląd charakterystyki próby oraz rozkładu, tendencji centralnej i zmienności zmiennych badanych. W niniejszym badaniu przeprowadzono analizy opisowe w celu scharakteryzowania próby uczestników i podsumowania kluczowych zmiennych przed wykonaniem analiz strukturalnych.
Tabela 1 podsumowuje charakterystykę demograficzną 280 studentów studiów licencjackich uczących się języka angielskie...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
W niniejszym badaniu zanalizowano zależności między stylem nauczania, wykorzystaniem ChatGPT, biegłością cyfrową, motywacją, FLCA a kreatywnością wśród saudyjskich studentów studiów licencjackich kierunków EFL, ze szczególnym uwzględnieniem mediacyjnej roli motywacji. Wyniki dostarczają dowodów dotyczących relacji między praktykami pedagogicznymi, wykorzystaniem technologii a charakterystyką ucznia w procesie nauki języka wspomaganej technologicznie. Pozytywny związek między stylem nauczania a motywacją studentów EFL (po...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Konflikt interesów:
Autor deklaruje brak konfliktów interesów.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Skala użytkowania ChatGPT (zaadaptowana) | Autorzy; zaadaptowana z Abbas et al. | N/A | Kwestionariusz składający się z ośmiu pytań, oceniający wykorzystanie ChatGPT przez studentów do nauki języka. |
| Skala kreatywności (zaadaptowana) | Autorzy; zaadaptowana z Govindasamy et al. | N/A | Kwestionariusz składający się z dwunastu pytań, oceniający oryginalność, elastyczność, płynność i szczegółowość. |
| Skala kompetencji cyfrowych (zaadaptowana) | Autorzy; zaadaptowana z Rodríguez-de-Dios et al. | N/A | Kwestionariusz składający się z dwudziestu dziewięciu pytań, mierzący sześć wymiarów kompetencji cyfrowych. |
| Skala lęku w klasie języka obcego (FLCA) (zaadaptowana) | Autorzy; zaadaptowana z Briesmaster & Briesmaster | N/A | Kwestionariusz składający się z dwudziestu siedmiu pytań, mierzący lęk komunikacyjny, lęk przed testami oraz strach przed negatywną oceną. |
| G*Power | Heinrich Heine University Düsseldorf | Wersja 3.1.9.7; RRID: SCR_013726 | Oprogramowanie użyte do analizy mocy statystycznej post hoc. |
| IBM SPSS Statistics | IBM Corp. | Wersja 26; RRID: SCR_002865 | Oprogramowanie statystyczne użyte do czyszczenia danych, statystyki opisowej, analiz rzetelności oraz analiz wstępnych. |
| Analiza dystansu Mahalanobisa | IBM SPSS Statistics | Wersja 26; RRID: SCR_002865 | Procedura statystyczna zaimplementowana w IBM SPSS Statistics w celu identyfikacji wielowymiarowych wartości odstających. |
| Skala motywacji (zaadaptowana) | Autorzy; zaadaptowana z Kanoksilapatham et al. | N/A | Kwestionariusz składający się z dwudziestu pytań, oceniający motywację uczącego się. |
| Kwestionariusz papierowy | Autorzy | N/A | Drukowana wersja ustrukturywowanego kwestionariusza samoopisowego, użyta do osobistego zbierania danych. |
| Bezpieczna internetowa platforma ankietowa | Google LLC | N/A | Platforma Google Forms użyta do elektronicznej dystrybucji kwestionariusza. |
| SmartPLS | SmartPLS GmbH | Wersja 4; RRID: SCR_036419 | Oprogramowanie użyte do modelowania równań strukturalnych metodą najmniejszych kwadratów częściowych (PLS-SEM), obejmujące ocenę modelu pomiarowego, analizę modelu strukturalnego, bootstrapping (5 000 prób) oraz analizę mediacji. |
| Ustrukturyzowany kwestionariusz samoopisowy | Autorzy | N/A | Kwestionariusz przeprowadzony w formie papierowej i elektronicznej z wykorzystaniem 5-stopniowej skali Likerta (1 = zdecydowanie się nie zgadzam do 5 = zdecydowanie się zgadzam). |
| Inwentarz Stylów Nauczania (zaadaptowany) | Autorzy; zaadaptowany z Inwentarza Stylów Nauczania Grashy | N/A | Kwestionariusz mierzący style nauczania: autorytarny, ekspercki, osobisty wzorzec, facylitator i delegujący. |
| Uniwersyteckie kanały komunikacji | University of Jeddah | N/A | Oficjalna poczta e-mail i ogłoszenia klasowe użyte do rekrutacji uczestników. |
Bibliografia
- Ansa H. Exploring the role of artificial intelligence (AI) in enhancing EFL education in Saudi Arabia: A review of opportunities, obstacles, and future directions. Educ Sci. 2026;16(6):981.
- Alshehri A, Aldossary S, Jamshed M, Banu S. Incorporating ChatGPT in Saudi EFL classrooms: Oscillating between expectations and anxiety. J Lang Teach Res. 2025;16(5):1673-81.
- Alzubi AA, Alelaiwi AS. Exploring EFL university teachers’ perceptions of AI-generative tools in Saudi Arabia: A mixed-methods study. Discov Comput. 2025;28(1):282.
- Alzubi AA, Nazim M, Alyami N. Do AI-generative tools kill or nurture creativity in EFL teaching and learning? Educ Inf Technol. 2025;30(11):15147-84.
- Allehyani FS, Albedah F, Jamshed M, Warda WU. Exploring Saudi EFL learners’ engagement with AI generative tools in educational settings: Perceptions, practices, and pedagogical outcomes. Theory Pract Lang Stud. 2025;15(6):1959-66.
- Almusharraf A, Bailey D. Generative AI use among Saudi and Korean language learners in higher education: Examination through a modified TAM framework. SAGE Open. 2025;15(4):21582440251387804.
- Alharbi MA, Hassan Al-Ahdal AA. Exploring Saudi EFL learners’ engagement with ChatGPT: A mixed-methods study of perceptions, attitudes, and intentions. SAGE Open. 2025;15(4):21582440251392080.
- Khoso AK, Honggang W, Darazi MA. Empowering creativity and engagement: The impact of generative artificial intelligence usage on Chinese EFL students’ language learning experience. Comput Hum Behav Rep. 2025;18:100627.
- Alalwi FS, Alqahtani N, Jamshed M, Ahmmed MF. AI-driven feedback for pedagogical innovation: Assessing ChatGPT’s impact on Saudi EFL learners’ writing proficiency. World. 2026;16(5).
- Alshehri N. Speaking with AI: Exploring EFL learners’ attitudes, engagement, and satisfaction through ChatGPT conversations. 2026. 10.2139/ssrn.6595190
- Metwally AA, Bin-Hady WR. Probing the necessity and advantages of AI integration training for EFL educators in Saudi Arabia. Cogent Educ. 2025;12(1):2472462.
- Elmahdi OE, et al. AI-Driven Vocabulary Acquisition in EFL Higher Education: Interdisciplinary Insights into Technological Innovation, Ethical Challenges, and Equitable Access. Forum Linguist Stud. 2025;7(4):477–491.
- Al-Nofaie H, Alwerthan TA. Appreciative inquiry into implementing artificial intelligence for the development of language student teachers. Sustainability (Basel). 2024;16(21):9361.
- Alshayban A. Exploring EFL learners’ use of AI outside the classroom. J Lang Teach Res. 2026;17(1).
- Abdelhalim SM, Alsehibany RA. Integrating AI-powered tools in EFL pronunciation instruction: Effects on accuracy and L2 motivation. Comput Assist Lang Learn. 2025;38:1-25.
- Khoso AK, Honggang W, Darazi MA. Trust and attitude towards AI as pathways to creativity: A TAM model study of EFL students’ digital literacy and AI acceptance. Humanit Soc Sci Commun. 2025;13(1):69.
- Xiong X. Influence of teaching styles of higher education teachers on students’ engagement in learning: The mediating role of learning motivation. Educ Chem Eng. 2025;51:87-102.
- Bartholomew KJ, et al. Beware of your teaching style: A school-year-long investigation of controlling teaching and student motivational experiences. Learn Instr. 2018;53:50-63.
- Wiangga IA. The impact of educators’ teaching styles on secondary school learners’ motivation in English. J Educ Manag Strategy. 2024;3(2):136-44.
- Sheikh A, Mahmood N. Effect of different teaching styles on students’ motivation towards English language learning at secondary level. Sci Int (Lahore). 2014;26:825-30.
- Marina I, Natalia M, Tatiana K, Nataliya S. The influence of the teaching style of communication on the motivation of students to learn foreign languages. J Lang Educ. 2019;5(2):67-77.
- Zalukhu FS, Laoli A, Zebua EP, Daeli H. The influence of teacher teaching styles on English learning motivation of eighth-grade students at SMP Negeri 1 Afulu. J Pembelajaran Bahasa dan Sastra. 2026;5(2):1545-54.
- Yue X, Hou X, Zhang J, Li M. The impact of controlling teaching style on student engagement and academic achievement: Differences across varied motivation profiles. Teach Teach Educ. 2026;176:105479.
- Idhaufi NL, Ashari ZM. Relationship between motivation and teachers’ teaching style among secondary school students in Kulai. Man India. 2017;97(12):299-307.
- Zolfaghari M, Janghorbanian Z, Krevan Brojerdi K, Aghaziarati A. Investigation of the role of teaching styles and student-teacher interaction in students’ academic achievement motivation. Educ Strateg Med Sci. 2020;13(3):220-8.
- Avecilla PA, Capiña XE, Javier AY. Teachers’ teaching style as perceived by students and its influence on students’ level of self-regulation and motivation in learning psychology. Technium Soc Sci J. 2023;43:213-24.
- Khoso AK, et al. The dual forces of AI: How generative AI and perceived AI dependency influence fear of missing out (FoMO) and EFL students’ vocabulary acquisition. J Vis Exp. 2025;(226):e69637.
- Ali JK, Shamsan MA, Hezam TA, Mohammed AA. Impact of ChatGPT on learning motivation: Teachers’ and students’ voices. J Engl Stud Arabia Felix. 2023;2(1):41-9.
- Song C, Song Y. Enhancing academic writing skills and motivation: Assessing the efficacy of ChatGPT in AI-assisted language learning for EFL students. Front Psychol. 2023;14:1260843.
- Khoso AK, et al. Integrating Sustainable Development Goals (SDGs) and generative AI to enhance language digital literacy and creativity in EFL learning environments. J Vis Exp. 2026;(228):e69445.
- Balcı Ö. The role of ChatGPT in English as a foreign language (EFL) learning and teaching: A systematic review. Int J Curr Educ Stud. 2024;3(1):66-82.
- Yamaoka K. ChatGPT’s motivational effects on Japanese university EFL learners: A qualitative analysis. Int J TESOL Stud. 2024;6(3).
- Afkarin MY, Asmara CH. Investigating the implementation of ChatGPT in English language education: Effects on student motivation and performance levels. Journey J Engl Lang Pedagogy. 2024;7(1):57-66.
- Alrabai F. The influence of teachers’ anxiety-reducing strategies on learners’ foreign language anxiety. Innov Lang Learn Teach. 2015;9(2):163-90.
- Kang S, Kim Y. Examining the quality of mobile-assisted video-making task outcomes: The role of proficiency, narrative ability, digital literacy, and motivation. Lang Teach Res. 2024;28(6):2326-53.
- Honggang W, Khoso AK, Althubyani AR. Technostress, digital fatigue, and AI dependency as antecedents of burnout and SDG-4 achievement in EFL classrooms. Sci Rep. 2026;16:15412.
- Sari AA, Ningsih SK. The influence of digital literacy in social media use on high school students’ intrinsic motivation in EFL learning. IDEAS J Engl Lang Teach Learn Linguist Lit. 2025;13(2):6634-51.
- Zhang Y. Impact of digital literacy on college students’ English proficiency: The mediating role of learning motivation and the moderating effect of technological self-efficacy. Acta Psychol (Amst). 2025;259:105452.
- Bender SM. Awareness of artificial intelligence as an essential digital literacy: ChatGPT and Gen-AI in the classroom. Changing Engl. 2024;31(2):161-74.
- Khoso AK, et al. The impact of ESL teachers’ emotional intelligence on ESL students’ academic engagement, reading and writing proficiency: Mediating role of ESL students’ motivation. Int J Early Child Spec Educ. 2022;14:3267-80.
- He M, Abbasi BN, He J. AI-driven language learning in higher education: An empirical study on self-reflection, creativity, anxiety, and emotional resilience in EFL learners. Humanit Soc Sci Commun. 2025;12(1):1-20.
- Wang HC. Exploring the relationships of achievement motivation and state anxiety to creative writing performance in English as a foreign language. Think Skills Creat. 2021;42:100948.
- Khan MA, Mahjabeen AN, Hussain F, Ur Rehman M. Investigating the correlation between writing anxiety and English creativity in Pakistani ESL students. Russ Law J. 2021;9(1):214-24.
- McDonough K, Crawford WJ, Mackey A. Creativity and EFL students’ language use during a group problem-solving task. TESOL Q. 2015;49(1):188-99.
- Rubino C, Luksyte A, Perry SJ, Volpone SD. How do stressors lead to burnout? The mediating role of motivation. J Occup Health Psychol. 2009;14(3):289-304.
- Halbesleben JRB, Bowler WM. Emotional exhaustion and job performance: The mediating role of motivation. J Appl Psychol. 2007;92(1):93-106.
- van Emmerik IJH, et al. The route to employability: Examining resources and the mediating role of motivation. Career Dev Int. 2012;17(2):104-19.
- Dana LP, et al. The impact of entrepreneurial education on technology-based enterprise development: The mediating role of motivation. Adm Sci (Basel). 2021;11(4):105.
- Kholifah N, Nurtanto M, Mutohhari F, et al. The mediating role of motivation and professional development in determining teacher performance in vocational schools. Cogent Educ. 2024;11(1):2421094.
- Güngör P. The relationship between reward management system and employee performance with the mediating role of motivation: A quantitative study on global banks. Procedia Soc Behav Sci. 2011;24:1510-20.
- Danish RQ, Khan MK, Shahid AU, et al. Effect of intrinsic rewards on task performance of employees: Mediating role of motivation. Int J Organ Leadersh. 2015;4:33-46.
- Mavhungu D, Bussin MH. The mediation role of motivation between leadership and public sector performance. SA J Hum Resour Manag. 2017;15(1):1-11.
- Faul F, Erdfelder E, Buchner A, Lang AG. Statistical power analyses using G*Power 3.1: Tests for correlation and regression analyses. Behav Res Methods. 2009;41(4):1149-60.
- Rodríguez-de-Dios I, Igartua JJ, González-Vázquez A. Development and validation of a digital literacy scale for teenagers. In: Proceedings of the Fourth International Conference on Technological Ecosystems for Enhancing Multiculturality; 2016. p. 1067-72.
- Abbas M, Jam FA, Khan TI. Is it harmful or helpful? Examining the causes and consequences of generative AI usage among university students. Int J Educ Technol High Educ. 2024;21(1):10.
- Grasha AF. Teaching with style: The integration of teaching and learning styles in the classroom. Alliance Publishers; Pittsburgh (PA); 1996.
- Briesmaster M, Briesmaster-Paredes J. The relationship between teaching styles and NNPSETs’ anxiety levels. System. 2015;49:145-56.
- Kanoksilapatham B, et al. Motivation of Thai university students from two disciplinary backgrounds using a hybrid questionnaire. LEARN J Lang Educ Acquis Res Netw. 2021;14(1):455-91.
- Govindasamy P, Cumming TM, Abdullah N. Validity and reliability of a needs analysis questionnaire for the development of a creativity module. J Res Spec Educ Needs. 2024;24(3):637-52.
- Hair JF, Risher JJ, Sarstedt M, Ringle CM. When to use and how to report the results of PLS-SEM. Eur Bus Rev. 2019;31(1):2-24.
- Zhang R, et al. Mediating effect of learning motivation and engagement on the relationship between generative artificial intelligence implementation and English as a foreign language proficiency. 2026. https://doi.org/10.21203/rs.3.rs-9075280/v1.
- Almira NF, Almira ZF, Vircavani C, Agustina E. A systematic review of teachers’ teaching styles and their impact on EFL student learning outcomes. J Appl Linguist Engl Educ. 2025;3(1):1-5.
- Reeve J. Teachers as facilitators: What autonomy-supportive teachers do and why their students benefit. Elem Sch J. 2006;106(3):225-36.
- Huang S, Dong L, Wang W, et al. Language is not all you need: Aligning perception with language models. In: Advances in Neural Information Processing Systems. 2023;36:72096-109.
- Liu L. An international graduate student’s ESL learning experience beyond the classroom. TESL Can J. 2011;29(1):77-92.
- van Laar E, van Deursen AJAM, van Dijk JAGM, De Haan J. The relation between 21st-century skills and digital skills: A systematic literature review. Comput Hum Behav. 2017;72:577-88.
- Al-Kahtani N. A survey assessing health science students’ perceptions of online learning at a Saudi higher education institution during the COVID-19 pandemic. Heliyon. 2022;8(9):e10688.
- Dewaele JM, Chen X, Padilla AM, Lake J. The flowering of positive psychology in foreign language teaching and acquisition research. Front Psychol. 2019;10:2128.
- Liu W, Li Y. A qualitative study of question-posing anxiety in Chinese postgraduates in UK TESOL programs. Sci Rep. 2025;16(1):2081.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.