Niniejsze badanie przedstawia lekki model redukcji halucynacji w dużych modelach językowych poprzez weryfikację na poziomie twierdzeń oraz adaptacyjne progowanie statystyczne. Poprzez selektywną korektę niepopartych twierdzeń z wykorzystaniem wnioskowania w języku naturalnym (Natural Language Inference), podejście to poprawia dokładność faktograficzną, zachowując jednocześnie niskie opóźnienia w odpowiedziach oraz praktyczną efektywność wdrożenia.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Adaptacyjna weryfikacja twierdzeń oparta na NLI z modelowaniem decyzji statystycznych w celu redukcji halucynacji o niskiej latencji w dużych modelach językowych
W tym artykule
Podsumowanie
Streszczenie
Duże modele językowe (LLMs) wykazują krytyczną tendencję do generowania faktograficznie błędnych, a jednocześnie płynnych językowo odpowiedzi – zjawisko to określa się mianem halucynacji, co stwarza poważne zagrożenia w zastosowaniach wymagających wysokiej precyzji. Istniejące strategie mitygacji, w tym generowanie wspomagane wyszukiwaniem (RAG) oraz próbkowanie samospójne, wprowadzają albo znaczące opóźnienia w procesie wnioskowania, albo zależą od zewnętrznej infrastruktury wiedzy, co ogranicza ich przydatność w systemach działających w czasie rzeczywistym. W niniejszej pracy zaproponowano lekki, dwuetapowy system weryfikacji twierdzeń, który rozkłada odpowiedzi LLM na atomowe twierdzenia faktograficzne i niezależnie weryfikuje każde z nich w oparciu o osobno wygenerowany tekst referencyjny, uzyskany za pomocą izolowanego promptu przywołującego fakty. Chociaż generator i weryfikator korzystają z tego samego modelu językowego, oddzielenie generowania odpowiedzi od przywoływania faktów ogranicza bezpośrednie warunkowanie odpowiedzi i łagodzi błąd potwierdzenia podczas weryfikacji przy użyciu wnioskowania w języku naturalnym (NLI), a zastosowanie adaptacyjnego progu statystycznego – zdefiniowanego jako τ = µ + kσ dla rozkładu wyników pewności NLI – pozwala na selektywną korektę wyłącznie twierdzeń sprzecznych. W przeciwieństwie do wcześniejszych metod opartych na NLI, które polegały na stałych granicach decyzyjnych, proponowany system dynamicznie dostosowuje próg weryfikacji do rozkładu pewności każdej odpowiedzi, wykazując stabilną wydajność we wszystkich ocenianych benchmarkach bez konieczności ponownego trenowania modelu. Testy przeprowadzone na zbiorach TruthfulQA i FEVER wykazały, że system redukuje wskaźnik halucynacji w TruthfulQA z 28% do 9% – co stanowi względny spadek o 67,9% – generując przy tym jedynie 160 ms dodatkowego opóźnienia względem bazowego modelu LLM i przewyższając modele SelfCheckGPT oraz FActScore pod względem dokładności wykrywania halucynacji. Wyniki te wskazują, że zaproponowany system zapewnia korzystny balans między wiarygodnością faktograficzną a opóźnieniem odpowiedzi w ocenianych benchmarkach, choć wymagana jest dalsza walidacja w różnych domenach i środowiskach wdrożeniowych.
Wprowadzenie
Duże modele językowe (LLM) stały się fundamentalnymi komponentami nowoczesnych systemów sztucznej inteligencji, wykazując niezwykłe możliwości w szerokim spektrum zadań z zakresu języka naturalnego, w tym w generowaniu tekstu, odpowiadaniu na pytania, streszczaniu oraz złożonym rozumowaniu1. Ich zdolność do tworzenia płynnych i spójnych kontekstowo odpowiedzi przyspieszyła ich wdrażanie w obszarach o dużym znaczeniu, takich jak systemy wspomagania decyzji klinicznych, analiza prawna, inżynieria oprogramowania oraz technologia edukacyjna2. Jednakże krytycznym i uporczywym ograniczeniem, które podważa ich niezawodność w tych środowiskach, są halucynacje, polegające na generowaniu przez modele odpowiedzi, które są poprawne językowo, lecz błędne merytorycznie, niepoparte dowodami lub całkowicie zmyślone 3. Badania empiryczne wskazują na współczynnik halucynacji wynoszący od 15% do ponad 40% w zależności od zadania i modelu, przy czym nawet najnowocześniejsze systemy, takie jak GPT-4, wykazują mierzalne niespójności faktyczne podczas ewaluacji specyficznej dla danej dziedziny2,3. Ograniczenie to niesie ze sobą poważne ryzyko w aplikacjach wymagających wysokiej precyzji, gdzie błędne wyniki mogą prowadzić do dezinformacji, błędnych diagnoz lub wadliwego podejmowania decyzji4. Halucynacje wynikają fundamentalnie z probabilistycznej natury modelowania języka – modele LLM generują tokeny poprzez przewidywanie statystycznie prawdopodobnych kontynuacji sekwencji wejściowych, a nie poprzez wyszukiwanie lub rozumowanie w oparciu o zweryfikowaną wiedzę faktyczną5. W konsekwencji generowane treści mogą zawierać brzmiące wiarygodnie, lecz nieprawdziwe twierdzenia, wprowadzać niepoparte dowodami stwierdzenia lub mieszać pojęcia powiązane semantycznie, ale odrębne pod względem faktycznym6.
Istniejące strategie łagodzenia tego problemu opierają się na kilku paradygmatach, z których każdy posiada istotne ograniczenia. Generowanie rozszerzone o wyszukiwanie (RAG) ogranicza halucynacje poprzez opieranie odpowiedzi na zewnętrznie pobranych dokumentach, jednak wprowadza znaczne opóźnienia, wymaga dostępu do aktualizowanych baz wiedzy i pozostaje podatne na błędy wyszukiwania w domenach specjalistycznych lub o ograniczonych zasobach7,8,9.
Mimo że generator odpowiedzi i generator referencji są instancjonowane przy użyciu tego samego podstawowego modelu GPT-3.5 Turbo, działają one w oparciu o różne cele promptowania i konteksty wykonawcze. Generator odpowiedzi tworzy nieograniczoną odpowiedź na zapytanie użytkownika, podczas gdy generator referencji wykonuje odizolowane zadanie przywołania faktów bez dostępu do wcześniej wygenerowanej odpowiedzi. Taka separacja ogranicza bezpośrednie efekty warunkowania odpowiedzi oraz minimalizuje błąd potwierdzenia podczas weryfikacji twierdzeń. W związku z tym ramy systemowe traktują wygenerowaną referencję jako niezależną proceduralnie, a nie statystycznie.
Niedawne badania analizowały również lekkie strategie dekodowania w celu ograniczenia halucynacji w generowaniu tekstu, bez polegania na zewnętrznym wyszukiwaniu lub wielokrotnej weryfikacji. Jednym z reprezentatywnych podejść jest Decoding by Contrasting Layers (DoLA), które poprawia faktyczność poprzez kontrastowanie reprezentacji z pośrednich i końcowych warstw transformera podczas dekodowania. W przeciwieństwie do ram weryfikacji po generowaniu, metody te ingerują bezpośrednio w proces generowania tokenów, a zatem optymalizują inny etap procesu generowania języka. Te komplementarne strategie pokazują, że mitygację halucynacji można osiągnąć zarówno podczas dekodowania, jak i poprzez weryfikację po generowaniu, przy czym każde z tych podejść oferuje odmienne kompromisy w zakresie obciążenia obliczeniowego, złożoności implementacji i wiarygodności faktograficznej.
Metody samospójności (self-consistency) zwiększają niezawodność faktograficzną poprzez próbkowanie wielu odpowiedzi i wybór najczęstszego lub najbardziej spójnego wyniku, jednak ich koszt obliczeniowy skaluje się liniowo wraz z liczbą próbek, co czyni je nieprzydatnymi w zastosowaniach wrażliwych na opóźnienia8. Podejścia oparte na iteracyjnym doprecyzowaniu (iterative refinement), które wielokrotnie korygują wyniki poprzez pętle samoprzypomnienia, stopniowo redukują wskaźniki błędów, ale znacząco wydłużają czas wnioskowania przy każdym kolejnym przejściu9. Metody weryfikacji oparte na NLI stanowią bardziej ukierunkowaną alternatywę poprzez ocenę wynikania semantycznego między wygenerowanymi twierdzeniami a tekstami referencyjnymi, lecz istniejące implementacje opierają się na stałych progach decyzyjnych, które nie adaptują się do zmiennych rozkładów ufności, domen lub zachowań modelu10,11. Wspólnie podejścia te albo nakładają niedopuszczalne obciążenie obliczeniowe, zależą od zewnętrznej infrastruktury, albo brakuje im adaptacyjności wymaganej do uogólnionego wdrożenia. Porównanie głównych cech tych podejść do weryfikacji halucynacji przedstawiono w tabeli uzupełniającej 1 (Supplementary Table 1).
W niniejszej pracy zaproponowano lekki, dwuetapowy system weryfikacji twierdzeń, zaprojektowany w celu ograniczenia halucynacji w wynikach LLM przy zachowaniu niskiego opóźnienia odpowiedzi. W pierwszym etapie LLM generuje wstępną odpowiedź, która następnie zostaje rozbita na atomowe twierdzenia faktyczne. W drugim etapie każde twierdzenie jest weryfikowane za pomocą wnioskowania w języku naturalnym (Natural Language Inference) względem oddzielnie wygenerowanego punktu odniesienia faktów, stworzonego w ramach odizolowanego procesu rozumowania, który nie ma dostępu do pierwotnie wygenerowanej odpowiedzi; decyzja o akceptacji lub korekcie na poziomie twierdzenia jest sterowana przez statystycznie wyprowadzony próg ufności. Główne wkłady tej pracy są następujące: (1) dwuetapowy potok weryfikacji na poziomie twierdzeń, który oddziela generowanie odpowiedzi od walidacji faktycznej, umożliwiając niezależną i ukierunkowaną ocenę każdego atomowego twierdzenia bez konieczności zewnętrznego wyszukiwania lub pełnej regeneracji odpowiedzi; (2) adaptacyjny mechanizm progowania statystycznego oparty na rozkładzie wyników ufności NLI (τ = µ + kσ), który dynamicznie określa granice akceptacji i korekty zamiast polegać na stałych regułach decyzyjnych, co poprawia odporność w różnych rozkładach ufności; (3) strategia selektywnej korekty, która ogranicza regenerację tylko do tych twierdzeń, które zostały zaklasyfikowane jako sprzeczne, co znacznie redukuje koszty obliczeniowe w porównaniu do ponownego próbkowania pełnej odpowiedzi lub podejść iteracyjnego ulepszania; (4) ewaluacja empiryczna na benchmarku skoncentrowanym na halucynacjach, wykazująca, że proponowany system redukuje wskaźnik halucynacji z 28% do 9%, utrzymując jednocześnie opóźnienie odpowiedzi w granicach praktycznego wdrożenia.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Badanie to nie obejmowało uczestników będących ludźmi, zwierząt, próbek biologicznych ani danych pacjentów. W związku z tym nie wymagano instytucjonalnej zgody komisji etycznej ani świadomej zgody.
Przegląd projektu badania
W celu poprawy rzetelności faktograficznej wyników generowanych przez duże modele językowe (LLM) wdrożono dwuetapowy schemat weryfikacji. Procedura obejmowała generowanie odpowiedzi, ekstrakcję twierdzeń, konstruowanie izolowanych referencji (Isolated Reference Construction), weryfikację opartą na wnioskowaniu w języku naturalnym (NLI), adaptacyjne podejmowanie decyzji statystycznych, selektywną korektę oraz końcowy montaż odpowiedzi. Schemat został oceniony z wykorzystaniem zbiorów danych benchmarkowych TruthfulQA oraz FEVER.
Ogólny schemat postępowania
Zapytanie użytkownika → Generowanie wstępnej odpowiedzi → Ekstrakcja twierdzeń → Niezależne generowanie referencji → Weryfikacja NLI → Obliczanie progu statystycznego → Korekta twierdzeń → Końcowa zweryfikowana odpowiedź. Ogólny schemat działania adaptacyjnego systemu weryfikacji twierdzeń został przedstawiony na Rysunku 1.
Przygotowanie zbioru danych
Zbiór danych TruthfulQA12, zawierający 817 pytań zorientowanych na fakty, został pobrany i przygotowany do ewaluacji. Zbiór danych FEVER13 składa się ze 185 445 adnotowanych twierdzeń oznaczonych jako Wspierane (Supported), Odparte (Refuted) lub Brak wystarczających informacji (Not Enough Information); w ewaluacji wykorzystano oznaczone dane rozwojowe z polami twierdzenia, dowodu oraz etykiety prawdy obiektywnej. Każde twierdzenie oceniano w odniesieniu do dostarczonego dowodu, natomiast oryginalną etykietę FEVER zachowano jako referencyjny wynik weryfikacji. Zbiór danych FEVER, zawierający pary twierdzenie-dowód do weryfikacji faktów, został pozyskany i poddany wstępnej obróbce. Pytania i twierdzenia wejściowe przekształcono do ustandaryzowanego formatu tekstowego. Przed rozpoczęciem eksperymentów usunięto zdublowane wpisy oraz niekompletne próbki. Zbiór TruthfulQA podzielono na podzbiory walidacyjne i testowe. Około 20% próbek TruthfulQA (164 pytania) wykorzystano do dostrojenia progu, natomiast pozostałe 653 pytania zarezerwowano do oceny wydajności. W przypadku FEVER twierdzenia dostarczone w benchmarku wykorzystano bezpośrednio jako jednostki weryfikacyjne i nie poddano ich procedurze generowania odpowiedzi oraz ekstrakcji twierdzeń zastosowanej w TruthfulQA. Charakterystyka zbiorów danych benchmarkowych wykorzystanych do opracowania i ewaluacji struktury została podsumowana w Tabeli 1.
Wstępna generacja odpowiedzi
Każde zapytanie zostało przekazane do bazowego modelu językowego. Odpowiedzi generowano przy użyciu próbkowania jądrowego (nucleus sampling) z temperaturą 0,7 i top-p wynoszącym 0,9. Maksymalna długość wyjścia została ograniczona do 256 tokenów. Wygenerowane odpowiedzi zapisano bez żadnego przetwarzania końcowego ani ręcznej modyfikacji. Wygenerowany tekst przekazano bezpośrednio do etapu ekstrakcji twierdzeń.
Ekstrakcja roszczeń
Każdą wygenerowaną odpowiedź rozłożono na niezależnie weryfikowalne stwierdzenia faktyczne. Do identyfikacji twierdzeń atomowych wykorzystano ustrukturyzowany prompt do dekompozycji. Stwierdzenia złożone oddzielono na minimalne jednostki faktyczne. Usunięto opinie subiektywne, wyrażenia stylistyczne oraz wypełniacze konwersacyjne. Każde wyodrębnione twierdzenie zapisano jako niezależną jednostkę weryfikacyjną.
Przykład:
Oryginalna odpowiedź:
"Marie Curie była fizykiem i chemikiem polskiego pochodzenia, która prowadziła pionierskie badania nad promieniotwórczością."
Wyodrębnione twierdzenia: (1) Marie Curie urodziła się w Polsce; (2) Marie Curie była fizykiem i chemikiem; (3) Marie Curie prowadziła badania nad promieniotwórczością.
Konstrukcja referencyjna izolowana:
Dla każdego wyodrębnionego twierdzenia wygenerowano niezależną referencję faktyczną. Model weryfikujący otrzymał jedynie oryginalne zapytanie użytkownika. Dostęp do oryginalnej wygenerowanej odpowiedzi został ograniczony, aby uniknąć błędu potwierdzenia. Zastosowano monit przypominający o faktach, aby zachęcić do zwięzłych odpowiedzi opartych na dowodach. Wygenerowane referencje zostały zapisane do późniejszej weryfikacji.
Weryfikacja wnioskowania w języku naturalnym
Każda para twierdzenie-referencja została przekazana do wstępnie wytrenowanego modelu NLI. Model NLI zaklasyfikował relację jako: wynikającą (entailment), neutralną lub sprzeczną (contradiction). Odnotowano prawdopodobieństwa ufności dla wszystkich trzech klas. Przypisano podpisany wynik weryfikacji: wartość dodatnią dla relacji wynikającej, zero dla neutralnej oraz wartość ujemną dla sprzeczności. Wszystkie wyniki weryfikacji zostały zebrane w celu obliczenia wartości progowej.
Adaptacyjne obliczanie progu statystycznego
Poziom pewności weryfikacji generowany przez model NLI znacznie różni się w zależności od odpowiedzi, ponieważ poszczególne zapytania generują różną liczbę twierdzeń, różny stopień złożoności semantycznej oraz odmienne rozkłady pewności. Stały próg globalny zakłada, że wszystkie odpowiedzi wykazują podobny profil pewności, co w praktyce rzadko występuje. Aby uwzględnić tę zmienność, proponowany framework szacuje granicę decyzyjną indywidualnie dla każdej odpowiedzi, wykorzystując średnią i odchylenie standardowe jej wyników weryfikacji. Średnia odzwierciedla ogólny poziom pewności odpowiedzi, natomiast odchylenie standardowe oddaje rozproszenie wartości pewności pomiędzy wyekstrahowanymi twierdzeniami. Ta adaptacyjna formulacja pozwala kryterium akceptacji dostosować się do niepewności specyficznej dla danej odpowiedzi, zamiast polegać na pojedynczym progu dla wszystkich danych wejściowych.
Obliczono średnią (µ) oraz odchylenie standardowe (σ) dla wszystkich podpisanych wyników weryfikacji.
Adaptacyjny próg decyzyjny obliczono jako:

gdzie τ oznacza próg adaptacyjny, µ oznacza średni wynik weryfikacji, σ oznacza odchylenie standardowe, a k oznacza parametr czułości.
Parametr czułości został zainicjowany na wartości 0,7. Twierdzenia zaklasyfikowane jako Wynikanie (Entailment) z wynikami większymi lub równymi +τ zostały zaakceptowane. Twierdzenia zaklasyfikowane jako Sprzeczność (Contradiction) z wynikami mniejszymi lub równymi −τ zostały oznaczone do poprawy. Twierdzenia z wynikami mieszczącymi się w przedziale (−τ, +τ) pozostały neutralne.
Selektywna korekta zastrzeżeń
Twierdzenie było przekazywane do korekty tylko wtedy, gdy model NLI klasyfikował parę twierdzenie-referencja jako sprzeczność (Contradiction), a odpowiadający jej podpisany wynik weryfikacji spełniał kryterium adaptacyjnego progu si ≤ -τ. Zatem decyzja o korekcie była wspólnie określana przez etykietę klasy NLI oraz specyficzny dla odpowiedzi próg statystyczny. Twierdzenia zaklasyfikowane jako wynikające (Entailment) z si ≥ τ zostały zaakceptowane, natomiast twierdzenia mieszczące się w przedziale -τ < si < τ uznano za neutralne i pozostawiono bez korekty. To połączone kryterium zapewniło, że korekta była stosowana wyłącznie do twierdzeń wykazujących zarówno sprzeczność semantyczną, jak i wystarczająco silne negatywne dowody weryfikacyjne.
Rekonstrukcja odpowiedzi
Zaakceptowane i poprawione twierdzenia zostały uporządkowane w ich pierwotnej sekwencji. Przywrócono granice zdań w celu zachowania czytelności. W razie potrzeby wprowadzono niewielkie korekty gramatyczne. Złożony wynik zapisano jako ostateczną zweryfikowaną odpowiedź.
Ocena wydajności
Ramę oceniono za pomocą czterech wskaźników: (1) Dokładność: proporcja odpowiedzi, które pozostały poprawne merytorycznie po weryfikacji; (2) Wynik F1: średnia harmoniczna precyzji i pełności wykrywania halucynacji; (3) Opóźnienie odpowiedzi: całkowity czas przetwarzania od przesłania zapytania do wygenerowania zweryfikowanej odpowiedzi; (4) Współczynnik halucynacji
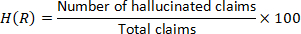
Opóźnienie raportowano jako średni czas wykonania z powtórzonych pomiarów. Ponieważ nie zachowano indywidualnych wartości opóźnień dla poszczególnych uruchomień, nie obliczono odchyleń standardowych ani przedziałów ufności.
Ocena poprawności specyficzna dla benchmarku
W przypadku TruthfulQA końcowa zweryfikowana odpowiedź była porównywana z referencyjnymi odpowiedziami zatwierdzonymi przez ludzi oraz listami błędnych odpowiedzi w benchmarku. Odpowiedź uznawano za poprawną, gdy zawarte w niej twierdzenia faktyczne były spójne z zaakceptowanymi informacjami w odpowiedziach i nie zawierały treści odpowiadających zidentyfikowanym wzorcom błędnych odpowiedzi. W przypadku FEVER każde twierdzenie w końcowym wyniku oceniano w odniesieniu do powiązanych z nim dowodów i oryginalnej adnotacji FEVER; twierdzenia uznane za „Supported” (potwierdzone) traktowano jako zweryfikowane faktycznie, natomiast twierdzenia „Refuted” (obalone) liczono jako błędne. Przypadki „Not Enough Information” (brak wystarczających informacji) pozostawiono jako nierozstrzygnięte, zamiast traktować je jako pozytywne dowody faktyczne. Wynikowe decyzje na poziomie poszczególnych twierdzeń zostały zagregowane w ramach każdego benchmarku, aby obliczyć raportowaną dokładność (Accuracy) oraz wskaźnik halucynacji (Hallucination Rate).
Środowisko eksperymentalne
Struktura została zaimplementowana przy użyciu języka Python 3.9. Operacje przetwarzania danych wykonano z wykorzystaniem bibliotek do analizy numerycznej i tabularnej. Model NLI pracował w trybie wnioskowania bez dodatkowego dostrajania. Eksperymenty przeprowadzono na stacji roboczej wyposażonej w procesor Intel Core i5, 16 GB RAM oraz 64-bitowy system operacyjny. Wszystkie oceny przeprowadzono w ustawieniu wnioskowania jednoprzepływowego w celu zapewnienia niskich opóźnień podczas pracy. Wszystkie eksperymenty przeprowadzono przy użyciu identycznych konfiguracji sprzętowych i programowych, aby zapewnić spójną ewaluację we wszystkich zbiorach danych i metodach bazowych.
Oczekiwany wynik
Protokół został zaprojektowany w celu generowania decyzji weryfikacyjnych na poziomie stwierdzeń poprzez identyfikację potencjalnie niepopartych twierdzeń i selektywne przesyłanie silnie sprzecznych treści do korekty. Oczekiwanym wynikiem jest zweryfikowana odpowiedź z ograniczoną liczbą niespójności faktycznych i minimalnym dodatkowym obciążeniem procesowym, w zależności od wydajności zaobserwowanej podczas ewaluacji eksperymentalnej.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Generowanie wstępnej odpowiedzi
Bazowy model językowy generował płynne i kontekstowo dopasowane odpowiedzi na pytania z obu zbiorów danych benchmarkowych. Jednak szczegółowa analiza ujawniła niepoparte dowodami i niezgodne z faktami stwierdzenia w kilku odpowiedziach. W zbiorze danych TruthfulQA system bazowy wykazał wskaźnik halucynacji na poziomie 28%, natomiast w zbiorze danych FEVER zaobserwowano wskaźnik halucynacji wynoszący 26%. Wyniki te potwierdziły, że bezpośrednie g...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Zaproponowany schemat poprawił wydajność weryfikacji faktów, unikając jednocześnie powtarzalnego próbkowania i zewnętrznego wyszukiwania informacji. W zbiorze TruthfulQA wskaźnik halucynacji spadł z 28% dla bazowego modelu LLM do 9% przy zastosowaniu pełnego schematu, natomiast dokładność wzrosła z 0,72 do 0,87. W zbiorze FEVER wskaźnik halucynacji spadł z 26% do 10%, a dokładność wzrosła z 0,74 do 0,89. Porównania te należy interpretować w kontekście ustawień eksperymentalnych i implementacji zastosowanych w niniejszym ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie deklarują żadnych konfliktów interesów.
Podziękowania
Autorzy pragną wyrazić szczerą wdzięczność swojej instytucji za zapewnienie środowiska akademickiego i zasobów obliczeniowych niezbędnych do przeprowadzenia niniejszych badań. Autorzy dziękują również twórcom i opiekunom publicznie dostępnych zbiorów danych referencyjnych wykorzystanych w tej pracy, które umożliwiły kompleksową ocenę proponowanego modelu. Podziękowania kierujemy do współpracowników oraz recenzentów za konstruktywne uwagi, które pomogły poprawić jakość i przejrzystość niniejszej pracy. Autorzy dziękują ponadto społeczności badawczej open-source za udostępnienie bibliotek oprogramowania i narzędzi, które ułatwiły przeprowadzanie eksperymentów, analizę danych oraz wizualizację wyników. Ich nieustanne wysiłki znacząco przyczyniły się do rozwoju badań w dziedzinie przetwarzania języka naturalnego i godnej zaufania sztucznej inteligencji. Autorzy oświadczają, że nie otrzymali żadnego zewnętrznego wsparcia finansowego ani funduszy na realizację tych badań.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Zbiór danych referencyjnych FEVER | FEVER Shared Task (Thorne et al.) | https://fever.ai/dataset/fever.html | Publicznie dostępny zbiór danych do weryfikacji faktów, składający się z par twierdzenie-dowód, używany do ewaluacji |
| GPT-3.5 Turbo (duży model językowy) | OpenAI | Model ID: gpt-3.5-turbo; https://developers.openai.com/api/docs/models/gpt-3.5-turbo | Używany zarówno jako generator odpowiedzi, jak i niezależny generator referencji, dostępny poprzez API OpenAI |
| NumPy | NumPy Developers (open source) | https://numpy.org/ | Biblioteka do obliczeń numerycznych wykorzystywana do kalkulacji statystycznych, w tym średniej i odchylenia standardowego wyników weryfikacji NLI |
| Openai (biblioteka klienta Python API) | OpenAI | https://github.com/openai/openai-python | Biblioteka klienta Python używana do przesyłania promptów i pobierania odpowiedzi z GPT-3.5 Turbo |
| pandas | pandas Development Team (open source) | https://pandas.pydata.org/ | Biblioteka do analizy danych tabelarycznych wykorzystywana do wstępnego przetwarzania zbiorów danych i obsługi wyników |
| Wstępnie wytrenowany model klasyfikacji Natural Language Inference (NLI) | Hugging Face model hub (model oparty na architekturze DeBERTa-v3-large firmy Microsoft) | MoritzLaurer/DeBERTa-v3-large-mnli-fever-anli-ling-wanli | Używany w trybie inferencji, bez dostrajania (fine-tuning), do klasyfikacji każdej pary twierdzenie-referencja jako wynikania (entailment), neutralności lub sprzeczności |
| Python | Python Software Foundation | Wersja 3.9; https://www.python.org/downloads/release/python-390/ | Główny język programowania użyty do implementacji frameworka weryfikacyjnego |
| SciPy | SciPy Developers (open source) | https://scipy.org/ | Biblioteka obliczeń naukowych wykorzystywana do wsparcia analizy statystycznej wyników eksperymentalnych |
| Transformers (biblioteka Hugging Face Transformers) | Hugging Face | https://github.com/huggingface/transformers | Biblioteka Python wykorzystywana do ładowania i uruchamiania wstępnie wytrenowanego modelu NLI |
| Zbiór danych referencyjnych TruthfulQA | Oryginalnie wydany przez Lin, Hilton i Evans | https://github.com/sylinrl/TruthfulQA | Publicznie dostępny benchmark zawierający 817 pytań zorientowanych na fakty, używany do strojenia progów i ewaluacji |
| Stacja robocza | Nie określono w manuskrypcie (proszę potwierdzić producenta/model) | Procesor Intel Core i5; 16 GB RAM; 64-bitowy system operacyjny | Sprzęt użyty do przeprowadzenia wszystkich eksperymentów w identycznych konfiguracjach |
| Uwaga: Wszystkie powyższe adresy URL zostały sprawdzone i potwierdzone jako aktywne w dacie sporządzenia tej tabeli. |
Bibliografia
- Dai Z, et al. Promptagator: Few-shot dense retrieval from 8 examples [conference presentation]. Presented at: The Eleventh International Conference on Learning Representations; 2022. [https://iclr.cc/virtual/2023/poster/10937]
- Achiam J, et al. GPT-4 technical report. arXiv. 2023;arXiv:2303.08774. [https://arxiv.org/abs/2303.08774]
- Ji Z, et al. Survey of hallucination in natural language generation. ACM Comput Surv. 2023;55(12):1-38.
- Bender EM, McMillan-Major A, Shmitchell S, Gebru T. On the dangers of stochastic parrots: Can language models be too big? [conference presentation]. Presented at: 2021 ACM Conference on Fairness, Accountability, and Transparency; 2021. [https://dl.acm.org/doi/10.1145/3442188.3445922]
- Devlin J, et al. BERT: Pre-training of deep bidirectional transformers for language understanding [conference presentation]. Presented at: 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2019. [https://arxiv.org/abs/1810.04805]
- Maynez J, Narayan S, Bohnet B, McDonald R. On faithfulness and factuality in abstractive summarization [conference presentation]. Presented at: 58th Annual Meeting of the Association for Computational Linguistics; 2020. [https://arxiv.org/abs/2005.00661]
- Brown T, et al. Language models are few-shot learners. Adv Neural Inf Process Syst. 2020;33:1877-901.
- Guu K, et al. Retrieval augmented language model pre-training [conference presentation]. Presented at: International Conference on Machine Learning; 2020. [https://arxiv.org/abs/2002.08909]
- Izacard G, Grave E. Leveraging passage retrieval with generative models for open domain question answering [conference presentation]. Presented at: 16th Conference of the European Chapter of the Association for Computational Linguistics; 2021. [https://arxiv.org/abs/2007.01282]
- Bowman SR, Angeli G, Potts C, Manning CD. A large annotated corpus for learning natural language inference [conference presentation]. Presented at: 2015 Conference on Empirical Methods in Natural Language Processing; 2015. [https://arxiv.org/abs/1508.05326]
- Platt J. Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. Adv Large Margin Classif. 1999;10(3):61-74.
- Lin S, Hilton J, Evans O. Truthfulqa: Measuring how models mimic human falsehoods. InProceedings of the 60th annual meeting of the association for computational linguistics (volume 1: long papers) 2022 May (pp. 3214-3252).
- Thorne J, Vlachos A, Christodoulopoulos C, Mittal A. FEVER: A large-scale dataset for fact extraction and verification [conference presentation]. Presented at: 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies; 2018. [https://aclanthology.org/N18-1074/]
- Williams A, Nangia N, Bowman SR. A broad-coverage challenge corpus for sentence understanding through inference. arXiv. 2017;arXiv:1704.05426.
- Manakul P, Liusie A, Gales M. SelfCheckGPT: Zero-resource black-box hallucination detection for generative large language models [conference presentation]. Presented at: 2023 Conference on Empirical Methods in Natural Language Processing; 2023.
- Min S, et al. FActScore: Fine-grained atomic evaluation of factual precision in long-form text generation. arXiv. 2023;arXiv:2305.14251.
- Cohen J. Statistical power analysis for the behavioral sciences. Routledge; New York; 2013.
- Kadavath S, et al. Language models (mostly) know what they know. arXiv. 2022;arXiv:2207.05221.
- Hendrycks D, et al. Aligning AI with shared human values. arXiv. 2020;arXiv:2008.02275.
- Lewis P, et al. Retrieval-augmented generation for knowledge-intensive NLP tasks. Adv Neural Inf Process Syst. 2020;33:9459-74.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Przedruki i uprawnienia
Ten artykuł został opublikowany
Film wkrótce dostępny