Niniejszy artykuł przedstawia wyjaśnialną strukturę opartą na sieciach CNN do klasyfikacji zmian skórnych, która łączy wysoką dokładność diagnostyczną z interpretowalnością modelu. System klasyfikuje obrazy zmian i generuje wizualne wyjaśnienia dla swoich przewidywań. Wyniki wykazują wysoką wydajność i zwiększoną przejrzystość, co wspiera podejmowanie decyzji klinicznych i pomaga dermatologom we wczesnym wykrywaniu chorób skóry.
Artykuł badawczy
Wyjaśnialna struktura wspomagania komputerowego w klasyfikacji zmian skórnych z wykorzystaniem głębokiego uczenia
W tym artykule
Podsumowanie
Streszczenie
Wykorzystanie głębokich splotowych sieci neuronowych do diagnostyki chorób skóry wykazało w różnych badaniach poziom dokładności zbliżony do wyników uzyskiwanych przez dermatologów. Niemniej jednak wciąż istnieje wiele wyzwań, w tym niewystarczająca wydajność i słaba generalizacja w niektórych przypadkach, a także niska interpretowalność związana z wykorzystaniem modeli typu „czarna skrzynka”. Stanowi to istotną przeszkodę w praktycznym wdrożeniu, ponieważ oprócz dokładnej diagnostyki wymagana jest wyjaśnialność, co sprawia, że znalezienie rozwiązania staje się konieczne. Aby przezwyciężyć wspomniane trudności, w niniejszym badaniu opracowano wyjaśnialną strukturę głębokiego uczenia do klasyfikacji zmian skórnych (EDLF-SLC). Struktura ta wykorzystuje różne podejścia w zakresie uczenia maszynowego i wyjaśnialnej sztucznej inteligencji (XAI), aby zapewnić poprawę zarówno dokładności, jak i interpretowalności w trzech etapach. W pierwszym etapie reprezentacje głębokie wyodrębnione z wielu wstępnie wytrenowanych architektur CNN są łączone, aby zachować komplementarne informacje dyskryminacyjne wyuczone przez różne architektury sieci przed klasyfikacją za pomocą SVM z jądrem funkcji radialnej. Następnie do klasyfikacji uzyskanych cech wykorzystuje się klasyfikatory maszyn wektorów nośnych (SVM) z jądrem funkcji radialnej. Na koniec predykcje dokonane przez model są interpretowane za pomocą lokalnych wyjaśnień interpretowalnych i niezależnych od modelu (LIME). Wyniki eksperymentalne pokazują, że EDLF-SLC osiąga 88,0% dokładności, 89,0% precyzji, 87,0% czułości oraz 88,0% wskaźnika F1, co wykazuje konkurencyjną wydajność w porównaniu z kilkoma niedawno opisanymi metodami w warunkach eksperymentalnych przyjętych w tym badaniu.
Wprowadzenie
Zmiany skórne stanowią główny problem w dermatologii i onkologii, ponieważ obejmują szerokie spektrum – od łagodnych nieprawidłowości po nowotwory złośliwe, takie jak czerniak, najgroźniejsza postać raka skóry. W 2020 roku na czerniaka zachorowało około 325 000 osób, a liczba zgonów na całym świecie przekroczyła 57 0001. Chociaż postępy w badaniach przesiewowych i leczeniu poprawiły rokowania pacjentów, opóźniona diagnostyka oraz ograniczony dostęp do opieki zdrowotnej wciąż przyczyniają się do wysokiej śmiertelności i utraty lat życia, szczególnie w młodszych grupach populacyjnych2,3.
Tradycyjna diagnostyka opiera się głównie na badaniu wizualnym i dermatoskopii, co sprawia, że proces ten jest zależny od doświadczenia klinicystów i podatny na subiektywizm, zmienność międzyobserwacyjną, niepotrzebne biopsje oraz wydłużony czas badania4,5,6. Aby wyeliminować te ograniczenia, głębokie uczenie, a w szczególności konwolucyjne sieci neuronowe (CNN), stało się skutecznym rozwiązaniem w automatycznej klasyfikacji zmian skórnych. Modele oparte na CNN, w tym DDCNN-F7, YOLOv7-XAI8 oraz kilka innych architektur9,10,11,12,13, wykazały wysoką dokładność diagnostyczną dzięki automatycznemu uczeniu się dyskryminatywnych cech obrazu. Pomimo sukcesów, większość modeli głębokiego uczenia działa jako tzw. „czarne skrzynki”, co ogranicza zaufanie klinicystów i utrudnia ich wdrażanie w rutynowej praktyce medycznej. W związku z tym wprowadzono techniki wyjaśnialnej sztucznej inteligencji, aby poprawić przejrzystość modeli poprzez dostarczanie wizualnych wyjaśnień przewidywań. Wśród tych metod, Local Interpretable Model-Agnostic Explanations generuje interpretowalne lokalne wyjaśnienia poprzez identyfikację obszarów obrazu, które mają największy wpływ na decyzje modelu14.
Klasyfikacja zmian skórnych ewoluowała od tradycyjnej oceny klinicznej do zaawansowanych diagnostycznych systemów opartych na AI, napędzana potrzebą dokładnego, wiarygodnego i wczesnego wykrywania raka skóry. Ewolucja ta przebiegała przez pięć głównych etapów — tradycyjne metody diagnostyczne, diagnostykę wspomaganą komputerowo (CAD), ML, DL, a ostatnio XAI oraz uczenie federacyjne (FL) — co odzwierciedla ciągłe wysiłki zmierzające do poprawy dokładności diagnostycznej, spójności, skalowalności i zaufania klinicznego, przy jednoczesnym przezwyciężaniu ograniczeń konwencjonalnego badania. Wczesne metody obliczeniowe próbowały naśladować rozumowanie kliniczne za pomocą ręcznie opracowanych deskryptorów obrazu wywodzących się z reguły ABCD, obejmujących asymetrię, nieregularność brzegów, zmienność koloru i średnicę zmiany. Cechy te łączono z sieciami bayesowskimi, drzewami decyzyjnymi, systemami ekspertowymi i modelami wnioskowania rozmytego w celu wsparcia diagnostyki czerniaka, przy czym w kilku badaniach zgłoszono dokładność klasyfikacji przekraczającą 90%15,16,17. Mimo że metody te stworzyły ważny fundament dla diagnostyki wspomaganej komputerowo, opierały się one całkowicie na ręcznie zaprojektowanych cechach i zdefiniowanych regułach diagnostycznych. W konsekwencji wykazywały one ograniczoną odporność na zmienność jakości obrazu, morfologii zmiany, oświetlenia oraz warunków akwizycji.
Aby rozwiązać te niedociągnięcia, jako etap pośredni między konwencjonalną analizą obrazu a nowoczesnymi ramami opartymi na AI pojawiły się klasyczne systemy CAD. Systemy CAD łączyły ręcznie opracowaną ekstrakcję cech z konwencjonalnymi klasyfikatorami w celu poprawy spójności diagnostycznej i wsparcia podejmowania decyzji klinicznych. Kilka podejść hybrydowych zintegrowało klasteryzację hierarchiczną z rekurencyjnymi sieciami neuronowymi i architekturami długiej krótkotrwałej pamięci (LSTM), osiągając dokładność klasyfikacji bliską 99,5%18. Inne frameworki oparte na CAD wykorzystywały klasyfikatory gradient boosting z wyjaśnieniami opartymi na SHAP, wykazując konkurencyjną dokładność diagnostyczną przy jednoczesnej poprawie przejrzystości modelu19. Chociaż systemy te stanowiły znaczącą poprawę w stosunku do podejść opartych wyłącznie na regułach, nadal w dużym stopniu polegały na ręcznej ekstrakcji cech, rozbudowanym przetwarzaniu wstępnym, starannie adnotowanych zestawach danych oraz wieloetapowych potokach przetwarzania.
Techniki uczenia maszynowego dodatkowo usprawniły zautomatyzowaną klasyfikację zmian skórnych, umożliwiając uczenie oparte na danych zamiast jawnego projektowania reguł. Frameworki hybrydowe łączące splotowe sieci neuronowe z konwencjonalnymi klasyfikatorami uczenia maszynowego, w tym regresją logistyczną i algorytmem k-najbliższych sąsiadów, wykazały wysoką skuteczność klasyfikacji na zbiorach danych referencyjnych, osiągając dokładność przekraczającą 95%9. Samonadzorowane uczenie multimodalne dodatkowo poprawiło reprezentację cech poprzez wspólne wykorzystanie obrazów dermoskopowych i klinicznych, co zmniejszyło zależność od obszernych ręcznych adnotacji przy jednoczesnej poprawie wyników klasyfikacji20. Dodatkowe badania łączyły CNN z uogólnioną analizą dyskryminacyjną, deskryptorami SURF oraz algorytmami optymalizacji w celu poprawy dyskryminacji cech i dokładności klasyfikacji21. Techniki automatycznego wyboru cech z wykorzystaniem DenseNet-201, InceptionV3 oraz algorytmów optymalizacji drzew binarnych dodatkowo usprawniły reprezentację cech, zachowując przy tym konkurencyjną wydajność diagnostyczną22. Podejścia oparte na uczeniu transferowym z wykorzystaniem wstępnie wytrenowanych architektur, takich jak AlexNet i GoogLeNet, wykazały również obiecujące możliwości klasyfikacji pomimo ograniczonej ilości danych treningowych23. Niemniej jednak większość metod ML nadal była zależna od starannie zaprojektowanych procedur wstępnego przetwarzania, ręcznie opracowanych strategii optymalizacji, zbalansowanych zbiorów danych oraz rozbudzonego strojenia hiperparametrów. Ich ograniczona walidacja zewnętrzna oraz wrażliwość na niezbalansowanie klas dodatkowo ograniczyły ich praktyczną przydatność w zróżnicowanych warunkach klinicznych.
Wprowadzenie DL zasadniczo przekształciło zautomatyzowaną klasyfikację zmian skórnych, umożliwiając uczenie end-to-end bezpośrednio z surowych danych obrazowych. Sieci CNN wyeliminowały potrzebę ręcznego projektowania cech, jednocześnie znacząco poprawiając wydajność diagnostyczną w wielu zestawach danych referencyjnych. Większość podejść opartych na CNN wykazała istotną poprawę w klasyfikacji zmian dzięki coraz bardziej zaawansowanym architekturom. Modele CNN uwzględniające symetrię badały istotne klinicznie cechy zmian, jednak osiągnęły jedynie umiarkowaną zrównoważoną dokładność24. Inne podejścia zintegrowały architektury EfficientNet z wyjaśnieniami LIME i SHAP w celu poprawy interpretowalności, wprowadzając jednocześnie ilościowe miary wiarygodności25. Hybrydowe systemy DL łączące segmentację zmian, uczenie zespołowe i sieci CNN osiągnęły doskonałe wyniki w wielu zestawach danych ISIC, lecz pozostały wrażliwe na jakość segmentacji i niezbilansowanie klas26.
W ostatnim czasie coraz bardziej zaawansowane architektury hybrydowe pozwoliły na dalsze zwiększenie dokładności klasyfikacji poprzez integrację komplementarnych technik DL. Warunkowe generatywne sieci przeciwstawne (Conditional generative adversarial networks) w połączeniu z YOLOv5 i analizą niezależnych komponentów osiągnęły dokładność klasyfikacji przekraczającą 99%, choć ich złożoność obliczeniowa ograniczyła praktyczne wdrożenie 27. Podobnie, hybrydowe architektury LSTM–ResNet skutecznie uczyły się reprezentacji przestrzenno-czasowych, lecz wymagały znacznie większych zasobów obliczeniowych28. Modele oparte na transformatorach, w tym Sap-Former, wykorzystywały globalne informacje kontekstowe w celu usprawnienia reprezentacji cech, jednak wymagały one rozbudowanego przetwarzania wstępnego, wielkoskalowych adnotowanych zbiorów danych oraz znacznej mocy obliczeniowej29. Lekkie alternatywy, takie jak S-MobileNet, próbowały zrównoważyć wydajność obliczeniową z dokładnością diagnostyczną30, podczas gdy metody nienadzorowanej adaptacji domenowej poprawiły generalizację między domenami, mimo mniejszej skuteczności w przypadku dostępności jedynie ograniczonej liczby próbek treningowych31. Hybrydowe sieci z mechanizmami uwagi, włączające zmodyfikowane moduły uwagi splotowej i snapshot ensemble learning, wykazały również obiecujące wyniki w klasyfikacji zmian skórnych w ospie małpiej, choć problemy związane z niezbalansowaniem klas, różnorodnością obrazów i ograniczoną wyjaśnialnością pozostały nierozwiązane32. Dostosowane architektury rezydualne, wykorzystujące głębsze projekty sieci i hybrydowe funkcje straty, dodatkowo zwiększyły dokładność klasyfikacji powyżej 99%, lecz wiązało się to ze znacznie większymi kosztami obliczeniowymi i dłuższym czasem uczenia33. Kompleksowe opracowania przeglądowe konsekwentnie wyciągały wniosek, że DL znacząco przewyższa tradycyjne podejścia oparte na ręcznie projektowanych cechach dzięki automatycznemu uczeniu dyskryminatywnych reprezentacji obrazów, wskazując jednocześnie na trwałe wyzwania związane z artefaktami obrazowania, zmiennością oświetlenia, złożonością obliczeniową oraz ograniczoną generalizacją kliniczną34.
Choć DL znacznie poprawiło dokładność diagnostyczną, obawy dotyczące przejrzystości modeli, szacowania niepewności oraz godnego zaufania wdrożenia klinicznego pobudziły rosnące zainteresowanie XAI oraz uczeniem federacyjnym. W kilku badaniach zbadano techniki kwantyfikacji niepewności, w tym predykcję konformalną, dropout Monte Carlo oraz ewidencyjne uczenie głębokie, wykazując, że wiarygodne szacowanie ufności może znacząco poprawić wsparcie decyzji, mimo narzucenia dodatkowych ograniczeń obliczeniowych i związanych z danymi35. Zaproponowano również ramy wzajemnego uczenia oparte na Transformerach, aby rozwiązać problem niezbalansowania klas przy jednoczesnej poprawie wydajności uczenia cech36. Inne podejścia łączyły pełnorozdzielcze sieci CNN z technikami optymalizacji opartymi na grafach w celu poprawy segmentacji i klasyfikacji zmian37, natomiast hybrydowe ramy uczenia głębokiego integrujące wiele komplementarnych reprezentacji cech osiągnęły dokładność klasyfikacji zbliżoną do 99,5%, mimo wymagania rozbudowanego przetwarzania wstępnego38.
Niedawne badania coraz częściej koncentrują się na bezpośrednim integrowaniu wyjaśnialności w ramach DL, aby zwiększyć zaufanie klinicystów i ułatwić praktyczne wdrożenie kliniczne. Systemy wyjaśnialne wykorzystujące wiele architektur splotowych sieci neuronowych wraz z Grad-CAM i Score-CAM z powodzeniem lokalizowały diagnostycznie istotne obszary zmian, zachowując jednocześnie konkurencyjne wyniki klasyfikacji zarówno na zbiorach danych wewnętrznych, jak i zewnętrznych39. Hybrydowe ramy CNN–Transformer łączące obrazy dermoskopowe z metadanymi klinicznymi dodatkowo poprawiły wydajność predykcyjną, wykorzystując SHAP i Grad-CAM do generowania klinicznie znaczących wyjaśnień wizualnych40. Dodatkowe hybrydowe architektury oparte na transformerach, integrujące EfficientNetV2S, Swin Transformers, zmodyfikowane sieci Xception oraz mechanizmy uwagi grafowej, skutecznie uchwyciły komplementarne globalne i lokalne cechy zmian, choć ich duża liczba parametrów i ograniczona wydajność w przypadku klas mniejszościowych ograniczyły praktyczne wdrożenie41. Podobnie, hybrydowe ramy YOLOv8–Vision Transformer wykazały poprawę w lokalizacji zmian, klasyfikacji wieloklasowej i interpretowalności wizualnej dzięki adaptacyjnej augmentacji wraz z wyjaśnieniami SHAP i Grad-CAM; jednak metody te nadal opierały się głównie na zbiorach danych referencyjnych i wykazywały ograniczoną odporność w odniesieniu do mniejszościowych kategorii zmian42. W kilku artykułach przeglądowych podsumowano te osiągnięcia, podkreślając zarówno znaczący postęp dokonany dzięki nowoczesnym technikom głębokiego uczenia, jak i uporczywe wyzwania związane z wydajnością obliczeniową, wyjaśnialnością, zależnością od zbiorów danych oraz walidacją kliniczną43,44,45. Tabela 1 podsumowuje niektóre z niedawno opublikowanych prac wykorzystujących algorytmy głębokiego uczenia do klasyfikacji zmian skórnych.
Mimo znaczących postępów osiągniętych przez niedawne metody DL w klasyfikacji zmian skórnych, większość istniejących podejść pozostaje ograniczona przez wysoką złożoność obliczeniową, zależność od dużych adnotowanych zbiorów danych, ograniczoną interpretowalność modeli oraz niewystarczającą walidację w zróżnicowanych, rzeczywistych warunkach klinicznych. Aby przezwyciężyć te ograniczenia, w niniejszej pracy zaproponowano framework EDLF-SLC, który integruje komplementarne cechy wyekstrahowane z wielu architektur CNN z klasyfikatorem SVM w celu zapewnienia odpornej i dokładnej klasyfikacji. Framework wykorzystuje ponadto ulepszony preprocessing w celu poprawy jakości obrazów i rozwiązania problemu niezbalansowania klas, jednocześnie implementując technikę LIME w celu dostarczenia wizualnych wyjaśnień poszczególnych predykcji, co zwiększa przejrzystość modelu i jego wiarygodność kliniczną.
Wkład niniejszego badania jest trójstopniowy. Po pierwsze, autorzy proponują solidne ramy metodologiczne, EDLF-SLC, które integrują zaawansowane splotowe sieci neuronowe (CNN) z klasyfikatorem maszyny wektorów nośnych (SVM) w celu uzyskania dokładnej i niezawodnej klasyfikacji zmian skórnych. Po drugie, autorzy wdrażają ulepszone techniki wstępnego przetwarzania, aby rozwiązać problem niezrównoważenia klas i zredukować szum obrazu, co poprawia jakość obrazów wejściowych oraz ogólną wydajność modelu klasyfikacji. Po trzecie, autorzy wykorzystują metodę Local Interpretable Model-agnostic Explanations (LIME) do wizualizacji i interpretacji poszczególnych predykcji modelu poprzez wyróżnienie obszarów obrazu, które najsilniej wpływają na decyzje klasyfikacyjne, zwiększając tym samym przejrzystość i interpretowalność zaproponowanych ram metodologicznych.
Protokół
W niniejszym badaniu nie uczestniczyli ochotnicy ani nie gromadzono możliwych do zidentyfikowania danych pacjentów. Wszystkie eksperymenty zostały przeprowadzone z wykorzystaniem publicznie dostępnego zbioru danych zmian skórnych ISIC 2020 pobranego z repozytorium Kaggle; w związku z tym nie wymagano zgody instytucjonalnej komisji etycznej ani świadomej zgody uczestników. Wszystkie materiały wykorzystane w tym badaniu znajdują się w Tabeli materiałów.
Ekstrakcja i fuzja cech
Obrazy zmian skórnych zostały przetworzone przy użyciu wielu wstępnie wytrenowanych modeli CNN. Wektory cech głębokich wyekstrahowane z wybranych architektur CNN zostały połączone w celu stworzenia ujednoliconej reprezentacji cech dla każdego obrazu zmiany skórnej. Przyjęta strategia fuzji zachowuje komplementarne informacje wizualne wyuczone przez różne architektury CNN, co pozwala następującemu klasyfikatorowi SVM wykorzystać zarówno niskopoziomowe charakterystyki tekstury, jak i wysokopoziomowe reprezentacje semantyczne. Chociaż techniki redukcji wymiarowości, takie jak analiza głównych składowych lub selekcja cech oparta na informacji wzajemnej, mogłyby zmniejszyć wymiarowość cech, celowo zachowano pełną reprezentację połączoną, ponieważ fuzjonowana przestrzeń cech pozostaje obliczeniowo zarządzalna dla zastosowanego klasyfikatora RBF-SVM, przy jednoczesnym zachowaniu komplementarnych informacji diagnostycznych wyekstrahowanych z heterogenicznych szkieletów CNN.
Klasyfikacja
Połączone wektory cech zostały wykorzystane do wytrenowania klasyfikatora SVM z jądrem RBF. W celu określenia optymalnych ustawień klasyfikacji zastosowano techniki optymalizacji hiperparametrów. Następnie klasyfikator przypisał zmiany skórne do odpowiednich klas.
Wyjaśnialność
Aby poprawić interpretowalność, zastosowano metodę LIME w celu wygenerowania wizualnych wyjaśnień wskazujących obszary obrazu, które mają najistotniejszy wpływ na wyniki klasyfikacji. Wyjaśnienia te pomogłyby klinicystom w zrozumieniu i walidacji decyzji modelu.
Plan oceny
Zaproponowany model został oceniony przy użyciu zestawu danych referencyjnych zmian skórnych. Wydajność oceniono za pomocą wskaźników Accuracy, Precision, Recall oraz F1-Score. Przeprowadzono eksperymenty porównawcze z istniejącymi podejściami opartymi na uczeniu maszynowym i głębokim uczeniu, aby wykazać skuteczność zaproponowanego modelu.
Oczekiwane wyniki
Oczekiwano, że badanie pozwoli na opracowanie dokładnego i interpretowalnego systemu klasyfikacji zmian skórnych. Wstępne wyniki eksperymentalne wskazują, że EDLF-SLC osiąga dokładność na poziomie 88.0%, precyzję 89.0%, czułość 87.0% oraz wynik F1-score 88.0%, przewyższając tym samym kilka konkurencyjnych metod. Przewidywano, że integracja wyjaśnień LIME zwiększy wiarygodność i ułatwi wdrożenie systemów diagnostycznych wspomaganych przez AI w praktyce klinicznej.
Znaczenie
Niniejsza praca wnosi wkład w rozwijającą się dziedzinę wyjaśnialnej sztucznej inteligencji w opiece zdrowotnej, rozwiązując problemy związane zarówno z wydajnością, jak i przejrzystością diagnozowania zmian skórnych. Zaproponowany model ma potencjał, aby wspierać dermatologów w podejmowaniu bardziej wiarygodnych i interpretowalnych decyzji diagnostycznych, co w ostateczności przełoży się na poprawę opieki nad pacjentem. Ponadto w tej sekcji autorzy przedstawili informacje dotyczące materiałów oraz metodologii zastosowanej w niniejszym badaniu. W szczególności autorzy rozpoczęli od opisu zbioru danych wykorzystanego w eksperymentach, a następnie przeszli do szczegółowego omówienia wyjaśnialnego modelu głębokiego uczenia do klasyfikacji zmian skórnych.
Zbiór danych
Przedstawiona praca opiera się na publicznie dostępnym zbiorze danych ISIC 2020 (International Skin Imaging Collaboration), do którego można uzyskać dostęp w serwisie Kaggle (https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign). Repozytorium ISIC uznawane jest za jedno z najlepszych źródeł w dziedzinie obrazowania dermatologicznego, ponieważ zapewnia szeroką gamę obrazów dermoskopowych różnych typów zmian skórnych, co pokazano na Rysunku 1. Co ważne, zbiór danych obejmuje obrazy zarówno zmian łagodnych, jak i złośliwych, co czyni go użytecznym do wykonywania zadań klasyfikacji binarnej w przypadku raka skóry 46. W obecnym zbiorze danych znajduje się 3 297 obrazów, z czego 1 800 jest łagodnych, a 1 497 złośliwych. Aby przeprowadzić bardziej efektywne eksperymenty, dane należało podzielić na zbiór treningowy i zbiór testowy. W szczególności dostępnych jest 2 637 obrazów treningowych, w tym 1 440 łagodnych i 1 197 złośliwych, natomiast zbiór testowy składa się z 660 obrazów, z czego 360 jest łagodnych, a 300 złośliwych. Podsumowanie zbioru danych przedstawiono w Tabeli 2.
Zaproponowany model EDLF-SLC
W niniejszej pracy zaproponowano wydajne i zrozumiałe rozwiązanie służące do klasyfikacji zmian skórnych na kategorie łagodne i złośliwe, wykorzystując nowatorską, wyjaśnialną technikę głębokiego uczenia opartą na podejściu hybrydowym, łączącym zalety wielu wstępnie wytrenowanych modeli konwolucyjnych sieci neuronowych. Konwolucyjne sieci neuronowe okazały się wysoce skuteczne w ekstrahcji wysokopoziomowych cech semantycznych z obrazów medycznych. Wykorzystując tę zdolność, zaproponowane wyjaśnialne ramy głębokiego uczenia do klasyfikacji zmian skórnych (EDLF-SLC) wykorzystują wiele wstępnie wytrenowanych modeli CNN w celu osiągnięcia lepszych wyników. Aby zapewnić niezbędną przejrzystość procesu podejmowania decyzji medycznych, w proponowanym podejściu zastosowano metodę LIME do generowania lokalnych, zrozumiałych dla człowieka wyjaśnień dla wyników wyjściowych. Cały schemat można podzielić na trzy główne etapy, przedstawione na Ryc. 2, a mianowicie: (1) wstępne przetwarzanie danych, (2) ekstrakcja cech i klasyfikacja oraz (3) interpretowalność.
Architektura i integracja modelu
W ramach etapu wstępnego wybrano siedem popularnych modeli głębokiego uczenia (MobileNetV2, ResNet50, EfficientNetB0, Xception, InceptionResNetV2, NASNetLarge oraz MobileNet) i oceniono je osobno na zbiorze walidacyjnym, a następnie wybrano cztery najskuteczniejsze modele (ResNet50, EfficientNetB0, MobileNet oraz Xception) do etapu ekstrakcji cech. W proponowanym schemacie każdy obraz wejściowy x został niezależnie przepuszczony przez wybrane wstępnie wytrenowane modele. Z każdego z tych modeli usunięto ostatnią warstwę w pełni połączoną, a wektory cech uzyskano z warstw poprzednich. Symbole fResNet50(x), fEfficientNetB0(x), fMobileNet(x) oraz fXception(x) odnoszą się do wyjściowych wektorów cech z każdego z wyżej wymienionych modeli. Poprzez konkatenację tych wektorów cech otrzymano nowy zagregowany wektor cech F(xi):
F(xi) = [f(ResNet50)(xi);f(EfficientNetB0)(xi);f(MobileNet)(xi);f(Xception)(xi)] (1)
Następnie F(xi) zostało przekazane do klasyfikatora SVM z rdzeniem funkcji radialnej (RBF) w celu uzyskania wyniku klasyfikacji. Cały algorytm dla proponowanego schematu przedstawiono w Pliku uzupełniającym 1.
Zaproponowane ramy przyjmują bezpośrednią fuzję na poziomie cech, ponieważ każda wstępnie wytrenowana architektura CNN wychwytuje różne cechy dyskryminacyjne zmian skórnych dzięki swojej odrębnej architekturze sieci i wyuczonej hierarchii cech. W konsekwencji konkatenacja tych heterogenicznych reprezentacji cech pozwala zachować informacje komplementarne, które przyczyniają się do bardziej kompleksowej charakterystyki zmian przed klasyfikacją. Chociaż techniki redukcji wymiarowości, takie jak analiza głównych składowych (PCA) lub selekcja cech oparta na wzajemnej informacji, mogłyby zmniejszyć wymiarowość zfuzowanej reprezentacji, celowo zachowano pełny zfuzowany wektor cech, ponieważ jego wymiarowość pozostaje obliczeniowo zarządzalna dla przyjętego klasyfikatora RBF-SVM, przy jednoczesnym zachowaniu komplementarnych informacji diagnostycznych wyekstrahowanych przez różne szkielety CNN. Projekt ten priorytetyzuje zatem zachowanie komplementarnych reprezentacji głębokich zamiast eliminowania potencjalnie informatywnych cech przed klasyfikacją.
Przygotowanie danych
Przygotowanie danych obejmowało wstępne przetwarzanie oraz podział zbioru danych na zbiory treningowy i testowy. Wstępne przetwarzanie ma na celu poprawę jakości danych poprzez eliminację niespójności, usuwanie duplikatów, formatowanie obrazów wejściowych oraz skalowanie cech w celu zapewnienia stabilnego treningu wysokiej jakości modelu. Wszystkie obrazy zostały znormalizowane do zakresu [−1, 1] za pomocą normalizacji Z-score:
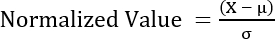 (2)
gdzie µ i σ oznaczają odpowiednio wartość średnią i odchylenie standardowe dla danego obrazu. Zbiór danych został podzielony na dwa podzbiory, tj. zbiór treningowy (70,0%) oraz zbiór testowy (30,0%).
Augmentacja danych
Aby uniknąć przeuczenia i zwiększyć zdolność modelu do generalizacji, w odniesieniu do zbioru treningowego zastosowano pewne augmentacje. Augmentacja obrazów polega na modyfikowaniu zdjęć w celu sztucznego rozszerzenia zbioru danych bez zmiany istotnych cech stanów medycznych. Potok augmentacji został zbudowany przy użyciu Keras Sequential API. Zastosowano takie transformacje jak losowe odwrócenie poziome, obrót pod niewielkim kątem, zmiana rozmiaru, skalowanie, regulacja jasności/kontrastu, przybliżanie oraz niewielkie przesunięcia. Reprezentatywne przykłady augmentowanych obrazów przedstawiono na Rysunku 3.
Modele wstępnie wytrenowane
W proponowanym schemacie przyjęto kilka wstępnie wytrenowanych modeli głębokiego uczenia w celu ekstrakcji cech z obrazów wejściowych. Modele te obejmują MobileNet, ResNet50, EfficientNetB0, Xception, NASNetLarge, Inception-ResNet-v2 oraz MobileNetV2. MobileNet i MobileNetV2 to lekkie modele głębokiego uczenia umożliwiające wydajne obliczenia dzięki zastosowaniu splotów rozdzielnych wgłębnie (depth-wise separable convolutions). ResNet50 wykorzystuje mechanizm połączeń rezydualnych do trenowania modelu, co pozwala uniknąć problemu zanikającego gradientu podczas uczenia. EfficientNetB0 zapewnia równowagę między wydajnością a precyzją dzięki podejściu polegającemu na skalowaniu złożonym (compound scaling). Xception rozszerza sieć Inception, wykorzystując sploty rozdzielne wgłębnie. NASNetLarge opiera się na wykorzystaniu automatycznego wyszukiwania architektury neuronowej (neural architecture search) w celu budowy optymalnych struktur głębokich sieci neuronowych, natomiast Inception-ResNet-v2 stanowi hybrydę modelu Inception i mechanizmu połączeń rezydualnych. Wektory cech wyekstrahowane z ResNet50 (1 024 cechy), EfficientNetB0 (1 280 cech), MobileNet (1 024 cechy) oraz Xception (2 048 cech) są łączone w celu uzyskania jednolitej reprezentacji 5 376-wymiarowej. Wybrano tę strategię fuzji, aby zachować komplementarne reprezentacje wyuczone przez różne architektury CNN, zamiast redukować reprezentację przed klasyfikacją. Powstały wektor cech jest następnie przekazywany do klasyfikatora RBF-SVM, który wyznacza optymalną nieliniową granicę decyzyjną w zfuzowanej przestrzeni cech.
Wyjaśnialny model AI (LIME)
Aby zapewnić lokalną interpretowalność przewidywań modelu, autorzy zastosowali metodę generowania lokalnych, zrozumiałych dla człowieka wyjaśnień dla każdego konkretnego przewidywania modelu, zwaną LIME47. W przypadku każdego obrazu wejściowego LIME najpierw dzieli go na mniejsze jednostki zwane superpikselami. Następnie z oryginalnego obrazu generowane są perturbacje, a dla każdej z nich szacowane są przewidywania z głębokiego modelu neuronowego. Następnie, na podstawie perturbacji, dopasowywany jest ważony model liniowy z wykorzystaniem wag zależnych od ich bliskości względem oryginalnej instancji wejściowej. Po dopasowaniu modelu liniowego szacowane są wyniki istotności cech, które wskazują na rolę każdego superpiksela w przewidywaniu końcowej etykiety. Wyniki istotności te są wizualnie zaznaczone na końcowym obrazie wyjaśniającym. Algorytm LIME przedstawiono w Pliku uzupełniającym 2.
Wyniki
Ocena wydajności opracowanego systemu klasyfikacji opiera się na tradycyjnych miarach ewaluacyjnych wynikających z macierzy pomyłek. Macierz pomyłek pozwala na pełne zrozumienie działania klasyfikatora poprzez przedstawienie liczby poprawnych i błędnych klasyfikacji dokonanych dla każdej zdefiniowanej klasy. W ten sposób można przeanalizować wszystkie rodzaje błędów. Na przykład zarówno wyniki fałszywie dodatnie, jak i fałszywie ujemne są szczególnie istotne w diagnostyce chorób. Wysokie wartości wyników fałszywie dodatnich mogą świadczyć o wysokiej czułości klasyfikatora, ale jednocześnie duża liczba wyników fałszywie ujemnych wskazuje na jego niską czułość i stwarza potencjalne zagrożenia dla zdrowia. W niniejszej pracy wykorzystano następujące wskaźniki wydajności: dokładność (accuracy), precyzję (precision), pełność (recall), wynik F1 (F1-score), swoistość (specificity), współczynnik prawdziwie dodatnich (TPR) oraz współczynnik fałszywie dodatnich (FPR). Wzory tych wskaźników zamieszczono poniżej:
Dokładność=(TP+TN)/(TP+TN+FP+FN) (3)
Precyzja = TP/(TP+FP) (4)
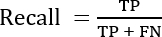 (5)
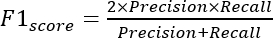 (6)
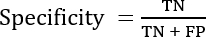 (7)
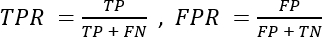 (8)
W tym przypadku TP określa liczbę złośliwych nowotworów skóry wykrytych przez system, natomiast TN wskazuje liczbę zmian łagodnych. Z kolei FP obrazuje liczbę błędnych decyzji, w których zmiany zostały zaklasyfikowane jako złośliwe, mimo że w rzeczywistości są łagodne. FN odzwierciedla liczbę błędnie rozpoznanych próbek łagodnych. W odniesieniu do klasyfikacji raka skóry, minimalizacja wyników fałszywie ujemnych jest niezwykle istotna ze względu na potencjalne negatywne skutki, jakie mogą z niej wynikać.
Wydajność modeli bazowych
Wszystkie eksperymenty obliczeniowe zostały przeprowadzone w środowisku chmurowym Google Colab. Warto zauważyć, że platforma ta umożliwia uruchamianie instancji maszyn wirtualnych z systemem operacyjnym Ubuntu 20.04. Do trenowania modeli bazowych wykorzystano język Python w wersji 3.9 oraz framework PyTorch w wersji 2.3.1. Ponadto wszystkie węzły obliczeniowe posiadały identyczną specyfikację: procesor Intel Xeon o częstotliwości 2.2 GHz, kartę graficzną NVIDIA Tesla T4 GPU, 16 GB RAM oraz pojemność dysku 70 GB. Taka konfiguracja eksperymentalna pozwoliła na ograniczenie zmienności wynikającej z zastosowania różnych platform sprzętowych oraz zwiększenie niezawodności i powtarzalności wyników. Pełne podsumowanie środowiska eksperymentalnego znajduje się w Tabeli 3.
Rysunek 4 przedstawia krzywe uczenia odpowiadające 100 epokom treningu dla architektury ResNet-50. Trening został przeprowadzony w oparciu o zbiór danych zawierający 2110 obrazów, podczas gdy rozmiar zbioru walidacyjnego wynosił 660 obrazów. Jak widać, podczas treningu dokładność stale rosła, osiągając niemal 90,0%. Jednocześnie wzrost dokładności obserwowano przez pierwsze 50 epok; po tym punkcie dokładność stała się niemal stała, co można uznać za oznakę zbieżności modelu. W przypadku walidacji model wykazał wartość AUC równą 86,0%, wykazując tym samym zadowalające właściwości dyskryminacyjne.
Macierz pomyłek przedstawiona na Rysunku 5 charakteryzuje wydajność modelu ResNet-50 pod kątem dokładności klasyfikacji dla zbioru testowego zawierającego 660 obrazów. Podczas ewaluacji model poprawnie rozpoznał 310 z 360 próbek łagodnych oraz 239 z 300 próbek złośliwych. Jednakże stosunkowo duża liczba próbek złośliwych została błędnie sklasyfikowana, co doprowadziło do uzyskania relatywnie wysokiej wartości wyników fałszywie ujemnych. Wynik ten należy przeanalizować szczegółowo ze względu na poważne konsekwencje tego rodzaju błędów przy praktycznym zastosowaniu klasyfikatora. Łącznie model osiągnął dokładność na poziomie 83,0%, przy precyzji (precision) wynoszącej 83,3%, czułości (recall) 83,3% oraz wskaźniku F1-score równym 83,3%.
Tabela 4 zawiera szczegółowy opis charakterystyki wydajności modelu ResNet-50 dla obu klas. Klasyfikator wykazał stosunkowo zrównoważone zachowanie pod kątem precyzji; dla próbek łagodnych jej wartość wyniosła 83,0%, natomiast dla próbek złośliwych precyzja wyniosła 84,0%. Podobnie wartości czułości (recall) osiągnęły 88,0% dla zmian łagodnych i 78,0% dla zmian złośliwych. Wartość support w tabeli reprezentuje liczbę próbek odpowiadających każdej klasie.
Zaproponowany model EDLF-SLC
Rycina 6 przedstawia AUC treningowe i walidacyjne zaproponowanego modelu w ciągu 300 epok. Metryka AUC odzwierciedla zdolność modelu do rozróżniania klas łagodnych i złośliwych, przy czym wyższe wartości wskazują na lepszą wydajność dyskryminacyjną. Jak zauważono, AUC treningowe wzrasta stabilnie w trakcie procesu uczenia, osiągając maksymalną wartość 1,00 w około 200. epoce. AUC walidacyjne również ulega stopniowej poprawie w początkowych etapach uczenia; jednak po około 150 epokach zaczyna osiągać plateau, co sugeruje konwergencję modelu. Końcowa wartość AUC walidacyjnego wynosząca 0,95 świadczy o silnej zdolności do generalizacji i efektywnej rozdzielności klas.
Macierz pomyłek proponowanego modelu, przedstawiona na Rysunku 7, pokazuje, że model prawidłowo sklasyfikował 299 próbek łagodnych i 272 próbek złośliwych, natomiast błędnie zaklasyfikował 28 przypadków łagodnych jako złośliwe i 61 przypadków złośliwych jako łagodne. Łącznie model uzyskał 571 prawidłowych predykcji i 89 błędnych klasyfikacji. Warto zauważyć, że większa liczba wyników fałszywie ujemnych (przypadki złośliwe błędnie sklasyfikowane jako łagodne) wskazuje na krytyczne ograniczenie, gdyż takie błędy mogą mieć istotne implikacje kliniczne. Niemniej jednak ogólna wydajność klasyfikacji pozostaje wysoka. W przeciwieństwie do podejść opartych na selekcji cech, które celowo usuwają wymiary przed klasyfikacją, proponowana struktura zachowuje pełną, zintegrowaną reprezentację głęboką wygenerowaną przez wiele heterogenicznych architektur CNN. Rozwiązanie to przyjęto, ponieważ każda sieć bazowa wyodrębnia komplementarne cechy zmian, a zachowanie pełnej reprezentacji pozwala klasyfikatorowi SVM wykorzystać połączone informacje dyskryminacyjne bez wykluczania potencjalnie informatywnych cech. W konsekwencji przyjęta strategia fuzji cech priorytetyzuje naukę reprezentacji komplementarnych, zachowując jednocześnie wykonalność obliczeniową.
Rysunek 8 przedstawia reprezentatywne przykłady wyników klasyfikacji uzyskanych za pomocą proponowanego modelu. Wyniki pokazują, że model przypisuje wysokie wskaźniki ufności do poprawnie sklasyfikowanych przypadków. W szczególności przypadki łagodne wykazują wysokie prawdopodobieństwa przewidywane (np. 99,84% i 99,85%), podczas gdy przypadki złośliwe również wykazują silny poziom ufności (np. 99,98% i 99,96%). Wyniki te wskazują, że model potrafi skutecznie odróżnić zmiany łagodne od złośliwych, nawet w trudnych wizualnie scenariuszach. Aby zwiększyć interpretowalność, zastosowano framework LIME do generowania lokalnych wyjaśnień dla przewidywań modelu, co przedstawiono na Rysunku 9A–D. LIME przybliża złożoną granicę decyzyjną modelu za pomocą lokalnie interpretowalnego modelu liniowego. Dla każdego obrazu wejściowego metoda ta generuje próbki zaburzone poprzez selektywne maskowanie superpikseli i ocenę odpowiadających im przewidywań. Następnie do tych próbek dopasowuje się ważony model liniowy, w którym wagi są określane na podstawie bliskości względem oryginalnego wejścia przy użyciu jądra funkcji radialnej. Wynikowe współczynniki reprezentują wkład każdego superpiksela w końcowe przewidywanie i są zdefiniowane jako:
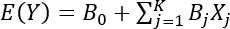 (9)
gdzie Xj ∈ {0, 1} oznacza obecność lub brak j-tego superpiksela, Bj reprezentuje odpowiadającą mu wagę wkładu, a B0 jest predykcją bazową. Współczynniki dodatnie (Bj > 0) wskazują obszary przyczyniające się do klasy złośliwej, natomiast współczynniki ujemne (Bj < 0) odpowiadają cechom łagodnym. Wizualizacje oparte na metodzie LIME, przedstawione na Rysunku 9B, D, wyróżniają najbardziej wpływowe obszary przyczyniające się do każdej decyzji klasyfikacyjnej. W przypadku zmian łagodnych model kładzie nacisk na obszary charakteryzujące się jednorodną pigmentacją i wyraźnymi granicami. W przeciwieństwie do nich, w przypadkach złośliwych wyróżnione obszary odpowiadają istotnym klinicznie cechom, takim jak nieregularne brzegi, heterogenność koloru i nietypowa tekstura. Intensywność wyróżnionych obszarów odzwierciedla wielkość odpowiadających im współczynników Bj.
Wyniki te wykazują, że model EDLF-SLC koncentruje się na cechach istotnych klinicznie, które są zgodne z uznanymi kryteriami dermatologicznymi, takimi jak reguła ABCD. Zgodność ta zwiększa interpretowalność i wiarygodność modelu, czyniąc go bardziej odpowiednim do wspomagania decyzji klinicznych. Ponadto na Rysunku 10 przedstawiono porównawcze wyniki wizualizacji uzyskane przy użyciu dodatkowych technik wyjaśnialności, w tym Grad-CAM, HiResCAM, GradCAM++, XGradCAM, LayerCAM, EigenGradCAM oraz EigenCAM, co dodatkowo potwierdza spójność zidentyfikowanych istotnych obszarów w różnych metodach. Porównanie wydajności proponowanego modelu EDLF-SLC oraz siedmiu modeli bazowych po przeszkoleniu przez 100 epok przedstawiono w Tabeli 5. Model EDLF-SLC uzyskał konkurencyjny wynik 0,88 dla każdej z ocenianych metryk w porównaniu z architekturami bazowymi ocenianymi w kontekście eksperymentalnym. Modele EfficientNetB0 i ResNet50 również uzyskały dobre wyniki, osiągając dokładności odpowiednio 0,85 i 0,83. Z kolei Inception-ResNetV2 wykazał najgorszą wydajność klasyfikacji spośród ocenianych modeli. Z drugiej strony, pomimo stosunkowo niższej dokładności klasyfikacji, jego wydajność obliczeniowa była wciąż porównywalna z wydajnością modeli bazowych. Proponowany model EDLF-SLC wykazał konkurencyjną wydajność w stosunku do ocenianych modeli bazowych w przyjętych warunkach eksperymentalnych.
Aby ocenić wydajność proponowanego rozwiązania w odniesieniu do istniejących podejść, w Tabeli 6 przedstawiono porównanie z reprezentatywnymi, najnowocześniejszymi metodami klasyfikacji zmian skórnych. Na przykład w pracy47 zgłoszono dokładność na poziomie 0,86, podczas gdy w48 zastosowano model oparty na zespołach (ensemble), który osiągnął podobną dokładność, ale niższą precyzję, pełność oraz wartość F1-score. Niedawne badania oparte na uczeniu zespołowym i wielu architekturach CNN25,49 wykazały dokładność do 0,87. W przyjętych warunkach eksperymentalnych proponowany framework EDLF-SLC osiągnął dokładność 0,88, wykorzystując jednolity, wyjaśnialny model bez konieczności stosowania dodatkowych komponentów, takich jak modele segmentacji zmian.
DOSTĘPNOŚĆ DANYCH
Dane wspierające wyniki niniejszego badania są otwarcie dostępne w serwisie Kaggle pod adresem https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign.
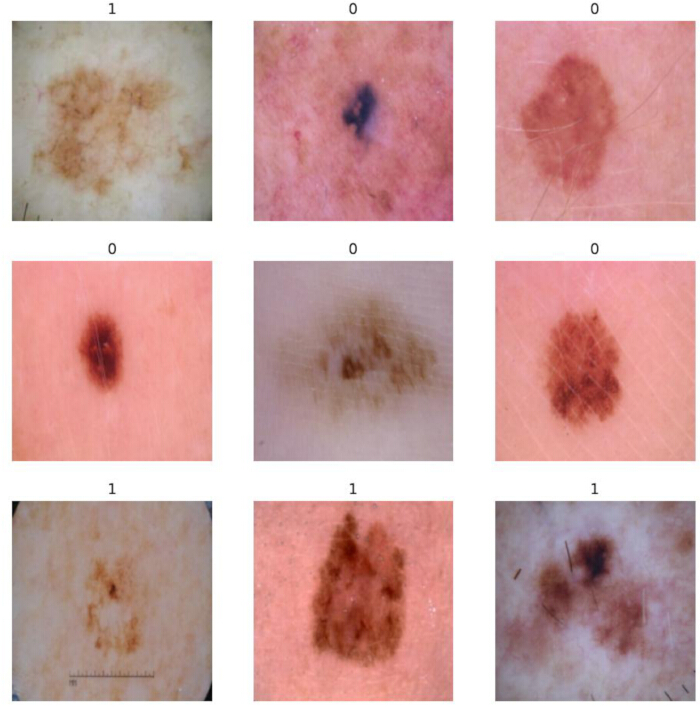
Rycina 1: Reprezentatywne obrazy dermoskopowe z zestawu danych ISIC ilustrujące dwie klasy diagnostyczne wykorzystane w niniejszym badaniu. Próbki są oznaczone jako łagodne (0) i złośliwe (1), co podkreśla zmienność morfologii, koloru i tekstury zmian w całym zestawie danych. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
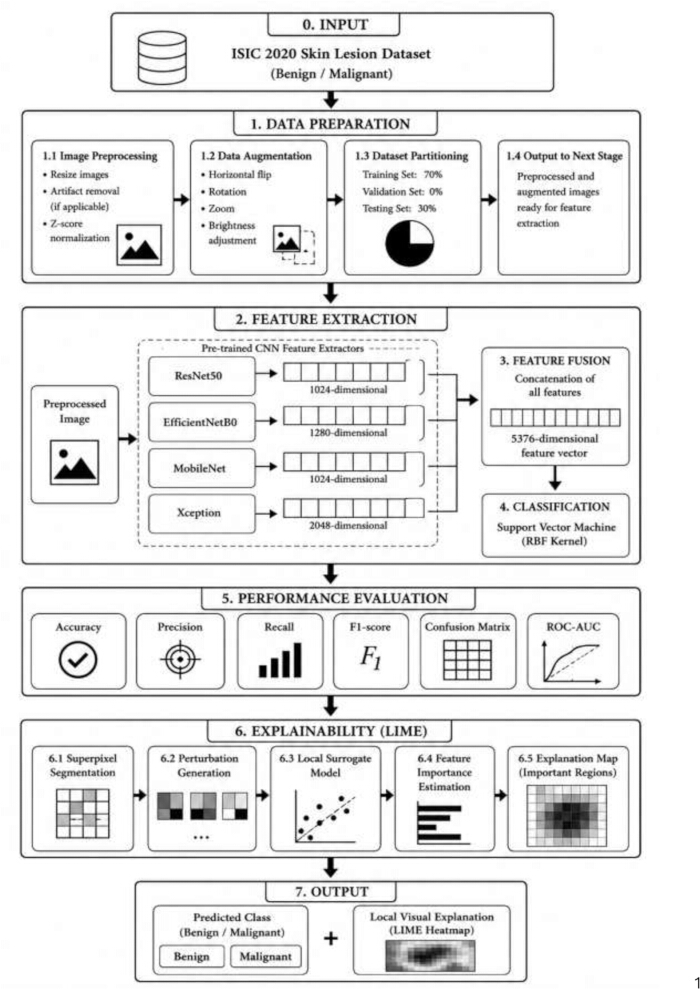
Rycina 2: Kompletny schemat proponowanego frameworka EDLF-SLC. Protokół rozpoczyna się od pozyskania obrazów z bazy ISIC 2020, po czym następują: przetwarzanie wstępne, augmentacja danych, partycjonowanie zbioru danych, głęboka ekstrakcja cech przy użyciu czterech wstępnie wytrenowanych architektur CNN, fuzja cech, klasyfikacja SVM, ocena wydajności oraz generowanie wyjaśnień w oparciu o LIME. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
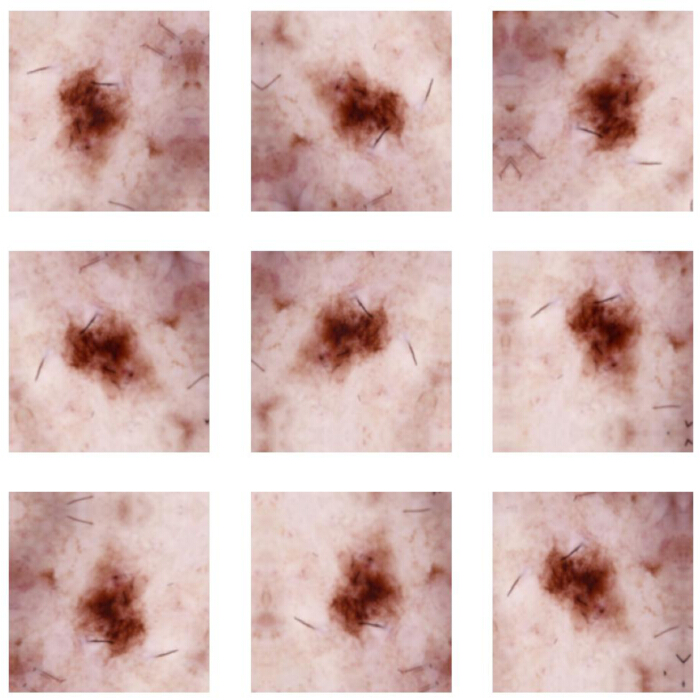
Rycina 3: Przykłady augmentowanych obrazów zmian skórnych wygenerowanych przy użyciu technik augmentacji danych. Obejmuje to odbicia poziome i pionowe, rotację, skalowanie oraz regulację jasności. Transformacje te zwiększają różnorodność zbioru danych, poprawiają odporność modelu i zmniejszają ryzyko przeuczenia podczas treningu. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
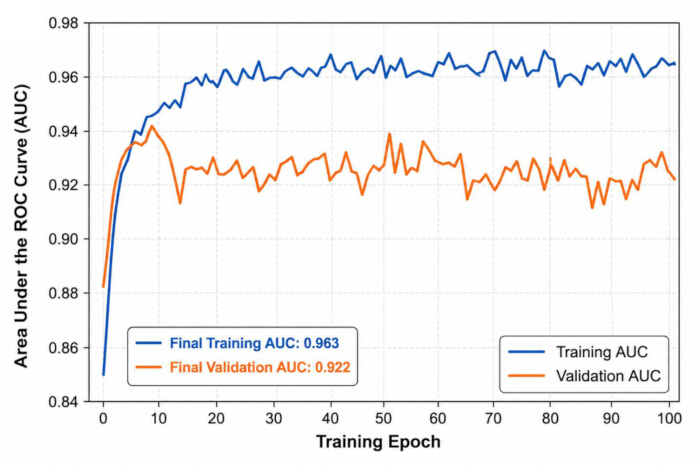
Rycina 4: Pole pod krzywą charakterystyki operacyjnej odbiornika (ROC-AUC) dla zbioru treningowego i walidacyjnego modelu ResNet-50 w ciągu 100 epok trenowania. Niebieska krzywa reprezentuje AUC treningowe, natomiast pomarańczowa krzywa reprezentuje AUC walidacyjne. Krzywe wykazują szybką zbieżność podczas początkowych epok trenowania, po której następuje stabilna optymalizacja z konsekwentnie wysoką wydajnością walidacji, co wskazuje na efektywną naukę i satysfakcjonującą generalizację na zbiorze walidacyjnym. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
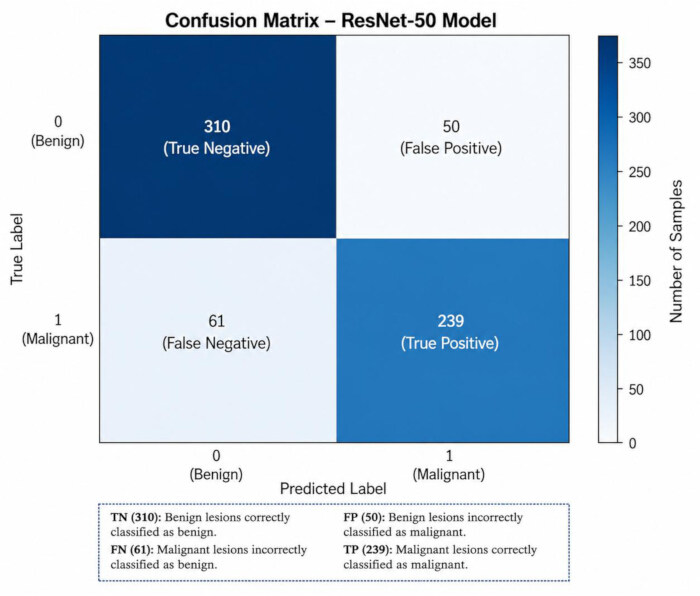
Rysunek 5: Macierz pomyłek modelu ResNet-50 na zbiorze testowym. Wiersze reprezentują rzeczywiste etykiety klas (0 = łagodna, 1 = złośliwa), natomiast kolumny reprezentują przewidziane etykiety klas. Elementy na przekątnej wskazują prawidłowo sklasyfikowane próbki (310 łagodnych i 239 złośliwych), podczas gdy elementy poza przekątną reprezentują próbki błędnie sklasyfikowane, w tym 50 wyników fałszywie dodatnich i 61 wyników fałszywie ujemnych. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
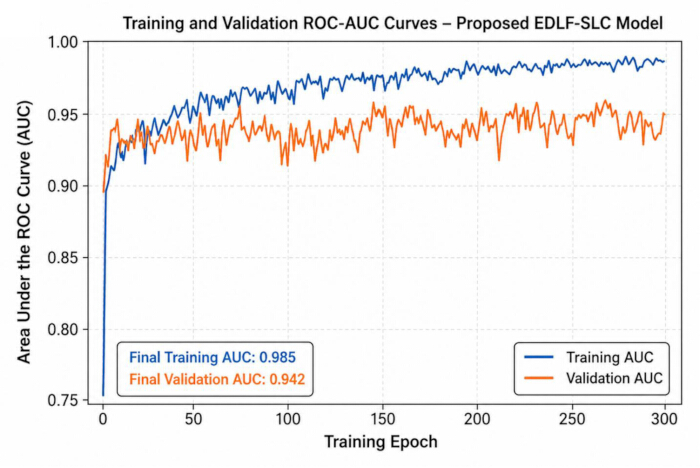
Rysunek 6: Pole pod krzywą charakterystyki operacyjnej odbiornika (ROC-AUC) dla zbioru treningowego i walidacyjnego zaproponowanego modelu EDLF-SLC w ciągu 300 epok treningowych. Niebieska krzywa reprezentuje AUC treningowe, natomiast pomarańczowa krzywa reprezentuje AUC walidacyjne. Model wykazuje szybką zbieżność podczas początkowych epok treningowych, po której następuje stabilna optymalizacja z konsekwentnie wysokimi wartościami AUC treningowego i walidacyjnego przez pozostałe epoki. Utrzymana wydajność walidacji świadczy o dobrej zdolności do generalizacji i stabilnym zachowaniu uczenia zaproponowanego frameworka EDLF-SLC na zbiorze walidacyjnym. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
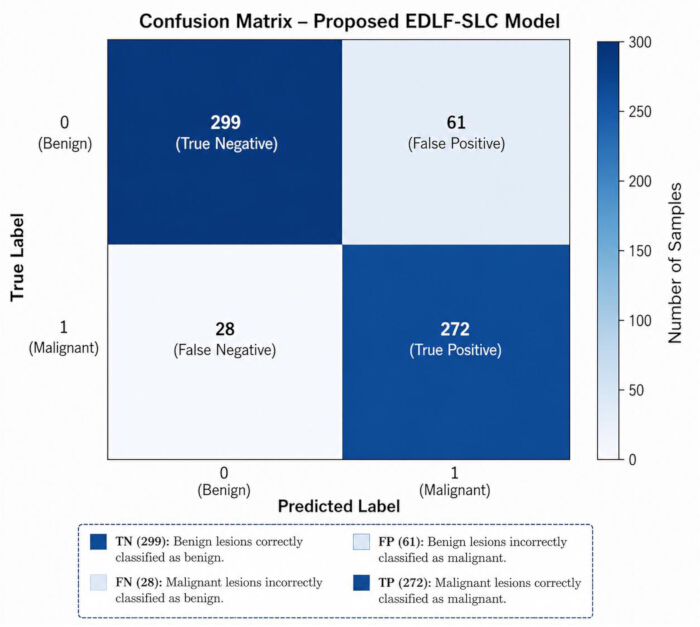
Rycina 7: Macierz pomyłek proponowanego modelu EDLF-SLC na zbiorze testowym. Wiersze reprezentują prawdziwe etykiety klas (0 = łagodna, 1 = złośliwa), natomiast kolumny reprezentują przewidywane etykiety klas. Elementy na przekątnej wskazują prawidłowo sklasyfikowane próbki (299 łagodnych i 272 złośliwych), podczas gdy elementy poza przekątną odpowiadają próbkom błędnie sklasyfikowanym, w tym 61 fałszywie dodatnich i 28 fałszywie ujemnych. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
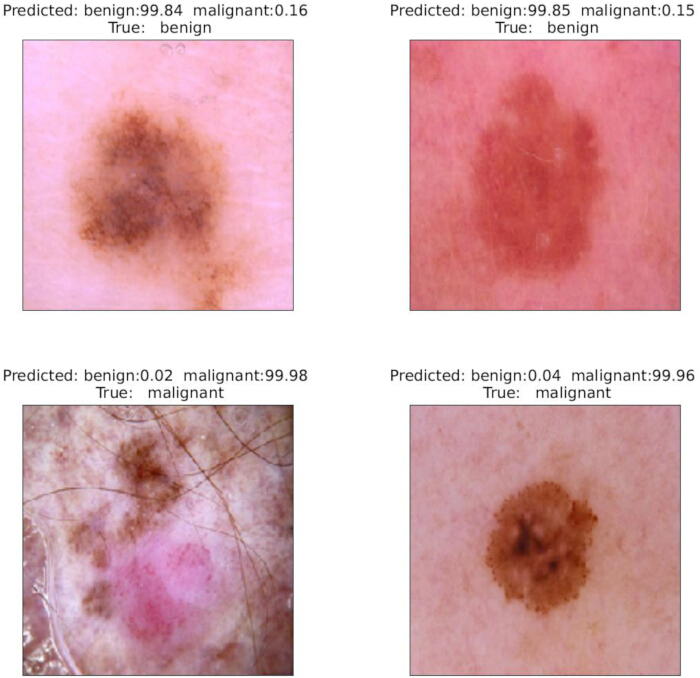
Rycina 8: Przykładowe przewidywania wygenerowane przez proponowany model EDLF-SLC. Rycina ta ilustruje poziomy ufności klasyfikacji dla zmian łagodnych i złośliwych oraz demonstruje zdolność dyskryminacyjną modelu. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
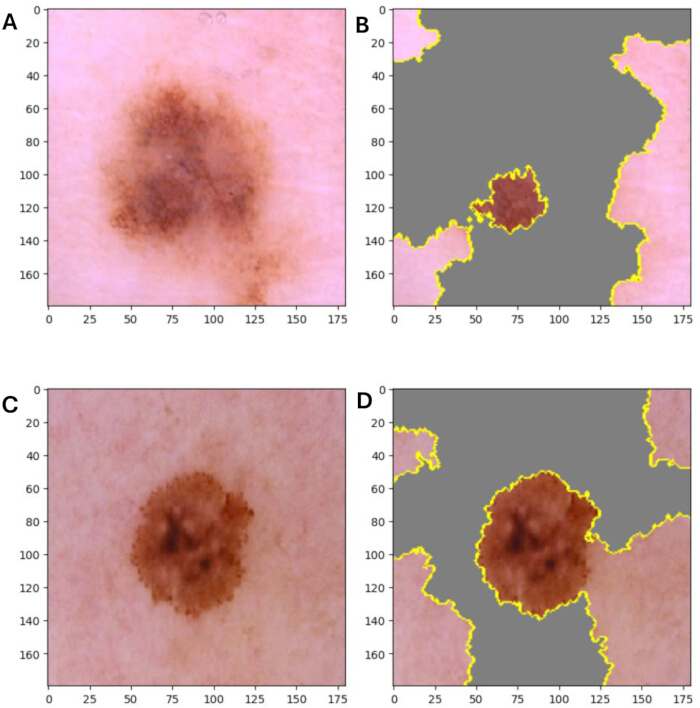
Rysunek 9: Lokalne wyjaśnienia oparte na LIME dla proponowanego modelu EDLF-SLC. Rysunek wyróżnia najbardziej wpływowe regiony superpikseli przyczyniające się do decyzji klasyfikacyjnych modelu. (A) Oryginalny obraz dermoskopowy łagodnej zmiany skórnej. (B) Wyjaśnienie LIME dla zmiany łagodnej, z wyróżnionymi superpikselami wskazującymi regiony, które w największym stopniu przyczyniły się do predykcji zmiany łagodnej. (C) Oryginalny obraz dermoskopowy złośliwej zmiany skórnej. (D) Wyjaśnienie LIME dla zmiany złośliwej, pokazujące dyskryminacyjne regiony superpikseli, które w przeważającym stopniu wpłynęły na klasyfikację jako złośliwa. Żółte granice wyznaczają wpływowe superpiksele zidentyfikowane przez LIME, natomiast szare obszary reprezentują regiony o minimalnym wkładzie w predykcję. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
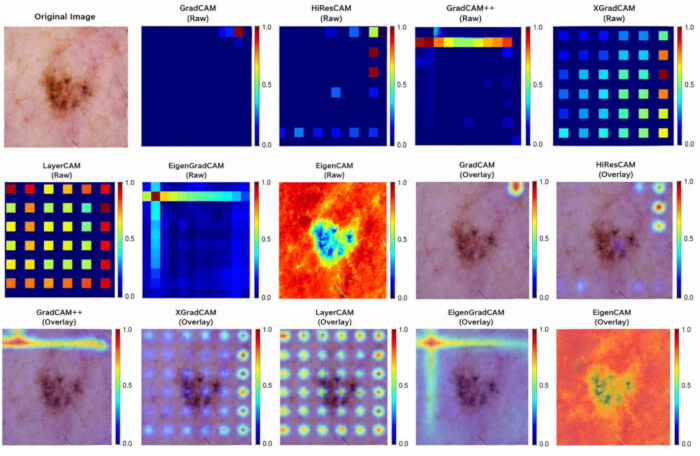
Rycina 10: Porównanie metod wyjaśnialności opartych na mapowaniu aktywacji klas (CAM) zastosowanych w proponowanym modelu EDLF-SLC. Rycina porównuje mapy lokalizacji wygenerowane przez GradCAM, HiResCAM, GradCAM++, XGradCAM, LayerCAM, EigenGradCAM oraz EigenCAM dla tego samego obrazu dermoskopowego. Pierwszy panel przedstawia oryginalny obraz wejściowy, a następnie odpowiadające mu surowe mapy aktywacji oraz nałożone mapy ciepła wygenerowane przez każdą z metod wyjaśnialności. Wizualizacje ilustrują różnice w lokalizacji przestrzennej i wyróżniają obszary obrazu, które w największym stopniu przyczyniają się do decyzji klasyfikacyjnej proponowanego frameworka EDLF-SLC. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
| Ref. | Rok | Zbiór danych | Rozmiar danych | Ekstrakcja cech | Metoda | Dokładność |
| 9 | 2022 | zbiór danych HAM10000 | 10015 obrazów zmian skórnych | Cechy koloru i kształtu | Algorytmy ML i modele splotowych sieci neuronowych (CNN) | 95.1% |
| 19 | 2023 | zbiór danych PH2 | 200 adnotowanych obrazów | Cechy: asymetria, smugi, kropki/globule, obszary regresji | Modele ML | 94.0% |
| 30 | 2024 | zbiór danych HAM10000 | 10 000 obrazów | Cechy koloru i kształtu | S-MobileNet | 97.7% |
| 28 | 2025 | Zbiory danych ISIC2020 i HAM10000 | ISIC2020 (12 670 obrazów) oraz HAM10000 (10 015 obrazów) | Kolor i kształt | Sieć rezydualna-długa krótkotrwała pamięć (R-LSTM50) | 95,7% (ISIC2020); 94,2% (HAM10000) |
| 32 | 2026 | Zbiór danych zmian skórnych w ospie małpiej (MSLD) | 770 obrazów | Kontekst i tekstura | DenseNet121, Xception, InceptionV3 oraz CBAM | 88% (DenseNet121) |
| 39 | 2025 | HAM10000 | 38 569 obrazów | Kontekst i tekstura | MobileNet, ResNet50, InceptionV3 i EfficientNet | 93,6% (MobileNet) |
| 40 | 2025 | ISIC 2019 | 2357 obrazów | Kontekst i przestrzeń | Wielomodalne uczenie głębokie oparte na sieciach CNN i transformerach | 98.71% |
| 41 | 2026 | ISIC 2019 | 25 000 obrazów | Kontekst i tekstura | TransXV2S | 95.26% |
| 42 | 2025 | HAM10000 | 10 015 obrazów | Kolor i kształt | ViT z YOLOv8 | 93% |
Tabela 1: Porównanie literatury. Podsumowanie niektórych niedawno opublikowanych prac wykorzystujących algorytmy uczenia głębokiego do klasyfikacji zmian skórnych.
| Zbiór danych | Łagodny | Złośliwy | Suma |
| Dane treningowe | 1440 | 1197 | 2637 |
| Dane testowe | 360 | 300 | 660 |
| Całkowite dane | 1800 | 1497 | 3297 |
Tabela 2: Rozkład zbioru danych.Rozkład próbek łagodnych i złośliwych w zbiorze danych ISIC 2020, z uwzględnieniem podziału na zbiory treningowy i testowy.
| Komponent | Specyfikacja |
| System operacyjny | Ubuntu 20.04 |
| Język programowania | Python 3.9 |
| Struktura DL | PyTorch 2.3.1 |
| Optymalizator | Adam |
| Harmonogramowanie tempa uczenia | 1e−3 |
| Liczba epok | 100/300 |
| procesor (CPU) | 2 vCPU 2,2 GHz |
| procesor graficzny | Tesla T4 (16 GB) × 1 |
| RAM | 16 GB |
| Parametry trenowalne | 2 430 353 (9,27 MB) |
| Parametry nietrenowalne | 133 434 397 (509,01 MB) |
Tabela 3: Specyfikacja systemu. Szczegółowa specyfikacja środowiska obliczeniowego, w tym ram programistycznych i zasobów sprzętowych wykorzystanych do trenowania i ewaluacji modelu.
| Klasa | Precyzja | Czułość (Recall) | wskaźnik F1 | Wsparcie |
| Klasa łagodna | 0.83 | 0.88 | 0.85 | 360 |
| Klasa złośliwa | 0.84 | 0.78 | 0.81 | 300 |
| Dokładność | - | - | 0.832 | 660 |
| Średnia makro | 0.84 | 0.83 | 0.83 | 660 |
| Średnia ważona | 0.84 | 0.83 | 0.83 | 660 |
Tabela 4: Raport klasyfikacji.Wydajność klasyfikacji modelu ResNet-50 na zbiorze testowym, zawierająca precyzję, pełność, wynik F1 oraz liczbę próbek (support) dla każdej klasy.
| Model | Dokładność | Precyzja | Czułość (Recall) | Wskaźnik F1 | Czas (s) |
| NASNetLarge | 0.77 | 0.76 | 0.77 | 0.76 | 2002.47 |
| EfficientNetB0 | 0.85 | 0.85 | 0.85 | 0.85 | 734.8 |
| Xception | 0.8 | 0.81 | 0.8 | 0.8 | 732.23 |
| ResNetV2 | 0.63 | 0.64 | 0.63 | 0.611 | 1072.34 |
| MobileNet | 0.79 | 0.8 | 0.79 | 0.79 | 629.29 |
| MobileNetV2 | 0.77 | 0.79 | 0.77 | 0.77 | 660.5 |
| ResNet50 | 0.83 | 0.83 | 0.83 | 0.83 | 749.77 |
| EDLF-SLC | 0.88 | 0.89 | 0.87 | 0.88 | 3279.77 |
Tabela 5: Porównanie wydajności modelu. Porównawcza wydajność proponowanego modelu EDLF-SLC oraz bazowych modeli głębokiego uczenia pod kątem dokładności, precyzji, pełności, wyniku F1 oraz czasu obliczeń.
| Model | Dokładność | Precyzja | Czułość | Wskaźnik F1 |
| ResNet-18 [25] | 0.85 | 0.85 | 0.85 | 0.85 |
| ResNet-50 z SVM [50] | 0.87 | 0.88 | 0.98 | 0.93 |
| Hybrydowe modele DL + SVM [48] | 0.86 | 0.84 | 0.8 | 0.84 |
| Hybrydowe modele DL + SVM [49] | 0.86 | 0.8 | 0.6 | 0.68 |
| Proponowany układ EDLF-SLC | 0.88 | 0.89 | 0.87 | 0.88 |
Tabela 6: Metryki porównania modeli. Porównanie wydajności proponowanego frameworka EDLF-SLC z najnowszymi, zaawansowanymi metodami klasyfikacji zmian skórnych.
Plik uzupełniający 1: Algorytm 1. Przebieg proponowanego schematu EDLF-SLC, przedstawiający wstępne przetwarzanie danych, ekstrakcję głębokich cech z wykorzystaniem wielu architektur CNN, klasyfikację opartą na SVM oraz wyjaśnialność opartą na LIME w celu prognozowania zmian skórnych. Kliknij tutaj, aby pobrać ten plik.
Plik uzupełniający 2: Algorytm 2. Przebieg procesu lokalnych wyjaśnień opartego na metodzie LIME, przedstawiający generowanie superpikseli, próbkowanie perturbacji, budowę modelu zastępczego oraz wizualizację obszarów obrazu, które w największym stopniu przyczyniły się do decyzji klasyfikacyjnej. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Zaproponowane wyjaśnialne ramy głębokiego uczenia do klasyfikacji zmian skórnych (EDLF-SLC) wykazują, że połączenie komplementarnych reprezentacji cech głębokich z wyjaśnialną sztuczną inteligencją może poprawić zarówno wydajność klasyfikacji, jak i przejrzystość modelu. Poprzez integrację wielu wstępnie wytrenowanych architektur CNN (ResNet50, EfficientNetB0, MobileNet oraz Xception) do ekstrakcji cech i zastosowanie maszyny wektorów nośnych (SVM) do końcowej klasyfikacji, ramy te wykorzystują mocne strony różnych ekstraktorów cech w celu generowania bogatszych i bardziej dyskryminujących reprezentacji zmian niż te uzyskane z pojedynczej sieci bazowej. Ponadto integracja lokalnych wyjaśnień niezależnych od modelu (LIME) zapewnia zlokalizowane wyjaśnienia wizualne, umożliwiając klinicystom zrozumienie obszarów obrazu, które w największym stopniu przyczyniają się do każdej predykcji, co zwiększa pewność co do decyzji diagnostycznych modelu.
Wyniki eksperymentalne wykazują, że EDLF-SLC osiąga konkurencyjne wyniki w porównaniu z bazowymi modelami CNN, takimi jak MobileNet, Xception i ResNet50, co podkreśla skuteczność fuzji cech komplementarnych oraz klasyfikacji opartej na SVM. Porównanie z niedawnymi, najnowocześniejszymi podejściami dodatkowo potwierdza konkurencyjność proponowanego schematu. Na przykład w dwóch badaniach48,49 zgłoszono dokładność na poziomie około 0,86 przy użyciu metod zespołowych, podczas gdy inne hybrydowe schematy CNN-SVM25,50,51,52,53 osiągnęły dokładność do 0,87, lecz opierały się na bardziej złożonych architekturach oraz dodatkowych modułach przetwarzania wstępnego lub segmentacji. W przeciwieństwie do nich, proponowany schemat osiąga dokładność 0,88 przy użyciu porównawczo uproszczonej architektury, nie wymagając wyraźnej segmentacji zmian, a jednocześnie zapewniając interpretowalne predykcje dzięki LIME. Wyniki te wskazują, że łączenie komplementarnych ekstraktorów cech CNN przed klasyfikacją SVM może zwiększyć skuteczność diagnostyczną przy zachowaniu prostoty architektury i przejrzystości.
Chociaż proponowany model poprawia dokładność klasyfikacji i interpretowalność, ulepszenie to odbywa się kosztem zwiększonych kosztów obliczeniowych. Całkowity czas trenowania EDLF-SLC wynosi około 3279,77 s, co jest wartością znacznie wyższą niż w przypadku pojedynczych modeli CNN, takich jak ResNet50 (749,77 s) i MobileNet (629,29 s). Ten dodatkowy narzut obliczeniowy wynika z trenowania wielu wstępnie wytrenowanych sieci CNN oraz przeprowadzania fuzji cech przed klasyfikacją. Taki kompromis jest powszechnie obserwowany w hybrydowych podejściach do uczenia oraz w metodach zespołowych, gdzie poprawę wydajności predykcyjnej osiąga się kosztem wyższych wymagań obliczeniowych. Niemniej jednak w systemach wspomagania decyzji klinicznych dokładność diagnostyczna, odporność i niezawodność są zazwyczaj uważane za ważniejsze niż efektywność trenowania, ponieważ bezpośrednio wpływają one na wyniki leczenia pacjentów.
Kolejną istotną zaletą proponowanego schematu jest jego wyjaśnialność. W przeciwieństwie do konwencjonalnych modeli głębokiego uczenia, które często funkcjonują jako czarne skrzynki, EDLF-SLC wykorzystuje LIME w celu zapewnienia specyficznych dla każdego przypadku wizualnych wyjaśnień procesu predykcji. Wyjaśnienia te pomagają klinicystom zweryfikować, czy model koncentruje się na klinicznie istotnych obszarach zmiany, co zwiększa przejrzystość, wspiera interpretację kliniczną i ułatwia zaufanie do diagnostyki wspomaganej przez AI. W konsekwencji proponowany schemat oferuje praktyczną równowagę między wydajnością predykcyjną a interpretowalnością modelu, co czyni go obiecującym komputerowym narzędziem wspomagania decyzji w klasyfikacji zmian skórnych.
Pomimo tych obiecujących wyników, należy wskazać na kilka ograniczeń. Po pierwsze, ramy metodyczne zostały ocenione wyłącznie z wykorzystaniem publicznie dostępnego zbioru danych ISIC, a ich zdolność do generalizacji w odniesieniu do obrazów uzyskanych w różnych warunkach klinicznych, przy użyciu różnych urządzeń obrazujących i w różnych populacjach pacjentów wymaga jeszcze walidacji. Po drugie, zastosowanie wielu wstępnie wytrenowanych architektur CNN nieuchronnie zwiększa złożoność obliczeniową i czas uczenia w porównaniu z modelami o pojedynczym szkielecie (single-backbone). Po trzecie, w trakcie eksperymentów przyjęto stałe ustawienia hiperparametrów, a dalsza optymalizacja może poprawić wydajność i adaptacyjność w odniesieniu do różnych zbiorów danych. Wreszcie, choć metoda LIME zwiększa przejrzystość modelu, jej objaśnienia mają charakter lokalny i zależą od perturbacji, co oznacza, że spójność objaśnień może różnić się między uruchomieniami i powinna zostać dodatkowo zweryfikowana przez ekspertów dermatologii przed rutynowym wdrożeniem klinicznym.
Przyszłe badania skupią się na walidacji proponowanego modelu z wykorzystaniem wielu wielkoskalowych i wieloośrodkowych zbiorów danych zmian skórnych, optymalizacji wydajności obliczeniowej poprzez lekkie techniki fuzji cech i kompresji modelu, badaniu zaawansowanych strategii optymalizacji hiperparametrów oraz rozszerzeniu modelu o wieloklasową klasyfikację zmian skórnych. Ponadto, integracja dodatkowych technik wyjaśnialnej sztucznej inteligencji (explainable AI) oraz przeprowadzenie prospektywnych ocen klinicznych z udziałem dermatologów dodatkowo wzmocnią niezawodność, interpretowalność i praktyczną przydatność proponowanego modelu w rzeczywistych warunkach klinicznych.
Oświadczenia
Autorzy oświadczają, że nie występuje konflikt interesów.
Podziękowania
Autorzy chcieliby wyrazić szczerą wdzięczność Uniwersytetowi w Taif za zapewnienie środowiska badawczego oraz wsparcia instytucjonalnego, które umożliwiły ukończenie niniejszej pracy.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Zbiór danych zmian skórnych ISIC 2020 | International Skin Imaging Collaboration (ISIC) | ISIC 2020 Challenge Dataset | Zbiór obrazów dermoskopowych wykorzystany do opracowania i ewaluacji modelu. |
| Keras | Keras Team | Zintegrowany z TensorFlow | Konstrukcja i trenowanie modeli głębokiego uczenia. |
| LIME (Local Interpretable Model-Agnostic Explanations) | Ribeiro et al. | Pakiet Python | Generowanie lokalnych wyjaśnień wizualnych dla predykcji modelu. |
| Matplotlib | Matplotlib Developers | Najnowsza kompatybilna wersja | Wizualizacja krzywych uczenia, macierzy pomyłek i wykresów ewaluacyjnych. |
| NumPy | NumPy Developers | Najnowsza kompatybilna wersja | Obliczenia numeryczne i manipulacja tablicami. |
| NVIDIA Tesla T4 GPU | NVIDIA Corporation | 16 GB VRAM | Akceleracja trenowania i inferencji modelu. |
| Pandas | Pandas Development Team | Najnowsza kompatybilna wersja | Przetwarzanie danych i zarządzanie wynikami eksperymentalnymi. |
| Wstępnie wytrenowane modele CNN | TensorFlow/Keras Applications | ResNet50, EfficientNetB0, MobileNet, Xception | Głęboka ekstrakcja cech z obrazów dermoskopowych. |
| Python | Python Software Foundation | Wersja 3.9 | Język programowania użyty do implementacji. |
| PyTorch | PyTorch Foundation | Wersja 2.3.1 | Framework głębokiego uczenia wykorzystany do ekstrakcji cech i implementacji modelu. |
| Scikit-learn | Scikit-learn Developers | Najnowsza kompatybilna wersja | Maszyna wektorów nośnych (SVM), metryki ewaluacyjne i wstępne przetwarzanie danych. |
| Maszyna wektorów nośnych (jądro RBF) | Scikit-learn | SVC | Klasyfikacja zfuzowanych głębokich reprezentacji cech. |
| TensorFlow | Google LLC | Wersja 2.x | Framework głębokiego uczenia do trenowania i inferencji modelu. |
| System operacyjny Ubuntu | Canonical Ltd. | Ubuntu 20.04 | Operacyjne środowisko eksperymentalne. |
Bibliografia
- Chan S, Reddy V, Myers B, Thibodeaux Q, Brown-Stone N, Liao W. Machine learning in dermatology: current applications, opportunities, and limitations. Dermatol Ther (Heidelb). 2020;10:365-386.
- Olsen CM. Global trends in melanoma mortality differ by sex and age. Br J Dermatol. 2020;183(6):985-986.
- Sun Y, Shen Y, Liu Q, Zhang H, Jia L, Chai Y, et al. Global trends in melanoma burden: a comprehensive analysis from the Global Burden of Disease Study, 1990-2021. J Am Acad Dermatol. 2025;92(1):100-107.
- Monika MK, Vignesh NA, Kumari CU, Kumar M, Lydia EL. Skin cancer detection and classification using machine learning. Mater Today Proc. 2020;33:4266-4270.
- Hosny KM, Elshora D, Mohamed ER, Vrochidou E, Papakostas GA. Deep learning and optimization-based methods for skin lesions segmentation: a review. IEEE Access. 2023.
- Baghdadi NA, Farghaly Abdelaliem SM, Malki A, Gad I, Ewis A, Atlam ES. Advanced machine learning techniques for cardiovascular disease early detection and diagnosis. J Big Data. 2023;10(1):144.
- Veeramani N, Jayaraman P, Krishankumar R, Ravichandran KS, Gandomi AH. DDCNN-F: double decker convolutional neural network feature fusion as a medical image classification framework. Sci Rep. 2024;14(1).
- Veeramani N, Jayaraman P. YOLOv7-XAI: multiclass skin lesion diagnosis using explainable artificial intelligence with fair decision making. Int J Imaging Syst Technol. 2024;34(6).
- Shetty B, Fernandes R, Rodrigues AP, Chengoden R, Bhattacharya S, Lakshmanna K. Skin lesion classification of dermoscopic images using machine learning and convolutional neural network. Sci Rep. 2022;12(1):18134.
- Ali AR, Li J, Yang G, O'Shea SJ. A machine learning approach to automatic detection of irregularity in skin lesion border using dermoscopic images. PeerJ Comput Sci. 2020;6:e268.
- Pham TTH, Luu TN, Nguyen TV, Huynh NT, Phan QH, Le TH. Polarimetric imaging combining optical parameters for classification of mice non-melanoma skin cancer tissue using machine learning. Heliyon. 2023;9(11).
- Liu N, Rejeesh M, Sundararaj V, Gunasundari B. ACO-KELM: anti coronavirus optimized kernel-based softplus extreme learning machine for classification of skin cancer. Expert Syst Appl. 2023;232:120719.
- Masud M, Almars AM, Rokaya MB, Meshref H, Gad I, Atlam ES. A novel lightweight convolutional neural network model to predict Alzheimer's disease applying weighted loss function. J Disabil Res. 2024;3(4):20240042.
- Kumar A, Veeraiah V, Gongada TN, Ahamad S, Khan H, Gupta A. Explainable machine learning models for clinical decision support systems. In: 2024 15th International Conference on Computing Communication and Networking Technologies (ICCCNT). Piscataway (NJ): IEEE; 2024. p. 1-6.
- Shahzad K, Wasim M, Pires IM, Garcia NM. Multi-classification of skin lesions using a deep learning-based convolutional neural network. Procedia Comput Sci. 2024;241:588-593.
- Celebi ME, Kingravi HA, Uddin B, Iyatomi H, Aslandogan YA, Stoecker WV, et al. A methodological approach to the classification of dermoscopy images. Comput Med Imaging Graph. 2007;31(6):362-373.
- Li CX, Shen CB, Xue K, Shen X, Jing Y, Wang ZY, et al. Artificial intelligence in dermatology: past, present, and future. Chin Med J (Engl). 2019;132(17):2017-2020.
- Ramprasad M, Nagesh S, Sahith V, Lankalapalli RK. Hierarchical agglomerative clustering based skin lesion detection with region-based neural networks classification. Meas Sens. 2023;29:100865.
- Khater T, Ansari S, Mahmoud S, Hussain A, Tawfik H. Skin cancer classification using explainable artificial intelligence on pre-extracted image features. Intell Syst Appl. 2023;20:200275.
- Wang H, Ahn E, Bi L, Kim J. Self-supervised multi-modality learning for multi-label skin lesion classification. Comput Methods Programs Biomed. 2025;265:108729.
- Thapar P, Rakhra M, Alsaadi M, Quraishi A, Deka A, Naga Ramesh JV. A hybrid grasshopper optimization algorithm for skin lesion segmentation and melanoma classification using deep learning. Healthc Anal. 2024;5:100326.
- Kumar S, Nath VK, Hazarika D. Blend of deep features and binary tree growth algorithm for skin lesion classification. Symmetry (Basel). 2023;15(12):2213.
- Chandrahaas BV, Mohanty SN, Panda SK, et al. An empirical study on classification of monkeypox skin lesion detection. EAI Endorsed Trans Pervasive Health Technol. 2023;9:e4.
- Talavera-Martínez L, Bibiloni P, Giacaman A, Taberner R, de Paz Hernando LJD, González-Hidalgo M. A novel approach for skin lesion symmetry classification with a deep learning model. Comput Biol Med. 2022;145:105450.
- Ieracitano C, Morabito FC, Hussain A, Suffian M, Mammone N. TIXAI: a trustworthiness index for explainable artificial intelligence in skin lesion classification. Neurocomputing. 2025;630:129701.
- Hasan MK, Elahi MTE, Alam MA, Jawad MT, Martí R. DermoExpert: skin lesion classification using a hybrid convolutional neural network through segmentation, transfer learning, and augmentation. Inform Med Unlocked. 2022;28:100819.
- Koparde S, Kotwal J, Deshmukh S, Adsure S, Chaudhari P, Kimbahune V. Conditional generative adversarial networks and YOLOv5 Darknet-based skin lesion localization and classification using an independent component analysis model. Inform Med Unlocked. 2024;47:101515.
- Padhy S, Dash S, Kumar N, Singh SP, Kumar G, Moral P. Temporal integration of ResNet features with LSTM for enhanced skin lesion classification. Results Eng. 2025;25:104201.
- Xin C, Liu Z, Ma Y, Wang D, Zhang J, Li L, et al. Transformer-guided self-adaptive network for multi-scale skin lesion image segmentation. Comput Biol Med. 2024;169:107846.
- Sulthana R, Chamola V, Hussain Z, Albalwy F, Hussain A. A novel end-to-end deep convolutional neural network-based skin lesion classification framework. Expert Syst Appl. 2024;246:123056.
- Chamarthi S, Fogelberg K, Brinker TJ, Niebling J. Mitigating the influence of domain shift in skin lesion classification: a benchmark study of unsupervised domain adaptation methods. Inform Med Unlocked. 2024;44:101430.
- Maity S, Paul S, Guha S, Dasgupta S, Ghosh M. Automated classification of monkeypox skin lesions using a hybrid deep learning model. Biomed Signal Process Control. 2026;126:110955.
- Nasir S, Bilal M, Khalidi H. Detection and classification of skin cancer by using CNN-enabled cloud storage data access control algorithm based on blockchain technology. Int J Theor Appl Comput Intell. 2025:145-169.
- Saba T. Computer vision for microscopic skin cancer diagnosis using handcrafted and non-handcrafted features. Microsc Res Tech. 2021;84(6):1272-1283.
- Fayyad J, Alijani S, Najjaran H. Empirical validation of conformal prediction for trustworthy skin lesion classification. Comput Methods Programs Biomed. 2024;253:108231.
- Liu P, Qian W, Li H, Cao J. A relationship-aware mutual learning method for lightweight skin lesion classification. Digit Commun Netw. 2025;11(3):603-612.
- Adla D, Reddy GVR, Nayak P, Karuna G. A full-resolution convolutional network with a dynamic graph cut algorithm for skin cancer classification and detection. Healthc Anal. 2023;3:100154.
- Thamizhamuthu R, Maniraj SP. Deep learning-based dermoscopic image classification system for robust skin lesion analysis. Trait Signal. 2023;40(3).
- Di Giammarco M, Santone A, Cesarelli M, Martinelli F, Mercaldo F. A method for skin lesion detection and localization by means of deep learning and reliable prediction explainability. Image Vis Comput. 2025;162:105675.
- Haq IU, Joarder HA, Khan AA, Shi X, Alsayaydeh JAJ, Yusof MFB, et al. XAAI-ledger: an explainable CNN-transformer-based multimodal deep learning framework for early detection of melanoma and non-melanoma skin cancers using dermoscopic and clinical data. Biomed Signal Process Control. 2026;123:110410.
- Saeed K, Shehzad M, Malik MGA, Ahmed S, Azar AT. TransXV2S-NET: a novel hybrid deep learning architecture with dual-contextual graph attention for multi-class skin lesion classification. Knowl Based Syst. 2026;337:115407.
- AbuAlkebash H, Saleh RAA, Ertunç HM. Automated explainable deep learning framework for multiclass skin cancer detection and classification using hybrid YOLOv8 and vision transformer (ViT). Biomed Signal Process Control. 2025;108:107934.
- Hasan MK, Ahamad MA, Yap CH, Yang G. A survey, review, and future trends of skin lesion segmentation and classification. Comput Biol Med. 2023;155:106624.
- Li H, Pan Y, Zhao J, Zhang L. Skin disease diagnosis with deep learning: a review. Neurocomputing. 2021;464:364-393.
- Wu Y, Chen B, Zeng A, Pan D, Wang R, Zhao S. Skin cancer classification with deep learning: a systematic review. Front Oncol. 2022;12:893972.
- Fanconic. Skin cancer: malignant vs benign dataset. Kaggle; 2023. Available from: https://www.kaggle.com/datasets/fanconic/skin-cancer-malignant-vs-benign
- Ribeiro MT, Singh S, Guestrin C. "Why should I trust you?": Explaining the predictions of any classifier. In: Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD '16). New York (NY): ACM; 2016. p. 1135-1144.
- Bassel A, Abdulkareem AB, Alyasseri ZAA, Sani NS, Mohammed HJ. Automatic malignant and benign skin cancer classification using a hybrid deep learning approach. Diagnostics (Basel). 2022;12(10):2472.
- Bhardwaj A, Rege PP. Skin lesion classification using deep learning. In: Advances in Signal and Data Processing: Select Proceedings of ICSDP 2019. Singapore: Springer; 2021. p. 575-589.
- Keerthana D, Venugopal V, Nath MK, Mishra M. Hybrid convolutional neural networks with SVM classifier for classification of skin cancer. Biomed Eng Adv. 2023;5:100069.
- Ahmed A, Siam AI, Atwa MA, Atwa EM, Abdelrahim EM, Atlam ES. An explainable YOLO-based deep learning framework for pneumonia detection from chest X-ray images. Algorithms. 2025;18(11):703.
- Farsi M, ZainEldin H, Sayed RF, El-Agamy ES, Atlam SA, Alsaedi M, et al. Deep learning for pathology: YOLOv8 with EigenCAM for reliable colorectal cancer diagnostics. Bioengineering (Basel). 2025;12(11):1203.
- Atwa EA, Atlam ES, Ahmed A, Atwa MA, Abdelrahim EM, Siam AI. Interpretable deep learning models for arrhythmia classification based on ECG signals using the PTB-XL dataset. Diagnostics (Basel). 2025;15(15):1950.