W niniejszym badaniu porównano pięć algorytmów uczenia maszynowego do klasyfikacji guzków tarczycy z wykorzystaniem cech obrazowania ultradźwiękowego o wysokiej rozdzielczości (super-resolution). Najlepsze wyniki uzyskał model SVM (dokładność 68,6%, pole pod krzywą AUC 0,690), identyfikując mikrozwapnienia oraz powiększenie po podaniu kontrastu jako kluczowe czynniki, jednak wyniki te wymagają zewnętrznej walidacji przed zastosowaniem w praktyce klinicznej.
Artykuł badawczy
Ilościowe cechy mikronaczyniowe w ultrasonografii o superrozdzielczości do klasyfikacji guzków tarczycy opartej na uczeniu maszynowym
69 wyświetleń
⸱
11 września 2026
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
W niniejszym badaniu porównano pięć algorytmów uczenia maszynowego — Random Forest (RF), Support Vector Machine (SVM), Decision Tree (DT), eXtreme Gradient Boosting (XGBoost) oraz Gradient Boosting (GB) — w celu klasyfikacji guzków tarczycy z wykorzystaniem cech ilościowych uzyskanych z konwencjonalnego badania ultrasonograficznego, ultrasonografii z kontrastem (CEUS) oraz ultrasonografii o superrozdzielczości (SRUS). Retrospektywne badanie objęło 68 guzków tarczycy u 63 pacjentów (30 łagodnych i 38 potwierdzonych jako rakowiak tarczycy [PTC]) i zostało przeanalizowane pod kątem 25 cech ilościowych z zastosowaniem pięciokrotnej walidacji krzyżowej z grupowaniem pacjentów, co zapewniło przypisanie wszystkich guzków od tego samego pacjenta do tej samej grupy (fold). Wydajność modeli podsumowano w ramach grup oraz na podstawie połączonych predykcji poza grupą (out-of-fold [OOF]), a dla najlepiej działającego modelu SVM przeprowadzono ukierunkowaną analizę OOF SHapley Additive exPlanations (SHAP) z wykorzystaniem wyjaśniacza opartego na permutacji. SVM osiągnął najwyższą średnią dokładność (0.686 ± 0.120) oraz średnią wartość pola pod krzywą charakterystyki operacyjnej odbiornika (ROC-AUC) (0.690 ± 0.164), przy połączonej czułości OOF wynoszącej 0.842 i swoistości 0.50, natomiast mikrowapnienia oraz powiększenie po podaniu kontrastu zostały zidentyfikowane jako najistotniejsze czynniki SHAP dla tego modelu. RF wykazał zrównoważoną wydajność (dokładność 5.9%, czułość 5.3%, swoistość 56.7%), podczas gdy DT wypadł słabo (dokładność 0.429, ROC-AUC 0.47), zbliżając się do poziomu losowego zgadywania. Badanie wykazało, że ilościowe pomiary SRUS mogą zostać włączone do konwencjonalnych klasyfikatorów; jednak wyniki mają charakter wstępny i wymagają prospektywnej walidacji wieloośrodkowej na większych kohortach przed wdrożeniem klinicznym.
Wprowadzenie
Guzki tarczycy stanowią bardzo powszechne znalezisko kliniczne, a wskaźniki ich wykrywalności w populacjach bezobjawowych podczas badania ultrasonograficznego sięgają 68%1. Niedawne metaanalizy wykazały, że globalna rozpowszechnioność guzków tarczycy wzrosła z 21,53% w latach 20–201 do 29,29% w latach 2012–2022, dotykając około jednej na cztery osoby w ogólnej populacji2,3. Wśród tych guzków w 7–15% przypadków ostatecznie diagnozowany jest rak tarczycy, z czego przeważającym podtypem jest rak brodawkowaty tarczycy (PTC)4,5. PTC odpowiada za 80–90% wszystkich nowotworów złośliwych tarczycy i stał się jednym z najszybciej rosnących typów raka, a wskaźniki zapadalności wzrosły z 4,8 do 14,9 na 10 0 osób w latach 1975–20126.
Konwencjonalne badanie ultrasonograficzne pozostaje podstawą oceny guzków tarczycy, oferując nieinwazyjną, kosztowo efektywną i powszechnie dostępną metodę diagnostyczną7. Tradycyjne cechy sonograficzne sugerujące złośliwość obejmują wyraźną hipoechogeniczność, nieregularne brzegi, mikrozwapnienia oraz kształt w pionie większy niż w poziomie8,9. Jest ona jednak zasadniczo ograniczona przez barierę dyfrakcji akustycznej, która redukuje rozdzielczość przestrzenną do około 10 µm10. Ograniczenie to znacząco utrudnia wizualizację mikrokrążenia i ocenę szczegółowej morfologii naczyń, które są krytycznymi parametrami w różnicowaniu łagodnych i złośliwych zmian tarczycy1. Obrazowanie przepływów w kolorowym Dopplerze (CDFI) oraz ultrasonografia z kontrastem (CEUS), mimo poprawy wykrywalności przepływu krwi, pozwalają na wizualizację jedynie naczyń o prędkości przepływu przekraczającej 1 cm/s i nadal pozostają ograniczone rozdzielczością dyfrakcyjną12,13.
Ultradźwięki o superrozdzielczości (SRUS), jako technologia przełomowa, pokonują tradycyjny limit dyfrakcyjny konwencjonalnych systemów ultradźwiękowych14,15. Dzięki wykorzystaniu kontrastowych mikropęcherzyków jako punktowych celów do lokalizacji i śledzenia, SRUS osiąga rozdzielczość przestrzenną w skali mikronowej, umożliwiając wizualizację i kwantyfikację mikrokrążenia na bezprecedensowym poziomie szczegółowości16,17. Technika ta pozwala na pomiar zarówno gęstości mikronaczyniowej (MVD), jak i szybkości przepływu w mikronaczyniach (MFR), zapewniając oceny strukturalne i funkcjonalne, które są nieosiągalne za pomocą nieinwazyjnego obrazowania17,18. Badania pilotażowe wykazały, że łagodne guzki tarczycy wykazują znacznie wyższą MFR niż guzki złośliwe, z wartościami średnimi odpowiednio 16,76 ± 6,82 mm/s oraz 9,86 ± 4,54 mm/s19. Wprowadzenie „ultradźwiękowej mikronaczyniomiki” — wysokoprzepustowej ekstrakcji cech ilościowych z obrazów SRUS — dodatkowo zwiększa potencjał precyzyjnej i spersonalizowanej oceny mikronaczyniowej.
Uczenie maszynowe (ML) zrewolucjonizowało analizę obrazowania medycznego, w szczególności w zakresie charakterystyki guzków tarczycy20,21. Modele głębokiego uczenia, a zwłaszcza konwolucyjne sieci neuronowe (CNN), osiągnęły w poprzednich badaniach wartości pola pod krzywą charakterystyki operacyjnej odbiornika (ROC-AUC) przekraczające 0,902,23,24. Podejścia oparte na zespołowym uczeniu maszynowym, łączące wiele algorytmów — w tym Random Forest (RF), maszyny wektorów nośnych (SVM), drzewa decyzyjne (DT), Gradient Boosting (GB) oraz eXtreme Gradient Boosting (XGBoost) — wykazały potencjał w poprawie dokładności diagnostycznej i odporności w odniesieniu do heterogenicznych zbiorów danych21. Jak niedawno kompleksowo przeanalizowali Habchi i wsp.25, dziedzina sztucznej inteligencji (AI) w diagnostyce raka tarczycy szybko się rozszerzyła, obejmując konwertery wizualne, duże modele językowe i architektury hybrydowe, co odzwierciedla rozwój tej dyscypliny w kierunku coraz bardziej złożonych ram diagnostycznych opartych na obrazowaniu.
Podczas gdy konwencjonalne cechy ultrasonograficzne były szeroko badane w połączeniu z algorytmami AI, kombinacja parametrów mikronaczyniowych o superrozdzielczości z modelami ML pozostaje w dużej mierze nieznana. Pomimo obiecującego potencjału technologii SRUS oraz udowodnionej skuteczności algorytmów uczenia maszynowego w obrazowaniu medycznym, kilka kluczowych pytań pozostaje bez odpowiedzi. Po pierwsze, która architektura uczenia maszynowego — czy tradycyjne algorytmy, takie jak RF i SVM, czy zaawansowane metody zespołowe, takie jak XGBoost i GB — wykazuje optymalną wydajność w odniesieniu do cech mikronaczyniowych pochodzących z SRUS? Po drugie, jak modele te wypadają w porównaniu pod kątem czułości, swoistości i ogólnej dokładności diagnostycznej w różnicowaniu łagodnych i złośliwych guzków tarczycy? Po trzecie, które parametry mikronaczyniowe wyodrębnione z obrazowania SRUS w największym stopniu wpływają na skuteczność klasyfikacji? Odpowiedź na te pytania jest niezbędna do stworzenia opartych na dowodach ram dla implementacji klinicznej diagnostyki guzków tarczycy wspomaganej przez SRUS.
W związku z tym niniejsze badanie ma na celu kompleksową ocenę wydajności pięciu algorytmów ML (RF, SVM, DT, XGBoost i GB) w klasyfikacji guzków tarczycy z wykorzystaniem danych z obrazowania mikro naczyniowego USG w superrozdzielczości. Poprzez systematyczne porównanie tych podejść i zidentyfikowanie najbardziej informacyjnych biomarkerów mikronaczyniowych, badanie to ma na celu usprawnienie paradygmatu diagnostycznego w charakterystyce guzków tarczycy oraz wniesienie wkładu w rosnącą bazę dowodów potwierdzających użyteczność kliniczną technologii SRUS w obrazowaniu onkologicznym. Postawiliśmy hipotezę, że uprzednio określony zestaw 25 cech pozwoli na dyskryminację guzków łagodnych i guzków zdiagnozowanych jako rakowiak brodawkowaty tarczycy na poziomie przekraczającym wynik przypadkowy. W celu ograniczenia wycieku informacji zastosowano walidację krzyżową z grupowaniem pacjentów, a w celu opisania sposobu wykorzystania zmierzonych zmiennych przez wybrany klasyfikator dodano ukierunkowaną analizę SHAP. Obie analizy miały charakter eksploracyjny.
Protokół
Projekt badania i populacja pacjentów
W niniejszym badaniu retrospektywnym przeanalizowano badania USG tarczycy wykonane w okresie od 13 czerwca 2024 do 13 stycznia 2025 roku. Protokół badania został zatwierdzony przez Komisję Etyczną Szpitala Przyjaźni w Pekinie, Capital Medical University (numer zatwierdzenia BFHHZS20240300) i przeprowadzono go zgodnie z zasadami etycznymi określonymi w Deklaracji Helsińskiej; z uwagi na retrospektywny charakter badania zrezygnowano z wymogu uzyskania świadomej zgody. Zestaw danych obejmował 68 guzków tarczycy u 63 pacjentów (30 łagodnych i 38 złośliwych), przyjmując guzek jako jednostkę analityczną. Diagnozy referencyjne oparto na wynikach cienkoigłowej aspiracji biopsji (FNAC) pod kontrolą USG. Grupa złośliwa składała się z 38 guzków, w których badaniu FNAC stwierdzono raka brodawczatego tarczycy.
Kryteria włączenia
Kwalifikowani pacjenci musieli spełniać wszystkie następujące kryteria: (1) poddanie konwencjonalnej ultrasonografii w skali szarości oraz badaniu Dopplerowskiemu, a następnie CEUS z satysfakcjonującą jakością obrazu umożliwiającą późniejszą analizę obrazowania przepływu mikronaczyniowego; (2) rozpoznanie cytopatologiczne PTC potwierdzone biopsją aspiracyjną cienkoigłową, z towarzyszącym pozytywnym wynikiem badania mutacji BRAFV600E lub bez niego; lub wynik cytologiczny w kategorii III według klasyfikacji Bethesda (atypia o nieokreślonym znaczeniu) przy jednoczesnym pozytywnym wyniku badania mutacji BRAFV600E; (3) rozpoznanie cytopatologiczne łagodnych guzków proliferacyjnych, guzków gruczolakowatych lub łagodnych guzków pęcherzykowych w kategorii II według klasyfikacji Bethesda bez towarzyszącego pozytywnego wyniku badania mutacji BRAFV600E.
Kryteria wykluczenia
Pacjentów wykluczono z badania, jeśli wystąpił którykolwiek z następujących warunków: (1) słaba jakość obrazów CEUS lub niewystarczający sygnał mikropęcherzykowy uniemożliwiający wiarygodną ocenę przepływu mikronaczyniowego; (2) brak wyników cytologicznych lub patomorfologicznych; (3) diagnoza histopatologiczna rzadkiego lub specjalnego podtypu raka tarczycy (np. warianty anaplastyczne); (4) znaleziska cytologiczne sugerujące nowotwór pęcherzykowy (kategoria IV według klasyfikacji Bethesda) lub każda zmiana o nieokreślonym pochodzeniu pęcherzykowym, niezależnie od statusu mutacyjnego; (5) zapalenie tarczycy Hashimoto
Pozyskiwanie obrazów USG, CEUS i SRUS
Wszystkie badania przeprowadzono przy użyciu referencyjnego systemu ultrasonograficznego i przetwornika liniowego. Pacjenci zostali ułożeni w pozycji tyłem z wyprośtem szyi. Guz docelowy zlokalizowano i zmierzono w trybie B-mode ultrasonografii; odnotowano obecność mikrozwapnień, a tę samą płaszczyznę obrazowania z centrowaniem na zmianie wykorzystano do oceny unaczynienia wewnątrzguźlowego za pomocą kolorowego Dopplera.
Po zapewnieniu dostępu dożylnego system przełączono w tryb CEUS/URM o niskim indeksie mechanicznym (URM oznacza obrazowanie mikroskopowe o ultrawysokiej rozdzielczości). Badanie CEUS przeprowadzono poprzez dożylny wtrysk bolusa SonoVue w ilości 1,2 mL, po którym natychmiast podano 5 ml soli fizjologicznej; w momencie podania bolusa uruchomiono licznik ekranowy oraz ciągłą akwizycję obrazów cine. Głowicę utrzymywano w stałej płaszczyźnie przy minimalnym nacisku, a pacjenta poproszono o unikanie połykania podczas fazy wlewania i wypłukiwania kontrastu.
W przypadku ilościowego CEUS, w celu wyznaczenia parametrów czasowo-intensywnościowych wykorzystano ograniczony do zmiany obszar zainteresowania. W przypadku SRUS, proces URM zlokalizował i śledził sygnały mikropęcherzyków po kontroli ruchu, a następnie wygenerował pomiary stosunku naczyń, złożoności, gęstości mikronaczyniowej, indeksu perfuzji oraz prędkości przepływu. Reprezentatywne eksporty obrazów wykazały ustawienia VSP 4, RES 2, CTR 3, SM 2, VEN 3 oraz CPT 10 s; odpowiednie ustawienia dla pozostałych badań były niedostępne.
25 zmiennych wejściowych modelu wymieniono w Tabeli 1 i pogrupowano według modalności pozyskania danych: wiek i płeć; mikrozwapnienia w trybie B; unaczynienie wewnątrzguźlaste w badaniu Color Doppler; jakościowe CEUS; ilościowe CEUS oraz 11 pomiarów mikrokrążenia w SRUS.
Wybór cech
W modelach uczenia maszynowego zachowano wszystkie 25 cech ilościowych. Wykorzystano wyłącznie cechy numeryczne; wykluczono imiona i nazwiska pacjentów, numery rejestracyjne oraz pola dotyczące wielkości zmian. Nie przeprowadzono selekcji cech w oparciu o dane, a do każdego klasyfikatora wprowadzono te same, wcześniej określone predyktory.
Standaryzacja cech
Przed walidacją krzyżową nie zastosowano żadnej transformacji, imputacji ani globalnego skalowania. Standaryzację zastosowano wyłącznie w przypadku SVM z funkcją bazową radialną (RBF) za pomocą potoku StandardScaler. Skaler był dopasowywany do węzłów treningowych w każdym folderze, a następnie stosowany do węzłów walidacyjnych w tym samym folderze. Klasyfikatory oparte na drzewach otrzymały oryginalne skale numeryczne:

gdzie x jest pierwotną wartością cechy, µ to średnia z folderu treningowego, a σ to odchylenie standardowe z folderu treningowego. Przetwarzanie wstępne w obrębie folderów zapobiegło wpływowi obserwacji walidacyjnych na parametry skalowania SVM.
Partycjonowanie danych
Podstawowa ocena wydajności została przeprowadzona z wykorzystaniem pięciokrotnej walidacji krzyżowej StratifiedGroupKFold z parametrami shuffle = True oraz random_state = 42. Identyfikator pacjenta zdefiniował 63 grupy, a wszystkie guzki od tego samego pacjenta zostały przypisane do tego samego folda. Żaden pacjent nie dostarczył guzków jednocześnie do podzbioru treningowego i walidacyjnego w obrębie jednego folda.
Trenowanie i walidacja modelu
Protokół szkoleniowy
Oceniono pięć klasyfikatorów: las losowy (random forest; 100 drzew; random_state = 42), maszynę wektorów wspierających z funkcją jądra RBF (radial-basis-function SVM; C = 1.0; gamma = scale; probability = True; potok StandardScaler; random_state = 42), drzewo decyzyjne (decision tree; kryterium Gini; nieograniczona głębokość; random_state = 42), XGBoost (100 estymatorów; learning_rate = 0.3; max_depth = 6; subsample = 1.0; colsample_bytree = 1.0; random_state = 42) oraz gradient boosting (100 estymatorów; learning_rate = 0.1; max_depth = 3; random_state = 42). Nie przeprowadzono przeszukiwania siatki (grid search), optymalizacji bayesowskiej, dostrajania progu ani zagnieżdżonej selekcji modelu.
Walidacja krzyżowa
W ramach każdego z pięciu podziałów grup pacjentów, modele były trenowane na pozostałych grupach pacjentów i ewaluowane na grupach wyłączonych. Dla każdego podziału obliczono dokładność, czułość, swoistość, precyzję, wynik F1 oraz ROC-AUC, a wyniki przedstawiono jako średnią ± SD. Przewidywania OOF z wszystkich 68 guzków zostały połączone, aby wygenerować jedną krzywą ROC z walidacją krzyżową oraz jedną macierz pomyłek dla każdego modelu.
Ocena wydajności
Metryki oceny
Wydajność modelu oceniano w obrębie każdego folderu walidacyjnego zgrupowanego pacjentów oraz na podstawie zbiorczych predykcji OOF, stosując następujące metryki:
Dokładność: Całkowita proporcja poprawnych przewidywań
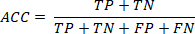
Czułość (Recall): Odsetek rzeczywistych guzków złośliwych, które zostały prawidłowo zidentyfikowane


Swoistość: Odsetek łagodnych guzków prawidłowo zidentyfikowanych
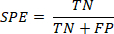
Precyzja (dodatnia wartość predykcyjna): Proporcja przewidzianych przypadków złośliwych, które rzeczywiście okazały się złośliwe
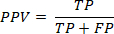
F1-Score: Średnia harmoniczna precyzji i pełności
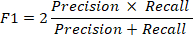
Pole pod krzywą charakterystyki operacyjnej odbiornika (ROC-AUC): Miara zdolności modelu do rozróżniania guzków łagodnych od złośliwych dla wszystkich progów klasyfikacji
gdzie TP = prawdziwie dodatnie (poprawnie zidentyfikowane guzki złośliwe), TN = prawdziwie ujemne (poprawnie zidentyfikowane guzki łagodne), FP = fałszywie dodatnie (guzki łagodne błędnie sklasyfikowane jako złośliwe) oraz FN = fałszywie ujemne (guzki złośliwe błędnie sklasyfikowane jako łagodne).
Analiza macierzy pomyłek
Macierze błędów OOF zostały wygenerowane poprzez agregację predykcji dokonanych dla każdego guzka wyłącznie w tej części zbioru (fold), w której pacjent ten został wykluczony. W ten sposób dla każdego guzka uzyskano predykcję z modelu wytrenowanego na guzkach innych pacjentów.
Analiza istotności cech
Dla modelu Random Forest obliczono wskaźniki istotności cech na podstawie średniego spadku zanieczyszczenia Gini we wszystkich drzewach decyzyjnych. Zidentyfikowano i uszeregowano 15 najważniejszych cech, aby określić, które parametry mikronaczyniowe miały najistotniejszy wpływ na skuteczność klasyfikacji.
Eksploracyjna analiza SHAP
Dla modelu SVM przeprowadzono ukierunkowaną analizę OOF SHAP z wykorzystaniem wyjaśniającego opartego na permutacji. Dla każdego pominiętego guzka w ramach walidacji krzyżowej jako rozkład tła wykorzystano wyłącznie odpowiadające mu obserwacje z folderu treningowego (128 permutacji antytetycznych; ziarno losowe = 20260716). Średnie bezwzględne wartości SHAP podsumowały wielkość wkładu, a wartości ze znakiem wskazały jego kierunek. Analiza miała charakter eksploracyjny i nie była wykorzystywana do wnioskowania o przyczynowości, identyfikacji niezależnych biomarkerów ani definiowania progów klinicznych.
Analiza statystyczna
Analiza porównawcza
Wydajność modelu została podsumowana opisowo w pięciu grupach walidacyjnych z podziałem na pacjentów oraz w zbiorczych predykcjach OOF. Nie przeprowadzono formalnych testów hipotez między modelami ani rankingu opartego na wartościach P, ponieważ grupy są ze sobą powiązane, a kohorta jest niewielka.
W celu porównania grup wyjściowych oceniano normalność rozkładu zmiennych ciągłych w każdej grupie wyników za pomocą testu Shapiro-Wilka. Stosowano test t Welcha, gdy obie grupy wykazywały rozkład zgodny z normalnym; w przeciwnym razie stosowano dwustronny test U Manna-Whitneya. Zmienne kategoryczne analizowano za pomocą testu chi-kwadrat Pearsona, a w przypadku rzadkich tabel 2 x 2 stosowano dokładny test Fishera. Wartości P były dwustronne, eksploracyjne i niekorygowane (alfa = 0,05).
Powtarzalność
Powtarzalność zapewniono poprzez określenie definicji grupy pacjentów, ustalenie stałego ziarna generatora liczb losowych (42), stałe konfiguracje klasyfikatorów oraz przetwarzanie wstępne w obrębie poszczególnych fałd. Identyfikatory służyły wyłącznie do grupowania i nie były wprowadzane jako predyktory ani eksportowane wraz z wynikami modelu.
Wyniki
Charakterystyka pacjentów i populacja badana
W badaniu uwzględniono łącznie 68 guzków tarczycy od 63 pacjentów, w tym 30 guzków łagodnych oraz 38 PTC. Jednostką analityczną był guzek, a grupowanie pacjentów zapobiegało obecności guzków od tego samego pacjenta w podzbiorach treningowym i walidacyjnym. Charakterystyka wyjściowa została podsumowana w Tabeli 2.
Rysunek 1 przedstawia technicznie udane rekonstrukcje SRUS/URM ograniczone do obszaru zmiany dla reprezentatywnego guzka łagodnego oraz guzka uznanego za PTC na podstawie cienkoigłowej aspiracji pod kontrolą USG (FNAC). Oba przykłady pokazują obrys zmiany, zrekonstruowaną mapę mikronaczyniową oraz wygenerowaną przez urządzenie nakładkę ilościową. Przykłady te demonstrują pomyślne pozyskanie danych i rekonstrukcję w obu klasach referencyjnych, ale same w sobie nie stanowią dowodu na separację diagnostyczną ani wydajność modelu.
Pięć klasyfikatorów oceniono z wykorzystaniem pięciokrotnej walidacji krzyżowej z grupowaniem pacjentów na zbiorze danych obejmującym 68 guzków. Metryki wydajności przedstawiono jako średnią z fałdów ± SD oraz zbiorcze wartości OOF w Tabeli 3. Rysunek 2, Rysunek 3 oraz Rysunek 4 przedstawiają krzywe ROC OOF, podsumowania metryk dla zgrupowanych fałdów oraz macierze pomyłek OOF.
Rysunek 4 przedstawia zagregowane macierze pomyłek OOF, w których każdy guzek był przewidywany wyłącznie przez model trenowany bez udziału guzków pochodzących od tego samego pacjenta. SVM poprawnie sklasyfikował 32 z 38 guzków złośliwych (czułość 0,842), ale błędnie zaklasyfikował 15 z 30 guzków łagodnych jako złośliwe (swoistość 0,500). Drzewo decyzyjne wykazało największą liczbę wyników fałszywie ujemnych i fałszywie dodatnich. Wzorce te pokazują, dlaczego sama dokładność jest niewystarczająca, i ilustrują zarówno pomyślne, jak i suboptymalne wyniki.
W ukierunkowanej analizie OOF SHAP (Rysunek 5 oraz Tabela 4) mikrowapnienia i powiększenie po kontraście wniosły największy modelowy wkład w prawdopodobieństwo złośliwości SVM, a następnie jednorodność wzmocnienia i płeć. Wyniki te opisują sposób, w jaki dopasowany model SVM wykorzystał zmierzone zmienne w tej kohorcie, i nie ustalają niezależnego znaczenia klinicznego.
Oświadczenie o dostępności danych
Dane stanowiące podstawę tego artykułu zostaną udostępnione na uzasadnioną prośbę skierowaną do autora korespondencyjnego.
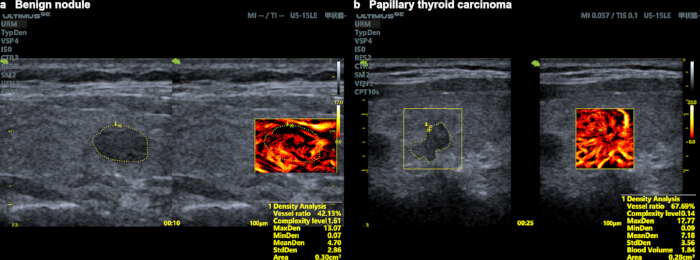
Rysunek 1. Reprezentatywne obrazy SRUS/URM ograniczone do obszaru zmiany. (A) Łagodny guzek tarczycy. (B) Papilarny rak tarczycy potwierdzony w badaniu FNAC pod kontrolą USG. Każdy panel przedstawia obrys zmiany oraz odpowiadającą mu rekonstrukcję mikronaczyniową z wygenerowaną przez urządzenie nakładką ilościową. Przykłady ilustrują pomyślne pozyskanie i rekonstrukcję obrazu i nie służą do oceny dokładności diagnostycznej. Skróty: SRUS = super-resolution ultrasound (ultradźwięki o super-rozdzielczości); URM = ultra-resolution microscopic imaging (obrazowanie mikroskopowe o ultra-rozdzielczości); FNAC = fine needle aspiration cytology (cytologia aspiracyjna cienkoigłowa). Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
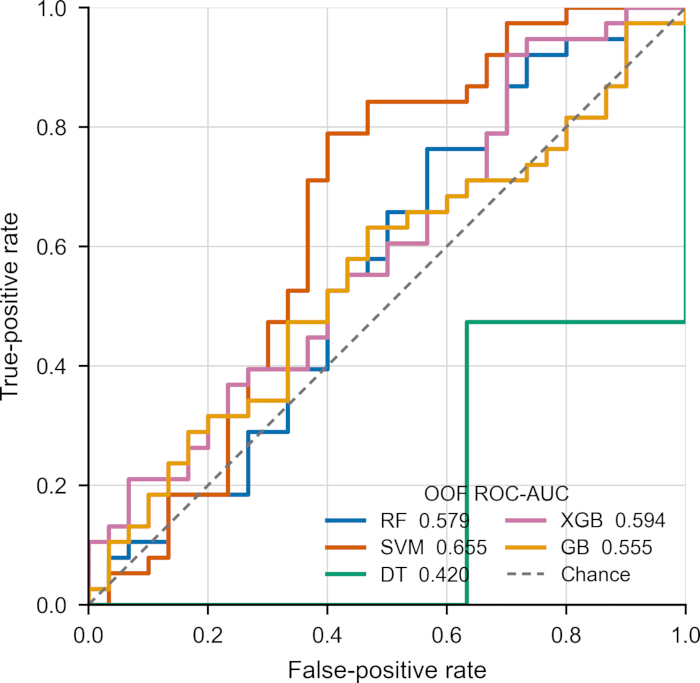
Rycina 2Krzywe ROC OOF pogrupowane według pacjentów dla pięciu klasyfikatorów. Każda krzywa podsumowuje jedną prognozę z zestawu walidacyjnego dla każdego guzka; przerywana przekątna oznacza dyskryminację przypadkową. Skróty: RF = Random Forest (lasy losowe); SVM = Support Vector Machine (maszyna wektorów wspierających); DT = Decision Tree (drzewo decyzyjne); XGB = eXtreme Gradient Boosting; GB = Gradient Boosting (wzmocnienie gradientowe); OOF = Out-of-fold (poza fałdą); ROC-AUC = Receiver Operating Characteristic-Area Under Curve (charakterystyka operacyjna odbiornika – powierzchnia pod krzywą). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
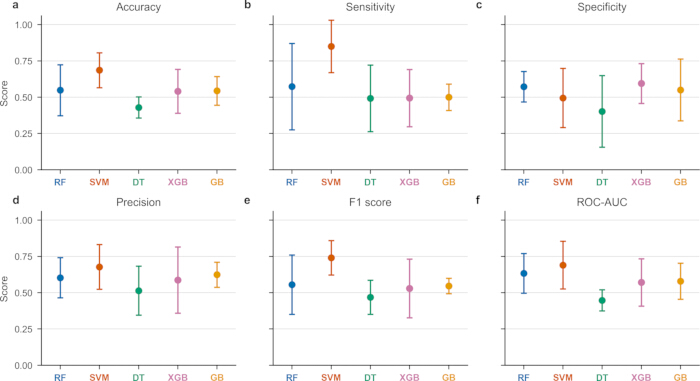
Rycina 3. Średnia ± SD dokładności, czułości, swoistości, precyzji, wyniku F1 oraz ROC-AUC w pięciu grupach walidacyjnych podzielonych według pacjentów. Skróty: SD = odchylenie standardowe; ROC-AUC = pole pod krzywą charakterystyki operacyjnej odbiornika. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
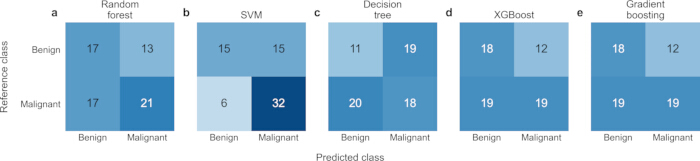
Rysunek 4. Macierze pomyłek OOF zgrupowane według pacjentów. Wiersze przedstawiają klasę referencyjną, a kolumny klasę przewidywaną. Każdy guzek był przewidywany przez model przeszkolony bez żadnych guzków pochodzących od tego samego pacjenta. Skrót: OOF = Out-of-fold. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
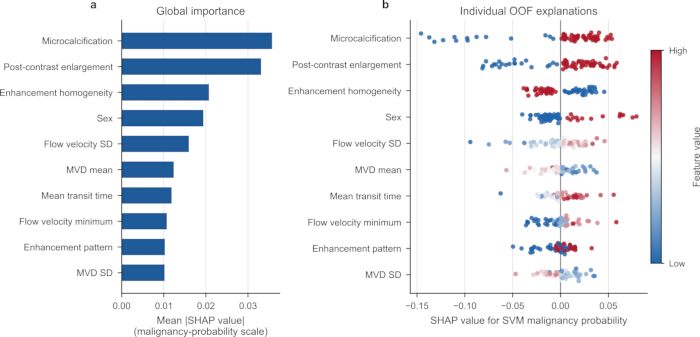
Rysunek 5. Analiza OOF SHAP dla SVM z wykorzystaniem wyjaśniacza opartego na permutacji. (A) Ranking dziesięciu największych średnich bezwzględnych wartości SHAP. (B) Podpisane wartości SHAP dla tych samych zmiennych w 68 prognozach z zestawu walidacyjnego. Skróty: OOF = Out-of-fold; SHAP = SHapley Additive exPlanations; SVM = Support Vector Machine; MVD = Microvascular density. Proszę kliknąć tutaj, aby zobaczyć powiększoną wersję tego rysunku.
| Źródło akwizycji | Predyktory | Obsługa modelu |
| Dane demograficzne | Wiek; płeć | Zmienne numeryczne arkusza roboczego; obie zachowane jako zdefiniowane w modelu dane wejściowe. |
| ultradźwięki w trybie B | Mikrowapnienia | Zmienna numeryczna arkusza; brak skalowania globalnego. |
| Kolorowy Doppler | Unaczynienie wewnątrzguzkowe (przepływ krwi) | Zaklasyfikowano jako predyktor Doppler kolorowy, a nie w trybie B. |
| Jakościowe CEUS | Powiększenie po podaniu kontrastu; wzorzec wzmocnienia; homogeniczność wzmocnienia | Zmienne numeryczne arkusza roboczego; zachowane jako wcześniej określone dane wejściowe. |
| Ilościowe CEUS | AUC, intensywność szczytowa, czas do osiągnięcia szczytu, czas dotarcia, czas narastania, średni czas przejścia, czas do połowy intensywności szczytowej | Siedem zmiennych krzywej czas-intensywność; brak imputacji lub skalowania globalnego. |
| mikronaczyniowy SRUS | stosunek naczyń, złożoność, MVD maksymalna/minimalna/średnia/SD, indeks perfuzji, prędkość przepływu maksymalna/minimalna/średnia/SD | Jedenaście zmiennych mikronaczyniowych; brak a priori selekcji cech. |
Tabela 1: Zmienne ilościowe i wstępne przetwarzanie danych. 25 wstępnie określonych predyktorów zostało pogrupowanych według źródła pozyskania: wiek i płeć; mikrowapnienia w trybie B; unaczynienie wewnątrzguźne w kolorowym Dopplerze; jakościowe i ilościowe pomiary CEUS; oraz pomiary mikrokrążenia w SRUS. Pola z nazwami, identyfikatorami rejestracyjnymi oraz rozmiarem zmiany zostały wykluczone. W macierzy 25 zmiennych nie odnotowano brakujących wartości. Tożsamość pacjentów służyła wyłącznie do grupowania. StandardScaler został dopasowany tylko w obrębie fałd treningowych SVM. Skróty: CEUS = ultrasonografia z kontrastem; SRUS = ultrasonografia o superrozdzielczości; SVM = maszyna wektorów nośnych.
| Źródło akwizycji | Charakterystyka | Guzki łagodne | Guzki złośliwe | Wartość p |
| (n = 30) | (n = 38) | |||
| Dane demograficzne | Wiek, lata | 48 (42, 55) | 48 (41, 52) | 0.551 |
| Dane demograficzne | Płeć, n (%) | 0.012 | ||
| Dane demograficzne | Kobiety | 26 (86.7%) | 27 (71.1%) | |
| Dane demograficzne | Mężczyźni | 4 (13.3%) | 11 (28.9%) | |
| USG w trybie B | ||||
| USG w trybie B | Mikrowapnienia, n (%) | 0.001 | ||
| USG w trybie B | Brak | 12 (40.0%) | 2 (5.3%) | |
| USG w trybie B | Obecne | 18 (60.0%) | 36 (94.7%) | |
| Kolorowy Doppler | Przepływ krwi, n (%) | 0.1 | ||
| Kolorowy Doppler | Brak | 7 (23.3%) | 8 (21.1%) | |
| Kolorowy Doppler | Obecny | 23 (76.7%) | 30 (78.9%) | |
| Jakościowe CEUS | Powiększenie po kontraście, n (%) | 0.001 | ||
| Jakościowe CEUS | Nie | 16 (53.3%) | 5 (13.2%) | |
| Jakościowe CEUS | Tak | 14 (46.7%) | 33 (86.8%) | |
| Jakościowe CEUS | Jednorodność wzmocnienia, n(%) | 0.087 | ||
| Jakościowe CEUS | Niejednorodne | 11 (36.7%) | 23 (60.5%) | |
| Jakościowe CEUS | Jednorodne | 19 (63.3%) | 15 (39.5%) | |
| Jakościowe CEUS | Wzór wzmocnienia, n (%) | |||
| Jakościowe CEUS | Hipowzmocnienie | 18 (60.0%) | 20 (52.6%) | |
| Jakościowe CEUS | Izowzmocnienie | 3 (10.0%) | 0 (0.0%) | |
| Jakościowe CEUS | Hiperwzmocnienie | 9 (30.0%) | 18 (47.4%) | |
| Ilościowe CEUS | ||||
| Ilościowe CEUS | Pole pod krzywą (AUC), dB·s | 3255.49 (2457.15, 4048.94) | 3620.76 (3096.36, 4066.75) | 0.201 |
| Ilościowe CEUS | Intensywność szczytowa (PI), dB | 48.93 (40.93, 55.78) | 50.22 (42.49, 56.82) | 0.621 |
| Ilościowe CEUS | Czas do osiągnięcia szczytu (TTP), s | 17.78 (16.47, 19.30) | 20.42 (17.53, 23.47) | 0.045 |
| Ilościowe CEUS | Czas dotarcia (AT), s | 9.88 (8.23, 11.53) | 9.88 (8.64, 11.53) | 0.1 |
| Ilościowe CEUS | Czas wzrostu (RT), s | 8.43 (6.92, 9.55) | 9.55 (7.00, 12.11) | 0.164 |
| Ilościowe CEUS | Średni czas przejścia (MTT), s | 69.38 (60.17, 87.84) | 82.82 (64.22, 99.15) | 0.102 |
| Ilościowe CEUS | Czas do połowy intensywności szczytowej (THP), s | 81.62 (70.53, 99.93) | 95.34 (73.60, 109.44) | 0.157 |
| Mikronaczyniowe SRUS | ||||
| Mikronaczyniowe SRUS | Wskaźnik naczyń, % | 56.29 (43.34, 71.44) | 57.81 (41.49, 70.24) | 0.772 |
| Mikronaczyniowe SRUS | Poziom złożoności | 1.68 (1.59, 1.73) | 1.62 (1.57, 1.69) | 0.083 |
| Mikronaczyniowe SRUS | Gęstość mikronaczyniowa — maksymalna | 15.24 (10.59, 17.88) | 13.28 (9.60, 15.92) | 0.142 |
| Mikronaczyniowe SRUS | Gęstość mikronaczyniowa — minimalna | 0.07 (0.05, 0.07) | 0.06 (0.04, 0.07) | 0.385 |
| Mikronaczyniowe SRUS | Gęstość mikronaczyniowa — średnia | 6.20 (3.46, 7.45) | 4.71 (3.74, 6.78) | 0.161 |
| Mikronaczyniowe SRUS | Gęstość mikronaczyniowa — SD | 3.15 (2.12, 3.64) | 2.56 (1.94, 3.04) | 0.085 |
| Mikronaczyniowe SRUS | Wskaźnik perfuzji | 6.81 (4.53, 9.05) | 7.12 (4.52, 9.90) | 0.666 |
| Mikronaczyniowe SRUS | Maksymalna prędkość przepływu, mm/s | 25.13 (22.24, 26.43) | 26.32 (23.86, 28.00) | 0.152 |
Tabela 2: Charakterystyka wyjściowa 30 łagodnych i 38 złośliwych guzków tarczycy. Demograficzna i obrazowa charakterystyka wyjściowa guzków łagodnych (n = 30) i złośliwych (n = 38). Wartości podano jako n (%) lub mediana (rozstęp międzykwartylny). Etykiety referencyjne przypisano na podstawie cienkoigłowej aspiracji pod kontrolą USG (FNAC); nie dysponowano badaniem histopatologicznym po operacji. Skróty: EUS = ultrasonografia z kontrastem; SRUS = ultrasonografia o wysokiej rozdzielczości (Super-resolution ultrasound).
| Klasyfikator | Dokładność | Czułość | Specyficzność | Precyzja | miara F1 | ROC-AUC | |
| appreciating Losy Lasów (Random Forest) | Walidacja StratifiedGroupKFold | 0.548 ± 0.176 | 0.573 ± 0.297 | 0.572 ± 0.105 | 0.603 ± 0.139 | 0.555 ± 0.204 | 0.633 ± 0.137 |
| połączone wyniki OOF (out-of-fold) | 0.559 | 0.553 | 0.567 | 0.618 | 0.583 | 0.579 | |
| SVM (maszyna wektorów wspierających) | Walidacja StratifiedGroupKFold | 0.686 ± 0.120 | 0.850 ± 0.180 | 0.495 ± 0.204 | 0.678 ± 0.154 | 0.740 ± 0.118 | 0.690 ± 0.164 |
| połączone OOF | 0.691 | 0.842 | 0.5 | 0.681 | 0.753 | 0.655 | |
| Drzewo decyzyjne | Walidacja StratifiedGroupKFold | 0.429 ± 0.073 | 0.492 ± 0.229 | 0.402 ± 0.247 | 0.514 ± 0.169 | 0.468 ± 0.117 | 0.447 ± 0.073 |
| połączone OOF | 0.426 | 0.474 | 0.367 | 0.486 | 0.48 | 0.42 | |
| XGBoost | Walidacja StratifiedGroupKFold | 0.541 ± 0.151 | 0.494 ± 0.197 | 0.595 ± 0.137 | 0.587 ± 0.228 | 0.530 ± 0.202 | 0.571 ± 0.163 |
| połączone OOF (out-of-fold) | 0.544 | 0.5 | 0.6 | 0.613 | 0.551 | 0.594 | |
| Gradient Boosting | Walidacja StratifiedGroupKFold | 0.544 ± 0.099 | 0.500 ± 0.091 | 0.550 ± 0.213 | 0.624 ± 0.087 | 0.546 ± 0.053 | 0.579 ± 0.124 |
| połączone OOF | 0.544 | 0.5 | 0.6 | 0.613 | 0.551 | 0.555 |
Tabela 3: Wyniki pięciokrotnej walidacji krzyżowej z grupowaniem pacjentów oraz zagregowane wyniki OOF. Wszystkie guzki pochodzące od tego samego pacjenta przypisano do tej samej grupy (fold). Wartości stanowią średnią ± SD z pięciu grup walidacyjnych StratifiedGroupKFold. 68 guzków pobrano z 63 grup pacjentów; każda grupa walidacyjna wykluczała 5–12 guzków z 12–13 grup pacjentów. Każda zagregowana wartość OOF opiera się na jednej predykcji na guzek wykonanej w grupie walidacyjnej, która wykluczała wszystkie guzki od danego pacjenta. Rysunek 3 przedstawia odpowiadające im zagregowane macierze pomyłek OOF. Skróty: OOF = out-of-fold; SVM = maszyna wektorów nośnych (Support Vector Machine).
| Ranga | Cecha | Średnia |SHAP| | SD średniej |SHAP| dla foldów |
| 1 | Mikrowapnienia | 0.0357 | 0.023 |
| 2 | Powiększenie po kontraście | 0.0331 | 0.0165 |
| 3 | Homogenność wzmocnienia | 0.0207 | 0.008 |
| 4 | Płeć | 0.0194 | 0.0109 |
| 5 | SD prędkości przepływu | 0.0159 | 0.01 |
| 6 | MVD średnia | 0.0124 | 0.0086 |
| 7 | Średni czas przejścia | 0.0118 | 0.0069 |
| 8 | Minimalna prędkość przepływu | 0.0107 | 0.0061 |
| 9 | Wzorzec wzmocnienia | 0.0103 | 0.0112 |
| 10 | MVD SD | 0.0102 | 0.0077 |
Tabela 4: Globalny ranking cech SHAP OOF dla modelu SVM. Wartości SHAP kwantyfikują wkład w prawdopodobieństwo złośliwości w modelu SVM. Każdy guzek został wyjaśniony raz w ramach przypisanej mu, wyłączonej z uczenia grupy walidacyjnej pacjentów. Wartości globalne to średnie bezwzględne wartości SHAP dla 68 wyjaśnień OOF; SD fold to odchylenie standardowe średnich bezwzględnych wartości dla poszczególnych foldów w pięciu foldach. Rankingi są specyficznymi dla modelu podsumowaniami eksploracyjnymi i nie stanowią efektów przyczynowych, niezależnych biomarkerów ani progów klinicznych. Skróty: OOF = out-of-fold; SVM = Support Vector Machine; MVD = gęstość mikronaczyniowa; SHAP = SHapley Additive exPlanations.
Dyskusja
Obecne podejścia diagnostyczne w przypadku guzków tarczycy opierają się głównie na konwencjonalnym badaniu ultrasonograficznym, które z natury pozostaje zależne od operatora i podatne na zmienność międzyobserwacyjną5, a także na niemożność wizualizacji mikrokrążenia poniżej limitu dyfrakcyjnego. Z naszej wiedzy wynika, że nasze badanie jest pierwszą kompleksową oceną wielu algorytmów uczenia maszynowego zastosowanych do danych obrazowania mikrokrążenia metodą ultrasonografii o superrozdzielczości (SRUS), co pozwoliło na uzyskanie obiektywnej oceny ilościowej ryzyka wystąpienia PTC w guzkach tarczycy w warunkach badawczych.
Głównym wkładem niniejszego badania jest analityczny model na poziomie pacjenta, który integruje pomiary SRUS oparte na lokalizacji z wykorzystaniem mikropęcherzyków kontrastowych z obrazowaniem ultradźwiękowym w trybie B, kolorowym Dopplerem, jakościową i ilościową metodą CEUS oraz zmiennymi klinicznymi w celu klasyfikacji guzków tarczycy. Nowość polega na włączeniu eksperymentalnie zmierzonych informacji mikronaczyniowych do predefiniowanego, multimodalnego zestawu 25 cech i ocenie go przy użyciu grupowania pacjentów odpornego na wyciek danych, a nie na nowej architekturze klasyfikatora. Wszystkie guzki od tego samego pacjenta zostały przypisane do jednego folderu; skaler SVM był dopasowywany wyłącznie do każdego folderu treningowego, a ocena modelu opierała się na pięciokrotnej walidacji z grupowaniem pacjentów, połączonych predykcjach OOF oraz ukierunkowanej analizie OOF SHAP. W ramach tego modelu SVM uzyskał najwyższą średnią dokładność (0,686 ± 0,120) i średnią wartość ROC-AUC (0,690 ± 0,164), jednak jego połączona swoistość OOF wyniosła jedynie 0,50, a wydajność różniła się pomiędzy folderami. Podsumowując, wyniki te ustanawiają powtarzalne podejście do oceny połączonych danych mikronaczyniowych i konwencjonalnych danych ultradźwiękowych na poziomie pacjenta, jednocześnie wskazując obszary wymagające dalszego dopracowania przed wdrożeniem klinicznym.
Wcześniejsze badania nad tarczycą potwierdziły możliwość zastosowania SRUS z użyciem mikropęcherzyków kontrastowych i wykazały różnice na poziomie grupowym w przepływie mikronaczyniowym w pilotażowej kohorcie 24 guzków26. Nasze badanie rozszerza ten dowód wykonalności obrazowania w trzech konkretnych aspektach. Po pierwsze, parametry gęstości naczyń, prędkości przepływu i perfuzji uzyskane za pomocą SRUS zostały przeanalizowane wraz z mikrozwapnieniami w trybie B, unaczynieniem wewnątrzguzkowym w kolorowym Dopplerze, jakościową i ilościową oceną CEUS oraz wiekiem i płcią, a nie jako odizolowane porównanie SRUS. Po drugie, w procesie wstępnego przetwarzania i walidacji jednostką podziału był pacjent, co zapobiegło wystąpieniu guzków od tego samego pacjenta zarówno w danych treningowych, jak i walidacyjnych. Po trzecie, ten sam schemat grupowania pacjentów powiązał wydajność modelu z połączonymi predykcjami OOF oraz ukierunkowaną analizą OOF SHAP. Wspólnie elementy te łączą akwizycję, ilościową charakterystykę mikronaczyniową, ewaluację modelu i jego interpretację w jeden powtarzalny schemat pracy, stanowiąc fundament dla przyszłych badań.
Zidentyfikowaliśmy szereg niedawnych badań dotyczących zastosowania AI i głębokiego uczenia w diagnostyce złośliwych guzków tarczycy. Warto odróżnić nasze podejście od tych metod. Feng i wsp. opracowali wieloośrodkowy, multimodalny model do przedoperacyjnej stratyfikacji ryzyka raka brodawkowatego tarczycy27, podczas gdy Gatta i wsp. zsyntetyzowali zewnętrznie oceniane modele uczenia maszynowego do diagnostyki różnicowej guzków łagodnych i złośliwych w oparciu o konwencjonalne obrazy USG tarczycy28. Li i wsp. zastosowali obliczeniową super-rozdzielczość pojedynczego obrazu w konwencjonalnym USG do lokalizacji guzków29, a He i wsp. wykorzystali radiomikę obrazów B-mode ulepszoną za pomocą GAN do przewidywania niediagnostycznego wyniku FNA (Bethesda I)30. Podejścia uwzględniające geometrię, uczenie transferowe oraz modele oparte na Transformerach dodatkowo ilustrują różnorodność algorytmiczną badań nad USG tarczycy31. Badania te wykorzystują konwencjonalne obrazy USG, multimodalne zmienne kliniczne lub obrazowe, bądź obliczeniowo ulepszone reprezentacje obrazów; nie służą one jednak do lokalizacji wstrzykniętych mikropęcherzyków kontrastowych ani do bezpośredniej kwantyfikacji gęstości mikronaczyniowej i przepływu na poziomie zmiany. Habchi i wsp. zastosowali framework uczenia transferowego oparty na VGG19 do konwencjonalnych obrazów USG tarczycy i zgłosili wysoką dokładność klasyfikacji na publicznym zbiorze danych32. Chociaż ich praca wykazała potencjał głębokiego uczenia w tej dziedzinie, opierała się ona wyłącznie na cechach obrazu B-mode.
W porównaniu do nich, specyficznym wkładem w niniejszej pracy jest wykorzystanie SRUS opartego na lokalizacji w celu uzyskania eksperymentalnie zmierzonych zmiennych mikronaczyniowych, ich integracja z konwencjonalnymi cechami USG i CEUS oraz ich ocena w grupach pacjentów. Przytoczone badania pozostają komplementarne, a nie stanowią bezpośrednich porównań wydajności, ponieważ różnią się danymi wejściowymi, punktami końcowymi, standardami referencyjnymi i projektami walidacyjnymi; tę komplementarność postrzegamy jako atut, gdyż sugeruje ona istnienie wielu niezależnych dróg do poprawy stratyfikacji ryzyka. Co istotne, nasze wyniki uzupełniają również podejścia oparte na głębokim uczeniu, takie jak framework Bandelet Transform z uwzględnieniem geometrii opracowany przez Habchi i wsp.31 oraz benchmarki transfer learningu autorstwa Xu i wsp., które koncentrują się na konwencjonalnej klasyfikacji obrazów w trybie B, a nie na ilościowych biomarkerach hemodynamicznych3 — są to zasadniczo różne modalności wejściowe, które rejestrują odmienne aspekty biologii nowotworu.
Nasze wyniki wskazują na istotne różnice w wydajności pięciu klasyfikatorów ewaluacyjnych. SVM osiąga najlepsze wyniki pod względem średniej dokładności (0.686 ± 0.120) oraz ROC-AUC (0.690 ± 0.164) i charakteryzuje się najniższym odchyleniem standardowym w walidacji krzyżowej, co świadczy o jego stabilnym działaniu w zadaniach z małymi próbkami. Połączona walidacja OOF dodatkowo potwierdziła, że czułość SVM wyniosła 84,2% (poprawnie zidentyfikowano 32 z 38 guzków złośliwych), a wskaźnik F1 wyniósł 0,753, co było najwyższym wynikiem spośród wszystkich modeli. Ta wysoka zdolność detekcji ma istotną wartość w praktyce klinicznej, ponieważ pominięcie diagnozy może prowadzić do poważnych konsekwencji. Jednakże swoistość wyniosła jedynie 50,0% (błędnie sklasyfikowano 15 z 30 guzków łagodnych), co jest wzorcem wymagającym ostrożnej interpretacji. Ta umiarkowana swoistość prawdopodobnie odzwierciedla wysokowymiarowy charakter naszego zbioru danych (25 predyktorów w stosunku do 30 próbek łagodnych). W tak rzadkiej przestrzeni cech granica decyzyjna SVM ulega nieproporcjonalnemu wpływowi kilku guzków łagodnych o mikro naczyniowych cechach przypominających zmiany złośliwe, co zmusza klasyfikator do przyjęcia konserwatywnej strategii — oznaczania przypadków niejednoznacznych jako złośliwe — w celu zminimalizowania wyników fałszywie ujemnych. Z perspektywy klinicznej taki kompromis jest akceptowalny w scenariuszach przesiewowych; konsekwencje przeoczenia diagnozy PTC mogą być znacznie poważniejsze niż skutki niepotrzebnego wykonania FNAC. W przyszłych badaniach należy nadać priorytet większej kohorcie próbek, w szczególności poprzez dodanie większej liczby próbek łagodnych, oraz ponownie przetestować uczenie wrażliwe na koszt lub metody redukcji wymiarowości, aby zachować czułość przy jednoczesnej poprawie swoistości.
RF wykazuje średnią dokładność (0,548 ± 0,176), która jest niższa niż w przypadku SVM. Jednak RF wykazał zrównoważoną zbiorczą wydajność OOF (dokładność 5,9%, czułość 5,3%, swoistość 56,7%), co jest wartościowe dla systemów wspomagania decyzji klinicznych. Ocena ważności oparta na nieczystości (impurity-based importance) sklasyfikowała średnie MVD, średnią prędkość przepływu oraz indeks perfuzji wśród wiodących zmiennych, co wskazuje na istotny sygnał SRUS. XGBoost oraz Gradient Boosting uzyskały wyniki pośrednie; żaden z tych modeli nie przewyższył RF, co prawdopodobnie wynika z wrażliwości hiperparametrów przy ograniczonej liczbie próbek (n = 68) i konserwatywnej regularyzacji. DT wykazało słabe wyniki (dokładność 0,429, ROC-AUC 0,47), zbliżając się do poziomu losowego zgadywania, co było oczekiwane ze względu na przeuczenie pojedynczego drzewa. Podsumowując, SVM jest preferowany, gdy priorytetem jest maksymalizacja czułości, podczas gdy RF oferuje zalety w postaci zrównoważonej wydajności i interpretowalności; oba modele wymagają dalszych badań.
Skupiona analiza SHAP zidentyfikowała mikrozwapnienia, powiększenie po kontraście oraz jednorodność wzmocnienia jako trzy najważniejsze czynniki prognostyczne, a następnie płeć i parametry SRUS, w tym odchylenie standardowe prędkości przepływu krwi, średnie MVD oraz średni czas przejścia. Dominują cechy konwencjonalne, jednak parametry SRUS dostarczają niezależnych, dodatkowych informacji. Znaczenie wskaźników SRUS jest zgodne z ich fizycznymi zaletami. SRUS może osiągnąć rozdzielczość rzędu ~10 µm, podczas gdy rozdzielczość tradycyjnego Dopplera jest ograniczona do ~20–30µm. Zhang i wsp. potwierdzili, że guzki złośliwe charakteryzują się niższą prędkością przepływu (9,86 vs. 16,76 mm/s, p < 0,01) oraz niższym MVD19, co odzwierciedla włóknistą i zdominowaną przez układ limfatyczny biologię PTC. Nasze wyniki SHAP są biologicznie uzasadnione, a zgodność z kryteriami TI-RADS potwierdza klinicznie istotne uczenie wzorców8.
Dokładna stratyfikacja ryzyka ma istotne znaczenie dla opieki nad pacjentami i podejmowania decyzji klinicznych. Jeśli guzki wysokiego ryzyka można będzie zidentyfikować za pomocą analizy ML obrazowania SRUS, pacjenci mogliby szybciej poddać się badaniu FNAC, co zmniejszyłoby lęk i zapobiegłoby progresji nowotworu. Wybrane guzki niskiego ryzyka mogą natomiast być monitorowane za pomocą ultradźwięków. Ilościowe pomiary mikro naczyniowe mogą w przyszłości uzupełnić konwencjonalne obserwacje w tym procesie. Jednakże niniejsze badanie nie sprawdzało, czy wyniki klasyfikatora poprawiają efektywność lekarzy, ograniczają niepotrzebne procedury FNAC lub zmieniają wyniki leczenia pacjentów. W związku z tym wyniki modelu nie powinny jeszcze kierować decyzjami klinicznymi. Należy je raczej traktować jako narzędzia badawcze, które stanowią dowód koncepcji i zapewniają podstawę do ewaluacji prospektywnej. Podczas analizy wszystkie guzki od jednego pacjenta muszą pozostać w tym samym foldzie, a preprocessing musi być dopasowany wyłącznie przy użyciu części treningowej tego foldu.
Należy wziąć pod uwagę kilka ograniczeń. Po pierwsze, była to retrospektywna, jednocentrowa analiza 68 guzków u 63 pacjentów, przeprowadzona bez zewnętrznej walidacji; niewielka liczebność próby może zwiększać ryzyko przeuczenia modelu (overfitting). Niemniej jednak, walidacja krzyżowa z grupowaniem pacjentów zapewnia pewną pewność co do wyników. Po drugie, wszystkie etykiety referencyjne uzyskano na podstawie cienkoigłowej aspiracji (FNAC) pod kontrolą USG, a nie badania histopatologicznego po operacji. FNAC dostarcza dowodów cytologicznych, ale nie jest równoważna z pooperacyjnym potwierdzeniem histologicznym i może wprowadzać błędy klasyfikacji, szczególnie w przypadku guzków określonych jako łagodne, mimo że ograniczyliśmy zakres guzków łagodnych i przeprowadziliśmy testy genu BRAFV600E we wszystkich guzkach. Po trzecie, grupa złośliwa była ograniczona do guzków zdiagnozowanych jako PTC w badaniu FNAC, co ogranicza możliwość uogólnienia wyników na inne nowotwory złośliwe tarczycy. Po czwarte, dodatkowe czynniki kliniczne (funkcja tarczycy, wywiad rodzinny) nie były systematycznie gromadzone. Wreszcie, nie przeprowadzono systematycznej optymalizacji hiperparametrów, analizy kalibracji ani niezależnego porównania z głębokim uczeniem opartym na obrazach. Pomimo tych ograniczeń, zgodność naszych ustaleń z biologicznym prawdopodobieństwem oraz istniejącą literaturą daje pewność co do ich poprawności. Przyszłe badania powinny priorytetowo traktować: (1) prospektywną walidację wieloośrodkową w większych kohortach z wykorzystaniem pooperacyjnej histopatologii; (2) fuzję multimodalną integrującą SRUS z elastografią i konwencjonalnym USG, (3) biomarkery surowicze, zestandaryzowane protokoły akwizycji oraz kryteria kontroli jakości34, a także optymalizację inżynierii cech.
Podsumowując, niniejsze badanie wykazuje możliwość zastosowania konwencjonalnych algorytmów uczenia maszynowego do ilościowych pomiarów mikrokrążenia w technice SRUS w celu wsparcia wstępnej klasyfikacji guzków tarczycy. SVM wykazał wysoką czułość, lecz ograniczoną swoistość, co potwierdza jego potencjalną rolę jako narzędzia wspomagającego przesiewowo, a nie zamiennika diagnostycznego. Choć są one wstępne, nasze wyniki ustanawiają powtarzalny, odporny na wyciek danych potok ewaluacyjny i uzasadniają przeprowadzenie prospektywnej walidacji w większych kohortach.
Oświadczenia
Autorzy nie deklarują żadnych konfliktów interesów.
Podziękowania
Autorzy dziękują pracownikom Zakładu Ultrasonografii Szpitala Przyjaźni w Pekinie (Beijing Friendship Hospital), Capital Medical University, za pomoc w gromadzeniu danych pacjentów.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Klasyfikator Decision Tree | scikit-learn | Version 1.5.2 | Klasyfikator uczenia maszynowego |
| Igła do biopsji aspiracyjnej cienkoigłowej | Stosowana do FNAC pod kontrolą USG | ||
| Klasyfikator Gradient Boosting | scikit-learn | Version 1.5.2 | Klasyfikator uczenia maszynowego |
| Kaniula dożylna | Stosowana do podawania kontrastu | ||
| Python | Python Software Foundation | Version 3.11.9 | Język programowania użyty do analizy uczenia maszynowego |
| Klasyfikator Random Forest | scikit-learn | Version 1.5.2 | Klasyfikator uczenia maszynowego |
| SHAP (permutation explainer) | SHAP Developers | Version 0.46.0 | Analiza wyjaśnialności modelu |
| SonoVue contrast agent | Bracco | Środek kontrastowy do badań CEUS/SRUS | |
| StandardScaler | scikit-learn | Version 1.5.2 | Standaryzacja cech dla potoku SVM |
| Sterylna sól fizjologiczna | Stosowana do przepłukania żyły po wstrzyknięciu kontrastu | ||
| StratifiedGroupKFold | scikit-learn | Version 1.5.2 | Kwalifikacja krzyżowa z grupowaniem pacjentów |
| Klasyfikator Support Vector Machine (SVM) | scikit-learn | Version 1.5.2 | Klasyfikator z jądrem funkcji radialnej (RBF) |
| U5-15LE linear-array transducer | VINNO Technology | U5-15LE | Liniowy przetwornik ultradźwiękowy |
| ULTIMUS 9E ultrasound system | VINNO Technology | ULTIMUS 9E | System obrazowania ultradźwiękowego stosowany do badań B-mode, Color Doppler, CEUS i SRUS |
| XGBoost | XGBoost Developers | Version 2.1.1 | Środowisko gradient boosting |
Bibliografia
- Mu C, et al. Mapping global epidemiology of thyroid nodules among general population: a systematic review and meta-analysis. Front Oncol. 2022;12:1029926.
- Moon JH, et al. Prevalence of thyroid nodules and their associated clinical parameters: a large-scale, multicenter-based health checkup study. Korean J Intern Med. 2018;33(4):753-62.
- Dean DS, Gharib H. Epidemiology of thyroid nodules. Best Pract Res Clin Endocrinol Metab. 2008;22(6):901-11.
- Uppal N, Collins R, James B. Thyroid nodules: global, economic, and personal burdens. Front Endocrinol (Lausanne). 2023;14:1113977.
- Durante C, et al. The diagnosis and management of thyroid nodules: a review. JAMA. 2018;319(9):914-24.
- Lim H, Devesa SS, Sosa JA, Check D, Kitahara CM. Trends in thyroid cancer incidence and mortality in the United States, 1974-2013. JAMA. 2017;317(13):1338-48.
- Gharib H, et al. American Association of Clinical Endocrinologists, American College of Endocrinology, and Associazione Medici Endocrinologi medical guidelines for clinical practice for the diagnosis and management of thyroid nodules—2016 update. Endocr Pract. 2016;22(5):622-39.
- Tessler FN, et al. ACR Thyroid Imaging, Reporting and Data System (TI-RADS): white paper of the ACR TI-RADS Committee. J Am Coll Radiol. 2017;14(5):587-95.
- Petranović Ovčariček P, et al. The 2025 ATA guidelines for differentiated thyroid cancer—ten years of professional debate and measured progress. Eur J Nucl Med Mol Imaging. 2026;53(4):2213-6.
- Christensen-Jeffries K, et al. Super-resolution ultrasound imaging. Ultrasound Med Biol. 2020;46(4):865-91.
- Carmeliet P. Angiogenesis in health and disease. Nat Med. 2003;9(6):653-60.
- Zhang B, et al. Utility of contrast-enhanced ultrasound for evaluation of thyroid nodules. Thyroid. 2010;20(1):51-7.
- Rago T, Vitti P. Role of thyroid ultrasound in the diagnostic evaluation of thyroid nodules. Best Pract Res Clin Endocrinol Metab. 2008;22(6):913-28.
- Xia S, et al. Super-resolution ultrasound and microvasculomics: a consensus statement. Eur Radiol. 2024;34(11):7503-13.
- Song P, Rubin JM, Lowerison MR. Super-resolution ultrasound microvascular imaging: is it ready for clinical use? Z Med Phys. 2023;33(3):309-23.
- Errico C, et al. Ultrafast ultrasound localization microscopy for deep super-resolution vascular imaging. Nature. 2015;527(7579):499-502.
- Couture O, Hingot V, Heiles B, Muleki-Seya P, Tanter M. Ultrasound localization microscopy and super-resolution: a state of the art. IEEE Trans Ultrason Ferroelectr Freq Control. 2018;65(8):1304-20.
- Gao JY, Hou C. Progresses and clinical application of super-resolution ultrasound imaging: a narrative review. Ultrasound J. 2025;17(1):29.
- Zhang G, et al. Ultrasound super-resolution imaging for the differential diagnosis of thyroid nodules: a pilot study. Front Oncol. 2022;12:978164.
- Wildman-Tobriner B, et al. Using artificial intelligence to revise ACR TI-RADS risk stratification of thyroid nodules: diagnostic accuracy and utility. Radiology. 2019;292(1):112-9.
- Toro-Tobon D, et al. Artificial intelligence in thyroidology: a narrative review of the current applications, associated challenges, and future directions. Thyroid. 2023;33(8):903-17.
- Peng S, et al. Deep learning-based artificial intelligence model to assist thyroid nodule diagnosis and management: a multicentre diagnostic study. Lancet Digit Health. 2021;3(4):e250-9.
- Chen C, et al. Deep learning to assist composition classification and thyroid solid nodule diagnosis: a multicenter diagnostic study. Eur Radiol. 2024;34(4):2323-33.
- Bini F, et al. Artificial intelligence in thyroid field: a comprehensive review. Cancers (Basel). 2021;13(19):4740.
- Habchi Y, Kheddar H, Himeur Y, Ghanem MC. Machine learning and transformers for thyroid carcinoma diagnosis. J Vis Commun Image Represent. 2026;115:104668.
- Zhang M, Wang X, Deng Y, Tang K. Multimodal ultrasound integration pathways and paradigm innovations in precision diagnosis and treatment of thyroid cancer. Acad Radiol. 2026. Epub ahead of print.
- Feng JW, et al. Development and validation of the multidimensional machine learning model for preoperative risk stratification in papillary thyroid carcinoma: a multicenter, retrospective cohort study. Cancer Imaging. 2025;25(1):98.
- Gatta E, et al. Machine learning for diagnosis of malignant thyroid nodules based on thyroid ultrasound: systematic review and meta-analysis of studies with external datasets. Eur J Radiol Open. 2026;16:100716.
- Li J, Guo Q, Peng S, Tan X. Super-resolution based nodule localization in thyroid ultrasound images through deep learning. Curr Med Imaging. 2024;20(1):e15734056269264.
- He S, et al. Super-resolution ultrasound radiomics for pre-FNA prediction of nondiagnostic (Bethesda I) thyroid nodules. Front Endocrinol (Lausanne). 2026;17:1710097.
- Habchi Y, Kheddar H, Ghanem MC, Hwaidi J. Adaptive bandelet transform and transfer learning for geometry-aware thyroid cancer ultrasound classification. Diagnostics (Basel). 2026;16(4):554.
- Habchi Y, Kheddar H, Himeur Y. Adaptive bandelet transform and transfer learning for geometry-aware thyroid cancer ultrasound classification [conference paper]. In: 2024 International Conference on Telecommunications and Intelligent Systems (ICTIS). IEEE; 2024. p. 1-6.
- Xu Y, Xu M, Geng Z, Liu J, Meng B. Thyroid nodule classification in ultrasound imaging using deep transfer learning. BMC Cancer. 2025;25(1):544.
- Gou TH, et al. Application value of super-resolution ultrasound imaging in the diagnosis of American College of Radiology Thyroid Imaging Reporting and Data System category 4 and 5 thyroid nodules. Zhongguo Yi Xue Ke Xue Yuan Xue Bao. 2026. doi:10.3881/j.issn.1000-503X.16808.