Ta przekrojowa analiza ukrytych profili przeprowadzona wśród 1420 chińskich studentów pozwoliła na zidentyfikowanie czterech odrębnych profili snu z wykorzystaniem PSQI. Zdrowsze profile snu były istotnie powiązane z wyższym poziomem umiarkowanej i intensywnej aktywności fizycznej, co sugeruje potrzebę wyznaczenia celów specyficznych dla wzorców snu w ramach promocji zdrowia na kampusach.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
Analiza latentnych profili wzorców snu i ich związku z poziomem aktywności fizycznej wśród chińskich studentów
* These authors contributed equally
W tym artykule
Podsumowanie
Streszczenie
Celem niniejszego badania przekrojowego była identyfikacja ukrytych profili wzorców snu wśród studentów oraz zbadanie ich powiązań z poziomem aktywności fizycznej (PA), aby dostarczyć dowodów empirycznych dla ukierunkowanych interwencji zdrowotnych w środowisku akademickim. Łącznie zrekrutowano 1420 studentów z trzech uniwersytetów w południowych Chinach, stosując wielostopniowe warstwowe losowanie skupieniowe. Jakość snu oraz poziom PA oceniono odpowiednio za pomocą Pittsburgh Sleep Quality Index (PSQI) oraz International Physical Activity Questionnaire-Short Form (IPAQ-SF). Analizę profilu latentnego (LPA), testy chi-kwadrat oraz analizy regresji logistycznej wielomianowej przeprowadzono przy użyciu odpowiedniego oprogramowania statystycznego. Na podstawie oszacowanych przez model prawdopodobieństw przynależności do klas zidentyfikowano cztery ukryte profile snu: sen zdrowy (4,7%), sen niewystarczający (24,8%), słabą jakość snu (20,3%) oraz ciężkie zaburzenia snu (10,2%); odpowiadające im zaobserwowane proporcje na podstawie przypisania do najbardziej prawdopodobnej klasy wyniosły odpowiednio 45,0%, 25,0%, 20,0% i 10,0% (n = 639, 35, 284 i 142). Płeć oraz poziom PA różniły się istotnie pomiędzy profilami. W porównaniu ze studentami z grupy ciężkich zaburzeń snu, studenci z grupy snu zdrowego częściej deklarowali umiarkowaną PA (iloraz szans (OR) = 4,69, 95% przedział ufności (CI): 2,92–7,51) oraz wysoką PA (OR = 7,5, 95% CI: 4,41–12,91). Studenci z grupy snu niewystarczającego również częściej deklarowali umiarkowaną PA (OR = 2,98, 95% CI: 1,83–4,86) oraz wysoką PA (OR = 5,02, 95% CI: 2,84–8,87). Wzorce snu studentów wykazały wyraźną heterogeniczność. Korzystne wzorce snu wiązały się z wyższym poziomem PA. Ze względu na przekrojowy charakter badania nie można wyciągać wniosków o związkach przyczynowo-skutkowych. Należy opracować zróżnicowane strategie interwencyjne w zależności od specyficznych dla danej podgrupy cech snu, a promowanie PA może być rozważone jako potencjalny cel behawioralny dla studentów z zaburzeniami snu.
Wprowadzenie
Sen jest niezbędny nie tylko do utrzymania podstawowych funkcji fizjologicznych, ale także do wspierania zdrowia fizycznego i psychicznego, rozwoju poznawczego oraz regulacji emocjonalnej1,2. Jednak w dzisiejszych, dynamicznie rozwijających się społeczeństwach zaburzenia snu stały się globalnym problemem zdrowia publicznego. Problemy ze snem są szczególnie widoczne wśród studentów, którzy po rozpoczęciu nauki na uniwersytecie często doświadczają mniejszej opieki rodzicielskiej i zmagają się z presją akademicką, adaptacją interpersonalną oraz nadmiernym korzystaniem z urządzeń elektronicznych3. Badania epidemiologiczne wykazały, że około 25%–60% studentów na całym świecie zgłasza różny stopień niskiej jakości snu lub deprywacji snu4,5. Utrzymujące się problemy ze snem mogą upośledzać funkcje ośrodkowego układu nerwowego, prowadząc do braku koncentracji i pogorszenia pamięci; mogą one również zwiększać ryzyko wystąpienia internalizujących problemów ze zdrowiem psychicznym, takich jak depresja i lęk6,7, a także zwiększać przyszłe ryzyko chorób układu sercowo-naczyniowego i zespołu metabolicznego8.
Poprzednie badania nad snem opierały się głównie na analizie zorientowanej na zmienne, oceniając stan snu na poziomie grupy przy użyciu wyników całkowitych ze zstandaryzowanych skal, takich jak Pittsburgh Sleep Quality Index (PSQI), lub średnich wyników dla konkretnych wymiarów9. Chociaż podejście to zapewnia intuicyjną ocenę ogólnego stopnia zaburzeń snu, w sposób dorozumiany zakłada ono jednorodność badanej populacji. W rzeczywistości sen jest wielowymiarowym procesem fizjologicznym obejmującym czas trwania snu, latencję snu, efektywność snu, nocne wybudzenia oraz dysfunkcje w ciągu dnia10. Osoby z tym samym całkowitym wynikiem w skali PSQI mogą wykazywać znacznie odmienne kombinacje objawów; na przykład jeden student może mieć przede wszystkim trudności z zasypianiem, podczas gdy inny może doświadczać wczesnego wybudzania się i senności w ciągu dnia. W ostatnich latach coraz większą uwagę poświęca się podejściom zorientowanym na osobę. Analiza profilu utajonego (Latent profile analysis, LPA) pozwala zidentyfikować nieobserwowalne, heterogeniczne podgrupy w danych poprzez maksymalizację różnic między profilami i minimalizację różnic wewnątrz profilu1,12. Dzięki zastosowaniu LPA badacze mogą dokładniej scharakteryzować specyficzne profile snu wśród studentów13, co pozwala na precyzyjniejsze określenie celów interwencji.
Aktywność fizyczna (AF) jest szeroko zalecana przez Światową Organizację Zdrowia oraz inne wytyczne dotyczące zdrowia publicznego jako fundament promocji zdrowia na każdym etapie życia14,15. Badania empiryczne i metaanalizy wykazały, że regularna aktywność fizyczna o umiarkowanej i wysokiej intensywności może poprawić wydolność krążeniowo-oddechową i zmniejszyć śmiertelność16,17, pomagając jednocześnie w łagodzeniu stresu psychologicznego i poprawie funkcji poznawczych18,19. Aktywność fizyczna jest również uważana za skuteczną niefarmakologiczną interwencję w przypadku problemów ze snem20,21. Pozytywne korelacje między aktywnością fizyczną a jakością snu odnotowano w badaniach kohortowych z wykorzystaniem obiektywnych urządzeń, takich jak akcelerometry2,23,24, a także w badaniach przekrojowych opartych na kwestionariuszach samoopisowych25,26. Co więcej, ćwiczenia fizyczne i sen zdają się pozostawać w dwukierunkowej zależności: odpowiednia ilość snu może zwiększać motywację i wytrzymałość podczas aktywności fizycznej, natomiast dzienny wydatek energetyczny może sprzyjać występowaniu snu wolnofalowego w nocy27,28.
Mimo powszechnej zgody co do korzyści wynikających z aktywności fizycznej dla ogólnej jakości snu, istniejąca literatura posiada kilka ograniczeń. Większość badań traktowała aktywność fizyczną jako zmienną niezależną przewidującą pojedynczy wynik jakości snu, pomijając tym samym możliwość, że różne wzorce snu mogą odpowiadać odrębnym kombinacjom cech stylu życia29,30. Stopień, w jakim poziomy aktywności fizycznej różnią się w zależności od latentnych profili snu wśród studentów, pozostaje niewystarczająco poznany.
W tym kontekście celem niniejszego badania było: (1) zidentyfikowanie ukrytych profili na podstawie wielowymiarowych wskaźników jakości snu wśród chińskich studentów przy użyciu LPA; oraz (2) zbadanie powiązań między profilami snu a poziomami aktywności fizycznej (niskim, umiarkowanym i wysokim) po uwzględnieniu zmiennych demograficznych. Postawiliśmy hipotezę, że wśród studentów wystąpi wiele heterogenicznych profili snu oraz że studenci o zdrowym wzorcu snu będą bardziej skłonni do osiągania umiarkowanego i intensywnego poziomu aktywności fizycznej niż osoby z ciężkimi zaburzeniami snu.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Badanie to zostało zatwierdzone przez Komisję Etyki Biomedycznej Uniwersytetu Jishou (Nr zatwierdzenia JSDX-2023-0034). Wszyscy uczestnicy byli studentami studiów licencjackich w trybie stacjonarnym w wieku 18–25 lat i przed przystąpieniem do badania wyrazili pisemną świadomą zgodę. Uzyskano zgodę od uczestniczących uczelni. Dane z ankiet wykorzystano wyłącznie do celów badań akademickich i analizowano anonimowo. Badanie przeprowadzono zgodnie z Deklaracją Helsińską oraz lokalnymi wymogami instytucjonalnymi.
Rekrutacja uczestników i plan próbkowania
W okresie od września do grudnia 2025 roku przeprowadzono przekrojowe badanie ankietowe wśród studentów studiów pierwszego stopnia z trzech uniwersytetów ogólnokształcących w południowych Chinach, stosując wielostopniowy zrandomizowany dobór próby warstwowej w grupach. W pierwszym etapie z listy publicznych uniwersytetów ogólnokształcących w południowych Chinach wybrano trzy uczelnie za pomocą losowania warstwowego, przy czym warstwy zdefiniowano według prowincjonalnych regionów administracyjnych, aby zapewnić reprezentatywność geograficzną. W drugim etapie, w obrębie każdego wybranego uniwersytetu, za pomocą komputerowo generowanych liczb losowych wybrano od dwóch do trzech pełnych grup z każdego roku studiów (od pierwszego do ostatniego) jako jednostki próbkowania grupowego, co dało łącznie 28 grup w trzech uniwersytetach. Zaproszono do udziału wszystkich studentów z wybranych grup, co przedstawiono na Rysunku 1. Kryteria włączenia były następujące: (1) status studenta studiów stacjonarnych pierwszego stopnia; (2) wiek od 18 do 25 lat; (3) dobrowolny udział potwierdzony pisemną świadomą zgodą. Kryteria wykluczenia obejmowały: (1) niedawne ciężkie choroby somatyczne lub przeciwwskazania do wysiłku fizycznego, takie jak złamania lub ciężka choroba serca; (2) aktualne stosowanie leków psychiatrycznych, np. w leczeniu ciężkiej depresji lub schizofrenii; (3) czas wypełniania kwestionariusza krótszy niż 180 s lub wyraźne niespójności logiczne, np. wybór tej samej opcji dla wszystkich pozycji. Rozdzielono łącznie 1 500 kwestionariuszy. Z 80 nieważnych kwestionariuszy odrzuconych podczas czyszczenia danych, 24 wyeliminowano z powodu czasu wypełnienia poniżej 180 s, 20 z powodu niespójności logicznych (np. identyczne odpowiedzi we wszystkich pozycjach lub odpowiedzi sprzeczne), 18 z powodu wieku poza zakresem 18–25 lat, 11 z powodu zbyt wielu brakujących danych (ponad 20% pozycji) i 7 z powodu zgłoszenia ciężkiej choroby somatycznej lub aktualnego stosowania leków psychiatrycznych. W rezultacie do analizy pozostało 1 420 ważnych kwestionariuszy, co daje efektywny wskaźnik odpowiedzi na poziomie 94,67%.
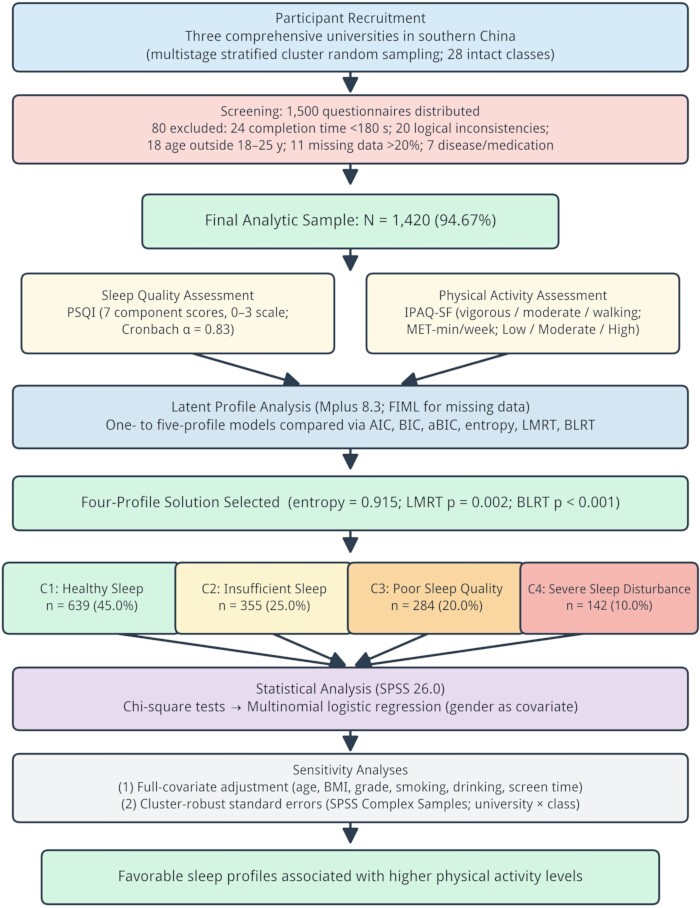
Rycina 1: Projekt badania i schemat analityczny. Schematyczny przegląd rekrutacji i przesiewu uczestników (rozdzielono 1 500 kwestionariuszy; wykluczono 80 osób; N = 1 420 włączonych), oceny za pomocą PSQI i IPAQ-SF, analizy profilu latentnego (porównano modele od jednego do pięciu profili przy użyciu AIC, BIC, aBIC, entropii, LMRT i BLRT), przypisania do czterech profili snu, dwu zmiennych testów chi-kwadrat, wielomianowej regresji logistycznej z płcią jako współzmienną oraz analiz wrażliwości (pełna korekta współzmiennych i błędy standardowe odporne na klastrowanie). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Ocena demograficzna i stylu życia
W celu uzyskania charakterystyki demograficznej i socjologicznej wykorzystano autorski kwestionariusz, obejmujący płeć (mężczyzna/kobieta), wiek (w latach), rok studiów (pierwszy/drugi/trzeci/czwarty), miejsce pochodzenia (miasto/wieś), wskaźnik masy ciała (BMI), historię palenia tytoniu, historię spożywania alkoholu oraz średni dzienny czas przed ekranem. BMI obliczono jako masę ciała w kilogramach podzieloną przez kwadrat wzrostu w metrach (BMI = weight [kg] / height [m]2). Przed analizą zweryfikowano zgłoszony wzrost i wagę pod kątem wartości mało prawdopodobnych; przypadki, w których wzrost wynosił <140 cm lub >200 cm, waga <30 kg lub >150 kg, lub BMI <12 kg/m2 lub >40 kg/m2, zostały oznaczone i sprawdzone z oryginalnymi zapisami, a potwierdzone wartości odstające wykluczono. Status palenia sklasyfikowano jako: nigdy, sporadyczne (palenie w niektóre dni, ale nie codziennie) lub regularne (codzienne palenie), w oparciu o zgłoszone zachowania w ciągu ostatniego miesiąca. Spożycie alkoholu sklasyfikowano jako: nigdy, sporadyczne (picie rzadziej niż raz w tygodniu) lub regularne (picie co najmniej raz w tygodniu) w ciągu ostatniego miesiąca. Średni dzienny czas przed ekranem oceniano, prosząc uczestników o podanie całkowitej liczby godzin dziennie spędzonych przed smartfonami, komputerami, tabletami i telewizorem w ciągu ostatniego miesiąca; dane zapisano jako zmienną ciągłą. Przed formalnym gromadzeniem danych przeprowadzono badanie pilotażowe kwestionariusza wśród 30 studentów studiów licencjackich, aby ocenić jasność pytań i czas wypełniania; na podstawie informacji zwrotnych z pilotażu wprowadzono niewielkie poprawki w sformułowaniach. Poprzednie badania sugerowały, że zmienne te mogą być czynnikami zakłócającymi związek między snem a aktywnością fizyczną30,31. Wszystkie instrumenty, oprogramowanie i materiały wykorzystane w tym badaniu wymieniono w Tabeli Materiałów.
Ocena jakości snu
Do oceny jakości snu uczestników w ciągu ostatniego miesiąca wykorzystano kwestionariusz PSQI, opracowany przez Buysse i współpracowników9. Skala składa się z 19 elementów samooceny, które tworzą siedem komponentów: subiektywną jakość snu, latencję zasypiania, czas trwania snu, rutynową efektywność snu, zaburzenia snu, stosowanie leków nasennych oraz dysfunkcję w ciągu dnia. Każdy komponent oceniany jest w skali od 0 (brak trudności) do 3 (znaczne trudności). Wyniki tych siedmiu ciągłych komponentów posłużyły jako wskaźniki obserwowane dla LPA. PSQI wykazał dobrą rzetelność i trafność w populacjach studentów w Chinach oraz na świecie30. W niniejszym badaniu współczynnik alfa Cronbacha dla tej skali wyniósł 0,83.
Ocena aktywności fizycznej
Do oceny aktywności fizycznej uczestników w ciągu ostatnich siedmiu dni wykorzystano kwestionariusz IPAQ-SF, opracowany przez Craiga i wsp.32. Kwestionariusz rejestruje częstotliwość (dni/tydzień) i czas trwania (minuty/dzień) intensywnej aktywności fizycznej, aktywności fizycznej o umiarkowanej intensywności oraz spacerów. Wartości metabolicznego ekwiwalentu zadań (MET) obliczano zgodnie z protokołem punktacji IPAQ: MET-min/tydzień dla spacerów = 3,3 × czas trwania × częstotliwość; MET-min/tydzień dla umiarkowanej intensywności = 4,0 × czas trwania × częstotliwość; oraz MET-min/tydzień dla intensywnej aktywności = 8,0 × czas trwania × częstotliwość. Wartości MET dla trzech rodzajów aktywności zsumowano, aby uzyskać całkowitą aktywność fizyczną. Uczestników zaklasyfikowano do grup wysokiej aktywności fizycznej (PA), umiarkowanej PA i niskiej PA zgodnie z kryteriami punktacji IPAQ-SF zwalidowanymi u studentów33. Wysoką PA zdefiniowano jako aktywność intensywną przez co najmniej trzy dni przy całkowitym poziomie aktywności fizycznej wynoszącym co najmniej 1 500 MET-min/tydzień lub dowolną kombinację spacerów, aktywności o umiarkowanej lub intensywnej intensywności przez siedem lub więcej dni przy całkowitym poziomie aktywności fizycznej wynoszącym co najmniej 3 000 MET-min/tydzień. Umiarkowaną PA zdefiniowano jako aktywność intensywną przez co najmniej trzy dni przez co najmniej 20 minut dziennie, lub aktywność o umiarkowanej intensywności i/lub spacery przez co najmniej pięć dni przez co najmniej 30 minut dziennie, lub dowolną kombinację aktywności osiągającą co najmniej 600 MET-min/tydzień. Niską PA zdefiniowano jako niespełnienie kryteriów dla umiarkowanej lub wysokiej PA. Oczyszczanie danych przeprowadzono zgodnie z oficjalnym protokołem punktacji IPAQ: wykluczono uczestników zgłaszających ponad 16 h całkowitej aktywności na dobę; dzienne czasy trwania w poszczególnych kategoriach ograniczono do 180 min przed obliczeniem MET-minut; a przypadki z logicznie niespójnymi odpowiedziami usunięto podczas oczyszczania danych.
Analiza statystyczna
W pierwszej kolejności przeprowadzono LPA przy użyciu oprogramowania do modelowania profilu latentnego (patrz Tabela materiałów)34. Spośród 1 420 uczestników u 33 osób (2,3%) wystąpiły częściowe brakujące dane w PSQI, przy czym brakowało 69 z 9 940 odpowiedzi na poziomie komponentów (0,69%; t.j. 1 420 uczestników × siedem wyników komponentów PSQI). Do obsługi tych brakujących wartości w ramach założenia o losowości braków (missing-at-random) zastosowano metodę pełnej informacji maksymalnej wiarygodności (FIML). Sekwencyjnie oszacowano modele od jednego do pięciu profili. Dopasowanie modelu oceniano za pomocą kryterium informacyjnego Akaike (AIC), bayesowskiego kryterium informacyjnego (BIC), BIC skorygowanego o wielkość próby (aBIC), entropii, testu ilorazu wiarygodności Lo-Mendell-Rubina (LMRT) oraz bootstrapowego testu ilorazu wiarygodności (BLRT). Niższe wartości AIC, BIC i aBIC wskazują na lepsze dopasowanie względne, natomiast wartości entropii bliższe 1 wskazują na wyższą dokładność klasyfikacji. Testy LMRT i BLRT wykorzystano do ustalenia, czy model z k profilami pasuje znacząco lepiej niż model z k − 1 profilami. Optymalne rozwiązanie profilowe wybrano, biorąc pod uwagę łącznie wskaźniki dopasowania statystycznego, entropię, wielkość klasy (żaden profil nie mógł zawierać mniej niż 5% próby) oraz interpretowalność merytoryczną, zgodnie z uznanymi wytycznymi dla analizy profilu latentnego11,35. Po wybraniu optymalnego rozwiązania profilowego, najbardziej prawdopodobna przynależność jednostek do klasy została wyeksportowana do oprogramowania do analizy statystycznej (patrz Tabela materiałów) w celu przeprowadzenia dalszych analiz. Do zbadania różnic w charakterystykach demograficznych i poziomach aktywności fizycznej w obrębie profili snu zastosowano testy chi-kwadrat Pearsona. Bivariatne testy chi-kwadrat wykazały, że tylko płeć i poziom aktywności fizycznej różniły się znacząco pomiędzy czterema profilami snu (w obu przypadkach p < 0,001), natomiast wiek, rocznik, BMI, palenie tytoniu, spożywanie alkoholu i czas spędzony przed ekranem nie różniły się znacząco (wszystkie p > 0,05; patrz Tabela uzupełniająca 1). W związku z tym, zgodnie z zasadą parsymonii, do modelu wielomianowej regresji logistycznej włączono jedynie płeć jako zmienną współzależną. Analiza wrażliwości z korektą o wszystkie zebrane zmienne współzależne wykazała ten sam wzorzec i istotność wyników (Tabela uzupełniająca 2). Przeprowadzono wielomianową regresję logistyczną, przyjmując poziom aktywności fizycznej jako zmienną zależną (niska PA = 0, umiarkowana PA = 1, wysoka PA = 2) i profil snu jako główną zmienną niezależną. Obliczono ilorazy szans (ORs) oraz 95% przedziały ufności (CIs). Wszystkie testy były dwustronne, a istotność statystyczną ustalono na poziomie p < 0,05. Ponieważ uczestnicy zostali zrekrutowani z pełnych klas w ramach uniwersytetów, przeprowadzono analizę wrażliwości przy użyciu modułu próbek złożonych (complex-samples) oprogramowania statystycznego (patrz Tabela materiałów), określając uniwersytet i klasę jako zmienne klastrujące, aby uzyskać błędy standardowe skorygowane o plan badania. Wyniki były zgodne z wynikami standardowej wielomianowej regresji logistycznej (Tabela uzupełniająca 3). Zanonimizowany surowy zbiór danych z angielskimi etykietami zmiennych oraz książka kodów zostały udostępnione jako Plik uzupełniający 1.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Wyekstrahowano modele z jedną do pięciu profili latentnych. Jak pokazano w Tabeli 1, wartości AIC, BIC i aBIC spadały wraz ze wzrostem liczby profili. Model czteroprofilowy wykazywał najwyższą wartość entropii (0,915), a zarówno test LMRT, jak i BLRT były istotne (p < 0,001). W przeciwieństwie do tego, LMRT dla modelu pięcioprofilowego nie był istotny (p = 0,085), a entropia spadła do poziomu 0,880. Z tego powodu, mimo że model pięcioprofilowy wykazał niższe kryteria informacyjne, wybrano model cztero...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Wykorzystując stosunkowo dużą próbę przekrojową, w niniejszym badaniu zastosowano podejście LPA skoncentrowane na osobie, aby zidentyfikować cztery heterogeniczne profile snu wśród chińskich studentów, a następnie zbadano związki między tymi profilami a różnymi poziomami aktywności fizycznej. Wyniki dostarczają cennej perspektywy w zrozumieniu grupowania zachowań zdrowotnych związanych ze snem i ćwiczeniami fizycznymi wśród studentów oraz wskazują bardziej precyzyjne cele dla interwencji w zakresie zdrowia publicznego w ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autor(zy) oświadczają, że niniejsza praca została przeprowadzona w przypadku braku jakichkolwiek komercyjnych lub finansowych zależności, które mogłyby zostać uznane za potencjalny konflikt interesów.
Podziękowania
Jesteśmy wdzięczni uczestniczącym uniwersytetom oraz wszystkim studentom, którzy wypełnili ankietę. Praca ta była wspierana przez projekt badawczy w dziedzinie nauk humanistycznych i społecznych dla młodych naukowców Ministerstwa Edukacji (Grant nr 23YJC89059) oraz prowincjonalny projekt badawczy reformy edukacji i nauczania w prowincji Hunan (Grant nr 202502069).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Kwestionariusz demograficzny i dotyczący stylu życia | Opracowany przez zespół badawczy | N/A | Użyty do zebrania danych dotyczących płci, wieku, roku studiów, miejsca pochodzenia, wskaźnika masy ciała, historii palenia, historii spożywania alkoholu oraz średniego dziennego czasu spędzanego przed ekranem. |
| Pitttsburgh Sleep Quality Index (PSQI) | Buysse et al., 1989 | DOI: 10.1016/0165-1781(89)9047-4 | Użyty do oceny jakości snu w ciągu ostatniego miesiąca. Siedem wyników składowych posłużyło jako wskaźniki obserwowane w analizie profilu utajonego. |
| International Physical Activity Questionnaire-Short Form (IPAQ-SF) | Craig et al., 203 | DOI: 10.1249/01.MSS.078924.61453 .FB | Użyty do oceny chodzenia, aktywności fizycznej o umiarkowanej intensywności oraz intensywnej aktywności fizycznej w ciągu ostatnich siedmiu dni. |
| Pisemny formularz świadomej zgody | Zespół badawczy i uczestniczące uniwersytety | Zatwierdzenie etyczne nr JSDX-2023-034 | Użyty do udokumentowania dobrowolnego udziału studentów studiów licencjackich w wieku 18-25 lat. |
| Procedura zbierania danych z kwestionariusza | Uczestniczące uniwersytety w południowych Chinach | N/A | Użyta do wielostopniowego stratyfikowanego losowania klastrowego oraz przeprowadzania ankiet między wrześniem a grudniem 2025 r. |
| Mplus | Muthen & Muthen | Wersja 8.3 | Użyty do przeprowadzenia analizy profilu utajonego na podstawie siedmiu wyników składowych PSQI. |
| IBM SPSS Statistics | IBM | Wersja 26.0 | Użyty do przeprowadzenia testów chi-kwadrat i analiz regresji logistycznej wielomianowej. |
| Microsoft Excel | Microsoft | N/A | Użyty do przygotowania oddzielnych plików tabel JoVE do przesłania. |
Bibliografia
- Chaput JP, et al. Sleeping hours: What is the ideal number and how does age impact this? Nat Sci Sleep. 2018;10:421–430.
- Li J, et al. Sleep in normal aging. Sleep Med Clin. 2018;13(1):1–11.
- Becker SP, et al. Sleep in a large, multi-university sample of college students: Sleep problem prevalence, sex differences, and mental health correlates. Sleep Health. 2018;4(2):174–181.
- Lund HG, et al. Sleep patterns and predictors of disturbed sleep in a large population of college students. J Adolesc Health. 2010;46(2):124–132.
- Chen X, et al. Sleep characteristics and health-related quality of life among a national sample of American young adults. Sleep. 2014;37(4):793–799.
- Steptoe A, et al. Sleep duration and health in young adults. Arch Intern Med. 2006;166(16):1689–1692.
- Zhai L, et al. Sleep duration and depression among adults: A meta-analysis of prospective studies. Depress Anxiety. 2015;32(9):664–670.
- Grandner MA, et al. Sleep: Important considerations for the prevention of cardiovascular disease. Curr Opin Cardiol. 2016;31(5):551–565.
- Buysse DJ, et al. The Pittsburgh Sleep Quality Index: A new instrument for psychiatric practice and research. Psychiatry Res. 1989;28(2):193–213.
- Hirshkowitz M, et al. National Sleep Foundation’s sleep time duration recommendations: Methodology and results summary. Sleep Health. 2015;1(1):40–43.
- Nylund-Gibson K, et al. Ten frequently asked questions about latent class analysis. Transl Issues Psychol Sci. 2018;4(4):440–461.
- Nylund KL, et al. Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Struct Equ Modeling. 2007;14(4):535–569.
- Lanza ST, et al. Latent class analysis: An alternative perspective on subgroup analysis in prevention and treatment. Prev Sci. 2013;14(2):157–168.
- Bull FC, et al. World Health Organization 2020 guidelines on physical activity and sedentary behaviour. Br J Sports Med. 2020;54(24):1451–1462.
- U.S. Department of Health and Human Services. Physical Activity Guidelines for Americans. 2nd ed. U.S. Department of Health and Human Services; Washington, DC; 2018.
- Stamatakis E, et al. Sitting time, physical activity, and risk of mortality in adults. J Am Coll Cardiol. 2019;73(16):2062–2072.
- Nystoriak MA, et al. Cardiovascular effects and benefits of exercise. Front Cardiovasc Med. 2018;5:135.
- Biddle SJH, et al. A systematic review of physical activity and health in emerging adults. J Sci Med Sport. 2015;18(6):633–638.
- Lubans D, et al. Physical activity for cognitive and mental health in youth: A systematic review of mechanisms. Pediatrics. 2016;138(3):e20161642.
- Kredlow MA, et al. The effects of physical activity on sleep: A meta-analytic review. J Behav Med. 2015;38(3):427–449.
- Wang F, et al. The effect of physical activity on sleep quality: A systematic review. Eur J Physiother. 2021;23(1):11–18.
- Buman MP, et al. Objectively measured physical activity and sleep in older men. J Sleep Res. 2014;23(2):164–171.
- Loprinzi PD, et al. Association between objectively-measured physical activity and sleep, NHANES 2005–2006. Ment Health Phys Act. 2011;4(2):65–69.
- Vandelanotte C, et al. Associations between objective sleep characteristics and physical activity and sedentary behaviours. J Sci Med Sport. 2019;22(5):565–570.
- Pedisic Z, et al. State of health in Australian adults: Does physical activity mitigate the negative impact of poor sleep? J Sci Med Sport. 2014;17(1):60–65.
- Memon AR, et al. Sleep and physical activity in university students: A systematic review and meta-analysis. Sleep Med Rev. 2021;58:101482.
- Kline CE. The bidirectional relationship between exercise and sleep: Implications for exercise adherence and sleep improvement. Am J Lifestyle Med. 2014;8(6):375–379.
- Dolezal BA, et al. Interrelationship between sleep and exercise: A systematic review. Adv Prev Med. 2017;2017:1364387.
- Gerber M, et al. Fitness and exercise as correlates of sleep complaints: Is it all in our minds? Med Sci Sports Exerc. 2010;42(5):893–901.
- Wu X, et al. Low physical activity and high screen time can increase the risks of mental health problems and poor sleep quality among Chinese college students. PLoS One. 2015;10(3):e0119607.
- Carter B, et al. Association between portable screen-based media device access or use and sleep outcomes: A systematic review and meta-analysis. JAMA Pediatr. 2016;170(12):1202–1208.
- Craig CL, et al. International Physical Activity Questionnaire: 12-country reliability and validity. Med Sci Sports Exerc. 2003;35(8):1381–1395.
- Dinger MK, et al. Validity and reliability of the International Physical Activity Questionnaire in college students. Am J Health Educ. 2006;37(6):337–343.
- Muthén LK, Muthén BO. Mplus User’s Guide. 8th ed. Muthén & Muthén; Los Angeles, CA; 1998–2017.
- Spurk D, et al. Latent profile analysis: A review and “how to” guide of its application within vocational behavior research. J Vocat Behav. 2020;120:103445.
- Rebar AL, et al. A meta-meta-analysis of the effect of physical activity on depression and anxiety in non-clinical adult populations. Health Psychol Rev. 2015;9(3):366–378.
- Yang PY, et al. Exercise training improves sleep quality in middle-aged and older adults with sleep problems: A systematic review. J Physiother. 2012;58(3):157–163.
- Irish LA, et al. The role of sleep hygiene in promoting public health: A review of empirical evidence. Sleep Med Rev. 2015;22:23–36.
- Driver HS, et al. Exercise and sleep. Sleep Med Rev. 2000;4(4):387–402.
- Morin CM, et al. Chronic insomnia. Lancet. 2012;379(9821):1129–1141.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.