Niniejszy protokół opisuje proces generowania zbioru danych pogodowych oraz systematyczną ocenę modeli uczenia maszynowego, głębokiego uczenia i modeli hybrydowych w celu prognozowania tłumienia atmosferycznego w wolnoprzestrzennej łączności optycznej w zróżnicowanych warunkach środowiskowych Iraku, w tym podczas burz piaskowych, mgły, deszczu i śniegu.
Artykuł badawczy
Uczenie maszynowe przewyższa głębokie uczenie w przewidywaniu tłumienia atmosferycznego w wolnoprzestrzennej łączności optycznej w warunkach pogodowych panujących w Iraku
W tym artykule
Podsumowanie
Streszczenie
Systemy optycznej łączności w wolnej przestrzeni oferują wysoką przepustowość, zwiększone bezpieczeństwo i pracę bez konieczności posiadania licencji, jednak są one w dużym stopniu narażone na degradację wydajności wynikającą z tłumienia atmosferycznego spowodowanego rozpraszaniem i absorpcją. Dokładne przewidywanie tłumienia jest szczególnie istotne w Iraku, gdzie środowisko charakteryzuje się wysoką temperaturą oraz występowaniem pyłu, mgły i deszczu w sposób losowy. Celem niniejszego badania jest ocena wydajności technik uczenia maszynowego, głębokiego uczenia oraz modelowania hybrydowego w przewidywaniu tłumienia atmosferycznego w systemach optycznej łączności w wolnej przestrzeni w różnych irackich warunkach pogodowych. Za pomocą uznanych fizycznych modeli propagacji utworzono syntetyczny zbiór danych składający się z 1500 próbek dla pięciu reżimów pogodowych: bezchmurnego nieba, mgły, deszczu, burz pyłowych i śniegu. Systematycznie oceniono piętnaście modeli predykcyjnych, obejmujących sześć technik uczenia maszynowego (Random Forest [RF], Extreme Gradient Boosting, Light Gradient Boosting Machine, Support Vector Regression, Linear Regression oraz K-Nearest Neighbors), sześć architektur głębokiego uczenia (Multilayer Perceptron, Deep Neural Network, Long Short-Term Memory [LSTM], One-Dimensional Convolutional Neural Network [CNN], CNN–LSTM oraz Attention-based Network) oraz trzy podejścia hybrydowe. Wyniki wykazały, że model RF osiągnął najlepsze rezultaty (R2 = 0,9654, root mean square error = 1,324 dB/km) w porównaniu z podejściami głębokiego uczenia (najlepszy R2 = 0,7766) i metodami hybrydowymi (najlepszy R2 = 0,9571). Istotność cech przeanalizowano za pomocą Shapley Additive exPlanations, wykazując, że najbardziej wpływowymi czynnikami były stężenie pyłu (67,3%) oraz widzialność (21,2%). Chociaż model RF zapewnił znacznie szybsze trenowanie i wnioskowanie, testy statystyczne nie wykazały istotnej różnicy między RF a najlepiej działającym podejściem hybrydowym (p = 0,083). Udowodniono, że wydajność konwencjonalnych technik uczenia maszynowego jest bardzo wysoka w szacowaniu tłumienia atmosferycznego w systemach łączności FSO w niesprzyjających warunkach środowiskowych, co jest zgodne z dobrze znanymi fizycznymi teoriami propagacji. Podkreślamy jednak, że wnioski te opierają się na danych syntetycznych i muszą zostać zwalidowane za pomocą rzeczywistych pomiarów atmosferycznych, zanim będą mogły zostać zastosowane w operacyjnych systemach FSO.
Wprowadzenie
Sieci komunikacyjne optycznej łączności w wolnej przestrzeni (FSO) oferują zazwyczaj wyższą przepustowość i lepsze bezpieczeństwo, jednak tłumienie atmosferyczne wynikające z rozpraszania i absorpcji stanowi główny czynnik ograniczający odległość komunikacyjną1. W niniejszej pracy przedstawiamy szczegółową analizę podejść opartych na uczeniu maszynowym, głębokim uczeniu oraz metod hybrydowych2 w celu oceny tłumienia sygnału FSO w wymagającym środowisku Iraku, charakteryzującym się wysokimi temperaturami, burzami piaskowymi i nieregularnymi opadami deszczu.
Systemy komunikacyjne FSO wyłoniły się jako jedno z obiecujących rozwiązań dla bezprzewodowej łączności o wysokiej przepustowości3, z szybkościami transmisji danych przekraczającymi 100 Gbps na dystansach od setek metrów do kilku kilometrów4. W przeciwieństwie do konwencjonalnych systemów częstotliwości radiowych, łącza FSO działają w spektrum widzialnym i podczerwonym, oferując takie korzyści jak praca bez konieczności posiadania licencji, odporność na zakłócenia elektromagnetyczne, zwiększone bezpieczeństwo dzięki wąskiej dywergencji wiązki oraz duża pojemność pasma5. Cechy te sprawiają, że FSO jest atrakcyjną technologią w zastosowaniach typu backhaul, łączach międzybudynkowych, sieciach odtwarzania po awariach oraz w łączności ostatniej mili, gdzie wdrożenie światłowodów jest zaporowo kosztowne6. Jednak komunikacja poprzez rozpraszanie, odchylenie wiązki i absorpcję7,8 jest silnie uzależniona od warunków środowiskowych pod kątem dostępności i wydajności. Wyzwanie to stanowi jedno z głównych ograniczeń systemów optycznej komunikacji w wolnej przestrzeni. Warunki pogodowe powodują duże wahania poziomów tłumienia (dB/km). Przy bezchmurnym niebie tłumienie może wynosić mniej niż 0,5 dB/km, podczas gdy gęsta mgła może spowodować, że tłumienie osiągnie ≥50 dB/km przy 1550 nm (według modelu mgły Kima, który przewiduje wartości tłumienia do 50 dB/km dla widzialności poniżej 50 m przy 1550 nm)9,10, a ulewny deszcz może spowodować tłumienie do 20–30 dB/km w zależności od natężenia opadów (według przewidywań modelu Carbonneau)11. Zatem dokładne przewidywanie tłumienia jest niezbędne do niezawodnego projektowania łączy, planowania sieci i adaptacyjnych strategii transmisji. Konwencjonalne metody opierają się na fizycznych modelach propagacji, takich jak model Kima dla mgły12, model Carbonneau dla deszczu13 oraz teoria rozpraszania Mie dla cząstek aerozolu14. Jednak choć modele te zapewniają solidne podstawy teoretyczne, często opierają się na dokładnych parametrach atmosferycznych, które nie zawsze są dostępne w praktyce, i często nie uwzględniają złożonych interakcji między współwystępującymi wieloma zjawiskami meteorologicznymi15.
Ekstremalna zmienność środowiskowa w Iraku stanowi znaczące wyzwanie dla wdrażania systemów optycznej komunikacji w wolnej przestrzeni. Warunki transmisji są dodatkowo utrudnione przez minimalne opady i sporadyczne epizody mgieł, podczas gdy temperatury zimą mogą spadać poniżej zera, a latem wzrastać powyżej 50 °C16. W regularnie wykorzystywanym widmie, takim jak 1550 nm w typowych długościach fal, burze piaskowe, określane lokalnie jako „al-haboob”, mogą ograniczyć widoczność do mniej niż 100 metrów, co prowadzi do wartości tłumienia przekraczających 20dB/km17. Aby systemy FSO mogły zostać z powodzeniem wdrożone w Iraku i innych krajach Bliskiego Wschodu, konieczne jest stworzenie wiarygodnych modeli predykcyjnych, które będą w stanie precyzyjnie oszacować wydajność systemu w tych zróżnicowanych warunkach środowiskowych18.
Nowoczesne osiągnięcia w dziedzinie uczenia maszynowego stanowią realną alternatywę dla konwencjonalnych technik modelowania opartych na fizyce. Zdolność metod uczenia maszynowego do bezpośredniego uczenia się złożonych nieliniowych korelacji między tłumieniem a czynnikami atmosferycznymi umożliwia wykrywanie subtelnych oddziaływań, które tradycyjne modele analityczne mogłyby pominąć19. W szeregu zadań związanych z prognozowaniem klimatologicznym lasy losowe (Random Forest, RF) oraz strategie gradient boostingu wykazały wysoką skuteczność20. Podobnie techniki głębokiego uczenia odniosły znaczące sukcesy w przetwarzaniu języka naturalnego, komputerowym rozpoznawaniu obrazu oraz prognozowaniu szeregów czasowych21. Podejścia te pozostają jednak niedostatecznie zbadane w kontekście przewidywania tłumienia w systemach FSO, szczególnie przy ograniczonych zbiorach danych i silnie zmiennych warunkach pogodowych22. Aby wypełnić tę lukę, niniejsza praca przedstawia szczegółowe badanie uczenia maszynowego, głębokiego uczenia oraz podejść hybrydowych w celu przewidywania tłumienia sygnału FSO w warunkach atmosferycznych Iraku. Osiągnięto to poprzez stworzenie odpowiednio zaprojektowanego syntetycznego zbioru danych opartego na znanych fizycznych modelach propagacji23. Stawiamy hipotezę, że w przypadku średniej wielkości tabelarycznych zbiorów danych środowiskowych z niewielką liczbą dominujących zmiennych predykcyjnych, wydajność prognostyczna metod zespołowych opartych na drzewach przewyższy złożone architektury głębokiego uczenia. Głównymi celami są: (1) ustanowienie metodologii bazowej dla porównania metod prognozowania w kontrolowanym środowisku symulacyjnym, (2) zidentyfikowanie najlepszych strategii algorytmicznych do przewidywania tłumienia atmosferycznego oraz (3) ocena istotności cech i interpretowalności modelu, aby uzyskać wgląd w czynniki środowiskowe mające największy wpływ na tłumienie. W pracy wykorzystano dane syntetyczne, jednak stworzono fundament pod późniejszą walidację z rzeczywistymi pomiarami eksperymentalnymi, co planowane jest w przyszłych badaniach. Ponadto włączono analizy istotności cech i interpretowalności, aby określić najważniejsze czynniki środowiskowe wpływające na tłumienie.
Protokół
Niniejsze badanie nie obejmowało uczestników będących ludźmi ani kręgowców, ani pobierania próbek tkanek. Wszystkie dane wykorzystane w tych badaniach zostały wygenerowane syntetycznie przy użyciu fizycznych modeli propagacji oraz publicznie dostępnych parametrów meteorologicznych. W związku z tym nie było wymagane uzyskanie zgody etycznej od Komisji Rewizyjnej (IRB) lub Instytucjonalnego Komitetu ds. Opieki i Wykorzystania Zwierząt (IACUC).
Generowanie zbioru danych w oparciu o fizyczną teorię propagacji. Zbiór danych został stworzony w celu odwzorowania godzinowych warunków atmosferycznych dla systemu optycznej łączności w wolnej przestrzeni w ciągu całego roku kalendarzowego (2024) dla warunków atmosferycznych w Iraku. Utworzono syntetyczną bazę danych zawierającą 1 500 próbek na godzinę.
Po pierwsze, warunki pogodowe zostały przypisane losowo na podstawie trendów regionalnych: bezchmurne niebo (54,3%), pył (24,9%), mgła (10,5%), deszcz (7,4%) i śnieg (2,8%). Po drugie, do każdej próbki zastosowano odpowiedni model tłumienia fizycznego w zależności od warunków pogodowych, tj. prawo Beera-Lamberta dla bezchmurnego nieba, model Kim dla mgły, teorię Carbonneau dla deszczu i teorię rozpraszania Mie dla burz pyłowych. Po trzecie, parametry systemu FSO ustawiono w następujący sposób: moc nadawcza 20 dBm, długość fali 1550 nm, odległość transmisji 3 km, apertura nadawcza 2,5 cm oraz apertura odbiorcza 20 cm. Po czwarte, tłumienie obliczono w dB/km dla każdej próbki. Na koniec cały zbiór danych został losowo podzielony na 1200 próbek treningowych (80%) i 300 próbek testowych (20%). Symulowane warunki obejmują duże stężenia pyłu związane z burzami piaskowymi, ulewami oraz zmiany temperatury od −4,89°C do 47,99°C. Warunki pogodowe i rozkłady parametrów wybrano na podstawie irackich zapisów klimatycznych z okresu 2020–2024. Wybrano pięć reżimów pogodowych (bezchmurne niebo, mgła, deszcz, burze pyłowe i śnieg), ponieważ obejmują one pełne spektrum warunków atmosferycznych wpływających na tłumienie FSO w Iraku, przy czym burze pyłowe są szczególnie powszechne na Bliskim Wschodzie. Do stworzenia rozkładu prawdopodobieństwa dla każdego warunku pogodowego wykorzystano historyczne dane meteorologiczne zebrane z regionów Iraku. Wynikowy rozkład był następujący: 54,3% czasu niebo jest bezchmurne (stan dominujący), 24,9% to pył (odzwierciedlający problem burz piaskowych w Iraku), 10,5% to mgła (częsta podczas zim w północnym Iraku), 7,4% to deszcz (niskie opady typowe dla Iraku) i 2,8% to śnieg (występujący niekiedy w północnych obszarach górskich). Odpowiednie parametry meteorologiczne modelowano za pomocą rozkładów prawdopodobieństwa dla każdego warunku pogodowego w następujący sposób: temperaturę modelowano za pomocą rozkładu normalnego (średnia 28,55±11,18°C) w zakresie od −4,89°C do 47,99°C na podstawie irackich ekstremów sezonowych; wilgotność modelowano za pomocą rozkładu jednostajnego (średnia 42,01±25,56%) od 0% do 100%; widzialność modelowano za pomocą rozkładu log-normalnego między 0,05 km a 29,99 km (średnia 13,10±10,91 km), aby uwzględnić częste zjawiska niskiej widzialności podczas burz pyłowych; stężenie pyłu modelowano za pomocą rozkładu wykładniczego między 0 a 4,96 mg/m3 (średnia 0,74±1,30 mg/m3) z wyższym prawdopodobieństwem dla niskich stężeń i długimi ogonami dla ekstremalnych zdarzeń pyłowych.
System komunikacyjny został zaprojektowany z mocą nadawczą 20 dBm, długością fali 1550 nm, dystansem transmisji do 3 km, aperturą nadawczą 2,5 cm oraz aperturą odbiorczą 20 cm w celu skompensowania strat wynikających z dywergencji. Parametry systemu FSO podzielono na dwie grupy: parametry stałe, które nie zmieniały się dla wszystkich próbek, oraz parametry zmienne, które były modyfikowane podczas generowania zbioru danych. Dla wszystkich 1500 próbek ustalono następujące parametry stałe: moc nadawczą (20 dBm), długość fali roboczej (1550 nm), aperturę nadawczą (średnica 2,5 cm, sprawność 0,7) oraz aperturę odbiorczą (średnica 20 cm, sprawność 0,7). Parametry te pozostały stałe, ponieważ stanowią one specyfikację fizyczną sprzętu systemu FSO i nie zmieniają się wraz z warunkami pogodowymi. Zbiór danych utworzono z 1500 próbek z następującymi parametrami zmiennymi: temperaturą (−4,89°C do 47,99°C), wilgotnością (0% do 100%), widzialnością (0,05 km do 29,99 km), stężeniem pyłu (0 do 4,96 mg/m3) oraz warunkami pogodowymi (bezchmurne niebo, mgła, deszcz, pył, śnieg). Parametry te modyfikowano zgodnie z rozkładami prawdopodobieństwa wyprowadzonymi z zapisów klimatycznych z Iraku dla lat 2020–2024. Dla każdej próbki obliczono wartość tłumienia (dB/km) przy użyciu odpowiadającego fizycznego modelu tłumienia, zgodnie z konkretną kombinacją warunków pogodowych i parametrów zmiennych.
Tłumienie fizyczne modelowano z wykorzystaniem modelu Carbonneau dla deszczu, prawa Beera-Lamberta dla przejrzystego nieba, teorii rozpraszania Mie dla pyłu oraz modelu Kim dla mgły24. Prawo Beera-Lamberta stosuje się w warunkach przejrzystego nieba, gdzie tłumienie jest zdominowane przez rozpraszanie i absorpcję molekularną, które maleją wykładniczo wraz z odległością25. Współczynnik ekstynkcji α przy 1550 nm wynika z rozpraszania Rayleigha przez cząsteczki powietrza oraz absorpcji przez gazy atmosferyczne26. Model Kim jest modelem specyficznym dla mgły, który wiąże tłumienie z widzialnością za pomocą współczynników empirycznych wyprowadzonych z rozkładów wielkości kropelek mgły. Wykładnik q zależny od długości fali uwzględnia rozpraszanie Mie27. Głównym parametrem modelu Carbonneau jest natężenie opadów R, ponieważ tłumienie przez deszcz zależy od wielkości i gęstości kropel deszczu, a współczynniki są wyprowadzone empirycznie dla 1550 nm i specjalnie skalibrowane dla długości fal optycznych28. Teoria rozpraszania Mie ma zastosowanie w warunkach zapylenia, ponieważ rozmiar cząsteczek pyłu (promień 0,1–100 μm) jest porównywalny z długością fali (1550 nm), a zespolony współczynnik załamania m = 1,55–0,005i dla pyłu z Bliskiego Wschodu obejmuje zarówno rozpraszanie, jak i absorpcję29. Zaimplementowano następujące modele tłumienia fizycznego z odpowiadającymi im równaniami i ustawieniami parametrów.
W warunkach bezchmurnego nieba zastosowano prawo Beera-Lamberta:
Aclear = 10×log₁₀(e(α×d)) (1)
gdzie α to współczynnik tłumienia (zmienny zgodnie z rozkładem normalnym wycentrowanym wokół 0,02 dB/km z odchyleniem ±0,005 dB/km przy 1550 nm w warunkach przejrzystości), a d to odległość transmisji (ustalona na 3 km). Dla warunków mgły zastosowano model Kim według równania:
Afog = 10×ln(10)/V×(λ/550)−q (2)
gdzie V to widoczność w kilometrach (zmienna od 0,05km do 10km), λ to długość fali w nanometrach (ustalona na 1550nm), a q to współczynnik rozkładu wielkości cząstek obliczony jako: q=1,6 dla V>50 km, q=1,3 dla 6<V<50 km, q=0,585×V(1/3) dla 1 <V<6km, q=0 dla 0,5<V<1km oraz q=0,5 dla V<0,5km. W przypadku warunków opadów deszczu zastosowano model Carbonneau:
Arain=0.023×R0.93 (3)
gdzie R to natężenie opadów w mm/h (zmienne od 0.25 do 50 mm/h zgodnie z irackimi zapisami opadów). W odniesieniu do warunków burzy piaskowej wykorzystano zależność wydajności ekstynkcji z zastosowaniem rozpraszania Mie:
Adust=10×log₁₀(e(τ×L)) (4)
gdzie τ=∫₀^∞ πr2Qext(r,λ,m)N(r)dr, r to promień cząstki (0,1–100μm zgodnie ze składem pyłu irackiego), Qext to efektywność ekstynkcji obliczona zgodnie z teorią Mie, λ=1550nm, m=1,55–0,005i to zespolony współczynnik załamania dla pyłu z Bliskiego Wschodu, a N(r) to rozkład wielkości cząstek modelowany za pomocą rozkładu log-normalnego z geometryczną średnią promieniem 2,5 μm i odchyleniem standardowym 2,0. Model tłumienia został zaimplementowany dla warunków śniegowych w następujący sposób:
Asnow = 0.1×S0.75 (5)
gdzie S oznacza intensywność opadów śniegu w mm/h (0,5–15 mm/h). To równanie empiryczne wybrano w oparciu o prace literaturowe30, w których opracowano modele tłumienia dla propagacji optycznej przez śnieg, wykorzystując teorię rozpraszania Mie zastosowaną do rozkładu wielkości płatków śniegu. Równanie jest ważne dla intensywności opadów śniegu między 0,5 a 15 mm/h i zakłada warunki śniegu suchego z typowymi średnicami płatków śniegu wynoszącymi 1–10 mm. Współczynnik 0,1 oraz wykładnik 0,75 uzyskano poprzez dopasowanie krzywej do obliczeń rozpraszania Mie30 dla śniegu przy długości fali 1550 nm. Model ten nie uwzględnia śniegu wilgotnego ani opadów mieszanych, które mogą mieć zmienne właściwości tłumienia, mimo że oferuje on rzetelną estymację dla śniegu suchego. Ponieważ podejście to jest efektywne obliczeniowo, często przywoływane w publikacjach dotyczących FSO i odpowiednie dla przewidywanych warunków śnieżnych w północnym Iraku (region Kurdystanu w styczniu i lutym), wybrano je do niniejszego badania. Wszystkie modele zaimplementowano w języku Python 3.9, wykorzystując bibliotekę Numpy do obliczeń numerycznych. Dopasowany model zastosowano do losowo wybranych warunków pogodowych i próbkowanych danych otoczenia, aby obliczyć wartość tłumienia dla każdej próbki. Uzyskany rozkład pogodowy obejmował 814 przypadków bezchmurnego nieba (54,27%), 375 zdarzeń pyłowych (25,00%), 157 zdarzeń mglistych (10,47%), 111 zdarzeń deszczowych (7,40%) oraz 43 zdarzeń śnieżnych (2,87%).
Do ustalenia proporcji sytuacji pogodowych wykorzystano analizę historycznych informacji meteorologicznych zgromadzonych ze stacji meteorologicznych w Iraku w kilku regionach (Bagdad, Basra, Mosul i Ramadi) w latach 2020–2024. Oryginalne dane dostarczyły Irakiacute Ministry of Transportation oraz Iraqi Meteorological Organization and Seismology (IMOS). W danych zawarto codzienne zapisy pogodowe dokumentujące aktualne warunki atmosferyczne dla każdego dnia. Wśród konkretnych charakterystyk wyodrębnionych z tych zapisów znalazły się: temperatura (dzienna minimalna, maksymalna i średnia), wilgotność względna, widzialność, ilość opadów deszczu oraz występowanie burz pyłowych. Otwarty portal danych rządu Iraku (https://www.motrans.gov.iq/) zapewnia dostęp do części danych IMOS; jednak konkretne zapisy wykorzystane w niniejszym badaniu nie są publicznie przechowywane w centralnym repozytorium. Informacje klimatyczne wykorzystane do obliczenia procentowego udziału warunków pogodowych i wartości parametrów podsumowano w Tabeli 1. Dni bezchmurne zdefiniowano jako dni bez opadów, z widzialnością większą niż 10 km i brakiem aktywności pyłowej, co stanowiło 54,27% z 1 825 zarejestrowanych dni. Dni z burzami pyłowymi (w tym pełna burza pyłowa (widzialność < 1 km) i pył zawieszony (widzialność 1–5 km)) stanowiły 25,00% dni, co wskazuje na wysoką częstotliwość występowania burz piaskowych w aridnym i semi-aridnym klimacie Iraku. Dni z widzialnością mniejszą niż 1 km spowodowaną zawieszeniem kropel wody (z wyłączeniem redukcji widzialności wywołanej pyłem) zaklasyfikowano jako dni mgliste. Odsetek dni mglistych wyniósł 10,47%, a dni te występowały głównie zimą w północnych regionach Iraku. Dni deszczowe, czyli dni z mierzalnymi opadami >0,1 mm, stanowiły 7,40%, co jest zgodne z niską średnią roczną sumą opadów w Iraku wynoszącą 150–200 mm na rok. Dni śnieżne (dni z akumulacją opadów zamrożonych) stanowiły 2,87% dni i ograniczały się do górzystych obszarów północnych (region Kurdystanu) w styczniu i lutym. Proporcje te zostały później wykorzystane jako wagi prawdopodobieństwa dla losowego próbkowania podczas generowania zbioru danych. W ten sposób syntetyczny zbiór danych odzwierciedla rzeczywistą częstotliwość występowania każdego stanu pogodowego w środowisku Iraku.
Kwestie związane z obciążeniem w generowaniu danych syntetycznych
Aby zminimalizować potencjalne błędy systematyczne, podjęto następujące kroki:
(1) Wybór rozkładu: Do wyboru rozkładów prawdopodobieństwa wykorzystano właściwości statystyczne źródłowych danych klimatycznych. Temperatura miała rozkład normalny ze średnią i odchyleniem standardowym zgodnie z zapisami IMOS. Wilgotność miała rozkład jednostajny w całym obserwowanym zakresie (0-100%). Przyjęto, że widzialność podąża za rozkładem log-normalnym, aby uwzględnić częste występowanie zjawisk niskiej widzialności podczas burz pyłowych. Stężenie pyłu podążało za rozkładem wykładniczym, w którym występowały wyższe prawdopodobieństwa przy niskich stężeniach oraz długie ogony w przypadku ekstremalnych zdarzeń pyłowych31. Było to zgodne z obserwowaną częstotliwością zjawisk pyłowych w Iraku32.
(2) Proporcje warunków pogodowych: Analiza zapisów IMOS z lat 2020–2024, obejmująca 1 825 codziennych obserwacji we wszystkich czterech regionach, wykazała następujące proporcje: 54,3% bezchmurnego nieba, 24,9% pyłu, 10,5% mgły, 7,4% deszczu i 2,8% śniegu. Dni bez opadów, z widocznością >10 km i brakiem aktywności pyłowej zdefiniowano jako dni z bezchmurnym niebem. Dni z burzami pyłowymi obejmowały zarówno pełne burze pyłowe (widoczność <1 km), jak i pył zawieszony (widoczność 1–5 km). Dzień mglisty zdefiniowano jako dzień, w którym widoczność była mniejsza niż 1 km, a przyczyną była zawiesina kropelek wody (a nie pył). Dni deszczowe zdefiniowano jako dni z mierzalnymi opadami >0,1 mm. Dni śnieżne zdefiniowano jako dni z nagromadzonymi opadami zamrożonymi33.
(3) Zakresy parametrów: Zakresy parametrów oparto na ekstremach zaobserwowanych w zapisach IMOS: temperatura wahała się od −4.89 °C (Mosul, zima) do 47.99 °C (Basra, lato), widzialność od 0.05 km (silne burze pyłowe) do 29.99 km (warunki przejrzyste), a stężenie pyłu od 0 do 4.96 mg/m3 (na podstawie maksymalnego stężenia pyłu zaobserwowanego podczas silnych zjawisk haboob)34.
(4) Założenia o niezależności: Przyjęto założenie, że parametry środowiskowe były próbkowane niezależnie, co stanowi uproszczenie warunków rzeczywistych, w których zmienne atmosferyczne są ze sobą skorelowane (np. wysokie stężenie pyłu często koreluje z niską widocznością). W celu zapewnienia kontrolowanego środowiska symulacyjnego do metodycznego porównania modeli przyjęto to założenie o niezależności 35. Skutki tych założeń zostały omówione w sekcji Dyskusja.
(5) Podział stratyfikowany: Podział na zbiór treningowy i testowy został przeprowadzony w sposób stratyfikowany w oparciu o kategorię warunków pogodowych (bezchmurne niebo, mgła, deszcz, pył, śnieg), aby zapewnić, że proporcja każdego z warunków pogodowych w zbiorach treningowym i testowym odpowiadała rozkładowi w oryginalnym zbiorze danych. W ten sposób zbiór testowy nie jest niezbalansowany pod względem rzadkich warunków pogodowych (zwłaszcza śniegu na poziomie 2,87%)36.
Potwierdzenie deterministycznego generowania celu
Ważne jest podkreślenie, że dobra zdolność prognostyczna zaobserwowana w tym przypadku może wynikać częściowo z faktu, że model nauczył się lub przybliżył deterministyczne równania fizyczne wykorzystane do generowania syntetycznych wartości docelowych37. W przeciwieństwie do rzeczywistych pomiarów eksperymentalnych, które zawierają szum pomiarowy, błędy aparatury i niemodelowane zjawiska fizyczne, syntetyczny zbiór danych zapewnia czystą, wolną od szumów relację między cechami wejściowymi a wartością docelową tłumienia. Wynika to z faktu, że wartości tłumienia zostały obliczone bezpośrednio z fizycznych modeli propagacji (prawo Beera-Lamberta, model Kim, model Carbonneau oraz teoria rozpraszania Mie) na podstawie parametrów wejściowych. Zatem ilościowe wskaźniki wydajności (R2, RMSE, MAE) reprezentują wyniki uzyskane na syntetycznych danych wyprowadzonych z równań i nie powinny być interpretowane jako oczekiwana wydajność w odniesieniu do zaszumionych danych obserwacyjnych lub eksperymentalnych. Wyniki te należy traktować przede wszystkim jako porównawczą ocenę metodologii modelowania w kontrolowanym środowisku symulacyjnym38.
Pełny zestaw cech do trenowania modelu
Zbiór danych treningowych zawierał 10 cech wejściowych do trenowania modelu:
1. Temperatura (°C)
2. Wilgotność (%)
3. Widzialność (km)
4. Stężenie pyłu (mg/m3)
5. Intensywność opadów (mm/h)
6. Intensywność opadów śniegu (mm/h)
7. Prędkość wiatru (m/s)
8. Ciśnienie atmosferyczne (hPa)
9. Miesiąc (numerycznie, 1–12)
10. Pora roku (kodowanie one-hot: wiosna, lato, jesień, zima)
Ważne wyjaśnienie: Warunki pogodowe (bezchmurne niebo, mgła, deszcz, kurz, śnieg) zostały wykorzystane jako zmienna kategorialna do stratyfikacji podczas podziału zbioru danych i nie zostały uwzględnione jako cechy wejściowe dla żadnego z modeli. Analiza SHAP obejmuje wyłącznie 10 wymienionych powyżej cech. Zmienna dotycząca pory roku została zakodowana metodą one-hot (4 kategorie: wiosna, lato, jesień, zima), a dla analizy SHAP wkłady zakodowanych zmiennych one-hot dla pór roku zostały zsumowane w celu uzyskania pojedynczej wartości wkładu pory roku. Ta połączona wartość reprezentuje całkowity wkład wszystkich zmiennych związanych z porą roku w przewidywanie tłumienia. Przed stworzeniem rysunku podsumowującego zidentyfikowano cztery zakodowane one-hot kolumny dotyczące pór roku, a ich wartości SHAP zostały zsumowane dla każdej próbki. Metoda ta gwarantuje, że wykorzystanie pory roku przez model jako złożonej zmiennej kategorialnej jest spójne z analizą SHAP.
Głównymi czynnikami środowiskowymi, które bezpośrednio wpływały na tłumienie optyczne poprzez mechanizmy fizyczne, były cechy 1–6. Dodanie cech 7 i 8 (prędkość wiatru i ciśnienie) jako uzupełniających czynników meteorologicznych może mieć pośredni wpływ na tłumienie poprzez oddziaływanie na stabilność powietrza i dyspersję aerozoli. Aby uwzględnić sezonowe zmienności warunków atmosferycznych, dołączono cechy 9–10 (miesiąc i pora roku) jako deskryptory czasowe. Wartość tłumienia (dB/km) została wykorzystana jako zmienna celu dla wszystkich modeli. Kluczowe statystyki zbioru danych obejmowały temperaturę (28.55°C ± 11.18°C), wilgotność (42.01% ± 25.56%), widzialność (13.10 ± 10.91 km; zakres: 0.05–29.99 km), stężenie pyłu (0.74 ± 1.30 mg/m3; maksimum: 4.96 mg/m3), tłumienie (4.80 ± 7.20 dB/km; zakres: 0.09–50.93 dB/km), zasięg operacyjny (5.74 ± 1.97 km) oraz stosunek sygnału do szumu (64.88 ± 15.07 dB). Zasięg operacyjny i SNR zostały obliczone z wartości tłumienia przy użyciu standardowych równań budżetu łącza FSO.
Obliczanie zakresu operacyjnego
Zakres operacyjny (w km) obliczono przy użyciu równania budżetu łącza:
Prx=Ptx×Gt×Gr×(λ/(4πR))2×10(−A×R/10) (6)
gdzie: Prx = moc odebrana (ustawiona na minimalną czułość −30 dBm); Ptx = moc nadawania (stała, 20 dBm); Gt = zysk nadajnika (obliczony na podstawie rozmiarów apertury); Gr = zysk odbiornika (obliczony na podstawie rozmiarów apertury); λ = długość fali (1550 nm); R = zasięg w km; A = tłumienie atmosferyczne w dB/km (obliczone na podstawie modeli fizycznych).
Zyski nadajnika i odbiornika: Zysk nadajnika (Gt) obliczono następująco: Gt = 10×log₁₀[0.7×(π×0.025/1.55×10⁻6)2] ≈ 44.2 dBi. Zysk odbiornika (Gr) obliczono następująco: Gr = 10×log₁₀[0.7×(π×0.20/1.55×10⁻6)2] ≈ 62.3 dBi. Apertura nadawcza miała średnicę 2.5 cm i sprawność 0.7. Apertura odbiorcza miała średnicę 20 cm i sprawność 0.7. Równanie rozwiązano iteracyjnie względem R, aby wyznaczyć maksymalną możliwą odległość łącza dla każdej wartości tłumienia.
Obliczanie stosunku sygnału do szumu
Wartość SNR (stosunek sygnału do szumu) w dB obliczono za pomocą równania:
SNR=Prx−10×log₁₀(kTB)−NF (7)
gdzie: Prx = moc odebrana w dBm (obliczona z budżetu łącza); k = 1.38×10⁻23 J/K (stała Boltzmanna); T = 290 K (temperatura odbiornika); B = 109 Hz (szerokość pasma odbiornika, 1 GHz); NF = 3 dB (miara szumów odbiornika). Poziom szumów obliczono jako:
10 × log10(kTB) ≈ −84 dBm (8)
Dla każdej próbki, po obliczeniu tłumienia A przy użyciu odpowiedniego modelu fizycznego, Zakres Operacyjny wyznaczono poprzez rozwiązanie bilansu łącza dla R, a SNR obliczono na podstawie wynikowej mocy odebranej Prx w tym zakresie.
Wartości zakresu operacyjnego dla konkretnych warunków pogodowych: zakres operacyjny różnił się w zależności od warunków pogodowych: bezchmurne niebo (7,12 ± 1,85 km), mgła (5,81 ± 1,92 km), śnieg (5,42 ± 1,56 km), deszcz (3,81 ± 0,98 km) oraz pył (3,72 ± 1,08 km). W bieżących obliczeniach nie zastosowano marginesu 3 dB; zakres operacyjny reprezentuje teoretyczny zasięg maksymalny bez marginesu systemowego. Raportowany zakres operacyjny (5,74 ± 1,97 km) stanowi ogólną średnią dla wszystkich warunków pogodowych39.
Stała odległość transmisji: W fizycznych modelach tłumienia odległość transmisji ustalono na 3 km. Jest to odległość łącza, dla której przeprowadzono obliczenia tłumienia. Raportowany zasięg operacyjny to teoretyczna odległość maksymalna obliczona przy użyciu równania budżetu łącza, która może różnić się od stałej odległości transmisji wynoszącej 3 km. Wartości tłumienia specyficzne dla warunków pogodowych odnotowano dla warunków przejrzystych (0,27±0,06 dB/km), mgły (1,88±1,92 dB/km), śniegu (6,45±2,54 dB/km), deszczu (13,58±6,32 dB/km) oraz pyłu (13,10±7,32 dB/km). Wszystkie wartości ilościowe przedstawione w niniejszej pracy podano jako średnia ± odchylenie standardowe (SD), chyba że zaznaczono inaczej40.
Wartość R2 z walidacji krzyżowej dla modelu Random Forest wynosi 0,960±0,007. W niektórych przypadkach, takich jak temperatura (−4,89 do 47,99°C), widzialność (0,05 do 29,99km), stężenie pyłu (0 do 4,96 mg/m3) oraz tłumienie (0,09 do 50,93dB/km), zakres (od najniższej do najwyższej wartości) podano w formie opisowej. Zbiór danych został podzielony na podgrupy do testowania (300 próbek; 20%) i trenowania (1200 próbek; 80%). Do podziału na zbiór treningowy i testowy zastosowano stratyfikowane próbkowanie losowe. Aby zapewnić, że odsetek każdego stanu pogodowego w zbiorze treningowym (80%) i testowym (20%) odpowiadał rozkładowi w oryginalnym zbiorze danych, zastosowano stratyfikację opartą na kategorii stanu pogodowego (bezchmurne niebo, mgła, deszcz, pył i śnieg). W szczególności 1200 (80%) z 1500 próbek przydzielono do zbioru uczenia, a 300 (20%) do zbioru testowego. Próbki dla każdej kategorii warunków meteorologicznych wybrano losowo przy zachowaniu oryginalnych proporcji: z 814 próbek dla bezchmurnego nieba (54,27%) 651 przydzielono do treningu, a 163 do testowania; z 375 próbek dla pyłu (25,00%) 300 do treningu i 75 do testowania; ze 157 próbek dla mgły (10,47%) 126 do treningu i 31 do testowania; ze 111 próbek dla deszczu (7,40%) 89 do treningu i 22 do testowania; z 43 próbek dla śniegu (2,87%) 34 do treningu i 9 do testowania. Losowanie w obrębie każdej warstwy wykonano z użyciem ziarna losowości (random seed) 42 w celu zapewnienia powtarzalności. Podejście stratyfikowane wybrano, aby zapobiec niezrównoważonej reprezentacji rzadkich stanów pogodowych (zwłaszcza śniegu na poziomie 2,87%) w zbiorze testowym, co w przeciwnym razie mogłoby prowadzić do niewiarygodnej oceny wydajności modelu dla tych warunków.
Ocena modelu uczenia maszynowego
Oceniono sześć metod uczenia maszynowego, w tym regresję wektorową (SVR) z jądrem funkcji radialnej (C = 100), k-najbliższych sąsiadów (KNN; k = 10, z wagowaniem dystansem), RF (200 drzew, maksymalna głębokość = 20), Extreme Gradient Boosting (XGBoost; 200 estymatorów, maksymalna głębokość = 10, współczynnik uczenia = 0.1), Light Gradient Boosting Machine (LightGBM; 200 estymatorów, maksymalna głębokość = 10, współczynnik uczenia = 0.1) oraz bazową regresję liniową. Dla wszystkich modeli uczenia maszynowego i uczenia głębokiego przeprowadzono strojenie hiperparametrów dla najważniejszych parametrów, natomiast dla parametrów niewymienionych zachowano wartości domyślne. W przypadku modeli uczenia maszynowego następujące parametry zostały jawnie dostrojone przy użyciu metody grid search z 5-krotną walidacją krzyżową na zbiorze treningowym: 1) Random Forest: liczba drzew (testowano: 50, 100, 150, 200, 250) oraz maksymalna głębokość (testowano: 10, 15, 20, 25, brak limitu), przy czym wybrano optymalne wartości: 200 drzew i głębokość 20. 2) XGBoost: liczba estymatorów (testowano: 100, 150, 200, 250), maksymalna głębokość (testowano: 6, 8, 10, 12) oraz współczynnik uczenia (testowano: 0.05, 0.1, 0.2), przy czym optymalne wartości wyniosły: 200 estymatorów, głębokość 10 i współczynnik uczenia 0.1. 3) LightGBM: zastosowano identyczne zakresy strojenia, co dało 200 estymatorów, głębokość 10 i współczynnik uczenia 0.1. 4) SVR: dostrojono parametr regularyzacji C (testowano: 1, 10, 50, 100) oraz współczynnik jądra gamma (testowano: „scale”, „auto”, 0.1, 0.01), przy czym optymalne wartości to C = 100 i jądro RBF. 5) KNN: dostrojono liczbę sąsiadów k (testowano: 3, 5, 7, 10, 15), przy czym optymalna wartość to k = 10 z włączonym głosowaniem ważonym dystansem.
Wszystkie pozostałe parametry dla tych modeli pozostawiono na wartościach domyślnych zdefiniowanych w scikit-learn (wersję przedstawiono w Tabeli materiałów; np. Random Forest: bootstrap=True, min_samples_split=2, min_samples_leaf=1; XGBoost: subsample=1.0, colsample_bytree=1.0, gamma=0). W przypadku modeli głębokiego uczenia architekturę (liczbę warstw i jednostek na warstwę) oraz współczynnik dropout (20%) dostrojono ręcznie poprzez iteracyjne eksperymenty na zbiorze walidacyjnym, natomiast optymalizator (Adam), początkową szybkość uczenia (0.001), cierpliwość wczesnego zatrzymania (20 epok) oraz parametry redukcji szybkości uczenia (czynnik 0.5, cierpliwość 10) ustawiono zgodnie ze standardową praktyką w literaturze i utrzymano na stałym poziomie we wszystkich eksperymentach z wykorzystaniem głębokiego uczenia.
Źródła danych klimatycznych
Historyczne informacje meteorologiczne zebrane ze stacji pogodowych w Iraku w kilku lokalizacjach (Bagdad, Basra, Mosul i Ramadi) w latach 2020–2024 zostały wykorzystane do obliczenia proporcji stanów pogodowych i rozkładów zmiennych. Surowe dane zostały udostępnione przez irańskie Ministerstwo Transportu oraz Irajską Organizację Meteorologiczną i Sejsmologiczną (IMOS). W danych uwzględniono codzienne zapisy pogodowe szczegółowo opisujące dominujący stan atmosferyczny dla każdego dnia. Konkretne zmienne uzyskane z tych zapisów obejmowały temperaturę (dobowe minimum, maksimum i średnią), wilgotność względną, widzialność, ilość opadów oraz występowanie burz piaskowych. Dane IMOS są częściowo dostępne za pośrednictwem portalu otwartych danych rządu Iraku (https://www.motrans.gov.iq/), choć konkretne zapisy wykorzystane w niniejszym badaniu nie są publicznie archiwizowane w centralnym repozytorium. Podsumowanie danych klimatycznych wykorzystanych do określenia proporcji warunków pogodowych i zakresów parametrów przedstawiono w Tabeli 1.
W celu dostrojenia hiperparametrów i oszacowania wydajności wszystkich modeli uczenia maszynowego zastosowano pięciokrotną walidację krzyżową na zbiorze treningowym (1200 próbek). Wszystkie zmienne wejściowe (temperatura, wilgotność, widzialność, stężenie pyłu, natężenie opadów deszczu, natężenie opadów śniegu, prędkość wiatru, ciśnienie) zostały przeskalowane za pomocą standaryzacji (normalizacja Z-score): x_scaled = (x − μ)/σ, gdzie μ i σ to odpowiednio średnia i odchylenie standardowe zbioru treningowego. Aby uniknąć wycieku danych, standaryzację przeprowadzano w obrębie każdego folderu walidacji krzyżowej, korzystając wyłącznie ze statystyk pochodzących z folderu treningowego. Modele oparte na drzewach (Random Forest, XGBoost, LightGBM) są niezmiennicze względem skali, jednak dla zapewnienia spójności we wszystkich modelach uczenia maszynowego zastosowano tę samą standaryzację. W przypadku modeli głębokiego uczenia zastosowano normalizację min-max: x_scaled = (x−x_min)/(x_max−x_min), która skaluje cechy do przedziału [0, 1] na podstawie wartości minimalnych i maksymalnych ze zbioru treningowego. Wybrano tę metodę, ponieważ ograniczone zakresy danych wejściowych prowadzą do szybszej zbieżności sieci neuronowych. Zbiór testowy został przeskalowany przy użyciu parametrów uzyskanych ze zbioru treningowego i nie był wykorzystywany do wyboru modelu ani dostrajania hiperparametrów.
Zarejestrowano kompletne wskaźniki wydajności, w tym współczynnik determinacji testowej (R2), pierwiastkowy błąd średniokwadratowy (RMSE), średni błąd absolutny (MAE), R2 z walidacji krzyżowej oraz czas trenowania. Czasy trenowania dla wszystkich modeli uczenia maszynowego i głębokiego podano w sekundach (s) dla modeli szybszych (regresja liniowa, KNN, SVR, Random Forest, XGBoost, LightGBM) oraz w minutach (min) dla modeli wolniejszych (architektury głębokiego uczenia). Wszystkie modele zostały wytrenowane w tym samym środowisku obliczeniowym, aby zapewnić rzetelne porównanie41.
Czas trenowania mierzono za pomocą modułu time w języku Python, tj. upływ czasu rzeczywistego od rozpoczęcia do zakończenia funkcji dopasowania modelu, z wyłączeniem czasu wymaganego do ładowania i wstępnego przetwarzania danych. Czas trenowania modelu głębokiego uczenia to czas potrzebny na ukończenie wszystkich epok aż do momentu wczesnego zatrzymania (early stopping). Obejmuje on propagację w przód, propagację wsteczną oraz weryfikację walidacyjną. Wszystkie eksperymenty przeprowadzono w warunkach, w których system nie uruchamiał innych procesów obciążających obliczeniowo, aby uzyskać spójne pomiary czasu. Podane czasy stanowią średnią z 5 niezależnych uruchomień (odchylenia standardowe)42.
Ocena modelu głębokiego uczenia
Oceniono sześć architektur głębokiego uczenia z wykorzystaniem akceleracji GPU, w tym wielowarstwowy perceptron (MLP; 64-32-16), głęboką sieć neuronową (DNN) z normalizacją wsadową (128-64-32-16), sieć pamięci długo- i krótkotrwałej (LSTM; 64-32 jednostki, długość sekwencji = 10), jednowymiarową splotową sieć neuronową (1D-CNN), hybrydowy model CNN–LSTM oraz sieć opartą na mechanizmie uwagi. Wszystkie modele głębokiego uczenia zostały zaimplementowane przy użyciu TensorFlow z interfejsem API Keras i uruchomione z akceleracją GPU (wersje sprzętowe i programowe znajdują się w Tabeli materiałów). Architektura 1D-CNN składała się z trzech warstw splotowych (64, 128 i 256 filtrów, rozmiar jądra 3, aktywacja ReLU, padding=’same’), dwóch warstw MaxPooling1D (rozmiar puli 2), warstwy GlobalAveragePooling1D, warstwy gęstej (Dense) z 128 jednostkami i aktywacją ReLU, warstwy Dropout (0,2) oraz gęstej warstwy wyjściowej (1 jednostka, aktywacja liniowa), co łącznie dawało około 245 000 trenowalnych parametrów. Hybrydowa architektura CNN-LSTM przyjmowała sekwencje wejściowe o 10 krokach czasowych z 5 cechami, wykorzystując dwie warstwy Conv1D (64 i 128 filtrów, rozmiar jądra 3, ReLU, padding=’same’), warstwę MaxPooling1D (rozmiar puli 2), dwie warstwy LSTM (64 i 32 jednostki, return_sequences=False), warstwy Dropout (0,2), warstwę gęstą (32 jednostki, ReLU) oraz gęstą warstwę wyjściową (1 jednostka, aktywacja liniowa), co łącznie dawało około 198 000 trenowalnych parametrów. Sieć oparta na mechanizmie uwagi wykorzystywała wielogłowicowy mechanizm uwagi z 4 głowicami (wymiary klucza i wartości wynoszące 64), gdzie wejście rzutowano na 64 wymiary, a następnie zastosowano skalowaną uwagę iloczynową (wzór: Attention(Q, K, V) = softmax(QKT/√d_k)), połączenia rezydualne, normalizację warstwową, sieć jednokierunkową (128→64 jednostki), globalne uśrednianie (global average pooling), Dropout (0,2), warstwę gęstą (32 jednostki, ReLU) oraz gęstą warstwę wyjściową (1 jednostka, aktywacja liniowa), co łącznie dawało około 167 000 trenowalnych parametrów43.
Wszystkie modele wykorzystywały wczesne zatrzymanie (patience = 20), redukcję szybkości uczenia (factor = 0.5, patience = 10), dropout (20%) oraz optymalizator Adam (learning rate = 0.001). Dla wszystkich modeli głębokiego uczenia rozmiar partii (batch size) ustawiono na 32 próbki, maksymalna liczba epok treningowych wynosiła 200 z zastosowaniem wczesnego zatrzymania (patience = 20, przywracanie najlepszych wag), a funkcją straty był średni błąd kwadratowy (MSE). Podział na zbiór treningowy i walidacyjny wyglądał następująco: z oryginalnych 1,200 próbek treningowych (po podziale na zbiór treningowy i testowy w stosunku 80/20), 80% (960 próbek) wykorzystano do uczenia, a 20% (240 próbek) do walidacji. Zastosowano stratyfikację podziału treningowo-walidacyjnego według warunków pogodowych w celu zachowania rozkładu. Zbiór walidacyjny służył wyłącznie do wczesnego zatrzymania, redukcji szybkości uczenia oraz monitorowania przeuczenia; nigdy nie był wykorzystywany do wyboru modelu ani dostrajania hiperparametrów poza tymi zautomatyzowanymi procedurami. W przypadku modeli uczenia maszynowego nie wydzielono osobnego zbioru walidacyjnego; zamiast tego zastosowano pięciokrotną walidację krzyżową na 1,200 próbkach treningowych w celu dostrojenia hiperparametrów i oszacowania wydajności44.
Uzasadnienie ewaluacji architektury LSTM oraz CNN–LSTM
Główny zbiór danych składa się z niezależnie wygenerowanych próbek pogodowych, jednak przetestowano również architektury LSTM oraz CNN–LSTM z następujących powodów: (1) rzeczywiste warunki atmosferyczne wykazują autokorelację czasową, a testowanie modeli opartych na sekwencjach pozwala określić, czy uchwycenie takich zależności mogłoby poprawić dokładność prognoz; (2) niedawne badania w zakresie prognozowania atmosferycznego wykazały potencjalną wartość architektur sekwencyjnych w modelowaniu ewolucji czasowej parametrów meteorologicznych34; (3) testowanie zróżnicowanego zakresu architektur zapewnia kompleksowe porównanie podejść metodologicznych, co stanowi kluczowy wkład niniejszej pracy; oraz (4) hybrydowa architektura CNN–LSTM łączy ekstrakcję cech przestrzennych z modelowaniem czasowym, co może być korzystne dla uchwycenia złożonych interakcji między wieloma zmiennymi atmosferycznymi45.
Formatowanie danych dla wejścia modelu sekwencyjnego
W przypadku architektur sekwencyjnych (LSTM i CNN–LSTM) dane wejściowe przekształcono z niezależnych próbek w pseudosekwencje z wykorzystaniem metody przesuwnego okna. W szczególności 1200 próbek treningowych pogrupowano najpierw według kategorii warunków pogodowych, aby zachować spójność fizyczną. W obrębie każdej kategorii pogodowej próbki uporządkowano zgodnie z wygenerowanymi znacznikami czasu (symulowane obserwacje godzinowe dla roku kalendarzowego 2024). Następnie zastosowano przesuwne okno o długości 10, aby utworzyć sekwencje wejściowe składające się z 10 kolejnych kroków czasowych (każdy z 5 cechami: temperaturą, wilgotnością, widzialnością, stężeniem pyłu i natężeniem opadów), w celu przewidzenia tłumienia w 11.th krok czasowy. Metoda ta zachowuje porządek czasowy symulowanych obserwacji, umożliwiając modelom sekwencyjnym naukę zależności czasowych. Struktura zbioru testowego była identyczna, z wyjątkiem zastosowania tej samej wielkości okna i zestawu cech. Przyznajemy, że ta pseudosekwencyjna struktura jest uproszczeniem metodologicznym i nie odzwierciedla rzeczywistej dynamiki czasowej. Zostało to odnotowane jako ograniczenie w sekcji Dyskusja.
Ocena podejść hybrydowych
Zbadano trzy podejścia hybrydowe. Pierwszym z nich był Voting Ensemble, który uśredniał predykcje z modeli Random Forest, XGBoost oraz Deep Neural Network przy użyciu równych wag (każdemu modelowi przypisano wagę 1/3), przy czym ostateczną predykcję obliczano jako:
ŷensemble=(1/3)ŷRF+(1/3)ŷXGB+(1/3)ŷDNN (9)
Wybrano równą wagę, aby uniknąć wprowadzania dodatkowych hiperparametrów i ocenić bazową wydajność zespołu bez stronniczości względem któregokolwiek z poszczególnych modeli. Drugie podejście wykorzystywało stacking z meta-uczniem Ridge. Uczniami bazowymi były Random Forest, XGBoost oraz głęboka sieć neuronowa (oparta na mechanizmie Attention). Procedura stackingu składała się z dwóch etapów: po pierwsze, każdy uczeń bazowy został przeszkolony na pełnym zbiorze treningowym obejmującym 1,200 próbek przy użyciu 5-krotnej walidacji krzyżowej w celu wygenerowania predykcji poza zakresem (out-of-fold), co pozwoliło na stworzenie nowej macierzy cech meta o rozmiarze 1,200×3 (jedna predykcja na model bazowy dla każdej próbki). Po drugie, meta-uczeń oparty na regresji Ridge (parametr regularyzacji L2 alpha=1.0) został przeszkolony na tych cechach meta, przyjmując oryginalne wartości tłumienia jako cel, aby wyznaczyć optymalne wagi kombinacji dla uczniów bazowych. Końcowa predykcja stackingu wynosiła:
ŷstacking=wRF×ŷRF+wXGB×ŷXGB+wDNN×ŷDNN (10)
gdzie wagi w zostały wyuczone przez meta-uczeń Ridge. Trzecim podejściem była fizycznie informowana sieć neuronowa (Physics-Informed Neural Network), która łączyła 70% predykcji sieci neuronowej z 30% predykcji modelu Kim dla próbek w warunkach mgły. Kombinacja została przeprowadzona za pomocą stałego uśredniania ważonego z wykorzystaniem następującego wzoru:
ŷhybrid=0.7×ŷneural+0.3×ŷKim (11)
gdzie ŷneural jest wyjściem sieci neuronowej opartej na mechanizmie Attention, a ŷKim to tłumienie obliczone z modelu mgły Kim na podstawie danych wejściowych dotyczących widzialności. W przypadku próbek bez mgły część fizyczna została ustawiona na 0, a model działał jako czysta sieć neuronowa. Wagi (70% neuronowe i 30% fizyczne) zostały ustalone na podstawie wstępnych eksperymentów na zbiorze walidacyjnym (a nie testowym), podczas których przetestowano kombinacje wag 90:10, 80:20, 70:30, 60:40 oraz 50:50. Wybrano podział 70/30, ponieważ zapewnił on najlepszą wartość R2 walidacji i nadal utrzymywał wystarczające ograniczenia fizyczne z modelu Kim, aby regularyzować przewidywania i uniknąć fizycznie nieplauzibilnych wyników, szczególnie w warunkach mgły, gdzie model Kim dostarcza ustalonych teoretycznych granic tłumienia.
Analiza istotności cech i interpretowalności
Do wyznaczenia rankingów istotności dla wszystkich 10 cech wejściowych wykorzystano model Random Forest z istotnością cech opartą na zanieczyszczeniu (redukcja wariancji). Analiza wykazała, że stężenie pyłu (67,3%) oraz widzialność (21,2%) były najważniejszymi predyktorami, które łącznie wyjaśniały 88,5% całkowitej istotności predykcyjnej. Trzecią najważniejszą cechą była intensywność opadów deszczu (6,0%), a następnie prędkość wiatru (2,1%), temperatura (1,5%), wilgotność (0,9%), miesiąc (0,5%), pora roku (0,3%), intensywność opadów śniegu (0,1%) oraz ciśnienie atmosferyczne (0,1%). Niskie wartości istotności dla cech czasowych (miesiąc i pora roku) wskazują, że sezonowe zmienności tłumienia atmosferycznego są uchwycone przede wszystkim przez podstawowe parametry środowiskowe, a nie tylko przez wzorce oparte na czasie.
Przeprowadzono analizę SHAP (Shapley Additive exPlanations), aby ocenić zależności między czynnikami środowiskowymi a tłumieniem. Wykorzystano moduł TreeExplainer z biblioteki SHAP, który jest specjalnie zoptymalizowany dla modeli opartych na drzewach, w tym Random Forest, XGBoost oraz LightGBM (wersję podano w Tabeli materiałów). Konfiguracja analizy SHAP była następująca: wytrenowany model Random Forest przekazano do modułu TreeExplainer, który obliczył wartości SHAP przy użyciu interwencyjnego (marginalnego) podejścia do atrybucji cech w oparciu o oczekiwanie warunkowe wyjściowego sygnału modelu. Wartości SHAP obliczono dla wszystkich 300 próbek zbioru testowego, tworząc macierz o rozmiarze 300 × 10 (jedna wartość SHAP na cechę w każdej próbce). Dla każdej cechy wartość SHAP reprezentowała jej wkład w predykcję względem poziomu bazowego (średniej predykcji modelu). Ujemne wartości SHAP wskazywały na przesunięcie w dół, natomiast dodatnie wartości SHAP oznaczały, że dana cecha zwiększyła przewidywaną wartość tłumienia. Siła wkładu była określona przez wielkość wartości SHAP. Rozkład wartości SHAP dla każdej cechy (z wykorzystaniem wykresów beeswarm), kierunek wpływu (korelacja między wartościami cech a wartościami SHAP) oraz rankingi istotności cech zostały zwizualizowane za pomocą wykresów podsumowujących. Do stworzenia wszystkich wizualizacji SHAP wykorzystano wbudowane funkcje rysujące biblioteki SHAP — shap.summary_plot() dla wykresu beeswarm oraz shap.bar_plot() dla globalnej istotności cech.
Obsługa zmiennych zakodowanych metodą one-hot: W celu zakodowania zmiennej pory roku wykorzystano najpierw cztery kolumny binarne (wiosna, lato, jesień i zima). Aby stworzyć pojedynczą wartość wkładu „pory roku” dla każdej próbki do analizy SHAP, wkłady tych czterech zmiennych zakodowanych metodą one-hot zostały połączone poprzez zsumowanie wartości SHAP dla każdej kategorii pory roku. Aby przeprowadzić to grupowanie, zidentyfikowano wszystkie kolumny odpowiadające grupom pór roku zakodowanym metodą one-hot, wyodrębniono ich wartości SHAP dla każdej próbki, a następnie zsumowano je elementowo. Wynikowe połączone wartości SHAP reprezentują całkowity wkład pory roku w prognozę tłumienia. Metoda ta umożliwia wyświetlenie jednego wiersza „pora roku” na wykresie podsumowującym SHAP i gwarantuje spójność z wykorzystaniem pory roku jako złożonej zmiennej kategorycznej w modelu. Ponieważ zsumowana wartość oferuje bardziej zrozumiały obraz całkowitego wkładu pory roku, wartości SHAP dla pór roku nie były prezentowane oddzielnie dla każdej kategorii.
Wyniki
Charakterystyka syntetycznego zbioru danych została podsumowana na Rysunku 1A–F. Zbiór danych obejmował warunki bezchmurnego nieba, zapylenia, mgły, deszczu i śniegu (Rysunek 1A), z próbkami rozłożonymi na pory gorąco-suche i chłodno-wilgotne (Rysunek 1B) oraz okresy dzienne i nocne (Rysunek 1C). Rozkłady temperatury, wilgotności i widzialności w różnych warunkach pogodowych przedstawiono na Rysunku 1D–F.
Modele uczenia maszynowego wykazały wysoką skuteczność prognostyczną w szacowaniu tłumienia atmosferycznego (Rycyna 2A–D; Tabela 3). RF osiągnął najwyższą ogólną skuteczność spośród ocenianych modeli, z testową wartością R2 wynoszącą 0,9654 oraz RMSE na poziomie 1,324 dB/km (Rycina 2A; Tabela 3). Model RF wyjaśnił 96,54% obserwowanej zmienności, zachowując błąd predykcji poniżej 1,5 dB/km. XGBoost również wykazał dobre wyniki (Rycina 2C), a następnie LightGBM (Rycina 2B). Robustność modelu została potwierdzona pięciokrotną walidacją krzyżową, w której RF osiągnął wartość R2 z walidacji krzyżowej równą 0,960 ± 0,007 (Rycina 2D). W przeciwieństwie do nich, K-Nearest Neighbors wykazał oznaki przeuczenia, z R2 dla zbioru treningowego wynoszącym 1,000 i R2 dla zbioru testowego 0,7341, podczas gdy regresja liniowa osiągnęła umiarkowaną skuteczność prognostyczną (Rycina 2A; Tabela 3).
Analiza istotności cech dla 10 wymienionych powyżej cech wejściowych przedstawiona jest na Rysunku 3A. Wartości względnej istotności uszeregowano w następujący sposób: stężenie pyłu (67,3%), widzialność (21,2%), natężenie opadów deszczu (6,0%), prędkość wiatru (2,1%), temperatura (1,5%), wilgotność (0,9%), miesiąc (0,5%), pora roku (0,3%), natężenie opadów śniegu (0,1%) oraz ciśnienie (0,1%). Zmienna „warunki pogodowe” została wykorzystana do stratyfikacji zbioru danych, lecz nie została uwzględniona w analizie istotności cech, ponieważ jest to kategoryczna zmienna złożona reprezentująca kilka podstawowych parametrów fizycznych, a jej wpływ jest ujęty w poszczególnych cechach środowiskowych. Analizy istotności cech i interpretowalności pozwoliły zidentyfikować zmienne środowiskowe najsilniej powiązane z tłumieniem (Rysunek 3A,B). Stężenie pyłu (67,3%), widzialność (21,2%) i natężenie opadów deszczu (6,0%) łącznie stanowiły 94,4% całkowitej istotności predykcyjnej (Rysunek 3A). Analiza SHAP dodatkowo wykazała, że wzrost stężenia pyłu oraz spadek widzialności wiązały się ze zwiększeniem przewidywanego tłumienia (Rysunek 3B).
Modele głębokiego uczenia wykazały niższą zdolność predykcyjną niż podejścia oparte na uczeniu maszynowym (Rysunek 4A–D). Najskuteczniejszy model głębokiego uczenia, sieć oparta na mechanizmie uwagi (Attention-based network), osiągnął R2 na poziomie 0,7766 oraz RMSE wynoszące 3,362 dB/km (Rysunek 4A). Architektury rekurencyjne wykazały szczególnie słabą skuteczność, przy czym zarówno modele LSTM, jak i CNN–LSTM generowały wartości R2 bliskie zeru oraz wartości RMSE przekraczające 7,19 dB/km (Rysunek 4B). Stosunkowo niska skuteczność architektur LSTM i CNN-LSTM (odpowiednio R2 = 0,0110 i 0,0109; RMSE = 7,193 dB/km i 7,196 dB/km) można częściowo wyjaśnić pseudosekwencyjnym charakterem danych wejściowych, który nie oddaje w pełni rzeczywistej dynamiki czasowej warunków atmosferycznych.
W przeciwieństwie do aplikacji czasu rzeczywistego dla szeregów czasowych, w których zależności sekwencyjne są silne i dobrze zdefiniowane, nasz zbiór danych składał się głównie z niezależnych próbek ze sztucznie narzuconym uporządkowaniem czasowym. Słaba wydajność predykcyjna tych architektur sugeruje, że informacje czasowe wyekstrahowane za pomocą podejścia z ruchomym oknem były albo niewystarczające, albo niereprezentatywne dla rzeczywistej ewolucji atmosferycznej (Rycina 4C). Potwierdza to nasz wniosek, że dla zbiorów danych tego rodzaju prostsze podejścia uczenia maszynowego są bardziej odpowiednie niż złożone modele głębokiego uczenia oparte na sekwencjach. Wydajność walidacji dla wszystkich architektur głębokiego uczenia podsumowano na Rycini 4D.
Wydajność uczenia maszynowego, głębokiego uczenia oraz podejść hybrydowych została podsumowana na Rysunku 5A,B oraz w Tabeli 3. spośród metod hybrydowych, Voting Ensemble osiągnął R2 wynoszący 0,9340 oraz RMSE wynoszący 1,827 dB/km (Rysunek 5A,B; Tabela 3). Ridge meta-learner stacking osiągnął R2 wynoszący 0,9571 oraz RMSE wynoszący 1,473 dB/km (Rysunek 5A,B; Tabela 3), zbliżając się do wydajności RF, lecz wymagając znacznie dłuższego czasu uczenia. Physics-Informed Neural Network osiągnął R2 = 0,8269 i RMSE = 2,960 dB/km (Rysunek 5A,B; Tabela 3) i wykazał lepsze wyniki niż modele głębokiego uczenia, lecz gorsze niż najlepsze podejścia uczenia maszynowego. Porównanie statystyczne modeli RF i Stacking Ensemble nie wykazało istotnej różnicy w wydajności predykcyjnej (Tabela 3; sparowany test t: t = −1,74, p = 0,083). Zatem, mimo że RF osiągnął najwyższą numeryczną wartość R2, różnica w stosunku do najlepszego podejścia hybrydowego nie była istotna statystycznie.
Ogólnie rzecz biorąc, wyniki potwierdzają hipotezę, że podejścia oparte na uczeniu maszynowym mogą dokładnie przewidywać tłumienie atmosferyczne w warunkach pogodowych panujących w Iraku. RF konsekwentnie osiągał najwyższą wydajność predykcyjną (Rycina 2A,B; Tabela 3), natomiast analizy istotności cech i SHAP zidentyfikowały stężenie pyłu oraz widzialność jako dominujące czynniki środowiskowe wpływające na tłumienie (Rycina 3A,B).
Oświadczenie dotyczące danych walidacyjnych: Wszystkie oceny modelu zostały przeprowadzone na syntetycznym zbiorze danych szczegółowo opisanym w sekcji Metody. W walidacji modelu nie wykorzystano danych eksperymentalnych ani obserwacyjnych dotyczących tłumienia atmosferycznego. Syntetyczny zbiór danych stworzono przy użyciu powszechnie znanych fizycznych modeli propagacji (prawo Beera-Lamberta, model Kim, model Carbonneau oraz teoria rozpraszania Mie), z parametrami meteorologicznymi wybranymi z rozkładów prawdopodobieństwa opartych na zapisach klimatycznych z Iraku. Jak zauważono w sekcji Metody, wysoka skuteczność predykcyjna może częściowo odzwierciedlać proces uczenia się modelu lub jego przybliżenie deterministycznych równań fizycznych użytych do wygenerowania wartości docelowych. W związku z tym ilościowe wskaźniki wydajności (R2, RMSE, MAE) reprezentują wyniki uzyskane na syntetycznych danych pochodzących z równań i powinny być interpretowane jako porównania względne między metodologiami modelowania w kontrolowanym środowisku symulacyjnym, a nie jako absolutne gwarancje wydajności dla operacyjnych systemów FSO. Podejście to zapewnia kontrolowane środowisko do porównawczej oceny metodologii modelowania predykcyjnego (wymienionych w Tabeli 2), ale nie zastępuje walidacji za pomocą rzeczywistych pomiarów tłumienia FSO w aktualnych warunkach pogodowych w Iraku.
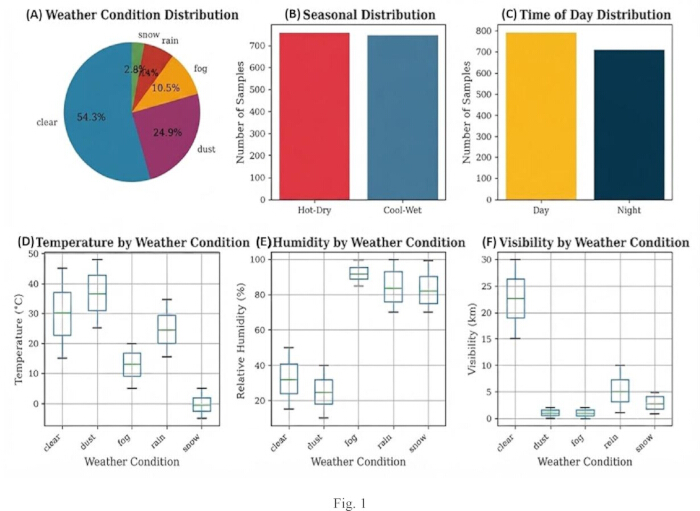
Rysunek 1: Charakterystyka syntetycznego zbioru danych i zmiennych środowiskowych wykorzystanych do modelowania tłumienia atmosferycznego. (A) Rozkład warunków meteorologicznych reprezentowanych w zbiorze danych, w tym sytuacji z bezchmurnym niebem, pyłem, mgłą, deszczem i śniegiem. (B) Sezonowy rozkład próbek w okresach gorąco-suchych i chłodno-wilgotnych. (C) Rozkład próbek pobranych w warunkach dziennych i nocnych. (D) Rozkłady temperatury dla poszczególnych warunków pogodowych. (E) Rozkłady wilgotności dla poszczególnych warunków pogodowych. (F) Rozkłady widzialności dla poszczególnych warunków pogodowych. Wykresy pudełkowe przedstawiają medianę (linia środkowa), rozstęp międzykwartylny (pudełko) oraz wartości minimalne i maksymalne (wąsy). Temperaturę podano w °C, wilgotność w %, a widzialność w km. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
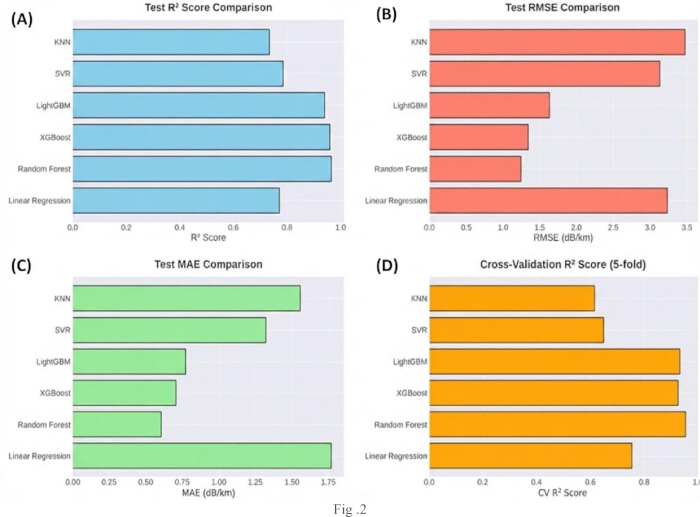
Rysunek 2: Porównanie wydajności modeli uczenia maszynowego w przewidywaniu tłumienia atmosferycznego. (A) Wyniki testowego współczynnika determinacji (R2) dla ocenianych modeli uczenia maszynowego, w tym regresji liniowej (Linear Regression), lasów losowych (Random Forest), ekstremalnego wzmacniania gradientowego (XGBoost), lekkiej maszyny wzmacniania gradientowego (LightGBM), regresji wektorów nośnych (SVR) oraz k-najbliższych sąsiadów (KNN). (B) Wartości testowego błędu średniokwadratowego (RMSE) dla każdego modelu uczenia maszynowego. (C) Wartości testowego średniego błędu bezwzględnego (MAE) dla każdego modelu uczenia maszynowego. (D) Wyniki współczynnika determinacji (R2) uzyskane w drodze pięciokrotnej walidacji krzyżowej. Wyższe wartości R2 oraz niższe wartości RMSE i MAE wskazują na lepszą wydajność predykcyjną. RMSE i MAE podano w dB/km. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
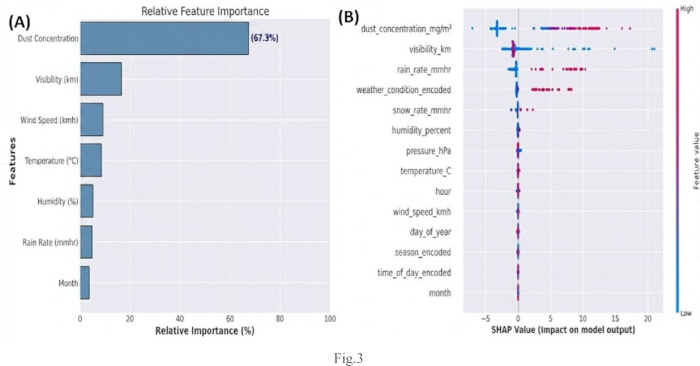
Rysunek 3: Analiza istotności cech i interpretowalności modelu dla prognozowania tłumienia atmosferycznego. (A) Ranking istotności cech oparty na względnej nieczystości z modelu Random Forest, pokazujący wkład wszystkich 10 zmiennych środowiskowych i czasowych w prognozowanie tłumienia. Najbardziej wpływową cechą było stężenie pyłu (67,3%), a następnie widzialność (21,2%), natężenie opadów deszczu (6,0%), prędkość wiatru (2,1%), temperatura (1,5%), wilgotność (0,9%), miesiąc (0,5%), pora roku (0,3%), natężenie opadów śniegu (0,1%) oraz ciśnienie atmosferyczne (0,1%). Względna istotność stanowi procent całkowitej istotności modelu. (B) Wykres podsumowujący SHapley Additive exPlanations (SHAP) ilustrujący wpływ poszczególnych cech na prognozy modelu. Macierz SHAP została obliczona dla 300 próbek ze zbioru testowego (300 × 10 cech). Dla zmiennej pory roku zakodowanej metodą one-hot (pierwotnie cztery kolumny binarne: wiosna, lato, jesień, zima), wartości SHAP zostały połączone poprzez zsumowanie czterech kategorii, aby uzyskać jedną wartość wkładu dla „pory roku” na próbkę. Każdy punkt reprezentuje próbkę, a skala kolorów wskazuje wartość cechy, od niskiej (niebieski) do wysokiej (czerwony). Dodatnie wartości SHAP wskazują na wzrost przewidywanego tłumienia, natomiast ujemne wartości SHAP wskazują na spadek przewidywanego tłumienia. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tego rysunku.
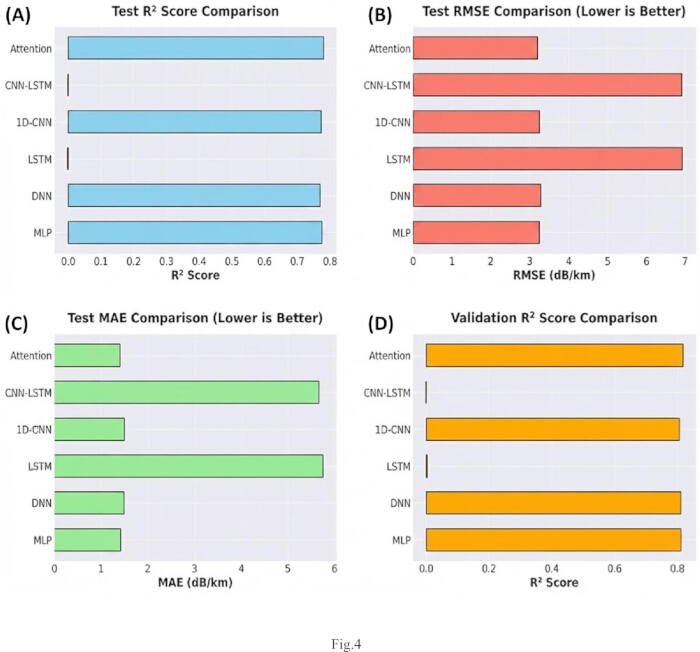
Rysunek 4: Porównanie wydajności modeli głębokiego uczenia w przewidywaniu tłumienia atmosferycznego. (A) Wyniki testowego współczynnika determinacji (R2) dla ocenianych architektur głębokiego uczenia, w tym wielowarstwowego perceptrona (MLP), głębokiej sieci neuronowej (DNN), długo-krótkotrwałej pamięci (LSTM), jednowymiarowej splotowej sieci neuronowej (1D-CNN), hybrydowej splotowej sieci neuronowej i długo-krótkotrwałej pamięci (CNN–LSTM) oraz modeli opartych na mechanizmie uwagi. (B) Wartości testowego błędu średniokwadratowego (RMSE) dla każdego modelu głębokiego uczenia. (C) Wartości testowego średniego błędu absolutnego (MAE) dla każdego modelu głębokiego uczenia. (D) Wyniki walidacyjnego współczynnika determinacji (R2) dla ocenianych modeli głębokiego uczenia. Wyższe wartości R2 oraz niższe wartości RMSE i MAE wskazują na lepszą wydajność predykcyjną. RMSE i MAE podano w dB/km. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
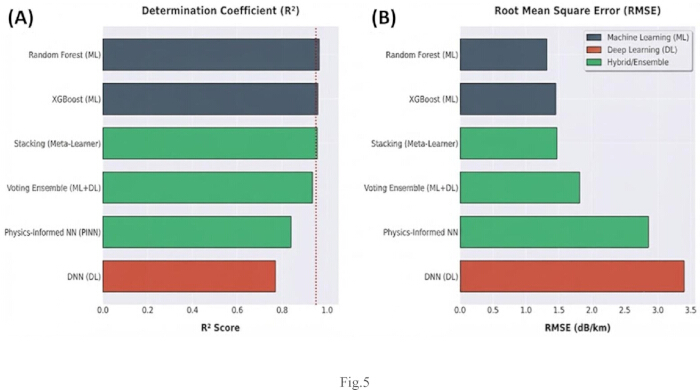
Rysunek 5: Porównanie wydajności modeli uczenia maszynowego, głębokiego uczenia oraz modeli hybrydowych w przewidywaniu tłumienia atmosferycznego. (A) Wartości współczynnika determinacji (R2) dla reprezentatywnych podejść opartych na uczeniu maszynowym, głębokim uczeniu oraz metodach hybrydowych, w tym modeli Random Forest, Extreme Gradient Boosting (XGBoost), Deep Neural Network (DNN), Voting Ensemble, Stacking oraz Physics-Informed Neural Network. (B) Wartości błędu średniokwadratowego (RMSE) dla tych samych modeli. Modele zostały podzielone na trzy kategorie oznaczone kolorami: uczenie maszynowe (ML), głębokie uczenie (DL) oraz techniki hybrydowe/zespołowe (ensemble). Wyższą wydajność predykcyjną wskazują wyższe wartości R2 oraz niższe wartości RMSE. RMSE wyrażono w dB/km. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
| Warunki pogodowe | Udział | Zakres temperatur | Zakres wilgotności | Zakres widzialności | Zakres głównego parametru |
| Bezchmurne niebo | 54.27% (814 próbek) | −4.89 do 47.99°C | 0–100% | >10 km | — |
| Pył | 25.00% (375 próbek) | 10–45°C | 10–60% | 0.05–5 km | Pył: 0–4.96 mg/m3 |
| Mgła | 10.47% (157 próbek) | −5 do 20°C | 70–100% | 0.05–1 km | — |
| Deszcz | 7.40% (111 próbek) | 5–30°C | 60–100% | 1–10 km | Deszcz: 0.25–50 mm/h |
| Śnieg | 2.87% (43 próbki) | −10 do 5°C | 50–100% | 0.5–5 km | Śnieg: 0.5–15 mm/h |
Tabela 1: Mierniki wydajności modeli uczenia maszynowego w przewidywaniu tłumienia atmosferycznego.
| Model | Test R2 | RMSE (dB/km) | MAE (dB/km) | CV R2 | Czas trenowania (s) |
| Random Forest | 0.9654 | 1.324 | 0.815 | 0.960 ± 0.007 | 1.6 |
| XGBoost | 0.9582 | 1.455 | 0.892 | 0.953 ± 0.009 | 2.1 |
| LightGBM | 0.9507 | 1.581 | 0.971 | 0.946 ± 0.011 | 1.8 |
| Regresja wektorów nośnych (SVR) | 0.8874 | 2.389 | 1.445 | 0.879 ± 0.015 | 3.2 |
| Regresja liniowa | 0.8358 | 2.889 | 1.791 | 0.831 ± 0.018 | 0.2 |
| K-najbliższych sąsiadów (KNN) | 0.7341 | 3.671 | 2.296 | 0.721 ± 0.022 | 0.8 |
Tabela 2: Ocena porównawcza wybranych modeli głębokiego uczenia, hybrydowych oraz uczenia maszynowego.
| Model | Kategoria | Test R2 | RMSE (dB/km) | Ranga |
| Las Losowy | uczenie maszynowe | 0.9654 | 1.324 | 1 |
| XGBoost | uczenie maszynowe | 0.9582 | 1.455 | 2 |
| Zestaw stosowy (Stacking Ensemble) | Hybrydowy | 0.9571 | 1.473 | 3 |
| LightGBM | uczenie maszynowe | 0.9507 | 1.581 | 4 |
| Zespołowe głosowanie | Hybrydowy | 0.934 | 1.827 | 5 |
| Sieć neuronowa informowana fizyką | Hybryda | 0.8269 | 2.96 | 6 |
| Uwaga | DL | 0.7766 | 3.362 | 7 |
| LSTM / CNN–LSTM | DL | −0.0006 | 7.195 | — |
Tabela 3: Porównanie wydajności obliczeniowej (trenowania i wnioskowania) każdego ocenionego modelu.
DOSTĘPNOŚĆ DANYCH:
Kompletny syntetyczny zestaw danych obejmujący 1 500 próbek ze wszystkimi cechami wejściowymi (temperatura, wilgotność, widzialność, stężenie pyłu, natężenie opadów deszczu, natężenie opadów śniegu, prędkość wiatru, ciśnienie atmosferyczne, miesiąc, pora roku i warunki pogodowe) oraz zmienną docelową (tłumienie w dB/km) został udostępniony jako plik uzupełniający do niniejszego manuskryptu pod adresem https://doi.org/10.5281/zenodo.21792999. Zbiór danych jest sformatowany w taki sposób, że każda próbka zajmuje jeden wiersz i zawiera wszystkie obliczone zmienne (zakres operacyjny oraz SNR).
Pełny kod implementacyjny, obejmujący: skrypty do generowania danych (implementacje modeli fizycznych); funkcje do wstępnego przetwarzania i skalowania cech; wszystkie implementacje modeli uczenia maszynowego; wszystkie implementacje modeli głębokiego uczenia; skrypty do ewaluacji i wizualizacji; oraz procedury dostrajania hiperparametrów i walidacji krzyżowej, ma zostać również dostarczony jako plik uzupełniający.
Źródłowe dane klimatyczne: Dane klimatyczne wykorzystane do zdefiniowania rozkładów danych syntetycznych pozyskano z Iraki Meteorological Organization and Seismology (IMOS) oraz z Iraki Ministry of Transport, obejmujące okres 2020–2024. Podsumowanie danych klimatycznych użytych do określenia proporcji warunków pogodowych i zakresów parametrów znajduje się w Tabeli uzupełniającej 1. Konkretne zapisy IMOS wykorzystane w niniejszym badaniu nie są publicznie archiwizowane w scentralizowanym repozytorium, ale można je zamówić bezpośrednio z IMOS. Statystyki podsumowujące i wyprowadzone rozkłady prawdopodobieństwa zostały przedstawione w materiałach uzupełniających, aby umożliwić reprodukowalność.
Informacje o repozytorium: Kod źródłowy i zestaw danych zostały zdeponowane w publicznym repozytorium (Zenodo) pod adresem https://doi.org/10.5281/zenodo.21792999.
Dyskusja
W celu prognozowania tłumienia powietrznego w systemach komunikacji FSO działających w warunkach pogodowych panujących w Iraku, w niniejszym badaniu oceniono techniki uczenia maszynowego, uczenia głębokiego oraz metody hybrydowe. Ponieważ wpływy atmosferyczne pozostają jednym z głównych problemów wpływających na wydajność i dostępność łącza, niedawne oceny podkreśliły rosnące znaczenie modelowania predykcyjnego dla systemów FSO21. Wyniki wykazały, że klasyczne podejścia uczenia maszynowego, w szczególności RF i XGBoost, zapewniły wysoką dokładność predykcyjną i w niektórych przypadkach numerycznie przewyższyły metody uczenia głębokiego i hybrydowe. Jednakże testy statystyczne nie wykazały istotnej różnicy (p=0,083) między RF a najlepszym zespołem hybrydowym (Stacking), co oznacza, że oba podejścia mogą osiągać podobne wyniki na tym zbiorze danych. Nasze ustalenia wskazują, że metody zespołowe oparte na drzewach są nadal bardzo wydajne w przypadku tabelarycznych danych środowiskowych o umiarkowanej wielkości próby i niewielkiej liczbie dominujących zmiennych predyktora. Analiza istotności cech wykazała, że stężenie pyłu i widzialność były głównymi czynnikami tłumienia, wspólnie wyjaśniając większość mocy predykcyjnej. Wynik ten jest zgodny z wcześniejszymi badaniami wykazującymi istotny wpływ mgły, pyłu, aerozoli i zanieczyszczeń atmosferycznych na propagację sygnału optycznego22,23,24,25. Podobne wnioski zgłoszono w aplikacjach monitorowania środowiska, gdzie modele uczenia maszynowego często zyskują dzięki zbiorom danych zawierającym niewielką liczbę wysoce informatywnych zmiennych26,27,28,29,30,31,32. Analiza SHAP dodatkowo poprawiła interpretowalność modelu poprzez ilościowe określenie wpływu poszczególnych parametrów środowiskowych na predykcje tłumienia.
Niższa wydajność modeli głębokiego uczenia może wynikać z kilku czynników. Rozmiar zbioru danych był stosunkowo niewielki jak na trenowanie złożonych architektur neuronowych (dostępne w https://doi.org/10.5281/zenodo.21792999), a zmienne środowiskowe wykazały silnie skoncentrowaną istotność cech. Poprzednie badania wykazały, że metody głębokiego uczenia zazwyczaj zyskują dzięki dużym zbiorom danych, hierarchicznym strukturom cech oraz złożonym reprezentacjom nieliniowym33,34,35,36,37. W przeciwieństwie do tego, zbiór danych dotyczący tłumienia wykorzystany w niniejszym badaniu zawierał ograniczoną liczbę dominujących predyktorów i brakowało w nim zależności czasowych wymaganych dla architektur rekurencyjnych. Słaba wydajność modeli LSTM oraz CNN–LSTM sugeruje, że mechanizmy uczenia sekwencyjnego mogą nie zapewniać istotnych korzyści w tym zastosowaniu.
Przewaga stężenia pyłu (67,3%) i widoczności (21,2%) jako predyktorów tłumienia atmosferycznego może wynikać z kilku czynników. Po pierwsze, rozpraszanie molekularne i absorpcja przy 1550 nm są przyćmione przez rozpraszanie Mie na cząsteczkach pyłu. W teorii Mie sprawność ekstynkcji Q_ext jest bardzo czuła na stężenie cząstek, a tłumienie skaluje się niemal liniowo ze stężeniem pyłu w zakresie stężeń od umiarkowanych do wysokich. Po drugie, Irak jest narażony na częste burze pyłowe (25,00% dni w naszych zapisach klimatycznych), które skutkują wartościami tłumienia rzędu 4–30 dB/km. Kontrastuje to z mgłą (10,47%, 0,5–10 dB/km) i deszczem (7,40%, 2–25 dB/km). Większa zmienność tłumienia pyłowego dostarcza silniejszych sygnałów, z których modele mogą się uczyć. Po trzecie, rozkład wykładniczy stężenia pyłu (0,4–4,96 mg/m3) generuje szeroki zakres wartości tłumienia. Długi ogon dla ekstremalnych zdarzeń pyłowych daje wysokie wartości tłumienia, które są istotne dla dokładnej predykcji. Po czwarte, model rozpraszania Mie wykazuje prostszą (w przybliżeniu liniową) zależność od stężenia pyłu, co jest łatwiejsze do przybliżenia dla modeli opartych na drzewach w porównaniu do bardziej złożonej relacji między widocznością a tłumieniem mgły w modelu Kim. Po piąte, odkrycie to ma znaczenie praktyczne, ponieważ burze pyłowe są jednymi z najtrudniejszych warunków środowiskowych dla FSO na Bliskim Wschodzie. Dokładna predykcja podczas zdarzeń pyłowych jest niezbędna dla niezawodnego działania systemu.
Otrzymane wyniki rozwijają badania nad komunikacją FSO, dostarczając praktycznych wytycznych w zakresie wyboru algorytmu do prognozowania tłumienia atmosferycznego. Dokładne prognozowanie tłumienia jest niezbędne dla planowania sieci, adaptacyjnego zarządzania łączami oraz niezawodnego wdrażania systemów komunikacji optycznej w trudnych środowiskach, takich jak Bliski Wschód23,28,30,36. Ponadto opracowana metodologia może mieć zastosowanie w innych problemach dotyczących prognozowania środowiskowego, obejmujących propagację w powietrzu, monitorowanie atmosfery oraz ocenę wydajności sieci optycznych38,39,40. Innymi metodami badania tej koncepcji mogą być wykorzystanie większych zbiorów danych z rzeczywistych zastosowań, zaawansowane techniki uczenia zespołowego, frameworki uczenia transferowego lub bardziej złożone architektury oparte na prawach fizyki41,42,43,44,45.
Zakres wniosków i kwestie uogólnialności
Wnioski z niniejszej pracy opierają się głównie na syntetycznym zbiorze danych wygenerowanym z uznanych fizycznych modeli propagacji (prawo Beera-Lamberta, model Kim, model Carbonneau oraz teoria rozpraszania Mie). Takie podejście metodologiczne niesie ze sobą pewne konsekwencje dla zakresu i generalizacji naszych wyników:
Wnioski z danych symulowanych: (1) Porównawczy ranking wydajności uczenia maszynowego, głębokiego uczenia oraz podejść hybrydowych w prognozowaniu tłumienia atmosferycznego. (2) Identyfikacja stężenia pyłu i widzialności jako dominujących środowiskowych predyktorów tłumienia optycznego w warunkach modelowanych. (3) Przewaga wydajności obliczeniowej drzewiastych metod zespołowych nad architekturami głębokiego uczenia. (4) Interpretowalność istotności cech i analiz SHAP w celu wyjaśnienia prognoz modelu.
Wnioski wymagające potwierdzenia w warunkach rzeczywistych: (1) Bezwzględne wartości R2 i RMSE uzyskane przez oceniane modele zależą od specyficznych cech syntetycznego zbioru danych i mogą odzwierciedlać fakt, że modele nauczyły się deterministycznych równań fizycznych wykorzystanych do generowania celów. (2) Należy jeszcze udowodnić, że najlepszy model, Random Forest, może zostać zastosowany w nieznanych rzeczywistych warunkach atmosferycznych. (3) Walidacja terenowa jest niezbędna, aby wyniki można było zastosować w operacyjnych jednostkach FSO zainstalowanych w Iraku. (4) Konieczne jest potwierdzenie, że zidentyfikowane rankingi istotności cech są odporne w warunkach pomiarów terenowych.
Ważne jest rozróżnienie między wynikami uzyskanymi na syntetycznych danych pochodzących z równań a wynikami na zaszumionych danych obserwacyjnych lub eksperymentalnych. Syntetyczny zbiór danych zapewnia czystą, wolną od szumów relację między cechami wejściowymi a docelowym tłumieniem, co może prowadzić do wyższych wskaźników wydajności predykcyjnej niż te, które można uzyskać przy użyciu rzeczywistych danych obarczonych szumem pomiarowym, błędami aparatury i niemodelowanymi zjawiskami fizycznymi. Zalecamy, aby przyszłe prace koncentrowały się na pozyskaniu rzeczywistych pomiarów tłumienia FSO w irackich warunkach pogodowych, w celu walidacji wyników przedstawionych w niniejszym badaniu oraz oceny rzeczywistej zdolności do generalizacji zaproponowanych metodologii.
Implikacje danych syntetycznych dla generalizacji modelu
Wpływ wykorzystania danych syntetycznych w niniejszym badaniu powinien zostać starannie rozważony w kontekście generalizacji modeli:
Zalety podejścia syntetycznego Zbiór danych jest spójny fizycznie i opiera się na uznanych ramach teoretycznych dzięki zastosowaniu sprawdzonych modeli propagacji fizycznej. Parametry meteorologiczne zostały wyodrębnione z zapisów meteorologicznych z Iraku, aby zbiór danych odzwierciedlał właściwości statystyczne rzeczywistych warunków pogodowych w tym kraju. Oprócz uniknięcia zmiennych zakłócających pomiary terenowe (takich jak błędy pomiarowe, kalibracja sprzętu czy niewystarczająca liczba zapisów danych), to kontrolowane środowisko umożliwia metodyczną analizę metodologii modelowania.
Ograniczenia w zakresie uogólniania wyników Zbiór danych syntetycznych wykazuje ograniczenia w odwzorowaniu pełnej złożoności rzeczywistego tłumienia atmosferycznego, w tym: (1) oddziaływań wielu zjawisk atmosferycznych występujących jednocześnie; (2) nieliniowego i niestacjonarnego zachowania parametrów atmosferycznych; (3) długoterminowej zmienności klimatycznej, której nie uwzględniają rozkłady próbkowania; (4) lokalnych efektów mikroklimatycznych, które mogą znacząco wpływać na propagację FSO; oraz (5) szumu i niepewności nieodłącznie związanych z gromadzeniem danych w warunkach rzeczywistych.
Kwestie błędów systematycznych w generowaniu danych syntetycznych Założenie niezależnego próbkowania parametrów środowiskowych (patrz Metody) jest nadmiernym uproszczeniem warunków rzeczywistych, w których zmienne atmosferyczne mają tendencję do korelacji (np. wysokie stężenia pyłu zazwyczaj korelują z niską widocznością). Założenie niezależności przyjęto w celu stworzenia kontrolowanego środowiska symulacyjnego do systematycznego porównania modeli. Metoda ta może jednak nie oddawać pełnej złożoności oddziaływań parametrów atmosferycznych. Stosujemy metodę podziału stratyfikowanego (zachowując proporcje warunków pogodowych w zbiorach treningowym i testowym), aby zminimalizować ryzyko niezrównoważonej reprezentacji rzadkich zjawisk w zbiorze testowym (w szczególności śniegu, który występuje w 2,87% przypadków).
Deterministyczne generowanie celu: Wysoka wydajność predykcyjna zaobserwowana w niniejszym badaniu może być częściowo wyjaśniona tym, że modele nauczyły się deterministycznych równań fizycznych wykorzystanych do wygenerowania wartości docelowych. W przeciwieństwie do tego, rzeczywiste dane eksperymentalne zawierają szum pomiarowy, błędy aparatury oraz niemodelowane zjawiska fizyczne, które utrudniają prognozowanie. W związku z tym ilościowe wskaźniki wydajności (R2, RMSE, MAE) należy interpretować jako porównania względne między metodologiami w kontrolowanym środowisku symulacyjnym, a nie jako absolutne gwarancje wydajności dla operacyjnych systemów FSO.
W związku z tym, choć porównawcze wyniki rankingów wydajności modeli są prawdopodobnie wiarygodne (ze względu na spójność fizyczną danych syntetycznych), bezwzględne mierniki wydajności (R2, RMSE, MAE) nie powinny być traktowane jako wskaźniki oczekiwanej wydajności w operacyjnych systemach FSO. Konieczne jest przetestowanie zdolności modelu do generalizacji w warunkach rzeczywistych, wykorzystując eksperymentalne pomiary tłumienia powietrza uzyskane w różnych warunkach pogodowych w Iraku.
Należy zwrócić uwagę na kilka ograniczeń. Po pierwsze, zamiast obserwacji terenowych, badanie oparto na syntetycznym zbiorze danych wygenerowanym przy użyciu znanych fizycznych modeli propagacji. Jak wspomniano wcześniej, ilościowe wskaźniki wydajności (R2, RMSE, MAE) nie powinny być traktowane jako absolutne gwarancje sprawności operacyjnych systemów FSO, lecz jako względne porównania podejść w kontrolowanym środowisku symulacyjnym. Po drugie, ze względu na wielkość zbioru danych, standardowe modele oraz modele głębokiego uczenia mogły nie być w stanie wypracować odpornych reprezentacji cech. Po trzecie, w celu skupienia się na prognozowaniu tłumienia, nie uwzględniono innych wskaźników wydajności FSO, takich jak dostępność połączenia, błędy celowania oraz zaniki wywołane turbulencjami. Po czwarte, do obliczenia proporcji warunków pogodowych wykorzystano dane historyczne z lat 2020–2024, co może nie odzwierciedlać dokładnie rocznych zmienności wzorców klimatycznych w Iraku. Po piąte, pseudosekwencyjna struktura danych wejściowych w modelach CNN–LSTM i LSTM jest uproszczeniem metodologicznym, które może nie w pełni oddawać dynamikę czasową w rzeczywistych zastosowaniach. Przy ocenie wyników należy wziąć pod uwagę te ograniczenia, ponieważ mogą one wpływać na uogólnialność otrzymanych wniosków.
Rekomendowany priorytet: Weryfikacja w rzeczywistym świecie. Najistotniejszym kierunkiem przyszłych prac jest gromadzenie i analiza rzeczywistych pomiarów tłumienia FSO w warunkach pogodowych panujących w Iraku. Powinno to obejmować: (1) ustanowienie stanowisk testowych FSO w różnych częściach Iraku (np. Bagdad, Basra, Mosul, Ramadi) w celu rejestracji regionalnych zmienności klimatu; (2) wykorzystanie skalibrowanych instrumentów w lokalizacjach FSO do jednoczesnego pomiaru parametrów atmosferycznych (temperatura, wilgotność, widzialność, stężenie pyłu); (4) dokumentowanie tłumienia podczas ekstremalnych zjawisk pogodowych (burze piaskowe, gęsta mgła, ulewny deszcz); (5) udostępnienie zebranych danych w celu umożliwienia reprodukowalności i badań porównawczych; oraz (3) kontynuowanie monitoringu przez co najmniej jeden pełny cykl roczny, aby uchwycić fluktuacje sezonowe. Taka praktyczna walidacja pozwoliłaby ocenić uogólnialność modelu i udoskonalić techniki predykcyjne opracowane w niniejszym badaniu.
Aby zwalidować i ulepszyć wygenerowane modele, przyszłe badania powinny skupić się na włączeniu rzeczywistych pomiarów FSO uzyskanych w warunkach pogodowych panujących w Iraku. Dalsze analizy mogłyby zbadać strategie uczenia transferowego wykorzystujące odpowiednie zbiory danych atmosferycznych, programy uczenia online dostosowujące się do zmieniających się warunków środowiskowych oraz hybrydowe strategie eksperymentalno-symulacyjne łączące dane pomiarowe z modelami fizycznymi. Dodatkowe badania nad wyjaśnialną sztuczną inteligencją (explainable AI) oraz zaawansowanymi podejściami do uczenia opartego na fizyce mogą również rzucić więcej światła na mechanizmy leżące u podstaw tłumienia powietrznego i zwiększyć odporność przyszłych systemów predykcyjnych.
Oświadczenia
Konflikt interesów: Autorzy nie deklarują żadnych konfliktów interesów.
Podziękowania
Autorzy oświadczają, że nie otrzymali zewnętrznego finansowania na przeprowadzenie tych badań. Składamy podziękowania dla International Applied and Theoretical Research Center (IATRC), Baghdad Quarter, Irak.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| CUDA Toolkit | NVIDIA Corporation | 11.8 | Biblioteka akceleracji GPU do trenowania głębokiego uczenia |
| cuDNN | NVIDIA Corporation | 8.6.0 | Biblioteka głębokich sieci neuronowych z akceleracją GPU |
| GPU (procesor graficzny) | NVIDIA Corporation | GeForce RTX 4090, 24 GB VRAM | Wykorzystywany do trenowania głębokiego uczenia z akceleracją GPU |
| CPU (procesor centralny) | Intel Corporation | Core i9-13900K, 24 cores/32 threads | Procesor stacji roboczej do trenowania i ewaluacji wszystkich modeli |
| Pamięć systemowa (RAM) | n/a | 64 GB DDR5, 5200 MHz | Pamięć stacji roboczej |
| Keras API | Open source (part of TensorFlow) | bundled with TensorFlow 2.11.0 | Wysokopoziomowe API głębokiego uczenia stosowane we wszystkich architekturach DL |
| LightGBM | Open source (Microsoft) | 3.3.5 | Framework gradient boostingu |
| NumPy | Open source (NumFOCUS) | 1.23.5 | Biblioteka obliczeń numerycznych |
| System operacyjny | Canonical Ltd. | Ubuntu 22.04 LTS | System operacyjny stacji roboczej |
| Python | Python Software Foundation | 3.9 | Język programowania używany do generowania danych i modelowania |
| scikit-learn | Open source | 1.2.2 | Biblioteka uczenia maszynowego (RF, SVR, KNN, regresja liniowa, walidacja krzyżowa, skalowanie) |
| SHAP (SHapley Additive exPlanations) | Open source | 0.41.0 | Biblioteka interpretowalności modeli, moduł TreeExplainer |
| TensorFlow | Open source (Google) | 2.11.0 | Framework głębokiego uczenia stosowany we wszystkich sześciu architekturach DL |
| XGBoost | Open source | 1.7.5 | Biblioteka Extreme Gradient Boosting |
Bibliografia
- Kadhim MS, Hussein H, Elwi TA. Hybrid ANN-Z method for modeling carbon nanotube-based reconfigurable intelligent surfaces for terahertz beam steering. J Vis Exp. 2026;in press.
- Raham JK, Alshaibi M, Elwi TA. SMS optical fiber laser sensor for transformer oil temperature monitoring-based IoT of AI control. Prog Electromagn Res B. 2026;118:72–86.
- Abdulkareem ZJ, Hamad TK, Elwi TA. Reconfigurable metasurface based on graphene optical antennas for dynamic beam steering. Sustain Eng Innov. 2025;7:127–136.
- Abdulsattar RK, et al. Optical-microwave sensor for real-time measurement of water contamination in oil derivatives. AEU Int J Electron Commun. 2023;170:154798. doi:10.1016/j.aeue.2023.154798.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote control of miniaturized 3D reconfigurable CRLH printed self-powered MIMO antenna array for 5G applications. Micromachines. 2022;13(12):2061. doi:10.3390/mi13122061.
- Al-Khaylani HH, Elwi TA, Ibrahim AA. Optically remote-controlled miniaturized 3D reconfigurable CRLH-printed MIMO antenna array for 5G applications. Microw Opt Technol Lett. 2023;65(2):603–610.
- Jassim DA, Elwi TA. Optical nano monopoles for interconnection of electronic chip applications. Optik. 2022;249:168142. doi:10.1016/j.ijleo.2021.168142.
- Elwi TA. A novel approach for modeling the geometry and constitutive parameters of an armchair single-wall carbon nanotube antenna operating in the NIR regime. Al-Ma’mon Coll J. 2014;(24):261–285.
- Mohammed, AB.F.A., Al-hadeethi, S.T., Al-khaylani, H.H. et al. An investigation of success probability and fidelity of quantum repeater in asymmetry in midpoint placement in fiber-based quantum networks. J Opt (2025). https://doi.org/10.1007/s12596-025-02866-6.
- Kim II, McArthur B, Korevaar EJ. Comparison of laser beam propagation at 785 nm and 1550 nm in fog and haze for optical wireless communications [conference paper]. Presented at: Optical Wireless Communications III; Boston, MA, USA; 2000. Proc SPIE. 2001;4214:26–37. https://doi.org/10.1117/12.417512.
- Okbi ZA, Alak IK, Abdulla EN, Al-Khaylani HH. Design and security analysis of an image encryption based on a gigabit passive optical network employing fiber-FSO protection at the last mile. J Opt Commun. 2025. doi:10.1515/joc-2025-0466.
- Ojo JS, Olaitan JA, Ojo OL. Characterization of fog-induced attenuation for optimizing optical propagation links in Nigeria. Results Opt. 2022;9:100279. doi:10.1016/j.rio.2022.100279.
- Khidher SA. Dust storms in Iraq: Past and present. Theor Appl Climatol. 2024;155:4721–4735.
- Ali, Alaa Hussein, Abdulla, Essam N. and Al-Azawi, Razi J.. "Security and network performance analysis of coexistence TWDM – NG-PON2, GPON and 10G-EPON systems based on Hill Cipher" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0435.
- Lionis A, et al. Using machine learning algorithms for accurate received optical power prediction of an FSO link over a maritime environment. Photonics. 2021;8(6):212. doi:10.3390/photonics8060212.
- Chen T, Guestrin C. XGBoost: A scalable tree boosting system [conference paper]. Presented at: 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining; San Francisco, CA, USA; 2016. p. 785–794. https://doi.org/10.1145/2939672.2939785.
- Bai Y, et al. Air pollutants concentrations forecasting using back propagation neural network based on wavelet decomposition with meteorological conditions. Atmos Pollut Res. 2016;7(3):557–566.
- LeCun Y, Bengio Y, Hinton G. Deep learning. Nature. 2015;521:436–444.
- Mousa, Ekhlass, Abdulla, Essam N. and Adnan, Salah A.. "Enhancing network security based on 10G-EPON with the use of the Hill cipher algorithm" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0201.
- Lu G, et al. A survey of deep learning for time series forecasting: Theories, datasets, and state-of-the-art techniques. Comput Mater Contin. 2025;85(2):2403–2441.
- Liu J, Yang X, Wei Y, Zhao F. Integrated THz/FSO communications: A review of practical constraints, applications and challenges. Micromachines. 2025;16(11):1297. doi:10.3390/mi16111297.
- Bott A, Sievers U, Zdunkowski W. A radiation fog model with a detailed treatment of the interaction between radiative transfer and fog microphysics. J Atmos Sci. 1990;47:2153–2166.
- Fadhil HA, et al. Optimization of free space optics parameters: An optimum solution for bad weather conditions. Optik. 2013;124(19):3969–3973.
- Osipov S, et al. Severe atmospheric pollution in the Middle East is attributable to anthropogenic sources. Commun Earth Environ. 2022;3:203. doi:10.1038/s43247-022-00514-6.
- Castellanos P, et al. Mineral dust optical properties for remote sensing and global modeling: A review. Remote Sens Environ. 2024;303:113982. doi:10.1016/j.rse.2023.113982.
- Lolli S. Urban PM2.5 concentration monitoring: A review of recent advances in ground-based, satellite, model, and machine learning integration. Urban Clim. 2025;63:102566. doi:10.1016/j.uclim.2025.102566.
- Ridha, Fay F., Abdulla, Essam N. and Abdulhadi, Ali H.. "Machine learning based on raw ensemble predictions scheme for TWDM-PON" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0373.
- Khalid H, Sajid SM, Cheema MI, Leitgeb E. Optical signal attenuation through smog in controlled laboratory conditions. Photonics. 2024;11(2):172. doi:10.3390/photonics11020172.
- Ejike O, Ndị D, Shakir MZ. Comparative study of machine learning-based rainfall prediction in tropical and temperate climates. Climate. 2025;13(8):167. doi:10.3390/cli13080167.
- Esmail MA, Fathallah H, Alouini MS. An experimental study of FSO link performance in desert environment. IEEE Commun Lett. 2016;20(9):1888–1891.
- Kshirsagar MP, Khare KC. Support vector regression models of stormwater quality for a mixed urban land use. Hydrology. 2023;10(3):66. doi:10.3390/hydrology10030066.
- Mosso S, Lapo K, Stiperski I. Revealing the drivers of turbulence anisotropy over flat and complex terrain: An interpretable machine learning approach. Boundary Layer Meteorol. 2025;191:51. doi:10.1007/s10546-025-00946-5.
- Mohsen S, Ali AM, Emam A. Automatic modulation recognition using CNN deep learning models. Multimed Tools Appl. 2024;83:7035–7056.
- Mienye ID, Swart TG, Obaido G. Recurrent neural networks: A comprehensive review of architectures, variants, and applications. Information. 2024;15(9):517. doi:10.3390/info15090517.
- Castelli M, et al. Generative adversarial networks for generating synthetic features for Wi-Fi signal quality. PLoS One. 2021;16(11). doi:10.1371/journal.pone.0260308.
- Al-Imran, Chowdhury MZ, Mofidul RB, Jang YM. Machine learning and deep learning in FSO communication: A comprehensive survey. ICT Express. 2025;11(6):1026–1046.
- Grose MG, Watson EA. Forecasting atmospheric turbulence conditions from prior environmental parameters using artificial neural networks. Appl Opt. 2023;62:3370–3379.
- Radhi SS, et al. Design a secure TWDM-PON via the Hill cipher algorithm. Opt Contin. 2025;4:1051–1064.
- Mushatet, Adil Fadhil, Fadil, Elaf A. and Abdulla, Essam N.. "High bit rate secure FSO system utilizing Hill coding" Journal of Optical Communications, 2025. https://doi.org/10.1515/joc-2025-0147.
- Musadaq R, Abdulwahid SN, Abd Alwahed NN, Abdulla EN. Security analysis of an image encryption algorithm based on Blowfish in GPON. J Opt Commun. 2025. doi:10.1515/joc-2025-0109.
- Raissi M, Yazdani A, Karniadakis GE. Hidden fluid mechanics: Learning velocity and pressure fields from flow visualizations. Science. 2020;367(6481):1026–1030.
- Vasiliauskaite V, Antulov-Fantulin N. Generalization of neural network models for complex network dynamics. Commun Phys. 2024;7:348. doi:10.1038/s42005-024-01837-w.
- Oh S, Hong SK. Physics-informed neural modeling of 2D transient electromagnetic fields. Appl Sci. 2025;15(23):12612. doi:10.3390/app152312612.
- Pradhan S, Bhattarai JS, Murugavel M, Sharma OP. Machine learning approaches to surpass the limitations of the Beer–Lambert law. ACS Omega. 2025;10(16):16597–16601.
- Pavlyshenko B. Using stacking approaches for machine learning models [conference paper]. Presented at: 2018 IEEE Second International Conference on Data Stream Mining and Processing (DSMP); Lviv, Ukraine; 2018. p. 255–258. https://doi.org/10.1109/DSMP.2018.8478522.