W niniejszym opracowaniu przedstawiamy protokół wzbogacania mitochondrialnego DNA z pojedynczych ludzkich oocytów przy użyciu Egzonukleazy V oraz przygotowania bibliotek do sekwencjonowania dupleksowego w celu wysokiej dokładności wykrywania wariantów mitochondrialnego DNA z wykorzystaniem platform sekwencjonowania kompatybilnych z systemem Illumina.
Artykuł metodologiczny
Protokół sekwencjonowania dupleksowego mitochondrialnego DNA w pojedynczych ludzkich oocytach
W tym artykule
Podsumowanie
Streszczenie
Oocyty są gęsto wypełnione mitochondriami – organellami wytwarzającymi energię, które posiadają własny genom, mitochondrialne DNA (mtDNA). Każda komórka zawiera wiele kopii mtDNA, przy czym liczba kopii różni się w zależności od rodzaju tkanki. Oocyty charakteryzują się najwyższą liczbą kopii mtDNA, zawierając setki tysięcy cząsteczek mtDNA na komórkę. Ponieważ mitochondria są dziedziczone wyłącznie w linii żeńskiej, dokładne wykrywanie wariantów mtDNA jest niezbędne w badaniach nad dziedzicznością, starzeniem się i chorobami. Obecność wielu kopii mtDNA pozwala na współistnienie cząsteczek typu dzikiego i zmutowanych w tej samej komórce, co określa się mianem heteroplazmii; w tym stanie warianty o niskiej częstotliwości oraz warianty de novo mogą występować z częstotliwością poniżej 1%. Konwencjonalne sekwencjonowanie nowej generacji (NGS) nie cechuje się wystarczającą dokładnością, aby niezawodnie odróżnić te rzadkie warianty od błędów wprowadzonych podczas przygotowania biblioteki i sekwencjonowania. W niniejszej pracy przedstawiamy protokół wzbogacania mtDNA z pojedynczych ludzkich oocytów przy użyciu egzonukleazy V w celu usunięcia liniowego DNA, a następnie przygotowania biblioteki do sekwencjonowania dupleksowego (duplex sequencing) w celu wysoce dokładnej analizy mtDNA. Ten schemat pracy umożliwia sekwencjonowanie pojedynczych oocytów z korekcją błędów, co ułatwia niezawodne wykrywanie rzadkich wariantów mtDNA oraz analizę heteroplazmii i mutagenezy de novo. Protokół zapewnia odtwarzalną metodę badania zmienności genomu mitochondrialnego w pojedynczych oocytach z wykorzystaniem platform sekwencjonowania kompatybilnych z systemem Illumina.
Wprowadzenie
Mitochondria odgrywają fundamentalną rolę w kluczowych procesach komórkowych, w tym w produkcji energii, apoptozie, sygnalizacji oraz homeostazie wapniowej1. Posiadają własny genom, mitochondrialne DNA (mtDNA), który u ssaków jest kolistą, dwuniciową cząsteczką o długości około 16,6 kb. Choć większość przodkowych genów mitochondrialnych została przeniesiona do genomu jądrowego podczas endosymbiozy, mtDNA zachowało 37 genów kodujących 13 polipeptydów fosforylacji oksydacyjnej (OXPHOS), 22 RNA transportowe (tRNA) oraz dwa RNA rybosomalne (rRNA)2. Mutacje w mtDNA mogą upośledzać ekspresję i funkcję genów mitochondrialnych, co może prowadzić do ciężkich zaburzeń3. Ponieważ mitochondria są dziedziczone wyłącznie w linii żeńskiej, mtDNA oocytów odgrywa krytyczną rolę w zapłodnieniu, rozwoju embrionalnym i zdrowiu potomstwa4. W związku z tym wykrywanie i charakterystyka mutacji mtDNA oraz ich częstotliwości budzą znaczne zainteresowanie. Przykładowo, zrozumienie mutogenezy linii zarodkowej związanej ze starzeniem się i chorobami jest ważnym warunkiem wstępnym do opracowania strategii terapeutycznych w leczeniu niepłodności kobiet.
W przeciwieństwie do DNA jądrowego, mtDNA występuje w wielu kopiach w jednej komórce — od setek do tysięcy kopii w komórkach somatycznych, w zależności od rodzaju tkanki, i ponad 100 000 kopii w dojrzałych oocytach4. Tak wysoka liczba kopii mtDNA sprawia, że oocyty są odpowiednie do badania mutagenezy mitochondrialnej na poziomie pojedynczej komórki. Jednak wykrywanie mutacji mtDNA de novo, zwłaszcza tych występujących z bardzo niską częstotliwością, pozostaje trudne, ponieważ wskaźniki błędów konwencjonalnego sekwencjonowania nowej generacji (NGS) przekraczają częstotliwość występowania wielu rzeczywistych wariantów5. W związku z tym wymagane są metody sekwencjonowania z korekcją błędów, aby odróżnić autentyczne mutacje od artefaktów wprowadzonych podczas przygotowania biblioteki, amplifikacji i sekwencjonowania. Jednym z takich podejść jest sekwencjonowanie dupleksowe (DS)6,7. W metodzie DS fragmenty DNA są ligowane z adapterami zawierającymi dwuniciowe, zrandomizowane, 12-nukleotydowe znaczniki molekularne przed amplifikacją. Te unikalne identyfikatory molekularne znakują każdą oryginalną cząsteczkę DNA na obu końcach, co pozwala na grupowanie odczytów sekwencyjnych pochodzących z tej samej nici matrycowej w rodziny na podstawie wspólnej sekwencji znacznika. Z każdej rodziny odczytów generowana jest sekwencja konsensusu pojedynczej nici (SSCS), po czym komplementarne SSCS pochodzące z oryginalnego dupleksu DNA są łączone w celu utworzenia sekwencji konsensusu dupleksowego (DCS). Tylko warianty wykryte w większości odczytów w obu komplementarnych SSCS i potwierdzone w wynikowym DCS są uznawane za prawdziwe mutacje, co pozwala na uzyskanie wskaźników błędów o kilka rzędów wielkości niższych niż w przypadku konwencjonalnych metod NGS8. Strategia ta jest szczególnie korzystna przy wykrywaniu niskoczęstotliwościowych wariantów mtDNA oraz heteroplazmii w pojedynczych komórkach.
Głównym ograniczeniem większości opublikowanych protokołów sekwencjonowania dupleksowego jest wymóg zastosowania stosunkowo dużych ilości wejściowego DNA podczas przygotowywania biblioteki, co sprawia, że metody te nie nadają się do zastosowań w obrębie pojedynczych komórek6,7,9. Ogólnym celem niniejszego protokołu jest umożliwienie wysoce dokładnego sekwencjonowania dupleksowego mtDNA z pojedynczych ludzkich oocytów poprzez zoptymalizowany proces wzbogacania mtDNA, przygotowania biblioteki i sekwencjonowania. Aby zminimalizować sekwencjonowanie nuklearnych fragmentów mitochondrialnego DNA (NUMTs) i zwiększyć wydajność sekwencjonowania, protokół ten obejmuje etap wzbogacania z wykorzystaniem egzonukleazy V, która selektywnie trawi liniowe DNA, zachowując koliste mtDNA. Wynikowy proces zapewnia praktyczne podejście do dokładnego wykrywania wariantów mtDNA w pojedynczych oocytach i jest odpowiedni do badań nad heteroplazmią, mutagenezą de novo, starzeniem się oraz chorobami mitochondrialnymi.
Protokół
Pozyskiwanie i przetwarzanie ludzkich oocytów zostało zatwierdzone przez Komisję Etyczną Uniwersytetu im. Johannesa Keplera w Linzu (nr zatwierdzenia 1293/2020). Wszystkie procedury należy przeprowadzać zgodnie z wytycznymi instytucjonalnymi, w tym w zakresie świadomej zgody, anonimizacji próbek oraz wszystkich obowiązujących przepisów regulujących wykorzystanie tkanek ludzkich.
UWAGA: Chociaż protokół ten został opisany dla oocytów ludzkich, należy dostosować specyficzne dla gatunku startery, aby zastosować ten schemat pracy do innych gatunków. Przez cały protokół należy używać materiałów eksploatacyjnych o niskim powinowactwie do DNA (np. probówek i końcówek do pipet), aby zminimalizować utratę próbki. Wszystkie etapy do momentu pierwszej puryfikacji należy przeprowadzić w oryginalnej probówce do pobierania oocytów o niskim powinowactwie. Nie należy mieszać próbek w wirówce typu vortex, ponieważ może to uszkodzić nici DNA. Zamiast tego składniki reakcji należy mieszać poprzez delikatne pipetowanie lub lekkie potrząsanie probówką, a następnie krótko wirować. Jeśli to możliwe, izolację DNA, przygotowanie mieszaniny głównej (master mix) oraz ustawienie reakcji należy przeprowadzać na dedykowanych stanowiskach do reakcji łańcuchowej polimerazy (PCR) lub w fizycznie oddzielonych obszarach laboratoryjnych, aby zminimalizować ryzyko kontaminacji.
1. Przygotowanie buforów i odczynników
- Przygotować bufor do lizy oocytów (OLB), 10 mM Tris-HCl, bufor TE, bufor TElow oraz 10 mM Tris-NaCl zgodnie z Tabelą 1, łącząc określone objętości roztworów stokowych i uzupełniając każdy roztwór do wyznaczonej objętości końcowej wodą klasy biologii molekularnej. Rozdzielić przygotowane bufory na aliquoty po 1 mL, przechowywać je w temperaturze 4°C i zużyć w ciągu 1 roku.
Tabela 1: Skład buforów wykorzystywanych w protokole. Składy buforów i stężenia końcowe dla przygotowania 10 mM Tris-HCl, buforu TE, buforu TElow, 10 mM Tris-NaCl oraz buforu do lizy oocytów (OLB). Wszystkie bufory należy przygotować z wody klasy molecular biology-grade. Jeśli jest to wymagane, przed przygotowaniem buforów należy dostosować pH roztworów zapasowych Tris-HCl i EDTA zgodnie z zaleceniami producenta. Bufor OLB jest uzupełniany o termolabilną proteinazę K bezpośrednio przed lizą próbek, zgodnie z opisem w protokole. Kliknij tutaj, aby pobrać ten plik.
2. Pobieranie pojedynczych oocytów
UWAGA: Oocyty ludzkie użyte w tym protokole zostały pobrane od pacjentek zakwalifikowanych do wstrzykiwania plemnika do cytoplazmy oocytu (ICSI) w Kinderwunsch Zentrum (centrum płodności) Szpitala Uniwersyteckiego im. Keplera w Linz w Austrii. Protokoły stymulacji jajników oparto na przewidywanej odpowiedzi jajników pacjentek, a dawki dostosowano do indywidualnych cech, w tym wieku, poziomu hormonu antymüllera (AMH) i masy ciała, zgodnie z zaleceniami Europejskiego Towarzystwa Reprodukcji Ludzkiej i Embriologii (ESHRE)10. Supresję przysadki osiągnięto za pomocą protokołów z agonistą lub antagonistą hormonu uwalniającego gonadotropiny (GnRH) w połączeniu ze stymulacją gonadotropinami w celu promowania dojrzewania pęcherzyków. Wzrost pęcherzyków monitorowano regularnie za pomocą przezpochwowego badania ultrasonograficznego przed wywołaniem owulacji. Następnie oocyty pobrano poprzez przezpochwową aspirację pęcherzykową, gromadząc płyn pęcherzykowy zawierający kompleksy cumulus-oocyt (COC)11. Do celów badawczych, po uzyskaniu świadomej zgody, udostępniono jedynie oocyty niedojrzałe lub niezapłodnione, które nie mogły zostać wykorzystane w leczeniu ICSI u pacjentek i w przeciwnym razie zostałyby zutylizowane. W pierwszej kolejności kontaktowano się z pacjentkami o wyższej liczbie pęcherzyków antralnych (AFC), ponieważ z większym prawdopodobieństwem uzyskiwano od nich niedojrzałe lub niezapłodnione oocyty odpowiednie do badań. Wszystkie procedury wykonane przed wyborem oocytów do badań muszą być zgodne z krajowymi przepisami dotyczącymi zapłodnienia in vitro oraz wykorzystania tkanek ludzkich. Wszystkie materiały należy obsługiwać w warunkach sterylnych w komorze z laminarnym przepływem powietrza. Należy upewnić się, że wszystkie materiały z certyfikatem CE oraz pożywki hodowlane, które mają bezpośredni kontakt z oocytami, są sterylne, wstępnie ogrzane do 37°C i utrzymywane przy pH 7,20–7,40.
- Po kontrolowanej hiperstymulacji owariów i transvaginalnym pobraniu oocytów, zebrać kompleksy oocyt-cumulus (COCs) z płynu pęcherzykowego i przenieść je do 750 µL pożywki GM501 Cult pod sterylnym olejem mineralnym.
- Usunąć otaczające komórki cumulus z błony przejrzystej (ZP) poprzez trawienie enzymatyczne hialuronidazą. Inkubować oocyty w 500 µL hialuronidazy GM501 (80 U/mL) przez 30–60 s w temperaturze 37°C, a następnie trzykrotnie przemyć w 750 µL pożywki GM501 Cult. Pozostałe komórki cumulus usunąć ostrożnie mechanicznie za pomocą pipet do denudacji.
- W przypadku oocytów w telofazie I (TI) lub metafazie II (MII), otworzyć ZP za pomocą serii impulsów laserowych w sąsiedztwie ciałka polarnego i usunąć pierwsze ciałko polarne przy użyciu mikromanipulatorów. Dostosować ustawienia lasera do grubości ZP (1–3 impulsy; czas trwania impulsu 1,5–2,6 ms; średnica plamki 16–20 µm). Użyć lasera do usunięcia wszelkich pozostałych komórek cumulus, aby zminimalizować kontaminację oocytu DNA komórek somatycznych.
- Każdy oocyt przenieść indywidualnie do 2–3 µL 1× soli fizjologicznej z buforem fosforanowym (PBS) do probówki low-binding o pojemności 200 µL. Natychmiast zamrozić probówkę w temperaturze −20°C. Do długotrwałego przechowywania przenieść zamrożone oocyty do −80°C.
UWAGA: Po rozmrożeniu przeprowadzić pozostałą część protokołu w sposób ciągły, bez przerw, aż do zakończenia pierwszego etapu amplifikacji. - Aby monitorować potencjalną kontaminację środowiskowym DNA w trakcie całego protokołu, włączyć kontrolę negatywną składającą się z 2 µL 1× PBS bez oocytu podczas przygotowywania biblioteki (od kroku 4 włącznie). Kontrolę negatywną przetwarzać identycznie jak wszystkie próbki oocytów. Na żadnym etapie protokołu w kontroli negatywnej nie powinno być wykryte DNA.
3. Synteza adapterów
UWAGA: Przygotuj adaptery przed rozpoczęciem przygotowania biblioteki. Syntetyzowane adaptery przechowuj w temperaturze −80°C do 3 miesięcy. Przygotuj alikwoty, aby uniknąć wielokrotnych cykli zamrażania i rozmrażania; nie zamrażaj ponownie adapterów po rozmrożeniu. Wszystkie sekwencje oligonukleotydów użyte w tym protokole wymieniono w Tabeli 2.
Tabela 2: Oligonukleotydy i startery użyte w protokole. W tabeli wymieniono wszystkie oligonukleotydy wykorzystane do syntezy adapterów, amplifikacji biblioteki, ilościowej reakcji łańcuchowej polimerazy (qPCR), kwantyfikacji biblioteki oraz szacowania wzbogacenia mitochondrialnego DNA (mtDNA), wraz z ich sekwencjami, metodami oczyszczania, dostarczonymi ilościami lub zalecanymi stężeniami roztworów stokowych oraz producentem. Przedstawiona sekwencja oligonukleotydu nośnikowego jest sekwencją przykładową użytą w tym protokole. Gwiazdka (*) w sekwencjach starterów oznacza wiązanie fosforotioatowe. Zrandomizowane nukleotydy (N) w adapterze mws55 reprezentują unikalny identyfikator molekularny (UMI), natomiast Y oznacza degenerowaną zasadę pirymidynową (C lub T). O ile nie wskazano inaczej, oligonukleotydy zostały zsyntetyzowane z zastosowaniem standardowego oczyszczania poprzez odsalanie. Kliknij tutaj, aby pobrać ten plik.
- Przygotować alikwot 96% etanolu (EtOH) i przechowywać go w temperaturze −20°C do późniejszych etapów oczyszczania. 80% EtOH przygotować świeżo bezpośrednio przed użyciem.
- W probówce o niskiej adsorpcji (low-binding) o pojemności 200 µL zmieszać po 20,5 µL oligonukleotydów mws51_short (100 µM) i mws55 (100 µM), aby uzyskać objętość całkowitą 41 µL (2000 pmol każdego oligonukleotydu).
- Inkubować połączone oligonukleotydy w temperaturze 95°C przez 5 min w termocyklerze z temperaturą pokrywy ustawioną na 110°C. Czas odmierzać od momentu osiągnięcia przez próbkę temperatury 95°C, wyłączyć termocykler po 5 min i pozostawić probówki wewnątrz urządzenia na 1 h, aby umożliwić powolne chłodzenie do temperatury pokojowej (RT) i hybrydyzację („annealed adapter”).
- Przygotować mieszaninę reakcyjną do elongacji (Extension Master Mix), łącząc 1× bufor NEB Buffer 2 (5,6 µL stoku 10×), 3,5 mM dideoksynukleotydotrifosforany (dNTPs; 5,6 µL stoku 10 mM), 11,5 U fragmentu Klenowa (2,3 µL stoku 5 U/µL) oraz 2,5 µL wody klasy biologii molekularnej do objętości końcowej 16 µL.
- Pobrać 1 µL zhybrydyzowanego adaptera przygotowanego w kroku 3.3, rozcieńczyć go 1:20 w buforze TElow, oznaczyć alikwot jako „annealed” i przechowywać w temperaturze 4°C do elektroforezy w żelu agarozowym.
- Dodać 16 µL mieszaniny Extension Master Mix do pozostałych 40 µL zhybrydyzowanych oligonukleotydów i dokładnie wymieszać.
- Inkubować reakcję w temperaturze 37°C przez 1 h przy temperaturze pokrywy termocyklera ustawionej na 47°C.
- Oczyścić elongowane oligonukleotydy poprzez precypitację EtOH. Do 56 µL mieszaniny reakcyjnej dodać 28 µL octanu amonu (NH4OAc) i dokładnie wymieszać.
- Przenieść całą reakcję do probówki low-binding o pojemności 1,5 mL i dodać 168 µL lodowatego 96% EtOH.
- Odwrócić probówkę kilka razy i inkubować w temperaturze −20°C przez 30 min, aby wyprecypitować DNA.
- Przygotować 1 mL świeżego 80% EtOH i schłodzić go do −20°C. Wstępnie schłodzić wirówkę do 4°C.
- Wirować przy 14 000 × g przez 30 min.
- Ostrożnie usunąć nadsącz, nie naruszając osadu (pelletu). Dodać 1 mL lodowatego 80% EtOH bez mieszania i odwracania probówki.
- Wirować przy 14 000 × g przez 5 min.
- Usunąć cały pozostały EtOH i suszyć osad DNA na powietrzu przez 10–15 min, aż do zniknięcia widocznego płynu i uzyskania przez osad przezroczystości. Nie doprowadzić do przesuszenia oligonukleotydów.
- Resuspendować osad w 41 µL wody klasy biologii molekularnej.
- Pobrać 1 µL, rozcieńczyć 1:20 w buforze TElow, oznaczyć alikwot jako „extended” i przechowywać w temperaturze 4°C.
- Przygotować mieszaninę reakcyjną do trawienia restrykcyjnego (Restriction Master Mix), łącząc 47 µL wody klasy biologii molekularnej, 1× bufor CutSmart Buffer (10 µL stoku 10×) oraz 15 U HpyCH4III (3 µL stoku 5 U/µL) do objętości końcowej 60 µL.
- Dodać 60 µL mieszaniny Restriction Master Mix do 40 µL oczyszczonych oligonukleotydów i dokładnie wymieszać.
- Inkubować reakcję w temperaturze 37°C przez 16 h przy temperaturze pokrywy termocyklera ustawionej na 47°C.
- Przygotować 6,5 mL świeżego 80% EtOH i schłodzić go do −20°C. Wstępnie schłodzić wirówkę do 4°C.
- Przenieść strawione adaptery do probówki low-binding o pojemności 1,5 mL i dodać 900 µL wody klasy biologii molekularnej.
- Dodać 500 µL NH4OAc i dokładnie wymieszać.
- Rozdzielić roztwór na sześć alikwotów po 250 µL w probówkach low-binding o pojemności 1,5 mL. Do każdej probówki dodać 500 µL lodowatego 96% EtOH.
- Odwrócić probówki kilka razy i inkubować w temperaturze −20°C przez 30 min, aby wyprecypitować DNA.
- Wirować przy 14 000 × g przez 30 min. Ostrożnie usunąć nadsącz, nie naruszając osadu. Do każdej probówki dodać 1 mL lodowatego 80% EtOH bez mieszania i odwracania. Wirować przy 14 000 × g przez 5 min.
- Usunąć cały pozostały EtOH i wysuszyć osady adapterów na powietrzu.
- Resuspendować każdy osad w 6,7 µL buforu Tris-NaCl i połączyć wszystkie sześć suspensji, aby uzyskać objętość końcową 41 µL. Pobrać 1 µL, rozcieńczyć 1:10 w buforze TElow, oznaczyć alikwot jako „cut” i przechowywać w temperaturze 4°C.
- Przygotować alikwoty stoku adaptera i przechowywać je w temperaturze −80°C. Zmierzyć stężenie adaptera oraz wyznaczyć stosunki absorbancji A260/280 i A260/230 alikwotu „cut” za pomocą spektrofotometru. Oczekiwane stężenie adaptera wynosi 30–50 µM, przy stosunku A260/280 >1,7 i stosunku A260/230 >1,9.
- Przeprowadzić elektroforezę alikwotów „annealed”, „extended” i „cut” w 2% żelu agarozowym przy 125 V przez 45 min, aby zweryfikować powstanie adaptera i kompletność trawienia restrykcyjnego (Rycina 1).
UWAGA: Alikwot „annealed” powinien zawierać dwa prążki reprezentujące frakcje zhybrydyzowane i niezhybrydyzowane. Oczekuje się, że zhybrydyzowany adapter będzie migrował na poziomie około 90 bp i będzie składać się z 13-bp regionu dwuniciowego z 68-nt jednoniciowym nawisem, natomiast niezhybrydyzowane oligonukleotydy migrują na poziomie około 60 bp. Po elongacji adapter składa się z 37-bp regionu dwuniciowego z 44-nt nawisem w kształcie litery Y i powinien migrować na poziomie około 110 bp. Po trawieniu restrykcyjnym z adaptera usuwany jest fragment 8-bp. Widoczne powinny być trzy prążki: dominujący prążek na poziomie około 100 bp (finalny adapter) oraz dwa słabe prążki na poziomie około 60 bp (pozostałe niezhybrydyzowane oligonukleotydy) i 8 bp (fragment restrykcyjny).
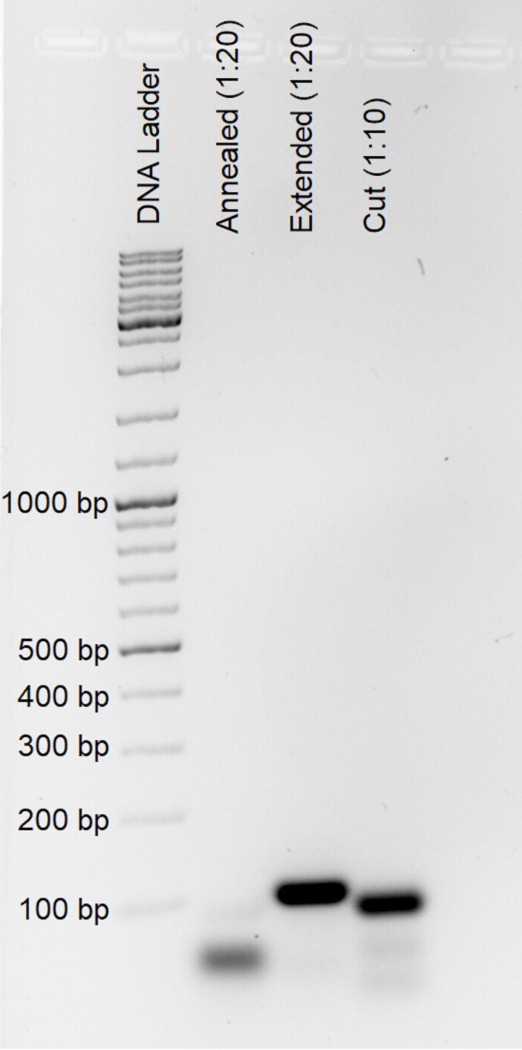
Rycina 1. Reprezentatywna analiza wielkości fragmentów produktów pośrednich oraz końcowych adapterów do sekwencjonowania dupleksowego. Alikwoty pobrane podczas syntezy adapterów po przeprowadzeniu wyżarzania oligonukleotydów („annealed”, rozcieńczenie 1:20), dopełniania nici („extended”, rozcieńczenie 1:20) oraz trawienia restrykcyjnego enzymem HpyCH4III („cut”, rozcieńczenie 1:10) zostały poddane elektroforezie w 2% żelu agarozowym w celu weryfikacji prawidłowego powstania adapterów do sekwencjonowania dupleksowego. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
4. Lizacja pojedynczego oocytu
- Przygotować bufor OLB uzupełniony termolabilną proteinazą K (OLB+), dodając 1 µL termolabilnej proteinazy K (0,120 U/µL) do 99 µL buforu OLB, aby uzyskać końcowe stężenie proteinazy K wynoszące 0,0012 U/µL.
- Odmrozić oocyty w temperaturze pokojowej. Natychmiast dodać 4 µL buforu OLB+ do każdego oocytu. Kilkukrotnie opłukać ścianki probówki buforem lizującym, aby zapewnić całkowite przeniesienie oocytu do buforu i zapobiec przyleganiu próbki do ścianek probówki.
- Dokładnie wymieszać próbkę, krótko odwirować w celu zebrania zawartości na dnie probówki i inkubować w temperaturze 37°C przez 16 h w termocyklerze z temperaturą pokrywy ustawioną na 47°C.
UWAGA: Przed fragmentacją nie przeprowadza się niezależnej oceny lizy oocytów. Inkubacja przez 16 h w określonych warunkach lizy jest zazwyczaj wystarczająca do całkowitej lizy pojedynczego oocytu. Ilość odzyskanego DNA może niemniej jednak różnić się ze względu na straty próbek podczas manipulacji oraz różnice w liczbie kopii mtDNA między oocytami. - Inaktywować termolabilną proteinazę K, inkubując próbki w temperaturze 55°C przez 15 min w termocyklerze z temperaturą pokrywy ustawioną na 75°C.
UWAGA: Kolejne etapy procedury należy przeprowadzić bez przerwy po lizie i inaktywacji proteinazy K, chyba że późniejszy krok protokołu wyraźnie wskazuje punkt zatrzymania.
5. Trawienie egzonukleazą V
- Przed przystąpieniem do dalszych czynności należy pozwolić próbkom wyrównać temperaturę do RT.
- Przygotować Master Mix egzonukleazy V, łącząc 4 µL 25 mM chlorku magnezu (MgCl₂), 1 µL 10 mM Tris-HCl, 1 µL 10 mM trifosforanu adenozyny (ATP) oraz 1 µL egzonukleazy V (stok 10 U/µL), aby uzyskać objętość końcową 7 µL.
- Przygotować roztwór roboczy rybonukleazy A (RNase A) o stężeniu 1 mg/mL poprzez rozcieńczenie 1 µL stoku RNase A o stężeniu 10 mg/mL w 99 µL wody jakości biologii molekularnej. Do każdej próbki lizowanych oocytów dodać około 0,1 µL rozcieńczonego roztworu RNase A.
UWAGA: Na tym etapie należy użyć odpowiedniej pipety. Przy jednoczesnym przetwarzaniu wielu próbek można zastosować odpowiednią pipetę wielokanałową, pod warunkiem zachowania środków ostrożności w celu uniknięcia zanieczyszczeń krzyżowych między próbkami. Ponieważ precyzja pipetowania może spaść przy dozowaniu tak małych objętości pipetą wielokanałową, należy dokładnie sprawdzić wszystkie kanały. Alternatywnie, krótkie zanurzenie końcówki pipety w rozcieńczonym roztworze RNase A jest wystarczające do przeniesienia około 0,1 µL. Niewielkie odchylenia od tej objętości nie wpływają na działanie protokołu. Przybliżoną objętość przenoszenia należy wcześniej zweryfikować za pomocą pipety jednokanałowej. - Do każdej próbki lizowanych oocytów dodać 7 µL Master Mixu egzonukleazy V i dokładnie wymieszać. Próbki inkubować w temperaturze 37°C przez 1 h w termocyklerze z temperaturą pokrywy ustawioną na 47°C.
- Do każdej próbki dodać 38 µL buforu TE, aby uzyskać końcową objętość reakcji około 51 µL. Inaktywować enzymy termicznie poprzez inkubację próbek w temperaturze 70°C przez 30 min w termocyklerze z temperaturą pokrywy ustawioną na 75°C.
- Niezwłocznie przystąpić do przygotowania biblioteki.
6. Fragmentacja
- Poddaj DNA fragmentacji za pomocą sonikacji, aby uzyskać średnią wielkość fragmentów około 550 par zasad (bp).
UWAGA: Niniejszy protokół opisuje fragmentację DNA przy użyciu instrumentu do ogniskowanej sonikacji Covaris M220, zwanego w dalszej części sonikatorem; można jednak stosować równoważne systemy. Ponieważ próbki po lizie zawierają oprócz DNA szczątki komórkowe, należy zoptymalizować warunki fragmentacji dla konkretnego urządzenia i rodzaju próbki, aby uzyskać stosunkowo wąski rozkład wielkości fragmentów skoncentrowany wokół zamierzonej wielkości fragmentu. - Przenieś całą objętość próbki (około 51 µL) do probówki do ogniskowanej sonikacji o pojemności 50 µL.
- Poddaj DNA fragmentacji przez 70 s, stosując Duty Factor 10%, Peak Incident Power 75 W oraz 200 Cycles per Burst w temperaturze 20°C.
- Natychmiast przenieś każdą sfragmentowaną próbkę (około 50 µL) z probówki do fragmentacji do probówki low-binding o pojemności 200 µL, ponieważ probówki do fragmentacji nie mają właściwości low-binding. W tym celu można ponownie wykorzystać oryginalną probówkę do zbierania oocytów. Sprawdź, czy w pokrywce probówki do fragmentacji nie pozostał płyn, i odzyskaj resztki próbki, aby zmaksymalizować jej odzysk.
- Przejdź niezwłocznie do etapu naprawy końców i dodawania ogonków A (A-tailing).
7. Naprawa końców/A-tailing
- Przygotować Master Mix do naprawy końców i dodawania ogonów A (End Repair/A-Tailing Master Mix), zawierający 7 µL buforu End Prep Reaction Buffer oraz 3 µL mieszaniny enzymów End Prep Enzyme Mix.
- Do każdej próbki dodać 10 µL Master Mixu do naprawy końców i dodawania ogonów A, aby uzyskać końcową objętość reakcji 60 µL. Wymieszać dokładnie, pipetując w górę i w dół 10 razy.
- Próbki inkubować w temperaturze 20°C przez 30 min przy wyłączonej pokrywie termocyklera, a następnie w temperaturze 65°C przez 30 min z temperaturą pokrywy ustawioną na 75°C.
- Niezwłocznie przystąpić do ligacji adapterów.
8. Ligacja adapterów
- Przygotować Ligation Master Mix zawierający 30 µL Ligation Mix oraz 1 µL Ligation Enhancer.
- Rozmrozić jedną porcję syntetycznego adaptera i rozcieńczyć go w stosunku 1:4000 w buforze Tris-NaCl.
- Do każdej próbki DNA po naprawie końców i dodaniu ogonków A dodać 1,5 µL rozcieńczonego adaptera. Dodać 31 µL Ligation Master Mix i dokładnie wymieszać.
- Próbki inkubować w temperaturze 20°C przez 15 min. Do każdej próbki dodać 1 µL rozcieńczonego adaptera, aby uzyskać końcową objętość reakcji 93,5 µL. Dokładnie wymieszać i inkubować w temperaturze 4°C przez 16 h.
- Niezwłocznie przystąpić do oczyszczania.
9. Oczyszczanie DNA z przyłączonymi adapterami
- Pozostawić kulki magnetyczne i bufor TElow w temperaturze pokojowej (RT) przez co najmniej 30 min w celu wyrównania temperatury. W tym czasie przygotować świeży 80% EtOH. Przygotować roztwór oligonukleotydu nośnikowego, dodając 1 µL oligonukleotydu nośnikowego (sekwencja niewystępująca w ludzkim genomie; patrz Tabela 2) do 99 µL buforu TElow, aby uzyskać stężenie końcowe 1 nM.
- Przenieść 74,8 µL kulek magnetycznych, co odpowiada stosunkowi kulek do próbki 0,8×, do probówki 1,5 mL o niskiej wiązalności (low-binding). Dodać całą objętość 93,5 µL DNA z przyłączonymi adapterami i dokładnie wymieszać.
- Inkubować mieszaninę kulek i próbki w temperaturze RT przez 15 min. Po 7,5 min delikatnie wymieszać zawiesinę i krótko odwirować probówkę.
- Krótko odwirować probówkę, umieścić ją na statywie magnetycznym i inkubować przez 5 min, aby umożliwić całkowite oddzielenie kulek. Ostrożnie usunąć i odrzucić klarowny nadsącz, a następnie natychmiast zamknąć probówkę.
- Dodać 400 µL 80% EtOH, inkubować przez 30 s i usunąć EtOH. Dodać 200 µL 80% EtOH, inkubować przez 30 s i usunąć EtOH.
- Zdjąć probówkę ze statywu magnetycznego i krótko odwirować. Ponownie umieścić probówkę na statywie magnetycznym, usunąć pozostały EtOH i suszyć kulki na powietrzu przez mniej niż 5 min.
- Dodać 50 µL buforu TElow uzupełnionego o oligonukleotydy nośnikowe. Zdjąć probówkę ze statywu magnetycznego i dokładnie resuspendować kulki poprzez pipetowanie.
- Inkubować zawiesinę w temperaturze RT przez 5 min, okazjonalnie mieszając. Krótko odwirować probówkę, ponownie umieścić ją na statywie magnetycznym i inkubować przez kolejne 5 min.
- Podczas ostatnich 5 min pierwszej separacji magnetycznej przygotować nową probówkę 1,5 mL o niskiej wiązalności zawierającą 40 µL kulek magnetycznych. Przenieść 50 µL eluatu do przygotowanej probówki, aby przeprowadzić drugie oczyszczanie przy stosunku kulek do próbki 0,8×.
- Dokładnie wymieszać i inkubować w temperaturze RT przez 15 min. Po 7,5 min delikatnie wymieszać zawiesinę i krótko odwirować probówkę.
- Umieścić probówkę na statywie magnetycznym i inkubować przez 5 min, aby umożliwić całkowite oddzielenie kulek. Ostrożnie usunąć i odrzucić klarowny nadsącz, a następnie natychmiast zamknąć probówkę.
- Dodać 400 µL 80% EtOH, inkubować przez 30 s i usunąć EtOH. Dodać 200 µL 80% EtOH, inkubować przez 30 s i usunąć EtOH.
- Zdjąć probówkę ze statywu magnetycznego i krótko odwirować. Ponownie umieścić probówkę na statywie magnetycznym, usunąć pozostały EtOH i suszyć kulki na powietrzu przez mniej niż 5 min.
- Dodać 15,5 µL Tris-HCl do każdej próbki. Zdjąć probówkę ze statywu magnetycznego i dokładnie resuspendować kulki poprzez pipetowanie.
- Inkubować zawiesinę w temperaturze RT przez 5 min, okazjonalnie mieszając. Krótko odwirować probówkę, ponownie umieścić ją na statywie magnetycznym i inkubować przez kolejne 5 min.
- Przenieść 15 µL eluatu do nowej probówki 200 µL o niskiej wiązalności. Pobrać 1 µL eluatu i rozcieńczyć go w stosunku 1:10 w Tris-HCl do analiz ilościowego PCR (qPCR) w zakresie attomoli oraz qPCR do wzbogacenia mtDNA (mitochondrialnego DNA).
10. Szacowanie ilości w attomolach
UWAGA: Należy określić przybliżoną ilość DNA z ligacją adapterów, aby dostosować ilość wejściową DNA oraz liczbę cykli w następnych reakcjach PCR do amplifikacji i indeksowania. Ze względu na ograniczoną ilość próbki, bezpośrednie pomiary stężenia mogą być niewiarygodne; dlatego ilość DNA należy oszacować za pomocą qPCR. Produkty amplifikacji należy przeanalizować za pomocą elektroforezy w żelu agarozowym, aby ocenić rozkład wielkości fragmentów i wykryć pozostałe dimery adapterów. Wartości Cq mogą się różnić w zależności od zastosowanych odczynników i urządzenia do PCR w czasie rzeczywistym. Korekty wartości Cq na podstawie wykrycia dimerów adapterów, a także ilości wejściowej DNA i liczby cykli PCR w dalszych etapach, opierają się głównie na obserwacjach empirycznych i mogą wymagać optymalizacji dla poszczególnych preparacji bibliotek.
- Przygotować attomolową mieszaninę Master Mix do qPCR zawierającą na jedną reakcję: 5 µL 2× KAPA HiFi HotStart Reaction Mix (dalej nazywanego 2× mieszaniną do PCR o wysokiej wierności), 1 µL Dual-NEBNext Universal PCR Primer for Illumina (10 µM; dalej nazywanego uniwersalnym starterem do biblioteki), 1 µL startera mws20 (10 µM), 0,5 µL 20× EvaGreen oraz 0,5 µL wody klasy biologii molekularnej.
- Dodać 8 µL mieszaniny Master Mix do każdego wyznaczonego dołka płytki 96-dołkowej kompatybilnej z qPCR. Dodać 2 µL próbki rozcieńczonej w stosunku 1:10, aby uzyskać końcową objętość reakcji 10 µL.
- Uszczelnić płytkę i krótko odwirować przed umieszczeniem w urządzeniu do PCR w czasie rzeczywistym.
- Przeprowadzić qPCR, stosując następujące warunki cykliczności termicznej: 45 s w 98°C, a następnie 45 cykli obejmujących 15 s w 98°C, 30 s w 65°C i 45 s w 72°C.
- Wyznaczyć cykl kwantyfikacji (Cq), ustawiając próg fluorescencji na 1 000 względnych jednostek fluorescencji (RFU).
UWAGA: Należy wybrać próg fluorescencji kompatybilny z urządzeniem do PCR w czasie rzeczywistym i stosować ten sam próg we wszystkich eksperymentach, aby umożliwić porównanie wartości Cq. - Rozdzielić produkty amplifikacji qPCR na żelu agarozowym 1,5% przy napięciu 125 V przez 40 min.
- Sprawdzić żel pod kątem obecności resztkowych dimerów adapterów. Dimery adapterów migrują na poziomie około 130 bp (Rycina 2).
- Jeśli dimery adapterów są widoczne, skorygować wartość Cq, stosując odpowiedni attomolowy współczynnik korekcji Cq (ACF) przedstawiony na Rycynie 2. Wybrać ACF w zależności od intensywności prążka dimerów adapterów zaobserwowanego na żelu agarozowym, posługując się przykładami reprezentatywnymi na Rycynie 2 jako punktem odniesienia. Optymalna wartość Cq skorygowana o ACF mieści się w zakresie 22–26; jednak wartości <29 są zazwyczaj akceptowalne.
UWAGA: Zamiast korygować wartość Cq, w razie potrzeby można przeprowadzić dodatkowe oczyszczanie, co jednak może skutkować znaczną utratą biblioteki. Próbki z silnymi prążkami dimerów adapterów są zazwyczaj powiązane z wysokimi wartościami Cq w attomolowym qPCR, co wskazuje na niską ilość wejściowego DNA. Próbki z wartościami Cq ≥29 zazwyczaj dają duże rozmiary rodzin i niską głębokość sekwencjonowania DNA mitochondrialnego (<100×), w związku z czym mogą zostać wykluczone z sekwencjonowania. Ponieważ wartości Cq zależą od urządzenia do PCR w czasie rzeczywistym oraz warunków testu, należy ustalić specyficzne dla laboratorium wartości odcięcia przy wdrażaniu tego protokołu.
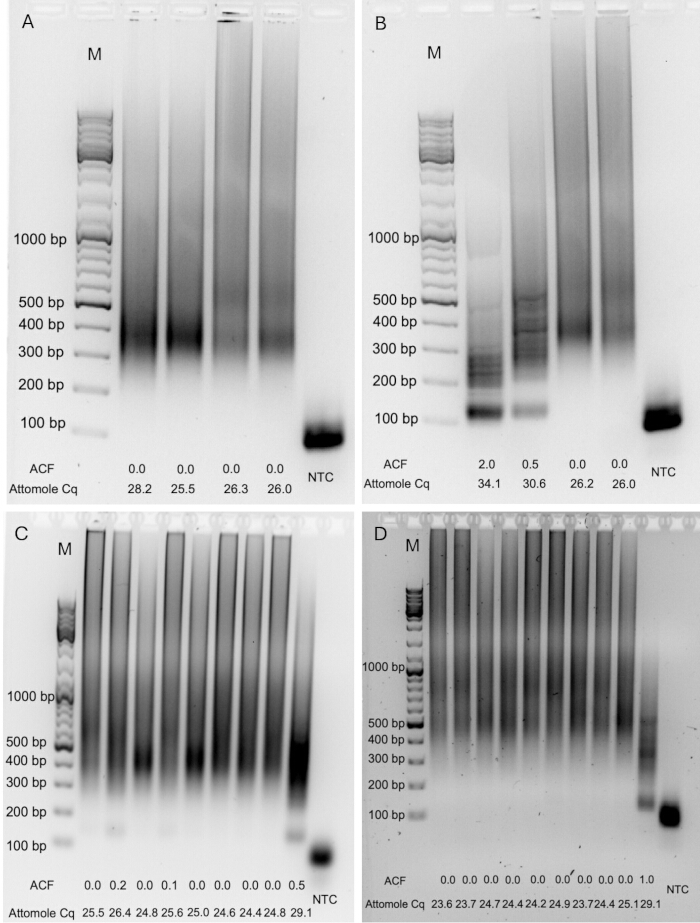
Rycina 2. Reprezentatywne produkty ilościowej PCR (qPCR) w ilości attomoli użyte do oszacowania ilości materiału wejściowego biblioteki oraz identyfikacji dimerów adapterów/starterów. Amplifikowane produkty qPCR w ilości attomoli przeanalizowano za pomocą elektroforezy w 1,5% żelu agarozy, aby ocenić rozkład wielkości fragmentów i wykryć pozostałe dimery adapterów/starterów. (A–D) Reprezentatywne przykłady bibliotek z różną ilością DNA z ligowanymi adapterami i różnym poziomem dimerów adapterów/starterów. Dla każdej próbki przedstawiono czynnik korekcyjny attomola Cq (ACF) oraz odpowiadający mu niekorygowany cykl kwantyfikacji (Cq). M, marker wielkości DNA; NTC, kontrola bez matrycy. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
11. Szacowanie wzbogacenia mtDNA (opcjonalnie)
UWAGA: Oszacuj stopień wzbogacenia mtDNA (mitochondrialnego DNA) za pomocą qPCR, stosując primery skierowane przeciwko mitochondrialnemu genowi ND6 oraz jądrowym elementom Alu. Oblicz różnicę w wartościach Cq między celami jądrowymi a mitochondrialnymi, aby oszacować wzbogacenie mtDNA. Wykorzystaj bezwzględną wartość Cq celu mitochondrialnego do oszacowania ilości mtDNA w próbce. Wartości Cq mogą się różnić w zależności od zastosowanych odczynników, materiałów eksploatacyjnych oraz urządzenia do PCR w czasie rzeczywistym. Dostosuj sekwencje primerów dla innych gatunków. W celu uzyskania primerów specyficznych dla myszy i makaków zapoznaj się z poprzednimi publikacjami12,13. Ten krok jest opcjonalny i służy do orientacyjnego oszacowania wzbogacenia mtDNA przed sekwencjonowaniem.
- Przygotować oddzielne mieszaniny Master Mix dla celów mitochondrialnych i jądrowych. Dla każdej reakcji połączyć 5 µL 2× PowerUp SYBR Green Mix, 0,4 µL każdego primera z odpowiedniej pary primerów (każdy 10 µM) oraz 2,1 µL wody klasy biologii molekularnej.
- Dodać 8 µL odpowiedniego Master Mix do każdego wyznaczonego dołka płytki 96-dołkowej kompatybilnej z qPCR. Dodać 2 µL próbki rozcieńczonej w stosunku 1:10, aby uzyskać końcową objętość reakcji 10 µL.
- Uszczelnić płytkę i krótko odwirować ją przed umieszczeniem w urządzeniu do PCR w czasie rzeczywistym.
- Przeprowadzić qPCR, stosując następujące warunki cyklicznej obróbki termicznej: 2 min w 95°C, a następnie 45 cykli obejmujących 15 s w 95°C, 20 s w 56°C oraz 30 s w 72°C.
- Wyznaczyć Cq, ustawiając próg fluorescencji na 100 RFU.
UWAGA: Należy wybrać próg fluorescencji kompatybilny z urządzeniem do PCR w czasie rzeczywistym i stosować ten sam próg we wszystkich eksperymentach, aby umożliwić porównanie wartości Cq. Po sekwencjonowaniu należy powiązać wartości Cq z wydajnością wzbogacenia uzyskaną z sekwencjonowania i wykorzystać te wartości jako referencje dla późniejszych przygotowań bibliotek. - Obliczyć ΔCq związane z wzbogaceniem, odejmując Cq celu jądrowego od Cq celu mitochondrialnego (CqmtDNA − CqnDNA). Po uzyskaniu wstępnych danych z sekwencjonowania należy wygenerować specyficzną dla laboratorium krzywą wzorcową w celu oszacowania proporcji odczytów z sekwencjonowania pochodzących z mtDNA.
UWAGA: Jeśli dane z sekwencjonowania nie są jeszcze dostępne, można użyć Równania 1, aby uzyskać przybliżoną wartość oczekiwanego procentu odczytów z sekwencjonowania pochodzących z mtDNA, korzystając z przykładowej krzywej wzorcowej wygenerowanej z siedmiu bibliotek oocytów (ΔCq = −0,8, 16,83%; ΔCq = −2,1, 33,62%; ΔCq = −3,0, 45,57%; ΔCq = −3,9, 60,34%; ΔCq = −5,0, 77,98%; ΔCq = −6,2, 89,25%; ΔCq = −8,4, 95,09%). Aby zapewnić wydajne usunięcie DNA jądrowego, należy osiągnąć wartość ΔCq <−1. Niższa wydajność wzbogacenia może zostać skompensowana poprzez przydzielenie dodatkowych odczytów z sekwencjonowania w celu uzyskania wystarczającej głębokości sekwencjonowania mtDNA; może to jednak zwiększyć zanieczyszczenie segmentami mitochondrialnego DNA w jądrze komórkowym (NUMT). Ponieważ zależność między ΔCq a zawartością mtDNA zależy od odczynników, materiałów eksploatacyjnych, aparatury i warunków eksperymentalnych, Równanie 1 należy traktować jako przykładową kalibrację i wszędzie tam, gdzie to możliwe, należy ustanowić specyficzne dla laboratorium krzywe wzorcowe.
Szacowane mtDNA (%) = −11,006 × ΔCq + 13,776 (1)
12. Amplifikacja biblioteki
UWAGA: Pierwszą amplifikację należy przeprowadzić w dwóch następujących po sobie etapach PCR. Pierwszą reakcję PCR wykonuje się przy użyciu pojedynczej startera w celu uzyskania amplifikacji liniowej. Następnie dodaje się drugiego startera, aby umożliwić amplifikację wykładniczą podczas drugiej reakcji PCR.
- Wyznacz ilość DNA wejściowego do pierwszej amplifikacji PCR, korzystając z wyników attomolowego qPCR.
- W przypadku bibliotek z pojedynczego oocytu należy używać próbek, których wartość Cq w attomolowym qPCR jest zazwyczaj większa niż 22. Jeśli próbka ma niższą wartość Cq, należy ją rozcieńczyć do wartości Cq wynoszącej około 22 zgodnie z Tabelą 3. Biblioteki z wartościami Cq ≥29 zazwyczaj charakteryzują się dużymi rozmiarami rodzin i niską głębokością sekwencjonowania mtDNA, dlatego nie są zalecane do dalszego przygotowania biblioteki lub sekwencjonowania.
- Przygotuj Master Mix do amplifikacji zawierający 20 µL 2× mieszaniny do PCR o wysokiej wierności (high-fidelity) oraz 4 µL primera mws20 (10 µM) na jedną reakcję.
- Dodaj 24 µL Master Mixu do amplifikacji do 14 µL rozcieńczonej próbki.
- Przeprowadź liniową amplifikację PCR, stosując następujące warunki cyklicznego termostatowania: 45 s w 98°C, a następnie 12 cykli: 15 s w 98°C, 30 s w 60°C i 45 s w 72°C, zakończonych etapem 2 min w 72°C.
- Dodaj 4 µL uniwersalnego primera bibliotecznego (10 µM) i dokładnie wymieszaj.
- Przeprowadź wykładniczą amplifikację PCR, stosując następujące warunki cyklicznego termostatowania: 45 s w 98°C, a następnie 9 cykli: 15 s w 98°C, 30 s w 65°C i 45 s w 72°C, zakończonych 2 minutową elongacją w 72°C.
UWAGA: Po zakończeniu pierwszej amplifikacji próbki można przechowywać w 4°C i w razie potrzeby wznowić protokół w późniejszym czasie. Wszystkie poprzednie kroki, od lizy oocytów do pierwszej amplifikacji, należy przeprowadzić bez przerwy. - Dodaj 10 µL wody klasy biologii molekularnej do każdej próbki.
- Oczyść amplifikowane DNA, używając 40 µL kulek magnetycznych (0,8× objętości próbki), zgodnie z drugą procedurą oczyszczania kulkami magnetycznymi opisaną w krokach 9.9–9.15. Przemyj kulki dwukrotnie 200 µL 80% EtOH, eluuj DNA w 15,5 µL Tris-HCl i przenieś 15 µL eluatu do nowej probówki 200 µL o niskim wiązaniu (low-binding).
UWAGA: Jest to odpowiedni moment na przerwanie pracy. Oczyszczone DNA należy przechowywać w 4°C lub bezzwłocznie przejść do indeksowania.
Tabela 3: Czynniki rozcieńczenia i odpowiadające im czynniki korekcyjne cyklu kwantyfikacji (Cq) ilościowej reakcji polimerazy w łańcuchu (qPCR), stosowane do standaryzacji ilości wprowadzanego DNA w pierwszej reakcji PCR amplifikacji biblioteki. Próbki z wartościami qPCR Cq w attomolach poniżej wartości docelowej rozcieńczono wodą klasy biologii molekularnej przed pierwszą reakcją PCR amplifikacji. Skorygowaną wartość Cq uzyskano poprzez dodanie odpowiedniego czynnika korekcji rozcieńczenia do eksperymentalnie zmierzonej wartości Cq, a następnie wykorzystano ją do określenia liczby cykli PCR indeksowania oraz docelowej głębokości sekwencjonowania (Tabela 4). Objętości próbki i wody zapewniają końcową objętość wsadu wynoszącą 14 µL dla pierwszej reakcji PCR amplifikacji. Gwiazdka (*) oznacza, że wymieniony czynnik korekcji rozcieńczenia należy dodać do eksperymentalnie zmierzonej wartości qPCR Cq w attomolach, aby uzyskać skorygowaną wartość Cq. Czynniki korekcyjne zostały określone empirycznie dla tego schematu postępowania. Kliknij tutaj, aby pobrać ten plik.
13. Indeksowanie
- Wyznaczyć liczbę cykli PCR indeksującego, korzystając z wartości Cq z qPCR w attomolach, skorygowanej o dimery i rozcieńczenie, zgodnie z Tabelą 4.
- Przygotować master mix do indeksowania zawierający 25 µL mieszanki 2× high-fidelity PCR mix oraz 10 µL par starterów Unique Dual Index Primer Pair o stężeniu 10 µM dla każdej próbki.
- Dodać 35 µL master mixu do indeksowania do 15 µL każdej amplifikowanej próbki.
- Przeprowadzić PCR indeksujący w następujących warunkach cyklicznych: 45 s w 98°C, a następnie odpowiednią liczbę cykli składających się z 15 s w 98°C, 30 s w 65°C i 45 s w 72°C, kończąc finalną elongacją w 72°C przez 2 min.
- Oczyścić zaindeksowane biblioteki, używając 40 µL kulek magnetycznych (0,8× objętości próbki). Przemyć kuleczki dwukrotnie 80% EtOH i eluować DNA do 21 µL buforu TElow.
- Przenieść eluat do probówki typu DNA low-binding.
- Zmierzyć stężenie DNA za pomocą zestawu Qubit High Sensitivity DNA Assay lub równoważnego testu fluorometrycznego.
- Przechowywać biblioteki w temperaturze 4°C przed sekwencjonowaniem lub w −80°C w przypadku długoterminowego przechowywania.
UWAGA: Jest to bezpieczny punkt przerwania procedury.
Tabela 4: Liczba cykli indeksującej reakcji łańcuchowej polimerazy (PCR) oraz docelowa głębokość sekwencjonowania określone na podstawie skorygowanego cyklu kwantyfikacji (Cq) ilościowej reakcji łańcuchowej polimerazy (qPCR) w attomolach.Skorygowana wartość Cq obejmuje eksperymentalnie zmierzoną wartość Cq qPCR w attomolach wraz z ewentualnym współczynnikiem korekcji dimerów adapterów (Rycina 2) oraz współczynnikiem korekcji rozcieńczenia (Tabela 3). Skorygowana wartość Cq została wykorzystana do określenia zarówno liczby cykli indeksującego PCR, jak i zalecanej liczby odczytów sekwencjonowania typu paired-end przypisanych do każdej biblioteki w celu ich połączenia (pooling). Przydziały docelowych odczytów sekwencjonowania służą jako wstępne wytyczne i mogą wymagać optymalizacji specyficznej dla danego laboratorium w zależności od urządzenia do PCR w czasie rzeczywistym, platformy sekwencjonowania, strategii multipleksowania oraz wymagań eksperymentalnych. Kliknij tutaj, aby pobrać ten plik.
14. Kontrola jakości
- Oceń jakość biblioteki, rozkład wielkości fragmentów oraz obecność pozostałości adapterów lub dimerów primerów za pomocą Bioanalizatora, TapeStation lub równoważnego instrumentu do analizy fragmentów kwasów nukleinowych. Wielkość fragmentów powinna mieścić się w zakresie od około 300 do 1 000 bp. Małe piki pozostałościowe (<5% intensywności fluorescencji próbki [RFU] w śladzie z Bioanalizatora) były zazwyczaj dopuszczalne (Rysunek 3A–D). Pozostałości adapterów lub dimery primerów pojawiały się jako wyraźne piki przy około 70–150 bp (Rysunek 3E–H). Końcowe stężenie biblioteki powinno wynosić co najmniej 5 ng/µL. W przypadku niespełnienia któregokolwiek z tych kryteriów jakościowych należy odnieść się do Pliku uzupełniającego 1 (Przewodnik rozwiązywania problemów).
- (Opcjonalnie) Jeśli wykryto dimery adapterów lub primerów (Rysunek 3E–H), dostosuj objętość biblioteki do 50 µL za pomocą wody klasy biologii molekularnej, dodaj 40 µL kulek magnetycznych (0,8× objętości próbki) i przeprowadź dodatkową puryfikację. Przemyj kulki dwukrotnie 80% EtOH i eluuj oczyszczoną bibliotekę w 21,5 µL buforu TElow.
- (Opcjonalnie) Powtórz analizę kontroli jakości (Krok 14.1), aby potwierdzić całkowite usunięcie dimerów adapterów i primerów.
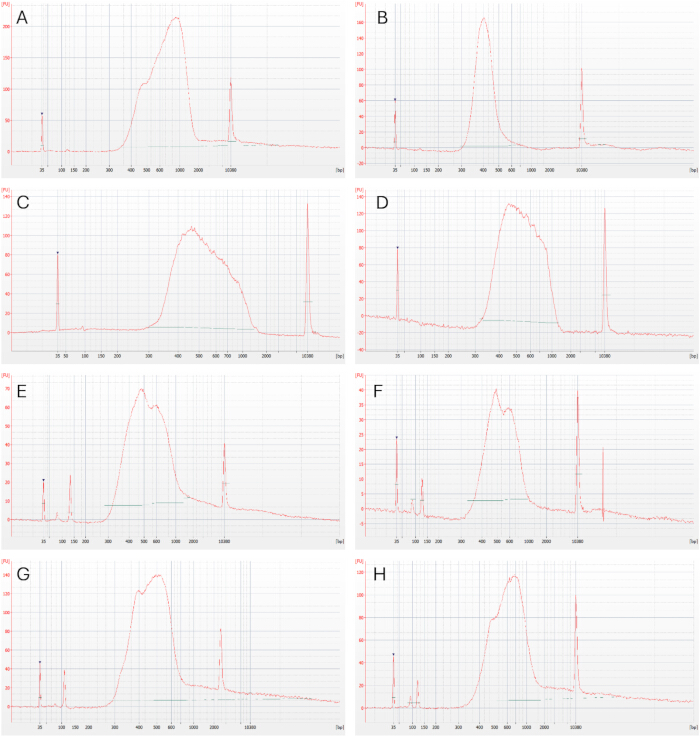
Rycina 3. Reprezentatywna analiza fragmentów zaindeksowanych bibliotek sekwencyjnych. Reprezentatywne elektroferogramy wygenerowane podczas analizy fragmentów za pomocą Bioanalyzer, przedstawiające jakość biblioteki po PCR indeksującej. (A–D) Biblioteki z oczekiwanym rozkładem wielkości fragmentów (około 300-1000 bp) i brakiem wykrywalnych dimerów adapterów/starterów, odpowiednie do sekwencjonowania bez dodatkowego oczyszczania. (E–H) Biblioteki zawierające pozostałości dimerów adapterów i/lub starterów, które wymagają dodatkowego oczyszczania za pomocą kulek magnetycznych przed sekwencjonowaniem. Piki przy około 35 bp i 10 380 bp odpowiadają odpowiednio dolnemu i górnemu markerowi wewnętrznemu. Kliknij tutaj, aby wyświetlić większą wersję tej ryciny.
15. Poolowanie i sekwencjonowanie
- Zmierz stężenie każdej zaindeksowanej biblioteki za pomocą testu ilościowego bibliotek opartego na qPCR, kompatybilnego z bibliotekami przygotowanymi do systemu Illumina, np. Collibri Library Quantification Kit, zgodnie z protokołem producenta. Rozcieńcz każdą bibliotekę w stosunku 1:100 000 w dostarczonym buforze do rozcieńczania bibliotek i przeanalizuj każdą próbkę w co najmniej dwóch powtórzeniach; zaleca się pomiary w trzech powtórzeniach. Przeanalizuj wzorce w trzech powtórzeniach.
- Oblicz średnią wartość cyklu kwantyfikacji (Cq) dla każdej próbki i wzorca. Wygeneruj krzywą wzorcową na podstawie średnich wartości Cq wzorców i oblicz stężenie każdej biblioteki zgodnie z instrukcjami producenta.
- Połącz biblioteki (pooling) zgodnie z planowaną liczbą odczytów typu paired-end, określoną na podstawie wartości Cq qPCR w attomolach skorygowanej o dimery adapterów i rozcieńczenie, uzyskanej w kroku 10, oraz zgodnie z przydziałami podanymi w Tabeli 4.
UWAGA: Stosunek łączenia zależy od skorygowanej wartości Cq każdej biblioteki oocytów i odpowiadającej jej docelowej liczby odczytów paired-end. Wartości w Tabeli 4 są przybliżone i mogą się różnić w zależności od instrumentu do PCR w czasie rzeczywistym. Należy ustalić wartości specyficzne dla laboratorium w celu uzyskania optymalnych wyników. - Oblicz względną frakcję łączenia dla każdej biblioteki, dzieląc jej docelową liczbę odczytów paired-end przez sumę odczytów docelowych przypisanych do wszystkich bibliotek. Określ wymaganą ilość każdej biblioteki, mnożąc tę frakcję przez całkowitą ilość molową końcowej puli, a następnie oblicz odpowiadającą jej objętość biblioteki na podstawie zmierzonego stężenia molowego. Połącz obliczone objętości, aby utworzyć końcową pulę.
- Sekwencjonuj połączone biblioteki przy użyciu platformy sekwencjonującej Illumina lub innej platformy kompatybilnej z sekwencjami adapterów Illumina. Zastosuj konfigurację paired-end z minimalną długością odczytu 2 × 150 bp. Zaleca się dłuższe odczyty, takie jak 2 × 250 lub 2 × 300 bp, ponieważ poprawiają one zdolność do identyfikacji i filtrowania odczytów pochodzących z krótszych segmentów mitochondrialnego DNA jądrowego (NUMTs).
- Sekwencjonuj połączone biblioteki, np. na platformie Illumina NovaSeq 6000, stosując dwukanałową chemię sekwencjonowania przez syntezę (sequencing-by-synthesis) z zestawem SP Reagent Kit v1.5 (500 cykli) i konfiguracją paired-end 2 × 250 bp, zawierającą 5% domieszki PhiX. Załaduj bibliotekę i przeprowadź sekwencjonowanie zgodnie z instrukcjami producenta. Reprezentatywna wydajność sekwencjonowania powinna osiągnąć ≥75% zasad z wynikiem jakości ≥Q30 oraz ≥60% klastrów przechodzących filtrację.
16. Analiza bioinformatyczna
UWAGA: Poniższy schemat opisuje analizę danych w systemie Galaxy z wykorzystaniem narzędzi analitycznych Du Novo8,14,15. Analizę można również przeprowadzić przy użyciu lokalnej instalacji Du Novo lub innego oprogramowania opracowanego dla danych sekwencjonowania dupleksowego.
- Prześlij zdemultipleksowane pliki FASTQ typu paired-end, wygenerowane za pomocą BCL Convert lub równoważnego narzędzia do demultipleksowania, do lokalnej instalacji Galaxy lub publicznie dostępnej instancji Galaxy14.
- Oceń jakość odczytów sekwencjonowania za pomocą FastQC (Galaxy wersja 0.72+galaxy1). Przeanalizuj co najmniej moduły Per Base Sequence Quality, Per Sequence GC Content oraz Adapter Content.
- Wygeneruj jednoniciowe sekwencje konsensusowe (SSCS) oraz DCS z zdemultipleksowanych plików FASTQ typu paired-end, korzystając z potoku Du Novo (Galaxy wersja 3.0.2). Do tworzenia SSCS zastosuj minimalną wielkość rodziny wynoszącą trzy odczyty i wyznacz nukleotyd konsensusowy, gdy występuje on w co najmniej 70% odczytów15. Włącz korekcję błędów kodów kreskowych z dopuszczalnością do trzech niedopasowań. Szczegółowe instrukcje dotyczące korzystania z potoku znajdują się w tutorialu Du Novo w Galaxy Training Network16.
- Użyj Sequence Content Trimmer (Galaxy wersja 0.2.3), aby usunąć zasady reprezentowane przez „NRYSWKMBDHV” i odrzuć odczyty krótsze niż 10 bp.
- Przytnij pierwsze 10 nukleotydów z końca 5′ każdego DCS za pomocą FASTQ Trimmer (Galaxy wersja 1.1.5), aby zredukować błąd związany z naprawą końców. Dopasuj przycięte odczyty DCS do ludzkiego genomu referencyjnego, takiego jak GRCh38.p14 zawierający zrewidowaną sekwencję referencyjną Cambridge (rCRS; NC_012920.1), używając BWA-MEM (Galaxy wersja 0.7.17.1).
UWAGA: Można stosować inne wersje genomu ludzkiego, w tym T2T-CHM13v2.0 lub nowsze wersje. - Przefiltruj pliki BAM za pomocą BAMTools Filter BAM datasets on a variety of attributes (Galaxy wersja 2.5.2+galaxy1). Zachowaj odczyty o jakości mapowania >20, które mapują się do chrM, stanowią dopasowania pierwotne (primary alignments), są sparowane, są poprawnie sparowane i mają zmapowaną parę. Kryteria te ograniczają potencjalne dopasowania pochodzące z NUMT17.
- Wyrównaj odczyty do lewej za pomocą Bam Left Align (Galaxy wersja 1.3.1). Przytnij nakładające się regiony sparowanych odczytów DCS za pomocą BAMUtil clipOverlap (Galaxy wersja 1.0.15+galaxy1).
- Wyznacz warianty jednonukleotydowe (SNV) oraz insercje/delecje (indele) za pomocą Call variants with LoFreq (Galaxy wersja 2.1.5+galaxy2) z ustawieniami domyślnymi.
- Wyklucz sparowane odczyty DCS zawierające więcej niż dwa warianty, jeśli występują, aby zredukować potencjalną kontaminację NUMT. Próbki z wydajnym wzbogaceniem mtDNA są zazwyczaj wolne od wykrywalnych odczytów pochodzących z NUMT; jednak niewystarczające usunięcie DNA jądrowego może skutkować obecnością sekwencji pochodzących z NUMT.
- Przeanalizuj każdą bibliotekę pod kątem potencjalnej kontaminacji krzyżowej między próbkami, wykorzystując różnice w sekwencjach mtDNA specyficzne dla dawcy, w tym warianty utrwalone i wysokoczęstotliwościowe heteroplazmie. W przypadku wykrycia kontaminacji krzyżowej zastosuj środki ostrożności opisane w Supplementary File 1 (Troubleshooting Guide). Jeśli rozkład wielkości fragmentów wykracza poza zalecany zakres lub średnia wielkość fragmentu wynosi >900 bp, przeprowadź podwójne oczyszczanie z selekcją wielkości, jak opisano wcześniej18.
- Przeprowadź dalsze analizy wykrytych wariantów zgodnie z celami badania.
- Do dalszych analiz włącz tylko próbki ze średnią głębokością sekwencjonowania mitochondrialnego DCS ≥100×. Nie stosowano stałych progów minimalnych dla liczby odczytów paired-end ani dla wydajności SSCS lub DCS.
Wyniki
Biblioteki do sekwencjonowania duplex przygotowano z ludzkich oocytów reprezentujących różne stadia dojrzewania, w tym oocytów w stadium pęcherzyka zarodkowego (GV), metafazy I (MI), MII, stadium pronukleusowego (0PN) oraz oocytów TI. Prawidłowo przygotowane biblioteki zsekwencjonowano na platformie Illumina NovaSeq 6000 przy użyciu ogniwa przepływowego SP z odczytami parzystymi 2 × 250 bp. Analizę danych przeprowadzono w środowisku Galaxy przy użyciu potoku Du Novo w celu grupowania rodzin odczytów i generowania odczytów konsensusowych8,14,15. Reprezentatywne wskaźniki sekwencjonowania dla poprawnie przetworzonych bibliotek podsumowano w Tabeli uzupełniającej 1, natomiast próbki, które podczas przygotowania biblioteki dały suboptymalne wyniki i zostały wykluczone z sekwencjonowania, podsumowano w Tabeli uzupełniającej 2.
W trakcie przygotowywania biblioteki wykonano kilka etapów kontroli jakości w celu oceny ilości DNA z przyłączonymi adapterami, wzbogacenia mtDNA, stężenia biblioteki oraz rozkładu wielkości fragmentów. Pierwszym krokiem kontroli jakości był test attomole qPCR, który służył do oszacowania ilości DNA z przyłączonymi adapterami (Rysunek 4A,B). Obliczoną wartość cyklu kwantyfikacji (Cq) skorygowano w przypadku wykrycia dimerów adapterów lub starterów podczas elektroforezy żelowej produktów amplifikacji qPCR (Rysunek 2A–D). Dimery adapterów lub starterów obserwowano zazwyczaj w próbkach o wyższych wartościach Cq, co wskazywało na mniejsze ilości DNA z przyłączonymi adapterami. Stosując warunki opisane w niniejszym protokole, uzyskano średnią skorygowaną wartość Cq dla attomole qPCR równą 25,8 (Tabela uzupełniająca 1). Na podstawie skorygowanej wartości Cq dostosowano ilość DNA wejściowego do pierwszej amplifikacji PCR zgodnie ze schematem rozcieńczeń przedstawionym w Tabeli 3. Próbki ze skorygowanymi wartościami Cq ≥22 stosowano bez rozcieńczania, natomiast próbki ze skorygowanymi wartościami Cq <22 rozcieńczano przed amplifikacją. Korekta ta została przeprowadzona w celu optymalizacji wielkości rodzin odczytów i zmniejszenia liczby wymaganych odczytów sekwencjonowania. Próbki ze skorygowanymi wartościami Cq >28 generowały zazwyczaj większe rodziny odczytów (średnia wielkość rodziny 21,8), co skutkowało mniejszą liczbą DCS i średnią głębokością sekwencjonowania mtDNA <200× (Tabela uzupełniająca 1). Doprowadzenie skorygowanej wartości Cq do zakresu 22–28 zaowocowało średnią wielkością rodziny 7,91, co jest bliskie wielkości rodziny wynoszącej około sześciu, którą wcześniej zgłoszono jako optymalną dla sekwencjonowania dupleksowego6,7. Niemniej jednak większe rodziny mogą być korzystne w przypadku próbek o bardzo niskiej ilości materiału wyjściowego, takich jak pojedyncze oocyty, ponieważ mogą one zwiększyć głębokość sekwencjonowania.
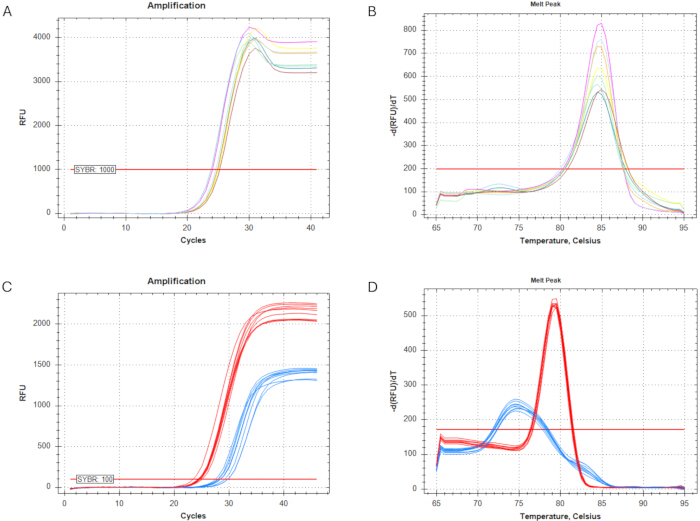
Rycina 4. Analizy ilościowej PCR (qPCR) wykorzystane do kwantyfikacji biblioteki i oszacowania stopnia wzbogacenia w mitochondrialne DNA (mtDNA). Oczyszczone DNA z przyłączonymi adapterami rozcieńczono 1:10 przed analizą qPCR. (A) Krzywe amplifikacji z analizy qPCR attomole wykorzystanej do oszacowania ilości DNA z przyłączonymi adapterami. Próg fluorescencji ustawiono na 1 000 względnych jednostek fluorescencji (RFU). (B) Analiza krzywych topnienia z analizy qPCR attomole. (C) Krzywe amplifikacji z analizy qPCR stopnia wzbogacenia w mtDNA. Próg fluorescencji ustawiono na 100 RFU. Amplifikacja mitochondrialnego celu subjednostki 6 dehydrogenazy NADH (ND6) jest zaznaczona kolorem czerwonym, a amplifikacja jądrowego celu elementu powtarzalnego Alu kolorem niebieskim. (D) Analiza krzywych topnienia mitochondrialnych i jądrowych produktów qPCR. Kliknij tutaj, aby zobaczyć powiększoną wersję tej ryciny.
Przed łączeniem bibliotek wszystkie biblioteki przeanalizowano za pomocą Bioanalyzer lub TapeStation w celu oceny rozkładu wielkości fragmentów oraz wykrycia pozostałości dimerów adapterów lub starterów. Reprezentatywne przykłady optymalnych bibliotek oraz bibliotek zawierających pozostałości dimerów adapterów lub starterów przedstawiono na Ryc. 3A–H. Dimery adapterów lub starterów pojawiły się jako piki w zakresie około 70–150 bp (Ryc. 3E–H); w przypadku ich wykrycia biblioteki poddano dodatkowemu oczyszczaniu za pomocą kulek magnetycznych przed sekwencjonowaniem. Ponieważ celowo pominięto selekcję wielkości w celu zminimalizowania strat próbek, sekwencjonowane biblioteki miały medianę wielkości insertu wynoszącą 275 bp (Tabela uzupełniająca 1).
Wzbogacenie mtDNA oszacowano za pomocą qPCR, wykorzystując loci docelowe mitochondrialne i jądrowe, co pozwoliło na przewidzenie proporcji odczytów sekwencjonowania, które powinny zmapować do genomu mitochondrialnego (Rycyna 4C,D). Średnie wartości Cq wynosiły 25,2 dla celu mitochondrialnego i 29,7 dla celu jądrowego (Tabela uzupełniająca 1), co odpowiada średniej wartości ΔCq (CqmtDNA − CqnDNA) wynoszącej −4,5. Średnio 67,5% parzystych odczytów sekwencjonowania zmapowało do referencyjnego genomu mitochondrialnego. Podczas łączenia bibliotek uwzględniono zarówno szacunkowe wzbogacenie mtDNA, jak i skorygowaną wartość Cq qPCR wyrażoną w attomolach. Bibliotekom o wyższych skorygowanych wartościach Cq i bardziej efektywnym wzbogaceniu mtDNA przypisano proporcjonalnie mniej odczytów sekwencjonowania, zgodnie ze schematem alokacji sekwencjonowania przedstawionym w Tabeli 4, aby zapewnić zrównoważoną wydajność sekwencjonowania we wszystkich próbkach.
Na podstawie skorygowanych wartości Cq z qPCR dla attomoli przypisano średnią alokację celu wynoszącą 4 miliony odczytów paired-end na bibliotekę (Tabela 4). Ze względu na niewydajną generację klastrów, po sekwencjonowaniu uzyskano średnio 1,3 miliona odczytów paired-end na bibliotekę; jednak wydajność sekwencjonowania ta była wystarczająca do późniejszej analizy duplex sequencing (Tabela uzupełniająca 1). Mapowanie DCS do mitochondrialnego genomu referencyjnego pozwoliło uzyskać medianę głębokości sekwencjonowania wynoszącą 567× w całym genomie mitochondrialnym (Rysunek 5A,B,D; Tabela uzupełniająca 1). Średnio na bibliotekę wygenerowano 344 554 SSCS oraz 96 322 DCS (Tabela uzupełniająca 1). Powstałe biblioteki miały średnią wielkość rodziny odczytów wynoszącą 8,32, przy czym większe rozmiary rodzin obserwowano zazwyczaj w bibliotekach o wyższych skorygowanych wartościach Cq z qPCR dla attomoli (Rysunek 5C,E; Tabela uzupełniająca 1). Wyniki te są spójne z uzyskanymi w poprzednim badaniu przeprowadzonym przy optymalnej gęstości klastrów, w którym osiągnięto medianę głębokości sekwencjonowania mtDNA wynoszącą 1 440×19.
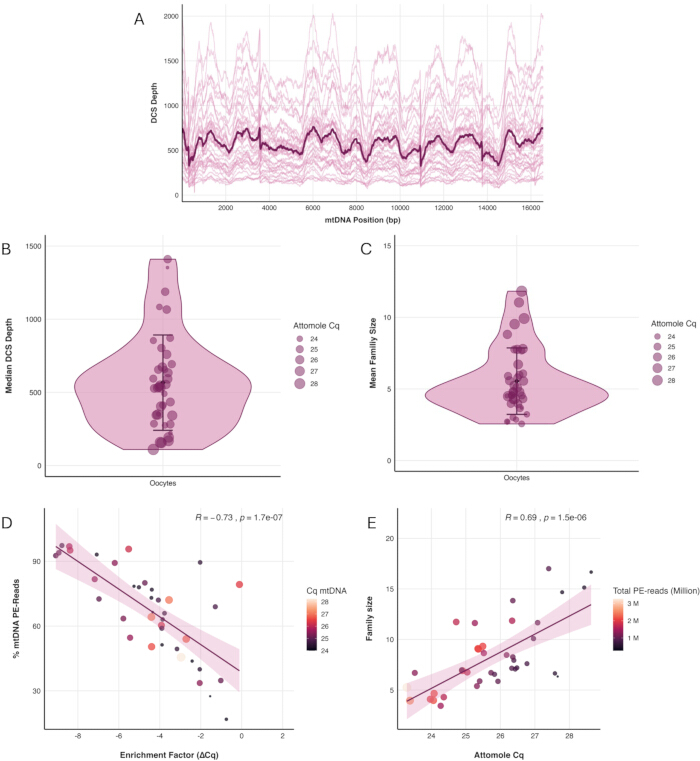
Rycina 5. Wydajność sekwencjonowania bibliotek duplex sequencing z pojedynczych oocytów. (A) Głębokość sekwencji konsensusu duplex (DCS) w obrębie genomu mitochondrialnego. Cienkie linie reprezentują poszczególne biblioteki, a pogrubiona linia reprezentuje średnią głębokość dla wszystkich bibliotek. (B) Rozkład mediany głębokości DCS dla poszczególnych bibliotek. (C) Rozkład średniej wielkości rodziny DCS dla poszczególnych bibliotek. Na wykresach (B) i (C) każdy punkt reprezentuje jedną bibliotekę, a kolor punktu wskazuje cykl kwantyfikacji qPCR w attomolach (Cq). (D) Korelacja Pearsona pomiędzy szacunkiem wzbogacenia mtDNA (ΔCq) a proporcją odczytów sekwencjonowania dopasowanych do referencyjnego genomu mitochondrialnego. (E) Korelacja Pearsona pomiędzy wartością Cq z qPCR w attomolach a średnią wielkością rodziny DCS. Na wykresach (D) i (E) każdy punkt reprezentuje jedną bibliotekę; kolor punktu wskazuje wartość Cq z qPCR w attomolach, a rozmiar punktu reprezentuje całkowitą liczbę odczytów paired-end uzyskanych dla danej biblioteki. n = 39 bibliotek. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Tabela uzupełniająca 1. Metryki sekwencjonowania i jakości bibliotek dla optymalnych bibliotek duplex sequencing oocytów ludzkich. Tabela ta podsumowuje metryki jakości bibliotek przed sekwencjonowaniem, pomiary ilościowej reakcji polimerazy łańcuchowej (qPCR), wydajność sekwencjonowania oraz wyniki analizy duplex sequencing dla bibliotek, które przeszły kontrolę jakości i zostały uwzględnione w dalszych analizach. Raportowane parametry obejmują stadium rozwoju oocytu, wyniki qPCR wzbogacenia mitochondrialnego DNA (mtDNA), pomiary qPCR w attomolach, współczynnik korekcji dimerów adapterów (ACF), liczbę cykli PCR indeksowania, zamierzoną głębokość sekwencjonowania paired-end, stężenie biblioteki, wydajność sekwencjonowania, wzbogacenie mtDNA, liczbę odczytów dla sekwencji konsensusu pojedynczej nici (SSCS) i sekwencji konsensusu duplex (DCS), statystyki wielkości rodziny, głębokość sekwencjonowania oraz rozkłady wielkości insertów. Identyfikatory próbek zostały zanonimizowane przed analizą. Zamierzone liczby odczytów paired-end przypisano zgodnie z poprawioną wartością cyklu kwantyfikacji (Cq) z qPCR w attomolach (Tabela 4). Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 2. Metryki jakości przed sekwencjonowaniem dla suboptymalnych bibliotek oocytów ludzkich wykluczonych z późniejszych analiz sekwencjonowania dupleksowego. Tabela ta podsumowuje wyniki kontroli jakości przed sekwencjonowaniem dla bibliotek, które nie spełniły kryteriów włączenia do późniejszych analiz sekwencjonowania. Raportowane parametry obejmują identyfikator próbki, stadium rozwoju oocytu, wyniki ilościowej reakcji łańcuchowej polimerazy (qPCR) dla wzbogacenia mitochondrialnego DNA (mtDNA), współczynnik korekcji dimerów adapterów (ACF), skorygowany cykl kwantyfikacji (Cq) qPCR w attomolach, liczbę cykli indeksującej reakcji łańcuchowej polimerazy (PCR) oraz stężenie biblioteki zmierzone za pomocą testu Qubit High Sensitivity DNA Assay. Biblioteki zostały wykluczone zgodnie z kryteriami kontroli jakości opisanymi w protokole. Kliknij tutaj, aby pobrać ten plik.
Plik uzupełniający 1. Przewodnik rozwiązywania problemów dotyczący przygotowania biblioteki do sekwencjonowania dupleksowego mtDNA z pojedynczych oocytów. Ten plik uzupełniający zawiera zalecenia dotyczące rozwiązywania problemów w krytycznych etapach procedury, w tym zapobiegania utracie próbek, przygotowania i oceny jakości adapterów, oczyszczania za pomocą kulek magnetycznych, kontroli jakości biblioteki, wydajności sekwencjonowania, kontaminacji międzypróbkowej oraz kontaminacji segmentami mitochondrialnego DNA w jądrze komórkowym (NUMT). Przewodnik uzupełnia protokół główny i należy się z nim zapoznać, gdy wskaźniki jakości biblioteki lub wydajność sekwencjonowania wykraczają poza zalecane zakresy. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Warianty mtDNA zidentyfikowane w oocytach odzwierciedlają kombinację mutagenezy de novo, przesunięć heteroplazmii między pokoleniami oraz wpływu starzenia się i chorób na linię zarodkową kobiety. Niniejszy protokół opisuje metodę wzbogacania mtDNA z pojedynczych oocytów, a następnie przygotowanie biblioteki do sekwencjonowania duplex oraz samo sekwencjonowanie, co umożliwia bardzo dokładną detekcję i analizę mutacji mtDNA. Pomimo wysokiej liczby kopii mtDNA obecnych w oocytach, ten schemat pracy wymaga przygotowania pełnej biblioteki sekwencjonowania z jednej komórki. W związku z tym, przez cały czas trwania procedury niezbędna jest ostrożna obsługa próbek, co szczegółowo opisano również w Pliku uzupełniającym 1 (Przewodnik rozwiązywania problemów). Pomimo ostrożnej obsługi próbek, około 5% przygotowań bibliotek może zakończyć się niepowodzeniem z powodu utraty oocytu podczas początkowych etapów manipulacji lub utraty próbki podczas przygotowania biblioteki.
Kontrola jakości w trakcie i po przygotowaniu biblioteki jest niezbędna do zweryfikowania pomyślnego ligowania adapterów, oceny wzbogacenia mtDNA, optymalizacji ilości wejściowego DNA do amplifikacji, wykrycia pozostałości dimerów adapterów lub starterów oraz określenia, czy wymagane są dodatkowe etapy oczyszczania lub amplifikacji. Stosowanie tego samego instrumentu do qPCR w czasie rzeczywistym we wszystkich preparacjach bibliotek zapewnia spójne warunki reakcji i poprawia porównywalność, powtarzalność oraz wiarygodność pomiarów wykorzystywanych do późniejszej kontroli jakości i optymalizacji protokołu. Liczba cykli PCR dla amplifikacji i indeksowania biblioteki opisana w niniejszym protokole może wymagać korekty w przypadku zastosowania innych instrumentów, enzymów lub odczynników. Początkowy etap amplifikacji jest podzielony na fazę amplifikacji liniowej z użyciem pojedynczego startera, po której następuje amplifikacja wykładnicza po dodaniu drugiego startera. Strategia ta minimalizuje prawdopodobieństwo, że błędy wprowadzone podczas pierwszego cyklu amplifikacji zostaną powielone do poziomu, w którym stają się trudne do odróżnienia od rzeczywistych mutacji DNA. Zalecana liczba cykli została dobrana w celu uzyskania optymalnej wielkości rodziny odczytów dla analizy duplex sequencing; mogą one jednak wymagać optymalizacji w zależności od ilości i jakości wejściowego DNA. Próbki z niższą ilością wejściowego DNA mogą wymagać dodatkowych cykli amplifikacji, natomiast próbki z większą ilością DNA mogą wymagać mniejszej liczby cykli, aby uniknąć nadmiernej amplifikacji i zachować złożoność biblioteki.
Chociaż niniejszy protokół został zaprezentowany z wykorzystaniem pojedynczych ludzkich oocytów, schemat postępowania nie ogranicza się wyłącznie do próbek ludzkich. Wcześniej zastosowaliśmy to samo podejście do badania mutagenezy linii zarodkowej u myszy i makaków12,13, co wskazuje, że przygotowanie bibliotek do sekwencjonowania duplex jest możliwe do zastosowania w przypadku oocytów wielu gatunków po optymalizacji specyficznych dla danego gatunku sekwencji starterów oraz, w razie potrzeby, innych parametrów doświadczalnych. Pomimo szerokiej stosowalności sekwencjonowania duplex, opisany tutaj proces wzbogacania mtDNA i przygotowania biblioteki nie jest łatwo przeniesiony na pojedyncze komórki somatyczne, ponieważ liczba kopii mtDNA w tych komórkach jest zazwyczaj o kilka rzędów wielkości niższa niż w oocytach, co ogranicza ilość wejściowego DNA dostępnego do przygotowania biblioteki. Niemniej jednak, biblioteki do sekwencjonowania duplex mogą być generowane z zbiorczych próbek komórek somatycznych, jeśli proces ten zostanie połączony z zoptymalizowanym wzbogacaniem mtDNA przed przygotowaniem biblioteki. Kolejnym ograniczeniem sekwencjonowania duplex jest konieczność fragmentacji DNA, która może wprowadzać błędy artefaktowe, szczególnie w pobliżu końców fragmentów. W konsekwencji zasady zlokalizowane na końcach fragmentów są zazwyczaj wykluczane z dalszych analiz, a proces fragmentacji może również wpływać na detekcję i charakterystykę insercji oraz delecji. Niedawne postępy w technologiach sekwencjonowania długich odczytów, w szczególności tych opracowanych przez Oxford Nanopore Technologies, mogą w przyszłości umożliwić wysoce dokładne sekwencjonowanie całych cząsteczek mitochondrialnego DNA bez fragmentacji. Jednak osiągnięcie dokładności wymaganej do wiarygodnej detekcji mutacji zależy obecnie od analizy natywnych, nieamplifikowanych cząsteczek DNA. Ponieważ ilość DNA obecna w pojedynczym oocycie jest niewystarczająca dla tych podejść, ich zastosowanie do tego typu próbek jest obecnie niepraktyczne.
W porównaniu do podejść stosowanych w poprzednich badaniach, w tym PCR długich fragmentów oraz konwencjonalnego sekwencjonowania masowo równoległego20,21,22, niniejszy protokół oferuje kilka zalet. Każdy etap amplifikacji niesie ze sobą ryzyko wprowadzenia mutacji artefaktowych, które mogą utrudniać wykrywanie wariantów o niskiej częstotliwości, co często wymusza stosowanie progów częstotliwości alleli mniejszościowych na poziomie co najmniej 1%. W przeciwieństwie do tego, znacznie niższy wskaźnik błędów osiągany w sekwencjonowaniu dupleksowym poprawia dokładność identyfikacji mutacji i przewyższa wyniki konwencjonalnych podejść sekwencjonowania5. W konsekwencji metoda ta zapewnia bardziej niezawodny schemat wykrywania i kwantyfikowania rzadkich mutacji mtDNA. Wykorzystując ten przepływ pracy, wykazaliśmy wcześniej, że w przeciwieństwie do większości tkanek somatycznych, oocyty w dużej mierze unikają związanej z wiekiem akumulacji mutacji mtDNA19. Pozostaje niejasne, czy ten pozorny efekt ochronny jest utrzymywany w stanach chorobowych zmieniających mikrośrodowisko jajnika, takich jak endometrioza, które upośledzają jakość oocytów, co uzasadnia dalsze badania.
Oświadczenia
Autorzy oświadczają, że nie istnieją żadne konflikty interesów.
Podziękowania
Szczerze dziękujemy zespołowi Centrum Zapłodnienia In Vitro Szpitala Uniwersyteckiego Kepler w Linz za wsparcie w pobieraniu oocytów. Dziękujemy również N. Stoler i A. Nekrutenko za opracowanie instancji analizy duplex sequencing w systemie Galaxy oraz za wskazówki dotyczące analizy danych. Praca ta była wspierana przez Austrian Science Fund (FWF) w ramach stypendium Schrödinger Fellowship (DOI: 10.55776/J4096; BA) oraz FWF Stand-Alone Project (DOI: 10.55776/P36928; BA). KDM otrzymał wsparcie częściowo z grantu R01GM116044 National Institutes of Health oraz z Willaman Chair Endowment Fund w Eberly College of Science na The Pennsylvania State University.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| 96 unikalnych par starterów z podwójnym indeksem | New England Biolabs | E6440S/L | Unikalne pary starterów z podwójnym indeksem do indeksowania PCR |
| Etanol bezwodny, stopień molecular biology, 96% | Fisher BioReagents | 15518181 | Przygotować świeży 80% etanol z wodą stopnia molecular biology |
| Agaroza, o niskiej elektroendozmozie | Biozym | 840000 | Do przygotowania żeli agarozowych 1,5% i 2% |
| Roztwór octanu amonu, 5 M | Thermo Fisher Scientific | J60688.AD | Stosowany do wytrącania etanolem |
| ATP, 10 mM | New England Biolabs | P0756S/L | Stosowany do trawienia egzonukleazą V |
| Zautomatyzowany instrument do elektroforezy | Agilent Technologies | G2992AA | Użyto wycofanego z eksploatacji urządzenia Agilent 2100 Bioanalyzer; można użyć urządzenia 4150 TapeStation lub równoważnego instrumentu do analizy fragmentów kwasów nukleinowych. |
| Zestaw Bioanalyzer High Sensitivity DNA Kit | Agilent Technologies | 5067-4626 | Do oceny rozkładu wielkości biblioteki oraz obecności dimerów adapterów/starterów |
| Oligonukleotyd nośnikowy | Integrated DNA Technologies (IDT) | Custom synthesis | Sekwencja niekomplementarna do genomu ludzkiego. Przykładowa sekwencja podana jest w Tabeli 2. Przygotować roztwór stokowy 100 nM i rozcieńczyć do stężenia końcowego 1 nM. |
| System detekcji PCR w czasie rzeczywistym CFX96 Touch | Bio-Rad | 12011319 | Instrument użyty w tej badaniu jest wycofany z eksploatacji; można użyć CFX Opus 96 lub równoważnego instrumentu do PCR w czasie rzeczywistym, choć wartości Cq mogą się różnić. |
| Zestaw Collibri Library Quantification Kit | Invitrogen | A38524100 | Do ilościowego oznaczania zaindeksowanych bibliotek przed łączeniem (poolingiem) |
| Pożywka do usuwania komórek cumulus zawierająca hialuronidazę (80 U/mL) | Gynemed | 4 HY 0010 | GM501 Hyaluronidase |
| Probówka PCR o niskim wiązaniu DNA, 200 µL | Corning | PCR-02-L-C | Probówka Axygen Maximum Recovery |
| Probówka o niskim wiązaniu DNA, 0,5 mL | Biozym | 710136 | |
| Probówka o niskim wiązaniu DNA, 1,5 mL | Biozym | 710176 | |
| Polimeraza DNA I, fragment duży (Klenow) (5 U/µL) | New England Biolabs | M0210S/L | Stosowany podczas elongacji adapterów |
| Mieszanina dNTP (equimolar dATP, dCTP, dGTP i dTTP), 10 mM | New England Biolabs | N0447S/L | Stosowana podczas elongacji adapterów |
| EDTA, 0,5 M (pH 8,0) | Fisher BioReagents | 10628203 | Składnik buforów TE i TElow |
| Barwnik EvaGreen, 20× | Biotium | 31077-T | Stosowany w attomolowej qPCR |
| Egzonukleaza V (RecBCD), 10 U/µL | New England Biolabs | M0345S/L | Stosowana do trawienia liniowego DNA |
| Grzebień o stałej wysokości | Bio-Rad | 1704446EDU | Do elektroforezy w żelu agarozowym |
| Instrument do sonikacji skupionej | Covaris | 500295 | Skupiony sonikator M220 |
| Probówka do sonikacji skupionej, 50 µL | Covaris | 520166 | microTUBE-50 AFA Fiber Screw-Cap |
| Barwnik do nakładania na żel, 6× | Thermo Fisher Scientific | R1161 | TriTrack DNA Loading Dye |
| Olej mineralny GM501 | Gynemed | 4 MO 0100 | Stosowany jako warstwa nad pożywką do zbierania oocytów w celu zapobiegania parowaniu i utrzymania stabilnych, sterylnych warunków hodowli, w tym temperatury, osmolalności i pH, podczas manipulacji oocytami |
| Mieszanina PCR o wysokiej wierności, 2× | KAPA Biosystems | KK2602 | KAPA HiFi HotStart ReadyMix |
| Fluorometryczny zestaw do oznaczania DNA o wysokiej czułości | Invitrogen | Q32854 | Qubit dsDNA High Sensitivity Assay Kit |
| Enzym restrykcyjny HpyCH4III (5 U/µL) | New England Biolabs | R0618S/L | Stosowany do restrykcyjnego trawienia adapterów |
| Wirówka laboratoryjna, chłodząca | Eppendorf | 5406000313 | Musi obsługiwać 14 000 × g w 4 °C |
| System laserowy do otwierania błony przejrzystej | Vitrolife | 19310/0146 | Stosowany do usuwania ciałka polarnego |
| Zestaw do przygotowania bibliotek | New England Biolabs | E7645S/L | NEBNext Ultra II DNA Library Prep Kit; zawiera odczynniki do naprawy końców/dodawania ogonów A i ligacji |
| Roztwór chlorku magnezu, 25 mM | New England Biolabs | B9021S/L | Stosowany do trawienia egzonukleazą V |
| Odczynnik do oczyszczania na kulkach magnetycznych | Beckman Coulter | A63881 | AMPure XP Beads |
| Stojak magnetyczny | Invitrogen | 12-321-D | Do separacji kulek magnetycznych |
| Mikromanipulator | Luigs & Neumann GmbH | SM II/2 | Stosowany do usuwania ciałka polarnego |
| Mikroskop | Olympus | IX51 | Stosowany do usuwania ciałka polarnego |
| Woda stopnia molecular biology | Thermo Fisher Scientific | 327290010 | Stosowana do przygotowania odczynników i rozcieńczeń |
| Pożywka do hodowli oocytów | Gynemed | 4 GM 501H-20 | Pożywka hodowlana GM501 |
| Płyta PCR, 96-dołkowa | Biozym | AF4TI-0960-C | Przezroczyste dołki, przezroczysta rama, niski profil, ze spódnicą |
| Uszczelka do płyty PCR | Bio-Rad | MSB1001B | Kompatybilna z instrumentem do PCR w czasie rzeczywistym |
| Bufor fosforanowo-solny (PBS), 20× | Cell Signaling Technology | 9808S | Rozcieńczyć do 1× wodą stopnia molecular biology |
| Pipety do manipulacji i przenoszenia kompleksów cumulus–oocyt (COC) i oocytów | CooperSurgical | MXL3-150 (150 µm) | Stosowane do mechanicznego usuwania komórek cumulus i przenoszenia COC oraz oocytów. Dodatkowe rozmiary pipet dostępne są na stronie producenta. |
| Zasilacz do elektroforezy żelowej | Bio-Rad | 1645050 | Zasilacz PowerPac Basic |
| PowerUp SYBR Green Master Mix, 2× | Applied Biosystems | 15350929 | Stosowany w testach qPCR dla mitochondriów i jądra |
| Fluorometr Qubit | Invitrogen | Q33238 | Użyto wycofanego z eksploatacji fluorometru Qubit 1; można użyć nowszej wersji lub równoważnego instrumentu do fluorometrycznego oznaczania ilości kwasów nukleinowych. |
| RNaza A, 10 mg/mL | Thermo Fisher Scientific | 10753721 | Rozcieńczyć do 1 mg/mL przed użyciem |
| Spektrofotometr | Thermo Fisher Scientific | NDULTRAGL | Użyto wycofanego z eksploatacji instrumentu NanoDrop OneC; można użyć nowszej wersji lub równoważnego spektrofotometru mikrobobjetowego. |
| Barwnik do żeli DNA SYBR Safe | Invitrogen | S33102 | Do elektroforezy w żelu agarozowym |
| Termocykler | Bio-Rad | 1861096 | Termocykler T100 |
| Termolabilna Proteinaza K (0,120 U/µL) | New England Biolabs | P8111S/L | Stosowana do lizy pojedynczych oocytów |
| Bufor Tris-octan-EDTA (TAE), 50× | Fisher Scientific | BP1332-1 | Rozcieńczyć do 1× do elektroforezy w żelu agarozowym |
| Tris-HCl (pH 8,0), 1 M | Fisher BioReagents | 10336763 | Stosowany do przygotowania odczynników i rozcieńczeń |
| Tween 20 | Fisher BioReagents | 11417160 | Składnik buforu do lizy oocytów |
| Uniwersalna drabinka DNA | Thermo Fisher Scientific | SM0333 | Gotowa do użycia drabinka DNA GeneRuler (100–1 000 bp) |
| Wide Mini-Sub Cell GT Cell | Bio-Rad | 1704468EDU | Do elektroforezy w żelu agarozowym |
| Wide Mini-Sub Cell GT UV-Transparent Gel Tray (15 × 7 cm) | Bio-Rad | 1704426 | Do elektroforezy w żelu agarozowym |
Bibliografia
- Dyall SD, Brown MT, Johnson PJ. Ancient invasions: from endosymbionts to organelles. Science. 2004;304:253-257. doi:10.1126/science.1094884.
- Pakendorf B, Stoneking M. Mitochondrial DNA and human evolution. Annu Rev Genomics Hum Genet. 2005;6:165-183. doi:10.1146/annurev.genom.6.080604.162249.
- Ng YS, Turnbull DM. Mitochondrial disease: genetics and management. J Neurol. 2016;263:179-191. doi:10.1007/s00415-015-7884-3.
- Shoubridge EA, Wai T. Mitochondrial DNA and the mammalian oocyte. In: St John JC, editor. Current Topics in Developmental Biology. Vol. 77: The Mitochondrion in the Germline and Early Development. San Diego (CA): Academic Press; 2007. p. 87-111. doi:10.1016/S0070-2153(06)77004-1.
- Fox EJ, Reid-Bayliss KS, Emond MJ, Loeb LA. Accuracy of next generation sequencing platforms. Next Gener Seq Appl. 2014;1:1000106. doi:10.4172/jngsa.1000106.
- Kennedy SR, et al. Detecting ultralow-frequency mutations by Duplex Sequencing. Nat Protoc. 2014;9:2586-2606. doi:10.1038/nprot.2014.170.
- Schmitt MW, et al. Detection of ultra-rare mutations by next-generation sequencing. Proc Natl Acad Sci U S A. 2012;109:14508-14513. doi:10.1073/pnas.1208715109.
- Stoler N, et al. Family reunion via error correction: an efficient analysis of duplex sequencing data. BMC Bioinformatics. 2020;21:96. doi:10.1186/s12859-020-3419-8.
- Abascal F, et al. Somatic mutation landscapes at single-molecule resolution. Nature. 2021;593:405-410. doi:10.1038/s41586-021-03477-4.
- The ESHRE Guideline Group on Ovarian Stimulation, Ata B, Bosch E, Broer S, Griesinger G, Grynberg M, et al. ESHRE guideline: ovarian stimulation for IVF/ICSI: an update in 2025. Hum Reprod. 2026;41:498-514. doi:10.1093/humrep/deag018.
- The ESHRE Working Group on Ultrasound in ART, et al. Recommendations for good practice in ultrasound: oocyte pick up. Hum Reprod Open. 2019;2019:hoz025. doi:10.1093/hropen/hoz025.
- Arbeithuber B, et al. Age-related accumulation of de novo mitochondrial mutations in mammalian oocytes and somatic tissues. PLoS Biol. 2020;18:e3000745. doi:10.1371/journal.pbio.3000745.
- Arbeithuber B, et al. Advanced age increases frequencies of de novo mitochondrial mutations in macaque oocytes and somatic tissues. Proc Natl Acad Sci U S A. 2022;119:e2118740119. doi:10.1073/pnas.2118740119.
- The Galaxy Community. The Galaxy platform for accessible, reproducible, and collaborative data analyses: 2024 update. Nucleic Acids Res. 2024;52:W83-W94. doi:10.1093/nar/gkae410.
- Stoler N, Arbeithuber B, Guiblet W, Makova KD, Nekrutenko A. Streamlined analysis of duplex sequencing data with Du Novo. Genome Biol. 2016;17:180. doi:10.1186/s13059-016-1039-4.
- Nekrutenko A, Stoler N. Calling very rare variants. Galaxy Training Network. Available from: https://training.galaxyproject.org/training-material/topics/variant-analysis/tutorials/dunovo/tutorial.html. Accessed July 25, 2026.
- Barnett DW, et al. BamTools: a C++ API and toolkit for analyzing and managing BAM files. Bioinformatics. 2011;27:1691-1692. doi:10.1093/bioinformatics/btr174.
- Illumina. Double sided size selection and bead clean up. Illumina Knowledge Base. Available from: https://knowledge.illumina.com/library-preparation/general-library-prep/library-preparation-general-library-prep-reference_material-list/000006157. Accessed July 25, 2026.
- Arbeithuber B, et al. Allele frequency selection and no age-related increase in human oocyte mitochondrial mutations. Sci Adv. 2025;11:eadw4954. doi:10.1126/sciadv.adw4954.
- Mertens J, et al. Mitochondrial DNA variants segregate during human preimplantation development into genetically different cell lineages that are maintained postnatally. Hum Mol Genet. 2022;31:3629-3642. doi:10.1093/hmg/ddac059.
- Mertens J, et al. Children born after assisted reproduction more commonly carry a mitochondrial genotype associating with low birthweight. Nat Commun. 2024;15:1232. doi:10.1038/s41467-024-45446-1.
- Van Der Kelen A, et al. The interplay between mitochondrial DNA genotypes, female infertility, ovarian response, and mutagenesis in oocytes. Hum Reprod Open. 2025;2025:hoae074. doi:10.1093/hropen/hoae074.
Przedruki i uprawnienia
Ten artykuł został opublikowany
Film wkrótce dostępny