Niniejszy protokół proponuje FedMediFormer-XAI – multimodalny system analityczny w diabetologii, który zapewnia prywatność danych dzięki uczeniu federacyjnemu, multimodalnym transformatorom, augmentacji opartej na dyfuzji, grafowemu systemowi spersonalizowanych rekomendacji lekowych oraz wyjaśnialnej sztucznej inteligencji, w celu dokładnego prognozowania, transparentnego podejmowania decyzji i spersonalizowanego zarządzania cukrzycą.
Artykuł metodologiczny
FedMediFormer-XAI: Federacyjne transformatory multimodalne z augmentacją dyfuzyjną i rekomendacją leków opartą na grafach w leczeniu cukrzycy
W tym artykule
Podsumowanie
Streszczenie
Zarządzanie cukrzycą napotyka szereg przeszkód, takich jak rozproszone dane opieki zdrowotnej, kwestie prywatności, słaba wyjaśnialność oraz brak spersonalizowanych wytycznych terapeutycznych. Niniejsza praca badawcza wprowadza FedMediFormer-XAI, zintegrowane i odpowiednie ramy, które łączą uczenie federacyjne, transformatory multimodalne, augmentację danych opartą na modelach dyfuzyjnych, grafowe sieci neuronowe (GNN) do rekomendacji leków oraz wyjaśnialną sztuczną inteligencję (XAI) w celu analizy danych dotyczących cukrzycy. System wykorzystuje różnorodne typy danych medycznych, np. dokumentację kliniczną, wskaźniki zdrowia populacyjnego, dane z ciągłego monitorowania glikemii, obrazy dna oka, pomiary z czujników urządzeń ubieralnych oraz informacje farmakologiczne. W celu generowania syntetycznych próbek i rozwiązania problemu niezbalansowania klas stosowane są modele dyfuzyjne, natomiast architektury transformatorów multimodalnych służą do uczenia relacji między bardzo różnymi źródłami danych. Uczenie federacyjne umożliwia współpracę przy trenowaniu modeli w sposób chroniący prywatność, bez konieczności udostępniania surowych danych pacjentów. Komponent GNN rejestruje interakcje pacjent-lek oraz lek-lek w celu spersonalizowanych rekomendacji lekowych. Metody wyjaśnialności, takie jak SHapley Additive exPlanations (SHAP), wizualizacja uwagi, zintegrowane gradienty (Integrated Gradients) oraz rozumowanie kontrfaktyczne, zapewniają przejrzyste interpretacje wyników predykcji i rekomendacji. W reprezentatywnej implementacji proponowane ramy osiągnęły dokładność 94,2%, precyzję 93,1%, czułość 92,8%, wynik F1-score 92,9%, współczynnik korelacji Matthews (MCC) 0,88 oraz pole pod krzywą charakterystyki operacyjnej odbiornika (AUC-ROC) 0,96. Moduł rekomendacji oparty na grafach osiągnął precyzję = 0,89, czułość = 0,84 oraz znormalizowany zdyskontowany zysk skumulowany (NDCG) = 0,91. Przedstawiony protokół zapewnia strukturalne podejście do integracji heterogenicznych danych opieki zdrowotnej przy użyciu transformatorów multimodalnych, uczenia federacyjnego, augmentacji opartej na dyfuzji, rekomendacji opartych na grafach oraz wyjaśnialnej sztucznej inteligencji. Raportowane wyniki obliczeniowe wykazują potencjał tych ram w zakresie predykcji cukrzycy i spersonalizowanej rekomendacji leków, podczas gdy projekt federacyjny wspiera zdecentralizowane zarządzanie danymi. Wymagana jest prospektywna wieloośrodkowa ocena kliniczna w celu ustalenia użyteczności klinicznej, generalizowalności i możliwości zastosowania w rzeczywistych warunkach.
Wprowadzenie
Cukrzyca znajduje się wśród najważniejszych przewlekłych chorób metabolicznych dotykających ludzkość i stanowi poważny problem zdrowia publicznego ze względu na swój wzrost, długofalowe skutki oraz ogromne koszty leczenia pacjentów1,2. Według raportu obecnie na całym świecie ponad 537 milionów dorosłych żyje z cukrzycą, a liczba ta ma znacząco wzrosnąć w ciągu najbliższych kilku dekad3. Jeśli wysoki poziom cukru we krwi nie zostanie opanowany, osoba chora będzie cierpieć na najpoważniejsze powikłania, takie jak choroba wieńcowa4, uszkodzenie nerek5, uszkodzenie nerwów6, utrata wzroku7 oraz udar mózgu8. W związku z tym rozpoznanie choroby na najwcześniejszym etapie, regularne monitorowanie stanu pacjenta oraz zapewnienie mu szkolenia poprzez zaawansowane podejścia medyczne są niezbędnymi krokami, aby pomóc pacjentom żyć zdrowiej, a tym samym zmniejszyć wydatki państwowego systemu opieki zdrowotnej9,10.
Obecnie upowszechnia się stosowanie elektronicznej dokumentacji medycznej (EHR), urządzeń ubieralnych, systemów ciągłego monitorowania glikemii (CGM), technologii obrazowania siatkówki oraz mobilnych aplikacji zdrowotnych, co generuje duże wolumeny heterogenicznych danych medycznych, które mogą zostać poddane analizie11. Te różnorodne narzędzia do gromadzenia danych mogą dostarczać zróżnicowanych informacji o ludzkim organizmie, jego zdolności do funkcjonowania na różnych etapach choroby, reakcji pacjenta na różne rodzaje leczenia oraz o jego zachowaniu w życiu codziennym12. Sztuczna inteligencja (AI) okazała się najlepszym rozwiązaniem do przetwarzania danych o wysokim stopniu złożoności, przewidywania cukrzycy, monitorowania choroby oraz wspierania lekarzy w podejmowaniu decyzji klinicznych13. Ponadto algorytmy uczenia maszynowego, w tym lasy losowe, maszyny wektorów nośnych oraz metody wzmacniania gradientowego, przyniosły doskonałe wyniki w ocenie ryzyka cukrzycy14. W ostatnim czasie architektury głębokiego uczenia umożliwiły automatyczną ekstrakcję cech i poprawiły wydajność predykcyjną w różnych zastosowaniach opieki zdrowotnej15.
Dzięki zastosowaniu metod uczenia multimodalnego, analiza danych dotyczących cukrzycy została znacznie usprawniona poprzez zintegrowanie ustrukturyzowanej dokumentacji klinicznej, pomiarów fizjologicznych, obrazów siatkówki oraz wskaźników behawioralnych w ramach jednej struktury predykcyjnej16. Wykorzystując wiele źródeł informacji, modele multimodalne potrafią zidentyfikować wzorce, które nie są widoczne przy osobnej analizie każdej z modalności17. Modele oparte na architekturze Transformer bardzo skutecznie nauczyli się niedawno rozpoznawać zależności długodystansowe oraz relacje kontekstowe z różnorodnych typów danych opieki zdrowotnej18. Jednakże problemy takie jak niezbalansowane klasy, brakujące dane, heterogeniczność danych oraz ograniczona generalizowalność wciąż utrudniają powszechne stosowanie multimodalnych systemów AI w warunkach klinicznych19.
Mimo tych postępów wiele istniejących inteligentnych systemów w diabetologii wciąż opiera się na scentralizowanych ramach uczenia, które z natury wymagają konsolidacji danych pacjentów z różnych instytucji w jednym repozytorium20. Takie metody prowadzą już do sporów dotyczących prywatności pacjentów, powiernictwa danych, cyberbezpieczeństwa i zgodności z przepisami21. W rzeczywistości, ze względu na kwestie prawne i etyczne, dostawcy usług medycznych są często ograniczeni w możliwościach udostępniania poufnych danych pacjentów22. W tym kontekście uczenie federacyjne staje się realnym rozwiązaniem, ponieważ umożliwia trenowanie modelu kolaboracyjnego bez konieczności udostępniania rzeczywistych danych pacjentów23. Dzięki zdecentralizowanej optymalizacji i bezpiecznej agregacji parametrów, uczenie federacyjne umożliwia analizę zdrowotną z zachowaniem prywatności poprzez wykorzystanie wiedzy z geograficznie rozproszonych zbiorów danych24. Niemniej jednak, obciążenie komunikacyjne, heterogeniczność klientów oraz stabilność zbieżności wciąż stanowią główne problemy w scenariuszach federacyjnej opieki zdrowotnej25.
Kolejną wadą obecnie stosowanych inteligentnych systemów w leczeniu cukrzycy jest brak przejrzystości oraz ograniczone wsparcie dla terapii spersonalizowanej. Wiele modeli głębokiego uczenia działa jak „czarne skrzynki”, co stanowi problem dla klinicystów pragnących zrozumieć rozumowanie stojące za prognozami i rekomendacjami26. Metody wyjaśnialnej sztucznej inteligencji (XAI), takie jak SHAP, Integrated Gradients, wizualizacja uwagi oraz rozumowanie kontrfaktyczne, wykazują ogromny potencjał w zakresie zwiększania przejrzystości modeli i zaufania lekarzy27. Ponadto grafowe sieci neuronowe (GNNs) stały się najbardziej zaawansowanymi narzędziami do rejestrowania interakcji pacjent-lek oraz lek-lek, co pozwala na personalizację rekomendacji farmakologicznych i ocenę bezpieczeństwa leczenia28. Nowe modele dyfuzyjne wprowadziły również rozwiązania umożliwiające generowanie autentycznych syntetycznych danych medycznych oraz rozwiązywanie problemu niezbalansowania klas29.
Transformery, uczenie federacyjne, generowanie syntetycznych danych oparte na modelach dyfuzyjnych, grafowe sieci neuronowe oraz wyjaśnialna sztuczna inteligencja wykazały obiecujące wyniki w zastosowaniach w opiece zdrowotnej; jednakże ich integracja w ramach jednej odtwarzalnej struktury inteligencji w cukrzycy pozostaje ograniczona. Istniejące podejścia zazwyczaj traktują te komponenty niezależnie, koncentrując się na uczeniu z zachowaniem prywatności bez spersonalizowanych rekomendacji leczenia, predykcji multimodalnej bez zdecentralizowanego treningu lub wyjaśnialności bez grafowego wsparcia decyzji klinicznych. Chociaż modele dyfuzyjne mogą wspierać balansowanie klas, a architektury transformerów potrafią uczyć się relacji między heterogenicznymi modalnościami opieki zdrowotnej, ustandaryzowane protokoły integracji tych komplementarnych technologii są wciąż nieliczne. W związku z tym niniejsza praca przedstawia ujednolicony protokół metodologiczny, który łączy predykcję multimodalną, augmentację opartą na dyfuzji, optymalizację federacyjną, grafową spersonalizowaną rekomendację leków oraz wyjaśnialną sztuczną inteligencję w ramach odtwarzalnego przepływu pracy, zapewniając jednocześnie podstawę do przyszłej walidacji klinicznej i wdrożenia.
W przeciwieństwie do badań zakładających dostępność multimodalnych zbiorów danych na poziomie pacjenta, niniejszy protokół integruje heterogeniczne publiczne zbiory danych bez przeprowadzania bezpośredniego dopasowania pacjentów. Dla każdego źródła danych trenowane są niezależne modele specyficzne dla danej modalności, a osadzenia cech ukrytych są łączone za pomocą mechanizmu uwagi między-modalnej (cross-modal attention). Taka konstrukcja pozwala zachować rygor metodologiczny, umożliwiając jednocześnie multimodalną integrację wiedzy z różnych repozytoriów opieki zdrowotnej.
Proponowany protokół jest przeznaczony przede wszystkim do rozwoju metodologicznego oraz rozproszonych środowisk sztucznej inteligencji w opiece zdrowotnej, w których heterogeniczne źródła danych są dostępne w oddzielnych repozytoriach lub instytucjach, a bezpośrednia centralizacja danych jest ograniczona. W obecnej implementacji zbiory danych specyficzne dla danej modalności są niezależne i nie są dopasowane do pacjentów; w związku z tym integracja multimodalna jest wykonywana na poziomie wyuczonych reprezentacji, a nie poprzez bezpośrednią odpowiedniość na poziomie pacjenta. Praktyczne zastosowanie wymagałoby odpowiednio powiązanych multimodalnych danych pacjentów, spójnego wstępnego przetwarzania i definicji wyników we wszystkich uczestniczących ośrodkach, odpowiedniej infrastruktury obliczeniowej oraz zgodności z obowiązującymi wymogami etycznymi, dotyczącymi prywatności i regulacyjnymi.
Niniejszy artykuł przedstawia FedMediFormer-XAI, federacyjny wielomodalny model transformer, który umożliwia zachowanie prywatności w ramach analityki cukrzycy poprzez funkcje predykcji, rekomendacji i wyjaśnialności w jednym systemie. Struktura ta integruje augmentację danych opartą na modelach dyfuzyjnych w celu rozwiązania problemu niezbalansowania klas, wielomodalne uczenie transformer do predykcji cukrzycy, uczenie federacyjne do wspólnego opracowywania modeli, personalizowaną rekomendację leków opartą na grafowych sieciach neuronowych oraz metody wyjaśnialnej sztucznej inteligencji, aby w przejrzysty sposób wspierać decyzje kliniczne. Ogólna architektura i schemat działania proponowanego modelu FedMediFormer-XAI zostały zilustrowane na Rysunku 1.
Główne wkład w ramach proponowanego systemu FedMediFormer-XAI zostały podsumowane w następujący sposób: (1) Przedstawiono ujednolicony protokół integrujący uczenie federacyjne, transformery multimodalne, augmentację danych opartą na dyfuzji, spersonalizowane rekomendacje leków oparte na grafowych sieciach neuronowych oraz wyjaśnialną sztuczną inteligencję w ramach jednego, powtarzalnego przepływu pracy dla analityki cukrzycy. (2) Opracowano strategię uczenia federacyjnego z zachowaniem prywatności, aby umożliwić wspólne trenowanie modelu pomiędzy symulowanymi, rozproszonymi klientami ochrony zdrowia bez udostępniania surowych danych pacjentów. (3) Wprowadzono multimodalną architekturę transformera do wspólnego uczenia się komplementarnych reprezentacji ze ustrukturyzowanych rekordów klinicznych, danych z ciągłego monitorowania glikemii, obrazów dna oka oraz wskaźników zdrowia populacji. (4) Włączono generowanie syntetycznych danych opartych na dyfuzji w celu zmniejszenia niezrównoważenia klas i poprawy odporności modelu, przy jednoczesnym zachowaniu charakterystyki statystycznej oryginalnych danych treningowych. (5) Wykorzystano moduł uczenia grafów heterogenicznych oparty na GraphSAGE do modelowania relacji pacjent-lek oraz lek-lek w celu spersonalizowanej rekomendacji leków i rankingu leczenia uwzględniającego interakcje. (6) Zintegrowano wiele technik wyjaśnialnej sztucznej inteligencji, w tym SHapley Additive exPlanations (SHAP), Integrated Gradients, wizualizację uwagi oraz wyjaśnienia kontrfaktyczne, aby zwiększyć przejrzystość modelu i zapewnić interpretowalne wyniki predykcji i rekomendacji. (7) Zapewniono kompleksowy protokół walidacji, obejmujący ocenę predykcyjną, ocenę uczenia federacyjnego, ewaluację rekomendacji, analizę wyjaśnialności, ocenę zorientowaną na klinicystów, walidację zewnętrzną oraz ocenę powtarzalności.
Protokół
Wszystkie zbiory danych wykorzystane w niniejszym badaniu zostały pobrane z publicznie dostępnych repozytoriów i zawierały zanonimizowane informacje o pacjentach. Obejmowały one Pima Indians Diabetes Dataset, CDC Diabetes Health Indicators Dataset, OhioT1DM Dataset, APTOS 2019 Blindness Detection Dataset, Drug Review Dataset oraz Drug-Drug Interaction Dataset. Badanie nie wiązało się z bezpośrednią rekrutacją pacjentów, interwencją, pobieraniem próbek ani dostępem do identyfikowalnych danych osobowych dotyczących stanu zdrowia. Praca ograniczyła się do wtórnej analizy publicznie dostępnych, zanonimizowanych zbiorów danych w celu opracowania i walidacji metodologicznej, a została przeprowadzona zgodnie z wymogami instytucjonalnymi dotyczącymi wykorzystania takich danych. Opisana w niniejszym protokole ocena zorientowana na człowieka jest przeznaczona do przyszłej implementacji i nie została przeprowadzona w obecnym badaniu. Badacze przeprowadzający tę ocenę powinni uzyskać odpowiednią zgodę Komisji Etyki Instytucjonalnej, pozyskać pisemną świadomą zgodę od wszystkich uczestników oraz przestrzegać obowiązujących wymogów instytucjonalnych, umów dotyczących wykorzystania danych oraz przepisów krajowych.
1. Konfiguracja środowiska obliczeniowego
- Zainstaluj język Python 3.11 jako główne środowisko programistyczne. Zainstaluj PyTorch 2.3 oraz TensorFlow 2.15 do opracowywania i trenowania modeli głębokiego uczenia. Zainstaluj bibliotekę Transformers (v4.45) w celu implementacji architektur opartych na transformerach.
- Zainstaluj PyTorch Geometric (v2.5) w celu wsparcia konstrukcji i trenowania grafowych sieci neuronowych. Zainstaluj SHAP (v0.47) oraz Captum (v0.8) do przeprowadzania analiz wyjaśnialności i atrybucji cech.
- Zainstaluj NumPy, Pandas oraz Scikit-learn do obliczeń numerycznych, wstępnego przetwarzania danych i narzędzi uczenia maszynowego. Zainstaluj OpenCV oraz Matplotlib do zadań związanych z przetwarzaniem obrazów i wizualizacją. Zainstaluj NetworkX do konstruowania i analizowania grafów oddziaływań leków.
- Zainstaluj CUDA Toolkit oraz kompatybilne sterowniki NVIDIA GPU, aby umożliwić obliczenia akcelerowane sprzętowo. Skonfiguruj procesor graficzny NVIDIA RTX 4090 z co najmniej 32 GB pamięci systemowej. Ustaw ziarno losowości (random seed) na 42 dla etapów trenowania, walidacji i testowania, aby zapewnić odtwarzalność wyników. Sprawdź instalację i kompatybilność używanych bibliotek programistycznych. Odnotuj wersje oprogramowania, specyfikację sprzętową oraz parametry konfiguracji modelu wykorzystane w analizie.
2. Przygotowanie i wstępne przetwarzanie zbiorów danych
- Pobrać i zorganizować wymagane zestawy danych klinicznych, fizjologicznych, obrazowych i farmakologicznych w repoztoriach specyficznych dla danej modalności oraz zweryfikować ich integralność. Potwierdzić charakterystykę zestawów danych, cele predykcji i poziomy integracji, zgodnie z tabelami 1 i 2. Przepływ pracy przedstawiono na rysunku 2.
- Usunąć zdublowane, nieprawidłowe lub niespójne rekordy, a także rekordy z brakującymi kluczowymi zmiennymi. Podzielić każdy odpowiedni zestaw danych na niezależne od pacjentów podzbiory treningowe (70%), walidacyjne (15%) i testowe (15%). Dopasować imputację medianą, skalowanie Min-Max oraz kodowanie kategoryczne wyłącznie na podzbiorze treningowym, a następnie zastosować dopasowane transformacje bez zmian do podzbiorów walidacyjnego i testowego. Generowanie syntetycznych danych przeprowadzić wyłącznie na podzbiorze treningowym. Zweryfikować partycjonowanie i zapobieganie wyciekom danych zgodnie z tabelą uzupełniającą 1.
- Zaimportować dane dotyczące poziomu glukozy, spożycia pokarmów, dawkowania insuliny, aktywności fizycznej i snu. Ustandaryzować znaczniki czasu, dopasować zdarzenia do regularnych odstępów, liniowo interpolować niezatytułowane wartości glukozy, podzielić rekordy ciągłe na okna o stałej długości i zastosować normalizację z-score w celu wygenerowania wejść dla transformera temporalnego.
- Wczytać obrazy dna oka i usunąć uszkodzone lub nieczytelne pliki, duplikaty, obrazy z brakującymi etykietami oraz obrazy z silnymi artefaktami lub niewystarczającą widocznością pola siatkówki.
- Zmienić rozmiar zachowanych obrazów do 224 × 224 pikseli, znormalizować intensywność pikseli do zakresu [0, 1] i zastosować adaptacyjną ekwalizację histogramu z ograniczonym kontrastem (CLAHE).
- Augmentować obrazy treningowe, stosując losowy obrót w zakresie ±15°, poziome odbicie lustrzane z prawdopodobieństwem 0,5, losowe przybliżenie w zakresie 0,9–1,1× oraz regulację jasności w zakresie ±20%. Nie stosować stochastycznej augmentacji do obrazów walidacyjnych ani testowych. Przechować przetworzone obrazy do trenowania Vision Transformera.
- Zintegrować reprezentacje specyficzne dla danej modalności zgodnie ze strategią integracji zestawów danych podsumowaną w tabeli 2. Nie przeprowadzać bezpośredniego dopasowania na poziomie pacjenta pomiędzy niezależnymi repozytoriami, gdy wspólne identyfikatory pacjentów są niedostępne.
- Przechowywać każdy publiczny zestaw danych jako niezależny zestaw specyficzny dla danej modalności, ponieważ identyfikatory pacjentów nie są współdzielone pomiędzy repozytoriami.
- Trenować niezależnie ekstraktory cech specyficzne dla danej modalności, korzystając z odpowiadających im zestawów danych: (a) rekordy kliniczne → koder TabTransformer; (b) wskaźniki zdrowia populacyjnego → koder TabTransformer; (c) ciągły monitoring glikemii → Temporal Transformer; (d) obrazy dna oka → Vision Transformer; (e) dane farmakologiczne → moduł GraphSAGE
- Niezależnie wyekstrahować osadzenia cech latentnych (latent feature embeddings) z każdej modalności. Połączyć wyłącznie wyuczone osadzenia latentne za pomocą zaproponowanego modułu fuzji z uwagą krzyżową (cross-modal attention fusion module), zamiast łączyć surowe rekordy pacjentów.
- Upewnić się, że pomiędzy niezależnymi publicznymi zestawami danych nie jest wykonywane sztuczne dopasowanie pacjentów. Utrzymywać niezależne partycje treningowe, walidacyjne i testowe dla każdego zestawu danych podczas preprocessingu, augmentacji i opracowywania modelu.
- Przechowywać zfusionowane multimodalne reprezentacje cech do późniejszej predykcji, uczenia federacyjnego, wyjaśnialności i spersonalizowanych rekomendacji lekowych (rysunek 2).
3. Przeprowadzenie augmentacji danych w oparciu o modele dyfuzyjne
- Zastosuj augmentację opartą na dyfuzji do ustrukturyzowanych tabularnych zbiorów danych klinicznych i zdrowia populacyjnego przy użyciu TabDDPM. Wygeneruj próbki syntetyczne wyłącznie z przetworzonego działu treningowego, aby zapobiec wyciekowi informacji. Skonfiguruj model zgodnie z Tabela uzupełniająca 2.
- Trenuj model TabDDPM przez maksymalnie 500 epok, korzystając z optymalizatora Adam (learning rate = 1 × 10⁻4; wielkość partii = 256). Zastosuj wczesne zatrzymanie (early stopping), jeśli strata walidacyjna nie ulegnie poprawie o co najmniej 0,001 przez 20 kolejnych epok. Wygeneruj syntetyczne próbki dla klas niedoreprezentowanych.
- Oceń jakość danych syntetycznych, wykorzystując statystykę Kołmogorowa–Smirnowa (KS), dywergencję Jensena–Shannona, odległość Wassersteina, analizę korelacji poszczególnych cech oraz wydajność klasyfikacji w zadaniach końcowych. Porównaj rozkłady cech oryginalnych i syntetycznych, stosując nakładanie histogramów, estymację gęstości jądrowej oraz współczynniki korelacji parzystej.
- Akceptuj próbki syntetyczne tylko wtedy, gdy rozkłady cech dla poszczególnych klas pozostają spójne z oryginalnymi danymi treningowymi (test KS, p > 0,05; dywergencja Jensena-Shannona < 0,10) i nie zawierają nierealistycznych wartości klinicznych. Połączone zaakceptowane próbki z oryginalnym zbiorem treningowym w celu wygenerowania zrównoważonego klasowo zbioru danych. Przepływ pracy augmentacji przedstawiono w Rysunek 3.
- Zweryfikuj dane syntetyczne poprzez ponowne wytrenowanie modelu predykcji cukrzycy z wykorzystaniem oryginalnego oraz rozszerzonego zbioru treningowego. Porównaj dokładność (Accuracy), wynik F1 (F1-score), współczynnik MCC oraz AUC-ROC, aby ocenić zmiany w generalizacji modelu i obciążeniu rozkładu.
4. Opracowanie multimodalnego modelu transformera
Skonfiguruj multimodalny transformator z koderami specyficznymi dla poszczególnych modalności dla ustrukturyzowanych danych klinicznych, sekwencji CGM oraz obrazów dna oka, zgodnie z ilustracją na Rysunku 4. Zintegruj wynikowe reprezentacje za pomocą uwagi między-modalnej (cross-modal attention) w celu przewidywania cukrzycy oraz spersonalizowanego rekomendowania leków w oparciu o grafy.
- Opracowanie kodera danych klinicznych
- Inicjalizacja architektury kodera TabTransformer. Wprowadzenie znormalizowanych zmiennych klinicznych i wskaźników zdrowia populacyjnego. Generowanie kontekstowych reprezentacji cech przy użyciu mechanizmów uwagi transformera.
- Konfiguracja kodera TabTransformer z 32 ustrukturyzowanymi zmiennymi wejściowymi danymi klinicznymi, wymiarem osadzania (embedding dimension) wynoszącym 128, czterema warstwami transformera, ośmioma głowicami uwagi, wymiarem warstwy feed-forward wynoszącym 512, współczynnikiem dropout na poziomie 0.20 oraz funkcją aktywacji Gaussian Error Linear Unit (GELU).
- Wyuczenie ukrytych osadzeń klinicznych oddających zależności między atrybutami pacjentów. Przechowywanie uzyskanych osadzeń klinicznych do integracji multimodalnej.
- Opracowanie kodera ciągłego monitorowania glikemii
- Inicjalizacja temporalnego kodera transformera. Wprowadzenie sekwencji z ciągłego monitorowania glikemii oraz pomiarów fizjologicznych. Wykorzystanie mechanizmów self-attention do kodowania zależności czasowych.
- Konfiguracja temporalnego transformera z długością sekwencji wynoszącą 96 kroków czasowych, interwałem próbkowania 15 min, wymiarem osadzania 128, czterema warstwami transformera, ośmioma głowicami uwagi, sinusoidalnym kodowaniem pozycyjnym oraz współczynnikiem dropout 0.20.
- Wygenerowanie osadzeń sekwencyjnych odzwierciedlających dynamikę glikemii pacjenta. Przygotowanie osadzeń temporalnych do kolejnego procesu fuzji.
- Opracowanie kodera Vision Transformer
- Inicjalizacja architektury Vision Transformer. Wprowadzenie wstępnie przetworzonych obrazów dna oka. Podział obrazów na fragmenty (patches) o stałym rozmiarze.
- Konfiguracja Vision Transformer z rozdzielczością obrazu wejściowego 224 × 224 pixels, rozmiarem fragmentu 16 × 16 pixels, wymiarem osadzania 768, 12 blokami transformera, 12 głowicami uwagi oraz współczynnikiem dropout 0.10.
- Generowanie reprezentacji cech na poziomie fragmentu. Pozyskanie cech wizualnych sygnalizujących patologie siatkówki i biomarkery związane z chorobą. Przechowywanie osadzeń obrazów do fuzji multimodalnej.
- Przeprowadzenie fuzji między-modalnej
- Ekstrakcja reprezentacji ukrytych z koderów danych klinicznych, CGM oraz Vision Transformer i rzutowanie każdej z nich na wspólną 256-wymiarową przestrzeń ukrytą przy użyciu niezależnych projekcji liniowych, a następnie normalizacji warstwowej (Layer Normalization).
- Konkatenacja rzutowanych tokenów modalności, dodanie wyuczalnych osadzeń typu modalności oraz zastosowanie wielogłowicowej uwagi między-modalnej (multi-head cross-modal attention) w celu umożliwienia wymiany informacji między reprezentacjami klinicznymi, CGM i siatkówki. Konfiguracja bloku uwagi z ośmioma głowicami, 256-wymiarową przestrzenią modelu, 1024-wymiarową warstwą feed-forward, aktywacją GELU, dropoutem 0.10, połączeniami rezydualnymi oraz normalizacją warstwową.
- Zastosowanie średniego pulingu (mean-pooling) dla każdej grupy tokenów specyficznych dla danej modalności i konkatenacja wynikowych reprezentacji. Rzutowanie skonkatenowanego 768-wymiarowego wektora na 512-wymiarową zunifikowaną reprezentację multimodalną oraz zachowanie wag uwagi i zfuzjowanych reprezentacji do późniejszych analiz wyjaśnialności i analiz ablacyjnych.
- Przekazanie zunifikowanej reprezentacji do modułów predykcji cukrzycy oraz rekomendacji leków opartych na GraphSAGE. Zachowanie oryginalnych podziałów treningowych, walidacyjnych i testowych dla poszczególnych modalności podczas procesu fuzji, bez sztucznego dopasowywania pacjentów między niezależnymi zbiorami danych.
- Konfiguracja transformera multimodalnego zgodnie z parametrami modelu podsumowanymi w Supplementary Table 3.
5. Konfiguracja uczenia federacyjnego
- Skonfiguruj strukturę uczenia federacyjnego (federated learning), aby umożliwić wspólne trenowanie modelu w geograficznie rozproszonych placówkach opieki zdrowotnej bez wymiany danych na poziomie pacjenta. Przeprowadź lokalną optymalizację modelu w każdej uczestniczącej placówce, korzystając z dostępnych lokalnie danych. Przesyłaj do centralnego serwera agregującego wyłącznie chronione parametry modelu. Zachowaj prywatność pacjentów, umożliwiając jednocześnie wspólny rozwój modeli multimodalnych.
- Rozdziel multimodalne zbiory danych i rozdziel je pomiędzy wielu klientów federacyjnych, aby zasymulować scenariusz współpracy różnych placówek opieki zdrowotnej bez udostępniania ich danych.
- Skonfiguruj sieć uczenia federacyjnego z 10 uczestniczącymi klientami-szpitalami, jednym centralnym serwerem agregującym, pięcioma lokalnymi epokami na rundę komunikacyjną, 100 rundami komunikacyjnymi, ułamkiem uczestnictwa klientów na poziomie 80%, losowym wyborem klientów w każdej rundzie komunikacyjnej oraz minimum ośmiu uczestniczących klientów na rundę.
- Przypisz każdemu klientowi zbiór danych należący do konkretnej instytucji, tak aby dane pozostały lokalne i poufne. Podziel multimodalne dane treningowe pomiędzy 10 symulowanych klientów-szpitali, stosując strategię rozkładu nie-IID (non-independent and identically distributed) opartą na rozkładzie Dirichleta , aby wygenerować heterogeniczne rozkłady klas, składy demograficzne oraz rozmiary zbiorów danych klientów.
- Użyj stałego ziarna losowości (random seed), aby zapewnić powtarzalność. Zweryfikuj wynikowe rozkłady na poziomie klientów i zachowaj te partycje przez cały okres treningu federacyjnego. Utrzymaj zbiory danych do walidacji i testowania niezależnie od partycji klientów.
- Zainicjuj każdego lokalnego klienta parametrami modelu globalnego otrzymanymi z centralnego serwera agregującego. Trenuj lokalny transformer multimodalny przez pięć epok, korzystając z lokalnych danych treningowych klienta. Optymalizuj lokalny model za pomocą optymalizatora AdamW przy współczynniku uczenia 1 × 10⁻4.
- Oblicz aktualizacje parametrów lokalnego modelu po zakończeniu treningu lokalnego. Zabezpiecz parametry lokalnego modelu przed przesłaniem do centralnego serwera agregującego. Prześlij chronione parametry lokalnego modelu do centralnego serwera agregującego w celu globalnej agregacji.
- Odbierz chronione parametry modelu od wszystkich uczestniczących klientów-szpitali. Zweryfikuj integralność otrzymanych aktualizacji modelu przed agregacją. Zagreguj lokalne wagi modelu za pomocą algorytmu Federated Averaging (FedAvg). Zaktualizuj globalny transformer multimodalny, korzystając z zagregowanych parametrów modelu.
- Rozdystrybuuj ponownie zaktualizowane parametry modelu globalnego do uczestniczących klientów-szpitali. Powtarzaj procedury treningu lokalnego i globalnej agregacji do czasu ukończenia 100 rund komunikacyjnych lub spełnienia zdefiniowanego kryterium zbieżności.
- Zabezpiecz przesyłane parametry modelu za pomocą określonego mechanizmu bezpiecznej agregacji i szyfrowania AES-256. Uautentykuj uczestniczących klientów za pomocą certyfikatów cyfrowych.
- Ustanów szyfrowane kanały komunikacyjne z wykorzystaniem protokołu Transport Layer Security (TLS) 1.3. Zachowaj jedynie zagregowane parametry modelu globalnego po zakończeniu każdej rundy komunikacyjnej.
- Oceń prywatność i bezpieczeństwo za pomocą analizy ekspozycji danych surowych, nieautoryzowanego udostępniania, wnioskowania o przynależności (membership inference) oraz inwersji modelu. W przypadku wnioskowania o przynależności porównaj AUC-ROC ataku z bazą losową (0,50); oceń inwersję za pomocą wskaźnika podobieństwa strukturalnego (SSIM) i szczytowego stosunku sygnału do szumu (PSNR) dla obrazów siatkówki oraz znormalizowanego błędu rekonstrukcji dla cech numerycznych.
- Zweryfikuj bezpieczną agregację, potwierdzając, że serwer nie ma dostępu do poszczególnych, niezagregowanych aktualizacji klientów. Zweryfikuj ochronę AES-256/TLS 1.3 i potwierdź, że nie występują niezaszyfrowane transmisje aktualizacji modelu.
- Porównaj metryki prywatności między konfiguracjami federacyjnymi a scentralizowanymi, gdzie jest to możliwe, i raportuj metryki określone w Tabeli uzupełniającej 4.
- Oszacuj złożoność obliczeniową lokalnego treningu transformera jako O(N × L × d2), gdzie N oznacza liczbę próbek, L oznacza liczbę warstw transformera, a d oznacza wymiar osadzenia (embedding dimension).
- Oszacuj złożoność obliczeniową agregacji federacyjnej jako O(K × P) na rundę komunikacyjną, gdzie K oznacza liczbę uczestniczących klientów, a P oznacza liczbę trenowalnych parametrów modelu.
- Wymieniaj wyłącznie chronione parametry modelu pomiędzy uczestniczącymi klientami a centralnym serwerem agregującym podczas każdej rundy komunikacyjnej. Oblicz narzut komunikacyjny na podstawie rozmiaru modelu, liczby uczestniczących klientów i liczby rund komunikacyjnych.
- Porównaj narzut wymiany parametrów z szacowanym kosztem przesyłania odpowiadających im multimodalnych zbiorów danych medycznych. Skonfiguruj strukturę uczenia federacyjnego zgodnie z parametrami podsumowanymi w Tabeli uzupełniającej 4. Przepływ pracy uczenia federacyjnego i proces agregacji parametrów przedstawiono na Ryc. 5.
6. Konstrukcja modułu spersonalizowanych rekomendacji lekowych
- Zaimportuj dane farmakologiczne, dane dotyczące leków, leczenia pacjentów oraz interakcji lekowych do środowiska obliczeniowego. Zbuduj heterogeniczny graf opieki zdrowotnej zawierający węzły reprezentujące pacjentów, leki, choroby, badania laboratoryjne i kliniczne czynniki ryzyka.
- Zdefiniuj relacje pacjent-choroba, pacjent-lek, choroba-lek, interakcje lek-lek oraz relacje pacjent-badanie laboratoryjne jako krawędzie grafu. Zweryfikuj strukturę grafu i usuń duplikaty, nieprawidłowe lub odizolowane relacje przed trenowaniem modelu.
- Reprezentuj węzły pacjentów za pomocą wieku, płci, wskaźnika masy ciała (BMI), HbA1c, glikemii, ciśnienia tętniczego oraz czasu trwania cukrzycy. Reprezentuj węzły leków za pomocą klasy leku, mechanizmu działania, dawkowania, częstotliwości podawania i znanych działań niepożądanych.
- Reprezentuj węzły chorób za pomocą stopnia nasilenia choroby, stadium choroby i związanych z nią powikłań. Zakoduj atrybuty kategoryczne i znormalizuj ciągłe cechy węzłów przed trenowaniem modelu GraphSAGE.
- Zainicjuj osadzenia (embeddings) węzłów przy użyciu wstępnie przetworzonych cech węzłów. Pobierz próbkę do 25 sąsiednich węzłów dla każdego węzła docelowego podczas agregacji sąsiedztwa. Agreguj reprezentacje sąsiednich węzłów przy użyciu agregacji średniej. Zaktualizuj osadzenia węzła docelowego przy użyciu zagregowanych reprezentacji sąsiedztwa.
- Zastosuj funkcję aktywacji ReLU (rectified linear unit) po każdej warstwie GraphSAGE. Znormalizuj wynikowe osadzenia węzłów. Powtórz procedurę agregacji sąsiedztwa w trzech warstwach GraphSAGE.
- Skonfiguruj model GraphSAGE z wymiarem ukrytym 256, wymiarem osadzenia 128, trzema warstwami GraphSAGE, rozmiarem próbkowania sąsiadów 25, współczynnikiem dropout 0,30, szybkością uczenia 1 × 10⁻4, rozmiarem partii (batch size) 512 i maksymalną liczbą 100 epok treningowych. Zoptymalizuj model przy użyciu optymalizatora Adam.
- Oblicz specyficzne dla pacjenta osadzenie z wytrenowanego modelu GraphSAGE. Oblicz osadzenia dla potencjalnych leków. Oblicz wskaźniki dopasowania między reprezentacją pacjenta a reprezentacjami potencjalnych leków. Uszereguj potencjalne leki zgodnie z ich przewidywanymi wskaźnikami dopasowania.
- Zidentyfikuj i usuń leki przeciwwskazane lub potencjalnie niebezpieczne, korzystając z dostępnych informacji o interakcjach lek-lek. Wybierz pięć najwyżej ocenionych dopuszczalnych leków jako spersonalizowane rekomendacje Top-5.
- Wytrenuj model rekomendacyjny przy użyciu funkcji straty Bayesian Personalized Ranking (BPR). Zoptymalizuj cel rankingowy, aby przypisać wyższe wyniki lekom klinicznie odpowiednim niż lekom mniej dopasowanym.
- Zidentyfikuj wpływowe węzły sąsiednie i klinicznie istotne relacje w grafie, które przyczyniają się do każdej rekomendacji leku. Oblicz wyniki atrybucji cech dla charakterystyk pacjenta, choroby, badań laboratoryjnych i leków, które wpływają na rekomendację.
- Wygeneruj wizualne wyjaśnienia oparte na grafie, pokazujące relacje przyczyniające się do każdej spersonalizowanej rekomendacji leku. Skonfiguruj model rekomendacyjny GraphSAGE zgodnie z parametrami podsumowanymi w Tabeli uzupełniającej 5. Przepływ pracy spersonalizowanej rekomendacji leków opartej na grafach przedstawiono na Rysunku 6.
7. Przeprowadź ocenę wyjaśnialności
- Przeprowadzenie analizy SHAP
- Wczytanie wytrenowanego transformera multimodalnego oraz odseparowanego zbioru testowego do środowiska obliczeniowego.
- Inicjalizacja wyjaśniacza SHAP przy użyciu wytrenowanego modelu predykcyjnego i próbki tła składającej się ze 100 próbek treningowych, wybranych wyłącznie ze zbioru treningowego metodą stratyfikowanego losowania zgodnie z klasą wyniku cukrzycy. Zachowanie w próbce tła przybliżonego rozkładu klas całej partycji treningowej oraz zastosowanie stałego ziarna losowości (random seed) 42 w celu zapewnienia powtarzalności wyboru próbek. Obliczenie wartości SHAP dla wybranych próbek testowych.
- Obliczenie globalnej istotności cech na podstawie bezwzględnych wartości SHAP, wygenerowanie globalnych i lokalnych wizualizacji SHAP oraz zachowanie obliczonych wartości do późniejszych analiz ilościowych i statystycznych.
- Przeprowadzenie analizy zintegrowanych gradientów (Integrated Gradients)
- Wybór reprezentatywnych próbek poprawnie i błędnie sklasyfikowanych z odseparowanego zbioru testowego. Zdefiniowanie wejść bazowych (baseline) specyficznych dla każdej modalności przed obliczeniem zintegrowanych gradientów. Zastosowanie bazy zerowej dla znormalizowanych numerycznych cech klinicznych i CGM, reprezentującej zerowy wkład znormalizowanej cechy, oraz obrazu o wartościach zerowych jako bazy dla znormalizowanego wejścia obrazu siatkówki.
- Obliczenie wyników atrybucji zintegrowanych gradientów przy użyciu 100 kroków interpolacji między bazą a oryginalnym wejściem. Normalizacja otrzymanych wyników atrybucji w celu umożliwienia porównania między cechami i modalnościami. Wygenerowanie wizualizacji atrybucji w celu zidentyfikowania wpływowych cech klinicznych, czasowych i obrazowych przyczyniających się do poszczególnych predykcji modelu.
- Przeprowadzenie wizualizacji uwagi (attention visualization)
- Ekstrakcja macierzy uwagi z wytrenowanych warstw transformera dla reprezentatywnych próbek testowych. Obliczenie średnich wag uwagi w ramach odpowiednich głowic uwagi. Wygenerowanie map ciepła uwagi w celu wizualizacji interakcji międzymodalnych pomiędzy reprezentacjami klinicznymi, czasowymi i obrazowymi siatkówki. Identyfikacja dominujących cech klinicznych, czasowych i siatkówkowych otrzymujących wysokie wagi uwagi podczas predykcji.
- Ekstrakcja wag uwagi z wytrenowanego transformera multimodalnego dla losowo wybranej próbki z odseparowanego zbioru testowego i wizualizacja odpowiadających im rozkładów uwagi dla cech klinicznych, czasowych CGM, przestrzennych siatkówki oraz uwagi międzymodalnej.
- Generowanie wyjaśnień kontrfaktycznych
- Wybór reprezentatywnych rekordów pacjentów z odseparowanego zbioru testowego. Zdefiniowanie klinicznie dopuszczalnych zakresów i ograniczeń dla modyfikowalnych cech pacjentów przed generowaniem próbek kontrfaktycznych. Ograniczenie cech ciągłych do ich obserwowanego zakresu w danych treningowych oraz ograniczenie cech kategorycznych do poprawnych kategorii zaobserwowanych w danych treningowych. Zakaz modyfikowania niezmiennych cech demograficznych, w tym wieku i płci.
- Generowanie próbek kontrfaktycznych poprzez minimalną modyfikację wyłącznie dozwolonych cech modyfikowalnych przy zachowaniu zdefiniowanych ograniczeń klinicznych i domenowych cech. Odrzucenie kontrfaktycznych próbek zawierających wartości spoza obserwowanego zakresu danych treningowych, nieprawidłowe stany kategoryczne lub modyfikacje cech niezmiennych. Identyfikacja najmniejszych, klinicznie prawdopodobnych modyfikacji cech wymaganych do zmiany przewidywanego wyniku.
- Raportowanie zmodyfikowanych cech, wartości oryginalnych, wartości kontrfaktycznych oraz odpowiadających im zmian w predykcjach modelu. Przepływ pracy oceny wyjaśnialności przedstawiono na Rysunku 7, natomiast reprezentatywne wyniki wizualizacji uwagi i wyjaśnień kontrfaktycznych zaprezentowano na Rysunku uzupełniającym 1.
- Ocena jakości wyjaśnień
- Obliczenie wierności (fidelity) w celu ilościowego określenia zgodności między wygenerowanymi wyjaśnieniami a zachowaniem modelu predykcyjnego. Obliczenie stabilności poprzez wielokrotne generowanie wyjaśnień przy niewielkich perturbacjach wejścia i porównywanie wynikowych wzorców atrybucji. Ocena spójności poprzez porównywanie wyjaśnień wygenerowanych dla klinicznie podobnych próbek testowych.
- Obliczenie rzadkości (sparsity) poprzez określenie liczby lub proporcji cech wnoszących istotny wkład do każdego wyjaśnienia. Ocena kompletności w celu ustalenia, czy przypisane cechy w wystarczający sposób wyjaśniają odpowiadający im wynik modelu. Ocena czułości poprzez pomiar zmian w wynikach atrybucji po kontrolowanych perturbacjach cech wejściowych.
- Obliczenie niefidelności (infidelity) w celu ilościowego określenia niezgodności między atrybucjami cech a obserwowanymi zmianami w predykcjach modelu. Rejestracja wszystkich ilościowych metryk wyjaśnialności do późniejszej analizy statystycznej.
- Przeprowadzenie prospektywnej walidacji klinicznej
- W przypadku przyszłej prospektywnej walidacji klinicznej należy uzyskać zgodę odpowiedniej Komisji Bioetycznej przed rekrutacją ekspertów klinicznych. Po uzyskaniu zgody etycznej należy zrekrutować 12 klinicystów, w tym sześciu endokrynologów, trzech diabetologów i trzech farmakologów klinicznych, oraz uzyskać świadomą zgodę od wszystkich uczestników przed rozpoczęciem oceny.
- Losowy wybór reprezentatywnych predykcji modelu i odpowiadających im wyjaśnień do oceny przez klinicystów. Przedstawienie wybranych wyjaśnień niezależnie każdemu uczestniczącemu klinicyście przy użyciu ustandaryzowanego formatu oceny.
- Poproszenie każdego klinicysty o ocenę przydatności, istotności klinicznej, interpretowalności i wiarygodności wyjaśnienia przy użyciu pięciostopniowej skali Likerta. Rejestracja zanonimizowanych ocen klinicystów oraz obliczenie zgodności między oceniającymi i odpowiednich miar statystycznych, zgodnie z opisem w kroku 7.7.
- Przeprowadzenie analizy statystycznej
- Ocena rozkładu ilościowych wyników oceny przed wyborem testu porównania statystycznego. Zastosowanie testu t-studenta dla par w przypadku pomiarów sparowanych o rozkładzie normalnym lub testu znaków Wilcoxona dla pomiarów sparowanych o rozkładzie nienormalnym, w zależności od potrzeb.
- Obliczenie kappa Fleissa w celu ilościowego określenia zgodności między oceniającymi wśród uczestniczących klinicystów. Obliczenie 95% przedziałów ufności dla głównych metryk wyjaśnialności i oceny klinicznej. Ustalenie progu istotności statystycznej na poziomie p < 0.05.
- Raportowanie obliczonych statystyk testowych, przedziałów ufności i wartości p wraz z odpowiadającymi im wynikami oceny. Ocena i raportowanie metryk wyjaśnialności zgodnie z kryteriami podsumowanymi w Tabeli uzupełniającej 6.
8. Ocena wydajności modelu
- Porównaj FedMediFormer-XAI z regresją logistyczną, lasami losowymi (Random Forest), XGBoost, TabTransformer, Vision Transformer, Temporal Transformer oraz scentralizowanym transformerem multimodalnym, wykorzystując wskaźniki accuracy, precision, recall, F1-score, MCC oraz AUC-ROC.
- Przeprowadź każdą ocenę modelu bazowego przy użyciu tej samej zdefiniowanej strategii uczenia, walidacji i testowania, aby zapewnić spójność porównania z proponowanym frameworkiem.
- Powtórz ocenę modelu w niezależnych przebiegach eksperymentalnych i zapisz metryki wydajności uzyskane w każdym z nich. Oblicz średnią, odchylenie standardowe (SD) oraz 95% przedział ufności (CI) dla wskaźników Accuracy, Precision, Recall, F1-score, MCC oraz AUC-ROC. Przedstaw wyniki wydajności jako średnia ± SD wraz z odpowiadającym im 95% CI.
- Oceń normalność rozkładu sparowanych różnic w wydajności między FedMediFormer-XAI a każdym z modeli bazowych. Zastosuj sparowany test t dla pomiarów o rozkładzie normalnym oraz test znaków Wilcoxona dla pomiarów o rozkładzie nienormalnym. Ustal próg istotności statystycznej na poziomie p < 0,05.
- Podaj odpowiednie statystyki testowe, wartości p oraz 95% przedziały ufności, aby określić istotność statystyczną i niepewność zaobserwowanych różnic w wydajności.
- Wyznacz liczbę wszystkich rund komunikacyjnych aż do momentu ostatecznej zbieżności modeli. Monitoruj wydajność modelu globalnego podczas uczenia federacyjnego. Przeanalizuj, jak zbieżność zmienia się w czasie w kolejnych rundach komunikacyjnych.
- Sprawdź skuteczność agregacji parametrów. Zbadaj, jak uczenie zdecentralizowane wpływa na wydajność predykcyjną. Przeprowadź porównanie wyników uczenia federacyjnego z wynikami uczenia scentralizowanego.
- Oceń zbieżność federacyjną w kolejnych rundach komunikacyjnych i porównaj wydajność predykcyjną modelu federacyjnego oraz scentralizowanego. Oceń rekomendacje leków, korzystając z wskaźników Precision@5, Recall@5 oraz NDCG@5.
- Wygeneruj próbki negatywne – próbki leków z puli kwalifikujących się leków kandydackich, wybierając preparaty, które nie zostały odnotowane jako pozytywne interakcje pacjent–lek dla danego pacjenta. Wyklucz z puli próbkowania negatywnego wszystkie znane interakcje pozytywne oraz wszystkie leki przeciwwskazane. Utrzymaj stały stosunek próbkowania negatywnego do pozytywnego wynoszący 1:1 dla uczenia rekomendacji i użyj stałego ziarna losowości (random seed) 42 w celu zapewnienia powtarzalności wyboru próbek negatywnych.
- Ustal odpowiedni zbiór elementów dla każdego pacjenta wyłącznie na podstawie odseparowanych danych ewaluacyjnych. Zdefiniuj zbiór elementów istotnych Ru dla pacjenta u jako zbiór leków spełniających kryteria pozytywnej interakcji pacjent–lek w odseparowanych rekordach prawdy obiektywnej (ground-truth). Do konstrukcji Ru nie używaj predykcji modelu. Usuń leki przeciwwskazane ze zbioru rekomendacji kandydackich przed wykonaniem rankingu.
- Wygeneruj pięć najwyżej ocenionych kwalifikujących się leków dla każdego pacjenta ewaluacyjnego. Oblicz Precision@5 jako proporcję pięciu rekomendowanych leków, które należą do zbioru elementów istotnych Ru danego pacjenta. Oblicz Recall@5 jako proporcję odzyskanych leków istotnych pacjenta spośród pięciu rekomendacji. Oblicz NDCG@5, wykorzystując stopniowaną istotność rekomendowanych leków, przypisując wyższą istotność lekom klinicznie odpowiednim i zerową istotność lekom nieistotnym. Zagreguj metryki dla wszystkich pacjentów ewaluacyjnych i podaj średnie wartości Precision@5, Recall@5 oraz NDCG@5.
- Skonstruuj prawdę obiektywną dla rekomendacji przed oceną modelu i przechowuj odseparowane interakcje pacjent–lek oddzielnie od danych do uczenia rekomendacji. Podczas uczenia GraphSAGE, próbkowania negatywnego lub rankingu kandydatów nie używaj interakcji leków ze zbioru testowego, etykiet ze zbioru testowego ani informacji o przyszłym leczeniu.
- Zmierz wskaźnik Fidelity, aby sprawdzić, jak dobrze wyjaśnienia odpowiadają zachowaniu modelu. Oceń stabilność wyjaśnień poprzez wielokrotne analizy. Oceń zrozumiałość (Comprehensibility) w oparciu o kryteria zorientowane na lekarza.
- Zbadaj spójność wyjaśnień dla różnych typów danych. Potwierdź wartość kliniczną wygenerowanych wyjaśnień. Metryki ewaluacyjne wykorzystane w całym badaniu zostały zestawione w Tabeli uzupełniającej 7.
9. Przeprowadź prospektywną walidację kliniczną
- Przeprowadzić prospektywną walidację kliniczną po uzyskaniu odpowiedniej zgody komisji etycznej oraz świadomej zgody uczestników, stosując procedury rekrutacji, oceny, gromadzenia danych i analizy statystycznej opisane w krokach 7.6–7.8. Projekt prospektywnej walidacji klinicznej, obejmujący skład grupy uczestników, kryteria oceny, warunki porównawcze oraz planowane analizy statystyczne, przedstawiono w Tabeli uzupełniającej 8.
10. Przeprowadzenie walidacji i oceny powtarzalności
- Przeprowadź badania ablacyjne poprzez systematyczne usuwanie poszczególnych komponentów z pełnego frameworka FedMediFormer-XAI, zachowując te same partycje zbioru danych, procedury preprocessingu, ustawienia treningowe oraz kryteria ewaluacji. Oceń pełny model oraz konfiguracje bez augmentacji dyfuzyjnej, uczenia federacyjnego, rekomendacji leków opartej na GraphSAGE oraz fuzji multimodalnej.
- Porównaj konfiguracje po ablacji z pełnym frameworkiem FedMediFormer-XAI, wykorzystując miary Accuracy, Precision, Recall, F1-score, MCC oraz AUC-ROC. Ilościowo określ zmianę w każdym z parametrów wydajności, aby określić wkład każdego komponentu frameworka. Porównaj wyniki walidacji z wynikami testów wewnętrznych w celu oceny zdolności do generalizacji. Przeprowadź testy istotności statystycznej, aby określić wiarygodność zaobserwowanych różnic w wydajności.
- Oceń zdolność do generalizacji frameworka, wykorzystując niezależny zewnętrzny zbiór danych, jeżeli taki zbiór z kompatybilnymi zmiennymi wejściowymi i definicjami wyników jest dostępny. Zastosuj te same procedury preprocessingu i ewaluacji, które zostały użyte dla wewnętrznego zbioru testowego, a następnie porównaj uzyskane wskaźniki wydajności z wynikami testów wewnętrznych.
- Przeprowadź analizę istotności statystycznej w ramach powtórzonych serii eksperymentalnych. Oceń normalność rozkładu sparowanych różnic w wydajności przed przeprowadzeniem testów statystycznych. Zastosuj test t dla prób zależnych w przypadku pomiarów sparowanych o rozkładzie normalnym oraz test znaków Wilcoxona dla pomiarów sparowanych o rozkładzie nienormalnym. Ustal próg istotności statystycznej na poziomie p < 0.05.
- Oblicz średnią oraz 95% przedział ufności dla Accuracy, Precision, Recall, F1-score, MCC i AUC-ROC. Przedstaw odpowiednie statystyki testowe, wartości p oraz przedziały ufności dla głównych porównań modeli. Udokumentuj wszystkie parametry modeli, procedury preprocessingu, konfiguracje treningowe i protokoły ewaluacji niezbędne do reprodukcji opisanych eksperymentów.
- Zabezpiecz kod źródłowy, pliki konfiguracyjne, skrypty ewaluacyjne oraz specyfikacje wytrenowanych modeli użyte w opisanych eksperymentach. Prowadź szczegółową dokumentację treningu modeli, ustawień eksperymentalnych, ziarn losowości (random seeds) oraz wyników ewaluacji.
- Zweryfikuj kompletność i spójność dostępnych materiałów do reprodukcji. Upewnij się, że udokumentowane metody i materiały dostarczają wystarczających informacji do niezależnego odtworzenia przebiegu eksperymentalnego.
- Podsumuj zasoby do reprodukcji oraz procedury walidacyjne wykorzystane w badaniu w Tabeli uzupełniającej 9. Udokumentuj procedurę badań ablacyjnych i kryteria ewaluacji służące do oceny wkładu głównych komponentów frameworka.
Wyniki
Analiza wydajności predykcyjnej
Model FedMediFormer-XAI wykazał poprawioną wydajność predykcyjną w porównaniu z ocenianymi modelami unimodalnymi oraz konwencjonalnymi modelami bazowymi. Augmentacja oparta na dyfuzji poprawiła reprezentację klasy mniejszościowej, a wynikową wydajność predykcyjną zestawiono w Tabeli 3. Ewaluacja z wielokrotnym uruchomieniem wykazała stabilną wydajność predykcyjną we wszystkich ocenianych modelach. FedMediFormer-XAI osiągnął najwyższą ogólną wydajność, z dokładnością (accuracy) 94,20 ± 0,34% (95% CI: 93,78–94,62), precyzją (precision) 93,10 ± 0,30% (95% CI: 92,73–93,47), czułością (recall) 92,80 ± 0,28% (95% CI: 92,45–93,15) oraz wynikiem F1-score 92,90 ± 0,28% (95% CI: 92,55–93,25). Model osiągnął współczynnik MCC wynoszący 0,8 ± 0,02 (95% CI: 0,86–0,90) oraz AUC-ROC na poziomie 0,96 ± 0,01 (95% CI: 0,95–0,97). Następną najlepszą ogólną wydajność zapewnił scentralizowany transformer multimodalny, natomiast modele unimodalne i konwencjonalne modele uczenia maszynowego wykazały porównawczo niższą wydajność predykcyjną. Wyniki te wskazują, że multimodalna nauka reprezentacji w połączeniu z optymalizacją federacyjną pozwala na uzyskanie poprawionej i bardziej stabilnej wydajności klasyfikacji cukrzycy.
Badanie ablacyjne
Ablację poszczególnych komponentów wykorzystano do oceny wkładu augmentacji dyfuzyjnej, uczenia federacyjnego, rekomendacji leków opartej na GraphSAGE oraz fuzji multimodalnej. Pełny framework FedMediFormer-XAI osiągnął dokładność na poziomie 94,20 ± 0,34%, precyzję 93,10 ± 0,30%, czułość 92,80 ± 0,28%, wynik F1 92,90 ± 0,28%, współczynnik MCC 0,8 ± 0,02 oraz AUC-ROC 0,96 ± 0,01 w pięciu niezależnych uruchomieniach. Usunięcie augmentacji dyfuzyjnej obniżyło dokładność do 91,80 ± 0,42%, co odpowiada spadkowi o 2,40 punktu procentowego, podczas gdy wynik F1 i AUC-ROC spadły odpowiednio do 90,30 ± 0,38% i 0,94 ± 0,01. Redukcja ta wskazuje na wkład augmentacji opartej na dyfuzji w reprezentację klas mniejszościowych oraz odporność predykcyjną.
Usunięcie uczenia federacyjnego (federated learning) spowodowało spadek dokładności do 93,10 ± 0,37%, co stanowi obniżenie o 1,10 punktu procentowego w stosunku do pełnego modelu. Precyzja (precision), pełność (recall), wskaźnik F1, MCC oraz AUC-ROC uległy również zmniejszeniu i wyniosły odpowiednio 92,20 ± 0,34%, 91,80 ± 0,32%, 92,0 ± 0,3%, 0,86 ± 0,02 oraz 0,95 ± 0,01. Porównanie to wykazuje wpływ konfiguracji federacyjnej na wydajność predykcyjną.
Usunięcie komponentu spersonalizowanych rekomendacji leków opartego na GraphSAGE spowodowało stosunkowo niewielką zmianę w wydajności przewidywania cukrzycy, przy czym dokładność spadła do 93,80 ± 0,35%, a wskaźnik F1 do 92,60 ± 0,30%. Odpowiednie wartości MCC i AUC-ROC wyniosły odpowiednio 0,87 ± 0,02 oraz 0,96 ± 0,01. Wynik ten wskazuje, że GraphSAGE przyczynia się przede wszystkim do spersonalizowanych rekomendacji leków, a nie bezpośrednio do określania wydajności klasyfikacji cukrzycy.
Największy spadek odnotowano po usunięciu fuzji multimodalnej. Dokładność spadła do 87,60 ± 0,5%, co stanowi spadek o 6,60 punktu procentowego, natomiast precyzja, czułość, wskaźnik F1, MCC oraz AUC-ROC spadły odpowiednio do 86,80 ± 0,51%, 85,90 ± 0,54%, 86,30 ± 0,52%, 0,76 ± 0,03 oraz 0,91 ± 0,01. Wynik ten dowodzi znaczenia wspólnego modelowania komplementarnych informacji pochodzących z danych klinicznych, CGM oraz obrazowania siatkówki.
Analiza uczenia federacyjnego
Struktura uczenia federacyjnego umożliwiła kolaboracyjny trening modelu pomiędzy rozproszonymi klientami, przy jednoczesnym zachowaniu zdecentralizowanego przetwarzania surowych danych pacjentów. Podczas treningu lokalny model każdego klienta był dostrajany indywidualnie, a następnie łączony za pomocą metody Federated Averaging. Po 10 rundach komunikacyjnych model globalny zbiegł się, a jego zdolność predykcyjna pozostała spójna z wynikami uczenia scentralizowanego. Struktura uczenia federacyjnego wykazała stabilną zbieżność w kolejnych rundach komunikacyjnych, pomimo heterogenicznego rozkładu danych u klientów. Wymiana chronionych parametrów pozwoliła na zachowanie zdecentralizowanego przetwarzania danych, podczas gdy model globalny utrzymał konkurencyjną wydajność predykcyjną w stosunku do scentralizowanej linii bazowej. Tabela 4 porównuje implementacje scentralizowaną i federacyjną. Uczenie federacyjne wymagało dodatkowego czasu treningu ze względu na narzut komunikacyjny, zachowując jednocześnie wydajność predykcyjną porównywalną z uczeniem scentralizowanym.
Analiza wydajności na poziomie zbiorów danych
Aby ocenić zdolność do generalizacji w różnych modalnościach opieki zdrowotnej, oceniono wydajność dla każdego zbioru danych osobno. Multimodalny model FedMediFormer-XAI wykazał wysoką i ogólnie konkurencyjną wydajność we wszystkich ocenianych zbiorach danych. Osiągnął on dokładność na poziomie odpowiednio 91,8%, 93,1%, 92,4% i 94,2% dla zbiorów danych Pima Indians Diabetes, CDC Diabetes Health Indicators, OhioT1DM oraz APTOS 2019. Choć w przypadku zbioru danych APTOS 2019 uzyskano nieco wyższą dokładność (94,7%) i precyzję (93,9%) niż w modelu multimodalnym, proponowane podejście multimodalne utrzymało konkurencyjną wydajność we wszystkich zbiorach danych i osiągnęło wartość AUC-ROC wynoszącą 0,96, co jest porównywalne z najwyższym wynikiem AUC-ROC na poziomie poszczególnych zbiorów. Ogólne wyniki na poziomie zbiorów danych przedstawiono w Tabeli 5. W przypadku pojedynczych zbiorów danych najlepsze wyniki osiągnięto przy samodzielnej analizie obrazów siatkówki, natomiast fuzja multimodalna zapewniła najbardziej stabilne i zrównoważone predykcje.
Analiza spersonalizowanych rekomendacji lekowych
Komponent rekomendacyjny oparty na grafowych sieciach neuronowych został oceniony przy użyciu informacji o skuteczności leków oraz danych o interakcjach lekowych; potencjalne leki uszeregowano zgodnie z wyuczonymi wynikami dopasowania pacjent-lek, a kombinacje przeciwwskazane wykluczono podczas generowania rekomendacji. Zastosowanie formatu grafu heterogenicznego oraz modelowanie interakcji pacjent-lek i lek-lek pozwoliło na przeprowadzenie szczegółowej analizy, co wsparło spersonalizowany dobór leków oraz ocenę bezpieczeństwa. Model rekomendacyjny GraphSAGE skutecznie uchwycił złożone relacje między pacjentami, chorobami, wynikami badań laboratoryjnych a lekami. Spersonalizowane rekomendacje wykazały wysoką wydajność rankingową, zachowując jednocześnie klinicznie istotne wyjaśnienia dzięki analizie sąsiedztwa grafu i atrybucji cech.
Zgodnie z Tabelą 6, moduł spersonalizowanych rekomendacji leków oceniono przy użyciu wskaźników Precision@5, Recall@5 oraz NDCG@5. Metryki te określają istotność i jakość rankingu pięciu najlepszych spersonalizowanych rekomendacji leków wygenerowanych przez moduł rekomendacyjny oparty na GraphSAGE. System rekomendacyjny osiągnął wysoką wydajność rankingu, przy precision = 0.89, recall = 0.84 i NDCG = 0.91.
Analiza wyjaśnialności
Struktura obejmuje SHAP, zintegrowane gradienty (Integrated Gradients), wizualizację uwagi oraz wyjaśnienia kontrfaktyczne, aby wesprzeć interpretację predykcji multimodalnych. SHAP został wykorzystany do ilościowego określenia wkładu na poziomie cech, zintegrowane gradienty do przypisania predykcji do cech wejściowych, wizualizacja uwagi do zbadania fokusu modelu w różnych modalnościach, a wyjaśnienia kontrfaktyczne do identyfikacji zmian cech związanych z alternatywnymi predykcjami. Rycina 8 przedstawia reprezentatywny wykres podsumowujący SHAP wygenerowany przez wytrenowany model FedMediFormer-XAI, natomiast Rycina 9 prezentuje reprezentatywne wizualizacje uwagi wyekstrahowane z wytrenowanego transformera. Ryciny te stanowią wyniki uzyskane z ewaluacji modelu, a nie schematyczne ilustracje proponowanej architektury.
Na Rysunku 8 przedstawiono rankingi istotności cech na poziomie zagregowanym. Cechy o wyższych bezwzględnych wartościach SHAP miały większy wpływ na prognozy modelu i były również zgodne z istniejącą wiedzą kliniczną.
Rysunek 9 przedstawia reprezentatywne wizualizacje uwagi wyekstrahowane bezpośrednio z wytrenowanego modelu FedMediFormer-XAI dla losowo wybranej próbki testowej z zestawu odseparowanego. Wizualizacje obejmują uwagę skupioną na cechach klinicznych, uwagę temporalną CGM, uwagę przestrzenną siatkówki oraz uwagę międzymodalną pomiędzy trzema modalnościami. Wizualizacja uwagi dodatkowo wykazała wyuczony przez model sposób rozkładu uwagi pomiędzy wieloma modalnościami. W wybranej próbce zaobserwowano względnie większą uwagę poświęconą HbA1c, czasowi trwania cukrzycy i wiekowi spośród cech klinicznych, natomiast mapa uwagi CGM wyróżniła kilka okresów z wyraźną zmiennością glikemii. Mapa uwagi siatkówki zidentyfikowała konkretne regiony obrazu przyczyniające się do reprezentacji modelu, a macierz uwagi międzymodalnej wykazała wzorce uwagi zarówno wewnątrzmodalnej, jak i międzymodalnej. Jak pokazano na Rysunku 9, reprezentatywne mapy uwagi pochodzące z modelu wyróżniają wybrane wzorce temporalne glikemii, wpływowe zmienne kliniczne oraz diagnostycznie istotne regiony obrazów siatkówki w próbce testowej z zestawu odseparowanego.
Wyniki oceny zorientowanej na człowieka
Zaprojektowano prospektywny protokół oceny zorientowanej na człowieka w celu zbadania zaufania klinicystów, interpretowalności, użyteczności, użyteczności klinicznej oraz istotności wyjaśnień w warunkach obejmujących samą predykcję oraz predykcję wraz z wyjaśnieniem. W proponowanej ocenie wezmą udział endokrynolodzy, specjaliści diabetologii oraz farmakolodzy kliniczni, po uzyskaniu odpowiedniej zgody Komisji Bioetycznej oraz świadomej zgody uczestników. Ponieważ ocena ta jest przeznaczona do przyszłego wdrożenia prospektywnego, w niniejszym protokole nie raportowano wyników efektów na poziomie klinicystów.
Tabela 7 podsumowuje proponowany prospektywny projekt oceny klinicznej oraz zdefiniowane kryteria oceny wpływu wyjaśnień na zaufanie klinicystów, interpretowalność i postrzeganą użyteczność. W ramach oceny prospektywnej porównane zostaną oceny przewidywań modelu dokonane przez klinicystów z towarzyszącymi im wyjaśnieniami oraz bez nich, z wykorzystaniem zdefiniowanych kryteriów w skali Likerta. Proponowany prospektywny schemat oceny wyjaśnialności zorientowany na człowieka został przedstawiony na Rysunku 10
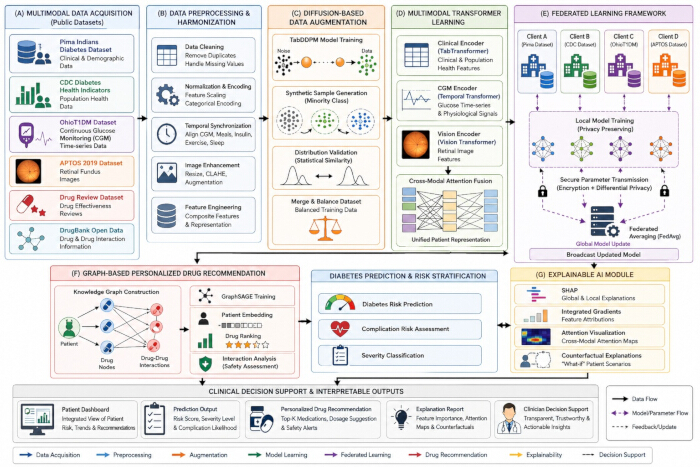
Rycina 1Ogólna architektura frameworka FedMediFormer-XAI. Schematyczny przegląd struktury FedMediFormer-XAI, przedstawiający multimodalne pozyskiwanie i wstępne przetwarzanie danych, augmentację opartą na dyfuzji, uczenie transformatorów specyficznych dla danej modalności, federacyjne trenowanie modelu, personalizowany dobór leków oparty na GraphSAGE oraz analizę wyjaśnialności. Struktura ta generuje predykcje cukrzycy, personalizowane rekomendacje lekowe oraz interpretowalne wyniki modelu. Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
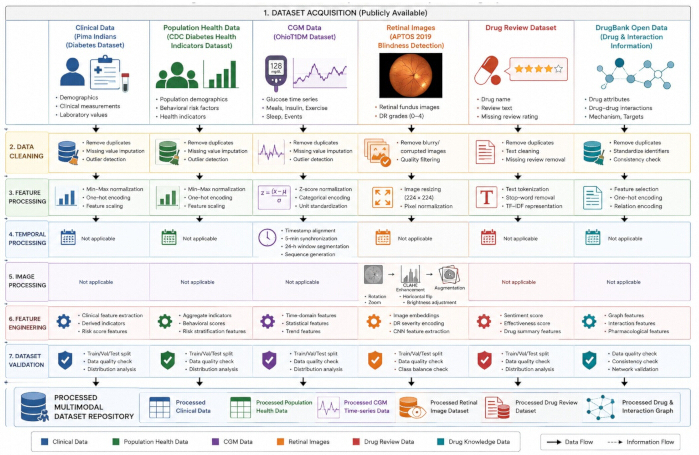
Rysunek 2Potok akwizycji i wstępnego przetwarzania multimodalnego zbioru danych. Schematyczny przebieg procesu pozyskiwania i wstępnego przetwarzania multimodalnych zbiorów danych wykorzystanych w FedMediFormer-XAI. Dane kliniczne i zdrowotne populacji, zapisy CGM, obrazy siatkówki oraz informacje farmakologiczne poddawane są specyficznej dla danej modalności kontroli jakości, wstępnemu przetwarzaniu, normalizacji, kodowaniu i augmentacji przed konwersją na reprezentacje gotowe do użycia w modelu w celu przeprowadzenia dalszych analiz. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ilustracji.
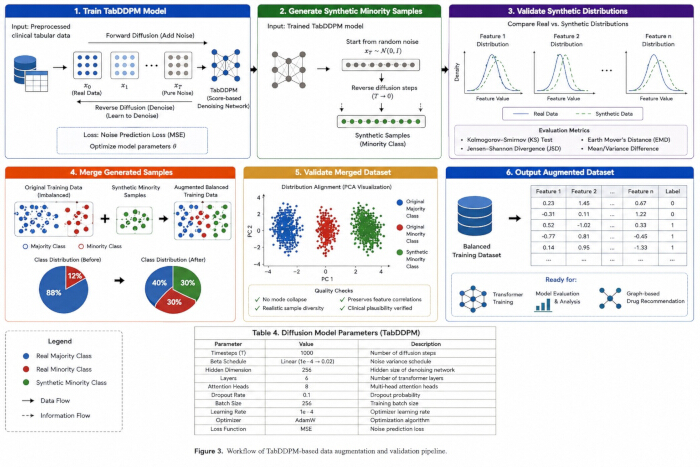
Rysunek 3: Przebieg procesu augmentacji danych oparty na dyfuzji. Schematyczny przebieg procesu augmentacji ustrukturyzowanych tabelarycznych danych treningowych z wykorzystaniem TabDDPM. Wygenerowane próbki poddawane są ocenie jakości oraz podobieństwa rozkładu przed zintegrowaniem ich z oryginalnymi danymi treningowymi w celu poprawy równowagi klas. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ilustracji.
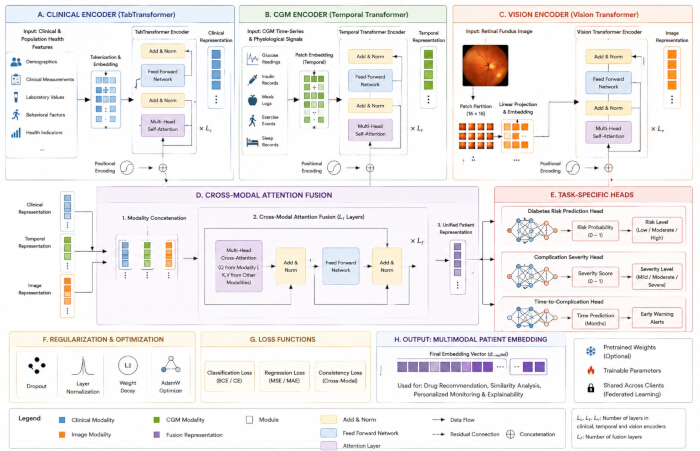
Rysunek 4Architektura proponowanej multimodalnej struktury transformera. Schemat architektury obejmujący (A) koder TabTransformer dla danych klinicznych, (B) temporal transformer encoder do danych z CGM oraz (C) koder Vision Transformer dla obrazów siatkówki. (D) Reprezentacje specyficzne dla danej modalności są integrowane za pomocą mechanizmu uwagi krzyżowej (cross-modal attention) w celu wygenerowania ujednoliconej reprezentacji multimodalnej. (E) Specyficzne dla zadań głowice predykcyjne generują wyniki modelu. (F) Komponenty regularyzacji i optymalizacji wspierają trenowanie modelu, a (Gproces optymalizacji jest sterowany przez funkcje strat klasyfikacji, regresji oraz spójności międzymodalnej. Wynikowa reprezentacja multimodalna wspiera zadania predykcji, rekomendacji i wyjaśnialności w dalszych etapach analizy. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
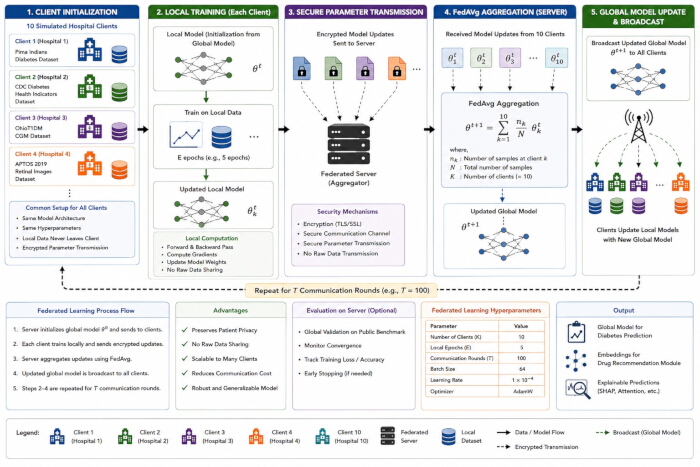
Rycina 5Struktura komunikacyjna uczenia federacyjnego. Schematyczny przebieg procesu uczenia federacyjnego w rozproszonych ośrodkach szpitalnych. Lokalne modele multimodalne są trenowane z wykorzystaniem danych specyficznych dla danego klienta, a zabezpieczone aktualizacje modelu są przesyłane do serwera centralnego w celu przeprowadzenia średniowania federacyjnego (Federated Averaging). Zagregowany model globalny jest następnie redystrybuowany do klientów w kolejnych rundach komunikacyjnych. Schemat przedstawia również bezpieczną wymianę parametrów oraz ocenę wymagań w zakresie prywatności, komunikacji i mocy obliczeniowej. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
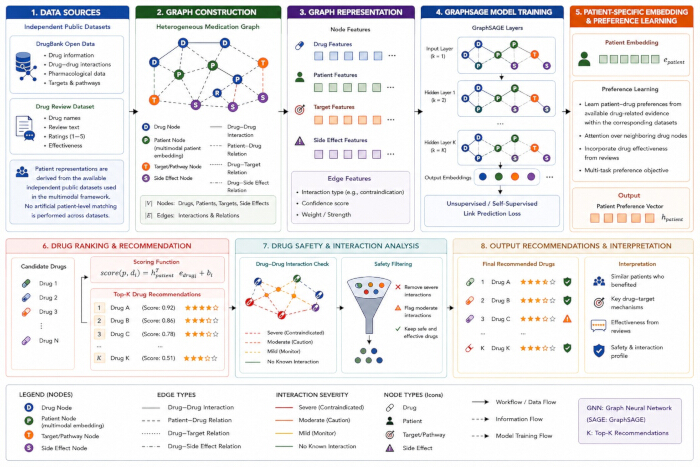
Rycina 6Przepływ pracy w systemie personalizowanych rekomendacji lekowych opartym na grafach. Schematyczny przebieg procesu spersonalizowanego rekomendowania leków w oparciu o GraphSAGE. Dane farmakologiczne oraz dane reprezentujące pacjentów są zorganizowane w postaci grafu heterogenicznego, który obejmuje istotne podmioty i relacje w ramach opieki zdrowotnej. Algorytm GraphSAGE uczy się reprezentacji pacjentów i leków, które są następnie wykorzystywane do obliczenia wyników dopasowania pacjenta do leku i rankingu potencjalnych preparatów. Kombinacje leków przeciwwskazane lub niebezpieczne są filtrowane przed wygenerowaniem końcowych rekomendacji typu Top-K, przy czym informacje oparte na grafie wspierają interpretację tych rekomendacji. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
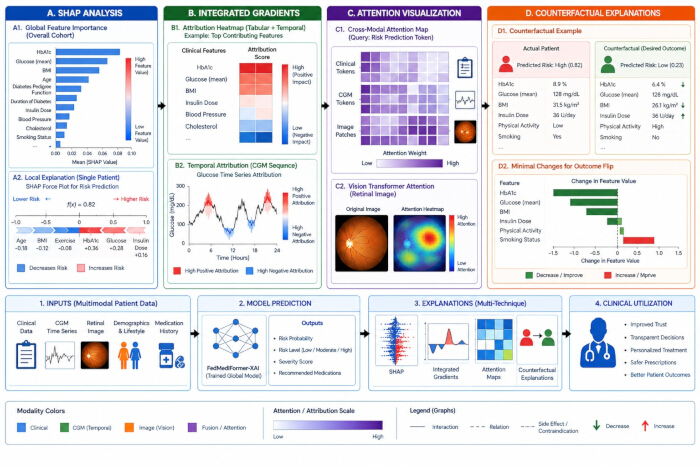
Rysunek 7Ramy oceny wyjaśnialności. Schematyczny przegląd procesu wyjaśnialności. (A) Analiza SHAP ocenia globalny i lokalny wkład cech; (B) Integrated Gradients dostarcza wyjaśnień opartych na atrybucji; (C) wizualizacja uwagi identyfikuje wpływowe cechy oraz interakcje między modalnościami; i (D) Analiza kontrfaktyczna identyfikuje zmiany cech związane ze zmienionymi predykcjami. Wynikowe wyjaśnienia wspierają interpretację predykcji modelu oraz personalizowane rekomendacje. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
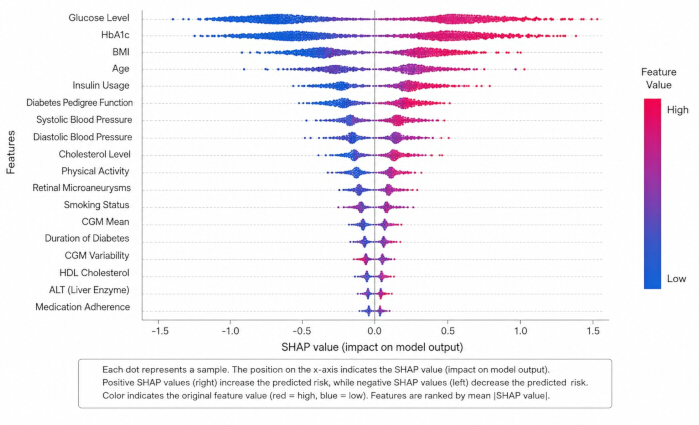
Rysunek 8Reprezentatywna analiza istotności cech SHAP pochodna z modelu, wygenerowana przez wytrenowany model FedMediFormer-XAIWykres podsumowujący SHAP przedstawia rozkład wartości SHAP dla analizowanych próbek, przy czym cechy zostały uszeregowane według ich średniego bezwzględnego wkładu SHAP. Dodatnie wartości SHAP wskazują na wkład w wyższe przewidywane ryzyko cukrzycy, natomiast wartości ujemne wskazują na wkład w niższe przewidywane ryzyko. Kolor reprezentuje odpowiadającą im wartość cechy, przy czym wyższe wartości cech są zaznaczone na czerwono, a niższe na niebiesko. Wykres stanowi rzeczywisty wynik wyjaśnialności pochodzący z modelu, a nie ilustrację schematyczną. Kliknij tutaj, aby wyświetlić powiększoną wersję tej figury.
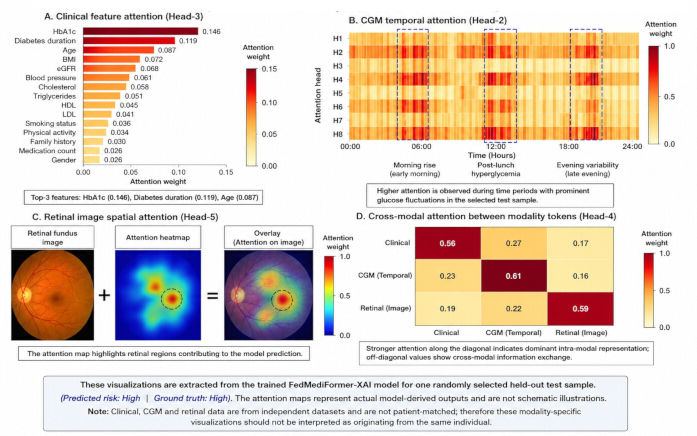
Rysunek 9Reprezentatywne wyniki uwagi wygenerowane przez wytrenowany model FedMediFormer-XAI dla jednej losowo wybranej próbki testowej z zestawu wydzielonego. (A) Uwaga poświęcona cechom klinicznym uzyskana z głowicy uwagi multimodalnego transformera, przedstawiająca względne wagi uwagi przypisane do cech klinicznych. (B) Uwaga czasowa w obrębie sekwencji CGM, ilustrująca okresy czasowe, które otrzymały większą uwagę modelu. (C) Uwaga przestrzenna dla obrazu dna siatkówki, obejmująca obraz oryginalny, mapę cieplną uwagi oraz nałożenie uwagi. (D) Uwaga międzymodalna (cross-modal attention) pomiędzy tokenami modalności klinicznej, CGM i siatkówkowej, przedstawiająca ważenie informacji wewnątrzmodalnych i międzymodalnych. Wyświetlone wizualizacje są wynikami wygenerowanymi przez wytrenowany model. Wagi uwagi przedstawiono dla wybranej próbki testowej i należy je interpretować jako wzorce uwagi modelu, a nie jako niezależne miary przyczynowości klinicznej. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
| Zbiór danych | Typ danych | Próbki/Zapisy | Cechy/Zawartość | Cel | Publiczna dostępność |
| Zbiór danych dotyczący cukrzycy u Indian Pima | Tabela kliniczna | 768 pacjentów | 8 zmiennych klinicznych | Przewidywanie ryzyka cukrzycy | Publiczny |
| Wskaźniki zdrowotne dotyczące cukrzycy według CDC | Zdrowie populacyjne | 253 680 rekordów | Dane demograficzne, styl życia, wskaźniki zdrowotne | Analiza ryzyka populacyjnego | Publiczne |
| Zbiór danych OhioT1DM | Szeregi czasowe CGM | 12 badanych | Glukoza, insulina, posiłki, wysiłek fizyczny, sen | Modelowanie czasowe cukrzycy | Publiczny |
| Wykrywanie ślepoty APTOS 2019 | Obrazy siatkówki | 3 62 obrazy | Fotografie dna oka z etykietami stopnia zaawansowania | Analiza retinopatii cukrzycowej | Publiczne |
| Zbiór danych opinii o lekach | Farmakologiczny | 215 063 recenzji | Skuteczność leków, oceny, recenzje | Rekomendacja leku | Publiczny |
| Otwarte dane DrugBank | Graf wiedzy o lekach | Tysiące leków | Interakcje lek-lek, cele, szlaki sygnałowe | Konstrukcja grafu | Dostęp publiczny/akademicki |
Tabela 1: Charakterystyka zbiorów danych. Podsumowanie publicznie dostępnych zbiorów danych wykorzystanych w niniejszym badaniu, w tym typu zbioru danych, wielkości próby, modalności danych, zawartości cech, zamierzonego celu oraz dostępności.
| Zbiór danych | Modalność | Cel predykcji | Poziom fuzji |
| Cukrzyca u Indian Pima | Kliniczne | Klasyfikacja cukrzycy | Osadzanie cech |
| Wskaźniki stanu zdrowia w zakresie cukrzycy według CDC | Zdrowie populacyjne | Przewidywanie ryzyka cukrzycy | Osadzanie cech |
| OhioT1DM | Ciągłe monitorowanie glikemii | Przewidywanie trendów glikemii | Osadzanie cech |
| APTOS 2019 | Obrazy dna oka | Analiza retinopatii cukrzycowej | Osadzanie cech |
| Przegląd leków + DrugBank | Farmakologiczny | Rekomendacja leku | Zanurzanie grafu |
Tabela 2: Strategia integracji multimodalnego zbioru danych. Podsumowanie zbiorów danych wykorzystanych do multimodalnej analizy danych w cukrzycy, zawierające modalność danych, cel predykcji oraz poziom, na którym integrowane są reprezentacje specyficzne dla danej modalności. Dane kliniczne, dane dotyczące zdrowia populacyjnego, dane z ciągłego monitorowania glikemii oraz obrazy siatkówki są reprezentowane jako osadzenia cech (feature embeddings), natomiast informacje farmakologiczne są integrowane za pomocą osadzeń grafowych w celu spersonalizowanej rekomendacji leków.
| Model | Dokładność, Średnia ± SD (95% CI) | Precyzja, średnia ± SD (95% CI) | Czułość, Średnia ± SD (95% CI) | Wskaźnik F1, średnia ± SD (95% CI) | MCC, średnia ± SD (95% CI) | AUC-ROC, średnia ± SD (95% CI) |
| Losowy Las | 83.60 ± 0.74 (82.68–84.52) | 82.70 ± 0.60 (81.96–83.44) | 81.90 ± 0.56 (81.21–82.59) | 82.30 ± 0.56 (81.61–82.99) | 0.67 ± 0.03 (0.63–0.71) | 0.88 ± 0.01 (0.87–0.89) |
| XGBoost | 85.30 ± 0.71 (84.42–86.18) | 84.70 ± 0.60 (83.96–85.44) | 83.80 ± 0.56 (83.11–84.49) | 84.20 ± 0.56 (83.51–84.89) | 0.70 ± 0.03 (0.66–0.74) | 0.90 ± 0.01 (0.89–0.91) |
| TabTransformer | 87.50 ± 0.52 (86.85–88.15) | 87.00 ± 0.60 (86.26–87.74) | 86.20 ± 0.56 (85.51–86.89) | 86.60 ± 0.56 (85.91–87.29) | 0.75 ± 0.03 (0.71–0.79) | 0.92 ± 0.01 (0.91–0.93) |
| Vision Transformer | 88.80 ± 0.50 (88.18–89.42) | 88.20 ± 0.60 (87.46–88.94) | 87.60 ± 0.56 (86.91–88.29) | 87.90 ± 0.56 (87.21–88.59) | 0.78 ± 0.03 (0.74–0.82) | 0.93 ± 0.01 (0.92–0.94) |
| Transformator czasowy | 87.20 ± 0.51 (86.57–87.83) | 86.60 ± 0.60 (85.86–87.34) | 85.90 ± 0.56 (85.21–86.59) | 86.20 ± 0.56 (85.51–86.89) | 0.74 ± 0.03 (0.70–0.78) | 0.91 ± 0.01 (0.90–0.92) |
| CNN-LSTM | 86.90 ± 0.58 (86.18–87.62) | 86.30 ± 0.60 (85.56–87.04) | 85.60 ± 0.55 (84.92–86.28) | 85.90 ± 0.56 (85.21–86.59) | 0.73 ± 0.03 (0.69–0.77) | 0.91 ± 0.01 (0.90–0.92) |
| Scentralizowany Transformator Multimodalny | 91.30 ± 0.12 (91.15–91.45) | 90.70 ± 0.60 (89.96–91.44) | 90.10 ± 0.56 (89.41–90.79) | 90.40 ± 0.56 (89.71–91.09) | 0.83 ± 0.03 (0.79–0.87) | 0.95 ± 0.01 (0.94–0.96) |
| FedMediFormer-XAI | 94.20 ± 0.34 (93.78–94.62) | 93.10 ± 0.30 (92.73–93.47) | 92.80 ± 0.28 (92.45–93.15) | 92.90 ± 0.28 (92.55–93.25) | 0.88 ± 0.02 (0.86–0.90) | 0.96 ± 0.01 (0.95–0.97) |
Tabela 3: Wydajność przewidywania cukrzycy. Porównawcza wydajność predykcyjna modelu FedMediFormer-XAI oraz bazowych modeli uczenia maszynowego i głębokiego z wykorzystaniem metryk dokładności (accuracy), precyzji (precision), czułości (recall), wyniku F1 (F1-score), współczynnika MCC oraz AUC-ROC.
| Metryka | Uczenie scentralizowane | Uczenie federacyjne |
| Dokładność (%) | 94.7 | 94.2 |
| AUC-ROC | 0.97 | 0.96 |
| Ochrona prywatności | Nie | Tak |
| Wymagane udostępnienie surowych danych | Tak | Nie |
| Rundy komunikacyjne | Nie dotyczy | 100 |
| Czas szkolenia (godziny) | 4.8 | 5.6 |
| Zgodność z przepisami | Umiarkowany | Wysoki |
Tabela 4: Wydajność uczenia federacyjnego w porównaniu z centralnym. Porównanie implementacji uczenia centralnego i federacyjnego pod kątem wydajności predykcyjnej, wymagań dotyczących udostępniania surowych danych, rund komunikacyjnych oraz czasu uczenia.
| Zbiór danych | Dokładność (%) | Precyzja (%) | Czułość (%) | AUC-ROC |
| Zbiór danych dotyczący cukrzycy u Indian Pima | 91.8 | 90.5 | 89.8 | 0.93 |
| Wskaźniki zdrowotne dotyczące cukrzycy według CDC | 93.1 | 92.2 | 91.6 | 0.95 |
| Zbiór danych OhioT1DM | 92.4 | 91.8 | 91.1 | 0.94 |
| Wykrywanie ślepoty APTOS 2019 | 94.7 | 93.9 | 93.5 | 0.96 |
| Fuzja multimodalna (FedMediFormer-XAI) | 94.2 | 93.1 | 92.8 | 0.96 |
Tabela 5: Wyniki na poziomie zbiorów danych. Analiza wydajności w poszczególnych zbiorach danych i konfiguracjach fuzji multimodalnej. Wyniki ilustrują wkład różnych modalności danych w ogólną wydajność predykcyjną.
| Metryka | Wartość |
| Precyzja@5 | 0.89 |
| Pełność@5 | 0.84 |
| NDCG@5 | 0.91 |
| Dokładność wykrywania interakcji lekowych | 0.95 |
| Zakres rekomendacji | 0.8 |
| Średni odwrotny rząd (MRR) | 0.86 |
| Wskaźnik zgodności z zasadami bezpieczeństwa | 0.94 |
Tabela 6: Wydajność spersonalizowanych rekomendacji leków. Ocena spersonalizowanych rekomendacji leków opartych na grafach z wykorzystaniem metryk rankingowych, dokładności wykrywania interakcji, pokrycia rekomendacji oraz oceny bezpieczeństwa leczenia.
| Kryterium oceny | Proponowany projekt ewaluacji |
| Zaufanie klinicystów | Ocena w pięciostopniowej skali Likerta |
| Interpretowalność | Ocena w pięciostopniowej skali Likerta |
| Znaczenie kliniczne | Ocena w pięciostopniowej skali Likerta |
| Użyteczność wyjaśnienia | Ocena w pięciostopniowej skali Likerta |
| Postrzegana użyteczność | Ocena w pięciostopniowej skali Likerta |
| Zgodność między sędziami | kappa Fleissa, do obliczenia po ocenie prospektywnej |
| Porównanie statystyczne | Test statystyczny dla par, w zależności od potrzeb po zebraniu danych |
| Uczestnicy | 12 klinicystów, za zgodą komisji etycznej oraz po uzyskaniu świadomej zgody |
| Status oceny | Ocena prospektywna/przyszła |
Tabela 7: Proponowane kryteria oceny skoncentrowane na człowieku. Proponowany prospektywny schemat oceny skoncentrowany na klinicyście w celu oceny użyteczności, istotności klinicznej, interpretowalności, wiarygodności i łatwości obsługi wyjaśnień FedMediFormer-XAI. Ocena obejmuje standaryzowaną ocenę w pięciostopniowej skali Likerta, zgodność między sędziami przy użyciu kappa Fleissa, porównanie statystyczne warunków z samą predykcją oraz predykcją z wyjaśnieniem, a także 95% przedziały ufności. Ocena kliniczna powinna zostać przeprowadzona wyłącznie po uzyskaniu zgody odpowiedniej Komisji Etyki Instytutowej oraz świadomej zgody pacjenta.
Tabela uzupełniająca 1: Strategia walidacji zbioru danychW celu zapewnienia powtarzalności oraz wiarygodnej oceny modelu wdrożono partycjonowanie zbioru danych, procedury walidacji, strategie równoważenia klas oraz środki kontroli jakości. Prosimy kliknąć tutaj, aby pobrać ten plik.
Tabela uzupełniająca 2: Parametry modelu dyfuzyjnegoUstawienia konfiguracji modelu dyfuzyjnego TabDDPM, obejmujące parametry trenowania, ustawienia optymalizacji, wymiary ukryte, strategię harmonogramowania szumu oraz specyfikacje generowania próbek syntetycznych. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 3: Konfiguracja transformera multimodalnegoKonfiguracja architektury multimodalnego transformera, obejmująca koder kliniczny, temporalny i obrazowy, wymiary osadzeń i fuzji, głowice uwagi, optymalizator, szybkość uczenia, rozmiar partii, epoki treningowe, kryterium wczesnego zatrzymania oraz skumulowaną funkcję straty treningowej. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 4: Konfiguracja uczenia federacyjnego. Parametry wykorzystane do federacyjnego uczenia z zachowaniem prywatności, w tym liczba uczestniczących szpitali, rundy komunikacyjne, lokalne epoki uczenia, współczynnik partycypacji klientów, algorytm agregacji, optymalizator, szybkość uczenia, metoda szyfrowania, protokół komunikacyjny oraz polityka udostępniania surowych danych. Prosimy kliknąć tutaj, aby pobrać ten plik.
Tabela uzupełniająca 5: Konfiguracja GraphSAGE. Konfiguracja heterogenicznego modułu spersonalizowanych rekomendacji leków opartego na GraphSAGE, obejmująca typ grafu, wymiary ukryte i osadzania (embeddingów), liczbę warstw grafu, rozmiar próbkowania sąsiedztwa, optymalizator, szybkość uczenia, rozmiar partii, liczbę epok treningowych, funkcję straty Bayesian Personalized Ranking oraz liczbę rekomendacji czołowych leków. Prosimy kliknąć tutaj, aby pobrać ten plik.
Tabela uzupełniająca 6: Metryki oceny wyjaśnialności. Metryki ilościowe i zorientowane na człowieka, stosowane do oceny wyjaśnialności architektury FedMediFormer-XAI. Metryki te oceniają wierność, stabilność, spójność, rzadkość, kompletność, czułość i niefidelność wyjaśnień, a także zgodność między sędziami oraz postrzeganą przez klinicystów jakość wyjaśnień. Prosimy kliknąć tutaj, aby pobrać ten plik.
Tabela uzupełniająca 7: Metryki ocenyDo oceny wydajności, odporności, jakości rankingu oraz interpretowalności frameworka wykorzystuje się metryki predykcyjne, uczenia federacyjnego, rekomendacji oraz wyjaśnialności. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 8: Projekt oceny zorientowanej na człowiekaProjekt badania ewaluacyjnego zorientowanego na klinicystę, obejmujący grupy uczestników, warunki oceny, kryteria oceny oraz procedury analizy statystycznej. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 9: Materiał dotyczący odtwarzalnościPodsumowanie zbiorów danych, specyfikacji implementacji, plików konfiguracyjnych, procedur ewaluacyjnych, dokumentacji oraz zapisów eksperymentalnych wymaganych do zapewnienia odtwarzalności proponowanego frameworka FedMediFormer-XAI. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Interpretacja kluczowych wyników
Reprezentatywne wyniki pokazują, że możliwe jest połączenie multimodalnego uczenia transformatorowego, uczenia federacyjnego, augmentacji opartej na dyfuzji, rekomendacji leków opartej na grafowych sieciach neuronowych oraz wyjaśnialnej sztucznej inteligencji w jednolity system inteligencji w cukrzycy. Poprzez integrację dokumentacji klinicznej, wskaźników zdrowia populacyjnego, danych z ciągłego monitorowania glikemii, obrazów dna oka oraz informacji farmakologicznych, proponowany system FedMediFormer-XAI wykazał wysoką skuteczność predykcyjną, wspierając jednocześnie interpretowalny i zdecentralizowany rozwój modelu. Metoda uczenia multimodalnego pozwoliła na wyodrębnienie informatywnych cech z różnych modalności opieki zdrowotnej, co doprowadziło do lepszego prognozowania cukrzycy i spersonalizowanych rekomendacji terapeutycznych.
Korzyści z uczenia federacyjnego
Kluczowym wkładem proponowanego modelu jest integracja uczenia federacyjnego, która umożliwia zdecentralizowane, wspólne budowanie modelu. Uczenie federacyjne różni się od tradycyjnych scentralizowanych metod uczenia tym, że pozwala wielu instytucjom uczestniczyć w trenowaniu modelu bez bezpośredniego udostępniania surowych danych pacjentów. Główne wyniki wykazały, że uczenie federacyjne utrzymało dokładność predykcyjną porównywalną z uczeniem scentralizowanym, wspierając jednocześnie zdecentralizowane zarządzanie danymi. Cecha ta jest szczególnie istotna w scenariuszach opieki zdrowotnej, gdzie udostępnianie danych jest ograniczone przez polityki instytucjonalne i wymagania dotyczące prywatności.
Analiza wyjaśnialności
Ocena wyjaśnialności wykazała, że analiza SHAP, zintegrowane gradienty (Integrated Gradients), wizualizacja uwagi oraz wyjaśnienia kontrfaktyczne mogą dostarczyć klinicznie istotnych spostrzeżeń na temat działania modelu. Wyjaśnienia globalne i lokalne w dużej mierze były zgodne co do najważniejszych predyktorów z perspektywy klinicznej (tj. pomiarów glukozy, wskaźnika masy ciała, wieku, schematów podawania insuliny oraz nieprawidłowości siatkówki). Wizualizacje uwagi wykazały również, że architektura transformera koncentrowała się na klinicznie istotnych cechach czasowych i obrazowych. Podejścia te zwiększają przejrzystość, dostarczając komplementarnych interpretacji predykcji modelu oraz wkładu poszczególnych cech.
Analiza spersonalizowanych rekomendacji leków
Proponujemy model rekomendacyjny oparty na GNN, który wraz z modelowaniem relacji pacjent-lek oraz lek-lek, dostarcza spersonalizowanych rekomendacji lekowych. W rzeczywistości heterogeniczna topologia grafu ułatwiła zarówno opanowanie wzorców skuteczności leczenia, jak i uwzględnienie bezpieczeństwa farmakoterapii. Doskonałe wyniki rekomendacji leków uzyskane w niniejszym badaniu ilustrują możliwości metod uczenia opartego na grafach w rozwijaniu inteligentnych systemów diabetologicznych, wykraczających poza przewidywanie chorób w kierunku spersonalizowanego rusztowania wsparcia terapeutycznego.
Ocena skoncentrowana na człowieku
Struktura ta obejmuje prospektywny protokół oceny skoncentrowanej na człowieku w celu zbadania wpływu wyjaśnialności na zaufanie klinicystów, interpretowalność, użyteczność oraz postrzeganą użyteczność kliniczną. Proponowana ocena porówna warunki obejmujące wyłącznie predykcję oraz predykcję wraz z wyjaśnieniem, przy użyciu zestandaryzowanych kryteriów oceny. Przyszła implementacja tej oceny, po uzyskaniu odpowiedniej zgody Komisji Etycznej ds. Badań Naukowych oraz świadomej zgody uczestników, dostarczy empirycznych dowodów na temat akceptacji przez klinicystów oraz praktycznej użyteczności generowanych wyjaśnień.
Kluczowe kroki dla pomyślnej i powtarzalnej implementacji
Kilka etapów proponowanego protokołu wymaga szczególnej uwagi w celu zapewnienia powtarzalności. Preprocessing i partycjonowanie zbioru danych powinny zachować separację na poziomie pacjenta i zapobiegać wyciekowi danych, natomiast określone rozkłady klientów non-IID powinny zostać zachowane podczas uczenia federacyjnego. Fuzja multimodalna powinna zachować zdefiniowane wymiary latentne, konfigurację uwagi, embeddingi typów modalności, normalizację oraz końcową projekcję. Augmentacja oparta na dyfuzji powinna wykorzystywać spójne parametry preprocessingu i uczenia, podczas gdy rekomendacja oparta na GraphSAGE powinna zachować spójne reprezentacje pacjent-lek, przesiewanie interakcji, definicje istotnych elementów oraz kryteria rankingu Top-K. Analiza wyjaśnialności powinna wykorzystywać stałe próbki tła SHAP, linie bazowe Integrated Gradients, procedury ekstrakcji uwagi oraz klinicznie dopuszczalne ograniczenia kontrfaktyczne. Wersje oprogramowania, ziarna losowości, konfiguracje modeli, partycje zbiorów danych oraz parametry ewaluacji powinny zostać udokumentowane, aby zminimalizować zmienność zależną od implementacji.
Ograniczenia
Przy interpretacji wyników niniejszego badania należy wziąć pod uwagę kilka ograniczeń. Po pierwsze, opracowanie i ocena ram systemu opierały się na publicznie dostępnych zbiorach danych, które mogą nie w pełni reprezentować różnorodność populacji pacjentów i środowisk klinicznych w rzeczywistych warunkach opieki zdrowotnej. Po drugie, choć uczenie federacyjne (federated learning) zostało ocenione z wykorzystaniem symulowanych klientów szpitalnych, nie przeprowadzono walidacji na szeroką skalę z udziałem niezależnych instytucji opieki zdrowotnej. Po trzecie, uczenie federacyjne wprowadza dodatkowe obciążenie komunikacyjne i obliczeniowe, co może wpływać na skalowalność w środowiskach o ograniczonych zasobach. Wreszcie, techniki wyjaśnialności zastosowane w tym badaniu są głównie metodami interpretacji post hoc i mogą nie w pełni oddawać złożone zachowanie modelu.
Zaproponowany protokół walidacji zorientowany na człowieka zakłada udział początkowego panelu 12 ekspertów klinicznych, w skład którego wchodzą endokrynolodzy, specjaliści ds. cukrzycy oraz farmakolodzy kliniczni. Taka wielkość próby jest przeznaczona do wstępnej oceny użyteczności i interpretowalności, a nie do ostatecznej walidacji klinicznej. Stosunkowo niewielka grupa ekspertów może ograniczać moc statystyczną i możliwość generalizacji wyników. Przyszłe badania prospektywne powinny zatem obejmować większe, wieloośrodkowe kohorty klinicystów reprezentujące zróżnicowane specjalności i warunki kliniczne.
Kluczowym ograniczeniem proponowanego modelu jest fakt, że dane kliniczne, z CGM, obrazowania siatkówki oraz dane dotyczące leków pochodzą z niezależnych publicznych zbiorów danych, a nie z dopasowanych do konkretnych pacjentów rekordów multimodalnych. W związku z tym komponent fuzji międzymodalnej należy interpretować jako ramy metodologiczne służące do integrowania komplementarnych reprezentacji modalności, a nie jako dowód wynikający z jednoczesnych pomiarów multimodalnych u tych samych pacjentów. Różnice w charakterystyce populacji, protokołach akwizycji, rozkładach cech i definicjach chorób w źródłowych zbiorach danych mogą wprowadzać rozbieżności w rozkładach i ograniczać stopień, w jakim wyuczone relacje międzymodalne reprezentują rzeczywiste powiązania na poziomie pacjenta. Choć protokół jawnie unika sztucznego dopasowywania pacjentów między niezależnymi zbiorami danych, taka konstrukcja ogranicza bezpośrednią ocenę specyficznych dla pacjenta interakcji multimodalnych i może wpływać na generalizowalność kliniczną. Z tego powodu zgłoszona wydajność multimodalna nie powinna być interpretowana jako równoważna walidacji na prospektywnie zgromadzonej, dopasowanej do pacjentów kohorcie multimodalnej. Przyszłe badania powinny zwalidować ten model przy użyciu większych, niezależnie zebranych zbiorów danych zawierających zsynchronizowane informacje kliniczne, z CGM, obrazowania siatkówki oraz dane o leczeniu pochodzące od tych samych pacjentów.
Rozwiązywanie problemów i modyfikacje protokołu
Kilka praktycznych kwestii może wpłynąć na wdrożenie proponowanego protokołu. Niezrównoważenie klas może obniżyć wydajność predykcyjną w przypadku niedostatecznej reprezentacji klas mniejszościowych; wyzwanie to można zredukować poprzez augmentację opartą na dyfuzji oraz strategie ponownego próbkowania. Brakujące wartości i niespójne formatowanie danych mogą wpływać na stabilność modelu i powinny zostać rozwiązane poprzez rygorystyczne procedury wstępnego przetwarzania. Konwergencja uczenia federacyjnego może stać się niestabilna, gdy zestawy danych klientów wykazują znaczną heterogeniczność; dostosowanie lokalnych epok uczenia, szybkości uczenia oraz częstotliwości agregacji może poprawić stabilność. Ograniczenia sprzętowe mogą również wpływać na wydajność uczenia, szczególnie podczas przetwarzania dużych multimodalnych zbiorów danych i architektur transformerów. W takich przypadkach zmniejszenie rozmiaru partii (batch size) lub złożoności modelu może poprawić wykonalność obliczeniową przy zachowaniu powtarzalności.
Kierunki przyszłych badań
Przyszłe badania mogą skupić się na integracji technologii cyfrowych bliźniaków (digital twins) w celu spersonalizowanej symulacji przebiegu chorób i planowania leczenia. Modele bazowe (foundation models) trenowane na wielkoskalowych multimodalnych zbiorach danych medycznych mogą dodatkowo usprawnić uczenie reprezentacji oraz generalizację modeli. Techniki wyjaśnialności przyczynowej mogłyby zapewnić głębszy wgląd w mechanizmy chorobowe i efekty terapeutyczne, wykraczając poza wyjaśnienia oparte na korelacji. Ponadto podejścia oparte na uczeniu ze wzmocnieniem mogą wspierać adaptacyjną optymalizację leczenia i dynamiczne strategie rekomendowania leków. Postępy te mogłyby dodatkowo zwiększyć użyteczność kliniczną i możliwości personalizacji systemów inteligencji w cukrzycy. Co więcej, generowane przez AI prognozy i rekomendacje lekowe powinny być traktowane jako narzędzia wspomagania decyzji, a nie zamienniki profesjonalnej oceny klinicznej. Odpowiedni nadzór człowieka pozostaje niezbędny dla odpowiedzialnego i etycznego wdrażania systemów sztucznej inteligencji w ochronie zdrowia.
Wnioski
FedMediFormer-XAI zapewnia odtwarzalny system integrujący uczenie multimodalne, trenowanie federacyjne, spersonalizowane rekomendacje leków oraz wyjaśnialność w obszarze analityki cukrzycy. Reprezentatywne wyniki potwierdzają wykonalność proponowanego schematu postępowania, jednak przed wdrożeniem klinicznym wymagana jest dalsza walidacja z wykorzystaniem dopasowanych multimodalnych zbiorów danych pacjentów, w szerszych warunkach klinicznych oraz poprzez prospektywną ocenę lekarską.
Oświadczenia
Autorzy oświadczają, że nie mają żadnych konkurencyjnych interesów finansowych, konfliktów interesów ani relacji osobistych, które mogłyby wpłynąć na prace przedstawione w niniejszym badaniu. Narzędzia sztucznej inteligencji zostały wykorzystane wyłącznie w celu pomocy w dopracowaniu języka, organizacji rękopisu, formatowaniu oraz redagowaniu podczas przygotowywania tego artykułu. Cała zawartość naukowa, projekt badania, metodologia, analiza danych, interpretacja wyników i wnioski zostały opracowane, zweryfikowane i zatwierdzone przez autorów. Autorzy biorą pełną odpowiedzialność za dokładność, rzetelność i oryginalność pracy przedstawionej w niniejszym rękopisie.
Podziękowania
Autorzy wyrażają wdzięczność twórcom i opiekunom publicznie dostępnych zbiorów danych oraz zasobów oprogramowania open-source wykorzystanych w niniejszym badaniu.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Szyfrowanie AES | NIST | AES-256 | Szyfrowanie danych w spoczynku / chronionych parametrów modelu w uczeniu federacyjnym |
| APTOS 2019 Blindness Detection Dataset | Kaggle/APTOS | 2019 Release | Zbiór obrazów dna oka; ogólnodostępny i zanonimizowany; https://www.kaggle.com/competitions/aptos2019-blindness-detection/data |
| Captum | Meta AI | Version 0.8 | Interpretowalność modelu i analiza atrybucji |
| CUDA Toolkit | NVIDIA | Version 12.2 | Obliczenia akcelerowane przez GPU |
| Diabetes Health Indicators Dataset (CDC BRFSS 2015) | CDC/BRFSS; Kaggle | 2015 Release | Wskaźniki zdrowia populacji; ogólnodostępny i zanonimizowany; https://www.kaggle.com/datasets/alexteboul/diabetes-health-indicators-dataset |
| Diabetic Retinopathy Detection Dataset | Kaggle | Public Release | Zbiór obrazów siatkówki; ogólnodostępny i zanonimizowany; https://www.kaggle.com/c/diabetic-retinopathy-detection/data |
| Certyfikaty cyfrowe | – | – | Uwierzytelnianie klienta w uczeniu federacyjnym |
| Drug Interaction Dataset | Kaggle | Public Release | Dane grafowe interakcji lek-lek; ogólnodostępny i zanonimizowany; https://www.kaggle.com/datasets/rohanharode07/drug-drug-interaction |
| Drug Review Dataset | UCI Machine Learning Repository | Dataset 462 | Zbiór danych o skuteczności i recenzjach leków; ogólnodostępny i zanonimizowany; https://archive.ics.uci.edu/dataset/462/drug+review+dataset+drugs+com |
| Matplotlib | Matplotlib Developers | Version 3.9 | Wizualizacja |
| MTS Diabetes Dataset | Kaggle | Public Release | Zbiór danych z czujników ubieralnych / do predykcji cukrzycy; ogólnodostępny i zanonimizowany; https://www.kaggle.com/datasets/marshalpatel3558/diabetespredictiondataset |
| NetworkX | NetworkX Developers | Version 3.3 | Konstrukcja i analiza grafów interakcji leków |
| NumPy | NumPy Developers | Version 1.26 | Obliczenia numeryczne |
| NVIDIA RTX 4090 GPU | NVIDIA | RTX 4090 | Trenowanie i wnioskowanie modelu; minimum 32 GB pamięci systemowej |
| OhioT1DM Dataset | Ohio University | Public Release | Zbiór danych z ciągłego monitorowania glikemii; ogólnodostępny i zanonimizowany; https://webpages.charlotte.edu/rbunescu/data/ohiot1dm/OhioT1DM-dataset.html |
| OpenCV | OpenCV Foundation | Version 4.10 | Przetwarzanie obrazów |
| Pandas | PyData | Version 2.2 | Przetwarzanie i wstępne przetwarzanie danych |
| Pima Indians Diabetes Dataset | UCI Machine Learning Repository | Dataset 34 | Kliniczny zbiór danych do predykcji cukrzycy; ogólnodostępny i zanonimizowany; https://archive.ics.uci.edu/dataset/34/diabetes |
| Python | Python Software Foundation | Version 3.11 | Główne środowisko programistyczne |
| PyTorch | Meta AI | Version 2.3 | Tworzenie i trenowanie modeli głębokiego uczenia |
| PyTorch Geometric | PyG Team | Version 2.5 | Konstrukcja i trenowanie grafowych sieci neuronowych |
| Scikit-learn | Scikit-learn Developers | Version 1.5 | Narzędzia uczenia maszynowego i ewaluacja |
| Mechanizm bezpiecznej agregacji | – | – | Chroniona agregacja lokalnych parametrów modelu w uczeniu federacyjnym |
| SHAP | SHAP Developers | Version 0.47 | Wyjaśnialna sztuczna inteligencja (XAI) i analiza atrybucji cech |
| TensorFlow | Version 2.15 | Tworzenie i trenowanie modeli głębokiego uczenia | |
| Transformers | Hugging Face | Version 4.45 | Implementacja architektury opartej na transformatorach |
| Transport Layer Security | IETF | TLS 1.3 | Szyfrowany kanał komunikacyjny do wymiany parametrów federacyjnych |
| Stacja robocza | Generyczna | – | Środowisko obliczeniowe; minimum 32 GB pamięci systemowej |
Bibliografia
- Al-Hejri AM, et al. A hybrid explainable federated-based vision transformer framework for breast cancer prediction via risk factors. Sci Rep. 2025;15:18453.
- Dosovitskiy A, et al. An image is worth 16×16 words: transformers for image recognition at scale [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2010.11929]
- Touvron H, et al. Training data-efficient image transformers & distillation through attention [conference presentation]. Presented at: 38th International Conference on Machine Learning; 2021. [https://arxiv.org/abs/2012.12877]
- Kotelnikov A, Baranchuk D, Rubachev I, Babenko A. TabDDPM: modelling tabular data with diffusion models [conference presentation]. Presented at: 40th International Conference on Machine Learning (ICML); 2023. [https://arxiv.org/abs/2209.15421]
- Pinaya WHL, et al. Brain imaging generation with latent diffusion models [conference presentation]. Presented at: International Conference on Medical Image Computing and Computer-Assisted Intervention (MICCAI); 2022. [https://arxiv.org/abs/2209.07162]
- Ho J, Jain A, Abbeel P. Denoising diffusion probabilistic models [conference presentation]. Presented at: Advances in Neural Information Processing Systems (NeurIPS); 2020. [https://arxiv.org/abs/2006.11239]
- Song Y, et al. Score-based generative modeling through stochastic differential equations [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); 2021. [https://arxiv.org/abs/2011.13456]
- Li T, Sahu AK, Talwalkar A, Smith V. Federated learning: challenges, methods, and future directions. IEEE Signal Process Mag. 2020;37(3):50-60.
- Kairouz P, et al. Advances and open problems in federated learning. Found Trends Mach Learn. 2021;14(1-2):1-210.
- Rieke N, et al. The future of digital health with federated learning. NPJ Digit Med. 2020;3:119.
- Kaissis GA, Makowski MR, Rückert D, Braren RF. Secure, privacy-preserving and federated machine learning in medical imaging. Nat Mach Intell. 2020;2(6):305-11.
- Sheller MJ, et al. Federated learning in medicine: facilitating multi-institutional collaborations without sharing patient data. Sci Rep. 2020;10:12598.
- McMahan HB, et al. Communication-efficient learning of deep networks from decentralized data [conference presentation]. Presented at: International Conference on Artificial Intelligence and Statistics (AISTATS); 2017. [https://arxiv.org/abs/1602.05629]
- Lundberg SM, et al. From local explanations to global understanding with explainable AI for trees. Nat Mach Intell. 2020;2(1):56-67.
- Ribeiro MT, Singh S, Guestrin C. Why should I trust you? Explaining the predictions of any classifier [conference presentation]. Presented at: ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (KDD); 2016. [https://arxiv.org/abs/1602.04938]
- Wachter S, Mittelstadt B, Russell C. Counterfactual explanations and algorithmic recourse in healthcare AI. AI Ethics. 2021;1(2):123-37.
- Chen J, Liao W, Yu W. Explainable AI for precision medicine: a systematic review. Brief Bioinform. 2024;25(2):bbae045.
- Zitnik M, Agrawal M, Leskovec J. Modeling polypharmacy side effects with graph neural networks. Bioinformatics. 2020;36(2):i457-i466.
- Wu Z, et al. A comprehensive survey on graph neural networks. IEEE Trans Neural Netw Learn Syst. 2021;32(1):4-24.
- Hamilton WL. Graph representation learning. Morgan & Claypool Publishers; San Rafael (CA); 2020.
- Shang J, Ma T, Xiao C, Sun J. Pre-training of graph augmented transformers for medication recommendation [conference presentation]. Presented at: International Joint Conference on Artificial Intelligence (IJCAI); 2021. [https://arxiv.org/abs/1906.00346]
- Wang X, et al. Neural graph collaborative filtering. IEEE Trans Knowl Data Eng. 2021;33(5):2136-49.
- Yu KH, Beam AL, Kohane IS. Artificial intelligence in healthcare. Nat Biomed Eng. 2021;5(8):719-31.
- Muhammad G, Hossain MS, Kumar N. EEG-based pathology detection for home health monitoring. IEEE J Sel Areas Commun. 2021;39(2):603-10.
- Alshehri F, Muhammad G. Internet of Things and edge computing in healthcare: a survey. IEEE Access. 2021;9:3660-78.
- Vaid A, et al. Federated learning of electronic health records to improve mortality prediction. JMIR Med Inform. 2021;9(1):e24207.
- Lim WYB, et al. Dynamic contract design for federated learning in smart healthcare applications. IEEE Internet Things J. 2021;8(23):16853-62.
- Chikumo OT, et al. Transformer-based models for disease prediction using electronic health records: a systematic review. J Appl Artif Intell Comput. 2026;10(1):1-18.
- Lai T. Interpretable medical imagery diagnosis with self-attentive transformers: a review of explainable AI for healthcare. Diagnostics (Basel). 2023;13(18):3021.