Niniejsze badanie łączy eksperyment scenariuszowy z elektrencefalografią, aby zbadać, w jaki sposób definiowanie roli eksperta i towarzysza wiąże się z zaufaniem w różnych kontekstach zadań medycznych.
Artykuł metodologiczny
Rola definiowania roli i zaufania do sztucznej inteligencji w medycynie: dowody z eksperymentu scenariuszowego i EEG
W tym artykule
Podsumowanie
Streszczenie
Internetowa sztuczna inteligencja medyczna ewoluowała z narzędzi analitycznych działających w tle do interfejsów usług skierowanych bezpośrednio do pacjenta, co sprawia, że kalibrowane zaufanie staje się coraz ważniejszym problemem w zakresie projektowania i zarządzania. Opierając się na teorii zgodności ról, badanie to analizowało, w jaki sposób definiowanie roli jako eksperta lub towarzysza wiąże się z zaufaniem w różnych kontekstach zadań medycznych. Badanie 1 wykorzystało eksperyment scenariuszowy o schemacie 2 (rola: ekspert vs towarzysz) × 2 (zadanie: konsultacja w sprawie choroby vs konsultacja zdrowotna) (N = 300). Definiowanie roli eksperta zwiększyło postrzegany profesjonalizm, podczas gdy definiowanie roli towarzysza zwiększyło poczucie obecności społecznej; oba te postrzegania były niezależnie powiązane z ogólnym zaufaniem przy jednoczesnym uwzględnieniu obu czynników. Pośredni związek poprzez profesjonalizm był uwarunkowany kontekstem zadania, jednak bezpośrednie porównanie metodą bootstrapowania nie wykazało, aby dwa wskaźniki moderowanej mediacji różniły się w odniesieniu do ogólnego zaufania. Diagnostyka pomiarów wskazała na znaczny overlap pomiędzy postrzeganym profesjonalizmem a zaufaniem poznawczym oraz pomiędzy obecnością społeczną a zaufaniem afektywnym, co wymaga ostrożnej interpretacji. Badanie 2 porównało sformułowania ramowane jako eksperckie i towarzyszące, wykorzystując EEG w 39 sparowanych obserwacjach. Definiowaniu roli eksperta towarzyszył wyższy wskaźnik ERS dla fal theta w linii środkowej czołowej oraz mniej ujemny, skorygowany względem linii bazowej wskaźnik ΔPLV theta dla elektrod FCz-F6, podczas gdy zachowanie na poziomie warunków nie wykazało wiarygodnych różnic w stopniu zaufania, czasie reakcji ani w częstotliwości braku odpowiedzi. Te wyniki EEG są eksploracyjnymi korelatami na poziomie procesów, a nie neuronalną walidacją warunkowego modelu pośredniego. Ogólnie rzecz biorąc, sygnały dotyczące roli wydają się kształtować niewykluczające się oceny zorientowane na kompetencje i zorientowane na relacje. Projektowanie ról powinno wspierać kalibrowane poleganie poprzez określenie granic możliwości, komunikowanie niepewności, ostrzeżenia oparte na ryzyku oraz odpowiednią eskalację, zamiast prostego maksymalizowania zaufania.
Wprowadzenie
Sztuczna inteligencja (AI) w medycynie obejmuje obecnie zarówno aplikacje zaplecza (back-end), takie jak rozpoznawanie obrazów, analiza patomorfologiczna i odkrywanie leków, jak i interfejsy usług skierowane bezpośrednio do pacjenta. Analizy branżowe przewidują dalszy wzrost rynku AI w ochronie zdrowia do 2033 roku1. Duże modele językowe umożliwiają systemom medycznej AI odpowiadanie na pytania dotyczące zdrowia, interpretowanie wyników badań, streszczanie informacji oraz udzielanie zaleceń w języku naturalnym2. Ta zmiana modyfikuje relację użytkownika z technologią. Analityczne narzędzie zaplecza jest oceniane przez klinicystów i organizacje, podczas gdy interfejs skierowany do pacjenta musi komunikować użytkownikom swoją rolę, podstawy dowodowe, stopień niepewności oraz ograniczenia. Medyczna AI może występować jako asystent diagnostyczny, interfejs lekarza rodzinnego lub towarzysz zarządzania zdrowiem, a każda z tych form może kształtować sposób, w jaki użytkownicy rozumieją tożsamość usługową systemu. W miarę jak systemy te coraz częściej uczestniczą w konsultacjach chorobowych i codziennym zarządzaniu zdrowiem, zaufanie staje się czymś więcej niż tylko stosunkiem do technologii. Wpływa ono na to, czy użytkownicy ujawniają informacje, uznają zalecenia za wiarygodne, wchodzą w interakcję z systemem i stosują się do wskazówek zdrowotnych. Zaufanie jest zatem kluczową kwestią projektową i zarządczą dla cyfrowych platform zdrowotnych.
Sama zdolność techniczna nie determinuje tego, czy użytkownicy uznają medyczną sztuczną inteligencję (AI) za wiarygodną i akceptowalną. Przeglądy dotyczące konwersacyjnych agentów w opiece zdrowotnej pokazują, że wdrożenie zależy od jakości interakcji, istotności klinicznej, przejrzystości oraz warunków implementacji3. Niedawne prace nad wiarygodnymi dowodami dla medycznej AI podobnie argumentują, że wydajność modelu jest niewystarczająca, chyba że twierdzenia są poparte dowodami odpowiednimi dla zamierzonego zastosowania4. Przejrzystość jest niezbędna, ponieważ pacjenci muszą być w stanie zidentyfikować granice możliwości, niepewność oraz podstawę rekomendacji, zamiast wnioskować o niezawodności jedynie na podstawie płynności języka5. Badania nad systemami informacyjnymi w podobny sposób definiują przyjęcie diagnostyki wspomaganej przez AI jako problem konfiguracji zaufania, w którym interpretowalność, ochrona prywatności i wskazówki interfejsu wspólnie kształtują akceptację6. Rozważania te są istotne dla interfejsów modeli językowych. Płynność może sprawić, że odpowiedź będzie łatwa do zrozumienia, pozostawiając jednak nierozstrzygnięte, czy system posiada wiedzę kliniczną, czy jego rekomendacja odnosi się do okoliczności użytkownika oraz kiedy konieczne jest przekazanie sprawy wykwalifikowanemu klinicyście. Istotnym pytaniem nie jest zatem tylko to, czy medyczna AI potrafi wygenerować odpowiedź, ale czy użytkownicy mogą ją ocenić z odpowiednim poziomem zaufania.
Zaufanie do medycznej sztucznej inteligencji (AI) jest zależne od kontekstu zadania. Badania nad oporem wobec medycznej AI wykazują, że użytkownicy mogą odrzucać rekomendacje algorytmiczne w przypadku decyzji o wysokim stopniu ryzyka, ponieważ uważają, że algorytm nie jest w stanie uwzględnić ich indywidualnych uwarunkowań7. Opór ten nie jest powszechny. Badania nad docenianiem algorytmów wskazują, że ludzie mogą preferować oceny algorytmiczne, gdy zadania są obiektywne, a reguły są bardziej przejrzyste8. W ramach internetowych konsultacji zdrowotnych personalizacja i staranność porad generowanych przez AI wpływają na zaufanie i stopień ich wdrażania9. Badania nad dyskretnym wyborem, porównujące tradycyjne, cyfrowe i oparte na AI konsultacje, wykazują podobnie, że preferencje i oczekiwania dotyczące zaufania różnią się w zależności od formatu10. Współpraca człowieka z AI może również zmniejszyć opór poprzez transfer zaufania z ludzkiej ekspertyzy na system usług wspierany przez AI11. Zaufanie do medycznej AI rozwija się zatem w wyniku interakcji między postrzeganym ryzykiem, wymaganiami zadania, stylem komunikacji a oceną systemu. Konsultacja w sprawie choroby uwypukla niepewność, możliwą stratę, konsekwencje diagnostyczne oraz koszty błędów. Konsultacje zdrowotne częściej dotyczą diety, ćwiczeń fizycznych, snu, przestrzegania zaleceń terapeutycznych i profilaktyki, gdzie większe znaczenie może mieć długotrwała interakcja i dostępność relacyjna. W konsekwencji ta sama wskazówka w interfejsie może zostać zinterpretowana inaczej, gdy użytkownik szuka pomocy w związku z możliwą chorobą, niż w przypadku długoterminowego zarządzania zdrowiem.
Kształtowanie roli jest jedną z cech interfejsu, za pomocą której można komunikować te oczekiwania. AI medyczna może być przedstawiona jako ekspert, co podkreśla autorytet zawodowy, ustrukturyzowane rozumowanie, granice kliniczne i dowody kompetencji, lub jako towarzysz, co kładzie nacisk na empatię, zapewnienie, wsparcie społeczne i ciągłość. Rozróżnienie to odnosi się do kompetencji i ciepła – dwóch wymiarów percepcji społecznej – ale nie jest jedynie wyborem między systemem kompetentnym a systemem ciepłym12. Styl komunikacji i kształtowanie sprawstwa wpływają na oceny agentów konwersacyjnych13. W mobilnych aplikacjach medycznych sygnały społeczne oraz obawy dotyczące prywatności wspólnie wpływają na zaufanie i intencje behawioralne14. Sygnały antropomorficzne w konwersacyjnych agentach opieki zdrowotnej mogą zwiększać obecność społeczną, zaufanie i akceptację, choć mogą one również tworzyć oczekiwania wykraczające poza możliwości systemu15. Badania nad zespołami ludzko-AI wykazują ponadto, że ciepło i kompetencje przewidują różne formy reaktywności16. W zadaniach wysokiego ryzyka zaufanie zależy od dopasowania roli w zespole, kontekstu zadania i naruszeń w wydajności17. Spójność między rolą społeczną chatbota a jego wydajnością wpływa również na budowanie i naprawę zaufania18. Sygnały eksperckie i towarzyszące sprawiają zatem, że istotne stają się różne standardy oceny, a nie jedynie zmieniają ton rozmowy.
Pozostają dwie luki badawcze. Po pierwsze, badania nie wyjaśniły, w jaki sposób istotność wskazówek zorientowanych na kompetencje i relacje zmienia się w zależności od wymagań zadań medycznych. Przeglądy dotyczące zaufania ludzi do AI podkreślają zależność od kontekstu, ale nie wyjaśniają, jak wskazówki dotyczące roli eksperta i towarzysza funkcjonują podczas konsultacji w stanach chorobowych i zdrowotnych19. Po drugie, badania nad zaufaniem do medycznej AI opierają się na samoopisach, dostarczając ograniczonych dowodów na temat procesów związanych z oceną uwarunkowaną ramami roli. Prywatność, przejrzystość, odpowiedzialność oraz stronniczość ograniczają również interpretację zewnętrznych wskazówek dotyczących roli20,21. Aby wypełnić te luki, niniejsze badanie opiera się na teorii kongruencji roli, która wyjaśnia ocenę poprzez zgodność między wskazówkami dotyczącymi roli a wymaganiami istotnymi dla kontekstu22. Badanie 1 wykorzystuje randomizowany eksperyment scenariuszowy 2 (rola: ekspert vs towarzysz) x 2 (zadanie: konsultacja w stanie choroby vs konsultacja w stanie zdrowia) (N = 300) w celu zbadania ramowania roli, kontekstu zadania oraz równoległych powiązań pośrednich poprzez postrzegany profesjonalizm i obecność społeczną. Badanie 2 wykorzystuje oddzielny eksperyment EEG w schemacie wewnątrzgrupowym (N = 39), aby porównać aktywność w paśmie theta w odpowiedzi na wypowiedzi sformułowane w ramach roli eksperta i towarzysza. Badanie 1 ocenia powiązania behawioralne i moderację kontekstową; Badanie 2 dostarcza eksploracyjnego porównania na poziomie procesów, a nie neuralnej walidacji warunkowego modelu pośredniego.
Ramy teoretyczne i opracowanie hipotez
Definiowanie roli w medycznym AI
Sztuczna inteligencja (AI) w medycynie działa w środowiskach o wysokiej stawce, obejmujących ryzyko wystąpienia chorób, zalecenia terapeutyczne, odpowiedzialność prawną oraz granice etyczne23. Definiowanie roli jest zatem istotne, ponieważ język interfejsu może sprawić, że granice możliwości, dowodów i odpowiedzialności staną się dla użytkowników bardziej lub mniej zauważalne. Badania nad przejrzystością podkreślają analogicznie, że systemy AI w medycynie powinny komunikować ograniczenia swoich możliwości oraz podstawy dowodowe5. Odpowiedzi w stylu eksperckim przekazują kompetencje poprzez formalną terminologię, ustrukturyzowane rozumowanie, określanie granic oraz rekomendacje działań, podczas gdy odpowiedzi w stylu towarzyszącym przekazują wsparcie relacyjne poprzez empatię, zapewnienie i sformułowania o charakterze współpracującym. Sygnały te nie są jedynie dekoracją interfejsu: kształtują one standardy, które użytkownicy stosują podczas oceny systemu24,25. Antropomorfizacja może wywoływać reakcje społeczne, ale może również tworzyć nierealistyczne oczekiwania i zacierać granice odpowiedzialności26,27. Badania nad zespołami człowiek-AI oraz chatbotami dodatkowo wskazują, że ciepło, kompetencje, dopasowanie roli do kontekstu oraz spójność między rolą społeczną a wydajnością wpływają na akceptację i zaufanie16,17,18. W niniejszym badaniu kongruencja roli odnosi się do zgodności między sygnałami przekazywanymi w odpowiedzi AI a wymaganiami oceniającymi, które są istotne w zadaniu konsultacyjnym22.
Podwójna ścieżka zaufania: Postrzegany profesjonalizm i obecność społeczna
Zgodność ról jest wnioskowana na podstawie zaobserwowanego oddziaływania roli na zadanie, a nie mierzona jako oddzielny konstrukt subiektywny. Interpretacja ta jest zatem powiązana z interakcją eksperymentalną i nie oznacza, że uczestnicy świadomie zgłaszali poczucie dopasowania roli. Zaufanie obejmuje oceny poznawcze dotyczące kompetencji i niezawodności oraz oceny afektywne dotyczące bezpieczeństwa i komfortu relacyjnego28,29,30. W przypadku wykorzystania AI w medycynie, użytkownicy oceniają zarówno to, czy system może wesprzeć decyzję zdrowotną, jak i to, czy interakcja z nim jest odczuwana jako wystarczająco bezpieczna i dostępna. Nadanie kontekstu eksperckiego powinno sprawić, że ewaluacja zorientowana na kompetencje stanie się bardziej wyraźna. Dowody z badań nad systemami wspierania decyzji klinicznych wskazują, że wyjaśnienia i informacje na temat rozumowania systemu wpływają na zaufanie i poleganie na nim31. W internetowych konsultacjach zdrowotnych personalizacja i troska są również powiązane z zaufaniem i akceptacją9. Postrzegany profesjonalizm oddaje ewaluację zorientowaną na kompetencje, która jest istotna dla zaufania25. Badania nad internetowymi konsultacjami zdrowotnymi podobnie identyfikują wiarygodność źródła jako istotną dla akceptacji sugestii zdrowotnych przez użytkowników32. Niniejsze badanie testuje zatem, czy nadanie kontekstu eksperckiego wiąże się z wyższym postrzeganym profesjonalizmem.
H1: Role towarzysza generuje niższy postrzegany profesjonalizm w porównaniu z medycznymi AI w stylu eksperckim.
Ramowanie w kontekście towarzyszącym powinno sprawić, że ocena relacyjna stanie się bardziej wyraźna. Obecność społeczna odnosi się do postrzeganej interpersonalnej jakości zapośredniczonej interakcji, a nie do przekonania, że system jest ludzki33. Jest ona powiązana z jakością interakcji, zaufaniem oraz akceptacją w usługach online i zdrowotnych agentach konwersacyjnych15,34.
Obecność społeczna może zmniejszać psychologiczny koszt ujawniania informacji o sobie i wspierać wymianę informacji podczas konsultacji online32. Niniejsze badanie sprawdza zatem, czy ramowanie towarzyszące wiąże się z wyższym poczuciem obecności społecznej.
H2: Role eksperckie generują niższą obecność społeczną w porównaniu z medycznymi AI w stylu towarzyszącym.
Postrzegany profesjonalizm oraz obecność społeczna są traktowane jako równoległe, niewzajemnie wykluczające się skojarzenia z zaufaniem. Właściwe poleganie na automatyzacji w sytuacjach wysokiego ryzyka zależy od możliwości systemu, jego ograniczeń i wymagań zadania, a nie wyłącznie od maksymalizacji zaufania35.
H3: Postrzegany profesjonalizm oraz obecność społeczna stanowią pozytywne predyktory zaufania w modelu symultanicznym.
Efekt moderujący kontekstu zadania
Te same wskazówki dotyczące roli mogą mieć różną wagę psychologiczną w zależności od zadań medycznych. Dopasowanie zadania do technologii (task-technology fit) dostarcza kontekstowego uzasadnienia dla badania, czy wskazówki dotyczące roli są zgodne z wymaganiami zadania36. Konsultacje chorobowe wiążą się z większą niepewnością, ryzykiem strat i kosztami błędów, co sprawia, że profesjonalizm, dokładność i jasne granice są szczególnie istotne7,37. Wskazówki eksperckie powinny zatem być ściślej dostosowane do tych wymagań niż wskazówki towarzyszące. Konsultacje zdrowotne koncentrują się na długoterminowym zarządzaniu zdrowiem, trwałości zachowań i ciągłości interakcji. Przeglądy systemów wspomagania decyzji klinicznych opartych na AI oraz konwersacyjnych agentów zdrowotnych podkreślają znaczenie informacji kontekstowych, możliwości podjęcia działań, interakcji oraz warunków wdrożenia3,38,39.
Niniejsze badanie zakłada, że różnica między ekspertem a towarzyszem w postrzeganym profesjonalizmie będzie większa w przypadku konsultacji dotyczącej choroby niż w przypadku konsultacji dotyczącej zdrowia. Brak istotności statystycznej interakcji w zakresie obecności społecznej nie jest traktowany jako dowód na niezmienność. Hipotezę sformułowano w następujący sposób:
H4: Kontekst zadania znacząco moderuje wpływ ról eksperckich na postrzegany profesjonalizm. Wpływ ten jest silniejszy w przypadku konsultacji w sprawie choroby niż w przypadku konsultacji dotyczących zdrowia.
Protokół
Przegląd badań
Badanie zostało przeprowadzone zgodnie z Deklaracją Helsińską i zostało zatwierdzone przez Komisję Etyczną Uniwersytetu Huaqiao (M2025021), co obejmowało zarówno eksperyment w scenariuszu online, jak i eksperyment EEG. Wszyscy uczestnicy wyrazili świadomą zgodę i otrzymali wynagrodzenie po zakończeniu badania.
Niniejsza praca zawiera dwa uzupełniające się badania (patrz Rycina 1). Badanie 1 jest randomizowanym eksperymentem scenariuszowym 2 × 2, który szacuje efekty ramowania roli i kontekstu zadania, ocenia strukturę pomiarową oraz testuje równoległe warunkowe powiązania pośrednie poprzez postrzegany profesjonalizm i obecność społeczną. Badanie 2 to eksperyment EEG w schemacie wewnątrzpodmiotowym, który porównuje aktywność w pasmie theta w przypadku stwierdzeń sformułowanych w ramach eksperta i towarzysza; zostało ono zinterpretowane jako eksploracyjne porównanie na poziomie procesowym. Badania dostarczają dowodów behawioralnych i neuronalnych na różnych poziomach; nie są one traktowane jako pojedynczy, progresywny mechanizm.
Badanie 1: Eksperyment scenariuszowy
Uczestnicy i projekt badania
W badaniu 1 zastosowano zrównoważony model 2 × 2 z próbami międzygrupowymi, uwzględniający ramowanie roli (ekspert vs towarzysz) oraz kontekst zadania (konsultacja w sprawie choroby vs konsultacja zdrowotna). Pierwotne obliczenia w programie G*Power zakładały średni efekt ogólny ANOVA (f = 0.25), α = .05 oraz moc = .80, co wskazywało na minimum 128 uczestników40. Ponieważ obliczenia te nie były dostosowane do warunkowych efektów pośrednich, zostały one przedstawione jako pierwotna podstawa rekrutacji, a nie jako dowód mocy dla moderowanej mediacji. Przy N = 300 i czterech zrównoważonych grup, analiza wrażliwości wykazała 80% mocy do wykrycia interakcji o wartości f = 0.162 (częściowe η2 = .026) przy α = .05.
Dodatkowo przeprowadzono analizę mocy post hoc opartą na symulacji dla wskaźników moderowanej mediacji, wykorzystując zestaw danych z kwestionariusza SPSS obejmujący 300 przypadków. Symulacja wygenerowała 1000 zrównoważonych próbek 2 × 2 z dopasowanego modelu równoległych mediatorów poprzez ponowne próbkowanie reszt empirycznych; każdy symulowany zestaw danych wykorzystywał 500 bootstrapowych przedziałów ufności percentylowych z ponownym próbkowaniem przypadków. Oszacowane prawdopodobieństwa, że przedział ufności wyklucza zero, wyniosły odpowiednio .698 dla wskaźnika profesjonalizmu, .157 dla wskaźnika obecności społecznej oraz .279 dla bezpośredniej różnicy między tymi dwoma wskaźnikami. Analiza ta jest uwarunkowana obserwowanymi współczynnikami, rozkładami reszt oraz specyfikacją modelu i nie stanowi a priori uzasadnienia wielkości próby. Pełna analiza mocy post hoc oparta na symulacji przedstawiona jest w Tabeli uzupełniającej S1.
Zrekrutowano trzystu uczestników za pośrednictwem platformy Credamo i losowo przydzielono ich do czterech warunków (n = 75 na grupę). Próba obejmowała 109 mężczyzn (36,3%) i 191 kobiet (63,7%); 43,7% osób było w wieku 21-30 lat, 41,3% w wieku 31-40 lat, a 69,7% posiadało stopień licencjata. Wszystkie wymagane elementy kwestionariusza zostały wypełnione. Nie zastosowano dedykowanych pytań kontrolnych ani prerejestrowanego kryterium wykluczenia na podstawie czasu wypełniania ankiety; żaden uczestnik nie został wykluczony. Mediana czasu wypełniania wynosiła 268 s (zakres = 67-1 894 s). W celu oceny wrażliwości na nienaturalnie szybkie odpowiedzi przeprowadzono analizę odporności post hoc, wykluczając odpowiedzi poniżej piątego percentyla czasu wypełniania (<125 s; n = 285 osób pozostało w próbie). Szczegółowe statystyki kontroli manipulacji oraz analizy wrażliwości czasu wypełniania ankiety przedstawiono w Tabeli uzupełniającej S2.
Bodźce eksperymentalne i procedura
Materiały stymulujące składały się z wprowadzenia do scenariusza zadania oraz odpowiedzi w dialogu z lekarzem AI, tworząc cztery kompletne zestawy eksperymentalne. Scenariusz konsultacji w przypadku choroby polegał na tym, że uczestnicy mieli wyobrazić sobie nawracający nocny ucisk w klatce piersiowej i kołatanie serca oraz obawę o to, czy wymagana jest natychmiastowa pomoc szpitalna. Scenariusz konsultacji zdrowotnej polegał na tym, że uczestnicy mieli wyobrazić sobie, iż cieszą się ogólnie dobrym zdrowiem i poszukują spersonalizowanego planu diety i ćwiczeń. Każda kategoria zadań była reprezentowana przez jeden scenariusz; w związku z tym wnioski są ograniczone do tych dwóch scenariuszy, a nie uogólnione na wszystkie konsultacje chorobowe i zdrowotne.
Wszystkie cztery zrzuty ekranu z kwestionariusza zawierały tę samą ikonę i wyświetlały nazwę systemu, Medical AI (DiagnosPro), dzięki czemu tożsamość wizualna pozostawała stała we wszystkich warunkach. Odpowiedzi sformułowane w roli eksperta wykorzystywały analizę strukturalną, stwierdzenia dotyczące ryzyka lub dowodów, język dyrektywny oraz wyraźne zalecenia dotyczące działań. Odpowiedzi sformułowane w roli towarzysza opierały się na empatii, zapewnieniu, sformułowaniach o charakterze współpracy oraz elastycznych sugestiach. Manipulacja ta stanowiła zatem zestaw spójnych z rolą komunikatów i wskazówek informacyjnych; nie izolowała ona ramowania roli od szczegółowości, możliwości podjęcia działań, pewności, szczegółów medycznych czy wsparcia emocjonalnego. Wspólna nazwa DiagnosPro mogła również przekazywać wskazówkę dotyczącą eksperckości we wszystkich warunkach. Pełny zestaw bodźców znajduje się w Pliku uzupełniającym 1.
Uczestnicy najpierw przeczytali formularz świadomej zgody, a następnie zostali losowo przydzieleni do jednego z czterech warunków eksperymentalnych. Po zapoznaniu się ze scenariuszem i bodźcem w postaci dialogu wypełnili kwestionariusz zgodnie ze swoimi odpowiedziami. Kwestionariusz rozpoczynał się od kontroli manipulacji, po których następowały pomiary postrzeganego profesjonalizmu, obecności społecznej, zaufania oraz dane demograficzne. Procedura trwała około 15 min.
We wszystkich skalach zastosowano 7-punktową skalę Likerta, w której 1 oznaczało zdecydowany brak zgody, a 7 zdecydowaną zgodę. Postrzegany profesjonalizm mierzono za pomocą trzech pozycji: „Ta medyczna AI jest zdolna do udzielania porad medycznych”, „Ta medyczna AI wydaje się bardzo profesjonalna” oraz „Ta medyczna AI jest ekspertem w dziedzinie medycyny” (α = .883)41. Obecność społeczną mierzono za pomocą trzech pozycji: „W interakcji z tą medyczną AI poczułem ludzki pierwiastek”, „Interakcja z tą medyczną AI sprawiła, że poczułem bliskość” oraz „Ta medyczna AI wydawała się towarzyska podczas interakcji” (α = .932)42. Zaufanie poznawcze składało się z trzech pozycji: „Mogę polegać na tej medycznej AI, ponieważ posiada ona umiejętności niezbędne do udzielania porad”, „Jestem pewien dokładności porad udzielanych przez tę medyczną AI” oraz „Ta medyczna AI posiada wystarczające możliwości, aby zająć się moim problemem zdrowotnym” (α = .837). Zaufanie afektywne składało się z trzech pozycji: „Ta medyczna AI sprawia, że czuję ciepło i troskę”, „Poleganie na tej medycznej AI sprawia, że czuję się bezpiecznie, ponieważ wydaje się ona dbać o moje zdrowie” oraz „Wierzę, że ta medyczna AI nie zrobiłaby mi celowo żadnej krzywdy” (α = .700). Zaufanie ogólne stanowiło średnią ze wszystkich sześciu pozycji dotyczących zaufania (α = .784). Miary te analizowano jako wyniki zorientowane na kompetencje, interpersonalne, zaufanie poznawcze, zaufanie afektywne i zaufanie ogólne, a nie jako konstrukty wzajemnie wykluczające się.
Analizę przeprowadzono w czterech etapach. W pierwszym etapie, za pomocą analizy czynnikowej potwierdzającej, porównano proponowany model czteroczynnikowy z alternatywnymi modelami dwuczynnikowym i jednoczynnikowym; zbadano wiarygodność złożoną, średnią wariancję wyodrębnioną, korelacje latentne oraz współczynniki heterotrait-monotrait. Po drugie, pełne modele factorialne 2 x 2 pozwoliły oszacować efekty główne i interakcje dla postrzeganego profesjonalizmu, obecności społecznej, zaufania poznawczego, zaufania afektywnego oraz zaufania ogólnego, z uwzględnieniem średnich dla poszczególnych komórek, przedziałów ufności i cząstkowego η2. Oszacowane średnie marginalne oraz 95% przedziały ufności przedstawiono na Rysunku 2. Po trzecie, w programie PROCESS 4.2 beta Model 7 wprowadzono postrzegany profesjonalizm i obecność społeczną jednocześnie jako mediatory równoległe, stosując 5 000 próbek bootstrapowych metodą percentylową43. Ramowanie roli zakodowano jako 1 = ekspert i 2 = towarzysz, a kontekst zadania jako 1 = konsultacja w sprawie choroby i 2 = konsultacja zdrowotna. Wspólny bootstrap re-samplingu bezpośrednio zestawiono z dwoma indeksami mediacji moderowanej. Po czwarte, zaufanie poznawcze i afektywne przeanalizowano osobno jako wyniki eksploracyjne. Ponieważ mediatory i wyniki mierzone były jednocześnie, oszacowania interpretuje się jako powiązania pośrednie zgodne z mediacją, a nie jako przyczynowe mechanizmy psychologiczne.
Badanie 2: Eksperyment EEG
Uczestnicy
Do badania 2 zrekrutowano 40 uczestników. Jednego uczestnika wykluczono z powodu przekroczenia 30% prób zanieczyszczonych artefaktami w co najmniej jednym warunku eksperymentalnym, w wyniku czego w końcowych analizach EEG pozostało 39 uczestników. Kryterium to zapewniło, że każdy zachowany uczestnik dostarczył co najmniej 70% prób w każdym warunku. Wszyscy uczestnicy wyrazili pisemną świadomą zgodę i otrzymali wynagrodzenie po zakończeniu eksperymentu. Informacje demograficzne nie mogły zostać przypisane do wszystkich zachowanych zapisów EEG, dlatego nie zostały one podsumowane dla końcowej próby EEG.
Bodźce eksperymentalne i procedura
Eksperyment przeprowadzono w standardowym laboratorium EEG z zastosowaniem schematu wewnątrzobiektowego, a bodźce prezentowano za pomocą programu E-Prime 2.1. Uczestnicy zostali poproszeni o wyobrażenie sobie interakcji z systemem medycznej sztucznej inteligencji oraz o ocenę zaufania do systemu w każdym z przedstawionych scenariuszy konsultacji medycznej. W eksperymencie manipulowano postrzeganą rolą systemu medycznej sztucznej inteligencji, obejmując warianty typu eksperckiego oraz typu towarzyszącego.
Opracowano łącznie 40 bodźców w postaci zdań w języku chińskim. Warunek typu eksperckiego zawierał 20 bodźców rozpoczynających się od sformułowania „Medical AI expert”, natomiast warunek typu towarzyszącego zawierał 20 równoległych bodźców rozpoczynających się od „Medical AI companion”. Scenariusze medyczne obejmowały zarówno profesjonalne funkcje diagnostyczne, takie jak przeprowadzanie wywiadu medycznego, analizowanie raportów z badań, ocena danych o tętnie, interpretacja testów genetycznych, ocena ryzyka choroby i rekomendowanie planów leczenia, jak i wspierające funkcje zarządzania zdrowiem, takie jak okazywanie troski o stan fizyczny, pytania o jakość snu, łagodzenie lęku, zapisywanie danych zdrowotnych, zachęcanie do przestrzegania zaleceń terapeutycznych oraz udzielanie codziennych wskazówek zdrowotnych. W związku z tym warunki te różniły się również pod względem treści semantycznej i złożoności; nie przeprowadzono niezależnego dopasowania bodźców ani testu wstępnego.
Przed właściwym eksperymentem uczestnicy wykonali krótki blok treningowy. Każna próba rozpoczynała się od krzyżyka fiksacyjnego wyświetlanego przez 500 ms, po którym następował zmienny odstęp pusty trwający 300–500 ms oraz oświadczenie dotyczące AI medycznej prezentowane przez 1 600 ms. Następnie uczestnicy dokonywali samodzielnej oceny zaufania w formie binarnej, naciskając klawisz F, aby wskazać zaufanie, lub klawisz J, aby wskazać brak zaufania (patrz Rysunek 3). Oświadczenia sformułowane w ramach roli eksperta i towarzysza prezentowano w losowej kolejności. Logi zadań z programu E-Prime wykazały 80 formalnych prób na każdy zapis zadania: 40 prób z ekspertem i 40 z towarzyszem, przy czym każde z 20 unikalnych oświadczeń przypisanych do danej roli zostało zaprezentowane dwukrotnie.
Dane z zadań behawioralnych
Dane z zadań behawioralnych były użyteczne dla 38 z 39 uczestników w końcowej próbie EEG; zapis zadania E-Prime jednego uczestnika był nieużyteczny. W związku z tym w analizach behawioralnych wykorzystano N = 38. Szczegółowe wyniki behawioralne oraz zestawienie próby przedstawiono w Tabeli uzupełniającej S3. Zaufanie kodowano jako odpowiedź klawiszem F; odpowiedzi klawiszem J oznaczały brak zaufania. Puste odpowiedzi lub zarejestrowany czas reakcji wynoszący 0 ms kodowano jako brakujące dane. Współczynnik zaufania obliczano spośród prób z udzieloną odpowiedzią, a czas reakcji podsumowano dla prób z udzieloną odpowiedzią. Dane neuronalne dostępne do analizy zawierały miary zagregowane według warunków, lecz nie zawierały wskaźników EEG na poziomie pojedynczych prób ani zweryfikowanego identyfikatora łączącego każdy zapis behawioralny z odpowiadającym mu zapisem EEG; w związku z tym nie oszacowano modelu mieszanego dla EEG i oceny zaufania na poziomie pojedynczych prób.
Rejestracja i analiza EEG
W celu utrzymania impedancji elektroda-skóra poniżej 5 kOhm zastosowano przewodzący żel elektrolityczny Quik-Gel. Domyślną referencją online urządzenia była elektroda FCz, a częstotliwość próbkowania wynosiła 1 000 Hz. Referencjonowanie offline do średniej z obu wyrostków sutkowatych wykonano za pomocą wbudowanej funkcji zmiany referencji programu CURRY; elektroda FCz została zachowana i automatycznie zrekonstruowana względem nowej referencji, bez użycia niestandardowych poleceń rekonstrukcji ani skryptów. Dalsze przetwarzanie offline przeprowadzono w programie MATLAB R2020b z wykorzystaniem narzędzi EEGLAB44 oraz ICLabel45. Próbkowanie danych zmniejszono do 500 Hz, a następnie zastosowano filtr pasmowo-przepustowy w zakresie od 0,1 do 40 Hz. Wadliwe kanały oraz segmenty danych z grubymi zanieczyszczeniami zidentyfikowano i usunięto poprzez inspekcję wizualną; nie stosowano automatycznej interpolacji ani automatycznych progów odrzucania segmentów. Następnie wykorzystano domyślną implementację runica w EEGLAB (Infomax ICA), a komponenty usuwano, gdy ICLabel przypisał prawdopodobieństwo co najmniej 0,70 do klasy artefaktu (np. aktywności ocznej, mięśniowej, kardiologicznej, zakłóceń sieciowych lub szumów kanału). Z analizy wykluczono uczestników, u których więcej niż 30% prób w którymkolwiek z warunków było zanieczyszczonych artefaktami, co zapewniło zachowanie co najmniej 70% prób w każdym warunku. Epoki obejmowały przedział od −1 000 do 1 996 ms. Do analizy łączności funkcjonalnej dane po wstępnym przetwarzaniu poddano ponownej redukcji częstotliwości próbkowania do 250 Hz, a elektrody peryferyjne, w tym P7, P8, F7 i F8, wykluczono przed szacowaniem synchronizacji fazowej.
Aktywność theta rejestrowana w przednio-środkowych obszarach skóry głowy była wiązana z obliczeniami angażowanymi przez wymagania dotyczące kontroli poznawczej46. Synchronizacja fazy w paśmie theta między przyśrodkowymi a bocznymi przednimi obszarami rozmieszczenia elektrod była również wiązana z koordynacją podczas przetwarzania związanego z kontrolą47. W szczególności zwiększoną synchronizację fazy w paśmie theta pomiędzy obszarami takimi jak FCz i F6 obserwowano po wykryciu konfliktu lub błędu48. Ponieważ te pomiary powierzchniowe skóry głowy nie są specyficzne wyłącznie dla kontroli poznawczej, traktuje się je tutaj jako zbieżne wskaźniki procesowe, a nie jako bezpośrednie odczyty pojedynczego mechanizmu poznawczego.
W pierwszej kolejności określono ilościowo synchronizację powiązaną z zdarzeniem (ERS) w paśmie theta 4–8 Hz w obszarze czołowym linii środkowej w oknie 800–1,000 ms po stymulacji. ERS obliczono za pomocą analizy czasowo-częstotliwościowej, przyjmując względną zmianę mocy względem linii bazowej przed stymulacją w przedziale od −500 do −200 ms. Wartości dodatnie wskazują na zwiększenie mocy (synchronizację), natomiast wartości ujemne wskazują na tłumienie mocy (desynchronizację). Po drugie, oszacowano łączność funkcjonalną po dalszej redukcji próbkowania wstępnie przetworzonych danych do 250 Hz i wykluczeniu elektrod peryferyjnych, w tym P7, P8, F7 i F8. Przed obliczeniem wartości blokowania fazy (PLV) w paśmie theta między FCz a F6 zastosowano krótkoczasową transformatę Fouriera (STFT). Zmianę PLV skorygowaną o linię bazową (ΔPLV) obliczono względem linii bazowej przed stymulacją w przedziale od −600 do −200 ms. Surowe PLV przyjmuje wartości od 0 do 1; w związku z tym ujemne wartości ΔPLV wskazują na spadek względem linii bazowej, a nie na ujemne blokowanie fazy. Te pomiary skalpowe interpretuje się jako eksploracyjne wzorce związane z przetwarzaniem kontrolnym i koordynacją przedczołową; nie identyfikują one bezpośrednio konkretnego procesu poznawczego ani źródła neuronalnego.
Wyniki
Badanie 1: Wyniki eksperymentu scenariuszowego
Model pomiarowy. Model czteroczynnikowy dopasował się lepiej niż alternatywy dwu- i jednoczynnikowe, jednak dopasowanie absolutne było niejednoznaczne: χ2(48) = 23.93, p < .01; CFI = .935; TLI = .91; RMSEA = .1; SRMR = .140. Standaryzowane ładunki mieściły się w zakresie od .382 do .937. Niezawodność złożona wyniosła .86 dla postrzeganego profesjonalizmu, .932 dla obecności społecznej, .840 dla zaufania poznawczego i .709 dla zaufania afektywnego; odpowiadające im wartości AVE wyniosły odpowiednio .72, .821, .636 i .474. Trafność dyskryminacyjna była ograniczona: wartości HTMT wyniosły .935 między postrzeganym profesjonalizmem a zaufaniem poznawczym oraz .926 między obecnością społeczną a zaufaniem afektywnym. Wyniki procesu warunkowego są zatem interpretowane z ostrożnością, a analizy zaufania w odniesieniu do poszczególnych wymiarów mają charakter eksploracyjny (Tabela 1).
Kontrole manipulacji. Uczestnicy w grupie z ramowaniem eksperckim (n = 150, M = 5,57, SD = 1,18) ocenili medyczną AI jako bardziej przypominającą eksperta niż uczestnicy w grupie z ramowaniem towarzyszącym (n = 150, M = 3,21, SD = 1,76). Ze względu na różnice wariancjach, F = 47,42, p < .01, zastosowano test Welcha, t(259,90) = 13,63, p < .01, różnica średnich = 2,36, 95% CI [2,02, 2,70]. Uczestnicy w stanie choroby (n = 150, M = 2,51, SD = 1,53) wystawili niższe oceny orientacji na zdrowie profilaktyczne niż uczestnicy w stanie zdrowia (n = 150, M = 5,98, SD = 1,2), F = 10,96, p = .01; t Welcha(284,1) = −21,70, p < .01, różnica średnich = −3,47, 95% CI [−3,79, −3,16]. Stopnie swobody Welcha nie są równe N − 2 w przypadku nierównych wariancji; we wszystkich analizach przyjęto N = 30.
Statystyki opisowe w podziale na warunki eksperymentalne. W przypadku ramowania eksperckiego, konsultacje dotyczące choroby i zdrowia przyniosły odpowiednio średnie wartości dla postrzeganego profesjonalizmu wynoszące 5,69 (SD = 0,83) i 5,85 (SD = 0,63), dla obecności społecznej 4,28 (SD = 1,54) i 4,25 (SD = 1,64) oraz dla ogólnego zaufania 5,45 (SD = 0,86) i 5,28 (SD = 0,87). W przypadku ramowania towarzyszącego, odpowiadające im średnie dla choroby i zdrowia wyniosły 4,52 (SD = 1,47) i 5,25 (SD = 0,94) dla postrzeganego profesjonalizmu, 5,68 (SD = 1,07) i 5,93 (SD = 0,74) dla obecności społecznej oraz 5,30 (SD = 1,02) i 5,61 (SD = 0,64) dla ogólnego zaufania. Tabela 2 przedstawia wszystkie przedziały ufności dla poszczególnych warunków oraz pełne testy factorialne.
Pełne wyniki analizy faktorialnej. Postrzegany profesjonalizm wykazał główny efekt ramowania roli, F(1, 296) = 56.92, p < .01, partial η2 = .161, główny efekt kontekstu zadania, F(1, 296) = 14.37, p < .01, partial η2 = .046, oraz interakcję rola × zadanie, F(1, 296) = 5.89, p = .016, partial η2 = .020. Obecność społeczna wykazała główny efekt ramowania roli, F(1, 296) = 105.57, p < .001, partial η2 = .263, lecz ani główny efekt zadania, F(1, 296) = 0.59, p = .42, ani interakcja, F(1, 296) = 0.84, p = .359, nie były istotne. Ten ostatni wynik wskazuje, że nie wykryto moderacji; nie ustanawia on jednak równoważności między zadaniami. W przypadku zaufania poznawczego interakcja rola × zadanie była istotna, F(1, 296) = 5.60, p = .019, partial η2 = .019; odpowiadająca jej interakcja nie była istotna dla zaufania afektywnego, F(1, 296) = 3.48, p = .063, partial η2 = .012. Zaufanie ogólne nie wykazało głównego efektu ramowania roli, F(1, 296) = 0.81, p = .369, ani głównego efektu zadania, F(1, 296) = 0.5, p = .459, ale interakcja rola × zadanie była istotna, F(1, 296) = 5.78, p = .017, partial η2 = .019. W konsultacji dotyczącej choroby zaufanie ogólne nie różniło się między ramowaniem towarzyszącym a eksperckim, średnia różnica = −0.15, SE = 0.14, t(296) = −1.06, p = .28, 95% CI [−0.42, 0.13]. W konsultacji dotyczącej zdrowia zaufanie ogólne było wyższe przy ramowaniu towarzyszącym, średnia różnica = 0.3, SE = 0.14, t(296) = 2.34, p = .020, 95% CI [0.05, 0.60].
Równoległe warunkowe powiązania pośrednie. Gdy postrzegany profesjonalizm i obecność społeczna zostały wprowadzone jednocześnie, oba czynniki wykazały pozytywny związek z ogólnym zaufaniem: odpowiednio b = 0.4872, SE = 0.0258, p < .01, 95% CI [0.4294, 0.5460] oraz b = 0.3293, SE = 0.0208, p < .01, 95% CI [0.2762, 0.3829]. Bezpośredni związek związany z framingiem roli nie był istotny: b = 0.0119, SE = 0.0680, p = .861, 95% CI [−0.1071, 0.1361]. Powiązania pośrednie dla profesjonalizmu wyniosły −0.5695 w przypadku konsultacji w sprawie choroby, 95% bootstrap CI [−0.7687, −0.3851], oraz −0.2923 w przypadku konsultacji w sprawie zdrowia, 95% bootstrap CI [−0.428, −0.1634]. Powiązania pośrednie dla obecności społecznej wyniosły 0.4625 w przypadku konsultacji w sprawie choroby, 95% bootstrap CI [0.3165, 0.6091], oraz 0.532 w przypadku konsultacji w sprawie zdrowia, 95% bootstrap CI [0.385, 0.7383] (Table 3). Indeks moderowanej mediacji poprzez postrzegany profesjonalizm wyniósł 0.2772, 95% bootstrap CI [0.0594, 0.5035], podczas gdy indeks poprzez obecność społeczną wyniósł 0.0907, 95% bootstrap CI [−0.0984, 0.308]. Bezpośredni kontrast bootstrapowy między indeksami nie był istotny: różnica = 0.1864, 95% bootstrap CI [−0.0856, 0.447]. Wyniki te wspierają zatem tezę o kontekstowej moderacji powiązania pośredniego z profesjonalizmem, ale nie wykazują statystycznie istotnych różnic w moderacji kontekstowej obu tych powiązań.
Eksploracyjne analizy wymiarów zaufania. W przypadku zaufania poznawczego kontrast między indeksami moderowanej mediacji dla profesjonalizmu i obecności społecznej był dodatni, różnica = 0.3707, 95% bootstrap CI [0.0493, 0.696]. W przypadku zaufania afektywnego odpowiadający mu kontrast nie został potwierdzony, różnica = 0.02, 95% bootstrap CI [−0.3421, 0.3127]. Oba mediatory zachowały dodatnie powiązania z obydwoma wymiarami zaufania, co wskazuje na efekty krzyżowe, a nie wyłączne. Ze względu na wysokie wartości HTMT, wyniki te nie powinny być interpretowane jako ostateczne rozdzielenie mechanizmów poznawczych i afektywnych.
Post hoc moc analizy moderowanej mediacji. Przy założeniach modelu dopasowanego i ponownego próbkowania residuów, oszacowane prawdopodobieństwo, że przedział ufności bootstrapowy oparty na percentylach wykluczył zero, wyniosło .698 dla indeksu profesjonalizmu, .157 dla indeksu obecności społecznej oraz .279 dla ich bezpośredniej różnicy (1 0 symulacji; 50 prób bootstrapowych na symulację). Te oszacowania dla przyjętego projektu badania wyjaśniają, dlaczego potwierdzony indeks profesjonalizmu oraz nieistotne statystycznie bezpośrednie porównanie nie powinny być interpretowane jako rozstrzygający dowód na różną moderację kontekstową.
Odporność w zależności od czasu ukończenia. Po wykluczeniu 15 odpowiedzi poniżej 125 s pozostało 285 przypadków. Interakcja ogólnego zaufania pozostała istotna, p = .029; wskaźnik profesjonalizmu pozostał potwierdzony, 95% bootstrap CI [0.0242, 0.4827]; a kontrast między wskaźnikami moderowanej mediacji pozostał nieistotny, 95% bootstrap CI [−0.1027, 0.4506]. Główne wnioski nie były zależne od 5% najszybszych odpowiedzi.
Badanie 2: Wyniki EEG
Frontalno-środkowe theta ERS. W końcowej próbie analitycznej (N = 39), theta ERS w oknie 4–8 Hz, 80–1,0 ms była wyższa przy sformułowaniu eksperckim (M = 0.2948, SD = 0.8218) niż przy sformułowaniu towarzyszącym (M = −0.042, SD = 1.215), średnia różnica = 0.369, 95% CI [0.0125, 0.614], t(38) = 2.10, p = .042, Cohen’s dz = 0.37, partial η2 = .104. Wartość p skorygowana metodą Holma dla dwóch raportowanych sparowanych wyników EEG wyniosła .042. Różnica ta wskazuje na odmienne przetwarzanie w pasmie theta w tym oknie czasowym zadania; samo theta ERS nie identyfikuje konkretnego procesu psychologicznego.
Zmiana PLV w pasmie theta dla pary FCz-F6 po korekcie o poziom bazowy (ΔPLV). W końcowej próbie analitycznej (N = 39), ΔPLV w pasmie theta było mniej ujemne przy ramowaniu eksperckim (M = −0.01, SD = 0.0546) niż przy ramowaniu towarzyszącym (M = −0.0350, SD = 0.0473), średnia różnica = 0.0239, 95% CI [0.058, 0.0420], t(38) = 2.68, p = .01, Cohen’s dz = 0.429, partial η2 = .159. Wartość p skorygowana metodą Holma dla dwóch raportowanych sparowanych wyników EEG wyniosła .02. Wzorzec ten reprezentuje mniejszy spadek spójności fazy theta względem poziomu bazowego przy ramowaniu eksperckim; samo w sobie nie dowodzi on silniejszej kontroli przedczołowej ani konkretnego mechanizmu poznawczego (patrz Rycina 4 i Tabela 4).
Wyniki zadania behawioralnego. W 38 analizowanych zapisach z zadania wskaźnik odpowiedzi zaufania wyniósł 83,1% (SD = 15,8%) przy sformułowaniu eksperckim i 82,4% (SD = 17,5%) przy sformułowaniu towarzyszącym, średnia różnica = 0,7 punktu procentowego, 95% CI [−0,9, 2,4], t(37) = 0,91, p = .371, dz = 0,147. Średnie czasy reakcji wyniosły odpowiednio 828,7 ms (SD = 204,6) i 826,1 ms (SD = 208,9), średnia różnica = 2,5 ms, 95% CI [−14,0, 19,1], t(37) = 0,31, p = .758, dz = 0,050. Wskaźniki braku odpowiedzi wyniosły odpowiednio 6,3% (SD = 7,4%) i 5,2% (SD = 6,3%), średnia różnica = 1,1 punktu procentowego, 95% CI [−1,0, 3,1], t(37) = 1,05, p = .302, dz = 0,170.
Oświadczenie o dostępności danych:
Zanonimizowane dane z kwestionariusza z Badania 1, wstępnie przetworzone pliki EEG oraz zbiorcze pliki wynikowe EEG wspierające Badanie 2 są publicznie dostępne w Open Science Framework (OSF) pod adresem https://doi.org/10.17605/OSF.IO/JKSP7. Materiały uzupełniające obejmują kompletne bodźce eksperymentalne (Plik uzupełniający 1), weryfikacje manipulacji, dodatkowe analizy behawioralne, analizy mocy post hoc oraz wspierające informacje metodologiczne.
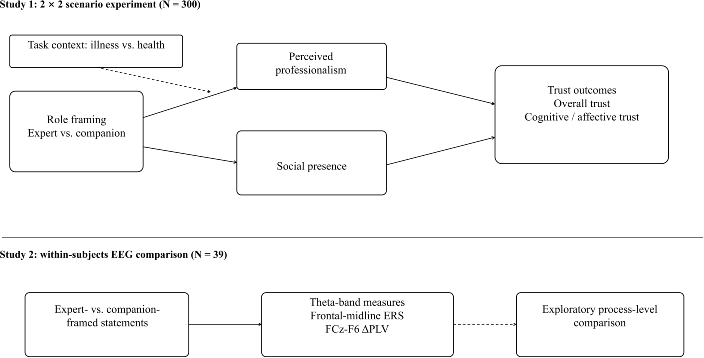
Rysunek 1Ramy badawcze. Badanie 1 jest eksperymentem scenariuszowym 2 × 2 (N = 30) badającym ramowanie roli, kontekst zadania oraz równoległe powiązania pośrednie za pośrednictwem postrzeganego profesjonalizmu i obecności społecznej. Badanie 2 stanowi eksploracyjne porównanie elektroencefalograficzne stwierdzeń sformułowanych w ramach roli eksperta i towarzysza (N = 39); nie testuje ono bezpośrednio warunkowego modelu pośredniego. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
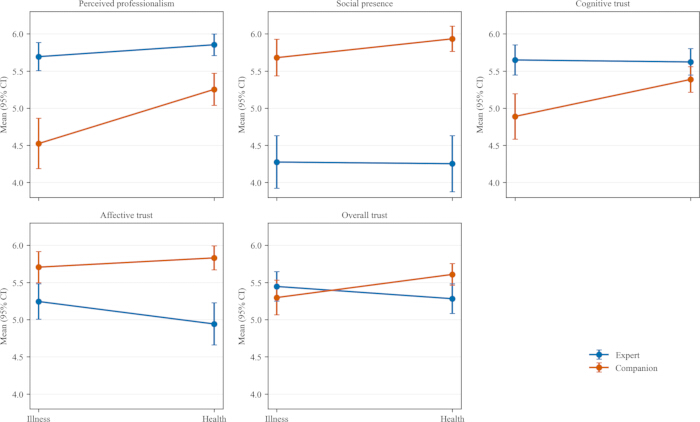
Rycina 2Wykresy interakcji ramy roli × kontekstu zadania dla postrzeganego profesjonalizmu, obecności społecznej, zaufania poznawczego, zaufania afektywnego i zaufania ogólnego. Punkty przedstawiają średnie dla komórek, a słupki błędów oznaczają 95-procentowe przedziały ufności (n = 75 na komórkę). Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
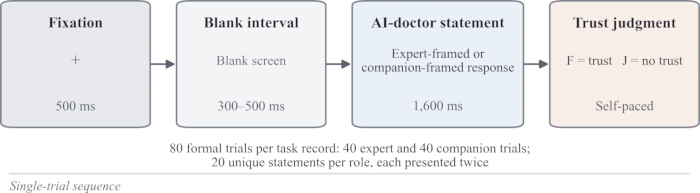
Rysunek 3Sekwencja pojedynczej próby w Badaniu 2. Każda próba składała się z 500 ms fiksacji, zmiennego przedziału pustego trwającego od 30 do 50 ms, wypowiedzi lekarza AI sformułowanej w kontekście eksperckim lub towarzyszącym trwającej 160 ms oraz binarnej oceny zaufania wykonywanej w tempie dostosowanym do uczestnika. Logi zadania w programie E-Prime wykazały 80 formalnych prób na każdy rekord zadania, z czego 40 prób przypadało na warunek ramowania roli, przy czym każde z 20 unikalnych stwierdzeń w danym warunku zostało zaprezentowane dwukrotnie. Aby wyświetlić powiększoną wersję tej ryciny, kliknij tutaj.
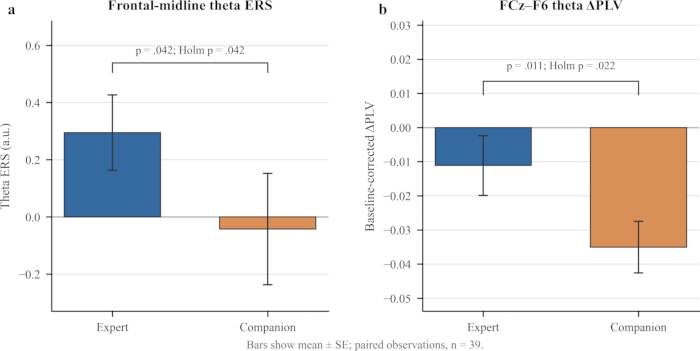
Rysunek 4Wpływ definiowania roli sztucznej inteligencji medycznej na ERS fal theta w obszarze przedczołowym-środkowym oraz PLV fal theta i delta w kanałach FCz-F6. (A) Frontalno-środkowa synchronizacja związana z zdarzeniem w pasmie theta. (B) Zmiana wartości blokowania fazy theta (ΔPLV) dla elektrod FCz-F6 skorygowana względem linii bazowej; wartości ujemne oznaczają spadek w stosunku do linii bazowej sprzed bodźca. Słupki przedstawiają średnią ± błąd standardowy (SE) dla n = 39. Testy t dla prób zależnych wykazały p = ,042 dla ERS theta oraz p = ,01 dla ΔPLV; wartości p skorygowane metodą Holma dla tych dwóch raportowanych wyników wyniosły odpowiednio ,042 i ,022. Skróty: Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Tabela 1: Diagnostyka modelu pomiarowego dla Badania 1. W tabeli przedstawiono standaryzowane ładunki, współczynnik α Cronbacha, niezawodność złożoną, średnią wariancję wyodrębnioną, korelacje latentne oraz wartości HTMT dla postrzeganego profesjonalizmu, obecności społecznej, zaufania poznawczego i zaufania afektywnego. N = 30. Model czteroczynnikowy dopasowany był lepiej niż modele alternatywne, jednak wskaźniki RMSEA i SRMR wskazały na słabe dopasowanie absolutne, a dwie wartości HTMT przekroczyły .90. Skróty: CR = niezawodność złożona; AVE = średnia wariancja wyodrębniona; HTMT = stosunek heterotrait-monotrait. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 2: Statystyki opisowe dla czterech warunków i pełne testy factorialne 2 × 2 dla Badania 1. Wartości w komórkach przedstawiają n, średnią, odchylenie standardowe oraz 95% przedział ufności; testy factorialne przedstawiają F, p oraz częściowe η2. N = 30; n = 75 na komórkę. Sformułowanie roli zakodowano jako 1 = ekspert i 2 = towarzysz; kontekst zadania zakodowano jako 1 = choroba i 2 = konsultacja zdrowotna. Współczynniki i przedziały ufności są niestandaryzowane. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 3: Równoległe warunkowe powiązania pośrednie w Badaniu 1. N = 30. Formułowanie roli zakodowano jako 1 = ekspert i 2 = towarzysz; kontekst zadania zakodowano jako 1 = konsultacja w sprawie choroby i 2 = konsultacja w sprawie zdrowia. Postrzegany profesjonalizm oraz obecność społeczna zostały wprowadzone jednocześnie. Szacunki są niesstandaryzowane, a przedziały ufności metodą bootstrapy centylowej wykorzystano dla 5 0 prób. Tabela zawiera warunkowe powiązania pośrednie, oba indeksy moderowanej mediacji oraz ich bezpośredni kontrast bootstrapowy. Bezpośredni kontrast między dwoma indeksami moderowanej mediacji dla ogólnego zaufania wyniósł 0,1864, 95% CI [-0,0856, 0,447]. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 4: Sparowane wyniki EEG w badaniu 2. N = 39 sparowanych obserwacji w końcowej próbce analitycznej. W tabeli przedstawiono średnie dla warunków, sparowane różnice średnich, 95% przedziały ufności, sparowane testy t , dz Cohena, częściowe η2 oraz skorygowane metodą Holma wartości p dla ERS theta w obszarze czołowym-środkowym oraz skorygowanego względem linii bazowej ΔPLV theta dla FCz-F6. Korekta Holma obejmuje jedynie dwa raportowane sparowane wyniki EEG i nie odtwarza żadnego nieudokumentowanego, szerszego przeszukiwania elektrod, pasm lub okien czasowych. Kliknij tutaj, aby pobrać tę tabelę.
Plik uzupełniający 1: Bodźce eksperymentalne użyte w badaniu 1. Plik zawiera pełną treść odpowiedzi medycznego AI sformułowanych w ramach perspektywy eksperckiej oraz towarzyszącej, wykorzystanych w scenariuszach konsultacji w przypadku choroby oraz konsultacji zdrowotnych. Udostępniono zarówno oryginał w języku chińskim, jak i tłumaczenie na język angielski.Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca S1. Post hoc analiza mocy oparta na symulacjach dla modelu moderowanej mediacji. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca S2. Statystyki kontroli manipulacji oraz analizy wrażliwości czasu wykonania dla badania 1. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca S3. Wyniki zadań behawioralnych, zestawienie próby i statystyki opisowe dla Badania 2. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
Implikacje teoretyczne
Oba badania dostarczają dowodów na różnych poziomach. Badanie 1 identyfikuje powiązania między rolą a zadaniem oraz równoległe powiązania pośrednie w randomizowanym eksperymencie scenariuszowym, natomiast Badanie 2 oferuje eksploracyjne porównanie EEG na poziomie procesów. Badania te wspierają zatem ograniczone ujęcie oceny ujętej w ramy roli, zamiast pojedynczego progresywnego mechanizmu. Wyniki rozszerzają teorię zgodności roli na medyczną AI, traktując zgodność jako dopasowanie między wskazówkami dotyczącymi roli a istotnymi dla zadania wymaganiami ewaluacyjnymi22. Ta interpretacja różni się od treści kompetencji-ciepła oraz dopasowania technologii do zadania. Wyniki dotyczące awersji do algorytmów i uznania dla algorytmów można rozumieć jako oceny zależne od kontekstu, określające, czy wskazówki dotyczące roli i możliwości pasują do zadania49,50.
Wyniki wspierają również istnienie równoległych, niewzajemnie wykluczających się powiązań między definiowaniem roli, postrzeganym profesjonalizmem, obecnością społeczną a zaufaniem. Ponieważ profesjonalizm pokrywa się z zaufaniem poznawczym, a obecność społeczna z zaufaniem afektywnym, dowody wskazują na zróżnicowaną treść ewaluacyjną, ale nie na dwa wyraźnie oddzielone mechanizmy. Interakcja roli i zadania w zakresie postrzeganego profesjonalizmu jest zgodna z zaproponowanym wyjaśnieniem opartym na zgodności roli. Dowody wspierają kontekstową moderację powiązania z profesjonalizmem, jednak nie wykazują one statystycznie asymetrycznych mechanizmów kontekstowych ani niezmienności w ścieżce obecności społecznej.
Wyniki EEG dostarczają eksploracyjnej perspektywy na poziomie procesowym. Oświadczenia sformułowane przez ekspertów wiązały się z wyraźnymi wzorcami w paśmie theta, jednak warunki różniły się również pod względem treści semantycznej i złożoności, a zachowania na poziomie warunków nie wykazały wiarygodnych różnic w poziomie zaufania. Pomiary EEG nie ustanawiają zatem odrębnego mechanizmu kontroli poznawczej lub zaufania. Wyniki neuronalne należy traktować jako generujące hipotezy. W badaniu 2 nie manipulowano kontekstem zadania, nie mierzono postrzeganego profesjonalizmu ani obecności społecznej i nie powiązano wskaźników EEG na poziomie prób z ocenami zaufania; wyniki EEG uzupełniają zatem, a nie walidują, warunkowy model pośredni.
Wyniki są zgodne z poleganiem odpowiednim, a nie maksymalnym. Poleganie na systemie automatycznym powinno być skalibrowane do możliwości systemu, jego ograniczeń oraz wymagań zadania35. Powiązane prace opisują adaptacyjne mechanizmy poznawcze, które mogą wspierać skalibrowane zaufanie i poleganie51. Perspektywa NeuroIS wspiera wykorzystanie miar neuronalnych jako uzupełnienia dowodów behawioralnych podczas badania procesów o wysokiej rozdzielczości czasowej52. Wcześniejsze badania fMRI wykazują również, że aktywność neuronalna podczas ocen zaufania w czasie rzeczywistym różni się w zależności od celów i kontekstów53.
Implikacje zarządcze
W przypadku internetowych platform medycznych praktycznym wnioskiem jest kalibrowane zaufanie, a nie prosta maksymalizacja wiary w system. Sygnały dotyczące roli powinny być dostosowane do wymagań zadania i połączone z komunikowaniem niepewności, wyraźnym określeniem granic możliwości, ostrzeżeniami opartymi na ryzyku oraz procedurą przekazywania sprawy do wykwalifikowanych klinicystów.
W modułach o wysokim stopniu ryzyka, obejmujących diagnostykę, interpretację nieprawidłowych wyników, porady medyczne lub triaż, wskazówki zorientowane na kompetencje mogą pomóc użytkownikom w rozpoznaniu granic dowodów i działań, nie nadając jednocześnie nieuzasadnionego autorytetu. W modułach o niższym stopniu pilności, takich jak dieta, ćwiczenia fizyczne, sen, przestrzeganie zaleceń i wsparcie emocjonalne, wskazówki zorientowane na relacje mogą wspierać zaangażowanie, nie wywołując fałszywego poczucia bezpieczeństwa ani niewłaściwej antropomorfizacji.
Projektowanie ról powinno być modułowe i oparte na scenariuszach, a nie na ustalonych ustawieniach osobowości. Konfiguracja roli powinna być zintegrowana z objaśnieniami, monitami dotyczącymi prywatności, etykietami ryzyka i mechanizmami eskalacji. Badania nad ładem zarządzania podkreślają, że przejrzystość, odpowiedzialność, zarządzanie stronniczością i prywatność muszą być projektowane wspólnie, aby wiarygodne wskazówki dotyczące roli w interfejsie front-endowym nie maskowały ryzyk w warstwie back-endowej6,20,21.
Ograniczenia badawcze i kierunki przyszłych badań
Badanie 1 jest eksperymentem scenariuszowym, a nie rzeczywistą konsultacją. Warunki nie zostały niezależnie wstępnie przetestowane pod kątem długości, częstotliwości słów, czytelności, dokładności, możliwości zastosowania, walencji emocjonalnej, pobudzenia, ryzyka, znaneści lub złożoności. Przyszłe badania powinny wykorzystywać wiele scenariuszy, neutralne nazwy systemów, bodźce dopasowane pod względem treści, niezależną manipulację lub pomiary oddzielone w czasie, a także efekty losowe na poziomie uczestnika i bodźca.
Badanie 2 dostarczyło dowodów EEG na poziomie procesów, jednak końcowe powiązanie demograficzne dla 39 osób było niepełne, stwierdzenia EEG nie zostały niezależnie dopasowane ani wstępnie przetestowane pod kątem długości zdań, częstotliwości słów, czytelności, walencji emocjonalnej, pobudzenia, postrzeganego ryzyka, znajomości i złożoności, a jawne etykiety ról mogły wywołać charakterystykę zapotrzebowania. W niniejszym badaniu wykorzystano skorygowaną o poziom bazowy wartość blokowania fazy (ΔPLV) jako zdefiniowaną miarę łączności funkcjonalnej. Choć ważony indeks przesunięcia fazowego (wPLI) jest mniej wrażliwy na przewodnictwo objętościowe, nie został on uwzględniony w pierwotnym schemacie analizy. Przyszłe badania powinny sprawdzić, czy obecne wyniki zostaną powtórzone przy użyciu wPLI lub innych uzupełniających miar łączności. Dostępne wyniki neuronalne są zagregowane według warunków i nie mogą być powiązane z ocenami zaufania na poziomie pojedynczych prób; w związku z tym nie oszacowano mieszanego modelu EEG-zachowanie na poziomie prób. PLV ze skalpu jest również wrażliwe na efekty wspólnej referencji i przewodnictwa objętościowego. Ograniczenia te oznaczają, że wyniki neuronalne powinny pozostać charakterem eksploracyjnym i nie powinny być interpretowane jako dowód na istnienie unikalnego mechanizmu kontroli poznawczej lub zaufania.
Oświadczenia
Autorzy nie deklarują żadnych konfliktów interesów.
Podczas przygotowywania niniejszej pracy autorzy wykorzystali ChatGPT w celu poprawy języka. Po skorzystaniu z tego narzędzia/usługi autorzy sprawdzili i w razie potrzeby zredagowali treść i biorą pełną odpowiedzialność za zawartość publikacji.
Podziękowania
Niniejszy projekt badawczy został wsparty przez National Social Sciences Funded General Projects, PRC (grant nr 22BGL006).
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Platforma do ankiet online Credamo | Credamo (Jianshu), China | Nie dotyczy | Platforma do ankiet online, randomizacji i rekrutacji uczestników wykorzystana w Badaniu 1. |
| Funkcja ponownego referencjonowania CURRY | Compumedics Neuroscan, USA | Wersja nieokreślona | Wbudowane offline'owe ponowne referencjonowanie z referencji online FCz na średnią z obustronnych wyrostków sutkowatych; FCz został automatycznie zrekonstruowany względem nowej referencji. |
| Czapka z elektrodami EEG, 64-kanałowa | Compumedics Neuroscan (Compumedics Limited), Australia | Model/numer katalogowy nieokreślony | 64-kanałowa czapka z elektrodami Ag/AgCl wykorzystana do ciągłego zapisu EEG. |
| EEGLAB | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Wersja 2023.0 | Narzędzia MATLAB wykorzystane do wstępnego przetwarzania EEG i analizy składowych niezależnych. |
| E-Prime | Psychology Software Tools, Inc., USA | Wersja 2.1 | Prezentacja bodźców i zbieranie reakcji w Badaniu 2. |
| G*Power | Heinrich Heine University Dusseldorf, Germany | Wersja 3.1.9.7 | Pierwotne obliczenia a priori wielkości próby, analiza wrażliwości interakcji oraz analiza mocy post hoc w oparciu o model dla Badania 1. |
| IBM SPSS Statistics | IBM Corp., USA | Wersja 27 | Środowisko statystyczne wykorzystane do uruchomienia makra PROCESS. |
| ICLabel | Swartz Center for Computational Neuroscience, University of California San Diego, USA | Wersja 1.7 | Wtyczka do EEGLAB wykorzystana do klasyfikacji artefaktowych składowych niezależnych. |
| MATLAB | The MathWorks, Inc., USA | Release R2020b | Środowisko obliczeniowe wykorzystane do przetwarzania i analizy EEG. |
| Makra PROCESS dla SPSS | Andrew F. Hayes, Canada | Wersja 4.2 beta | Model 7 z postrzeganym profesjonalizmem i obecnością społeczną wprowadzonymi jednocześnie jako mediatory równoległe, przy użyciu 5 000 procentylowych prób bootstrap w Badaniu 1. |
| Przewodzący żel elektrolityczny Quik-Gel | Compumedics Neuroscan (Compumedics Limited), Australia | Numer katalogowy nieokreślony; 32 oz | Żel przewodzący wykorzystany do redukcji impedancji elektroda-skóra podczas zapisu EEG. |
| Wzmacniacz EEG SynAmps2 | Compumedics Neuroscan (Compumedics Limited), Australia | SynAmps2; numer katalogowy nieokreślony | Wzmacniacz EEG 64-256-kanałowy skonfigurowany do zapisu 64-kanałowego. |
Bibliografia
- Grand View Research. Artificial intelligence in healthcare market size & share, industry report, 2033 [Internet]. Grand View Research; [cited 2026 Jul 11]. Available from: https://www.grandviewresearch.com/industry-analysis/artificial-intelligence-ai-healthcare-market
- Singhal K, et al. Large language models encode clinical knowledge. Nature. 2023;620(7972):172-80.
- Laranjo L, et al. Conversational agents in healthcare: a systematic review. J Am Med Inform Assoc. 2018;25(9):1248-58.
- Kouzy R, Hong JC, Bitterman DS. One shot at trust: building credible evidence for medical artificial intelligence. Lancet Digit Health. 2025;7(7):100883.
- Kim C, Gadgil SU, Lee SI. Transparency of medical artificial intelligence systems. Nat Rev Bioeng. 2026;4(1):11-29.
- Bian X, Chen Y, Yang A. Configuring trust in AI-augmented healthcare: the role of AI interpretability and data privacy in patient adoption of AI-assisted diagnosis. Int J Inf Manage. 2026;88:103039.
- Longoni C, Bonezzi A, Morewedge CK. Resistance to medical artificial intelligence. J Consum Res. 2019;46(4):629-50.
- Logg JM, Minson JA, Moore DA. Algorithm appreciation: people prefer algorithmic to human judgment. Organ Behav Hum Decis Process. 2019;151:90-103.
- Qin H, et al. Examining the impact of personalization and carefulness in AI-generated health advice: trust, adoption, and insights in online healthcare consultations experiments. Technol Soc. 2024;79:102726.
- Mayer CJ, et al. User preferences and trust in hypothetical analog, digitalized and AI-based medical consultation scenarios: an online discrete choice survey. Comput Human Behav. 2024;161:108419.
- Du G, Zhou C, Cheng X. Reducing consumers’ resistance to AI agents in online healthcare consultations: the role of human-AI teaming from a trust transfer perspective. J Bus Res. 2026;206:115959.
- Fiske ST, Cuddy AJC, Glick P, Xu J. A model of often mixed stereotype content: competence and warmth respectively follow from perceived status and competition. J Pers Soc Psychol. 2002;82(6):878-902.
- Araujo T. Living up to the chatbot hype: the influence of anthropomorphic design cues and communicative agency framing on conversational agent and company perceptions. Comput Human Behav. 2018;85:183-9.
- Zhang J, Luximon Y, Li Q. Seeking medical advice in mobile applications: how social cue design and privacy concerns influence trust and behavioral intention in impersonal patient-physician interactions. Comput Human Behav. 2022;130:107178.
- Li Q, Luximon Y, Zhang J. The influence of anthropomorphic cues on patients’ perceived anthropomorphism, social presence, trust building, and acceptance of health care conversational agents: within-subject web-based experiment. J Med Internet Res. 2023;25:e44479.
- Harris-Watson AM, et al. Social perception in human-AI teams: warmth and competence predict receptivity to AI teammates. Comput Human Behav. 2023;145:107765.
- Schelble BG, et al. Addressing the role of context on trust in human-AI teams: the influence of team role and violation type in high-risk tasks. Ergonomics. 2025. doi:10.1080/00140139.2025.2570300.
- Mou Y, Ye X, Ma W. Building and repairing trust in chatbots: the interplay between social role and performance during interactions. Behav Sci (Basel). 2026;16(1):118.
- Glikson E, Woolley AW. Human trust in artificial intelligence: review of empirical research. Acad Manage Ann. 2020;14(2):627-60.
- Luo Y, Li S, Ye Q, Zheng J. How privacy calculus builds user engagement through trust in AI medical consultation. Electron Mark. 2025;35(1):50.
- Nouis SCE, Uren V, Jariwala S. Evaluating accountability, transparency, and bias in AI-assisted healthcare decision-making: a qualitative study of healthcare professionals’ perspectives in the UK. BMC Med Ethics. 2025;26(1):89.
- Eagly AH, Karau SJ. Role congruity theory of prejudice toward female leaders. Psychol Rev. 2002;109(3):573-98.
- Laï MC, Brian M, Mamzer MF. Perceptions of artificial intelligence in healthcare: findings from a qualitative survey study among actors in France. J Transl Med. 2020;18(1):14.
- Feine J, Gnewuch U, Morana S, Maedche A. A taxonomy of social cues for conversational agents. Int J Hum Comput Stud. 2019;132:138-61.
- Mayer RC, Davis JH, Schoorman FD. An integrative model of organizational trust. Acad Manage Rev. 1995;20(3):709-34.
- Nass C, Moon Y. Machines and mindlessness: social responses to computers. J Soc Issues. 2000;56(1):81-103.
- Epley N, Waytz A, Cacioppo JT. On seeing human: a three-factor theory of anthropomorphism. Psychol Rev. 2007;114(4):864-86.
- McAllister DJ. Affect- and cognition-based trust as foundations for interpersonal cooperation in organizations. Acad Manage J. 1995;38(1):24-59.
- McKnight DH, Choudhury V, Kacmar C. Developing and validating trust measures for e-commerce: an integrative typology. Inf Syst Res. 2002;13(3):334-59.
- Johnson D, Grayson K. Cognitive and affective trust in service relationships. J Bus Res. 2005;58(4):500-7.
- Bussone A, Stumpf S, O’Sullivan D. The role of explanations on trust and reliance in clinical decision support systems [conference paper]. Presented at: 2015 International Conference on Healthcare Informatics; 2015. p. 160-9. doi:10.1109/ICHI.2015.26.
- Li Y, Chen L, Fu L. Vicarious interaction in online health consultation service: the effects of generative AI’s anthropomorphism and social support on intended responses through social presence and source credibility. Int J Hum Comput Interact. 2025;41(17):11209-26.
- Short J, Williams E, Christie B. The social psychology of telecommunications. John Wiley & Sons; London; 1976.
- Gefen D, Straub DW. Consumer trust in B2C e-commerce and the importance of social presence: experiments in e-products and e-services. Omega. 2004;32(6):407-24.
- Lee JD, See KA. Trust in automation: designing for appropriate reliance. Hum Factors. 2004;46(1):50-80.
- Goodhue DL, Thompson RL. Task-technology fit and individual performance. MIS Q. 1995;19(2):213-36.
- Castelo N, Bos MW, Lehmann DR. Task-dependent algorithm aversion. J Mark Res. 2019;56(5):809-25.
- Parsons CS, et al. Task-technology fit of artificial intelligence-based clinical decision support systems: a review of qualitative studies. BMC Med Inform Decis Mak. 2025;25(1):397.
- Wutz M, Hermes M, Winter V, Köberlein-Neu J. Factors influencing the acceptability, acceptance, and adoption of conversational agents in health care: integrative review. J Med Internet Res. 2023;25:e46548.
- Faul F, Erdfelder E, Lang AG, Buchner A. G*Power 3: a flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behav Res Methods. 2007;39(2):175-91.
- Tadros FJ, et al. Perceived professionalism of a dietitian is not influenced by attire or white coat: a prospective, randomized online study. Top Clin Nutr. 2021;36(3):231-41.
- Shams G, Kim KK, Kim K. Enhancing service recovery satisfaction with chatbots: the role of humor and informal language. Int J Hosp Manag. 2024;120:103782.
- Hayes AF. Introduction to mediation, moderation, and conditional process analysis: a regression-based approach. 3rd ed. Guilford Press; New York; 2022.
- Delorme A, Makeig S. EEGLAB: an open source toolbox for analysis of single-trial EEG dynamics including independent component analysis. J Neurosci Methods. 2004;134(1):9-21.
- Pion-Tonachini L, Kreutz-Delgado K, Makeig S. ICLabel: an automated electroencephalographic independent component classifier, dataset, and website. Neuroimage. 2019;198:181-97.
- Cavanagh JF, Frank MJ. Frontal theta as a mechanism for cognitive control. Trends Cogn Sci. 2014;18(8):414-21.
- Buzzell GA, et al. Adolescent cognitive control, theta oscillations, and social observation. Neuroimage. 2019;198:13-30.
- Cavanagh JF, Cohen MX, Allen JJB. Prelude to and resolution of an error: EEG phase synchrony reveals cognitive control dynamics during action monitoring. J Neurosci. 2009;29(1):98-105.
- Dietvorst BJ, Simmons JP, Massey C. Algorithm aversion: people erroneously avoid algorithms after seeing them err. J Exp Psychol Gen. 2015;144(1):114-26.
- Jussupow E, Benbasat I, Heinzl A. An integrative perspective on algorithm aversion and appreciation in decision-making. MIS Q. 2024;48(4):1575-90.
- Lebiere C, Blaha L, Fallon C, Jefferson BA. Adaptive cognitive mechanisms to maintain calibrated trust and reliance in automation. Front Robot AI. 2021;8:652776.
- Dimoka A, et al. On the use of neurophysiological tools in IS research: developing a research agenda for NeuroIS. MIS Q. 2012;36(3):679-702.
- Riedl R, Hubert M, Kenning P. Are there neural gender differences in online trust? An fMRI study on the perceived trustworthiness of eBay offers. MIS Q. 2010;34(2):397-428.