Niniejsze badanie obliczeniowe przedstawia uwzględniający przedziały anatomiczne (compartment-aware) schemat postępowania służący do walidacji publicznych transkryptomów wirusów oddechowych, wykazując, że odpowiedzi gospodarza w nosie i krwi wykazują ograniczoną zgodność na poziomie genów, ale generują powtarzalne, biologicznie interpretowalne moduły specyficzne dla danego przedziału w niezależnych zestawach danych, porównaniach klinicznych, analizach regeneracji podłużnej oraz analizach odporności.
Artykuł badawczy
Analiza porównawcza transkryptomów wirusów oddechowych z uwzględnieniem przedziałów tkankowych dla modułów odpowiedzi gospodarza w nosie i krwi: badanie obliczeniowe
W tym artykule
Podsumowanie
Streszczenie
Publiczne transkryptomy wirusów oddechowych są cenne w badaniu odpowiedzi gospodarza, jednak różnice w źródle tkanki, definicji kontroli i projekcie badania mogą zakłócać analizy zbiorcze. Opracowaliśmy uwzględniający przedziały anatomiczne (compartment-aware) przepływ obliczeniowy, aby ustalić, czy można zidentyfikować powtarzalną aktywność odpowiedzi gospodarza przy zachowaniu biologicznego kontekstu nosa i krwi. Parowana kohorta pediatryczna GSE117827 posłużyła jako zbiór danych kotwiczący, obejmujący transkryptomy z wymazów z nosa i krwi pełnej w przypadkach objawowego zakażenia picornawirusami, objawowego zakażenia wirusem syncytialnym układu oddechowego, bezobjawowego wykrycia picornawirusów oraz kontroli negatywnych pod kątem wirusów. Po filtrowaniu zgodnie z wytycznymi HUGO Gene Nomenclature Committee (HGNC) przeanalizowano 27 685 genów. Na podstawie najsilniejszych dodatnich odpowiedzi zdefiniowano oddzielne, 50-genowe moduły kodujące białka dla nosa i krwi, które zablokowano przed ewaluacją zewnętrzną. Efekty na poziomie genów dla nosa i krwi były niemal niezależne (Pearson r = 0,015), a moduły dzieliły sześć genów o nakładającej się randze w analizie eksploracyjnej (indeks Jaccarda = 0,064). Niemniej jednak moduł nosowy oddzielił zakażenia od kontroli w niezależnych kohortach górnych dróg oddechowych, osiągając wartości powierzchni pod krzywą charakterystyki operacyjnej odbiornika (AUROC) wynoszące 0,749, 0,693 i 0,609, podczas gdy moduł krwi osiągnął AUROC na poziomie 0,832, 0,924 i 0,870 w zewnętrznych kohortach krwi. W podłużnych danych z naturalnych zakażeń dopasowane wyniki spadały od fazy ostrej choroby do momentu wypisu, przy parowanych deltach wynoszących 0,436 dla próbek z nosa i 0,330 dla krwi. Trzy dodatkowe zestawy danych referencyjnych obejmujące 666 zewnętrznych próbek, wraz z grupami kontrolnymi genów losowych, analizami zakresu wielkości modułów, stabilnością bootstrapową, korelacjami programów markerowych oraz podziałem wariancji, określiły solidność i ograniczenia przepływu obliczeniowego. Zestaw 33 mRNA (kwasu rybonukleinowego posłańca) Pandyi pozostał silniejszy w różnicowaniu zakażeń wirusowych od bakteryjnych, podczas gdy moduł krwi wykazywał również wzrost w przebiegu bakteryjnego zapalenia płuc. Wyniki te wspierają wykorzystanie modułów specyficznych dla przedziału anatomicznego jako reużywalnych wyników aktywności odpowiedzi gospodarza do porównywania kohort i monitorowania rekonwalescencji, a nie jako uniwersalnych biomarkerów pan-tkankowych lub samodzielnych klasyfikatorów patogenów.
Wprowadzenie
Sygnatury transkrypcyjne gospodarza są powszechnie wykorzystywane do klasyfikacji zespołów zakaźnych i porównywania odpowiedzi immunologicznych na różne patogeny1,2,3,4,5. Wirusy układu oddechowego często aktywują nakładające się geny stymulowane interferonem (ISGs), mediatory zapalne oraz szlaki prezentacji antygenów6,7,8,9,10. Niedawne badania parowane i podłużne pokazują również, że lokalne odpowiedzi w drogach oddechowych i odpowiedzi systemowe mogą różnić się pod względem czasu wystąpienia, składu komórkowego oraz nasilenia11. Kwestia ta wykracza poza wirusa grypy, wirusa RSV, rynowirusy i SARS-CoV-2. Ludzki metapneumowirus pozostaje istotną przyczyną chorób układu oddechowego, jednak literatura dotycząca odpowiedzi gospodarza i interwencji terapeutycznych w jego przypadku wciąż powstaje12,13. Obserwacje te, obejmujące infekcje wirusami układu oddechowego, dodatkowo podkreślają różnice między lokalną odpowiedzią w drogach oddechowych a systemową odpowiedzią gospodarza14. W przypadku obliczeniowych badań nad interakcjami gospodarz-wirus praktycznym pytaniem nie jest zatem tylko to, czy odpowiedź występuje. Pytaniem jest to, czy publiczne dane mogą zostać ponownie wykorzystane za pomocą przejrzystego przepływu pracy (workflow), który zachowuje kontekst tkankowy i pozwala na uzyskanie reprodukowalnych wyników odpowiedzi gospodarza.
Większość publicznych zbiorów danych transkryptomicznych wirusów oddechowych nie została zaprojektowana z myślą o czystej inferencji międzywirusowej lub międzytkankowej. Źródło tkanki, czas pobrania, stopień nasilenia choroby, wiek, definicja grupy kontrolnej i platforma często zmieniają się jednocześnie. Wysokoprzepustowe zbiory danych ekspresyjnych są również podatne na niepożądane zmienności techniczne i na poziomie badania15,16. W związku z tym analiza połączona może wykazać silną sygnaturę interferonową lub zapalną, jednocześnie maskując jej pochodzenie. Próbki z nosa odzwierciedlają biologię odpornościową nabłonka i błon śluzowych, podczas gdy krew pełna odzwierciedla systemowe odpowiedzi leukocytów. Traktowanie tych przedziałów jako wymiennych sprawia, że wynik jest łatwy do obliczenia, ale trudny do zinterpretowania.
Analizę opracowaliśmy w oparciu o GSE117827, kohortę par nos-krew z tego samego badania, zamiast korzystać z największego dostępnego zbioru odkrywczego17. Kohorta ta jest mała, ale pozwala zredukować zakłócenia międzybadawcze podczas porównywania wielkości efektów w nosie i krwi. Obejmuje ona objawowe zakażenia picornawirusami, objawowe zakażenia RSV, bezobjawowe wykrycie picornawirusów oraz kontrole negatywne pod kątem obecności wirusów. Użyliśmy jej zatem jedynie jako punktu odniesienia dla oddzielnych modułów specyficznych dla poszczególnych przedziałów. Przynależność do modułów została ustalona przed testowaniem zewnętrznym. Stabilność selekcji w małej kohorcie zbadano za pomocą warstwowego bootstrapowania (resampling), analizy zerowej dla losowych genów oraz analizy wrażliwości na wielkość modułu.
Dodaliśmy warstwę referencyjną z komparatorami bakteryjnymi i niezakaźnymi. Zbiór GSE63990 zawiera próbki krwi pełnej pobrane od pacjentów z ostrymi chorobami dróg oddechowych, zakwalifikowane jako wirusowe, bakteryjne lub niezakaźne18. Zbiór GSE40012 zawiera próbki od osób z ciężkim, pozpitalnym zapaleniem płuc, zespołem ogólnoustrojowej reakcji zapalnej (SIRS) oraz od zdrowych osób kontrolnych19. Kohorty te pozwalają sprawdzić, czy dany moduł odzwierciedla ogólną aktywność odpowiedzi gospodarza, czy też specyficzność dla klasy patogenów. Zbiór GSE53543 został przeanalizowany oddzielnie jako benchmark zaburzeń wywołanych rynowirusami w mononuklearnych komórkach krwi obwodowej (PBMC) ex vivo. Mierzy on reaktywność leukocytów pod wpływem kontrolowanego bodźca, jednak nie jest on równoważny naturalnej infekcji.
Nasze założenie jest celowo konserwatywne. Nie próbujemy udowodnić istnienia uniwersalnego sygnatury przeciwwirusowej na podstawie heterogenicznych danych publicznych. Zamiast tego sprawdzamy, czy przepływ pracy uwzględniający przedziały anatomiczne może wygenerować wyniki modułów, które pozostaną użyteczne po testach zewnętrznych. Przewidziane zastosowanie jest uzupełniające dla klasyfikatorów diagnostycznych, takich jak Pandya 33-mRNA. Moduły te oceniają aktywność odpowiedzi gospodarza w nosie i krwi w różnych kohortach, etapach powrotu do zdrowia i gradientach objawów. Nie są one przeznaczone do przypisywania klasy patogenu.
Protokół
W niniejszym badaniu dokonano ponownej analizy zanonimizowanych, ogólnodostępnych danych, co nie wiązało się z nowym naborem uczestników, interwencją ani pobieraniem próbek. W związku z powyższym, dla niniejszej analizy wtórnej nie było wymagane uzyskanie zgody komisji etyki instytucjonalnej ani nowej świadomej zgody uczestników. Zgoda komisji etycznej oraz świadoma zgoda dla badań pierwotnych zostały zgłoszone przez odpowiednich autorów danych.
Projekt badania i logika przepływu pracy
Przeprowadziliśmy retrospektywne bioinformatyczne badanie oparte na publicznych danych, wykorzystując zbiory danych zdeponowane w bazie Gene Expression Omnibus20,21. Nie generowano nowych próbek pacjentów, eksperymentów na hodowlach komórkowych, modeli zwierzęcych ani walidacji laboratoryjnej (wet-lab). Przepływ pracy oparto na projekcie z priorytetem dla kotwic (anchor-first design). Zbiór GSE117827 wykorzystano do szacowania wielkości efektu, konstrukcji modułów, oceny zgodności między przedziałami oraz analizy gradientu objawów. Niezależne zestawy danych wprowadzono dopiero po ustaleniu przynależności do modułów. Przepływ pracy obejmował kotwiczenie w parach przedziałów, mapowanie HGNC i filtrowanie białek kodujących, oddzielną konstrukcję modułów dla nosa i krwi, walidację z dopasowaniem tkankowym i podłużną, benchmarking kliniczny oraz analizy odpornościowe. Analizy potwierdzające obejmowały zablokowane testy z dopasowaniem tkankowym i testy podłużne. Analizy genów nakładających się, gradientu objawów, programów markerowych oraz analizy wariancji miały charakter eksploracyjny lub opisowy.
Kohorta zakotwiczenia i główny kontrast
Zbiór GSE117827 zawiera profile ekspresji z wymazów z nosa i krwi pełnej od 26 dzieci: 9 przypadków objawowego zakażenia pikornawirusami, 5 przypadków bezobjawowego wykrycia pikornawirusów, 6 przypadków objawowego zakażenia RSV oraz 6 bezobjawowych kontroli u których nie wykryto wirusów17. W dwóch przypadkach RSV brakowało próbek krwi. Zatem pełny projekt zakotwiczenia obejmował 50 próbek, a główny kontrast między grupą zakażoną a kontrolną zawierał 40 próbek po wykluczeniu bezobjawowych detekcji pikornawirusów z konstrukcji modułów. W głównym kontraście próbki z objawowym zakażeniem pikornawirusami oraz objawowym zakażeniem RSV oznaczono jako zakażone, natomiast bezobjawowe próbki u których nie wykryto wirusów oznaczono jako kontrole. Bezobjawowych detekcji pikornawirusów nie traktowano jako kontroli, ponieważ wykrycie wirusa bez objawów jest biologicznie odmienne od stanu zdrowia bez obecności wirusa. Próbki te pominięto podczas konstrukcji modułów, a następnie wykorzystano do analizy gradientu objawów.
Mapowanie sond i przetwarzanie wstępne
Zestaw GSE117827 został sprofilowany na platformie GPL23126. Identyfikatory klastrów transkrypcyjnych zmapowano na symbole genów, korzystając z pliku adnotacji Clariom D Human na36, hg38 udostępnionego przez platformę GEO GPL24539. Zachowano wyłącznie symbole zatwierdzone przez HGNC22. Usunięto sondy kontrolne, sondy ERCC, niezmapowane klastry transkrypcyjne oraz symbole niezatwierdzone. W przypadku wielu klastrów transkrypcyjnych mapujących na ten sam zatwierdzony symbol, dane scalono, obliczając medianę ekspresji. Po filtrowaniu i scalaniu do analizy kotwic dostępnych było 27 685 genów. Transformację log₂(x + 1) zastosowano tylko wtedy, gdy 95. percentyl macierzy ekspresji przekraczał 50, co wskazywało na niezalogarytmizowaną skalę intensywności. Geny z więcej niż 20% brakującymi wartościami zostały usunięte; pozostałe brakujące wartości zastąpiono medianą w obrębie danego genu. Następnie każdy gen został ustandaryzowany we wszystkich próbkach w danym zbiorze danych według wzoru z = (x − średnia)/odchylenie standardowe próbki (ddof = 1). Genom o zerowej wariancji przypisano ustandaryzowaną wartość 0. Konstrukcja modułów została ograniczona do wpisów sklasyfikowanych jako geny kodujące białka w kompletnym zbiorze HGNC.
Analiza wielkości efektu i konstrukcja modułów
Przedziały nosowe i krwi przeanalizowano oddzielnie. Próbki wirusowe objawowe porównano z kontrolami wirusowo ujemnymi, stosując standaryzowane różnice średnich Hedges g oraz dwustronne testy Welcha23. Wartość Hedges g obliczono jako różnicę średnich (grupa zakażona minus grupa kontrolna) podzieloną przez połączone odchylenie standardowe i pomnożoną przez poprawkę dla małych próbek 1 − 3/(4df − 1), gdzie df = nzakażone + nkontrolne − 2. Testy Welcha przeprowadzono przy założeniu nierówności wariancji. Współczynniki fałszywych odkryć Benjamini–Hochberga obliczono dla wszystkich badanych genów w obrębie każdego przedziału24. Ponieważ w małej kohorcie kotwic żadne geny kodujące białka nie spełniły wcześniej określonego rygorystycznego kryterium kombinowanego (FDR < 0,05 oraz Hedges g > 0,8), geny o dodatnim efekcie uszeregowano najpierw według rosnącej dwustronnej wartości P testu Welcha, a następnie według malejącej wartości Hedges g, stosując symbol genu jako ostateczny deterministyczny czynnik rozstrzygający przy identycznych wartościach. 50 najwyżej sklasyfikowanych genów utworzyło każdy główny moduł. Liczbę pięćdziesięciu genów wybrano a priori jako umiarkowaną wielkość modułu, która zachowuje szerokość biologiczną przy jednoczesnym ograniczeniu utraty danych z powodu brakujących genów pomiędzy platformami. Wielkość modułu nie była dostrajana do zewnętrznych wyników AUROC. Analizy czułości z wykorzystaniem 10, 25, 50, 100 i 200 genów przyniosły ten sam jakościowy wynik separacji kotwic. Celem była odtwarzalność na poziomie modułu, a nie identyfikacja pojedynczych genów.
Zgodność międzyprzedziałowa
Szacunki Hedgesa g dla nosa i krwi dopasowano według genów i porównano za pomocą korelacji Pearsona i Spearmana. Nakładanie się 50 najwyższych modułów dla nosa i 50 najwyższych dla krwi podsumowano za pomocą liczby wspólnych genów oraz indeksu Jaccarda. Geny nakładające się zinterpretowano jako eksploracyjne kandydaty do nakładania się rang międzyprzedziałowych, a nie jako zwalidowane, konserwatywne biomarkery.
Zewnętrzna walidacja z dopasowaniem do tkanki
Walidacja wyników modułów została przeprowadzona z wykorzystaniem niezależnych publicznych zbiorów danych z interpretowalnymi grupami źródłowymi. Walidacja dla górnych dróg oddechowych obejmowała próbki z płukania nosa RSV z zestawu GSE41374 oraz zbiory danych SARS-CoV-2 GSE152075 i GSE156063. Walidacja krwi obejmowała zbiór GSE171110 oraz dwie oddzielnie znormalizowane jednostki GSE38900: GPL10558 (36 próbek; 28 RSV i 8 kontrolnych) oraz GPL6884 (138 próbek; 107 RSV i 31 kontrolnych). Dla każdego zewnętrznego zbioru danych sondy zostały przypisane do symboli HGNC, a zdublowane symbole zostały scalone poprzez obliczenie średniej ekspresji. W obrębie każdego zbioru danych zastosowano te same reguły transformacji, filtrowania brakujących wartości, imputacji medianą oraz standaryzacji z> dla poszczególnych genów, które wykorzystano dla zbioru kotwiczącego. Wynik modułu obliczono jako nieważoną średnią zestandaryzowanych wartości ekspresji dla genów wchodzących w skład danego modułu. Wartości AUROC, średnia precyzja (average precision) oraz FDR z testu Welcha zostały podane jako mierniki przenośności, a nie jako szacunki klinicznej wydajności diagnostycznej.
Duże kliniczne zestawy referencyjne i zestawy danych z perturbacji ex vivo
Dwa zestawy danych z krwi pełnej zostały wykorzystane jako punkty odniesienia (benchmarks) kliniczne, a nie jako kohorty odkrywcze. W GSE63990 próbki przypisano na podstawie zdeponowanych metadanych stanu zakażenia do grupy wirusowych infekcji dróg oddechowych (n = 117), bakteryjnych infekcji dróg oddechowych (n = 73) lub chorób niezakaźnych (n = 90); próbki bez jednej z tych jednoznacznych etykiet zostały wykluczone18. W GSE40012 zdeponowane pola diagnostyczne zmapowano na zapalenie płuc wywołane wirusem grypy A (n = 39), bakteryjne zapalenie płuc bez grypy (n = 61), Zespół Odpowiedzi Systemowej na Zapalenie (SIRS) bez zapalenia płuc (n = 40), zdrowe kontrole (n = 36) lub mieszane bakteryjne/grypowe zapalenie płuc (n = 14)19. Próbki z mieszanym zapaleniem płuc bakteryjnym/grypowym zostały opisane, lecz wykluczono je z binarnych porównań referencyjnych.
Zbiór GSE53543 zawiera 196 profilów PBMC ex vivo pochodzących od 98 osób. Każda osoba dostarczyła jedną próbkę kontrolną (tylko medium) oraz jedną próbkę eksponowaną na rhinovirus 16 przez 24 h; identyfikatory badanych potwierdziły istnienie 98 pełnych par. Główny punkt odniesienia raportował AUROC dla 98 próbek stymulowanych i 98 próbek niestymulowanych, ponieważ AUROC jest miarą separacji rang. Parowanie pacjentów zachowano w metadanych i wykorzystano w sparowanej analizie czułości różnic w wynikach. Ten eksperyment był analizowany oddzielnie od naturalnych infekcji klinicznych i nie był wykorzystywany do wspierania roszczeń diagnostyki klinicznej.
Pobrano surowe macierze serii GEO dla GSE63990, GSE40012 oraz GSE53543. Dla GSE63990 zastosowano GPL571, dla GSE40012 GPL6947, a dla GSE53543 GPL10558. Sondy przypisano do symboli zatwierdzonych przez HGNC, a powtarzające się przypisania zredukowano poprzez obliczenie średniej ekspresji. Wykorzystano zdeponowane macierze znormalizowane. Ogólna zasada 95. percentyla spowodowała zastosowanie transformacji log₂(x + 1) wyłącznie dla macierzy w skali nielogarytmicznej. Zbiór GSE53543 został już poddany transformacji log₂, normalizacji niezależnej od rangi oraz korekcie ze względu na dzień przetwarzania przez pierwotnych badaczy, w związku z czym nie stosowano dodatkowej transformacji logarytmicznej. Po usunięciu genów z więcej niż 20% brakującymi wartościami i uzupełnieniu pozostałych braków wartością mediany, każdy gen został poddany standaryzacji z we wszystkich próbkach w obrębie danego zbioru danych. Warstwa referencyjna zawierała 470 klinicznych próbek krwi pełnej oraz 196 próbek PBMC ex vivo.
Walidacja sygnatury referencyjnej
Kotwiczne moduły nosowe i krwi zostały poddane walidacji w odniesieniu do trzech nieważonych zestawów referencyjnych. Oficjalny zestaw 33 mRNA według Pandyi został opracowany na podstawie uzupełniającej tabeli 1 z oryginalnego raportu klasyfikatora5. Komparator Andres-Terre obejmował 33 geny ukierunkowane na interferon, wyselekcjonowane z raportowanej sygnatury wielowirusowej3. Komparator Hallmark obejmował rdzenny podzbiór 33 genów interferonu alfa powiązany ze zbiorem MSigDB HALLMARK_INTERFERON_ALPHA_RESPONSE25,26. Pełne listy genów dla wszystkich trzech zestawów referencyjnych znajdują się w Supplementary Data 1. Wyniki referencyjne te nie odtwarzają oryginalnych klasyfikatorów ważonych. Dla każdego zbioru danych obliczono wynik jako nieważoną średnią dostępnych wyników z dla poszczególnych genów; wymagano obecności co najmniej trzech reprezentatywnych genów, a liczba reprezentowanych genów została odnotowana. Kontrasty walidacyjne obejmowały: wirusowe vs bakteryjne, wirusowe vs niezakaźne, wirusowe vs bakteryjne-lub-niezakaźne, wirusowe vs zdrowe/kontrolne oraz bakteryjne vs zdrowe/kontrolne, w zależności od dostępności wymaganych grup. Jako mierniki walidacyjne zinterpretowano AUROC oraz średnią precyzję. Wartości P z testu Welcha zostały skorygowane za pomocą procedury Benjamini–Hochberg dla wszystkich poprawnych kombinacji zbioru danych, kontrastu i modułu w tabeli walidacyjnej.
Niezależna walidacja podłużna
Sparowane zestawy danych z fazy ostrej i wypisu GSE97741 oraz GSE97742 zostały wykorzystane wyłącznie do walidacji podłużnej27. Próbki oznaczone w zdeponowanych metadanych jako pojedyncza infekcja RSV (RSVsi) lub rinowirus (hRV) stanowiły podstawę analizy; koinfekcje RSV (RSVco) zachowano jedynie w wynikach uzupełniających. Etykiety fazy ostrej i wypisu wyekstrahowano z nazw próbek. Próbki dopasowano według zestawu danych, przedziału, grupy wirusów i identyfikatora pacjenta, zachowując jedynie pacjentów z oboma punktami czasowymi. Główna grupa połączona składała się z 38 par RSVsi i 30 par hRV (68 par na przedział).
Do selekcji genów, doprecyzowania modułów ani dostrajania progów nie wykorzystano zbiorów GSE97741 ani GSE97742. Zbiory te zarezerwowano do walidacji zewnętrznej. Identyfikatory sond przypisano do zatwierdzonych symboli HGNC, a duplikaty symboli scalono poprzez obliczenie mediany ekspresji. Przed obliczeniem stałych wyników modułowych dla GSE117827 zastosowano tę samą zasadę transformacji logarytmicznej dla 95. percentyla, filtr wartości brakujących, imputację medianą oraz procedury standaryzacji z dla każdego genu w obrębie zbioru danych.
Dla każdej tkanki i modułu wyniki w fazie ostrej i w momencie wypisu zostały sparowane według obiektu i grupy wirusowej. Dla każdej pary obliczono różnicę między wynikiem w fazie ostrej a wynikiem w momencie wypisu. Wartość Cohen dz obliczono jako średnią różnicę sparowaną podzieloną przez odchylenie standardowe próby. Zgłoszono wyniki dwustronnych sparowanych testów t oraz dwustronnych testów znaków Wilcoxona, wraz z AUROC dla separacji wyników w fazie ostrej względem momentu wypisu. Wartości FDR według metody Benjamini–Hochberg obliczono dla wszystkich 20 prawidłowych sparowanych testów t w pełnych wynikach podłużnych (dwa zestawy danych, dwa źródła modułów i pięć z góry określonych podsumowań grup wirusowych).
Analiza gradientu objawów i analiza post-hoc
Po ustaleniu przynależności do modułów, wykrycia picornavirusu u osobników bezobjawowych w zbiorze GSE117827, które zostały wyłączone z analizy, wykorzystano wyłącznie do analizy gradientu objawów. Porządkowa ocena kliniczna wynosiła 0 dla kontroli ujemnych pod kątem wirusa, 1 dla bezobjawowych wykryć picornavirusu oraz 2 dla infekcji objawowej. Korelację Spearmana zastosowano do oceny trendu porządkowego, natomiast test Kruskala–Wallisa posłużył do oceny ogólnych różnic pomiędzy trzema grupami. Dwustronne testy post-hoc Mann–Whitneya U porównywały trzy pary grup. Korekcję Benjamini–Hochberga zastosowano oddzielnie w każdym przedziale dla rodziny trzech porównań parzystych.
Analiza wzbogacenia funkcjonalnego
Geny z modułów nosowych i krwi przeanalizowano za pomocą narzędzia Enrichr poprzez gseapy, korzystając z bibliotek MSigDB Hallmark 2020, Reactome 2022 oraz GO Biological Process 202325,26,28,29,30,31. Enrichr wykorzystał standardowy model nadreprezentacji oparty na dokładnym teście Fishera. Za istotne uznano zgłaszane przez biblioteki wartości P skorygowane metodą Benjamini–Hochberg < 0.05. Osiem najistotniejszych terminów dla każdego modułu z trzech analizowanych bibliotek uszeregowano według skorygowanej wartości P. Wyniki wzbogacenia wykorzystano wyłącznie do interpretacji.
Analizy odporności, programu markerów i wariancji
Analizy odporności miały na celu sprawdzenie, czy wyniki zależały od wielkości modułu lub przypadkowego doboru. Oceńiono moduły o wielkości 10, 25, 50, 100 i 200 genów. W analizie zerowej dla genów losowych uniwersum kwalifikowalnych genów obejmowało geny kodujące białka HGNC reprezentowane w przetworzonej macierzy GSE117827. Pobrano pięćset 50-genowych zestawów bez zwracania, używając ziarna losowości NumPy 20260622. Ponowny dobór metodą bootstrap ograniczono do 1000 genów kodujących białka o dodatnim efekcie, które zajęły najwyższe miejsca w oryginalnej analizie kotwic dla każdego przedziału. W każdej próbie geny kodujące białka o dodatnim efekcie uszeregowano według rosnącej dwustronnej wartości P testu Welcha, a następnie według malejącej różnicy średnich. Wybrano 50 najwyżej sklasyfikowanych genów. Stabilność genów obliczono jako liczbę wyborów podzieloną przez 100. Przedstawiono 20 genów o najwyższej częstotliwości wyboru w każdym przedziale.
Wyniki programów markerowych wykorzystano jako pomoce opisowe, a nie jako szacunki frakcji komórkowych. Przeanalizowano sześć wyselekcjonowanych programów: nabłonkowy (EPCAM, KRT8, KRT18, KRT19, MUC1, KRT5, KRT14, SCGB1A1, FOXJ1), monocytarny/makrofagiczny (LYZ, LST1, S100A8, S100A9, FCGR3A, FCGR1A, CD14, MS4A7, CTSS), neutrofilowy (S100A8, S100A9, MPO, ELANE, CEACAM8, FCGR3B, OLFM4, MMP8), T/NK (CD3D, CD3E, TRAC, NKG7, GNLY, PRF1, GZMB, KLRD1, IL7R), B/plazmatyczny (MS4A1, CD79A, CD79B, MZB1, JCHAIN, IGHG1, SDC1) oraz mieloidalny interferonowy (SIGLEC1, IFI27, IFI44L, ISG15, MX1, OAS1, RSAD2, IFIT3). Wynik każdego programu obliczono jako średnią dostępnych wartości z dla poszczególnych genów, przy wymaganiu obecności co najmniej trzech reprezentatywnych genów. Wartości P testu Spearmana skorygowano za pomocą procedury Benjamini–Hochberg dla pełnej rodziny korelacji zbiór danych–moduł–program. Jednoczynnikowe eta-kwadrat obliczono jako sumę kwadratów międzygrupowych podzieloną przez całkowitą sumę kwadratów dla każdej pary moduł–czynnik. Wiersze, w których brakowało odpowiedniego czynnika, wykluczono z tych obliczeń. Analiza ta miała charakter opisowy i nie uwzględniała korekty dla czynników wzajemnie skorelowanych.
Powtarzalność
Wszystkie analizy przeprowadzono przy użyciu skryptowych przepływów pracy w języku Python 3.12.13, z wykorzystaniem pakietów oprogramowania i wersji podanych w Tabeli materiałów. W procedurach randomizowanych zastosowano stałe ziarno (seed) o wartości 20260622. Publiczne macierze ekspresji z bazy GEO przetwarzano przy użyciu spójnej struktury projektu, która rozdzielała surowe dane wejściowe, dane przetworzone, wyniki statystyczne, tabele i ryciny. Definicje modułów, rekordy kurateli próbek, szacunki wielkości efektu, statystyki walidacyjne, wyniki wzbogacenia, analizy odporności oraz dane źródłowe rycin zostały zachowane w celu umożliwienia niezależnej weryfikacji. Kod analityczny, specyfikacje zależności oraz wspierające pochodne dane są dostępne zgodnie z opisem w oświadczeniu o dostępności danych.
Wyniki
Benchmarking z wykorzystaniem kroków kotwiczących (anchor-step) oddzielił efekty genów specyficznych dla tkanek od efektów ogólnotkankowych
Opracowana macierz kotwicząca GSE17827 zawierała 27 685 genów zatwierdzonych przez HGNC. Główny kontrast dla nosa obejmował 15 próbek od osób zakażonych objawowo i 6 próbek kontrolnych ujemnych pod kątem obecności wirusa; kontrast dla krwi obejmował 13 próbek od osób zakażonych objawowo i 6 próbek kontrolnych (Tabela 1). Ponieważ ta niewielka kohorta nie może zapewnić stabilnego wykrywania pojedynczych genów, została ona wykorzystana jako kotwica dla par przedziałów. Stabilność oceniono na poziomie modułów za pomocą resamplingu bootstrapowego, testów zerowych dla genów losowych, walidacji zewnętrznej oraz analizy wrażliwości na wielkość modułu.
| [Proszę wprowadzić tekst źródłowy do tłumaczenia] | Grupa | Warunek | Kontrast pierwotny | n |
| Krew | RSV | Zainfekowany | Tak | 4 |
| Krew | Bezoobjawowy picornawirus | Wtórny | Nie | 5 |
| Krew | Symptomatyczny pikornawirus | Zainfekowane | Tak | 9 |
| Krew | Kontrola negatywna bez wirusa | Kontrola | Tak | 6 |
| Nosowy | RSV | Zainfekowany | Tak | 6 |
| Nosowy | bezoobjawowy picornawirus | Wtórny | Nie | 5 |
| Nosowy | Objawowe picornawirusy | Zainfekowane | Tak | 9 |
| Nosowy | Kontrola negatywna wirusa | Kontrola | Tak | 6 |
Tabela 1: Projekt kotwic GSE17827 po kuracji głównego kontrastu. Rozkład próbek w przedziałach krwi i nosa w sparowanym zestawie kotwic po kuracji głównego kontrastu. Próbki z objawowym wirusem RSV (oddechowym syncytialnym) oraz objawowym picornawirusem sklasyfikowano jako zainfekowane i włączono do głównego kontrastu, natomiast kontrole ujemne pod kątem obecności wirusa sklasyfikowano jako kontrole i włączono do głównego kontrastu. Próbki z bezobjawowym picornawirusem wyznaczono jako wtórne i wykluczono z konstrukcji modułu; zostały one wykorzystane wyłącznie w eksploracyjnej analizie gradientu objawów. W dwóch przypadkach RSV brakowało próbek krwi, co poskutkowało uzyskaniem czterech próbek krwi i sześciu próbek z nosa dla RSV.
Wśród 27 685 wspólnych genów szacunki Hedges g dla nosa i krwi były niemal nieskorelowane (Pearson r = 0,015; Rysunek 1). Wynik ten uzyskano w ramach jednego badania, co czyni go mniej podatnym na różnice międzybadawcze niż połączone porównanie międzykohortowe. Gęsta centralna chmura wskazuje, że większość genów nie zmieniała się w podobny sposób w obu przedziałach. Wyróżnione geny wspólne stanowiły wyjątki, znajdując się na szczycie obu list rankingowych. Wzorzec ten uzasadnia oddzielną konstrukcję modułów dla nosa i krwi.
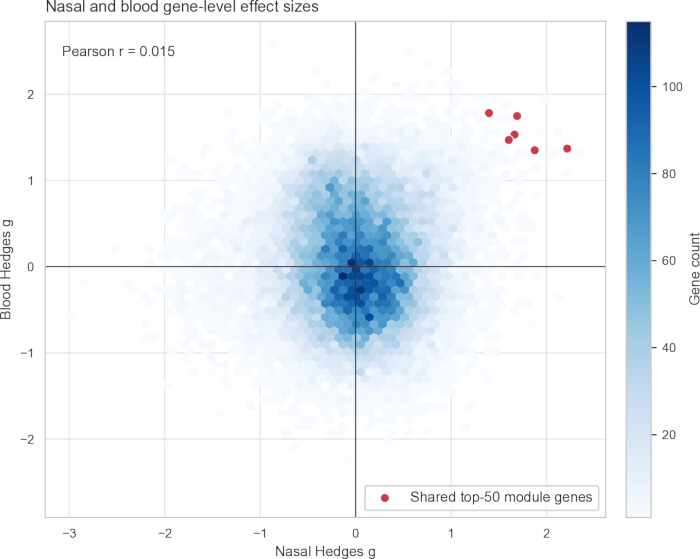
Rycina 1Wielkości efektu na poziomie genów w próbkach z nosa i krwi w sparowanej kohorcie kotwiczącej GSE17827. Żywopłoty g wartości porównują infekcję objawową z kontrolami negatywnymi pod kątem obecności wirusa dla 27 685 genów. Na osi x przedstawiono szacunki dla nosa (15 osób zakażonych, 6 kontroli), a na osi y szacunki dla krwi (13 osób zakażonych, 6 kontroli). Cieniowanie heksagonalne (hexagonal-bin shading) wskazuje liczbę genów w każdym przedziale. Czerwone punkty oznaczają sześć genów wspólnych dla 50 najważniejszych modułów nosa i krwi. Pearson Proszę podać tekst źródłowy do przetłumaczenia. = 0.015. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Konstrukcja modułów doprowadziła do niewielkiego pokrycia skupionego wokół interferonów
50 czołowych modułów nosowych i krwiowych współdzieliło sześć genów: ISG15, ACRBP, IFIT1, RSAD2, CCRL2 oraz XAF1 (indeks Jaccarda = 0,064; Tabela 2; Rysunek 2). ISG15, IFIT1, RSAD2 i XAF1 są zgodne z biologią przeciwwirusową powiązaną z interferonami32,3,34. CCRL2 należy interpretować raczej w kontekście zapalnej migracji leukocytów35. ACRBP nie posiada ustalonej roli przeciwwirusowej. Wszystkie sześć genów zgłoszono w celu zachowania przejrzystości, jednak żadnego z nich nie uznano za zwalidowany biomarker międzytkankowy. Wartości FDR dla pojedynczych genów nie były istotne w małej kohorcie zakotwiczającej. Główny wniosek opiera się zatem na zablokowanej walidacji na poziomie modułów, a nie na liście części wspólnych.
| Gen | Nasal Hedges g | Nasal FDR | Blood Hedges g | Blood FDR | Interpretacja |
| ISG15 | 2.215 | 0.213 | 1.369 | 0.42 | Gen przeciwwirusowy stymulowany interferonem; pokrycie eksploracyjne |
| ACRBP | 1.69 | 0.205 | 1.748 | 0.429 | Brak ustalonej roli przeciwwirusowej; zachowano dla przejrzystości |
| IFIT1 | 1.875 | 0.213 | 1.35 | 0.42 | Gen przeciwwirusowy stymulowany interferonem; pokrycie eksploracyjne |
| RSAD2 | 1.63 | 0.213 | 1.532 | 0.442 | Gen przeciwwirusowy stymulowany interferonem; pokrycie eksploracyjne |
| CCRL2 | 1.396 | 0.217 | 1.782 | 0.42 | Kontekst zapalnej migracji leukocytów; nieswoisty dla wirusów |
| XAF1 | 1.603 | 0.26 | 1.47 | 0.442 | Czynnik apoptozy powiązany z interferonem; pokrycie eksploracyjne |
Tabela 2: Pełny eksploracyjny nakład pomiędzy najwyżej sklasyfikowanymi modułami nosowymi i krwi. Wszystkie sześć wspólnych genów jest przedstawionych wraz z wartościami Hedges g dla nosa i krwi oraz wartościami FDR dla poszczególnych genów. Wszystkie sześć genów traktuje się jako eksploracyjne kandydaty do nakładu rankingowego, ponieważ wartości FDR dla poszczególnych genów nie były istotne w małej kohorcie zakotwiczającej. Gen ACRBP zachowano w celu zachowania przejrzystości, mimo braku potwierdzonej roli przeciwwirusowej. Żaden z sześciu genów nie jest prezentowany jako zwalidowany uniwersalny biomarker; główny dowód opiera się na zewnętrznej walidacji na poziomie modułów.
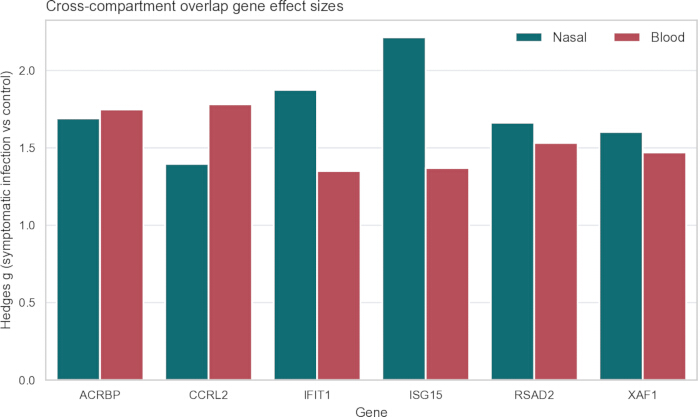
Rycina 2Wielkości efektu dla sześciu eksploracyjnie zidentyfikowanych genów wspólnych dla krwi i wydzieliny z nosa. Poziomy w nosie i we krwi g estymacje przedstawiono dla ACRBP, CCRL2, IFIT1, ISG15, RSAD2 oraz XAF1 w zbiorze GSE17827. Wartości dodatnie wskazują na wyższą ekspresję w infekcji objawowej niż w kontrolach negatywnych pod kątem obecności wirusa. Pełny zakres pokrycia przedstawiono w celu zachowania przejrzystości; wartości FDR dla pojedynczych genów nie były istotne, a geny te nie są prezentowane jako zwalidowane uniwersalne biomarkery. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Wzbogacenie funkcjonalne stanowiło biologiczną weryfikację zawartości modułów
Oba moduły były wzbogacone o szlaki interferonowe i przeciwwirusowe, choć skład genów i siła wzbogacenia różniły się od siebie (Rycina 3). Przedstawiono osiem najistotniejszych terminów dla każdego modułu. W przypadku modułu nosowego wśród wiodących terminów znalazły się: Hallmark interferon-gamma response (skorygowane P = 2,23 × 10⁻24), Hallmark interferon-alpha response (skorygowane P = 1,40 × 10⁻2), Reactome interferon-alpha/beta signalling (skorygowane P = 3,64 × 10⁻19) oraz GO defense response to virus (skorygowane P = 5,47 × 10⁻15). Moduł krwi wykazał tę samą ogólną charakterystykę biologiczną przy niższej sile wzbogacenia: interferon-alpha response (skorygowane P = 3,87 × 10⁻6), Reactome interferon-alpha/beta signaling (skorygowane P = 5,70 × 10⁻6), interferon-gamma response (skorygowane P = 8,89 × 10⁻6) oraz defense response to virus (skorygowane P = 1,07 × 10⁻4). Wyniki te potwierdzają spójność biologiczną, nie sugerując przy tym identycznego rankingu genów w poszczególnych przedziałach.
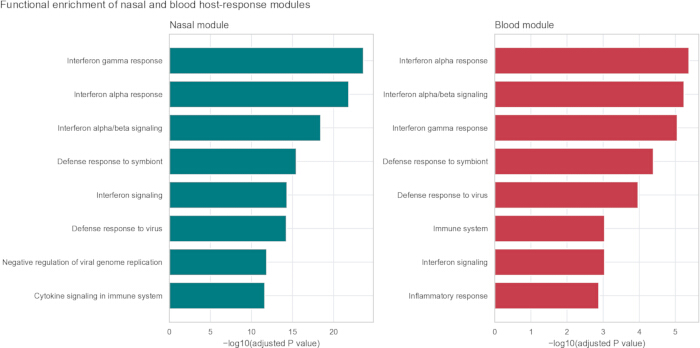
Rycina 3Wybrane terminy wzbogacenia dla modułów nosowych i krwi. Analizę nadreprezentacji przeprowadzono przy użyciu narzędzia Enrichr z wykorzystaniem baz Hallmark 2020, Reactome 202 oraz GO Biological Process 2023. Wybrano osiem terminów z najniższymi wartościami skorygowanymi metodą Benjamini–Hochberga P przedstawiono wartości dla każdego modułu. Długość słupka reprezentuje −log10(skorygowane) P wartość). Panele lewy i prawy przedstawiają odpowiednio moduły dotyczące nosa i krwi. Terminy wyświetlane są z wielkiej litery na początku zdania. Analiza wzbogacenia nie zmieniła przynależności do modułów. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Zablokowane moduły zostały przetestowane w zewnętrznej walidacji z dopasowaniem tkankowym
Zablokowany moduł nosowy osiągnął wartości AUROC wynoszące 0,749 w GSE41374, 0,693 w GSE152075 i 0,609 w GSE156063 (Tabela 3; Rycina 4). Zablokowany moduł krwi osiągnął wartości AUROC wynoszące 0,832 w GSE1710, 0,924 w jednostce GPL1058 w GSE3890 oraz 0,870 w jednostce GPL684. Wyniki wewnętrznych kotwic pominięto, ponieważ ze względu na sposób konstrukcji są one obciążone optymistycznie. Zewnętrzne wartości AUROC traktowane są jako podsumowania przenośności. Nie ustalają one czułości klinicznej, swoistości ani gotowości do diagnostyki.
| Kohorta | Próbka/wirus | Moduł | n dodatnie | n ujemne | Reprezentowane geny | AUROC | Średnia precyzja | Test Welcha FDR |
| GSE152075 | SARS-CoV-2 w górnych drogach oddechowych | Nosowy | 430 | 54 | 50 | 0.693 | 0.935 | 2,20 × 10⁻⁴ |
| GSE156063 | SARS-CoV-2 w górnych drogach oddechowych | Nosowy | 93 | 100 | 49 | 0.609 | 0.551 | 1,38 × 10⁻² |
| GSE1710 | krew pełna SARS-CoV-2 | Krew | 44 | 10 | 50 | 0.832 | 0.959 | 7,94 × 10⁻⁴ |
| GSE3890-GPL1058 | całkowita krew RSV | Krew | 28 | 8 | 50 | 0.924 | 0.979 | 7,94 × 10⁻⁴ |
| GSE3890-GPL6884 | całkowita krew RSV | Krew | 107 | 31 | 49 | 0.87 | 0.962 | 3,47 × 10⁻¹⁵ |
| GSE41374 | płukanie nosa w kierunku RSV | Nosowy | 76 | 10 | 50 | 0.749 | 0.951 | 2,63 × 10⁻² |
Tabela 3: Zewnętrzna walidacja wyników modułów z dopasowaniem tkanek. Zablokowany moduł nosowy został przetestowany w zbiorach GSE41374, GSE152075 i GSE156063, a zablokowany moduł krwi w zbiorze GSE1710 oraz jednostkach platformy GSE3890 GPL1058 i GPL684. Tabela przedstawia liczbę próbek pozytywnych i negatywnych, reprezentowane geny modułu, AUROC, średnią precyzję (average precision) oraz FDR testu Welcha. Pominięto wyniki wewnętrznych kotwic. AUROC oraz średnia precyzja są raportowane jako podsumowania przenaszalności, a nie jako szacunki wydajności diagnostyki klinicznej.
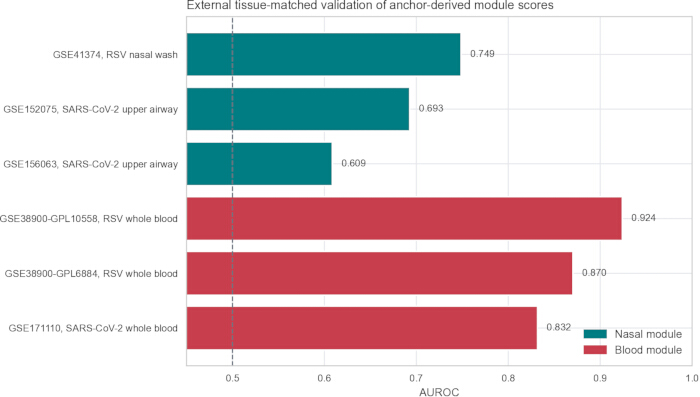
Rysunek 4Zewnętrzna przenośność wyników punktowych modułów dopasowanych do tkanek. Przedstawiono wartości AUROC dla modułu nosowego w zbiorach GSE41374 (76 RSV, 10 kontroli), GSE152075 (430 SARS-CoV-2, 54 kontroli) i GSE156063 (93 SARS-CoV-2, 10 kontroli) oraz dla modułu krwi w zbiorach GSE1710 (4 SARS-CoV-2, 10 kontroli), GSE3890-GPL1058 (28 RSV, 8 kontroli) i GSE3890-GPL684 (107 RSV, 31 kontroli). Wyniki stanowią nieważone średnie reprezentatywnych wartości z dla poszczególnych genów. Linia przerywana oznacza AUROC = 0,5. Wartości te są podsumowaniami przenaszalności, a nie szacunkami diagnostyki klinicznej. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Walidacja podłużna pozwoliła sprawdzić, czy wyniki ulegają obniżeniu podczas rekonwalescencji
Towarzyszące zestawy danych GSE9741/GSE9742 zapewniły niezależne środowisko walidacji dla naturalnych zakażeń, zawierające próbki z fazy ostrej oraz z momentu wypisu z szpitala pobrane od hospitalizowanych dzieci27. Próbki te nie były wykorzystywane jako dane odkrywcze dla grupy kontrolnej zdrowych osób. Służyły one do oceny, czy wyniki modułów pochodne od genów kotwic spadły od fazy ostrej choroby do momentu wypisu.
W przypadku wcześniej określonej grupy łączonej z pojedynczą infekcją RSV i rinowirusem, w każdej tkance przeanalizowano 68 par badanych (Tabela 4; Rycina 5). Moduł krwi uległ zmniejszeniu od fazy ostrej choroby do momentu wypisu z krwi (średni delta = 0.30; Cohen dz = 0.740; FDR testu sparowanego = 1.98 × 10⁻7; AUROC = 0.765). Moduł nosowy uległ również zmniejszeniu w próbkach z nosogardzieli (średni delta = 0.436; Cohen dz = 0.47; FDR testu sparowanego = 3.06 × 10⁻4; AUROC = 0.679). Sparowane trajektorie oraz ich błędy standardowe wskazują, że spadek na poziomie grupy nie był spowodowany kilkoma niesparowanymi wartościami ekstremalnymi.
| Zbiór danych | Próbka źródłowa | Moduł | Tkanka dopasowana | n par | Średnia różnica (delta) przy wypisie ostrym | Cohen dz | AUROC | FDR dla testów sparowanych |
| GSE97741 | Krew | Krew | Tak | 68 | 0.330 | 0.740 | 0.765 | 1,98 × 10⁻⁷ |
| GSE97741 | Krew | Nosowy | Nie | 68 | 0.479 | 0.721 | 0.755 | 3,19 × 10⁻⁷ |
| GSE97742 | nosogardzielny | Krew | Nie | 68 | 0.361 | 0.914 | 0.845 | 9,42 × 10⁻¹⁰ |
| GSE97742 | Nosogardzielny | Nosowy | Tak | 68 | 0.436 | 0.477 | 0.679 | 3,06 × 10⁻⁴ |
Tabela 4: Niezależna podłużna walidacja fazy ostrej względem fazy wypisu. Tabela przedstawia liczbę pełnych par, średnią różnicę wyników (faza ostra minus faza wypisu), współczynnik Cohen dz, AUROC oraz FDR testu sparowanego dla stałych modułów w zbiorach GSE9741 i GSE97742. Dodatnia wartość delta wskazuje na wyższy wynik modułu podczas ostrej fazy choroby. Wartości FDR testu sparowanego to dwustronne wartości P testu t dla prób zależnych, skorygowane metodą Benjamini–Hochberga i obliczone dla wszystkich 20 prawidłowych sparowanych testów t w pełnym zestawieniu podłużnym.
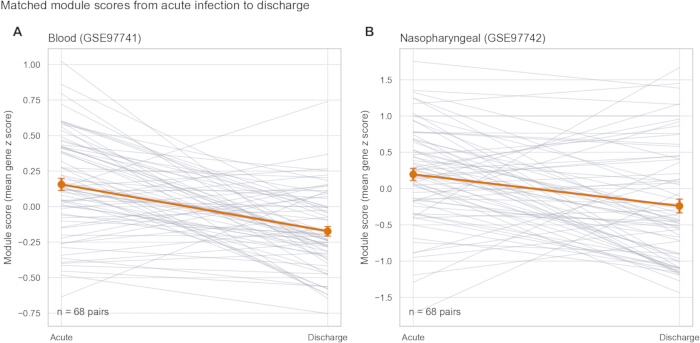
Rysunek 5Sparowane zmiany wyników modułów od fazy ostrej choroby do wypisu. (A) Wyniki modułów krwi w krwi pełnej (GSE9741). (B) Wyniki modułów nosowych w próbkach z nosogardzieli (GSE9742). Każdy panel zawiera 68 kompletnych par badanych: 38 pojedynczych zakażeń RSV i 30 zakażeń rhinovirusem. Cienkie linie łączą pomiary dopasowane do konkretnego badanego. Pomarańczowe punkty oznaczają średnie grupowe, a pomarańczowe słupki błędów oznaczają błąd standardowy średniej. Dwustronny test sparowany t wykonano testy i testy znaków Wilcoxona; zastosowano korektę FDR według metody Benjamini–Hochberga dla 20 prawidłowych par w analizie podłużnej t testy Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Testy międzyprzedziałowe ujawniły istotny niuans. Moduł krwi zastosowany do próbek z nosogardzieli dał wartość AUROC wynoszącą 0.845, mimo że indywidualne wielkości efektu dla nosa i krwi były słabo zgodne w kotwicy. Analiza sparowanych trajektorii wykazała spójny spadek wyniku, a nie odwrócony rozkład etykiet. Zatem wynik ten nie jest dowodem na to, że te same pojedyncze geny dominują w obu tkankach. Wskazuje on raczej, że skoordynowany program interferonowy/zapalny może być streszczony przez różne, lecz częściowo redundantne zestawy genów. Specyficzność przedziałowa jest najsilniejsza na poziomie rankingu genów i nie jest bezwzględna na poziomie ścieżek lub wyników.
Testowanie zachowania gradientu objawów na podstawie wyodrębnionych detekcji bezobjawowych
Detekcje bezobjawowych picornavirusów w zbiorze GSE17827 zostały wykluczone z konstrukcji modułu, aby uniknąć ich włączenia do głównej grupy kontrolnej. Ta wyodrębniona grupa posłużyła następnie jako biologiczna weryfikacja. W obu przedziałach wyniki modułów rosły w uporządkowanych grupach: kontroli negatywnej pod kątem wirusa, detekcji bezobjawowej picornavirusów oraz infekcji objawowej (Rysunek 6A,B).
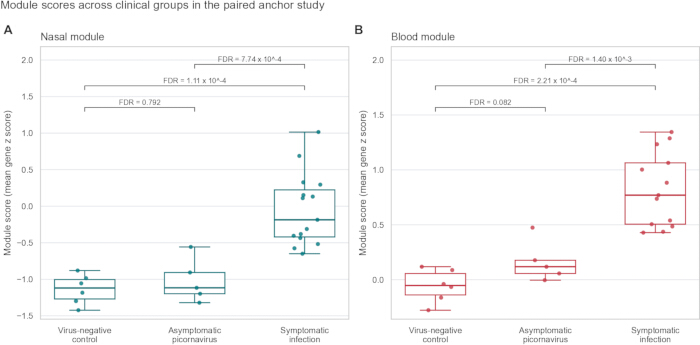
Rysunek 6Wyniki modułów w obrębie odseparowanego gradientu objawów. (A) Moduł nosowy: 6 kontroli ujemnych pod kątem wirusów, 5 detekcji bezobjawowych picornawirusów oraz 15 infekcji objawowych. (B) Moduł krwi: 6 kontroli ujemnych pod kątem wirusów, 5 detekcji pikornawirusów u osób bezobjawowych oraz 13 infekcji objawowych. Punkty reprezentują poszczególne próbki. Linie środkowe oznaczają mediany; pola pudełek obejmują zakres od 25. do 75. percentyla, a wąsy sięgają najbardziej ekstremalnych wartości w zakresie 1,5-krotności rozstępu międzykwartylnego. Etykiety przedstawiają wyniki dwustronnych porównań post-hoc testem U Manna–Whitneya z korektą Benjamini–Hochberga dla trzech porównań w każdym przedziale. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Moduł nosowy korelował z porządkową oceną objawów (Spearman rho = 0.818, P = 3.28 × 10⁻7; Kruskal-Wallis P = 1.57 × 10⁻4). Moduł krwi wykazał podobny gradient (rho = 0.861, P = 6.89 × 10⁻8; Kruskal-Wallis P = 1.92 × 10⁻4). Po korekcie w obrębie każdej rodziny trzech porównań, infekcja objawowa różniła się od kontroli oraz detekcji bezobjawowych w obu przedziałach. Detekcje bezobjawowe nie różniły się od kontroli negatywnych pod kątem wirusa (nasal FDR = 0.792; blood FDR = 0.082). Moduły te odzwierciedlały zatem aktywność odpowiedzi gospodarza w przebiegu objawowym wyraźniej niż sama detekcja wirusa.
Punkty odniesienia klinicznego zdefiniowały granicę między odpowiedzią gospodarza a swoistością patogenu
Punkty odniesienia klinicznego zdefiniowały rozróżnienie między aktywnością odpowiedzi gospodarza a klasyfikacją patogenów (Tabela 5; Rysunek 7). W zbiorze GSE6390 moduł nosowy wykazał wartości AUROC wynoszące 0,782 dla chorób wirusowych w porównaniu do bakteryjnych oraz 0,791 dla chorób wirusowych w porównaniu do niezakaźnych. Moduł krwi wykazał AUROC odpowiednio 0,678 i 0,753. Komparator Pandya 3-mRNA uzyskał lepsze wyniki, z AUROC wynoszącymi odpowiednio 0,867 i 0,852. Wynik ten jest oczekiwany dla zestawu zaprojektowanego do rozróżniania infekcji wirusowych od niewirusowych i wskazuje, że moduły kotwiczące nie powinny być prezentowane jako zamienne klasyfikatory diagnostyczne.
| Zbiór danych | Kontrast | Kotwica nosowa | Zakotwiczenie krwi | mRNA Pandya 3 | Andres-Terre ISG | Charakterystyczny interferon-alfa |
| GSE6390 | Wirusowe a bakteryjne | 0.782 | 0.678 | 0.867 | 0.833 | 0.831 |
| GSE6390 | Wirusowe a niezakaźne | 0.791 | 0.753 | 0.852 | 0.851 | 0.848 |
| GSE40012 | Zapalenie płuc o etiologii wirusowej a bakteryjnej | 0.755 | 0.789 | 0.893 | 0.867 | 0.872 |
| GSE4012 | Zapalenie płuc o etiologii wirusowej a zespół ogólnoustrojowej reakcji zapalnej (SIRS) | 0.897 | 0.907 | 0.985 | 0.965 | 0.956 |
| GSE40012 | Zapalenie płuc o etiologii wirusowej a grupa zdrowa | 0.804 | 0.986 | 0.923 | 0.906 | 0.891 |
| GSE40012 | Zapalenie płuc pochodzenia bakteryjnego a stan zdrowia | 0.476 | 0.917 | 0.465 | 0.391 | 0.378 |
| GSE53543 | PBMC stymulowane rhinovirusem ex vivo w porównaniu z PBMC niestymulowanymi | 1 | 0.957 | 1 | 1 | 1 |
Tabela 5: Wyniki AUROC dla modułów kotwiczących i referencyjnych zestawów odpowiedzi gospodarza. GSE6390 i GSE4012 to kohorty kliniczne krwi pełnej. GSE53543 to eksperyment zaburzeń PBMC ex vivo obejmujący 98 par badanych, raportowany oddzielnie od naturalnych kohort klinicznych. Zestawy referencyjne oceniano jako nieważone średnie genów, a nie jako pierwotne klasyfikatory ważone. Wartości AUROC są podane jako mierniki benchmarkowe, a nie jako szacunki wydajności diagnostyki klinicznej.
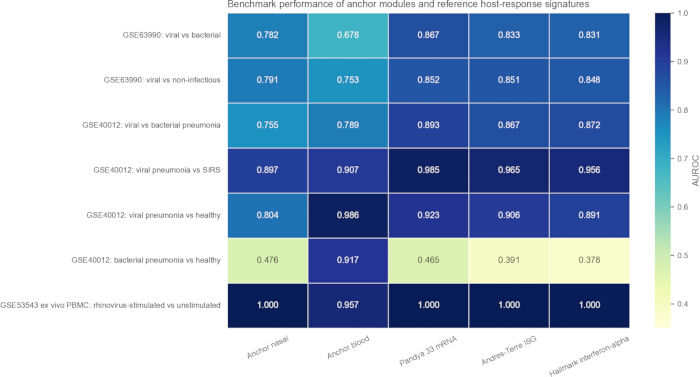
Rysunek 7Benchmarking AUROC modułów kotwiczących i referencyjnych zestawów odpowiedzi gospodarza. Wiersze przedstawiają z góry określone kontrasty w zbiorach GSE63990, GSE4012 i GSE53543; kolumny przedstawiają dwa moduły kotwiczące (anchor modules) oraz trzy nieważone zestawy referencyjne. Zbiór GSE53543 jest oznaczony jako PBMC stymulowane rhinovirusem ex vivo w porównaniu z niestymulowanymi i jest przedstawiony oddzielnie od naturalnych kohort klinicznych. Komparator Hallmark jest oznaczony jako Hallmark interferon-alpha. Wartości w komórkach wskazują wartości AUROC wykorzystane do benchmarkingu metody i nie powinny być interpretowane jako szacunki wydajności diagnostyki klinicznej. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej figury.
Badanie GSE4012 doprecyzowało tę granicę. Komparator Pandyi osiągnął wartości AUROC na poziomie 0,893 dla zapalenia płuc o etiologii wirusowej w porównaniu do bakteryjnej oraz 0,985 dla zapalenia płuc wirusowego w porównaniu do SIRS. Moduł krwi oddzielił zapalenie płuc wywołane grypą A od zdrowych grup kontrolnych (AUROC = 0,986) oraz od SIRS (AUROC = 0,907), ale oddzielił również bakteryjne zapalenie płuc od zdrowych grup kontrolnych (AUROC = 0,917). Moduł krwi mierzy zatem szeroką aktywność zapalną systemową oraz aktywność związaną z interferonem. Nie jest on specyficzny dla wirusów, a wysoki wynik nie pozwala na przypisanie klasy patogenu.
W oddzielnym benchmarku ex vivo GSE53543 dla PBMC, moduł nosowy oraz komparatory interferonowe osiągnęły wartość AUROC wynoszącą 1,0 w porównaniu PBMC stymulowanych rhinovirusem do PBMC w samym medium; moduł krwi osiągnął wartość AUROC 0,957. Wszyscy 98 badanych dostarczyło par warunków. Ten kontrolowany wynik potwierdza responsywność ocenianych programów na stymulację rhinovirusem. Nie stanowi on oceny wydajności diagnostyki klinicznej.
Testy odporności zweryfikowały wielkość modułu, alternatywy losowe oraz stabilność selekcji
Separacja kotwic pozostała niezmieniona dla 10, 25, 50, 100 i 20 najwyżej sklasyfikowanych genów (Rycina 8A). Te wewnętrzne wartości AUROC nie stanowią walidacji zewnętrznej, ale pokazują, że wynik jakościowy nie zależał od wyboru dokładnie 50 genów. W 50 losowych zestawach 50 genów mediany AUROC dla próby zerowej wyniosły 0,489 dla nosa i 0,705 dla krwi; odpowiadające im 9. percentyle wyniosły 0,72 i 0,872 (Rycina 8B). Obserwowane moduły przekroczyły te rozkłady zerowe. Częstotliwości selekcji bootstrapowej były rozłożone, a nie skoncentrowane w jednej niezmienniczej liście (Rycina 8C). Wynik ten bezpośrednio odzwierciedla małą próbę kotwic. Potwierdza on stabilny sygnał zagregowany, jednocześnie ostrzegając przed traktowaniem każdego wybranego genu jako stałego.
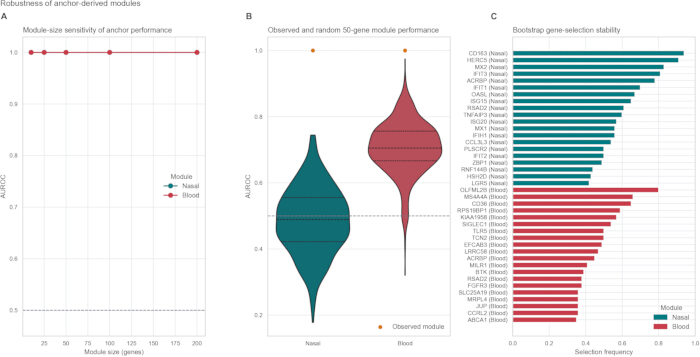
Rycina 8Analizy odporności w zależności od wielkości modułu, losowych genów oraz metody bootstrap. (A) Wartości Anchor AUROC dla rozmiarów modułów obejmujących 10, 25, 50, 100 i 20 genów; wartości te stanowią wewnętrzne kontrole czułości. (B) Rozkłady AUROC dla 50 losowych zestawów 50 genów kodujących białka, pobranych bez zastrzeżeń z genów reprezentowanych w GSE17827 (seed = 20260622). Pomarańczowe punkty wskazują obserwowane wartości AUROC dla modułów. Linie poziome wewnątrz każdego wykresu skrzypcowego oznaczają 25. percentyl, medianę oraz 75. percentyl. (C) Ponowne próbkowanie metodą bootstrap ograniczono do 100 genów kodujących białka o najwyższym dodatnim efekcie, które zajęły najwyższe pozycje w pierwotnej analizie kotwicowej dla każdego przedziału. Słupki przedstawiają 20 genów o najwyższej częstotliwości wyboru w każdym przedziale; częstotliwość wyboru obliczono jako liczbę wyborów podzieloną przez 10. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Analizy programów markerów i wariancji wyjaśniły, co mierzą uzyskane wyniki
W zbiorach GSE4012, GSE53543 i GSE6390 oba moduły korelowały najsilniej z mieloidalnym programem interferonowym (Ryc. 9A). Korelacje dla modułu nosowego wynosiły odpowiednio 0,812, 0,878 i 0,82; korelacje dla modułu krwi wynosiły 0,517, 0,843 i 0,74. Podział wariancji miał charakter opisowy (Tabela 6; Ryc. 9B). W przypadku modułu krwi stan kliniczny oraz szczegółowa grupa wyjaśniały większą część wariancji (eta-kwadrat odpowiednio 0,282 i 0,250) niż zbiór danych (0,06), typ próbki (0,026) lub grupa źródłowa (0,025). Dla modułu nosowego szczegółowa grupa i stan kliniczny również wyjaśniały większą wariancję niż zbiór danych, typ próbki lub grupa źródłowa. Zatem stan biologiczny i szczegółowa grupa odpowiadały za większe frakcje wariancji wyników modułów niż zbiór danych lub typ próbki, choć niezerowy wpływ zbiorów danych i składu tkanek pozostaje ograniczeniem przy ponownym wykorzystaniu publicznych danych z sekwencjonowania bulk.
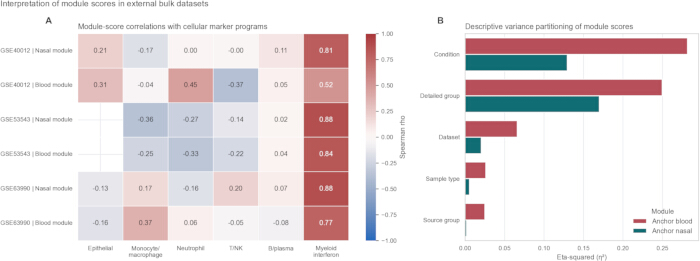
Rycina 9Korelacje między markerami a programem oraz opisowy podział wariancji. (A) Korelacje Spearmana między wynikami modułów a wynikami sześciu programów markerowych w zbiorach GSE4012, GSE53543 i GSE6390. Programy wymagały obecności co najmniej trzech reprezentatywnych genów. P wartości zostały skorygowane dla wszystkich korelacji zbiór danych-moduł-program. Puste komórki oznaczają kombinacje niedostępne lub niemożliwe do oszacowania po uwzględnieniu wymagań dotyczących genów i próbek. (B) jednoczynnikowy eta-kwadrat (η2; suma kwadratów międzygruпоowych/całkowita suma kwadratów) dla stanu, szczegółowej grupy, zbioru danych, rodzaju próbki i grupy źródłowej. Analiza objęła 934 wyniki dla modułu krwi oraz 1469 wyników dla modułu nosowego i ma charakter opisowy, a nie przyczynowy. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
| Moduł | Czynnik | Eta-kwadrat | n próbek |
| Krew kotwicząca | Warunek | 0.282 | 934 |
| Krew zakotwiczona | Szczegółowa grupa | 0.25 | 934 |
| Krew zakotwiczona | Zbiór danych | 0.066 | 934 |
| Krew kotwicząca | Typ próbki | 0.026 | 934 |
| Kotwiczenie krwi | Grupa źródłowa | 0.025 | 934 |
| Kotwica nosowa | Szczegółowa grupa | 0.17 | 1469 |
| Kotwica nosowa | Warunek | 0.13 | 1469 |
| Kotwica nosowa | Zbiór danych | 0.021 | 1469 |
| Kotwica nosowa | Typ próbki | 0.006 | 1469 |
| Kotwica nosowa | Grupa źródłowa | 0.002 | 1469 |
Tabela 6: Opisowy podział wariancji wyników modułów. Dla każdej pary moduł-czynnik przedstawiono jeden wiersz wraz z odpowiadającą wartością eta-kwadrat oraz wielkością próby. Eta-kwadrat obliczono jako sumę kwadratów między grupami podzieloną przez całkowitą sumę kwadratów po wykluczeniu wierszy z brakującymi wynikami modułu lub czynnikiem. Czynniki oceniano indywidualnie; w związku z tym analiza ma charakter opisowy, nie uwzględnia wzajemnie skorelowanych czynników i nie powinna być interpretowana w sposób przyczynowy.
Dostępność danych:
Wszystkie zestawy danych transkryptomicznych analizowane w niniejszym badaniu są publicznie dostępne w bazie Gene Expression Omnibus pod numerami dostępu GSE117827, GSE41374, GSE152075, GSE156063, GSE1710, GSE3890, GSE9741, GSE9742, GSE6390, GSE4012 oraz GSE53543. Dane pochodzące z analiz, które stanowią podstawę głównych rycin i tabel, a także kod analizy są dostępne u autora korespondencyjnego na uzasadnioną prośbę. W badaniu nie wykorzystano żadnych danych na poziomie uczestnika o ograniczonym dostępie ani danych nowo wygenerowanych.
Dyskusja
Główny wniosek ma charakter operacyjny: należy zacząć od analizy konkretnego przedziału, a nie od największej wspólnej macierzy. Zbiór GSE117827 jest niewielki, ale jego sparowany projekt pozwala na bezpośrednie porównanie nosa i krwi w ramach jednego badania. Korelacja efektu na poziomie genów bliska zeru wskazuje, że wspólna lista rankingowa dla wszystkich tkanek ukryłaby istotną strukturę przedziałową. Z tego względu bardziej uzasadnionym projektem było zastosowanie oddzielnych modułów. Ich wydajność zewnętrzna i podłużna potwierdza odtwarzalność aktywności odpowiedzi gospodarza na poziomie modułów, a nie uniwersalnej listy genów.
Przenoszalność na poziomie genów i na poziomie modułów jest różna. Moduł krwi wykazał wysoką skuteczność w podłużnych próbkach z nosogardzieli (AUROC 0,845), pomimo słabej zgodności między wielkościami efektów dla poszczególnych próbek z nosa i krwi. Sparowane trajektorie nie wykazały odwrócenia etykiet. Bardziej prawdopodobnym wyjaśnieniem jest redundancja szlaków: skoordynowana aktywność interferonowa i zapalna może być podsumowana przez różne podzbiory genów w różnych przedziałach6,7,8,9,10,11,32,33,34. To dlatego opisujemy moduły jako uwzględniające przedziały (compartment-aware), a nie wykluczające poszczególne przedziały (compartment-exclusive). Dokładne rankingi różnią się od siebie, ale wspólny komponent na poziomie szlaku pozostaje wykrywalny. Profile typu bulk mieszają również zmiany w ekspresji ze zmianami w składzie komórkowym. Korelacje programów markerowych mogą wskazać na ten problem, ale nie mogą dostarczyć mechanizmów rozdzielczych na poziomie komórek36,37.
Wskaźniki kliniczne definiują drugą granicę. Komparatory Pandya 33-mRNA oraz interferonu okazały się skuteczniejsze w rozróżnianiu etiologii wirusowej od bakteryjnej. Moduły kotwiczące odpowiadają na inne pytanie: jak silnie próbka wykazuje program ostrej odpowiedzi gospodarza? Moduł krwi zwiększył swoją aktywność również w przypadku bakteryjnego zapalenia płuc. Należy go zatem interpretować jako ogólną ocenę aktywności zapalnej systemowej/interferonowej, a nie jako klasyfikator specyficzny dla wirusów. Wysoki wynik może wspierać porównywanie kohort, monitorowanie odpowiedzi lub opis stanu zapalnego, ale nie pozwala na identyfikację patogenu. Rosnące znaczenie kliniczne wirusów, takich jak metapneumowirus ludzki, przemawia dodatkowo za walidacją obejmującą różnorodne patogeny i dopasowane tkanki, zamiast ekstrapolacji z ograniczonego zestawu wirusów12,13.
Sześć genów nakładających się ma charakter eksploracyjny. ISG15, IFIT1, RSAD2 i XAF1 pełnią prawdopodobnie role powiązane z interferonem32,33,34; CCRL2 jest powiązany z zapalną migracją leukocytów35; ACRBP nie posiada ustalonej interpretacji przeciwwirusowej. Mała kohorta oraz nieistotne statystycznie wartości FDR dla poszczególnych genów uniemożliwiają sformułowanie silniejszych wniosków. Innowacja metodologiczna leży gdzie indziej: w zastosowaniu sparowanej kotwicy w obrębie tego samego badania, zablokowanych modułów specyficznych dla przedziałów, zewnętrznych testów z dopasowaniem tkankowym, analizy odzysku sparowanego, benchmarkingu z klinicznym komparatorem oraz jawnych kontroli randomizacji, wielkości, bootstrapowania, markerów i wariancji. Taka hierarchia dowodów zapewnia konserwatywne ramy interpretacji wyników.
Pozostaje kilka ograniczeń. Kohorta kotwicząca zawiera jedynie 15 zainfekowanych i 6 kontrolnych próbek z nosa oraz 13 zainfekowanych i 6 kontrolnych próbek krwi. Wyniki bootstrapowania potwierdzają, że przynależność poszczególnych genów nie jest w pełni stabilna. Przypadki RSV objawowego i picornawirusów zostały połączone, zatem efekty kotwiczenia nie są specyficzne dla konkretnego wirusa. Kohorty zewnętrzne różnią się wiekiem, platformą, ciężkością przebiegu, czasem pobrania próbek oraz definicją grupy kontrolnej. GSE53543 jest badaniem perturbacji sparowanych ex vivo. GSE63990 i GSE40012 dostarczają przydatnych porównań klinicznych, ale nie zawierają sparowanych próbek z nosa i krwi. Dane dotyczące miana wirusa, czasu trwania objawów, zapotrzebowania na tlen i ciężkości przebiegu nie były spójnie dostępne. Silniejszy projekt prospektywny powinien obejmować pobieranie wymazów z nosa i krwi od tych samych uczestników w dopasowanych punktach czasowych, wraz z pomiarami miana wirusa i objawów, grupami porównawczymi z bakteriami oraz grupami ujemnymi pod kątem wirusów objawowych, a także walidacją w rozdzielczości pojedynczych komórek11,14,36,37.
Podsumowując, obecnie dostępne publiczne transkryptomy potwierdzają powtarzalność modułów aktywności odpowiedzi gospodarza w nosie i krwi, pod warunkiem zachowania kontekstu tkankowego. Nie potwierdzają one natomiast istnienia wymiennej sygnatury genowej wspólnej dla wszystkich tkanek. Powiązana kotwica wykazała niewielką zgodność na poziomie genów, podczas gdy wyniki zablokowanych modułów przenosiły się w obrębie dopasowanych tkanek i spadały podczas rekonwalescencji. Odpowiedź modułu krwi w bakteryjnym zapaleniu płuc oraz lepsza skuteczność uznanego klasyfikatora w rozróżnianiu infekcji wirusowych od bakteryjnych definiują przeznaczenie tych narzędzi: moduły te opisują aktywność odpowiedzi gospodarza i umożliwiają przejrzyste porównywanie kohort; nie są one samodzielnymi klasyfikatorami patogenów. Kod analizy oraz pochodne dane są dostępne zgodnie z opisem w oświadczeniu o dostępności danych, aby umożliwić niezależną weryfikację i ponowne wykorzystanie schematu postępowania.
Oświadczenia
Autorzy oświadczają, że nie istnieją żadne finansowe ani niefinansowe konflikty interesów związane z niniejszą pracą.
Podziękowania
Autorzy dziękują badaczom i uczestnikom publicznych badań GEO, które zostały poddane ponownej analizie w niniejszej pracy. Żadne inne osoby nie spełniły kryteriów autorstwa. Niniejsze badanie nie otrzymało żadnego konkretnego grantu z żadnej agencji finansującej w sektorze publicznym, komercyjnym lub non-profit.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Zestaw genów stymulowanych interferonem dla wielu wirusów Andres-Terre | Andres-Terre et al. | Komparator 33 genów; Supplementary Data 1 | Nieważony komparator zorientowany na interferon, opracowany na podstawie zgłoszonej sygnatury wielu wirusów; pełna lista genów znajduje się w Supplementary Data 1. |
| Enrichr | Ma'ayan Laboratory | Dostęp 18 sierpnia 2026; RRID:SCR_001575 | Zasób nadreprezentacji zestawów genów dostępny za pośrednictwem gseapy. |
| Gene Expression Omnibus | National Center for Biotechnology Information | GEO; RRID:SCR_005012 | Publiczne repozytorium transkryptomów wykorzystane do dostępu do analizowanych zbiorów danych. |
| Gene Ontology | Gene Ontology Consortium | GO Biological Process 2023; RRID:SCR_002811 | Biblioteka adnotacji funkcjonalnych wykorzystana za pośrednictwem Enrichr. |
| GPL10558 | NCBI GEO | GPL10558 | Platforma dla GSE53543 i jednostki walidacyjnej GSE38900 obejmującej 36 próbek. |
| GPL23126 | NCBI GEO | GPL23126 | Platforma ekspresji dla GSE117827. |
| GPL24539 | NCBI GEO | Clariom_D_Human.na36.hg38. probeset.csv | Adnotacja Clariom D Human na36, hg38 użyta do mapowania klastrów transkryptów dla GSE117827. |
| GPL571 | NCBI GEO | GPL571 | Adnotacja platformy zastosowana do GSE63990. |
| GPL6884 | NCBI GEO | GPL6884 | Platforma dla jednostki walidacyjnej RSV z krwi pełnej GSE38900 obejmującej 138 próbek. |
| GPL6947 | NCBI GEO | GPL6947 | Adnotacja platformy zastosowana do GSE40012. |
| GSE117827 | NCBI GEO | GSE117827 | Podstawowy sparowany zbiór danych kotwiczących z wymazów z nosa i krwi pełnej. |
| GSE152075 | NCBI GEO | GSE152075 | Zewnętrzny zbiór danych walidacyjnych z górnych dróg oddechowych dla SARS-CoV-2. |
| GSE156063 | NCBI GEO | GSE156063 | Zewnętrzny zbiór danych walidacyjnych z górnych dróg oddechowych dla SARS-CoV-2. |
| GSE171110 | NCBI GEO | GSE171110 | Zewnętrzny zbiór danych walidacyjnych z krwi pełnej dla SARS-CoV-2. |
| GSE38900 | NCBI GEO | GSE38900; GPL10558 i GPL6884 | Zewnętrzna walidacja RSV z krwi pełnej, analizowana jako osobno normalizowane jednostki platformowe 36- i 138-próbkowe. |
| GSE40012 | NCBI GEO | GSE40012 | Benchmark kliniczny dla zapalenia płuc wywołanego grypą A, zapalenia płuc bakteryjnego, SIRS oraz zdrowej grupy kontrolnej. |
| GSE41374 | NCBI GEO | GSE41374 | Zewnętrzny zbiór danych walidacyjnych z płukania nosa dla RSV. |
| GSE53543 | NCBI GEO | GSE53543 | Sparowany benchmark zaburzeń rhinovirus w PBMC ex vivo obejmujący 98 osób i 196 próbek. |
| GSE63990 | NCBI GEO | GSE63990 | Kliniczny benchmark krwi pełnej dla infekcji wirusowych, bakteryjnych i nieinfekcyjnych. |
| GSE97741 | NCBI GEO | GSE97741 | Podłużny zbiór danych walidacyjnych z krwi pełnej (faza ostra versus wypis). |
| GSE97742 | NCBI GEO | GSE97742 | Podłużny zbiór danych walidacyjnych z nosogardzieli (faza ostra versus wypis). |
| gseapy | twórcy gseapy | Wersja 1.3.1 | Interfejs Python wykorzystywany do zapytań do Enrichr. |
| Zasób symboli genów HGNC | HUGO Gene Nomenclature Committee | Dostęp 18 sierpnia 2026; RRID:SCR_002827 | Zatwierdzony zasób normalizacji symboli genów i klasyfikacji kodujących białka. |
| Matplotlib | zespół programistyczny Matplotlib | Wersja 3.11.1 | Generowanie rycin. |
| Zestawy genów MSigDB Hallmark | Broad Institute | Hallmark 2020; RRID:SCR_016863 | Biblioteka wzbogaceń Hallmark dostępna za pośrednictwem Enrichr. |
| Zestaw genów odpowiedzi na interferon-alfa MSigDB Hallmark | Broad Institute | HALLMARK_INTERFERON_ALPHA_ RESPONSE; rdzeniowy podzbiór 33 genów w Supplementary Data 1 | Nieważony komparator interferonu-alfa; dokładny podzbiór znajduje się w Supplementary Data 1. |
| NumPy | twórcy NumPy | Wersja 2.5.2 | Obliczenia numeryczne i losowanie z ziarnem. |
| pandas | zespół programistyczny pandas | Wersja 3.0.5 | Przetwarzanie danych tabelarycznych. |
| Zestaw genów odpowiedzi gospodarza Pandya 33-mRNA | Pandya et al. | Supplementary Table 1; Supplementary Data 1 | Oficjalny zestaw 33 genów oceniany jako nieważony komparator. |
| Python | Python Software Foundation | Wersja 3.12.13 | Środowisko analizy obliczeniowej. |
| Reactome | Reactome | Reactome 2022; RRID:SCR_003485 | Biblioteka wzbogaceń szlaków dostępna za pośrednictwem Enrichr. |
| scikit-learn | twórcy scikit-learn | Wersja 1.9.0 | Obliczenia AUROC i średniej precyzji. |
| SciPy | twórcy SciPy | Wersja 1.18.0 | Testy Welcha, t-testy dla prób zależnych, testy Wilcoxona, Manna–Whitneya oraz testy korelacji. |
| Seaborn | zespół programistyczny Seaborn | Wersja 0.13.2 | Grafika statystyczna. |
| statsmodels | twórcy statsmodels | Wersja 0.14.6 | Narzędzia statystyczne. |
Bibliografia
- Zaas AK, et al. Gene expression signatures diagnose influenza and other symptomatic respiratory viral infections in humans. Cell Host Microbe. 2009;6(3):207-17.
- Woods CW, et al. A host transcriptional signature for presymptomatic detection of infection in humans exposed to influenza H1N1 or H3N2. PLoS One. 2013;8(1):e52198.
- Andres-Terre M, et al. Integrated, multi-cohort analysis identifies conserved transcriptional signatures across multiple respiratory viruses. Immunity. 2015;43(6):1199-211.
- Herberg JA, et al. Diagnostic test accuracy of a 2-transcript host RNA signature for discriminating bacterial vs viral infection in febrile children. JAMA. 2016;316(8):835-45.
- Pandya R, et al. A machine learning classifier using 33 host immune response mRNAs accurately distinguishes viral and non-viral acute respiratory illnesses in nasal swab samples. Genome Med. 2023;15(1):64.
- Ioannidis I, et al. Plasticity and virus specificity of the airway epithelial cell immune response during respiratory virus infection. J Virol. 2012;86(10):5422-36.
- Mejias A, et al. Whole blood gene expression profiles to assess pathogenesis and disease severity in infants with respiratory syncytial virus infection. PLoS Med. 2013;10(11):e1001549.
- Blanco-Melo D, et al. Imbalanced host response to SARS-CoV-2 drives development of COVID-19. Cell. 2020;181(5):1036-45.e9.
- Hadjadj J, et al. Impaired type I interferon activity and inflammatory responses in severe COVID-19 patients. Science. 2020;369(6504):718-24.
- Mick E, et al. Upper airway gene expression reveals suppressed immune responses to SARS-CoV-2 compared with other respiratory viruses. Nat Commun. 2020;11(1):5854.
- Yoshida M, et al. Local and systemic responses to SARS-CoV-2 infection in children and adults. Nature. 2022;602(7896):321-7.
- Jamali MC, et al. Respiratory infections by human metapneumovirus: epidemiological evidence and treatment prospects. Res J Pharm Technol. 2026;19(8):3905-12. doi:10.52711/0974-360X.2026.00549.
- Gao G, Lin R, Ma D. Human metapneumovirus: pathogenesis, epidemiology, diagnostic technologies, and potential intervention strategies. Virol J. 2025;22(1):376.
- Lim FY, et al. homeRNA self-blood collection enables high-frequency temporal profiling of presymptomatic host immune kinetics to respiratory viral infection: a prospective cohort study. EBioMedicine. 2025;112:105531.
- Johnson WE, Li C, Rabinovic A. Adjusting batch effects in microarray expression data using empirical Bayes methods. Biostatistics. 2007;8(1):118-27.
- Leek JT, et al. The sva package for removing batch effects and other unwanted variation in high-throughput experiments. Bioinformatics. 2012;28(6):882-3.
- Yu J, et al. Host gene expression in nose and blood for the diagnosis of viral respiratory infection. J Infect Dis. 2019;219(7):1151-61.
- Tsalik EL, et al. Host gene expression classifiers diagnose acute respiratory illness etiology. Sci Transl Med. 2016;8(322):322ra11.
- Parnell GP, et al. A distinct influenza infection signature in the blood transcriptome of patients with severe community-acquired pneumonia. Crit Care. 2012;16(4):R157.
- Edgar R, Domrachev M, Lash AE. Gene Expression Omnibus: NCBI gene expression and hybridization array data repository. Nucleic Acids Res. 2002;30(1):207-10.
- Barrett T, et al. NCBI GEO: archive for functional genomics data sets-update. Nucleic Acids Res. 2013;41(D1):D991-5.
- Tweedie S, et al. Genenames.org: the HGNC and VGNC resources in 2021. Nucleic Acids Res. 2021;49(D1):D939-46.
- Welch BL. The generalization of Student's problem when several different population variances are involved. Biometrika. 1947;34(1-2):28-35.
- Benjamini Y, Hochberg Y. Controlling the false discovery rate: a practical and powerful approach to multiple testing. J R Stat Soc Series B Stat Methodol. 1995;57(1):289-300.
- Subramanian A, et al. Gene set enrichment analysis: a knowledge-based approach for interpreting genome-wide expression profiles. Proc Natl Acad Sci U S A. 2005;102(43):15545-50.
- Liberzon A, et al. The Molecular Signatures Database Hallmark Gene Set Collection. Cell Syst. 2015;1(6):417-25.
- Do LAH, et al. Host transcription profile in nasal epithelium and whole blood of hospitalized children under 2 years of age with respiratory syncytial virus infection. J Infect Dis. 2018;217(1):134-46.
- Ashburner M, et al. Gene Ontology: tool for the unification of biology. Nat Genet. 2000;25(1):25-9.
- The Gene Ontology Consortium. The Gene Ontology resource: enriching a GOld mine. Nucleic Acids Res. 2021;49(D1):D325-34.
- Gillespie M, et al. The Reactome pathway knowledgebase 2022. Nucleic Acids Res. 2022;50(D1):D687-92.
- Kuleshov MV, et al. Enrichr: a comprehensive gene set enrichment analysis web server 2016 update. Nucleic Acids Res. 2016;44(W1):W90-7.
- Schoggins JW, et al. A diverse range of gene products are effectors of the type I interferon antiviral response. Nature. 2011;472(7344):481-5.
- Schneider WM, Chevillotte MD, Rice CM. Interferon-stimulated genes: a complex web of host defenses. Annu Rev Immunol. 2014;32:513-45.
- Perng YC, Lenschow DJ. ISG15 in antiviral immunity and beyond. Nat Rev Microbiol. 2018;16(7):423-39.
- Schioppa T, et al. Molecular basis for CCRL2 regulation of leukocyte migration. Front Cell Dev Biol. 2020;8:615031.
- Avila Cobos F, et al. Benchmarking of cell type deconvolution pipelines for transcriptomics data. Nat Commun. 2020;11(1):5650.
- Maden SK, et al. Challenges and opportunities to computationally deconvolve heterogeneous tissue with varying cell sizes using single-cell RNA-sequencing datasets. Genome Biol. 2023;24(1):288.