W niniejszej pracy badawczej przedstawiono metodę FusionNetX, która poprzez wzmocnienie możliwości fuzji cech modeli DenseNet121 i EfficientNetB7 służy do klasyfikacji guzów mózgu na pięciu publicznie dostępnych zbiorach danych z zastosowaniem augmentacji danych, przetwarzania wstępnego oraz dostosowania hybrydowego modelu (fuzja pośrednia), co pozwoliło na osiągnięcie wyników w przedziale od 98,77% do 99,89%, przewyższając inne metody w wielu parametrach ewaluacyjnych.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł metodologiczny
FusionNetX: Model głębokiej fuzji cech wykorzystujący MRI i głębokie uczenie w celu usprawnionej detekcji guzów mózgu
W tym artykule
Podsumowanie
Streszczenie
Guzy mózgu są uważane za jedną z najgroźniejszych chorób na świecie, a ich błędna diagnoza naraża życie pacjentów i obniża wskaźnik przeżywalności. Obrazowanie rezonansem magnetycznym (MRI) z wykorzystaniem technik opartych na głębokim uczeniu, w szczególności konwolucyjnych sieci neuronowych, jest kluczowe dla pokonania tej przeszkody, ponieważ umożliwia bardziej szczegółowe badanie wewnętrznej struktury mózgu i oferuje wyjątkowe możliwości uczenia oraz predykcji. Potrzeba dokładnej diagnozy guza w mózgu pozostaje znacząca. W związku z tym zaproponowano ulepszony model DL oparty na fuzji cech (FusionNetX), który wykorzystuje moc dwóch wstępnie wytrenowanych modeli, DenseNet121 i EfficientNetB7, stosując dostosowane hiperparametry dostrajania, w tym warstwy trenowalne i nietrenowalne. Zaproponowany model FusionNetX zastosowano do pięciu publicznie dostępnych zbiorów danych guzów mózgu: Br35H, Figshare, Sartaj, Masoud oraz Balanced Brain Tumor. W celu poprawy jakości obrazów i przeciwdziałania przeuczeniu zastosowano etapy przetwarzania wstępnego, obejmujące zmianę rozmiaru i augmentację danych. Przy użyciu różnych metryk oceny wydajności, takich jak dokładność (accuracy), strata (loss), dodatnia wartość predykcyjna (positive predicted value), ujemna wartość predykcyjna (negative predictive value), współczynnik prawdziwie dodatnich (true positive rate), współczynnik prawdziwie ujemnych (true negative rate), wskaźnik F1 (F1-score), współczynnik fałszywie ujemnych (false negative rate) oraz współczynnik fałszywie dodatnich (false positive rate), stwierdzono, że proponowany model FusionNetX osiągnął dokładność na poziomie 99.33% dla Br35H, 99.13% dla Figshare, 99.89% dla Masoud, 99.19% dla BBT-Dataset oraz 98.77% dla Sartaj. Ponadto pięć zbiorów danych guzów mózgu oceniono z wykorzystaniem fuzji późnej (late fusion) oraz fuzji opartej na mechanizmie uwagi (attention-based fusion), aby wykazać znaczenie proponowanego modelu FusionNetX; wyniki były znacznie lepsze, z przyrostami od 0.3% do 1.9% we wszystkich zbiorach danych. Ponadto obliczono charakterystykę ROC (receiver operating characteristic curve), a wyniki z różnych metryk oceny wydajności wskazują, że proponowany model FusionNetX potrafi dokładnie wykrywać i przewidywać guzy mózgu, pomagając praktykom medycznym w podejmowaniu terminowych decyzji.
Wprowadzenie
Nowotwory są obecnie najgroźniejszą chorobą ludzkiego organizmu ze względu na ich dotkliwość i tempo wzrostu, podczas gdy liczne schorzenia nowotworowe, takie jak guzy mózgu, rak piersi, guzki płuc, rak nerki i inne, występują w organizmie człowieka, powodując wzrost wskaźnika śmiertelności. Nowotwór rozwija się, gdy komórki lub tkanki w organizmie człowieka namnażają się w sposób nieprawidłowy. Gdy nowotwór daje przerzuty, może uszkodzić inne organy i stać się bardziej niebezpieczny1. Ponieważ mózg kontroluje każdą funkcję organizmu, jakiekolwiek jego uszkodzenie może mieć dalekosiężne konsekwencje dla całego ciała. Dlatego guzy lub nowotwory mózgu są tak śmiertelne dla ludzi2. Dodatkowo guzy mózgu dzielą się na dwie główne kategorie: łagodne i złośliwe. Termin „łagodny” oznacza w zasadzie brak charakteru nowotworowego; jest to jedynie problem w obrębie mózgu, który można rozwiązać poprzez zmianę otoczenia. Jednak w przypadku złośliwości uznaje się je za niebezpieczne ze względu na ich naturę przerzutową, polegającą na przemieszczaniu się nieprawidłowych komórek lub tkanek do innych części ciała lub z nich, co zakłóca pracę innych organów, zwiększając tym samym rozprzestrzenianie się raka w organizmie3.
Ponadto, według American Brain Tumor Association oraz Światowej Organizacji Zdrowia (WHO), guzy przysadki, oponiaki i glejaki stanowią trzy główne kategorie nowotworów mózgu4. Glejaki wywodzą się z komórek glejowych, które odżywiają neurony w mózgu. Guzy przysadki powstają w przysadce mózgowej, znajdującej się u podstawy mózgu i odpowiedzialnej za różne funkcje organizmu; z kolei oponiaki rozwijają się w oponach mózgowo-rdzeniowych, które chronią błony otaczające mózg i rdzeń kręgowy. Co więcej, w celach diagnostycznych do badania wewnętrznych części ciała powszechnie stosuje się wiele metod obrazowania medycznego, w tym promieniowanie rentgenowskie, tomografię komputerową (CT) oraz rezonans magnetyczny (MRI)5,6. Każda z tych metod ma swoje zalety i wady. MRI jest techniką obrazowania, która dostarcza szczegółowych obrazów tkanek miękkich i komórek w organizmie, zwłaszcza w mózgu. Nowotwór wiąże się z obecnością nieprawidłowych tkanek lub komórek w organizmie, a MRI umożliwia precyzyjne obrazowanie tych zmian, co czyni go bardziej użyteczną metodą diagnostyczną w przypadku guzów mózgu lub nowotworów. Dodatkowo MRI jest bezpieczniejsze od innych metod obrazowania, ponieważ podczas badań anatomicznych wnętrza ciała nie emituje szkodliwego promieniowania.
Dodatkowo w celu rozwiązania problemów diagnostycznych związanych z guzami mózgu stosuje się wiele metod obliczeniowych, w tym uczenie maszynowe (ML), przetwarzanie obrazów (IP) oraz głębokie uczenie (DL), a każde z tych podejść jest stosowane do obrazów uzyskanych za pomocą różnych modalności obrazowania w celu diagnozowania nowotworu7. Podejścia te uczą się ukrytych wzorców i struktur różnych obiektów na obrazach, aby diagnozować raka poprzez identyfikację wzorców w obszarze objętym zmianami. Każda metoda obliczeniowa ma swoje zalety i wady w procesie diagnostycznym. Podejścia oparte na ML i IP wykorzystują ręcznie projektowane cechy (handcrafted features), co najczęściej prowadzi do niedokładnych prognoz i błędnej diagnozy, szczególnie w przypadku większych zbiorów danych8. Aby przezwyciężyć problemy związane z ręczną ekstrakcją cech, przechodzi się w stronę modeli opartych na głębokim uczeniu, powszechnie nazywanych modelami opartymi na splotowych sieciach neuronowych (CNN), które uczą się i automatycznie ekstrahują najlepsze cechy z obrazów w celu dokładnej diagnozy guzów. Podejścia oparte na DL są obecnie powszechnie stosowane w obrazowaniu medycznym do diagnozowania chorób organizmu ludzkiego, szczególnie w celu wczesnego i dokładnego wykrywania guzów mózgu, raka piersi, raka płuc i innych chorób, ze względu na ich zdolność do uczenia się i ekstrahowania złożonych wzorców w danych wielkoskalowych, co pozwala na uzyskanie bardziej precyzyjnych wyników9. Głównym problemem w modelach DL jest wysokie zużycie zasobów oraz kwestia próbkowania danych, co rozwiązuje inne podejście oparte na głębokim uczeniu, zwane uczeniem transferowym10 (TL), w którym do diagnozowania choroby wykorzystuje się modele wstępnie wytrenowane, co pozwala zaoszczędzić czas i zasoby. Wczesna i dokładna diagnoza problemów zdrowotnych jest możliwa dzięki modelom wstępnie wytrenowanym, które nauczyły się już podstawowych cech związanych z teksturą, kolorem, krawędziami i innymi elementami z dużego zbioru danych. Modele te można następnie przenieść na nowy, wcześniej nieznany zbiór danych, wykorzystując strukturę modelu oraz dodając hiperparametry oraz warstwy trenowalne i nietrenowalne11. Przeprowadzono znaczną liczbę badań nad klasyfikacją guzów mózgu, a Tabela 112,13,14,15,16,17,18,19,20,21,22,23 przedstawia szczegóły tych badań, w tym zastosowane podejścia, zbiory danych i wyniki. Mimo to żadna z prac badawczych nie zastosowała metodologii łączącej dwa modele uczenia transferowego w celu skutecznej ekstrakcji cech i dostosowania technik regularyzacji w celu zapewnienia stabilnego treningu i testowania. Rozbudowana ewaluacja proponowanej metodologii dostarcza informacji na temat wydajności modelu w odniesieniu do różnych cech guzów mózgu.
| Ref | Podejście | Próbki danych | Wyniki | Ograniczenia |
| 12 | Dostosowana sieć CNN | Br35H | Accuracy = 97.45%, | Wciąż istnieje potrzeba poprawy wyników; zamiast stosowania autorskiej sieci CNN, lepiej wykorzystać istniejący model CNN z modyfikacjami. |
| Loss = 0.1141%, | ||||
| Recall = 98.09%, | ||||
| F1-Score = 97.69%, | ||||
| Precision = 97.29%, | ||||
| Augmentowany Br35H | Accuracy = 98.99%, | |||
| Precision = 98.90%, | ||||
| Loss = 0.0570%, | ||||
| Recall = 98.91%, | ||||
| F1-Score = 99.04% | ||||
| 13 | Model DNN z fuzją cech | Br35H | Accuracy = 98.22%, | Wciąż istnieje potrzeba poprawy wyników, a zamiast stosowania dostosowanego modelu, należy rozważyć wykorzystanie istniejącego modelu do fuzji cech. |
| FNR = 1.77%, | ||||
| Sensitivity = 98.2%, | ||||
| F1-Score = 98%, | ||||
| Specificity = 98%, | ||||
| Figshare | Accuracy = 98.01%, | |||
| Sensitivity = 96.03%, | ||||
| F1-Score = 96%, | ||||
| Specificity = 98.67%, | ||||
| FNR = 3.96% | ||||
| 14 | AlexNet z SGD | Br35H | Accuracy = 98.79%, | Nadal istnieje potrzeba poprawy wyników; należy również sprawdzić zaawansowane modele oparte na CNN na różnych próbkach danych. |
| MCR = 1.20%, | ||||
| Sensitivity = 98.98%, | ||||
| Specificity = 98.58%, | ||||
| F1-Score = 98.82% | ||||
| 15 | InceptionV3 | Figshare | Accuracy = 98.89%, | Autorzy wykorzystali zbiór danych Figshare, który zawiera trzy klasy guzów; zamiast je klasyfikować, określają jedynie obecność lub brak guza; nadal istnieje potrzeba poprawy wyników oraz kategoryzacji klas guzów. |
| SensitivityB = 95.28%, | ||||
| SensitivityM = 94.47% | ||||
| 16 | Zoptymalizowana ResNet50 | Figshare | Accuracy = 99.03%, | Konieczne jest obliczenie pozostałych parametrów oceny wydajności oraz wprowadzenie dalszych usprawnień w wynikach. |
| Recall = 99%, | ||||
| F1-Score = 99% | ||||
| 17 | Res-BRNet | Br35H | Accuracy = 98.22%, | Wciąż istnieje potrzeba poprawy wyników. |
| Sensitivity = 98.11%, | ||||
| Precision = 98.22%, | ||||
| Figshare | F1-Score = 98.41% | |||
| 18 | ResNet101 + DenseNet121 | Figshare | Accuracy = 99.18%, | Odnotowano niewielką poprawę wyników; istnieje potrzeba sprawdzenia większej liczby zbiorów danych związanych z guzami mózgu. |
| Recall = 99.11%, | ||||
| F1-Score = 99.08, | ||||
| Precision = 99.07%, | ||||
| Sartaj | Accuracy = 97.24%, | |||
| Recall = 97.58%, | ||||
| F1-Score = 97.28%, | ||||
| Precision = 97.06%, | ||||
| 19 | CNN-SVM | Brats | Accuracy = 98.02%, | Istnieje potrzeba zastosowania istniejących modeli wraz z SVM, a także dalszej poprawy wyników. |
| F1-Score = 98.31%, | ||||
| Precision = 98.09%, | ||||
| Sensitivity = 98.53%, | ||||
| Specificity = 97.30%, | ||||
| Sartaj | Accuracy = 96.83%, | |||
| Precision = 95.36%, | ||||
| Sensitivity = 94.73%, | ||||
| Specificity = 97.56%, | ||||
| F1-Score = 95% | ||||
| 20 | Dostrojona EfficientNetB3 | Figshare | Accuracy = 98.70% | W celu poprawy wyników konieczne jest zastosowanie wspomnianych wariantów EfficientNetB3. |
| Sartaj | Accuracy = 97.50% | |||
| 21 | InceptionV4 | Masoud | Accuracy = 98.7%, | Wymagana jest poprawa wyników poprzez wykorzystanie większej liczby zbiorów danych. |
| Precision = 99%, | ||||
| Sensitivity = 98%, | ||||
| Specificity = 99%, | ||||
| F1-Score = 99.1% | ||||
| 22 | VGG16 | Masoud | Accuracy = 98% | Istnieje potrzeba poprawy wyników poprzez sprawdzenie większej liczby modeli głębokich sieci neuronowych. |
| 23 | MFR-CNN | Masoud | Accuracy = 94%, | W zaproponowanym rozwiązaniu zastosowano złożoną architekturę. |
| Recall = 96%, | ||||
| F1-Score = 96%, | ||||
| Precision = 96%, |
Tabela 1: Analiza porównawcza najnowszych prac badawczych. Tabela podsumowuje istniejące badania wraz z zastosowanymi podejściami, próbkami danych, wynikami i ograniczeniami. Kliknij tutaj, aby pobrać tę tabelę.
Tabela 1 przedstawia przegląd istniejących podejść, wskazując na ich ograniczenia w zakresie poprawy wyników oraz konieczność stosowania istniejących modeli DL, przy jednoczesnej ocenie ich wydajności w odniesieniu do różnych parametrów statystycznych, a wszystko to w ramach wydajnego systemu, który zapewnia lepsze rezultaty dla różnych zbiorów danych dotyczących guzów mózgu.
Cele badania i sformułowanie problemu
Ręczna interpretacja jest czasochłonna i obarczona zmiennością międzyobserwacyjną; dlatego szybka i dokładna kategoryzacja typów guzów mózgu na podstawie MRI jest kluczowa dla podejmowania decyzji klinicznych. Większość dzisiejszych podejść DL do zautomatyzowanej klasyfikacji guzów mózgu opiera się na pojedynczej sieci szkieletowej lub prostej fuzji na poziomie decyzji, co nie wykorzystuje w pełni komplementarnych reprezentacji cech z wielu wstępnie wytrenowanych architektur, a często są one walidowane jedynie na pojedynczym zbiorze danych, co ogranicza pewność co do ich generalizowalności.
Celem niniejszego projektu badawczego jest opracowanie i dostarczenie kompletnej, dokładnej metody diagnozowania nowotworów mózgu u ludzi przy użyciu dwuszkieletowego frameworka DL (EfficientNetB7 i DenseNet121), który wykorzystuje komplementarne reprezentacje cech w celu umożliwienia niezawodnej klasyfikacji guzów mózgu na podstawie obrazowania MRI. W pracy oceniono również odporność frameworka na wielu niezależnych, publicznych zbiorach danych. Takie podejście może pomóc radiologom i ratownikom medycznym w szybkim i skutecznym diagnozowaniu guzów mózgu, ratując życie pacjentów dzięki możliwości wczesnego rozpoznania i klasyfikacji zmian.
Aby rozwiązać konkretny problem badawczy i zrealizować cele niniejszego projektu, sformułowano następujące pytania badawcze oraz określono wkład w udzielenie odpowiedzi na te pytania: 1) Czy fuzja na poziomie cech (pośrednia) dwóch wstępnie wytrenowanych sieci szkieletowych jest skuteczniejsza niż techniki fuzji na poziomie decyzji (późna) oraz fuzja oparta na mechanizmie uwagi w klasyfikacji guzów mózgu? 2) Czy proponowany system zapewni spójną wydajność klasyfikacji w wielu niezależnie pozyskanych zbiorach danych MRI guzów mózgu?
Zakres niniejszego badania ogranicza się do klasyfikacji na poziomie obrazu (2D plaster MRI), z wykorzystaniem pięciu publicznie dostępnych zbiorów danych MRI guzów mózgu (Br35H, Figshare, Sartaj, Masoud oraz BBT-Dataset); ocena została przeprowadzona niezależnie dla każdego zbioru, a nie między zbiorami danych; zastosowano konkretną architekturę, potok przetwarzania wstępnego oraz konfigurację eksperymentalną opisaną w sekcji metodologii. Badanie nie obejmuje walidacji na poziomie pacjenta ani testowania w warunkach wdrożenia klinicznego.
Główne wkład tej pracy badawczej są następujące: 1) Głównym wkładem niniejszej pracy jest wykorzystanie podwójnych modeli wstępnie wytrenowanych w celu lepszej ekstrakcji cech, w tym DenseNet121 oraz EfficientNetb7 z optymalizacją hiperparametrów. 2) Innowacyjna architektura modelu z zaawansowaną techniką regularyzacji, zintegrowana z konkatenowanymi cechami z podwójnego modelu wstępnie wytrenowanego, zapewniająca stabilne wyniki. 3) Zastosowano skuteczną strategię augmentacji danych w celu zwiększenia różnorodności próbek treningowych, co pozwala na naukę bardziej ogólnych i specyficznych cech oraz eliminuje problemy z przeuczeniem. 4) Wydajność proponowanego modelu została oceniona na pięciu różnych, publicznie dostępnych zbiorach danych guzów mózgu, z uwzględnieniem różnych statystycznych parametrów ewaluacji, w tym dokładności (accuracy), wskaźnika błędnej klasyfikacji (misclassification rate), precyzji (precision), negatywnej wartości predykcyjnej (negative predictive value), czułości (sensitivity), swoistości (specificity), wskaźnika F1-Score, odsetka wyników fałszywie ujemnych (false negative rate) oraz odsetka wyników fałszywie dodatnich (false positive rate).
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
Najbardziej zagrażającą chorobą na świecie jest guz mózgu. Dokładna diagnoza może mieć kluczowe znaczenie dla przeżywalności pacjentów. Niemniej jednak wciąż istnieje potrzeba opracowania precyzyjnego systemu diagnostycznego, który pozwoliłby na wykrycie guzów mózgu we wczesnym stadium. Aby rozwiązać ten problem, zaproponowano bardziej niezawodną technikę dokładnego wykrywania guzów mózgu we wczesnych stadiach, wykorzystując hybrydowy, podwójny mechanizm głębokiego uczenia z optymalizowanymi hiperparametrami i dostrojonymi warstwami w oparciu o modele DenseNet121 oraz EfficientNetB7. Zaproponowane podejście przyjmuje jako dane wejściowe dwuwymiarowe obrazy MRI i generuje prognozę dotyczącą występowania lub braku guza dla zbioru danych do klasyfikacji binarnej Br35H, a także kategoryzację guza dla czterech pozostałych zbiorów danych do klasyfikacji wieloklasowej. W związku z tym w tej sekcji przedstawiono główne etapy zaproponowanego podejścia, od gromadzenia danych po końcowy wynik, w tym akwizycję danych, wstępne przetwarzanie danych, podział danych, wybór modelu, ekstrakcję cech,B prognozowanie guza oraz ewaluację zaproponowanego modelu, zgodnie z przedstawionym na Rysunku 1.
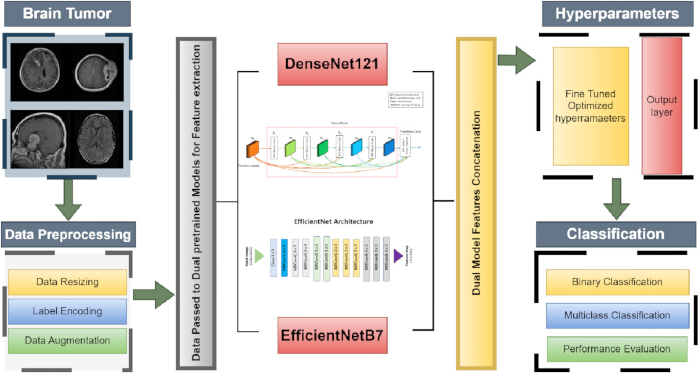
Rycina 1Proponowany schemat metodologii. Ten schemat przedstawia ogólną architekturę proponowanego modelu, obejmującą pozyskiwanie i przetwarzanie wstępne danych; dwa wstępnie wytrenowane modele do ekstrakcji cech; konkatenację ich cech oraz dostrajanie hiperparametrów w celu klasyfikacji guza i jego typu. Kliknij tutaj, aby wyświetlić większą wersję tej figury.
Pozyskiwanie danych
W każdych badaniach eksperymentalnych pierwszym krokiem jest pozyskanie danych. W tym celu wybrano pięć różnych, publicznie dostępnych zestawów danych, w tym Br35H24, Figshare25, Sartaj26, Masoud27 oraz zestaw danych obrazowych MRI z guzami mózgu z otwartoźródłowej biblioteki Kaggle28, które były już wykorzystywane przez wielu naukowców w diagnostyce wykrywania guzów mózgu. Zestaw danych Br35H zawiera 3 0 obrazów podzielonych na dwie klasy: obrazy mózgu zdrowego i chorego (z guzem), po 1 50 w każdej klasie, natomiast zestaw danych Figshare składa się z 3 064 obrazów, podzielonych na trzy grupy w zależności od typu guza: 1 426 obrazów glejaków, 708 obrazów oponiaków oraz 930 obrazów guzów przysadki mózgowej. Zestaw danych Sartaj zawiera 3 264 obrazy podzielone na cztery klasy guzów: glejaki (926 obrazów), oponiaki (937 obrazów), guzy przysadki mózgowej (901 obrazów) oraz mózg zdrowy lub bez guza (50 obrazów). Ponadto zestaw danych Masoud obejmuje również cztery różne klasy guzów, a obrazy do nich pobrano z trzech wyżej wymienionych zestawów; łącznie jest to 7 023 obrazy, które dalej podzielono na glejaki (1 621 obrazów), oponiaki (1 645 obrazów), guzy przysadki (1 757 obrazów) oraz mózg zdrowy lub bez guza (2 00 obrazów). Ostatnim wybranym zestawem jest zbiór oparty na obrazach MRI, który również obejmuje cztery klasy z łączną liczbą 5 248 obrazów, podzielonych na typy guzów: 1 312 obrazów glejaków, 1 312 obrazów oponiaków, 1 312 obrazów przysadki mózgowej i 1 312 obrazów mózgu zdrowego lub bez guza, co stanowi równomierny podział na typy guzów i jest uznawane za zrównoważony zestaw danych.
Preprocessing danych
Po akwizycji danych kolejnym krokiem jest przetwarzanie wstępne, które jest niezbędne dla uzyskania lepszych wyników i bardziej przydatne dla podejść obliczeniowych w celu ekstrakcji i nauki optymalnych cech z danych, co prowadzi do bardziej dokładnych rezultatów. Pierwszym zastosowanym krokiem była zmiana rozmiaru obrazów. Wybrano pięć publicznie dostępnych zbiorów danych z różnymi klasami i rozmiarami obrazów (nawet w obrębie tego samego zbioru dla różnych klas guzów), które następnie ujednolicono do wymiarów 24 x 24 dla lepszej interpretacji i uczenia modelu. Ponadto w odniesieniu do wszystkich zbiorów danych zastosowano augmentację danych poprzez generowanie dodatkowych próbek pod różnymi kątami, co poprawiło ekstrakcję cech i proces uczenia modeli DL. W tym celu zastosowano zakres rotacji 7% dla wszystkich obrazów, obracając je o maksymalnie 7 stopni. Dodatkowo zastosowano 5% losnego przesunięcia w poziomie i pionie dla wszystkich obrazów, z przesunięciem o 5% wysokości i szerokości względem obrazów oryginalnych. Następnie obrazy powiększono o 10% w stosunku do oryginałów, a na koniec wszystkie obrazy odwrócono poziomo i pionowo. Głównym powodem przeprowadzenia augmentacji danych29 jest przeciwdziałanie przeuczeniu (overfitting) i poprawa generalizacji modeli poprzez trenowanie ich na różnych przekształconych wersjach oryginalnych próbek danych. Przed podziałem zbiorów danych na zestaw treningowy i walidacyjny zastosowano kodowanie etykiet (label encoding), co jest pomocne przy obliczaniu funkcji straty podczas treningu i walidacji, a także sprawia, że próbki danych są bardziej odpowiednie do poprawnego przetwarzania etykiet przez modele. Dodatkowo zbiór danych podzielono na zestawy treningowy i walidacyjny w stosunku 80% do 20%30 dla każdego z nich; Tabela 2 przedstawia ogólną dystrybucję próbek danych oraz ich proporcje w podziale na trening i walidację.
| Zbiór danych | Klasy nowotworów | Całkowita liczba obrazów | Obrazy treningowe | Obrazy walidacyjne |
| Br35H | Zdrowy | 1500 | 1200 | 300 |
| Guz | 1500 | 1200 | 300 | |
| Łączna liczba obrazów | 3000 | 2400 | 600 | |
| Figshare | Glejak | 1426 | 1141 | 285 |
| Oponiak | 708 | 566 | 142 | |
| Przysadka mózgowa | 930 | 744 | 186 | |
| Łączna liczba obrazów | 3064 | 2451 | 613 | |
| Sartaj | Glioma | 926 | 741 | 185 |
| Meningiom | 937 | 749 | 188 | |
| Brak guza | 500 | 400 | 100 | |
| Przysadka mózgowa | 901 | 721 | 180 | |
| Łączna liczba obrazów | 3264 | 2611 | 653 | |
| Masoud | Glejak | 1621 | 1297 | 324 |
| Oponiak | 1645 | 1316 | 329 | |
| Brak guza | 2000 | 1600 | 400 | |
| Przysadka mózgowa | 1757 | 1405 | 352 | |
| Łączna liczba obrazów | 7023 | 5618 | 1405 | |
| Zbalansowany zbiór danych guzów mózgu (BBT-Dataset) | Glioma | 1312 | 1050 | 262 |
| Oponiak | 1312 | 1050 | 262 | |
| Brak guza | 1312 | 1050 | 262 | |
| Przysadka mózgowa | 1312 | 1050 | 262 | |
| Łączna liczba obrazów | 5248 | 4200 | 1048 |
Tabela 2: Rozkład zbioru danych. Tabela przedstawia statystyki dla poszczególnych klas dotyczące całkowitej liczby obrazów, liczby obrazów treningowych oraz walidacyjnych w zbiorach danych dotyczących guzów mózgu.
Zbiór danych Br35H składa się z 300 obrazów, z czego 240 wybrano do treningu, a 60 do walidacji. Zbiór danych Figshare obejmuje 3064 obrazy. Ze wszystkich obrazów 2451 wybrano do treningu, a pozostałe 613 do walidacji. Zbiór danych Sartaj zawiera łącznie 3264 obrazy, z czego 261 wykorzystano do treningu, a pozostałe 653 do walidacji. Zbiór danych Masoud posiada łącznie 7023 obrazy; z tych 5618 wykorzystano do treningu, a pozostałe 1405 do walidacji. Zbiór danych BBT obejmuje łącznie 5248 obrazów. Z całkowitej liczby obrazów 420 przeznaczono do celów treningowych, natomiast pozostałe 1048 obrazów przeznaczono do celów walidacji. Ponadto poniższa Rycina 2 przedstawia różne obrazy guzów mózgu.
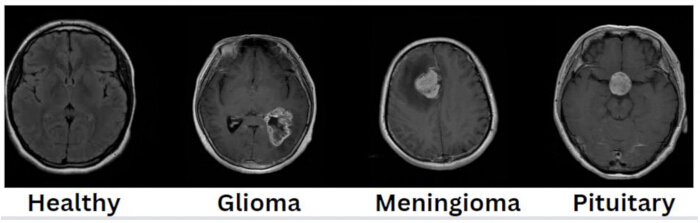
Rysunek 2Obrazy guzów mózgu, w tym typy guzów. Zbiór danych zawiera cztery obrazy zdrowej tkanki mózgu oraz trzy obrazy nowotworowe: glejaka, oponiaka i gruczolaka przysadki mózgowej. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Proponowany model
Po etapie wstępnego przetwarzania kolejnym krokiem jest zaproponowanie modelu treningowego skutecznego wyłącznie w klasyfikacji guzów mózgu. W tym celu zaproponowano wydajny model treningowy, przeznaczony specjalnie do klasyfikacji guzów mózgu. Zaproponowano nowatorski i wydajny model pretreningowy oparty na hybrydowej fuzji cech, obejmujący DenseNet12131,32 oraz EfficientNetB73, które zostały wykorzystane do ekstrakcji cech z obrazów; następnie wyekstrahowane cechy zostały sprzężone i przekazane do różnych dostrojonych hiperparametrów, w tym warstw trenowalnych i nietrenowalnych, aby dokładnie zdiagnozować guzy mózgu. Model ten został zaimplementowany na pięciu różnych, publicznie dostępnych zbiorach danych, omówionych w powyższych odpowiednich sekcjach. Ponadto model DenseNet121 został opracowany przez Gao Huanga i jego współpracowników w 2017 roku i składa się ze 121 warstw. Głównym celem tego modelu było skupienie się na maksymalizacji ponownego wykorzystania cech oraz uniknięcie problemu zanikającego gradientu34. Warstwy w tym modelu są zorganizowane w bloki gęste (dense blocks), z których każdy zawiera wiele warstw splotowych ekstrahujących i uczących się cech. Każda warstwa przyjmuje jako wejście mapę cech ze wszystkich poprzednich warstw, a jej wyjście jest połączone z wyjściami tych warstw i przekazywane jako wejście do kolejnych warstw w tym samym bloku w sposób jednokierunkowy (feed-forward). Ponadto między blokami gęstymi dodano warstwy przejścia, z których każda składa się z warstwy splotowej 1 × 1, warstwy BatchNormalization oraz warstw uśredniającego pulingu (average pooling) 2 × 2, które redukują mapę cech w celu kontrolowania złożoności modelu. Co więcej, przed globalną warstwą uśredniającego pulingu do klasyfikacji dodano warstwę końcową z funkcją aktywacji (AF) SoftMax. Podstawowa konstrukcja modelu DenseNet121 przedstawiona jest na Rysunku 334 poniżej.
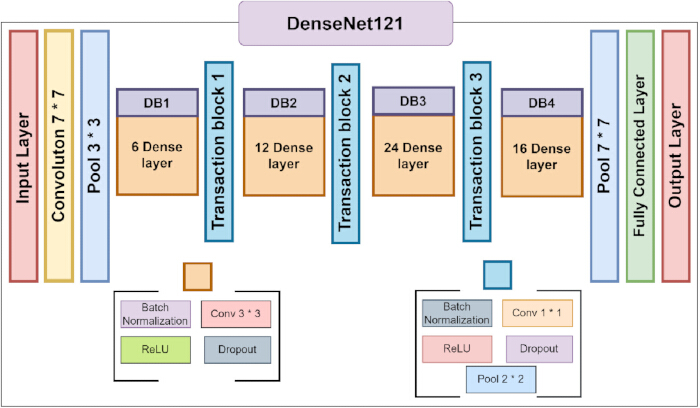
Rysunek 3Szczegóły architektury DenseNet12134. Rysunek ten przedstawia szczegóły architektury modelu DenseNet121, w tym wszystkie bloki gęste i przejścia. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Ponadto model EfficientNetB7 został opracowany przez Tan i Lee w 2019 roku. Należy on do rodziny EfficientNet, obejmującej warianty od B0 do B7, a jego głównym celem jest osiągnięcie lepszej wydajności niż w przypadku innych modeli przy jednoczesnym wykorzystaniu mniejszej liczby parametrów i mniejszej mocy obliczeniowej. Szerokość modelu (liczba kanałów na warstwę), głębokość (liczba warstw) oraz rozdzielczość mogą być dostrojone za pomocą skalowania złożonego (compound scaling), które stanowi kluczową cechę tego modelu. Co więcej, model ten składa się z bloków MBConv (mobile inverted bottleneck convolutional), które posiadają warstwę ekspansji splotowej 1 × 1 odpowiedzialną za zwiększanie liczby kanałów, sploty głębokościowo rozdzielne (depthwise separable convolution) odpowiedzialne za nakładanie splotu na każdy kanał osobno oraz warstwę projekcji splotowej 1 × 1, która redukuje liczbę kanałów do wartości pierwotnej. Ponadto każdy blok MBConv zawiera bloki Squeeze and Excitation (SE)35, które rekalibrują cechy wzdłuż kanałów, pomagając sieci skupić się na tych najważniejszych. Ponadto, zamiast funkcji sigmoidalnej lub jakiejkolwiek innej funkcji aktywacji (AF), zastosowano funkcję Swish, która działa lepiej niż ReLU dzięki dopuszczeniu wartości ujemnych, co usprawnia przepływ gradientu. Dodatkowo, w celu klasyfikacji, przed warstwą globalnego uśredniania pulingu (global average pooling) dodano końcową warstwę wyjściową z funkcją aktywacji SoftMax. Rysunek 435 przedstawia podstawową budowę modelu EfficientNetB7, natomiast Rysunek 5 przedstawia zalecaną architekturę modelu.
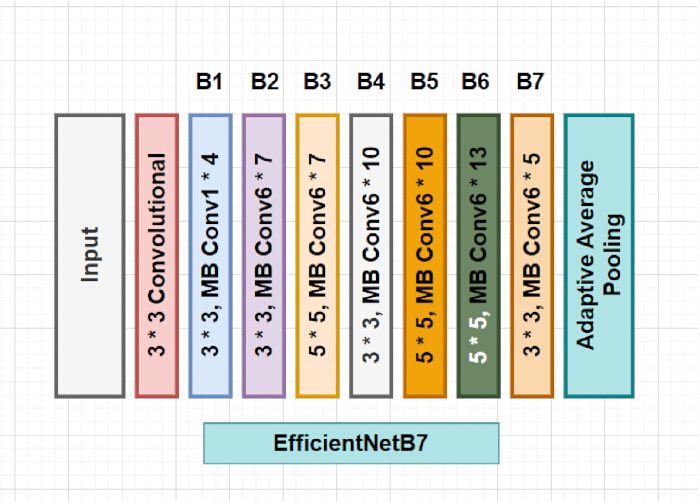
Rysunek 4Szczegóły architektury EfficientNetB735. Na tym rysunku przedstawiono szczegóły architektury modelu EfficientNetB7, w tym wszystkie mobilne odwrócone bloki splotowe typu bottleneck. Prosimy kliknąć tutaj, aby wyświetlić powiększoną wersję tej ryciny.
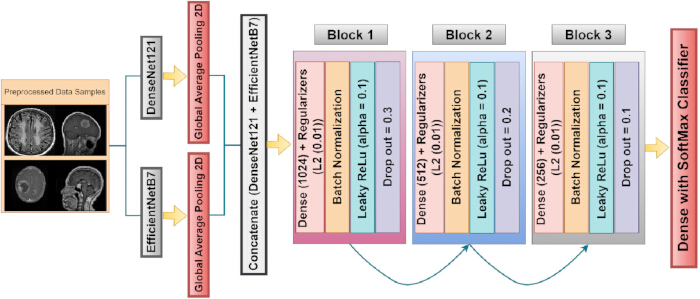
Rysunek 5Proponowana architektura hybrydowego modelu fusion. Zaproponowana architektura ilustruje sposób przekazywania wstępnie przetworzonych obrazów do ekstraktora cech, który składa się z trzech dostosowanych bloków o różnych hiperparametrach, za którymi następuje warstwa wyjściowa. Aby wyświetlić powiększoną wersję tego rysunku, kliknij tutaj.
Dodatkowo, wstępne cechy zostały wyekstrahowane z pretrained modeli DenseNet121 oraz EfficientNetB7. Zaktualizowane wagi pretrained modeli zostały wczytane do modeli trenowanych, a niepodlegające trenowaniu warstwy bazowe modeli zostały zamrożone, aby zapobiec ponownemu trenowaniu modelu. Powinno to pomóc modelowi zachować najlepszą wiedzę z poprzednich etapów, dostosować ją w świetle nowych próbek danych w celu poprawy zbieżności oraz skupić się na dodatkowych warstwach w celu trenowania i ekstrakcji zaawansowanych cech. Poniższe równania 1 i 2 przedstawiają działanie modeli DenseNet121 oraz EfficientNetB7.
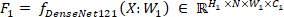 (1)
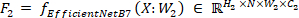 (2)
Powyższe równania 1 i 2 przedstawiają działanie wstępnie wytrenowanego modelu w zakresie ekstrakcji cech; F1 oznacza mapy cech wyjściowych generowane przez wstępnie wytrenowany model DenseNet121, a F2 oznacza mapy cech wyjściowych generowane przez wstępnie wytrenowany model EfficientNetB7 poprzez przetwarzanie obrazów wejściowych, reprezentowanych przez X. Ponadto W1 i W2 są parametrami uczącymi lub wagami powiązanymi odpowiednio z pierwszymi blokami i warstwami modeli DenseNet121 oraz EfficientNetB7. Co więcej, ∈ RN ×H1×W1×C1 oraz ∈ RN ×H2×W2×C2 reprezentują wymiary map cech wyjściowych modeli DenseNet121 i EfficientNetB7, odpowiednio o wymiarach H1 ×N×W1×C1 oraz H2 ×N×W2×C2, gdzie N reprezentuje rozmiar partii (batch size) obrazów, który przyjęto jako 16. Ponadto H1×W1 reprezentuje odpowiednio wysokość i szerokość obrazów dla modelu DenseNet121, a H2×W2 reprezentuje wysokość i szerokość obrazów dla modelu EfficientNetB7, dla których wybrano wymiary 24 × 24. C1 i C2 reprezentują odpowiednio kanały kolorów dla modeli DenseNet121 i EfficientNetB7. Po uzyskaniu map cech wyjściowych z modelu w postaci 2560 kanałów wyjściowych z EfficientNetB7 i 1024 z DenseNet121, do map cech wyjściowych zastosowano warstwę global average pooling 2D36, aby zredukować wymiar przestrzenny poprzez obliczenie średniej ze wszystkich wymiarów przestrzennych do pojedynczego wektora, co ułatwia przekazanie danych do następnej warstwy w celu lepszej ekstrakcji cech i rozpoznawania wzorców w zakresie cech interpretowalnych.
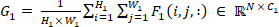 (3)
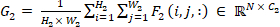 (4)
Powyższe równania 3 i 4 przedstawiają działanie warstwy globalnego uśredniania pulingu 2D (global average pooling 2D) zastosowanej odpowiednio do modeli DenseNet121 i EfficientNetB7, gdzie  i
 przedstawia procedurę normalizacji sumy poprzez podzielenie całkowitej liczby lokalizacji przestrzennych dla obu modeli, aby zapewnić, że skumulowany wynik jest średnią, a nie prostą sumą.
 i
 reprezentuje sumowanie w obrębie wymiarów przestrzennych map cech, podczas gdy ii j Służą one jedynie do iteracji odpowiednio po wysokości i szerokości, aby zsumować mapy cech dla obu modeli. Ponadto, F1(i, j, :) i F2(i, j, :) reprezentuje wartości map cech w konkretnych pozycjach przestrzennych (i, j) we wszystkich kanałach odpowiednio dla modeli DenseNet121 i EfficientNetB7. Operacja ta agreguje informacje przestrzenne w bardziej zwartą i dokładną reprezentację, zachowując jednocześnie najważniejsze cechy każdego obrazu. Ponadto wyjścia z warstw globalnego uśredniania (global average pooling) są łączone w celu utworzenia pojedynczego wektora cech dla każdej próbki, co często służy do fuzji cech z różnych modeli w celu poprawy wydajności poprzez wykorzystanie mocnych stron obu modeli; równanie 5 przedstawia sposób działania tego procesu.
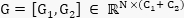 (5)
Powyższe równanie 5 przedstawia procedurę konkatenacji dwóch różnych wektorów cech modeli [G1, G2], gdzie G1 reprezentuje wektor cech modelu DenseNet121, a G2 reprezentuje wektor cech modelu EfficientNetB7. Kształt skonkatenowanego wektora cech jest reprezentowany przez RN ×(C1+ C2), gdzie N to rozmiar partii (batch size), reprezentujący liczbę próbek przetwarzanych równolegle, a (C1+ C2) to całkowita liczba cech uzyskanych odpowiednio z modelu 1 i 2, która wynosi około 3584 i są one przetwarzane równolegle; skonkatenowany wyjściowy wektor cech jest reprezentowany przez G. Ponadto dodano trzy różne bloki w celu modyfikacji modelu hybrydowego dla ekstrakcji bardziej złożonych cech, poprawy generalizacji i zapobiegania przeuczeniu, aby uzyskać bardziej dokładne i wydajne wyniki. Każdy blok składa się z warstwy gęstej (dense layer) o różnej liczbie neuronów: pierwszy blok posiada 1024 neurony w swoich warstwach gęstych, co pozwala na uchwycenie szerokiego zakresu cech i bardziej ogólnych wzorców w danych, podczas gdy drugi blok posiada 512 neuronów w warstwie gęstej, co służy do doprecyzowania cech poprzez redukcję wymiarowości i skupienie się na bardziej specyficznych wzorcach. Trzeci blok zawiera 256 neuronów w warstwie gęstej, które w sposób bardziej specyficzny destylują cechy, aby zapewnić, że do warstwy wyjściowej w celu wykonania właściwego zadania przekazywane są tylko najistotniejsze cechy i wzorce. Ponadto do każdej warstwy gęstej w każdym bloku dodano podejścia oparte na regularyzacji L237, aby zapobiec przeuczeniu poprzez penalizowanie większych wag, co jednocześnie sprawia, że model staje się bardziej złożony. Po każdym bloku wprowadzono również warstwę dropout38, aby losowo ignorować odpowiednio 30%, 20% i 10% neuronów dla bloków 1, 2 i 3, co wymusza na sieciach wypracowanie bardziej odpornych cech, które nie są zależne od pojedynczego neuronu. Dalej, aby ustabilizować proces uczenia, po każdej warstwie gęstej zastosowano warstwę BatchNormalization39, co zapewnia, że aktywacje pozostają w stabilnym zakresie i pomaga modelowi uniknąć problemów takich jak zanikające gradienty (vanishing gradients) i eksplodujące gradienty (exploding gradients) w fazie uczenia. Dodatkowo warstwa BatchNormalization przyspieszyła proces uczenia, co pozwoliło modelowi szybciej osiągnąć zbieżność poprzez wygładzenie obszaru funkcji straty, ułatwiając optymalizatorom znalezienie minimum globalnego. Ponadto w każdym bloku, w celu wprowadzenia nieliniowości, zastosowano aktywację leaky ReLU40, która pozwala modelowi uczyć się złożonych wzorców; leaky ReLU posiada przewagę nad innymi funkcjami aktywacji, zapewniając, że neuron nie stanie się nieaktywny poprzez dopuszczenie małego, niezerowego gradientu dla wartości wejściowych ujemnych. Poniższe równanie 6 przedstawia działanie różnych bloków zintegrowanych z hybrydowym modelem fuzji.
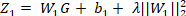 (6)
Po uzyskaniu skoncatenowanego wektora, G przechodzi przez warstwę gęstą (w pełni połączoną) bloku 1 składającą się z 1024 neuronów, gdzie macierz wag W1 przekształca wektor wejściowy G w 1024-wymiarowy wektor wyjściowy, a każdy element wektora wyjściowego jest kombinacją liniową cech wejściowych. Następnie do każdego z 1024 elementów wyjścia dodawany jest wektor obciążenia b1, co pozwala modelowi na niezależne przesunięcie wyniku cech wejściowych. Ponadto człon regularyzacji L2: λ||W1||22 penalizuje duże wagi, co zapobiega nadmiernemu poleganiu modelu na pojedynczym neuronie i pomaga uniknąć przeuczenia. Przy czym macierz wag konkretnej warstwy w sieci neuronowej to W1, podczas gdy ||W1||22 oznacza kwadrat normy L2 macierzy wag W1, a λ jest parametrem regularyzacji kontrolującym stopień zastosowanej regularyzacji, który we wszystkich blokach został ustawiony na 0.1. Z1 staje się nową reprezentacją cech po zastosowaniu warstwy gęstej oraz regularyzacji L2 na danych przekazanych z wektora skoncatenowanego G, co przedstawiono w równaniu 6.
Po otrzymaniu wyjścia z warstwy gęstej bloku 1 jako Z1, zastosowano warstwę BatchNormalization, która służy do przyspieszenia procesu uczenia; poniższe równanie 7 obrazuje zasadę jej działania.
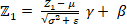 (7)
σ2 reprezentuje wariancję wyjścia ostatniej warstwy Z1 w obrębie partii (batch), natomiast μ to średnia wyjścia Z1, obliczana oddzielnie dla każdego neuronu, których w pierwszej warstwie gęstej było 1024. Z kolei ε jest niewielką stałą wprowadzoną w celu zapewnienia stabilności numerycznej i zapobiegania dzieleniu przez zero. Znormalizowane wyjście może być dostosowywane przez model poprzez zmianę parametrów skalowania γ, a przesunięte za pomocą parametru przesunięcia β; oba parametry są możliwe do wyuczenia. Ostatecznie zastosowanie warstwy BatchNormalization do wyjścia warstwy gęstej sprawia, że znormalizowane wyjście Z1 gwarantuje spójny rozkład aktywacji w różnych warstwach, co pomaga stabilizować i przyspieszać proces uczenia. Po BatchNormalization znormalizowane wyjście Z1 przechodzi przez funkcję aktywacji leaky ReLU, która wprowadza do sieci nieliniowość pomagającą w nauce złożonych wzorców w danych. Zamiast funkcji ReLU lub innej funkcji aktywacji, wybrano leaky ReLU, która jest zmodyfikowaną wersją funkcji ReLU uwzględniającą również małe wartości ujemne, zamiast sprowadzać je do 0 jak w przypadku ReLU, co pozwala przezwyciężyć problem „wymierającego ReLU” (dying ReLU). Równanie 8 poniżej przedstawia zasadę jej działania.
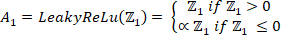 (8)
Gdzie Z1 stanowi wyjście warstwy BatchNormalization, która jest przekazywana do funkcji Leaky ReLU jako wejście w celu wprowadzenia nieliniowości, natomiast ∝ jest małą stałą używaną do określenia nachylenia ujemnej części funkcji. Ponadto A1 reprezentuje wynik uzyskany po zastosowaniu nieliniowości. Na koniec, do wyniku A1 otrzymanego z aktywacji Leaky ReLU zostaje zastosowana warstwa dropout, co przedstawiono w równaniu 9.
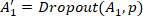 (9)
Gdzie A1 jest oryginalnym wyjściem funkcji aktywacji otrzymanym z ostatniej funkcji aktywacji ReLu, a p to współczynnik dropout, który przyjmuje wartości od 0 do 1 i został ustalony odpowiednio na 0,3, 0,2 oraz 0,1 dla trzech warstw blokowych w celu usunięcia określonej frakcji neuronów. Ponadto A1′ przedstawia zmodyfikowane wyjście po zastosowaniu warstwy dropout, w której niektóre neurony zostały ustawione na 0. Główną zaletą stosowania tej metody jest zapobieganie problemom z przeuczeniem (overfitting) oraz ograniczenie współadaptacji. Następnie wyjście z bloku 1 A1′ jest przekazywane do kolejnego bloku w celu ponownej ekstrakcji bardziej abstrakcyjnych cech; zastosowano w nim te same parametry co w bloku 1, z wyjątkiem zastosowania 512 neuronów w warstwie gęstej (dense layer) zamiast 1024 oraz współczynnika dropout wynoszącego 0,2 zamiast 0,3, podczas gdy pozostałe sekwencje operacyjne pozostają bez zmian, co opisano w poniższych równaniach od 10 do 13.
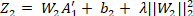 (10)
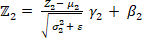 (11)
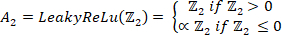 (12)
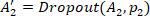 (13)
Po otrzymaniu wyniku z bloku 1 w postaci A1′, zostanie on przekazany do gęstej warstwy (w pełni połączonej) bloku 2 z 512 neuronami, gdzie macierz wag W2 przekształca wektor wejściowy A1′ w 512-wymiarowy wektor wyjściowy, a każdy element wektora wyjściowego stanowi kombinację liniową cech wejściowych. Następnie do każdego z 512 elementów wyjściowych dodawany jest wektor przesunięcia b2, co pozwala modelowi na niezależne przesuwanie wyników cech wejściowych. Dodatkowo zastosowano regularyzację L2, w której: λ||W2||22 penalizuje duże wagi, co służy ograniczeniu przeuczenia poprzez zapobieganie nadmiernemu poleganiu modelu na dowolnym konkretnym neuronie w tym bloku. Przy czym W2 jest macierzą wag konkretnej warstwy w sieci neuronowej, a λ jest parametrem regularyzacji kontrolującym stopień zastosowanej regularyzacji, który przyjął wartość 0.1. Z2 staje się nową reprezentacją cech po zastosowaniu gęstej warstwy oraz regularyzacji L2 na wejściu przekazanym z bloku 1, co przedstawiono w równaniu 10.
Ponadto, do nowej cechy Z2 zastosowano warstwę BatchNormalization, która posłużyła do przyspieszenia procesu trenowania; σ22 reprezentuje wariancję w obrębie partii (batch), natomiast μ2 jest średnią wyjścia Z2. Choć ε jest małą stałą wprowadzoną w celu zapewnienia stabilności numerycznej, γ jest wyuczalnym parametrem skali, który umożliwia modelowi modyfikację znormalizowanego wyjścia, a β jest wyuczalnym parametrem przesunięcia, który pozwala modelowi przesuwać znormalizowane wyjście. Ostatecznie, po zastosowaniu warstwy BatchNormalization, przedstawionej w równaniu 1, znormalizowane wyjście Z2 przeszło przez funkcję aktywacji leaky ReLU, która wprowadziła nieliniowość do sieci, co pokazano w równaniu 12. Gdzie Z2 stanowi wyjście warstwy BatchNormalization, które trafia do Leaky ReLU jako wejście w celu wykonania operacji nieliniowej. Natomiast A2 przedstawia wyjście otrzymane po zastosowaniu nieliniowości.
Na koniec do wyjścia A2, otrzymanego jako wejście z aktywacji Leaky ReLU, zastosowano warstwę dropout, co przedstawiono w równaniu 13. Gdzie A2 jest wyjściem z ostatniej funkcji aktywacji ReLU, a p2 to współczynnik dropout, który dla tego bloku wybrano jako 0,2 w celu usunięcia części neuronów. Ponadto A2′ przedstawia zmodyfikowane wyjście po zastosowaniu warstwy dropout, w której niektóre neurony zostały ustawione na 0. Następnie wyjście z bloku 2, A2′, zostało przekazane do trzeciego bloku w celu ponownej ekstrakcji bardziej abstrakcyjnych cech. Zastosowano w nim te same parametry co w bloku 2, z wyjątkiem 256 neuronów w warstwie gęstej zamiast 512 oraz współczynnika dropout wynoszącego 0,1 zamiast 0,2; pozostałe sekwencje operacyjne są identyczne, co opisano w poniższych równaniach od 14 do 17.
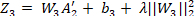 (14)
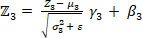 (15)
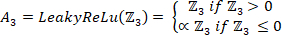 (16)
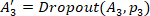 (17)
Po otrzymaniu wyniku z bloku 2 w postaci A2′, zostaje on przekazany do warstwy gęstej (w pełni połączonej) bloku 3 z 256 neuronami, gdzie macierz wag W3 przekształca wektor wejściowy A2′ w 256-wymiarowy wektor wyjściowy, a każdy element wektora wyjściowego jest kombinacją liniową cech wejściowych. Następnie do każdego z 256 elementów wyjścia dodawany jest wektor biasu b3, co pozwala modelowi niezależnie przesuwać wyjście cech wejściowych. Ponadto zastosowano regularyzację L2, w której: λ||W3||22 penalizuje duże wagi, co zapobiega nadmiernej zależności modelu od pojedynczego neuronu i pomaga uniknąć przeuczenia. Gdzie W3 jest macierzą wag konkretnej warstwy w sieci neuronowej, a stopień zastosowanej regularyzacji jest kontrolowany przez parametr regularyzacji λ, który został ustawiony na 0,01. Z3 staje się nową reprezentacją cech po zastosowaniu warstwy gęstej oraz regularyzacji L2 na wejściu przekazanym z bloku 3, co przedstawiono w równaniu 14.
Ponadto zastosowano warstwę BatchNormalization dla nowej cechy Z3, co posłużyło do przyspieszenia procesu uczenia; σ32 reprezentuje wariancję w obrębie partii (batch), natomiast μ3 jest średnią wartości wyjściowej Z3. Z kolei ε to mała stała dodawana w celu zapewnienia stabilności numerycznej. Znormalizowane wyjście może być dostosowane przez model za pomocą nauczalnego parametru skalowania γ3 oraz przesunięte za pomocą nauczalnego parametru przesunięcia β3. Ostatecznie, po zastosowaniu warstwy BatchNormalization, przedstawionej w równaniu 15, znormalizowane wyjście Z3 przeszło przez funkcję aktywacji leaky ReLU, która wprowadziła nieliniowość do sieci, co pokazano w równaniu 16. Gdzie Z3 stanowi wyjście warstwy BatchNormalization, które jest przekazywane do Leaky ReLU jako wejście w celu wprowadzenia nieliniowości, natomiast A3 określa wyjście otrzymane po zastosowaniu nieliniowości.
Na koniec, do wyjścia A3 otrzymanego jako wejście z aktywacji Leaky ReLU, co przedstawiono w równaniu 17, zastosowano warstwę dropout. Gdzie A3 jest wyjściem otrzymanym z ostatniej funkcji aktywacji ReLU, a p3 to współczynnik dropout, który dla tego bloku wybrano jako 0,1 w celu usunięcia frakcji neuronów. Dalej, A3′ przedstawia zmodyfikowane wyjście po zastosowaniu warstwy dropout, w którym niektóre neurony zostały ustawione na 0.
Ponadto sygnał wyjściowy z bloku 3 A3′ przechodził przez ostatnią warstwę gęstą w celu klasyfikacji, z liczbą neuronów K odpowiadającą rzeczywistej liczbie klas w zbiorze danych, co opisano w równaniu 18 poniżej.
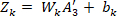 (18)
Macierz wag powiązana z grubą warstwą to Wk, która odpowiada za przekształcenie 256-wymiarowego wektora A3′ w wektor k-wymiarowy, reprezentujący wyuczone cechy z poprzedniego bloku, który stanowi wynik wyjściowy. Ponadto bk reprezentuje wektor obciążenia (bias), który koryguje predykcję, aby zapewnić niezerowy wynik funkcji aktywacji przy zerowym wejściu, a Zk jest wynikiem końcowej warstwy przed zastosowaniem funkcji aktywacji i generuje logity dla każdej klasy; na koniec zastosowano klasyfikator SoftMax41, który przekształca logit Zk w prawdopodobieństwo każdej klasy, co przedstawiono w równaniach 19 i 20.
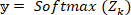 (19)
 (20)
Gdzie przewidywane prawdopodobieństwo itej klasy jest reprezentowane przez yi, K to liczba klas, natomiast Zk, i to logit dla itej klasy, a eZk, i to wartość wykładnicza logitu itej klasy. y przedstawia rozkład prawdopodobieństwa wszystkich możliwych klas i zapewnia, że suma prawdopodobieństw wynosi 1. Poniższa Tabela 3 zawiera szczegółowe informacje o hiperparametrach użytych do trenowania proponowanego modelu hybrydowego, w tym szczegóły architektoniczne przyjęte w celu poprawy odtwarzalności i wydajności.
| Hiperparametry | Proponowany model (FusionNetX) |
| Rozmiar obrazu | 224 × 224 |
| Architektura szkieletowa | Wstępnie wytrenowane modele EfficientNetB7 i DenseNet121 jako BBA1 i BBA2 |
| Augmentacja danych | Zakres obrotu = 7, |
| Szerokość/wysokość – zakres przesunięcia do 0,05, | |
| Zakres powiększenia do 0,01, | |
| Odbicie poziome/pionowe | |
| Współczynnik podziału danych | 80% do uczenia i 20% do walidacji przy zastosowaniu próbkowania warstwowego z ustalonym parametrem random_state = 42 |
| Ekstrakcja i fuzja cech | Do wyjścia każdego z głównych modułów (backbone) zastosowano globalne uśrednianie (global average pooling): 2560 dla BBA1 oraz 1024 dla BBA2, które następnie połączono, aby uzyskać wspólne wektory cech o wymiarze 3584. |
| Struktura bloku w pełni połączonego | 3 bloki w pełni połączone z jedną warstwą wyjściową. Każdy blok zawiera regularyzację L2 (λ=0,01), BatchNormalization, LeakyReLU (α=0,01), Dropout (odpowiednio 0,3, 0,2 i 0,1) oraz wymiar ukryty (odpowiednio 1024, 512, 256). W głowicy fuzji nie wprowadzono dodatkowych połączeń pomijających (Skip connections). |
| Funkcja aktywacji | Leaky ReLU & SoftMax |
| Optymalizator i szybkość uczenia | Adam z wartością 0,01 ustaloną na stałe, bez zastosowania harmonogramu tempa uczenia. |
| Funkcja straty | rzadka entropia krzyżowa kategoryczna |
| Wielkość partii | 16 |
| Epoki | 10 stałych epok dla każdego zbioru danych |
| Wykorzystana platforma | Notatnik Kaggle z procesorem GPU P100 i 16 GB pamięci VRAM z wykorzystaniem platform TensorFlow i Keras. |
Tabela 3: Hiperparametry użyte do trenowania proponowanego modelu oraz szczegóły proponowanej architektury.Tabela ta przedstawia szczegóły strukturalne i architektoniczne proponowanego modelu, wraz z dostrojonymi parametrami oraz środowiskiem implementacyjnym.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
W tej części szczegółowo omówiono wyniki testowania proponowanego modelu podwójnej fuzji cech na pięciu otwartych zbiorach danych dotyczących nowotworów mózgu, w tym Br35H, Figshare, Sartaj, Masoud oraz Balanced Brain tumor; ich wydajność oceniono w oparciu o różne statystyczne parametry ewaluacji, takie jak dokładność42,43,4, wskaźnik błędnej klasyfikacji (MCR)45, precyzja, określana również jako PPV
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
Podsumowując, zaproponowany model działał w następujący sposób: Po pierwsze, rozmiar obrazu wybrano jako 224 × 224, co jest umiarkowanym rozmiarem dla każdego modelu uczenia głębokiego, pozwalającym na ekstrakcję i naukę odpowiednich cech z próbek danych przy jednoczesnym zachowaniu wszystkich istotnych informacji. Następnie przeprowadzono augmentację danych, co sprzyja urozmaiceniu kierunków próbek danych i odgrywa istotną rolę w ekstrakcji cech z różnych płaszczyzn lub kątów; zakres obrotu wybrano jako 7%, a zakres prz...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie mają żadnych informacji do ujawnienia i nie stwierdzono konfliktu interesów. Ponadto, do przygotowania rękopisu oraz rycin nie wykorzystano narzędzi AI.
Podziękowania
Autorzy są wdzięczni za wsparcie udzielone przez Princess Nourah bint Abdulrahman University Researchers Supporting Project (PNURSP2026R192), Princess Nourah bint Abdulrahman University, Rijad, Arabia Saudyjska. Autorzy dziękują również uczestnikom badań oraz instytucjom, które przyczyniły się do realizacji niniejszej pracy.
Finansowanie:
Praca ta była wspierana przez grant Narodowej Fundacji Badań Korei (NRF) finansowany przez rząd Korei (MSIT) (nr RS-2023-00218176) oraz Fundusz Badawczy Uniwersytetu Soonchunhyang. Projekt wspierania badaczy Uniwersytetu Księżniczki Nourah bint Abdulrahman numer (PNURSP2026R192), Uniwersytet Księżniczki Nourah bint Abdulrahman, Rijad, Arabia Saudyjska.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Zbiór danych Br35H Brain Tumor Dataset | Kaggle (dostawca zbioru danych) | https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection | Publiczny zbiór danych; klasyfikacja binarna (guz / brak guza) 300 obrazów MRI |
| Zbiór danych Figshare Brain Tumor Dataset | Kaggle / Figshare | https://doi.org/10.6084/m9.figshare.1512427 | Publiczny zbiór danych; klasyfikacja wieloklasowa (glioma, oponiak, guz przysadki) 3064 obrazy MRI |
| Zbiór danych Sartaj Brain Tumor Classification MRI Dataset | Kaggle (zbiór danych opracowany przez Sartaja Bhuvajiego) | https://doi.org/10.34740/kaggle/dsv/12745533 | Publiczny zbiór danych; klasyfikacja wieloklasowa (glioma, oponiak, brak guza, guz przysadki) 3264 obrazy MRI |
| Zbiór danych Masoud Brain Tumor MRI Dataset | Kaggle (zbiór danych opracowany przez Masouda Nickparvara) | https://doi.org/10.34740/kaggle/dsv/14832123 | Publiczny zbiór danych; klasyfikacja wieloklasowa (glioma, oponiak, brak guza, guz przysadki) 7023 obrazy MRI |
| BBT-Dataset (Brain Tumor Dataset) | Kaggle (dostawca zbioru danych) | https://doi.org/10.34740/kaggle/dsv/6758053 | Publiczny zbiór danych; zbalansowana klasyfikacja wieloklasowa guzów mózgu 5248 obrazy MRI |
| Python | Python Software Foundation | https://www.python.org | Język programowania, wersja 3.10.13 |
| TensorFlow / Keras | Google / programiści TensorFlow | https://www.tensorflow.org | Framework do głębokiego uczenia; konstrukcja, trenowanie i ewaluacja modelu, wersja 2.15.0 |
| EfficientNetB7 (wstępnie wytrenowany) | Google / Keras Applications | https://keras.io/api/applications/efficientnet/ | Szkielet (backbone) wstępnie wytrenowany na zbiorze ImageNet; ekstrakcja cech |
| DenseNet121 (wstępnie wytrenowany) | Keras Applications | https://keras.io/api/applications/densenet/ | Szkielet (backbone) wstępnie wytrenowany na zbiorze ImageNet; ekstrakcja cech |
| scikit-learn | programiści scikit-learn (NumFOCUS) | https://scikit-learn.org | Kodowanie etykiet, podział na zbiór treningowy i testowy, metryki ewaluacji (raport klasyfikacji, macierz pomyłek, ROC/AUC) |
| OpenCV (cv2) | zespół OpenCV | https://opencv.org | Ładowanie i zmiana rozmiaru obrazów |
| NumPy | programiści NumPy (NumFOCUS) | https://numpy.org | Obliczenia numeryczne i operacje na tablicach |
| pandas | zespół programistyczny pandas (NumFOCUS) | https://pandas.pydata.org | Organizacja danych i tabulacja metryk |
Bibliografia
- He Z, et al. A review on methods for diagnosis of breast cancer cells and tissues. Cell Prolif. 2020;53(7):e12822. doi:10.1111/cpr.12822.
- Siegel RL, Giaquinto AN, Jemal A. Cancer statistics, 2024. CA Cancer J Clin. 2024;74(1):12–49.
- Varuna Shree N, Kumar TNR. Identification and classification of brain tumor MRI images with feature extraction using DWT and probabilistic neural network. Brain Inform. 2018;5(1):23–30.
- Ghoreishi Mokri SM, Valadbeygi N, Grigoryeva V. Diagnosis of glioma, menigioma and pituitary brain tumor using MRI images recognition by deep learning in Python. EAI Endorsed Trans Intell Syst Mach Learn Appl. 2024;1:1–9.
- Sadeghi MH, et al. Deep learning in ovarian cancer diagnosis: a comprehensive review of various imaging modalities. Pol J Radiol. 2024;89:e30–e48.
- Anari S, Safarpour H, Cunneen M, Bendechache M. AR-EpiAid: an augmented reality decision support system for real-time interpretation of multimodal epilepsy data [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468245.
- Iyortsuun NK, et al. A review of machine learning and deep learning approaches on mental health diagnosis. Healthcare (Basel). 2023;11(3):285. doi:10.3390/healthcare11030285.
- An Q, Rahman S, Zhou J, Kang JJ. A comprehensive review on machine learning in the healthcare industry: classification, restrictions, opportunities, and challenges. Sensors (Basel). 2023;23(9):4178. doi:10.3390/s23094178.
- Iqbal S, Qureshi AN, Li J, Mahmood T. On the analyses of medical images using traditional machine learning techniques and convolutional neural networks. Arch Comput Methods Eng. 2023;30:3173–3233.
- Chhimpa GR, et al. A transfer learning-driven fine-tuning of YOLOv10 for improved brain tumor detection in MRI images. Sci Rep. 2026;16:98. doi:10.1038/s41598-025-28813-w.
- Akbarian S, Seyyed-Kalantari L, Khalvati F, Dolatabadi E. Evaluating knowledge transfer in the neural network for medical images. IEEE Access. 2023;11. doi:10.1109/ACCESS.2023.3283216.
- Meena G, Mohbey KK, Acharya M, Lokesh K. An improved convolutional neural network-based model for detecting brain tumors from augmented MRI images. J Auton Intell. 2023;6:1–19.
- Ata MM, Yousef RN, Karim FK, Khafaga DS. An improved deep structure for accurately recognizing brain tumors. Comput Syst Sci Eng. 2023;46(2):1597–1616.
- Khushi HMT, et al. Performance analysis of state-of-the-art CNN architectures for brain tumour detection. Int J Imaging Syst Technol. 2024;34:e22949. doi:10.1002/ima.22949.
- Agarwal M, et al. Deep learning for enhanced brain tumor detection and classification. Results Eng. 2024;22:102117. doi:10.1016/j.rineng.2024.102117.
- Peddinti AS, Maloji S. Optimised ResNet50 for multiclass classification of brain tumors. Scalable Comput Pract Exp. 2024;25(3):1667–1680.
- Zahoor MM, et al. Brain tumor MRI classification using a novel deep residual and regional CNN. Biomedicines. 2024;12(7):1395. doi:10.3390/biomedicines12071395.
- Chen W, et al. A robust approach for multitype classification of brain tumors using deep feature fusion. Front Neurosci. 2024;18:1288274. doi:10.3389/fnins.2024.1288274.
- Suryawanshi S, Patil SB. Efficient brain tumor classification with a hybrid CNN-SVM approach in MRI. J Adv Inf Technol. 2024;15:340–354.
- Reyes D, Sánchez J. Performance of convolutional neural networks for the classification of brain tumors using magnetic resonance imaging. Heliyon. 2024;10:e25468. doi:10.1016/j.heliyon.2024.e25468.
- Bibi N, et al. A transfer learning-based approach for brain tumor classification. IEEE Access. 2024;12:111218–111238.
- Albalawi E, et al. Integrated approach of federated learning with transfer learning for classification and diagnosis of brain tumor. BMC Med Imaging. 2024;24:110. doi:10.1186/s12880-024-01261-0.
- Alkhatib AJ, et al. Diagnosing brain tumors from MRI images through a multi-fused CNN with auxiliary layers. Sustain Mach Intell J. 2024;6(1):4–13.
- Hamada A. Br35H: Brain Tumor Detection 2020 [dataset]. Kaggle; 2020. Available from: https://www.kaggle.com/datasets/ahmedhamada0/brain-tumor-detection.
- Cheng J. Brain tumor dataset [dataset]. Figshare; 2024. Available from: https://doi.org/10.6084/m9.figshare.1512427.
- Bhuvaji S. Brain Tumor Classification (MRI) [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/12745533.
- Nickparvar M. Brain Tumor MRI Dataset [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/14832123.
- Jayanti V. Brain Tumor MRIs [dataset]. Kaggle; cited 2026 Jul 30. Available from: https://doi.org/10.34740/kaggle/dsv/6758053.
- Tuteja P, et al. Augmented multimodal fusion for optimized brain tumor detection: evaluation and comparative analysis. J Vis Exp. 2025;(220):e67822. doi:10.3791/67822.
- Rasool N, et al. CNN-TumorNet: leveraging explainability in deep learning for precise brain tumor diagnosis on MRI images. Front Oncol. 2025;15:1554559. doi:10.3389/fonc.2025.1554559.
- Huang G, Liu Z, van der Maaten L, Weinberger KQ. Densely connected convolutional networks [conference paper]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition; Honolulu, HI, USA; 2017. p. 4700–4708. Available from: https://openaccess.thecvf.com/content_cvpr_2017/html/Huang_Densely_Connected_Convolutional_CVPR_2017_paper.html.
- Tuteja P, Wani MA, Wani NA, Bedi J. EASE-Net: an explainable AI-based segmentation and ensemble network for interpretable brain tumor diagnosis and classification in MRI images. Arab J Sci Eng. 2026;in press. doi:10.1007/s13369-026-11350-7.
- Tan M, Le QV. EfficientNet: rethinking model scaling for convolutional neural networks [conference paper]. Presented at: 36th International Conference on Machine Learning; Long Beach, CA, USA; 2019. p. 6105–6114. Available from: https://proceedings.mlr.press/v97/tan19a.html.
- Vellaichamy AS, Swaminathan A, Varun C, Kalaivani S. Multiple plant leaf disease classification using DenseNet-121 architecture. Int J Electr Eng Technol. 2021;12(5):38–57.
- Naidji MR, Elberrichi Z. Automatic detection of COVID-19 from chest X-ray images using the EfficientNet-B7 CNN model with channel-wise attention. Int J Comput Digit Syst. 2024;15:1443–1456.
- Malla PP, Sahu S, Alutaibi AI. Classification of tumors in brain MR images using a deep convolutional neural network and global average pooling. Processes. 2023;11(3):679. doi:10.3390/pr11030679.
- Shi G, Zhang J, Li H, Wang C. Enhance the performance of deep neural networks via L2 regularization on the input of activations. Neural Process Lett. 2019;50:57–75.
- Srivastava N, et al. Dropout: a simple way to prevent neural networks from overfitting. J Mach Learn Res. 2014;15:1929–1958.
- Ioffe S, Szegedy C. Batch normalization: accelerating deep network training by reducing internal covariate shift [conference paper]. Presented at: 32nd International Conference on Machine Learning; Lille, France; 2015. p. 448–456. Available from: https://proceedings.mlr.press/v37/ioffe15.html.
- Varshney M, Singh P. Optimizing nonlinear activation functions for convolutional neural networks. Signal Image Video Process. 2021;15:1323–1330.
- Bera S, Shrivastava VK. Analysis of various optimizers on a deep convolutional neural network model in the application of hyperspectral remote-sensing image classification. Int J Remote Sens. 2020;41:2664–2683.
- Safarpour H, et al. A dual-phase segmentation framework utilizing Gumbel-Softmax and a cascaded Swin Transformer for multiclass brain tumor segmentation. Research Square. 2025:doi:10.21203/rs.3.rs-7093467/v1.
- Seyrek EC, Uysal M. A comparative analysis of various activation functions and optimizers in a convolutional neural network for hyperspectral image classification. Multimed Tools Appl. 2024;83:53785–53816.
- Maxwell AE, Warner TA, Guillén LA. Accuracy assessment in convolutional neural network-based deep-learning remote-sensing studies—part 1: literature review. Remote Sens (Basel). 2021;13(13):2450. doi:10.3390/rs13132450.
- Villon S, et al. A new method to control error rates in automated species identification with deep-learning algorithms. Sci Rep. 2020;10:10972. doi:10.1038/s41598-020-67573-7.
- Rasool N, et al. TransResUNet: revolutionizing glioma brain tumor segmentation through transformer-enhanced residual UNet. IEEE Access. 2024;12:72105–72116.
- Chen Y, et al. Evaluation efficiency of hybrid deep-learning algorithms with neural-network decision-tree and boosting methods for predicting groundwater potential. Geocarto Int. 2022;37:5564–5584.
- Alakus TB, Turkoglu I. Comparison of deep-learning approaches to predict COVID-19 infection. Chaos Solitons Fractals. 2020;140:110120. doi:10.1016/j.chaos.2020.110120.
- Ranjbarzadeh R, et al. Explainable attention-guided Swin Transformer networks for brain tumor segmentation from 3D MRI. Lect Notes Netw Syst. 2026;1730:110–128. Available from: https://lero.ie/bibliography/explainable-attention-guided-swin-transformer-networks-for-brain-tumor-segmentation-from-3d-mri/.
- Ranjbarzadeh R, et al. A global-local 3D brain tumor segmentation model using vision transformers and axial state-space modeling [conference paper]. Presented at: 3rd International Conference on Artificial Intelligence, Computer, Data Sciences, and Applications; Boracay Island, Philippines; 2026. https://doi.org/10.1109/ACDSA67686.2026.11468214.
- Hussain SS, et al. Next-generation automation in neuro-oncology: advanced neural networks for MRI-based brain tumor segmentation and classification. IEEE Access. 2025;13:41141–41158.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.