Niniejszy artykuł przedstawia nadzorowany przez człowieka przepływ pracy obliczeniowej w celu zbadania powracających reprezentacji kobiet na 433 chińskich obrazach eksportowych z ery Qing. Siedem kategorii referencyjnych zdefiniowanych przez ludzi oraz powtarzające się wskazówki wizualne charakteryzują wzorce w obrębie korpusu, podczas gdy wyniki ograniczają się do pobranych obrazów i nie mierzą rzeczywistości społecznej okresu Qing ani odbioru historycznego.
Artykuł badawczy
Tożsamość kobieca i wyobrażenia klasowe w chińskich obrazach eksportowych z okresu dynastii Qing: badanie interpretacji międzykulturowej wspomagane przez sztuczną inteligencję
W tym artykule
Podsumowanie
Streszczenie
W niniejszym badaniu przeanalizowano powtarzające się reprezentacje tożsamości kobiecej oraz wizualne wskazówki kodujące klasę społeczną w korpusie 433 chińskich obrazów eksportowych z dynastii Qing, datowanych na lata 1757–1911. Przepływ pracy łączył model CLIP ViT-B/32 do wstępnego etykietowania, lokalizację wspomaganą modelem Segment Anything Model (SAM), redukcję wymiarowości i klasteryzację oraz ręczne kodowanie ikonograficzne przeprowadzone przez dwóch niezależnych koderów. Etykiety CLIP posłużyły do wstępnej organizacji, SAM pełnił funkcję narzędzia wspomagającego lokalizację, a rozstrzygnięte kodowanie ludzkie dostarczyło kategorii referencyjnych. Wyniki zbiorcze pozwoliły zidentyfikować siedem ludzkich kategorii referencyjnych: elita/piękno (n = 112), pracujące (n = 72), domowe (n = 64), służba (n = 58), rytualne/ślubne (n = 45), targowe (n = 43) oraz artystyczne (n = 39). Wstępne etykiety obliczeniowe były zgodne z ludzkimi etykietami referencyjnymi dla 356 z 433 obrazów (82,2%), przy czym czułość na poziomie kategorii wahała się od 73,3% do 88,4%. Do charakterystyki profili wizualnych tych kategorii wykorzystano powtarzające się kombinacje ubioru, otoczenia przestrzennego, przedmiotów, postawy oraz przedstawionych relacji społecznych. Ewaluacja 433 par etykiet AI–człowiek na poziomie poszczególnych przypadków pozwoliła uzyskać kompleksowe wyniki precyzji, czułości i miary F1 na poziomie kategorii, a także macierz pomyłek szczegółowo opisującą wzorce klasyfikacji. Walidacja klastrów potwierdziła wybrany sposób grupowania i wykazała zgodność między uzyskanymi klastrami a zdefiniowanymi przez ludzi kategoriami referencyjnymi. Ogólnie rzecz biorąc, powtarzające się kombinacje ubioru, otoczenia przestrzennego, przedmiotów, postawy i relacji społecznych wskazują na ustrukturyzowane typologie malarskie w badanym korpusie. Wyniki te charakteryzują reprezentację wizualną w chińskich obrazach eksportowych z okresu dynastii Qing, lecz nie powinny być interpretowane jako bezpośrednie mierniki statusu prawnego, doświadczeń życiowych, popytu rynkowego czy historycznego odbioru za granicą.
Wprowadzenie
Chińskie obrazy eksportowe z okresu dynastii Qing stanowiły część handlowych i kulturowych sieci łączących Kanton i inne centra kolekcjonerskie z nabywcami z Europy i Ameryki od końca XVIII wieku1,2,3,4,5. Kupcy, podróżnicy, dyplomaci, misjonarze i kolekcjonerzy nabywali te obrazy jako przenośne towary, pamiątki, źródła informacji wizualnych oraz przedstawienia miejsc, zawodów, produkcji, obyczajów i typów społecznych. Ich obieg odzwierciedlał zatem zarówno praktyki chińskich warsztatów, jak i oczekiwania rynków zewnętrznych.
Zagraniczny popyt sprzyjał rozpoznawalnym tematom, formatom seryjnym, powtarzalnym motywom oraz scenom, które można było kolekcjonować i porównywać. Warsztaty dostosowywały media, skalę, kompozycję i tematykę do celów sprzedażowych, podczas gdy nabywcy często preferowali czytelne przedstawienia rzemiosł, ceremonii, wnętrz, ogrodów, ulic oraz malowniczych typów społecznych. Powtarzające się wersje scen z warsztatów kantońskich dodatkowo demonstrują, w jaki sposób artyści i asystenci adaptowali ikonografię oraz zachodnie środki wyrazu malarskiego dla zagranicznych patronów1,2,3,4,5. Chociaż popyt rynkowy mógł wpływać na to, co było wytwarzane i zachowane, obecny korpus nie mierzy bezpośrednio preferencji ani reakcji poszczególnych nabywców.
Obrazy te należy zatem traktować jako źródła wybiórcze i zapośredniczone, a nie jako kompleksowe zapisy życia codziennego. Przedstawione na nich sceny mogą idealizować, upraszczać, standaryzować lub adaptować praktyki społeczne poprzez konwencje warsztatowe, selekcję rynkową, nabytki muzealne, katalogowanie i digitalizację1,2,3,4,5. Interpretacja historyczna musi odróżniać cechy bezpośrednio obserwowalne na obrazach od wniosków dotyczących przedstawionych osób, warunków produkcji oraz znaczeń, jakie późniejsi widzowie przypisywali tym dziełom.
Postacie kobiece stanowią ukierunkowany sposób badania tego rozróżnienia. Odzież, fryzura, postawa, otoczenie przestrzenne, przedmioty, czynności oraz relacje z innymi postaciami mogą grupować kobiety w wizualnie powtarzalne role, w tym kategorie elitarno-urodowe, domowe, służebne, robotnicze, rynkowe, wykonawcze oraz rytualne/ślubne. Kategorie te są analitycznymi opisami wzorców przedstawieniowych i same w sobie nie określają rangi prawnej, zamożności, zawodu, etniczności, przynależności do dynastii Banner lub Han, charakteru moralnego ani tożsamości życiowej.
Cyfrowa historia sztuki oraz komputerowe rozpoznawanie obrazów (computer vision) mogą ułatwiać wielkoskalowe porównania zdigitalizowanych kolekcji wizualnych, umożliwiając jednocześnie krytyczną analizę założeń zawartych w modelach obliczeniowych6,7. Modele wizualno-językowe mogą pomagać w identyfikacji i organizacji powracających motywów wizualnych, choć stronniczość kulturowa pozostaje istotnym ograniczeniem w przypadku zastosowania współczesnych słowników modelowych do historycznych obrazów spoza kręgu kultury zachodniej8. Powiązane badania obliczeniowe nad tradycyjnym malarstwem chińskim w podobny sposób wykazują wartość łączenia ilościowego wykrywania wzorców z interpretacją opartą na wiedzy historycznej9.
Niniejsze badanie odnosi się do trzech pytań: (1) Które uznane, zakodowane przez ludzi kategorie tożsamości żeńskiej są reprezentowane w korpusie? (2) Jakie kombinacje ubrań, ustawień przestrzennych, obiektów, postawy i relacji społecznych charakteryzują te kategorie? (3) W jaki sposób ogólna dokładność dopasowania (exact-match accuracy) oraz pełność (recall) na poziomie kategorii różnią się pomiędzy siedmioma kategoriami? Przepływ pracy opiera się na podejściach obliczeniowych stosowanych w tradycyjnym malarstwie chińskim9, ograniczając jednocześnie swoje twierdzenia historyczne do wybranych obrazów i udokumentowanych analiz.
Zamierzony wkład ma charakter zarówno historiograficzny, jak i techniczny. Porównanie w skali całego korpusu pozwala zidentyfikować powtarzające się formuły obrazowe, które mogą zostać następnie poddane kontekstualizacji poprzez wnikliwą analizę historyczną. Takie podejście może wspomóc badania nad płcią, hierarchią, reprezentacjami życia codziennego oraz spotkaniami międzykulturowymi, bez traktowania częstotliwości występowania obrazów jako dowodu na powszechność społeczną, a podobieństwa wizualnego jako dowodu na tożsamość historyczną.
Protokół
Projekt badania i jednostka analityczna
Każdy obraz lub wpis w katalogu traktowano jako jedną jednostkę analityczną. Zastosowano obserwacyjny projekt oparty na korpusie, łączący przegląd metadanych, wstępną organizację komputerową, niezależne kodowanie ręczne oraz interpretację historii sztuki. Okres badania określono na lata 1757–1911, a kryteria włączenia i wykluczenia stosowano w ramach tego przedziału czasowego. Analizie poddano historyczne dzieła sztuki oraz powiązane z nimi metadane katalogowe. W przypadku porównywania rozkładów w przedziałach czasowych o różnej długości, liczebność znormalizowano względem czasu trwania przedziału, natomiast w interpretacji uwzględniono potencjalne błędy wynikające z przeżywalności i nabytego zbioru.
Konstrukcja i wybór korpusu
Rekordy kandydujące pobrano z cytowanych katalogów muzealnych, archiwów cyfrowych oraz opublikowanych katalogów. Dla każdego rekordu kandydującego zachowano informacje o instytucji, tytule, dacie lub przedziale dat, medium, numerze inwentarzowym lub katalogowym, stałym adresie URL źródła, dacie pobrania oraz oświadczeniu dotyczącym praw. Linki do źródeł zachowano nawet w przypadkach, gdy odpowiadający im plik obrazu nie mógł zostać legalnie redystrybuowany. Opisana procedura selekcji rozpoczęła się od 612 obrazów kandydujących. Z tej liczby wykluczono 85, ponieważ wykraczały one poza okres 1757–1911 lub tradycję malarstwa eksportowego, 58 wykluczono z powodu bycia współczesnymi reprodukcjami, rozmycia obrazu lub przedstawiania niewłaściwych tematów, 29 wykluczono z powodu braku możliwej do zidentyfikowania postaci kobiecej lub niewystarczającej rozdzielczości obrazu, a 7 wykluczono ze względu na niewystarczające metadane. Ostateczny korpus analityczny objął 433 rekordy.
Standaryzacja metadanych i przetwarzanie wstępne obrazów
Każdemu obrazowi w końcowym korpusie analitycznym przypisano stabilny identyfikator QEP w zakresie od QEP_001 do QEP_433. Zachowano powiązane metadane muzealne, w tym instytucję, numer inwentarzowy, tytuł, datę, technikę lub materiały, miejsce pochodzenia, link źródłowy oraz dostępny opis katalogowy. Na potrzeby analizy wizualnej odnotowano wstępną etykietę AI, kategorię zweryfikowaną przez człowieka, liczbę postaci kobiecych, grupę wiekową, posturę, ubiór, otoczenie przestrzenne, powiązane obiekty oraz relacje społeczne. Każdy obraz zaklasyfikowano do jednej z siedmiu głównych kategorii: elita/piękno, domowa, służąca, pracująca, targowa, artystyczna lub rytualna/ślubna. W scenach zawierających wiele postaci kobiecych, postać centralną identyfikowano na podstawie widocznej dominacji i znaczenia dla narracji. W przypadku braku jednej dominującej postaci kobiecej, kategorię główną przypisywano na podstawie przedstawionej aktywności przewodniej i ogólnego kontekstu sceny. Nakładające się kategorie rozstrzygano, nadając priorytet przedstawionej aktywności i kontekstowi sceny nad samym ubiorami lub wyglądem. Przypadki niejednoznaczne były niezależnie recenzowane przez obu koderów i rozstrzygane w drodze konsensusu. Obrazy źródłowe zapisano w formacie JPEG lub PNG. Przycięto wyłącznie obramowania stron internetowych, ramki katalogowe lub marginesy niebędące częścią obrazu. Treść malarska nie była rekonstruowana, przekolorowywana, ulepszana ani odnawiana.
Wstępne etykietowanie oparte na CLIP
Koder obrazów CLIP ViT-B/32 został wykorzystany do wstępnej analizy podobieństwa obraz-tekst9. Do kandydujących terminów tożsamości należały: elite woman, domestic woman, female servant, working woman, market woman, female performer, bride oraz ritual woman. Terminy opisujące scenę obejmowały: Chinese interior, garden, street market, workshop, tea production, textile work oraz ceremonial scene. Dla każdego obrazu zachowano pełny zestaw szablonów promptów, ich kolejność, wszelkie ansamble promptów, procedury normalizacji tekstu, reguły decyzyjne, wyniki ufności oraz przypadki remisów.
Pełna lista promptów została zastosowana spójnie do wszystkich obrazów przy użyciu modelu OpenAI CLIP ViT-B/32 zaimplementowanego w języku Python 3.10 z bibliotekami PyTorch 2.0.1 oraz OpenAI CLIP. Wnioskowanie przeprowadzono na procesorze GPU z obsługą CUDA z rozmiarem partii (batch size) wynoszącym 32 przy zastosowaniu precyzji FP32. Każdy obraz został przeskalowany i przycięty do rozmiaru 224 × 224 pikseli z centrum obrazu, a kanały RGB zostały znormalizowane przy użyciu transformacji wstępnego przetwarzania powiązanej z modelem ViT-B/32. Prompty tekstowe sformułowano w oparciu o zdefiniowane powyżej deskryptory tożsamości i sceny, a następnie zakodowano za pomocą koderów tekstu CLIP. Obliczono podobieństwo cosinusowe między znormalizowanymi osadzeniami (embeddings) obrazów i tekstu, a prompt z najwyższą wartością podobieństwa przypisano jako wstępną etykietę AI. Wartości podobieństwa dla wszystkich kandydatów na etykiety zachowano do późniejszego przeglądu przez człowieka. Zastosowano stałe ziarno losowości (random seed) o wartości 42, a identyczne procedury wstępnego przetwarzania, szablony promptów i reguły decyzyjne zastosowano do wszystkich 433 obrazów.
Lokalizacja wspomagana przez SAM
Model Segment Anything (SAM) został wykorzystany wyłącznie do lokalizacji postaci, odzieży, mebli, narzędzi, przedmiotów rytualnych oraz obszarów architektonicznych w celu przeprowadzenia wizualnej inspekcji przez człowieka. Należy podkreślić, że SAM nie uczestniczył w procesie klasyfikacji; wygenerowane przez niego maski, wycinki i pochodne cechy zostały odseparowane od procesów etykietowania i klastrowania CLIP, co zapewniło, że zastosowanie SAM dostarczyło jedynie pomocy w lokalizacji, nie wpływając i nie zawyżając wyników klasyfikacji.
W razie potrzeby stosowano ręczne podpowiedzi punktowe lub ramki ograniczające, aby doprecyzować lokalizację elementów wizualnych. Maski SAM generowano dla postaci kobiecych, odzieży, mebli, narzędzi, przedmiotów rytualnych oraz elementów architektonicznych, a każdy wynik segmentacji poddawano inspekcji wizualnej w celu sprawdzenia prawidłowości pokrycia obszaru. Powstałe maski wspomagały identyfikację i analizę istotnych cech ikonograficznych, lecz nie były wykorzystywane do etykietowania CLIP ani przypisywania kategorii.
Redukcja wymiarowości i klasteryzacja
Obliczono osadzenia obrazów CLIP, a do wizualizacji dwuwymiarowej wykorzystano UMAP z odległością cosinusową10. Zapisano reprezentację wykorzystaną do klasteryzacji wraz z procedurą wstępnego przetwarzania, wymiarowością i definicją odległości.
W celu zidentyfikowania powtarzających się grup wizualnych w korpusie zastosowano algorytmy K-średnich oraz klasteryzację hierarchiczną do reprezentacji cech obrazów11. Kandydackie rozwiązania K-średnich dla k = 5–9 oceniono przy użyciu współczynnika sylwetki (silhouette coefficient) oraz indeksu Daviesa-Bouldina. Wykorzystano inicjalizację K-means++ z parametrami n_init = 10, max_iter = 300, tol = 1 × 10⁻4 oraz random_state = 42. Klasteryzację hierarchiczną przeprowadzono metodą aglomeracyjną z zastosowaniem średniego wiązania (average linkage) i odległości cosinusowej. Potencjalne rozwiązania porównano pod kątem ilościowych indeksów walidacji, stabilności klastrów oraz interpretowalności z perspektywy historii sztuki, a końcowy podział na klastry wybrano ze względu na najbardziej spójną reprezentację powtarzających się wzorców wizualnych. Wynikowe przypisanie do klastrów dla każdego z 433 obrazów zachowano do późniejszego porównania z kategoriami zakodowanymi przez ludzi.
Kodowanie ręczne, szkolenie i rozstrzyganie rozbieżności
Dwoje koderów niezależnie przeanalizowało wszystkie 433 obrazy, korzystając z ujednoliconego klucza kodowego obejmującego kategorię główną, liczbę postaci, grupę wiekową, postawę, ubiór, otoczenie przestrzenne, przedmioty oraz relacje społeczne. Przed etapem rozstrzygania rozbieżności zachowano osobne zapisy dla każdego kodera. Koderzy posiadali odpowiednie przygotowanie w zakresie historii sztuki i analizy wizualnej, a ich szkolenie oparto na zestandaryzowanym podręczniku kodowania oraz reprezentatywnych przykładach z korpusu malarstwa. Przed rozpoczęciem formalnego kodowania przeprowadzono ćwiczenie kalibracyjne na 30 obrazach, aby zapewnić spójną interpretację siedmiu kategorii tożsamości i pięciu wymiarów wskazówek wizualnych.
Podczas formalnego kodowania obaj koderzy niezależnie oceniali wszystkie kwalifikujące się obrazy, nie mając wglądu w decyzje kodowania drugiej osoby, wstępne etykiety AI oraz przypisania do klastrów. Niezawodność między koderami oceniono za pomocą kappa Cohena. Obserwowana wartość kappa dla głównej kategorii tożsamości wyniosła 0,88, a dla kategorycznych zmiennych wskazówek wizualnych wahała się od 0,79 do 0,92, co wykazało silną zgodność między koderami. Rozbieżności rozstrzygano w drodze dyskusji i konsensusu, a rozstrzygnięte kategorie i kody wskazówek wizualnych zapisywano do późniejszej analizy12. Zachowano etykiety sprzed rozstrzygnięć.
Zgodność AI–człowiek i szacowanie wydajności
Ustalona przez ludzi kategoria posłużyła jako punkt odniesienia do porównania opisowego z jedną wstępną etykietą AI dla każdego obrazu. Ogólna dokładność dopasowania idealnego została obliczona jako 356/433 (82,2%). Czułość kategorii obliczono jako liczbę idealnych dopasowań AI–człowiek podzieloną przez liczbę przypadków w referencyjnej kategorii ludzkiej dla każdej grupy. Wsparcie kategorii, idealne dopasowania, niedopasowania oraz odpowiadające im mianowniki zostały przedstawione w sposób jawny.
Na podstawie 433 sparowanych etykiet przypisanych przez AI i ludzi na poziomie poszczególnych przypadków, obliczono liczbę wyników fałszywie dodatnich dla klasy docelowej oraz precyzję, czułość i wskaźniki F1 dla każdej kategorii. Sporządzono pełną macierz pomyłek w celu analizy wzorców klasyfikacji poza przekątną, co posłużyło następnie jako podstawa do przeglądu niezgodności, opracowania taksonomii błędów oraz ustalenia reguł rozstrzygania.
Pakiet odtwarzalności i materiały
Przepływ obliczeniowy oraz pomocnicze materiały badawcze zostały zorganizowane w repozytorium z kontrolą wersji. Pakiet odtwarzalności został zaprojektowany tak, aby zawierać skrypty do przetwarzania wstępnego, analizy CLIP, lokalizacji SAM, UMAP, klastrowania, analizy zgodności oraz generowania rycin, wraz z księgą kodową do kodowania ręcznego, plikami konfiguracyjnymi, informacjami o zależnościach, wynikami wyprowadzonymi na poziomie poszczególnych przypadków oraz czytelnym dla maszyn wykazem źródeł obrazów i informacji o prawach autorskich. Materiałom badawczym przekazanym do archiwum przypisano trwały identyfikator, aby ułatwić odtwarzalność i ponowne wykorzystanie danych.
Do organizacji i zarządzania metadanymi wykorzystano program Microsoft Excel 2021. W analizach obliczeniowych zastosowano model CLIP ViT-B/32 do wstępnego etykietowania wizualno-językowego, model SAM do lokalizacji elementów wizualnych, metodę UMAP z odległością cosinusową do redukcji wymiarowości oraz algorytmy K-średnich i klastrowanie hierarchiczne do eksploracyjnej analizy wzorców. Rozwiązania klastrowe oceniano za pomocą współczynnika sylwetki (silhouette coefficient) oraz indeksu Daviesa-Bouldina, a zgodność między koderami oceniano przy użyciu statystyki kappa Cohena. W celu zapewnienia odtwarzalności udokumentowano środowisko programistyczne, konfiguracje modeli, ustawienia obliczeniowe oraz ziarna losowe stosowane w całym przebiegu prac.
Wyniki
Budowa korpusu i skład opisowy
Rysunek 1 przedstawia czteropanelowy przegląd korpusu. Rysunek 1A pokazuje zgłoszony proces przesiewowy, od 612 rekordów kandydujących do 43 rekordów zachowanych. Rysunek 1B prezentuje reprezentatywne przykłady mediów i formatów. Rysunek 1C przedstawia liczebność w czterech przedziałach czasowych, a Rysunek 1D podsumowuje skład korpusu pod względem źródła i medium. Ponieważ przedziały czasowe obejmują nierówne okresy, liczby te opisują skład pobranego korpusu i nie powinny być interpretowane jako historyczne tempo produkcji.
Tabela 1 podsumowuje zagregowane cechy korpusu. Kolekcje muzealne stanowiły 302 rekordy, archiwa cyfrowe 81, a opublikowane katalogi 50. Media skategoryzowano jako akwarele eksportowe (n = 176), obrazy na papierze z rdzenia (n = 12), karty albumów eksportowych (n = 83), malarstwo figuralne (n = 41) oraz inne formaty (n = 21). Metadane skategoryzowano jako kompletne (n = 288), częściowe (n = 18) lub minimalne (n = 27). Postacie kobiece skategoryzowano jako centralne (n = 214), drugoplanowe (n = 102) lub liczne (n = 17). Każdy blok klasyfikacji obejmował wszystkie 43 rekordy.
Wstępne etykiety AI i kategorie referencyjne opracowane przez ludzi
Tabela 2 podsumowuje zbiorczą zgodność między wstępnymi etykietami wygenerowanymi przez AI a kategoriami referencyjnymi opracowanymi przez ludzi dla 433 obrazów, natomiast Tabela uzupełniająca 1 zawiera odpowiadające im wstępne etykiety AI na poziomie poszczególnych przypadków, klasyfikacje koderów, rozstrzygnięte kategorie referencyjne opracowane przez ludzi, status dopasowania oraz przypisania do klastrów. Ogólnie etykiety AI i referencyjne opracowane przez ludzi były zgodne w przypadku 356 obrazów, co odpowiada dokładności dopasowania wynoszącej 82,2%. Przywołanie na poziomie kategorii obliczono jako proporcję dokładnych dopasowań AI–człowiek w stosunku do liczby przypadków w kategorii referencyjnej opracowanej przez ludzi dla każdej kategorii.
Czułość (recall) na poziomie kategorii wynosiła od 73.3% dla scen rytualnych/ślubnych (3/45) do 8.4% dla kategorii elity/urody (9/12). Czułość wyniosła 84.7% dla pracy fizycznej (61/72), 82.1% dla występów (32/39), 79.7% dla zajęć domowych (51/64), 79.3% dla służby (46/58) oraz 79.1% dla rynku (34/43). Ogólna zgodność całkowita wyniosła 356/43 (82.2%). Ocena par na poziomie poszczególnych przypadków umożliwiła obliczenie precyzji oraz wskaźników F1 dla wszystkich siedmiu kategorii, które wyniosły odpowiednio od 74.5% do 89.2% dla precyzji oraz od 0.75 do 0.8 dla wskaźników F1. Kompleksowa macierz pomyłek, szczegółowo przedstawiająca wyniki fałszywie dodatnie dla klas docelowych oraz wzorce poza przekątną, została przedstawiona na Rysunku uzupełniającym 1.
Zgłoszone podsumowania wzorców obliczeniowych
Rysunek 2 przedstawia cztery zgłoszone wizualizacje analizy obliczeniowej. Rysunek 2A pokazuje galerię dziewięciu obrazów z kolorowymi nakładkami segmentacji używanymi do lokalizacji wizualnej i weryfikacji. Rysunek 2B przedstawia wykres rozrzutu UMAP zgłoszonych osadzeń obrazów CLIP z zaznaczonymi konturami gęstości C1–C7. Rysunek 2C porównuje zgłoszoną liczbę obrazów (pełne kropki) z czułością na poziomie kategorii (otwarte kółka), a Rysunek 2D prezentuje galerię reprezentatywnych obrazów pogrupowanych według tych samych etykiet. Walidacja klastrów potwierdziła wybrane rozwiązanie klastrowania, które dało wynik współczynnika sylwetki 0,54 oraz indeks Daviesa–Bouldina 0,92. Mapowanie klastrów na kategorie ludzkie wykazało silną zgodność, przy czym każdy otrzymany klaster odpowiadał głównie odrębnej kategorii referencyjnej zdefiniowanej przez człowieka.
Tabela 3 przedstawia siedem zgłoszonych profili obliczeniowych z wielkościami prób odpowiadającymi siedmiu kategoriom referencyjnym ustalonym przez ekspertów. Tabela kontyngencji klastrów według kategorii została przedstawiona w Tabeli uzupełniającej 2 i pokazuje rozkład siedmiu rozstrzygniętych kategorii referencyjnych dla ludzi w obrębie klastrów C1–C7. Analiza tych przypisań klastrowych na poziomie poszczególnych przypadków wykazała, że klastrowanie obliczeniowe odtworzyło struktury wizualne, które ściśle odpowiadały siedmiu referencyjnym kategoriom ustalonym przez ekspertów.
Asocjacje wskazówek wizualnych i synteza interpretacyjna
Tabela 4 podsumowuje jakościowe profile wskazówek wizualnych wykorzystanych do charakterystyki siedmiu kategorii zakodowanych przez ludzi. Profile te opisują powtarzające się powiązania między ubiorem, otoczeniem przestrzennym, postawą, przedmiotami i relacjami społecznymi. Nie zostały one wyprowadzone z ilościowej tabulacji krzyżowej, w związku z czym nie ustalono na ich podstawie statusu prawnego, przynależności etnicznej, przyczyn społecznych ani odbioru przez publiczność.
Rysunek 3 integruje opisowe podsumowania ilościowe zakodowanych cech wizualnych z interpretacyjnym modelem koncepcyjnym. Rysunek 3A przedstawia siedem rozstrzygniętych kategorii referencyjnych dla ludzi oraz wielkości ich próbek. Rysunek 3B pokazuje względne powiązania między tymi kategoriami a zakodowanymi markerami wizualnymi w pięciu wymiarach: odzieży, otoczeniu przestrzennym, obiektach, postawie i relacjach społecznych. Wyświetlone siły powiązań zostały obliczone na podstawie adnotacji na poziomie przypadków w każdej kategorii referencyjnej dla ludzi. Rysunek 3C podsumowuje zależności między kategoriami referencyjnymi dla ludzi, wymiarami markerów wizualnych a archetypami implikacji klasowych, wykorzystując ważone przepływy wyprowadzone z zakodowanych obserwacji. Te ilościowe zależności charakteryzują powtarzające się wzorce reprezentacyjne w próbkowanych obrazach i nie powinny być interpretowane jako szacunki historycznych rozkładów demograficznych lub społecznych. Rysunek 3D przedstawia koncepcyjny model interpretacji międzykulturowej i powinien być rozumiany jako historycznie uargumentowane ramy interpretacyjne, a nie empirycznie przetestowana ścieżka przyczynowa.
Zintegrowana interpretacja wzorców wizualnych
W całym korpusie siedem kategorii tożsamości kobiecej charakteryzowało się powtarzającymi się kombinacjami ubioru, otoczenia przestrzennego, przedmiotów, postawy oraz relacji społecznych. Kombinacje te dostarczyły opisowych dowodów na istnienie utrwalonych konwencji wizualnych w analizowanych obrazach. Interpretacje historyczne dotyczące płci, hierarchii i mediacji międzykulturowej pozostały na poziomie wnioskowania.
Wszystkie razem wzięte, zagregowane wyniki pozwoliły zidentyfikować siedem kategorii tożsamości kobiet określonych przez ludzi oraz pięć powracających wymiarów służących do ich charakterystyki: ubiór, otoczenie przestrzenne, przedmioty, postawa oraz relacje społeczne. Wstępne etykiety AI były zgodne z ustalonymi przez ludzi kategoriami w 356 z 433 obrazów (82,2%), przy czym najniższa czułość na poziomie kategorii odnotowano dla scen rytualnych/ślubnych (73,3%). Wyniki te wsparły opisową organizację i porównanie korpusu. Etykiety AI i ludzkie na poziomie poszczególnych przypadków umożliwiły oszacowanie precyzji i miary F1 na poziomie kategorii. Osobno przeprowadzona analiza skupień zidentyfikowała struktury odpowiadające siedmiu kategoriom określonym przez ludzi. Niemniej jednak, te obliczeniowe wyniki charakteryzują konwencje reprezentacji wizualnej, a nie ustanawiają twierdzeń przyczynowych dotyczących historycznej rzeczywistości społecznej lub odbioru przez publiczność.
DOSTĘPNOŚĆ DANYCH:
Dane wspierające niniejsze badanie, w tym metadane, informacje o źródłach i zapisy z przesiewu, są dostępne za pośrednictwem Zenodo pod adresem https://doi.org/10.5281/zenodo.2130291.
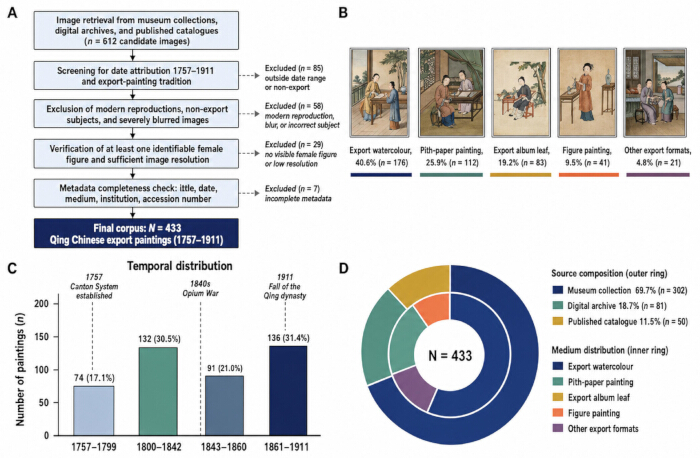
Rysunek 1Konstrukcja korpusu i analiza opisowa próby 43 obrazów. (A) Sekwencyjna selekcja 612 potencjalnych obrazów, w wyniku której wyłoniono 43 obrazy kwalifikujące się do badania. Kryteria wykluczenia obejmowały obrazy spoza okresu objętego badaniem lub spoza tradycji malarstwa eksportowego (n = 85), współczesne reprodukcje, obrazy rozmyte lub z błędnie zidentyfikowanym tematem (n = 58), obrazy bez możliwej do zidentyfikowania postaci kobiecej lub o niewystarczającej rozdzielczości (n = 29) oraz rekordy z niewystarczającymi metadanymi (n = 7). (BReprezentatywne przykłady pięciu mediów i formatów: akwarele eksportowe (40,6%, n = 176), obrazy na papierze z rdzenia (25,9%, n = 12), karty albumów eksportowych (19,2%, n = 83), obrazy przedstawiające postacie (9,5%, n = 41) oraz inne formaty eksportowe (4,8%, n = 21).C) Rozkład pobranych próbek obrazów w czterech przedziałach chronologicznych. (D) Rozkład źródeł pozyskiwania (zewnętrzny pierścień) oraz mediów/formatów (wewnętrzny pierścień). Procenty odnoszą się do całkowitej próby (N = 43) i zostały zaokrąglone do jednego miejsca po przecinku. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
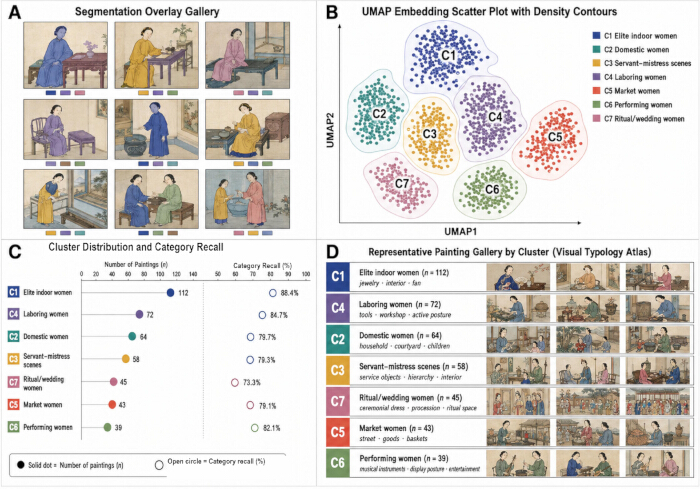
Rysunek 2Przedstawiono segmentację, wizualizację osadzeń, rozkład klastrów, czułość kategorii oraz reprezentatywne obrazy. (A) Galeria dziewięciu obrazów z kolorowymi nakładkami segmentacyjnymi, wykorzystywanych do lokalizacji postaci lub elementów wizualnych w celu ich weryfikacji. (B) Wykres rozrzutu UMAP zgłoszonych osadzeń obrazów CLIP z konturami gęstości i etykietami C1–C7. (C) Zgłoszona liczba obrazów (pełne kropki, górna oś) i przypomnienie kategorii (otwarte kółka, dolna oś); przypomnienie kategorii stanowi iloraz dokładnych dopasowań i wsparcia referencyjnego człowieka. Przedziały ufności oraz słupki błędów nie zostały przedstawione. (D) Galeria reprezentatywnych obrazów pogrupowana według etykiet C1–C7, z obrazami wybranymi na podstawie ich bliskości do odpowiednich centroidów skupień. Skróty: AI = sztuczna inteligencja; CLIP = Contrastive Language–Image Pre-training; SAM = Segment Anything Model; UMAP = Uniform Manifold Approximation and Projection; C1–C7 = zgłoszone etykiety 1–7. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
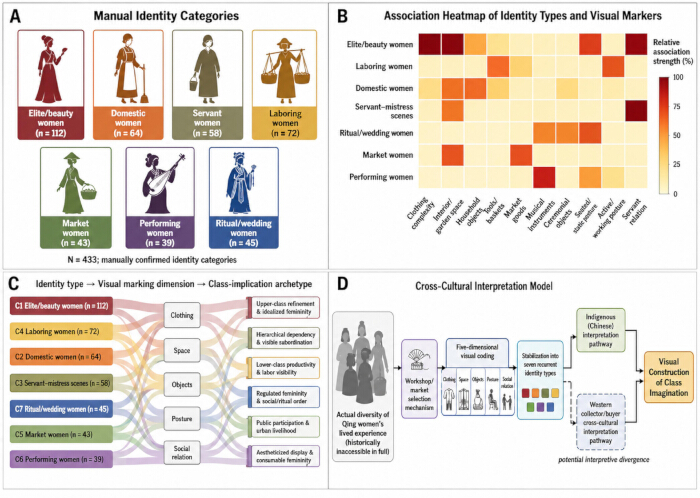
Rysunek 3Asocjacje wskazówek wizualnych i międzykulturowe ramy interpretacyjne. (A) Siedem zweryfikowanych kategorii tożsamości żeńskiej w odniesieniu do człowieka oraz liczebność prób w korpusie 43 obrazów. (B) Mapa ciepła korelacji przedstawiająca względną siłę powiązań między siedmioma kategoriami referencyjnymi dla ludzi a zakodowanymi markerami wizualnymi w zakresie odzieży, otoczenia przestrzennego, obiektów, postawy i relacji społecznych. Siła powiązań została wyprowadzona z adnotacji na poziomie przypadków w obrębie każdej kategorii. (C) Reprezentacja aluwialna podsumowująca ważone zależności między kategoriami referencyjnymi dla ludzi, wymiarami oznakowania wizualnego a archetypami implikacji klas na podstawie zakodowanych obserwacji. (D) Koncepcyjny międzykulturowy model interpretacyjny łączący przedstawione działania, wybór warsztatu i rynku, pięciowymiarowe kodowanie wizualne, powtarzające się typy tożsamości oraz potencjalne ścieżki interpretacyjne. Kliknij tutaj, aby wyświetlić powiększoną wersję tej ryciny.
Tabela 1: Charakterystyka korpusu i kompletność metadanych (N = 43). Liczebności i procenty podsumowują sześć oddzielnych bloków: przedział dat, źródło, nośnik lub format, kompletność metadanych, reprezentację postaci kobiecych oraz typ sceny. W każdym bloku mianownikiem jest N = 43, a suma wynosi 43; procenty stanowią proporcje korpusu w obrębie bloku, zaokrąglone do jednego miejsca po przecinku. Kliknij tutaj, aby pobrać ten plik.
Tabela 2: Wstępne etykiety AI i kategorie referencyjne opracowane przez człowieka (N = 43). Support oznacza liczbę obrazów przypisanych do każdej kategorii referencyjnej opracowanej przez człowieka. Dokładne dopasowania wskazują obrazy, dla których wstępna etykieta wygenerowana przez AI odpowiadała kategorii referencyjnej opracowanej przez człowieka. Pełność (recall) na poziomie kategorii oblicza się jako liczbę dokładnych dopasowań podzieloną przez liczbę referencyjnych supportów opracowanych przez człowieka. Kliknij tutaj, aby pobrać ten plik.
Tabela 3: Podsumowanie zgłoszonego profilu obliczeniowego. C1–C7 odwzorowują zwalidowane rozmiary profilu i dominujące etykiety. Integracja przypisań klastrów na poziomie przypadków oraz tabela kontyngencji klastrów według kategorii potwierdzają, że klasteryzacja nienadzorowana skutecznie uchwyciła struktury wizualne odpowiadające siedmiu kategoriom referencyjnym ustalonym przez człowieka. Kliknij tutaj, aby pobrać ten plik.
Tabela 4: Profilowe jakościowe kategorii tożsamości żeńskiej i wizualnych wskazówek związanych z klasą społeczną. Liczby i wartości procentowe podsumowują kategorie referencyjne określone przez ludzi, natomiast ubiór, przestrzeń, obiekty, postawa i relacje społeczne charakteryzują powtarzające się profile wizualne przypisane do każdej kategorii. Interpretacje związane z klasą społeczną stanowią odczytania ikonograficzne wzorców obrazowych, a nie bezpośrednie pomiary historycznego statusu społecznego. Kliknij tutaj, aby pobrać ten plik.
Rycina uzupełniająca 1: Macierz pomyłek porównująca wstępne etykiety AI z rozstrzygniętymi kategoriami referencyjnymi ustalonymi przez człowieka dla korpusu 43 obrazów.Wiersze reprezentują rozstrzygnięte kategorie referencyjne ustalone przez człowieka (etykiety prawdziwe), a kolumny reprezentują wstępne kategorie wygenerowane przez CLIP (etykiety przewidywane). Wartości w komórkach wskazują liczbę obrazów dla każdej kombinacji etykiet AI–człowiek. Komórki na przekątnej reprezentują dokładne dopasowania AI–człowiek, przy czym odpowiadająca im czułość na poziomie kategorii została przedstawiona jako wartość procentowa. Komórki poza przekątną reprezentują niezgodności między wstępną klasyfikacją AI a rozstrzygniętą kategorią referencyjną ustaloną przez człowieka. Ogólna dokładność dopasowań dokładnych wyniosła 82,2% (356/43). Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 1: Porównanie na poziomie przypadków wstępnych etykiet AI, rozstrzygniętych kategorii referencyjnych ustalonych przez człowieka oraz przypisań do klastrów UMAP. Każdy wiersz reprezentuje jeden z 43 chińskich obrazów eksportowych z okresu dynastii Qing włączonych do korpusu analitycznego. Tabela zawiera stabilny identyfikator obrazu QEP, wstępną etykietę CLIP ViT-B/32, niezależne klasyfikacje Koderów Ludzkich 1 i 2, rozstrzygniętą kategorię referencyjną ustaloną przez człowieka, status zgodności AI–człowiek oraz przypisanie do klastra UMAP. „Exact Match” oznacza zgodność między wstępną etykietą AI a rozstrzygniętą kategorią referencyjną ustaloną przez człowieka; „Mismatch” oznacza brak zgodności. Rozstrzygnięta kategoria ludzka służyła jako klasyfikacja referencyjna dla analiz zgodności AI–człowiek. Kliknij tutaj, aby pobrać ten plik.
Tabela uzupełniająca 2: Tabela kontyngencji kategorii referencyjnych ustalonych przez ludzi oraz przypisań do klastrów obliczeniowych.Wiersze reprezentują siedem rozstrzygniętych kategorii referencyjnych ustalonych przez ludzi, a kolumny reprezentują klastry C1–C7 uzyskane z obliczeniowej analizy klastrowania. Wartości w komórkach wskazują liczbę obrazów przypisanych do każdej kombinacji kategoria–klaster. Całkowite wsparcie reprezentuje liczbę obrazów w każdej ludzkiej kategorii referencyjnej. Koncentracja obserwacji w kombinacjach kategoria–klaster zapewnia opisową ocenę zgodności pomiędzy niezależnie wyprowadzonymi klastrami obliczeniowymi a rozstrzygniętymi kategoriami referencyjnymi ustalonymi przez ludzi. Kliknij tutaj, aby pobrać ten plik.
Dyskusja
W ramach dostarczonych podsumowań zbiorczych 433 rekordy zostały uporządkowane w siedem kategorii odniesienia dla ludzi i opisane za pomocą pięciu rodzin wskazówek wizualnych. Największą kategorią była elita/piękno (112/433), a 356 etykiet wstępnych było zgodnych z raportowanym odniesieniem ludzkim (82,2%). Są to obserwacje korpusowe. Wspierają one badanie powracających formuł obrazowych, ale nie potwierdzają silniejszej tezy, że formuły te wiernie odzwierciedlają społeczeństwo Qing lub wywołały konkretną reakcję u zagranicznej publiczności13.
Normatywny dyskurs dotyczący płci, pozycja w gospodarstwie domowym, praca oraz prawo dynastii Qing kształtowały życie kobiet, nie determinując go jednak w sposób jednolity. Badania nad kobietami z okresu wysokiego Qing dokumentują ich udział w pracy, pisaniu, rytuałach, religii i rozrywkach, obok preskryptywnych reżimów rodzinnych i wymogów czystości. Osiem Sztandarów tworzyło dziedziczną i wieloetniczną grupę statusową zdefiniowaną przez prawo i praktykę administracyjną; przynależność do Sztandarów nie powinna zatem być automatycznie utożsamiana z etnicznością mandżurską14,15,16,17. W niniejszym badaniu ubiór, postawa, przedmioty i otoczenie są wskazówkami obrazowymi, a nie dowodami na rangę prawną, przynależność do Sztandarów lub grupy Han, etniczność, zgodność moralną czy przeżywaną tożsamość. Do sformułowania takich twierdzeń wymagane byłyby dowody archiwalne i prawne.
Wyniki obliczeniowe wymagają również powściągliwości kulturowej i technicznej. Nie należy zakładać, że ogólne modele wizyjno-językowe są neutralne kulturowo. Opublikowane wyniki CulturalVQA wykazują nierówną wydajność w zależności od regionów i aspektów kulturowych, jednak wspomniany benchmark nie oceniał modelu CLIP ViT-B/32 ani nie wykorzystywał historycznej sztuki Azji Wschodniej8,18,19. Stanowi on zatem motywację, a nie zamiennik dla benchmarku dopasowanego do konkretnego przypadku w tym korpusie. Do czasu przeprowadzenia takiego eksperymentu, CLIP służy jako wstępna pomoc organizacyjna, a nie jako autorytet w kwestii tożsamości lub hierarchii dynastii Qing. Potok obliczeniowy potwierdził, że SAM funkcjonował wyłącznie jako pomocniczy dowód lokalizacji; żadne maski ani cechy pochodne z masek nie były używane jako dane wejściowe do etykietowania lub klastrowania, co zapewniło, że kategoryzacja wizualna opierała się wyłącznie na globalnych osadzeniach semantycznych niesegmentowanych obrazów. Badania nad dziedzictwem cyfrowym podkreślają również znaczenie wrażliwości kulturowej, nadzoru interdyscyplinarnego, dostępności, ochrony danych oraz przejrzystości procesów pracy20.
Historycznie istotność tych wzorów wiąże się z handlem malarstwem eksportowym: chińskie warsztaty i zagraniczny popyt selekcjonowały i standaryzowały tematy, które były łatwe w transporcie, czytelne i kolekcjonowalne; powtarzające się obrazy warsztatowe świadczą również o kopiowaniu z wprowadzeniem wariacji, a nie o czysto mechanicznym powielaniu1,2,3,4,5. Korpus ten może zatem przyczynić się do badań nad historią płci, hierarchii, ikonografią życia codziennego oraz spotkaniami międzykulturowymi, pokazując, które formuły powtarzają się na dużą skalę. Nie dowodzi on jednak, że obrazy te stanowią wyczerpujące zapisy etnograficzne. Porównanie komputerowe może wspierać wnikliwą analizę tekstu i kontekstualizację międzykulturową21, natomiast dowody z rejestrów produkcji, historii zakupów i odbioru muszą stanowić podstawę dla twierdzeń dotyczących intencji rynkowych lub znaczenia dla odbiorcy.
Odpowiedzi afektywne i poznawcze pozostają kierunkiem dalszych badań, a nie wynikiem niniejszego opracowania. Shi i współpracownicy połączyli oceny preferencji, analizę wymiarów ukrytych oraz okulografię (eye-tracking), aby rozróżnić ścieżki emocjonalne, formalno-estetyczne i poznawcze w reakcjach na obrazy z serii Xiashi Pinprick Lantern22. Porównywalny projekt badawczy mógłby sprawdzić, czy widzowie w różny sposób zwracają uwagę na ubiór, przedmioty, postawę lub hierarchię w malarstwie eksportowym. Ponieważ w niniejszym badaniu nie zebrano ocen, danych z okulografii ani innych danych dotyczących odbiorców, nie można wnioskować o pobudzeniu emocjonalnym, istotności wizualnej ani recepcji wyłącznie na podstawie treści obrazów.
Ograniczenia mają charakter teoretyczny, metodologiczny i praktyczny. Pod względem teoretycznym kategorie wskazówek materiałowych upraszczają kwestie płci, relacji domowych, hierarchii prawnej, etniczności oraz doświadczeń życiowych. Pod względem metodologicznym wnioskowania są ograniczone przez przeżywalność materiałów, procesy gromadzenia, digitalizacji, metadanych, modele zero-shot, kodowanie oraz błędy wynikające z nierównomierności okresów czasowych. Choć potok analityczny wykazuje wysoką skuteczność w wykrywaniu wzorców, te strukturalne błędy podkreślają konieczność traktowania wyników obliczeniowych jako analiz konwencji obrazowania, a nie jako przejrzystych okien na rzeczywistość społeczną dynastii Qing. Praktycznie, prawa do obrazów ograniczają ich redystrybucję, a wyniki mogą nie być generalizowalne dla różnych instytucji, okresów, mediów lub środowisk obliczeniowych. Biorąc pod uwagę te ograniczenia, badanie oferuje nadzorowane przez człowieka ramy przekształcania powtarzalnych obserwacji wizualnych w sprawdzalne pytania historyczne, zamiast automatycznych konkluzji. Jako studium interpretacyjne, a nie interwencyjne, nie oceniało ono postępów w realizacji żadnego z Celów Zrównoważonego Rozwoju (SDG) ani wskaźników. Przedmiot badania jest jednak istotny dla Celu 5, a dokumentacja uwzględniająca prawa autorskie i międzykulturowe ujęcie edukacyjne są konceptualnie zbieżne z celami 11.4 oraz 4.7; nie mierzono jednak żadnych wyników SDG. Dostarczony pakiet reprodukowalności dostosowuje badanie do niedawnych postulatów dotyczących transparentnych przepływów pracy w dziedzictwie cyfrowym oraz do wymagań FAIR w zakresie trwałych identyfikatorów, bogatych metadanych, licencji, pochodzenia oraz ponownego wykorzystania danych, algorytmów, narzędzi i przepływów pracy20,23.
Oświadczenia
Autorzy nie mają nic do ujawnienia.
Podziękowania
Autorzy dziękują Victoria and Albert Museum, British Museum, Metropolitan Museum of Art, Smithsonian National Museum of Asian Art, Peabody Essex Museum, Hong Kong Museum of Art, British Library, Getty Research Institute oraz innym instytucjom przechowującym zbiory i zespołom katalogującym, których rekordy online wsparły proces odkrywania korpusu. Dostęp do rekordu online nie oznacza zgody na redystrybucję obrazu; prawa do poszczególnych paneli oraz linki do źródeł są zatem dokumentowane osobno. Autorzy dziękują również otwartym społecznościom badawczym wspierającym CLIP i SAM, a także za wsparcie administracyjne ze strony City University of Macau oraz Guangdong Polytechnic Normal University.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| CLIP ViT-B/32 | OpenAI | OpenAI CLIP, ViT-B/32 | Model wizualno-językowy wykorzystywany do wstępnej analizy podobieństwa obraz-tekst – oraz przypisywania wstępnych etykiet AI. |
| Stacja robocza obliczeniowa | Stacja robocza obliczeniowa autorów’ | GPU z obsługą CUDA; należy podać dokładną konfigurację sprzętową | Stacja robocza wykorzystywana do wnioskowania CLIP i SAM oraz analiz obliczeniowych; należy podać specyfikację GPU, CPU, RAM, systemu operacyjnego i CUDA z oryginalnego środowiska uruchomieniowego. |
| Matplotlib | Zespół programistów Matplotlib | Pakiet Python; należy podać dokładną wersję | Wykorzystywany do wizualizacji obliczeniowej oraz generowania rycin i wykresów analitycznych. |
| Microsoft Excel 2021 | Microsoft Corporation | Microsoft Excel 2021 | Wykorzystywany do organizacji metadanych, zapisów przesiewowych i zarządzania tabelarycznymi danymi badania. |
| NumPy | Programiści NumPy | Pakiet Python; należy podać dokładną wersję | Wykorzystywany do obliczeń numerycznych oraz manipulowania tablicami cech obrazów i tablicami analitycznymi. |
| pandas | Zespół programistów pandas | Pakiet Python; należy podać dokładną wersję | Wykorzystywany do obsługi ustrukturyzowanych danych, przetwarzania metadanych i organizacji wyników analitycznych na poziomie poszczególnych przypadków. |
| Python 3.10 | Python Software Foundation | Python 3.10 | Środowisko programistyczne wykorzystane do implementacji obliczeniowego przepływu pracy analizy obrazów. |
| PyTorch 2.0.1 | PyTorch Foundation | PyTorch 2.0.1 | Framework głębokiego uczenia wykorzystywany do kodowania obrazów i tekstu w oparciu o CLIP oraz do wnioskowania na GPU. |
| scikit-learn | Programiści scikit-learn | Pakiet Python; należy podać dokładną wersję | Wykorzystywany do klastrowania metodą K-średnich, klastrowania aglomeracyjnego, obliczeń współczynnika sylwetki, indeksu Daviesa–-Bouldina oraz kappa Cohena’. |
| Segment Anything Model (SAM) | Meta AI Research | SAM | Model segmentacji wykorzystywany do lokalizacji postaci kobiecych, odzieży, mebli, narzędzi, obiektów rytualnych i obszarów architektonicznych do inspekcji wizualnej. |
| umap-learn | McInnes i inni | Implementacja UMAP w Pythonie | Wykorzystywany do redukcji wymiarowości i dwuwymiarowej wizualizacji osadzeń obrazów CLIP z wykorzystaniem odległości cosinusowej. |
Bibliografia
- Gao J, Zhang Y, Liu J, Sousa JP. A digital humanities approach to Chinese export watercolours: a case study on the Victoria and Albert Museum collection. Digit Scholarsh Humanit. 2026;41(2):692-714.
- Liu H, Fu C, Li W. Silk road heritage: the artistic representation of port trading culture in the images of characters in Qing Dynasty Guangzhou export paintings. PLoS One. 2024;19(10):e0308309.
- Ao J, Ye Z, Li W, Ji S. Impressions of Guangzhou city in Qing Dynasty export paintings in the context of trade economy: a color analysis of paintings based on k-means clustering algorithm. Herit Sci. 2024;12:77.
- Mok MKW. Chinese export paintings: a marketing success story. Cambridge Scholars Publishing; Newcastle upon Tyne; 2025.
- Yaron E. The many versions of the painting of Tingqua's studio: painting copying and originality in nineteenth-century Canton. Humanit Soc Sci Commun. 2020;7:132.
- Impett L, Offert F. There is a digital art history. Vis Resour. 2022;38(2):186-209.
- Münster S. Artificial intelligence for digital heritage innovation: setting up a R&D agenda for Europe. Heritage. 2024;7(2):794-816.
- Foka A, Griffin G. AI, cultural heritage, and bias: some key queries that arise from the use of GenAI. Heritage. 2024;7(11):6125-6136.
- Zhang W. Computational approaches for traditional Chinese painting: from the Six Principles of Painting perspective. J Comput Sci Technol. 2024;39(2):269-285.
- McInnes L, Healy J, Saul N, Großberger L. UMAP: Uniform Manifold Approximation and Projection. J Open Source Softw. 2018;3(29):861.
- Rousseeuw PJ. Silhouettes: a graphical aid to the interpretation and validation of cluster analysis. J Comput Appl Math. 1987;20:53-65.
- Cohen J. A coefficient of agreement for nominal scales. Educ Psychol Meas. 1960;20(1):37-46.
- Stejskal J. Art-historical empiricism and digital visualization of cultural heritage. Synthese. 2025;205:132.
- Mann S. Precious records: women in China's long eighteenth century. Stanford University Press; Stanford; 1997.
- Porter DC. Slaves of the emperor: service, privilege, and status in the Qing Eight Banners. Columbia University Press; New York; 2023.
- Sommer MH. Sex, law, and society in late imperial China. Stanford University Press; Stanford; 2000.
- Theiss JM. Disgraceful matters: the politics of chastity in eighteenth-century China. University of California Press; Berkeley; 2005.
- Nayak S, et al. Benchmarking vision language models for cultural understanding [conference paper]. Presented at: 2024 Conference on Empirical Methods in Natural Language Processing; Miami, Florida, USA; 2024. https://aclanthology.org/2024.emnlp-main.329/
- Vitaloni C, Shullani D, Baracchi D. A comparative study of vision language models for Italian cultural heritage. Heritage. 2025;8(3):95.
- Li W. Systematic review: a scientometric analysis of the status, trends and challenges in the application of digital technology to cultural heritage conservation (2019-2024). npj Herit Sci. 2025;13:90.
- Zhang W, et al. CultiVerse: towards cross-cultural understanding for paintings with large language model [conference paper]. Presented at: 33rd ACM International Conference on Multimedia; Dublin, Ireland; 2025. https://doi.org/10.1145/3746027.3755698
- Shi W. A dual-path approach to emotional arousal and visual cognition in intangible cultural heritage: the case of Xiashi Pinprick Lantern Pictures. Digit Scholarsh Humanit. 2026;41(1):376-395.
- Wilkinson MD, et al. The FAIR Guiding Principles for scientific data management and stewardship. Sci Data. 2016;3:160018.