VoiceNet-RAI integruje cechy MFCC, wielojęzyczne osadzenia wav2vec 2.0 oraz EfficientNet-Lite w celu klasyfikacji płci i wieku na podstawie danych głosowych. System ten osiąga dokładność do 97,87% w podzbiorze języka angielskiego i wspiera odpowiedzialne zastosowania w rozpoznawaniu mowy, uwierzytelnianiu oraz informatyce śledczej.
Subskrypcja JoVE jest wymagana do oglądania tego materiału. Zaloguj się lub rozpocznij bezpłatny okres próbny.
Artykuł badawczy
VoiceNet: Odpowiedzialny wielojęzyczny system sztucznej inteligencji do rozpoznawania mowy w celu klasyfikacji płci i wieku
127 wyświetleń
⸱
11 września 2026
W tym artykule
Podsumowanie
Streszczenie
Dokładna klasyfikacja płci i wieku na podstawie danych głosowych jest istotna dla spersonalizowanej, bezpiecznej i etycznej interakcji człowiek-komputer (HCI). W związku z rosnącym wykorzystaniem dużych, wstępnie wytrenowanych modeli mowy, takich jak wav2vec 2.0, istnieje potrzeba odpowiedzialnego wykorzystania tych reprezentacji do wielojęzycznego i świadomego kwestii prywatności wnioskowania demograficznego. Niniejsze badanie proponuje VoiceNet-RAI, ramy głębokiego uczenia (DL), które integrują mel-częstotliwościowe współczynniki cepstralne (MFCCs) z wielojęzycznymi embeddingami wav2vec 2.0 opartymi na transformerach w architekturze EfficientNet-Lite, aby wspierać dokładną, sprawiedliwą i przejrzystą klasyfikację w różnych kontekstach językowych. System ten łączy informacje kontekstowe i spektralne, aby zwiększyć odporność w zmiennych warunkach nagrywania. Eksperymenty na wielojęzycznych danych mowy obejmujących 28 języków wykazują wysoką skuteczność klasyfikacji, przy czym podzbiór języka angielskiego osiągnął dokładność 97,87%, precyzję 98,61%, czułość 98,70% oraz wynik F1 na poziomie 98,65%. Walidacja zewnętrzna z wykorzystaniem zbioru danych Mozilla Common Voice przyniosła dokładność 98,27% dla klasyfikacji płci, co dowodzi zdolności do generalizacji na niezależnym zbiorze danych. Analiza ablacyjna wykazała ponadto, że połączenie cech MFCC i wav2vec 2.0 poprawia wydajność w porównaniu z reprezentacjami surowymi oraz opartymi wyłącznie na MFCC. Wyniki te demonstrują potencjał hybrydowych spektralno-kontekstowych reprezentacji mowy dla odpornej i odpowiedzialnej klasyfikacji płci i wieku.
Wprowadzenie
Rozpoznawanie głosu jest kluczowym elementem ludzkiej komunikacji, za pomocą którego jednostki wyrażają swoje uczucia, myśli i cele. Ludzki głos powstaje w procesie biologicznym, w którym powietrze wydychane z płuc jest kształtowane w dźwięk przez organy artykulacyjne, takie jak wargi, język i zęby1. Ucho odgrywa istotną rolę w identyfikacji głosu i potrafi odróżnić głosy męskie od żeńskich na podstawie takich cech jak głośność i wysokość dźwięku. Jedną z cech przyczyniających się do znacznych różnic w wysokości głosu między mężczyznami a kobietami jest dymorfizm płciowy2. Klasyfikacja wieku i płci na podstawie głosu ma zastosowanie w wielu obszarach, w tym w interakcji człowiek-maszyna, zautomatyzowanym rozpoznawaniu płci, spersonalizowanych powitaniach, wstępnej klasyfikacji emocji w mowie oraz klasyfikacji połączeń w oparciu o płeć3.
Mowa jest nieodłącznym elementem ludzkich interakcji. Ludzki głos posiada wiele cech, które różnią się między osobnikami i mogą dostarczać informacji o stanach emocjonalnych i psychicznych, a także o wieku i płci. Te wielowymiarowe cechy mogą być wykorzystywane w takich zastosowaniach, jak systemy bezpieczeństwa oparte na głosie oraz asystenci Sztucznej Inteligencji (AI) zorientowani na mowę. Inne obszary, w których analiza głosu jest istotna, to systemy automatycznej weryfikacji mówcy (ASV) oraz systemy AI oparte na emocjach. Systemy wprowadzania danych oparte na głosie mogą również zredukować przestrzeń wyszukiwania w bazach danych4,5. Ponadto systemy bezpieczeństwa oparte na AI mogą wykorzystywać dane głosowe w takich zastosowaniach, jak dochodzenia kryminalne i ochrona ofiar. Głosy męskie i żeńskie wykazują różne cechy ze względu na różnice w właściwościach rezonansowych traktu głosowego. Cechy te mogą być ekstrahowane z sygnałów mowy w formie odpowiedniej do przetwarzania obliczeniowego, co umożliwia klasyfikację płci na podstawie danych głosowych6,7. W związku z tym niezbędne są efektywne algorytmy uczenia dla klasyfikacji płci opartej na głosie. Algorytmy głębokiego uczenia (DL) są szczególnie odpowiednie do klasyfikacji związanej z mową ze względu na ich zdolność do uczenia się złożonych wzorców z danych audio. Takie modele, w zależności od architektury, mogą zawierać warstwy splotowe, rekurencyjne, sploty czasowe lub warstwy w pełni połączone. Warstwy te mogą uczyć się istotnych cech akustycznych, w tym barwy i wysokości dźwięku. Po przeszkoleniu model może klasyfikować płeć z wcześniej nieznanych nagrań audio8. Kolejnym ważnym obszarem badań nad uczeniem maszynowym (ML) jest klasyfikacja wieku na podstawie nagrań głosu. Algorytmy ML mogą wykorzystywać cechy akustyczne, takie jak wysokość, barwa i amplituda, do identyfikacji wzorców związanych z wiekiem. Techniki takie jak analiza głównych składowych (PCA) mogą być również stosowane do ekstrahowania informacyjnych wzorców z danych mowy i potencjalnego poprawienia wydajności klasyfikacji9.
DL wykazuje wysoką skuteczność w zastosowaniach takich jak rozpoznawanie obrazów, emocji i mowy. W szczególności głębokie sieci neuronowe (DNN) są szeroko wykorzystywane w zadaniach związanych z mową. W niniejszym badaniu podejścia oparte na DL zastosowano do klasyfikacji głosu w połączeniu z uznanymi technikami ekstrakcji cech. Mel-częstotliwościowe współczynniki cepstralne (MFCC) wychwytują istotne charakterystyki widmowe sygnałów mowy i zapewniają wydajną reprezentację do dalszego przetwarzania. Wyekstrahowane cechy są następnie integrowane w ramach struktury uczenia transferowego (transfer learning) w celu klasyfikacji płci i wieku na podstawie głosu10,11.
W niedawnych badaniach coraz częściej stosuje się reprezentacje mowy oparte na uczeniu nadzorowanym (self-supervised) oraz modelu Transformer do klasyfikacji cech mówcy. Badacze analizowali uprzedzenia demograficzne, w tym związane z płcią i wiekiem, w modelach mowy z uczeniem nadzorowanym, takich jak HuBERT i wav2vec 2.0, podkreślając znaczenie ewaluacji uwzględniającej sprawiedliwość (fairness-aware evaluation)12. W ostatnim czasie podejścia oparte na modelu Transformer, niezależne od języka, wykazały skuteczność wyuczonych kontekstowych reprezentacji mowy w rozpoznawaniu płci w warunkach wielojęzycznych i zaszumionych13. Sinha i współpracownicy przeprowadzili dalsze badania nad reprezentacjami modelu wav2vec 2.0 w poszczególnych warstwach pod kątem klasyfikacji wieku i płci, wykazując, że różne warstwy Transformera przechwytują zróżnicowane poziomy informacji związanych z mówcą14. Rozwoje te stanowią podstawę do zaproponowania frameworka VoiceNet-RAI, który łączy konwencjonalne informacje widmowe oparte na MFCC z kontekstowymi reprezentacjami wav2vec 2.0, uwzględniając jednocześnie kwestie wielojęzyczności oraz zasad odpowiedzialnej sztucznej inteligencji (Responsible AI).
Niedawne badania wykazały, że wiek i płeć mówcy mogą być charakteryzowane przy użyciu zarówno konwencjonalnych cech akustycznych, jak i reprezentacji opartych na głębokim uczeniu. Podejścia łączące informacje akustyczne i czasowe wykazały, że komplementarne charakterystyki mowy mogą poprawić skuteczność klasyfikacji wieku i płci15,16. Powiązane badania dowiodły również, że przekształcone cechy mowy generowane przy użyciu głębokich reprezentacji wąskiego gardła (deep bottleneck representations) mogą zwiększyć dokładność klasyfikacji wieku i płci mówcy17. Wyniki te wspierają szersze zastosowanie reprezentacji spektralnych, czasowych oraz wyuczonych w zadaniach klasyfikacji obejmujących mowę i sygnały pochodne od mowy.
Wiele badań analizowało rozpoznawanie wieku i płci z mowy z wykorzystaniem metod uczenia maszynowego i głębokiego uczenia18,19,20,21,22,23,24,25,26,27,28,29,30. Nowsze podejścia badały przekształcone reprezentacje MFCC oraz głębokie sieci neuronowe w celu klasyfikacji wieku i płci mówcy31, podczas gdy zmienność wielojęzyczna i zależna od języka pozostaje istotnym zagadnieniem przy opracowywaniu odpornych systemów demograficznej klasyfikacji głosu. Różnice w wymowie, strukturze fonetycznej, charakterystyce mówcy oraz warunkach nagrywania mogą ograniczać generalizowalność modelu w odniesieniu do różnych języków i populacji. W związku z tym zastosowanie komplementarnych reprezentacji widmowych i kontekstowych mowy może zwiększyć odporność systemów w środowiskach wielojęzycznych.
Choć w podejściach hybrydowych wcześniej łączono wiele cech akustycznych lub klasyfikatory zespołowe w celu rozpoznawania demografii na podstawie głosu, VoiceNet-RAI różni się poprzez integrację dwóch komplementarnych poziomów reprezentacji mowy w ramach jednolitego schematu. W szczególności konwencjonalne cechy MFCC zachowują lokalne charakterystyki widmowe i wokalne, podczas gdy wav2vec 2.0 dostarcza kontekstualnych reprezentacji wyuczonych z surowej mowy przy użyciu kodera Transformer. Zamiast polegać wyłącznie na ręcznie opracowanych deskryptorach akustycznych lub pojedynczej głębokiej reprezentacji, VoiceNet-RAI wykonuje fuzję na poziomie cech czasowo zagregowanych reprezentacji MFCC i wav2vec 2.0, a następnie dopracowuje wynikową reprezentację hybrydową za pomocą EfficientNet-Lite. Nowością naukowa jest zatem skoordynowana integracja reprezentacji widmowych, kontekstowych z nadzorem własnym oraz lekkich reprezentacji głębokich do klasyfikacji płci i wieku, wraz z ewaluacją wielojęzyczną, walidacją na niezależnym zbiorze danych oraz analizą sprawiedliwości podgrup. Takie połączenie rozszerza konwencjonalne hybrydowe potoki klasyfikacji mowy poza fuzję cech zorientowaną na dokładność, w stronę frameworka, który jednocześnie uwzględnia komplementarność reprezentacji, projekt lekkiego modelu, generalizowalność oraz Odpowiedzialną AI (Responsible AI).
Główne wkłady niniejszej pracy obejmują opracowanie podejścia do identyfikacji płci i wieku na podstawie danych głosowych poprzez integrację cech MFCC i wav2vec 2.0 z modelem EfficientNet-Lite. Przeprowadzono szeroko zakrojone eksperymenty na zbiorze nagrań głosowych w 28 językach, oceniając cechy oryginalne, cechy MFCC, cechy wav2vec 2.0 oraz ich kombinacje za pomocą modeli ML i DL. Wydajność modeli oceniano zarówno na pełnym wielojęzycznym zbiorze danych, jak i na podzbiorze w języku angielskim. Strukturę tę poddano dalszej ocenie z perspektywy wielojęzyczności oraz Odpowiedzialnej Sztucznej Inteligencji (Responsible AI) poprzez analizy podgrup specyficznych dla płci i języka, ewaluację niezależną od mówcy oraz walidację z wykorzystaniem zbioru danych Mozilla Common Voice. Ponadto wydajność zaproponowanej struktury porównano z najnowocześniejszymi podejściami opisanymi w literaturze przedmiotu i przedstawiono wyniki walidacji krzyżowej. Przeprowadzono obszerny przegląd powiązanych badań, a Tabela 1 podsumowuje te studia, uwzględniając modele, zbiory danych oraz raportowane wyniki19,20,21,22,23,24,25,26,27,28,29,30,31.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Protokół
W niniejszym badaniu wykorzystano publicznie dostępne zestawy danych BVC Challenging Voice Set oraz Mozilla Common Voice, bez bezpośredniego udziału uczestników. W związku z tym nie wymagano instytucjonalnej zgody komisji etycznej ani dodatkowej świadomej zgody. Przetwarzano jedynie dane niezbędne do klasyfikacji płci i wieku, nie podejmując prób identyfikacji poszczególnych mówców. Pełna metodologia przepływu pracy proponowanego modelu została przedstawiona na Rysunku 1.
Pozyskiwanie danych
Zbiór danych wykorzystany w proponowanym podejściu składał się z plików audio w formacie .wav pochodzących z BVC Challenging Voice Set, publicznie dostępnego zbioru danych głosowych opracowanego przez grupę Biometrics Vision and Computing (BVC) i hostowanego na GitHub32. Zbiór zawierał nagrania głosowe 526 osób, w tym 336 mężczyzn i 190 kobiet. Obejmował on około 3 964 nagrań, w tym nagrania pojedynczych i wielokrotnych zdań dla każdego mówcy. Tabela 2 podsumowuje charakterystykę demograficzną, zakres językowy, właściwości nagrań, strategię partycjonowania danych oraz ustawienia preprocessingu zastosowane dla zbiorów mowy w proponowanej strukturze VoiceNet-RAI.
Ekstrakcja cech
Pliki audio zostały przetworzone w celu wyodrębnienia kluczowych właściwości, które następnie zapisano w pliku CSV. Metadane, w tym wiek, płeć i sposób wymowy mówcy, wyekstrahowano z odpowiadających im plików README. Do przetwarzania plików WAV i wyodrębniania istotnych cech wykorzystano język Python wraz z pakietem SciPy. Szybką transformatę Fouriera (FFT) oraz funkcje częstotliwości z biblioteki NumPy zastosowano do konwersji sygnałów audio z dziedziny czasu do dziedziny częstotliwości. Pliki WAV przedstawiały amplitudę jako funkcję czasu; jednak dla zadania klasyfikacji większe znaczenie miały charakterystyki związane z częstotliwością, które pozwoliłyby odróżnić głosy męskie od żeńskich33.
W celu przekształcenia sygnałów audio w reprezentacje w dziedzinie częstotliwości zaimplementowano dyskretną transformatę Fouriera (DFT) przy użyciu algorytmu FFT. Transformata Fouriera przekształca sygnał z dziedziny czasu w widmo częstotliwości. Ponieważ widmo to nie zachowywało informacji czasowych, sygnał audio podzielono na nakładające się segmenty, a do każdego z nich zastosowano transformatę Fouriera zgodnie z podejściem krótkoczasowej transformaty Fouriera (STFT). Funkcja np.fft.fft wygenerowała zespolone widmo częstotliwości, natomiast np.fft.fftfreq dostarczyła odpowiadające im częstotliwości próbkowania. W katalogu z próbkami dostępnych było 10 plików audio dla jednego mówcy. Każdy plik WAV przetworzono przy użyciu okien przesuwnych o szerokości 200 ms, aby wyodrębnić częstotliwości dominujące. Przykładowo, 4-sekundowe nagranie audio pozwoliło uzyskać listę 20 wartości częstotliwości. W przypadku katalogu zawierającego 10 nagrań, 10 odpowiadających im list, z których każda zawierała 20 wartości częstotliwości, połączono w listę list. Częstotliwości przefiltrowano tak, aby zachować wartości między 20 Hz a 280 Hz, wykluczając potencjalne szumy w okolicach 50 Hz.
Hybrydowa reprezentacja cech MFCC i wav2vec 2.0
Aby uchwycić zarówno wysokopoziomowe kontekstowe reprezentacje mowy, jak i niskopoziomowe charakterystyki akustyczne, w badaniu zastosowano hybrydową strategię ekstrakcji cech, integrującą cechy MFCC z embeddingami wav2vec 2.0 opartymi na architekturze Transformer.
Ekstrakcja cech MFCC
Współczynniki cepstralne częstotliwości Mel (MFCC) są szeroko stosowanymi cechami w przetwarzaniu mowy i sygnałów audio, szczególnie w takich zastosowaniach jak rozpoznawanie mowy i identyfikacja mówcy34,35. W niniejszym badaniu ekstrakcja MFCC przekształciła sygnały audio w wektory cech reprezentujące istotne pod względem percepcyjnym charakterystyki mowy. Proces rozpoczęto od preemfazy w celu wzmocnienia komponentów wysokoczęstotliwościowych, a następnie zastosowano ramowanie i oknowanie, aby podzielić sygnał na krótkie, nakładające się ramki. Każda próbka audio została najpierw poddana resamplingu do 16 kHz i podzielona na ramki o długości 25 ms z nakładaniem się wynoszącym 10 ms. Następnie do każdej ramki zastosowano szybką transformatę Fouriera, aby przekształcić sygnał z dziedziny czasu do dziedziny częstotliwości.
Otrzymane widmo częstotliwości przepuszczono przez szereg banków filtrów Mel, które przybliżają nieliniową odpowiedź częstotliwościową ludzkiego percepcji słuchowej. Banki filtrów te podkreślały częstotliwości bardziej istotne percepcyjnie, redukując jednocześnie wkład tych mniej informatywnych. Następnie obliczono logarytm wyjścia każdego banku filtrów, aby przybliżyć logarytmiczną czułość ludzkiego słuchu na głośność. Do logarytmicznych energii banków filtrów zastosowano dyskretną transformatę kosinusową (DCT), aby odkorelować współczynniki i uzyskać zwartą reprezentację sygnału audio. Wynikowe współczynniki, znane jako MFCC, uchwyciły istotne charakterystyki widmowe mowy. MFCC zostały wykorzystane do klasyfikacji płci i wieku, ponieważ oddają one cechy akustyczne różnicujące głosy pod względem tych atrybutów.
ekstrakcja osadzeń wav2vec 2.0
Model wav2vec 2.0 Base został wstępnie wytrenowany na wielkoskalowych, nieoznakowanych korpusach mowy. Model składał się z wielowarstwowego kodera Transformer, który przetwarzał wejściowe surowe przebiegi falowe i generował kontekstowe osadzenia mowy36.
Dla wejściowego przebiegu fali x ∈ RT model wav2vec 2.0 wygenerował sekwencję reprezentacji latentnych:
Z = {z1,z1,....,zn},zi ∈ R768 (1)
gdzie każdy wektor zanurzenia miał wymiar 768. Aby uzyskać reprezentację o stałej długości odpowiednią do klasyfikacji, zastosowano operację czasowego uśredniania (temporal mean pooling) we wszystkich krokach czasowych.
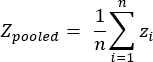 (2)
Mechanizm fuzji cech
Cechy MFCC oraz wav2vec 2.0 zostały połączone poprzez konkatenację na poziomie cech. W szczególności cechy MFCC zostały najpierw zagregowane przy użyciu uśredniania czasowego w celu uzyskania wektora o stałej długości.
m ∈ R40 (3)
Końcowy hybrydowy wektor cech uzyskano w następujący sposób:
h = [m || zpooled] ∈ R808 (4)
gdzie || oznacza konkatenację. Fuzja ta połączyła głębokie osadzenia kontekstowe z ręcznie opracowanymi cechami widmowymi, co pozwoliło modelowi uchwycić zarówno wysokopoziomowe informacje semantyczne, jak i precyzyjne wzorce akustyczne.
Wszystkie próbki audio zostały najpierw poddane ponownemu próbkowaniu do częstotliwości 16 kHz. Cechy MFCC obliczono w ramach poszczególnych ramek i uśredniono w czasie, aby uzyskać stały wektor 40-wymiarowy, natomiast osadzenia wav2vec 2.0 poddano uśrednianiu (mean-pooling) w czasie w celu uzyskania reprezentacji 768-wymiarowej. Ponieważ oba zestawy cech zostały przekształcone w wektory o stałej długości przed fuzją, wyrównanie czasowe na poziomie ramek nie było wymagane. Powstałe reprezentacje MFCC i wav2vec zostały następnie złączone w hybrydowy wektor cech o wymiarowości 808 przed przekazaniem do modelu klasyfikacji.
Integracja z EfficientNet-Lite
Złączony wektor cech, h, został przekształcony do formatu odpowiedniego dla uczenia cech i dostarczony jako dane wejściowe do modelu EfficientNet-Lite w celu przeprowadzenia treningu. W pełni połączona warstwa projekcyjna zmapowała najpierw 808-wymiarowy wektor na wyżej wymiarową przestrzeń latentną, po czym bloki EfficientNet-Lite doprecyzowały cechy hierarchiczne. W celu ograniczenia przeuczenia i poprawy generalizacji modelu zastosowano warstwy normalizacji wsadowej (batch normalization) oraz warstwy dropout. Do wygenerowania końcowych przewidywanych prawdopodobieństw dla klas płci i wieku użyto funkcji aktywacji SoftMax. Złączona reprezentacja, h ∈ R808, była początkowo traktowana jako jednowymiarowy wektor cech i przekazana przez w pełni połączoną warstwę projekcyjną, która zmapowała go do 4 096 wymiarów. Następnie rzutowana reprezentacja została przekształcona w tensor o wymiarach 1 × 64 × 64 przed wprowadzeniem do architektury EfficientNet-Lite.
Aby dostosować model do jednokanałowej reprezentacji cech mowy, zamiast konwencjonalnego trójkanałowego wejścia obrazu, zmodyfikowano oryginalną warstwę splotową wejściową EfficientNet-Lite, zmieniając liczbę kanałów wejściowych z trzech na jeden. Pozostałe bloki ekstrakcji cech EfficientNet-Lite zachowano bez istotnych modyfikacji architektonicznych. Do końcowych map cech zastosowano adaptacyjną warstwę globalnego uśredniania (global average pooling), aby uzyskać reprezentację o stałej długości. Oryginalny moduł klasyfikacyjny zastąpiono specyficzną dla zadania warstwą w pełni połączoną, zawierającą dwie jednostki wyjściowe dla klasyfikacji płci oraz odpowiednią liczbę jednostek wyjściowych dla zdefiniowanych grup wiekowych. Na koniec zastosowano funkcję aktywacji SoftMax w celu wygenerowania prawdopodobieństw klas. Zaproponowana reprezentacja hybrydowa połączyła nowoczesne embeddingi mowy z uczeniem samosuperwizowanym z tradycyjnymi cechami przetwarzania sygnałów. Embeddingi wav2vec 2.0 uchwyciły informacje kontekstowe i długodystansowe zależności, podczas gdy cechy MFCC dostarczyły uzupełniających, niskopoziomowych informacji akustycznych. Integracja tych reprezentacji poprawiła wydajność klasyfikacji, szczególnie w warunkach mowy zaszumionej i wielojęzycznej.
Klasyfikator ML
W niniejszym badaniu przeanalizowano wydajność wielu algorytmów ML w zakresie klasyfikacji płci oraz grup wiekowych na podstawie głosu.
Las Losowy
Do stworzenia odpornego klasyfikatora uczenia maszynowego (ML) wykorzystano Random Forest (RF), który łączy wiele drzew decyzyjnych (DT), aby zwiększyć dokładność prognoz i ograniczyć przeuczenie. RF działa w oparciu o procedurę uczenia zespołowego, w której wyniki z wielu drzew są agregowane w celu wygenerowania końcowej predykcji37,38. Podejście to pozwala RF na wychwytywanie różnorodnych wzorców w danych przy jednoczesnym ograniczeniu przeuczenia, które jest częste w przypadku pojedynczych drzew decyzyjnych. Losowość wprowadzona podczas budowy drzew poprawiła zdolność modelu do generalizacji, co sprawia, że RF jest odpowiedni do zadań klasyfikacyjnych, takich jak określanie płci i wieku na podstawie danych głosowych.
Regresja logistyczna
Do klasyfikacji wykorzystano regresję logistyczną (LR) jako statystyczny model uczenia maszynowego (ML)39. W przypadku klasyfikacji binarnej LR szacuje prawdopodobieństwo wystąpienia wyniku na podstawie cech wejściowych przy użyciu funkcji logistycznej (sigmoidalnej), a otrzymane prawdopodobieństwa służą do generowania przewidywań klas. LR była stosowana również w problemach klasyfikacji wieloklasowej obejmującej więcej niż dwie klasy. W klasyfikacji wieloklasowej LR wykorzystywała podejścia takie jak one-vs-rest lub regresję SoftMax, w zależności od ustawień klasyfikacji.
Klasyfikator Extra Trees
Klasyfikator Extra Trees (ETC) został zastosowany jako algorytm uczenia zespołowego, który łączy wiele drzew decyzyjnych (DT) w celu generowania prognoz40,41. W przeciwieństwie do RF, ETC wprowadza dodatkową losowość poprzez przypadkowy wybór cech kandydackich oraz progów podziału podczas budowy drzew. Procedura ta pozwoliła na wygenerowanie mniej skorelowanych drzew i zmniejszyła wrażliwość modelu na pojedyncze cechy, co poprawiło odporność na szum. Jako kryterium podziału do oceny istotności cech i partycjonowania danych wykorzystano indeks Giniego.
Maszyna wektorów wspierających
Maszyna wektorów wspierających (SVM) została wykorzystana jako klasyfikator ML do wyznaczenia optymalnej granicy decyzyjnej w wielowymiarowej przestrzeni cech42. Celem było określenie hiperpłaszczyzny, która maksymalizowała margines między klasami. Większy margines między granicą decyzyjną a najbliższymi punktami danych zazwyczaj sprzyjał lepszej separacji klas i generalizacji. SVM znajdował zastosowanie w wielu zadaniach ML, w tym w klasyfikacji, regresji oraz analizie danych opartej na cechach.
Splotowe sieci neuronowe
Splotowe sieci neuronowe (CNN) były wykorzystywane jako modele głębokiego uczenia (DL) w zadaniach klasyfikacji obejmujących ustrukturyzowane reprezentacje danych obrazowych i dźwiękowych. Jednowymiarowe sieci CNN (1D-CNN) były również szeroko stosowane w analizie danych sekwencyjnych i tekstowych. Architektury CNN wykorzystywały filtry splotowe oraz operacje próbkowania (pooling), aby wyekstrahować dyskryminacyjne cechy z danych wejściowych43,44. W celu klasyfikacji płci i wieku na podstawie danych głosowych, sieci CNN stosowano do reprezentacji pochodnych mowy, aby nauczyć się wzorców związanych z wysokością dźwięku, częstotliwością, tonem i innymi charakterystykami wokalnymi istotnymi dla rozróżniania grup wiekowych i płci.
VGG19
VGG19 został wykorzystany jako architektura DL charakteryzująca się głęboką, stosunkowo jednorodną hierarchiczną strukturą ekstrakcji cech45. Jego architektura wykorzystuje małe filtry splotowe 3 × 3 w 19 warstwach, co umożliwia progresywną ekstrakcję cech dyskryminacyjnych. W zastosowaniu do reprezentacji pochodnych z mowy, VGG19 przechwytywał zarówno niskopoziomowe wzorce akustyczne, takie jak wariacje wysokości i częstotliwości, jak i wyższego poziomu cechy dyskryminacyjne. Jego głęboka architektura umożliwiła progresywną abstrakcję cech do modelowania charakterystyk głosowych związanych z płcią i wiekiem.
EfficientNet-Lite
Jako wydajna obliczeniowo architektura DL zastosowano EfficientNet-Lite46,47. Model wykorzystał strategię zrównoważonego skalowania, aby osiągnąć wysoką skuteczność klasyfikacji przy jednoczesnym zapotrzebowaniu na mniejsze zasoby obliczeniowe niż w przypadku cięższych architektur DL. Zastosowane podejście do skalowania złożonego łączyło głębokość modelu, jego szerokość oraz rozdzielczość wejściową w celu zapewnienia efektywnej ekstrakcji cech.
Do proponowanego frameworku VoiceNet-RAI wybrano model EfficientNet-Lite ze względu na jego lekką architekturę oraz korzystny balans między wydajnością klasyfikacji a złożonością modelu. W porównaniu z cięższymi architekturami, wykorzystuje on wydajne bloki splotowe oraz skalowanie złożone (compound scaling), aby osiągnąć skuteczną naukę cech przy mniejszej liczbie parametrów i niższych wymaganiach obliczeniowych. Cechy te sprawiły, że EfficientNet-Lite jest odpowiedni dla proponowanego frameworku klasyfikacji mowy i stwarza potencjał do wdrożenia w środowiskach o ograniczonych zasobach.
MobileNet
MobileNet został wykorzystany jako lekka architektura DL dla aplikacji o ograniczonych zasobach obliczeniowych, w tym dla środowisk obliczeń mobilnych i krawędziowych48. Jego wydajność obliczeniowa została osiągnięta przede wszystkim dzięki splotom głębokim rozdzielnym (depthwise separable convolutions), które zredukowały liczbę parametrów i operacji obliczeniowych w porównaniu z konwencjonalnymi architekturami splotowymi. Cechy te sprawiły, że MobileNet był odpowiedni do oceny klasyfikacji płci i wieku na podstawie danych głosowych, przy zachowaniu stosunkowo niskich wymagań obliczeniowych.
InceptionV3
Do ekstrakcji hierarchicznych cech z reprezentacji pochodzących z mowy wykorzystano InceptionV3 jako architekturę głęboką49. Architektura ta zawierała operacje splotowe, poolingowe oraz mieszane, aby ekstrahować cechy na różnych poziomach abstrakcji. W celu klasyfikacji płci i wieku na podstawie danych głosowych, InceptionV3 posłużył do nauki złożonych wzorców akustycznych i reprezentacji hierarchicznych związanych ze zmianami w charakterystyce głosowej.
Parametry oceny
Dokładność (accuracy) była jedną z najczęściej stosowanych metryk oceny w zadaniach klasyfikacji50. Chociaż dokładność stanowiła przydatną miarę ogólnej skuteczności klasyfikacji, nie zawsze zapewniała ona kompleksową ocenę, szczególnie w przypadku niezbalansowanych zbiorów danych. Dlatego do oceny wydajności modelu wykorzystano dodatkowe metryki, w tym precyzję (precision), pełność (recall) oraz miarę F1 (F1-score). Metryki te umożliwiły bardziej szczegółową ocenę poprzez uwzględnienie poprawnych i błędnych predykcji dla każdej klasy.
Dokładność zdefiniowano jako stosunek liczby poprawnie sklasyfikowanych obserwacji do całkowitej liczby obserwacji. Chociaż dokładność była szczególnie informacyjna dla zrównoważonych zbiorów danych, zbiór danych wykorzystany w niniejszym badaniu był niezrównoważony. W związku z tym przy obliczaniu i interpretacji metryk klasyfikacji uwzględniono wyniki prawdziwie dodatnie (TP), fałszywie dodatnie (FP), prawdziwie ujemne (TN) oraz fałszywie ujemne (FN). Poniższe równanie przedstawia standardową definicję dokładności:
Dokładność = (TP+TN)/(TP+TN+FP+FN)×100 (5)
Precyzja ocenia zdolność klasyfikatora do zwracania wyłącznie istotnych instancji:
Precyzja= TP/(TP+FP) ×100 (6)
Czułość (ang. recall), znana również jako sensitivity, mierzy zdolność klasyfikatora do zidentyfikowania wszystkich istotnych instancji:
Czułość= TP/(FN+TP) × 100 (7)
Wskaźnik F1-score łączy precyzję i pełność w jednej mierze i jest szczególnie użyteczny przy ocenie wydajności klasyfikacji na niezbalansowanych zbiorach danych:
F1-Score =2 ×(PPV ×TPR)/(TPR+PPV) × 100 (8)
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Wyniki
Experimental results for age and gender classification were evaluated using MFCC-based and hybrid feature representations with ML and DL models. The dataset was partitioned into training and testing sets at an 80:20 ratio, with 80% used for training and 20% for testing. Speaker-level partitioning was applied to prevent recordings from the same speaker from appearing in both sets.
The hyperparameters and implementation details of the proposed framework are summarized in Table 3...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Dyskusja
W niniejszej pracy opracowano i oceniono zautomatyzowany system klasyfikacji płci i wieku na podstawie danych głosowych poprzez integrację cech MFCC oraz osadzeń wav2vec 2.0 z modelem EfficientNet-Lite. W wstępnych eksperymentach, przy użyciu pierwotnych cech, model EfficientNet-Lite osiągnął dokładność na poziomie 83,48%, precyzję 82,87%, czułość 84,28% oraz wartość F1-score wynoszącą 83,54%. Po integracji cech MFCC odnotowano znaczną poprawę wydajności, osiągając dokładność 92,64%, precyzję 93,79%, czułość 94,92% oraz ...
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Oświadczenia
Autorzy nie zgłaszają żadnych konfliktów interesów.
Podziękowania
Autorzy chciałyby podziękować Projektowi Wspierania Badaczy Uniwersytetu Księżniczki Nourah bint Abdulrahman numer (PNURSP2026R748), Uniwersytetowi Księżniczki Nourah bint Abdulrahman w Rijadzie, Arabia Saudyjska, za sfinansowanie tych badań.
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Zestaw głosów wymagających BVC | Grupa Biometrii, Wizji i Informatyki / OgeNI | Zestaw głosów utrudniających BVC | https://github.com/OgeNI/BVC_Challenging_Voice_Set |
| EfficientNet-Lite | EfficientNet-Lite, zastosowany dokładny wariant | https://github.com/tensorflow/tpu/tree/master/models/official/efficientnet/lite | |
| procesor graficzny | NVIDIA | Tesla K80 | https://www.nvidia.com/ |
| Zbiór danych Mozilla Common Voice | Mozilla Foundation | Common Voice, wersja wykorzystana w eksperymentach | https://www.kaggle.com/datasets/mozillaorg/common-voice/data |
| NumPy | Programiści NumPy | Dokładna wersja wykorzystana w eksperymentach | https://numpy.org/ |
| Procesor | Intel | Intel Core i7-8265U | https://www.intel.com/ |
| Python | Python Software Foundation | Dokładna wersja wykorzystana w eksperymentach | https://www.python.org/ |
| PyTorch | PyTorch Foundation | Dokładna wersja użyta w eksperymentach | https://pytorch.org/ |
| Scikit-learn | Deweloperzy Scikit-learn | Dokładna wersja użyta w eksperymentach | https://scikit-learn.org/ |
| SciPy | Programiści SciPy | Dokładna wersja zastosowana w eksperymentach | https://scipy.org/ |
| wav2vec 2.0 Base | Meta AI | facebook/wav2vec2-base | https://huggingface.co/facebook/wav2vec2-base |
| Windows 11 | Microsoft | Windows 11, dokładna edycja/kompilacja, jeśli dostępna | https://www.microsoft.com/windows/windows-11 |
Bibliografia
- Pahwa A, Aggarwal G. Speech feature extraction for gender recognition. Int J Image Graph Signal Process. 2016;8:17.
- Ericsdotter C, Ericsson AM. Gender differences in vowel duration in read Swedish: Preliminary results. Work Pap Lund Univ Dep Linguist Phon. 2001;49:34-37.
- Gamit MR, Dhameliya K, Bhatt NS. Classification techniques for speech recognition: A review. Int J Emerg Technol Adv Eng. 2015;5:58-63.
- Rabiner LR, Juang BH. Fundamentals of Speech Recognition. PTR Prentice Hall; Englewood Cliffs, NJ; 1993.
- Hansen JHL, Hasan T. Speaker recognition by machines and humans: A tutorial review. IEEE Signal Process Mag. 2015;32(6):74-99.
- Zhang Y, et al. Towards end-to-end speech recognition with deep convolutional neural networks [conference presentation]. Presented at: Interspeech 2016; San Francisco, CA; 2016. p. 410-414. Available from: https://www.isca-archive.org/interspeech_2016/zhang16b_interspeech.html
- Kabil SH, Muckenhirn H, Magimai-Doss M. On learning to identify genders from raw speech signal using CNNs [conference presentation]. Presented at: Interspeech 2018; Hyderabad, India; 2018. p. 287-291. Available from: https://www.isca-archive.org/interspeech_2018/kabil18_interspeech.html
- Albawi S, Mohammed TA, Al-Zawi S. Understanding of a convolutional neural network [conference presentation]. Presented at: 2017 International Conference on Engineering and Technology (ICET); Antalya, Türkiye; 2017. p. 1-6. Available from: https://ieeexplore.ieee.org/document/8308186
- Abdi H, Williams LJ. Principal component analysis. Wiley Interdiscip Rev Comput Stat. 2010;2(4):433-459.
- Mavaddati S. Voice-based age, gender, and language recognition based on ResNet deep model and transfer learning in spectro-temporal domain. Neurocomputing. 2024;580:127429.
- Jiang H, et al. 3WD-DRT: A three-way decision enhanced dynamic routing transformer for cost-sensitive multimodal sentiment analysis. Inf Sci. 2026;725:122704.
- Jameel HK, Al Ghrairi AHT, Neamah MM. Self-supervised learning for speech recognition: A review. Dijlah J Eng Sci. 2026;3(2).
- Anidjar OH, Yozevitch R. Transformer-based language-independent gender recognition in noisy audio environments. Sci Rep. 2025;15(1):14421.
- Sinha A, Kathania HK, Kurimo M. A study on the layer-wise transferability of self-supervised learning features for children's speech processing tasks. Speech Commun. 2026;180:103392.
- Li M, Han KJ, Narayanan SS. Automatic speaker age and gender recognition using acoustic and prosodic level information fusion. Comput Speech Lang. 2013;27(1):151-167.
- Sánchez-Hevia HA, Gil-Pita R, Utrilla-Manso M, Rosa-Zurera M. Age group classification and gender recognition from speech with temporal convolutional neural networks. Multimed Tools Appl. 2022;81:3535-3552.
- Abu Mallouh A, Qawaqneh Z, Barkana BD. New transformed features generated by deep bottleneck extractor and a GMM–UBM classifier for speaker age and gender classification. Neural Comput Appl. 2018;30:2581-2593.
- Almomani A, et al. Age and gender classification using backpropagation and bagging algorithms. Comput Mater Contin. 2023;74(2):3045-3062.
- Sahar RM, Rao TS, Anuradha S, Rao BS. Performance analysis of ML algorithms to detect gender based on voice. In: Recent Trends in Intensive Computing. 2021. p. 163-171. Available from: https://journals.sagepub.com/doi/abs/10.3233/APC210192
- Kone VS, et al. Voice-based gender and age recognition system [conference presentation]. Presented at: 2023 International Conference on Advancement in Computation & Computer Technologies (InCACCT); Gharuan, India; 2023. p. 74-80. Available from: https://ieeexplore.ieee.org/document/10141801
- Alhussein M, Muhammad G. Voice gender recognition under unconstrained environments using self-attention. Appl Acoust. 2021;175:107823.
- Yücesoy E. Automatic age and gender recognition using ensemble learning. Appl Sci. 2024;14(16):6868.
- Alnuaim AA, et al. Speaker gender recognition based on deep neural networks and ResNet50. Wirel Commun Mob Comput. 2022;2022:4444388.
- Ibrahim F, Nahar KMO, Al-Shannaq MA. Gender identification and age estimation of Arabic speaker using machine learning. J Theor Appl Inf Technol. 2020;98(19):3242-3256.
- Kannapiran P, Sindha MMR. Voice-based gender recognition model using FRT and LightGBM. Teh Vjesn. 2023;30:282-291.
- Alkhammash EH, Hadjouni M, Elshewey AM. A hybrid ensemble stacking model for gender voice recognition approach. Electronics. 2022;11:1750.
- Mutiany M, Herlistiono IO. Gender detection by voice using deep learning. Int J Innov Sci Res Technol. 2020;5(10):841-845.
- Raahul A, Sapthagiri R, Pankaj PK, Vijayarajan V. Voice based gender classification using machine learning. IOP Conf Ser Mater Sci Eng. 2017;263(4):042083. Available from: https://iopscience.iop.org/article/10.1088/1757-899X/263/4/042083
- Iloanusi O, et al. Voice recognition and gender classification in the context of native languages and lingua franca [conference presentation]. Presented at: 2019 6th International Conference on Soft Computing & Machine Intelligence (ISCMI); Johannesburg, South Africa; 2019. p. 175-179. Available from: https://ieeexplore.ieee.org/document/9004306
- Gupta Y, Gangwar K, Singhal M, Hemavathi D. Gender and age recognition using audio data-artificial neural networks. In: Soft Computing for Security Applications: Proceedings of ICSCS 2021. Springer; 2022. p. 449-470. Available from: https://link.springer.com/chapter/10.1007/978-981-16-5301-8_34
- Qawaqneh Z, Mallouh AA, Barkana BD. Deep neural network framework and transformed MFCCs for speaker’s age and gender classification. Knowl-Based Syst. 2017;115:5-14.
- OgeNI. BVC Challenging Voice Set [Internet]. GitHub; 2025 [cited 2026 Aug 16]. Available from: https://github.com/OgeNI/BVC_Challenging_Voice_Set
- Oppenheim AV, Schafer RW. Discrete-Time Signal Processing. 3rd ed. Pearson; Upper Saddle River, NJ; 2010.
- Logan B. Mel frequency cepstral coefficients for music modeling [conference presentation]. Presented at: International Society for Music Information Retrieval Conference (ISMIR); Plymouth, UK; 2000. Available from: https://ismir.net/conferences/ismir-2000/
- Davis SB, Mermelstein P. Comparison of parametric representations for monosyllabic word recognition in continuously spoken sentences. IEEE Trans Acoust Speech Signal Process. 1980;28(4):357-366.
- Baevski A, Zhou H, Mohamed A, Auli M. wav2vec 2.0: A framework for self-supervised learning of speech representations [conference presentation]. Presented at: Advances in Neural Information Processing Systems 33 (NeurIPS 2020); Virtual; 2020. p. 12449-12460. Available from: https://proceedings.neurips.cc/paper/2020/hash/92d1e1eb1cd6f9fba3227870bb6d7f07-Abstract.html
- Yıldırım Ş, Bingöl MS. Metaheuristic approaches to enhance voice-based gender identification using machine learning methods. Appl Sci. 2025;15(23):12815.
- Breiman L. Random forests. Mach Learn. 2001;45:5-32.
- Hosmer DW Jr, Lemeshow S, Sturdivant RX. Applied Logistic Regression. 3rd ed. Wiley; Hoboken, NJ; 2013.
- Geurts P, Ernst D, Wehenkel L. Extremely randomized trees. Mach Learn. 2006;63:3-42.
- Yücesoy E, Nabiyev VV. A new approach with score-level fusion for the classification of a speaker age and gender. Comput Electr Eng. 2016;53:29-39.
- Cortes C, Vapnik V. Support-vector networks. Mach Learn. 1995;20:273-297.
- Abdel-Hamid O, et al. Convolutional neural networks for speech recognition. IEEE/ACM Trans Audio Speech Lang Process. 2014;22(10):1533-1545.
- Nasaruddin N, Pratama Tresma MAP, Muchamad MK, Fuadi Z. Voice frequency-based gender classification using convolutional neural network for smart home. IEEE Access. 2024;12:104190-104203.
- Simonyan K, Zisserman A. Very deep convolutional networks for large-scale image recognition [conference presentation]. Presented at: International Conference on Learning Representations (ICLR); San Diego, CA; 2015. Available from: https://iclr.cc/archive/www/2015.html
- Tan M, Le QV. EfficientNet: Rethinking model scaling for convolutional neural networks [conference presentation]. Presented at: 36th International Conference on Machine Learning (ICML); Long Beach, CA; 2019. p. 6105-6114. Available from: https://proceedings.mlr.press/v97/tan19a.html
- Ertam F. An effective gender recognition approach using voice data via deeper LSTM networks. Appl Acoust. 2019;156:351-358.
- Zhao L, Wang L, Jia Y, Cui Y. A lightweight deep neural network with higher accuracy. PLoS One. 2022;17(8):e0271225.
- Szegedy C, et al. Rethinking the Inception architecture for computer vision [conference presentation]. Presented at: IEEE Conference on Computer Vision and Pattern Recognition (CVPR); Las Vegas, NV; 2016. p. 2818-2826. Available from: https://openaccess.thecvf.com/content_cvpr_2016/html/Szegedy_Rethinking_the_Inception_CVPR_2016_paper.html
- Sokolova M, Lapalme G. A systematic analysis of performance measures for classification tasks. Inf Process Manag. 2009;45(4):427-437.
- Mozilla Common Voice Project. Common Voice Dataset [Internet]. 2024 [cited 2024 Jun 18]. Available from: https://www.kaggle.com/datasets/mozillaorg/common-voice/data
Dostęp ograniczony. Zaloguj się lub rozpocznij wersję próbną, aby wyświetlić tę treść.