Niniejszy protokół integruje multimodalne zapisy behawioralne w celu oceny obserwowalnych korelatów wysiłku poznawczego oraz funkcjonalnej skuteczności rewizji w tłumaczeniu pisemnym i tłumaczeniu widzenia z języka angielskiego na chiński. Łączy on rejestrowanie naciśnięć klawiszy, przechwytywanie ekranu, analizę audio, kodowanie na podstawie transkrypcji oraz zestandaryzowaną ocenę jakości.
Artykuł metodologiczny
Protokół behawioralny do oceny wysiłku poznawczego i rewizji strategicznej w zadaniach tłumaczenia pisemnego oraz tłumaczenia z tekstu w relacji angielsko-chińskiej
W tym artykule
Podsumowanie
Streszczenie
Niniejszy artykuł przedstawia multimodalny protokół behawioralny służący do badania obserwowalnych korelatów wysiłku poznawczego oraz strategicznej rewizji podczas pisemnego tłumaczenia i tłumaczenia z tekstu (sight interpreting) z języka angielskiego na chiński. W przypadku tłumaczenia pisemnego zsynchronizowano logi uderzeń klawiszy i nagrania ekranu, natomiast w tłumaczeniu z tekstu wykorzystano nagrania audio i transkrypcje słowo w słowo. Epizody rewizji i autokorekty zakodowano według rodzaju oraz wyniku funkcjonalnego (skuteczny, neutralny lub szkodliwy), niezależnie od całościowych ocen jakości produktu końcowego. W demonstracji z udziałem 62 uczestników przydzielonych do grup początkujących i przeszkolonych, obie grupy wykonały dwa rodzaje zadań w kolejności zrównoważonej. Uczestnicy przeszkoleni uzyskali wyższe średnie oceny jakości produktu końcowego w tłumaczeniu pisemnym (20.1 ± 2.1 vs. 16.8 ± 2.3) i tłumaczeniu z tekstu (18.9 ± 2.4 vs. 15.4 ± 2.6) oraz wyższy odsetek skutecznych rewizji lub autokorekt. Ponieważ pauzy, usunięcia, latencja rozpoczęcia oraz gęstość rewizji są pośrednimi i zależnymi od zadania wskaźnikami, interpretuje się je jako korelaty behawioralne wymagające triangulacji, a nie jako bezpośrednie miary jednolitego konstruktu. Protokół jest przeznaczony dla kontrolowanych tekstów ekspozycyjnych i może zostać dostosowany do innych par językowych po ponownej kalibracji obsługi metod wprowadzania danych, progów pauz, porównywalności tekstów oraz procedur oceniania.
Wprowadzenie
Pisemne tłumaczenie oraz tłumaczenie widokowe z języka angielskiego na chiński wymagają zrozumienia tekstu źródłowego, transferu międzyjęzykowego oraz sformułowania tekstu w języku docelowym, jednak narzucają one odmienne warunki zadaniowe. Tłumaczenie pisemne umożliwia wielokrotne czytanie i odroczoną edycję, podczas gdy tłumaczenie widokowe wymaga produkcji ustnej w znacznie bardziej rygorystycznych ograniczeniach czasowych. Obciążenie poznawcze, trudność przetwarzania i wysiłek poznawczy są konstruktami powiązanymi, ale niewymiennymi: obciążenie dotyczy wymagań zadania, natomiast wysiłek odnosi się do zasobów, jakie uczestnik angabuje w odpowiedzi na te wymagania. Wysiłek poznawczy jest ukryty i wielowymiarowy; dlatego latencja, pauzy, pominięcia oraz gęstość korekt są tutaj traktowane jako korelaty behawioralne, które mogą odzwierciedlać planowanie, monitorowanie, procesy motoryczne lub trudność i muszą być interpretowane łącznie, a nie jako bezpośrednie pomiary wysiłku1,2,3,4,5,6,7,8.
Badania zorientowane na proces łączą oceny produktów z zapisami behawioralnymi zsynchronizowanymi w czasie, aby zidentyfikować, kiedy i w jaki sposób zapadają decyzje przekładowe. Rejestracja naciśnięć klawiszy jest informacyjna w przypadku sekwencji produkcji i rewizji, jednak chińskie metody wprowadzania tekstu mogą oddzielać fizyczne zdarzenia klawiaturowe od zatwierdzonych znaków; dlatego konieczne jest zsynchronizowane nagrywanie ekranu, aby zrekonstruować widoczny stan tekstu9,10,11. Progi pauz są wyborami analitycznymi, a nie uniwersalnymi granicami poznawczymi, a krótsze progi mogą istotnie zmienić wnioski oparte na analizie pauz8,12. W konsekwencji protokół wymaga wyraźnych kontroli synchronizacji, analiz wrażliwości progów oraz oddzielenia miar specyficznych dla zadania od miar wspólnych.
Sama częstotliwość rewizji nie wskazuje, czy monitorowanie poprawia wynik. Rewizje pisemne i ustne autokorekty mogą dotyczyć wyboru leksykalnego, składni, znaczenia lub stylu, jednak ich funkcjonalny rezultat musi być oceniany w odniesieniu do znaczenia źródłowego oraz bezpośrednio poprzedzającego segmentu docelowego. Badania nad tłumaczeniem widocznym w parach angielski-chiński i chiński-angielski wykazują, że szkolenie, kierunkowość, koordynacja oko-głosowa oraz specyficzne dla danego języka wyzwalacze problemów mogą zmieniać wzorce wydajności13,14,15,16. Z tego powodu typ epizodu, wynik epizodu, jakość produktu końcowego oraz zachowania związane z przekazem są kodowane jako oddzielne zmienne.
Protokół został opracowany dla dorosłych uczniów lub przeszkolonych tłumaczy/interpretatorów pracujących z krótkimi, niespecjalistycznymi tekstami ekspozycyjnymi w kontrolowanych sesjach komputerowych. Jest on najbardziej odpowiedni w przypadkach, gdy możliwe jest przechwycenie zapisów uderzeń klawiszy i ekranu dla produkcji pisemnej oraz nagranie wysokiej jakości dźwięku dla produkcji ustnej. Ramy te można dostosować do innych par językowych, jednak dopasowanie tekstu, segmentacja na jednostki informacyjne, zachowanie klawiatury lub metody wprowadzania danych, progi pauzy oraz punkty odniesienia dla ocen muszą zostać ponownie zwalidowane dla każdej pary językowej i systemu pisma17. Demonstracja porównuje warunki zadań, zamiast przypisywać wszystkie różnice wyłącznie modalności, ponieważ różnią się również długość tekstu, limity czasowe, tryb wyjściowy oraz możliwości rewizji.
Protokół
Wszystkie metody obejmujące udział ludzi zostały przeprowadzone zgodnie z wytycznymi instytucjonalnymi i uzyskały wyraźną zgodę Komisji Etyki Badań z Udziałem Ludzi w Guilin Institute of Information Technology (nr zgody UYHAJ2025899). Przed przystąpieniem do badania od wszystkich uczestników uzyskano pisemną świadomą zgodę. Pełna lista sprzętu i oprogramowania wykorzystanego w niniejszym badaniu znajduje się w Tabeli materiałów.
1. Rekrutacja uczestników i przydział do grup
- Zrekrutuj 62 uczestników, w tym studentów filologii angielskiej lub tłumacznictwa oraz stażystów zawodnego tłumaczenia ustnego. Zweryfikuj, czy wszyscy uczestnicy są rodzimymi użytkownikami języka chińskiego i posiadają prawidłowy lub skorygowany do normy wzrok i słuch.
- Przypisz uczestników z mniej niż 12-miesięcznym stażem ustrukturyzowanego szkolenia z tłumaczenia do grupy początkującej, a osoby z co najmniej 12-miesięcznym stażem do grupy przeszkolonej. Raportuj oddzielnie wcześniejszą praktykę w tłumaczeniu pisemnym i tłumaczeniu ustnym z tekstu dla wszystkich uczestników.
- Przeprowadź przesiew uczestników przed przydzieleniem zadań, aby wykluczyć osoby, które miały wcześniej kontakt z tekstami źródłowymi, wykazują nieskorygowanych zaburzeń sensorycznych lub nie potrafią korzystać ze standardowej chińskiej metody wprowadzania tekstu.
- Wykluczaj zadania po nagraniu wyłącznie z wcześniej określonych powodów, takich jak niedozwolone użycie zewnętrznych narzędzi, niepełna realizacja, uszkodzone pliki lub nieużytkowe nagrania audio.
- Prowadź rejestr wykluczonych zadań bez danych umożliwiających identyfikację osób. Raportuj ostateczną analizowaną próbkę w sposób spójny w tekście oraz na Rysunku 1A–D.
2. Wybór materiałów i ocena pilotażowa
- Wybierz krótkie angielskie teksty eksponujące z ogólnych dziedzin akademickich, edukacyjnych, społecznych lub komunikacji publicznej. Wykorzystaj teksty do tłumaczenia pisemnego o długości około 180–220 słów oraz teksty do tłumaczenia ustnego z tekstu (sight translation) o długości około 120–160 słów.
- Dopasuj lub statystycznie skoryguj długość tekstu, trudność leksykalną, złożoność składniową, gęstość informacji oraz stopień znajomości tematu we wszystkich warunkach zadań.
- Zleć trzem ekspertom bilingwalnym niezależną ocenę trudności leksykalnej, złożoności składniowej, gęstości informacji, znajomości tematu oraz przydatności do transferu w skali od 1 do 5 punktów (1 = bardzo niska, 5 = bardzo wysoka).
- Oblicz dwukierunkowy współczynnik korelacji wklasowej (ICC) z efektami losowymi z 95% przedziałem ufności dla średnich ocen. Zrewiduj elementy wykazujące słabą zgodność (ICC < 0,75).
- Zachowaj pary tekstów tylko wtedy, gdy ustandaryzowane zmienne dopasowujące mieszczą się w marginesie tolerancji ±10%.
- Zdefiniuj jednostkę informacyjną jako najmniejszą propozycję tekstu źródłowego, która wyraża jedną niezależnie ocenialną ideę, relację lub zdarzenie. Rozstrzygnij rozbieżności dotyczące granic jednostek przed przeprowadzeniem zadań.
- Przeprowadź pilotaż instrukcji, metody wprowadzania danych, synchronizacji, jakości dźwięku i limitów czasowych z uczestnikami, którzy nie są włączeni do głównej analizy. Zarejestruj rozkłady czasu wykonania oraz proporcję osób osiągających każdy limit czasowy.
- Zrewiduj tekst lub limit czasowy, gdy uczestnicy pilotażu wykazują efekt sufitu/podłogi (ceiling/floor performance), trwałą niejednoznaczność lub niestabilność nagrań. Udokumentuj każdą zmianę przed rozpoczęciem głównego badania.
3. Administracja zadaniami i konfiguracja rejestracji
- Testuj uczestników indywidualnie w cichym, wyciszonym pomieszczeniu, korzystając ze zestandaryzowanych konfiguracji sprzętowych i programowych.
- Odczytaj zestandaryzowany skrypt instrukcji i umożliw jedną nieeksperymentalną próbę praktyczną. Zabroń korzystania ze słowników, wyszukiwarek, generatywnej sztucznej inteligencji, tłumaczeń maszynowych oraz zewnętrznych korpusów.
- Zastosuj kontrbalans dwóch kolejności zadań (najpierw tłumaczenie pisemne vs najpierw tłumaczenie z tekstu) w obrębie każdej grupy treningowej i zachowaj 5-minutowy odstęp na odpoczynek.
- Przygotuj listę przydziału przed zakończeniem rekrutacji i utaj assignment aż do potwierdzenia kwalifikowalności. W przypadku użycia wielu tekstów źródłowych, zastosuj kontrbalans tożsamości tekstów niezależnie od kolejności zadań i zachowaj zmienną text-ID do analizy.
- Wyświetl angielski tekst źródłowy w sposób ciągły i poleć uczestnikowi przygotowanie dokładnego, naturalnego tłumaczenia na język chiński w wyznaczonym polu wprowadzania. Pozwól na nieogranicowaną edycję, ale surowo zabroń wklejania zewnętrznych tekstów.
- Zastosuj 20-minutowy limit czasu ustalony w badaniu pilotażowym, nie wyświetlając zegara odliczającego czas, i odnotuj, czy limit ten został osiągnięty.
- Rejestruj cały proces tłumaczenia pisemnego w sposób ciągły, wykorzystując oprogramowanie do logowania naciśnięć klawiszy zsynchronizowane z ciągłym nagrywaniem ekranu. Zachowaj końcowe wyniki tłumaczenia wraz z plikami logów z sygnaturą czasową do późniejszej ekstrakcji behawioralnej.
- Wyświetl na ekranie tekst źródłowy do tłumaczenia z tekstu i poleć uczestnikowi rozpoczęcie ustnej interpretacji na język chiński bez sporządzania notatek pisemnych.
- Konsekwentnie stosuj 6-minutowy limit czasu i odnotuj, czy limit ten został osiągnięty. Odróżnij obserwację ograniczoną czasowo od obserwacji zakończonej w zwykły sposób.
- Nagraj wypowiedzi ustne za pomocą cyfrowego oprogramowania do przechwytywania dźwięku. Sporządź z tych nagrań rygorystyczne transkrypcje słowo w słowo, aby ułatwić późniejsze kodowanie.
4. Ekstrakcja wskaźników procesów behawioralnych
- Wyodrębnij behawioralne korelaty zadań pisemnych z plików dziennika, definiując latencję początkową jako odstęp czasu od wystąpienia bodźca do wprowadzenia pierwszego znaku chińskiego.
- Wyodrębnij całkowity czas wykonywania zadania, liczbę i czas trwania pauz, wskaźnik usuwania tekstu, gęstość rewizji oraz tempo produkcji. Zachowaj surowe znaczniki czasu oraz dokładny mianownik użyty dla każdej znormalizowanej miary.
- Przyjmij 2 s jako operacyjny próg pauzy w pisaniu. Zgłoś, czy uwzględniono pauzy podczas nawigacji kursorem, zaznaczania tekstu lub wyboru kandydata w metodzie wprowadzania danych.
- Wyodrębnij behawioralne korelaty zadań ustnych z przebiegu fali i zweryfikowanego transkrypcji, definiując latencję początkową jako odstęp czasu od prezentacji bodźca do pierwszej znaczącej wypowiedzi w języku docelowym.
- Wyklucz wdech, odchrząkiwanie i porzucone dźwięki nieleksykalne z obliczeń latencji początkowej. Wyodrębnij całkowity czas tłumaczenia ustnego, pauzy milczące, pauzy wypełnione, powtórzenia, fałszywe starty, autokorekty oraz tempo mowy.
- Zdefiniuj ustną pauzę milczącą jako ciszę wewnątrz wypowiedzi trwającą co najmniej 1,0 s. Zweryfikuj granice pauz z przebiegiem fali i zweryfikowaną transkrypcją oraz wyklucz ciszę początkową i końcową z liczby pauz wewnątrz wypowiedzi.
- Sporządź rekord kontroli jakości dla każdego przeprowadzonego zadania. Udokumentuj, czy odpowiedni plik procesu jest czytelny i kompletny, czy transkrypcja została zweryfikowana oraz czy kodowanie zostało zakończone lub rozstrzygnięte. Zachowaj oryginalny rekord i rejestruj wszelkie poprawki w ścieżce audytu.
5. Kodowanie rewizji strategicznej i oralnej autokorekty
- Odtwórz każdą wprowadzoną poprawkę poprzez zestawienie logu naciśnięć klawiszy, nagrania ekranu oraz tekstu końcowego.
- Traktuj epizod jako ciąg czynności edycyjnych skierowanych do tego samego segmentu docelowego; zamknij epizod, gdy proces tworzenia zostanie wznowiony w innym miejscu przez co najmniej 2 s lub gdy edytowany jest inny segment.
UWAGA: W przypadku wprowadzania znaków języka chińskiego odróżnij zmiany w kompozycji przed zatwierdzeniem od usunięć tekstu docelowego po zatwierdzeniu i koduj jako poprawki tekstowe tylko te drugie. - Przypisz jeden główny typ poprawki w oparciu o zmiany semantyczne, syntaktyczne, leksykalne lub stylistyczne. Dopuszczalne jest użycie drugiego tagu w przypadkach nakładających się, jednak do wzajemnie wykluczających się zliczeń używaj tagu głównego. Zastosuj przykłady opracowane w Supplementary File 1.
- Sporządź dosłowną transkrypcję z sygnaturami czasowymi przed zakodowaniem ustnych autokorekt. Poleć pierwszemu transkrybentowi oznaczenie treści leksykalnej, pauz wypełnionych, powtórzeń, fałszywych startów, urwań zdań oraz fragmentów niezrozumiałych.
- Zleć drugiemu przeszkolonemu recenzentowi sprawdzenie transkrypcji z nagraniem audio i rozstrzygnięcie rozbieżności przy zachowaniu oryginalnych sygnatur czasowych audio.
- Zdefiniuj ustną autokorektę jako jawne sformułowanie na nowo, które zastępuje, uzupełnia lub koryguje bezpośrednio poprzedzający segment w języku docelowym. Nie wyciągaj wniosków o ukrytym monitorowaniu wyłącznie na podstawie ciszy. Zastosuj te same reguły decyzyjne dotyczące leksyki, syntaktyki, semantyki i stylistyki do ustnych autokorekt.
- Koduj dokładne powtórzenie bez zmiany korygującej jako dysfluencję, przerwany start, po którym następuje nowa konstrukcja, jako fałszywy start wraz z korektą, a pominięcie lub błędne tłumaczenie bez jawnego sformułowania na nowo jako błąd wyjściowy.
- Gdy nagranie audio jest niejasne lub gdy dwie kategorie pozostają równie prawdopodobne, oznacz epizod jako niejednoznaczny. Zachowaj tymczasowe tagi dla epizodów niejednoznacznych i rozstrzygnij je przed analizą niezawodności.
- Oceń wynik funkcjonalny poprzez porównanie segmentów docelowych przed i po epizodzie z jednostką informacyjną źródła oraz lokalnym kontekstem docelowym. Dokonaj tej oceny przed ujawnieniem końcowej oceny całościowej. Nie traktuj zmiany w ocenie całościowej jako definicji skuteczności.
- Zastosuj podwójne kodowanie dla co najmniej 20% wyników wybranych z obu grup i kolejności zadań, a następnie oblicz niezawodność na podstawie niezależnych kodów przed rozstrzygnięciem.
- Przeprowadź ponowne szkolenie i ponowne kodowanie, gdy zgodność między sędziami spadnie poniżej wartości kappa Cohen'a 0,80. Udokumentuj ten dokładny próg oraz wszelkie podjęte działania korygujące.
6. Ocena jakości i modelowanie statystyczne
- Oceń każde końcowe tłumaczenie pisemne oraz przekład z tekstu (sight-interpreting) za pomocą 25-punktowej rubryki analitycznej zawartej w Supplementary File 1.
- Oceń dokładność, kompletność, odpowiedniość leksykalną, spójność oraz naturalność w języku docelowym w skali od 0 do 5, korzystając z określonych punktów odniesienia. Nie modyfikuj kryteriów oceny po zapoznaniu się z przynależnością do grup.
- Poleć oceniającym korzystanie zarówno z nagrań audio, jak i zweryfikowanych transkrypcji w odniesieniu do wymiarów przekładu z tekstu. Analizuj miary pauz i dysfluencji oddzielnie od wyników z rubryki.
- Przeszkol dwóch niezależnych oceniających, korzystając z księgi kodowej i co najmniej 10 przykładów ćwiczeniowych, zapewniając oceniającym ślepe próbki w kwestii grupy uczestników i kolejności zadań.
- Po niezależnym punktowaniu i kodowaniu epizodów oblicz niezawodność przed dyskusją. Rozwiązuj rozbieżności drogą konsensusu i konsultuj się z trzecim oceniającym tylko wtedy, gdy nie uda się osiągnąć porozumienia.
- Zgłoś dwukierunkowy współczynnik korelacji wewnątrzklasowej z efektami losowymi dla bezwzględnej zgodności w przypadku uśrednionych ciągłych wyników jakości. Zgłoś kapę Cohena dla głównego kategorycznego kodu rewizji oraz oddzielną kapę dla kodu wyniku efektywny/neutralny/szkodliwy. Podaj dokładną liczbę i procent epizodów zakodowanych podwójnie.
- Przed analizą sprawdź, czy każdy plik procesu jest czytelny i kompletny, dopasuj dzienniki zadań pisemnych do odpowiadających im nagrań ekranu oraz zweryfikuj transkrypcje z nagraniami audio.
- Odnotuj błędy dopasowania, problemy z zrozumiałością oraz podjęte działania korygujące w dzienniku kontroli jakości. Znormalizuj miary częstotliwości, przyjmując 100 jednostek informacyjnych tekstu źródłowego dla częstotliwości pauz oraz 100 wyprodukowanych znaków chińskich dla gęstości rewizji pisemnej.
- Koduj wynik funkcjonalny niezależnie od końcowej holistycznej oceny jakości. Koduj epizod jako efektywny, gdy segment po rewizji poprawia tekst, nie wprowadzając nowych problemów; jako neutralny, gdy nie powoduje istotnej zmiany; i jako szkodliwy, gdy wprowadza błąd.
- Oblicz wskaźnik efektywności jako liczbę epizodów efektywnych podzieloną przez wszystkie epizody możliwe do zaklasyfikowania, wykluczając epizody dwuznaczne z mianownika.
- Analizuj demonstrację jako eksploracyjny zbiór danych z pomiarami powtarzanymi. Określ model efektów stałych w celu przewidzenia całkowitej oceny jakości, wykorzystując warunki zadania, grupę treningową, metryki pauz, gęstość rewizji, wskaźnik efektywności, obciążenie dysfluencją oraz tempo mowy.
- Uwzględnij losowy punkt przecięcia dla uczestnika; uwzględnij losowe efekty tekstu źródłowego tylko wtedy, gdy projekt zawiera wystarczającą liczbę niezależnie pobranych tekstów.
- Wycentruj predyktory ciągłe, sprawdź reszty oraz kolinearność. Zgłoś metodę estymacji, wersję oprogramowania, β, SE, 95% CI, dokładne wartości p, komponenty wariancji, AIC, BIC oraz marginalny/warunkowy R2. Opisz analizę jako eksploracyjną i unikaj potwierdzających twierdzeń przyczynowo-skutkowych.
- Wyeksportuj reprodukowalny pakiet analizy zawierający zanonimizowane dane, słownik, księgę kodową, rubrykę, szczegóły oprogramowania, skrypty i wyniki. Przed publikacją potwierdź, że każda wartość w rysunkach i tabelach może zostać powiązana z nazwaną zmienną i etapem analizy.
Wyniki
Charakterystyka wyjściowa uczestników i dostępność danych
W kwestionariuszu wzięło udział 62 uczestników (31 początkujących i 31 przeszkolonych), a arkusz zadań zawierał 124 wpisy, co wskazuje na dwa ukończone zadania na każdego uczestnika (Tabela 1). Grupa początkujących posiadała mniej niż 12 miesięcy ustrukturyzowanego szkolenia z tłumaczenia (zaobserwowane maksimum, 8,6 miesiąca), natomiast grupa przeszkolona posiadała co najmniej 12 miesięcy (zaobserwowane minimum, 13,3 miesiąca). Rozkłady wieku, płci, czasu nauki języka angielskiego, biegłości oraz kolejności wykonywanych zadań były podobne w obu grupach. Rysunek 1 przedstawia końcową analizowaną próbkę i prawidłowo rozróżnia dane specyficzne dla zadań: logi uderzeń klawiszy i nagrania ekranu odnoszą się do tłumaczenia pisemnego, nagrania audio i transkrypcje dosłowne odnoszą się do tłumaczenia z widoku, a oceny jakości odnoszą się do obu tych form.
Profile behawioralne w zależności od warunków zadania
Profile behawioralne różniły się pomiędzy dwoma wariantami zadań oraz pomiędzy grupami treningowymi (Tabela 2; Rycina 2A–E). Tłumaczenie pisemne charakteryzowało się dłuższym czasem wykonania oraz dłuższymi średnimi pauzami, podczas gdy tłumaczenie ustne z tekstu wykazywało większą liczbę pauz na 10 jednostek informacji poniżej raportowanego progu. W każdym wariancie zadania grupa przeszkolona wykonywała zadania szybciej i osiągała wyższe średnie wyniki jakościowe. Kontrastów tych nie należy interpretować jako wyłącznie efektów modalności, ponieważ różniły się również długość tekstu, limit czasowy, tryb przekazu oraz możliwość dokonania korekty. Pauzy nie są jednolicie zakłócające: pauza może odzwierciedlać nierozwiązaną trudność, skuteczne planowanie, monitorowanie lub aktywność związaną z metodą wprowadzania danych, dlatego mierniki pauz interpretuje się łącznie z miernikami korekty, płynności przekazu i jakości.
Strategiczna rewizja, samonaprawa i modelowanie predykcyjne
Struktura kodowania oddzielała typ epizodu od wyniku funkcjonalnego (Tabela 3; Rysunek 3A–D). Przeszkoleni uczestnicy generowali więcej epizodów poprawki pisemnej niż nowicjusze (12,4 ± 3,7 vs. 8,9 ± 3,0 na zadanie), podczas gdy całkowita liczba ustnych autokorekt nie różniła się istotnie między grupami (4,9 ± 1,6 vs. 4,4 ± 1,5 na zadanie). Grupa przeszkolona miała niemniej jednak większą proporcję efektywnych epizodów w obu zadaniach. Przedstawione w Tabeli 4 podsumowanie efektów mieszanych obrazuje powiązania, a nie ścieżki przyczynowe; dlatego na Rysunku 3E wyświetlono zgłoszone szacunki efektów stałych i przedziały ufności zamiast diagramu przyczynowego.
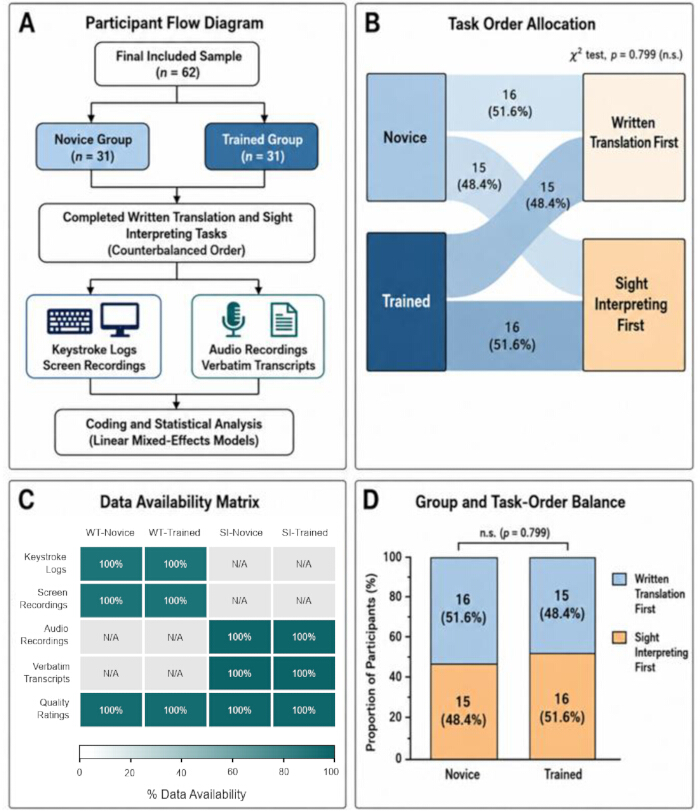
Rycina 1Przepływ uczestników, przydział kolejności zadań oraz dostępność danych specyficznych dla zadań. (A) Końcowa analizowana próba obejmująca 62 uczestników i 124 zapisy zadań. (B) Zrównoważony przydział kolejności zadań w grupach osób początkujących i przeszkolonych. (C) Macierz dostępności, w której logi naciśnięć klawiszy i nagrania ekranu dotyczą wyłącznie tłumaczenia pisemnego, nagrania audio i transkrypcje dosłowne wyłącznie tłumaczenia ustnego z tekstu, a oceny jakości obu zadań. (D) Bilans grup według kolejności (test chi-kwadrat, p = 0,799). n = 62 uczestników (po 31 na grupę). Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
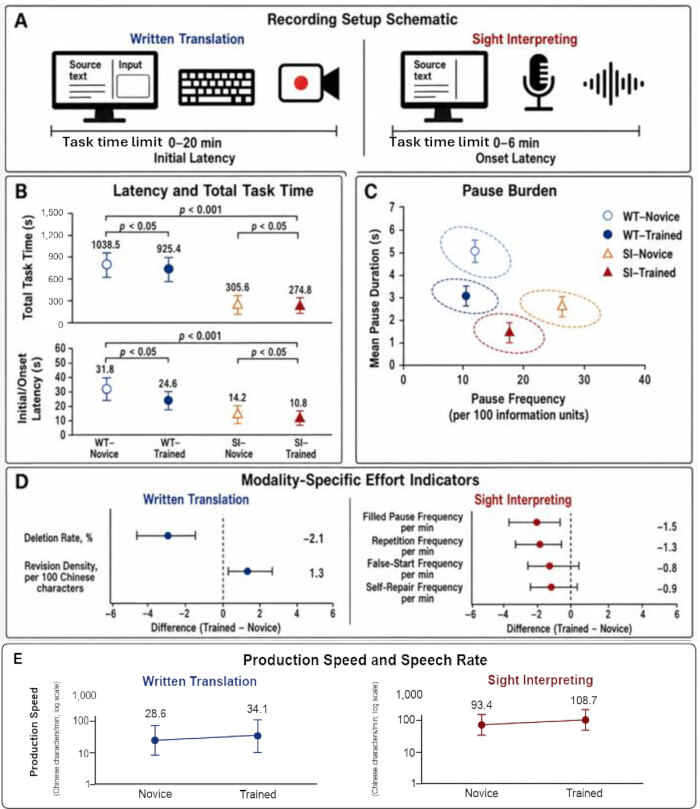
Rycina 2Profile behawioralne w warunkach zadań z tłumaczenia pisemnego i tłumaczenia z tekstu. (A) Układ rejestracyjny dostosowany do konkretnego zadania. (B) Latencja początkowa/moment wystąpienia oraz całkowity czas wykonania zadania. (C) Rozkład łączny częstotliwości pauz i średniego czasu trwania pauzy. (D) Wskaźniki usuwania, poprawiania i dysfluencji mowy specyficzne dla zadania. (E) Tempo produkcji pisemnej i tempo mowy. Na panelach B, C i E punkty oraz słupki błędów przedstawiają średnie grupowe ± SD; na panelu D punkty przedstawiają różnice średnich między grupą przeszkoloną a nowicjuszami, a słupki błędów przedstawiają 95% przedziały ufności. n = 31 uczestników w grupie. Na panelu E oś y jest przedstawiona w skali logarytmicznej. Kliknij tutaj, aby wyświetlić powiększoną wersję tego rysunku.
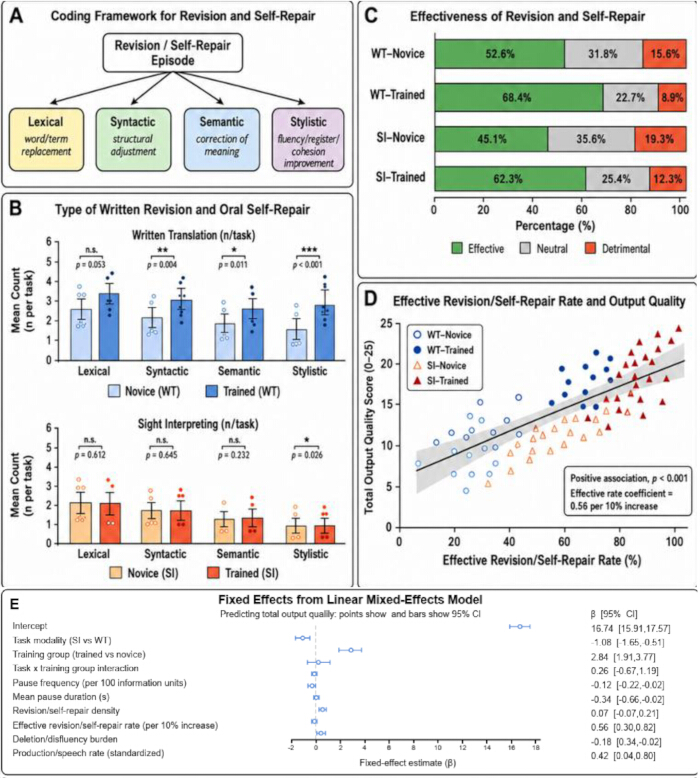
Rycina 3Kodowanie rewizyjne/samonaprawcze, wyniki funkcjonalne i korelacje z jakością wyników. (A) Schemat decyzyjny do niezależnego przypisywania typu epizodu i wyniku funkcjonalnego. (B) Średnia liczba epizodów leksykalnych, syntaktycznych, semantycznych i stylistycznych w każdym warunku zadania. (C) Średnie proporcje epizodów efektywnych, neutralnych i szkodliwych. (D) Związek opisowy między częstotliwością epizodów efektywnych a całkowitą oceną jakości wyników. (Ewykres leśny przedstawiający efekty stałe z liniowego modelu mieszanego z 95% przedziałami ufności (szczegółowo opisane w Tabela 4); wykres ma charakter asocjacyjny i nie przedstawia modelu ścieżek przyczynowych. Kliknij tutaj, aby wyświetlić większą wersję tej ilustracji.
| Zmienne | Grupa początkująca (n = 31) | Grupa przeszkolona (n = 31) | Wartość p |
| Wiek, lata | 21.9 ± 1.7 | 2.4 ± 1.9 | 0.279 |
| Kobiety, n (%) | 2 (71.0) | 21 (67.7) | 0.79 |
| Czas nauki języka angielskiego, lata | 12.4 ± 2.1 | 12.9 ± 2.2 | 0.36 |
| Wynik biegłości w języku angielskim | 548.6 ± 41.3 | 562.4 ± 45.8 | 0.216 |
| Czas szkolenia z tłumaczenia pisemnego, miesiące | 5.6 ± 3.0 | 18.7 ± 5.4 | <0.01 |
| Czas szkolenia z tłumaczenia ustnego, miesiące | 2.3 ± 2.1 | 13.9 ± 5.7 | <0.01 |
| Wcześniejsza praktyka w tłumaczeniu pisemnym ≥5 zadań, n (%) | 9 (29.0) | 24 (7.4) | <0.01 |
| Wcześniejsza praktyka w tłumaczeniu z tekstu ≥5 zadań, n (%) | 5 (16.1) | 20 (64.5) | <0.01 |
| Najpierw tłumaczenie pisemne, n (%) | 16 (51.6) | 15 (48.4) | 0.79 |
| Najpierw tłumaczenie z tekstu, n (%) | 15 (48.4) | 16 (51.6) | 0.79 |
Tabela 1: Charakterystyka uczestników i wyjściowe profile treningu językowego w podziale na grupy. Zmienne przedstawiono jako średnia ± odchylenie standardowe dla danych ciągłych oraz jako liczebność (procenty) dla danych kategorycznych. Raportowane wartości p odzwierciedlają porównania międzygrupowe w celu weryfikacji wyjściowej równowagi demograficznej i potwierdzenia zamierzonych różnic w czasie trwania treningu.
| Zmienne | Tłumaczenie pisemne: Początkujący (n = 31) | Tłumaczenie pisemne Grupa przeszkolona (n = 31) | Interpretacja doraźna – początkujący (n = 31) | Przeszkoleni w tłumaczeniu z widoku (n = 31) | Efekt zadania p | Efekt grupowy p |
| Opóźnienie początkowe, s | 31.8 ± 12.4 | 24.6 ± 9.7 | 14.2 ± 5.6 | 10.8 ± 4.2 | <0.001 | 0.003 |
| Całkowity czas wykonania zadania, s | 1038.5 ± 168.2 | 925.4 ± 151.6 | 305.6 ± 59.3 | 274.8 ± 50.7 | <0.001 | 0.004 |
| Częstotliwość pauz na 100 jednostek informacji | 18.6 ± 6.1 | 14.2 ± 5.0 | 24.8 ± 7.4 | 19.6 ± 6.3 | <0.001 | 0.001 |
| Średni czas trwania pauzy, s | 4.1 ± 1.2 | 3.3 ± 1.0 | 2.7 ± 0.8 | 2.3 ± 0.7 | 0.012 | 0.002 |
| Szybkość produkcji/mowy, znaki chińskie/min | 28.6 ± 6.7 | 34.1 ± 7.5 | 93.4 ± 18.9 | 108.7 ± 20.4 | 0.001 | |
| Wskaźnik delecji, % | 8.9 ± 3.4 | 6.8 ± 2.7 | 0.009 | |||
| Gęstość korekty na 100 znaków chińskich | 7.6 ± 2.8 | 8.9 ± 3.1 | 0.087 | |||
| Częstość pauz wypełnionych na minutę | 5.7 ± 1.9 | 4.2 ± 1.6 | 0.002 | |||
| Częstotliwość powtórzeń, na min | 4.9 ± 1.8 | 3.6 ± 1.4 | 0.004 | |||
| Częstotliwość fałszywych startów, na min | 2.8 ± 1.1 | 2.0 ± 0.9 | 0.006 | |||
| Częstotliwość samonaprawy, na min | 4.8 ± 1.7 | 3.9 ± 1.4 | 0.031 | |||
| Całkowita ocena jakości, 0–25 | 16.8 ± 2.3 | 20.1 ± 2.1 | 15.4 ± 2.6 | 18.9 ± 2.4 | 0.002 | <0.001 |
| Dokładność, 0–5 | 3.4 ± 0.7 | 4.1 ± 0.6 | 3.1 ± 0.8 | 3.8 ± 0.7 | 0.004 | <0.001 |
| Kompletność, 0–5 | 3.3 ± 0.8 | 4.0 ± 0.6 | 3.0 ± 0.8 | 3.7 ± 0.7 | 0.006 | <0.001 |
| Właściwość leksykalna, 0–5 | 3.2 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.041 | <0.001 |
| Spójność, 0–5 | 3.5 ± 0.6 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.6 | 0.003 | <0.001 |
| Naturalność języka docelowego, 0–5 | 3.4 ± 0.7 | 4.0 ± 0.6 | 3.1 ± 0.7 | 3.8 ± 0.7 | 0.007 | <0.001 |
Tabela 2: Wskaźniki procesów behawioralnych i jakość wyników w zależności od warunków zadania i grup. Wartości przedstawiono jako średnia ± odchylenie standardowe. Podane wartości p wskazują na główne efekty modalności zadania (tłumaczenie pisemne vs. tłumaczenie z widoku) oraz doświadczenia w szkoleniu (nowicjusze vs. przeszkoleni) dla każdej zmiennej procesu i jakości.
| Zmienne | Tłumaczenie pisemne dla początkujących | Przeszkolony w tłumaczeniu pisemnym | p wartość | Tłumaczenie wzrokowe dla początkujących | Tłumaczenie wzrokowe (wyćwiczone) | p wartość |
| Rewizja leksykalna/autokorekta, n/zadanie | 3.4 ± 1.5 | 4.2 ± 1.7 | 0.053 | 1.8 ± 0.8 | 1.7 ± 0.7 | 0.612 |
| Rewizja syntaktyczna/samokorekta, n/zadanie | 2.1 ± 1.1 | 3.0 ± 1.2 | 0.004 | 1.1 ± 0.7 | 1.2 ± 0.8 | 0.645 |
| Rewizja semantyczna/samokorekta, n/zadanie | 1.8 ± 1.0 | 2.5 ± 1.1 | 0.011 | 0.9 ± 0.6 | 1.1 ± 0.7 | 0.232 |
| Rewizja stylistyczna/autokorekta, n/zadanie | 1.6 ± 0.9 | 2.7 ± 1.2 | <0.001 | 0.6 ± 0.4 | 0.9 ± 0.6 | 0.026 |
| Całkowita liczba epizodów rewizji/samokorekty, n/zadanie | 8.9 ± 3.0 | 12.4 ± 3.7 | <0.001 | 4.4 ± 1.5 | 4.9 ± 1.6 | 0.209 |
| Skuteczne epizody, % | 52.6 ± 13.5 | 68.4 ± 12.1 | <0.001 | 45.1 ± 14.2 | 62.3 ± 13.0 | <0.001 |
| Epizody neutralne, % | 31.8 ± 10.4 | 22.7 ± 8.8 | 0.001 | 35.6 ± 11.7 | 25.4 ± 9.6 | 0.001 |
| Epizody niekorzystne, % | 15.6 ± 7.1 | 8.9 ± 5.6 | <0.001 | 19.3 ± 8.6 | 12.3 ± 6.8 | 0.001 |
Tabela 3: Typ i skuteczność poprawek pisemnych oraz ustnych autokorekt w różnych warunkach zadań. Typy epizodów podano jako średnią liczbę na zadanie (± odchylenie standardowe), a wyniki funkcjonalne jako średnie wartości procentowe (± odchylenie standardowe). Wartości p wskazują istotność różnic między grupami w obrębie każdej modalności zadania.
| Efekty stałe | β | SE | 95% CI | p wartość |
| Punkt przecięcia | 16.74 | 0.42 | 15.91 do 17.57 | <0.001 |
| Tryb zadania: tłumaczenie widokowe a tłumaczenie pisemne | -1.08 | 0.29 | -1,65 do -0,51 | <0.001 |
| Grupa szkoleniowa: przeszkolona vs początkująca | 2.84 | 0.47 | 1,91 do 3,7 | <0.001 |
| Modalność zadania × grupa treningowa | 0.26 | 0.47 | -0,67 do 1,19 | 0.581 |
| Częstotliwość pauz na 10 jednostek informacji | -0.12 | 0.05 | -0,22 do -0,02 | 0.018 |
| Średni czas trwania pauzy, s | -0.34 | 0.16 | -0,66 do -0,02 | 0.041 |
| Gęstość rewizji/samonaprawy | 0.07 | 0.07 | -0,07 do 0,21 | 0.334 |
| Efektywny wskaźnik rewizji/samonaprawy na każde zwiększenie o 10% | 0.56 | 0.13 | 0,30 do 0,82 | <0.001 |
| Obciążenie usunięciami/dysfluencjami | -0.18 | 0.08 | -0,34 do -0,02 | 0.027 |
| Szybkość produkcji/mowy, zestandaryzowana | 0.42 | 0.19 | 0,04 do 0,80 | 0.032 |
Tabela 4: Raportowane efekty stałe z liniowego modelu mieszanego przewidującego całkowitą jakość wyników.Podsumowanie zawiera niestandaryzowane współczynniki (β), błędy standardowe (SE), 95% przedziały ufności (CI) oraz dokładne wartości p dla wszystkich określonych predyktorów zadań i zachowań.
Dyskusja
Niniejsze badanie przedstawia multimodalny protokół pomiaru obserwowalnych wskaźników procesu oraz kodowania strategicznej rewizji w pisemnym tłumaczeniu oraz tłumaczeniu widzenia z języka angielskiego na chiński. Protokół ten nie mierzy bezpośrednio jednolitej zmiennej wysiłku poznawczego. Zamiast tego latencję, pauzy, usunięcia oraz wzorce rewizji interpretuje się jako behawioralne korelaty zależne od zadania, których znaczenie wynika z triangulacji z zsynchronizowanymi zapisami i dowodami dotyczącymi jakości produktu końcowego1,2,3,4,5,6,7,8. Dwa zadania różnią się również pod względem materiałów, czasu, formy produktu końcowego oraz możliwości wprowadzania poprawek; zatem reprezentatywne kontrasty opisują różnice wynikające z warunków zadania, a nie odizolowane efekty modalności. Głównym wkładem analitycznym jest oddzielenie częstotliwości rewizji od wyniku funkcjonalnego. W raportowanych podsumowaniach przeszkoleni uczestnicy wprowadzili więcej poprawek pisemnych, a nie mniej, podczas gdy całkowita liczba ustnych autokorekt nie różniła się znacząco między grupami. Wyższe proporcje skutecznych epizodów sugerują, że monitorowanie jakości może być bardziej informacyjne niż surowa częstotliwość, jednak interpretacja ta zależy od przejrzystych reguł decyzyjnych, niezależnego kodowania wyników oraz raportowanej niezawodności. Książka kodowa i opracowane przykłady w Pliku uzupełniającym 1 mają na celu zapewnienie odtwarzalności tego rozróżnienia, a nie mają charakteru promocyjnego.
Kluczowe etapy to wyrównanie zapisów krzyżowych, jakość dźwięku, weryfikacja transkrypcji oraz spójność kodowania. Podczas wyrównywania logów i nagrań należy sprawdzić dostępne znaczniki czasu oraz wskazówki dotyczące granic zadań. Przed transkrypcją należy sprawdzić dźwięk pod kątem przesterowania i zrozumiałości, a proponowane granice pauz muszą zostać zweryfikowane z przebiegiem fali i transkrypcją. W przypadku danych wejściowych w języku chińskim uderzenia klawiszy podczas komponowania nie powinny być utożsamiane z korektami zatwierdzonych znaków. Kontrole te oraz podjęte działania korygujące powinny zostać odnotowane w dzienniku kontroli jakości.
Interpretację ograniczają pewne zastrzeżenia. W demonstracji wykorzystano kohorty studentów i stażystów, krótkie teksty o charakterze ogólnym, zróżnicowaną długość zadań i limity czasowe, a także próbę opartą na dostępności uczestników. Warunki zadań różnią się również pod względem trybu generowania odpowiedzi i możliwości korekty, a zbiór danych nie zawiera niezależnie dobranych identyfikatorów tekstów źródłowych, co uniemożliwia oszacowanie zmienności na poziomie tekstu. Ponadto progi pauzy są wyborami operacyjnymi, a dłuższe przerwy mogą odzwierciedlać zarówno proces planowania, jak i nierozwiązane trudności. Generalizacja wyników na profesjonalistów, dziedziny specjalistyczne, inne pary językowe lub inne systemy pisma wymaga ponownej walidacji materiałów, obsługi metod wprowadzania danych, progów oraz punktów odniesienia dla punktacji.
Przyszłe badania mogą łączyć zapisy behawioralne z okulografią, pupillometrią lub subiektywnymi miarami obciążenia pracą, aby przetestować, które pauzy i poprawki odpowiadają uwadze, odczuwanemu wysiłkowi lub skutecznemu planowaniu5,6,13,14,15,16. Shreve i wsp. wykorzystali okulografię w tłumaczeniu widzącym i nie powinni być cytowani jako autorzy badania nad pupillometrią18; pupillometria jest omawiana bezpośrednio przez Seebera5. Takie multimodalne rozszerzenia powinny zachować rozdzielenie między wymaganiami zadania, włożonym wysiłkiem, obserwowanym zachowaniem a wynikami. Przedstawiony protokół najlepiej zatem wykorzystać jako przejrzyste ramy oceny procesu, których wskaźniki wspierają, lecz same w sobie nie rozstrzygają, twierdzeń dotyczących utajonego wysiłku poznawczego.
Oświadczenia
Autorzy nie zgłaszają żadnych komercyjnych ani finansowych konfliktów interesów. W odniesieniu do zastosowania sztucznej inteligencji, autorzy oświadczają, że podczas procesu redakcji wykorzystano OpenAI Codex wyłącznie w celu pomocy w korekcie językowej, weryfikacji spójności, przygotowaniu naniesionych poprawek oraz ponownym wygenerowaniu układów rycin w oparciu o dane dostarczone przez autorów. Autorzy skrupulatnie sprawdzili wszystkie wyniki wygenerowane przy wsparciu SI i biorą pełną odpowiedzialność za dokładność, rzetelność oraz oryginalność ostatecznego manuskryptu. Strukturalny arkusz roboczy, na którym opierają się przedstawione podsumowania, jest publicznie dostępny w serwisie Zenodo (https://doi.org/10.5281/zenodo.21189434). Plik uzupełniający 1 zawiera podręcznik kodowania oraz zakotwiczony arkusz oceny jakości.
Podziękowania
Autor dziękuje Guilin Institute of Information Technology za wsparcie laboratoryjne, ekspertom dwujęzycznym, którzy ocenili teksty źródłowe, niezależnym recenzentom oraz uczestnikom. Badanie to nie otrzymało żadnego konkretnego grantu z żadnej instytucji finansującej w sektorze publicznym, komercyjnym ani non-profit.
Materiały
| Nazwa | Firma | Numer katalogowy | Komentarze |
|---|---|---|---|
| Oprogramowanie do analizy akustycznej (Praat) | Paul Boersma and David Weenink | https://www.fon.hum.uva.nl/praat/ | |
| Komputer stacjonarny | Dell | OptiPlex | |
| Oprogramowanie do cyfrowego nagrywania dźwięku (Audacity) | Audacity Team | https://www.audacityteam.org/ | |
| Oprogramowanie do rejestracji naciśnięć klawiszy (Inputlog) | University of Antwerp | https://www.inputlog.net/ | |
| Oprogramowanie do nagrywania ekranu (OBS Studio) | OBS Project | https://democreator.wondershare.com/ | |
| Oprogramowanie do analizy statystycznej (SPSS) | IBM | Version 27 |
Bibliografia
- Gieshoff AC, Heeb AH. Cognitive load and cognitive effort: probing the psychological reality of a conceptual difference. Transl Cogn Behav. 2023;6(1):3–28.
- Sweller J, van Merriënboer JJG, Paas F. Cognitive architecture and instructional design. Educ Psychol Rev. 1998;10(3):251–96.
- Paas F, Tuovinen JE, Tabbers H, Van Gerven PWM. Cognitive load measurement as a means to advance cognitive load theory. Educ Psychol. 2003;38(1):63–71.
- Gile D. Basic Concepts and Models for Interpreter and Translator Training. Amsterdam: John Benjamins; 2009.
- Seeber KG. Cognitive load in simultaneous interpreting: measures and methods. Target. 2013;25(1):18–32.
- Ferreira A, Schwieter JW, Gottardo A, Jones JA. Cognitive effort in direct and inverse translation performance: insight from eye-tracking technology. Cad Trad. 2016;36(3):60–80.
- Zou D, Zhang J. Measuring the invisible: clarifying the concept of cognitive effort in translation and interpreting processes. Curr Trends Transl Teach Learn E. 2023;10:217–58.
- Lacruz I, Shreve GM, Angelone E. Average pause ratio as an indicator of cognitive effort in post-editing: a case study. Workshop on Post-Editing Technology and Practice. San Diego: Association for Machine Translation in the Americas; 2012. p. 21–30.
- Qassem M, Al Thowaini BM. Cognitive processes and translation quality: Evidence from keystroke-logging software. J Psycholinguist Res. 2023;52(5):1589–604.
- Ma X, Li D. Effect of word order asymmetry on the cognitive load of English–Chinese sight translation: Evidence from eye movement data. Transl Interpret Stud. 2024;19(1):105–31.
- Leijten M, Van Waes L. Keystroke logging in writing research: using Inputlog to analyze and visualize writing processes. Written Commun. 2013;30(3):358–92.
- Heilmann A, Neumann S, editors. Dynamic pause assessment of keystroke logged data for the detection of complexity in translation and monolingual text production. Proceedings of the Workshop on Computational Linguistics for Linguistic Complexity; 2016; Osaka: COLING.
- Su W, Li D. Identifying translation problems in English-Chinese sight translation: an eye-tracking experiment. Transl Interpret Stud. 2019;14(1):110–34.
- Su W, Li D. Exploring processing patterns of Chinese-English sight translation: an eye-tracking study. Babel. 2020;66(6):999–1024.
- Su W, Li D. Exploring the effect of interpreting training: eye-tracking English-Chinese sight interpreting. Lingua. 2021;256:103094.
- Su W. Eye-voice span in sight interpreting: an eye-tracking investigation. Perspectives. 2023;31(5):969–85.
- Rojo López AM, Muñoz Martín R. Research Methods in Cognitive Translation and Interpreting Studies. Amsterdam: John Benjamins; 2025.
- Shreve GM, Lacruz I, Angelone E. Cognitive effort, syntactic disruption, and visual interference in a sight translation task. Transl Interpret Stud. 2010;5(1):63–84.
Przedruki i uprawnienia
Ten artykuł został opublikowany
Film wkrótce dostępny